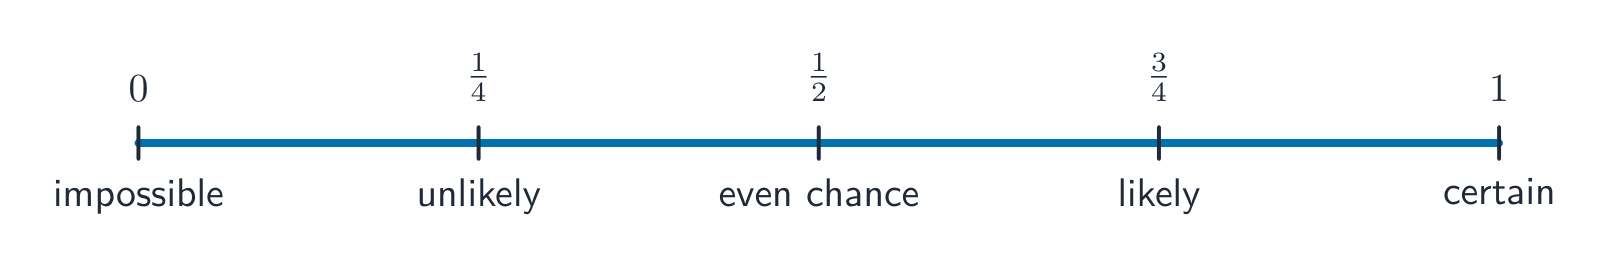Bỏ qua nội dung
Môn học

AP Thống kê

Mẹo

AP Statistics bao gồm khám phá dữ liệu, lấy mẫu và thiết kế thực nghiệm, xác suất và biến ngẫu nhiên, phân phối lấy mẫu và suy luận — khoảng tin cậy và kiểm định ý nghĩa. Có rất ít đại số; độ khó nằm ở việc nói đúng về sự không chắc chắn.

Mọi câu trả lời suy luận đều có bốn phần: đặt tên quy trình, kiểm tra điều kiện, tính toán và kết luận trong ngữ cảnh với liên kết đến giả thuyết thay thế. Bảng chấm điểm đánh giá cả bốn phần, nên chỉ có p-value chính xác thì điểm số vẫn thấp.

Ngôn ngữ được chấm điểm. "Chúng tôi bác bỏ H₀" không phải là "chúng tôi chứng minh H₁"; khoảng tin cậy nói về hành vi dài hạn của phương pháp, chứ không phải xác suất một khoảng cụ thể chứa tham số. Những phân biệt này quyết định điểm số.

Các ghi chú đi qua tất cả chín đơn vị với mỗi quy trình suy luận được trình bày từng bước. Các FRQs đã công bố có trong thư viện. Thống kê cho điểm khi nêu rõ điều kiện và diễn giải trong ngữ cảnh, vì vậy mọi câu trả lời hướng dẫn đều nêu các điều kiện trước khi tiến hành kiểm định.

  • 1

    Khám phá Dữ liệu Một biến số

    Xem bài học
    1.1

    Giới thiệu Thống kê: Chúng ta có thể học được gì từ dữ liệu?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.A: Xác định các câu hỏi cần trả lời, dựa trên sự biến thiên của dữ liệu một biến. [Kỹ năng 1.A]

    • VAR-1.A.1 Các con số có thể truyền tải thông tin có ý nghĩa, khi được đặt trong ngữ cảnh.
    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Thống kê là khoa học tìm hiểu từ dữ liệu – các con số hoặc nhãn được thu thập từ thế giới thực. Dữ liệu có sự biến thiên, vì vậy chúng ta mô tả các xu hướng và giải thích cho sự biến thiên thay vì mong đợi mọi giá trị đều khớp nhau. Một câu hỏi thống kê dự kiến một câu trả lời dựa trên dữ liệu có sự biến thiên.

    Hai phân biệt chạy贯穿 throughout toàn bộ khóa học. Một tham số là tóm tắt số học của toàn bộ quần thể; một thống kê là tóm tắt số học của một mẫu - chúng ta sử dụng thống kê để ước lượng tham số mà chúng ta không thể đo trực tiếp. Và thống kê mô tả chỉ tóm tắt tập dữ liệu đang có, trong khi thống kê suy luận sử dụng mẫu để đưa ra và kiểm tra các tuyên bố về quần thể lớn hơn.

    1.2

    Ngôn ngữ của Sự biến thiên: Biến số

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.B: Xác định các biến số trong một bộ dữ liệu. [Kỹ năng 2.A]

    • VAR-1.B.1 Một biến số là một đặc điểm thay đổi từ cá thể này sang cá thể khác.

    Mục tiêu học tập VAR-1.C: Phân loại các loại biến số. [Kỹ năng 2.A]

    • VAR-1.C.1 Một biến số phân loại nhận các giá trị là tên phân loại hoặc nhãn nhóm.
    • VAR-1.C.2 Một biến số định lượng là biến số nhận các giá trị số học cho một đại lượng được đo lường hoặc đếm được.
      • Ví dụ minh họa cho VAR-1.C:
        • Biến số phân loại:
          • Tay chủ yếu
          • Nhóm tuổi (trẻ hoặc già)
          • Trình độ học vấn cao nhất đạt được
        • Các biến định lượng:
          • Tuổi của một công trình
          • Chiều cao của một đứa trẻ
          • Nồng độ của một mẫu thử

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một biến số là một đặc điểm có thể khác nhau giữa các cá nhân. Hai loại:

    • Định tính (phân loại): giá trị là nhãn/nhóm (màu mắt, thương hiệu).
    • Định lượng: giá trị là các số bạn có thể thực hiện phép toán trên đó (chiều cao, tuổi). Biến số định lượng là rời rạc (đếm được) hoặc liên tục (đo lường).

    Việc chọn biểu đồ và tóm tắt phù hợp phụ thuộc vào loại bạn đang có.

    Khám phá

    Định tính hay Định lượng?

    Mọi biến đều là phân loại (nó gán đơn vị vào một nhóm) hoặc định lượng (một con số đo lường bạn có thể lấy trung bình). Loại nào quyết định biểu đồ và tóm tắt bạn được phép sử dụng.

    1.3

    Biểu diễn Biến số Định tính bằng Bảng

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.A: Biểu diễn dữ liệu định tính bằng bảng tần số hoặc tần số tương đối. [Kỹ năng 2.B]

    • UNC-1.A.1 Bảng tần số cho biết số trường hợp落入 vào mỗi danh mục. Bảng tần số tương đối cho biết tỷ lệ phần trăm các trường hợp落入 vào mỗi danh mục.

    Mục tiêu học tập UNC-1.B: Mô tả dữ liệu định tính được biểu diễn trong bảng tần số hoặc bảng tần số tương đối. [Kỹ năng 2.A]

    • UNC-1.B.1 Phần trăm, tần số tương đối và tốc độ đều cung cấp cùng thông tin với tỷ lệ phần trăm.
    • UNC-1.B.2 Số lượng và tần số tương đối của dữ liệu định tính tiết lộ thông tin có thể được sử dụng để biện minh cho các tuyên bố về dữ liệu trong ngữ cảnh.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một bảng tần số liệt kê số lượng (tần số) của từng danh mục; một bảng tần số tương đối liệt kê tỷ lệ (số lượng ÷ tổng) của từng danh mục. Tần số tương đối cho phép bạn so sánh các nhóm có kích thước khác nhau một cách công bằng.

    1.4

    Biểu diễn Biến số Định tính bằng Biểu đồ

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.C: Biểu diễn dữ liệu định tính bằng đồ thị. [Kỹ năng 2.B]

    • UNC-1.C.1 Biểu đồ cột (hoặc biểu đồ thanh) được sử dụng để hiển thị tần số (số lượng) hoặc tần số tương đối (tỷ lệ phần trăm) cho dữ liệu định tính.
    • UNC-1.C.2 Chiều cao hoặc chiều dài của mỗi cột trong biểu đồ cột tương ứng với số lượng hoặc tỷ lệ phần trăm các quan sát落入 trong mỗi danh mục.
    • UNC-1.C.3 Có rất nhiều cách khác để biểu diễn tần số (số lượng) hoặc tần số tương đối (tỷ lệ phần trăm) cho dữ liệu định tính.

    Mục tiêu học tập UNC-1.D: Mô tả dữ liệu định tính được biểu diễn bằng đồ thị. [Kỹ năng 2.A]

    • UNC-1.D.1 Các biểu diễn đồ thị của biến định tính tiết lộ thông tin có thể được sử dụng để biện minh cho các tuyên bố về dữ liệu trong ngữ cảnh.

    Mục tiêu học tập UNC-1.E: So sánh nhiều bộ dữ liệu định tính. [Kỹ năng 2.D]

    • UNC-1.E.1 Bảng tần số, biểu đồ cột hoặc các biểu diễn khác có thể được sử dụng để so sánh hai hoặc nhiều bộ dữ liệu theo cùng một biến định tính.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Biểu đồ cột hiển thị số lượng hoặc tỷ lệ của từng danh mục dưới dạng các cột tách biệt; biểu đồ tròn hiển thị tỷ trọng của từng danh mục trong tổng thể. Chiều cao cột (hoặc lát cắt) cho phép bạn so sánh các danh mục ngay lập tức. Các cột có thể được sắp xếp theo kích thước hoặc theo thứ tự danh mục tự nhiên.

    Khám phá

    Hiển thị biến phân loại dưới dạng biểu đồ tròn

    Một biểu đồ tròn biến tỷ lệ phần trăm của mỗi danh mục so với tổng thể thành một miếng: tỷ lệ lớn hơn thì miếng lớn hơn, và tất cả các miếng cộng lại tạo thành 100%. Nó là hình ảnh của bảng tần suất tương đối.

    1.5

    Biểu diễn Biến số Định lượng bằng Biểu đồ

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.F: Phân loại các loại biến định lượng. [Kỹ năng 2.A]

    • UNC-1.F.1 Biến rời rạc có thể nhận một số giá trị đếm được. Số giá trị có thể hữu hạn hoặc vô hạn đếm được, ví dụ như các số đếm.
    • UNC-1.F.2 Biến liên tục có thể nhận vô số giá trị, nhưng những giá trị đó không thể đếm được. Bất kể khoảng cách giữa hai giá trị của biến liên tục nhỏ đến đâu, luôn có thể xác định được một giá trị khác nằm giữa chúng.
      • Ví dụ minh họa cho UNC-1.F:
        • Một biến rời rạc:
          • Số học sinh trong một lớp
        • Một biến liên tục:
          • Chiều cao của một đứa trẻ

    Mục tiêu học tập UNC-1.G: Biểu diễn dữ liệu định lượng bằng đồ thị. [Kỹ năng 2.B]

    • UNC-1.G.1 Trong biểu đồ tần số (histogram), chiều cao của mỗi cột cho biết số lượng hoặc tỷ lệ phần trăm các quan sát落入 trong khoảng tương ứng với cột đó. Thay đổi độ rộng khoảng có thể làm thay đổi hình dáng của biểu đồ tần số.
    • UNC-1.G.2 Trong biểu đồ thân lá, mỗi giá trị dữ liệu được chia thành "thân" (chữ số đầu tiên hoặc các chữ số đầu) và "lá" (thường là chữ số cuối).
    • UNC-1.G.3 Biểu đồ chấm biểu diễn mỗi quan sát bằng một chấm, với vị trí trên trục hoành tương ứng với giá trị dữ liệu của quan sát đó, với các giá trị gần giống nhau xếp chồng lên nhau.
    • UNC-1.G.4 Biểu đồ tích lũy biểu diễn số lượng hoặc tỷ lệ phần trăm của bộ dữ liệu nhỏ hơn hoặc bằng một số đã cho.
    • UNC-1.G.5 Có rất nhiều cách khác để biểu diễn đồ thị phân phối của dữ liệu định lượng.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với các con số, hãy sử dụng biểu đồ chấm, biểu đồ thân lá, hoặc histogram (các cột trên khoảng giá trị gọi là ô class). Những biểu đồ này hiển thị phân phối – cách các giá trị lan tỏa. Độ rộng ô class của histogram sẽ thay đổi hình ảnh, vì vậy hãy chọn nó để tiết lộ hình dáng.

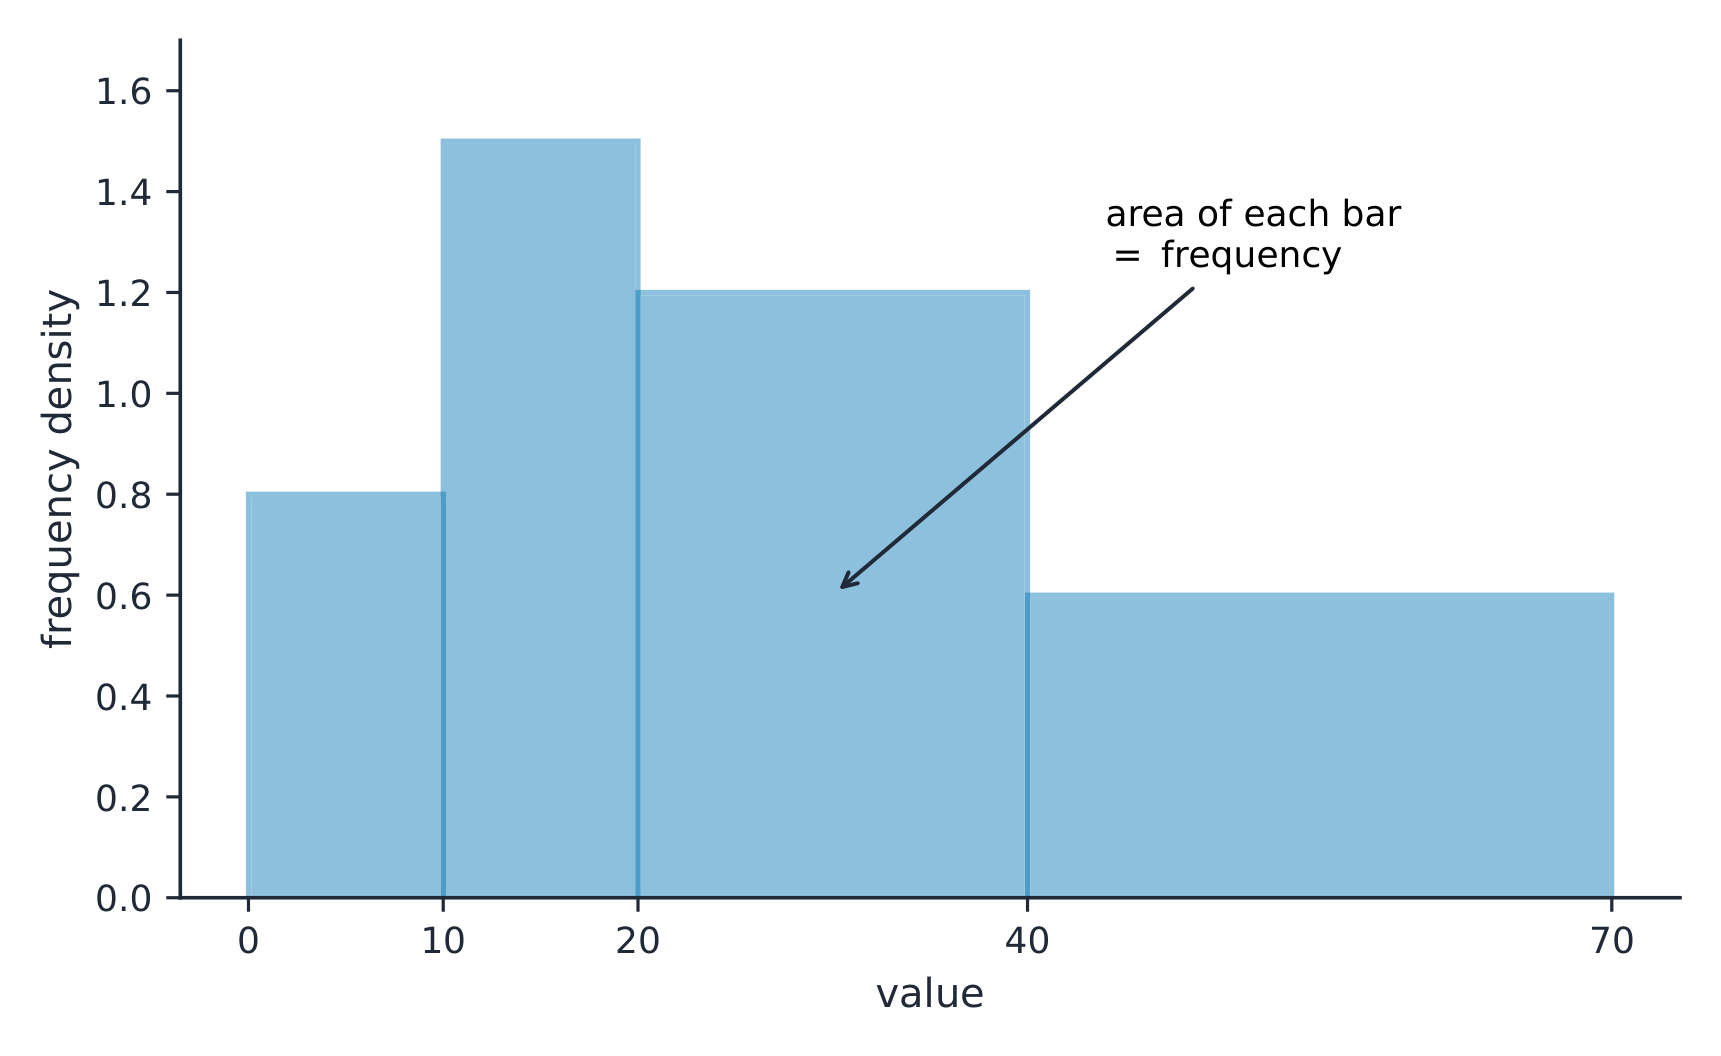
    Trên histogram với độ rộng lớp không đồng đều, diện tích cột là tần số
    Trên histogram với độ rộng lớp không đồng đều, diện tích cột là tần số
    Khám phá

    Khám phá cách độ rộng ô ảnh hưởng đến biểu đồ tần suất

    Một biểu đồ tần suất nhóm dữ liệu thành các ô có chiều rộng bằng nhau và vẽ một thanh trên mỗi ô. Thay đổi các ô và để ý rằng cùng một dữ liệu có thể trông gợn sóng (quá hẹp) hoặc mịn màng (quá rộng) — hình dạng là một sự lựa chọn.

    Từ vựng Luyện tập
    English Tiếng Việt
    Statistics/stəˈtɪstɪks/ Thống kê
    data/ˈdeɪtə/ dữ liệu
    variation/ˌveərɪˈeɪʃn/ biến tấu
    parameter/pəˈræmɪtə/ parameter
    statistic/stəˈtɪstɪk/ thống kê
    descriptive statistics/dɪˈskrɪptɪv stəˈtɪstɪks/ thống kê mô tả
    inferential statistics/ɪnfəˈrenʃl stəˈtɪstɪks/ thống kê suy luận
    variable/ˈveərɪəbl/ biến
    Categorical/ˌkætɪˈɡɒrɪkl/ Phân loại
    Quantitative/ˈkwɒntɪteɪtɪv/ Định lượng
    frequency table/ˈfriːkwənsi ˈteɪbl/ bảng tần suất
    relative frequency/ˈrelətɪv ˈfriːkwənsi/ tần suất tương đối
    proportion/prəˈpɔːʃn/ tỷ lệ
    Bar charts/bɑː tʃɑːts/ biểu đồ cột
    dotplot/ˈdɒtplɒt/ biểu đồ chấm
    stem-and-leaf plot/stem ænd liːf plɒt/ biểu đồ thân lá
    histogram/ˈhɪstəɡræm/ biểu đồ tần số (histogram)
    1.6

    Mô tả Phân phối của Biến số Định lượng

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.H: Mô tả các đặc điểm của phân phối dữ liệu định lượng. [Kỹ năng 2.A]

    • UNC-1.H.1 Mô tả phân phối của dữ liệu định lượng bao gồm hình dạng, trung tâm và độ biến thiên (phân tán), cũng như bất kỳ đặc điểm bất thường nào như giá trị ngoại lai, khoảng trống, cụm dữ liệu, hoặc nhiều đỉnh.
    • UNC-1.H.2 Giá trị ngoại lai cho dữ liệu một biến là các điểm dữ liệu bất thường nhỏ hoặc lớn so với phần còn lại của dữ liệu.
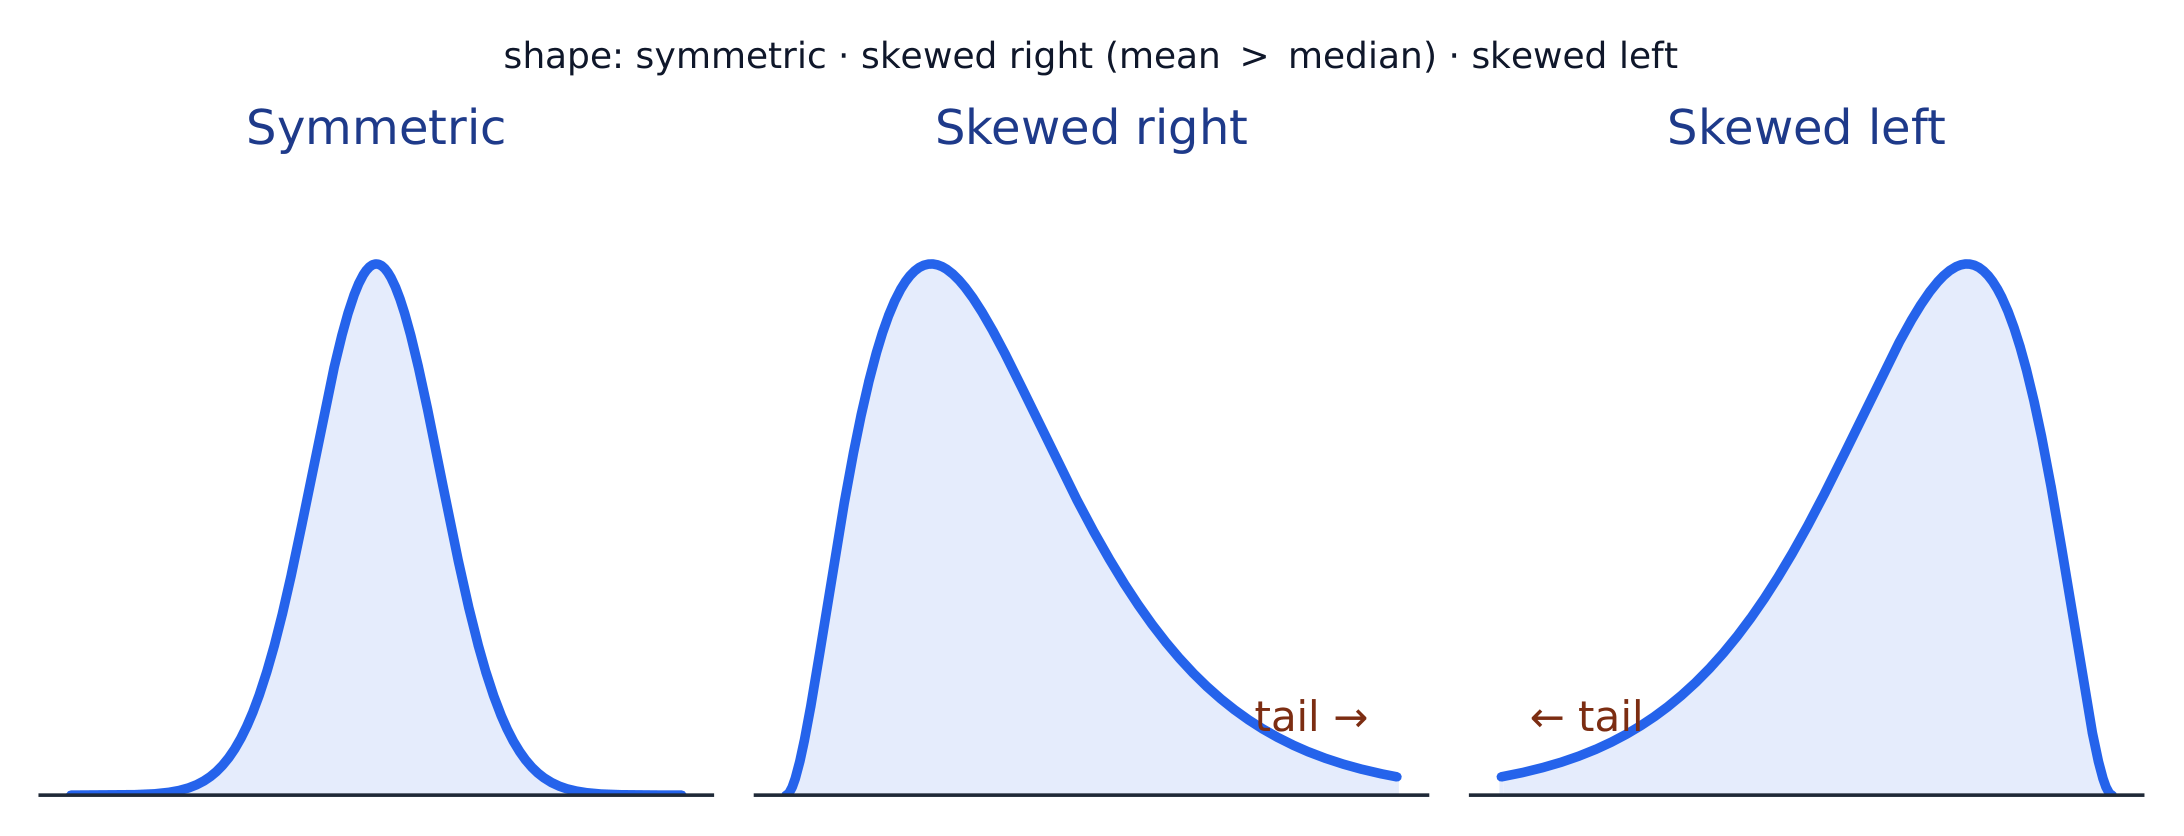
    • UNC-1.H.3 Phân phối lệch về bên phải (lệch dương) nếu đuôi bên phải dài hơn đuôi bên trái. Phân phối lệch về bên trái (lệch âm) nếu đuôi bên trái dài hơn đuôi bên phải. Phân phối đối xứng nếu nửa bên trái là ảnh phản chiếu của nửa bên phải.
    • UNC-1.H.4 Đồ thị một biến với một đỉnh chính được gọi là đơn modal. Đồ thị với hai đỉnh nổi bật là song modal. Đồ thị mà chiều cao của mỗi cột xấp xỉ bằng nhau (không có đỉnh nổi bật) là xấp xỉ đồng đều.
    • UNC-1.H.5 Khoảng trống là một vùng của phân phối giữa hai giá trị dữ liệu nơi không có dữ liệu quan sát nào.
    • UNC-1.H.6 Cụm dữ liệu là sự tập trung của dữ liệu thường được tách biệt bởi các khoảng trống.
    • UNC-1.H.7 Thống kê mô tả không gán các thuộc tính của bộ dữ liệu cho quần thể lớn hơn, nhưng có thể cung cấp cơ sở cho các phỏng đoán để kiểm tra tiếp theo.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Mô tả bốn điều (nhớ SOCS):

    • Hình dáng: đối xứng, hoặc lệch trái/phải (một đuôi dài ở phía đó), và số lượng đỉnh - một đỉnh chính là đơn mode, hai đỉnh nổi bật là hai mode, và các cột xấp xỉ bằng nhau là đồng đều.
    • Giá trị ngoại lai: các giá trị bất thường xa so với phần còn lại.
    • Trung tâm: một giá trị điển hình (trung bình hoặc trung vị).
    • Độ phân tán: mức độ biến thiên của các giá trị (phạm vi, IQR, độ lệch chuẩn).

    Luôn mô tả hình dạng/trung tâm/độ phân tán trong ngữ cảnh, kèm đơn vị.

    Hình dạng của phân phối: đối xứng, lệch phải (đuôi dài bên phải), hoặc lệch trái
    Hình dạng của phân phối: đối xứng, lệch phải (đuôi dài bên phải), hoặc lệch trái
    Từ vựng Luyện tập
    English Tiếng Việt
    distribution/ˌdɪstrɪˈbjuːʃn/ phân phối
    Shape/ʃeɪp/ Hình dạng
    skewed/skjuːd/ lệch
    unimodal/ˌʌnɪˈmɒdl/ unimodal
    bimodal/baɪˈmɒdl/ bimodal
    uniform/ˈjuːnɪfɔːm/ đều
    Outliers/ˈaʊtlaɪəz/ ngoại lai
    1.7

    Thống kê tóm tắt cho biến định lượng

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.I: Tính toán các thước đo trung tâm và vị trí cho dữ liệu định lượng. [Kỹ năng 2.C]

    • UNC-1.I.1 Một số liệu thống kê là một bản tóm tắt số học của dữ liệu mẫu.
    • UNC-1.I.2 Trung bình cộng là tổng của tất cả các giá trị dữ liệu chia cho số lượng giá trị. Đối với mẫu, trung bình cộng được ký hiệu là $x$-bar: $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, trong đó $x_i$ đại diện cho $i^{\text{th}}$ điểm dữ liệu trong mẫu và $n$ đại diện cho số lượng giá trị dữ liệu trong mẫu.
    • UNC-1.I.3 Median (trung vị) của một tập dữ liệu là giá trị ở giữa khi dữ liệu đã được sắp xếp. Khi số lượng điểm dữ liệu là số chẵn, median có thể nhận bất kỳ giá trị nào nằm giữa hai giá trị ở giữa. Trong AP Statistics, giá trị thường dùng nhất cho median của tập dữ liệu có số lượng giá trị chẵn là trung bình cộng của hai giá trị ở giữa.
    • UNC-1.I.4 Tứ phân vị thứ nhất, Q1, là median của nửa tập dữ liệu đã sắp xếp từ giá trị tối thiểu đến vị trí của median. Tứ phân vị thứ ba, Q3, là median của nửa tập dữ liệu đã sắp xếp từ vị trí của median đến giá trị tối đa. Q1 và Q3 tạo thành ranh giới cho 50% giá trị ở giữa trong một tập dữ liệu đã sắp xếp.
    • UNC-1.I.5 P $p^{\text{th}}$ phần trăm được hiểu là giá trị mà $p\%$ của dữ liệu nhỏ hơn hoặc bằng nó.

    Mục tiêu học tập UNC-1.J: Tính toán các Measures of variability (đo lường độ phân tán) cho dữ liệu định lượng. [Kỹ năng 2.C]

    • UNC-1.J.1 Ba Measures of variability (hoặc spread - độ trải rộng) thường dùng trong phân phối là khoảng biến thiên (range), khoảng tứ phân vị (interquartile range), và độ lệch chuẩn.
    • UNC-1.J.2 Khoảng biến thiên (range) được định nghĩa là hiệu giữa giá trị dữ liệu lớn nhất và giá trị dữ liệu nhỏ nhất. Khoảng tứ phân vị (IQR) được định nghĩa là hiệu giữa tứ phân vị thứ ba và tứ phân vị thứ nhất: $Q3 - Q1$. Cả khoảng biến thiên và khoảng tứ phân vị đều là những cách đo lường độ phân tán hợp lý của phân phối một biến định lượng.
    • UNC-1.J.3 Độ lệch chuẩn là một cách để đo lường độ phân tán của phân phối một biến định lượng. Đối với mẫu, độ lệch chuẩn được ký hiệu là $s$: $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. Bình phương của độ lệch chuẩn mẫu, $s^2$, được gọi là phương sai mẫu.
    • UNC-1.J.4 Thay đổi đơn vị đo lường sẽ ảnh hưởng đến các giá trị thống kê đã tính toán.

    Mục tiêu học tập UNC-1.K: Giải thích việc lựa chọn một Measure of center (đo lường trung tâm) và/hoặc Measure of variability (đo lường độ phân tán) cụ thể để mô tả một tập dữ liệu định lượng. [Kỹ năng 4.B]

    • UNC-1.K.1 Có nhiều phương pháp xác định giá trị ngoại lai. Hai phương pháp thường được sử dụng trong khóa học này là:
      • UNC-1.K.1.i Một giá trị ngoại lai là giá trị lớn hơn $1.5 \times \text{IQR}$ trên tứ phân vị thứ ba hoặc nhỏ hơn $1.5 \times \text{IQR}$ dưới tứ phân vị thứ nhất.
      • UNC-1.K.1.ii Một giá trị ngoại lai là giá trị nằm cách 2 hoặc nhiều độ lệch chuẩn hơn lên trên, hoặc xuống dưới, trung bình cộng.
    • UNC-1.K.2 Trung bình cộng, độ lệch chuẩn và khoảng biến thiên được coi là không kháng cự (nonresistant hoặc non-robust) vì chúng bị ảnh hưởng bởi các giá trị ngoại lai. Median và IQR được coi là kháng cự (resistant hoặc robust), vì các giá trị ngoại lai không làm thay đổi đáng kể (nếu có) giá trị của chúng.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Độ lệch chuẩn: độ phân tán quanh trung bình
    • Trung tâm: trung bình $\bar{x}=\dfrac{\sum x_i}{n}$ (giá trị trung bình) và trung vị (giá trị ở giữa). Trung vị kháng lại giá trị ngoại lai; trung bình bị kéo về phía lệch.
    • Độ phân tán: phạm vi, khoảng tứ phân vị $\text{IQR}=Q_3-Q_1$ (50% dữ liệu ở giữa), và độ lệch chuẩn $s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (khoảng cách điển hình từ trung bình; bình phương của nó là biến số).
    • Tóm tắt năm số: min, $Q_1$, trung vị, $Q_3$, max.

    Sử dụng các số liệu kháng (trung vị, IQR) cho dữ liệu lệch; trung bình và độ lệch chuẩn cho dữ liệu gần như đối xứng.

    Percentile của một giá trị là phần trăm dữ liệu nằm ở hoặc dưới giá trị đó – vì vậy trung vị là percentile thứ 50 và $Q_1$ là percentile thứ 25. Một biểu đồ tần suất tương đối lũy tiến giúp đọc percentile dễ dàng: với mỗi giá trị, nó biểu diễn tỷ lệ dữ liệu ở hoặc dưới giá trị đó, tăng từ 0 đến 1. Đi lên từ một giá trị đến đường cong và sang ngang để tìm percentile của nó, hoặc ngược lại các bước để tìm giá trị tại một percentile cho trước (cách đọc này cũng áp dụng được từ bảng tần suất lũy tiến).

    Ví dụ có hướng dẫn. Với dữ liệu $4, 8, 6, 10, 7$: trung bình là $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. Sắp xếp thành $4,6,7,8,10$, trung vị là giá trị ở giữa, $7$. Trung bình và trung vị trùng khớp ở đây vì dữ liệu gần như đối xứng.

    Từ vựng Luyện tập
    English Tiếng Việt
    mean/miːn/ trung bình
    median/ˈmiːdiːən/ trung vị
    interquartile range/ˌɪntəˈkwɔːtaɪl reɪndʒ/ khoảng tứ phân vị
    standard deviation/ˈstændəd ˌdiːvɪˈeɪʃn/ độ lệch chuẩn
    variance/ˈveərɪəns/ độ phân tán
    five-number summary/faɪv ˈnʌmbə ˈsʌməri/ bộ năm số
    percentile/pəˈsentaɪl/ phân vị
    cumulative relative frequency graph/ˈkjuːmjʊlətɪv ˈrelətɪv ˈfriːkwənsi ɡræf/ biểu đồ tần số tương đối lũy kế
    1.8

    Biểu diễn đồ thị của thống kê tóm tắt

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.L: Biểu diễn đồ thị các Thống kê Tóm tắt cho dữ liệu định lượng. [Kỹ năng 2.B]

    • UNC-1.L.1 Kết hợp lại, giá trị dữ liệu tối thiểu, tứ phân vị thứ nhất (Q1), median, tứ phân vị thứ ba (Q3), và giá trị dữ liệu tối đa tạo thành bộ năm số tóm tắt (five-number summary).
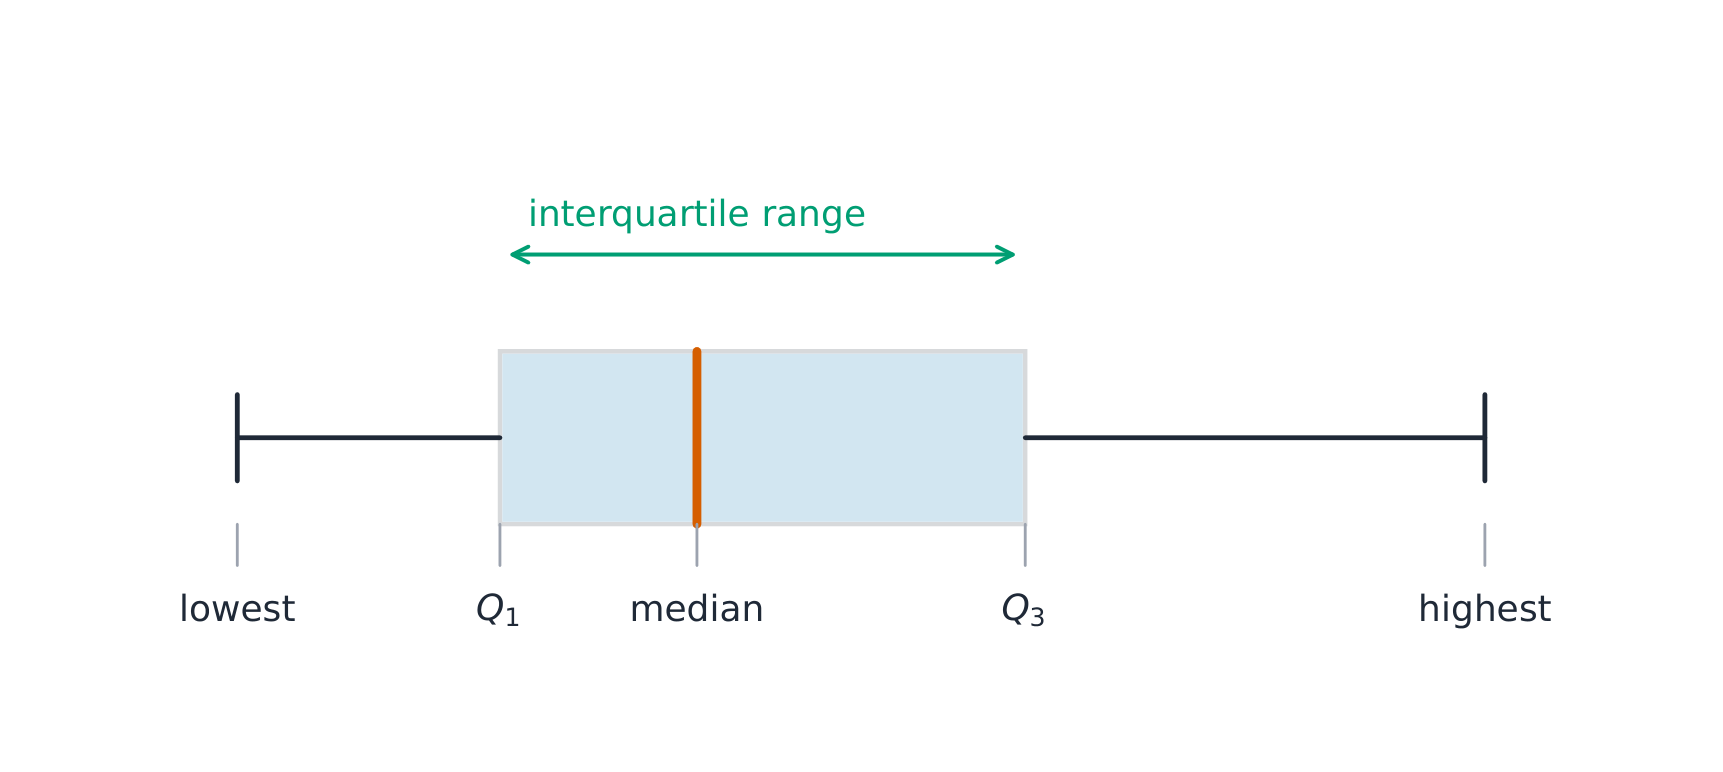
    • UNC-1.L.2 Một boxplot (biểu đồ hộp) là biểu diễn đồ thị của bộ năm số tóm tắt (tối thiểu, tứ phân vị thứ nhất, median, tứ phân vị thứ ba, tối đa). Phần hộp đại diện cho 50% dữ liệu ở giữa, với đường kẻ tại vị trí median và hai đầu hộp tương ứng với các tứ phân vị. Các đường thẳng ("mũi") kéo dài từ các tứ phân vị đến điểm cực đoan nhất không phải là giá trị ngoại lai, và các giá trị ngoại lai được chỉ báo bằng ký hiệu riêng biệt bên ngoài điểm này.

    Mục tiêu học tập UNC-1.M: Mô tả các Thống kê Tóm tắt của dữ liệu định lượng được biểu diễn đồ thị. [Kỹ năng 2.A]

    • UNC-1.M.1 Các Thống kê Tóm tắt của dữ liệu định lượng, hoặc các tập dữ liệu định lượng, có thể được sử dụng để biện minh cho các tuyên bố về dữ liệu trong ngữ cảnh cụ thể.
    • UNC-1.M.2 Nếu một phân phối khá đối xứng, thì trung bình cộng và median sẽ tương đối gần nhau. Nếu một phân phối lệch phải, thì trung bình cộng thường nằm bên phải của median. Nếu phân phối lệch trái, thì trung bình cộng thường nằm bên trái của median.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một boxplot vẽ tóm tắt năm số: một hộp từ $Q_1$ đến $Q_3$ với trung vị bên trong, và các râu nối đến các giá trị cực đoan không phải ngoại lai. Một điểm là ngoại lai nếu nằm xa hơn $1.5\times\text{IQR}$ so với một tứ phân vị – quy tắc mà bạn có thể được yêu cầu áp dụng. Boxplot rất lý tưởng để so sánh nhiều nhóm bên cạnh nhau.

    Ví dụ minh họa. Một tập dữ liệu có $Q_1=20$ và $Q_3=32$, do đó $\text{IQR}=12$. Các hàng rào ngoại lai là $Q_1-1.5(12)=2$ và $Q_3+1.5(12)=50$. Bất kỳ giá trị nào nhỏ hơn $2$ hoặc lớn hơn $50$ đều bị đánh dấu là ngoại lai.

    Biểu đồ hộp và râu thể hiện các phân vị và phạm vi
    Biểu đồ box-and-whisker hiển thị các tứ phân vị và phạm vi
    Biểu đồ hộp vẽ tóm tắt năm số; phần hộp trải dài theo IQR
    Boxplot vẽ tóm tắt năm số; hộp trải dài theo IQR
    Khám phá

    Khám phá tóm tắt năm số dưới dạng hộp

    Kéo $Q_1$, trung vị, và $Q_3$ để xem hộp (chiều dài của nó là IQR) và làm thế nào vị trí trung vị bên trong hộp tiết lộ độ lệch — trung vị gần $Q_1$ báo hiệu phân phối lệch phải.

    Từ vựng Luyện tập
    English Tiếng Việt
    boxplot/ˈbɒksplɒt/ boxplot
    normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ phân phối chuẩn
    1.9

    So sánh Phân phối của Biến Định lượng

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.N: So sánh các biểu diễn đồ thị cho nhiều tập dữ liệu định lượng. [Kỹ năng 2.D]

    • UNC-1.N.1 Bất kỳ loại biểu diễn đồ thị nào, ví dụ: histogram, boxplot đặt cạnh nhau, v.v., đều có thể được sử dụng để so sánh hai hoặc nhiều mẫu độc lập về trung tâm, độ phân tán, cụm, khoảng trống, giá trị ngoại lai và các đặc điểm khác.

    Mục tiêu học tập UNC-1.O: So sánh các Thống kê Tóm tắt cho nhiều tập dữ liệu định lượng. [Kỹ năng 2.D]

    • UNC-1.O.1 Bất kỳ loại tóm tắt số nào (ví dụ: trung bình cộng, độ lệch chuẩn, tần suất tương đối, v.v.) đều có thể được sử dụng để so sánh hai hoặc nhiều mẫu độc lập.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Để so sánh hai hoặc nhiều nhóm, hãy so sánh hình dạng, trung tâm và độ phân tán, và đề cập đến ngoại lai – luôn sử dụng từ ngữ so sánh ("Nhóm A có trung vị cao hơn Nhóm B") và trong ngữ cảnh. Đừng chỉ mô tả từng nhóm riêng lẻ; hãy đưa ra sự so sánh rõ ràng.

    Khám phá

    So sánh phân phối với biểu đồ hộp

    Một biểu đồ hộp vẽ tóm tắt năm số. Đặt hai biểu đồ hộp trên cùng một thang đo so sánh trung tâm (trung vị), độ phân tán (IQR = chiều rộng hộp) và độ lệch ngay lập tức — cách công bằng để so sánh các nhóm.

    1.10

    Phân phối Chuẩn

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-2
    The normal distribution can be used to represent some population distributions.

    VAR-2.A
    Compare a data distribution to the normal distribution model. [Skill 2.D]

    • VAR-2.A.1 A parameter is a numerical summary of a population.
    • VAR-2.A.2 Some sets of data may be described as approximately normally distributed. A normal curve is mound-shaped and symmetric. The parameters of a normal distribution are the population mean, $\mu$, and the population standard deviation, $\sigma$.
    • VAR-2.A.3 For a normal distribution, approximately 68% of the observations are within 1 standard deviation of the mean, approximately 95% of observations are within 2 standard deviations of the mean, and approximately 99.7% of observations are within 3 standard deviations of the mean. This is called the empirical rule.
    • VAR-2.A.4 Many variables can be modeled by a normal distribution.
      • Illustrative examples for VAR-2.A:
        • Variables that can be modeled by a normal distribution:
          • Body temperature
          • Weight of a loaf of bread

    VAR-2.B
    Determine proportions and percentiles from a normal distribution. [Skill 3.A]

    • VAR-2.B.1 A standardized score for a particular data value is calculated as (data value − mean)/(standard deviation), and measures the number of standard deviations a data value falls above or below the mean.
    • VAR-2.B.2 One example of a standardized score is a $z$-score, which is calculated as $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. A $z$-score measures how many standard deviations a data value is from the mean.
    • VAR-2.B.3 Technology, such as a calculator, a standard normal table, or computer-generated output, can be used to find the proportion of data values located on a given interval of a normally distributed random variable.
    • VAR-2.B.4 Given the area of a region under the graph of the normal distribution curve, it is possible to use technology, such as a calculator, a standard normal table, or computer-generated output, to estimate parameters for some populations.

    VAR-2.C
    Compare measures of relative position in data sets. [Skill 2.D]

    • VAR-2.C.1 Percentiles and $z$-scores may be used to compare relative positions of points within a data set or between data sets.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

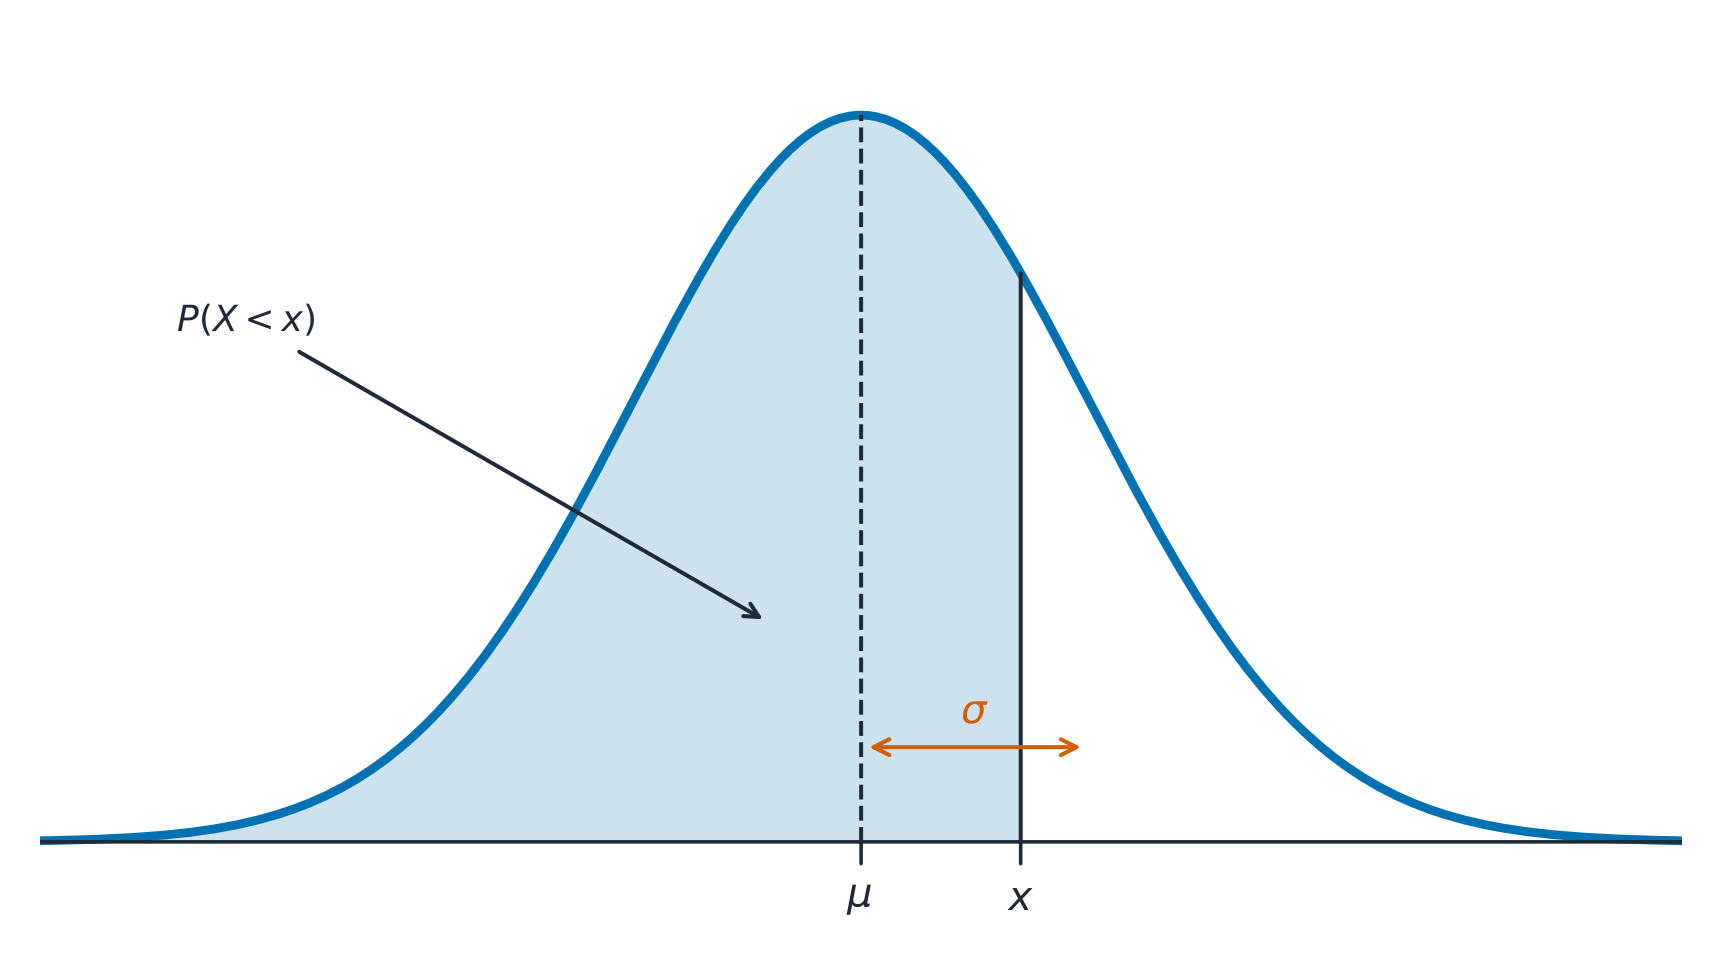
    Một phân phối chuẩn là mô hình đối xứng, hình chuông được mô tả bởi trung bình $\mu$ và độ lệch chuẩn $\sigma$. Quy tắc thực nghiệm (68–95–99.7): khoảng 68% giá trị nằm trong $1\sigma$ của trung bình, 95% trong $2\sigma$, và 99.7% trong $3\sigma$.

    Đường cong chuẩn: xác suất là diện tích bên dưới nó, có tâm tại trung bình
    Đường cong chuẩn: xác suất là diện tích bên dưới đường cong, lấy trung bình cộng làm tâm

    Một $z$-score đo lường xem một giá trị cách trung bình bao nhiêu độ lệch chuẩn:

    $$z=\frac{x-\mu}{\sigma}.$$
    Chuyển đổi sang điểm z ($z$-score), sau đó sử dụng bảng phân phối chuẩn hoặc công cụ tính toán để tìm tỷ lệ (diện tích) nằm dưới, trên hoặc giữa các giá trị – và thực hiện quá trình ngược lại để tìm một giá trị từ một percentile cho trước.

    Ví dụ minh họa. Điểm kiểm tra tuân theo phân phối chuẩn với $\mu=500$ và $\sigma=100$. Một điểm số $700$ có $z=\dfrac{700-500}{100}=2$. Theo quy tắc thực nghiệm, $95\%$ điểm nằm trong khoảng $2\sigma$, do đó $2.5\%$ nằm trên $700$ – nghĩa là một điểm $700$ tương ứng vào khoảng percentile thứ $97.5$.

    Đường cong chuẩn và quy tắc 68-95-99.7 thực nghiệm
    Đường cong chuẩn và quy tắc thực nghiệm 68-95-99.7
    Khám phá

    Khám phá diện tích dưới đường cong chuẩn

    Tỷ lệ dữ liệu nhỏ hơn một giá trị bằng diện tích dưới đường cong ở bên trái giá trị đó. tô đậm một đuôi hay một dải trung tâm để thấy quy tắc thực nghiệm 68–95–99.7 và đọc một điểm $z$ như một diện tích.

    Từ vựng Luyện tập
    English Tiếng Việt
    empirical rule/emˈpɪrɪkl ruːl/ quy tắc thực nghiệm
    $z$-score/ˈzed skɔː/ $z$-score
    1.10

    Mẹo làm bài thi

    • Mô tả phân phối bằng hình dạng, trung tâm, độ phân tán và ngoại lai (SOCS) – luôn trong ngữ cảnh.
    • Trung bình bị kéo bởi ngoại lai; trung vị kháng lại chúng, vì vậy ưu tiên dùng trung vị cho dữ liệu lệch.
    • Đối với phân phối chuẩn hãy sử dụng quy tắc 68–95–99.7 và z-scores $z=\tfrac{x-\mu}{\sigma}$.
    • So sánh phân phối bằng boxplot đặt cạnh nhau và nhận xét về trung tâm, độ phân tán và hình dạng.
    • Độ lệch chuẩn đo lường khoảng cách điển hình từ trung bình; IQR đi đôi với trung vị.
  • 2

    Khám phá Dữ liệu Hai biến số

    Xem bài học
    2.1

    Hai Biến Có Liên Quan Không?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.D: Xác định các câu hỏi cần trả lời về các mối quan hệ tiềm năng trong dữ liệu. [Kỹ năng 1.A]

    • VAR-1.D.1 Các mẫu hình và mối liên hệ rõ ràng trong dữ liệu có thể mang tính ngẫu nhiên hoặc không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Dữ liệu hai biến cho phép ta đặt câu hỏi liệu hai đặc điểm có liên quan hay không – liệu việc biết một cái có cho ta thông tin về cái kia hay không. Một biến giải thích ("dữ liệu đầu vào") có thể giúp dự đoán một biến phản hồi ("dữ liệu đầu ra"). Sự liên quan không đồng nghĩa với nguyên nhân-kết quả.

    2.2

    Hai Biến Định tính

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.P: So sánh các biểu diễn số và đồ thị cho hai biến định tính. [Kỹ năng 2.D]

    • UNC-1.P.1 Biểu đồ cột đặt cạnh nhau, biểu đồ cột phân đoạn, và biểu đồ mosaic là các ví dụ về biểu đồ cột cho một biến định tính, được phân tách theo các danh mục của một biến định tính khác.
    • UNC-1.P.2 Các biểu diễn đồ thị của hai biến định tính có thể được sử dụng để so sánh các phân phối và/hoặc xác định xem các biến có liên quan với nhau hay không.
    • UNC-1.P.3 Bảng hai chiều, còn gọi là bảng liên hệ, được sử dụng để tóm tắt hai biến phân loại. Các ô trong bảng có thể chứa số liệu tần suất hoặc tần suất tương đối.
    • UNC-1.P.4 Tần suất tương đối chung là tần suất của một ô chia cho tổng số của toàn bộ bảng.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một bảng hai chiều (bảng chéo) đếm số cá thể theo hai biến định tính cùng lúc. Phân phối biên là tổng dòng hoặc cột được viết dưới dạng phân số của tổng chung (chính các tổng đó chỉ là số đếm). So sánh các ô bên trong cho thấy liệu các biến có liên quan hay không.

    2.3

    So sánh Các Nhóm với Phân phối Có Điều kiện

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.Q: Tính toán thống kê cho hai biến phân loại. [Kỹ năng 2.C]

    • UNC-1.Q.1 Tần suất tương đối biên là tổng các hàng và cột trong bảng hai chiều chia cho tổng số của toàn bộ bảng.
    • UNC-1.Q.2 Tần suất tương đối điều kiện là tần suất tương đối của một phần cụ thể trong bảng liên hệ (ví dụ: tần suất ô trong một hàng chia cho tổng số của hàng đó).

    Mục tiêu học tập UNC-1.R: So sánh thống kê cho hai biến phân loại. [Kỹ năng 2.D]

    • UNC-1.R.1 Các thống kê tóm tắt cho hai biến phân loại có thể được sử dụng để so sánh phân phối và/hoặc xác định xem các biến có liên quan với nhau hay không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một phân phối điều kiện là phân phối của một biến bên trong một danh mục cố định của biến kia (tìm được bằng cách chia mỗi ô cho tổng dòng hoặc tổng cột của nó). Nếu các phân phối điều kiện khác nhau across các nhóm, hai biến là liên quan; nếu chúng giống nhau, thì không có sự liên quan. Biểu đồ thanh phân đoạn hoặc biểu đồ mosaiac hiển thị chúng.

    2.4

    Biểu đồ Scatter cho Hai Biến Định lượng

    Chương trình

    Hiểu biết bền vững (UNC-1): Các biểu đồ và số liệu thống kê giúp chúng ta xác định và biểu diễn các đặc điểm chính của dữ liệu.

    Mục tiêu học tập UNC-1.S: Biểu diễn dữ liệu định lượng hai biến bằng biểu đồ phân tán. [Kỹ năng 2.B]

    • UNC-1.S.1 Một tập dữ liệu định lượng hai biến bao gồm các quan sát của hai biến định lượng khác nhau trên các cá thể trong một mẫu hoặc quần thể.
    • UNC-1.S.2 Biểu đồ phân tán hiển thị hai giá trị số cho mỗi quan sát, một giá trị tương ứng với giá trị trên trục $x$ và một giá trị tương ứng với giá trị trên trục $y$.
    • UNC-1.S.3 Biến giải thích là biến mà các giá trị của nó được sử dụng để giải thích hoặc dự đoán các giá trị tương ứng của biến phản hồi.

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.A: Mô tả các đặc điểm của biểu đồ phân tán. [Kỹ năng 2.A]

    • DAT-1.A.1 Một mô tả về biểu đồ phân tán bao gồm hình dạng, hướng, độ mạnh và các đặc điểm bất thường.
    • DAT-1.A.2 Hướng của mối liên hệ được hiển thị trong biểu đồ phân tán, nếu có, có thể được mô tả là dương tính hoặc âm tính.
    • DAT-1.A.3 Mối liên hệ dương tính có nghĩa là khi giá trị của một biến tăng lên, giá trị của biến kia cũng có xu hướng tăng lên. Mối liên hệ âm tính có nghĩa là khi giá trị của một biến tăng lên, giá trị của biến kia có xu hướng giảm xuống.
    • DAT-1.A.4 Hình dạng của mối liên hệ được hiển thị trong biểu đồ phân tán, nếu có, có thể được mô tả là tuyến tính hoặc phi tuyến tính ở mức độ khác nhau.
    • DAT-1.A.5 Độ mạnh của mối liên hệ là mức độ các điểm riêng lẻ tuân theo một mẫu cụ thể, ví dụ như tuyến tính, và có thể được thể hiện trong biểu đồ phân tán. Độ mạnh có thể được mô tả là mạnh, trung bình hoặc yếu.
    • DAT-1.A.6 Các đặc điểm bất thường của biểu đồ phân tán bao gồm các cụm điểm hoặc các điểm có sự chênh lệch tương đối lớn giữa giá trị của biến phản hồi và giá trị dự đoán cho biến phản hồi đó.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một biểu đồ phân tán biểu diễn mỗi cá nhân dưới dạng một điểm, biến giải thích trên trục $x$ và biến phản hồi trên trục $y$. Mô tả nó theo DUFS: Hướng (tăng/giảm), Đặc điểm bất thường (điểm ngoại lệ, cụm), Dạng (tuyến tính hay cong) và Độ mạnh (các điểm có sát với quy luật không) – luôn đặt trong ngữ cảnh.
    Đường hồi quy tốt nhất chạy qua giữa các điểm phân tán
    Đường hồi quy tốt nhất chạy qua giữa các điểm phân tán
    2.5

    Tương quan

    Chương trình

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.B: Xác định hệ số tương quan cho mối quan hệ tuyến tính. [Kỹ năng 2.C]

    • DAT-1.B.1 Hệ số tương quan, $r$, cho biết hướng và định lượng độ mạnh của mối liên hệ tuyến tính giữa hai biến định lượng.
    • DAT-1.B.2 Hệ số tương quan có thể được tính bằng: $r = \dfrac{1}{n-1} \sum \left( \dfrac{x_i - \bar{x}}{s_x} \right) \left( \dfrac{y_i - \bar{y}}{s_y} \right)$. Tuy nhiên, cách phổ biến nhất để xác định $r$ là sử dụng công nghệ.
    • DAT-1.B.3 Một hệ số tương quan gần 1 hoặc $-1$ không nhất thiết có nghĩa là mô hình tuyến tính là phù hợp.

    Mục tiêu học tập DAT-1.C: Giải thích hệ số tương quan cho mối quan hệ tuyến tính. [Kỹ năng 4.B]

    • DAT-1.C.1 Hệ số tương quan, $r$, không có đơn vị và luôn nằm trong khoảng từ $-1$ đến 1, bao gồm cả hai giá trị biên. Giá trị $r = 0$ cho thấy không có mối liên hệ tuyến tính. Giá trị $r = 1$ hoặc $r = -1$ cho thấy có mối liên hệ tuyến tính hoàn hảo.
    • DAT-1.C.2 Một mối quan hệ cảm nhận hoặc thực tế giữa hai biến không có nghĩa là sự thay đổi của một biến gây ra sự thay đổi của biến kia. Nói cách khác, tương quan không nhất thiết ngụ ý nguyên nhân - kết quả.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    r thực sự đo lường điều gì

    Hệ số tương quan $r$ đo sức mạnh và chiều của mối quan hệ tuyến tính. Nó chạy từ $-1$ đến $1$: gần $\pm 1$ là tuyến tính mạnh, gần $0$ là tuyến tính yếu. $r$ không có đơn vị và không thay đổi nếu bạn hoán đổi các biến. Cảnh báo: $r$ chỉ đo sức mạnh tuyến tính, nó không kháng cự với giá trị ngoại lai, và một $r$ mạnh không chứng minh được nguyên nhân.

    Tương quan dương tăng cùng nhau; tương quan âm di chuyển ngược chiều
    Tương quan dương cùng tăng; tương quan âm di chuyển ngược chiều nhau
    Khám phá

    Cường độ mối quan hệ tuyến tính

    Hệ số tương quan $r$ chạy từ $-1$ đến $1$: gần $\pm1$, các điểm bám sát đường thẳng; gần 0, chúng phân tán rời rạc. Thay đổi giá trị này và quan sát đám mây điểm thu hẹp lại hay mở rộng ra.

    2.6

    Mô hình Hồi quy Tuyến tính

    Chương trình

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.D: Tính toán giá trị dự đoán bằng mô hình hồi quy tuyến tính. [Kỹ năng 2.C]

    • DAT-1.D.1 Một mô hình hồi quy tuyến tính đơn giản là một phương trình sử dụng biến giải thích, $x$, để dự đoán biến phản hồi, $y$.
    • DAT-1.D.2 Giá trị dự đoán, ký hiệu bởi $\hat{y}$, được tính bằng $\hat{y} = a + bx$, trong đó $a$ là giao điểm trên trục $y$ và $b$ là độ dốc của đường hồi quy, và $x$ là giá trị của biến giải thích.
    • DAT-1.D.3 Ngoại suy là dự đoán một giá trị phản hồi bằng cách sử dụng một giá trị của biến giải thích nằm ngoài khoảng các giá trị $x$ được sử dụng để xác định đường hồi quy. Giá trị dự đoán kém đáng tin cậy hơn như một ước lượng khi chúng ta ngoại suy càng xa.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đường hồi quy bình phương tối thiểu dự đoán biến phản hồi: $\hat{y}=a+bx$, nơi $\hat{y}$ là biến phản hồi đã dự đoán. Độ dốc $b$ là sự thay đổi dự đoán trong $y$ cho mỗi một đơn vị tăng lên ở $x$; giao điểm trục $y$ $a$ là giá trị dự đoán $y$ khi $x=0$. Giải thích cả hai trong ngữ cảnh và kèm đơn vị – đây là kỹ năng đánh giá. Tránh ngoại suy (dự đoán xa ngoài phạm vi dữ liệu).

    Ví dụ có lời giải. Một nghiên cứu về giờ học ($x$) và điểm bài kiểm tra ($y$) cho ra $\hat{y}=20+3x$. Độ dốc có nghĩa là mỗi giờ học thêm tương ứng với mức tăng dự đoán là $3$ điểm. Một học sinh học $5$ giờ được dự đoán đạt điểm $\hat{y}=20+3(5)=35$.

    Khám phá

    Vẽ đường hồi quy bình phương tối thiểu

    Một đường hồi quy là đường thẳng phù hợp tốt nhất, tối thiểu hóa tổng bình phương các khoảng cách dọc. Hệ số góc của nó dự đoán sự thay đổi của $y$ theo mỗi đơn vị của $x$.

    2.7

    Phần dư

    Chương trình

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.E: Biểu diễn sự khác biệt giữa các giá trị đo lường và giá trị dự đoán bằng biểu đồ phần dư. [Kỹ năng 2.B]

    • DAT-1.E.1 Phần dư là sự khác biệt giữa giá trị thực tế và giá trị dự đoán: $\text{residual} = y - \hat{y}$.
    • DAT-1.E.2 Biểu đồ phần dư là biểu đồ của các phần dư theo các giá trị của biến giải thích hoặc các giá trị phản hồi dự đoán.

    Mục tiêu học tập DAT-1.F: Mô tả hình dạng của mối liên hệ trong dữ liệu hai biến bằng biểu đồ phần dư. [Kỹ năng 2.A]

    • DAT-1.F.1 Sự ngẫu nhiên rõ ràng trong biểu đồ phần dư của một mô hình tuyến tính là bằng chứng cho thấy hình dạng tuyến tính của mối liên hệ giữa các biến.
    • DAT-1.F.2 Biểu đồ phần dư có thể được sử dụng để kiểm tra tính phù hợp của một mô hình đã chọn.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Hồi quy bình phương tối thiểu

    Phần dư là giá trị thực trừ đi giá trị dự đoán, $y-\hat{y}$: khoảng cách mà một điểm nằm phía trên (+) hoặc phía dưới (−) đường thẳng. Biểu đồ phần dư vẽ phần dư theo $x$. Nếu nó cho thấy không có quy luật (phân tán ngẫu nhiên), mô hình tuyến tính là phù hợp; một quy luật cong hoặc mở rộng cho thấy mô hình tuyến tính không phù hợp.

    Ví dụ có lời giải. Tiếp tục nghiên cứu trên, một học sinh học $5$ giờ thực tế đạt điểm $40$. Phần dư là $y-\hat{y}=40-35=+5$: đường thẳng đã dự đoán thấp hơn $5$ điểm, vì vậy điểm này nằm phía trên đường thẳng.

    Bốn tập dữ liệu có cùng r và đường hồi quy nhưng bốn hình dạng khác nhau
    Lưu ý về $r$ và đường thẳng: cả bốn tập dữ liệu đều có cùng $r=0.82$ và cùng $\hat{y}=3.0+0.5x$, nhưng chỉ tập đầu tiên thực sự là tuyến tính. Các biểu đồ phân tán hầu như không khác nhau — chính biểu đồ phần dư bên dưới mới làm lộ rõ độ cong, điểm ngoại lệ và điểm có sức nặng cao.
    2.8

    Bình phương tối thiểu và Mức độ phù hợp của Hồi quy

    Chương trình

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.G: Ước lượng tham số cho mô hình đường hồi quy bình phương tối thiểu. [Kỹ năng 2.C]

    • DAT-1.G.1 Mô hình hồi quy bình phương tối thiểu tối thiểu hóa tổng bình phương phần dư và chứa điểm $(\bar{x}, \bar{y})$.
    • DAT-1.G.2 Hệ số góc, $b$, của đường hồi quy có thể được tính theo công thức $b = r \left( \dfrac{s_y}{s_x} \right)$, trong đó $r$ là hệ số tương quan giữa $x$ và $y$, $s_y$ là độ lệch chuẩn mẫu của biến phản ứng, $y$, và $s_x$ là độ lệch chuẩn mẫu của biến giải thích, $x$.
    • DAT-1.G.3 Đôi khi, $y$-trục (trục tung) của đường thẳng không có ý nghĩa thực tế trong ngữ cảnh.
    • DAT-1.G.4 Trong hồi quy tuyến tính đơn giản, $r^2$ là bình phương của hệ số tương quan, $r$. Nó còn được gọi là hệ số xác định. $r^2$ là tỷ lệ biến thiên của biến phản ứng được giải thích bởi biến giải thích trong mô hình.

    Mục tiêu học tập DAT-1.H: Giải thích các hệ số của mô hình đường hồi quy bình phương tối thiểu. [Kỹ năng 4.B]

    • DAT-1.H.1 Các hệ số của mô hình hồi quy bình phương tối thiểu là độ dốc ước lượng và $y$-trục (trục tung).
    • DAT-1.H.2 Hệ số góc là mức thay đổi của giá trị dự báo $y$ đối với mỗi đơn vị gia tăng của $x$.
    • DAT-1.H.3 Giá trị $y$-trục (trục tung) là giá trị dự báo của biến phản hồi khi biến giải thích bằng $0$. Công thức cho $y$-trục (trục tung), $a$, là $a = \bar{y} - b\bar{x}$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đường bình phương tối thiểu giảm thiểu tổng bình phương phần dư
    Đường bình phương tối thiểu tối thiểu hóa tổng các phần dư bình phương

    Đường thẳng tối thiểu hóa tổng các phần dư bình phương. Mức độ phù hợp của nó được đo bằng:

    • $s$, độ lệch chuẩn của phần dư – sai số dự đoán điển hình, theo đơn vị của biến phản hồi.
    • $r^2$, hệ số xác định – tỷ lệ phần biến động trong $y$ mà mô hình tuyến tính giải thích (giá trị nằm giữa $0$ và $1$; nhân với $100$ để biểu thị dưới dạng phần trăm). Báo cáo trong ngữ cảnh: "$r^2 = 0.81$ có nghĩa là 81% biến động trong $y$ được giải thích bởi mối liên hệ tuyến tính với $x$."
    Từ vựng Luyện tập
    English Tiếng Việt
    associated/əˈsəʊsɪeɪtɪd/ liên quan
    explanatory variable/ekˈsplænətəri ˈveərɪəbl/ biến giải thích
    response variable/rɪˈspɒns ˈveərɪəbl/ biến phản hồi
    two-way table/tuː weɪ ˈteɪbl/ bảng hai chiều
    marginal distributions/ˈmɑːdʒɪnl ˌdɪstrɪˈbjuːʃnz/ phân phối biên
    conditional distribution/kənˈdɪʃənl ˌdɪstrɪˈbjuːʃn/ phân phối điều kiện
    Segmented bar charts/seɡˈmentɪd bɑː tʃɑːts/ Biểu đồ cột phân đoạn
    scatterplot/ˈskætəplɒt/ biểu đồ tán xạ
    correlation coefficient/ˌkɒrɪˈleɪʃn ˌkəʊɪˈfɪʃənt/ hệ số tương quan
    least-squares regression line/liːst skweəz rɪˈɡreʃn laɪn/ đường hồi quy bình phương tối thiểu
    slope/sləʊp/ hệ số góc
    y-intercept/waɪ ˌɪntəˈsept/ Giao điểm với trục tung
    extrapolation/ekˈstræpəleɪʃn/ ngoại suy
    residual/rɪˈsɪdʒuːəl/ phần dư
    residual plot/rɪˈsɪdʒuːəl plɒt/ biểu đồ dư thừa
    coefficient of determination/ˌkəʊɪˈfɪʃənt ɒv dɪˌtɜːmɪˈneɪʃn/ hệ số xác định
    high-leverage/haɪ ˈliːvərɪdʒ/ có sức tác động cao
    influential/ˌɪnfluːˈenʃl/ có ảnh hưởng
    2.9

    Sai lệch khỏi Đường thẳng

    Chương trình

    Hiểu biết cốt lõi (DAT-1): Các mô hình hồi quy có thể cho phép chúng ta dự đoán phản hồi trước những thay đổi của biến giải thích.

    Mục tiêu học tập DAT-1.I: Xác định các điểm ảnh hưởng trong hồi quy. [Kỹ năng 2.A]

    • DAT-1.I.1 Một điểm ngoại lai trong hồi quy là một điểm không tuân theo xu hướng chung được thể hiện ở phần dữ liệu còn lại và có phần dư lớn khi Đường hồi quy bình phương tối thiểu (LSRL) được tính toán.
    • DAT-1.I.2 Một điểm có sức nặng cao (high-leverage point) trong hồi quy có giá trị $x$ lớn hơn hoặc nhỏ hơn đáng kể so với các quan sát khác.
    • DAT-1.I.3 Một điểm ảnh hưởng trong hồi quy là bất kỳ điểm nào mà nếu bị loại bỏ sẽ làm thay đổi mối quan hệ đáng kể. Ví dụ bao gồm độ dốc khác biệt nhiều, $y$-trục (trục tung), và/hoặc tương quan. Điểm ngoại lai và điểm có lực cao thường mang tính ảnh hưởng.

    Mục tiêu học tập DAT-1.J: Tính giá trị dự báo sử dụng đường hồi quy bình phương tối thiểu cho bộ dữ liệu đã được biến đổi. [Kỹ năng 2.C]

    • DAT-1.J.1 Việc biến đổi các biến, chẳng hạn như tính logarit tự nhiên của từng giá trị của biến phản ứng hoặc bình phương từng giá trị của biến giải thích, có thể được sử dụng để tạo ra các bộ dữ liệu đã biến đổi, vốn có dạng tuyến tính hơn so với dữ liệu chưa biến đổi.
    • DAT-1.J.2 Sự tăng lên của tính ngẫu nhiên trong biểu đồ phần dư sau khi biến đổi dữ liệu và/hoặc việc di chuyển $r^2$ đến một giá trị gần 1 hơn cung cấp bằng chứng cho thấy đường hồi quy bình phương tối thiểu của dữ liệu đã biến đổi là mô hình phù hợp hơn để dự báo các phản ứng đối với biến giải thích so với đường hồi quy của dữ liệu chưa biến đổi.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một số điểm ảnh hưởng mạnh đến đường thẳng. Điểm có sức nặng cao có giá trị $x$ cực đoan; điểm có ảnh hưởng thay đổi đáng kể độ dốc hoặc $r$ khi bị loại bỏ; điểm ngoại lệ ở đây là điểm có phần dư lớn. Khi quy luật cong, hãy biến đổi một biến (ví dụ: lấy logarit) để làm thẳng nó, sau đó fit đường thẳng vào dữ liệu đã biến đổi.

    2.9

    Mẹo làm bài thi

    • Trên biểu đồ phân tán mô tả hướng, dạng, độ mạnh và điểm ngoại lệ; $r$ nằm trong khoảng $-1$ đến $1$.
    • Tương quan không phải là nguyên nhân – một biến ẩn có thể thúc đẩy cả hai.
    • Giải thích độ dốc của đường bình phương tối thiểu trong ngữ cảnh ("mỗi một đơn vị của $x$, dự đoán $y$ thay đổi $b$").
    • Kiểm tra biểu đồ phần dư: không có quy luật có nghĩa là đường thẳng phù hợp; độ cong có nghĩa là không. Tránh ngoại suy.
    • $r^2$ là tỷ lệ phần biến động trong $y$ được mô hình giải thích.
  • 3

    Thu thập Dữ liệu

    Xem bài học
    3.1

    Chúng ta Có Nên Tin Dữ liệu thu thập được Không?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.E: Xác định các câu hỏi cần trả lời về phương pháp thu thập dữ liệu. [Kỹ năng 1.A]

    • VAR-1.E.1 Các phương pháp thu thập dữ liệu không dựa trên yếu tố ngẫu nhiên dẫn đến kết luận không đáng tin cậy.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một kết luận chỉ tốt bằng dữ liệu đứng sau nó. Cách thức thu thập dữ liệu quyết định những gì bạn có thể kết luận – liệu bạn có thể khái quát hóa cho quần thể, hay có thể khẳng định nguyên nhân và kết quả hay không. Dữ liệu thu thập kém thậm chí còn tệ hơn là không có gì.

    3.2

    Nghiên cứu Quan sát và Thực nghiệm

    Chương trình

    Hiểu biết bền vững (DAT-2): Cách chúng ta thu thập dữ liệu ảnh hưởng đến những gì chúng ta có thể và không thể nói về một quần thể.

    Mục tiêu học tập DAT-2.A: Xác định loại hình nghiên cứu. [Kỹ năng 1.C]

    • DAT-2.A.1 Một quần thể bao gồm tất cả các đối tượng hoặc chủ thể quan tâm.
    • DAT-2.A.2 Một mẫu được chọn để nghiên cứu là một tập con của quần thể.
    • DAT-2.A.3 Trong nghiên cứu quan sát, các điều trị không được áp đặt. Các nhà nghiên cứu xem xét dữ liệu từ một mẫu cá nhân (hồi cứu) hoặc theo dõi một mẫu cá nhân vào tương lai để thu thập dữ liệu (tiên tiến) nhằm khám phá một chủ đề quan tâm về quần thể. Khảo sát mẫu là một loại nghiên cứu quan sát thu thập dữ liệu từ một mẫu nhằm tìm hiểu về quần thể mà mẫu đó được抽取 từ.
    • DAT-2.A.4 Trong thí nghiệm, các điều kiện khác nhau (điều trị) được gán cho các đơn vị thí nghiệm (tham gia viên hoặc chủ thể).

    Mục tiêu học tập DAT-2.B: Xác định các khái quát hóa và kết luận thích hợp dựa trên các nghiên cứu quan sát. [Kỹ năng 4.A]

    • DAT-2.B.1 Chỉ thích hợp khi đưa ra các khái quát hóa về một quần thể dựa trên các mẫu được chọn ngẫu nhiên hoặc đại diện cho quần thể đó.
    • DAT-2.B.2 Một mẫu chỉ có thể khái quát hóa sang quần thể mà từ đó mẫu được chọn.
    • DAT-2.B.3 Không thể xác định các mối quan hệ nguyên nhân - kết quả giữa các biến sử dụng dữ liệu thu thập được từ một nghiên cứu quan sát.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    • Trong nghiên cứu quan sát, bạn đo lường các cá nhân mà không cố gắng tác động đến chúng. Nó có thể cho thấy sự liên kết, nhưng không phải nguyên nhân, vì các biến ẩn có thể giải thích mối liên hệ đó.
    • Trong thực nghiệm, bạn chủ động áp dụng một liệu pháp và so sánh các phản hồi. Một thực nghiệm được thiết kế tốt có thể thiết lập mối quan hệ nguyên nhân - kết quả.
    Khám phá

    Nghiên cứu quan sát hay thí nghiệm?

    Trong một thí nghiệm, nhà nghiên cứu áp đặt can thiệp (và có thể chứng minh nguyên nhân); một nghiên cứu quan sát chỉ ghi lại những gì đang xảy ra sẵn (và chỉ có thể chứng minh mối liên hệ, không phải nguyên nhân).

    3.3

    Lấy mẫu ngẫu nhiên

    Chương trình

    Hiểu biết bền vững (DAT-2): Cách chúng ta thu thập dữ liệu ảnh hưởng đến những gì chúng ta có thể và không thể nói về một quần thể.

    Mục tiêu học tập DAT-2.C: Xác định phương pháp lấy mẫu, dựa trên mô tả về một nghiên cứu. [Kỹ năng 1.C]

    • DAT-2.C.1 Khi một đối tượng từ quần thể chỉ có thể được chọn một lần, điều này được gọi là lấy mẫu không hoàn lại. Khi một đối tượng từ quần thể có thể được chọn nhiều lần, điều này được gọi là lấy mẫu hoàn lại.
    • DAT-2.C.2 Một mẫu ngẫu nhiên đơn giản (SRS) là một mẫu trong đó mọi nhóm có kích thước cho trước đều có cơ hội ngang nhau để được chọn. Phương pháp này là nền tảng cho nhiều loại cơ chế lấy mẫu. Một vài ví dụ về các cơ chế dùng để thu được SRSs bao gồm đánh số các cá nhân và sử dụng máy phát số ngẫu nhiên để chọn những ai được đưa vào mẫu, bỏ qua các trường hợp trùng lặp, sử dụng bảng số ngẫu nhiên, hoặc rút một lá bài từ bộ bài mà không hoàn lại.
    • DAT-2.C.3 Mẫu ngẫu nhiên phân tầng bao gồm việc chia một tổng thể thành các nhóm riêng biệt, gọi là các tầng, dựa trên các thuộc tính hoặc đặc điểm chung (sự phân nhóm đồng nhất). Trong mỗi tầng, một mẫu ngẫu nhiên đơn được chọn, và các đơn vị được chọn được kết hợp để tạo thành mẫu.
    • DAT-2.C.4 Mẫu cụm bao gồm việc chia một tổng thể thành các nhóm nhỏ hơn, gọi là các cụm. Lý tưởng nhất, có sự khác biệt bên trong mỗi cụm, và các cụm tương tự nhau về cấu trúc của chúng. Một mẫu ngẫu nhiên đơn các cụm được chọn từ tổng thể để tạo thành mẫu cụm. Dữ liệu được thu thập từ tất cả các quan sát trong các cụm đã chọn.
    • DAT-2.C.5 Mẫu ngẫu nhiên hệ thống là phương pháp mà các thành viên mẫu từ tổng thể được chọn theo một điểm bắt đầu ngẫu nhiên và một khoảng cách định kỳ cố định.
    • DAT-2.C.6 Tổng điều tra chọn tất cả các mục/đối tượng trong một tổng thể.

    Mục tiêu học tập DAT-2.D: Giải thích tại sao một phương pháp lấy mẫu cụ thể là phù hợp hoặc không phù hợp cho một tình huống cho trước. [Kỹ năng 1.C]

    • DAT-2.D.1 Mỗi phương pháp lấy mẫu đều có ưu điểm và nhược điểm tùy thuộc vào câu hỏi cần trả lời và tổng thể từ đó mẫu sẽ được抽取.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Để tìm hiểu về quần thể, bạn cần lấy một mẫu. Lấy mẫu ngẫu nhiên bảo vệ chống lại thiên kiến chọn lọc và cho phép bạn khái quát hóa (nó không thể sửa chữa thiếu phủ, phản hồi không trả lời, hoặc thiên kiến phản hồi – xem bên dưới). Các thiết kế phổ biến:

    • Mẫu ngẫu nhiên đơn giản (SRS): mọi nhóm có kích thước được chọn đều có khả năng ngang nhau.
    • Phân tầng: chia quần thể thành các tầng tương đồng, sau đó lấy mẫu trong từng tầng.
    • Phân cụm: chia thành các cụm, ngẫu nhiên chọn toàn bộ các cụm.
    • Có hệ thống: chọn cứ mỗi $k$ cá nhân bắt đầu từ một điểm ngẫu nhiên.
    Bốn thiết kế lấy mẫu ngẫu nhiên: ai được chọn, và như thế nào
    Bốn thiết kế lấy mẫu ngẫu nhiên: ai được chọn, và làm thế nào

    Mẫu tiện lợi hoặc mẫu phản hồi tự nguyện là không ngẫu nhiên và có thiên lệch.

    Ví dụ minh họa. Để khảo sát một trường học, một quản trị viên liệt kê tất cả học sinh theo lớp và chọn ngẫu nhiên $20$ từ mỗi lớp. Đây là mẫu phân tầng – các lớp là các tầng – điều này đảm bảo mọi lớp đều được đại diện, khác với SRS có thể do may mắn mà抽取 ít người từ một lớp.

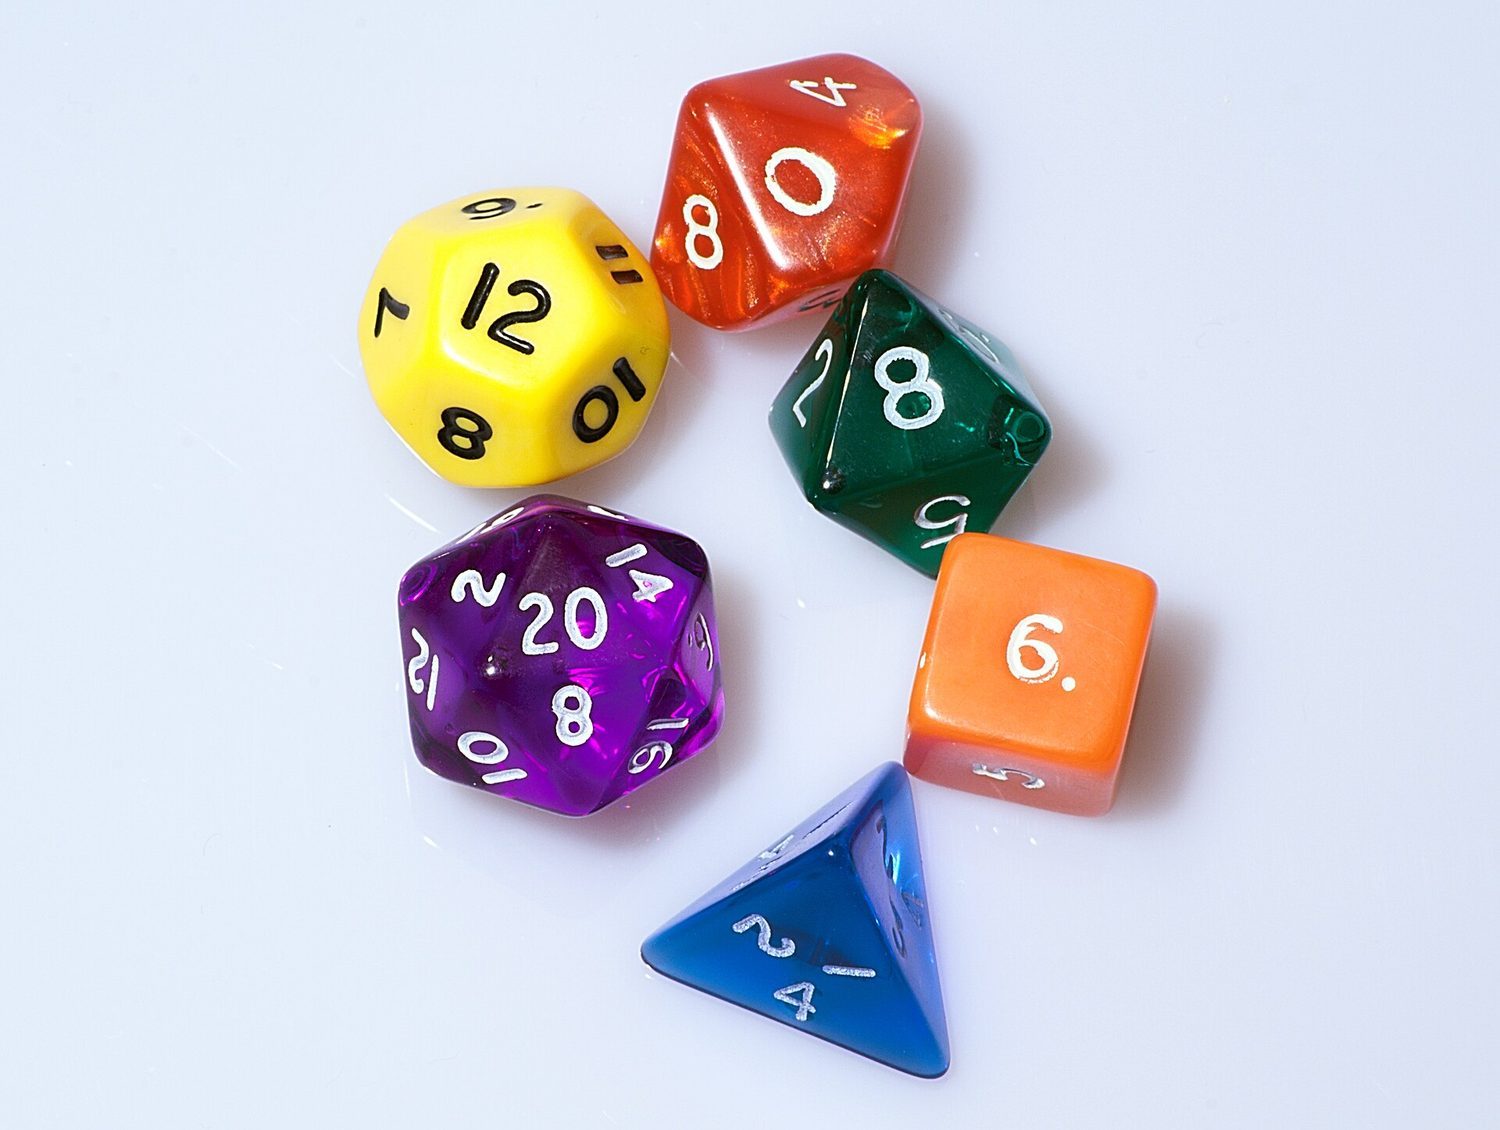
    Kết quả ngẫu nhiên: xúc xắc tạo khả năng ngang nhau cho mỗi mặt trong điều kiện công bằng
    Kết quả ngẫu nhiên: xúc xắc tạo khả năng ngang nhau cho mỗi mặt trong điều kiện công bằng
    3.4

    Khi Lấy Mẫu Ra Sao

    Chương trình

    Hiểu biết bền vững (DAT-2): Cách chúng ta thu thập dữ liệu ảnh hưởng đến những gì chúng ta có thể và không thể nói về một quần thể.

    Mục tiêu học tập DAT-2.E: Xác định các nguồn thiên lệch tiềm tàng trong các phương pháp lấy mẫu. [Kỹ năng 1.C]

    • DAT-2.E.1 Thiên lệch xảy ra khi một số phản ứng được ưu tiên có hệ thống so với những phản ứng khác.
    • DAT-2.E.2 Khi một mẫu chỉ bao gồm những người tình nguyện hoặc những người chọn tham gia, mẫu thường sẽ không đại diện cho tổng thể (thiên lệch phản hồi tự nguyện).
    • DAT-2.E.3 Khi một phần của tổng thể có cơ hội thấp hơn để được đưa vào mẫu, mẫu thường sẽ không đại diện cho tổng thể (thiên lệch che phủ dưới).
    • DAT-2.E.4 Những cá nhân được chọn cho mẫu nhưng không thể thu thập dữ liệu (hoặc từ chối trả lời) có thể khác biệt so với những cá nhân mà dữ liệu có thể thu thập được (thiên lệch không phản hồi).
    • DAT-2.E.5 Các vấn đề trong dụng cụ hoặc quy trình thu thập dữ liệu dẫn đến thiên lệch phản hồi. Ví dụ bao gồm các câu hỏi gây nhầm lẫn hoặc mang tính dẫn dắt (thiên lệch cách đặt câu hỏi) và các phản hồi do chính người trả lời cung cấp.
    • DAT-2.E.6 Các phương pháp lấy mẫu phi ngẫu nhiên (ví dụ: mẫu chọn theo tiện lợi hoặc phản hồi tự nguyện) làm tăng khả năng xuất hiện thiên lệch vì chúng không sử dụng may mắn để chọn các cá nhân.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Thiên lệch khiến ước lượng sai lệch hệ thống so với thực tế:

    • Che phủ không đầy đủ: một số nhóm bị loại khỏi khung lấy mẫu.
    • Không phản hồi: những người được chọn không trả lời.
    • Thiên lệch phản hồi: người trả lời không chính xác (câu hỏi xấu, chủ đề nhạy cảm).

    Thiên lệch liên quan đến một lỗi nhất quán theo một hướng – tăng kích thước mẫu không khắc phục được nó.

    Mẫu tiện lợi bỏ sót quần thể: thiên lệch len lỏi vào khi việc chọn không ngẫu nhiên
    Mẫu tiện lợi bỏ sót quần thể: thiên lệch len lỏi vào khi việc chọn không ngẫu nhiên
    Từ vựng Luyện tập
    English Tiếng Việt
    bias/ˈbaɪəs/ sự thiên lệch
    Simple random sample (SRS)/ˈsɪmpl ˈrændəm ˈsæmpl/ Mẫu ngẫu nhiên đơn (SRS)
    Stratified/ˈstrætɪfaɪd/ Phân tầng
    Cluster/ˈklʌstə/ Nhóm
    Systematic/ˌsɪstəˈmætɪk/ Hệ thống
    convenience sample/kənˈviːnɪəns ˈsæmpl/ mẫu thuận tiện
    Undercoverage/ˌʌndəˈkʌvərɪdʒ/ sự thiếu hụt trong phạm vi mẫu
    Nonresponse/ˌnɒnrɪˈspɒns/ không phản hồi
    Response bias/rɪˈspɒns ˈbaɪəs/ thiên lệch phản hồi
    control group/kənˈtrəʊl ɡruːp/ nhóm đối chứng
    placebo/pləˈsiːbəʊ/ giả dược
    Random assignment/ˈrændəm əˈsaɪnmənt/ phân bổ ngẫu nhiên
    Replication/ˌreplɪˈkeɪʃn/ Lặp lại
    Confounding/kənˈfaʊndɪŋ/ biến gây nhiễu
    Blinding/ˈblaɪndɪŋ/ che giấu thông tin
    single-blind/ˈsɪŋɡl blaɪnd/ một bên mặc dù
    double-blind/ˈdʌbl blaɪnd/ mặc dù hai bên đều mù
    Blocking/ˈblɒkɪŋ/ nhóm hóa
    3.5

    Thiết Kế Thí Nghiệm

    Chương trình

    Hiểu biết dai dẳng (VAR-3): Các thực nghiệm được thiết kế tốt có thể thiết lập bằng chứng về mối quan hệ nhân quả.

    Mục tiêu học tập VAR-3.A: Xác định các thành phần của một thực nghiệm. [Kỹ năng 1.C]

    • VAR-3.A.1 Các đơn vị thực nghiệm là các cá nhân (có thể là con người hoặc các đối tượng nghiên cứu khác) được gán các điều trị. Khi các đơn vị thực nghiệm bao gồm con người, đôi khi họ được gọi là người tham gia hoặc đối tượng.
    • VAR-3.A.2 Một biến giải thích (hoặc yếu tố) trong một thực nghiệm là một biến mà các mức độ của nó được thao tác chủ ý. Các mức độ hoặc sự kết hợp các mức độ của biến giải thích được gọi là các điều trị.
    • VAR-3.A.3 Một biến phản hồi trong một thực nghiệm là một kết quả từ các đơn vị thực nghiệm được đo sau khi các điều trị đã được áp dụng.
    • VAR-3.A.4 Một biến nhiễu trong một thực nghiệm là một biến liên quan đến biến giải thích và ảnh hưởng đến biến phản hồi, có thể tạo ra cảm giác sai lầm về mối liên hệ giữa hai biến.

    Mục tiêu học tập VAR-3.B: Mô tả các yếu tố của một thực nghiệm được thiết kế tốt. [Kỹ năng 1.B]

    • VAR-3.B.1 Một thực nghiệm được thiết kế tốt nên bao gồm các yếu tố sau:
      • a. So sánh ít nhất hai nhóm điều trị, trong đó một nhóm có thể là nhóm đối chứng.
      • b. Gán/ngân sách ngẫu nhiên các điều trị cho các đơn vị thực nghiệm.
      • c. Lặp lại (nhiều hơn một đơn vị thực nghiệm trong mỗi nhóm điều trị).
      • d. Kiểm soát các biến nhiễu tiềm tàng khi phù hợp.

    Mục tiêu học tập VAR-3.C: So sánh các thiết kế và phương pháp thực nghiệm. [Kỹ năng 1.C]

    • VAR-3.C.1 Trong thiết kế hoàn toàn ngẫu nhiên, các điều trị được gán cho các đơn vị thực nghiệm hoàn toàn ngẫu nhiên. Việc gán ngẫu nhiên có xu hướng cân bằng các hiệu ứng của các biến không được kiểm soát (biến nhiễu) để các khác biệt trong phản hồi có thể được quy cho các điều trị.
    • VAR-3.C.2 Các phương pháp để gán ngẫu nhiên các điều trị cho các đơn vị thực nghiệm trong thiết kế hoàn toàn ngẫu nhiên bao gồm sử dụng bộ phát số ngẫu nhiên, bảng giá trị ngẫu nhiên, rút thẻ không thay thế, v.v.
    • VAR-3.C.3 Trong thực nghiệm một mù, các đối tượng không biết điều trị nào họ đang nhận, nhưng các thành viên trong đội ngũ nghiên cứu thì biết, hoặc ngược lại.
    • VAR-3.C.4 Trong thực nghiệm hai mù, cả các đối tượng lẫn các thành viên trong đội ngũ nghiên cứu tương tác với họ đều không biết điều trị nào một đối tượng đang nhận.
    • VAR-3.C.5 Nhóm đối chứng là một tập hợp các đơn vị thực nghiệm không được giao điều trị quan tâm hoặc được giao điều trị với chất vô hiệu (placebo) nhằm xác định xem điều trị quan tâm có tác động hay không.
    • VAR-3.C.6 Hiệu ứng placebo xảy ra khi các đơn vị thực nghiệm có phản hồi với một chất placebo.
    • VAR-3.C.7 Đối với thiết kế khối ngẫu nhiên hoàn chỉnh, các điều trị được gán hoàn toàn ngẫu nhiên trong từng khối.
    • VAR-3.C.8 Khối đảm bảo rằng ở đầu thực nghiệm, các đơn vị trong mỗi khối giống nhau với nhau về ít nhất một biến khối. Thiết kế khối ngẫu nhiên giúp tách biệt biến đổi tự nhiên khỏi các khác biệt do biến khối.
    • VAR-3.C.9 Thiết kế cặp tương ứng là một trường hợp đặc biệt của thiết kế khối ngẫu nhiên. Sử dụng biến khối, các đơn vị thực nghiệm (dù là con người hay không) được sắp xếp thành từng cặp được phân loại dựa trên các yếu tố liên quan. Các cặp tương ứng có thể hình thành tự nhiên hoặc do nhà thí nghiệm tạo ra. Mỗi cặp đều nhận cả hai điều trị bằng cách gán ngẫu nhiên một điều trị cho một thành viên trong cặp và sau đó gán điều trị còn lại cho thành viên thứ hai của cặp. Thay vào đó, mỗi đơn vị thực nghiệm có thể nhận cả hai điều trị.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Các thí nghiệm tốt tuân theo ba nguyên tắc:

    • So sánh với nhóm đối chứng (thường là giả dược).
    • Phân bổ ngẫu nhiên đối tượng vào các phương pháp điều trị, để cân bằng các biến số khác.
    • Lặp lại: đủ đối tượng cho mỗi phương pháp điều trị để phát hiện hiệu ứng thực sự.
    Một thí nghiệm hoàn toàn ngẫu nhiên so sánh nhóm điều trị với nhóm đối chứng
    Một thí nghiệm hoàn toàn ngẫu nhiên so sánh nhóm điều trị với nhóm đối chứng

    Nhiễu loạn xảy ra khi một biến số khác gắn liền với phương pháp điều trị nên không thể tách biệt tác động; phân bổ ngẫu nhiên giúp ngăn ngừa điều này. Che giấu ẩn ai đang nhận phương pháp điều trị nào để tránh hiệu ứng kỳ vọng: trong nghiên cứu một che giấu, chỉ một bên giữ bí mật (thường là đối tượng, hoặc chỉ những người đánh giá kết quả), trong khi trong nghiên cứu hai che giấu, cả đối tượng lẫn các nhà nghiên cứu tương tác với họ đều không biết, chặn đứng cả hiệu ứng giả dược và đánh giá thiên vị. Chia nhóm gộp các đối tượng giống nhau và phân bổ ngẫu nhiên trong từng nhóm con để giảm biến異.

    Thử nghiệm lâm sàng: phân bổ ngẫu nhiên tách biệt nhóm điều trị khỏi nhóm đối chứng
    Thử nghiệm lâm sàng: phân bổ ngẫu nhiên tách biệt điều trị khỏi đối chứng
    Từ vựng Luyện tập
    English Tiếng Việt
    population/ˌpɒpjʊˈleɪʃn/ dân số
    observational study/ɒbzəˈveɪʃənl ˈstʌdi/ nghiên cứu quan sát
    experiment/ekˈsperɪmənt/ thí nghiệm
    3.6

    Chọn Thiết Kế Phù Hợp

    Chương trình

    Hiểu biết dai dẳng (VAR-3): Các thực nghiệm được thiết kế tốt có thể thiết lập bằng chứng về mối quan hệ nhân quả.

    Mục tiêu Học tập VAR-3.D: Giải thích tại sao một thiết kế thực nghiệm cụ thể là phù hợp. [Kỹ năng 1.C]

    • VAR-3.D.1 Mỗi thiết kế thực nghiệm đều có những ưu điểm và nhược điểm tùy thuộc vào câu hỏi nghiên cứu, nguồn lực sẵn có và bản chất của các đơn vị thực nghiệm.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Khớp thiết kế với mục tiêu: dùng thiết kế hoàn toàn ngẫu nhiên cho đối tượng đồng nhất; thiết kế chia nhóm ngẫu nhiên khi một biến số đã biết (giới tính, tuổi) ảnh hưởng đến phản hồi; thiết kế cặp ghép khi mỗi đối tượng có thể đóng vai trò đối chứng của chính mình. Nêu cách bạn sẽ tiến hành phân bổ ngẫu nhiên.

    3.7

    Những Gì Thí Nghiệm Cho Phép Bạn Kết Luận

    Chương trình

    Hiểu biết dai dẳng (VAR-3): Các thực nghiệm được thiết kế tốt có thể thiết lập bằng chứng về mối quan hệ nhân quả.

    Mục tiêu Học tập VAR-3.E: Giải thích kết quả của một thực nghiệm được thiết kế tốt. [Kỹ năng 4.B]

    • VAR-3.E.1 Suy luận thống kê quy các kết luận dựa trên dữ liệu cho phân phối từ đó dữ liệu được thu thập.
    • VAR-3.E.2 Việc gán ngẫu nhiên các điều trị cho các đơn vị thực nghiệm cho phép các nhà nghiên cứu kết luận rằng những thay đổi quan sát được quá lớn đến mức khó có thể xảy ra do ngẫu nhiên. Những thay đổi này được gọi là có ý nghĩa thống kê.
    • VAR-3.E.3 Sự khác biệt có ý nghĩa thống kê giữa hoặc trong các nhóm điều trị thực nghiệm là bằng chứng cho thấy các điều trị đã gây ra hiệu ứng.
    • VAR-3.E.4 Nếu các đơn vị thực nghiệm được sử dụng trong một thực nghiệm đại diện cho một nhóm đơn vị lớn hơn, kết quả của thực nghiệm có thể được ngoại suy hóa cho nhóm lớn hơn. Việc chọn ngẫu nhiên các đơn vị thực nghiệm mang lại cơ hội tốt hơn để các đơn vị này là đại diện.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Hai câu hỏi quyết định phạm vi kết luận:

    • Phân bổ ngẫu nhiên đã dùng chưa? Nếu có, sự khác biệt có ý nghĩa có thể归因于 treatment (nguyên nhân) – đối với những đối tượng này.
    • Lấy mẫu ngẫu nhiên từ quần thể? Nếu có, kết quả chính quy hóa sang quần thể đó.

    Chỉ có thí nghiệm có phân bổ ngẫu nhiên mới hỗ trợ tuyên bố nguyên nhân - kết quả; chỉ có lấy mẫu ngẫu nhiên mới hỗ trợ chính quy hóa. Hãy nêu rõ đúng những gì bạn có.

    Ví dụ minh họa. Các nhà nghiên cứu phân bổ ngẫu nhiên $100$ tình nguyện viên vào một loại thuốc mới hoặc giả dược, và nhóm thuốc cải thiện đáng kể hơn. Nhờ phân bổ ngẫu nhiên, sự cải thiện có thể归因于 thuốc (nguyên nhân) – nhưng vì các đối tượng không được lấy mẫu ngẫu nhiên, kết luận chỉ áp dụng cho những tình nguyện viên này và không tự động chính quy hóa cho tất cả mọi người.

    Từ vựng Luyện tập
    English Tiếng Việt
    treatment/ˈtriːtmənt/ điều kiện xử lý (treatment)
    sample/ˈsæmpl/ mẫu
    Random sampling/ˈrændəm ˈsæmplɪŋ/ Lấy mẫu ngẫu nhiên
    3.7

    Mẹo làm bài thi

    • Phân biệt nghiên cứu quan sát (tìm thấy mối liên hệ) và thí nghiệm (có thể chỉ ra nguyên nhân).
    • Lấy mẫu tốt là ngẫu nhiên (SRS, phân tầng, cụm) — hãy cẩn trọng với thiên lệch (phản hồi tự nguyện, che phủ không đầy đủ, không phản hồi).
    • Thí nghiệm tốt sử dụng đối chứng, phân bổ ngẫu nhiên và lặp lại; chia nhóm xử lý biến gây phiền toái đã biết.
    • Chỉ có thí nghiệm phân bổ ngẫu nhiên mới hỗ trợ kết luận nguyên nhân - kết quả.
    • Đặt tên cho quần thể, mẫu, và bất kỳ nhiễu loạn nào một cách rõ ràng.
  • 4

    Xác suất, Biến số Ngẫu nhiên, và Phân phối Xác suất

    Xem bài học
    4.1

    Random and Non-Random Patterns

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu Học tập VAR-1.F: Xác định các câu hỏi gợi ý từ các mẫu trong dữ liệu. [Kỹ năng 1.A]

    • VAR-1.F.1 Các mẫu trong dữ liệu không nhất thiết có nghĩa là sự biến thiên không phải là ngẫu nhiên.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Something is random 随机 if individual outcomes are uncertain but a regular pattern emerges over many repetitions. Short-run results look erratic; long-run relative frequencies settle down. This long-run stability is what makes probability useful.

    Từ vựng Luyện tập
    English Tiếng Việt
    random/ˈrændəm/ ngẫu nhiên
    4.2

    Estimating Probabilities Using Simulation

    Chương trình

    Hiểu biết Bền vững (UNC-2): Mô phỏng cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu Học tập UNC-2.A: Ước lượng xác suất bằng mô phỏng. [Kỹ năng 3.A]

    • UNC-2.A.1 Một quá trình ngẫu nhiên tạo ra các kết quả được quyết định bởi may mắn.
    • UNC-2.A.2 Một kết quả là hệ quả của một lần thử nghiệm của quá trình ngẫu nhiên.
    • UNC-2.A.3 Một sự kiện là một tập hợp các kết quả.
    • UNC-2.A.4 Mô phỏng là một cách để mô hình hóa các sự kiện ngẫu nhiên, sao cho các kết quả mô phỏng khớp chặt chẽ với các kết quả thực tế. Tất cả các kết quả có thể xảy ra đều được gắn với một giá trị sẽ được quyết định bởi may mắn. Ghi lại số lần xuất hiện của các kết quả mô phỏng và tổng số lần.
    • UNC-2.A.5 Tần suất tương đối của một kết quả hoặc sự kiện trong dữ liệu mô phỏng hoặc thực nghiệm có thể được sử dụng để ước lượng xác suất của kết quả hoặc sự kiện đó.
    • UNC-2.A.6 Định luật số lớn phát biểu rằng các xác suất mô phỏng (thực nghiệm) có xu hướng tiến gần hơn đến xác suất thực tế khi số lần thử tăng lên.
      • Ví dụ minh họa cho UNC-2.A:
        • Một kết quả: Lăn ra một giá trị cụ thể trên một xúc xắc sáu mặt là một trong sáu kết quả có thể xảy ra.
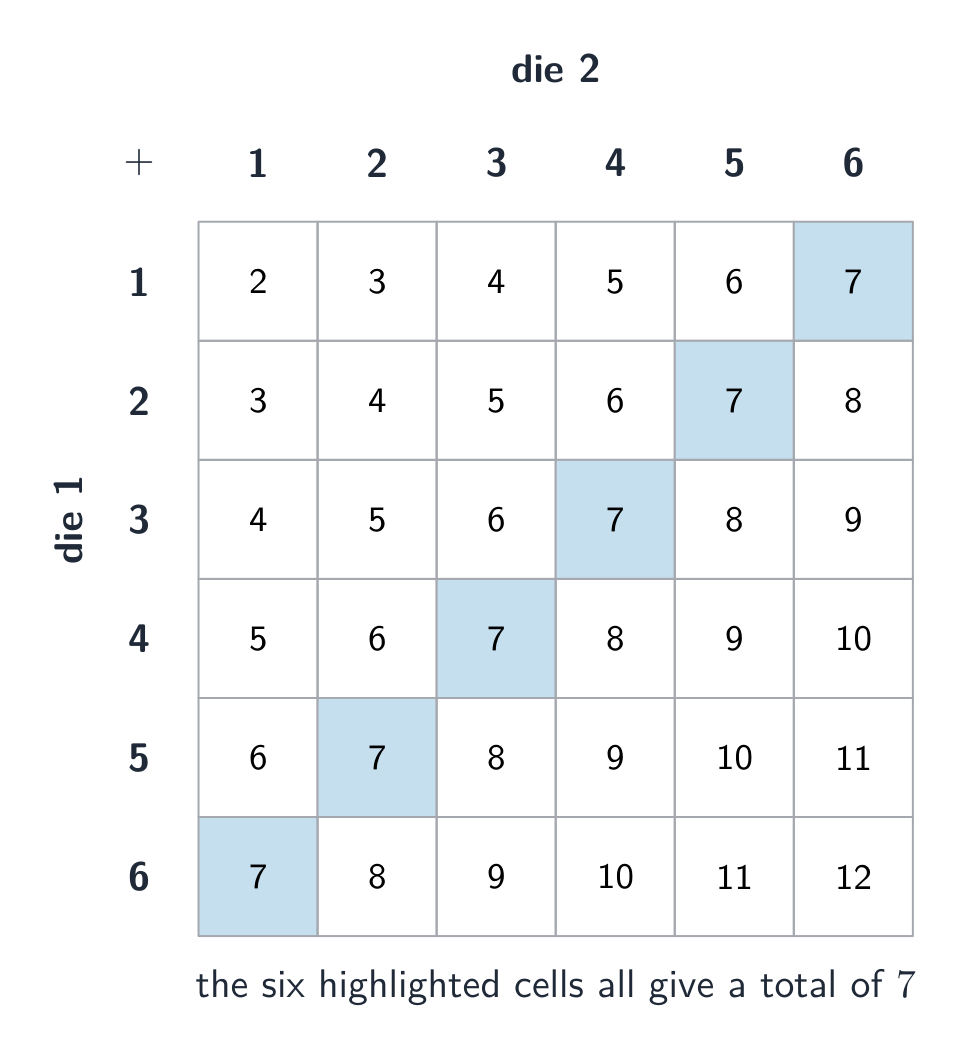
        • Một sự kiện: Khi gieo hai xúc xắc sáu mặt, một sự kiện có thể là tổng bằng bảy. Tập hợp các kết quả tương ứng sẽ là $(1, 6)$, $(2, 5)$, $(3, 4)$, $(4, 3)$, $(5, 2)$, và $(6, 1)$, trong đó các cặp thứ tự biểu thị (giá trị mặt trên xúc xắc này, giá trị mặt trên xúc xắc kia).

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    A simulation 模拟 imitates a chance process using random digits or technology. Steps: state the model, assign digits to outcomes, run many trials, and record the proportion of trials meeting the condition. The resulting proportion estimates the probability – more trials give a better estimate.

    Từ vựng Luyện tập
    English Tiếng Việt
    simulation/ˌsɪmjʊˈleɪʃn/ mô phỏng
    4.3

    Introduction to Probability

    Chương trình

    Hiểu biết bền vững (VAR-4): Mức độ khả dĩ của một sự kiện ngẫu nhiên có thể được định lượng hóa.

    Mục tiêu học tập VAR-4.A: Tính xác suất cho các sự kiện và phần bù của chúng. [Kỹ năng 3.A]

    • VAR-4.A.1 Không gian mẫu của một quá trình ngẫu nhiên là tập hợp tất cả các kết quả không chồng chéo lẫn nhau.
    • VAR-4.A.2 Nếu tất cả các kết quả trong không gian mẫu đều có khả năng xảy ra như nhau, thì xác suất một sự kiện E sẽ xảy ra được định nghĩa là tỷ lệ: $\dfrac{\text{number of outcomes in event E}}{\text{total number of outcomes in sample space}}$
    • VAR-4.A.3 Xác suất của một sự kiện là một số nằm trong khoảng từ 0 đến 1, bao gồm cả hai đầu mút.
    • VAR-4.A.4 Xác suất của biến cố đối (bổ túc) của một biến cố E, $E'$ hoặc $E^{C}$ (tức là không phải E), bằng với $1 - P(E)$.

    Mục tiêu học tập VAR-4.B: Giải thích ý nghĩa của các xác suất cho các sự kiện. [Kỹ năng 4.B]

    • VAR-4.B.1 Xác suất của các sự kiện trong các tình huống có thể lặp lại có thể được giải thích là tần suất tương đối mà sự kiện đó sẽ xảy ra trong dài hạn.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    The probability 概率 of an event is a number from $0$ to $1$ giving its long-run relative frequency. The sample space 样本空间 is the set of all outcomes. For an event $A$, the complement 补 rule: $P(A^c)=1-P(A)$. Probabilities of all outcomes sum to $1$.

    Probability runs from 0 (impossible) to 1 (certain)
    Probability runs from 0 (impossible) to 1 (certain)
    The four aces from a deck of playing cards
    A deck of cards is a classic source of probability: 52 equally likely outcomes make the chances easy to count
    Khám phá

    Khám phá xác suất với xúc xắc

    Xác suất là tỷ lệ lâu dài mà một kết quả xảy ra. Xúc xắc nhiều lần và để ý các tỷ lệ thực nghiệm dần ổn định về phía các giá trị lý thuyết.

    Từ vựng Luyện tập
    English Tiếng Việt
    probability/ˌprɒbəˈbɪlɪti/ xác suất
    sample space/ˈsæmpl speɪs/ không gian mẫu
    complement/ˈkɒmplɪmənt/ phần bù
    4.4

    Mutually Exclusive Events

    Chương trình

    Hiểu biết bền vững (VAR-4): Mức độ khả dĩ của một sự kiện ngẫu nhiên có thể được định lượng hóa.

    Mục tiêu học tập VAR-4.C: Giải thích tại sao hai sự kiện là (hoặc không phải là) not/Set disjoint. [Kỹ năng 4.B]

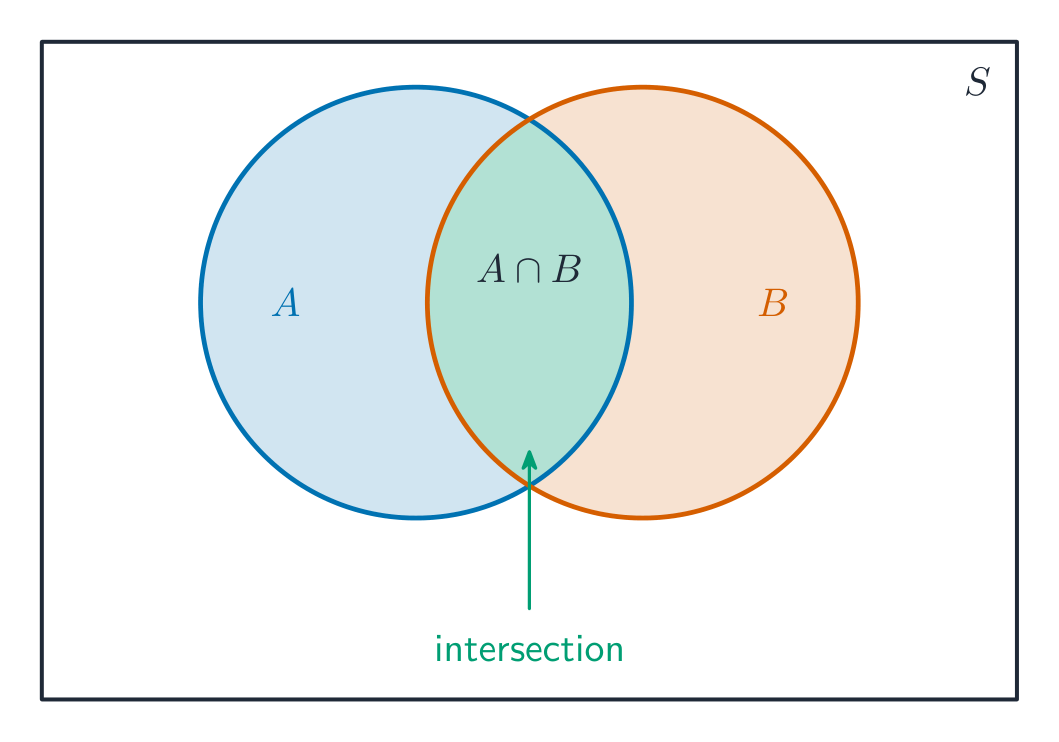
    • VAR-4.C.1 Xác suất để cả hai biến cố $A$ và $B$ cùng xảy ra, đôi khi được gọi là xác suất đồng thời, là xác suất của giao của $A$ và $B$, ký hiệu là $P(A \cap B)$.
    • VAR-4.C.2 Hai sự kiện được gọi là not/Set disjoint hoặc rời nhau nếu chúng không thể xảy ra cùng lúc. Do đó $P(A \cap B) = 0$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Two events are mutually exclusive 互斥 (disjoint) if they cannot both happen. Then the addition rule simplifies:

    $$P(A\text{ or }B)=P(A)+P(B)\quad(\text{if mutually exclusive}).$$
    In general, $P(A\text{ or }B)=P(A)+P(B)-P(A\text{ and }B)$ – subtract the overlap so it is not counted twice.

    A Venn diagram: the overlap is the intersection of two events
    A Venn diagram: the overlap is the intersection of two events
    Từ vựng Luyện tập
    English Tiếng Việt
    mutually exclusive/ˈmjuːtʃuːəli eksˈkluːsɪv/ tách biệt
    4.5

    Conditional Probability

    Chương trình

    Hiểu biết bền vững (VAR-4): Mức độ khả dĩ của một sự kiện ngẫu nhiên có thể được định lượng hóa.

    Mục tiêu học tập VAR-4.D: Tính xác suất có điều kiện. [Kỹ năng 3.A]

    • VAR-4.D.1 Xác suất để sự kiện $A$ xảy ra, biết rằng sự kiện $B$ đã xảy ra, được gọi là xác suất có điều kiện và ký hiệu là $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.
    • VAR-4.D.2 Quy tắc nhân phát biểu rằng xác suất để hai sự kiện $A$ và $B$ cùng xảy ra bằng xác suất để sự kiện $A$ xảy ra nhân với xác suất để sự kiện $B$ xảy ra, biết rằng $A$ đã xảy ra. Điều này được ký hiệu là $P(A \cap B) = P(A) \cdot P(B \mid A)$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Conditional probability

    The conditional probability 条件概率 of $A$ given $B$ is

    $$P(A\mid B)=\frac{P(A\text{ and }B)}{P(B)}.$$
    It is the chance of $A$ once you know $B$ happened. Two-way tables make these easy: restrict to the row/column for $B$, then find $A$'s share.

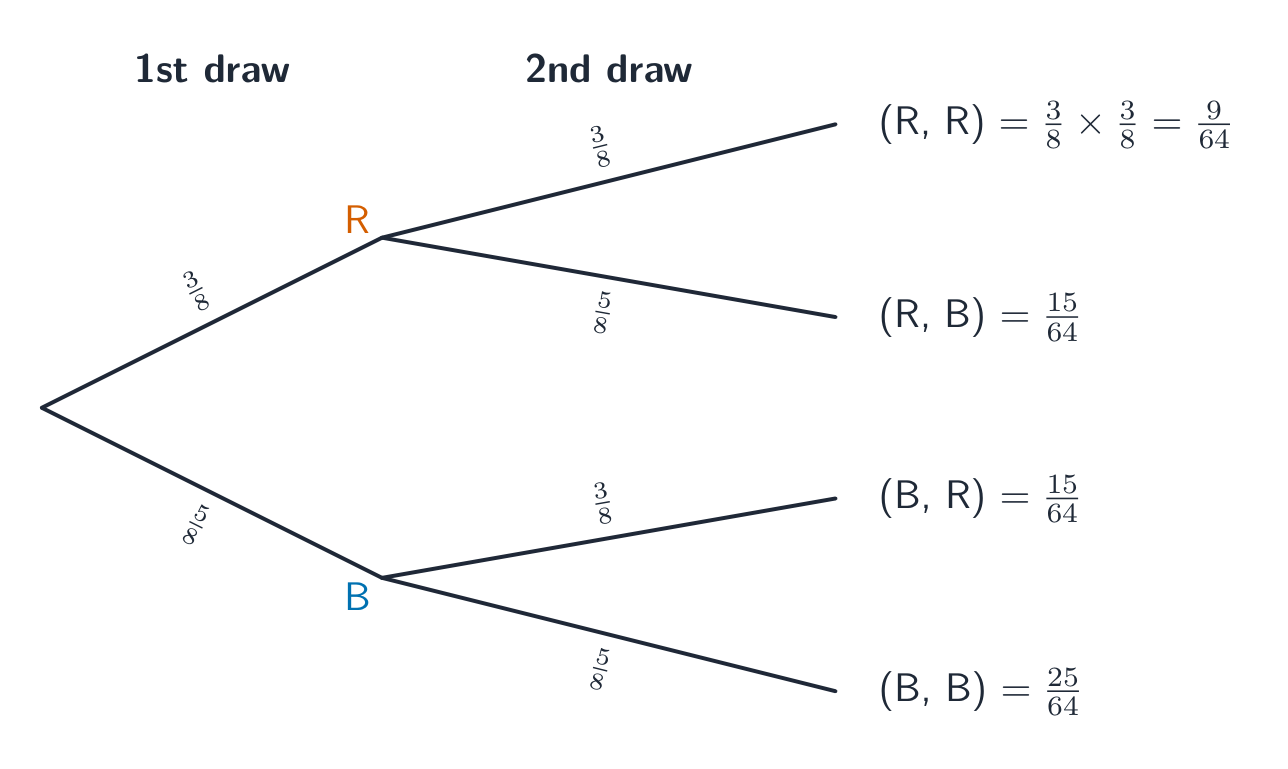
    On a tree diagram, multiply the probabilities along the branches
    On a tree diagram, multiply the probabilities along the branches
    Khám phá

    Cập nhật xác suất dựa trên thông tin mới

    Xác suất có điều kiện $P(B\mid A)$ là khả năng xảy ra của $B$ khi bạn biết $A$ đã xảy ra. Thay đổi các xác suất nhánh và hãy xem việc có điều kiện định hình lại kết quả như thế nào.

    Từ vựng Luyện tập
    English Tiếng Việt
    conditional probability/kənˈdɪʃənl ˌprɒbəˈbɪlɪti/ xác suất có điều kiện
    4.6

    Independent Events and Unions of Events

    Chương trình

    Hiểu biết bền vững (VAR-4): Mức độ khả dĩ của một sự kiện ngẫu nhiên có thể được định lượng hóa.

    Mục tiêu học tập VAR-4.E: Tính xác suất cho các sự kiện độc lập và hợp của hai sự kiện. [Kỹ năng 3.A]

    • VAR-4.E.1 Hai sự kiện $A$ và $B$ độc lập nếu và chỉ nếu việc biết sự kiện $A$ đã xảy ra (hoặc sẽ xảy ra) không làm thay đổi xác suất để sự kiện $B$ xảy ra.
    • VAR-4.E.2 Nếu và chỉ nếu hai sự kiện $A$ và $B$ độc lập, thì $P(A \mid B) = P(A)$, $P(B \mid A) = P(B)$ và $P(A \cap B) = P(A) \cdot P(B)$.
    • VAR-4.E.3 Xác suất để sự kiện $A$ hoặc sự kiện $B$ (hoặc cả hai) xảy ra là xác suất của hợp của $A$ và $B$, ký hiệu là $P(A \cup B)$.
    • VAR-4.E.4 Quy tắc cộng phát biểu rằng xác suất để sự kiện $A$ hoặc sự kiện $B$ hoặc cả hai xảy ra bằng xác suất để sự kiện $A$ xảy ra cộng với xác suất để sự kiện $B$ xảy ra trừ đi xác suất để cả hai sự kiện $A$ và $B$ cùng xảy ra. Điều này được ký hiệu là $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Events are independent 独立 if knowing one does not change the other's probability: $P(A\mid B)=P(A)$. Then the multiplication rule simplifies:

    $$P(A\text{ and }B)=P(A)\,P(B)\quad(\text{if independent}).$$
    Independent is not the same as mutually exclusive – mutually exclusive events with nonzero probability are actually dependent (if one happens, the other cannot).

    A sample space diagram lists every equally likely outcome
    A sample space diagram lists every equally likely outcome
    Khám phá

    Kết hợp các sự kiện bằng sơ đồ Venn

    Đối với hợp $P(A\cup B)=P(A)+P(B)-P(A\cap B)$ — bạn trừ đi phần giao để tránh đếm trùng. Chuyển đổi phép toán để thấy mỗi vùng sáng lên.

    Từ vựng Luyện tập
    English Tiếng Việt
    independent/ˌɪndɪˈpendənt/ độc lập
    4.7

    Random Variables and Probability Distributions

    Chương trình

    Hiểu biết bền vững (VAR-5): Các phân phối xác suất có thể được sử dụng để mô hình hóa sự biến thiên trong các quần thể.

    Mục tiêu học tập VAR-5.A: Biểu diễn phân phối xác suất cho một biến ngẫu nhiên rời rạc. [Kỹ năng 2.B]

    • VAR-5.A.1 Các giá trị của một biến ngẫu nhiên là các kết quả số học của hành vi ngẫu nhiên.
    • VAR-5.A.2 Một biến ngẫu nhiên rời rạc là một biến chỉ có thể nhận một số lượng giá trị đếm được. Mỗi giá trị đều có một xác suất tương ứng gắn liền. Tổng các xác suất trên tất cả các giá trị có thể phải bằng 1.
    • VAR-5.A.3 Một phân phối xác suất có thể được biểu diễn dưới dạng đồ thị, bảng hoặc hàm số hiển thị các xác suất liên quan đến các giá trị của một biến ngẫu nhiên.
    • VAR-5.A.4 Một phân phối xác suất lũy tích có thể được biểu diễn dưới dạng bảng hoặc hàm số hiển thị xác suất nhỏ hơn hoặc bằng mỗi giá trị của biến ngẫu nhiên.
      • Ví dụ minh họa cho VAR-5.A: Kết quả của các lần thử của một quá trình ngẫu nhiên:
        • Tổng các kết quả khi lăn hai xúc xắc
        • Số con chó con trong một lứa sinh ngẫu nhiên của một giống chó nhất định

    Mục tiêu học tập VAR-5.B: Giải thích một phân phối xác suất. [Kỹ năng 4.B]

    • VAR-5.B.1 Việc giải thích một phân phối xác suất cung cấp thông tin về hình dạng, trung tâm và độ phân tán của một quần thể và cho phép người ta đưa ra kết luận về quần thể quan tâm.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    A random variable 随机变量 assigns a number to each outcome of a chance process. A probability distribution 概率分布 lists each possible value with its probability (they sum to $1$). A distribution can be discrete (a table of values) or continuous (an area-under-a-curve model like the normal).

    Từ vựng Luyện tập
    English Tiếng Việt
    random variable/ˈrændəm ˈveərɪəbl/ biến ngẫu nhiên
    probability distribution/ˌprɒbəˈbɪlɪti ˌdɪstrɪˈbjuːʃn/ phân phối xác suất
    4.8

    Mean and Standard Deviation of Random Variables

    Chương trình

    Hiểu biết bền vững (VAR-5): Các phân phối xác suất có thể được sử dụng để mô hình hóa sự biến thiên trong các quần thể.

    Mục tiêu học tập VAR-5.C: Tính toán các tham số cho một biến ngẫu nhiên rời rạc. [Kỹ năng 3.B]

    • VAR-5.C.1 Một giá trị số đo lường một đặc trưng của một quần thể hoặc phân phối của một biến ngẫu nhiên được gọi là tham số, đây là một giá trị cố định đơn lẻ.
    • VAR-5.C.2 Trung bình, hay giá trị kỳ vọng, cho một biến ngẫu nhiên rời rạc $X$ là $\mu_X = \sum x_i \cdot P(x_i)$.
    • VAR-5.C.3 Độ lệch chuẩn cho một biến ngẫu nhiên rời rạc $X$ là $\sigma_X = \sqrt{\sum (x_i - \mu_x)^2 \cdot P(x_i)}$.

    Mục tiêu học tập VAR-5.D: Giải thích các tham số cho một biến ngẫu nhiên rời rạc. [Kỹ năng 4.B]

    • VAR-5.D.1 Các tham số cho một biến ngẫu nhiên rời rạc nên được giải thích bằng đơn vị phù hợp và trong bối cảnh của một quần thể cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    The mean (expected value) 期望值 of a discrete random variable is the probability-weighted average:

    $$\mu_X=E(X)=\sum x_i\,P(x_i).$$
    The standard deviation $\sigma_X=\sqrt{\sum (x_i-\mu_X)^2\,P(x_i)}$ measures typical spread from the mean. The expected value is the long-run average outcome, not a value you expect on any single trial.

    Worked example. A game pays $\$5$ with probability $0.2$ and costs you $\$1$ (a $-1$ outcome) with probability $0.8$. The expected value is

    $$E(X)=5(0.2)+(-1)(0.8)=1-0.8=\$0.20,$$
    so over many plays you gain about $20$ cents per play on average, even though no single play gives exactly that.

    Từ vựng Luyện tập
    English Tiếng Việt
    mean (expected value)/miːn/ trung bình (giá trị kỳ vọng)
    4.9

    Combining Random Variables

    Chương trình

    Hiểu biết bền vững (VAR-5): Các phân phối xác suất có thể được sử dụng để mô hình hóa sự biến thiên trong các quần thể.

    Mục tiêu học tập VAR-5.E: Tính toán các tham số cho tổ hợp tuyến tính của các biến ngẫu nhiên. [Kỹ năng 3.B]

    • VAR-5.E.1 Đối với các biến ngẫu nhiên $X$ và $Y$ và các số thực $a$ và $b$, kỳ vọng (trung bình) của $aX + bY$ là $a\mu_x + b\mu_y$.
    • VAR-5.E.2 Hai biến ngẫu nhiên độc lập nếu việc biết thông tin về một biến không làm thay đổi phân phối xác suất của biến kia.
    • VAR-5.E.3 Đối với các biến ngẫu nhiên độc lập $X$ và $Y$ và các số thực $a$ và $b$, kỳ vọng (trung bình) của $aX + bY$ là $a\mu_x + b\mu_y$, và phương sai của $aX + bY$ là $a^2\sigma^2_x + b^2\sigma^2_y$.

    Mục tiêu học tập VAR-5.F: Mô tả tác động của các phép biến đổi tuyến tính lên các tham số của biến ngẫu nhiên. [Kỹ năng 3.C]

    • VAR-5.F.1 Đối với $Y = a + bX$, phân phối xác suất của biến ngẫu nhiên đã biến đổi, $Y$, có cùng hình dạng với phân phối xác suất của $X$, miễn là $a > 0$ và $b > 0$. Kỳ vọng (trung bình) của $Y$ là $\mu_y = a + b\mu_x$. Độ lệch chuẩn của $Y$ là $\sigma_y = |b|\sigma_x$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    When you add or subtract random variables, means add: $\mu_{X\pm Y}=\mu_X\pm\mu_Y$. If $X$ and $Y$ are independent, variances add (even when subtracting):

    $$\sigma^2_{X\pm Y}=\sigma^2_X+\sigma^2_Y.$$
    Take the square root for the standard deviation. Also, scaling: $\mu_{aX+b}=a\mu_X+b$ and $\sigma_{aX+b}=|a|\sigma_X$.

    4.10

    Introduction to the Binomial Distribution

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu Học tập UNC-3.A: Ước lượng xác suất của biến ngẫu nhiên nhị thức bằng dữ liệu từ mô phỏng. [Kỹ năng 3.A]

    • UNC-3.A.1 Một phân phối xác suất có thể được xây dựng bằng các quy tắc xác suất hoặc ước lượng bằng mô phỏng sử dụng bộ phát số ngẫu nhiên.
    • UNC-3.A.2 Biến ngẫu nhiên nhị thức, $X$, đếm số lần thành công trong $n$ thử nghiệm độc lập lặp lại, mỗi thử nghiệm có hai kết quả có thể xảy ra (thành công hoặc thất bại), với xác suất thành công là $p$ và xác suất thất bại là $1 - p$.

    Mục tiêu Học tập UNC-3.B: Tính toán xác suất cho phân phối nhị thức. [Kỹ năng 3.A]

    • UNC-3.B.1 Xác suất để một biến ngẫu nhiên nhị thức, $X$, có đúng $x$ lần thành công trong $n$ thử nghiệm độc lập, khi xác suất thành công là $p$, được tính theo công thức $P(X = x) = \binom{n}{x} p^x (1 - p)^{n-x}, x = 0, 1, 2, \ldots, n$. Đây là hàm xác suất nhị thức.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    The binomial distribution

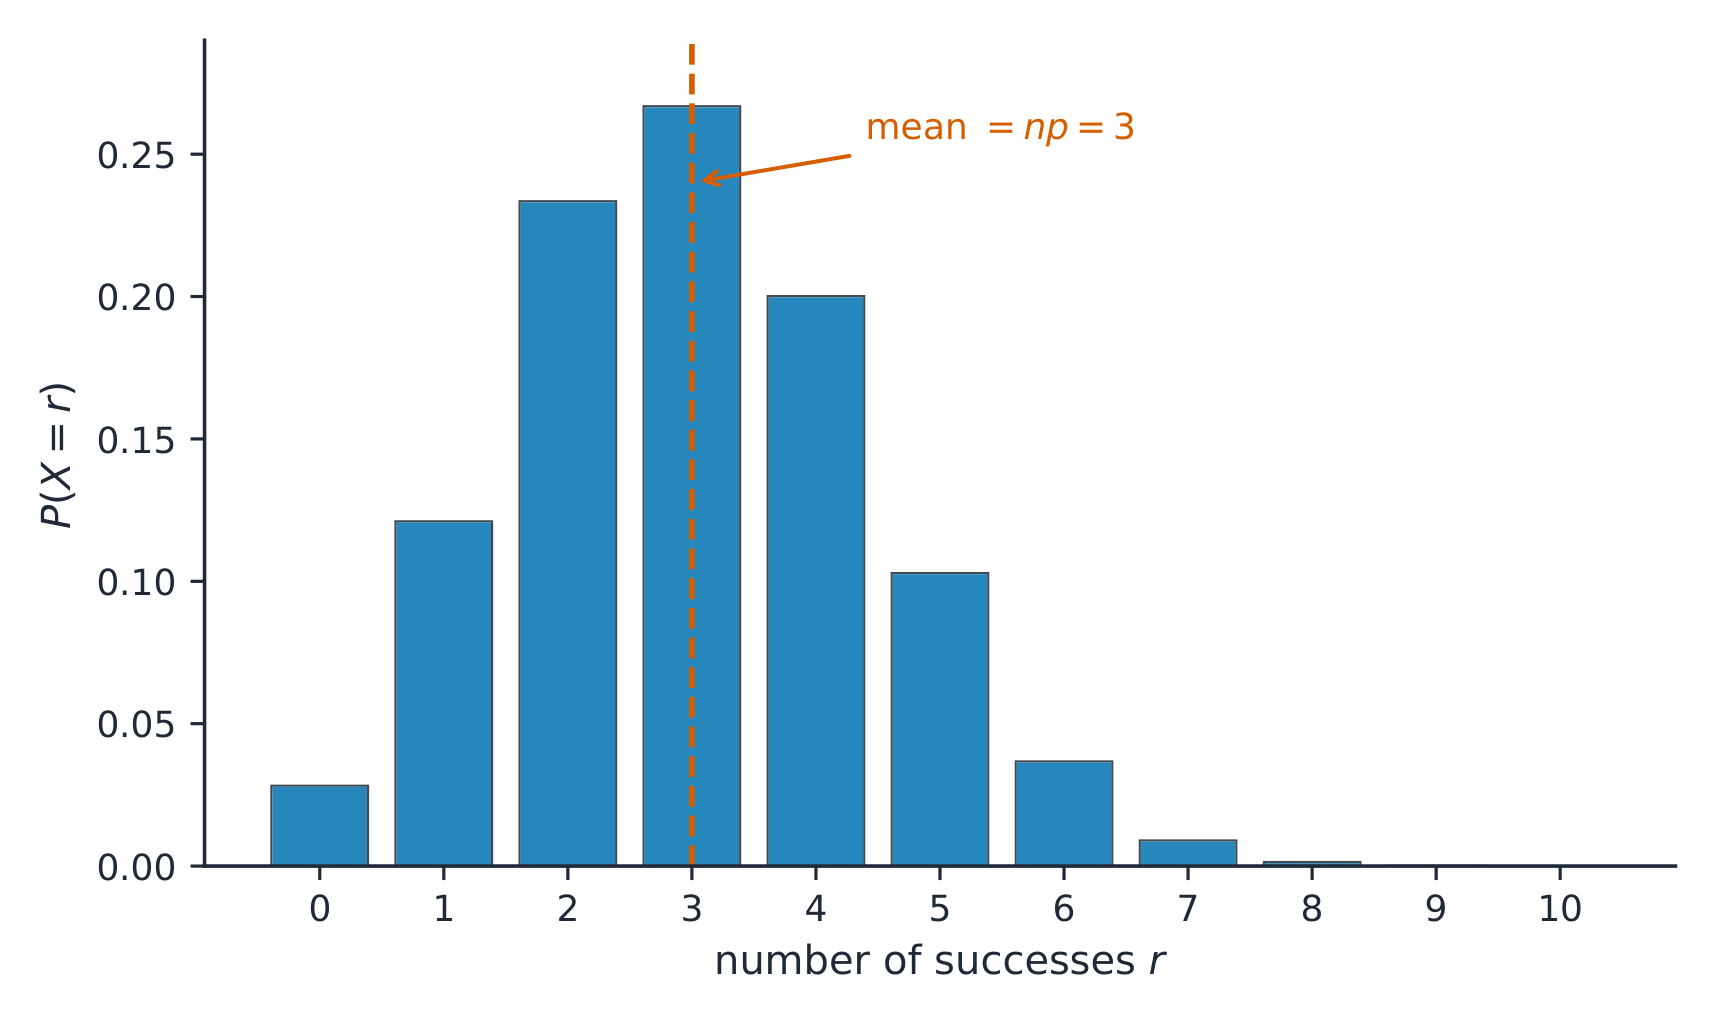
    A binomial 二项 setting (BINS): a fixed number $n$ of Independent trials, each with two outcomes (success/failure) and the same success probability $p$. The random variable $X=$ number of successes. Its probability:

    $$P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}.$$

    The binomial distribution, with mean n times p
    The binomial distribution, with mean n times p
    Khám phá

    Tạo hình dạng phân phối nhị thức

    Một phân phối nhị thức đếm số thành công trong $n$ thử nghiệm độc lập, mỗi thử nghiệm có xác suất $p$. Thay đổi $n$ và $p$ và hãy xem các thanh dịch chuyển và phân tán.

    Từ vựng Luyện tập
    English Tiếng Việt
    binomial/baɪˈnəʊmɪəl/ nhị thức
    4.11

    Parameters for a Binomial Distribution

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu Học tập UNC-3.C: Tính toán các tham số cho phân phối nhị thức. [Kỹ năng 3.B]

    • UNC-3.C.1 Nếu một biến ngẫu nhiên là nhị thức, trung bình của nó, $\mu_x$, là $np$ và độ lệch chuẩn, $\sigma_x$, là $\sqrt{np(1 - p)}$.

    Mục tiêu Học tập UNC-3.D: Giải thích xác suất và tham số cho phân phối nhị thức. [Kỹ năng 4.B]

    • UNC-3.D.1 Xác suất và tham số cho phân phối nhị thức nên được giải thích bằng các đơn vị thích hợp và trong bối cảnh của một quần thể hoặc tình huống cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    For a binomial $X$ with $n$ trials and success probability $p$:

    $$\mu_X=np,\qquad \sigma_X=\sqrt{np(1-p)}.$$
    Use these for "how many successes do we expect, and how much do they vary" questions.

    Worked example. A player makes $70\%$ of free throws. In $n=10$ shots, the probability of exactly $8$ makes is

    $$P(X=8)=\binom{10}{8}(0.7)^8(0.3)^2=45\times0.0576\times0.09\approx0.23,$$
    and the expected number of makes is $\mu=np=10(0.7)=7$, with $\sigma=\sqrt{10(0.7)(0.3)}\approx1.45$.

    4.12

    The Geometric Distribution

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu Học tập UNC-3.E: Tính toán xác suất cho biến ngẫu nhiên hình học. [Kỹ năng 3.A]

    • UNC-3.E.1 Đối với một chuỗi các thử nghiệm độc lập, biến ngẫu nhiên hình học, $X$, chỉ ra số thứ tự của thử nghiệm mà lần thành công đầu tiên xảy ra. Mỗi thử nghiệm có hai kết quả có thể xảy ra (thành công hoặc thất bại) với xác suất thành công là $p$ và xác suất thất bại là $1 - p$.
    • UNC-3.E.2 Xác suất để lần thành công đầu tiên trong các thử nghiệm độc lập lặp lại với xác suất thành công $p$ xảy ra ở thử nghiệm thứ $x$ được tính theo công thức $P(X = x) = (1 - p)^{x-1} p, x = 1, 2, 3, \ldots$. Đây là hàm xác suất hình học.

    Mục tiêu Học tập UNC-3.F: Tính toán các tham số của phân phối hình học. [Kỹ năng 3.B]

    • UNC-3.F.1 Nếu một biến ngẫu nhiên là hình học, trung bình của nó, $\mu_x$, là $\dfrac{1}{p}$ và độ lệch chuẩn, $\sigma_x$, là $\dfrac{\sqrt{(1 - p)}}{p}$.

    Mục tiêu Học tập UNC-3.G: Giải thích xác suất và tham số cho phân phối hình học. [Kỹ năng 4.B]

    • UNC-3.G.1 Xác suất và tham số cho phân phối hình học nên được giải thích bằng các đơn vị thích hợp và trong bối cảnh của một quần thể hoặc tình huống cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    A geometric 几何 setting is the same as binomial but with no fixed $n$: you keep trying until the first success. The random variable $Y=$ the trial of the first success:

    $$P(Y=k)=(1-p)^{k-1}\,p,\qquad \mu_Y=\frac{1}{p}.$$
    So the expected number of trials until the first success is $1/p$.

    Từ vựng Luyện tập
    English Tiếng Việt
    geometric/ˌdʒiːəʊˈmetrɪk/ hình học
    4.12

    Exam tips

    • A probability lies in $[0,1]$; use the complement ($1-P$) and add mutually exclusive events.
    • For independent events multiply; for "and/or" use the general addition and conditional rules.
    • Expected value = $\sum(\text{value}\times\text{probability})$.
    • Recognise binomial (fixed $n$, two outcomes, constant $p$) and geometric settings.
    • Draw a tree or table for multi-stage problems and multiply along branches.
  • 5

    Phân phối Lấy mẫu

    Xem bài học
    5.1

    Tại sao Hai mẫu Không Bao giờ Trùng Khớp: Biến động Lấy mẫu

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.G: Xác định các câu hỏi gợi ý từ sự biến thiên trong thống kê đối với các mẫu thu thập từ cùng một quần thể. [Kỹ năng 1.A]

    • VAR-1.G.1 Sự biến thiên trong thống kê của các mẫu lấy từ cùng một quần thể có thể do ngẫu nhiên hoặc không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một thống kê (như trung bình mẫu $\bar{x}$ hay tỷ lệ mẫu $\hat{p}$) được tính toán từ một mẫu và dao động từ mẫu này sang mẫu khác – đây là biến động lấy mẫu. Một tham số ($\mu$ hoặc $p$) là chân lý cố định về quần thể. Phân phối lấy mẫu là phân phối của một thống kê trên tất cả các mẫu có thể có với kích thước cho trước – nó đóng vai trò cầu nối từ một mẫu sang suy luận.

    5.2

    Đường cong Chuẩn như một Mô hình cho Thống kê

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-6
    The normal distribution may be used to model variation.

    VAR-6.A
    Calculate the probability that a particular value lies in a given interval of a normal distribution. [Skill 3.A]

    • VAR-6.A.1 A continuous random variable is a variable that can take on any value within a specified domain. Every interval within the domain has a probability associated with it.
    • VAR-6.A.2 A continuous random variable with a normal distribution is commonly used to describe populations. The distribution of a normal random variable can be described by a normal, or "bell-shaped," curve.
    • VAR-6.A.3 The area under a normal curve over a given interval represents the probability that a particular value lies in that interval.
      • Illustrative examples for VAR-6.A: Continuous random variable: If one looks at a clock at a random time, the probability that the minute hand is between the 3 and the 6 is one fourth.

    VAR-6.B
    Determine the interval associated with a given area in a normal distribution. [Skill 3.A]

    • VAR-6.B.1 The boundaries of an interval associated with a given area in a normal distribution can be determined using $z$-scores or technology, such as a calculator, a standard normal table, or computer-generated output.
    • VAR-6.B.2 Intervals associated with a given area in a normal distribution can be determined by assigning appropriate inequalities to the boundaries of the intervals:
      • a. $P(X < x_a) = \dfrac{p}{100}$ means that the lowest $p\%$ of values lie to the left of $x_a$.
      • b. $P(x_a < X < x_b) = \dfrac{p}{100}$ means that $p\%$ of values lie between $x_a$ and $x_b$.
      • c. $P(X > x_b) = \dfrac{p}{100}$ means that the highest $p\%$ of values lie to the right of $x_b$.
      • d. To determine the most extreme $p\%$ of values requires dividing the area associated with $p\%$ into two equal areas on either extreme of the distribution: $P(X < x_a) = \dfrac{1}{2}\dfrac{p}{100}$ and $P(X > x_b) = \dfrac{1}{2}\dfrac{p}{100}$ means that half of the $p\%$ most extreme values lie to the left of $x_a$ and half of the $p\%$ most extreme values lie to the right of $x_b$.

    VAR-6.C
    Determine the appropriateness of using the normal distribution to approximate probabilities for unknown distributions. [Skill 3.C]

    • VAR-6.C.1 Normal distributions are symmetrical and "bell-shaped." As a result, normal distributions can be used to approximate distributions with similar characteristics.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Phân phối chuẩn

    Đối với các mẫu đủ lớn, nhiều phân phối lấy mẫu xấp xỉ chuẩn. Điều đó cho phép chúng ta mô tả một thống kê bằng một trung tâm (kỳ vọng của nó), một độ phân tán (sai số chuẩn) và hình dạng chuẩn – rồi từ đó tính toán khả năng xảy ra của một kết quả mẫu cụ thể.

    Khám phá

    Sử dụng đường cong chuẩn để tìm tỷ lệ

    Mô hình chuẩn hóa chuyển một tập hợp các giá trị thành một diện tích = một tỷ lệ. Tô đậm một dải region để đọc được phần trăm mẫu nằm trong khoảng đó (quy tắc 68-95-99.7).

    5.3

    Định giới hạn Trung tâm

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.H: Ước lượng phân phối mẫu bằng cách mô phỏng. [Kỹ năng 3.C]

    • UNC-3.H.1 Phân phối mẫu của một thống kê là phân phối các giá trị của thống kê đó đối với tất cả các mẫu có kích thước cho trước từ một quần thể cho trước.
    • UNC-3.H.2 Định lý giới hạn trung tâm (CLT) phát biểu rằng khi kích thước mẫu đủ lớn, phân phối mẫu của trung bình một biến ngẫu nhiên sẽ xấp xỉ phân phối chuẩn.
    • UNC-3.H.3 Định lý giới hạn trung tâm yêu cầu các giá trị mẫu phải độc lập với nhau và $n$ phải đủ lớn.
    • UNC-3.H.4 Phân phối ngẫu nhiên hóa là tập hợp các thống kê được sinh ra từ quá trình mô phỏng dựa trên giả thiết các giá trị tham số đã biết. Đối với thí nghiệm ngẫu nhiên hóa, điều này có nghĩa là lặp lại việc phân bổ lại/gián phân ngẫu nhiên các giá trị phản hồi vào các nhóm xử lý.
    • UNC-3.H.5 Phân phối mẫu của một thống kê có thể được mô phỏng bằng cách tạo ra các mẫu ngẫu nhiên lặp lại từ một quần thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Định lý giới hạn trung tâm

    Định giới hạn Trung tâm (CLT): đối với trung bình mẫu, nếu kích thước mẫu $n$ đủ lớn (một quy tắc phổ biến là $n\ge 30$), phân phối lấy mẫu của $\bar{x}$ xấp xỉ chuẩn, bất kể hình dạng của quần thể. Kích thước $n$ càng lớn, phân phối càng gần chuẩn và tập trung chặt chẽ hơn.

    Trung bình mẫu gần như chuẩn bất kể hình dạng của quần thể
    Trung bình mẫu gần như chuẩn bất kể hình dạng của quần thể
    Khám phá

    Xem phân phối mẫu trở thành chuẩn

    Định lý giới hạn trung tâm: với mẫu đủ lớn, phân phối của trung bình mẫu xấp xỉ chuẩn — bất kể hình dạng của tổng thể.

    Từ vựng Luyện tập
    English Tiếng Việt
    statistic/stəˈtɪstɪk/ thống kê
    sampling variability/ˈsæmplɪŋ ˌveərɪəˈbɪlɪti/ biến thiên trong lấy mẫu
    parameter/pəˈræmɪtə/ parameter
    sampling distribution/ˈsæmplɪŋ ˌdɪstrɪˈbjuːʃn/ phân phối mẫu
    standard error/ˈstændəd ˈerə/ sai số chuẩn
    Central Limit Theorem/ˈsentrəl ˈlɪmɪt ˈθɪərəm/ Định lý Giới hạn Trung tâm
    unbiased/ʌnˈbaɪəst/ không thiên lệch
    5.4

    Dự đoán Tốt và Dự đoán Xấu: Độ thiên lệch

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.I: Giải thích tại sao một ước lượng viên là không thiên hoặc có thiên. [Kỹ năng 4.B]

    • UNC-3.I.1 Khi ước lượng tham số quần thể, một ước lượng viên được coi là không thiên nếu, về mặt trung bình, giá trị của ước lượng viên bằng với tham số quần thể.

    Mục tiêu học tập UNC-3.J: Tính toán các ước lượng cho một tham số quần thể. [Kỹ năng 3.B]

    • UNC-3.J.1 Khi ước lượng tham số của quần thể, một ước lượng viên thể hiện sự biến thiên có thể được mô hình hóa bằng xác suất.
    • UNC-3.J.2 Một thống kê mẫu là một ước lượng điểm cho tham số tương ứng của quần thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một thống kê được gọi là không thiên lệch nếu kỳ vọng của phân phối lấy mẫu của nó bằng tham số – nghĩa là nó chính xác trung bình. Độ thiên lệch liên quan đến việc trung tâm bị lệch; biến động liên quan đến độ phân tán. Một ước lượng tốt vừa không thiên lệch (trung tâm đúng) vừa có độ biến động thấp (chính xác); mẫu lớn hơn giảm độ biến động nhưng không khắc phục được độ thiên lệch do lấy mẫu kém.

    Bốn phân phối lấy mẫu cắt ngang giữa độ thiên lệch và biến động, so với tham số thực tế
    Độ lệch và độ biến thiên là hai lỗi riêng biệt. Chỉ có ước lượng ở góc trên bên trái vừa nằm chính giữa $\theta$, vừa tập trung; còn ước lượng ở góc dưới bên trái thì chính xác nhưng luôn luôn sai, điều mà không một lượng dữ liệu nào thêm vào cũng có thể khắc phục được.
    5.5

    Phân phối lấy mẫu của tỷ lệ mẫu

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.K: Xác định các tham số của phân phối mẫu cho tỷ lệ mẫu. [Kỹ năng 3.B]

    • UNC-3.K.1 Đối với mẫu độc lập (lấy mẫu có hoàn lại) của một biến phân loại từ một quần thể có tỷ lệ quần thể $p$, phân phối mẫu của tỷ lệ mẫu, $\hat{p}$, có trung bình $\mu_{\hat{p}} = p$ và độ lệch chuẩn $\sigma_{\hat{p}} = \sqrt{\dfrac{p(1-p)}{n}}$.
    • UNC-3.K.2 Nếu lấy mẫu không hoàn lại, độ lệch chuẩn của tỷ lệ mẫu sẽ nhỏ hơn so với công thức trên. Nếu kích thước mẫu nhỏ hơn 10% kích thước quần thể, sự chênh lệch này là không đáng kể.

    Mục tiêu học tập UNC-3.L: Xác định xem phân phối mẫu cho tỷ lệ mẫu có thể được mô tả xấp xỉ theo phân phối chuẩn hay không. [Kỹ năng 3.C]

    • UNC-3.L.1 Đối với một biến phân loại, phân phối mẫu của tỷ lệ mẫu, $\hat{p}$, sẽ có phân phối chuẩn xấp xỉ, miễn là kích thước mẫu đủ lớn: $np \geq 10$ và $n(1-p) \geq 10$

    Mục tiêu học tập UNC-3.M: Giải thích xác suất và tham số cho phân phối mẫu của tỷ lệ mẫu. [Kỹ năng 4.B]

    • UNC-3.M.1 Xác suất và tham số cho phân phối mẫu của tỷ lệ mẫu nên được giải thích sử dụng đơn vị phù hợp và trong ngữ cảnh của một quần thể cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với tỷ lệ mẫu $\hat{p}$ từ một mẫu ngẫu nhiên đơn (SRS): kỳ vọng là $p$ (không thiên lệch), và độ tiêu chuẩn là

    $$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
    Độ phân tán này có hai tên: nó là độ tiêu chuẩn của phân phối lấy mẫu, và được gọi là sai số chuẩn khi bạn phải ước lượng nó từ mẫu (thay thế $p$ bằng $\hat p$) — đây chính là những gì các đơn vị suy luận sau này thực hiện. Nó xấp xỉ phân phối chuẩn khi $np\ge 10$ và $n(1-p)\ge 10$ (điều kiện Số lượng lớn), và điều kiện $10\%$ ($n\le 0.10N$) giữ cho các quan sát gần như độc lập.

    Ví dụ minh họa. Giả sử $40\%$ cử tri ủng hộ một dự luật ($p=0.4$) và bạn lấy mẫu $n=100$. Sai số chuẩn là $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. Xác suất để một mẫu đưa ra kết quả $\hat{p}>0.5$ là $z=\dfrac{0.5-0.4}{0.049}=2.04$, vì vậy $P(\hat p>0.5)\approx0.02$ – việc một đa số xuất hiện trong mẫu sẽ là điều đáng ngạc nhiên.

    5.6

    So sánh hai nhóm: Sự chênh lệch tỷ lệ mẫu

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.N: Xác định các tham số của phân phối mẫu cho hiệu số tỷ lệ mẫu. [Kỹ năng 3.B]

    • UNC-3.N.1 Đối với một biến phân loại, khi lấy mẫu ngẫu nhiên có hoàn lại từ hai quần thể độc lập có tỷ lệ quần thể $p_1$ và $p_2$, phân phối mẫu của hiệu số tỷ lệ mẫu $\hat{p}_1 - \hat{p}_2$ có trung bình $\mu_{\hat{p}_1 - \hat{p}_2} = p_1 - p_2$ và độ lệch chuẩn $\sigma_{\hat{p}_1 - \hat{p}_2} = \sqrt{\dfrac{p_1(1-p_1)}{n_1} + \dfrac{p_2(1-p_2)}{n_2}}$.
    • UNC-3.N.2 Nếu lấy mẫu không hoàn lại, độ lệch chuẩn của hiệu số tỷ lệ mẫu sẽ nhỏ hơn so với công thức trên. Nếu kích thước mẫu nhỏ hơn 10% kích thước quần thể, sự chênh lệch này là không đáng kể.

    Mục tiêu học tập UNC-3.O: Xác định xem phân phối mẫu cho hiệu số tỷ lệ mẫu có thể được mô tả xấp xỉ theo phân phối chuẩn hay không. [Kỹ năng 3.C]

    • UNC-3.O.1 Phân phối mẫu của hiệu số tỷ lệ mẫu $\hat{p}_1 - \hat{p}_2$ sẽ có phân phối chuẩn xấp xỉ, miễn là kích thước mẫu đủ lớn: $n_1 p_1 \geq 10, n_1(1-p_1) \geq 10, n_2 p_2 \geq 10, n_2(1-p_2) \geq 10$.

    Mục tiêu học tập UNC-3.P: Giải thích xác suất và tham số cho phân phối mẫu của hiệu số tỷ lệ. [Kỹ năng 4.B]

    • UNC-3.P.1 Tham số cho phân phối mẫu của hiệu số tỷ lệ nên được giải thích sử dụng đơn vị phù hợp và trong ngữ cảnh của các quần thể cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với $\hat{p}_1-\hat{p}_2$ từ hai mẫu độc lập: kỳ vọng là $p_1-p_2$, và do các mẫu độc lập nên biến cộng lại:

    $$\sigma_{\hat p_1-\hat p_2}=\sqrt{\frac{p_1(1-p_1)}{n_1}+\frac{p_2(1-p_2)}{n_2}}.$$
    Nó xấp xỉ phân phối chuẩn khi điều kiện Số lượng lớn được thỏa mãn ở cả hai mẫu.

    5.7

    Phân phối lấy mẫu của trung bình mẫu

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.Q: Xác định các tham số cho phân phối mẫu của trung bình mẫu. [Kỹ năng 3.B]

    • UNC-3.Q.1 Đối với một biến định lượng, khi lấy mẫu ngẫu nhiên có hoàn lại từ một quần thể có trung bình $\mu$ và độ lệch chuẩn $\sigma$, phân phối mẫu của trung bình mẫu có trung bình $\mu_{\bar{x}} = \mu$ và độ lệch chuẩn $\sigma_{\bar{x}} = \dfrac{\sigma}{\sqrt{n}}$.
    • UNC-3.Q.2 Nếu lấy mẫu không hoàn lại, độ lệch chuẩn của trung bình mẫu sẽ nhỏ hơn so với công thức trên. Nếu kích thước mẫu nhỏ hơn 10% kích thước quần thể, sự chênh lệch này là không đáng kể.

    Mục tiêu học tập UNC-3.R: Xác định xem phân phối mẫu của trung bình mẫu có thể được mô tả xấp xỉ theo phân phối chuẩn hay không. [Kỹ năng 3.C]

    • UNC-3.R.1 Đối với một biến định lượng, nếu phân phối quần thể có thể được mô hình hóa bằng phân phối chuẩn, thì phân phối mẫu của trung bình mẫu, $\bar{x}$, cũng có thể được mô hình hóa bằng phân phối chuẩn.
    • UNC-3.R.2 Đối với một biến định lượng, nếu phân phối quần thể không thể được mô hình hóa bằng phân phối chuẩn, thì phân phối mẫu của trung bình mẫu, $\bar{x}$, có thể được mô hình hóa xấp xỉ bởi phân phối chuẩn, miễn là kích thước mẫu đủ lớn, ví dụ: lớn hơn hoặc bằng 30.

    Mục tiêu học tập UNC-3.S: Giải thích xác suất và tham số cho phân phối mẫu của trung bình mẫu. [Kỹ năng 4.B]

    • UNC-3.S.1 Xác suất và tham số cho phân phối mẫu của trung bình mẫu nên được giải thích sử dụng đơn vị phù hợp và trong ngữ cảnh của một quần thể cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với trung bình mẫu $\bar{x}$ từ một mẫu ngẫu nhiên đơn (SRS): kỳ vọng là $\mu$ (không thiên lệch), và độ tiêu chuẩn là

    $$\sigma_{\bar x}=\frac{\sigma}{\sqrt{n}}.$$
    Phân bố của nó là chuẩn nếu tổng thể phân phối chuẩn, hoặc xấp xỉ chuẩn đối với mẫu lớn $n$ theo Định lý Giới hạn Trung tâm. Lưu ý độ phân tán co lại theo tỷ lệ $\sqrt{n}$ – nhân bốn kích thước mẫu thì sai số chuẩn giảm đi một nửa.

    Ví dụ minh họa. Một tổng thể có $\mu=70$ và $\sigma=12$. Đối với các mẫu có $n=36$, phân phối lấy mẫu của $\bar{x}$ được đặt tại $70$ với sai số chuẩn là $\dfrac{12}{\sqrt{36}}=2$. Xác suất để trung bình mẫu vượt quá $73$ là $z=\dfrac{73-70}{2}=1.5$, vì vậy $P(\bar x>73)\approx0.067$.

    Phân phối lấy mẫu của trung bình thu hẹp lại và trở nên chuẩn hơn khi n tăng
    Tổng thể ở bên trái bị lệch mạnh, nhưng mọi phân phối lấy mẫu của $\bar{x}$ đều được đặt tại $\mu$. Một sample size $n$ lớn hơn làm co lại sai số chuẩn $\sigma/\sqrt{n}$, vì vậy đường cong trở nên cao hơn và hẹp hơn – và nó cũng thẳng hơn: vẫn rõ ràng bị lệch ở $n=2$, gần như hoàn toàn chuẩn (nét đứt) đến $n=30$.
    5.8

    So sánh hai nhóm: Sự chênh lệch trung bình mẫu

    Chương trình

    Hiểu biết Bền vững (UNC-3): Lập luận xác suất cho phép chúng ta dự đoán các mẫu trong dữ liệu.

    Mục tiêu học tập UNC-3.T: Xác định các tham số của phân phối mẫu cho hiệu số trung bình mẫu. [Kỹ năng 3.B]

    • UNC-3.T.1 Đối với một biến định lượng, khi lấy mẫu ngẫu nhiên có hoàn lại từ hai quần thể độc lập có trung bình quần thể $\mu_1$ và $\mu_2$ cùng độ lệch chuẩn quần thể $\sigma_1$ và $\sigma_2$, phân phối mẫu của hiệu số trung bình mẫu $\bar{x}_1 - \bar{x}_2$ có trung bình $\mu_{(\bar{x}_1 - \bar{x}_2)} = \mu_1 - \mu_2$ và độ lệch chuẩn $\sigma_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}$.
    • UNC-3.T.2 Nếu lấy mẫu không hoàn lại, độ lệch chuẩn của hiệu số trung bình mẫu sẽ nhỏ hơn so với công thức trên. Nếu kích thước mẫu nhỏ hơn 10% kích thước quần thể, sự chênh lệch này là không đáng kể.

    Mục tiêu học tập UNC-3.U: Xác định xem phân phối mẫu của hiệu số trung bình mẫu có thể được mô tả xấp xỉ theo phân phối chuẩn hay không. [Kỹ năng 3.C]

    • UNC-3.U.1 Phân phối lấy mẫu của hiệu số trung bình mẫu $\bar{x}_1 - \bar{x}_2$ có thể được mô hình hóa bằng phân phối chuẩn nếu hai phân phối tổng thể đều có thể được mô hình hóa bằng phân phối chuẩn.
    • UNC-3.U.2 Phân phối lấy mẫu của hiệu số trung bình mẫu $\bar{x}_1 - \bar{x}_2$ có thể được xấp xỉ bởi một phân phối chuẩn nếu hai phân phối tổng thể không thể được mô hình hóa bằng phân phối chuẩn nhưng cả hai kích thước mẫu đều lớn hơn hoặc bằng 30.

    Mục tiêu học tập UNC-3.V: Giải thích xác suất và tham số cho phân phối lấy mẫu của hiệu số trung bình mẫu. [Kỹ năng 4.B]

    • UNC-3.V.1 Xác suất và tham số cho phân phối lấy mẫu của hiệu số trung bình mẫu cần được giải thích sử dụng đơn vị phù hợp và trong ngữ cảnh của các tổng thể cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với $\bar{x}_1-\bar{x}_2$ từ hai mẫu độc lập: kỳ vọng là $\mu_1-\mu_2$, và (độc lập, nên biến cộng lại)

    $$\sigma_{\bar x_1-\bar x_2}=\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}}.$$
    Đây là nền tảng cho suy luận hai mẫu trong các đơn vị tiếp theo.

    5.8

    Mẹo làm bài thi

    • Một phân phối lấy mẫu là sự phân phối của một thống kê qua nhiều mẫu, được đặt tại tham số thực tế.
    • Định lý Giới hạn Trung tâm: đối với một mẫu đủ lớn, trung bình mẫu sẽ xấp xỉ phân phối chuẩn, ngay cả khi tổng thể không phải là phân phối chuẩn.
    • Mẫu lớn hơn tạo ra ít biến thiên hơn (một sai số chuẩn nhỏ hơn).
    • Kiểm tra các điều kiện (ngẫu nhiên, độc lập/10%, đủ lớn) trước khi sử dụng mô hình chuẩn.
    • Phân biệt rõ những gì thay đổi — thống kê — so với tham số cố định.
  • 6

    Suy luận cho Dữ liệu Phân loại: Tỷ lệ

    Xem bài học
    6.1

    Tại sao cần phân phối chuẩn?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.H: Xác định các câu hỏi gợi ý từ sự biến đổi trong hình dạng của các phân phối mẫu được抽取 từ cùng một tổng thể. [Kỹ năng 1.A]

    • VAR-1.H.1 Sự biến đổi trong hình dạng của phân phối dữ liệu có thể là ngẫu nhiên hoặc không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Vì tỷ lệ mẫu $\hat{p}$ xấp xỉ phân phối chuẩn (khi các điều kiện được thỏa mãn), chúng ta có thể đo lường khoảng cách mà kết quả mẫu nằm so với một giá trị được nêu lên theo đơn vị sai số chuẩn, và biến điều đó thành xác suất. Đây chính là yếu tố khiến suy luận – rút ra kết luận về tổng thể từ một mẫu – trở nên khả thi.

    6.2

    Khoảng tin cậy cho tỷ lệ

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    UNC-4
    An interval of values should be used to estimate parameters, in order to account for uncertainty.

    UNC-4.A
    Identify an appropriate confidence interval procedure for a population proportion. [Skill 1.D]

    • UNC-4.A.1 The appropriate confidence interval procedure for a one-sample proportion for one categorical variable is a one sample $z$-interval for a proportion.

    UNC-4.B
    Verify the conditions for calculating confidence intervals for a population proportion. [Skill 4.C]

    • UNC-4.B.1 In order to make assumptions necessary for inference on population proportions, means, and slopes, we must check for independence in data collection methods and for selection of the appropriate sampling distribution.
    • UNC-4.B.2 In order to calculate a confidence interval to estimate a population proportion, $p$, we must check for independence and that the sampling distribution is approximately normal.
      • a. To check for independence:
        • i. Data should be collected using a random sample or a randomized experiment.
        • ii. When sampling without replacement, check that $n \leq 10\%N$, where $N$ is the size of the population.
      • b. To check that the sampling distribution of $\hat{p}$ is approximately normal (shape):
        • i. For categorical variables, check that both the number of successes, $n\hat{p}$, and the number of failures, $n(1-\hat{p})$ are at least 10 so that the sample size is large enough to support an assumption of normality.

    UNC-4.C
    Determine the margin of error for a given sample size and an estimate for the sample size that will result in a given margin of error for a population proportion. [Skill 3.D]

    • UNC-4.C.1 Based on sample data, the standard error of a statistic is an estimate for the standard deviation for the statistic. The standard error of $\hat{p}$ is $SE_{\hat{p}} = \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
    • UNC-4.C.2 A margin of error gives how much a value of a sample statistic is likely to vary from the value of the corresponding population parameter.
    • UNC-4.C.3 For categorical variables, the margin of error is the critical value ($z^*$) times the standard error (SE) of the relevant statistic, which equals $z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$ for a one sample proportion.
    • UNC-4.C.4 The formula for margin of error can be rearranged to solve for $n$, the minimum sample size needed to achieve a given margin of error. For this purpose, use a guess for $\hat{p}$ or use $\hat{p} = 0.5$ in order to find an upper bound for the sample size that will result in a given margin of error.

    UNC-4.D
    Calculate an appropriate confidence interval for a population proportion. [Skill 3.D]

    • UNC-4.D.1 In general, an interval estimate can be constructed as point estimate ± (margin of error). For a one-sample proportion, the interval estimate is $\hat{p} \pm z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
      • Clarifying statement: Formulas for interval estimates do not appear explicitly on the AP Statistics Formula Sheet provided with the AP Statistics Exam. However, these formulas do not need to be memorized, as they can be constructed based on the general test statistic formula and the relevant standard error formulas that are provided on the formula sheet.
    • UNC-4.D.2 Critical values represent the boundaries encompassing the middle C% of the standard normal distribution, where C% is an approximate confidence level for a proportion.

    UNC-4.E
    Calculate an interval estimate based on a confidence interval for a population proportion. [Skill 3.D]

    • UNC-4.E.1 Confidence intervals for population proportions can be used to calculate interval estimates with specified units.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Ý nghĩa của khoảng tin cậy

    Một khoảng tin cậy ước lượng tham số dưới dạng một khoảng: thống kê $\pm$ biên độ sai số.

    $$\hat{p}\pm z^{*}\sqrt{\frac{\hat{p}(1-\hat{p})}{n}}.$$
    $z^{*}$ là giá trị tới hạn cho mức độ tin cậy (ví dụ: $1.96$ cho 95%). Điều kiện: mẫu ngẫu nhiên, Số lượng lớn ($n\hat p\ge 10$ và $n(1-\hat p)\ge 10$), và điều kiện 10%. Giải thích: "Chúng tôi tự tin 95% rằng tỷ lệ thực tế của... nằm giữa... và...". Giải thích mức độ: "Trong 95% các mẫu, phương pháp này tạo ra một khoảng chứa tỷ lệ thực tế."

    Qua nhiều mẫu, khoảng 95% các khoảng tin cậy 95% chứa tỷ lệ thực tế
    Qua nhiều mẫu, khoảng 95% các khoảng tin cậy 95% chứa tỷ lệ thực tế

    Ví dụ minh họa. Trong một mẫu ngẫu nhiên gồm $200$ người, $120$ ủng hộ một chính sách, do đó $\hat{p}=0.60$. Một khoảng tin cậy $95\%$ sử dụng $z^*=1.96$:

    $$0.60\pm1.96\sqrt{\frac{0.60(0.40)}{200}}=0.60\pm0.068=(0.532,\ 0.668).$$
    Chúng ta $95\%$ tự tin rằng tỷ lệ thực tế của những người ủng hộ nằm trong khoảng từ $53.2\%$ đến $66.8\%$.

    Một khoảng tin cậy 95% kéo dài 1.96 độ tiêu chuẩn ở mỗi bên của ước lượng
    Một khoảng tin cậy 95% kéo dài 1.96 độ tiêu chuẩn ở mỗi bên của ước lượng

    Chọn kích thước mẫu. Để giữ biên độ sai số không vượt quá mức mục tiêu $m$, hãy đặt $z^{*}\sqrt{\dfrac{\hat p(1-\hat p)}{n}}\le m$ và giải phương trình để tìm $n$. Khi bạn không có ước tính nào cho $\hat p$, hãy sử dụng $\hat p=0.5$: điều này khiến $\hat p(1-\hat p)$ đạt giá trị lớn nhất có thể, cung cấp kích thước mẫu yêu cầu an toàn (lớn nhất). Luôn làm tròn kết quả lên trên về số nguyên người gần nhất.

    Ví dụ minh họa. Bạn cần khảo sát bao nhiêu người để có khoảng tin cậy $95\%$ với biên độ sai số tối đa là $0.03$? Sử dụng $\hat p=0.5$ và $z^*=1.96$:

    $$n=\frac{(z^*)^2\,\hat p(1-\hat p)}{m^2}=\frac{1.96^2(0.5)(0.5)}{0.03^2}=\frac{0.9604}{0.0009}\approx1067.1,$$
    vì vậy bạn cần khảo sát $1068$ người (luôn làm tròn lên, vì nếu làm tròn xuống thì $1067$ sẽ khiến biên độ sai số hơi lớn một chút).

    Từ vựng Luyện tập
    English Tiếng Việt
    inference/ˈɪnfərəns/ suy luận
    confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ khoảng tin cậy
    margin of error/ˈmɑːdʒɪn ɒv ˈerə/ biên độ sai số
    confidence level/ˈkɒnfɪdəns ˈlevl/ mức độ tin cậy
    significance test/sɪɡˈnɪfɪkəns test/ kiểm định ý nghĩa
    null hypothesis/nʌl haɪˈpɒθəsɪs/ giả thuyết không
    alternative hypothesis/ɔːlˈtɜːnətɪv haɪˈpɒθəsɪs/ giả thuyết thay thế
    test statistic/test stəˈtɪstɪk/ thống kê kiểm định
    significance level/sɪɡˈnɪfɪkəns ˈlevl/ mức ý nghĩa
    Type I error/taɪp aɪ ˈerə/ lỗi loại I
    Type II error/taɪp ˈtuː ˈerə/ lỗi loại II
    power/ˈpaʊə/ công suất
    combined (pooled)/kəmˈbaɪnd/ tổ hợp (gộp)
    6.3

    Chứng minh một tuyên bố từ khoảng tin cậy

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu học tập UNC-4.F: Giải thích khoảng tin cậy cho tỷ lệ tổng thể. [Kỹ năng 4.B]

    • UNC-4.F.1 Một khoảng tin cậy cho tỷ lệ tổng thể hoặc chứa tỷ lệ tổng thể hoặc không, bởi vì mỗi khoảng dựa trên dữ liệu mẫu ngẫu nhiên, vốn thay đổi từ mẫu này sang mẫu khác.
    • UNC-4.F.2 Chúng ta có độ tin cậy C% rằng khoảng tin cậy cho tỷ lệ tổng thể đã bao gồm tỷ lệ tổng thể.
    • UNC-4.F.3 Trong các lần lấy mẫu ngẫu nhiên lặp lại với cùng kích thước mẫu, khoảng C% các khoảng tin cậy được tạo ra sẽ bao gồm tỷ lệ tổng thể.
    • UNC-4.F.4 Việc giải thích khoảng tin cậy cho tỷ lệ một mẫu cần bao gồm đề cập đến mẫu đã lấy và các chi tiết về tổng thể mà nó đại diện.
      • Ví dụ minh họa cho UNC-4.F.4: Khi diễn giải một khoảng tin cậy 99% từ (0.268, 0.292), dựa trên tỷ lệ học sinh lớp mười hai trong mẫu đại diện quốc gia trả lời đúng một câu hỏi trắc nghiệm cụ thể: "Chúng ta tự tin 99 phần trăm rằng khoảng từ 0.268 đến 0.292 chứa tỷ lệ tổng thể của tất cả học sinh lớp mười hai Hoa Kỳ sẽ trả lời đúng câu hỏi này" (2011 FRQ 6(a)).

    Mục tiêu học tập UNC-4.G: Chứng minh một tuyên bố dựa trên khoảng tin cậy cho tỷ lệ tổng thể. [Kỹ năng 4.D]

    • UNC-4.G.1 Một khoảng tin cậy cho tỷ lệ tổng thể cung cấp một khoảng giá trị có thể cung cấp bằng chứng đủ mạnh để hỗ trợ một tuyên bố cụ thể trong ngữ cảnh.

    Mục tiêu học tập UNC-4.H: Xác định mối quan hệ giữa kích thước mẫu, độ rộng của khoảng tin cậy, mức độ tin cậy và sai số biên cho tỷ lệ tổng thể. [Kỹ năng 4.A]

    • UNC-4.H.1 Khi mọi yếu tố khác không đổi, độ rộng của khoảng tin cậy cho tỷ lệ tổng thể có xu hướng giảm khi kích thước mẫu tăng lên. Đối với tỷ lệ tổng thể, độ rộng của khoảng tỷ lệ thuận với $\dfrac{1}{\sqrt{n}}$.
    • UNC-4.H.2 Đối với một mẫu cho trước, độ rộng của khoảng tin cậy cho tỷ lệ tổng thể tăng lên khi mức độ tin cậy tăng.
    • UNC-4.H.3 Độ rộng của khoảng tin cậy cho tỷ lệ tổng thể chính bằng hai lần sai số biên.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Để đánh giá một giá trị được nêu lên: nếu nó nằm bên trong khoảng tin cậy, dữ liệu phù hợp với nó; nếu nằm bên ngoài, dữ liệu đưa ra bằng chứng phản bác lại nó. Hãy dựa vào kết luận xem các giá trị khả dĩ có bao gồm tuyên bố hay không, trong ngữ cảnh cụ thể.

    6.4

    Thiết lập kiểm định cho tỷ lệ

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-6
    The normal distribution may be used to model variation.

    VAR-6.D
    Identify the null and alternative hypotheses for a population proportion. [Skill 1.F]

    • VAR-6.D.1 The null hypothesis is the situation that is assumed to be correct unless evidence suggests otherwise, and the alternative hypothesis is the situation for which evidence is being collected.
    • VAR-6.D.2 For hypotheses about parameters, the null hypothesis contains an equality reference (=, ≥, or ≤), while the alternative hypothesis contains a strict inequality (<, >, or ≠). The type of inequality in the alternative hypothesis is based on the question of interest. Alternative hypotheses with < or > are called one-sided, and alternative hypotheses with ≠ are called two-sided. Although the null hypothesis for a one-sided test may include an inequality symbol, it is still tested at the boundary of equality.
    • VAR-6.D.3 The null hypothesis for a population proportion is: $H_0 : p = p_0$, where $p_0$ is the null hypothesized value for the population proportion.
    • VAR-6.D.4 A one-sided alternative hypothesis for a proportion is either $H_a : p < p_0$ or $H_a : p > p_0$. A two-sided alternate hypothesis is $H_a : p_1 \neq p_2$.
    • VAR-6.D.5 For a one-sample $z$-test for a population proportion, the null hypothesis specifies a value for the population proportion, usually one indicating no difference or effect.

    VAR-6.E
    Identify an appropriate testing method for a population proportion. [Skill 1.E]

    • VAR-6.E.1 For a single categorical variable, the appropriate testing method for a population proportion is a one-sample $z$-test for a population proportion.

    VAR-6.F
    Verify the conditions for making statistical inferences when testing a population proportion. [Skill 4.C]

    • VAR-6.F.1 In order to make statistical inferences when testing a population proportion, we must check for independence and that the sampling distribution is approximately normal:
      • a. To check for independence:
        • i. Data should be collected using a random sample or a randomized experiment.
        • ii. When sampling without replacement, check that $n \leq 10\%N$.
      • b. To check that the sampling distribution of $\hat{p}$ is approximately normal (shape):
        • i. Assuming that $H_0$ is true $(p = p_0)$, verify that both the number of successes, $np_0$, and the number of failures, $n(1-p_0)$ are at least 10 so that that the sample size is large enough to support an assumption of normality.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một kiểm định ý nghĩa cân bằng bằng chứng chống lại một tuyên bố. Phát biểu giả thuyết không $H_0$ và giả thuyết thay thế $H_a$ liên quan đến tham số $p$:

    $$H_0: p=p_0 \qquad H_a: p\neq p_0 \ (\text{or } <,\, >).$$
    Kiểm tra cùng các điều kiện (ngẫu nhiên, Đếm Lớn sử dụng $p_0$, 10%). Thống kê kiểm định đếm số sai số chuẩn cách xa $p_0$:
    $$z=\frac{\hat p-p_0}{\sqrt{p_0(1-p_0)/n}}.$$

    Ví dụ có lời giải. Một công ty tuyên bố $90\%$ sự hài lòng ($p_0=0.90$); một mẫu gồm $100$ tìm thấy $84$ hài lòng ($\hat{p}=0.84$). Kiểm tra $H_0:p=0.90$ so với $H_a:p\neq0.90$ ở mức $\alpha=0.05$:

    $$z=\frac{0.84-0.90}{\sqrt{0.90(0.10)/100}}=\frac{-0.06}{0.03}=-2.0,$$
    cho ra một giá trị $p$ hai phía khoảng $2(0.023)=0.046$. Vì $0.046<0.05$, từ chối $H_0$ – có bằng chứng cho thấy tỷ lệ thỏa mãn thực tế khác với (hay thấp hơn) $90\%$.

    Kiểm tra hai phía 5% từ chối giả thuyết không trong các phần đuôi được tô màu
    Kiểm tra hai phía 5% từ chối giả thuyết không trong các phần đuôi được tô màu
    6.5

    Giải thích Giá trị p

    Chương trình

    Hiểu biết bền vững (VAR-6): Phân phối chuẩn có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-6.G: Tính toán thống kê kiểm định và $p$-value phù hợp cho tỷ lệ tổng thể. [Kỹ năng 3.E]

    • VAR-6.G.1 Phân phối của thống kê kiểm định giả sử giả thuyết không là đúng (phân phối không) có thể là phân phối ngẫu nhiên hoặc, khi một mô hình xác suất được giả định là đúng, là một phân phối lý thuyết ($z$).
    • VAR-6.G.2 Khi sử dụng một $z$-test, thống kê kiểm định được chuẩn hóa có thể được viết: $\text{test statistic} = \dfrac{\text{sample statistic} - \text{null value of the parameter}}{\text{standard deviation of the statistic}}$. Đây được gọi là $z$-statistic cho tỷ lệ.
    • VAR-6.G.3 Thống kê kiểm định cho tỷ lệ tổng thể là: $z = \dfrac{\hat{p} - p_0}{\sqrt{\dfrac{p_0(1-p_0)}{n}}}$.
      • Phát biểu làm rõ: Các công thức cho thống kê kiểm định không xuất hiện rõ ràng trong Bảng Công thức AP Statistics đi kèm với kỳ thi AP Statistics. Tuy nhiên, các công thức này không cần phải học thuộc lòng, vì chúng có thể được xây dựng dựa trên công thức thống kê kiểm định chung và các công thức sai số chuẩn liên quan được cung cấp trong bảng công thức.
    • VAR-6.G.4 Một $p$-value là xác suất thu được một thống kê kiểm định cực đoan hoặc cực đoan hơn so với thống kê kiểm định quan sát được khi giả thuyết không và mô hình xác suất được giả định là đúng. Mức ý nghĩa có thể được给出 hoặc do nhà nghiên cứu xác định.

    Hiểu biết bền vững (DAT-3): Kiểm định ý nghĩa giúp chúng ta đưa ra quyết định về các giả thuyết trong một ngữ cảnh cụ thể.

    Mục tiêu học tập DAT-3.A: Giải thích $p$-value của một kiểm định ý nghĩa cho tỷ lệ tổng thể. [Kỹ năng 4.B]

    • DAT-3.A.1 $p$-value là tỷ lệ các giá trị của phân phối không cực đoan hoặc cực đoan hơn so với giá trị quan sát được của thống kê kiểm định. Điều này là:
      • a. Tỷ lệ ở mức hoặc cao hơn giá trị quan sát được của thống kê kiểm định, nếu giả thuyết thay thế là >.
      • b. Tỷ lệ ở mức hoặc thấp hơn giá trị quan sát được của thống kê kiểm định, nếu giả thuyết thay thế là <.
      • c. Tỷ lệ nhỏ hơn hoặc bằng âm của giá trị tuyệt đối của thống kê kiểm định cộng với tỷ lệ lớn hơn hoặc bằng giá trị tuyệt đối của thống kê kiểm định, nếu giả thuyết thay thế là ≠.
    • DAT-3.A.2 Một cách giải thích $p$-value của một kiểm định ý nghĩa cho tỷ lệ một mẫu phải nhận ra rằng $p$-value được tính toán bằng cách giả định rằng mô hình xác suất và giả thuyết không là đúng, tức là bằng cách giả định rằng tỷ lệ tổng thể thực tế bằng với giá trị cụ thể được nêu trong giả thuyết không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Ý nghĩa của p-value

    Giá trị P $p$ là xác suất thu được kết quả mẫu cực đoan hoặc cực đoan hơn so với kết quả quan sát được, giả sử $H_0$ là đúng. Một giá trị $p$ nhỏ có nghĩa là dữ liệu sẽ gây bất ngờ nếu $H_0$ đúng – đây là bằng chứng chống lại $H_0$. Nó không phải là xác suất mà $H_0$ là đúng.

    Khám phá

    Giá trị p như là diện tích đuôi

    Một giá trị p là xác suất, nếu giả thuyết không đúng, của kết quả cực đoan ít nhất bằng thế này — chính là diện tích đuôi được tô đậm. Giá trị p nhỏ làm nghi ngờ giả thuyết không.

    Từ vựng Luyện tập
    English Tiếng Việt
    p-value/piː ˈvæljuː/ p-value
    6.6

    Kết luận của một Bài kiểm tra

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    DAT-3
    Significance testing allows us to make decisions about hypotheses within a particular context.

    DAT-3.B
    Justify a claim about the population based on the results of a significance test for a population proportion. [Skill 4.E]

    • DAT-3.B.1 The significance level, $\alpha$, is the predetermined probability of rejecting the null hypothesis given that it is true.
    • DAT-3.B.2 A formal decision explicitly compares the $p$-value to the significance level, $\alpha$. If the $p$-value $\leq \alpha$, reject the null hypothesis. If the $p$-value $> \alpha$, fail to reject the null hypothesis.
    • DAT-3.B.3 Rejecting the null hypothesis means there is sufficient statistical evidence to support the alternative hypothesis. Failing to reject the null means there is insufficient statistical evidence to support the alternative hypothesis.
    • DAT-3.B.4 The conclusion about the alternative hypothesis must be stated in context.
    • DAT-3.B.5 A significance test can lead to rejecting or not rejecting the null hypothesis, but can never lead to concluding or proving that the null hypothesis is true. Lack of statistical evidence for the alternative hypothesis is not the same as evidence for the null hypothesis.
    • DAT-3.B.6 Small $p$-values indicate that the observed value of the test statistic would be unusual if the null hypothesis and probability model were true, and so provide evidence for the alternative. The lower the $p$-value, the more convincing the statistical evidence for the alternative hypothesis.
    • DAT-3.B.7 $p$-values that are not small indicate that the observed value of the test statistic would not be unusual if the null hypothesis and probability model were true, so do not provide convincing statistical evidence for the alternative hypothesis nor do they provide evidence that the null hypothesis is true.
    • DAT-3.B.8 A formal decision explicitly compares the $p$-value to the significance $\alpha$. If the $p$-value $\leq \alpha$, then reject the null hypothesis, $H_0 : p = p_0$. If the $p$-value $> \alpha$, then fail to reject the null hypothesis.
    • DAT-3.B.9 The results of a significance test for a population proportion can serve as the statistical reasoning to support the answer to a research question about the population that was sampled.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    So sánh giá trị $p$ với mức ý nghĩa $\alpha$ (thường là $0.05$):

    • $p\le\alpha$: từ chối $H_0$ – có bằng chứng thuyết phục cho $H_a$.
    • $p>\alpha$: không từ chối $H_0$ – không đủ bằng chứng cho $H_a$ (b bao giờ "chấp nhận $H_0$").

    Luôn viết kết luận trong ngữ cảnh, liên hệ lại với tuyên bố ban đầu.

    6.7

    Lỗi Loại I và Lỗi Loại II

    Chương trình

    Hiểu Biết Bền Vững (UNC-5): Xác suất của lỗi loại I và loại II ảnh hưởng đến suy luận.

    Mục Tiêu Học Tập UNC-5.A: Xác định lỗi loại I và loại II. [Kỹ năng 1.B]

    • UNC-5.A.1 Lỗi loại I xảy ra khi giả thuyết không đúng nhưng bị bác bỏ (dương tính giả).
    • UNC-5.A.2 Lỗi loại II xảy ra khi giả thuyết không sai nhưng không bị bác bỏ (âm tính giả).
      • Bảng Lỗi: Với Giá trị Thực tế của Tổng thể ở hàng đầu ($H_0$ đúng; $H_a$ đúng) và Quyết định ở cột bên trái (Bác bỏ $H_0$; Không bác bỏ $H_0$): Bác bỏ $H_0$ khi $H_0$ đúng = Lỗi loại I; Bác bỏ $H_0$ khi $H_a$ đúng = Quyết định đúng; Không bác bỏ $H_0$ khi $H_0$ đúng = Quyết định đúng; Không bác bỏ $H_0$ khi $H_a$ đúng = Lỗi loại II.

    Mục Tiêu Học Tập UNC-5.B: Tính xác suất của lỗi loại I và loại II. [Kỹ năng 3.A]

    • UNC-5.B.1 Mức ý nghĩa, $\alpha$, là xác suất mắc lỗi loại I, nếu giả thuyết không đúng.
    • UNC-5.B.2 Công suất của một bài kiểm định là xác suất mà bài kiểm định sẽ bác bỏ đúng một giả thuyết không sai.
    • UNC-5.B.3 Xác suất mắc lỗi loại II $= 1 - power$.

    Mục Tiêu Học Tập UNC-5.C: Xác định các yếu tố ảnh hưởng đến xác suất lỗi trong kiểm định ý nghĩa. [Kỹ năng 4.A]

    • UNC-5.C.1 Xác suất của lỗi loại II giảm đi khi bất kỳ điều nào sau đây xảy ra, miễn là các yếu tố khác không thay đổi:
      • i. Kích thước mẫu tăng lên.
      • ii. Mức ý nghĩa ($\alpha$) của một bài kiểm định tăng lên.
      • iii. Sai số chuẩn giảm xuống.
      • iv. Giá trị tham số thực tế nằm xa hơn so với giá trị của giả thuyết không.

    Mục Tiêu Học Tập UNC-5.D: Giải thích lỗi loại I và loại II. [Kỹ năng 4.B]

    • UNC-5.D.1 Việc lỗi loại I hay loại II nghiêm trọng hơn phụ thuộc vào tình huống cụ thể.
    • UNC-5.D.2 Vì mức ý nghĩa, $\alpha$, là xác suất của lỗi loại I, nên hậu quả của lỗi loại I sẽ ảnh hưởng đến các quyết định về mức ý nghĩa.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Lỗi Loại I và Lỗi Loại II
    • Lỗi Loại I: từ chối một $H_0$ đúng (báo động giả). Xác suất xảy ra là $\alpha$.
    • Lỗi Loại II: không từ chối một $H_0$ sai (bỏ sót phát hiện). Xác suất xảy ra là $\beta$.
    • Công suất $=1-\beta$ là xác suất phát hiện chính xác một hiệu ứng thực sự. Công suất tăng khi kích thước mẫu lớn hơn, hiệu ứng lớn hơn, hoặc $\alpha$ lớn hơn.

    Mô tả từng loại lỗi và hậu quả của nó trong ngữ cảnh của bài toán.

    Khám phá

    Hai cách mà một phép kiểm định có thể sai

    Lỗi Loại I bác bỏ một giả thuyết không đúng (cảnh báofalse); lỗi Loại II giữ lại một giả thuyết không sai (lờ bỏ). Việc giảm một loại thường làm tăng loại kia.

    6.8

    Khoảng tin cậy cho Sự chênh lệch Tỷ lệ

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục Tiêu Học Tập UNC-4.I: Xác định thủ tục khoảng tin cậy phù hợp cho việc so sánh tỷ lệ tổng thể. [Kỹ năng 1.D]

    • UNC-4.I.1 Thủ tục khoảng tin cậy phù hợp cho việc so sánh hai mẫu tỷ lệ đối với một biến phân loại là khoảng $z$ hai mẫu cho sự chênh lệch giữa các tỷ lệ tổng thể.

    Mục Tiêu Học Tập UNC-4.J: Kiểm tra các điều kiện để tính toán khoảng tin cậy cho sự chênh lệch giữa các tỷ lệ tổng thể. [Kỹ năng 4.C]

    • UNC-4.J.1 Để tính toán khoảng tin cậy nhằm ước lượng sự chênh lệch giữa các tỷ lệ, chúng ta phải kiểm tra tính độc lập và đảm bảo rằng phân phối mẫu xấp xỉ phân phối chuẩn:
      • a. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng hai mẫu ngẫu nhiên độc lập hoặc một thí nghiệm gán ngẫu nhiên.
        • ii. Khi抽取 mẫu không hoàn hồi, hãy kiểm tra rằng $n_1 \leq 10\%N_1$ và $n_2 \leq 10\%N_2$.
      • b. Để kiểm tra rằng phân phối mẫu của $\hat{p}_1 - \hat{p}_2$ xấp xỉ phân phối chuẩn (hình dạng).
        • i. Đối với các biến phân loại, hãy kiểm tra rằng $n_1\hat{p}_1$, $n_1(1-\hat{p}_1)$, $n_2\hat{p}_2$, và $n_2\left(1-\hat{p}_2\right)$ đều lớn hơn hoặc bằng một giá trị quy trước, thường là 5 hoặc 10.

    Mục Tiêu Học Tập UNC-4.K: Tính toán khoảng tin cậy phù hợp cho việc so sánh tỷ lệ tổng thể. [Kỹ năng 3.D]

    • UNC-4.K.1 Đối với việc so sánh tỷ lệ, ước lượng khoảng là $(\hat{p}_1 - \hat{p}_2) \pm z^* \sqrt{\dfrac{\hat{p}_1(1-\hat{p}_1)}{n_1} + \dfrac{\hat{p}_2(1-\hat{p}_2)}{n_2}}$.
      • Câu làm rõ: Các công thức cho ước lượng khoảng không xuất hiện trực tiếp trong Bảng Công thức AP Statistics đi kèm Bài thi AP Statistics. Tuy nhiên, các công thức này không cần phải học thuộc lòng vì chúng có thể được xây dựng dựa trên công thức thống kê kiểm định chung và các công thức sai số chuẩn liên quan được cung cấp trong bảng công thức.

    Mục Tiêu Học Tập UNC-4.L: Tính toán ước lượng khoảng dựa trên khoảng tin cậy cho sự chênh lệch tỷ lệ. [Kỹ năng 3.D]

    • UNC-4.L.1 Khoảng tin cậy cho sự chênh lệch tỷ lệ có thể được sử dụng để tính toán ước lượng khoảng với các đơn vị cụ thể.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Để so sánh hai tỷ lệ, ước tính $p_1-p_2$:

    $$(\hat p_1-\hat p_2)\pm z^{*}\sqrt{\frac{\hat p_1(1-\hat p_1)}{n_1}+\frac{\hat p_2(1-\hat p_2)}{n_2}}.$$
    Các điều kiện phải thỏa mãn trong cả hai mẫu, và các mẫu phải độc lập.

    6.9

    Chứng minh một Tuyên bố về Hai Tỷ lệ

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục Tiêu Học Tập UNC-4.M: Giải thích khoảng tin cậy cho sự chênh lệch tỷ lệ. [Kỹ năng 4.B]

    • UNC-4.M.1 Trong các lần lấy mẫu ngẫu nhiên lặp lại với cùng kích thước mẫu, khoảng C% các khoảng tin cậy tạo thành sẽ bao hàm sự chênh lệch tỷ lệ tổng thể.
    • UNC-4.M.2 Việc giải thích khoảng tin cậy cho sự chênh lệch tỷ lệ tổng thể cần bao gồm tham chiếu đến mẫu đã lấy và chi tiết về tổng thể mà nó đại diện.

    Mục Tiêu Học Tập UNC-4.N: Chứng minh một tuyên bố dựa trên khoảng tin cậy cho sự chênh lệch tỷ lệ. [Kỹ năng 4.D]

    • UNC-4.N.1 Một khoảng tin cậy cho sự chênh lệch tỷ lệ tổng thể cung cấp một khoảng giá trị có thể cung cấp bằng chứng đủ để hỗ trợ một tuyên bố cụ thể trong ngữ cảnh.
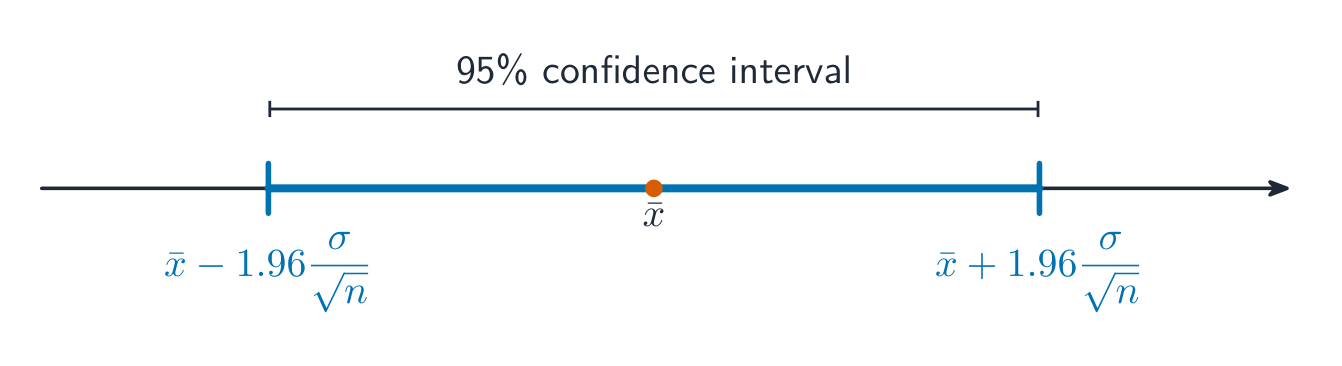
    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Nếu khoảng tin cậy cho $p_1-p_2$ chứa $0$, dữ liệu phù hợp với không có sự chênh lệch; nếu nằm hoàn toàn trên hoặc dưới $0$, có bằng chứng về sự chênh lệch (theo hướng đó). Nêu rõ hướng và ngữ cảnh.

    6.10

    Thiết lập Kiểm tra cho Sự chênh lệch

    Chương trình

    Hiểu biết bền vững (VAR-6): Phân phối chuẩn có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-6.H: Xác định giả thuyết không và giả thuyết đối với hiệu số tỉ lệ tổng thể. [Kỹ năng 1.F]

    • VAR-6.H.1 Đối với kiểm định hai mẫu để so sánh hiệu số tỉ lệ, giả thuyết không quy định một giá trị $0$ cho hiệu số tỉ lệ tổng thể, biểu thị không có sự khác biệt hay tác động nào.
    • VAR-6.H.2 Giả thuyết không cho hiệu số tỉ lệ là: $H_0 : p_1 = p_2$, hoặc $H_0 : p_1 - p_2 = 0$.
    • VAR-6.H.3 Một giả thuyết đối một phía cho hiệu số tỉ lệ là $H_a : p_1 < p_2$, hoặc, $H_a : p_1 > p_2$. Một giả thuyết đối hai phía cho hiệu số tỉ lệ là $H_a : p_1 \neq p_2$.

    Mục tiêu học tập VAR-6.I: Xác định phương pháp kiểm định phù hợp cho hiệu số tỉ lệ tổng thể. [Kỹ năng 1.E]

    • VAR-6.I.1 Đối với một biến phân loại duy nhất, phương pháp kiểm định phù hợp cho hiệu số tỉ lệ tổng thể là kiểm định $z$-hai mẫu cho hiệu số giữa hai tỉ lệ tổng thể.

    Mục tiêu học tập VAR-6.J: Kiểm tra các điều kiện để thực hiện suy luận thống kê khi kiểm định hiệu số tỉ lệ tổng thể. [Kỹ năng 4.C]

    • VAR-6.J.1 Để thực hiện suy luận thống kê khi kiểm định hiệu số giữa các tỉ lệ tổng thể, chúng ta phải kiểm tra tính độc lập và đảm bảo rằng phân phối lấy mẫu xấp xỉ phân phối chuẩn:
      • a. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng hai mẫu ngẫu nhiên độc lập hoặc một thí nghiệm gán ngẫu nhiên.
        • ii. Khi抽取 mẫu không hoàn hồi, hãy kiểm tra rằng $n_1 \leq 10\%N_1$ và $n_2 \leq 10\%N_2$.
      • b. Để kiểm tra rằng phân phối lấy mẫu của $\hat{p}_1 - \hat{p}_2$ xấp xỉ phân phối chuẩn (hình dạng):
        • i. Đối với mẫu kết hợp, hãy định nghĩa tỷ lệ kết hợp (hoặc tỷ lệ gộp), $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$. Giả sử rằng $H_0$ đúng, $(p_1 - p_2 = 0$ hoặc $p_1 = p_2)$, hãy kiểm tra rằng $n_1\hat{p}_c$, $n_1\left(1-\hat{p}_c\right)$, $n_2\hat{p}_c$, và $n_2\left(1-\hat{p}_c\right)$ đều lớn hơn hoặc bằng một giá trị đã được quy định trước, thường là 5 hoặc 10.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Giả thuyết so sánh hai tỷ lệ: $H_0: p_1=p_2$ so với $H_a: p_1\neq p_2$ (hoặc $<,>$). Vì $H_0$ nói rằng các tỷ lệ bằng nhau, hãy dùng tỷ lệ mẫu gộp (pooled) $\hat p_c=\dfrac{\text{total successes}}{\text{total sample size}}$ để ước tính $p$ chung.

    6.11

    Thực hiện Kiểm tra cho Sự chênh lệch

    Chương trình

    Hiểu biết bền vững (VAR-6): Phân phối chuẩn có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-6.K: Tính toán thống kê kiểm định phù hợp cho hiệu số tỉ lệ tổng thể. [Kỹ năng 3.E]

    • VAR-6.K.1 Thống kê kiểm định cho hiệu số tỉ lệ là: $z = \dfrac{(\hat{p}_1 - \hat{p}_2) - 0}{\sqrt{\hat{p}_c(1-\hat{p}_c)}\sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}}$, trong đó $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$.
      • Câu làm rõ: Các công thức cho thống kê kiểm định không xuất hiện trực tiếp trên Bảng Công thức AP Statistics đi kèm với Kỳ thi AP Statistics. Tuy nhiên, các công thức này không cần phải học thuộc lòng, vì chúng có thể được xây dựng dựa trên công thức thống kê kiểm định chung và các công thức sai số chuẩn cho từng thống kê kiểm định liên quan được cung cấp trên bảng công thức.

    Hiểu biết bền vững (DAT-3): Kiểm định ý nghĩa giúp chúng ta đưa ra quyết định về các giả thuyết trong một ngữ cảnh cụ thể.

    Mục tiêu học tập DAT-3.C: Giải thích giá trị $p$ của một kiểm định ý nghĩa cho hiệu số tỉ lệ tổng thể. [Kỹ năng 4.B]

    • DAT-3.C.1 Một lời giải thích về giá trị $p$ của một kiểm định ý nghĩa cho hiệu số tỉ lệ tổng thể cần nhận ra rằng giá trị $p$ được tính toán bằng cách giả thiết rằng giả thuyết không là đúng, tức là bằng cách giả thiết rằng các tỉ lệ tổng thể thực tế bằng nhau.

    Mục tiêu học tập DAT-3.D: Chứng minh một tuyên bố về tổng thể dựa trên kết quả của một kiểm định ý nghĩa cho hiệu số tỉ lệ tổng thể. [Kỹ năng 4.E]

    • DAT-3.D.1 Một quyết định chính thức so sánh rõ ràng giá trị $p$ với mức ý nghĩa $\alpha$. Nếu $p\text{-value} \leq \alpha$, thì bác bỏ giả thuyết không, $H_0 : p_1 = p_2$, hoặc $H_0 : p_1 - p_2 = 0$. Nếu giá trị $p$ $> \alpha$, thì không đủ cơ sở để bác bỏ giả thuyết không.
    • DAT-3.D.2 Kết quả của một kiểm định ý nghĩa cho hiệu số tỉ lệ tổng thể có thể đóng vai trò là lập luận thống kê để hỗ trợ câu trả lời cho một câu hỏi nghiên cứu về hai tổng thể đã được抽取 mẫu.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Thống kê hai tỷ lệ gộp $z$:

    $$z=\frac{\hat p_1-\hat p_2}{\sqrt{\hat p_c(1-\hat p_c)\left(\frac{1}{n_1}+\frac{1}{n_2}\right)}}.$$
    Tìm giá trị $p$ từ mô hình chuẩn, so sánh với $\alpha$, và đưa ra kết luận trong ngữ cảnh – cùng logic bốn bước như kiểm định một tỷ lệ.

    6.11

    Mẹo làm bài thi

    • Nêu các điều kiện (ngẫu nhiên, 10%, số lượng lớn $np,\,nq\ge10$) trước khi suy luận về tỷ lệ nào.
    • Khoảng tin cậy = ước tính $\pm$ + sai số biên; "tin cậy 95%" đề cập đến tỷ lệ bắt được của phương pháp theo thời gian dài.
    • Đối với kiểm tra, viết $H_0$ và $H_a$, tính thống kê kiểm tra, tìm giá trị p, và so sánh với $\alpha$.
    • Giá trị p nhỏ là bằng chứng chống lại $H_0$; không từ chối không chứng minh $H_0$.
    • Mẫu lớn hơn làm giảm sai số biên; mức độ tin cậy cao hơn làm mở rộng nó.
  • 7

    Suy luận cho Dữ liệu Định lượng: Trung bình

    Xem bài học
    7.1

    Tôi Có Nên Lo about Lỗi Không?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.I: Xác định các câu hỏi gợi ý từ xác suất sai số trong suy luận thống kê. [Kỹ năng 1.A]

    • VAR-1.I.1 Biến thiên ngẫu nhiên có thể dẫn đến sai số trong suy luận thống kê.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Lỗi Loại I và Lỗi Loại II

    Suy luận cho trung bình hoạt động giống như suy luận cho tỷ lệ, với một thay đổi: chúng ta hiếm khi biết độ lệch chuẩn tổng thể $\sigma$, nên ước lượng nó bằng mẫu $s$. Sự bất định thêm này có nghĩa là chúng ta sử dụng phân phối $t$ thay vì phân phối chuẩn – một phân phối có hình chuông nhưng đuôi dày hơn, và nó phụ thuộc vào bậc tự do $df=n-1$; khi $n$ tăng lên nó tiến tới phân phối chuẩn.

    Từ vựng Luyện tập
    English Tiếng Việt
    distribution/ˌdɪstrɪˈbjuːʃn/ phân phối
    degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ bậc tự do
    paired data/peəd ˈdeɪtə/ dữ liệu ghép cặp
    7.2

    Khoảng tin cậy cho Trung bình

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-7
    The $t$-distribution may be used to model variation.

    VAR-7.A
    Describe $t$-distributions. [Skill 3.C]

    • VAR-7.A.1 When $s$ is used instead of $\sigma$ to calculate a test statistic, the corresponding distribution, known as the $t$-distribution, varies from the normal distribution in shape, in that more of the area is allocated to the tails of the density curve than in a normal distribution.
    • VAR-7.A.2 As the degrees of freedom increase, the area in the tails of a $t$-distribution decreases.

    UNC-4
    An interval of values should be used to estimate parameters, in order to account for uncertainty.

    UNC-4.O
    Identify an appropriate confidence interval procedure for a population mean, including the mean difference between values in matched pairs. [Skill 1.D]

    • UNC-4.O.1 Because $\sigma$ is typically not known for distributions of quantitative variables, the appropriate confidence interval procedure for estimating the population mean of one quantitative variable for one sample is a one-sample $t$-interval for a mean.
    • UNC-4.O.2 For one quantitative variable, $X$, that is normally distributed, the distribution of $t = \dfrac{(\overline{x} - \mu)}{\frac{s}{\sqrt{n}}}$ is a $t$-distribution with $n-1$ degrees of freedom.
    • UNC-4.O.3 Matched pairs can be thought of as one sample of pairs. Once differences between pairs of values are found, inference for confidence intervals proceeds as for a population mean.

    UNC-4.P
    Verify the conditions for calculating confidence intervals for a population mean, including the mean difference between values in matched pairs. [Skill 4.C]

    • UNC-4.P.1 In order to calculate confidence intervals to estimate a population mean, we must check for independence and that the sampling distribution is approximately normal:
      • a. To check for independence:
        • i. Data should be collected using a random sample or a randomized experiment.
        • ii. When sampling without replacement, check that $n \leq 10\%N$, where $N$ is the size of the population.
      • b. To check that the sampling distribution of $\overline{x}$ is approximately normal (shape):
        • i. If the observed distribution is skewed, $n$ should be greater than 30.
        • ii. If the sample size is less than 30, the distribution of the sample data should be free from strong skewness and outliers.

    UNC-4.Q
    Determine the margin of error for a given sample size for a one-sample $t$-interval. [Skill 3.D]

    • UNC-4.Q.1 The critical value $t^*$ with $n-1$ degrees of freedom can be found using a table or computer-generated output.
    • UNC-4.Q.2 The standard error for a sample mean is given by $SE = \dfrac{s}{\sqrt{n}}$, where $s$ is the sample standard deviation.
    • UNC-4.Q.3 For a one-sample $t$-interval for a mean, the margin of error is the critical value ($t^*$) times the standard error ($SE$), which equals $t^*\left(\dfrac{s}{\sqrt{n}}\right)$.

    UNC-4.R
    Calculate an appropriate confidence interval for a population mean, including the mean difference between values in matched pairs. [Skill 3.D]

    • UNC-4.R.1 The point estimate for a population mean is the sample mean, $\overline{x}$.
    • UNC-4.R.2 For the population mean for one sample with unknown population standard deviation, the confidence interval is $\overline{x} \pm t^* \dfrac{s}{\sqrt{n}}$.

    Boundary statement: Formulas for interval estimates do not appear explicitly on the AP Statistics Formula Sheet provided with the AP Statistics Exam. However, these formulas do not need to be memorized, as they can be constructed based on the general test statistic formula and the relevant standard error formulas that are provided on the formula sheet.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Ý nghĩa của khoảng tin cậy

    Khoảng tin cậy một mẫu $t$ cho $\mu$:

    $$\bar{x}\pm t^{*}\frac{s}{\sqrt{n}}.$$
    $t^{*}$ là giá trị tới hạn với $df=n-1$. Điều kiện: mẫu ngẫu nhiên, Normal/Large Sample (tổng thể phân phối chuẩn, hoặc $n\ge 30$ theo CLT, hoặc mẫu tương đối đối xứng không có ngoại lệ), và điều kiện 10%. Giải thích khoảng tin cậy và mức độ tin cậy trong ngữ cảnh.
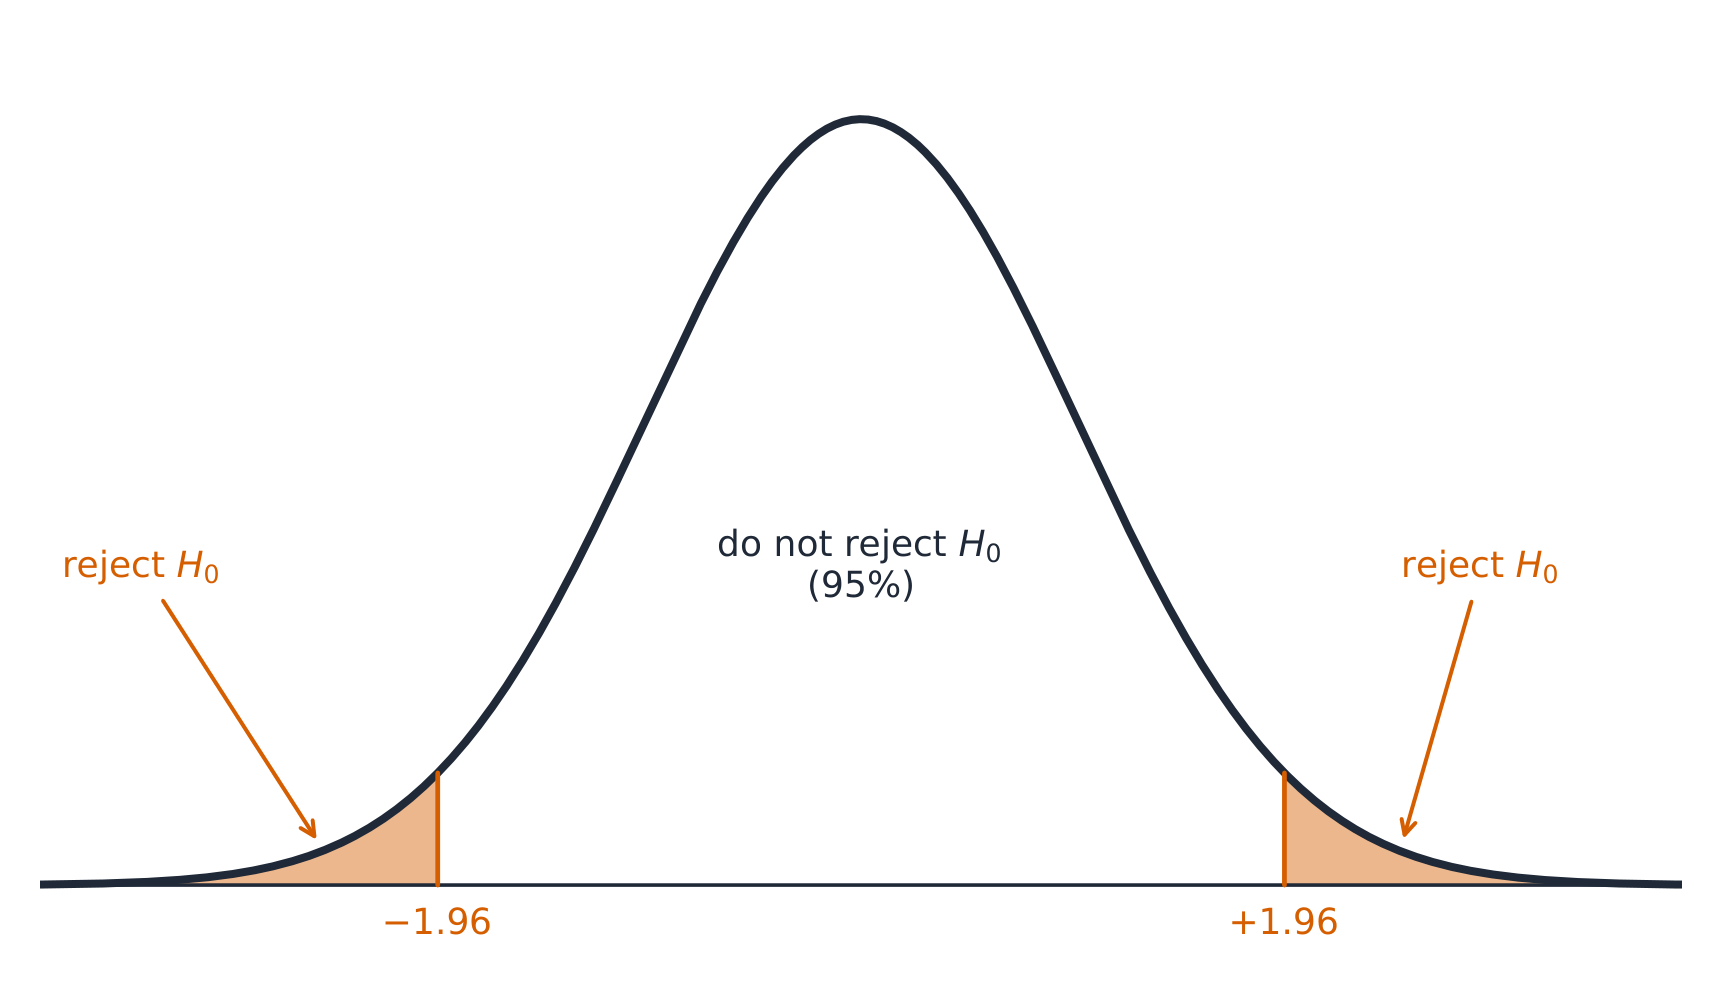
    Ví dụ minh họa. Một mẫu ngẫu nhiên gồm $n=25$ phần tử có trung bình $\bar{x}=50$ và độ lệch chuẩn $s=8$. Đối với khoảng tin cậy $95\%$, $df=24$ sẽ cho ra $t^*=2.064$:

    $$50\pm2.064\cdot\frac{8}{\sqrt{25}}=50\pm2.064(1.6)=50\pm3.3=(46.7,\ 53.3).$$

    Phân phối t có đỉnh thấp hơn và đuôi nặng hơn so với phân phối chuẩn
    Phân phối t có đỉnh thấp hơn và đuôi nặng hơn so với phân phối chuẩn
    Các khoảng tin cậy 95% lặp lại: khoảng 95% bao hàm tham số thực tế
    "Tin cậy 95%" mô tả phương pháp, không phải một khoảng tin cậy cụ thể: qua nhiều mẫu, khoảng 95% các khoảng tin cậy chứa $\mu$ và khoảng 5% bỏ sót.
    Khám phá

    Tại sao khoảng tin cậy t rộng hơn khoảng tin cậy z

    Khoảng tin cậy trung bình dùng $t^*$, không phải $1.96$, vì $\sigma$ được ước lượng bởi $s$. Kéo df xuống và bạn sẽ thấy $t^*$ tăng lên — tại $df=10$ nó bằng $2.228$, và khoảng tin cậy rộng hơn cho giá trị này. Kéo df lên và $t^*$ giảm dần về $1.96$, đó là lý do các mẫu lớn có thể sử dụng $z$.

    7.3

    Chứng minh một Tuyên bố về Trung bình

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu học tập UNC-4.S: Diễn giải khoảng tin cậy cho trung bình tổng thể, bao gồm độ chênh lệch trung bình giữa các giá trị trong cặp ghép. [Kỹ năng 4.B]

    • UNC-4.S.1 Một khoảng tin cậy cho trung bình tổng thể hoặc chứa trung bình tổng thể hoặc không chứa, vì mỗi khoảng dựa trên dữ liệu từ một mẫu ngẫu nhiên, vốn biến động từ mẫu này sang mẫu khác.
    • UNC-4.S.2 Chúng ta có C% sự tin tưởng rằng khoảng tin cậy cho trung bình tổng thể bao hàm trung bình tổng thể.
    • UNC-4.S.3 Một diễn giải khoảng tin cậy cho trung bình tổng thể bao gồm tham chiếu đến mẫu đã thu thập và chi tiết về tổng thể mà nó đại diện.
      • Ví dụ minh họa cho UNC-4.S.3: Khi diễn giải một khoảng tin cậy 96% cho chiều dài chân trung bình của tất cả các dấu chân tìm thấy trong hang dựa trên một mẫu ngẫu nhiên các dấu chân trong hang: "Chúng ta tự tin 96% rằng chiều dài chân trung bình của tất cả các dấu chân tìm thấy trong hang nằm trong khoảng tin cậy" (dựa trên 2000 FRQ 2).

    Mục tiêu học tập UNC-4.T: Justify a claim based on a confidence interval for a population mean, including the mean difference between values in matched pairs. [Kỹ năng 4.D]

    • UNC-4.T.1 Một khoảng tin cậy cho trung bình tổng thể cung cấp một khoảng giá trị có thể cung cấp đủ bằng chứng để hỗ trợ một tuyên bố cụ thể trong ngữ cảnh.

    Mục tiêu học tập UNC-4.U: Xác định mối quan hệ giữa kích thước mẫu, độ rộng của khoảng tin cậy, mức độ tin cậy và sai số biên cho trung bình tổng thể. [Kỹ năng 4.A]

    • UNC-4.U.1 Khi tất cả các yếu tố khác không đổi, độ rộng của khoảng tin cậy cho trung bình tổng thể có xu hướng giảm khi kích thước mẫu tăng lên.
    • UNC-4.U.2 Đối với một trung bình đơn lẻ, độ rộng của khoảng tin cậy tỷ lệ thuận với $\dfrac{1}{\sqrt{n}}$.
    • UNC-4.U.3 Đối với một mẫu xác định, độ rộng của khoảng tin cậy cho trung bình tổng thể tăng khi mức độ tin cậy tăng.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Giống như tỷ lệ: một trung bình được tuyên bố nằm trong khoảng tin cậy thì khả thi; ngoài khoảng tin cậy, dữ liệu cung cấp bằng chứng chống lại nó. Trả lời trong ngữ cảnh sử dụng phạm vi khả thi.

    7.4

    Thiết lập Kiểm tra cho Trung bình

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-7
    The $t$-distribution may be used to model variation.

    VAR-7.B
    Identify an appropriate testing method for a population mean with unknown $\sigma$, including the mean difference between values in matched pairs. [Skill 1.E]

    • VAR-7.B.1 The appropriate test for a population mean with unknown $\sigma$ is a one-sample $t$-test for a population mean.
    • VAR-7.B.2 Matched pairs can be thought of as one sample of pairs. Once differences between pairs of values are found, inference for significance testing proceeds as for a population mean.

    VAR-7.C
    Identify the null and alternative hypotheses for a population mean with unknown $\sigma$, including the mean difference between values in matched pairs. [Skill 1.F]

    • VAR-7.C.1 The null hypothesis for a one-sample $t$-test for a population mean is $H_0 : \mu = \mu_0$, where $\mu_0$ is the hypothesized value. Depending upon the situation, the alternative hypothesis is $H_a : \mu < \mu_0$, or $H_a : \mu > \mu_0$, or $H_a : \mu \neq \mu_0$.
    • VAR-7.C.2 When finding the mean difference, $\mu_d$, between values in a matched pair, it is important to define the order of subtraction.

    VAR-7.D
    Verify the conditions for the test for a population mean, including the mean difference between values in matched pairs. [Skill 4.C]

    • VAR-7.D.1 In order to make statistical inferences when testing a population mean, we must check for independence and that the sampling distribution is approximately normal:
      • a. To check for independence:
        • i. Data should be collected using a random sample or a randomized experiment.
        • ii. When sampling without replacement, check that $n \leq 10\%N$.
      • b. To check that the sampling distribution of $\overline{x}$ is approximately normal (shape):
        • i. If the observed distribution is skewed, $n$ should be greater than 30.
        • ii. If the sample size is less than 30, the distribution of the sample data should be free from strong skewness and outliers.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Ý nghĩa của p-value

    Đặt giả thuyết về $\mu$: $H_0:\mu=\mu_0$ so với $H_a:\mu\neq\mu_0$ (hoặc $<,>$). Kiểm tra các điều kiện tương tự. Thống kê một mẫu $t$:

    $$t=\frac{\bar{x}-\mu_0}{s/\sqrt{n}},\qquad df=n-1.$$

    Ví dụ có lời giải. Kiểm tra $H_0:\mu=45$ so với $H_a:\mu\neq45$ cho mẫu trên ($\bar{x}=50$, $s=8$, $n=25$):

    $$t=\frac{50-45}{8/\sqrt{25}}=\frac{5}{1.6}=3.13,\qquad df=24.$$
    Giá trị $t$ này nằm xa trong đuôi phân phối (kiểm định hai phía $p<0.01$), vì vậy từ chối $H_0$ – bằng chứng mạnh mẽ cho thấy trung bình không phải là $45$. Lưu ý rằng $45$ cũng nằm ngoài khoảng tin cậy $95\%$ $(46.7,53.3)$, dẫn đến cùng kết luận qua hai cách tiếp cận khác nhau.

    7.5

    Thực hiện Kiểm tra cho Trung bình

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-7
    The $t$-distribution may be used to model variation.

    VAR-7.E
    Calculate an appropriate test statistic for a population mean, including the mean difference between values in matched pairs. [Skill 3.E]

    • VAR-7.E.1 For a single quantitative variable when random sampling with replacement from a population that can be modeled with a normal distribution with mean $\mu$ and standard deviation $\sigma$, the sampling distribution of $t = \dfrac{\overline{x} - \mu}{\frac{s}{\sqrt{n}}}$ has a $t$-distribution with $n - 1$ degrees of freedom.

    Boundary statement: The formulas for test statistics do not appear explicitly on the AP Statistics Formula Sheet provided with the AP Statistics Exam. However, these formulas do not need to be memorized, as they can be constructed based on the general test statistic formula and the relevant standard error formulas that are provided on the formula sheet.

    DAT-3
    Significance testing allows us to make decisions about hypotheses within a particular context.

    DAT-3.E
    Interpret the $p$-value of a significance test for a population mean, including the mean difference between values in matched pairs. [Skill 4.B]

    • DAT-3.E.1 An interpretation of the $p$-value of a significance test for a population mean should recognize that the $p$-value is computed by assuming that the null hypothesis is true, i.e., by assuming that the true population mean is equal to the particular value stated in the null hypothesis.

    DAT-3.F
    Justify a claim about the population based on the results of a significance test for a population mean. [Skill 4.E]

    • DAT-3.F.1 A formal decision explicitly compares the $p$-value to the significance $\alpha$. If the $p$-value $\leq \alpha$, then reject the null hypothesis, $H_0 : \mu = \mu_0$. If the $p$-value $> \alpha$, then fail to reject the null hypothesis.
    • DAT-3.F.2 The results of a significance test for a population mean can serve as the statistical reasoning to support the answer to a research question about the population that was sampled.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Tìm giá trị $p$ từ phân phối $t$ với $df=n-1$ bậc tự do, so sánh với mức ý nghĩa $\alpha$, và đưa ra kết luận trong bối cảnh cụ thể – từ chối hoặc không từ chối $H_0$, sau đó giải thích ý nghĩa của kết quả đối với tuyên bố ban đầu. Trình bày tên kiểm định, thống kê, khoảng tin cậy, và giá trị $df$ $p$.

    Khám phá

    Đọc giá trị p từ đường cong t

    Giá trị p là diện tích đuôi được tô đậm vượt qua thống kê $t$ của bạn — cả hai đuôi đối với một $H_a$ hai phía. Đường cong chuẩn nét đứt phía sau $t$ cho thấy những gì bạn đã nhận được nếu sử dụng sai $z$: ở df nhỏ, đuôi $t$ rõ ràng dày hơn, nên giá trị p thực tế lớn hơn so với dự đoán của phân phối chuẩn.

    7.6

    Khoảng tin cậy cho Sự chênh lệch Hai Trung bình

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu Học tập UNC-4.V: Xác định quy trình khoảng tin cậy phù hợp cho độ chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 1.D]

    • UNC-4.V.1 Xét một mẫu ngẫu nhiên đơn giản từ tổng thể 1 có kích thước $n_1$, trung bình $\mu_1$, và độ lệch chuẩn $\sigma_1$ và một mẫu ngẫu nhiên đơn giản thứ hai từ tổng thể 2 có kích thước $n_2$, trung bình $\mu_2$, và độ lệch chuẩn $\sigma_2$. Nếu phân phối của tổng thể 1 và 2 là chuẩn hoặc nếu cả $n_1$ và $n_2$ đều lớn hơn 30, thì phân phối mẫu của độ chênh lệch trung bình, $\overline{x}_1 - \overline{x}_2$ cũng là chuẩn. Trung bình của phân phối mẫu của $\overline{x}_1 - \overline{x}_2$ là $\mu_1 - \mu_2$. Độ lệch chuẩn của $\overline{x}_1 - \overline{x}_2$ là $\sqrt{\dfrac{(\sigma_1)^2}{n_1} + \dfrac{(\sigma_2)^2}{n_2}}$.
    • UNC-4.V.2 Quy trình khoảng tin cậy phù hợp cho một biến định lượng từ hai mẫu độc lập là khoảng tin cậy hai mẫu $t$ cho hiệu giữa các trung bình tổng thể.

    Mục tiêu Học tập UNC-4.W: Kiểm tra các điều kiện để tính toán khoảng tin cậy cho độ chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 4.C]

    • UNC-4.W.1 Để tính toán khoảng tin cậy nhằm ước lượng độ chênh lệch giữa hai trung bình tổng thể, chúng ta phải kiểm tra tính độc lập và phân phối mẫu xấp xỉ chuẩn:
      • a. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng hai mẫu ngẫu nhiên độc lập hoặc một thí nghiệm gán ngẫu nhiên.
        • ii. Khi抽取 mẫu không hoàn hồi, hãy kiểm tra rằng $n_1 \leq 10\%N_1$ và $n_2 \leq 10\%N_2$.
      • b. Để kiểm tra xem phân phối mẫu của $(\overline{x}_1 - \overline{x}_2)$ có xấp xỉ chuẩn (hình dạng) hay không:
        • i. Nếu các phân phối quan sát được bị lệch, cả $n_1$ và $n_2$ đều phải lớn hơn 30.

    Mục tiêu Học tập UNC-4.X: Xác định sai số biên cho độ chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 3.D]

    • UNC-4.X.1 Đối với độ chênh lệch giữa hai trung bình mẫu, sai số biên là giá trị tới hạn ($t^*$) nhân với sai số chuẩn ($SE$) của độ chênh lệch giữa hai trung bình.
    • UNC-4.X.2 Sai số chuẩn cho sự chênh lệch giữa hai trung bình mẫu với độ lệch chuẩn mẫu là $s_1$ và $s_2$, sai số chuẩn là $\sqrt{\dfrac{(s_1)^2}{n_1} + \dfrac{(s_2)^2}{n_2}}$.

    Mục tiêu học tập UNC-4.Y: Tính khoảng tin cậy phù hợp cho sự chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 3.D]

    • UNC-4.Y.1 Ước lượng điểm cho sự chênh lệch giữa hai trung bình tổng thể là sự chênh lệch giữa hai trung bình mẫu, $\overline{x}_1 - \overline{x}_2$.
    • UNC-4.Y.2 Đối với hiệu của hai trung bình tổng thể khi độ lệch chuẩn tổng thể chưa biết, khoảng tin cậy là $(\overline{x}_1 - \overline{x}_2) \pm t^* \sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}$ trong đó $\pm t^*$ là các giá trị tới hạn cho phần C% ở trung tâm của phân phối $t$ với bậc tự do thích hợp có thể tìm thấy bằng công cụ kỹ thuật số.

    Tuyên bố biên: Các công thức cho ước lượng khoảng không xuất hiện rõ ràng trên Bảng Công thức AP Thống kê được cung cấp kèm theo kỳ thi AP Thống kê. Tuy nhiên, các công thức này không cần phải thuộc lòng, vì chúng có thể được xây dựng dựa trên công thức thống kê kiểm định chung và các công thức sai số chuẩn liên quan được cung cấp trên bảng công thức.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với các mẫu độc lập, ước tính $\mu_1-\mu_2$:

    $$(\bar{x}_1-\bar{x}_2)\pm t^{*}\sqrt{\frac{s_1^2}{n_1}+\frac{s_2^2}{n_2}}.$$
    Các điều kiện phải thỏa mãn trong cả hai mẫu. (Sử dụng công nghệ để tính $df$; không gộp phương sai trong kỳ thi AP.)

    Ngẫu nhiên hóa là nền tảng cho so sánh công bằng giữa hai nhóm trong kiểm tra hiệu trung bình
    Ngẫu nhiên hóa là nền tảng cho so sánh công bằng giữa hai nhóm trong kiểm tra hiệu trung bình
    7.7

    Chứng minh một tuyên bố về Hai Mean

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu học tập UNC-4.Z: Giải thích khoảng tin cậy cho sự chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 4.B]

    • UNC-4.Z.1 Trong các lần lấy mẫu ngẫu nhiên lặp lại với cùng kích thước mẫu, khoảng C% các khoảng tin cậy được tạo ra sẽ bao gồm sự chênh lệch giữa hai trung bình tổng thể.
    • UNC-4.Z.2 Một lời giải thích cho khoảng tin cậy cho sự chênh lệch giữa hai trung bình tổng thể cần tham chiếu đến các mẫu đã lấy và cung cấp chi tiết về các tổng thể mà chúng đại diện.
      • Ví dụ minh họa cho UNC-4.Z.2: Khi diễn giải khoảng tin cậy cho hiệu giữa thời gian phản ứng trung bình của hai trạm cứu hỏa (phía bắc - phía nam): "Dựa trên các mẫu này, ta có thể tự tin 95 phần trăm rằng hiệu của thời gian phản ứng trung bình tổng thể (bắc - nam) nằm trong khoảng từ -2.37 phút đến 0.37 phút" (2009 FRQ 4).

    Mục tiêu học tập UNC-4.AA: Chứng minh một tuyên bố dựa trên khoảng tin cậy cho sự chênh lệch giữa hai trung bình tổng thể. [Kỹ năng 4.D]

    • UNC-4.AA.1 Khoảng tin cậy cho sự chênh lệch giữa hai trung bình tổng thể cung cấp một khoảng giá trị có thể cung cấp bằng chứng đủ để hỗ trợ một tuyên bố cụ thể trong ngữ cảnh.
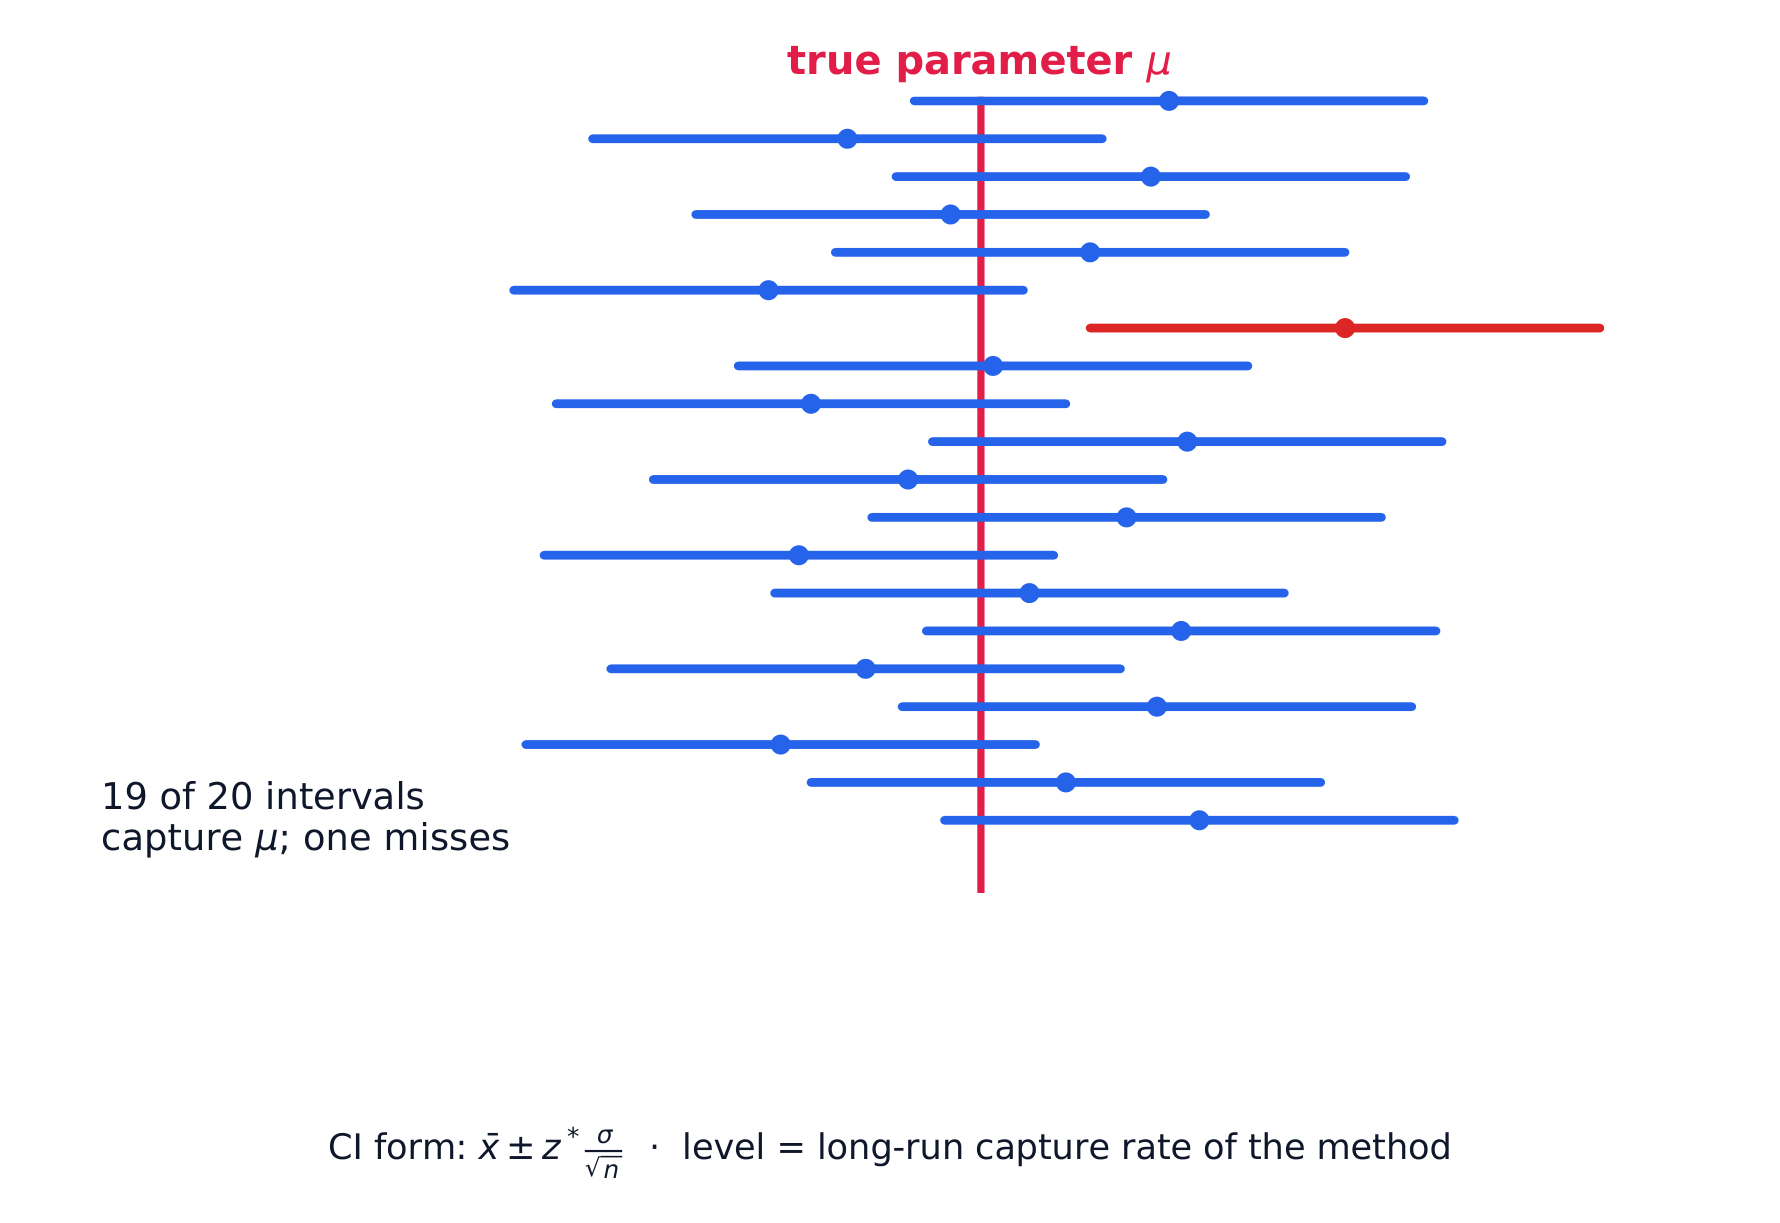
    Mục tiêu học tập UNC-4.AB: Xác định tác động của kích thước mẫu lên độ rộng của khoảng tin cậy cho sự chênh lệch giữa hai trung bình. [Kỹ năng 4.A]

    • UNC-4.AB.1 Khi giữ nguyên mọi yếu tố khác không đổi, độ rộng của khoảng tin cậy cho sự chênh lệch giữa hai trung bình có xu hướng giảm khi kích thước mẫu tăng lên.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Nếu khoảng tin cậy cho $\mu_1-\mu_2$ chứa $0$, dữ liệu phù hợp với giả thuyết mean bằng nhau; nếu nó loại trừ $0$, có bằng chứng về sự khác biệt theo hướng đó. Diễn giải trong ngữ cảnh.

    7.8

    Thiết lập Kiểm định cho Hiệu của Hai Mean

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-7
    The $t$-distribution may be used to model variation.

    VAR-7.F
    Identify an appropriate selection of a testing method for a difference of two population means. [Skill 1.E]

    • VAR-7.F.1 For a quantitative variable, the appropriate test for a difference of two population means is a two-sample $t$-test for a difference of two population means.

    VAR-7.G
    Identify the null and alternative hypotheses for a difference of two population means. [Skill 1.F]

    • VAR-7.G.1 The null hypothesis for a two-sample $t$-test for a difference of two population means, $\mu_1$ and $\mu_2$, is: $H_0 : \mu_1 - \mu_2 = 0$, or $H_0 : \mu_1 = \mu_2$. The alternative hypothesis is $H_a : \mu_1 - \mu_2 < 0$, or $H_a : \mu_1 - \mu_2 > 0$, or $H_a : \mu_1 - \mu_2 \neq 0$, or $H_a : \mu_1 > \mu_2$, or $H_a : \mu_1 < \mu_2$, or $H_a : \mu_1 \neq \mu_2$.

    VAR-7.H
    Verify the conditions for the significance test for the difference of two population means. [Skill 4.C]

    • VAR-7.H.1 In order to make statistical inferences when testing a difference between population means, we must check for independence and that the sampling distribution is approximately normal:
      • a. Individual observations should be independent:
        • i. Data should be collected using simple random samples or a randomized experiment.
        • ii. When sampling without replacement, check that $n_1 \leq 10\%N_1$ and $n_2 \leq 10\%N_2$.
      • b. The sampling distribution of $\overline{x}_1 - \overline{x}_2$ should be approximately normal (shape).
        • i. If the observed distribution is skewed, both $n_1$ and $n_2$ should be greater than 30.
        • ii. If the sample size is less than 30, the distribution of the sample data should be free from strong skewness and outliers. This should be checked for BOTH samples.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Giả thuyết: $H_0:\mu_1=\mu_2$ so với $H_a:\mu_1\neq\mu_2$ (hoặc $<,>$). Phân biệt hai mẫu độc lập với dữ liệu ghép cặp – đối với dữ liệu ghép cặp (trước/sau, chủ thể được ghép đôi), trước hết hãy tính hiệu số giữa các cặp, sau đó áp dụng quy trình một mẫu $t$ lên các hiệu số này.

    7.9

    Thực hiện Kiểm định cho Hiệu của Hai Mean

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-7
    The $t$-distribution may be used to model variation.

    VAR-7.I
    Calculate an appropriate test statistic for a difference of two means. [Skill 3.E]

    • VAR-7.I.1 For a single quantitative variable, data collected using independent random samples or a randomized experiment from two populations, each of which can be modeled with a normal distribution, the sampling distribution of $t = \dfrac{(\overline{x}_1 - \overline{x}_2) - (\mu_1 - \mu_2)}{\sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}}$ is an approximate $t$-distribution with degrees of freedom that can be found using technology. The degrees of freedom fall between the smaller of $n_1 - 1$ and $n_2 - 1$ and $n_1 + n_2 - 2$.
      • Illustrative examples for VAR-7.I.1: In a study comparing mean recovery times for two surgical procedures to repair a torn anterior cruciate ligament (ACL), the group receiving one procedure had a sample size of 110, while the group receiving the other procedure had a sample size of 100. The degrees of freedom fall between 100 (the smaller of 110 and 100) and 208 (110 + 100 - 2). The degrees of freedom may be determined using technology. If the test statistic for this study is $t \approx 7.13$, then the $p$-value is the area greater than 7.13 for a $t$-distribution with $df = 207.18$ (2018 FRQ 4).

    Boundary statement: The formulas for test statistics do not appear explicitly on the AP Statistics Formula Sheet provided with the AP Statistics Exam. However, these formulas do not need to be memorized, as they can be constructed based on the general test statistic formula and the standard error formulas for each of the relevant test statistics that are provided on the formula sheet.

    DAT-3
    Significance testing allows us to make decisions about hypotheses within a particular context.

    DAT-3.G
    Interpret the $p$-value of a significance test for a difference of population means. [Skill 4.B]

    • DAT-3.G.1 An interpretation of the $p$-value of a significance test for a two-sample difference of population means should recognize that the $p$-value is computed by assuming that the null hypothesis is true, i.e., by assuming that the true population means are equal to each other.

    DAT-3.H
    Justify a claim about the population based on the results of a significance test for a difference of two population means in context. [Skill 4.E]

    • DAT-3.H.1 A formal decision explicitly compares the $p$-value to the significance $\alpha$. If the $p$-value $\leq \alpha$, then reject the null hypothesis, $H_0 : \mu_1 - \mu_2 = 0$, or $H_0 : \mu_1 = \mu_2$. If the $p$-value $> \alpha$, then fail to reject the null hypothesis.
    • DAT-3.H.2 The results of a significance test for a two-sample test for a difference between two population means can serve as the statistical reasoning to support the answer to a research question about the populations that were sampled.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Thống kê hai mẫu $t$:

    $$t=\frac{(\bar{x}_1-\bar{x}_2)-0}{\sqrt{\frac{s_1^2}{n_1}+\frac{s_2^2}{n_2}}}.$$
    Lấy giá trị $p$ (công nghệ cho $df$), so sánh với $\alpha$, đưa ra kết luận trong ngữ cảnh.
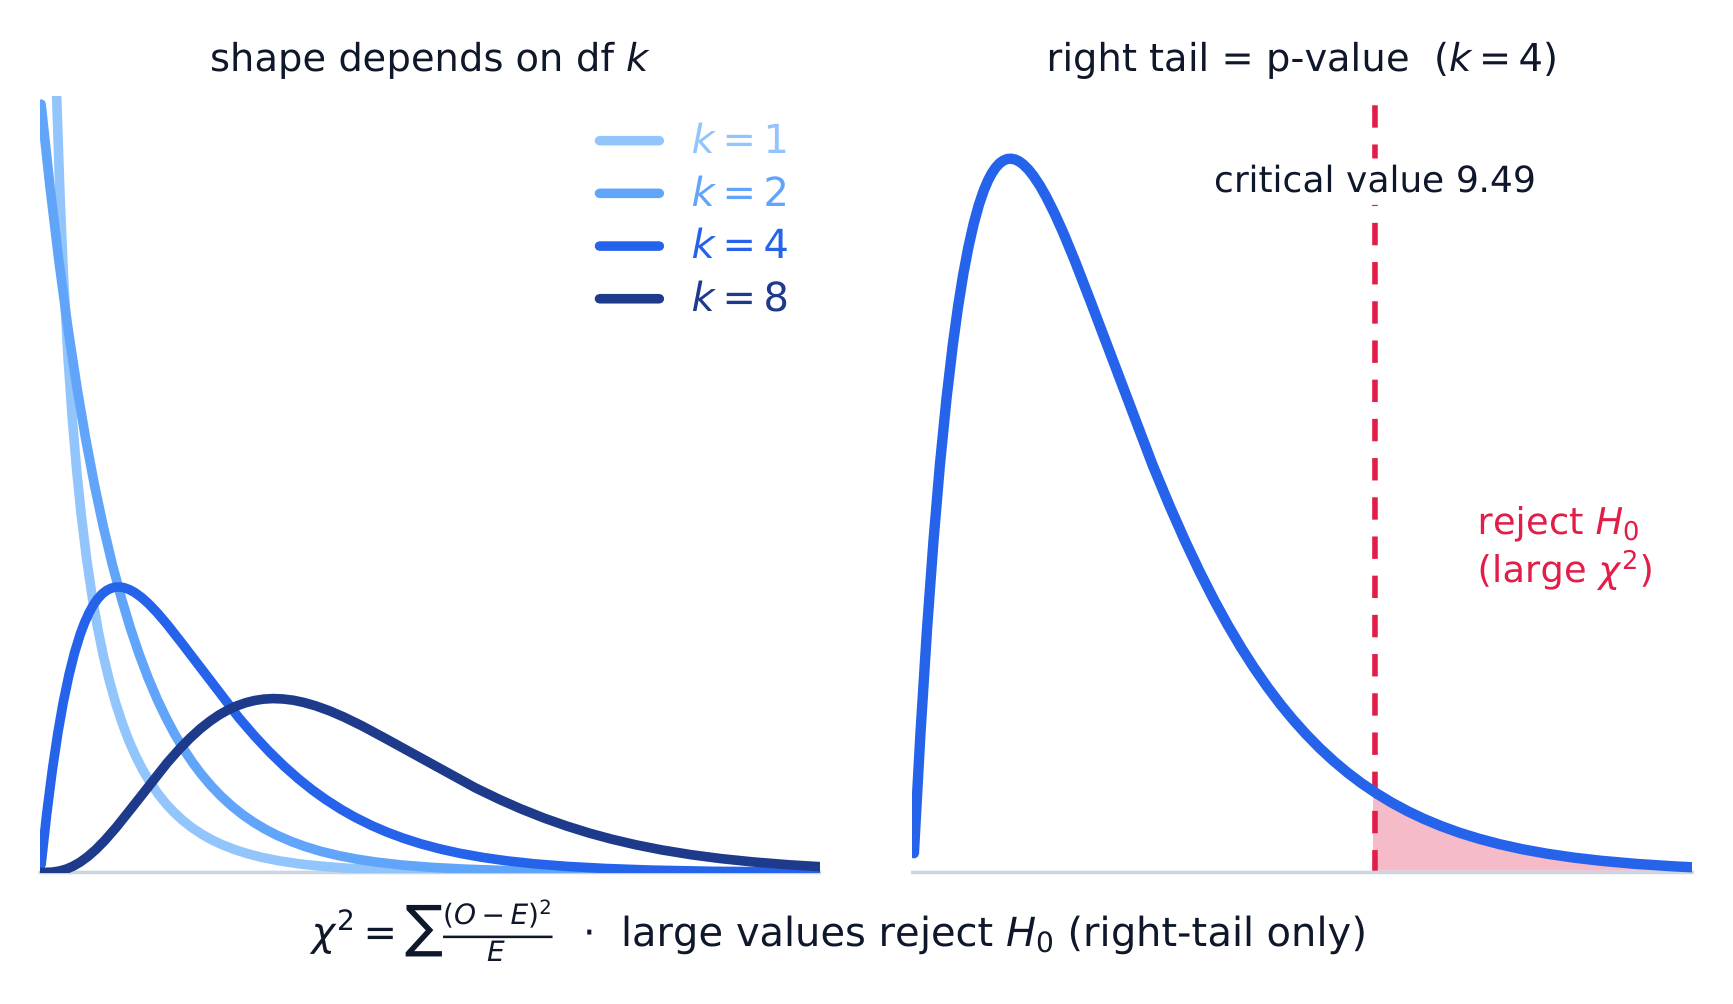
    7.10

    Chọn và Truyền đạt Quy trình

    Chương trình

    Chủ đề này nhằm tập trung vào kỹ năng lựa chọn quy trình suy luận phù hợp, khi sinh viên đã có sẵn một loạt các tùy chọn. Sinh viên nên được tạo cơ hội thực hành về thời điểm và cách thức áp dụng tất cả các mục tiêu học tập liên quan đến suy luận involving tỷ lệ hoặc trung bình.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Kỹ năng thi khó nhất là chọn đúng quy trình: một hay hai mẫu? tỷ lệ hay mean? cặp hay độc lập? khoảng tin cậy hay kiểm định? Đọc kỹ đề bài để xem cái gì đang được ước lượng hoặc tuyên bố, sau đó nêu tên quy trình, kiểm tra điều kiện, thực hiện và truyền đạt kết luận rõ ràng với con số và ngữ cảnh.
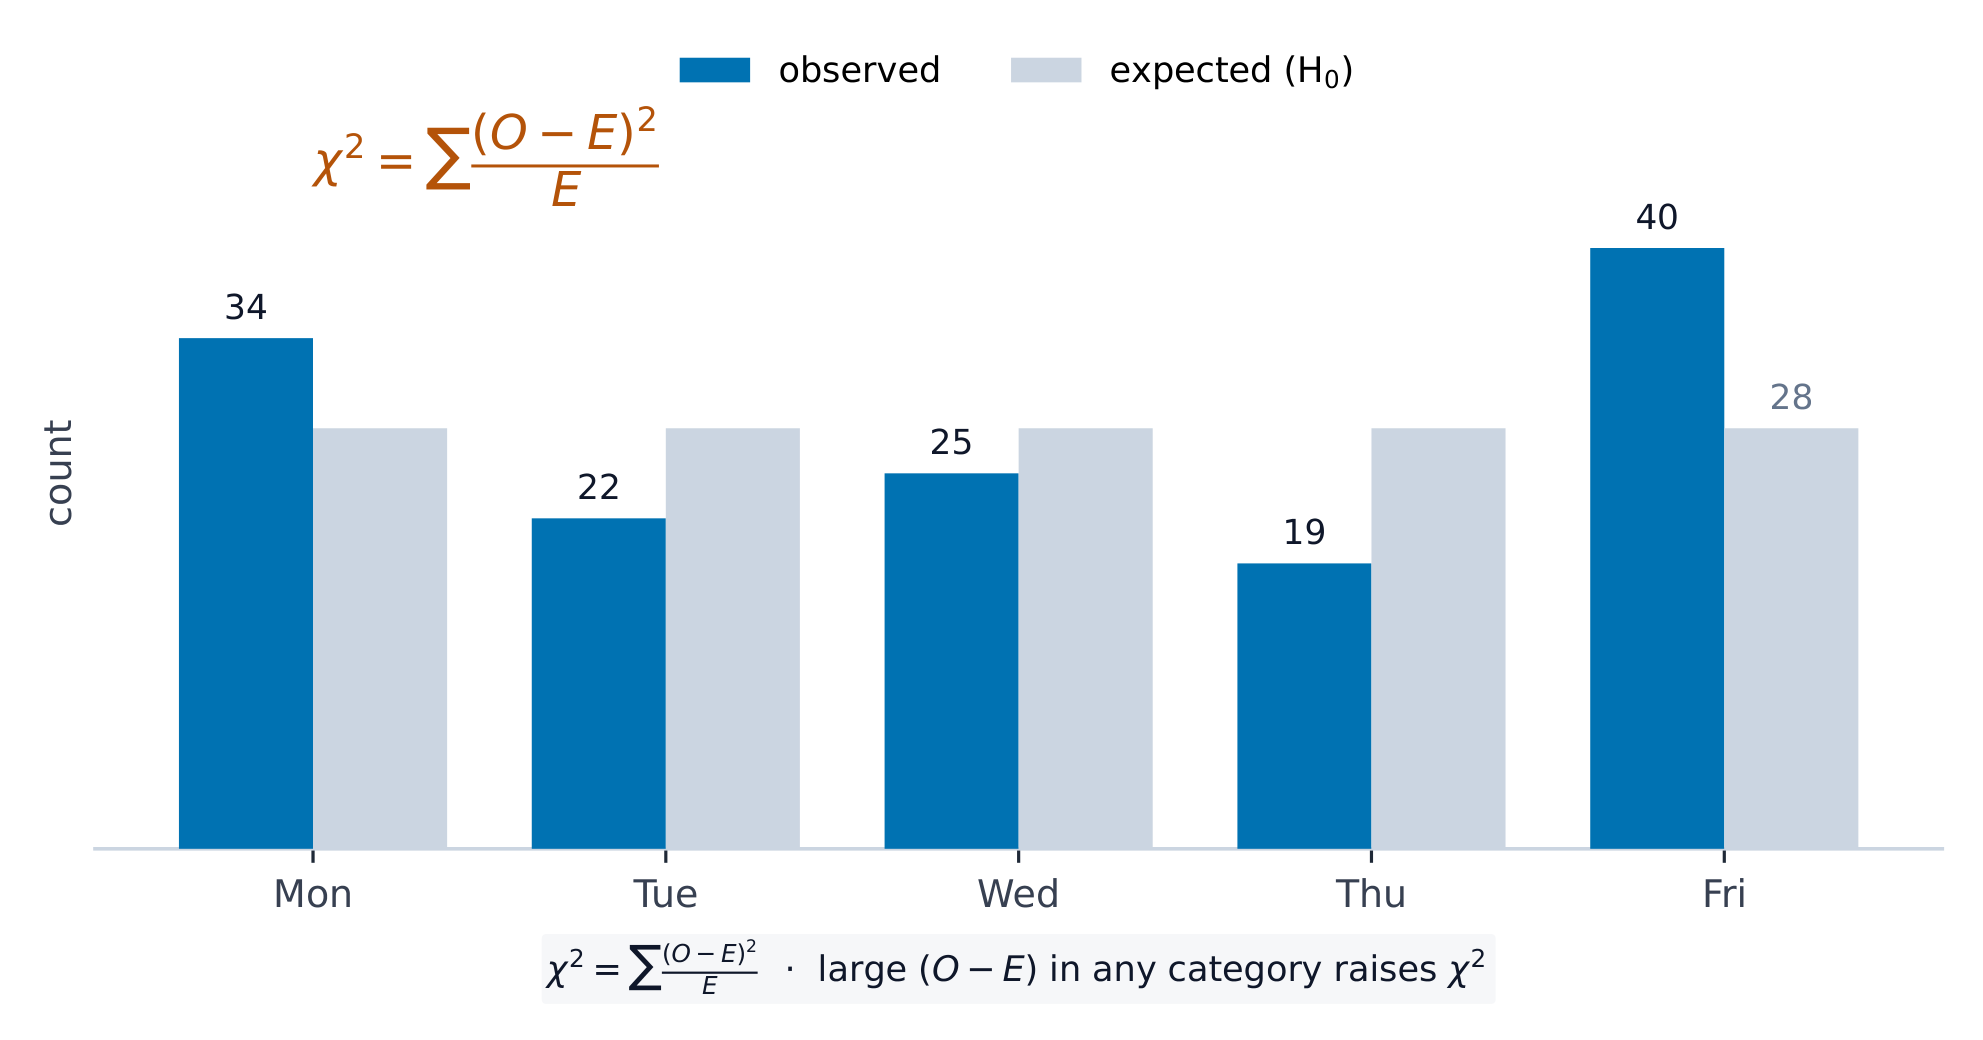
    7.10

    Mẹo làm bài thi

    • Sử dụng quy trình t cho mean (population $\sigma$ chưa biết) – phân phối t có đuôi dày hơn phân phối chuẩn.
    • Kiểm tra điều kiện: ngẫu nhiên, độc lập, và xấp xỉ chuẩn (hoặc sample size lớn $n$).
    • Diễn giải khoảng tin cậy và kiểm định trong ngữ cảnh, luôn gắn liền với tham số (mean thực tế).
    • Match đúng quy trình: một mẫu, hai mẫu, hoặc cặp (tìm kiếm sự ghép đôi tự nhiên).
    • Nêu bậc tự do; đối với kiểm định $t$ hai mẫu, sử dụng giá trị từ công nghệ (hoặc, bằng tay, giá trị $n-1$ bảo thủ nhỏ hơn).
  • 8

    Suy luận cho Dữ liệu Phân loại: Chi-Square

    Xem bài học
    8.1

    Kết quả của Tôi có Bất ngờ không?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.J: Identify questions suggested by variation between observed and expected counts in categorical data. [Skill 1.A]

    • VAR-1.J.1 Sự biến thiên giữa những gì chúng ta tìm thấy và những gì chúng ta mong đợi có thể mang tính ngẫu nhiên hoặc không.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Khi dữ liệu là đếm trải rộng qua nhiều danh mục, chúng ta kiểm tra xem các số đếm quan sát có khác với những gì một tuyên bố dự đoán hay không. Công cụ là thống kê chi-square ($\chi^2$), tổng các khoảng cách chuẩn hóa giữa số đếm quan sát và kỳ vọng:

    $$\chi^2=\sum \frac{(\text{observed}-\text{expected})^2}{\text{expected}}.$$
    Một giá trị $\chi^2$ lớn có nghĩa là số đếm quan sát nằm xa so với kỳ vọng – bằng chứng chống lại tuyên bố. Phân phối chi-square lệch phải và phụ thuộc vào bậc tự do của nó.

    Từ vựng Luyện tập
    English Tiếng Việt
    chi-square/kaɪ skweə/ chi-squared
    degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ bậc tự do
    8.2

    Thiết lập Kiểm định Goodness-of-Fit

    Chương trình

    Hiểu biết bền vững (VAR-8): Phân phối chi-square có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-8.A: Describe chi-square distributions. [Skill 3.C]

    • VAR-8.A.1 Số lượng kỳ vọng của dữ liệu phân loại là số lượng phù hợp với giả thuyết không. Nói chung, số lượng kỳ vọng là kích thước mẫu nhân với xác suất.

      Thống kê chi-square đo khoảng cách giữa số lượng quan sát và số lượng kỳ vọng tương đối với số lượng kỳ vọng.

      Các phân phối chi-square có giá trị dương và bị lệch về bên phải. Trong cùng một họ đường cong mật độ, độ lệch trở nên ít rõ rệt hơn khi bậc tự do tăng lên.

    Mục tiêu học tập VAR-8.B: Identify the null and alternative hypotheses in a test for a distribution of proportions in a set of categorical data. [Skill 1.F]

    • VAR-8.B.1 Đối với bài kiểm tra độ phù hợp chi-square, giả thuyết không chỉ định các tỷ lệ không cho mỗi danh mục, và giả thuyết thay thế là ít nhất một trong những tỷ lệ này không như đã chỉ định trong giả thuyết không.

    Mục tiêu học tập VAR-8.C: Identify an appropriate testing method for a distribution of proportions in a set of categorical data. [Skill 1.E]

    • VAR-8.C.1 Khi xem xét phân phối tỷ lệ cho một biến phân loại, bài kiểm tra thích hợp là bài kiểm tra chi-square cho độ phù hợp.

    Mục tiêu học tập VAR-8.D: Calculate expected counts for the chi-square test for goodness of fit. [Skill 3.A]

    • VAR-8.D.1 Số lượng kỳ vọng cho bài kiểm tra độ phù hợp chi-square là (kích thước mẫu)(tỷ lệ không).

    Mục tiêu học tập VAR-8.E: Verify the conditions for making statistical inferences when testing goodness of fit for a chi-square distribution. [Skill 4.C]

    • VAR-8.E.1 Để đưa ra suy luận thống kê cho bài kiểm tra độ phù hợp chi-square, chúng ta phải kiểm tra các điều kiện sau:
      • a. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng mẫu ngẫu nhiên hoặc thí nghiệm gán ngẫu nhiên.
        • ii. Khi lấy mẫu không thay thế, hãy kiểm tra rằng $n \leq 10\%N$.
      • b. Bài kiểm tra độ phù hợp chi-square trở nên chính xác hơn với nhiều quan sát, vì vậy nên sử dụng các số lượng lớn (hình dạng).
        • i. Một phép kiểm tra thận trọng cho các số lượng lớn là tất cả các số lượng kỳ vọng đều lớn hơn 5.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Kiểm định chi-square (χ²)

    Một goodness-of-fit (GOF) test kiểm tra xem một biến danh mục có tuân theo phân phối được tuyên bố (ví dụ: "con xúc xắc công bằng") hay không. Giả thuyết:

    $$H_0:\text{the distribution is as claimed}\qquad H_a:\text{at least one proportion differs}.$$
    Số đếm kỳ vọng cho mỗi danh mục $=n\times(\text{claimed proportion})$. Điều kiện: mẫu ngẫu nhiên, tất cả số đếm kỳ vọng $\ge 5$, và điều kiện 10%.

    Phân phối chi-bình phương và vùng bác bỏ đuôi bên phải của nó
    Phân phối chi-square lệch phải. Một thống kê lớn rơi vào phần đuôi phải được tô bóng vượt quá giá trị tới hạn – đó là nơi bạn bác bỏ mô hình.
    Từ vựng Luyện tập
    English Tiếng Việt
    goodness-of-fit (GOF)/ˈɡʊdnəs ɒv fɪt/ kiểm tra độ phù hợp (GOF)
    8.3

    Thực hiện Goodness-of-Fit Test

    Chương trình

    Hiểu biết bền vững (VAR-8): Phân phối chi-square có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-8.F: Calculate the appropriate statistic for the chi-square test for goodness of fit. [Skill 3.E]

    • VAR-8.F.1 Thống kê kiểm tra cho bài kiểm tra độ phù hợp chi-square là
      • Phương trình: $\chi^2 = \sum \dfrac{(Observed\ count - Expected\ count)^2}{Expected\ count}$, với $degrees\ of\ freedom = number\ of\ categories - 1$.
    • VAR-8.F.2 Phân phối của thống kê kiểm tra khi giả thuyết không là đúng (phân phối không) có thể là phân phối gán ngẫu nhiên hoặc, khi một mô hình xác suất được coi là đúng, là phân phối lý thuyết (chi-square).

    Mục tiêu học tập VAR-8.G: Determine the $p$-value for chi-square test for goodness of fit significance test. [Skill 3.E]

    • VAR-8.G.1 Giá trị $p$ cho bài kiểm tra độ phù hợp chi-square với một số bậc tự do được tìm thấy bằng bảng phù hợp hoặc kết quả tạo bởi máy tính.

    Hiểu biết bền vững (DAT-3): Kiểm định ý nghĩa giúp chúng ta đưa ra quyết định về các giả thuyết trong một ngữ cảnh cụ thể.

    Mục tiêu học tập DAT-3.I: Diễn giải giá trị $p$ cho kiểm tra chi-squared cho độ phù hợp. [Kỹ năng 4.B]

    • DAT-3.I.1 Một cách diễn giải giá trị $p$ cho bài kiểm tra độ phù hợp chi-square là xác suất, với giả thuyết không và mô hình xác suất là đúng, của việc thu được thống kê kiểm tra giống hoặc cực đoan hơn giá trị quan sát.

    Mục tiêu học tập DAT-3.J: Justify a claim about the population based on the results of a chi-square test for goodness of fit. [Skill 4.E]

    • DAT-3.J.1 Việc quyết định bác bỏ hay không bác bỏ giả thuyết không dựa trên sự so sánh giữa giá trị $p$ và mức ý nghĩa, $\alpha$.
    • DAT-3.J.2 Kết quả của một bài kiểm tra độ phù hợp chi-square có thể làm cơ sở lập luận thống kê để hỗ trợ câu trả lời cho một câu hỏi nghiên cứu về tổng thể đã được lấy mẫu.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Tính $\chi^2=\sum\dfrac{(O-E)^2}{E}$ theo công thức $df=(\text{number of categories})-1$. Tìm giá trị $p$ từ phân phối chi-bình phương (đuôi trên), so sánh với mức ý nghĩa $\alpha$, và đưa ra kết luận trong bối cảnh cụ thể. Một thành phần lớn trong tổng sum chỉ ra nhóm có sự lệch lạc nhiều nhất so với kỳ vọng.

    Chi-bình phương so sánh tần suất quan sát với những tần suất dự kiến dưới giả thuyết không
    Chi-square so sánh số đếm quan sát với số đếm kỳ vọng dưới giả thuyết không

    Ví dụ tính toán. Một con xúc xắc lăn $60$ lần cho các số đếm $8,10,12,9,11,10$. Nếu nó công bằng, mỗi số đếm kỳ vọng là $60/6=10$, vì vậy

    $$\chi^2=\frac{(8-10)^2}{10}+\frac{(10-10)^2}{10}+\frac{(12-10)^2}{10}+\frac{(9-10)^2}{10}+\frac{(11-10)^2}{10}+\frac{(10-10)^2}{10}=0.4+0+0.4+0.1+0.1+0=1.0,$$
    với $df=6-1=5$. Viết ra mọi danh mục, bao gồm cả hai danh mục khớp chính xác với số đếm kỳ vọng của chúng và do đó cộng thêm $0$ – tổng chạy qua tất cả sáu danh mục, và $df$ đếm các danh mục, không chỉ những cái khác biệt. Giá trị $\chi^2$ này nhỏ (giá trị $p$ lớn), vì vậy chúng ta không bác bỏ $H_0$ – không có bằng chứng cho thấy xúc xắc không công bằng.

    Khám phá

    Khám phá phân phối chi-bình phương và giá trị p của nó

    Giá trị p là diện tích ở đuôi phải vượt qua thống kê kiểm định của bạn, do đó một $\chi^2$ lớn hơn có nghĩa là giá trị p nhỏ hơn. Kéo $\chi^2$ để xem diện tích này co lại, và kéo df để thấy toàn bộ họ thay đổi hình dạng — lệch phải mạnh khi df nhỏ, đối xứng hơn khi df tăng.

    8.4

    Số đếm Kỳ vọng trong Bảng Hai chiều

    Chương trình

    Hiểu biết bền vững (VAR-8): Phân phối chi-square có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-8.H: Calculate expected counts for two-way tables of categorical data. [Skill 3.A]

    • VAR-8.H.1 Số lượng kỳ vọng trong một ô cụ thể của bảng hai chiều dữ liệu phân loại có thể được tính bằng công thức:
      • Phương trình: $expected\ count = \dfrac{(row\ total)(column\ total)}{table\ total}$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Đối với bảng hai chiều, số đếm kỳ vọng trong một ô (dưới "không có liên kết") là

    $$E=\frac{(\text{row total})\times(\text{column total})}{\text{grand total}}.$$
    Đây là số đếm bạn sẽ thấy nếu biến hàng và cột không liên quan đến nhau.

    Ví dụ tính toán. Trong một bảng hai chiều, tổng hàng của một ô là $40$, tổng cột của nó là $50$, và tổng đại số là $200$. Số đếm kỳ vọng của nó là $E=\dfrac{40\times50}{200}=10$. Lặp lại cho từng ô sẽ cho bảng kỳ vọng để so sánh với bảng quan sát.

    Một bảng tính tổ chức tần suất phân loại trước khi kiểm tra chi-bình phương
    Bảng tính tổ chức số liệu phân loại trước khi kiểm định chi-squared
    8.5

    Homogeneity or Independence?

    Chương trình

    Hiểu biết bền vững (VAR-8): Phân phối chi-square có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-8.I: Xác định giả thuyết không và giả thuyết thay thế cho kiểm định chi-squared về tính đồng nhất hoặc độc lập. [Kỹ năng 1.F]

    • VAR-8.I.1 Các giả thuyết phù hợp cho kiểm định chi-squared về tính đồng nhất là:

      $H_0$: Không có sự khác biệt trong phân phối của một biến phân loại giữa các quần thể hoặc điều trị.

      $H_a$: Có sự khác biệt trong phân phối của một biến phân loại giữa các quần thể hoặc điều trị.

    • VAR-8.I.2 Các giả thuyết phù hợp cho kiểm định chi-squared về tính độc lập là:

      $H_0$: Không có mối liên hệ nào giữa hai biến phân loại trong một quần thể xác định, hoặc hai biến phân loại là độc lập với nhau.

      $H_a$: Hai biến phân loại trong một quần thể có mối liên hệ hoặc phụ thuộc vào nhau.

    Mục tiêu học tập VAR-8.J: Xác định phương pháp kiểm tra phù hợp để so sánh phân phối trong bảng số liệu chéo của dữ liệu phân loại. [Kỹ năng 1.E]

    • VAR-8.J.1 Khi so sánh phân phối để xác định xem tỷ lệ trong từng danh mục đối với dữ liệu phân loại thu thập từ các quần thể khác nhau có giống nhau hay không, phép kiểm tra phù hợp là kiểm định chi-squared về tính đồng nhất.
    • VAR-8.J.2 Để xác định xem các biến hàng và cột trong bảng số liệu chéo của dữ liệu phân loại có thể có mối liên hệ trong quần thể được lấy mẫu hay không, phép kiểm tra phù hợp là kiểm định chi-squared về tính độc lập.

    Mục tiêu học tập VAR-8.K: Kiểm chứng các điều kiện để đưa ra suy luận thống kê khi kiểm định phân phối chi-squared về tính độc lập hoặc tính đồng nhất. [Kỹ năng 4.C]

    • VAR-8.K.1 Để thực hiện suy luận thống kê cho kiểm định chi-squared đối với bảng số liệu chéo (tính đồng nhất hoặc tính độc lập), chúng ta phải kiểm chứng những điều sau:
      • a. Để kiểm tra tính độc lập:
        • i. Đối với kiểm định độc lập: Dữ liệu nên được thu thập bằng cách sử dụng mẫu ngẫu nhiên đơn giản.
        • ii. Đối với kiểm định đồng nhất: Dữ liệu nên được thu thập bằng cách sử dụng mẫu phân tầng ngẫu nhiên hoặc thí nghiệm gán ngẫu nhiên.
        • iii. Khi lấy mẫu không hoàn lại, hãy kiểm tra rằng $n \leq 10\%N$.
      • b. Các kiểm định chi-squared về tính độc lập và tính đồng nhất trở nên chính xác hơn khi có nhiều quan sát hơn, do đó cần sử dụng các giá trị đếm lớn (hình dạng).
        • i. Một phép kiểm tra thận trọng cho các số lượng lớn là tất cả các số lượng kỳ vọng đều lớn hơn 5.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Hai kiểm định sử dụng cùng $\chi^2$ toán học nhưng trả lời các câu hỏi khác nhau:

    • Test for homogeneity: các phân phối của một biến danh mục có giống nhau across several populations or groups (separate samples/treatments)?
    • Test for independence: hai biến danh mục có liên quan within a single population (one sample, two variables measured)?

    Thiết kế (nhiều mẫu vs một mẫu) quyết định việc sử dụng tên và giả thuyết nào.

    Từ vựng Luyện tập
    English Tiếng Việt
    Test for homogeneity/test fɔː ˈhɒməʊdʒneɪti/ Kiểm tra tính đồng nhất
    Test for independence/test fɔː ˌɪndɪˈpendəns/ Kiểm tra tính độc lập
    8.6

    Thực hiện Test for Homogeneity or Independence

    Chương trình
    Enduring UnderstandingLearning ObjectiveEssential Knowledge

    VAR-8
    The chi-square distribution may be used to model variation.

    VAR-8.L
    Calculate the appropriate statistic for a chi-square test for homogeneity or independence. [Skill 3.E]

    • VAR-8.L.1 The appropriate test statistic for a chi-square test for homogeneity or independence is the chi-square statistic:
      • Equation: $\chi^2 = \sum \dfrac{(Observed\ count - Expected\ count)^2}{Expected\ count}$, with degrees of freedom equal to: $(number\ of\ rows - 1)(number\ of\ columns - 1)$.

    VAR-8.M
    Determine the $p$-value for a chi-square significance test for independence or homogeneity. [Skill 3.E]

    • VAR-8.M.1 The $p$-value for a chi-square test for independence or homogeneity for a number of degrees of freedom is found using the appropriate table or technology.
    • VAR-8.M.2 For a test of independence or homogeneity for a two-way table, the $p$-value is the proportion of values in a chi-square distribution with appropriate degrees of freedom that are equal to or larger than the test statistic.

    DAT-3
    Significance testing allows us to make decisions about hypotheses within a particular context.

    DAT-3.K
    Interpret the $p$-value for the chi-square test for homogeneity or independence. [Skill 4.B]

    • DAT-3.K.1 An interpretation of the $p$-value for the chi-square test for homogeneity or independence is the probability, given the null hypothesis and probability model are true, of obtaining a test statistic as, or more, extreme than the observed value.

    DAT-3.L
    Justify a claim about the population based on the results of a chi-square test for homogeneity or independence. [Skill 4.E]

    • DAT-3.L.1 A decision to either reject or fail to reject the null hypothesis for a chi-square test for homogeneity or independence is based on comparison of the $p$-value to the significance level, $\alpha$.
    • DAT-3.L.2 The results of a chi-square test for homogeneity or independence can serve as the statistical reasoning to support the answer to a research question about the population that was sampled (independence) or the populations that were sampled (homogeneity).

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Tính số đếm kỳ vọng, sau đó $\chi^2=\sum\dfrac{(O-E)^2}{E}$ qua tất cả các ô, với

    $$df=(\text{rows}-1)(\text{columns}-1).$$
    Điều kiện: dữ liệu ngẫu nhiên, tất cả số đếm kỳ vọng $\ge 5$, điều kiện 10%. Tìm giá trị $p$, so sánh với $\alpha$, và kết luận trong ngữ cảnh – bằng chứng về sự khác biệt giữa các nhóm (homogeneity) hoặc về mối liên hệ (independence).

    8.7

    Chọn Quy trình Danh mục Đúng

    Chương trình

    Chủ đề này nhằm tập trung vào kỹ năng chọn quy trình suy luận phù hợp khi học sinh đã có sẵn một loạt các lựa chọn. Học sinh nên được tạo cơ hội thực hành khi nào và làm thế nào để áp dụng tất cả các mục tiêu học tập liên quan đến suy luận cho dữ liệu phân loại.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Quyết định dựa trên thiết lập: một biến phân loại so với phân phối được cho là $\Rightarrow$ tốt độ phù hợp; một mẫu được phân loại chéo bởi hai biến $\Rightarrow$ độc lập; nhiều mẫu/nhóm được so sánh $\Rightarrow$ tương đồng. So sánh đúng hai tỷ lệ có thể sử dụng cả kiểm tra hai tỷ lệ $z$ hay kiểm tra chi-squared, nhưng chỉ dành cho giả thuyết thay thế hai đuôi, nơi chúng khớp nhau chính xác ($\chi^2=z^2$). Kiểm tra chi-squared luôn là hai đuôi, nên không thể đưa ra kết luận có hướng: nếu $H_a$ là một đuôi (ví dụ $p_1>p_2$), hãy dùng kiểm tra $z$.

    Khám phá

    Đây là kiểm định chi-bình phương nào?

    Cả ba kiểm định đều sử dụng cùng $\chi^2$ tính toán, vì vậy điểm số thuộc về việc đặt tên đúng cái. Thiết kế quyết định — bao nhiêu mẫu đã được lấy, và bao nhiêu biến số đã được đo trên mỗi đơn vị.

    8.7

    Mẹo làm bài thi

    • Sử dụng $\chi^2=\sum\tfrac{(O-E)^2}{E}$ cho dữ liệu phân loại; luôn chia cho tần suất dự kiến.
    • Chọn đúng kiểm tra: tốt độ phù hợp (một biến), độc lập, hoặc tương đồng (bảng hai chiều).
    • Tính tần suất dự kiến là $\tfrac{\text{row total}\times\text{column total}}{\text{grand total}}$ và kiểm tra mỗi cái đều ≥ $\ge5$.
    • Một $\chi^2$ lớn (p-value nhỏ) có nghĩa là tần suất quan sát khác với tần suất dự kiến hơn mức ngẫu nhiên.
    • Nêu đúng bậc tự do (số hạng mục $-1$, hoặc $(r-1)(c-1)$).
  • 9

    Suy luận cho Dữ liệu Định lượng: Hệ số góc

    Xem bài học
    9.1

    Các Điểm Those Có Thẳng Hàng Không?

    Chương trình

    Hiểu biết bền vững (VAR-1): Vì sự biến thiên có thể ngẫu nhiên hoặc không, nên những kết luận đều mang tính bất định.

    Mục tiêu học tập VAR-1.K: Xác định các câu hỏi gợi ý từ sự biến thiên trong biểu đồ phân tán. [Kỹ năng 1.A]

    • VAR-1.K.1 Sự biến thiên trong vị trí của các điểm so với đường lý thuyết có thể là ngẫu nhiên hoặc không ngẫu nhiên.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một biểu đồ scatter mẫu cung cấp một độ dốc mẫu $b$ cho đường hồi quy bình phương tối thiểu – nhưng một mẫu khác sẽ cho độ dốc hơi khác. Vì vậy $b$ là một thống kê có biến động lấy mẫu, ước lượng độ dốc thực (quần thể) $\beta$. Đơn vị này tiến hành suy luận cho $\beta$: liệu có mối quan hệ tuyến tính thực sự không, và nó mạnh đến đâu?

    9.2

    Khoảng Tin Cậy Cho Độ Dốc

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu học tập UNC-4.AC: Xác định quy trình khoảng tin cậy phù hợp cho hệ số góc của mô hình hồi quy. [Kỹ năng 1.D]

    • UNC-4.AC.1 Xét một biến phản hồi, $y$, có quan hệ tuyến tính với một biến giải thích, $x$. Đối với một mẫu ngẫu nhiên đơn gồm $n$ quan sát, đường hồi quy mẫu, $\hat{y} = a + bx$, là ước lượng của đường hồi quy tổng thể, $\mu_y = \alpha + \beta x$. Đối với một quan sát cụ thể, $(x_i, y_i)$, phần dư từ đường hồi quy mẫu, $y_i - \hat{y}_i = y_i - (a + bx_i)$, là ước lượng của $y_i - (\alpha + \beta x_i)$, độ lệch của biến phản hồi so với đường hồi quy tổng thể. Đối với tất cả các điểm $(x, y)$ trong tổng thể, độ lệch chuẩn của tất cả các độ lệch của biến phản hồi so với đường hồi quy tổng thể, $\sigma$, có thể được ước lượng bởi độ lệch chuẩn của các phần dư từ đường hồi quy mẫu, $s = \sqrt{\dfrac{\sum\left(y_i - \hat{y}_i\right)^2}{n-2}}$. (Lưu ý: Công thức này sử dụng $n-2$ ở mẫu số thay vì $n-1$ vì hai tham số, $\alpha$ và $\beta$, phải được ước lượng để thu được các giá trị dự đoán từ đường hồi quy bình phương tối thiểu.)
    • UNC-4.AC.2 Đối với mẫu ngẫu nhiên đơn gồm $n$ quan sát, gọi $b$ là hệ số góc của đường hồi quy mẫu. Khi đó, trung bình của phân phối lấy mẫu cho $b$ bằng hệ số góc tổng thể: $\mu_b = \beta$. Độ lệch chuẩn của phân phối lấy mẫu cho $b$ là $\sigma_b = \dfrac{\sigma}{\sigma_x \sqrt{n}}$, trong đó $\sigma_x = \sqrt{\dfrac{\sum\left(x_i - \bar{x}\right)^2}{n}}$.
    • UNC-4.AC.3 Khoảng tin cậy phù hợp cho độ dốc của mô hình hồi quy là khoảng $t$ cho độ dốc.

    Mục tiêu học tập UNC-4.AD: Kiểm tra các điều kiện để tính khoảng tin cậy cho độ dốc của mô hình hồi quy. [Kỹ năng 4.C]

    • UNC-4.AD.1 Để tính khoảng tin cậy nhằm ước lượng độ dốc của đường hồi quy, chúng ta cần kiểm tra các điều sau:
      • a. Quan hệ thực tế giữa $x$ và $y$ là tuyến tính. Phân tích phần dư có thể được sử dụng để xác minh tính tuyến tính.
      • b. Độ lệch chuẩn của $y$, $\sigma_y$, không thay đổi theo $x$. Phân tích phần dư có thể được sử dụng để kiểm tra xem độ lệch chuẩn xấp xỉ bằng nhau cho tất cả các $x$ hay không.
      • c. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng mẫu ngẫu nhiên hoặc thí nghiệm được gán ngẫu nhiên.
        • ii. Khi lấy mẫu không thay thế, hãy kiểm tra rằng $n \le 10\% N$.
      • d. Đối với một giá trị cụ thể của $x$, các phản hồi (các giá trị $y$) phân phối xấp xỉ theo phân phối chuẩn. Phân tích các biểu diễn đồ thị của phần dư có thể được sử dụng để kiểm tra tính chuẩn.
        • i. Nếu phân phối quan sát bị lệch, $n$ nên lớn hơn 30.

    Mục tiêu học tập UNC-4.AE: Xác định biên độ sai số đã cho cho độ dốc của mô hình hồi quy. [Kỹ năng 3.D]

    • UNC-4.AE.1 Đối với độ dốc của đường hồi quy, biên độ sai số là giá trị tới hạn $\left(t^*\right)$ nhân với sai số chuẩn ($SE$) của độ dốc.
    • UNC-4.AE.2 Sai số chuẩn cho độ dốc của đường hồi quy với độ lệch chuẩn mẫu, $s$, là $SE = \dfrac{s}{s_x \sqrt{n-1}}$, trong đó $s$ là ước lượng của $\sigma$ và $s_x$ là độ lệch chuẩn mẫu của các giá trị $x$.

    Mục tiêu học tập UNC-4.AF: Tính toán khoảng tin cậy phù hợp cho độ dốc của mô hình hồi quy. [Kỹ năng 3.D]

    • UNC-4.AF.1 Ước lượng điểm cho độ dốc của mô hình hồi quy là độ dốc của đường拟合 tốt nhất (đường hồi quy), $b$.
    • UNC-4.AF.2 Đối với độ dốc của mô hình hồi quy, ước lượng khoảng là $b \pm t^* \left(SE_b\right)$.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Một khoảng tin cậy $t$ cho độ dốc thực $\beta$:

    $$b\pm t^{*}\,SE_b,\qquad df=n-2,$$
    trong đó $b$ là độ dốc mẫu và $SE_b$ là sai số chuẩn của nó (đọc từ đầu ra máy tính). Điều kiện (LINER): mối quan hệ thực là Tuyến tính, các quan sát Độc lập, phần dư Normal, và phần dư có Bằng độ rộng (kiểm tra biểu đồ phần dư và biểu đồ tần suất phần dư), từ dữ liệu Ngẫu nhiên. Diễn giải khoảng tin cậy cho $\beta$ trong ngữ cảnh, với đơn vị của $y$ trên đơn vị của $x$.

    Biểu đồ phần dư ngẫu nhiên, không có mô hình hỗ trợ các điều kiện; một đường cong hoặc hình quạt thì không
    Biểu đồ phần dư ngẫu nhiên, không có mô hình hỗ trợ các điều kiện; một đường cong hoặc hình quạt thì không

    Biểu đồ phần dư là nơi bạn kiểm tra Tuyến tính và Bằng spread: bạn muốn thấy một đám mây vô định dạng quanh giá trị 0. Một đường cong có nghĩa là mối quan hệ không tuyến tính; một hình quạt (spread tăng theo $x$) có nghĩa là phần dư không có equal spread – cả hai đều vi phạm điều kiện.

    Ví dụ đã giải. Đầu ra hồi quy cho độ dốc $b=2.5$ với $SE_b=0.8$ từ $n=20$ điểm. Đối với khoảng tin cậy $95\%$, $df=18$ cho $t^*=2.101$:

    $$2.5\pm2.101(0.8)=2.5\pm1.68=(0.82,\ 4.18).$$
    Vì $0$ không nằm trong khoảng tin cậy, có bằng chứng về mối quan hệ tuyến tính dương.

    Suy luận độ dốc dựa trên đường hồi quy bình phương tối thiểu qua các điểm
    Suy luận độ dốc dựa trên đường hồi quy bình phương tối thiểu qua các điểm
    Hồi quy bình phương tối thiểu: đường thẳng làm giảm tổng bình phương phần dư
    Hồi quy bình phương tối thiểu: đường thẳng làm giảm tổng bình phương phần dư
    Khám phá

    Suy luận cho độ dốc hồi quy

    Độ dốc mẫu thay đổi từ mẫu này sang mẫu khác; khoảng tin cậy và kiểm định t yêu cầu liệu độ dốc thực sự có thể bằng không (không có mối quan hệ tuyến tính) hay không.

    Từ vựng Luyện tập
    English Tiếng Việt
    scatterplot/ˈskætəplɒt/ biểu đồ tán xạ
    sample slope/ˈsæmpl sləʊp/ hệ số góc của mẫu
    regression/rɪˈɡreʃn/ hồi quy
    sampling variability/ˈsæmplɪŋ ˌveərɪəˈbɪlɪti/ biến thiên trong lấy mẫu
    true (population) slope/truː sləʊp/ hệ số góc thực tế (của tổng thể)
    inference/ˈɪnfərəns/ suy luận
    linear/ˈlɪnɪə/ tuyến tính
    residual plot/rɪˈsɪdʒuːəl plɒt/ biểu đồ dư thừa
    9.3

    Chứng Minh Một Tuyên Về关于 Độ Dốc

    Chương trình

    Hiểu biết bền vững (UNC-4): Một khoảng giá trị nên được sử dụng để ước lượng tham số, nhằm tính đến sự không chắc chắn.

    Mục tiêu học tập UNC-4.AG: Giải thích khoảng tin cậy cho độ dốc của mô hình hồi quy. [Kỹ năng 4.B]

    • UNC-4.AG.1 Trong các lần lấy mẫu ngẫu nhiên lặp lại với cùng kích thước mẫu, khoảng C% các khoảng tin cậy được tạo ra sẽ bao gồm độ dốc của mô hình hồi quy, tức là độ dốc thực tế của đường hồi quy tổng thể.
    • UNC-4.AG.2 Một cách giải thích cho khoảng tin cậy cho độ dốc của đường hồi quy nên bao gồm tham chiếu đến mẫu đã lấy và các chi tiết về tổng thể mà nó đại diện.

    Mục tiêu học tập UNC-4.AH: Chứng minh một tuyên bố dựa trên khoảng tin cậy cho độ dốc của mô hình hồi quy. [Kỹ năng 4.D]

    • UNC-4.AH.1 Một khoảng tin cậy cho độ dốc của mô hình hồi quy cung cấp một khoảng các giá trị có thể cung cấp bằng chứng đủ mạnh để hỗ trợ một tuyên bố cụ thể trong ngữ cảnh.
    Mục tiêu học tập UNC-4.AI: Xác định ảnh hưởng của kích thước mẫu lên độ rộng của khoảng tin cậy cho độ dốc của mô hình hồi quy. [Kỹ năng 4.A]

    • UNC-4.AI.1 Khi mọi thứ khác không đổi, độ rộng của khoảng tin cậy cho độ dốc của mô hình hồi quy có xu hướng giảm khi kích thước mẫu tăng lên.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Nếu khoảng tin cậy cho $\beta$ chứa $0$, độ dốc bằng 0 là khả dĩ – không có bằng chứng về mối quan hệ tuyến tính. Nếu khoảng tin cậy hoàn toàn dương hoặc âm, có bằng chứng về mối quan hệ tuyến tính thực (dương hoặc âm). Nêu hướng trong ngữ cảnh.
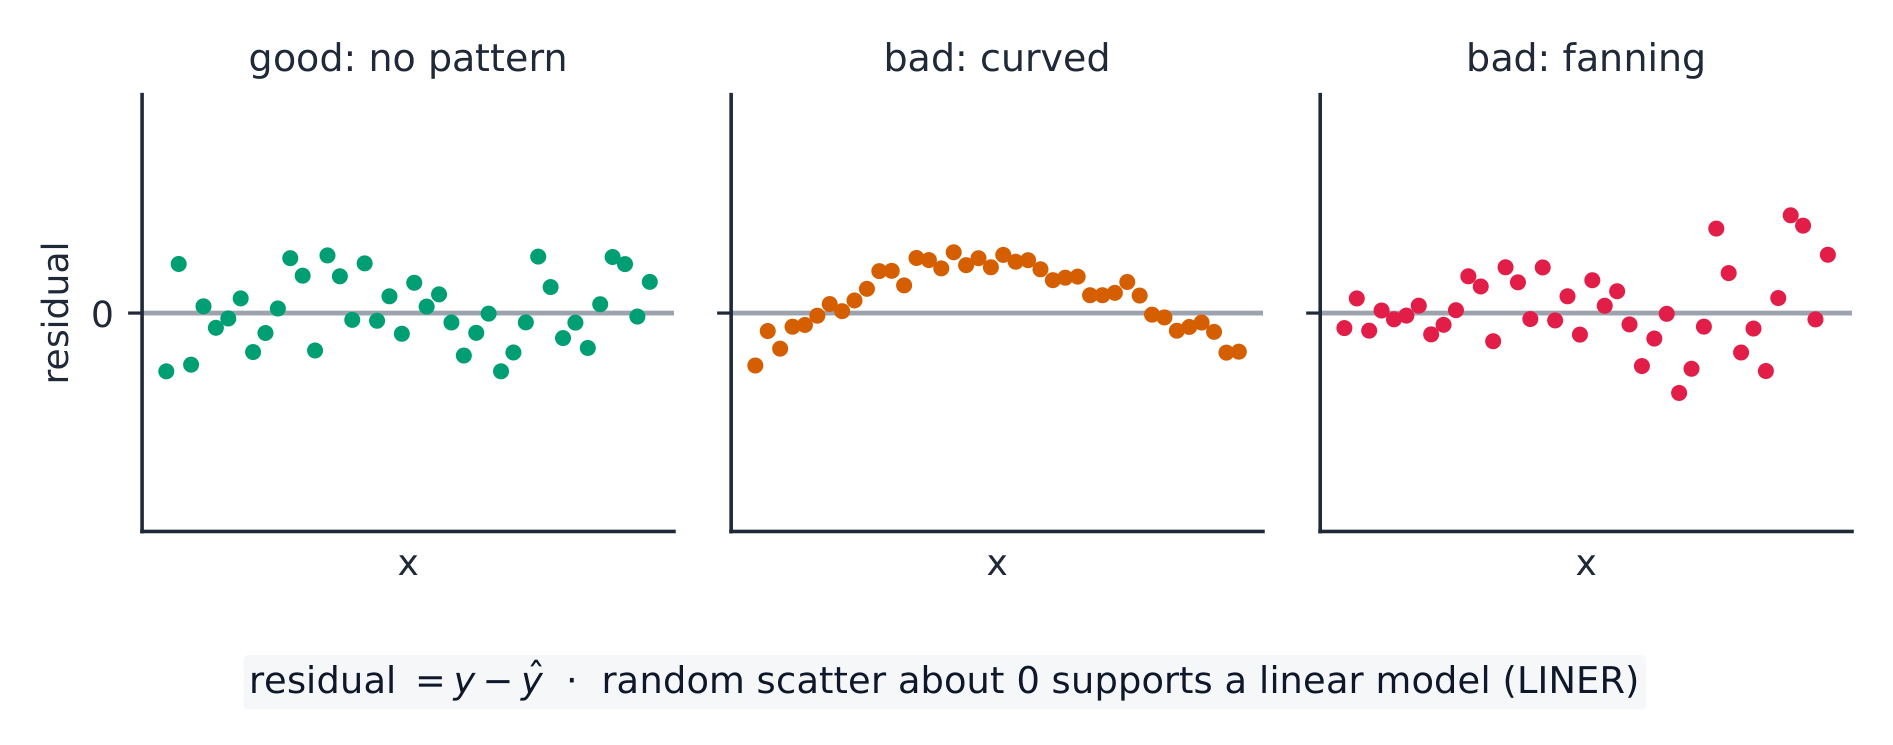
    9.4

    Thiết Lập Một Kiểm Tra Cho Độ Dốc

    Chương trình

    Hiểu biết bền vững (VAR-7): Phân phối $t$ có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-7.J: Xác định sự lựa chọn phương pháp kiểm tra phù hợp cho độ dốc của mô hình hồi quy. [Kỹ năng 1.E]

    • VAR-7.J.1 Bài kiểm tra phù hợp cho độ dốc của mô hình hồi quy là bài kiểm tra $t$ cho độ dốc.

    Mục tiêu học tập VAR-7.K: Xác định giả thuyết không và giả thuyết đối phù hợp cho độ dốc của mô hình hồi quy. [Kỹ năng 1.F]

    • VAR-7.K.1 Giả thuyết không cho bài kiểm tra $t$ cho độ dốc là: $H_0 : \beta = \beta_0$, trong đó $\beta_0$ là giá trị được giả định từ giả thuyết không. Giả thuyết đối là $H_0 : \beta < \beta_0$ hoặc $H_0 : \beta > \beta_0$, hoặc $H_0 : \beta \neq \beta_0$.

    Mục tiêu học tập VAR-7.L: Xác minh các điều kiện cho bài kiểm tra ý nghĩa cho độ dốc của mô hình hồi quy. [Kỹ năng 4.C]

    • VAR-7.L.1 Để đưa ra suy luận thống kê khi kiểm tra độ dốc của mô hình hồi quy, chúng ta cần kiểm tra các điều sau:
      • a. Quan hệ thực tế giữa $x$ và $y$ là tuyến tính. Phân tích phần dư có thể được sử dụng để xác minh tính tuyến tính.
      • b. Độ lệch chuẩn của $y$, $\sigma_y$, không thay đổi theo $x$. Phân tích phần dư có thể được sử dụng để kiểm tra xem độ lệch chuẩn xấp xỉ bằng nhau cho tất cả các $x$ hay không.
      • c. Để kiểm tra tính độc lập:
        • i. Dữ liệu nên được thu thập bằng cách sử dụng mẫu ngẫu nhiên hoặc thí nghiệm được gán ngẫu nhiên.
        • ii. Khi lấy mẫu không thay thế, hãy kiểm tra rằng $n \le 10\% N$.
      • d. Đối với một giá trị cụ thể của $x$, các phản hồi (các giá trị $y$) phân phối xấp xỉ theo phân phối chuẩn. Phân tích các biểu diễn đồ thị của phần dư có thể được sử dụng để kiểm tra tính chuẩn.
        • i. Nếu phân phối quan sát bị lệch, $n$ nên lớn hơn 30.
        • ii. Nếu kích thước mẫu nhỏ hơn 30, phân phối dữ liệu mẫu nên không có độ lệch mạnh và ngoại lệ.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Kiểm tra thông thường hỏi liệu có bất kỳ mối quan hệ tuyến tính nào không:

    $$H_0:\beta=0 \quad(\text{no linear relationship})\qquad H_a:\beta\neq 0 \ (\text{or } <,\,>).$$
    Kiểm tra các điều kiện LINER. Đây là một kiểm tra $t$-test trên độ dốc.

    Kiểm tra biểu đồ phần dư trước khi tin tưởng khoảng tin cậy hoặc kiểm tra độ dốc
    Kiểm tra biểu đồ phần dư trước khi tin tưởng khoảng tin cậy hoặc kiểm tra độ dốc
    9.5

    Thực Hiện Một Kiểm Tra Cho Độ Dốc

    Chương trình

    Hiểu biết bền vững (VAR-7): Phân phối $t$ có thể được sử dụng để mô hình hóa sự biến thiên.

    Mục tiêu học tập VAR-7.M: Tính toán thống kê kiểm tra phù hợp cho độ dốc của mô hình hồi quy. [Kỹ năng 3.E]

    • VAR-7.M.1 Phân phối của độ dốc của mô hình hồi quy khi giả thiết tất cả các điều kiện được thỏa mãn và giả thuyết không đúng (phân phối không) là phân phối $t$.
    • VAR-7.M.2 Đối với hồi quy tuyến tính đơn giản khi lấy mẫu ngẫu nhiên từ một quần thể cho biến phản hồi có thể được mô hình hóa bằng phân phối chuẩn cho mỗi giá trị của biến giải thích, phân phối mẫu của $t = \dfrac{b - \beta}{SE_b}$ có phân phối $t$ với bậc tự do bằng $n - 2$. Khi kiểm tra hệ số góc trong mô hình hồi quy tuyến tính đơn giản với một tham số, hệ số góc, bài kiểm tra cho hệ số góc có $df = n - 1$.

    Hiểu biết bền vững (DAT-3): Kiểm định ý nghĩa giúp chúng ta đưa ra quyết định về các giả thuyết trong một ngữ cảnh cụ thể.

    Mục tiêu học tập DAT-3.M: Diễn giải giá trị $p$ của phép kiểm tra ý nghĩa cho hệ số góc của mô hình hồi quy. [Kỹ năng 4.B]

    • DAT-3.M.1 Một diễn giải giá trị $p$ của phép kiểm tra ý nghĩa cho hệ số góc của mô hình hồi quy cần lưu ý rằng giá trị $p$ được tính toán bằng cách giả định giả thuyết không đúng, tức là giả định rằng hệ số góc thực tế của tổng thể bằng với giá trị cụ thể nêu trong giả thuyết không.

    Mục tiêu học tập DAT-3.N: Bảo vệ một tuyên bố về quần thể dựa trên kết quả của bài kiểm tra ý nghĩa cho hệ số góc của mô hình hồi quy. [Kỹ năng 4.E]

    • DAT-3.N.1 Một quyết định chính thức so sánh giá trị $p$ với mức ý nghĩa $\alpha$. Nếu giá trị $p$ nhỏ hơn hoặc bằng $\le \alpha$, thì bác bỏ giả thuyết không, $H_0 : \beta = \beta_0$. Nếu giá trị $p$ lớn hơn $> \alpha$, thì không bác bỏ giả thuyết không.
    • DAT-3.N.2 Kết quả của bài kiểm tra ý nghĩa cho hệ số góc của mô hình hồi quy có thể đóng vai trò là lập luận thống kê để hỗ trợ câu trả lời cho một câu hỏi nghiên cứu về mẫu đó.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Thống kê độ dốc $t$:

    $$t=\frac{b-0}{SE_b},\qquad df=n-2.$$
    Cả hai $b$ và $SE_b$ đều lấy trực tiếp từ kết quả hồi quy. Tìm giá trị $p$ từ phân phối $t$, so sánh với $\alpha$, và đưa ra kết luận trong ngữ cảnh – bằng chứng (hoặc không có) về mối quan hệ tuyến tính giữa hai biến.

    Lưu ý phần đuôi. Kết quả hồi quy luôn in giá trị $p$ hai-đuôi (cho $H_a:\beta\neq 0$). Nếu $H_a$ của bạn là một-đuôi, hãy chia đôi nó – và trước tiên hãy kiểm tra xem độ dốc mẫu thực sự chỉ hướng theo cách mà $H_a$ tuyên bố hay không; nếu nó chỉ hướng ngược lại, giá trị $p$ một-đuôi sẽ nằm trên $0.5$ và bạn không thể bác bỏ $H_0$.

    Ví dụ đã giải. Đối với cùng đầu ra ($b=2.5$, $SE_b=0.8$, $n=20$), kiểm tra $H_0:\beta=0$:

    $$t=\frac{2.5-0}{0.8}=3.13,\qquad df=18,$$
    một giá trị $p$ nhỏ ($<0.01$), vì vậy bác bỏ $H_0$ – bằng chứng thuyết phục về mối quan hệ tuyến tính. Điều này phù hợp với khoảng tin cậy, đã loại trừ $0$.

    9.6

    Chọn Thủ续 Phù Hợp

    Chương trình

    Chủ đề này nhằm tập trung vào kỹ năng lựa chọn thủ tục suy luận phù hợp khi học sinh đã có sẵn một loạt các tùy chọn. Học sinh nên được tạo cơ hội thực hành khi nào và làm thế nào để áp dụng tất cả các mục tiêu học tập liên quan đến suy luận.

    Nguồn: Mô tả Khóa học và Bài thi College Board AP

    Trong toàn bộ suy luận thống kê, xác định: điều gì được ước lượng hoặc tuyên bố (tỷ lệ, trung bình, hiệu số, phân phối tần số, hay độ dốc), bao nhiêu mẫu, và loại thiết kế nào (độc lập hay cặp; mẫu hay thí nghiệm). Sau đó đặt tên cho quy trình, kiểm tra các điều kiện, tiến hành thực hiện, và truyền đạt kết luận với thống kê, giá trị $p$ hoặc khoảng tin cậy, cùng câu trả lời bằng ngôn ngữ thông thường trong ngữ cảnh. Kỹ năng chọn lọc và truyền đạt này chính là điểm mấu chốt mà câu hỏi về nhiệm vụ khám phá đánh giá cao nhất.
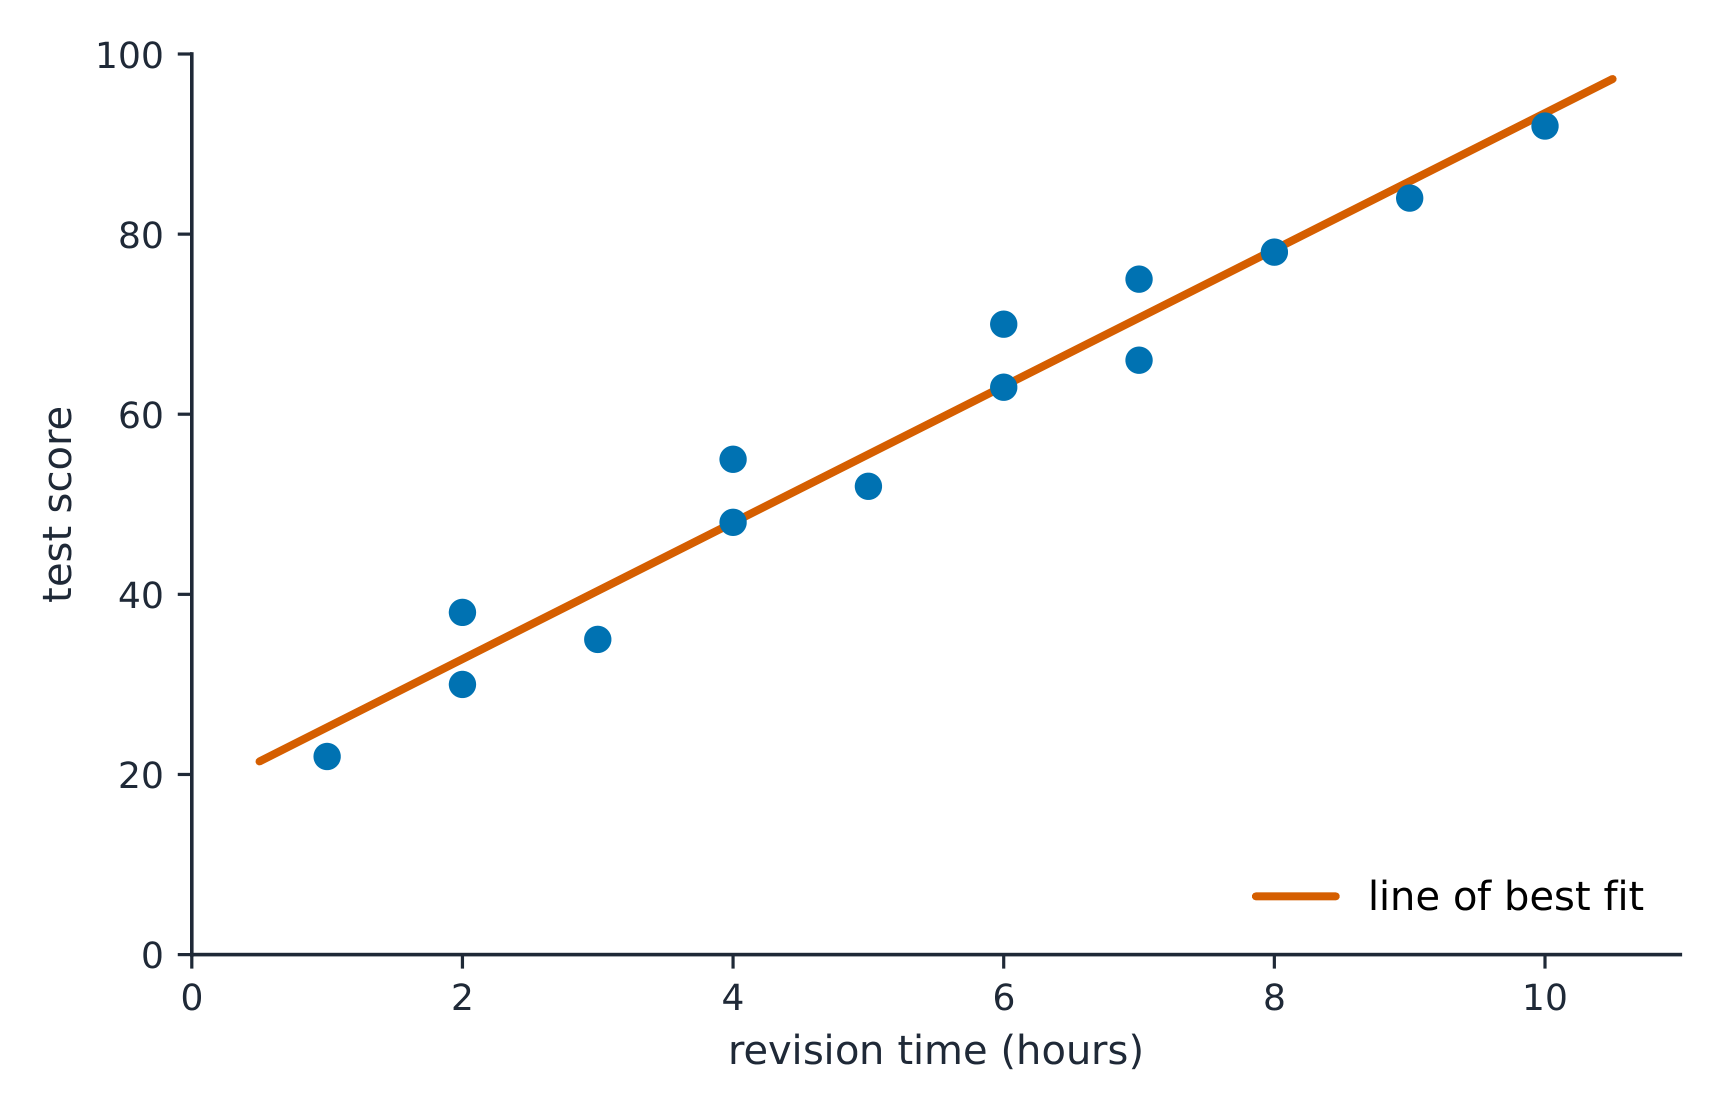
    9.6

    Mẹo làm bài thi

    • Suy luận cho độ dốc kiểm tra xem độ dốc thực có phải là $0$ (không có mối quan hệ tuyến tính) không.
    • Nếu khoảng tin cậy của độ dốc bao gồm 0, bạn không thể kết luận có mối quan hệ tuyến tính thực – các biến vẫn có thể liên quan theo cách cong.
    • Đọc độ dốc, sai số chuẩn, thống kê t, và p-value trực tiếp từ đầu ra máy tính – nhưng p-value in sẵn là hai đuôi, vì vậy hãy chia đôi nó cho một kiểm tra một đuôi $H_a$.
    • Kiểm tra các điều kiện hồi quy (tuyến tính, độc lập, phần dư xấp xỉ normal, equal spread) qua biểu đồ phần dư.
    • Diễn giải khoảng tin cậy và kiểm tra trong ngữ cảnh, gắn liền với độ dốc thực.

Đăng nhập hoặc tạo tài khoản

IGCSE, A-Level & AP