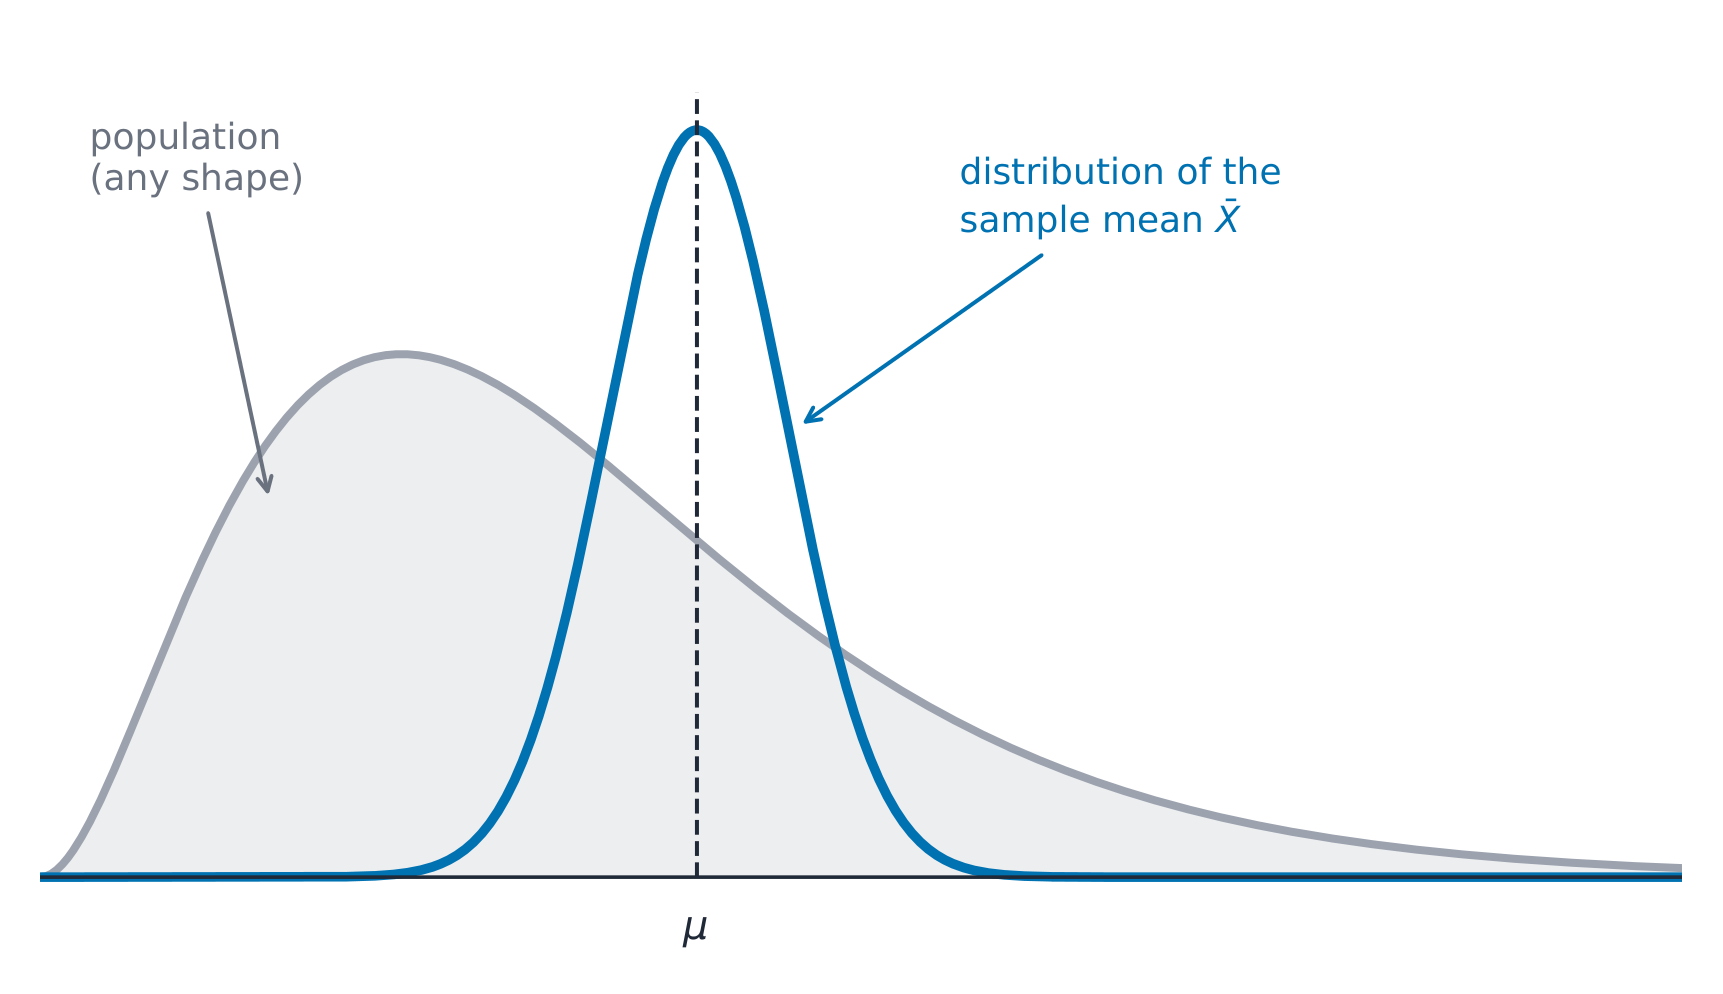
Para uma proporção amostral $\hat{p}$ de uma SRS: a média é $p$ (não tendenciosa), e o desvio padrão é
$$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
Essa dispersão tem dois nomes: é o
desvio padrão da distribuição amostral, e é chamado de
erro padrão quando você precisa estimá-lo a partir da amostra (substituindo
$p$ por
$\hat p$) — o que exatamente as unidades de inferência posteriores fazem.
É aproximadamente
normal quando
$np\ge 10$ e
$n(1-p)\ge 10$ (a condição
Contagens Grandes), e a condição
$10\%$ (
$n\le 0.10N$) mantém as observações quase independentes.
Exemplo resolvido. Suponha que $40\%$ dos eleitores favoritem uma medida ($p=0.4$) e você amostre $n=100$. O erro padrão é $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. A chance de uma amostra dar $\hat{p}>0.5$ é $z=\dfrac{0.5-0.4}{0.049}=2.04$, então $P(\hat p>0.5)\approx0.02$ – uma maioria na amostra seria surpreendente.