AP Statistics cobre explorar dados, amostragem e desenho experimental, probabilidade e variáveis aleatórias, distribuições de amostragem e inferência — intervalos de confiança e testes de significância. Há pouca álgebra; a dificuldade está em dizer a coisa certa sobre incerteza.
Toda resposta de inferência tem quatro partes: nome o procedimento, verifique as condições, calcule e conclua no contexto com uma ligação à hipótese alternativa. O gabarito avalia todas as quatro, então um p-valor correto sozinho nota mal.
Linguagem é avaliada. "Rejeitamos H₀" não é "provamos H₁"; um intervalo de confiança trata-se do comportamento de longo prazo do método, não da probabilidade de que um intervalo particular contenha o parâmetro. Essas distinções decidem as marcas.
As notas trabalham todas as nove unidades com cada procedimento de inferência definido passo a passo. FRQs liberadas estão na biblioteca. Estatística dá pontos para declarar as condições e interpretar no contexto, então toda resposta resolvida nomeia as condições antes de rodar o teste.
Introduzindo Estatísticas: O Que Podemos Aprender com os Dados?
Programa
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.A: Identificar perguntas a serem respondidas, baseando-se na variação em dados de uma variável. [Habilidade 1.A]
VAR-1.A.1 Números podem transmitir informações significativas quando colocados em contexto.
Fonte: College Board AP Course and Exam Description
Estatística 统计学 é a ciência de aprender a partir de dados 数据 – números ou rótulos recolhidos do mundo real. Os dados variam, por isso descrevemos padrões e contabilizamos a variação 变异 em vez de esperar que cada valor coincida. Uma questão estatística antecipa uma resposta baseada em dados que variam.
Two distinctions run through the whole course. A parâmetro 参数 is a numerical summary of a whole população; a estatística 统计量 is a numerical summary of a amostra - we use the statistic to estimate the parameter we cannot measure directly. And estatística descritiva 描述统计 only summarise the data set in hand, while estatística inferencial 推断统计 use a sample to make and test claims about the larger population.
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.B: Identificar variáveis em um conjunto de dados. [Habilidade 2.A]
VAR-1.B.1 Uma variável é uma característica que muda de um indivíduo para outro.
Objetivo de Aprendizagem VAR-1.C: Classificar tipos de variáveis. [Habilidade 2.A]
VAR-1.C.1 Uma variável categórica assume valores que são nomes de categorias ou rótulos de grupos.
VAR-1.C.2 Uma variável quantitativa é aquela que assume valores numéricos para uma quantidade medida ou contada.
Exemplos ilustrativos para VAR-1.C:
Variáveis categóricas:
Mão dominante
Faixa etária (jovem ou velho)
Grau mais alto obtido
Variáveis quantitativas:
Idade de uma estrutura
Altura de uma criança
Concentração de uma amostra
Fonte: College Board AP Course and Exam Description
A variável 变量 is a characteristic that can differ between individuals. Two kinds:
Categórica 分类 (qualitative): values are labels/groups (eye colour, brand).
Quantitativa 定量: values are numbers you can do arithmetic on (height, age). Quantitative variables are discretas (countable) or contínuas (measured).
Escolher o gráfico e o resumo corretos depende de qual tipo você tem.
Explorar
Categorical ou quantitativa?
Cada variável é ou categórica (ela rotula cada unidade com um grupo) ou quantitativa (um número medido que você pode tirar a média). Que tipo ela é decide os gráficos e resumos que você tem permissão para usar.
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.A: Representar dados categóricos usando tabelas de frequência ou frequência relativa. [Habilidade 2.B]
UNC-1.A.1 Uma tabela de frequência fornece o número de casos que caem em cada categoria. Uma tabela de frequência relativa fornece a proporção de casos que caem em cada categoria.
Objetivo de Aprendizagem UNC-1.B: Descrever dados categóricos representados em tabelas de frequência ou relativas. [Habilidade 2.A]
UNC-1.B.1 Porcentagens, frequências relativas e taxas fornecem as mesmas informações que proporções.
UNC-1.B.2 Contagens e frequências relativas de dados categóricos revelam informações que podem ser usadas para justificar afirmações sobre os dados em contexto.
Fonte: College Board AP Course and Exam Description
Uma tabela de frequência 频数 lista a contagem (frequência) de cada categoria; uma tabela de frequência relativa 相对 frequência lista a proporção 比例 de cada categoria (contagem ÷ total). As frequências relativas permitem comparar grupos de tamanhos diferentes de forma justa.
1.4
Representando uma Variável Categórica com Gráficos
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.C: Representar dados categóricos graficamente. [Habilidade 2.B]
UNC-1.C.1 Gráficos de barras (ou diagramas de barras) são usados para exibir frequências (contagens) ou frequências relativas (proporções) para dados categóricos.
UNC-1.C.2 A altura ou comprimento de cada barra em um gráfico de barras corresponde ao número ou proporção de observações que caem dentro de cada categoria.
UNC-1.C.3 Existem muitas maneiras adicionais de representar frequências (contagens) ou frequências relativas (proporções) para dados categóricos.
Objetivo de Aprendizagem UNC-1.D: Descrever dados categóricos representados graficamente. [Habilidade 2.A]
UNC-1.D.1 Representações gráficas de uma variável categórica revelam informações que podem ser usadas para justificar afirmações sobre os dados em contexto.
Objetivo de Aprendizagem UNC-1.E: Comparar vários conjuntos de dados categóricos. [Habilidade 2.D]
UNC-1.E.1 Tabelas de frequência, gráficos de barras ou outras representações podem ser usadas para comparar dois ou mais conjuntos de dados em termos da mesma variável categórica.
Fonte: College Board AP Course and Exam Description
Gráficos de barras 条形 mostram a contagem ou proporção de cada categoria como barras separadas; um gráfico circular mostra a quota de cada categoria do todo. As alturas das barras (ou fatias) permitem comparar categorias de relance. As barras podem estar ordenadas por tamanho ou por uma ordem natural de categorias.
Explorar
Mostre uma variável categórica como um gráfico de pizza
Um gráfico de pizza transforma a participação de cada categoria do todo em uma fatia: uma participação maior é uma fatia maior, e todas as fatias juntas formam 100%. É uma imagem de uma tabela de frequência relativa.
1.5
Representando uma Variável Quantitativa com Gráficos
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.F: Classificar tipos de variáveis quantitativas. [Habilidade 2.A]
UNC-1.F.1 Uma variável discreta pode assumir um número contável de valores. O número de valores pode ser finito ou infinitamente contável, como com os números naturais.
UNC-1.F.2 Uma variável contínua pode assumir infinitos valores, mas esses valores não podem ser contados. Não importa quão pequeno seja o intervalo entre dois valores de uma variável contínua, sempre é possível determinar outro valor entre eles.
Exemplos ilustrativos para UNC-1.F:
Uma variável discreta:
Número de alunos em uma turma
Uma variável contínua:
Altura de uma criança
Objetivo de Aprendizagem UNC-1.G: Representar dados quantitativos graficamente. [Habilidade 2.B]
UNC-1.G.1 Em um histograma, a altura de cada barra mostra o número ou proporção de observações que caem dentro do intervalo correspondente àquela barra. Alterar as larguras dos intervalos pode mudar a aparência do histograma.
UNC-1.G.2 Em um gráfico de talo e folha, cada valor de dado é dividido em um "talo" (o primeiro dígito ou dígitos) e uma "folha" (geralmente o último dígito).
UNC-1.G.3 Um dotplot representa cada observação por um ponto, com a posição no eixo horizontal correspondendo ao valor de dado daquela observação, com valores quase idênticos empilhados uns sobre os outros.
UNC-1.G.4 Um gráfico cumulativo representa o número ou proporção de um conjunto de dados menor ou igual a um número dado.
UNC-1.G.5 Existem muitas maneiras adicionais de representar graficamente distribuições de dados quantitativos.
Fonte: College Board AP Course and Exam Description
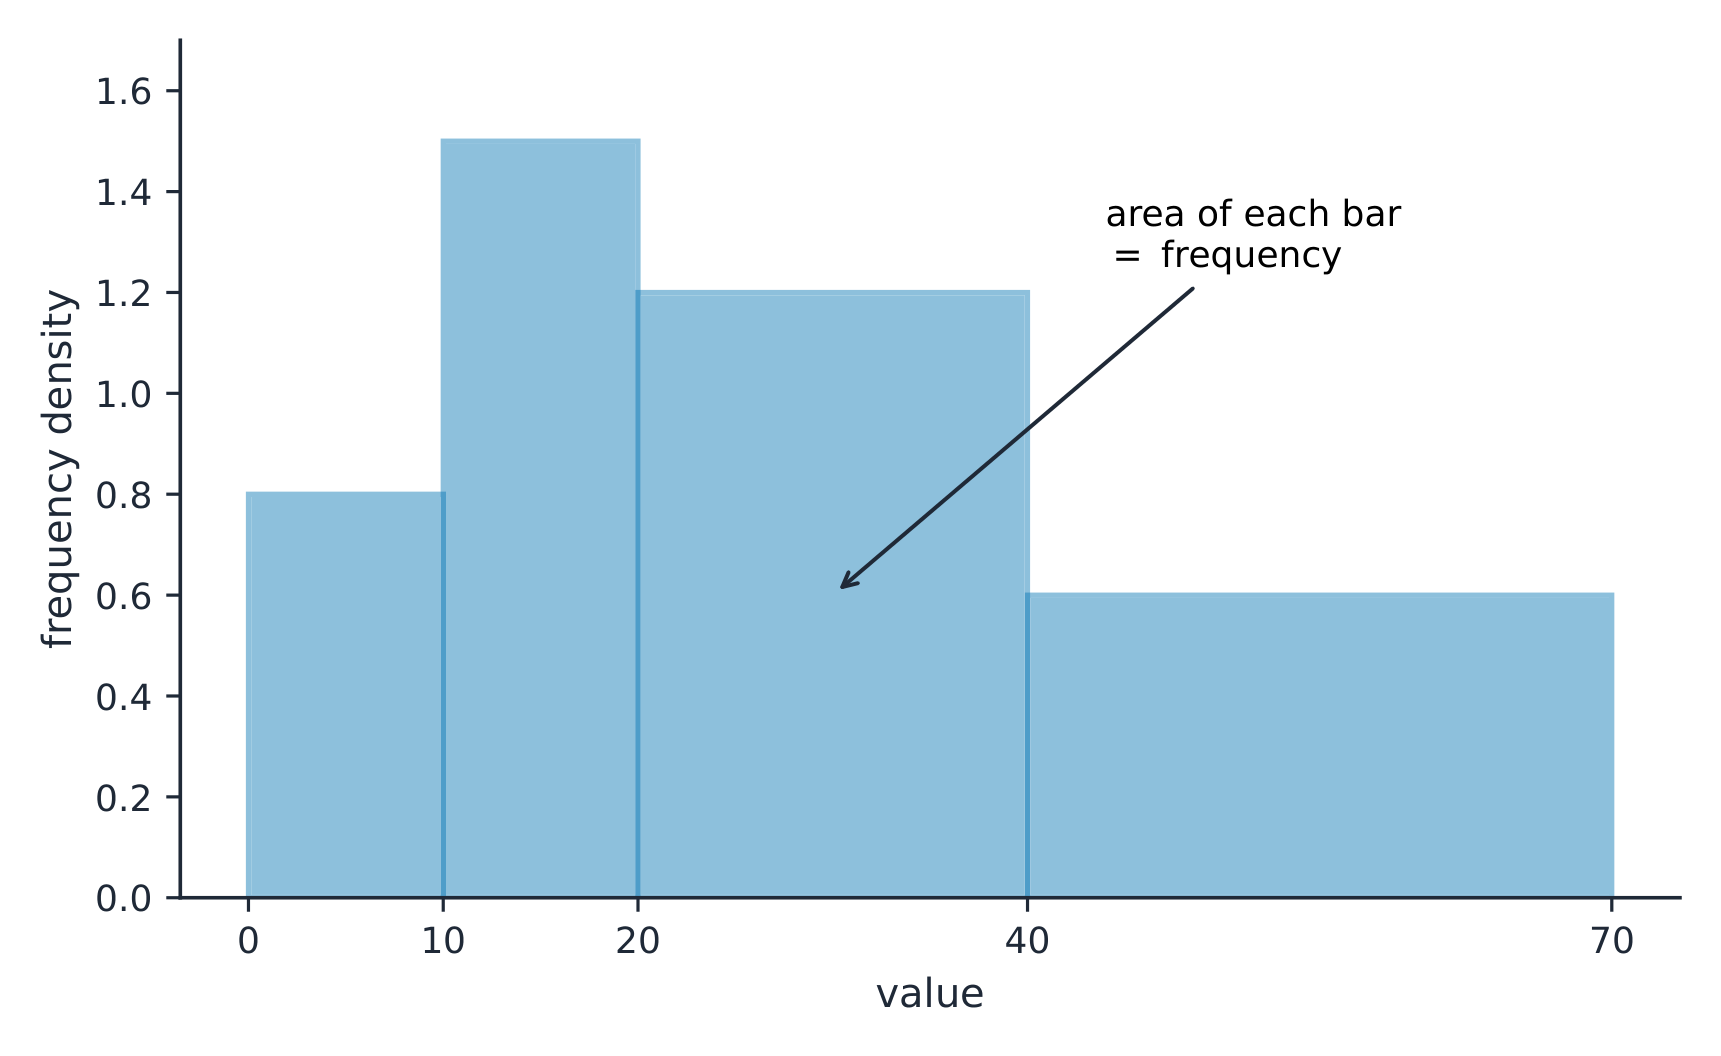
Para números, use um gráfico de pontos 点图, diagrama de caule-e-folhas 茎叶图 ou histograma 直方 (barras sobre intervalos de valores chamados classes). Estes mostram a distribuição 分布 – como os valores se espalham. A largura da classe num histograma altera a imagem, por isso escolha-a para revelar a forma.
Em um histograma com larguras de classe desiguais, a área da barra é a frequência
Explorar
Explore como a largura da bin molda um histograma
Um histograma agrupa dados em bins de largura igual e desenha uma barra sobre cada um. Mude os bins e note como os mesmos dados podem parecer irregulares (muito estreitos) ou suaves (muito largos) — a forma é uma escolha.
Descrevendo a Distribuição de uma Variável Quantitativa
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.H: Descrever as características das distribuições de dados quantitativos. [Habilidade 2.A]
UNC-1.H.1 As descrições da distribuição de dados quantitativos incluem forma, centro e variabilidade (dispersão), bem como quaisquer características incomuns, como valores atípicos, lacunas, aglomerados ou múltiplos picos.
UNC-1.H.2 Valores atípicos para dados de uma variável são pontos de dados incomummente pequenos ou grandes em relação ao restante dos dados.
UNC-1.H.3 Uma distribuição é assimétrica à direita (assimetria positiva) se a cauda direita for mais longa que a esquerda. Uma distribuição é assimétrica à esquerda (assimetria negativa) se a cauda esquerda for mais longa que a direita. Uma distribuição é simétrica se a metade esquerda for a imagem espelhada da metade direita.
UNC-1.H.4 Gráficos univariados com um único pico principal são conhecidos como unimodais. Gráficos com dois picos proeminentes são bimodais. Um gráfico onde a altura de cada barra é aproximadamente a mesma (sem picos proeminentes) é aproximadamente uniforme.
UNC-1.H.5 Uma lacuna é uma região de uma distribuição entre dois valores de dados onde não há dados observados.
UNC-1.H.6 Aglomerados são concentrações de dados geralmente separadas por lacunas.
UNC-1.H.7 Estatística descritiva não atribui propriedades de um conjunto de dados a uma população maior, mas pode fornecer a base para conjecturas para testes subsequentes.
Fonte: College Board AP Course and Exam Description
Describe four things (remember SOCS):
Forma 形状: symmetric, or assimétrica 偏斜 left/right (a long tail on that side), and how many peaks - one main peak is unimodal 单峰, two prominent peaks bimodal 双峰, and roughly equal bars uniforme 均匀.
Valores atípicos 离群值: unusual values far from the rest.
Centro: a typical value (mean or median).
Dispersão: how much the values vary (range, IQR, standard deviation).
Sempre descreva forma/centro/dispersão no contexto, com unidades.
A forma de uma distribuição: simétrica, assimétrica à direita (cauda longa à direita), ou assimétrica à esquerda
cumulative relative frequency graph/ˈkjuːmjʊlətɪv ˈrelətɪv ˈfriːkwənsi ɡræf/
累积相对频率图
lěi jī xiāng duì pín lǜ tú
1.7
Estatísticas Resumidas para uma Variável Quantitativa
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.I: Calcular medidas de centro e posição para dados quantitativos. [Habilidade 2.C]
UNC-1.I.1 Uma estatística é um resumo numérico de dados amostrais.
UNC-1.I.2 A média é a soma de todos os valores de dados dividida pelo número de valores. Para uma amostra, a média é denotada por $x$: $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, onde $x_i$ representa o $i^{\text{th}}$ ponto de dados na amostra e $n$ representa o número de valores de dados na amostra.
UNC-1.I.3 A mediana de um conjunto de dados é o valor central quando os dados estão ordenados. Quando o número de pontos de dados é par, a mediana pode assumir qualquer valor entre os dois valores centrais. Em Estatística AP, o valor mais comumente usado para a mediana de um conjunto de dados com um número par de valores é a média dos dois valores centrais.
UNC-1.I.4 O primeiro quartil, Q1, é a mediana da metade do conjunto de dados ordenado do mínimo até a posição da mediana. O terceiro quartil, Q3, é a mediana da metade do conjunto de dados ordenado da posição da mediana até o máximo. Q1 e Q3 formam os limites para os 50% centrais de valores em um conjunto de dados ordenado.
UNC-1.I.5 O $p^{\text{th}}$ percentil é interpretado como o valor que tem $p\%$ dos dados menores ou iguais a ele.
Objetivo de Aprendizagem UNC-1.J: Calcular medidas de variabilidade para dados quantitativos. [Habilidade 2.C]
UNC-1.J.1 Três medidas de variabilidade (ou dispersão) comumente usadas em uma distribuição são a amplitude, a amplitude interquartil e o desvio padrão.
UNC-1.J.2 A amplitude é definida como a diferença entre o valor máximo de dados e o valor mínimo de dados. A amplitude interquartil (AIQ) é definida como a diferença entre o terceiro e o primeiro quartis: $Q3 - Q1$. Tanto a amplitude quanto a amplitude interquartil são formas possíveis de medir a variabilidade da distribuição de uma variável quantitativa.
UNC-1.J.3 O desvio padrão é uma maneira de medir a variabilidade da distribuição de uma variável quantitativa. Para uma amostra, o desvio padrão é denotado por $s$: $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. O quadrado do desvio padrão da amostra, $s^2$, é chamado de variância da amostra.
UNC-1.J.4 Alterar unidades de medida afeta os valores das estatísticas calculadas.
Objetivo de Aprendizagem UNC-1.K: Explicar a seleção de uma medida específica de centro e/ou variabilidade para descrever um conjunto de dados quantitativos. [Habilidade 4.B]
UNC-1.K.1 Existem muitos métodos para determinar valores atípicos. Dois métodos frequentemente usados neste curso são:
UNC-1.K.1.i Um valor atípico é um valor maior que $1.5 \times \text{IQR}$ acima do terceiro quartil ou mais que $1.5 \times \text{IQR}$ abaixo do primeiro quartil.
UNC-1.K.1.ii Um valor atípico é um valor localizado a 2 ou mais desvios padrões acima, ou abaixo, da média.
UNC-1.K.2 A média, o desvio padrão e a amplitude são considerados não resistentes (ou não robustos) porque são influenciados por valores atípicos. A mediana e a AIQ são consideradas resistentes (ou robustas), pois valores atípicos não afetam significativamente (se é que afetam) seu valor.
Fonte: College Board AP Course and Exam Description
Standard deviation: spread about the mean
Centro: a média 均值$\bar{x}=\dfrac{\sum x_i}{n}$ (média aritmética) e a mediana 中位数 (valor do meio). A mediana resiste aos valores extremos; a média é atraída para uma assimetria.
Dispersão: o intervalo, a amplitude interquartil 四分位距$\text{IQR}=Q_3-Q_1$ (middle 50%), and the desvio padrão 标准差$s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (typical distance from the mean; its square is the variância 方差).
O resumo de cinco números 五数概括: min, $Q_1$, mediana, $Q_3$, max.
Use medidas resistentes (median, IQR) for skewed data; mean and standard deviation for roughly symmetric data.
A percentil 百分位数 de um valor é a porcentagem dos dados abaixo ou igual a ele – então a mediana é o percentil 50 e $Q_1$ o 25º. Um gráfico de frequência relativa cumulativa 累积相对频率图 torna os percentis fáceis de ler: para cada valor, plotar a proporção dos dados abaixo ou igual a ele, subindo de 0 a 1. Suba de um valor até a curva e vá até seu percentil, ou inverta os passos para encontrar o valor em um determinado percentil (a mesma leitura funciona a partir de uma tabela de frequência cumulativa).
Exemplo resolvido. Para os dados $4, 8, 6, 10, 7$: a média é $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. Ordenando para $4,6,7,8,10$, a mediana é o valor do meio, $7$. A média e a mediana concordam aqui porque os dados são aproximadamente simétricos.
Representações Gráficas das Estatísticas Resumidas
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.L: Representar graficamente estatísticas resumidas para dados quantitativos. [Habilidade 2.B]
UNC-1.L.1 Juntos, o valor mínimo de dados, o primeiro quartil (Q1), a mediana, o terceiro quartil (Q3) e o valor máximo de dados compõem o resumo de cinco números.
UNC-1.L.2 Um diagrama de caixa é uma representação gráfica do resumo de cinco números (mínimo, primeiro quartil, mediana, terceiro quartil, máximo). A caixa representa os 50% centrais de dados, com uma linha na mediana e as extremidades da caixa correspondentes aos quartis. Linhas ("bigornas") estendem-se dos quartis até o ponto mais extremo que não é um valor atípico, e os valores atípicos são indicados por seu próprio símbolo além disso.
Objetivo de Aprendizagem UNC-1.M: Descrever estatísticas resumidas de dados quantitativos representados graficamente. [Habilidade 2.A]
UNC-1.M.1 Estatísticas resumidas de dados quantitativos, ou de conjuntos de dados quantitativos, podem ser usadas para justificar afirmações sobre os dados no contexto.
UNC-1.M.2 Se uma distribuição for relativamente simétrica, então a média e a mediana estarão relativamente próximas uma da outra. Se uma distribuição for assimétrica à direita, então a média geralmente estará à direita da mediana. Se a distribuição for assimétrica à esquerda, então a média geralmente estará à esquerda da mediana.
Fonte: College Board AP Course and Exam Description
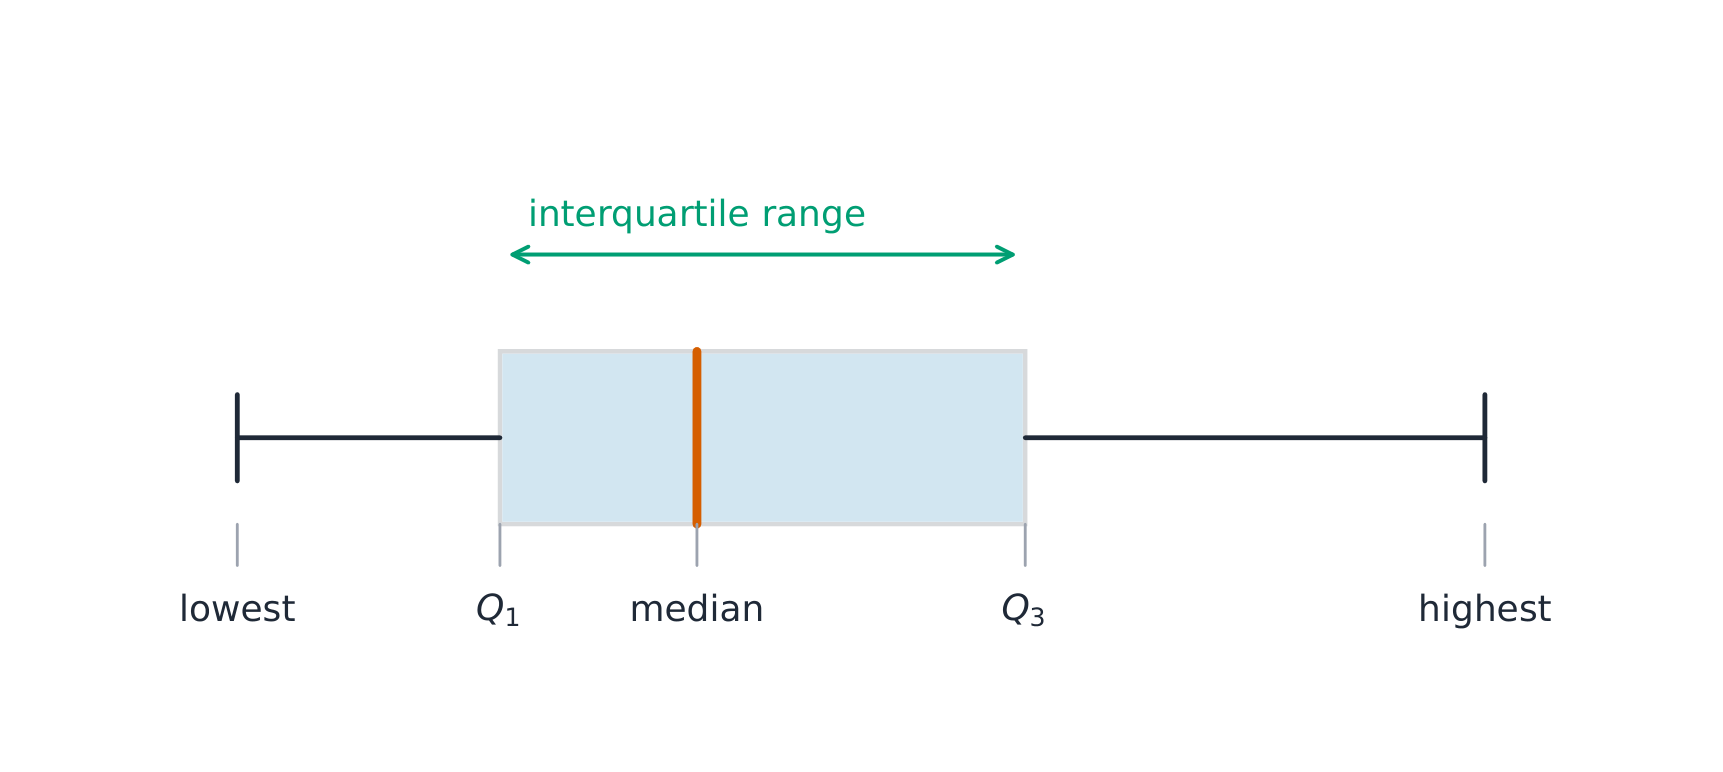
Um diagrama de caixa 箱线图 desenha o resumo de cinco números: uma caixa de $Q_1$ a $Q_3$ com a mediana dentro, e bigodes até os valores extremos não outliers. Um ponto é um outlier 异常值 se estiver mais de $1.5\times\text{IQR}$ além de um quartil – uma regra que você pode ser solicitado a aplicar. Os diagramas de caixa são ideais para comparar vários grupos lado a lado.
Exemplo resolvido. Um conjunto de dados tem $Q_1=20$ e $Q_3=32$, logo $\text{IQR}=12$. As cercas de valores extremos são $Q_1-1.5(12)=2$ e $Q_3+1.5(12)=50$. Qualquer valor abaixo de $2$ ou acima de $50$ é sinalizado como um valor extremo.
Um diagrama de caixa e bigodes mostra os quartis e a amplitudeUm diagrama de caixa desenha o resumo de cinco números; a caixa abrange o IQR
Explorar
Explore o resumo de cinco números como um diagrama de caixa
Arraste $Q_1$, a mediana, e $Q_3$ para ver a caixa (seu comprimento é o IQR) e como a posição da mediana dentro da caixa revela assimetria — uma mediana próxima a $Q_1$ sinaliza uma distribuição com assimetria à direita.
Comparando Distribuições de uma Variável Quantitativa
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.N: Comparar representações gráficas para vários conjuntos de dados quantitativos. [Habilidade 2.D]
UNC-1.N.1 Qualquer uma das representações gráficas, p. ex., histogramas, diagramas de caixa lado a lado, etc., pode ser usada para comparar duas ou mais amostras independentes em termos de centro, variabilidade, aglomerados, lacunas, valores atípicos e outras características.
Objetivo de Aprendizagem UNC-1.O: Comparar estatísticas resumidas para vários conjuntos de dados quantitativos. [Habilidade 2.D]
UNC-1.O.1 Qualquer um dos resumos numéricos (p. ex., média, desvio padrão, frequência relativa, etc.) pode ser usado para comparar duas ou mais amostras independentes.
Fonte: College Board AP Course and Exam Description
Para comparar dois ou mais grupos, compare forma, centro e dispersão, e mencione outliers – sempre com palavras comparativas ("O Grupo A tem uma mediana maior que o Grupo B") e no contexto. Não descreva apenas cada grupo separadamente; faça a comparação explicitamente.
Explorar
Compare distribuições com diagramas de caixa
Um diagrama de caixa desenha o resumo de cinco números. Colocar dois diagramas de caixa na mesma escala compara seu centro (mediana), dispersão (IQR = largura da caixa) e assimetria de relance — a maneira justa de comparar grupos.
1.10
A Distribuição Normal
Programa
Compreensão Permanente (VAR-2): A distribuição normal pode ser usada para representar algumas distribuições populacionais.
Objetivo de Aprendizagem VAR-2.A: Comparar uma distribuição de dados ao modelo de distribuição normal. [Habilidade 2.D]
VAR-2.A.1 Um parâmetro é um resumo numérico de uma população.
VAR-2.A.2 Alguns conjuntos de dados podem ser descritos como aproximadamente normalmente distribuídos. Uma curva normal tem formato de montanha e é simétrica. Os parâmetros de uma distribuição normal são a média populacional, $\mu$, e o desvio padrão populacional, $\sigma$.
VAR-2.A.3 Para uma distribuição normal, aproximadamente 68% das observações estão dentro de 1 desvio padrão da média, aproximadamente 95% das observações estão dentro de 2 desvios padrão da média e aproximadamente 99.7% das observações estão dentro de 3 desvios padrão da média. Isso é chamado de regra empírica.
VAR-2.A.4 Muitas variáveis podem ser modeladas por uma distribuição normal.
Exemplos ilustrativos para VAR-2.A:
Variáveis que podem ser modeladas por uma distribuição normal:
Temperatura corporal
Peso de uma fatia de pão
Objetivo de Aprendizagem VAR-2.B: Determinar proporções e percentis a partir de uma distribuição normal. [Habilidade 3.A]
VAR-2.B.1 Um escore padronizado para um valor de dado específico é calculado como (valor do dado − média)/(desvio padrão) e mede o número de desvios padrões que um valor de dado está acima ou abaixo da média.
VAR-2.B.2 Um exemplo de escore padronizado é um escore $z$, que é calculado como $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. Um escore $z$ mede quantos desvios padrões um valor de dado está da média.
VAR-2.B.3 Tecnologia, como uma calculadora, uma tabela normal padrão ou saída gerada por computador, pode ser usada para encontrar a proporção de valores de dados localizados em um intervalo dado de uma variável aleatória normalmente distribuída.
VAR-2.B.4 Dada a área de uma região sob o gráfico da curva de distribuição normal, é possível usar tecnologia, como uma calculadora, uma tabela normal padrão ou saída gerada por computador, para estimar parâmetros para algumas populações.
Objetivo de Aprendizagem VAR-2.C: Comparar medidas de posição relativa em conjuntos de dados. [Habilidade 2.D]
VAR-2.C.1 Percentis e escores $z$ podem ser usados para comparar posições relativas de pontos dentro de um conjunto de dados ou entre conjuntos de dados.
Fonte: College Board AP Course and Exam Description
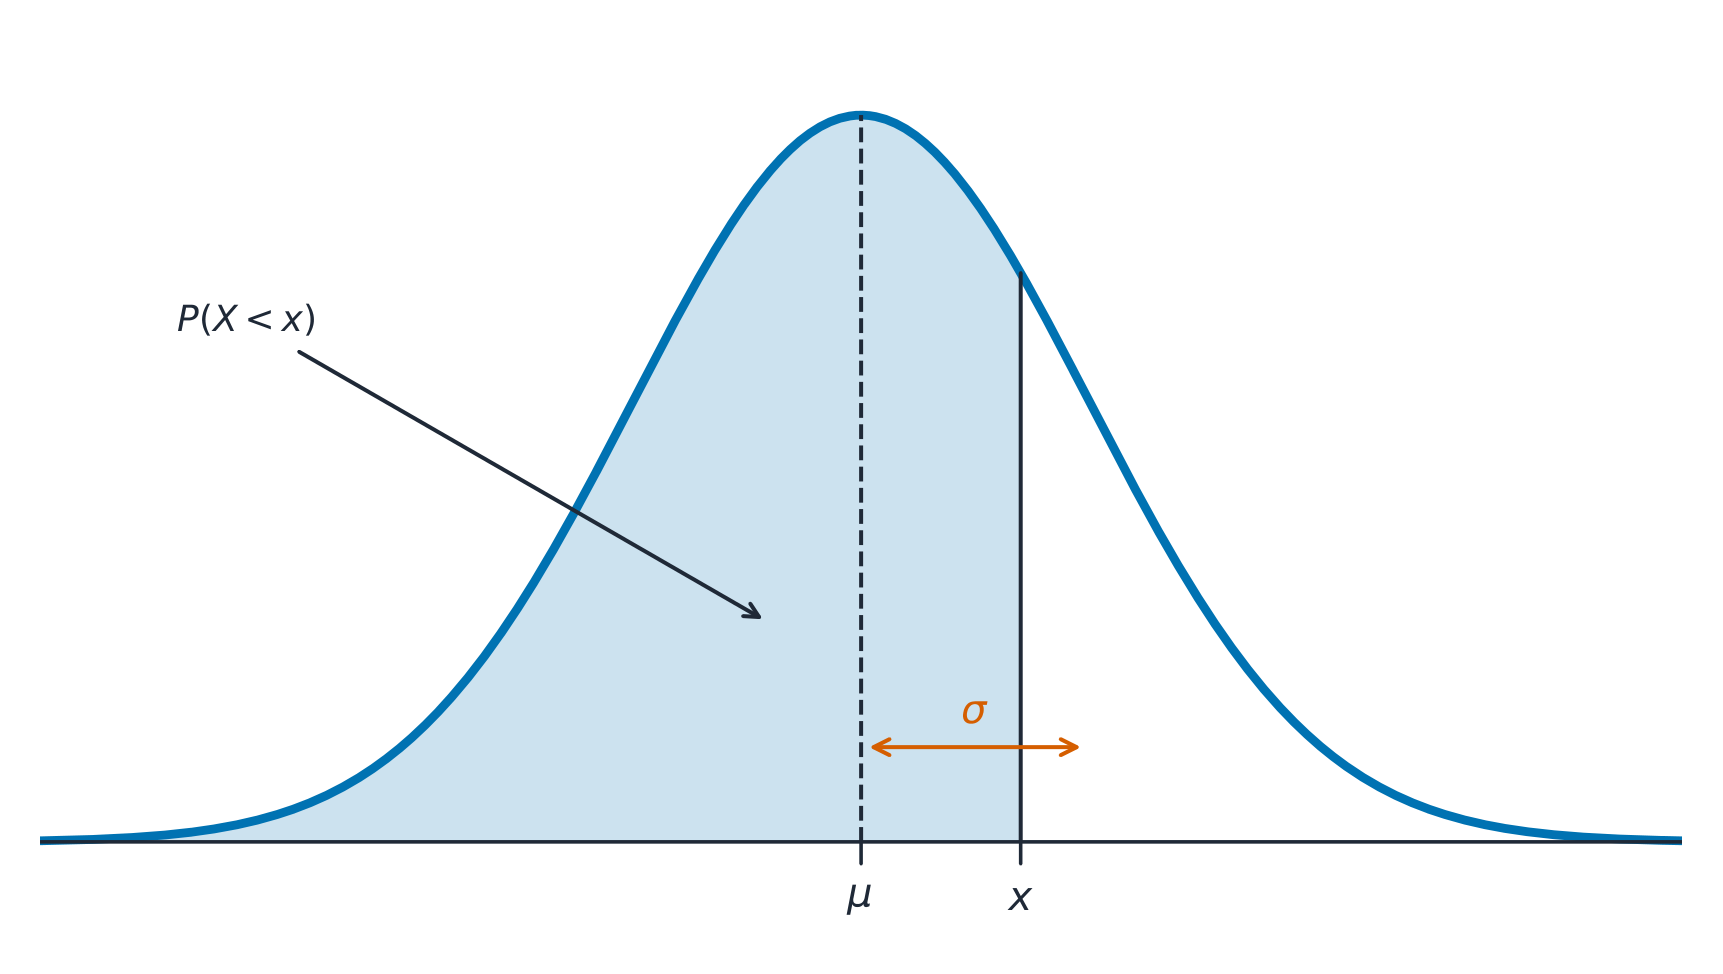
A distribuição normal 正态分布 is a symmetric, bell-shaped model described by its mean $\mu$ and standard deviation $\sigma$. The regra empírica 经验法则 (68–95–99.7): about 68% of values lie within $1\sigma$ of the mean, 95% within $2\sigma$, and 99.7% within $3\sigma$.
A curva normal: uma probabilidade é a área sob ela, centrada na média
Uma $z$-score 标准分数 mede quantos desvios padrão um valor está da média:
$$z=\frac{x-\mu}{\sigma}.$$
Converta para uma pontuação $z$, em seguida, use a tabela normal ou tecnologia para encontrar a proporção (área) abaixo, acima ou entre valores – e inverta o processo para encontrar um valor a partir de um determinado percentil.
Exemplo resolvido. As pontuações dos testes são normalmente distribuídas com $\mu=500$ e $\sigma=100$. Uma pontuação de $700$ tem $z=\dfrac{700-500}{100}=2$. Pela regra empírica, $95\%$ das pontuações estão dentro de $2\sigma$, então $2.5\%$ ficam acima de $700$ – o que significa que uma $700$ está aproximadamente no $97.5$º percentil.
A curva normal e a regra empírica 68-95-99.7
Explorar
Explore a área sob a curva normal
A proporção de dados abaixo de um valor igual à área sob a curva à sua esquerda. Sombreie uma cauda ou uma banda central para ver a regra empírica 68–95–99.7 e leia um escore-z $z$ como uma área.
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.D: Identificar perguntas a serem respondidas sobre possíveis relações nos dados. [Habilidade 1.A]
VAR-1.D.1 Padrões e associações aparentes nos dados podem ser aleatórios ou não.
Fonte: College Board AP Course and Exam Description
Dados de duas variáveis nos permitem perguntar se duas características estão associadas 关联 – se saber uma diz algo sobre a outra. Uma variável explicativa 解释变量 (o "input") pode ajudar a prever uma variável resposta 响应变量 (o "output"). Associação não é a mesma coisa que causalidade.
2.2
Duas Variáveis Categóricas
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.P: Comparar representações numéricas e gráficas para duas variáveis categóricas. [Habilidade 2.D]
UNC-1.P.1 Gráficos de barras lado a lado, gráficos de barras segmentados e mosaicos são exemplos de gráficos de barras para uma variável categórica, detalhados por categorias de outra variável categórica.
UNC-1.P.2 Representações gráficas de duas variáveis categóricas podem ser usadas para comparar distribuições e/ou determinar se as variáveis estão associadas.
UNC-1.P.3 Uma tabela de contingência, também chamada de tabela de dupla entrada, é usada para resumir duas variáveis categóricas. As entradas nas células podem ser contagens de frequência ou frequências relativas.
UNC-1.P.4 Uma frequência relativa conjunta é a frequência de uma célula dividida pelo total de toda a tabela.
Fonte: College Board AP Course and Exam Description
Uma tabela de contingência 双向表 (tabela cruzada) conta indivíduos por duas variáveis categóricas ao mesmo tempo. Uma distribuição marginal 边缘分布 é o total de uma linha ou coluna escrito como fração do total geral (os totais em si são apenas contagens). Comparar as células internas mostra se as variáveis estão relacionadas.
2.3
Comparando Grupos com Distribuições Condicionais
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.Q: Calcular estatísticas para duas variáveis categóricas. [Habilidade 2.C]
UNC-1.Q.1 As frequências relativas marginais são os totais das linhas e colunas em uma tabela de contingência divididos pelo total de toda a tabela.
UNC-1.Q.2 Uma frequência relativa condicional é uma frequência relativa para uma parte específica da tabela de contingência (p. ex., frequências de células em uma linha divididas pelo total dessa linha).
Objetivo de Aprendizagem UNC-1.R: Comparar estatísticas para duas variáveis categóricas. [Habilidade 2.D]
UNC-1.R.1 Estatísticas resumidas para duas variáveis categóricas podem ser usadas para comparar distribuições e/ou determinar se as variáveis estão associadas.
Fonte: College Board AP Course and Exam Description
Uma distribuição condicional 条件分布 é a distribuição de uma variável dentro de uma categoria fixa da outra (encontrada dividindo cada célula pelo seu total de linha ou coluna). Se as distribuições condicionais diferirem entre grupos, as duas variáveis estão associadas; se forem iguais, não há associação. Gráficos de barras segmentados 分段条形图 ou diagramas de mosaico os exibem.
2.4
Diagramas de Dispersão para Duas Variáveis Quantitativas
Programa
Compreensão Permanente (UNC-1): Representações gráficas e estatísticas nos permitem identificar e representar características-chave dos dados.
Objetivo de Aprendizagem UNC-1.S: Representar dados bivariados quantitativos usando gráficos de dispersão. [Habilidade 2.B]
UNC-1.S.1 Um conjunto de dados bivariados quantitativos consiste em observações de duas variáveis quantitativas diferentes feitas em indivíduos em uma amostra ou população.
UNC-1.S.2 Um gráfico de dispersão mostra dois valores numéricos para cada observação, um correspondente ao valor no eixo $x$ e um correspondente ao valor no eixo $y$.
UNC-1.S.3 Uma variável explicativa é uma variável cujos valores são usados para explicar ou prever valores correspondentes para a variável resposta.
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.A: Descrever as características de um gráfico de dispersão. [Habilidade 2.A]
DAT-1.A.1 Uma descrição de um gráfico de dispersão inclui forma, direção, intensidade e características incomuns.
DAT-1.A.2 A direção da associação mostrada em um gráfico de dispersão, se houver, pode ser descrita como positiva ou negativa.
DAT-1.A.3 Uma associação positiva significa que, à medida que os valores de uma variável aumentam, os valores da outra variável tendem a aumentar. Uma associação negativa significa que, à medida que os valores de uma variável aumentam, os valores da outra variável tendem a diminuir.
DAT-1.A.4 A forma da associação mostrada em um gráfico de dispersão, se houver, pode ser descrita como linear ou não-linear em diversos graus.
DAT-1.A.5 A intensidade da associação é quão de perto os pontos individuais seguem um padrão específico, p. ex., linear, e pode ser mostrada em um gráfico de dispersão. A intensidade pode ser descrita como forte, moderada ou fraca.
DAT-1.A.6 Características incomuns de um gráfico de dispersão incluem aglomerados de pontos ou pontos com discrepâncias relativamente grandes entre o valor da variável resposta e um valor previsto para a variável resposta.
Fonte: College Board AP Course and Exam Description
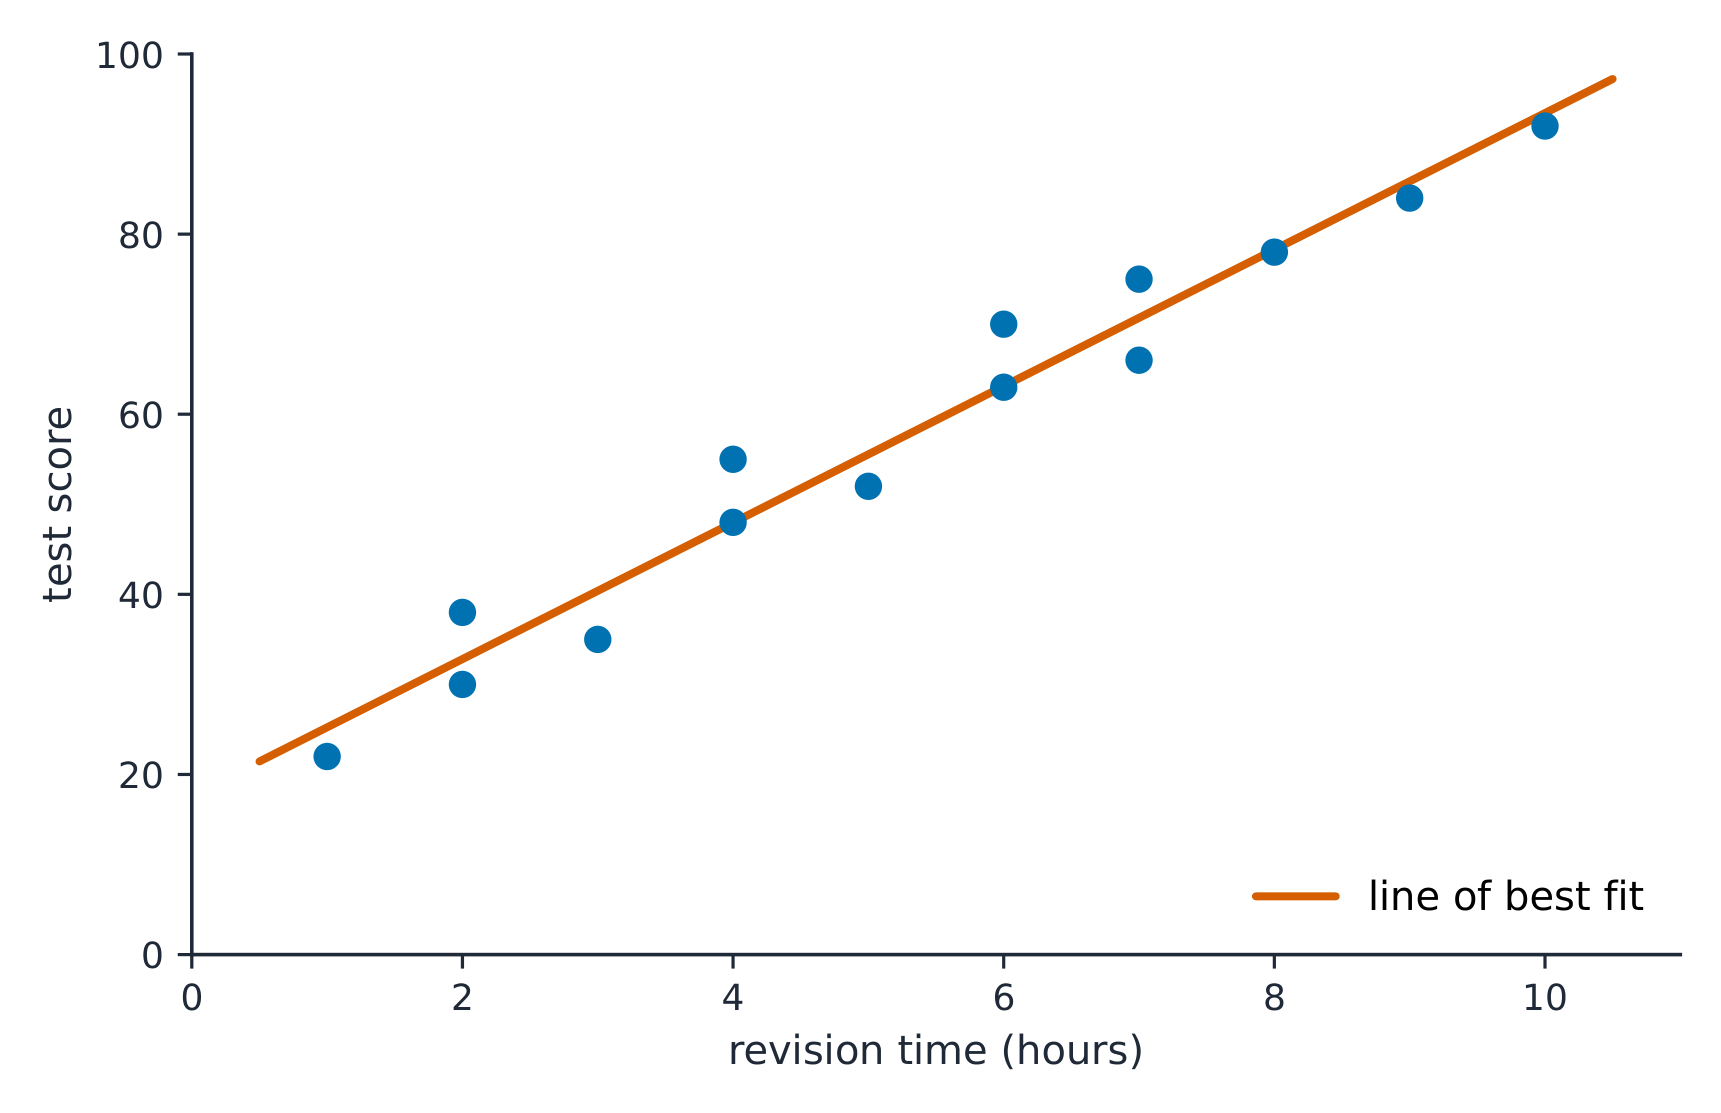
Um diagrama de dispersão 散点图 plota cada indivíduo como um ponto, variável explicativa no eixo $x$ e variável resposta no eixo $y$. Descreva-o com DUFS: Direção (positiva/negativa), Características incomuns (outliers, aglomerados), Forma (linear ou curvilínea) e Força (quão apertadamente os pontos seguem o padrão) – sempre em contexto.
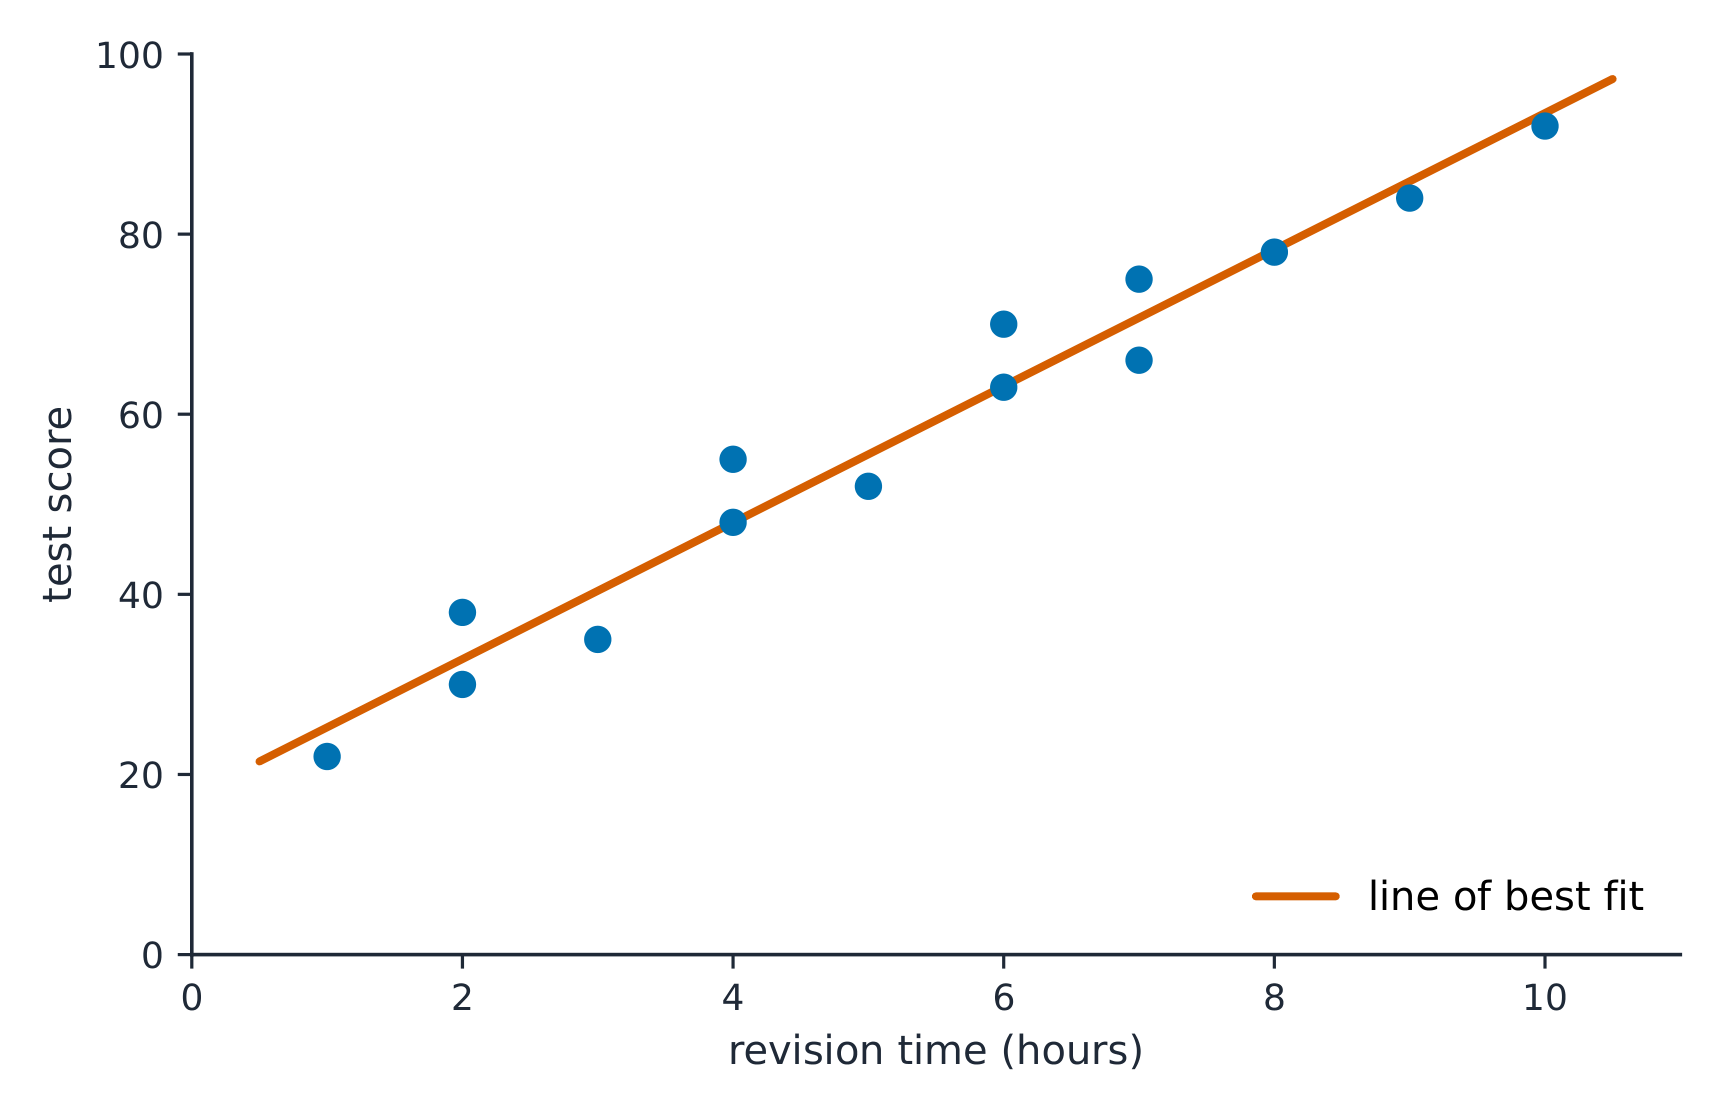
Uma linha de melhor ajuste passa pelo meio dos pontos espalhados
2.5
Correlação
Programa
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.B: Determinar a correlação para uma relação linear. [Habilidade 2.C]
DAT-1.B.1 A correlação, $r$, fornece a direção e quantifica a força da associação linear entre duas variáveis quantitativas.
DAT-1.B.2 O coeficiente de correlação pode ser calculado por: $r = \dfrac{1}{n-1} \sum \left( \dfrac{x_i - \bar{x}}{s_x} \right) \left( \dfrac{y_i - \bar{y}}{s_y} \right)$. No entanto, a maneira mais comum de determinar $r$ é usando tecnologia.
DAT-1.B.3 Um coeficiente de correlação próximo de 1 ou $-1$ não significa necessariamente que um modelo linear seja apropriado.
Objetivo de Aprendizagem DAT-1.C: Interpretar a correlação para uma relação linear. [Habilidade 4.B]
DAT-1.C.1 A correlação, $r$, é adimensional (sem unidades) e está sempre entre $-1$ e 1, inclusive. Um valor de $r = 0$ indica que não há associação linear. Um valor de $r = 1$ ou $r = -1$ indica que há uma associação linear perfeita.
DAT-1.C.2 Uma relação percebida ou real entre duas variáveis não significa que mudanças em uma variável causem mudanças na outra. Ou seja, correlação não implica necessariamente causalidade.
Fonte: College Board AP Course and Exam Description
O que r realmente mede
O coeficiente de correlação 相关系数$r$ mede a força e direção de uma relação linear. Ele varia de $-1$ a $1$: próximo de $\pm 1$ é forte linear, próximo de $0$ é fraco linear. $r$ não tem unidades e não muda se você inverter as variáveis. Avisos: $r$ só mede a força linear, não é resistente a outliers, e um forte $r$ não prova causalidade.
Correlação positiva sobe juntas; correlação negativa move em direções opostas
Explorar
Força de uma relação linear
Correlação$r$ varia de $-1$ a $1$: perto de $\pm1$ os pontos abraçam uma linha, perto de 0 eles se espalham. Mude-o e observe a nuvem apertar ou se espalhar.
2.6
Modelos de Regressão Linear
Programa
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.D: Calcular um valor de resposta previsto usando um modelo de regressão linear. [Habilidade 2.C]
DAT-1.D.1 Um modelo de regressão linear simples é uma equação que usa uma variável explicativa, $x$, para prever a variável resposta, $y$.
DAT-1.D.2 O valor de resposta previsto, denotado por $\hat{y}$, é calculado como $\hat{y} = a + bx$, onde $a$ é o intercepto-$y$ e $b$ é a inclinação (coeficiente angular) da linha de regressão, e $x$ é o valor da variável explicativa.
DAT-1.D.3 Extrapolação é prever um valor de resposta usando um valor para a variável explicativa que esteja além do intervalo de valores-$x$ usados para determinar a linha de regressão. O valor previsto é menos confiável como estimativa quanto maior for a extrapolação.
Fonte: College Board AP Course and Exam Description
A linha de regressão de mínimos quadrados 最小二乘回归线 prediz a resposta: $\hat{y}=a+bx$, onde $\hat{y}$ é a resposta prevista. A inclinação 斜率$b$ é a mudança prevista em $y$ por cada aumento de uma unidade em $x$; o $y$-intercepto 截距$a$ é a $y$ prevista quando $x=0$. Interprete ambos em contexto e com unidades – uma habilidade avaliada. Evite extrapolação 外推 (prever muito fora dos dados).
Exemplo resolvido. Um estudo sobre horas de estudo ($x$) e pontuação no teste ($y$) resulta em $\hat{y}=20+3x$. A inclinação significa que cada hora extra de estudo está associada a um aumento previsto de $3$ pontos. Um aluno que estuda $5$ horas é previsto para obter $\hat{y}=20+3(5)=35$.
Explorar
Ajuste uma linha de mínimos quadrados
Uma linha de regressão é o melhor ajuste de linha reta, minimizando as distâncias verticais ao quadrado. Sua inclinação prevê como $y$ muda por unidade de $x$.
2.7
Resíduos
Programa
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.E: Representar diferenças entre respostas medidas e previstas usando gráficos de resíduos. [Habilidade 2.B]
DAT-1.E.1 O resíduo é a diferença entre o valor real e o valor previsto: $\text{residual} = y - \hat{y}$.
DAT-1.E.2 Um gráfico de resíduos é um gráfico de resíduos versus valores da variável explicativa ou valores de resposta previstos.
Objetivo de Aprendizagem DAT-1.F: Descrever a forma de associação de dados bivariados usando gráficos de resíduos. [Habilidade 2.A]
DAT-1.F.1 A aparente aleatoriedade em um gráfico de resíduos para um modelo linear é evidência de uma forma linear para a associação entre as variáveis.
DAT-1.F.2 Gráficos de resíduos podem ser usados para investigar a adequação de um modelo selecionado.
Fonte: College Board AP Course and Exam Description
Regressão pelos mínimos quadrados
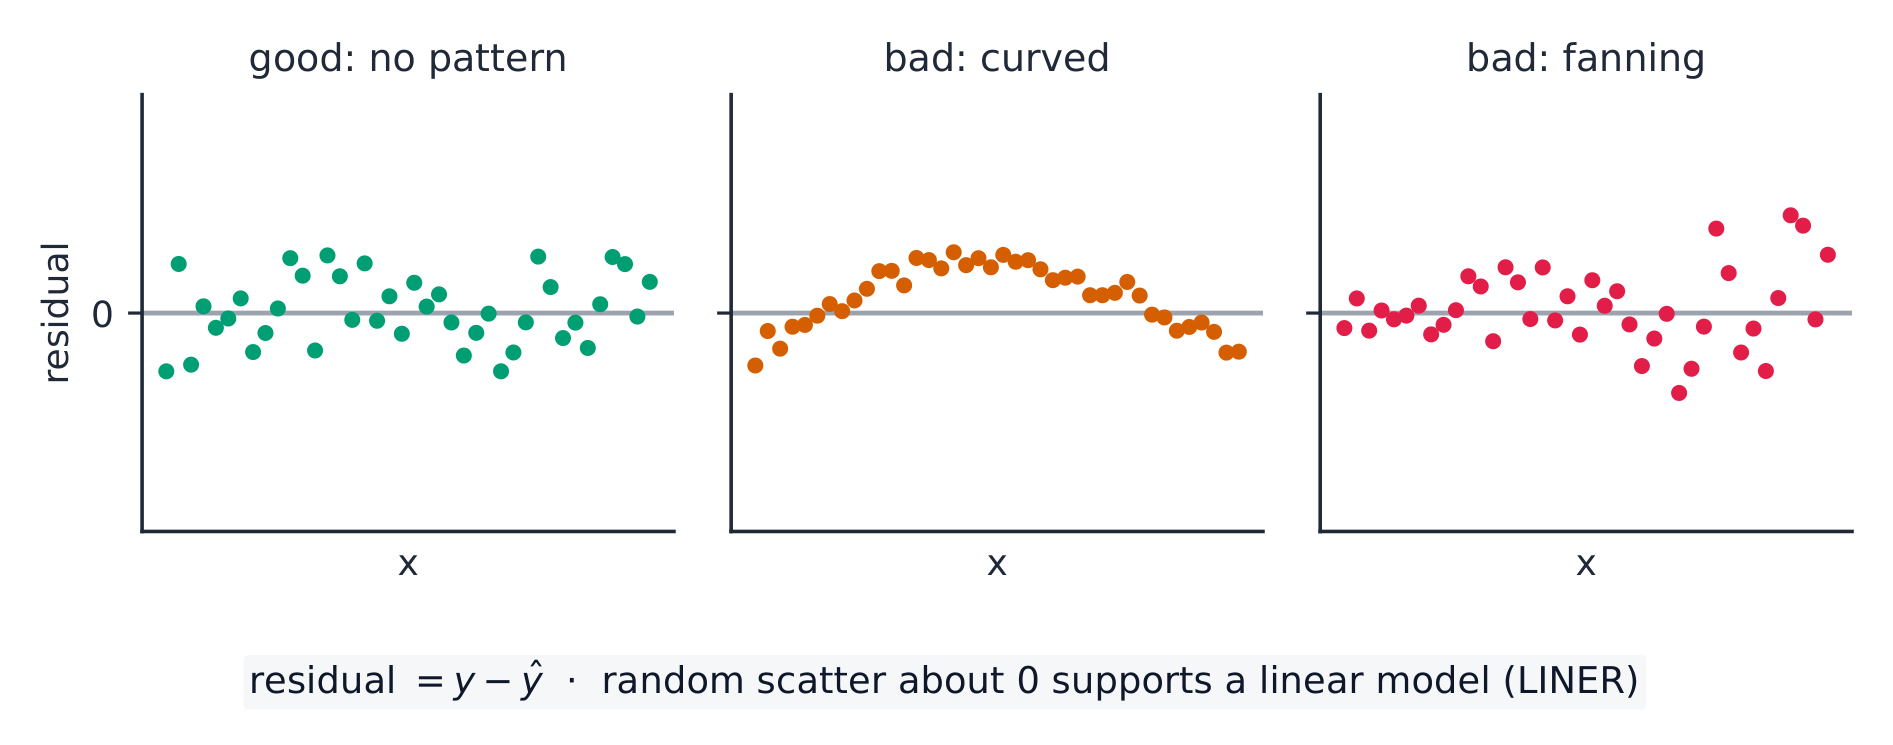
Um resíduo 残差 é o valor real menos o previsto, $y-\hat{y}$: quão longe um ponto fica acima (+) ou abaixo (−) da linha. Um gráfico de resíduos 残差图 grafica resíduos contra $x$. Se mostrar nenhum padrão (dispersão aleatória), um modelo linear é apropriado; um padrão curvo ou em leque indica que o modelo linear é um mau ajuste.
Exemplo resolvido. Continuando o estudo acima, um aluno que estudou $5$ horas obteve realmente $40$. O resíduo é $y-\hat{y}=40-35=+5$: a linha subestimou em $5$ pontos, então este ponto fica acima da linha.
Um alerta sobre $r$ e a linha: todos os quatro conjuntos de dados têm o mesmo $r=0.82$ e a mesma $\hat{y}=3.0+0.5x$, mas apenas o primeiro é genuinamente linear. Os diagramas de dispersão mal diferem — o que expõe a curva, o outlier e o ponto de alta alavancagem é o gráfico de resíduos abaixo de cada um.
2.8
Mínimos Quadrados de Regressão e Seu Ajuste
Programa
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.G: Estimar parâmetros para o modelo da linha de regressão dos mínimos quadrados. [Habilidade 2.C]
DAT-1.G.1 O modelo de regressão dos mínimos quadrados minimiza a soma dos quadrados dos resíduos e contém o ponto $(\bar{x}, \bar{y})$.
DAT-1.G.2 A inclinação, $b$, da linha de regressão pode ser calculada como $b = r \left( \dfrac{s_y}{s_x} \right)$ onde $r$ é a correlação entre $x$ e $y$, $s_y$ é o desvio padrão amostral da variável resposta, $y$, e $s_x$ é o desvio padrão amostral da variável explicativa, $x$.
DAT-1.G.3 Às vezes, o intercepto-$y$ da linha não tem uma interpretação lógica no contexto.
DAT-1.G.4 Na regressão linear simples, $r^2$ é o quadrado da correlação, $r$. É também chamado de coeficiente de determinação. $r^2$ é a proporção da variação na variável resposta que é explicada pela variável explicativa no modelo.
Objetivo de Aprendizagem DAT-1.H: Interpretar coeficientes para o modelo da linha de regressão dos mínimos quadrados. [Habilidade 4.B]
DAT-1.H.1 Os coeficientes do modelo de regressão dos mínimos quadrados são a inclinação estimada e o intercepto-$y$.
DAT-1.H.2 A inclinação é a quantidade pela qual o valor previsto-$y$ muda para cada aumento de uma unidade em $x$.
DAT-1.H.3 O valor do intercepto-$y$ é o valor previsto da variável resposta quando a variável explicativa é igual a $0$. A fórmula para o intercepto-$y$, $a$, é $a = \bar{y} - b\bar{x}$.
Fonte: College Board AP Course and Exam Description
A linha de mínimos quadrados minimiza a soma dos resíduos ao quadrado
A linha minimiza a soma dos resíduos ao quadrado. Seu ajuste é medido por:
$s$, o desvio padrão dos resíduos – o erro de previsão típico, nas unidades da resposta.
$r^2$, o coeficiente de determinação 决定系数 – a proporção da variação em $y$ que o modelo linear explica (um valor entre $0$ e $1$; multiplique por $100$ para expressar como percentual). Relate-o em contexto: "$r^2 = 0.81$ significa que 81% da variação em $y$ é explicada pela relação linear com $x$."
coefficient of determination/ˌkəʊɪˈfɪʃənt ɒv dɪˌtɜːmɪˈneɪʃn/
决定系数
jué dìng xì shù
high-leverage/haɪ ˈliːvərɪdʒ/
高杠杆
gāo gàng gǎn
influential/ˌɪnfluːˈenʃl/
有影响的
yǒu yǐng xiǎng de
2.9
Partidas da Linearidade
Programa
Compreensão Duradoura (DAT-1): Modelos de regressão podem nos permitir prever respostas a mudanças em uma variável explicativa.
Objetivo de Aprendizagem DAT-1.I: Identificar pontos influentes em regressão. [Habilidade 2.A]
DAT-1.I.1 Um ponto atípico em regressão é um ponto que não segue a tendência geral mostrada no restante dos dados e possui um resíduo grande quando a Linha de Regressão dos Mínimos Quadrados (LSRL) é calculada.
DAT-1.I.2 Um ponto de alta alavancagem em regressão possui um valor-$x$ substancialmente maior ou menor do que os outros observações possuem.
DAT-1.I.3 Um ponto influente em regressão é qualquer ponto que, se removido, altere a relação substancialmente. Exemplos incluem inclinação muito diferente, intercepto-$y$ e/ou correlação. Pontos atípicos e pontos de alta alavancagem são frequentemente influentes.
Objetivo de Aprendizagem DAT-1.J: Calcular uma resposta prevista usando uma linha de regressão dos mínimos quadrados para um conjunto de dados transformados. [Habilidade 2.C]
DAT-1.J.1 Transformações de variáveis, como avaliar o logaritmo natural de cada valor da variável resposta ou elevar ao quadrado cada valor da variável explicativa, podem ser usadas para criar conjuntos de dados transformados, que podem ter uma forma mais linear do que os dados não transformados.
DAT-1.J.2 Maior aleatoriedade em gráficos de resíduos após a transformação de dados e/ou movimento de $r^2$ para um valor mais próximo de 1 oferece evidências de que a linha de regressão dos mínimos quadrados para os dados transformados é um modelo mais adequado para usar para prever respostas à variável explicativa do que a linha de regressão para os dados não transformados.
Fonte: College Board AP Course and Exam Description
Alguns pontos afetam fortemente a linha. Um ponto de alta alavancagem 高杠杆 tem um valor extremo de $x$; um ponto influente 有影响的 altera notavelmente a inclinação ou $r$ quando removido; um outlier aqui é um ponto com grande resíduo. Quando o padrão é curvo, transforme uma variável (ex. tomar logaritmo) para linearizá-la, depois ajuste uma linha aos dados transformados.
2.9
Dicas de prova
Em um diagrama de dispersão descreva direção, forma, força e outliers; $r$ varia de $-1$ a $1$.
Correlação não é causalidade – uma variável latente pode impulsionar ambas.
Interprete a inclinação da linha de mínimos quadrados em contexto ("por uma unidade de $x$, a $y$ prevista muda em $b$").
Verifique um gráfico de resíduos: nenhum padrão significa que uma linha ajusta; uma curva significa que não ajusta. Evite extrapolação.
$r^2$ é a fração da variação em $y$ explicada pelo modelo.
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.E: Identificar perguntas a serem respondidas sobre métodos de coleta de dados. [Habilidade 1.A]
VAR-1.E.1 Métodos para coleta de dados que não dependem do acaso resultam em conclusões não confiáveis.
Fonte: College Board AP Course and Exam Description
Uma conclusão é tão boa quanto os dados por trás dela. Como os dados são coletados determina o que você pode concluir – se pode generalizar para uma população 总体, e se pode afirmar causa e efeito. Dados mal coletados podem ser piores do que nenhuns.
3.2
Estudos Observacionais e Experimentos
Programa
Compreensão Duradoura (DAT-2): A forma como coletamos dados influencia o que podemos e não podemos dizer sobre uma população.
Objetivo de Aprendizagem DAT-2.A: Identificar o tipo de estudo. [Habilidade 1.C]
DAT-2.A.1 Uma população consiste em todos os itens ou sujeitos de interesse.
DAT-2.A.2 Uma amostra selecionada para estudo é um subconjunto da população.
DAT-2.A.3 Em um estudo observacional, tratamentos não são impostos. Investigadores examinam dados de uma amostra de indivíduos (retrospectivo) ou seguem uma amostra de indivíduos para o futuro coletando dados (prospectivo) a fim de investigar um tópico de interesse sobre a população. Uma pesquisa amostral é um tipo de estudo observacional que coleta dados de uma amostra na tentativa de aprender sobre a população da qual a amostra foi retirada.
DAT-2.A.4 Em um experimento, diferentes condições (tratamentos) são atribuídas às unidades experimentais (participantes ou sujeitos).
Objetivo de Aprendizagem DAT-2.B: Identificar generalizações e determinações apropriadas baseadas em estudos observacionais. [Habilidade 4.A]
DAT-2.B.1 Somente é apropriado fazer generalizações sobre uma população com base em amostras que são selecionadas aleatoriamente ou que sejam representativas dessa população.
DAT-2.B.2 Uma amostra só é generalizável para a população da qual a amostra foi selecionada.
DAT-2.B.3 Não é possível determinar relações causais entre variáveis usando dados coletados em um estudo observacional.
Fonte: College Board AP Course and Exam Description
Em um estudo observacional 观察性研究 você mede indivíduos sem tentar influenciá-los. Pode mostrar associação, mas não causalidade, porque variáveis latentes podem explicar o vínculo.
Em um experimento 实验 você deliberadamente impõe um tratamento 处理 e compara respostas. Um experimento bem projetado pode estabelecer causa e efeito.
Explorar
Estudo observacional ou experimento?
Em um experimento, o pesquisador impõe um tratamento (e pode mostrar causa); um estudo observacional apenas registra o que já acontece (e pode mostrar associação, não causa).
Compreensão Duradoura (DAT-2): A forma como coletamos dados influencia o que podemos e não podemos dizer sobre uma população.
Objetivo de Aprendizagem DAT-2.C: Identificar um método de amostragem, dada uma descrição de um estudo. [Habilidade 1.C]
DAT-2.C.1 Quando um item de uma população pode ser selecionado apenas uma vez, isso é chamado de amostragem sem reposição. Quando um item da população pode ser selecionado mais de uma vez, isso é chamado de amostragem com reposição.
DAT-2.C.2 Uma amostra aleatória simples (SRS) é uma amostra na qual todo grupo de tamanho dado tem uma chance igual de ser escolhido. Este método é a base para muitos tipos de mecanismos de amostragem. Alguns exemplos de mecanismos usados para obter SRSs incluem numerar indivíduos e usar um gerador de números aleatórios para selecionar quais incluí-los na amostra, ignorando repetições, usando uma tabela de números aleatórios ou retirando uma carta de um baralho sem reposição.
DAT-2.C.3 Uma amostra aleatória estratificada envolve a divisão de uma população em grupos separados, chamados estratos, com base em atributos ou características compartilhadas (agrupamento homogêneo). Dentro de cada estrato, uma amostra aleatória simples é selecionada, e as unidades selecionadas são combinadas para formar a amostra.
DAT-2.C.4 Uma amostra de conglomerados envolve a divisão de uma população em grupos menores, chamados conglomerados. Idealmente, há heterogeneidade dentro de cada conglomerado, e conglomerados são semelhantes uns aos outros em sua composição. Uma amostra aleatória simples de conglomerados é selecionada da população para formar a amostra de conglomerados. Os dados são coletados de todas as observações nos conglomerados selecionados.
DAT-2.C.5 Uma amostra aleatória sistemática é um método no qual membros da amostra de uma população são selecionados de acordo com um ponto inicial aleatório e um intervalo periódico fixo.
DAT-2.C.6 Um censo seleciona todos os itens/sujeitos em uma população.
Objetivo de Aprendizagem DAT-2.D: Explicar por que um determinado método de amostragem é ou não é apropriado para uma situação dada. [Habilidade 1.C]
DAT-2.D.1 Existem vantagens e desvantagens para cada método de amostragem dependendo da pergunta que deve ser respondida e da população da qual a amostra será extraída.
Fonte: College Board AP Course and Exam Description
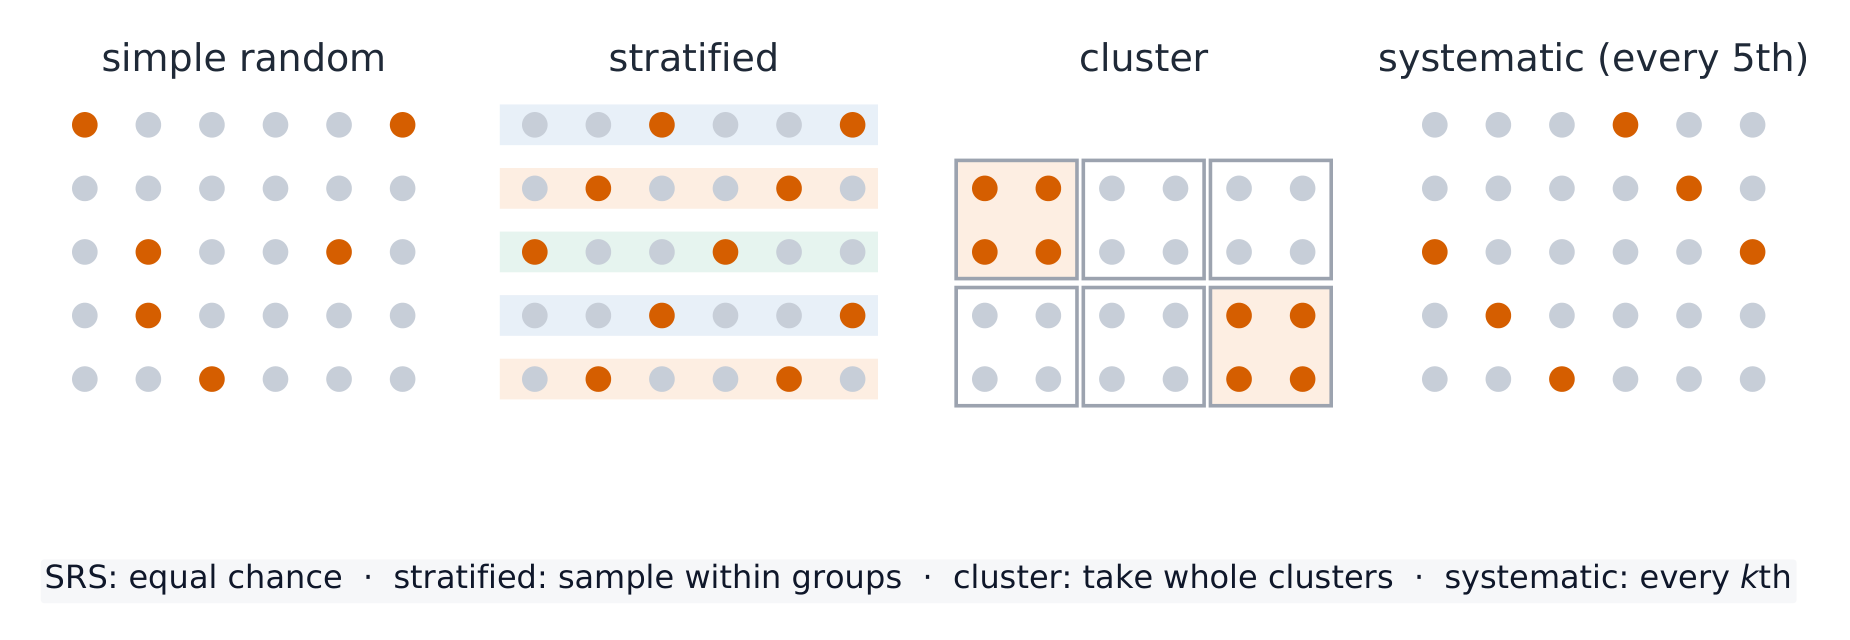
Para aprender sobre uma população, você tira uma amostra 样本. Amostragem aleatória 随机抽样 protege contra viés de seleção e permite generalizar (não corrige subcobertura, não-resposta ou viés de resposta – veja abaixo). Desenhos comuns:
Amostra aleatória simples (SRS) 简单随机样本: todo grupo do tamanho escolhido tem igual probabilidade.
Estratificada 分层: divida a população em estratos semelhantes, depois amostra dentro de cada um.
Por conglomerados 整群: divide em conglomerados, escolhe conglomerados inteiros aleatoriamente.
Sistemática 系统: seleciona a cada $k$º indivíduo a partir de um início aleatório.
Quatro desenhos de amostragem aleatória: quem é selecionado e como
Uma amostra de conveniência 方便样本 ou de resposta voluntária não é aleatória e é viciada.
Exemplo resolvido. Para pesquisar uma escola, um administrador lista todos os alunos por série e seleciona aleatoriamente $20$ de cada série. Esta é uma amostra estratificada – as séries são os estratos – o que garante que todas as séries estejam representadas, ao contrário de uma SRS que poderia, por acaso, tirar poucos de uma série.
Resultados aleatórios: dados fazem cada face ter igual probabilidade em condições justas
3.4
Quando a Amostragem Dá Errado
Programa
Compreensão Duradoura (DAT-2): A forma como coletamos dados influencia o que podemos e não podemos dizer sobre uma população.
Objetivo de Aprendizagem DAT-2.E: Identificar potenciais fontes de viés em métodos de amostragem. [Habilidade 1.C]
DAT-2.E.1 Viés ocorre quando certas respostas são sistematicamente favorecidas em detrimento de outras.
DAT-2.E.2 Quando uma amostra é composta inteiramente por voluntários ou pessoas que escolhem participar, a amostra tipicamente não será representativa da população (viés de resposta voluntária).
DAT-2.E.3 Quando uma parte da população tem uma chance reduzida de ser incluída na amostra, a amostra tipicamente não será representativa da população (viés de subcobertura).
DAT-2.E.4 Indivíduos selecionados para a amostra para os quais dados não podem ser obtidos (ou que se recusam a responder) podem diferir daqueles para os quais dados podem ser obtidos (viés de não-resposta).
DAT-2.E.5 Problemas no instrumento ou processo de coleta de dados resultam em viés de resposta. Exemplos incluem perguntas confusas ou tendenciosas (viés de formulação de perguntas) e respostas autorreferidas.
DAT-2.E.6 Métodos de amostragem não aleatória (por exemplo, amostras escolhidas por conveniência ou resposta voluntária) introduzem potencial para viés porque não usam o acaso para selecionar os indivíduos.
Fonte: College Board AP Course and Exam Description
Viés faz estimativas falharem sistematicamente na verdade:
Subcobertura 覆盖不足: alguns grupos ficam de fora da grade amostral.
Não-resposta 无回应: pessoas selecionadas não respondem.
Viés de resposta 回应偏差: pessoas respondem imprecisamente (má formulação, tópicos sensíveis).
O viés trata-se de um erro constante em uma direção – aumentar o tamanho da amostra não o corrige.
Amostras de conveniência perdem a população: o viés se infiltra quando a seleção não é aleatória
Compreensão Duradoura (VAR-3): Experimentos bem desenhados podem estabelecer evidências de relações causais.
Objetivo de Aprendizagem VAR-3.A: Identificar os componentes de um experimento. [Habilidade 1.C]
VAR-3.A.1 As unidades experimentais são os indivíduos (que podem ser pessoas ou outros objetos de estudo) aos quais tratamentos são atribuídos. Quando as unidades experimentais consistem em pessoas, elas são às vezes referidas como participantes ou sujeitos.
VAR-3.A.2 Uma variável explicativa (ou fator) em um experimento é uma variável cujos níveis são manipulados intencionalmente. Os níveis ou combinações de níveis da(s) variável(is) explicativa(s) são chamados de tratamentos.
VAR-3.A.3 Uma variável de resposta em um experimento é um resultado das unidades experimentais que é medido após a administração dos tratamentos.
VAR-3.A.4 Uma variável de confusão em um experimento é uma variável que está relacionada à variável explicativa e influencia a variável de resposta, podendo criar uma percepção falsa de associação entre as duas.
Objetivo de Aprendizagem VAR-3.B: Descrever elementos de um experimento bem desenhado. [Habilidade 1.B]
VAR-3.B.1 Um experimento bem desenhado deve incluir o seguinte:
a. Comparações de pelo menos dois grupos de tratamento, dos quais um pode ser um grupo controle.
b. Atribuição aleatória/atribuição de tratamentos às unidades experimentais.
c. Replicação (mais de uma unidade experimental em cada grupo de tratamento).
d. Controle de possíveis variáveis de confusão quando apropriado.
Objetivo de Aprendizagem VAR-3.C: Comparar desenhos experimentais e métodos. [Habilidade 1.C]
VAR-3.C.1 Em um delineamento totalmente aleatório, os tratamentos são atribuídos às unidades experimentais completamente ao acaso. A atribuição aleatória tende a equilibrar os efeitos de variáveis não controladas (de confusão) para que diferenças nas respostas possam ser atribuídas aos tratamentos.
VAR-3.C.2 Métodos para atribuir aleatoriamente tratamentos às unidades experimentais em um delineamento totalmente aleatório incluem o uso de gerador de números aleatórios, tabela de valores aleatórios, retirada de chips sem reposição, etc.
VAR-3.C.3 Em um experimento com apenas um cego, os sujeitos não sabem qual tratamento estão recebendo, mas os membros da equipe de pesquisa sabem, ou vice-versa.
VAR-3.C.4 Em um experimento duplo-cego, nem os sujeitos nem os membros da equipe de pesquisa que interagem com eles sabem qual tratamento um sujeito está recebendo.
VAR-3.C.5 Um grupo controle é um conjunto de unidades experimentais que não recebem um tratamento de interesse ou recebem um tratamento com substância inerte (placebo) para determinar se o tratamento de interesse tem efeito.
VAR-3.C.6 O efeito placebo ocorre quando as unidades experimentais têm uma resposta a um placebo.
VAR-3.C.7 Para delineamentos de blocos completos aleatórios, os tratamentos são atribuídos completamente ao acaso dentro de cada bloco.
VAR-3.C.8 O bloqueio garante que, no início do experimento, as unidades dentro de cada bloco sejam semelhantes entre si em relação a pelo menos uma variável de bloqueio. Um delineamento de blocos aleatórios ajuda a separar a variabilidade natural das diferenças devidas à variável de bloqueio.
VAR-3.C.9 Um delineamento de pares pareados é um caso especial de delineamento de blocos aleatórios. Usando uma variável de bloqueio, os sujeitos (sejam pessoas ou não) são organizados em pares pareados em fatores relevantes. Pares pareados podem ser formados naturalmente ou pelo experimentador. Cada par recebe ambos os tratamentos atribuindo aleatoriamente um tratamento a um membro do par e subsequentemente atribuindo o tratamento restante ao segundo membro do par. Alternativamente, cada sujeito pode receber ambos os tratamentos.
Fonte: College Board AP Course and Exam Description
Bons experimentos seguem três princípios:
Comparação com um grupo controle 对照组 (muitas vezes um placebo 安慰剂).
Alocação aleatória 随机分配 de sujeitos aos tratamentos, para equilibrar outras variáveis.
Replicação 重复: suficientes sujeitos por tratamento para ver um efeito real.
Um experimento totalmente aleatório compara um grupo de tratamento com um grupo controle
Confounding 混杂 ocorre quando outra variável está associada ao tratamento, de modo que seus efeitos não podem ser separados; a atribuição aleatória protege contra isso. Blinding 盲法 oculta quem recebe qual tratamento para evitar efeitos de expectativa: em um estudo single-blind 单盲 apenas uma parte fica sem saber (geralmente os sujeitos, ou apenas as pessoas que avaliam o resultado), enquanto em um estudo double-blind 双盲nenhum dos sujeitos nem os pesquisadores que interagem com eles sabem, bloqueando tanto o efeito placebo quanto a avaliação tendenciosa. Blocking 区组 agrupa sujeitos semelhantes e randomiza dentro de cada bloco para reduzir a variabilidade.
Um ensaio clínico: a atribuição aleatória separa o tratamento do controle
Compreensão Duradoura (VAR-3): Experimentos bem desenhados podem estabelecer evidências de relações causais.
Objetivo de Aprendizagem VAR-3.D: Explicar por que um determinado desenho experimental é adequado. [Habilidade 1.C]
VAR-3.D.1 Existem vantagens e desvantagens para cada desenho experimental dependendo da questão de interesse, dos recursos disponíveis e da natureza das unidades experimentais.
Fonte: College Board AP Course and Exam Description
Combine o design com o objetivo: use um design totalmente aleatorizado para sujeitos uniformes; um design de bloco aleatorizado quando uma variável conhecida (sexo, idade) afeta a resposta; um design pares emparelhados quando cada sujeito pode servir como seu próprio controle. Declare como você realizaria a randomização.
3.7
What an Experiment Lets You Conclude
Programa
Compreensão Duradoura (VAR-3): Experimentos bem desenhados podem estabelecer evidências de relações causais.
Objetivo de Aprendizagem VAR-3.E: Interpretar os resultados de um experimento bem desenhado. [Habilidade 4.B]
VAR-3.E.1 A inferência estatística atribui conclusões baseadas em dados à distribuição da qual os dados foram coletados.
VAR-3.E.2 A atribuição aleatória de tratamentos às unidades experimentais permite aos pesquisadores concluir que algumas mudanças observadas são tão grandes que é improvável que tenham ocorrido por acaso. Tais mudanças são consideradas estatisticamente significativas.
VAR-3.E.3 Diferenças estatisticamente significativas entre ou entre grupos de tratamento experimental são evidências de que os tratamentos causaram o efeito.
VAR-3.E.4 Se as unidades experimentais usadas em um experimento forem representativas de um grupo maior de unidades, os resultados de um experimento podem ser generalizados para o grupo maior. A seleção aleatória das unidades experimentais oferece melhores chances de que as unidades sejam representativas.
Fonte: College Board AP Course and Exam Description
Two questions decide the scope of a conclusion:
Atribuição aleatória foi usada? Então uma diferença significativa pode ser atribuída ao tratamento (causalidade) – para esses sujeitos.
Amostragem aleatória de uma população? Então os resultados generalizam para essa população.
Apenas um experimento com atribuição aleatória suporta uma alegação de causa e efeito; apenas a amostragem aleatória suporta a generalização. Diga exatamente qual você tem.
Exemplo resolvido. Os pesquisadores atribuem aleatoriamente $100$voluntários a um novo medicamento ou placebo, e o grupo do medicamento melhora significativamente mais. Devido à atribuição aleatória, a melhoria pode ser atribuída ao medicamento (causalidade) – mas como os sujeitos não foram amostrados aleatoriamente, a conclusão aplica-se apenas a esses voluntários e não se generaliza automaticamente para todos.
3.7
Dicas de prova
Distinga um estudo observacional (encontra associação) de um experimento (pode mostrar causalidade).
Boa amostragem é aleatória (SRS, estratificada, conglomerado) – cuidado com viés (resposta voluntária, subcobertura, não resposta).
Bons experimentos usam controle, randomização e replicação; o bloqueio lida com uma variável incômoda conhecida.
Apenas um experimento randomizado suporta uma conclusão de causa e efeito.
Name the population, sample, and any confounding clearly.
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.F: Identificar perguntas sugeridas por padrões nos dados. [Habilidade 1.A]
VAR-1.F.1 Padrões nos dados não significam necessariamente que a variação não é aleatória.
Fonte: College Board AP Course and Exam Description
Algo é aleatório 随机 se os resultados individuais são incertos, mas um padrão regular emerge ao longo de muitas repetições. Os resultados de curto prazo parecem erráticos; as frequências relativas de longo prazo se estabilizam. Essa estabilidade de longo prazo é o que torna a probabilidade útil.
4.2
Estimando Probabilidades Usando Simulação
Programa
Compreensão Duradoura (UNC-2): A simulação nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-2.A: Estimar probabilidades usando simulação. [Habilidade 3.A]
UNC-2.A.1 Um processo aleatório gera resultados que são determinados pelo acaso.
UNC-2.A.2 Um resultado é o produto de um ensaio de um processo aleatório.
UNC-2.A.3 Um evento é um conjunto de resultados.
UNC-2.A.4 Simulação é uma maneira de modelar eventos aleatórios, de modo que resultados simulados correspondam de perto a resultados do mundo real. Todos os resultados possíveis estão associados a um valor a ser determinado pelo acaso. Registre as contagens de resultados simulados e a contagem total.
UNC-2.A.5 A frequência relativa de um resultado ou evento em dados simulados ou empíricos pode ser usada para estimar a probabilidade desse resultado ou evento.
UNC-2.A.6 A lei dos grandes números afirma que probabilidades simuladas (empíricas) tendem a se aproximar da probabilidade verdadeira à medida que o número de ensaios aumenta.
Exemplos ilustrativos para UNC-2.A:
Um resultado: Lançar um valor específico em um dado de seis lados é um dos seis resultados possíveis.
Um evento: Ao lançar dois dados de seis faces, um evento seria a soma sete. A coleção correspondente de resultados seria $(1, 6)$, $(2, 5)$, $(3, 4)$, $(4, 3)$, $(5, 2)$ e $(6, 1)$, onde os pares ordenados indicam (valor da face em um dado, valor da face no outro dado).
Fonte: College Board AP Course and Exam Description
Uma simulação 模拟 imita um processo de acaso usando dígitos aleatórios ou tecnologia. Etapas: declarar o modelo, atribuir dígitos aos resultados, executar muitos ensaios e registrar a proporção de ensaios que atendem à condição. A proporção resultante estima a probabilidade – mais ensaios dão uma estimativa melhor.
4.3
Introdução à Probabilidade
Programa
Compreensão Essencial (VAR-4): A probabilidade de um evento aleatório pode ser quantificada.
Objetivo de Aprendizagem VAR-4.A: Calcular probabilidades para eventos e seus complementos. [Habilidade 3.A]
VAR-4.A.1 O espaço amostral de um processo aleatório é o conjunto de todos os resultados não sobrepostos possíveis.
VAR-4.A.2 Se todos os resultados do espaço amostral forem igualmente prováveis, então a probabilidade de um evento E ocorrer é definida como a fração: $\dfrac{\text{number of outcomes in event E}}{\text{total number of outcomes in sample space}}$
VAR-4.A.3 A probabilidade de um evento é um número entre 0 e 1, inclusive.
VAR-4.A.4 A probabilidade do complemento de um evento E, $E'$ ou $E^{C}$ (ou seja, não E), é igual a $1 - P(E)$.
Objetivo de Aprendizagem VAR-4.B: Interpretar probabilidades para eventos. [Habilidade 4.B]
VAR-4.B.1 As probabilidades de eventos em situações repetíveis podem ser interpretadas como a frequência relativa com que o evento ocorrerá a longo prazo.
Fonte: College Board AP Course and Exam Description
A probabilidade 概率 de um evento é um número de $0$ a $1$ que dá sua frequência relativa de longo prazo. O espaço amostral 样本空间 é o conjunto de todos os resultados. Para um evento $A$, a regra do complemento 补: $P(A^c)=1-P(A)$. As probabilidades de todos os resultados somam $1$.
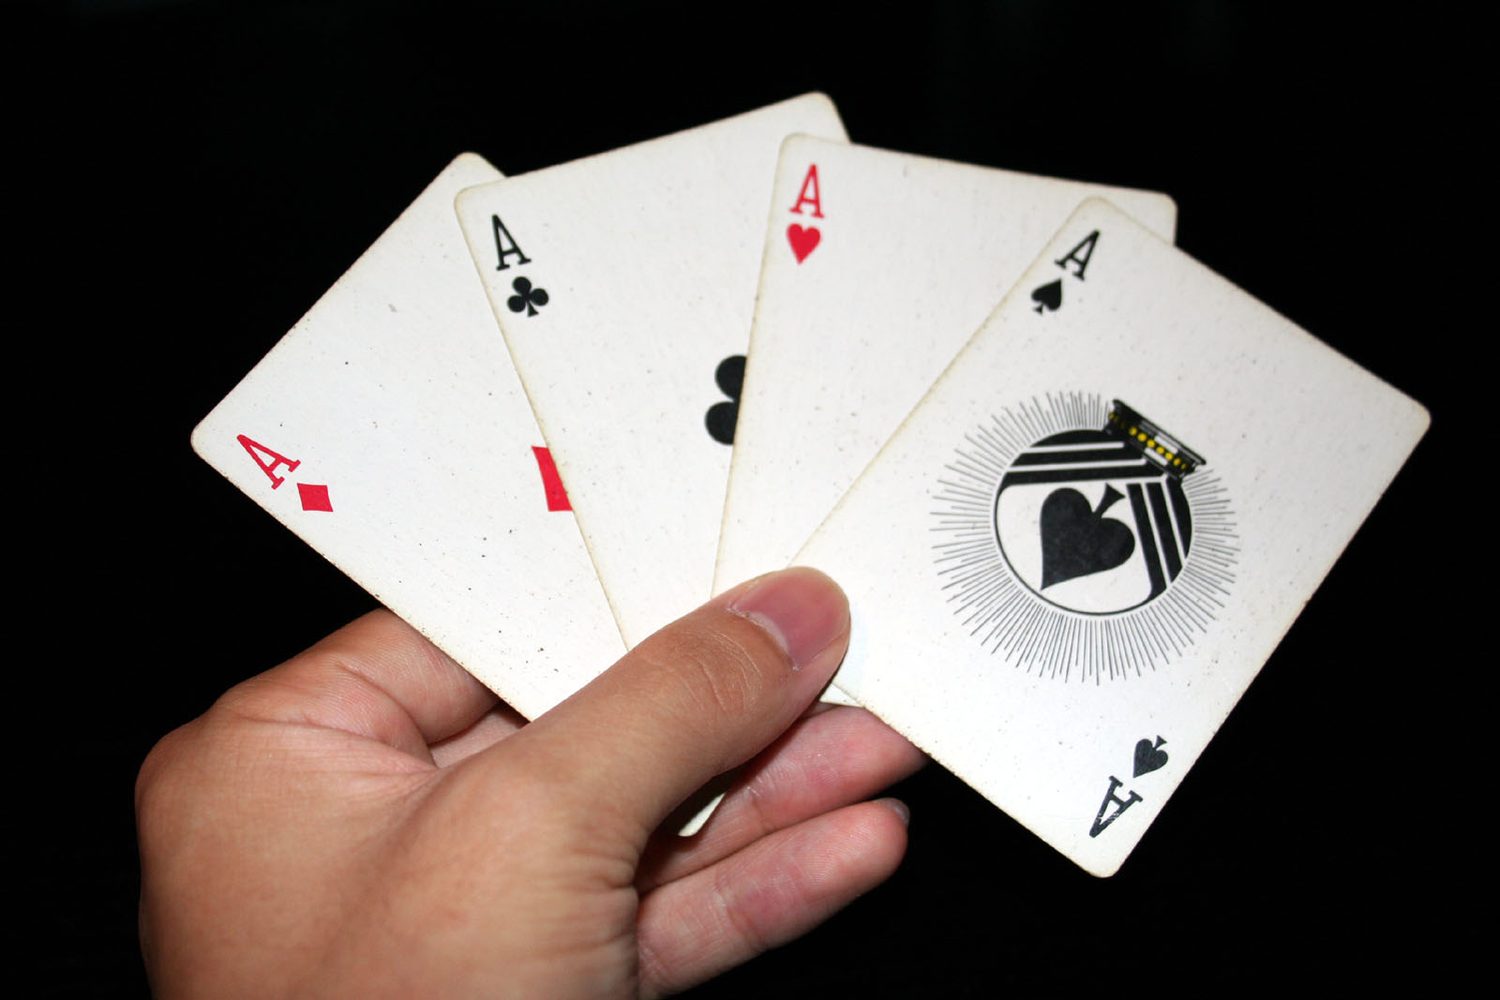
Probability runs from 0 (impossible) to 1 (certain)Um baralho de cartas é uma fonte clássica de probabilidade: 52 resultados igualmente prováveis tornam as chances fáceis de contar
Explorar
Explore probabilidade com dados
Probabilidade é a fração de longo prazo das vezes que um resultado ocorre. Jogue os dados muitas vezes e observe as proporções experimentais convergirem para os valores teóricos.
Compreensão Essencial (VAR-4): A probabilidade de um evento aleatório pode ser quantificada.
Objetivo de Aprendizagem VAR-4.C: Explicar por que dois eventos são (ou não são) mutuamente exclusivos. [Habilidade 4.B]
VAR-4.C.1 A probabilidade de que os eventos $A$ e $B$ ambos ocorrerem, às vezes chamada de probabilidade conjunta, é a probabilidade da interseção de $A$ e $B$, denotada $P(A \cap B)$.
VAR-4.C.2 Dois eventos são mutuamente exclusivos ou disjuntos se não puderem ocorrer ao mesmo tempo. Portanto, $P(A \cap B) = 0$.
Fonte: College Board AP Course and Exam Description
Dois eventos são mutuamente exclusivos 互斥 (disjuntos) se não podem acontecer ambos. Então a regra da adição simplifica-se:
$$P(A\text{ or }B)=P(A)+P(B)\quad(\text{if mutually exclusive}).$$
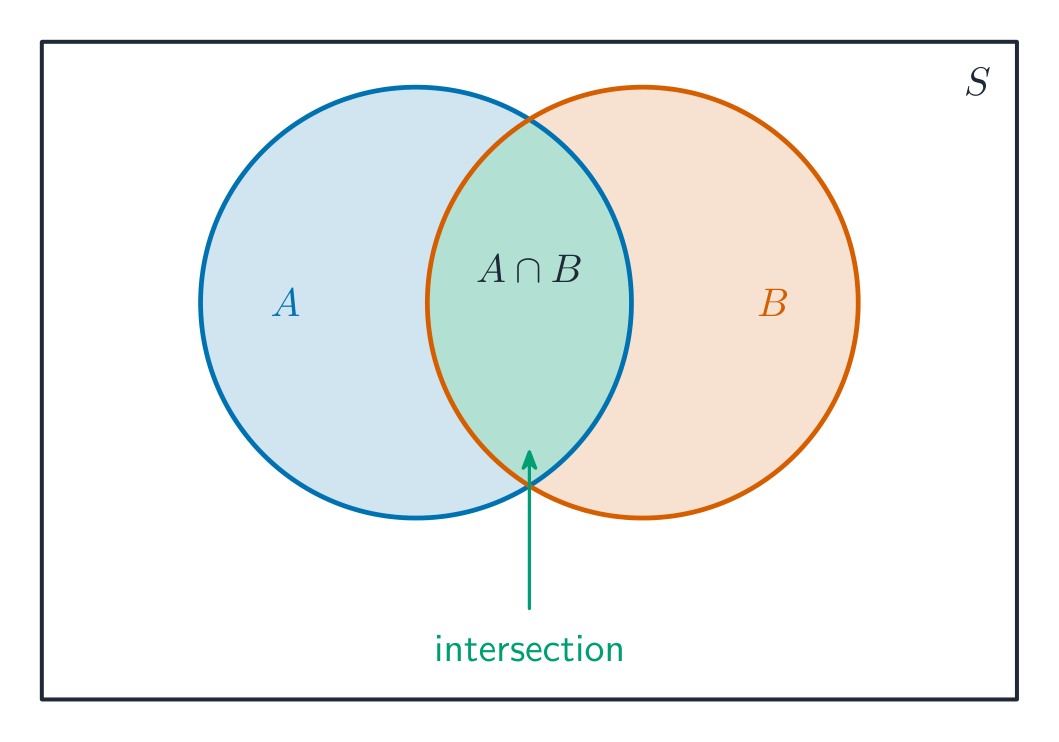
Em geral, $P(A\text{ or }B)=P(A)+P(B)-P(A\text{ and }B)$ – subtraia a interseção para que não seja contada duas vezes.
Um diagrama de Venn: a sobreposição é a interseção de dois eventos
Compreensão Essencial (VAR-4): A probabilidade de um evento aleatório pode ser quantificada.
Objetivo de Aprendizagem VAR-4.D: Calcular probabilidades condicionais. [Habilidade 3.A]
VAR-4.D.1 A probabilidade de que o evento $A$ ocorrer dado que o evento $B$ ocorreu é chamada de probabilidade condicional e denotada $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.
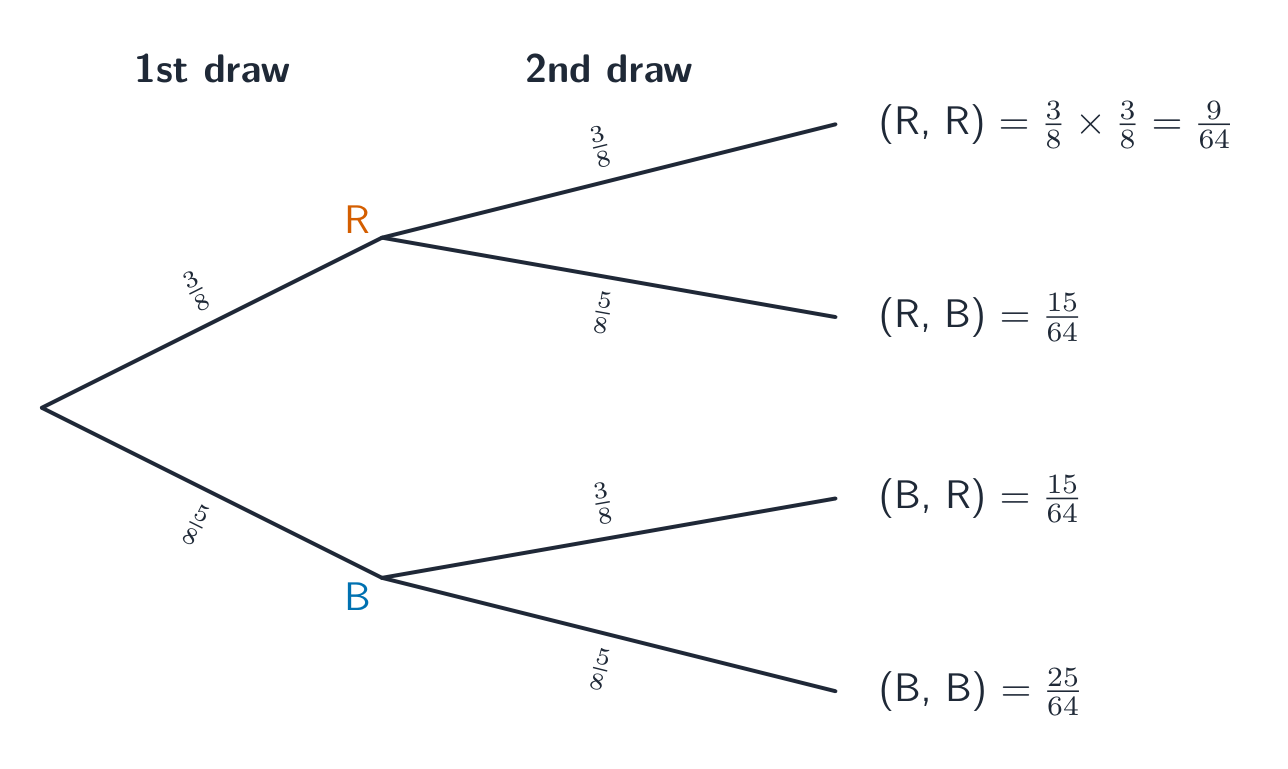
VAR-4.D.2 A regra da multiplicação afirma que a probabilidade de que os eventos $A$ e $B$ ocorram ambos é igual à probabilidade de que o evento $A$ ocorra multiplicada pela probabilidade de que o evento $B$ ocorra, dado que $A$ ocorreu. Isso é denotado $P(A \cap B) = P(A) \cdot P(B \mid A)$.
Fonte: College Board AP Course and Exam Description
Probabilidade condicional
A conditional probability 条件概率 of $A$ given $B$ is
$$P(A\mid B)=\frac{P(A\text{ and }B)}{P(B)}.$$
É a chance de $A$ uma vez que você saiba que $B$ aconteceu. Tabelas de dupla entrada facilitam isso: restrinja-se à linha/coluna para $B$, então encontre a participação de $A$.
Em um diagrama de árvore, multiplique as probabilidades ao longo dos ramos
Explorar
Atualizar uma probabilidade com novas informações
Probabilidade condicional$P(B\mid A)$ é a chance de $B$ depois que você sabe que $A$ ocorreu. Altere as probabilidades dos ramos e observe como a condicionamento remodela o resultado.
Compreensão Essencial (VAR-4): A probabilidade de um evento aleatório pode ser quantificada.
Objetivo de Aprendizagem VAR-4.E: Calcular probabilidades para eventos independentes e para a união de dois eventos. [Habilidade 3.A]
VAR-4.E.1 Os eventos $A$ e $B$ são independentes se, e somente se, saber se o evento $A$ ocorreu (ou ocorrerá) não altera a probabilidade de que o evento $B$ ocorrerá.
VAR-4.E.2 Se, e somente se, os eventos $A$ e $B$ forem independentes, então $P(A \mid B) = P(A)$, $P(B \mid A) = P(B)$ e $P(A \cap B) = P(A) \cdot P(B)$.
VAR-4.E.3 A probabilidade de que o evento $A$ ou o evento $B$ (ou ambos) ocorrerem é a probabilidade da união de $A$ e $B$, denotada $P(A \cup B)$.
VAR-4.E.4 A regra da adição afirma que a probabilidade de que o evento $A$ ou o evento $B$ ou ambos ocorrerão é igual à probabilidade de que o evento $A$ ocorrer mais a probabilidade de que o evento $B$ ocorrer menos a probabilidade de que ambos os eventos $A$ e $B$ ocorram. Isso é denotado $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
Fonte: College Board AP Course and Exam Description
Os eventos são independentes 独立 se saber um não altera a probabilidade do outro: $P(A\mid B)=P(A)$. Então a regra de multiplicação simplifica:
$$P(A\text{ and }B)=P(A)\,P(B)\quad(\text{if independent}).$$
Independente não é o mesmo que mutuamente exclusivo – eventos mutuamente exclusivos com probabilidade não nula são na verdade dependentes (se um acontece, o outro não pode).
Um diagrama de espaço amostral lista todos os resultados igualmente prováveis
Explorar
Combinar eventos com um diagrama de Venn
Para uma união$P(A\cup B)=P(A)+P(B)-P(A\cap B)$ — subtraia a interseção para que não seja contada duas vezes. Alterne a operação para ver cada região acender.
probability distribution/ˌprɒbəˈbɪlɪti ˌdɪstrɪˈbjuːʃn/
概率分布
gài lǜ fēn bù
4.7
Random Variables and Probability Distributions
Programa
Compreensão Essencial (VAR-5): As distribuições de probabilidade podem ser usadas para modelar variações em populações.
Objetivo de Aprendizagem VAR-5.A: Representar a distribuição de probabilidade para uma variável aleatória discreta. [Habilidade 2.B]
VAR-5.A.1 Os valores de uma variável aleatória são os resultados numéricos do comportamento aleatório.
VAR-5.A.2 Uma variável aleatória discreta é uma variável que pode assumir apenas um número contável de valores. Cada valor tem uma probabilidade associada a ele. A soma das probabilidades sobre todos os valores possíveis deve ser 1.
VAR-5.A.3 Uma distribuição de probabilidade pode ser representada como um gráfico, tabela ou função mostrando as probabilidades associadas aos valores de uma variável aleatória.
VAR-5.A.4 Uma distribuição de probabilidade acumulativa pode ser representada como uma tabela ou função mostrando a probabilidade de ser menor ou igual a cada valor da variável aleatória.
Exemplos ilustrativos para VAR-5.A: Resultados de ensaios de um processo aleatório:
A soma dos resultados ao lançar dois dados
O número de filhotes em uma ninhada selecionada aleatoriamente de uma certa raça de cachorro
Objetivo de Aprendizagem VAR-5.B: Interpretar uma distribuição de probabilidade. [Habilidade 4.B]
VAR-5.B.1 Uma interpretação de uma distribuição de probabilidade fornece informações sobre a forma, o centro e a dispersão de uma população e permite tirar conclusões sobre a população de interesse.
Fonte: College Board AP Course and Exam Description
Uma variável aleatória 随机variable atribui um número a cada resultado de um processo de chance. Uma distribuição de probabilidade 概率分布 lista cada valor possível com sua probabilidade (eles somam $1$). Uma distribuição pode ser discreta (uma tabela de valores) ou contínua (um modelo de área sob uma curva, como o normal).
4.8
Média e Desvio Padrão de Variáveis Aleatórias
Programa
Compreensão Essencial (VAR-5): As distribuições de probabilidade podem ser usadas para modelar variações em populações.
Objetivo de Aprendizagem VAR-5.C: Calcular parâmetros para uma variável aleatória discreta. [Habilidade 3.B]
VAR-5.C.1 Um valor numérico que mede uma característica de uma população ou da distribuição de uma variável aleatória é conhecido como parâmetro, que é um valor único e fixo.
VAR-5.C.2 A média, ou valor esperado, para uma variável aleatória discreta $X$ é $\mu_X = \sum x_i \cdot P(x_i)$.
VAR-5.C.3 O desvio padrão para uma variável aleatória discreta $X$ é $\sigma_X = \sqrt{\sum (x_i - \mu_x)^2 \cdot P(x_i)}$.
Objetivo de Aprendizagem VAR-5.D: Interpretar parâmetros para uma variável aleatória discreta. [Habilidade 4.B]
VAR-5.D.1 Parâmetros para uma variável aleatória discreta devem ser interpretados usando unidades apropriadas e dentro do contexto de uma população específica.
Fonte: College Board AP Course and Exam Description
A média (valor esperado) 期望值 de uma variável aleatória discreta é a média ponderada pela probabilidade:
$$\mu_X=E(X)=\sum x_i\,P(x_i).$$
O desvio padrão$\sigma_X=\sqrt{\sum (x_i-\mu_X)^2\,P(x_i)}$ mede a dispersão típica em relação à média. O valor esperado é a média de longo prazo dos resultados, não um valor que você espera em qualquer único teste.
Exemplo resolvido. Um jogo paga $\$5$ with probability $0.2$ and costs you $\$1$ (um resultado $-1$) com probabilidade $0.8$. O valor esperado é
$$E(X)=5(0.2)+(-1)(0.8)=1-0.8=\$0.20,$$
então, em muitas jogadas, você ganha cerca de $20$ centavos por jogada em média, embora nenhuma jogada única forneça exatamente isso.
4.9
Combinando Variáveis Aleatórias
Programa
Compreensão Essencial (VAR-5): As distribuições de probabilidade podem ser usadas para modelar variações em populações.
Objetivo de Aprendizagem VAR-5.E: Calcular parâmetros para combinações lineares de variáveis aleatórias. [Habilidade 3.B]
VAR-5.E.1 Para variáveis aleatórias $X$ e $Y$ e números reais $a$ e $b$, a média de $aX + bY$ é $a\mu_x + b\mu_y$.
VAR-5.E.2 Duas variáveis aleatórias são independentes se saber informações sobre uma delas não alterar a distribuição de probabilidade da outra.
VAR-5.E.3 Para variáveis aleatórias independentes $X$ e $Y$ e números reais $a$ e $b$, a média de $aX + bY$ é $a\mu_x + b\mu_y$, e a variância de $aX + bY$ é $a^2\sigma^2_x + b^2\sigma^2_y$.
Objetivo de Aprendizagem VAR-5.F: Descrever os efeitos de transformações lineares de parâmetros de variáveis aleatórias. [Habilidade 3.C]
VAR-5.F.1 Para $Y = a + bX$, a distribuição de probabilidade da variável aleatória transformada, $Y$, tem a mesma forma que a distribuição de probabilidade para $X$, desde que $a > 0$ e $b > 0$. A média de $Y$ é $\mu_y = a + b\mu_x$. O desvio padrão de $Y$ é $\sigma_y = |b|\sigma_x$.
Fonte: College Board AP Course and Exam Description
Quando você adiciona ou subtrai variáveis aleatórias, as médias se somam: $\mu_{X\pm Y}=\mu_X\pm\mu_Y$. Se $X$ e $Y$ são independentes, as variâncias se somam (mesmo ao subtrair):
$$\sigma^2_{X\pm Y}=\sigma^2_X+\sigma^2_Y.$$
Tire a raiz quadrada para obter o desvio padrão. Além disso, escala: $\mu_{aX+b}=a\mu_X+b$ e $\sigma_{aX+b}=|a|\sigma_X$.
4.10
Introdução à Distribuição Binomial
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.A: Estimar probabilidades de variáveis aleatórias binomiais usando dados de uma simulação. [Habilidade 3.A]
UNC-3.A.1 Uma distribuição de probabilidade pode ser construída usando as regras de probabilidade ou estimada com uma simulação usando geradores de números aleatórios.
UNC-3.A.2 Uma variável aleatória binomial, $X$, conta o número de sucessos em $n$ ensaios independentes repetidos, cada ensaio tendo dois resultados possíveis (sucesso ou falha), com a probabilidade de sucesso $p$ e a probabilidade de falha $1 - p$.
Objetivo de Aprendizagem UNC-3.B: Calcular probabilidades para uma distribuição binomial. [Habilidade 3.A]
UNC-3.B.1 A probabilidade de que uma variável aleatória binomial, $X$, tenha exatamente $x$ sucessos para $n$ ensaios independentes, quando a probabilidade de sucesso é $p$, é calculada como $P(X = x) = \binom{n}{x} p^x (1 - p)^{n-x}, x = 0, 1, 2, \ldots, n$. Esta é a função de probabilidade binomial.
Fonte: College Board AP Course and Exam Description
A distribuição binomial
Um cenário binomial 二项 (BINS): um número fixo $n$ de tentativas Independentes, cada uma com dois resultados (sucesso/falha) e a mesma probabilidade de sucesso $p$. A variável aleatória $X=$ número de sucessos. Sua probabilidade:
$$P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}.$$
The binomial distribution, with mean n times p
Explorar
Modelar uma distribuição binomial
Uma distribuição binomial conta sucessos em $n$ ensaios independentes, cada um com probabilidade $p$. Altere $n$ e $p$ e observe as barras se deslocarem e espalharem.
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.C: Calcular parâmetros para uma distribuição binomial. [Habilidade 3.B]
UNC-3.C.1 Se uma variável aleatória for binomial, sua média, $\mu_x$, é $np$ e seu desvio padrão, $\sigma_x$, é $\sqrt{np(1 - p)}$.
Objetivo de Aprendizagem UNC-3.D: Interpretar probabilidades e parâmetros para uma distribuição binomial. [Habilidade 4.B]
UNC-3.D.1 Probabilidades e parâmetros para uma distribuição binomial devem ser interpretados usando unidades adequadas e dentro do contexto de uma população ou situação específica.
Fonte: College Board AP Course and Exam Description
For a binomial $X$ with $n$ trials and success probability $p$:
$$\mu_X=np,\qquad \sigma_X=\sqrt{np(1-p)}.$$
Use isso para perguntas de "quantos sucessos esperamos, e quanto eles variam".
Exemplo resolvido. Um jogador acerta $70\%$ dos arremessos livres. Em $n=10$ arremessos, a probabilidade de exatamente $8$ acertos é
e o número esperado de acertos é $\mu=np=10(0.7)=7$, com $\sigma=\sqrt{10(0.7)(0.3)}\approx1.45$.
4.12
A Distribuição Geométrica
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.E: Calcular probabilidades para variáveis aleatórias geométricas. [Habilidade 3.A]
UNC-3.E.1 Para uma sequência de ensaios independentes, uma variável aleatória geométrica, $X$, dá o número do ensaio no qual o primeiro sucesso ocorre. Cada ensaio tem dois resultados possíveis (sucesso ou falha) com a probabilidade de sucesso $p$ e a probabilidade de falha $1 - p$.
UNC-3.E.2 A probabilidade de que o primeiro sucesso para ensaios independentes repetidos com probabilidade de sucesso $p$ ocorra no ensaio $x$ é calculada como $P(X = x) = (1 - p)^{x-1} p, x = 1, 2, 3, \ldots$. Esta é a função de probabilidade geométrica.
Objetivo de Aprendizagem UNC-3.F: Calcular parâmetros de uma distribuição geométrica. [Habilidade 3.B]
UNC-3.F.1 Se uma variável aleatória for geométrica, sua média, $\mu_x$, é $\dfrac{1}{p}$ e seu desvio padrão, $\sigma_x$, é $\dfrac{\sqrt{(1 - p)}}{p}$.
Objetivo de Aprendizagem UNC-3.G: Interpretar probabilidades e parâmetros para uma distribuição geométrica. [Habilidade 4.B]
UNC-3.G.1 Probabilidades e parâmetros para uma distribuição geométrica devem ser interpretados usando unidades adequadas e dentro do contexto de uma população ou situação específica.
Fonte: College Board AP Course and Exam Description
Um cenário geométrico 几何 é o mesmo que o binomial, mas com nenhum $n$ fixo: você continua tentando até o primeiro sucesso. A variável aleatória $Y=$ o teste do primeiro sucesso:
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.G: Identificar perguntas sugeridas pela variação nas estatísticas de amostras coletadas da mesma população. [Habilidade 1.A]
VAR-1.G.1 A variação nas estatísticas de amostras retiradas da mesma população pode ser aleatória ou não.
Fonte: College Board AP Course and Exam Description
Uma estatística 统计量 (como uma média amostral $\bar{x}$ ou proporção amostral $\hat{p}$) é calculada a partir de uma amostra e varia de amostra para amostra – isso é variabilidade de amostragem 抽样变异. Um parâmetro 参数 ($\mu$ ou $p$) é a verdade fixa sobre a população. A distribuição de amostragem 抽样分布 é a distribuição de uma estatística sobre todas as amostras possíveis de um determinado tamanho – ela é a ponte de uma amostra para a inferência.
5.2
The Normal Curve as a Model for a Statistic
Programa
Compreensão Essencial (VAR-6): A distribuição normal pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-6.A: Calcular a probabilidade de que um valor particular esteja em um intervalo dado de uma distribuição normal. [Habilidade 3.A]
VAR-6.A.1 Uma variável aleatória contínua é uma variável que pode assumir qualquer valor dentro de um domínio especificado. Todo intervalo dentro do domínio tem uma probabilidade associada a ele.
VAR-6.A.2 Uma variável aleatória contínua com uma distribuição normal é comumente usada para descrever populações. A distribuição de uma variável aleatória normal pode ser descrita por uma curva normal ou "em forma de sino".
VAR-6.A.3 A área sob uma curva normal sobre um intervalo dado representa a probabilidade de que um valor particular esteja nesse intervalo.
Exemplos ilustrativos para VAR-6.A: Variável aleatória contínua: Se olhar para um relógio em um momento aleatório, a probabilidade de o ponteiro dos minutos estar entre o 3 e o 6 é um quarto.
Objetivo de Aprendizagem VAR-6.B: Determinar o intervalo associado a uma área dada em uma distribuição normal. [Habilidade 3.A]
VAR-6.B.1 Os limites de um intervalo associado a uma determinada área em uma distribuição normal podem ser determinados usando escores-z $z$ ou tecnologia, como uma calculadora, uma tabela normal padrão ou saída gerada por computador.
VAR-6.B.2 Intervalos associados a uma área dada em uma distribuição normal podem ser determinados atribuindo desigualdades apropriadas aos limites dos intervalos:
a. $P(X < x_a) = \dfrac{p}{100}$ significa que os menores $p\%$ de valores estão à esquerda de $x_a$.
b. $P(x_a < X < x_b) = \dfrac{p}{100}$ significa que $p\%$ de valores estão entre $x_a$ e $x_b$.
c. $P(X > x_b) = \dfrac{p}{100}$ significa que os maiores $p\%$ de valores estão à direita de $x_b$.
d. Para determinar os valores mais extremos $p\%$ de valores, requer dividir a área associada a $p\%$ em duas áreas iguais nos extremos da distribuição: $P(X < x_a) = \dfrac{1}{2}\dfrac{p}{100}$ e $P(X > x_b) = \dfrac{1}{2}\dfrac{p}{100}$ significam que metade dos $p\%$ valores mais extremos está à esquerda de $x_a$ e metade dos $p\%$ valores mais extremos está à direita de $x_b$.
Objetivo de Aprendizagem VAR-6.C: Determinar a adequação do uso da distribuição normal para aproximar probabilidades para distribuições desconhecidas. [Habilidade 3.C]
VAR-6.C.1 As distribuições normais são simétricas e "em forma de sino." Como resultado, as distribuições normais podem ser usadas para aproximar distribuições com características semelhantes.
Fonte: College Board AP Course and Exam Description
A distribuição normal
Para amostras grandes o suficientes, muitas distribuições de amostragem são aproximadamente normais. Isso nos permite descrever uma estatística por um centro (sua média), uma dispersão (seu erro padrão 标准误) e uma forma normal – e então calcular quão provável é um determinado resultado amostral.
Explorar
Usar a curva normal para encontrar uma proporção
O modelo normal converte uma faixa de valores em uma área = uma proporção. Sombree uma faixa para ler a fração de amostras que caem dentro dela (regra do 68-95-99.7).
5.3
O Teorema Central do Limite
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.H: Estimar distribuições de amostragem usando simulação. [Habilidade 3.C]
UNC-3.H.1 Uma distribuição de amostragem de uma estatística é a distribuição de valores para a estatística para todas as amostras possíveis de um tamanho dado de uma dada população.
UNC-3.H.2 O teorema central limite (TCL) afirma que quando o tamanho da amostra é suficientemente grande, uma distribuição de amostragem da média de uma variável aleatória será aproximadamente normalmente distribuída.
UNC-3.H.3 O teorema central limite exige que os valores da amostra sejam independentes uns dos outros e que $n$ seja suficientemente grande.
UNC-3.H.4 Uma distribuição de randomização é uma coleção de estatísticas geradas por simulação assumindo valores conhecidos para os parâmetros. Para um experimento aleatorizado, isso significa realocar/reatribuir repetidamente os valores da resposta aos grupos de tratamento de forma aleatória.
UNC-3.H.5 A distribuição amostral de uma estatística pode ser simulada gerando amostras aleatórias repetidas de uma população.
Fonte: College Board AP Course and Exam Description
O Teorema do Limite Central
O Teorema do Limite Central 中心极限定理 (CLT): para uma média amostral, se o tamanho da amostra $n$ for grande o suficiente (uma regra comum é $n\ge 30$), a distribuição de amostragem de $\bar{x}$ é aproximadamente normal, independentemente da forma da população. Quanto maior $n$, mais normal e mais apertada a distribuição.
A média amostral é quase normal independentemente da forma da população
Explorar
Observar uma distribuição amostral tornar-se normal
O Teorema do Limite Central: para uma amostra grande o suficiente, a distribuição da média amostral é aproximadamente normal, independentemente da forma da população.
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.I: Explicar por que um estimador é ou não viesado. [Habilidade 4.B]
UNC-3.I.1 Ao estimar um parâmetro populacional, um estimador é não viesado se, em média, o valor do estimador for igual ao parâmetro populacional.
Objetivo de Aprendizagem UNC-3.J: Calcular estimativas para um parâmetro populacional. [Habilidade 3.B]
UNC-3.J.1 Ao estimar um parâmetro populacional, um estimador exibe variabilidade que pode ser modelada usando probabilidade.
UNC-3.J.2 Uma estatística amostral é um estimador pontual do correspondente parâmetro populacional.
Fonte: College Board AP Course and Exam Description
Uma estatística é não enviesada 无偏 se a média de sua distribuição de amostragem for igual ao parâmetro – ela está correta em média. Viés refere-se ao centro estar fora; variabilidade refere-se à dispersão. Um bom estimador é ambos não enviesado (centralizado corretamente) e de baixa variabilidade (preciso); amostras maiores reduzem a variabilidade, mas não corrigem o viés de uma amostragem ruim.
Viés e variabilidade são falhas separadas. Apenas o estimador do canto superior esquerdo está tanto centrado em $\theta$ quanto compacto; o do canto inferior esquerdo é preciso, mas consistentemente errado, o que nenhuma quantidade extra de dados corrigirá.
5.5
The Sampling Distribution of a Sample Proportion
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.K: Determinar parâmetros de uma distribuição amostral para proporções amostrais. [Habilidade 3.B]
UNC-3.K.1 Para amostras independentes (amostragem com reposição) de uma variável categórica de uma população com proporção populacional $p$, a distribuição amostral da proporção amostral, $\hat{p}$, tem média $\mu_{\hat{p}} = p$ e desvio padrão $\sigma_{\hat{p}} = \sqrt{\dfrac{p(1-p)}{n}}$.
UNC-3.K.2 Se a amostragem for sem reposição, o desvio padrão da proporção amostral será menor do que aquele dado pela fórmula acima. Se o tamanho da amostra for inferior a 10% do tamanho da população, a diferença é desprezível.
Objetivo de Aprendizagem UNC-3.L: Determinar se uma distribuição amostral para uma proporção amostral pode ser descrita como aproximadamente normal. [Habilidade 3.C]
UNC-3.L.1 Para uma variável categórica, a distribuição amostral da proporção amostral, $\hat{p}$, terá uma distribuição aproximadamente normal, desde que o tamanho da amostra seja suficientemente grande: $np \geq 10$ e $n(1-p) \geq 10$
Objetivo de Aprendizagem UNC-3.M: Interpretar probabilidades e parâmetros para uma distribuição amostral para proporções amostrais. [Habilidade 4.B]
UNC-3.M.1 Probabilidades e parâmetros para uma distribuição amostral para proporções amostrais devem ser interpretados usando unidades apropriadas e dentro do contexto de uma população específica.
Fonte: College Board AP Course and Exam Description
Para uma proporção amostral $\hat{p}$ de uma SRS: a média é $p$ (não tendenciosa), e o desvio padrão é
$$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
Essa dispersão tem dois nomes: é o desvio padrão da distribuição amostral, e é chamado de erro padrão quando você precisa estimá-lo a partir da amostra (substituindo $p$ por $\hat p$) — o que exatamente as unidades de inferência posteriores fazem.
É aproximadamente normal quando $np\ge 10$ e $n(1-p)\ge 10$ (a condição Contagens Grandes), e a condição $10\%$ ($n\le 0.10N$) mantém as observações quase independentes.
Exemplo resolvido. Suponha que $40\%$ dos eleitores favoritem uma medida ($p=0.4$) e você amostre $n=100$. O erro padrão é $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. A chance de uma amostra dar $\hat{p}>0.5$ é $z=\dfrac{0.5-0.4}{0.049}=2.04$, então $P(\hat p>0.5)\approx0.02$ – uma maioria na amostra seria surpreendente.
5.6
Comparando Dois Grupos: Diferença de Proporções Amostrais
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.N: Determinar parâmetros de uma distribuição amostral para uma diferença em proporções amostrais. [Habilidade 3.B]
UNC-3.N.1 Para uma variável categórica, ao realizar amostragem aleatória com reposição de duas populações independentes com proporções populacionais $p_1$ e $p_2$, a distribuição amostral da diferença em proporções amostrais $\hat{p}_1 - \hat{p}_2$ tem média $\mu_{\hat{p}_1 - \hat{p}_2} = p_1 - p_2$ e desvio padrão $\sigma_{\hat{p}_1 - \hat{p}_2} = \sqrt{\dfrac{p_1(1-p_1)}{n_1} + \dfrac{p_2(1-p_2)}{n_2}}$.
UNC-3.N.2 Se a amostragem for sem reposição, o desvio padrão da diferença em proporções amostrais será menor do que aquele dado pela fórmula acima. Se os tamanhos das amostras forem inferiores a 10% dos tamanhos das populações, a diferença é desprezível.
Objetivo de Aprendizagem UNC-3.O: Determinar se uma distribuição amostral para uma diferença de proporções amostrais pode ser descrita como aproximadamente normal. [Habilidade 3.C]
UNC-3.O.1 A distribuição amostral da diferença em proporções amostrais $\hat{p}_1 - \hat{p}_2$ terá uma distribuição aproximadamente normal, desde que os tamanhos das amostras sejam suficientemente grandes: $n_1 p_1 \geq 10, n_1(1-p_1) \geq 10, n_2 p_2 \geq 10, n_2(1-p_2) \geq 10$.
Objetivo de Aprendizagem UNC-3.P: Interpretar probabilidades e parâmetros para uma distribuição amostral para diferenças em proporções. [Habilidade 4.B]
UNC-3.P.1 Parâmetros para uma distribuição amostral para diferenças em proporções devem ser interpretados usando unidades apropriadas e dentro do contexto de populações específicas.
Fonte: College Board AP Course and Exam Description
Para $\hat{p}_1-\hat{p}_2$ de duas amostras independentes: a média é $p_1-p_2$, e como as amostras são independentes, as variâncias somam:
É aproximadamente normal quando a condição Contagens Grandes se aplica em ambas as amostras.
5.7
A Distribuição Amostral da Média Amstral
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.Q: Determinar parâmetros para uma distribuição amostral para médias amostrais. [Habilidade 3.B]
UNC-3.Q.1 Para uma variável numérica, ao realizar amostragem aleatória com reposição de uma população com média $\mu$ e desvio padrão $\sigma$, a distribuição amostral da média amostral tem média $\mu_{\bar{x}} = \mu$ e desvio padrão $\sigma_{\bar{x}} = \dfrac{\sigma}{\sqrt{n}}$.
UNC-3.Q.2 Se a amostragem for sem reposição, o desvio padrão da média amostral será menor do que aquele dado pela fórmula acima. Se o tamanho da amostra for inferior a 10% do tamanho da população, a diferença é desprezível.
Objetivo de Aprendizagem UNC-3.R: Determinar se uma distribuição amostral de uma média amostral pode ser descrita como aproximadamente normal. [Habilidade 3.C]
UNC-3.R.1 Para uma variável numérica, se a distribuição populacional puder ser modelada com uma distribuição normal, a distribuição amostral da média amostral, $\bar{x}$, pode ser modelada com uma distribuição normal.
UNC-3.R.2 Para uma variável numérica, se a distribuição populacional não puder ser modelada com uma distribuição normal, a distribuição amostral da média amostral, $\bar{x}$, pode ser modelada aproximadamente por uma distribuição normal, desde que o tamanho da amostra seja suficientemente grande, ex.: maior ou igual a 30.
Objetivo de Aprendizagem UNC-3.S: Interpretar probabilidades e parâmetros para uma distribuição amostral para médias amostrais. [Habilidade 4.B]
UNC-3.S.1 Probabilidades e parâmetros para uma distribuição amostral para médias amostrais devem ser interpretados usando unidades apropriadas e dentro do contexto de uma população específica.
Fonte: College Board AP Course and Exam Description
Para uma média amostral $\bar{x}$ de uma SRS: a média é $\mu$ (não tendenciosa), e o desvio padrão é
$$\sigma_{\bar x}=\frac{\sigma}{\sqrt{n}}.$$
Sua forma é normal se a população for normal, ou aproximadamente normal para grandes $n$ pelo TCL. Note que a dispersão diminui proporcionalmente a $\sqrt{n}$ – quadruplicar a amostra reduz pela metade o erro padrão.
Exemplo resolvido. Uma população tem $\mu=70$ e $\sigma=12$. Para amostras de $n=36$, a distribuição amostral de $\bar{x}$ está centrada em $70$ com erro padrão $\dfrac{12}{\sqrt{36}}=2$. A chance de uma média amostral exceder $73$ é $z=\dfrac{73-70}{2}=1.5$, então $P(\bar x>73)\approx0.067$.
A população à esquerda é fortemente enviesada, porém toda distribuição amostral de $\bar{x}$ está centrada em $\mu$. Um maior $n$ encolhe o erro padrão $\sigma/\sqrt{n}$, então a curva fica mais alta e mais estreita – e também se alinha: ainda claramente enviesada em $n=2$, quase exatamente normal (tracejada) em $n=30$.
Comparando Dois Grupos: Diferença de Médias Amstrais
Programa
Compreensão Duradoura (UNC-3): O raciocínio probabilístico nos permite antecipar padrões nos dados.
Objetivo de Aprendizagem UNC-3.T: Determinar parâmetros de uma distribuição amostral para uma diferença em médias amostrais. [Habilidade 3.B]
UNC-3.T.1 Para uma variável numérica, ao realizar amostragem aleatória com reposição de duas populações independentes com médias populacionais $\mu_1$ e $\mu_2$ e desvios padrões populacionais $\sigma_1$ e $\sigma_2$, a distribuição amostral da diferença em médias amostrais $\bar{x}_1 - \bar{x}_2$ tem média $\mu_{(\bar{x}_1 - \bar{x}_2)} = \mu_1 - \mu_2$ e desvio padrão $\sigma_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}$.
UNC-3.T.2 Se a amostragem for sem reposição, o desvio padrão da diferença em médias amostrais será menor do que aquele dado pela fórmula acima. Se os tamanhos das amostras forem inferiores a 10% dos tamanhos das populações, a diferença é desprezível.
Objetivo de Aprendizagem UNC-3.U: Determinar se uma distribuição amostral de uma diferença em médias amostrais pode ser descrita como aproximadamente normal. [Habilidade 3.C]
UNC-3.U.1 A distribuição amostral da diferença em médias amostrais $\bar{x}_1 - \bar{x}_2$ pode ser modelada com uma distribuição normal se as duas distribuições populacionais puderem ser modeladas com uma distribuição normal.
UNC-3.U.2 A distribuição amostral da diferença em médias amostrais $\bar{x}_1 - \bar{x}_2$ pode ser modelada aproximadamente por uma distribuição normal se as duas distribuições populacionais não puderem ser modeladas com uma distribuição normal, mas ambos os tamanhos das amostras forem maiores ou iguais a 30.
Objetivo de Aprendizagem UNC-3.V: Interpretar probabilidades e parâmetros para uma distribuição amostral para diferenças em médias amostrais. [Habilidade 4.B]
UNC-3.V.1 Probabilidades e parâmetros para uma distribuição amostral para diferenças em médias amostrais devem ser interpretados usando unidades apropriadas e dentro do contexto de populações específicas.
Fonte: College Board AP Course and Exam Description
Para $\bar{x}_1-\bar{x}_2$ de duas amostras independentes: a média é $\mu_1-\mu_2$, e (independentes, então variâncias somam)
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.H: Identificar perguntas sugeridas pela variação nas formas das distribuições de amostras retiradas da mesma população. [Habilidade 1.A]
VAR-1.H.1 A variação nas formas das distribuições de dados pode ser aleatória ou não.
Fonte: College Board AP Course and Exam Description
Porque uma proporção amostral $\hat{p}$ é aproximadamente normalmente distribuída (quando as condições são atendidas), podemos medir o quanto um resultado amostral se afasta de um valor afirmado em erros padrão, e transformar isso em probabilidade. É isso que torna a inferência 推断 – tirar conclusões sobre uma população a partir de uma amostra – possível.
6.2
Intervalo de Confiança para uma Proporção
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.A: Identificar um procedimento de intervalo de confiança adequado para uma proporção populacional. [Habilidade 1.D]
UNC-4.A.1 O procedimento de intervalo de confiança apropriado para uma proporção de uma amostra para uma variável categórica é um intervalo-z $z$ de uma amostra para uma proporção.
Objetivo de Aprendizagem UNC-4.B: Verificar as condições para calcular intervalos de confiança para uma proporção populacional. [Habilidade 4.C]
UNC-4.B.1 Para fazer as suposições necessárias para inferência sobre proporções populacionais, médias e coeficientes angulares, devemos verificar a independência nos métodos de coleta de dados e a seleção da distribuição de amostragem apropriada.
UNC-4.B.2 Para calcular um intervalo de confiança para estimar uma proporção populacional, $p$, devemos verificar a independência e que a distribuição amostral é aproximadamente normal.
a. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$, onde $N$ é o tamanho da população.
b. Para verificar que a distribuição amostral de $\hat{p}$ é aproximadamente normal (forma):
i. Para variáveis categóricas, verifique que tanto o número de sucessos, $n\hat{p}$, quanto o número de fracassos, $n(1-\hat{p})$ sejam pelo menos 10, para que o tamanho da amostra seja grande o suficiente para apoiar uma suposição de normalidade.
Objetivo de Aprendizagem UNC-4.C: Determinar a margem de erro para um tamanho de amostra dado e uma estimativa para o tamanho de amostra que resultará em uma dada margem de erro para uma proporção populacional. [Habilidade 3.D]
UNC-4.C.1 Com base em dados amostrais, o erro padrão de uma estatística é uma estimativa do desvio padrão dessa estatística. O erro padrão de $\hat{p}$ é $SE_{\hat{p}} = \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
UNC-4.C.2 Uma margem de erro indica o quanto o valor de uma estatística amostral tende a variar em relação ao valor do correspondente parâmetro populacional.
UNC-4.C.3 Para variáveis categóricas, a margem de erro é o valor crítico ($z^*$) vezes o erro padrão (EP) da estatística relevante, que é igual a $z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$ para uma proporção amostral única.
UNC-4.C.4 A fórmula da margem de erro pode ser rearranjada para resolver $n$, o tamanho mínimo da amostra necessário para alcançar uma determinada margem de erro. Para esse fim, use um palpite para $\hat{p}$ ou use $\hat{p} = 0.5$ para encontrar um limite superior para o tamanho da amostra que resultará em uma determinada margem de erro.
Objetivo de Aprendizagem UNC-4.D: Calcular um intervalo de confiança adequado para uma proporção populacional. [Habilidade 3.D]
UNC-4.D.1 Em geral, uma estimativa por intervalo pode ser construída como estimativa pontual ± (margem de erro). Para uma proporção amostral única, a estimativa por intervalo é $\hat{p} \pm z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
Declaração de esclarecimento: As fórmulas para estimativas de intervalo não aparecem explicitamente na Folha de Fórmulas da AP Statistics fornecida no AP Statistics Exam. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral da estatística de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
UNC-4.D.2 Valores críticos representam os limites que abrangem a parte central C% da distribuição normal padrão, onde C% é um nível de confiança aproximado para uma proporção.
Objetivo de Aprendizagem UNC-4.E: Calcular uma estimativa de intervalo baseada em um intervalo de confiança para uma proporção populacional. [Habilidade 3.D]
UNC-4.E.1 Intervalos de confiança para proporções populacionais podem ser usados para calcular estimativas de intervalo com unidades especificadas.
Fonte: College Board AP Course and Exam Description
O que um intervalo de confiança significa
Um intervalo de confiança 置信区间 estima o parâmetro como uma faixa: estatística $\pm$margem de erro 误差幅度.
$z^{*}$ é o valor crítico para o nível de confiança 置信水平 (ex. $1.96$ para 95%). Condições: amostra aleatória, Contagens Grandes ($n\hat p\ge 10$ e $n(1-\hat p)\ge 10$), e a condição 10%. Interprete-o: "Temos 95% de confiança de que a verdadeira proporção de... está entre... e...". Interprete o nível: "Em 95% das amostras, este método produz um intervalo que captura a verdadeira proporção.".
Em muitas amostras, cerca de 95% dos intervalos de confiança de 95% capturam a verdadeira proporção
Exemplo resolvido. Em uma amostra aleatória de $200$ pessoas, $120$ apoiam uma política, então $\hat{p}=0.60$. Um intervalo $95\%$ usa $z^*=1.96$:
Estamos $95\%$ confiantes de que a verdadeira proporção de apoiadores está entre $53.2\%$ e $66.8\%$.
Um intervalo de confiança 95% estende-se 1.96 desvios padrão em cada lado da estimativa
Escolhendo o tamanho da amostra. Para manter a margem de erro não maior que um alvo $m$, defina $z^{*}\sqrt{\dfrac{\hat p(1-\hat p)}{n}}\le m$ e resolva para $n$. Quando não tiver uma estimativa de $\hat p$, use $\hat p=0.5$: isso torna $\hat p(1-\hat p)$ o maior possível, fornecendo o tamanho de amostra necessário seguro (maior). Sempre arredonde o resultado para cima para a próxima pessoa inteira.
Exemplo resolvido. Quantas pessoas você deve pesquisar para um intervalo $95\%$ com margem de erro no máximo $0.03$? Usando $\hat p=0.5$ e $z^*=1.96$:
Justificando uma Afirmação a Partir de um Intervalo
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.F: Interpretar um intervalo de confiança para uma proporção populacional. [Habilidade 4.B]
UNC-4.F.1 Um intervalo de confiança para uma proporção populacional contém a proporção populacional ou não, porque cada intervalo é baseado em dados de amostra aleatória, que variam de amostra para amostra.
UNC-4.F.2 Estamos confiantes em C% de que o intervalo de confiança para uma proporção populacional captura a proporção populacional.
UNC-4.F.3 Em amostragens aleatórias repetidas com o mesmo tamanho de amostra, aproximadamente C% dos intervalos de confiança criados capturarão a proporção populacional.
UNC-4.F.4 Interpretar um intervalo de confiança para uma proporção de uma única amostra deve incluir uma referência à amostra retirada e detalhes sobre a população que ela representa.
Exemplos ilustrativos para UNC-4.F.4: Para interpretar um intervalo de confiança de 99% de (0.268, 0.292), com base na proporção de uma amostra nacionalmente representativa de estudantes do décimo segundo ano que responderam corretamente a uma questão específica de múltipla escolha: "Temos 99% de confiança de que o intervalo de 0.268 a 0.292 contém a proporção populacional de todos os estudantes do décimo segundo ano dos Estados Unidos que responderiam a essa questão corretamente" (2011 FRQ 6(a)).
Objetivo de Aprendizagem UNC-4.G: Justificar uma afirmação baseada em um intervalo de confiança para uma proporção populacional. [Habilidade 4.D]
UNC-4.G.1 Um intervalo de confiança para uma proporção populacional fornece um intervalo de valores que pode fornecer evidências suficientes para sustentar uma afirmação particular no contexto.
Objetivo de Aprendizagem UNC-4.H: Identificar as relações entre tamanho de amostra, largura de um intervalo de confiança, nível de confiança e margem de erro para uma proporção populacional. [Habilidade 4.A]
UNC-4.H.1 Quando todas as outras coisas permanecem iguais, a largura do intervalo de confiança para uma proporção populacional tende a diminuir à medida que o tamanho da amostra aumenta. Para uma proporção populacional, a largura do intervalo é proporcional a $\dfrac{1}{\sqrt{n}}$.
UNC-4.H.2 Para uma amostra dada, a largura do intervalo de confiança para uma proporção populacional aumenta à medida que o nível de confiança aumenta.
UNC-4.H.3 A largura de um intervalo de confiança para uma proporção populacional é exatamente duas vezes a margem de erro.
Fonte: College Board AP Course and Exam Description
Para julgar um valor afirmado: se estiver dentro do intervalo, os dados são consistentes com ele; se estiver fora, os dados fornecem evidências contra ele. Baseie a conclusão em se os valores plausíveis incluem a afirmação, no contexto.
6.4
Configurando um Teste para uma Proporção
Programa
Compreensão Essencial (VAR-6): A distribuição normal pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-6.D: Identificar as hipóteses nula e alternativa para uma proporção populacional. [Habilidade 1.F]
VAR-6.D.1 A hipótese nula é a situação que é assumida como correta a menos que evidências sugiram o contrário, e a hipótese alternativa é a situação para a qual evidências estão sendo coletadas.
VAR-6.D.2 Para hipóteses sobre parâmetros, a hipótese nula contém uma referência de igualdade (=, ≥ ou ≤), enquanto a hipótese alternativa contém uma desigualdade estrita (<, > ou ≠). O tipo de desigualdade na hipótese alternativa baseia-se na questão de interesse. Hipóteses alternativas com < or > são chamadas unilaterais, e hipóteses alternativas com ≠ são chamadas bilaterais. Embora a hipótese nula para um teste unilateral possa incluir um símbolo de desigualdade, ela ainda é testada no limite de igualdade.
VAR-6.D.3 A hipótese nula para uma proporção populacional é: $H_0 : p = p_0$, onde $p_0$ é o valor hipotetizado nulo para a proporção populacional.
VAR-6.D.4 Uma hipótese alternativa unilateral para uma proporção é ou $H_a : p < p_0$ ou $H_a : p > p_0$. Uma hipótese alternativa bilateral é $H_a : p_1 \neq p_2$.
VAR-6.D.5 Para um teste $z$ de uma amostra única para uma proporção populacional, a hipótese nula especifica um valor para a proporção populacional, geralmente um que indica nenhuma diferença ou efeito.
Objetivo de Aprendizagem VAR-6.E: Identificar um método de teste adequado para uma proporção populacional. [Habilidade 1.E]
VAR-6.E.1 Para uma única variável categórica, o método de teste apropriado para uma proporção populacional é um teste $z$ de uma amostra única para uma proporção populacional.
Objetivo de Aprendizagem VAR-6.F: Verificar as condições para fazer inferências estatísticas ao testar uma proporção populacional. [Habilidade 4.C]
VAR-6.F.1 Para fazer inferências estatísticas ao testar uma proporção populacional, devemos verificar a independência e que a distribuição de amostragem é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$.
b. Para verificar que a distribuição amostral de $\hat{p}$ é aproximadamente normal (forma):
i. Assumindo que $H_0$ é verdadeiro $(p = p_0)$, verifique que tanto o número de sucessos, $np_0$, quanto o número de fracassos, $n(1-p_0)$, sejam pelo menos 10, para que o tamanho da amostra seja grande o suficiente para suportar uma suposição de normalidade.
Fonte: College Board AP Course and Exam Description
Um teste de significância 显著性检验 pondera evidências contra uma afirmação. Formule uma hipótese nula 原假设$H_0$ e uma hipótese alternativa 备择假设$H_a$ sobre o parâmetro $p$:
Verifique as mesmas condições (aleatório, Contagens Grandes usando $p_0$, 10%). A estatística de teste 检验统计量 conta quantos erros padrão estão fora de $p_0$:
$$z=\frac{\hat p-p_0}{\sqrt{p_0(1-p_0)/n}}.$$
Exemplo resolvido. Uma empresa afirma $90\%$ de satisfação ($p_0=0.90$); uma amostra de $100$ encontra $84$ satisfeitos ($\hat{p}=0.84$). Teste $H_0:p=0.90$ vs $H_a:p\neq0.90$ em $\alpha=0.05$:
dando um p-valor bilateral $p$ de aproximadamente $2(0.023)=0.046$. Como $0.046<0.05$, rejeite $H_0$ – há evidências de que a taxa real de satisfação difere de (é inferior a) $90\%$.
Um teste bilateral de 5% rejeita a hipótese nula nas caudas sombreadas
6.5
Interpretando P-valores
Programa
Compreensão Essencial (VAR-6): A distribuição normal pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-6.G: Calcular uma estatística de teste adequada e um valor $p$ para uma proporção populacional. [Habilidade 3.E]
VAR-6.G.1 A distribuição da estatística de teste assumindo que a hipótese nula é verdadeira (distribuição nula) pode ser uma distribuição de randomização ou, quando um modelo probabilístico é assumido como verdadeiro, uma distribuição teórica ($z$).
VAR-6.G.2 Ao usar um teste $z$, a estatística de teste padronizada pode ser escrita: $\text{test statistic} = \dfrac{\text{sample statistic} - \text{null value of the parameter}}{\text{standard deviation of the statistic}}$. Isso é chamado de estatística $z$ para proporções.
VAR-6.G.3 A estatística de teste para uma proporção populacional é: $z = \dfrac{\hat{p} - p_0}{\sqrt{\dfrac{p_0(1-p_0)}{n}}}$.
Declaração de esclarecimento: As fórmulas para estatísticas de teste não aparecem explicitamente na Folha de Fórmulas da AP Statistics fornecida no AP Statistics Exam. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral da estatística de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
VAR-6.G.4 O valor-p ($p$) é a probabilidade de se obter uma estatística de teste tão extrema ou mais extrema do que a observada, quando a hipótese nula e o modelo probabilístico são assumidos como verdadeiros. O nível de significância pode ser fornecido ou determinado pelo pesquisador.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.A: Interpretar o valor-p $p$ de um teste de significância para uma proporção populacional. [Habilidade 4.B]
DAT-3.A.1 A $p$-valor é a proporção de valores para a distribuição nula que são tão extremos ou mais extremos do que o valor observado da estatística de teste. Isso é:
a. A proporção igual ou superior ao valor observado do estatístico de teste, se a alternativa for >.
b. A proporção igual ou inferior ao valor observado do estatístico de teste, se a alternativa for <.
c. A proporção menor ou igual ao negativo do valor absoluto do estatístico de teste mais a proporção maior ou igual ao valor absoluto do estatístico de teste, se a alternativa for ≠.
DAT-3.A.2 Uma interpretação do valor-p $p$ de um teste de significância para uma proporção amostral deve reconhecer que o valor-p $p$ é calculado assumindo que o modelo probabilístico e a hipótese nula são verdadeiros, ou seja, assumindo que a verdadeira proporção populacional é igual ao valor específico declarado na hipótese nula.
Fonte: College Board AP Course and Exam Description
O que um p-value significa
O $p$-value P值是得到与观察到的结果一样极端或更极端的样本结果的概率,假设$H_0$ 为真。小的$p$-值意味着如果$H_0$ 成立,数据会令人惊讶——这是反对$H_0$ 的证据。它不是$H_0$ 为真的概率。
Explorar
Um valor p como uma área de cauda
Um valor p é a probabilidade, se a hipótese nula fosse verdadeira, de um resultado pelo menos tão extremo quanto este — a área da cauda sombreada. Valores p pequenos lançam dúvidas sobre a hipótese nula.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.B: Justificar uma afirmação sobre a população com base nos resultados de um teste de significância para uma proporção populacional. [Habilidade 4.E]
DAT-3.B.1 O nível de significância, $\alpha$, é a probabilidade predeterminada de rejeitar a hipótese nula dado que ela é verdadeira.
DAT-3.B.2 Uma decisão formal compara explicitamente o $p$-valor ao nível de significância, $\alpha$. Se o $p$-valor $\leq \alpha$, rejeite a hipótese nula. Se o $p$-valor $> \alpha$, não rejeite a hipótese nula.
DAT-3.B.3 Rejeitar a hipótese nula significa que há evidência estatística suficiente para apoiar a hipótese alternativa. Não rejeitar a hipótese nula significa que há evidência estatística insuficiente para apoiar a hipótese alternativa.
DAT-3.B.4 A conclusão sobre a hipótese alternativa deve ser expressa em contexto.
DAT-3.B.5 Um teste de significância pode levar à rejeição ou à não rejeição da hipótese nula, mas nunca pode levar à conclusão ou prova de que a hipótese nula é verdadeira. A falta de evidência estatística para a hipótese alternativa não é a mesma coisa que evidência para a hipótese nula.
DAT-3.B.6 Valores $p$ baixos indicam que o valor observado da estatística de teste seria incomum se a hipótese nula e o modelo probabilístico fossem verdadeiros, fornecendo assim evidências para a alternativa. Quanto menor o valor $p$, mais convincente é a evidência estatística para a hipótese alternativa.
DAT-3.B.7 Valores-p $p$ que não são pequenos indicam que o valor observado da estatística de teste não seria incomum se a hipótese nula e o modelo probabilístico fossem verdadeiros, portanto, não fornecem evidência estatística convincente para a hipótese alternativa nem fornecem evidências de que a hipótese nula é verdadeira.
DAT-3.B.8 Uma decisão formal compara explicitamente o $p$-valor ao nível de significância $\alpha$. Se o $p$-valor $\leq \alpha$, rejeite a hipótese nula, $H_0 : p = p_0$. Se o $p$-valor $> \alpha$, não rejeite a hipótese nula.
DAT-3.B.9 Os resultados de um teste de significância para uma proporção populacional podem servir como raciocínio estatístico para supportar a resposta a uma questão de pesquisa sobre a população amostrada.
Fonte: College Board AP Course and Exam Description
Compare o valor $p$ ao nível de significância 显著性水平$\alpha$ (geralmente $0.05$):
p-valor ≤ $p\le\alpha$: rejeite $H_0$ – há evidências convincentes para $H_a$.
p-valor > $p>\alpha$: não rejeite $H_0$ – não há evidências suficientes para $H_a$ (nunca "aceite $H_0$").
Sempre escreva a conclusão no contexto, voltando à afirmação.
6.7
Erros Tipo I e Tipo II
Programa
Compreensão Permanente (UNC-5): As probabilidades de erros Tipo I e Tipo II influenciam a inferência.
Objetivo de Aprendizagem UNC-5.A: Identificar erros Tipo I e Tipo II. [Habilidade 1.B]
UNC-5.A.1 Um erro Tipo I ocorre quando a hipótese nula é verdadeira e é rejeitada (falso positivo).
UNC-5.A.2 Um erro Tipo II ocorre quando a hipótese nula é falsa e não é rejeitada (falso negativo).
Tabela de Erros: Com o Valor Populacional Real no topo ($H_0$ verdadeiro; $H_a$ verdadeiro) e a Decisão na lateral (Rejeitar $H_0$; Não Rejeitar $H_0$): Rejeitar $H_0$ quando $H_0$ verdadeiro = Erro Tipo I; Rejeitar $H_0$ quando $H_a$ verdadeiro = Decisão Correta; Não Rejeitar $H_0$ quando $H_0$ verdadeiro = Decisão Correta; Não Rejeitar $H_0$ quando $H_a$ verdadeiro = Erro Tipo II.
Objetivo de Aprendizagem UNC-5.B: Calcular a probabilidade de erros Tipo I e Tipo II. [Habilidade 3.A]
UNC-5.B.1 O nível de significância, $\alpha$, é a probabilidade de cometer um Erro Tipo I, se a hipótese nula for verdadeira.
UNC-5.B.2 O poder de um teste é a probabilidade de que um teste rejeite corretamente uma hipótese nula falsa.
UNC-5.B.3 A probabilidade de cometer um Erro Tipo II é $= 1 - power$.
Objetivo de Aprendizagem UNC-5.C: Identificar fatores que afetam a probabilidade de erros em testes de significância. [Habilidade 4.A]
UNC-5.C.1 A probabilidade de um erro Tipo II diminui quando qualquer um dos seguintes ocorre, desde que os outros não mudem:
i. O tamanho da amostra aumenta.
ii. O nível de significância ($\alpha$) de um teste aumenta.
iii. O erro padrão diminui.
iv. O valor real do parâmetro está mais longe da hipótese nula.
Objetivo de Aprendizagem UNC-5.D: Interpretar erros Tipo I e Tipo II. [Habilidade 4.B]
UNC-5.D.1 Se um erro Tipo I ou Tipo II é mais consequente depende da situação.
UNC-5.D.2 Como o nível de significância, $\alpha$, é a probabilidade de um Erro Tipo I, as consequências de um Erro Tipo I influenciam as decisões sobre um nível de significância.
Fonte: College Board AP Course and Exam Description
Erros Tipo I e Tipo II
Um Erro Tipo I 第一类错误: rejeitar uma $H_0$verdadeira (um alarme falso). Sua probabilidade é $\alpha$.
Um Erro Tipo II 第二类错误: não rejeitar uma $H_0$falsa (uma detecção perdida). Sua probabilidade é $\beta$.
A potência 检验效能$=1-\beta$ é a chance de detectar corretamente um efeito real. A potência aumenta com uma amostra maior, um efeito maior ou um $\alpha$ maior.
Descreva cada erro e sua consequência no contexto do problema.
Explorar
Duas maneiras pelas quais um teste pode estar errado
Um erro do Tipo I rejeita uma hipótese nula verdadeira (falso alarme); um erro do Tipo II mantém uma hipótese nula falsa (uma falha). Reduzir um geralmente aumenta o outro.
6.8
Intervalo de Confiança para a Diferença de Proporções
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.I: Identificar um procedimento de intervalo de confiança apropriado para uma comparação de proporções populacionais. [Habilidade 1.D]
UNC-4.I.1 O procedimento de intervalo de confiança apropriado para uma comparação de duas amostras de proporções para uma variável categórica é um intervalo $z$ de duas amostras para uma diferença entre proporções populacionais.
Objetivo de Aprendizagem UNC-4.J: Verificar as condições para calcular intervalos de confiança para uma diferença entre proporções populacionais. [Habilidade 4.C]
UNC-4.J.1 Para calcular intervalos de confiança para estimar uma diferença entre proporções, devemos verificar a independência e que a distribuição de amostragem é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando duas amostras aleatórias independentes ou um experimento aleatorizado.
ii. Quando a amostragem for sem reposição, verifique que $n_1 \leq 10\%N_1$ e $n_2 \leq 10\%N_2$.
b. Para verificar que a distribuição amostral de $\hat{p}_1 - \hat{p}_2$ é aproximadamente normal (forma).
i. Para variáveis categóricas, verifique que $n_1\hat{p}_1$, $n_1(1-\hat{p}_1)$, $n_2\hat{p}_2$ e $n_2\left(1-\hat{p}_2\right)$ sejam todos maiores ou iguais a algum valor predeterminado, tipicamente 5 ou 10.
Objetivo de Aprendizagem UNC-4.K: Calcular um intervalo de confiança apropriado para uma comparação de proporções populacionais. [Habilidade 3.D]
UNC-4.K.1 Para uma comparação de proporções, a estimativa por intervalo é $(\hat{p}_1 - \hat{p}_2) \pm z^* \sqrt{\dfrac{\hat{p}_1(1-\hat{p}_1)}{n_1} + \dfrac{\hat{p}_2(1-\hat{p}_2)}{n_2}}$.
Declaração de esclarecimento: As fórmulas para estimativas de intervalo não aparecem explicitamente na Folha de Fórmulas da AP Statistics fornecida no AP Statistics Exam. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral da estatística de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
Objetivo de Aprendizagem UNC-4.L: Calcular uma estimativa de intervalo com base em um intervalo de confiança para uma diferença de proporções. [Habilidade 3.D]
UNC-4.L.1 Intervalos de confiança para uma diferença em proporções podem ser usados para calcular estimativas de intervalo com unidades especificadas.
Fonte: College Board AP Course and Exam Description
As condições devem ser atendidas em ambas as amostras, e as amostras devem ser independentes.
6.9
Justificando uma Afirmação Sobre Duas Proporções
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.M: Interpretar um intervalo de confiança para uma diferença de proporções. [Habilidade 4.B]
UNC-4.M.1 Em amostragens aleatórias repetidas com o mesmo tamanho de amostra, aproximadamente C% dos intervalos de confiança criados capturarão a diferença nas proporções populacionais.
UNC-4.M.2 Interpretar um intervalo de confiança para a diferença entre proporções populacionais deve incluir uma referência à amostra coletada e detalhes sobre a população que ela representa.
Objetivo de Aprendizagem UNC-4.N: Justificar uma afirmação com base em um intervalo de confiança para uma diferença de proporções. [Habilidade 4.D]
UNC-4.N.1 Um intervalo de confiança para a diferença em proporções populacionais fornece um intervalo de valores que pode fornecer evidência suficiente para apoiar uma afirmação particular em contexto.
Fonte: College Board AP Course and Exam Description
Se o intervalo para $p_1-p_2$ contiver $0$, os dados são consistentes com nenhuma diferença; se estiver inteiramente acima ou abaixo de $0$, há evidências de uma diferença (nessa direção). Declare a direção e o contexto.
6.10
Configurando um Teste para a Diferença
Programa
Compreensão Essencial (VAR-6): A distribuição normal pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-6.H: Identificar as hipóteses nula e alternativa para uma diferença de duas proporções populacionais. [Habilidade 1.F]
VAR-6.H.1 Para um teste de duas amostras para uma diferença de duas proporções, a hipótese nula especifica um valor de $0$ para a diferença nas proporções populacionais, indicando nenhuma diferença ou efeito.
VAR-6.H.2 A hipótese nula para uma diferença em proporções é: $H_0 : p_1 = p_2$, ou $H_0 : p_1 - p_2 = 0$.
VAR-6.H.3 Uma hipótese alternativa unilateral para uma diferença em proporções é $H_a : p_1 < p_2$, ou, $H_a : p_1 > p_2$. Uma hipótese alternativa bilateral para uma diferença de proporções é $H_a : p_1 \neq p_2$.
Objetivo de Aprendizagem VAR-6.I: Identificar um método de teste adequado para a diferença de duas proporções populacionais. [Habilidade 1.E]
VAR-6.I.1 Para uma única variável categórica, o método de teste apropriado para a diferença de duas proporções populacionais é um teste-z $z$ de dois amostras para uma diferença entre duas proporções populacionais.
Objetivo de Aprendizagem VAR-6.J: Verificar as condições para fazer inferências estatísticas ao testar uma diferença de duas proporções populacionais. [Habilidade 4.C]
VAR-6.J.1 Para fazer inferências estatísticas ao testar uma diferença entre proporções populacionais, devemos verificar a independência e que a distribuição amostral é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando duas amostras aleatórias independentes ou um experimento aleatorizado.
ii. Quando a amostragem for sem reposição, verifique que $n_1 \leq 10\%N_1$ e $n_2 \leq 10\%N_2$.
b. Para verificar que a distribuição amostral de $\hat{p}_1 - \hat{p}_2$ é aproximadamente normal (forma):
i. Para a amostra combinada, defina a proporção combinada (ou agrupada), $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$. Assumindo que $H_0$ é verdadeira, $(p_1 - p_2 = 0$ ou $p_1 = p_2)$, verifique que $n_1\hat{p}_c$, $n_1\left(1-\hat{p}_c\right)$, $n_2\hat{p}_c$ e $n_2\left(1-\hat{p}_c\right)$ são todos maiores ou iguais a algum valor predeterminado, tipicamente 5 ou 10.
Fonte: College Board AP Course and Exam Description
As hipóteses comparam as duas proporções: $H_0: p_1=p_2$ versus $H_a: p_1\neq p_2$ (ou $<,>$). Como $H_0$ diz que as proporções são iguais, use uma proporção combinada (pooled) 合并$\hat p_c=\dfrac{\text{total successes}}{\text{total sample size}}$ para estimar a comum $p$.
6.11
Realizando um Teste para a Diferença
Programa
Compreensão Essencial (VAR-6): A distribuição normal pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-6.K: Calcular uma estatística de teste adequada para a diferença de duas proporções populacionais. [Habilidade 3.E]
VAR-6.K.1 A estatística de teste para uma diferença em proporções é: $z = \dfrac{(\hat{p}_1 - \hat{p}_2) - 0}{\sqrt{\hat{p}_c(1-\hat{p}_c)}\sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}}$, onde $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$.
Declaração de esclarecimento: As fórmulas para estatísticas de teste não aparecem explicitamente na Folha de Fórmulas da AP Statistics fornecida no AP Statistics Exam. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral da estatística de teste e nas fórmulas do erro padrão para cada uma das estatísticas de teste relevantes que são fornecidas na folha de fórmulas.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.C: Interpretar o valor-p $p$ de um teste de significância para uma diferença de proporções populacionais. [Habilidade 4.B]
DAT-3.C.1 Uma interpretação do valor-p $p$ de um teste de significância para uma diferença de duas proporções populacionais deve reconhecer que o valor-p $p$ é computado assumindo que a hipótese nula é verdadeira, ou seja, assumindo que as verdadeiras proporções populacionais são iguais entre si.
Objetivo de Aprendizagem DAT-3.D: Justificar uma afirmação sobre a população com base nos resultados de um teste de significância para uma diferença de proporções populacionais. [Habilidade 4.E]
DAT-3.D.1 Uma decisão formal compara explicitamente o valor-p $p$ ao nível de significância $\alpha$. Se o valor-p $p\text{-value} \leq \alpha$, então rejeite a hipótese nula, $H_0 : p_1 = p_2$, ou $H_0 : p_1 - p_2 = 0$. Se o valor-p $p$ for maior ou igual a $> \alpha$, então falhe em rejeitar a hipótese nula.
DAT-3.D.2 Os resultados de um teste de significância para uma diferença entre duas proporções populacionais podem servir como raciocínio estatístico para sustentar a resposta a uma pergunta de pesquisa sobre as duas populações amostradas.
Fonte: College Board AP Course and Exam Description
A estatística de proporção combinada de duas amostras $z$:
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.I: Identificar perguntas sugeridas por probabilidades de erros em inferência estatística. [Habilidade 1.A]
VAR-1.I.1 A variação aleatória pode resultar em erros na inferência estatística.
Fonte: College Board AP Course and Exam Description
Erros Tipo I e Tipo II
A inferência para uma média funciona como a inferência para uma proporção, com uma mudança: raramente conhecemos o desvio padrão populacional $\sigma$, então o estimamos com a amostra $s$. Essa incerteza extra significa que usamos a distribuição t$t$ em vez da normal – uma distribuição 分布 que é em forma de sino mas com caudas mais pesadas, e depende dos graus de liberdade 自由度$df=n-1$; à medida que $n$ cresce, ela se aproxima da normal.
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.A: Descrever distribuições $t$. [Habilidade 3.C]
VAR-7.A.1 Quando $s$ é usado em vez de $\sigma$ para calcular uma estatística de teste, a distribuição correspondente, conhecida como distribuição $t$, varia da distribuição normal na forma, pois mais da área é alocada nas caudas da curva de densidade do que em uma distribuição normal.
VAR-7.A.2 À medida que os graus de liberdade aumentam, a área nas caudas de uma distribuição $t$ diminui.
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.O: Identificar um procedimento de intervalo de confiança apropriado para uma média populacional, incluindo a diferença média entre valores em pares pareados. [Habilidade 1.D]
UNC-4.O.1 Como $\sigma$ geralmente não é conhecido para distribuições de variáveis quantitativas, o procedimento de intervalo de confiança apropriado para estimar a média populacional de uma variável quantitativa para uma amostra é um intervalo $t$ de uma amostra para uma média.
UNC-4.O.2 Para uma variável quantitativa, $X$, que segue uma distribuição normal, a distribuição de $t = \dfrac{(\overline{x} - \mu)}{\frac{s}{\sqrt{n}}}$ é uma distribuição $t$ com $n-1$ graus de liberdade.
UNC-4.O.3 Pares pareados podem ser pensados como uma única amostra de pares. Uma vez que as diferenças entre os pares de valores são encontradas, a inferência para intervalos de confiança prossegue como para uma média populacional.
Objetivo de Aprendizagem UNC-4.P: Verificar as condições para o cálculo de intervalos de confiança para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 4.C]
UNC-4.P.1 Para calcular intervalos de confiança para estimar uma média populacional, devemos verificar a independência e que a distribuição amostral é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$, onde $N$ é o tamanho da população.
b. Para verificar que a distribuição amostral de $\overline{x}$ é aproximadamente normal (forma):
i. Se a distribuição observada for assimétrica, $n$ deve ser maior que 30.
ii. Se o tamanho da amostra for menor que 30, a distribuição dos dados da amostra deve estar livre de assimetria forte e outliers.
Objetivo de Aprendizagem UNC-4.Q: Determinar a margem de erro para um tamanho de amostra dado para um intervalo $t$ de uma amostra única. [Habilidade 3.D]
UNC-4.Q.1 O valor crítico $t^*$ com $n-1$ graus de liberdade pode ser encontrado usando uma tabela ou saída gerada por computador.
UNC-4.Q.2 O erro padrão para uma média amostral é dado por $SE = \dfrac{s}{\sqrt{n}}$, onde $s$ é o desvio padrão amostral.
UNC-4.Q.3 Para um intervalo $t$ de uma amostra para uma média, a margem de erro é o valor crítico ($t^*$) vezes o erro padrão ($SE$), que é igual a $t^*\left(\dfrac{s}{\sqrt{n}}\right)$.
Objetivo de Aprendizagem UNC-4.R: Calcular um intervalo de confiança adequado para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 3.D]
UNC-4.R.1 A estimativa pontual para uma média populacional é a média amostral, $\overline{x}$.
UNC-4.R.2 Para a média populacional de uma amostra com desvio padrão populacional desconhecido, o intervalo de confiança é $\overline{x} \pm t^* \dfrac{s}{\sqrt{n}}$.
Declaração de fronteira: As fórmulas para estimativas de intervalo não aparecem explicitamente na Folha de Fórmulas de Estatística AP fornecida no Exame de Estatística AP. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral do estatístico de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
Fonte: College Board AP Course and Exam Description
O que um intervalo de confiança significa
Um intervalo $t$ de uma amostra para $\mu$:
$$\bar{x}\pm t^{*}\frac{s}{\sqrt{n}}.$$
$t^{*}$ é o valor crítico com $df=n-1$. Condições: amostra aleatória, Normal/Amostra Grande (população normal, ou $n\ge 30$ pelo TCL, ou uma amostra aproximadamente simétrica sem outliers), e a condição 10%. Interprete o intervalo e o nível de confiança no contexto.
Exemplo resolvido. Uma amostra aleatória de $n=25$ tem $\bar{x}=50$ e $s=8$. Para um intervalo $95\%$, $df=24$ dá $t^*=2.064$:
A distribuição t tem um pico mais baixo e caudas mais pesadas do que a normal"95% confident" descreve o método, não um intervalo: em muitas amostras, cerca de 95% dos intervalos contêm $\mu$ e cerca de 5% não o contêm.
Explorar
Por que um intervalo t é mais largo que um intervalo z
Um intervalo para a média usa $t^*$, não $1.96$, porque $\sigma$ é estimado por $s$. Arraste graus de liberdade (df) para baixo e observe $t^*$ crescer — em $df=10$ ele é $2.228$, e o intervalo é mais largo para ele. Arraste df para cima e $t^*$ cai de volta para perto de $1.96$, razão pela qual amostras grandes podem usar $z$.
7.3
Justificando uma Afirmativa Sobre uma Média
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.S: Interpretar um intervalo de confiança para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 4.B]
UNC-4.S.1 Um intervalo de confiança para uma média populacional contém a média populacional ou não, porque cada intervalo se baseia em dados de uma amostra aleatória, que varia de amostra para amostra.
UNC-4.S.2 Estamos C% confiantes de que o intervalo de confiança para uma média populacional captura a média populacional.
UNC-4.S.3 Uma interpretação de um intervalo de confiança para uma média populacional inclui uma referência à amostra coletada e detalhes sobre a população que ela representa.
Exemplos ilustrativos para UNC-4.S.3: Para interpretar um intervalo de confiança de 96% para o comprimento médio do pé em todas as pegadas encontradas em uma caverna, com base em uma amostra aleatória específica de pegadas na caverna: "Temos 96% de confiança de que o comprimento médio do pé em todas as pegadas encontradas na caverna está dentro do intervalo de confiança" (com base no 2000 FRQ 2).
Objetivo de Aprendizagem UNC-4.T: Justificar uma afirmação baseada em um intervalo de confiança para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 4.D]
UNC-4.T.1 Um intervalo de confiança para uma média populacional fornece um intervalo de valores que pode fornecer evidências suficientes para apoiar uma afirmação particular no contexto.
Objetivo de Aprendizagem UNC-4.U: Identificar as relações entre o tamanho da amostra, a largura de um intervalo de confiança, o nível de confiança e a margem de erro para uma média populacional. [Habilidade 4.A]
UNC-4.U.1 Quando todas as outras coisas permanecem as mesmas, a largura de um intervalo de confiança para uma média populacional tende a diminuir à medida que o tamanho da amostra aumenta.
UNC-4.U.2 Para uma média única, a largura do intervalo é proporcional a $\dfrac{1}{\sqrt{n}}$.
UNC-4.U.3 Para uma amostra dada, a largura do intervalo de confiança para uma média populacional aumenta à medida que o nível de confiança aumenta.
Fonte: College Board AP Course and Exam Description
Assim como com proporções: uma média alegada dentro do intervalo é plausível; fora do intervalo, os dados fornecem evidências contra ela. Responda no contexto usando a faixa plausível.
7.4
Configurando um Teste para uma Média
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.B: Identificar um método de teste adequado para uma média populacional com $\sigma$ desconhecido, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 1.E]
VAR-7.B.1 O teste apropriado para uma média populacional com $\sigma$ desconhecido é um teste $t$ de uma amostra para uma média populacional.
VAR-7.B.2 Pares pareados podem ser pensados como uma única amostra de pares. Uma vez que as diferenças entre os pares de valores são encontradas, a inferência para testes de significância prossegue como para uma média populacional.
Objetivo de Aprendizagem VAR-7.C: Identificar as hipóteses nula e alternativa para uma média populacional com $\sigma$ desconhecido, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 1.F]
VAR-7.C.1 A hipótese nula para um teste $t$ de uma amostra para uma média populacional é $H_0 : \mu = \mu_0$, onde $\mu_0$ é o valor hipotetizado. Dependendo da situação, a hipótese alternativa é $H_a : \mu < \mu_0$, ou $H_a : \mu > \mu_0$, ou $H_a : \mu \neq \mu_0$.
VAR-7.C.2 Ao encontrar a média das diferenças, $\mu_d$, entre valores em um par pareado, é importante definir a ordem da subtração.
Objetivo de Aprendizagem VAR-7.D: Verificar as condições para o teste para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 4.C]
VAR-7.D.1 Para fazer inferências estatísticas ao testar uma média populacional, devemos verificar a independência e que a distribuição amostral é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$.
b. Para verificar que a distribuição amostral de $\overline{x}$ é aproximadamente normal (forma):
i. Se a distribuição observada for assimétrica, $n$ deve ser maior que 30.
ii. Se o tamanho da amostra for menor que 30, a distribuição dos dados da amostra deve estar livre de assimetria forte e outliers.
Fonte: College Board AP Course and Exam Description
O que um p-value significa
Formule hipóteses sobre $\mu$: $H_0:\mu=\mu_0$ versus $H_a:\mu\neq\mu_0$ (ou $<,>$). Verifique as mesmas condições. A estatística $t$ de uma única amostra:
Este $t$ está muito na cauda (dois lados, $p<0.01$), então rejeite $H_0$ – forte evidência de que a média não é $45$. Observe que $45$ também cai fora do intervalo de $95\%$$(46.7,53.3)$, a mesma conclusão por duas vias.
7.5
Realizando um Teste para uma Média
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.E: Calcular um estatístico de teste adequado para uma média populacional, incluindo a média das diferenças entre valores em pares pareados. [Habilidade 3.E]
VAR-7.E.1 Para uma única variável quantitativa quando a amostragem com reposição é feita de uma população que pode ser modelada com uma distribuição normal com média $\mu$ e desvio padrão $\sigma$, a distribuição amostral de $t = \dfrac{\overline{x} - \mu}{\frac{s}{\sqrt{n}}}$ tem uma distribuição $t$ com $n - 1$ graus de liberdade.
Declaração de fronteira: As fórmulas para estatísticos de teste não aparecem explicitamente na Folha de Fórmulas de Estatística AP fornecida no Exame de Estatística AP. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral do estatístico de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de aprendizagem DAT-3.E: Interpretar o valor $p$ de um teste de significância para uma média populacional, incluindo a diferença média entre valores em pares emparelhados. [Habilidade 4.B]
DAT-3.E.1 Uma interpretação do valor-p $p$ de um teste de significância para uma média populacional deve reconhecer que o valor-p $p$ é calculado assumindo que a hipótese nula é verdadeira, ou seja, assumindo que a verdadeira média populacional é igual ao valor específico declarado na hipótese nula.
Objetivo de Aprendizagem DAT-3.F: Justificar uma afirmação sobre a população com base nos resultados de um teste de significância para uma média populacional. [Habilidade 4.E]
DAT-3.F.1 Uma decisão formal compara explicitamente o valor $p$ ao nível de significância $\alpha$. Se o valor $p$ for menor ou igual a $\leq \alpha$, rejeite a hipótese nula, $H_0 : \mu = \mu_0$. Se o valor $p$ for maior que $> \alpha$, não rejeite a hipótese nula.
DAT-3.F.2 Os resultados de um teste de significância para uma média populacional podem servir como raciocínio estatístico para suportar a resposta a uma pergunta de pesquisa sobre a população que foi amostrada.
Fonte: College Board AP Course and Exam Description
Encontre o valor-$p$ da distribuição $t$ com $df=n-1$, compare ao $\alpha$ e conclua no contexto – rejeite ou não rejeite $H_0$, depois declare o que isso significa para a afirmativa. Mostre o nome do teste, a estatística, $df$ e o valor-$p$.
Explorar
Ler um valor p na curva t
O valor p é a área da cauda sombreada além da sua estatística $t$ — ambas as caudas para um $H_a$ bilateral. A curva normal tracejada atrás de $t$ mostra o que você teria obtido ao usar erroneamente $z$: em poucos graus de liberdade, a cauda $t$ é visivelmente mais grossa, então o verdadeiro valor p é maior do que o sugerido pela normal.
7.6
Intervalo de Confiança para a Diferença de Duas Médias
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.V: Identificar um procedimento de intervalo de confiança adequado para a diferença de duas médias populacionais. [Habilidade 1.D]
UNC-4.V.1 Considere uma amostra aleatória simples da população 1 de tamanho $n_1$, média $\mu_1$ e desvio padrão $\sigma_1$ e uma segunda amostra aleatória simples da população 2 de tamanho $n_2$, média $\mu_2$ e desvio padrão $\sigma_2$. Se as distribuições das populações 1 e 2 forem normais ou se ambos $n_1$ e $n_2$ forem maiores que 30, então a distribuição amostral da diferença de médias, $\overline{x}_1 - \overline{x}_2$ também é normal. A média para a distribuição amostral de $\overline{x}_1 - \overline{x}_2$ é $\mu_1 - \mu_2$. O desvio padrão de $\overline{x}_1 - \overline{x}_2$ é $\sqrt{\dfrac{(\sigma_1)^2}{n_1} + \dfrac{(\sigma_2)^2}{n_2}}$.
UNC-4.V.2 O procedimento de intervalo de confiança apropriado para uma variável quantitativa para duas amostras independentes é um intervalo $t$ de duas amostras para uma diferença entre médias populacionais.
Objetivo de Aprendizagem UNC-4.W: Verificar as condições para calcular intervalos de confiança para a diferença de duas médias populacionais. [Habilidade 4.C]
UNC-4.W.1 Para calcular intervalos de confiança para estimar a diferença de médias populacionais, devemos verificar a independência e que a distribuição amostral é aproximadamente normal:
a. Para verificar a independência:
i. Os dados devem ser coletados usando duas amostras aleatórias independentes ou um experimento aleatorizado.
ii. Quando a amostragem for sem reposição, verifique que $n_1 \leq 10\%N_1$ e $n_2 \leq 10\%N_2$.
b. Para verificar que a distribuição amostral de $(\overline{x}_1 - \overline{x}_2)$ deve ser aproximadamente normal (forma):
i. Se as distribuições observadas forem assimétricas, tanto $n_1$ quanto $n_2$ devem ser maiores que 30.
Objetivo de Aprendizagem UNC-4.X: Determinar a margem de erro para a diferença de duas médias populacionais. [Habilidade 3.D]
UNC-4.X.1 Para a diferença de duas médias amostrais, a margem de erro é o valor crítico ($t^*$) vezes o erro padrão ($SE$) da diferença de duas médias.
UNC-4.X.2 O erro padrão para a diferença em duas médias amostrais com desvios padrão amostrais, $s_1$ e $s_2$, é $\sqrt{\dfrac{(s_1)^2}{n_1} + \dfrac{(s_2)^2}{n_2}}$.
Objetivo de Aprendizagem UNC-4.Y: Calcular um intervalo de confiança adequado para a diferença de duas médias populacionais. [Habilidade 3.D]
UNC-4.Y.1 A estimativa pontual para a diferença de duas médias populacionais é a diferença nas médias amostrais, $\overline{x}_1 - \overline{x}_2$.
UNC-4.Y.2 Para uma diferença de duas médias populacionais onde os desvios padrão populacionais não são conhecidos, o intervalo de confiança é $(\overline{x}_1 - \overline{x}_2) \pm t^* \sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}$ onde $\pm t^*$ são os valores críticos para o C% central de uma distribuição $t$ com os graus de liberdade apropriados que podem ser encontrados usando tecnologia.
Declaração de fronteira: As fórmulas para estimativas de intervalo não aparecem explicitamente na Folha de Fórmulas de Estatística AP fornecida no Exame de Estatística AP. No entanto, essas fórmulas não precisam ser decoradas, pois podem ser construídas com base na fórmula geral do estatístico de teste e nas fórmulas relevantes de erro padrão que estão fornecidas na folha de fórmulas.
Fonte: College Board AP Course and Exam Description
Para amostras independentes, estime $\mu_1-\mu_2$:
As condições devem ser satisfeitas em ambas as amostras. (Use tecnologia para o $df$; não ponha as variâncias em conjunto no exame AP.)
A randomização fundamenta a comparação justa de dois grupos em um teste de diferença de médias
7.7
Justificando uma Afirmativa Sobre Duas Médias
Programa
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.Z: Interpretar um intervalo de confiança para a diferença de médias populacionais. [Habilidade 4.B]
UNC-4.Z.1 Em amostragens aleatórias repetidas com o mesmo tamanho de amostra, aproximadamente C% dos intervalos de confiança criados capturarão a diferença das médias populacionais.
UNC-4.Z.2 Uma interpretação para um intervalo de confiança para a diferença de duas médias populacionais deve incluir uma referência às amostras coletadas e detalhes sobre as populações que elas representam.
Exemplos ilustrativos para UNC-4.Z.2: Para interpretar um intervalo de confiança para a diferença entre os tempos médios de resposta de duas estações de bombeiros (norte - sul): "Com base nessas amostras, pode-se ter 95 por cento de confiança de que a diferença nas médias populacionais dos tempos de resposta (norte - sul) está entre -2.37 minutos e 0.37 minutos" (2009 FRQ 4).
Objetivo de Aprendizagem UNC-4.AA: Justificar uma afirmação baseada em um intervalo de confiança para a diferença de médias populacionais. [Habilidade 4.D]
UNC-4.AA.1 Um intervalo de confiança para a diferença de médias populacionais fornece um intervalo de valores que pode fornecer evidências suficientes para apoiar uma afirmação particular no contexto.
Objetivo de Aprendizagem UNC-4.AB: Identificar os efeitos do tamanho da amostra na largura de um intervalo de confiança para a diferença de duas médias. [Habilidade 4.A]
UNC-4.AB.1 Quando todas as outras coisas permanecem as mesmas, a largura do intervalo de confiança para a diferença de duas médias tende a diminuir à medida que os tamanhos das amostras aumentam.
Fonte: College Board AP Course and Exam Description
Se o intervalo para $\mu_1-\mu_2$ conter $0$, os dados são consistentes com médias iguais; se excluir $0$, há evidência de diferença nessa direção. Interprete no contexto.
7.8
Configurando um Teste para a Diferença de Médias
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.F: Identificar uma seleção apropriada de método de teste para a diferença de duas médias populacionais. [Habilidade 1.E]
VAR-7.F.1 Para uma variável quantitativa, o teste apropriado para a diferença de duas médias populacionais é um teste t de duas amostras $t$ para a diferença de duas médias populacionais.
Objetivo de Aprendizagem VAR-7.G: Identificar as hipóteses nula e alternativa para a diferença de duas médias populacionais. [Habilidade 1.F]
VAR-7.G.1 A hipótese nula para um teste t de duas amostras $t$ para a diferença de duas médias populacionais, $\mu_1$ e $\mu_2$, é: $H_0 : \mu_1 - \mu_2 = 0$, ou $H_0 : \mu_1 = \mu_2$. A hipótese alternativa é $H_a : \mu_1 - \mu_2 < 0$, ou $H_a : \mu_1 - \mu_2 > 0$, ou $H_a : \mu_1 - \mu_2 \neq 0$, ou $H_a : \mu_1 > \mu_2$, ou $H_a : \mu_1 < \mu_2$, ou $H_a : \mu_1 \neq \mu_2$.
Objetivo de Aprendizagem VAR-7.H: Verificar as condições para o teste de significância para a diferença de duas médias populacionais. [Habilidade 4.C]
VAR-7.H.1 Para fazer inferências estatísticas ao testar uma diferença entre médias populacionais, devemos verificar a independência e que a distribuição amostral é aproximadamente normal:
a. As observações individuais devem ser independentes:
i. Os dados devem ser coletados usando amostras aleatórias simples ou um experimento randomizado.
ii. Quando a amostragem for sem reposição, verifique que $n_1 \leq 10\%N_1$ e $n_2 \leq 10\%N_2$.
b. A distribuição amostral de $\overline{x}_1 - \overline{x}_2$ deve ser aproximadamente normal (forma).
i. Se a distribuição observada for assimétrica, tanto $n_1$ quanto $n_2$ devem ser maiores que 30.
ii. Se o tamanho da amostra for menor que 30, a distribuição dos dados da amostra deve estar livre de assimetria forte e outliers. Isso deve ser verificado para AMOAS amostras.
Fonte: College Board AP Course and Exam Description
Hipóteses: $H_0:\mu_1=\mu_2$ versus $H_a:\mu_1\neq\mu_2$ (ou $<,>$). Distinga duas amostras independentes de dados pareados 配对数据 – para dados pareados (antes/depois, sujeitos pareados), primeiro calcule as diferenças e execute um procedimento de uma única amostra$t$ sobre elas.
7.9
Realizando um Teste para a Diferença de Médias
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.I: Calcular uma estatística de teste apropriada para a diferença de duas médias. [Habilidade 3.E]
VAR-7.I.1 Para uma única variável quantitativa, dados coletados usando amostras aleatórias independentes ou um experimento randomizado de duas populações, cada uma das quais pode ser modelada com uma distribuição normal, a distribuição amostral de $t = \dfrac{(\overline{x}_1 - \overline{x}_2) - (\mu_1 - \mu_2)}{\sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}}$ é uma distribuição t aproximada $t$ com graus de liberdade que podem ser encontrados usando tecnologia. Os graus de liberdade ficam entre o menor de $n_1 - 1$ e $n_2 - 1$ e $n_1 + n_2 - 2$.
Exemplos ilustrativos para VAR-7.I.1: Em um estudo que comparava os tempos médios de recuperação para dois procedimentos cirúrgicos para reparar um ligamento cruzado anterior (LCA) rompido, o grupo que recebeu um procedimento tinha um tamanho amostral de 110, enquanto o grupo que recebeu o outro procedimento tinha um tamanho amostral de 100. Os graus de liberdade estão entre 100 (o menor de 110 e 100) e 208 (110 + 100 - 2). Os graus de liberdade podem ser determinados usando tecnologia. Se a estatística de teste para este estudo for $t \approx 7.13$, então o $p$-valor é a área maior que 7.13 para uma distribuição $t$-com $df = 207.18$ (2018 FRQ 4).
Declaração de limite: As fórmulas para estatísticas de teste não aparecem explicitamente na Folha de Fórmulas de Estatística AP fornecida no Exame de Estatística AP. No entanto, essas fórmulas não precisam ser memorizadas, pois podem ser construídas com base na fórmula geral da estatística de teste e nas fórmulas do erro padrão para cada uma das estatísticas de teste relevantes que são fornecidas na folha de fórmulas.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.G: Interpretar o valor p $p$ de um teste de significância para a diferença de médias populacionais. [Habilidade 4.B]
DAT-3.G.1 Uma interpretação do valor p $p$ de um teste de significância para a diferença de duas médias populacionais deve reconhecer que o valor p $p$ é calculado assumindo que a hipótese nula é verdadeira, ou seja, assumindo que as verdadeiras médias populacionais são iguais entre si.
Objetivo de Aprendizagem DAT-3.H: Justificar uma afirmação sobre a população com base nos resultados de um teste de significância para a diferença de duas médias populacionais no contexto. [Habilidade 4.E]
DAT-3.H.1 Uma decisão formal compara explicitamente o valor p $p$ ao nível de significância $\alpha$. Se o valor p $p$ for ≤ $\leq \alpha$, então rejeite a hipótese nula, $H_0 : \mu_1 - \mu_2 = 0$, ou $H_0 : \mu_1 = \mu_2$. Se o valor p $p$ for > $> \alpha$, então falhe em rejeitar a hipótese nula.
DAT-3.H.2 Os resultados de um teste de significância para um teste de duas amostras para a diferença entre duas médias populacionais podem servir como raciocínio estatístico para supportar a resposta a uma questão de pesquisa sobre as populações que foram amostradas.
Fonte: College Board AP Course and Exam Description
Obtenha o valor-$p$ (tecnologia para $df$), compare ao $\alpha$ e conclua no contexto.
7.10
Selecionando e Comunicando um Procedimento
Programa
Este tópico tem como foco a habilidade de selecionar um procedimento de inferência apropriado, agora que os alunos têm uma gama de opções. Os alunos devem ter oportunidades de praticar quando e como aplicar todos os objetivos de aprendizagem relacionados à inferência envolvendo proporções ou médias.
Fonte: College Board AP Course and Exam Description
A habilidade mais difícil no exame é escolher o procedimento correto: uma ou duas amostras? proporção ou média? pareado ou independente? intervalo de confiança ou teste? Leia a pergunta para saber o que está sendo estimado ou afirmado, depois nomeie o procedimento, verifique suas condições, realize-o e comunique a conclusão claramente com números e contexto.
7.10
Dicas de prova
Use procedimentos t para médias (população $\sigma$ desconhecida) — a distribuição t tem caudas mais pesadas que a normal.
Verifique as condições: aleatório, independente e aproximadamente normal (ou grande $n$).
Interprete um intervalo e um teste no contexto, sempre atrelados ao parâmetro (a verdadeira média).
Combine o procedimento certo: uma amostra, duas amostras ou pareado (procure um pareamento natural).
Declare os graus de liberdade; para um teste de duas amostras $t$ use o valor da tecnologia (ou, à mão, o menor ⟨conservador⟩ $n-1$).
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.J: Identificar perguntas sugeridas pela variação entre contagens observadas e esperadas em dados categóricos. [Habilidade 1.A]
VAR-1.J.1 A variação entre o que encontramos e o que esperamos encontrar pode ser aleatória ou não.
Fonte: College Board AP Course and Exam Description
Quando os dados são contagens espalhadas por várias categorias, testamos se as contagens observadas diferem do que uma afirmativa prevê. A ferramenta é a estatística qui-quadrado 卡方 ($\chi^2$), que soma as lacunas padronizadas entre contagens observadas e esperadas:
Um $\chi^2$ grande significa que as contagens observadas estão longe das esperadas – evidência contra a afirmativa. A distribuição qui-quadrado é assimétrica à direita e depende de seus graus de liberdade 自由度.
8.2
Configurando um Bom Teste de Ajuste
Programa
Entendimento Duradouro (VAR-8): A distribuição qui-quadrada pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-8.A: Descrever distribuições qui-quadradas. [Habilidade 3.C]
VAR-8.A.1 As contagens esperadas de dados categóricos são contagens consistentes com a hipótese nula. Em geral, uma contagem esperada é um tamanho de amostra vezes uma probabilidade.
A estatística qui-quadrada mede a distância entre contagens observadas e esperadas em relação às contagens esperadas.
As distribuições qui-quadrada têm valores positivos e são assimétricas à direita. Dentro de uma família de curvas de densidade, a assimetria se torna menos pronunciada com o aumento dos graus de liberdade.
Objetivo de Aprendizagem VAR-8.B: Identificar as hipóteses nula e alternativa em um teste para a distribuição de proporções em um conjunto de dados categóricos. [Habilidade 1.F]
VAR-8.B.1 Para um teste qui-quadrado de ajuste de bondade, a hipótese nula especifica proporções nulas para cada categoria, e a hipótese alternativa é que pelo menos uma dessas proporções não seja conforme especificado na hipótese nula.
Objetivo de Aprendizagem VAR-8.C: Identificar um método de teste apropriado para a distribuição de proporções em um conjunto de dados categóricos. [Habilidade 1.E]
VAR-8.C.1 Ao considerar uma distribuição de proporções para uma variável categórica, o teste apropriado é o teste qui-quadrado de ajuste de bondade.
Objetivo de Aprendizagem VAR-8.D: Calcular contagens esperadas para o teste qui-quadrado de ajuste de bondade. [Habilidade 3.A]
VAR-8.D.1 As contagens esperadas para um teste qui-quadrado de ajuste de bondade são (tamanho da amostra)(proporção nula).
Objetivo de Aprendizagem VAR-8.E: Verificar as condições para fazer inferências estatísticas ao testar o ajuste de bondade para uma distribuição qui-quadrada. [Habilidade 4.C]
VAR-8.E.1 Para fazer inferências estatísticas para um teste qui-quadrado de ajuste de bondade, devemos verificar o seguinte:
a. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$.
b. O teste qui-quadrado de ajuste de bondade torna-se mais preciso com mais observações, portanto, grandes contagens devem ser usadas (forma).
i. Uma verificação conservadora para grandes contagens é que todas as contagens esperadas devem ser maiores que 5.
Fonte: College Board AP Course and Exam Description
O teste qui-quadrado (χ²)
Um teste de ajuste de distribuição (GOF) 拟合优度 verifica se uma variável categórica segue uma distribuição alegada (ex: "o dado é justo"). Hipóteses:
$$H_0:\text{the distribution is as claimed}\qquad H_a:\text{at least one proportion differs}.$$
Contagem esperada para cada categoria $=n\times(\text{claimed proportion})$. Condições: amostra aleatória, todas as contagens esperadas $\ge 5$ e a condição de 10%.
A distribuição qui-quadrado é assimétrica à direita. Uma estatística grande cai na cauda sombreada à direita além do valor crítico – é ali que você rejeita o modelo.
VAR-8.F.2 A distribuição da estatística de teste assumindo que a hipótese nula é verdadeira (distribuição nula) pode ser uma distribuição de randomização ou, quando um modelo de probabilidade é assumido como verdadeiro, uma distribuição teórica (qui-quadrada).
Objetivo de Aprendizagem VAR-8.G: Determinar o valor p $p$ para o teste qui-quadrado de ajuste de bondade. [Habilidade 3.E]
VAR-8.G.1 O valor p $p$ para um teste qui-quadrado de ajuste de bondade para um número de graus de liberdade é encontrado usando a tabela apropriada ou saída gerada por computador.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.I: Interpretar o valor p $p$ para o teste qui-quadrado de ajuste de bondade. [Habilidade 4.B]
DAT-3.I.1 Uma interpretação do valor p $p$ para o teste qui-quadrado de ajuste de bondade é a probabilidade, dado que a hipótese nula e o modelo de probabilidade são verdadeiros, de obter uma estatística de teste tão ou mais extrema que o valor observado.
Objetivo de Aprendizagem DAT-3.J: Justificar uma afirmação sobre a população com base nos resultados de um teste qui-quadrado de ajuste de bondade. [Habilidade 4.E]
DAT-3.J.1 Uma decisão de rejeitar ou falhar em rejeitar a hipótese nula é baseada na comparação do valor p $p$ ao nível de significância, $\alpha$.
DAT-3.J.2 Os resultados de um teste qui-quadrado de ajuste de bondade podem servir como raciocínio estatístico para supportar a resposta a uma questão de pesquisa sobre a população que foi amostrada.
Fonte: College Board AP Course and Exam Description
Calcule $\chi^2=\sum\dfrac{(O-E)^2}{E}$ com $df=(\text{number of categories})-1$. Encontre o valor-$p$ da distribuição qui-quadrado (cauda superior), compare ao $\alpha$ e conclua no contexto. Um componente grande da soma aponta para a categoria que mais se desvia.
Qui-quadrado compara contagens observadas com as esperadas sob a hipótese nula
Exemplo resolvido. Um dado rolado $60$ vezes dá contagens $8,10,12,9,11,10$. Se for justo, cada contagem esperada é $60/6=10$, então
com $df=6-1=5$. Escreva todas as categorias, incluindo as duas que correspondem exatamente às suas contagens esperadas e, portanto, adicionam $0$ – a soma percorre todas as seis categorias, e $df$ conta categorias, não apenas as que diferem. Este $\chi^2$ é pequeno (um valor-$p$ grande), então não rejeitamos$H_0$ – nenhuma evidência de que o dado seja injusto.
Explorar
Explorar a distribuição qui-quadrado e seu valor p
O valor p é a área na cauda direita além da sua estatística de teste, então um $\chi^2$maior significa um valor p menor. Arraste $\chi^2$ para observar essa área encolher e arraste df para ver toda a família mudar de forma — fortemente assimétrica à direita em poucos df, mais simétrica à medida que df cresce.
8.4
Contagens Esperadas em Tabelas Bidimensionais
Programa
Entendimento Duradouro (VAR-8): A distribuição qui-quadrada pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-8.H: Calcular contagens esperadas para tabelas de dupla entrada de dados categóricos. [Habilidade 3.A]
VAR-8.H.1 A contagem esperada em uma célula específica de uma tabela de dupla entrada de dados categóricos pode ser calculada usando a fórmula:
Esta é a contagem que você veria se as variáveis de linha e coluna fossem não relacionadas.
Exemplo resolvido. Em uma tabela bidimensional, o total da linha de uma célula é $40$, seu total da coluna é $50$, e o total geral é $200$. Sua contagem esperada é $E=\dfrac{40\times50}{200}=10$. Repetir para cada célula dá a tabela esperada para comparar com a observada.
Uma planilha organiza contagens categóricas antes de um teste qui-quadrado
8.5
Homogeneidade ou Independência?
Programa
Entendimento Duradouro (VAR-8): A distribuição qui-quadrada pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-8.I: Identificar as hipóteses nula e alternativa para um teste qui-quadrado de homogeneidade ou independência. [Habilidade 1.F]
VAR-8.I.1 As hipóteses adequadas para um teste qui-quadrado de homogeneidade são:
$H_0$: Não há diferença nas distribuições de uma variável categórica entre populações ou tratamentos.
$H_a$: Há diferença nas distribuições de uma variável categórica entre populações ou tratamentos.
VAR-8.I.2 As hipóteses adequadas para um teste qui-quadrado de independência são:
$H_0$: Não há associação entre duas variáveis categóricas em uma dada população, ou as duas variáveis categóricas são independentes.
$H_a$: Duas variáveis categóricas em uma população estão associadas ou dependentes.
Objetivo de Aprendizagem VAR-8.J: Identificar um método de teste adequado para comparar distribuições em tabelas de dados categóricos de duas vias. [Habilidade 1.E]
VAR-8.J.1 Ao comparar distribuições para determinar se as proporções em cada categoria para dados categóricos coletados de diferentes populações são as mesmas, o teste adequado é o teste qui-quadrado de homogeneidade.
VAR-8.J.2 Para determinar se as variáveis de linha e coluna em uma tabela de duas vias de dados categóricos podem estar associadas na população da qual os dados foram amostrados, o teste adequado é o teste qui-quadrado de independência.
Objetivo de Aprendizagem VAR-8.K: Verificar as condições para fazer inferências estatísticas ao testar uma distribuição qui-quadrada de independência ou homogeneidade. [Habilidade 4.C]
VAR-8.K.1 Para fazer inferências estatísticas para um teste qui-quadrado para tabelas de duas vias (homogeneidade ou independência), devemos verificar o seguinte:
a. Para verificar a independência:
i. Para um teste de independência: Os dados devem ser coletados usando uma amostra aleatória simples.
ii. Para um teste de homogeneidade: Os dados devem ser coletados usando uma amostragem estratificada aleatória ou experimento randomizado.
iii. Ao amostrar sem reposição, verifique que $n \leq 10\%N$.
b. Os testes qui-quadrado de independência e homogeneidade tornam-se mais precisos com mais observações, portanto, contagens grandes devem ser usadas (forma).
i. Uma verificação conservadora para grandes contagens é que todas as contagens esperadas devem ser maiores que 5.
Fonte: College Board AP Course and Exam Description
Dois testes usam a mesma matemática de $\chi^2$ mas respondem a perguntas diferentes:
Teste de homogeneidade 同质性: as distribuições de uma variável categórica são as mesmas em várias populações ou grupos (amostras/tratamentos separados)?
Teste de independência 独立性: duas variáveis categóricas estão associadas dentro de uma única população (uma amostra, duas variáveis medidas)?
O delineamento (várias amostras vs. uma amostra) decide qual nome e hipóteses usar.
8.6
Realizando um Teste de Homogeneidade ou Independência
Programa
Entendimento Duradouro (VAR-8): A distribuição qui-quadrada pode ser usada para modelar variações.
Objetivo de Aprendizagem VAR-8.L: Calcular a estatística adequada para um teste qui-quadrado de homogeneidade ou independência. [Habilidade 3.E]
VAR-8.L.1 A estatística de teste adequada para um teste qui-quadrado de homogeneidade ou independência é a estatística qui-quadrada:
Objetivo de Aprendizagem VAR-8.M: Determinar o valor-p $p$ para um teste de significância qui-quadrado para independência ou homogeneidade. [Habilidade 3.E]
VAR-8.M.1 O valor-p $p$ para um teste qui-quadrado para independência ou homogeneidade para um número de graus de liberdade é encontrado usando a tabela apropriada ou tecnologia.
VAR-8.M.2 Para um teste de independência ou homogeneidade para uma tabela de contingência bidimensional, o valor-p $p$ é a proporção de valores em uma distribuição qui-quadrado com graus de liberdade apropriados que são iguais ou maiores do que a estatística de teste.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.K: Interpretar o valor-p $p$ para o teste qui-quadrado para homogeneidade ou independência. [Habilidade 4.B]
DAT-3.K.1 Uma interpretação do valor-p $p$ para o teste qui-quadrado para homogeneidade ou independência é a probabilidade, dado que a hipótese nula e o modelo probabilístico são verdadeiros, de obter uma estatística de teste tão extrema ou mais extrema do que o valor observado.
Objetivo de Aprendizagem DAT-3.L: Justificar uma afirmação sobre a população com base nos resultados de um teste qui-quadrado de homogeneidade ou independência. [Habilidade 4.E]
DAT-3.L.1 A decisão de rejeitar ou não rejeitar a hipótese nula para um teste qui-quadrado para homogeneidade ou independência baseia-se na comparação do valor-p $p$ com o nível de significância, $\alpha$.
DAT-3.L.2 Os resultados de um teste qui-quadrado de homogeneidade ou independência podem servir como raciocínio estatístico para apoiar a resposta a uma questão de pesquisa sobre a população que foi amostrada (independência) ou as populações que foram amostradas (homogeneidade).
Fonte: College Board AP Course and Exam Description
Calcule as contagens esperadas, depois $\chi^2=\sum\dfrac{(O-E)^2}{E}$ sobre todas as células, com
$$df=(\text{rows}-1)(\text{columns}-1).$$
Condições: dados aleatórios, todas as contagens esperadas $\ge 5$, condição de 10%. Encontre o valor-$p$, compare ao $\alpha$ e conclua no contexto – evidência de diferença entre grupos (homogeneidade) ou de associação (independência).
8.7
Escolhendo o Procedimento Categórico Correto
Programa
Este tópico destina-se a focar na habilidade de selecionar um procedimento de inferência adequado agora que os alunos têm uma gama de opções. Os alunos devem ter oportunidades de praticar quando e como aplicar todos os objetivos de aprendizagem relacionados à inferência para dados categóricos.
Fonte: College Board AP Course and Exam Description
Decida pelo delineamento: uma variável categórica contra uma distribuição alegada $\Rightarrow$ajuste; uma amostra cruzada por duas variáveis $\Rightarrow$independência; várias amostras/grupos comparados $\Rightarrow$homogeneidade. Comparar apenas duas proporções pode usar um teste de duas proporções $z$ ou um teste qui-quadrado, mas apenas para uma alternativa bidirecional, onde eles concordam exatamente ($\chi^2=z^2$). Um teste qui-quadrado é sempre bidirecional, então não pode dar uma conclusão direcional: se $H_a$ for unidirecional (digamos $p_1>p_2$), use o teste de $z$.
Explorar
Qual teste qui-quadrado é este?
Todos os três testes usam a mesma aritmética $\chi^2$, então os pontos são conquistados ao nomear o correto. O desenho decide — quantas amostras foram coletadas e quantas variáveis foram medidas em cada unidade.
8.7
Dicas de prova
Use $\chi^2=\sum\tfrac{(O-E)^2}{E}$ para dados categóricos; sempre divida pela contagem esperada.
Escolha o teste certo: ajuste (uma variável), independência ou homogeneidade (tabela bidimensional).
Calcule as contagens esperadas como $\tfrac{\text{row total}\times\text{column total}}{\text{grand total}}$ e verifique se cada uma é $\ge5$.
Um $\chi^2$ grande (pequeno valor-p) significa que as contagens observadas diferem das esperadas mais do que o acaso permitiria.
Declare os graus de liberdade corretamente (categorias $-1$, ou $(r-1)(c-1)$).
Compreensão Permanente (VAR-1): Dado que a variação pode ser aleatória ou não, as conclusões são incertas.
Objetivo de Aprendizagem VAR-1.K: Identificar questões sugeridas pela variação em gráficos de dispersão. [Habilidade 1.A]
VAR-1.K.1 A variação nas posições dos pontos em relação a uma linha teórica pode ser aleatória ou não aleatória.
Fonte: College Board AP Course and Exam Description
Um gráfico de dispersão 散点图 de amostra fornece uma inclinação da amostra 样本斜率$b$ para a reta de regressão 回归 de mínimos quadrados – mas uma amostra diferente daria uma inclinação ligeiramente diferente. Portanto, $b$ é uma estatística com variabilidade de amostragem 抽样变异性, estimando a inclinação verdadeira (populacional) 总体斜率$\beta$. Esta unidade faz inferência 推断 para $\beta$: existe uma relação linear 线性 real e quão forte ela é?
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.AC: Identificar um procedimento de intervalo de confiança adequado para a inclinação de um modelo de regressão. [Habilidade 1.D]
UNC-4.AC.1 Considere uma variável de resposta, $y$, que está linearmente relacionada a uma variável explicativa, $x$. Para uma amostra aleatória simples de $n$ observações, a reta de regressão amostral, $\hat{y} = a + bx$, é uma estimativa da reta de regressão populacional $\mu_y = \alpha + \beta x$. Para uma observação particular, $(x_i, y_i)$, o resíduo da reta de regressão amostral, $y_i - \hat{y}_i = y_i - (a + bx_i)$, é uma estimativa de $y_i - (\alpha + \beta x_i)$, o desvio da variável de resposta da reta de regressão populacional. Para todos os pontos $(x, y)$ na população, o desvio padrão de todos os desvios da variável de resposta da reta de regressão populacional, $\sigma$, pode ser estimado pelo desvio padrão dos resíduos da reta de regressão amostral, $s = \sqrt{\dfrac{\sum\left(y_i - \hat{y}_i\right)^2}{n-2}}$. (Nota: Esta fórmula usa $n-2$ no denominador em vez de $n-1$ porque dois parâmetros, $\alpha$ e $\beta$, devem ser estimados para obter os valores previstos da reta de regressão de mínimos quadrados.)
UNC-4.AC.2 Para uma amostra aleatória simples de $n$ observações, seja $b$ representando a inclinação de uma reta de regressão amostral. Então a média da distribuição de amostragem para $b$ é igual à inclinação populacional: $\mu_b = \beta$. O desvio padrão da distribuição de amostragem para $b$ é $\sigma_b = \dfrac{\sigma}{\sigma_x \sqrt{n}}$, onde $\sigma_x = \sqrt{\dfrac{\sum\left(x_i - \bar{x}\right)^2}{n}}$.
UNC-4.AC.3 O intervalo de confiança apropriado para a inclinação de um modelo de regressão é um intervalo de confiança $t$ para a inclinação.
Objetivo de Aprendizagem UNC-4.AD: Verificar as condições para calcular intervalos de confiança para a inclinação de um modelo de regressão. [Habilidade 4.C]
UNC-4.AD.1 Para calcular um intervalo de confiança para estimar a inclinação de uma reta de regressão, devemos verificar o seguinte:
a. A verdadeira relação entre $x$ e $y$ é linear. A análise de resíduos pode ser usada para verificar a linearidade.
b. O desvio padrão para $y$, $\sigma_y$, não varia com $x$. A análise de resíduos pode ser usada para verificar desvios padrão aproximadamente iguais para todas as $x$.
c. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \le 10\% N$.
d. Para um valor particular de $x$, as respostas (valores de $y$) são aproximadamente normalmente distribuídas. A análise de representações gráficas de resíduos pode ser usada para verificar a normalidade.
i. Se a distribuição observada for assimétrica, $n$ deve ser maior que 30.
Objetivo de Aprendizagem UNC-4.AE: Determinar a margem de erro dada para a inclinação de um modelo de regressão. [Habilidade 3.D]
UNC-4.AE.1 Para a inclinação de uma reta de regressão, a margem de erro é o valor crítico $\left(t^*\right)$ vezes o erro padrão ($SE$) da inclinação.
UNC-4.AE.2 O erro padrão para a inclinação de uma reta de regressão com desvio padrão amostral, $s$, é $SE = \dfrac{s}{s_x \sqrt{n-1}}$, onde $s$ é a estimativa de $\sigma$ e $s_x$ é o desvio padrão amostral dos valores de $x$.
Objetivo de Aprendizagem UNC-4.AF: Calcular um intervalo de confiança adequado para a inclinação de um modelo de regressão. [Habilidade 3.D]
UNC-4.AF.1 A estimativa pontual para a inclinação de um modelo de regressão é a inclinação da reta de melhor ajuste, $b$.
UNC-4.AF.2 Para a inclinação de um modelo de regressão, a estimativa de intervalo é $b \pm t^* \left(SE_b\right)$.
Fonte: College Board AP Course and Exam Description
Um intervalo $t$ para a verdadeira inclinação $\beta$:
$$b\pm t^{*}\,SE_b,\qquad df=n-2,$$
onde $b$ é a inclinação da amostra e $SE_b$ seu erro padrão (lido na saída do computador). Condições (LINER): a relação verdadeira é Linear, as observações são Independentes, os resíduos são Normais e os resíduos têm Equal amplitude (verifique o gráfico de resíduos e um histograma de resíduos), de dados Random. Interprete o intervalo para $\beta$ no contexto, com unidades de $y$ por unidade de $x$.
Um gráfico de resíduos aleatório e sem padrão apoia as condições; uma curva ou um leque não apoia
O gráfico de resíduos 残差图 é onde você verifica Linear e Equal-spread: você quer uma nuvem sem forma em torno de zero. Uma curva significa que a relação não é linear; um leque (amplitude crescendo com $x$) significa que os resíduos não têm amplitude igual – ambos violam uma condição.
Exemplo resolvido. A saída de regressão dá inclinação $b=2.5$ com $SE_b=0.8$ de $n=20$ pontos. Para um intervalo de $95\%$, $df=18$ dá $t^*=2.101$:
$$2.5\pm2.101(0.8)=2.5\pm1.68=(0.82,\ 4.18).$$
Como $0$ não está no intervalo, há evidência de uma relação linear positiva.
A inferência da inclinação é baseada na reta de mínimos quadrados através dos pontosRegressão de mínimos quadrados: a reta que minimiza a soma dos resíduos quadrados
Explorar
Inferência para um coeficiente angular de regressão
O coeficiente angular amostral varia de amostra para amostra; um intervalo de confiança e um teste t perguntam se o coeficiente angular verdadeiro poderia ser zero (sem relação linear).
Compreensão Permanente (UNC-4): Um intervalo de valores deve ser usado para estimar parâmetros, a fim de levar em conta a incerteza.
Objetivo de Aprendizagem UNC-4.AG: Interpretar um intervalo de confiança para a inclinação de um modelo de regressão. [Habilidade 4.B]
UNC-4.AG.1 Em amostragens aleatórias repetidas com o mesmo tamanho de amostra, aproximadamente C% dos intervalos de confiança criados capturarão a inclinação do modelo de regressão, ou seja, a verdadeira inclinação da reta de regressão populacional.
UNC-4.AG.2 Uma interpretação para um intervalo de confiança para a inclinação de uma reta de regressão deve incluir uma referência à amostra retirada e detalhes sobre a população que ela representa.
Objetivo de Aprendizagem UNC-4.AH: Justificar uma afirmação com base em um intervalo de confiança para a inclinação de um modelo de regressão. [Habilidade 4.D]
UNC-4.AH.1 Um intervalo de confiança para a inclinação de um modelo de regressão fornece um intervalo de valores que pode fornecer evidências suficientes para apoiar uma afirmação particular no contexto.
Objetivo de Aprendizagem UNC-4.AI: Identificar os efeitos do tamanho da amostra na largura de um intervalo de confiança para a inclinação de um modelo de regressão. [Habilidade 4.A]
UNC-4.AI.1 Quando todas as outras coisas permanecem as mesmas, a largura do intervalo de confiança para a inclinação de um modelo de regressão tende a diminuir à medida que o tamanho da amostra aumenta.
Fonte: College Board AP Course and Exam Description
Se o intervalo de confiança para $\beta$ contém $0$, uma inclinação nula é plausível — não há evidência de relação linear. Se o intervalo for inteiramente positivo ou negativo, há evidência de uma real (positiva ou negativa) relação linear. Indique a direção em contexto.
9.4
Configurando um Teste para uma Inclinação
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.J: Identificar a seleção adequada de um método de teste para a inclinação de um modelo de regressão. [Habilidade 1.E]
VAR-7.J.1 O teste apropriado para a inclinação de um modelo de regressão é um teste t $t$ para uma inclinação.
Objetivo de Aprendizagem VAR-7.K: Identificar hipóteses nula e alternativa adequadas para a inclinação de um modelo de regressão. [Habilidade 1.F]
VAR-7.K.1 A hipótese nula para um teste t $t$ para uma inclinação é: $H_0 : \beta = \beta_0$, onde $\beta_0$ é o valor hipotetizado da hipótese nula. A hipótese alternativa é $H_0 : \beta < \beta_0$ ou $H_0 : \beta > \beta_0$, ou $H_0 : \beta \neq \beta_0$.
Objetivo de Aprendizagem VAR-7.L: Verificar as condições para o teste de significância para a inclinação de um modelo de regressão. [Habilidade 4.C]
VAR-7.L.1 Para fazer inferências estatísticas ao testar a inclinação de um modelo de regressão, devemos verificar o seguinte:
a. A verdadeira relação entre $x$ e $y$ é linear. A análise de resíduos pode ser usada para verificar a linearidade.
b. O desvio padrão para $y$, $\sigma_y$, não varia com $x$. A análise de resíduos pode ser usada para verificar desvios padrão aproximadamente iguais para todas as $x$.
c. Para verificar a independência:
i. Os dados devem ser coletados usando uma amostra aleatória ou um experimento randomizado.
ii. Ao amostrar sem reposição, verifique que $n \le 10\% N$.
d. Para um valor particular de $x$, as respostas (valores de $y$) são aproximadamente normalmente distribuídas. A análise de representações gráficas de resíduos pode ser usada para verificar a normalidade.
i. Se a distribuição observada for assimétrica, $n$ deve ser maior que 30.
ii. Se o tamanho da amostra for menor que 30, a distribuição dos dados da amostra deve estar livre de assimetria forte e outliers.
Fonte: College Board AP Course and Exam Description
O teste usual questiona se existe alguma relação linear:
$$H_0:\beta=0 \quad(\text{no linear relationship})\qquad H_a:\beta\neq 0 \ (\text{or } <,\,>).$$
Verifique as condições LINER. Este é um teste $t$ sobre a inclinação.
Verifique os gráficos de resíduo antes de confiar em um IC de inclinação ou teste
9.5
Realizando um Teste para uma Inclinação
Programa
Compreensão Duradoura (VAR-7): A distribuição $t$ pode ser usada para modelar a variação.
Objetivo de Aprendizagem VAR-7.M: Calcular uma estatística de teste apropriada para a pendente de um modelo de regressão. [Habilidade 3.E]
VAR-7.M.1 A distribuição da pendente de um modelo de regressão assumindo que todas as condições estão satisfeitas e a hipótese nula é verdadeira (distribuição nula) é uma distribuição $t$.
VAR-7.M.2 Para regressão linear simples quando há amostragem aleatória de uma população para a variável resposta que pode ser modelada com uma distribuição normal para cada valor da variável explicativa, a distribuição amostral de $t = \dfrac{b - \beta}{SE_b}$ tem uma distribuição $t$ com graus de liberdade iguais a $n - 2$. Ao testar a pendente em um modelo de regressão linear simples com um parâmetro, a pendente, o teste para a pendente tem $df = n - 1$.
Compreensão Duradoura (DAT-3): Os testes de significância nos permitem tomar decisões sobre hipóteses dentro de um contexto particular.
Objetivo de Aprendizagem DAT-3.M: Interpretar o valor $p$ de um teste de significância para a pendente de um modelo de regressão. [Habilidade 4.B]
DAT-3.M.1 Uma interpretação do valor $p$ de um teste de significância para a pendente de um modelo de regressão deve reconhecer que o valor $p$ é calculado assumindo que a hipótese nula é verdadeira, ou seja, assumindo que a verdadeira pendente populacional é igual ao valor particular declarado na hipótese nula.
Objetivo de Aprendizagem DAT-3.N: Justificar uma afirmação sobre a população com base nos resultados de um teste de significância para a pendente de um modelo de regressão. [Habilidade 4.E]
DAT-3.N.1 Uma decisão formal compara explicitamente o valor $p$ à significância $\alpha$. Se o valor $p$ for $\le \alpha$, então rejeite a hipótese nula, $H_0 : \beta = \beta_0$. Se o valor $p$ for $> \alpha$, então não rejeite a hipótese nula.
DAT-3.N.2 Os resultados de um teste de significância para a pendente de um modelo de regressão podem servir como raciocínio estatístico para apoiar a resposta a uma questão de pesquisa sobre essa amostra.
Fonte: College Board AP Course and Exam Description
A estatística de inclinação $t$:
$$t=\frac{b-0}{SE_b},\qquad df=n-2.$$
Ambos $b$ e $SE_b$ vêm diretamente da saída da regressão. Encontre o valor-$p$ na distribuição $t$, compare com $\alpha$ e conclua em contexto — evidência (ou não) de uma relação linear entre as duas variáveis.
Observe as caudas. A saída de regressão sempre imprime o valor-$p$bilateral (para $H_a:\beta\neq 0$). Se seu $H_a$ for unilateral, divida-o pela metade — e primeiro verifique se a inclinação amostral realmente aponta na direção que $H_a$ afirma; se apontar para o outro lado, o valor-$p$ unilateral será maior que $0.5$ e você não pode rejeitar $H_0$.
Exemplo resolvido. Para a mesma saída ($b=2.5$, $SE_b=0.8$, $n=20$), teste $H_0:\beta=0$:
$$t=\frac{2.5-0}{0.8}=3.13,\qquad df=18,$$
um pequeno valor-$p$ ($<0.01$), então rejeite $H_0$ — evidência convincente de uma relação linear. Isso condiz com o intervalo, que excluiu $0$.
9.6
Selecionando o Procedimento Correto
Programa
Este tópico destina-se a focar na habilidade de selecionar um procedimento de inferência adequado agora que os alunos têm uma gama de opções. Os alunos devem ter oportunidades de praticar quando e como aplicar todos os objetivos de aprendizagem relacionados à inferência.
Fonte: College Board AP Course and Exam Description
Em toda a inferência, identifique: o quê está sendo estimado ou afirmado (uma proporção, uma média, uma diferença, uma distribuição de contagens ou uma inclinação), quantas amostras, e qual delineamento (independente ou pareado; amostral ou experimental). Em seguida, nomeie o procedimento, verifique suas condições, realize-o e comunique a conclusão com a estatística, o valor-$p$ ou intervalo, e uma resposta em linguagem simples em contexto. Essa habilidade de selecionar e comunicar é o que a questão de tarefa investigativa mais recompensa.
9.6
Dicas de prova
A inferência para uma inclinação testa se a verdadeira inclinação é $0$ (nenhuma relação linear).
Se o intervalo de confiança de uma inclinação inclui 0, você não pode concluir uma relação linear real — as variáveis ainda podem estar relacionadas de forma curva.
Leia a inclinação, erro padrão, estatística t e valor-p diretamente da saída do computador — mas o valor-p impresso é bilateral, então divida pela metade para um teste $H_a$ unilateral.
Verifique as condições de regressão (linearidade, independência, resíduos aproximadamente normais, dispersão igual) por meio do gráfico de resíduo.
Interprete o intervalo e o teste em contexto, vinculados à verdadeira inclinação.