| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension des magnitudes binaires et de la différence entre les préfixes binaires et décimaux | Comprendre la différence entre et utiliser : • kibi et kilo • mebi et mega • gibi et giga • tebi et tera |
| Montrer une compréhension des différents systèmes numériques | Utiliser les bases binaire, décimale, hexadécimale et le Code Binaire Décimal (BCD) ainsi que la représentation du complément à un et du complément à deux pour les nombres binaires |
| Convertir une valeur entière d'une base/representation numérique à une autre | |
| Effectuer des additions et soustractions binaires | En utilisant des entiers binaires positifs et négatifs |
| Montrer comment peut se produire un débordement | |
| Décrire des applications pratiques où le Code Binaire Décimal (BCD) et l'Hexadécimal sont utilisés | |
| Montrer une compréhension et être capable de représenter des données de caractères sous leur forme binaire interne, selon le jeu de caractères utilisé | Les étudiants sont censés être familiers avec ASCII (American Standard Code for Information Interchange), ASCII étendu et Unicode. Les étudiants ne seront pas tenus de mémoriser des codes de caractères particuliers |
Conseils
L'informatique A-Level (9618) est deux moitiés qui semblent être des sujets différents. La moitié de la théorie va de la représentation de l'information et de la communication à travers le matériel, les processeurs, les logiciels système, la sécurité, les bases de données et l'éthique. La moitié pratique est les algorithmes, les structures de données, la programmation et le développement logiciel, et le niveau A2 ajoute la récursion et la programmation orientée objet.
Les épreuves de théorie sont marquées bien plus littéralement que les étudiants ne s'y attendent. Il y a un vocabulaire correct — noms de registres, modes d'adressage, formes normales, la différence exacte entre la validation et la vérification — et une paraphrase rapporte généralement zéro. Apprenez les définitions dans le libellé du syllabus.
Les épreuves de programmation récompensent l'écriture de code à la main jusqu'à ce qu'il compile dans votre tête.
-
1
Représentation de l'information
Regarder la leçon1.1
Systèmes numériques

Programme
Source : Programme Cambridge International
Comptage en binaire : 0 à 15 Les trois systèmes numériques 数制 que vous devez maîtriser :
- décimal 十进制 (base 10) — utilise les chiffres 0 à 9. Les positions valent des puissances de dix.
- binaire 二进制 (base 2) — utilise 0 et 1. Les positions valent des puissances de deux. Chaque octet 字节 contient 8 bits 位.
- hexadécimal 十六进制 (base 16) — utilise 0 à 9 puis A à F pour 10 à 15. Chaque chiffre hexadécimal représente exactement 4 bits.
Un abaque représente les nombres par position — le même principe que celui du décimal, du binaire et de l'hexadécimal Conversions
Décimal → binaire : diviser successivement par 2 et noter les restes, lire de bas en haut. Ou soustraire la plus grande position de valeur 位值 (puissance de 2) compatible.
Exemple : $558_{10}$ : $558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$. Sur 12 bits :
0010 0010 1110.Binaire → hexadécimal : regrouper les bits en nibbles 半字节 (4 bits) depuis la droite et convertir chacun.
0010 0010 1110→2 2 E→22E.Hexadécimal → binaire : remplacer chaque chiffre hexadécimal par son motif sur 4 bits. Hexadécimal → décimal : multiplier chaque chiffre par sa position de valeur.
22E$= 2 \times 256 + 2 \times 16 + 14 = 558$.Exemple résolu. Convertir le décimal 200 en binaire sur 8 bits, puis en hexadécimal.
$200 = 128 + 64 + 8$, donc le binaire est
11001000. En nibbles,11001000$= 12$ et $8$, soit $\text{C}$ et $8$, ainsi l'hexadécimal estC8.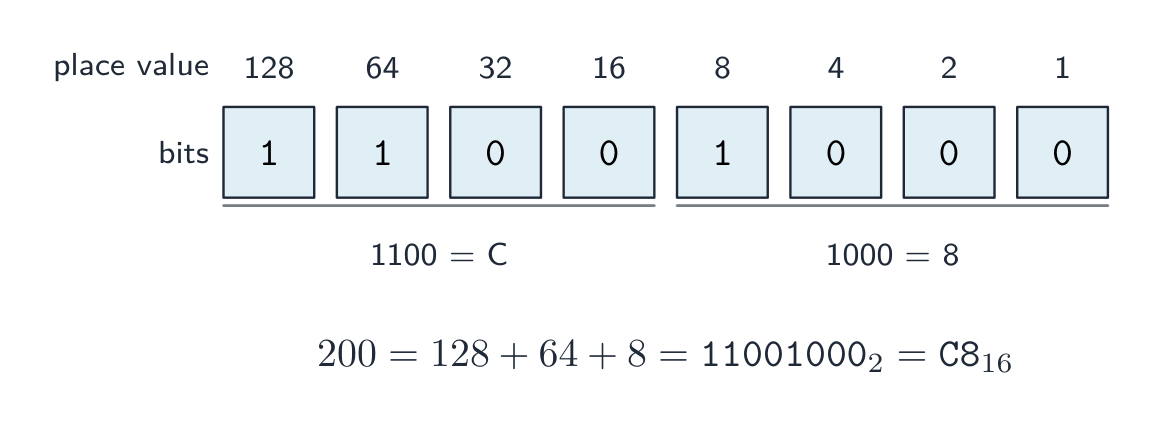
Lire 200 depuis ses positions de valeur, puis regrouper les bits en nibbles pour obtenir l'hexadécimal C8 Combien de bits ?
Les questions d'examen fixent la largeur du registre 寄存器宽度 (8, 12 ou 16 bits). Remplir avec des zéros de tête jusqu'à cette largeur : $558$ sur 12 bits est
0010 0010 1110, jamais10 0010 1110.Pour trouver le nombre minimum de bits nécessaires pour stocker une valeur, déterminer quelles positions de valeur sont requises :
- un entier non signé de $0$ à $2^{n} - 1$ nécessite $n$ bits : $200$ nécessite 8 bits (le maximum est $255$), $1000$ nécessite 10 bits (le maximum est $1023$), $16$ nécessite 5 bits (4 bits s'arrêtent à $15$).
- un entier signed à complément à deux de $-2^{n-1}$ à $2^{n-1} - 1$ nécessite $n$ bits : $-200$ nécessite 9 bits, car 8 bits s'arrêtent à $-128$.
- un chiffre hexadécimal nécessite 4 bits, un chiffre BCD nécessite 4 bits, et un caractère ASCII nécessite 7 bits (8 pour l'ASCII étendu).
Préfixes binaires vs décimaux
Deux familles de préfixes ressemblent mais diffèrent — décimal (puissances de 10) et binaire (puissances de 2) :
Décimal (SI) Binaire (mémoire) kilo $= 10^{3}$ kibi (Ki) $= 2^{10} = 1024$ méga $= 10^{6}$ mebi (Mi) $= 2^{20}$ giga $= 10^{9}$ gibi (Gi) $= 2^{30}$ téra $= 10^{12}$ tebi (Ti) $= 2^{40}$ Ainsi, un tébibyte (TiB) est légèrement supérieur à un téraoctet (To). Un disque « 1 To » contient $10^{12}$ octets, mais un système d'exploitation qui affiche en TiB montrera un nombre plus faible.
ExplorerBinaire, décimal et hexadécimal
Tapez un nombre et voyez-le en binaire, décimal et hexadécimal simultanément — et comment les valeurs de position s'additionnent.
Vocabulaire EntrainerAnglais Chinois Pinyin number system/ˈnʌmbə ˈsɪstəm/ 数制 shù zhì binary/ˈbaɪnəri/ 二进制 èr jìn zhì denary/ˈdiːnəri/ 十进制 shí jìn zhì place value/pleɪs ˈvæljuː/ 位值 wèi zhí byte/baɪt/ 字节 zì jié bit/bɪt/ 位 wèi hexadecimal/ˌheksəˈdesɪml/ 十六进制 shí liù jìn zhì nibble/ˈnɪbl/ 半字节 bàn zì jié register width/ˈredʒɪstə wɪtθ/ 寄存器宽度 jì cún qì kuān dù register/ˈredʒɪstə/ 寄存器 jì cún qì 1.1
Arithmétique binaire
Addition binaire
Ajouter colonne par colonne de droite à gauche, en reportant comme en décimal :
Bit A Bit B Report entrant Bit somme Report sortant 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 1 0 0 1 1 1 1 1 1 Débordement 溢出 se produit lorsque le résultat nécessite plus de bits que le registre 寄存器 ne peut contenir — le report sortant de la colonne la plus à gauche est le bit de débordement.
Exemple résolu. Ajouter les entiers non signés sur 8 bits $10110101$ et $01101100$, et commenter le résultat.
$10110101 + 01101100 = 1\,00100001$. La réponse nécessite 9 bits, elle ne tient donc pas dans un registre sur 8 bits : un débordement s'est produit. Une réponse complète nomme l'erreur et explique pourquoi, en utilisant la taille de mot donnée par la question : « Débordement : le résultat exact ($289$) est supérieur à la valeur maximale qu'un registre sur 8 bits peut contenir ($255$), donc le report sortant du bit de poids fort est perdu et le résultat stocké ($00100001 = 33$) est incorrect. »
Soustraction binaire
La méthode habituelle est l'addition en complément à deux 补码 : pour effectuer $A - B$, former le complément à deux de $B$ (inverser chaque bit et ajouter 1), puis additionner, et ignorer tout report final sortant.
Pour soustraire $00011110$ à $01100100$ (entier non signé sur 8 bits) :
- complément à deux de $00011110$ : inverser → $11100001$, ajouter 1 → $11100010$.
- additionner à $01100100$ : résultat $1\,01000110$ (9 bits) — ignorer le 1 initial → $01000110 = 70_{10}$. Vérification : $100 - 30 = 70$. ✓
Entiers signés en complément à deux
Dans un nombre en complément à deux sur $n$ bits :
- le bit de poids fort 最高有效位 (MSB) est le bit de signe 符号位 : 0 = positif, 1 = négatif.
- pour lire un nombre négatif : inverser chaque bit, ajouter 1, puis changer le signe.
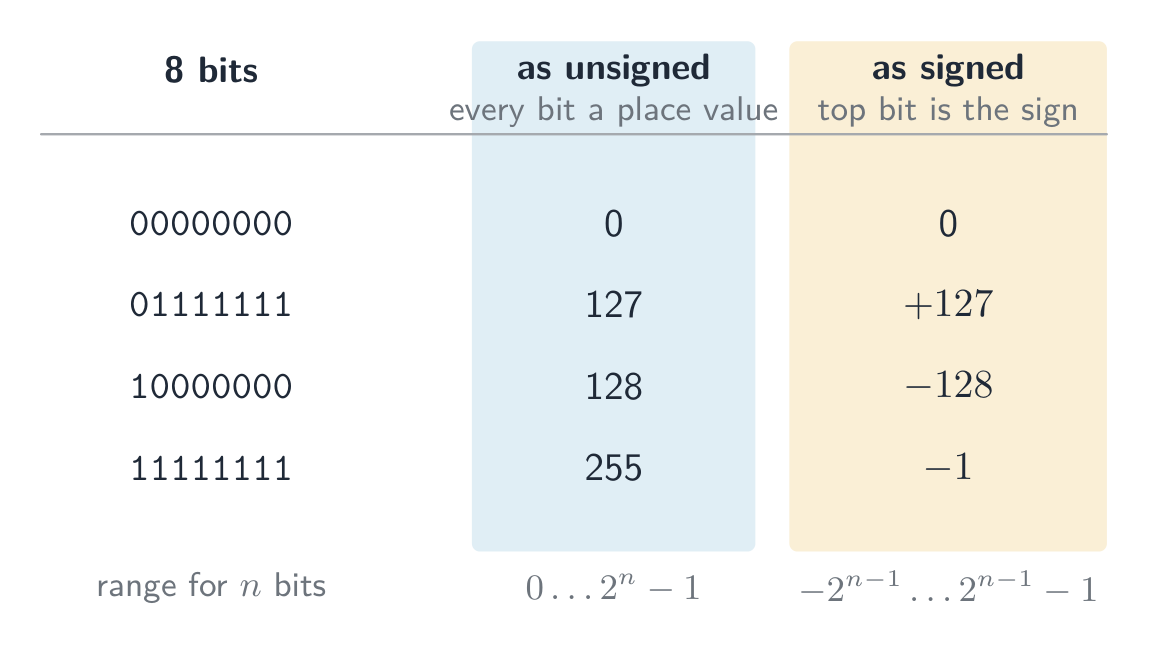
Donc $11100010$ est négatif ; inverser → $00011101$, ajouter 1 → $00011110 = 30$, c'est donc $-30$. C'est un entier signé 有 signed integer (contrairement à un non signé 无 signed one). La plage pour $n$ bits est $-2^{n-1}$ à $+2^{n-1} - 1$ ; pour 8 bits, $-128$ ($10000000$) à $+127$ ($01111111$).
Les mêmes bits signifient des nombres différents selon la convention de lecture. En tant qu'entier non signé, chaque bit est une valeur de position, donc 8 bits vont de $0$ à $255$ ; en tant qu'entier signé en complément à deux, le bit de poids fort est le signe, donc les mêmes 8 bits vont de $-128$ à $+127$. Le motif $11111111$ est $255$ lu d'une manière et $-1$ de l'autre — rien dans les bits eux-mêmes ne dit lequel.
Le même octet lu en non signé et en signé : seule l'interprétation convenue les distingue
 Complément à deux sur 8 bits : le bit de signe divise la plage entre négatif ($-128$ à $-1$) et positif ($0$ à $127$)
Exemple résolu. Quelle valeur décimale représente le nombre en complément à deux sur 8 bits $10110100$ ?
Le MSB est 1, donc il est négatif. Inverser → $01001011$, ajouter 1 → $01001100 = 76$, donc la valeur est $-76$. Vérification avec les valeurs positionnelles : $-128 + 32 + 16 + 4 = -76$.
Exemple résolu. Écrire $-108$ comme un entier en complément à deux sur 12 bits.
Commencez par $+108$ sur 12 bits : $108 = 64 + 32 + 8 + 4$, donc
0000 0110 1100. Inversez chaque bit :1111 1001 0011. Ajoutez 1 :1111 1001 0100. Vérifiez avec les valeurs de position, où le bit de poids fort vaut $-2^{11} = -2048$ : $-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$. ✓Pour 12 bits, la plage va de $-2048$ (
1000 0000 0000) à $+2047$ (0111 1111 1111). Les questions demandant les valeurs minimale et maximale cherchent ces deux motifs, apprenez donc la règle : le nombre le plus négatif est un 1 suivi de zéros ; le plus positif est un 0 suivi de uns.Un décalage arithmétique 算术移位 déplace tous les bits vers la gauche ou la droite tout en conservant le signe : un décalage d'une place vers la droite divise la valeur par deux et recopie le bit de signe dans l'espace vide à gauche, donc un nombre négatif reste négatif (
1111 1001 0100décalé de trois places vers la droite donne1111 1111 0010, qui est $-14$ : $-108 / 8 = -13.5$, et un décalage vers la droite arrondit vers le bas). Un décalage vers la gauche double la valeur. Les décalages font partie du jeu d'instructions assembleur dans le sujet 4, mais cette question porte sur le calcul numérique ici.Le débordement en arithmétique signée survient lorsque le résultat exact sort de cette plage — repéré lorsque le bit de signe change faussement (deux positifs donnant un négatif, ou deux négatifs donnant un positif).
Complément à un
Avant le complément à deux, un ancien schéma appelé complément à un 反码 représentait un nombre négatif en simplement inversant tous les bits du positif — il n'y a pas d'étape « ajouter 1 ».
- $+30 = 00011110$, donc en complément à un $-30 = 11100001$ (juste l'inverse).
- Inconvénient : il possède deux zéros — $00000000$ ($+0$) et $11111111$ ($-0$) — ce qui gaspille un motif de bits et rend l'arithmétique fastidieuse.
Le complément à deux (inverser et ajouter 1) élimine le zéro négatif : il possède un seul zéro et permet aux additions et soustractions d'utiliser le même circuit. C'est pourquoi les ordinateurs modernes stockent les entiers signés en complément à deux, et non en complément à un.
ExplorerBinaire & entiers signés
octet = Σ valeurs de position
Voir comment un motif de 8 bits se mappe sur un nombre (et comment il déborderait au-delà de 255).
ExplorerBits signés en complément à deux
Le bit de gauche porte une valeur de position négative. Changez n'importe quel bit — ou cliquez sur Negate (inversez chaque bit, puis ajoutez 1) — et watch la valeur signée changer.
Vocabulaire EntrainerAnglais Chinois Pinyin unsigned/ʌnˈsaɪnd/ 无符号 wú fú hào signed integer/saɪnd ˈɪntɪdʒə/ 有符号整数 yǒu fú hào zhěng shù sign bit/saɪn bɪt/ 符号位 fú hào wèi arithmetic shift/ˌærɪθˈmetɪk ʃɪft/ 算术移位 suàn shù yí wèi one's complement/wʌnz ˈkɒmplɪmənt/ 反码 fǎn mǎ 7-segment display/ˈsevən ˈseɡmənt dɪˈspleɪ/ 七段显示器 qī duàn xiǎn shì qì memory address/ˈmeməri əˈdres/ 内存地址 nèi cún dì zhǐ 1.1
Code décimal codé en binaire (BCD)
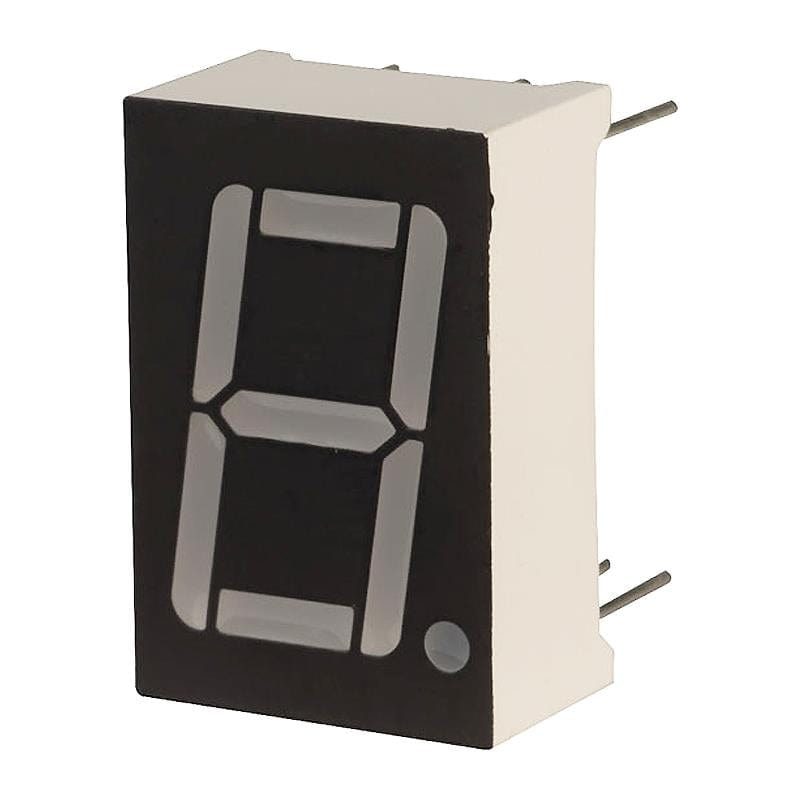
En BCD 二进码十进数, chaque chiffre décimal est écrit sous sa propre forme de 4 bits. Le nombre $93$ est
1001 0011en BCD — pas le binaire 93 ($01011101$). Chaque demi-octet n'utilise que 0–9 ; les motifs $1010$–$1111$ sont invalides.Lecture BCD :
0010 0111 0101→ 2, 7, 5 → 275.Utilisation : calculatrices, horloges numériques et appareils affichant des chiffres décimaux — chaque chiffre commande un 7-segments afficheur 七段显示器. Le code de devise utilise souvent le BCD pour éviter les erreurs d'arrondi liées à la conversion de fractions telles que 0.1 en binaire.
Une réponse « justifier » doit relier l'utilisation à une propriété du BCD : chaque chiffre décimal a ses propres 4 bits, donc un chiffre peut être envoyé directement à son afficheur, ou ajouté chiffre par chiffre, sans conversion de tout le nombre ; et une fraction décimale telle que $0.10$ est stockée exactement, ce qu'une fraction binaire ne peut pas faire.
Un afficheur à sept segments montre un chiffre décimal, souvent piloté par du BCD Vocabulaire EntrainerAnglais Chinois Pinyin BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù 1.1
Hexadécimal — utilisations pratiques

L'hexadécimal est une façon compacte d'écrire du binaire (1 chiffre hexa = 4 bits) :
Un octet est deux demi-octets ; chaque demi-octet est un chiffre hexa - adresses mémoire 内存地址 en programmation bas niveau —
0x7FFE. - valeurs de couleur en HTML/CSS —
#FF8800. - adresses MAC —
AC:DE:48:00:11:22.
L'hexadécimal ne modifie pas les données stockées — il rend simplement le binaire plus facile pour les humains.
1.1
Codes de caractères

Les ordinateurs stockent le texte sous forme de nombres ; chaque caractère a un code point 码point défini par un ensemble de caractères 字符集.
ASCII
- ASCII utilise 7 bits — 128 code points. Lettres latines de base, chiffres, ponctuation et codes de contrôle.
- ASCII étendu utilise 8 bits — 256 code points ; les 128 inférieurs correspondent à ASCII, les 128 supérieurs varient selon la région.
Chaque caractère est stocké comme un nombre — quelques code points ASCII en décimal et binaire Unicode
- Unicode est un ensemble de caractères universel couvrant presque tous les systèmes d'écriture, ainsi que des symboles et des émojis.
- encodages 编码 courants : UTF-8 (1 à 4 octets, compatible ASCII), UTF-16 (2 ou 4 octets), UTF-32 (fixe 4 octets).
Pourquoi Unicode bat ASCII
- il représente beaucoup plus de caractères (tous les systèmes d'écriture, émojis) ; ASCII ne couvre que l'anglais de base.
- les fichiers sont portables sans confusion de page de code, et permettent le texte multilingue dans un même document.
- compromis : les fichiers Unicode sont généralement plus gros pour un texte en anglais uniquement.
Lorsqu'une question demande les différences, donnez-les par paires avec des chiffres : ASCII utilise 7 bits (ASCII étendu 8), donc 128 (256) caractères ; Unicode utilise jusqu'à 32 bits (UTF-8 utilise 1 à 4 octets), donc plus d'un million de code points. ASCII ne couvre que l'anglais de base ; Unicode couvre tous les systèmes d'écriture, et ses 128 premiers code points sont ceux d'ASCII. En UTF-8, une lettre anglaise prend toujours 1 octet, donc un nom de fichier anglais de 40 lettres fait 40 octets en ASCII et en UTF-8, tandis qu'un caractère chinois en prend 3.
ExplorerUn caractère est stocké sous forme de nombre
Chaque caractère possède un numéro de code : 'A' vaut 65. Inversez les bits pour voir ce code en binaire et en hexadécimal, exactement comme l'ordinateur le conserve.
Vocabulaire EntrainerAnglais Chinois Pinyin code point/kəʊd pɔɪnt/ 码点 mǎ diǎn 1.2
Images bitmap
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension de la manière dont les données d'une image bitmap sont encodées Utiliser et comprendre les termes : pixel, en-tête de fichier, résolution d'image, résolution d'écran, profondeur de couleur / profondeur de bits Effectuer des calculs pour estimer la taille de fichier d'une image bitmap Monter une compréhension des effets du changement d'éléments d'une image bitmap sur la qualité de l'image et la taille du fichier Utiliser les termes : résolution d'image, profondeur de couleur / profondeur de bits Montrer une compréhension de la manière dont les données d'un graphisme vectoriel sont encodées Utiliser les termes : objet de dessin, propriété, liste de dessins Justifier l'utilisation d'une image bitmap ou d'un graphisme vectoriel pour une tâche donnée Montrer une compréhension de la manière dont le son est représenté et encodé Utiliser les termes : échantillonnage, taux d'échantillonnage, résolution d'échantillonnage, données analogiques et numériques Montrer une compréhension de l'impact du changement du taux d'échantillonnage et de la résolution Y compris l'impact sur la taille du fichier et la précision Source : Programme Cambridge International
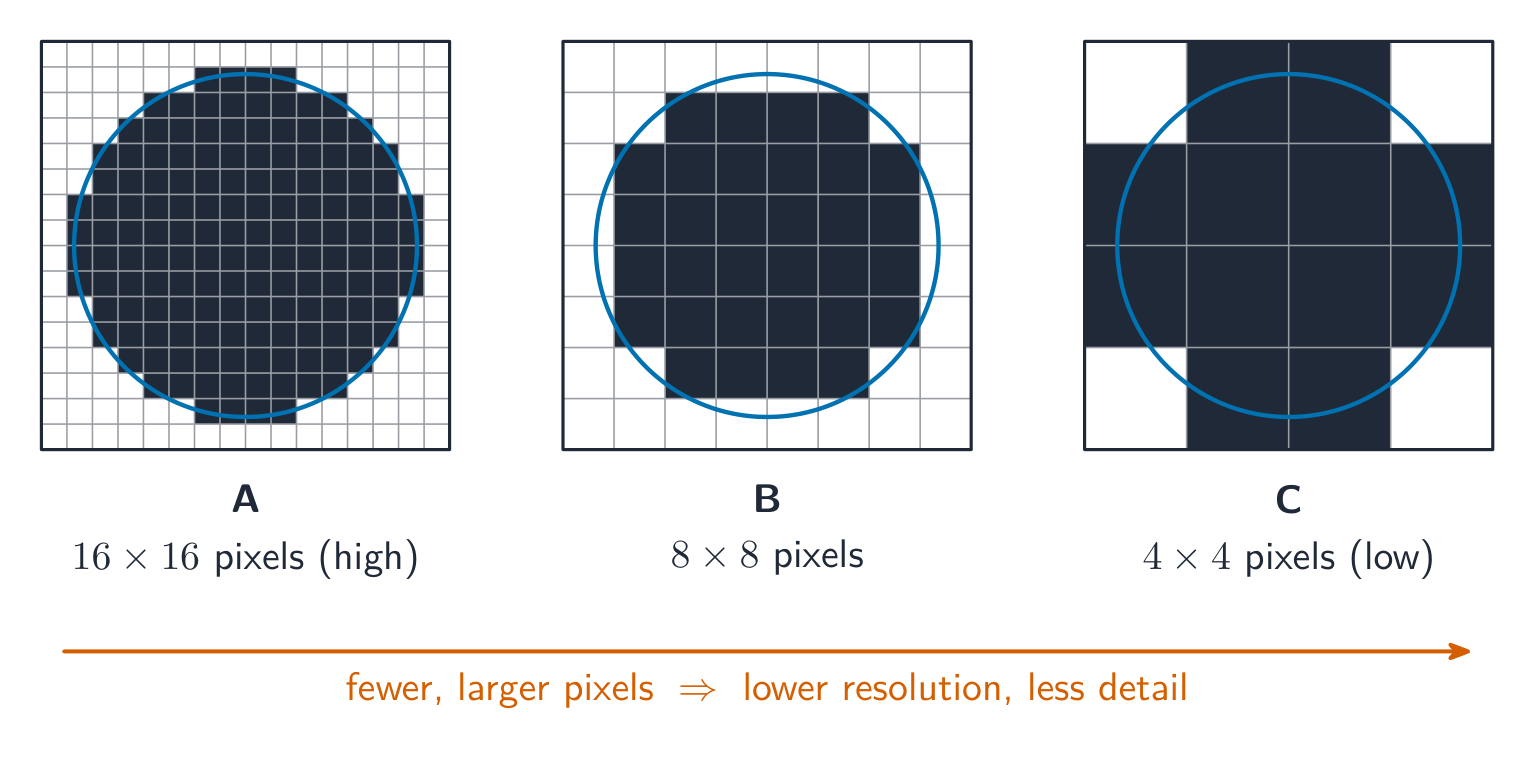
Une image bitmap 位图 (aussi appelée image matricielle) stocke la couleur de chaque pixel 像素 dans une grille. Au début du fichier, un en-tête de fichier 文件头 enregistre les métadonnées de l'image — sa largeur, sa hauteur et sa profondeur de couleur — pour que le logiciel sache comment lire les données de pixels qui suivent.
- résolution d'image 图像分辨率 : la taille propre de la bitmap, largeur × hauteur en pixels (ex. 1920 × 1080).
- résolution d'écran 屏幕分辨率 : la largeur × hauteur que l'affichage peut montrer. Si la résolution d'une image est supérieure à celle de l'écran, elle est mise à l'échelle pour s'adapter ; une image basse résolution paraît pixelisée lorsqu'elle est étirée sur un écran haute résolution.
- profondeur de couleur 颜色深度 (profondeur de bits 位深度) : bits par pixel. 1 bit → noir/blanc ; 8 bits → 256 couleurs ; 24 bits → 16.7 millions ("vraie couleur").
La même image stockée à trois résolutions, de haute (A) à basse (C) : moins de pixels plus grands signifient moins de détails Taille du fichier
$$\text{size in bits} = \text{width} \times \text{height} \times \text{bit depth}.$$Diviser par 8 pour obtenir des octets, par 1024 pour des KiB, etc. Exemple : une image de $3000 \times 2000$ à 24 bpp fait $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ bits $\approx 17.2\ \text{MiB}$.
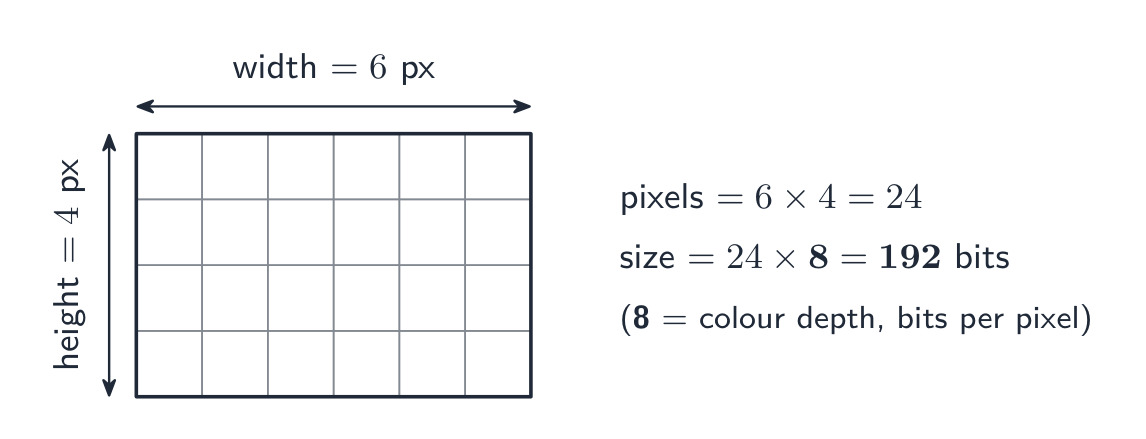
La même formule sur de petits nombres : compter les pixels, puis multiplier par la profondeur de couleur Indiquer les unités utilisées. La grille acceptera $1\ \text{MB} = 10^{6}$ octets (le préfixe SI) ou $1\ \text{MiB} = 1024 \times 1024$ octets (le préfixe binaire), tant que votre calcul montre lequel ; la même image fait $18.0\ \text{MB}$ ou $17.2\ \text{MiB}$. Ajoutez la taille de l'en-tête de fichier si la question en fournit une.
Une vidéo est une séquence d'images bitmap, chaque image étant un frame 帧. Avant compression, sa taille correspond à la taille d'une frame $\times$ le frame rate 帧率 (images par seconde) $\times$ la durée en secondes : 30 images par seconde de $1920 \times 1080$ pixels à 24 bits correspondent à $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ bits, soit environ $187\ \text{MB}$, pour chaque seconde. C'est pourquoi la vidéo est toujours compressée.
Modification des paramètres
- résolution plus faible → fichier plus petit, moins de détails (aspect flou ou pixelisé lors du zoom).
- profondeur de couleur plus faible → fichier plus petit, mais les dégradés lisses présentent des bandes de couleur.
- augmented de l'un ou l'autre → fichier plus grand, meilleure qualité.
Vocabulaire EntrainerAnglais Chinois Pinyin bitmap/ˈbɪtmæp/ 位图 wèi tú pixel/ˈpɪksl/ 像素 xiàng sù file header/faɪl ˈhedə/ 文件头 wén jiàn tóu bit depth/bɪt depθ/ 位深度 wèi shēn dù frame/freɪm/ 帧 zhēn frame rate/freɪm reɪt/ 帧率 zhēn lǜ 1.2
Graphismes vectoriels
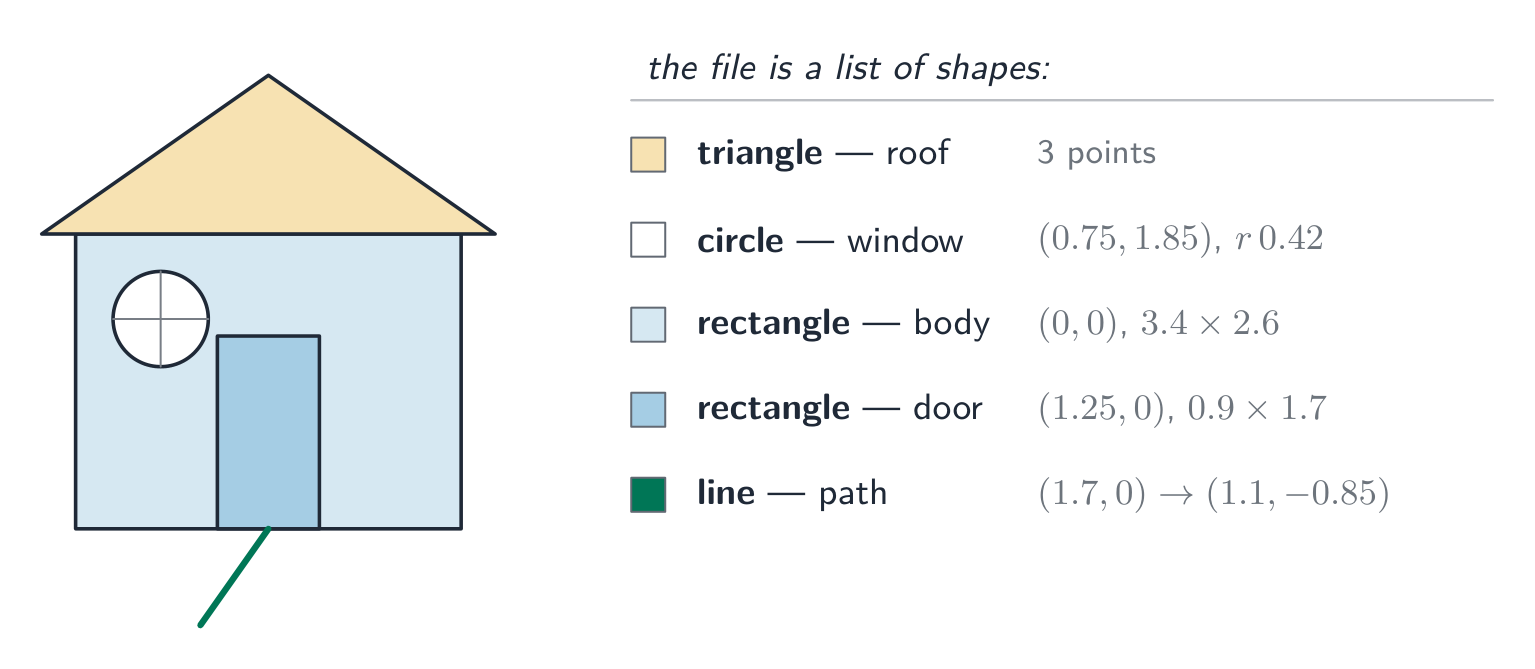
Un graphisme vectoriel 矢量图形 stocke les instructions 用于绘制图像的指令作为 drawing list 绘图列表 — une liste ordonnée de drawing objects 绘图对象 (géométriques primitives 图元 : lignes, courbes, polygones, cercles). Chaque objet de dessin possède des properties 属性 telles que la couleur, le remplissage, l'épaisseur de ligne et la position (coordonnées). Pour l'afficher, le programme renders 渲染 la liste de dessins à n'importe quelle résolution requise.
Une image vectorielle est constituée de formes géométriques étiquetées, chacune avec des attributs Bitmap vs vectoriel
Tâche Meilleur choix Pourquoi Photographie Bitmap Les détails complexes au niveau des pixels ne peuvent pas être décrits sous forme de formes géométriques. Logo, icône, panneau Vectoriel Bords nets ; mise à l'échelle à n'importe quelle taille sans flou. Dessin technique Vectoriel Géométrie précise et mise à l'échelle. Peinture, texture Bitmap Détail tonal fluide par zone. Avantage vectoriel : il scales without losing quality — un logo vectoriel reste net à n'importe quelle taille, tandis qu'un bitmap devient flou lors du zoom. Inconvénient vectoriel : il ne peut pas décrire un détail arbitraire au niveau des pixels (photographies).
Une réponse "justify" relie le choix à la tâche. "Le logo doit apparaître sur une carte de visite et sur un panneau publicitaire, c'est donc qu'il devrait être un graphisme vectoriel : il est stocké comme des objets de dessin et est re-rendered sharply at any size, whereas a bitmap would show its pixels when enlarged." Pour une photographie, l'argument va dans l'autre sens : il n'y a pas de formes à décrire, donc la couleur de chaque pixel doit être stockée.

Agrandi, les pixels d'un bitmap deviennent dentelés ; un vectoriel reste fluide à n'importe quelle taille ExplorerLaboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin vector graphic/ˈvektə ˈɡræfɪk/ 矢量图形 shǐ liàng tú xíng drawing list/ˈdrɔːɪŋ lɪst/ 绘图列表 huì tú liè biǎo drawing objects/ˈdrɔːɪŋ ˈɒbdʒekts/ 绘图对象 huì tú duì xiàng primitive/ˈprɪmɪtɪv/ 图元 tú yuán properties/ˈprɒpətiz/ 属性 shǔ xìng render/ˈrendə/ 渲染 xuàn rǎn 1.2
Son
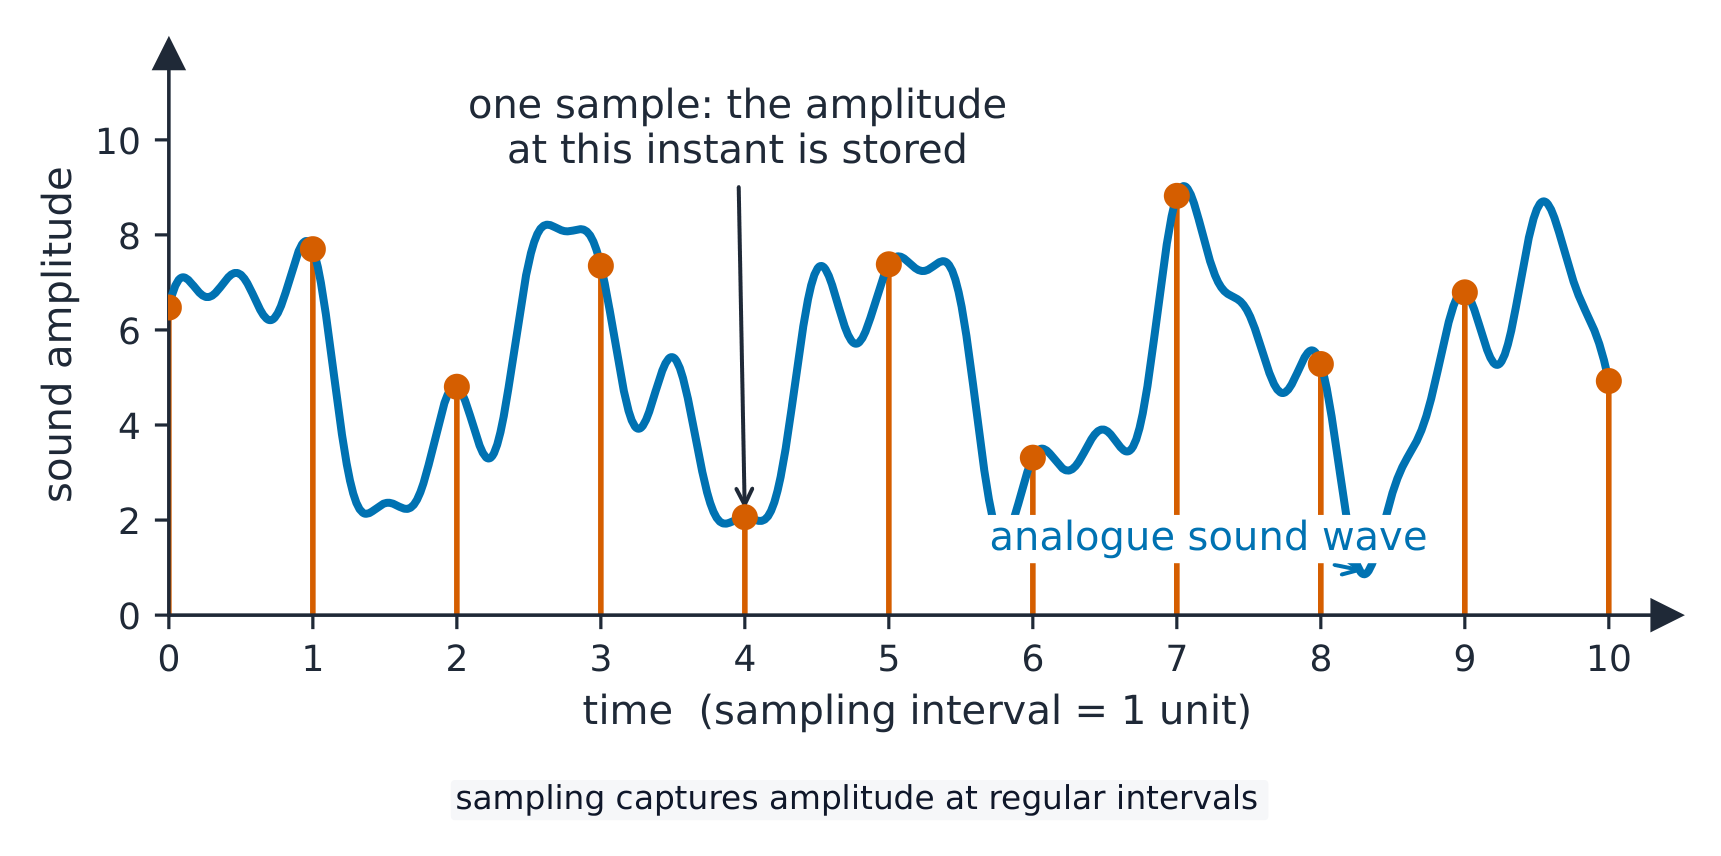
Une onde continue de analogue data 模拟数据 (le son) est convertie en digital data 数字数据 par sampling 采样 :
- sampling rate 采样率 — échantillons par seconde (Hz). La qualité CD est $44.1\ \text{kHz}$.
- sampling resolution 采样分辨率 (bit depth) — bits par amplitude amplitude 振幅 d'un échantillon. La qualité CD est de 16 bits.
Échantillonnage d'une onde sonore : son amplitude est lue à chaque intervalle de temps Taille du fichier
$$\text{size in bits} = \text{sampling rate} \times \text{resolution} \times \text{duration} \times \text{channels}.$$Un extrait stéréo CD de 10 secondes : $44100 \times 16 \times 10 \times 2 = 14\,112\,000$ bits $\approx 1.68\ \text{MiB}$.
Modification des paramètres
- sampling rate plus élevé → capte les hautes fréquences, fichier plus grand.
- sample resolution plus élevée → étapes d'amplitude plus fines, moins de bruit de quantisation 量化, fichier plus grand.
- réduction de l'un ou l'autre → fichier plus petit, perte de qualité claire.
(Le taux d'échantillonnage doit être au moins le double de la fréquence la plus haute que vous souhaitez conserver.)

Le taux d'échantillonnage est le nombre d'échantillons par seconde ; la règle de Nyquist explique pourquoi il doit être au moins égal au double de la fréquence maximale conservée ExplorerÉchantillonnage du son
y = a sin(bt + c)
L'échantillonnage mesure une onde sonore à des intervalles réguliers ; un taux plus élevé la reproduit plus fidèlement.
Vocabulaire EntrainerAnglais Chinois Pinyin digit/ˈdɪdʒɪt/ 数位 shù wèi analogue data/ˈænəlɒɡ ˈdeɪtə/ 模拟数据 mó nǐ shù jù digital data/ˈdɪdʒɪtl ˈdeɪtə/ 数字数据 shù zì shù jù sampling/ˈsæmplɪŋ/ 采样 cǎi yàng sampling rate/ˈsæmplɪŋ reɪt/ 采样率 cǎi yàng lǜ sampling resolution/ˈsæmplɪŋ ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ amplitude/ˈæmplɪtjuːd/ 振幅 zhèn fú sample resolution/ˈsæmpl ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ quantisation/ˌkwɒntaɪˈzeɪʃn/ 量化 liàng huà 1.3
Compression
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension du besoin et des exemples d'utilisation de la compression Montrer une compréhension de la compression avec perte et sans perte et justifier l'utilisation d'une méthode dans une situation donnée Montrer une compréhension de la manière dont un fichier texte, une image bitmap, un graphisme vectoriel et un fichier sonore peuvent être compressés Y compris l'utilisation de l'encodage par longueur de séquence (RLE) Source : Programme Cambridge International
Compression 压缩 réduit la taille du fichier, économisant l'espace de stockage et la bandwidth 带宽 de transmission. Deux types :
- lossless 无损 — les données d'origine sont récupérées exactement (textes, programmes, ZIP/PNG).
- lossy 有损 — certains détails sont supprimés pour obtenir des fichiers beaucoup plus petits (JPEG, MP3, vidéo).
Quand utiliser lequel
- lossless pour les documents, le code source, les images médicales — tout ce qui nécessite des données exactes.
- lossy pour le streaming multimédia. Le Real-time video streaming utilise une compression lossy car il doit envoyer d'énormes quantités de données en temps réel sur une bande passante limitée ; une compression lossless ne la réduirait pas suffisamment. Une vidéo HD brute pèse des gigaoctets par minute, donc sans compression, l'image resterait constamment figée.
Une réponse "justify" nomme la méthode, puis la raison tirée de la situation : "Lossless, parce que le tableur doit être restauré exactement ; une seule valeur modifiée rendrait les comptes incorrects." Ou : "Lossy, parce que les photographies sont visionnées sur un écran de téléphone où les détails perdus ne sont pas visibles, et que les fichiers plus petits s'envoient plus vite et occupent moins de stockage."
Méthodes lossless
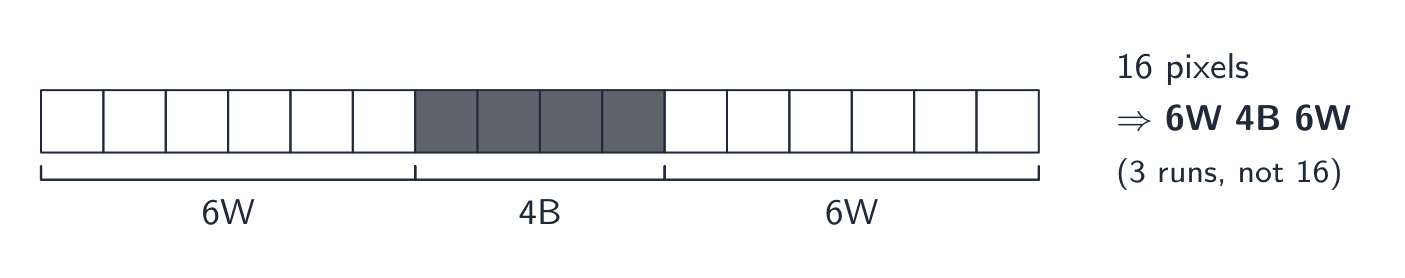
- run-length encoding 行程编码 (RLE) : stocker "les $n$ valeurs suivantes sont $x$" au lieu de répéter $x$. Idéal pour les zones planes ; inutile pour les données bruyantes.
- dictionary methods 字典编码 (ZIP, PNG) : remplacer les séquences d'octets répétées par une référence courte. Bon pour le texte et le code.
- Huffman coding 霍夫曼编码 : attribuer des codes courts aux symboles fréquents et des codes longs aux symboles rares, ramenant la longueur moyenne du code près de l'entropy 熵 des données.
Comment chaque type de fichier est compressé :
- fichier texte : les méthodes de dictionnaire et le codage Huffman transforment les mots et caractères fréquents en codes courts. Le texte doit rester lossless, car un seul caractère modifié change le sens.
- image bitmap : RLE pour les suites de pixels identiques (icônes, diagrammes, numérisations noir et blanc) ; JPEG lossy pour les photographies, ou une profondeur de couleur ou une résolution inférieure.
- graphisme vectoriel : la liste de dessins est déjà petite ; supprimer les objets de dessin inutiles, réduire le nombre de décimales des coordonnées, ou appliquer une méthode lossless comme ZIP au fichier.
- fichier audio : MP3 ou AAC lossy supprime ce que l'oreille ne peut entendre ; un taux ou une résolution d'échantillonnage inférieurs sont également lossy ; les formats lossless conservent chaque échantillon et réduisent le fichier bien moins.
Codage par longueur de course sur une seule ligne : 16 pixels deviennent 3 runs 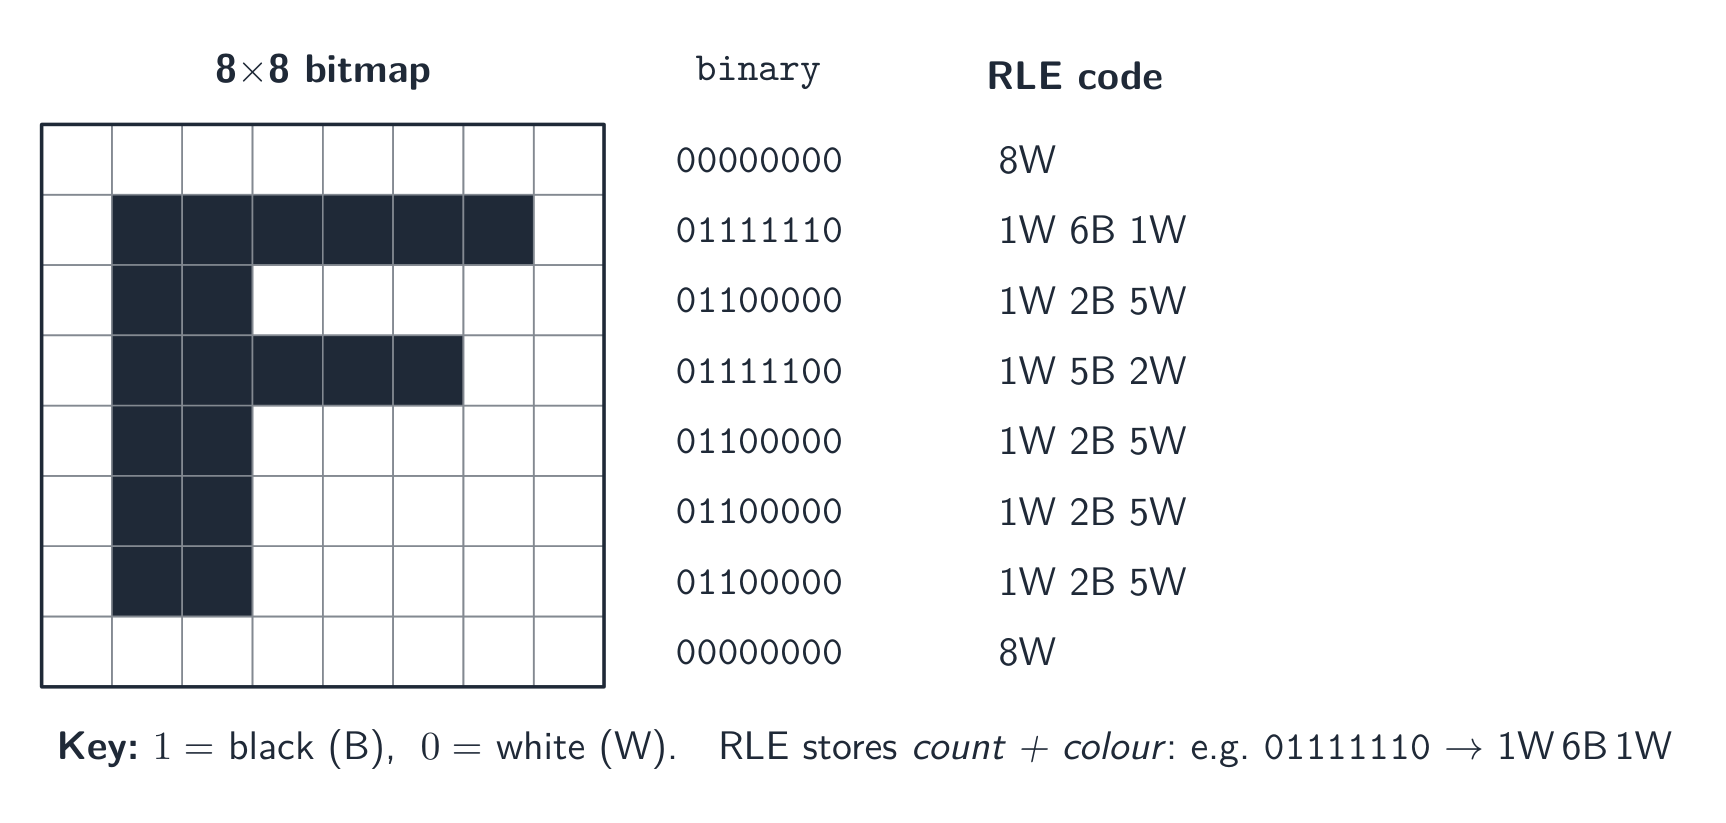
Codage par longueur de course de la lettre F dans une grille noir et blanc $8\times8$ 
Codage par dictionnaire : chaque séquence répétée est stockée une seule fois, et chaque occurrence devient un index court 
Codage de Huffman : le symbole le plus fréquent obtient le code le plus court, donc BANANE nécessite 10 bits au lieu de 12 Méthodes lossy
- images (JPEG) : supprimer les détails fins et les différences de couleur que l'œil voit à peine.
- sound (MP3, AAC) : supprimer les hautes fréquences que nous entendons moins bien, et les sons faibles cachés par des sons plus forts.
- video combine la compression spatial 空间 (dans chaque frame, comme JPEG) avec la compression temporal 时间 (la plupart des frames ne stockent que les différences par rapport à la frame précédente).

Compression methods: lossless versus lossy, with common examples ExplorerEncodage par suites
Regardez une série de symboles répétés se compresser en un comptage — simple compression sans perte.
Vocabulaire EntrainerAnglais Chinois Pinyin encoding/enˈkəʊdɪŋ/ 编码 biān mǎ compression/kəmˈpreʃn/ 压缩 yā suō bandwidth/ˈbændwɪdθ/ 带宽 dài kuān lossless/ˈlɒsləs/ 无损 wú sǔn lossy/ˈlɒsi/ 有损 yǒu sǔn run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ 行程编码 xíng chéng biān mǎ dictionary methods/ˈdɪkʃənəri ˈmeθədz/ 字典编码 zì diǎn biān mǎ Huffman coding/ˈhʌfmən ˈkəʊdɪŋ/ 霍夫曼编码 huò fū màn biān mǎ entropy/ˈentrəpi/ 熵 shāng spatial/ˈspeɪʃl/ 空间 kōng jiān temporal/ˈtempərəl/ 时间 shí jiān 1.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition bit un unique chiffre binaire, 0 ou 1 byte un groupe de 8 bits binary prefix un multiplicateur qui est une puissance de 2 (kibi = 1024) plutôt qu'une puissance de 10 (kilo = 1000) two's complement une manière de représenter des entiers signés dans laquelle le bit de poids fort a une valeur de position négative overflow le résultat d'un calcul est trop grand pour être représenté dans le nombre de bits disponibles Binary Coded Decimal chaque chiffre décimal est stocké sous forme de son propre motif binaire de 4 bits character set l'ensemble des caractères qu'un ordinateur peut représenter, chacun avec son propre code binaire pixel l'élément le plus petit d'une image bitmap, stockant une valeur de couleur image resolution le nombre de pixels dans une image, donné en largeur par hauteur screen resolution le nombre de pixels qu'un affichage peut montrer, donné en largeur par hauteur colour depth le nombre de bits utilisés pour stocker la couleur d'un pixel sampling rate le nombre d'échantillons du son prélevés par seconde sampling resolution le nombre de bits utilisés pour stocker l'amplitude d'un échantillon lossless compression compression dont les données d'origine peuvent être récupérées exactement lossy compression compression qui supprime définitivement certaines données, rendant impossible la récupération de l'original run-length encoding remplacer une suite de valeurs répétées par une valeur et un compteur Vocabulaire EntrainerAnglais Chinois Pinyin overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ 最高有效位 zuì gāo yǒu xiào wèi two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ character set/ˈkærɪktə set/ 字符集 zì fú jí colour depth/ˈkʌlə depθ/ 颜色深度 yán sè shēn dù image resolution/ˈɪmɪdʒ ˌrezəˈluːʃn/ 图像分辨率 tú xiàng fēn biàn lǜ screen resolution/skriːn ˌrezəˈluːʃn/ 屏幕分辨率 píng mù fēn biàn lǜ 1.3
Conseils d'examen
- Montrer le calcul pour les conversions de base : décimal → binaire par positions, binaire → hexadécimal en nibbles (groupes de 4 bits).
- Pour two's complement le MSB est négatif ; pour négater, invert and add 1 ; faire attention à l'overflow lorsque le bit de signe bascule mal.
- Distanguer bitmap (pixels ; taille de fichier $=$ largeur $\times$ height $\times$ colour depth) de vector (commandes de dessin ; scales without loss).
- La taille du fichier sonore dépend de sample rate $\times$ bit depth $\times$ temps — plus de chacun signifie une meilleure qualité mais un fichier plus grand.
- Comparez la compression sans perte vs avec perte et donnez un usage pour chacun.
Erreurs courantes
- Expliquer un dépassement de capacité avec « la réponse était supérieure à 255 » ou « elle a 9 bits ». Indiquez la taille de mot donnée par la question, puis précisez que le résultat ne peut pas être représenté dans cette taille.
- Créer un nombre négatif en positionnant le bit de poids fort à 1 et en laissant le reste (signe et magnitude). En complément à deux, il faut inverser chaque bit de la valeur positive, puis ajouter 1.
- Oublier d'ajouter des zéros de remplissage à un nombre converti pour atteindre la largeur du registre demandée par la question.
- Mélanger les bits et les octets dans un calcul de taille de fichier. Travaillez en bits, divisez par 8 une seule fois, et précisez si vous avez utilisé 1000 ou 1024.
- Répondre à « décrire » en langage courant (« l'image devient pire »). Utilisez les termes du programme : moins de couleurs, banding, résolution d'image plus faible, pixels plus grands.
-
2
Communication
Regarder la leçon2.1
Réseaux : objectifs et avantages
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension du but et des avantages des dispositifs de réseau Montrer la compréhension des caractéristiques d'un LAN (réseau local) et d'un WAN (réseau étendu) Expliquer les modèles client-serveur et pair-à-pair des ordinateurs en réseau Rôles des différents ordinateurs au sein des modèles de réseau et de sous-réseau Avantages et inconvénients de chaque modèle Justifier l'utilisation d'un modèle pour une situation donnée Montrer la compréhension des clients minces et lourds et des différences entre eux Montrer la compréhension des topologies bus, étoile, maillage et hybrides Comprendre comment les paquets sont transmis entre deux hôtes pour une topologie donnée Justifier l'utilisation d'une topologie pour une situation donnée Montrer la compréhension du calcul en nuage Incluant l'utilisation de nuages publics et privés Avantages et inconvénients du calcul en nuage Montrer la compréhension des différences entre et des implications de l'utilisation des réseaux sans fil et filaires Décrire les caractéristiques du câble en cuivre, du câble à fibre optique, des ondes radio (y compris le WiFi), des micro-ondes, des satellites Décrire le matériel utilisé pour supporter un LAN Y compris commutateur, serveur, Carte d'interface réseau (NIC), Carte d'interface réseau sans fil (WNIC), Points d'accès sans fil (WAP), câbles, pont, répéteur Décrire le rôle et la fonction d'un routeur dans un réseau Montrer la compréhension d'Ethernet et de la manière dont les collisions sont détectées et évitées Y compris Carrier Sense Multiple Access/Collision Detection (CSMA/CD) Montrer la compréhension du streaming binaire Méthodes de streaming binaire, c'est-à-dire en temps réel et à la demande. Importance des débits binaires, vitesse large bande sur le streaming binaire Montrer la compréhension des différences entre le World Wide Web (WWW) et Internet Décrire le matériel utilisé pour supporter Internet Y compris modems, PSTN (Réseau téléphonique public commuté), lignes dédiées, réseau cellulaire Expliquer l'utilisation des adresses IP dans la transmission de données sur Internet Y compris : • format d'une adresse IP incluant IPv4 et IPv6 • utilisation du subnetting dans un réseau • comment une adresse IP est associée à un appareil sur un réseau • différence entre une adresse IP publique et une adresse IP privée et les implications pour la sécurité • différence entre une adresse IP statique et une adresse IP dynamique Expliquer comment une Uniform Resource Locator (URL) est utilisée pour localiser une ressource sur le World Wide Web (WWW) et le rôle du Domain Name Service (DNS) Source : Programme Cambridge International
Un réseau 网络 est un ensemble de dispositifs informatiques connectés afin qu'ils puissent communiquer et partager des ressources. Avantages :
- partage de ressources (imprimantes, serveurs de fichiers, internet) — moins cher que d'équiper chaque ordinateur individuellement.
- partage de données — plusieurs utilisateurs accèdent aux mêmes fichiers.
- gestion centralisée — installer des logiciels, gérer les utilisateurs et effectuer des sauvegardes une seule fois sur un serveur.
- communication — e-mail, appels vidéo, messagerie.
- accès à distance — travailler depuis n'importe où.
ExplorerLab de routage réseau
Suivez les données depuis un appareil à travers le matériel réseau et les protocoles.
Vocabulaire EntrainerAnglais Chinois Pinyin ISP/ˌaɪ es ˈpiː/ 互联网服务提供商 hù lián wǎng fú wù tí gōng shāng cell phone network/sel fəʊn ˈnetwɜːk/ 蜂窝网络 fēng wō wǎng luò subnets/ˈsʌbnets/ 子网 zi wǎng subnet mask/ˈsʌbnet mæsk/ 子网掩码 zi wǎng yǎn mǎ 2.1
LAN vs WAN
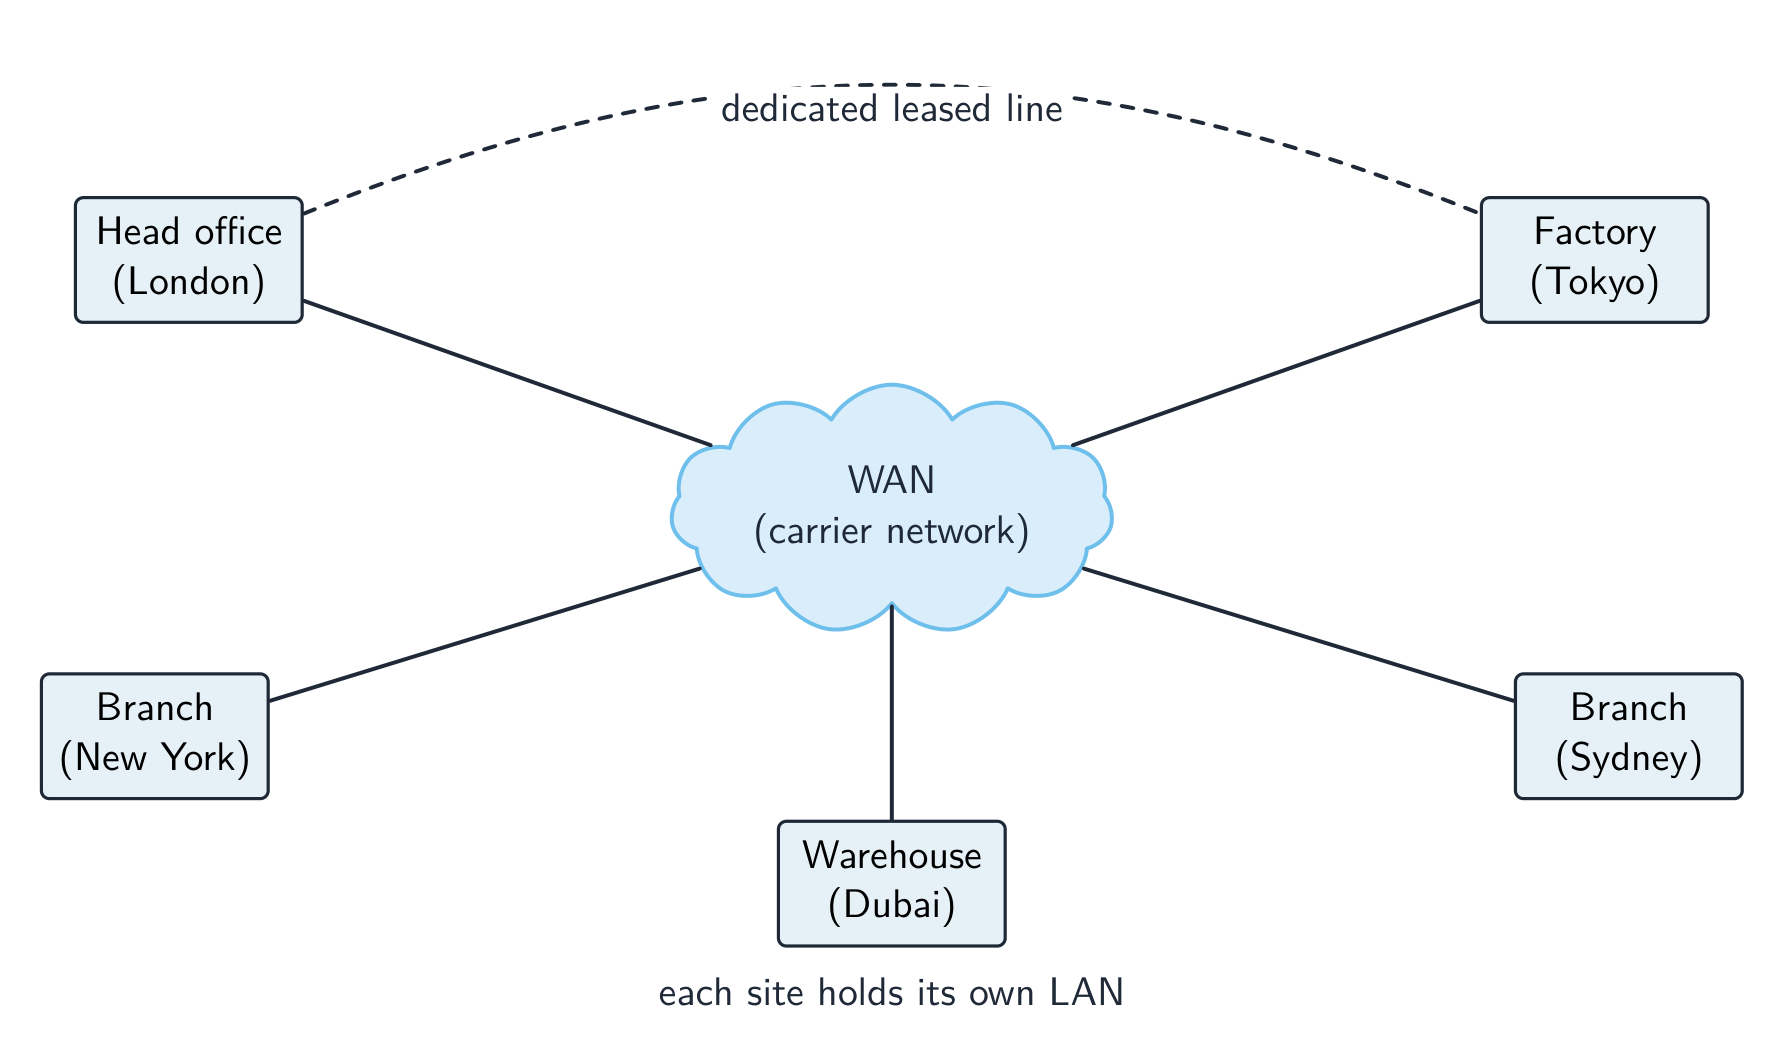
Un réseau local 局域网 (LAN) couvre une petite zone — une maison, un bureau ou une école, généralement propriété de l'organisation, avec des débits élevés et une faible latence 延迟.
Un réseau étendu 广域网 (WAN) couvre une grande zone — une ville, un pays ou le monde (Internet est le plus grand WAN). Il utilise l'infrastructure d'un opérateur de télécommunications — souvent le Réseau téléphonique public commuté 公共交换电话网 (PSTN), des lignes louées ou la fibre — avec des débits inférieurs et une latence plus élevée. Un WAN connecte plusieurs LAN entre eux.
Pour « citez deux caractéristiques d'un LAN » : il couvre une petite zone géographique (un site ou un bâtiment) ; le matériel appartient à l'organisation et n'est pas loué chez un opérateur ; il se connecte via ses propres commutateurs, câbles et points d'accès. Pour « deux façons dont un WAN diffère » : il couvre une grande zone géographique ; il utilise une infrastructure tierce (louée ou publique) ; les débits sont plus faibles et la latence plus élevée ; il relie généralement plusieurs LAN. Une école sur un seul site est un LAN ; une entreprise avec des bureaux dans deux villes a besoin d'un WAN, avec une ligne louée ou Internet reliant les sites. Justifiez votre choix en fonction de la zone couverte et de la propriété des liens.
Un réseau étendu relie de nombreux systèmes sur une grande zone 2.1
Client-serveur et pair-to-peer

Client-serveur
- Des machines puissantes agissent comme des serveurs 服务器, fournissant des services (fichiers, pages web, e-mail).
- D'autres machines sont des clients 客户端 qui sollicitent ces services.
- Centralisé et facile à gérer, mais le serveur constitue un point unique de défaillance sauf s'il est sauvegardé.
Dans un réseau client-serveur, les clients demandent des services à un serveur central Pair-to-pair (P2P)
- Toutes les machines sont des pairs 对等网络 égaux ; chacune peut être à la fois client et serveur (pair-to-pair 对等网络).
- Les ressources sont réparties parmi les pairs — aucun serveur central. Robuste face à une panne unique, mais plus difficile à maintenir sécurisé et cohérent.
Choix d'un modèle. Le client-serveur convient à une école ou une entreprise : les fichiers sont stockés et sauvegardés centralement, un utilisateur se connecte avec un compte unique depuis n'importe quelle machine, les logiciels et la sécurité sont gérés une seule fois, et le serveur peut être une machine puissante. Les inconvénients sont le coût du serveur et d'un technicien, ainsi que le fait que le serveur soit un point unique de défaillance. Le pair-to-pair convient à quelques amis partageant des fichiers ou à un jeu : pas de serveur à acheter, facile à configurer, et chaque utilisateur garde le contrôle de sa propre machine. Les inconvénients mentionnés par le sujet : les fichiers sont dispersés sur plusieurs machines, rendant la sauvegarde difficile et un fichier indisponible lorsque la machine de son propriétaire est éteinte ; chaque machine doit être sécurisée séparément ; et un pair servant les autres ralentit le système. Un jeu en ligne joué via un navigateur Web avec d'autres utilisateurs suit le modèle client-serveur : le navigateur est le client, et le jeu ainsi que son monde virtuel partagé tournent sur le serveur de l'entreprise, qui maintient la cohérence de la vue de chaque joueur.
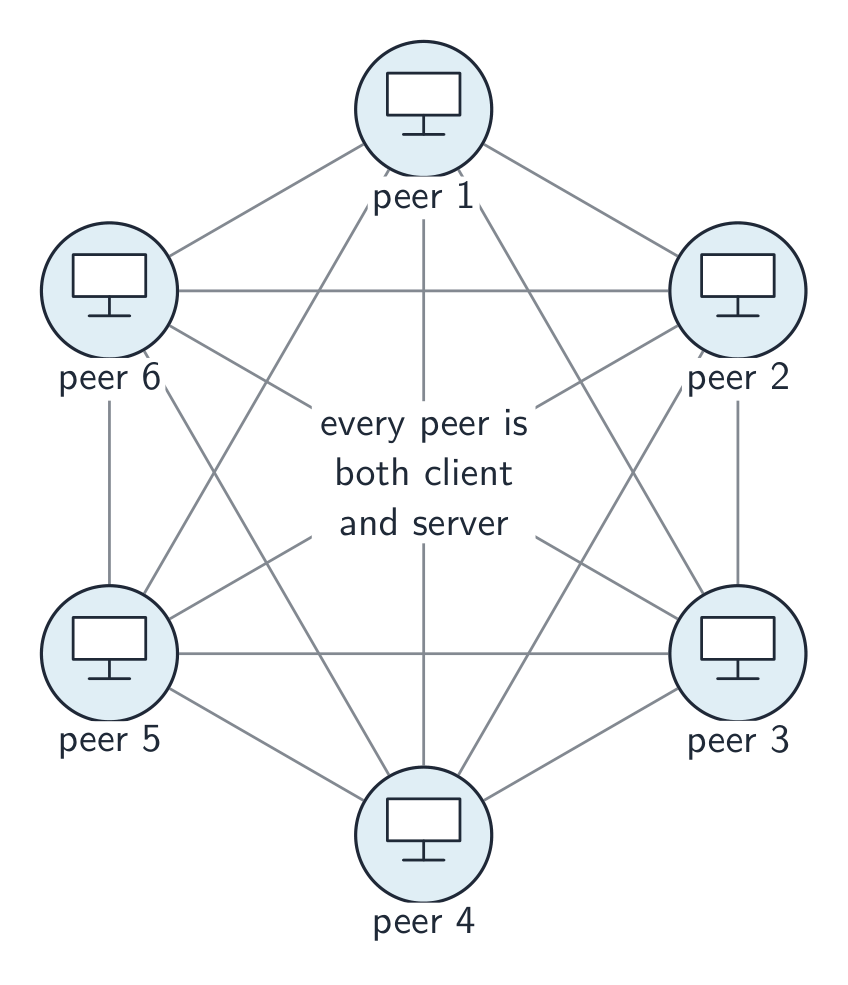
Dans un réseau pair-to-pair, chaque nœud est à la fois client et serveur Vocabulaire EntrainerAnglais Chinois Pinyin server/ˈsɜːvə/ 服务器 fú wù qì client/ˈklaɪənt/ 客户端 kè hù duān peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò thick client/θɪk ˈklaɪənt/ 胖客户端 pàng kè hù duān thin client/θɪn ˈklaɪənt/ 瘦客户端 shòu kè hù duān 2.1
Clients fins et clients épais
Un client fin 瘦 client effectue peu de traitement localement et repose sur un serveur puissant (terminaux Web, bureautique distante). Un client épais 胖 client dispose d'un puissant traitement local et de stockage et exécute lui-même des applications complètes (un PC de bureau standard).
Fonctionnalité Client fin Client épais Traitement local minimal substantiel Stockage local minimal substantiel Dépendance au réseau élevée réduite Charge du serveur élevée réduite Les rôles : dans un modèle de client fin, le serveur effectue le traitement et stocke les données, et le client n'envoie que les entrées et affiche les sorties. Un terminal bon marché suffit, et tout est sauvegardé et mis à jour sur le serveur, mais rien ne fonctionne si le réseau ou le serveur tombe en panne. Dans un modèle de client épais, le client exécute le logiciel et stocke les fichiers lui-même, ce qui lui permet de fonctionner sans connexion réseau et réduit la charge sur le serveur, au prix de clients plus puissants (et plus coûteux) qui doivent chacun être mis à jour et sécurisés. Une salle d'informatique scolaire peut utiliser des clients fins (bon marché, gestion centralisée) ; un éditeur vidéo a besoin d'un client épais.
2.1
Topologies de réseau
La topologie 拓扑 désigne la disposition des nœuds et des liens.
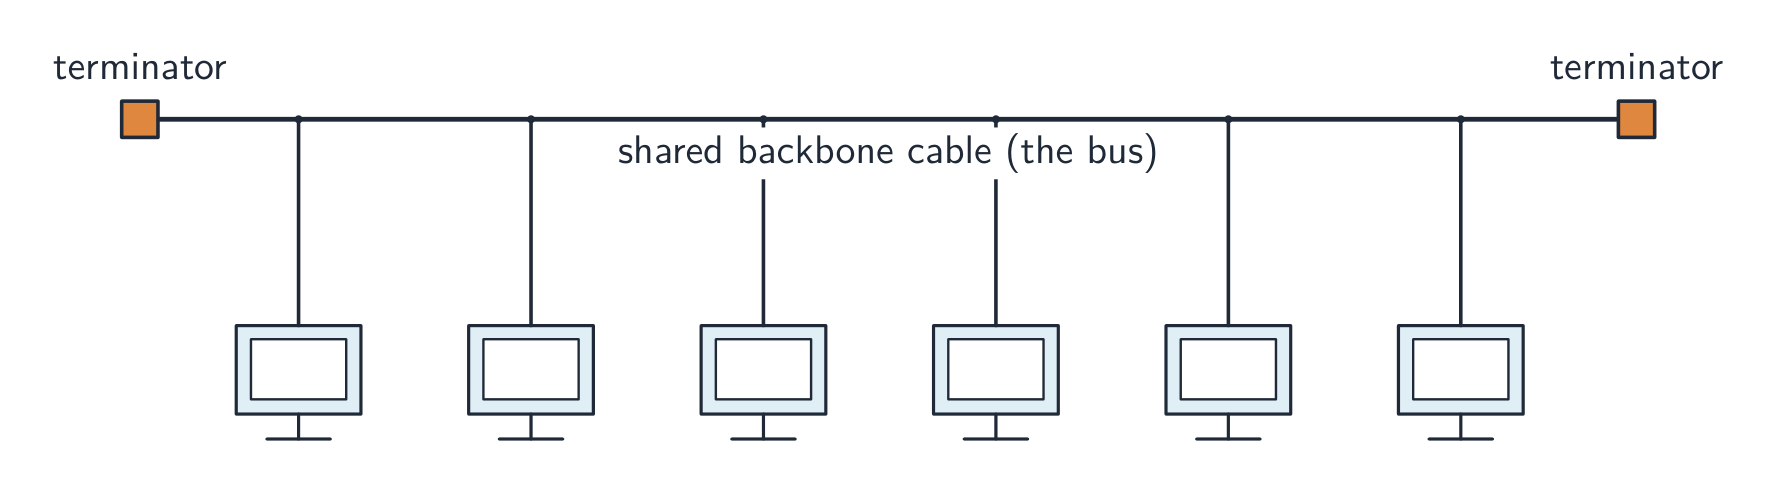
- bus 总线 — tous les appareils sur un câble partagé unique. Bon marché ; si le bus tombe en panne, tout le LAN s'arrête ; les performances diminuent lorsque plus d'appareils partagent la bande passante 带宽.
- étoile 星形 — chaque appareil est connecté à un commutateur central. La panne d'un appareil n'affecte pas les autres ; la panne du commutateur met tout hors tension. C'est la topologie la plus courante aujourd'hui.
- maillage 网状 — chaque appareil est directement lié aux autres, offrant de multiples chemins. Très tolérante aux pannes 容错 (le trafic est redirigé) mais nécessite beaucoup de câblage.
- hybride — un mélange (une étoile dans chaque bureau, des liens maillés entre les bureaux).
Topologie en bus : tous les appareils partagent un seul câble avec un terminateurs à chaque extrémité 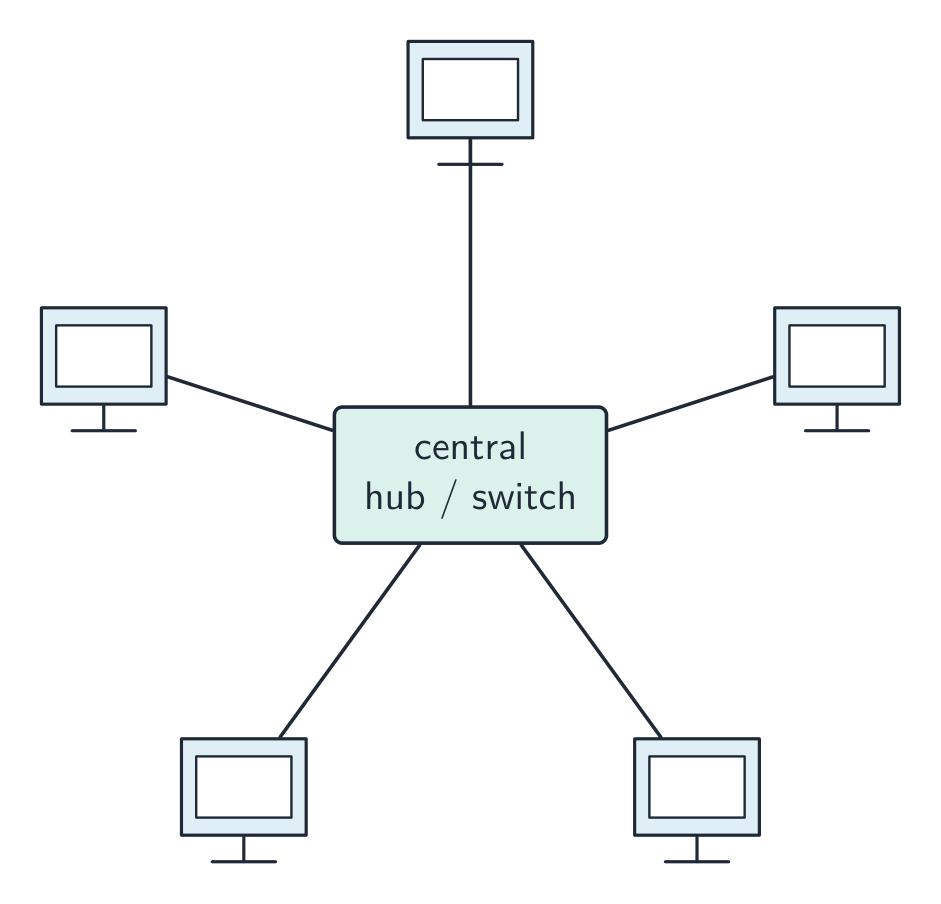
Topologie en étoile : chaque appareil est connecté à un concentrateur ou un commutateur central 
Topologie en maillage : chaque appareil est directement lié aux autres 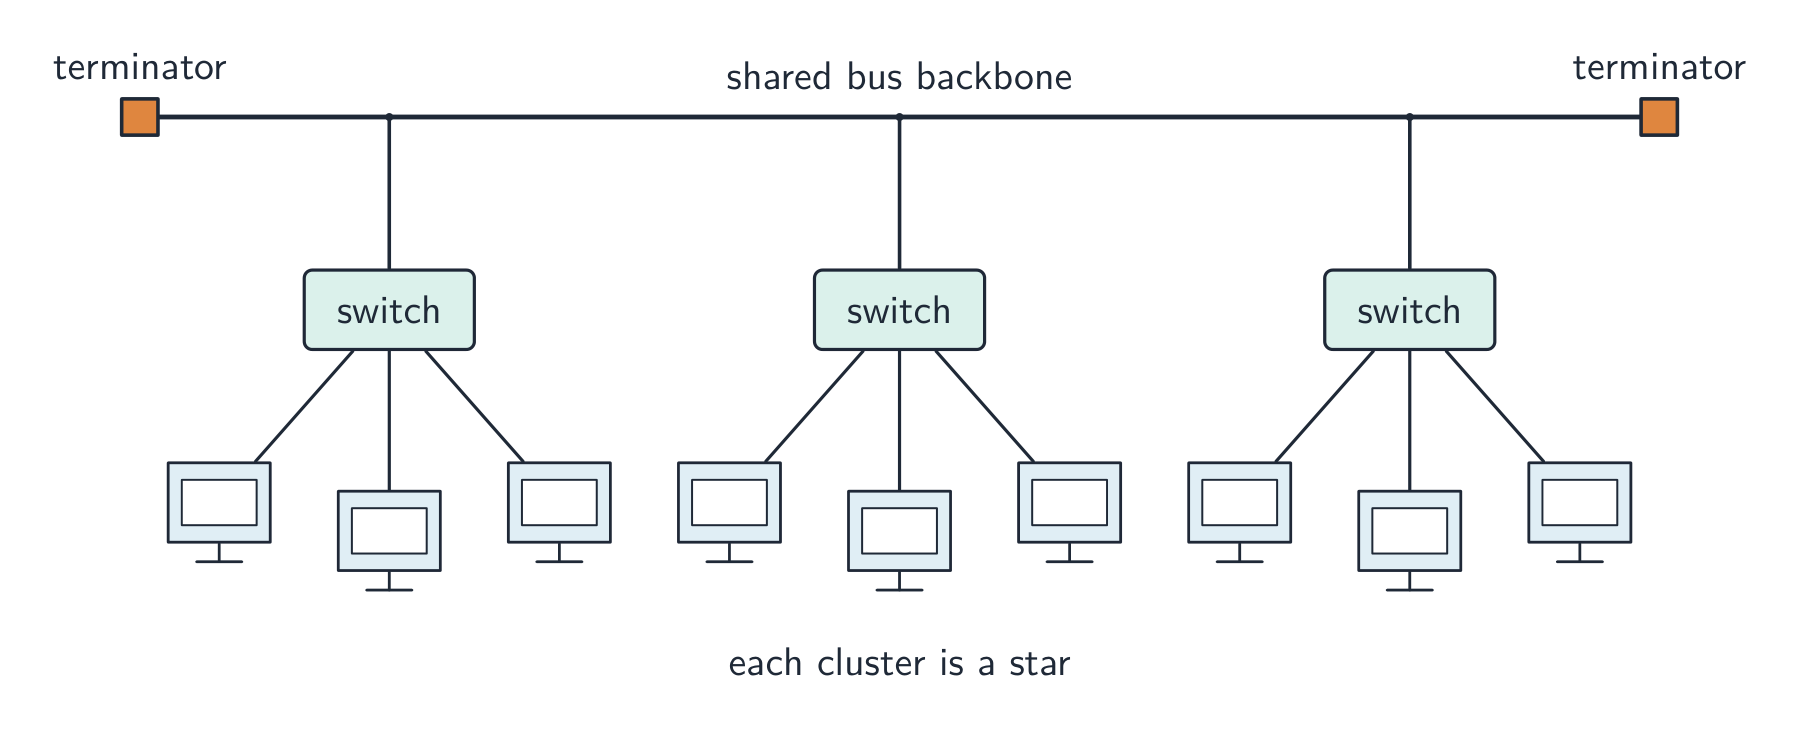
Topologie hybride : grappes en étoile reliées par un bus central Comment les paquets voyagent dans chaque topologie
Bus : l'appareil émetteur place le paquet sur le câble partagé ; tous les appareils le voient, mais seul celui dont l'adresse correspond le reçoit. Un seul appareil peut transmettre à la fois, donc des collisions peuvent survenir (CSMA/CD, ci-dessous). Étoile : l'expéditeur transmet le paquet au commutateur central, qui lit l'adresse de destination et le transmet uniquement sur le câble menant à cet appareil ; deux autres appareils peuvent parler simultanément. Maillage : le paquet est transmis de nœud en nœud selon l'une des plusieurs routes possibles jusqu'à la destination ; si un lien tombe en panne, une autre route est utilisée.
Pour justifier une topologie : une étoile pour une salle de classe ou un bureau (un câble en panne n'affecte qu'un seul appareil ; un appareil est facile à ajouter ; avec un commutateur, il n'y a pas de collisions) ; un maillage où la fiabilité prime (un hôpital, le backbone d'Internet) ; un bus uniquement où le coût est primordial et peu d'appareils le partagent. « Dessinez la topologie en étoile » signifie : le commutateur au centre, une ligne reliant le commutateur à chaque ordinateur, et le serveur (et le routeur, s'il y en a un) sur leurs propres lignes vers le commutateur.
ExplorerComparez les topologies réseau
Explorez les quatre topologies. Chacune fait un compromis entre coût, vitesse et résistance aux pannes — remarquez ce qui met tout le réseau hors tension dans chacun d'eux.
Vocabulaire EntrainerAnglais Chinois Pinyin topology/təˈpɒlədʒi/ 拓扑 tuò pū bus/bʌs/ 总线 zǒng xiàn bandwidth/ˈbændwɪdθ/ 带宽 dài kuān star/stɑː/ 星形 xīng xíng mesh/meʃ/ 网状 wǎng zhuàng fault-tolerant/fɒlt ˈtɒlərənt/ 容错 róng cuò hub/hʌb/ 集线器 jí xiàn qì packet/ˈpækɪt/ 数据包 shù jù bāo 2.1
Calcul en nuage
Le calcul en nuage 云计算 fournit des services informatiques (serveurs, stockage, logiciels) via Internet, hébergés par un tiers. Avantages : évolutivité 可扩展性 (payez ce dont vous avez besoin), coûts réduits, accès depuis n'importe où, et centres de données fiables et redondants. Inconvénients : nécessite Internet, vos données sont détenues par un tiers, et risque de verrouillage fournisseur.
Pour la définition d'une marque : le calcul en nuage consiste à fournir des services informatiques à la demande (stockage, traitement, logiciels) via Internet par un tiers. Un cloud public 公有云 est détenu par un fournisseur et partagé par de nombreux clients via Internet ; un cloud privé 私有云 est dédié à une organisation, sur son propre matériel ou hébergé exclusivement pour elle. Avantages acceptés par le barème : les fichiers sont accessibles depuis n'importe quel dispositif avec une connexion Internet ; le stockage s'adapte en haut et en bas selon les besoins ; le fournisseur gère le matériel, les sauvegardes et les mises à jour de sécurité ; pas de serveur local à acheter ou à maintenir. Inconvénients : aucun accès sans connexion Internet ; les données sont sur le matériel d'un tiers, donc la sécurité et la confidentialité dépendent du fournisseur ; un coût d'abonnement continu ; le fournisseur pourrait faire faillite ou subir une attaque ; les gros fichiers peuvent être lents à transférer. Une réponse à « pourquoi l'entreprise utilise-t-elle un cloud public » indique qu'elle n'a pas besoin de son propre matériel, paie uniquement pour ce qu'elle utilise, et que ses utilisateurs peuvent y accéder depuis n'importe où.
2.1
Filaire vs sans fil
- filaires (Ethernet 以太网 via paires torsadées 双绞线 ou fibre optique 光纤) : vitesse plus élevée, latence plus faible, moins d'erreurs, plus sécurisé.
- sans fil (Wi-Fi, Bluetooth, cellulaires) : pas de câbles, mobilité des appareils, mais plus lent, sensible aux interférences et à l'écoute clandestine.
Pour la même génération, le filaire l'emporte sur la vitesse et la fiabilité ; le sans fil l'emporte sur la commodité.
Médias de transmission
Milieu Caractéristiques câble en cuivre (paire torsadée, coaxial) bon marché et facile à installer ; transporte un signal électrique ; sensible aux interférences électromagnétiques ; le signal s'affaiblit avec la distance, nécessitant des répéteurs ; bande passante inférieure à celle de la fibre câble à fibre optique impulsions lumineuses dans une gaine en verre ; très haute bande passante ; transmission sur de longues distances sans répéteur ; insensible aux interférences ; difficile à intercepter, donc sécurisé ; coûteux et nécessite une installation qualifiée ondes radio (y compris WiFi) aucun câblage, permettant aux appareils de se déplacer ; portée de quelques dizaines de mètres, affaiblie par les murs ; fréquence partagée, entraînant des interférences et une vitesse réduite ; peut être interceptée, nécessitant un chiffrement micro-ondes ondes radio à haute fréquence pour les liaisons point à point ; nécessitent une visibilité directe ; affectées par la pluie et les bâtiments ; haute bande passante satellites couvrent les zones reculées et l'ensemble du globe ; forte latence car le signal doit parcourir l'aller-retour vers l'orbite ; sensibles aux intempéries ; coûteux L'examen demande la comparaison dans les deux sens. Le câblé l'emporte sur le sans fil en termes de vitesse, de fiabilité (pas d'interférences), de sécurité (un câble doit être physiquement piraté) et de stabilité ; le sans fil l'emporte sur le câblé en matière de mobilité, de coût d'installation et d'ajout d'un appareil sans câblage. L'utilisation des deux permet aux étudiants de se déplacer avec des ordinateurs portables et des téléphones tout en maintenant des postes fixes offrant une connexion plus rapide et sécurisée, et un appareil sans port réseau peut quand même se connecter. Les satellites remplacent le cuivre pour atteindre des endroits inaccessibles au câblage, mais avec une latence accrue, des interférences météorologiques et un coût plus élevé.
Vocabulaire EntrainerAnglais Chinois Pinyin ethernet/ˈiːθənet/ 以太网 yǐ tài wǎng twisted-pair/ˈtwɪstɪd peə/ 双绞线 shuāng jiǎo xiàn fibre-optic/ˈfaɪbə ˈɒptɪk/ 光纤 guāng xiān repeater/rɪˈpiːtə/ 中继器 zhōng jì qì network interface card/ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 网络接口卡 wǎng luò jiē kǒu kǎ MAC address/mæk əˈdres/ MAC地址 MAC dì zhǐ wireless network interface card/ˈwaɪələs ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 无线网络接口卡 wú xiàn wǎng luò jiē kǒu kǎ wireless access point/ˈwaɪələs ˈækses pɔɪnt/ 无线接入点 wú xiàn jiē rù diǎn bridge/brɪdʒ/ 网桥 wǎng qiáo 2.1
Matériel LAN

- carte réseau 网络接口卡 (NIC) — permet à un appareil d'envoyer et de recevoir des données sur le réseau ; possède une adresse MAC unique MAC地址 (une adresse matérielle de 48 bits). Un appareil sans fil utilise une carte réseau sans fil 无线网络接口卡 (WNIC).
- commutateur 交换机 — achemine les trames Ethernet uniquement vers le port correspondant à l'adresse MAC de destination.
- concentrateur 集线器 — dispositif plus simple qui copie le trafic vers tous les ports (maintenant obsolète).
- point d'accès sans fil 无线接入点 (WAP) — permet aux clients sans fil de rejoindre un LAN câblé.
- câblage : paire torsadée pour les courtes distances ; fibre optique pour les distances plus longues et plus rapides.
- serveur — ordinateur fournissant un service aux autres appareils : fichiers, impression, pages web, stockage d'e-mails.
- pont 网桥 — relie deux segments LAN en un seul réseau, transférant le trafic entre eux.
- répéteur 中继器 — reçoit un signal affaibli et le retransmet à pleine puissance pour étendre la portée du câble.
Les fonctions d'une WNIC, pour une description de quatre points : elle convertit les données en signaux radio et inversement ; elle porte l'adresse MAC unique de l'appareil ; elle connecte l'appareil à un point d'accès sans fil et suit le protocole sans fil (canal et fréquence utilisés) ; et elle décode les signaux entrants pour l'appareil. Deux dispositifs pouvant physiquement connecter trente ordinateurs avec NIC : un commutateur ou un concentrateur.
Un commutateur réseau : le câble de chaque appareil est branché sur l'un de ses ports 
Une prise RJ-45 sur un câble Ethernet à paire torsadée 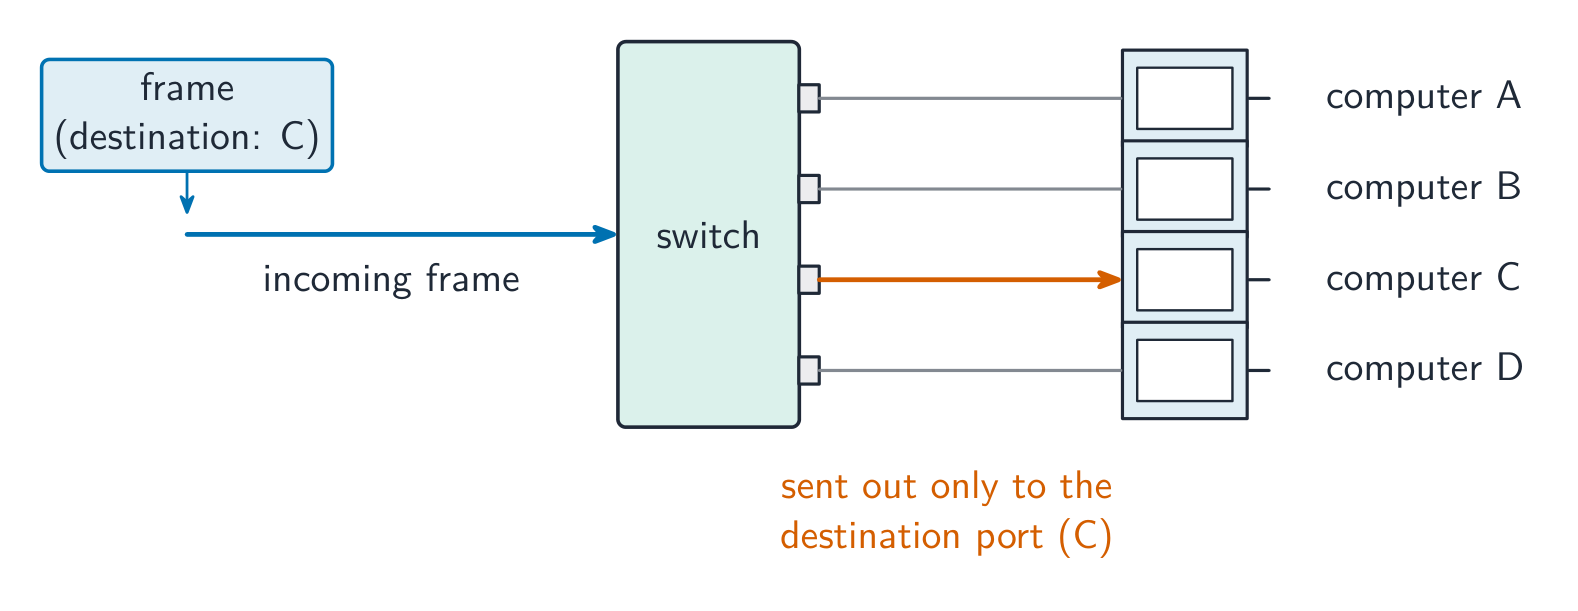
Un commutateur envoie chaque trame uniquement vers le port de sa destination Vocabulaire EntrainerAnglais Chinois Pinyin network/ˈnetwɜːk/ 网络 wǎng luò switch/swɪtʃ/ 交换机 jiāo huàn jī 2.1
Routeurs
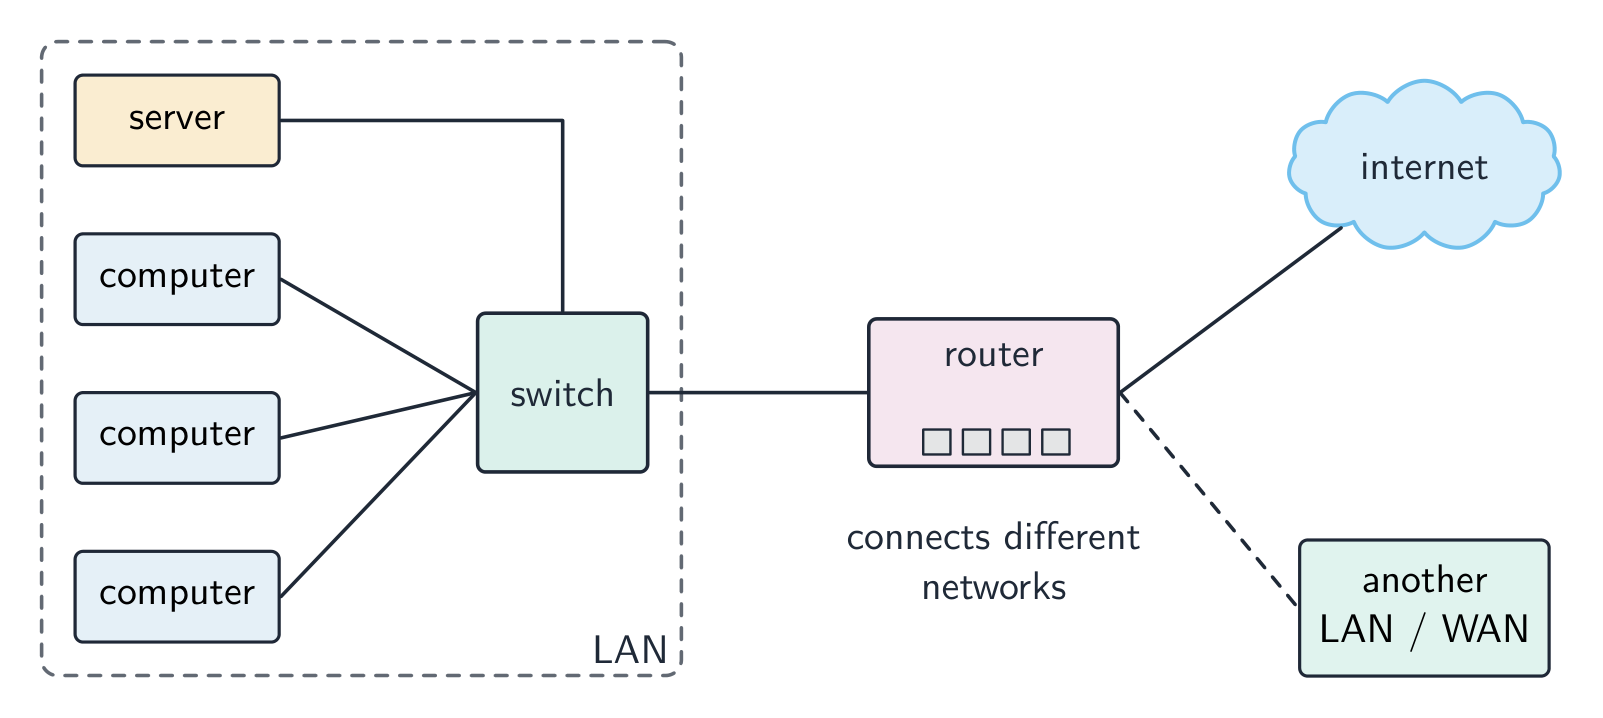
Un routeur 路由器 connecte différents réseaux et achemine les données entre eux — généralement à la frontière d'un LAN et d'Internet. Il effectue :
- acheminement — lit l'adresse IP de destination IP地址 de chaque paquet 数据包 et l'envoie par le bon port, en utilisant une table de routage 路由表.
- conversion d'adresses réseau 网络地址转换 (NAT) — permet à de nombreuses adresses LAN privées de partager une seule adresse IP publique.
- DHCP 动态主机配置协议 — distribue des adresses IP privées aux appareils LAN.
- pare-feu 防火墙 — bloque le trafic entrant non souhaité.
Dans le commutation de paquets 分组交换, un message est découpé en paquets envoyés indépendamment. Chaque routeur lit l'adresse IP de destination d'un paquet, recherche le prochain saut dans sa table de routage et l'achemine, de sorte que les paquets d'un même message peuvent emprunter des routes différentes et sont réassemblés dans l'ordre à destination. Un routeur reçoit et achemine effectivement des paquets entre réseaux et distribue des adresses IP ; il ne cherche pas l'adresse IP d'une URL (DNS s'en charge) et ne stocke pas de pages web. Un routeur domestique contient également le modem et le point d'accès sans fil, ainsi un seul boîtier connecte le LAN à Internet.
*Un routeur connecte un LAN à Internet ou à un autre réseauVocabulaire EntrainerAnglais Chinois Pinyin router/ˈruːtə/ 路由器 lù yóu qì DHCP/ˌdiː eɪtʃ siː ˈpiː/ 动态主机配置协议 dòng tài zhǔ jī pèi zhì xié yì firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn 2.1
Ethernet et CSMA/CD

Ethernet est la norme (protocole) pour les LAN câblés : les appareils sont reliés par des câbles à paire torsadée ou en fibre, les données sont envoyées sous forme de trames contenant les adresses MAC source et de destination, et un support partagé utilise CSMA/CD pour gérer les collisions. Sur les supports partagés, une collision 冲突 peut survenir lorsque deux appareils envoient simultanément. Le protocole est CSMA/CD 载波侦听多路访问/冲突检测 (Carrier Sense Multiple Access with Collision Detection) :
- détection de porteuse — écouter avant d'envoyer ; attendre si le câble est occupé.
- accès multiple — plusieurs appareils partagent le support.
- détection de collision — continuer à écouter pendant l'envoi ; un choc est une collision.
- lors d'une collision, les deux s'arrêtent, envoient un signal de brouillage brief, puis attendent un temps de retrait aléatoire avant de réessayer.
Les trois tâches, selon les termes du schéma : l'appareil écoute (détecte la porteuse) avant de transmettre ; il continue de vérifier la présence d'une collision pendant la transmission ; lors d'une collision, il s'arrête, envoie un signal de brouillage, attend un temps aléatoire et retransmet.
L'Ethernet commutée moderne utilise des liens point à point plein-duplex 全双工, rendant les collisions impossibles.
*Le processus CSMA/CD pour gérer les collisions sur les supports partagésVocabulaire EntrainerAnglais Chinois Pinyin collision/kəˈlɪʒn/ 冲突 chōng tū CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè 2.1
Flux de bits

Le streaming 流式传输 envoie des multimédias sous forme de flux continu que le lecteur interprète à l'arrivée, au lieu de télécharger le fichier entier d'abord.
- en temps réel (direct) : capturé et diffusé en direct (sport en direct, appels vidéo). Impossible de rembobiner ; une faible latence est essentielle.
- à la demande : enregistré au préalable sur un serveur (YouTube, Netflix). Possibilité de mettre en pause et de rembobiner ; le serveur peut mettre en tampon 缓冲 à l'avance.
Le streaming en temps réel fonctionne comme un court pipeline :
- capturer et échantillonner la source (caméra ou microphone).
- encoder les données, en utilisant la compression 压缩 pour réduire la taille.
- envoyer les données sur le réseau sous forme de paquets.
- le lecteur met en tampon un peu, puis diffuse en direct — supprimant tout paquet arriving tard, car un flux en direct ne peut pas attendre.
Une compression avec perte 有损 est utilisée ici : les images animées masquent les petites pertes, et le flux doit être suffisamment petit pour tenir dans la bande passante.
Pourquoi une vidéo est compressée avant le streaming en temps réel : le flux non compressé nécessiterait plus de bande passante que la connexion ne peut offrir, ce qui entraînerait des retards d'arrivée des images et des interruptions de lecture. La compression réduit le nombre de bits, permettant au débit binaire 比特率 de rester inférieur à la vitesse de la large bande, la latence de rester faible, et de réduire le besoin de stockage et de coûts aux deux extrémités. Le débit binaire doit être inférieur à la vitesse de la connexion : un débit plus élevé offre une meilleure qualité mais nécessite une connexion plus rapide, et si les données arrivent plus lentement qu'elles ne sont lues, le tampon se vide et la vidéo fige. Le streaming à la demande peut mettre en tampon davantage de fichier à l'avance, gérant mieux une connexion lente ; le streaming en temps réel ne peut pas.
*Des données transitent du serveur vers un tampon avant que le lecteur multimédia ne les liseVocabulaire EntrainerAnglais Chinois Pinyin bit streaming/bɪt ˈstriːmɪŋ/ 流式传输 liú shì chuán shū buffer/ˈbʌfə/ 缓冲 huǎn chōng compression/kəmˈpreʃn/ 压缩 yā suō lossy/ˈlɒsi/ 有损 yǒu sǔn bit rate/bɪt reɪt/ 比特率 bǐ tè lǜ 2.1
Internet et le World Wide Web

L'internet 互联网 est un réseau mondial de réseaux utilisant un ensemble de protocoles 协议 commun (TCP/IP). Le World Wide Web 万维网 (WWW) est un service fonctionnant dessus : documents hypertextes identifiés par des URLs, visualisés dans des navigateurs via HTTP/HTTPS. L'e-mail et le transfert de fichiers sont d'autres services internet faisant partie intégrante du WWW.
Webmail utilise les deux : le WWW, car la boîte mail est une page web accessible via une URL dans un navigateur par HTTP ; et Internet, car l'e-mail lui-même traverse le réseau de réseaux (l'e-mail est un service internet séparé du web).
*Le Web est un service fonctionnant au-dessus d'InternetMatériel supportant Internet
- modem 调制解调器 — convertit le signal numérique de l'ordinateur en signal analogique pour une ligne téléphonique, et inversement à l'autre bout (modulation et démodulation).
- RTPS — le réseau téléphonique public d'échanges et de lignes ; une connexion dial-up ou DSL transporte des données Internet dessus.
- ligne dédiée 专线 — une ligne louée entre une organisation et son FAI : toujours active, avec une bande passante fixe non partagée, donc plus rapide et fiable, mais coûteuse.
- réseau cellulaire 蜂窝网络 — l'appareil envoie des données par radio vers la tour cellulaire la plus proche (station de base) ; les tours sont reliées au réseau de l'opérateur téléphonique, qui achemine les données vers Internet ; lorsque l'appareil bouge, il passe d'une cellule à la suivante.
 *Trois façons d'accéder à Internet : un modem et le RTPS, une ligne dédiée, et le réseau cellulaireVocabulaire Entrainer
Anglais Chinois Pinyin internet/ˈɪntənet/ 互联网 hù lián wǎng local area network/ˈləʊkl ˈeərɪə ˈnetwɜːk/ 局域网 jú yù wǎng latency/ˈleɪtənsi/ 延迟 yán chí wide area network/waɪd ˈeərɪə ˈnetwɜːk/ 广域网 guǎng yù wǎng Public Switched Telephone Network/ˈpʌblɪk swɪtʃt ˈtelɪfəʊn ˈnetwɜːk/ 公共交换电话网 gōng gòng jiāo huàn diàn huà wǎng protocol/ˈprəʊtəkɒl/ 协议 xié yì IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo network address translation/ˈnetwɜːk əˈdres trænˈsleɪʃn/ 网络地址转换 wǎng luò dì zhǐ zhuǎn huàn modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì full-duplex/fʊl ˈdjuːpleks/ 全双工 quán shuāng gōng World Wide Web/wɜːld waɪd web/ 万维网 wàn wéi wǎng dedicated line/ˈdedɪkeɪtɪd laɪn/ 专线 zhuān xiàn 2.1
Adresses IP
Une adresse IP identifie de manière unique un appareil.
- IPv4 — 32 bits, quatre nombres décimaux de 0 à 255 (
192.168.1.10) ; environ $4.3 \times 10^{9}$ adresses (maintenant épuisées). - IPv6 — 128 bits, huit groupes de quatre chiffres hexadécimaux ; environ $3.4 \times 10^{38}$ adresses.
IPv4 est écrit sous la forme de quatre groupes de nombres décimaux séparés par des points ; chaque groupe est un nombre sur 8 bits, allant donc de 0 à 255. IPv6 est écrit sous la forme de huit groupes de quatre chiffres hexadécimaux séparés par des deux-points,
2001:0db8:0000:0000:0000:ff00:0042:8329, et une série de groupes nuls peut être abrégée en::. Ainsi,192.168.3.2n'est pas de l'IPv6 : il possède quatre groupes au lieu de huit, séparés par des points plutôt que par des deux-points, et ses groupes sont décimaux, non hexadécimaux.256.0.0.An'est pas une adresse valide de l'un ou l'autre type : un groupe IPv4 ne peut dépasser 255 et ne peut contenir de lettres, et IPv6 nécessiterait des deux-points et huit groupes.Sous-réseautage
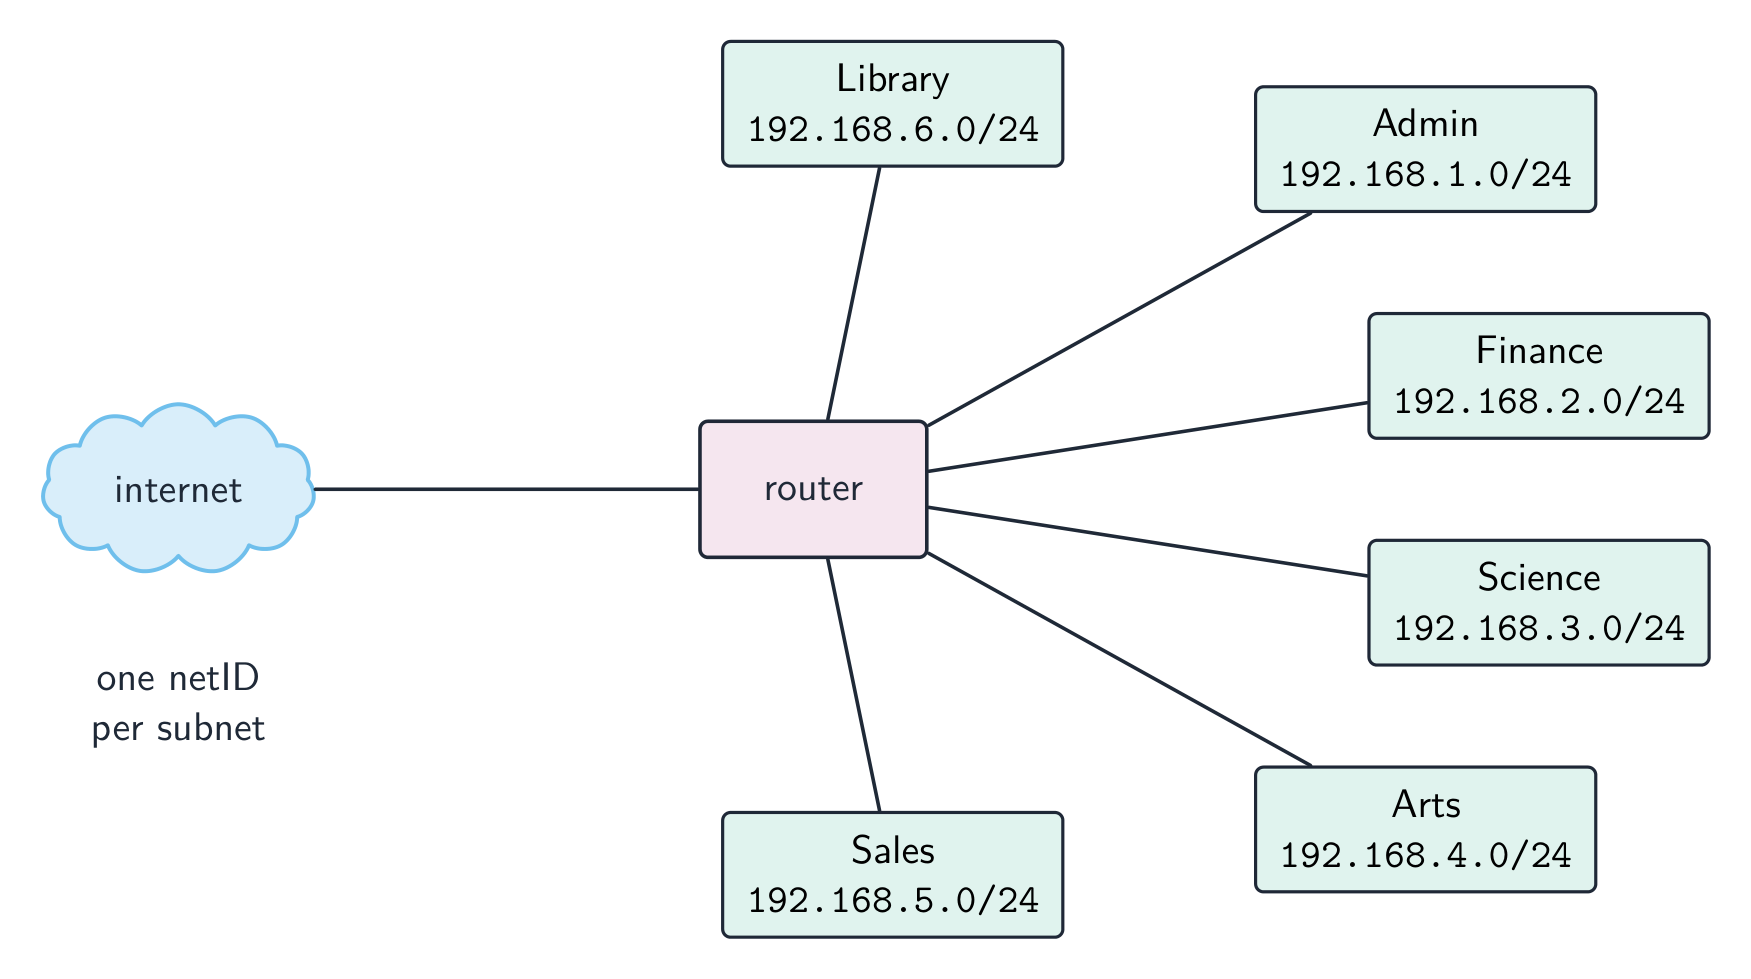
Un réseau peut être divisé en sous-réseaux 子网. L'adresse IP se divise en une partie réseau et une partie hôte, définies par un masque de sous-réseau 子网掩码 (par ex.
255.255.255.0= les 24 premiers bits sont le réseau). Le sous-réseautage améliore la gestion, réduit le trafic de diffusion et renforce la sécurité.Les deux parties d'une adresse dans un sous-réseau : l'ID réseau (les premiers bits, identiques pour chaque appareil de ce sous-réseau, donnés par les uns dans le masque) et l'ID hôte (les bits restants, uniques à chaque appareil). Avantages de la sous-référenciation, pour « décrivez deux avantages » : moins de trafic sur chaque partie, car les broadcasts restent dans leur sous-réseau ; meilleure sécurité, car le trafic d'un département est gardé des autres ; gestion plus facile et diagnostic des pannes ; utilisation plus efficace des adresses. Deux appareils avec le masque
255.255.255.0sont dans des sous-réseaux différents lorsque leurs trois premiers groupes diffèrent.Division d'un réseau en sous-réseaux, un netID par département Adresses publiques et privées
- Les adresses privées sont utilisées au sein d'un LAN et ne sont pas routables sur Internet (par ex.
192.168.0.0/16). - Une adresse IP publique est unique à l'échelle mondiale et routable, attribuée par un FAI 互联网服务提供商.
Les appareils situés derrière NAT avec des adresses privées ne sont pas directement accessibles depuis Internet, ce qui offre une certaine protection.
Les descriptions attendues par les tableaux : une adresse publique est visible sur Internet et unique à l'échelle globale, allouée par le FAI ; une adresse privée n'est visible qu'à l'intérieur du LAN, est réutilisée par de nombreux LANs et nécessite NAT pour accéder à Internet. Une adresse statique ne change jamais (définie manuellement ou réservée, comme pour un serveur) ; une adresse dynamique est allouée par DHCP à chaque connexion de l'appareil et peut changer.
Statique vs dynamique
- Une adresse IP statique est fixe ; utilisée pour les serveurs qui doivent être trouvés à une adresse connue.
- Une adresse IP dynamique est attribuée par DHCP et peut changer ; plus pratique pour les appareils clients et utilise efficacement un pool d'adresses limité.
Exemple résolu. Un hôte a l'adresse IP
192.168.10.130avec le masque de sous-réseau255.255.255.192. Sur quel réseau se trouve-t-il, et192.168.10.200est-il sur le même ? Le dernier octet du masque,192, est11000000en binaire, donc les premiers 26 bits sont la partie réseau et les derniers 6 bits adressent l'hôte. Cela fait que les sous-réseaux avancent par pas de $256 - 192 = 64$ :.0,.64,.128,.192. L'adresse130tombe dans le bloc commençant à.128, donc l'hôte est sur le réseau192.168.10.128/26, dont les hôtes utilisables vont de.129à.190(.191est l'adresse de broadcast).200tombe dans le bloc suivant (.192), donc il est sur un sous-réseau différent et le trafic entre les deux doit passer par un routeur. Obtenez la taille du bloc à partir du masque en premier ($256$ moins l'octet de masque) - deviner à partir des trois premiers octets est ce qui fait échouer ces exercices.2.1
URL et DNS
Une URL 统一资源定位符 (Uniform Resource Locator) localise une ressource sur le WWW :
https://www.example.com/about/contact.html protocol domain name path- protocole :
http,https, etc. - nom de domaine 域名 : une adresse de serveur lisible.
- chemin : la ressource sur ce serveur.
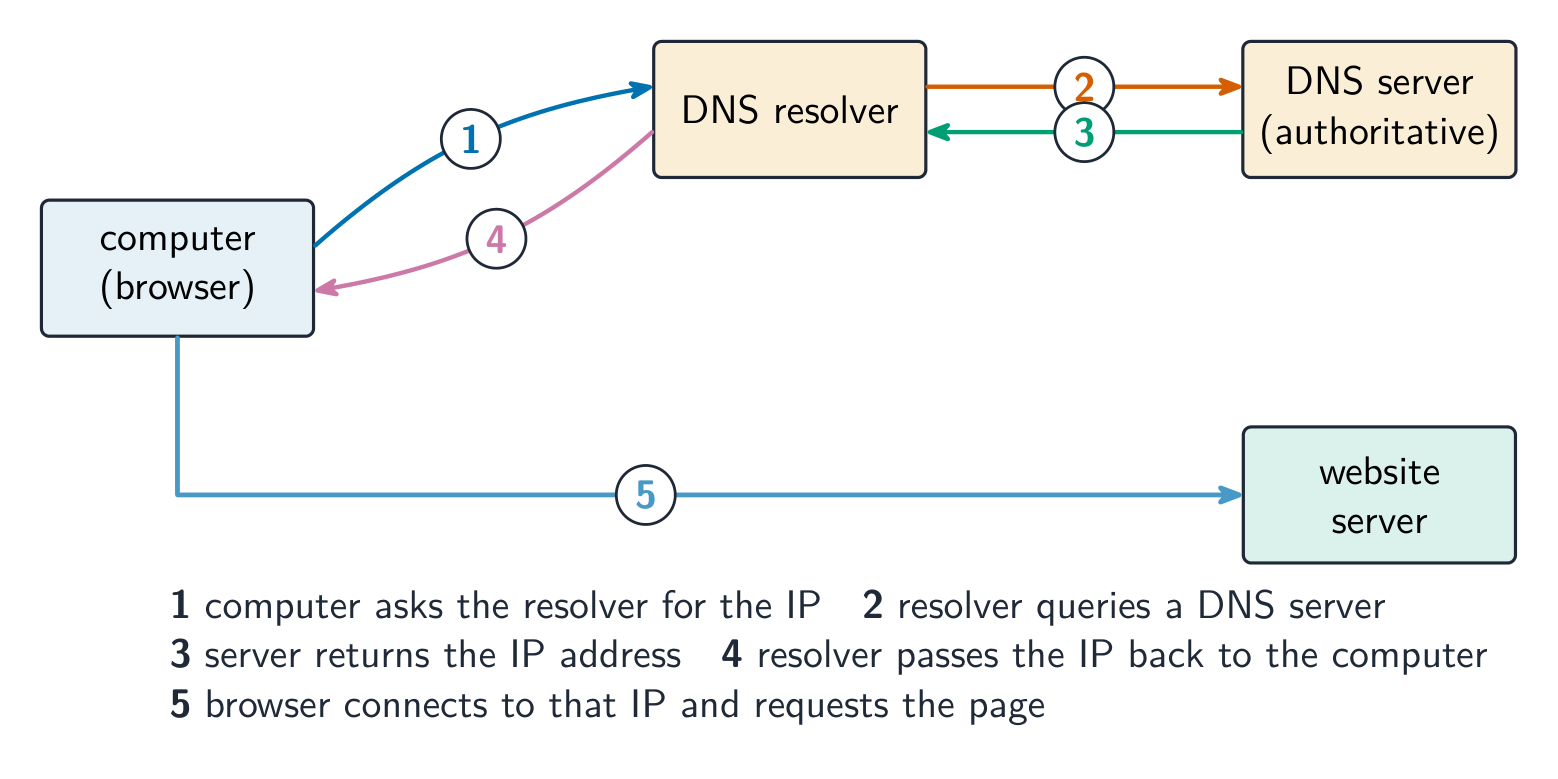
Le Système de Noms de Domaine 域名系统 (DNS, aussi appelé Domain Name Service) est un ensemble distribué de serveurs qui convertit les noms de domaine en adresses IP. Lorsque vous tapez une URL, le navigateur demande à un résolveur DNS l'IP, qui interroge les serveurs DNS (racine → niveau supérieur → autoritaire) jusqu'à la trouver ; le navigateur se connecte ensuite à cette IP et demande le chemin. Le DNS épargne aux humains la mémorisation des adresses IP et permet à un site de changer de serveur sans changer son nom.
Pour « expliquer comment le navigateur utilise l'URL » : le navigateur découpe l'URL en protocole, nom de domaine et chemin ; il envoie le nom de domaine à un serveur DNS, qui retourne l'IP correspondante (un cache sur l'ordinateur ou chez le FAI peut répondre en premier) ; il ouvre une connexion vers cette IP en utilisant le protocole (HTTPS sur le port 443) ; il envoie une requête pour le chemin ; et le serveur web retourne la page, que le navigateur affiche. Si la recherche DNS échoue, le navigateur signale que le serveur ne peut être trouvé.
Comment DNS trouve l'adresse IP d'un site web avant que le navigateur ne se connecte ExplorerComment DNS trouve un site web
Étape par étape d'une recherche DNS. Le réseau achemine par adresse IP, pas par nom — donc avant que quoi que ce soit ne charge, DNS doit convertir le nom de domaine en adresse IP.
Vocabulaire EntrainerAnglais Chinois Pinyin URL/ˌjuː ɑː ˈel/ 统一资源定位符 tǒng yī zī yuán dìng wèi fú domain name/dəˈmeɪn neɪm/ 域名 yù míng Domain Name System/dəˈmeɪn neɪm ˈsɪstəm/ 域名系统 yù míng xì tǒng 2.1
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
Terme Définition LAN un réseau couvrant une petite zone géographique, généralement un seul site, dont le matériel est propriété de l'organisation WAN un réseau couvrant une grande zone géographique, reliant des LANs via des liens tiers (loués ou publics) client-serveur un modèle où des ordinateurs clients demandent des services à un serveur central plus puissant qui les fournit pair-à-pair un modèle où chaque ordinateur est égal et peut agir à la fois comme client et serveur, sans serveur central client léger un client qui effectue peu de traitement ou de stockage lui-même et dépend du serveur pour les deux client lourd un client qui effectue son propre traitement et stockage et peut fonctionner sans le serveur topologie maillée une topologie où chaque appareil est connecté directement à plusieurs autres, offrant plus d'un itinéraire entre deux appareils cloud computing services de calcul à la demande (stockage, traitement, logiciel) fournis sur Internet par un tiers Ethernet protocole standard pour les LAN filaires, transmettant les données sous forme de trames et utilisant CSMA/CD sur un support partagé interrupteur dispositif qui achemine chaque trame uniquement vers le port de son adresse MAC de destination, au sein d'un LAN routeur dispositif qui connecte des réseaux et achemine les paquets entre eux selon leur adresse IP de destination bit streaming envoi d'un flux continu de bits afin que le récepteur lit les médias à mesure qu'ils arrivent, sans télécharger le fichier entier au préalable internet le réseau mondial de réseaux utilisant les protocoles TCP/IP World Wide Web l'ensemble des pages web hyperliées, identifiées par des URL et accessibles sur Internet via un navigateur URL l'adresse qui localise une ressource sur le web : protocole, nom de domaine et chemin DNS service qui traduit un nom de domaine en l'adresse IP du serveur contenant la ressource Vocabulaire EntrainerAnglais Chinois Pinyin cloud computing/klaʊd kəmˈpjuːtɪŋ/ 云计算 yún jì suàn scalability/ˌskeɪləˈbɪlɪti/ 可扩展性 kě kuò zhǎn xìng public cloud/ˈpʌblɪk klaʊd/ 公有云 gōng yǒu yún private cloud/ˈpraɪvət klaʊd/ 私有云 sī yǒu yún 2.1
Conseils d'examen
- Distinguer LAN vs WAN et client-serveur vs pair-à-pair selon qui stocke et contrôle les ressources.
- Associer chaque topologie (bus, étoile, maillée) à ses avantages et inconvénients (coût, fiabilité, collisions).
- Connaître la fonction de chaque dispositif : un interrupteur dirige au sein d'un LAN par adresse MAC, un routeur achemine entre réseaux par IP.
- Expliquer le bit streaming et pourquoi le buffering est nécessaire (les données arrivent à un rythme différent de celui de la lecture).
- Distinguer IPv4 vs IPv6 et adresses publiques et privées ; DNS convertit une URL en une adresse IP.
Erreurs courantes
- Dire qu'un switch fonctionne par adresse IP. Un switch achemine par adresse MAC au sein du LAN ; le routeur achemine par adresse IP entre les réseaux.
- Traiter Internet et le World Wide Web comme la même chose. Le Web est un service qui s'exécute sur Internet ; le courriel et le transfert de fichiers en sont d'autres.
- Donner « plus rapide » comme seule comparaison entre filaire et sans fil. Dire plus rapide et plus fiable et plus sûr, et donner le côté sans fil (mobilité, absence de câblage) lorsque la question demande une comparaison.
- Écrire qu'un routeur trouve l'adresse IP pour une URL. C'est DNS qui fait cela ; le routeur achemine les paquets vers lui.
- Décrire IPv6 avec des points et des groupes décimaux. Huit groupes de quatre chiffres hexadécimaux, séparés par des deux-points.
- Dessiner une topologie en étoile comme un anneau ou une chaîne. Chaque appareil a sa propre ligne vers le switch au centre.
-
3
Matériel
Regarder la leçon3.1
Ordinateurs et leurs composants
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension du besoin d'entrée, de sortie, de mémoire primaire et de stockage secondaire (y compris amovible) Montrer la compréhension des systèmes embarqués Y compris : avantages et inconvénients des systèmes embarqués Décrire les principales opérations des dispositifs matériels Y compris : Imprimante laser, imprimante 3D, microphone, enceintes, disque dur magnétique, mémoire flash (statique), lecteur/graveur de disque optique, écran tactile, casque de réalité virtuelle Montrer la compréhension de l'utilisation des tampons Expliquer les différences entre la Mémoire vive (RAM) et la Mémoire morte (ROM) Y compris leur utilisation dans une gamme d'appareils et de systèmes Expliquer les différences entre la RAM statique (SRAM) et la RAM dynamique (DRAM) Y compris l'utilisation de SRAM et DRAM dans une gamme d'appareils et de systèmes et les raisons d'utiliser l'un plutôt que l'autre selon l'appareil et son utilisation Expliquer la différence entre la ROM programmable (PROM), la ROM effaçable programmable (EPROM) et la ROM effaçable programmable électriquement (EEPROM) Montrer une compréhension des systèmes de surveillance et de contrôle Y compris : • différence entre surveillance et contrôle • utilisation de capteurs (y compris température, pression, infrarouge, son) et actionneurs • importance de la rétroaction Source : Programme Cambridge International
Un ordinateur polyvalent possède quatre blocs de construction :
- dispositifs d'entrée 输入设备 — font entrer les données (clavier, souris, microphone, scanner, capteurs).
- dispositifs de sortie 输出设备 — affichent les résultats (écran, haut-parleurs, imprimante, actionneurs).
- mémoire primaire 主存储器 — mémoire rapide accessible directement par le processeur 处理器 (CPU). Contient le programme en cours et ses données.
- stockage secondaire 辅助存储器 — plus lent, plus grand, conserve les programmes et les données lorsqu'ils ne sont pas utilisés (disque dur, SSD, disque optique, clé USB).
Le programme demande pourquoi chacun est nécessaire. Les dispositifs d'entrée sont nécessaires car l'ordinateur ne peut traiter que les données et instructions saisies. Les dispositifs de sortie sont nécessaires pour présenter les résultats sous une forme utilisable par les personnes. La mémoire primaire est nécessaire car le processeur ne peut exécuter des instructions et utiliser des données que celles retenues dans la mémoire qu'il peut adresser directement, et il doit y accéder rapidement. Le stockage secondaire est nécessaire car la mémoire primaire est volatile et de capacité limitée : les programmes et données doivent survivre à la coupure d'alimentation, dans un stockage plus grand et moins cher, et le stockage amovible permet de transférer des données entre ordinateurs ou de les conserver en sauvegarde.
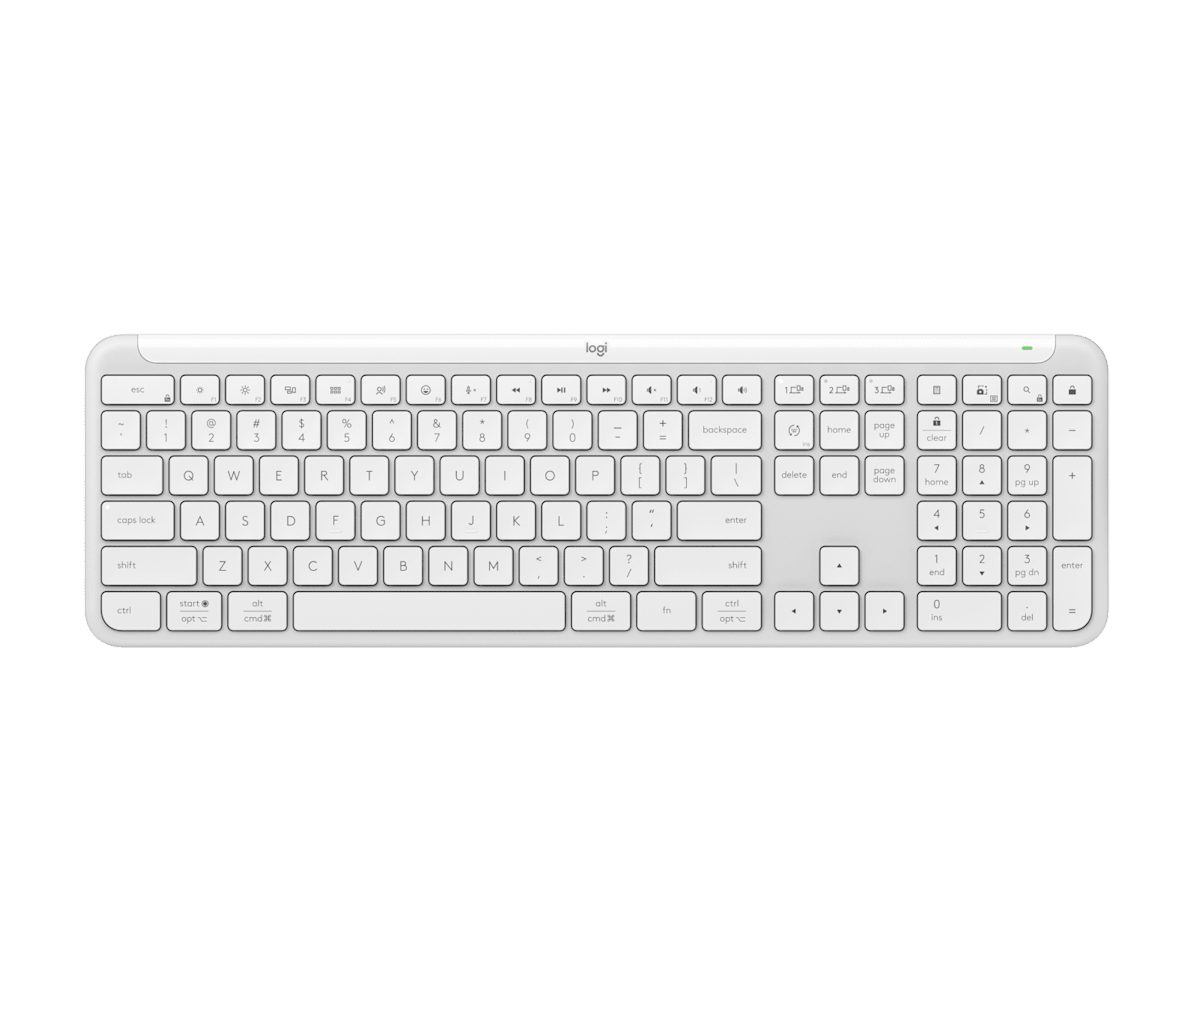
Un clavier : un dispositif d'entrée courant pour taper du texte et des commandes 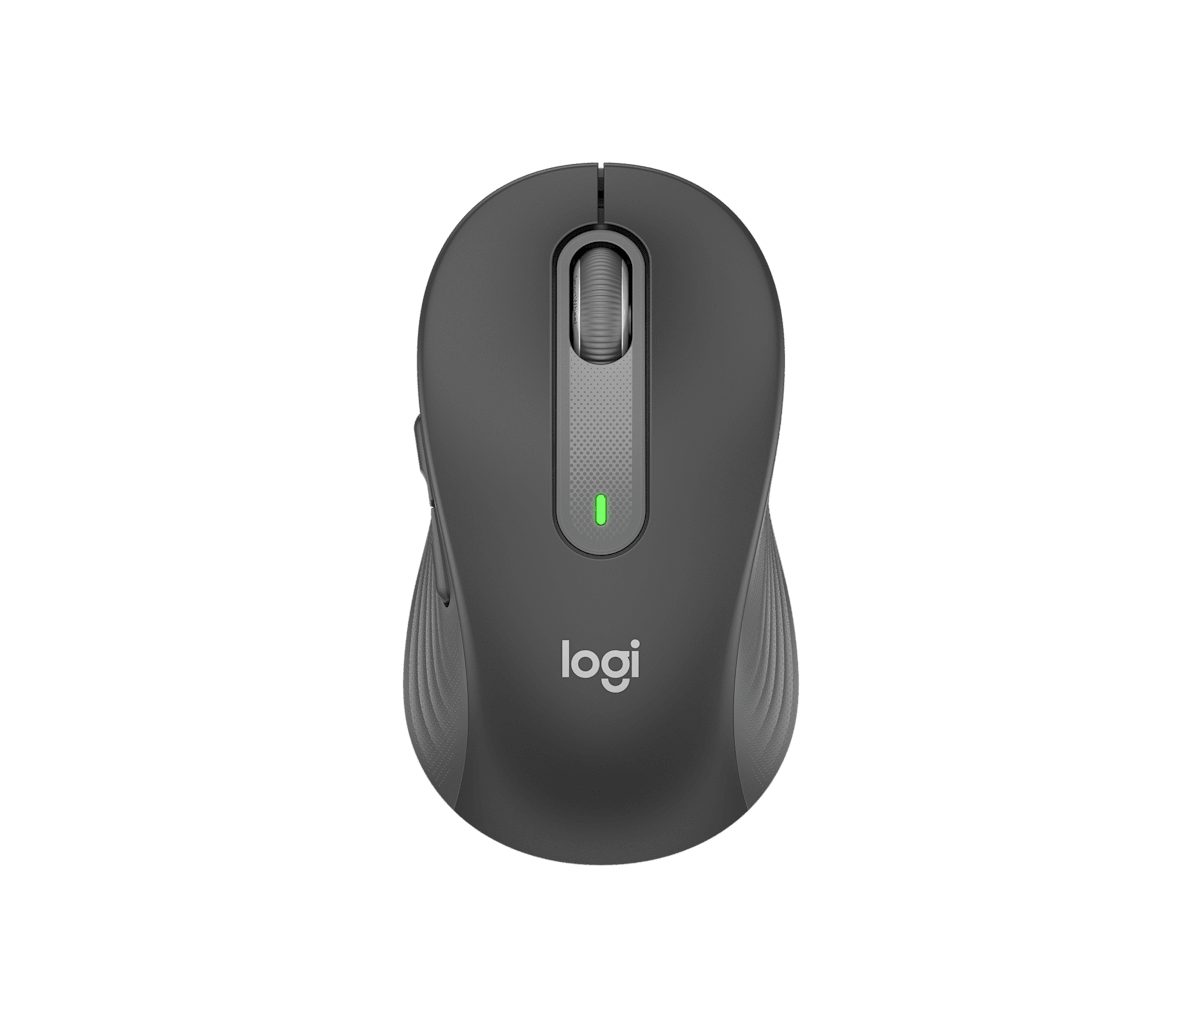
Une souris : un dispositif de pointage d'entrée 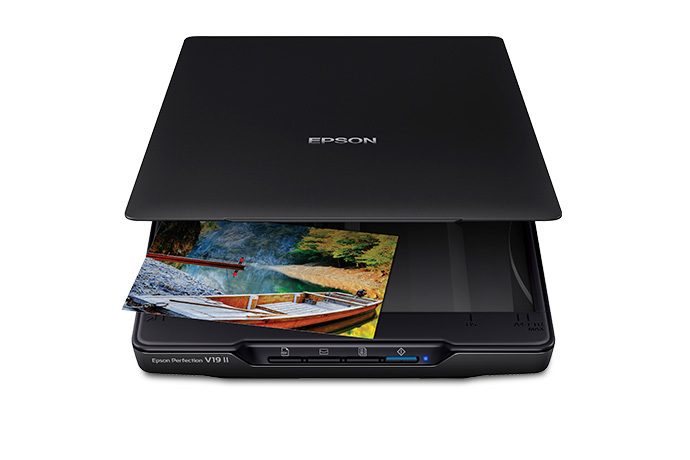
Un scanner plat : un dispositif d'entrée qui transforme une page papier en image numérique 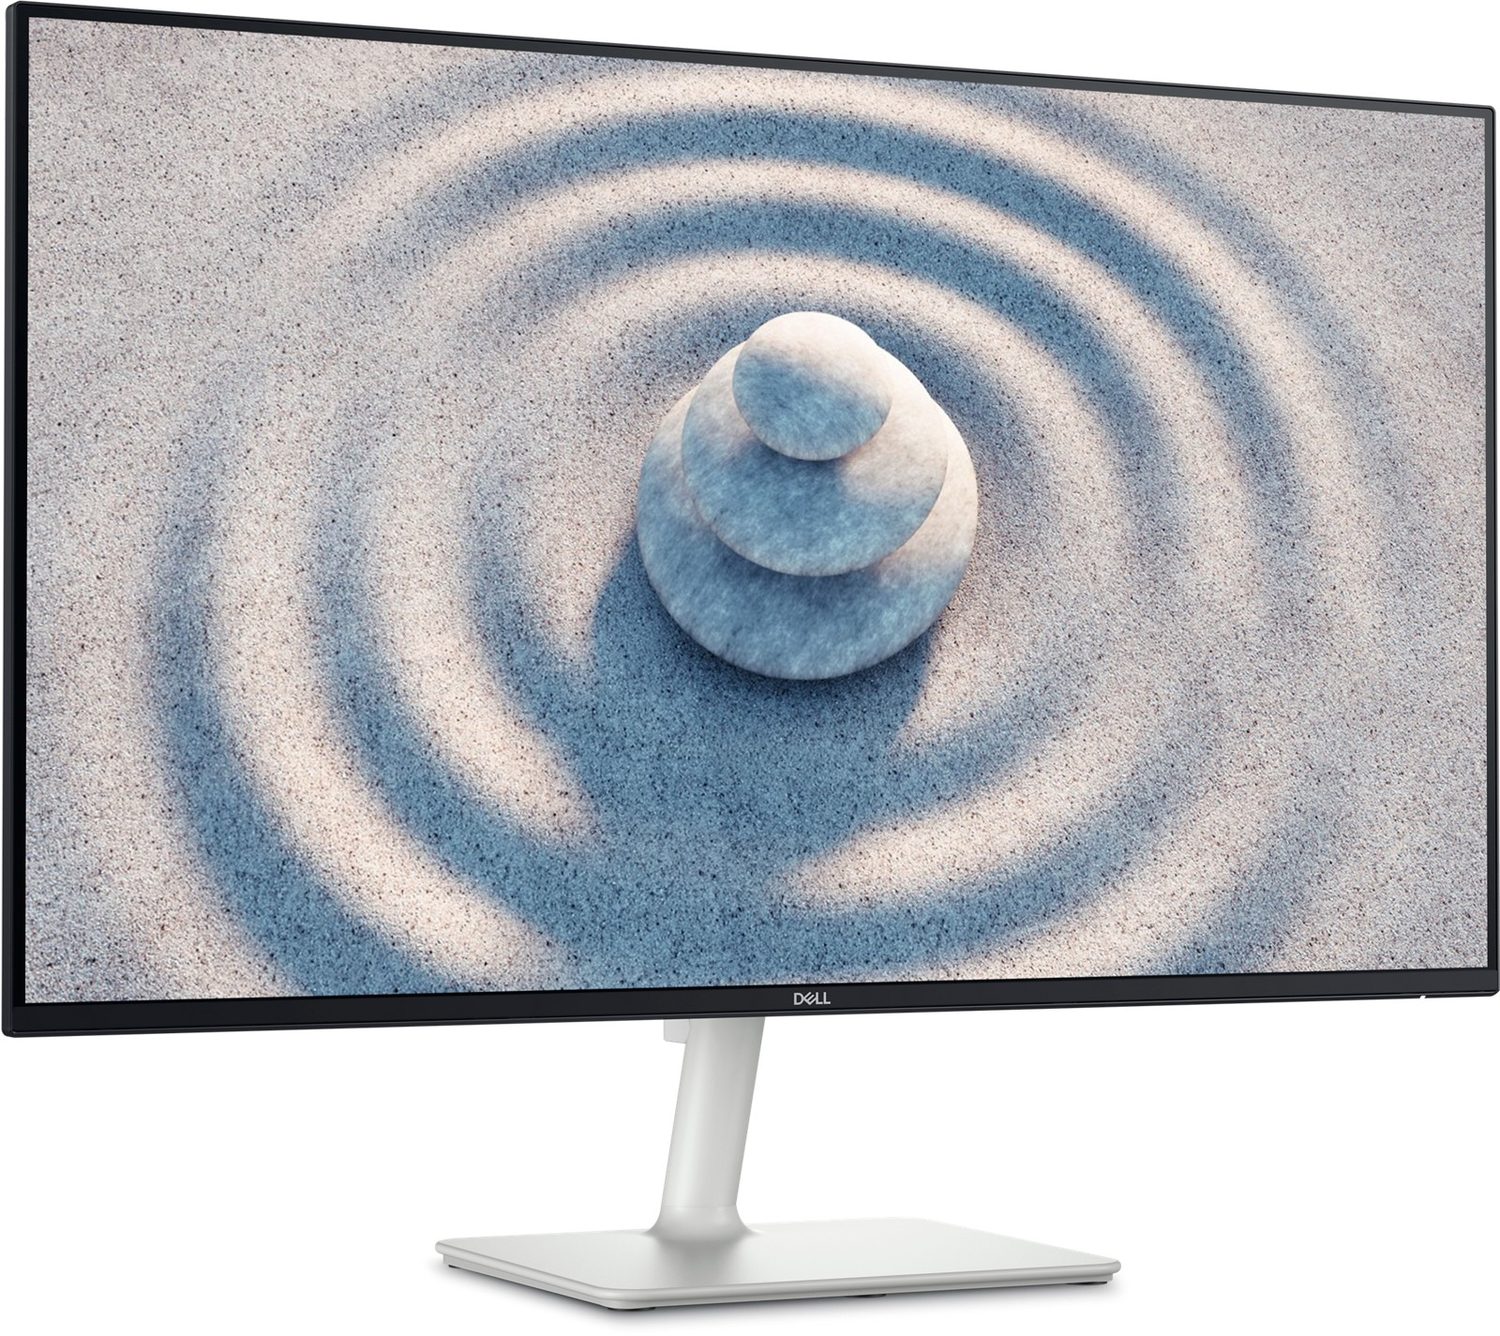
Un moniteur : un périphérique de sortie courant qui affiche l'image de l'écran ExplorerAppuyez sur les blocs d'un système informatique
Explorez les quatre blocs ainsi que le CPU. Les données circulent entrée → traitement → sortie, tandis que la mémoire primaire contient le programme en cours et le stockage secondaire le conserve pour plus tard.
ExplorerLab de routage réseau
Suivez les données depuis un appareil à travers le matériel réseau et les protocoles.
3.1
Systèmes embarqués
Un système embarqué 嵌入式系统 est un ordinateur intégré dans un autre appareil pour effectuer une tâche fixe (lave-linge, micro-ondes, unité de moteur de voiture, thermostat).
- avantages : optimisé pour une seule tâche, donc il est petit, consomme peu d'énergie et est bon marché à produire en série ; fiable, car il exécute un programme fixe avec peu de risques de défaillance ; démarre rapidement et ne nécessite aucune configuration utilisateur ; facile à utiliser grâce à une interface simple.
- inconvénients : limité à sa seule tâche, donc il ne peut pas être mis à niveau pour faire plus ; difficile à mettre à jour (son firmware 固件 peut nécessiter des outils spéciaux ou ne peut pas être modifié du tout) ; difficile à diagnostiquer, et généralement tout l'appareil doit être remplacé en cas de panne ; s'il est connecté à un réseau, il peut représenter une faille de sécurité, car son logiciel est rarement patché.
Une question « décrire les inconvénients » demande que chaque inconvénient soit formulé comme une réponse complète : quelle est la limitation et ce qu'elle signifie pour l'utilisateur, par exemple « le firmware ne peut pas être mis à jour, donc une faille de sécurité découverte ultérieurement ne peut pas être corrigée ».
Vocabulaire EntrainerAnglais Chinois Pinyin firmware/ˈfɜːmweə/ 固件 gù jiàn 3.1
Principaux périphériques matériels
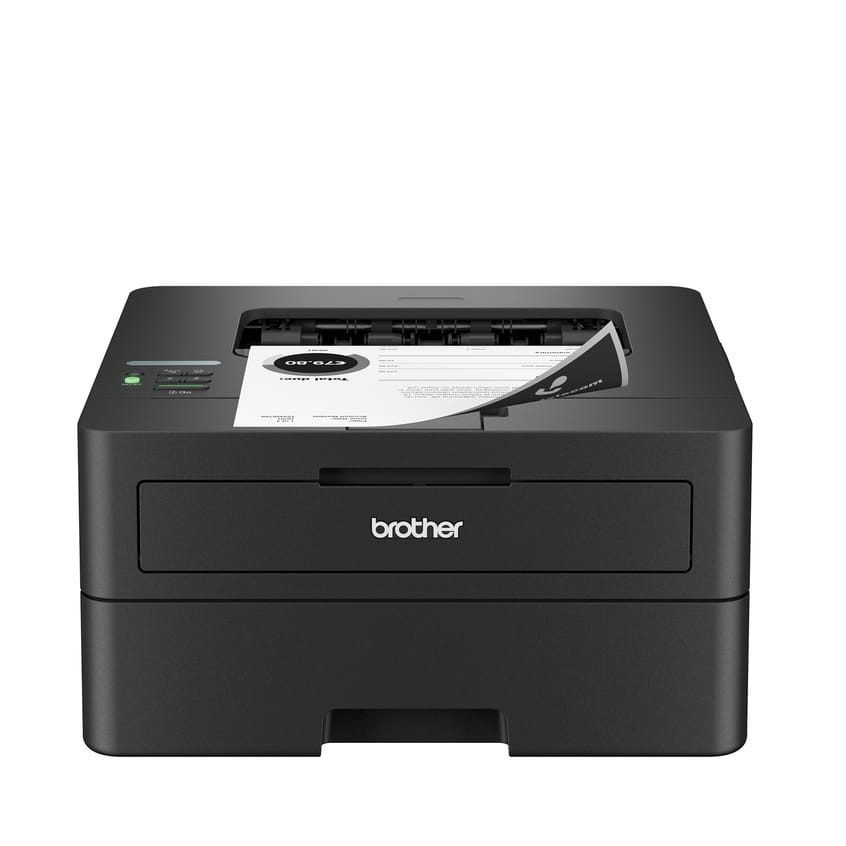
Imprimante laser
Une imprimante laser 激光打印机 scanne l'image de la page sur un tambour photosensible chargé. Le toner 墨粉 adhère aux zones chargées, se transfère sur le papier, et est fondu par un fuser. Rapide, nette, haute capacité.
Une imprimante laser : impression rapide et nette utilisant un tambour chargé et du toner Comment ça marche, selon les étapes listées dans la grille de notation :
- Les données de la page sont envoyées au tampon de l'imprimante.
- Le tambour reçoit une charge électrostatique uniforme.
- Un laser, réfléchi par un miroir rotatif, scanne l'image de la page sur le tambour, enlevant la charge là où il frappe, de sorte que la charge restante sur le tambour correspond à l'image.
- Le toner, une poudre chargée, est attiré uniquement vers les parties chargées du tambour.
- Le papier reçoit la charge opposée et roule contre le tambour, de sorte que le toner se transfère dessus.
- Le fuser 定影器, une paire de rouleaux chauffants, fait fondre le toner dans le papier. Le tambour est ensuite déchargé et nettoyé pour la page suivante.
Imprimante 3D
Une imprimante 3D 3D打印机 construit un objet couche par couche : FDM fait fondre un filament plastique via une buse ; stéréolithographie polymérise une résine liquide avec un laser UV. Utilisée pour les prototypes et les pièces médicales personnalisées.

Une imprimante 3D FDM construit un objet couche par couche en faisant fondre un filament plastique Comment ça marche :
- Un modèle de l'objet est conçu dans un logiciel CAD (ou numérisé).
- Un logiciel de tranchage divise le modèle en couches horizontales fines et produit les instructions pour chacune d'elles.
- L'imprimante construit l'objet couche par couche : une imprimante FDM fait fondre un filament 塑料丝 plastique et le dépose via une buse mobile ; une imprimante à résine polymérise une résine liquide avec un laser ou une lumière UV ; une imprimante à poudre lie une poudre avec un laser.
- Chaque couche s'agglomère à la couche inférieure, et la plateforme (ou la buse) descend d'une épaisseur de couche.
- Lorsque la dernière couche est terminée, tout matériau de soutien est retiré. Utilisations incluent les prototypes, les pièces médicales personnalisées telles que les prothèses, et les pièces détachées imprimées à la demande.
Microphone et haut-parleurs
Un microphone 麦克风 convertit le son en signal électrique (un diaphragme vibre, changeant la charge d'un condensateur 电容器 ou la position d'une bobine) ; le signal est numérisé par un convertisseur analogique-numérique 模数转换器 (ADC). Un haut-parleur fait l'inverse : un signal variable actionne une bobine dans un champ magnétique, déplaçant un cône pour produire du son.
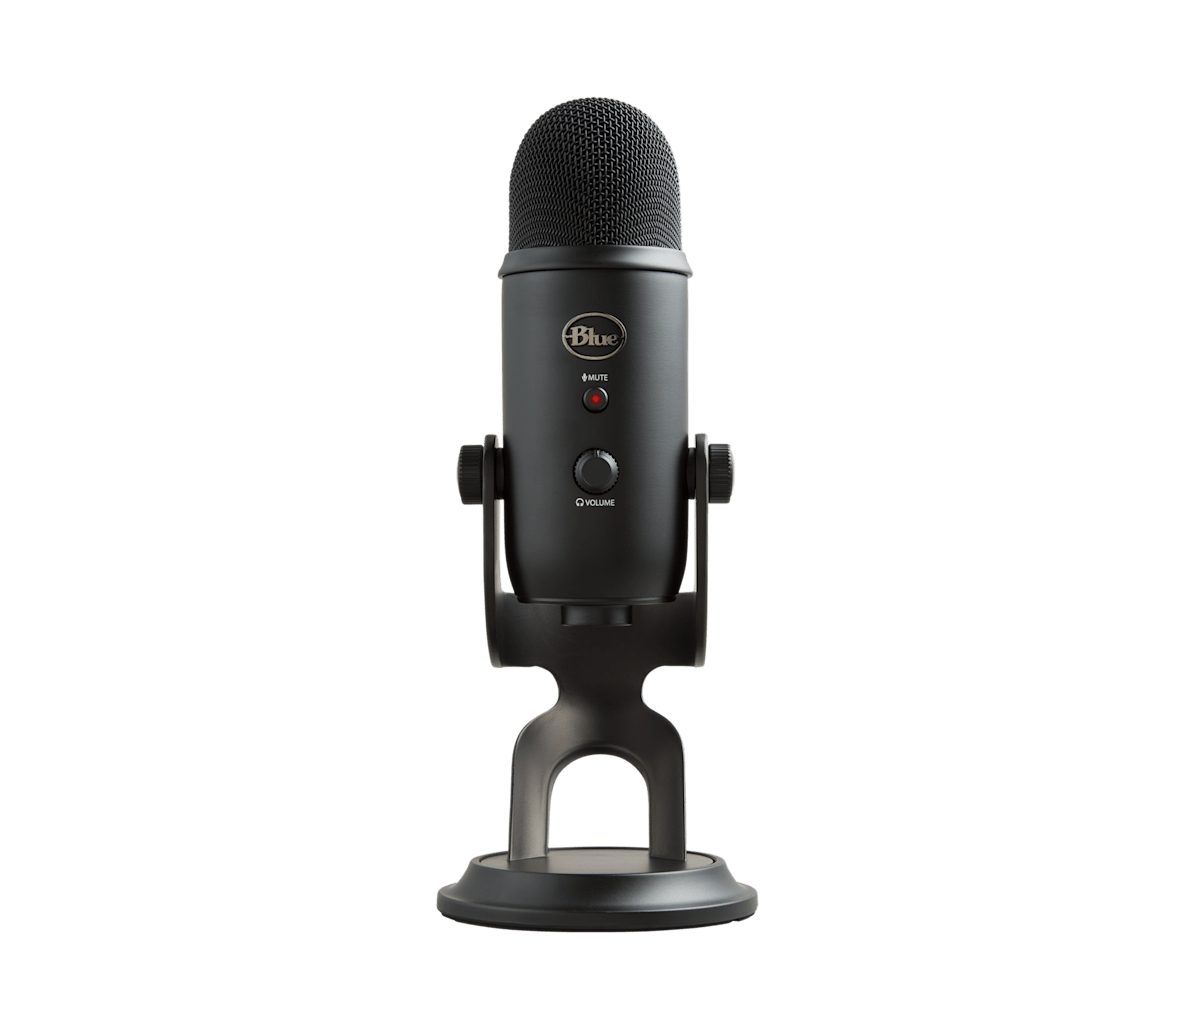
Un microphone convertit le son en signal électrique 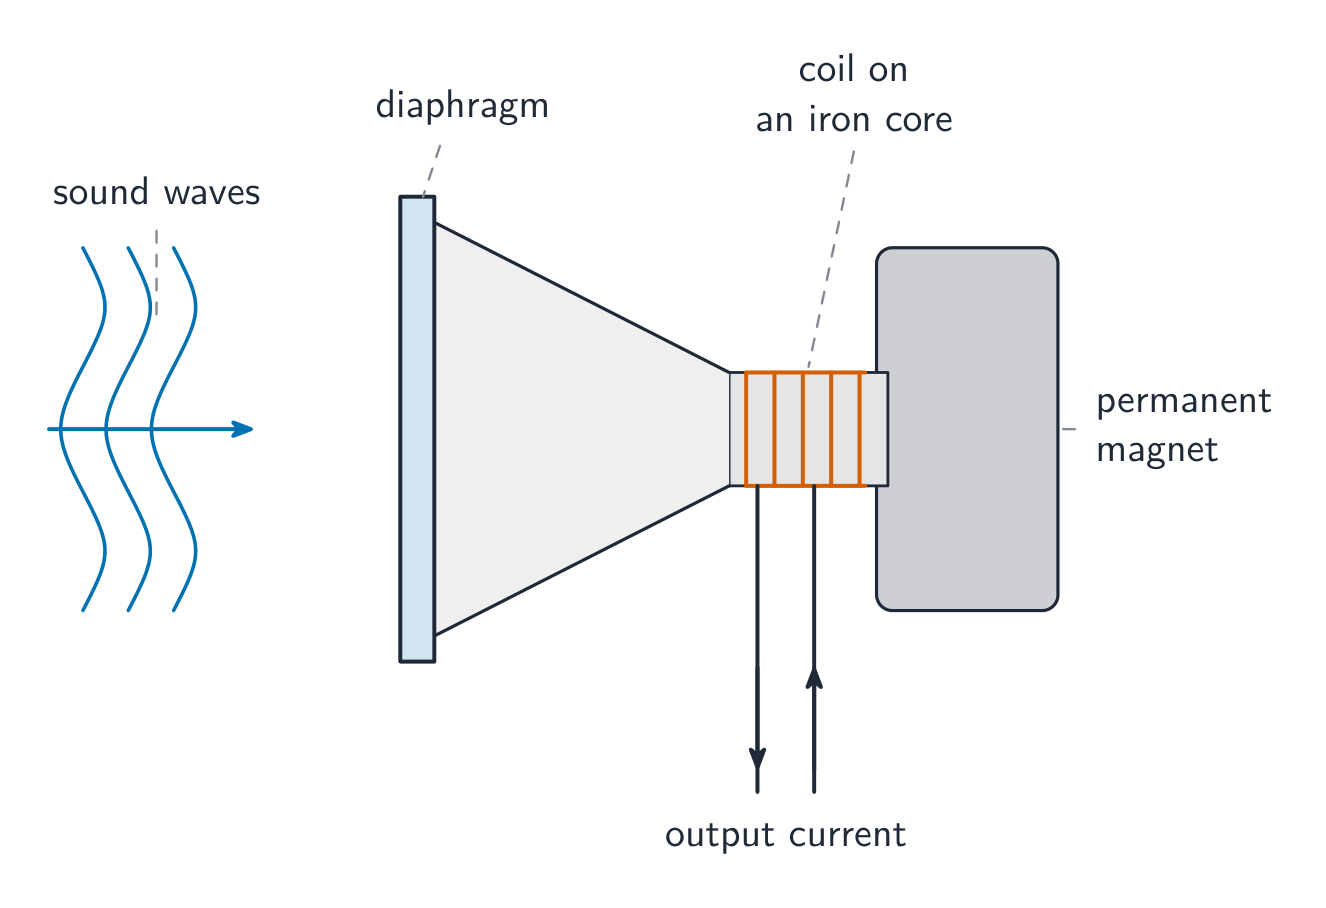
À l'intérieur d'un microphone : le son vibre la membrane et la bobine pour produire un courant 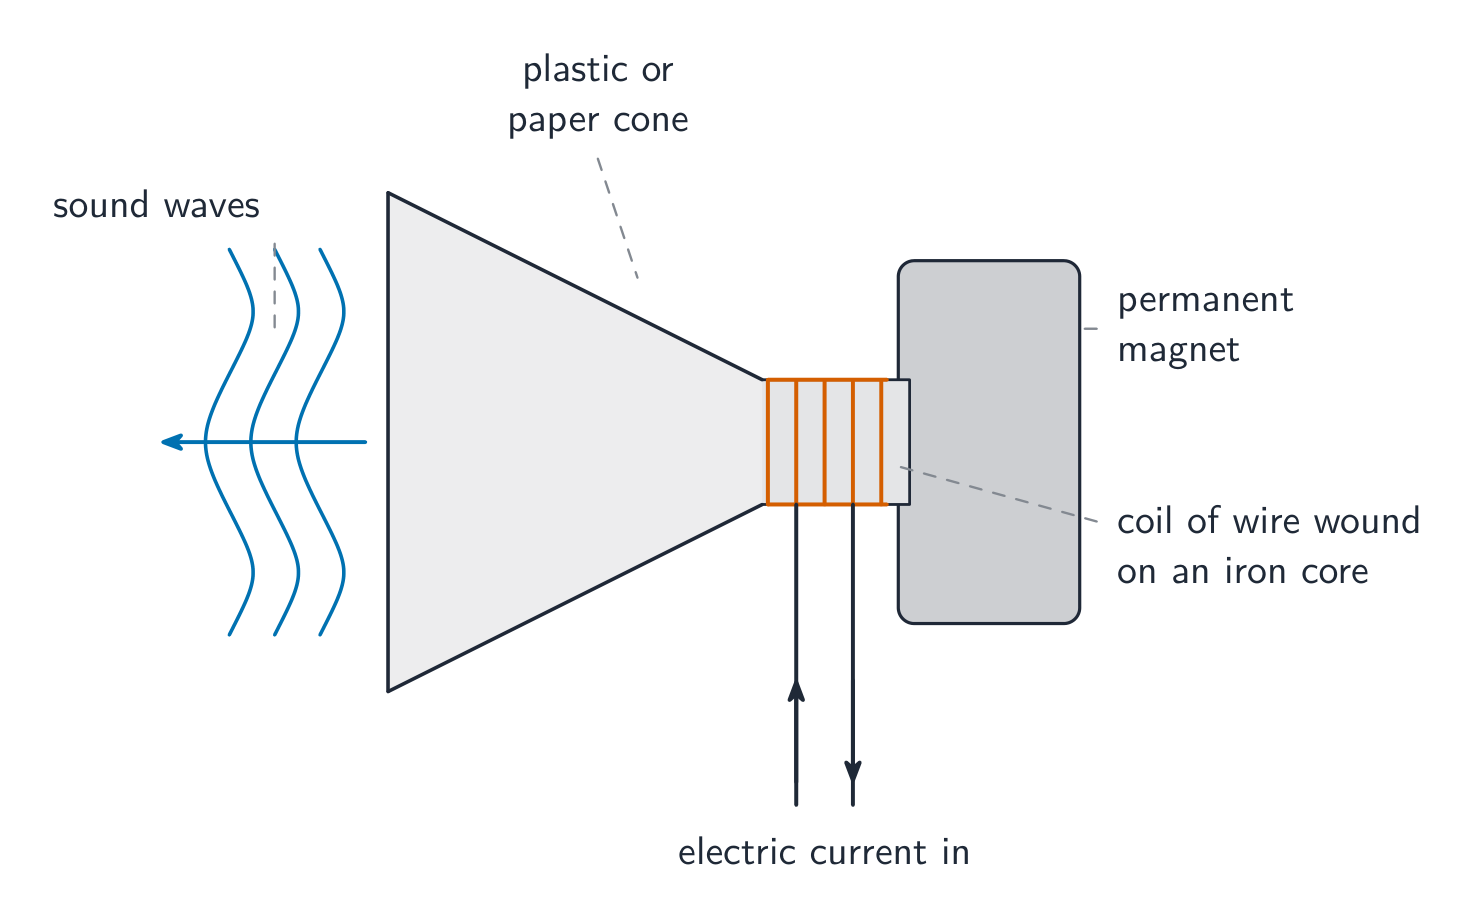
À l'intérieur d'un haut-parleur : un courant variable dans la bobine déplace le cône pour produire du son Comment fonctionne un microphone : des ondes sonores font vibrer un diaphragme 膜片 ; dans un microphone dynamique, une bobine attachée au diaphragme se déplace dans un champ magnétique, induisant ainsi un courant variable dans celle-ci, et dans un microphone condensateur, le diaphragme est une plaque d'un condensateur dont la capacité change lorsqu'il bouge ; le signal analogique variable est ensuite échantillonné par un ADC et stocké sous forme numérique. Un haut-parleur parcourt la chaîne à l'envers : un convertisseur numérique-analogique 数模转换器 (DAC) produit un courant variable, le courant dans la bobine crée un champ magnétique changeant qui pousse contre l'aimant permanent, la bobine et le cône se déplacent vers l'intérieur et l'extérieur, et le mouvement du cône produit des ondes de pression dans l'air.
Disque dur magnétique (HDD)
Un disque dur 硬盘 stocke des données sur des plateaux tournants recouverts de matériau magnétique. Chaque plateau possède des pistes 磁道 divisées en secteurs 扇区. Une tête de lecture/écriture 读写头 flotte juste au-dessus et magnétise de petites régions (écriture) ou les détecte (lecture). Bon marché par gigaoctet, mais plus lent que les SSD et possédant des pièces mobiles.
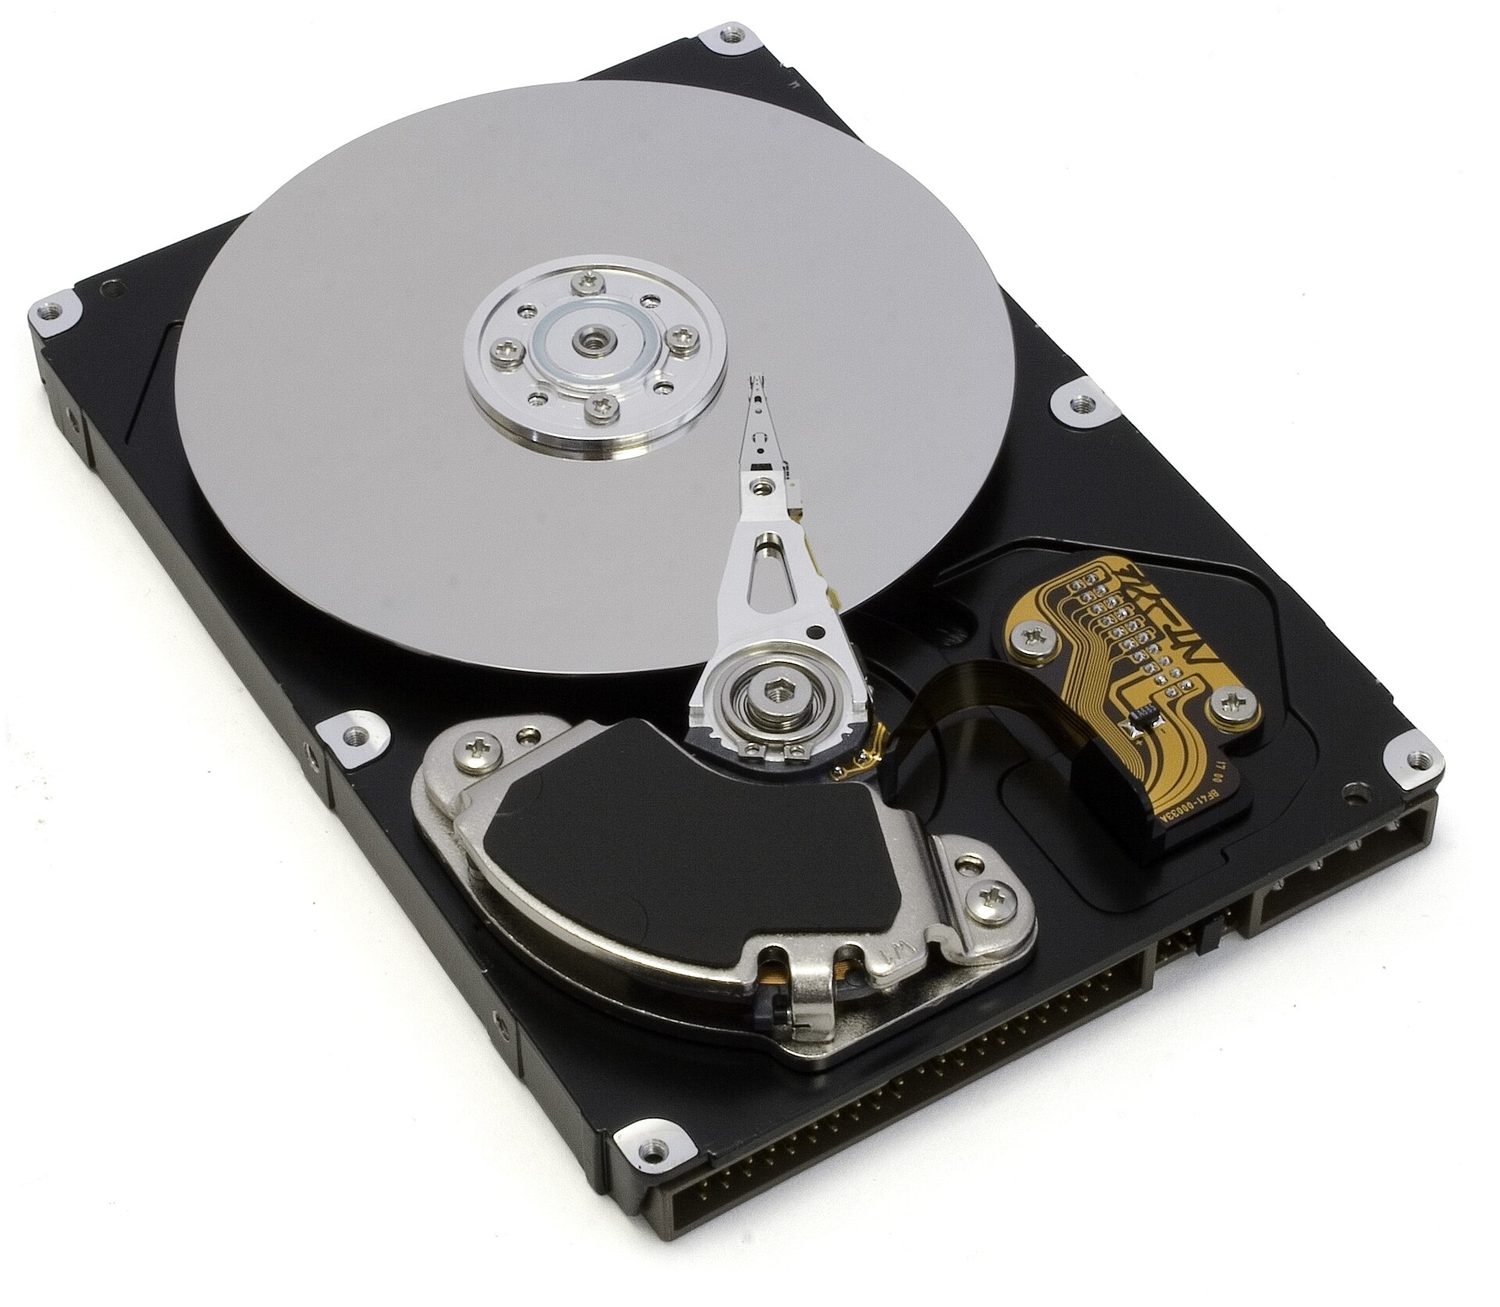
Un disque dur ouvert : le bras actionneur porte la tête de lecture/écriture au-dessus d'un plateau 
Pistes et secteurs sur un plateau de disque dur Comment ça marche : les plateaux tournent à grande vitesse (milliers de tours par minute) ; chaque surface est divisée en pistes concentriques et chaque piste en secteurs ; les têtes de lecture/écriture sur des bras actionneurs 磁头臂 se déplacent sur les plateaux jusqu'à la bonne piste ; pour écrire, la tête magnétise une petite région avec l'une des deux polarités, représentant 0 ou 1 ; pour lire, elle détecte la polarité alors que la région passe dessous. Les délais, attendant que le bras atteigne la piste et que le secteur tourne, expliquent pourquoi un disque dur est plus lent qu'un SSD.
Mémoire tout solide (flash)
Un disque tout solide 固态硬盘 stocke des données sous forme de charge dans des transistors 晶体管, sans pièces mobiles. Accès aléatoire plus rapide que les HDD, plus robuste, faible consommation, mais plus cher par gigaoctet ; chaque cellule s'use après de nombreuses écritures.

À l'intérieur d'un SSD : les données sont stockées dans des puces de mémoire flash, sans pièces mobiles (comparer avec le disque dur ci-dessus) Comment ça marche : chaque cellule est un transistor à grille flottante 浮栅晶体管 ; une charge piégée sur la grille flottante représente un bit et y reste lorsque l'alimentation est coupée ; une puce contrôleur mape chaque adresse vers une cellule et répartit les écritures sur les cellules, car une cellule ne survit qu'à un nombre limité d'écritures.
Disque dur magnétique Disque tout solide Pièces mobiles plateaux et têtes aucune Vitesse plus lent : délais de recherche et de rotation accès aléatique beaucoup plus rapide Coût par gigaoctet plus bas plus élevé Robustesse endommagé par les chocs ; bruyant ; plus d'énergie résistant aux chocs ; silencieux ; moins d'énergie Durée de vie nombreuses réécritures ; usure mécanique cycles d'écriture limités par cellule Une question « pourquoi un serveur utilise-t-il des disques durs plutôt que des SSD » demande la colonne de gauche : moins cher par gigaoctet pour de très grandes capacités, longue durée de vie sous réécriture constante, et récupération de données plus facile.
Disc optique
Un laser détecte les réflexions provenant de petites cavités sur un disc optique 光盘 (CD, DVD, Blu-ray). Le lecteur est un lecteur graveur de disc optiques : l'écriture utilise un laser plus puissant pour modifier la réflectivité de la surface.
Un lecteur de disc optique : un laser lit de petites cavités sur un CD, DVD ou Blu-ray Comment ça marche : le disc comporte une longue piste spirale de cavités 凹坑 et de plateaux 平台 (les zones plates entre elles) ; le disc tourne et un laser est focalisé sur la piste ; la lumière réfléchie depuis un plateau diffère de celle réfléchie au bord d'une cavité, et un capteur lumineux lit chaque changement comme un 1 et l'absence de changement comme un 0. L'écriture utilise un laser plus puissant pour changer la réflectivité d'une couche de colorant ou d'alliage. Un Blu-ray utilise un laser bleu à longueur d'onde plus courte, de sorte que ses cavités sont plus petites et rapprochées, ce qui explique pourquoi il contient plus de données qu'un DVD.
Écran tactile
Un écran tactile 触摸屏 détecte le contact. Résistif 电阻式 : deux couches conductrices pressées ensemble ; fonctionne avec n'importe quoi mais est moins précis. Capacitif 电容式 : un doigt perturbe un champ de charge ; précis, multi-touch, utilisé dans les téléphones.
Un écran tactile détecte l'endroit où un doigt touche le verre Comment ça marche : un écran résistif a deux couches conductrices fines séparées par des espacements ; appuyer pousse la couche supérieure sur la couche inférieure, fermant un circuit à cet endroit, et le contrôleur lit la tension pour trouver les coordonnées. Un écran capacitif a une couche de verre revêtue d'un conducteur transparent qui retient une charge ; un doigt qui le touche tire un petit courant, le courant est mesuré à chaque coin, et le contrôleur calcule la position du toucher à partir des différences. Les écrans capacitifs répondent à une légère touche et à plusieurs doigts à la fois, mais pas à un doigt ganté ou à un stylet ordinaire.
Casque de réalité virtuelle
Un casque de réalité virtuelle 虚拟现实 (VR) possède deux petits écrans (un par œil) et des capteurs de mouvement (accéléromètre 加速度计, gyroscope 陀螺仪) qui suivent le mouvement de la tête pour que la scène se déplace lorsque vous regardez autour de vous.

Un casque de réalité virtuelle : deux petits écrans et des capteurs de mouvement suivent la tête Fonctionnement : chaque œil voit son propre écran à travers une lentille, et les deux images diffèrent légèrement, ce qui permet au cerveau de percevoir la profondeur ; des capteurs (accéléromètre, gyroscope, parfois caméras) signalent la position de la tête et sa direction ; l'ordinateur re-rend la scène depuis cet angle de vue plusieurs fois par seconde, donc tourner la tête fait pivoter le champ de vision ; des écouteurs produisent un son qui correspond à la direction. Utilisé pour les jeux vidéo, la formation via des simulateurs de vol ou de chirurgie, et la visualisation de conceptions avant leur fabrication.
Vocabulaire EntrainerAnglais Chinois Pinyin input devices/ˈɪnpʊt dɪˈvaɪsɪz/ 输入设备 shū rù shè bèi microphone/ˈmaɪkrəfəʊn/ 麦克风 mài kè fēng optical disc/ˈɒptɪkl dɪsk/ 光盘 guāng pán laser printer/ˈleɪzə ˈprɪntə/ 激光打印机 jī guāng dǎ yìn jī drum/drʌm/ 感光鼓 gǎn guāng gǔ toner/ˈtəʊnə/ 墨粉 mò fěn fuser/ˈfjuːsə/ 定影器 dìng yǐng qì 3D printer/ˌθriː ˈdiː ˈprɪntə/ 3D打印机 3D dǎ yìn jī filament/ˈfɪləmənt/ 塑料丝 sù liào sī diaphragm/ˈdaɪəfræm/ 膜片 mó piàn capacitor/kəˈpæsɪtə/ 电容器 diàn róng qì analogue-to-digital converter/ˈænəlɒɡ tə ˈdɪdʒɪtl kənˈvɜːtə/ 模数转换器 mó shù zhuǎn huàn qì digital-to-analogue converter/ˈdɪdʒɪtl tʊ ˈænəlɒɡ kənˈvɜːtə/ 数模转换器 shù mó zhuǎn huàn qì tracks/træks/ 磁道 cí dào sectors/ˈsektəz/ 扇区 shàn qū read/write head/riːd raɪt hed/ 读写头 dú xiě tóu actuator arms/ˈæktʃuːeɪtə ɑːmz/ 磁头臂 cí tóu bì solid-state drive/ˈsɒlɪd steɪt draɪv/ 固态硬盘 gù tài yìng pán transistors/trænˈzɪstəz/ 晶体管 jīng tǐ guǎn floating-gate transistor/ˈfləʊtɪŋ ɡeɪt trænˈzɪstə/ 浮栅晶体管 fú zhà jīng tǐ guǎn pits/pɪts/ 凹坑 āo kēng lands/lændz/ 平台 píng tái touchscreen/ˈtʌtʃskriːn/ 触摸屏 chù mō píng resistive/rɪˈzɪstɪv/ 电阻式 diàn zǔ shì capacitive/kəˈpæsɪtɪv/ 电容式 diàn róng shì virtual reality/ˈvɜːtʃuːəl rɪˈælɪti/ 虚拟现实 xū nǐ xiàn shí accelerometer/əkˌseləˈrɒmɪtə/ 加速度计 jiā sù dù jì gyroscope/ˈdʒaɪrəskəʊp/ 陀螺仪 tuó luó yí 3.1
Tampons
Un tampon 缓冲 est une mémoire qui retient temporairement des données pendant qu'elles transitent entre des dispositifs de vitesses différentes. Exemple : le CPU écrit un document dans un tampon d'imprimante rapidement, puis peut effectuer d'autres tâches tandis que l'imprimante imprime depuis le tambon à son propre rythme. Les tampons évitent qu'un dispositif rapide n'attende un dispositif lent (ils sont aussi utilisés dans le streaming, le clavier et l'accès aux disques).
"Expliquez pourquoi une imprimante 3D a besoin d'un tampon" : l'ordinateur envoie les données d'impression beaucoup plus vite que l'imprimante ne peut construire les couches, donc les données sont stockées dans le tampon jusqu'à ce que l'imprimante soit prête à les traiter, libérant ainsi le processeur pour d'autres tâches. Lorsque le tampon est bas, l'imprimante envoie une interruption 中断 pour demander plus de données (sujet 4). Un flux vidéo fonctionne de la même manière : le tampon se remplit à l'avance pour que la lecture continue, afin qu'une brève baisse de la vitesse du réseau n'arrête pas l'image.
Vocabulaire EntrainerAnglais Chinois Pinyin interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 3.1
RAM et ROM
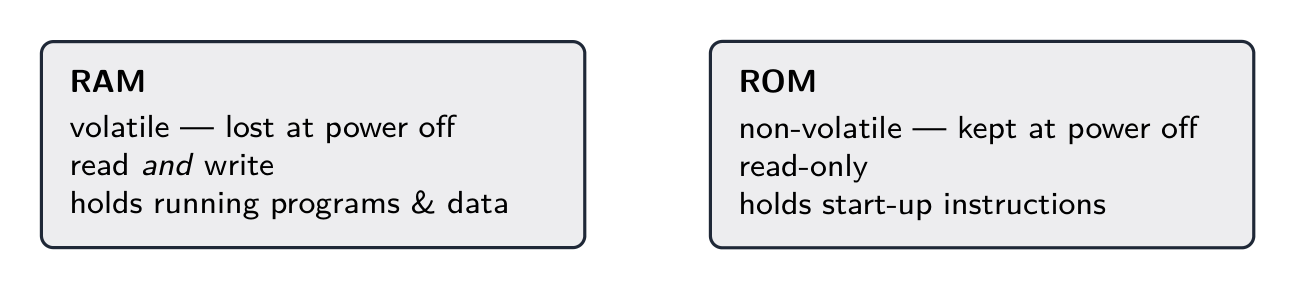
- RAM 随机存取存储器 (Mémoire vive) — volatile 易失性 (perd les données sans alimentation). Contient le système d'exploitation, les programmes en cours d'exécution et leurs données ; elle est constamment lue et écrite.
- ROM 只读存储器 (Mémoire morte) — non volatile 非易失性 (conserve les données sans alimentation). Généralement écrite une seule fois ; contient le micrologiciel nécessaire au démarrage (le BIOS / chargeur de démarrage).
La RAM est volatile et lecture/écriture ; la ROM est non-volatile et lecture seule La ROM amorce le système ; la RAM contient ensuite le travail actif.
RAM ROM Volatile ? oui : le contenu est perdu lors de la coupure d'alimentation non : le contenu est conservé sans alimentation Lecture/écriture ? lue et écrite constamment lecture seule en utilisation normale Contient le système d'exploitation, les programmes en cours d'exécution et leurs données le micrologiciel et le programme de bootstrap qui démarrent l'ordinateur Taille grande, et peut généralement être augmentée petite et fixe Usage typique mémoire principale d'un ordinateur ou d'un téléphone code de démarrage d'un PC ; programme complet d'un système embarqué tel qu'une machine à laver Plus de RAM permet à un ordinateur de contenir plus de programmes et de données simultanément, réduisant ainsi les échanges entre mémoire et disque et améliorant la vitesse ; c'est la réponse à "expliquez pourquoi l'ordinateur avec plus de RAM performe mieux".
Un module RAM (DIMM) se branche sur la carte mère comme mémoire vive rapide de l'ordinateur Le partage de cette mémoire est important aussi dans un appareil portable : son programme fixe doit rester disponible après la coupure d'alimentation, tandis que ses lectures en direct changent durant l'utilisation.
Un moniteur de fréquence cardiaque porté au poignet ExplorerDispositif et laboratoire de stockage
Classez les exemples informatiques selon leur rôle dans un système.
Vocabulaire EntrainerAnglais Chinois Pinyin RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì ROM/rɒm/ 只读存储器 zhī dú cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì hard disk/hɑːd dɪsk/ 硬盘 yìng pán volatile/ˈvɒlətaɪl/ 易失性 yì shī xìng non-volatile/nɒn ˈvɒlətaɪl/ 非易失性 fēi yì shī xìng 3.1
SRAM vs DRAM
- SRAM 静态RAM (RAM statique) stocke chaque bit dans un flip-flop 触发器 composé de plusieurs transistors. Rapide, mais coûteuse et peu dense. Utilisée pour le cache 高速缓存 du CPU.
- DRAM 动态RAM (RAM dynamique) stocke chaque bit sous forme de charge sur un condensateur minuscule. Moins chère et plus dense, mais plus lente, et doit être rafraîchie 刷新 (réécrite) des milliers de fois par seconde. Utilisée pour la mémoire vive.
Utilisez la SRAM pour la petite mémoire rapide (cache) ; la DRAM pour la grande mémoire vive.
SRAM DRAM Chaque bit stocké dans un flip-flop de plusieurs transistors un condensateur et un transistor Nécessite un rafraîchissement ? non oui, des milliers de fois par seconde Vitesse plus rapide plus lente Densité et coût moins de bits par puce, plus cher plus de bits par puce, moins cher Alimentation consomme moins quand au repos consomme plus, en raison du rafraîchissement Utilisée pour cache processeur mémoire vive, y compris dans les systèmes embarqués "Expliquez pourquoi le système embarqué utilise la DRAM" : il a besoin d'une grande quantité de mémoire à faible coût dans un petit espace, et ses exigences de vitesse sont modestes, donc la DRAM, moins chère et plus dense, est le bon choix ; la SRAM est réservée au petit cache où la vitesse prime.
Vocabulaire EntrainerAnglais Chinois Pinyin SRAM/ˈesræm/ 静态 jìng tài DRAM/ˈdiːræm/ 动态 dòng tài flip-flop/flɪp flɒp/ 触发器 chù fā qì cache/kæʃ/ 高速缓存 gāo sù huǎn cún refreshed/rɪˈfreʃt/ 刷新 shuā xīn 3.1
PROM, EPROM et EEPROM
Variantes de ROM programmables après fabrication :
- PROM (ROM programmable) — écrite une seule fois (fusibles grillés par un programmeur) ; ne peut pas être modifiée.
- EPROM (ROM effaçable programmable) — effacée par lumière UV intense à travers une fenêtre, puis réécrite (toute la puce en une fois).
- EEPROM (ROM effaçable programmable électriquement) — effacée et réécrite électriquement, octet par octet, directement dans le circuit. La mémoire Flash est une dérivée optimisée pour l'effacement par blocs.
Une puce EPROM avec une fenêtre pour l'effacement ultraviolet PROM EPROM EEPROM Écriture une seule fois, par l'utilisateur avec un programmeur plusieurs fois plusieurs fois Effacement par impossible lumière ultraviolette à travers une fenêtre de quartz un signal électrique Efface rien toute la puce en une fois un octet ou un bloc à la fois Doit être retirée du circuit pour être reprogrammée ? non applicable oui non "Donnez deux différences entre EPROM et EEPROM" demande deux lignes de ce tableau, chacune stated pour les deux types.
3.1
Systèmes de surveillance et de contrôle
Les deux lisent des capteurs ; la différence réside dans ce qu'ils font ensuite.
- surveillance 监控 — collecte et rapporte des données mais ne prend aucune action (une station météo enregistrant des relevés).
- système de contrôle 控制系统 — utilise les données des capteurs pour décider et agir via des actionneurs, généralement dans une boucle de rétroaction (un thermostat allumant/éteignant une chaudière).
La réponse à trois marques « décrivez les différences » : un système de surveillance mesure uniquement, enregistre ou affiche les lectures, et au mieux émet un avertissement ; un système de contrôle compare chaque lecture avec une valeur prédéfinie 预设值 et, si elle est hors plage, envoie des signaux aux actionneurs qui modifient le processus physique ; le changement est ensuite mesuré à nouveau, donc un système de contrôle contient une rétroaction et un système de surveillance n'en a pas. Si un système donné est l'un ou l'autre est décidé par ce test : un système de pont qui mesure la hauteur d'un véhicule et allume un panneau d'avertissement est de la surveillance, car rien de ce qu'il fait ne change le véhicule ; un système qui abaisse une barrière est du contrôle.
Exemple résolu. Décrivez comment un système automatique ouvre une porte quand une personne est à moins de 2 mètres et la ferme quand personne n'est là.
Un capteur infrarouge ou ultrasonore mesure la distance vers tout objet devant la porte ; la lecture analogique est convertie en numérique par un CNA et envoyée au processeur ; le processeur compare la distance aux 2 mètres préréglés ; si elle est inférieure, le processeur envoie un signal à l'actionneur (un moteur) pour ouvrir la porte ; le capteur continue de mesurer, et quand aucune lecture inférieure à 2 mètres n'est reçue, le processeur signale au moteur de fermer la porte. La mesure répétée après chaque action est la rétroaction qui empêche la porte de s'ouvrir et de se fermer aux mauvais moments.
La surveillance rapporte des données ; un système de contrôle agit via une boucle de rétroaction Capteurs et actionneurs
Un capteur 传感器 convertit une grandeur physique en signal : température (une thermistance 热敏电阻 ou thermocouple), pression (jauge de contrainte), infrarouge, son. Les signaux analogiques nécessitent d'abord un CNA. Un actionneur 执行器 fait l'inverse — convertit un signal en action (un moteur, une valve, un chauffage, un buzzer).

Une thermistance : un capteur de température dont la résistance change avec la chaleur 
Un petit moteur électrique : un actionneur qui convertit un signal en mouvement Rétroaction
Dans un système de contrôle, l'actionneur modifie l'environnement, que les capteurs mesurent ensuite à nouveau — une boucle de rétroaction 反馈. Sans rétroaction, le système ne peut pas se corriger ni savoir quand s'arrêter (un thermostat sans rétroaction de température chaufferait indéfiniment).
ExplorerLa boucle de rétroaction de contrôle
Parcourez le tour de boucle qu'un thermostat ou un pilote automatique répète. Un système de contrôle ne se contente pas de lire le monde — il agit, puis remesure, se corrigeant encore et encore.
Vocabulaire EntrainerAnglais Chinois Pinyin actuator/ˈæktʃuːeɪtə/ 执行器 zhí xíng qì primary memory/ˈpraɪməri ˈmeməri/ 主存储器 zhǔ cún chǔ qì processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì monitoring/ˈmɒnɪtərɪŋ/ 监控 jiān kòng feedback/ˈfiːdbæk/ 反馈 fǎn kuì preset value/ˈpriːset ˈvæljuː/ 预设值 yù shè zhí thermistor/ˈθɜːmɪstə/ 热敏电阻 rè mǐn diàn zǔ 3.2
Portes logiques

Programme
Les candidats doivent être capables de : Notes et orientations Utiliser les symboles de porte logique suivants : [NOT, AND, OR, NAND, NOR, XOR] Comprendre et définir les fonctions des portes : NOT, AND, OR, NAND, NOR et XOR (EOR) Toutes les portes sauf la porte NOT n'auront que deux entrées. Construire la table de vérité pour chacune des portes logiques ci-dessus Construire un circuit logique À partir de : • un énoncé de problème • une expression logique • une table de vérité Construire une table de vérité À partir de : • un énoncé de problème • un circuit logique • une expression logique Construire une expression logique À partir de : • un énoncé de problème • un circuit logique • une table de vérité Source : Programme Cambridge International
L'additionneur partiel : XOR + AND additionnent deux bits Une porte logique 逻辑门 est un petit circuit effectuant une opération booléenne 布尔 unique. Les entrées et sorties valent 0 (faux, bas) ou 1 (vrai, haut). Connaître le symbole, la fonction et la table de vérité 真值表 pour chaque porte.
Les symboles des six portes logiques NON (inverseur)
A NON A 0 1 1 0 ET — sortie 1 seulement si toutes les entrées sont 1
A B A ET B 0 0 0 0 1 0 1 0 0 1 1 1 OU — sortie 1 si au moins une entrée est 1
A B A OU B 0 0 0 0 1 1 1 0 1 1 1 1 NAND (NON ET) — sortie 0 seulement quand toutes les entrées sont 1
A B A NAND B 0 0 1 0 1 1 1 0 1 1 1 0 NOR (NON OU) — sortie 1 seulement quand toutes les entrées sont 0
A B A NOR B 0 0 1 0 1 0 1 0 0 1 1 0 XOR (OU exclusif, aussi appelé EOR) — sortie 1 si les entrées sont différentes
A B A XOR B 0 0 0 0 1 1 1 0 1 1 1 0 ExplorerPortes logiques
Basculez les entrées et choisissez une porte. Chaque porte a sa propre règle — les blocs de construction de chaque circuit numérique.
Vocabulaire EntrainerAnglais Chinois Pinyin logic gate/ˈlɒdʒɪk ɡeɪt/ 逻辑门 luó jí mén Boolean/ˈbuːlɪən/ 布尔 bù ěr 3.2
Circuits logiques
Un circuit logique 逻辑电路 est un réseau de portes exécutant une expression booléenne. Vous devez pouvoir passer d'un énoncé de problème, à une expression logique, à une table de vérité et à un schéma de circuit.
L'énoncé écrit les expressions en mots,
X = (A AND NOT B) OR (B AND C), et accepte la forme algébrique $X = A\overline{B} + BC$ où un point (ou rien) est ET, un signe plus est OU, et une barre est NON. Utilisez celle que pose la question.De l'expression au circuit
Dessinez une porte par opérateur et câblez-les. Pour $X = (A \text{ AND } B) \text{ OR } (\text{NOT } C)$ : une porte NON sur $C$, une porte ET sur $A$ et $B$, puis une porte OU sur les deux résultats.
Portes câblées ensemble pour exécuter une expression booléenne Du circuit à l'expression
Travaillez à partir des entrées, en étiquetant la sortie de chaque porte logique, jusqu'à atteindre la sortie finale.
Exemple résolu. Écrivez l'expression du circuit ci-dessous, puis complétez sa table de vérité.
Étiquetez chaque sortie intermédiaire : ici P est A ET NON B et Q est B ET C, donc X est P OU Q Étiquetez les sorties des portes : $P = A \text{ AND NOT } B$, $Q = B \text{ AND } C$, donc $X = P \text{ OR } Q = (A \text{ AND NOT } B) \text{ OR } (B \text{ AND } C)$. Ensuite, ajoutez une colonne pour chaque sortie intermédiaire dans la table de vérité, afin que chaque ligne puisse être vérifiée porte par porte :
A B C NOT B P Q X 0 0 0 1 0 0 0 0 0 1 1 0 0 0 0 1 0 0 0 0 0 0 1 1 0 0 1 1 1 0 0 1 1 0 1 1 0 1 1 1 0 1 1 1 0 0 0 0 0 1 1 1 0 0 1 1 Dessiner un circuit à partir d'une expression correspond à parcourir le chemin inverse : commencez par les parenthèses intérieures, dessinez une porte par opérateur, placez une porte NON sur le fil de toute entrée apparaissant avec NON, gardez les entrées à gauche et la sortie unique à droite, et étiquetez la sortie avec sa lettre. Chaque ligne doit aboutir à une entrée de porte ou à la sortie ; une ligne qui ne va nulle part perd la note.
Du circuit à la table de vérité
Pour $n$ entrées, il y a $2^{n}$ lignes. Répertoriez toutes les combinaisons d'entrées ; pour chacune, calculez les portes internes puis la sortie.
De la table de vérité à l'expression (somme de produits)
Pour chaque ligne qui produit 1, écrivez un ET des entrées (avec NON sur toute entrée valant 0 dans cette ligne) ; OR ces termes ensemble. Exemple : une table qui vaut 1 uniquement aux $(A=0,B=1)$ et $(A=1,B=0)$ donne $\overline{A}B + A\overline{B}$, ce qui est $A \text{ XOR } B$.
D'un énoncé de problème
Transformez l'anglais en expression booléenne d'abord : "A and B" → A AND B ; "A or B or both" → A OR B ; "exactly one of A and B" → A XOR B ; "neither A nor B" → A NOR B ; "not both" → A NAND B.
Exemple résolu. L'alarme d'une machine $X$ se déclenche lorsque la barrière est ouverte ($A=1$) ET soit le moteur tourne ($B=1$), soit la température est élevée ($C=1$). Écrivez l'expression booléenne et indiquez les lignes où $X=1$. Transformez l'anglais en logique clause par clause : "either B or C" est $B + C$, et "A et that" est $X = A\cdot(B + C)$. Pour les lignes, $X=1$ nécessite $A=1$ ET au moins l'un de $B$, $C$ égal à 1 - donc $(A,B,C) = (1,0,1)$, $(1,1,0)$ et $(1,1,1)$, trois lignes sur huit. Remarquez que $A=0$ ne peut jamais déclencher l'alarme, quel que soient $B$ et $C$. Encadrez l'OR avant de faire le ET : $X = A\cdot B + C$ est un circuit entièrement différent, celui qui déclencherait l'alarme à haute température même si la barrière est fermée.
ExplorerAdditionneur partiel
Reliez XOR et AND aux mêmes deux entrées : XOR donne le bit de somme, AND donne la retenue. Cliquez sur A et B.
ExplorerCircuits logiques
les portes s'assemblent en circuits
Chaque porte a une règle fixe ; les chaîner construit tous les circuits — commencez par une porte.
Vocabulaire EntrainerAnglais Chinois Pinyin logic circuit/ˈlɒdʒɪk ˈsɜːkɪt/ 逻辑电路 luó jí diàn lù 3.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition embedded system un système informatique ayant une fonction dédiée intégrée dans un dispositif plus vaste buffer une zone de mémoire tampon qui stocke temporairement des données lors de leur transfert entre des dispositifs fonctionnant à des vitesses différentes RAM mémoire volatile qui peut être lue et écrite, contenant les programmes et les données en cours d'utilisation ROM mémoire non volatile dont le contenu ne peut pas être modifié en fonctionnement normal, contenant les instructions de démarrage SRAM RAM statique qui stocke chaque bit dans un bascule (flip-flop) et ne nécessite aucun rafraîchissement DRAM RAM dynamique qui stocke chaque bit sous forme de charge sur un condensateur et doit être continuellement rafraîchie monitoring system un système utilisant des capteurs pour mesurer et rapporter sur un processus physique sans le modifier control system un système utilisant des lectures de capteurs pour décider et exécuter des actions, via des actionneurs, qui modifient un processus physique sensor un dispositif qui mesure une grandeur physique et la convertit en signal pour l'ordinateur actuator un dispositif qui convertit un signal provenant de l'ordinateur en une action physique feedback la sortie d'un système de contrôle étant mesurée et renvoyée comme entrée afin que le système puisse se corriger lui-même logic gate un circuit électronique effectuant une opération booléenne sur une ou plusieurs entrées binaires pour donner une sortie binaire truth table un tableau répertoriant toutes les combinaisons d'entrées d'un circuit logique avec la sortie correspondante pour chacune Vocabulaire EntrainerAnglais Chinois Pinyin sensor/ˈsensə/ 传感器 chuán gǎn qì output devices/ˈaʊtpʊt dɪˈvaɪsɪz/ 输出设备 shū chū shè bèi embedded system/emˈbedɪd ˈsɪstəm/ 嵌入式系统 qiàn rù shì xì tǒng buffer/ˈbʌfə/ 缓冲 huǎn chōng control system/kənˈtrəʊl ˈsɪstəm/ 控制系统 kòng zhì xì tǒng truth table/truːθ ˈteɪbl/ 真值表 zhēn zhí biǎo 3.2
Conseils d'examen
- Distinuez RAM (volatile, lecture/écriture) de ROM (non volatile, contient le bootstrap) ; SRAM (cache, plus rapide) de DRAM (mémoire principale, nécessitant un rafraîchissement).
- Pour un circuit logique, construisez l'expression booléenne porte par porte, puis une table de vérité couvrant toutes les combinaisons d'entrées.
- Apprenez le symbole, l'expression et la table de vérité pour chaque porte (AND, OR, NOT, NAND, NOR, XOR).
- Expliquez un buffer (tampon temporaire reliant deux vitesses différentes) et le rôle d'une interruption.
Erreurs courantes
- Nommer l'appareil au lieu de décrire son fonctionnement. « Il utilise un laser » ne rapporte rien ; les étapes (charger le tambour, le laser retire la charge, le toner est attiré, transféré, fixé) rapportent les points.
- Dire qu'un système de surveillance "contrôle" quelque chose. Si rien ne modifie le processus physique, c'est une surveillance ; ajoutez l'actionneur et le retour d'information et cela devient un contrôle.
- Écrire que la RAM "stocke des fichiers de manière permanente" ou que la ROM "stocke les données de l'utilisateur". La RAM est une mémoire de travail volatile ; la ROM contient les instructions de démarrage fixes.
- Une table de vérité avec moins de $2^{n}$ lignes, ou des lignes dans un ordre aléatoire. Comptez en binaire de 000 à 111 pour ne manquer aucune combinaison.
- Dessiner deux fils sortant d'une même sortie de porte par précaution, ou laisser un fil qui ne termine nulle part. Dessinez exactement les connexions nécessaires à l'expression.
-
4
Fonctionnement de base du processeur
Regarder la leçon4.1
Architecture Von Neumann
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension du modèle de base Von Neumann pour un système informatique et du concept de programme stocké Montrer la compréhension du but et du rôle des registres, y compris la différence entre les registres à usage général et les registres à usage spécial Registres à usage spécial incluant : • Compteur de programme (PC) • Enregistreur de données mémoire (MDR) • Enregistreur d'adresse mémoire (MAR) • L'accumulateur (ACC) • Registre index (IX) • Enregistreur d'instruction courante (CIR) • Registre d'état Montrer la compréhension du but et des rôles de l'Unité arithmétique et logique (ALU), de l'Unité de commande (CU) et de l'horloge système, du Stockage à accès immédiat (IAS) Montrer la compréhension de la manière dont les données sont transférées entre divers composants du système informatique en utilisant le bus d'adresse, le bus de données et le bus de contrôle Montrer la compréhension de la manière dont les facteurs contribuent aux performances du système informatique Y compris : • type de processeur et nombre de cores • la largeur du bus • vitesse d'horloge • mémoire cache Comprendre comment différents ports assurent la connexion à des périphériques Y compris la connexion à : • Universal Serial Bus (USB) • High Definition Multimedia Interface (HDMI) • Video Graphics Array (VGA) Décrire les étapes du cycle Fetch-Execute (F-E) Décrire et utiliser la notation 'register transfer' pour décrire le cycle F-E Montrer la compréhension du but des interruptions Y compris : • causes possibles d'interruptions • applications des interruptions • utilisation d'une routine de service d'interruption (ISR) • moment où les interruptions sont détectées pendant le cycle fetch-execute • manière dont les interruptions sont gérées Source : Programme Cambridge International
Le cycle fetch-décodage-exécution L'architecture Von Neumann 冯·诺依曼体系结构 sous-tend presque tous les ordinateurs à usage général :
- une mémoire unique — la Immediate Access Store 立即存取存储器 (IAS) — contient à la fois les instructions de programme et les données (le concept de stored program 存储程序).
- non processor 处理器 (CPU) récupère les instructions depuis la mémoire et les exécute une par une.
- les instructions s'exécutent dans l'ordre sauf si une branche modifie le flux.
L'idée de stored-program rend l'ordinateur flexible : changer le programme change ce qu'il fait, sans câblage.
ExplorerTapez sur les parties d'un ordinateur de Von Neumann
Explorez chaque bloc. Le CPU (unité de contrôle, ALU, registres) communique avec une seule mémoire principale via les bus — et cette mémoire partagée unique pour les instructions ET les données est l'idée de Von Neumann.
Vocabulaire EntrainerAnglais Chinois Pinyin Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ 立即存取存储器 lì jí cún qǔ cún chǔ qì stored program/stɔːd ˈprəʊɡræm/ 存储程序 cún chǔ chéng xù processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì 4.1
Les principales parties du CPU

Toutes ces parties sont situées à l'intérieur d'une petite puce. Le diagramme plus loin dans cette section montre comment elles sont connectées ; la photo ci-dessous montre le réel.
Un processeur moderne : tout le processeur est une seule petite puce (ici vue de dessous, montrant les contacts) 
Le socle de processeur correspondant sur la carte mère : les contacts de la puce viennent se poser sur ces broches Arithmetic and Logic Unit (ALU)
L'ALU 算术逻辑单元 effectue les opérations arithmétiques (addition, soustraction, …) et logiques (AND, OR, comparaisons). Elle prend des opérandes depuis les registers 寄存器 et place les résultats dans un registre.
Unité de contrôle (CU)
L'control unit 控制单元 décode chaque instruction et envoie les signaux de contrôle pour l'exécuter — ouvrir les chemins de données, dire à l'ALU quoi faire, et contrôler les lectures et écritures mémoire.
System clock
L'horloge envoie un flux régulier d'impulsions qui maintiennent le CPU synchronisé. Chaque instruction prend un nombre fixe de cycles, et la vitesse d'horloge 时钟频率 (par ex. 3.8 GHz) est un facteur de performance.
"Expliquez comment la CU et l'horloge système travaillent ensemble" : l'horloge émet des impulsions à fréquence fixe ; la control unit utilise chaque impulsion pour avancer le cycle fetch-execute d'un cran, envoyant ses signaux de contrôle en phase avec les impulsions, de sorte que chaque partie du processeur change d'état simultanément. Une horloge plus rapide signifie plus d'étapes par seconde, jusqu'au point où les circuits ne peuvent plus se stabiliser entre les impulsions.
Registres
Les registers sont de petites mémoires très rapides à l'intérieur du CPU. Les special purpose registers 专用寄存器 ont chacune une tâche fixe dans le cycle :
- Program Counter 程序计数器 (PC) — l'adresse de l'suivante instruction.
- Memory Address Register 内存地址寄存器 (MAR) — l'adresse lue ou écrite.
- Memory Data Register 内存数据寄存器 (MDR) — les données allant vers ou venant de la mémoire.
- Current Instruction Register 当前指令寄存器 (CIR) — l'instruction actuellement décodée.
- Accumulator 累加器 (ACC) — la valeur sur laquelle l'ALU travaille.
- Status Register 状态寄存器 — contient des flags 标志 (carry, zero, negative, overflow) utilisés par les branches. Chaque flag est un bit, positionné ou effacé par l'ALU après une opération : le flag zero après une comparaison qui a matches, le flag carry quand une addition a débordé le registre, le flag negative quand un résultat est négatif. Un saut conditionnel lit les flags pour décider de brancher, et un flag overflow peut déclencher une interruption.
- Index Register 变址寄存器 — un décalage ajouté à une adresse dans l'adressage indexé ; l'incrémenter permet de parcourir un tableau un élément à la fois.
La question "complete the table describing the role of each register" demande une phrase précise par registre en ces termes : le PC contient l'adresse de la prochaine instruction à récupérer ; le MAR contient l'adresse de l'emplacement lu ou écrit ; le MDR contient les données ou l'instruction juste lues depuis, ou sur le point d'être écrites vers, cet emplacement ; le CIR contient l'instruction actuellement décodée et exécutée ; l'ACC contient le résultat de la dernière opération arithmétique ou logique.
General-purpose registers 通用寄存器 sont utilisés par le programmeur pour des valeurs temporaires durant un calcul. Les mouvements de données entre registers et mémoire sont écrits en notation register transfer 寄存器传送 — par ex.
MAR ← [PC]("copiez le contenu du PC dans le MAR").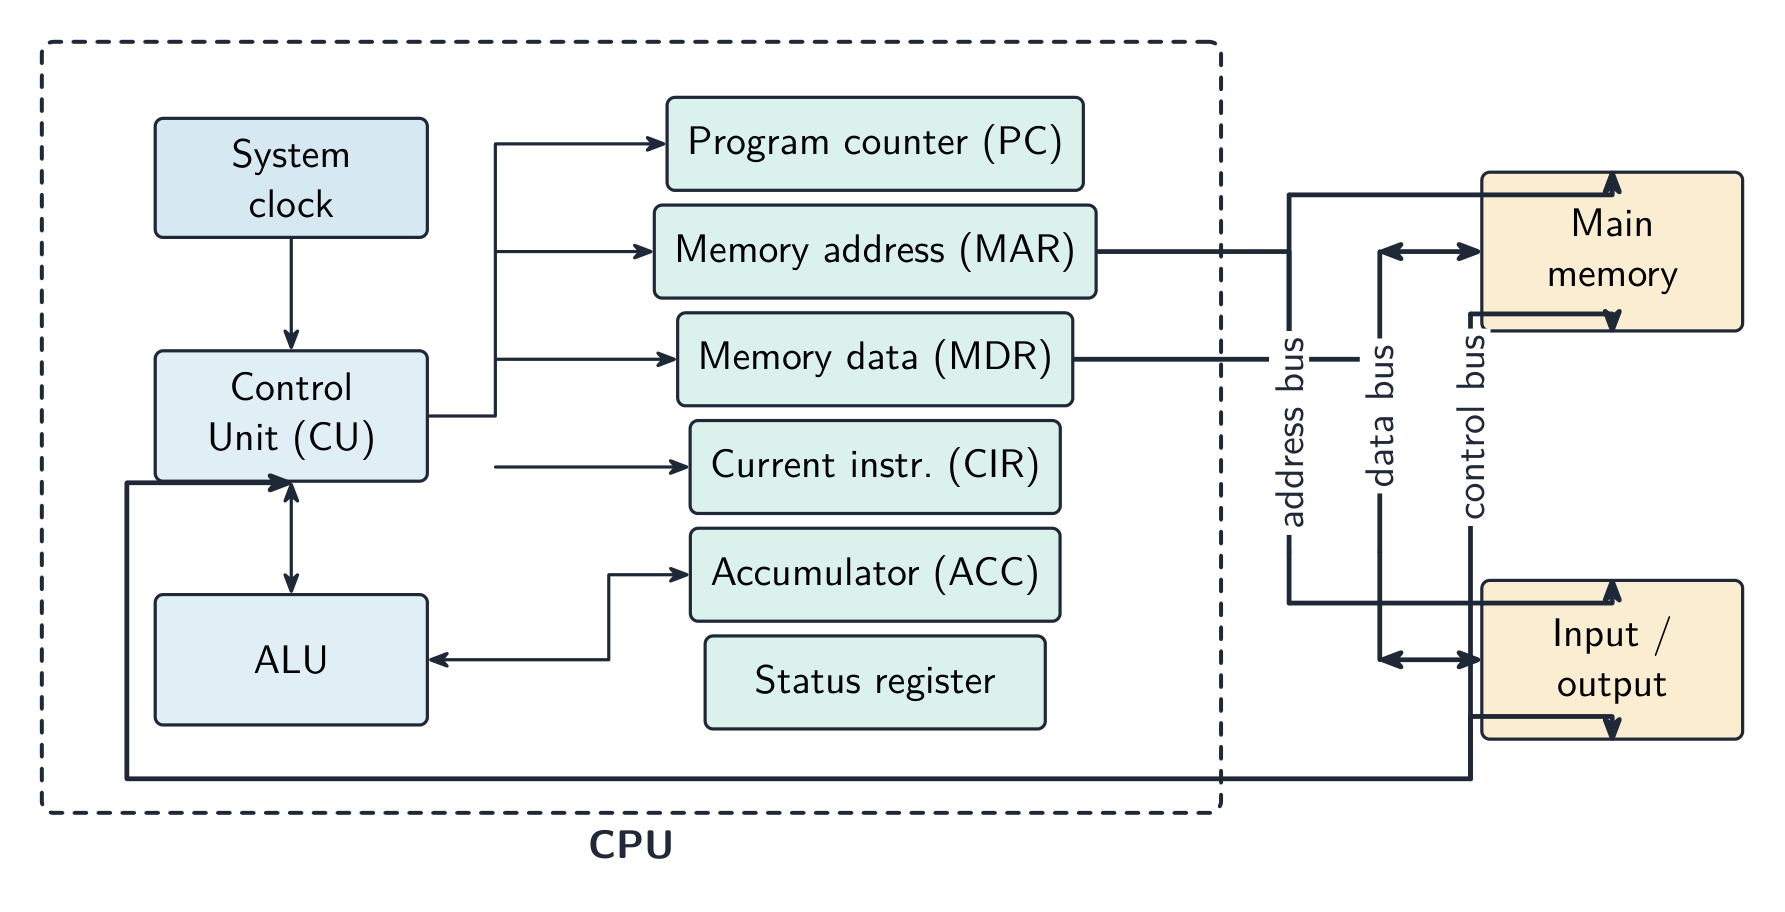
Le CPU Von Neumann : registers, control unit et ALU reliés par des buses Vocabulaire EntrainerAnglais Chinois Pinyin Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ 冯·诺依曼体系结构 féng · nuò yī màn tǐ xì jié gòu arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ 算术逻辑单元 suàn shù luó jí dān yuán ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán register/ˈredʒɪstə/ 寄存器 jì cún qì control unit/kənˈtrəʊl ˈjuːnɪt/ 控制单元 kòng zhì dān yuán clock speed/klɒk spiːd/ 时钟频率 shí zhōng pín lǜ special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ 专用寄存器 zhuān yòng jì cún qì Program Counter/ˈprəʊɡræm ˈkaʊntə/ 程序计数器 chéng xù jì shù qì Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ 内存地址寄存器 nèi cún dì zhǐ jì cún qì Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ 内存数据寄存器 nèi cún shù jù jì cún qì Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ 当前指令寄存器 dāng qián zhǐ lìng jì cún qì accumulator/əˈkjuːmjʊleɪtə/ 累加器 lěi jiā qì Status Register/ˈsteɪtəs ˈredʒɪstə/ 状态寄存器 zhuàng tài jì cún qì flags/flæɡz/ 标志 biāo zhì Index Register/ˈɪndeks ˈredʒɪstə/ 变址寄存器 biàn zhǐ jì cún qì indexed addressing/ˈɪndekst əˈdresɪŋ/ 变址寻址 biàn zhǐ xún zhǐ general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ 通用寄存器 tōng yòng jì cún qì register transfer/ˈredʒɪstə ˈtrænsfɜː/ 寄存器传送 jì cún qì chuán sòng buses/ˈbʌsɪz/ 总线 zǒng xiàn 4.1
Bus

Trois buses internes 总线 (ensembles de fils parallèles) connectent les parties :
- address bus 地址总线 — transporte l'adresse mémoire. Unidirectionnel (CPU → mémoire).
- data bus 数据总线 — transporte les données. Bidirectionnel.
- control bus 控制总线 — transporte les signaux de contrôle (lecture, écriture, interruption). Bidirectionnel.
Une adresse-bus de $n$ bits peut accéder à $2^{n}$ emplacements mémoire. La largeur du bus de données détermine le nombre de bits transférés par accès (souvent la taille mot).
Les trois bus système reliant le CPU, la mémoire et l'entrée/sortie 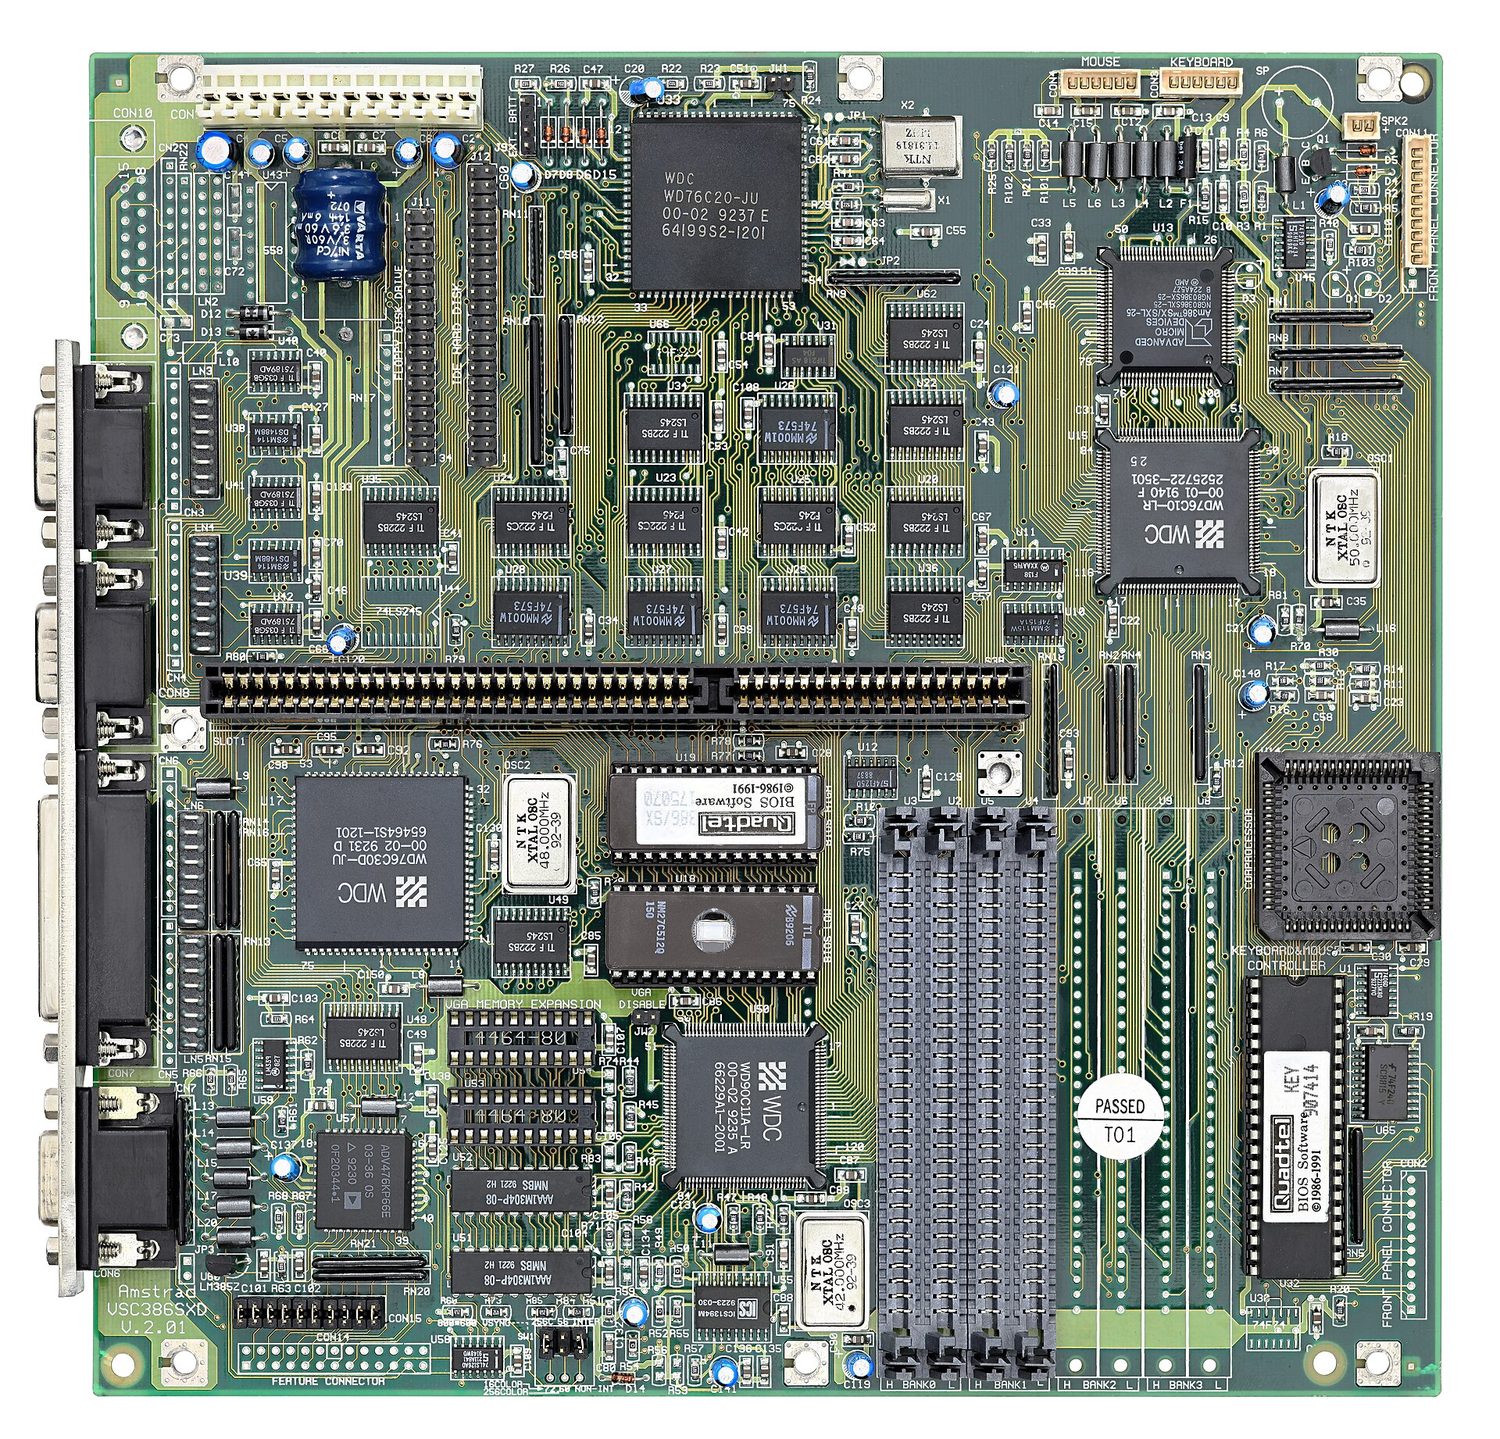
Une carte mère : le CPU, la mémoire et les E/S reposent tous sur un même ensemble de bus — les pistes imprimées qui les relient Vocabulaire EntrainerAnglais Chinois Pinyin control bus/kənˈtrəʊl bʌs/ 控制总线 kòng zhì zǒng xiàn address bus/əˈdres bʌs/ 地址总线 dì zhǐ zǒng xiàn data bus/ˈdeɪtə bʌs/ 数据总线 shù jù zǒng xiàn word size/wɜːd saɪz/ 字长 zì cháng number of cores/ˈnʌmbə ɒv kɔːz/ 核心 hé xīn cores/kɔːz/ 核心 hé xīn amount of RAM/əˈmaʊnt ɒv ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì 4.1
Ce qui affecte la performance
- vitesse d'horloge — plus de cycles par seconde.
- nombre de cœurs 核心 — un CPU multi-cœur exécute plusieurs threads simultanément.
- taille mot 字长 — un CPU 64 bits traite des blocs de 64 bits par cycle et peut adresser bien plus de mémoire qu'un 32 bits.
- quantité de RAM 随机存取存储器 — plus de RAM retient davantage du jeu de travail ; trop peu force le système d'exploitation à faire du pageage 页 vers le disque.
- mémoire cache 高速缓存 taille — plus de cache réduit le temps d'accès moyen à la mémoire.
- type de stockage secondaire 辅助存储器 — un SSD charge les programmes bien plus vite qu'un HDD.
- largeur et vitesse du bus — des buses plus larges/rapides transmettent les données plus rapidement.
Associez les spécifications à la charge de travail : un quad-core bat un dual-core sur les tâches parallèles, mais une vitesse par cœur supérieure gagne sur les tâches monothreaded.
Chaque facteur est une réponse de deux points avec une raison associée :
- Plus de cœurs : chaque cœur peut chercher et exécuter sa propre instruction en même temps, donc plusieurs programmes, ou les threads d'un seul programme, s'exécutent en parallèle. Mais un programme doit être écrit pour utiliser plus d'un cœur, donc doubler les cœurs ne double pas la vitesse.
- Vitesse d'horloge plus élevée : plus de cycles recherche-exécution par seconde, donc plus d'instructions par seconde ; la limite est la chaleur produite.
- Bus plus large : un bus de données plus large转移更多位 in each transfer, so fewer transfers are needed for the same data; a wider address bus can address more memory locations.
- Mémoire cache : une petite mémoire rapide située à l'intérieur ou à côté du processeur qui conserve les instructions et les données utilisées le plus récemment ou le plus souvent. Les lire depuis le cache est beaucoup plus rapide que depuis la RAM, donc le processeur passe moins de temps en attente.
"Expliquez pourquoi l'ordinateur neuf performe mieux" se répond en comparant les deux spécifications ligne par ligne : une vitesse d'horloge plus élevée exécute plus d'instructions par seconde, plus de cœurs exécutent plus de tâches à la fois, plus de cache signifie moins d'accès lents à la RAM, et plus de RAM signifie moins de transferts vers le disque.
Vocabulaire EntrainerAnglais Chinois Pinyin RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì page/peɪdʒ/ 页 yè cache memory/kæʃ ˈmeməri/ 高速缓存 gāo sù huǎn cún cache/kæʃ/ 高速缓存 gāo sù huǎn cún secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 4.1
Ports
Un port 端口 est une prise physique pour connecter un périphérique 外围设备 :
- USB (Universal Serial Bus) — usage général (claviers, lecteurs, téléphones).
- HDMI (High Definition Multimedia Interface) — vidéo numérique et audio vers un écran.
- VGA (Video Graphics Array) — sortie vidéo analogique plus ancienne vers un moniteur.
- Ethernet (RJ-45) — LAN filaire. Jacks audio — écouteurs/microphone.
Différents ports utilisent des signaux différents, donc un câble HDMI ne s'insère pas dans une prise USB. USB-C est inhabituel car il transporte vidéo, données et alimentation.
"Expliquez comment l'ordinateur se connecte au moniteur via HDMI" : le port HDMI envoie la vidéo et l'audio comme un seul signal numérique via un seul câble, donc aucune conversion analogique n'est nécessaire et l'image n'est pas dégradée ; le câble supporte des résolutions haute définition et le port du moniteur décode le signal. Un périphérique USB est branchement et utilisation immédiate : lorsqu'il est connecté, l'ordinateur le détecte, l'identifie, charge ou installe le pilote dont il a besoin, et peut lui fournir de l'alimentation, tout cela sans redémarrage.
Vocabulaire EntrainerAnglais Chinois Pinyin port/pɔːt/ 端口 duān kǒu peripheral/pəˈrɪfərəl/ 外围设备 wài wéi shè bèi 4.1
Cycle Fetch-Execute

Le CPU répète le cycle fetch-execute 取指-执行周期, une itération par instruction machine.
Fetch
- l'adresse du PC est copiée dans le MAR.
- le PC est incrémenté pour pointer vers l'instruction suivante.
- un signal read part sur le bus de contrôle.
- la mémoire place l'instruction sur le bus de données.
- elle est copiée dans le MDR, puis dans le CIR.
L'examen demande ces étapes en register transfer notation 寄存器传送记法, où
[X]signifie le contenu du registre X et[[MAR]]signifie le contenu de l'emplacement mémoire dont l'adresse est dans le MAR :MAR ← [PC] the address of the next instruction goes to the MAR PC ← [PC] + 1 the PC now points to the following instruction MDR ← [[MAR]] the instruction at that address is read into the MDR CIR ← [MDR] the instruction is copied into the CIR for decodingL'ordre est important : le PC est incrémenté immédiatement après que son adresse ait été copiée, afin qu'une saut exécuté ultérieurement puisse encore le modifier. Pendant l'exécution, la même notation décrit chaque instruction ; pour
LDD 200, par exemple,MAR ← 200,MDR ← [[MAR]],ACC ← [MDR].Les transferts de registres lors d'un fetch : PC → MAR → mémoire → MDR → CIR, avec incrémentation du PC Decode
La CU décode l'instruction dans le CIR — quelle opération, et quels opérandes ou adresses.
Execute
La CU l'exécute : arithmétique/logique va vers l'ALU (résultat vers l'ACC) ; un load/store déplace des données entre la mémoire et un registre ; un branch modifie le PC. Puis le cycle recommence.

Le cycle fetch-execute, avec vérification des interruptions à chaque fois ExplorerLe cycle fetch-execute
Tapez autour de la boucle que le CPU répète des milliards de fois par seconde. Regardez comment le fetch utilise les registres PC/MAR/MDR/CIR, puis comment le decode et l'execute agissent sur ce qui a été cherché.
ExplorerLe cycle recherche-exécution
Parcourez comment le CPU exécute une instruction — cherchez-la en mémoire, décoder-la, puis exécutez-la, encore et encore.
Vocabulaire EntrainerAnglais Chinois Pinyin fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ 取指-执行周期 qǔ zhǐ - zhí xíng zhōu qī register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ 寄存器传送记法 jì cún qì chuán sòng jì fǎ 4.1
Interrupts
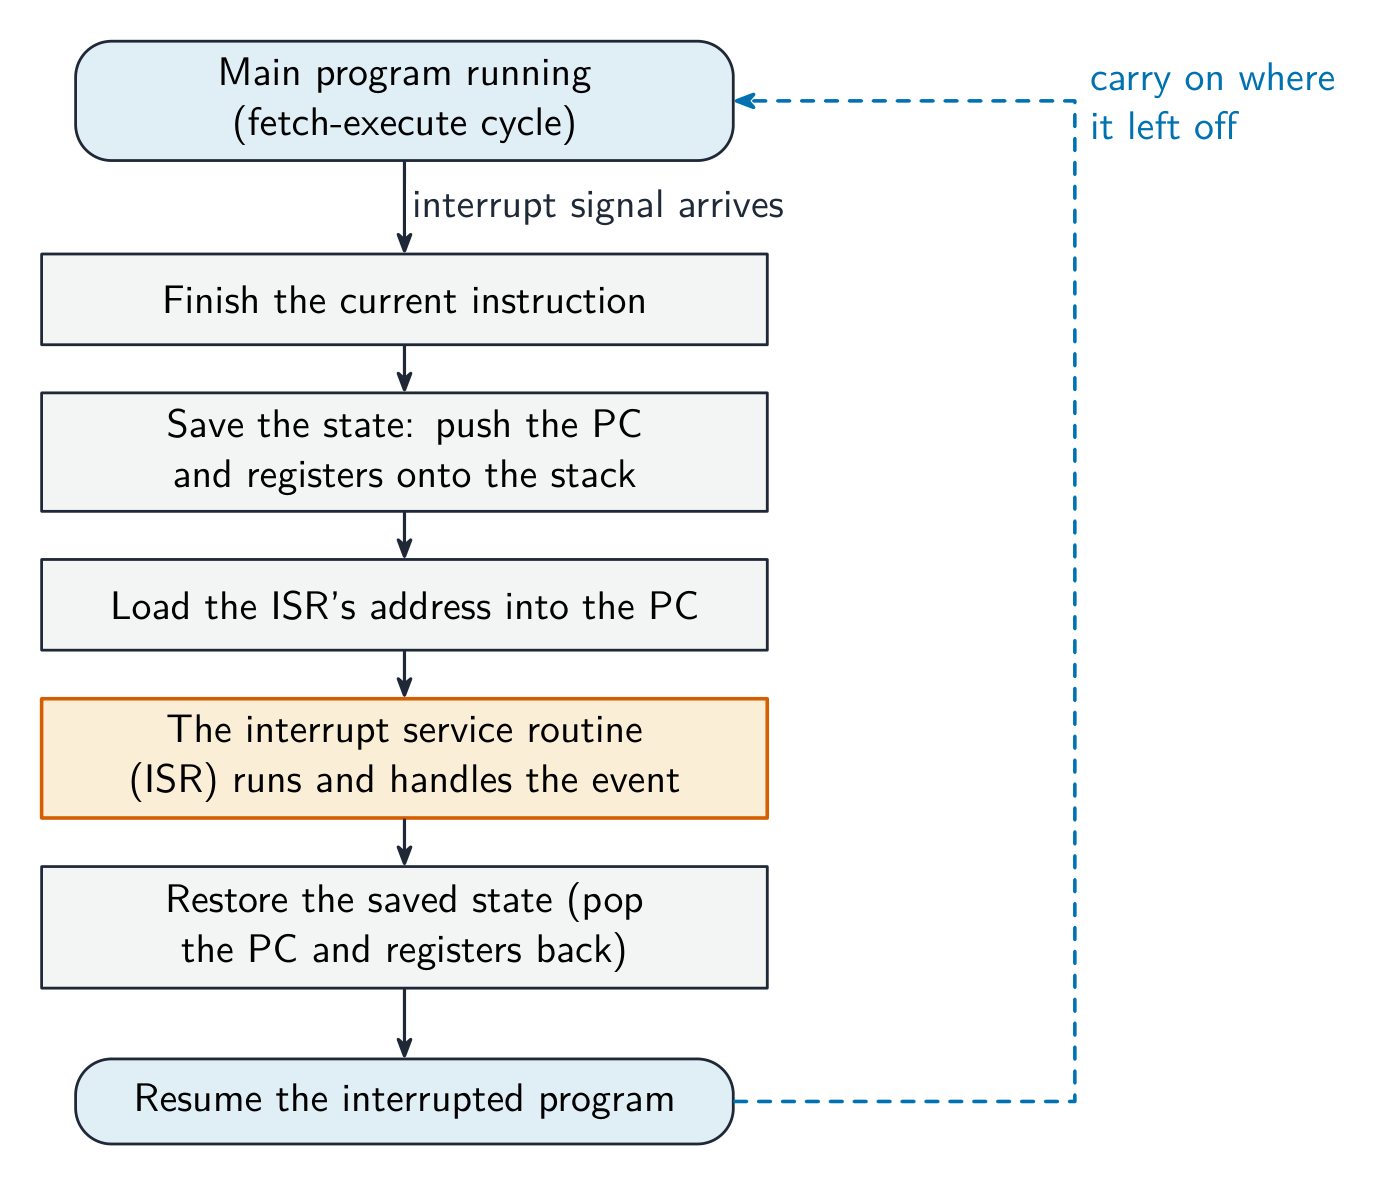
Une interrupt 中断 est un signal qui pauses le cycle normal pour que le CPU puisse gérer un événement urgent (une touche pressée, un paquet arrivant, une panne matérielle, division par zéro, horloge OS).
Gérer une :
- termine l'instruction actuelle.
- save the state (PC et registres).
- charge l'adresse de la interrupt service routine 中断服务程序 (ISR) dans le PC et exécute-la.
- l'ISR gère l'événement.
- restore l'état sauvegardé et continue.
Les interrupts permettent au système de répondre rapidement sans que le CPU surveille constamment les appareils, et sont la méthode par laquelle le OS fait du multitasking.
"Expliquez comment une interrupt provenant d'un périphérique d'entrée est détectée et gérée dans le cycle F-E" est une réponse de quatre points avec ces éléments : le périphérique envoie un signal d'interruption qui positionne le flag d'interruption dans le interrupt register 中断寄存器 ; le processeur vérifie ce registre à la fin de chaque cycle fetch-execute, après que l'instruction actuelle ait fini d'être exécutée ; si un flag est positionné et que l'interruption a une priorité supérieure à la tâche actuelle, le contenu du PC et des autres registres est sauvegardé sur la pile 栈 ; l'adresse de la routine de service d'interruption est chargée dans le PC et la routine s'exécute ; lorsqu'elle finit, les valeurs sauvegardées sont restaurées depuis la stack et le programme interrompu reprend là où il s'était arrêté.
Causes dignes d'être nommées : une interrupt matérielle venant d'un appareil (une touche pressée, tampon d'imprimante vide, paquet réseau arrivant), une interrupt logicielle due à une faute (division par zéro, instruction illégale, dépassement d'arithmétique), une interrupt d'horloge provenant du système d'exploitation marquant la fin d'une tranche de temps, et un avertissement de coupure de courant.
Comment une interrupt s'intègre dans le cycle fetch-execute Vocabulaire EntrainerAnglais Chinois Pinyin interrupt/ˈɪntərʌpt/ 中断 zhōng duàn interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ 中断服务程序 zhōng duàn fú wù chéng xù interrupt register/ˈɪntərʌpt ˈredʒɪstə/ 中断寄存器 zhōng duàn jì cún qì stack/stæk/ 栈 zhàn 4.2
Assembly language and machine code

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la relation entre le langage assembleur et le code machine Décrire les différentes étapes du processus d'assemblage pour un assembleur à deux passages Appliquer le processus de l'assembleur à deux passages à un programme assembleur simple donné Tracer un programme assembleur simple donné Montrer la compréhension que l'ensemble des instructions est groupé Y compris les groupes suivants : • Mouvement de données • Entrée et sortie de données • Opérations arithmétiques • Instructions inconditionnelles et conditionnelles • Instructions de comparaison Montrer la compréhension et être capable d'utiliser différents modes d'adressage Y compris immédiat, direct, indirect, indexé, relatif Source : Programme Cambridge International
Le CPU exécute réellement le machine code 机器码 — motifs de bits, spécifiques à une architecture. L'assembly language 汇编语言 est une forme lisible, avec une instruction par instruction machine, écrite en utilisant des mnemonics 助记符 comme
LDD,ADD,JMP. Un assembler 汇编器 le traduit en machine code.Un assembler transforme des mnemonics en motifs de bits de machine code Two-pass assembler
Un assembleur à deux passes lit la source deux fois :
- pass 1 construit une symbol table 符号表 : chaque fois qu'un label 标签 (comme
LOOP:) apparaît, on note son adresse ; aucun code produit encore. - pass 2 génère le code : traduit chaque instruction, et quand l'une référence un label (comme
JMP LOOP), cherche son adresse dans la table des symboles.
Deux passes gèrent les forward references 前向引用 (un saut vers un label défini plus tard).
Exemple résolu. Appliquez le processus à deux passes à ce programme, dont la première instruction est stockée à l'adresse 100.
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
Le passage 1 lit chaque ligne, compte l'adresse qu'elle occupera, et enregistre chaque étiquette dans la table des symboles :
LOOP= 101 (la ligneDEC) etCOUNT= 105 (la ligne de données). Aucun code n'est produit. Le passage 2 relit le programme et traduit chaque ligne en code machine, remplaçant chaque mnémonique par son code opérationnel 操作码 et chaque adresse symbolique par le nombre de la table des symboles :LDD COUNTdevient le code opérationnel pourLDDavec l'opérande 操作数 105, etJPN LOOPdevient le code opérationnel pourJPNavec l'opérande 101. Le saut en arrière versLOOPaurait pu être résolu en un seul passage, mais un saut avant vers une étiquette non encore vue ne le pouvait pas, c'est pourquoi l'assembleur fait deux passages.Example instruction set
Cambridge utilise un petit ensemble générique, imprimé dans la table de référence de l'examen, avec un registre à usage général, l'accumulateur (ACC), et un registre index (IX). Un operand écrit
#nest un nombre décimal,Bnun nombre binaire et&nun nombre hexadécimal ;<address>est un numéro d'emplacement ou un label.Groupe Instruction Ce qu'il fait Data movement LDM #ncharge le nombre n dans ACC (immédiat) LDD <address>charge le contenu de l'adresse dans ACC (direct) LDI <address>l'adresse contient une autre adresse ; charge le contenu de celle-ci dans ACC (indirect) LDX <address>ajouter IX à l'adresse et charger le contenu du résultat dans ACC (indexé) LDR #ncharger le nombre n dans IX MOV <register>copier ACC dans le registre nommé (IX) STO <address>stocker le contenu de ACC à l'adresse Entrée et sortie INlire une frappe clavier et mettre son code ASCII dans ACC OUTafficher le caractère dont le code ASCII est dans ACC Arithmétique ADD <address>/ADD #nadditionner le contenu de l'adresse, ou le nombre, à ACC SUB <address>/SUB #nsoustraire à ACC INC <register>/DEC <register>ajouter 1 à, ou soustraire 1 à, ACC ou IX Comparer CMP <address>/CMP #ncomparer ACC avec le contenu de l'adresse, ou avec n, et définir le drapeau CMI <address>comparer ACC avec le contenu de l'adresse stocké à l'adresse (indirect) Saut JMP <address>sauter vers l'adresse inconditionnellement JPE <address>/JPN <address>sauter si la dernière comparaison était égale / non égale Manipulation des bits AND,OR,XORavec#n,Bn,&nou<address>opération bit à bit sur ACC LSL #n/LSR #ndécaler ACC logiquement de n positions vers la gauche ou la droite ENDterminer le programme La question « les instructions en langage assembleur sont groupées » demande les noms des groupes et une instruction de chacun : mouvement de données, entrée/sortie, arithmétique, sauts inconditionnels et conditionnels, comparaison et manipulation des bits.
ExplorerComment fonctionne un assembleur à deux passages
Parcourez-le. L'assembleur lit votre code deux fois : le passage 1 trouve simplement l'emplacement de chaque étiquette, afin que le passage 2 puisse remplir les adresses — c'est ainsi qu'un saut vers une étiquette définie plus tard fonctionne encore.
Vocabulaire EntrainerAnglais Chinois Pinyin operand/ˈɒpərænd/ 操作数 cāo zuò shù assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ mnemonics/nɪˈmɒnɪks/ 助记符 zhù jì fú assembler/əˈsemblə/ 汇编器 huì biān qì symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo label/ˈleɪbl/ 标签 biāo qiān forward references/ˈfɔːwəd ˈrefrənsɪz/ 前向引用 qián xiàng yǐn yòng opcode/ˈɒpkəʊd/ 操作码 cāo zuò mǎ 4.2
Modes d'adressage
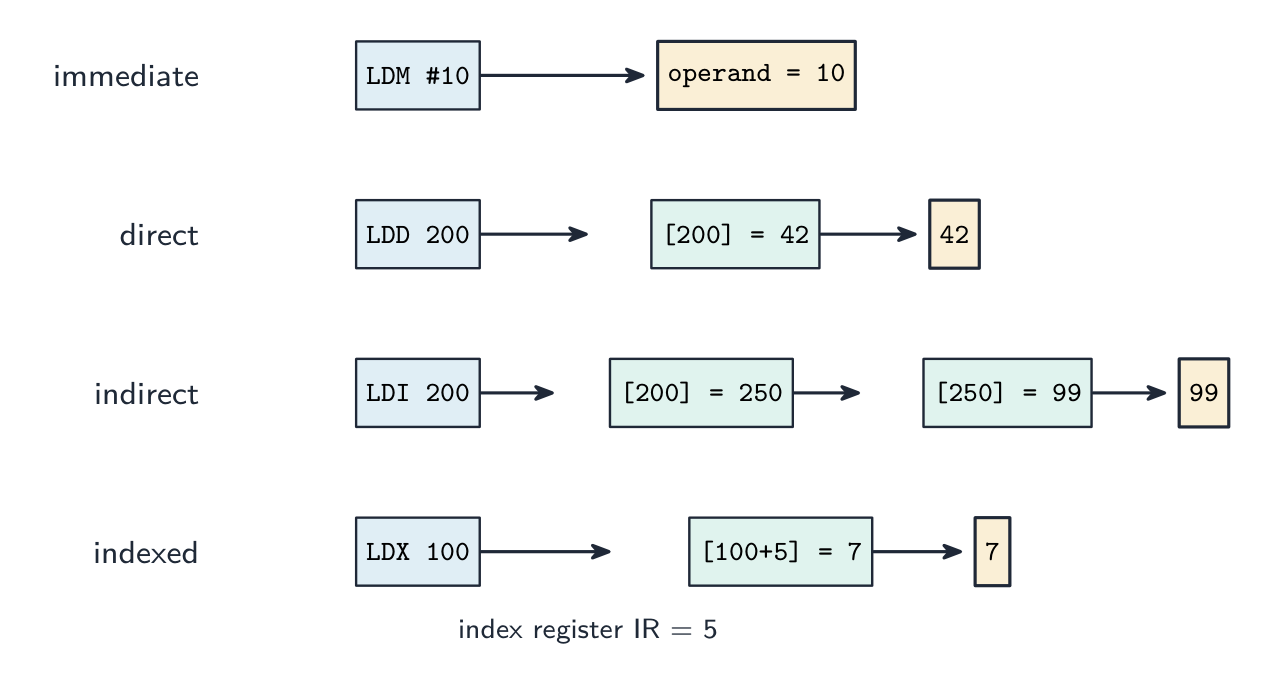
Le mode d'adressage 寻址方式 (les modes d'adressage) indique comment le CPU trouve l'opérande :
- adressage immédiat 立即寻址 — l'opérande est la valeur dans l'instruction.
LDM #10charge 10. - adressage direct 直接寻址 — l'instruction contient une adresse ; l'opérande est la valeur à cet endroit.
LDD 200. - adressage indirect 间接寻址 — l'instruction contient une adresse qui contient une autre adresse, qui est les données.
LDI 200. - adressage indexé 变址寻址 — l'adresse effective est
address + index register; utilisé pour les tableaux.LDX 100avec IR = 5 lit l'adresse 105.
(Adressage relatif 相对寻址 donne l'adresse comme un décalage par rapport au PC — utilisé pour les sauts.)
Comment chaque mode d'adressage accède à son opérande — immédiat, direct, indirect et indexé Exemple résolu. La mémoire contient : emplacement
200=250, emplacement250=99, emplacement105=7. Le registre index contient5. Que contient l'accumulateur après chacun deLDM #200,LDD 200,LDI 200etLDX 100? Suivez jusqu'où chaque mode doit chercher.LDM #200est immédiat - l'opérande est le nombre écrit dans l'instruction, donc l'accumulateur contient 200.LDD 200est direct - aller à l'emplacement 200 et prendre ce qu'il y a : 250.LDI 200est indirect - l'emplacement 200 contient 250, qui est une autre adresse, donc continuer vers l'emplacement 250 : 99.LDX 100est indexé - ajouter le registre index à l'adresse, $100 + 5 = 105$, et lire l'emplacement 105 : 7. Comptez les sauts pour les distinguer : immédiat 0, direct 1, indirect 2, indexé 1 (une fois l'index ajouté).Vocabulaire EntrainerAnglais Chinois Pinyin addressing mode/əˈdresɪŋ məʊd/ 寻址方式 xún zhǐ fāng shì immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ 立即寻址 lì jí xún zhǐ direct addressing/daɪˈrekt əˈdresɪŋ/ 直接寻址 zhí jiē xún zhǐ indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ 间接寻址 jiàn jiē xún zhǐ relative addressing/ˈrelətɪv əˈdresɪŋ/ 相对寻址 xiāng duì xún zhǐ logical shift/ˈlɒdʒɪkl ʃɪft/ 逻辑移位 luó jí yí wèi cyclic shift/ˈsaɪklɪk ʃɪft/ 循环移位 xún huán yí wèi 4.2
Tracé d'un programme assembleur
Pour le tracer : faites un tableau avec des colonnes pour le PC, ACC, registre index, chaque variable et tout drapeau. Passez pas à pas à travers les instructions, mettez à jour le tableau après chacune ; suivez les branches lorsqu'elles changent le PC ; arrêtez à
END. Un motif courant est une boucle sur un tableau utilisant l'adressage indexé.Exemple résolu. Tracez ce programme. L'adresse 200 contient 5 et l'adresse 201 contient 0.
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
Écrivez une ligne pour chaque instruction exécutée, en ne remplissant que les colonnes qui changent :
Instruction ACC 200 201 Sortie début 5 0 LDD 2005 CMP #0JPE 108non pris OUTcaractère de code 5 DEC ACC4 STO 2004 LDD 2010 JMP 100LDD 2004 et ainsi de suite, jusqu'à ce que
LDD 200charge 0, la comparaison définisse le drapeau égal,JPE 108soit exécutée et le programme se termine. Trois points vérifiés par l'examinateur : unCMPne modifie aucun registre, seulement un drapeau ; un saut non pris compte toujours comme exécuté ; etOUTproduit un caractère, donc il va dans la colonne de sortie, pas dans la colonne ACC. "Décrivez l'effet du changement deLDD 10enLDM #10" : l'ACC contiendrait le nombre 10 au lieu du contenu de l'adresse 10.4.3
Décalages binaires

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension et effectuer des décalages binaires Logique, arithmétique et cyclique Décalage gauche, décalage droit Montrer la compréhension de la manière dont la manipulation binaire peut être utilisée pour surveiller/contrôler un dispositif Effectuer des opérations de manipulation binaire Tester et définir un bit (en utilisant le masquage binaire) Étiquette d'instruction | Opcode | Opérande Explication AND #n / Bn / &n Opération ET binaire du contenu de ACC avec l'opérande AND Opération ET binaire du contenu de ACC avec le contenu de XOR #n / Bn / &n Opération XOR binaire du contenu de ACC avec l'opérande XOR Opération XOR binaire du contenu de ACC avec le contenu de OR #n / Bn / &n Opération OU binaire du contenu de ACC avec l'opérande OR Opération OU binaire du contenu de ACC avec le contenu de LSL #n Les bits dans ACC sont décalés logiquement n positions vers la gauche. Des zéros sont introduits à l'extrémité droite LSR #n Les bits dans ACC sont décalés logiquement n positions vers la droite. Des zéros sont introduits à l'extrémité gauche Étiquette d'une instruction Donne une adresse symbolique Toutes les questions supposeront qu'il n'y a qu'un seul registre à usage général disponible (Accumulateur) ACC désigne Accumulateur IX désigne Registre Index peut être une adresse absolue ou symbolique # désigne un nombre décimal, ex. #123 B désigne un nombre binaire, ex. B01001010 & désigne un nombre hexadécimal, ex. &4A Source : Programme Cambridge International
Un décalage logique 逻辑移位 déplace tous les bits vers la gauche ou la droite de quelques places, en remplissant les nouvelles positions avec 0.
- décalage à gauche de 1 (
LSL #1) — les bits se déplacent vers la gauche, un 0 entre à droite ; pour un nombre non signé, c'est × 2. - décalage à droite de 1 (
LSR #1) — les bits se déplacent vers la droite, un 0 entre à gauche ; pour un nombre non signé, c'est integer ÷ 2.
Décaler de $n$ positions multiplie ou divise par $2^{n}$. Exemple :
00001011(11)LSL #1→00010110(22).Les bits décalés hors de l'extrémité sont perdus, donc la multiplication n'est correcte que tant qu'ils étaient zéros.
LSL #2sur l'entier en complément à deux11001010donne00101000: les deux 1s qui sont sortis par la gauche ont disparu, le bit de signe a changé, et le résultat n'est plus quatre fois l'original.Un décalage logique à droite conserve le bit de signe pour qu'un nombre négatif signé reste négatif. Un décalage cyclique 循环移位 (rotation) renvoie le bit qui tombe d'une extrémité à l'autre, afin qu'aucun bit ne soit perdu.
"Montrez le résultat d'un décalage logique à droite de 3 places sur
10011110" : copiez le bit de signe dans chaque place vacante,11110011. Le même décalage sur01011100donne00001011. Un décalage cyclique à gauche de 1 sur10000110donne00001101: le 1 de tête réapparaît à droite.Décalage logique gauche ($\times 2$), logique droit ($\div 2$) et arithmétique droit (conserve le bit de signe) La différence entre les deux décalages à droite est un seul bit. Prenez
11110000, qui est 240 lu comme non signé et $-16$ lu comme signé.LSR #1apporte un 0 et donne01111000$= 120$, qui est la moitié correcte de 240.ASR #1copie le bit de signe et donne11111000$= -8$, qui est la moitié correcte de $-16$. Aucun n'est faux — chacun divise la valeur par deux selon une lecture.
Décalage logique et arithmétique droit sur le même byte : seul le bit entrant à gauche diffère Manipulation des bits pour surveillance/contrôle
Les dispositifs embarqués utilisent souvent un bit 位 d'un registre par signal (par exemple bit $n$ = LED $n$). En utilisant un masque 掩码 — masquage de bits — vous pouvez :
- positionner le bit $n$ :
R = R ORun masque avec le bit $n$ positionné. - désactiver le bit $n$ :
R = R ANDun masque avec le bit $n$ désactivé et le reste activé. - inverser le bit $n$ :
R = R XORun masque avec le bit $n$ activé. - tester le bit $n$ :
R ANDle masque, puis vérifier si le résultat est non nul.
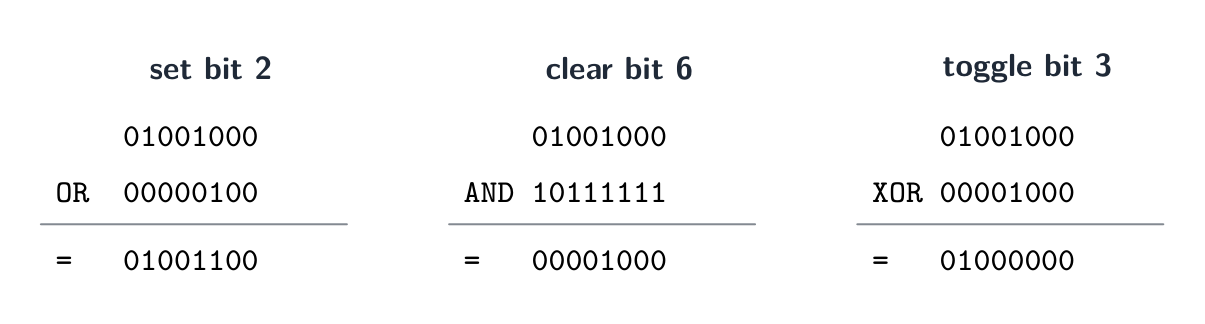
Activer un bit avec OR, le désactiver avec AND, l'inverser avec XOR — chacun utilisant un masque La manipulation des bits est rapide, utilise peu de mémoire et permet à un octet de contenir jusqu'à 8 états marche/arrêt.
Dans l'ensemble d'instructions de l'examen, ce sont
AND,ORetXORavec un masque écrit comme opérande décimal, binaire ou hexadécimal. Avec ACC contenant10101100:Instruction Masque Résultat dans ACC Effet AND B000011110000111100001100garde seulement les quatre bits de poids faible (désactive les autres) OR #10000000110101101positionne le bit de poids faible, laissant les autres inchangés XOR &FF1111111101010011inverse tous les bits AND B00001000puisCMP #00000100000001000teste le bit 3 : la comparaison n'est pas égale, donc le bit 3 était positionné LSL #210110000décale à gauche de deux places, perdant les deux bits supérieurs LSR #300010101décale à droite de trois places, des zéros entrant à gauche "Écrivez l'instruction qui active le bit de poids faible à 1 et laisse les autres inchangés" :
OR #1, ouOR B00000001. Pour désactiver un bit, utilisezANDavec un masque ayant un 0 à cet endroit et des 1 ailleurs ; pour tester un bit,ANDavec un masque ayant un 1 uniquement à cet endroit, puis comparez le résultat avec zéro. Dans un dispositif de surveillance, un bit d'un registre par capteur permet à une seuleANDde vérifier si un capteur particulier est allumé, et unORactive le bit de commande d'un actionneur sans perturber les autres.ExplorerDécalez et masquez les bits d'un octet
Choisissez un opérateur et observez chaque bit de résultat. Un décalage gauche (<<) moves every bit up one place (×2); a right shift (>>) les déplace vers la droite (÷2) ; AND avec un masque efface les bits que vous ne voulez pas.
Vocabulaire EntrainerAnglais Chinois Pinyin bit/bɪt/ 位 wèi mask/mæsk/ 掩码 yǎn mǎ 4.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition concept de programme stocké les instructions du programme et les données sont toutes deux stockées en mémoire principale, et les instructions sont fetchées et exécutées une par une registre un petit emplacement de stockage très rapide à l'intérieur du processeur avec un but spécifique Compteur de programme le registre contenant l'adresse de la prochaine instruction à être fetchée Registre d'adresse mémoire le registre contenant l'adresse de l'emplacement mémoire lu ou écrit Registre de données mémoire le registre contenant les données ou l'instruction récemment lues depuis, ou sur le point d'être écrites dans, la mémoire Registre d'instruction courante le registre contenant l'instruction actuellement décodée et exécutée Accumulateur le registre à usage général contenant le résultat de la dernière opération arithmétique ou logique mémoire cache petite mémoire rapide proche du processeur contenant des instructions et des données fréquemment utilisées interruption un signal provenant d'un périphérique ou d'un programme qui fait que le processeur pause la tâche actuelle et exécute un service d'interruption langage assembleur un langage de bas niveau dans lequel chaque instruction mnémotechnique correspond à une instruction de code machine adressage immédiat l'opérande est la valeur écrite dans l'instruction adressage direct l'opérande est le contenu de l'adresse écrite dans l'instruction adressage indirect l'adresse dans l'instruction contient l'adresse de l'opérande adressage indexé l'adresse de l'opérande est l'adresse dans l'instruction plus le contenu du registre d'index adressage relatif l'adresse de l'opérande est donnée comme un décalage par rapport à l'adresse de l'instruction courante décalage logique chaque bit se déplace du nombre de places indiqué et des zéros remplissent les cases libérées 4.3
Conseils d'examen
- Apprendre le cycle prélever-exécuter en termes de transfert de registres (PC, MAR, MDR, CIR, ACC) et ce qui incrémente le PC.
- Nommer la fonction de chaque registre ; le bus d'adresses est unidirectionnel, le bus de données est bidirectionnel.
- Distinguer les modes d'adressage (immédiat, direct, indirect, indexé) — une question fréquente.
- Expliquer comment la vitesse d'horloge, le nombre de cœurs, la taille du cache et la longueur du mot influencent les performances.
- Pour un décalage binaire, indiquer s'il est logique ou arithmétique ; un décalage vers la gauche multiplie par 2, un décalage vers la droite divise par 2.
Erreurs courantes
- Dire que le PC contient l'instruction courante, ou que le MDR contient une adresse. Le PC contient l'adresse de l'instruction suivante ; le MDR contient des données ou une instruction, jamais une adresse.
- Omettre l'incrémentation du PC lors de la phase de prélèvement, ou la placer après l'exécution. Elle a lieu dès que l'adresse a été copiée dans le MAR.
- Lire
LDD 10comme "charger 10".LDD 10charge le contenu de l'adresse 10 ;LDM #10charge le nombre 10. - Placer une valeur dans la colonne ACC pour
CMPouOUT. Une comparaison définit uniquement un drapeau ; une sortie va vers la colonne de sortie. - Dire qu'une interruption est traitée "immédiatement". Le processeur termine l'instruction courante et vérifie les interruptions à la fin du cycle.
- Utiliser un décalage logique droit sur un nombre négatif en complément à deux. Seul un décalage arithmétique conserve le bit de signe.
-
5
Logiciels système
Regarder la leçon5.1
Systèmes d'exploitation

Programme
Les candidats doivent être capables de : Notes et orientations Expliquer pourquoi un système informatique nécessite un Système d'exploitation (OS) Expliquer les tâches clés de gestion assurées par le Système d'exploitation Y compris la gestion de la mémoire, la gestion des fichiers, la gestion de la sécurité, la gestion du matériel (entrée/sortie/périphériques), la gestion des processus Comprendre la nécessité des logiciels utilitaires typiques fournis avec un système d'exploitation Y compris formateur de disque, antivirus, logiciel de défragmentation, analyse du contenu du disque / logiciel de réparation de disque, compression de fichiers, logiciel de sauvegarde Comprendre les bibliothèques de programmes Y compris : • les logiciels en cours de développement sont souvent construits à l'aide de code existant provenant de bibliothèques de programmes • les avantages pour le développeur d'un logiciel construit à l'aide de fichiers de bibliothèque, y compris les fichiers Dynamic Link Library (DLL) Source : Programme Cambridge International
Pourquoi un ordinateur a besoin d'un OS
Le matériel seul peut seulement prélever et exécuter des instructions — il ne sait rien des fichiers, programmes, réseaux ou utilisateurs. Le système d'exploitation 操作系统 (OS) est la couche logicielle qui :
- gère le matériel (processeur 处理器, mémoire, E/S, stockage) pour les programmes en cours d'exécution.
- fournit des services (système de fichiers, réseau, comptes utilisateurs) via une interface claire, afin que les programmes n'aient pas à communiquer directement avec le matériel.
- fournit une interface utilisateur (ligne de commande, GUI, tactile).
- permet à plusieurs programmes de partager le matériel en toute sécurité — chacun obtient un temps CPU équitable et est maintenu hors de la mémoire des autres.
Sans OS, chaque programme aurait ses propres pilotes, et un seul programme pourrait s'exécuter en toute sécurité à la fois.
"Décrire la fonction d'un OS" — la liste à cinq points. L'OS (1) fournit une interface entre l'utilisateur et le matériel ; (2) masque la complexité du matériel à l'utilisateur et aux programmes applicatifs ; (3) gère les ressources matérielles — temps processeur, mémoire, stockage et périphériques d'E/S — et les partage entre les programmes ; (4) charge les logiciels applicatifs en mémoire et les exécute, offrant à chaque programme la même plateforme d'exécution ; (5) permet à plusieurs programmes de s'exécuter simultanément (multitasking 多任务处理) tout en maintenant leur sécurité ainsi que celle des données des utilisateurs. Donnez cinq points différents ; "il fait fonctionner l'ordinateur" ou "il gère les ressources" seul ne rapporte aucun point.
Un système d'exploitation de bureau gère l'écran, les fichiers et les programmes pour l'utilisateur 
Un téléphone en a tout autant besoin : c'est un système d'exploitation mobile, Android Tâches de gestion clés
Le syllabus en nomme cinq. Chaque point ci-dessous est une chose que l'OS fait réellement, ce qu'une question "décrire" attend.
- gestion de la mémoire 内存管理 — alloue de la mémoire à chaque programme lors de son chargement, garde la mémoire de chaque programme séparée (protection mémoire 内存保护) pour qu'aucun ne puisse écraser l'autre, libère la mémoire quand un programme se termine, et échange des pages entre RAM 随机存取存储器 et stockage secondaire 辅助存储器 (le disque) (mémoire virtuelle 虚拟内存 / fragmentation 分页) pour permettre d'avoir plus de programmes ouverts que la mémoire physique ne le permet.
- gestion des processus 进程管理 — un programme en cours d'exécution est un processus 进程. L'OS crée et supprime des processus, décide quel processus aura le CPU suivant (ordonnancement 调度) et pendant combien de temps (une tranche de temps 时间片), bascule entre eux, résout les conflits lorsque deux veulent la même ressource, et peut tuer celui qui ne répond plus.
- gestion du matériel (entrées/sorties et périphériques) — communique avec chaque appareil via son pilote de périphérique 设备驱动, met en file d'attente et tamponne les données allant vers les dispositifs lents comme une imprimante, répond aux interruptions 中断 des appareils, et partage un appareil entre plusieurs programmes.
- gestion de fichiers — crée, nomme, copie, déplace et supprime des fichiers et dossiers, maintient la structure des répertoires 目录 et un enregistrement de l'emplacement de chaque fichier sur le disque, alloue de l'espace disque aux fichiers, et impose des droits d'accès 访问权限 (lecture / écriture / exécution) pour chaque utilisateur.
- gestion de la sécurité — comptes utilisateurs et mots de passe (authentification 身份验证), droits d'accès, chiffrement des données stockées, pare-feu, mises à jour de sécurité automatiques, et journalisation des actions.
Les tâches principales gérées par le système d'exploitation 
La protection mémoire maintient chaque application dans sa propre zone de mémoire Comment la gestion de la mémoire et des processus soutiennent le multitasking (un favori à quatre points). La gestion de la mémoire charge plusieurs programmes en mémoire en même temps, chacun dans sa propre zone protégée, et suit quelles adresses appartiennent à quels programmes ; la gestion des processus partage le processeur entre eux — chaque processus s'exécute pendant une tranche de temps, l'OS sauvegarde son état et bascule vers le suivant, et ce changement est si rapide que tous les programmes semblent s'exécuter ensemble. Les interruptions permettent à l'OS de reprendre le processeur à un processus dès qu'un périphérique nécessite une attention.
Interruptions. Une interruption matérielle 硬件中断 vient d'un appareil : une touche pressée, un clic de souris, une imprimante sans papier, une fin de transfert de disque, une panne de courant. Une interruption logicielle 软件中断 vient d'un programme : division par zéro, instruction invalide, tentative d'utilisation d'une mémoire dont on ne dispose pas, ou demande de service OS. Le gesteur d'interruptions 中断处理程序 de l'OS sauvegarde l'état du processus en cours, traite l'interruption, puis restaure le processus (le sujet 4 couvre le détail prélever-exécuter).
Logiciels utilitaires
Programmes utilitaires 实用程序 sont des logiciels système qui entretiennent, réparent ou optimisent l'ordinateur plutôt que d'accomplir une tâche utilisateur ; l'examinateur accepte "effectue une tâche de maintenance spécifique qui améliore les performances ou la sécurité". La plupart des OS les incluent :

Programmes utilitaires : antivirus, sauvegarde, compression et défragmentation - formateur de disque — prépare un nouveau disque (ou efface un ancien) pour utilisation : configure son système de fichiers et ses partitions, supprimant toute donnée existante.
- scanneur de virus (antivirus 杀毒软件) — scanne les fichiers et la mémoire, compare le code contre une base de données de signatures connues de virus signatures 签名 et surveille les comportements suspects, puis met en quarantaine ou supprime ce qu'il trouve ; s'exécute selon un planning et à chaque téléchargement, et doit être mis à jour au fur et à mesure de l'apparition de nouveaux virus.
- logiciel de défragmentation (défragmentateur de disque 碎片整理) — un disque dur stocke un fichier dans les blocs libres disponibles, donc après de nombreux enregistrements et suppressions, un fichier est dispersé (fragmenté 碎片化) sur le plateau et la tête de lecture/écriture doit sauter entre les morceaux. Le défragmentateur regroupe les morceaux de chaque fichier côte à côte et rassemble l'espace libre en une seule région, afin que les fichiers se chargent plus vite et que les nouveaux fichiers ne soient pas fragmentés. Inutile sur un SSD, qui n'a pas de tête mobile.
- analyse de contenu de disque / logiciel de réparation de disque — montre ce qui occupe l'espace disque (fichiers volumineux, dupliqués ou temporaires) pour pouvoir les supprimer ; trouve et répare les secteurs défectueux, clusters perdus et erreurs de système de fichiers.
- compression de fichiers (compression 压缩) — réduit la taille des fichiers pour qu'ils nécessitent moins de stockage et se transmettent plus vite ; l'archivage regroupe de nombreux fichiers en un seul.
- logiciel de sauvegarde (backup 备份) — copie des fichiers vers un autre support (disque externe, réseau, cloud) selon un planning pour restaurer les données après perte, corruption ou attaque de ransomware ; une copie complète est suivie de sauvegardes incrémentielles 增量备份 de seuls les éléments modifiés.
- non pare-feu 防火墙 (filtre le trafic réseau selon des règles) et des outils de chiffrement, pour la sécurité ; un moniteur système et des mises à jour automatiques.
Inclure ces outils avec l'OS économise à l'utilisateur l'installation de chacun séparément.
Quel utilitaire fait quoi. Performances : défragmentation (accès aux fichiers plus rapide), réparation de disque (un disque avec des erreurs est lent ou échoue), analyse de contenu de disque (libération d'espace en supprimant les ordures), compression (plus de place sur le disque). Sécurité : scanneur de virus, pare-feu, chiffrement et sauvegarde (la seule récupération possible face au ransomware). Une question "tirer une ligne" associe chaque utilitaire à exactement une finalité — apprenez les paires ci-dessus et utilisez les noms du syllabus.
Exemple résolu. Expliquez comment la défragmentation peut améliorer les performances d'un ordinateur (3 points).
Au fil du temps, un fichier est stocké dans des blocs dispersés sur le disque dur, donc sa lecture nécessite de nombreux mouvements de la tête de lecture/écriture. Le défragmentateur réorganise les blocs pour que chaque fichier soit stocké de manière contiguë et que l'espace libre soit groupé. Les fichiers sont ensuite lus avec moins de mouvements de tête, ils se chargent donc plus vite, et les nouveaux fichiers peuvent être écrits dans un espace continu.
ExplorerOù se situe le système d'exploitation
Tapez chaque couche. Le SOS est la couche intermédiaire — il se situe entre vos applications et le matériel, partageant la machine en toute sécurité afin que les programmes ne touchent jamais directement le matériel.
Vocabulaire EntrainerAnglais Chinois Pinyin multitasking/ˈmʌltitæskɪŋ/ 多任务处理 duō rèn wù chǔ lǐ memory management/ˈmeməri ˈmænɪdʒmənt/ 内存管理 nèi cún guǎn lǐ memory protection/ˈmeməri prəˈtekʃn/ 内存保护 nèi cún bǎo hù RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì virtual memory/ˈvɜːtʃuːəl ˈmeməri/ 虚拟内存 xū nǐ nèi cún paging/ˈpeɪdʒɪŋ/ 分页 fēn yè process management/ˈprəʊses ˈmænɪdʒmənt/ 进程管理 jìn chéng guǎn lǐ process/ˈprəʊses/ 进程 jìn chéng scheduling/ˈʃedjuːlɪŋ/ 调度 diào dù time slice/taɪm slaɪs/ 时间片 shí jiān piàn device driver/dɪˈvaɪs ˈdraɪvə/ 设备驱动 shè bèi qū dòng interrupts/ˈɪntərʌpts/ 中断 zhōng duàn directory/daɪˈrektəri/ 目录 mù lù access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng hardware interrupt/ˈhɑːdweə ˈɪntərʌpt/ 硬件中断 yìng jiàn zhōng duàn software interrupt/ˈsɒftweə ˈɪntərʌpt/ 软件中断 ruǎn jiàn zhōng duàn interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù utility program/juːˈtɪlɪti ˈprəʊɡræm/ 实用程序 shí yòng chéng xù antivirus/ˌæntɪˈvaɪrəs/ 杀毒软件 shā dú ruǎn jiàn backup/ˈbækʌp/ 备份 bèi fèn compression/kəmˈpreʃn/ 压缩 yā suō disk defragmenter/dɪsk ˌdiːˈfræɡmentə/ 碎片整理 suì piàn zhěng lǐ signatures/ˈsɪɡnɪtʃəz/ 签名 qiān míng fragmented/fræɡˈmentɪd/ 碎片化 suì piàn huà incremental backups/ˌɪŋkrɪˈmentl ˈbækʌps/ 增量备份 zēng liàng bèi fèn 5.1
Bibliothèques de programmes

Une bibliothèque de programmes 程序库 est du code pré-écrit (sous-routines 子程序, classes, modules) que les programmes réutilisent au lieu de l'écrire eux-mêmes — par exemple, une bibliothèque mathématique, une bibliothèque réseau, une bibliothèque graphique.
Un nouveau programme réutilisant des routines prêtes à l'emploi depuis des bibliothèques Avantages : gain de temps (code tout fait), fiabilité (bien testé, largement utilisé) et standardisation (comportement cohérent).
La liste des avantages pour l'examinateur, du point de vue du développeur. Les routines de bibliothèque 库例程 sont déjà écrites et testées, ce qui rend le développement plus rapide et moins coûteux ; elles sont fiables et, étant utilisées par de nombreux programmes, largement exemptes d'erreurs ; le développeur n'a pas besoin d'expertise dans ce domaine (graphismes, compression, cryptage, recherche de chemin) ; le programme est plus facile à maintenir car le code commun se trouve au même endroit ; et une équipe entière peut utiliser les mêmes routines, garantissant des résultats cohérents. Inconvénients : une routine peut ne pas faire exactement ce dont vous avez besoin et vous ne pouvez pas la modifier ; votre programme dépend de la disponibilité, de la correction et de la sécurité de la bibliothèque — un bogue ou une faille de sécurité dans la bibliothèque constitue un bogue dans votre programme ; et vous devez apprendre comment l'appeler.
- une bibliothèque statique 静态库 est copiée dans l'exécutable au moment de la compilation (elle fonctionne seule, mais est plus volumineuse et nécessite une recompile pour être mise à jour).
- une bibliothèque dynamique 动态库 (DLL, Dynamic Link Library ;
.so) est chargée en temps d'exécution (exécutables plus petits, partagés entre plusieurs programmes, mis à jour une fois pour toutes).
Statique : la bibliothèque est copiée dans l'exécutable. Dynamique : un fichier de bibliothèque partagée est chargé en temps d'exécution Fichiers Dynamic Link Library (DLL). Une DLL est une bibliothèque chargée en mémoire uniquement lorsqu'un programme l'appelle, en temps d'exécution, et reste sous forme de fichier séparé plutôt que d'être copiée dans l'exécutable. Avantages : l'exécutable est plus petit ; plusieurs programmes en cours d'exécution partagent une seule copie de la DLL en mémoire ; une DLL peut être mise à jour (correction de bogue, nouvel appareil) sans recompiler les programmes qui l'utilisent ; et la mémoire n'est utilisée que tant que la routine est nécessaire. Inconvénients : le programme ne s'exécutera pas si la DLL est absente, déplacée ou si sa version est incorrecte ; une DLL mise à jour peut casser un programme qui comptait sur l'ancien comportement ; et une fausse DLL placée à sa place s'exécute avec les droits du programme.
Exemple résolu. Une équipe écrivant un logiciel pour un robot restaurant utilise une bibliothèque de programmes incluant une routine pour trouver le chemin le plus court entre les tables. Expliquez deux avantages et un inconvénient pour l'équipe.
Avantages : la routine est déjà écrite et testée, donc l'équipe gagne du temps et peut se fier au résultat ; l'équipe n'a pas besoin de comprendre elle-même les algorithmes de recherche de chemin et peut consacrer ce temps aux fonctionnalités propres du robot. Inconvénient : la routine peut ne pas gérer les besoins exacts du restaurant (chaises mobiles, couloirs sens unique) et l'équipe ne peut pas la modifier, ils doivent donc contourner ses limites.
ExplorerLaboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin compiler/kəmˈpaɪlə/ 编译器 biān yì qì object code/ˈɒbdʒekt kəʊd/ 目标代码 mù biāo dài mǎ 5.2
Traducteurs de langages

Programme
Les candidats doivent être capables de : Notes et orientations Comprendre la nécessité de : • un assembleur pour la traduction d'un programme en langage assembleur • un compilateur pour la traduction d'un programme en langage de haut niveau • un interpréteur pour la traduction et l'exécution d'un programme en langage de haut niveau Expliquer les avantages et inconvénients de l'utilisation d'un compilateur ou d'un interpréteur et justifier l'utilisation de chacun Savoir que les programmes en langage de haut niveau peuvent être partiellement compilés et partiellement interprétés, comme Java (mode console) Décrire les fonctionnalités d'un Environnement de Développement Intégré (IDE) typique Y compris : • pour la programmation, incluant des invitations contextuelles • pour la détection initiale d'erreurs, incluant des vérifications syntaxiques dynamiques • pour la présentation, incluant le formatage automatique, l'expansion et le repliement des blocs de code • pour le débogage, incluant l'exécution pas à pas, les points d'arrêt, c'est-à-dire les variables, expressions, fenêtre de rapport Source : Programme Cambridge International
Vous écrivez du code source ; l'ordinateur exécute le code machine 机器码. Un traducteur 翻译器 assure la conversion entre les deux.
Assembleur
Un assembleur 汇编er traduit le langage assembleur 汇编语言 en code machine : chaque instruction mnémotechnique (
LDD,ADD,JMP) devient exactement une instruction de code machine, et les adresses symboliques et les étiquettes sont remplacées par des adresses réelles. Il est nécessaire car le processeur n'exécute que du code machine, et l'assembleur est utilisé lorsque le programmeur a besoin d'un contrôle direct du matériel (systèmes embarqués, pilotes de périphériques).Compilateur
Un compilateur 编译器 traduit un programme de haut niveau en code machine une seule fois, avant son exécution. - il signale tous les erreurs au moment de la compilation ; une fois propre, il produit un exécutable 可执行文件 autonome qui s'exécute sans que le compilateur soit installé et peut être lancé de nombreuses fois. - généralement plus rapide en temps d'exécution (aucune traduction pendant l'exécution), mais lié à un CPU/OS spécifique — recompiler pour chaque plateforme.
- il signale toutes les erreurs au moment de la compilation ; une fois propre, il produit un exécutable 可执行文件 autonome qui s'exécute sans que le compilateur soit installé et peut être exécuté plusieurs fois.
- généralement plus rapide à l'exécution (pas de traduction pendant l'exécution), mais lié à un seul CPU/OS — recompiler pour chaque plateforme.
La description en deux points : un compilateur traduit le programme entier en langage machine (code objet 目标代码) avant qu'il ne soit exécuté, produit un fichier exécutable et signale toutes les erreurs de syntaxe ensemble sous forme de liste à la fin de la traduction. Il n'exécute pas le programme.
Interprète
Un interprète 解释器 traduit et exécute un programme de haut niveau ligne par ligne, ne produisant aucun exécutable. - il signale une erreur lorsqu'il atteint cette ligne, puis s'arrête ; vous pouvez la corriger et continuer — excellent pour le développement. - l'interprète doit être installé pour exécuter le programme ; généralement plus lent (chaque exécution entraîne une re-traduction), mais facile à porter sur différentes plateformes.
- il signale une erreur lorsqu'il atteint cette ligne, puis s'arrête ; vous pouvez la corriger et continuer — bon pour le développement.
- l'interpréteur doit être installé pour exécuter le programme ; généralement plus lent (chaque exécution re-traduit), mais facile à porter sur différentes plateformes.
La description en deux points : un interpréteur traduit une instruction du programme de haut niveau à la fois et l'exécute immédiatement avant de passer à la suivante ; aucun fichier exécutable n'est produit ; il s'arrête à la première erreur rencontrée et la signale. Le code source et l'interpréteur doivent être présents à chaque exécution du programme.
Un compilateur traduit une fois en un programme autonome ; un interpréteur traduit ligne par ligne, à chaque exécution Choisir entre eux
la vitesse d'exécution est importante vous voulez des cycles édit-exécution rapides distribuer à des utilisateurs sans outils de dev écrire des scripts multiplateformes le programme s'exécute de nombreuses fois le programme est petit ou s'exécute une seule fois enseigner aux débutants enseigner les débutants Avantages et inconvénients, tels que listés par le barème.
compilateur interpréteur ce dont l'utilisateur a besoin seulement l'exécutable ; pas de traducteur, et le code source reste privé le code source et l'interprète détection des erreurs toutes les erreurs listées d'un coup, après la traduction du programme entier chaque erreur signalée à la ligne où elle se produit, au fur et à mesure du développement modification du code recompiler le programme entier après chaque changement éditer et relancer immédiatement portabilité le code machine ne s'exécute que sur une plateforme ; recompiler pour chacune la même source s'exécute partout où un interprète existe portabilité le code machine s'exécute sur une seule plateforme ; recompiler pour chacune la même source s'exécute partout où un interpréteur existe Exemple corrigé. Un développeur utilise un interpréteur pendant l'écriture d'un programme et un compilateur lorsqu'il est terminé. Expliquez comment chacun est utilisé (4 points).
Pendant le développement, l'interpréteur exécute le programme partiellement écrit immédiatement, sans attendre une traduction complète ; lorsqu'il rencontre une erreur, il signale la ligne, afin que le développeur la corrige et relance immédiatement — un cycle éditer-exécuter rapide plus facile pour le débogage. Lorsque le programme est terminé, le compilateur traduit l'ensemble du programme en un exécutable qui s'exécute plus rapidement, ne nécessite pas de traducteur sur l'ordinateur de l'utilisateur et ne révèle pas le code source, il peut donc être vendu au public.
Hybride : Java
La formule du syllabus est « partiellement compilé et partiellement interprété » : l'étape de compilation détecte les erreurs de syntaxe et produit un bytecode compact et portable 可移植 ; l'étape d'interprétation permet à ce seul fichier bytecode de s'exécuter sur n'importe quelle machine disposant d'une machine virtuelle, au détriment de la vitesse. Java en mode console (un programme texte lancé depuis la ligne de commande) est l'exemple du syllabus.
La phrase du syllabus est « partiellement compilé et partiellement interprété » : l'étape du compilateur détecte les erreurs de syntaxe et produit du bytecode compact et portable 可移植的 ; l'étape d'interprétation permet à ce fichier bytecode unique de s'exécuter sur n'importe quelle machine disposant d'une machine virtuelle, au prix d'une certaine vitesse. Java en mode console (un programme texte lancé depuis la ligne de commande) est l'exemple du syllabus.
 Exemple résolu. Le code source Java est compilé en bytecode, qu'une JVM interprète ensuite. Pourquoi utiliser les deux au lieu de compiler directement vers du code machine ? Un compilateur produit du code machine pour non processeur et système d'exploitation spécifiques, donc un programme compilé sur une machine ne s'exécutera pas sur une autre. Le compilateur Java cible au contraire une machine virtuelle, de sorte que le bytecode produit est identique partout ; chaque plateforme fournit alors sa propre JVM pour interpréter ce bytecode en ses propres instructions natives. Un seul fichier compilé s'exécute donc partout où une JVM existe — « écrire une fois, exécuter partout ». Le prix est la vitesse : interpréter du bytecode est plus lent que d'exécuter du code natif, c'est pourquoi une vraie JVM utilise également la compilation JIT pour convertir le bytecode fréquemment exécuté en code natif pendant l'exécution du programme. Nommez les deux aspects — les marks sont attribués à la portabilité achetée au prix de la vitesse.
Exemple corrigé. Le code source Java est compilé en bytecode, qu'une JVM interprète ensuite. Pourquoi utiliser les deux, plutôt que de compiler directement en code machine ? Un compilateur produit du code machine pour non processeur et système d'exploitation donnés, donc un programme compilé sur une machine ne fonctionnera pas sur une autre. Le compilateur Java cible à la place une machine virtuelle, donc le bytecode qu'il produit est identique partout ; chaque plateforme fournit ensuite sa propre JVM pour interpréter ce bytecode en ses propres instructions natives. Un fichier compilé unique fonctionne donc partout où une JVM existe - « écrire une fois, exécuter partout ». Le prix est la vitesse : l'interprétation du bytecode est plus lente que l'exécution de code natif, c'est pourquoi une vraie JVM utilise également la compilation JIT pour transformer le bytecode fréquemment exécuté en code natif pendant l'exécution du programme. Nommez les deux côtés - les points sont accordés pour la portabilité achetée au prix de la vitesse.
ExplorerLe routeur du compilateur : source vers programme exécuté
Étape par étape du fonctionnement d'un compilateur — traduire le programme entier une fois, avant son exécution. Contrastez-le avec un interpréteur, qui traduit et exécute ligne par ligne.
Vocabulaire EntrainerAnglais Chinois Pinyin interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì portable/ˈpɔːtəbl/ 可移植的 kě yí zhí de 5.2
Environnement de Développement Intégré (IDE)

Un environnement de développement intégré 集成开发环境 (IDE) regroupe les outils pour écrire, tester et déboguer le code dans une seule application :
Le syllabus classe les fonctionnalités en quatre catégories. Apprenez quelle fonctionnalité appartient à quel groupe, car les questions vous demanderont de les classer et de décrire une fonctionnalité de chaque groupe.Le syllabus regroupe les fonctionnalités en quatre catégories. Apprenez quelle fonctionnalité appartient à quel groupe, car les questions vous demandent de les trier et d'en décrire une de chaque groupe.
- Pour la programmation : les invites contextuelles 上下文相关提示 — au fur et à mesure que vous tapez, l’IDE affiche les identifiants, mots-clés ou paramètres qui conviennent à cet endroit du code ; la complétion automatique 自动补linine le nom pour vous ; l’indentation automatique et la correspondance des parenthèses maintiennent la mise en forme correcte pendant la saisie.
- Pour la détection initiale des erreurs : vérifications de syntaxe dynamiques 动态语法检查 — l'éditeur vérifie la syntaxe au fur et à mesure de la saisie et souligne ou met en surbrillance une erreur immédiatement, avant la traduction du programme ; après la traduction, messages d'erreur avec numéros de ligne.
- Pour la présentation : prettyprint 代码美化 — les mots-clés, identifiants, chaînes et commentaires affichés dans différentes couleurs ou polices (surbrillance de syntaxe 语法高亮) avec une indentation cohérente, afin que la structure soit visible en un coup d'œil ; développer et réduire les blocs de code — masquer le corps d'une boucle, d'un IF ou d'une sous-routine pour voir le plan.
- Pour le débogage : les breakpoints 断点 — le programme s'arrête lorsqu'il atteint une ligne marquée ; le single stepping 单步执行 — à partir de l'arrêt, exécuter une ligne à la fois ; une fenêtre qui affiche les valeurs actuelles des variables et expressions 随着它们变化;et une report window 报告窗口 qui liste les erreurs, les avertissements et la sortie.
Autres fonctionnalités : intégration du traducteur (compiler ou exécuter avec une touche unique, erreurs affichées en ligne), un debugger 调试器 qui pilote les fonctionnalités de débogage ci-dessus, intégration au version control 版本控制 (git), gestion de projet, système d'aide, outils de refactoring 重构 (renommage sécurisé) et intégration aux unit test 单元测试。

Les fonctionnalités de l'IDE comportent les noms du syllabus, aux endroits où vous les verriez à l'écran Un IDE accélère le développement en regroupant écrire → exécuter → déboguer → corriger derrière une seule interface. IDEs courantes : Visual Studio, PyCharm, Eclipse, VS Code.

Un debugger : définir un breakpoint, exécuter, puis s'arrêter pour inspecter les variables et parcourir le code pas à pas Exemple résolu. Une fonction
Calculate()retourne une valeur inattendue lorsque le programme s'exécute. Décrivez comment les fonctionnalités de débogage d'une IDE typique aident à trouver la cause (4 points).Définissez un breakpoint sur la première ligne de
Calculate(), afin que le programme s'y arrête plutôt que de passer tout simplement. Ensuite, effectuez un single-step à travers la fonction, une ligne à la fois. Après chaque étape, lisez les valeurs des variables et de toute expression que vous avez demandé à l'IDE de watch (surveiller), et comparez-les avec les valeurs attendues ; la première ligne après laquelle une valeur est incorrecte est là où se trouve l'erreur logique. La report window affiche tout message d'erreur d'exécution et la sortie produite jusqu'alors.Exemple résolu. Placez chaque fonctionnalité dans son groupe de syllabus : prettyprint, invitation contextuelle, vérification syntaxique dynamique, breakpoint, réduire/étendre les blocs de code, fenêtre de rapport.
Codage : invitation contextuelle. Détection initiale d'erreurs : vérification syntaxique dynamique. Présentation : prettyprint, réduction/étirement des blocs de code. Débogage : breakpoint, fenêtre de rapport.
Vocabulaire EntrainerAnglais Chinois Pinyin debugger/ˈdiːbʌɡə/ 调试器 tiáo shì qì context-sensitive prompts/ˈkɒntekst ˈsensɪtɪv prɒmpts/ 上下文相关提示 shàng xià wén xiāng guān tí shì auto-complete/ˈɔːtəʊ kəmˈpliːt/ 自动补全 zì dòng bǔ quán dynamic syntax checks/daɪˈnæmɪk ˈsɪntæks tʃeks/ 动态语法检查 dòng tài yǔ fǎ jiǎn chá prettyprint/ˈpretɪprɪnt/ 代码美化 dài mǎ měi huà syntax highlighting/ˈsɪntæks ˈhaɪlaɪtɪŋ/ 语法高亮 yǔ fǎ gāo liàng breakpoints/ˈbreɪkpɔɪnts/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng report window/rɪˈpɔːt ˈwɪndəʊ/ 报告窗口 bào gào chuāng kǒu version control/ˈvɜːʃn kənˈtrəʊl/ 版本控制 bǎn běn kòng zhì refactoring/rɪˈfæktərɪŋ/ 重构 chóng gòu unit test/ˈjuːnɪt test/ 单元测试 dān yuán cè shì 5.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition operating system logiciel qui gère le matériel et les ressources de l'ordinateur et fournit une interface entre l'utilisateur, les programmes applicatifs et le matériel utility software logiciel système qui effectue une tâche spécifique pour maintenir, optimiser ou protéger l'ordinateur, tel qu'un antivirus ou un défragmentateur program library un ensemble de routines pré-écrites et testées (sous-routines, classes, modules) qu'un programme peut utiliser au lieu d'en écrire ses propres Dynamic Link Library (DLL) une bibliothèque de programmes dont les routines sont chargées en mémoire uniquement lorsque le programme les appelle, en temps d'exécution, et qui sont partagées entre les programmes assembler un traducteur qui convertit un programme en langage assembleur en code machine, une instruction par instruction compiler un traducteur qui convertit l'intégralité d'un programme en langage de haut niveau en code machine avant son exécution, produisant un fichier exécutable interpreter un traducteur qui traduit et exécute un programme en langage de haut niveau une instruction à la fois integrated development environment une application unique qui fournit les outils pour écrire, traduire, exécuter et déboguer un programme context-sensitive prompt une invitation contextuelle qui suggère des identifiants, des mots-clés ou des paramètres qui conviennent au point actuel du code dynamic syntax check la vérification de la syntaxe du code alors qu'il est tapé et signalant une erreur avant que le programme ne soit traduit prettyprint l'affichage du code avec des mots-clés, des identifiants et des commentaires dans différentes couleurs ou polices et avec une indentation cohérente breakpoint une ligne marquée à laquelle le programme en cours d'exécution s'arrête afin que les variables puissent être inspectées single stepping l'exécution d'un programme suspendu une instruction à la fois sous le contrôle du programmeur Vocabulaire EntrainerAnglais Chinois Pinyin operating system/ˈɒpəreɪtɪŋ ˈsɪstəm/ 操作系统 cāo zuò xì tǒng processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng static library/ˈstætɪk ˈlaɪbrəri/ 静态库 jìng tài kù executable/ɪɡˈzekjʊtəbl/ 可执行文件 kě zhí xíng wén jiàn dynamic library/daɪˈnæmɪk ˈlaɪbrəri/ 动态库 dòng tài kù translator/trænˈsleɪtə/ 翻译器 fān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembler/əˈsemblə/ 汇编器 huì biān qì assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/ 集成开发环境 jí chéng kāi fā huán jìng 5.2
Conseils d'examen
- Énumérez les tâches du OS par leurs noms de syllabus (gestion de la mémoire, des processus, du matériel, des fichiers et de la sécurité) et dites ce que chacune fait — "gérer les ressources" seul est trop vague.
- Comparez compiler vs interpreter vs assembler : ce que chacun traduit, quand il le traduit, et comment les erreurs sont signalées.
- Expliquez ce qu'une IDE fournit en utilisant les groupes de syllabus : codage, détection initiale d'erreurs, présentation, débogage.
- Une réponse "avantage pour le développeur" nomme l'économie du développeur : temps, coût, expertise, fiabilité ou maintenance. Un "inconvénient" nomme une dépendance : disponibilité, version, adaptation, sécurité.
- Pour "décrire le fonctionnement" d'un traducteur, donnez trois choses : ce qui est traduit (programme entier ou une instruction), quand (avant l'exécution ou pendant l'exécution), et comment les erreurs sont signalées (toutes en même temps ou à la première erreur).
Erreurs courantes
- Écrire "le OS contrôle l'ordinateur" ou "gère les ressources" sans exemple de tâche. Chaque marque correspond à une tâche nommée avec ce qu'elle fait.
- Dire qu'un interpreter "compile ligne par ligne". Un interpreter traduit et exécute chaque instruction ; il ne produit jamais un exécutable.
- Dire qu'un compilateur exécute le programme. Il traduit seulement ; l'exécutable s'exécute plus tard, sans le compilateur.
- Placer une DLL "à l'intérieur" de l'exécutable. C'est une bibliothèque statique ; une DLL reste un fichier séparé chargé en temps d'exécution.
- Dire que la défragmentation "supprime" ou "compresse" les fichiers, ou qu'elle est nécessaire sur un SSD. Elle ne déplace que les blocs pour que chaque fichier soit stocké de manière contiguë.
- Classer le prettyprint ou la réduction des blocs sous "débogage". Ce sont des fonctionnalités de présentation ; le débogage concerne les breakpoints, le single stepping, la surveillance des variables et la fenêtre de rapport.
-
6
Sécurité, confidentialité et intégrité des données
Regarder la leçon6.1
Sécurité, confidentialité et intégrité — trois idées distinctes
Programme
Les candidats doivent être capables de : Notes et orientations Expliquer la différence entre les termes sécurité, vie privée et intégrité des données Apprécier la nécessité tant de la sécurité des données que de la sécurité du système informatique Décrire les mesures de sécurité conçues pour protéger les systèmes informatiques, allant du PC autonome au réseau d'ordinateurs Y compris comptes utilisateurs, mots de passe, techniques d'authentification telles que les signatures numériques et la biométrie, pare-feu, logiciel antivirus, anti-spyware, chiffrement Comprendre les menaces pesant sur la sécurité des ordinateurs et des données posées par les réseaux et Internet Y compris malveillance (virus, spyware), hackers, hameçonnage, pharming Décrire les méthodes permettant de limiter les risques posés par ces menaces Décrire les méthodes de sécurité conçues pour protéger la sécurité des données Y compris chiffrement, droits d'accès Source : Programme Cambridge International
Cela semble similaire mais signifie des choses différentes :
- security 安全 — protéger les données contre l'accès, la modification ou la destruction unauthorised 未授权.
- privacy 隐私 — le droit d'un individu à contrôler qui voit ses données personnelles, avec consentement et objectif clair.
- integrity 完整性 — les données étant accurate and complete — non corrompues ou modifiées accidentellement.
Un fichier peut être secure (seules les bonnes personnes peuvent l'ouvrir) mais manquer d'intégrité (une faute de frappe l'a corrompu) ; ou exact mais pas private (n'importe qui peut le lire). Les trois sont nécessaires.
Les différences que le scheme veut, une phrase chacune : security est garder les données à l'abri de la perte et de l'accès non autorisé ; privacy est garder les données confidentielles, de sorte que seuls ceux ayant le droit de les voir peuvent ; integrity est les données étant correctes, cohérentes et complètes. Donc "la différence entre security et privacy" : security est de protéger les données contre l'accès, la modification ou la perte par des personnes qui ne devraient pas y avoir accès ; privacy est du droit de l'individu de décider qui peut voir ses données personnelles. "La différence entre security et integrity" : security protège les données contre l'accès non autorisé ; integrity est de s'assurer que les données sont exactes et à jour, ce que la validation et la vérification protègent.
ExplorerLaboratoire de risque et de responsabilité
Triez les exemples selon la règle, le risque ou la protection impliquée.
Vocabulaire EntrainerAnglais Chinois Pinyin security/sɪˈkjʊərɪti/ 安全 ān quán privacy/ˈprɪvəsi/ 隐私 yǐn sī integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng unauthorised/ʌnˈɔːθəraɪzd/ 未授权 wèi shòu quán 6.1
Pourquoi la sécurité est importante
Deux choses à protéger : les data elles-mêmes (les garder confidentielles, intactes et disponibles) et le computer system (un système compromis peut attaquer d'autres, voler des identifiants, ou être retenu en otage).
"Pourquoi l'école doit-elle garder les deux sécurisés ?" Données : ce sont des données personnelles et confidentielles, donc elles ne doivent pas être lues, modifiées ou supprimées par une personne non autorisée, et leur perte empêcherait l'école de fonctionner. Système : un intrus qui accède au système informatique peut installer un malware, l'utiliser pour attaquer d'autres systèmes, endommager le matériel ou le logiciel, ou le verrouiller avec du ransomware ; un système sécurisé est la première ligne de défense pour les données qu'il contient.
6.1
Menaces provenant des réseaux et d'Internet

Les menaces se divisent en trois groupes.
Un attaquant man-in-the-middle s'assoie entre les deux parties - Malware 恶意软件 (malicious software) — programmes nuisibles :
- virus 病毒 — code auto-copiant qui s'attache à d'autres programmes et se propage lorsqu'ils s'exécutent.
- worm 蠕虫 — code auto-copiant qui se propage sur des networks 网络 sans action de l'utilisateur.
- Trojan horse 木马 — semble utile mais cache du code malveillant.
- spyware 间谍软件 — collecte secrètement des informations (frappes de clavier, mots de passe).
- ransomware 勒索软件 — chiffre vos fichiers et exige un paiement.
- adware 广告软件 — pousse des publicités indésirables.
2. Tricking people (attaques sociales) :
- phishing 网络钓鱼 — faux e-mails/sites qui trompent les utilisateurs pour leur faire donner des identifiants.
- pharming 域名欺骗 — redirige un utilisateur vers un site fake même lorsqu'ils tapent la bonne adresse.
- social engineering 社会工程 — tromper les gens pour qu'ils révèlent des informations.
Les descriptions du scheme pour les quatre menaces nommées : un virus est un logiciel malveillant qui se réplique (se copie lui-même), s'attache à d'autres fichiers et supprime ou corrompt les données ; spyware est un logiciel malveillant qui enregistre les frappes de clavier et les actions de l'utilisateur et les envoie à un tiers pour obtenir des mots de passe et des données personnelles ; un email de phishing se fait passer pour provenir d'une organisation légitime et contient un lien vers un site fake où l'utilisateur est invité à fournir des détails personnels ou bancaires ; pharming est un code malveillant installé sur l'ordinateur de l'utilisateur ou sur un serveur web qui redirige l'utilisateur vers un site fake bien qu'ils aient tapé la bonne adresse. Similitudes entre spyware et virus : tous deux sont du malware, tous deux sont installés sans la connaissance de l'utilisateur, tous deux peuvent envoyer des données à un tiers ou endommager le système ; la différence est qu'un virus se réplique tandis que le spyware enregistre et transmet des informations. Phishing et pharming mènent tous deux l'utilisateur à un site fake qui collecte leurs données ; phishing nécessite que l'utilisateur clique sur un lien dans un email, pharming fonctionne via du code sur l'ordinateur ou le serveur DNS et ne nécessite pas d'email.
3. Attacks on the network :
- hacking 黑客入侵 par des hackers 黑客 — accès non autorisé, souvent via des mots de passe faibles ou des failles logicielles.
- denial of service 拒绝服务 (DoS/DDoS) — inonde un serveur pour empêcher les utilisateurs légitimes d'y accéder.
- eavesdropping 窃听 — interception de données en transit (risque sur le Wi-Fi public).
- man-in-the-middle 中间人攻击 — un attaquant relaye ou modifie secrètement les messages entre deux parties.
Exemple résolu. Identifiez et décrivez deux menaces pesant sur les données d'un réseau scolaire, et proposez une méthode de prévention différente pour chacune.
Menace 1, malware : un virus copié sur un ordinateur via une pièce jointe ou un téléchargement se reproduit et corrompt ou supprime des fichiers ; prévention : logiciel antivirus qui scanne les fichiers et est tenu à jour. Menace 2, hacking : une personne non autorisée accède au réseau, par exemple en devinant un mot de passe faible, et lit ou modifie les données ; prévention : pare-feu bloquant les connexions non autorisées, ou mots de passe robustes avec authentification à double facteur. Une troisième paire, phishing : un courriel amène l'utilisateur vers un site frauduleux collectant ses identifiants ; prévention : formation des utilisateurs pour vérifier l'expéditeur et l'URL, et filtrage des courriels. La mesure doit correspondre à la menace : le chiffrement n'arrête pas un virus, et l'antivirus n'arrête pas le phishing.
Malware par comportement : auto-réplicatif (virus, ver) versus caché/déguisé (cheval de Troie, spyware, ransomware, adware) Vocabulaire EntrainerAnglais Chinois Pinyin malware/ˈmælweə/ 恶意软件 è yì ruǎn jiàn ransomware/ˈrænsəmweə/ 勒索软件 lè suǒ ruǎn jiàn networks/ˈnetwɜːks/ 网络 wǎng luò man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī virus/ˈvaɪrəs/ 病毒 bìng dú worm/wɜːm/ 蠕虫 rú chóng Trojan horse/ˈtrəʊdʒn hɔːs/ 木马 mù mǎ spyware/ˈspaɪweə/ 间谍软件 jiàn dié ruǎn jiàn adware/ˈædweə/ 广告软件 guǎng gào ruǎn jiàn phishing/ˈfɪʃɪŋ/ 网络钓鱼 wǎng luò diào yú pharming/ˈfɑːmɪŋ/ 域名欺骗 yù míng qī piàn social engineering/ˈsəʊʃl ˌendʒɪˈnɪərɪŋ/ 社会工程 shè huì gōng chéng hacking/ˈhækɪŋ/ 黑客入侵 hēi kè rù qīn hackers/ˈhækəz/ 黑客 hēi kè denial of service/dɪˈnaɪəl ɒv ˈsɜːvɪs/ 拒绝服务 jù jué fú wù eavesdropping/ˈiːvzdrɒpɪŋ/ 窃听 qiè tīng 6.1
Mesures de sécurité

Les mesures protègent à la fois la sécurité des données (contre la perte, le vol ou la corruption) et la sécurité du système informatique (son matériel, son logiciel et son réseau).
PC autonome
- un mot de passe fort ; antivirus tenu à jour ; mises à jour logicielles rapides ; backup 备份 vers un support séparé ; chiffrement 加密 du disque entier ; écran verrouillé.
PC connecté
Tout ce qui précède, plus un pare-feu 防火墙, des permissions par utilisateur (droits administrateur uniquement pour les admins), gestion centralisée des comptes utilisateurs 用户账户, et journaux d'audit 审计日志 (qui s'est connecté, ce qu'il a touché).
Comment fonctionnent les mesures, selon le vocabulaire exigé par le programme :
- pare-feu : examine chaque transmission entrante et sortante et la compare avec des critères définis (liste blanche ou noire d'adresses, ports et protocoles) ; bloque toute connexion ne répondant pas aux critères ; peut empêcher l'accès à certains sites et alerter des tentatives d'accès non autorisées.
- chiffrement : les données sont brouillées (codées) avec une clé en texte chiffré, de sorte qu'une copie interceptée ne peut être comprise sans la clé ; le récepteur utilise une clé pour le décrypter. Il protège les données en transit et au repos, mais n'empêche pas leur interception ou leur suppression.
- mots de passe et comptes utilisateurs : seul un utilisateur connaissant le mot de passe peut se connecter ; un mot de passe fort (long, caractères variés, changé régulièrement) ne peut être deviné ; les comptes se verrouillent après plusieurs échecs ; chaque compte dispose de ses propres droits d'accès.
- logiciels antivirus et antispyware : scanne les fichiers et programmes contre une base de signatures de malwares connus, vérifie le comportement, met en quarantaine ou supprime ce qu'il trouve, et doit être mis à jour pour reconnaître les nouveaux malwares.
- droits d'accès : chaque utilisateur (ou groupe) reçoit des permissions pour chaque fichier ou table, comme lecture seule ou lecture/écriture, afin qu'un utilisateur ne puisse voir ou modifier que les données qui ne lui appartiennent pas ; une base de données peut également afficher à chaque utilisateur une vue contenant uniquement les champs dont il a besoin.
- biométrie : l'appareil capture une image du visage, de l'empreinte digitale ou de l'iris, la convertit en données numériques, la compare avec les données stockées pour cet utilisateur et n'autorise l'accès qu'en cas de correspondance ; cela ne peut être oublié, prêté ou deviné comme un mot de passe.
- sauvegardes : une copie des données sur un support séparé, conservée hors site, permettant de restaurer les données perdues ou corrompues.
Pour restreindre les risques liés au malware, en trois points : installer un logiciel anti-malware et le tenir à jour ; utiliser un pare-feu ; ne pas ouvrir de pièces jointes ni télécharger de fichiers depuis des sources inconnues ; maintenir le système d'exploitation et les applications à jour ; former les utilisateurs.
Un pare-feu se situe entre l'ordinateur de l'utilisateur et Internet À travers Internet
- VPN 虚拟专用网 — chiffre le trafic entre l'utilisateur et la passerelle d'entreprise.
- HTTPS / TLS — chiffre le trafic web.
- signatures numériques 数字签名 — attestent de l'expéditeur d'un message et qu'il n'a pas été modifié en transit.
- détection d'intrusion — surveille le trafic à la recherche de motifs d'attaque connus.
Comment une signature numérique authentifie un document (cinq points) : l'expéditeur fait passer le message dans une fonction de hachage pour produire un digest ; l'expéditeur chiffre le digest avec sa clé privée, et ce digest chiffré constitue la signature numérique ; le message et la signature sont envoyés ensemble ; le récepteur déchiffre la signature avec la clé publique de l'expéditeur pour récupérer le digest ; le récepteur hache le message reçu et compare les deux digests ; si ils correspondent, le message provient bien de l'expéditeur (seul lui détient la clé privée) et n'a pas été altéré lors de la transmission. Une signature prouve l'expéditeur et l'intégrité du message ; elle ne masque pas le contenu, c'est le rôle du chiffrement du message.
Une signature numérique : un hachage du message, chiffré avec la clé privée de l'expéditeur, vérifié par le récepteur contre un nouveau hachage Vocabulaire EntrainerAnglais Chinois Pinyin firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng two-factor authentication/tuː ˈfæktə ɔːˌθentɪˈkeɪʃn/ 双因素认证 shuāng yīn sù rèn zhèng authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng backup/ˈbækʌp/ 备份 bèi fèn user accounts/ˈjuːzə əˈkaʊnts/ 用户账户 yòng hù zhàng hù audit logs/ˈɔːdɪt lɒɡz/ 审计日志 shěn jì rì zhì ciphertext/ˈsaɪfətekst/ 密文 mì wén access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn VPN/ˌviː piː ˈen/ 虚拟专用网 xū nǐ zhuān yòng wǎng digital signatures/ˈdɪdʒɪtl ˈsɪɡnɪtʃəz/ 数字签名 shù zì qiān míng private key/ˈpraɪvət kiː/ 私钥 sī yào public key/ˈpʌblɪk kiː/ 公钥 gōng yào authorisation/ˌɔːθəraɪˈzeɪʃn/ 授权 shòu quán least-privilege/liːst ˈprɪvɪlɪdʒ/ 最小权限 zuì xiǎo quán xiàn plaintext/ˈpleɪntekst/ 明文 míng wén Symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì access control/ˈækses kənˈtrəʊl/ 访问控制 fǎng wèn kòng zhì check digit/tʃek ˈdɪdʒɪt/ 校验位 jiào yàn wèi 6.1
Appariement des mesures aux menaces
- interception en transit → chiffrer les données (HTTPS, VPN). Le texte chiffré intercepté est inutile sans la clé.
- accès non autorisé → authentification forte 身份验证 (mots de passe longs ; authentification à double facteur 双因素认证 avec un code téléphonique ou une clé) ; autorisation des utilisateurs 授权 ; verrouillage après des échecs de connexion.
- malware → logiciel antivirus et anti-spyware 反间谍软件 avec scan en temps réel ; mise à jour de correctifs ; éviter les téléchargements non fiables.
- phishing → formation des utilisateurs ; filtrage des courriels ; vérifier l'URL avant de saisir les identifiants.
- menaces internes → principe de moindres privilèges 最小权限 (donner à chaque utilisateur seulement ce dont il a besoin) ; audit.
- DDoS → limitation de débit et filtrage du trafic.
Pour des données confidentielles traversant Internet, la méthode du programme est le chiffrement : les données sont codées avec une clé en texte chiffré, de sorte qu'une personne non autorisée qui les intercepte ne peut pas les lire, et seul le destinataire prévu, qui possède la clé, peut les décoder. Pour un fichier exécutable envoyé par courriel pour test, la même réponse s'applique (chiffrer le fichier, ou l'envoyer via une connexion chiffrée), ainsi qu'un mot de passe sur le fichier lui-même.
Vocabulaire EntrainerAnglais Chinois Pinyin anti-spyware/ˈænti ˈspaɪweə/ 反间谍软件 fǎn jiàn dié ruǎn jiàn biometrics/ˌbaɪəʊˈmetrɪks/ 生物识别 shēng wù shí bié 6.1
Protection des données elles-mêmes
- chiffrement — convertir le texte clair 明文 en texte chiffré 密文 avec une clé. Chiffrement symétrique 对称加密 (AES) utilise une clé partagée ; chiffrement asymétrique 非对称加密 (RSA) utilise une clé publique 公钥 et une clé privée 私钥. Protège les données au repos et en transit.
- contrôle d'accès 访问控制 — permissions de fichiers (lecture/écriture/exécution) et droits d'accès 访问权限, imposés par le système d'exploitation.
- authentification — les techniques d'authentification vérifient l'utilisateur : quelque chose que vous connaissez (mot de passe), avez (jeton, téléphone), ou êtes (biométrie 生物识别 — empreinte, visage, iris) ; combinaison la plus sûre.
- sauvegardes — conserver des copies (certaines hors site) pour pouvoir récupérer les données en cas de perte ou de corruption.
- sécurité physique — salles de serveurs verrouillées, câbles de sécurité.
Droits d'accès dans une base de données, décrits pour trois points : chaque utilisateur reçoit un compte avec un nom d'utilisateur et un mot de passe ; l'administrateur de base de données attribue à chaque compte des permissions pour chaque table, comme lecture seule, lecture/écriture ou aucun accès ; les utilisateurs ne voient que les tables et les champs auxquels ils ont droit, de sorte qu'un client ne peut pas ouvrir la table du personnel et qu'un commis peut lire mais pas modifier les prix. Le SGBD impose cela via ses droits d'accès et ses vues, et peut également chiffrer les données stockées.
Le chiffrement symétrique utilise une clé partagée ; le chiffrement asymétrique utilise une clé publique pour chiffrer et une clé privée pour décrypter 
Un jeton de sécurité affiche un code changeant pour l'authentification à double facteur ("quelque chose que vous avez") 
Un lecteur d'empreintes vérifie "quelque chose que vous êtes" — une caractéristique de la personne, pas un mot de passe ExplorerChiffrer avec un chiffrement de César
Changez le décalage — c'est la clé. Chaque lettre glisse de cet endroit le long de l'alphabet pour former le texte chiffré, et la même clé le ramène en arrière. Cette clé partagée est la cryptographie symétrique en miniature.
Vocabulaire EntrainerAnglais Chinois Pinyin encryption/enˈkrɪpʃn/ 加密 jiā mì 6.2
Intégrité des données
Programme
Les candidats doivent être capables de : Notes et orientations Décrire comment la validation des données et la vérification des données aident à protéger l'intégrité des données Décrire et utiliser des méthodes de validation des données Y compris vérification de plage, vérification de format, vérification de longueur, vérification de présence, vérification d'existence, vérification de limite, chiffre de contrôle Décrire et utiliser des méthodes de vérification des données lors de la saisie et du transfert de données Lors de la saisie incluant vérification visuelle, double saisie Lors du transfert incluant vérification de parité (octet et bloc), somme de contrôle Source : Programme Cambridge International
Les données ont de l'intégrité lorsqu'elles sont exactes et complètes. Deux techniques : validation des données (repérer les mauvaises données avant stockage) et vérification des données (confirmer que les données ont été saisies ou transférées correctement).
Validation — les données ont-elles du sens ?
Validation 验证 vérifie les données selon des règles logiques, automatiquement :
- test de plage — dans les limites (un mois est compris entre 1 et 12).
- test de limite — du bon côté d'une limite unique (par exemple, âge ≥ 18).
- test d'existence — l'objet référencé existe (par exemple, un code produit figure dans la table).
- test de longueur — le bon nombre de caractères.
- test de type / caractère — le bon type de données (un champ téléphone n'autorise que les chiffres).
- test de format — correspond à un motif (une adresse e-mail doit contenir
@). - test de présence — les champs obligatoires ne sont pas vides.
- chiffre de contrôle 校验位 — un chiffre supplémentaire calculé à partir des autres (ISBN, numéros de carte) qui repère les erreurs de transcription.
Exemple corrigé. Dans un schéma simple de chiffre de contrôle, le chiffre de contrôle est le reste de la division de la somme des chiffres par $10$, ajouté au numéro. Le nombre $4162$ a une somme de chiffres $13$, donc il est stocké sous la forme $41623$. Un utilisateur tape $14623$ : les deux premiers chiffres sont échangés, mais la somme reste $13$, donc le chiffre de contrôle correspond toujours et l'erreur n'est pas détectée. Un utilisateur qui tape $41523$ est détecté, car $4 + 1 + 5 + 2 = 12$ donne le chiffre de contrôle $2$. Un schéma qui détecte les chiffres échangés pondère différemment chaque position, comme le fait la vérification ISBN-13 (pondérations $1, 3, 1, 3, \ldots$, puis le chiffre qui rend le total multiple de $10$). Un chiffre de contrôle est une validation : il teste le numéro contre une règle au moment de son entrée.
- contrôle de consultation et contrôle de cohérence (par ex. date de livraison ≥ date de commande).
La validation capture les données mal formatées, mais pas les données qui ont le bon format tout en étant factuellement fausses ("Bob" pour "Bib").
Exemple résolu. Identifiez la vérification de validation que chaque morceau de pseudocode effectue.
Pseudocode Contrôle IF x < 0 OR x > 10 THEN OUTPUT "Invalid"contrôle de plage : la valeur doit se situer entre deux limites IF x = "" THEN OUTPUT "Invalid"contrôle de présence : le champ ne doit pas être vide IF NOT(x = "Red" OR x = "Yellow" OR x = "Blue") THEN OUTPUT "Invalid"contrôle de consultation (existence) : la valeur doit faire partie d'une liste IF LENGTH(x) <> 6 THEN OUTPUT "Invalid"contrôle de longueur : le bon nombre de caractères IF MID(x, 1, 1) < "A" OR MID(x, 1, 1) > "Z" THEN OUTPUT "Invalid"contrôle de format : un caractère particulier doit être une lettre Pour valider un numéro d'immatriculation automobile qui doit comporter une lettre, trois chiffres et deux lettres : un contrôle de format teste chaque position par rapport à son motif, et un contrôle de longueur confirme six caractères. Pour valider une date de naissance : un contrôle de format (
DD/MM/YYYY), un contrôle de plage (le mois est de $1$ à $12$, l'année n'est pas dans le futur) et un contrôle de présence (il n'est pas laissé vide). Une note entre $0$ et le maximum du test nécessite un contrôle de type (un entier) et un contrôle de plage, avec la limite supérieure lue depuis l'enregistrement lui-même du test : c'est ainsi que la validation protège l'intégrité, en refusant les données qui ne pourraient pas être correctes.Vérification — les données ont-elles été saisies ou transférées correctement ?
Vérification 核对 vérifie que les données n'ont pas été modifiées lors du passage d'un endroit à un autre.
Pendant la saisie : double saisie (la taper deux fois et comparer, comme pour un nouveau mot de passe) ou contrôle visuel.
Selon les termes du schéma, la double saisie consiste à saisir les données deux fois, par la même personne ou par deux personnes, et à faire comparer l'ordinateur les deux versions et à signaler toute différence ; un contrôle visuel est la comparaison par la personne de ce qui est à l'écran avec le document source d'origine et la correction de toute différence avant l'enregistrement. Les deux protègent l'intégrité en s'assurant que les données stockées correspondent à la source. Même après la validation et la vérification, les données peuvent toujours être fausses : elles peuvent sembler logiques et correspondre à la source, mais la source elle-même était erronée, ou l'utilisateur a tapé une valeur différente mais valide de celle prévue.
Pendant le transfert (les bits peuvent basculer) :
- contrôle de parité 奇偶校验 — un bit supplémentaire rend le nombre de 1s pair (parité paire) ou impair. Le récepteur recompte. Capture les erreurs sur un seul bit.
- somme de contrôle 校验和 — l'expéditeur envoie une valeur récapitulative des données ; le récepteur la recalculent et la compare.
- contrôle de redondance cyclique 循环冗余校验 (CRC) — une somme de contrôle plus puissante utilisant la division polynomiale, capturant beaucoup plus de types d'erreurs.
Un contrôle de bloc de parité 奇偶块校验 va plus loin et localise l'erreur. Organisez les octets dans une grille : donnez à chaque octet un bit de parité de ligne, puis calculez un octet de parité supplémentaire dont les bits sont la parité de colonne des octets ci-dessus. Un seul bit basculé échoue maintenant une ligne et une colonne – leur intersection localise exactement quel bit a changé, de sorte qu'il peut même être corrigé.
Exemple résolu. Quatre octets sont envoyés avec parité paire, suivis d'un octet de parité. Trouvez le bit qui a été corrompu.
Un contrôle de bloc de parité : la ligne qui échoue et la colonne qui échouent se croisent au bit basculé Comptez les 1s dans chaque ligne et chaque colonne. Chaque ligne et chaque colonne doivent contenir un nombre pair de bits ; l'octet 3 en contient cinq et la colonne 4 en contient trois. Le bit situé à l'intersection de cette ligne et de cette colonne est celui qui a changé, il est donc réinitialisé de 1 à 0. Une vérification de parité détecte seule une erreur dans un octet mais ne permet pas d'identifier le bit concerné ; deux erreurs dans le même octet s'annulent et passent inaperçues. Une somme de contrôle, expliquée pour trois points : l'émetteur applique un algorithme au bloc de données afin de produire une valeur de somme de contrôle ; les données et la somme de contrôle sont envoyées ensemble ; le récepteur applique le même algorithme aux données reçues ; si les deux sommes de contrôle correspondent, les données sont acceptées, sinon elles sont rejetées et renvoyées.
Le bit de parité est réglé pour rendre le nombre de 1s pair ou impair 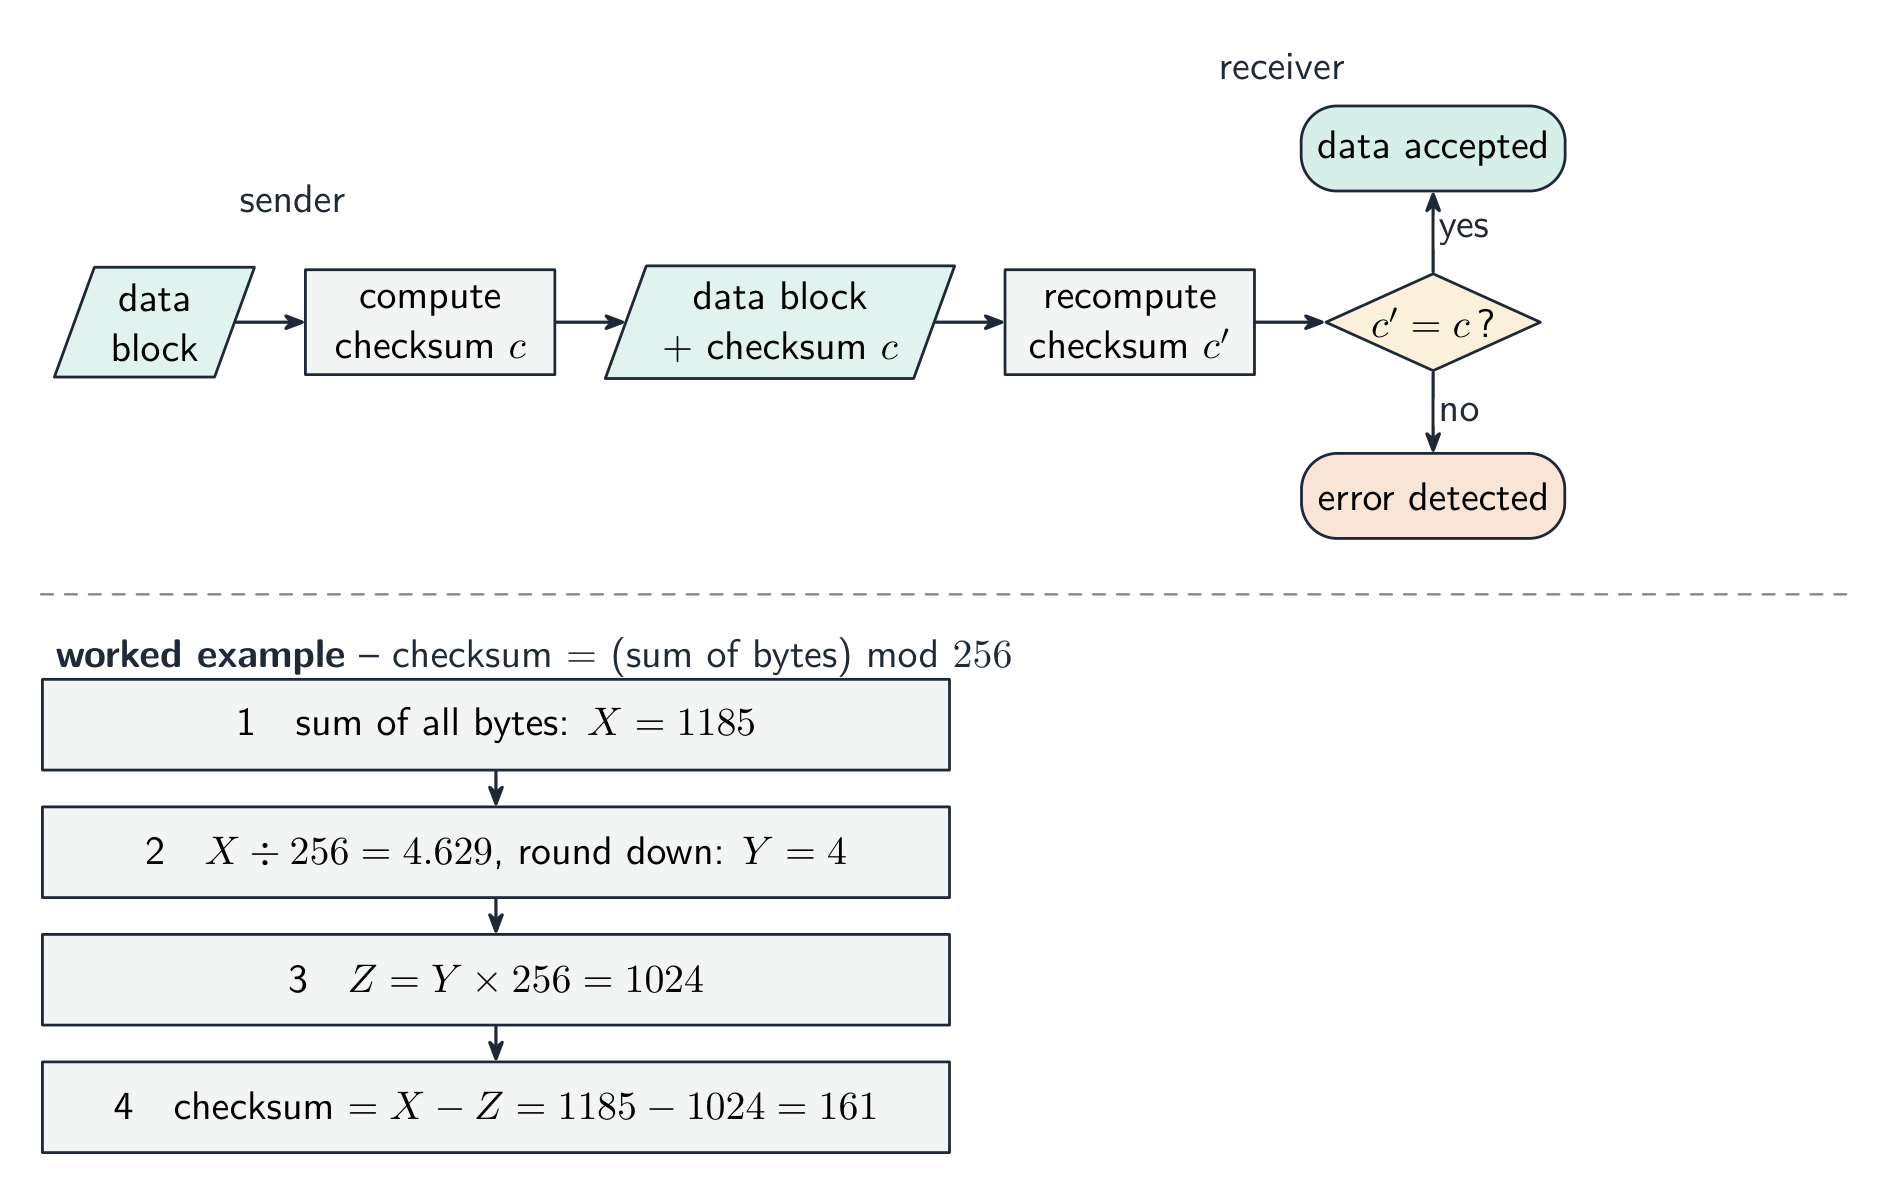
Calcul d'une somme de contrôle pour un bloc de données La vérification prouve uniquement ce qui est arrivé correspond à ce qui a été envoyé — pas que les données sont correctes, ni contre un tamponnement délibéré. La validation demande « est-ce logique ? » ; la vérification demande « a-t-il été copié correctement ? » — utilisez les deux.
Les questions de tableau trient les méthodes selon quand elles sont utilisées : pendant la saisie des données, double saisie et contrôle visuel ; pendant le transfert de données, contrôle de parité (octet ou bloc) et somme de contrôle. Transférer des fichiers vidéo d'une caméra vers un serveur utilise une somme de contrôle : la caméra la calcule, le serveur la recalculent, un désaccord signifie retransmission.
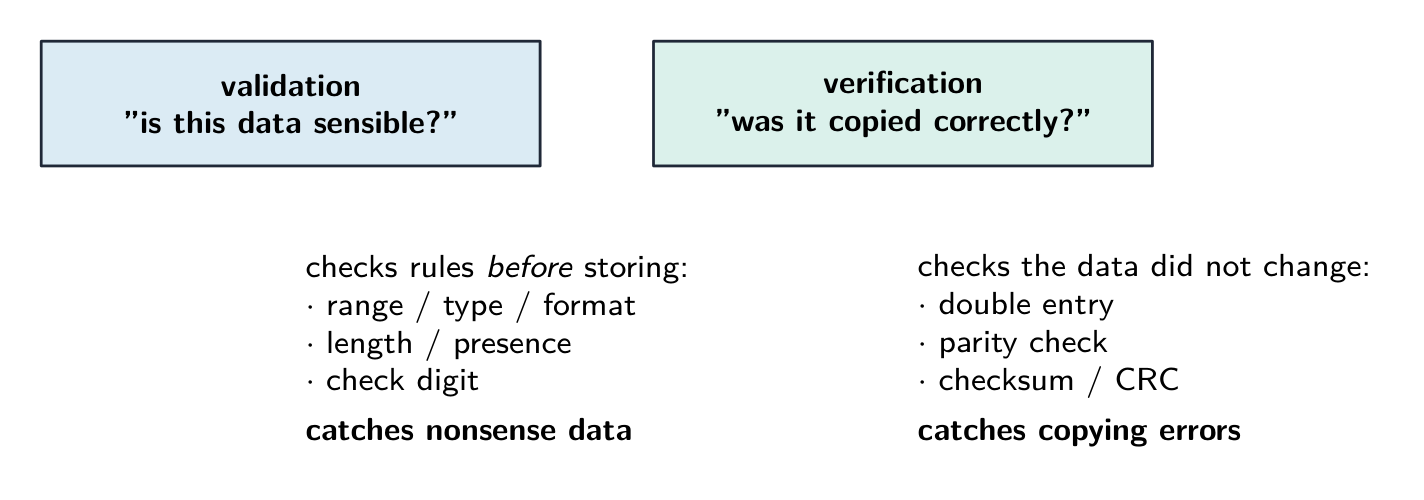
La validation vérifie que les données ont du sens ; la vérification vérifie qu'elles ont été copiées sans changement Exemple résolu. Un utilisateur tape sa date de naissance comme
31/02/2009, et tape son adresse e-mail deux fois. Quelle vérification capture quelle erreur, et quelle est la différence ? La validation demande « ces données sont-elles logiques ? » - l'ordinateur la teste contre une règle, et un contrôle de format ou de plage rejette31/02/2009car février n'a jamais 31 jours. La vérification demande « ces données ont-elles été saisies correctement ? » - taper l'e-mail deux fois est une double saisie, et comparer les deux copies capture une faute de frappe. La limite est ce qui fait de cette question une question favorite : la validation ne peut jamais vous dire que les données sont correctes, seulement qu'elles sont possibles -01/02/2009passe toutes les règles de validation même si l'utilisateur était en réalité né un jour différent. Dites ce que chaque contrôle peut et ne peut pas capturer.ExplorerLaboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng verification/ˌverɪfɪˈkeɪʃn/ 核对 hé duì parity check/ˈpærɪti tʃek/ 奇偶校验 jī ǒu jiào yàn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé cyclic redundancy check/ˈsaɪklɪk rɪˈdʌndənsi tʃek/ 循环冗余校验 xún huán rǒng yú jiào yàn parity block check/ˈpærɪti blɒk tʃek/ 奇偶块校验 jī ǒu kuài jiào yàn 6.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
Terme Définition sécurité des données maintenir les données en sécurité contre la perte et l'accès non autorisé, le changement ou la suppression confidentialité des données maintenir les données confidentielles, de sorte qu'elles ne soient vues que par ceux qui ont le droit de les voir intégrité des données les données étant précises, cohérentes et complètes malware logiciel malveillant installé sans la connaissance de l'utilisateur pour endommager un système ou voler des données virus malware qui se réplique, s'attache à d'autres fichiers et corrompt ou supprime des données spyware malware qui enregistre les frappes au clavier ou les actions de l'utilisateur et les envoie à un tiers phishing un e-mail faisant semblant d'être d'une organisation légitime qui conduit l'utilisateur à un site web frauduleux pour collecter des données personnelles pharming code malveillant qui redirige l'utilisateur vers un site web frauduleux même lorsque la bonne adresse est saisie pare-feu matériel ou logiciel qui examine tout le trafic entrant ou sortant d'un système selon des critères définis et bloque ce qui ne les respecte pas chiffrement brouiller les données avec une clé en texte chiffré, de sorte qu'elles ne puissent pas être comprises sans la clé pour les déchiffrer signature numérique un hachage d'un message chiffré avec la clé privée de l'expéditeur, utilisé pour prouver qui l'a envoyé et qu'il n'a pas été altéré validation des données contrôle automatique que les données saisies sont raisonnables et suivent des règles établies vérification des données contrôle que les données ont été saisies ou transférées correctement, en les comparant avec la source ou avec une valeur recalculée chiffre de contrôle chiffre supplémentaire calculé à partir des autres chiffres d'un numéro et ajouté à celui-ci, afin qu'une erreur dans le numéro puisse être détectée contrôle de parité bit supplémentaire ajouté à un octet pour que le nombre de 1s soit pair (ou impair), que le récepteur recompte somme de contrôle une valeur calculée à partir d'un bloc de données par un algorithme et envoyée avec lui, recalculée par le destinataire et comparée 6.2
Conseils d'examen
- Gardez les trois idées séparées : sécurité (maintenir les données en sécurité), confidentialité (qui peut les voir), intégrité (les maintenir correctes).
- Associez chaque menace (malware, piratage, phishing, interception) à une mesure (pare-feu, chiffrement, authentification, droits d'accès).
- Le chiffrement protège la confidentialité, pas l'intégrité — utilisez une somme de contrôle, la parité ou un chiffre de contrôle pour l'intégrité.
- Distinuez un virus, ver et Cheval de Troie et comment chacun se propage.
Erreurs courantes
- Donner la même mesure pour deux menaces, ou une mesure qui ne correspond pas à la menace. Chaque menace dans le tableau a besoin d'une prévention différente qui l'arrête réellement.
- Nommer une mesure sans dire comment elle fonctionne. « Pare-feu » obtient des points lorsqu'il est suivi de « compare le trafic avec des critères définis et bloque ce qui échoue ».
- Qualifier la validation comme un contrôle que les données sont correctes. La validation vérifie que les données sont raisonnables ; la vérification vérifie qu'elle correspond à la source. Aucun ne prouve qu'elle est vraie.
- Dire qu'une signature numérique chiffre le message. Elle chiffre un hachage du message avec la clé privée ; le récepteur le déchiffre avec la clé publique et compare les hachages.
- Décrire un chiffre de contrôle comme une vérification, ou un contrôle de parité comme une validation. Le chiffre de contrôle est une règle de validation à la saisie ; parité et sommes de contrôle vérifient un transfert.
- Écrire qu'un virus « envoie des données à un tiers » et que le spyware « se réplique ». C'est le virus qui se réplique ; c'est le spyware qui enregistre.
-
7
Éthique et propriété intellectuelle
Regarder la leçon7.1
Éthique pour les professionnels de l'informatique
Programme
Les candidats doivent être capables de : Notes et orientations Comprendre la nécessité et l'objectif de l'éthique en tant que professionnel de l'informatique Comprendre l'importance de rejoindre une organisation professionnelle éthique incluant BCS (British Computer Society), IEEE (Institute of Electrical and Electronic Engineers) Comprendre la nécessité d'agir de manière éthique et l'impact d'une action éthique ou non éthique dans une situation donnée Comprendre la nécessité d'une législation sur le droit d'auteur Comprendre les différents types de licences logicielles et justifier l'utilisation d'une licence pour une situation donnée Les licences incluent Free Software Foundation, Open Source Initiative, partageable et logiciel commercial Comprendre l'Intelligence Artificielle (IA) Comprendre l'impact de l'IA incluant les questions sociales, économiques et environnementales Comprendre les applications de l'IA Source : Programme Cambridge International
Un professionnel de l'informatique est quelqu dont le travail — logiciel, systèmes, réseaux, données — affecte d'autres personnes. Comme ce travail est technique, les autres ne peuvent souvent pas juger s'il a été accompli avec compétence ou honnêteté. La profession suit donc des éthiques 伦理 partagées (principes de bonne conduite).
Pourquoi l'éthique est importante
- confiance — les utilisateurs et les employeurs font confiance aux professionnels pour qu'ils agissent dans leur intérêt. Sans cette confiance, les logiciels perdent en crédibilité.
- impact — les logiciels gèrent des dispositifs médicaux, la banque, les véhicules. Un travail négligent ou malhonnête peut nuire aux personnes.
Les organismes professionnels (BCS, ACM, IEEE) publient des codes d'éthique pour leurs membres.
La vidéosurveillance soulève des préoccupations concernant la vie privée — l'un des enjeux éthiques qu'un professionnel de l'informatique doit évaluer 
Les équipements électroniques jetés (DEEE) constituent un coût environnemental croissant de l'informatique 
Le développement logiciel affecte le bien-être du public de plusieurs manières Principes typiques
- intérêt public en premier — protéger la sécurité et le bien-être de ceux qui sont touchés.
- honnêteté et compétence — être honnête sur ses compétences ; ne pas prétendre à une expertise que l'on ne possède pas.
- confidentialité 保密性 — protéger les informations privées des clients et des employeurs.
- éviter les conflits d'intérêts 利益冲突 — ne pas prendre de travail où son intérêt entre en conflit avec celui du client.
- maintenir ses compétences à jour ; respecter la propriété intellectuelle 知识产权 et la vie privée 隐私 ; traiter les collègues équitablement.
Adhésion à un organisme professionnel
Le programme nomme deux organismes : le BCS (British Computer Society) et l'IEEE (Institute of Electrical and Electronics Engineers). Tous deux publient un code de déontologie 行为准则 que les membres s'engagent à suivre. Les avantages de l'adhésion, selon les termes du programme : un ensemble de directives éthiques à suivre, afin que les décisions ne soient pas laissées à l'appréciation personnelle ; la formation, les conférences et les publications qui maintiennent le membre à jour ; des conseils et un soutien, y compris une aide juridique, lorsqu'un problème survient ; et un statut professionnel reconnu, afin que les employeurs et les clients fassent confiance au travail du membre. Les conséquences de ne pas adhérer : aucune orientation sur les décisions éthiques, de sorte que le programmeur peut agir de manière non éthique sans s'en rendre compte ; moins de crédibilité auprès des employeurs et des clients, rendant plus difficile l'obtention de travaux ; aucun soutien en cas de litige ; et se mettre à jour avec les développements et la loi. L'objectif d'un code de déontologie (deux points) : créer un environnement de travail sûr, respectueux et professionnel, et s'assurer que chaque employé comprend ce qui est attendu et les conséquences de ses actes.
Exemple résolu. Expliquez pourquoi un programmeur doit agir de manière éthique envers ses collègues et envers le public.
Collègues : les traiter équitablement et sans discrimination ; respecter leur travail, leurs idées et leurs informations confidentielles ; être honnête sur ses erreurs et accorder le mérite là où il est dû ; soutenir leur développement plutôt que de le compromettre. Le public : protéger leurs données personnelles et leur vie privée ; produire des logiciels sûrs, fiables et correctement testés, car les défauts peuvent causer des dommages ; être honnête sur ce que le logiciel peut faire ; n'accepter que les travaux relevant de sa compétence ; obéir à la loi et considérer les effets plus larges sur la société et l'environnement. Chaque partie obtient des points pour une raison et sa conséquence, et non simplement pour le mot "équité" seul.
Agir de manière éthique vs non éthique
Agir de manière éthique protège les utilisateurs, renforce la réputation, réduit les risques juridiques et crée la confiance. Agir de manière non éthique (passer à côté des tests, cacher des bugs, mal utiliser des données) peut nuire aux vrais utilisateurs, entraîner un licenciement ou des poursuites judiciaires, endommager la réputation et éroder la confiance générale envers la technologie.
Lorsque vous faites face à une décision limite : identifiez dont les intérêts sont concernés, vérifiez le code d'éthique et la loi, pesez les conséquences, demandez à un supérieur de confiance, et choisissez l'option qui protège les utilisateurs avant la commodité à court terme.
Exemple résolu. L'outil IA de recrutement de votre équipe trie les CV dix fois plus vite, mais vous remarquez qu'il rejette davantage de candidats âgés. Le lancer de cet outil plait à votre manager, mais cela traite injustement un groupe. Le choix éthique est de le retenir jusqu'à ce que le biais soit corrigé — l'intérêt public et l'équité priment sur la commodité à court terme.
L'éthique s'applique aussi aux utilisateurs. Un étudiant qui connecte un ordinateur personnel au réseau scolaire devrait respecter la vie privée et les données des autres, ne pas utiliser les réseaux sociaux de manière inappropriée ou harceler les autres, ne pas télécharger ou partager du matériel protégé par le droit d'auteur, ne pas introduire de logiciels malveillants ou essayer d'accéder à des systèmes auxquels il n'a pas accès, et utiliser le réseau à la fin pour laquelle il a été fourni. Une réponse « donner trois considérations éthiques » liste trois de ces éléments.
ExplorerLaboratoire de risque et de responsabilité
Triez les exemples selon la règle, le risque ou la protection impliquée.
7.1
Droit d'auteur

Le droit d'auteur 版权 est le droit légal du créateur d'une œuvre originale de contrôler la manière dont elle est copiée, distribuée, modifiée et exécutée. Il s'applique automatiquement (sans inscription) au code source, aux logiciels, aux documents, aux images, à l'audio et à la vidéo.
Sans le droit d'auteur, chacun pourrait copier librement un logiciel, le développeur ne serait pas payé, et le plagiat deviendrait légal. Avec le droit d'auteur, les développeurs peuvent gagner de l'argent sur leur travail (encourageant ainsi la création de plus de logiciels), les utilisateurs savent qui l'a créé, et la réutilisation se fait aux conditions du développeur via des licences. Le droit d'auteur dure longtemps (souvent 70 ans après la mort du créateur). Les idées générales et les algorithmes ne sont pas couverts par le droit d'auteur mais peuvent l'être par un brevet 专利.
Pourquoi un programmeur devrait copyrighter un programme, selon les termes du programme : être identifié comme propriétaire et auteur (reconnaissance formelle de la propriété) ; afin qu'il y ait des conséquences légales si quelqu'un le copie ou le vole ; pour empêcher les concurrents de vendre le même travail ; et pour pouvoir gagner de l'argent en le licenciant. Le droit d'auteur s'applique au programme tel qu'il est écrit ; un programme différent effectuant la même tâche ne l'infinge pas.
Le droit d'auteur est automatique et durable ; un brevet doit être déposé et dure environ 20 ans ExplorerLaboratoire de risque et de responsabilité
Triez les exemples selon la règle, le risque ou la protection impliquée.
Vocabulaire EntrainerAnglais Chinois Pinyin copyright/ˈkɒpɪraɪt/ 版权 bǎn quán patent/ˈpeɪtənt/ 专利 zhuān lì software licence/ˈsɒftweə ˈlaɪsəns/ 软件许可证 ruǎn jiàn xǔ kě zhèng proprietary/prəˈpraɪətəri/ 专有 zhuān yǒu 7.1
Licences logicielles
Une licence logicielle 软件许可证 est un contrat accordant la permission d'utiliser un logiciel aux conditions du propriétaire ; choisir et appliquer une licence s'appelle la licensing logicielle.
Commercial (propriétaire)
- le logiciel commercial est vendu : vous achetez une licence ; le logiciel est utilisé uniquement selon ses termes.
- le code source n'est pas fourni (un produit propriétaire 专有) ; vous ne pouvez pas le modifier ou le redistribuer.
- exemples : Microsoft Office, Adobe Photoshop, la plupart des jeux vidéo.
Utilisé lorsque le développeur souhaite générer des revenus par utilisateur et garder le contrôle du code.
Open-source
- le code source est public ; les utilisateurs peuvent le lire, le modifier et le redistribuer (open-source 开源).
- les licences permissives (MIT, BSD) permettent presque toute utilisation ; les licences copyleft 著佐权 (GPL) exigent que les versions modifiées soient publiées sous la même licence (« partage à l'identique »).
- la Free Software Foundation (FSF) et l'Open Source Initiative (OSI) promeuvent et approuvent les licences open-source.
Le programme nomme les deux, et ils sont marqués comme réponses distinctes. Free Software (terme de la FSF) signifie libre au sens de la liberté, pas du prix : l'utilisateur peut exécuter le programme à tout but, l'étudier et le modifier (le code source doit donc être disponible), redistribuer les copies, et distribuer les versions modifiées ; une fee peut encore être facturée pour une copie. Open Source (définition de l'OSI) exige que le code source soit disponible, que le programme puisse être modifié et redistribué, et que la licence ne discrimine aucune personne ou domaine d'utilisation. « Identifiez deux types de licences permettant à d'autres personnes de modifier et redistribuer le programme » est répondu par ces deux-là.
- exemples : Linux, Python, Apache.
Utilisé lorsque le développeur souhaite que le logiciel soit largement utilisé et amélioré par la communauté.
Freeware et shareware
- freeware 免费软件 — gratuit, sans code source, peut être redistribué mais pas modifié (Acrobat Reader, WhatsApp).
- shareware 共享软件 — gratuit pendant une période d'essai, puis vous payez pour continuer à l'utiliser ; pas de code source.
Les descriptions du programme : shareware est distribué gratuitement pour une essai (une durée limitée ou des fonctionnalités limitées) et l'utilisateur paie pour continuer à utiliser la version complète ; logiciel commercial est vendu contre une fee, le code source n'est pas fourni, la licence protège la propriété intellectuelle du développeur, et la fee achète généralement du support et des mises à jour. Avantages du shareware pour le programmeur : les utilisateurs peuvent essayer le programme avant d'acheter, donc ils sont plus susceptibles d'acheter ; il se répand largement à peu près sans coûts de publicité ; et ceux qui le gardent paient. Avantages d'une licence commerciale : le développeur perçoit une fee pour chaque copie ; le code et ses droits restent protégés ; et les revenus financent le support, les mises à jour et le développement ultérieur.
Type Coût Code source Redistribuer Modifier Commercial Payant Non Non Non Open-source Gratuit Oui Oui Souvent, avec conditions Freeware Gratuit Non Oui Non Shareware Essai gratuit, puis payant Non Parfois Non Choix d'une licence selon l'objectif du développeur Pour justifier un choix de licence, liez-le à l'objectif du développeur (revenus, portée, communauté), aux besoins des utilisateurs (coût, personnalisation) et au cas d'utilisation.
Exemple résolu. Un programmeur a écrit un jeu à vendre au grand public. Identifiez la licence la plus appropriée et justifiez-la.
Une licence commerciale : le jeu est vendu contre une fee, donc le programmeur gagne de l'argent sur chaque copie ; le code source n'est pas publié, donc personne ne peut copier le jeu ou le modifier et le revendre comme sien ; la licence protège la propriété intellectuelle ; et les acheteurs reçoivent des mises à jour et du support. L'open source ne conviendrait pas, car le code source serait disponible, permettant au jeu d'être copié, modifié et redistribué sans paiement.
Exemple résolu. Un programme aide les acheteurs en lisant à haute voix les étiquettes des produits. Expliquez pourquoi une licence open source pourrait ne pas être appropriée.
Le code source serait accessible, donc il pourrait être modifié ; une version modifiée pourrait afficher de mauvaises informations sur le produit, ce qui amènerait les acheteurs à se tromper d'article ; et le programmeur perdrait le contrôle de la qualité et de la sécurité de ce qui est distribué sous le nom du programme. À l'inverse, les programmes sont libérés en open source afin que d'autres développeurs puissent les améliorer et les étendre, qu'ils soient adoptés massivement gratuitement, et que les utilisateurs puissent les adapter à leurs propres besoins.
Vocabulaire EntrainerAnglais Chinois Pinyin open-source/ˈəʊpən sɔːs/ 开源 kāi yuán copyleft/ˈkɒpɪleft/ 著佐权 zhù zuǒ quán freeware/ˈfriːweə/ 免费软件 miǎn fèi ruǎn jiàn shareware/ˈʃeəweə/ 共享软件 gòng xiǎng ruǎn jiàn artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí Deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì recommendation systems/ˌrekəmenˈdeɪʃn ˈsɪstəmz/ 推荐系统 tuī jiàn xì tǒng autonomous vehicles/ɔːˈtɒnəməs ˈvɪəklz/ 自动驾驶汽车 zì dòng jià shǐ qì chē optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 7.1
Intelligence Artificielle (IA)

L'intelligence artificielle 人工智能 construit des systèmes qui effectuent des tâches autrefois considérées comme nécessitant une intelligence humaine — reconnaissance vocale et visuelle, traduction, jeu, conduite automobile.
La plupart des IA modernes utilisent l'apprentissage automatique 机器学习 — des algorithmes qui s'améliorent dans une tâche en apprenant des modèles à partir de grandes quantités de données, au lieu d'être programmés étape par étape. L'apprentissage profond 深度学习, utilisant des réseaux de neurones 神经网络 avec de nombreuses couches, est l'approche dominante aujourd'hui.
Exemples quotidiens
Les tâches de l'IA se divisent en deux catégories : comprendre l'entrée, et produire une sortie ou des décisions.
Comprendre l'entrée :
- reconnaissance vocale 语音识别 — conversion de la parole en texte (assistants vocaux).
- reconnaissance d'images 图像识别 — détection d'objets, de visages ou de texte dans des images.
Produire une sortie ou des décisions :
- traduction automatique 机器翻译 — traduction automatique entre langues.
- systèmes de recommandation 推荐系统 — suggestion de produits, de vidéos ou de musique.
- véhicules autonomes 自动驾驶汽车 et robots.
Un scénario d'examen courant : un programme lit une étiquette avec une caméra, la traduit et la lit à haute voix — en utilisant la reconnaissance optique de caractères 光学字符识别 pour trouver les mots, la traduction automatique pour les convertir, et la synthèse vocale 文本转语音 pour l'audio.
Scénario courant : ROC → traduction automatique → synthèse vocale lit une étiquette étrangère à haute voix Une réponse à « expliquer comment l'IA est utilisée » valant quatre points suit le processus étape par étape : la reconnaissance d'images (ROC) analyse les pixels de la photographie pour localiser les caractères ; les motifs de pixels sont convertis en caractères et mots individuels ; la traduction automatique convertit les mots dans la langue de l'utilisateur ; et la synthèse vocale produit la sortie parlée. Chaque étape vaut un point.
Avantages
- accessibilité — l'IA vocale/visuelle aide les personnes ayant des déficiences ; la traduction aide les non-locuteurs natifs.
- productivité — l'automatisation des tâches répétitives libère les personnes pour le travail créatif.
- aide à la décision — l'IA repère des modèles dans d'immenses bases de données (diagnostic médical, détection de fraude).
- toujours disponible, et personnalisé pour chaque utilisateur.
Impacts : sociaux, économiques, environnementaux
Le programme demande l'impact de l'IA sous trois rubriques, et une question en nomme une. Donnez l'impact et sa conséquence.
- Social : avantages — un programme de lecture d'étiquettes aide les personnes souffrant d'un handicap visuel, celles qui ne peuvent pas lire la langue, et celles ayant des difficultés de lecture ; la reconnaissance faciale dans un aéroport accélère les contrôles d'identité et peut empêcher l'entrée de personnes recherchées. Inconvénients — la reconnaissance faciale peut mal identifier des gens et surveiller tout le monde sans consentement, entraînant une perte de vie privée ; les étudiants qui utilisent l'IA pour faire leurs devoirs peuvent ne pas développer leur capacité de raisonnement et de résolution de problèmes, peuvent y依赖 au lieu d'apprendre, et peuvent perdre la collaboration et la communication en face à face qu'apporte le travail ensemble.
- Économique : un module de diagnostic de pannes par IA dans un garage diagnostique plus vite et plus précisément, donc plus de véhicules sont réparés par jour et les coûts baissent ; mais moins de mécaniciens qualifiés seront nécessaires, donc des emplois sont perdus, et le module doit être acheté et entretenu. Plus généralement, l'IA augmente la productivité et crée de nouveaux emplois dans certains domaines tout en éliminant des emplois routiniers dans d'autres.
- Environnemental : l'entraînement et l'exécution de grands modèles consomment énormément d'électricité et d'eau pour le refroidissement dans les centres de données, et le matériel devient des déchets électroniques ; d'un autre côté, l'IA est utilisée pour réduire la consommation d'énergie dans les bâtiments, optimiser les transports et surveiller l'environnement.
- Éthique (la question de classe) : une IA qui note des travaux ou surveille des étudiants doit être équitable envers chaque élève, ne doit pas fuiter leurs données, doit être explicable lorsqu'elle prend une décision à leur sujet, et ne doit pas remplacer le jugement d'un enseignant là où cela compte.
Préoccupations
- biais 偏见 — des modèles injustes dans les données d'entraînement deviennent des décisions d'IA injustes (recrutement, prêt).
- remplacement d'emplois — l'IA peut remplacer certains rôles.
- vie privée — l'entraînement utilise souvent de grandes quantités de données personnelles.
- transparence — les grands modèles sont des « boîtes noires », difficiles à expliquer.
- responsabilité — quand l'IA se trompe, qui est responsable : le développeur, l'utilisateur ou l'opérateur ?
- mauvaise utilisation — deepfakes, désinformation, surveillance.

Comment le biais entre dans l'IA : données biaisées → modèle biaisé → décisions injustes Les professionnels doivent comprendre les limites de l'IA qu'ils construisent, informer les utilisateurs, et réduire les dommages.
ExplorerLaboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin ethics/ˈeθɪks/ 伦理 lún lǐ privacy/ˈprɪvəsi/ 隐私 yǐn sī confidentiality/ˌkɒnfɪˌdenʃiˈæləti/ 保密性 bǎo mì xìng conflicts of interest/ˈkɒnflɪkts ɒv ˈɪntrest/ 利益冲突 lì yì chōng tū intellectual property/ˌɪntəˈlektʃuːəl ˈprɒpəti/ 知识产权 zhī shí chǎn quán code of conduct/kəʊd ɒv ˈkɒndʌkt/ 行为准则 xíng wéi zhǔn zé bias/ˈbaɪəs/ 偏见 piān jiàn 7.1
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
Terme Définition éthique les principes moraux qui régissent le comportement d'une personne, dans une profession les normes définies dans son code de déontologie code de déontologie les règles qu'une organisation ou un organisme professionnel fixe pour le comportement de ses membres droit d'auteur le droit légal du créateur d'une œuvre originale de contrôler la manière dont elle est copiée, distribuée et modifiée licence logicielle l'accord juridique qui stipule comment un logiciel peut être utilisé, copié et distribué logiciel commercial logiciel vendu contre rémunération, sans code source, sous une licence protégeant la propriété intellectuelle du développeur logiciel libre (FSF) logiciel dont les utilisateurs sont libres d'exécuter, d'étudier, de modifier et de redistribuer, son code source étant disponible open source (OSI) logiciel dont le code source est disponible et qui peut être modifié et redistribué selon sa licence shareware logiciel distribué gratuitement pour une période d'essai ou avec des fonctionnalités limitées, après quoi l'utilisateur paie pour continuer freeware logiciel gratuit à utiliser et à copier, mais dont le code source n'est pas publié et qui ne peut pas être modifié intelligence artificielle systèmes informatiques effectuant des tâches qui nécessitent normalement une intelligence humaine, comme la reconnaissance d'images et de parole apprentissage automatique forme d'IA dans laquelle un système s'améliore dans une tâche en apprenant des modèles à partir de données plutôt que par programmation explicite 7.1
Conseils d'examen
- Répondez aux questions d'éthique selon un code de déontologie professionnel (intérêt public, compétence, honnêteté), et non selon votre opinion personnelle.
- Distinuez le droit d'auteur (protège l'expression) d'un brevet (protège une invention).
- Comparez les licences logicielles : propriétaire, open source, freeware, shareware et FOSS.
Erreurs courantes
- Donner une opinion personnelle (« c'est faux ») au lieu d'une raison avec une conséquence (« un logiciel défectueux peut nuire aux utilisateurs, donc il doit être testé »).
- Traiter le logiciel libre et le freeware comme la même chose. Le logiciel libre concerne la liberté d'étudier et de modifier le code ; le freeware est simplement gratuit.
- Dire que open source signifie gratuit. Cela signifie que le code source est disponible et peut être modifié et redistribué ; des frais peuvent toujours être facturés.
- Écrire que le droit d'auteur doit être enregistré. Il s'applique automatiquement à l'œuvre dès sa création.
- Nommer un impact sans sa conséquence. « Perte d'emplois » rapporte des points lorsque cela est lié à la cause : l'IA fait le diagnostic, donc moins de mécaniciens sont nécessaires.
- Décrire ce qu'est l'IA au lieu de dire comment elle est utilisée. Les points concernent les étapes : reconnaître, convertir, traduire, parler.
-
8
Bases de données
Regarder la leçon8.1
Stockage basé sur des fichiers et ses limites
Programme
Les candidats doivent être capables de : Notes et orientations Comprendre les limites de l'utilisation d'une approche basée sur les fichiers pour le stockage et la récupération des données Décrire les caractéristiques d'une base de données relationnelle qui répondent aux limites d'une approche basée sur les fichiers Comprendre et utiliser la terminologie associée à un modèle de base de données relationnelle Y compris entité, tableau, enregistrement, champ, tuple, attribut, clé primaire, clé candidate, clé secondaire, clé étrangère, relation (un-à-plusieurs, un-à-un, plusieurs-à-plusieurs), intégrité référentielle, indexation Utiliser un diagramme entité-relations (E-R) pour documenter la conception d'une base de données Comprendre le processus de normalisation Première Forme Normale (1FN), Deuxième Forme Normale (2FN) et Troisième Forme Normale (3FN) Expliquer pourquoi un ensemble donné de tables de base de données est, ou n'est pas, en 3FN Produire une conception de base de données normalisée pour une description de base de données, un ensemble de données donné ou un ensemble de tables donné Source : Programme Cambridge International
Avant les bases de données, les programmes stockaient les données dans des fichiers plats 平面文件 — généralement un fichier par programme. Cela convient pour les petites données mais échoue à grande échelle.
Le stockage basé sur des fichiers conserve les données dans des fichiers séparés, comme des papiers dans un classeur — difficile à rechercher et facile à dupliquer Limitations
- redondance des données 数据冗余 — les mêmes données (l'adresse d'un client) sont conservées dans plusieurs fichiers, un par programme, gaspillant ainsi de l'espace de stockage et obligeant à mettre à jour toutes les copies.
- incohérence des données 数据不一致 — lorsqu'une copie est mise à jour et une autre non, les fichiers divergent et personne ne sait lequel est correct.
- dépendance des données — chaque programme est écrit pour la structure exacte de ses fichiers ; changer la longueur d'un champ ou ajouter un champ oblige à réécrire tous les programmes qui lisent ce fichier.
- pas d'accès partagé — un fichier est verrouillé tant qu'un programme l'utilise, donc les utilisateurs ne peuvent pas travailler sur les données simultanément.
- intégrité 完整性 faible — aucune règle centrale n'empêche une valeur invalide ou un lien vers un client inexistant ; sécurité faible — l'accès est par fichier, pas par champ ; et les requêtes croisées nécessitent un nouveau programme à chaque fois.

L'approche basée sur les fichiers : chaque programme garde ses propres fichiers Une base de données relationnelle 关系数据库 corrige ces défauts en stockant les données dans des tables gérées par un seul logiciel (le SGBD) que tous les programmes utilisent.
L'approche base de données : un SGBD sert tous les programmes Pourquoi une base de données relationnelle est meilleure — la réponse à trois points. Chaque élément de donnée est stocké une seule fois, dans une seule table, et les tables sont liées par des clés, ce qui élimine la redondance et l'incohérence ; les données sont indépendantes des programmes, qui demandent au SGBD ce dont ils ont besoin et ne sont pas affectés lorsque la structure change ; et le SGBD applique des règles d'intégrité, contrôle l'accès par utilisateur et par champ, permet à plusieurs utilisateurs d'accéder simultanément aux données, et répond à n'importe quelle requête sans qu'un nouveau programme soit écrit.
Exemple résolu. Un atelier de réparation stocke ses clients, ses appareils et ses chantiers de réparation en utilisant une approche basée sur des fichiers, un fichier par programme. Donnez trois problèmes que cela pose et décrivez comment une base de données relationnelle les résoudrait.
Le nom et le numéro de téléphone du client sont stockés dans le fichier réparations et dans le fichier factures (redondance) ; lorsque le client change de numéro, un seul fichier est mis à jour et l'autre non (incohérence) ; et lorsque l'atelier souhaite obtenir un nouveau rapport — réparations par technicien — il faut écrire un nouveau programme pour lire les fichiers (pas de requêtes ad hoc). Dans une base de données relationnelle, le client est stocké une seule fois dans une table CLIENT et référencé via l'ID_Client depuis la table REPARATION, donc une modification est effectuée une seule fois et est visible partout ; le rapport est une simple requête SQL.
8.1
Modèle relationnel — termes
- table 表 (relation) — une grille de lignes et de colonnes ; une table par type d'entité 实体 (ex.
CUSTOMER). - record 记录 (row, also called a tuple 元组) — une ligne ; une instance de l'entité.
- champ 字段 (column, also called an attribute 属性) — une colonne ; un élément d'information concernant chaque enregistrement.
- primary key 主键 — un champ (ou plusieurs champs) qui identifie de manière unique chaque enregistrement ; jamais nul ou dupliqué.
- foreign key 外键 — un champ dont la valeur correspond à la clé primaire d'une autre table, reliant les deux tables.
- composite key 复合键 — une clé primaire constituée de deux champs ou plus combinés.
- candidate key 候选键 — tout champ (ou ensemble de champs) qui pourrait être la clé primaire.
- secondary key 次键 — un champ non principal indexé pour permettre des recherches rapides.
- indexing 索引 — la création d'un index sur un champ afin que les recherches et les jointures s'exécutent plus rapidement.
- referential integrity 参照完整性 — toute valeur de clé étrangère doit correspondre à une clé primaire existante (pas d'enregistrements orphelins).
Une table est écrite en abrégé avec la clé primaire soulignée et les clés étrangères notées :
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Une clé étrangère relie deux tables : ORDER.CustomerID correspond à la clé primaire CUSTOMER.CustomerID Exemple résolu. Expliquez ce que signifient entité, clé primaire et intégrité référentielle dans une base de données relationnelle, et complétez le tableau terme ↔ description pour tuple et attribut.
Une entité est quelque chose à propos duquel des données sont stockées — une personne, un objet ou un événement — qui devient une table. Une clé primaire est l'attribut (ou combinaison d'attributs) qui identifie de manière unique chaque enregistrement dans une table. L'intégrité référentielle signifie que toute valeur de clé étrangère doit correspondre à la valeur d'une clé primaire dans la table vers laquelle elle renvoie, afin qu'un enregistrement ne puisse pas faire référence à un enregistrement inexistant. Un tuple est une ligne d'une table (un enregistrement) ; un attribut est une colonne (un champ). Apprenez les paires : table/relation, record/tuple, field/attribute.
ExplorerLire une table relationnelle avec SELECT
Une table relationnelle est constituée de lignes (enregistrements) et de colonnes (champs). WHERE garde les lignes correspondant à une condition ; SELECT garde ensuite uniquement les colonnes demandées.
Vocabulaire EntrainerAnglais Chinois Pinyin flat files/flæt faɪlz/ 平面文件 píng miàn wén jiàn data redundancy/ˈdeɪtə rɪˈdʌndənsi/ 数据冗余 shù jù rǒng yú data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ 数据不一致 shù jù bù yī zhì field/fiːld/ 字段 zì duàn integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ 关系数据库 guān xì shù jù kù table/ˈteɪbl/ 表 biǎo record/ˈrekɔːd/ 记录 jì lù tuple/ˈtuːpl/ 元组 yuán zǔ attribute/ˈætrɪbjuːt/ 属性 shǔ xìng primary key/ˈpraɪməri kiː/ 主键 zhǔ jiàn foreign key/ˈfɒrən kiː/ 外键 wài jiàn composite key/ˈkɒmpəzɪt kiː/ 复合键 fù hé jiàn candidate key/ˈkændɪdeɪt kiː/ 候选键 hòu xuǎn jiàn secondary key/ˈsekəndəri kiː/ 次键 cì jiàn indexing/ˈɪndeksɪŋ/ 索引 suǒ yǐn referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ 参照完整性 cān zhào wán zhěng xìng entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ 实体关系图 shí tǐ guān xì tú 8.1
Diagrammes entité-relational (E-R)

Un diagramme entité-relational 实体关系图 montre la structure : chaque entité est un rectangle, chaque relation une ligne, avec la cardinalité 基数 marquée à chaque extrémité :
- one-to-one (1:1).
- one-to-many 一对多 (1:M) — chaque Client a beaucoup de Commandes ; chaque Commande a un seul Client.
- many-to-many (M:N) — les Élèves suivent beaucoup de Cours, et les Cours ont beaucoup d'Élèves.
Un diagramme E-R : une classe a beaucoup d'étudiants 
Symboles patte de corbeau pour la cardinalité d'une relation Une relation many-to-many ne peut pas être stockée directement. Décomposez-la en deux relations one-to-many via une link table 连接表 contenant les deux clés étrangères :
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Une table de liaison résout une relation many-to-many en deux relations one-to-many Tracer le diagramme E-R pour un ensemble de tables donné. Chaque table devient une entité. Une relation existe là où une table contient une clé étrangère vers une autre ; elle part de la table contenant la clé étrangère (l'extrémité beaucoup) vers la table dont c'est la clé primaire (l'extrémité non). Une table avec deux clés étrangères et aucune autre identité est généralement une table de liaison résolvant une relation many-to-many. Étiquetez chaque ligne avec le type de relation.
Tracer le diagramme à partir des tables : chaque clé étrangère est une relation one-to-many, avec le "beaucoup" à la table qui la contient Exemple résolu. Un atelier de réparation possède les tables
CUSTOMER(CustomerID, Name, Phone),DEVICE(DeviceID, CustomerID, Type, Model),TECHNICIAN(TechnicianID, Name)etREPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifiez les relations et leurs types.DEVICEcontientCustomerID, donc CUSTOMER–DEVICE est one-to-many (un client, beaucoup d'appareils).REPAIRcontientDeviceID, donc DEVICE–REPAIR est one-to-many ; il contient égalementTechnicianID, donc TECHNICIAN–REPAIR est one-to-many. Il n'y a pas de ligne directe CUSTOMER–REPAIR : le lien passe par DEVICE. Trois lignes, trois pattes de corbeau, toutes aux extrémités REPAIR ou DEVICE.Vocabulaire EntrainerAnglais Chinois Pinyin cardinality/ˌkɑːdɪˈnælɪti/ 基数 jī shù one-to-many/wʌn tə ˈmeni/ 一对多 yī duì duō link table/lɪŋk ˈteɪbl/ 连接表 lián jiē biǎo 8.1
Normalisation

Normalisation 规范化 organise les tables pour réduire la redondance et l'incohérence, en passant par les formes normales 范式 dans l'ordre.
- First normal form (1NF) — chaque champ contient une seule valeur (atomique 原子), sans groupes répétés, et avec une clé primaire.
- Second normal form (2NF) — en 1NF, et chaque champ non-clé dépend de la totalité de la clé primaire (ceci ne concerne que les clés composites).
- Third normal form (3NF) — en 2NF, et chaque champ non-clé dépend uniquement de la clé primaire, pas d'un autre champ non-clé (pas de dépendance transitive 传递依赖).
Une conception en 3NF stocke chaque fait une seule fois, donc les anomalies d'insertion/mise à jour/suppression disparaissent. Le compromis est plus de tables et plus de jointures. Visez la 3NF.
Pour produire une conception en 3NF : trouvez les entités et leurs attributs ; choisissez une clé primaire pour chacune ; divisez les champs répétés/non-atomiques (1NF) ; divisez les champs dépendant d'une partie d'une clé composite (2NF) ; divisez les champs dépendant transitivement de la clé (3NF) ; ajoutez des clés étrangères pour les relations.
La normalisation élimine la redondance en séparant les données répétées dans leur propre table Exemple résolu. La table
ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity)a la clé primaire composite(OrderID, ProductID). Normalisez-la en 3NF. Testez chaque champ non-clé contre la clé.Quantitydépend de les deuxOrderIDetProductID, ce qui est correct. MaisCustomerIDdépend deOrderIDseul - seulement une partie de la clé composite. C'est une dépendance partielle, donc la table n'est pas en 2NF. Séparez-la enORDER_LINE(OrderID, ProductID, Quantity)etORDER(OrderID, CustomerID, CustomerName). Maintenant testez la 3NF : dans cette nouvelle tableORDER,CustomerNamedépend deCustomerID, qui n'est pas la clé - une dépendance transitive. Séparez encore :ORDER(OrderID, CustomerID)etCUSTOMER(CustomerID, CustomerName). Nommez la dépendance qui viole chaque forme (partielle viole la 2NF, transitive viole la 3NF) ; dire "elle contient des données répétées" décrit le symptôme mais ne rapporte aucun point.Les trois questions à poser à toute table. Chaque cellule contient-elle une seule valeur, sans groupe répété ? Si non, elle n'est pas en 1NF. Si la clé est composite, chaque champ non-clé dépend-il de la totalité de la clé ? Si certains champs dépendent d'une partie, il y a une dépendance partielle 部分依赖 et la table n'est pas en 2NF. Chaque champ non-clé dépend-il uniquement de la clé ? Si un champ dépend d'un autre champ non-clé, il y a une dépendance transitive et la table n'est pas en 3NF. Une réponse expliquant pourquoi la table n'est pas en 3NF doit nommer la dépendance et les champs concernés.
La 1NF supprime le groupe répété, la 2NF la dépendance partielle, la 3NF la dépendance transitive Exemple résolu. Un magasin de location de voitures enregistre chaque location comme
RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), où une location peut inclure plusieurs voitures. Expliquez pourquoi la table n'est pas normalisée et produisez une conception en 3NF.Pas en 1NF : les champs de voiture
CarReg, CarModel, DailyRate, Daysforment un groupe répété — une location a plusieurs voitures. Déplacez-les versRENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days)avec la clé composite(RentalID, CarReg). Pas en 2NF : dansRENTAL_CAR,CarModeletDailyRatedépendent deCarRegseul — une dépendance partielle. Déplacez-les versCAR(CarReg, CarModel, DailyRate), laissantRENTAL_CAR(RentalID, CarReg, Days). Pas en 3NF : dansRENTAL,CustomerNameetCustomerPhonedépendent deCustomerID, un champ non-clé — une dépendance transitive. Déplacez-les versCUSTOMER(CustomerID, CustomerName, CustomerPhone), laissantRENTAL(RentalID, RentalDate, CustomerID). La conception 3NF est constituée de quatre tables —CUSTOMER,RENTAL,RENTAL_CAR,CAR— avecCustomerID,RentalIDetCarRegcomme clés étrangères ; soulignez toutes les clés primaires.Vocabulaire EntrainerAnglais Chinois Pinyin normalisation/ˌnɔːməlaɪˈzeɪʃn/ 规范化 guī fàn huà normal forms/ˈnɔːml fɔːmz/ 范式 fàn shì atomic/əˈtɒmɪk/ 原子 yuán zi transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ 传递依赖 chuán dì yī lài partial dependency/ˈpɑːʃl dɪˈpendənsi/ 部分依赖 bù fèn yī lài 8.2
Système de gestion de base de données (DBMS)

Programme
Les candidats doivent être capables de : Notes et orientations Comprendre les fonctionnalités fournies par un Système de gestion de bases de données (SGBD) qui répondent aux problèmes d'une approche basée sur les fichiers Y compris : • gestion des données, y compris le maintien d'un dictionnaire de données • modélisation des données • schéma logique • intégrité des données • sécurité des données, y compris les procédures de sauvegarde et l'utilisation des droits d'accès aux individus / groupes d'utilisateurs Comprendre comment les outils logiciels trouvés dans un SGBD sont utilisés en pratique Y compris l'utilisation et l'objectif de : • interface développeur • processeur de requêtes Source : Programme Cambridge International
Un SGBD 数据库管理系统 gère la base de données de manière centralisée. Fonctionnalités corrigeant les limites basées sur les fichiers :
- data dictionary 数据字典 — une description de chaque table, champ, type et clé ; les programmes l'interrogent au lieu de codifier en dur la structure.
- contrôle de la redondance/cohérence — chaque fait stocké une seule fois.
- concurrent access 并发访问 contrôle — les verrous et transactions permettent à plusieurs utilisateurs de travailler simultanément.
- backup 备份 et récupération ; sécurité et permissions par utilisateur.
- règles d'intégrité — clés, contraintes d'unicité et de plage, appliquées centralisées.
- transactions 事务 — un groupe d'opérations qui réussissent toutes ou échouent toutes.
- vues 视图 — tables virtuelles qui affichent à chaque utilisateur "sa" tranche de données.
- data management 数据管理 et data modelling 数据建模 — contrôlent la manière dont les données sont stockées et définissent leur structure sous forme de logical schema 逻辑模式 (la conception logique, indépendante du stockage physique).
- data integrity 数据完整性 et data security 数据安全 — imposent la correction et contrôlent l'accès de manière centralisée.
- non query processor 查询处理器 exécute des requêtes ; une developer interface 开发者接口 fournit des outils et des API pour créer des applications.
Ses outils incluent un éditeur de dictionnaire de données, un constructeur de requêtes, un constructeur de formulaires, un générateur de rapports, la gestion des utilisateurs et un éditeur SQL.
Ce que contient le dictionnaire de données (une question « donnez trois éléments ») : les noms des tables ; les noms des champs dans chaque table ; le type de données et la longueur de chaque champ ; les clés primaires et étrangères ainsi que les relations entre les tables ; les règles de validation ; les index ; et qui peut accéder à chaque table. C'est des métadonnées — des données sur les données — et le SGBD l'utilise pour vérifier chaque requête et chaque modification.
Comment le SGBD garde les données en sécurité (une question « décrivez deux méthodes ») : authentication 身份验证 — un nom d'utilisateur et un mot de passe, ou une donnée biométrique, avant tout accès ; access rights — chaque utilisateur ou groupe n'est autorisé à lire, écrire ou supprimer que certaines tables ou certains champs, souvent via une view ; encryption des données stockées et des données envoyées, afin qu'un fichier copié soit illisible ; backups pris régulièrement, pour pouvoir restaurer les données après perte ; et un journal de transactions enregistrant qui a changé quoi.
Les deux outils logiciels. La developer interface est ce qu'un programmeur utilise pour construire la base de données et les applications associées : créer des tables et définir les clés et validations, écrire des requêtes et du SQL, et concevoir des formulaires et des rapports, sans savoir comment les données sont stockées physiquement. Le query processor prend une requête (SQL provenant d'un programme ou une requête construite dans l'interface), la vérifie par rapport au dictionnaire de données, détermine la façon la plus efficace de l'exécuter, récupère les données et retourne les résultats.
Logical schema. Le SGBD garde la conception logique (quelles tables et quels champs existent et comment ils se relationnent) séparée du physical storage (fichiers, index, blocs disque). Les programmes travaillent avec le schéma logique, de sorte que le stockage physique peut être réorganisé sans modifier un seul programme — c'est l'indépendance des données à laquelle manquait l'approche basée sur les fichiers.
Le stockage physique que cache le schéma logique : les plateaux tournants d'un disque dur et sa tête de lecture/écriture ExplorerLab de service de base de données
Regardez comment un SGBD transforme une requête en accès partagé sécurisé aux données.
ExplorerLab de service de base de données
Regardez comment un SGBD transforme une requête en accès partagé sécurisé aux données.
Vocabulaire EntrainerAnglais Chinois Pinyin data dictionary/ˈdeɪtə ˈdɪkʃənəri/ 数据字典 shù jù zì diǎn concurrent access/kənˈkʌrənt ˈækses/ 并发访问 bìng fā fǎng wèn transactions/trænˈsækʃnz/ 事务 shì wù backup/ˈbækʌp/ 备份 bèi fèn views/vjuːz/ 视图 shì tú data management/ˈdeɪtə ˈmænɪdʒmənt/ 数据管理 shù jù guǎn lǐ data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ 数据建模 shù jù jiàn mó logical schema/ˈlɒdʒɪkl ˈskiːmə/ 逻辑模式 luó jí mó shì data integrity/ˈdeɪtə ɪnˈteɡrɪti/ 数据完整性 shù jù wán zhěng xìng data security/ˈdeɪtə sɪˈkjʊərɪti/ 数据安全 shù jù ān quán query processor/ˈkwɪərɪ ˈprəʊsesə/ 查询处理器 chá xún chǔ lǐ qì developer interface/dɪˈveləpə ˈɪntəfeɪs/ 开发者接口 kāi fā zhě jiē kǒu authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng 8.3
DDL et DML
Programme
Les candidats doivent être capables de : Notes et orientations Comprendre que le SGBD effectue toute création/modification de la structure de la base de données via son Langage de définition de données (DDL) Comprendre que le SGBD effectue toutes les requêtes et maintenance des données via son DML Comprendre que la norme industrielle pour le DDL et le DML est le Structured Query Language (SQL) Comprendre une instruction SQL donnée Comprendre les instructions SQL (DDL) données et être capable d'écrire de simples instructions SQL (DDL) en utilisant un sous-ensemble d'instructions Créer une base de données (CREATE DATABASE) Créer une définition de tableau (CREATE TABLE), y compris la création d'attributs avec des types de données appropriés : • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Modifier une définition de tableau (ALTER TABLE) Ajouter une clé primaire à un tableau (PRIMARY KEY (field)) Ajouter une clé étrangère à un tableau (FOREIGN KEY (field) REFERENCES Table (Field)) Écrire un script SQL pour interroger ou modifier les données (DML) stockées dans (au maximum deux) tables de base de données Requêtes incluant SELECT... DE, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG Maintenance des données incluant INSERT INTO, DELETE FROM, UPDATE Source : Programme Cambridge International
SQL 结构化查询语言 (Structured Query Language) possède deux moitiés :
DDL construit la structure de la base de données ; DML travaille avec les données - Data Definition Language 数据定义语言 (DDL) — crée ou modifie la structure (tables, clés, contraintes).
- Data Manipulation Language 数据操纵语言 (DML) — travaille avec les données (insertion, mise à jour, suppression, query 查询).
Bases de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Ajouter une clé étrangère :
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Modifier et supprimer :
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Types courants :
INTEGER,REAL,VARCHAR(n),CHAR(n)(aussiCHARACTER(n)),DATE,TIME,BOOLEAN,DECIMAL(p, s).Bases de DML
Requête avec
SELECT:
Une requête SELECT retourne uniquement les lignes correspondant à sa condition SELECT Name, Phone FROM CUSTOMER WHERE City = 'London' ORDER BY Name ASC;SELECTliste les champs,FROMnomme la table,WHEREfiltre les lignes,ORDER BYtrie.Un join 连接 combine deux tables grâce à une relation de clé étrangère :
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
Les parties d'une requête, dans l'ordre où elles doivent être écrites Fonctions agrégées 聚合函数 (
COUNT,SUM,AVG,MIN,MAX) sont souvent utilisées avecGROUP BY:SELECT CustomerID, COUNT(*) AS NumOrders FROM ORDER GROUP BY CustomerID;Insertion, mise à jour, suppression :
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Toujours mettre une clause
WHEREsurUPDATEetDELETE, sinon la modification touche toutes les lignes.Conseils pour le SQL d'examen
- utiliser les noms exacts de table et de champ donnés dans l'énoncé.
- mettre des guillemets simples autour des chaînes (
'Smith') ; ne pas mettre de guillemets autour des nombres. - comparaisons :
=,<,>,<=,>=,<>. LIKE 'A%'correspond à tout commençant par A (%= n'importe quelle chaîne,_= un caractère) ;IN (1,2,3);BETWEEN 10 AND 20.- combiner des conditions avec
AND/OR/NOT, et terminer chaque instruction par un point-virgule.
Le motif DDL attendu à l'examen. Chaque
CREATE TABLEnomme chaque champ avec son type, marque la clé primaire, et déclare chaque clé étrangère avec la table qu'elle référence ; une clé composite est déclarée sur sa propre ligne :CREATE TABLE RENTAL_CAR ( RentalID INTEGER, CarReg VARCHAR(8), Days INTEGER, PRIMARY KEY (RentalID, CarReg), FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID), FOREIGN KEY (CarReg) REFERENCES CAR(CarReg) );Exemple résolu. En utilisant
CUSTOMER(CustomerID, Name, Phone)etDEVICE(DeviceID, CustomerID, Type, Model), écrire des scripts SQL pour : (a) lister le nom et le numéro de téléphone de chaque client possédant un appareil de type'tablet', par ordre alphabétique de nom ; (b) compter les appareils de chaque type ; (c) enregistrer que le client 17 a maintenant le numéro de téléphone'0771 234 5678'; (d) ajouter un nouvel appareil, ID 305, un'laptop'de modèle'X1'appartenant au client 17.(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c)
UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;(d)INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');Des points sont attribués par clause — les champs, les tables, la condition de jointure, la clause
WHERE, la clauseORDER BY— donc un script avec une mauvaise clause obtient tout de même les points des autres. ÉcrireTable.Fielddès que deux tables sont impliquées.Exemple résolu. Expliquer ce que fait ce script :
SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;Il affiche le nom de chaque technicien avec le coût total des réparations effectuées par ce technicien, une ligne par technicien : les deux tables sont jointes sur TechnicianID, les lignes sont groupées par nom, et les coûts de chaque groupe sont additionnés. Quand on demande ce que fait un script, décrire le résultat, pas la syntaxe.
ExplorerAssembler deux tables avec INNER JOIN
Un joint associe les lignes où la clé étrangère correspond à la clé primaire — ici Orders.CustomerID = Customer.CustomerID — et combine chaque paire correspondante en une ligne plus large.
ExplorerSELECT … WHERE
Parcourez une requête : WHERE conserve les lignes qui correspondent, puis SELECT choisit les colonnes que vous avez demandées.
Vocabulaire EntrainerAnglais Chinois Pinyin query/ˈkwɪərɪ/ 查询 chá xún SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán join/dʒɔɪn/ 连接 lián jiē Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ 数据定义语言 shù jù dìng yì yǔ yán Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ 数据操纵语言 shù jù cāo zòng yǔ yán aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ 聚合函数 jù hé hán shù 8.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition entity quelque chose pour lequel des données sont stockées — une personne, un objet ou un événement — qui devient une table dans une base de données relationnelle attribute un élément de données concernant une entité (une colonne de la table) tuple une ligne d'une table : une instance de l'entité primary key un attribut, ou une combinaison d'attributs, qui identifie de manière unique chaque enregistrement dans une table foreign key un attribut dans une table dont la valeur correspond à une clé primaire dans une autre table, utilisé pour lier les deux candidate key tout attribut (ou combinaison) qui pourrait être choisi comme clé primaire secondary key un attribut non-primaire qui est indexé afin que la table puisse être recherchée ou triée rapidement dessus composite key une clé primaire constituée de deux attributs ou plus ensemble referential integrity chaque valeur de clé étrangère doit correspondre à une valeur de clé primaire existante dans la table à laquelle elle se réfère first normal form une table dans laquelle chaque attribut est atomique, il n'y a pas de groupes répétés, et il y a une clé primaire second normal form en 1NF, et chaque attribut non-clé dépend de l'ensemble de la clé primaire (pas de dépendance partielle) third normal form en 2NF, et aucun attribut non-clé ne dépend d'un autre attribut non-clé (pas de dépendance transitive) data dictionary les métadonnées qu'un SGBD conserve sur la structure de la base de données : tables, champs, types, clés, relations, validation DDL / DML le langage utilisé pour définir ou modifier la structure d'une base de données / le langage utilisé pour interroger et maintenir les données dans celle-ci Vocabulaire EntrainerAnglais Chinois Pinyin entity/ˈentɪti/ 实体 shí tǐ 8.3
Conseils d'examen
- Définir exactement les termes : entity, attribute, primary key, foreign key, et les types de relations (1:1, 1:many, many:many).
- Donner une raison pour chaque forme normale : 1NF (pas de groupes répétés), 2NF (pas de dépendance partielle), 3NF (pas de dépendance hors-clé) — et nommer les champs concernés.
- Expliquer ce qu'un DBMS fournit (indépendance des données, sécurité, intégrité, accès concurrentiel, dictionnaire de données, interface développeur, processeur de requêtes).
- Distuer DDL (définir la structure) de DML (interroger et modifier les données), et écrire la clause SQL une par une :
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Pour dessiner un diagramme E-R à partir de tables, trouver d'abord chaque clé étrangère : chaque clé étrangère représente une relation un-à-beaucoup, avec le "beaucoup" dans la table qui la contient.
Erreurs courantes
- Dessiner une relation beaucoup-à-beaucoup directement. Elle doit être scindée en deux relations un-à-beaucoup via une table lien contenant les deux clés étrangères.
- Expliquer "pas en 3NF" par "les données sont répétées". Nommer la dépendance (partielle ou transitive) et les champs concernés.
- Des guillemets doubles autour des chaînes en SQL, ou des guillemets autour des nombres. Les chaînes prennent
'single quotes'; les nombres n'en prennent aucun. - Omettre la condition
ONaprèsINNER JOIN. Sans cela, les deux tables ne sont pas liées. - Placer un champ ordinaire à côté de
COUNTouSUMdans unSELECTsansGROUP BY. UPDATEouDELETEsans uneWHERE. Cela modifie ou supprime toutes les lignes de la table.
Vocabulaire EntrainerAnglais Chinois Pinyin DBMS/ˌdiː biː em ˈes/ 数据库管理系统 shù jù kù guǎn lǐ xì tǒng -
9
Conception d'algorithmes et résolution de problèmes
Regarder la leçon9.1
Pensée computationnelle

Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension de l'abstraction Besoin et avantages de l'utilisation de l'abstraction Décrire la finalité de l'abstraction Produire un modèle abstrait d'un système en n'incluant que les détails essentiels Décrire et utiliser la décomposition Décomposer les problèmes en sous-problèmes menant au concept de module de programme (procédure / fonction) Source : Programme Cambridge International
Pensée computationnelle 计算思维 est l'ensemble des outils mentaux pour analyser un problème et concevoir une solution qu'un ordinateur peut exécuter. Deux concepts clés sont l'abstraction et la décomposition.
La pensée computationnelle décompose un grand problème en petites parties plus faciles — comme résoudre un puzzle Abstraction
Abstraction 抽象 signifie garder les caractéristiques essentielles d'un problème et ignorer les détails insignifiants, offrant un modèle plus simple.
Exemples :
- une carte de réseau ferroviaire garde les gares et les lignes mais omet la géographie.
- une class en programmation orientée objet garde seulement les attributs et méthodes dont le système a besoin.
- une fonction cache une partie du travail derrière un nom.
Un modèle complet de n'importe quel problème réel serait trop vaste pour être raisonné, donc l'abstraction est essentielle.
L'examinateur demande le but de l'abstraction et ses avantages. But : produire un modèle plus simple d'un problème qui ne contient que les détails nécessaires pour le résoudre. Avantages : le problème est plus facile à comprendre et à programmer ; le programme est plus petit, plus rapide à écrire et à tester ; le même modèle peut être réutilisé pour des problèmes similaires. Lorsqu'on vous demande de produire un modèle abstrait d'un système, listez uniquement les données et actions dont la tâche a besoin. Pour un horaire scolaire, cela signifie les classes, les salles, les enseignants et les créneaux ; cela ne signifie pas la couleur des salles ou l'âge des enseignants.
L'abstraction conserve l'essentiel (stations et lignes) et rejette les détails sans importance (la géographie) Décomposition
Décomposition 分解 signifie découper un grand problème en sous-problèmes plus petits, chacun plus facile à résoudre et traité un par un.
- identifier les parties principales de la tâche.
- découper chacune en sous-tâches plus petites.
- continuer jusqu'à ce que chaque partie soit assez petite pour être conçue directement.
- résoudre les petites tâches et les combiner.
Pour la gestion des stocks : "gérer les stocks" → "enregistrer les ventes", "enregistrer les livraisons", "produire des rapports" → ("enregistrer les ventes") "rechercher le produit", "diminuer le nombre de stocks", "sauvegarder la transaction". La décomposition rend les grands problèmes gérables, permet à une équipe de diviser le travail et fournit du code modulaire — chaque module devient une procédure 过程 ou fonction.
"Expliquez pourquoi on utilise la décomposition" est une question de trois points avec une forme fixe. Donnez trois avantages distincts : chaque sous-problème 子问题 est assez petit pour être conçu, codé et testé indépendamment ; différents programmeurs peuvent travailler sur différents modules 模块 simultanément ; un module déjà existant (ou une routine de bibliothèque) peut être réutilisé, et une erreur est plus facile à trouver car elle se trouve dans un seul module. Un diagramme structurel (thème 12) est le diagramme d'une décomposition : le programme en haut, ses modules en dessous, et les données transmises entre eux.
Décomposer un programme en modules et sous-modules ExplorerRésoudre un problème à la manière computationnelle
Parcourez les quatre piliers dans l'ordre de leur utilisation — décomposez le problème, repérez ce qui se répète, extraitez l'essentiel, puis rédigez les étapes.
Vocabulaire EntrainerAnglais Chinois Pinyin computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ 计算思维 jì suàn sī wéi abstraction/əbˈstrækʃn/ 抽象 chōu xiàng decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě sub-problem/sʌb ˈprɒbləm/ 子问题 zi wèn tí procedure/prəˈsiːdʒə/ 过程 guò chéng modules/ˈmɒdjuːlz/ 模块 mó kuài identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú 9.2
Algorithmes
Programme
Les candidats doivent être capables de : Notes et orientations Comprendre qu'un algorithme est une solution à un problème exprimée sous forme de séquence d'étapes définies Utiliser des noms d'identifiants appropriés pour représenter les données utilisées par un problème et les représenter à l'aide d'une table d'identifiants Écrire un pseudocode contenant une entrée, un traitement et une sortie Écrire un pseudocode utilisant les trois constructeurs fondamentaux de la séquence, de la sélection et de l'itération (répétition) Documenter un simple algorithme à l'aide d'une description en anglais structuré, d'un diagramme de flux ou d'un pseudocode Écrire un pseudocode à partir de : • une description en anglais structuré • un diagramme de flux Tracer un diagramme de flux à partir de : • une description en anglais structuré • un pseudocode Décrire et utiliser le processus de raffinement progressif pour exprimer un algorithme à un niveau de détail à partir duquel la tâche peut être programmée Utiliser des énoncés logiques pour définir des parties d'une solution algorithmique Source : Programme Cambridge International
Tri à bulles, passe par passe Un algorithme 算法 est une solution exprimée sous la forme d'une séquence d'étapes définies. Chaque étape est sans ambiguïté 无歧义 (une seule signification), déterministe 确定性 (même entrée → même sortie), finie (les étapes se terminent) et efficace (chacune peut être exécutée). Un algorithme dit ce qu'il faut faire, indépendamment du langage de programmation utilisé pour son implémentation.
ExplorerSélection : suivez les branches IF / ELSE
Faites glisser la note et observez quelle branche s'exécute. La sélection teste chaque condition à tour de rôle et prend la PREMIÈRE qui est vraie — c'est ainsi que fonctionne IF … ELSE IF … ELSE.
Vocabulaire EntrainerAnglais Chinois Pinyin algorithm/ˈælɡərɪθəm/ 算法 suàn fǎ sequence/ˈsiːkwəns/ 顺序 shùn xù unambiguous/ʌnæmˈbɪɡjuːəs/ 无歧义 wú qí yì deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng 9.2
Tableau des identifiants

Lorsque vous commencez un algorithme, listez chaque élément de données dans un tableau des identifiants 标识符表 — son identifiant 标识符 (le nom de la variable 变量), son type de données 数据类型, et sa description. Le tableau de l'examen possède exactement ces trois colonnes :
Identifiant Type de données Description CategorySTRINGla catégorie de produit SaleDateDATEquand l'article a été vendu ItemCostREALcoût de l'article InStockBOOLEANTRUEsi en stockSalesARRAY[1:30] OF REALles totaux journaliers des ventes des 30 derniers jours Utilisez des noms descriptifs (
ItemCost, pasx) : un identifiant commence par une lettre, ne contient pas d'espaces et s'écrit de la même manière à chaque apparition. Les types courants sontINTEGER,REAL,STRING,CHAR,BOOLEAN,DATE, ainsi que les tableaux. Le tableau vous force à nommer chaque élément de données avant d'écrire du code, et une question "compléter le tableau des identifiants" attribue un point pour chaque type de données ou description correcte, alors écrivez le type exactement comme le guide de pseudocode.Un tableau des identifiants nomme chaque élément de données avant d'écrire du code Vocabulaire EntrainerAnglais Chinois Pinyin identifier table/aɪˈdentɪfaɪə ˈteɪbl/ 标识符表 biāo shí fú biǎo variable/ˈveərɪəbl/ 变量 biàn liàng data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng Boolean/ˈbuːlɪən/ 布尔 bù ěr 9.2
Pseudocode — les trois constructions de base

Pseudocode 伪代码 est une méthode structurée et neutre vis-à-vis du langage pour décrire les algorithmes.
Les trois blocs de construction de tout algorithme : séquence, sélection et itération 1. Séquence
Les étapes s'exécutent les unes après les autres (séquence 顺序) :
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Sélection
Un choix des étapes à exécuter, basé sur une condition (sélection 选择) :
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Pour plus d'options, utilisez
CASE OF ... ENDCASE.3. Itération
Répéter un bloc (itération 迭代, une boucle 循环) :
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Une boucle WHILE teste la condition avant chaque passe (peut s'exécuter zéro fois) ; une boucle REPEAT...UNTIL teste après chaque passe (s'exécute toujours au moins une fois).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
Une boucle WHILE teste avant l'exécution du corps ; une boucle REPEAT ... UNTIL teste après, donc son corps s'exécute toujours au moins une fois Choisir la boucle est lui-même un point :
FORlorsque vous connaissez le nombre de passages (une boucle à compteur 计数循环) ;WHILElorsque la boucle pourrait ne jamais s'exécuter (une boucle à précondition 前测循环) ;REPEAT ... UNTILlorsqu'elle doit s'exécuter au moins une fois, comme pour valider une saisie (une boucle à postcondition 后测循环). Une réponse "décrire la construction d'itération" nomme la construction, indique où la condition est testée et donne la conséquence (zéro fois ou au moins une fois).Opérations courantes
- affectation 赋值:
x ← 5(une flèche ;=sert à la comparaison). - entrée/sortie :
INPUT variable,OUTPUT expression. - comparaisons
=,<>,<,>,<=,>=; logiqueAND,OR,NOT. - arithmétique
+ - * /, plusDIV(division entière) etMOD(reste). - chaînes :
LENGTH,LEFT,RIGHT,MID, et&pour la concaténation 拼接 (jonction).
Le pseudocode attendu par l'examen
Chaque réponse de pseudocode est notée selon le guide de pseudocode publié par Cambridge. Écrivez ces formes exactement :
Construction Pseudocode Variable DECLARE Total : INTEGERTableau DECLARE Marks : ARRAY[1:30] OF REALConstante CONSTANT MaxTries = 3Affectation Total ← Total + ValueEntrée / Sortie INPUT NameOUTPUT "Hello ", NameSélection CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASEBoucle FOR FOR i ← 1 TO 10 STEP 2...NEXT iBoucle WHILE WHILE Total < 100 DO...ENDWHILEBoucle REPEAT REPEAT...UNTIL Mark >= 0Arithmétique entière 17 DIV 5 = 317 MOD 5 = 2Chaînes LENGTH(S),LEFT(S, 3),RIGHT(S, 2)MID(S, 2, 4),UCASE(S),LCASE(S)Conversions INT(3.7) = 3,NUM_TO_STR(12)STR_TO_NUM("4.5"),ASC('A') = 65,CHR(66) = 'B'Aléatoire RAND(100)INT(RAND(100)) + 1RAND(100)donne un nombre réel de 0 jusqu'à (mais sans inclure) 100.INT(RAND(100)) + 1donne un entier de 1 à 100.Deux habitudes rapportent des points à chaque question : déclarer toutes les variables utilisées, avec le type tiré de votre tableau des identifiants, et initialiser 初始化 tous les compteurs 计数器 et totaux (
Count ← 0,Total ← 0) avant la boucle qui les modifie.Entrée → Traitement → Sortie
Tout programme suit cette forme :
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Lister les entrées et sorties d'abord rend l'algorithme plus clair.
Exemple résolu. Écrivez un pseudocode qui lit 100 entiers et affiche combien d'entre eux, ainsi que leur somme, se situent entre 10 et 20 inclusivement.
Tableau des identifiants :
Count : INTEGER(compteur de boucle),Value : INTEGER(l'entier juste lu),InRange : INTEGER(combien étaient dans la plage),Total : INTEGER(leur somme).DECLARE Count, Value, InRange, Total : INTEGER InRange ← 0 Total ← 0 FOR Count ← 1 TO 100 INPUT Value IF Value >= 10 AND Value <= 20 THEN InRange ← InRange + 1 Total ← Total + Value ENDIF NEXT Count OUTPUT InRange, TotalSi la question demande ensuite d'"identifier deux constructions et indiquer comment chacune est utilisée", répondez de la même manière : itération, la boucle
FORrépète la lecture 100 fois ; sélection, la statementIFajoute une valeur uniquement si elle est dans la plage.Exemple résolu. Un programme tire un entier secret de 1 à 100. L'utilisateur devine jusqu'à ce qu'il ait raison ; après chaque mauvaise tentative, le programme dit "Trop bas" ou "Trop haut", et à la fin il affiche combien de tentatives ont été faites.
Tableau des identifiants :
Secret : INTEGER(le nombre à deviner),Guess : INTEGER(l'entrée de l'utilisateur),Tries : INTEGER(combien de tentatives jusqu'à présent).DECLARE Secret, Guess, Tries : INTEGER Secret ← INT(RAND(100)) + 1 Tries ← 0 REPEAT INPUT Guess Tries ← Tries + 1 IF Guess < Secret THEN OUTPUT "Too low" ELSE IF Guess > Secret THEN OUTPUT "Too high" ENDIF ENDIF UNTIL Guess = Secret OUTPUT "You took ", Tries, " guesses"Une boucle
REPEAT ... UNTILest le bon choix car l'utilisateur doit deviner au moins une fois. Les points concernent : le nombre aléatoire dans la bonne plage, une boucle qui s'arrête sur une bonne réponse, le compteur qui commence à zéro et augmente à l'intérieur de la boucle, les deux messages dans les bonnes conditions, et la sortie finale.
Le même jeu de devinettes sous forme de diagramme de flux : les deux losanges de décision sont les deux instructions IF, et la flèche de retour est la boucle REPEAT ... UNTIL Exemple résolu. Afficher deux entiers aléatoires différents, chacun compris entre $-10$ et $10$ inclusivement.
Il y a 21 valeurs possibles, donc
INT(RAND(21))donne 0 à 20 et soustraire 10 décale la plage vers $-10$ à $10$. Le second nombre doit être généré à nouveau jusqu'à ce qu'il diffère du premier :DECLARE First, Second : INTEGER First ← INT(RAND(21)) - 10 REPEAT Second ← INT(RAND(21)) - 10 UNTIL Second <> First OUTPUT First, Second
Tout programme suit la forme Entrée, Traitement, Sortie ExplorerIF … ELSE sélection
Modifiez la valeur et observez quelle branche s'exécute — comment un programme prend une décision.
Vocabulaire EntrainerAnglais Chinois Pinyin pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú selection/sɪˈlekʃn/ 选择 xuǎn zé iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài loop/luːp/ 循环 xún huán count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán assignment/əˈsaɪnmənt/ 赋值 fù zhí concatenation/kənˌkætəˈneɪʃn/ 拼接 pīn jiē initialise/ɪˈnɪʃəlaɪz/ 初始化 chū shǐ huà counter/ˈkaʊntə/ 计数器 jì shù qì structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ 逐步求精 zhú bù qiú jīng logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ 逻辑语句 luó jí yǔ jù precedence/ˈpresɪdəns/ 优先级 yōu xiān jí De Morgan's law/də ˈmɔːɡənz lɔː/ 德摩根定律 dé mó gēn dìng lǜ 9.2
Trois notations

Le même algorithme peut être écrit de trois façons.
- anglais structuré 结构化英语 — langue naturelle avec indentation et mots-clés fixes ; bon pour une description de haut niveau.
- diagramme de flux 流程图 — un schéma avec des formes standards :
Forme Signification Rectangle arrondi Démarrer / Arrêter Parallelogramme Entrée / Sortie Rectangle Traitement Losange Décision Flèche Flux de contrôle - pseudocode — la notation des mots-clés ci-dessus ; proche du code.
Vous devez pouvoir convertir entre n'importe quelle paire : chaque
IFest un losange de décision, chaque boucle est une flèche de retour, et une séquence est constituée de rectangles empilés.SI ... ALORS ... SINON ... FIN SI
Un organigramme pour calculer la moyenne d'une liste de nombres, utilisant les formes standards 9.2
Affinement progressif

Affinement progressif 逐步求精 commence par un aperçu de haut niveau et développe chaque étape jusqu'à ce qu'elle soit assez petite pour être codée. Pour la moyenne de $n$ nombres :
Niveau 1 :
Read in the numbers
Compute the average
Output the average
Niveau 2 :
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
Chaque affinement conserve la structure précédente et ajoute des détails.
Une question de six points sur l'« application de l'affinement progressif » vous donne un aperçu de haut niveau et demande de développer chaque étape en instructions concrètes qu'un programmeur pourrait coder. Gardez les étapes dans le même ordre, nommez les données que chaque étape lit ou produit, et arrêtez-vous lorsque chaque ligne correspond à une seule entrée, affectation, sortie, boucle ou condition. Par exemple, « valider le mot de passe » devient : saisir le mot de passe ; vérifier que sa longueur est d'au moins 8 ; vérifier qu'il contient au moins un chiffre ; afficher « accepté » si les deux vérifications réussissent, sinon afficher « rejeté ».
Affinement progressif : développez chaque étape de haut niveau en pseudocode détaillé ExplorerRaffinement progressif : plan vers code
Descendez les niveaux. Vous commencez avec toute la tâche en une seule ligne et continuez à développer chaque étape en parties plus petites — jusqu'à ce que chaque étape soit suffisamment simple pour être codée directement.
9.2
Énoncé logique
Une instruction logique 逻辑语句 est une condition Booléenne 布尔 qui contrôle la branching, construite à partir de comparaisons (
x > 10), de connecteurs (AND,OR,NOT) et de parenthèses. Utilisez-la comme condition deIF,WHILEouREPEAT...UNTIL:WHILE attempts < 3 AND NOT loggedIn DO INPUT password IF password = correctPassword THEN loggedIn ← TRUE ELSE attempts ← attempts + 1 ENDIF ENDWHILEPrécédence 优先级 (du plus élevé au plus bas) :
NOT, puisAND, puisOR. Utilisez des parenthèses en cas de doute. Erreurs courantes :a = 1 OR 2est incorrect — écriveza = 1 OR a = 2.NOT a > 5signifieNOT (a > 5), c'est-à-direa <= 5.NOT (A AND B)est équivalent à(NOT A) OR (NOT B)(Loi de De Morgan 德摩根定律) — utile pour simplifier les conditions.
Transformer une phrase en énoncé logique est une compétence testée directement dans les examens. « Un billet est gratuit pour toute personne de moins de 5 ans ou de plus de 65 ans » devient
Age < 5 OR Age > 65. « Une note est valide si c'est un nombre entier allant de 0 à 100 » devientMark >= 0 AND Mark <= 100. « La boucle s'arrête quand le fichier est terminé ou dix enregistrements ont été lus » devientUNTIL EOF(File) OR Count = 10. Écrivez chaque comparaison en entier :Age > 65etAge < 5, jamaisAge > 65 OR < 5.Précédence : NOT se lie d'abord à loggedIn, puis AND combine les deux côtés Exemple résolu. Écrivez une table d'identifiants et du pseudocode pour lire 10 nombres et afficher le plus grand. La table d'identifiants nomme chaque variable avec son type de données et son but :
Count : INTEGER(compteur de boucle),Num : REAL(le nombre fraîchement lu),Max : REAL(le plus grand trouvé jusqu'ici).Max ← -999999 FOR Count ← 1 TO 10 INPUT Num IF Num > Max THEN Max ← Num ENDIF NEXT Count OUTPUT MaxLa décision de conception qui porte les points est l'initialisation de
Max: elle doit commencer plus basse que toute entrée possible - ou, plus sûrement encore, être définie sur le premier nombre lu. Si vous l'initialisez à0, l'algorithme retournera faussement 0 pour une liste de nombres négatifs, un bug que votre trace ne révèlera que si les données de test incluent un nombre négatif.9.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition abstraction conservation des détails essentiels d'un problème en omettant ceux qui ne sont pas nécessaires décomposition fractionnement d'un problème en sous-problèmes plus petits, chacun pouvant être résolu séparément algorithme solution à un problème exprimée sous forme de séquence d'étapes définies table d'identifiants tableau répertoriant chaque identifiant utilisé dans un algorithme avec son type de données et une description de son but pseudocode méthode structurée et indépendante de langage pour écrire les étapes d'un algorithme organigramme diagramme montrant les étapes et décisions d'un algorithme à l'aide de symboles standards reliés par des flèches séquence instructions exécutées les unes après les autres dans l'ordre écrit sélection choix des instructions à exécuter selon une condition itération répétition d'un groupe d'instructions tant qu'une condition est vraie ou jusqu'à ce qu'elle soit satisfaite affinement progressif fractionnement de chaque étape d'un aperçu en étapes plus petites, répété jusqu'à ce que chaque étape puisse être codée directement énoncé logique condition construite à partir de comparaisons et des opérateurs ET, OU et NON qui évalue VRAI ou FAUX 9.2
Conseils d'examen
- Définissez un algorithme comme une séquence non ambiguë, finie et déterministe d'étapes, indépendante du langage.
- Utilisez correctement les trois constructions — séquence, sélection, itération — et gardez une table d'identifiants avec des types de données.
- Fractionnez un problème par décomposition et abstraction, puis par affinement progressif.
- Écrivez du pseudocode qui pourrait réellement s'exécuter : déclarez les variables et suivez le style de pseudocode de l'examen.
Erreurs courantes
- Utiliser
=pour assigner une valeur. L'affectation est←;=est une comparaison. - Oublier
ENDIF,ENDWHILE,ENDCASEouNEXT. Chaque construction se ferme, et le mot de fermeture est où le point pour cette construction est vérifié. - Ne pas initialiser un total ou un compteur avant la boucle, de sorte que l'algorithme additionne à une valeur qui n'a jamais existé.
- Utiliser une boucle
FORquand le nombre de répétitions est inconnu. Lire jusqu'à une valeur sentinelle ou une bonne réponse nécessiteWHILEouREPEAT ... UNTIL. - Écrire
Age > 65 OR < 5. Chaque côté deORetANDdoit être une comparaison complète. - Répondre « expliquez pourquoi la décomposition est utilisée » avec un seul avantage écrit trois fois. Trois points nécessitent trois avantages différents.
-
10
Types et structures de données
Regarder la leçon10.1
Choix des types de données
Programme
Les candidats doivent être capables de : Notes et orientations Sélectionner et utiliser des types de données appropriés pour la résolution d'un problème y compris entier, réel, char, chaîne, Booléen, datte (le pseudocode utilisera les types de données suivants : INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) Montrer une compréhension de la finalité d'une structure d'enregistrement pour contenir un ensemble de données de différents types de données sous un identifiant unique Écrire du pseudocode pour définir une structure d'enregistrement Écrire du pseudocode pour lire des données depuis une structure d'enregistrement et sauvegarder des données vers une structure d'enregistrement Source : Programme Cambridge International
Chaque variable a besoin d'un type de données 数据类型 — le genre de valeur qu'elle contient et les opérations autorisées :
INTEGER— un nombre entier (42,-7). Pour les comptes, indices, IDs.REAL— un nombre comportant une partie décimale (3.14). Pour l'argent, les mesures.STRING— des caractères entre guillemets ("Hello"). Pour le texte.CHAR— un seul caractère ('A').BOOLEAN—TRUEouFALSE. Pour les indicateurs booléens.DATE— une date calendaire.
Choisissez le type précis le plus petit adapté :
INTEGERpour les comptes entiers,BOOLEANpour les indicateurs booléens (pas les chaînes"yes"/"no").Les tableaux « donner le type de données approprié » sont décidés par l'utilisation de la valeur : la note moyenne d'une classe est
REAL(elle a une partie fractionnaire) ; une adresse e-mail estSTRING; le nombre d'étudiants estINTEGER; si un étudiant a payé estBOOLEAN; une date de naissance estDATE; un index de tableau est toujoursINTEGER; une seule lettre de grade estCHAR; un numéro de téléphone est unSTRING, car il commence par0et n'est jamais utilisé dans des calculs arithmétiques. UnBOOLEANest utilisé pour un indicateur avec seulement deux états : si une recherche a trouvé sa cible, si un membre a payé, si un siège est réservé. Pour le tableau des identifiants, le nom de la variable doit être significatif aussi :NumberOfPeople, pasn.10.1
Enregistrements

Un enregistrement 记录 (une structure d'enregistrement 记录结构) contient plusieurs champs de types différents sous un même nom — utile lorsque plusieurs valeurs décrivent une seule chose.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Ceci définit le type
TStockItem; declarez des variables de celui-ci :DECLARE Item1 : TStockItem DECLARE Items : ARRAY[1:100] OF TStockItemUtilisez la notation point pour accéder à chaque champ 字段 :
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Utilisez un enregistrement lorsque des valeurs appartiennent toujours ensemble (un client, un article en stock) ; utilisez des variables séparées pour des valeurs sans rapport.
Exemple résolu. Un club stocke, pour chaque élève, un ID élève (chaîne), un nom, une date de naissance et jusqu'à trois numéros de club (entiers). Écrivez du pseudocode pour déclarer le type d'enregistrement, un tableau pour contenir $3000$ élèves, et une instruction qui stocke un nom dans le premier élément.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Les points :
TYPEavec l'identifiant etENDTYPE; chaque champ déclaré avec un type approprié ; le tableau déclaré avec ses bornes etOF Student; le champ atteint avec l'index et un point. Une question « indiquez l'erreur dans la déclaration d'enregistrement » pointe généralement vers unENDTYPEmanquant, un champ sans type, ou un champ déclaré comme unSTRINGqui doit contenir des données arithmétiques. Deux conventions rapportent des points indépendamment : un élément inutilisé est marqué avec une valeur qui ne peut pas être des données réelles (une chaîne vide,-1, un ID de0), et il est recommandé d'utiliser le même marqueur partout afin que chaque module puisse reconnaître un emplacement inutilisé ; un champ de club inutilisé est0. Les avantages d'un tableau d'enregistrements, pour une question « citez trois avantages » : toutes les données pour une entité sont conservées sous un seul identifiant ; les champs peuvent avoir des types de données différents ; un seul tableau remplace plusieurs tableaux parallèles qui devraient être maintenus en phase ; l'ensemble peut être traité par une seule boucle ou transmis comme unique paramètre ; et ajouter un champ modifie uniquement la définition du type. Pour un seul client, la structure adaptée est un enregistrement (champs de types différents sous un même nom) ; pour tous les clients, c'est un tableau d'enregistrements.
*Un enregistrement contient plusieurs champs de types différents sous un même nomExplorerUn enregistrement regroupe des champs sous un nom unique
Un enregistrement regroupe des champs liés ensemble. Chaque champ est une étiquette nommée à laquelle vous accédez avec la notation point — Item1.Category — et non par un index numérique.
Vocabulaire EntrainerAnglais Chinois Pinyin array/əˈreɪ/ 数组 shù zǔ record/ˈrekɔːd/ 记录 jì lù record structure/ˈrekɔːd ˈstrʌktʃə/ 记录结构 jì lù jié gòu field/fiːld/ 字段 zì duàn element/ˈelɪmənt/ 元素 yuán sù bounds/baʊndz/ 边界 biān jiè 10.2
Tableaux

Programme
Les candidats doivent être capables de : Notes et orientations Utiliser les termes techniques associés aux tableaux Y compris index, borne supérieure et borne inférieure Sélectionner une structure de données appropriée (tableau 1D ou tableau 2D) pour une tâche donnée Écrire du pseudocode pour des tableaux 1D et 2D Écrire du pseudocode pour traiter des données de tableau Trier en utilisant un tri à bulles Rechercher en utilisant une recherche linéaire Source : Programme Cambridge International
Un tableau 数组 est une collection ordonnée d'éléments de même type, sous un même nom, atteinte par un index 索引.
- élément 元素 — un item dans le tableau.
- bornes 边界 — les indices valides les plus bas et les plus hauts.
- dimension 维度 — 1-D (liste), 2-D (tableau), etc.
- borne inférieure 下界 et borne supérieure 上界 — le premier et le dernier index valide ; le nombre d'éléments est borne supérieure moins borne inférieure plus un, et pour un tableau 2-D, le produit des deux compteurs.
Ainsi, dans
ThisArray[n] ← 42, le tableau a une dimension, l'index est la variablen(unINTEGER), et l'élément à cet index reçoit42. Avant de déclarer un tableau, il faut connaître son type de données ainsi que ses bornes. Pour déclarer $120$ valeurs pouvant comporter une décimale :DECLARE Data : ARRAY[1:120] OF REAL; un tableau de chaînes de caractères à $150$ lignes et deux colonnes :DECLARE Data : ARRAY[1:150, 1:2] OF STRING, qui contient $300$ éléments. Les avantages d'un tableau par rapport à des variables séparées, pour une question de deux points : un seul identificateur au lieu de trente ; les éléments peuvent être traités par une boucle avec l'index comme compteur ; la taille est facile à modifier ; et l'ensemble peut être transmis à un module en tant qu'un seul paramètre. Un tableau peut également remplacer une série d'instructions de sélection :DaysInMonth[Month]cherche la réponse directement au lieu de douze clausesIF, ce qui est plus court, plus rapide à écrire et plus facile à maintenir.Tableaux 1-D
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Traiter chaque élément avec une boucle
FOR:FOR i ← 1 TO 5 OUTPUT Names[i] NEXT i
*Un tableau 1-D (une liste) avec indices et bornesTableaux 2-D (tableau 2D)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
Le premier index correspond à la ligne, le second à la colonne. Utiliser des boucles imbriquées pour visiter chaque cellule. Utiliser 1-D pour une séquence unique, 2-D pour deux dimensions naturelles (une grille, lignes × colonnes).
 *Un tableau 2-D (un tableau) avec indices de lignes et de colonnes
Opérations courantes
Une recherche linéaire 线性查找 vérifie chaque élément jusqu'à ce qu'il soit trouvé :
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Pour trouver une somme, un total, un maximum ou un minimum, définir une variable courante puis parcourir :
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Un tri à bulles 冒泡排序 met un tableau en ordre : passer à travers en comparant chaque paire adjacente et échanger celles qui ne sont pas dans l'ordre ; répéter les passes jusqu'à ce qu'une passe ne provoque aucun échange.
L'examen Paper 2 demande ces algorithmes sous forme de pseudocode et de descriptions en mots, et parfois dans leur version "efficace" :
- Valeur maximale : définir
Largestà la première élément ; pour chaque élément restant, si celui-ci est plus grand queLargest, le stocker dansLargest; après la boucle, afficherLargest. Pour la position de la valeur maximale, garder une seconde variable qui stocke l'index chaque fois queLargestchange. - Recherche linéaire retournant une position : définir
FoundAt ← -1avant la boucle (une valeur qui ne peut jamais être un index valide, donc cela signifie "non trouvé") ; parcourir le tableau ; lorsque l'élément correspond, stocker l'index et sortir de la boucle ; après la boucle, testerFoundAt. - Compter ou afficher les éléments non vides : comparer chaque élément avec le marqueur d'un élément inutilisé (
""ou-1) et compter ou n'afficher que ceux qui diffèrent. - Supprimer un élément : trouver son index par une recherche linéaire ; déplacer tous les éléments suivants d'une place vers le début, afin de combler le vide ; marquer le dernier élément comme inutilisé (ou diminuer le compteur).
- Insérer dans un tableau trié : trouver le premier index dont l'élément est plus grand ; déplacer cet élément et tous les suivants d'une place vers la fin ; stocker la nouvelle valeur dans le vide.
- Tri à bulles efficace : un indicateur
Swappedpour arrêter les passes dès qu'une passe ne provoque aucun échange, et une limite supérieure qui diminue d'une unité à chaque passe car la valeur maximale a déjà atteint la fin.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Les points concernent la boucle externe qui répète jusqu'à ce qu'il n'y ait plus d'échanges, l'indicateur défini à l'intérieur de la
IF, l'échange sur trois lignes avec une variable temporaire, et la limite décroissante. Un tri en "étapes" (affinement progressif) est : répéter jusqu'à ce que ce soit trié ; à chaque passe, comparer les paires adjacentes ; échanger une paire hors d'ordre ; après chaque passe, la plus grande valeur non triée se trouve à la fin. Deux tableaux 1-D de registres ou de données parallèles sont traités avec une seule boucle et un seul index ; un tableau 2-D nécessite une boucle imbriquée, l'externe sur les lignes et l'interne sur les colonnes, et une recherche dans une ligne fixe l'index de ligne et boucle sur la colonne.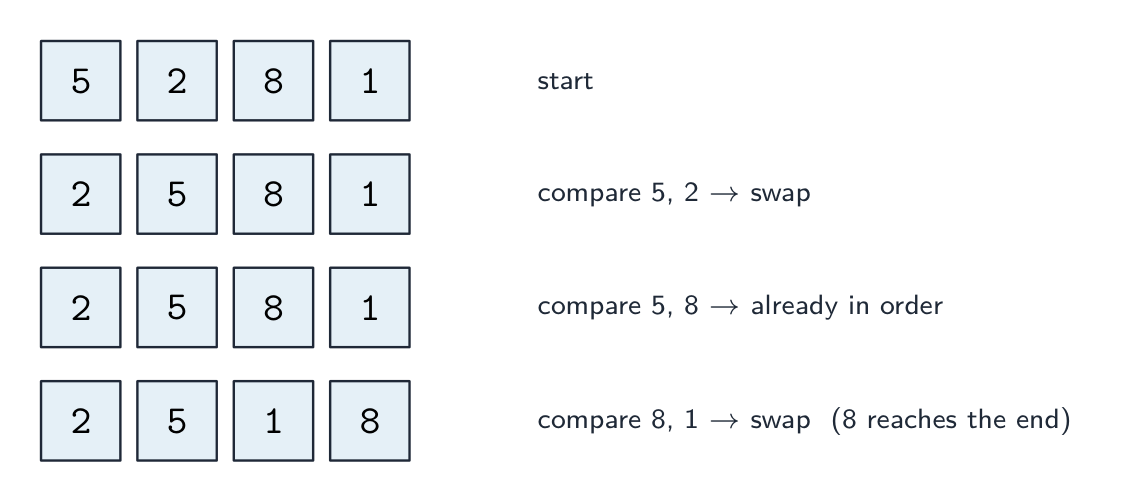 *Une passe d'un tri à bulles : les paires adjacentes sont comparées et échangées, faisant remonter la plus grande valeur à la finExplorer
Un tableau à 2 dimensions
Choisissez une ligne et une colonne pour lire un élément — comment une grille de données est stockée et indexée.
Vocabulaire EntrainerAnglais Chinois Pinyin index/ˈɪndeks/ 索引 suǒ yǐn dimension/daɪˈmenʃn/ 维度 wéi dù bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù 10.3
Fichiers
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension de la nécessité des fichiers Écrire du pseudocode pour gérer des fichiers texte composés d'une ou plusieurs lignes Source : Programme Cambridge International
Un fichier 文件 est des données stockées sur un stockage secondaire 辅助存储器, conservées entre les exécutions du programme. Les variables en RAM disparaissent quand le programme s'arrête, donc pour sauvegarder des données de manière permanente (scores élevés, registres, paramètres), le programme écrit dans un fichier. Les fichiers permettent aussi aux programmes de partager des données et de reprendre depuis un état sauvegardé.
*Les variables en RAM disparaissent quand le programme s'arrête ; un fichier sur disque persiste entre les exécutionsUn fichier texte 文本文件 contient une ou plusieurs lignes de caractères lisibles ; les programmes lisent et écrivent des fichiers texte ligne par ligne. Ouvrir un fichier avant utilisation et le fermer après :
OPENFILE "data.txt" FOR READ // or FOR WRITE, FOR APPEND WHILE NOT EOF("data.txt") DO READFILE "data.txt", LineString OUTPUT LineString ENDWHILE CLOSEFILE "data.txt"EOFteste la fin de fichier 文件结束 avant la lecture. Pour écrire :OPENFILE "log.txt" FOR WRITE FOR i ← 1 TO 100 WRITEFILE "log.txt", "Event " & i NEXT i CLOSEFILE "log.txt"Toujours fermer chaque fichier — sinon les écritures tamponnées peuvent être perdues et d'autres programmes peuvent être bloqués.
Pourquoi les fichiers (deux points) : les données sont conservées après la fin du programme, donc elles sont disponibles la prochaine fois que le programme s'exécute ; elles peuvent être partagées avec d'autres programmes ; et elles peuvent contenir plus que ce qui tient en mémoire. La caractéristique d'un fichier texte qui permet à un programme de le parcourir est qu'il s'agit d'une séquence de lignes, lues une après l'autre à partir du début. Les trois modes :
READpour lire à partir du début ;WRITEpour créer un nouveau fichier, ce qui supprime tout contenu existant, donc il ne peut pas être utilisé pour ajouter à un fichier ;APPENDpour ajouter des lignes à la fin d'un fichier existant. TesterEOFavant chaque lecture, et ouvrir le fichier une seule fois, même lorsque plusieurs modules l'utilisent.Exemple résolu. Écrire un pseudocode pour une procédure
LastLines(FileName : STRING)qui affiche les trois dernières lignes d'un fichier texte, dans l'ordre.PROCEDURE LastLines(BYVAL FileName : STRING) DECLARE LineX, LineY, LineZ : STRING LineX ← "" LineY ← "" LineZ ← "" OPENFILE FileName FOR READ WHILE NOT EOF(FileName) DO LineX ← LineY LineY ← LineZ READFILE FileName, LineZ ENDWHILE CLOSEFILE FileName OUTPUT LineX OUTPUT LineY OUTPUT LineZ ENDPROCEDUREChaque nouvelle ligne pousse les trois précédentes vers l'avant, de sorte qu'à la fin du fichier, les trois variables contiennent ses trois dernières lignes ; un fichier avec moins de lignes affiche des chaînes vides. Pour afficher les cinq premières lignes, compter les lignes lues et arrêter la boucle à cinq ou à
EOF, selon le premier arrivé ; un fichier vide est détecté parEOFétantTRUEimmédiatement après l'ouverture.Champs dans une ligne. Un fichier texte contient des chaînes, donc un registre est écrit comme une seule ligne avec ses champs joints par un séparateur 分隔符 caractère, et chaque nombre ou booléen converti avec
NUM_TO_STR(et lu avecSTR_TO_NUM, ou en le comparant à"TRUE"). Choisir un séparateur qui ne peut jamais apparaître dans les données : une virgule ou|pour les noms et les nombres, jamais un espace lorsque le nom peut en contenir un. Si un champ peut contenir n'importe quel caractère, le séparateur peut être confondu avec les données ; la solution est de mettre chaque champ sur sa propre ligne, ou d'écrire la longueur du champ avant celui-ci. Un élément par ligne est simple à relire mais utilise plus de lignes et rend un registre moins visible comme une unité. Lire un fichier dont les lignes sont dans un ordre connu (croissant par ID) permet à la recherche de s'arrêter dès qu'un ID plus grand est lu, au lieu de lire jusqu'à la fin. Un fichier de sauvegarde créé à chaque sauvegarde de jeu a besoin d'un nom de fichier significatif, par exemple le nom du joueur et la date/heure, afin que toute sauvegarde précédente puisse être restaurée. *Une ligne d'un fichier texte est un registre : champs joints par un séparateur, convertis à leurs types lors de la relectureExplorer
Gestion d'un fichier : ouvrir → utiliser → fermer
Parcourez le cycle de vie suivi par chaque fichier. Les deux parties faciles à oublier sont de tester EOF pendant la lecture dans une boucle, et de toujours fermer à la fin.
Vocabulaire EntrainerAnglais Chinois Pinyin file/faɪl/ 文件 wén jiàn secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 10.4
Types de Données Abstraits (ADT)

Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension qu'un ADT est un ensemble de données et un ensemble d'opérations sur ces données Montrer une compréhension qu'une pile, une fichier et une liste chaînée sont des exemples d'ADTs Décrire les caractéristiques clés d'une pile, d'une fichier et d'une liste chaînée et justifier leur utilisation pour une situation donnée Utiliser une pile, une fichier et une liste chaînée pour stocker des données Les candidats ne seront pas tenus d'écrire du pseudocode pour ces structures, mais ils devraient être capables d'ajouter, modifier et supprimer des données dans ces structures Décrire comment une fichier, une pile et une liste chaînée peuvent être implémentées en utilisant des tableaux Source : Programme Cambridge International
*Liste chaînée : insertion par recâblage de pointeurs
*Pile vs file : LIFO et FIFO
Un Type de Données Abstrait 抽象数据类型 (ADT) est une collection de données plus des opérations dessus, défini par ce qu'il fait, pas comment il est stocké. L'utilisateur travaille uniquement via les opérations ; l'implémentation est cachée, donc elle peut changer sans affecter le code utilisant l'ADT. Connaître trois : pile, file, liste chaînée.
La définition à un point : un ADT est une collection de données accompagnée d'un ensemble d'opérations sur ces données. Une pile, une file, une liste chaînée, un arbre binaire et un tableau sont tous des ADT. Pour justifier un choix : une file lorsque les éléments doivent être traités dans l'ordre d'arrivée (trames d'impression, frappes de touches, clients dans un magasin), car c'est premier entré, premier sorti ; une pile lorsque le dernier élément doit être traité en premier (annuler, revenir dans les pages web, inverser une commande, les adresses de retour des appels imbriqués), car c'est dernier entré, premier sorti ; une liste chaînée lorsque les éléments sont insérés et supprimés au milieu d'une séquence ordonnée souvent, car seuls les pointeurs changent et rien n'a besoin d'être déplacé. Pour comparer une pile et une file : toutes deux sont des structures linéaires d'éléments avec un ordre, toutes deux sont implémentées avec un tableau et des pointeurs, et toutes deux nécessitent une vérification de plein avant l'ajout et de vide avant la suppression ; une pile a un seul pointeur et ajoute/supprime à la même extrémité, une file a deux pointeurs et ajoute à une extrémité et supprime à l'autre.
Pile
Une pile 栈 fonctionne selon l'ordre Dernier entré, premier sorti 后进先出 (Last In, First Out - Dernier entré, premier sorti). Opérations : repousser 入栈 (ajouter au sommet), populer 出栈 (retirer du sommet), peek (regarder le sommet), et tests de vide/plein. Usages : historique d'annulation, adresses de retour des appels de fonction, analyse d'expressions, backtrack.
*Push et pop modifient le pointeur top ; le pointeur de base reste immobileExemple résolu. Une pile de caractères contient, de la base vers le haut,
'P','N','Z','X','Y','W', avec le pointeur de sommet de pile à'W'(emplacement mémoire 202 de 200-207). Les opérationsPOP,POP,PUSH 'A',PUSH 'B',POPsont effectuées. Que contient la pile et où pointe le pointeur ?Les deux pops retirent
'W'puis'Y'; les pushes ajoutent'A'puis'B'à leur place ; la dernière pop retire'B'. La pile contient maintenant'P','N','Z','X','A'et le pointeur est à'A', l'emplacement 203. La valeur qui se trouve sur la pile depuis le plus longtemps est l'élément du bas,'P'; au maximum cinq pops supplémentaires sont possibles avant que la pile ne soit vide, et une pop sur une pile vide constitue une erreur, c'est pourquoiPop()teste d'abord si elle est vide. Une fonctionPush()qui retourneTRUEen succès teste d'abord si le pointeur est en haut du tableau (plein) et retourneFALSEsi tel est le cas. Les éléments du tableau n'ont pas besoin d'être initialisés avant utilisation, car le seul pointeur indique quels éléments sont utilisés.
Une pile de livres est une pile que vous pouvez voir. Vous ne pouvez ajouter ou retirer un livre que par le haut, donc celui que vous avez mis en dernier est celui que vous retirez en premier — c'est exactement LIFO File d'attente
Une file d'attente 队列 fonctionne selon l'ordre FIFO 先进先出 (First In, First Out). Opérations : enfiler 入队 (ajouter à l'arrière), défiler 出队 (retirer de l'avant), et tests pour vide/plein. Utilisations : impression en file d'attente, ordonnancement, recherche en largeur, tamponnage.
En queue ajoute à l'arrière ; dequeue retire de l'avant Pour décrire l'ajout d'un élément : vérifier que la file n'est pas pleine ; stocker l'élément à la position indiquée par le pointeur de fin de file ; incrémenter le pointeur de fin (et le compteur). Pour décrire le retrait : vérifier que la file n'est pas vide ; lire l'élément au pointeur avant ; incrémenter le pointeur avant (et décrémenter le compteur). Énoncer la convention que vous utilisez : si le pointeur de fin marque la prochaine case libre, l'égalité des pointeurs avant et de fin signifie que la file est vide ; s'il marque le dernier élément, des pointeurs égaux signifient un seul élément. Dans une file linéaire, le pointeur avant ne peut jamais reculer, donc les cases derrière lui sont gaspillées ; c'est ce que corrige la file circulaire ci-dessous. Les deux caractéristiques d'une file à énoncer : les éléments sont ajoutés à l'arrière et retirés de l'avant, donc le premier ajouté est le premier retiré.
Une file de personnes est une file que vous pouvez voir. Vous vous placez à l'arrière et êtes servi de l'avant, donc celui qui a attendu le plus longtemps est servi en premier — c'est exactement FIFO Liste chaînée
Une liste chaînée 链表 stocke les données sous forme de séquence de nœuds 节点. Chaque nœud contient une valeur et un pointeur 指针 vers le nœud suivant ; un pointeur de tête marque le début, et le pointeur du dernier nœud est un sentinelle (par ex.
NULL). Opérations : insertion, suppression, recherche, et traversée 遍历 (visiter chaque nœud dans l'ordre). Son avantage par rapport à un tableau est une insertion/suppression peu coûteuse (il suffit d'ajuster les pointeurs) ; son inconvénient est un accès aléatoire lent (vous devez suivre les pointeurs depuis la tête).
Une liste chaînée : chaque nœud pointe vers le suivant Ajouter un nœud dans l'ordre (quatre points) : traverser la liste depuis la tête, en suivant les pointeurs, jusqu'à ce que le nœud situé avant la position soit trouvé (le dernier nœud dont la valeur est inférieure) ; prendre un nœud libre et y stocker la nouvelle valeur ; définir le pointeur du nouveau nœud sur l'adresse que le nœud précédent pointait ; définir le pointeur du nœud précédent sur le nouveau nœud. Si la nouvelle valeur doit être placée au début, c'est le pointeur de tête qui est modifié. Supprimer un nœud : trouver le nœud situé avant celui-ci, et définir le pointeur de ce nœud sur l'adresse que le nœud supprimé pointait, afin que la liste le contourne ; le nœud libéré retourne à la liste des libres. Comparé à un tableau 1-D, insérer ou supprimer dans une liste chaînée ne nécessite aucun déplacement des autres éléments, et la liste peut grandir jusqu'à ce que la mémoire manque ; le coût est le pointeur supplémentaire stocké avec chaque élément, et atteindre l'élément $n$ implique de suivre $n$ pointeurs, puisqu'il n'y a pas d'index direct.
ExplorerUne liste chaînée : des nœuds joints par des pointeurs
Chaque nœud stocke une valeur et un pointeur vers le nœud suivant. Insérer ou supprimer ne fait que relier les pointeurs — aucun élément ne se décale, contrairement à un tableau.
ExplorerPiles et files
Empiler et dépiler. Une pile (stack) est last-in-first-out ; une fichier (queue) est first-in-first-out — deux types de structures de données abstraites (ADT) clés.
Vocabulaire EntrainerAnglais Chinois Pinyin stack/stæk/ 栈 zhàn push/pʊʃ/ 入栈 rù zhàn separator/ˈsepəreɪtə/ 分隔符 fēn gé fú linked list/lɪŋkt lɪst/ 链表 liàn biǎo queue/kjuː/ 队列 duì liè LIFO/ˈlaɪfəʊ/ 后进先出 hòu jìn xiān chū FIFO/ˈfaɪfəʊ/ 先进先出 xiān jìn xiān chū pop/pɒp/ 出栈 chū zhàn enqueue/enˈkjuː/ 入队 rù duì dequeue/diːˈkjuː/ 出队 chū duì traverse/trəˈvɜːs/ 遍历 biàn lì free list/friː lɪst/ 空闲列表 kòng xián liè biǎo 10.4
Implémentation des TAD avec des tableaux

Pile utilisant un tableau
Conserver les éléments dans
Stack[1:MaxSize]avec un entierTop(0 quand vide).Push(x): siTop = MaxSizela pile est pleine (overflow 溢出) ; sinonTop ← Top + 1;Stack[Top] ← x.Pop(): siTop = 0la pile est vide (sous-débordement 下溢) ; sinon retournerStack[Top]etTop ← Top - 1.
File d'attente utilisant un tableau circulaire
Une file simple laisse
FrontetRearmarcher hors du tableau, gaspillant le début. La solution est un tableau circulaire 循环数组 — lorsqu'un pointeur atteintMaxSize, il fait le tour pour revenir à 1 :Enqueue(x): vérifier plein ; sinonRear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): vérifier vide ; sinon retournerQueue[Front]etFront ← (Front MOD MaxSize) + 1.
Suivre un compteur séparé pour distinguer vide de plein.
L'algorithme pour le pointeur de fin, en mots : si le compteur égale la taille, signaler que la file est pleine et arrêter ; sinon ajouter un au pointeur de fin ; s'il dépasse maintenant le dernier index, le définir sur le premier index ; stocker l'élément à cet endroit et ajouter un au compteur. Les déclarations qu'une réponse "décrire la déclaration et l'initialisation" notée sur cinq points liste : le tableau avec sa taille et son type d'élément ; un pointeur avant et un pointeur de fin, tous deux initialisés au premier index (ou le pointeur avant au premier index et le pointeur de fin à la prochaine case libre) ; et un compteur d'éléments, initialisé à $0$.
Par exemple, avec
MaxSize = 6: siRear = 5, alors(5 MOD 6) + 1 = 6, donc le prochain élément va dans la case 6 ; siRear = 6, alors(6 MOD 6) + 1 = 1, donc le pointeur fait le tour vers la case 1.Une file d'attente circulaire fait faire le tour aux pointeurs vers le début du tableau Liste chaînée utilisant un tableau
Utiliser un tableau de structures, chacune avec un
Nextindex :TYPE TNode DECLARE Value : INTEGER DECLARE Next : INTEGER // index of the next node, or -1 for end ENDTYPE DECLARE Nodes : ARRAY[1:MaxSize] OF TNode DECLARE Head : INTEGER // index of first node, -1 if empty DECLARE FreeListHead : INTEGER // first available free nodeUne liste libre 空闲列表 enchaîne les cases inutilisées, tout comme la liste de données enchaîne ses cases utilisées. Pour insérer : prendre une case dans
FreeListHead, définir la valeur du nouveau nœud etNext, et mettre à jour leNextdu nœud précédent (ouHead). Pour supprimer : délier le nœud et retourner sa case à la liste libre. Cela offre la flexibilité d'une structure chaînée avec l'allocation statique d'un tableau.
Une liste chaînée stockée dans un tableau : un tableau de données et un tableau de pointeurs Exemple résolu. Une liste chaînée est maintenue dans un tableau
Dataet un tableauPointer, avecStartpointant vers l'index 1. La liste est 1 → 3 → 4 (l'index 1 contientD40, l'index 3 contientD32, l'index 4 contientD11, dont le pointeur est $\emptyset$) ; la liste libre commence à l'index 2 et continue 2 → 5. InsérerD6entreD32etD11.Prendre le premier nœud libre, l'index 2, et définir
FreeStartsur son pointeur, 5 ; stockerD6dansData[2]; définirPointer[2]sur la valeurPointer[3]contenue, qui est 4 ; définirPointer[3]sur 2. La liste lit 1 → 3 → 2 → 4 et la liste libre est 5 → $\emptyset$. La réponse à « comment implémenter une liste chaînée » correspond exactement à ces parties : un tableau (ou tableau de structures) pour les données, un tableau parallèle pour les pointeurs contenant des indices, un pointeur de début, un pointeur de liste libre et une valeur nulle telle que $-1$ pour la fin.Exemple corrigé. Une file circulaire est maintenue dans un tableau de taille 5 (indices 0 à 4) avec
Front = 3,Rear = 3et un élément stocké. Deux éléments sont ajoutés, puis deux sont retirés. Où se trouvent les pointeurs, et pourquoi utiliser une file circulaire ? Chaque déplacement utilise(pointer + 1) MOD size, donc les pointeurs se wrap. Ajouter deux fois déplaceRear: $3 \rightarrow 4$, puis $4 \rightarrow 0$ (car $(4+1) \bmod 5 = 0$), doncRear = 0et trois éléments sont stockés. Retirer deux fois déplaceFrontde la même manière : $3 \rightarrow 4$, puis $4 \rightarrow 0$, laissantFront = 0et un élément. Le wrap est tout le point : dans une file de queue linéaire, les pointeurs avancent vers la fin et l'espace libéré à l'avant est gaspillé même lorsque la file est vide. Rappelez-vous qu'une file retire à l'Avant et ajoute à l'Arrière - une pile utilise un seul pointeur pour les deux.ExplorerImplémenter des TADs avec des tableaux
FIFO
Une fichier est premier-entré-premier-sorti — enfiler à l'arrière, défiler depuis le devant.
Vocabulaire EntrainerAnglais Chinois Pinyin pointer/ˈpɔɪntə/ 指针 zhǐ zhēn node/nəʊd/ 节点 jié diǎn overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū underflow/ˌʌndəˈfləʊ/ 下溢 xià yì circular array/ˈsɜːkjʊlə əˈreɪ/ 循环数组 xún huán shù zǔ 10.4
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
Terme Définition record une structure de données qui contient un ensemble d'éléments de données (champs) de différents types de données sous un identifiant unique array une structure de données qui contient un nombre fixe d'éléments du même type de données sous un identifiant unique, chacun étant accédé par un index index le nombre qui identifie un élément d'un tableau upper bound, lower bound l'index valide le plus grand et le plus petit d'un tableau text file un fichier qui stocke les données sous forme de lignes de caractères, qu'un programme lit et écrit une ligne à la fois abstract data type un ensemble de données accompagné d'un ensemble d'opérations sur ces données pile une liste dans laquelle les éléments sont ajoutés et retirés du même bout, le sommet, donc le dernier élément ajouté est le premier retiré (LIFO) file d'attente une liste dans laquelle les éléments sont ajoutés à l'arrière et retirés de l'avant, donc le premier ajouté est le premier retiré (FIFO) linked list une liste dans laquelle chaque nœud contient un élément de données et un pointeur vers le nœud suivant, avec un pointeur de début vers le premier nœud pointer une variable qui contient l'adresse (ou l'index) d'un nœud ou d'une position dans une structure recherche linéaire vérifier chaque élément à tour de rôle depuis le premier jusqu'à ce que la cible soit trouvée ou la fin atteinte bubble sort passages répétés à travers le tableau comparant les paires adjacentes et échangeant celles qui sont mal classées, jusqu'à ce qu'un passage ne fasse aucun échange Vocabulaire EntrainerAnglais Chinois Pinyin data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng lower bound/ˈləʊə baʊnd/ 下界 xià jiè upper bound/ˈʌpə baʊnd/ 上界 shàng jiè linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo text file/tekst faɪl/ 文本文件 wén běn wén jiàn end of file/end ɒv faɪl/ 文件结束 wén jiàn jié shù Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ 抽象数据类型 chōu xiàng shù jù lèi xíng 10.4
Conseils d'examen
- Choisir la bonne structure de données et la justifier (un record pour des champs mixtes, un tableau 2-D pour une grille).
- Savoir implémenter une pile, une file d'attente et une liste chaînée avec un tableau et des pointeurs (sommet ; avant/arrière ; suivant).
- Distinguer un TAD (son comportement) de son implémentation (tableau plus pointeurs).
Erreurs courantes
- Une déclaration d'enregistrement sans
ENDTYPE, ou des champs sans types. Chaque champ est une ligneDECLAREavec un type. - Lire au-delà de la fin d'un fichier, ou écrire avec
WRITEalors que le fichier doit conserver son contenu. TesterEOFavant chaque lecture ; utiliserAPPENDpour ajouter. - Écrire un nombre dans un fichier texte sans le convertir. Un fichier contient des chaînes :
NUM_TO_STRout,STR_TO_NUMback. - Oublier les vérifications.
Pushet enqueue testent d'abord si plein ;Popet dequeue testent d'abord si vide, et la réponse le dit. - Perdre le reste de la liste lors de l'insertion d'un nœud. Définir le pointeur du nouveau nœud sur le nœud suivant ancien avant de modifier le pointeur du nœud précédent.
- Une recherche linéaire qui ne dit jamais « non trouvé ». Initialisez la position à $-1$ et testez-la après la boucle.
-
11
Programmation
Regarder la leçon11.1
Bases de la programmation

Programme
Les candidats doivent être capables de : Notes et orientations Implémenter et écrire du pseudocode à partir d'une conception donnée présentée sous forme de diagramme de flux de programme ou d'anglais structuré Écrire des instructions de pseudocode pour : • la déclaration et l'initialisation de constantes • la déclaration de variables • l'assignation de valeurs aux variables • les expressions impliquant n'importe quel opérateur arithmétique ou logique l'entrée au clavier et la sortie sur la console Utiliser des fonctions intégrées et des routines de bibliothèque Toutes les fonctions non données dans le guide de pseudocode seront fournies. Les fonctions de manipulation de chaînes seront toujours données Source : Programme Cambridge International
La programmation transforme une conception en instructions écrites sous forme de code 
Un programmeur écrit le code et le teste au fur et à mesure De la conception au code
Vous devriez être capable de transformer une conception — un organigramme 流程图 (program flowchart) ou anglais structuré 结构化英语 — en pseudo-code 伪代码, puis dans un langage réel :
- repérez les variables 变量 et leurs types de données 数据类型.
- convertissez les boîtes d'entrée/sortie en
INPUT/OUTPUT. - convertissez les losanges de décision en
IF...ELSE...ENDIF(ouCASE). - convertissez les flèches de boucle en
WHILE,REPEAT...UNTIL, ouFOR. - convertissez les boîtes de traitement en affectations ou calculs.
- vérifiez en effectuant un traçage avec une petite entrée.
Chaque symbole d'organigramme devient un mot-clé de pseudo-code Constantes et variables
Une constante 常量 retient une valeur qui ne change jamais ; une variable retient une valeur qui peut changer. Déclarez-les avec un type :
La valeur d'une variable peut changer ; une constante reste fixe CONSTANT Pi = 3.14159 DECLARE Radius : REAL DECLARE Area : REAL Radius ← 5 Area ← Pi * Radius * RadiusUtilisez des constantes pour les valeurs fixes qui reviennent (
Pi,MaxScore) ; elles rendent le code plus clair et facile à modifier en un seul endroit.Dans l'examen, une constante est la réponse à la question « identifier un moyen plus approprié de représenter » une valeur fixe, comme un taux de taxe ou un score maximum, qui apparaît à plusieurs endroits dans le pseudo-code. Les avantages que le barème liste : la valeur est définie une seule fois et ne peut pas être modifiée accidentellement par le programme ; un changement est fait en un seul endroit et atteint toutes les instructions qui l'utilisent ; l'identifiant donne à la valeur un sens (
MaxScoreplutôt que100), donc le code est plus facile à lire et à vérifier ; et il y a moins de risque d'erreur de frappe dans une longue valeur telle que3.14159. Une question « indiquer une valeur qui pourrait être remplacée par une constante » demande la littérale du pseudo-code (0.2,40), pas un nouveau nom.Chaque variable est déclarée une seule fois, avec un identificateur 标识符 (son nom) et un type de données, avant qu'elle ne soit utilisée. Les six types dans le guide de pseudo-code 9618 :
Type Contient Écrit dans le code comme Usage typique INTEGERnombres entiers 42,-3un compteur, un index de tableau, un compteur de boucle REALnombres avec une partie fractionnaire 3.75un prix, une moyenne CHARun seul caractère 'A'(guillemets simples)une lettre de note, une touche de menu STRINGune séquence de caractères "Hello"(guillemets doubles)un nom, un code postal BOOLEANTRUEouFALSETRUEun indicateur tel que FoundDATEune date calendaire 12/05/2026une date de naissance Une question « donner le type de données approprié » se répond selon la manière dont la variable est utilisée dans le pseudo-code : une valeur avec une virgule décimale est
REAL; quelque chose défini àTRUEouFALSEestBOOLEAN; une valeur entre guillemets simples estCHAR; une valeur utilisée comme index de tableau, ou avecDIVetMOD, estINTEGER. Écrivez le type en majuscules, orthographié comme le guide l'écrit.Exemple résolu. Indiquez le type de données approprié pour chaque variable.
Found ← FALSE Initial ← 'K' Price ← 12.99 Count ← Count + 1 Name ← "Li Wei"FoundestBOOLEAN(elle retientFALSE) ;InitialestCHAR(un caractère entre guillemets simples) ;PriceestREAL(une valeur décimale) ;CountestINTEGER(un compteur qui augmente de un) ;NameestSTRING(du texte entre guillemets doubles).Affectation et expressions
Utilisez
←pour l'affectation 赋值 :Total ← Total + 1 Average ← Sum / CountLes expressions utilisent des opérateurs 运算符 :
- arithmétiques
+ - * /, plusDIV(division entière) etMOD(reste) :7 DIV 2 = 3;7 MOD 2 = 1. - comparaisons
=,<>,<,>,<=,>=. - logique
AND,OR,NOT.
Précédence 优先级 (du plus élevé au plus bas) :
NOT→* / DIV MOD→+ -→ comparaisons →AND→OR. Utilisez des parenthèses si vous n'en êtes pas sûr.Entrée et sortie
OUTPUT "Enter your name:"
INPUT Name
OUTPUT "Hello, ", Name
Fonctions intégrées et routines de bibliothèque
De nombreuses tâches disposent de routines de bibliothèque 库例程 prêtes, donc vous n'avez pas besoin de les écrire. La feuille d'insertion Paper 2 insérer 附页 répertorie celles que vous pouvez utiliser, avec leurs noms exacts, paramètres et types de retour ; toute autre fonction dont une question a besoin est donnée dans l'énoncé. Les noms ci-dessous sont ceux de l'insert.
VALetSTRsont des noms IGCSE et n'apparaissent ni dans le document 9618, donc ils ne rapportent rien.UCASEetLCASEsont d'un cas différent : ce sont des 9618, définis dans le Guide de Pseudo-code, mais ils prennent un seulCHAR, et l'insert ne les répertorie absolument pas — pour une chaîne complète sur Paper 2, la routine estTO_UPPER.Une bibliothèque de programmes 程序库 contient des routines déjà écrites, compilées et testées ; un programme les appelle au lieu d'en écrire ses propres. Les avantages que le barème accepte, pour une question « citez trois avantages » : les routines sont déjà testées, donc elles sont moins susceptibles de contenir des erreurs ; elles économisent du temps de développement ; elles peuvent faire des choses qu'un programmeur ne pourrait pas écrire (statistiques complexes, graphismes) ; elles sont écrites par des experts et réutilisées dans de nombreux programmes ; et une routine avec une interface fixe peut être appelée depuis n'importe où dans le programme.
Routine Retourne Exemple LENGTH(s)le nombre de caractères dans sLENGTH("Hello") = 5LEFT(s, n)/RIGHT(s, n)les premiers / derniers ncaractèresRIGHT("Hello", 2) = "lo"MID(s, start, n)ncaractères à partir de la positionstart(les positions comptent à partir de 1)MID("Hello", 2, 3) = "ell"TO_UPPER(s)/TO_LOWER(s)sen majuscules / en minusculesTO_UPPER("ab1") = "AB1"NUM_TO_STR(x)/STR_TO_NUM(s)un nombre sous forme de chaîne / une chaîne sous forme de nombre STR_TO_NUM("3.5") = 3.5IS_NUM(s)TRUEsisest un nombre valideIS_NUM("12a") = FALSEASC(c)/CHR(n)le code caractère de c/ le caractère avec le codenASC('A') = 65,CHR(66) = 'B'INT(x)la partie entier de xINT(7.9) = 7RAND(n)un nombre réel aléatoire de 0 jusqu'à, mais sans inclure, nINT(RAND(6)) + 1est un lancer de déDAY(d),MONTH(d),YEAR(d)les parties d'un DATEYEAR(TODAY())DAYINDEX(d),SETDATE(d, m, y),TODAY()le jour de la semaine (1 = Dimanche) ; une date construite à partir de trois entiers ; la date d'aujourd'hui EOF(f)TRUElorsque le fichierfn'a plus de lignes à lireWHILE NOT EOF("data.txt")Les chaînes sont jointes avec
&(concaténation 连接) :"A" & "BC"est"ABC". Utilisez les noms exacts de l'insert, avec les paramètres dans son ordre.Les dates et nombres aléatoires apparaissent sous forme d'instructions sur une ligne.
SETDATE(17, 11, 2007)construit le 17 novembre 2007 ;12 - MONTH(MyDOB)est le nombre de mois du mois de naissance jusqu'à la fin de l'année ;IF DAYINDEX(MyDOB) = 5 THENteste pour un jeudi, car dimanche est le jour 1.RAND(n)retourne un nombre réel de0jusqu'à, mais sans inclure,n, donc un entier aléatoire deLowàHighinclus estINT(RAND(High - Low + 1)) + Low:INT(RAND(21)) - 10donne une valeur de-10à10.
Les routines de chaîne courantes agissant sur s = "COMPUTER"(positions 1–8)Exemple résolu. Évaluez chaque expression, sachant
Word ← "Program",Code ← 'Q'etN ← 7.Expression Valeur Pourquoi LENGTH(Word)7sept caractères MID(Word, 4, 2)"gr"deux caractères, commençant à la position 4 LEFT(Word, 3) & "!""Pro!"joints avec &TO_UPPER(RIGHT(Word, 2))"AM"la fonction interne s'exécute en premier ASC(Code) - ASC('A')16'Q'est 81 et'A'est 65N DIV 2 + N MOD 243 + 1NUM_TO_STR(N) & "th""7th"le nombre devient d'abord une chaîne INT(N / 2)33.5est coupé à sa partie entièreTravaillez de l'intérieur vers l'extérieur, et gardez les guillemets :
"7"est une chaîne et7est un nombre.Exemple résolu. Chaque instruction peut contenir une erreur dans son utilisation d'une fonction ou d'un opérateur. Décrivez l'erreur, ou écriveZ NO ERROR. (Supposez que chaque variable a le bon type.)
Instruction Erreur Result ← 2 & 4&joint des chaînes ;2et4sont des entiers, donc+est nécessaireSubString ← MID("pseudocode", 4, 1)NO ERROR : un caractère à partir de la position 4, "u"IF x = 3 OR 4 THENORa besoin d'un Booléen de chaque côté :IF x = 3 OR x = 4 THENResult ← Status AND INT(x / 2)ANDa besoin de deux Booléens ;INT(x / 2)est un entierMessage ← "Done" + LENGTH(MyString)+ne peut pas ajouter une chaîne à un entier :"Done" & NUM_TO_STR(LENGTH(MyString))Chaque opérateur fonctionne sur des types particuliers :
&sur les chaînes,+ - * / DIV MODsur les nombres,AND OR NOTsur les Booléens, et= <>sur deux valeurs du même type. Un tableau « évaluez chaque expression, ou écrivez ERROR » est noté de la même façon :LENGTH(42)et"A" + 1sont ERROR, car le type ne correspond pas à la fonction ou à l'opérateur.Exemple résolu. Avec
Points ← 100,Active ← TRUEetExempt ← FALSE, évaluez chaque expression.Expression Valeur Pourquoi (Points > 99) OR ActiveTRUEles deux côtés sont vrais ; l'un suffirait (Points MOD 2 = 0) OR ExemptTRUE100 MOD 2est0(Points <= 75) AND (Active OR Exempt)FALSEle premier côté est faux, et ANDa besoin des deux(Active OR NOT Active) AND NOT ExemptTRUEActive OR NOT Activeest toujours vraiLa dernière expression se simplifie :
X OR NOT XestTRUEquel que soitX, donc toute l'expression n'est queNOT Exempt. Évaluez d'abord les parenthèses, puisNOT, ensuiteAND, puisOR.ExplorerUne variable est une boîte étiquetée
Chaque affectation stocke une seule valeur dans une boîte nommée ; réaffecter le même nom l'écrase. Suivez le programme et observez chaque boîte prendre sa valeur actuelle.
Vocabulaire EntrainerAnglais Chinois Pinyin flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ variables/ˈveərɪəblz/ 变量 biàn liàng data types/ˈdeɪtə taɪps/ 数据类型 shù jù lèi xíng assignment/əˈsaɪnmənt/ 赋值 fù zhí constant/ˈkɒnstənt/ 常量 cháng liàng identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú function/ˈfʌŋkʃn/ 函数 hán shù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng insert/ˈɪnsɜːt/ 附页 fù yè parameters/pəˈræmɪtəz/ 参数 cān shù program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù concatenation/kənˌkætəˈneɪʃn/ 连接 lián jiē 11.2
Sélection
Programme
Les candidats doivent être capables de : Notes et orientations Utiliser du pseudocode pour écrire : • une instruction 'IF' incluant la clause 'ELSE' et des instructions IF imbriquées • une structure 'CASE' • une boucle 'contrôlée par compteur' : • une boucle 'post-condition' • une boucle 'pré-condition' Justifier pourquoi une structure de boucle peut être mieux adaptée pour résoudre un problème que les autres Source : Programme Cambridge International
Sélection 选择 choisit quelles étapes s'exécutent.
IF age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Un IF...ELSE teste la condition une seule fois, puis exécute exactement une branche Pour plus de deux cas, vous pouvez utiliser un IF imbriqué nested 嵌套, mais une forte imbrication est difficile à lire — un
CASEest plus propre lors du test d'une valeur contre plusieurs options :CASE OF Grade "A": OUTPUT "Excellent" "B": OUTPUT "Good" OTHERWISE: OUTPUT "Try again" ENDCASECambridge
CASEpermet les valeurs simples, les listes de valeurs (1, 2, 3:) et les plages (1 TO 5:).Un IF imbriqué est un IF à l'intérieur d'une branche d'un autre IF. Chaque
IFa besoin de son propreENDIF, et l'examinateur vérifie que chaque construction est fermée :IF Mark >= 50 THEN IF Mark >= 80 THEN OUTPUT "Distinction" ELSE OUTPUT "Pass" ENDIF ELSE OUTPUT "Fail" ENDIFLes limites sont là où des points sont perdus. "Une note de 50 ou plus suffit" est
Mark >= 50, pasMark > 50; la dernièreCASEbranche, pour "tout le reste", s'écritOTHERWISE, pas une condition comme> 200. Une mauvaise comparaison ici est une erreur logique 逻辑错误 : le programme s'exécute, mais donne la mauvaise sortie pour certaines entrées — et une table de traçage avec une valeur limite telle que50est la méthode pour la détecter.
Une instruction CASE exécute la branche qui correspond à la valeur Exemple résolu. Réécrivez ceci avec la même fonctionnalité, sans utiliser de structure CASE.
CASE OF MySwitch
    1: ThisChar ← 'a'
    2: ThisChar ← 'y'
    3: ThisChar ← '7'
    OTHERWISE: ThisChar ← '*'
ENDCASE
Chaque valeur devient une branche d'une chaîne de IFs, et
OTHERWISEdevient la dernièreELSE:IF MySwitch = 1 THEN ThisChar ← 'a' ELSE IF MySwitch = 2 THEN ThisChar ← 'y' ELSE IF MySwitch = 3 THEN ThisChar ← '7' ELSE ThisChar ← '*' ENDIF ENDIF ENDIFDeux clauses qui attribuent la même valeur sont fusionnées en une seule clause avec une liste de valeurs :
1, 2: ThisChar ← 'a'. Les gardes sont testés dans l'ordre : avec des plages telles que1 TO 50:suivies de40 TO 60:, une valeur de45suit la première branche correspondante, donc une attribution dans une branche ultérieure peut ne jamais être exécutée — et lorsque les branches précédentes couvrent déjà toutes les valeurs possibles, la brancheOTHERWISEn'est jamais atteinte non plus.Dans l'autre sens, les IF imbriqués qui testent plusieurs booléens sont plus clairs sous la forme d'une condition par résultat :
IF A AND B AND C THEN CALL Sub1(), puisIF A AND B AND NOT C THEN CALL Sub2(), et ainsi de suite. Le regroupement des tests avecANDetORélimine l'imbrication, etIF A THENest accepté à la place deIF A = TRUE THEN.ExplorerSélection (SI / SINON)
Changez l'entrée et voyez quelle branche s'exécute — l'essence de la sélection.
Vocabulaire EntrainerAnglais Chinois Pinyin nested/ˈnestɪd/ 嵌套 qiàn tào logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo 11.2
Itération

Itération 迭代 répète un bloc. Trois boucles diffèrent par le nombre de fois que le corps s'exécute.
Boucle contrôlée par compteur (FOR)
Une boucle contrôlée par compteur 计数循环 — utilisez-la lorsque vous savez combien de fois répéter :
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Un
STEPpeut modifier le compteur (par ex.FOR i ← 10 TO 1 STEP -1). Idéal pour un nombre fixe de répétitions ou pour traiter chaque élément d'un tableau 数组.Boucle à précondition (WHILE)
Une boucle à précondition 前测循环 teste la condition avant chaque passage, elle peut donc s'exécuter zéro fois :
WHILE total < 100 DO
    INPUT n
    total ← total + n
ENDWHILE
Boucle à postcondition (REPEAT...UNTIL)
Une boucle à postcondition 后测循环 teste la condition après chaque passage, elle s'exécute donc toujours au moins une fois :
REPEAT
    INPUT password
UNTIL password = correctPassword
Choisir la bonne boucle
Les trois boucles diffèrent par l'emplacement du test de condition — avant le corps (WHILE), après (REPEAT), ou un nombre défini de fois (FOR) - compteur connu à l'avance → FOR.
- peut nécessiter zéro passages → WHILE.
- toujours au moins un passage → REPEAT...UNTIL.
Justifiez votre choix selon si le compteur est connu et si le corps doit s'exécuter au moins une fois. Une question typique donne un scénario ("demander un mot de passe jusqu'à ce qu'il soit correct, mais toujours demander au moins une fois") et demande quelle boucle convient.
Les deux points sont attribués au nom de la boucle et à la raison, dans les termes du barème : count-controlled, because the number of iterations is known before the loop starts; post-condition, because the loop body must be executed at least once; pre-condition, because the loop may not need to execute at all. Une boucle sur les quatre éléments d'un tableau écrit comme un
WHILEavec un compteur est "pas la plus appropriée" : le compteur, quatre, est connu, donc une boucleFORconvient.Exemple résolu. Quelle boucle convient à chaque tâche ? (a) imprimer la table de multiplication de 12 ; (b) continuer à lire des nombres jusqu'à ce que l'utilisateur entre 0 ; (c) demander un mot de passe jusqu'à ce qu'il soit correct. Choisissez en demandant combien de fois le corps s'exécute et quand le test a lieu. (a) Le compteur est connu à l'avance (12), donc utilisez une boucle FOR. (b) Le compteur est inconnu, et la toute première entrée pourrait déjà être 0 - donc le test doit venir avant le corps : une boucle WHILE, qui s'exécute zéro ou plus fois. (c) Le compteur est inconnu, mais vous devez toujours demander au moins une fois avant qu'il y ait quoi que ce soit à tester - donc le test vient après le corps : une REPEAT...UNTIL, qui s'exécute une ou plus fois. La question décisive est de savoir si le corps doit s'exécuter au moins une fois : WHILE peut s'exécuter zéro fois, REPEAT s'exécute toujours une fois.
Exécution manuelle avec une table de traçage
Une table de traçage 跟踪表 enregistre la valeur de chaque variable pendant que vous faites une exécution manuelle 手工跟踪 (passez en revue à la main) un algorithme. C'est comment vous testez une boucle sur papier, et c'est une question de six points sur la plupart des Paper 2s.
DECLARE Count, Total : INTEGER
Count ← 1
Total ← 0
WHILE Total < 10
    Total ← Total + Count * 2
    Count ← Count + 1
ENDWHILE
OUTPUT Count, Total
Count Total Total < 10 OUTPUT 1 0 TRUE 2 2 TRUE 3 6 TRUE 4 12 FAUX 4, 12 Règles qui rapportent les points : une colonne par variable, dans l'ordre donné par la question ; n'écrivez une valeur que lorsqu'elle changement ; commencez une nouvelle ligne à chaque fois que la boucle se répète ; évaluez la condition avec les valeurs actuelles, et arrêtez-vous dès qu'elle est
FALSE; mettez la sortie dans sa propre colonne, exactement tel qu'elle apparaîtrait. Tracez l'algorithme tel qu'il est écrit, pas celui que vous pensez avoir été intendu — s'il ne s'arrête jamais, dites-le.Exemple résolu. Quelles constructions utilise chaque ligne — sélection, itération ou appel de sous-routine ?
Pseudocode Sélection Itération Subroutine IF Ready = TRUE THEN CALL Start()FIN SI |
FOR I ← 1 TO 20 ... NEXT I| | yes | | |WHILE NOT IsFull() ... ENDWHILE| | yes | yes | |CASE OF Key ... OTHERWISE ... ENDCASE| yes | | |IFetCASEsont des sélections ;FOR,WHILEetREPEATsont des itérations ; un nom suivi de parenthèses —Start(),IsFull()— est un appel à une procédure ou une fonction, partout où il apparaît, y compris dans une condition.ExplorerSuivez une boucle, passage par passage
Un tableau de traçage enregistre chaque variable après chaque passage de la boucle. Observez le compteur i grimper pendant que le total cumulatif se construit — exactement ce qu'une question de traçage d'examen vous demande de remplir.
ExplorerTracer une boucle
Parcourez la boucle et observez les variables changer à chaque itération — c'est exactement ce qu'enregistre une table de traçage.
Vocabulaire EntrainerAnglais Chinois Pinyin selection/sɪˈlekʃn/ 选择 xuǎn zé iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng 11.3
Procédures et fonctions

Programme
Les candidats doivent être capables de : Notes et orientations Définir et utiliser une procédure Expliquer où, dans la construction d'un algorithme, il serait approprié d'utiliser une procédure Utiliser des paramètres Une procédure peut avoir zéro, un ou plusieurs paramètres Un paramètre peut être passé par référence ou par valeur Définir et utiliser une fonction Expliquer où, dans la construction d'un algorithme, il est approprié d'utiliser une fonction Une fonction est utilisée dans une expression, ex. la valeur de retour remplace l'appel Utiliser la terminologie associée aux procédures et fonctions y compris en-tête de procédure/fonction, interface de procédure/fonction, paramètre, argument, valeur de retour Écrire du pseudocode efficace Source : Programme Cambridge International
Programmation structurée 结构化编程 construit un programme à partir de petites sous-routines 子程序 nommées, chacune ayant une seule tâche.
Procédure
Une procédure 过程 est un bloc nommé qui exécute une action ; elle peut prendre des paramètres 参数 mais ne retourne pas de valeur.
PROCEDURE Greet(name : STRING)
    OUTPUT "Hello, ", name
ENDPROCEDURE

CALL Greet("Ada")
Fonction
Une fonction 函数 est semblable à une procédure mais elle retourne une valeur qui fait partie d'une expression.
FUNCTION Square(x : INTEGER) RETURNS INTEGER
    RETURN x * x
ENDFUNCTION

result ← Square(5) + 1     // result = 26
Utilisez une procédure lorsque la sous-routine effectue une action ; utilisez une fonction lorsqu'elle calcule une valeur pour l'appelant.
Le syllabus demande où, dans la construction d’un algorithme, chacun est approprié. Une procédure est appropriée lorsque le même groupe d’étapes est nécessaire à plusieurs endroits (valider une entrée, imprimer un menu, échanger deux valeurs) : les étapes sont écrites une fois et
CALLées par nom. Une fonction est appropriée lorsqu’une seule valeur doit être calculée puis utilisée dans une expression — un total, un résultatTRUE/FALSE, le plus grand de deux nombres — car la valeur de retour 返回值 remplace l’appel :IF IsValid(Code) THEN.Une procédure exécute une action et ne retourne rien ; une fonction retourne une valeur que vous utilisez dans une expression Paramètres
Un paramètre est une variable qu'une sous-routine déclare pour recevoir une entrée ; les valeurs fournies par l'appelant sont des arguments 实参. Deux façons de les passer :
- passage par valeur 传值 — la routine reçoit une copie ; les modifications à l'intérieur n'affectent pas l'appelant. Utilisez pour les entrées qu'elle lit uniquement.
- passage par référence 传引用 — la routine reçoit une référence à la variable de l'appelant ; les modifications affectent l'appelant. Utilisez lorsqu'elle doit mettre à jour un paramètre.
Passage par valeur copie la valeur dans une nouvelle boîte ; passage par référence permet à la routine de modifier la propre variable de l'appelant PROCEDURE Swap(BYREF a : INTEGER, BYREF b : INTEGER) DECLARE temp : INTEGER temp ← a a ← b b ← temp ENDPROCEDURELe pseudocode Cambridge écrit le mode dans l'en-tête,
BYVALouBYREF, avant chaque paramètre. Si aucun n'est écrit,BYVALest supposé, donc une routine qui doit modifier la variable de l'appelant —Swap, ou une procédure qui met à jour un total accumulé — nécessiteBYREFdans son en-tête.Exemple résolu. Quelle est la sortie ?
PROCEDURE Adjust(BYREF X : INTEGER, BYVAL Y : INTEGER) X ← X + Y Y ← Y * 2 ENDPROCEDURE A ← 5 B ← 3 CALL Adjust(A, B) OUTPUT A, BXest une référence àA, doncAdevient8.Yest une copie deB, donc doublerYlaisseBà3. La sortie est8, 3. Si l'en-tête avait ditBYVAL X,Aserait toujours5.Variables locales vs globales
Une variable locale 局部变量 est déclarée à l'intérieur d'une sous-routine et n'existe que tant qu'elle s'exécute. Une variable globale 全局变量 est déclarée à l'extérieur et est visible partout. Privilégiez les variables locales et les paramètres — une utilisation excessive des variables globales rend le code difficile à suivre et à tester. (La zone où un nom est visible est sa portée 作用域.)
La différence d'une ligne : une variable globale peut être accédée de n'importe où dans le programme, une variable locale uniquement à l'intérieur de la sous-routine qui la déclare. Avantages des variables locales acceptés par le barème : le même identificateur peut être utilisé dans une autre sous-routine sans conflit ; la valeur ne peut pas être changée accidentellement par d'autres parties du programme ; la mémoire est libérée lorsque la sous-routine se termine ; et la sous-routine est autonome, elle peut donc être testée individuellement et réutilisée dans un autre programme.
Une variable locale est créée chaque fois que la sous-routine est appelée et détruite lors du retour, elle ne peut donc pas conserver une valeur d'un appel à l'autre. Une procédure qui construit une chaîne sur des appels répétés a donc besoin que cette chaîne soit globale (ou passée
BYREF). SiMyStringest changée d'une variable globale à une variable locale déclarée à l'intérieur deMyOutput(), chaque appel commence avec une nouvelleMyStringvide, le texte ajouté par les appels précédents est perdu, et la procédure "ne fonctionne pas comme prévu".
Une variable locale est une nouvelle boîte vide à chaque appel ; seule une variable globale (ou un paramètre BYREF) conserve une valeur entre les appels 
Une variable globale est visible partout ; une variable locale n'existe que dans sa propre procédure Quand utiliser une sous-routine
Utilisez une sous-routine lorsque :
- la même logique apparaît à plusieurs endroits — écrivez-la une fois, appelez-la plusieurs fois.
- un bloc a un but nommé clair — le nom documente ce qu'il fait.
- le programme est complexe — divisez-le en parties (décomposition 分解).
- vous voulez tester une partie isolément.
Ne les rendez pas si petites que le coût de l'appel dépense plus que le travail à l'intérieur.
Terminologie
- définition — le bloc
PROCEDURE ... ENDPROCEDURE(ou fonction). - appel — là où il est invoqué. argument — une valeur passée. paramètre — la variable qui le reçoit.
- valeur de retour — ce qu'une fonction renvoie.
- en-tête de procédure/fonction — la première ligne donnant le nom et les paramètres (
PROCEDURE Name(params)ouFUNCTION Name(params) RETURNS type). - interface de procédure/fonction / signature 签名 — nom + paramètres + type de retour : ce qu'un appelant doit savoir pour l'utiliser.
Exemple résolu. Décrivez chaque terme utilisé dans l'en-tête
FUNCTION Pass2(Count : INTEGER) RETURNS BOOLEAN.Terme Signification FUNCTIONune sous-routine qui retourne une valeur Pass2l'identifiant utilisé pour l'appeler Countle paramètre : l'identifiant qui reçoit l'argument passé INTEGERle type de données du paramètre RETURNS BOOLEANle type de données de la valeur retournée par la fonction Les deux identifiants dans
PROCEDURE MyProc(Count : INTEGER, Message : STRING)sont des paramètres : ils reçoivent les valeurs passées lors de l'appel de la procédure et sont utilisés à l'intérieur comme des variables locales.Pour convertir une procédure en fonction : remplacez
PROCEDUREparFUNCTIONet ajoutezRETURNS <type>; remplacez leOUTPUT(ou le paramètreBYREFqui transportait le résultat vers l'extérieur) par une instructionRETURN; et modifiez chaque appel pour que la valeur retournée soit utilisée,Result ← Unpack(Text)au lieu deCALL Unpack(Text, Result). Pour une question « écrire l'en-tête », écrivez toute la ligne :FUNCTION Calculate(Expression : STRING) RETURNS INTEGER. Un paramètre tableau est passé par référence, donc une procédure qui écrit dans un tableau modifie le tableau de l'appelant.Lorsqu'un programme acquiert un nouveau module, l'interface est d'abord agreed : le nom, les paramètres (combien, dans quel ordre, de quel type) et le type de retour, ainsi que toute donnée globale que le module lit ou écrit. Un module envoyant un rappel avant une date limite a besoin du record (ou de son index) comme paramètre et ne retourne rien, c'est donc une procédure ; le programme principal l'appelle une fois par record.
Écrire un module pour Paper 2
La moitié de Paper 2 est « écrire du pseudocode pour le module X ». Le barème attribue une marque par élément, donc un module inachevé obtient encore des points pour chaque bonne partie. Les éléments que l'examinateur recherche :
Chaque partie d'une réponse de module porte sa propre marque, donc écrivez-les toutes même si l'une est incertaine - L'en-tête, tel que décrit par la question :
PROCEDURE Name(Param : TYPE)ouFUNCTION Name(Param : TYPE) RETURNS TYPE, avecBYREFoù la routine doit modifier l'argument. - Déclarations locales :
DECLAREchaque variable locale avec son type, et initialisez les compteurs et totaux (Count ← 0). - La boucle visitant chaque élément :
FOR Index ← 1 TO 50pour un tableau dont la taille est donnée ;WHILE NOT EOF(...)pour un fichier. - La condition, avec la bonne comparaison et borne, sur le bon élément :
IF Score[Index] > Limit THEN. - La mise à jour à l'intérieur de la branche : le compteur augmenté, la valeur stockée, ou le message affiché.
- La fin :
RETURNune fois, après la boucle, dans une fonction ;ENDFUNCTIONouENDPROCEDURE; et chaqueIF,FORetWHILEfermé.
Exemple résolu. Un tableau global
Score : ARRAY[1:50] OF INTEGERcontient les notes. Écrivez une fonctionCountAbove(Limit : INTEGER)qui retourne combien de notes sont supérieures àLimit.FUNCTION CountAbove(BYVAL Limit : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 50 IF Score[Index] > Limit THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count ENDFUNCTIONMarques : l'en-tête avec son paramètre et
RETURNS INTEGER;Countdéclaré et mis à0; une boucle sur les 50 éléments ; la comparaison> Limit(pas>=) ; le compteur mis à jour à l'intérieur duIF;RETURN Countaprès la boucle. Le programme principal utilise la valeur de retour dans une expression ou une sortie :OUTPUT "Above 70: ", CountAbove(70).Exemple résolu. Écrivez une fonction
IsValid(Code : STRING)qui retourneTRUElorsqueCodeest deux lettres majuscules suivies de quatre chiffres — le format 格式AB1234— etFALSEsinon.FUNCTION IsValid(BYVAL Code : STRING) RETURNS BOOLEAN DECLARE Index : INTEGER DECLARE Ch : STRING IF LENGTH(Code) <> 6 THEN RETURN FALSE ENDIF FOR Index ← 1 TO 6 Ch ← MID(Code, Index, 1) IF Index <= 2 THEN IF Ch < "A" OR Ch > "Z" THEN RETURN FALSE ENDIF ELSE IF Ch < "0" OR Ch > "9" THEN RETURN FALSE ENDIF ENDIF NEXT Index RETURN TRUE ENDFUNCTIONLe contrôle de longueur vient en premier, donc
MIDn'est jamais demandé pour une position inexistante. Une validation 验证 comme celle-ci retourne unBOOLEANpour que l'appelant puisse écrireIF IsValid(Entry) THEN ... ELSE OUTPUT "Invalid code" ENDIF: un message à l'utilisateur est affiché par l'appelant, pas par la fonction — une fonction calcule, une procédure agit.Exemple résolu. Écrivez une fonction
IsPalindrome(Word : STRING)qui retourneTRUElorsqueWordse lit de la même manière à l'envers, comme"RACECAR".Comparez les caractères des deux extrémités, en avançant vers l'intérieur : la position
Indexest appariée avec la positionLen - Index + 1, et seule la première moitié doit être testée.
Un contrôle de palindrome appaire la position iavec la positionLen - i + 1et s'arrête au milieuFUNCTION IsPalindrome(BYVAL Word : STRING) RETURNS BOOLEAN DECLARE Len, Index : INTEGER Len ← LENGTH(Word) FOR Index ← 1 TO Len DIV 2 IF MID(Word, Index, 1) <> MID(Word, Len - Index + 1, 1) THEN RETURN FALSE ENDIF NEXT Index RETURN TRUE ENDFUNCTIONLes mêmes trois outils — une
FORsur les positions,MID(s, i, 1)pour lire un caractère, et&pour construire une nouvelle chaîne — répondent à la plupart des modules de chaînes sur Paper 2 : compter combien de fois un caractère apparaît (IF MID(s, i, 1) = Ch THEN Count ← Count + 1), remplacer chaque instance d'un caractère (ajouter soitNewCharou le caractère original àNewStringà chaque position), masquer tout sauf les quatre derniers chiffres d'un numéro de carte (ajouter'*'pour chaque position jusqu'àLen - 4), ou écrire votre propreMID()en joignant les caractères deStartàStart + Length - 1. DemanderMIDpour une position beyond la fin de la chaîne est une erreur d'exécution, donc vérifiezLENGTHd'abord.Fichiers. Les valeurs dans les variables disparaissent quand le programme se termine, donc un module qui doit conserver des données pour la prochaine exécution les écrit dans un fichier :
OPENFILE "scores.txt" FOR WRITE, uneWRITEFILE "scores.txt", NUM_TO_STR(Score[Index])par ligne à l'intérieur de la boucle, etCLOSEFILE "scores.txt"une fois, après la boucle ; la lecture utiliseFOR READ,READFILEetWHILE NOT EOF("scores.txt"). Topic 10 a la section complète sur les fichiers ; ici les marques sont pour l'ouverture dans le bon mode, la lecture ou l'écriture à l'intérieur de la boucle, et la fermeture une fois après celle-ci.ExplorerLa pile d'appels : poussée lors de l'appel, retirée lors du retour
Appeler une sous-routine pousse un nouveau cadre sur le dessus ; retourner retire celui-ci et renvoie une valeur à l'appelant. L'appel en cours d'exécution est toujours le cadre du sommet.
Vocabulaire EntrainerAnglais Chinois Pinyin array/əˈreɪ/ 数组 shù zǔ operators/ˈɒpəreɪtəz/ 运算符 yùn suàn fú precedence/ˈpresɪdəns/ 优先级 yōu xiān jí procedure/prəˈsiːdʒə/ 过程 guò chéng structured programming/ˈstrʌktʃəd ˈprəʊɡræmɪŋ/ 结构化编程 jié gòu huà biān chéng subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù return value/rɪˈtɜːn ˈvæljuː/ 返回值 fǎn huí zhí arguments/ˈɑːɡjuːmənts/ 实参 shí cān pass by value/pæs baɪ ˈvæljuː/ 传值 chuán zhí pass by reference/pæs baɪ ˈrefrəns/ 传引用 chuán yǐn yòng global variable/ˈɡləʊbl ˈveərɪəbl/ 全局变量 quán jú biàn liàng local variable/ˈləʊkl ˈveərɪəbl/ 局部变量 jú bù biàn liàng scope/skəʊp/ 作用域 zuò yòng yù decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě signature/ˈsɪɡnɪtʃə/ 签名 qiān míng format/ˈfɔːmæt/ 格式 gé shì Validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù 11.3
Écrire du pseudocode efficace

Trois caractéristiques qui facilitent la compréhension du pseudocode — la réponse à une question « énoncer trois caractéristiques » — sont les identifiants significatifs (
Total, past), l'indentation des instructions à l'intérieur de chaque construction, et les commentaires (// ...) expliquant le but ; les mots-clés en majuscules, une instruction par ligne et des lignes vides entre les sections sont aussi acceptés. Le pseudocode efficace va plus loin :- déplacer les invariants hors des boucles — si une valeur (un invariant 不变量) ne change pas avec le compteur de boucle, calculez-la une fois avant la boucle.
- sortir d'une boucle tôt lorsque la réponse est trouvée (arrêter une recherche linéaire 线性查找 dès que la cible apparaît).
- éviter le travail redondant — stocker un résultat et le réutiliser au lieu de recalculer.
- choisir la bonne structure de données — un tableau bat de nombreux variables séparées lorsque les éléments appartiennent ensemble.
- remplacer les IF imbriqués profonds par CASE lorsqu'on teste une valeur contre beaucoup.
- commenter l'intention, pas la mécanique (
// validate the postcode, pas// loop 6 times). - utiliser des noms significatifs (
numberOfPupils, pasn) et initialiser les variables avant usage.
Déplacer le travail inchangé hors de la boucle afin qu'il s'exécute une fois Vocabulaire EntrainerAnglais Chinois Pinyin invariant/ɪnˈveərɪənt/ 不变量 bù biàn liàng linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù 11.3
Tests et erreurs
Trois types d'erreurs, chacun trouvé d'une manière différente :
Erreur Ce que c'est Exemple Trouvé par erreur de syntaxe 语法错误 une instruction qui viole les règles du langage une⟩ ENDIFmanquante ;OUTPT "Hi"le traducteur, avant l'exécution du programme erreur d'exécution 运行时错误 le programme s'exécute, mais une instruction ne peut être exécutée division par zéro ; un index de tableau de 0 ou 51 ; une fonction appelée avec un paramètre invalide ; une boucle qui ne se termine jamais, donc le programme « gèle » pendant l'exécution : le programme s'arrête ou reste bloqué erreur logique le programme s'exécute jusqu'au bout, mais la sortie est fausse >au lieu de>=; un total jamais mis à0le test avec une table de traçage et des données de test choisies Un IDE 集成开发环境 aide à trouver les deux derniers : un point d'arrêt 断point arrête le programme à une ligne choisie ; le pas à pas 单步执行 exécute ensuite une instruction à la fois ; et la fenêtre de rapport (ou surveillance) montre la valeur de chaque variable à cet instant, donc la ligne où une valeur devient erronée est vue directement. Les méthodes de test et les données de test sont dans le topic 12.
Vocabulaire EntrainerAnglais Chinois Pinyin IDE/ˌaɪ diː ˈiː/ 集成开发环境 jí chéng kāi fā huán jìng breakpoint/ˈbreɪkpɔɪnt/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng 11.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-le exactement.
Terme Définition procédure une sous-routine qui effectue une tâche (une séquence d'étapes) et ne retourne pas de valeur ; elle est appelée avec CALLfonction une sous-routine qui retourne une valeur unique au point où elle a été appelée, donc elle peut être utilisée dans une expression paramètre l'identifiant dans l'en-tête d'une sous-routine qui reçoit une valeur ou une référence lorsque la sous-routine est appelée argument la valeur (ou variable) fournie dans l'appel, associée à un paramètre passage par valeur une copie de la valeur de l'argument est donnée à la sous-routine, donc les modifications à l'intérieur n'affectent pas la variable originale passage par référence l'adresse de la variable est donnée à la sous-routine, donc les modifications à l'intérieur changent la variable originale en-tête la première ligne d'une définition de sous-routine : son nom, ses paramètres et, pour une fonction, son type de retour interface ce qu'un programme appelant doit savoir pour utiliser une sous-routine : son nom, ses paramètres (nombre, ordre, type) et son type de retour valeur de retour la valeur qu'une fonction renvoie à l'expression qui l'a appelée variable locale déclarée à l'intérieur d'une sous-routine ; elle n'existe que pendant l'exécution de la sous-routine et ne peut être utilisée que dans celle-ci variable globale déclarée en dehors de toute sous-routine ; elle peut être utilisée partout dans le programme boucle contrôlée par compteur répète un nombre fixe de fois, contrôlée par un compteur ( FOR ... NEXT)boucle précondition teste sa condition avant chaque itération, donc le corps peut ne jamais s'exécuter ( WHILE ... ENDWHILE)boucle postcondition teste sa condition après chaque itération, donc le corps s'exécute au moins une fois ( REPEAT ... UNTIL)constante une valeur nommée qui ne peut pas changer pendant l'exécution du programme sous-routine bloc de code autonome qui effectue une tâche et est appelé par son nom : une procédure ou une fonction routine de bibliothèque sous-routine déjà écrite et testée, disponible pour être appelée depuis un programme 11.3
Conseils d'examen
- Distiguez une procédure (pas de valeur de retour) d'une fonction (renvoie une valeur) ; maîtrisez le passage par valeur vs par référence.
- Choisissez la bonne boucle : contrôlée par compteur (FOR) lorsque le nombre de répétitions est connu, contrôlée par condition (WHILE/REPEAT) sinon.
- Distiguez les variables locales vs globales et leur portée ; privilégiez les variables locales dans les modules réutilisables.
- Utilisez les noms exacts des routines et l'ordre des paramètres de l'insertion.
VALetSTRsont des noms IGCSE et ne rapportent aucun point ;UCASEetLCASEsont de vraies routines 9618 du Guide de Pseudocode mais agissent sur un seul caractère, donc sur Paper 2, une chaîne entière prendTO_UPPERouTO_LOWER. - Dans une réponse « écrire du pseudocode », l'en-tête, les déclarations, la boucle, la condition, la mise à jour et la ⟨
RETURN⟩ rapportent chacun un point : écrivez les six parties, même si l'une vous est incertaine.
Erreurs courantes
- Appeler une fonction sans utiliser ce qu’elle retourne. Assigner le résultat, ou l’utiliser dans l’expression ou la sortie :
Sorted ← BubbleSort(MyArray, 7). - Passer une longueur d'un :
6pour un tableau de sept éléments, ou le dernier index où la longueur était souhaitée. Décidez si le paramètre est une longueur ou un index, et vérifiez que le dernier élément est visité. - Fermer un fichier à l'intérieur de la boucle qui le lit. Ouvrez une fois, fermez une fois, après la boucle.
- Utiliser l'entrée directement comme nom de fichier. Ajoutez l'extension donnée par la question :
FileName ← Choice & ".txt". - Laisser des structures ouvertes. Chaque
IFa sonENDIF, chaqueFORa sonNEXT, chaqueWHILEa sonENDWHILE, et chaque fonction a sonRETURN; le schéma prévoit une marque pour cela. - Mauvaises bornes :
>pour "au moins" (qui est>=), ou unFORqui commence à0pour un tableau déclaré[1:50]. - Un compteur ou un total qui n'est jamais initialisé à
0avant la boucle. - Dans une table de traçage, réécrire toutes les variables à chaque ligne, ou modifier une valeur avant que la instruction qui la modifie ne se soit exécutée.
- Moitié de condition :
IF x = 3 OR 4— chaque côté deORetANDdoit être une comparaison complète. Et+ne joint pas les chaînes ;&le fait. - Déclarer comme locale une valeur qui doit persister entre les appels. Un total cumulé ou une chaîne construite sur plusieurs appels est global ou
BYREF.
-
12
Développement logiciel
Regarder la leçon12.1
Cycle de vie du développement de programme
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension de la finalité d'un cycle de vie du développement Montrer une compréhension de la nécessité de différents cycles de vie du développement selon le programme développé Y compris : waterfall, itératif, développement rapide d'applications (RAD) Décrire les principes, avantages et inconvénients de chaque type de cycle de vie Montrer une compréhension des étapes d'analyse, de conception, de codage, de test et de maintenance dans le cycle de vie du développement de programmes Source : Programme Cambridge International
Un cycle de vie du développement 开发生命周期 est l'ensemble des étapes de l'idée au logiciel fini et maintenu. Il existe pour planifier, gérer et contrôler un projet — construire le bon produit, à temps, avec une bonne qualité.
Les logiciels sont construits par des équipes qui suivent un cycle de vie du développement pour rester coordonnées 
Un organigramme planifie la logique d'un programme lors de la phase de conception du cycle Pourquoi un cycle de vie est nécessaire
La liste de l'examinateur pour "le but d'un cycle de vie du développement" : il divise un grand projet en étapes qui peuvent être planifiées et gérées ; il assure que les spécifications sont trouvées et approuvées avant le début de la conception et du codage ; il intègre les tests et la documentation plutôt que de les laisser à la fin ; il permet à l'équipe de suivre les progrès selon des jalons et de gérer les risques ; et il offre au client des points définis pour revoir le travail. Sans lui, une équipe code d'abord et découvre tardivement qu'elle a construit la mauvaise chose.
Pourquoi il y en a différents
Aucun cycle de vie unique ne convient à tous les projets, donc plusieurs cycles de vie du développement existent. Le choix dépend de la taille et de la complexité, de la clarté des spécifications 需求 au départ, du changement attendu, du niveau de risque, de l'équipe et de l'échéance.
Modèles courants
- Cascade 瀑布模型 — séquence linéaire (Analyse → Conception → Codage → Tests → Maintenance), chaque étape terminée avant la suivante. Clair et bien documenté ; bon pour des spécifications stables, mais faible face aux changements en cours de projet, et le client ne voit rien fonctionner jusqu'à la fin.
- Modèle itératif 迭代模型 — passes répétées, chacune produisant une version partielle qui est revue et affinée. Repère les problèmes plus tôt ; bon quand les spécifications sont découvertes au fil du temps, mais plus difficile à estimer.
- Développement rapide d'applications 快速应用开发 (RAD) — forte utilisation d'un prototype 原型 et des retours utilisateurs. Livraison très rapide de la première version ; bon pour des spécifications changeantes, mais dépend de la disponibilité des utilisateurs et convient mieux aux petits systèmes.
- Agile 敏捷 — itérations courtes ("sprints"), collaboration et tests constants. Flexible et adaptatif, mais nécessite un client engagé et une équipe compétente.
Le modèle en cascade : chaque étape est terminée avant que la suivante ne commence 
Le modèle itératif : des passes répétées affinent le programme 
Développement rapide d'applications : les équipes travaillent sur des parties en parallèle Principes, avantages et inconvénients — tel que listé par le barème.
Modèle Principe Avantages Inconvénients Cascade les étapes s'exécutent dans un ordre fixe, chacune terminée et validée avant que la suivante ne commence ; revenir signifie redémarrer la séquence simple à gérer ; chaque étape est entièrement documentée ; les spécifications sont fixées tôt, donc coûts et délais peuvent être estimés inflexible une fois une étape terminée ; aucun logiciel fonctionnel jusqu'à la fin ; une erreur d'analyse est coûteuse à corriger plus tard ; le client ne peut pas voir les progrès Itératif une petite version fonctionnelle est construite d'abord, puis améliorée répétitivement par des versions successives jusqu'à la complétion logiciel fonctionnel tôt et souvent ; problèmes repérés dans les premières versions ; les retours du client façonnent chaque version ; les spécifications peuvent changer difficile d'estimer le temps et le coût totaux ; les tests répétés exigent des efforts ; nécessite la disponibilité du client ; peut dériver si les versions ne sont pas planifiées RAD des prototypes de parties du système sont construits rapidement et affinés avec l'utilisateur jusqu'à acceptation, souvent en parallèle par plusieurs équipes livraison très rapide d'une première version ; l'utilisateur est impliqué tout au long, donc le produit correspond à ses besoins ; les changements sont faciles à absorber nécessite des développeurs compétents et des utilisateurs engagés ; la documentation est faible ; moins adapté aux grands systèmes ou critiques pour la sécurité Exemple résolu. Une entreprise doit être la première à lancer un site web pour une nouvelle console de jeux, et la conception changera au fur et à mesure que les caractéristiques de la console seront annoncées. Nommez le cycle de vie le plus adapté et justifiez-le.
RAD. Un prototype du site peut être construit et montré aux utilisateurs en quelques jours, et affiné alors que les spécifications changent ; le site est assez petit pour une approche pilotée par prototype, et la rapidité de livraison est l'exigence principale. La Cascade fixerait les spécifications avant qu'une seule page ne soit construite et ne livrerait rien jusqu'à la fin.
Les étapes standards
Chaque étape a un but, une sortie et des activités typiques — une question "décrire la … étape" demande deux ou trois de ces éléments.
- analyse — découvrir quoi le programme doit faire. Activités : entretiens, questionnaires et observation du système actuel ; étude de faisabilité ; accord sur la spécification des exigences, contre laquelle chaque étape ultérieure est vérifiée.
- conception — décider comment il le fera. Sorties : la carte structurelle (modules et paramètres), organigrammes ou pseudocode pour chaque module, tables d'identificateurs et structures de données, mises en page des écrans et fichiers, et le plan de test écrit maintenant, à partir de la spécification, avant tout code existant.
- codage (implémentation 实现) — écrire le programme dans un langage de haut niveau, module par module, en suivant la conception ; chaque module est testé au fur et à mesure qu'il est écrit.
- tests — exécuter le programme selon le plan de test (données normales, anormales, extrêmes et limites) et corriger les erreurs trouvées ; les tests d'intégration, alpha, bêta et d'acceptation suivent.
- maintenance 维护 — après la mise en production, corriger les défauts, adapter le programme à un nouveau matériel, logiciel ou loi, et l'améliorer (voir ci-dessous).
Exemple résolu. Complétez le diagramme en cascade Analyse → ? → ? → ? → Maintenance et décrivez ce qui se passe à l'étape de conception.
Les étapes manquantes sont Conception, Codage, Tests. À l'étape de conception, les exigences sont transformées en plan pour le programme : le problème est décomposé en modules (une carte structurelle), l'algorithme de chaque module est écrit sous forme de pseudocode ou d'organigramme, les structures de données et identificateurs sont choisis, les écrans et fichiers sont mis en page, et le plan de test est écrit à partir de la spécification.
ExplorerLe cycle de développement logiciel
Parcourez les étapes que chaque projet traverse. Obtenir les bonnes exigences en analyse est primordial — une erreur détectée en test est beaucoup plus coûteuse à corriger qu'une erreur détectée tôt.
ExplorerLaboratoire de processus logiciel
Classez les exemples de développement par étape ou outil auquel ils appartiennent.
Vocabulaire EntrainerAnglais Chinois Pinyin development life cycle/dɪˈveləpmənt laɪf ˈsaɪkl/ 开发生命周期 kāi fā shēng mìng zhōu qī requirements/rɪˈkwaɪəmənts/ 需求 xū qiú waterfall/ˈwɔːtəfɔːl/ 瀑布模型 pù bù mó xíng maintenance/ˈmeɪntənəns/ 维护 wéi hù iterative model/ˈɪtərətɪv ˈmɒdl/ 迭代模型 dié dài mó xíng Rapid Application Development/ˈræpɪd ˌæplɪˈkeɪʃn dɪˈveləpmənt/ 快速应用开发 kuài sù yìng yòng kāi fā prototype/ˈprəʊtəʊtaɪp/ 原型 yuán xíng Agile/ˈædʒaɪl/ 敏捷 mǐn jié 12.2
Outils de conception de programme
Programme
Les candidats doivent être capables de : Notes et orientations Utiliser un organigramme fonctionnel pour décomposer un problème en sous-tâches et exprimer les paramètres passés entre les divers modules/procédures/fonctions qui font partie de la conception de l'algorithme Décrire la finalité d'un organigramme fonctionnel Construire un organigramme fonctionnel pour un problème donné Dériver du pseudocode équivalent à partir d'un organigramme fonctionnel Montrer une compréhension de la finalité des diagrammes de transition d'état pour documenter un algorithme Source : Programme Cambridge International
Carte structurelle
Une carte structurelle 结构图 montre la décomposition hiérarchique 分解 d'un programme en modules (sous-routines 子程序) et les paramètres 参数 passés entre eux. Chaque module est un rectangle ; des lignes relient l'appelant (en haut) au appelé (en bas) ; de petites flèches montrent les données descendant et les résultats remontant. La conception peut ensuite être transformée en pseudocode 伪代码 équivalent.
                CalculatePay
            /        |         \
       GetEmployee  CalculateBonus  CalculateTax
       Returns:     Takes: sales    Takes: gross
       employeeID   Returns: bonus  Returns: tax
C'est un outil de phase de conception, et on peut y lire les signatures des procédures.
Un organigramme de structure : modules et paramètres transmis entre eux Les symboles demandés par l'examinateur. Une boîte est un module ; une ligne relie un appelant (en haut) aux modules qu'il appelle (en bas), se lisant de gauche à droite dans l'ordre des appels. Une petite flèche avec un cercle ouvert à sa queue est un couple de données — un paramètre passé vers le bas dans un module ou une valeur retournée vers le haut ; une flèche avec un cercle plein est un couple de contrôle, un indicateur (généralement BOOLEAN) qui informe l'appelant de ce qui s'est produit. Un losange à une branche signifie une sélection : seul un des modules situés en dessous est appelé, selon une condition. Une flèche courbe balayant les liens signifie une itération : les modules situés en dessous sont appelés répétitivement dans une boucle.
Les symboles de l'organigramme de structure : couples de données et de contrôle, losange de sélection et flèche d'itération Exemple résolu. Quatre modules sont définis comme
PROCEDURE Main(),PROCEDURE ReadData(BYREF Count : INTEGER),FUNCTION IsValid(Value : INTEGER) RETURNS BOOLEANetPROCEDURE Report(Total : INTEGER, Count : INTEGER). Main appelle ReadData, puis appelle IsValid une fois pour chaque valeur lue, puis appelle Report. Décrire l'organigramme de structure.Main en haut ; ReadData, IsValid et Report alignés en dessous, de gauche à droite selon l'ordre d'appel. Sur le lien ReadData, un couple de données montant
Count(un paramètre BYREF revient). Sur le lien IsValid, un couple de données descendantValueet un couple de contrôle montant (le résultat BOOLEAN), avec une flèche d'itération courbe sur ce lien car il est appelé pour chaque valeur. Sur le lien Report, deux couples de données descendants,TotaletCount. En lisant dans l'autre sens, une fonction est tout module qui retourne une valeur — son en-tête doit contenirRETURNSet le type retourné.Diagramme de transition d'état
Un diagramme de transition d'état 状态转换图 montre les états 状态 auxquels un système peut être et les événements qui le font passer de l'un à l'autre — utile pour les distributeurs automatiques, les feux de signalisation, les interfaces utilisateur. Les diagrammes de transition d'état servent à documenter le comportement d'un algorithme ou d'un système. Chaque état est un cercle ; chaque transition est une flèche étiquetée avec l'événement.
   coin inserted               item selected
[Idle] --------------→ [Awaiting selection] ----------→ [Dispensing]
Il rend facile de repérer les transitions manquantes (« que se passe-t-il si une deuxième pièce est insérée en attendant la sélection ? »).
Un diagramme de transition d'état pour un verrou de porte avec code 259 Lecture et dessin d'un tel diagramme. Chaque transition est étiquetée entrée | sortie (ou condition | action) : ce qui s'est produit, puis ce que fait le système lorsqu'il change d'état. Une question donne un tableau de état actuel, entrée, sortie, prochain état et demande le diagramme, ou l'inverse — chaque ligne du tableau correspond exactement à une flèche. Vérifier que chaque état a une flèche sortante pour chaque entrée possible, y compris celles qui laissent l'état inchangé (une flèche qui boucle sur le même état).
Exemple résolu. Un contrôleur de pompe a les états pompe éteinte et pompe allumée. Dans pompe éteinte, l'entrée niveau bas détecté produit la sortie activer la pompe et passe à pompe allumée ; dans pompe allumée, niveau normal détecté produit désactiver la pompe et passe à pompe éteinte. Toute autre entrée laisse l'état inchangé. Dessiner le tableau.
État actuel Entrée Sortie Prochain état pompe éteinte niveau bas détecté activer la pompe pompe allumée pompe éteinte niveau normal détecté — pompe éteinte pompe allumée niveau normal détecté désactiver la pompe pompe éteinte pompe allumée niveau bas détecté — pompe allumée Les deux lignes « sans changement » deviennent des flèches de boucle sur le diagramme ; les omettre coûte la marque pour exhaustivité.
ExplorerLaboratoire de processus logiciel
Classez les exemples de développement par étape ou outil auquel ils appartiennent.
Vocabulaire EntrainerAnglais Chinois Pinyin structure chart/ˈstrʌktʃə tʃɑːt/ 结构图 jié gòu tú parameters/pəˈræmɪtəz/ 参数 cān shù pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ test plan/test plæn/ 测试计划 cè shì jì huà implementation/ˌɪmplɪmənˈteɪʃn/ 实现 shí xiàn boundary data/ˈbaʊndəri ˈdeɪtə/ 边界数据 biān jiè shù jù acceptance testing/əkˈseptəns ˈtestɪŋ/ 验收测试 yàn shōu cè shì hierarchical decomposition/haɪəˈrɑːkɪkl ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù state-transition diagram/steɪt trænˈsɪʃn ˈdaɪəɡræm/ 状态转换图 zhuàng tài zhuǎn huàn tú states/steɪts/ 状态 zhuàng tài syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù 12.3
Erreurs
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension des moyens d'exposer et d'éviter les fautes dans les programmes Localiser et identifier les différents types d'erreurs • erreurs de syntaxe • erreurs logiques • erreurs d'exécution Corriger les erreurs identifiées Montrer une compréhension des méthodes de test disponibles et sélectionner des données appropriées pour une méthode donnée Y compris exécution à sec, parcours, boîte blanche, boîte noire, intégration, alpha, bêta, acceptation, module fantoche Montrer une compréhension de la nécessité d'une stratégie de test et d'un plan de test et de leur contenu probable Choisir des données de test appropriées pour un plan de test Y compris normale, anormal et extrême/frontière Montrer une compréhension de la nécessité d'une maintenance continue d'un système et des différences entre chaque type de maintenance Y compris parfaite, adaptative, corrective Analyser un programme existant et apporter des modifications pour améliorer ses fonctionnalités Source : Programme Cambridge International
- erreur de syntaxe 语法错误 — viole la grammaire du langage (crochet manquant, mot-clé mal orthographié). Détectée au moment de la traduction ; le programme ne peut pas tourner tant qu'elle n'est pas corrigée.
- erreur d'exécution 运行时错误 — survient pendant l'exécution (division par zéro, fichier introuvable, indice de tableau hors limites). Le programme crash ou lève une exception ; corriger en ajoutant des vérifications.
- erreur logique 逻辑错误 — le programme tourne mais donne des résultats faux (utilisation de
+pour-, décalage d'un élément dans une boucle, conditions dans le mauvais ordre). La plus difficile à trouver ; le seul signe est une sortie erronée, donc utiliser des tests minutieux et des tracés.
Quand chaque erreur apparaît : syntaxe à la traduction, exécution pendant le run, logique dans la sortie Exposition et évitement des fautes. Les fautes sont exposées par les tests selon un plan de test, par un essai manuel ou un tableau de trace, par une inspection collective avec des collègues, et par le débogueur de l'IDE (points d'arrêt, pas à pas, observation des variables). Elles sont évitées en concevant avant de coder (organigramme de structure, pseudocode), en utilisant du code modulaire avec des identifiants et commentaires significatifs, par la validation de chaque entrée, en gérant les exceptions plutôt que de laisser un runtime error crasher le programme, et par les vérifications dynamiques de syntaxe de l'IDE au fur et à mesure de la frappe.
Exemple résolu. Indiquer le type d'erreur dans chaque cas et comment elle se manifeste. (a)
Result <- STR_TO_NUM(x) / STR_TO_NUM(y)est exécuté avecy = "0". (b) La même ligne est exécutée avecx = "12a". (c) Une boucle écrite commeFOR i <- 1 TO 9traite un tableau à dix éléments. (d)OUTPUT "Total: " Totalmanque une virgule.(a) Erreur d'exécution — division par zéro ; le programme crash quand cette ligne est exécutée avec ces données. (b) Erreur d'exécution — la chaîne ne peut pas être convertie en nombre. (c) Erreur logique — le programme tourne mais le dixième élément n'est jamais traité, donc la sortie est fausse. (d) Erreur de syntaxe — l'instruction viole les règles du langage et est rapportée par le traducteur avant l'exécution du programme.
Exemple résolu. Corriger les erreurs dans ce pseudocode, qui devrait afficher la moyenne de dix notes.
Total <- 0
FOR i <- 1 TO 10
    INPUT Mark
    Total <- Total + Mark
NEXT i
Average <- Total / 9
OUTPUT "Average" Average
La division doit se faire par 10, pas par 9 (erreur logique) ; la ligne de sortie doit avoir une virgule ou un
&entre la chaîne et la valeur (erreur de syntaxe) ; etAveragen'est jamais déclaré comme REAL (erreur de syntaxe ou d'exécution, selon le langage). Dire quelle ligne et quelle est la ligne corrigée :Average <- Total / 10.12.3
Méthodes de test
- essai manuel 手工跟踪 — tracer le code sur papier, notant la valeur de chaque variable dans un tableau.
- inspection collective 走查 — examen par une équipe du code.
- test blanc 白盒测试 — conçu à partir de la structure interne du code, couvrant chaque instruction, branche et boucle.
- test noir 黑盒测试 — conçu uniquement à partir de la spécification : fournir des entrées, vérifier les sorties.
- test d'intégration 集成测试 — combiner les modules et tester les interfaces entre eux.
- test alpha α测试 — par les développeurs/en interne avant la mise en production ; test beta β测试 — par un groupe limité d'utilisateurs réels dans leur propre environnement.
- test d'acceptation 验收测试 — par le client, pour décider si le produit est conforme à ses besoins.
- module fantôme 桩 — un substitut pour un module qui n'existe pas encore, afin de pouvoir tester la structure de haut en bas.
Le test noir vérifie la spécification ; le test blanc vérifie les chemins du code Quelle méthode, quand. Un essai manuel et une inspection collective ne nécessitent pas d'ordinateur — l'essai manuel consiste à tracer l'algorithme avec un tableau de trace 跟踪表 ; l'inspection collective est une réunion où l'auteur explique le code ligne par ligne et les collègues cherchent les fautes, ce qui permet aussi de diffuser la connaissance du code au sein de l'équipe et de le vérifier par rapport à la conception. Les tests blancs sont écrits par quelqu'un qui peut voir le code et visent à explorer tous les chemins ; les tests noirs sont écrits à partir de la spécification et vérifient uniquement les entrées par rapport aux sorties attendues, donc ils peuvent être faits par un utilisateur ou un testeur externe. Le test d'intégration suit le test de module : des modules passant individuellement peuvent échouer lorsque les données transmises entre eux ont le mauvais type ou sont dans le mauvais ordre. Le test alpha est en interne ; le test bêta fournit une candidate à un échantillon d'utilisateurs réels, qui signalent les fautes liées à un usage réel ; le test d'acceptation est le client vérifiant le produit fini par rapport aux exigences avant de payer. Un module fantôme permet de commencer le test de haut en bas avant que tous les modules n'existent.
Un module fantôme remplace un module qui n'est pas encore écrit, permettant ainsi de tester maintenant les modules situés au-dessus Exemple résolu. Après que le programme ait passé ses tests en interne, il a été remis à un groupe d'utilisateurs pour essai avant la mise en production. Nommer ce type de test et indiquer ce qui se passe ensuite.
Test beta — utilisateurs réels dans leur propre environnement, signalant les fautes que les développeurs n'avaient pas trouvées. Les fautes sont corrigées, puis le client effectue un test d'acceptation par rapport aux exigences et le programme est mis en production ; les fautes découvertes en utilisation réelle sont ensuite traitées par une maintenance corrective.
Exemple résolu. Donner trois avantages de tester un programme par inspection collective.
Les erreurs sont trouvées par des personnes qui n'ont pas écrit le code et le lisent donc sans préjugés ; la logique est vérifiée par rapport à la conception et à la spécification, pas seulement par rapport aux données de test ; plusieurs personnes apprennent comment fonctionne le code, ce qui facilite la maintenance ultérieure ; et aucune donnée de test ni ordinateur fonctionnel n'est nécessaire, donc cela peut être fait tôt.
Vocabulaire EntrainerAnglais Chinois Pinyin stub/stʌb/ 桩 zhuāng corrective maintenance/kəˈrektɪv ˈmeɪntənəns/ 纠正性维护 jiū zhèng xìng wéi hù test strategy/test ˈstrætədʒi/ 测试策略 cè shì cè lüè normal data/ˈnɔːml ˈdeɪtə/ 正常数据 zhèng cháng shù jù abnormal data/əbˈnɔːml ˈdeɪtə/ 异常数据 yì cháng shù jù extreme data/ekˈstriːm ˈdeɪtə/ 极端数据 jí duān shù jù perfective maintenance/pəˈfektɪv ˈmeɪntənəns/ 完善性维护 wán shàn xìng wéi hù adaptive maintenance/əˈdæptɪv ˈmeɪntənəns/ 适应性维护 shì yìng xìng wéi hù 12.3
Stratégie et plan de test
Une stratégie de test 测试策略 est l'approche de haut niveau — quels types de tests, qui les effectue, quand, et les critères pour passer à l'étape suivante. Un plan de test 测试计划 est la liste détaillée des tests — chacun avec des données d'entrée, une sortie attendue, et une colonne pour la sortie effective.
Ce que chacun contient. Une stratégie de test indique quelles méthodes de test seront utilisées à quelle étape (test de module par le programmeur, puis intégration, alpha, bêta, acceptance), qui est responsable de chaque étape, quels jeux de données sont nécessaires et les critères pour passer à l'étape suivante. Un plan de test liste les tests individuels : pour chacun, le module ou la fonctionnalité sous test, les données d'entrée, la raison pour laquelle les données ont été choisies (normales, anormales, extrêmes, aux limites), le résultat attendu, un espace pour le résultat réel, et ce qu'il faut faire s'ils diffèrent. Le plan est rédigé à l'étape de conception, à partir des spécifications, afin de tester ce que le programme devrait faire plutôt que ce qu'il fait par hasard.
Choisir des données de test
Pour chaque champ ou condition, inclure trois types :
- données normales 正常数据 — valeurs typiques dans la plage valide (pour des notes de 0 à 100 :
50,75). - données anormales 异常数据 — valeurs qui devraient être rejetées (
-10,200,"abc"). - données extrêmes 极端数据 — les valeurs les plus grandes et les plus petites encore acceptées (
0et100). - données limites 边界数据 — valeurs aux bords, là où se cachent les erreurs d'off-by-one (chaque extrême accepté et la valeur rejetée juste à l'extérieur :
0/-1,100/101).
Données de test pour un champ de 0 à 100 : normales à l'intérieur, extrêmes aux limites, anormales à l'extérieur Exemple résolu. Un champ accepte une note d'examen de 0 à 100. Fournissez des données de test de chaque type avec leur résultat attendu. Normal :
50- accepté, une valeur typique dans la plage. Anormal :-10,200,"abc"- tous rejetés, car hors plage ou mauvais type de données. Extrême :0et100- les plus grandes et les plus petites valeurs encore acceptées. Limite : les paires traversant chaque bord --1rejeté avec0accepté, et100accepté avec101rejeté. Chaque valeur doit porter son résultat attendu, sinon le plan de test ne prouve rien. Extrême et limite sont les deux types le plus souvent confondus : une valeur extrême se situe à l'intérieur et est acceptée, tandis qu'un test de limite est toujours une paire de part et d'autre du bord - c'est exactement là que se cachent les erreurs d'off-by-one.Exemple résolu. Un composant passe si son poids, mesuré au gramme près, est dans un écart de 3 g par rapport à la cible de 50 g, c.-à-d. de 47 g à 53 g inclus. Établissez les lignes du plan de test pour cette vérification.
Données de test Type Raison Résultat attendu 50 normale une valeur typique bien à l'intérieur de la plage accepté 47, 53 extrême (limite) les plus petites et plus grandes valeurs qui doivent encore être acceptées accepté 46, 54 limite les valeurs juste à l'extérieur de la plage, là où une erreur d'off-by-one les accepterait rejeté 20, 90 anormal valeurs très hors de la plage rejeté "abc", −5 anormal mauvais type, poids négatif rejeté Chaque ligne doit indiquer pourquoi la valeur a été choisie et ce qui devrait se passer ; une simple liste de nombres n'apporte aucun point.
12.3
Maintenance
La majeure partie du coût d'un programme réside dans sa maintenance. Trois types :
Trois types de maintenance : perfective, adaptive et corrective - maintenance perfective 完善性维护 — améliorer les performances ou les fonctionnalités même si cela fonctionne déjà (une requête plus rapide, une nouvelle option).
- maintenance adaptive 适应性维护 — maintenir le fonctionnement dans un environnement en évolution (un nouveau système d'exploitation, une nouvelle API, un changement législatif).
- maintenance corrective 纠正性维护 — corriger les bugs découverts en utilisation.
Un programme peut avoir besoin des trois tout au long de sa vie.
Pourquoi chacun est nécessaire — les raisons listées dans le barème. Corrective : une anomalie est signalée par un utilisateur après la mise en production, ou une sortie incorrecte est remarquée dans des circonstances particulières non couvertes par les tests. Adaptive : le système d'exploitation, le matériel ou le navigateur sont mis à jour ; une loi ou une règle d'entreprise change (taux fiscaux, exigences de protection des données) ; le programme doit fonctionner avec un nouveau système externe ou format de fichier. Perfective : les utilisateurs demandent des fonctionnalités supplémentaires ou une meilleure interface ; le programme est rendu plus rapide ou consomme moins de mémoire ; le code est nettoyé pour faciliter les modifications futures.
Exemple résolu. (a) Un programme mis en production affiche une valeur erronée dans certaines circonstances. (b) Le matériel exécutant un programme est remplacé. (c) Les clients demandent que le programme de fidélité du café envoie un message à l'anniversaire d'un client. Nommez le type de maintenance dans chaque cas.
(a) Corrective — une défaillance du programme livré est en cours de correction. (b) Adaptive — le programme est modifié pour s'exécuter dans son nouvel environnement. (c) Perfective — une fonctionnalité est ajoutée à un programme fonctionnant déjà.
12.3
Modifier un programme existant
Lorsqu'on demande d'ajouter une fonctionnalité ou de corriger un bug :
- lire le code existant jusqu'à comprendre l'algorithme et le flux de données.
- localiser l'emplacement du changement — quelle sous-routine, quelles lignes.
- apporter le changement aussi petit que possible — ne pas réécrire du code fonctionnant.
- mettre à jour les parties connexes — tout appelant d'une liste de paramètres changée, toute routine utilisant une structure de données modifiée.
- tester le nouveau comportement et l'ancien (regression testing 回归测试 — vérifier que vous n'avez rien cassé).
- documenter le changement.
Des commentaires clairs, des noms significatifs, des sous-routines décomposées et une carte de structure rendent un programme beaucoup plus facile à modifier — c'est pourquoi les outils de conception comptent même après la première mise en production.
Analyser un programme que vous n'avez pas écrit. Commencez par la table des identifiants et les en-têtes de modules : ils vous indiquent ce que chaque module reçoit et retourne avant de lire une seule ligne de son corps. Ensuite, tracez l'algorithme avec une table de traçage pour une petite entrée, en notant d'où vient chaque valeur de sortie. Ce n'est qu'alors que vous décidez où va l'amélioration — généralement un nouveau module appelé depuis l'existant, pour perturber le moins possible le code fonctionnant — et écrivez la pseudocode pour le changement ainsi que les données de test qui le prouvent.
Vocabulaire EntrainerAnglais Chinois Pinyin regression testing/rɪˈɡreʃn ˈtestɪŋ/ 回归测试 huí guī cè shì 12.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition cycle de développement la séquence des étapes, de l'analyse à la maintenance, suivie pour produire et prendre en charge un programme modèle en cascade (waterfall) un cycle de vie où les étapes sont exécutées dans un ordre fixe, chacune étant terminée avant que la suivante ne commence modèle itératif un cycle de vie où une version fonctionnelle est produite puis affinée répétément jusqu'à ce qu'elle soit complète développement rapide d'applications (RAD) un cycle de vie qui construit rapidement des prototypes, les affinant avec les retours utilisateurs jusqu'à leur acceptation carte de structure un diagramme montrant comment un programme est décomposé en modules, l'ordre dans lequel ils sont appelés et les paramètres passés entre eux diagramme à transitions d'état un diagramme montrant les états dans lesquels un système peut se trouver et les entrées qui provoquent ses transitions erreur de syntaxe une erreur dans l'écriture d'une instruction, brisant ainsi les règles du langage et empêchant la traduction erreur logique une erreur dans l’algorithme, donc le programme s’exécute mais produit le mauvais résultat erreur d'exécution une erreur survenant pendant l'exécution du programme, comme une division par zéro, et l'arrêtant essai manuel (dry run) parcourir l'algorithme à la main, enregistrant les valeurs des variables dans une table de traçage walkthrough un examen où l'auteur parcourt le code avec des collègues cherchant des erreurs stub un module substitut avec le bon en-tête retournant une valeur fixe, utilisé pour permettre le test des modules qui l'appellent plan de test une liste des tests à effectuer, chacun avec ses données de test, la raison des données et le résultat attendu données limites valeurs à chaque bord de la plage valide, tant la dernière valeur acceptée que la première valeur rejetée maintenance corrective / adaptive / perfective correction de fautes découvertes en utilisation / modification du programme pour s'adapter à un environnement changé / amélioration d'un programme fonctionnant déjà Vocabulaire EntrainerAnglais Chinois Pinyin dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo walkthrough/ˈwɔːkθruː/ 走查 zǒu chá white-box testing/waɪt bɒks ˈtestɪŋ/ 白盒测试 bái hé cè shì black-box testing/blæk bɒks ˈtestɪŋ/ 黑盒测试 hēi hé cè shì integration testing/ˌɪntɪˈɡreɪʃn ˈtestɪŋ/ 集成测试 jí chéng cè shì alpha testing/ˈælfə ˈtestɪŋ/ α测试 α cè shì beta testing/ˈbiːtə ˈtestɪŋ/ β测试 β cè shì 12.3
Conseils d'examen
- Comparer les modèles de développement (cascade, itératif, RAD) par principe, avantage, inconvénient, et connaître les cinq étapes du cycle de vie du développement de programme et ce que chacune produit.
- Distinguer les erreurs de syntaxe, logique et d'exécution selon quand elles apparaissent : lors de la traduction, dans la sortie, pendant l'exécution.
- Choisir des données de test de chaque type — normal, anormal, extrême et limite — et donner pour chaque valeur sa raison et son résultat attendu.
- Distinguer les types de maintenance (corrective, adaptive, perfective) selon pourquoi le changement est effectué.
- Sur une carte de structure, nommer chaque symbole : boîte, ligne d'appel, couple de données, couple de contrôle, losange de sélection, flèche d'itération. En lisant les en-têtes de modules sur un graphique, rappelez-vous qu'une fonction a
RETURNS.
Erreurs courantes
- Décrire une étape de cycle de vie uniquement par son nom (« à l'étape de conception, le programme est conçu »). Dire ce qui est produit : carte de structure, pseudocode, plan de test.
- Appeler une mauvaise sortie une « erreur d'exécution ». Si le programme s'exécute jusqu'à la fin, c'est une erreur logique.
- Donner des données limites comme étant seulement les extrêmes. La note nécessite les valeurs des deux côtés du bord.
- Traiter les tests alpha et bêta comme identiques. Alpha est interne aux développeurs ; bêta est par de vrais utilisateurs externes.
- Confondre maintenance adaptive et perfective. Adaptive répond à un changement extérieur au programme ; perfective améliore un programme dont personne n'avait besoin de changer.
- Dessiner une carte de structure avec les modules dans n'importe quel ordre. Ils se lisent de gauche à droite dans l'ordre des appels, et chaque paramètre nécessite sa flèche.
-
13
Représentation des données
Regarder la leçon13.1
Types de données définis par l'utilisateur

Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension de la nécessité des types définis par l'utilisateur Définir et utiliser des types non composites Y compris énuméré, pointeur Définir et utiliser des types de données composites Y compris ensemble, enregistrement et classe/objet Choisir et concevoir un type de données défini par l'utilisateur approprié pour un problème donné Source : Programme Cambridge International
Les types intégrés (
INTEGER,REAL,STRING,CHAR,BOOLEAN) couvrent les cas les plus simples. Pour des problèmes plus complexes, vous pouvez définir des types de données définis par l'utilisateur 用户定义类型, rendant le code plus clair et le compilateur plus strict.Pourquoi ils sont nécessaires
Un type intégré
STRINGpermet de stocker des nonsens dans un champ qui devrait contenir l'une de quelques valeurs légales ; un type défini par l'utilisateur peut le restreindre. Les entités réelles sont généralement une collection de valeurs de différents types. EtDECLARE Taxi : Vehicleest plus clair (autodocumentant) queDECLARE Taxi : STRING."Décrire l'objectif d'un type de données défini par l'utilisateur" (deux points). Un type de données défini par le programmeur, construit à partir de types existants (intégrés), afin de représenter des données spécifiques au problème lorsque aucun type intégré ne convient. Les deux parties rapportent : défini par le programmeur et basé sur des types existants. L'examinateur accepte également « pour rendre le programme plus facile à lire et à maintenir » comme point de soutien, jamais seul.
"Expliquer ce que signifient les types de données non-composites et composites" (quatre points). Un type non-composite est défini sans référence à un autre type : il contient une valeur unique, par exemple un entier, un réel ou une valeur énumérée. Un type composite est une collection de types autres (qui peuvent eux-mêmes être composites) : il contient plusieurs valeurs sous un seul identifiant, par exemple un enregistrement, un ensemble, un tableau ou une classe. Donner un exemple avec chaque définition ; l'examen demande un seul exemple.
Types non-composites
Type énuméré
Un type énuméré 枚举类型 a des valeurs qui constituent une liste fixe de constantes nommées :
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Les noms sont des valeurs du nouveau type (stockées internement comme de petits entiers) ; vous ne pouvez attribuer aucune valeur en dehors de la liste. Utilisations : jours de la semaine, couleurs, codes de statut.
"Énoncer ce que signifie un type de données énuméré." Un type utilisateur non-composite défini en listant toutes ses valeurs possibles (dans l'ordre). Comme les valeurs sont ordonnées, elles peuvent être comparées et parcourues : avec
TYPE Month = (January, February, ..., December), le testIF ThisMonth > Juneest légal, et les valeurs sont stockées internement comme des entiers. Le pseudocode comporte trois parties et l'examen note chacune : le mot-cléTYPE, l'identifiant avec=, et la liste entre crochets séparée par des virgules.Exemple résolu. Écrire un pseudocode pour définir un type énuméré pour les jours où une école est ouverte (lundi à vendredi), et déclarer une variable de ce type initialisée à mercredi.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Une variable de type énuméré ne peut pas recevoir une valeur en dehors de la liste, c'est là tout l'intérêt :
Today ← Saturdayest une erreur de compilation, alors qu'uneSTRINGaurait accepté"Saturdy".Un type énuméré est une liste fixe de valeurs nommées Pointeur
Un pointeur 指针 contient l'adresse mémoire d'une autre variable (ou
NULLpour « aucune cible »). Les pointeurs construisent des structures dynamiques (listes chaînées, arbres) et passent des références sans copier.TYPE PNode = ^TNode // pointer to a TNode DECLARE p : PNode p ← NEW TNode p^.Value ← 42 // dereference to reach the fieldsPour déréférencer 解引用 (
p^) signifie accéder à la variable vers laquelle il pointe."Énoncer ce que signifie un type de données pointeur." Un type non-composite dont la valeur est l'adresse mémoire (une référence) d'une variable d'un type donné. Le pseudocode déclare le type avec un accent circonflexe devant le type vers lequel il pointe, et l'examen demande exactement cette ligne :
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Les pointeurs sont ce dont sont constitués une liste chaînée dynamique ou un arbre binaire (Sujet 19) : chaque nœud contient un pointeur vers le suivant. Deux points sont souvent perdus ici : écrire le type pointeur comme s'il contenait la valeur elle-même, et oublier l'accent circonflexe lors de la lecture via le pointeur.

Un pointeur contient une adresse ; p^le déréférence pour accéder aux champs du nœudTypes composites
Un type composite 复合类型 (l'un des types de données composites) regroupe plusieurs valeurs sous un même nom.
Un ensemble est une collection non ordonnée de valeurs uniques 
Un enregistrement regroupe des champs de types différents sous un même nom - enregistrement 记录 (Sujet 10) — des champs de types différents dans un bloc
TYPE ... ENDTYPE. - ensemble 集合 — une collection non ordonnée de valeurs uniques, avec des opérations add, remove, test d'appartenance, union, intersection :
DECLARE Available : SET OF Colour Available ← {Red, Blue} IF Green IN Available THEN ... ENDIF- classe 类 / objet 对象 — le type composite POO, combinant des champs de données (attributs 属性) avec des opérations dessus (méthodes 方法). Un objet est une instance d'une classe :
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Choisir un type
Utiliser énuméré pour une valeur issue d'une liste fixe, pointeur pour l'indirection, enregistrement pour un groupe de champs, ensemble pour une collection non ordonnée et unique, et classe lorsque vous avez besoin d'état et de comportement ensemble.
"Décrire le type de données défini par l'utilisateur ensemble" (trois points). Un type composite qui contient une collection de valeurs du même type, sans ordre particulier et sans doublons ; les valeurs peuvent être ajoutées et supprimées, et on peut tester l'appartenance d'une valeur. Déclarer le type avec
SET OF, puis définir une constante d'ensemble avec ses valeurs entre crochets :TYPE EvenNumbers = SET OF INTEGER DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers TYPE SymbolSet = SET OF CHAR DEFINE Operators ('+', '-', '*', '/') : SymbolSet"Décrire le type de données défini par l'utilisateur enregistrement" (trois points). Un type composite composé d'un nombre fixe de champs (éléments), chacun ayant son propre identifiant et son propre type, référencé sous un seul identifiant ; les champs sont accédés avec la notation point.
Exemple résolu. Écrire un pseudocode pour déclarer un type d'enregistrement
ClubMemberpour le prénom, le nom de famille, le code d'adhésion (un entier), la date d'adhésion et si les cotisations ont été payées d'un membre d'un club ; puis déclarer une variable et définir deux de ses champs.TYPE ClubMember DECLARE FirstName : STRING DECLARE LastName : STRING DECLARE Code : INTEGER DECLARE DateJoined : DATE DECLARE FeesPaid : BOOLEAN ENDTYPE DECLARE NewMember : ClubMember NewMember.LastName ← "Chen" NewMember.FeesPaid ← TRUEChaque champ nécessite sa propre ligne
DECLAREavec un type approprié, le bloc se termine parENDTYPE, et un champ 字段 est atteint commevariable.field. On demande de choisir un type pour chaque champ, de l'associer aux données : un code qui n'est jamais comparé qu'à d'autres est unSTRINGs'il peut contenir des lettres, unINTEGERsi des opérations arithmétiques ou de tri sont nécessaires ; un oui/non estBOOLEAN; une date estDATE. Un champ qui peut prendre l'une de quelques valeurs nommées (espèce d'un animal de compagnie, couleur) est celui pour lequel il faut créer un type énuméré.
Un tableau d'enregistrements : chaque élément est un enregistrement entier, un index choisit l'élément, et un point choisit le champ Enregistrements dans les tableaux et les fichiers. Une table de nombreux membres est
DECLARE Members : ARRAY[1:100] OF ClubMember; alorsMembers[3].LastNameest un champ d'un élément, et une boucle sur l'index traite chaque enregistrement. Un enregistrement est aussi l'unité naturelle écrite et lue depuis un fichier (ci-dessous), un enregistrement parPUTRECORDouWRITEFILE.Exemple résolu. Un type composite
Petstocke le nom (chaîne), l'espèce (l'un de dog, cat, rabbit ou hamster) et le poids en kilogrammes (réel) de chaque animal de compagnie. Définir les types et déclarer une variable.TYPE Species = (Dog, Cat, Rabbit, Hamster) TYPE Pet DECLARE Name : STRING DECLARE Kind : Species DECLARE Weight : REAL ENDTYPE DECLARE MyPet : Pet MyPet.Kind ← RabbitLe type énuméré est défini en premier, car l'enregistrement l'utilise : l'ordre compte en pseudocode comme dans un compilateur.
Classes en pseudocode. Une classe est le type composite qui porte également du comportement. L'examen demande la déclaration avec ses attributs marqués
PRIVATE, un constructeur 构造函数 nomméNEWqui les initialise, etPUBLICméthodes pour obtenir ou modifier ces attributs :CLASS Appointment PRIVATE PatientName : STRING PRIVATE Treatment : STRING PRIVATE Medication : STRING PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING) PatientName ← Name Treatment ← Treat Medication ← Med ENDPROCEDURE PUBLIC FUNCTION GetTreatment() RETURNS STRING RETURN Treatment ENDFUNCTION ENDCLASS DECLARE Visit : Appointment Visit ← NEW Appointment("A. Chen", "filling", "none") OUTPUT Visit.GetTreatment()Les attributs sont privés afin qu'ils ne puissent être modifiés que via des méthodes (encapsulation, Sujet 20) ; le constructeur est une procédure appelée
NEWavec un paramètre par attribut ; un getter est une fonction qui retourne l'attribut. Chacun de ceux-ci rapporte une marque distincte.ExplorerLaboratoire de concepts de programmation
Reliez les exemples au concept de programmation qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ 用户定义类型 yòng hù dìng yì lèi xíng field/fiːld/ 字段 zì duàn record/ˈrekɔːd/ 记录 jì lù set/set/ 集合 jí hé class/klæs/ 类 lèi composite type/ˈkɒmpəzɪt taɪp/ 复合类型 fù hé lèi xíng enumerated type/ɪˈnjuːməreɪtɪd taɪp/ 枚举类型 méi jǔ lèi xíng pointer/ˈpɔɪntə/ 指针 zhǐ zhēn linked list/lɪŋkt lɪst/ 链表 liàn biǎo dereference/ˌdiːˈrefrəns/ 解引用 jiě yǐn yòng object/ˈɒbdʒekt/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ 文件组织 wén jiàn zǔ zhī 13.2
Organisation et accès aux fichiers
Programme
Les candidats doivent être capables de : Notes et orientations Montrer une compréhension des méthodes d'organisation de fichiers et sélectionner une méthode appropriée d'organisation de fichiers et d'accès aux fichiers pour un problème donné Y compris sérieux, séquentiel (en utilisant un champ clé), aléatoire (en utilisant une clé d'enregistrement) Montrer la compréhension des méthodes d'accès aux fichiers Incluant l'accès séquentiel pour les fichiers serials et séquentiels, l'accès direct pour les fichiers séquentiels et aléatoires Montrer la compréhension des algorithmes de hachage Décrire et utiliser différents algorithmes de hachage pour lire et écrire des données dans un fichier séquentiel ou aléatoire Source : Programme Cambridge International
L'organisation des fichiers 文件组织 est la manière dont les données sont disposées ; l'accès aux fichiers est la manière dont le programme accède à un enregistrement.
- fichier sériel 串行文件 — les enregistrements dans l'ordre d'ajout, sans tri. L'accès est séquentiel uniquement ; l'ajout en fin de fichier est rapide ; la recherche est lente. Utilisé pour les journaux et les traces d'audit.
- fichier séquentiel 顺序文件 — les enregistrements triés par une clé. La recherche est plus rapide (on peut s'arrêter tôt ou faire une recherche binaire) ; l'insertion est lente (les enregistrements doivent être déplacés). Utilisé pour les fichiers maîtres mis à jour par lots.
- fichier aléatoire 随机文件 (fichier à accès direct) — les enregistrements à des positions calculées à partir de la clé (souvent par hachage). L'accès direct par clé est très rapide ; la lecture dans l'ordre des clés est plus difficile. Utilisé pour les grandes tables de recherche et les comptes clients.
Fichier sériel : les enregistrements sont conservés dans l'ordre d'ajout 
Fichier séquentiel : les enregistrements sont triés par un champ clé 
Fichier aléatoire : les enregistrements sont situés à des positions calculées à partir de la clé Les deux méthodes d'accès sont l'accès séquentiel 顺序存取 (lecture du début à la fin) et l'accès direct 直接存取 (saut directement vers une position connue). Associer la structure à l'opération dominante : les recherches par clé unique favorisent l'accès aléatoire ; les rapports dans l'ordre favorisent l'accès séquentiel.
Décrire chaque organisation (la formulation qui rapporte des points). Sériel : les enregistrements sont stockés les uns après les autres dans l'ordre auquel ils ont été ajoutés, sans classement par clé. Séquentiel : les enregistrements sont stockés dans l'ordre d'un champ clé (triés). Aléatoire : chaque enregistrement est stocké à une adresse calculée à partir de sa clé par un algorithme de hachage, donc les enregistrements ne sont dans aucun ordre. Comparer sériel et séquentiel : les deux stockent les enregistrements les uns après les autres et les deux sont lus séquentiellement, mais un fichier séquentiel est trié par clé, donc une recherche peut s'arrêter dès qu'une clé supérieure à la cible est lue, et un nouvel enregistrement doit être inséré à sa position correcte (généralement en réécrivant le fichier), tandis qu'un fichier sériel est simplement ajouté en fin de fichier.

Les deux méthodes d'accès en tant que procédures : l'accès direct calcule où regarder ; l'accès séquentiel regarde partout tour à tour Décrire chaque méthode d'accès. Accès séquentiel : commencer au début du fichier et lire les enregistrements un après l'autre (dans l'ordre de stockage) jusqu'à ce que l'enregistrement requis soit trouvé ou la fin du fichier atteinte. Appliqué à un fichier série, cela signifie lire tous les enregistrements jusqu'à la correspondance, et parcourir tout le fichier pour établir qu'un enregistrement est absent ; appliqué à un fichier séquentiel, la recherche peut s'arrêter plus tôt, dès qu'une clé supérieure à celle de la cible est lue. Accès direct : l'adresse de l'enregistrement est calculée à partir de sa clé (par un algorithme de hachage, ou depuis un index), et le programme va directement à cette position sans lire les enregistrements qui précèdent ; c'est la méthode d'accès pour les fichiers aléatoires, et pour un enregistrement référencé par une adresse unique sur un disque.
Choix. Un fichier maître de paie ou de facturation d'utilités traité par lot, en lisant chaque enregistrement tour à tour, convient à un fichier séquentiel ; un journal de transactions dans l'ordre de leur survenue convient à un fichier série ; un fichier de stock ou de clients où des enregistrements uniques sont recherchés et mis à jour par clé pendant l'exécution du programme convient à un fichier aléatoire avec accès direct.
Gestion des fichiers en pseudocode. L'examen attend les instructions standards, et Paper 3 définit des algorithmes qui les utilisent :
Tâche Instructions ouvrir un fichier texte OPENFILE "Scores.txt" FOR READ(ouFOR WRITE, qui crée ou écrase, ouFOR APPEND)lire ou écrire une ligne READFILE "Scores.txt", LineetWRITEFILE "Scores.txt", Linetester la fin WHILE NOT EOF("Scores.txt")fermer CLOSEFILE "Scores.txt"ouvrir un fichier aléatoire OPENFILE "Stock.dat" FOR RANDOMse déplacer vers une position d'enregistrement SEEK "Stock.dat", Addresslire ou écrire un enregistrement entier GETRECORD "Stock.dat", ItemetPUTRECORD "Stock.dat", ItemExemple résolu. Un fichier aléatoire
Stock.datcontient des enregistrements de typeStockItem, stockés à l'adresse donnée parItemID MOD 100. Écrire un pseudocode qui stocke un nouvel élément à son adresse hachée si cette position est vide, en signalant la position si elle est déjà occupée.DECLARE Item, Existing : StockItem DECLARE Address : INTEGER INPUT Item.ItemID, Item.Description, Item.Quantity Address ← Item.ItemID MOD 100 OPENFILE "Stock.dat" FOR RANDOM SEEK "Stock.dat", Address GETRECORD "Stock.dat", Existing IF Existing.ItemID = 0 THEN // 0 marks an empty position ENDIF SEEK "Stock.dat", Address PUTRECORD "Stock.dat", Item OUTPUT "Stored at ", Address ELSE OUTPUT "Position ", Address, " is in use" ENDIF CLOSEFILE "Stock.dat"Deux détails que le barème vérifie :
SEEKavant chaqueGETRECORDouPUTRECORD(la lecture déplace la position, donc rechercher à nouveau avant d’écrire), et le fichier ouvertFOR RANDOMet fermé à la fin. Pour copier chaque enregistrement d’un fichier aléatoire vers un autre, boucler sur les adresses avecSEEK,GETRECORDdepuis un fichier etPUTRECORDvers l’autre, en sautant les positions vides.ExplorerVoie d'accès au fichier
Suivre un fichier depuis le stockage jusqu'au programme et retour en toute sécurité.
Vocabulaire EntrainerAnglais Chinois Pinyin serial file/ˈsɪərɪəl faɪl/ 串行文件 chuàn xíng wén jiàn sequential file/siːˈkwenʃl faɪl/ 顺序文件 shùn xù wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn direct access/daɪˈrekt ˈækses/ 直接存取 zhí jiē cún qǔ hash function/hæʃ ˈfʌŋkʃn/ 散列函数 sàn liè hán shù sequential access/siːˈkwenʃl ˈækses/ 顺序存取 shùn xù cún qǔ deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng 13.2
Hachage

Une fonction de hachage 散列函数 (un algorithme de hachage) prend une clé d'enregistrement et produit une adresse où l'enregistrement est stocké. Une bonne fonction est rapide, déterministe 确定性, et répartit uniformément les clés.
Algorithmes de hachage courants pour les emplacements $N$ : hachage modulo
address ← key MOD N; pliage (diviser la clé, ajouter les morceaux, MOD N) ; hachage de chaîne (sommer les codes caractères, MOD N).Une collision 冲突 est lorsque deux clés hachent vers la même adresse. Trois façons de la résoudre :
Stratégie Fonctionnement Compromis probing linéaire 线性探测 utiliser la case libre suivante (avec retournement) simple, mais les clés font des amas chaînage 链接法 chaque case pointe vers une liste chaînée 链表 d'enregistrements pas d'amas, mais plus de mémoire re-hachage appliquer une deuxième fonction de hachage répartit les clés, mais demande plus de travail Résoudre une collision de hachage : le probing linéaire utilise la prochaine case libre ; le chaînage maintient une liste chaînée par case Pour rechercher : hacher la clé, lire cette case ; si les clés correspondent, c'est fini, sinon suivre la stratégie de résolution jusqu'à une correspondance ou une case vide. Pour insérer : hacher la clé, écrire dans cette case ou la prochaine case libre. Garder le facteur de charge 装填因子 (enregistrements ÷ cases) inférieur à environ 70% pour des recherches quasi-O(1).
"Expliquer ce qu'on entend par algorithme de hachage dans le contexte de l'accès aux fichiers" (trois points). Un calcul (fonction) effectué sur le champ clé d'un enregistrement qui produit une valeur, utilisée comme adresse (emplacement) de stockage de l'enregistrement dans le fichier et à partir de laquelle il est récupéré. Le même calcul sur la même clé donne toujours la même adresse, c'est pourquoi l'enregistrement peut être retrouvé sans recherche.
"Esquisser deux méthodes pour contourner une collision." (1) Probing linéaire (adressage ouvert) : stocker l'enregistrement dans l'emplacement libre suivant après l'adresse calculée, en tournant vers le début si nécessaire ; pour récupérer, commencer à l'adresse hachée et lire vers l'avant jusqu'à la correspondance de la clé. (2) Une zone de débordement 溢出区 ou chaînage : stocker l'enregistrement en collision dans une zone de débordement séparée (ou une liste chaînée attachée à l'adresse), qui est parcourue séquentiellement après échec de la correspondance à l'adresse principale. Soit marque ; décrire la récupération ainsi que le stockage.
Exemple résolu. Un fichier aléatoire a 11 positions d'enregistrement, numérotées de 0 à 10, et l'algorithme de hachage est
Address ← Key MOD 11. Les enregistrements avec les clés 1250, 1381, 1452, 1613 et 1470 sont stockés dans cet ordre, utilisant le probing linéaire. Montrer où chaque enregistrement va, et décrire comment la clé 1470 est récupérée.$1250 \bmod 11 = 7$ ; $1381 \bmod 11 = 6$ ; $1452 \bmod 11 = 0$ ; $1613 \bmod 11 = 7$, une collision avec 1250, donc 1613 prend la prochaine position libre, 8 ; $1470 \bmod 11 = 7$ à nouveau, et les positions 7 et 8 sont pleines, donc 1470 va à 9. Pour récupérer 1470 : calculer $7$, lire la position 7 (clé 1250, pas de correspondance), lire 8 (1613, non), lire 9 (1470, trouvé). Si une position vide est atteinte avant une correspondance, l’enregistrement n’est pas dans le fichier. Les collisions sont le prix d’un petit fichier : un bon algorithme de hachage répartit uniformément les clés, et le fichier reste bien en dessous de sa capacité maximale afin que les sondages restent courts.
ExplorerUne table de hachage
Observez chaque clé être hachée vers un seau (seau). Un bon hachage répartit les clés pour que les recherches restent rapides.
Vocabulaire EntrainerAnglais Chinois Pinyin collision/kəˈlɪʒn/ 冲突 chōng tū linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ 线性探测 xiàn xìng tàn cè chaining/ˈtʃeɪnɪŋ/ 链接法 liàn jiē fǎ load factor/ləʊd ˈfæktə/ 装填因子 zhuāng tián yīn zi overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ 溢出区 yì chū qū overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū 13.3
Nombres à virgule flottante

Programme
Les candidats doivent être capables de : Notes et orientations Décrire le format des nombres réels à virgule flottante binaires Utiliser la forme en complément à deux Comprendre les effets du changement de l'allocation de bits entre la mantisse et l'exposant dans une représentation à virgule flottante Convertir les nombres réels à virgule flottante binaires en décimaux et vice versa Normaliser les nombres à virgule flottante Comprendre les raisons de la normalisation Montrer la compréhension des conséquences du fait qu'une représentation binaire n'est qu'une approximation du nombre réel qu'elle représente (dans certains cas) Comprendre comment l'underflow et l'overflow peuvent se produire Montrer la compréhension que les représentations binaires peuvent entraîner des erreurs d'arrondi Source : Programme Cambridge International
Pour stocker des nombres réels de tailles très différentes, les ordinateurs utilisent un format à virgule flottante 浮点 — une forme binaire de notation scientifique, avec deux champs :
- une mantisse 尾数 — les chiffres significatifs.
- non exposant 指数 — la puissance de 2 à multiplier par.
Les deux sont stockés comme des entiers en complément à deux 补码. La valeur est
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$Lire la mantisse comme une fraction binaire — le premier bit après la virgule vaut $1/2$, le suivant $1/4$, puis $1/8$, etc. Donc
0.1010000est $1/2 + 1/8 = 0.625$ ; avec exposant00000010(= 2), la valeur est $0.625 \times 2^{2} = 2.5$.Les valeurs de position d'une mantisse de 8 bits et d'un exposant de 8 bits Conversion
- binaire → décimal : lire la mantisse (utiliser les règles du complément à deux si négative) comme fraction, lire l'exposant comme entier signé, puis multiplier la mantisse par $2^{\text{exponent}}$.
- décimal → binaire : écrire le nombre comme fraction binaire × puissance de 2, puis stocker la mantisse et l'exposant dans les formats convenus.
Exemple résolu. Un nombre a une mantisse
10110000et un exposant00000011. Trouver sa valeur décimale.L'exposant
00000011est $+3$. La mantisse commence par un 1, donc elle est négative. Lue comme1.0110000en complément à deux, le bit de signe vaut $-1$ et les bits de fraction ajoutent $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, donc la mantisse est $-1 + 0.375 = -0.625$. Puis$$\text{number} = -0.625 \times 2^{3} = -5.0.$$Exemple résolu. Stocker $+2.5$ dans ce format.
En binaire $2.5 = 10.1$. Écrit comme fraction normalisée, $2.5 = 0.101 \times 2^{2}$. Donc la mantisse est
01010000(bit de signe 0, ensuite.101) et l'exposant est00000010($= 2$).Format de l'examen : complément à deux, une mantisse et un exposant
L'examen indique un format tel que 10 bits pour la mantisse et 6 bits pour l'exposant, tous deux en complément à deux. Le point binaire de la mantisse se situe après son premier bit (signe), donc une mantisse positive est
0.xxxxxxxxxet une négative1.xxxxxxxxx; l'exposant est un entier signé ordinaire. Toute conversion utilise les mêmes trois étapes : lire la mantisse comme fraction (règles du complément à deux si elle commence par 1), lire l'exposant comme entier, multiplier par $2^{\text{exponent}}$.Exemple résolu (binaire vers décimal). Mantisse
0101100000, exposant000011.Mantisse : $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exposant : $000011_2 = 3$. Valeur : $0.6875 \times 2^{3} = 5.5$.
Exemple résolu (mantisse négative). Mantisse
1011000000, exposant000010.La mantisse commence par 1, donc elle est négative. Sa valeur est $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$ ; exposant $= 2$ ; valeur $-0.625 \times 4 = -2.5$. (Alternativement, prendre le complément à deux de la mantisse,
0101000000$= 0.625$, et ajouter le signe moins.) Un exposant négatif tel que111110$= -2$ divise plutôt : une mantisse de $0.5$ avec cet exposant est $0.5 \times 2^{-2} = 0.125$.Exemple résolu (décimal vers binaire). Stocker $+6.5$ et $-6.5$ dans le format 10 bits et 6 bits, normalisés.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, donc la mantisse est
0110100000et l'exposant000011. Pour $-6.5$, prendre le complément à deux de la mantisse :1001100000(vérification : $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, et $-0.8125 \times 8 = -6.5$), exposant000011inchangé. Le signe ne va jamais dans l'exposant ; un nombre négatif a une mantisse négative.Normalisation
Un nombre est normalisé 规格化 lorsque le premier bit significatif est immédiatement après la virgule binaire (pas de zéros de tête gaspillés). Cela maximise la précision, car chaque bit de la mantisse porte une information. Pour normaliser, décaler la mantisse vers la gauche et diminuer l'exposant (ou décaler vers la droite et l'augmenter) jusqu'à ce que le premier bit significatif soit en place ; la valeur reste inchangée. Pour les mantisses négatives (complément à deux), le bit de signe (1) est immédiatement suivi d'un 0.
Reconnaître et produire la forme normalisée. Une mantisse positive normalisée commence
01; une négative commence10. Donc0011000000n'est pas normalisée (décaler vers la gauche d'une place et soustraire un à l'exposant :0110000000, exposant un de moins) et1100000000non plus (décaler vers la gauche jusqu'à ce que le motif soit10...). Chaque décalage vers la gauche de la mantisse doit être compensé par une soustraction d'un à l'exposant, sinon la valeur change."Expliquer pourquoi les nombres sont stockés sous forme normalisée" (deux points). (1) Elle offre la précision maximale (exactitude) pour le nombre de bits disponibles, car aucun bit n'est gaspillé sur des zéros de tête (ou des uns de tête pour un nombre négatif) ; (2) chaque nombre a alors une représentation unique, permettant de les comparer ; et (3) elle optimise l'utilisation de la plage disponible. Any two of these score.

Normalisation : décaler la mantisse vers la gauche pour supprimer les zéros non significatifs, en abaissant l’exposant du même montant Approximation et erreurs d'arrondi
De nombreux réels décimaux ne peuvent pas être stockés exactement en binaire — par exemple, $0.1_{10}$ est la fraction binaire répétitive $0.000110011\ldots_{2}$, qui doit être tronquée. Conséquences :
- arrondis arrondis s'accumulent sur de nombreuses opérations (
0.1 + 0.2n'est pas exactement0.3). - comparaisons échouent — ne jamais tester un réel pour l'égalité. Tester que la différence est inférieure à une petite tolérance,
IF Difference < 0.000001, où la différence est prise dans le bon sens ou via une fonction modulo que la question définirait.ABSn'est ni dans l'insert 9618 ni dans le Guide de Pseudocode, donc ne pas le supposer : le guide indique que toute fonction nécessaire par la question sera fournie. - soustraire deux valeurs quasi-égales entraîne une perte de précision.
- débordement débordement (un résultat trop grand pour la plage de l'exposant) et sous-débordement sous-débordement (un résultat trop petit, arrondi à zéro) se produisent lorsque l'exposant sort de sa plage.
Pour des besoins d'exactitude (monnaie), utiliser fixe-point fixe-point ou BCD BCD au lieu du virgule flottante.
Le même nombre total de bits partagé de deux manières : les bits de mantisse achètent la précision, les bits d'exposant achètent la plage, et l'un ne peut croître qu'aux dépens de l'autre "Décrire l'effet du changement d'allocation des bits" (trois points). Avec un nombre total de bits fixe, augmenter la mantisse et réduire l'exposant donne une plus grande précision précision (plus de chiffres significatifs, erreurs d'arrondissement plus petites) mais une plus petite plage plage (les plus grandes et plus petites magnitudes stockables diminuent) ; augmenter l'exposant fait l'inverse : une plus grande plage aux dépens de la précision. Nommer les deux effets et les deux directions.
Plus grand et plus petit. Dans le format à mantisse de 10 bits et exposant de 6 bits, le nombre positif le plus grand a une mantisse
0111111111($= 1 - 2^{-9}$) et un exposant011111($= 31$) : environ $2^{31}$. Le plus petit nombre normalisé positif a une mantisse0100000000($= 0.5$) et un exposant100000($= -32$) : $0.5 \times 2^{-32} = 2^{-33}$. Le nombre le plus négatif a une mantisse1000000000($= -1$) et un exposant $31$ : $-2^{31}$."Expliquer ce que signifient débordement et sous-débordement." Un débordement se produit lorsque le résultat d'un calcul est plus grand que le plus grand nombre représentable, donc l'exposant aurait besoin de plus de bits qu'il n'en a ; un sous-débordement se produit lorsqu'un résultat est plus petit que le plus petit (non-zéro) nombre représentable, trop proche de zéro pour que l'exposant l'exprime, donc il est stocké comme zéro. Les deux proviennent de la plage de l'exposant, pas de celle de la mantisse.
Pourquoi une représentation binaire n'est qu'une approximation. Une fraction binaire ne peut représenter exactement que des sommes de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ ; une valeur telle que $0.1$ ou $\tfrac{1}{3}$ a un développement binaire infini, et la mantisse a un nombre fixe de bits, donc la valeur stockée est la plus proche qui s'y adapte. La différence est une erreur d'arrondi ; elle est petite pour un seul nombre mais s'accumule lors de calculs répétés (ajouter $0.1$ dix fois peut ne pas donner exactement $1$), c'est pourquoi les nombres réels ne devraient jamais être testés pour une égalité exacte.
ExplorerConstruire un nombre en virgule flottante
Inverser les bits de la mantisse et de l'exposant pour former une valeur, et vérifier si elle est normalisée.
ExplorerNormalisation d'un nombre en virgule flottante
Effectuer la normalisation. Décaler la mantisse pour éliminer les zéros non significatifs initiaux — et ajuster l'exposant en conséquence — conserve la même valeur tout en utilisant chaque bit pour la précision.
Vocabulaire EntrainerAnglais Chinois Pinyin floating-point/ˈfləʊtɪŋ pɔɪnt/ 浮点 fú diǎn mantissa/mænˈtɪsə/ 尾数 wěi shù exponent/ekˈspəʊnənt/ 指数 zhǐ shù two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ normalised/ˈnɔːməlaɪzd/ 规格化 guī gé huà rounding errors/ˈraʊndɪŋ ˈerəz/ 舍入误差 shě rù wù chā underflow/ˌʌndəˈfləʊ/ 下溢 xià yì fixed-point/fɪkst pɔɪnt/ 定点 dìng diǎn BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù precision/prɪˈsɪʒn/ 精度 jīng dù range/reɪndʒ/ 范围 fàn wéi 13.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition type de données défini par l'utilisateur un type de données défini par le programmeur, basé sur des types existants, pour représenter des données spécifiques au problème type non-composite un type défini sans référence à un autre type ; il contient une seule valeur (entier, réel, énuméré, pointeur) type composite un type composé d'autres types ; il contient plusieurs valeurs sous un identificateur unique (enregistrement, ensemble, tableau, classe) type énuméré un type non-composite défini en listant toutes ses valeurs possibles, dans l'ordre type pointeur un type non-composite dont la valeur est l'adresse mémoire d'une variable d'un type donné ensemble un type composite contenant une collection de valeurs d'un type, sans ordre et sans doublons enregistrement un type composite avec un nombre fixe de champs, chacun ayant son propre identificateur et son propre type, accédés par notation pointée classe un type composite combinant des attributs (données) avec les méthodes (procédures et fonctions) qui agissent dessus ; un objet est une instance d'une classe fichier sériel des enregistrements stockés les uns après les autres dans l'ordre dans lequel ils ont été ajoutés fichier séquentiel des enregistrements stockés les uns après les autres dans l'ordre d'un champ clé fichier aléatoire des enregistrements stockés à des adresses calculées à partir de leurs clés par un algorithme de hachage accès séquentiel lire les enregistrements tour à tour depuis le début du fichier jusqu'à ce que celui requis soit trouvé accès direct calculer l'adresse d'un enregistrement à partir de sa clé et aller directement à cette position algorithme de hachage un calcul effectué sur la clé d'un enregistrement qui donne l'adresse à laquelle l'enregistrement est stocké et retrouvé collision deux clés différentes produisant la même adresse mantisse la partie d'un nombre virgule flottante qui contient ses bits significatifs, sous forme de fraction en complément à deux exposant l'entier en complément à deux donnant la puissance de deux par laquelle la mantisse est multipliée normalisé un nombre virgule flottante dont la mantisse commence par 01 (positif) ou 10 (négatif), afin qu'aucun bit ne soit gaspillé sur des zéros ou uns initiaux débordement un résultat trop grand pour être représenté dans le nombre de bits disponibles sous-débordement un résultat non-nul trop petit pour être représenté, donc il est stocké comme zéro erreur d'arrondi la différence entre un nombre réel et la valeur la plus proche que la représentation binaire peut contenir 13.3
Conseils d'examen
- Les déclarations de pseudocode sont marquées ligne par ligne :
TYPE ... = (...)pour énuméré,TYPE ... = ^...pour pointeur,TYPE ... = SET OF ...puisDEFINE ... (...) : ...pour un ensemble,TYPE ... DECLARE ... ENDTYPEpour un enregistrement,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpour une classe. - Associer le type aux données : valeurs nommées fixes, énuméré ; un groupe de champs différents, enregistrement ; une collection de valeurs uniques, ensemble ; données plus comportement, classe ; une adresse, pointeur.
- L'organisation des fichiers concerne la manière dont les enregistrements sont stockés ; l'accès aux fichiers concerne la manière dont ils sont trouvés. Sériel et séquentiel se lisent séquentiellement ; les fichiers aléatoires utilisent l'accès direct via un hachage de la clé. La recherche séquentielle d'un fichier séquentiel peut s'arrêter tôt ; d'un fichier sériel, elle ne peut pas.
- Pseudocode fichier aléatoire :
OPENFILE ... FOR RANDOM,SEEKavant chaqueGETRECORDouPUTRECORD,CLOSEFILEà la fin. Expliquer comment une collision est résolue lorsque vous décrivez le hachage. - Virgule flottante : mantisse comme fraction en complément à deux (point après le bit de signe), exposant comme entier, multiplier par $2^{\text{exponent}}$ ; décaler vers la gauche et soustraire un à l'exposant pour normaliser ; la mantisse achète la précision, l'exposant achète la plage.
- Les trois réponses "explique" classiques : pourquoi normaliser (précision, forme unique, plage), l'effet de réallouer des bits (précision contre plage), et pourquoi $0.1$ ne peut pas être stocké exactement (une fraction binaire infinie dans une mantisse finie).
Erreurs courantes
- Écrire
DECLAREau lieu deTYPEpour un nouveau type, ou omettreENDTYPE; déclarer un ensemble sansSET OF, ou un type énuméré avec des guillemets autour de ses valeurs. - Mettre le signe d'un nombre virgule flottante dans l'exposant ; le signe est le premier bit de la mantisse.
- Lire une mantisse négative comme si elle était signe-magnitude ; c'est un complément à deux, donc
1011000000est $-0.625$, pas $-0.375$. - Déplacer la mantisse pour la normaliser sans changer l'exposant, ou le changer dans le mauvais sens (décaler vers la gauche, exposant vers le bas).
- Décrire un fichier aléatoire comme étant "dans un ordre aléatoire" ; les enregistrements sont à des adresses calculées à partir de leurs clés.
- Dire que l'accès séquentiel lit "tout le fichier" pour un fichier séquentiel ; il s'arrête lorsqu'une clé plus grande est rencontrée.
- Expliquer le hachage sans dire ce que la valeur calculée sert à (l'adresse pour stocker et récupérer l'enregistrement), ou sans moyen de gérer les collisions.
- Définir le débordement comme "trop de chiffres" au lieu d'un résultat dépassant la plus grande valeur représentable, ou en blâmer la mantisse.
- enregistrement 记录 (Sujet 10) — des champs de types différents dans un bloc
-
14
Technologies de communication et Internet
Regarder la leçon14.1
Pourquoi les protocoles sont nécessaires
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la nécessité d'un protocole pour la communication entre ordinateurs Montrer la compréhension de la manière dont l'implémentation d'un protocole peut être vue comme une pile, où chaque couche a sa propre fonctionnalité Montrer la compréhension de la suite de protocoles TCP/IP Quatre couches (Application, Transport, Internet, Lien) But et fonction de chaque couche Application lors de l'envoi d'un message d'un hôte à un autre sur Internet Montrer la compréhension des protocoles (HTTP, FTP, POP3, IMAP, SMTP, BitTorrent) et de leurs buts Le protocole BitTorrent permet le partage de fichiers pair-à-pair Source : Programme Cambridge International
Un protocole protocole est un ensemble de règles régissant la façon dont les appareils communiquent. Les deux extrémités doivent suivre les mêmes règles, sinon les signaux d'un côté sont sans sens pour l'autre. Les protocoles définissent le format des données (où se situent les adresses et le contenu utile), l'ordre des messages (qui parle en premier, quand accuser réception), le sens de chaque message, la temporisation (délais de temporisation, retransmissions) et que faire en cas d'erreur. Sans protocole convenu, la communication échoue — comme deux personnes parlant des langues différentes sans traducteur.
"Expliquer pourquoi les protocoles sont essentiels pour la communication entre ordinateurs" (trois points). (1) Un protocole est un ensemble de règles convenu par l'expéditeur et le récepteur ; (2) sans cela, les deux ordinateurs interpréteraient les données différemment (format, ordre, sens de chaque partie), donc le message ne pourrait pas être compris ; (3) il permet à des ordinateurs de types et fabricants différents de communiquer, car tout le monde implémente la même norme. Mentionner ce que couvrent les règles : le format des données, l'ordre des messages, la détection et la récupération d'erreurs, ainsi que la vitesse ou la temporisation.
Un protocole est les règles partagées : format, ordre, temporisation et erreurs Vocabulaire EntrainerAnglais Chinois Pinyin protocol/ˈprəʊtəkɒl/ 协议 xié yì 14.1
Protocoles en couches
Le réseautage est complexe, donc il est divisé en couches couches, chacune ayant une tâche focalisée, ne parlant qu'à la couche supérieure et inférieure. Avantages : modularité modularité (remplacer une couche — par exemple Ethernet par Wi-Fi — sans toucher aux autres), standardisation (interopérabilité des fournisseurs) et abstraction abstraction (vous ignorez les détails gérés ailleurs). Internet utilise la suite de protocoles TCP/IP suite de protocoles (4 couches).
Vocabulaire EntrainerAnglais Chinois Pinyin abstraction/əbˈstrækʃn/ 抽象 chōu xiàng protocol suite/ˈprəʊtəkɒl swiːt/ 协议栈 xié yì zhàn application layer/ˌæplɪˈkeɪʃn ˈleɪə/ 应用层 yìng yòng céng transport layer/ˈtrænspɔːt ˈleɪə/ 传输层 chuán shū céng port numbers/pɔːt ˈnʌmbəz/ 端口号 duān kǒu hào 14.1
Suite de protocoles TCP/IP

Couche Rôle Exemples Application ce que fait le programme utilisateur HTTP, FTP, SMTP, IMAP Transport livraison de bout en bout entre processus TCP, UDP Internet routage de paquets entre réseaux IP Lien envoi de bits sur le support physique Ethernet, Wi-Fi Les quatre couches de la suite de protocoles TCP/IP La finalité de chaque couche, selon les termes du corrigé. Couche application : fournit les protocoles que les applications utilisateurs utilisent (HTTP pour le web, SMTP pour l'email) et l'interface entre l'application et le réseau ; elle produit les données à envoyer et les transmet à la couche transport. Couche transport : établit la connexion bout en bout, découpe les données en paquets (segments) et ajoute des numéros de port et des numéros de séquence ; à réception, elle réassemble les paquets dans l'ordre et demande ceux qui manquent (TCP), ou envoie sans ces garanties (UDP). Couche Internet : ajoute les adresses IP source et destination pour former des paquets IP (datagrammes) et les route à travers les réseaux via des routeurs ; elle ne garantit pas la livraison. Couche liaison : ajoute les adresses MAC et les bits de vérification d'erreur pour former une trame et transmet les bits sur le réseau local physique (Ethernet ou Wi-Fi) via la carte d'interface réseau. « Compléter la pile » signifie ces quatre couches, dans cet ordre, de haut en bas : Application, Transport, Internet, Liaison.

Encapsulation : chaque couche ajoute son propre en-tête 首部 à ce qu'elle reçoit de la couche supérieure, de sorte que les bits sur le fil portent quatre jeux d'informations ; le récepteur les retire une couche à la fois « Décrivez comment la suite TCP/IP est appliquée lors de l'envoi d'un message d'une hôte à une autre » (cinq points). Chez l'expéditeur, le message passe vers le bas de la pile : (1) la couche application produit les données en utilisant un protocole tel que HTTP ou SMTP ; (2) la couche transport le découpe en paquets et ajoute un en-tête avec les numéros de port et un numéro de séquence ; (3) la couche internet ajoute un en-tête avec les adresses IP source et destination et choisit le chemin ; (4) la couche liaison ajoute les adresses MAC du prochain appareil et envoie la trame sur le lien physique. Les routeurs沿途 lisent l'en-tête de la couche internet et acheminent chaque paquet. Chez le récepteur, la trame passe vers le haut de la pile : chaque couche retire et traite son propre en-tête, la couche transport réassemble les paquets dans l'ordre des numéros de séquence et demande ceux qui manquent, et la couche application présente le message. Le même protocole à chaque couche aux deux extrémités est ce qui rend l'échange possible.
Couche application
La couche application 应用层 offre des services aux programmes utilisateurs et définit les protocoles qu'ils utilisent (HTTP pour le web, SMTP pour l'email). C'est là qu'un programmeur travaille le plus souvent.
Couche transport
La couche transport 传输层 livre les données bout en bout entre les processus, identifiés par des numéros de port 端口号. Deux protocoles :
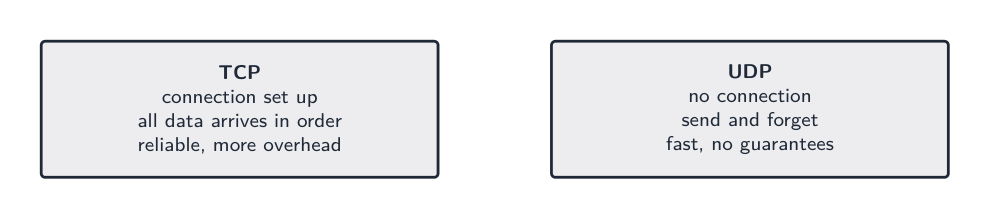
TCP se connecte et livre dans l'ordre ; UDP envoie et oublie - TCP 传输控制协议 — orienté connexion 面向连接 : établit une connexion, s'assure que toutes les données arrivent dans l'ordre, retransmet les paquets 数据包 perdus, contrôle le débit. Fiable mais avec une charge. Utilisé par HTTP, HTTPS, SMTP, FTP.
- UDP 用户数据报协议 — sans connexion 无连接 : envoie et oublie, sans accusés de réception ni ordonnancement. Faible charge, aucune garantie. Utilisé pour le streaming, DNS et le gaming, où la vitesse prime sur la fiabilité.
Couche Internet
La couche Internet 网络层 transporte des paquets entre les hôtes en utilisant IP. Chaque paquet a une adresse IP source et une adresse IP destination IP地址, et des routeurs 路由器 le font avancer. Elle ne garantit pas la livraison — c'est le rôle de TCP.
Un routeur domestique assure cette fonction pour votre maison : il lit l'adresse de destination de chaque paquet et l'envoie vers l'internet, et retour vers le bon appareil.
Un routeur Wi-Fi domestique : il achemine les paquets entre vos appareils et l'internet Avant que le routeur n'accède à l'internet plus vaste, un modem 调制解调iroise relie la maison à l'opérateur internet via son câble ou sa ligne téléphonique. Ses voyants indiquent que le lien est actif et en ligne.
Un modem à câbles connecte un réseau domestique à l'opérateur internet Couche liaison
La couche liaison 链路层 envoie des bits sur un lien physique (Ethernet, Wi-Fi). Elle ajoute un en-tête de trame avec des adresses MAC MAC地址 et gère l'accès au support (ex. CSMA/CD 载波侦听多路访问/冲突检测 sur Ethernet).
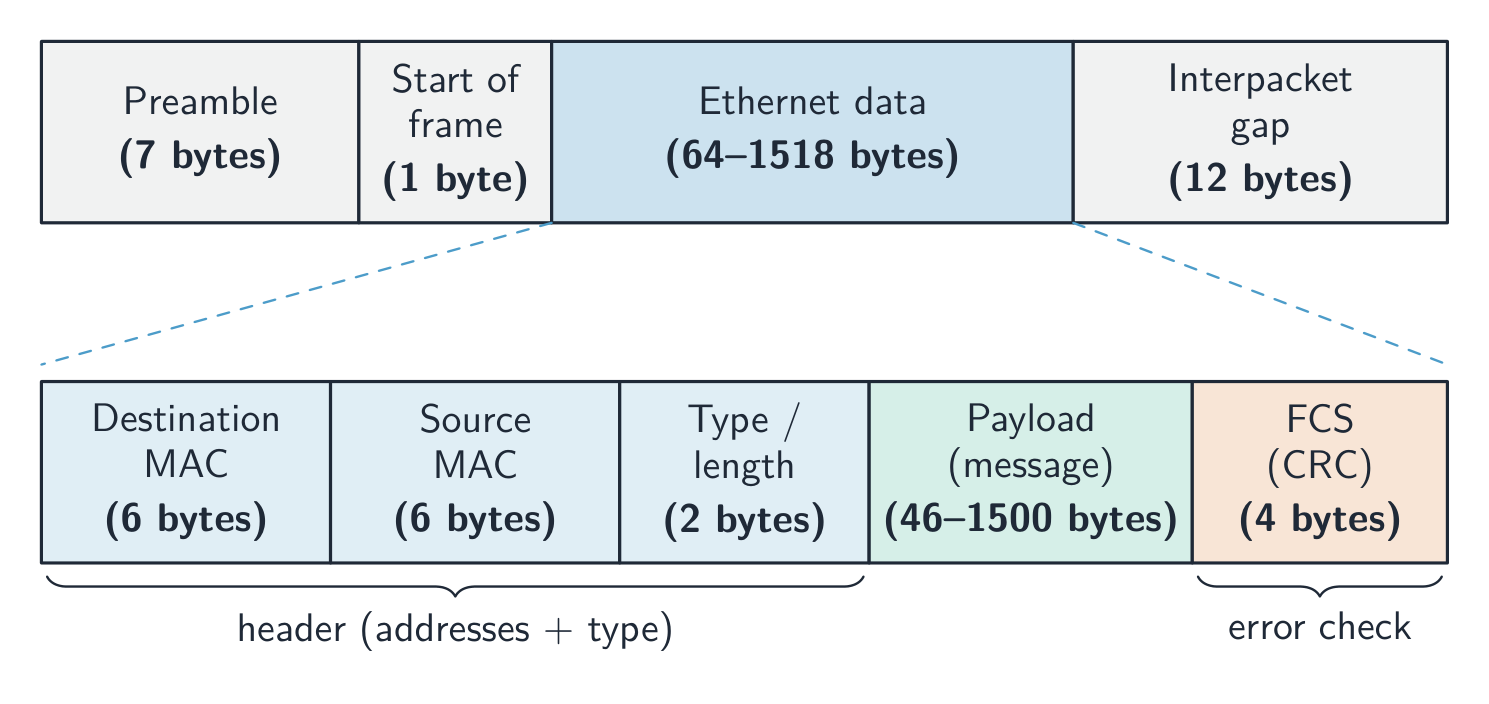
Les parties d'une trame Ethernet typique Sur un réseau local filaire, un interrupteur 交换机 relie plusieurs appareils. Chaque appareil se branche dans un port avec un câble Ethernet (connecteur RJ45), et le switch utilise les adresses MAC dans chaque trame pour l'envoyer uniquement au bon port.
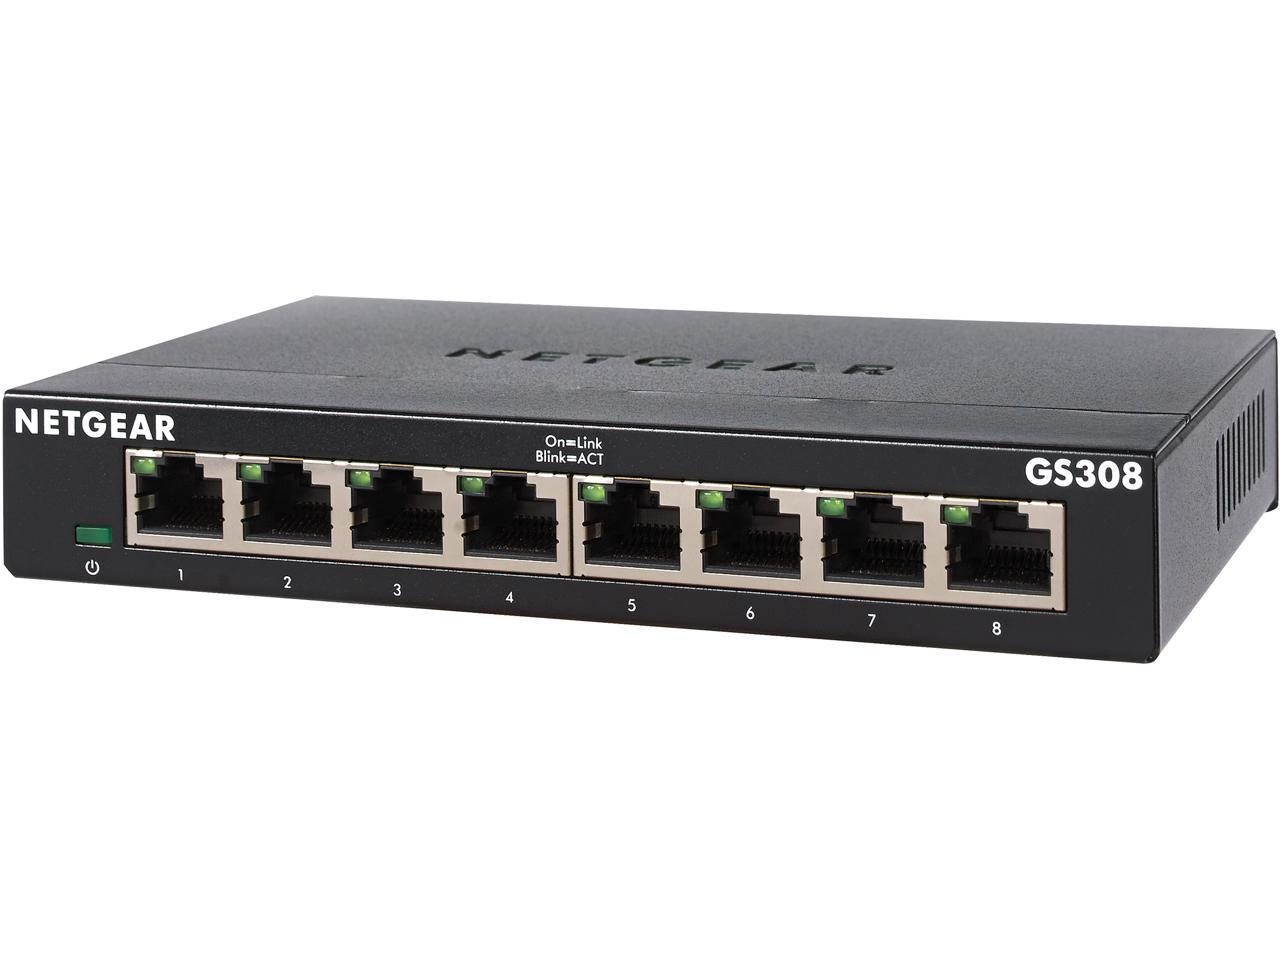
Un switch de réseau connecte de nombreux appareils filaires sur un réseau local Le lien physique peut être un fil cuivre, un signal radio (Wi-Fi) ou un câble à fibre optique 光纤. Dans un câble à fibre optique, les bits voyagent sous forme de flashes de lumière à travers de très fines tiges de verre, ce qui est rapide et permet de transporter des données sur de longues distances.
Un câble à fibre optique : les données voyagent sous forme de lumière à travers de fines tiges de verre Un lien radio peut atteindre beaucoup plus loin. Un parabolique satellite 卫星天线 envoie et reçoit des signaux radio vers et depuis un satellite, transportant des données vers des endroits que les liens filaires ne peuvent pas facilement atteindre.
Un parabolique envoie et reçoit des données par radio sur de longues distances ExplorerAppuyez sur les quatre couches du modèle TCP/IP
Explorez chaque couche. Les données voyagent VERS LE BAS de la pile lors de l'envoi (chaque couche ajoute son en-tête) et remontent lors de la réception — et toute couche peut être remplacée sans toucher aux autres.
Vocabulaire EntrainerAnglais Chinois Pinyin layers/ˈleɪəz/ 层 céng modularity/ˌmɒdjʊˈlærɪti/ 模块化 mó kuài huà TCP/ˌtiː siː ˈpiː/ 传输控制协议 chuán shū kòng zhì xié yì connection-oriented/kəˈnekʃn ˈɔːrɪəntɪd/ 面向连接 miàn xiàng lián jiē packets/ˈpækɪts/ 数据包 shù jù bāo UDP/ˌjuː diː ˈpiː/ 用户数据报协议 yòng hù shù jù bào xié yì connectionless/kəˈnekʃənləs/ 无连接 wú lián jiē internet layer/ˈɪntənet ˈleɪə/ 网络层 wǎng luò céng routers/ˈruːtəz/ 路由器 lù yóu qì modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì link layer/lɪŋk ˈleɪə/ 链路层 liàn lù céng CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè switch/swɪtʃ/ 交换机 jiāo huàn jī fibre-optic cable/ˈfaɪbə ˈɒptɪk ˈkeɪbl/ 光纤 guāng xiān satellite dish/ˈsætəlaɪt dɪʃ/ 卫星天线 wèi xīng tiān xiàn 14.1
Protocoles courants de la couche application
- HTTP 超文本传输协议 — les navigateurs récupèrent des pages web auprès de serveurs (via TCP, port 80). HTTPS est HTTP sur TLS — chiffré, port 443.
- FTP 文件传输协议 — transfère des fichiers entre client et serveur.
- SMTP 简单邮件传输协议 — envoie l'email entre client et serveur, et entre serveurs. La réception utilise POP3 ou IMAP.
- POP3 — télécharge l'email et le supprime généralement du serveur. IMAP — laisse l'email sur le serveur et le synchronise sur tous les appareils, afin que la même boîte de réception apparaisse partout.
- BitTorrent — un protocole pair-à-pair 对等网络 ; un fichier est divisé en morceaux téléchargés depuis de nombreux pairs en parallèle, de sorte qu'aucun serveur unique ne porte toute la charge.
BitTorrent : un traceur aide les pairs à se trouver, puis ils partagent directement les morceaux de fichier La finalité de chaque protocole, selon les termes qui rapportent des points.
Protocole Finalité (indiquez-le) HTTP transfère des pages web (hypertexte) entre un serveur web et un navigateur ; HTTPS est la version chiffrée FTP transfère des fichiers entre un client et un serveur (téléchargement et chargement vers/un serveur de fichiers) SMTP envoie l'email d'un client vers un serveur de messagerie, et entre serveurs de messagerie (protocole de type "push") POP3 télécharge l'email du serveur vers le client, généralement en le supprimant du serveur, afin qu'il soit lu sur un seul appareil IMAP permet au client de lire et gérer l'email restant sur le serveur, afin que la même boîte mail soit visible sur chaque appareil BitTorrent partage des fichiers pair-à-pair : des morceaux d'un fichier sont téléchargés depuis et envoyés vers de nombreux autres utilisateurs simultanément Interrogé sur les deux protocoles email, donnez SMTP pour l'envoi et POP3 ou IMAP pour la réception ; si on vous demande de décrire IMAP, précisez que les messages restent sur le serveur et sont synchronisés sur les appareils, ce qui diffère de POP3.
« Décrivez comment les fichiers sont partagés en utilisant le protocole BitTorrent » (quatre points). (1) Le fichier est découpé en morceaux (généralement 256 Ko chacun), et un petit fichier torrent les décrit (leurs hash) et nomme un traceur 追踪器. (2) Un pair voulant le fichier contacte le traceur, qui conserve une liste des pairs dans la grappe 群 partageant actuellement ce fichier. (3) Le pair télécharge différents morceaux de nombreux pairs en même temps, et dès qu'il détient un morceau, il l'envoie vers les autres ; un pair ayant le fichier entier est un seed 种子, un autre qui télécharge encore est un leecher. (4) Lorsque tous les morceaux sont réunis, ils sont réassemblés et vérifiés contre les hashes. « Expliquez ce que signifie le partage de fichiers pair-à-pair » : il n'y a pas de serveur central contenant le fichier ; chaque ordinateur est à la fois un client et un serveur, téléchargeant de et envoyant vers les autres, de sorte que la charge et la bande passante sont réparties sur la grappe et plus il y a de pairs, plus c'est rapide.
ExplorerLab de routage réseau
Suivez les données depuis un appareil à travers le matériel réseau et les protocoles.
Vocabulaire EntrainerAnglais Chinois Pinyin HTTP/ˌeɪtʃ tiː tiː ˈpiː/ 超文本传输协议 chāo wén běn chuán shū xié yì FTP/ˌef tiː ˈpiː/ 文件传输协议 wén jiàn chuán shū xié yì SMTP/ˌes em tiː ˈpiː/ 简单邮件传输协议 jiǎn dān yóu jiàn chuán shū xié yì peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò tracker/ˈtrækə/ 追踪器 zhuī zōng qì swarm/swɔːm/ 群 qún seed/siːd/ 种子 zhǒng zi 14.2
Commutation de circuit vs commutation de paquets

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la commutation par circuit Avantages, inconvénients et domaines d'application Montrer la compréhension de la commutation par paquets Avantages, inconvénients et domaines d'application Montrer la compréhension de la fonction d'un routeur dans la commutation par paquets Expliquer comment la commutation par paquets est utilisée pour transmettre des messages à travers un réseau, y compris Internet Source : Programme Cambridge International
Commutation de circuit
Un chemin dédié est établi entre les deux extrémités avant tout envoi de données (commutation de circuit 电路交换), réservé pour toute la conversation, puis libéré. Il offre une bande passante réservée 带宽 et une livraison dans l'ordre, mais est inefficace pendant les silences et lent à mettre en place. Exemple classique : le réseau téléphonique traditionnel.
Commulation de circuit : un chemin dédié est réservé bout en bout « Décrivez la commutation de circuit comme méthode de transmission de données » (trois points). (1) Un chemin dédié (circuit) est mis en place entre l'expéditeur et le récepteur avant l'envoi de toute donnée ; (2) le message entier est envoyé le long de ce chemin, dans l'ordre, sous forme de flux continu ; (3) le circuit est réservé pour la durée de la communication et libéré ensuite.
Avantages et inconvénients. Avantages : toute la bande passante du circuit est disponible et garantie ; les données arrivent dans l'ordre sans réassemblage ni délai une fois le circuit établi ; le trajet ne change pas, ce qui rend le timing prévisible (idéal pour la voix et la vidéo en temps réel). Inconvénients : un temps est consacré à l'établissement du circuit avant tout envoi ; le circuit est réservé même lorsque aucune donnée n'est transmise, donc la bande passante est gaspillée et d'autres utilisateurs ne peuvent pas la partager ; les deux extrémités doivent être libres simultanément ; une panne n'importe où sur le chemin coupe tout le appel, et il n'y a pas de route alternative automatique. Où il est approprié : un appel téléphonique ou un lien vidéo en direct, où un flux continu et ininterrompu prime sur l'efficacité.
Commutation par paquets
Les données sont découpées en paquets, chacun envoyé indépendamment (commutation par paquets 分组交换). Chaque paquet porte l'adresse de destination ; les routeurs prennent des décisions par paquet, donc les paquets peuvent emprunter des routes différentes et arriver dans un désordre, et la destination les réassemble. C'est efficace (un lien est multiplexé 多路复用 entre de nombreuses conversations), robuste (réacheminement autour d'une panne), mais présente une latence variable 延迟 et des pertes possibles (TCP gère la fiabilité). Utilisé par Internet.
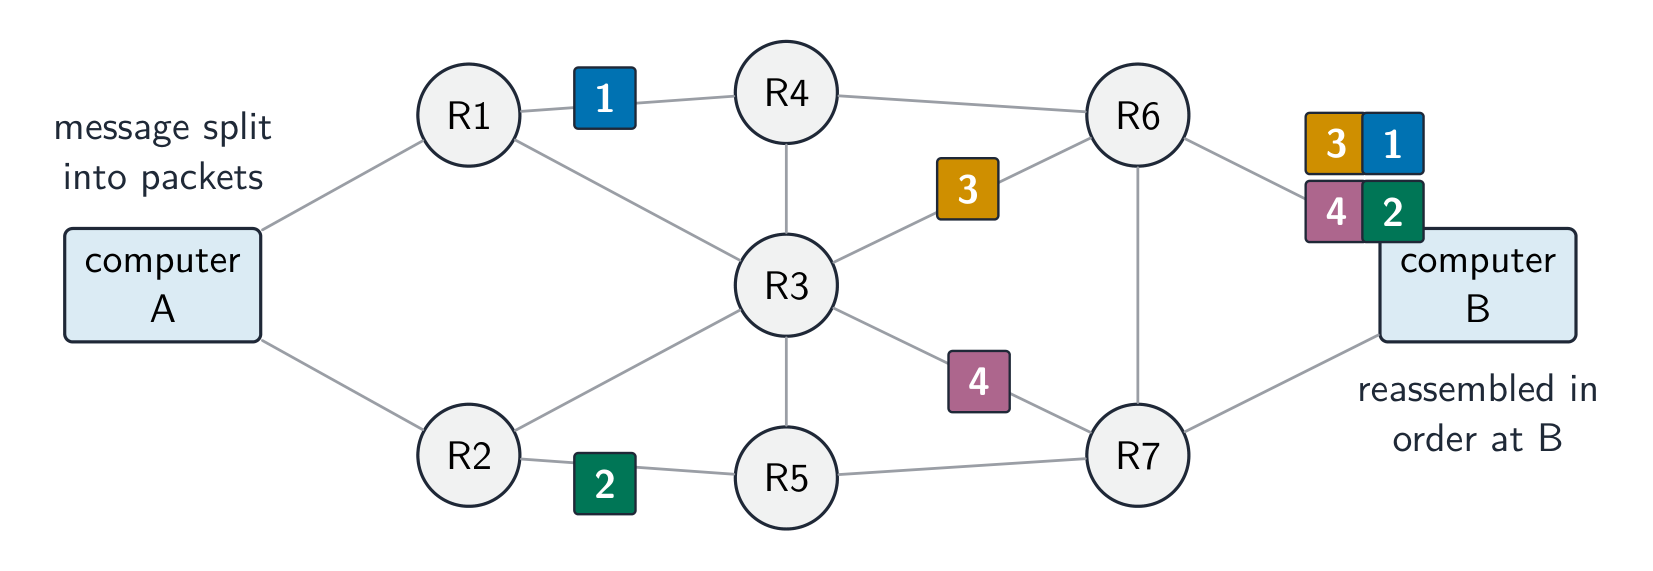
Commutation par paquets : les paquets voyagent indépendamment et peuvent emprunter des routes différentes 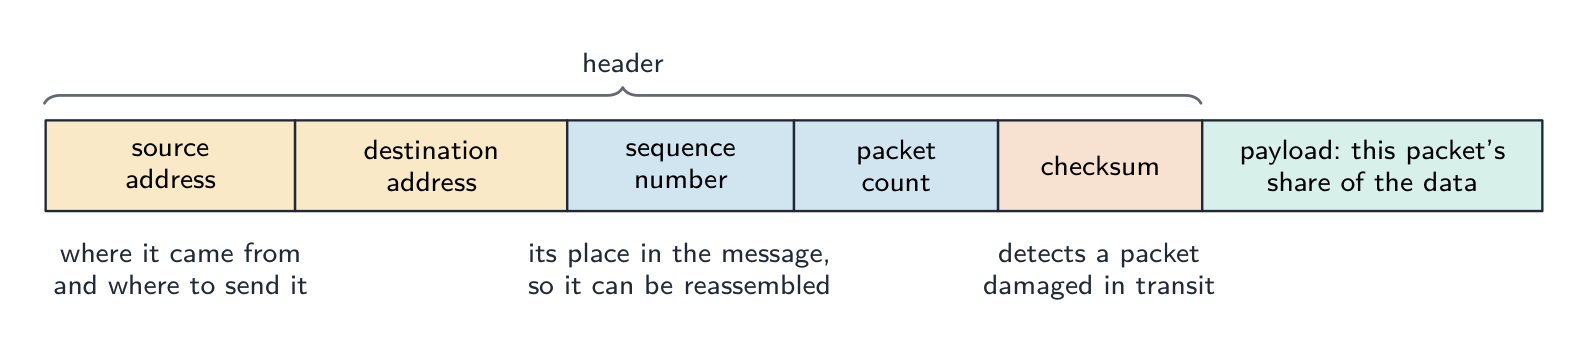
Ce qui permet à un paquet de voyager seul : les adresses indiquent où aller, le numéro de séquence indique quelle partie du message c'est, et la somme de contrôle montre s'il est arrivé intact "Décrivez comment la commutation par paquets est utilisée pour transmettre des messages sur un réseau (quatre points). (1) Le message est découpé en paquets d'une taille maximale fixe ; (2) chaque paquet reçoit un en-tête contenant les adresses source et destination, un numéro de séquence 序号 et une vérification d'erreur ; (3) chaque paquet est envoyé indépendamment et peut emprunter une route différente, choisie par les routeurs qu'il rencontre ; (4) à la destination, les paquets sont réassemblés dans l'ordre grâce aux numéros de séquence, et tout paquet manquant est demandé à nouveau. Si la question exclut la vérification et la réexpédition, omettez la dernière clause.
"Décrivez la fonction d'un routeur dans la commutation par paquets (trois points). Un routeur reçoit un paquet, lit l'adresse IP de destination dans son en-tête, et consulte sa table de routage 路由表 pour décider du prochain saut optimal vers cette destination, en tenant compte du trafic (congestion) et des liens défaillants ; il transmet ensuite le paquet vers ce lien. Les paquets d'un même message peuvent partir par des routes différentes ; le routeur met les paquets en file d'attente lorsqu'un lien est occupé.
"Décrivez deux façons dont la commutation par paquets garantit la réception complète du message." (1) Chaque paquet porte un numéro de séquence, afin que le récepteur puisse remettre les paquets dans l'ordre et identifier ceux qui sont manquants, et (2) le récepteur envoie une acquittement 确认 pour les paquets reçus ; un paquet non acquitté dans un délai imparti est réexpédié par l'expéditeur. Une somme de contrôle 校验和 dans chaque paquet permet au récepteur de détecter un paquet corrompu et de le rejeter, ce qui déclenche sa réexpédition.
Avantages et inconvénients. Avantages : pas de circuit à établir ; les liens du réseau sont partagés par de nombreux messages, donc la bande passante est utilisée efficacement ; les paquets peuvent être réacheminés autour d'un lien défaillant ou congestionné, rendant la transmission robuste ; un paquet perdu ou endommagé nécessite uniquement sa réexpédition, et non celle du message entier. Inconvénients : les paquets peuvent arriver hors ordre et doivent être réassemblés, certains peuvent être perdus ou retardés ; les en-têtes ajoutent une surcharge ; le délai variable le rend moins adapté à la voix et la vidéo en temps réel sans mesures supplémentaires ; un réseau surchargé perd des paquets. Où il est approprié : e-mail, pages web, téléchargements de fichiers et tout trafic « en rafales », et Internet en général.
Aspect Commutation de circuits Commutation de paquets Chemin dédié, réservé partagé, par paquet Temps d'établissement lent aucun Utilisation de la bande passante inefficace efficace Ordre dans l'ordre peut être hors ordre Robustesse une panne coupe le circuit réacheminement autour des pannes Convient aux flux à débit constant (voix) flux en rafales (web, e-mail) Les réseaux modernes utilisent la commutation par paquets pour son efficacité et sa résilience.
Quatre différences, énoncées par paires. (1) La commutation par circuit établit un chemin dédié avant l'envoi ; la commutation par paquets envoie sans établir de chemin. (2) Dans la commutation par circuit, le message entier suit une seule route ; dans la commutation par paquets, les paquets peuvent emprunter des routes différentes. (3) La commutation par circuit livre les données dans l'ordre sans réassemblage ; la commutation par paquets nécessite des numéros de séquence pour le réassembler. (4) La commutation par circuit réserve la bande passante pour une conversation même au repos ; la commutation par paquets partage les liens entre de nombreux messages. (Également acceptable : un lien défaillant coupe un circuit mais les paquets sont réacheminés ; la commutation par circuit convient aux flux en temps réel, la commutation par paquets aux données en rafales.) Écrivez chaque différence comme les deux moitiés ; un seul côté ne rapporte rien.
Décrire la commutation par paquets en quelques phrases
Une bonne réponse d'examen : "Le message est découpé en petits paquets. Chaque paquet porte les adresses de destination et source ainsi qu'un numéro de séquence. Chaque paquet traverse le réseau indépendamment, avec des routeurs choisissant le prochain saut par paquet. Les paquets peuvent emprunter des chemins différents et arriver dans un désordre. La destination utilise les numéros de séquence pour réassembler le message, et les paquets manquants peuvent être demandés à nouveau."
Exemple corrigé. Un appel téléphonique et un gros téléchargement de fichier partagent un réseau. Quelle méthode de commutation convient à chacun, et pourquoi ? Un appel téléphonique a besoin d'un flux régulier avec faible latence, et il souffrirait gravement si des fragments arrivaient tard ou hors ordre - donc la commutation par circuit lui convient : un chemin dédié est établi pour tout l'appel et sa capacité est réservée pendant toute la durée. Un téléchargement de fichier ne se soucie pas du timing ou de l'ordre d'arrivée, car le récepteur le réassemble, et il tire profit de la capacité disponible - donc la commutation par paquets lui convient : le fichier est découpé en paquets qui voyagent indépendamment, chacun portant des adresses source et destination et un numéro de séquence, avec des routeurs choisissant un prochain saut par paquet. Nommez la propriété du trafic qui dicte cela : capacité réservée et faible latence pour l'appel, efficacité et résilience pour le téléchargement.
ExplorerLe trajet d'un paquet sur Internet
Passez en revue la commutation de paquets. Le message est découpé, chaque paquet trouve son propre chemin, et la destination les remet ensemble — c'est pourquoi Internet est si efficace et difficile à interrompre.
Vocabulaire EntrainerAnglais Chinois Pinyin circuit switching/ˈsɜːkɪt ˈswɪtʃɪŋ/ 电路交换 diàn lù jiāo huàn reserved bandwidth/rɪˈzɜːvd ˈbændwɪdθ/ 带宽 dài kuān packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn multiplexed/ˌmʌltɪˈplekst/ 多路复用 duō lù fù yòng variable latency/ˈveərɪəbl ˈleɪtənsi/ 延迟 yán chí sequence number/ˈsiːkwəns ˈnʌmbə/ 序号 xù hào routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo acknowledgement/əkˈnɒlɪdʒmənt/ 确认 què rèn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ MAC addresses/mæk əˈdresɪz/ MAC地址 MAC dì zhǐ bandwidth/ˈbændwɪdθ/ 带宽 dài kuān latency/ˈleɪtənsi/ 延迟 yán chí header/ˈhedə/ 首部 shǒu bù 14.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition Protocole un ensemble de règles régissant la transmission des données, convenu entre l'expéditeur et le récepteur pour que les deux l'interprètent de la même manière empilement de protocoles les couches de protocoles, chacune ayant sa propre fonction, qui assurent ensemble la communication ; chaque couche communique uniquement avec les couches supérieures et inférieures couche application fournit les protocoles utilisés par les applications pour échanger des données (HTTP, SMTP, FTP, IMAP, POP3) couche transport établit la communication de bout en bout, découpe les données en paquets avec des numéros de port et de séquence, les réassemble et demande les manquants (TCP), ou envoie sans garanties (UDP) couche internet ajoute les adresses IP pour former des paquets et les achemine entre les réseaux via des routeurs couche liaison ajoute les adresses MAC pour former des trames et transmet les bits sur le réseau local physique routeur un appareil qui lit l'adresse de destination d'un paquet et le transmet le long du meilleur chemin disponible vers cette destination commutation par circuit un chemin de communication dédié est établi entre les deux extrémités avant l'envoi des données et maintenu pour toute la transmission commutation par paquets le message est découpé en paquets, chacun avec un en-tête, envoyés indépendamment sur des routes potentiellement différentes et réassemblés à la destination paquet unité de données comportant un en-tête (adresses, numéro de séquence, vérification d'erreur) et un corps utile pair-à-pair partage de fichiers sans serveur central, chaque ordinateur agissant à la fois comme client et serveur 14.2
Conseils d'examen
- Pourquoi les protocoles : règles partagées, même interprétation, quel que soit le type d'ordinateur. Pourquoi les couches : chaque couche a une tâche unique et peut être modifiée indépendamment.
- Les quatre couches dans l'ordre, de haut en bas : Application, Transport, Internet, Liaison. Donnez la tâche de chaque couche en une phrase, et la réponse "message d'hôte à hôte" comme une descente puis une remontée de la pile.
- Les objectifs des protocoles sont des phrases courtes : HTTP pages web, FTP fichiers, SMTP envoi d'e-mail, POP3 téléchargement d'e-mail, IMAP e-mail conservé sur le serveur, BitTorrent pièces pair-à-pair depuis un essaim.
- Commutation par circuit : chemin dédié d'abord, message entier, maintenu pendant la durée. Commutation par paquets : découpé, en-tête avec adresses et numéro de séquence, routes indépendantes, réassemblage. Avantages et inconvénients viennent par paires opposées.
- Un routeur lit l'adresse de destination, consulte sa table de routage, transmet le long du meilleur chemin ; c'est la question sur la commutation par paquets que l'examen pose le plus souvent.
- "Où il est approprié" : commutation par circuit pour un appel téléphonique ou une vidéo en direct ; commutation par paquets pour l'e-mail, le web et les téléchargements.
Erreurs courantes
- Définir un protocole comme un "langage" ou un "logiciel" ; c'est un ensemble de règles.
- Placer les couches dans le mauvais ordre, ou donner les sept couches OSI au lieu des quatre de TCP/IP.
- Décrire la couche transport comme "routage" ou la couche internet comme "découpage en paquets" ; les ports et le découpage appartiennent au transport, les adresses IP et le routage appartiennent à Internet.
- Confondre POP3 avec IMAP, ou dire que SMTP reçoit des e-mails.
- Décrire la commutation par paquets sans l'en-tête (adresses et numéro de séquence) ou sans réassemblage.
- Dire qu'un routeur "envoie le paquet partout" ; il choisit un seul prochain saut depuis sa table de routage.
- Donner un avantage de la commutation par paquets comme un inconvénient de la commutation par circuit sans énoncer le côté commutation par circuit ; chaque différence nécessite les deux moitiés.
- Prétendre que la commutation par paquets garantit la livraison d'elle-même ; ce sont les numéros de séquence et les acquittements de la couche transport qui le font.
-
15
Matériel et machines virtuelles
Regarder la leçon15.1
Processeurs RISC vs CISC
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension des ordinateurs à jeu d'instructions réduit (RISC) et des ordinateurs à jeu d'instructions complexe (CISC) Différences entre RISC et CISC Comprendre la gestion des interruptions sur les processeurs CISC et RISC Montrer la compréhension de l'importance/usage du pipelining et des registres dans les processeurs RISC Montrer la compréhension des quatre architectures informatiques de base SISD, SIMD, MISD, MIMD Montrer la compréhension des caractéristiques des ordinateurs parallèles massifs Montrer la compréhension du concept de machine virtuelle Donner des exemples du rôle des machines virtuelles Comprendre les avantages et limites des machines virtuelles Source : Programme Cambridge International
Deux styles de conception de CPU. Le CPU se branche directement sur la carte mère 主板, la carte principale reliant le processeur, la mémoire et toutes les autres parties de l'ordinateur.
CISC a beaucoup d'instructions complexes ; RISC en a peu, simples 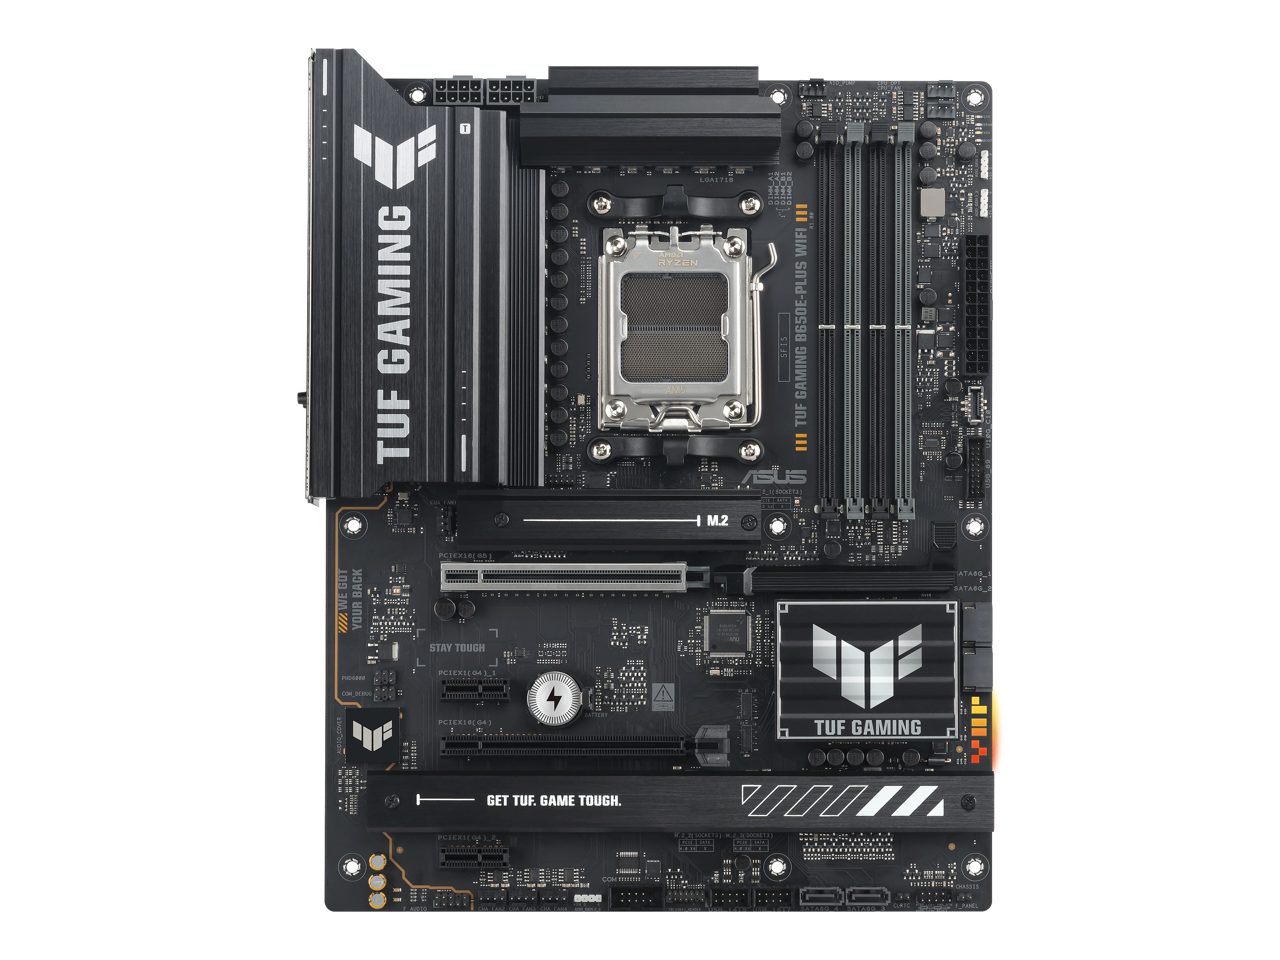
Une carte mère relie le CPU, la mémoire et autres composants ensemble CISC
Un CISC 复杂指令集 (Complex Instruction Set Computers) possède de nombreuses instructions souvent complexes (une instruction peut effectuer plusieurs accès mémoire et opérations), de longueur variable, ce qui rend le décodage complexe. Il effectue davantage par instruction en matériel. Exemples : Intel x86.
RISC
Un RISC 精简指令集 (Reduced Instruction Set Computers) possède un petit ensemble d'instructions simples, chacune effectuant une opération de base, toutes de longueur fixe (décodage rapide). Seules les instructions load et store accèdent à la mémoire ; tout le reste est de register 寄存器 à register. Les programmes sont plus longs mais chaque instruction est rapide et prévisible, ce qui convient au pipelinage. Exemples : ARM, RISC-V.
Fonctionnalité CISC RISC Jeu d'instructions nombreux peu Longueur des instructions variable fixe Accès mémoire nombreuses instructions seulement load/store Amenable au pipeline difficile naturellement Cycles par instruction variable généralement 1 Le compromis consiste à faire plus par instruction (CISC) contre exécuter chaque instruction plus vite et de manière prévisible (RISC). Les puces Intel modernes traduisent les instructions CISC en micro-opérations RISC simplifiées en interne.
"Identifiez quatre caractéristiques d'un processeur RISC." N'importe lesquelles de quatre : un petit jeu d'instructions simples ; des instructions de longueur fixe (un mot) ; la plupart des instructions s'achèvent en un cycle d'horloge ; beaucoup de registres à usage général ; seules les instructions load et store accèdent à la mémoire (toute l'arithmétique est de register à register) ; contrôle hard-wired (pas de microcode) ; conçu pour le pipelining ; le compiler effectue plus de travail, donc les programmes contiennent plus d'instructions et nécessitent plus de mémoire. "Identifiez quatre caractéristiques d'un processeur CISC." N'importe lesquelles de quatre : un grand jeu d'instructions, dont beaucoup sont complexes (une instruction peut effectuer plusieurs opérations) ; instructions de longueur variable ; instructions prenant plusieurs cycles d'horloge ; moins de registres ; instructions pouvant accéder directement à la mémoire ; contrôle microprogrammé ; moins adapté au pipelining ; programmes plus courts, donc un compilateur plus simple et moins de mémoire. "Décrivez ce que signifient RISC et CISC" (deux points chacun) : nommez l'acronyme et donnez l'idée définissante (peu d'instructions simples monocycle ; beaucoup d'instructions complexes multicycle).
Gestion des interruptions sur les deux architectures. Sur un processeur CISC, l'instruction courante, aussi complexe soit-elle, est terminée avant que l'interruption ne soit traitée ; le processeur sauvegarde ensuite le contenu de ses registres (y compris le compteur programme) sur la pile, saute vers le routine de service d'interruption, et restaure les registres après. Sur un processeur RISC avec un pipeline, plusieurs instructions sont en cours d'exécution au moment où l'interruption 中断 arrive, donc le processeur doit soit laisser toutes les instructions du pipeline terminer, soit discarder (flush) les instructions partiellement exécutées et les redémarrer après l'interruption ; dans les deux cas, le pipeline est vidé, les registres sont sauvegardés, et la routine de service s'exécute. La formulation de l'examen : "le pipelining rend la gestion des interruptions plus complexe, car le contenu du pipeline doit être géré avant que l'interruption ne puisse être traitée".
Vocabulaire EntrainerAnglais Chinois Pinyin motherboard/ˈmʌðəbɔːd/ 主板 zhǔ bǎn CISC/sɪsk/ 复杂指令集 fù zá zhǐ lìng jí RISC/rɪsk/ 精简指令集 jīng jiǎn zhǐ lìng jí register/ˈredʒɪstə/ 寄存器 jì cún qì interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 15.1
Pipelining

Un pipeline 流水线 traite les instructions en stages chevauchants, comme une chaîne d'assemblage : Fetch → Decode → Execute (dans l'ALU 算术逻辑单元) → Memory access → Write back. Chaque stage travaille sur une instruction différente à la fois, donc une fois le pipeline rempli, une instruction se termine par cycle. Les instructions RISC à longueur fixe et simples font en sorte que chaque stage prenne le même temps. Un pipeline peut subir un stalling sur un hazard 冒险 — un hazard de données (une instruction a besoin d'un résultat pas encore prêt) ou un hazard de contrôle (une branchement rend l'adresse suivante inconnue).
Le pipelining chevauche les stages de six instructions, donc une se termine chaque cycle Les puces RISC gardent les données dans beaucoup de registres parce que la mémoire est lente et les registres rapides ; le compilateur alloue les valeurs aux registres judicieusement.
"Décrivez l'utilisation du pipelining dans les processeurs RISC" (trois points). (1) Le cycle fetch-execute est divisé en stages (fetch, decode, execute, memory access, write back) ; (2) plusieurs instructions sont dans le pipeline à la fois, chacune à un stage différent, donc pendant qu'une est exécutée, la suivante est décodée et celle d'après est fetched ; (3) une nouvelle instruction commence, et une se termine, dans chaque cycle d'horloge une fois le pipeline plein, ce qui augmente le throughput 吞吐量 (le nombre d'instructions terminées par seconde), bien que chaque instruction prenne encore le même temps individuellement. Les instructions RISC à longueur fixe monocycle sont ce qui rend les stages égaux et le pipeline possible.
Exemple résolu. Un processeur utilise cinq stages de pipeline (IF, ID, OF, EX, WB). Quatre instructions entrent dans le pipeline l'une après l'autre. À quel cycle la dernière instruction se termine-t-elle, et combien de cycles prendraient ces quatre instructions sans pipelining ?
L’instruction 1 occupe IF au cycle 1, ID en 2, OF en 3, EX en 4 et WB en 5 ; l’instruction 2 commence un cycle plus tard et se termine au cycle 6 ; l’instruction 3 au cycle 7 ; l’instruction 4 au cycle 8. En général, $n$ instructions à travers $k$ stades prennent $n + k - 1$ cycles, ici $4 + 5 - 1 = 8$. Sans pipeline, chaque instruction prend tous les cinq cycles avant que la suivante ne commence : $4 \times 5 = 20$ cycles. Le tableau de l’examen est rempli en écrivant les stades de chaque instruction en diagonale, une colonne à droite de l’instruction précédente.
Un processeur fonctionnant à cette vitesse dégage beaucoup de chaleur, donc un heat-sink 散热器 et un ventilateur sont placés dessus. Les ailettes métalliques dissipent la chaleur et le ventilateur l'éloigne, maintenant le CPU suffisamment frais pour fonctionner.

Un heat-sink et un ventilateur de CPU transportent la chaleur loin du processeur ExplorerComment le pipelinage se remplit
Passez en revue les cycles d'horloge. Une fois le pipeline plein, une nouvelle instruction se termine tous les cycles — bien que chacune prenne encore plusieurs stades — parce que les stades de différentes instructions se chevauchent.
Vocabulaire EntrainerAnglais Chinois Pinyin pipeline/ˈpaɪplaɪn/ 流水线 liú shuǐ xiàn ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán hazard/ˈhæzəd/ 冒险 mào xiǎn throughput/ˈθruːpʊt/ 吞吐量 tūn tǔ liàng heat-sink/hiːt sɪŋk/ 散热器 sàn rè qì Flynn's taxonomy/flɪnz tækˈsɒnəmi/ 弗林分类 fú lín fēn lèi 15.1
Taxonomie de Flynn

La taxonomie de Flynn 弗林分类 classe les ordinateurs selon le nombre de flux d'instructions et de données :
- SISD — une instruction, un flux de données (un cœur unique traditionnel).
- SIMD 单指令多数据 — une instruction agit sur de nombreux éléments de données simultanément (GPU, extensions vectorielles CPU). Idéal pour les images, vidéo, tableaux scientifiques.
- MISD — plusieurs opérations sur les mêmes données ; rare, surtout théorique.
- MIMD 多指令多数据 — de nombreux processeurs exécutent différentes instructions sur différentes données (CPU multi-cœurs, clusters). Le plus général.
Décrire les quatre architectures (deux points chacune). SISD : non processeur unique exécute une instruction à la fois sur un élément de données ; pas de parallélisme, la machine von Neumann traditionnelle. SIMD : une instruction est appliquée simultanément à de nombreux éléments de données, par de multiples éléments de traitement agissant synchronisés ; utilisé pour le traitement matriciel et graphique. MISD : plusieurs processeurs appliquent différentes instructions aux mêmes données ; rarement utilisé, par exemple un système tolérant aux pannes où plusieurs processeurs vérifient un seul flux. MIMD : de nombreux processeurs, chacun exécutant ses propres instructions sur ses propres données, indépendamment ; l'ordinateur multi-cœur et le cluster.
SIMD : de nombreux processeurs exécutent la même instruction sur différentes données Une carte graphique 显卡 (avec son GPU) est un exemple réel de matériel SIMD : elle possède des milliers de petits cœurs exécutant la même instruction sur de nombreux pixels ou nombres simultanément, d'où la rapidité des GPU pour les images, vidéo et apprentissage automatique.

Une carte graphique : son GPU exécute la même instruction sur de nombreux éléments de données simultanément (SIMD) 
MIMD : chaque processeur exécute ses propres instructions sur ses propres données Vocabulaire EntrainerAnglais Chinois Pinyin SIMD/ˈsɪmdiː/ 单指令多数据 dān zhǐ lìng duō shù jù MIMD/ˈmɪmdiː/ 多指令多数据 duō zhǐ lìng duō shù jù graphics card/ˈɡræfɪks kɑːd/ 显卡 xiǎn kǎ massively parallel/ˈmæsɪvli ˈpærəlel/ 大规模并行 dà guī mó bìng xíng 15.1
Ordinateurs massivement parallèles

Un système massivement parallel 大规模并行 utilise des milliers de processeurs sur un réseau rapide, chacun avec sa propre mémoire (distributed memory 分布式内存), échangeant des données par messages. C'est du MIMD, nécessite un logiciel spécifiquement écrit (MPI, CUDA), et convient à la simulation climatique, à l'entraînement de machine learning 机器学习 à grande échelle, et à l'astrophysique. Les plus grands supercomputers 超级计算机 sont massivement parallèles.
"Esquissez les caractéristiques des ordinateurs massivement parallèles" (trois points). Un très grand nombre de processeurs (milliers), chacun avec sa propre mémoire, connectés par un réseau (une interconnexion haute vitesse ou un bus) afin qu'ils puissent passer des messages entre eux ; ils travaillent simultanément sur des parties du même problème, donc le problème doit être écrit comme un programme pouvant être divisé en parties s'exécutant en parallèle et combinant leurs résultats. C'est une disposition MIMD.
Les processeurs vivent dans des racks de server 服务器 hauts, occupant souvent toute une pièce (un data centre 数据中心), câblés ensemble pour travailler sur un gros problème en même temps.
Des rangées de serveurs dans un data centre, comme ceux utilisés pour le calcul massivement parallèle Vocabulaire EntrainerAnglais Chinois Pinyin distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ 分布式内存 fēn bù shì nèi cún machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí supercomputers/ˌsuːpəkəmˈpjuːtəz/ 超级计算机 chāo jí jì suàn jī server/ˈsɜːvə/ 服务器 fú wù qì data centre/ˈdeɪtə ˈsentə/ 数据中心 shù jù zhōng xīn 15.1
Machines virtuelles
Une virtual machine 虚拟机 (VM) est une émulation logicielle d'un ordinateur entier — le logiciel à l'intérieur voit un CPU, une mémoire et des disques qui semblent réels mais sont gérés par un logiciel hôte.
- une system VM exécute un OS complet. Un hypervisor 虚拟机监控器 crée et gère les VM, chacune amorçant son propre OS invité. Utilisations : exécuter différents OS sur une même machine ; consolidation de serveurs ; sandboxing 沙箱 (logiciel risqué exécuté isolément) ; snapshots.
- une process (language) VM exécute un programme dans du bytecode 字节码 portable — la JVM (Java), le CLR (.NET), CPython. Avantages : portabilité (« écrire une fois, exécuter partout »), vérifications de sécurité en temps d'exécution, et just-in-time compilation 即时编译 pour une vitesse quasi-native. Le coût est une couche supplémentaire et la nécessité d'avoir la VM installée.
Un vrai ordinateur, plusieurs apparents : le système d'exploitation hôte et l'hyperviseur partagent le matériel, et chaque système d'exploitation invité s'exécute comme s'il avait sa propre machine "Décrivez ce que signifie une machine virtuelle" (deux points). Une émulation (implémentation) logicielle d'un système informatique qui s'exécute sur un ordinateur hôte et se comporte, pour les programmes qui y tournent, comme un ordinateur physique séparé avec son propre processeur, sa mémoire et son stockage. Le système d'exploitation hôte 宿主操作系统 s'exécute sur le matériel réel, gère les ressources réelles et (via l'hyperviseur) crée et contrôle les machines virtuelles ; chaque système d'exploitation invité 客户操作系统 s'exécute à l'intérieur d'une machine virtuelle, gère les applications qui y sont, et ignore que son matériel est virtuel.
Avantages (donner deux). Plusieurs systèmes d'exploitation différents peuvent s'exécuter sur une même machine simultanément ; des logiciels peuvent être testés sur de nombreux systèmes sans acheter le matériel ; un nouveau système informatique peut être émulé et testé avant sa construction ; chaque VM est isolée, donc un crash ou un malware dans l'une n'affecte pas l'hôte ni les autres ; les VMs peuvent être copiées, déplacées et sauvegardées sous forme de fichiers, et un serveur peut être partagé entre de nombreux utilisateurs, réduisant les coûts matériels. Limitations (donner deux). Une VM s'exécute plus lentement que le matériel réel car chaque instruction passe par la couche d'émulation ; elle consomme la mémoire et la puissance de traitement de l'hôte, donc l'hôte doit être puissant ; certaines fonctionnalités ou périphériques matériels ne sont pas exactement émulés, donc le logiciel testé peut se comporter différemment sur la vraie machine ; des licences sont nécessaires pour chaque OS invité, et la configuration du système nécessite une expertise.
ExplorerLaboratoire de concepts informatiques
Classez les exemples concrets selon le concept informatique qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī hypervisor/ˌhaɪpəˈvaɪzə/ 虚拟机监控器 xū nǐ jī jiān kòng qì sandboxing/ˈsændbɒksɪŋ/ 沙箱 shā xiāng bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ 宿主操作系统 sù zhǔ cāo zuò xì tǒng guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ 客户操作系统 kè hù cāo zuò xì tǒng Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ 布尔代数 bù ěr dài shù Boolean/ˈbuːlɪən/ 布尔 bù ěr truth tables/truːθ ˈteɪblz/ 真值表 zhēn zhí biǎo De Morgan's laws/də ˈmɔːɡənz lɔːz/ 德摩根定律 dé mó gēn dìng lǜ 15.2
Algèbre booléenne
Programme
Les candidats doivent être capables de : Notes et orientations Produire des tables de vérité pour des circuits logiques incluant des additeurs demi et complets Peut inclure des portes logiques avec plus de deux entrées Montrer la compréhension d'un bascule (SR, JK) Dessiner un circuit logique et dériver une table de vérité pour une basculle Comprendre le rôle des bascules comme éléments de stockage de données Montrer la compréhension de l'algèbre de Boolean Comprendre les lois de De Morgan Effectuer l'algèbre de Boolean en utilisant les lois de De Morgan Simplifier un circuit/logique en utilisant l'algèbre de Boolean Montrer la compréhension des cartes de Karnaugh (K-map) Comprendre les avantages de l'utilisation des cartes de Karnaugh Résoudre des problèmes logiques en utilisant les cartes de Karnaugh Source : Programme Cambridge International
L'additionneur partiel : XOR + AND additionnent deux bits Algèbre booléenne 布尔代数 simplifie les expressions booléennes 布尔, qui peuvent également être décrites par des tables de vérité 真值表. Symboles :
+pour OR,·pour AND (souvent omis), une barre au-dessus pour NOT.Les lois clés incluent les lois commutative, associative et distributive (comme en algèbre ordinaire), ainsi que :
- identité $A + 0 = A$, $A \cdot 1 = A$ ; nul $A + 1 = 1$, $A \cdot 0 = 0$.
- idempotent $A + A = A$ ; inverse $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- Lois de De Morgan 德摩根定律 : $(A + B)' = A' \cdot B'$ ; $(A \cdot B)' = A' + B'$ — nier l'ensemble, échanger AND/OR, nier chaque opérande.
- absorption 吸收律 : $A + AB = A$.
La simplification réduit le nombre de termes, donc le circuit logique résultant a moins de portes. Exemple : $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
Les lois avec leurs noms (citer le nom à chaque étape quand "montrer tout le calcul" est demandé).
Loi Forme OR Forme AND identité $A + 0 = A$ $A \cdot 1 = A$ nul (annulation) $A + 1 = 1$ $A \cdot 0 = 0$ idempotent $A + A = A$ $A \cdot A = A$ complément (inverse) $A + \overline{A} = 1$ $A \cdot \overline{A} = 0$ commutative $A + B = B + A$ $A \cdot B = B \cdot A$ associative $A + (B + C) = (A + B) + C$ $A(BC) = (AB)C$ distributive $A + BC = (A + B)(A + C)$ $A(B + C) = AB + AC$ absorption $A + AB = A$ $A(A + B) = A$ De Morgan $\overline{A + B} = \overline{A} \cdot \overline{B}$ $\overline{A \cdot B} = \overline{A} + \overline{B}$ double négation $\overline{\overline{A}} = A$ Exemple résolu. Simplifier $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, en montrant tout le calcul.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan sur la barre extérieure) $= A \cdot B + A + B$ (double négation) $= A + B$ (absorption, $A + AB = A$, appliqué avec $A + B$ absorbant $AB$).
Exemple résolu. Simplifier $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (De Morgan) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (distributif) $= \overline{A}\,\overline{B} + 0$ (idempotent, complémentaire) $= \overline{A}\,\overline{B}$.
Exemple résolu. Simplifier $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributive) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complément, identité) $= \overline{B}(\overline{A} + AC)$ (distributive) $= \overline{B}(\overline{A} + C)$, utilisant $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Appliquer De Morgan à un terme à trois entrées fonctionne de la même manière : $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Somme-de-produits à partir d'une table de vérité. Prendre chaque ligne dont la sortie est 1, écrire l'AND de ses entrées (une variable barrée où elle est 0), et OR les termes : une ligne avec $A = 1, B = 0, C = 1$ donne $A\,\overline{B}\,C$. C'est la forme somme-de-produits 积之和 demandée à l'examen, et c'est le point de départ tant pour la simplification algébrique que pour la carte de Karnaugh.
ExplorerAlgèbre booléenne
A·B, A+B, Ā …
L'algèbre booléenne n'est que ces portes écrites sous forme d'expressions — comparez les tables de vérité.
ExplorerTables de vérité booléennes
Choisissez un opérateur et les entrées pour construire sa table de vérité — l'algèbre derrière les circuits logiques.
Vocabulaire EntrainerAnglais Chinois Pinyin absorption/əbˈsɔːpʃn/ 吸收律 xī shōu lǜ sum-of-products/sʌm ɒv ˈprɒdʌkts/ 积之和 jī zhī hé Karnaugh map/ˈkɑːnɔː mæp/ 卡诺图 kǎ nuò tú Gray code/ɡreɪ kəʊd/ 格雷码 gé léi mǎ half adder/hɑːf ˈædə/ 半加器 bàn jiā qì 15.2
Cartes de Karnaugh
Une carte de Karnaugh 卡诺图 (K-map) simplifie une expression booléenne en regroupant des 1 adjacents d'une table de vérité. Les colonnes et lignes utilisent l'ordre code Gray 格雷码 (
00,01,11,10) afin que les cellules adjacentes diffèrent par une seule variable.Placer un 1 dans chaque cellule où la sortie est 1. Trouver des groupes rectangulaires de 1s dont les côtés sont des puissances de 2 (1, 2, 4, 8), en faisant le tour des bords si cela permet un plus grand groupe. Plus le groupe est grand, plus le terme est simple : un groupe de 2 fait disparaître une variable, un groupe de 4 en fait disparaître deux, et ainsi de suite — les variables qui changent dans le groupe disparaissent. ORer les termes de groupe ensemble pour l'expression simplifiée. Couvrir tous les 1s en utilisant le moins de groupes, les plus grands possible.
Exemple résolu. Une carte de Karnaugh pour $A$ et $B$ a des 1s dans les cellules $\overline{A}B$ et $AB$. Simplifier. Les deux 1s sont adjacents - ils partagent la colonne $B=1$ - donc les regrouper comme un rectangle de 2. À l'intérieur de ce groupe $B$ reste 1 tout au long tandis que $A$ changement de 0 à 1, et toute variable qui change dans un groupe disparaît. Donc le groupe laisse simplement $X = B$. Comparer cela avec la somme des produits lue directement depuis la table, $\overline{A}B + AB$ : le même circuit, deux portes en moins. Deux règles font la plupart du travail - rendre chaque groupe aussi grand que possible (un groupe de 2 fait disparaître une variable, 4 en fait disparaître deux, 8 en fait disparaître trois), et se souvenir que la carte fait le tour de ses bords, donc les colonnes gauche et droite sont adjacentes. Ce tour est le regroupement que la plupart des candidats manquent.
Boucles de 1, 2, 4 ou 8 uns ; le terme pour une boucle conserve uniquement les variables qui ne changent pas à l'intérieur. Les bords se rejoignent, donc une boucle peut faire le tour, et les quatre coins comptent comme adjacents Construire et lire une carte K. Étiqueter les colonnes $AB$ et les lignes $C$ (ou $CD$) dans l'ordre code-Gray
00 01 11 10, afin que les cellules voisines diffèrent par une seule variable. Placer un 1 dans chaque cellule dont le minterme apparaît dans l'expression (ou dont la ligne de la table de vérité affiche 1). Ensuite, tracer les moins, plus grands boucles qui couvrent chaque 1 : chaque boucle doit être un rectangle de $1, 2, 4$ ou $8$ cellules, les boucles peuvent se chevaucher, peuvent faire le tour des bords gauche-droit et haut-bas, et les quatre coins ensemble forment une boucle. Pour chaque boucle, écrire les variables qui sont constantes à l'intérieur (barrées si 0), et ORer les termes de boucle : c'est la somme-de-produits optimale. Pourquoi utiliser une ? Elle donne l'expression la plus simple sans algèbre, en quelques étapes, avec moins de risques d'erreur, et la même carte convient à trois ou quatre variables.Exemple résolu. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
Sur la carte à trois variables, les 1s remplissent les colonnes 00, 01 et 10 dans les deux lignes. La boucle de quatre sur les colonnes 00 et 01 a $A = 0$ tout au long et $B$, $C$ varient toutes deux : terme $\overline{A}$. La boucle de quatre sur les colonnes 00 et 10 (en faisant le tour) a $B = 0$ tout au long : terme $\overline{B}$. Donc $Z = \overline{A} + \overline{B}$, ce que confirme l'algèbre booléenne : $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Deux boucles de deux seraient également correctes mais pas optimales ; une boucle est aussi grande que le permettent les 1s.
Exemple résolu (quatre variables). Une carte a des 1s seulement dans ses quatre coins : $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ et $A\,\overline{B}\,C\,\overline{D}$. Parce que les lignes supérieures et inférieures sont adjacentes et que les colonnes extérieures le sont aussi, les coins forment une boucle de quatre ; $B = 0$ et $D = 0$ dans chacun d'eux tandis que $A$ et $C$ varient, donc $Z = \overline{B}\,\overline{D}$.
15.2
Demi-additionneur et additionneur complet

Un demi-additionneur 半加器 additionne deux bits simples $A$ et $B$, donnant une somme $S$ et une retenue 进位 $C$ :
A B S C 0 0 0 0 0 1 1 0 1 0 1 0 1 1 0 1 Donc $S = A \text{ XOR } B$ et $C = A \text{ AND } B$. Il ignore toute retenue d'entrée — d'où "demi".
Un demi-additionneur, en tant que bloc et en tant que circuit d'une porte XOR et d'une porte AND Un additionneur complet 全加器 additionne trois bits ($A$, $B$, retenue entrante), donnant une somme et une retenue sortante : $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Il peut être construit à partir de deux additionneurs partiels plus une porte OU. Enchaîner des additionneurs complets (chaque retenue sortante alimentant la retenue entrante suivante) crée un additionneur « ripple-carry » multi-bits.
Un additionneur complet est construit à partir de deux demi-additionneurs et d'une porte OR Table de vérité de l'additionneur complet. Avec les entrées $A$, $B$ et la retenue d'entrée $C_{\text{in}}$ : la somme $S$ est 1 quand un nombre impair d'entrées est 1, et la retenue de sortie est 1 quand deux ou plus d'entrées sont 1.
$A$ $B$ $C_{\text{in}}$ $S$ $C_{\text{out}}$ 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 0 0 1 0 1 0 1 0 1 1 1 0 0 1 1 1 1 1 1 Les questions de circuit que l'examen pose. Étant donné un circuit d'une porte XOR et d'une porte AND partageant deux entrées, ou deux demi-additionneurs et une porte OR, "compléter la table de vérité (montrer votre calcul)" signifie ajouter une colonne pour chaque sortie de porte intermédiaire et remplir les lignes dans l'ordre ; "donner le nom du circuit" est demi-additionneur ou additionneur complet ; "indiquer la finalité de chaque sortie" est la somme des bits et la retenue vers la colonne suivante. Somme-de-produits pour le demi-additionneur : $S = \overline{A}B + A\overline{B}$, $C = AB$. Une chaîne d'additionneurs complets, chacun passant sa retenue de sortie à la retenue d'entrée suivante, additionne deux nombres multi-bits.
ExplorerLes portes à l'intérieur d'un additionneur
Le bit de somme d'un demi-additionneur est une porte XOR et sa retenue est une porte AND — alternez A et B et observez la ligne de la table de vérité s'allumer.
Vocabulaire EntrainerAnglais Chinois Pinyin carry/ˈkæri/ 进位 jìn wèi full adder/fʊl ˈædə/ 全加器 quán jiā qì 15.2
Bascules (Flip-flops)
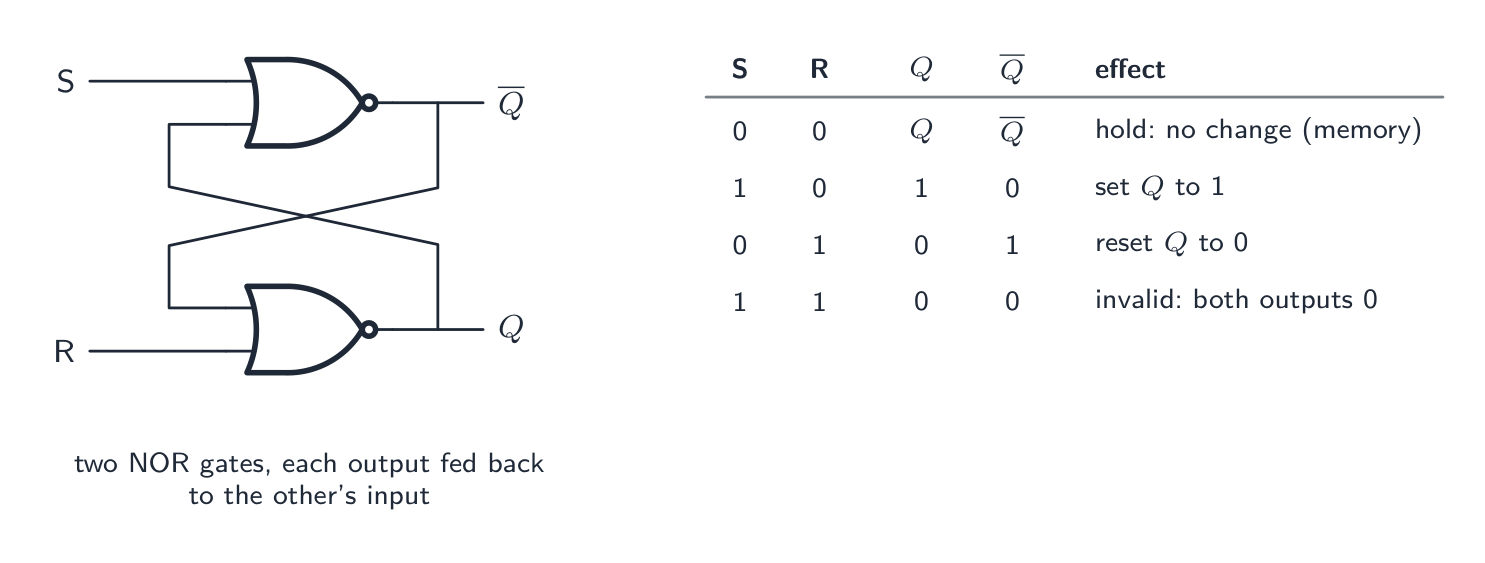
Une bascule 触发器 est un circuit bistable 双稳态 — deux états stables (0 et 1) — qui mémorise son état. Elle stocke un bit et constitue l'élément de base des registres et de la SRAM.
Bascule SR
Une basculle SR SR触发器 a des entrées S (set/positionnement) et R (reset/réinitialisation) et des sorties Q et $\overline{Q}$.
S=1,R=0positionne Q à 1 ;S=0,R=1la réinitialise à 0 ;S=0,R=0maintient ;S=1,R=1est invalide. Construite à partir de deux portes NOR croisées.La bascule SR : deux portes NOR s'alimentant mutuellement. Avec les deux entrées à 0, les sorties maintiennent ce qu'elles étaient, ce qui est la mémoire ; S positionne Q à 1, R la réinitialise, et S = R = 1 n'est pas autorisé "Dessinez un circuit logique pour une bascule SR et étiquetez les entrées." Deux portes NOR (ou deux portes NAND), la sortie de chaque porte étant connectée en retour à l'une des entrées de l'autre ; l'entrée libre d'une porte est S, celle de l'autre R ; les sorties sont $Q$ et $\overline{Q}$. La rétroaction est ce qui rapporte des points : sans elle, il n'y a pas de mémoire. "Énoncez le rôle d'une bascule." Pour stocker un bit de données ; c'est l'élément mémoire de base à partir duquel sont construits les registres et la RAM statique, et elle conserve sa valeur jusqu'à ce qu'elle soit délibérément modifiée. L'entrée invalide $S = R = 1$ rend les deux sorties égales à 0, de sorte que $\overline{Q}$ n'est plus le complément de $Q$, et l'état après le retour des deux entrées à 0 est imprévisible, ce qui constitue la faiblesse de la bascule SR.
Bascule JK
Une bascule JK JK触发器 améliore cette configuration en utilisant l'entrée précédemment invalide
1,1comme toggle 翻转 (la sortie s'inverse). Cela la rend idéale pour construire des compteurs 计数器 (une chaîne de bascules en mode toggle). Elle est généralement horlogée — les entrées ne sont activées qu'en bord d'horloge, maintenant les bascules synchronisées.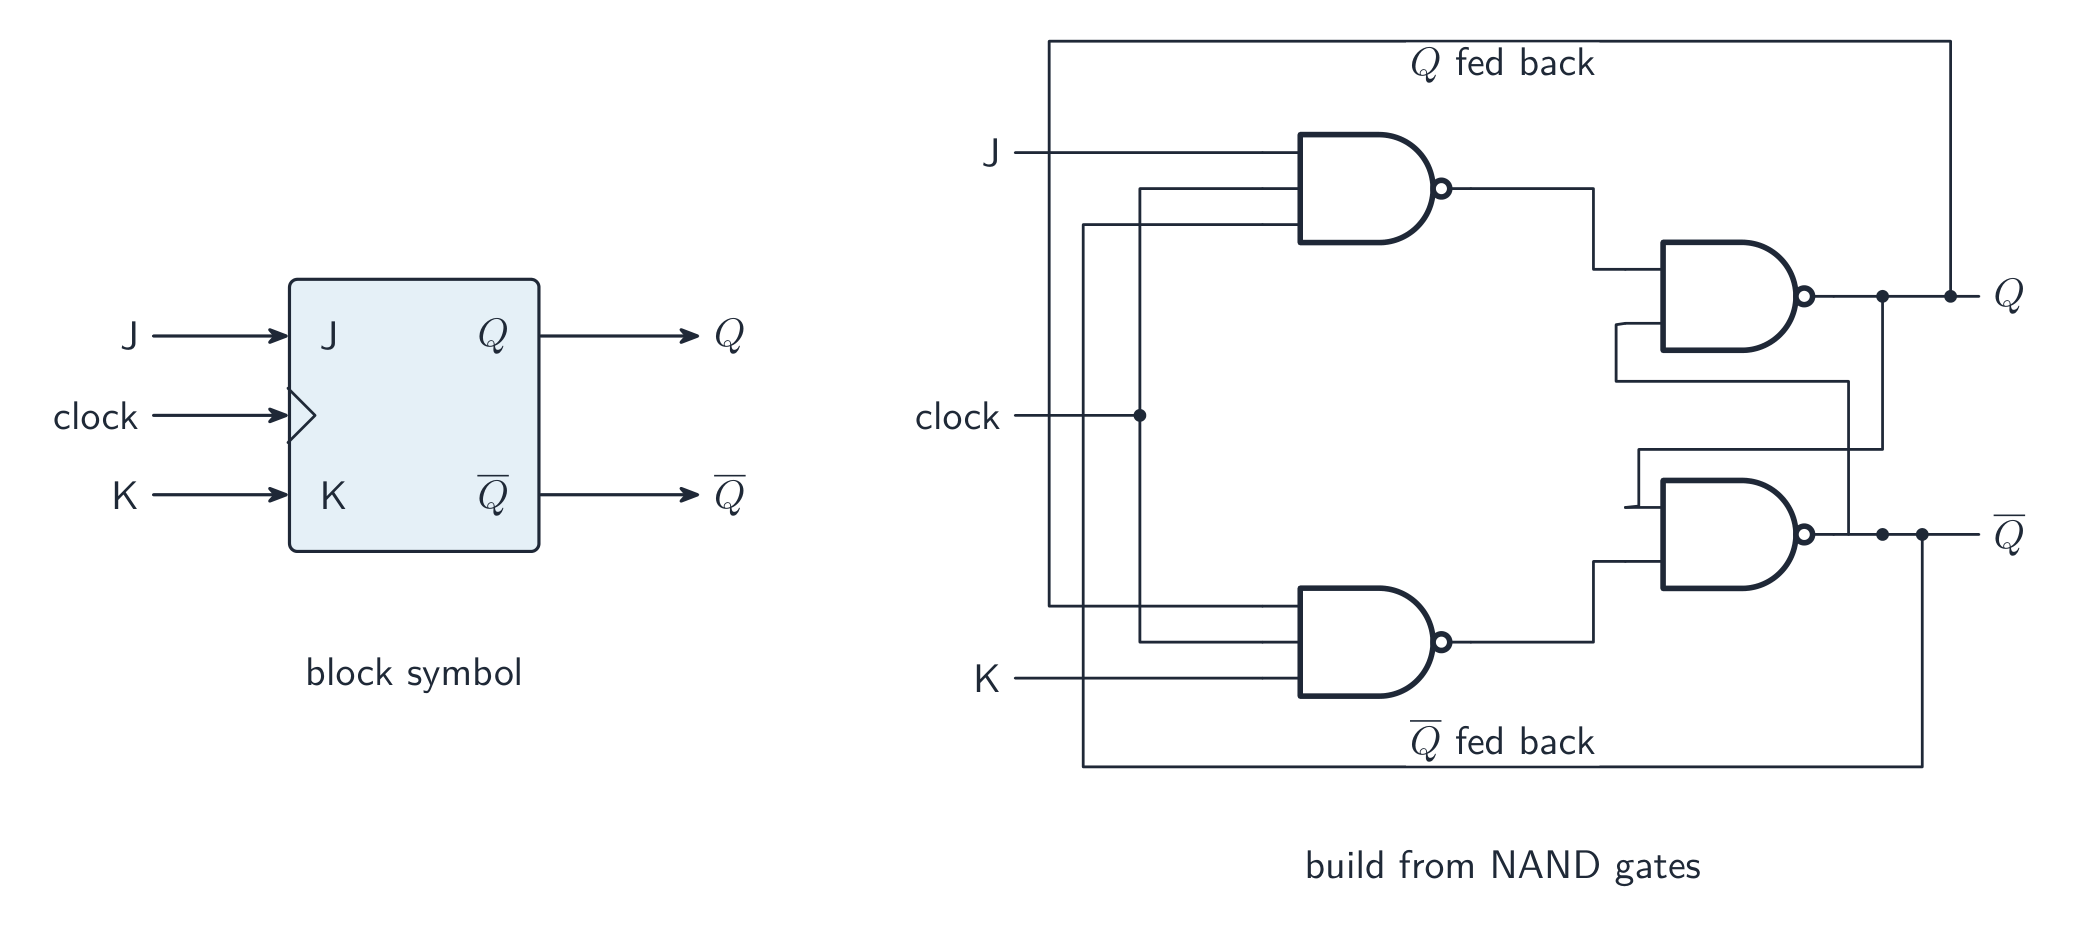
Une bascule JK : son symbole et sa réalisation à partir de portes NAND Les bascules constituent les briques de construction des registres (n bits = n bascules), des compteurs et des cellules SRAM 静态RAM.
Tableau de vérité d'une bascule JK. L'entrée clock 时钟 détermine quand les entrées J et K sont lues, de sorte que la sortie ne change qu'au passage d'un front d'horloge : avec $J = K = 0$, la sortie est maintenue ; $J = 1, K = 0$ définit $Q$ à 1 ; $J = 0, K = 1$ la remet à zéro à 0 ; $J = K = 1$ la retourne (Q devient $\overline{Q}$). La dernière ligne correspond exactement à l'entrée interdite de la bascule SR transformée en entrée utile, ce qui explique pourquoi la bascule JK est préférée : chaque combinaison d'entrées est valide, et le fonctionnement horlogé en fait la brique de construction des compteurs et des registres à décalage.
Vocabulaire EntrainerAnglais Chinois Pinyin flip-flop/flɪp flɒp/ 触发器 chù fā qì bistable/baɪˈsteɪbl/ 双稳态 shuāng wěn tài toggle/ˈtɒɡl/ 翻转 fān zhuǎn counters/ˈkaʊntəz/ 计数器 jì shù qì SRAM/ˈesræm/ 静态RAM jìng tài RAM clock/klɒk/ 时钟 shí zhōng SR flip-flop/ˌes ˈɑː flɪp flɒp/ SR触发器 SR chù fā qì JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ JK触发器 JK chù fā qì 15.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition RISC un processeur avec un petit ensemble d'instructions simples, de longueur fixe, la plupart exécutées en un seul cycle d'horloge, utilisant de nombreux registres et le pipeline CISC un processeur avec un grand ensemble d'instructions complexes, de longueur variable, dont beaucoup prennent plusieurs cycles d'horloge et accèdent directement à la mémoire pipeline division du cycle fetch-execute en étapes afin que plusieurs instructions soient traitées simultanément, chacune se trouvant à une étape différente SISD / SIMD / MISD / MIMD une instruction sur un élément de données ; une instruction sur plusieurs éléments de données ; plusieurs instructions sur un élément de données ; plusieurs instructions sur plusieurs éléments de données ordinateur massivement parallèle milliers de processeurs, chacun avec sa propre mémoire, connectés par un réseau et travaillant simultanément sur un même problème machine virtuelle émulation logicielle d'un système informatique s'exécutant sur un ordinateur hôte et se comportant comme un ordinateur physique distinct hyperviseur logiciel créant des machines virtuelles et partageant le matériel de l'hôte entre elles tableau de vérité table listant toutes les combinaisons d'entrées d'un circuit logique avec les sortie(s) résultante(s) somme-de-produits expression booléenne écrite sous forme de OU de termes ET, un terme pour chaque combinaison d'entrées donnant 1 carte de Karnaugh grille des sorties du tableau de vérité, disposées selon l'ordre Gray, dans laquelle des boucles de 1 adjacents donnent l'expression simplifiée demi-additionneur circuit additionnant deux bits, produisant une somme et une retenue additionneur complet circuit additionnant deux bits et une retenue entrante, produisant une somme et une retenue sortante bascule circuit bistable stockant un bit, conservant sa sortie jusqu'à ce que ses entrées la modifient 15.2
Conseils d'examen
- RISC et CISC sont répondus sous forme de listes de caractéristiques : simple, fixe, un cycle, nombreux registres, charge/sauvegarde, pipeline face à complexe, variable, multi-cycles, moins de registres, accès direct à la mémoire, microcode. Quatre de chaque.
- Pipeline : étapes, plusieurs instructions à la fois, une terminée par cycle, débit accru ; $n + k - 1$ cycles pour $n$ instructions traversant $k$ étapes ; les interruptions doivent vider le pipeline.
- Les quatre catégories de Flynn sont "combien de flux d'instructions" par "combien de flux de données" ; dire ce qui s'exécute sur quoi. Massivement parallèle : nombreux processeurs, propre mémoire, réseau, même problème.
- Machine virtuelle : émulation d'un ordinateur sur un hôte ; OS hôte sur le matériel, hyperviseur le partageant, OS invité à l'intérieur. Deux avantages et deux limites, chacun une phrase complète.
- Algèbre de Boole : nommez chaque loi au fur et à mesure de son utilisation ; De Morgan inverse l'opérateur et nie chaque terme ; vérifiez avec un tableau de vérité si vous avez des doutes.
- Carte K : ordre Gray, plus grandes boucles de 1/2/4/8, enveloppement autorisé, un terme par boucle avec les variables inchangées. Expliquez pourquoi : expression la plus simple sans algèbre.
- Demi-additionneur donne somme et retenue ; additionneur complet prend aussi une retenue entrante ; bascule SR est deux portes NOR/NAND croisées et stocke un bit ; JK 1,1 toggle.
Erreurs courantes
- Échanger les listes de caractéristiques RISC et CISC, ou proposer "plus rapide" comme caractéristique ; donner les caractéristiques de conception, pas un verdict.
- Décrire le pipeline comme "exécutant des instructions en parallèle sur plusieurs cœurs" ; ce sont des étapes d'un seul processeur qui se chevauchent.
- Confondre SIMD (une instruction, plusieurs données) avec MIMD (plusieurs des deux), ou décrire MISD comme le cas courant.
- Définir une machine virtuelle comme "une copie d'un ordinateur" sans le mot émulation ni l'hôte et l'invité.
- Appliquer De Morgan seulement à une partie d'une expression sous une longue barre, ou supprimer la barre sans échanger AND pour OR.
- Boucler un groupe de trois, ou un groupe non rectangulaire, dans une carte K ; ordonner les colonnes 00, 01, 10, 11 au lieu de l'ordre Gray.
- Écrire la retenue d'un demi-additionneur comme XOR et la somme comme AND.
- Dessiner une bascule SR comme deux portes sans rétroaction, ou omettre l'état invalide de son tableau de vérité.
-
16
Logiciels système
Regarder la leçon16.1
Comment un SGBD maximise l'utilisation des ressources

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la manière dont un OS peut maximiser l'utilisation des ressources Décrire les moyens par lesquels l'interface utilisateur cache les complexités du matériel à l'utilisateur Montrer la compréhension de la gestion des processus Le concept de multitâche et d'un processus Les états du processus : en cours d'exécution, prêt et bloqué La nécessité de la planification et la fonction et les avantages des différentes routines de planification (y compris round robin, shortest job first, first come first served, shortest remaining time) Comment le noyau du OS agit comme gestionnaire d'interruptions et comment la gestion des interruptions est utilisée pour gérer la planification de bas niveau Montrer la compréhension de la mémoire virtuelle, du paginement et de la segmentation pour la gestion de la mémoire Les concepts de paginement, de mémoire virtuelle et de segmentation La différence entre paginage et segmentation Comment les pages peuvent être remplacées Comment un thrashing de disque peut se produire Source : Programme Cambridge International
Un ordinateur possède de nombreuses ressources (temps CPU, mémoire, disque, E/S) et de nombreux programmes qui y concurrencent l'accès. Le SGBD les partage équitablement et efficacement afin que chacun soit bien utilisé et que le système reste réactif :
Le SGBD partage le CPU, la mémoire, le disque et l'E/S entre les programmes - multitâche 多任务 — alterner rapidement le CPU entre les processus afin que plusieurs semblent s'exécuter simultanément.
- gestion de la mémoire — attribuer à chaque processus la mémoire nécessaire ; utiliser le paging 分页 sur disque lorsque la RAM manque.
- spooling 假脱机 et tamponnage — files d'attente des tâches d'impression sur disque pour que le CPU n'attend jamais l'imprimante.
- cache — conserver les données récemment utilisées du disque dans le cache 高速缓存 / RAM.

Le processeur est une ressource clé que le SGBD partage entre les tâches concurrentes 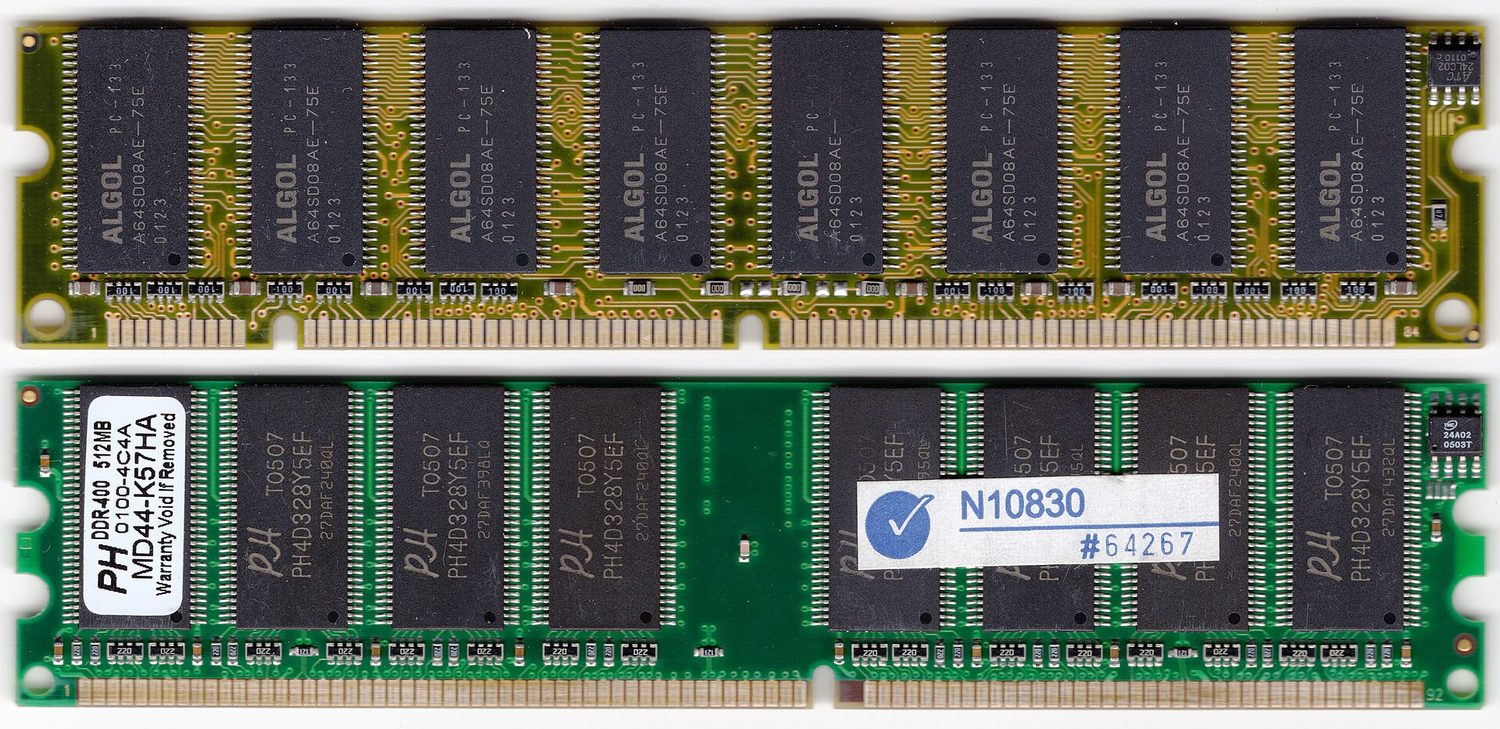
Le SGBD gère également la mémoire (RAM), décidant ce qu'il faut y garder et ce qu'il faut mettre en paging vers le disque Vocabulaire EntrainerAnglais Chinois Pinyin multi-tasking/ˈmʌlti ˈtæskɪŋ/ 多任务 duō rèn wù paging/ˈpeɪdʒɪŋ/ 分页 fēn yè spooling/ˈspuːlɪŋ/ 假脱机 jiǎ tuō jī cache/kæʃ/ 高速缓存 gāo sù huǎn cún 16.1
Interface utilisateur
L'interface utilisateur masque le matériel derrière des abstractions conviviales : l'utilisateur voit des fenêtres, menus et dossiers, pas des adresses ou secteurs. Un clic sur une icône fait trouver au SGBD le programme sur disque, allouer la mémoire, le charger et le démarrer. Une CLI (ligne de commande) est puissante et scriptable pour les experts ; une GUI (graphique) est plus facile à apprendre. La plupart des systèmes offrent les deux.
"Décrivez deux façons dont les complexités du matériel sont masquées à l'utilisateur." (1) L'utilisateur travaille avec des fichiers et dossiers par nom, et le SGBD les traduit en pistes, secteurs et blocs du disque ; (2) l'utilisateur lance un programme par un clic ou une commande, et le SGBD le charge, alloue la mémoire et le planifie sans que l'utilisateur connaisse aucune adresse ; (3) les pilotes de périphérique permettent à l'utilisateur d'imprimer ou de sauvegarder sans connaître le contrôle de l'imprimante ou du disque ; (4) une interface graphique remplace les commandes niveau machine par des icônes, fenêtres et menus. L'avantage pour un étudiant, avec un exemple : le SGBD rend le matériel utilisable sans connaissances techniques, par exemple en enregistrant un document sur une clé USB en glissant son icône.
"Montrez comment un SGBD maximise l'utilisation des ressources." Il planifie le processeur pour qu'il ne soit jamais inactif tant qu'un processus est prêt ; il gère la mémoire, l'allouant aux processus, le récupérant et l'étendant avec la mémoire virtuelle ; il gère l'entrée/sortie, utilisant des tampons et le spooling pour faire chevaucher le travail des dispositifs rapides et lents ; et il gère le stockage, gardant la trace de l'espace libre et des fichiers. Chaque point nomme une ressource et ce que le SGBD en fait.
16.1
Gestion des processus
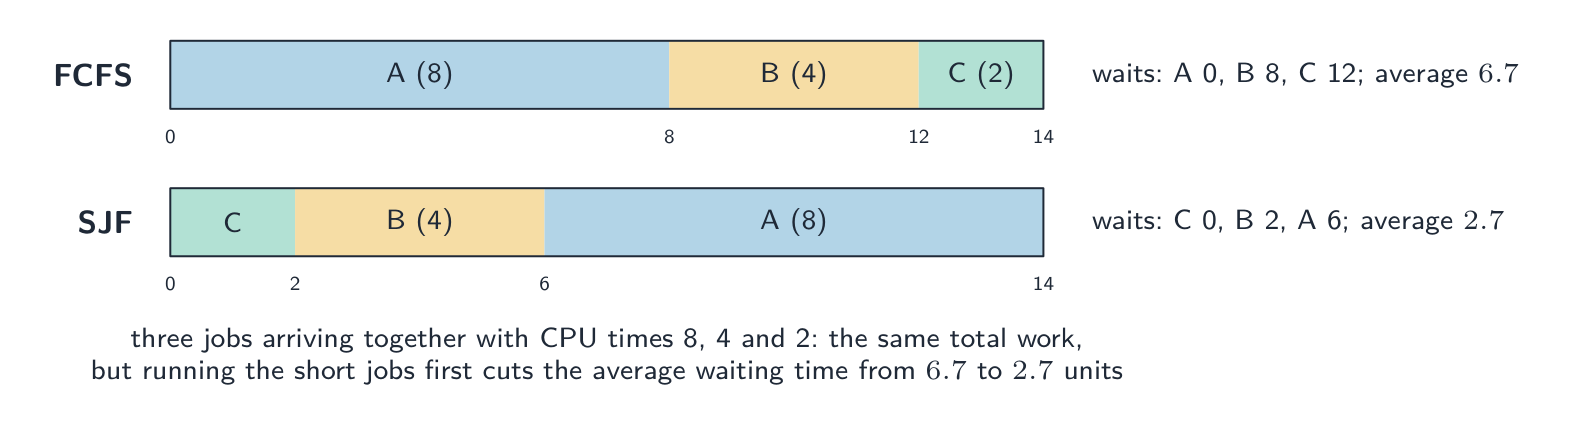
Un processus 进程 est un programme en cours d'exécution — son code, son état actuel, sa mémoire et ses fichiers ouverts.
Planification
Le planificateur 调度器 choisit quel processus prêt s'exécute ensuite et pendant combien de temps :
- round robin 轮转 — chaque processus obtient un time slice 时间片 fixe, puis passe à la fin de la file d'attente.
- premier arrivé, premier servi ; plus court travail en premier ; temps restant le plus court (exécuter le travail ayant le moins de travail restant) ; priorité ; files de feedback multiniveau.
Le compromis concerne la réactivité vs le débit vs l'équité.
"Décrivez ce que signifie le multitâche et comment il profite à la gestion des processus." Plusieurs processus sont maintenus en mémoire en même temps et le processeur bascule entre eux si rapidement qu'ils semblent s'exécuter simultanément, chacun recevant tour à tour une part du temps processeur. L'avantage : le processeur n'est jamais laissé inactif pendant qu'un processus attend une entrée ou une sortie, donc le débit est plus élevé et l'utilisateur peut travailler sur plusieurs programmes à la fois. "Expliquez la nécessité de la planification." Il y a plus de processus que de processeurs, donc une décision doit être prise sur quel processus s'exécute ensuite et pendant combien de temps ; la planification assure que chaque processus avance, que le processeur est pleinement utilisé, que les temps de réponse sont acceptables, et que les priorités peuvent être respectées.
Le même travail dans un ordre différent : plus court travail en premier sort les courtes tâches de l'arrière-plan, donc la plupart des tâches attendent moins, au risque qu'une longue tâche attende indéfiniment Les routines de planification, telles que l'examen les veut décrites.
Routine Fonction Avantage Inconvénient first come first served (FCFS) les processus s’exécutent dans l’ordre d’arrivée dans la file d’attente prête, chacun jusqu’à son achèvement simple ; chaque processus est traité à tour de rôle, aucun n’est affamé un long processus bloque tous les courts qui le suivent ; mauvaise réponse shortest job first (SJF) le processus prêt avec la durée d’exécution estimée la plus courte s’exécute ensuite, jusqu’à son achèvement minimise le temps d’attente moyen ; beaucoup de courts processus terminent rapidement les durées doivent être connues à l’avance ; un long processus peut ne jamais s’exécuter (affamation) shortest remaining time (SRT) version préemptive 抢占式 de SJF : si un nouveau processus arrive avec moins de temps restant que celui qui s’exécute, il prend le relais les courts processus sont servis encore plus vite ; bon débit plus de changements de contexte ; un long processus peut être interrompu à plusieurs reprises et souffrir d’affamation round robin (RR) chaque processus prêt reçoit à tour de rôle une tranche de temps fixe ; lorsqu'elle expire, le processus va à la fin de la file d'attente équitable ; chaque processus répond dans un temps borné, adapté à l'utilisation interactive surcharge due au changement de contexte ; une tranche très courte gaspille du temps, une longue retarde les autres priorité le processus prêt ayant la priorité la plus élevée s’exécute en premier les travaux importants ou critiques en temps réel sont effectués en premier les processus de faible priorité peuvent souffrir d’affamation sauf si les priorités vieillissent Exemple résolu. Trois processus arrivent ensemble avec des temps CPU de 8, 4 et 2 ms. Comparer le temps d’attente moyen sous FCFS (dans l’ordre d’arrivée A, B, C) et sous shortest job first.
FCFS : A attend 0, B attend 8, C attend 12 ; moyenne $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF exécute C, B, A : C attend 0, B attend 2, A attend 6 ; moyenne $2.7\ \text{ms}$. Le travail total est le même, 14 ms dans les deux cas ; l’ordre décide de qui attend. Round robin avec un quantum de 2 ms donnerait à A, B et C chacun un tour dans les 6 premières ms, donc C termine à 6 ms, B à 12 ms et A à 14 ms : le plus réactif, pas le plus rapide en moyenne.
Ordonnancement first-come-first-served de quatre processus 
Round-robin : chaque processus obtient un quantum de temps fixe à tour de rôle, puis le suivant s’exécute (contrairement à first-come-first-served) États des processus
Un processus est nouveau, prêt (en attente du CPU), en cours d’exécution, bloqué 阻塞 (en attente d’E/S ou d’un verrou), ou terminé. Quand son quantum de temps se termine, il passe de running → ready ; quand il demande une E/S, il passe de running → blocked ; quand l’E/S se termine, il passe de blocked → ready.
Un processus passe entre les états new, ready, running, blocked et terminated Les trois états et pourquoi un processus change d’état. Running : le processus a le processeur. Ready : il pourrait s’exécuter mais attend le processeur. Blocked : il ne peut pas s’exécuter tant qu’autre chose ne se produit pas. Raisons de chaque transition, dont l’examen demande une à la fois : running to ready quand son quantum de temps se termine, ou quand un processus de priorité supérieure devient prêt et le préempte (une interruption) ; running to blocked quand il demande une entrée ou sortie ou attend une ressource ou un autre processus ; blocked to ready quand l’E/S pour laquelle il attendait se termine (signalée par une interruption) ; ready to running quand l’ordonnanceur le dispatche. Un processus bloqué ne peut jamais passer directement à running : il doit devenir ready d’abord.
Bloc de contrôle de processus et changement de contexte
Pour chaque processus, le système d’exploitation conserve un bloc de contrôle de processus 进程控制块 (PCB) — le compteur programme sauvegardé, les registres, l’état et les informations mémoire.
Un changement de contexte sauvegarde l’état d’un processus et charge celui d’un autre - non changement de contexte 上下文切换 suspend un processus et en démarre un autre : il sauvegarde l’état dans un PCB et le restaure depuis un autre. Ce petit coût est payé à chaque changement.
- le noyau 内核 (le cœur du SE) agit comme un gestionnaire d’interruptions 中断处理程序. Lorsqu’un périphérique ou la minuterie déclenche une interruption, la gestion des interruptions 中断处理 sauvegarde le processus en cours et exécute la routine appropriée — c’est ce qui pilote l’ordonnancement de bas niveau.
« Décrivez comment le noyau agit comme gestionnaire d’interruptions » (deux marques). Lorsqu’une interruption est déclenchée, le noyau sauvegarde l’état du processus en cours (ses registres et son compteur programme, dans son bloc de contrôle de processus), identifie la source et la priorité de l’interruption, exécute la routine de service d’interruption appropriée, puis restaure le processus interrompu (ou un de priorité supérieure) afin que l’exécution continue. C’est ainsi que la minuterie termine un quantum de temps et qu’une opération d’E/S terminée débloque un processus.
Communication inter-processus
Les processus sont isolés, donc le SE fournit la communication inter-processus 进程间通信 : tubes 管道 (la sortie d’un programme alimente l’entrée d’un autre), mémoire partagée 共享内存 (une région que plusieurs processus peuvent utiliser), et passage de messages.
ExplorerLe cycle de vie d'un processus
Suivez le parcours dans la boucle d'un processus. Il ne s'exécute que lorsque le planificateur le choisit ; la nécessité d'E/S l'envoie en attente bloquée, et la fin de sa tranche temporelle le renvoie en état prêt — en boucle jusqu'à sa fin.
Vocabulaire EntrainerAnglais Chinois Pinyin process/ˈprəʊses/ 进程 jìn chéng scheduler/ˈʃedjʊlə/ 调度器 diào dù qì round robin/raʊnd ˈrɒbɪn/ 轮转 lún zhuàn time slice/taɪm slaɪs/ 时间片 shí jiān piàn pre-emptive/priː ˈemptɪv/ 抢占式 qiǎng zhàn shì blocked/blɒkt/ 阻塞 zǔ sè process control block/ˈprəʊses kənˈtrəʊl blɒk/ 进程控制块 jìn chéng kòng zhì kuài context switch/ˈkɒntekst swɪtʃ/ 上下文切换 shàng xià wén qiè huàn kernel/ˈkɜːnl/ 内核 nèi hé interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ 中断处理 zhōng duàn chǔ lǐ inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ 进程间通信 jìn chéng jiān tōng xìn pipes/paɪps/ 管道 guǎn dào shared memory/ʃeəd ˈmeməri/ 共享内存 gòng xiǎng nèi cún virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ 虚拟地址空间 xū nǐ dì zhǐ kōng jiān 16.1
Mémoire virtuelle, pagination, segmentation
Chaque processus obtient son propre espace d’adressage virtuel 虚拟地址空间 — une plage propre et contiguë d’adresses que le SE mappe vers la mémoire physique. Cela donne à chaque processus un espace simple, protège les processus les uns contre les autres, et permet à la mémoire totale de dépasser la RAM physique.
Dans la pagination, l’espace virtuel est divisé en pages 页 de taille fixe et la mémoire physique en cadres 页框 de même taille. Une table de pages mappe chaque page à un cadre. Si une page accédée n’est pas en RAM — une faute de page 缺页 — le SE la lit depuis le fichier d’échange 交换文件 dans un cadre, évictant une autre page si la RAM est pleine. Des fautes fréquentes causent le thrashing 抖动 (thrashing disque), où le SE passe la plupart de son temps à échanger des pages au lieu de faire un travail utile.
Le paging mappe chaque page de mémoire logique vers une frame de mémoire physique Dans la segmentation 分段, la mémoire est divisée en segments logiques de taille variable (code, pile, tas), chacun ayant ses propres permissions. De nombreux systèmes utilisent le paging au sein des segments.
La segmentation mappe des segments de taille variable à l'aide d'une table de cartographie des segments "Expliquez ce que signifie la mémoire virtuelle" (trois points). Le stockage secondaire (disque) est utilisé pour étendre la RAM, de sorte que la mémoire disponible semble plus grande que la mémoire physique ; l'espace d'adresse d'un processus est divisé en pages, et seules les pages actuellement nécessaires sont conservées en RAM tandis que le reste attend sur le disque ; les pages sont échangées entre la RAM et le disque selon les besoins, et le système d'exploitation traduit chaque adresse virtuelle en une adresse physique. Pourquoi un OS en a besoin : les programmes en cours d'exécution peuvent avoir besoin de plus de mémoire que la RAM installée ; cela permet de faire fonctionner plus (ou de plus gros) programmes simultanément ; un programme peut être plus grand que la mémoire physique ; la mémoire est utilisée efficacement car seules les parties actives des programmes occupent la RAM.
Paging contre segmentation : la différence recherchée par l'examen. Le paging divise la mémoire en blocs de taille fixe (pages et frames) choisis par le matériel, sans égard à la structure du programme, et la cartographie est invisible pour le programmeur ; la segmentation divise un programme en unités logiques de taille variable (une procédure, un tableau, la pile) dont les tailles et les limites suivent le programme, de sorte qu'un segment peut être protégé ou partagé en tant qu'unité. "Décrivez le processus de segmentation" : le programme est divisé en segments de différentes tailles, chacun recevant un numéro de segment ; une table de segments enregistre où commence chaque segment en mémoire et sa longueur ; une adresse logique est un numéro de segment plus un décalage, et le système d'exploitation ajoute le décalage à l'adresse de base du segment pour trouver l'emplacement physique.
"Expliquez ce qu'est le thrashing de disque" et quand il se produit. Le thrashing de disque 磁盘抖动 est l'état dans lequel les pages sont échangées dans et hors de la RAM si fréquemment que le processeur passe plus de temps à déplacer des pages qu'à exécuter des instructions, et le système ralentit presque jusqu'à l'arrêt complet. Cela se produit lorsque la RAM est trop petite pour les pages dont ont besoin les processus en cours d'exécution (leurs ensembles actifs) : une page qui vient d'être déplacée est nécessaire presque immédiatement, elle est donc récupérée, ce qui chasse une autre page bientôt nécessaire, et ainsi de suite. Trop de processus, ou un programme qui accède à la mémoire de manière imprévisible, provoquent cet état ; plus de RAM ou moins de processus le résolvent.
ExplorerQue se passe-t-il lors d'une faute de page
Parcourez une faute de page. Lorsque le programme accède à une page non présente en RAM, le OS la récupère silencieusement depuis le disque et met à jour la table de pages — permettant au programme d'avoir plus de mémoire qu'il n'y en a physiquement.
Vocabulaire EntrainerAnglais Chinois Pinyin pages/ˈpeɪdʒɪz/ 页 yè frames/freɪmz/ 页框 yè kuāng page fault/peɪdʒ fɒlt/ 缺页 quē yè swap file/swɒp faɪl/ 交换文件 jiāo huàn wén jiàn thrashing/ˈθræʃɪŋ/ 抖动 dǒu dòng segmentation/ˌseɡmənˈteɪʃn/ 分段 fēn duàn disk thrashing/dɪsk ˈθræʃɪŋ/ 磁盘抖动 cí pán dǒu dòng interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì compiler/kəmˈpaɪlə/ 编译器 biān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ lexical analysis/ˈleksɪkl əˈnæləsɪs/ 词法分析 cí fǎ fēn xī tokens/ˈtəʊkənz/ 词法单元 cí fǎ dān yuán syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ 语法分析 yǔ fǎ fēn xī abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ 抽象语法树 chōu xiàng yǔ fǎ shù syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù semantic analysis/səˈmæntɪk əˈnæləsɪs/ 语义分析 yǔ yì fēn xī code generation/kəʊd ˌdʒenəˈreɪʃn/ 代码生成 dài mǎ shēng chéng code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ 代码优化 dài mǎ yōu huà symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo grammar/ˈɡræmə/ 文法 wén fǎ Backus-Naur Form/ˈbækəs nɔː fɔːm/ 巴科斯-诺尔范式 bā kē sī - nuò ěr fàn shì production rule/prəˈdʌkʃn ruːl/ 产生式 chǎn shēng shì 16.2
Comment un interpréteur exécute un programme
Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la manière dont un interpréteur peut exécuter des programmes sans produire de version traduite Montrer la compréhension des diverses étapes de la compilation d'un programme Incluant l'analyse lexicale, l'analyse syntaxique, la génération de code et l'optimisation Montrer la compréhension de la manière dont la grammaire d'un langage peut être exprimée à l'aide de diagrammes de syntaxe ou de notation Backus-Naur Form (BNF) Montrer la compréhension de la manière dont la notation polonaise inversée (RPN) peut être utilisée pour évaluer des expressions Source : Programme Cambridge International
Un interpréteur 解释器 traduit et exécute le source simultanément. Pour chaque instruction, il lit la ligne, effectue l'analyse lexicale et syntaxique, vérifie les types, puis exécute l'action, et passe à la suivante. Les erreurs sont signalées immédiatement et il s'arrête généralement ; aucun exécutable n'est produit. La traduction est refaite à chaque exécution (plus lent), mais elle offre un retour rapide pour le développement et est portable.
"Expliquez comment un interpréteur exécute un programme sans produire de version traduite" (trois points). L'interpréteur prend une instruction (ligne) à la fois, la traduit (analyse), et l'exécute immédiatement, avant de passer à la suivante ; aucune version traduite du programme entier n'est créée ou stockée, donc chaque instruction est traduite chaque fois qu'elle est exécutée, y compris chaque passage dans une boucle ; si une instruction contient une erreur, l'exécution s'arrête là et l'erreur est signalée. C'est ce qui rend un interpréteur utile pour le développement et les tests (les erreurs sont trouvées dès qu'elles sont atteintes, et un changement peut être essayé immédiatement) mais plus lent pour l'exécution des programmes terminés.
16.2
Étapes de la compilation
Un compilateur 编译器 transforme le source en code machine 机器码 en phases :
- analyse lexicale 词法分析 — le lexer regroupe les caractères en jetons 词法单元 (mots-clés, identifiants, opérateurs, littéraux), en ignorant les espaces blancs et les commentaires.
- analyse syntaxique (parsing) 语法分析 — vérifie que les jetons correspondent à la grammaire et construit un arbre syntaxique abstrait 抽象语法树. Une parenthèse manquante donne une erreur de syntaxe 语法错误.
- analyse sémantique 语义分析 — vérifie que le programme a du sens (variables déclarées, types correspondants).
- génération de code 代码生成 — parcourt l'arbre et émet le code cible, choisissant les registres et les dispositions.
- optimisation du code 代码优化 — remove redundant work, fold constants, reorder for the pipeline.
La sortie est un exécutable.
Les phases de compilation, du code source à un exécutable optimisé L'objectif de chaque étape, dans les termes qui rapportent des points. Analyse lexicale : supprime les espaces blancs et les commentaires ; convertit les caractères du code source en jetons (mots clés, identifiants, opérateurs, constantes), vérifie que chacun est valide dans le langage ; introduit les identifiants dans la table des symboles 符号表. Analyse syntaxique : vérifie que la séquence de jetons respecte la grammaire (règles de syntaxe) du langage ; construit un arbre d'analyse (arbre syntaxique abstrait) ; signale les erreurs de syntaxe ; la vérification des types et celle des déclarations de variables sont parfois comptées ici comme analyse sémantique. Génération de code : convertit l'arbre vérifié en code objet ou code machine (éventuellement via un code intermédiaire), allouant mémoire et registres. Optimisation : rend le code plus rapide ou utilisant moins de mémoire, en éliminant les instructions redondantes, en combinant ou simplifiant les calculs, et en réorganisant les boucles, sans modifier ce que fait le programme. La question d'appariement associe chaque étape à l'une de ces descriptions.
ExplorerLes phases de compilation
Parcourez ce qu'un compilateur fait à votre source. Chaque phase transmet sa sortie à la suivante — les caractères deviennent des jetons, les jetons forment un arbre, l'arbre devient du code machine optimisé.
16.2
Grammaire : BNF et diagrammes syntaxiques
Une grammaire 文法 dit quelles séquences de jetons constituent des programmes valides.
Forme de Backus-Naur 巴科斯-诺尔范式 (BNF) est textuelle. Une règle de production 产生式 a la forme :
<symbol> ::= alternative1 | alternative2 | ...Chaque alternative est une séquence de symboles terminaux 终结符 (texte littéral) et de symboles non-terminaux 非终结符 (autres noms de règles) :
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
La troisième règle récursive exprime « une lettre suivie de n'importe quel nombre de lettres ou de chiffres ». Une instruction
IF:<if-statement> ::= IF <condition> THEN <statement> ENDIF | IF <condition> THEN <statement> ELSE <statement> ENDIFUn diagramme syntaxique 语法图 (diagramme ferroviaire) montre la même chose graphiquement : des boîtes pour les non-terminaux, des boîtes arrondies pour les terminaux, des flèches pour les chemins valides, des boucles pour la répétition. Les deux notations sont équivalentes. Le parseur utilise la grammaire pour décider si un programme est valide.
Un diagramme syntaxique (ferroviaire) pour une instruction d'affectation 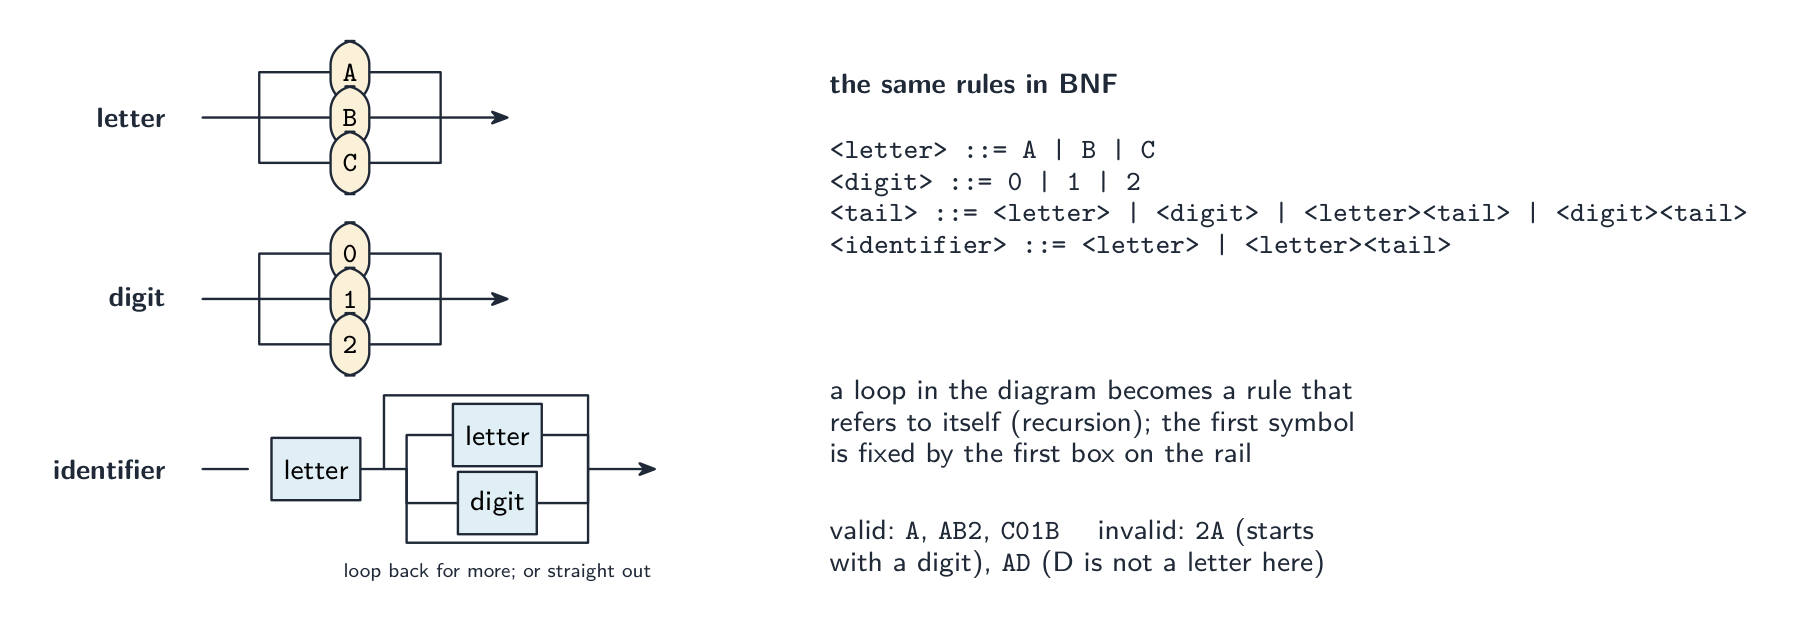
Un diagramme syntaxique et une règle BNF disent la même chose : un choix devient des alternatives séparées par des barres, et une boucle devient une règle qui se réfère à elle-même Lire les diagrammes de l'examen. Chaque diagramme définit un non-terminal ; suivez les flèches de l'entrée à la sortie, et tout chemin que vous pouvez tracer est une chaîne valide. Un choix de boîtes côte à côte est un ensemble d'alternatives ; une boucle vers l'arrière signifie « répéter autant de fois que vous voulez » ; une boîte pour un autre non-terminal signifie « insérer n'importe quoi que cette règle permet ». « Expliquer pourquoi la chaîne est invalide » demande la règle qu'elle viole, en mots :
9Kest invalide comme variable car le premier caractère doit être une lettre, pas un chiffre ;JJ90est un mot de passe invalide si la règle ne permet qu'une lettre avant les chiffres, ou siJn'est pas dans l'ensemble des lettres listées. Vérifiez toujours la chaîne par rapport à l'ensemble de caractères que le diagramme autorise réellement, pas par rapport à ce qu'un vrai langage accepterait.Écrire du BNF à partir d'un diagramme. Chaque diagramme devient une règle
<name> ::= ...; les alternatives sont séparées par|; une séquence est écrite un symbole après l'autre ; et la répétition s'écrit avec récursion, car le BNF n'a pas de symbole de boucle : « une ou plusieurs lettres » est<word> ::= <letter> | <letter><word>, et « zéro ou plusieurs chiffres après une lettre » est<variable> ::= <letter> | <letter><digits>avec<digits> ::= <digit> | <digit><digits>.Exemple résolu. Complétez le BNF pour un numéro d'immatriculation de véhicule qui doit commencer par deux lettres (de
A B C) suivies d'un, deux ou trois chiffres (de0 1 2).<letter> ::= A | B | C <digit> ::= 0 | 1 | 2 <digits> ::= <digit> | <digit><digit> | <digit><digit><digit> <registration> ::= <letter><letter><digits>AB12est valide ;A12ne l'est pas (seulement une lettre) ;AB1234ne l'est pas (quatre chiffres) ;AD1ne l'est pas (Dn'est pas une lettre listée). On vous demande d'ajouter une contrainte telle que « le troisième caractère peut aussi être un symbole », ajoutez l'alternative supplémentaire à la règle pour cette position uniquement, et définissez<symbol>avec sa propre règle.Exemple résolu. Écrivez le BNF pour une expression qui est une variable, suivie d'un opérateur, suivie soit d'une variable soit d'un nombre, où une variable est une seule lettre minuscule de
a b cet un opérateur est+ou-.<variable> ::= a | b | c <operator> ::= + | - <number> ::= <digit> | <digit><number> <expression> ::= <variable><operator><variable> | <variable><operator><number>La règle récursive
<number>permet n'importe quel nombre de chiffres ; les deux alternatives de<expression>couvrent les deux cas nommés dans la définition. Gardez tous les non-terminaux entre chevrons et tous les terminaux sans eux.Vocabulaire EntrainerAnglais Chinois Pinyin terminal/ˈtɜːmɪnl/ 终结符 zhōng jié fú non-terminal/nɒn ˈtɜːmɪnl/ 非终结符 fēi zhōng jié fú syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ 语法图 yǔ fǎ tú 16.2
Notation polonaise inversée (RPN)
En notation infixe 中缀, l'opérateur se situe entre ses opérandes (
3 + 4 * 2), nécessitant des parenthèses et des règles de priorité. En Notation Polonaise Inversée 逆波兰表示法 (RPN, postfixe 后缀), l'opérateur suit ses opérandes (3 4 2 * +), ne nécessitant aucune parenthèse.Conversion de l'infixe vers RPN
Utilisez une pile 栈 d'opérateurs. Parcourez de gauche à droite : sortez un opérande ; pour un opérateur, poppez d'abord tout opérateur empilé de précédence supérieure ou égale 优先级 vers la sortie, puis poussez-le ; poussez
(; sur), poppez vers la sortie jusqu'à ce que le(correspondant soit trouvé. À la fin, poppez tous les opérateurs. Exemple :(3 + 4) * 2→3 4 + 2 *.Évaluation de RPN
Utilisez une pile d'opérandes. Balayez de gauche à droite : empilez chaque opérande ; sur un opérateur, sortez les deux sommets, appliquez-le, et empilez le résultat. Évaluation de
3 4 2 * +:Jeton Pile 33 43, 4 23, 4, 2 *3, 8 +11 Résultat : 11. RPN ne nécessite pas de parenthèses au moment de l'évaluation et convient à une machine à pile — c'est ainsi que fonctionnent la JVM et de nombreux interpréteurs de bytecode 字节码.
« Expliquer pourquoi RPN est utilisé pour évaluer des expressions » (deux points). Dans RPN, les opérateurs apparaissent dans l'ordre dans lequel ils sont appliqués, donc une expression peut être évaluée en un unique passage de gauche à droite avec aucune parenthèse et aucune règle de priorité ; elle est donc plus simple et plus rapide pour le compilateur ou l'interpréteur à traiter. « Identifier, avec des raisons, une structure de données appropriée » : une pile, car l'évaluation nécessite les opérandes empilés le plus récemment en premier (dernier entré, premier sorti) : chaque opérande est empilé, et chaque opérateur sort les deux sommets, s'applique lui-même, et empile le résultat. Montrez le contenu de la pile après chaque jeton si demandé.
Conversion manuelle de l'infixe vers RPN. (1) Mettez entièrement l'expression entre parenthèses en utilisant les règles de priorité ; (2) déplacez chaque opérateur juste après la parenthèse fermante de sa propre paire ; (3) supprimez les parenthèses. Donc $(a - b) * (a + c) / 7$ devient $((a - b) * (a + c)) / 7$, puis
a b - a c + * 7 /. Notez que*et/sont appliqués de gauche à droite, donc la division est le dernier opérateur, pas la multiplication. Autres conversions : $((7 + 3) - (2 * 8)) / 6$ est7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$ est7 2 - 8 + 9 5 - /; $a * b + b - d + 15$ esta b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$ est2 6 - 13 7 + * 5 /.Conversion de RPN vers l'infixe. Parcourez la RPN avec une pile d'expressions : empilez chaque opérande ; pour chaque opérateur, sortez-en deux, écrivez-les de part et d'autre de celui-ci entre parenthèses, et empilez le résultat. Donc
a b / 4 * a b + -est $((a / b) * 4) - (a + b)$ ;5 2 + 9 3 - / 3 *est $((5 + 2) / (9 - 3)) * 3$ ;b a c - + d b + * c /est $((b + (a - c)) * (d + b)) / c$ ;a b - c + c a - * d /est $(((a - b) + c) * (c - a)) / d$. Gardez les parenthèses : les supprimer peut changer le sens.Exemple résolu. Évaluez
a b - c d + * e /lorsque $a = 17$, $b = 5$, $c = 7$, $d = 3$ et $e = 10$, en montrant la pile.Jeton Action Pile (sommet à droite) aempiler 17 17 bempiler 5 17, 5 -sortir 5 et 17, empiler $17 - 5$ 12 cempiler 7 12, 7 dempiler 3 12, 7, 3 +sortir 3 et 7, empiler $7 + 3$ 12, 10 *sortir 10 et 12, empiler $12 \times 10$ 120 eempiler 10 120, 10 /sortir 10 et 120, empiler $120 / 10$ 12 Résultat 12. L'ordre des sorties importe pour
-et/: la valeur sortie en deuxième est l'opérande de gauche, donca b -est $a - b$, pas $b - a$. Deux autres, de la même manière :d a b + * c a - /avec $a = 6, b = 12, c = 15, d = 5$ donne $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$ ;c a - b d + * b c + /avec $a = 4, b = 12, c = 24, d = 6$ donne $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.Exemple résolu. Convertissez $(A + B) \times (C - D)$ en RPN, puis évaluez $(3 + 4) \times (5 - 2)$. Parcourez de gauche à droite en utilisant une pile d'opérateurs. Poussez
(; sortezA; poussez+; sortezB; sur), poppez jusqu'au(correspondant, donnantA B +jusqu'à présent. Poussez×, et la deuxième parenthèse se comporte de la même manière, donnantC D -. À la fin, poppez le×. Résultat :A B + C D - ×. Pour évaluer les nombres, utilisez une pile d'opérandes : poussez 3, poussez 4 ;+poppe les deux et pousse 7 ; poussez 5, poussez 2 ;-poppe les deux et pousse 3 ;×poppe 7 et 3 et pousse 21. Deux choses rendent cela fiable : les opérandes conservent leur ordre original lors de la conversion (seuls les opérateurs bougent), et chaque opérateur agit sur les deux valeurs immédiatement en dessous sur la pile.ExplorerPrécédence des opérateurs — ce que la NPI élimine
En arithmétique infixée ordinaire, × et ÷ lient plus fort que + et −, il faut donc appliquer les règles dans le bon ordre. La Notation Polonaise Inversée écrit les opérandes en premier (3 4 2 × + 1 −), fixant l'ordre pour qu'aucune règle de précédence ne soit nécessaire.
Vocabulaire EntrainerAnglais Chinois Pinyin infix/ˈɪnfɪks/ 中缀 zhōng zhuì Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ 逆波兰表示法 nì bō lán biǎo shì fǎ postfix/ˈpəʊstfɪks/ 后缀 hòu zhuì stack/stæk/ 栈 zhàn precedence/ˈpresɪdəns/ 优先级 yōu xiān jí bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ 16.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition multi-tâche plusieurs processus maintenus en mémoire à la fois, le processeur basculant entre eux afin qu'ils semblent s'exécuter simultanément processus un programme qui a été chargé en mémoire et qui s'exécute (ou est prêt à l'être) en cours / prêt / bloqué possède le processeur / attend le processeur / ne peut continuer qu'après un événement tel que la fin d'E/S ordonnancement décider quel processus prêt obtient le processeur suivant, et pendant combien de temps ordonnancement préemptif le processus en cours peut être interrompu et déplacé vers prêt afin qu'un autre processus s'exécute mémoire virtuelle utiliser un stockage secondaire pour étendre la RAM, ne conservant en mémoire physique que les pages actuellement nécessaires pagination diviser la mémoire et les programmes en pages de taille fixe qui sont transférées entre disque et RAM selon les besoins segmentation diviser un programme en segments logiques de taille variable, chacun mappé en mémoire par une table de segments thrashing de disque les pages étant échangées entre RAM et disque si souvent qu'il y a peu de traitement utile interpréteur traduit et exécute un programme une instruction à la fois, sans produire de version traduite compilateur traduit un programme entier de haut niveau en code machine (objet) avant son exécution analyse lexicale convertit le code source en jetons, enlevant les espaces blancs et les commentaires, et construit la table des symboles analyse syntaxique vérifie que les jetons respectent la grammaire du langage et construit un arbre d'analyse Forme de Backus–Naur une notation pour la grammaire d'un langage : règles de la forme <name> ::= alternativesconstruites à partir de terminaux et de non-terminauxNotation polonaise inverse une façon d'écrire des expressions avec chaque opérateur après ses opérandes, afin qu'elles puissent être évaluées avec une pile et sans parenthèses 16.2
Conseils d'examen
- Les questions sur le SO sont notées selon les mécanismes nommés : ordonnancement, gestion de la mémoire, tamponnement et spooling E/S, gestion de fichiers ; pour l'interface, noms de fichiers au lieu d'adresses, clics au lieu de commandes, pilotes, GUI.
- États des processus avec leurs transitions et la raison de chacune ; routines d'ordonnancement en tant que fonction plus avantage plus inconvénient ; le noyau sauvegarde l'état, identifie l'interruption, le sert, restaure.
- Mémoire virtuelle : le disque étend la RAM, pages échangées, traduction d'adresse ; le paginage est de taille fixe et invisible, la segmentation est de taille variable et logique ; thrashing (thrashing) est un échange au lieu du travail effectif.
- Interpréteur : une instruction à la fois, traduite puis exécutée, rien n'est stocké. Étapes du compilateur : jetons et table des symboles, grammaire et arbre de parsing, code, optimisation.
- BNF : une règle par diagramme,
|pour le choix, récursion pour la répétition, terminaux nus et non-terminaux entre crochets angulaires. Dites quelle règle une chaîne viole. - RPN : opérateurs après les opérandes, évaluez avec une pile, montrez chaque étape ; convertissez en encadrant entièrement ; lors de la conversion retour, gardez les parenthèses.
Erreurs courantes
- Décrire le multitâche comme « exécuter plusieurs programmes en même temps » sans dire que le processeur bascule entre eux.
- Envoyer un processus bloqué directement à l'état exécution, ou donner « time slice ended » (fin de tranche de temps) comme raison du passage de l'exécution au blocage.
- Confondre shortest job first (non préemptive) avec shortest remaining time (préemptive), ou round robin avec priorité.
- Définir la mémoire virtuelle comme « utiliser le disque dur comme RAM » sans mentionner l'échange de pages.
- Dire qu'un interpréteur « convertit le programme en code machine et ensuite l'exécute » ; c'est un compilateur.
- Placer la vérification syntaxique dans l'analyse lexicale, ou l'optimisation avant la génération de code dans la question de correspondance.
- Écrire la répétition BNF sous la forme
<letter>*ou avec une ellipse ; utilisez la récursion. Omettre les crochets angulaires autour des non-terminaux. - Inverser les opérandes de
-ou/lors de l'évaluation RPN, ou écrire la RPN de $a * b + c$ sous la formea b c + *.
-
17
Sécurité
Regarder la leçon17.1
Comment fonctionne le chiffrement

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension du fonctionnement de la cryptographie Incluant l'utilisation de clés publiques, privées, texte clair, texte chiffré, chiffrement, cryptographie à clé symétrique et cryptographie à clé asymétrique Comment les clés peuvent être utilisées pour envoyer un message privé du public vers un individu/organisation Comment les clés peuvent être utilisées pour envoyer un message vérifié au public Comment les données sont chiffrées et déchiffrées, en utilisant la cryptographie symétrique et asymétrique But, avantages et inconvénients de la cryptographie quantique Avoir conscience de la Secure Socket Layer (SSL) / Transport Layer Security (TLS) But de SSL/TLS Utilisation de SSL/TLS dans la communication client-serveur Situations où l'utilisation de SSL/TLS serait appropriée Montrer la compréhension de la certification numérique Comment un certificat numérique est acquis Comment un certificat numérique est utilisé pour produire des signatures numériques Source : Programme Cambridge International
Chiffrement 加密 transforme du plaintext 明文 (texte clair) lisible en ciphertext 密文 (texte chiffré) illisible en utilisant une opération mathématique qui dépend d'une clé (clé). Seule une personne disposant de la bonne clé peut l'inverser — decryption 解密 — pour retrouver le texte clair. Un attaquant interceptant le ciphertext sans la clé ne voit que des données sans sens, car essayer toutes les clés possibles prendrait trop longtemps. Une approche plus récente, quantum cryptography 量子密码学, utilise la physique quantique pour partager une clé de manière à révéler tout espionnage.
La machine Enigma a chiffré des messages pendant la Seconde Guerre mondiale — un dispositif de chiffrement mécanique précoce 
Le chiffrement brouille le plaintext avec une clé ; le déchiffrement l'inverse Chiffrement symétrique
Chiffrement symétrique 对称加密 (cryptographie à clé symétrique) utilise la same key (même clé) pour le chiffrement et le déchiffrement, donc l'expéditeur et le destinataire doivent tous deux détenir la clé secrète. C'est rapide (rapide) et adapté aux bulk data (données massives) (un disque entier, un flux vidéo). Son problème est la key distribution 密钥分发 : comment partager la clé en toute sécurité au départ ? La cryptographie asymétrique résout cela.
"Décrivez ce qu'est le chiffrement à clé symétrique" (deux points). La même clé est utilisée pour chiffrer le texte clair et déchiffrer le texte chiffré, de sorte que la clé doit être partagée entre l'expéditeur et le destinataire et tenue secrète par tout le reste. Deux inconvénients. La clé doit être échangée avant que le message ne puisse être envoyé, et si elle est interceptée en transit, l'intercepteur peut lire tous les messages ; une clé distincte est nécessaire pour chaque paire de correspondants ; et cela ne fournit aucune preuve de qui a envoyé le message, car les deux parties détiennent la même clé. "Donnez deux raisons d'utiliser la cryptographie par clés" : afin que les données soient illisibles pour quiconque les intercepte (confidentialité) ; afin que le destinataire soit sûr que les données proviennent de l'expéditeur déclaré et n'ont pas été modifiées (authenticité et intégrité 完整性). Les deux méthodes sont la cryptographie à clé symétrique et asymétrique.
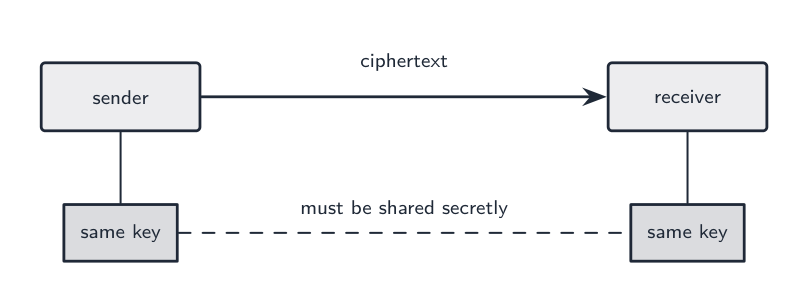
Le chiffrement symétrique utilise la même clé secrète aux deux extrémités Chiffrement asymétrique (à clé publique)
Chiffrement asymétrique 非对称加密 (cryptographie à clé asymétrique) donne à chaque utilisateur une pair (paire) de clés liées : une public key 公钥 (clé publique) qu'ils publient, et une private key 私钥 (clé privée) qu'ils gardent secrète. Les données chiffrées avec la clé publique peuvent être déchiffrées only (uniquement) avec la clé privée correspondante, et vice versa.

Chaque utilisateur a une clé publique à partager et une clé privée à garder secrète Pour envoyer un message secret à Alice : obtenir sa clé publique publiée, chiffrer avec, et envoyer. Seule Alice — détenant la clé privée correspondante — peut déchiffrer. Aucun échange préalable de clé n'est nécessaire. Le compromis est que c'est much slower (beaucoup plus lent) que le symétrique, donc il n'est pas utilisé pour les grandes quantités de données.
"State what is meant by a private key." Une clé connue uniquement de son propriétaire (jamais transmise), utilisée pour déchiffrer des données chiffrées avec la clé publique correspondante, et pour créer des signatures numériques. "Describe the process of asymmetric encryption" (four marks): (1) le récepteur génère une pair (paire) de clés, une clé publique et une clé privée, mathématiquement liées ; (2) la public key (clé publique) est mise à disposition de quiconque souhaite lui envoyer un message ; (3) l'expéditeur encrypts (chiffre) le plaintext avec la public key (clé publique) du récepteur ; (4) le ciphertext ne peut être decrypted with the receiver's private key (déchiffré avec la clé privée du récepteur), qui ne quitte jamais le récepteur, donc personne qui intercepte le message ne peut le lire.
Worked example. Fred veut envoyer un document confidentiel à Sheila. Expliquez comment le chiffrement asymétrique est utilisé.
Sheila a une paire de clés ; elle envoie sa public (publique) clé à Fred (ou il l'obtient depuis son certificat). Fred chiffre le document avec la Sheila's public key (clé publique de Sheila) et envoie le ciphertext. Seul le private key (clé privée) de Sheila peut le déchiffrer, et seule Sheila la détient, donc personne d'autre, y compris Fred une fois chiffré, ne peut lire le document. Les clés sont utilisées dans le sens du receiver (récepteur) : sa clé publique pour verrouiller, sa clé privée pour déverrouiller. Une organisation qui détient une paire de clés « pour recevoir des transmissions sécurisées » fait exactement cela : elle publie la clé publique, garde la clé privée, et déchiffre ce qui arrive.
Two differences between symmetric and asymmetric encryption. Symmetric uses une clé pour les deux directions ; asymétrique utilise two clés liées, une pour chiffrer et l'autre pour déchiffrer. Dans le chiffrement symétrique, la clé doit être kept secret by both parties (gardée secrète par les deux parties) et échangée en toute sécurité ; dans le chiffrement asymétrique, la clé publique peut être published (publiée) et seule la clé privée est secrète. Le chiffrement symétrique est beaucoup plus vite (plus rapide) et convient aux grandes quantités de données ; l'asymétrique est plus lent, donc il est utilisé pour les clés et signatures plutôt que pour les données massives.
Une clé privée doit rester secrète, donc elle est parfois conservée sur une hardware security key 硬件安全密钥 (clé de sécurité matérielle). Vous la branchez ou la touchez pour prouver votre identité, et la clé secrète ne quitte jamais l'appareil.
 *Une clé de sécurité matérielle stocke une clé secrète pour prouver votre identité
Approche hybride (utilisée par presque tous les systèmes réels)
Utiliser le chiffrement asymétrique pour échanger une session key 会话密钥 (clé de session) fraîche, puis utiliser cette clé symétrique pour les données :
- le client crée une clé de session aléatoire.
- il chiffre la clé de session avec la clé publique du serveur.
- le serveur la déchiffre avec sa clé privée.
- les deux extrémités partagent maintenant la clé de session et utilisent le chiffrement symétrique rapide pour la suite.
C'est ainsi que HTTPS et SSH fonctionnent.
La version de l'examen du problème d'échange de clés. "Une clé symétrique doit être échangée avant l'envoi du message. Expliquez comment la clé peut être échangée en toute sécurité." L'expéditeur chiffre la clé symétrique avec la clé publique du destinataire et l'envoie ; le destinataire la déchiffre avec sa clé privée ; les deux détiennent désormais la clé symétrique, qui n'a jamais été exposée en transit, et l'utilisent pour les messages. Le chiffrement asymétrique résout le problème de distribution ; le chiffrement symétrique effectue ensuite le travail rapide.
 *L'approche hybride : la crypto asymétrique partage une clé de session une fois, puis le chiffrement symétrique rapide protège les données
Hachage (lié, mais pas du chiffrement)
Une fonction cryptographic hash 密码散列 (hachage cryptographique) prend n'importe quelle entrée et produit un digest 摘要 (hachage) de taille fixe tel que la même entrée donne toujours le même digest, il est impossible de trouver deux entrées avec le même digest, et un minuscule changement dans l'entrée change complètement le digest. Le hachage est one-way (sens unique) — vous ne pouvez pas récupérer l'entrée. Il est utilisé pour stocker les vérifications de mot de passe, les vérifications d'integrity (intégrité), et les signatures numériques.
 *Un hachage cryptographique donne un digest fixe ; un minuscule changement d'entrée le change complètement, et il ne peut pas être inversé
Cryptographie quantique
La cryptographie quantique utilise la physique de la lumière pour distribuer des clés : les bits d'une clé sont envoyés sous forme de photons dont les états quantiques codent les valeurs. "Décrire son but" : transmettre une clé de chiffrement de manière sûre, de telle sorte que toute tentative d'interception soit détectée, car mesurer un photon change son état ; un espion 窃听者 laisse donc des traces, et la clé corrompue est jetée pour en envoyer une nouvelle. Avantages : l'interception est toujours détectable ; la clé ne peut être copiée sans être altérée ; elle est sécurisée contre les futures avancées en puissance de calcul (une clé mathématique peut être brisée à terme, une clé quantique ne peut être lue sans la perturber). Inconvénients : elle nécessite du matériel spécialisé et coûteux ; elle fonctionne uniquement sur des distances limitées via une fibre optique dédiée (ou ligne de visée), pas sur Internet existant ; elle ne distribue que la clé, le chiffrement ordinaire protégeant toujours le message ; c'est une technologie nouvelle avec peu de fournisseurs et peu d'expérience.
ExplorerHachage et effet d'avalanche
Un hash est à sens unique : facile à calculer, pratiquement impossible à inverser. Une petite modification de l'entrée provoque un changement important et imprévisible dans la sortie — l'effet d'avalanche qui rend les hashes excellents pour les mots de passe.
ExplorerLe chiffrement de César
Décalez chaque lettre pour chiffrer le message. Un chiffrement simple illustre l'idée d'une clé — et pourquoi une petite clé est facile à casser.
Vocabulaire EntrainerAnglais Chinois Pinyin encryption/enˈkrɪpʃn/ 加密 jiā mì plaintext/ˈpleɪntekst/ 明文 míng wén ciphertext/ˈsaɪfətekst/ 密文 mì wén decryption/dɪˈkrɪpʃn/ 解密 jiě mì quantum cryptography/ˈkwɒntəm krɪpˈtɒɡrəfi/ 量子密码学 liàng zǐ mì mǎ xué eavesdropper/ˈiːvzdrɒpə/ 窃听者 qiè tīng zhě symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì key distribution/kiː ˌdɪstrɪˈbjuːʃn/ 密钥分发 mì yào fēn fā asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng public key/ˈpʌblɪk kiː/ 公钥 gōng yào private key/ˈpraɪvət kiː/ 私钥 sī yào hardware security key/ˈhɑːdweə sɪˈkjʊərɪti kiː/ 硬件安全密钥 yìng jiàn ān quán mì yào session key/ˈseʃn kiː/ 会话密钥 huì huà mì yào cryptographic hash/ˌkrɪptəˈɡræfɪk hæʃ/ 密码散列 mì mǎ sàn liè digest/ˈdaɪdʒest/ 摘要 zhāi yào 17.1
SSL / TLS
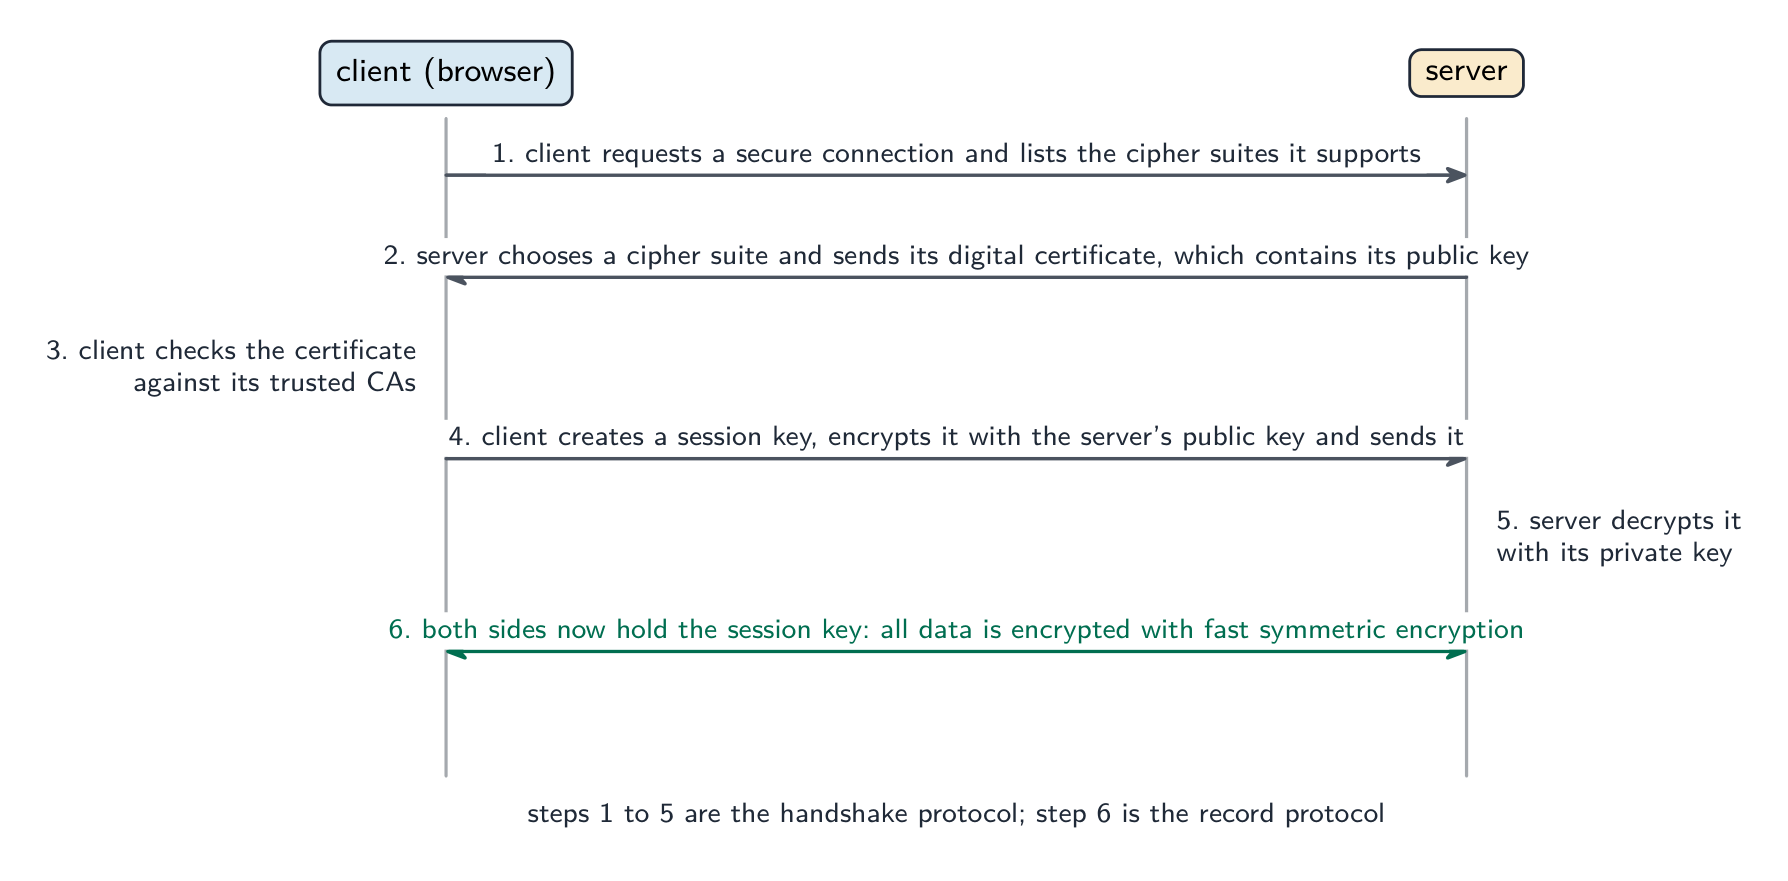
TLS (Transport Layer Security, successeur du Secure Socket Layer, SSL) est un protocole qui assure le chiffrement et l'authentification des données transmises sur un réseau. Il chiffre les données en transit, authentifie le serveur par un certificat, et garantit l'intégrité (détection des altérations).
Esquisse d'un échange TLS :
- le client se connecte et propose des options de chiffrement.
- le serveur en sélectionne une et envoie son certificat numérique (avec sa clé publique) — l'émission et la validation de ces certificats constituent la certification numérique.
- le client vérifie le certificat.
- les deux extrémités échangent une nouvelle clé de session via la cryptographie asymétrique.
- tout trafic ultérieur utilise un chiffrement symétrique rapide avec la clé de session.
Le résultat est un tunnel chiffré, authentifié et protégé par une vérification d'intégrité pour les protocoles de niveau supérieur (HTTP, SMTP). Il convient partout où des informations sensibles sont transmises : navigation web HTTPS, banque en ligne et paiements, courriel sécurisé et VPNs.
"Décrire le but de SSL/TLS" et "énumérer deux fonctions." Le but est de fournir une communication sécurisée entre un client et un serveur sur un réseau. Ses fonctions : il chiffre les données envoyées afin qu'elles ne puissent être lues si elles sont interceptées ; il authentifie 认证 le serveur (et optionnellement le client) au moyen d'un certificat numérique, permettant au client de savoir qu'il communique avec le site légitime ; et il vérifie l'intégrité des données pour détecter toute modification en transit. Deux exemples d'utilisation appropriée : banque en ligne et achats en ligne (paiements par carte) ; également connexions, courriels privés, transfert de fichiers, VoIP et messagerie instantanée : toute transaction où des données privées traversent Internet.
Les deux protocoles constituant TLS. Le protocole handshake 握手 met en place la session : il définit les algorithmes de chiffrement (suite de chiffrement), authentifie le serveur via son certificat et échange la clé de session. Le protocole record transporte ensuite les données : il chiffre chaque message avec la clé de session, ajoute une vérification d'intégrité et le transmet à la couche de transport.
Comment une session sécurisée commence : le certificat prouve l'identité du serveur, la clé publique du serveur protège la clé de session lors de son acheminement, et la clé de session protège tout ce qui suit "Expliquer comment SSL/TLS est utilisé lors de l'initialisation d'une communication client-serveur" (six points). (1) Le client (navigateur) envoie une requête au serveur demandant une connexion sécurisée, précisant les méthodes de chiffrement supportées. (2) Le serveur renvoie son certificat numérique, contenant sa clé publique. (3) Le client vérifie le certificat pour s'assurer qu'il est valide (émis par une Autorité de Certification de confiance, non expiré, pour le bon domaine). (4) Le client génère une clé de session, la chiffre avec la clé publique du serveur et l'envoie. (5) Le serveur déchiffre la clé de session avec sa clé privée. (6) Les deux parties détiennent désormais la clé de session et toutes les données ultérieures sont envoyées en utilisant un chiffrement symétrique avec celle-ci. Donner les étapes dans cet ordre ; les points sont attribués pour le certificat, la clé publique, la clé de session et le passage au chiffrement symétrique.
ExplorerLe handshake TLS
Parcourez ce qui se passe avant qu'un cadenas n'apparaisse. La crypto à clés publiques lente est utilisée uniquement pour convenir d'une clé partagée ; la page réelle voyage ensuite sous un chiffrement symétrique rapide.
Vocabulaire EntrainerAnglais Chinois Pinyin TLS/ˌtiː el ˈes/ 传输层安全 chuán shū céng ān quán authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng authenticates/ɔːˈθentɪkeɪts/ 认证 rèn zhèng handshake/ˈhændʃeɪk/ 握手 wò shǒu 17.1
Certificats numériques
Un certificat numérique 数字证书 lie une identité (un domaine, une organisation) à une clé publique, et est signé par une Autorité de Certification 证书颁发机构 (CA) de confiance. Il contient le sujet (l'identité identifiée), la clé publique du sujet, l'émetteur (la CA), une période de validité, et la signature de la CA couvrant l'ensemble.
Une Autorité de Certification émet un certificat numérique liant une identité à une clé publique Pour le vérifier, le client (qui possède une liste d'autorités de certification racine de confiance) doit :
- vérifier les dates d'expiration.
- vérifier que le nom du sujet correspond à l'URL.
- vérifier qu'il est signé par une CA de confiance, en utilisant la clé publique de la CA pour vérifier la signature.
- remonter la chaîne de certificats jusqu'à une racine de confiance.
Si l'une de ces vérifications échoue, le navigateur affiche l'avertissement « Votre connexion n'est pas privée ». Lorsqu'il vérifie correctement, le client sait que l'identité a été vérifiée par une CA de confiance, que la clé publique appartient bien à cette identité, et que le certificat est encore valable.
"Décrire ce qu'est un certificat numérique" (deux points). Un document électronique, émis par une Autorité de Certification, qui vérifie l'identité de son propriétaire (une personne, une organisation ou un site web) et contient la clé publique du propriétaire. Éléments contenus dans un certificat : le numéro de série ; le nom du propriétaire (sujet) et, pour un site web, son domaine ; la clé publique du propriétaire ; le nom de la CA émettrice ; la période de validité (dates) ; l'algorithme de signature utilisé ; et la signature numérique de la CA couvrant l'ensemble du certificat.
"Expliquer comment une organisation obtient un certificat numérique" (quatre points). (1) L'organisation génère sa propre paire de clés, une clé publique et une clé privée. (2) Elle envoie une requête contenant sa clé publique et ses détails d'identité à une Autorité de Certification. (3) La CA vérifie l'identité (s'assure que le demandeur est bien l'organisation ou détient le domaine). (4) La CA crée le certificat contenant la clé publique et l'identité, le signe avec sa propre clé privée, et le retourne. (5) L'installation du certificat sur son serveur permet à celui-ci de l'envoyer aux clients. La clé privée ne quitte jamais l'organisation.
"Expliquer pourquoi un certificat numérique est nécessaire pour valider une signature numérique." Pour vérifier une signature, le récepteur a besoin de la clé publique de l'expéditeur et doit être sûr que cette clé appartient réellement à l'expéditeur présumé ; le certificat fournit la clé publique associée à l'identité, et comme le certificat est signé par une CA de confiance, le récepteur peut faire confiance à ce lien. Sans cela, un imposteur pourrait publier une clé publique sous le nom de quelqu'un d'autre et signer des messages en son nom. Le même raisonnement répond à la question « quoi inclure avec un programme téléchargé d'Internet pour prouver qu'il est authentique » : une signature numérique, vérifiée par rapport au certificat de l'éditeur.
Vocabulaire EntrainerAnglais Chinois Pinyin digital certificate/ˈdɪdʒɪtl səˈtɪfɪkət/ 数字证书 shù zì zhèng shū Certificate Authority/səˈtɪfɪkət əˈθɒrɪti/ 证书颁发机构 zhèng shū bān fā jī gòu man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī 17.1
Signatures numériques
Une signature numérique 数字签名 prouve qui a signé un message et qu'il n'a pas été modifié. Pour signer :
- calculer un hash cryptographique du message.
- chiffrer le hash avec la clé privée de l'expéditeur — c'est la signature.
- envoyer le message et la signature.
Pour vérifier : calculer le hash du message reçu ; déchiffrer la signature avec la clé publique de l'expéditeur pour obtenir le hash de l'expéditeur ; comparer. Si elles correspondent, le message a été signé par le détenteur de la clé privée (authentification 身份验证) et n'a pas été modifié (intégrité). Une signature ne masque pas le message — pour la confidentialité, il faut aussi chiffrer et signer.
Signer hache le message et chiffre le digest avec la clé privée ; le récepteur le vérifie avec la clé publique "Expliquer le rôle d'un certificat numérique dans la création d'une signature numérique" (trois points). Le certificat de l'expéditeur a été émis par une CA et contient la clé publique de l'expéditeur ainsi que son identité ; l'expéditeur produit la signature en hachant le message et en chiffrant le hash avec sa clé privée, qui est le partenaire de la clé du certificat ; le récepteur utilise la clé publique du certificat pour déchiffrer le hash, et comme le certificat lie cette clé à l'expéditeur, la signature prouve qui a signé.
"Expliquer comment une signature numérique est utilisée pour vérifier un message" (quatre points). (1) Le récepteur déchiffre la signature avec la clé publique de l'expéditeur (tirée de son certificat), ce qui restitue le hash calculé par l'expéditeur. (2) Le récepteur hache le message reçu avec le même algorithme de hachage. (3) Les deux hashes sont comparés. (4) S'ils correspondent, le message provient du détenteur de la clé privée (authentique) et n'a pas été modifié depuis sa signature (intégrité) ; s'ils diffèrent, le message est rejeté. Un banquier recevant des données confidentielles avec une signature effectue exactement cette vérification avant de faire confiance ; les données elles-mêmes peuvent être séparément chiffrées avec la clé publique du banquier pour assurer la confidentialité.
Mise en commun
Une requête sécurisée vers
https://www.bank.com: le serveur envoie son certificat ; le client le vérifie auprès des CAs de confiance ; le client utilise la clé publique du serveur pour échanger une clé de session ; ensuite, les données circulent chiffrées avec cette clé. Le chiffrement empêche les espions, le certificat prouve l'identité du serveur, et les vérifications d'intégrité bloquent une attaque de l'homme du milieu 中间人攻击 modifiant les données.Exemple résolu. Alice envoie un contrat à Bob. Elle veut que Bob soit certain qu'il provient d'elle et n'a pas été modifié, et elle veut que personne d'autre ne puisse le lire. Quelles clés utilise-t-elle, et dans quelle direction ? Ce sont deux tâches différentes nécessitant deux paires de clés différentes. Pour la signature (authentification et intégrité) : Alice hache le contrat et chiffre ce hash avec sa propre clé privée ; Bob le déchiffre avec la clé publique d'Alice et le compare à son propre hash du message. Seule Alice détient sa clé privée, donc seule elle a pu la produire. Pour la confidentialité : Alice chiffre le contrat lui-même avec la clé publique de Bob, afin que seul la clé privée de Bob puisse l'ouvrir. Une règle permet de s'y retrouver avec les quatre clés : vous signez avec votre propre clé privée et chiffrez avec la clé publique du destinataire. Une signature seule ne masque pas le message.
Vocabulaire EntrainerAnglais Chinois Pinyin digital signature/ˈdɪdʒɪtl ˈsɪɡnɪtʃə/ 数字签名 shù zì qiān míng 17.1
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition chiffrement conversion des données lisibles en texte chiffré à l'aide d'un algorithme et d'une clé afin qu'il ne puisse être compris s'il est intercepté données lisibles / texte chiffré les données originales lisibles / la forme chiffrée et illisible de celles-ci cryptographie à clé symétrique la même clé secrète est utilisée pour chiffrer et déchiffrer, elle doit donc être partagée en toute sécurité par les deux parties cryptographie à clé asymétrique une paire de clés liées est utilisée : la clé publique chiffre et seule la clé privée correspondante déchiffre clé publique clé rendue accessible à tous, utilisée pour chiffrer les messages destinés à son propriétaire et vérifier ses signatures clé privée clé connue uniquement de son propriétaire, utilisée pour déchiffrer les messages chiffrés avec la clé publique et pour signer SSL/TLS protocoles assurant une communication sécurisée (chiffrée, authentifiée, vérifiée pour l'intégrité) entre un client et un serveur certificat numérique document électronique délivré par une Autorité de Certification qui vérifie l'identité du propriétaire et contient sa clé publique signature numérique hash d'un message chiffré avec la clé privée de l'expéditeur, prouvant l'origine et l'intégralité du message Autorité de Certification organisation de confiance qui vérifie les identités et délivre et signe les certificats numériques cryptographie quantique utilisation des états quantiques de photons pour distribuer des clés de manière à ce que toute interception soit détectée 17.1
Conseils d'examen
- Symétrique : une seule clé secrète partagée, rapide, mais l'échange de clés est une faiblesse. Asymétrique : clé publique pour chiffrer, clé privée pour déchiffrer, lent, pas de problème d'échange. Deux différences, deux inconvénients, deux raisons : l'examen demande ces éléments par paires.
- La confidentialité utilise les clés du récepteur (publique pour verrouiller, privée pour déverrouiller) ; une signature utilise les clés de l'expéditeur (privée pour signer, publique pour vérifier). Dites toujours de quelle clé il s'agit.
- Le démarrage de TLS compte six étapes : requête, certificat avec clé publique, vérification, clé de session chiffrée avec la clé publique, déchiffrée avec la clé privée, chiffrement symétrique ensuite.
- Un certificat combine identité et clé publique, signé par une AC ; son acquisition implique création de paires de clés, demande, vérification, signature et installation. Il est nécessaire pour valider une signature car il prouve à quelle clé publique celle-ci appartient.
- Une signature est un hash chiffré avec la clé privée ; la vérification consiste à déchiffrer, recalculer le hash et comparer. Intégrité et authenticité sont les deux aspects qu'elle prouve.
- La cryptographie quantique distribue des clés et détecte l'écoute clandestine ; ses limites sont le coût, la distance et la nouveauté.
Erreurs courantes
- Dire qu'un message est chiffré avec la clé publique de l'expéditeur ; c'est la clé publique du récepteur qui chiffre, et la clé privée du récepteur qui déchiffre.
- Décrire une signature comme « chiffrant le message avec la clé privée » au lieu de chiffrer son hash.
- Affirmer qu'un certificat contient la clé privée ; il contient la clé publique et l'identité, signés par l'AC.
- Énumérer « le serveur envoie sa clé privée » lors du poignée de main TLS ; seule la clé publique transite, à l'intérieur du certificat.
- Donner « SSL/TLS accélère la connexion » comme fonction ; ses fonctions sont le chiffrement, l'authentification et l'intégrité.
- Confondre hachage et chiffrement : un hash est irréversible et n'utilise pas de clé ; le chiffrement est réversible avec la clé.
- Répondre « pourquoi un certificat est-il nécessaire pour une signature » par « pour le chiffrer » ; il est nécessaire pour faire confiance à la clé publique.
-
18
Intelligence artificielle (IA)
Regarder la leçon18.1
Qu'est-ce que l'IA

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la manière dont les graphes peuvent être utilisés pour faciliter l'Intelligence Artificielle (IA) But et structure d'un graphe Utiliser l'algorithme A* et l'algorithme de Dijkstra pour effectuer des recherches sur un graphe Les candidats ne seront pas tenus d'écrire des algorithmes pour configurer, accéder ou effectuer des recherches sur des graphes Montrer la compréhension de la manière dont les réseaux neuronaux artificiels ont contribué à l'apprentissage automatique Montrer la compréhension de l'Deep Learning, de l'Apprentissage Automatique et de l'Apprentissage par Renforcement et des raisons d'utiliser ces méthodes. Comprendre les catégories d'apprentissage automatique, y compris l'apprentissage supervisé, l'apprentissage non supervisé Montrer la compréhension de la rétropropagation des erreurs et des méthodes de régression en apprentissage automatique Source : Programme Cambridge International
Intelligence artificielle 人工智能 (IA) crée des systèmes capables d'accomplir des tâches normalement réservées à l'intelligence humaine — reconnaissance de la parole et des images, traduction, jeux, conduite automobile, génération de texte. La plupart des IA modernes utilisent l'apprentissage automatique 机器学习 — algorithmes apprenant des modèles à partir de données plutôt que programmés étape par étape. À l'intérieur, l'apprentissage profond 深度学习, utilisant des réseaux de neurones 神经网络 à multiples couches, domine depuis les années 2010.
Un robot humanoïde 人形机器人 intègre plusieurs de ces capacités dans un seul corps : il utilise l'IA pour voir des visages, comprendre la parole et bouger son visage et ses bras de manière réaliste.
Un robot humanoïde utilise l'IA pour voir, écouter et répondre comme une personne 
L'apprentissage profond fait partie de l'apprentissage automatique, qui fait partie de l'IA ExplorerLaboratoire de type d'apprentissage IA
Classez les exemples d'IA selon le type d'apprentissage ou la préoccupation impliquée.
Vocabulaire EntrainerAnglais Chinois Pinyin humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ 人形机器人 rén xíng jī qì rén 18.1
Graphes en IA
De nombreux problèmes d'IA reposent sur un graphe 图 — des nœuds 节点 (états, lieux) reliés par des arêtes 边 (mouvements, relations).
- recherche de chemin : les routes forment un graphe ; l'itinéraire le plus court est une recherche dans le graphe (algorithme de Dijkstra, algorithme A*).
- jeux vidéo : chaque position du plateau est un nœud, chaque coup une arête ; minimax 极小化极大 avec élagage alpha-bêta explore l'arbre de jeu.
- recherche dans l'espace des états : un problème de planification consiste à passer d'un état à l'autre en appliquant des opérateurs pour atteindre un but.
- représentation des connaissances : un réseau sémantique 语义网络 a des concepts comme nœuds et des relations comme arêtes (« chien EST-UN animal ») ; un graphe de connaissances 知识图谱 stocke des faits sur le monde pour les moteurs de recherche et assistants.
Les problèmes d'IA reposent souvent sur un graphe ; ici, le chemin le plus court est mis en évidence Les outils standards pour naviguer dans les graphes incluent la recherche en largeur 广度优先搜索 et la recherche en profondeur 深度优先搜索.
« Décrivez la finalité et la structure d'un graphe dans un système IA. » Finalité : représenter un problème sous forme d'ensemble d'états (ou lieux) et des mouvements possibles entre eux, afin qu'un algorithme puisse le parcourir pour trouver une solution, comme le chemin le plus court ou le moins cher, ou le meilleur mouvement suivant. Structure : ensemble de nœuds (sommets), chacun représentant un état, un lieu ou un objet, reliés par des arêtes représentant les connexions entre eux ; chaque arête peut porter un poids (coût, distance ou temps), et les arêtes peuvent être orientées (sens unique) ou non orientées. « Expliquez l'utilisation des graphes pour faciliter l'IA » : le graphe est le modèle sur lequel s'exécutent les algorithmes de recherche de l'IA : A* et l'algorithme de Dijkstra trouvent des chemins optimaux (navigation, routage), les positions de jeu forment un arbre exploré pour trouver le meilleur coup, et les connaissances stockées sous forme de graphe permettent au système de raisonner sur la manière dont les faits sont liés.
 Le graphe utilisé ci-dessous : les chiffres sur les arêtes sont les vraies distances ; les chiffres rouges sont l'estimation heuristique 启发式 de chaque nœud indiquant la distance restante vers le but, utilisée uniquement par A*
Algorithme de Dijkstra. Il trouve la distance la plus courte du point de départ à chaque nœud. Tenez un tableau des meilleures distances trouvées jusqu'à présent vers chaque nœud (départ 0, tous les autres infini). Prenez répétitivement le nœud non visité ayant la distance la plus petite, marquez-le comme visité, et pour chaque voisin vérifiez si passer par ce nœud donne une distance plus courte ; si oui, mettez à jour et enregistrez d'où il vient. Arrêtez-vous lorsque tous les nœuds sont visités (ou la cible atteinte).
Exemple résolu. Trouvez les distances les plus courtes de H vers tous les autres nœuds dans le graphe ci-dessus.
étape visite H A B C D G début 0 ∞ ∞ ∞ ∞ ∞ 1 H (0) 0 4 (H) 3 (H) ∞ ∞ ∞ 2 B (3) 0 4 (H) 3 ∞ 9 (B) ∞ 3 A (4) 0 4 3 9 (A) 8 (A) ∞ 4 D (8) 0 4 3 9 (A) 8 10 (D) 5 C (9) 0 4 3 9 8 10 (D) 6 G (10) Distances minimales : A 4, B 3, D 8, C 9, G 10, et le chemin vers G est H–A–D–G (lire les étiquettes « venu de » à l'envers). À l'étape 3, A offre à D une distance de $4 + 4 = 8$, meilleure que les 9 trouvés via B, donc D est mis à jour ; à l'étape 5, C pourrait atteindre G à $9 + 3 = 12$, pire que 10, donc rien ne change. Montrer ces comparaisons constitue le « calcul » demandé par la question.
Algorithme A*. Dijkstra explore dans toutes les directions. A* ajoute une heuristique $h$, une estimation de la distance restant à parcourir, et expandit toujours le nœud ayant la plus petite $f = g + h$, où $g$ est la distance parcourue jusqu'à présent. Avec une heuristique raisonnable (ne jamais surestimer), il trouve le même chemin le plus court tout en explorant beaucoup moins de nœuds, c'est pourquoi les GPS et les jeux l'utilisent. L'examen fournit $h$ pour chaque nœud et un tableau à remplir.
Exemple résolu. Trouvez un chemin de H à G avec A*, en montrant le calcul.
nœud expandi $g$ jusqu'à présent $h$ $f = g + h$ voisins ajoutés (nœud : $g$, $h$, $f$) H 0 7 7 A: 4, 5, 9; B: 3, 6, 9 B (ex æquo avec A ; l'un ou l'autre) 3 6 9 D via B : 9, 2, 11 A 4 5 9 C : 9, 3, 12 ; D via A : 8, 2, 10 (meilleur que 11, garder) D 8 2 10 G : 10, 0, 10 ; C via D : 9 (pas meilleur) G 10 0 10 but atteint Chemin H–A–D–G, longueur 10, identique à celui de Dijkstra, mais C n'a jamais été expandi. Chaque fois qu'un nœud est atteint par un deuxième itinéraire, gardez la plus petite $g$ ; la recherche se termine lorsque le but est le nœud ayant la plus petite $f$. Indiquez les valeurs $g$, $h$ et $f$ dans chaque ligne : ce sont les points attribués.
Vocabulaire EntrainerAnglais Chinois Pinyin graph/ɡræf/ 图 tú nodes/nəʊdz/ 节点 jié diǎn edges/ˈedʒɪz/ 边 biān minimax/ˈmɪnɪmæks/ 极小化极大 jí xiǎo huà jí dà semantic network/səˈmæntɪk ˈnetwɜːk/ 语义网络 yǔ yì wǎng luò knowledge graph/ˈnɒlɪdʒ ɡræf/ 知识图谱 zhī shí tú pǔ breadth-first search/bredθ fɜːst sɜːtʃ/ 广度优先搜索 guǎng dù yōu xiān sōu suǒ depth-first search/depθ fɜːst sɜːtʃ/ 深度优先搜索 shēn dù yōu xiān sōu suǒ weight/weɪt/ 权重 quán zhòng heuristic/hjuːˈrɪstɪk/ 启发式 qǐ fā shì labels/ˈleɪblz/ 标签 biāo qiān 18.1
Réseaux de neurones artificiels (RNA)
Un RNA s'inspire des neurones du cerveau. Un neurone artificiel 人工神经元 :
- prend plusieurs valeurs d'entrée, multiplie chacune par un poids 权重, et les additionne avec un terme de biais 偏置项.
- applique une fonction d'activation 激活函数 (une fonction non linéaire telle que ReLU) à la somme.
- produit le résultat, qui alimente les neurones situés plus loin.
Un neurone unique : chaque entrée multipliée par son poids, additionnée à un biais, puis traitée par une fonction d'activation Les neurones sont organisés en couches : une couche d'entrée, une ou plusieurs couches cachées 隐藏层 (où des motifs internes utiles sont appris), et une couche de sortie. Avec de nombreuses couches cachées, c'est un réseau neuronal profond 深度神经网络, et son entraînement relève du deep learning.
Un réseau neuronal comportant une couche d'entrée, deux couches cachées et une couche de sortie Les RNN permettent aux modèles d'apprendre des motifs complexes directement à partir de données brutes (pixels, audio, texte) sans conception manuelle de caractéristiques — ce qui a conduit à des percées dans la reconnaissance d'images 图像识别, la reconnaissance vocale 语音识别, la traduction automatique 机器翻译 et le jeu vidéo. Ils performant bien avec de grandes quantités de données, des entrées bruitées ou très complexes, et des motifs trop difficiles à capturer par des règles explicites.
"Expliquez ce qu'est un réseau neuronal artificiel." Un modèle inspiré du réseau de neurones du cerveau, composé de couches de nœuds connectés : une couche d'entrée, une ou plusieurs couches cachées et une couche de sortie. Chaque connexion possède un poids ; chaque nœud somme ses entrées pondérées et transmet le résultat à travers une fonction d'activation vers la couche suivante. "Expliquez comment les RNN permettent l'apprentissage automatique" (trois points) : le réseau est entraîné sur de nombreux exemples ; pour chaque exemple, la sortie est comparée au résultat attendu et l'erreur est utilisée pour ajuster les poids (rétropropagation) afin que l'erreur diminue ; après avoir vu suffisamment d'exemples, les poids encodent les motifs des données, et le réseau peut alors classifier ou prédire pour de nouvelles données jamais vues auparavant. "Indiquez la raison d'avoir plusieurs couches cachées" : chaque couche supplémentaire combine les caractéristiques trouvées par la couche précédente en des caractéristiques plus complexes et plus abstraites, permettant au réseau d'apprendre des relations plus complexes (lignes, puis formes, puis objets) ; c'est cela qui rend un réseau "profond".
ExplorerTouchez les parties d'un réseau neuronal
Explorez les couches. Les données circulent de gauche à droite : la couche d'entrée prend les caractéristiques, les couches cachées apprennent des motifs, et la couche de sortie donne la réponse — chaque connexion portant un poids ajusté par l'entraînement.
Vocabulaire EntrainerAnglais Chinois Pinyin artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ 人工神经元 rén gōng shén jīng yuán bias term/ˈbaɪəs tɜːm/ 偏置项 piān zhì xiàng activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ 激活函数 jī huó hán shù hidden layers/ˈhɪdn ˈleɪəz/ 隐藏层 yǐn cáng céng deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ 深度神经网络 shēn dù shén jīng wǎng luò image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ 强化学习 qiáng huà xué xí supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ 监督学习 jiān dū xué xí 18.1
Apprentissage automatique, apprentissage profond, apprentissage par renforcement
Apprentissage automatique
Le terme générique désignant tout algorithme apprenant à partir de données. Trois paradigmes :
- apprentissage supervisé 监督学习 — les données comportent des étiquettes 标签 (images taguées "chat"/"chien") ; l'algorithme apprend la relation entrée → étiquette. Utilisé pour la classification 分类 (une catégorie) et la régression.
- apprentissage non supervisé 无监督学习 — pas d'étiquettes ; l'algorithme découvre la structure, par exemple un cluster 聚类的 regroupement de clients similaires.
- apprentissage par renforcement (ci-dessous).
Utilisez l'AM lorsque des règles explicites seraient irréalistes (filtres anti-spam, recommandations, détection de fraudes).
Les mêmes données vues sous deux angles : avec des étiquettes, la tâche consiste à apprendre ce qui sépare les classes ; sans étiquettes, la tâche est de découvrir qu'il existe des groupes en soi "Décrivez l'apprentissage supervisé et non supervisé" (selon les formulations marquées). Apprentissage supervisé : l'algorithme est entraîné sur des données d'entraînement 训练数据 étiquetées, chaque exemple étant associé à la sortie correcte (la cible) ; il apprend la relation entre les entrées et les sorties et l'utilise pour classifier ou prédire de nouvelles entrées ; les réponses étant connues pendant l'entraînement, l'erreur peut être mesurée. Apprentissage non supervisé : les données sont non étiquetées, sans réponses correctes fournies ; l'algorithme cherche des motifs, structures ou regroupements dans les données par lui-même (regroupement d'éléments similaires, découverte d'associations) ; la sortie est un ensemble de catégories ou de relations qui n'avaient pas été définies à l'avance. Comment ils diffèrent : données étiquetées contre données non étiquetées ; sorties connues contre structure découverte ; l'apprentissage supervisé est utilisé pour prédire (classification, régression), l'apprentissage non supervisé pour explorer (clustering, détection d'anomalies). Les deux sont des catégories de l'apprentissage automatique ; le troisième est l'apprentissage par renforcement.

Apprentissage supervisé : un modèle est entraîné sur des données étiquetées, puis reconnait de nouvelles données Apprentissage profond
Une sous-catégorie de l'AM utilisant des réseaux neuronaux profonds. Les couches inférieures apprennent des motifs simples (lignes, phonèmes), les couches supérieures les combinent en concepts abstraits. Il nécessite beaucoup de données et beaucoup de puissance de calcul (GPU) ; pour de petits jeux de données, des méthodes d'AM plus simples font souvent mieux.
"Expliquez ce qu'est l'apprentissage profond" (trois points). Apprentissage automatique utilisant des réseaux neuronaux artificiels dotés de nombreuses couches cachées (réseaux profonds) ; le réseau est entraîné sur de très grandes quantités de données, et chaque couche extrait des caractéristiques à partir de la sortie de la couche inférieure, de sorte que le réseau apprend lui-même les caractéristiques nécessaires plutôt que de les voir spécifiées par le programmeur. Raisons de son utilisation : il peut résoudre des problèmes trop complexes pour des règles manuscrites ou des modèles peu profonds (reconnaissance faciale, compréhension de la parole, traduction de texte) ; il s'améliore à mesure que plus de données deviennent disponibles ; il élimine le besoin d'ingénierie de caractéristiques humaine ; et il peut gérer des données non structurées telles que des images, du son et du texte. Comment le rendre plus efficace : plus de données d'entraînement (et mieux étiquetées) ; plus de couches ou de nœuds, dans les limites du sur-apprentissage ; plus de puissance de traitement (GPU) et temps d'entraînement ; réglage du taux d'apprentissage et d'autres paramètres. Exemples : reconnaissance vocale dans les assistants vocaux, reconnaissance d'images dans les examens médicaux et les voitures autonomes, traduction automatique, systèmes de recommandation.
Apprentissage par renforcement
Dans l'apprentissage par renforcement 强化学习, un agent 智能体 agit dans un environnement ; chaque action modifie l'état et rapporte une récompense 奖励. L'agent apprend une politique 策略 (une stratégie) qui maximise la récompense totale au fil du temps, par essai-erreur sans étiquettes au départ. Utilisé pour les problèmes de décision séquentielle — jeux, contrôle robotique, conduite autonome.
"Expliquez ce qu'est l'apprentissage par renforcement" (trois points). Un agent apprend en interagissant avec son environnement : il effectue une action, l'environnement passe à un nouvel état et rapporte une récompense (ou une pénalité), et l'agent ajuste son comportement pour maximiser la récompense totale au fil du temps. Il n'y a pas de données étiquetées : l'agent apprend par essai-erreur, découvrant quelles actions sont bonnes grâce aux récompenses qu'il reçoit, et forme progressivement une politique indiquant quoi faire dans chaque état. Utilisé là où la bonne réponse n'est pas connue à l'avance mais où le résultat d'une action peut être noté : jeu vidéo (échecs, Go), contrôle robotique, gestion des feux de circulation, allocation de ressources. Un ordinateur jouant aux échecs contre un utilisateur apprend ainsi, ou explore l'arbre du jeu avec minimax pour choisir le coup dont le pire résultat est le meilleur.
Apprentissage par renforcement : l'agent agit, l'environnement retourne un nouvel état et une récompense, et l'agent en tire des enseignements Une voiture autonome 自动驾驶汽车 est un exemple réel. Les capteurs Lidar 激光雷达 et caméras (l'unité rotative sur le toit) construisent une image en direct de la route, et une politique apprise décide comment diriger, accélérer et freiner en toute sécurité.

Une voiture autonome utilise des caméras et des capteurs Lidar pour percevoir la route autour d'elle 
Bras robotiques industriels sur une ligne de production : l'apprentissage par renforcement peut enseigner à un robot à contrôler ses mouvements Vocabulaire EntrainerAnglais Chinois Pinyin classification/ˌklæsɪfɪˈkeɪʃn/ 分类 fēn lèi cluster/ˈklʌstə/ 聚类 jù lèi training data/ˈtreɪnɪŋ ˈdeɪtə/ 训练数据 xùn liàn shù jù learning rate/ˈlɜːnɪŋ reɪt/ 学习率 xué xí lǜ self-driving car/self ˈdraɪvɪŋ kɑː/ 自动驾驶汽车 zì dòng jià shǐ qì chē agent/ˈeɪdʒənt/ 智能体 zhì néng tǐ reward/rɪˈwɔːd/ 奖励 jiǎng lì policy/ˈpɒlɪsi/ 策略 cè lüè lidar/ˈlaɪdɑː/ 激光雷达 jī guāng léi dá backpropagation/ˌbækprəpəˈɡeɪʃn/ 反向传播 fǎn xiàng chuán bō 18.1
Entraînement d'un RNN : rétropropagation
L'entraînement ajuste les poids pour que les sorties correspondent aux cibles. La méthode standard est la rétropropagation 反向传播 (rétropropagation d'erreurs) combinée à la descente de gradient 梯度下降. Pour chaque exemple d'entraînement :
- passage avant — acheminer l'entrée jusqu'à la sortie.
- calculer l'erreur avec une fonction de perte 损失函数 (un nombre unique représentant l'écart de la sortie).
- passage arrière — propager l'erreur en sens inverse, calculant le gradient de chaque poids (sa contribution à l'erreur) en utilisant la règle de chaîne.
- mettre à jour les poids d'un petit pas (défini par le taux d'apprentissage 学习率) réduisant l'erreur.
Répéter sur de nombreux exemples et de nombreux passages (épisodes 训练轮次) jusqu'à ce que l'erreur cesse de diminuer. Le nom « back » vient de l'étape 3 : l'erreur circule depuis la sortie vers l'arrière jusqu'à l'entrée, permettant de trouver le gradient de chaque poids en un seul balayage. Après entraînement, une nouvelle entrée nécessite un seul passage avant pour obtenir une prédiction.
"Décrivez la méthode de rétropropagation des erreurs" (quatre points). (1) Une entrée est envoyée vers l'avant à travers le réseau et sa sortie est comparée à la sortie attendue (cible) ; (2) la différence constitue l'erreur ; (3) l'erreur est propagée en arrière à travers le réseau, couche par couche de la sortie vers l'entrée, et la part de l'erreur attribuée à chaque poids est calculée ; (4) les poids sont ajustés proportionnellement à leur contribution, dans la direction qui réduit l'erreur ; (5) le processus est répété avec de nombreux exemples jusqu'à ce que l'erreur soit aussi faible que requis. L'intérêt de cette méthode est qu'un réseau avec des couches cachées n'a aucun moyen direct de savoir quel poids interne a causé une erreur de sortie ; la rétropropagation répartit la responsabilité.
L'entraînement ajuste les poids pour atteindre l'erreur minimale Vocabulaire EntrainerAnglais Chinois Pinyin gradient descent/ˈɡreɪdɪənt dɪˈsent/ 梯度下降 tī dù xià jiàng loss function/lɒs ˈfʌŋkʃn/ 损失函数 sǔn shī hán shù epochs/ˈiːpɒks/ 训练轮次 xùn liàn lún cì 18.1
Régression

Certaines tâches prédisent un nombre (prix d'une maison, température de demain) — régression 回归, contrairement à la classification (une catégorie).
La régression linéaire 线性回归 ajuste une droite (ou un hyperplan) :
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$Choisissez les coefficients pour minimiser la somme des erreurs au carré par rapport aux données d'entraînement. Utilisez-le lorsque la relation semble approximativement linéaire et que vous souhaitez un modèle interprétable. Pour des données courbes, utilisez des méthodes de régression polynomiale, à arbre de décision ou à réseau neuronal — même principe : définissez un modèle, définissez une fonction de perte, et ajustez les paramètres pour la minimiser. La régression et la classification sont toutes deux supervisées ; le choix dépend du fait que la réponse soit un nombre ou une catégorie.
"Décrivez les méthodes de régression en apprentissage automatique" (deux points). Méthodes statistiques qui identifient la relation entre des variables d'entrée et une sortie continue, en ajustant une fonction (une droite ou une courbe) sur les données d'entraînement avec l'erreur totale minimale ; la fonction ajustée est ensuite utilisée pour prédire la sortie pour de nouvelles entrées. La régression linéaire ajuste une droite ; d'autres méthodes ajustent des courbes. La régression prédit une valeur (un prix, une température, un temps) ; la classification prédit une catégorie, c'est cette distinction que l'examen demande.
La régression linéaire ajuste la droite qui rend l'erreur totale au carré (les écarts en pointillés) aussi faible que possible ExplorerAjustement d'une droite de régression
Faites glisser les contrôles. La régression linéaire trace la droite qui minimise la somme des carrés des distances aux points de données — elle prédit ensuite un nombre pour toute nouvelle entrée.
Vocabulaire EntrainerAnglais Chinois Pinyin regression/rɪˈɡreʃn/ 回归 huí guī unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ 无监督学习 wú jiān dū xué xí linear regression/ˈlɪnɪə rɪˈɡreʃn/ 线性回归 xiàn xìng huí guī optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 18.1
Comment l'IA est utilisée dans un scénario réel
De nombreux scénarios d'examen suivent le même schéma — un modèle d'apprentissage profond formé sur des données étiquetées, souvent plusieurs combinés dans un pipeline :
- identification des clients dans un magasin automatisé : le système est formé sur des images faciales étiquetées ; une caméra capture un visage ; la reconnaissance d'image extrait une représentation ; elle est comparée aux clients enregistrés ; la correspondance la plus proche identifie la personne.
- lecture de texte depuis des images : la reconnaissance d'image trouve les zones de texte ; la reconnaissance optique de caractères 光学字符识别 extrait les caractères ; la traduction machine les convertit ; la synthèse vocale 文本转语音 les lit à voix haute.
- détection des articles au guichet : une IA de détection d'objets, formée sur des images de produits étiquetées, voit quels articles vont dans un panier et facture le compte.
Au moment où un utilisateur interagit avec le système, le modèle est rapide — il effectue uniquement une inférence en avantpropagation ; l'intelligence réside dans les motifs appris lors de l'entraînement.
Réponses types pour les questions de scénario. Une caméra de parking lit les plaques d'immatriculation : la caméra capture une image ; une IA formée sur de nombreuses images étiquetées de plaques localise la plaque dans l'image ; la reconnaissance de caractères (un classificateur d'apprentissage profond, encore formé sur des caractères étiquetés) convertit la plaque en texte ; le texte est stocké avec l'heure et apparié lorsque la voiture quitte le lieu. Un système de vidéosurveillance détecte et suit une personne : un logiciel de reconnaissance d'image formé sur des images de personnes étiquetées identifie une personne dans chaque trame ; le système compare les trames successives pour suivre son mouvement ; un mouvement inhabituel peut déclencher une alerte. Parole convertie en commandes : la reconnaissance vocale formée sur de nombreuses voix enregistrées convertit le son en texte ; le système apparie le texte à un ensemble de commandes connues ; il s'améliore à mesure qu'il est corrigé. Une caméra qui met au point sur les visages : un modèle de détection de visages formé sur des visages étiquetés trouve la zone du visage, et l'objectif est ajusté pour mettre cette zone au point. Connexion bancaire par reconnaissance faciale : l'application capture le visage, un réseau profond en extrait les caractéristiques, et elles sont comparées aux caractéristiques stockées pour ce client. Dans tous les cas, le schéma est : formé sur des exemples étiquetés, extrait des caractéristiques, apparie ou classe une nouvelle entrée.
Exemple résolu. Pour chaque tâche, dites si elle nécessite une régression ou une classification, et à quoi ressemblerait la couche de sortie d'un ANN : (a) prévoir la température de demain ; (b) décider si un e-mail est du spam. Demandez quelle sorte de chose est prédite. (a) Une température est un nombre sur une échelle continue, donc c'est une régression, et la couche de sortie est un neuron unique contenant cette valeur. (b) Spam ou non-spam est une catégorie, donc c'est une classification, et la sortie donne une probabilité par classe. Les deux sont un apprentissage supervisé : chacun a besoin d'exemples étiquetés pour l'entraînement, et l'entraînement ajuste les poids par rétropropagation pour réduire l'erreur. La question décisive est simplement nombre-ou-catégorie - pas à quel point la tâche semble difficile.
18.1
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition graphe (en IA) un ensemble de nœuds représentant des états ou des emplacements, reliés par des arêtes représentant des connexions, souvent pondérées, qu'un algorithme de recherche peut explorer algorithme de Dijkstra trouve la distance la plus courte d'un nœud de départ à tous les autres nœuds en visitant toujours le nœud non visité ayant la plus petite distance jusqu'à présent algorithme A* une recherche de chemin le plus court qui développe le nœud ayant la plus petite somme de la distance parcourue plus une estimation heuristique de la distance vers l'objectif réseau de neurones artificiels un modèle des neurones du cerveau : des couches de nœuds reliés par des connexions pondérées, formés en ajustant les poids apprentissage automatique algorithmes qui apprennent à partir de données et s'améliorent avec l'expérience plutôt que de suivre des règles fixes apprentissage supervisé apprentissage à partir de données d'entraînement étiquetées dans lesquelles la sortie correcte pour chaque entrée est connue apprentissage non supervisé apprentissage à partir de données non étiquetées en trouvant des motifs, des groupements ou une structure dans celles-ci apprentissage par renforcement un agent apprend par essai-erreur, choisissant des actions dans un environnement pour maximiser les récompenses reçues apprentissage profond apprentissage automatique utilisant des réseaux de neurones avec de nombreuses couches cachées, formés sur de grandes quantités de données, chaque couche extrayant des caractéristiques de celle du dessous rétropropagation des erreurs comparer la sortie du réseau avec la cible, passer l'erreur en arrière à travers les couches et ajuster chaque poids pour la réduire régression ajuster une fonction aux données d'entraînement afin de prédire une valeur de sortie continue à partir d'entrées 18.1
Conseils d'examen
- Les réponses sur les graphes nomment les nœuds, les arêtes et les poids, et ce qu'ils représentent ; puis l'algorithme. Dijkstra : tableau des distances, visiter le plus petit, mettre à jour les voisins. A* : $g$, $h$ et $f = g + h$ dans chaque ligne, développer le plus petit $f$.
- Les réponses sur les ANN nomment les couches, les connexions pondérées et l'entraînement ; l'apprentissage profond ajoute de nombreuses couches cachées, de grandes données et une extraction automatique de caractéristiques, avec une raison et un exemple.
- Les trois catégories en une ligne chacune : données étiquetées et sorties connues ; données non étiquetées et structure découverte ; agent, environnement, actions et récompenses.
- Rétropropagation : comparer avec la cible, erreur en arrière à travers les couches, ajuster les poids pour la réduire, répéter. La régression prédit une valeur ; la classification prédit une catégorie.
- Les questions de scénario veulent le pipeline : formé sur des exemples étiquetés, extrait des caractéristiques, reconnaît ou classe une nouvelle entrée ; nommer le type d'IA (reconnaissance d'image, reconnaissance vocale, apprentissage profond).
Erreurs courantes
- Décrire un graphe comme "un graphique" ; en IA, ce sont des nœuds et des arêtes.
- Exécuter Dijkstra en choisissant le voisin le plus proche du nœud actuel plutôt que la plus petite distance globale non encore visitée ; ou oublier de mettre à jour un nœud lorsqu'un itinéraire plus court apparaît.
- Ajouter $h$ dans $g$ pour l'étape suivante dans A* ; $g$ est seulement la vraie distance, $h$ est recalculé à partir du tableau.
- Dire que l'apprentissage profond est "apprendre beaucoup" ; ce sont les nombreuses couches cachées.
- Confondre l'apprentissage non supervisé avec l'apprentissage par renforcement ; le premier trouve une structure dans les données, le second apprend à partir de récompenses.
- Décrire la rétropropagation sans la comparaison avec la sortie attendue ou sans dire que les poids sont ajustés.
- Appeler une prédiction de prix "classification" ; une valeur continue est une régression.
-
19
Pensée computationnelle et résolution de problèmes
Regarder la leçon19.1
Algorithmes de recherche

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension des méthodes de recherche linéaire et de recherche binaire Écrire un algorithme pour implémenter une recherche linéaire Écrire un algorithme pour implémenter une recherche binaire Les conditions nécessaires à l'utilisation d'une recherche binaire Comment la performance d'une recherche binaire varie selon le nombre d'éléments de données Montrer la compréhension des méthodes de tri par insertion et de tri à bulles Écrire un algorithme pour implémenter un tri par insertion Écrire un algorithme pour implémenter un tri à bulles La performance d'une routine de tri peut dépendre de l'ordre initial des données et du nombre d'éléments de données Montrer la compréhension et utiliser les Types de Données Abstraits (ADT) Écrire des algorithmes pour trouver un élément dans chacun des suivants : liste chaînée, arbre binaire Écrire des algorithmes pour insérer un élément dans chacun des suivants : pile, file d'attente, liste chaînée, arbre binaire Écrire des algorithmes pour supprimer un élément de chacun des suivants : pile, file d'attente, liste chaînée Montrer la compréhension qu'un graphe est un exemple d'ADT. Décrire les caractéristiques principales d'un graphe et justifier son utilisation pour une situation donnée. Les candidats ne seront pas tenus d'écrire du code pour une structure de graphe Montrer comment il est possible d'implémenter des ADTs à partir d'un autre ADT Décrire les ADTs suivants et démontrer comment ils peuvent être implémentés à partir de types intégrés appropriés ou d'autres ADTs : pile, file d'attente, liste chaînée, dictionnaire, arbre binaire Montrer la compréhension que différents algorithmes effectuant la même tâche peuvent être comparés en utilisant des critères (p. ex., temps nécessaire pour terminer la tâche et mémoire utilisée) Incluant l'utilisation de la notation Big O pour spécifier la complexité temporelle et spatiale Source : Programme Cambridge International
Big O : comment les algorithmes évoluent Tri par insertion : glisser chaque carte à sa place Tri à bulles, passe par passe Recherche binaire : diviser par deux et vaincre Une recherche trouve une valeur cible dans un ensemble (souvent un tableau 数组) et retourne sa position, ou "non trouvé".
Rechercher dans une liste triée, comme un annuaire téléphonique, est bien plus rapide que vérifier chaque entrée une par une Recherche linéaire
Une recherche linéaire 线性查找 parcourt du début à la fin, comparant chaque élément avec la cible :
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Aucune préparation n'est nécessaire, donc cela fonctionne sur n'importe quelle liste. Cas le plus défavorable O($n$) (cible à la fin ou absente) ; meilleur cas 1 comparaison. Utilisez-le sur des données non triées ou de petites listes. (La ⟨
-1⟩ retournée est une valeur sentinelle — une position impossible qui signifie "non trouvé" ; l'appelant testeIF result = -1.)La version de l'examen. Paper 3 vous demande de compléter une recherche linéaire écrite avec un indicateur et une boucle
WHILE, et Paper 4 d'écrire une fonction qui retourne l'index ou un compteur. Tous deux ressemblent à ceci :FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 100 IF Data[Index] = Target THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count // how many times Target occurs; 0 means not found ENDFUNCTIONPour s'arrêter à la première correspondance au lieu de cela, utilisez une boucle
WHILE Index <= 100 AND NOT Foundqui définitFound ← TRUEet mémorise l'index. Les points sont pour la boucle sur chaque élément, la comparaison, et ce qui est retourné lorsque la valeur est absente.
La recherche linéaire vérifie chaque lettre à tour de rôle — 23 comparaisons pour trouver W Recherche binaire
Une recherche binaire 二分查找 nécessite que les données soient triées. Regardez l'élément central ; s'il est la cible, c'est fini ; si la cible est plus petite, cherchez dans la moitié gauche, sinon dans la moitié droite — divisant la plage par deux à chaque fois :
low ← 1
high ← n
WHILE low <= high DO
    mid ← (low + high) DIV 2
    IF A[mid] = target THEN
        RETURN mid
    ENDIF
    IF A[mid] < target THEN
        low ← mid + 1
    ELSE
        high ← mid - 1
    ENDIF
ENDWHILE
RETURN -1
Cas le plus défavorable O($\log_{2} n$) — pour un million d'éléments, environ 20 comparaisons. Beaucoup plus rapide que la recherche linéaire sur de grands tableaux triés, mais vous devez d'abord trier (un coût ponctuel O($n \log n$)), ce qui vaut le coup si vous recherchez de nombreuses fois.
"Énoncez la condition nécessaire pour une recherche binaire." Les données doivent être ordonnées (triées, croissantes ou décroissantes, sur la clé recherchée). "Décrivez comment effectuer une recherche binaire" (trois points) : (1) trouvez l'élément central de la liste (ou de la plage actuelle) et comparez-le avec la cible ; (2) s'il correspond, la recherche se termine ; si la cible est plus petite, répétez sur la moitié inférieure, si plus grande, sur la moitié supérieure ; (3) continuez à diviser par deux la plage jusqu'à ce que l'élément soit trouvé ou que la plage soit vide, ce qui signifie qu'il n'est pas présent.
La version de l'examen, avec les bornes et un indicateur, est celle à reproduire lorsque l'on vous demande de compléter l'algorithme :
DECLARE Lower, Upper, Mid : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    Mid ← (Lower + Upper) DIV 2
    IF Names[Mid] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[Mid] < Target THEN
            Lower ← Mid + 1
        ELSE
            Upper ← Mid - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT Mid
ELSE
    OUTPUT "Not found"
ENDIF
"Expliquez comment les performances varient avec le nombre d'éléments." Chaque comparaison réduit de moitié le nombre d'éléments restants, donc le nombre maximum de comparaisons est environ $\log_{2} n$ : doubler la taille de la liste ajoute seulement non comparaison de plus. C'est O($\log n$). "Comparez la recherche linéaire et binaire" : une recherche linéaire nécessite jusqu'à $n$ comparaisons (O($n$)) et, en moyenne, la moitié, mais fonctionne sur des données non triées ; une recherche binaire nécessite au maximum $\log_{2} n$ (O($\log n$)) et est beaucoup plus rapide pour de grandes listes, mais les données doivent d'abord être triées et elle doit permettre l'accès direct à l'élément central (un tableau, pas une liste chaînée). Pour $1000$ éléments : $1000$ contre $10$ comparaisons.
La recherche binaire réduit la plage de moitié à chaque étape (bas / milieu / haut) — juste 3 comparaisons pour trouver W 
Un catalogue de cartes : ce sont les enregistrements triés qui rendent possible une recherche binaire — réduisez de moitié, regardez, réduisez de nouveau ExplorerRecherche linéaire vs binaire
Recherchez une valeur. La recherche dichotomique divise la liste par deux à chaque étape (uniquement sur des données triées) ; la recherche linéaire vérifie un par un.
Vocabulaire EntrainerAnglais Chinois Pinyin insertion sort/ɪnˈsɜːʃn sɔːt/ 插入排序 chā rù pái xù bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù binary search/ˈbaɪnəri sɜːtʃ/ 二分查找 èr fēn chá zhǎo array/əˈreɪ/ 数组 shù zǔ linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo 19.1
Algorithmes de tri
Tri à bulles
Un tri à bulles 冒泡排序 parcourt répétément le tableau, échangeant les paires adjacentes qui ne sont pas dans l'ordre, de sorte que le plus grand élément "bulle" vers la fin à chaque passage :
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Cas optimal O($n$) (déjà trié, avec sortie anticipée) ; moyen/mauvais cas O($n^{2}$). Simple mais lent pour de grands $n$.
Tri par insertion
Un tri par insertion 插入排序 construit un préfixe trié à partir de la gauche, insérant chaque nouvel élément à sa place en décalant les éléments plus grands vers la droite :
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Cas optimal O($n$) (déjà trié) ; pire cas O($n^{2}$). Bon pour les tableaux petits ou presque triés. Il trie in place 原地 et est stable 稳定 (conserve l'ordre des éléments égaux).
Suivi d'un tri
Une tâche courante consiste à montrer le tableau après chaque passe externe. Pour
[D, T, H, R]avec le tri par insertion : passe 1 (clé T) pas de changement ; passe 2 (clé H) →[D, H, T, R]; passe 3 (clé R) →[D, H, R, T].Écrire un tri de zéro. "Écrivez un pseudocode pour trier
DataArray[1:1000]par ordre croissant" est répondu par un tri à bulles complet avec le indicateur de sortie anticipée, ou un tri par insertion, déclaré et indenté ; les deux obtiennent la note maximale s'ils fonctionnent pour toute entrée :DECLARE Pass, Index, Temp : INTEGER DECLARE Swapped : BOOLEAN Pass ← 1 REPEAT Swapped ← FALSE FOR Index ← 1 TO 1000 - Pass IF DataArray[Index] > DataArray[Index + 1] THEN Temp ← DataArray[Index] DataArray[Index] ← DataArray[Index + 1] DataArray[Index + 1] ← Temp Swapped ← TRUE ENDIF NEXT Index Pass ← Pass + 1 UNTIL Swapped = FALSE OR Pass = 1000Pour un ordre décroissant, remplacez
>par<; pour trier des enregistrements ou un tableau 2D par un champ, comparez ce champ mais échangez l'enregistrement entier (ou toutes les colonnes). On vous demande d'écrire un tri par insertion "qui effectue la même tâche" qu'un tri à bulles donné : gardez le même nom de tableau et la même direction et reproduisez le tri par insertion ci-dessus avec la comparaison inversée si l'ordre est décroissant."Décrivez deux façons dont les performances d'un tri sont affectées par les données" (deux points). (1) Le nombre d'éléments : un tri $O(n^{2})$ prend quatre fois plus longtemps pour deux fois plus d'éléments. (2) Dans quelle mesure les données sont déjà en ordre : un tri à bulles avec un indicateur, ou un tri par insertion, se termine en une seule passe sur des données déjà triées ($O(n)$) et fait le plus de travail sur des données en ordre inverse ; le nombre d'échanges dépend du nombre de paires désordonnées. (Aussi accepté : la plage ou le nombre de valeurs dupliquées, et si les éléments sont de grands enregistrements coûteux à déplacer.) Les tris à bulles et par insertion sont tous deux O($n^{2}$) dans les pire et cas moyens et O($n$) au mieux ; les tris rapides et par fusion sont O($n \log n$), c'est pourquoi ils sont utilisés pour les grandes données.
Un tri par insertion de [D, T, H, R], déplaçant chaque clé à sa place passage par passageExplorerRegardez un tri s'exécuter
Parcourez un tri et observez les barres se ranger dans l'ordre — comment fonctionne un algorithme de tri, étape par étape.
Vocabulaire EntrainerAnglais Chinois Pinyin in place/ɪn pleɪs/ 原地 yuán dì stable/ˈsteɪbl/ 稳定 wěn dìng 19.1
ADT dans les algorithmes
Les Types de Données Abstraits (ADT) du Topic 10 apparaissent à l'intérieur de nombreux algorithmes : une pile 栈 guide la traversal en profondeur et l'undo ; une fichier 队列 guide la traversal en largeur et l'ordre d'impression ; une liste chaînée 链表 permet aux données de croître et de diminuer.
Les ADT peuvent être construits à partir d'autres ADT, pas seulement à partir de tableaux : une file à partir de deux piles ; une pile à partir d'une liste chaînée (push = ajouter une tête nœud 节点) ; une file à partir d'une liste chaînée avec des pointeurs de tête et de queue pointers 指针 ; un arbre binaire 二叉树 à partir de nœuds avec deux pointeurs enfants ; un dictionnaire 字典 stocke des paires clé→valeur (souvent sur une table de hachage). Empiler ainsi sépare les préoccupations — l'algorithme utilisant l'ADT n'a pas besoin de savoir comment il est construit.
Les ADT que l'examen vous demande de décrire et d'implémenter
Pile (last in, first out) : les éléments sont ajoutés (pushed) et retirés (popped) à la même extrémité, le sommet ; un pointeur
TopOfStackgarde l'index de l'élément du sommet. Implémenté avec un tableau et ce seul pointeur : push vérifie que la pile n'est pas pleine, incrémente le pointeur et stocke l'élément ; pop vérifie qu'elle n'est pas vide, retourne l'élément du sommet et décrémente le pointeur.FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN IF TopOfStack = 9 THEN // full (array 0 to 9) RETURN FALSE ENDIF TopOfStack ← TopOfStack + 1 StackData[TopOfStack] ← Item RETURN TRUE ENDFUNCTION FUNCTION Pop() RETURNS INTEGER IF TopOfStack = -1 THEN // empty RETURN -1 ENDIF TopOfStack ← TopOfStack - 1 RETURN StackData[TopOfStack + 1] ENDFUNCTIONFile (first in, first out) : les éléments rejoignent à l'arrière (enfiler) et partent de l'avant (défiler) ; deux pointeurs et un compteur. Dans une file linéaire, le pointeur avant glisse le long du tableau jusqu'à ce que l'espace au début soit gaspillé ; une file circulaire 循环队列 fait tourner les deux pointeurs autour avec
MOD, de sorte que chaque cellule est réutilisée.Une file circulaire : les pointeurs arrière et avant avancent avec MOD, de sorte que les premières cellules du tableau sont réutilisées une fois leurs éléments partis FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN IF Count = 6 THEN // full RETURN FALSE ENDIF Rear ← (Rear + 1) MOD 6 QueueArray[Rear] ← Item Count ← Count + 1 RETURN TRUE ENDFUNCTION FUNCTION Dequeue() RETURNS STRING IF Count = 0 THEN // empty RETURN "" ENDIF DECLARE Item : STRING Item ← QueueArray[Front] Front ← (Front + 1) MOD 6 Count ← Count - 1 RETURN Item ENDFUNCTIONListe chaînée : une séquence de nœuds, chacun contenant un élément de données et un pointeur vers le nœud suivant ; un pointeur de départ donne le premier nœud et un pointeur nul (0 ou $-1$) termine la liste. Dans une implémentation par tableau, deux tableaux parallèles contiennent les données et les pointeurs, et les cellules inutilisées sont enchaînées dans une liste libre 空闲列表 de sorte qu'une insertion sait où placer le nouveau nœud.
Une liste chaînée dans deux tableaux : l'ordre de la liste est dans les pointeurs, pas dans les positions ; insérer un nom signifie prendre une cellule de la liste libre et relier deux pointeurs FUNCTION FindInList(Target : STRING) RETURNS INTEGER // index, or 0 if absent DECLARE Current : INTEGER Current ← Start WHILE Current <> 0 IF Data[Current] = Target THEN RETURN Current ENDIF Current ← Pointer[Current] ENDWHILE RETURN 0 ENDFUNCTIONPour insérer dans une liste ordonnée : prenez la première cellule libre (
NewNode ← FreeList,FreeList ← Pointer[FreeList]), stockez l'élément, puis parcourez la liste avec un pointeurPreviousetCurrentjusqu'àData[Current] > Itemou la fin ; définissezPointer[NewNode] ← CurrentetPointer[Previous] ← NewNode(ouStart ← NewNodesi cela va en premier). Pour supprimer, relier le nœud précédent au-delà de celui supprimé et retourner la cellule à la liste libre.Arbre binaire : un nœud racine, chaque nœud contenant des données, un pointeur gauche vers un sous-arbre de valeurs plus petites et un pointeur droit vers un sous-arbre de valeurs plus grandes. Implémenté comme un tableau 2D (ou trois tableaux 1D)
Tree[Index, 0..2]pour le pointeur gauche, les données, le pointeur droit, avec un pointeur racine et un pointeur next-free.FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER // index, or -1 DECLARE Current : INTEGER Current ← Root WHILE Current <> -1 IF Tree[Current, 1] = Target THEN RETURN Current ENDIF IF Target < Tree[Current, 1] THEN Current ← Tree[Current, 0] // go left ELSE Current ← Tree[Current, 2] // go right ENDIF ENDWHILE RETURN -1 ENDFUNCTIONPour insérer : stockez l'élément dans le prochain nœud libre avec les deux pointeurs $-1$ ; si l'arbre est vide, faites-en la racine ; sinon, descendez depuis la racine, allez à gauche ou à droite par comparaison, jusqu'à ce que le pointeur que vous suivriez soit $-1$, et définissez ce pointeur vers le nouveau nœud. Un ADT à partir d'un autre ADT : une pile est une liste chaînée où push et pop fonctionnent tous deux au début ; une file est une liste chaînée avec un pointeur de départ et un pointeur de fin ; une file peut être faite à partir de deux piles (push sur l'une, pop de l'autre, tout déplacer quand la seconde est vide) ; les nœuds d'un arbre binaire sont des enregistrements ou objets liés par des pointeurs, donc il est construit à partir d'une structure de liste de nœuds. Dites quelles opérations du nouveau ADT correspondent à quelles opérations de l'ancien.

Un arbre binaire : chaque nœud a jusqu'à deux nœuds enfants 
Trois traversals en profondeur d'un arbre binaire : pré-ordre, in-ordre (ordre trié) et post-ordre Vocabulaire EntrainerAnglais Chinois Pinyin linked list/lɪŋkt lɪst/ 链表 liàn biǎo stack/stæk/ 栈 zhàn queue/kjuː/ 队列 duì liè node/nəʊd/ 节点 jié diǎn pointers/ˈpɔɪntəz/ 指针 zhǐ zhēn binary tree/ˈbaɪnəri triː/ 二叉树 èr chā shù dictionary/ˈdɪkʃənəri/ 字典 zì diǎn circular queue/ˈsɜːkjʊlə kjuː/ 循环队列 xún huán duì liè free list/friː lɪst/ 空闲列表 kòng xián liè biǎo time complexity/taɪm kəmˈpleksɪti/ 时间复杂度 shí jiān fù zá dù Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ 大O表示法 dà O biǎo shì fǎ space complexity/speɪs kəmˈpleksɪti/ 空间复杂度 kōng jiān fù zá dù 19.1
Comparaison des algorithmes
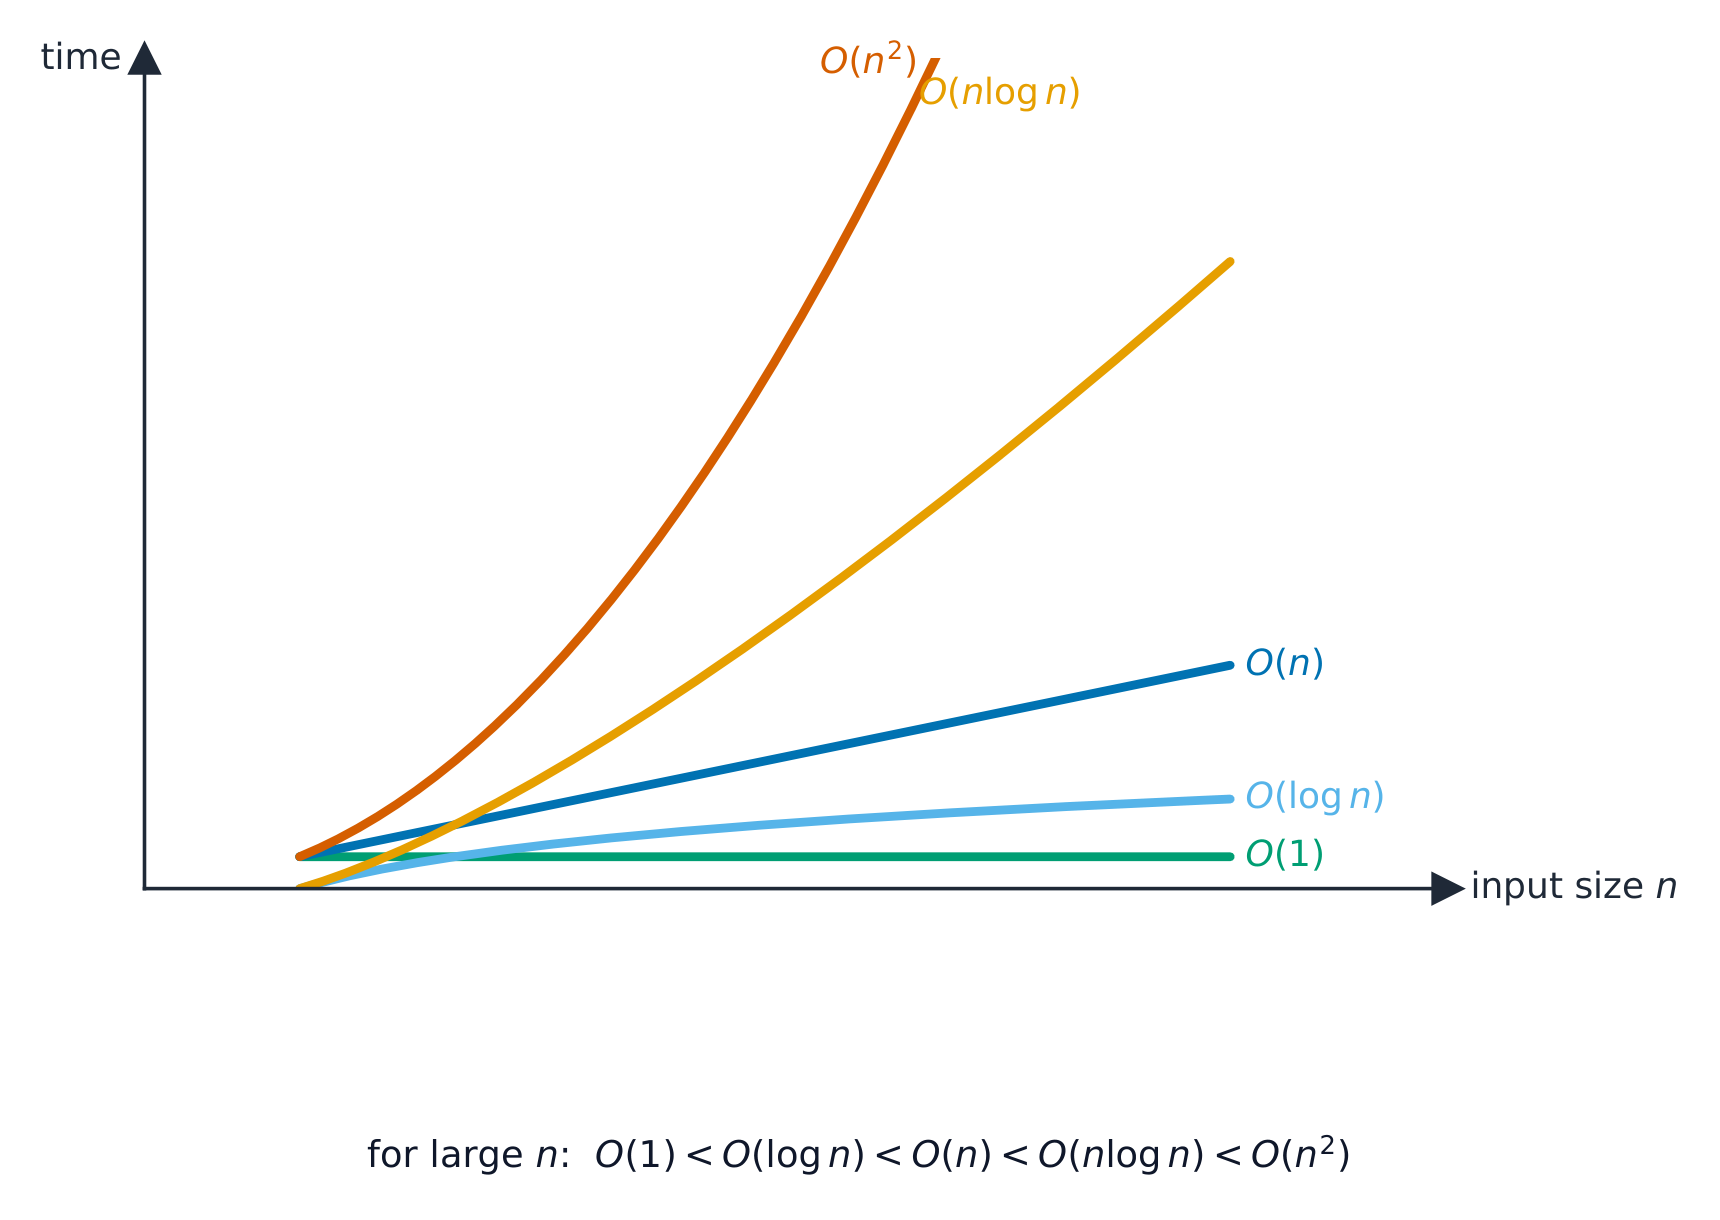
Complexité temporelle
La complexité temporelle 时间复杂度 est la façon dont le temps d'exécution augmente avec la taille de l'entrée $n$, écrite en notation Big-O 大O表示法 (le terme dominant) : O(1) constant, O($\log n$) recherche binaire, O($n$) recherche linéaire, O($n \log n$) bons tris, O($n^{2}$) tri à bulles/tri par insertion. Un ordre inférieur est meilleur à grande échelle, même si un autre algorithme est plus rapide pour de petites $n$.
Pour rendre cela concret : pour trier un million d'éléments, un tri $O(n \log n)$ se termine en une fraction de seconde, tandis qu'un tri $O(n^{2})$ peut prendre des minutes.
Exemple résolu. Une liste triée contient $1000$ éléments. Combien de comparaisons chaque recherche nécessite-t-elle dans le pire cas ?
Une recherche linéaire vérifie les éléments un par un, donc elle peut nécessiter jusqu'à $1000$ comparaisons — c'est $O(n)$. Une recherche binaire réduit la liste de moitié à chaque étape, donc elle nécessite au maximum $\lceil \log_2 1000 \rceil = 10$ comparaisons — c'est $O(\log n)$. Doubler la liste à $2000$ éléments ajoute seulement non comparaison à la recherche binaire, mais jusqu'à un autre $1000$ à la recherche linéaire — c'est pourquoi l'ordre de croissance, pas la vitesse brute, décide du gagnant à grande échelle.
Décrire un ordre. O(1): le temps est constante, indépendant du nombre d'éléments (ajout dans une pile, lecture d'un élément de tableau). O($\log n$): le temps croît avec le logarithme du nombre d'éléments, donc doubler les données n'ajoute qu'une étape fixe supplémentaire (recherche binaire). O($n$): le temps croît proportionnellement au nombre d'éléments (recherche linéaire, un seul parcours d'une liste). O($n \log n$): un peu pire que linéaire (tri efficaces). O($n^{2}$): le temps croît avec le carré du nombre d'éléments, donc doubler les données quadruple le temps (tri à bulles et tri par insertion). "Donner la complexité Big O d'une recherche binaire de
Names[0:99]" est répondu $O(\log n)$, et "décrire sa signification" comme ci-dessus ; la notation Big O mesure comment le temps ou la mémoire s'échelle, pas le temps réel.Comment les ordres de croissance communs se comparent : un ordre plus petit gagne à grande échelle 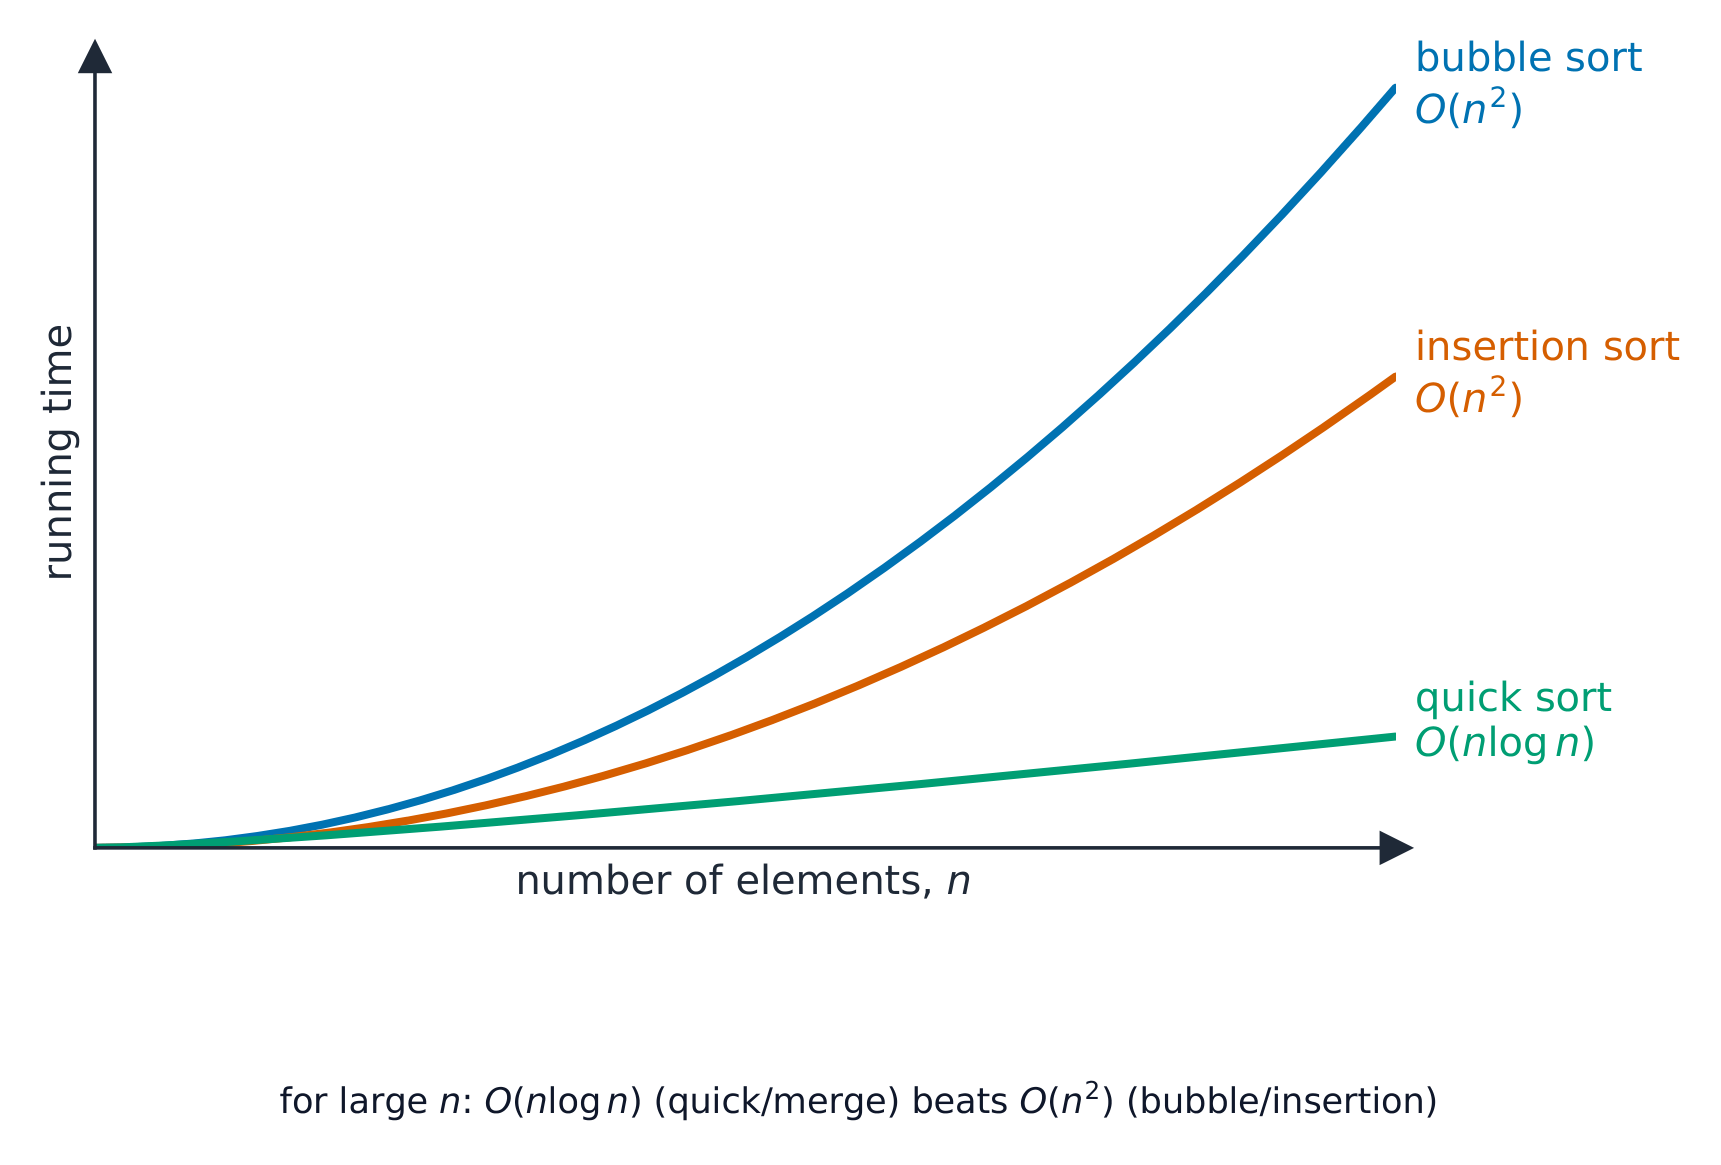
Comment le temps de tri croît avec le nombre d'éléments $n$ : $O(n^2)$ tris s'éloignent d'un $O(n\log n)$ tri Complexité spatiale
Complexité spatiale 空间复杂度 est la mémoire supplémentaire nécessaire. Le tri à bulles et le tri par insertion utilisent O(1) d'espace supplémentaire (en place) ; le tri fusion utilise O($n$) ; la récursion utilise de la mémoire de pile proportionnelle à sa profondeur. Il existe souvent un compromis temps-mémoire.
Autres critères
Simplicité (plus facile à coder et à maintenir), stabilité et adaptativité (plus rapide sur des données presque triées). Le bon algorithme dépend des données et des contraintes.
ExplorerLa croissance du temps d'exécution avec n
Faites glisser n vers le haut et comparez les courbes : O(1) et O(log n) restent presque plats, O(n) monte régulièrement, O(n²) explose. C'est pourquoi le Big-O — et non un chronomètre — est la manière dont nous comparons les algorithmes sur de grandes entrées.
ExplorerCroissance en notation Big-O
Changez la taille de l'entrée n et comparez la vitesse à laquelle le travail de chaque algorithme augmente — l'idée derrière la complexité temporelle.
19.2
Récursivité

Programme
Les candidats doivent être capables de : Notes et orientations Montrer la compréhension de la récursivité Caractéristiques essentielles de la récursivité Comment la récursivité est exprimée dans un langage de programmation Écrire et tracer des algorithmes récursifs Quand l'utilisation de la récursivité est bénéfique Avoir conscience de ce qu'un compilateur doit faire pour traduire du code de programmation récursif Utilisation des piles et du déroulement Source : Programme Cambridge International
Récursivité : la pile d'appels s'enroule et se déroule Les algorithmes récursifs utilisent la récursivité 递归 : une routine s'appelle elle-même avec une version plus petite du même problème, jusqu'à ce qu'un cas de base 基本情形 arrête la chaîne. Elle comporte deux parties : le cas de base (assez petit pour être résolu directement — sans lui, la récursivité ne s'arrête jamais) et le cas récursif 递归情形 (réduire l'entrée et s'appeler elle-même).
Factorielle 阶乘:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
La récursivité est naturelle pour les problèmes auto-similaires : arbres, diviser pour régner 分治 (recherche binaire, tri fusion) et structures de données imbriquées. Lorsqu'elle est mal adaptée, une boucle est généralement plus propre.
"Décrivez ce que signifie la récursivité" (deux points). Une fonction ou une procédure définie en termes d'elle-même : elle s'appelle elle-même depuis son propre corps, avec une version plus petite du problème à chaque fois, jusqu'à ce qu'un cas de base soit atteint. "Énoncez trois caractéristiques essentielles de la récursivité" : (1) un cas de base (condition d'arrêt) qui retourne une valeur sans appel ultérieur ; (2) un cas général 一般情形 dans lequel la routine s'appelle elle-même ; (3) chaque appel rapproche le problème du cas de base (le paramètre est réduit), afin que la récursivité se termine. Certains schémas ajoutent : les valeurs sont retournées lorsque les appels se déroulent.
"Décrivez quand l'utilisation de la récursivité est bénéfique, et donnez un exemple." Lorsque le problème est défini naturellement en termes de versions plus petites de lui-même, de sorte que la solution récursive est plus courte, plus claire et plus proche de la définition mathématique qu'une boucle ne pourrait l'être : factorielle ou nombre de Fibonacci, recherche binaire, parcours d'un arbre binaire, tri fusion ou quicksort, et traitement de structures imbriquées telles que des dossiers contenant des dossiers. C'est un mauvais choix lorsque la profondeur est grande (la pile peut déborder) ou lorsqu'un sous-problème identique est calculé de nombreuses fois (Fibonacci naïf).
Tracé d'un appel récursif
Pour
Factorial(4): les appels descendent jusqu'àFactorial(1)=1, puis le déroulement multiplie vers le haut :2*1=2,3*2=6,4*6=24. Résultat final24. Suivez chaque appel en attente sur une pile.Exemple corrigé. La fonction ci-dessous est donnée sans explication. Tracez
Unknown(3, 5)et indiquez sa sortie et sa valeur de retour.FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER IF X < Y THEN OUTPUT X + Y RETURN Unknown(X + 1, Y - 1) + 1 ELSE RETURN 0 ENDIF ENDFUNCTIONAppel 1 : $X = 3, Y = 5$ : $3 < 5$, sortie 8, appel
Unknown(4, 4). Appel 2 : $4 < 4$ est faux, retour 0. Déroulement : l'appel 1 retourne $0 + 1 = 1$. Sortie 8, valeur de retour 1. Écrivez le tracé sous forme de tableau avec une ligne par appel (paramètres, condition, sortie, ce qu'il retourne), et effectuez les retours depuis l'appel le plus profond vers le haut : c'est-à-dire le déroulement que cherche le barème.Exemple corrigé (Fibonacci).
Fib(n)retournenlorsquen < 2, sinonFib(n - 1) + Fib(n - 2). TrouvezFib(5).Fib(5) = Fib(4) + Fib(3);Fib(4) = Fib(3) + Fib(2);Fib(3) = Fib(2) + Fib(1);Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. DoncFib(3) = 1 + 1 = 2,Fib(4) = 2 + 1 = 3,Fib(5) = 3 + 2 = 5. Le cas de base est atteint beaucoup de fois (Fib(2)est calculé trois fois), c'est pourquoi cette version est lente : elle effectue 15 appels pour $n = 5$ et double approximativement le nombre d'appels pour chaque augmentation de $n$.Conversion de la récursivité en itération. Chaque routine récursive peut être réécrite avec une boucle, ce qui utilise moins de mémoire et est plus rapide : conservez un résultat accumulé et boulez du cas de base vers le haut. Factorielle sous forme de boucle :
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Interpellé pour convertir un tri par insertion ou une recherche récursive en une version itérative, remplacez l'appel à soi-même par une boucle sur l'index que la récursivité parcourait, et transformez le cas de base en condition de sortie de boucle.
La récursivité utilise la pile d'appels : les appels poussent des trames vers le bas jusqu'au cas de base, puis les retours se déroulent vers le haut Risques
- récursivité infinie si le cas de base est manqué — plantage avec une débordement de pile 栈溢出.
- forte consommation de mémoire pour une récursivité profonde.
- lent si cela répète des travaux (Fibonacci naïf est exponentiel — utilisez une boucle ou la mémoïsaion 记忆化).
ExplorerLa récursivité se déroule depuis les feuilles vers le haut
Parcourir fib(4) dans l'ordre où les appels se terminent réellement : les feuilles (cas de base) se résolvent d'abord, puis chaque parent combine ses enfants. Remarquez que fib(2) est calculé deux fois — ce travail répété explique pourquoi la récursivité naïve est lente.
Vocabulaire EntrainerAnglais Chinois Pinyin recursion/rɪˈkɜːʃn/ 递归 dì guī call stack/kɔːl stæk/ 调用栈 diào yòng zhàn base case/beɪs keɪs/ 基本情形 jī běn qíng xíng recursive case/rɪˈkɜːsɪv keɪs/ 递归情形 dì guī qíng xíng factorial/fækˈtɔːrɪəl/ 阶乘 jiē chéng divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ 分治 fēn zhì general case/ˈdʒenərəl keɪs/ 一般情形 yì bān qíng xíng parameters/pəˈræmɪtəz/ 参数 cān shù stack overflow/stæk ˌəʊvəˈfləʊ/ 栈溢出 zhàn yì chū memoisation/ˌmeməʊaɪˈzeɪʃn/ 记忆化 jì yì huà local variables/ˈləʊkl ˈveərɪəblz/ 局部变量 jú bù biàn liàng stack frame/stæk freɪm/ 栈帧 zhàn zhēn return address/rɪˈtɜːn əˈdres/ 返回地址 fǎn huí dì zhǐ 19.2
Ce que fait le compilateur pour le code récursif
La récursivité nécessite que chaque appel dispose de sa propre copie de ses paramètres 参数 et variables locales 局部变量. Le compilateur conserve ces éléments sur la pile d'appels 调用栈. Pour chaque appel, il pousse une trame de pile 栈帧 contenant les paramètres, les variables locales et l'adresse de retour 返回地址 (où reprendre chez l'appelant). Quand la fonction retourne, la valeur de retour est rendue, la trame est retirée, et le contrôle reprend à l'adresse de retour.
Parce que chaque appel a sa propre trame, les appels récursifs ne s'écrasent pas mutuellement leurs variables. La pile peut devenir grande pour une récursivité profonde, ce qui explique pourquoi une récursivité très profonde peut la faire déborder. C'est le même mécanisme d'appel et de retour utilisé pour les appels ordinaires (non récursifs) — il n'y a pas de "mécanisme spécial de récursivité".
"Expliquez pourquoi une pile est appropriée pour implémenter la récursivité" (trois points). Chaque appel récursif doit sauvegarder son adresse de retour, ses paramètres et ses variables locales, et les appels sont terminés dans l'ordre inverse de celui dans lequel ils ont été faits (le dernier appel fait est le premier à terminer), ce qui correspond exactement au comportement dernier entré, premier sorti d'une pile : chaque nouvel appel pousse une trame, et chaque retour retire la trame la plus récente, restaurant l'état de l'appelant et lui indiquant où continuer. C'est le travail du compilateur lorsqu'il traduit le code récursif : il génère la poussée d'une trame de pile à chaque appel et le retrait à chaque retour, et les trames se déroulent alors que les résultats reviennent.
19.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition recherche linéaire vérifier chaque item à tour de rôle depuis le début jusqu'à ce que la cible soit trouvée ou la fin atteinte recherche binaire comparer répétitivement la cible avec l'élément central d'une liste triée et éliminer la moitié qui ne peut pas la contenir tri à bulles passer répétitivement à travers la liste, échanger les éléments adjacents qui sont dans le mauvais ordre, jusqu'à ce qu'un passage ne fasse aucun échange tri par insertion prendre chaque élément successivement et l'insérer à sa place correcte parmi les éléments déjà triés type de données abstrait un ensemble de données et les opérations qui peuvent y être effectuées, défini indépendamment de la manière dont il est stocké pile une structure dernier entré, premier sorti avec push et pop en haut fichier une structure premier entré, premier sorti avec des éléments ajoutés à l'arrière et retirés à l'avant liste chaînée une séquence de nœuds, chacun contenant des données et un pointeur vers le nœud suivant, avec un pointeur de départ arbre binaire des nœuds contenant chacun des données et des pointeurs vers un sous-arbre gauche de valeurs inférieures et un sous-arbre droit de valeurs supérieures notation Big O une façon de classifier le temps (ou la mémoire) nécessaire par un algorithme selon sa croissance avec la taille de l'entrée récursivité une routine qui s'appelle elle-même avec une version plus petite du problème jusqu'à ce qu'un cas de base arrête les appels cas de base la condition selon laquelle une routine récursive retourne sans s'appeler elle-même déroulement les retours d'une chaîne d'appels récursifs, du dernier appel au premier, alors que les trames de pile sont retirées 19.2
Conseils d'examen
- Recherches : la recherche linéaire ne nécessite aucun ordre et O($n$) ; la recherche binaire nécessite un tableau trié, divise par deux à chaque étape et est en O($\log n$). Connaître les deux algorithmes par cœur, y compris les bornes et le drapeau.
- Tries : tri à bulles avec indicateur d'échange, tri par insertion avec une clé qui décale les éléments plus grands vers la droite ; tous deux en O($n^{2}$) dans le pire des cas, O($n$) sur des données déjà triées. Les performances dépendent du nombre d'éléments et de leur degré de tri.
- Les implémentations de TDA sont une gestion de pointeurs : un pointeur supérieur ; avant, arrière et compteur avec MOD ; début, pointeurs et liste libre ; racine avec pointeurs gauche et droit. Toujours vérifier les états plein et vide.
- Big O concerne l'échelle : constant, logarithmique, linéaire, carré. Dire "doublester les données ajoute une comparaison" pour une recherche binaire.
- Récursivité : cas de base, cas général, progression vers le cas de base ; bénéfique lorsque le problème est défini en termes de lui-même ; une pile contient les adresses de retour et les variables car les appels retournent dans l'ordre inverse. Tracez avec un tableau et déroulez depuis l'appel le plus profond.
Erreurs courantes
- Utiliser une recherche binaire sur des données non triées, ou sur une liste chaînée ; et définir
Lower ← Midau lieu deMid + 1, ce qui boucle indéfiniment. - Une boucle intérieure de tri à bulles qui parcourt toute le tableau à chaque passe, ou un échange sans variable temporaire.
- Un push ou enqueue qui ne teste pas l'état plein, ou un pop ou dequeue qui ne teste pas l'état vide.
- Déplacer le pointeur avant de la file sans MOD dans une file circulaire, ou considérer front = rear comme signifiant toujours vide.
- Insérer dans une liste chaînée en décalant le contenu du tableau ; seuls les pointeurs changent.
- Une fonction récursive sans cas de base, ou dont l'appel récursif ne rend pas le problème plus petit.
- Tracer un appel récursif mais oublier d'ajouter le travail en attente sur le chemin retour.
- Répondre "pourquoi une pile" par "parce que c'est rapide" ; la raison est l'ordre dernier entré, premier sorti des retours.
-
20
Programmation avancée
Regarder la leçon20.1
Paradigmes de programmation

Programme
Les candidats doivent être capables de : Notes et orientations Comprendre ce qu'on entend par un paradigme de programmation Montrer la compréhension des caractéristiques de plusieurs paradigmes de programmation : • Bas niveau Programmation bas niveau : • compréhension et capacité à écrire du code bas niveau utilisant divers modes d'adressage : immédiat, direct, indirect, indexé et relatif • Impératif (Procédural) Programmation impérative (procédurale) : • Connaissances supposées et compréhension de la programmation structurée (voir détails dans la section contenu AS 11.3) • compréhension et capacité à écrire du code de programmation impératif (procédural) utilisant des variables, des structures, des procédures et des fonctions. Voir détails dans le contenu AS • Orienté objet Programmation Orientée Objet (POO) : • compréhension de la terminologie associée à la POO (incluant objets, propriétés/attributs, méthodes, classes, héritage, polymorphisme, contenances (agrégation), encapsulation, getters, setters, instances) • compréhension de la façon de résoudre un problème en concevant des classes appropriées • compréhension et capacité à écrire du code démontrant l'utilisation de la POO • Déclaratif Programmation déclarative : • compréhension et capacité à résoudre un problème en écrivant des faits et des règles appropriés basés sur les informations fournies • compréhension et capacité à écrire du code capable de satisfaire un objectif en utilisant des faits et des règles Source : Programme Cambridge International
Un paradigme de programmation 编程范式 est un style de programmation — une façon de structurer les programmes, avec ses propres idées et fonctionnalités langagières. Quatre paradigmes de programmation figurent dans ce programme.
"Décrivez ce que signifie un langage impératif (procédural)" (deux points). Un langage dans lequel le programme est une séquence d'instructions exécutées dans l'ordre et qui modifient l'état du programme ; le programmeur dit comment la tâche est réalisée, en utilisant des procédures, une séquence, une sélection et une itération. "Décrivez ce que signifie un langage déclaratif" : *le programme énonce des faits et des règles (ce qui est connu et ce qui est souhaité) et le moteur d'inférence du langage détermine comment trouver la réponse ; le programmeur ne donne pas la séquence d'étapes.
Identifier le paradigme à partir d'un exemple de code (une question régulière de Paper 3) :
LDD 200,ADD #5,STO 201sont de bas niveau (mnémoniques, registres, adresses mémoire) ;FOR Count ← 1 TO 10 … NEXT Countavec procédures et affectations est impératif ;CLASS Dog … PRIVATE Name : STRING … PUBLIC PROCEDURE NEW(…)est orienté objet ;type(lion, wild).etdangerous(X) IF type(X, wild)est déclaratif (logique). Dans la question d'appariement : bas niveau correspond à « mnémoniques qui correspondent directement aux instructions machine », impératif à « une séquence d'instructions qui modifient l'état », POO à « objets qui combinent attributs et méthodes », déclaratif à « faits et règles, sans ordre d'exécution donné ».Quatre paradigmes : bas niveau, impératif, orienté objet et déclaratif Programmation bas niveau
Programmation proche du matériel en code machine 机器码 ou langage assembleur 汇编语言, où chaque instruction correspond à ce que le CPU exécute. Elle offre un accès direct aux registres 寄存器 et aux adresses mémoire 内存地址, en utilisant différents modes d'adressage 寻址方式 (immédiat, direct, indirect, indexé et relatif). C'est très rapide et compact, mais spécifique à l'architecture, fastidieux et difficile à maintenir. C'est la programmation bas niveau 低级, utilisée pour les pilotes, le firmware et les chargeurs de démarrage.
Les cinq modes d'adressage. Le programme demande du code bas niveau utilisant chaque mode d'adressage (l'ensemble d'instructions se trouve au Topic 4). L'oprande d'une instruction de chargement peut être lu de cinq façons, et l'examen donne le contenu de la mémoire et demande ce que contient l'accumulateur :
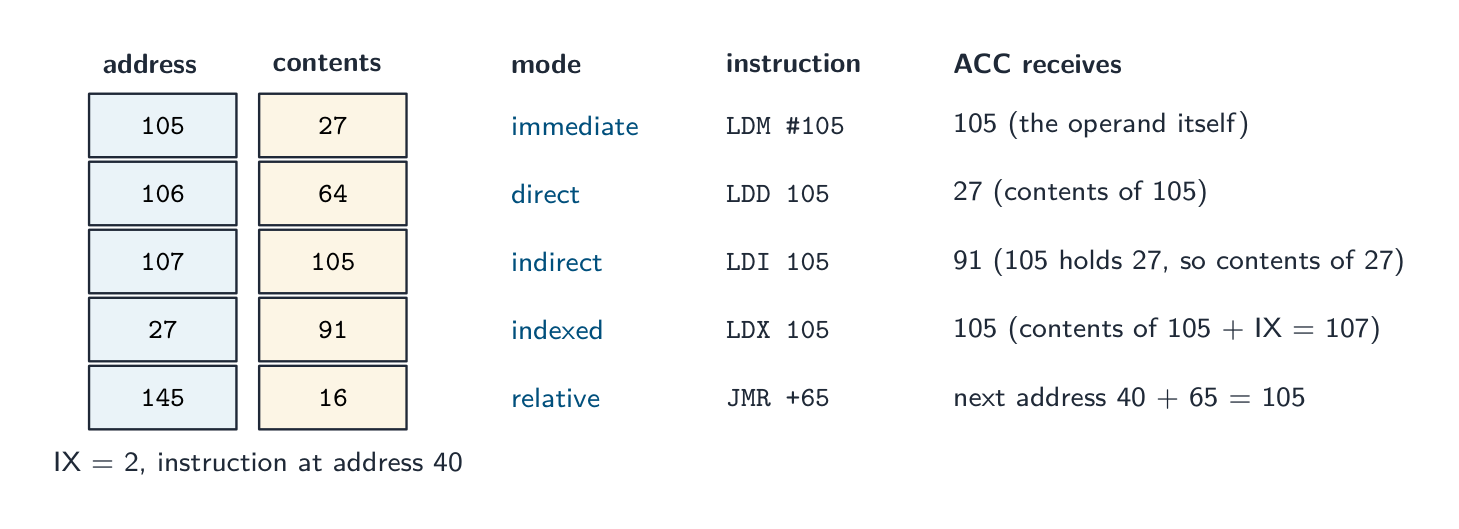
Le même opmande, 105, lu de cinq façons : comme une valeur, comme une adresse, comme l'adresse d'une adresse, comme une adresse plus le registre indexé, et comme un décalage par rapport à l'instruction actuelle - immédiat (
LDM #105) : l'oprande est la valeur ; ACC devient 105. - direct (
LDD 105) : l'oprande est l'adresse de la valeur ; ACC devient le contenu de 105, ici 27. - indirect (
LDI 105) : l'oprande est l'adresse d'une adresse ; ACC devient le contenu de 27, ici 91. Utilisé pour les pointeurs et pour les données dont la position est décidée à l'exécution. - indexé (
LDX 105) : l'adresse est l'oprande plus le registre indexé IX ; avec IX = 2, ACC devient le contenu de 107. Utilisé pour parcourir un tableau en incrémentant IX. - relatif (
JMR +65) : la cible est un décalage par rapport à l'adresse de l'instruction actuelle, ce qui rend le code relocalisable.
Exemple résolu. Mémoire : 105 contient 27, 106 contient 64, 200 contient 0. Écrire du code pour additionner les contenus de 105 et 106, stocker le résultat dans 200 et l'afficher.
LDD 105(ACC = 27),ADD 106(ACC = 91),STO 200,OUT. Pour doubler la valeur dans 105 au lieu de cela :LDD 105,ADD 105,STO 105. Indiquer le contenu des registres après chaque ligne lorsqu'on demande de tracer l'exécution.Programmation impérative (procédurale)
En programmation impérative 命令式编程, le programmeur écrit une série de commandes qui changent l'état du programme — affectations, conditions, boucles, appels de fonctions. Les variables 变量 stockent l'état ; les instructions le modifient ; le code est organisé en procédures et fonctions (aussi appelées programmation structurée ou structurale). C'est le style des Topics 9 et 11 (Python, C). Fort lorsque l'algorithme a des étapes séquentielles claires.
Programmation orientée objet (POO)
En programmation orientée objet 面向对象编程, les programmes sont construits à partir d'objets 对象 — des unités combinant des données (attributs 属性) et des opérations (méthodes 方法). Les objets sont des instances 实例 de classes 类. Les quatre piliers :
- encapsulation 封装 — les données d'un objet sont cachées derrière ses méthodes ; le code extérieur n'utilise que les méthodes publiques, pas les données directement. Cela protège l'objet et permet de modifier son interne sans casser les appelants. Par exemple, un
BankAccountcache sesbalance; vous ne les modifiez qu'à traversdeposit()etwithdraw(), ce qui peut imposer une règle comme "ne jamais descendre sous zéro". - héritage 继承 — un sous-classe 子类 spécialise une superclasse 父类, héritant de ses attributs et méthodes et ajoutant ou redéfinissant 重写 ces derniers. Modélise "est-un" ("un Manager est un Employee").
- polymorphisme 多态 — différents objets répondent à la même appel de méthode différemment ; l'appelant ne doit pas connaître le type exact. Chaque
ShapepossèdeArea(), et unCircleet unRectanglel'implémentent chacun à leur manière. - abstraction 抽象 — montrer une interface simple et cacher l'implémentation.
Autres termes :
- non constructeur 构造函数 est une méthode spéciale exécutée lors de la création d'un objet, pour initialiser ses attributs.
- les getters et setters lisent et écrivent les attributs d'un objet (ses propriétés) via des méthodes.
- l'agrégation 聚合 et l'containment 包含 construisent un objet à partir d'autres objets (une relation "a-un").
La POO est utilisée pour les grands systèmes, les interfaces graphiques, les simulations et les jeux.
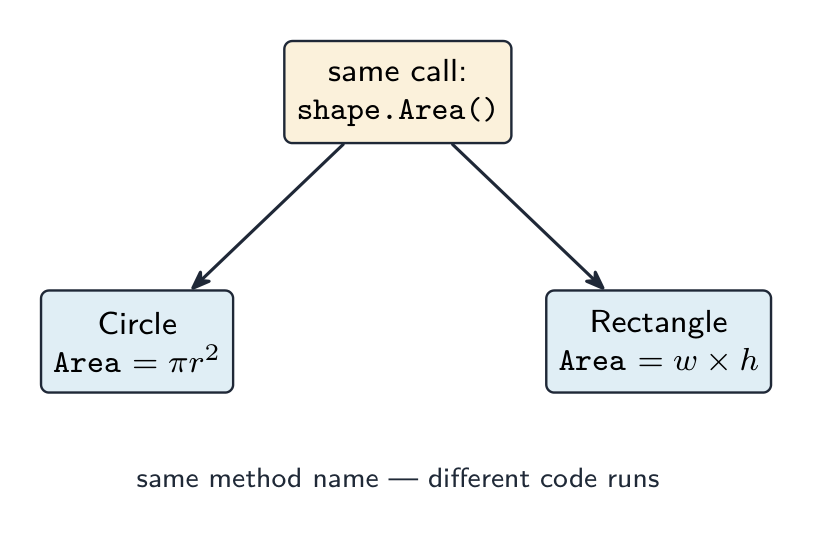 *Polymorphisme : le même appel de méthode exécute le code propre de chaque objet
 *Un diagramme de classes pour Shape : attributs privés et méthodes publiques
 *Héritage : partTime et fullTime sont des sous-classes de employee
 *Encapsulation : les données d'un objet sont privées, atteintes uniquement via ses méthodes publiques
POO selon la correction de l'examineur
Définitions. Classe : non modèle (plan) qui définit les attributs et méthodes des objets de ce type. Objet : une instance d'une classe, créée à partir d'elle, avec ses propres valeurs pour les attributs ("une occurrence d'un objet" est l'expression de l'examen pour une instance). Attribut (propriété) : un élément de données appartenant à une classe. Méthode : une procédure ou fonction appartenant à une classe qui agit sur ses attributs. Encapsulation : combiner les attributs et méthodes dans une classe et restreindre l'accès externe aux données : les attributs sont privés et ne peuvent être lus ou modifiés que via des méthodes publiques. Héritage : une sous-classe acquiert les attributs et méthodes de sa classe parente (super) et peut ajouter les siennes ou les redéfinir. Polymorphisme : des méthodes avec le même nom qui se comportent différemment dans différentes classes ; typiquement une sous-classe redéfinit une méthode de son parent, et la bonne version s'exécute pour chaque objet. Containment : une classe possède un objet d'une autre classe comme attribut (une voiture a un moteur). "Identifier la caractéristique qui restreint l'accès externe aux données" est l'encapsulation ; "le terme pour une occurrence d'un objet" est l'instance.
"Esquisser la structure d'une classe" (trois points) : les attributs (propriétés) qui stockent les données de l'objet, généralement déclarés privés ; les méthodes (procédures et fonctions) qui agissent sur ces attributs, généralement publiques ; et un constructeur, une méthode qui s'exécute lors de la création d'un objet pour initialiser les attributs. "Donner trois avantages de la POO" : le code est réutilisé grâce à l'héritage ; les données sont protégées par l'encapsulation, donc elles ne peuvent être modifiées que par les méthodes propres à la classe ; un grand programme est divisé en classes écrites et testées indépendamment, ce qui facilite l'entretien et l'extension ; les classes modélisent des entités réelles, donc la conception est plus facile à comprendre ; le polymorphisme permet au même appel de fonctionner pour différents objets.
La classe en pseudocode, tel que défini par Paper 3 :
CLASS Car
    PRIVATE Registration : STRING
    PRIVATE Year : INTEGER
    PRIVATE Mileage : INTEGER
    PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER)
        Registration ← NewReg
        Year ← NewYear
        Mileage ← 0
    ENDPROCEDURE
    PUBLIC FUNCTION GetMileage() RETURNS INTEGER
        RETURN Mileage
    ENDFUNCTION
    PUBLIC PROCEDURE AddMileage(Extra : INTEGER)
        Mileage ← Mileage + Extra
    ENDPROCEDURE
ENDCLASS
Un objet est créé avec
MyCar ← NEW Car("AB12 CDE", 2020)et utilisé avecMyCar.AddMileage(150)etOUTPUT MyCar.GetMileage(). Une sous-classe réutilise le constructeur parent viaSUPER:CLASS ElectricCar INHERITS Car PRIVATE BatteryCapacity : REAL PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER, NewCapacity : REAL) SUPER.NEW(NewReg, NewYear) BatteryCapacity ← NewCapacity ENDPROCEDURE ENDCLASSLa même classe en Python, tel que attendu par Paper 4 : les attributs sont rendus privés avec un double underscore, le constructeur est
__init__, et une sous-classe nomme son parent entre parenthèses et appellesuper().__init__(…):class Car: def __init__(self, reg, year): self.__registration = reg self.__year = year self.__mileage = 0 def get_mileage(self): return self.__mileage def add_mileage(self, extra): self.__mileage = self.__mileage + extra class ElectricCar(Car): def __init__(self, reg, year, capacity): super().__init__(reg, year) self.__capacity = capacity cars = [] cars.append(Car("AB12 CDE", 2020)) cars.append(ElectricCar("EV21 XYZ", 2023, 75.0)) cars[1].add_mileage(150) print(cars[1].get_mileage())En Java, les mêmes concepts sont
private/publicchamps, un constructeur portant le nom de la classe,extendsetsuper(…); en VB.NETPrivate/Public,Sub New,InheritsetMyBase.New. Une méthode polymorphe est écrite dans la classe parente et redéfinie (override) dans la classe enfant avec le même nom ; un appel via une variable de type parent exécute la version de l'enfant.Structures de données comme objets. Paper 4 construit une pile, une liste chaînée ou un arbre binaire à partir d'une classe
Nodedont les attributs sont les données et une ou deux références vers d'autres nœuds ; une classeTree(ouLinkedList) contient la racine (ou le début) et les méthodes. *Un arbre binaire construit à partir d'objets : chaque Node contient Data plus les références Left et Right, et Tree contient Root ; l'insertion parcourt les références
CLASS Node
    PUBLIC Data : INTEGER
    PUBLIC Left : Node          // NULL when there is no child
    PUBLIC Right : Node
    PUBLIC PROCEDURE NEW(NewData : INTEGER)
        Data ← NewData
        Left ← NULL
        Right ← NULL
    ENDPROCEDURE
ENDCLASS

CLASS Tree
    PRIVATE Root : Node
    PUBLIC PROCEDURE Insert(NewData : INTEGER)
        DECLARE NewNode, Current : Node
        DECLARE Placed : BOOLEAN
        NewNode ← NEW Node(NewData)
        IF Root = NULL THEN
            Root ← NewNode
        ELSE
            Current ← Root
            Placed ← FALSE
            WHILE NOT Placed
                IF NewData < Current.Data THEN
                    IF Current.Left = NULL THEN
                        Current.Left ← NewNode
                        Placed ← TRUE
                    ELSE
                        Current ← Current.Left
                    ENDIF
                ELSE
                    IF Current.Right = NULL THEN
                        Current.Right ← NewNode
                        Placed ← TRUE
                    ELSE
                        Current ← Current.Right
                    ENDIF
                ENDIF
            ENDWHILE
        ENDIF
    ENDPROCEDURE
ENDCLASS
Une méthode find parcourt le même chemin et retourne
TRUElorsqueCurrent.Data = Target,FALSElorsqu'elle atteintNULL; une méthode de sortie en ordre infixe est récursive : elle affiche le sous-arbre gauche, puis le nœud, enfin le sous-arbre droit. Pour une liste chaînée, le nœud possède une référence,Next, et la classe de liste détientStart; pour une pile construite à partir d'une liste, les opérations push et pop s'effectuent toutes deux àStart.Exemple résolu. Un jeu a des personnages. Chacun a un nom, une santé (commençant à 100) et une position donnée par X et Y. Écrire une classe
Characteravec un constructeur et une méthodeMove(DX, DY); puis une sous-classeWizardqui ajouteMana(commençant à 50) et une méthodeCastSpell()qui prend 10 mana et retourneTRUEs'il y en avait assez.CLASS Character PRIVATE Name : STRING PRIVATE Health : INTEGER PRIVATE X : INTEGER PRIVATE Y : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) Name ← NewName Health ← 100 X ← StartX Y ← StartY ENDPROCEDURE PUBLIC PROCEDURE Move(DX : INTEGER, DY : INTEGER) X ← X + DX Y ← Y + DY ENDPROCEDURE ENDCLASS CLASS Wizard INHERITS Character PRIVATE Mana : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) SUPER.NEW(NewName, StartX, StartY) Mana ← 50 ENDPROCEDURE PUBLIC FUNCTION CastSpell() RETURNS BOOLEAN IF Mana >= 10 THEN Mana ← Mana - 10 RETURN TRUE ELSE RETURN FALSE ENDIF ENDFUNCTION ENDCLASSLes points sont pour les attributs privés, un constructeur qui définit chaque attribut, la ligne d'héritage, l'appel au constructeur parent, et une méthode qui utilise et modifie les données propres de l'objet. Quand la question demande un diagramme de classes, dessiner une boîte en trois parties (nom ; attributs avec
-pour privé ; méthodes avec+pour public) et relier une sous-classe à son parent avec une flèche pointant vers le parent.Programmation déclarative
En programmation déclarative 声明式编程, vous dites ce que calculer, pas comment — l'exécutant détermine les étapes. Deux sortes :
- programmation fonctionnelle 函数式编程 — construite à partir de fonctions pures 纯函数 (pas d'effets secondaires 副作用 ; même entrée donne toujours même sortie) composées ensemble. Exemples : Haskell, Lisp.
- programmation logique 逻辑编程 — définit des faits et des règles ; le moteur répond à un objectif (requête) par inférence. Exemple : Prolog.
Un exemple déclaratif familier est SQL 结构化查询语言 :
SELECT * FROM Customer WHERE Country = 'UK'dit ce que vous voulez, pas comment parcourir les enregistrements.Faits, règles et objectifs sont ce que l'examen teste dans le paradigme déclaratif. Étant donné ces faits 事实 (déclarations qui sont vraies) et une règle 规则 (une conclusion qui est vraie lorsque ses conditions sont remplies) :
01 type(leopard, wild).
02 type(lion, wild).
03 type(tabby, domestic).
04 size(leopard, large).
05 size(lion, large).
06 size(tabby, small).
07 dangerous(X) IF type(X, wild) AND size(X, large).
"Écrivez le résultat de l'objectif
type(X, wild)" :X = leopard, X = lion. Le moteur fait correspondre l'objectif avec chaque fait à tour de rôle ; chaque correspondance est une solution, et une lettre majuscule est une variable que la correspondance remplit. "Écrivez un fait pour montrer qu'un guépard est sauvage" :type(cheetah, wild)."Expliquez ce que fait la ligne 07" : elle définit une règle dont la conclusion estdangerous(X), qui est vraie pour toutXqui est à la fois sauvage et grand, doncdangerous(A)retourneA = leopard, A = lion. "Écrivez une règle : une caractéristiqueFpeut être disponible pour un style de carrosserieBsiFest une caractéristique etBest un style de carrosserie etFn'est pas indisponible pourB" :may_be_available(F, B) IF feature(F) AND body_style(B) AND NOT unavailable(F, B). Copiez les noms de prédicat et l'ordre des arguments exacts utilisés dans les faits de la question ; un nouveau fait se termine par un point, et les conditions d'une règle sont jointes parAND.Comparaison des paradigmes
Paradigme Force Langages typiques Bas niveau contrôle maximal, vitesse assembleur Impérative directe, intuitive C, Python Orientée objet modulaire, modèle des entités Java, C#, Python Fonctionnelle claire, sans effets secondaires Haskell, F# Logique inférence, règles Prolog Base de données requêtes sur données SQL Les langages modernes mixent souvent les paradigmes — Python prend en charge tous ceux-ci : procédural, POO et fonctionnel. Le bon dépend du problème.
ExplorerLaboratoire de concepts de programmation
Reliez les exemples au concept de programmation qu'ils illustrent.
Vocabulaire EntrainerAnglais Chinois Pinyin programming paradigm/ˈprəʊɡræmɪŋ ˈpærədaɪm/ 编程范式 biān chéng fàn shì facts/fækts/ 事实 shì shí rule/ruːl/ 规则 guī zé low-level/ləʊ ˈlevl/ 低级 dī jí registers/ˈredʒɪstəz/ 寄存器 jì cún qì memory addresses/ˈmeməri əˈdresɪz/ 内存地址 nèi cún dì zhǐ objects/ˈɒbdʒekts/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán addressing modes/əˈdresɪŋ məʊdz/ 寻址方式 xún zhǐ fāng shì array/əˈreɪ/ 数组 shù zǔ imperative programming/ɪmˈperətɪv ˈprəʊɡræmɪŋ/ 命令式编程 mìng lìng shì biān chéng Variables/ˈveərɪəblz/ 变量 biàn liàng object-oriented programming/ˈɒbdʒekt ˈɔːrɪəntɪd ˈprəʊɡræmɪŋ/ 面向对象编程 miàn xiàng duì xiàng biān chéng instances/ˈɪnstənsɪz/ 实例 shí lì classes/ˈklæsɪz/ 类 lèi encapsulation/ɪnˌkæpsjʊˈleɪʃn/ 封装 fēng zhuāng inheritance/ɪnˈherɪtəns/ 继承 jì chéng subclass/ˈsʌbklæs/ 子类 zi lèi superclass/ˈsuːpəklæs/ 父类 fù lèi overriding/ˌəʊvəˈraɪdɪŋ/ 重写 chóng xiě polymorphism/ˈpɒlɪmɔːfɪzəm/ 多态 duō tài abstraction/əbˈstrækʃn/ 抽象 chōu xiàng constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù aggregation/ˌæɡrɪˈɡeɪʃn/ 聚合 jù hé containment/kənˈteɪnmənt/ 包含 bāo hán declarative programming/dɪˈklærətɪv ˈprəʊɡræmɪŋ/ 声明式编程 shēng míng shì biān chéng functional programming/ˈfʌŋkʃənl ˈprəʊɡræmɪŋ/ 函数式编程 hán shù shì biān chéng pure functions/pjʊə ˈfʌŋkʃnz/ 纯函数 chún hán shù side effects/saɪd ɪˈfekts/ 副作用 fù zuò yòng logic programming/ˈlɒdʒɪk ˈprəʊɡræmɪŋ/ 逻辑编程 luó jí biān chéng SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán 20.2
Traitement de fichiers
Programme
Les candidats doivent être capables de : Notes et orientations Écrire du code pour effectuer des opérations de traitement de fichiers Ouvrir (en mode lecture, écriture, ajout) et fermer un fichier Lire un enregistrement depuis un fichier et écrire un enregistrement vers un fichier Effectuer des opérations de traitement de fichiers sur des fichiers série, séquentiels, aléatoires Montrer la compréhension d'une exception et de l'importance de la gestion des exceptions Savoir quand il est approprié d'utiliser la gestion des exceptions Écrire du code de programme pour utiliser la gestion des exceptions Source : Programme Cambridge International
Cela étend la gestion des fichiers 文件 depuis le Sujet 10, traitant des fichiers série, séquentiels et aléatoires (accès direct). Opérations en pseudocode :
OPENFILE name FOR READ | WRITE | APPEND(READ ouvre un fichier existant, WRITE crée/supprime, APPEND ajoute à la fin) ;READFILE name, line;WRITEFILE name, value;CLOSEFILE name; etEOF(name)qui est VRAI à la fin.Lire un fichier entier :
OPENFILE "names.txt" FOR READ
WHILE NOT EOF("names.txt") DO
    READFILE "names.txt", thisName
    OUTPUT thisName
ENDWHILE
CLOSEFILE "names.txt"
Rechercher dans un fichier (s'arrêter quand trouvé) :
found ← FALSE
OPENFILE "people.txt" FOR READ
WHILE NOT EOF("people.txt") AND NOT found DO
    READFILE "people.txt", line
    IF line = target THEN
        found ← TRUE
    ENDIF
ENDWHILE
CLOSEFILE "people.txt"
Mise à jour d'un fichier in-place
La plupart des langages ne peuvent pas éditer un fichier texte in-place. Au lieu de cela : ouvrir l'original en READ et un fichier temporaire en WRITE ; pour chaque ligne, écrire la nouvelle version si elle doit changer, sinon l'originale ; fermer les deux ; puis remplacer l'original par le fichier temp. Ce même motif gère la suppression de lignes (les sauter) et l'insertion de lignes.
Mise à jour d'un fichier in-place : lire l'original, écrire les modifications vers un fichier temp, puis remplacer l'original Enregistrements et fichiers à accès aléatoire
Modes d'ouverture.
READ: le fichier doit exister et la lecture commence au début.WRITE: un fichier nouveau est créé, et un fichier existant de ce nom est écrasé.APPEND: l'écriture ajoute à la fin d'un fichier existant. Tout fichier ouvert est fermé avecCLOSEFILE, etEOF(name)estTRUEquand le dernier élément a été lu.Trois organisations de fichiers. Dans un fichier série, les enregistrements sont dans l'ordre où ils ont été ajoutés ; dans un fichier séquentiel, ils sont dans l'ordre de la clé ; les deux se lisent depuis le début. Un fichier aléatoire 随机文件 (fichier à accès direct) stocke chaque enregistrement à une adresse calculée à partir de sa clé via une fonction de hachage 哈希, donc un seul enregistrement est trouvé sans lire les autres. Les enregistrements sont déclarés comme un type défini par l'utilisateur :
TYPE AccountRecord
    DECLARE AccNo : INTEGER
    DECLARE Name : STRING
    DECLARE Balance : REAL
    DECLARE Active : BOOLEAN
ENDTYPE
Trouver un enregistrement dans un fichier aléatoire : la clé est hachée vers une adresse, le curseur du fichier saute directement vers cette case et l'enregistrement est lu ; aucun autre enregistrement n'est touché Les opérations de fichier aléatoire en pseudocode sont
OPENFILE "Acc.dat" FOR RANDOM,SEEK "Acc.dat", Address(déplacer le curseur du fichier vers cet enregistrement),GETRECORD "Acc.dat", Rec(lire l'enregistrement à cet endroit) etPUTRECORD "Acc.dat", Rec(écrire l'enregistrement à cet endroit). Trouver un client par numéro de compte, tel que défini dans Paper 3 :DECLARE Rec : AccountRecord DECLARE Target, Address : INTEGER INPUT Target Address ← Target MOD 1000 // the hashing function OPENFILE "Acc.dat" FOR RANDOM SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec WHILE Rec.AccNo <> Target AND Rec.AccNo <> 0 // 0 marks an empty slot Address ← Address + 1 // a collision: try the next slot SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec ENDWHILE IF Rec.AccNo = Target THEN OUTPUT Rec.Name, Rec.Balance ELSE OUTPUT "No such account" ENDIF CLOSEFILE "Acc.dat"Pour stocker un enregistrement, hachez sa clé,
SEEKvers l'adresse etPUTRECORD, en passant devant toute case déjà occupée. Les marques vont au hachage, au SEEK avant le GET ou PUT, à la comparaison avec la cible, à la gestion d'une collision, et à la fermeture du fichier.Exemple résolu.
ActiveFile.datcontientAccountRecordenregistrements. Écrivez un pseudocode qui copie tous les enregistrements dont le champActiveestFALSEà la fin deArchiveFile.dat.DECLARE Rec : AccountRecord OPENFILE "ActiveFile.dat" FOR READ OPENFILE "ArchiveFile.dat" FOR APPEND WHILE NOT EOF("ActiveFile.dat") READFILE "ActiveFile.dat", Rec IF Rec.Active = FALSE THEN WRITEFILE "ArchiveFile.dat", Rec ENDIF ENDWHILE CLOSEFILE "ActiveFile.dat" CLOSEFILE "ArchiveFile.dat"Fichiers texte en Python (Paper 4) :
file = open("HighScore.txt", "r"), puisfor line in file:avecline.strip()etline.split(",")pour séparer les champs,int(…)pour convertir une note, etfile.close(); pour écrire,open(name, "w")(ou"a"pour ajouter) etfile.write(str(score) + "\n"). Une table des meilleurs scores est lue dans une liste d'enregistrements, la nouvelle note est insérée à sa place, et toute la liste est réécrite. L'examinateur marque l'ouverture avec le mode correct, une boucle qui lit chaque ligne, la conversion du texte en nombres, et la fermeture.Pièges
Oublier de fermer un fichier (données peuvent être perdues) ; ouvrir en WRITE au lieu d'APPEND (écrase tout) ; lire au-delà de
EOF; chemins codés en dur — un chemin comme/Users/Admin/data.txtcasse sur une autre machine, donc utilisez une constante relative telle queDataFile = "./data/scores.txt".ExplorerVoie d'accès au fichier
Suivre un fichier depuis le stockage jusqu'au programme et retour en toute sécurité.
Vocabulaire EntrainerAnglais Chinois Pinyin file/faɪl/ 文件 wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn hashing/ˈhæʃɪŋ/ 哈希 hā xī 20.2
Gestion des exceptions
Une exception 异常 est une erreur ou une condition inattendue pendant l'exécution — division par zéro, fichier non trouvé, panne réseau, indice de tableau 数组 hors limites. La gestion des exceptions 异常处理 permet à un programme de la détecter et d'y répondre gracieusement au lieu de planter.
Cela importe parce que les vrais programmes font face à des erreurs qui ne peuvent pas être évitées à l'avance (fichiers déplacés, réseaux coupés, mauvaise saisie) ; sans cela, chaque opération nécessite sa propre vérification
IF; et cela sépare le flux normal de la gestion des erreurs, afin que le chemin principal reste clair. Par exemple, un fichier peut être supprimé par un autre utilisateur entre le moment où votre programme vérifie son existence et celui où il l'ouvre réellement — vous ne pouvez pas empêcher cela, seulement gérer l'échec quand il survient."Décrivez, avec un exemple, ce qu'est une exception (deux marks). Un événement inattendu ou une erreur qui survient pendant l'exécution d'un programme (à l'exécution) et interrompt son flux normal ; par exemple diviser par zéro, ouvrir un fichier qui n'existe pas, convertir une saisie non numérique en entier, un indice de tableau hors limites, ou épuiser la mémoire. "Identifier deux causes possibles d'exceptions" s'answer à partir de cette liste, plus "un périphérique ou un réseau n'est pas disponible" et "type de données invalide saisi".
"Énoncez les raisons d'inclure la gestion des exceptions (trois marks). Empêcher le programme de planter (se terminer inopinément) ; afficher un message significatif à l'utilisateur plutôt qu'une erreur système ; permettre au programme de se récupérer et de continuer, par exemple en demandant la saisie à nouveau, ou de fermer les fichiers en sécurité avant de se terminer ; et parce que certaines erreurs ne peuvent pas être prédites quand le programme est écrit. "Décrivez comment éviter la terminaison du programme due à une exception" : placer les instructions qui pourraient lever une exception dans un bloc TRY ; écrire un bloc EXCEPT (catch) pour cette exception qui la gère, par exemple en affichant un message, afin que l'exécution continue après le bloc au lieu de s'arrêter. "Expliquez ce qu'est la gestion des exceptions" : détecter une exception quand elle survient et exécuter du code (le gesteur) qui s'en occupe afin que le programme continue.
Motif
TRY
    OPENFILE "data.txt" FOR READ
    READFILE "data.txt", line
    OUTPUT line
    CLOSEFILE "data.txt"
EXCEPT FileNotFound
    OUTPUT "Sorry, the file does not exist."
EXCEPT ReadError
    OUTPUT "Sorry, error reading the file."
ENDTRY
Le bloc
TRYcontient le code susceptible d'échouer ; le premier blocEXCEPTcorrespondant s'exécute. Les vrais langages ont aussi un catch-allEXCEPTet un blocFINALLYqui s'exécute qu'il y ait eu une exception ou non — utile pour le nettoyage (fermer les fichiers).Flux d'exception : une exception passe au EXCEPT correspondant ; FINALLY s'exécute toujours avant que le programme ne continue Lever une exception
Une sous-routine qui détecte une erreur peut lever 抛出 une exception afin que l'appelant la gère :
PROCEDURE Divide(a : INTEGER, b : INTEGER) RETURNS INTEGER
    IF b = 0 THEN
        RAISE DivideByZero
    ENDIF
    RETURN a DIV b
ENDPROCEDURE
Où gérer les exceptions
Gérez-les près de l'erreur si la réponse est simple (un message, une rétentative), ou plus haut dans la pile d'appels 调用栈 si seul le code externe sait quoi faire (une boucle GUI de niveau supérieur log l'erreur et affiche une boîte de dialogue amicale). Ne jamais absorber silencieusement les exceptions — au moins loguez-les, sinon le débogage devient impossible.
Exceptions courantes :
FileNotFound,IOError,DivisionByZero,IndexOutOfRange,InvalidArgument,NullReference,OutOfMemory. Envelopper chaque opération défaillante dans unTRYavec les gestionnairesEXCEPTappropriés permet d'obtenir un programme qui se dégrade gracieusement au lieu de planter.Exemple résolu (Paper 4). Écrivez une fonction qui lit des nombres entiers, un par ligne, depuis un fichier dont le nom est passé en paramètre et les retourne dans une liste. Elle ne doit pas planter si le fichier n'existe pas ou si une ligne n'est pas un nombre entier.
def read_scores(filename):
    scores = []
    try:
        file = open(filename, "r")
        for line in file:
            scores.append(int(line))
        file.close()
    except FileNotFoundError:
        print("The file", filename, "does not exist")
    except ValueError:
        print("A line in the file was not a whole number")
    return scores
Le bloc
trycontient le code susceptible de provoquer une erreur (l'ouverture et la conversion) ; chaqueexceptnomme une exception spécifique et effectue une action utile ; la fonction retourne toujours une liste, permettant ainsi au programmeur appelant de poursuivre son exécution. En Java, la même structure correspond àtry { … } catch (FileNotFoundException e) { … } catch (NumberFormatException e) { … }; en VB.NET, elle correspond àTry … Catch ex As FileNotFoundException … End Try. Points attribués : les instructions risquées à l'intérieur du bloc try, les noms corrects des exceptions, un message pour chacune, et la poursuite de l'exécution du programme par la suite ; un bloc catch-allexcept:entraîne la perte de points pour le plantage, mais pas celle pour la mention « exception appropriée ».Exemple résolu. Un fichier texte de membres nécessite la modification du numéro de téléphone d'un membre. Pourquoi le programme ne peut-il pas simplement écraser cette ligne, et quel est le motif ? Les lignes d'un fichier texte ont des longueurs différentes, et le fichier ne contient pas d'espaces pour absorber une différence : un remplacement plus long empiéterait sur l'enregistrement suivant, et un remplacement plus court laisserait une partie de l'ancienne ligne en arrière-plan. Le motif consiste donc à ouvrir l'original en mode READ (lecture) et un fichier temporary (temporaire) en mode WRITE (écriture), lire chaque ligne successivement, écrire la version new (nouvelle) pour la ligne modifiée et la ligne original (originale) pour toutes les autres, fermer les deux fichiers, puis replace (remplacer) l'original par le fichier temporaire. La même structure gère la suppression (sautez la ligne) et l'insertion (écrivez la ligne supplémentaire). Notez que every (chaque) ligne est écrite, pas seulement celle qui a changé - écrire uniquement le nouveau record et perdre le reste du fichier constitue une erreur classique.
ExplorerComment la gestion des exceptions s'écoule
Passez en revue ce qui se passe quand le code échoue. L'exception saute hors du flux normal vers un handler, FINALLY nettoie des deux côtés, et le programme continue au lieu de planter.
Vocabulaire EntrainerAnglais Chinois Pinyin exception/ekˈsepʃn/ 异常 yì cháng exception handling/ekˈsepʃn ˈhændlɪŋ/ 异常处理 yì cháng chǔ lǐ raise/reɪz/ 抛出 pāo chū call stack/kɔːl stæk/ 调用栈 diào yòng zhàn 20.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
Terme Définition paradigme de programmation un style ou une façon de programmer, avec sa propre méthode de structuration d'un programme langage impératif le programme est une séquence d'instructions qui changent l'état du programme ; le programmeur décrit comment la tâche est réalisée langage déclaratif le programme énonce des faits et des règles, et le moteur d'inférence détermine comment trouver la réponse classe un modèle définissant les attributs et les méthodes des objets de ce type objet (instance) une occurrence d'une classe, avec ses propres valeurs pour les attributs attribut un élément de données appartenant à une classe méthode une procédure ou une fonction appartenant à une classe et agissant sur ses attributs encapsulation regrouper les attributs et les méthodes dans une classe et restreindre l'accès externe aux données, afin qu'elles soient modifiées uniquement via des méthodes publiques héritage une sous-classe acquiert les attributs et les méthodes de sa classe parente et peut les ajouter ou les redéfinir polymorphisme méthodes portant le même nom mais se comportant différemment selon les classes constructeur une méthode qui s'exécute lors de la création d'un objet et initialise ses attributs contenance une classe possède un objet d'une autre classe comme l'un de ses attributs fait une affirmation dans un programme déclaratif qui est vraie règle une conclusion qui est valide lorsque ses conditions sont remplies fichier séquentiel, linéaire, aléatoire enregistrements dans l'ordre d'ajout ; enregistrements triés par clé ; chaque enregistrement à une adresse calculée à partir de sa clé exception une erreur inattendue ou un événement pendant l'exécution qui interrompt le flux normal gestion des exceptions détecter une exception lorsqu'elle survient et exécuter du code capable de la gérer afin que le programme poursuive son exécution 20.2
Conseils d'examen
- Paradigmes : connaître la description en une ligne de chacun et être prêt à nommer le paradigme à partir d'un échantillon de code ; les questions de bas niveau portent sur les cinq modes d'adressage et ce que reçoit l'accumulateur.
- Les définitions POO reviennent à chaque session : classe, objet, attribut, méthode, encapsulation, héritage, polymorphisme, constructeur. Écrire une classe en pseudocode avec des attributs PRIVATE (privés), un PUBLIC NEW (public) et des getters ; une sous-classe avec INHERITS (hérite) et SUPER.NEW.
- Déclaratif : un objectif avec une variable retourne tous les faits correspondants ; une règle est une conclusion IF (si) les conditions sont réunies avec AND (et) ; copier exactement les noms de prédicat de la question.
- Fichiers : les trois modes et ce que chacun fait à un fichier existant ; READFILE dans une boucle WHILE NOT EOF ; les fichiers aléatoires utilisent un hash, SEEK, GETRECORD et PUTRECORD, avec un risque de collision.
- Exceptions : définition avec exemple, trois raisons de les gérer, et TRY avec un EXCEPT nommé permettant au programme de continuer.
Erreurs courantes
- Décrire un programme déclaratif comme « une séquence d'étapes donnant la réponse » ; il énonce ce qui est vrai et ce qui est souhaité, pas comment.
- Confondre un objet avec une classe, ou une instance avec un attribut ; la question « une occurrence d'un objet » attend « instance ».
- Déclarer les attributs PUBLICS, ou y accéder depuis l'extérieur de la classe au lieu d'utiliser un getter, ce qui annule l'encapsulation.
- Constructeur de sous-classe qui définit directement les attributs parents au lieu d'appeler SUPER.NEW.
- Expliquer le polymorphisme comme « beaucoup d'objets » ; c'est le même nom de méthode se comportant différemment pour différentes classes.
- Ouvrir un fichier FOR WRITE (pour écriture) pour ajouter un enregistrement, ce qui détruit le contenu existant ; utiliser APPEND (ajouter).
- Lire un fichier aléatoire à partir du début ; faire un SEEK vers l'adresse hachée d'abord.
- Placer le gestionnaire d'exception autour du code qui ne peut pas échouer, ou capturer tout sans message, ou décrire la gestion des exceptions comme « vérifier l'entrée avec IF ».
- immédiat (