| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension de la manière dont un OS peut maximiser l'utilisation des ressources | |
| Décrire les moyens par lesquels l'interface utilisateur cache les complexités du matériel à l'utilisateur | |
| Montrer la compréhension de la gestion des processus | Le concept de multitâche et d'un processus Les états du processus : en cours d'exécution, prêt et bloqué La nécessité de la planification et la fonction et les avantages des différentes routines de planification (y compris round robin, shortest job first, first come first served, shortest remaining time) Comment le noyau du OS agit comme gestionnaire d'interruptions et comment la gestion des interruptions est utilisée pour gérer la planification de bas niveau |
| Montrer la compréhension de la mémoire virtuelle, du paginement et de la segmentation pour la gestion de la mémoire | Les concepts de paginement, de mémoire virtuelle et de segmentation La différence entre paginage et segmentation Comment les pages peuvent être remplacées Comment un thrashing de disque peut se produire |
Logiciels système
Informatique A-Level · Sujet 16
 14:07
Ressources, Compilateurs & RPN
Ouvrir un navigateur, un lecteur de musique et un jeu. Vous avez un seul processeur — peut-être quelques cœurs — mais tous semblent tourner en même temps. Et ensemble, ils veulent plus…
Narration en anglais · Sous-titres anglais + 中文 incrustés
16.1
Comment un SGBD maximise l'utilisation des ressources

Programme
Source : Programme Cambridge International
Un ordinateur possède de nombreuses ressources (temps CPU, mémoire, disque, E/S) et de nombreux programmes qui y concurrencent l'accès. Le SGBD les partage équitablement et efficacement afin que chacun soit bien utilisé et que le système reste réactif :
- multitâche 多任务 — alterner rapidement le CPU entre les processus afin que plusieurs semblent s'exécuter simultanément.
- gestion de la mémoire — attribuer à chaque processus la mémoire nécessaire ; utiliser le paging 分页 sur disque lorsque la RAM manque.
- spooling 假脱机 et tamponnage — files d'attente des tâches d'impression sur disque pour que le CPU n'attend jamais l'imprimante.
- cache — conserver les données récemment utilisées du disque dans le cache 高速缓存 / RAM.

Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| multi-tasking/ˈmʌlti ˈtæskɪŋ/ | 多任务 | duō rèn wù |
| paging/ˈpeɪdʒɪŋ/ | 分页 | fēn yè |
| spooling/ˈspuːlɪŋ/ | 假脱机 | jiǎ tuō jī |
| cache/kæʃ/ | 高速缓存 | gāo sù huǎn cún |
16.1
Interface utilisateur
L'interface utilisateur masque le matériel derrière des abstractions conviviales : l'utilisateur voit des fenêtres, menus et dossiers, pas des adresses ou secteurs. Un clic sur une icône fait trouver au SGBD le programme sur disque, allouer la mémoire, le charger et le démarrer. Une CLI (ligne de commande) est puissante et scriptable pour les experts ; une GUI (graphique) est plus facile à apprendre. La plupart des systèmes offrent les deux.
"Décrivez deux façons dont les complexités du matériel sont masquées à l'utilisateur." (1) L'utilisateur travaille avec des fichiers et dossiers par nom, et le SGBD les traduit en pistes, secteurs et blocs du disque ; (2) l'utilisateur lance un programme par un clic ou une commande, et le SGBD le charge, alloue la mémoire et le planifie sans que l'utilisateur connaisse aucune adresse ; (3) les pilotes de périphérique permettent à l'utilisateur d'imprimer ou de sauvegarder sans connaître le contrôle de l'imprimante ou du disque ; (4) une interface graphique remplace les commandes niveau machine par des icônes, fenêtres et menus. L'avantage pour un étudiant, avec un exemple : le SGBD rend le matériel utilisable sans connaissances techniques, par exemple en enregistrant un document sur une clé USB en glissant son icône.
"Montrez comment un SGBD maximise l'utilisation des ressources." Il planifie le processeur pour qu'il ne soit jamais inactif tant qu'un processus est prêt ; il gère la mémoire, l'allouant aux processus, le récupérant et l'étendant avec la mémoire virtuelle ; il gère l'entrée/sortie, utilisant des tampons et le spooling pour faire chevaucher le travail des dispositifs rapides et lents ; et il gère le stockage, gardant la trace de l'espace libre et des fichiers. Chaque point nomme une ressource et ce que le SGBD en fait.
16.1
Gestion des processus
Un processus 进程 est un programme en cours d'exécution — son code, son état actuel, sa mémoire et ses fichiers ouverts.
Planification
Le planificateur 调度器 choisit quel processus prêt s'exécute ensuite et pendant combien de temps :
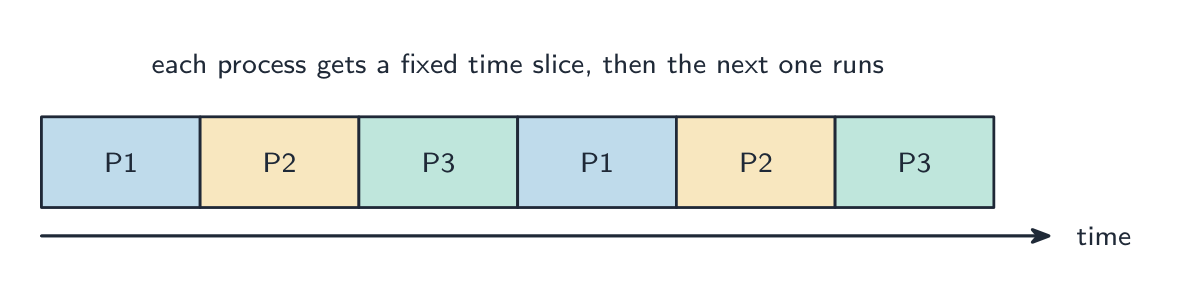
- round robin 轮转 — chaque processus obtient un time slice 时间片 fixe, puis passe à la fin de la file d'attente.
- premier arrivé, premier servi ; plus court travail en premier ; temps restant le plus court (exécuter le travail ayant le moins de travail restant) ; priorité ; files de feedback multiniveau.
Le compromis concerne la réactivité vs le débit vs l'équité.
"Décrivez ce que signifie le multitâche et comment il profite à la gestion des processus." Plusieurs processus sont maintenus en mémoire en même temps et le processeur bascule entre eux si rapidement qu'ils semblent s'exécuter simultanément, chacun recevant tour à tour une part du temps processeur. L'avantage : le processeur n'est jamais laissé inactif pendant qu'un processus attend une entrée ou une sortie, donc le débit est plus élevé et l'utilisateur peut travailler sur plusieurs programmes à la fois. "Expliquez la nécessité de la planification." Il y a plus de processus que de processeurs, donc une décision doit être prise sur quel processus s'exécute ensuite et pendant combien de temps ; la planification assure que chaque processus avance, que le processeur est pleinement utilisé, que les temps de réponse sont acceptables, et que les priorités peuvent être respectées.
Les routines de planification, telles que l'examen les veut décrites.
| Routine | Fonction | Avantage | Inconvénient |
|---|---|---|---|
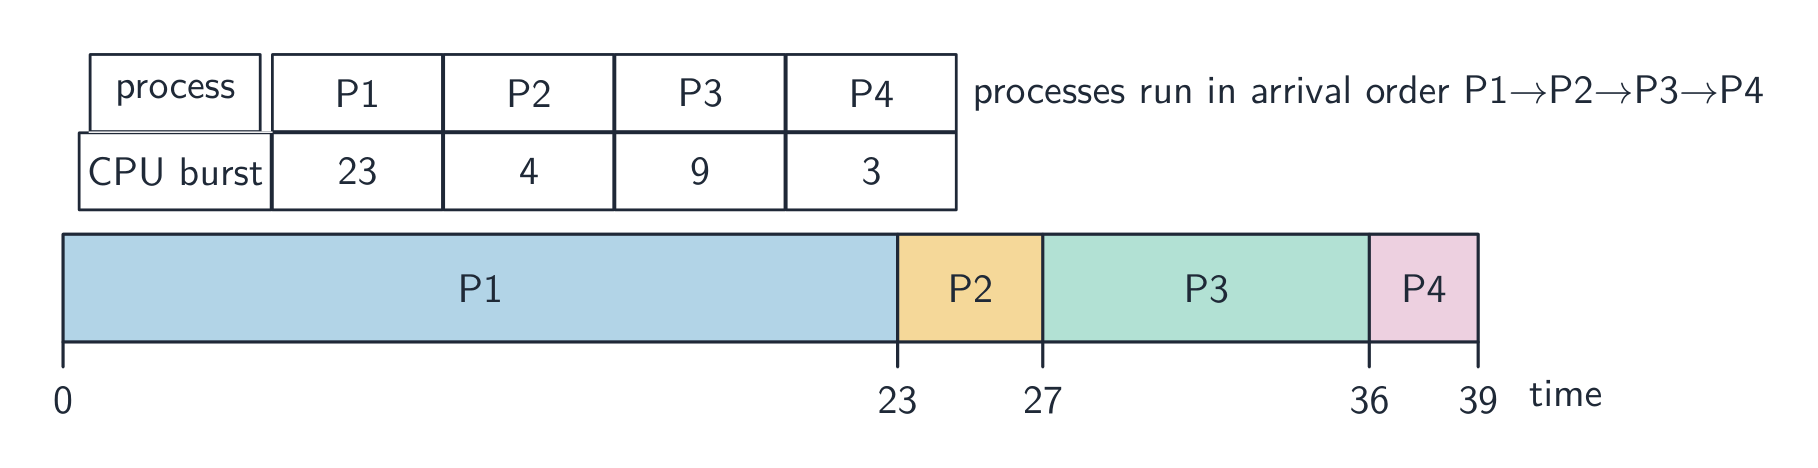
| first come first served (FCFS) | les processus s’exécutent dans l’ordre d’arrivée dans la file d’attente prête, chacun jusqu’à son achèvement | simple ; chaque processus est traité à tour de rôle, aucun n’est affamé | un long processus bloque tous les courts qui le suivent ; mauvaise réponse |
| shortest job first (SJF) | le processus prêt avec la durée d’exécution estimée la plus courte s’exécute ensuite, jusqu’à son achèvement | minimise le temps d’attente moyen ; beaucoup de courts processus terminent rapidement | les durées doivent être connues à l’avance ; un long processus peut ne jamais s’exécuter (affamation) |
| shortest remaining time (SRT) | version préemptive 抢占式 de SJF : si un nouveau processus arrive avec moins de temps restant que celui qui s’exécute, il prend le relais | les courts processus sont servis encore plus vite ; bon débit | plus de changements de contexte ; un long processus peut être interrompu à plusieurs reprises et souffrir d’affamation |
| round robin (RR) | chaque processus prêt reçoit à tour de rôle une tranche de temps fixe ; lorsqu'elle expire, le processus va à la fin de la file d'attente | équitable ; chaque processus répond dans un temps borné, adapté à l'utilisation interactive | surcharge due au changement de contexte ; une tranche très courte gaspille du temps, une longue retarde les autres |
| priorité | le processus prêt ayant la priorité la plus élevée s’exécute en premier | les travaux importants ou critiques en temps réel sont effectués en premier | les processus de faible priorité peuvent souffrir d’affamation sauf si les priorités vieillissent |
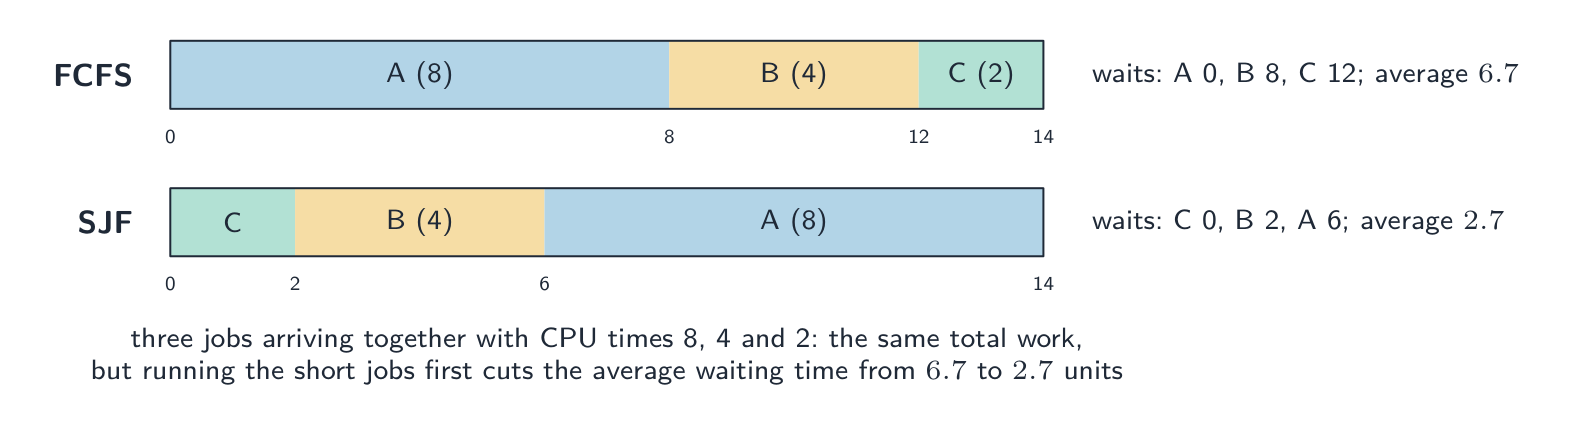
Exemple résolu. Trois processus arrivent ensemble avec des temps CPU de 8, 4 et 2 ms. Comparer le temps d’attente moyen sous FCFS (dans l’ordre d’arrivée A, B, C) et sous shortest job first.
FCFS : A attend 0, B attend 8, C attend 12 ; moyenne $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF exécute C, B, A : C attend 0, B attend 2, A attend 6 ; moyenne $2.7\ \text{ms}$. Le travail total est le même, 14 ms dans les deux cas ; l’ordre décide de qui attend. Round robin avec un quantum de 2 ms donnerait à A, B et C chacun un tour dans les 6 premières ms, donc C termine à 6 ms, B à 12 ms et A à 14 ms : le plus réactif, pas le plus rapide en moyenne.
États des processus
Un processus est nouveau, prêt (en attente du CPU), en cours d’exécution, bloqué 阻塞 (en attente d’E/S ou d’un verrou), ou terminé. Quand son quantum de temps se termine, il passe de running → ready ; quand il demande une E/S, il passe de running → blocked ; quand l’E/S se termine, il passe de blocked → ready.
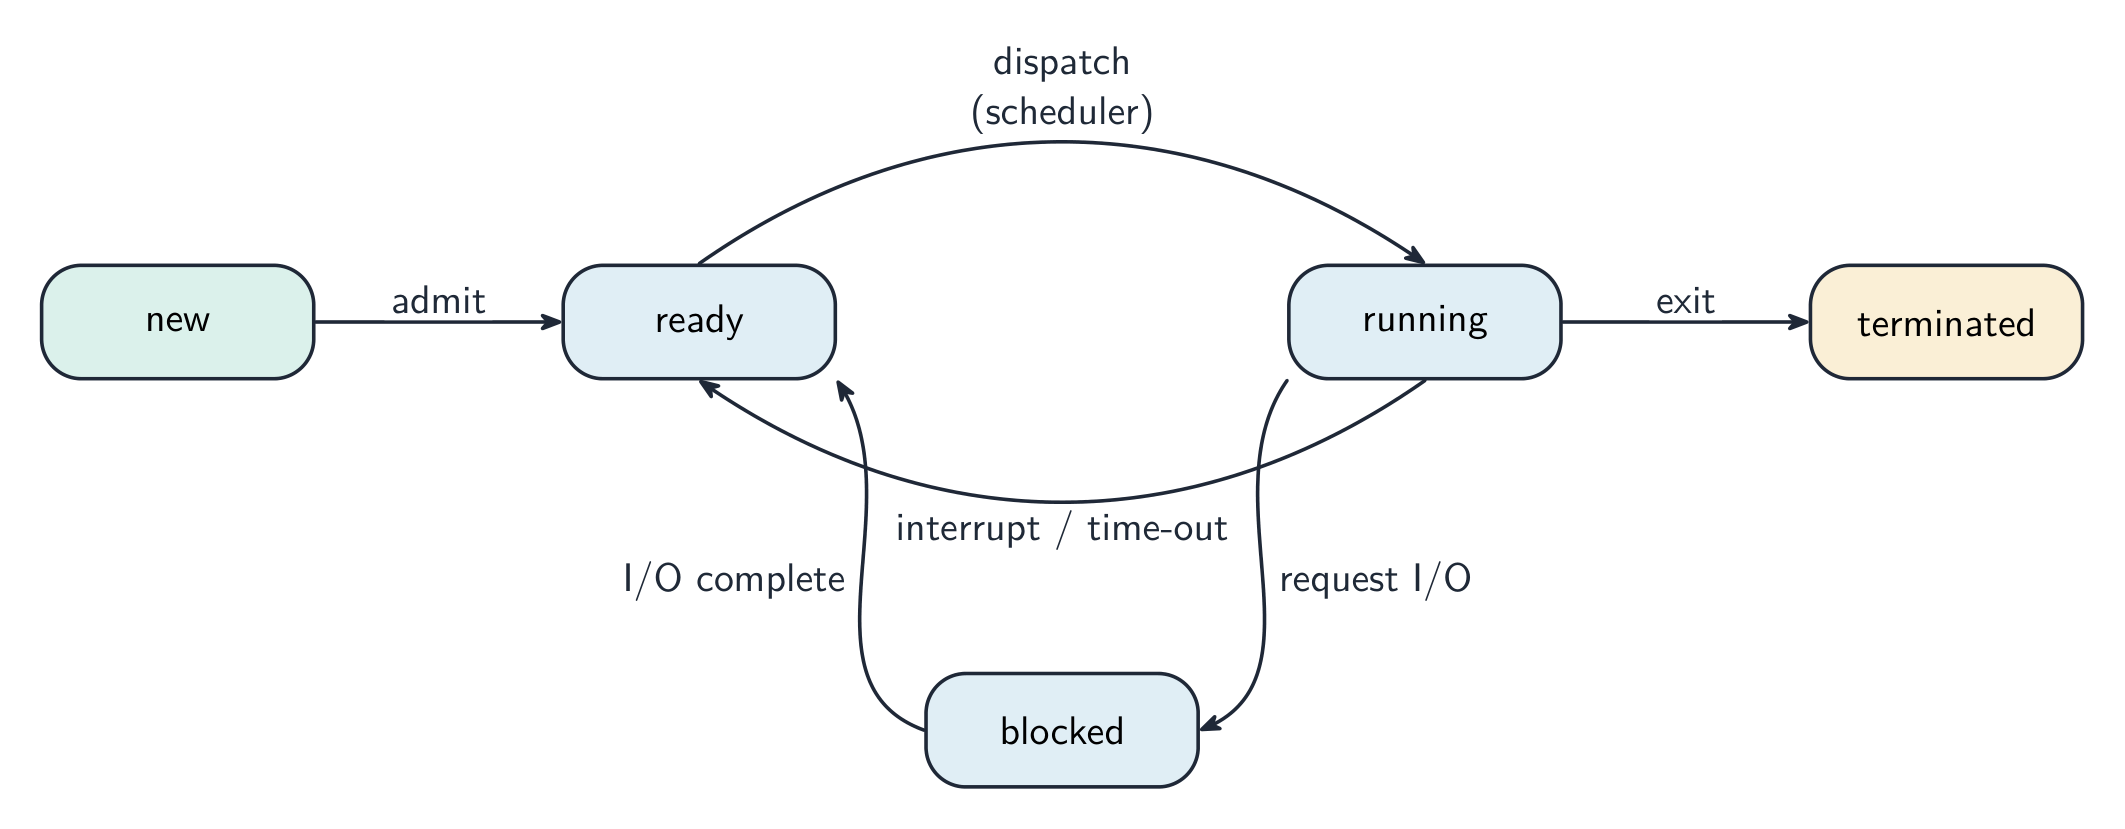
Les trois états et pourquoi un processus change d’état. Running : le processus a le processeur. Ready : il pourrait s’exécuter mais attend le processeur. Blocked : il ne peut pas s’exécuter tant qu’autre chose ne se produit pas. Raisons de chaque transition, dont l’examen demande une à la fois : running to ready quand son quantum de temps se termine, ou quand un processus de priorité supérieure devient prêt et le préempte (une interruption) ; running to blocked quand il demande une entrée ou sortie ou attend une ressource ou un autre processus ; blocked to ready quand l’E/S pour laquelle il attendait se termine (signalée par une interruption) ; ready to running quand l’ordonnanceur le dispatche. Un processus bloqué ne peut jamais passer directement à running : il doit devenir ready d’abord.
Bloc de contrôle de processus et changement de contexte
Pour chaque processus, le système d’exploitation conserve un bloc de contrôle de processus 进程控制块 (PCB) — le compteur programme sauvegardé, les registres, l’état et les informations mémoire.
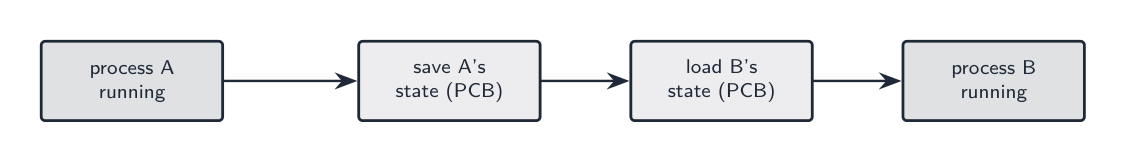
- non changement de contexte 上下文切换 suspend un processus et en démarre un autre : il sauvegarde l’état dans un PCB et le restaure depuis un autre. Ce petit coût est payé à chaque changement.
- le noyau 内核 (le cœur du SE) agit comme un gestionnaire d’interruptions 中断处理程序. Lorsqu’un périphérique ou la minuterie déclenche une interruption, la gestion des interruptions 中断处理 sauvegarde le processus en cours et exécute la routine appropriée — c’est ce qui pilote l’ordonnancement de bas niveau.
« Décrivez comment le noyau agit comme gestionnaire d’interruptions » (deux marques). Lorsqu’une interruption est déclenchée, le noyau sauvegarde l’état du processus en cours (ses registres et son compteur programme, dans son bloc de contrôle de processus), identifie la source et la priorité de l’interruption, exécute la routine de service d’interruption appropriée, puis restaure le processus interrompu (ou un de priorité supérieure) afin que l’exécution continue. C’est ainsi que la minuterie termine un quantum de temps et qu’une opération d’E/S terminée débloque un processus.
Communication inter-processus
Les processus sont isolés, donc le SE fournit la communication inter-processus 进程间通信 : tubes 管道 (la sortie d’un programme alimente l’entrée d’un autre), mémoire partagée 共享内存 (une région que plusieurs processus peuvent utiliser), et passage de messages.
Explorer
Le cycle de vie d'un processus
Suivez le parcours dans la boucle d'un processus. Il ne s'exécute que lorsque le planificateur le choisit ; la nécessité d'E/S l'envoie en attente bloquée, et la fin de sa tranche temporelle le renvoie en état prêt — en boucle jusqu'à sa fin.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| process/ˈprəʊses/ | 进程 | jìn chéng |
| scheduler/ˈʃedjʊlə/ | 调度器 | diào dù qì |
| round robin/raʊnd ˈrɒbɪn/ | 轮转 | lún zhuàn |
| time slice/taɪm slaɪs/ | 时间片 | shí jiān piàn |
| pre-emptive/priː ˈemptɪv/ | 抢占式 | qiǎng zhàn shì |
| blocked/blɒkt/ | 阻塞 | zǔ sè |
| process control block/ˈprəʊses kənˈtrəʊl blɒk/ | 进程控制块 | jìn chéng kòng zhì kuài |
| context switch/ˈkɒntekst swɪtʃ/ | 上下文切换 | shàng xià wén qiè huàn |
| kernel/ˈkɜːnl/ | 内核 | nèi hé |
| interrupt handler/ˈɪntərʌpt ˈhændlə/ | 中断处理程序 | zhōng duàn chǔ lǐ chéng xù |
| interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ | 中断处理 | zhōng duàn chǔ lǐ |
| inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ | 进程间通信 | jìn chéng jiān tōng xìn |
| pipes/paɪps/ | 管道 | guǎn dào |
| shared memory/ʃeəd ˈmeməri/ | 共享内存 | gòng xiǎng nèi cún |
| virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ | 虚拟地址空间 | xū nǐ dì zhǐ kōng jiān |
16.1
Mémoire virtuelle, pagination, segmentation
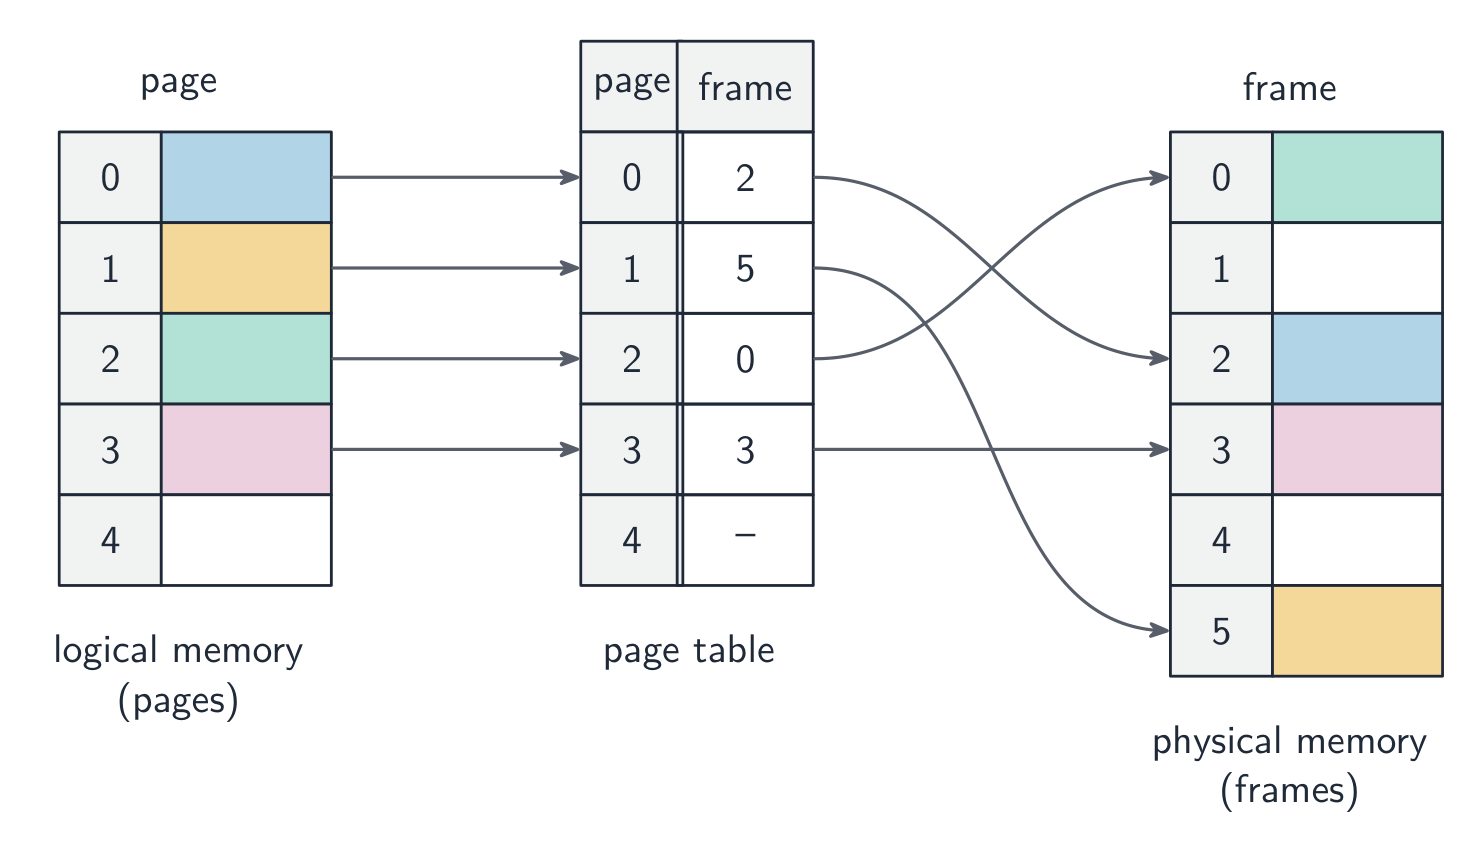
Chaque processus obtient son propre espace d’adressage virtuel 虚拟地址空间 — une plage propre et contiguë d’adresses que le SE mappe vers la mémoire physique. Cela donne à chaque processus un espace simple, protège les processus les uns contre les autres, et permet à la mémoire totale de dépasser la RAM physique.
Dans la pagination, l’espace virtuel est divisé en pages 页 de taille fixe et la mémoire physique en cadres 页框 de même taille. Une table de pages mappe chaque page à un cadre. Si une page accédée n’est pas en RAM — une faute de page 缺页 — le SE la lit depuis le fichier d’échange 交换文件 dans un cadre, évictant une autre page si la RAM est pleine. Des fautes fréquentes causent le thrashing 抖动 (thrashing disque), où le SE passe la plupart de son temps à échanger des pages au lieu de faire un travail utile.
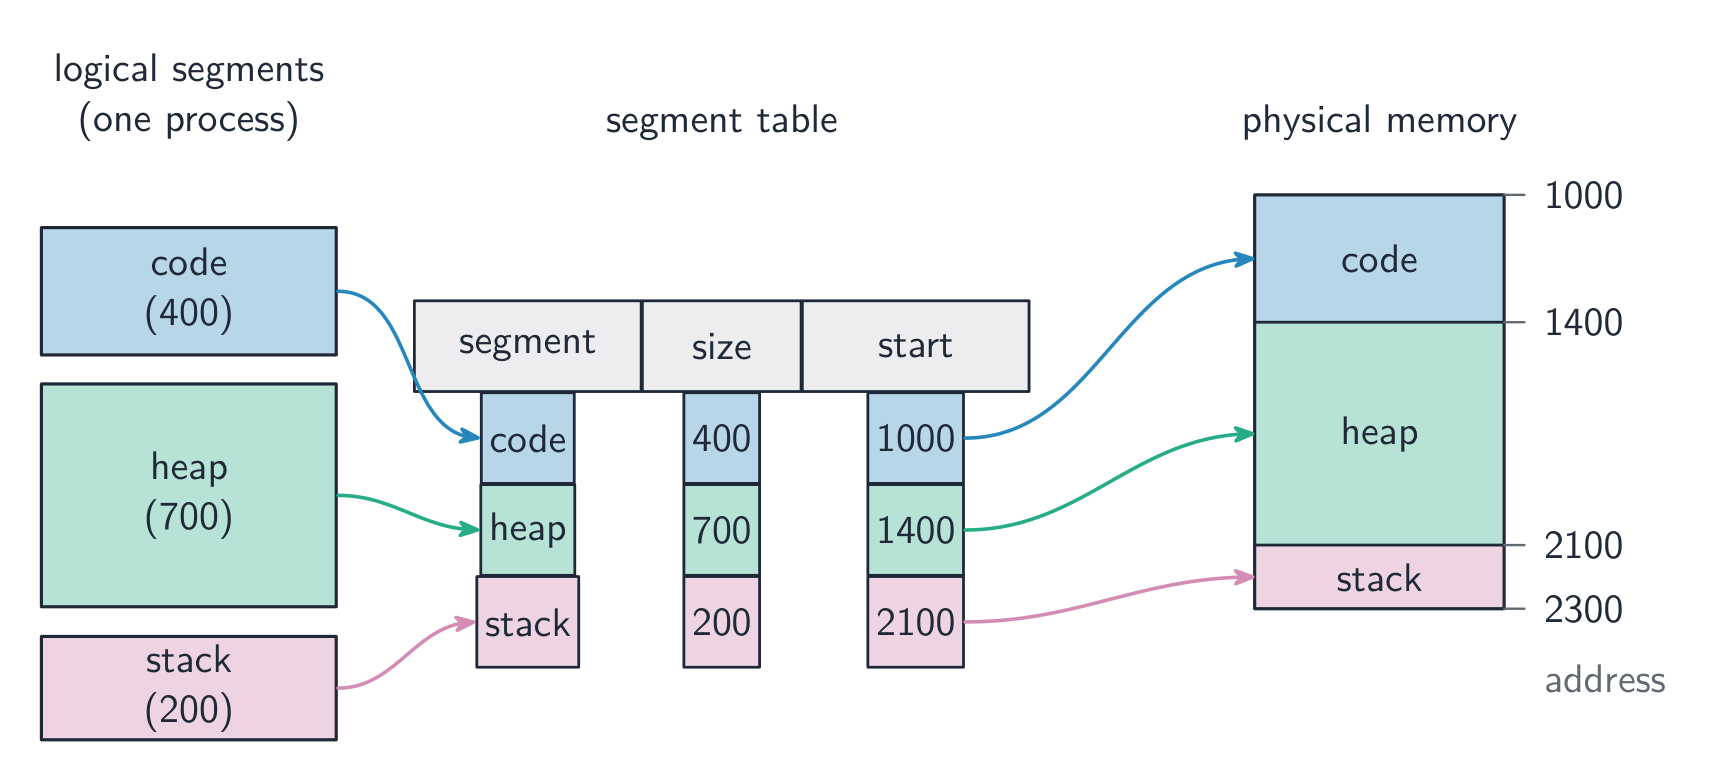
Dans la segmentation 分段, la mémoire est divisée en segments logiques de taille variable (code, pile, tas), chacun ayant ses propres permissions. De nombreux systèmes utilisent le paging au sein des segments.
"Expliquez ce que signifie la mémoire virtuelle" (trois points). Le stockage secondaire (disque) est utilisé pour étendre la RAM, de sorte que la mémoire disponible semble plus grande que la mémoire physique ; l'espace d'adresse d'un processus est divisé en pages, et seules les pages actuellement nécessaires sont conservées en RAM tandis que le reste attend sur le disque ; les pages sont échangées entre la RAM et le disque selon les besoins, et le système d'exploitation traduit chaque adresse virtuelle en une adresse physique. Pourquoi un OS en a besoin : les programmes en cours d'exécution peuvent avoir besoin de plus de mémoire que la RAM installée ; cela permet de faire fonctionner plus (ou de plus gros) programmes simultanément ; un programme peut être plus grand que la mémoire physique ; la mémoire est utilisée efficacement car seules les parties actives des programmes occupent la RAM.
Paging contre segmentation : la différence recherchée par l'examen. Le paging divise la mémoire en blocs de taille fixe (pages et frames) choisis par le matériel, sans égard à la structure du programme, et la cartographie est invisible pour le programmeur ; la segmentation divise un programme en unités logiques de taille variable (une procédure, un tableau, la pile) dont les tailles et les limites suivent le programme, de sorte qu'un segment peut être protégé ou partagé en tant qu'unité. "Décrivez le processus de segmentation" : le programme est divisé en segments de différentes tailles, chacun recevant un numéro de segment ; une table de segments enregistre où commence chaque segment en mémoire et sa longueur ; une adresse logique est un numéro de segment plus un décalage, et le système d'exploitation ajoute le décalage à l'adresse de base du segment pour trouver l'emplacement physique.
"Expliquez ce qu'est le thrashing de disque" et quand il se produit. Le thrashing de disque 磁盘抖动 est l'état dans lequel les pages sont échangées dans et hors de la RAM si fréquemment que le processeur passe plus de temps à déplacer des pages qu'à exécuter des instructions, et le système ralentit presque jusqu'à l'arrêt complet. Cela se produit lorsque la RAM est trop petite pour les pages dont ont besoin les processus en cours d'exécution (leurs ensembles actifs) : une page qui vient d'être déplacée est nécessaire presque immédiatement, elle est donc récupérée, ce qui chasse une autre page bientôt nécessaire, et ainsi de suite. Trop de processus, ou un programme qui accède à la mémoire de manière imprévisible, provoquent cet état ; plus de RAM ou moins de processus le résolvent.
Explorer
Que se passe-t-il lors d'une faute de page
Parcourez une faute de page. Lorsque le programme accède à une page non présente en RAM, le OS la récupère silencieusement depuis le disque et met à jour la table de pages — permettant au programme d'avoir plus de mémoire qu'il n'y en a physiquement.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| pages/ˈpeɪdʒɪz/ | 页 | yè |
| frames/freɪmz/ | 页框 | yè kuāng |
| page fault/peɪdʒ fɒlt/ | 缺页 | quē yè |
| swap file/swɒp faɪl/ | 交换文件 | jiāo huàn wén jiàn |
| thrashing/ˈθræʃɪŋ/ | 抖动 | dǒu dòng |
| segmentation/ˌseɡmənˈteɪʃn/ | 分段 | fēn duàn |
| disk thrashing/dɪsk ˈθræʃɪŋ/ | 磁盘抖动 | cí pán dǒu dòng |
| interpreter/ɪnˈtɜːprɪtə/ | 解释器 | jiě shì qì |
| compiler/kəmˈpaɪlə/ | 编译器 | biān yì qì |
| machine code/məˈʃiːn kəʊd/ | 机器码 | jī qì mǎ |
| lexical analysis/ˈleksɪkl əˈnæləsɪs/ | 词法分析 | cí fǎ fēn xī |
| tokens/ˈtəʊkənz/ | 词法单元 | cí fǎ dān yuán |
| syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ | 语法分析 | yǔ fǎ fēn xī |
| abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ | 抽象语法树 | chōu xiàng yǔ fǎ shù |
| syntax error/ˈsɪntæks ˈerə/ | 语法错误 | yǔ fǎ cuò wù |
| semantic analysis/səˈmæntɪk əˈnæləsɪs/ | 语义分析 | yǔ yì fēn xī |
| code generation/kəʊd ˌdʒenəˈreɪʃn/ | 代码生成 | dài mǎ shēng chéng |
| code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ | 代码优化 | dài mǎ yōu huà |
| symbol table/ˈsɪmbl ˈteɪbl/ | 符号表 | fú hào biǎo |
| grammar/ˈɡræmə/ | 文法 | wén fǎ |
| Backus-Naur Form/ˈbækəs nɔː fɔːm/ | 巴科斯-诺尔范式 | bā kē sī - nuò ěr fàn shì |
| production rule/prəˈdʌkʃn ruːl/ | 产生式 | chǎn shēng shì |
16.2
Comment un interpréteur exécute un programme
Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer la compréhension de la manière dont un interpréteur peut exécuter des programmes sans produire de version traduite | |
| Montrer la compréhension des diverses étapes de la compilation d'un programme | Incluant l'analyse lexicale, l'analyse syntaxique, la génération de code et l'optimisation |
| Montrer la compréhension de la manière dont la grammaire d'un langage peut être exprimée à l'aide de diagrammes de syntaxe ou de notation Backus-Naur Form (BNF) | |
| Montrer la compréhension de la manière dont la notation polonaise inversée (RPN) peut être utilisée pour évaluer des expressions |
Source : Programme Cambridge International
Un interpréteur 解释器 traduit et exécute le source simultanément. Pour chaque instruction, il lit la ligne, effectue l'analyse lexicale et syntaxique, vérifie les types, puis exécute l'action, et passe à la suivante. Les erreurs sont signalées immédiatement et il s'arrête généralement ; aucun exécutable n'est produit. La traduction est refaite à chaque exécution (plus lent), mais elle offre un retour rapide pour le développement et est portable.
"Expliquez comment un interpréteur exécute un programme sans produire de version traduite" (trois points). L'interpréteur prend une instruction (ligne) à la fois, la traduit (analyse), et l'exécute immédiatement, avant de passer à la suivante ; aucune version traduite du programme entier n'est créée ou stockée, donc chaque instruction est traduite chaque fois qu'elle est exécutée, y compris chaque passage dans une boucle ; si une instruction contient une erreur, l'exécution s'arrête là et l'erreur est signalée. C'est ce qui rend un interpréteur utile pour le développement et les tests (les erreurs sont trouvées dès qu'elles sont atteintes, et un changement peut être essayé immédiatement) mais plus lent pour l'exécution des programmes terminés.
16.2
Étapes de la compilation
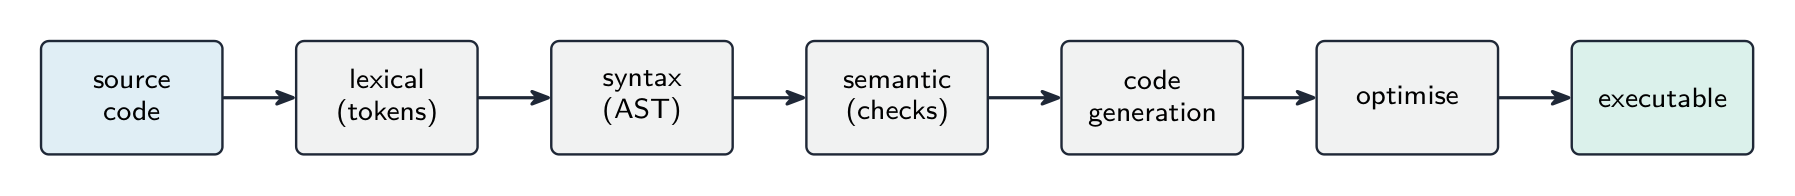
Un compilateur 编译器 transforme le source en code machine 机器码 en phases :
- analyse lexicale 词法分析 — le lexer regroupe les caractères en jetons 词法单元 (mots-clés, identifiants, opérateurs, littéraux), en ignorant les espaces blancs et les commentaires.
- analyse syntaxique (parsing) 语法分析 — vérifie que les jetons correspondent à la grammaire et construit un arbre syntaxique abstrait 抽象语法树. Une parenthèse manquante donne une erreur de syntaxe 语法错误.
- analyse sémantique 语义分析 — vérifie que le programme a du sens (variables déclarées, types correspondants).
- génération de code 代码生成 — parcourt l'arbre et émet le code cible, choisissant les registres et les dispositions.
- optimisation du code 代码优化 — remove redundant work, fold constants, reorder for the pipeline.
La sortie est un exécutable.
L'objectif de chaque étape, dans les termes qui rapportent des points. Analyse lexicale : supprime les espaces blancs et les commentaires ; convertit les caractères du code source en jetons (mots clés, identifiants, opérateurs, constantes), vérifie que chacun est valide dans le langage ; introduit les identifiants dans la table des symboles 符号表. Analyse syntaxique : vérifie que la séquence de jetons respecte la grammaire (règles de syntaxe) du langage ; construit un arbre d'analyse (arbre syntaxique abstrait) ; signale les erreurs de syntaxe ; la vérification des types et celle des déclarations de variables sont parfois comptées ici comme analyse sémantique. Génération de code : convertit l'arbre vérifié en code objet ou code machine (éventuellement via un code intermédiaire), allouant mémoire et registres. Optimisation : rend le code plus rapide ou utilisant moins de mémoire, en éliminant les instructions redondantes, en combinant ou simplifiant les calculs, et en réorganisant les boucles, sans modifier ce que fait le programme. La question d'appariement associe chaque étape à l'une de ces descriptions.
Explorer
Les phases de compilation
Parcourez ce qu'un compilateur fait à votre source. Chaque phase transmet sa sortie à la suivante — les caractères deviennent des jetons, les jetons forment un arbre, l'arbre devient du code machine optimisé.
16.2
Grammaire : BNF et diagrammes syntaxiques
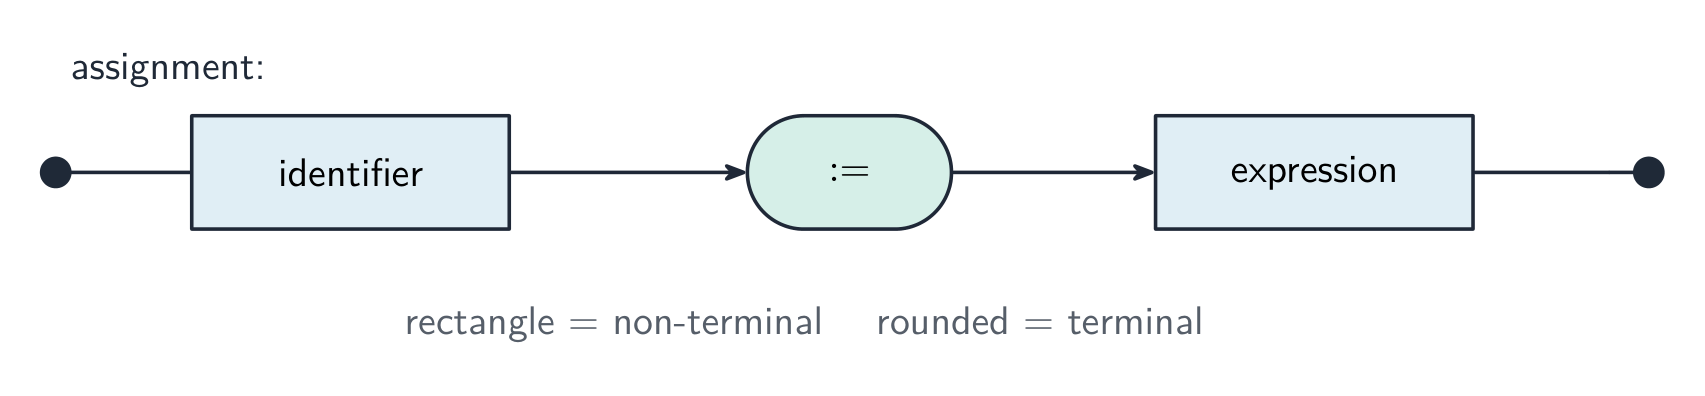
Une grammaire 文法 dit quelles séquences de jetons constituent des programmes valides.
Forme de Backus-Naur 巴科斯-诺尔范式 (BNF) est textuelle. Une règle de production 产生式 a la forme :
<symbol> ::= alternative1 | alternative2 | ...
Chaque alternative est une séquence de symboles terminaux 终结符 (texte littéral) et de symboles non-terminaux 非终结符 (autres noms de règles) :
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
La troisième règle récursive exprime « une lettre suivie de n'importe quel nombre de lettres ou de chiffres ». Une instruction IF :
<if-statement> ::= IF <condition> THEN <statement> ENDIF
                 | IF <condition> THEN <statement> ELSE <statement> ENDIF
Un diagramme syntaxique 语法图 (diagramme ferroviaire) montre la même chose graphiquement : des boîtes pour les non-terminaux, des boîtes arrondies pour les terminaux, des flèches pour les chemins valides, des boucles pour la répétition. Les deux notations sont équivalentes. Le parseur utilise la grammaire pour décider si un programme est valide.
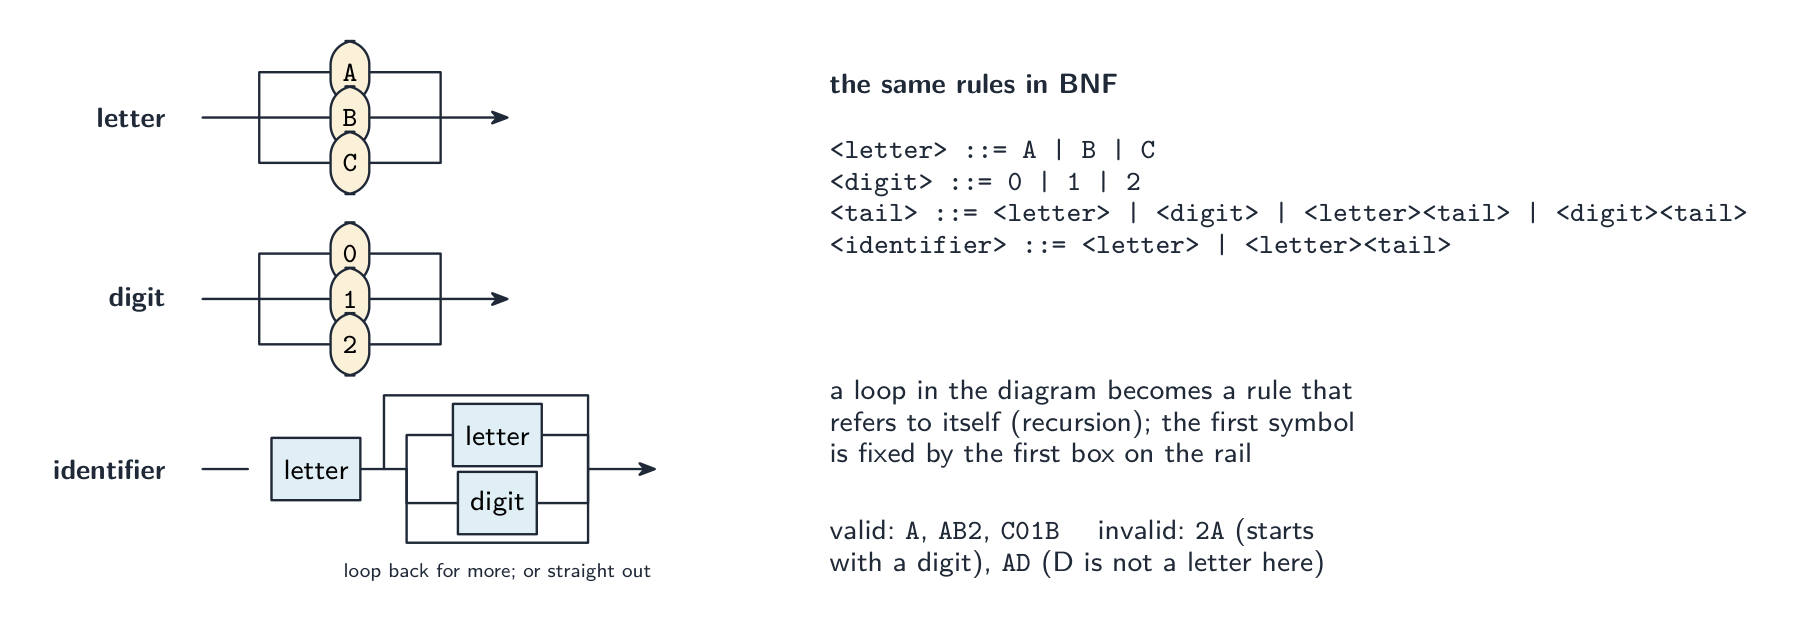
Lire les diagrammes de l'examen. Chaque diagramme définit un non-terminal ; suivez les flèches de l'entrée à la sortie, et tout chemin que vous pouvez tracer est une chaîne valide. Un choix de boîtes côte à côte est un ensemble d'alternatives ; une boucle vers l'arrière signifie « répéter autant de fois que vous voulez » ; une boîte pour un autre non-terminal signifie « insérer n'importe quoi que cette règle permet ». « Expliquer pourquoi la chaîne est invalide » demande la règle qu'elle viole, en mots : 9K est invalide comme variable car le premier caractère doit être une lettre, pas un chiffre ; JJ90 est un mot de passe invalide si la règle ne permet qu'une lettre avant les chiffres, ou si J n'est pas dans l'ensemble des lettres listées. Vérifiez toujours la chaîne par rapport à l'ensemble de caractères que le diagramme autorise réellement, pas par rapport à ce qu'un vrai langage accepterait.
Écrire du BNF à partir d'un diagramme. Chaque diagramme devient une règle <name> ::= ... ; les alternatives sont séparées par | ; une séquence est écrite un symbole après l'autre ; et la répétition s'écrit avec récursion, car le BNF n'a pas de symbole de boucle : « une ou plusieurs lettres » est <word> ::= <letter> | <letter><word>, et « zéro ou plusieurs chiffres après une lettre » est <variable> ::= <letter> | <letter><digits> avec <digits> ::= <digit> | <digit><digits>.
Exemple résolu. Complétez le BNF pour un numéro d'immatriculation de véhicule qui doit commencer par deux lettres (de A B C) suivies d'un, deux ou trois chiffres (de 0 1 2).
<letter>       ::= A | B | C
<digit>        ::= 0 | 1 | 2
<digits>       ::= <digit> | <digit><digit> | <digit><digit><digit>
<registration> ::= <letter><letter><digits>
AB12 est valide ; A12 ne l'est pas (seulement une lettre) ; AB1234 ne l'est pas (quatre chiffres) ; AD1 ne l'est pas (D n'est pas une lettre listée). On vous demande d'ajouter une contrainte telle que « le troisième caractère peut aussi être un symbole », ajoutez l'alternative supplémentaire à la règle pour cette position uniquement, et définissez <symbol> avec sa propre règle.
Exemple résolu. Écrivez le BNF pour une expression qui est une variable, suivie d'un opérateur, suivie soit d'une variable soit d'un nombre, où une variable est une seule lettre minuscule de a b c et un opérateur est + ou -.
<variable>   ::= a | b | c
<operator>   ::= + | -
<number>     ::= <digit> | <digit><number>
<expression> ::= <variable><operator><variable> | <variable><operator><number>
La règle récursive <number> permet n'importe quel nombre de chiffres ; les deux alternatives de <expression> couvrent les deux cas nommés dans la définition. Gardez tous les non-terminaux entre chevrons et tous les terminaux sans eux.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| terminal/ˈtɜːmɪnl/ | 终结符 | zhōng jié fú |
| non-terminal/nɒn ˈtɜːmɪnl/ | 非终结符 | fēi zhōng jié fú |
| syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ | 语法图 | yǔ fǎ tú |
16.2
Notation polonaise inversée (RPN)
En notation infixe 中缀, l'opérateur se situe entre ses opérandes (3 + 4 * 2), nécessitant des parenthèses et des règles de priorité. En Notation Polonaise Inversée 逆波兰表示法 (RPN, postfixe 后缀), l'opérateur suit ses opérandes (3 4 2 * +), ne nécessitant aucune parenthèse.
Conversion de l'infixe vers RPN
Utilisez une pile 栈 d'opérateurs. Parcourez de gauche à droite : sortez un opérande ; pour un opérateur, poppez d'abord tout opérateur empilé de précédence supérieure ou égale 优先级 vers la sortie, puis poussez-le ; poussez ( ; sur ), poppez vers la sortie jusqu'à ce que le ( correspondant soit trouvé. À la fin, poppez tous les opérateurs. Exemple : (3 + 4) * 2 → 3 4 + 2 *.
Évaluation de RPN
Utilisez une pile d'opérandes. Balayez de gauche à droite : empilez chaque opérande ; sur un opérateur, sortez les deux sommets, appliquez-le, et empilez le résultat. Évaluation de 3 4 2 * + :
| Jeton | Pile |
|---|---|
3 |
3 |
4 |
3, 4 |
2 |
3, 4, 2 |
* |
3, 8 |
+ |
11 |
Résultat : 11. RPN ne nécessite pas de parenthèses au moment de l'évaluation et convient à une machine à pile — c'est ainsi que fonctionnent la JVM et de nombreux interpréteurs de bytecode 字节码.
« Expliquer pourquoi RPN est utilisé pour évaluer des expressions » (deux points). Dans RPN, les opérateurs apparaissent dans l'ordre dans lequel ils sont appliqués, donc une expression peut être évaluée en un unique passage de gauche à droite avec aucune parenthèse et aucune règle de priorité ; elle est donc plus simple et plus rapide pour le compilateur ou l'interpréteur à traiter. « Identifier, avec des raisons, une structure de données appropriée » : une pile, car l'évaluation nécessite les opérandes empilés le plus récemment en premier (dernier entré, premier sorti) : chaque opérande est empilé, et chaque opérateur sort les deux sommets, s'applique lui-même, et empile le résultat. Montrez le contenu de la pile après chaque jeton si demandé.
Conversion manuelle de l'infixe vers RPN. (1) Mettez entièrement l'expression entre parenthèses en utilisant les règles de priorité ; (2) déplacez chaque opérateur juste après la parenthèse fermante de sa propre paire ; (3) supprimez les parenthèses. Donc $(a - b) * (a + c) / 7$ devient $((a - b) * (a + c)) / 7$, puis a b - a c + * 7 /. Notez que * et / sont appliqués de gauche à droite, donc la division est le dernier opérateur, pas la multiplication. Autres conversions : $((7 + 3) - (2 * 8)) / 6$ est 7 3 + 2 8 * - 6 / ; $(7 - 2 + 8) / (9 - 5)$ est 7 2 - 8 + 9 5 - / ; $a * b + b - d + 15$ est a b * b + d - 15 + ; $(2 - 6) * (13 + 7) / 5$ est 2 6 - 13 7 + * 5 /.
Conversion de RPN vers l'infixe. Parcourez la RPN avec une pile d'expressions : empilez chaque opérande ; pour chaque opérateur, sortez-en deux, écrivez-les de part et d'autre de celui-ci entre parenthèses, et empilez le résultat. Donc a b / 4 * a b + - est $((a / b) * 4) - (a + b)$ ; 5 2 + 9 3 - / 3 * est $((5 + 2) / (9 - 3)) * 3$ ; b a c - + d b + * c / est $((b + (a - c)) * (d + b)) / c$ ; a b - c + c a - * d / est $(((a - b) + c) * (c - a)) / d$. Gardez les parenthèses : les supprimer peut changer le sens.
Exemple résolu. Évaluez a b - c d + * e / lorsque $a = 17$, $b = 5$, $c = 7$, $d = 3$ et $e = 10$, en montrant la pile.
| Jeton | Action | Pile (sommet à droite) |
|---|---|---|
a |
empiler 17 | 17 |
b |
empiler 5 | 17, 5 |
- |
sortir 5 et 17, empiler $17 - 5$ | 12 |
c |
empiler 7 | 12, 7 |
d |
empiler 3 | 12, 7, 3 |
+ |
sortir 3 et 7, empiler $7 + 3$ | 12, 10 |
* |
sortir 10 et 12, empiler $12 \times 10$ | 120 |
e |
empiler 10 | 120, 10 |
/ |
sortir 10 et 120, empiler $120 / 10$ | 12 |
Résultat 12. L'ordre des sorties importe pour - et / : la valeur sortie en deuxième est l'opérande de gauche, donc a b - est $a - b$, pas $b - a$. Deux autres, de la même manière : d a b + * c a - / avec $a = 6, b = 12, c = 15, d = 5$ donne $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$ ; c a - b d + * b c + / avec $a = 4, b = 12, c = 24, d = 6$ donne $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.
Exemple résolu. Convertissez $(A + B) \times (C - D)$ en RPN, puis évaluez $(3 + 4) \times (5 - 2)$. Parcourez de gauche à droite en utilisant une pile d'opérateurs. Poussez ( ; sortez A ; poussez + ; sortez B ; sur ), poppez jusqu'au ( correspondant, donnant A B + jusqu'à présent. Poussez ×, et la deuxième parenthèse se comporte de la même manière, donnant C D -. À la fin, poppez le ×. Résultat : A B + C D - ×. Pour évaluer les nombres, utilisez une pile d'opérandes : poussez 3, poussez 4 ; + poppe les deux et pousse 7 ; poussez 5, poussez 2 ; - poppe les deux et pousse 3 ; × poppe 7 et 3 et pousse 21. Deux choses rendent cela fiable : les opérandes conservent leur ordre original lors de la conversion (seuls les opérateurs bougent), et chaque opérateur agit sur les deux valeurs immédiatement en dessous sur la pile.
Explorer
Précédence des opérateurs — ce que la NPI élimine
En arithmétique infixée ordinaire, × et ÷ lient plus fort que + et −, il faut donc appliquer les règles dans le bon ordre. La Notation Polonaise Inversée écrit les opérandes en premier (3 4 2 × + 1 −), fixant l'ordre pour qu'aucune règle de précédence ne soit nécessaire.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| infix/ˈɪnfɪks/ | 中缀 | zhōng zhuì |
| Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ | 逆波兰表示法 | nì bō lán biǎo shì fǎ |
| postfix/ˈpəʊstfɪks/ | 后缀 | hòu zhuì |
| stack/stæk/ | 栈 | zhàn |
| precedence/ˈpresɪdəns/ | 优先级 | yōu xiān jí |
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
16.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| multi-tâche | plusieurs processus maintenus en mémoire à la fois, le processeur basculant entre eux afin qu'ils semblent s'exécuter simultanément |
| processus | un programme qui a été chargé en mémoire et qui s'exécute (ou est prêt à l'être) |
| en cours / prêt / bloqué | possède le processeur / attend le processeur / ne peut continuer qu'après un événement tel que la fin d'E/S |
| ordonnancement | décider quel processus prêt obtient le processeur suivant, et pendant combien de temps |
| ordonnancement préemptif | le processus en cours peut être interrompu et déplacé vers prêt afin qu'un autre processus s'exécute |
| mémoire virtuelle | utiliser un stockage secondaire pour étendre la RAM, ne conservant en mémoire physique que les pages actuellement nécessaires |
| pagination | diviser la mémoire et les programmes en pages de taille fixe qui sont transférées entre disque et RAM selon les besoins |
| segmentation | diviser un programme en segments logiques de taille variable, chacun mappé en mémoire par une table de segments |
| thrashing de disque | les pages étant échangées entre RAM et disque si souvent qu'il y a peu de traitement utile |
| interpréteur | traduit et exécute un programme une instruction à la fois, sans produire de version traduite |
| compilateur | traduit un programme entier de haut niveau en code machine (objet) avant son exécution |
| analyse lexicale | convertit le code source en jetons, enlevant les espaces blancs et les commentaires, et construit la table des symboles |
| analyse syntaxique | vérifie que les jetons respectent la grammaire du langage et construit un arbre d'analyse |
| Forme de Backus–Naur | une notation pour la grammaire d'un langage : règles de la forme <name> ::= alternatives construites à partir de terminaux et de non-terminaux |
| Notation polonaise inverse | une façon d'écrire des expressions avec chaque opérateur après ses opérandes, afin qu'elles puissent être évaluées avec une pile et sans parenthèses |
16.2
Conseils d'examen
- Les questions sur le SO sont notées selon les mécanismes nommés : ordonnancement, gestion de la mémoire, tamponnement et spooling E/S, gestion de fichiers ; pour l'interface, noms de fichiers au lieu d'adresses, clics au lieu de commandes, pilotes, GUI.
- États des processus avec leurs transitions et la raison de chacune ; routines d'ordonnancement en tant que fonction plus avantage plus inconvénient ; le noyau sauvegarde l'état, identifie l'interruption, le sert, restaure.
- Mémoire virtuelle : le disque étend la RAM, pages échangées, traduction d'adresse ; le paginage est de taille fixe et invisible, la segmentation est de taille variable et logique ; thrashing (thrashing) est un échange au lieu du travail effectif.
- Interpréteur : une instruction à la fois, traduite puis exécutée, rien n'est stocké. Étapes du compilateur : jetons et table des symboles, grammaire et arbre de parsing, code, optimisation.
- BNF : une règle par diagramme,
|pour le choix, récursion pour la répétition, terminaux nus et non-terminaux entre crochets angulaires. Dites quelle règle une chaîne viole. - RPN : opérateurs après les opérandes, évaluez avec une pile, montrez chaque étape ; convertissez en encadrant entièrement ; lors de la conversion retour, gardez les parenthèses.
Erreurs courantes
- Décrire le multitâche comme « exécuter plusieurs programmes en même temps » sans dire que le processeur bascule entre eux.
- Envoyer un processus bloqué directement à l'état exécution, ou donner « time slice ended » (fin de tranche de temps) comme raison du passage de l'exécution au blocage.
- Confondre shortest job first (non préemptive) avec shortest remaining time (préemptive), ou round robin avec priorité.
- Définir la mémoire virtuelle comme « utiliser le disque dur comme RAM » sans mentionner l'échange de pages.
- Dire qu'un interpréteur « convertit le programme en code machine et ensuite l'exécute » ; c'est un compilateur.
- Placer la vérification syntaxique dans l'analyse lexicale, ou l'optimisation avant la génération de code dans la question de correspondance.
- Écrire la répétition BNF sous la forme
<letter>*ou avec une ellipse ; utilisez la récursion. Omettre les crochets angulaires autour des non-terminaux. - Inverser les opérandes de
-ou/lors de l'évaluation RPN, ou écrire la RPN de $a * b + c$ sous la formea b c + *.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.