| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Comprendre les limites de l'utilisation d'une approche basée sur les fichiers pour le stockage et la récupération des données | |
| Décrire les caractéristiques d'une base de données relationnelle qui répondent aux limites d'une approche basée sur les fichiers | |
| Comprendre et utiliser la terminologie associée à un modèle de base de données relationnelle | Y compris entité, tableau, enregistrement, champ, tuple, attribut, clé primaire, clé candidate, clé secondaire, clé étrangère, relation (un-à-plusieurs, un-à-un, plusieurs-à-plusieurs), intégrité référentielle, indexation |
| Utiliser un diagramme entité-relations (E-R) pour documenter la conception d'une base de données | |
| Comprendre le processus de normalisation | Première Forme Normale (1FN), Deuxième Forme Normale (2FN) et Troisième Forme Normale (3FN) |
| Expliquer pourquoi un ensemble donné de tables de base de données est, ou n'est pas, en 3FN | |
| Produire une conception de base de données normalisée pour une description de base de données, un ensemble de données donné ou un ensemble de tables donné |
Bases de données
Informatique A-Level · Sujet 8
 17:18
Bases de données & Modèle relationnel
Avant les bases de données, chaque programme gardait ses propres fichiers plats — un fichier par programme. Imaginez un magasin. Le programme de ventes, le programme de facturation et le programme d'expédition…
Narration en anglais · Sous-titres anglais + 中文 incrustés
8.1
Stockage basé sur des fichiers et ses limites
Programme
Source : Programme Cambridge International
Avant les bases de données, les programmes stockaient les données dans des fichiers plats 平面文件 — généralement un fichier par programme. Cela convient pour les petites données mais échoue à grande échelle.
Limitations
- redondance des données 数据冗余 — les mêmes données (l'adresse d'un client) sont conservées dans plusieurs fichiers, un par programme, gaspillant ainsi de l'espace de stockage et obligeant à mettre à jour toutes les copies.
- incohérence des données 数据不一致 — lorsqu'une copie est mise à jour et une autre non, les fichiers divergent et personne ne sait lequel est correct.
- dépendance des données — chaque programme est écrit pour la structure exacte de ses fichiers ; changer la longueur d'un champ ou ajouter un champ oblige à réécrire tous les programmes qui lisent ce fichier.
- pas d'accès partagé — un fichier est verrouillé tant qu'un programme l'utilise, donc les utilisateurs ne peuvent pas travailler sur les données simultanément.
- intégrité 完整性 faible — aucune règle centrale n'empêche une valeur invalide ou un lien vers un client inexistant ; sécurité faible — l'accès est par fichier, pas par champ ; et les requêtes croisées nécessitent un nouveau programme à chaque fois.

Une base de données relationnelle 关系数据库 corrige ces défauts en stockant les données dans des tables gérées par un seul logiciel (le SGBD) que tous les programmes utilisent.
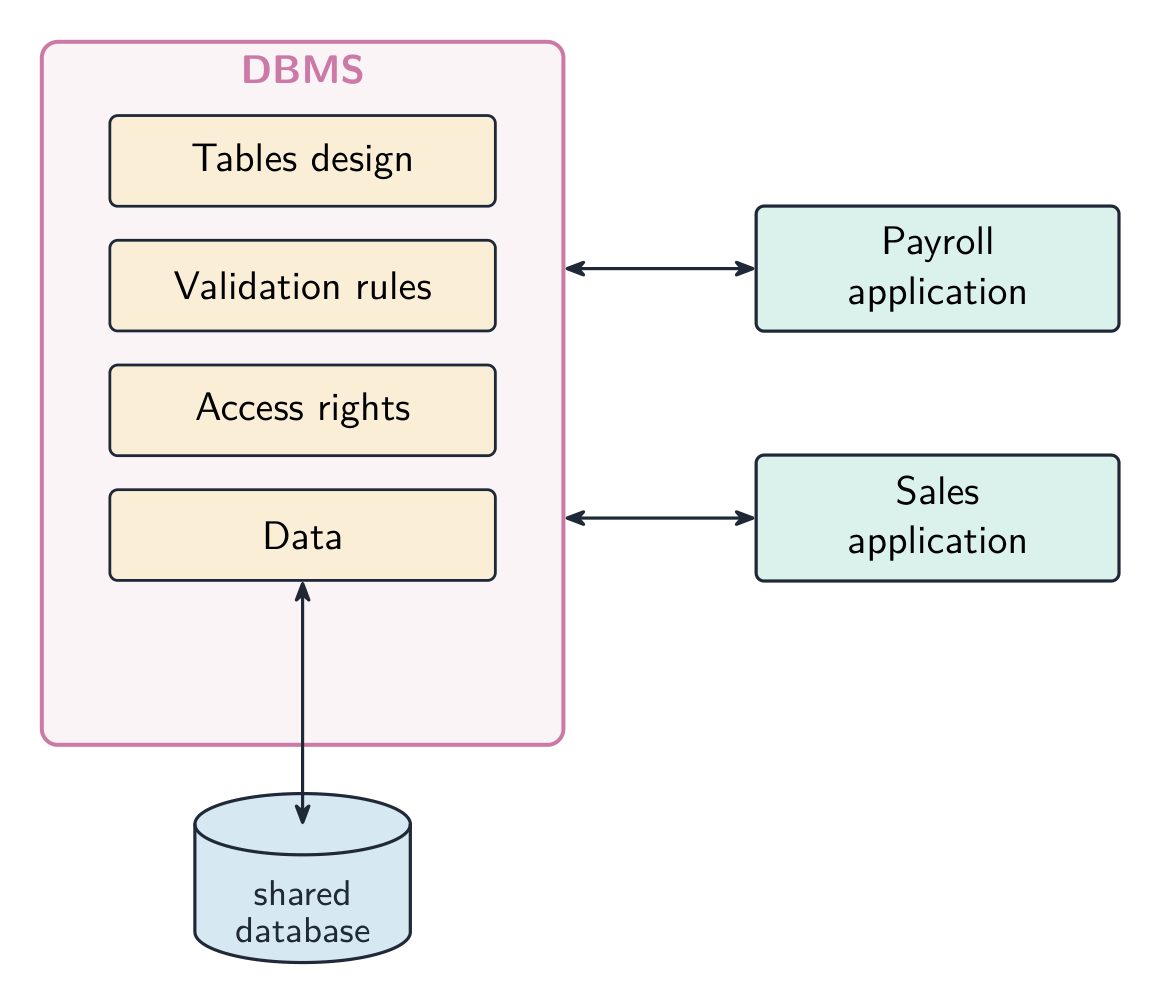
Pourquoi une base de données relationnelle est meilleure — la réponse à trois points. Chaque élément de donnée est stocké une seule fois, dans une seule table, et les tables sont liées par des clés, ce qui élimine la redondance et l'incohérence ; les données sont indépendantes des programmes, qui demandent au SGBD ce dont ils ont besoin et ne sont pas affectés lorsque la structure change ; et le SGBD applique des règles d'intégrité, contrôle l'accès par utilisateur et par champ, permet à plusieurs utilisateurs d'accéder simultanément aux données, et répond à n'importe quelle requête sans qu'un nouveau programme soit écrit.
Exemple résolu. Un atelier de réparation stocke ses clients, ses appareils et ses chantiers de réparation en utilisant une approche basée sur des fichiers, un fichier par programme. Donnez trois problèmes que cela pose et décrivez comment une base de données relationnelle les résoudrait.
Le nom et le numéro de téléphone du client sont stockés dans le fichier réparations et dans le fichier factures (redondance) ; lorsque le client change de numéro, un seul fichier est mis à jour et l'autre non (incohérence) ; et lorsque l'atelier souhaite obtenir un nouveau rapport — réparations par technicien — il faut écrire un nouveau programme pour lire les fichiers (pas de requêtes ad hoc). Dans une base de données relationnelle, le client est stocké une seule fois dans une table CLIENT et référencé via l'ID_Client depuis la table REPARATION, donc une modification est effectuée une seule fois et est visible partout ; le rapport est une simple requête SQL.
8.1
Modèle relationnel — termes
- table 表 (relation) — une grille de lignes et de colonnes ; une table par type d'entité 实体 (ex.
CUSTOMER). - record 记录 (row, also called a tuple 元组) — une ligne ; une instance de l'entité.
- champ 字段 (column, also called an attribute 属性) — une colonne ; un élément d'information concernant chaque enregistrement.
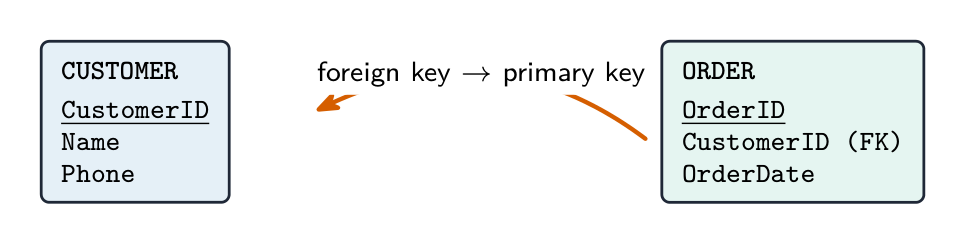
- primary key 主键 — un champ (ou plusieurs champs) qui identifie de manière unique chaque enregistrement ; jamais nul ou dupliqué.
- foreign key 外键 — un champ dont la valeur correspond à la clé primaire d'une autre table, reliant les deux tables.
- composite key 复合键 — une clé primaire constituée de deux champs ou plus combinés.
- candidate key 候选键 — tout champ (ou ensemble de champs) qui pourrait être la clé primaire.
- secondary key 次键 — un champ non principal indexé pour permettre des recherches rapides.
- indexing 索引 — la création d'un index sur un champ afin que les recherches et les jointures s'exécutent plus rapidement.
- referential integrity 参照完整性 — toute valeur de clé étrangère doit correspondre à une clé primaire existante (pas d'enregistrements orphelins).
Une table est écrite en abrégé avec la clé primaire soulignée et les clés étrangères notées :
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Exemple résolu. Expliquez ce que signifient entité, clé primaire et intégrité référentielle dans une base de données relationnelle, et complétez le tableau terme ↔ description pour tuple et attribut.
Une entité est quelque chose à propos duquel des données sont stockées — une personne, un objet ou un événement — qui devient une table. Une clé primaire est l'attribut (ou combinaison d'attributs) qui identifie de manière unique chaque enregistrement dans une table. L'intégrité référentielle signifie que toute valeur de clé étrangère doit correspondre à la valeur d'une clé primaire dans la table vers laquelle elle renvoie, afin qu'un enregistrement ne puisse pas faire référence à un enregistrement inexistant. Un tuple est une ligne d'une table (un enregistrement) ; un attribut est une colonne (un champ). Apprenez les paires : table/relation, record/tuple, field/attribute.
Explorer
Lire une table relationnelle avec SELECT
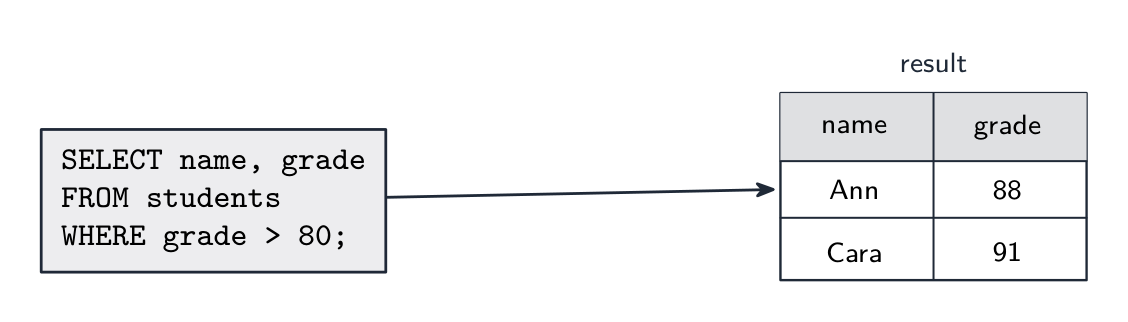
Une table relationnelle est constituée de lignes (enregistrements) et de colonnes (champs). WHERE garde les lignes correspondant à une condition ; SELECT garde ensuite uniquement les colonnes demandées.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| flat files/flæt faɪlz/ | 平面文件 | píng miàn wén jiàn |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | 数据冗余 | shù jù rǒng yú |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | 数据不一致 | shù jù bù yī zhì |
| field/fiːld/ | 字段 | zì duàn |
| integrity/ɪnˈteɡrɪti/ | 完整性 | wán zhěng xìng |
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | 关系数据库 | guān xì shù jù kù |
| table/ˈteɪbl/ | 表 | biǎo |
| record/ˈrekɔːd/ | 记录 | jì lù |
| tuple/ˈtuːpl/ | 元组 | yuán zǔ |
| attribute/ˈætrɪbjuːt/ | 属性 | shǔ xìng |
| primary key/ˈpraɪməri kiː/ | 主键 | zhǔ jiàn |
| foreign key/ˈfɒrən kiː/ | 外键 | wài jiàn |
| composite key/ˈkɒmpəzɪt kiː/ | 复合键 | fù hé jiàn |
| candidate key/ˈkændɪdeɪt kiː/ | 候选键 | hòu xuǎn jiàn |
| secondary key/ˈsekəndəri kiː/ | 次键 | cì jiàn |
| indexing/ˈɪndeksɪŋ/ | 索引 | suǒ yǐn |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | 参照完整性 | cān zhào wán zhěng xìng |
| entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ | 实体关系图 | shí tǐ guān xì tú |
8.1
Diagrammes entité-relational (E-R)

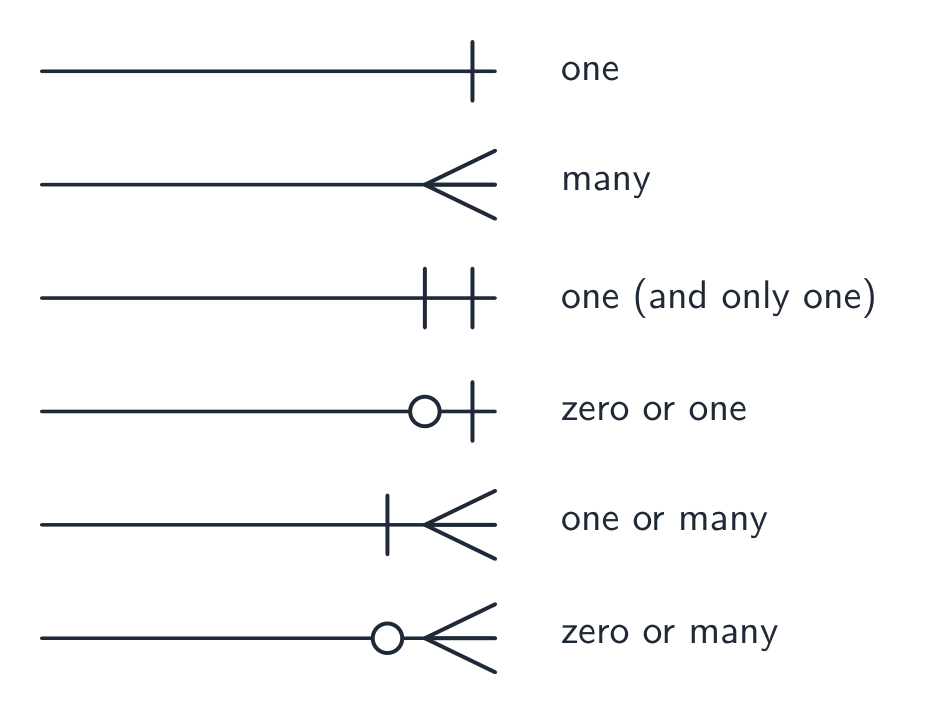
Un diagramme entité-relational 实体关系图 montre la structure : chaque entité est un rectangle, chaque relation une ligne, avec la cardinalité 基数 marquée à chaque extrémité :
- one-to-one (1:1).
- one-to-many 一对多 (1:M) — chaque Client a beaucoup de Commandes ; chaque Commande a un seul Client.
- many-to-many (M:N) — les Élèves suivent beaucoup de Cours, et les Cours ont beaucoup d'Élèves.
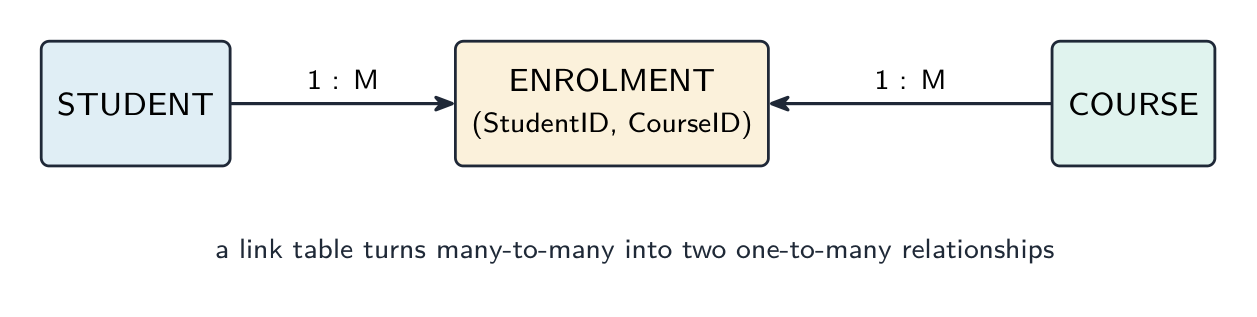
Une relation many-to-many ne peut pas être stockée directement. Décomposez-la en deux relations one-to-many via une link table 连接表 contenant les deux clés étrangères :
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Tracer le diagramme E-R pour un ensemble de tables donné. Chaque table devient une entité. Une relation existe là où une table contient une clé étrangère vers une autre ; elle part de la table contenant la clé étrangère (l'extrémité beaucoup) vers la table dont c'est la clé primaire (l'extrémité non). Une table avec deux clés étrangères et aucune autre identité est généralement une table de liaison résolvant une relation many-to-many. Étiquetez chaque ligne avec le type de relation.
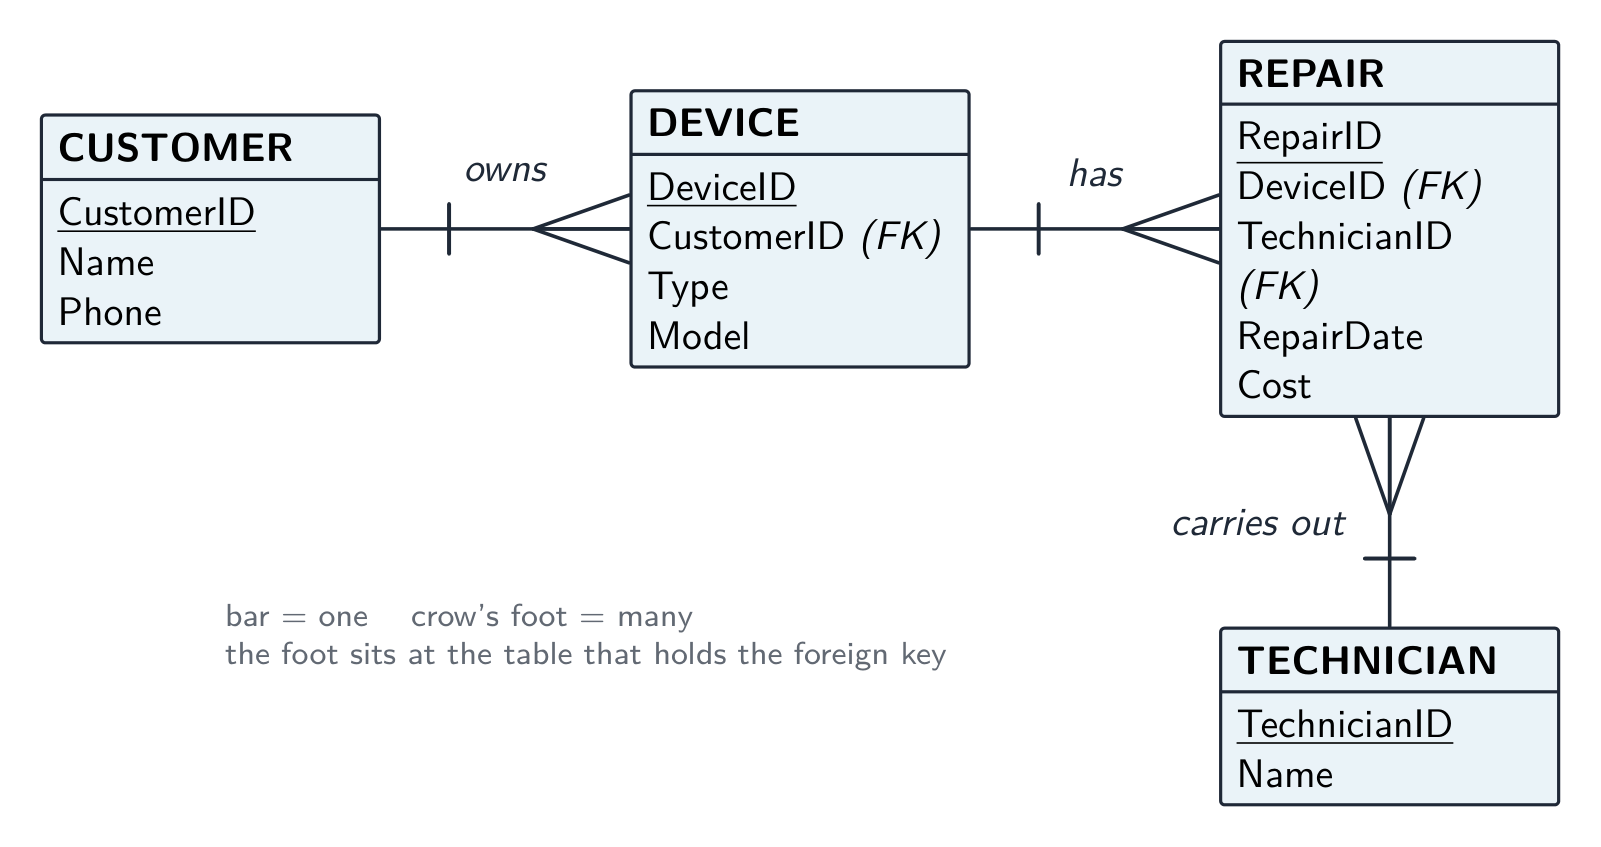
Exemple résolu. Un atelier de réparation possède les tables CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) et REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifiez les relations et leurs types.
DEVICE contient CustomerID, donc CUSTOMER–DEVICE est one-to-many (un client, beaucoup d'appareils). REPAIR contient DeviceID, donc DEVICE–REPAIR est one-to-many ; il contient également TechnicianID, donc TECHNICIAN–REPAIR est one-to-many. Il n'y a pas de ligne directe CUSTOMER–REPAIR : le lien passe par DEVICE. Trois lignes, trois pattes de corbeau, toutes aux extrémités REPAIR ou DEVICE.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| cardinality/ˌkɑːdɪˈnælɪti/ | 基数 | jī shù |
| one-to-many/wʌn tə ˈmeni/ | 一对多 | yī duì duō |
| link table/lɪŋk ˈteɪbl/ | 连接表 | lián jiē biǎo |
8.1
Normalisation

Normalisation 规范化 organise les tables pour réduire la redondance et l'incohérence, en passant par les formes normales 范式 dans l'ordre.
- First normal form (1NF) — chaque champ contient une seule valeur (atomique 原子), sans groupes répétés, et avec une clé primaire.
- Second normal form (2NF) — en 1NF, et chaque champ non-clé dépend de la totalité de la clé primaire (ceci ne concerne que les clés composites).
- Third normal form (3NF) — en 2NF, et chaque champ non-clé dépend uniquement de la clé primaire, pas d'un autre champ non-clé (pas de dépendance transitive 传递依赖).
Une conception en 3NF stocke chaque fait une seule fois, donc les anomalies d'insertion/mise à jour/suppression disparaissent. Le compromis est plus de tables et plus de jointures. Visez la 3NF.
Pour produire une conception en 3NF : trouvez les entités et leurs attributs ; choisissez une clé primaire pour chacune ; divisez les champs répétés/non-atomiques (1NF) ; divisez les champs dépendant d'une partie d'une clé composite (2NF) ; divisez les champs dépendant transitivement de la clé (3NF) ; ajoutez des clés étrangères pour les relations.
Exemple résolu. La table ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) a la clé primaire composite (OrderID, ProductID). Normalisez-la en 3NF. Testez chaque champ non-clé contre la clé. Quantity dépend de les deux OrderID et ProductID, ce qui est correct. Mais CustomerID dépend de OrderID seul - seulement une partie de la clé composite. C'est une dépendance partielle, donc la table n'est pas en 2NF. Séparez-la en ORDER_LINE(OrderID, ProductID, Quantity) et ORDER(OrderID, CustomerID, CustomerName). Maintenant testez la 3NF : dans cette nouvelle table ORDER, CustomerName dépend de CustomerID, qui n'est pas la clé - une dépendance transitive. Séparez encore : ORDER(OrderID, CustomerID) et CUSTOMER(CustomerID, CustomerName). Nommez la dépendance qui viole chaque forme (partielle viole la 2NF, transitive viole la 3NF) ; dire "elle contient des données répétées" décrit le symptôme mais ne rapporte aucun point.
Les trois questions à poser à toute table. Chaque cellule contient-elle une seule valeur, sans groupe répété ? Si non, elle n'est pas en 1NF. Si la clé est composite, chaque champ non-clé dépend-il de la totalité de la clé ? Si certains champs dépendent d'une partie, il y a une dépendance partielle 部分依赖 et la table n'est pas en 2NF. Chaque champ non-clé dépend-il uniquement de la clé ? Si un champ dépend d'un autre champ non-clé, il y a une dépendance transitive et la table n'est pas en 3NF. Une réponse expliquant pourquoi la table n'est pas en 3NF doit nommer la dépendance et les champs concernés.
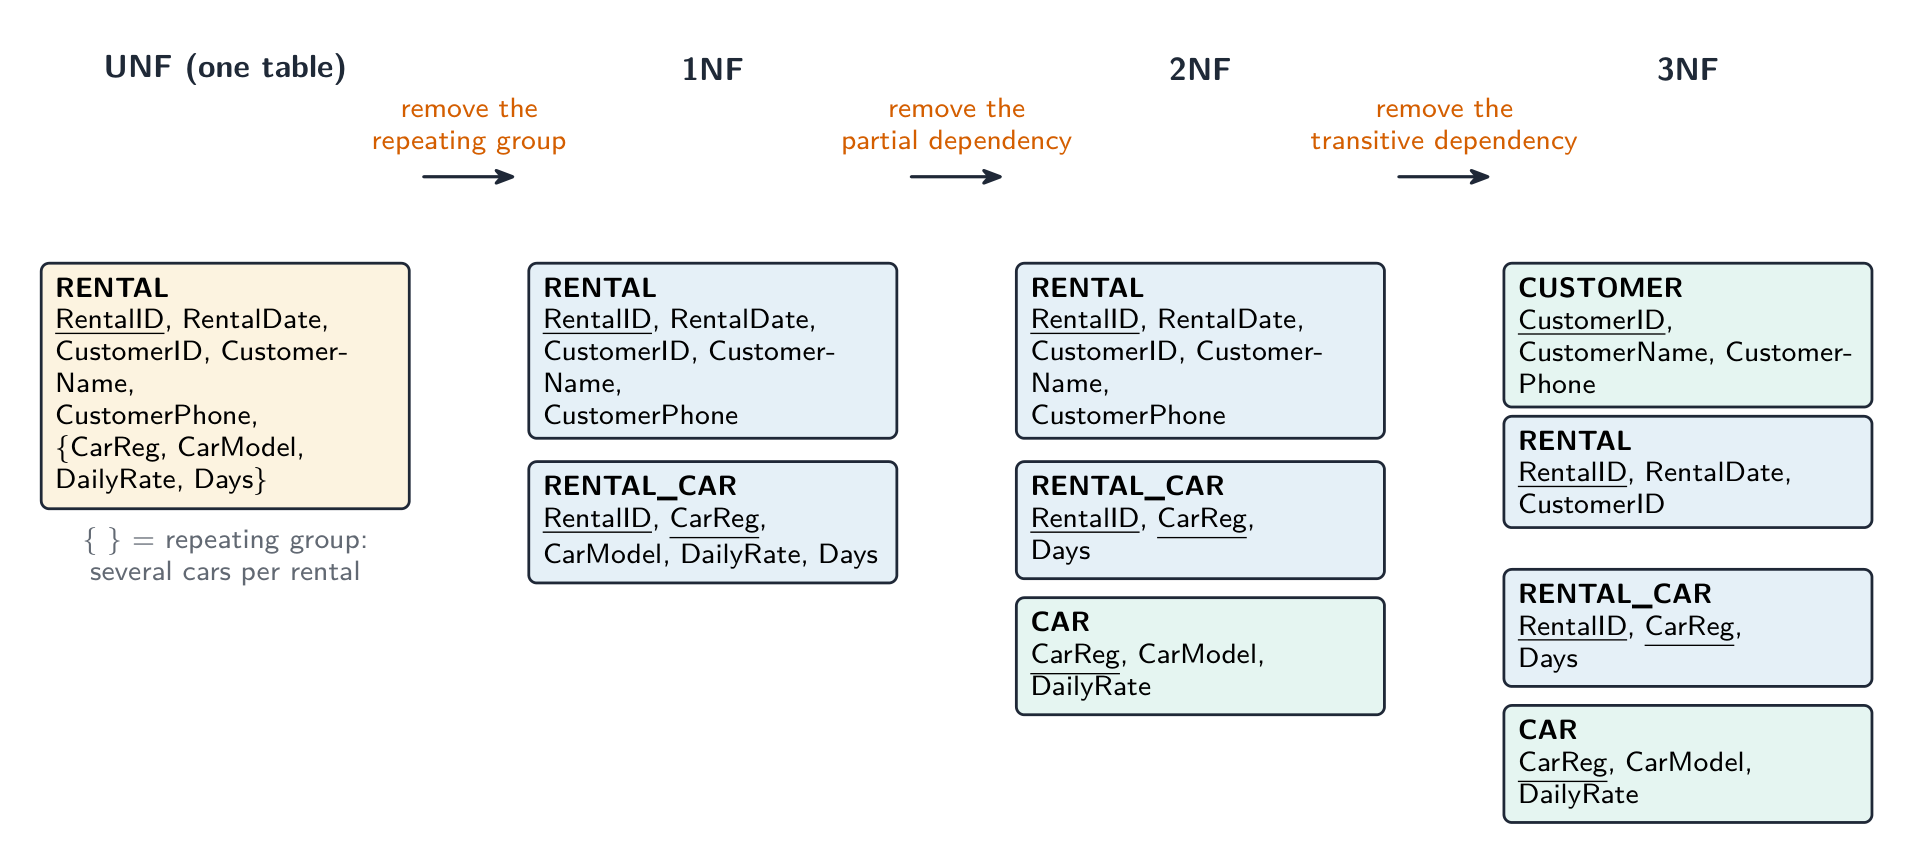
Exemple résolu. Un magasin de location de voitures enregistre chaque location comme RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), où une location peut inclure plusieurs voitures. Expliquez pourquoi la table n'est pas normalisée et produisez une conception en 3NF.
Pas en 1NF : les champs de voiture CarReg, CarModel, DailyRate, Days forment un groupe répété — une location a plusieurs voitures. Déplacez-les vers RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) avec la clé composite (RentalID, CarReg). Pas en 2NF : dans RENTAL_CAR, CarModel et DailyRate dépendent de CarReg seul — une dépendance partielle. Déplacez-les vers CAR(CarReg, CarModel, DailyRate), laissant RENTAL_CAR(RentalID, CarReg, Days). Pas en 3NF : dans RENTAL, CustomerName et CustomerPhone dépendent de CustomerID, un champ non-clé — une dépendance transitive. Déplacez-les vers CUSTOMER(CustomerID, CustomerName, CustomerPhone), laissant RENTAL(RentalID, RentalDate, CustomerID). La conception 3NF est constituée de quatre tables — CUSTOMER, RENTAL, RENTAL_CAR, CAR — avec CustomerID, RentalID et CarReg comme clés étrangères ; soulignez toutes les clés primaires.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| normalisation/ˌnɔːməlaɪˈzeɪʃn/ | 规范化 | guī fàn huà |
| normal forms/ˈnɔːml fɔːmz/ | 范式 | fàn shì |
| atomic/əˈtɒmɪk/ | 原子 | yuán zi |
| transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ | 传递依赖 | chuán dì yī lài |
| partial dependency/ˈpɑːʃl dɪˈpendənsi/ | 部分依赖 | bù fèn yī lài |
8.2
Système de gestion de base de données (DBMS)

Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Comprendre les fonctionnalités fournies par un Système de gestion de bases de données (SGBD) qui répondent aux problèmes d'une approche basée sur les fichiers | Y compris : • gestion des données, y compris le maintien d'un dictionnaire de données • modélisation des données • schéma logique • intégrité des données • sécurité des données, y compris les procédures de sauvegarde et l'utilisation des droits d'accès aux individus / groupes d'utilisateurs |
| Comprendre comment les outils logiciels trouvés dans un SGBD sont utilisés en pratique | Y compris l'utilisation et l'objectif de : • interface développeur • processeur de requêtes |
Source : Programme Cambridge International
Un SGBD 数据库管理系统 gère la base de données de manière centralisée. Fonctionnalités corrigeant les limites basées sur les fichiers :
- data dictionary 数据字典 — une description de chaque table, champ, type et clé ; les programmes l'interrogent au lieu de codifier en dur la structure.
- contrôle de la redondance/cohérence — chaque fait stocké une seule fois.
- concurrent access 并发访问 contrôle — les verrous et transactions permettent à plusieurs utilisateurs de travailler simultanément.
- backup 备份 et récupération ; sécurité et permissions par utilisateur.
- règles d'intégrité — clés, contraintes d'unicité et de plage, appliquées centralisées.
- transactions 事务 — un groupe d'opérations qui réussissent toutes ou échouent toutes.
- vues 视图 — tables virtuelles qui affichent à chaque utilisateur "sa" tranche de données.
- data management 数据管理 et data modelling 数据建模 — contrôlent la manière dont les données sont stockées et définissent leur structure sous forme de logical schema 逻辑模式 (la conception logique, indépendante du stockage physique).
- data integrity 数据完整性 et data security 数据安全 — imposent la correction et contrôlent l'accès de manière centralisée.
- non query processor 查询处理器 exécute des requêtes ; une developer interface 开发者接口 fournit des outils et des API pour créer des applications.
Ses outils incluent un éditeur de dictionnaire de données, un constructeur de requêtes, un constructeur de formulaires, un générateur de rapports, la gestion des utilisateurs et un éditeur SQL.
Ce que contient le dictionnaire de données (une question « donnez trois éléments ») : les noms des tables ; les noms des champs dans chaque table ; le type de données et la longueur de chaque champ ; les clés primaires et étrangères ainsi que les relations entre les tables ; les règles de validation ; les index ; et qui peut accéder à chaque table. C'est des métadonnées — des données sur les données — et le SGBD l'utilise pour vérifier chaque requête et chaque modification.
Comment le SGBD garde les données en sécurité (une question « décrivez deux méthodes ») : authentication 身份验证 — un nom d'utilisateur et un mot de passe, ou une donnée biométrique, avant tout accès ; access rights — chaque utilisateur ou groupe n'est autorisé à lire, écrire ou supprimer que certaines tables ou certains champs, souvent via une view ; encryption des données stockées et des données envoyées, afin qu'un fichier copié soit illisible ; backups pris régulièrement, pour pouvoir restaurer les données après perte ; et un journal de transactions enregistrant qui a changé quoi.
Les deux outils logiciels. La developer interface est ce qu'un programmeur utilise pour construire la base de données et les applications associées : créer des tables et définir les clés et validations, écrire des requêtes et du SQL, et concevoir des formulaires et des rapports, sans savoir comment les données sont stockées physiquement. Le query processor prend une requête (SQL provenant d'un programme ou une requête construite dans l'interface), la vérifie par rapport au dictionnaire de données, détermine la façon la plus efficace de l'exécuter, récupère les données et retourne les résultats.
Logical schema. Le SGBD garde la conception logique (quelles tables et quels champs existent et comment ils se relationnent) séparée du physical storage (fichiers, index, blocs disque). Les programmes travaillent avec le schéma logique, de sorte que le stockage physique peut être réorganisé sans modifier un seul programme — c'est l'indépendance des données à laquelle manquait l'approche basée sur les fichiers.
Explorer
Lab de service de base de données
Regardez comment un SGBD transforme une requête en accès partagé sécurisé aux données.
Explorer
Lab de service de base de données
Regardez comment un SGBD transforme une requête en accès partagé sécurisé aux données.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| data dictionary/ˈdeɪtə ˈdɪkʃənəri/ | 数据字典 | shù jù zì diǎn |
| concurrent access/kənˈkʌrənt ˈækses/ | 并发访问 | bìng fā fǎng wèn |
| transactions/trænˈsækʃnz/ | 事务 | shì wù |
| backup/ˈbækʌp/ | 备份 | bèi fèn |
| views/vjuːz/ | 视图 | shì tú |
| data management/ˈdeɪtə ˈmænɪdʒmənt/ | 数据管理 | shù jù guǎn lǐ |
| data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ | 数据建模 | shù jù jiàn mó |
| logical schema/ˈlɒdʒɪkl ˈskiːmə/ | 逻辑模式 | luó jí mó shì |
| data integrity/ˈdeɪtə ɪnˈteɡrɪti/ | 数据完整性 | shù jù wán zhěng xìng |
| data security/ˈdeɪtə sɪˈkjʊərɪti/ | 数据安全 | shù jù ān quán |
| query processor/ˈkwɪərɪ ˈprəʊsesə/ | 查询处理器 | chá xún chǔ lǐ qì |
| developer interface/dɪˈveləpə ˈɪntəfeɪs/ | 开发者接口 | kāi fā zhě jiē kǒu |
| authentication/ɔːˌθentɪˈkeɪʃn/ | 身份验证 | shēn fèn yàn zhèng |
8.3
DDL et DML
Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Comprendre que le SGBD effectue toute création/modification de la structure de la base de données via son Langage de définition de données (DDL) | |
| Comprendre que le SGBD effectue toutes les requêtes et maintenance des données via son DML | |
| Comprendre que la norme industrielle pour le DDL et le DML est le Structured Query Language (SQL) | Comprendre une instruction SQL donnée |
| Comprendre les instructions SQL (DDL) données et être capable d'écrire de simples instructions SQL (DDL) en utilisant un sous-ensemble d'instructions | Créer une base de données (CREATE DATABASE) Créer une définition de tableau (CREATE TABLE), y compris la création d'attributs avec des types de données appropriés : • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Modifier une définition de tableau (ALTER TABLE) Ajouter une clé primaire à un tableau (PRIMARY KEY (field)) Ajouter une clé étrangère à un tableau (FOREIGN KEY (field) REFERENCES Table (Field)) |
| Écrire un script SQL pour interroger ou modifier les données (DML) stockées dans (au maximum deux) tables de base de données | Requêtes incluant SELECT... DE, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG |
| Maintenance des données incluant INSERT INTO, DELETE FROM, UPDATE |
Source : Programme Cambridge International
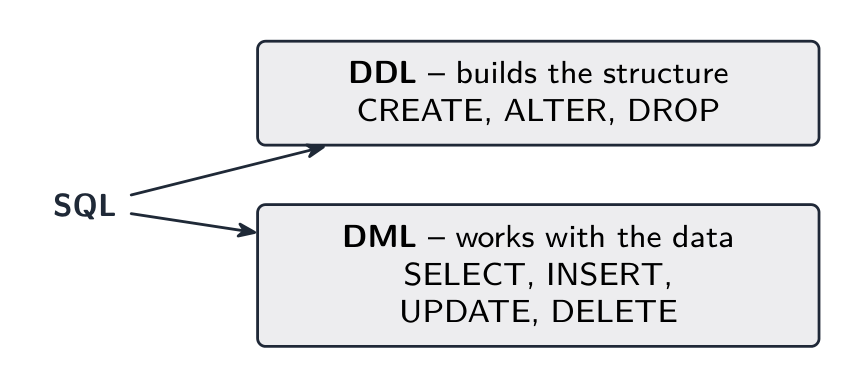
SQL 结构化查询语言 (Structured Query Language) possède deux moitiés :
- Data Definition Language 数据定义语言 (DDL) — crée ou modifie la structure (tables, clés, contraintes).
- Data Manipulation Language 数据操纵语言 (DML) — travaille avec les données (insertion, mise à jour, suppression, query 查询).
Bases de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Ajouter une clé étrangère :
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Modifier et supprimer :
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Types courants : INTEGER, REAL, VARCHAR(n), CHAR(n) (aussi CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
Bases de DML
Requête avec SELECT :
SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT liste les champs, FROM nomme la table, WHERE filtre les lignes, ORDER BY trie.
Un join 连接 combine deux tables grâce à une relation de clé étrangère :
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
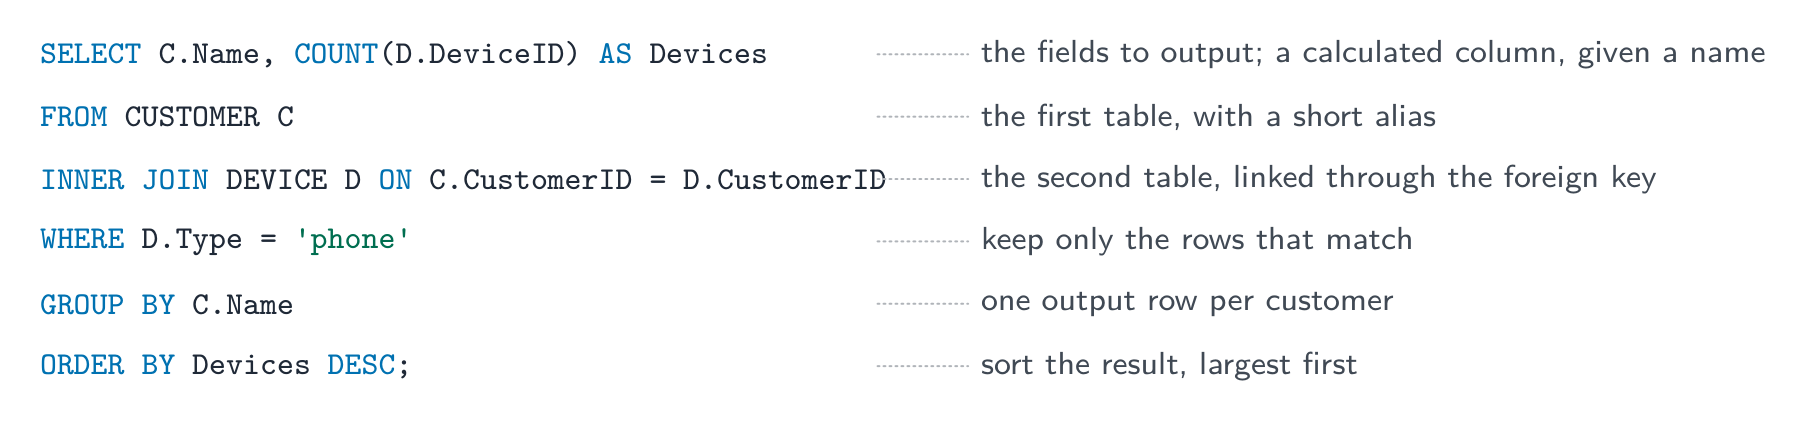
Fonctions agrégées 聚合函数 (COUNT, SUM, AVG, MIN, MAX) sont souvent utilisées avec GROUP BY :
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
Insertion, mise à jour, suppression :
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Toujours mettre une clause WHERE sur UPDATE et DELETE, sinon la modification touche toutes les lignes.
Conseils pour le SQL d'examen
- utiliser les noms exacts de table et de champ donnés dans l'énoncé.
- mettre des guillemets simples autour des chaînes (
'Smith') ; ne pas mettre de guillemets autour des nombres. - comparaisons :
=,<,>,<=,>=,<>. LIKE 'A%'correspond à tout commençant par A (%= n'importe quelle chaîne,_= un caractère) ;IN (1,2,3);BETWEEN 10 AND 20.- combiner des conditions avec
AND/OR/NOT, et terminer chaque instruction par un point-virgule.
Le motif DDL attendu à l'examen. Chaque CREATE TABLE nomme chaque champ avec son type, marque la clé primaire, et déclare chaque clé étrangère avec la table qu'elle référence ; une clé composite est déclarée sur sa propre ligne :
CREATE TABLE RENTAL_CAR (
  RentalID INTEGER,
  CarReg VARCHAR(8),
  Days INTEGER,
  PRIMARY KEY (RentalID, CarReg),
  FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID),
  FOREIGN KEY (CarReg) REFERENCES CAR(CarReg)
);
Exemple résolu. En utilisant CUSTOMER(CustomerID, Name, Phone) et DEVICE(DeviceID, CustomerID, Type, Model), écrire des scripts SQL pour : (a) lister le nom et le numéro de téléphone de chaque client possédant un appareil de type 'tablet', par ordre alphabétique de nom ; (b) compter les appareils de chaque type ; (c) enregistrer que le client 17 a maintenant le numéro de téléphone '0771 234 5678' ; (d) ajouter un nouvel appareil, ID 305, un 'laptop' de modèle 'X1' appartenant au client 17.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Des points sont attribués par clause — les champs, les tables, la condition de jointure, la clause WHERE, la clause ORDER BY — donc un script avec une mauvaise clause obtient tout de même les points des autres. Écrire Table.Field dès que deux tables sont impliquées.
Exemple résolu. Expliquer ce que fait ce script : SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
Il affiche le nom de chaque technicien avec le coût total des réparations effectuées par ce technicien, une ligne par technicien : les deux tables sont jointes sur TechnicianID, les lignes sont groupées par nom, et les coûts de chaque groupe sont additionnés. Quand on demande ce que fait un script, décrire le résultat, pas la syntaxe.
Explorer
Assembler deux tables avec INNER JOIN
Un joint associe les lignes où la clé étrangère correspond à la clé primaire — ici Orders.CustomerID = Customer.CustomerID — et combine chaque paire correspondante en une ligne plus large.
Explorer
SELECT … WHERE
Parcourez une requête : WHERE conserve les lignes qui correspondent, puis SELECT choisit les colonnes que vous avez demandées.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| query/ˈkwɪərɪ/ | 查询 | chá xún |
| SQL/ˌes kjuː ˈel/ | 结构化查询语言 | jié gòu huà chá xún yǔ yán |
| join/dʒɔɪn/ | 连接 | lián jiē |
| Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ | 数据定义语言 | shù jù dìng yì yǔ yán |
| Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ | 数据操纵语言 | shù jù cāo zòng yǔ yán |
| aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ | 聚合函数 | jù hé hán shù |
8.3
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| entity | quelque chose pour lequel des données sont stockées — une personne, un objet ou un événement — qui devient une table dans une base de données relationnelle |
| attribute | un élément de données concernant une entité (une colonne de la table) |
| tuple | une ligne d'une table : une instance de l'entité |
| primary key | un attribut, ou une combinaison d'attributs, qui identifie de manière unique chaque enregistrement dans une table |
| foreign key | un attribut dans une table dont la valeur correspond à une clé primaire dans une autre table, utilisé pour lier les deux |
| candidate key | tout attribut (ou combinaison) qui pourrait être choisi comme clé primaire |
| secondary key | un attribut non-primaire qui est indexé afin que la table puisse être recherchée ou triée rapidement dessus |
| composite key | une clé primaire constituée de deux attributs ou plus ensemble |
| referential integrity | chaque valeur de clé étrangère doit correspondre à une valeur de clé primaire existante dans la table à laquelle elle se réfère |
| first normal form | une table dans laquelle chaque attribut est atomique, il n'y a pas de groupes répétés, et il y a une clé primaire |
| second normal form | en 1NF, et chaque attribut non-clé dépend de l'ensemble de la clé primaire (pas de dépendance partielle) |
| third normal form | en 2NF, et aucun attribut non-clé ne dépend d'un autre attribut non-clé (pas de dépendance transitive) |
| data dictionary | les métadonnées qu'un SGBD conserve sur la structure de la base de données : tables, champs, types, clés, relations, validation |
| DDL / DML | le langage utilisé pour définir ou modifier la structure d'une base de données / le langage utilisé pour interroger et maintenir les données dans celle-ci |
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| entity/ˈentɪti/ | 实体 | shí tǐ |
8.3
Conseils d'examen
- Définir exactement les termes : entity, attribute, primary key, foreign key, et les types de relations (1:1, 1:many, many:many).
- Donner une raison pour chaque forme normale : 1NF (pas de groupes répétés), 2NF (pas de dépendance partielle), 3NF (pas de dépendance hors-clé) — et nommer les champs concernés.
- Expliquer ce qu'un DBMS fournit (indépendance des données, sécurité, intégrité, accès concurrentiel, dictionnaire de données, interface développeur, processeur de requêtes).
- Distuer DDL (définir la structure) de DML (interroger et modifier les données), et écrire la clause SQL une par une :
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Pour dessiner un diagramme E-R à partir de tables, trouver d'abord chaque clé étrangère : chaque clé étrangère représente une relation un-à-beaucoup, avec le "beaucoup" dans la table qui la contient.
Erreurs courantes
- Dessiner une relation beaucoup-à-beaucoup directement. Elle doit être scindée en deux relations un-à-beaucoup via une table lien contenant les deux clés étrangères.
- Expliquer "pas en 3NF" par "les données sont répétées". Nommer la dépendance (partielle ou transitive) et les champs concernés.
- Des guillemets doubles autour des chaînes en SQL, ou des guillemets autour des nombres. Les chaînes prennent
'single quotes'; les nombres n'en prennent aucun. - Omettre la condition
ONaprèsINNER JOIN. Sans cela, les deux tables ne sont pas liées. - Placer un champ ordinaire à côté de
COUNTouSUMdans unSELECTsansGROUP BY. UPDATEouDELETEsans uneWHERE. Cela modifie ou supprime toutes les lignes de la table.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| DBMS/ˌdiː biː em ˈes/ | 数据库管理系统 | shù jù kù guǎn lǐ xì tǒng |
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.