| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Montrer une compréhension de l'abstraction | Besoin et avantages de l'utilisation de l'abstraction Décrire la finalité de l'abstraction Produire un modèle abstrait d'un système en n'incluant que les détails essentiels |
| Décrire et utiliser la décomposition | Décomposer les problèmes en sous-problèmes menant au concept de module de programme (procédure / fonction) |
Conception d'algorithmes et résolution de problèmes
Informatique A-Level · Sujet 9
 14:52
Pensée computationnelle
Voici une tâche : construire un système pour gérer tout le stock d'un magasin — chaque produit, chaque vente, chaque livraison, chaque rapport. En tant que problème unique, c'est trop grand pour…
Narration en anglais · Sous-titres anglais + 中文 incrustés
9.1
Pensée computationnelle

Programme
Source : Programme Cambridge International
Pensée computationnelle 计算思维 est l'ensemble des outils mentaux pour analyser un problème et concevoir une solution qu'un ordinateur peut exécuter. Deux concepts clés sont l'abstraction et la décomposition.
Abstraction
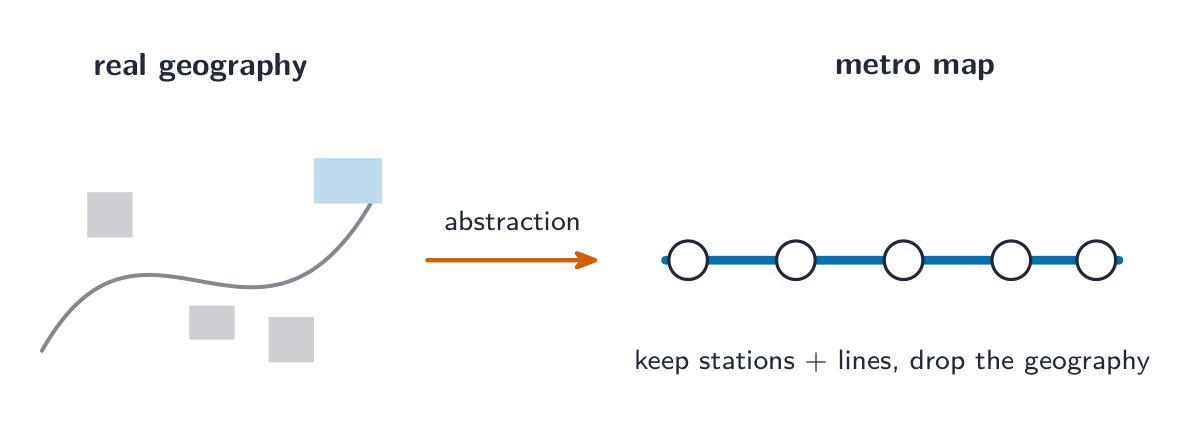
Abstraction 抽象 signifie garder les caractéristiques essentielles d'un problème et ignorer les détails insignifiants, offrant un modèle plus simple.
Exemples :
- une carte de réseau ferroviaire garde les gares et les lignes mais omet la géographie.
- une class en programmation orientée objet garde seulement les attributs et méthodes dont le système a besoin.
- une fonction cache une partie du travail derrière un nom.
Un modèle complet de n'importe quel problème réel serait trop vaste pour être raisonné, donc l'abstraction est essentielle.
L'examinateur demande le but de l'abstraction et ses avantages. But : produire un modèle plus simple d'un problème qui ne contient que les détails nécessaires pour le résoudre. Avantages : le problème est plus facile à comprendre et à programmer ; le programme est plus petit, plus rapide à écrire et à tester ; le même modèle peut être réutilisé pour des problèmes similaires. Lorsqu'on vous demande de produire un modèle abstrait d'un système, listez uniquement les données et actions dont la tâche a besoin. Pour un horaire scolaire, cela signifie les classes, les salles, les enseignants et les créneaux ; cela ne signifie pas la couleur des salles ou l'âge des enseignants.
Décomposition
Décomposition 分解 signifie découper un grand problème en sous-problèmes plus petits, chacun plus facile à résoudre et traité un par un.
- identifier les parties principales de la tâche.
- découper chacune en sous-tâches plus petites.
- continuer jusqu'à ce que chaque partie soit assez petite pour être conçue directement.
- résoudre les petites tâches et les combiner.
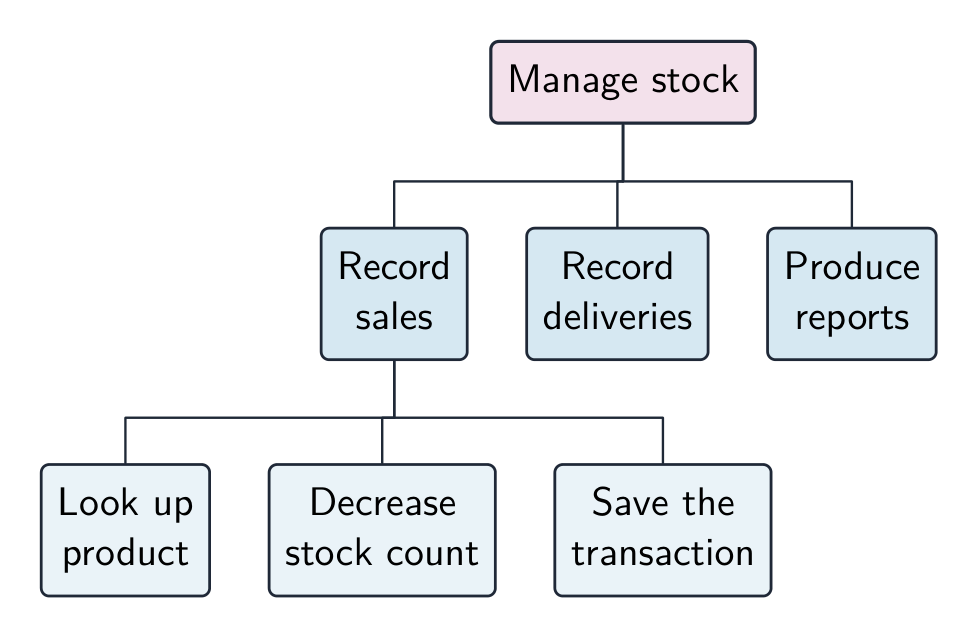
Pour la gestion des stocks : "gérer les stocks" → "enregistrer les ventes", "enregistrer les livraisons", "produire des rapports" → ("enregistrer les ventes") "rechercher le produit", "diminuer le nombre de stocks", "sauvegarder la transaction". La décomposition rend les grands problèmes gérables, permet à une équipe de diviser le travail et fournit du code modulaire — chaque module devient une procédure 过程 ou fonction.
"Expliquez pourquoi on utilise la décomposition" est une question de trois points avec une forme fixe. Donnez trois avantages distincts : chaque sous-problème 子问题 est assez petit pour être conçu, codé et testé indépendamment ; différents programmeurs peuvent travailler sur différents modules 模块 simultanément ; un module déjà existant (ou une routine de bibliothèque) peut être réutilisé, et une erreur est plus facile à trouver car elle se trouve dans un seul module. Un diagramme structurel (thème 12) est le diagramme d'une décomposition : le programme en haut, ses modules en dessous, et les données transmises entre eux.
Explorer
Résoudre un problème à la manière computationnelle
Parcourez les quatre piliers dans l'ordre de leur utilisation — décomposez le problème, repérez ce qui se répète, extraitez l'essentiel, puis rédigez les étapes.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ | 计算思维 | jì suàn sī wéi |
| abstraction/əbˈstrækʃn/ | 抽象 | chōu xiàng |
| decomposition/ˌdiːkɒmpəˈzɪʃn/ | 分解 | fēn jiě |
| sub-problem/sʌb ˈprɒbləm/ | 子问题 | zi wèn tí |
| procedure/prəˈsiːdʒə/ | 过程 | guò chéng |
| modules/ˈmɒdjuːlz/ | 模块 | mó kuài |
| identifier/aɪˈdentɪfaɪə/ | 标识符 | biāo shí fú |
9.2
Algorithmes
Programme
| Les candidats doivent être capables de : | Notes et orientations |
|---|---|
| Comprendre qu'un algorithme est une solution à un problème exprimée sous forme de séquence d'étapes définies | |
| Utiliser des noms d'identifiants appropriés pour représenter les données utilisées par un problème et les représenter à l'aide d'une table d'identifiants | |
| Écrire un pseudocode contenant une entrée, un traitement et une sortie | |
| Écrire un pseudocode utilisant les trois constructeurs fondamentaux de la séquence, de la sélection et de l'itération (répétition) | |
| Documenter un simple algorithme à l'aide d'une description en anglais structuré, d'un diagramme de flux ou d'un pseudocode | |
| Écrire un pseudocode à partir de : • une description en anglais structuré • un diagramme de flux | |
| Tracer un diagramme de flux à partir de : • une description en anglais structuré • un pseudocode | |
| Décrire et utiliser le processus de raffinement progressif pour exprimer un algorithme à un niveau de détail à partir duquel la tâche peut être programmée | |
| Utiliser des énoncés logiques pour définir des parties d'une solution algorithmique |
Source : Programme Cambridge International
Un algorithme 算法 est une solution exprimée sous la forme d'une séquence d'étapes définies. Chaque étape est sans ambiguïté 无歧义 (une seule signification), déterministe 确定性 (même entrée → même sortie), finie (les étapes se terminent) et efficace (chacune peut être exécutée). Un algorithme dit ce qu'il faut faire, indépendamment du langage de programmation utilisé pour son implémentation.
Explorer
Sélection : suivez les branches IF / ELSE
Faites glisser la note et observez quelle branche s'exécute. La sélection teste chaque condition à tour de rôle et prend la PREMIÈRE qui est vraie — c'est ainsi que fonctionne IF … ELSE IF … ELSE.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| algorithm/ˈælɡərɪθəm/ | 算法 | suàn fǎ |
| sequence/ˈsiːkwəns/ | 顺序 | shùn xù |
| unambiguous/ʌnæmˈbɪɡjuːəs/ | 无歧义 | wú qí yì |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 确定性 | què dìng xìng |
9.2
Tableau des identifiants

Lorsque vous commencez un algorithme, listez chaque élément de données dans un tableau des identifiants 标识符表 — son identifiant 标识符 (le nom de la variable 变量), son type de données 数据类型, et sa description. Le tableau de l'examen possède exactement ces trois colonnes :
| Identifiant | Type de données | Description |
|---|---|---|
Category |
STRING |
la catégorie de produit |
SaleDate |
DATE |
quand l'article a été vendu |
ItemCost |
REAL |
coût de l'article |
InStock |
BOOLEAN |
TRUE si en stock |
Sales |
ARRAY[1:30] OF REAL |
les totaux journaliers des ventes des 30 derniers jours |
Utilisez des noms descriptifs (ItemCost, pas x) : un identifiant commence par une lettre, ne contient pas d'espaces et s'écrit de la même manière à chaque apparition. Les types courants sont INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE, ainsi que les tableaux. Le tableau vous force à nommer chaque élément de données avant d'écrire du code, et une question "compléter le tableau des identifiants" attribue un point pour chaque type de données ou description correcte, alors écrivez le type exactement comme le guide de pseudocode.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| identifier table/aɪˈdentɪfaɪə ˈteɪbl/ | 标识符表 | biāo shí fú biǎo |
| variable/ˈveərɪəbl/ | 变量 | biàn liàng |
| data type/ˈdeɪtə taɪp/ | 数据类型 | shù jù lèi xíng |
| Boolean/ˈbuːlɪən/ | 布尔 | bù ěr |
9.2
Pseudocode — les trois constructions de base

Pseudocode 伪代码 est une méthode structurée et neutre vis-à-vis du langage pour décrire les algorithmes.
1. Séquence
Les étapes s'exécutent les unes après les autres (séquence 顺序) :
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Sélection
Un choix des étapes à exécuter, basé sur une condition (sélection 选择) :
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Pour plus d'options, utilisez CASE OF ... ENDCASE.
3. Itération
Répéter un bloc (itération 迭代, une boucle 循环) :
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Une boucle WHILE teste la condition avant chaque passe (peut s'exécuter zéro fois) ; une boucle REPEAT...UNTIL teste après chaque passe (s'exécute toujours au moins une fois).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100

Choisir la boucle est lui-même un point : FOR lorsque vous connaissez le nombre de passages (une boucle à compteur 计数循环) ; WHILE lorsque la boucle pourrait ne jamais s'exécuter (une boucle à précondition 前测循环) ; REPEAT ... UNTIL lorsqu'elle doit s'exécuter au moins une fois, comme pour valider une saisie (une boucle à postcondition 后测循环). Une réponse "décrire la construction d'itération" nomme la construction, indique où la condition est testée et donne la conséquence (zéro fois ou au moins une fois).
Opérations courantes
- affectation 赋值:
x ← 5(une flèche ;=sert à la comparaison). - entrée/sortie :
INPUT variable,OUTPUT expression. - comparaisons
=,<>,<,>,<=,>=; logiqueAND,OR,NOT. - arithmétique
+ - * /, plusDIV(division entière) etMOD(reste). - chaînes :
LENGTH,LEFT,RIGHT,MID, et&pour la concaténation 拼接 (jonction).
Le pseudocode attendu par l'examen
Chaque réponse de pseudocode est notée selon le guide de pseudocode publié par Cambridge. Écrivez ces formes exactement :
| Construction | Pseudocode |
|---|---|
| Variable | DECLARE Total : INTEGER |
| Tableau | DECLARE Marks : ARRAY[1:30] OF REAL |
| Constante | CONSTANT MaxTries = 3 |
| Affectation | Total ← Total + Value |
| Entrée / Sortie | INPUT NameOUTPUT "Hello ", Name |
| Sélection | CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASE |
| Boucle FOR | FOR i ← 1 TO 10 STEP 2 ... NEXT i |
| Boucle WHILE | WHILE Total < 100 DO ... ENDWHILE |
| Boucle REPEAT | REPEAT ... UNTIL Mark >= 0 |
| Arithmétique entière | 17 DIV 5 = 317 MOD 5 = 2 |
| Chaînes | LENGTH(S), LEFT(S, 3), RIGHT(S, 2)MID(S, 2, 4), UCASE(S), LCASE(S) |
| Conversions | INT(3.7) = 3, NUM_TO_STR(12)STR_TO_NUM("4.5"), ASC('A') = 65, CHR(66) = 'B' |
| Aléatoire | RAND(100)INT(RAND(100)) + 1 |
RAND(100) donne un nombre réel de 0 jusqu'à (mais sans inclure) 100. INT(RAND(100)) + 1 donne un entier de 1 à 100.
Deux habitudes rapportent des points à chaque question : déclarer toutes les variables utilisées, avec le type tiré de votre tableau des identifiants, et initialiser 初始化 tous les compteurs 计数器 et totaux (Count ← 0, Total ← 0) avant la boucle qui les modifie.
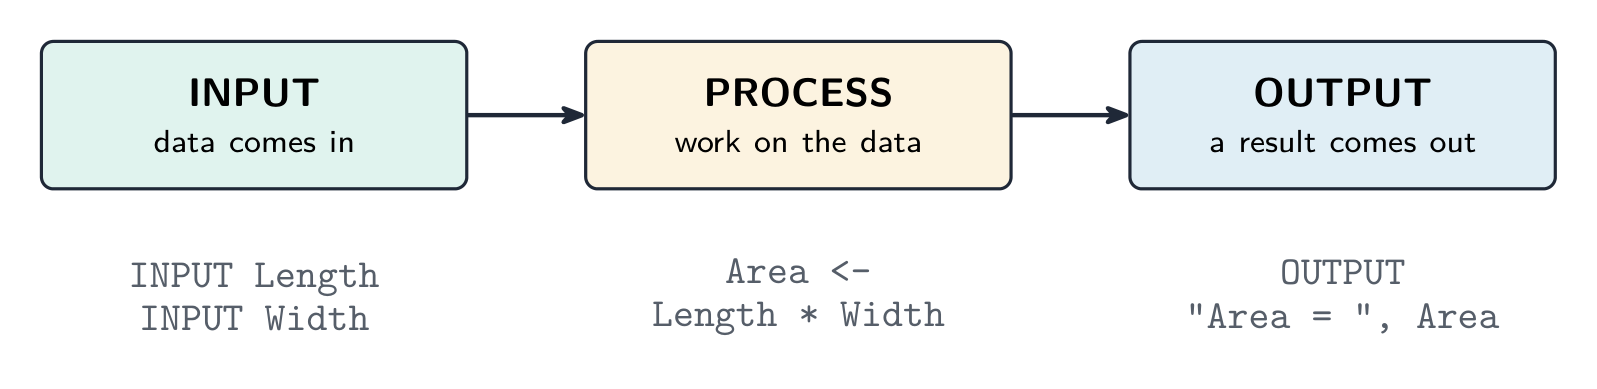
Entrée → Traitement → Sortie
Tout programme suit cette forme :
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Lister les entrées et sorties d'abord rend l'algorithme plus clair.
Exemple résolu. Écrivez un pseudocode qui lit 100 entiers et affiche combien d'entre eux, ainsi que leur somme, se situent entre 10 et 20 inclusivement.
Tableau des identifiants : Count : INTEGER (compteur de boucle), Value : INTEGER (l'entier juste lu), InRange : INTEGER (combien étaient dans la plage), Total : INTEGER (leur somme).
DECLARE Count, Value, InRange, Total : INTEGER
InRange ← 0
Total ← 0
FOR Count ← 1 TO 100
    INPUT Value
    IF Value >= 10 AND Value <= 20 THEN
        InRange ← InRange + 1
        Total ← Total + Value
    ENDIF
NEXT Count
OUTPUT InRange, Total
Si la question demande ensuite d'"identifier deux constructions et indiquer comment chacune est utilisée", répondez de la même manière : itération, la boucle FOR répète la lecture 100 fois ; sélection, la statement IF ajoute une valeur uniquement si elle est dans la plage.
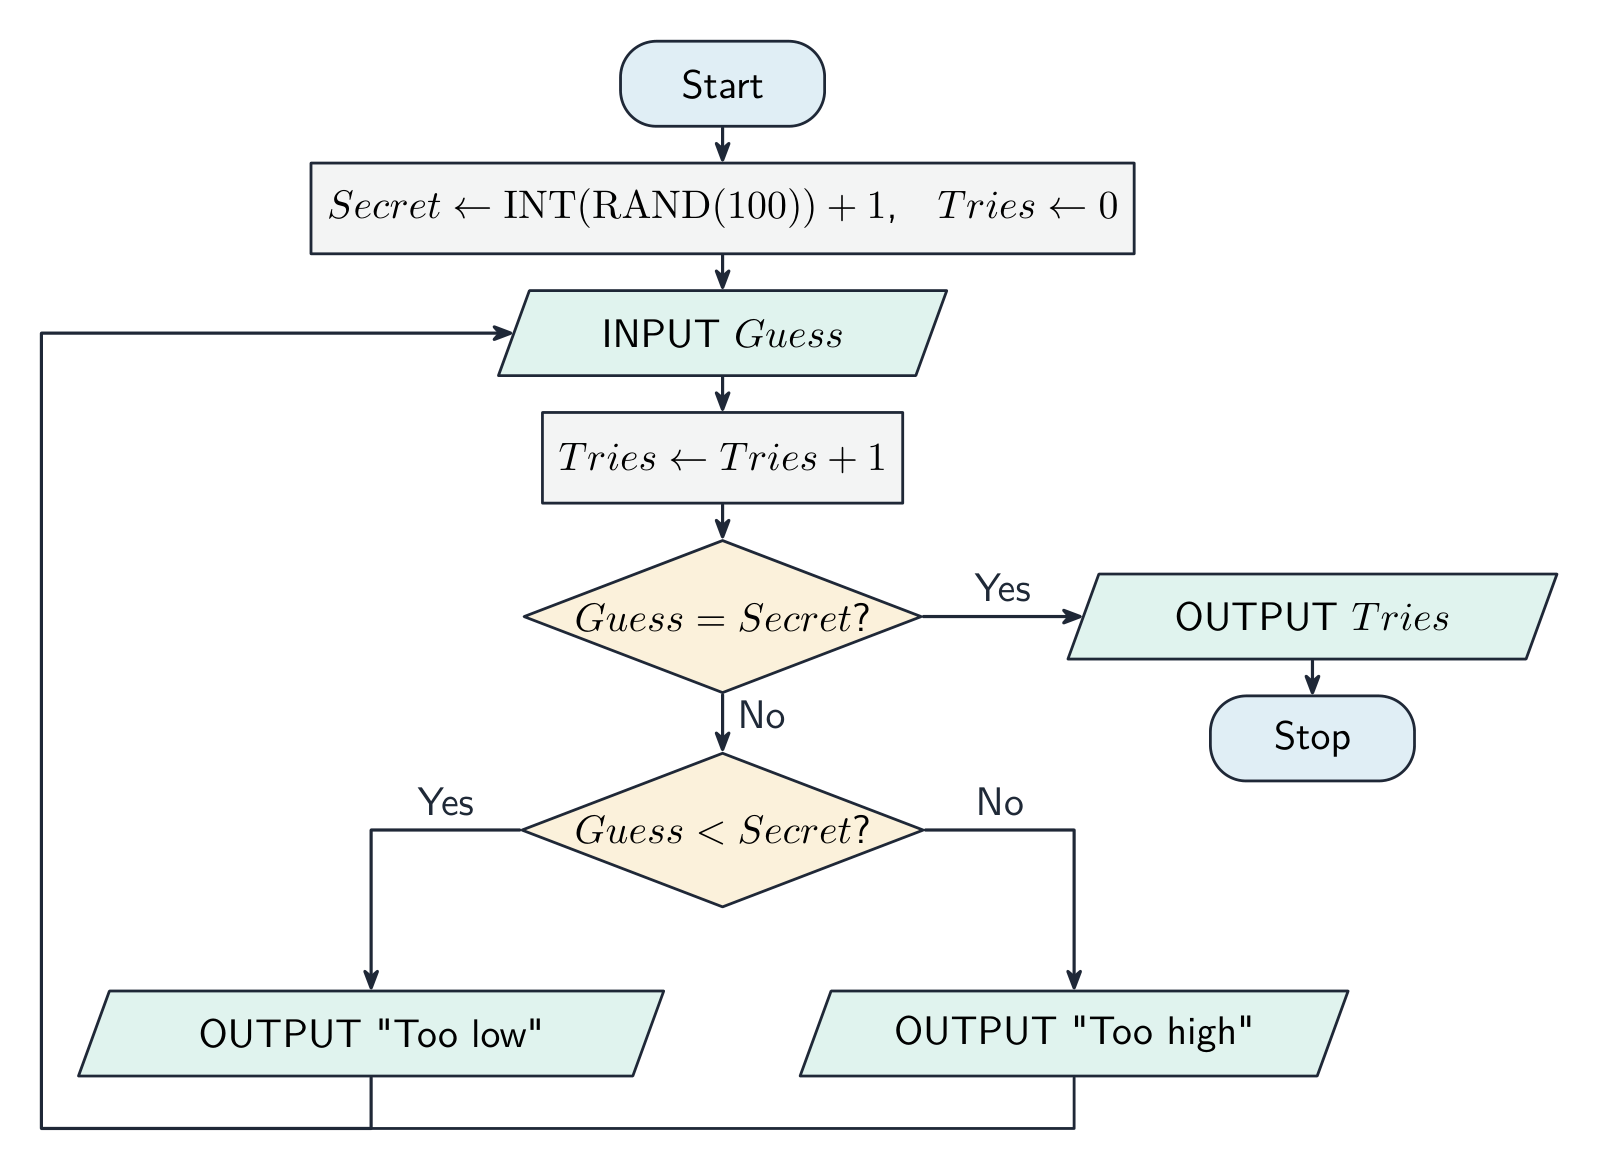
Exemple résolu. Un programme tire un entier secret de 1 à 100. L'utilisateur devine jusqu'à ce qu'il ait raison ; après chaque mauvaise tentative, le programme dit "Trop bas" ou "Trop haut", et à la fin il affiche combien de tentatives ont été faites.
Tableau des identifiants : Secret : INTEGER (le nombre à deviner), Guess : INTEGER (l'entrée de l'utilisateur), Tries : INTEGER (combien de tentatives jusqu'à présent).
DECLARE Secret, Guess, Tries : INTEGER
Secret ← INT(RAND(100)) + 1
Tries ← 0
REPEAT
    INPUT Guess
    Tries ← Tries + 1
    IF Guess < Secret THEN
        OUTPUT "Too low"
    ELSE
        IF Guess > Secret THEN
            OUTPUT "Too high"
        ENDIF
    ENDIF
UNTIL Guess = Secret
OUTPUT "You took ", Tries, " guesses"
Une boucle REPEAT ... UNTIL est le bon choix car l'utilisateur doit deviner au moins une fois. Les points concernent : le nombre aléatoire dans la bonne plage, une boucle qui s'arrête sur une bonne réponse, le compteur qui commence à zéro et augmente à l'intérieur de la boucle, les deux messages dans les bonnes conditions, et la sortie finale.
Exemple résolu. Afficher deux entiers aléatoires différents, chacun compris entre $-10$ et $10$ inclusivement.
Il y a 21 valeurs possibles, donc INT(RAND(21)) donne 0 à 20 et soustraire 10 décale la plage vers $-10$ à $10$. Le second nombre doit être généré à nouveau jusqu'à ce qu'il diffère du premier :
DECLARE First, Second : INTEGER
First ← INT(RAND(21)) - 10
REPEAT
    Second ← INT(RAND(21)) - 10
UNTIL Second <> First
OUTPUT First, Second
Explorer
IF … ELSE sélection
Modifiez la valeur et observez quelle branche s'exécute — comment un programme prend une décision.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| pseudocode/ˈsuːdəʊkəʊd/ | 伪代码 | wěi dài mǎ |
| flowchart/ˈfləʊtʃɑːt/ | 流程图 | liú chéng tú |
| selection/sɪˈlekʃn/ | 选择 | xuǎn zé |
| iteration/ˌɪtəˈreɪʃn/ | 迭代 | dié dài |
| loop/luːp/ | 循环 | xún huán |
| count-controlled loop/kaʊnt kənˈtrəʊld luːp/ | 计数循环 | jì shù xún huán |
| pre-condition loop/priː kənˈdɪʃn luːp/ | 前测循环 | qián cè xún huán |
| post-condition loop/pəʊst kənˈdɪʃn luːp/ | 后测循环 | hòu cè xún huán |
| assignment/əˈsaɪnmənt/ | 赋值 | fù zhí |
| concatenation/kənˌkætəˈneɪʃn/ | 拼接 | pīn jiē |
| initialise/ɪˈnɪʃəlaɪz/ | 初始化 | chū shǐ huà |
| counter/ˈkaʊntə/ | 计数器 | jì shù qì |
| structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ | 结构化英语 | jié gòu huà yīng yǔ |
| stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ | 逐步求精 | zhú bù qiú jīng |
| logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ | 逻辑语句 | luó jí yǔ jù |
| precedence/ˈpresɪdəns/ | 优先级 | yōu xiān jí |
| De Morgan's law/də ˈmɔːɡənz lɔː/ | 德摩根定律 | dé mó gēn dìng lǜ |
9.2
Trois notations

Le même algorithme peut être écrit de trois façons.
- anglais structuré 结构化英语 — langue naturelle avec indentation et mots-clés fixes ; bon pour une description de haut niveau.
- diagramme de flux 流程图 — un schéma avec des formes standards :
| Forme | Signification |
|---|---|
| Rectangle arrondi | Démarrer / Arrêter |
| Parallelogramme | Entrée / Sortie |
| Rectangle | Traitement |
| Losange | Décision |
| Flèche | Flux de contrôle |
- pseudocode — la notation des mots-clés ci-dessus ; proche du code.
Vous devez pouvoir convertir entre n'importe quelle paire : chaque IF est un losange de décision, chaque boucle est une flèche de retour, et une séquence est constituée de rectangles empilés.
SI ... ALORS ... SINON ... FIN SI
9.2
Affinement progressif

Affinement progressif 逐步求精 commence par un aperçu de haut niveau et développe chaque étape jusqu'à ce qu'elle soit assez petite pour être codée. Pour la moyenne de $n$ nombres :
Niveau 1 :
Read in the numbers
Compute the average
Output the average
Niveau 2 :
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
Chaque affinement conserve la structure précédente et ajoute des détails.
Une question de six points sur l'« application de l'affinement progressif » vous donne un aperçu de haut niveau et demande de développer chaque étape en instructions concrètes qu'un programmeur pourrait coder. Gardez les étapes dans le même ordre, nommez les données que chaque étape lit ou produit, et arrêtez-vous lorsque chaque ligne correspond à une seule entrée, affectation, sortie, boucle ou condition. Par exemple, « valider le mot de passe » devient : saisir le mot de passe ; vérifier que sa longueur est d'au moins 8 ; vérifier qu'il contient au moins un chiffre ; afficher « accepté » si les deux vérifications réussissent, sinon afficher « rejeté ».
Explorer
Raffinement progressif : plan vers code
Descendez les niveaux. Vous commencez avec toute la tâche en une seule ligne et continuez à développer chaque étape en parties plus petites — jusqu'à ce que chaque étape soit suffisamment simple pour être codée directement.
9.2
Énoncé logique
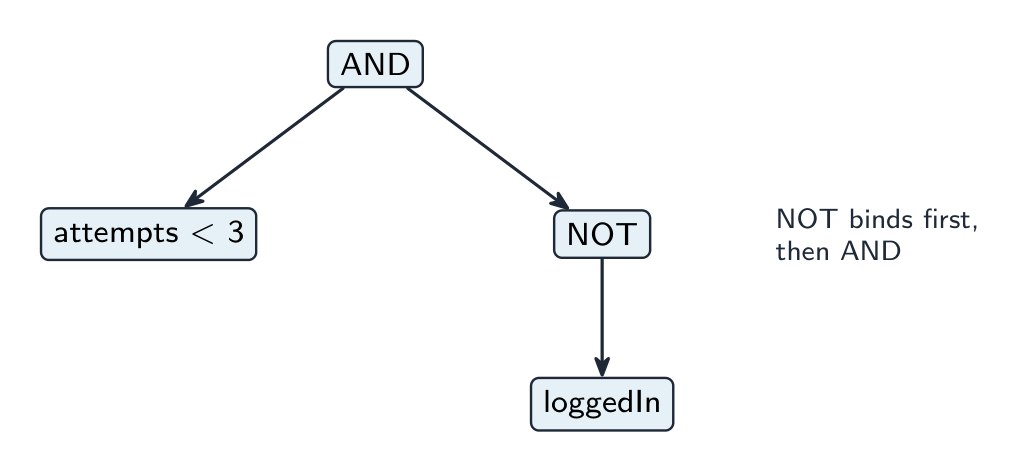
Une instruction logique 逻辑语句 est une condition Booléenne 布尔 qui contrôle la branching, construite à partir de comparaisons (x > 10), de connecteurs (AND, OR, NOT) et de parenthèses. Utilisez-la comme condition de IF, WHILE ou REPEAT...UNTIL :
WHILE attempts < 3 AND NOT loggedIn DO
    INPUT password
    IF password = correctPassword THEN
        loggedIn ← TRUE
    ELSE
        attempts ← attempts + 1
    ENDIF
ENDWHILE
Précédence 优先级 (du plus élevé au plus bas) : NOT, puis AND, puis OR. Utilisez des parenthèses en cas de doute. Erreurs courantes :
a = 1 OR 2est incorrect — écriveza = 1 OR a = 2.NOT a > 5signifieNOT (a > 5), c'est-à-direa <= 5.NOT (A AND B)est équivalent à(NOT A) OR (NOT B)(Loi de De Morgan 德摩根定律) — utile pour simplifier les conditions.
Transformer une phrase en énoncé logique est une compétence testée directement dans les examens. « Un billet est gratuit pour toute personne de moins de 5 ans ou de plus de 65 ans » devient Age < 5 OR Age > 65. « Une note est valide si c'est un nombre entier allant de 0 à 100 » devient Mark >= 0 AND Mark <= 100. « La boucle s'arrête quand le fichier est terminé ou dix enregistrements ont été lus » devient UNTIL EOF(File) OR Count = 10. Écrivez chaque comparaison en entier : Age > 65 et Age < 5, jamais Age > 65 OR < 5.
Exemple résolu. Écrivez une table d'identifiants et du pseudocode pour lire 10 nombres et afficher le plus grand. La table d'identifiants nomme chaque variable avec son type de données et son but : Count : INTEGER (compteur de boucle), Num : REAL (le nombre fraîchement lu), Max : REAL (le plus grand trouvé jusqu'ici).
Max ← -999999
FOR Count ← 1 TO 10
    INPUT Num
    IF Num > Max THEN
        Max ← Num
    ENDIF
NEXT Count
OUTPUT Max
La décision de conception qui porte les points est l'initialisation de Max : elle doit commencer plus basse que toute entrée possible - ou, plus sûrement encore, être définie sur le premier nombre lu. Si vous l'initialisez à 0, l'algorithme retournera faussement 0 pour une liste de nombres négatifs, un bug que votre trace ne révèlera que si les données de test incluent un nombre négatif.
9.2
Définitions acceptées par l'examinateur
Une question de définition est notée selon un libellé fixe. Apprenez-les exactement et ne donnez qu'une seule réponse.
| Terme | Définition |
|---|---|
| abstraction | conservation des détails essentiels d'un problème en omettant ceux qui ne sont pas nécessaires |
| décomposition | fractionnement d'un problème en sous-problèmes plus petits, chacun pouvant être résolu séparément |
| algorithme | solution à un problème exprimée sous forme de séquence d'étapes définies |
| table d'identifiants | tableau répertoriant chaque identifiant utilisé dans un algorithme avec son type de données et une description de son but |
| pseudocode | méthode structurée et indépendante de langage pour écrire les étapes d'un algorithme |
| organigramme | diagramme montrant les étapes et décisions d'un algorithme à l'aide de symboles standards reliés par des flèches |
| séquence | instructions exécutées les unes après les autres dans l'ordre écrit |
| sélection | choix des instructions à exécuter selon une condition |
| itération | répétition d'un groupe d'instructions tant qu'une condition est vraie ou jusqu'à ce qu'elle soit satisfaite |
| affinement progressif | fractionnement de chaque étape d'un aperçu en étapes plus petites, répété jusqu'à ce que chaque étape puisse être codée directement |
| énoncé logique | condition construite à partir de comparaisons et des opérateurs ET, OU et NON qui évalue VRAI ou FAUX |
9.2
Conseils d'examen
- Définissez un algorithme comme une séquence non ambiguë, finie et déterministe d'étapes, indépendante du langage.
- Utilisez correctement les trois constructions — séquence, sélection, itération — et gardez une table d'identifiants avec des types de données.
- Fractionnez un problème par décomposition et abstraction, puis par affinement progressif.
- Écrivez du pseudocode qui pourrait réellement s'exécuter : déclarez les variables et suivez le style de pseudocode de l'examen.
Erreurs courantes
- Utiliser
=pour assigner une valeur. L'affectation est←;=est une comparaison. - Oublier
ENDIF,ENDWHILE,ENDCASEouNEXT. Chaque construction se ferme, et le mot de fermeture est où le point pour cette construction est vérifié. - Ne pas initialiser un total ou un compteur avant la boucle, de sorte que l'algorithme additionne à une valeur qui n'a jamais existé.
- Utiliser une boucle
FORquand le nombre de répétitions est inconnu. Lire jusqu'à une valeur sentinelle ou une bonne réponse nécessiteWHILEouREPEAT ... UNTIL. - Écrire
Age > 65 OR < 5. Chaque côté deORetANDdoit être une comparaison complète. - Répondre « expliquez pourquoi la décomposition est utilisée » avec un seul avantage écrit trois fois. Trois points nécessitent trois avantages différents.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.