חומר הדף הזה מכסה נושא 4: הסתברות וסטטיסטיקה נוספת. הוא מוסיף חלוקות רציפות, הסקת דגימות קטנות, בדיקות chi-squared ובדיקות לא פרמטריות, ופונקציות יצירת הסתברות.
סיכום והסתברות נוספים
מתמטיקה מתקדמת A-Level · נושא 4
 8:08
סיכום והסתברות נוספים
דובלין, שנת ⟦nineteen-oh-eight⟧. בתוך מפעל הבירה גינס, כימיסט צעיר בשם ויליאם גוסט מתמודד עם בעיה פרקטית מאוד. הוא יכול לבדוק רק מספר מעטות של…
קריאת קול באנגלית · תרגום אנגלי + סינית שרוף בתוך הסרטון
4.1
משתנים אקראיים רציפים

סיילבוס
| המועמדים אמורים להיות מסוגלים: | הערות לדוגמאות |
|---|---|
| להשתמש בפונקציית צפיפות הסתברות שעשויה להיות מוגדרת במקטעים | |
| להשתמש בתוצאה הכללית $\text{E}(g(X)) = \int f(x)g(x) \, \mathrm{d}x$ כאשר $f(x)$ היא פונקציית צפיפות ההסתברות של המשתנה הרנדומלי הרציף $X$ ו$g(X)$ היא פונקציה של $X$ | |
| להבין ולהשתמש בקשר בין פונקציית צפיפות ההסתברות (PDF) לבין פונקציית ההתפלגות המצטברת (CDF), ולהשתמש באחת מהן כדי לחשב הסתברויות או אחוזונים | |
| להשתמש בפונקציות התפלגות מצטברת (CDFs) של משתנים קשורים במקרים פשוטים. | לדוגמה: נתונה CDF של משתנה $X$, מצאו את ה-CDF של משתנה קשור $Y$, ומכאן את ה-PDF שלו, לדוגמה כאשר $Y = X^3$. |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
משתנה רציף $X$ מתואר על ידי פונקציית צפיפות הסתברות $f(x)$, שעשויה להיות מוגדרת בקטעים. ההסתברות בטווח נתון שווה לשטח תחת $f$, והמוצע של כל פונקציה של $X$ הוא
$$E(g(X)) = \int g(x)\,f(x)\,dx.$$
פונקציית ההתפלגות המצטברת $F(x) = P(X \leqslant x)$ היא הסכמה רצה: $F(x) = \displaystyle\int_{-\infty}^{x} f(t)\,dt$, ו-$f(x) = F'(x)$. השתמש ב-$F$ כדי למצוא הסתברויות ו-אחוזונים (לדוגמה, ה-מחצית פותר את $F(x) = 0.5$).

דוגמה פתורה. למשתנה יש $f(x) = \tfrac12 x$ עבור $0 \leqslant x \leqslant 2$. מצא את המחצית.
פונקציית ההתפלגות המצטברת היא $F(x) = \displaystyle\int_0^x \tfrac12 t\,dt = \tfrac14 x^2$. השווה $F(m) = 0.5$:
$$\tfrac14 m^2 = 0.5 \;\Rightarrow\; m^2 = 2 \;\Rightarrow\; m = \sqrt{2} = 1.41.$$
התפלגות של משתנה קשור. אם $Y=g(X)$, מצא את ההתפלגות של $Y$ דרך הפונקציה המצטברת שלו. עבור $Y=X^2$: $F_Y(y)=P(X^2\leqslant y)=P(-\sqrt y\leqslant X\leqslant\sqrt y)=F_X(\sqrt y)-F_X(-\sqrt y)$, ואז גזור עבור $f_Y=F_Y'$. כאשר $g$ הוא פונקציה עולה מונוטונית, קיים קיצור דרך, $F_Y(y)=F_X\big(g^{-1}(y)\big)$.
דוגמה פתורה. עם $f_X(x)=\tfrac12 x$ על $[0,2]$ (ולכן $F_X(x)=\tfrac14 x^2$), נניח $Y=X^2$. עבור $0\leqslant y\leqslant 4$, $F_Y(y)=F_X(\sqrt y)=\tfrac14 y$, ולכן $f_Y(y)=F_Y'(y)=\tfrac14$ – כלומר, $Y$ אחידה על $[0,4]$.
חקור
משתנים מקריים רציפים
P(a < X < b) = ∫ f(x) dx
למשתנה רציף, הסתברות היא ה-שטח מתחת לעקומת הצפיפות.
מילון מונחים
אימון
| English | עברית |
|---|---|
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | פונקציית צפיפות הסתברות |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | פונקציית ההתפלגות המצטברת |
| percentiles/pəˈsentaɪlz/ | אחוזונים |
| median/ˈmiːdiːən/ | חציון |
| hypothesis test/haɪˈpɒθəsɪs test/ | מבחן הנחות |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | מרווח סמך |
| pooled estimate/puːld ˈestɪmət/ | הערכה משולבת |
| chi-squared test/kaɪ skweəd test/ | מבחן קאי-ריבוע |
| theoretical distribution/θɪəˈretɪkl ˌdɪstrɪˈbjuːʃn/ | התפלגות תיאורטית |
| degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ | דרגות חופש |
| goodness of fit/ˈɡʊdnəs ɒv fɪt/ | מתאם התאמה |
| independence/ˌɪndɪˈpendəns/ | עצמאות |
| contingency table/kənˈtɪndʒənsi ˈteɪbl/ | טבלת תלות |
| non-parametric test/nɒn ˌpærəˈmetrɪk test/ | מבחן לא פרמטרי |
4.2
היסק באמצעות התפלגות נורמלית ו-t

סיילבוס
| Candidates should be able to: | Notes and examples |
|---|---|
| formulate hypotheses and apply a hypothesis test concerning the population mean using a small sample drawn from a normal population of unknown variance, using a t-test | |
| calculate a pooled estimate of a population variance from two samples | Calculations based on either raw or summarised data may be required. |
| formulate hypotheses concerning the difference of population means, and apply, as appropriate: - a 2-sample t-test - a paired sample t-test - a test using a normal distribution | The ability to select the test appropriate to the circumstances of a problem is expected. |
| determine a confidence interval for a population mean, based on a small sample from a normal population with unknown variance, using a t-distribution | |
| determine a confidence interval for a difference of population means, using a t-distribution or a normal distribution, as appropriate. |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
כאשר הדגימה קטנה ושונות האוכלוסייה אינה ידועה, סמך את בדיקת ההיפותזה שלך על התפלגות ה-$t$ במקום על הנורמלית. אותה רעיון נותן מרווח אמון למוצע:
$$\bar{x} \pm t\,\frac{s}{\sqrt{n}},$$
שם $t$ נובע מטבלות $t$ עם $n - 1$ דרגות חופש. להשוות בין שני אוכלוסיות, השתמש במבחן שתי-דגימות (2-דגימה) או דגימת זוגות $t$-test, לאחר שמצאת הערכת שילוב של השונות המשותפת כאשר מתאים.

דוגמה פתורה. לדגימה של $n = 10$ יש מוצע $\bar{x} = 50$ ושטיח סטנדרטי $s = 4$. מצא מרווח אמון ב-$95\%$ למוצע (השתמש ב-$t = 2.262$ עבור $9$ דרגות חופש).
$$50 \pm 2.262\times\frac{4}{\sqrt{10}} = 50 \pm 2.86 \;\Rightarrow\; (47.1,\ 52.9).$$
חקור
מדום דגימות קטנות יש להשתמש ב-t במקום ב-z
כאשר יש לך $\sigma$ לא ידועים, משתמשים ב-$t$, ול-$t$ יש זנבות כבדים יותר מאשר הנורמלי (מצויר בקו מקווקוה מאחוריו) — ולכן הערכים הקריטיים שלו הם גדולים יותר והמרווח רחב יותר. במעבר לדוגמה המפורטת עם $9$ דרגות חופש, הווידג'ט מציג $t^* = 2.262$, בדיוק כמו הערך בטבלה שהשתמשנו בו למעלה. גרור את df כלפי מעלה וה-$t$ מתכנס אל הנורמלי.
חקור
החלוקה הנורמלית
צללו זנב כדי למצוא הסתברות — זהו הבסיס למרווחי אמון ולמבחני הישגיות.
4.3
בדיקות קוואי-ריבוע
סיילבוס
| המועמדים אמורים להיות מסוגלים: | הערות לדוגמאות |
|---|---|
| התאמת חלוקה תיאורטית, כפי שנקבע על ידי הנחת יסוד נתונה, לנתונים הנתונים | השאלות לא יכללו חישובים ארוכים. |
| ביצוע מבחן $\chi^2$, עם מספר הדרגות החופשי המתאים, לבצע את אנליזת ההתאמה הטובה ההתאמת | יש לשלב מחלקות כך שתדירות מצופה בכל אחת תהיה לפחות 5. |
| ביצוע מבחן $\chi^2$, עם מספר הדרגות החופשי המתאים, לבדיקת עצמאות בטבלת קונטינגנצי. | אינו נדרש תיקון יייטס. כאשר מתאים, יש לשלב שורות או עמודות כך שתדירות מצופה בתא כלשהו תהיה לפחות 5. |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
בדיקת $\chi^2$ (בדיקת קוואי-ריבוע) משווה ספירות נצפות $O$ לספירות מצופות $E$ ממערכת התפלגות תיאורטית:
$$\chi^2 = \sum \frac{(O - E)^2}{E}.$$
השוו זאת לערך בטבלה עבור מספר נכון של דרגות חופש. שימוש כפול: בדיקת התאמה (האם הנתונים עוקבים אחר הדגם המוצע?), ובדיקה לעצמאות של שני משתנים בטבלת תלות.
דוגמה פותרת. ארבע קטגוריות בעלות סיכוי שווה נותנות ספירות נצפות $20, 30, 25, 25$ (לכן כל ספירה צפויה היא $25$). בדוק את ההתאמה ברמת $5\%$.
$$\chi^2 = \frac{(20-25)^2 + (30-25)^2 + 0 + 0}{25} = \frac{25 + 25}{25} = 2.$$
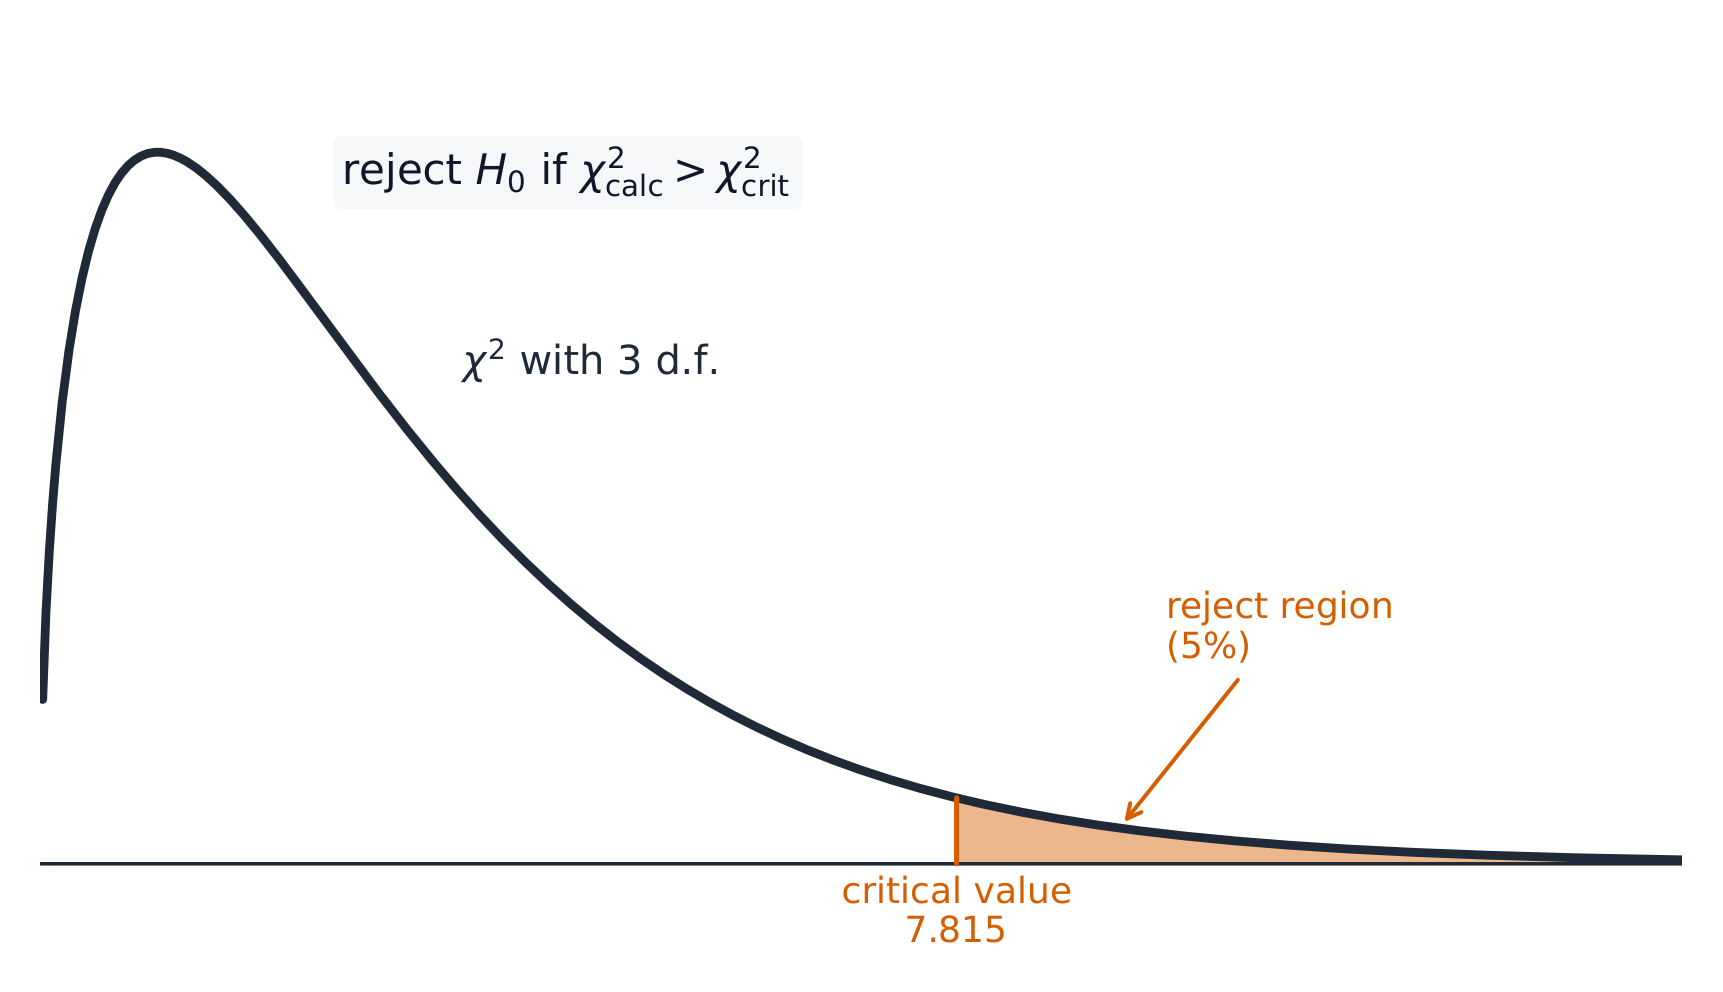
עם $4 - 1 = 3$ דרגות חופש, הערך בטבלה הוא $7.815$. מכיוון ש$2 < 7.815$, אל תדחה את הדגם.
חקור
התפלגות קי-ריבוע והזנב ה-5% שלה
הדוגמה המפורטת בדף מציגה $\chi^2 = 2$ עם $3$ דרגות חופש לעומת ערך טבלאי של $7.815$ — הווידג'ט משחזר את שניהם. גרור את df כדי לראות מדוע הערך הקריטי משתנה בהתאם למספר הקטגוריות.
חקור
דרך מבחן קי-ריבוע
עקוב אחר ספירות מצופות ומצופות להחלטת מבחן.
4.4
בדיקות לא פרמטריות

סיילבוס
| המועמדים אמורים להיות מסוגלים: | הערות לדוגמאות |
|---|---|
| הבנת הרעיון של מבחן פארמטרי והיכרות עם מצבים שבהם מבחן כזה עשוי להיות שימושי | לדוגמה: בעת דגימה מאוכלוסייה שאין להניח שהיא חלוקה נורמלית. |
| הבנת היסוד של מבחן הסימן, מבחן דירוג הסימן של וילקוקסון ומבחן סך הדירוגים של וילקוקסון | כולל ידע בכך שמבחני וילקוקסון תקפים רק לחלוקות סימטריות. |
| שימוש במבחן סימן למדגם יחיד ובמבחן דירוג הסימן של וילקוקסון למדגם יחיד, כדי לבדוק הנחה לגבי מדiane האוכלוסייה | כולל שימוש בקירובים נורמליים כאשר מתאים. השאלות לא יכללו דירוגים זרים או תצפיות השוות לערך המדiane של האוכלוסייה הנבדק. |
| שימוש במבחן סימן למדגם זוגי, במבחן דירוג הסימן של וילקוקסון למדגם זוגי ובמבחן סך הדירוגים של וילקוקסון, בהתאם, כדי לבדוק זהות אוכלוסיות. | כולל שימוש בקירובים נורמליים כאשר מתאים. השאלות לא יכללו דירוגים זרים או זוגות עם הפרש אפס. |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
בדיקה לא פרמטרית אינה מניחה שהנתונים הם נורמליים, ולכן היא שימושית כאשר הנחת זו אינה מתקיימת. הבסיסיות שבהן הן:
- הבדיקה על הסימן: ספור כמה ערכים נופעים מעל ומטה מהמדiane המוצע, ובצע את הבדיקה על הספירות הללו עם מודל בינומי;
- בדיקת רכיבי הסימן של וילקוקסון (הבדיקה עבור זוגות תואמים לנתונים זוגיים), המשמשת גם את גודל ההבדלים, ולא רק את הסימנים שלהם;
- בדיקת סכום הרכיבים של וילקוקסון, להשוואה בין שני דגימות נפרדות.
דוגמה פותרת. בדוק האם המדiane היא $5$. בדגימה של $10$ ערכים (שאינם שווים ל$5$), $9$ נמצאים מעל $5$ ו$1$ נמצא מתחת. בדוק ברמת $5\%$ (שני-זנבים).
תחת $H_0$ (מדiane $= 5$) מספר הערכים מעל עוקב אחרי $B(10, 0.5)$. התוצאה הנצפת ($9$ מעל) היא קיצונית, לכן מצאו $P(X \geq 9) = \binom{10}{9}(0.5)^{10} + (0.5)^{10} = \dfrac{11}{1024} = 0.0107$. לבדיקה דו-זנבית השוו לערך $\tfrac{1}{2}(5\%) = 0.025$. מכיוון ש$0.0107 < 0.025$, דחו את $H_0$: ישנה עדות לכך שמדiane אינה $5$.
חקור
בוחר מבחן לא פרמטרי
בחרו את המבחן המבוסס על רתימות המתאים למצב הנתונים.
מילון מונחים
אימון
| English | עברית |
|---|---|
| sign test/saɪn test/ | מבחן סימן |
| Wilcoxon signed-rank test/ˈwɪlkɒksn saɪnd ræŋk test/ | מבחן דירוג הסינים של וילקוקסון |
| Wilcoxon rank-sum test/ˈwɪlkɒksn ræŋk sʌm test/ | מבחן סכום הדירוגים של וילקסון |
| probability generating function/ˌprɒbəˈbɪlɪti ˈdʒenəreɪtɪŋ ˈfʌŋkʃn/ | פונקציית יצירת הסתברות |
| Further Probability & Statistics/ˈfɜːðə ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | סיכום והסתברות נוספים |
4.5
פונקציות יצירת הסתברות

סיילבוס
| המועמדים אמורים להיות מסוגלים: | הערות לדוגמאות |
|---|---|
| הבנת מושג פונקציית יצירת הסתברות (PGF) והרכבה ושימוש בפונקציה זו לחלוקות נתונות | כולל החלוקה האחידה הדיסקרטית, הבינומית, הגיאומטרית והפואסון. |
| שימוש בנוסחאות עבור הממוצע והשונות של משתנה מקרי דיסקרטי במונחי ה-PGF שלה, ושימוש בנוסחאות אלו לחישוב הממוצע והשונות של חלוקת הסתברות נתונה | |
| שימוש בתוצאה לפיה ה-PGF של סכום משתנים מקריים בלתי תלויים הוא מכפלת ה-PGFs של משתנים אלו. |
מקור: הסיילבוס הבינלאומי של קמבריד'ג'
פונקציית יצירת ההסתברות של משתנה דיסקרטי $X$ היא
$$G(t) = E(t^X) = \sum_x P(X = x)\,t^x.$$
היא ארוזה את כל ההתפלגות בפונקציה אחת. הממוצע והשונות מגיעים מהגזירות שלה בנקודה $t = 1$: $E(X) = G'(1)$ ו$\mathrm{Var}(X) = G''(1) + G'(1) - \big(G'(1)\big)^2$. בנוסף, פונקציית יצירת ההסתברות של סכום של משתנים עצמאיים היא מכפלת פונקציות יצירת ההסתברות שלהם.
דוגמה פותרת. $X$ יש $P(X=0) = 0.5$, $P(X=1) = 0.3$, $P(X=2) = 0.2$. מצאו $E(X)$ באמצעות פונקציית יצירת ההסתברות.
כאן $G(t) = 0.5 + 0.3t + 0.2t^2$, ולכן $G'(t) = 0.3 + 0.4t$ וכן
$$E(X) = G'(1) = 0.3 + 0.4 = 0.7.$$

חקור
מעבדת פונקציית יצירת הסתברות
G(x) = p0 + p1 x + p2 x^2 + ...
שנה ב-x וראה כיצד PGF מאחסן סיכומי הסתברות כחזקות של x.
4.5
טיפים לבחינות
- עבור משתנה אקראי רציף, הפונקציה צפיפות הסתברות (pdf) משתלבת ל-$1$ על פני התחום שלה, ו-$E(X) = \int x f(x)\,dx$.
- השתמש ב-$t$-חלוקה כאשר הדגימה קטנה ושונות האוכלוסייה אינה ידועה; ציין את דרגות החופש.
- למבחן chi-squared חשב $\sum (O-E)^2/E$, השווה לערך הקריטי בדרגות החופש הנכונות, ושלב קבוצות עם $E < 5$.
- ציין $H_0$ ו-$H_1$ ותן את המסקנה בהקשר לכל בדיקה.
שיעורים אינטראקטיביים בנושא זה
לעבור על הדברים צעד אחר צעד, עם תרגילים לבדיקה מיידית.