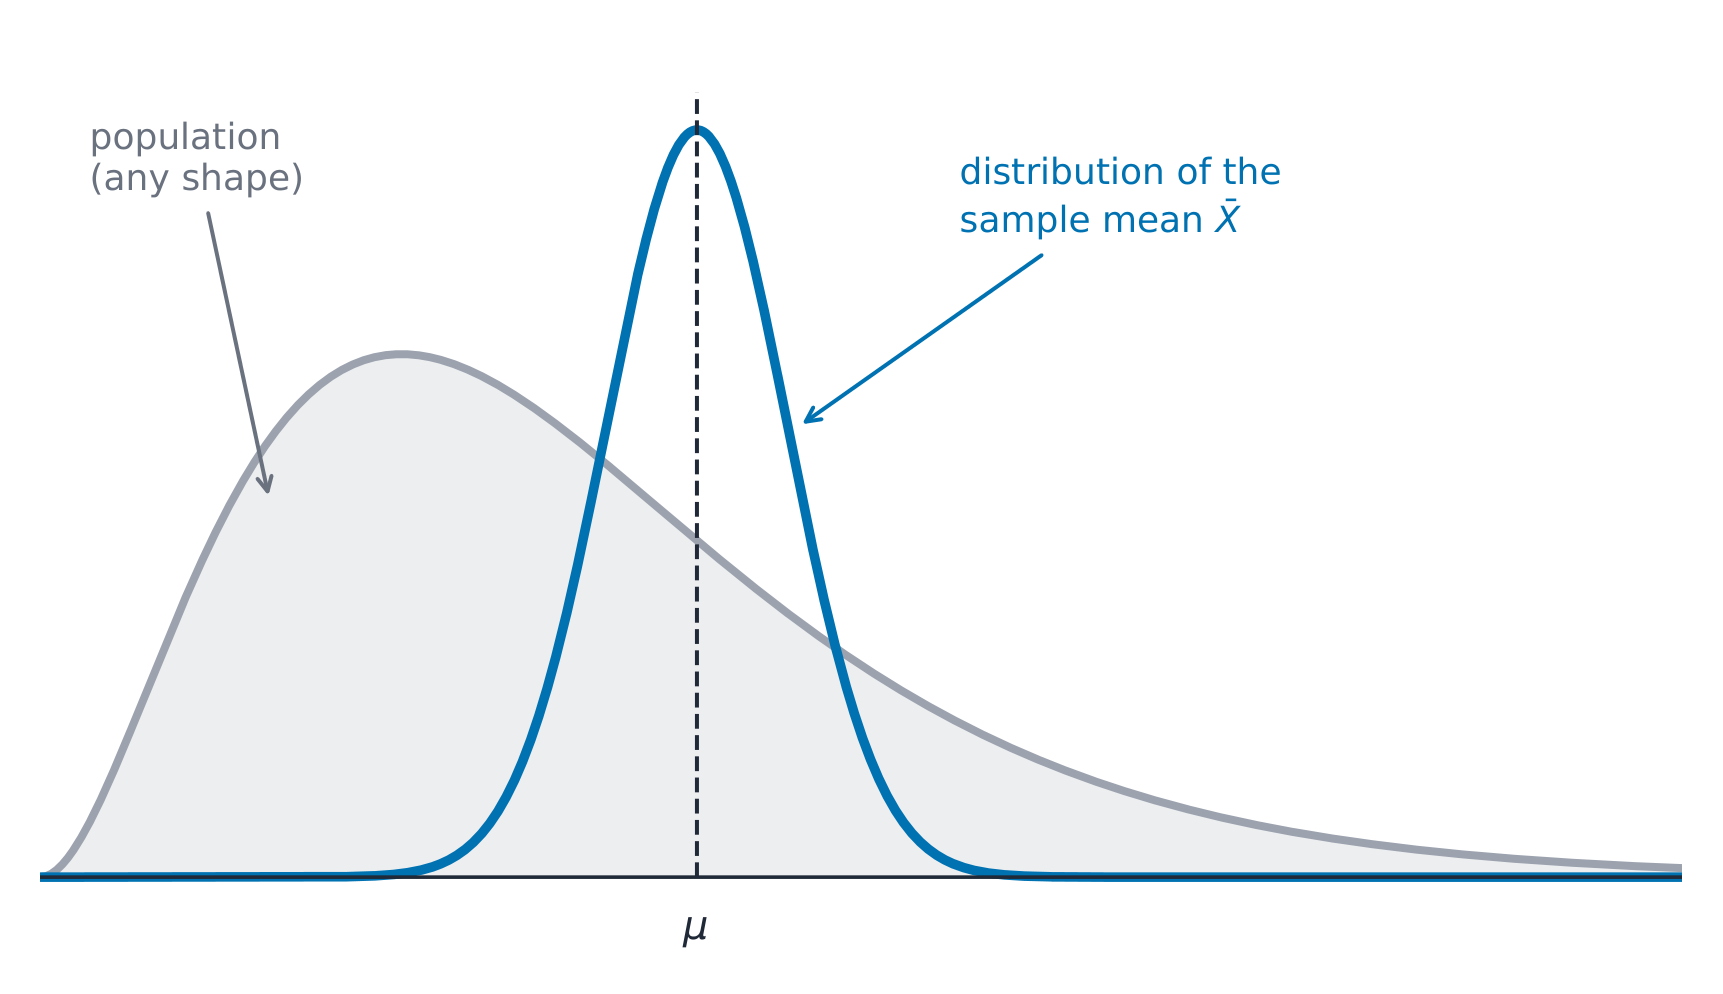
Pour une proportion d'échantillon $\hat{p}$ provenant d'un SRS : la moyenne est $p$ (sans biais), et l'écart-type est
$$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
Cette dispersion a deux noms : c'est l'
écart-type de la distribution d'échantillonnage, et on l'appelle
erreur standard une fois que vous devez l'estimer à partir de l'échantillon (en remplaçant
$p$ par
$\hat p$) — ce que font exactement les unités d'inférence ultérieures.
Elle est approximativement
normale lorsque
$np\ge 10$ et
$n(1-p)\ge 10$ (la condition des
Grandes Comptages), et la condition
$10\%$ (
$n\le 0.10N$) maintient les observations quasi-indépendantes.
Exemple résolu. Supposons que $40\%$ des électeurs favorisent une mesure ($p=0.4$) et que vous échantillonnez $n=100$. L'erreur standard est $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. La probabilité qu'un échantillon donne $\hat{p}>0.5$ est $z=\dfrac{0.5-0.4}{0.049}=2.04$, donc $P(\hat p>0.5)\approx0.02$ – une majorité dans l'échantillon serait surprenante.