AP Statistics couvre l'exploration des données, la conception d'échantillonnage et expérimentale, la probabilité et les variables aléatoires, les distributions d'échantillonnage, et l'inférence — intervalles de confiance et tests de signification. Il y a peu d'algèbre ; la difficulté est de dire la bonne chose sur l'incertitude.
Chaque réponse d'inférence a quatre parties : nommez la procédure, vérifiez les conditions, calculez, et concluez en contexte avec un lien vers l'hypothèse alternative. La grille évalue les quatre, donc une simple p-valeur correcte rapporte mal.
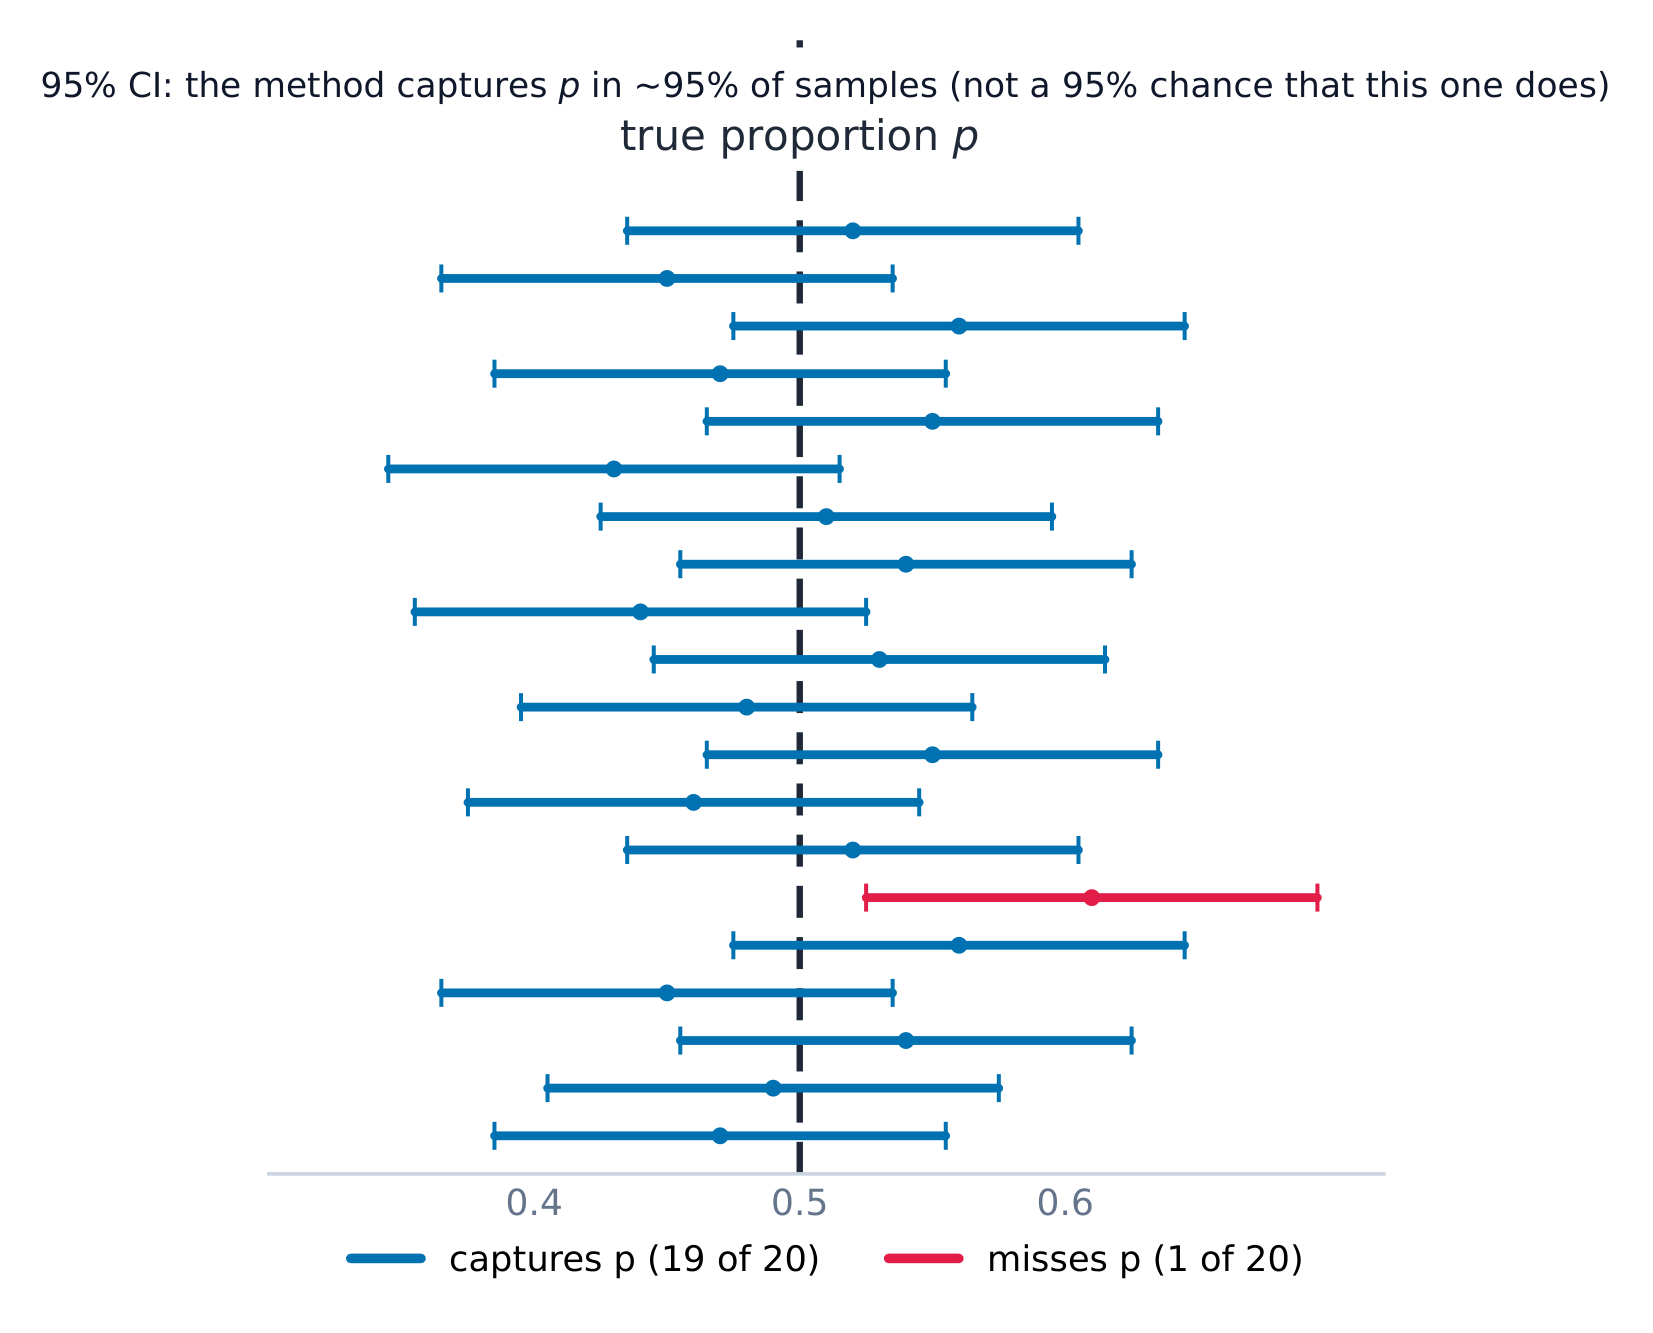
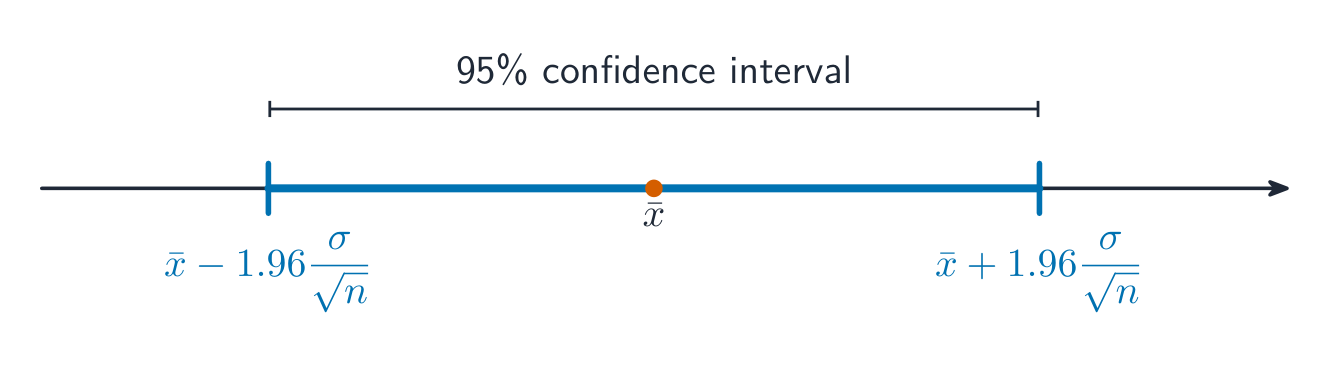
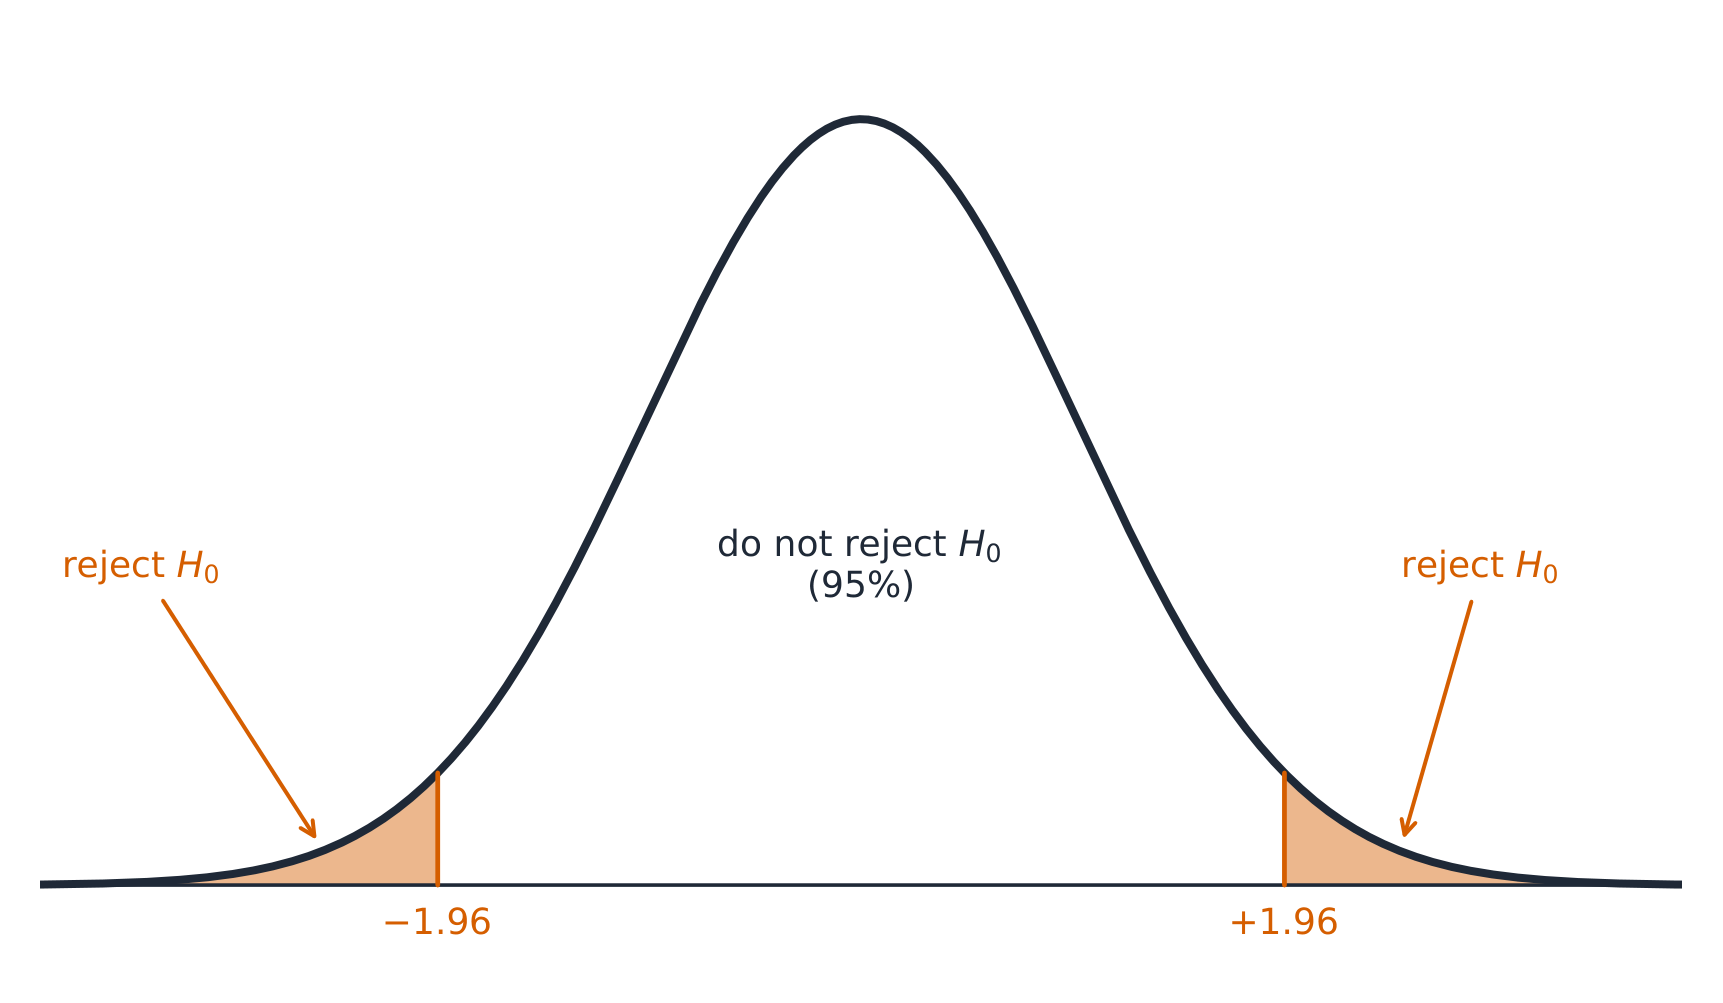
Le langage est noté. « Nous rejetons H₀ » n'est pas « nous prouvons H₁ » ; un intervalle de confiance concerne le comportement à long terme de la méthode, pas la probabilité qu'un intervalle particulier contienne le paramètre. Ces distinctions décident des marks.
Les notes travaillent à travers toutes les neuf unités avec chaque procédure d'inférence exposée étape par étape. Les FRQs publiés sont dans la bibliothèque. Statistics donne des marks pour l'énoncé des conditions et l'interprétation en contexte, donc chaque réponse travaillée nomme les conditions avant de lancer le test.
Introduction aux statistiques : Que pouvons-nous apprendre des données ?
Programme
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.A : Identifier les questions à répondre, basé sur la variation dans des données à une variable. [Compétence 1.A]
VAR-1.A.1 Les nombres peuvent transmettre des informations significatives lorsqu'ils sont placés dans un contexte.
Source : Description du cours et de l'examen AP College Board
La statistique est la science qui consiste à apprendre à partir de données – des nombres ou des étiquettes collectés dans le monde réel. Les données varient, nous décrivons donc des modèles et tenons compte de la variation plutôt que de nous attendre à ce que chaque valeur corresponde. Une question statistique anticipe une réponse basée sur des données qui varient.
Deux distinctions traversent tout le cours. Un paramètre est un résumé numérique d'une population entière ; une statistique est un résumé numérique d'un échantillon – nous utilisons la statistique pour estimer le paramètre que nous ne pouvons pas mesurer directement. Et les statistiques descriptives ne font que résumer l'ensemble de données en main, tandis que les statistiques inférentielles utilisent un échantillon pour formuler et tester des affirmations concernant la population plus large.
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.B : Identifier les variables dans un ensemble de données. [Compétence 2.A]
VAR-1.B.1 Une variable est une caractéristique qui change d'un individu à l'autre.
Objectif d'apprentissage VAR-1.C : Classer les types de variables. [Compétence 2.A]
VAR-1.C.1 Une variable catégorielle prend des valeurs qui sont des noms de catégories ou des étiquettes de groupes.
VAR-1.C.2 Une variable quantitative est celle qui prend des valeurs numériques pour une quantité mesurée ou comptée.
Exemples illustratifs pour VAR-1.C :
Variables catégorielles :
Main dominante
Groupe d'âge (jeune ou vieux)
Diplôme le plus élevé obtenu
Variables quantitatives :
Âge d'une structure
Taille d'un enfant
Concentration d'un échantillon
Source : Description du cours et de l'examen AP College Board
Une variable est une caractéristique qui peut différer entre les individus. Deux sortes :
Catégorielle (qualitative) : les valeurs sont des étiquettes/groupes (couleur des yeux, marque).
Quantitative : les valeurs sont des nombres sur lesquels on peut effectuer des calculs (taille, âge). Les variables quantitatives sont discrètes (comptables) ou continues (mesurées).
Choisir le bon graphique et le bon résumé dépend du type dont vous disposez.
Explorer
Catégorielle ou quantitative ?
Chaque variable est soit catégorielle (elle étiquette chaque unité avec un groupe) soit quantitative (un nombre mesuré que vous pouvez moyenne). Le type de variable décide des graphiques et résumés que vous avez le droit d'utiliser.
Représenter une variable catégorielle avec des tableaux
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.A : Représenter des données catégorielles à l'aide de tableaux de fréquences ou de fréquences relatives. [Compétence 2.B]
UNC-1.A.1 Un tableau de fréquences donne le nombre de cas tombant dans chaque catégorie. Un tableau de fréquences relatives donne la proportion de cas tombant dans chaque catégorie.
Objectif d'apprentissage UNC-1.B : Décrire des données catégorielles représentées dans des tableaux de fréquences ou relatives. [Compétence 2.A]
UNC-1.B.1 Les pourcentages, les fréquences relatives et les taux fournissent toutes les mêmes informations que les proportions.
UNC-1.B.2 Les effectifs et les fréquences relatives des données catégorielles révèlent des informations qui peuvent être utilisées pour justifier des affirmations sur les données dans leur contexte.
Source : Description du cours et de l'examen AP College Board
Un tableau de fréquence liste le comptage (fréquence) de chaque catégorie ; un tableau de fréquence relative liste la proportion (comptage ÷ total) de chaque catégorie. Les fréquences relatives permettent de comparer équitablement des groupes de tailles différentes.
Représenter une variable catégorielle avec des graphiques
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
UNC-1.C.1 Les diagrammes en barres (ou graphiques en barres) sont utilisés pour afficher les fréquences (effectifs) ou les fréquences relatives (proportions) pour des données catégorielles.
UNC-1.C.2 La hauteur ou la longueur de chaque barre dans un graphique en barres correspond soit au nombre, soit à la proportion d'observations tombant dans chaque catégorie.
UNC-1.C.3 Il existe de nombreuses autres façons de représenter les fréquences (effectifs) ou les fréquences relatives (proportions) pour des données catégorielles.
UNC-1.D.1 Les représentations graphiques d'une variable catégorielle révèlent des informations qui peuvent être utilisées pour justifier des affirmations sur les données dans leur contexte.
Objectif d'apprentissage UNC-1.E : Comparer plusieurs ensembles de données catégorielles. [Compétence 2.D]
UNC-1.E.1 Des tableaux de fréquences, des diagrammes en barres ou d'autres représentations peuvent être utilisés pour comparer deux ensembles de données ou plus concernant la même variable catégorielle.
Source : Description du cours et de l'examen AP College Board
Les diagrammes en barres montrent le comptage ou la proportion de chaque catégorie sous forme de barres séparées ; un diagramme circulaire montre la part de chaque catégorie dans l'ensemble. La hauteur des barres (ou des parts) permet de comparer les catégories d'un coup d'œil. Les barres peuvent être triées par taille ou selon un ordre naturel de catégorie.
Explorer
Montrer une variable catégorielle comme un diagramme circulaire
Un diagramme circulaire transforme la part de chaque catégorie dans le total en une tranche : une part plus grande est une tranche plus grande, et toutes les tranches ensemble font 100 %. C'est une image d'un tableau de fréquence relative.
1.5
Représenter une variable quantitative avec des graphiques
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.F : Classer les types de variables quantitatives. [Compétence 2.A]
UNC-1.F.1 Une variable discrète peut prendre un nombre dénombrable de valeurs. Le nombre de valeurs peut être fini ou infiniment dénombrable, comme avec les nombres entiers.
UNC-1.F.2 Une variable continue peut prendre infiniment de valeurs, mais ces valeurs ne peuvent pas être comptées. Peu importe à quel point l'intervalle entre deux valeurs d'une variable continue est petit, il est toujours possible de déterminer une autre valeur entre elles.
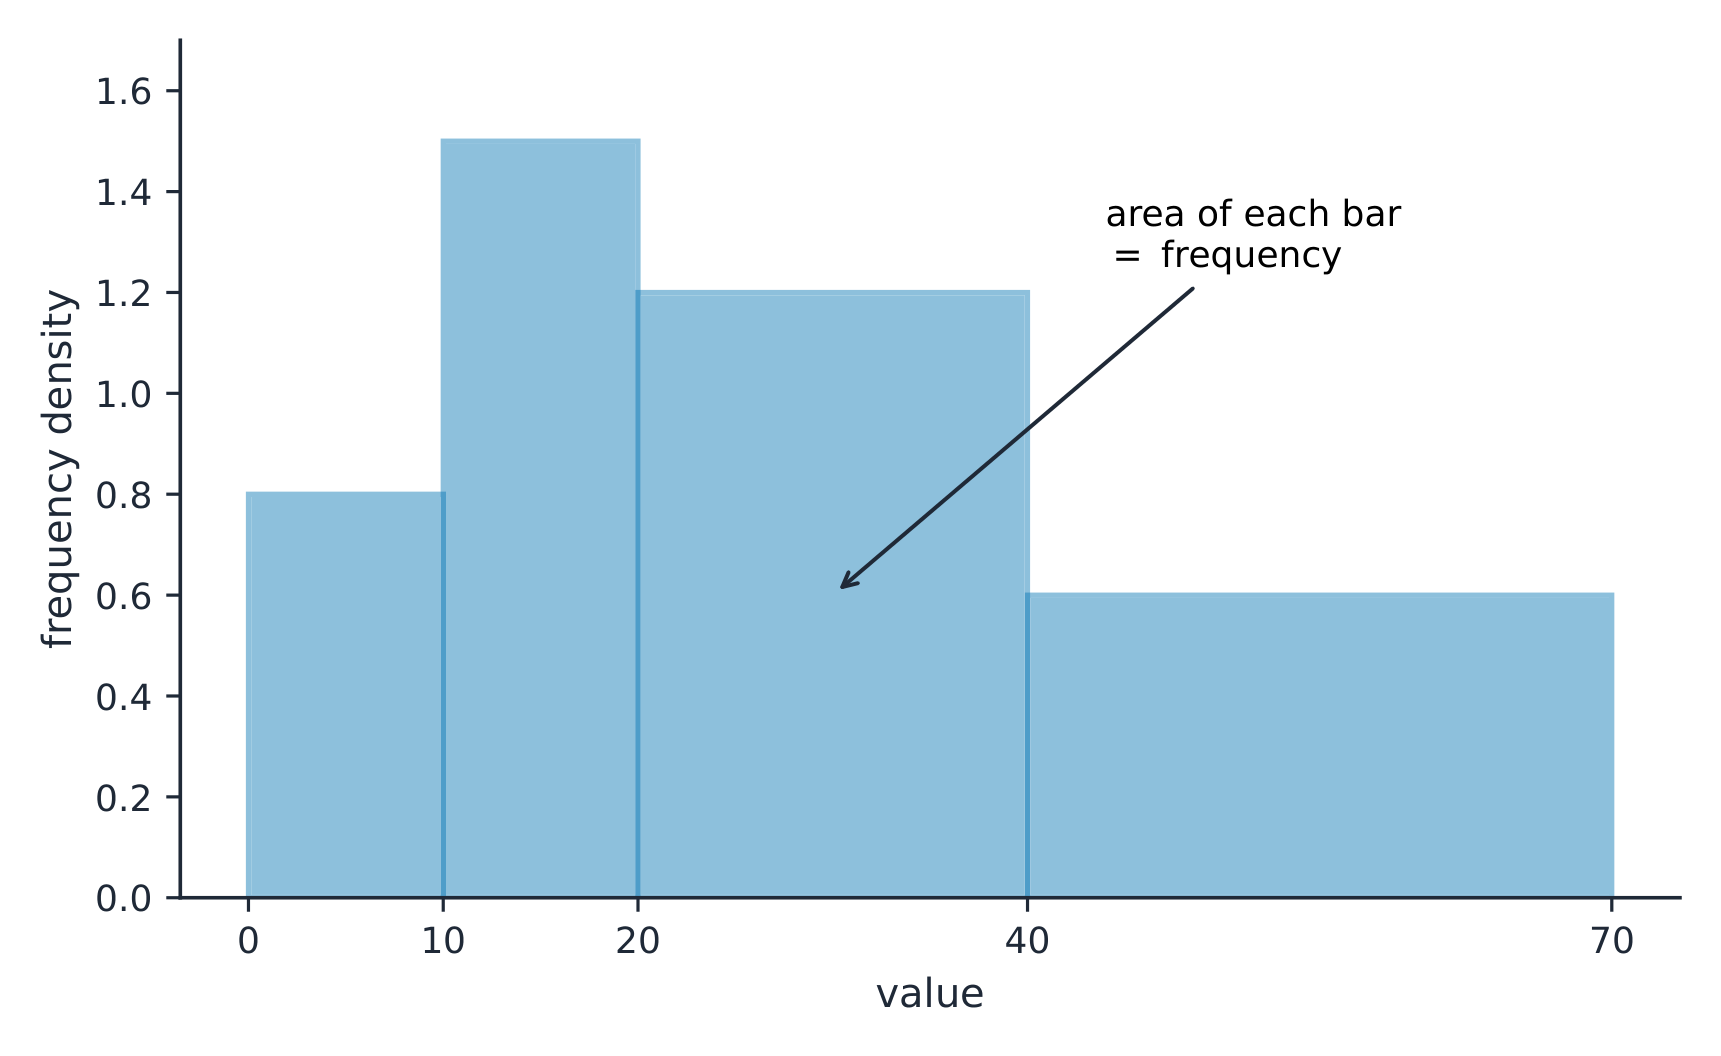
UNC-1.G.1 Dans un histogramme, la hauteur de chaque barre indique le nombre ou la proportion d'observations qui tombent dans l'intervalle correspondant à cette barre. Modifier les largeurs d'intervalle peut changer l'apparence de l'histogramme.
UNC-1.G.2 Dans un diagramme tiges et feuilles, chaque valeur de données est divisée en une « tige » (le premier chiffre ou les premiers chiffres) et une « feuille » (généralement le dernier chiffre).
UNC-1.G.3 Un nuage de points représente chaque observation par un point, dont la position sur l'axe horizontal correspond à la valeur de données de cette observation, avec des valeurs presque identiques empilées les unes sur les autres.
UNC-1.G.4 Un graphique cumulatif représente le nombre ou la proportion d'un ensemble de données inférieur ou égal à un nombre donné.
UNC-1.G.5 Il existe de nombreuses autres façons de représenter graphiquement les distributions de données quantitatives.
Source : Description du cours et de l'examen AP College Board
Pour les nombres, utilisez un nuage de points (dotplot), un diagramme tiges-feuilles ou un histogramme (barres sur des intervalles de valeurs appelés classes). Ceux-ci montrent la distribution – comment les valeurs se dispersent. La largeur de classe d'un histogramme change l'image, choisissez-la donc pour révéler la forme.
Sur un histogramme avec des largeurs de classe inégales, l'aire des barres représente la fréquence
Explorer
Explorer comment la largeur des classes façonne un histogramme
Un histogramme regroupe les données en classes de largeur égale et dessine une barre au-dessus de chacune. Changez les classes et remarquez comment les mêmes données peuvent paraître irrégulières (trop étroites) ou lisses (trop larges) — la forme est un choix.
Décrire la distribution d'une variable quantitative
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.H : Décrire les caractéristiques des distributions de données quantitatives. [Compétence 2.A]
UNC-1.H.1 Les descriptions de la distribution de données quantitatives incluent la forme, le centre et la variabilité (dispersion), ainsi que toute caractéristique inhabituelle telle que des valeurs aberrantes, des intervalles, des amas ou plusieurs pics.
UNC-1.H.2 Pour les données à une variable, les valeurs aberrantes sont des points de données anormalement petits ou grands par rapport au reste des données.
UNC-1.H.3 Une distribution est asymétrique vers la droite (asymétrie positive) si la queue droite est plus longue que la gauche. Une distribution est asymétrique vers la gauche (asymétrie négative) si la queue gauche est plus longue que la droite. Une distribution est symétrique si la moitié gauche est l'image miroir de la moitié droite.
UNC-1.H.4 Les graphiques univariés avec un seul pic principal sont appelés unimodaux. Les graphiques avec deux pics proéminents sont bimodaux. Un graphique où chaque hauteur de barre est approximativement la même (pas de pics proéminents) est approximativement uniforme.
UNC-1.H.5 Un intervalle est une région d'une distribution entre deux valeurs de données où il n'y a pas de données observées.
UNC-1.H.6 Les amas sont des concentrations de données généralement séparées par des intervalles.
UNC-1.H.7 La statistique descriptive n'attribue pas les propriétés d'un ensemble de données à une population plus large, mais peut fournir la base pour des conjectures destinées à être testées ultérieurement.
Source : Description du cours et de l'examen AP College Board
Décrivez quatre éléments (rappelez-vous SOCS) :
Forme : symétrique, ou asymétrique gauche/droite (une longue queue de ce côté), et nombre de pics – un pic principal est unimodal, deux pics proéminents bimodal, et des barres approximativement égales uniforme.
Valeurs aberrantes : des valeurs inhabituelles loin du reste.
Centre : une valeur typique (moyenne ou médiane).
Dispersion : l'étendue de variation des valeurs (étendue, IQR, écart-type).
Décrivez toujours la forme/centre/dispersion dans le contexte, avec les unités.
La forme d'une distribution : symétrique, asymétrique droite (longue queue droite) ou asymétrique gauche
Statistiques récapitulatives pour une variable quantitative
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.I : Calculer les mesures de centre et de position pour les données quantitatives. [Compétence 2.C]
UNC-1.I.1 Une statistique est un résumé numérique de données d'échantillon.
UNC-1.I.2 La moyenne est la somme de toutes les valeurs de données divisée par le nombre de valeurs. Pour un échantillon, la moyenne est notée $x$-barre : $\bar{x} = \dfrac{1}{n}\sum_{i=1}^{n} x_i$, où $x_i$ représente le $i^{\text{th}}$ point de données dans l'échantillon et $n$ représente le nombre de valeurs de données dans l'échantillon.
UNC-1.I.3 La médiane d'un ensemble de données est la valeur centrale lorsque les données sont ordonnées. Lorsque le nombre de points de données est pair, la médiane peut prendre n'importe quelle valeur entre les deux valeurs centrales. En statistiques AP, la valeur la plus couramment utilisée pour la médiane d'un ensemble de données avec un nombre pair de valeurs est la moyenne des deux valeurs centrales.
UNC-1.I.4 Le premier quartile, Q1, est la médiane de la moitié de l'ensemble de données ordonnées allant du minimum à la position de la médiane. Le troisième quartile, Q3, est la médiane de la moitié de l'ensemble de données ordonnées allant de la position de la médiane au maximum. Q1 et Q3 forment les limites pour les 50 % centraux des valeurs dans un ensemble de données ordonné.
UNC-1.I.5 Le $p^{\text{th}}$ percentile est interprété comme la valeur qui a $p\%$ des données inférieures ou égales à elle.
Objectif d'apprentissage UNC-1.J : Calculer les mesures de variabilité pour les données quantitatives. [Compétence 2.C]
UNC-1.J.1 Trois mesures de variabilité (ou dispersion) couramment utilisées dans une distribution sont l'étendue, l'étendue interquartile et l'écart-type.
UNC-1.J.2 L'étendue est définie comme la différence entre la valeur maximale de données et la valeur minimale de données. L'étendue interquartile (EIQ) est définie comme la différence entre le troisième et le premier quartile : $Q3 - Q1$. À la fois l'étendue et l'étendue interquartile sont des moyens possibles de mesurer la variabilité de la distribution d'une variable quantitative.
UNC-1.J.3 L'écart-type est un moyen de mesurer la variabilité de la distribution d'une variable quantitative. Pour un échantillon, l'écart-type est noté $s$ : $s_x = \sqrt{\dfrac{1}{n-1}\sum(x_i - \bar{x})^2}$. Le carré de l'écart-type de l'échantillon, $s^2$, est appelé la variance de l'échantillon.
UNC-1.J.4 Changer les unités de mesure affecte les valeurs des statistiques calculées.
Objectif d'apprentissage UNC-1.K : Expliquer le choix d'une mesure particulière de centre et/ou de variabilité pour décrire un ensemble de données quantitatives. [Compétence 4.B]
UNC-1.K.1 Il existe de nombreuses méthodes pour déterminer les valeurs aberrantes. Deux méthodes fréquemment utilisées dans ce cours sont :
UNC-1.K.1.i Une valeur aberrante est une valeur supérieure à $1.5 \times \text{IQR}$ au-dessus du troisième quartile ou inférieure à $1.5 \times \text{IQR}$ en dessous du premier quartile.
UNC-1.K.1.ii Une valeur aberrante est une valeur située à 2 écarts-types ou plus au-dessus, ou en dessous, de la moyenne.
UNC-1.K.2 La moyenne, l'écart-type et l'étendue sont considérés comme non résistants (ou non robustes) car ils sont influencés par les valeurs aberrantes. La médiane et l'EIQ sont considérés comme résistants (ou robustes), car les valeurs aberrantes ne modifient pas grandement (si du tout) leur valeur.
Source : Description du cours et de l'examen AP College Board
Écart-type : dispersion autour de la moyenne
Centre : la moyenne$\bar{x}=\dfrac{\sum x_i}{n}$ (moyenne arithmétique) et la médiane (valeur centrale). La médiane résiste aux valeurs aberrantes ; la moyenne est tirée vers une asymétrie.
Dispersion : l'étendue, l'intervalle interquartile$\text{IQR}=Q_3-Q_1$ (50 % centra), et l'écart-type$s_x=\sqrt{\dfrac{\sum(x_i-\bar{x})^2}{n-1}}$ (distance typique par rapport à la moyenne ; son carré est la variance).
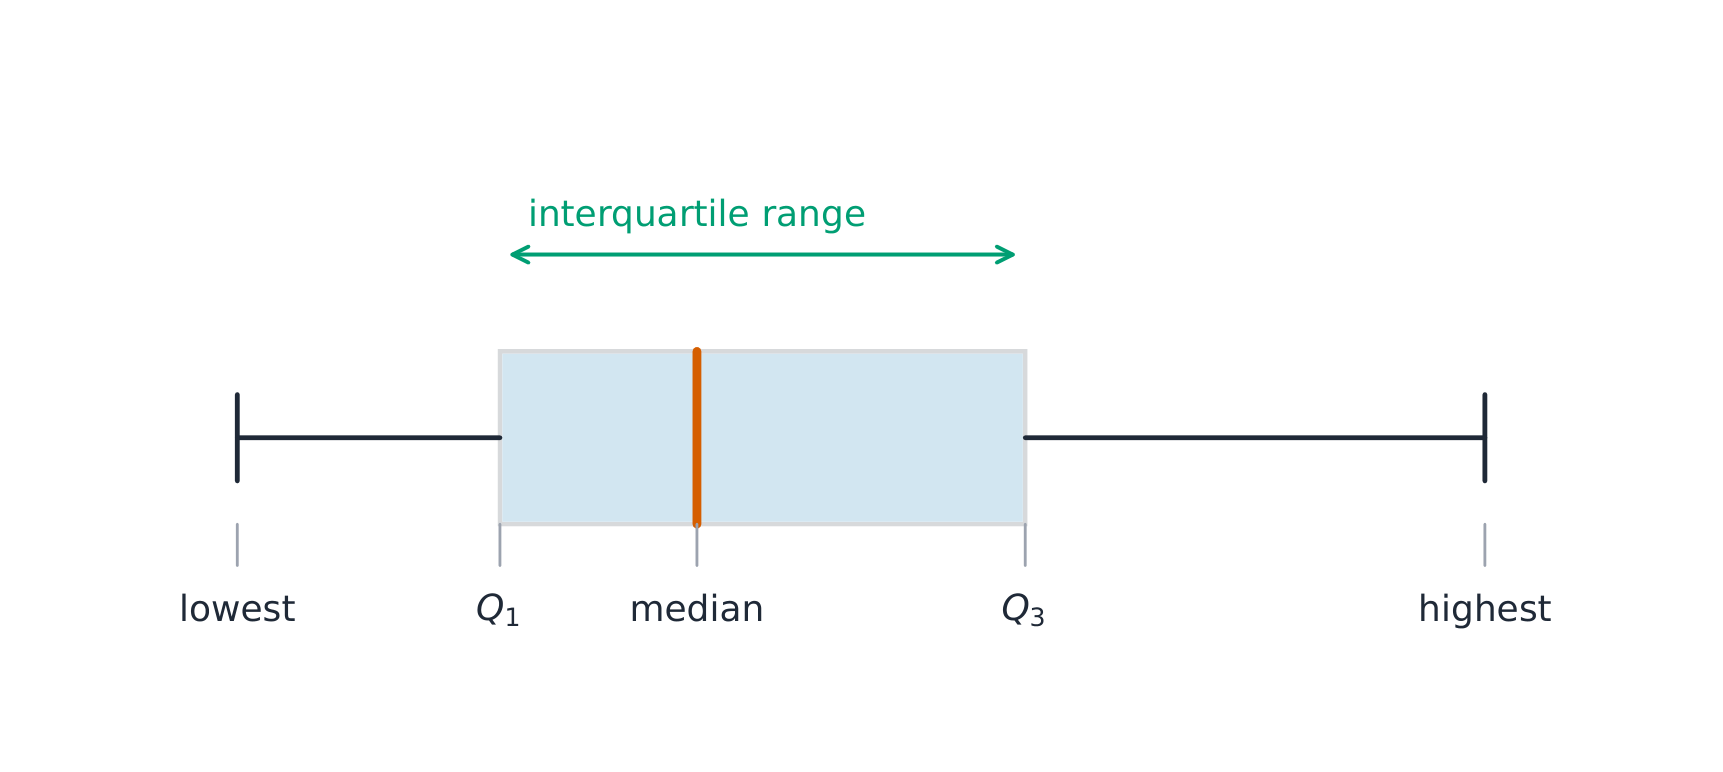
Le résumé à cinq nombres : min, $Q_1$, médiane, $Q_3$, max.
Utilisez des mesures résistantes (médiane, IQR) pour les données asymétriques ; la moyenne et l'écart-type pour les données approximativement symétriques.
Le percentile d'une valeur est le pourcentage de données situées à cette valeur ou en dessous – ainsi la médiane est le 50e percentile et $Q_1$ le 25e. Un graphique de fréquence relative cumulative rend les percentiles faciles à lire : pour chaque valeur, il trace la proportion de données à cette valeur ou en dessous, montant de 0 à 1. Montez depuis une valeur jusqu'à la courbe puis traversez jusqu'à son percentile, ou inversez les étapes pour trouver la valeur à un percentile donné (la même lecture fonctionne à partir d'un tableau de fréquence cumulative).
Exemple résolu. Pour les données $4, 8, 6, 10, 7$ : la moyenne est $\bar{x}=\dfrac{4+8+6+10+7}{5}=\dfrac{35}{5}=7$. En les triant vers $4,6,7,8,10$, la médiane est la valeur centrale, $7$. La moyenne et la médiane coïncident ici car les données sont approximativement symétriques.
cumulative relative frequency graph/ˈkjuːmjʊlətɪv ˈrelətɪv ˈfriːkwənsi ɡræf/
累积相对频率图
lěi jī xiāng duì pín lǜ tú
1.8
Représentations graphiques des statistiques récapitulatives
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.L : Représenter graphiquement les statistiques récapitulatives pour les données quantitatives. [Compétence 2.B]
UNC-1.L.1 Ensemble, la valeur minimale de données, le premier quartile (Q1), la médiane, le troisième quartile (Q3) et la valeur maximale de données constituent le résumé à cinq nombres.
UNC-1.L.2 Un diagramme en boîte est une représentation graphique du résumé à cinq nombres (minimum, premier quartile, médiane, troisième quartile, maximum). La boîte représente les 50 % centraux des données, avec une ligne à la médiane et les extrémités de la boîte correspondant aux quartiles. Des lignes (« moustaches ») s'étendent des quartiles vers le point le plus extrême qui n'est pas une valeur aberrante, et les valeurs aberrantes sont indiquées par leur propre symbole au-delà de celui-ci.
Objectif d'apprentissage UNC-1.M : Décrire les statistiques récapitulatives des données quantitatives représentées graphiquement. [Compétence 2.A]
UNC-1.M.1 Les statistiques récapitulatives des données quantitatives, ou d'ensembles de données quantitatives, peuvent être utilisées pour justifier des affirmations sur les données dans leur contexte.
UNC-1.M.2 Si une distribution est relativement symétrique, alors la moyenne et la médiane sont relativement proches l'une de l'autre. Si une distribution est asymétrique vers la droite, alors la moyenne est généralement à droite de la médiane. Si la distribution est asymétrique vers la gauche, alors la moyenne est généralement à gauche de la médiane.
Source : Description du cours et de l'examen AP College Board
Un boxplot (boîte à moustaches) dessine le résumé à cinq nombres : une boîte de $Q_1$ à $Q_3$ avec la médiane à l'intérieur, et des moustaches jusqu'aux valeurs extrêmes non aberrantes. Un point est une valeur aberrante s'il se trouve à plus de $1.5\times\text{IQR}$ au-delà d'un quartile – une règle que vous pouvez être amené à appliquer. Les boxplots sont idéaux pour comparer plusieurs groupes côte à côte.
Exemple résolu. Un jeu de données a $Q_1=20$ et $Q_3=32$, donc $\text{IQR}=12$. Les seuils de valeurs aberrantes sont $Q_1-1.5(12)=2$ et $Q_3+1.5(12)=50$. Toute valeur inférieure à $2$ ou supérieure à $50$ est signalée comme une valeur aberrante.
Un diagramme boîte à moustaches montre les quartiles et l'étendueUn boxplot dessine le résumé à cinq nombres ; la boîte couvre l'IQR
Explorer
Explorer la résumé à cinq nombres comme diagramme en boîte
Faites glisser $Q_1$, la médiane, et $Q_3$ pour voir la boîte (sa longueur est l'étendue interquartile) et comment la position de la médiane à l'intérieur de la boîte révèle la asymétrie — une médiane proche de $Q_1$ signale une distribution asymétrique à droite.
Comparer les distributions d'une variable quantitative
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.N : Comparer les représentations graphiques pour plusieurs ensembles de données quantitatives. [Compétence 2.D]
UNC-1.N.1 N'importe quelle représentation graphique, p. ex., histogrammes, diagrammes en boîte côte à côte, etc., peut être utilisée pour comparer deux ou plusieurs échantillons indépendants sur le centre, la variabilité, les amas, les intervalles, les valeurs aberrantes et d'autres caractéristiques.
Objectif d'apprentissage UNC-1.O : Comparer les statistiques récapitulatives pour plusieurs ensembles de données quantitatives. [Compétence 2.D]
UNC-1.O.1 N'importe quelles résumés numériques (p. ex., moyenne, écart-type, fréquence relative, etc.) peuvent être utilisés pour comparer deux ou plusieurs échantillons indépendants.
Source : Description du cours et de l'examen AP College Board
Pour comparer deux groupes ou plus, comparez la forme, le centre et la dispersion, et mentionnez les valeurs aberrantes – toujours avec des termes comparatifs (« Le groupe A a une médiane plus élevée que le groupe B ») et dans le contexte. Ne décrivez pas simplement chaque groupe séparément ; explicitez la comparaison.
Explorer
Comparer les distributions avec des diagrammes en boîte
Un diagramme en boîte dessine le résumé à cinq nombres. Placer deux diagrammes en boîte sur la même échelle compare leur centre (médiane), leur dispersion (écart interquartile = largeur de la boîte) et leur asymétrie d'un coup d'œil — la manière juste de comparer des groupes.
1.10
La distribution normale
Programme
Compréhension durable (VAR-2) : La distribution normale peut être utilisée pour représenter certaines distributions de population.
Objectif d'apprentissage VAR-2.A : Comparer une distribution de données au modèle de distribution normale. [Compétence 2.D]
VAR-2.A.1 Un paramètre est une synthèse numérique d'une population.
VAR-2.A.2 Certains ensembles de données peuvent être décrits comme approximativement normalement distribués. Une courbe normale a une forme de cloche et est symétrique. Les paramètres d'une distribution normale sont la moyenne de la population, $\mu$, et l'écart-type de la population, $\sigma$.
VAR-2.A.3 Pour une distribution normale, environ 68% des observations se trouvent dans 1 écart-type de la moyenne, environ 95% des observations se trouvent dans 2 écarts-types de la moyenne, et environ 99.7% des observations se trouvent dans 3 écarts-types de la moyenne. C'est ce qu'on appelle la règle empirique.
VAR-2.A.4 De nombreuses variables peuvent être modélisées par une distribution normale.
Exemples illustratifs pour VAR-2.A :
Variables qui peuvent être modélisées par une distribution normale :
Température corporelle
Poids d'une tranche de pain
Objectif d'apprentissage VAR-2.B : Déterminer des proportions et des percentiles à partir d'une distribution normale. [Compétence 3.A]
VAR-2.B.1 Une score standardisé pour une valeur de données particulière est calculé comme (valeur de données − moyenne)/(écart-type), et mesure le nombre d'écarts-types qu'une valeur de données se trouve au-dessus ou en dessous de la moyenne.
VAR-2.B.2 Un exemple de score standardisé est un score $z$, qui est calculé comme $z\text{-score} = \left(\dfrac{x_i - \mu}{\sigma}\right)$. Un score $z$ mesure combien d'écarts-types une valeur de données est éloignée de la moyenne.
VAR-2.B.3 La technologie, telle qu'une calculatrice, une table de loi normale standardisée ou une sortie générée par ordinateur, peut être utilisée pour trouver la proportion de valeurs de données situées sur un intervalle donné d'une variable aléatoire normalement distribuée.
VAR-2.B.4 Étant donné l'aire d'une région sous la courbe de la distribution normale, il est possible d'utiliser la technologie, telle qu'une calculatrice, une table de loi normale standardisée ou une sortie générée par ordinateur, pour estimer les paramètres de certaines populations.
Objectif d'apprentissage VAR-2.C : Comparer les mesures de position relative dans des ensembles de données. [Compétence 2.D]
VAR-2.C.1 Les percentiles et les scores $z$ peuvent être utilisés pour comparer les positions relatives de points au sein d'un ensemble de données ou entre des ensembles de données.
Source : Description du cours et de l'examen AP College Board
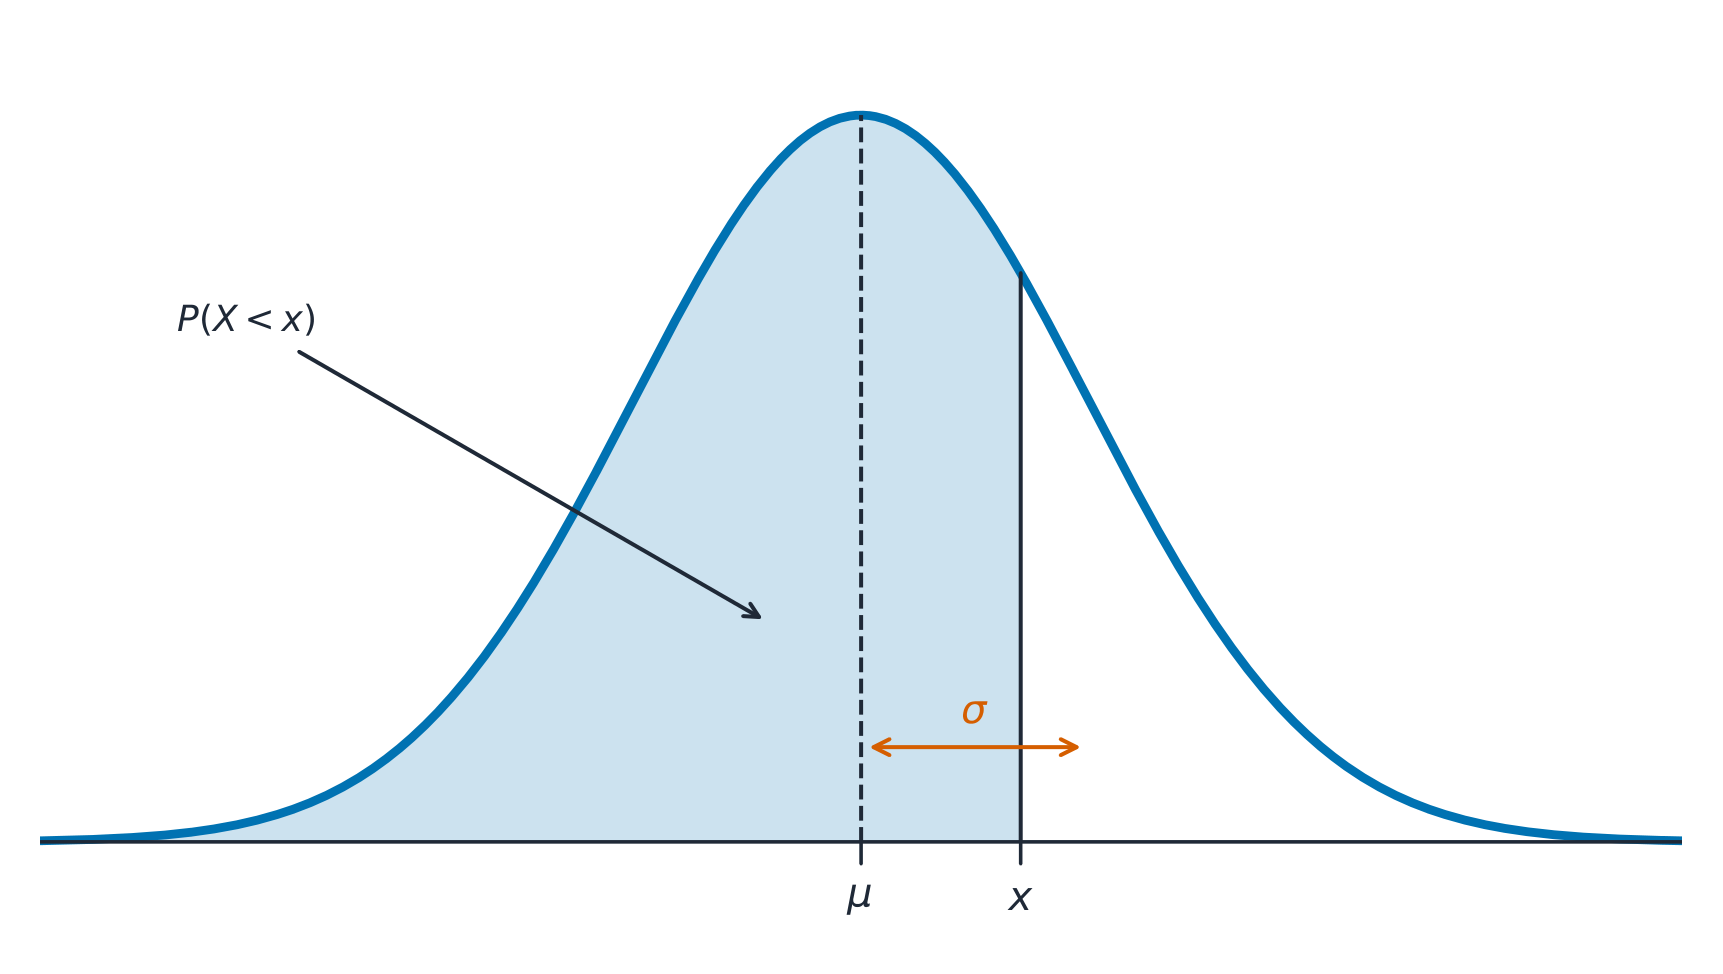
Une distribution normale 正态分布 est un modèle symétrique en forme de cloche, défini par sa moyenne $\mu$ et son écart-type $\sigma$. La règle empirique 经验法则 (68–95–99.7) : environ 68 % des valeurs se situent dans l'intervalle $1\sigma$ autour de la moyenne, 95 % dans $2\sigma$, et 99.7 % dans $3\sigma$.
La courbe normale : une probabilité est l'aire sous celle-ci, centrée sur la moyenne
Un $z$-score mesure combien d'écart-types une valeur est éloignée de la moyenne :
$$z=\frac{x-\mu}{\sigma}.$$
Convertissez en un $z$-score, puis utilisez la table normale ou la technologie pour trouver la proportion (aire) en dessous, au-dessus ou entre les valeurs – et inversez le processus pour trouver une valeur à partir d'un percentile donné.
Exemple résolu. Les scores de test sont normaux avec $\mu=500$ et $\sigma=100$. Un score de $700$ correspond à $z=\dfrac{700-500}{100}=2$. Selon la règle empirique, $95\%$ des scores se situent dans $2\sigma$, donc $2.5\%$ se trouvent au-dessus de $700$ – ce qui signifie qu'un $700$ est environ au $97.5$e percentile.
La courbe normale et la règle empirique 68-95-99.7
Explorer
Explorer l'aire sous la courbe normale
La proportion des données inférieures à une valeur correspond à l'aire sous la courbe à sa gauche. Mettez en évidence une queue ou une bande centrale pour visualiser la règle empirique 68–95–99.7 et interpréter un score $z$ comme une aire.
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.D : Identifier les questions à répondre concernant les relations potentielles dans les données. [Compétence 1.A]
VAR-1.D.1 Les motifs et associations apparents dans les données peuvent être aléatoires ou non.
Source : Description du cours et de l'examen AP College Board
Les données à deux variables nous permettent de demander si deux caractéristiques sont associées 关联 – savoir l'une permet d'en déduire quelque chose sur l'autre. Une variable explicative 解释变量 (l'« entrée ») peut aider à prédire une variable réponse 响应变量 (la « sortie »). L'association n'est pas la même que la causalité.
2.2
Deux variables catégorielles
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.P : Comparer les représentations numériques et graphiques pour deux variables catégorielles. [Compétence 2.D]
UNC-1.P.1 Les graphiques à barres côte à côte, les graphiques à barres segmentés et les diagrammes en mosaïque sont des exemples de graphiques à barres pour une variable catégorielle, détaillés par catégories d'une autre variable catégorielle.
UNC-1.P.2 Les représentations graphiques de deux variables catégorielles peuvent être utilisées pour comparer des distributions et/ou déterminer si les variables sont associées.
UNC-1.P.3 Un tableau croisé, également appelé tableau de contingence, est utilisé pour résumer deux variables catégorielles. Les entrées dans les cellules peuvent être des comptes de fréquences ou des fréquences relatives.
UNC-1.P.4 Une fréquence relative jointe est une fréquence de cellule divisée par le total pour l'ensemble du tableau.
Source : Description du cours et de l'examen AP College Board
Un tableau croisé 双向表 (tableau de contingence) compte les individus selon deux variables catégorielles simultanément. Une distribution marginale 边缘分布 est un total de ligne ou de colonne exprimé comme fraction du total général (les totaux eux-mêmes ne sont que des comptes). Comparer les cellules intérieures montre si les variables sont liées.
2.3
Comparaison de groupes avec des distributions conditionnelles
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.Q : Calculer les statistiques pour deux variables catégorielles. [Compétence 2.C]
UNC-1.Q.1 Les fréquences relatives marginales sont les totaux de ligne et de colonne dans un tableau croisé divisés par le total pour l'ensemble du tableau.
UNC-1.Q.2 Une fréquence relative conditionnelle est une fréquence relative pour une partie spécifique du tableau de contingence (p. ex., fréquences de cellules dans une ligne divisées par le total pour cette ligne).
Objectif d'apprentissage UNC-1.R : Comparer les statistiques pour deux variables catégorielles. [Compétence 2.D]
UNC-1.R.1 Les statistiques récapitulatives pour deux variables catégorielles peuvent être utilisées pour comparer des distributions et/ou déterminer si les variables sont associées.
Source : Description du cours et de l'examen AP College Board
Une distribution conditionnelle 条件分布 est la distribution d'une variable à l'intérieur d'une catégorie fixe de l'autre (obtenue en divisant chaque cellule par son total de ligne ou de colonne). Si les distributions conditionnelles diffèrent entre les groupes, les deux variables sont associées ; si elles sont identiques, il n'y a pas d'association. Les diagrammes à bandes segmentées 分段条形图 ou les mosaïques les représentent.
2.4
Nuages de points pour deux variables quantitatives
Programme
Compréhension durable (UNC-1) : Les représentations graphiques et statistiques nous permettent d'identifier et de représenter les caractéristiques clés des données.
Objectif d'apprentissage UNC-1.S : Représenter des données quantitatives bivariées à l'aide de nuages de points. [Compétence 2.B]
UNC-1.S.1 Un ensemble de données quantitatives bivariées consiste en des observations de deux variables quantitatives différentes faites sur des individus dans un échantillon ou une population.
UNC-1.S.2 Un nuage de points montre deux valeurs numériques pour chaque observation, l'une correspondant à la valeur sur l'axe $x$ et l'autre correspondant à la valeur sur l'axe $y$.
UNC-1.S.3 Une variable explicative est une variable dont les valeurs sont utilisées pour expliquer ou prédire les valeurs correspondantes pour la variable réponse.
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.A : Décrire les caractéristiques d'un nuage de points. [Compétence 2.A]
DAT-1.A.1 Une description d'un nuage de points comprend la forme, la direction, la force et les caractéristiques inhabituelles.
DAT-1.A.2 La direction de l'association montrée dans un nuage de points, s'il y en a une, peut être décrite comme positive ou négative.
DAT-1.A.3 Une association positive signifie qu'à mesure que les valeurs d'une variable augmentent, les valeurs de l'autre variable ont tendance à augmenter. Une association négative signifie qu'à mesure que les valeurs d'une variable augmentent, les valeurs de l'autre variable ont tendance à diminuer.
DAT-1.A.4 La forme de l'association montrée dans un nuage de points, s'il y en a une, peut être décrite comme linéaire ou non-linéaire à divers degrés.
DAT-1.A.5 La force de l'association est la mesure dans laquelle les points individuels suivent un motif spécifique, p. ex., linéaire, et peut être montrée dans un nuage de points. La force peut être décrite comme forte, modérée ou faible.
DAT-1.A.6 Les caractéristiques inhabituelles d'un nuage de points incluent des regroupements de points ou des points présentant des écarts relativement importants entre la valeur de la variable réponse et une valeur prédite pour cette variable.
Source : Description du cours et de l'examen AP College Board
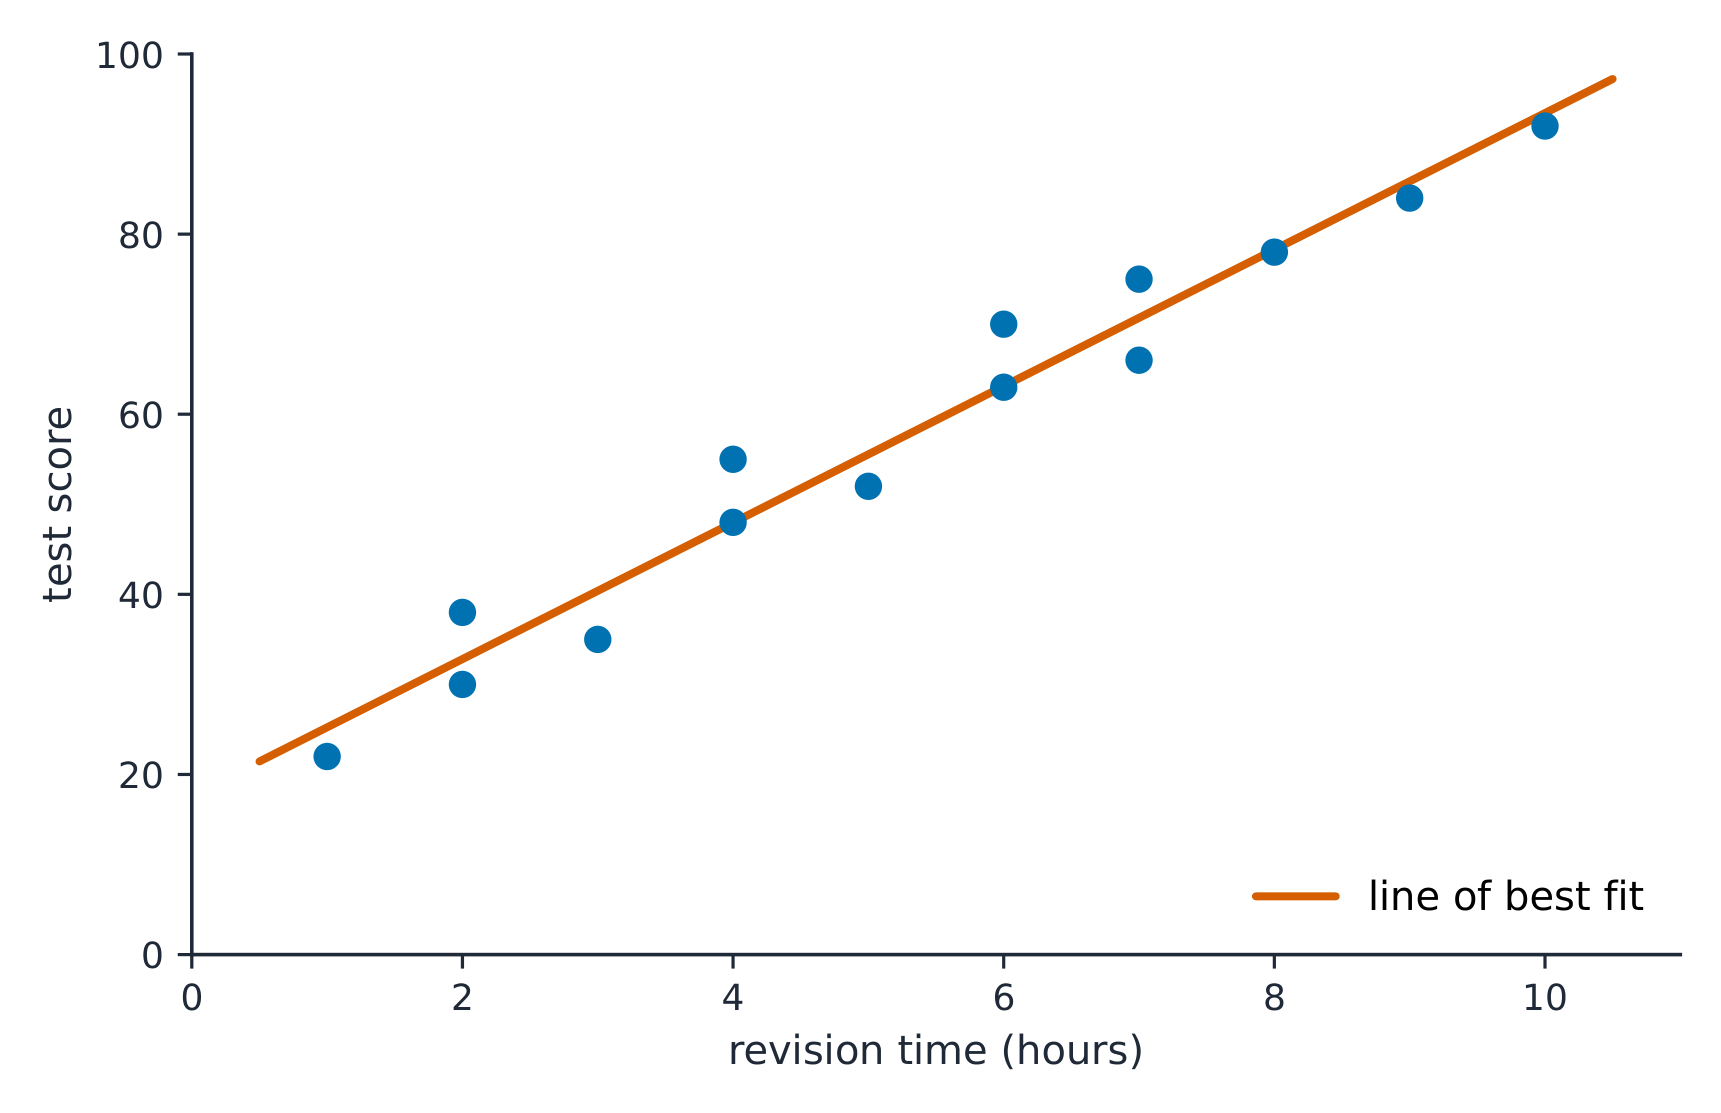
Un nuage de points 散点图 représente chaque individu par un point, la variable explicative sur l'axe $x$ et la variable réponse sur l'axe $y$. Le décrire avec DUFS : Direction (positive/négative), Caractéristiques inhabituelles (valeurs aberrantes, regroupements), Forme (linéaire ou courbe) et Force (à quel point les points suivent le motif) – toujours en contexte.
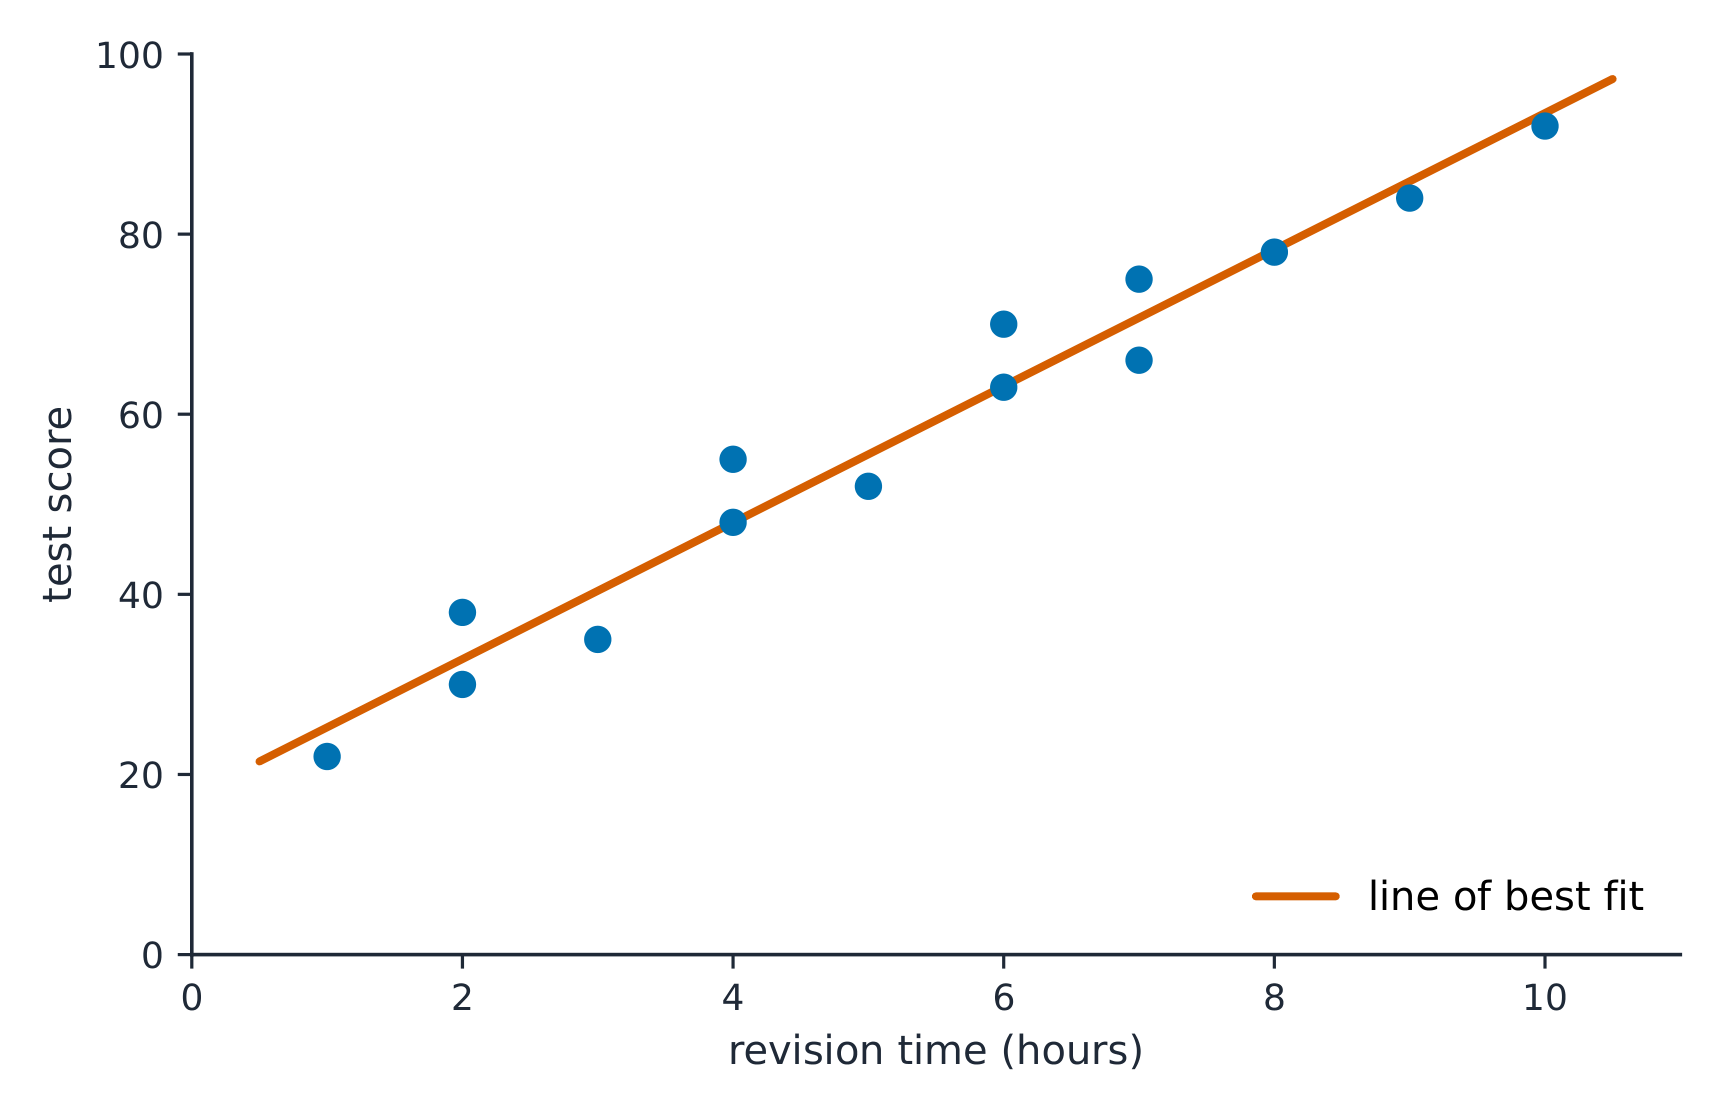
Une droite de tendance traverse le milieu des points dispersés
2.5
Corrélation
Programme
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.B : Déterminer la corrélation pour une relation linéaire. [Compétence 2.C]
DAT-1.B.1 La corrélation, $r$, donne la direction et quantifie la force de l'association linéaire entre deux variables quantitatives.
DAT-1.B.2 Le coefficient de corrélation peut être calculé par : $r = \dfrac{1}{n-1} \sum \left( \dfrac{x_i - \bar{x}}{s_x} \right) \left( \dfrac{y_i - \bar{y}}{s_y} \right)$. Cependant, le moyen le plus courant de déterminer $r$ est d'utiliser une technologie.
DAT-1.B.3 Un coefficient de corrélation proche de 1 ou de $-1$ ne signifie pas nécessairement qu'un modèle linéaire est approprié.
Objectif d'apprentissage DAT-1.C : Interpréter la corrélation pour une relation linéaire. [Compétence 4.B]
DAT-1.C.1 La corrélation, $r$, est sans unité, et toujours comprise entre $-1$ et 1, inclus. Une valeur de $r = 0$ indique qu'il n'y a aucune association linéaire. Une valeur de $r = 1$ ou de $r = -1$ indique qu'il y a une association linéaire parfaite.
DAT-1.C.2 Une relation perçue ou réelle entre deux variables ne signifie pas que les changements dans une variable causent des changements dans l'autre. Autrement dit, la corrélation n'implique pas nécessairement la causalité.
Source : Description du cours et de l'examen AP College Board
Ce que r mesure réellement
Le coefficient de corrélation 相关系数$r$ mesure la force et la direction d'une relation linéaire. Il varie de $-1$ à $1$ : proche de $\pm 1$ indique une forte linéarité, proche de $0$ une faible linéarité. $r$ n'a aucune unité et ne change pas si l'on inverse les variables. Avertissements : $r$ ne mesure que la force linéaire, il n'est pas résistant aux valeurs aberrantes, et une forte $r$ ne prouve pas la causalité.
Corrélation positive monte ensemble ; corrélation négative va dans des directions opposées
Explorer
Force d'une relation linéaire
Corrélation$r$ varie de $-1$ à $1$ : près de $\pm1$ les points épousent une ligne, près de 0 ils se dispersent. Changez-la et regardez le nuage se resserrer ou s'étendre.
2.6
Modèles de régression linéaire
Programme
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.D : Calculer une valeur de réponse prédite en utilisant un modèle de régression linéaire. [Compétence 2.C]
DAT-1.D.1 Un modèle de régression linéaire simple est une équation qui utilise une variable explicative, $x$, pour prédire la variable réponse, $y$.
DAT-1.D.2 La valeur de réponse prédite, notée $\hat{y}$, est calculée comme $\hat{y} = a + bx$, où $a$ est l'ordonnée à l'origine $y$ et $b$ est la pente de la droite de régression, et $x$ est la valeur de la variable explicative.
DAT-1.D.3 L'extrapolation consiste à prédire une valeur de réponse en utilisant une valeur pour la variable explicative qui se situe au-delà de l'intervalle des valeurs de $x$ utilisées pour déterminer la droite de régression. La valeur prédite est moins fiable en tant qu'estimation plus nous extrapolons.
Source : Description du cours et de l'examen AP College Board
La droite de régression des moindres carrés 最小二乘回归线 prédit la réponse : $\hat{y}=a+bx$, où $\hat{y}$ est la réponse prédite. La pente 斜率$b$ est le changement prévu de $y$ pour une augmentation d'une unité de $x$ ; l'intercept $y$ 截距$a$ est la réponse prévue lorsque $y$ lorsque $x=0$. Interpréter les deux en contexte et avec des unités – une compétence évaluée. Éviter l'extrapolation 外推 (prédire loin hors des données).
Exemple résolu. Une étude sur les heures d'étude ($x$) et le score de test ($y$) donne $\hat{y}=20+3x$. La pente signifie que chaque heure supplémentaire d'étude est associée à une augmentation prévue de $3$ points. Un étudiant qui étudie $5$ heures est prévu pour obtenir un score de $\hat{y}=20+3(5)=35$.
Explorer
Ajuster une ligne des moindres carrés
Une ligne de régression est le meilleur ajustement linéaire, minimisant les distances verticales au carré. Sa pente prédit comment $y$ change par unité de $x$.
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.E : Représenter les différences entre les réponses mesurées et prédites à l'aide de graphiques de résidus. [Compétence 2.B]
DAT-1.E.1 Le résidu est la différence entre la valeur réelle et la valeur prédite : $\text{residual} = y - \hat{y}$.
DAT-1.E.2 Un graphique de résidus est un graphique des résidus par rapport aux valeurs de la variable explicative ou aux valeurs de réponse prédites.
Objectif d'apprentissage DAT-1.F : Décrire la forme de l'association des données bivariées à l'aide de graphiques de résidus. [Compétence 2.A]
DAT-1.F.1 L'apparente randomisation dans un graphique de résidus pour un modèle linéaire est une preuve d'une forme linéaire à l'association entre les variables.
DAT-1.F.2 Les graphiques de résidus peuvent être utilisés pour examiner l'adéquation d'un modèle sélectionné.
Source : Description du cours et de l'examen AP College Board
Régression des moindres carrés
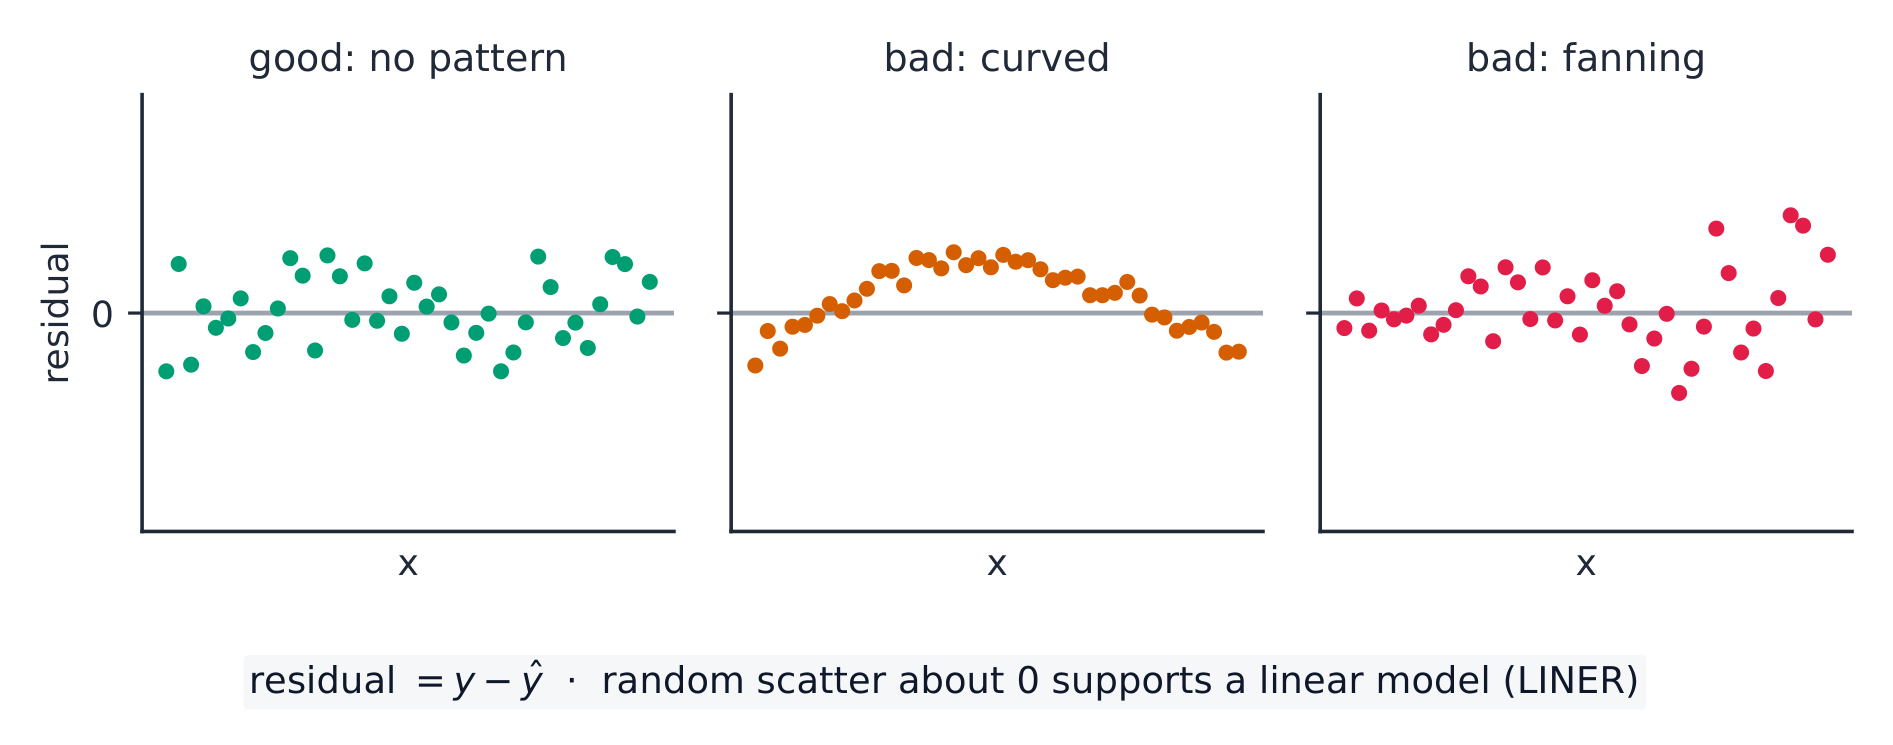
Un résidu 残差 est réel moins prévu, $y-\hat{y}$ : à quelle distance un point se situe au-dessus (+) ou en dessous (-) de la droite. Un graphique des résidus 残差图 trace les résidus contre $x$. S'il ne montre aucun motif (dispersion aléatoire), un modèle linéaire est approprié ; un motif courbé ou évasé signifie que le modèle linéaire est un mauvais ajustement.
Exemple résolu. En poursuivant l'étude ci-dessus, un étudiant qui a étudié $5$ heures a obtenu réellement $40$. Le résidu est $y-\hat{y}=40-35=+5$ : la droite a sous-prédit de $5$ points, donc ce point se trouve au-dessus de la droite.
Une mise en garde concernant $r$ et la droite : les quatre jeux de données ont le même $r=0.82$ et la même $\hat{y}=3.0+0.5x$, mais seul le premier est véritablement linéaire. Les nuages de points diffèrent peu à peine – c'est le graphique des résidus ci-dessous de chacun qui révèle la courbe, la valeur aberrante et le point à haute influence.
2.8
Moindres carrés et ajustement de la régression
Programme
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.G : Estimer les paramètres du modèle de la droite de régression des moindres carrés. [Compétence 2.C]
DAT-1.G.1 Le modèle de régression des moindres carrés minimise la somme des carrés des résidus et contient le point $(\bar{x}, \bar{y})$.
DAT-1.G.2 La pente, $b$, de la droite de régression peut être calculée comme $b = r \left( \dfrac{s_y}{s_x} \right)$ où $r$ est la corrélation entre $x$ et $y$, $s_y$ est l'écart-type échantillonnal de la variable réponse, $y$, et $s_x$ est l'écart-type échantillonnal de la variable explicative, $x$.
DAT-1.G.3 Parfois, l'ordonnée à l'origine $y$ de la droite n'a pas d'interprétation logique dans le contexte.
DAT-1.G.4 En régression linéaire simple, $r^2$ est le carré de la corrélation, $r$. On l'appelle également le coefficient de détermination. $r^2$ représente la proportion de variation de la variable réponse expliquée par la variable explicative dans le modèle.
Objectif d'apprentissage DAT-1.H : Interpréter les coefficients du modèle de la droite de régression des moindres carrés. [Compétence 4.B]
DAT-1.H.1 Les coefficients du modèle de régression des moindres carrés sont la pente estimée et l'ordonnée à l'origine $y$.
DAT-1.H.2 La pente est la quantité dont la valeur $y$ prédite change pour chaque augmentation d'une unité de $x$.
DAT-1.H.3 La valeur de l'ordonnée à l'origine $y$ est la valeur prédite de la variable de réponse lorsque la variable explicative est égale à $0$. La formule pour l'ordonnée à l'origine $y$, $a$, est $a = \bar{y} - b\bar{x}$.
Source : Description du cours et de l'examen AP College Board
La droite des moindres carrés minimise la somme des résidus au carré
La droite minimise la somme des résidus au carré. Son ajustement est mesuré par :
$s$, l'écart-type des résidus – l'erreur de prédiction typique, dans les unités de la réponse.
$r^2$, le coefficient de détermination 决定系数 – la proportion de la variation de $y$ expliquée par le modèle linéaire (une valeur comprise entre $0$ et $1$ ; multiplier par $100$ pour l'exprimer en pourcentage). Le rapporter en contexte : "$r^2 = 0.81$ signifie que 81 % de la variation de $y$ est expliquée par la relation linéaire avec $x$."
coefficient of determination/ˌkəʊɪˈfɪʃənt ɒv dɪˌtɜːmɪˈneɪʃn/
决定系数
jué dìng xì shù
high-leverage/haɪ ˈliːvərɪdʒ/
高杠杆
gāo gàng gǎn
influential/ˌɪnfluːˈenʃl/
有影响的
yǒu yǐng xiǎng de
2.9
Écarts par rapport à la linéarité
Programme
Compréhension durable (DAT-1) : Les modèles de régression peuvent nous permettre de prédire les réponses aux changements d'une variable explicative.
Objectif d'apprentissage DAT-1.I : Identifier les points influents en régression. [Compétence 2.A]
DAT-1.I.1 Un point aberrant en régression est un point qui ne suit pas la tendance générale montrée dans le reste des données et présente un grand résidu lorsque la Droite de Régression des Moindres Carrés (DRMC) est calculée.
DAT-1.I.2 Un point à fort levier en régression a une valeur $x$ nettement plus grande ou plus petite que celle des autres observations.
DAT-1.I.3 Un point influent en régression est tout point dont la suppression modifie substantiellement la relation. Cela peut se traduire par une pente, une ordonnée à l'origine $y$ et/ou une corrélation très différentes. Les valeurs aberrantes et les points à forte levier sont souvent influents.
Objectif d'apprentissage DAT-1.J : Calculer une réponse prédite en utilisant une droite de régression des moindres carrés pour un ensemble de données transformées. [Compétence 2.C]
DAT-1.J.1 Les transformations de variables, telles que l'évaluation du logarithme naturel de chaque valeur de la variable réponse ou le carré de chaque valeur de la variable explicative, peuvent être utilisées pour créer des ensembles de données transformées, qui peuvent être plus linéaires que les données non transformées.
DAT-1.J.2 Une augmentation de l'aléatoire dans les diagrammes de résidus après transformation des données et/ou un mouvement de $r^2$ vers une valeur plus proche de 1 offre la preuve que la droite de régression des moindres carrés pour les données transformées est un modèle plus approprié à utiliser pour prédire les réponses à la variable explicative que la droite de régression pour les données non transformées.
Source : Description du cours et de l'examen AP College Board
Certains points affectent fortement la droite. Un point à haute influence 高杠杆 a une valeur extrême sur l'axe $x$ ; un point influent 有影响的 modifie notablement la pente ou $r$ lorsqu'il est retiré ; ici, une valeur aberrante est un point avec un grand résidu. Quand le motif est courbé, transformer une variable (ex. : prendre un logarithme) pour la lineariser, puis ajuster une droite aux données transformées.
2.9
Conseils d'examen
Sur un nuage de points, décrire la direction, la forme, la force et les valeurs aberrantes ; $r$ varie de $-1$ à $1$.
La corrélation n'est pas la causalité – une variable cachée peut entraîner les deux.
Interpréter la pente de la droite des moindres carrés en contexte (« pour une unité de $x$, la prédiction de $y$ change de $b$ »).
Vérifier un graphique des résidus : aucun motif signifie qu'une droite s'adapte ; une courbe signifie qu'elle ne s'adapte pas. Éviter l'extrapolation.
$r^2$ est la fraction de la variation de $y$ expliquée par le modèle.
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.E : Identifier les questions à répondre concernant les méthodes de collecte de données. [Compétence 1.A]
VAR-1.E.1 Les méthodes de collecte de données qui ne reposent pas sur le hasard aboutissent à des conclusions non fiables.
Source : Description du cours et de l'examen AP College Board
Une conclusion n'est aussi bonne que les données qui la sous-tendent. Comment les données sont collectées dicte ce que vous pouvez conclure – si vous pouvez généraliser à une population 总体, et si vous pouvez affirmer une cause et effet. De mauvaises données peuvent être pires qu'aucune donnée.
Compréhension essentielle (DAT-2) : La façon dont nous collectons les données influence ce que nous pouvons et ne pouvons pas dire sur une population.
Objectif d'apprentissage DAT-2.A : Identifier le type d'étude. [Compétence 1.C]
DAT-2.A.1 Une population consiste en tous les éléments ou sujets d'intérêt.
DAT-2.A.2 Un échantillon sélectionné pour l'étude est un sous-ensemble de la population.
DAT-2.A.3 Dans une étude observationnelle, les traitements ne sont pas imposés. Les enquêteurs examinent les données pour un échantillon d'individus (rétrospectif) ou suivent un échantillon d'individus vers l'avenir en collectant des données (prospectif) afin d'enquêter sur un sujet d'intérêt concernant la population. Un sondage est un type d'étude observationnelle qui collecte des données auprès d'un échantillon dans le but d'en apprendre davantage sur la population dont l'échantillon provient.
DAT-2.A.4 Dans une expérience, différentes conditions (traitements) sont assignées aux unités expérimentales (participants ou sujets).
Objectif d'apprentissage DAT-2.B : Identifier les généralisations et déterminations appropriées basées sur des études observationnelles. [Compétence 4.A]
DAT-2.B.1 Il n'est approprié de faire des généralisations sur une population que sur la base d'échantillons sélectionnés aléatoirement ou autrement représentatifs de cette population.
DAT-2.B.2 Un échantillon n'est généralisable que vers la population à partir de laquelle il a été sélectionné.
DAT-2.B.3 Il n'est pas possible de déterminer des relations causales entre les variables en utilisant des données collectées dans une étude observationnelle.
Source : Description du cours et de l'examen AP College Board
Dans une étude observationnelle 观察性研究, vous mesurez des individus sans essayer de les influencer. Elle peut montrer une association, mais pas la causalité, car des variables cachées peuvent expliquer le lien.
Dans une expérience 实验, vous imposez délibérément un traitement 处理 et comparez les réponses. Une expérience bien conçue peut établir la cause et l'effet.
Explorer
Étude observationnelle ou expérience ?
Dans une expérience, le chercheur impose un traitement (et peut montrer la causalité) ; une étude observationnelle enregistre seulement ce qui arrive déjà (et peut montrer une association, pas la causalité).
3.3
Échantillonnage aléatoire
Programme
Compréhension essentielle (DAT-2) : La façon dont nous collectons les données influence ce que nous pouvons et ne pouvons pas dire sur une population.
Objectif d'apprentissage DAT-2.C : Identifier une méthode d'échantillonnage, étant donné une description d'une étude. [Compétence 1.C]
DAT-2.C.1 Lorsqu'un élément d'une population ne peut être sélectionné qu'une seule fois, on parle d'échantillonnage sans remise. Lorsqu'un élément de la population peut être sélectionné plus d'une fois, on parle d'échantillonnage avec remise.
DAT-2.C.2 Un échantillon aléatoire simple (EAS) est un échantillon dans lequel chaque groupe de taille donnée a une chance égale d'être choisi. Cette méthode est la base de nombreux types de mécanismes d'échantillonnage. Quelques exemples de mécanismes utilisés pour obtenir des EAS incluent la numérotation des individus et l'utilisation d'un générateur de nombres aléatoires pour sélectionner lesquels inclure dans l'échantillon, en ignorant les répétitions, l'utilisation d'une table de nombres aléatoires, ou le tirage d'une carte d'un jeu de cartes sans remise.
DAT-2.C.3 Un échantillon aléatoire stratifié implique la division d'une population en groupes séparés, appelés strates, basés sur des attributs ou caractéristiques partagées (groupement homogène). À l'intérieur de chaque strate, un échantillon aléatoire simple est sélectionné, et les unités sélectionnées sont combinées pour former l'échantillon.
DAT-2.C.4 Un échantillon par grappes implique la division d'une population en petits groupes, appelés grappes. Idéalement, il y a de l'hétérogénéité au sein de chaque grappe, et les grappes sont similaires les unes aux autres dans leur composition. Un échantillon aléatoire simple de grappes est sélectionné à partir de la population pour former l'échantillon de grappes. Les données sont collectées auprès de toutes les observations dans les grappes sélectionnées.
DAT-2.C.5 Un échantillon aléatoire systématique est une méthode selon laquelle les membres de l'échantillon d'une population sont sélectionnés selon un point de départ aléatoire et un intervalle fixe et périodique.
DAT-2.C.6 Un recensement sélectionne tous les éléments/sujets d'une population.
Objectif d'apprentissage DAT-2.D : Expliquer pourquoi une méthode d'échantillonnage particulière est ou n'est pas appropriée pour une situation donnée. [Compétence 1.C]
DAT-2.D.1 Il y a des avantages et des inconvénients pour chaque méthode d'échantillonnage dépendant de la question à répondre et de la population à partir de laquelle l'échantillon sera tiré.
Source : Description du cours et de l'examen AP College Board
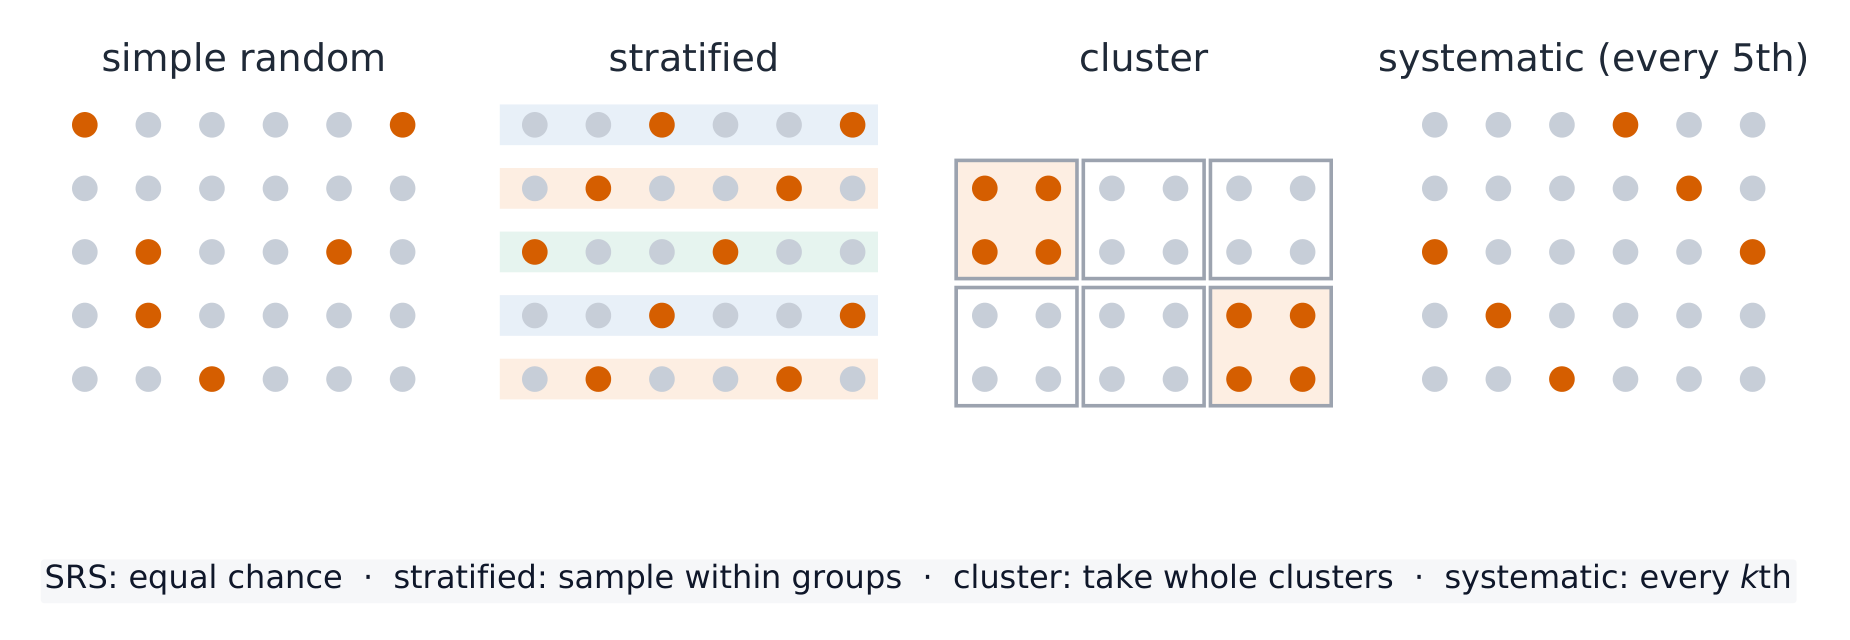
Pour apprendre sur une population, vous prenez un échantillon 样本. L'échantillonnage aléatoire 随机抽样 protège contre le biais de sélection bias et permet de généraliser (il ne corrige pas la couverture insuffisante, le non-réponse ou le biais de réponse – voir ci-dessous). Conceptions courantes :
Échantillon aléatoire simple (EAS) 简单随机样本 : tout groupe de la taille choisie a autant de chances d'être tiré.
Stratifié 分层 : diviser la population en strates similaires, puis échantillonner dans chacune.
Par grappes 整群 : diviser en grappes, choisir aléatoirement des grappes entières.
Systématique 系统 : choisir tous les $k$e individus depuis un départ aléatoire.
Quatre conceptions d'échantillonnage aléatoire : qui est sélectionné, et comment
Un échantillon de commodité 方便样本 ou un échantillon à réponse volontaire n'est pas aléatoire et est biaisé.
Exemple résolu. Pour enquêter dans un établissement scolaire, un administrateur liste tous les élèves par niveau et tire aléatoirement $20$ de chaque niveau. C'est un échantillon stratifié – les niveaux sont les strates – ce qui garantit que chaque niveau est représenté, contrairement à un EAS qui pourrait tirer par hasard peu d'élèves d'un niveau.
Résultats aléatoires : les dés rendent chaque face également probable dans des conditions justes
Compréhension essentielle (DAT-2) : La façon dont nous collectons les données influence ce que nous pouvons et ne pouvons pas dire sur une population.
Objectif d'apprentissage DAT-2.E : Identifier les sources potentielles de biais dans les méthodes d'échantillonnage. [Compétence 1.C]
DAT-2.E.1 Le biais se produit lorsque certaines réponses sont systématiquement favorisées par rapport à d'autres.
DAT-2.E.2 Lorsqu'un échantillon est composé entièrement de volontaires ou de personnes qui choisissent de participer, l'échantillon ne sera généralement pas représentatif de la population (biais de réponse volontaire).
DAT-2.E.3 Lorsqu'une partie de la population a une probabilité réduite d'être incluse dans l'échantillon, celui-ci ne sera généralement pas représentatif de la population (biais de sous-couverture).
DAT-2.E.4 Les individus sélectionnés pour l'échantillon pour lesquels les données ne peuvent être obtenues (ou qui refusent de répondre) peuvent différer de ceux pour lesquels les données peuvent être obtenues (biais de non-réponse).
DAT-2.E.5 Des problèmes dans l'instrument ou le processus de collecte des données entraînent un biais de réponse. Exemples : questions confuses ou orientantes (biais de formulation des questions) et réponses auto-déclarées.
DAT-2.E.6 Les méthodes d'échantillonnage non aléatoires (par exemple, échantillons choisis par commodité ou par réponse volontaire) introduisent un potentiel de biais car elles n'utilisent pas le hasard pour sélectionner les individus.
Source : Description du cours et de l'examen AP College Board
Le biais fait que les estimations manquent systématiquement la vérité :
Couverture insuffisante 覆盖不足 : certains groupes sont exclus de la liste d'échantillonnage.
Non-réponse 无回应 : les personnes sélectionnées ne répondent pas.
Biais de réponse 回应偏差 : les répondants répondent de manière inexacte (mauvaise formulation, sujets sensibles).
Le biais concerne une erreur constante dans une direction – augmenter la taille de l'échantillon ne le corrige pas.
Les échantillons de commodité manquent la population : le biais s'infiltre quand la sélection n'est pas aléatoire
3.5
Concevoir une expérience
Programme
Compréhension durable (VAR-3) : Une expérience bien conçue peut établir des preuves de relations causales.
Objectif d'apprentissage VAR-3.A : Identifier les composantes d'une expérience. [Compétence 1.C]
VAR-3.A.1 Les unités expérimentales sont les individus (qui peuvent être des personnes ou d'autres objets d'étude) auxquels des traitements sont assignés. Lorsque les unités expérimentales consistent en des personnes, elles sont parfois désignées comme participants ou sujets.
VAR-3.A.2 Une variable explicative (ou facteur) dans une expérience est une variable dont les niveaux sont manipulés intentionnellement. Les niveaux ou combinaisons de niveaux de la variable explicative(s) sont appelés traitements.
VAR-3.A.3 Une variable réponse dans une expérience est un résultat provenant des unités expérimentales qui est mesuré après l'administration des traitements.
VAR-3.A.4 Une variable de confusion dans une expérience est une variable liée à la variable explicative et influençant la variable réponse, pouvant créer une fausse perception d'association entre les deux.
Objectif d'apprentissage VAR-3.B : Décrire les éléments d'une expérience bien conçue. [Compétence 1.B]
VAR-3.B.1 Une expérience bien conçue doit comprendre ce qui suit :
a. Comparaisons d'au moins deux groupes de traitement, dont l'un pourrait être un groupe témoin.
b. Affectation/allocation aléatoire des traitements aux unités expérimentales.
c. Réplication (plus d'une unité expérimentale dans chaque groupe de traitement).
d. Contrôle des variables de confusion potentielles lorsque cela est approprié.
Objectif d'apprentissage VAR-3.C : Comparer les conceptions et méthodes expérimentales. [Compétence 1.C]
VAR-3.C.1 Dans une conception entièrement randomisée, les traitements sont assignés aux unités expérimentales complètement au hasard. L'affectation aléatoire tend à équilibrer les effets des variables non contrôlées (de confusion) afin que les différences dans les réponses puissent être attribuées aux traitements.
VAR-3.C.2 Les méthodes pour affecter aléatoirement des traitements aux unités expérimentales dans une conception entièrement randomisée incluent l'utilisation d'un générateur de nombres aléatoires, d'une table de valeurs aléatoires, du tirage de jetons sans remise, etc.
VAR-3.C.3 Dans une expérience simple-aveugle, les sujets ne savent pas quel traitement ils reçoivent, mais les membres de l'équipe de recherche le savent, ou vice versa.
VAR-3.C.4 Dans une expérience double-aveugle, ni les sujets ni les membres de l'équipe de recherche interagissant avec eux ne savent quel traitement un sujet reçoit.
VAR-3.C.5 Un groupe témoin est un ensemble d'unités expérimentales ne recevant ni un traitement d'intérêt ni un traitement contenant une substance inactive (placebo), afin de déterminer si le traitement d'intérêt a un effet.
VAR-3.C.6 L'effet placebo se produit lorsque les unités expérimentales ont une réponse à un placebo.
VAR-3.C.7 Pour les conceptions à blocs complets randomisés, les traitements sont assignés complètement au hasard au sein de chaque bloc.
VAR-3.C.8 Le blocage garantit qu'au début de l'expérience, les unités au sein de chaque bloc sont similaires les unes aux autres concernant au moins une variable de blocage. Une conception à blocs randomisés aide à séparer la variabilité naturelle des différences dues à la variable de blocage.
VAR-3.C.9 Une conception par paires appariées est un cas particulier d'une conception à blocs randomisés. En utilisant une variable de blocage, les sujets (qu'ils soient des personnes ou non) sont disposés en paires appariées sur des facteurs pertinents. Les paires appariées peuvent se former naturellement ou par l'expérimentateur. Chaque paire reçoit les deux traitements en assignant aléatoirement un traitement à un membre de la paire et en attribuant ultérieurement le traitement restant au second membre de la paire. Alternativement, chaque sujet peut recevoir les deux traitements.
Source : Description du cours et de l'examen AP College Board
Les bonnes expériences suivent trois principes :
Comparaison avec un groupe témoin 对照组 (souvent un placebo 安慰剂).
Affectation aléatoire 随机分配 des sujets aux traitements, pour équilibrer les autres variables.
Réplication 重复 : assez de sujets par traitement pour observer un effet réel.
Une expérience entièrement randomisée compare un groupe traité avec un groupe témoin
La confusion se produit lorsqu'une autre variable est liée au traitement de sorte que leurs effets ne puissent pas être séparés ; l'affectation aléatoire protège contre cela. Le masquage cache qui reçoit quel traitement pour empêcher les effets d'attente : dans une étude simple aveugle, seule une partie est tenue ignorante (généralement les sujets, ou seulement ceux qui évaluent le résultat), tandis que dans une étude double aveugle, ni les sujets ni les chercheurs qui interagissent avec eux ne savent, bloquant à la fois l'effet placebo et l'évaluation biaisée. Le blocage regroupe des sujets similaires et randomise au sein de chaque bloc pour réduire la variabilité.
Un essai clinique : l'assignation aléatoire sépare le traitement du groupe témoin
Compréhension durable (VAR-3) : Une expérience bien conçue peut établir des preuves de relations causales.
Objectif d'apprentissage VAR-3.D : Expliquer pourquoi une conception expérimentale particulière est appropriée. [Compétence 1.C]
VAR-3.D.1 Il y a des avantages et des inconvénients pour chaque conception expérimentale selon la question d'intérêt, les ressources disponibles et la nature des unités expérimentales.
Source : Description du cours et de l'examen AP College Board
Correspondez la conception à l'objectif : utilisez une conception entièrement randomisée pour des sujets uniformes ; une conception à blocs randomisés lorsqu'une variable connue (sexe, âge) affecte la réponse ; une conception paires appariées lorsque chaque sujet peut servir de son propre contrôle. Indiquez comment vous procéderiez à la randomisation.
3.7
What an Experiment Lets You Conclude
Programme
Compréhension durable (VAR-3) : Une expérience bien conçue peut établir des preuves de relations causales.
Objectif d'apprentissage VAR-3.E : Interpréter les résultats d'une expérience bien conçue. [Compétence 4.B]
VAR-3.E.1 L'inférence statistique attribue des conclusions basées sur des données à la distribution d'où proviennent ces données.
VAR-3.E.2 L'affectation aléatoire des traitements aux unités expérimentales permet aux chercheurs de conclure que certains changements observés sont si importants qu'il est peu probable qu'ils soient dus au hasard. De tels changements sont dits statistiquement significatifs.
VAR-3.E.3 Des différences statistiquement significatives entre ou parmi les groupes de traitement expérimental constituent des preuves que les traitements ont causé l'effet.
VAR-3.E.4 Si les unités expérimentales utilisées dans une expérience sont représentatives d'un plus grand groupe d'unités, les résultats d'une expérience peuvent être généralisés à ce plus grand groupe. Une sélection aléatoire des unités expérimentales offre de meilleures chances que celles-ci soient représentatives.
Source : Description du cours et de l'examen AP College Board
Two questions decide the scope of a conclusion:
Assignation aléatoire utilisée ? Alors une différence significative peut être attribuée au traitement (causalité) – pour ces sujets.
Échantillonnage aléatoire tiré d'une population ? Alors les résultats se généralisent à cette population.
Seul un实验 avec assignation aléatoire soutient une affirmation de cause à effet ; seul un échantillonnage aléatoire soutient la généralisation. Dites exactement lequel vous avez.
Exemple résolu. Les chercheurs assignent aléatoirement $100$bénévoles à un nouveau médicament ou un placebo, et le groupe du médicament s'améliore significativement plus. En raison de l'affectation aléatoire, l'amélioration peut être attribuée au médicament (causalité) – mais parce que les sujets n'étaient pas échantillonnés aléatoirement, la conclusion ne s'applique qu'à ces bénévoles et ne se généralise pas automatiquement à tout le monde.
3.7
Conseils d'examen
Distinguez une étude observationnelle (trouve une association) d'un experiment (peut montrer une causalité).
Un bon échantillonnage est aléatoire (SRS, stratifié, en grappes) — méfiez-vous des biais (réponse volontaire, sous-couverture, non-réponse).
Les bons experiments utilisent le contrôle, la randomisation et la réplication ; le blocage gère une variable nuisible connue.
Seul un experiment randomisé soutient une conclusion de cause à effet.
Name the population, sample, and any confounding clearly.
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.F : Identifier les questions suggérées par les motifs dans les données. [Compétence 1.A]
VAR-1.F.1 Les motifs dans les données ne signifient pas nécessairement que la variation n'est pas aléatoire.
Source : Description du cours et de l'examen AP College Board
Quelque chose est aléatoire si les résultats individuels sont incertains mais qu'un modèle régulier émerge sur de nombreuses répétitions. Les résultats à court terme semblent erratiques ; les fréquences relatives à long terme se stabilisent. Cette stabilité à long terme est ce qui rend la probabilité utile.
4.2
Estimer des probabilités à l'aide de simulations
Programme
Compréhension durable (UNC-2) : La simulation nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-2.A : Estimer les probabilités à l'aide de simulations. [Compétence 3.A]
UNC-2.A.1 Un processus aléatoire génère des résultats déterminés par le hasard.
UNC-2.A.2 Un résultat est la conséquence d'un essai d'un processus aléatoire.
UNC-2.A.3 Un événement est un ensemble de résultats.
UNC-2.A.4 La simulation est un moyen de modéliser des événements aléatoires, de sorte que les résultats simulés correspondent étroitement aux résultats réels. Tous les résultats possibles sont associés à une valeur à déterminer par le hasard. Enregistrer les comptes des résultats simulés et le total des comptes.
UNC-2.A.5 La fréquence relative d'un résultat ou d'un événement dans des données simulées ou empiriques peut être utilisée pour estimer la probabilité de ce résultat ou événement.
UNC-2.A.6 La loi des grands nombres stipule que les probabilités simulées (empiriques) ont tendance à se rapprocher de la vraie probabilité lorsque le nombre d'essais augmente.
Exemples illustratifs pour UNC-2.A :
Un résultat : Obtenir une valeur particulière sur un dé à six faces est l'un des six résultats possibles.
Un événement : Lors du lancer de deux dés à six faces, un événement serait une somme de sept. L'ensemble correspondant des résultats serait $(1, 6)$, $(2, 5)$, $(3, 4)$, $(4, 3)$, $(5, 2)$ et $(6, 1)$, où les paires ordonnées indiquent (valeur de la face sur un dé, valeur de la face sur l'autre dé).
Source : Description du cours et de l'examen AP College Board
Une simulation imite un processus de hasard en utilisant des chiffres aléatoires ou la technologie. Étapes : énoncer le modèle, attribuer des chiffres aux résultats, effectuer de nombreux essais et enregistrer la proportion d'essais répondant à la condition. La proportion résultante estime la probabilité – plus d'essais donnent une meilleure estimation.
Compréhension durable (VAR-4) : La probabilité d'un événement aléatoire peut être quantifiée.
Objectif d'apprentissage VAR-4.A : Calculer les probabilités pour des événements et leurs compléments. [Compétence 3.A]
VAR-4.A.1 L'espace échantillonnal d'un processus aléatoire est l'ensemble de tous les résultats possibles non chevauchants.
VAR-4.A.2 Si toutes les issues de l'espace sample sont également probables, alors la probabilité qu'un événement E se produise est définie comme la fraction : $\dfrac{\text{number of outcomes in event E}}{\text{total number of outcomes in sample space}}$
VAR-4.A.3 La probabilité d'un événement est un nombre compris entre 0 et 1, inclus.
VAR-4.A.4 La probabilité du complément d'un événement E, $E'$ ou $E^{C}$ (c'est-à-dire non E), est égale à $1 - P(E)$.
Objectif d'apprentissage VAR-4.B : Interpréter les probabilités pour des événements. [Compétence 4.B]
VAR-4.B.1 Les probabilités d'événements dans des situations répétitives peuvent être interprétées comme la fréquence relative avec laquelle l'événement se produira à long terme.
Source : Description du cours et de l'examen AP College Board
La probabilité 概率 d'un événement est un nombre compris entre $0$ et $1$ qui donne sa fréquence relative à long terme. L'espace échantillon 样本空间 est l'ensemble de tous les résultats possibles. Pour un événement $A$, la règle du complément 补 : $P(A^c)=1-P(A)$. Les probabilités de tous les résultats s'additionnent à $1$.
Probability runs from 0 (impossible) to 1 (certain)Un jeu de cartes est une source classique de probabilité : 52 issues également probables facilitent le comptage des chances
Explorer
Explorer la probabilité avec des dés
Probabilité est la fraction à long terme du nombre de fois qu'un résultat se produit. Lancez les dés plusieurs fois et observez les proportions expérimentales converger vers les valeurs théoriques.
Compréhension durable (VAR-4) : La probabilité d'un événement aléatoire peut être quantifiée.
Objectif d'apprentissage VAR-4.C : Expliquer pourquoi deux événements sont (ou ne sont pas) mutuellement exclusifs. [Compétence 4.B]
VAR-4.C.1 La probabilité que les événements $A$ et $B$ se produisent tous les deux, parfois appelée probabilité conjointe, est la probabilité de l'intersection de $A$ et $B$, notée $P(A \cap B)$.
VAR-4.C.2 Deux événements sont mutuellement exclusifs ou disjoints s'ils ne peuvent pas se produire en même temps. Donc $P(A \cap B) = 0$.
Source : Description du cours et de l'examen AP College Board
Deux événements sont mutuellement exclusifs (disjoints) s'ils ne peuvent pas tous deux se produire. Alors la règle d'addition se simplifie :
$$P(A\text{ or }B)=P(A)+P(B)\quad(\text{if mutually exclusive}).$$
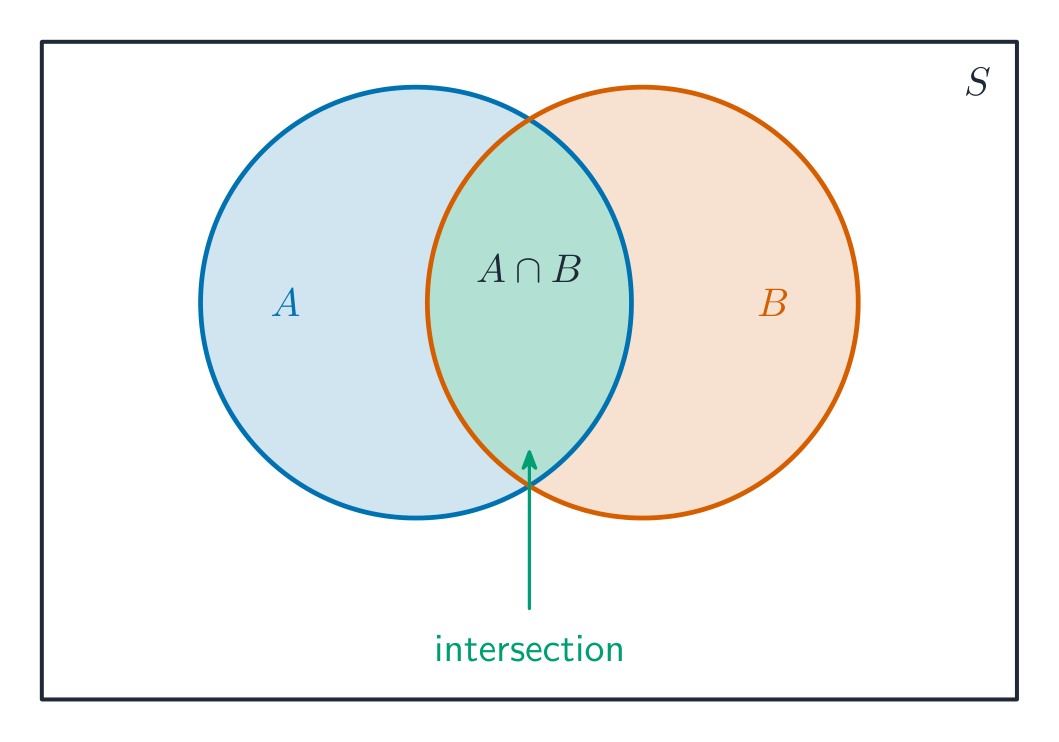
En général, $P(A\text{ or }B)=P(A)+P(B)-P(A\text{ and }B)$ – soustrayez le chevauchement afin qu'il ne soit pas compté deux fois.
Un diagramme de Venn : la superposition est l'intersection de deux événements
Compréhension durable (VAR-4) : La probabilité d'un événement aléatoire peut être quantifiée.
Objectif d'apprentissage VAR-4.D : Calculer les probabilités conditionnelles. [Compétence 3.A]
VAR-4.D.1 La probabilité que l'événement $A$ se produise sachant que l'événement $B$ s'est produit est appelée probabilité conditionnelle et notée $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.
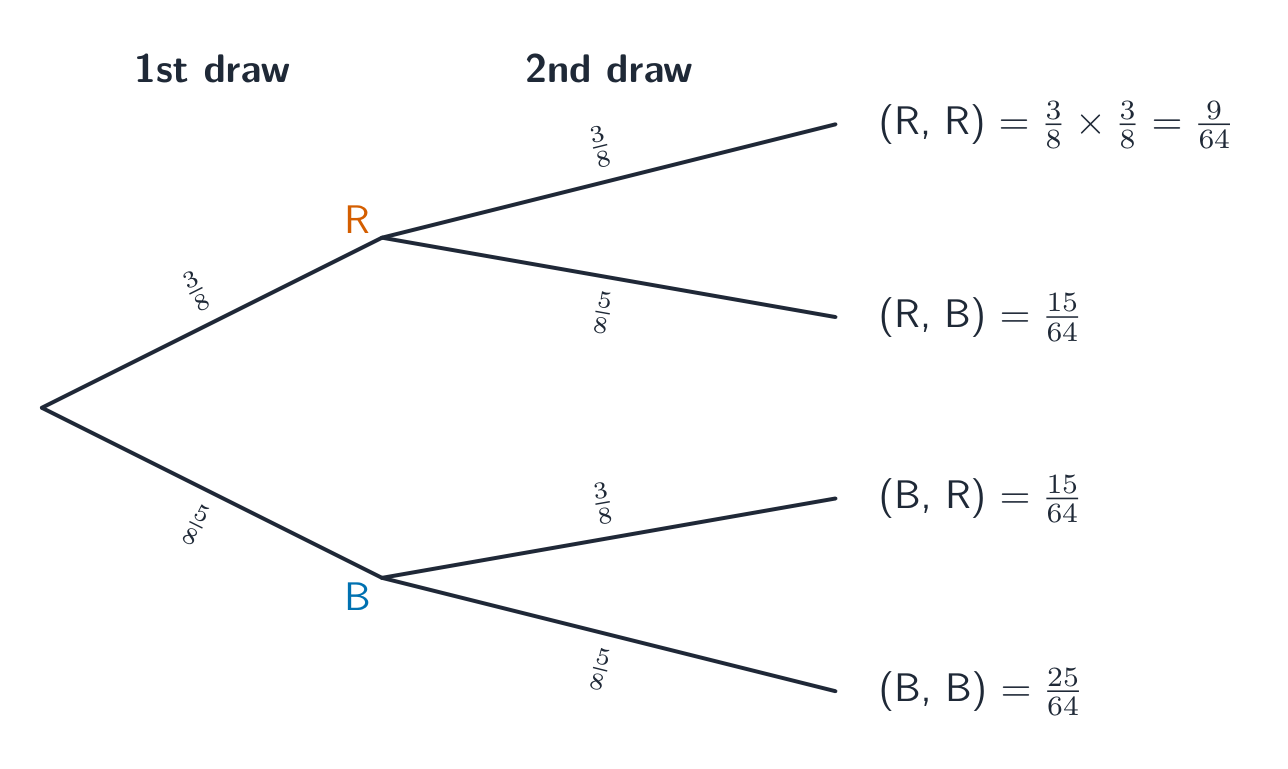
VAR-4.D.2 La règle de multiplication stipule que la probabilité que les événements $A$ et $B$ se produisent tous les deux est égale à la probabilité que l'événement $A$ se produise multipliée par la probabilité que l'événement $B$ se produise, sachant que $A$ s'est produit. Cela se note $P(A \cap B) = P(A) \cdot P(B \mid A)$.
Source : Description du cours et de l'examen AP College Board
Probabilité conditionnelle
Le conditional probability 条件概率 of $A$ given $B$ is
$$P(A\mid B)=\frac{P(A\text{ and }B)}{P(B)}.$$
C'est la chance de $A$ une fois que vous savez que $B$ s'est produit. Les tableaux à double entrée facilitent cela : restreignez-vous à la ligne/colonne pour $B$, puis trouvez la part de $A$.
Sur un arbre de probabilités, multipliez les probabilités le long des branches
Explorer
Mettre à jour une probabilité avec de nouvelles informations
Probabilité conditionnelle$P(B\mid A)$ est la chance que $B$ se produise une fois que vous savez que $A$ s'est produit. Modifiez les probabilités des branches et observez comment le conditionnement reshape le résultat.
Compréhension durable (VAR-4) : La probabilité d'un événement aléatoire peut être quantifiée.
Objectif d'apprentissage VAR-4.E : Calculer les probabilités pour des événements indépendants et pour l'union de deux événements. [Compétence 3.A]
VAR-4.E.1 Les événements $A$ et $B$ sont indépendants si, et seulement si, savoir si l'événement $A$ s'est produit (ou se produira) ne change pas la probabilité que l'événement $B$ se produise.
VAR-4.E.2 Si, et seulement si, les événements $A$ et $B$ sont indépendants, alors $P(A \mid B) = P(A)$, $P(B \mid A) = P(B)$ et $P(A \cap B) = P(A) \cdot P(B)$.
VAR-4.E.3 La probabilité que l'événement $A$ ou l'événement $B$ (ou les deux) se produise est la probabilité de l'union de $A$ et $B$, notée $P(A \cup B)$.
VAR-4.E.4 La règle d'addition stipule que la probabilité que l'événement $A$ ou l'événement $B$ ou les deux se produise est égale à la probabilité que l'événement $A$ se produise plus la probabilité que l'événement $B$ se produise moins la probabilité que les deux événements $A$ et $B$ se produisent. Cela se note $P(A \cup B) = P(A) + P(B) - P(A \cap B)$.
Source : Description du cours et de l'examen AP College Board
Les événements sont indépendants 独立 si connaître l'un ne change pas la probabilité de l'autre : $P(A\mid B)=P(A)$. La règle de multiplication se simplifie alors :
$$P(A\text{ and }B)=P(A)\,P(B)\quad(\text{if independent}).$$
L'indépendance n'est pas la même chose que l'exclusion mutuelle – les événements mutuellement exclusifs avec une probabilité non nulle sont en fait dépendants (si l'un se produit, l'autre ne peut pas).
Un diagramme de l'espace des énumérations liste chaque issue également probable
Explorer
Combiner des événements avec un diagramme de Venn
Pour une union$P(A\cup B)=P(A)+P(B)-P(A\cap B)$ — vous soustrayez l'intersection afin qu'elle ne soit pas comptée deux fois. Changez l'opération pour voir chaque région s'illuminer.
probability distribution/ˌprɒbəˈbɪlɪti ˌdɪstrɪˈbjuːʃn/
概率分布
gài lǜ fēn bù
4.7
Random Variables and Probability Distributions
Programme
Compréhension durable (VAR-5) : Les distributions de probabilité peuvent être utilisées pour modéliser la variation dans les populations.
Objectif d'apprentissage VAR-5.A : Représenter la distribution de probabilité d'une variable aléatoire discrète. [Compétence 2.B]
VAR-5.A.1 Les valeurs d'une variable aléatoire sont les résultats numériques du comportement aléatoire.
VAR-5.A.2 Une variable aléatoire discrète est une variable qui ne peut prendre qu'un nombre fini de valeurs. Chaque valeur a une probabilité associée. La somme des probabilités sur toutes les valeurs possibles doit être égale à 1.
VAR-5.A.3 Une distribution de probabilité peut être représentée sous forme de graphique, de tableau ou de fonction montrant les probabilités associées aux valeurs d'une variable aléatoire.
VAR-5.A.4 Une distribution de probabilité cumulative peut être représentée sous forme de tableau ou de fonction montrant la probabilité d'être inférieur ou égal à chaque valeur de la variable aléatoire.
Exemples illustratifs pour VAR-5.A : Résultats d'essais d'un processus aléatoire :
La somme des résultats pour le lancer de deux dés
Le nombre de chiots dans une portée sélectionnée au hasard chez une certaine race de chien
Objectif d'apprentissage VAR-5.B : Interpréter une distribution de probabilité. [Compétence 4.B]
VAR-5.B.1 Une interprétation d'une distribution de probabilité fournit des informations sur la forme, le centre et la dispersion d'une population et permet de tirer des conclusions sur la population d'intérêt.
Source : Description du cours et de l'examen AP College Board
Une variable aléatoire attribue un nombre à chaque issue d'un processus hasardeux. Une distribution de probabilité liste chaque valeur possible avec sa probabilité (elles s'additionnent à $1$). Une distribution peut être discrète (un tableau de valeurs) ou continue (un modèle sous une courbe comme la normale).
4.8
Moyenne et écart-type des variables aléatoires
Programme
Compréhension durable (VAR-5) : Les distributions de probabilité peuvent être utilisées pour modéliser la variation dans les populations.
Objectif d'apprentissage VAR-5.C : Calculer les paramètres d'une variable aléatoire discrète. [Compétence 3.B]
VAR-5.C.1 Une valeur numérique mesurant une caractéristique d'une population ou la distribution d'une variable aléatoire est connue sous le nom de paramètre, qui est une valeur unique et fixe.
VAR-5.C.2 La moyenne, ou valeur attendue, pour une variable aléatoire discrète $X$ est $\mu_X = \sum x_i \cdot P(x_i)$.
VAR-5.C.3 L'écart-type pour une variable aléatoire discrète $X$ est $\sigma_X = \sqrt{\sum (x_i - \mu_x)^2 \cdot P(x_i)}$.
Objectif d'apprentissage VAR-5.D : Interpréter les paramètres d'une variable aléatoire discrète. [Compétence 4.B]
VAR-5.D.1 Les paramètres d'une variable aléatoire discrète doivent être interprétés en utilisant des unités appropriées et dans le contexte d'une population spécifique.
Source : Description du cours et de l'examen AP College Board
La moyenne (valeur attendue) d'une variable aléatoire discrète est la moyenne pondérée par les probabilités :
$$\mu_X=E(X)=\sum x_i\,P(x_i).$$
L'écart type$\sigma_X=\sqrt{\sum (x_i-\mu_X)^2\,P(x_i)}$ mesure l'écart typique par rapport à la moyenne. La valeur attendue est la moyenne des résultats à long terme, et non une valeur que l'on s'attend à obtenir sur un essai unique.
Exemple résolu. Un jeu paie $\$5$ with probability $0.2$ and costs you $\$1$ (une issue $-1$) avec une probabilité $0.8$. La valeur attendue est
$$E(X)=5(0.2)+(-1)(0.8)=1-0.8=\$0.20,$$
donc sur de nombreuses parties, vous gagnez environ $20$ centimes par partie en moyenne, bien qu'aucune partie unique ne donne exactement cela.
4.9
Combinaison de Variables Aléatoires
Programme
Compréhension durable (VAR-5) : Les distributions de probabilité peuvent être utilisées pour modéliser la variation dans les populations.
Objectif d'apprentissage VAR-5.E : Calculer les paramètres des combinaisons linéaires de variables aléatoires. [Compétence 3.B]
VAR-5.E.1 Pour les variables aléatoires $X$ et $Y$ et les nombres réels $a$ et $b$, la moyenne de $aX + bY$ est $a\mu_x + b\mu_y$.
VAR-5.E.2 Deux variables aléatoires sont indépendantes si le fait de connaître des informations sur l'une d'elles ne modifie pas la distribution de probabilité de l'autre.
VAR-5.E.3 Pour des variables aléatoires indépendantes $X$ et $Y$ et des nombres réels $a$ et $b$, la moyenne de $aX + bY$ est $a\mu_x + b\mu_y$, et la variance de $aX + bY$ est $a^2\sigma^2_x + b^2\sigma^2_y$.
Objectif d'apprentissage VAR-5.F : Décrire les effets des transformations linéaires des paramètres des variables aléatoires. [Compétence 3.C]
VAR-5.F.1 Pour $Y = a + bX$, la distribution de probabilité de la variable aléatoire transformée, $Y$, a la même forme que la distribution de probabilité pour $X$, tant que $a > 0$ et $b > 0$. La moyenne de $Y$ est $\mu_y = a + b\mu_x$. L'écart-type de $Y$ est $\sigma_y = |b|\sigma_x$.
Source : Description du cours et de l'examen AP College Board
Lorsque vous additionnez ou soustrayez des variables aléatoires, les moyennes s'additionnent : $\mu_{X\pm Y}=\mu_X\pm\mu_Y$. Si $X$ et $Y$ sont indépendants, les variances s'additionnent (même lors de la soustraction) :
$$\sigma^2_{X\pm Y}=\sigma^2_X+\sigma^2_Y.$$
Prenez la racine carrée pour l'écart type. De plus, mise à l'échelle : $\mu_{aX+b}=a\mu_X+b$ et $\sigma_{aX+b}=|a|\sigma_X$.
4.10
Introduction à la distribution binomiale
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.A : Estimer les probabilités de variables aléatoires binomiales en utilisant des données de simulation. [Compétence 3.A]
UNC-3.A.1 Une distribution de probabilité peut être construite en utilisant les règles de probabilité ou estimée avec une simulation utilisant des générateurs de nombres aléatoires.
UNC-3.A.2 Une variable aléatoire binomiale, $X$, compte le nombre de succès dans $n$ essais indépendants répétés, chaque essai ayant deux issues possibles (succès ou échec), avec la probabilité de succès $p$ et la probabilité d'échec $1 - p$.
Objectif d'apprentissage UNC-3.B : Calculer les probabilités pour une distribution binomiale. [Compétence 3.A]
UNC-3.B.1 La probabilité qu'une variable aléatoire binomiale, $X$, ait exactement $x$ succès pour $n$ essais indépendants, lorsque la probabilité de succès est $p$, est calculée comme $P(X = x) = \binom{n}{x} p^x (1 - p)^{n-x}, x = 0, 1, 2, \ldots, n$. C'est la fonction de probabilité binomiale.
Source : Description du cours et de l'examen AP College Board
La loi binomiale
Un cadre binomial (BINS) : un nombre fixe $n$ d'Indépendants essais, chacun avec deux issues (succès/échec) et la même probabilité de succès $p$. La variable aléatoire $X=$ est le nombre de succès. Sa probabilité :
$$P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}.$$
The binomial distribution, with mean n times p
Explorer
Modéliser une distribution binomiale
Une distribution binomiale compte les succès dans $n$ essais indépendants, chacun ayant une probabilité $p$. Modifiez $n$ et $p$ et observez les barres se déplacer et s'étaler.
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.C : Calculer les paramètres d'une distribution binomiale. [Compétence 3.B]
UNC-3.C.1 Si une variable aléatoire est binomiale, sa moyenne, $\mu_x$, est $np$ et son écart-type, $\sigma_x$, est $\sqrt{np(1 - p)}$.
Objectif d'apprentissage UNC-3.D : Interpréter les probabilités et les paramètres d'une distribution binomiale. [Compétence 4.B]
UNC-3.D.1 Les probabilités et les paramètres d'une distribution binomiale doivent être interprétés en utilisant des unités appropriées et dans le contexte d'une population ou situation spécifique.
Source : Description du cours et de l'examen AP College Board
For a binomial $X$ with $n$ trials and success probability $p$:
$$\mu_X=np,\qquad \sigma_X=\sqrt{np(1-p)}.$$
Utilisez ceci pour les questions « combien de succès attendons-nous, et varient-ils beaucoup ».
Exemple résolu. Un joueur marque $70\%$ des lancers francs. Sur $n=10$ tirs, la probabilité d'avoir exactement $8$ marques est
et le nombre attendu de marques est $\mu=np=10(0.7)=7$, avec $\sigma=\sqrt{10(0.7)(0.3)}\approx1.45$.
4.12
La Distribution Géométrique
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.E : Calculer les probabilités pour des variables aléatoires géométriques. [Compétence 3.A]
UNC-3.E.1 Pour une série d'essais indépendants, une variable aléatoire géométrique, $X$, donne le numéro de l'essai auquel survient le premier succès. Chaque essai a deux issues possibles (succès ou échec) avec la probabilité de succès $p$ et la probabilité d'échec $1 - p$.
UNC-3.E.2 La probabilité que le premier succès pour des essais indépendants répétés avec une probabilité de succès $p$ survienne à l'essai $x$ est calculée comme $P(X = x) = (1 - p)^{x-1} p, x = 1, 2, 3, \ldots$. C'est la fonction de probabilité géométrique.
Objectif d'apprentissage UNC-3.F : Calculer les paramètres d'une distribution géométrique. [Compétence 3.B]
UNC-3.F.1 Si une variable aléatoire est géométrique, sa moyenne, $\mu_x$, est $\dfrac{1}{p}$ et son écart-type, $\sigma_x$, est $\dfrac{\sqrt{(1 - p)}}{p}$.
Objectif d'apprentissage UNC-3.G : Interpréter les probabilités et les paramètres d'une distribution géométrique. [Compétence 4.B]
UNC-3.G.1 Les probabilités et les paramètres d'une distribution géométrique doivent être interprétés en utilisant des unités appropriées et dans le contexte d'une population ou situation spécifique.
Source : Description du cours et de l'examen AP College Board
Un cadre géométrique 几何 est similaire au cadre binomial mais avec pas de $n$ fixe : on continue d'essayer jusqu'à ce qu'il y ait un premier succès. La variable aléatoire $Y=$ est l'essai du premier succès :
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.G : Identifier les questions suggérées par la variation des statistiques pour des échantillons collectés dans la même population. [Compétence 1.A]
VAR-1.G.1 La variation des statistiques pour des échantillons prélevés dans la même population peut être aléatoire ou non.
Source : Description du cours et de l'examen AP College Board
Une statistique 统计量 (comme une moyenne d'échantillon $\bar{x}$ ou une proportion d'échantillon $\hat{p}$) est calculée à partir d'un échantillon et varie d'un échantillon à l'autre – c'est la variabilité d'échantillonnage 抽样变异. Un paramètre 参数 ($\mu$ ou $p$) est la vérité fixe concernant la population. La distribution d'échantillonnage 抽样分布 est la distribution d'une statistique sur tous les échantillons possibles d'une taille donnée – c'est le pont entre un seul échantillon et l'inférence.
5.2
The Normal Curve as a Model for a Statistic
Programme
Compréhension durable (VAR-6) : La distribution normale peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-6.A : Calculer la probabilité qu'une valeur particulière se trouve dans un intervalle donné d'une distribution normale. [Compétence 3.A]
VAR-6.A.1 Une variable aléatoire continue est une variable qui peut prendre n'importe quelle valeur dans un domaine spécifié. Chaque intervalle dans le domaine a une probabilité associée.
VAR-6.A.2 Une variable aléatoire continue avec une distribution normale est couramment utilisée pour décrire des populations. La distribution d'une variable aléatoire normale peut être décrite par une courbe normale ou en « forme de cloche ».
VAR-6.A.3 L'aire sous une courbe normale sur un intervalle donné représente la probabilité qu'une valeur particulière se trouve dans cet intervalle.
Exemples illustratifs pour VAR-6.A : Variable aléatoire continue : Si l'on regarde une horloge à un moment aléatoire, la probabilité que l'aiguille des minutes soit entre 3 et 6 est un quart.
Objectif d'apprentissage VAR-6.B : Déterminer l'intervalle associé à une aire donnée dans une distribution normale. [Compétence 3.A]
VAR-6.B.1 Les bornes d'un intervalle associé à une zone donnée dans une distribution normale peuvent être déterminées à l'aide de scores $z$ ou de technologies, telles qu'une calculatrice, une table de la loi normale standard ou des sorties générées par ordinateur.
VAR-6.B.2 Les intervalles associés à une aire donnée dans une distribution normale peuvent être déterminés en attribuant des inégalités appropriées aux bornes des intervalles :
a. $P(X < x_a) = \dfrac{p}{100}$ signifie que le bas $p\%$ de valeurs se trouvent à gauche de $x_a$.
b. $P(x_a < X < x_b) = \dfrac{p}{100}$ signifie que $p\%$ de valeurs se trouvent entre $x_a$ et $x_b$.
c. $P(X > x_b) = \dfrac{p}{100}$ signifie que les $p\%$ plus élevés de valeurs se trouvent à droite de $x_b$.
d. Pour déterminer les valeurs les plus extrêmes $p\%$, il faut diviser l'aire associée à $p\%$ en deux parties égales de part et d'autre de la distribution : $P(X < x_a) = \dfrac{1}{2}\dfrac{p}{100}$ et $P(X > x_b) = \dfrac{1}{2}\dfrac{p}{100}$ signifie que la moitié des $p\%$ valeurs les plus extrêmes se trouvent à gauche de $x_a$ et la moitié des $p\%$ valeurs les plus extrêmes se trouvent à droite de $x_b$.
Objectif d'apprentissage VAR-6.C : Déterminer l'opportunité d'utiliser la distribution normale pour approximer les probabilités pour des distributions inconnues. [Compétence 3.C]
VAR-6.C.1 Les distributions normales sont symétriques et en « forme de cloche ». Par conséquent, elles peuvent être utilisées pour approximer des distributions ayant des caractéristiques similaires.
Source : Description du cours et de l'examen AP College Board
La loi normale
Pour des échantillons suffisamment grands, de nombreuses distributions d'échantillonnage sont approximativement normales. Cela nous permet de décrire une statistique par un centre (sa moyenne), une dispersion (son erreur type 标准误), et une forme normale – puis de calculer la probabilité qu'un résultat d'échantillon donné soit obtenu.
Explorer
Utiliser la courbe normale pour trouver une proportion
Un modèle normale transforme une plage de valeurs en une aire = une proportion. Hachurez une bande pour lire la fraction d'échantillons qui tombe dans cette plage (la règle 68-95-99.7).
5.3
Le théorème central limite
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.H : Estimer les distributions d'échantillonnage en utilisant la simulation. [Compétence 3.C]
UNC-3.H.1 Une distribution d'échantillonnage d'une statistique est la distribution des valeurs de cette statistique pour tous les échantillons possibles d'une taille donnée provenant d'une population donnée.
UNC-3.H.2 Le théorème central limite (TCL) stipule que lorsque la taille de l'échantillon est suffisamment grande, une distribution d'échantillonnage de la moyenne d'une variable aléatoire sera approximativement normalement distribuée.
UNC-3.H.3 Le théorème central limite exige que les valeurs de l'échantillon soient indépendantes les unes des autres et que $n$ soit suffisamment grand.
UNC-3.H.4 Une distribution de randomisation est un ensemble de statistiques générées par simulation en supposant des valeurs connues pour les paramètres. Pour une expérience randomisée, cela signifie réallouer/réattribuer à nouveau aléatoirement les valeurs de la variable réponse aux groupes de traitement.
UNC-3.H.5 La distribution d'échantillonnage d'une statistique peut être simulée en générant des échantillons aléatoires répétés à partir d'une population.
Source : Description du cours et de l'examen AP College Board
Le Théorème Central Limite
Le Théorème Central Limite 中心极限定理 (TCL) : pour une moyenne d'échantillon, si la taille de l'échantillon $n$ est suffisamment grande (une règle courante est $n\ge 30$), la distribution d'échantillonnage de $\bar{x}$ est approximativement normale, quel que soit la forme de la population. Plus $n$ est grand, plus la distribution est normale et resserrée.
La moyenne d'échantillon est presque normale quelle que soit la forme de la population
Explorer
Observer la transformation d'une distribution d'échantillonnage en normalité
Le Théorème Central Limite : pour un échantillon suffisamment grand, la distribution de la moyenne de l'échantillon est approximativement normale, quelle que soit la forme de la population.
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.I : Expliquer pourquoi un estimateur est ou n'est pas sans biais. [Compétence 4.B]
UNC-3.I.1 Lors de l'estimation d'un paramètre de population, un estimateur est sans biais si, en moyenne, la valeur de l'estimateur est égale au paramètre de la population.
Objectif d'apprentissage UNC-3.J : Calculer des estimations pour un paramètre de population. [Compétence 3.B]
UNC-3.J.1 Lors de l'estimation d'un paramètre de population, un estimateur présente une variabilité qui peut être modélisée à l'aide de probabilités.
UNC-3.J.2 Une statistique d'échantillon est un estimateur ponctuel du paramètre de population correspondant.
Source : Description du cours et de l'examen AP College Board
Une statistique est non biaisée 无偏 si la moyenne de sa distribution d'échantillonnage est égale au paramètre – elle est correcte en moyenne. Le biais concerne le décalage du centre ; la variabilité concerne l'étalement. Un bon estimateur est à la fois non biaisé (centré correctement) et à faible variabilité (précis) ; de plus grands échantillons réduisent la variabilité mais ne corrigent pas le biais dû à un mauvais échantillonnage.
Le biais et la variabilité sont des défauts séparés. Seul l'estimateur en haut à gauche est à la fois centré sur $\theta$ et resserré ; celui en bas à gauche est précis mais toujours faux, ce qu'aucune quantité supplémentaire de données ne pourra corriger.
5.5
The Sampling Distribution of a Sample Proportion
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.K : Déterminer les paramètres d'une distribution d'échantillonnage pour les proportions d'échantillon. [Compétence 3.B]
UNC-3.K.1 Pour des échantillons indépendants (tirage avec remise) d'une variable catégorielle provenant d'une population avec proportion de population $p$, la distribution d'échantillonnage de la proportion d'échantillon, $\hat{p}$, a une moyenne, $\mu_{\hat{p}} = p$ et un écart-type, $\sigma_{\hat{p}} = \sqrt{\dfrac{p(1-p)}{n}}$.
UNC-3.K.2 Si le tirage est effectué sans remise, l'écart-type de la proportion d'échantillon est inférieur à celui donné par la formule ci-dessus. Si la taille de l'échantillon est inférieure à 10 % de la taille de la population, la différence est négligeable.
Objectif d'apprentissage UNC-3.L : Déterminer si une distribution d'échantillonnage pour une proportion d'échantillon peut être décrite comme approximativement normale. [Compétence 3.C]
UNC-3.L.1 Pour une variable catégorielle, la distribution d'échantillonnage de la proportion d'échantillon, $\hat{p}$, aura une distribution approximativement normale, à condition que la taille de l'échantillon soit suffisamment grande : $np \geq 10$ et $n(1-p) \geq 10$
Objectif d'apprentissage UNC-3.M : Interpréter les probabilités et les paramètres pour une distribution d'échantillonnage pour une proportion d'échantillon. [Compétence 4.B]
UNC-3.M.1 Les probabilités et les paramètres pour une distribution d'échantillonnage pour une proportion d'échantillon doivent être interprétés en utilisant des unités appropriées et dans le contexte d'une population spécifique.
Source : Description du cours et de l'examen AP College Board
Pour une proportion d'échantillon $\hat{p}$ provenant d'un SRS : la moyenne est $p$ (sans biais), et l'écart-type est
$$\sigma_{\hat p}=\sqrt{\frac{p(1-p)}{n}}.$$
Cette dispersion a deux noms : c'est l'écart-type de la distribution d'échantillonnage, et on l'appelle erreur standard une fois que vous devez l'estimer à partir de l'échantillon (en remplaçant $p$ par $\hat p$) — ce que font exactement les unités d'inférence ultérieures.
Elle est approximativement normale lorsque $np\ge 10$ et $n(1-p)\ge 10$ (la condition des Grandes Comptages), et la condition $10\%$ ($n\le 0.10N$) maintient les observations quasi-indépendantes.
Exemple résolu. Supposons que $40\%$ des électeurs favorisent une mesure ($p=0.4$) et que vous échantillonnez $n=100$. L'erreur standard est $\sigma_{\hat p}=\sqrt{\dfrac{0.4(0.6)}{100}}=0.049$. La probabilité qu'un échantillon donne $\hat{p}>0.5$ est $z=\dfrac{0.5-0.4}{0.049}=2.04$, donc $P(\hat p>0.5)\approx0.02$ – une majorité dans l'échantillon serait surprenante.
5.6
Comparer deux groupes : Différence des proportions d'échantillon
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.N : Déterminer les paramètres d'une distribution d'échantillonnage pour une différence de proportions d'échantillon. [Compétence 3.B]
UNC-3.N.1 Pour une variable catégorielle, lors d'un tirage aléatoire avec remise de deux populations indépendantes avec proportions de population $p_1$ et $p_2$, la distribution d'échantillonnage de la différence de proportions d'échantillon $\hat{p}_1 - \hat{p}_2$ a une moyenne, $\mu_{\hat{p}_1 - \hat{p}_2} = p_1 - p_2$ et un écart-type, $\sigma_{\hat{p}_1 - \hat{p}_2} = \sqrt{\dfrac{p_1(1-p_1)}{n_1} + \dfrac{p_2(1-p_2)}{n_2}}$.
UNC-3.N.2 Si le tirage est effectué sans remise, l'écart-type de la différence de proportions d'échantillon est inférieur à celui donné par la formule ci-dessus. Si les tailles d'échantillon sont inférieures à 10 % des tailles de population, la différence est négligeable.
Objectif d'apprentissage UNC-3.O : Déterminer si une distribution d'échantillonnage pour une différence de proportions d'échantillon peut être décrite comme approximativement normale. [Compétence 3.C]
UNC-3.O.1 La distribution d'échantillonnage de la différence de proportions d'échantillon $\hat{p}_1 - \hat{p}_2$ aura une distribution approximativement normale à condition que les tailles d'échantillon soient suffisamment grandes : $n_1 p_1 \geq 10, n_1(1-p_1) \geq 10, n_2 p_2 \geq 10, n_2(1-p_2) \geq 10$.
Objectif d'apprentissage UNC-3.P : Interpréter les probabilités et les paramètres pour une distribution d'échantillonnage pour une différence de proportions. [Compétence 4.B]
UNC-3.P.1 Les paramètres pour une distribution d'échantillonnage pour une différence de proportions doivent être interprétés en utilisant des unités appropriées et dans le contexte de populations spécifiques.
Source : Description du cours et de l'examen AP College Board
Pour $\hat{p}_1-\hat{p}_2$ provenant de deux échantillons indépendants : la moyenne est $p_1-p_2$, et comme les échantillons sont indépendants, les variances s'additionnent :
Elle est approximativement normale lorsque la condition des Grandes Comptages est satisfaite dans les deux échantillons.
5.7
Distribution d'échantillonnage de la moyenne d'un échantillon
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.Q : Déterminer les paramètres d'une distribution d'échantillonnage pour les moyennes d'échantillon. [Compétence 3.B]
UNC-3.Q.1 Pour une variable numérique, lors d'un tirage aléatoire avec remise d'une population avec moyenne $\mu$ et écart-type, $\sigma$, la distribution d'échantillonnage de la moyenne d'échantillon a une moyenne $\mu_{\bar{x}} = \mu$ et un écart-type $\sigma_{\bar{x}} = \dfrac{\sigma}{\sqrt{n}}$.
UNC-3.Q.2 Si le tirage est effectué sans remise, l'écart-type de la moyenne d'échantillon est inférieur à celui donné par la formule ci-dessus. Si la taille de l'échantillon est inférieure à 10 % de la taille de la population, la différence est négligeable.
Objectif d'apprentissage UNC-3.R : Déterminer si une distribution d'échantillonnage d'une moyenne d'échantillon peut être décrite comme approximativement normale. [Compétence 3.C]
UNC-3.R.1 Pour une variable numérique, si la distribution de la population peut être modélisée par une distribution normale, la distribution d'échantillonnage de la moyenne d'échantillon, $\bar{x}$, peut être modélisée par une distribution normale.
UNC-3.R.2 Pour une variable numérique, si la distribution de la population ne peut pas être modélisée par une distribution normale, la distribution d'échantillonnage de la moyenne d'échantillon, $\bar{x}$, peut être modélisée approximativement par une distribution normale, à condition que la taille de l'échantillon soit suffisamment grande, par exemple supérieure ou égale à 30.
Objectif d'apprentissage UNC-3.S : Interpréter les probabilités et les paramètres pour une distribution d'échantillonnage pour une moyenne d'échantillon. [Compétence 4.B]
UNC-3.S.1 Les probabilités et les paramètres pour une distribution d'échantillonnage pour une moyenne d'échantillon doivent être interprétés en utilisant des unités appropriées et dans le contexte d'une population spécifique.
Source : Description du cours et de l'examen AP College Board
Pour une moyenne d'échantillon $\bar{x}$ provenant d'un SRS : la moyenne est $\mu$ (sans biais), et l'écart-type est
$$\sigma_{\bar x}=\frac{\sigma}{\sqrt{n}}.$$
Sa forme est normale si la population est normale, ou approximativement normale pour de grands $n$ grâce au TCL. Notez que la dispersion diminue selon $\sqrt{n}$ – quadrupler l'échantillon divise par deux l'erreur standard.
Exemple résolu. Une population a $\mu=70$ et $\sigma=12$. Pour des échantillons de $n=36$, la distribution d'échantillonnage de $\bar{x}$ est centrée sur $70$ avec une erreur standard de $\dfrac{12}{\sqrt{36}}=2$. La probabilité qu'une moyenne d'échantillon dépasse $73$ est $z=\dfrac{73-70}{2}=1.5$, donc $P(\bar x>73)\approx0.067$.
La population de gauche est fortement asymétrique, yet chaque distribution d'échantillonnage de $\bar{x}$ est centrée sur $\mu$. Un grand $n$ réduit l'erreur standard $\sigma/\sqrt{n}$, donc la courbe devient plus haute et plus étroite – et elle s'aplatit aussi : encore nettement asymétrique à $n=2$, presque exactement normale (pointillés) à $n=30$.
Comparer deux groupes : Différence des moyennes d'échantillon
Programme
Compréhension durable (UNC-3) : Le raisonnement probabiliste nous permet d'anticiper des motifs dans les données.
Objectif d'apprentissage UNC-3.T : Déterminer les paramètres d'une distribution d'échantillonnage pour une différence de moyennes d'échantillon. [Compétence 3.B]
UNC-3.T.1 Pour une variable numérique, lors d'un tirage aléatoire avec remise de deux populations indépendantes avec moyennes de population $\mu_1$ et $\mu_2$ et écarts-types de population $\sigma_1$ et $\sigma_2$, la distribution d'échantillonnage de la différence de moyennes d'échantillon $\bar{x}_1 - \bar{x}_2$ a une moyenne $\mu_{(\bar{x}_1 - \bar{x}_2)} = \mu_1 - \mu_2$ et un écart-type, $\sigma_{(\bar{x}_1 - \bar{x}_2)} = \sqrt{\dfrac{\sigma_1^2}{n_1} + \dfrac{\sigma_2^2}{n_2}}$.
UNC-3.T.2 Si le tirage est effectué sans remise, l'écart-type de la différence de moyennes d'échantillon est inférieur à celui donné par la formule ci-dessus. Si les tailles d'échantillon sont inférieures à 10 % des tailles de population, la différence est négligeable.
Objectif d'apprentissage UNC-3.U : Déterminer si une distribution d'échantillonnage d'une différence de moyennes d'échantillon peut être décrite comme approximativement normale. [Compétence 3.C]
UNC-3.U.1 La distribution d'échantillonnage de la différence de moyennes d'échantillon $\bar{x}_1 - \bar{x}_2$ peut être modélisée par une distribution normale si les deux distributions de population peuvent être modélisées par une distribution normale.
UNC-3.U.2 La distribution d'échantillonnage de la différence de moyennes d'échantillon $\bar{x}_1 - \bar{x}_2$ peut être modélisée approximativement par une distribution normale si les deux distributions de population ne peuvent pas être modélisées par une distribution normale mais que les deux tailles d'échantillon sont supérieures ou égales à 30.
Objectif d'apprentissage UNC-3.V : Interpréter les probabilités et les paramètres pour une distribution d'échantillonnage pour une différence de moyennes d'échantillon. [Compétence 4.B]
UNC-3.V.1 Les probabilités et les paramètres pour une distribution d'échantillonnage pour une différence de moyennes d'échantillon doivent être interprétés en utilisant des unités appropriées et dans le contexte de populations spécifiques.
Source : Description du cours et de l'examen AP College Board
Pour $\bar{x}_1-\bar{x}_2$ provenant de deux échantillons indépendants : la moyenne est $\mu_1-\mu_2$, et (indépendant, donc variances s'additionnent)
Ceci est la base pour l'inférence à deux échantillons dans les unités suivantes.
5.8
Conseils d'examen
Une distribution d'échantillonnage est la distribution d'une statistique sur de nombreux échantillons, centrée sur le vrai paramètre.
Le Théorème Central Limite : pour un échantillon assez grand, la moyenne de l'échantillon est approximativement normale, même si la population ne l'est pas.
Les grands échantillons donnent moins de variabilité (une erreur standard plus petite).
Vérifiez les conditions (aléatoire, indépendant/10%, assez grand) avant d'utiliser un modèle normal.
Gardez distinct ce qui varie — la statistique — du paramètre fixe.
6
Inférence pour les données catégorielles : proportions
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.H : Identifier les questions suggérées par la variation des formes des distributions d'échantillons prélevés dans la même population. [Compétence 1.A]
VAR-1.H.1 La variation des formes des distributions de données peut être aléatoire ou non.
Source : Description du cours et de l'examen AP College Board
Parce qu'une proportion d'échantillon $\hat{p}$ est approximativement normalement distribuée (lorsque les conditions sont remplies), nous pouvons mesurer à quelle distance un résultat d'échantillon est d'une valeur prétendue en erreurs standards, et convertir cela en probabilité. C'est ce qui rend l'inférence 推断 – tirer des conclusions sur une population à partir d'un échantillon – possible.
6.2
Intervalle de Confiance pour une Proportion
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.A : Identifier une procédure d'intervalle de confiance appropriée pour une proportion de population. [Compétence 1.D]
UNC-4.A.1 La procédure d'intervalle de confiance appropriée pour une proportion à échantillon unique concernant une variable catégorielle est un intervalle de type $z$ à échantillon unique pour une proportion.
Objectif d'apprentissage UNC-4.B : Vérifier les conditions pour le calcul des intervalles de confiance pour une proportion de population. [Compétence 4.C]
UNC-4.B.1 Afin de faire les hypothèses nécessaires pour l'inférence sur les proportions de population, les moyennes et les pentes, nous devons vérifier l'indépendance dans les méthodes de collecte de données et la sélection de la distribution d'échantillonnage appropriée.
UNC-4.B.2 Afin de calculer un intervalle de confiance pour estimer une proportion de population, $p$, nous devons vérifier l'indépendance et le fait que la distribution d'échantillonnage soit approximativement normale.
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \leq 10\%N$, où $N$ est la taille de la population.
b. Pour vérifier que la distribution d'échantillonnage de $\hat{p}$ est approximativement normale (forme) :
i. Pour les variables catégorielles, vérifier que le nombre de succès, $n\hat{p}$, et le nombre d'échecs, $n(1-\hat{p})$ sont tous deux d'au moins 10 afin que la taille de l'échantillon soit suffisamment grande pour soutenir une hypothèse de normalité.
Objectif d'apprentissage UNC-4.C : Déterminer la marge d'erreur pour une taille d'échantillon donnée et une estimation de la taille d'échantillon qui entraînerait une marge d'erreur donnée pour une proportion de population. [Compétence 3.D]
UNC-4.C.1 Sur la base des données d'échantillon, l'erreur standard d'une statistique est une estimation de l'écart-type de cette statistique. L'erreur standard de $\hat{p}$ est $SE_{\hat{p}} = \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
UNC-4.C.2 Une marge d'erreur indique la quantité dont une valeur d'une statistique d'échantillon peut varier par rapport à la valeur du paramètre de population correspondant.
UNC-4.C.3 Pour les variables catégorielles, la marge d'erreur est la valeur critique ($z^*$) multipliée par l'erreur standard (ES) de la statistique pertinente, ce qui équivaut à $z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$ pour une proportion à échantillon unique.
UNC-4.C.4 La formule de la marge d'erreur peut être réarrangée pour résoudre $n$, la taille minimale d'échantillon nécessaire pour obtenir une marge d'erreur donnée. À cette fin, utiliser une estimation pour $\hat{p}$ ou utiliser $\hat{p} = 0.5$ afin de trouver une borne supérieure pour la taille de l'échantillon qui résultera en une marge d'erreur donnée.
Objectif d'apprentissage UNC-4.D : Calculer un intervalle de confiance approprié pour une proportion de population. [Compétence 3.D]
UNC-4.D.1 En général, une estimation par intervalle peut être construite comme estimation ponctuelle ± (marge d'erreur). Pour une proportion à échantillon unique, l'estimation par intervalle est $\hat{p} \pm z^* \sqrt{\dfrac{\hat{p}(1-\hat{p})}{n}}$.
Énoncé clarifiant : Les formules pour les estimations par intervalle n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules n'ont pas besoin d'être mémorisées, car elles peuvent être construites à partir de la formule générale de la statistique de test et des formules d'erreur-type pertinentes fournies sur la feuille de formules.
UNC-4.D.2 Les valeurs critiques représentent les limites englobant le milieu C% de la distribution normale standard, où C% est un niveau de confiance approximatif pour une proportion.
Objectif d'apprentissage UNC-4.E : Calculer une estimation par intervalle basée sur un intervalle de confiance pour une proportion de population. [Compétence 3.D]
UNC-4.E.1 Les intervalles de confiance pour les proportions de population peuvent être utilisés pour calculer des estimations par intervalle avec des unités spécifiées.
Source : Description du cours et de l'examen AP College Board
Ce qu'un intervalle de confiance signifie
Un intervalle de confiance 置信区间 estime le paramètre sous forme d'intervalle : statistique $\pm$marge d'erreur 误差幅度.
$z^{*}$ est la valeur critique pour le niveau de confiance 置信水平 (ex. $1.96$ pour 95 %). Conditions : échantillon aléatoire, Grandes Comptages ($n\hat p\ge 10$ et $n(1-\hat p)\ge 10$), et condition des 10 %. Interprétez-le : « Nous sommes confiants à 95 % que la vraie proportion de... est comprise entre... et... ». Interprétez le niveau : « Dans 95 % des échantillons, cette méthode produit un intervalle qui capture la vraie proportion. »
Sur de nombreux échantillons, environ 95 % des intervalles de confiance à 95 % capturent la vraie proportion
Exemple résolu. Dans un échantillon aléatoire de $200$ personnes, $120$ soutiennent une politique, donc $\hat{p}=0.60$. Un intervalle $95\%$ utilise $z^*=1.96$ :
Nous sommes confiants à $95\%$ que la vraie proportion de soutiens est comprise entre $53.2\%$ et $66.8\%$.
Un intervalle de confiance à 95 % s'étend sur 1.96 erreurs standards de chaque côté de l'estimation
Choix de la taille de l'échantillon. Pour maintenir la marge d'erreur au plus égale à une cible $m$, fixez $z^{*}\sqrt{\dfrac{\hat p(1-\hat p)}{n}}\le m$ et résolvez pour $n$. Quand vous n'avez pas d'estimation de $\hat p$, utilisez $\hat p=0.5$ : cela rend $\hat p(1-\hat p)$ aussi grand que possible, donnant la taille d'échantillon requise sûre (la plus grande). Arrondissez toujours le résultat au supérieur à la personne entière suivante.
Exemple résolu. Combien de personnes devez-vous sonder pour un intervalle $95\%$ avec une marge d'erreur au maximum de $0.03$ ? En utilisant $\hat p=0.5$ et $z^*=1.96$ :
Justifier une affirmation à partir d'un intervalle
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.F : Interpréter un intervalle de confiance pour une proportion de population. [Compétence 4.B]
UNC-4.F.1 Un intervalle de confiance pour une proportion de population contient soit la proportion de population, soit il ne la contient pas, car chaque intervalle est basé sur des données d'échantillon aléatoires, qui varient d'un échantillon à l'autre.
UNC-4.F.2 Nous avons C% de confiance que l'intervalle de confiance pour une proportion de population capture la proportion de population.
UNC-4.F.3 Dans un échantillonnage aléatoire répété avec la même taille d'échantillon, environ C% des intervalles de confiance créés captureront la proportion de population.
UNC-4.F.4 L'interprétation d'un intervalle de confiance pour une proportion à un échantillon doit inclure une référence à l'échantillon pris et des détails sur la population qu'il représente.
Exemples illustratifs pour UNC-4.F.4 : Pour interpréter un intervalle de confiance de 99 % allant de (0.268, 0.292), basé sur la proportion d'élèves de douzième année issus d'un échantillon représentatif au niveau national ayant répondu correctement à une question particulière à choix multiples : « Nous sommes 99 pour cent confiants que l'intervalle allant de 0.268 à 0.292 contient la proportion populationnelle de tous les élèves de douzième année aux États-Unis qui répondraient correctement à cette question » (2011 FRQ 6(a)).
Objectif d'apprentissage UNC-4.G : Justifier une affirmation basée sur un intervalle de confiance pour une proportion de population. [Compétence 4.D]
UNC-4.G.1 Un intervalle de confiance pour une proportion de population fournit un intervalle de valeurs qui peut fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Objectif d'apprentissage UNC-4.H : Identifier les relations entre la taille de l'échantillon, la largeur d'un intervalle de confiance, le niveau de confiance et la marge d'erreur pour une proportion de population. [Compétence 4.A]
UNC-4.H.1 Lorsque toutes les autres choses restent égales, la largeur de l'intervalle de confiance pour une proportion de population a tendance à diminuer lorsque la taille de l'échantillon augmente. Pour une proportion de population, la largeur de l'intervalle est proportionnelle à $\dfrac{1}{\sqrt{n}}$.
UNC-4.H.2 Pour un échantillon donné, la largeur de l'intervalle de confiance pour une proportion de population augmente lorsque le niveau de confiance augmente.
UNC-4.H.3 La largeur d'un intervalle de confiance pour une proportion de population est exactement le double de la marge d'erreur.
Source : Description du cours et de l'examen AP College Board
Pour juger une valeur prétendue : si elle se trouve à l'intérieur de l'intervalle, les données sont compatibles avec elle ; si elle se trouve à l'extérieur, les données fournissent des preuves contre elle. Bases la conclusion sur le fait que les valeurs plausibles incluent ou non l'affirmation, dans le contexte.
6.4
Établir un test pour une proportion
Programme
Compréhension durable (VAR-6) : La distribution normale peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-6.D : Identifier les hypothèses nulle et alternative pour une proportion de population. [Compétence 1.F]
VAR-6.D.1 L'hypothèse nulle est la situation supposée correcte sauf preuve du contraire, et l'hypothèse alternative est la situation pour laquelle des preuves sont recueillies.
VAR-6.D.2 Pour les hypothèses concernant les paramètres, l'hypothèse nulle contient une référence d'égalité (=, ≥, ou ≤), tandis que l'hypothèse alternative contient une inégalité stricte (<, >, ou ≠). Le type d'inégalité dans l'hypothèse alternative est basé sur la question d'intérêt. Les hypothèses alternatives avec < or > sont appelées unilatérales, et les hypothèses alternatives avec ≠ sont appelées bilatérales. Bien que l'hypothèse nulle pour un test unilatéral puisse inclure un symbole d'inégalité, elle est toujours testée à la limite de l'égalité.
VAR-6.D.3 L'hypothèse nulle pour une proportion de population est : $H_0 : p = p_0$, où $p_0$ est la valeur hypothétisée nulle pour la proportion de population.
VAR-6.D.4 Une hypothèse alternative unilatérale pour une proportion est soit $H_a : p < p_0$ soit $H_a : p > p_0$. Une hypothèse alternative bilatérale est $H_a : p_1 \neq p_2$.
VAR-6.D.5 Pour un test $z$ à échantillon unique pour une proportion de population, l'hypothèse nulle spécifie une valeur pour la proportion de population, souvent indiquant aucune différence ou effet.
Objectif d'apprentissage VAR-6.E : Identifier une méthode de test appropriée pour une proportion de population. [Compétence 1.E]
VAR-6.E.1 Pour une variable catégorielle unique, la méthode de test appropriée pour une proportion de population est un test $z$ à un échantillon pour une proportion de population.
Objectif d'apprentissage VAR-6.F : Vérifier les conditions pour effectuer une inférence statistique lors du test d'une proportion de population. [Compétence 4.C]
VAR-6.F.1 Afin de faire une inférence statistique lors du test d'une proportion de population, nous devons vérifier l'indépendance et que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \leq 10\%N$.
b. Pour vérifier que la distribution d'échantillonnage de $\hat{p}$ est approximativement normale (forme) :
i. En supposant que $H_0$ est vraie $(p = p_0)$, vérifier que le nombre de succès, $np_0$, et le nombre d'échecs, $n(1-p_0)$ sont tous deux d'au moins 10 afin que la taille de l'échantillon soit suffisamment grande pour soutenir une hypothèse de normalité.
Source : Description du cours et de l'examen AP College Board
Un test de significativité 显著性检验 pèse les preuves contre une affirmation. Énoncez une hypothèse nulle 原假设$H_0$ et une hypothèse alternative 备择假设$H_a$ concernant le paramètre $p$ :
Vérifiez les mêmes conditions (aléatoire, Grandes Comptages utilisant $p_0$, 10 %). La statistique de test 检验统计量 compte les erreurs standards depuis $p_0$ :
$$z=\frac{\hat p-p_0}{\sqrt{p_0(1-p_0)/n}}.$$
Exemple résolu. Une entreprise affirme $90\%$ de satisfaction ($p_0=0.90$) ; un échantillon de $100$ trouve $84$ satisfaits ($\hat{p}=0.84$). Testez $H_0:p=0.90$ contre $H_a:p\neq0.90$ à $\alpha=0.05$ :
donnant une valeur-P biface $p$ d'environ $2(0.023)=0.046$. Puisque $0.046<0.05$, rejeter $H_0$ – il y a des preuves que le taux de satisfaction réel diffère de (est inférieur à) $90\%$.
Un test biface à 5 % rejette l'hypothèse nulle dans les queues hachurées
6.5
Interpréter les valeurs-P
Programme
Compréhension durable (VAR-6) : La distribution normale peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-6.G : Calculer une statistique de test appropriée et une valeur $p$ pour une proportion de population. [Compétence 3.E]
VAR-6.G.1 La distribution de la statistique de test en supposant que l'hypothèse nulle est vraie (distribution nulle) peut être soit une distribution de randomisation, soit, lorsqu'un modèle probabiliste est supposé vrai, une distribution théorique ($z$).
VAR-6.G.2 Lors de l'utilisation d'un test $z$, la statistique de test standardisée peut s'écrire : $\text{test statistic} = \dfrac{\text{sample statistic} - \text{null value of the parameter}}{\text{standard deviation of the statistic}}$. On appelle cela une statistique $z$ pour les proportions.
VAR-6.G.3 La statistique de test pour une proportion de population est : $z = \dfrac{\hat{p} - p_0}{\sqrt{\dfrac{p_0(1-p_0)}{n}}}$.
Énoncé clarifiant : Les formules pour les statistiques de test n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules n'ont pas besoin d'être mémorisées, car elles peuvent être construites à partir de la formule générale de la statistique de test et des formules d'erreur-type pertinentes fournies sur la feuille de formules.
VAR-6.G.4 Une valeur $p$ est la probabilité d'obtenir une statistique de test aussi extrême ou plus extrême que la statistique de test observée lorsque l'hypothèse nulle et le modèle probabiliste sont supposés vrais. Le niveau de significativité peut être donné ou déterminé par le chercheur.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.A : Interpréter la valeur $p$ d'un test de significativité pour une proportion de population. [Compétence 4.B]
DAT-3.A.1 La valeur $p$ est la proportion des valeurs de la distribution nulle qui sont aussi extrêmes ou plus extrêmes que la valeur observée de la statistique de test. Il s'agit de :
a. La proportion supérieure ou égale à la valeur observée de la statistique de test, si l'hypothèse alternative est >.
b. La proportion inférieure ou égale à la valeur observée de la statistique de test, si l'hypothèse alternative est <.
c. La proportion inférieure ou égale à l'opposé de la valeur absolue de la statistique de test plus la proportion supérieure ou égale à la valeur absolue de la statistique de test, si l'hypothèse alternative est ≠.
DAT-3.A.2 L'interprétation de la valeur $p$ d'un test de significativité pour une proportion à échantillon unique doit reconnaître que la valeur $p$ est calculée en supposant que le modèle probabiliste et l'hypothèse nulle sont vrais, c'est-à-dire en supposant que la vraie proportion de population est égale à la valeur particulière indiquée dans l'hypothèse nulle.
Source : Description du cours et de l'examen AP College Board
Ce qu'est une valeur p
La valeur $p$ P值 est la probabilité d'obtenir un résultat d'échantillon aussi extrême ou plus extrême que l'observation, en supposant que $H_0$ est vraie. Une petite valeur $p$ signifie que les données seraient surprenantes si $H_0$ tenait – preuve contre $H_0$. Ce n'est pas la probabilité que $H_0$ soit vraie.
Explorer
Une valeur p comme aire de queue
Une valeur p est la probabilité, si l'hypothèse nulle était vraie, d'obtenir un résultat au moins aussi extrême — l'aire ombragée de la queue. Les petites valeurs p remettent en question l'hypothèse nulle.
6.6
Conclure un test
Programme
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.B : Justifier une affirmation sur la population basée sur les résultats d'un test de signification pour une proportion de population. [Compétence 4.E]
DAT-3.B.1 Le niveau de significativité, $\alpha$, est la probabilité prédéterminée de rejeter l'hypothèse nulle étant donné qu'elle est vraie.
DAT-3.B.2 Une décision formelle compare explicitement la valeur $p$ au niveau de significativité, $\alpha$. Si la valeur $p$$\leq \alpha$, rejeter l'hypothèse nulle. Si la valeur $p$$> \alpha$, ne pas rejeter l'hypothèse nulle.
DAT-3.B.3 Rejeter l'hypothèse nulle signifie qu'il existe des preuves statistiques suffisantes pour soutenir l'hypothèse alternative. Ne pas rejeter l'hypothèse nulle signifie qu'il existe des preuves statistiques insuffisantes pour soutenir l'hypothèse alternative.
DAT-3.B.4 La conclusion concernant l'hypothèse alternative doit être formulée dans le contexte.
DAT-3.B.5 Un test de signification peut conduire à rejeter ou non rejeter l'hypothèse nulle, mais ne peut jamais conduire à conclure ou prouver que l'hypothèse nulle est vraie. L'absence de preuves statistiques pour l'hypothèse alternative n'est pas la même chose que des preuves pour l'hypothèse nulle.
DAT-3.B.6 Les petites valeurs $p$ indiquent que la valeur observée de la statistique de test serait inhabituelle si l'hypothèse nulle et le modèle probabiliste étaient vrais, fournissant ainsi des preuves en faveur de l'alternative. Plus la valeur $p$ est faible, plus les preuves statistiques en faveur de l'hypothèse alternative sont convaincantes.
DAT-3.B.7 Les valeurs $p$ qui ne sont pas faibles indiquent que la valeur observée de la statistique de test ne serait pas inhabituelle si l'hypothèse nulle et le modèle probabiliste étaient vrais, ne fournissant donc pas de preuves statistiques convaincantes en faveur de l'hypothèse alternative, ni ne fournissant de preuves que l'hypothèse nulle est vraie.
DAT-3.B.8 Une décision formelle compare explicitement la valeur $p$ au niveau de significativité $\alpha$. Si la valeur $p$$\leq \alpha$, alors rejeter l'hypothèse nulle, $H_0 : p = p_0$. Si la valeur $p$$> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.B.9 Les résultats d'un test de signification pour une proportion de population peuvent servir de raisonnement statistique pour répondre à une question de recherche sur la population qui a été échantillonnée.
Source : Description du cours et de l'examen AP College Board
Comparer la valeur $p$ au niveau de signification 显著性水平$\alpha$ (souvent $0.05$) :
$p\le\alpha$ : rejeter $H_0$ – il y a des preuves convaincantes pour $H_a$.
$p>\alpha$ : ne pas rejeter $H_0$ – pas assez de preuves pour $H_a$ (jamais "accepter $H_0$").
Toujours rédiger la conclusion dans le contexte, en revenant à l'affirmation.
6.7
Erreurs de Type I et Type II
Programme
Compréhension durable (UNC-5) : Les probabilités d'erreurs de type I et de type II influencent l'inférence.
Objectif d'apprentissage UNC-5.A : Identifier les erreurs de type I et de type II. [Compétence 1.B]
UNC-5.A.1 Une erreur de type I se produit lorsque l'hypothèse nulle est vraie et est rejetée (positif faux).
UNC-5.A.2 Une erreur de type II se produit lorsque l'hypothèse nulle est fausse et n'est pas rejetée (négatif faux).
Tableau des erreurs : Avec la valeur réelle de la population en haut ($H_0$ vraie ; $H_a$ vraie) et la décision sur le côté (Rejeter $H_0$ ; Ne pas rejeter $H_0$) : Rejeter $H_0$ quand $H_0$ vraie = Erreur de Type I ; Rejeter $H_0$ quand $H_a$ vraie = Décision correcte ; Ne pas rejeter $H_0$ quand $H_0$ vraie = Décision correcte ; Ne pas rejeter $H_0$ quand $H_a$ vraie = Erreur de Type II.
Objectif d'apprentissage UNC-5.B : Calculer la probabilité d'une erreur de type I et de type II. [Compétence 3.A]
UNC-5.B.1 Le niveau de significativité, $\alpha$, est la probabilité de commettre une erreur de Type I, si l'hypothèse nulle est vraie.
UNC-5.B.2 La puissance d'un test est la probabilité qu'un test rejette correctement une hypothèse nulle fausse.
UNC-5.B.3 La probabilité de commettre une erreur de Type II $= 1 - power$.
Objectif d'apprentissage UNC-5.C : Identifier les facteurs qui affectent la probabilité d'erreurs dans les tests de signification. [Compétence 4.A]
UNC-5.C.1 La probabilité d'une erreur de type II diminue lorsque l'un des événements suivants se produit, à condition que les autres ne changent pas :
i. La taille de l'échantillon augmente.
ii. Augmentation du niveau de significativité ($\alpha$) d'un test.
iii. L'erreur standard diminue.
iv. La vraie valeur du paramètre est plus éloignée de l'hypothèse nulle.
Objectif d'apprentissage UNC-5.D : Interpréter les erreurs de type I et de type II. [Compétence 4.B]
UNC-5.D.1 Qu'une erreur de type I ou de type II soit plus conséquente dépend de la situation.
UNC-5.D.2 Puisque le niveau de significativité, $\alpha$, est la probabilité d'une erreur de Type I, les conséquences d'une erreur de Type I influencent les décisions concernant un niveau de significativité.
Source : Description du cours et de l'examen AP College Board
Erreurs de Type I et Type II
Une erreur de Type I 第一类错误 : rejeter une $H_0$vraie (une fausse alarme). Sa probabilité est $\alpha$.
Une erreur de Type II 第二类错误 : ne pas rejeter une $H_0$fausse (un manque de détection). Sa probabilité est $\beta$.
La puissance 检验效能$=1-\beta$ est la probabilité de détecter correctement un effet réel. La puissance augmente avec un plus grand échantillon, un plus grand effet, ou un plus grand $\alpha$.
Décrivez chaque erreur et sa conséquence dans le contexte du problème.
Explorer
Deux façons dont un test peut être erroné
Une erreur de Type I rejette une hypothèse nulle vraie (fausse alerte) ; une erreur de Type II conserve une hypothèse nulle fausse (manque détection). Abaisser l'une augmente généralement l'autre.
6.8
Intervalle de Confiance pour une Différence de Proportions
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.I : Identifier une procédure d'intervalle de confiance appropriée pour une comparaison de proportions de population. [Compétence 1.D]
UNC-4.I.1 La procédure d'intervalle de confiance appropriée pour une comparaison à deux échantillons de proportions pour une variable catégorielle est un intervalle de type $z$ à deux échantillons pour une différence entre les proportions de population.
Objectif d'apprentissage UNC-4.J : Vérifier les conditions pour le calcul d'intervalles de confiance pour une différence entre proportions de population. [Compétence 4.C]
UNC-4.J.1 Afin de calculer des intervalles de confiance pour estimer une différence entre proportions, nous devons vérifier l'indépendance et que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide de deux échantillons aléatoires indépendants ou d'une expérience randomisée.
ii. Lors du tirage sans remise, vérifiez que $n_1 \leq 10\%N_1$ et $n_2 \leq 10\%N_2$.
b. Pour vérifier que la distribution d'échantillonnage de $\hat{p}_1 - \hat{p}_2$ est approximativement normale (forme).
i. Pour les variables catégorielles, vérifier que $n_1\hat{p}_1$, $n_1(1-\hat{p}_1)$, $n_2\hat{p}_2$, et $n_2\left(1-\hat{p}_2\right)$ sont tous tous supérieurs ou égaux à une valeur prédéterminée, généralement 5 ou 10.
Objectif d'apprentissage UNC-4.K : Calculer un intervalle de confiance approprié pour une comparaison de proportions de population. [Compétence 3.D]
UNC-4.K.1 Pour une comparaison de proportions, l'estimation par intervalle est $(\hat{p}_1 - \hat{p}_2) \pm z^* \sqrt{\dfrac{\hat{p}_1(1-\hat{p}_1)}{n_1} + \dfrac{\hat{p}_2(1-\hat{p}_2)}{n_2}}$.
Énoncé clarifiant : Les formules pour les estimations par intervalle n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules n'ont pas besoin d'être mémorisées, car elles peuvent être construites à partir de la formule générale de la statistique de test et des formules d'erreur-type pertinentes fournies sur la feuille de formules.
Objectif d'apprentissage UNC-4.L : Calculer une estimation par intervalle basée sur un intervalle de confiance pour une différence de proportions. [Compétence 3.D]
UNC-4.L.1 Les intervalles de confiance pour une différence de proportions peuvent être utilisés pour calculer des estimations par intervalle avec des unités spécifiées.
Source : Description du cours et de l'examen AP College Board
Pour comparer deux proportions, estimez $p_1-p_2$ :
Les conditions doivent être remplies dans les deux échantillons, et les échantillons doivent être indépendants.
6.9
Justifier une affirmation sur deux proportions
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.M : Interpréter un intervalle de confiance pour une différence de proportions. [Compétence 4.B]
UNC-4.M.1 Dans un échantillonnage aléatoire répété avec la même taille d'échantillon, environ C% des intervalles de confiance créés captureront la différence dans les proportions de population.
UNC-4.M.2 L'interprétation d'un intervalle de confiance pour une différence entre proportions de population doit inclure une référence à l'échantillon pris et des détails sur la population qu'il représente.
Objectif d'apprentissage UNC-4.N : Justifier une affirmation basée sur un intervalle de confiance pour une différence de proportions. [Compétence 4.D]
UNC-4.N.1 Un intervalle de confiance pour une différence de proportions de population fournit un intervalle de valeurs qui peut fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Source : Description du cours et de l'examen AP College Board
Si l'intervalle pour $p_1-p_2$ contient $0$, les données sont compatibles avec aucune différence ; s'il est entièrement au-dessus ou en dessous de $0$, il y a des preuves d'une différence (dans cette direction). Énoncez la direction et le contexte.
6.10
Établir un test pour une différence
Programme
Compréhension durable (VAR-6) : La distribution normale peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-6.H : Identifier les hypothèses nulle et alternative pour une différence de deux proportions de population. [Compétence 1.F]
VAR-6.H.1 Pour un test à deux échantillons pour une différence de deux proportions, l'hypothèse nulle spécifie une valeur de $0$ pour la différence dans les proportions de population, indiquant aucune différence ou effet.
VAR-6.H.2 L'hypothèse nulle pour une différence de proportions est : $H_0 : p_1 = p_2$, ou $H_0 : p_1 - p_2 = 0$.
VAR-6.H.3 Une hypothèse alternative unilatérale pour une différence de proportions est $H_a : p_1 < p_2$, ou, $H_a : p_1 > p_2$. Une hypothèse alternative bilatérale pour une différence de proportions est $H_a : p_1 \neq p_2$.
Objectif d'apprentissage VAR-6.I : Identifier une méthode de test appropriée pour la différence de deux proportions de population. [Compétence 1.E]
VAR-6.I.1 Pour une variable catégorielle unique, la méthode de test appropriée pour la différence de deux proportions de population est un test $z$ à deux échantillons pour une différence entre deux proportions de population.
Objectif d'apprentissage VAR-6.J : Vérifier les conditions permettant de faire des inférences statistiques lors du test d'une différence de deux proportions de population. [Compétence 4.C]
VAR-6.J.1 Afin de faire des inférences statistiques lors du test d'une différence entre des proportions de population, nous devons vérifier l'indépendance et le fait que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide de deux échantillons aléatoires indépendants ou d'une expérience randomisée.
ii. Lors du tirage sans remise, vérifiez que $n_1 \leq 10\%N_1$ et $n_2 \leq 10\%N_2$.
b. Pour vérifier que la distribution d'échantillonnage de $\hat{p}_1 - \hat{p}_2$ est approximativement normale (forme) :
i. Pour l'échantillon combiné, définissez la proportion combinée (ou groupée), $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$. En supposant que $H_0$ est vraie $(p_1 - p_2 = 0$ ou $p_1 = p_2)$, vérifiez que $n_1\hat{p}_c$, $n_1\left(1-\hat{p}_c\right)$, $n_2\hat{p}_c$, et $n_2\left(1-\hat{p}_c\right)$ sont tous supérieurs ou égaux à une valeur prédéterminée, généralement soit 5 ou 10.
Source : Description du cours et de l'examen AP College Board
Les hypothèses comparent les deux proportions : $H_0: p_1=p_2$ contre $H_a: p_1\neq p_2$ (ou $<,>$). Comme $H_0$ dit que les proportions sont égales, utilisez une proportion combinée (pooled) 合并 proportion d'échantillon $\hat p_c=\dfrac{\text{total successes}}{\text{total sample size}}$ pour estimer la commune $p$.
6.11
Effectuer un test pour une différence
Programme
Compréhension durable (VAR-6) : La distribution normale peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-6.K : Calculer une statistique de test appropriée pour la différence de deux proportions de population. [Compétence 3.E]
VAR-6.K.1 La statistique de test pour une différence de proportions est : $z = \dfrac{(\hat{p}_1 - \hat{p}_2) - 0}{\sqrt{\hat{p}_c(1-\hat{p}_c)}\sqrt{\dfrac{1}{n_1} + \dfrac{1}{n_2}}}$, où $\hat{p}_c = \dfrac{n_1\hat{p}_1 + n_2\hat{p}_2}{n_1 + n_2}$.
Éclaircissement : Les formules pour les statistiques de test n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules n'ont pas besoin d'être mémorisées, car elles peuvent être construites sur la base de la formule générale de la statistique de test et des formules d'erreur type pour chacune des statistiques de test pertinentes qui sont fournies sur la feuille de formules.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.C : Interpréter la valeur $p$ d'un test de significativité pour une différence de proportions de population. [Compétence 4.B]
DAT-3.C.1 L'interprétation de la valeur $p$ d'un test de significativité pour une différence entre deux proportions de population doit reconnaître que la valeur $p$ est calculée en supposant que l'hypothèse nulle est vraie, c'est-à-dire en supposant que les vraies proportions de population sont égales les unes aux autres.
Objectif d'apprentissage DAT-3.D : Justifier une affirmation sur la population basée sur les résultats d'un test de significativité pour une différence de proportions de populations. [Compétence 4.E]
DAT-3.D.1 Une décision formelle compare explicitement la valeur $p$ au niveau de significativité $\alpha$. Si la valeur $p\text{-value} \leq \alpha$, alors rejeter l'hypothèse nulle, $H_0 : p_1 = p_2$, ou $H_0 : p_1 - p_2 = 0$. Si la valeur $p$$> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.D.2 Les résultats d'un test de significativité pour une différence de deux proportions de populations peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche concernant les deux populations qui ont été échantillonnées.
Source : Description du cours et de l'examen AP College Board
La statistique à deux proportions combinées ⟨$z$⟩ :
Trouver la valeur $p$ depuis le modèle normal, comparer à $\alpha$, et conclure dans le contexte – la même logique en quatre étapes que le test de proportion unique.
6.11
Conseils d'examen
Énoncez les conditions (aléatoire, 10 %, grandes comptages $np,\,nq\ge10$) avant toute inférence sur les proportions.
Un intervalle de confiance = estimation $\pm$ marge d'erreur ; « 95 % confiant » fait référence au taux de capture à long terme de la méthode.
Pour un test, écrire $H_0$ et $H_a$, calculer la statistique de test, trouver la valeur p, et comparer à $\alpha$.
Une petite valeur p est une preuve contre$H_0$ ; ne pas rejeter ne prouve pas$H_0$.
Des échantillons plus grands réduisent la marge d'erreur ; un niveau de confiance plus élevé l'élargit.
7
Inférence pour les données quantitatives : moyennes
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.I : Identifier les questions suggérées par les probabilités d'erreurs dans l'inférence statistique. [Compétence 1.A]
VAR-1.I.1 La variation aléatoire peut entraîner des erreurs dans l'inférence statistique.
Source : Description du cours et de l'examen AP College Board
Erreurs de Type I et Type II
L'inférence pour une moyenne fonctionne comme l'inférence pour une proportion, avec un changement : nous ignorons rarement l'écart-type de la population $\sigma$, donc nous l'estimons avec l'échantillon $s$. Cette incertitude supplémentaire signifie que nous utilisons la distribution $t$ au lieu de la normale – une distribution 分布 qui est en forme de cloche mais avec des queues plus lourdes, et elle dépend des degrés de liberté 自由度$df=n-1$ ; à mesure que $n$ augmente, elle approche la normale.
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.A : Décrire les distributions $t$. [Compétence 3.C]
VAR-7.A.1 Lorsque $s$ est utilisé au lieu de $\sigma$ pour calculer une statistique de test, la distribution correspondante, connue sous le nom de distribution $t$, diffère de la distribution normale par sa forme, car une plus grande partie de la surface est allouée aux queues de la courbe de densité que dans une distribution normale.
VAR-7.A.2 À mesure que les degrés de liberté augmentent, la surface dans les queues d'une distribution $t$ diminue.
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.O : Identifier une procédure d'intervalle de confiance appropriée pour une moyenne de population, y compris la différence de moyenne entre des valeurs appariées. [Compétence 1.D]
UNC-4.O.1 Parce que $\sigma$ est généralement inconnu pour les distributions de variables quantitatives, la procédure d'intervalle de confiance appropriée pour estimer la moyenne de population d'une variable quantitative pour un échantillon est un intervalle de type $t$ à échantillon unique pour une moyenne.
UNC-4.O.2 Pour une variable quantitative, $X$, qui suit une distribution normale, la distribution de $t = \dfrac{(\overline{x} - \mu)}{\frac{s}{\sqrt{n}}}$ est une distribution $t$ avec $n-1$ degrés de liberté.
UNC-4.O.3 Les paires appariées peuvent être considérées comme un seul échantillon de paires. Une fois les différences entre les paires de valeurs trouvées, l'inférence pour les intervalles de confiance se fait comme pour une moyenne de population.
Objectif d'apprentissage UNC-4.P : Vérifier les conditions pour calculer des intervalles de confiance pour une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 4.C]
UNC-4.P.1 Afin de calculer des intervalles de confiance pour estimer une moyenne de population, nous devons vérifier l'indépendance et que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \leq 10\%N$, où $N$ est la taille de la population.
b. Pour vérifier que la distribution d'échantillonnage de $\overline{x}$ est approximativement normale (forme) :
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
ii. Si la taille de l'échantillon est inférieure à 30, la distribution des données de l'échantillon ne doit pas présenter d'asymétrie forte ni de valeurs aberrantes.
Objectif d'apprentissage UNC-4.Q : Déterminer la marge d'erreur pour une taille d'échantillon donnée pour un intervalle de type $t$ à échantillon unique. [Compétence 3.D]
UNC-4.Q.1 La valeur critique $t^*$ avec $n-1$ degrés de liberté peut être trouvée à l'aide d'un tableau ou d'une sortie générée par ordinateur.
UNC-4.Q.2 L'erreur standard pour une moyenne d'échantillon est donnée par $SE = \dfrac{s}{\sqrt{n}}$, où $s$ est l'écart-type de l'échantillon.
UNC-4.Q.3 Pour un intervalle de type $t$ à échantillon unique pour une moyenne, la marge d'erreur est la valeur critique ($t^*$) multipliée par l'erreur standard ($SE$), ce qui équivaut à $t^*\left(\dfrac{s}{\sqrt{n}}\right)$.
Objectif d'apprentissage UNC-4.R : Calculer un intervalle de confiance approprié pour une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 3.D]
UNC-4.R.1 L'estimateur ponctuel pour une moyenne de population est la moyenne de l'échantillon, $\overline{x}$.
UNC-4.R.2 Pour la moyenne de population pour un seul échantillon avec écart-type de population inconnu, l'intervalle de confiance est $\overline{x} \pm t^* \dfrac{s}{\sqrt{n}}$.
Déclaration aux limites : Les formules pour les estimations d'intervalle n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules ne doivent pas être mémorisées, car elles peuvent être construites à partir de la formule générale du test statistique et des formules d'erreur standard pertinentes qui sont fournies sur la feuille de formules.
Source : Description du cours et de l'examen AP College Board
Ce qu'un intervalle de confiance signifie
Un intervalle $t$ à un échantillon pour $\mu$ :
$$\bar{x}\pm t^{*}\frac{s}{\sqrt{n}}.$$
$t^{*}$ est la valeur critique avec $df=n-1$. Conditions : échantillon aléatoire, Normal/Grand Échantillon (population normale, ou $n\ge 30$ par le TCL, ou un échantillon approximativement symétrique sans valeurs aberrantes), et condition des 10 %. Interprétez l'intervalle et le niveau de confiance dans le contexte.
Exemple résolu. Un échantillon aléatoire de $n=25$ a $\bar{x}=50$ et $s=8$. Pour un intervalle $95\%$, $df=24$ donne $t^*=2.064$ :
La loi t a un sommet plus bas et des queues plus épaisses que la normale"Avec une confiance de 95 %" décrit la méthode, pas un intervalle unique : sur de nombreux échantillons, environ 95 % des intervalles contiennent $\mu$ et environ 5 % ne le contiennent pas.
Explorer
Pourquoi un intervalle t est plus large qu'un intervalle z
Un intervalle pour la moyenne utilise $t^*$, pas $1.96$, car $\sigma$ est estimé par $s$. Faites glisser dl vers le bas et observez $t^*$ augmenter — à $df=10$ il vaut $2.228$, et l'intervalle est plus large pour cela. Faites glisser dl vers le haut et $t^*$ redescend vers $1.96$, ce qui explique pourquoi les grands échantillons peuvent utiliser $z$.
7.3
Justifier une affirmation concernant une moyenne
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.S : Interpréter un intervalle de confiance pour une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 4.B]
UNC-4.S.1 Un intervalle de confiance pour une moyenne de population contient soit la moyenne de population, soit il ne la contient pas, car chaque intervalle est basé sur des données provenant d'un échantillon aléatoire, qui varie d'un échantillon à l'autre.
UNC-4.S.2 Nous sommes confiants à C% que l'intervalle de confiance pour une moyenne de population capture la moyenne de population.
UNC-4.S.3 Une interprétation d'un intervalle de confiance pour une moyenne de population inclut une référence à l'échantillon prélevé et des détails sur la population qu'il représente.
Exemples illustratifs pour UNC-4.S.3 : Pour interpréter un intervalle de confiance à 96% pour la longueur moyenne des pieds pour toutes les empreintes trouvées dans une grotte basé sur un échantillon particulier d'empreintes aléatoirement sélectionné dans la grotte : « Nous sommes confiants à 96% que la longueur moyenne des pieds pour toutes les empreintes trouvées dans la grotte tombe dans l'intervalle de confiance » (basé sur FRQ 2000 2).
Objectif d'apprentissage UNC-4.T : Justifier une affirmation basée sur un intervalle de confiance pour une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 4.D]
UNC-4.T.1 Un intervalle de confiance pour une moyenne de population fournit un intervalle de valeurs qui peut fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Objectif d'apprentissage UNC-4.U : Identifier les relations entre la taille de l'échantillon, la largeur d'un intervalle de confiance, le niveau de confiance et la marge d'erreur pour une moyenne de population. [Compétence 4.A]
UNC-4.U.1 Lorsque tout le reste reste constant, la largeur d'un intervalle de confiance pour une moyenne de population a tendance à diminuer lorsque la taille de l'échantillon augmente.
UNC-4.U.2 Pour une seule moyenne, la largeur de l'intervalle est proportionnelle à $\dfrac{1}{\sqrt{n}}$.
UNC-4.U.3 Pour un échantillon donné, la largeur de l'intervalle de confiance pour une moyenne de population augmente lorsque le niveau de confiance augmente.
Source : Description du cours et de l'examen AP College Board
Comme pour les proportions : une moyenne prétendue à l'intérieur de l'intervalle est plausible ; si elle est à l'extérieur, les données apportent des preuves contre cette affirmation. Répondez en contexte en utilisant la plage plausible.
7.4
Préparer un test pour une moyenne
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.B : Identifier une méthode de test appropriée pour une moyenne de population avec $\sigma$ inconnu, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 1.E]
VAR-7.B.1 Le test approprié pour une moyenne de population avec $\sigma$ inconnu est un $t$-test à un échantillon pour une moyenne de population.
VAR-7.B.2 Les paires appariées peuvent être considérées comme un seul échantillon de paires. Une fois les différences entre les paires de valeurs trouvées, l'inférence pour les tests de significativité se fait comme pour une moyenne de population.
Objectif d'apprentissage VAR-7.C : Identifier les hypothèses nulle et alternative pour une moyenne de population avec $\sigma$ inconnu, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 1.F]
VAR-7.C.1 L'hypothèse nulle d'un test $t$ à un échantillon pour la moyenne d'une population est $H_0 : \mu = \mu_0$, où $\mu_0$ est la valeur hypothétisée. Selon la situation, l'hypothèse alternative est $H_a : \mu < \mu_0$, ou $H_a : \mu > \mu_0$, ou $H_a : \mu \neq \mu_0$.
VAR-7.C.2 Lors du calcul de la différence moyenne, $\mu_d$, entre les valeurs dans une paire appariée, il est important de définir l'ordre de la soustraction.
Objectif d'apprentissage VAR-7.D : Vérifier les conditions pour le test d'une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 4.C]
VAR-7.D.1 Afin de faire des inférences statistiques lors du test d'une moyenne de population, nous devons vérifier l'indépendance et que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \leq 10\%N$.
b. Pour vérifier que la distribution d'échantillonnage de $\overline{x}$ est approximativement normale (forme) :
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
ii. Si la taille de l'échantillon est inférieure à 30, la distribution des données de l'échantillon ne doit pas présenter d'asymétrie forte ni de valeurs aberrantes.
Source : Description du cours et de l'examen AP College Board
Ce qu'est une valeur p
Énoncez les hypothèses concernant $\mu$ : $H_0:\mu=\mu_0$ contre $H_a:\mu\neq\mu_0$ (ou $<,>$). Vérifiez les mêmes conditions. La statistique $t$ à un seul échantillon :
Cette valeur $t$ est très éloignée dans la queue de distribution (queue double pour $p<0.01$), donc rejeter $H_0$ – forte preuve que la moyenne n'est pas $45$. Remarquez que $45$ se trouve également hors de l'intervalle de $95\%$$(46.7,53.3)$, la même conclusion par deux voies différentes.
7.5
Exécuter un test pour une moyenne
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.E : Calculer un test statistique approprié pour une moyenne de population, y compris la différence moyenne entre les valeurs dans les paires appariées. [Compétence 3.E]
VAR-7.E.1 Pour une seule variable quantitative lorsqu'un échantillonnage aléatoire avec remise est effectué à partir d'une population qui peut être modélisée avec une distribution normale de moyenne $\mu$ et d'écart-type $\sigma$, la distribution d'échantillonnage de $t = \dfrac{\overline{x} - \mu}{\frac{s}{\sqrt{n}}}$ suit une distribution $t$ avec $n - 1$ degrés de liberté.
Déclaration aux limites : Les formules pour les test statistiques n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules ne doivent pas être mémorisées, car elles peuvent être construites à partir de la formule générale du test statistique et des formules d'erreur standard pertinentes qui sont fournies sur la feuille de formules.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.E : Interpréter la valeur $p$ d'un test de significativité pour une moyenne de population, y compris la différence de moyenne entre les valeurs appariées. [Compétence 4.B]
DAT-3.E.1 L'interprétation de la valeur $p$ d'un test de signification pour une moyenne de population doit reconnaître que la valeur $p$ est calculée en supposant que l'hypothèse nulle est vraie, c'est-à-dire en supposant que la moyenne réelle de la population est égale à la valeur particulière indiquée dans l'hypothèse nulle.
Objectif d'apprentissage DAT-3.F : Justifier une affirmation sur la population basée sur les résultats d'un test de significativité pour une moyenne de population. [Compétence 4.E]
DAT-3.F.1 Une décision formelle compare explicitement la valeur $p$ au seuil de signification $\alpha$. Si la valeur $p$$\leq \alpha$, alors rejeter l'hypothèse nulle, $H_0 : \mu = \mu_0$. Si la valeur $p$$> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.F.2 Les résultats d'un test de significativité pour une moyenne de population peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche sur la population qui a été échantillonnée.
Source : Description du cours et de l'examen AP College Board
Trouvez la valeur de $p$ à partir de la distribution $t$ avec $df=n-1$, comparez-la à $\alpha$, et concluez en contexte – rejetez ou ne rejetez pas $H_0$, puis expliquez ce que cela signifie pour l'affirmation. Indiquez le nom du test, la statistique, $df$, et la valeur de $p$.
Explorer
Lire une valeur p sur la courbe t
La valeur p est l'aire de la queue ombragée au-delà de votre statistique $t$ — les deux queues pour un $H_a$ bilatéral. La courbe normale en pointillés derrière $t$ montre ce que vous auriez obtenu en utilisant incorrectement $z$ : à faible dl, la queue $t$ est visiblement plus épaisse, donc la véritable valeur p est plus grande que ne le suggérerait la normale.
7.6
Intervalle de confiance pour la différence de deux moyennes
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.V : Identifier une procédure d'intervalle de confiance appropriée pour une différence de deux moyennes de population. [Compétence 1.D]
UNC-4.V.1 Considérons un échantillon aléatoire simple de population 1 de taille $n_1$, de moyenne $\mu_1$ et d'écart-type $\sigma_1$ et un second échantillon aléatoire simple de population 2 de taille $n_2$, de moyenne $\mu_2$ et d'écart-type $\sigma_2$. Si les distributions des populations 1 et 2 sont normales ou si both $n_1$ et $n_2$ sont supérieures à 30, alors la distribution d'échantillonnage de la différence des moyennes, $\overline{x}_1 - \overline{x}_2$ est également normale. La moyenne pour la distribution d'échantillonnage de $\overline{x}_1 - \overline{x}_2$ est $\mu_1 - \mu_2$. L'écart-type de $\overline{x}_1 - \overline{x}_2$ est $\sqrt{\dfrac{(\sigma_1)^2}{n_1} + \dfrac{(\sigma_2)^2}{n_2}}$.
UNC-4.V.2 La procédure d'intervalle de confiance appropriée pour une variable quantitative avec deux échantillons indépendants est un intervalle de confiance à deux échantillons $t$ pour une différence entre les moyennes des populations.
Objectif d'apprentissage UNC-4.W : Vérifier les conditions pour calculer des intervalles de confiance pour la différence de deux moyennes de population. [Compétence 4.C]
UNC-4.W.1 Afin de calculer des intervalles de confiance pour estimer une différence de moyennes de population, nous devons vérifier l'indépendance et que la distribution d'échantillonnage est approximativement normale :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide de deux échantillons aléatoires indépendants ou d'une expérience randomisée.
ii. Lors du tirage sans remise, vérifiez que $n_1 \leq 10\%N_1$ et $n_2 \leq 10\%N_2$.
b. Pour vérifier que la distribution d'échantillonnage de $(\overline{x}_1 - \overline{x}_2)$ devrait être approximativement normale (forme) :
i. Si les distributions observées sont asymétriques, both $n_1$ et $n_2$ should be greater than 30.
Objectif d'apprentissage UNC-4.X : Déterminer la marge d'erreur pour la différence de deux moyennes de population. [Compétence 3.D]
UNC-4.X.1 Pour la différence de deux moyennes d'échantillon, la marge d'erreur est la valeur critique ($t^*$) multipliée par l'erreur standard ($SE$) de la différence de deux moyennes.
UNC-4.X.2 L'erreur standard pour la différence de deux moyennes d'échantillon avec des écarts-types d'échantillon, $s_1$ et $s_2$, est $\sqrt{\dfrac{(s_1)^2}{n_1} + \dfrac{(s_2)^2}{n_2}}$.
Objectif d'apprentissage UNC-4.Y : Calculer un intervalle de confiance approprié pour une différence de deux moyennes de population. [Compétence 3.D]
UNC-4.Y.1 L'estimateur ponctuel pour la différence de deux moyennes de population est la différence des moyennes d'échantillon, $\overline{x}_1 - \overline{x}_2$.
UNC-4.Y.2 Pour une différence de deux moyennes de population où les écarts-types de population ne sont pas connus, l'intervalle de confiance est $(\overline{x}_1 - \overline{x}_2) \pm t^* \sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}$ où $\pm t^*$ sont les valeurs critiques pour le C% central d'une distribution $t$ avec les degrés de liberté appropriés qui peuvent être trouvés à l'aide de la technologie.
Déclaration aux limites : Les formules pour les estimations d'intervalle n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules ne doivent pas être mémorisées, car elles peuvent être construites à partir de la formule générale du test statistique et des formules d'erreur standard pertinentes qui sont fournies sur la feuille de formules.
Source : Description du cours et de l'examen AP College Board
Pour des échantillons indépendants, estimez $\mu_1-\mu_2$ :
Les conditions doivent être remplies dans les deux échantillons. (Utilisez la technologie pour la valeur de $df$ ; ne fusionnez pas les variances lors de l'examen AP.)
La randomisation sous-tend une comparaison équitable entre deux groupes dans un test de différence de moyennes
7.7
Justifier une affirmation concernant deux moyennes
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.Z : Interpréter un intervalle de confiance pour une différence de moyennes de population. [Compétence 4.B]
UNC-4.Z.1 Lors d'échantillonnages aléatoires répétés avec la même taille d'échantillon, environ C% des intervalles de confiance créés captureront la différence des moyennes de population.
UNC-4.Z.2 Une interprétation pour un intervalle de confiance pour la différence de deux moyennes de population doit inclure une référence aux échantillons prélevés et des détails sur les populations qu'ils représentent.
Exemples illustratifs pour UNC-4.Z.2 : Pour interpréter un intervalle de confiance pour une différence entre les temps de réponse moyens de deux casernes de pompiers (nord - sud) : « D’après ces échantillons, on peut être 95 % confiant que la différence entre les temps de réponse moyens de la population (nord - sud) se situe entre -2.37 minutes et 0.37 minutes » (2009 FRQ 4).
Objectif d'apprentissage UNC-4.AA : Justifier une affirmation basée sur un intervalle de confiance pour une différence de moyennes de population. [Compétence 4.D]
UNC-4.AA.1 Un intervalle de confiance pour une différence de moyennes de population fournit un intervalle de valeurs qui peut fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Objectif d'apprentissage UNC-4.AB : Identifier les effets de la taille de l'échantillon sur la largeur d'un intervalle de confiance pour la différence de deux moyennes. [Compétence 4.A]
UNC-4.AB.1 Lorsque tout reste égal par ailleurs, la largeur de l'intervalle de confiance pour la différence de deux moyennes a tendance à diminuer lorsque les tailles d'échantillon augmentent.
Source : Description du cours et de l'examen AP College Board
Si l'intervalle pour $\mu_1-\mu_2$ contient $0$, les données sont cohérentes avec des moyennes égales ; s'il exclut $0$, il y a des preuves d'une différence dans ce sens. Interprétez en contexte.
7.8
Préparer un test pour une différence de moyennes
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.F : Identifier une sélection appropriée d'une méthode de test pour une différence de deux moyennes de population. [Compétence 1.E]
VAR-7.F.1 Pour une variable quantitative, le test approprié pour une différence de deux moyennes de population est un test t $t$ à deux échantillons pour une différence de deux moyennes de population.
Objectif d'apprentissage VAR-7.G : Identifier les hypothèses nulle et alternative pour une différence de deux moyennes de population. [Compétence 1.F]
VAR-7.G.1 L'hypothèse nulle pour un test $t$ à deux échantillons pour une différence de deux moyennes de population, $\mu_1$ et $\mu_2$, est : $H_0 : \mu_1 - \mu_2 = 0$, ou $H_0 : \mu_1 = \mu_2$. L'hypothèse alternative est $H_a : \mu_1 - \mu_2 < 0$, ou $H_a : \mu_1 - \mu_2 > 0$, ou $H_a : \mu_1 - \mu_2 \neq 0$, ou $H_a : \mu_1 > \mu_2$, ou $H_a : \mu_1 < \mu_2$, ou $H_a : \mu_1 \neq \mu_2$.
Objectif d'apprentissage VAR-7.H : Vérifier les conditions pour le test de significativité pour la différence de deux moyennes de population. [Compétence 4.C]
VAR-7.H.1 Afin de faire des inférences statistiques lors du test d'une différence entre les moyennes de population, nous devons vérifier l'indépendance et le fait que la distribution d'échantillonnage soit approximativement normale :
a. Les observations individuelles doivent être indépendantes :
i. Les données doivent être collectées à l'aide d'échantillons aléatoires simples ou d'une expérience randomisée.
ii. Lors du tirage sans remise, vérifiez que $n_1 \leq 10\%N_1$ et $n_2 \leq 10\%N_2$.
b. La distribution d'échantillonnage de $\overline{x}_1 - \overline{x}_2$ doit être approximativement normale (forme).
i. Si la distribution observée est asymétrique, both $n_1$ et $n_2$ should be greater than 30.
ii. Si la taille de l'échantillon est inférieure à 30, la distribution des données de l'échantillon doit être exempte d'asymétrie forte et de valeurs aberrantes. Cela doit être vérifié POUR LES DEUX échantillons.
Source : Description du cours et de l'examen AP College Board
Hypothèses : $H_0:\mu_1=\mu_2$ contre $H_a:\mu_1\neq\mu_2$ (ou $<,>$). Distinuez deux échantillons indépendants de données appariées 配对数据 – pour les données appariées (avant/après, sujets appariés), calculez d'abord les différences et appliquez une procédure $t$ à un seul échantillon sur celles-ci.
7.9
Exécuter un test pour une différence de moyennes
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.I : Calculer une statistique de test appropriée pour une différence de deux moyennes. [Compétence 3.E]
VAR-7.I.1 Pour une seule variable quantitative, des données collectées à l'aide d'échantillons aléatoires indépendants ou d'une expérience randomisée provenant de deux populations, dont chacune peut être modélisée par une distribution normale, la distribution d'échantillonnage de $t = \dfrac{(\overline{x}_1 - \overline{x}_2) - (\mu_1 - \mu_2)}{\sqrt{\dfrac{s_1^2}{n_1} + \dfrac{s_2^2}{n_2}}}$ est une approximate $t$-distribution avec des degrés de liberté qui peuvent être trouvés à l'aide d'une technologie. Les degrés de liberté se situent entre le plus petit de $n_1 - 1$ et $n_2 - 1$ et $n_1 + n_2 - 2$.
Exemples illustratifs pour VAR-7.I.1: Dans une étude comparant les temps de récupération moyens pour deux procédures chirurgicales visant à réparer un ligament croisé antérieur (LCA) déchiré, le groupe ayant reçu l'une des procédures avait une taille d'échantillon de 110, tandis que le groupe ayant reçu l'autre procédure avait une taille d'échantillon de 100. Les degrés de liberté se situent entre 100 (le plus petit de 110 et 100) et 208 (110 + 100 - 2). Les degrés de liberté peuvent être déterminés à l'aide d'un logiciel. Si la statistique de test pour cette étude est $t \approx 7.13$, alors la valeur $p$-p est la surface supérieure à 7.13 pour une distribution $t$-t avec $df = 207.18$ (2018 FRQ 4).
Déclaration limite : Les formules pour les statistiques de test n'apparaissent pas explicitement sur la Feuille de formules AP Statistics fournie avec l'examen AP Statistics. Cependant, ces formules ne doivent pas être mémorisées, car elles peuvent être construites sur la base de la formule générale de la statistique de test et des formules d'erreur standard pour chacune des statistiques de test pertinentes fournies sur la feuille de formules.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.G : Interpréter la valeur $p$ d'un test de signification pour une différence de moyennes de population. [Compétence 4.B]
DAT-3.G.1 Une interprétation de la valeur p $p$ d'un test de significativité pour une différence de deux moyennes de population à deux échantillons doit reconnaître que la valeur p $p$ est calculée en supposant que l'hypothèse nulle est vraie, c'est-à-dire en supposant que les vraies moyennes de population sont égales les unes aux autres.
Objectif d'apprentissage DAT-3.H : Justifier une affirmation sur la population basée sur les résultats d'un test de significativité pour une différence de deux moyennes de population dans le contexte. [Compétence 4.E]
DAT-3.H.1 Une décision formelle compare explicitement la valeur $p$ au seuil de signification $\alpha$. Si la valeur $p$$\leq \alpha$, alors rejeter l'hypothèse nulle, $H_0 : \mu_1 - \mu_2 = 0$, ou $H_0 : \mu_1 = \mu_2$. Si la valeur $p$$> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.H.2 Les résultats d'un test de significativité pour un test à deux échantillons pour une différence entre deux moyennes de population peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche sur les populations qui ont été échantillonnées.
Source : Description du cours et de l'examen AP College Board
Obtenez la valeur de $p$ (technologie pour $df$), comparez-la à $\alpha$, et concluez en contexte.
7.10
Choisir et communiquer une procédure
Programme
Ce sujet vise à se concentrer sur la compétence de sélectionner une procédure d'inférence appropriée, maintenant que les étudiants disposent d'un éventail d'options. Les étudiants devraient avoir l'occasion de pratiquer quand et comment appliquer tous les objectifs d'apprentissage relatifs à l'inférence impliquant des proportions ou des moyennes.
Source : Description du cours et de l'examen AP College Board
La compétence d'examen la plus difficile est de choisir la bonne procédure : un ou deux échantillons ? proportion ou moyenne ? apparié ou indépendant ? intervalle de confiance ou test ? Lisez la question pour identifier ce qui est estimé ou affirmé, puis nommez la procédure, vérifiez ses conditions, exécutez-la, et communiquez clairement la conclusion avec des chiffres et le contexte.
7.10
Conseils d'examen
Utilisez des procédures t pour les moyennes (la population $\sigma$ est inconnue) – la distribution t a des queues plus épaisses que la normale.
Vérifiez les conditions : aléatoire, indépendant et approximativement normal (ou grand $n$).
Interprétez un intervalle et un test en contexte, toujours liés au paramètre (la vraie moyenne).
Associez la bonne procédure : un seul échantillon, deux échantillons ou apparié (recherchez un appariement naturel).
Énoncez les degrés de liberté ; pour un test $t$ à deux échantillons, utilisez la valeur donnée par la technologie (ou, à la main, le plus petit conservateur $n-1$).
8
Inférence pour les données catégorielles : Khi-deux (Chi-Square)
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.J : Identifier les questions suggérées par une variation entre les effectifs observés et attendus dans des données catégorielles. [Compétence 1.A]
VAR-1.J.1 La variation entre ce que nous trouvons et ce que nous nous attendions à trouver peut être aléatoire ou non.
Source : Description du cours et de l'examen AP College Board
Lorsque les données sont des comptages répartis dans plusieurs catégories, nous testons si les comptages observés diffèrent de ceux prédits par une affirmation. L'outil est la statistique chi-carré 卡方 ($\chi^2$), qui additionne les écarts standardisés entre les comptages observés et attendus :
Une grande valeur de $\chi^2$ signifie que les comptages observés sont loin des valeurs attendues – preuve contre l'affirmation. La distribution chi-carré est asymétrique à droite et dépend de ses degrés de liberté 自由度.
8.2
Préparer un bon test d'ajustement
Programme
Compréhension durable (VAR-8) : La distribution du khi-deux peut être utilisée pour modéliser une variation.
Objectif d'apprentissage VAR-8.A : Décrire les distributions du khi-deux. [Compétence 3.C]
VAR-8.A.1 Les effectifs attendus des données catégorielles sont des effectifs cohérents avec l'hypothèse nulle. En général, un effectif attendu est une taille d'échantillon multipliée par une probabilité.
La statistique du khi-deux mesure la distance entre les effectifs observés et attendus par rapport aux effectifs attendus.
Les distributions du khi-deux ont des valeurs positives et sont asymétriques à droite. Au sein d'une famille de courbes de densité, l'asymétrie devient moins prononcée avec l'augmentation des degrés de liberté.
Objectif d'apprentissage VAR-8.B : Identifier les hypothèses nulle et alternative dans un test pour la distribution de proportions dans un ensemble de données catégorielles. [Compétence 1.F]
VAR-8.B.1 Pour un test d'ajustement du khi-deux, l'hypothèse nulle spécifie les proportions nulles pour chaque catégorie, et l'hypothèse alternative est qu'au moins l'une de ces proportions n'est pas telle que spécifiée dans l'hypothèse nulle.
Objectif d'apprentissage VAR-8.C : Identifier une méthode de test appropriée pour une distribution de proportions dans un ensemble de données catégorielles. [Compétence 1.E]
VAR-8.C.1 En considérant une distribution de proportions pour une variable catégorielle, le test approprié est le test du khi-deux pour l'ajustement.
Objectif d'apprentissage VAR-8.D : Calculer les effectifs attendus pour le test du khi-deux pour l'ajustement. [Compétence 3.A]
VAR-8.D.1 Les effectifs attendus pour un test d'ajustement du khi-deux sont (taille de l'échantillon)(proportion nulle).
Objectif d'apprentissage VAR-8.E : Vérifier les conditions pour faire des inférences statistiques lors du test d'ajustement pour une distribution du khi-deux. [Compétence 4.C]
VAR-8.E.1 Afin de faire des inférences statistiques pour un test d'ajustement du khi-deux, nous devons vérifier les points suivants :
a. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \leq 10\%N$.
b. Le test du khi-deux pour l'ajustement devient plus précis avec davantage d'observations, donc des grands effectifs doivent être utilisés (forme).
i. Un contrôle conservateur pour les grands effectifs est que tous les effectifs attendus doivent être supérieurs à 5.
Source : Description du cours et de l'examen AP College Board
Le test du chi-carré (χ²)
Un test d'ajustement (GOF) 拟合优度 vérifie si une variable catégorielle suit une distribution prétendue (ex. "le dé est équitable"). Hypothèses :
$$H_0:\text{the distribution is as claimed}\qquad H_a:\text{at least one proportion differs}.$$
Comptage attendu pour chaque catégorie $=n\times(\text{claimed proportion})$. Conditions : échantillon aléatoire, tous les comptages attendus $\ge 5$, et condition des 10 %.
La distribution du chi-carré est asymétrique à droite. Une grande statistique atterrit dans la queue droite ombrée au-delà de la valeur critique – c'est là que vous rejetez le modèle.
VAR-8.F.2 La distribution de la statistique de test en supposant que l'hypothèse nulle est vraie (distribution nulle) peut être soit une distribution de randomisation, soit, lorsqu'un modèle probabiliste est supposé être vrai, une distribution théorique (khi-deux).
Objectif d'apprentissage VAR-8.G : Déterminer la valeur p $p$ pour le test de significativité du khi-deux pour l'ajustement. [Compétence 3.E]
VAR-8.G.1 La valeur p $p$ pour un test du khi-deux pour l'ajustement avec un certain nombre de degrés de liberté est trouvée à l'aide de la table appropriée ou de la sortie générée par ordinateur.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.I : Interpréter la valeur p $p$ pour le test du khi-deux pour l'ajustement. [Compétence 4.B]
DAT-3.I.1 Une interprétation de la valeur p $p$ pour le test du khi-deux pour l'ajustement est la probabilité, étant donné que l'hypothèse nulle et le modèle de probabilité sont vrais, d'obtenir une statistique de test aussi extrême ou plus que la valeur observée.
Objectif d'apprentissage DAT-3.J : Justifier une affirmation sur la population basée sur les résultats d'un test du khi-deux pour l'ajustement. [Compétence 4.E]
DAT-3.J.1 Une décision de rejeter ou de ne pas rejeter l'hypothèse nulle est basée sur la comparaison de la valeur p $p$ au niveau de significativité, $\alpha$.
DAT-3.J.2 Les résultats d'un test du khi-deux pour l'ajustement peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche sur la population qui a été échantillonnée.
Source : Description du cours et de l'examen AP College Board
Calculez $\chi^2=\sum\dfrac{(O-E)^2}{E}$ avec $df=(\text{number of categories})-1$. Trouvez la valeur de $p$ à partir de la distribution du chi-carré (queue supérieure), comparez-la à $\alpha$, et concluez en contexte. Un grand composant de la somme indique la catégorie qui s'écarte le plus.
Le chi-carré compare les comptages observés avec ceux attendus sous l'hypothèse nulle
Exemple résolu. Un dé lancé $60$ fois donne les comptages $8,10,12,9,11,10$. S'il est équitable, chaque comptage attendu est $60/6=10$, donc
avec $df=6-1=5$. Écrivez chaque catégorie, y compris les deux qui correspondent exactement à leur comptage attendu et ajoutent donc $0$ – la somme porte sur les six catégories, et $df$ compte les catégories, pas seulement celles qui diffèrent. Cette valeur de $\chi^2$ est faible (une grande valeur de $p$), donc nous ne rejetons pas$H_0$ – aucune preuve que le dé est truqué.
Explorer
Explorer la distribution chi-deux et sa valeur p
La valeur p est l'aire dans la queue droite au-delà de votre statistique de test, donc une $\chi^2$plus grande signifie une valeur p plus petite. Faites glisser $\chi^2$ pour observer cette zone rétrécir, et faites glisser dl pour voir toute la famille changer de forme — fortement asymétrique à droite à faible dl, plus symétrique lorsque dl augmente.
8.4
Comptages attendus dans les tableaux à double entrée
Programme
Compréhension durable (VAR-8) : La distribution du khi-deux peut être utilisée pour modéliser une variation.
Objectif d'apprentissage VAR-8.H : Calculer les effectifs attendus pour les tableaux à double entrée de données catégorielles. [Compétence 3.A]
VAR-8.H.1 L'effectif attendu dans une cellule particulière d'un tableau à double entrée de données catégorielles peut être calculé en utilisant la formule :
C'est le comptage que vous observeriez si les variables de ligne et de colonne étaient non liées.
Exemple résolu. Dans un tableau à double entrée, le total de ligne d'une cellule est $40$, son total de colonne est $50$, et le total général est $200$. Son comptage attendu est $E=\dfrac{40\times50}{200}=10$. Répéter pour chaque cellule donne le tableau attendu à comparer avec l'observé.
Un tableur organise les comptages catégoriels avant un test du chi-carré
8.5
Homogénéité ou Indépendance ?
Programme
Compréhension durable (VAR-8) : La distribution du khi-deux peut être utilisée pour modéliser une variation.
Objectif d'apprentissage VAR-8.I : Identifier les hypothèses nulle et alternative pour un test du khi-deux pour l'homogénéité ou l'indépendance. [Compétence 1.F]
VAR-8.I.1 Les hypothèses appropriées pour un test du khi-deux pour l'homogénéité sont :
$H_0$ : Il n'y a pas de différence dans les distributions d'une variable catégorielle entre les populations ou les traitements.
$H_a$ : Il y a une différence dans les distributions d'une variable catégorielle entre les populations ou les traitements.
VAR-8.I.2 Les hypothèses appropriées pour un test du khi-deux pour l'indépendance sont :
$H_0$ : Il n'y a pas d'association entre deux variables catégorielles dans une population donnée, ou les deux variables catégorielles sont indépendantes.
$H_a$ : Deux variables catégorielles dans une population sont associées ou dépendantes.
Objectif d'apprentissage VAR-8.J : Identifier une méthode d'essai appropriée pour comparer des distributions dans des tableaux à double entrée de données catégorielles. [Compétence 1.E]
VAR-8.J.1 Lors de la comparaison de distributions pour déterminer si les proportions de chaque catégorie pour des données catégorielles collectées auprès de différentes populations sont identiques, le test approprié est le test du khi-deux pour l'homogénéité.
VAR-8.J.2 Pour déterminer si les variables de ligne et de colonne dans un tableau à double entrée de données catégorielles pourraient être associées dans la population d'où les données ont été échantillonnées, le test approprié est le test du khi-deux pour l'indépendance.
Objectif d'apprentissage VAR-8.K : Vérifier les conditions permettant de faire des inférences statistiques lors du test d'une distribution du khi-deux pour l'indépendance ou l'homogénéité. [Compétence 4.C]
VAR-8.K.1 Afin de faire des inférences statistiques pour un test du khi-deux sur des tableaux à double entrée (homogénéité ou indépendance), nous devons vérifier ce qui suit :
a. Pour vérifier l'indépendance :
i. Pour un test d'indépendance : Les données doivent être collectées à l'aide d'un échantillon aléatoire simple.
ii. Pour un test d'homogénéité : Les données doivent être collectées à l'aide d'un échantillon aléatoire stratifié ou d'une expérience randomisée.
iii. Lors d'un échantillonnage sans replacement, vérifiez que $n \leq 10\%N$.
b. Les tests du khi-deux pour l'indépendance et l'homogénéité deviennent plus précis avec davantage d'observations, donc des comptes élevés doivent être utilisés (forme).
i. Un contrôle conservateur pour les grands effectifs est que tous les effectifs attendus doivent être supérieurs à 5.
Source : Description du cours et de l'examen AP College Board
Deux tests utilisent la même mathématique de $\chi^2$ mais répondent à des questions différentes :
Test d'homogénéité 同质性 : les distributions d'une variable catégorielle sont-elles les mêmes chez plusieurs populations ou groupes (échantillons/traitements séparés) ?
Test d'indépendance 独立性 : deux variables catégorielles sont-elles associées au sein d'une seule population (un échantillon, deux variables mesurées) ?
La conception (plusieurs échantillons contre un seul échantillon) détermine quel nom et quelles hypothèses utiliser.
8.6
Exécuter un test d'homogénéité ou d'indépendance
Programme
Compréhension durable (VAR-8) : La distribution du khi-deux peut être utilisée pour modéliser une variation.
Objectif d'apprentissage VAR-8.L : Calculer la statistique appropriée pour un test du khi-deux pour l'homogénéité ou l'indépendance. [Compétence 3.E]
VAR-8.L.1 La statistique de test appropriée pour un test du khi-deux pour l'homogénéité ou l'indépendance est la statistique du khi-deux :
Équation :$\chi^2 = \sum \dfrac{(Observed\ count - Expected\ count)^2}{Expected\ count}$, avec des degrés de liberté égaux à : $(number\ of\ rows - 1)(number\ of\ columns - 1)$.
Objectif d'apprentissage VAR-8.M : Déterminer la valeur $p$ pour un test de signification du khi-deux pour l'indépendance ou l'homogénéité. [Compétence 3.E]
VAR-8.M.1 La valeur $p$ pour un test du khi-deux pour l'indépendance ou l'homogénéité pour un nombre de degrés de liberté est trouvée à l'aide de la table appropriée ou de la technologie.
VAR-8.M.2 Pour un test d'indépendance ou d'homogénéité pour un tableau à double entrée, la valeur $p$ est la proportion de valeurs dans une distribution du khi-deux avec des degrés de liberté appropriés qui sont égales ou supérieures à la statistique de test.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.K : Interpréter la valeur $p$ pour le test du khi-deux pour l'homogénéité ou l'indépendance. [Compétence 4.B]
DAT-3.K.1 Une interprétation de la valeur $p$ pour le test du chi-deux d'homogénéité ou d'indépendance est la probabilité, sous l'hypothèse nulle et le modèle probabiliste supposés vrais, d'obtenir une statistique de test aussi extrême ou plus extrême que la valeur observée.
Objectif d'apprentissage DAT-3.L : Justifier une affirmation concernant la population basée sur les résultats d'un test du khi-deux pour l'homogénéité ou l'indépendance. [Compétence 4.E]
DAT-3.L.1 Une décision de rejeter ou de ne pas rejeter l'hypothèse nulle pour un test du khi-deux pour l'homogénéité ou l'indépendance est basée sur la comparaison de la valeur $p$ au niveau de signification, $\alpha$.
DAT-3.L.2 Les résultats d'un test du khi-deux pour l'homogénéité ou l'indépendance peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche sur la population qui a été échantillonnée (indépendance) ou les populations qui ont été échantillonnées (homogénéité).
Source : Description du cours et de l'examen AP College Board
Calculez les comptages attendus, puis $\chi^2=\sum\dfrac{(O-E)^2}{E}$ sur toutes les cellules, avec
$$df=(\text{rows}-1)(\text{columns}-1).$$
Conditions : données aléatoires, tous les comptages attendus $\ge 5$, condition des 10 %. Trouvez la valeur de $p$, comparez-la à $\alpha$, et concluez en contexte – preuve d'une différence entre les groupes (homogénéité) ou d'une association (indépendance).
8.7
Choisir la bonne procédure catégorielle
Programme
Ce sujet vise à se concentrer sur la compétence de sélection d'une procédure d'inférence appropriée maintenant que les étudiants disposent d'un éventail d'options. Les étudiants devraient avoir l'occasion de pratiquer quand et comment appliquer tous les objectifs d'apprentissage relatifs aux inférences pour des données catégorielles.
Source : Description du cours et de l'examen AP College Board
Décider par la configuration : une variable catégorielle contre une distribution claimée $\Rightarrow$goodness-of-fit ; un échantillon croisé par deux variables $\Rightarrow$indépendance ; plusieurs échantillons/groupes comparés $\Rightarrow$homogénéité. Comparer juste deux proportions peut utiliser soit un test de différence de proportions $z$, soit un test du chi-carré, mais seulement pour une alternative bilatérale, où elles concordent exactement ($\chi^2=z^2$). Un test du chi-carré est toujours bilatéral, donc il ne peut pas donner une conclusion directionnelle : si $H_a$ est unilatérale (par exemple $p_1>p_2$), utiliser le test $z$.
Explorer
De quel test chi-deux s'agit-il ?
Les trois tests utilisent la même arithmétique $\chi^2$, donc les points sont gagnés en nommant le bon test. Le design décide — combien d'échantillons ont été pris, et combien de variables ont été mesurées sur chaque unité.
Compréhension durable (VAR-1) : Étant donné que la variation peut être aléatoire ou non, les conclusions sont incertaines.
Objectif d'apprentissage VAR-1.K : Identifier les questions suggérées par la variation dans les nuages de points. [Compétence 1.A]
VAR-1.K.1 La variation des positions des points par rapport à une ligne théorique peut être aléatoire ou non aléatoire.
Source : Description du cours et de l'examen AP College Board
Un nuage de points 散点图 d'échantillon donne une pente d'échantillon 样本斜率$b$ pour la droite de régression 回归 des moindres carrés – mais un autre échantillon donnerait une pente légèrement différente. Donc $b$ est une statistique avec variabilité d'échantillonnage 抽样变异性, estimant la pente réelle (population) 总体斜率$\beta$. Cette unité fait de l'inférence 推断 pour $\beta$ : y a-t-il une véritable relation linéaire 线性, et quelle est sa force ?
9.2
Intervalle de confiance pour une pente
Programme
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.AC : Identifier une procédure d'intervalle de confiance appropriée pour la pente d'un modèle de régression. [Compétence 1.D]
UNC-4.AC.1 Considérez une variable réponse, $y$, qui est linéairement liée à une variable explicative, $x$. Pour un échantillon aléatoire simple de $n$ observations, la droite de régression de l'échantillon, $\hat{y} = a + bx$, est une estimation de la droite de régression de la population $\mu_y = \alpha + \beta x$. Pour une observation particulière, $(x_i, y_i)$, le résidu de la droite de régression de l'échantillon, $y_i - \hat{y}_i = y_i - (a + bx_i)$, est une estimation de $y_i - (\alpha + \beta x_i)$, l'écart de la variable réponse par rapport à la droite de régression de la population. Pour tous les points $(x, y)$ dans la population, l'écart-type de tous les écarts de la variable réponse par rapport à la droite de régression de la population, $\sigma$, peut être estimé par l'écart-type des résidus de la droite de régression de l'échantillon, $s = \sqrt{\dfrac{\sum\left(y_i - \hat{y}_i\right)^2}{n-2}}$. (Remarque : Cette formule utilise $n-2$ au dénominateur au lieu de $n-1$ car deux paramètres, $\alpha$ et $\beta$, doivent être estimés pour obtenir les valeurs prédites à partir de la droite de régression des moindres carrés.)
UNC-4.AC.2 Pour un échantillon aléatoire simple de $n$ observations, soit $b$ représentant la pente d'une droite de régression de l'échantillon. Alors la moyenne de la distribution d'échantillonnage pour $b$ est égale à la pente de la population : $\mu_b = \beta$. L'écart-type de la distribution d'échantillonnage pour $b$ est $\sigma_b = \dfrac{\sigma}{\sigma_x \sqrt{n}}$, où $\sigma_x = \sqrt{\dfrac{\sum\left(x_i - \bar{x}\right)^2}{n}}$.
UNC-4.AC.3 L'intervalle de confiance approprié pour la pente d'un modèle de régression est un intervalle de confiance $t$ pour la pente.
Objectif d'apprentissage UNC-4.AD : Vérifier les conditions pour calculer des intervalles de confiance pour la pente d'un modèle de régression. [Compétence 4.C]
UNC-4.AD.1 Afin de calculer un intervalle de confiance pour estimer la pente d'une droite de régression, nous devons vérifier ce qui suit :
a. La relation réelle entre $x$ et $y$ est linéaire. L'analyse des résidus peut être utilisée pour vérifier la linéarité.
b. L'écart-type pour $y$, $\sigma_y$, ne varie pas avec $x$. L'analyse des résidus peut être utilisée pour vérifier des écarts-types approximativement égaux pour toutes les $x$.
c. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \le 10\% N$.
d. Pour une valeur particulière de $x$, les réponses (valeurs $y$) sont approximativement normalement distribuées. L'analyse de représentations graphiques des résidus peut être utilisée pour vérifier la normalité.
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
Objectif d'apprentissage UNC-4.AE : Déterminer la marge d'erreur donnée pour la pente d'un modèle de régression. [Compétence 3.D]
UNC-4.AE.1 Pour la pente d'une droite de régression, la marge d'erreur est la valeur critique $\left(t^*\right)$ multipliée par l'erreur standard ($SE$) de la pente.
UNC-4.AE.2 L'erreur standard pour la pente d'une droite de régression avec un écart-type de l'échantillon, $s$, est $SE = \dfrac{s}{s_x \sqrt{n-1}}$, où $s$ est l'estimation de $\sigma$ et $s_x$ est l'écart-type de l'échantillon des valeurs $x$.
Objectif d'apprentissage UNC-4.AF : Calculer un intervalle de confiance approprié pour la pente d'un modèle de régression. [Compétence 3.D]
UNC-4.AF.1 L'estimateur ponctuel pour la pente d'un modèle de régression est la pente de la droite de meilleure ajustement, $b$.
UNC-4.AF.2 Pour la pente d'un modèle de régression, l'estimation par intervalle est $b \pm t^* \left(SE_b\right)$.
Source : Description du cours et de l'examen AP College Board
Un intervalle de $t$ pour la vraie pente $\beta$ :
$$b\pm t^{*}\,SE_b,\qquad df=n-2,$$
où $b$ est la pente d'échantillon et $SE_b$ son erreur type (lu dans la sortie ordinateur). Conditions (LINER) : la relation réelle est Linéaire, observations Indépendantes, résidus Normaux, et résidus ont une dispersion Égale (vérifiez le graphique des résidus et un histogramme des résidus), provenant de données Aléatoires. Interprétez l'intervalle pour $\beta$ en contexte, avec les unités de $y$ par unité de $x$.
Un graphique de résidus aléatoire et sans motif soutient les conditions ; une courbe ou un entonnoir ne le font pas
Le graphique des résidus 残差图 est l'endroit où vous vérifiez Linéarité et Dispersion Égale : vous voulez un nuage sans forme autour de zéro. Une courbe signifie que la relation n'est pas linéaire ; un entonnoir (dispersion croissante avec $x$) signifie que les résidus n'ont pas une dispersion égale – les deux violent une condition.
Exemple résolu. La sortie de régression donne une pente $b=2.5$ avec $SE_b=0.8$ à partir de $n=20$ points. Pour un intervalle de $95\%$, $df=18$ donne $t^*=2.101$ :
$$2.5\pm2.101(0.8)=2.5\pm1.68=(0.82,\ 4.18).$$
Parce que $0$ n'est pas dans l'intervalle, il y a des preuves d'une relation linéaire positive.
L'inférence sur la pente est basée sur la droite de régression des moindres carrés passant par les pointsRégression des moindres carrés : la droite qui minimise la somme des carrés des résidus
Explorer
Inférence pour la pente d'une régression
La pente de l'échantillon varie d'un échantillon à l'autre ; un intervalle de confiance et un test t demandent si la vraie pente pourrait être zéro (pas de relation linéaire).
Compréhension durable (UNC-4) : Un intervalle de valeurs doit être utilisé pour estimer des paramètres, afin de tenir compte de l'incertitude.
Objectif d'apprentissage UNC-4.AG : Interpréter un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.B]
UNC-4.AG.1 Dans des échantillonnages aléatoires répétés avec la même taille d'échantillon, environ C% des intervalles de confiance créés captureront la pente du modèle de régression, c.-à-d. la vraie pente de la droite de régression de la population.
UNC-4.AG.2 Une interprétation pour un intervalle de confiance pour la pente d'une droite de régression doit inclure une référence à l'échantillon pris et des détails sur la population qu'il représente.
Objectif d'apprentissage UNC-4.AH : Justifier une affirmation basée sur un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.D]
UNC-4.AH.1 Un intervalle de confiance pour la pente d'un modèle de régression fournit un intervalle de valeurs qui peuvent fournir des preuves suffisantes pour soutenir une affirmation particulière dans le contexte.
Objectif d'apprentissage UNC-4.AI : Identifier les effets de la taille de l'échantillon sur la largeur d'un intervalle de confiance pour la pente d'un modèle de régression. [Compétence 4.A]
UNC-4.AI.1 Lorsque tout reste égal ailleurs, la largeur de l'intervalle de confiance pour la pente d'un modèle de régression a tendance à diminuer lorsque la taille de l'échantillon augmente.
Source : Description du cours et de l'examen AP College Board
Si l'intervalle de confiance pour $\beta$ contient $0$, une pente nulle est plausible – aucune preuve d'une relation linéaire. Si l'intervalle est entièrement positif ou négatif, il existe des preuves d'une véritable relation linéaire (positive ou négative). Indiquez la direction dans le contexte.
9.4
Poser un test pour une pente
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.J : Identifier la sélection appropriée d'une méthode de test pour la pente d'un modèle de régression. [Compétence 1.E]
VAR-7.J.1 Le test approprié pour la pente d'un modèle de régression est un test $t$ pour une pente.
Objectif d'apprentissage VAR-7.K : Identifier les hypothèses nulle et alternative appropriées pour la pente d'un modèle de régression. [Compétence 1.F]
VAR-7.K.1 L'hypothèse nulle pour un test $t$ pour une pente est : $H_0 : \beta = \beta_0$, où $\beta_0$ est la valeur hypothétique de l'hypothèse nulle. L'hypothèse alternative est $H_0 : \beta < \beta_0$ ou $H_0 : \beta > \beta_0$, ou $H_0 : \beta \neq \beta_0$.
Objectif d'apprentissage VAR-7.L : Vérifier les conditions pour le test de signification pour la pente d'un modèle de régression. [Compétence 4.C]
VAR-7.L.1 Afin de faire des inférences statistiques lors du test pour la pente d'un modèle de régression, nous devons vérifier ce qui suit :
a. La relation réelle entre $x$ et $y$ est linéaire. L'analyse des résidus peut être utilisée pour vérifier la linéarité.
b. L'écart-type pour $y$, $\sigma_y$, ne varie pas avec $x$. L'analyse des résidus peut être utilisée pour vérifier des écarts-types approximativement égaux pour toutes les $x$.
c. Pour vérifier l'indépendance :
i. Les données doivent être collectées à l'aide d'un échantillon aléatoire ou d'une expérience randomisée.
ii. Lors de l'échantillonnage sans remise, vérifier que $n \le 10\% N$.
d. Pour une valeur particulière de $x$, les réponses (valeurs $y$) sont approximativement normalement distribuées. L'analyse de représentations graphiques des résidus peut être utilisée pour vérifier la normalité.
i. Si la distribution observée est asymétrique, $n$ doit être supérieur à 30.
ii. Si la taille de l'échantillon est inférieure à 30, la distribution des données de l'échantillon ne doit pas présenter d'asymétrie forte ni de valeurs aberrantes.
Source : Description du cours et de l'examen AP College Board
Le test habituel demande s'il existe une quelconque relation linéaire :
$$H_0:\beta=0 \quad(\text{no linear relationship})\qquad H_a:\beta\neq 0 \ (\text{or } <,\,>).$$
Vérifiez les conditions LINER. Il s'agit d'un test $t$ sur la pente.
Vérifiez les graphiques des résidus avant de faire confiance à un IC de pente ou un test
9.5
Effectuer un test pour une pente
Programme
Compréhension durable (VAR-7) : La distribution $t$ peut être utilisée pour modéliser la variation.
Objectif d'apprentissage VAR-7.M : Calculer une statistique de test appropriée pour la pente d'un modèle de régression. [Compétence 3.E]
VAR-7.M.1 La distribution de la pente d'un modèle de régression en supposant que toutes les conditions sont remplies et l'hypothèse nulle est vraie (distribution nulle) suit une distribution $t$.
VAR-7.M.2 Pour la régression linéaire simple, lorsque l'échantillonnage aléatoire provient d'une population dont la réponse peut être modélisée par une distribution normale pour chaque valeur de la variable explicative, la distribution d'échantillonnage de $t = \dfrac{b - \beta}{SE_b}$ suit une distribution $t$ avec des degrés de liberté égaux à $n - 2$. Lors du test de la pente dans un modèle de régression linéaire simple avec un seul paramètre, la pente, le test de la pente a $df = n - 1$.
Compréhension durable (DAT-3) : Les tests de significativité nous permettent de prendre des décisions concernant des hypothèses dans un contexte particulier.
Objectif d'apprentissage DAT-3.M : Interpréter la valeur-$p$ d'un test de signification pour la pente d'un modèle de régression. [Compétence 4.B]
DAT-3.M.1 Une interprétation de la valeur-$p$ d'un test de signification pour la pente d'un modèle de régression doit reconnaître que la valeur-$p$ est calculée en supposant que l'hypothèse nulle est vraie, c'est-à-dire en supposant que la pente réelle de la population est égale à la valeur particulière indiquée dans l'hypothèse nulle.
Objectif d'apprentissage DAT-3.N : Justifier une affirmation sur la population sur la base des résultats d'un test de signification pour la pente d'un modèle de régression. [Compétence 4.E]
DAT-3.N.1 Une décision formelle compare explicitement la valeur-$p$ au seuil de signification-$\alpha$. Si la valeur-$p$ est $\le \alpha$, alors rejeter l'hypothèse nulle, $H_0 : \beta = \beta_0$. Si la valeur-$p$ est $> \alpha$, alors ne pas rejeter l'hypothèse nulle.
DAT-3.N.2 Les résultats d'un test de signification pour la pente d'un modèle de régression peuvent servir de raisonnement statistique pour soutenir la réponse à une question de recherche concernant cet échantillon.
Source : Description du cours et de l'examen AP College Board
La statistique de pente $t$ :
$$t=\frac{b-0}{SE_b},\qquad df=n-2.$$
Les deux $b$ et $SE_b$ proviennent directement de la sortie de régression. Trouvez la valeur $p$ à partir de la distribution $t$, comparez-la à $\alpha$, et concluez dans le contexte – preuve (ou non) d'une relation linéaire entre les deux variables.
Surveillez les queues. La sortie de régression affiche toujours la valeur à deux queues$p$ (pour $H_a:\beta\neq 0$). Si votre $H_a$ est à une queue, divisez-la par deux – mais vérifiez d'abord que la pente de l'échantillon pointe réellement dans la direction que prétend $H_a$ ; si elle pointe dans l'autre sens, la valeur $p$ à une queue est supérieure à $0.5$ et vous ne pouvez pas rejeter $H_0$.
Exemple résolu. Pour la même sortie ($b=2.5$, $SE_b=0.8$, $n=20$), testez $H_0:\beta=0$ :
$$t=\frac{2.5-0}{0.8}=3.13,\qquad df=18,$$
une petite valeur $p$ ($<0.01$), donc rejetez $H_0$ – preuve convaincante d'une relation linéaire. Cela correspond à l'intervalle, qui excluait $0$.
9.6
Sélectionner la bonne procédure
Programme
Ce sujet vise à se concentrer sur la compétence consistant à sélectionner une procédure d'inférence appropriée maintenant que les étudiants disposent d'un éventail d'options. Les étudiants doivent avoir l'occasion de pratiquer quand et comment appliquer tous les objectifs d'apprentissage relatifs à l'inférence.
Source : Description du cours et de l'examen AP College Board
Dans toute l'inférence, identifiez : quoi est estimé ou affirmé (une proportion, une moyenne, une différence, une distribution de comptes ou une pente), combien d'échantillons, et quel type de conception (indépendante ou appariée ; échantillon ou expérience). Ensuite, nommez la procédure, vérifiez ses conditions, effectuez-la, communiquez la conclusion avec la statistique, la valeur $p$ ou l'intervalle, et une réponse en langage simple dans le contexte. Cette compétence de sélection et de communication est ce que la question de tâche d'enquête récompense le plus.
9.6
Conseils d'examen
L'inférence pour une pente teste si la vraie pente est $0$ (aucune relation linéaire).
Si l'intervalle de confiance d'une pente inclut 0, vous ne pouvez pas conclure à une réelle relation linéaire – les variables peuvent toujours être liées de manière courbe.
Lisez la pente, l'erreur standard, la statistique t et la valeur p directement depuis la sortie informatique – mais la valeur p imprimée est à deux queues, divisez-la donc par deux pour une valeur $H_a$ à une queue.
Vérifiez les conditions de régression (linéarité, indépendance, résidus approximativement normaux, dispersion égale) via le graphique des résidus.
Interprétez l'intervalle et le test dans le contexte, liés à la vraie pente.