Este material cobre o Tema 6: Probabilidade & Estatística 概率统计 2. Adiciona o modelo Poisson, combinação de variáveis aleatórias, distribuições contínuas e os conceitos de estimação e teste.
Probabilidade e Estatística 2
Matemática do A-Level · Tópico 6
 10:06
Probabilidade e Estatística 2
Cambridge, nos anos vinte. Em uma festa no jardim, uma senhora diz algo surpreendente. Ela afirma que consegue provar se o leite foi derramado primeiro no copo…
Narração em inglês · Legendas em inglês + 中文 gravadas
6.1
A distribuição Poisson
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| • usar fórmulas para calcular probabilidades para a distribuição $\text{Po}(\lambda)$ | |
| • use o fato de que se $X \sim \text{Po}(\lambda)$ então a média e a variância de $X$ são cada uma iguais a $\lambda$ | Provas não são necessárias. |
| • compreender a relevância da distribuição de Poisson para a distribuição de eventos aleatórios, e usar a distribuição de Poisson como modelo | |
| • usar a distribuição de Poisson como aproximação à distribuição binomial quando apropriado | As condições de que $n$ é grande e $p$ é pequena devem ser conhecidas; $n > 50$ e $np < 5$, aproximadamente. |
| • usar a distribuição normal, com correção de continuidade, como aproximação à distribuição de Poisson quando apropriado. | A condição de que $\lambda$ é grande deve ser conhecida; $\lambda > 15$, aproximadamente. |
Fonte: Programa Cambridge International
*Pessoas chegando aleatoriamente em uma fila seguem uma distribuição Poisson.
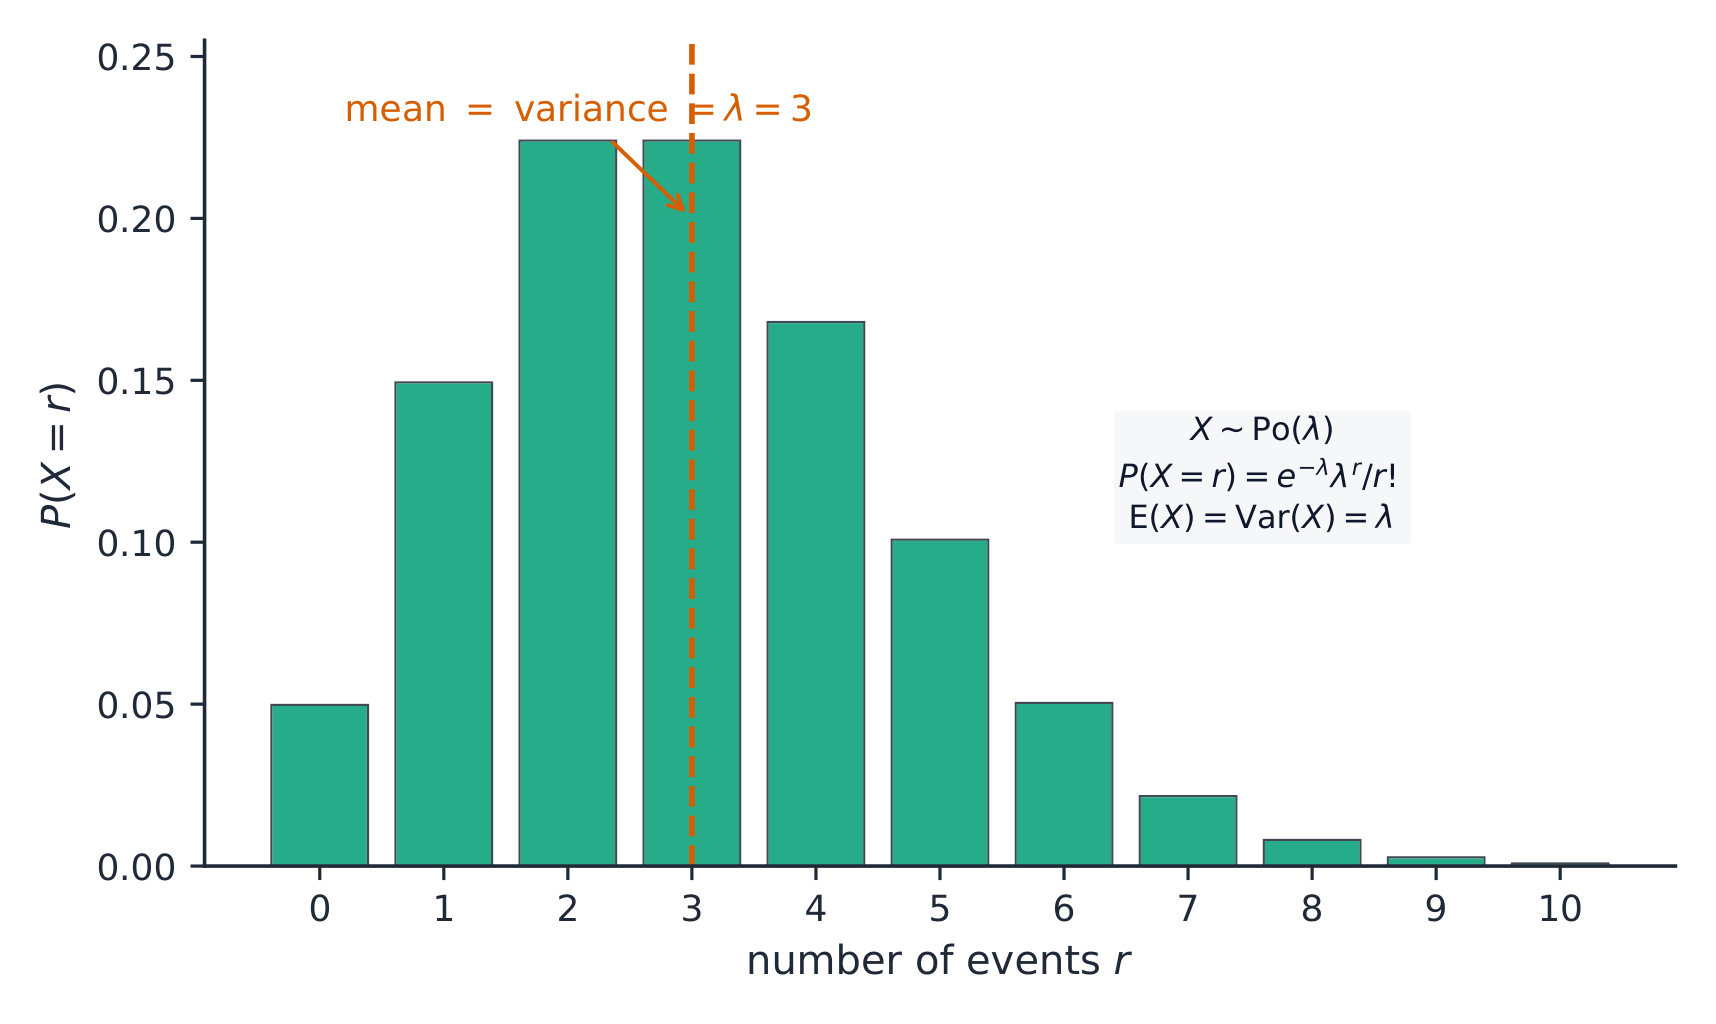
A distribuição Poisson 泊松分布 $X \sim \mathrm{Po}(\lambda)$ modela o número de eventos aleatórios em um intervalo fixo, quando os eventos ocorrem a uma taxa média estável $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
Para uma variável Poisson, a média e a variância são ambas iguais a $\lambda$. A distribuição Poisson é uma boa aproximação 近似 à distribuição binomial quando $n$ é grande e $p$ é pequena. A distribuição normal (com correção de continuidade) aproxima a Poisson quando $\lambda$ é grande.
Exemplo resolvido. $X \sim \mathrm{Po}(3)$. Encontre $P(X = 2)$.
$$P(X = 2) = e^{-3}\frac{3^2}{2!} = e^{-3}\times 4.5 = 0.224.$$
Explorar
A distribuição de Poisson
Altere a média λ. A Poisson modela o número de eventos aleatórios em um intervalo fixo — eventos raros dão uma forma assimétrica.
6.2
Combinações lineares de variáveis aleatórias
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| • usar, ao resolver problemas, os resultados de que – $\text{E}(aX + b) = a\text{E}(X) + b$ e $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ para $X$ e $Y$ independentes – se $X$ tem uma distribuição normal então também tem $aX + b$ – se $X$ e $Y$ têm distribuições normais independentes então $aX + bY$ tem uma distribuição normal – se $X$ e $Y$ têm distribuições de Poisson independentes então $X + Y$ tem uma distribuição de Poisson. | Provas desses resultados não são necessárias. |
Fonte: Programa Cambridge International
Ao alterar uma variável por uma regra linear, a expectativa 期望 (média) e a variância 方差 seguem estas regras:
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
Para duas variáveis independentes $X$ e $Y$:
$$E(aX + bY) = aE(X) + bE(Y), \qquad \mathrm{Var}(aX + bY) = a^2\,\mathrm{Var}(X) + b^2\,\mathrm{Var}(Y).$$
Dois fatos úteis: se $X$ tem uma distribuição normal 正态分布, então $aX + b$ também tem; e a soma de variáveis Poisson independentes é novamente Poisson.
Exemplo resolvido. $X$ tem média $5$ e variância $4$. Encontre $E(3X - 1)$ e $\mathrm{Var}(3X - 1)$.
$$E(3X - 1) = 3(5) - 1 = 14, \qquad \mathrm{Var}(3X - 1) = 3^2 \times 4 = 36.$$
Explorar
Laboratório de combinação linear
E(aX + b) = aE(X) + b
Altere um fator de escala e veja como o valor esperado escala.
6.3
Variáveis aleatórias contínuas
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| • compreender o conceito de uma variável aleatória contínua, e recordar e usar propriedades de uma função de densidade de probabilidade | Para funções de densidade definidas apenas sobre um único intervalo; o domínio pode ser infinito, p.ex. $\frac{3}{x^4}$ para $x \geqslant 1$. |
| • usar uma função de densidade de probabilidade para resolver problemas envolvendo probabilidades, e para calcular a média e a variância de uma distribuição. | Incluindo a localização da mediana ou outras percentis de uma distribuição pela consideração direta de uma área usando a função de densidade. Conhecimento explícito da função de distribuição acumulada não é incluído. |
Fonte: Programa Cambridge International
Uma variável aleatória contínua 连续型随机变量 pode assumir qualquer valor em um intervalo. Suas probabilidades vêm de uma função de densidade de probabilidade 概率密度函数 $f(x)$, com duas propriedades principais:
$$f(x) \geqslant 0, \qquad \int_{-\infty}^{\infty} f(x)\,dx = 1.$$
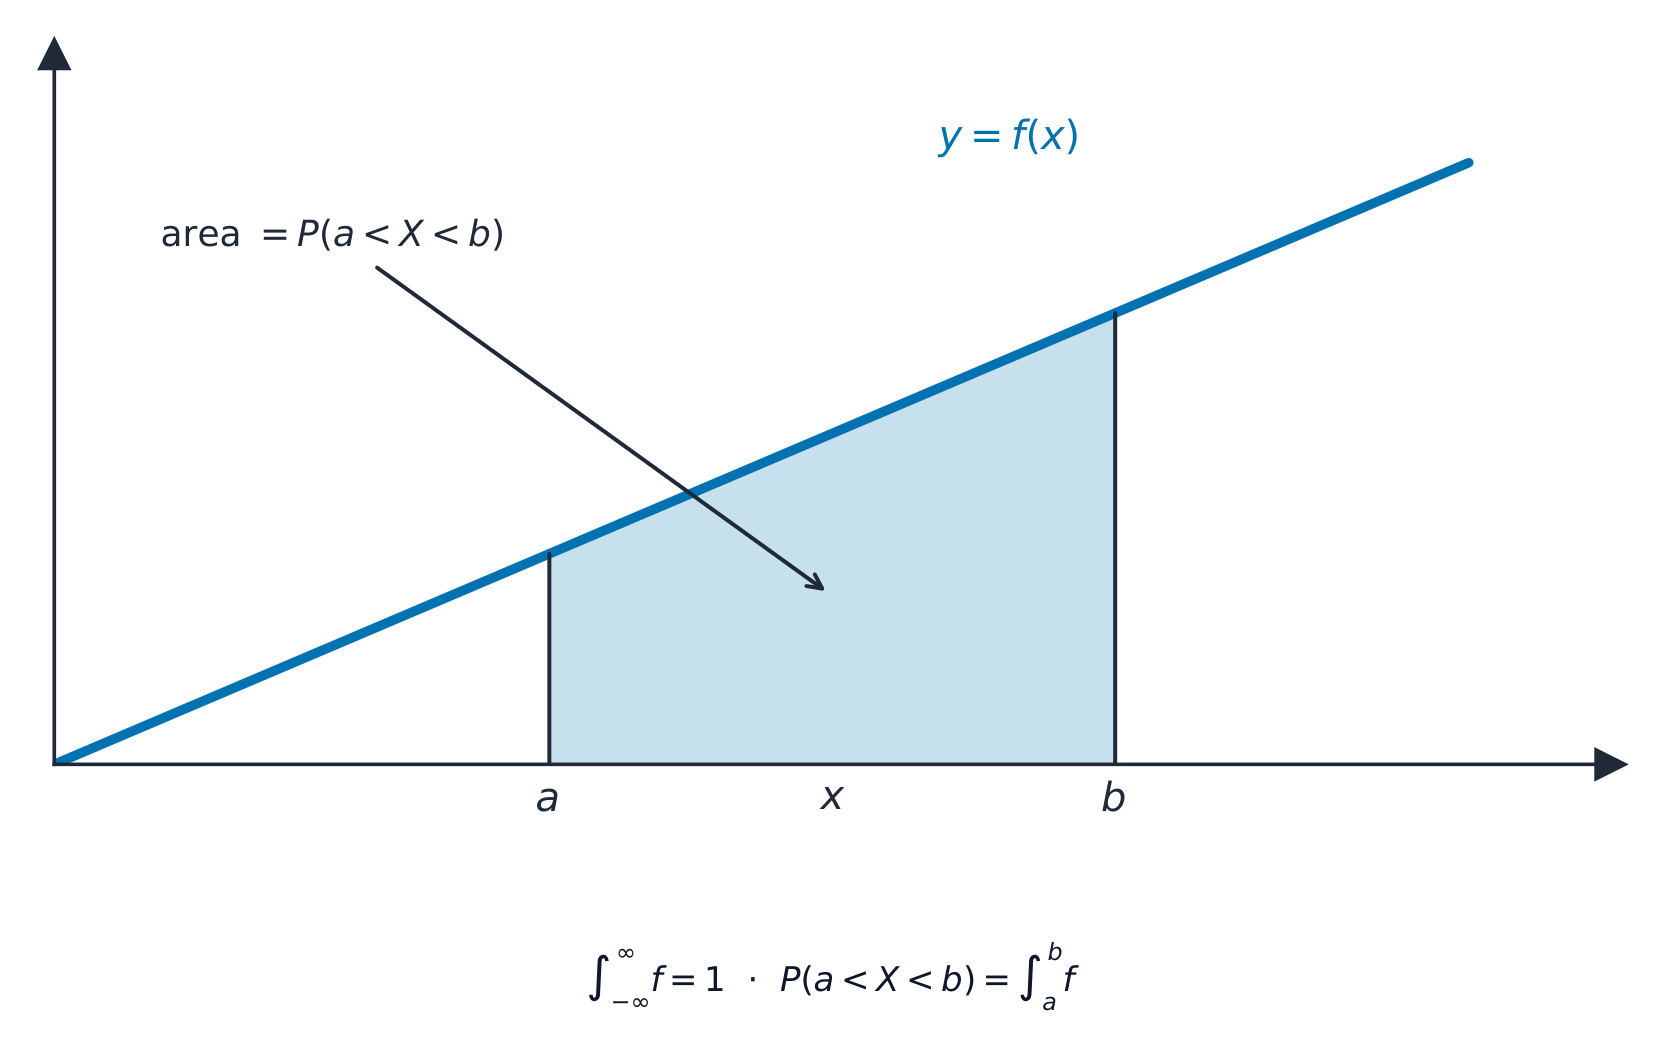
Uma probabilidade é a área sob $f$, e a média é encontrada por integração:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
A função de distribuição acumulada 累积分布函数 é $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; a mediana 中位数 resolve $F(m) = 0.5$, e outros percentis 百分位数 resolvem $F(x) = p$.
Exemplo resolvido. Uma variável contínua tem $f(x) = \tfrac12 x$ para $0 \leqslant x \leqslant 2$ (e $0$ em outro lugar). Encontre $E(X)$.
$$E(X) = \int_0^2 x\cdot\tfrac12 x\,dx = \int_0^2 \tfrac12 x^2\,dx = \left[\tfrac{x^3}{6}\right]_0^2 = \frac{8}{6} = \frac{4}{3}.$$
A variância usa a mesma ideia, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. Para a mesma $f(x)=\tfrac12 x$ em $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, logo $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Explorar
Área = probabilidade
P(a < X < b) = ∫ f(x) dx
Para uma variável contínua, probabilidade é a área sob a curva de densidade entre dois valores.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| Poisson distribution/ˈpɔɪsn ˌdɪstrɪˈbjuːʃn/ | 泊松分布 | pō sōng fēn bù |
| approximation/əˌprɒksɪˈmeɪʃn/ | 近似 | jìn sì |
| expectation/ekspɪkˈteɪʃn/ | 期望 | qī wàng |
| variance/ˈveərɪəns/ | 方差 | fāng chà |
| normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ | 正态分布 | zhèng tài fēn bù |
| continuous random variable/kənˈtɪnjuːəs ˈrændəm ˈveərɪəbl/ | 连续型随机变量 | lián xù xíng suí jī biàn liàng |
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | 概率密度函数 | gài lǜ mì dù hán shù |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | 累积分布函数 | lěi jī fēn bù hán shù |
| median/ˈmiːdiːən/ | 中位数 | zhōng wèi shù |
| percentiles/pəˈsentaɪlz/ | 百分位数 | bǎi fēn wèi shù |
| sample/ˈsæmpl/ | 样本 | yàng běn |
| population/ˌpɒpjʊˈleɪʃn/ | 总体 | zǒng tǐ |
| randomness/ˈrændəmnəs/ | 随机性 | suí jī xìng |
| biased/ˈbaɪəst/ | 有偏 | yǒu piān |
| Central Limit Theorem/ˈsentrəl ˈlɪmɪt ˈθɪərəm/ | 中心极限定理 | zhōng xīn jí xiàn dìng lǐ |
| unbiased estimates/ʌnˈbaɪəst ˈestɪməts/ | 无偏估计 | wú piān gū jì |
6.4
Amostragem e estimação

Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| • compreender a distinção entre uma amostra e uma população, e apreciar a necessidade de aleatoriedade na escolha de amostras | |
| • explicar em termos simples por que um determinado método de amostragem pode ser insatisfatório | Incluindo um entendimento elementar do uso de números aleatórios na produção de amostras aleatórias. Conhecimento de métodos específicos de amostragem, como amostragem por quotas ou estratificada, não é necessário. |
| • reconhecer que uma média amostral pode ser considerada uma variável aleatória, e usar os fatos de que $\text{E}(\overline{X}) = \mu$ e que $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$ | |
| • usar o fato de que $\overline{X}$ tem uma distribuição normal se $X$ tem uma distribuição normal | |
| • usar o Teorema Central do Limite quando apropriado | Apenas um entendimento informal do Teorema Central do Limite (TCL) é necessário; para grandes tamanhos de amostra, a distribuição de uma média amostral é aproximadamente normal. |
| • calcular estimativas não viciadas da média e da variância populacionais a partir de uma amostra, usando dados brutos ou resumidos | Apenas um entendimento simples do termo 'não viciado' é necessário, p.ex. que embora estimativas individuais variem, o processo fornece um resultado preciso 'em média'. |
| • determinar e interpretar um intervalo de confiança para a média populacional em casos onde a população tem distribuição normal com variância conhecida ou quando uma grande amostra é usada | |
| • determinar, a partir de uma grande amostra, um intervalo de confiança aproximado para uma proporção populacional. |
Fonte: Programa Cambridge International
*Estatística estuda uma amostra para aprender sobre toda uma população.
Uma amostra 样本 é um pequeno grupo escolhido de toda a população 总体. Uma amostra aleatória precisa de aleatoriedade 随机性, para que cada membro tenha chance justa de ser selecionado.
Alguns métodos são insatisfatórios porque são viesados 有偏: amostrar apenas voluntários, ou as primeiras 20 pessoas a chegarem, superrepresenta certos tipos de pessoas. Uma amostra genuinamente aleatória usa números aleatórios – numerar cada membro da população, depois extrair números (de uma tabela ou gerador) para decidir quem está na amostra.
A média amostral $\bar{X}$ é ela própria uma variável aleatória, com
$$E(\bar{X}) = \mu, \qquad \mathrm{Var}(\bar{X}) = \frac{\sigma^2}{n}.$$
Pelo Teorema Central Limite 中心极限定理, para uma amostra grande $\bar{X}$ é aproximadamente normal, independente da forma da população.

De uma amostra, você pode encontrar estimativas não viesadas 无偏估计 da média e variância populacionais. Um intervalo de confiança 置信区间 fornece uma faixa que provavelmente contém a média verdadeira. Quando a população é normal com $\sigma$ conhecido (ou a amostra é grande), um intervalo $95\%$ é
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$
 *Um intervalo de confiança $95\%$ se estende $1.96$ erros padrão de cada lado da média amostral.
Você também pode encontrar um intervalo de confiança para uma proporção populacional 总体比例 a partir de uma amostra grande.
Exemplo resolvido. Uma amostra de $n = 64$ tem média $\bar{x} = 50$, de uma população com $\sigma = 8$. Encontre um intervalo de confiança $95\%$ para a média populacional.
$$50 \pm 1.96\times\frac{8}{\sqrt{64}} = 50 \pm 1.96 \;\Rightarrow\; (48.0,\ 52.0).$$
Explorar
A distribuição amostral
X̄ ~ N(μ, σ²/n)
Pelo Teorema do Limite Central, as médias amostrais seguem uma curva normal — mais estreita para amostras maiores.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | 置信区间 | zhì xìn qū jiān |
| population proportion/ˌpɒpjʊˈleɪʃn prəˈpɔːʃn/ | 总体比例 | zǒng tǐ bǐ lì |
6.5
Testes de hipótese
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| • compreender a natureza de um teste de hipótese, a diferença entre testes unilaterais e bilaterais, e os termos hipótese nula, hipótese alternativa, nível de significância, região de rejeição (ou região crítica), região de aceitação e estatística de teste | Resultados de testes de hipóteses devem ser interpretados em termos dos contextos em que as questões são apresentadas. |
| • formular hipóteses e realizar um teste de hipótese no contexto de uma única observação de uma população que tem uma distribuição binomial ou Poisson, usando – avaliação direta de probabilidades – uma aproximação normal à distribuição binomial ou de Poisson, quando apropriado | |
| • formular hipóteses e realizar um teste de hipótese concernente à média populacional em casos onde a população tem distribuição normal com variância conhecida ou quando uma grande amostra é usada | |
| • compreender os termos Erro Tipo I e Erro Tipo II em relação a testes de hipóteses | |
| • calcular as probabilidades de cometer Erros Tipo I e Tipo II em situações específicas envolvendo testes baseados em uma distribuição normal ou avaliação direta de probabilidades binomiais ou de Poisson. |
Fonte: Programa Cambridge International
Um teste de hipótese 假设检验 usa dados amostrais para julgar uma afirmação. Você estabelece duas declarações: a hipótese nula 原假设 $H_0$ (a afirmação sendo testada, geralmente "sem mudança") e a hipótese alternativa 备择假设 $H_1$ (o que você suspeita em vez disso). O teste é unilateral 单尾 se $H_1$ aponta para um lado (ex: $\mu > 50$) e bilateral 双尾 se permite ambos os sentidos ($\mu \neq 50$).
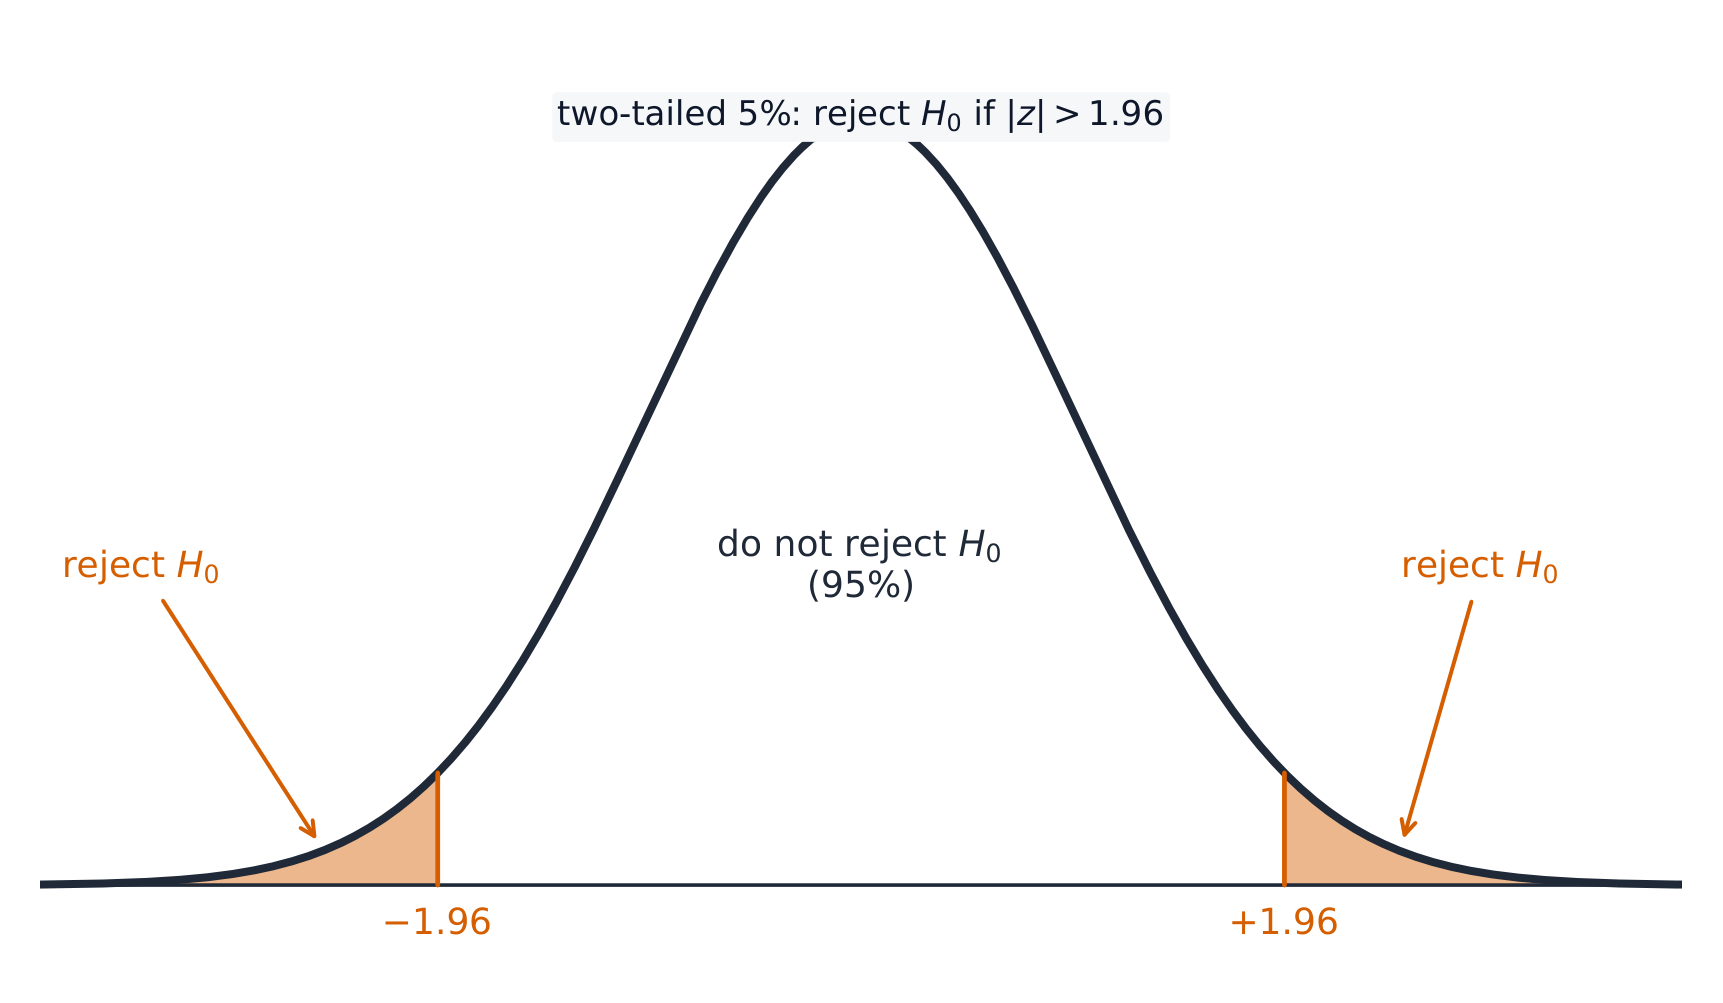
Você define um nível de significância 显著性水平 (frequentemente $5\%$), calcula uma estatística de teste 检验统计量 a partir dos dados e verifica se ela cai na região de rejeição 拒绝域 (também chamada de região crítica); se cair, você rejeita $H_0$, caso contrário, a estatística está na região de aceitação.
Dois erros são possíveis: um Erro Tipo I 第一类 erro é rejeitar $H_0$ quando ele é realmente verdadeiro; um Erro Tipo II 第二类 erro é aceitar $H_0$ quando ele é realmente falso. Você pode encontrar suas probabilidades a partir da região de rejeição: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – isso equivale ao nível de significância – e $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ verdadeiro para um valor declarado$)$, calculado a partir da distribuição binomial, Poisson ou normal.
Exemplo resolvido. Afirma-se que uma população tem média $50$, com $\sigma = 8$. Uma amostra de $n = 64$ dá $\bar{x} = 52$. Teste no nível $5\%$ se a média mudou.
$H_0\!: \mu = 50$ e $H_1\!: \mu \neq 50$ (bilateral). A estatística de teste é
$$z = \frac{\bar{x} - \mu}{\sigma/\sqrt{n}} = \frac{52 - 50}{8/8} = 2.$$
O valor crítico em $5\%$ (bilateral) é $1.96$. Como $2 > 1.96$, você rejeita $H_0$: há evidências de que a média mudou.
Exemplo resolvido (um teste binomial). Uma moeda é dita justa, mas suspeita de cair coroa raramente demais: $H_0\!:p=0.5$, $H_1\!:p<0.5$. Em $n=30$ lançamentos, você vê $X=9$ coroas. Sob $H_0$, $X\sim B(30,0.5)$, então a probabilidade unilateral da cauda é
$$P(X\leqslant 9)=\sum_{k=0}^{9}\binom{30}{k}(0.5)^{30}\approx 0.021.$$
Como $0.021<0.05$, rejeita-se $H_0$: a moeda parece realmente tendenciosa contra coroas. (Para grandes $n$, a binomial é aproximada por uma normal; um teste Poisson funciona da mesma forma para eventos raros. E aqui, se a regra é "rejeitar quando $X\leqslant 9$", então $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Explorar
A região de rejeição
rejeite H₀ se z < −z*
A cauda sombreada é a região de rejeição — se a estatística de teste cair lá, rejeite H₀.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| hypothesis test/haɪˈpɒθəsɪs test/ | 假设检验 | jiǎ shè jiǎn yàn |
| null hypothesis/nʌl haɪˈpɒθəsɪs/ | 原假设 | yuán jiǎ shè |
| alternative hypothesis/ɔːlˈtɜːnətɪv haɪˈpɒθəsɪs/ | 备择假设 | bèi zé jiǎ shè |
| one-tailed/wʌn teɪld/ | 单尾 | dān wěi |
| two-tailed/tuː teɪld/ | 双尾 | shuāng wěi |
| significance level/sɪɡˈnɪfɪkəns ˈlevl/ | 显著性水平 | xiǎn zhù xìng shuǐ píng |
| test statistic/test stəˈtɪstɪk/ | 检验统计量 | jiǎn yàn tǒng jì liàng |
| rejection region/rɪˈdʒekʃn ˈriːdʒn/ | 拒绝域 | jù jué yù |
| Type I error/taɪp aɪ ˈerə/ | 第一类错误 | dì yī lèi cuò wù |
| Type II error/taɪp ˈtuː ˈerə/ | 第二类错误 | dì èr lèi cuò wù |
| Probability & Statistics/ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | 概率统计 | gài lǜ tǒng jì |
6.5
Dicas de prova
- Use a distribuição Poisson para eventos raros, aleatórios e independentes; sua média iguala sua variância ($= \lambda$).
- Ao combinar variáveis aleatórias independentes, variâncias se somam (elas nunca se subtraem).
- Para um teste de hipótese, declare $H_0$ e $H_1$, o nível de significância, a estatística de teste e uma conclusão no contexto.
- Para um intervalo de confiança, use o valor correto de $z$ (ou $t$) e interprete-o com palavras.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.