Skip to content · ⁨Passer au contenu⁩

Probabilités et Statistiques 1

Mathématiques A-Level · Topic 5 · ⁨Sujet 5⁩

Train · ⁨Entrainer⁩
Video lesson for this topic · ⁨Leçon vidéo pour ce sujet⁩ Open the video page · ⁨Ouvrir la page vidéo⁩
11:38

Probabilités et Statistiques 1

Lancez un dé unique, et le résultat est n'importe quoi. Mais lancez-le des milliers de fois, ou mesurez les tailles de milliers de gens, et quelque chose de remarquable…

English narration · English + 中文 subtitles burned in · ⁨Narration en anglais · Sous-titres anglais + 中文 incrustés⁩

English

This handout covers Topic 5: Probability & Statistics 概率统计 1. It is about describing data, counting choices, and working out the chance of events.

Français

Cette fiche couvre le Sujet 5 : Probabilités & Statistiques 概率统计 1. Il s'agit de décrire des données, de compter des choix et de calculer la probabilité d'événements.

5.1

Representation of data · ⁨Représentation des données⁩

Syllabus · ⁨Programme⁩
English
Candidates should be able to: Notes and examples
• select a suitable way of presenting raw statistical data, and discuss advantages and/or disadvantages that particular representations may have
• draw and interpret stem-and-leaf diagrams, box-and-whisker plots, histograms and cumulative frequency graphs Including back-to-back stem-and-leaf diagrams.
• understand and use different measures of central tendency (mean, median, mode) and variation (range, interquartile range, standard deviation) e.g. in comparing and contrasting sets of data.
• use a cumulative frequency graph e.g. to estimate medians, quartiles, percentiles, the proportion of a distribution above (or below) a given value, or between two values.
• calculate and use the mean and standard deviation of a set of data (including grouped data) either from the data itself or from given totals $\Sigma x$ and $\Sigma x^2$, or coded totals $\Sigma(x - a)$ and $\Sigma(x - a)^2$, and use such totals in solving problems which may involve up to two data sets.
Français
Les candidats doivent être capables de : Notes et exemples
• choisir une méthode appropriée pour présenter des données statistiques brutes, et discuter des avantages et/ou inconvénients que peuvent avoir certaines représentations particulières
• dessiner et interpréter des diagrammes tiges-feuilles, des boîtes à moustaches, des histogrammes et des graphiques de fréquence cumulative Y compris les diagrammes tiges-feuilles dos-à-dos.
• comprendre et utiliser différentes mesures de tendance centrale (moyenne, médiane, mode) et de variation (étendue, étendue interquartile, écart-type) p.ex. dans la comparaison et la confrontation d'ensembles de données.
• utiliser un graphique de fréquence cumulative p.ex. pour estimer les médianes, les quartiles, les percentiles, la proportion d'une distribution au-dessus (ou en dessous) d'une valeur donnée, ou entre deux valeurs.
• calculer et utiliser la moyenne et l'écart-type d'un ensemble de données (y compris des données groupées), soit à partir des données elles-mêmes, soit à partir des totaux donnés $\Sigma x$ et $\Sigma x^2$, ou des totaux codés $\Sigma(x - a)$ et $\Sigma(x - a)^2$, et utiliser ces totaux pour résoudre des problèmes pouvant impliquer jusqu'à deux ensembles de données.

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English

Choose a diagram that suits the data. You should be able to draw and read:

  • a stem-and-leaf diagram 茎叶图 (keeps the original values and shows the shape); two data sets are compared with a back-to-back 背靠背 version – a shared central stem, one set's leaves increasing to the left and the other's to the right, so you can compare their medians and spreads at a glance;
  • a box-and-whisker plot 箱线图 (shows the lowest value, the three quartiles, and the highest value);
  • a histogram 直方图 (for grouped data, where the area of each bar shows the frequency);
  • a cumulative frequency 累积频数 graph (running totals, used to estimate the median and quartiles).

Averages and spread

A measure of central tendency 集中趋势 is a single "middle" value:

  • the mean 平均数 $\bar{x} = \dfrac{\sum x}{n}$ (the average);
  • the median 中位数 (the middle value when the data is in order);
  • the mode 众数 (the most common value).

A measure of variation 离散程度 shows how spread out the data is:

  • the range (of data) 极差 (highest $-$ lowest);
  • the interquartile range 四分位距 (upper quartile $-$ lower quartile);
  • the standard deviation 标准差 $\sigma = \sqrt{\dfrac{\sum x^2}{n} - \bar{x}^2}$.

You often work from the totals $\sum x$ and $\sum x^2$. The square of the standard deviation is the variance 方差.

Worked example. For $10$ values, $\sum x = 50$ and $\sum x^2 = 300$. Find the mean and standard deviation.

$$\bar{x} = \frac{50}{10} = 5, \qquad \sigma = \sqrt{\frac{300}{10} - 5^2} = \sqrt{30 - 25} = \sqrt{5} = 2.24.$$

Coding 编码 makes big numbers easier. Replace each value by $t=x-a$ for a convenient assumed mean 假定平均数 $a$. Then $\bar{x}=a+\bar{t}$, while the standard deviation is unchanged (shifting every value does not spread the data). So from the coded totals $\sum(x-a)$ and $\sum(x-a)^2$ you get $\bar x$ and $\sigma$ directly, and two data sets can be compared through their coded totals.

Français

Choisissez un diagramme adapté aux données. Vous devez être capable de dessiner et de lire :

  • un diagramme tiges et feuilles 茎叶图 (conserve les valeurs originales et montre la forme) ; deux ensembles de données sont comparés avec une version dos à dos 背靠背 – une tige centrale partagée, les feuilles d'un ensemble augmentant vers la gauche et celles de l'autre vers la droite, permettant de comparer leurs médianes et étendues d'un coup d'œil;
  • un diagramme en boîte à moustaches 箱线图 (montre la valeur minimale, les trois quartiles et la valeur maximale);
  • un histogramme 直方图 (pour des données groupées, où l'aire de chaque barre représente la fréquence);
  • un graphique de fréquence cumulative 累积频数 (total cumulatif, utilisé pour estimer la médiane et les quartiles).
Une courbe cumulative en S avec des lignes pointillées lisant la médiane à mi-fréquence totale
Une courbe de fréquence cumulative est en S ; lire la médiane depuis la moitié de la fréquence totale, et les quartiles depuis un et trois quarts
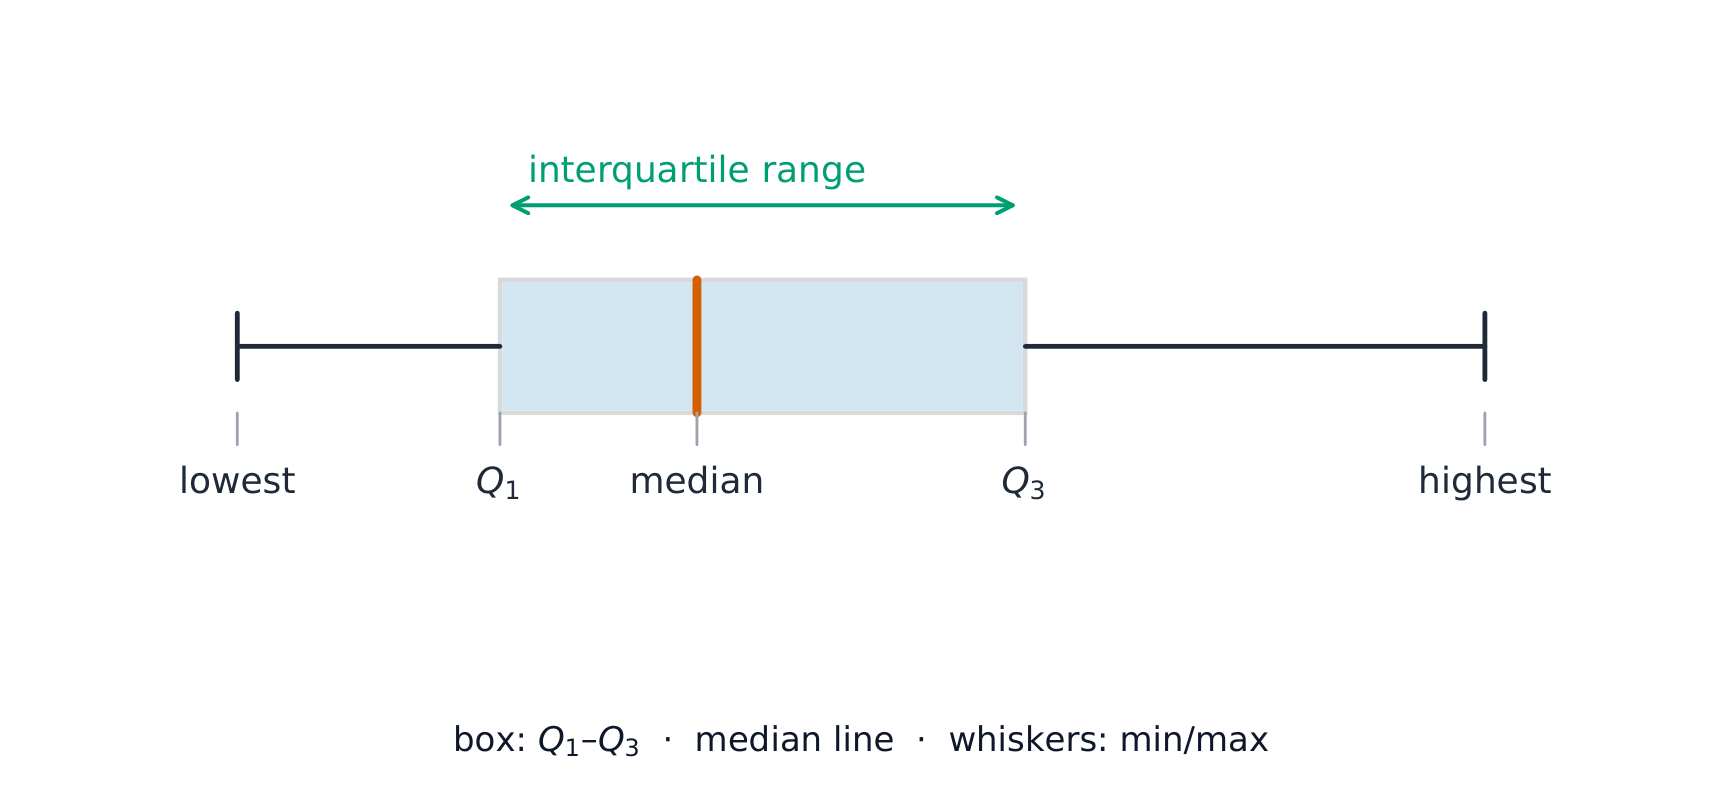
Un diagramme en boîte à moustaches avec des moustaches jusqu'aux valeurs minimales et maximales et une boîte de quartiles
La boîte s'étend des quartiles $Q_1$ à $Q_3$ ; les moustaches atteignent les valeurs minimale et maximale.

Moyennes et dispersion

Une mesure de tendance centrale 集中趋势 est une seule valeur "centrale" :

  • la moyenne 平均数 $\bar{x} = \dfrac{\sum x}{n}$ (la moyenne arithmétique);
  • la médiane 中位数 (la valeur centrale lorsque les données sont ordonnées);
  • le mode 众数 (la valeur la plus fréquente).

Une mesure de variation 离散程度 montre à quel point les données sont dispersées :

  • l'étendue (des données) 极差 (max $-$ min);
  • l'étendue interquartile 四分位距 (quartile supérieur $-$ quartile inférieur);
  • l'écart-type 标准差 $\sigma = \sqrt{\dfrac{\sum x^2}{n} - \bar{x}^2}$.

On travaille souvent à partir des totaux $\sum x$ et $\sum x^2$. Le carré de l'écart-type est la variance 方差.

Exemple résolu. Pour $10$ valeurs, $\sum x = 50$ et $\sum x^2 = 300$. Trouvez la moyenne et l'écart type.

$$\bar{x} = \frac{50}{10} = 5, \qquad \sigma = \sqrt{\frac{300}{10} - 5^2} = \sqrt{30 - 25} = \sqrt{5} = 2.24.$$

Codage 编码 rend les grands nombres plus faciles. Remplacer chaque valeur par $t=x-a$ pour une moyenne supposée 假定平均数 convenable $a$. Ensuite $\bar{x}=a+\bar{t}$, tandis que l'écart-type reste inchangé (décaler toutes les valeurs ne disperse pas les données). Donc, à partir des totaux codés $\sum(x-a)$ et $\sum(x-a)^2$, on obtient directement $\bar x$ et $\sigma$, et deux ensembles de données peuvent être comparés via leurs totaux codés.

Explore · ⁨Explorer⁩

Dispersion et cloche

P(−k < Z < k)

La dispersion est mesurée en écarts types — environ 68 % des données se situent dans 1 écart type, 95 % dans 2.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
stem-and-leaf diagram/stem ænd liːf ˈdaɪəɡræm/ 茎叶图 jīng yè tú
back-to-back/bæk tə bæk/ 背靠背 bèi kào bèi
box-and-whisker plot/bɒks ænd ˈwɪskə plɒt/ 箱线图 xiāng xiàn tú
histogram/ˈhɪstəɡræm/ 直方图 zhí fāng tú
cumulative frequency/ˈkjuːmjʊlətɪv ˈfriːkwənsi/ 累积频数 lěi jī pín shuò
measure of central tendency/ˈmeʒə ɒv ˈsentrəl ˈtendənsi/ 集中趋势 jí zhōng qū shì
mean/miːn/ 平均数 píng jūn shù
median/ˈmiːdiːən/ 中位数 zhōng wèi shù
mode/məʊd/ 众数 zhòng shù
variation/ˌveərɪˈeɪʃn/ 离散程度 lí sàn chéng dù
variance/ˈveərɪəns/ 方差 fāng chà
Coding/ˈkəʊdɪŋ/ 编码 biān mǎ
assumed mean/əˈsjuːmd miːn/ 假定平均数 jiǎ dìng píng jūn shù
5.2

Permutations and combinations · ⁨Permutations et combinaisons⁩

Syllabus · ⁨Programme⁩
English
Candidates should be able to: Notes and examples
• understand the terms permutation and combination, and solve simple problems involving selections
• solve problems about arrangements of objects in a line, including those involving – repetition (e.g. the number of ways of arranging the letters of the word ‘NEEDLESS’) – restriction (e.g. the number of ways several people can stand in a line if two particular people must, or must not, stand next to each other). Questions may include cases such as people sitting in two (or more) rows. Questions about objects arranged in a circle will not be included.
Français
Les candidats doivent être capables de : Notes et exemples
• comprendre les termes permutation et combinaison, et résoudre des problèmes simples impliquant des sélections
• résoudre des problèmes concernant l'arrangement d'objets en ligne, y compris ceux impliquant – la répétition (p.ex. le nombre de façons d'arranger les lettres du mot 'NEEDLESS') – la restriction (p.ex. le nombre de façons dont plusieurs personnes peuvent se tenir en ligne si deux personnes spécifiques doivent, ou ne doivent pas, se tenir côte à côte). Les questions peuvent inclure des cas tels que des personnes assises en deux (ou plus) rangées. Les questions sur des objets disposés en cercle ne seront pas incluses.

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English

A permutation 排列 is an arrangement where order matters; a combination 组合 is a selection where order does not matter. The numbers are

$${}^nP_r = \frac{n!}{(n-r)!}, \qquad {}^nC_r = \binom{n}{r} = \frac{n!}{r!\,(n-r)!}.$$
To arrange objects in a line when some are repeated, divide by the factorial of each repeat count.

Worked example. How many different arrangements are there of the letters of the word NEEDLESS?

There are $8$ letters, with E repeated $3$ times and S repeated $2$ times:

$$\frac{8!}{3!\,2!} = \frac{40320}{6 \times 2} = 3360.$$

Français

Une permutation 排列 est un arrangement où l'ordre compte ; une combinaison 组合 est une sélection où l'ordre ne compte pas. Les nombres sont

$${}^nP_r = \frac{n!}{(n-r)!}, \qquad {}^nC_r = \binom{n}{r} = \frac{n!}{r!\,(n-r)!}.$$
Pour disposer des objets en ligne quand certains sont répétés, diviser par la factorielle de chaque compteur de répétition.

Permutation : l'ordre compte (AB ≠ BA). Combinaison : l'ordre ne compte pas ({A,B} = {B,A})
L'ordre importe pour une permutation, mais pas pour une combinaison

Exemple résolu. Combien y a-t-il de dispositions différentes des lettres du mot NEEDLESS ?

Il y a $8$ lettres, avec E répété $3$ fois et S répété $2$ fois :

$$\frac{8!}{3!\,2!} = \frac{40320}{6 \times 2} = 3360.$$

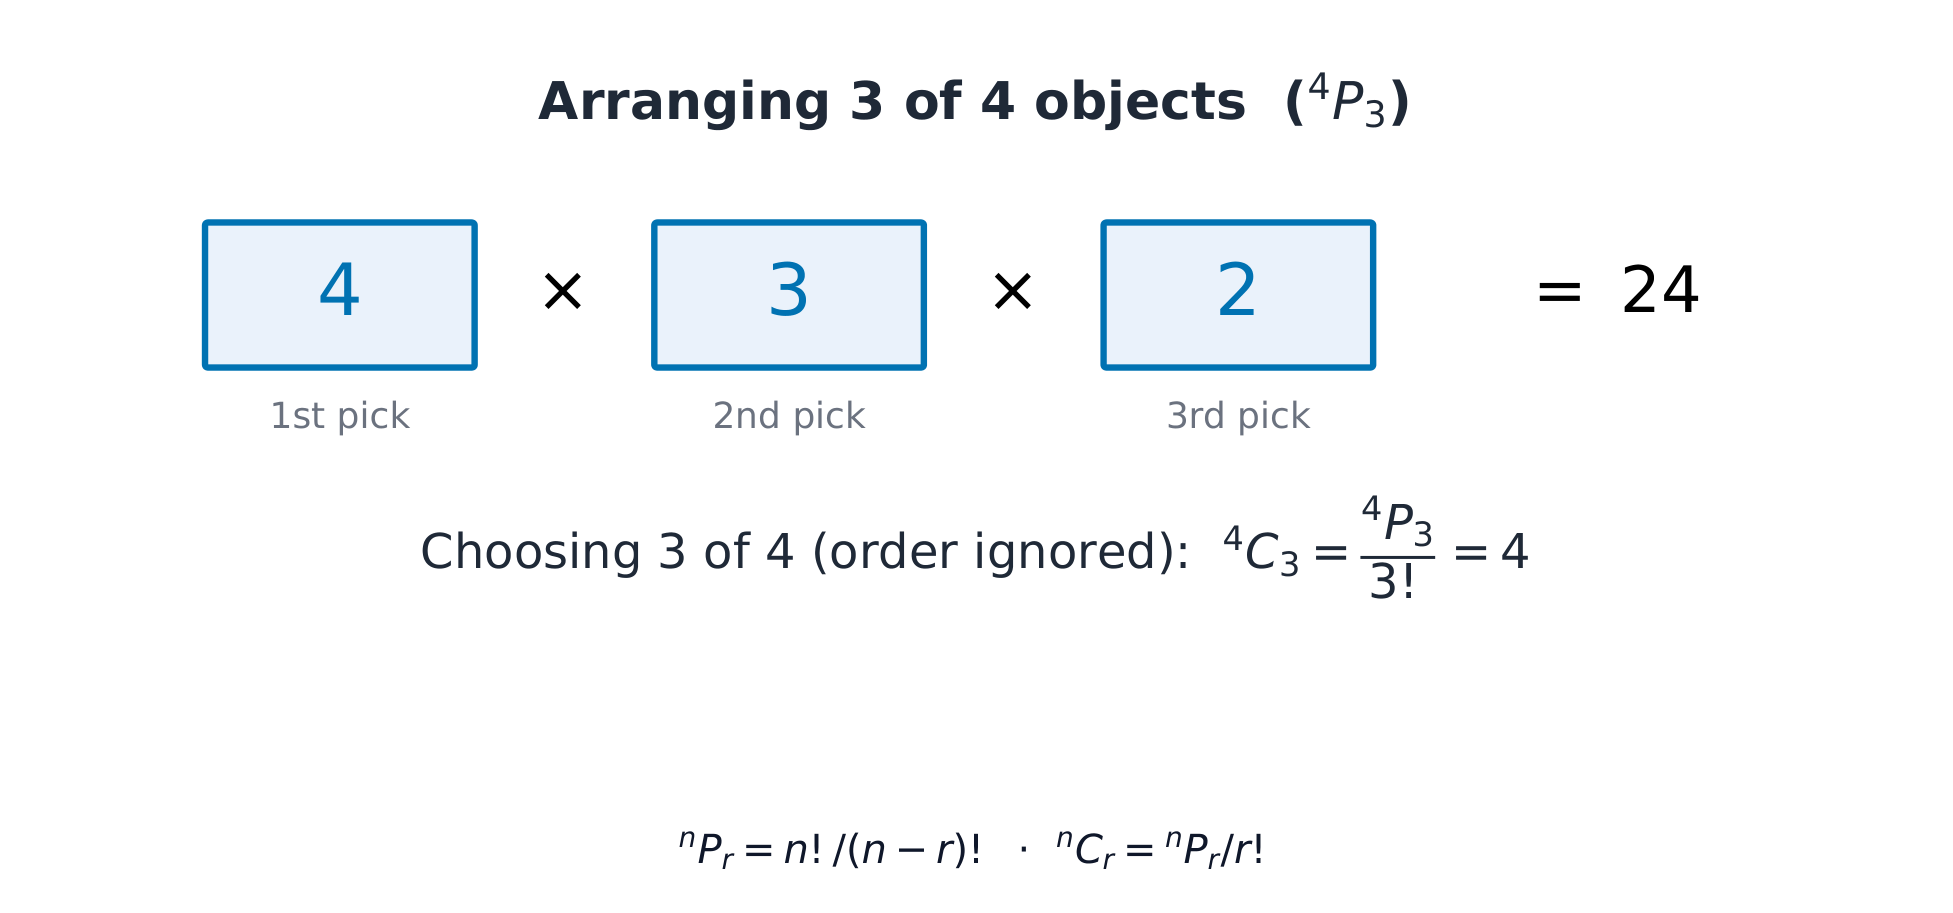
Disposer 3 parmi 4 objets : 4×3×2 = 24 = ⁴P₃ ; les combinaisons divisent par r!
nPr = n!/(n−r)!; nCr = nPr/r!
Explore · ⁨Explorer⁩

Laboratoire sur les permutations et combinaisons

Choisissez si l'ordre importe dans un problème de dénombrement.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
range (of data)/reɪndʒ/ 极差 jí chà
interquartile range/ˌɪntəˈkwɔːtaɪl reɪndʒ/ 四分位距 sì fēn wèi jù
standard deviation/ˈstændəd ˌdiːvɪˈeɪʃn/ 标准差 biāo zhǔn chà
permutation/ˌpɜːmjuːˈteɪʃn/ 排列 pái liè
combination/ˌkɒmbɪˈneɪʃn/ 组合 zǔ hé
mutually exclusive events/ˈmjuːtʃuːəli eksˈkluːsɪv ɪˈvents/ 互斥事件 hù chì shì jiàn
independent events/ˌɪndɪˈpendənt ɪˈvents/ 独立事件 dú lì shì jiàn
conditional probability/kənˈdɪʃənl ˌprɒbəˈbɪlɪti/ 条件概率 tiáo jiàn gài lǜ
discrete random variable/dɪˈskriːt ˈrændəm ˈveərɪəbl/ 离散型随机变量 lí sàn xíng suí jī biàn liàng
probability distribution table/ˌprɒbəˈbɪlɪti ˌdɪstrɪˈbjuːʃn ˈteɪbl/ 概率分布表 gài lǜ fēn bù biǎo
expectation/ekspɪkˈteɪʃn/ 期望 qī wàng
binomial distribution/baɪˈnəʊmɪəl ˌdɪstrɪˈbjuːʃn/ 二项分布 èr xiàng fēn bù
geometric distribution/ˌdʒiːəʊˈmetrɪk ˌdɪstrɪˈbjuːʃn/ 几何分布 jǐ hé fēn bù
5.3

Probability · ⁨Probabilité⁩

Syllabus · ⁨Programme⁩
English
Candidates should be able to: Notes and examples
evaluate probabilities in simple cases by means of enumeration of equiprobable elementary events, or by calculation using permutations or combinations e.g. the total score when two fair dice are thrown. e.g. drawing balls at random from a bag containing balls of different colours.
use addition and multiplication of probabilities, as appropriate, in simple cases Explicit use of the general formula $\text{P}(A \cup B) = \text{P}(A) + \text{P}(B) - \text{P}(A \cap B)$ is not required.
understand the meaning of exclusive and independent events, including determination of whether events $A$ and $B$ are independent by comparing the values of $\text{P}(A \cap B)$ and $\text{P}(A) \times \text{P}(B)$
calculate and use conditional probabilities in simple cases. e.g. situations that can be represented by a sample space of equiprobable elementary events, or a tree diagram. The use of $\text{P}(A|B) = \frac{\text{P}(A \cap B)}{\text{P}(B)}$ may be required in simple cases.
Français
Les candidats doivent être capables de : Notes et exemples
évaluer les probabilités dans des cas simples par énumération d'événements élémentaires équiprobables, ou par calcul utilisant les permutations ou les combinaisons p.ex. le score total lors du lancer de deux dés équitables. p.ex. tirage de billes au hasard depuis un sac contenant des billes de différentes couleurs.
utiliser l'addition et la multiplication des probabilités, selon le cas, dans des situations simples L'utilisation explicite de la formule générale $\text{P}(A \cup B) = \text{P}(A) + \text{P}(B) - \text{P}(A \cap B)$ n'est pas requise.
comprendre la signification des événements exclusifs et indépendants, y compris la détermination du fait que les événements $A$ et $B$ sont indépendants en comparant les valeurs de $\text{P}(A \cap B)$ et $\text{P}(A) \times \text{P}(B)$
calculer et utiliser les probabilités conditionnelles dans des cas simples. ex. situations qui peuvent être représentées par un espace échantillon d'événements élémentaires équiprobables, ou un arbre probabiliste. L'utilisation de $\text{P}(A|B) = \frac{\text{P}(A \cap B)}{\text{P}(B)}$ peut être requise dans des cas simples.

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English

Find a probability by counting equally likely outcomes, or by using permutations and combinations. Combine probabilities with these rules:

  • addition for "or": $P(A \cup B) = P(A) + P(B) - P(A \cap B)$;
  • multiplication for "and" when events are independent: $P(A \cap B) = P(A)\,P(B)$.

Two events are mutually exclusive events 互斥事件 if they cannot both happen, and independent events 独立事件 if one happening does not change the chance of the other. To test independence, check whether $P(A \cap B) = P(A)\times P(B)$. A conditional probability 条件概率 is the chance of $A$ given that $B$ has happened: $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.

Worked example. Events have $P(A) = 0.5$, $P(B) = 0.4$ and $P(A \cap B) = 0.2$. Are $A$ and $B$ independent?

Test: $P(A)\times P(B) = 0.5 \times 0.4 = 0.2 = P(A \cap B)$. The values are equal, so $A$ and $B$ are independent.

Français
Un assortiment de dés polyédriques
Dés : un point de départ familier pour la probabilité.

Trouver une probabilité en comptant les issues également probables, ou en utilisant des permutations et combinaisons. Combiner les probabilités avec ces règles :

  • addition pour "ou" : $P(A \cup B) = P(A) + P(B) - P(A \cap B)$;
  • multiplication pour "et" lorsque les événements sont indépendants : $P(A \cap B) = P(A)\,P(B)$.
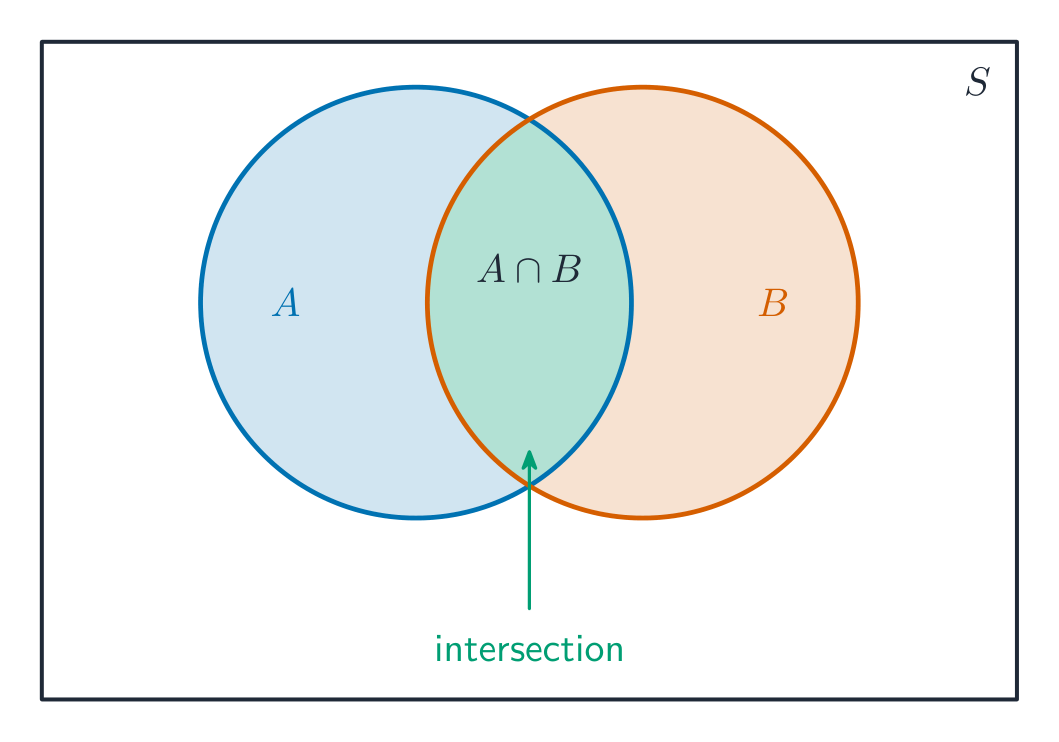
Deux cercles superposés dans un rectangle, avec le chevauchement ombragé comme intersection
Le chevauchement des deux cercles est $A\cap B$ ; la règle d'addition le soustrait une fois pour ne pas le compter deux fois.

Deux événements sont des événements mutuellement exclusifs 互斥事件 si ils ne peuvent pas se produire tous les deux, et des événements indépendants 独立事件 si la survenue de l'un ne change pas la chance de l'autre. Pour tester l'indépendance, vérifier si $P(A \cap B) = P(A)\times P(B)$. Une probabilité conditionnelle 条件概率 est la chance de $A$ sachant que $B$ s'est produit : $P(A \mid B) = \dfrac{P(A \cap B)}{P(B)}$.

Exemple résolu. Des événements ont $P(A) = 0.5$, $P(B) = 0.4$ et $P(A \cap B) = 0.2$. $A$ et $B$ sont-ils indépendants ?

Test : $P(A)\times P(B) = 0.5 \times 0.4 = 0.2 = P(A \cap B)$. Les valeurs sont égales, donc $A$ et $B$ sont indépendants.

Explore · ⁨Explorer⁩

Probabilité conditionnelle

Changez les probabilités et lisez l'arbre. C'est ainsi que P(A et B) et la probabilité conditionnelle s'articulent.

5.4

Discrete random variables · ⁨Variables aléatoires discrètes⁩

Syllabus · ⁨Programme⁩
English
Candidates should be able to: Notes and examples
draw up a probability distribution table relating to a given situation involving a discrete random variable $X$, and calculate $\text{E}(X)$ and $\text{Var}(X)$
use formulae for probabilities for the binomial and geometric distributions, and recognise practical situations where these distributions are suitable models Including the notations $\text{B}(n, p)$ and $\text{Geo}(p)$. $\text{Geo}(p)$ denotes the distribution in which $p_r = p(1 - p)^{r-1}$ for $r = 1, 2, 3, \dots$.
use formulae for the expectation and variance of the binomial distribution and for the expectation of the geometric distribution. Proofs of formulae are not required.
Français
Les candidats doivent être capables de : Notes et exemples
dresser une table de distribution de probabilité relative à une situation donnée impliquant une variable aléatoire discrète $X$, et calculer $\text{E}(X)$ et $\text{Var}(X)$
utiliser les formules pour les probabilités des distributions binomiale et géométrique, et reconnaître des situations pratiques où ces distributions constituent des modèles appropriés Y compris les notations $\text{B}(n, p)$ et $\text{Geo}(p)$. $\text{Geo}(p)$ désigne la distribution dans laquelle $p_r = p(1 - p)^{r-1}$ pour $r = 1, 2, 3, \dots$.
utiliser les formules pour l'espérance et la variance de la distribution binomiale et pour l'espérance de la distribution géométrique. La démonstration des formules n'est pas requise.

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English

A discrete random variable 离散型随机变量 $X$ takes separate values, each with a probability. List them in a probability distribution table 概率分布表; the probabilities must add to $1$. Then the expectation 期望 (mean) and variance are

$$E(X) = \sum x\,P(X = x), \qquad \mathrm{Var}(X) = \sum x^2\,P(X = x) - \big(E(X)\big)^2.$$

Two special models:

  • the binomial distribution 二项分布 $X \sim B(n, p)$, for the number of successes in $n$ independent trials: $P(X = r) = \binom{n}{r}p^r(1-p)^{n-r}$, with $E(X) = np$ and $\mathrm{Var}(X) = np(1-p)$;
  • the geometric distribution 几何分布, for the trial on which the first success happens: $P(X = r) = (1-p)^{r-1}p$, with $E(X) = \dfrac{1}{p}$.

Worked example. $X \sim B(10, 0.3)$. Find $P(X = 2)$ and $E(X)$.

$$P(X = 2) = \binom{10}{2}(0.3)^2(0.7)^8 = 45 \times 0.09 \times 0.05765 = 0.233, \qquad E(X) = 10 \times 0.3 = 3.$$

Français

Une variable aléatoire discrète 离散型随机变量 $X$ prend des valeurs distinctes, chacune avec une probabilité. Les lister dans un tableau de distribution de probabilité 概率分布表 ; les probabilités doivent additionner à $1$. Ensuite l'espérance 期望 (moyenne) et la variance sont

$$E(X) = \sum x\,P(X = x), \qquad \mathrm{Var}(X) = \sum x^2\,P(X = x) - \big(E(X)\big)^2.$$

Deux modèles spéciaux :

  • la distribution binomiale 二项分布 $X \sim B(n, p)$, pour le nombre de succès en $n$ essais indépendants : $P(X = r) = \binom{n}{r}p^r(1-p)^{n-r}$, avec $E(X) = np$ et $\mathrm{Var}(X) = np(1-p)$;
  • la distribution géométrique 几何分布, pour l'essai sur lequel le premier succès survient : $P(X = r) = (1-p)^{r-1}p$, avec $E(X) = \dfrac{1}{p}$.

Exemple résolu. $X \sim B(10, 0.3)$. Trouver $P(X = 2)$ et $E(X)$.

$$P(X = 2) = \binom{10}{2}(0.3)^2(0.7)^8 = 45 \times 0.09 \times 0.05765 = 0.233, \qquad E(X) = 10 \times 0.3 = 3.$$

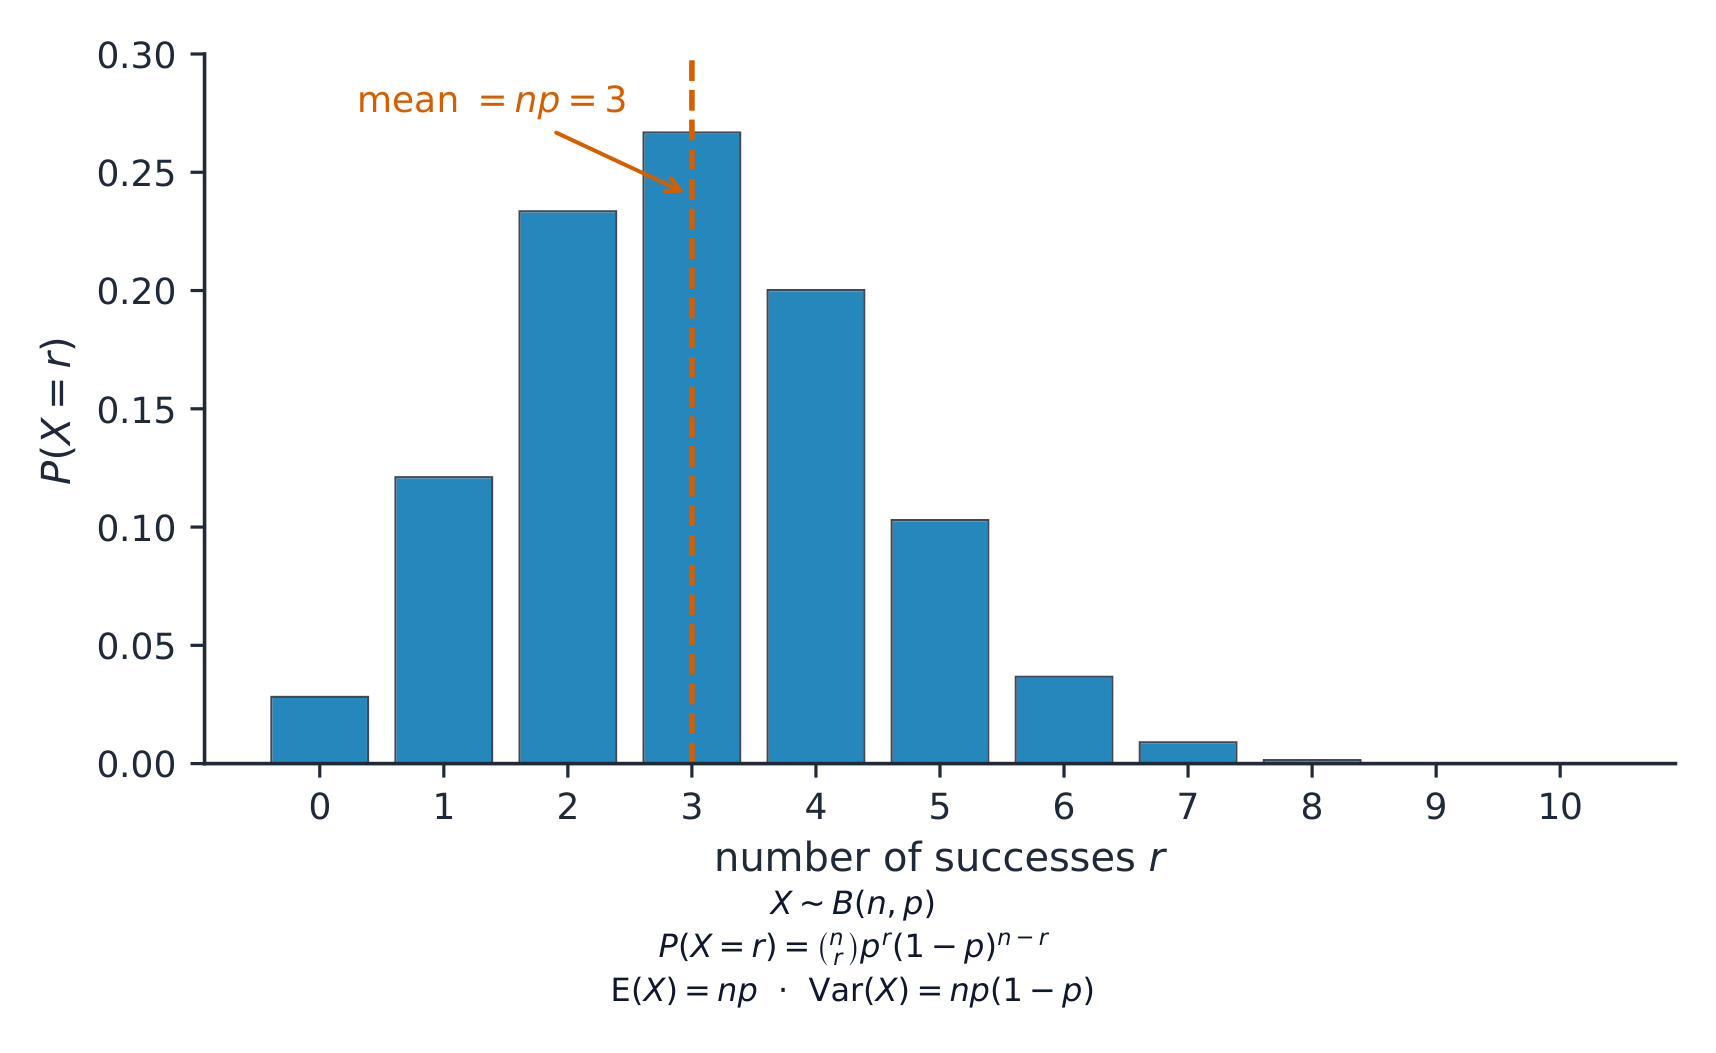
Un diagramme en barres de la distribution binomiale B(10, 0.3) avec la moyenne marquée à 3
La distribution $B(10,0.3)$ : chaque barre est $P(X=r)$, regroupée autour de la moyenne $np=3$.
Explore · ⁨Explorer⁩

Une distribution discrète

Changez n et p pour une distribution binomiale et observez les barres — la probabilité de chaque nombre de succès.

5.5

The normal distribution · ⁨La distribution normale⁩

Syllabus · ⁨Programme⁩
English
Candidates should be able to: Notes and examples
understand the use of a normal distribution to model a continuous random variable, and use normal distribution tables Sketches of normal curves to illustrate distributions or probabilities may be required.
solve problems concerning a variable $X$, where $X \sim N(\mu, \sigma^2)$, including: – finding the value of $P(X > x_1)$, or a related probability, given the values of $x_1$, $\mu$, $\sigma$. – finding a relationship between $x_1$, $\mu$ and $\sigma$ given the value of $P(X > x_1)$ or a related probability For calculations involving standardisation, full details of the working should be shown. e.g. $Z = \frac{(X - \mu)}{\sigma}$
recall conditions under which the normal distribution can be used as an approximation to the binomial distribution, and use this approximation, with a continuity correction, in solving problems. $n$ sufficiently large to ensure that both $np > 5$ and $nq > 5$.
Français
Les candidats doivent être capables de : Notes et exemples
comprendre l'utilisation d'une distribution normale pour modéliser une variable aléatoire continue, et utiliser les tables de distribution normale Des croquis de courbes normales illustrant des distributions ou des probabilités peuvent être requis.
résoudre des problèmes concernant une variable $X$, où $X \sim N(\mu, \sigma^2)$, y compris : – trouver la valeur de $P(X > x_1)$, ou une probabilité associée, étant donné les valeurs de $x_1$, $\mu$, $\sigma$. – trouver une relation entre $x_1$, $\mu$ et $\sigma$ étant donné la valeur de $P(X > x_1)$ ou une probabilité associée Pour les calculs impliquant la standardisation, les détails complets du raisonnement doivent être fournis. p.ex. $Z = \frac{(X - \mu)}{\sigma}$
rappeler les conditions sous lesquelles la distribution normale peut être utilisée comme approximation de la distribution binomiale, et utiliser cette approximation, avec une correction de continuité, pour résoudre des problèmes. $n$ suffisamment grand pour s'assurer que $np > 5$ et $nq > 5$.

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English
The 68-95-99.7 rule

The normal distribution 正态分布 models a continuous random variable 连续型随机变量 with a symmetric bell shape. Write $X \sim N(\mu, \sigma^2)$, where $\mu$ is the mean and $\sigma$ is the standard deviation. To use the tables, by standardisation 标准化 convert to the variable $Z \sim N(0, 1)$:

$$Z = \frac{X - \mu}{\sigma}.$$

Then $P(X < x) = P\!\left(Z < \dfrac{x - \mu}{\sigma}\right)$, which you read from the normal table $\Phi$.

The normal distribution is also a good approximation 近似 to the binomial when $n$ is large. Because you replace a discrete variable by a continuous one, apply a continuity correction 连续性校正 (adjust by $0.5$).

Worked example. Bags of rice have mass $X \sim N(\mu, 0.14^2)$. Given that $P(X < 1.48) = 0.22$, find $\mu$.

From the table, $P(Z < z) = 0.22$ gives $z = -0.772$. So

$$\frac{1.48 - \mu}{0.14} = -0.772 \;\Rightarrow\; \mu = 1.48 + 0.772 \times 0.14 = 1.59\ \text{kg (3 s.f.)}.$$

Français
La règle 68-95-99.7
Un tableau de Galton avec des billes formant une forme de cloche
Un plateau de Galton : des boules tombant sur des broches s'empilent selon la distribution normale en forme de cloche.

La distribution normale 正态分布 modélise une variable aléatoire continue 连续型随机变量 avec une forme de cloche symétrique. Écrivez $X \sim N(\mu, \sigma^2)$, où $\mu$ est la moyenne et $\sigma$ l'écart-type. Pour utiliser les tableaux, par standardisation 标准化, convertissez en la variable $Z \sim N(0, 1)$ :

$$Z = \frac{X - \mu}{\sigma}.$$

Puis $P(X < x) = P\!\left(Z < \dfrac{x - \mu}{\sigma}\right)$, que vous lisez dans le tableau normal $\Phi$.

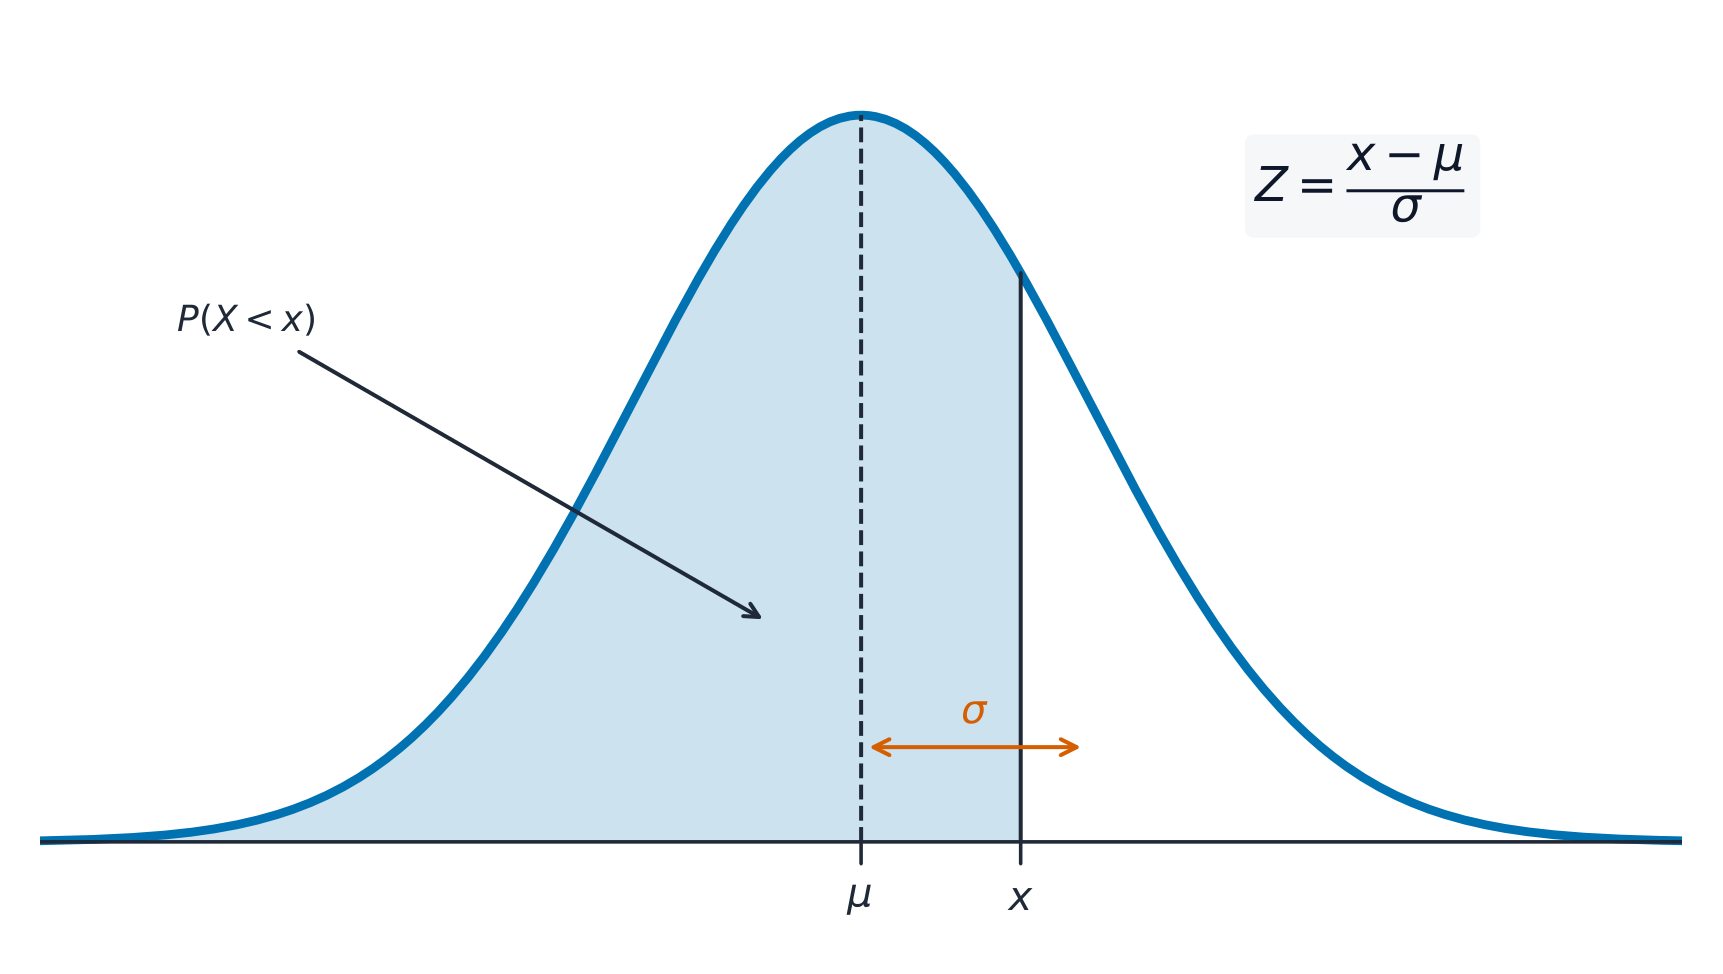
Une courbe en cloche symétrique centrée sur la moyenne avec l'aire jusqu'à une valeur x ombragée
Une probabilité normale est une aire sous la courbe en cloche ; la standardisation la redimensionne à $Z\sim N(0,1)$.

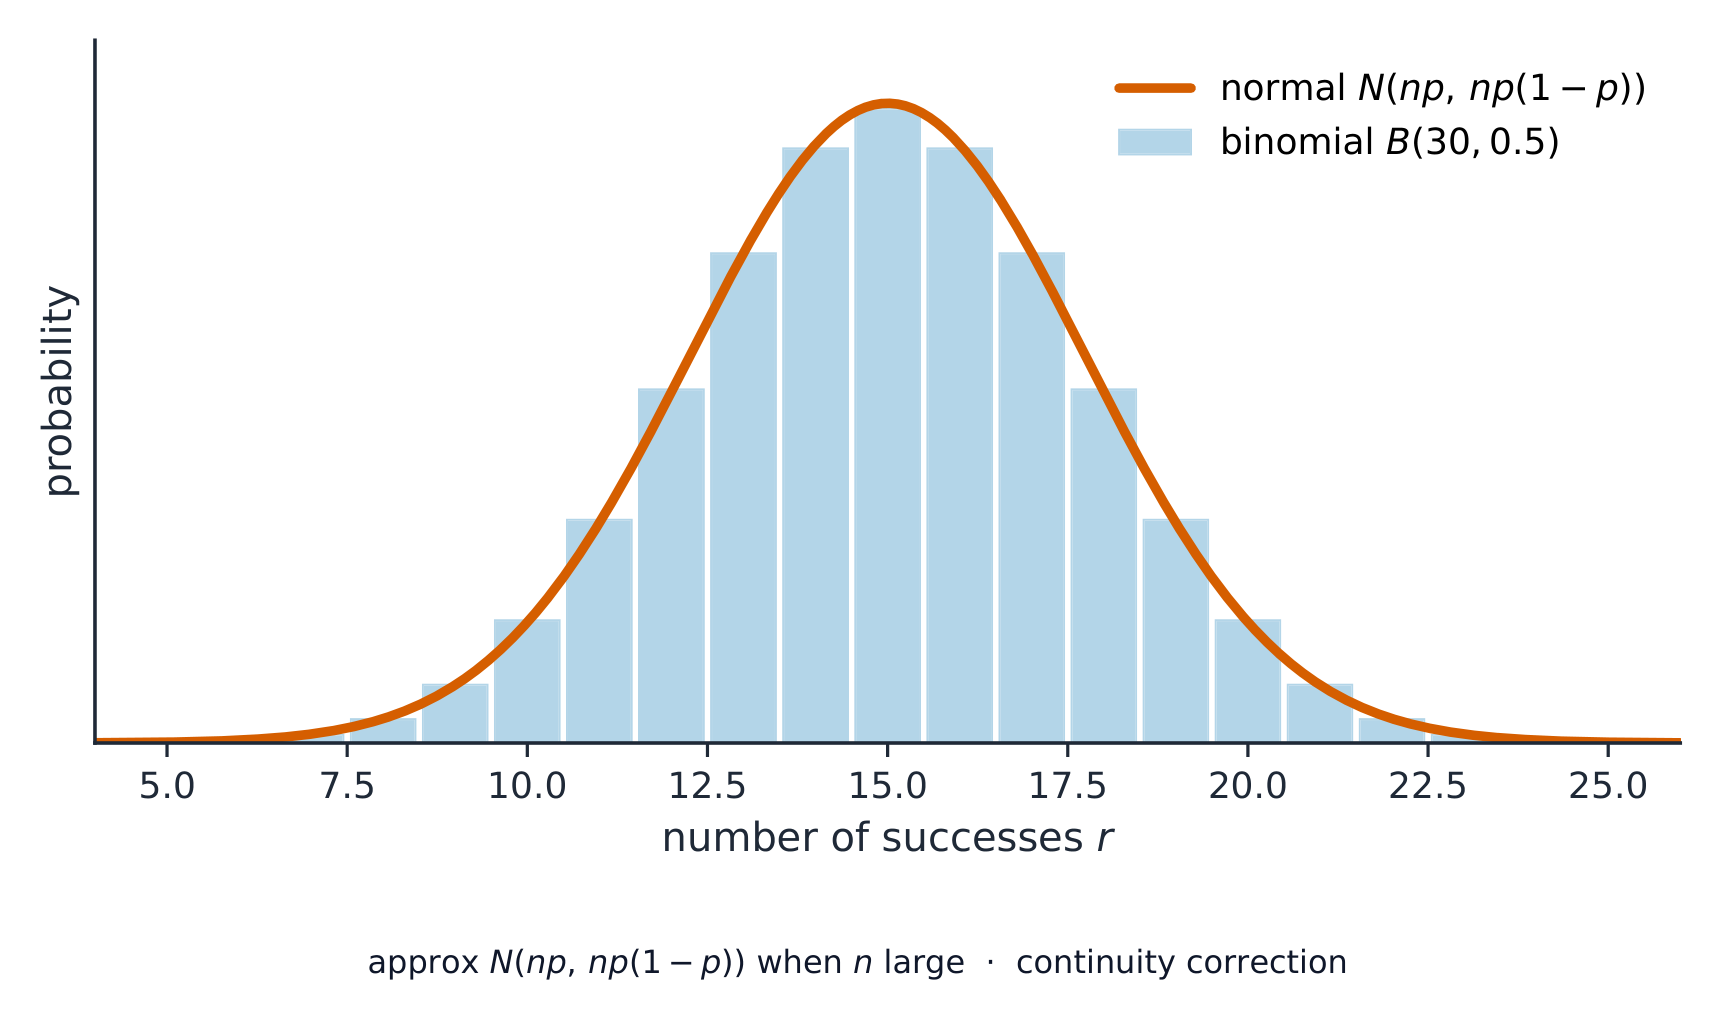
La distribution normale est aussi une bonne approximation 近似 de la binomiale lorsque $n$ est grand. Comme vous remplacez une variable discrète par une continue, appliquez une correction de continuité 连续性校正 (ajustez de $0.5$).

Les barres d'une distribution binomiale avec une courbe normale correspondante dessinée par-dessus
Lorsque $n$ est grand, les barres binomiales suivent une courbe normale de même moyenne et variance.

Exemple résolu. Les sacs de riz ont une masse $X \sim N(\mu, 0.14^2)$. Sachant que $P(X < 1.48) = 0.22$, trouvez $\mu$.

D'après le tableau, $P(Z < z) = 0.22$ donne $z = -0.772$. Donc

$$\frac{1.48 - \mu}{0.14} = -0.772 \;\Rightarrow\; \mu = 1.48 + 0.772 \times 0.14 = 1.59\ \text{kg (3 s.f.)}.$$

Explore · ⁨Explorer⁩

La loi normale

Ombrez l'aire pour trouver une probabilité. Une valeur z mesure combien d'écarts-types un point est éloigné de la moyenne.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ 正态分布 zhèng tài fēn bù
continuous random variable/kənˈtɪnjuːəs ˈrændəm ˈveərɪəbl/ 连续型随机变量 lián xù xíng suí jī biàn liàng
standardisation/ˌstændədaɪˈzeɪʃn/ 标准化 biāo zhǔn huà
approximation/əˌprɒksɪˈmeɪʃn/ 近似 jìn sì
continuity correction/kɒntɪˈnjuːɪti kəˈrekʃn/ 连续性校正 lián xù xìng jiào zhèng
Probability & Statistics/ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ 概率统计 gài lǜ tǒng jì
central tendency/ˈsentrəl ˈtendənsi/ 集中趋势 jí zhōng qū shì
Watch lesson · ⁨Regarder la leçon⁩
5.5

Exam tips · ⁨Conseils d'examen⁩

English
  • Decide whether order matters: permutations ($^nP_r$) when it does, combinations ($^nC_r$) when it does not.
  • For a discrete random variable, check the probabilities sum to $1$ and use $E(X) = \sum x\,P(X=x)$.
  • For the normal distribution, standardise with $z = (x - \mu)/\sigma$, sketch and shade, then read the table.
  • Apply a continuity correction when approximating a discrete variable by the normal.
Français
  • Décidez si l'ordre importe : permutations ($^nP_r$) s'il compte, combinaisons ($^nC_r$) s'il ne compte pas.
  • Pour une variable aléatoire discrète, vérifiez que les probabilités s'additionnent à $1$ et utilisez $E(X) = \sum x\,P(X=x)$.
  • Pour la distribution normale, standardisez avec $z = (x - \mu)/\sigma$, dessinez et hachez, puis lisez le tableau.
  • Appliquez une correction de continuité lors de l'approximation d'une variable discrète par la normale.

Interactive lessons on this topic · ⁨Leçons interactives sur ce sujet⁩

Work through it step by step, with instant-check exercises. · ⁨Traversez-le étape par étape, avec des exercices à vérification instantanée.⁩

Past Papers · ⁨Épreuves Passées⁩

More topics in Mathématiques A-Level · ⁨Plus de sujets dans Mathématiques A-Level⁩

Log in or create account · ⁨Se connecter ou créer un compte⁩

IGCSE, A-Level & AP