Cambridge, les années 1920. Lors d'une réception dans un jardin, une dame dit quelque chose de surprenant. Elle prétend pouvoir goûter et déterminer si le lait a été versé dans la tasse…
English narration · English + 中文 subtitles burned in · Narration en anglais · Sous-titres anglais + 中文 incrustés
English
This handout covers Topic 6: Probability & Statistics 概率统计 2. It adds the Poisson model, combining random variables, continuous distributions, and the ideas of estimation and testing.
Français
Cette fiche couvre le Sujet 6 : Probabilités & Statistiques 概率统计 2. Elle ajoute le modèle de Poisson, la combinaison de variables aléatoires, les distributions continues, et les notions d'estimation et de test.
6.1
The Poisson distribution · La distribution de Poisson
Syllabus · Programme
English
Candidates should be able to:
Notes and examples
• use formulae to calculate probabilities for the distribution $\text{Po}(\lambda)$
• use the fact that if $X \sim \text{Po}(\lambda)$ then the mean and variance of $X$ are each equal to $\lambda$
Proofs are not required.
• understand the relevance of the Poisson distribution to the distribution of random events, and use the Poisson distribution as a model
• use the Poisson distribution as an approximation to the binomial distribution where appropriate
The conditions that $n$ is large and $p$ is small should be known; $n > 50$ and $np < 5$, approximately.
• use the normal distribution, with continuity correction, as an approximation to the Poisson distribution where appropriate.
The condition that $\lambda$ is large should be known; $\lambda > 15$, approximately.
Français
Les candidats doivent être capables de :
Notes et exemples
utiliser les formules pour calculer des probabilités pour la distribution $\text{Po}(\lambda)$
utiliser le fait que si $X \sim \text{Po}(\lambda)$ alors la moyenne et la variance de $X$ sont chacune égales à $\lambda$
La démonstration n'est pas requise.
comprendre la pertinence de la distribution de Poisson pour la distribution d'événements aléatoires, et utiliser la distribution de Poisson comme modèle
utiliser la distribution de Poisson comme approximation de la distribution binomiale là où cela est approprié
Les conditions que $n$ est grand et $p$ est petit doivent être connues ; $n > 50$ et $np < 5$, approximativement.
utiliser la distribution normale, avec correction de continuité, comme approximation de la distribution de Poisson là où cela est approprié.
La condition que $\lambda$ est grand doit être connue ; $\lambda > 15$, approximativement.
Source: Cambridge International syllabus · Source : Programme Cambridge International
English
The Poisson distribution 泊松分布$X \sim \mathrm{Po}(\lambda)$ models the number of random events in a fixed interval, when events happen at a steady average rate $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
For a Poisson variable the mean and the variance are both equal to $\lambda$. The Poisson distribution is a good approximation 近似 to the binomial distribution when $n$ is large and $p$ is small. The normal distribution (with continuity correction) approximates the Poisson when $\lambda$ is large.
Worked example.$X \sim \mathrm{Po}(3)$. Find $P(X = 2)$.
Les arrivées aléatoires de personnes dans une file suivent une distribution de Poisson.
La distribution de Poisson 泊松分布$X \sim \mathrm{Po}(\lambda)$ modélise le nombre d'événements aléatoires dans un intervalle fixe, quand ils se produisent à un taux moyen stable $\lambda$ :
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
Pour une variable de Poisson, la moyenne et la variance sont toutes deux égales à $\lambda$. La distribution de Poisson est une bonne approximation 近似 de la distribution binomiale lorsque $n$ est grand et $p$ est petit. La distribution normale (avec correction de continuité) approxime la Poisson lorsque $\lambda$ est grand.
Exemple résolu.$X \sim \mathrm{Po}(3)$. Trouvez $P(X = 2)$.
Linear combinations of random variables · Combinaisons linéaires de variables aléatoires
Syllabus · Programme
English
Candidates should be able to:
Notes and examples
• use, when solving problems, the results that – $\text{E}(aX + b) = a\text{E}(X) + b$ and $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ for independent $X$ and $Y$ – if $X$ has a normal distribution then so does $aX + b$ – if $X$ and $Y$ have independent normal distributions then $aX + bY$ has a normal distribution – if $X$ and $Y$ have independent Poisson distributions then $X + Y$ has a Poisson distribution.
Proofs of these results are not required.
Français
Les candidats doivent être capables de :
Notes et exemples
• utiliser, lors de la résolution de problèmes, les résultats suivants : – $\text{E}(aX + b) = a\text{E}(X) + b$ et $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ pour des $X$ indépendantes et $Y$ – si $X$ suit une loi normale alors $aX + b$ aussi – si $X$ et $Y$ suivent des lois normales indépendantes alors $aX + bY$ suit une loi normale – si $X$ et $Y$ suivent des lois de Poisson indépendantes alors $X + Y$ suit une loi de Poisson.
Les démonstrations de ces résultats ne sont pas requises.
Source: Cambridge International syllabus · Source : Programme Cambridge International
English
When you change a variable by a linear rule, the expectation 期望 (mean) and variance 方差 follow these rules:
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
Deux faits utiles : si $X$ suit une distribution normale 正态分布, alors $aX + b$ aussi ; et la somme de variables de Poisson indépendantes est encore de Poisson.
Exemple résolu.$X$ a pour moyenne $5$ et variance $4$. Trouvez $E(3X - 1)$ et $\mathrm{Var}(3X - 1)$.
Continuous random variables · Variables aléatoires continues
Syllabus · Programme
English
Candidates should be able to:
Notes and examples
• understand the concept of a continuous random variable, and recall and use properties of a probability density function
For density functions defined over a single interval only; the domain may be infinite, e.g. $\frac{3}{x^4}$ for $x \geqslant 1$.
• use a probability density function to solve problems involving probabilities, and to calculate the mean and variance of a distribution.
Including location of the median or other percentiles of a distribution by direct consideration of an area using the density function. Explicit knowledge of the cumulative distribution function is not included.
Français
Les candidats doivent être capables de :
Notes et exemples
comprendre le concept d'une variable aléatoire continue, et rappeler et utiliser les propriétés d'une fonction de densité de probabilité
Pour les fonctions de densité définies sur un seul intervalle uniquement ; le domaine peut être infini, p.ex. $\frac{3}{x^4}$ pour $x \geqslant 1$.
utiliser une fonction de densité de probabilité pour résoudre des problèmes impliquant des probabilités, et pour calculer la moyenne et la variance d'une distribution.
Y compris la localisation de la médiane ou d'autres percentiles d'une distribution par considération directe d'une aire utilisant la fonction de densité. La connaissance explicite de la fonction de répartition n'est pas incluse.
Source: Cambridge International syllabus · Source : Programme Cambridge International
English
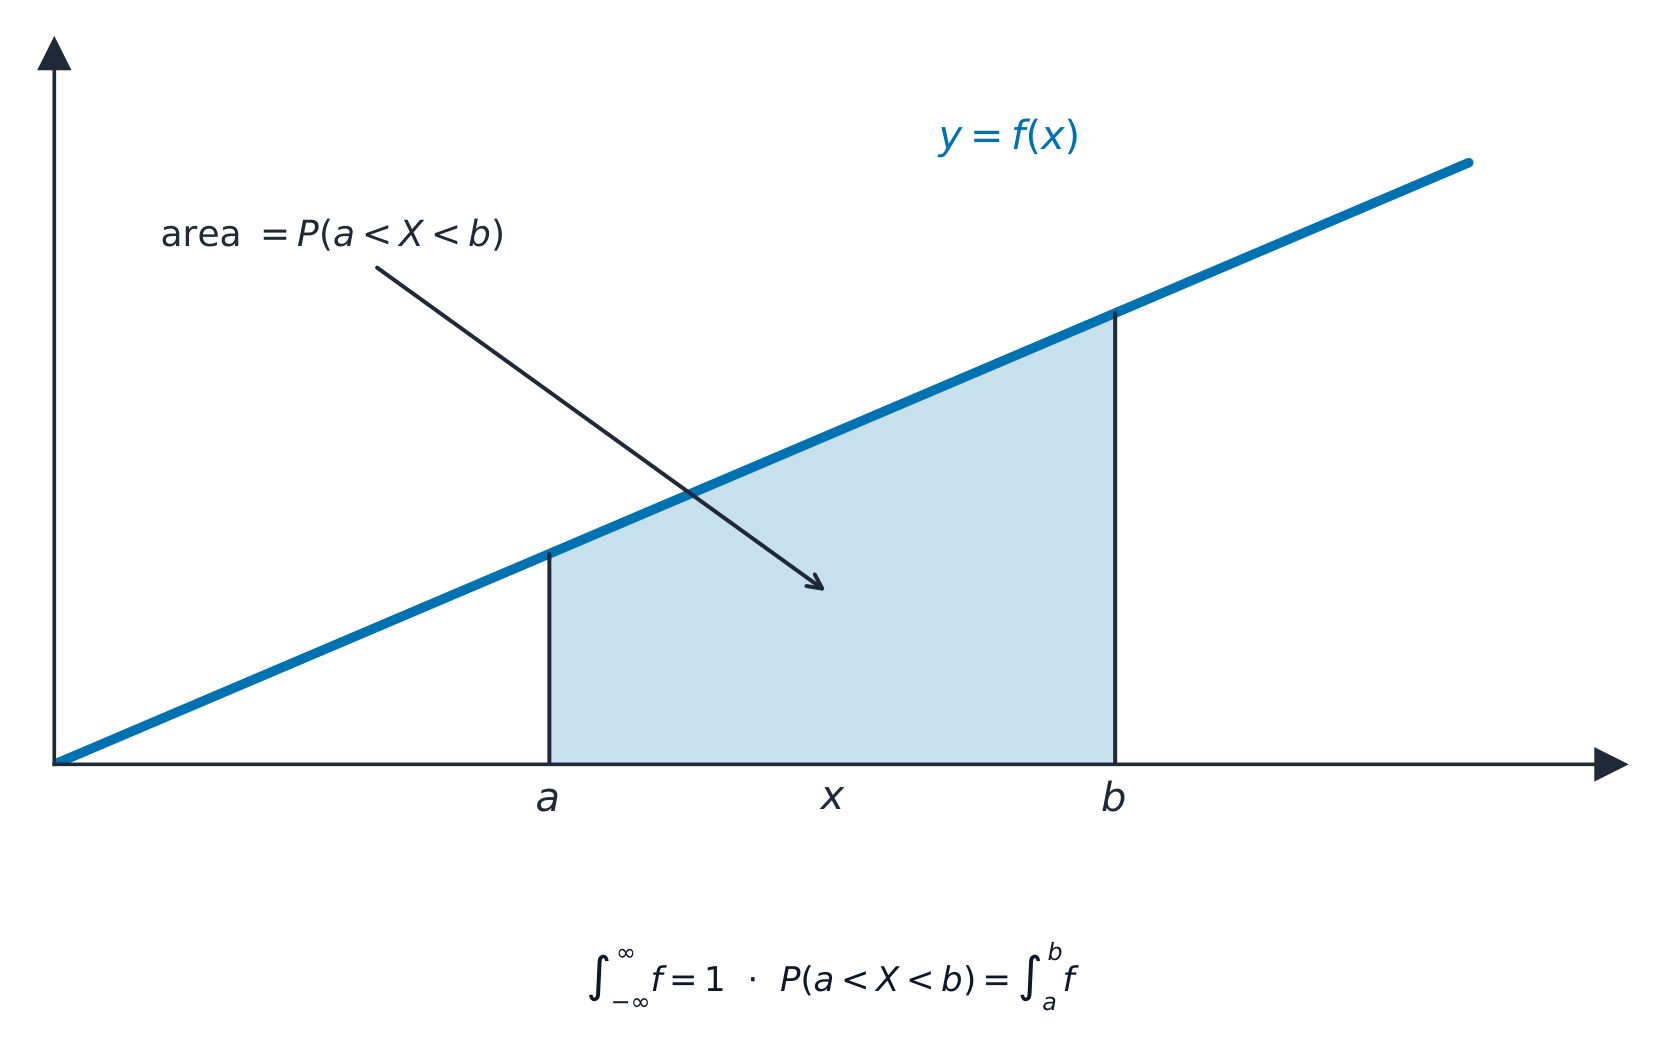
A continuous random variable 连续型随机变量 can take any value in a range. Its probabilities come from a probability density function 概率密度函数$f(x)$, with two key properties:
A probability is the area under $f$, and the mean is found by integration:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
The cumulative distribution function 累积分布函数 is $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; the median 中位数 solves $F(m) = 0.5$, and other percentiles 百分位数 solve $F(x) = p$.
Worked example. A continuous variable has $f(x) = \tfrac12 x$ for $0 \leqslant x \leqslant 2$ (and $0$ elsewhere). Find $E(X)$.
The variance uses the same idea, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. For the same $f(x)=\tfrac12 x$ on $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, so $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Français
Une variable aléatoire continue 连续型随机变量 peut prendre n'importe quelle valeur dans un intervalle. Ses probabilités proviennent d'une fonction de densité de probabilité 概率密度函数$f(x)$, avec deux propriétés clés :
Une probabilité est l'aire sous $f$, et la moyenne se trouve par intégration :
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
La fonction de répartition 累积分布函数 est $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$ ; la médiane 中位数 résout $F(m) = 0.5$, et d'autres percentiles 百分位数 résolvent $F(x) = p$.
Pour une variable continue, la probabilité $P(a est l'aire sous $f(x)$ entre $a$ et $b$.
Exemple résolu. Une variable continue a $f(x) = \tfrac12 x$ pour $0 \leqslant x \leqslant 2$ (et $0$ ailleurs). Trouvez $E(X)$.
La variance utilise la même idée, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. Pour les mêmes $f(x)=\tfrac12 x$ sur $[0,2]$ : $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, donc $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Explore · Explorer
Aire = probabilité
P(a < X < b) = ∫ f(x) dx
Pour une variable continue, la probabilité est l'aire sous la courbe de densité entre deux valeurs.
Sampling and estimation · Échantillonnage et estimation
Syllabus · Programme
English
Candidates should be able to:
Notes and examples
• understand the distinction between a sample and a population, and appreciate the necessity for randomness in choosing samples
• explain in simple terms why a given sampling method may be unsatisfactory
Including an elementary understanding of the use of random numbers in producing random samples. Knowledge of particular sampling methods, such as quota or stratified sampling, is not required.
• recognise that a sample mean can be regarded as a random variable, and use the facts that $\text{E}(\overline{X}) = \mu$ and that $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$
• use the fact that $\overline{X}$ has a normal distribution if $X$ has a normal distribution
• use the Central Limit Theorem where appropriate
Only an informal understanding of the Central Limit Theorem (CLT) is required; for large sample sizes, the distribution of a sample mean is approximately normal.
• calculate unbiased estimates of the population mean and variance from a sample, using either raw or summarised data
Only a simple understanding of the term 'unbiased' is required, e.g. that although individual estimates will vary the process gives an accurate result 'on average'.
• determine and interpret a confidence interval for a population mean in cases where the population is normally distributed with known variance or where a large sample is used
• determine, from a large sample, an approximate confidence interval for a population proportion.
Français
Les candidats doivent être capables de :
Notes et exemples
comprendre la distinction entre un échantillon et une population, et apprécier la nécessité de la randomisation dans le choix des échantillons
expliquer en termes simples pourquoi une méthode d'échantillonnage donnée peut être insatisfaisante
Y compris une compréhension élémentaire de l'utilisation de nombres aléatoires pour produire des échantillons aléatoires. La connaissance de méthodes d'échantillonnage particulières, telles que l'échantillonnage par quotas ou stratifié, n'est pas requise.
reconnaître qu'une moyenne d'échantillon peut être considérée comme une variable aléatoire, et utiliser les faits que $\text{E}(\overline{X}) = \mu$ et que $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$
utiliser le fait que $\overline{X}$ suit une distribution normale si $X$ suit une distribution normale
utiliser le Théorème Central Limite là où c'est approprié
Seule une compréhension informelle du Théorème Central Limite (TCL) est requise ; pour de grands tailles d'échantillon, la distribution d'une moyenne d'échantillon est approximativement normale.
calculer des estimations sans biais de la moyenne et de la variance de la population à partir d'un échantillon, en utilisant soit des données brutes, soit des données résumées
Seule une compréhension simple du terme 'sans biais' est requise, p.ex. que bien que les estimations individuelles varient, le processus donne un résultat précis 'en moyenne'.
déterminer et interpréter un intervalle de confiance pour la moyenne de la population dans les cas où la population est normalement distribuée avec une variance connue ou où un grand échantillon est utilisé
déterminer, à partir d'un grand échantillon, un intervalle de confiance approximatif pour une proportion de population.
Source: Cambridge International syllabus · Source : Programme Cambridge International
English
A sample 样本 is a small group chosen from the whole population 总体. A random sample needs randomness 随机性, so that every member has a fair chance of being chosen.
Some methods are unsatisfactory because they are biased 有偏: sampling only volunteers, or the first 20 people to arrive, over-represents certain kinds of people. A genuinely random sample uses random numbers – number every member of the population, then draw numbers (from a table or a generator) to decide who is in the sample.
The sample mean $\bar{X}$ is itself a random variable, with
By the Central Limit Theorem 中心极限定理, for a large sample $\bar{X}$ is approximately normal, whatever the shape of the population.
From a sample you can find unbiased estimates 无偏估计 of the population mean and variance. A confidence interval 置信区间 gives a range that probably contains the true mean. When the population is normal with known $\sigma$ (or the sample is large), a $95\%$ interval is
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$
You can also find a confidence interval for a population proportion 总体比例 from a large sample.
Worked example. A sample of $n = 64$ has mean $\bar{x} = 50$, from a population with $\sigma = 8$. Find a $95\%$ confidence interval for the population mean.
Les statistiques étudient un échantillon pour apprendre sur une population entière.
Un échantillon 样本 est un petit groupe choisi parmi toute la population 总体. Un échantillon aléatoire nécessite de la randomisation 随机性, afin que chaque membre ait une chance équitable d'être sélectionné.
Certaines méthodes sont insatisfaisantes car elles sont biaisées 有偏 : prélever uniquement des volontaires ou les 20 premières personnes arrivées sureprésente certains types de personnes. Un véritable échantillon aléatoire utilise des nombres aléatoires – numérotez chaque membre de la population, puis tirez des nombres (à partir d'un tableau ou d'un générateur) pour décider qui est dans l'échantillon.
La moyenne de l'échantillon $\bar{X}$ est elle-même une variable aléatoire, avec
Par le Théorème Central Limite 中心极限定理, pour un grand échantillon $\bar{X}$ est approximativement normale, quelle que soit la forme de la population.
Quelle que soit la forme de la population, la moyenne de l'échantillon $\bar{X}$ a une distribution étroite, quasi-normale, centrée sur $\mu$.
À partir d'un échantillon, vous pouvez trouver des estimations sans biais 无偏估计 de la moyenne et de la variance de la population. Un intervalle de confiance 置信区间 fournit une plage qui contient probablement la vraie moyenne. Quand la population est normale avec une variance connue $\sigma$ (ou l'échantillon est grand), un intervalle $95\%$ est
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$
Un intervalle de confiance $95\%$ s'étend sur $1.96$ erreurs standards de chaque côté de la moyenne de l'échantillon.
Vous pouvez également trouver un intervalle de confiance pour une proportion de population 总体比例 à partir d'un grand échantillon.
Exemple résolu. Un échantillon de $n = 64$ a pour moyenne $\bar{x} = 50$, provenant d'une population avec $\sigma = 8$. Trouvez un intervalle de confiance $95\%$ pour la moyenne de la population.
• understand the nature of a hypothesis test, the difference between one-tailed and two-tailed tests, and the terms null hypothesis, alternative hypothesis, significance level, rejection region (or critical region), acceptance region and test statistic
Outcomes of hypothesis tests are expected to be interpreted in terms of the contexts in which questions are set.
• formulate hypotheses and carry out a hypothesis test in the context of a single observation from a population which has a binomial or Poisson distribution, using – direct evaluation of probabilities – a normal approximation to the binomial or the Poisson distribution, where appropriate
• formulate hypotheses and carry out a hypothesis test concerning the population mean in cases where the population is normally distributed with known variance or where a large sample is used
• understand the terms Type I error and Type II error in relation to hypothesis tests
• calculate the probabilities of making Type I and Type II errors in specific situations involving tests based on a normal distribution or direct evaluation of binomial or Poisson probabilities.
Français
Les candidats doivent être capables de :
Notes et exemples
comprendre la nature d'un test d'hypothèse, la différence entre les tests à une queue et à deux queues, et les termes hypothèse nulle, hypothèse alternative, niveau de significativité, zone de rejet (ou zone critique), zone d'acceptation et statistique de test
Les résultats des tests d'hypothèses doivent être interprétés en termes de contextes dans lesquels les questions sont posées.
formuler des hypothèses et effectuer un test d'hypothèse dans le contexte d'une observation unique provenant d'une population ayant une distribution binomiale ou de Poisson, en utilisant – l'évaluation directe des probabilités – une approximation normale de la distribution binomiale ou de Poisson, là où c'est approprié
formuler des hypothèses et effectuer un test d'hypothèse concernant la moyenne de la population dans les cas où la population est normalement distribuée avec une variance connue ou où un grand échantillon est utilisé
comprendre les termes erreur de Type I et erreur de Type II par rapport aux tests d'hypothèses
calculer les probabilités de commettre des erreurs de Type I et de Type II dans des situations spécifiques impliquant des tests basés sur une distribution normale ou l'évaluation directe de probabilités binomiales ou de Poisson.
Source: Cambridge International syllabus · Source : Programme Cambridge International
English
A hypothesis test 假设检验 uses sample data to judge a claim. You set up two statements: the null hypothesis 原假设$H_0$ (the claim being tested, usually "no change") and the alternative hypothesis 备择假设$H_1$ (what you suspect instead). The test is one-tailed 单尾 if $H_1$ points one way (e.g. $\mu > 50$) and two-tailed 双尾 if it allows both ways ($\mu \neq 50$).
You fix a significance level 显著性水平 (often $5\%$), work out a test statistic 检验统计量 from the data, and see whether it lands in the rejection region 拒绝域 (also called the critical region); if it does you reject $H_0$, otherwise the statistic is in the acceptance region.
Two mistakes are possible: a Type I error 第一类错误 is rejecting $H_0$ when it is actually true; a Type II error 第二类错误 is accepting $H_0$ when it is actually false. You can find their probabilities from the rejection region: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – this equals the significance level – and $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ true for a stated value$)$, computed from the binomial, Poisson, or normal distribution.
Worked example. A population is claimed to have mean $50$, with $\sigma = 8$. A sample of $n = 64$ gives $\bar{x} = 52$. Test at the $5\%$ level whether the mean has changed.
$H_0\!: \mu = 50$ and $H_1\!: \mu \neq 50$ (two-tailed). The test statistic is
The critical value at $5\%$ (two-tailed) is $1.96$. Since $2 > 1.96$, you reject $H_0$: there is evidence the mean has changed.
Worked example (a binomial test). A coin is claimed fair but suspected of landing heads too rarely: $H_0\!:p=0.5$, $H_1\!:p<0.5$. In $n=30$ tosses you see $X=9$ heads. Under $H_0$, $X\sim B(30,0.5)$, so the one-tailed tail probability is
Since $0.021<0.05$, reject $H_0$: the coin does seem biased against heads. (For large $n$ the binomial is approximated by a normal; a Poisson test works the same way for rare events. And here, if the rule is "reject when $X\leqslant 9$", then $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Français
Un test d'hypothèse 假设检验 utilise des données d'échantillon pour juger d'une affirmation. Vous établissez deux énoncés : l'hypothèse nulle 原假设$H_0$ (l'affirmation testée, généralement "aucun changement") et l'hypothèse alternative 备择假设$H_1$ (ce que vous soupçonnez à la place). Le test est unilatéral 单尾 si $H_1$ pointe dans un sens (ex. $\mu > 50$) et bilatéral 双尾 s'il permet les deux sens ($\mu \neq 50$).
Vous fixez un niveau de signification 显著性水平 (souvent $5\%$), calculez une statistique de test 检验统计量 à partir des données, et voyez si elle tombe dans la zone de rejet 拒绝域 (aussi appelée zone critique) ; si c'est le cas, vous rejetez $H_0$, sinon la statistique est dans la zone d'acceptation.
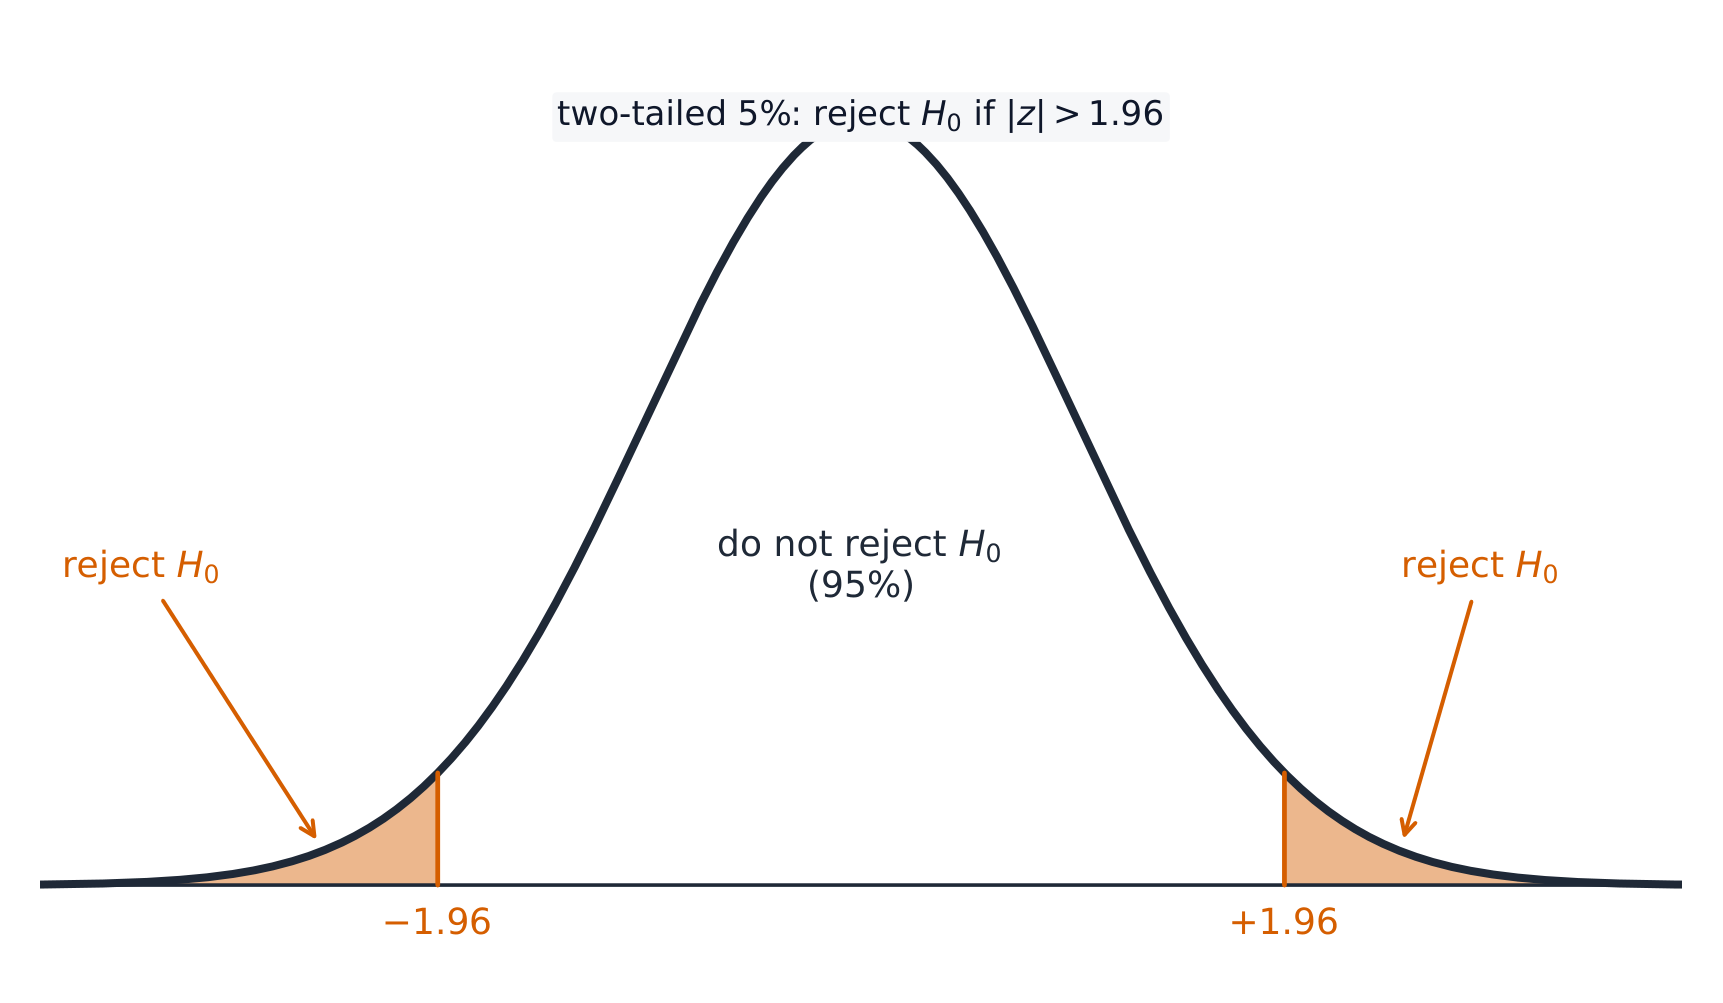
Un test bilatéral à $5\%$ rejette $H_0$ seulement si la statistique de test tombe dans une queue hachurée au-delà de $\pm1.96$.
Deux erreurs sont possibles : une erreur de Type I 第一类 erreur consiste à rejeter $H_0$ quand elle est en fait vraie ; une erreur de Type II 第二类 erreur consiste à accepter $H_0$ quand elle est en fait fausse. Vous pouvez trouver leurs probabilités depuis la zone de rejet : $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – cela équivaut au niveau de signification – et $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ vrai pour une valeur donnée$)$, calculé à partir de la binomiale, de Poisson ou de la normale.
Exemple résolu. On prétend qu'une population a une moyenne $50$, avec $\sigma = 8$. Un échantillon de $n = 64$ donne $\bar{x} = 52$. Testez au niveau $5\%$ si la moyenne a changé.
$H_0\!: \mu = 50$ et $H_1\!: \mu \neq 50$ (bilatéral). La statistique de test est
La valeur critique à $5\%$ (bilatéral) est $1.96$. Puisque $2 > 1.96$, vous rejetez $H_0$ : il y a des preuves que la moyenne a changé.
Exemple résolu (test binomial). Une pièce est censée être juste mais suspectée de tomber trop rarement pile : $H_0\!:p=0.5$, $H_1\!:p<0.5$. En $n=30$ lancers, vous observez $X=9$ têtes. Sous $H_0$, $X\sim B(30,0.5)$, donc la probabilité de queue unilatérale est
Puisque $0.021<0.05$, rejetez $H_0$ : la pièce semble bien biaisée contre les têtes. (Pour un grand $n$, la binomiale est approximée par une normale ; un test Poisson fonctionne de la même manière pour les événements rares. Et ici, si la règle est "rejeter lorsque $X\leqslant 9$", alors $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Explore · Explorer
La région de rejet
rejeter H₀ si z < −z*
La zone hachurée file d'attente est la région de rejet — si la statistique de test y tombe, rejeter H₀.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Sélectionnez-en une et le site vous suit — notes, documents, vidéos et exercices s'ouvrent dessus.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Tapez pour rechercher des notes, leçons, code, vocabulaire et examens dans toutes les matières.