Cette fiche couvre le Topic 4 : Probabilités et Statistiques Avancées 进阶概率统计. Elle ajoute les distributions continues, l'inférence sur petits échantillons, les tests du chi-deux et non paramétriques, ainsi que les fonctions génératrices de probabilité.
Probabilités et Statistiques Supplémentaires
Mathématiques Supérieures A-Level · Sujet 4
 8:08
Probabilités et Statistiques Supplémentaires
Dublin, dix-neuf-cent-huit. À l'intérieur de la brasserie Guinness, un jeune chimiste nommé William Gosset fait face à un problème très concret. Il ne peut tester que quelques lots de…
Narration en anglais · Sous-titres anglais + 中文 incrustés
4.1
Variables aléatoires continues
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| utiliser une fonction de densité de probabilité pouvant être définie par morceaux | |
| utiliser le résultat général $\text{E}(g(X)) = \int f(x)g(x) \, \mathrm{d}x$ où $f(x)$ est la fonction de densité de probabilité de la variable aléatoire continue $X$ et $g(X)$ est une fonction de $X$ | |
| comprendre et utiliser la relation entre la fonction de densité de probabilité (PDF) et la fonction de répartition (CDF), et utiliser l'une ou l'autre pour évaluer des probabilités ou des percentiles | |
| utiliser les fonctions de répartition (CDF) de variables apparentées dans des cas simples. | ex. : étant donné la CDF d'une variable $X$, trouver la CDF d'une variable apparentée $Y$, et ainsi sa PDF, ex. où $Y = X^3$. |
Source : Programme Cambridge International
Une variable continue $X$ est décrite par une fonction de densité de probabilité 概率密度函数 $f(x)$, qui peut être définie par morceaux. La probabilité sur un intervalle est l'aire sous $f$, et la moyenne de toute fonction de $X$ est
$$E(g(X)) = \int g(x)\,f(x)\,dx.$$
La fonction de répartition 累积分布函数 $F(x) = P(X \leqslant x)$ est le cumul : $F(x) = \displaystyle\int_{-\infty}^{x} f(t)\,dt$, et $f(x) = F'(x)$. Utilisez $F$ pour trouver des probabilités et les percentiles 百分位数 (par exemple, la médiane 中位数 résout $F(x) = 0.5$).
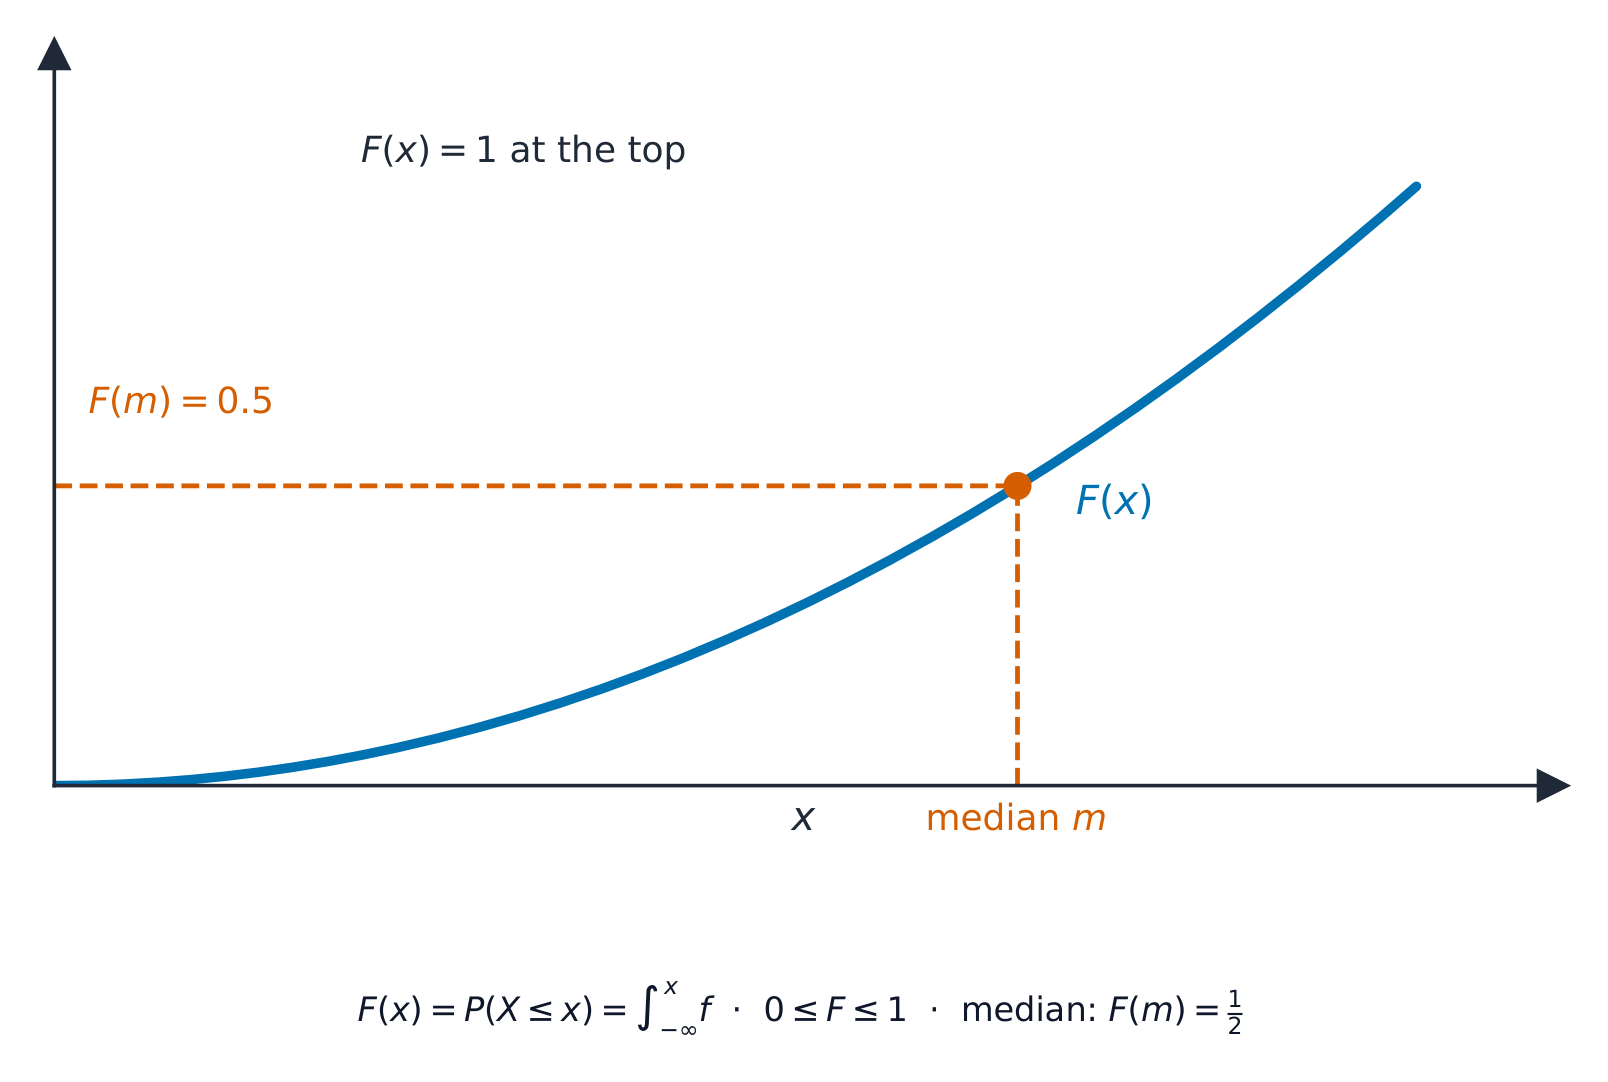
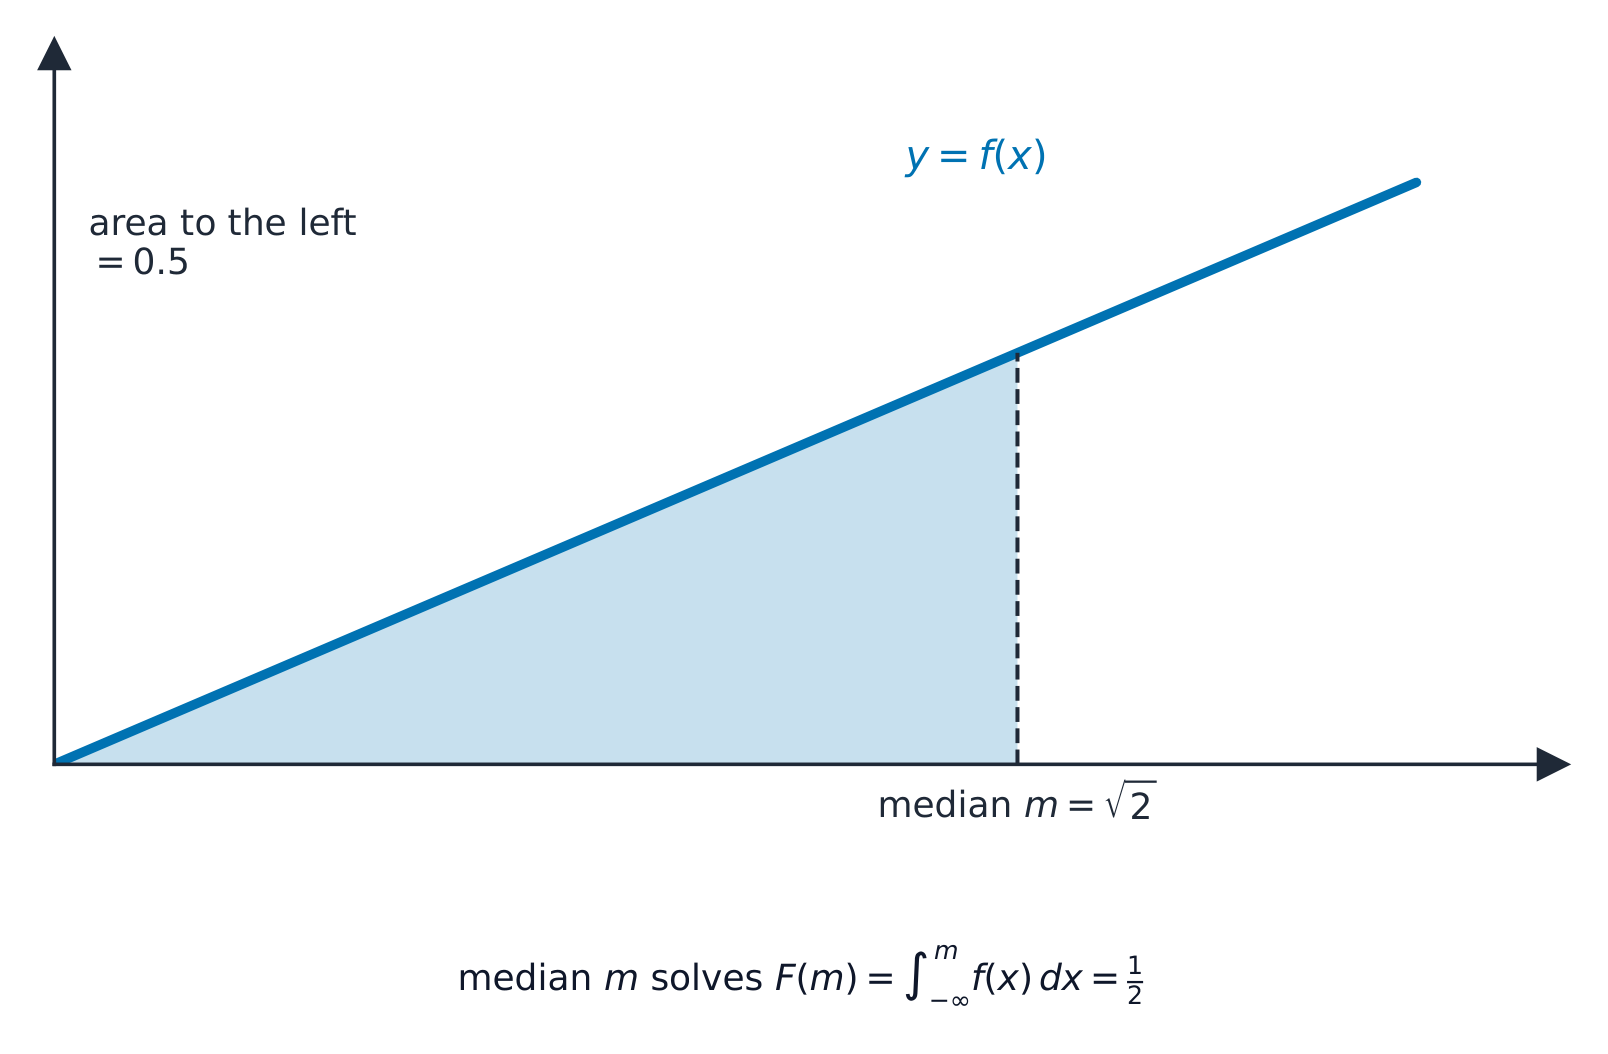
Exemple résolu. Une variable a $f(x) = \tfrac12 x$ pour $0 \leqslant x \leqslant 2$. Trouvez la médiane.
La fonction de répartition est $F(x) = \displaystyle\int_0^x \tfrac12 t\,dt = \tfrac14 x^2$. Poser $F(m) = 0.5$ :
$$\tfrac14 m^2 = 0.5 \;\Rightarrow\; m^2 = 2 \;\Rightarrow\; m = \sqrt{2} = 1.41.$$
La distribution d'une variable liée. Oui $Y=g(X)$, trouvez la distribution de $Y$ via sa fonction de répartition. Pour $Y=X^2$ : $F_Y(y)=P(X^2\leqslant y)=P(-\sqrt y\leqslant X\leqslant\sqrt y)=F_X(\sqrt y)-F_X(-\sqrt y)$, puis dériver pour obtenir $f_Y=F_Y'$. Quand $g$ est strictement croissante, il y a un raccourci, $F_Y(y)=F_X\big(g^{-1}(y)\big)$.
Exemple résolu. Avec $f_X(x)=\tfrac12 x$ sur $[0,2]$ (donc $F_X(x)=\tfrac14 x^2$), posons $Y=X^2$. Pour $0\leqslant y\leqslant 4$, $F_Y(y)=F_X(\sqrt y)=\tfrac14 y$, donc $f_Y(y)=F_Y'(y)=\tfrac14$ – c'est-à-dire, $Y$ est uniforme sur $[0,4]$.
Explorer
Variables aléatoires continues
P(a < X < b) = ∫ f(x) dx
Pour une variable continue, la probabilité est l'aire sous la courbe de densité.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | 概率密度函数 | gài lǜ mì dù hán shù |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | 累积分布函数 | lěi jī fēn bù hán shù |
| percentiles/pəˈsentaɪlz/ | 百分位数 | bǎi fēn wèi shù |
| median/ˈmiːdiːən/ | 中位数 | zhōng wèi shù |
| hypothesis test/haɪˈpɒθəsɪs test/ | 假设检验 | jiǎ shè jiǎn yàn |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | 置信区间 | zhì xìn qū jiān |
| pooled estimate/puːld ˈestɪmət/ | 合并估计 | hé bìng gū jì |
| chi-squared test/kaɪ skweəd test/ | 卡方检验 | kǎ fāng jiǎn yàn |
| theoretical distribution/θɪəˈretɪkl ˌdɪstrɪˈbjuːʃn/ | 理论分布 | lǐ lùn fēn bù |
| degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ | 自由度 | zì yóu dù |
| goodness of fit/ˈɡʊdnəs ɒv fɪt/ | 拟合优度 | nǐ hé yōu dù |
| independence/ˌɪndɪˈpendəns/ | 独立性 | dú lì xìng |
| contingency table/kənˈtɪndʒənsi ˈteɪbl/ | 列联表 | liè lián biǎo |
| non-parametric test/nɒn ˌpærəˈmetrɪk test/ | 非参数检验 | fēi cān shù jiǎn yàn |
4.2
Inférence utilisant les distributions normale et t

Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| formuler des hypothèses et appliquer un test d'hypothèse concernant la moyenne de population en utilisant un petit échantillon prélevé dans une population normale de variance inconnue, à l'aide d'un test-t | |
| calculer une estimation regroupée de la variance de population à partir de deux échantillons | Des calculs basés sur des données brutes ou résumées peuvent être requis. |
| formuler des hypothèses concernant la différence des moyennes de populations, et appliquer, selon le cas : - un test-t à 2 échantillons - un test-t apparié - un test utilisant une distribution normale | Il est attendu de pouvoir sélectionner le test approprié aux circonstances d'un problème. |
| déterminer un intervalle de confiance pour la moyenne d'une population, basé sur un petit échantillon provenant d'une population normale de variance inconnue, à l'aide d'une distribution t | |
| déterminer un intervalle de confiance pour la différence des moyennes de populations, en utilisant une distribution t ou une distribution normale, selon le cas. |
Source : Programme Cambridge International
Quand l'échantillon est petit et la variance de la population inconnue, basez votre test d'hypothèse 假设检验 sur la distribution $t$ plutôt que sur la normale. La même idée donne un intervalle de confiance 置信区间 pour la moyenne :
$$\bar{x} \pm t\,\frac{s}{\sqrt{n}},$$
où $t$ vient des tables $t$ avec $n - 1$ degrés de liberté. Pour comparer deux populations, utilisez un test $t$ à deux échantillons (2-sample) ou paires appariées, après avoir trouvé une estimation poolée 合并估计 de la variance commune si pertinent.
Exemple résolu. Un échantillon de $n = 10$ a une moyenne $\bar{x} = 50$ et un écart-type $s = 4$. Trouvez un intervalle de confiance $95\%$ pour la moyenne (utilisez $t = 2.262$ pour $9$ degrés de liberté).
$$50 \pm 2.262\times\frac{4}{\sqrt{10}} = 50 \pm 2.86 \;\Rightarrow\; (47.1,\ 52.9).$$
Explorer
Pourquoi les petits échantillons nécessitent t au lieu de z
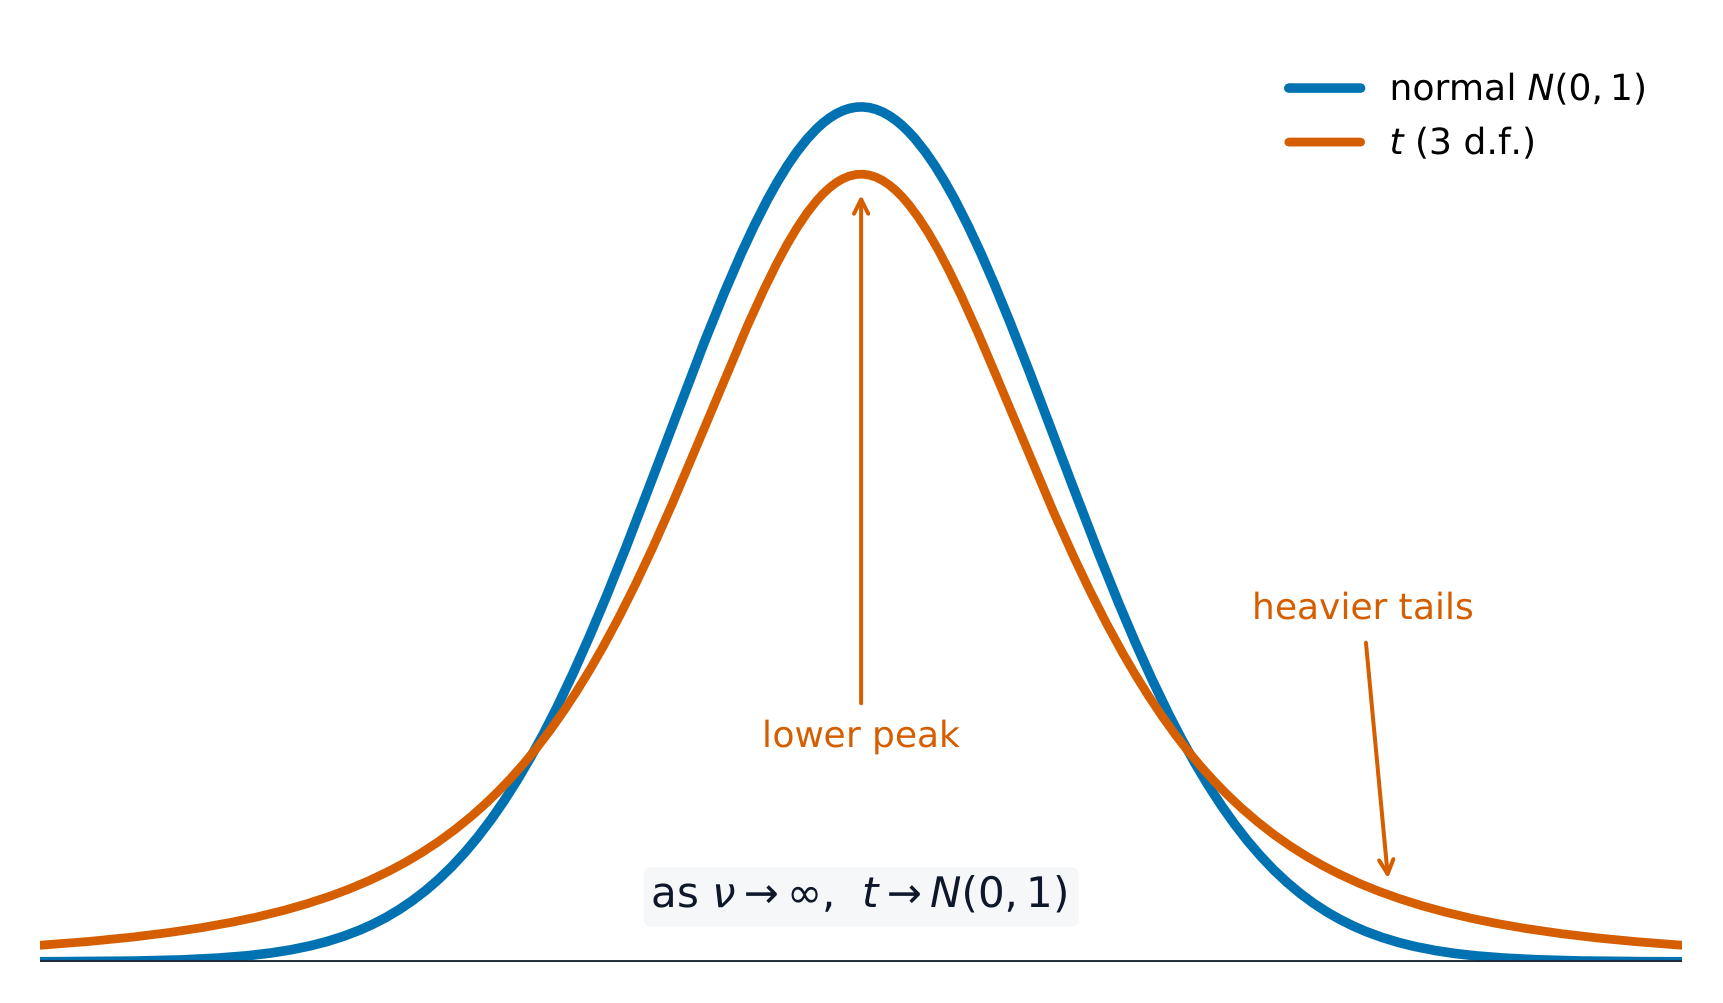
Avec $\sigma$ inconnu, vous utilisez $t$, et $t$ a des queues plus lourdes que la normale (dessinée en pointillés derrière elle) — donc ses valeurs critiques sont plus grandes et l'intervalle est plus large. À $9$ degrés de liberté dans l'exemple résolu, le widget indique $t^* = 2.262$, exactement la valeur de table utilisée ci-dessus. Augmentez ddl et $t$ se superpose à la normale.
Explorer
La loi normale
Ombrez une queue pour trouver une probabilité — la base des intervalles de confiance et des tests d'hypothèses.
4.3
Tests du chi-deux
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| ajuster une distribution théorique, telle que prescrite par une hypothèse donnée, aux données fournies | Les questions ne comporteront pas de longs calculs. |
| utiliser un test $\chi^2$-quadré, avec le nombre approprié de degrés de liberté, pour effectuer l'analyse correspondante d'adéquation | Les classes doivent être combinées de sorte que chaque fréquence attendue soit d'au moins 5. |
| utiliser un test $\chi^2$-quadré, avec le nombre approprié de degrés de liberté, pour tester l'indépendance dans un tableau de contingence. | La correction de Yates n'est pas requise. Selon le cas, combiner les lignes ou les colonnes afin que la fréquence attendue dans chaque cellule soit d'au moins 5. |
Source : Programme Cambridge International
Un test $\chi^2$ (test du chi-deux 卡方检验) compare les effectifs observés $O$ aux effectifs attendus $E$ issus d'une distribution théorique 理论分布 :
$$\chi^2 = \sum \frac{(O - E)^2}{E}.$$
Comparez cela avec une valeur de tableau pour le bon nombre de degrés de liberté 自由度. Deux usages : un test d'adéquation 拟合优度 (les données suivent-elles le modèle proposé ?), et un test d'indépendance 独立性 de deux variables dans un tableau de contingence 列联表.
Exemple résolu. Quatre catégories également probables donnent des effectifs observés $20, 30, 25, 25$ (donc chaque effectif attendu est $25$). Testez l'adéquation au niveau $5\%$.
$$\chi^2 = \frac{(20-25)^2 + (30-25)^2 + 0 + 0}{25} = \frac{25 + 25}{25} = 2.$$
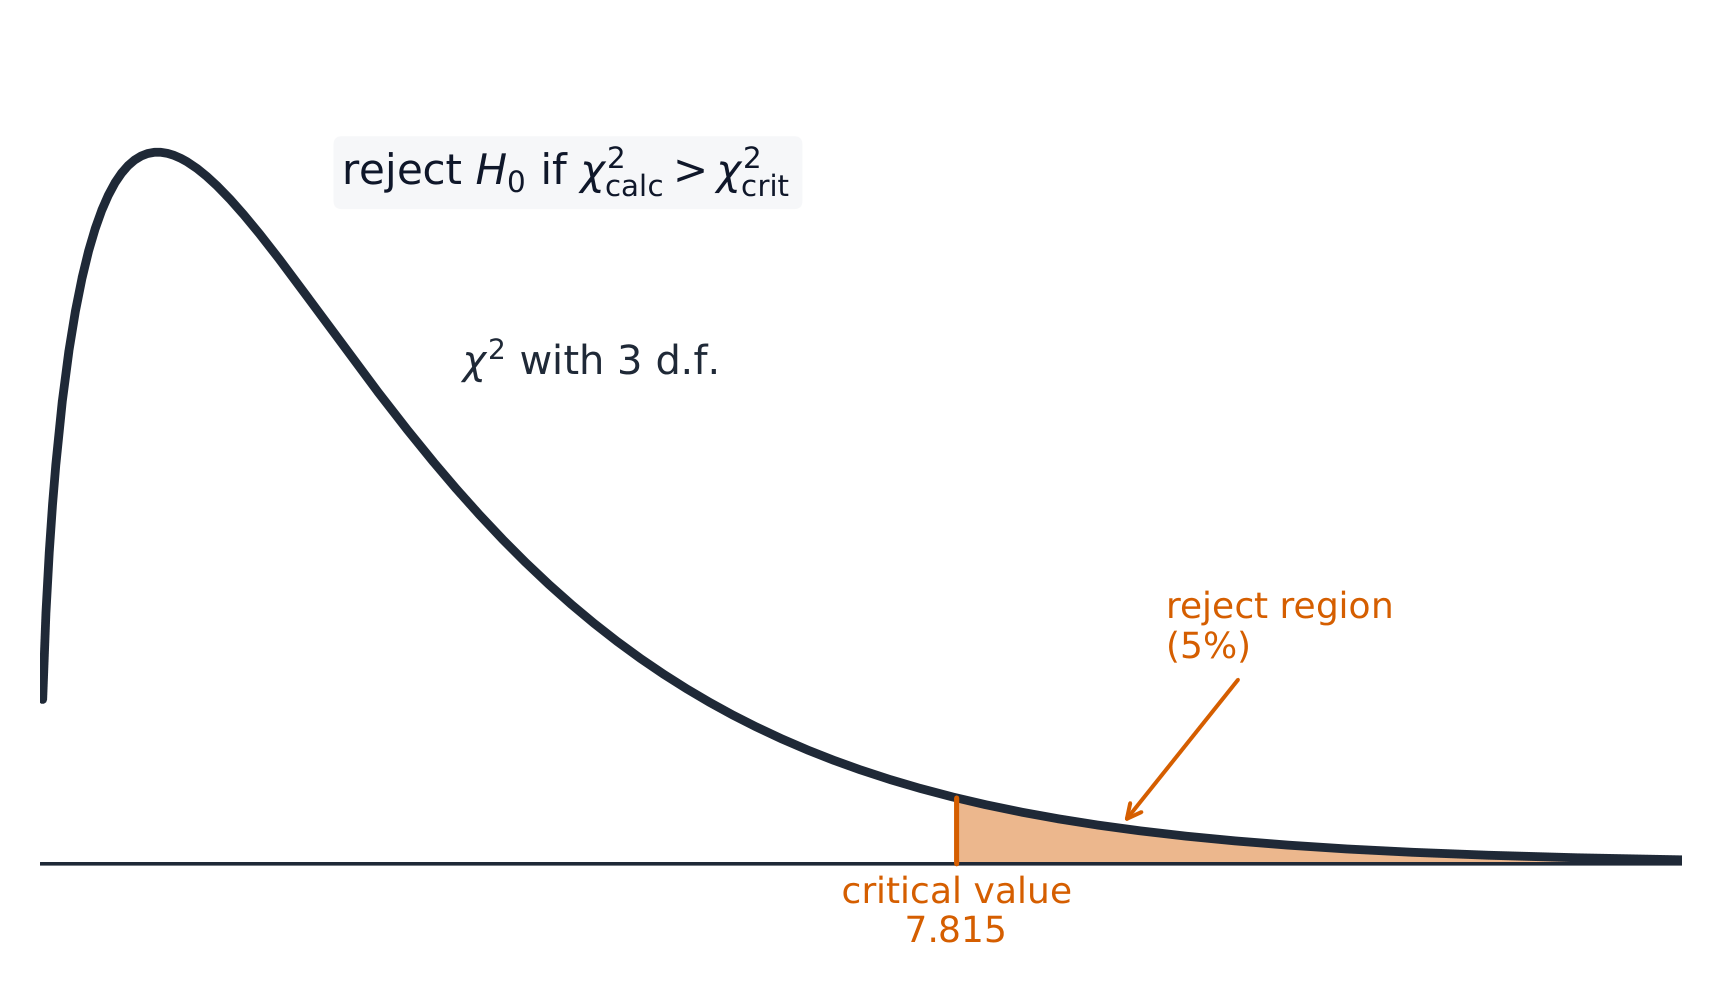
Avec $4 - 1 = 3$ degrés de liberté, la valeur du tableau est $7.815$. Puisque $2 < 7.815$, ne pas rejeter le modèle.
Explorer
La loi du chi carré et sa queue à 5 %
L'exemple résolu sur cette page donne $\chi^2 = 2$ avec $3$ degrés de liberté contre une valeur de table de $7.815$ — le widget reproduit les deux. Faites glisser ddl pour voir pourquoi la valeur critique change avec le nombre de catégories.
Explorer
Parcours du test du khi-deux
Suivez les effectifs observés et attendus jusqu'à une décision de test.
4.4
Tests non paramétriques
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| comprendre l'idée d'un test non paramétrique et apprécier les situations où un tel test pourrait être utile | ex. : lors d'un prélèvement dans une population qui ne peut pas être supposée normalement distribuée. |
| comprendre le principe du test des signes, du test des rangs signés de Wilcoxon et du test de somme des rangs de Wilcoxon | Y compris la connaissance que les tests de Wilcoxon ne sont valables que pour les distributions symétriques. |
| utiliser un test des signes à un seul échantillon et un test des rangs signés de Wilcoxon à un seul échantillon pour tester une hypothèse concernant la médiane d'une population | Y compris l'utilisation d'approximations normales selon le cas. Les questions ne porteront pas sur des rangs liés ni sur des observations égales à la valeur médiane de population testée. |
| utiliser un test des signes apparié, un test des rangs signés de Wilcoxon apparié et un test de somme des rangs de Wilcoxon, selon le cas, pour tester l'identité des populations. | Y compris l'utilisation d'approximations normales selon le cas. Les questions ne porteront pas sur des rangs liés ni sur des paires de différences nulles. |
Source : Programme Cambridge International
Un test non paramétrique 非参数检验 ne fait aucune hypothèse sur la normalité des données, ce qui est utile quand cette hypothèse échoue. Les principaux sont :
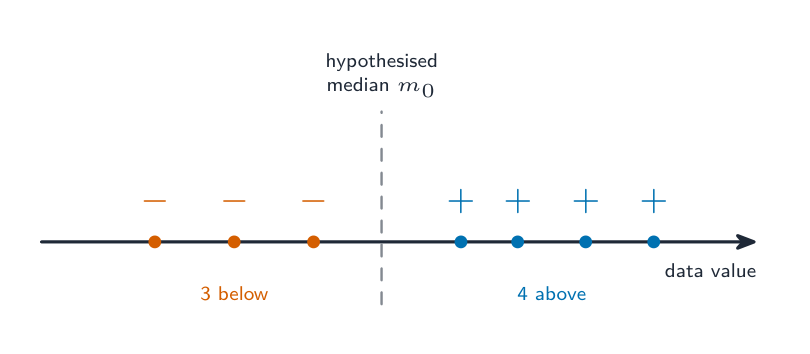
- le test des signes 符号检验 : compter combien de valeurs sont au-dessus et en dessous d'une médiane proposée, et tester ces comptes avec un modèle binomial;
- le test des rangs signés de Wilcoxon 威尔科克森符号秩检验 (le test pour paires appariées matched-pairs pour des données appariées), qui utilise aussi les amplitudes des différences, pas seulement leurs signes;
- le test de somme des rangs de Wilcoxon 威尔科克森秩和检验, pour comparer deux échantillons indépendants.
Exemple résolu. Tester si une médiane est $5$. Dans un échantillon de $10$ valeurs (aucune égale à $5$), $9$ sont au-dessus $5$ et $1$ sont en dessous. Testez au niveau $5\%$ (bilatéral).
Sous $H_0$ (médiane $= 5$), le nombre au-dessuit suit $B(10, 0.5)$. Le résultat observé ($9$ au-dessus) est extrême, donc trouvez $P(X \geq 9) = \binom{10}{9}(0.5)^{10} + (0.5)^{10} = \dfrac{11}{1024} = 0.0107$. Pour un test bilatéral, comparez avec $\tfrac{1}{2}(5\%) = 0.025$. Puisque $0.0107 < 0.025$, rejeter $H_0$ : il y a des preuves que la médiane n'est pas $5$.
Explorer
Choix du test non paramétrique
Choisissez le test basé sur les rangs qui correspond à la situation des données.
Vocabulaire
Entrainer
| Anglais | Chinois | Pinyin |
|---|---|---|
| sign test/saɪn test/ | 符号检验 | fú hào jiǎn yàn |
| Wilcoxon signed-rank test/ˈwɪlkɒksn saɪnd ræŋk test/ | 威尔科克森符号秩检验 | wēi ěr kē kè sēn fú hào zhì jiǎn yàn |
| Wilcoxon rank-sum test/ˈwɪlkɒksn ræŋk sʌm test/ | 威尔科克森秩和检验 | wēi ěr kē kè sēn zhì hé jiǎn yàn |
| probability generating function/ˌprɒbəˈbɪlɪti ˈdʒenəreɪtɪŋ ˈfʌŋkʃn/ | 概率母函数 | gài lǜ mǔ hán shù |
| Further Probability & Statistics/ˈfɜːðə ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | 进阶概率统计 | jìn jiē gài lǜ tǒng jì |
4.5
Fonctions génératrices de probabilité
Programme
| Les candidats doivent être capables de : | Notes et exemples |
|---|---|
| comprendre le concept de fonction génératrice de probabilité (PGF) et construire et utiliser la PGF pour des distributions données | Y compris les distributions uniformes discrètes, binomiales, géométriques et de Poisson. |
| utiliser les formules de la moyenne et de la variance d'une variable aléatoire discrète en fonction de sa PGF, et utiliser ces formules pour calculer la moyenne et la variance d'une distribution de probabilité donnée | |
| utiliser le résultat selon lequel la PGF de la somme de variables aléatoires indépendantes est le produit des PGF de ces variables. |
Source : Programme Cambridge International
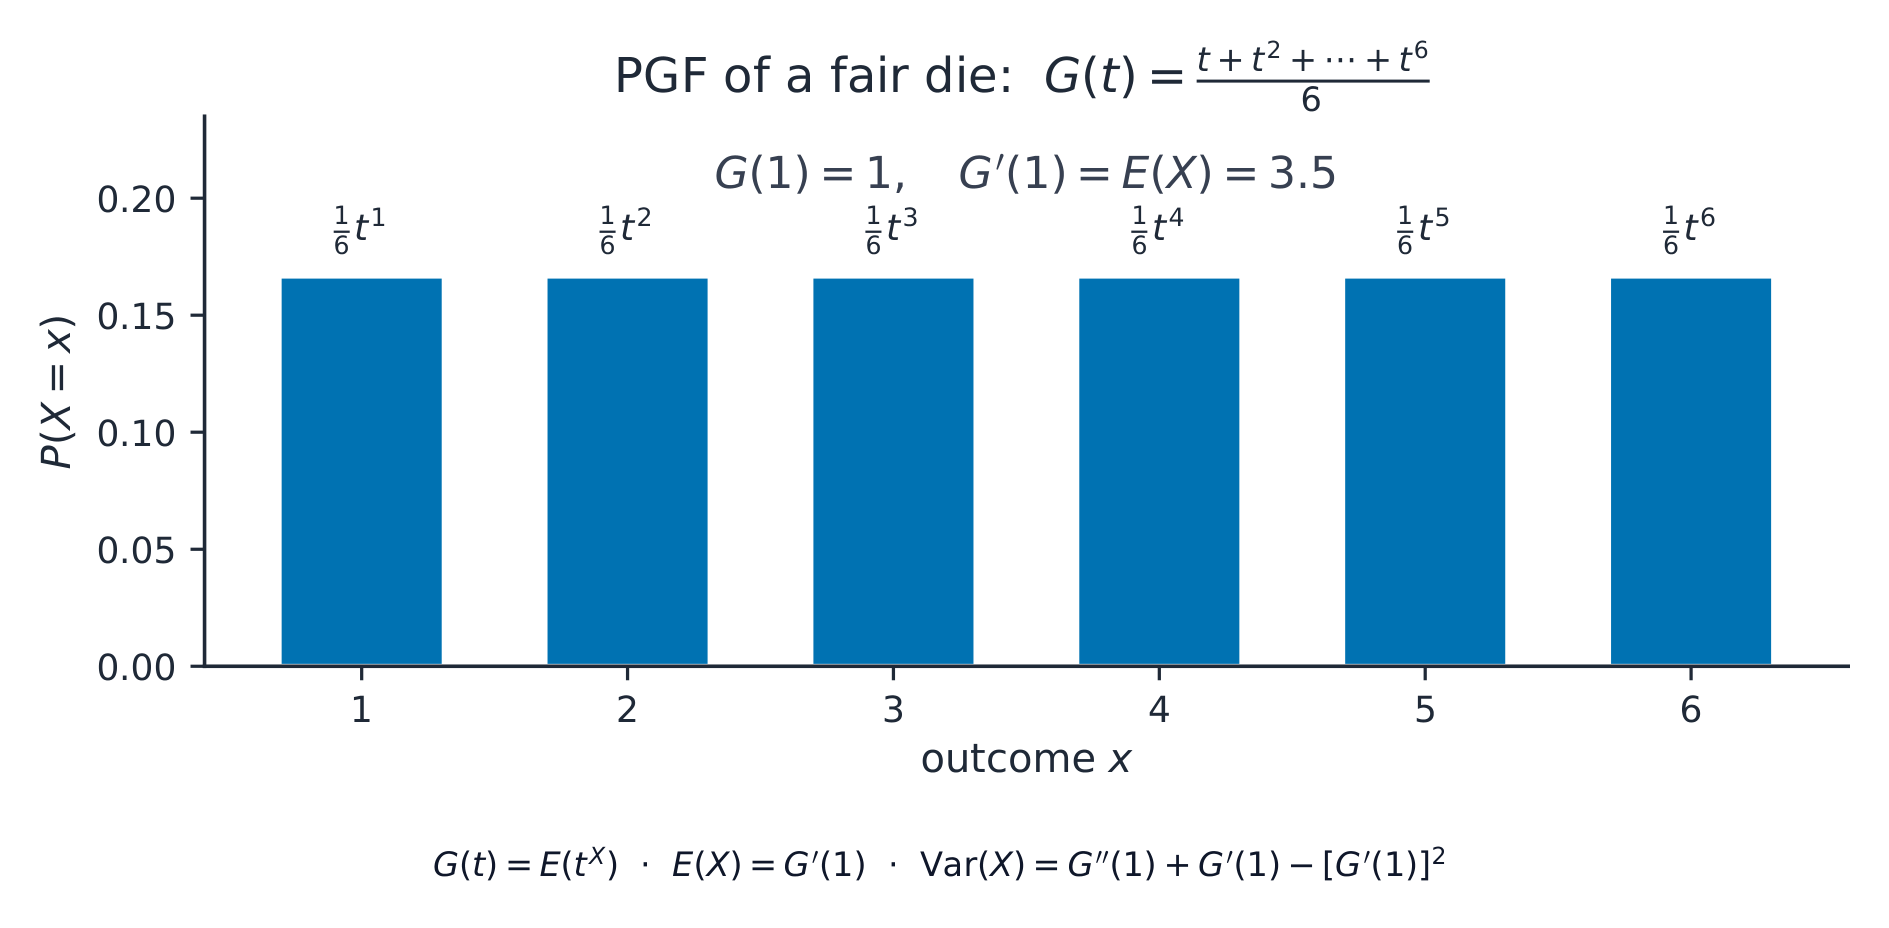
La fonction génératrice de probabilité 概率母函数 d'une variable discrète $X$ est
$$G(t) = E(t^X) = \sum_x P(X = x)\,t^x.$$
Elle regroupe toute la distribution dans une seule fonction. La moyenne et la variance proviennent de ses dérivées en $t = 1$ : $E(X) = G'(1)$ et $\mathrm{Var}(X) = G''(1) + G'(1) - \big(G'(1)\big)^2$. De plus, la FGP d'une somme de variables indépendantes est le produit de leurs FGP.
Exemple résolu. $X$ a $P(X=0) = 0.5$, $P(X=1) = 0.3$, $P(X=2) = 0.2$. Trouvez $E(X)$ en utilisant la FGP.
Ici $G(t) = 0.5 + 0.3t + 0.2t^2$, donc $G'(t) = 0.3 + 0.4t$ et
$$E(X) = G'(1) = 0.3 + 0.4 = 0.7.$$
Explorer
Laboratoire de fonction génératrice de probabilité
G(x) = p0 + p1 x + p2 x^2 + ...
Changez x et voyez comment une PGF stocke les probabilités dans les puissances de x.
4.5
Conseils d'examen
- Pour une variable aléatoire continue, la pdf intègre à $1$ sur son domaine, et $E(X) = \int x f(x)\,dx$.
- Utilisez la distribution $t$ quand l'échantillon est petit et la variance de la population inconnue ; précisez les degrés de liberté.
- Pour un test du chi-deux, calculez $\sum (O-E)^2/E$, comparez avec la valeur critique aux bons degrés de liberté, et regroupez les classes avec $E < 5$.
- Énoncez $H_0$ et $H_1$ et donnez la conclusion dans le contexte pour chaque test.
Leçons interactives sur ce sujet
Traversez-le étape par étape, avec des exercices à vérification instantanée.