Esta hoja de trabajo cubre el Tema 6: Probabilidad y Estadística 概率统计 2. Añade el modelo de Poisson, la combinación de variables aleatorias, distribuciones continuas y los conceptos de estimación y prueba.
Probabilidad y Estadística 2
A-Level Matemáticas · Tema 6
 10:06
Probabilidad y Estadística 2
Cambridge, los años veinte. En una fiesta en el jardín, una dama dice algo sorprendente. Afirma que puede distinguir si la leche se vertió primero o después…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
6.1
La distribución de Poisson
Syllabus
| Los candidatos deben ser capaces de: | Notas y ejemplos |
|---|---|
| • usar fórmulas para calcular probabilidades para la distribución $\text{Po}(\lambda)$ | |
| • utilizar el hecho de que si $X \sim \text{Po}(\lambda)$, entonces la media y la varianza de $X$ son cada una iguales a $\lambda$ | No se requieren demostraciones. |
| • comprender la relevancia de la distribución de Poisson respecto a la distribución de eventos aleatorios, y utilizar la distribución de Poisson como modelo | |
| • utilizar la distribución de Poisson como aproximación a la distribución binomial cuando sea apropiado | Deberían conocerse las condiciones en las que $n$ es grande y $p$ es pequeña; $n > 50$ y $np < 5$, aproximadamente. |
| • utilizar la distribución normal, con corrección por continuidad, como aproximación a la distribución de Poisson cuando sea apropiado. | Debería conocerse la condición de que $\lambda$ es grande; $\lambda > 15$, aproximadamente. |
Fuente: Plan de estudios Cambridge International
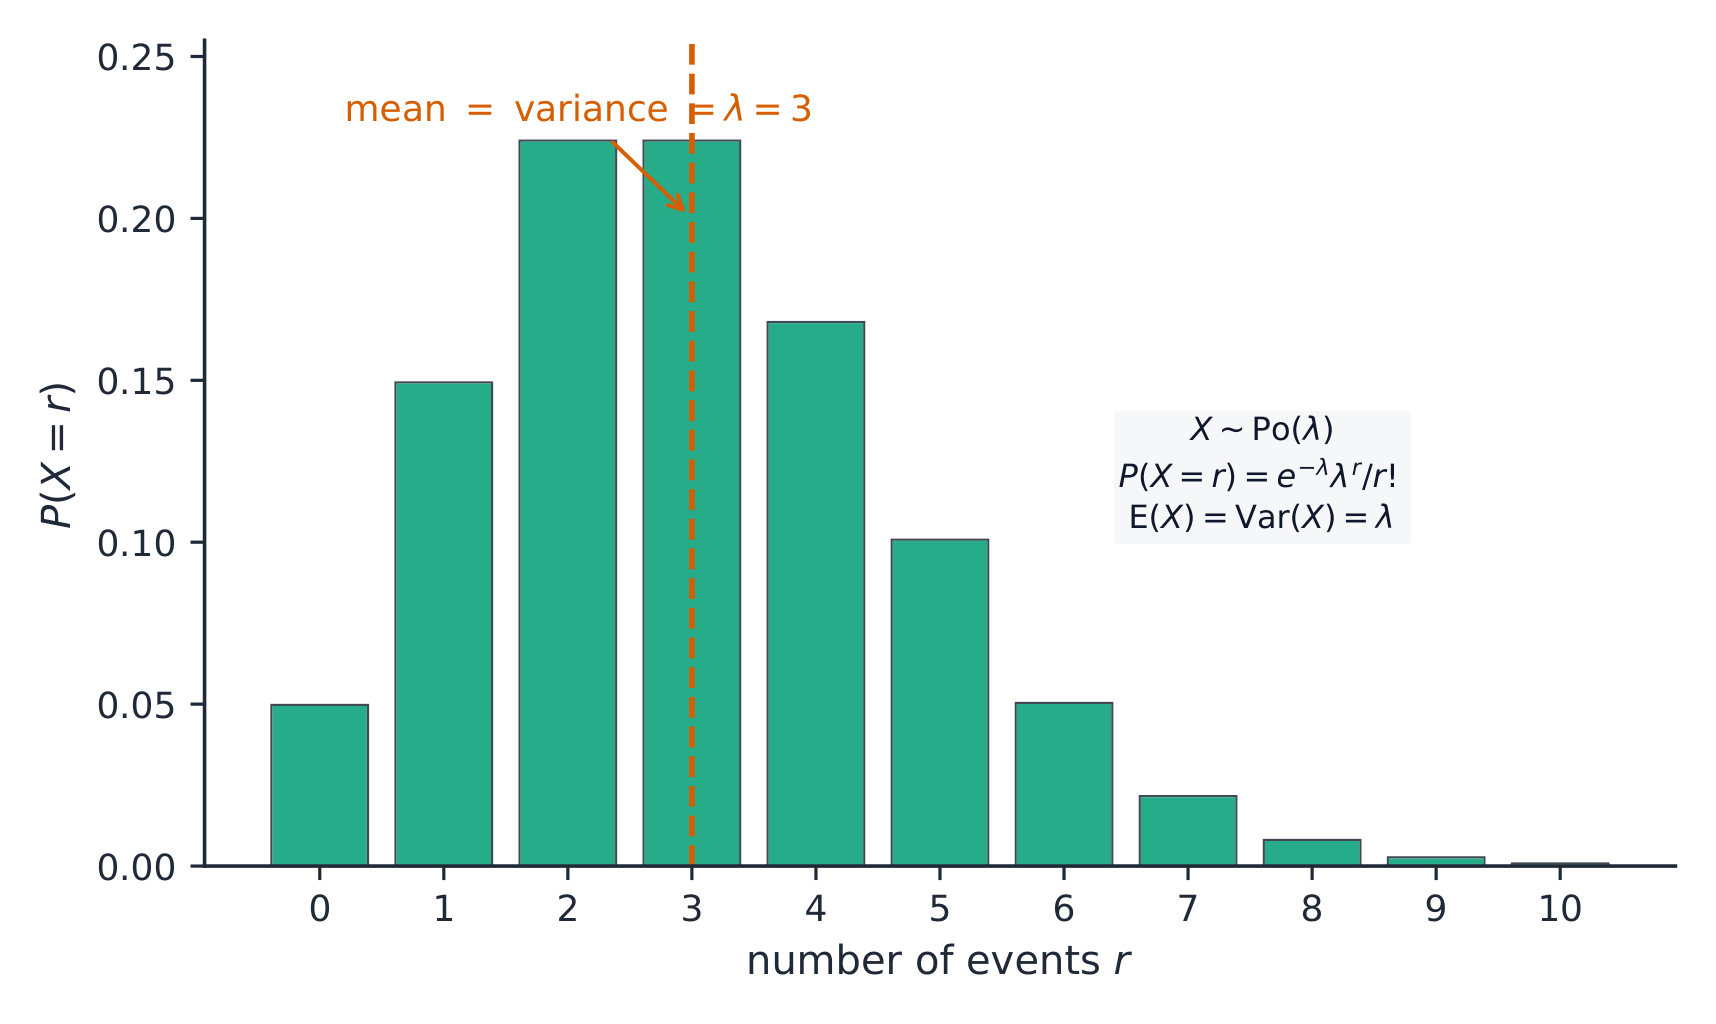
La distribución de Poisson 泊松分布 $X \sim \mathrm{Po}(\lambda)$ modela el número de eventos aleatorios en un intervalo fijo, cuando los eventos ocurren a una tasa promedio constante $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
Para una variable de Poisson, tanto la media como la varianza son iguales a $\lambda$. La distribución de Poisson es una buena aproximación 近似 a la distribución binomial cuando $n$ es grande y $p$ es pequeña. La distribución normal (con corrección de continuidad) aproxima a la Poisson cuando $\lambda$ es grande.
Ejemplo resuelto. $X \sim \mathrm{Po}(3)$. Calcule $P(X = 2)$.
$$P(X = 2) = e^{-3}\frac{3^2}{2!} = e^{-3}\times 4.5 = 0.224.$$
Explorar
La distribución de Poisson
Cambia la media λ. Poisson modela el número de eventos aleatorios en un intervalo fijo: los eventos raros dan una forma sesgada.
6.2
Combinaciones lineales de variables aleatorias
Syllabus
| Los candidatos deben ser capaces de: | Notas y ejemplos |
|---|---|
| • utilizar, al resolver problemas, los resultados siguientes: – $\text{E}(aX + b) = a\text{E}(X) + b$ y $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ para $X$ e $Y$ independientes – si $X$ tiene una distribución normal, entonces $aX + b$ también la tiene – si $X$ e $Y$ tienen distribuciones normales independientes, entonces $aX + bY$ tiene una distribución normal – si $X$ e $Y$ tienen distribuciones de Poisson independientes, entonces $X + Y$ tiene una distribución de Poisson. | No se requieren demostraciones de estos resultados. |
Fuente: Plan de estudios Cambridge International
Cuando se cambia una variable según una regla lineal, la esperanza 期望 (media) y la varianza 方差 siguen estas reglas:
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
Para dos variables independientes $X$ e $Y$:
$$E(aX + bY) = aE(X) + bE(Y), \qquad \mathrm{Var}(aX + bY) = a^2\,\mathrm{Var}(X) + b^2\,\mathrm{Var}(Y).$$
Dos hechos útiles: si $X$ tiene una distribución normal 正态分布, entonces $aX + b$ también la tiene; y la suma de variables de Poisson independientes vuelve a ser Poisson.
Ejemplo resuelto. $X$ tiene media $5$ y varianza $4$. Calcule $E(3X - 1)$ y $\mathrm{Var}(3X - 1)$.
$$E(3X - 1) = 3(5) - 1 = 14, \qquad \mathrm{Var}(3X - 1) = 3^2 \times 4 = 36.$$
Explorar
Laboratorio de combinación lineal
E(aX + b) = aE(X) + b
Cambie un factor de escala y observe cómo se escala el valor esperado.
6.3
Variables aleatorias continuas
Syllabus
| Los candidatos deben ser capaces de: | Notas y ejemplos |
|---|---|
| • comprender el concepto de una variable aleatoria continua, y recordar y utilizar las propiedades de una función de densidad de probabilidad | Para funciones de densidad definidas sobre un único intervalo; el dominio puede ser infinito, p. ej., $\frac{3}{x^4}$ para $x \geqslant 1$. |
| • utilizar una función de densidad de probabilidad para resolver problemas que involucren probabilidades, y para calcular la media y la varianza de una distribución. | Incluye la localización de la mediana u otros percentiles de una distribución mediante la consideración directa de un área utilizando la función de densidad. El conocimiento explícito de la función de distribución acumulada no está incluido. |
Fuente: Plan de estudios Cambridge International
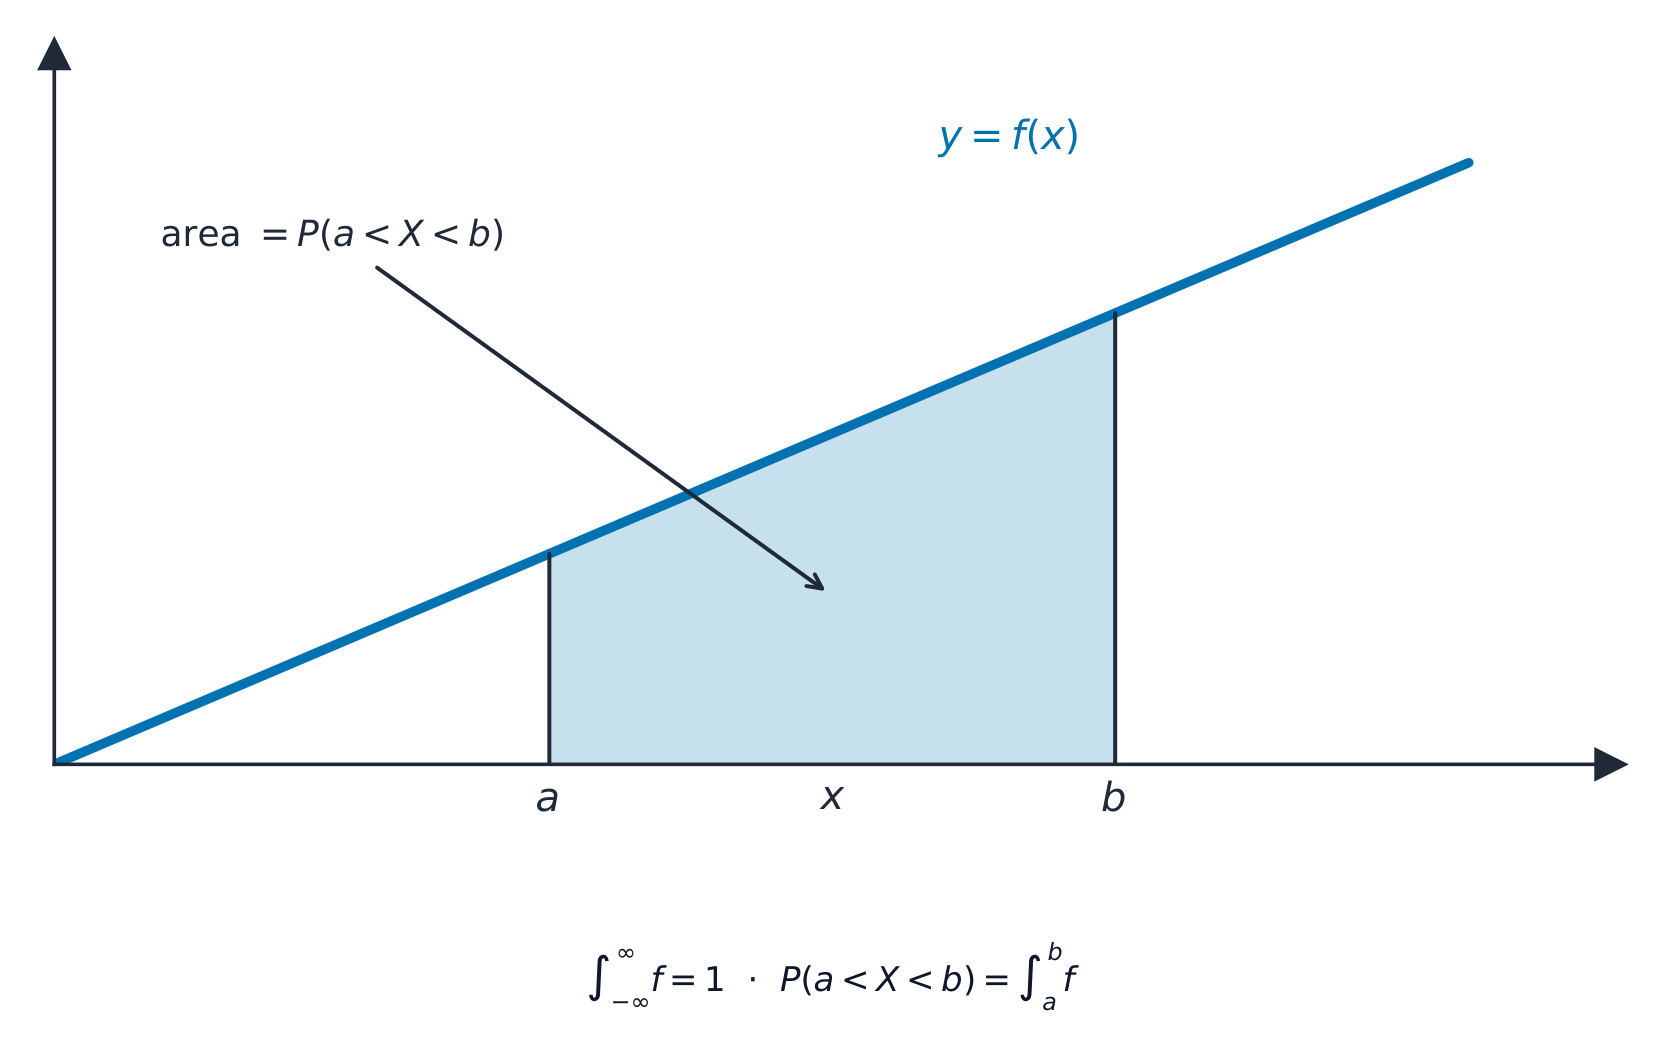
Una variable aleatoria continua 连续型随机变量 puede tomar cualquier valor en un rango. Sus probabilidades provienen de una función de densidad de probabilidad 概率密度函数 $f(x)$, con dos propiedades clave:
$$f(x) \geqslant 0, \qquad \int_{-\infty}^{\infty} f(x)\,dx = 1.$$
Una probabilidad es el área bajo $f$, y la media se encuentra por integración:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
La función de distribución acumulativa 累积分布函数 es $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; la mediana 中位数 resuelve $F(m) = 0.5$, y otros percentiles 百分ílicores resuelven $F(x) = p$.
Ejemplo resuelto. Una variable continua tiene $f(x) = \tfrac12 x$ para $0 \leqslant x \leqslant 2$ (y $0$ en otro caso). Calcule $E(X)$.
$$E(X) = \int_0^2 x\cdot\tfrac12 x\,dx = \int_0^2 \tfrac12 x^2\,dx = \left[\tfrac{x^3}{6}\right]_0^2 = \frac{8}{6} = \frac{4}{3}.$$
La varianza usa la misma idea, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. Para la misma $f(x)=\tfrac12 x$ en $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, así que $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Explorar
Área = probabilidad
P(a < X < b) = ∫ f(x) dx
Para una variable continua, la probabilidad es el área bajo la curva de densidad entre dos valores.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| Poisson distribution/ˈpɔɪsn ˌdɪstrɪˈbjuːʃn/ | 泊松分布 | pō sōng fēn bù |
| approximation/əˌprɒksɪˈmeɪʃn/ | 近似 | jìn sì |
| expectation/ekspɪkˈteɪʃn/ | 期望 | qī wàng |
| variance/ˈveərɪəns/ | 方差 | fāng chà |
| normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ | 正态分布 | zhèng tài fēn bù |
| continuous random variable/kənˈtɪnjuːəs ˈrændəm ˈveərɪəbl/ | 连续型随机变量 | lián xù xíng suí jī biàn liàng |
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | 概率密度函数 | gài lǜ mì dù hán shù |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | 累积分布函数 | lěi jī fēn bù hán shù |
| median/ˈmiːdiːən/ | 中位数 | zhōng wèi shù |
| percentiles/pəˈsentaɪlz/ | 百分位数 | bǎi fēn wèi shù |
| sample/ˈsæmpl/ | 样本 | yàng běn |
| population/ˌpɒpjʊˈleɪʃn/ | 总体 | zǒng tǐ |
| randomness/ˈrændəmnəs/ | 随机性 | suí jī xìng |
| biased/ˈbaɪəst/ | 有偏 | yǒu piān |
| Central Limit Theorem/ˈsentrəl ˈlɪmɪt ˈθɪərəm/ | 中心极限定理 | zhōng xīn jí xiàn dìng lǐ |
| unbiased estimates/ʌnˈbaɪəst ˈestɪməts/ | 无偏估计 | wú piān gū jì |
6.4
Muestreo y estimación

Syllabus
| Los candidatos deben ser capaces de: | Notas y ejemplos |
|---|---|
| • comprender la distinción entre una muestra y una población, y apreciar la necesidad de la aleatoriedad en la selección de muestras | |
| • explicar en términos sencillos por qué un determinado método de muestreo puede ser insatisfactorio | Incluyendo una comprensión elemental del uso de números aleatorios para obtener muestras aleatorias. No se requiere conocimiento de métodos de muestreo específicos, como el muestreo por cuotas o estratificado. |
| • reconocer que una media muestral puede considerarse como una variable aleatoria, y utilizar los hechos de que $\text{E}(\overline{X}) = \mu$ y que $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$ | |
| • utilizar el hecho de que $\overline{X}$ tiene una distribución normal si $X$ tiene una distribución normal | |
| • aplicar el Teorema del Límite Central cuando sea apropiado | Solo se requiere una comprensión informal del Teorema del Límite Central (TLC); para tamaños de muestra grandes, la distribución de una media muestral es aproximadamente normal. |
| • calcular estimadores insesgados de la media y la varianza de la población a partir de una muestra, utilizando datos crudos o resumidos | Solo se requiere una comprensión simple del término 'insesgado', p. ej., que aunque las estimaciones individuales variarán, el proceso proporciona un resultado preciso 'en promedio'. |
| • determinar e interpretar un intervalo de confianza para la media de la población en casos donde la población está distribuida normalmente con varianza conocida o cuando se utiliza una muestra grande | |
| • determinar, a partir de una muestra grande, un intervalo de confianza aproximado para una proporción poblacional. |
Fuente: Plan de estudios Cambridge International
Una muestra 样本 es un grupo pequeño elegido de toda la población 总体. Una muestra aleatoria necesita aleatoriedad 随机性, para que cada miembro tenga una oportunidad justa de ser elegido.
Algunos métodos son insatisfactorios porque están sesgados 有偏: encuestar solo voluntarios o a las primeras 20 personas en llegar sobre-representan ciertos tipos de personas. Una muestra verdaderamente aleatoria usa números aleatorios: numere a cada miembro de la población, luego extraiga números (de una tabla o un generador) para decidir quién está en la muestra.
La media muestral $\bar{X}$ es en sí misma una variable aleatoria, con
$$E(\bar{X}) = \mu, \qquad \mathrm{Var}(\bar{X}) = \frac{\sigma^2}{n}.$$
Por el Teorema Central del Límite 中心极限定理, para una muestra grande $\bar{X}$ es aproximadamente normal, independientemente de la forma de la población.

De una muestra se pueden obtener estimadores insesgados 无偏估计 de la media y la varianza de la población. Un intervalo de confianza 置信区间 da un rango que probablemente contiene la media verdadera. Cuando la población es normal con $\sigma$ conocida (o la muestra es grande), un intervalo del $95\%$ es
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$

También se puede encontrar un intervalo de confianza para una proporción poblacional 总体比例 a partir de una muestra grande.
Ejemplo resuelto. Una muestra de $n = 64$ tiene media $\bar{x} = 50$, procedente de una población con $\sigma = 8$. Calcule un intervalo de confianza del $95\%$ para la media de la población.
$$50 \pm 1.96\times\frac{8}{\sqrt{64}} = 50 \pm 1.96 \;\Rightarrow\; (48.0,\ 52.0).$$
Explorar
La distribución muestral
X̄ ~ N(μ, σ²/n)
Por el Teorema del Límite Central, las medias muestrales siguen una curva normal — más estrecha para muestras más grandes.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | 置信区间 | zhì xìn qū jiān |
| population proportion/ˌpɒpjʊˈleɪʃn prəˈpɔːʃn/ | 总体比例 | zǒng tǐ bǐ lì |
6.5
Pruebas de hipótesis
Syllabus
| Los candidatos deben ser capaces de: | Notas y ejemplos |
|---|---|
| • comprender la naturaleza de una prueba de hipótesis, la diferencia entre pruebas de una cola y pruebas de dos colas, y los términos hipótesis nula, hipótesis alternativa, nivel de significancia, región de rechazo (o región crítica), región de aceptación y estadístico de prueba | Se espera que los resultados de las pruebas de hipótesis se interpreten en función de los contextos en los que se plantean las preguntas. |
| • formular hipótesis y realizar una prueba de hipótesis en el contexto de una sola observación de una población con distribución binomial o Poisson, utilizando – evaluación directa de probabilidades – una aproximación normal a la distribución binomial o a la distribución Poisson, cuando corresponda | |
| • formular hipótesis y realizar una prueba de hipótesis sobre la media poblacional en casos donde la población tiene distribución normal con varianza conocida o donde se utiliza una muestra grande | |
| • comprender los términos error Tipo I y error Tipo II en relación con las pruebas de hipótesis | |
| • calcular las probabilidades de cometer errores Tipo I y Tipo II en situaciones específicas que involucren pruebas basadas en la distribución normal o en la evaluación directa de probabilidades binomiales o Poisson. |
Fuente: Plan de estudios Cambridge International
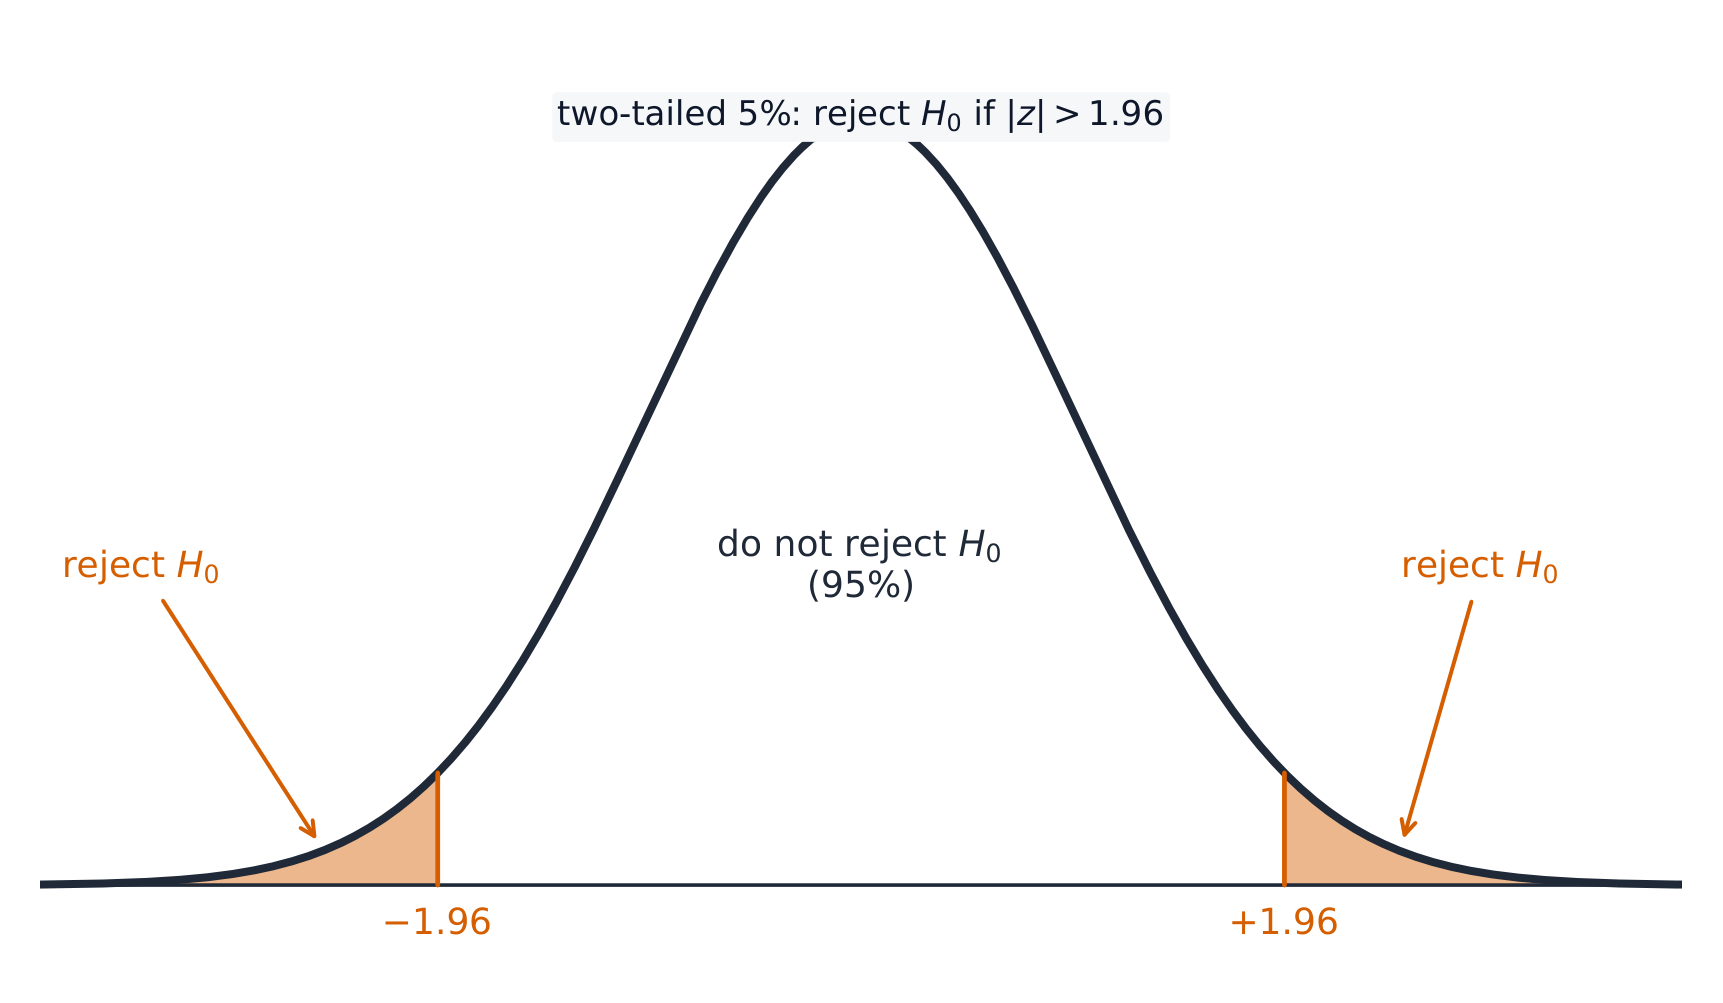
Una prueba de hipótesis 假设检验 usa datos muestrales para evaluar una afirmación. Establece dos enunciados: la hipótesis nula 原假设 $H_0$ (la afirmación que se pone a prueba, usualmente "sin cambio") y la hipótesis alternativa 备择假设 $H_1$ (lo que sospecha en su lugar). La prueba es unilateral 单尾 si $H_1$ apunta en una dirección (ej. $\mu > 50$) y bilateral 双尾 si permite ambas direcciones ($\mu \neq 50$).
Se fija un nivel de significancia 显著性水平 (usualmente $5\%$), se calcula un estadístico de prueba 检验统计量 a partir de los datos, y se observa si cae en la región de rechazo 拒绝域 (también llamada región crítica); si lo hace, se rechaza $H_0$, de lo contrario el estadístico está en la región de aceptación.
Son posibles dos errores: un error Tipo I 第一类 error es rechazar $H_0$ cuando en realidad es verdadero; un error Tipo II 第二类 error es aceptar $H_0$ cuando en realidad es falso. Se pueden encontrar sus probabilidades desde la región de rechazo: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – esto es igual al nivel de significancia – y $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ verdadero para un valor declarado$)$, calculado desde la distribución binomial, de Poisson o normal.
Ejemplo resuelto. Se afirma que una población tiene media $50$, con $\sigma = 8$. Una muestra de $n = 64$ da $\bar{x} = 52$. Pruebe al nivel del $5\%$ si la media ha cambiado.
$H_0\!: \mu = 50$ y $H_1\!: \mu \neq 50$ (bilateral). El estadístico de prueba es
$$z = \frac{\bar{x} - \mu}{\sigma/\sqrt{n}} = \frac{52 - 50}{8/8} = 2.$$
El valor crítico al $5\%$ (bilateral) es $1.96$. Dado que $2 > 1.96$, se rechaza $H_0$: hay evidencia de que la media ha cambiado.
Ejemplo resuelto (una prueba binomial). Se afirma que una moneda es justa pero se sospecha que sale cara muy rara vez: $H_0\!:p=0.5$, $H_1\!:p<0.5$. En $n=30$ lanzamientos se obtienen $X=9$ caras. Bajo $H_0$, $X\sim B(30,0.5)$, por lo que la probabilidad unilateral de la cola es
$$P(X\leqslant 9)=\sum_{k=0}^{9}\binom{30}{k}(0.5)^{30}\approx 0.021.$$
Dado que $0.021<0.05$, se rechaza $H_0$: la moneda parece estar sesgada contra salir cara. (Para $n$ grande la binomial se aproxima con una normal; una prueba de Poisson funciona de la misma manera para eventos raros. Y aquí, si la regla es "rechazar cuando $X\leqslant 9$", entonces $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Explorar
La región de rechazo
rechazar H₀ si z < −z*
La cola sombreada es la región de rechazo — si el estadístico de prueba cae allí, rechaza H₀.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| hypothesis test/haɪˈpɒθəsɪs test/ | 假设检验 | jiǎ shè jiǎn yàn |
| null hypothesis/nʌl haɪˈpɒθəsɪs/ | 原假设 | yuán jiǎ shè |
| alternative hypothesis/ɔːlˈtɜːnətɪv haɪˈpɒθəsɪs/ | 备择假设 | bèi zé jiǎ shè |
| one-tailed/wʌn teɪld/ | 单尾 | dān wěi |
| two-tailed/tuː teɪld/ | 双尾 | shuāng wěi |
| significance level/sɪɡˈnɪfɪkəns ˈlevl/ | 显著性水平 | xiǎn zhù xìng shuǐ píng |
| test statistic/test stəˈtɪstɪk/ | 检验统计量 | jiǎn yàn tǒng jì liàng |
| rejection region/rɪˈdʒekʃn ˈriːdʒn/ | 拒绝域 | jù jué yù |
| Type I error/taɪp aɪ ˈerə/ | 第一类错误 | dì yī lèi cuò wù |
| Type II error/taɪp ˈtuː ˈerə/ | 第二类错误 | dì èr lèi cuò wù |
| Probability & Statistics/ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | 概率统计 | gài lǜ tǒng jì |
6.5
Consejos para el examen
- Use la distribución de Poisson para eventos raros, aleatorios e independientes; su media es igual a su varianza ($= \lambda$).
- Al combinar variables aleatorias independientes, las varianzas se suman (nunca se restan).
- Para una prueba de hipótesis, plantee $H_0$ y $H_1$, el nivel de significancia, el estadístico de prueba y una conclusión en contexto.
- Para un intervalo de confianza, use el valor correcto de $z$ (o $t$) e interprete verbalmente.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.