เอกสารฉบับนี้ครอบคลุมหัวข้อที่ 6: ความน่าจะเป็นและสถิติ 2 เพิ่มโมเดลปอยซง การรวมตัวแปรสุ่ม การแจกแจงแบบต่อเนื่อง และแนวคิดด้านการประมาณค่าและการทดสอบ
ความน่าจะเป็นและสถิติ 2
Mathematics A-Level · หัวข้อ 6
 10:06
ความน่าจะเป็นและสถิติ 2
แคมบริดจ์, สิบเก้า-เทวินตี้. ในงานปาร์ตี้สวน女士说了什么令人惊讶的话。她声称她能尝出牛奶是先倒进杯子还是先倒进茶里…
การบรรยายภาษาอังกฤษ · คำบรรยายภาษาอังกฤษ + 中文 ลอยตัวบนภาพ
6.1
การแจกแจงปอยซง
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและตัวอย่าง |
|---|---|
| • ใช้สูตรเพื่อคำนวณความน่าสำหรับการแจกแจง $\text{Po}(\lambda)$ | |
| • ใช้ข้อเท็จจริงที่ว่าหาก $X \sim \text{Po}(\lambda)$ แล้วค่าเฉลี่ยและความแปรปรวนของ $X$ จะมีค่าเท่ากับ $\lambda$ เท่ากันทุกประการ | ไม่จำเป็นต้องพิสูจน์ |
| • เข้าใจความสำคัญของ การแจกแจงปัวซง ต่อการแจกแจงของเหตุการณ์สุ่ม, และใช้ การแจกแจงปัวซง เป็นโมเดล | |
| • ใช้ การแจกแจงปัวซง เป็นการประมาณค่าให้แก่ การแจกแจงแบบทวินาม เมื่อเหมาะสม | เงื่อนไขที่ $n$ มีขนาดใหญ่และ $p$ มีขนาดเล็กควรรู้; $n > 50$ และ $np < 5$, ประมาณ. |
| • ใช้ การแจกแจงปกติ, พร้อม การแก้ไขความต่อเนื่อง, เป็นการประมาณค่าให้แก่ การแจกแจงปัวซง เมื่อเหมาะสม. | เงื่อนไขที่ $\lambda$ มีขนาดใหญ่ควรรู้; $\lambda > 15$, ประมาณ. |
แหล่งที่มา: หลักสูตร Cambridge International
การแจกแจงแบบ ปอยซง $X \sim \mathrm{Po}(\lambda)$ จำแนกจำนวนเหตุการณ์แบบสุ่มในช่วงเวลาที่กำหนด เมื่อเหตุการณ์เกิดขึ้นด้วยอัตราเฉลี่ยคงที่ $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
สำหรับตัวแปรปัวซง ค่าเฉลี่ยและความแปรปรวนจะมีค่าเท่ากับ $\lambda$ เท่ากัน การแจกแจงปัวซอนเป็นการ ประมาณ ที่ดีของการ แจกแจงแบบไบนอมιαล เมื่อ $n$ มีค่ามากและ $p$ มีค่าน้อย การแจกแจงปกติ (ด้วยการแก้ไขความต่อเนื่อง) เป็นการประมาณการปัวซอนเมื่อ $\lambda$ มีค่ามาก
ตัวอย่างวิธีทำ $X \sim \mathrm{Po}(3)$. จงหา $P(X = 2)$
$$P(X = 2) = e^{-3}\frac{3^2}{2!} = e^{-3}\times 4.5 = 0.224.$$

สำรวจ
การแจกแจงปอยซง
เปลี่ยนค่าเฉลี่ย λ Poisson ใช้จำลองจำนวน เหตุการณ์สุ่ม ในช่วงเวลาที่กำหนด — เหตุการณ์หายากให้รูปร่างเบ้
6.2
ผลรวมเชิงเส้นของตัวแปรสุ่ม
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและตัวอย่าง |
|---|---|
| • ใช้, ในการแก้ปัญหา, ผลลัพธ์ดังนี้: – $\text{E}(aX + b) = a\text{E}(X) + b$ และ $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ สำหรับ $X$ และ $Y$ ที่เป็นอิสระต่อกัน – หาก $X$ มีการแจกแจงปกติ แล้ว $aX + b$ ก็มีการแจกแจงปกติเช่นกัน – หาก $X$ และ $Y$ มีการแจกแจงปกติที่เป็นอิสระต่อกัน แล้ว $aX + bY$ จะมีการแจกแจงปกติ – หาก $X$ และ $Y$ มีการแจกแจงปัวซงที่เป็นอิสระต่อกัน แล้ว $X + Y$ จะมีการแจกแจงปัวซง | ไม่จำเป็นต้องพิสูจน์ผลลัพธ์เหล่านี้ |
แหล่งที่มา: หลักสูตร Cambridge International
เมื่อคุณเปลี่ยนตัวแปรด้วยกฎเชิงเส้น ค่าคาดหมาย (ค่าเฉลี่ย) และ ส่วนเบี่ยงเบนมาตรฐาน จะปฏิบัติตามกฎเหล่านี้:
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
สำหรับตัวแปรสองตัวที่เป็น อิสระต่อกัน $X$ และ $Y$:
$$E(aX + bY) = aE(X) + bE(Y), \qquad \mathrm{Var}(aX + bY) = a^2\,\mathrm{Var}(X) + b^2\,\mathrm{Var}(Y).$$
ข้อเท็จจริงที่มีประโยชน์สองประการ: ถ้า $X$ มีการแจกแจงแบบ ปกติ那么 $aX + b$ ก็มีการแจกแจงแบบปกติเช่นกัน; และผลบวกของตัวแปรปอยซงที่เป็นอิสระต่อกัน仍然是 ปอยซง
ตัวอย่างวิธีทำ $X$ มีค่าเฉลี่ย $5$ และส่วนเบี่ยงเบนมาตรฐาน $4$. จงหา $E(3X - 1)$ และ $\mathrm{Var}(3X - 1)$
$$E(3X - 1) = 3(5) - 1 = 14, \qquad \mathrm{Var}(3X - 1) = 3^2 \times 4 = 36.$$
สำรวจ
การทดลองผลรวมเชิงเส้น
E(aX + b) = aE(X) + b
เปลี่ยนปัจจัยการขยายและดูว่าค่าคาดหมายมีการเปลี่ยนแปลงอย่างไร
6.3
ตัวแปรสุ่มต่อเนื่อง
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและตัวอย่าง |
|---|---|
| • เข้าใจแนวคิดของ ตัวแปรสุ่มแบบต่อเนื่อง, และจำและใช้คุณสมบัติของ ฟังก์ชันความหนาแน่นความน่าจะเป็น | สำหรับฟังก์ชันความหนาแน่นที่นิยามบนช่วงเดียวเท่านั้น; ขอบเขตอาจเป็นอนันต์, เช่น $\frac{3}{x^4}$ สำหรับ $x \geqslant 1$. |
| • ใช้ ฟังก์ชันความหนาแน่นความน่าจะเป็น เพื่อแก้ปัญหาที่เกี่ยวข้องกับความน่าจะเป็น, และคำนวณ ค่าเฉลี่ย และ ความแปรปรวน ของการแจกแจง. | รวมถึงการหาตำแหน่งของ มัธยฐาน หรือ เปอร์เซนไทล์ อื่นๆ ของการแจกแจงโดยการพิจารณาพื้นที่โดยตรงผ่านฟังก์ชันความหนาแน่น. ความรู้โดยตรงเกี่ยวกับ ฟังก์ชันการแจกแจงสะสม ไม่ได้รวมอยู่ในเนื้อหา. |
แหล่งที่มา: หลักสูตร Cambridge International
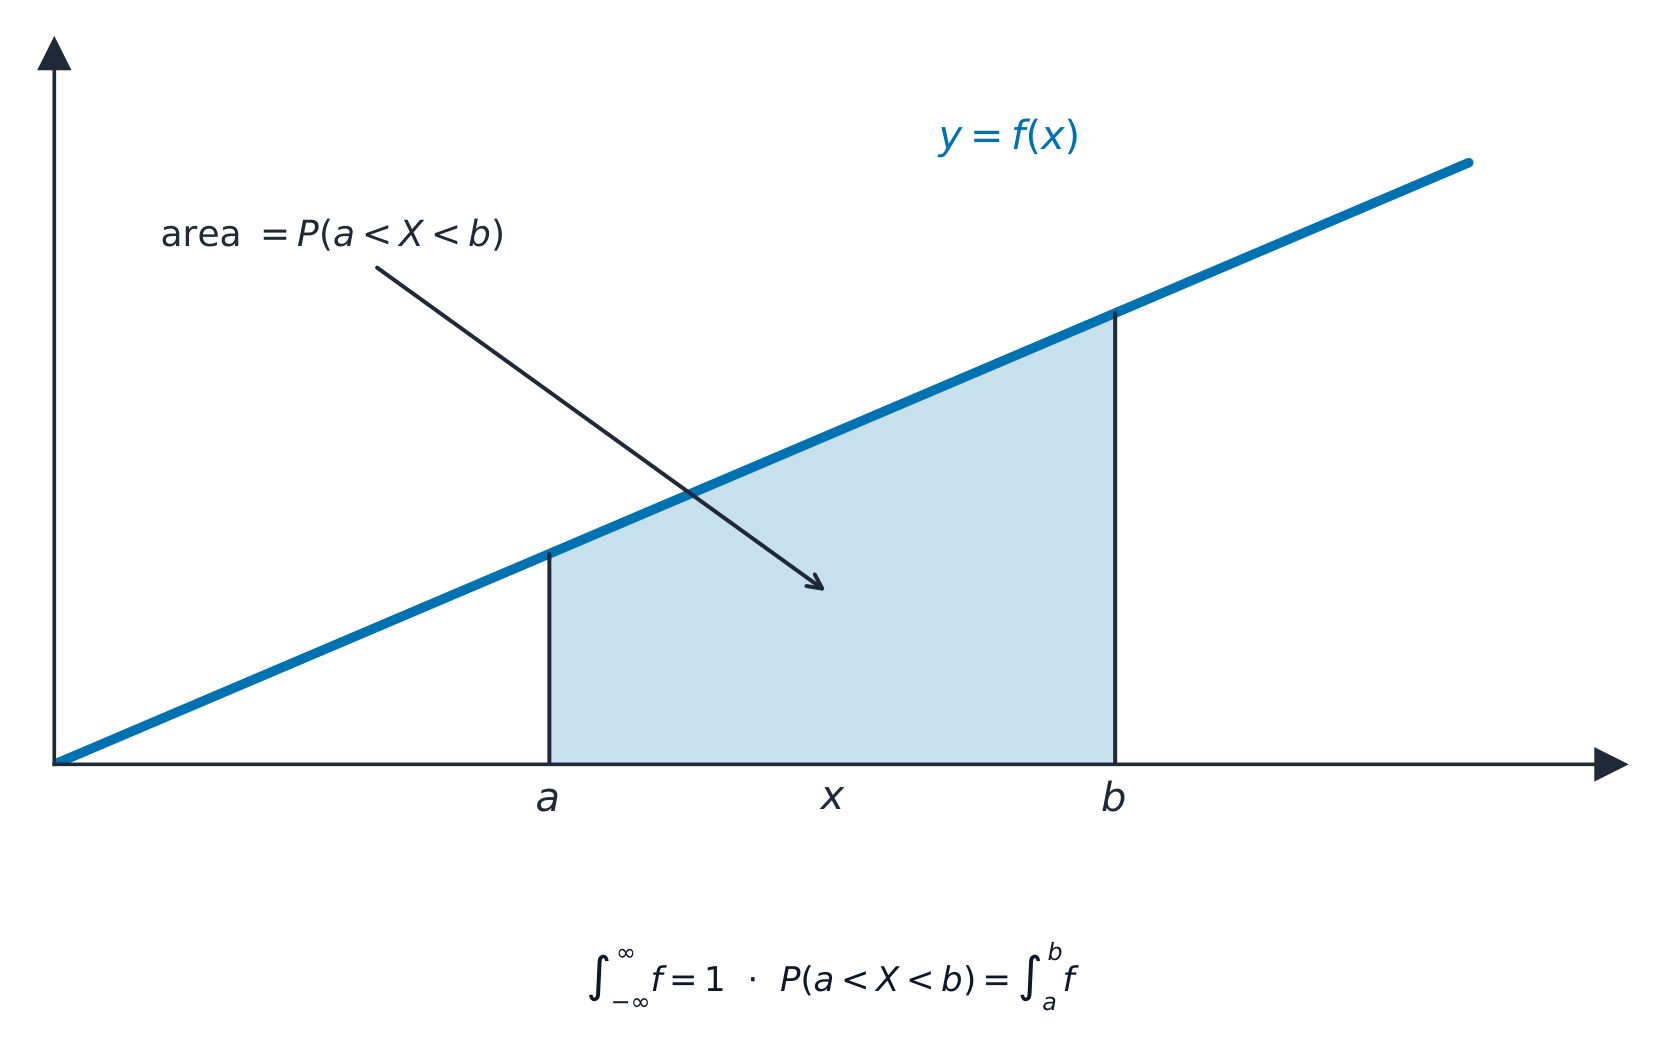
ตัวแปรสุ่มแบบ ต่อเนื่อง สามารถมีค่าใดๆ ในช่วงหนึ่ง ความน่าจะเป็นของมันมาจาก ฟังก์ชันความหนาแน่นของความน่าจะเป็น $f(x)$ ซึ่งมีคุณสมบัติสำคัญสองประการ:
$$f(x) \geqslant 0, \qquad \int_{-\infty}^{\infty} f(x)\,dx = 1.$$
ความน่าจะเป็นคือพื้นที่ใต้ $f$ และค่าเฉลี่ยหาได้จากการอินทิเกรต:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
ฟังก์ชันการแจกแจงสะสมคือ $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; ค่ามัธยฐาน แก้สมการ $F(m) = 0.5$ และ เปอร์เซนไทล์ อื่นๆ แก้สมการ $F(x) = p$
ตัวอย่างวิธีทำ ตัวแปรต่อเนื่องมี $f(x) = \tfrac12 x$ สำหรับ $0 \leqslant x \leqslant 2$ (และ $0$ ที่อื่น). จงหา $E(X)$
$$E(X) = \int_0^2 x\cdot\tfrac12 x\,dx = \int_0^2 \tfrac12 x^2\,dx = \left[\tfrac{x^3}{6}\right]_0^2 = \frac{8}{6} = \frac{4}{3}.$$
ส่วนเบี่ยงเบนมาตรฐาน ใช้แนวคิดเดียวกันกับ $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. สำหรับ $f(x)=\tfrac12 x$ เดียวกันบน $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, ดังนั้น $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$
สำรวจ
พื้นที่ = ความน่าจะเป็น
P(a < X < b) = ∫ f(x) dx
สำหรับตัวแปรต่อเนื่อง ความน่าจะเป็น คือ พื้นที่ใต้เส้นโค้งความหนาแน่นระหว่างสองค่า
6.4
การสุ่มตัวอย่างและการประมาณค่า
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและตัวอย่าง |
|---|---|
| • เข้าใจความแตกต่างระหว่าง ตัวอย่าง (sample) และ ประชากร (population) และตระหนักถึงความจำเป็นของการเลือกตัวอย่างแบบสุ่ม | |
| • อธิบายในเชิงพื้นฐานว่าทำไม วิธีการสุ่มตัวอย่าง ที่กำหนดให้ อาจไม่เหมาะสม | รวมถึงความเข้าใจเบื้องต้นเกี่ยวกับการใช้ ตัวเลขสุ่ม ในการสร้าง ตัวอย่างสุ่ม ไม่จำเป็นต้องรู้วิธีการสุ่มตัวอย่างแบบเฉพาะเจาะจงเช่น Quota หรือ Stratified sampling |
| • รับรู้ได้ว่า ค่าเฉลี่ยจากตัวอย่าง (sample mean) สามารถมองเป็น ตัวแปรสุ่ม (random variable) ได้ และใช้ข้อเท็จจริงที่ว่า $\text{E}(\overline{X}) = \mu$ และว่า $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$ | |
| • ใช้ข้อเท็จจริงที่ว่า $\overline{X}$ มี การแจกแจงปกติ (normal distribution) หาก $X$ มีการแจกแจงปกติ | |
| • ใช้ ทฤษฎีบทกลางของขีดจำกัด เมื่อเหมาะสม | ต้องการเพียงความเข้าใจแบบไม่เป็นทางการของ ทฤษฎีบทกลางของขีดจำกัด (CLT); สำหรับขนาดตัวอย่างที่ใหญ่ การแจกแจงของค่าเฉลี่ยตัวอย่างจะเป็นแบบปกติโดยประมาณ |
| • คำนวณ ค่าประมาณที่ไม่มีอคติ ของ ค่าเฉลี่ย และ ความแปรปรวน ของประชากรจากตัวอย่าง โดยใช้ข้อมูลดิบหรือข้อมูลที่สรุปแล้ว | ต้องการเพียงความเข้าใจอย่างง่ายของคำว่า 'ไม่มีอคติ' เช่น แม้ค่าประมาณแต่ละตัวจะแตกต่างกัน แต่กระบวนการนี้จะให้ผลลัพธ์ที่แม่นยำ 'โดยเฉลี่ย' |
| • หาและตีความ ช่วงความเชื่อมั่น (confidence interval) สำหรับค่าเฉลี่ยประชากร ในกรณีที่ประชากรมีการแจกแจงปกติโดยมีความแปรปรวนทราบแล้ว หรือเมื่อใช้ตัวอย่างที่มีขนาดใหญ่ | |
| • หา ช่วงความเชื่อมั่นโดยประมาณ สำหรับ สัดส่วนประชากร (population proportion) จากตัวอย่างที่มีขนาดใหญ่ |
แหล่งที่มา: หลักสูตร Cambridge International
ตัวอย่าง คือกลุ่มย่อยที่เลือกมาจาก ประชากร ทั้งหมด ตัวอย่างสุ่ม ต้องการ ความสุ่ม เพื่อให้สมาชิกแต่ละคนมีโอกาสถูกเลือกอย่างเสมอภาค
บางวิธีการ ไม่เหมาะสม เพราะมีความ ลำเอียง: การสุ่มเฉพาะอาสาสมัคร หรือคนที่มา 20 คนแรก จะตัวแทนของกลุ่มคนบางประเภทมากเกินไป ตัวอย่างสุ่มที่แท้จริงใช้ ตัวเลขสุ่ม – กำหนดหมายเลขให้กับสมาชิกทุกคนในประชากร แล้วดึงตัวเลข (จากตารางหรือเครื่องสร้างตัวเลขสุ่ม) เพื่อตัดสินใครอยู่ในตัวอย่าง
ค่าเฉลี่ยตัวอย่าง $\bar{X}$ เป็นตัวแปรสุ่มเอง โดยมี
$$E(\bar{X}) = \mu, \qquad \mathrm{Var}(\bar{X}) = \frac{\sigma^2}{n}.$$
ตาม ทฤษฎีบทحدกลาง สำหรับตัวอย่างขนาดใหญ่ $\bar{X}$ จะเป็นการแจกแจงปกติโดยประมาณ ไม่ว่ารูปร่างของประชากรจะเป็นอย่างไร

จากตัวอย่างคุณสามารถหาค่า ประมาณที่ไม่ลำเอียง ของค่าเฉลี่ยและส่วนเบี่ยงเบนมาตรฐานของประชากร ช่วงความเชื่อมั่น ให้ช่วงที่คาดว่าจะมีค่าเฉลี่ยจริง เมื่อประชากรเป็นปกติและมี $\sigma$ ที่ทราบ (หรือตัวอย่างมีขนาดใหญ่), ช่วง $95\%$ คือ
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$

คุณยังสามารถหาค่าช่วงความเชื่อมั่นสำหรับ สัดส่วนประชากร จากตัวอย่างขนาดใหญ่ได้
ตัวอย่างวิธีทำ ตัวอย่างขนาด $n = 64$ มีค่าเฉลี่ย $\bar{x} = 50$ จากประชากรที่มี $\sigma = 8$. จงหาช่วงความเชื่อมั่น $95\%$ สำหรับค่าเฉลี่ยของประชากร
$$50 \pm 1.96\times\frac{8}{\sqrt{64}} = 50 \pm 1.96 \;\Rightarrow\; (48.0,\ 52.0).$$
สำรวจ
การแจกแจงของตัวอย่าง
X̄ ~ N(μ, σ²/n)
โดย ทฤษฎีบทحدกลาง ค่าเฉลี่ยตัวอย่างจะปฏิบัติตามรูปทรง ปกติ — จะแคบลงเมื่อขนาดตัวอย่างใหญ่ขึ้น
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| Poisson distribution/ˈpɔɪsn ˌdɪstrɪˈbjuːʃn/ | การแจกแจงพอยซง |
| approximation/əˌprɒksɪˈmeɪʃn/ | การประมาณค่า |
| expectation/ekspɪkˈteɪʃn/ | ค่าคาดหมาย |
| variance/ˈveərɪəns/ | ความแปรปรวน |
| normal distribution/ˈnɔːml ˌdɪstrɪˈbjuːʃn/ | การแจกแจงปกติ |
| continuous random variable/kənˈtɪnjuːəs ˈrændəm ˈveərɪəbl/ | ตัวแปรสุ่มแบบต่อเนื่อง |
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | ฟังก์ชันความหนาแน่นความน่าจะเป็น |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | ฟังก์ชันการแจกแจงสะสม |
| median/ˈmiːdiːən/ | มัธยฐาน |
| percentiles/pəˈsentaɪlz/ | percentiles |
| sample/ˈsæmpl/ | ตัวอย่าง |
| population/ˌpɒpjʊˈleɪʃn/ | ประชากร |
| randomness/ˈrændəmnəs/ | ความสุ่ม |
| biased/ˈbaɪəst/ | มีอคติ |
| Central Limit Theorem/ˈsentrəl ˈlɪmɪt ˈθɪərəm/ | ทฤษฎีบทحدกลาง |
| unbiased estimates/ʌnˈbaɪəst ˈestɪməts/ | ประมาณค่าที่ไม่เอนเอียง |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | confidence interval |
| population proportion/ˌpɒpjʊˈleɪʃn prəˈpɔːʃn/ | สัดส่วนประชากร |
6.5
การทดสอบสมมติฐาน
หลักสูตร
| ผู้เข้าสอบควรสามารถ: | หมายเหตุและตัวอย่าง |
|---|---|
| • เข้าใจธรรมชาติของการ ทดสอบสมมติฐาน ความแตกต่างระหว่าง การทดสอบแบบหางเดียว (one-tailed) และ การทดสอบสองหาง (two-tailed) และคำศัพท์ เช่น สมมติฐานศูนย์ (null hypothesis), สมมติฐานทางเลือก (alternative hypothesis), ระดับนัยสำคัญ (significance level), พื้นที่ปฏิเสธ (rejection region) หรือ พื้นที่วิกฤต (critical region), พื้นที่ยอมรับ (acceptance region) และ สถิติทดสอบ (test statistic) | ผลลัพธ์ของการทดสอบสมมติฐานควรถูกตีความในบริบทของสถานการณ์ที่โจทย์กำหนด |
| • ตั้งสมมติฐานและดำเนินการ ทดสอบสมมติฐาน ในกรณีที่มีข้อมูลจากประชากรเพียงจุดเดียวซึ่งมี การแจกแจงแบบทวินาม (binomial) หรือ การแจกแจงแบบปัวซง (Poisson) โดยใช้ – การคำนวณความน่าจะเป็นโดยตรง – การประมาณค่าด้วยปกติสำหรับการแจกแจงแบบทวินามหรือปัวซง เมื่อเหมาะสม | |
| • ตั้งสมมติฐานและดำเนินการ ทดสอบสมมติฐาน เกี่ยวกับค่าเฉลี่ยของประชากร ในกรณีដែលประชากรมีการแจกแจงแบบปกติโดยทราบความแปรปรวน หรือเมื่อใช้ตัวอย่างที่มีขนาดใหญ่ | |
| • เข้าใจความหมายของ ข้อผิดพลาดประเภทที่หนึ่ง (Type I error) และ ข้อผิดพลาดประเภทที่สอง (Type II error) ในบริบทของการทดสอบสมมติฐาน | |
| • คำนวณความน่าจะเป็นในการเกิด ข้อผิดพลาดประเภทที่หนึ่ง และ ข้อผิดพลาดประเภทที่สอง ในสถานการณ์เฉพาะที่เกี่ยวข้องกับการทดสอบที่อิงจากการแจกแจงแบบปกติ หรือการคำนวณความน่าจะเป็นโดยตรงจากการแจกแจงแบบทวินามหรือปัวซง |
แหล่งที่มา: หลักสูตร Cambridge International
การทดสอบสมมติฐาน ใช้ข้อมูลจากตัวอย่างเพื่อตัดสินข้ออ้าง คุณตั้งข้อความสองข้อ: สมมติฐานศูนย์ $H_0$ (ข้ออ้างที่กำลังทดสอบ มักจะ "ไม่มีการเปลี่ยนแปลง") และ สมมติฐานทางเลือก $H_1$ (สิ่งที่คุณสงสัยไว้แทน) การทดสอบเป็น ทางเดียว หาก $H_1$ ชี้ไปในทิศทางหนึ่ง (เช่น $\mu > 50$) และเป็น สองทาง หากอนุญาตให้ทั้งสองทิศทาง ($\mu \neq 50$)
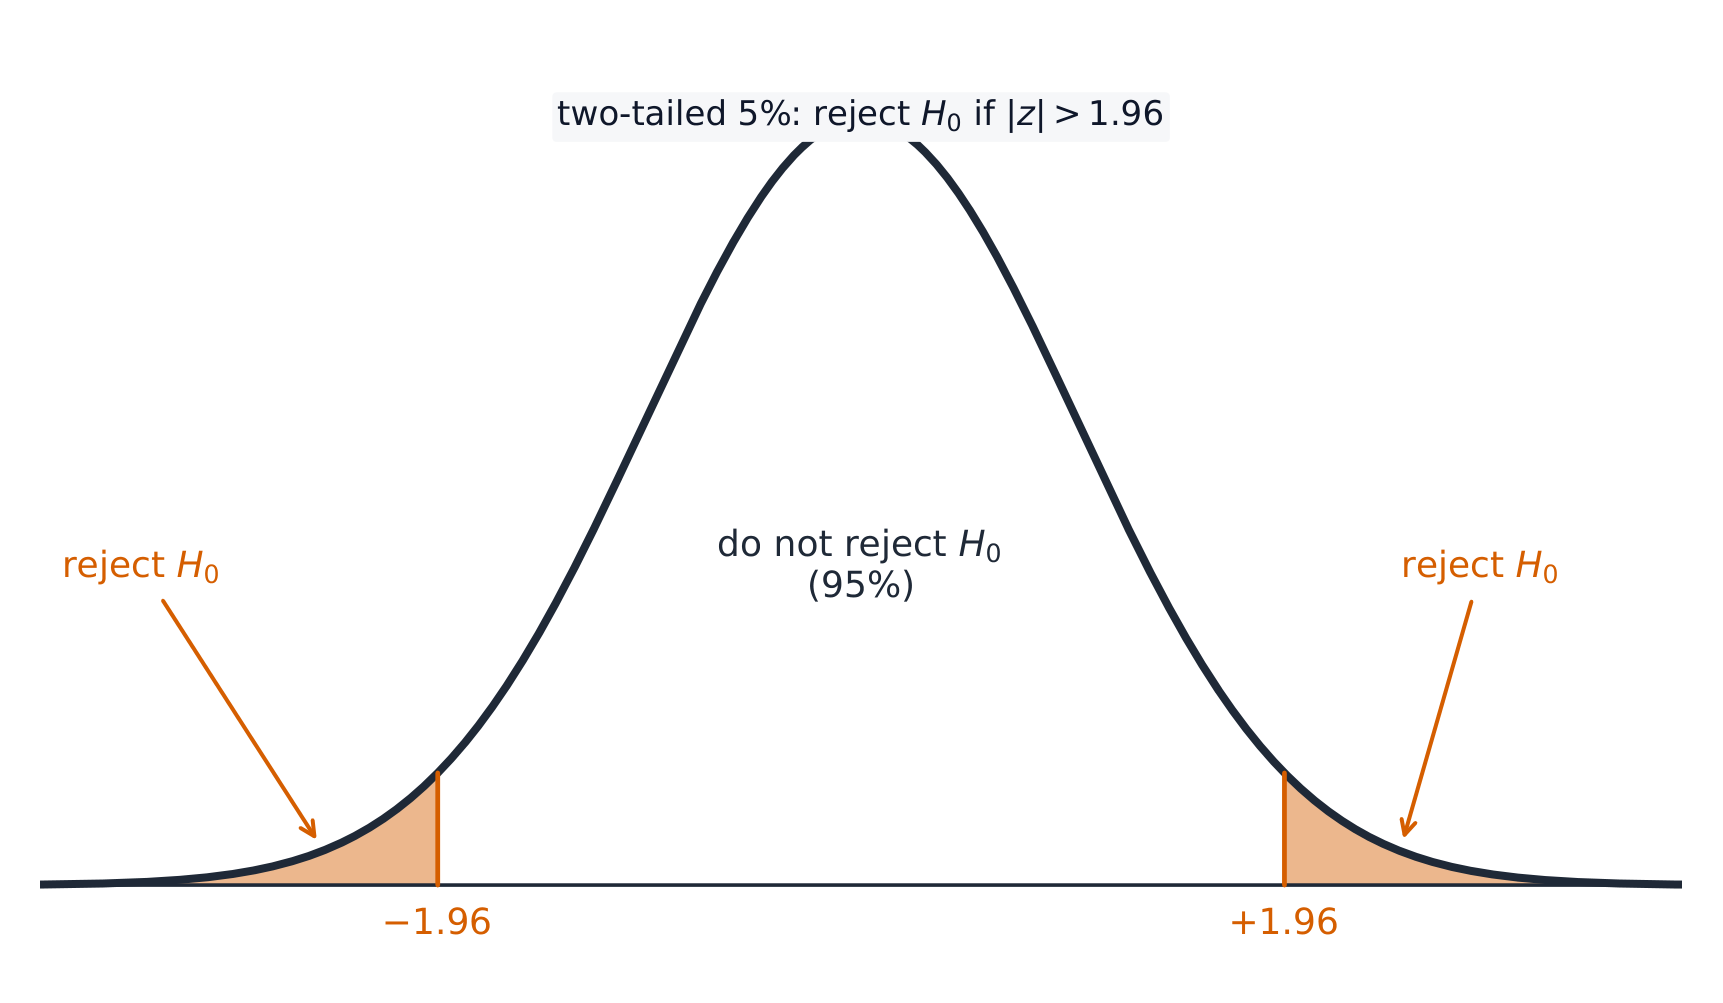
คุณกำหนด ระดับนัยสำคัญ (มักจะเป็น $5\%$), คำนวณ ค่าสถิติทดสอบ จากข้อมูล และดูว่ามันตกอยู่ใน เขตปฏิเสธ (หรือเรียกว่า เขตวิกฤต) หรือไม่; หากใช่คุณปฏิเสธ $H_0$, มิฉะนั้นค่าสถิติจะอยู่ใน เขตยอมรับ
ข้อผิดพลาดที่เป็นไปได้มีสองประเภท: ความผิดพลาดประเภทที่ I คือการปฏิเสธ $H_0$ ทั้งที่มันเป็นจริง; ความผิดพลาดประเภทที่ II คือการยอมรับ $H_0$ ทั้งที่มันไม่เป็นจริง คุณสามารถหาความน่าจะเป็นของพวกมันได้จากพื้นที่ปฏิเสธ: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – ซึ่งเท่ากับระดับนัยสำคัญ – และ $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ เป็นจริงสำหรับค่าที่กำหนด$)$, คำนวณจากกระจายตัวแบบทวินาม, ปอยซง หรือปกติ.
ตัวอย่างวิธีทำ. ประชากรถูกอ้างว่ามีค่าเฉลี่ย $50$, โดย $\sigma = 8$. ตัวอย่างขนาด $n = 64$ ให้ค่า $\bar{x} = 52$. ทดสอบที่ระดับ $5\%$ ว่าค่าเฉลี่ยมีการเปลี่ยนแปลงหรือไม่
$H_0\!: \mu = 50$ และ $H_1\!: \mu \neq 50$ (สองหาง). ค่าสถิติการทดสอบคือ
$$z = \frac{\bar{x} - \mu}{\sigma/\sqrt{n}} = \frac{52 - 50}{8/8} = 2.$$
ค่าวิกฤตที่ $5\%$ (สองหาง) คือ $1.96$. เนื่องจาก $2 > 1.96$, คุณจึงปฏิเสธ $H_0$: มีหลักฐานว่าค่าเฉลี่ยได้เปลี่ยนแปลงแล้ว
ตัวอย่างวิธีทำ (การทดสอบแบบทวินาม). เหรียญถูกอ้างว่าเป็นเหรียญยุติธรรมแต่สงสัยว่าจะออกหน้าหัวน้อยเกินไป: $H_0\!:p=0.5$, $H_1\!:p<0.5$. ในการโยน $n=30$ ครั้ง คุณเห็น $X=9$ หน้าหัว. ภายใต้ $H_0$, $X\sim B(30,0.5)$, ดังนั้นความน่าจะเป็นของหางด้านเดียวคือ
$$P(X\leqslant 9)=\sum_{k=0}^{9}\binom{30}{k}(0.5)^{30}\approx 0.021.$$
เนื่องจาก $0.021<0.05$, ปฏิเสธ $H_0$: เหรียญดูเหมือนจะมีอคติไม่ออกหน้าหัวจริงๆ (สำหรับ $n$ ที่ใหญ่ การกระจายแบบทวินามจะถูกประมาณด้วยแบบปกติ; การทดสอบแบบปอยซง ทำงานในลักษณะเดียวกันสำหรับเหตุการณ์ที่หายาก. และที่นี่, หากกฎคือ "ปฏิเสธเมื่อ $X\leqslant 9$", แล้ว $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
สำรวจ
เขตปฏิเสธ
ปฏิเสธ H₀ ถ้า z < −z*
ส่วน หาง ที่ทึบสีคือ เขตปฏิเสธ — หากค่าสถิติการทดสอบตกลงในพื้นที่นี้ ให้ปฏิเสธ H₀
คำศัพท์
ฝึกฝน
| English | ไทย |
|---|---|
| hypothesis test/haɪˈpɒθəsɪs test/ | การทดสอบสมมติฐาน |
| null hypothesis/nʌl haɪˈpɒθəsɪs/ | สมมติฐานศูนย์ |
| alternative hypothesis/ɔːlˈtɜːnətɪv haɪˈpɒθəsɪs/ | สมมติฐานทางเลือก (alternative hypothesis) |
| one-tailed/wʌn teɪld/ | ด้านเดียว |
| two-tailed/tuː teɪld/ | สองด้าน |
| significance level/sɪɡˈnɪfɪkəns ˈlevl/ | ระดับนัยสำคัญ |
| test statistic/test stəˈtɪstɪk/ | สถิติทดสอบ |
| rejection region/rɪˈdʒekʃn ˈriːdʒn/ | เขตปฏิเสธ |
| Type I error/taɪp aɪ ˈerə/ | ข้อผิดพลาดประเภท I |
| Type II error/taɪp ˈtuː ˈerə/ | ข้อผิดพลาดประเภท II |
| Probability & Statistics/ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | ความน่าจะเป็น & สถิติ |
6.5
ข้อแนะนำสำหรับการสอบ
- ใช้ การกระจายแบบปอยซง สำหรับเหตุการณ์ที่หายาก, สุ่ม และเป็นอิสระต่อกัน; ค่าเฉลี่ยของมันเท่ากับความแปรปรวน ($= \lambda$).
- เมื่อรวมตัวแปรสุ่มที่เป็นอิสระเข้าด้วยกัน, ความแปรปรวนจะบวกกัน (พวกเขาจะไม่เคยหักล้างกัน)
- สำหรับ การทดสอบสมมติฐาน, ระบุ $H_0$ และ $H_1$, ระดับนัยสำคัญ, ค่าสถิติการทดสอบ, และสรุปผล ตามบริบท
- สำหรับ ช่วงความเชื่อมั่น, ใช้ค่า $z$ (หรือ $t$) ที่ถูกต้องและตีความด้วยคำพูด.
บทเรียนเชิงโต้ตอบสำหรับหัวข้อนี้
ทำทีละขั้นตอน พร้อมแบบฝึกหัดตรวจสอบผลทันที