Este material cobre o Tópico 4: Probabilidade e Estatística Avançada 进阶概率统计. Adiciona distribuições contínuas, inferência para pequenas amostras, testes qui-quadrado e não paramétricos, e funções geradoras de probabilidade.
Probabilidade e Estatística Avançadas
Matemática Avançada do A-Level · Tópico 4
 8:08
Probabilidade e Estatística Avançadas
Dublin, mil novecentos e oito. Dentro da cervejaria Guinness, um jovem químico chamado William Gosset enfrenta um problema muito prático. Ele só pode testar alguns lotes de…
Narração em inglês · Legendas em inglês + 中文 gravadas
4.1
Variáveis aleatórias contínuas
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| usar uma função de densidade de probabilidade que pode ser definida por partes | |
| usar o resultado geral $\text{E}(g(X)) = \int f(x)g(x) \, \mathrm{d}x$ onde $f(x)$ é a função de densidade de probabilidade da variável aleatória contínua $X$ e $g(X)$ é uma função de $X$ | |
| compreender e usar a relação entre a função de densidade de probabilidade (PDF) e a função de distribuição acumulada (CDF), e usar qualquer uma delas para avaliar probabilidades ou percentis | |
| usar funções de distribuição acumulada (CDFs) de variáveis relacionadas em casos simples. | p.ex. dada a CDF de uma variável $X$, encontrar a CDF de uma variável relacionada $Y$, e consequentemente sua PDF, p.ex. onde $Y = X^3$. |
Fonte: Programa Cambridge International
Uma variável contínua $X$ é descrita por uma função densidade de probabilidade 概率密度函数 $f(x)$, que pode ser definida por partes. A probabilidade sobre um intervalo é a área sob $f$, e a média de qualquer função de $X$ é
$$E(g(X)) = \int g(x)\,f(x)\,dx.$$
A função de distribuição acumulada 累积分布函数 $F(x) = P(X \leqslant x)$ é o total acumulado: $F(x) = \displaystyle\int_{-\infty}^{x} f(t)\,dt$, e $f(x) = F'(x)$. Use $F$ para encontrar probabilidades e percentis 百分位数 (por exemplo, a mediana 中imedia resolve $F(x) = 0.5$).
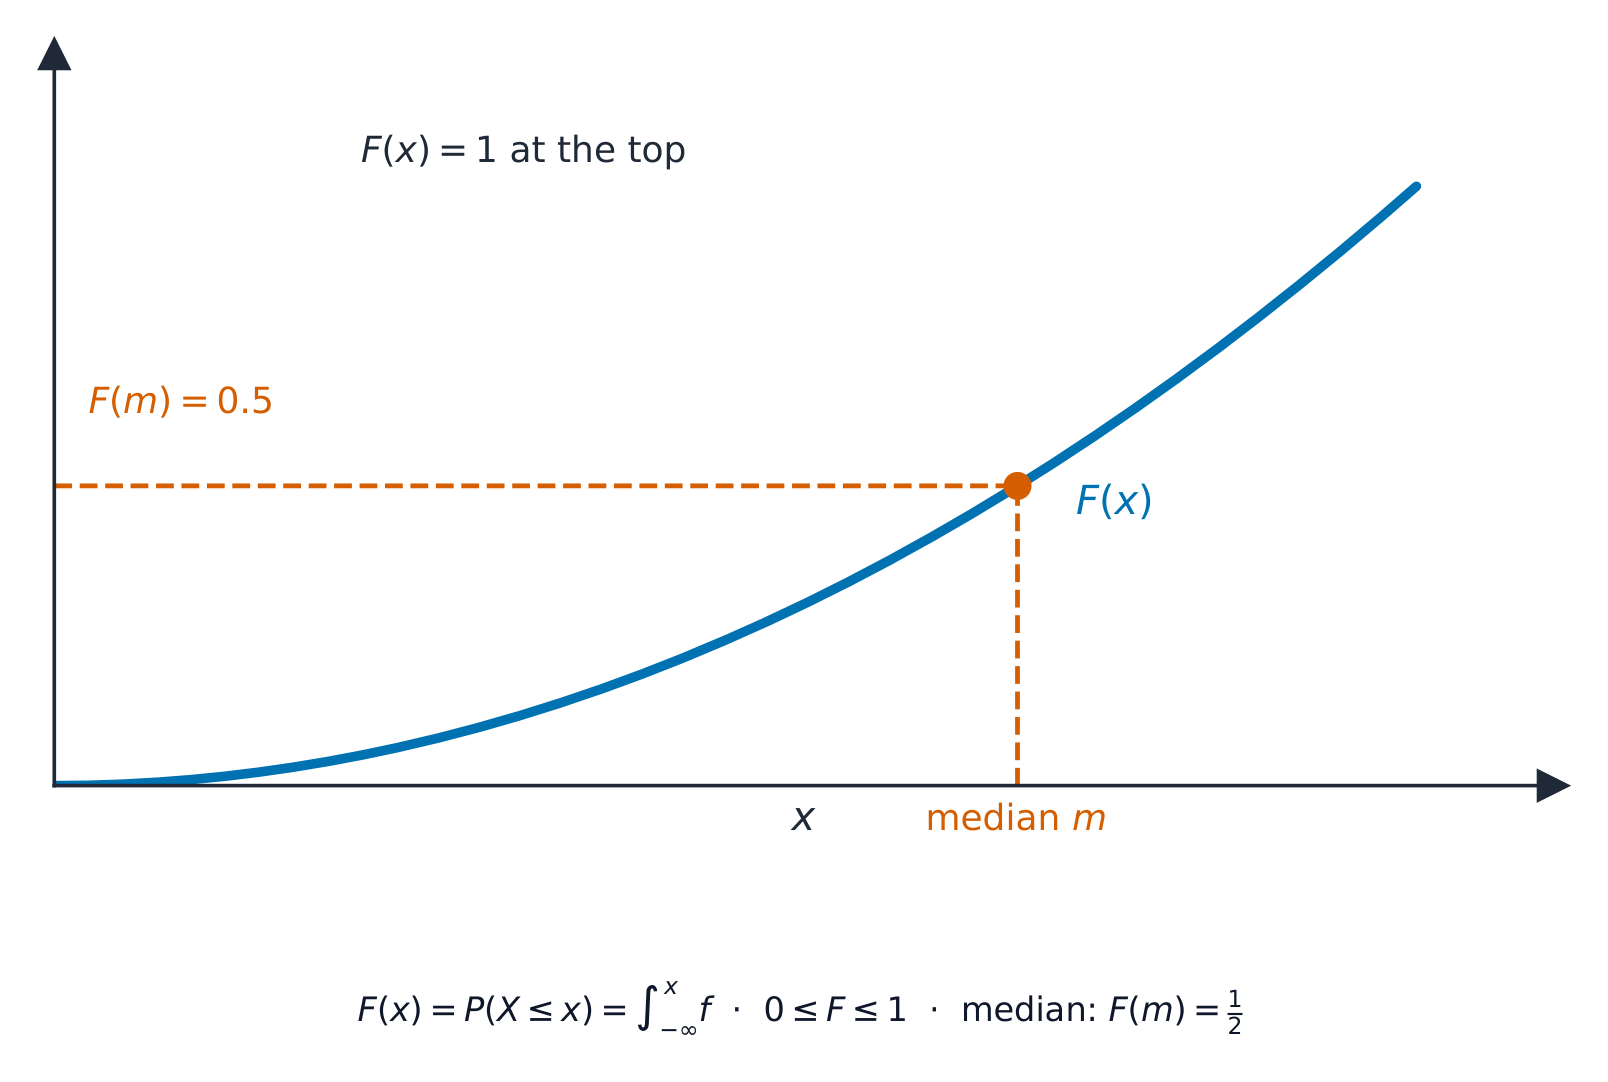
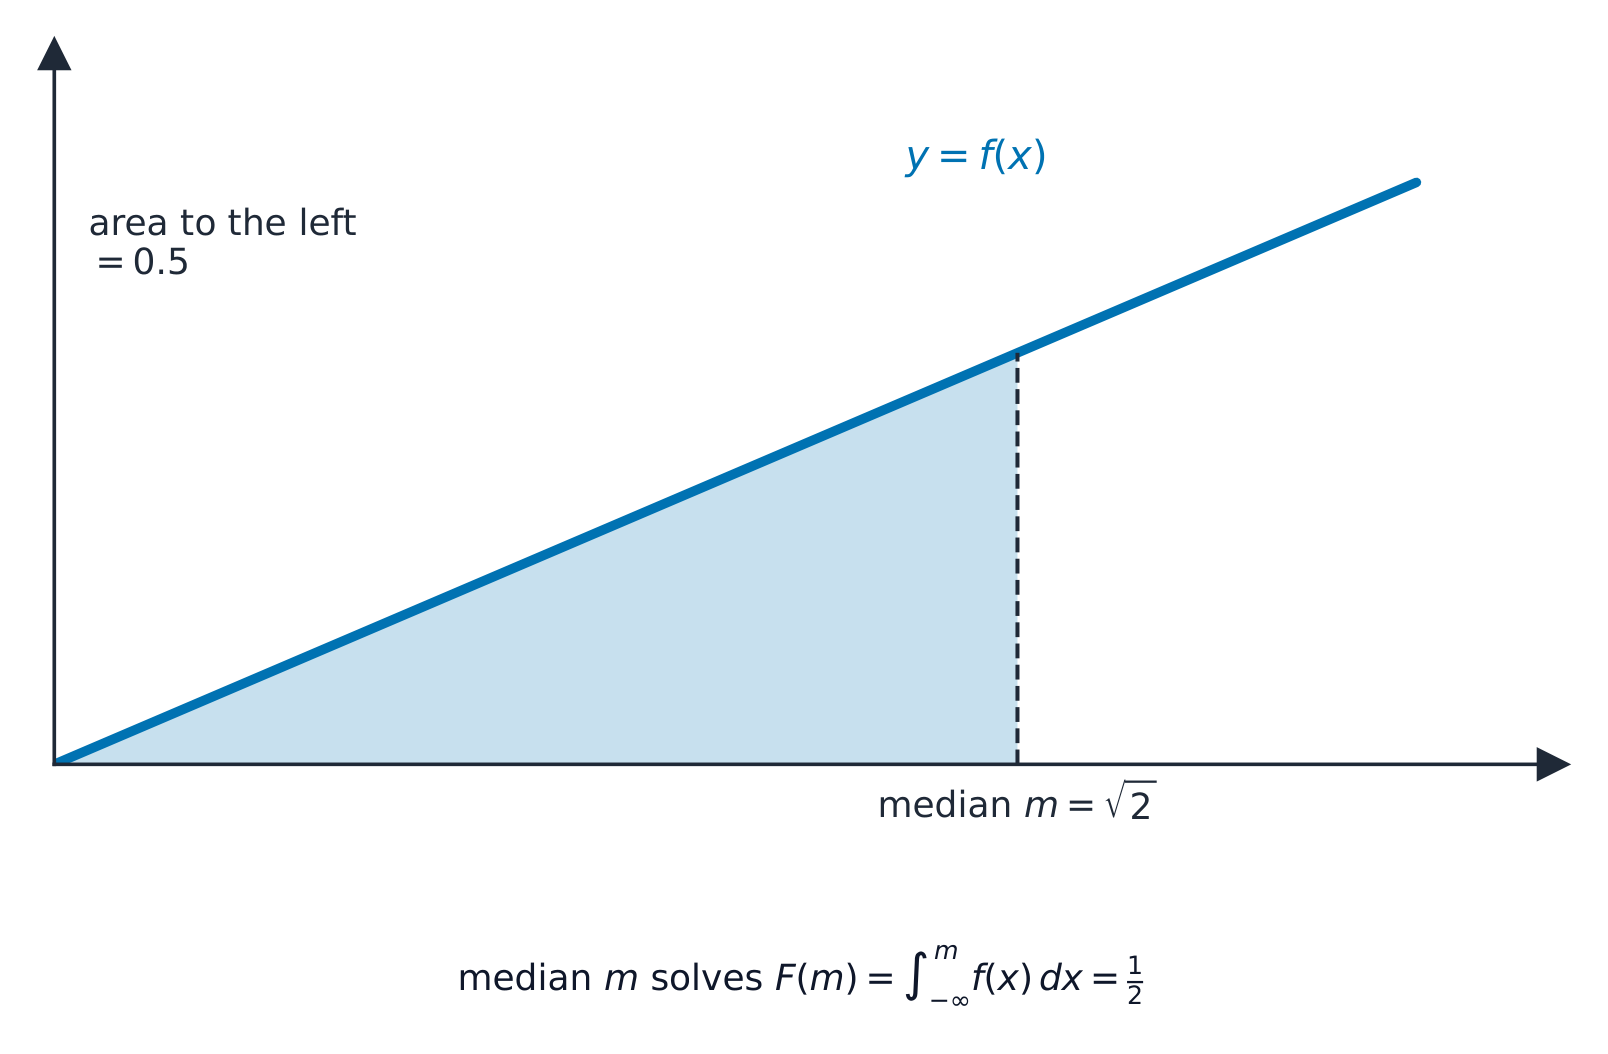
Exemplo resolvido. Uma variável tem $f(x) = \tfrac12 x$ para $0 \leqslant x \leqslant 2$. Encontre a mediana.
A função de distribuição acumulada é $F(x) = \displaystyle\int_0^x \tfrac12 t\,dt = \tfrac14 x^2$. Defina $F(m) = 0.5$:
$$\tfrac14 m^2 = 0.5 \;\Rightarrow\; m^2 = 2 \;\Rightarrow\; m = \sqrt{2} = 1.41.$$
A distribuição de uma variável relacionada. Se $Y=g(X)$, encontre a distribuição de $Y$ através de sua função cumulativa. Para $Y=X^2$: $F_Y(y)=P(X^2\leqslant y)=P(-\sqrt y\leqslant X\leqslant\sqrt y)=F_X(\sqrt y)-F_X(-\sqrt y)$, então diferencie para $f_Y=F_Y'$. Quando $g$ é monotonicamente crescente há um atalho, $F_Y(y)=F_X\big(g^{-1}(y)\big)$.
Exemplo resolvido. Com $f_X(x)=\tfrac12 x$ em $[0,2]$ (logo $F_X(x)=\tfrac14 x^2$), seja $Y=X^2$. Para $0\leqslant y\leqslant 4$, $F_Y(y)=F_X(\sqrt y)=\tfrac14 y$, logo $f_Y(y)=F_Y'(y)=\tfrac14$ – isto é, $Y$ é uniforme em $[0,4]$.
Explorar
Variáveis aleatórias contínuas
P(a < X < b) = ∫ f(x) dx
Para uma variável contínua, a probabilidade é a área sob a curva de densidade.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| probability density function/ˌprɒbəˈbɪlɪti ˈdensɪti ˈfʌŋkʃn/ | 概率密度函数 | gài lǜ mì dù hán shù |
| cumulative distribution function/ˈkjuːmjʊlətɪv ˌdɪstrɪˈbjuːʃn ˈfʌŋkʃn/ | 累积分布函数 | lěi jī fēn bù hán shù |
| percentiles/pəˈsentaɪlz/ | 百分位数 | bǎi fēn wèi shù |
| median/ˈmiːdiːən/ | 中位数 | zhōng wèi shù |
| hypothesis test/haɪˈpɒθəsɪs test/ | 假设检验 | jiǎ shè jiǎn yàn |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | 置信区间 | zhì xìn qū jiān |
| pooled estimate/puːld ˈestɪmət/ | 合并估计 | hé bìng gū jì |
| chi-squared test/kaɪ skweəd test/ | 卡方检验 | kǎ fāng jiǎn yàn |
| theoretical distribution/θɪəˈretɪkl ˌdɪstrɪˈbjuːʃn/ | 理论分布 | lǐ lùn fēn bù |
| degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ | 自由度 | zì yóu dù |
| goodness of fit/ˈɡʊdnəs ɒv fɪt/ | 拟合优度 | nǐ hé yōu dù |
| independence/ˌɪndɪˈpendəns/ | 独立性 | dú lì xìng |
| contingency table/kənˈtɪndʒənsi ˈteɪbl/ | 列联表 | liè lián biǎo |
| non-parametric test/nɒn ˌpærəˈmetrɪk test/ | 非参数检验 | fēi cān shù jiǎn yàn |
4.2
Inferência usando distribuições normal e t

Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| formular hipóteses e aplicar um teste de hipótese referente à média populacional usando uma pequena amostra extraída de uma população normal de variância desconhecida, usando um teste-t | |
| calcular uma estimativa agrupada da variância populacional a partir de duas amostras | Podem ser necessárias cálculos baseados em dados brutos ou resumidos. |
| formular hipóteses relativas à diferença das médias populacionais e aplicar, conforme apropriado: - um teste-t para 2 amostras - um teste-t para amostras pareadas - um teste usando uma distribuição normal | Espera-se a capacidade de selecionar o teste adequado às circunstâncias de um problema. |
| determinar um intervalo de confiança para a média populacional, baseado em uma pequena amostra de uma população normal com variância desconhecida, usando uma distribuição t | |
| determinar um intervalo de confiança para a diferença das médias populacionais, usando uma distribuição t ou uma distribuição normal, conforme apropriado. |
Fonte: Programa Cambridge International
Quando uma amostra é pequena e a variância populacional é desconhecida, baseie seu teste de hipótese 假设检验 na distribuição $t$ em vez da normal. A mesma ideia dá um intervalo de confiança 置信区间 para a média:
$$\bar{x} \pm t\,\frac{s}{\sqrt{n}},$$
onde $t$ vem das tabelas $t$ com $n - 1$ graus de liberdade. Para comparar duas populações, use um teste t de amostra dupla (2-sample) ou amostra pareada $t$, após encontrar uma estimativa agrupada 合并估计 da variância compartilhada quando apropriado.
Exemplo resolvido. Uma amostra de $n = 10$ tem média $\bar{x} = 50$ e desvio padrão $s = 4$. Encontre um intervalo de confiança $95\%$ para a média (use $t = 2.262$ para $9$ graus de liberdade).
$$50 \pm 2.262\times\frac{4}{\sqrt{10}} = 50 \pm 2.86 \;\Rightarrow\; (47.1,\ 52.9).$$
Explorar
Por que pequenas amostras precisam de t em vez de z
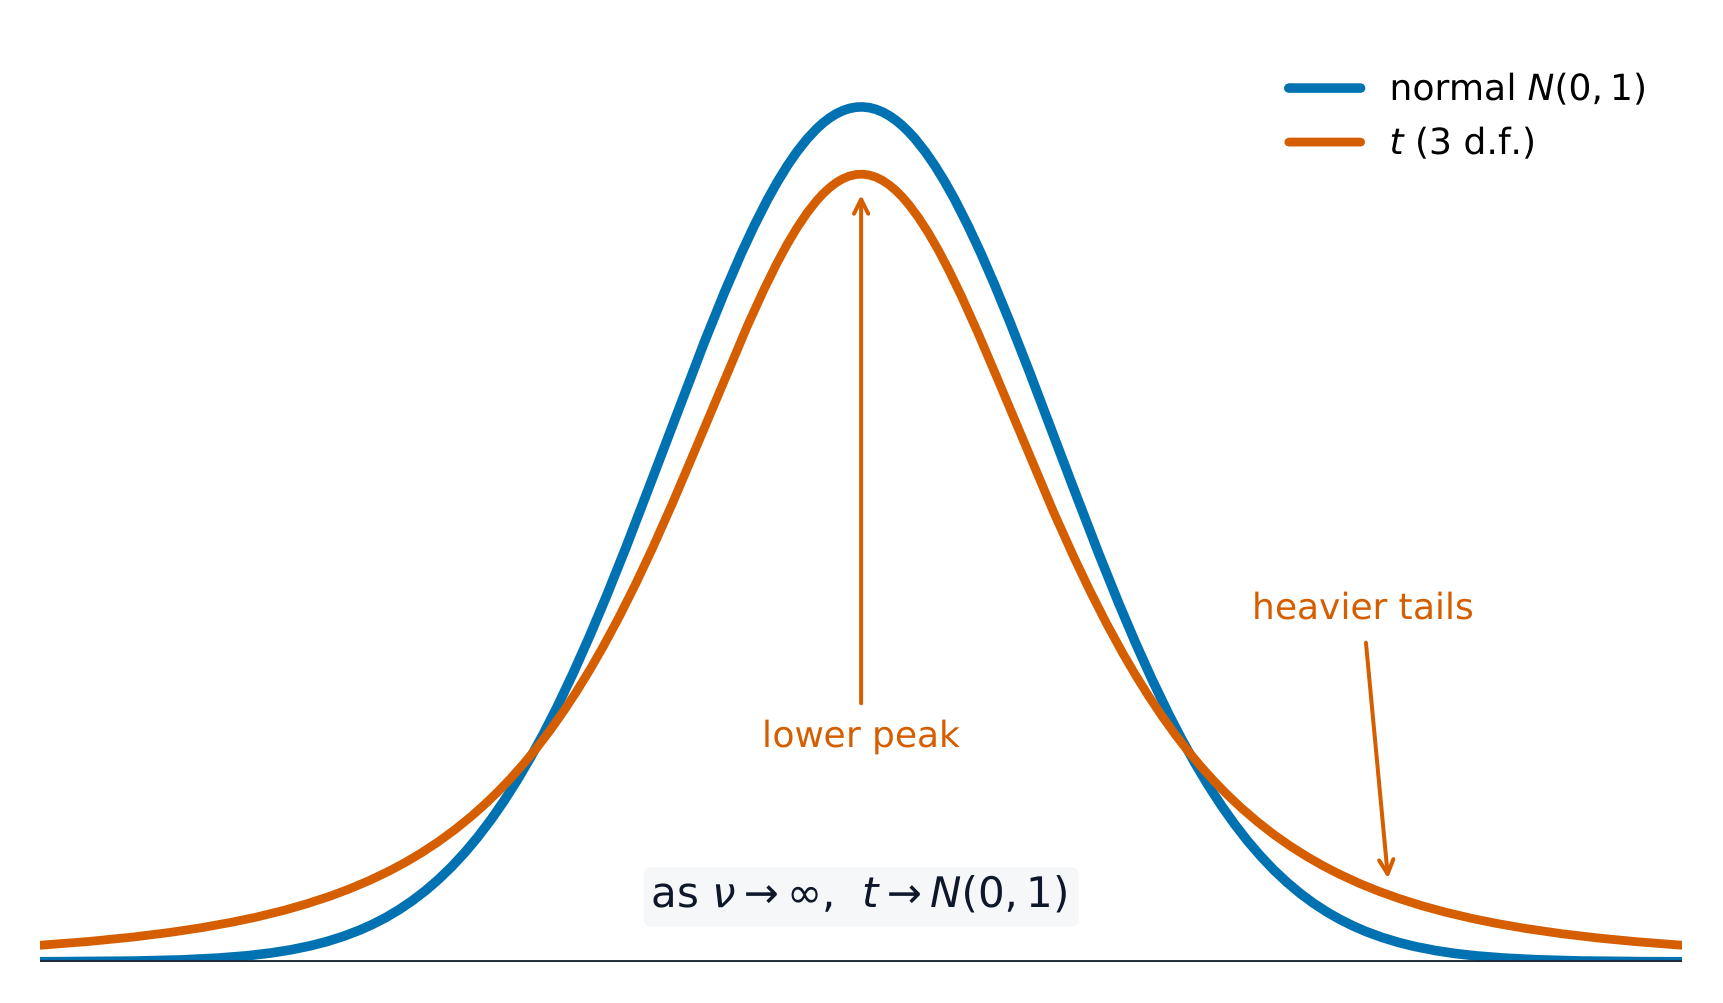
Com $\sigma$ desconhecido, você usa $t$, e $t$ tem caudas mais pesadas que a normal (desenhada tracejada atrás dela) — então seus valores críticos são maiores e o intervalo é mais amplo. No exemplo resolvido de $9$ graus de liberdade, o widget lê $t^* = 2.262$, exatamente o valor de tabela usado acima. Varie gl para cima e $t$ se sobrepõe à normal.
Explorar
A distribuição normal
Sombreie uma cauda para encontrar uma probabilidade — a base dos intervalos de confiança e testes de hipótese.
4.3
Testes Qui-Quadrado
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| ajustar uma distribuição teórica, conforme prescrito por uma hipótese dada, aos dados fornecidos | As questões não envolverão cálculos extensos. |
| usar um teste $\chi^2$-quadrado, com o número apropriado de graus de liberdade, para realizar a correspondente análise de ajuste de boa qualidade | As classes devem ser combinadas de modo que cada frequência esperada seja pelo menos 5. |
| usar um teste $\chi^2$-quadrado, com o número apropriado de graus de liberdade, para independência em uma tabela de contingência. | A correção de Yates não é exigida. Quando apropriado, linhas ou colunas devem ser combinadas de modo que a frequência esperada em cada célula seja pelo menos 5. |
Fonte: Programa Cambridge International
Um teste $\chi^2$ (teste qui-quadrado 卡方检验) compara contagens observadas $O$ com contagens esperadas $E$ de uma distribuição teórica 理论分布:
$$\chi^2 = \sum \frac{(O - E)^2}{E}.$$
Compare isso com um valor de tabela para o número correto de graus de liberdade 自由度. Dois usos: um teste de ajuste de bondade 拟合优度 (se os dados seguem o modelo proposto?) e um teste de independência 独立性 de duas variáveis em uma tabela de contingência 列联表.
Exemplo resolvido. Quatro categorias igualmente prováveis dão contagens observadas $20, 30, 25, 25$ (logo cada contagem esperada é $25$). Teste o ajuste no nível $5\%$.
$$\chi^2 = \frac{(20-25)^2 + (30-25)^2 + 0 + 0}{25} = \frac{25 + 25}{25} = 2.$$
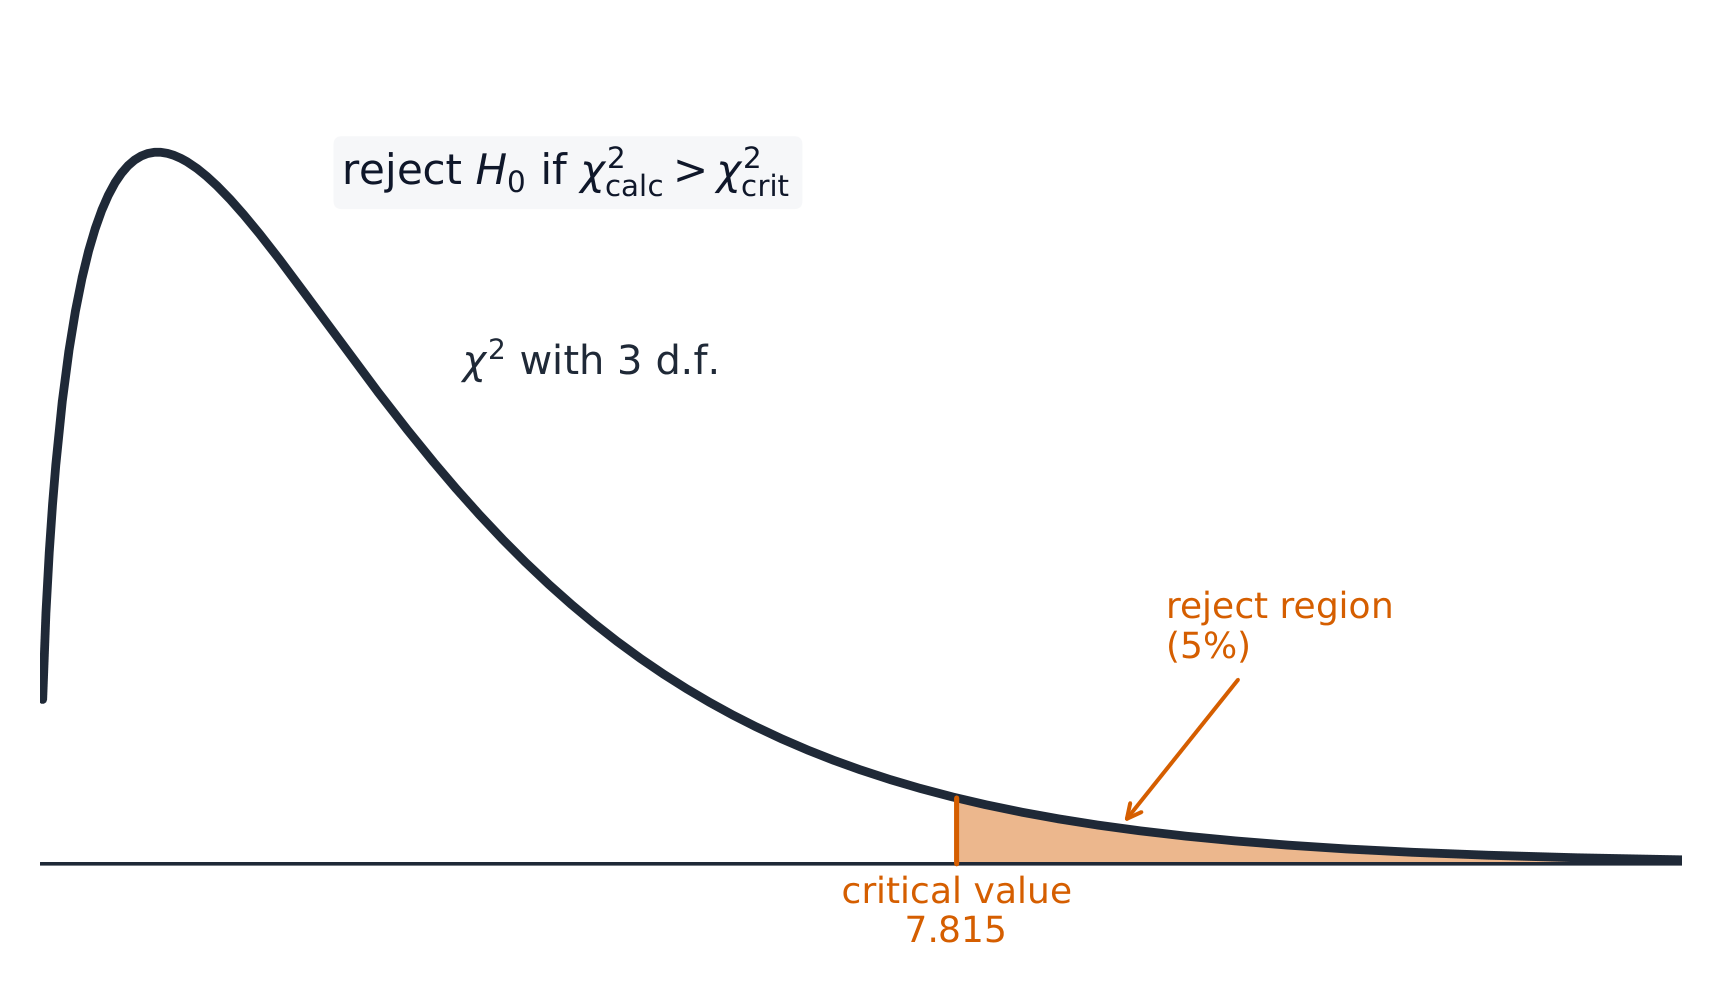
Com $4 - 1 = 3$ graus de liberdade, o valor da tabela é $7.815$. Como $2 < 7.815$, não rejeite o modelo.
Explorar
A distribuição qui-quadrado e sua cauda de 5%
O exemplo resolvido nesta página dá $\chi^2 = 2$ com $3$ graus de liberdade contra um valor de tabela de $7.815$ — o widget reproduz ambos. Arraste gl para ver por que o valor crítico muda com o número de categorias.
Explorar
Rota do teste qui-quadrado
Siga as contagens observadas e esperadas até uma decisão de teste.
4.4
Testes não paramétricos
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| compreender a ideia de um teste não paramétrico e apreciar situações em que tal teste poderia ser útil | p.ex. ao amostrar de uma população que não possa ser assumida como normalmente distribuída. |
| compreender a base do teste de sinais, o teste de postos assinados de Wilcoxon e o teste de soma de postos de Wilcoxon | Incluindo conhecimento de que os testes de Wilcoxon são válidos apenas para distribuições simétricas. |
| usar um teste de sinais de uma única amostra e um teste de postos assinados de Wilcoxon de uma única amostra para testar uma hipótese sobre a mediana populacional | Incluindo o uso de aproximações normais quando apropriado. As questões não envolverão postos iguais ou observações iguais ao valor da mediana populacional sendo testada. |
| usar um teste de sinais para amostras pareadas, um teste de postos assinados pareados de Wilcoxon e um teste de soma de postos de Wilcoxon, conforme apropriado, para testar a identidade de populações. | Incluindo o uso de aproximações normais quando apropriado. As questões não envolverão postos iguais ou pares de diferenças zero. |
Fonte: Programa Cambridge International
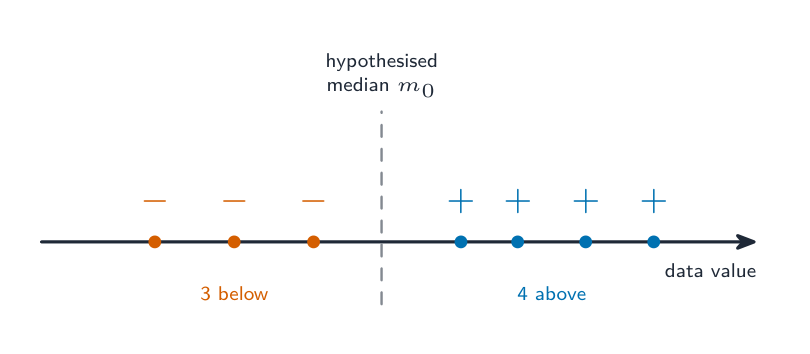
Um teste não paramétrico 非参数检验 não faz suposição de que os dados são normais, sendo útil quando essa suposição falha. Os básicos são:
- o teste dos sinais 符号检验: conte quantos valores estão acima e abaixo de uma mediana proposta, e teste essas contagens com um modelo binomial;
- o teste de posto sinalizado de Wilcoxon 威尔科克森符号秩检验 (o teste para pareamento matched-pairs para dados pareados), que também usa os tamanhos das diferenças, não apenas seus sinais;
- o teste de soma de postos de Wilcoxon 威尔科克森秩和检验, para comparar duas amostras separadas.
Exemplo resolvido. Teste se uma mediana é $5$. Em uma amostra de $10$ valores (nenhum igual a $5$), $9$ ficam acima $5$ e $1$ fica abaixo. Teste no nível $5\%$ (bilateral).
Sob $H_0$ (mediana $= 5$), o número acima segue $B(10, 0.5)$. O resultado observado ($9$ acima) é extremo, então encontre $P(X \geq 9) = \binom{10}{9}(0.5)^{10} + (0.5)^{10} = \dfrac{11}{1024} = 0.0107$. Para um teste bilateral, compare com $\tfrac{1}{2}(5\%) = 0.025$. Como $0.0107 < 0.025$, rejeite $H_0$: há evidências de que a mediana não é $5$.
Explorar
Selecionador de testes não paramétricos
Escolha o teste baseado em postos que corresponda à situação dos dados.
Vocabulário
Treinar
| Inglês | Chinês | Pinyin |
|---|---|---|
| sign test/saɪn test/ | 符号检验 | fú hào jiǎn yàn |
| Wilcoxon signed-rank test/ˈwɪlkɒksn saɪnd ræŋk test/ | 威尔科克森符号秩检验 | wēi ěr kē kè sēn fú hào zhì jiǎn yàn |
| Wilcoxon rank-sum test/ˈwɪlkɒksn ræŋk sʌm test/ | 威尔科克森秩和检验 | wēi ěr kē kè sēn zhì hé jiǎn yàn |
| probability generating function/ˌprɒbəˈbɪlɪti ˈdʒenəreɪtɪŋ ˈfʌŋkʃn/ | 概率母函数 | gài lǜ mǔ hán shù |
| Further Probability & Statistics/ˈfɜːðə ˌprɒbəˈbɪlɪti ænd stəˈtɪstɪks/ | 进阶概率统计 | jìn jiē gài lǜ tǒng jì |
4.5
Funções geradoras de probabilidade
Programa
| Os candidatos devem ser capazes de: | Notas e exemplos |
|---|---|
| compreender o conceito de uma função geradora de probabilidade (PGF) e construir e usar a PGF para distribuições dadas | Incluindo as distribuições uniforme discreta, binomial, geométrica e de Poisson. |
| usar fórmulas para a média e variância de uma variável aleatória discreta em termos de sua PGF, e usar essas fórmulas para calcular a média e variância de uma dada distribuição de probabilidade | |
| usar o resultado de que a PGF da soma de variáveis aleatórias independentes é o produto das PGFs dessas variáveis aleatórias. |
Fonte: Programa Cambridge International
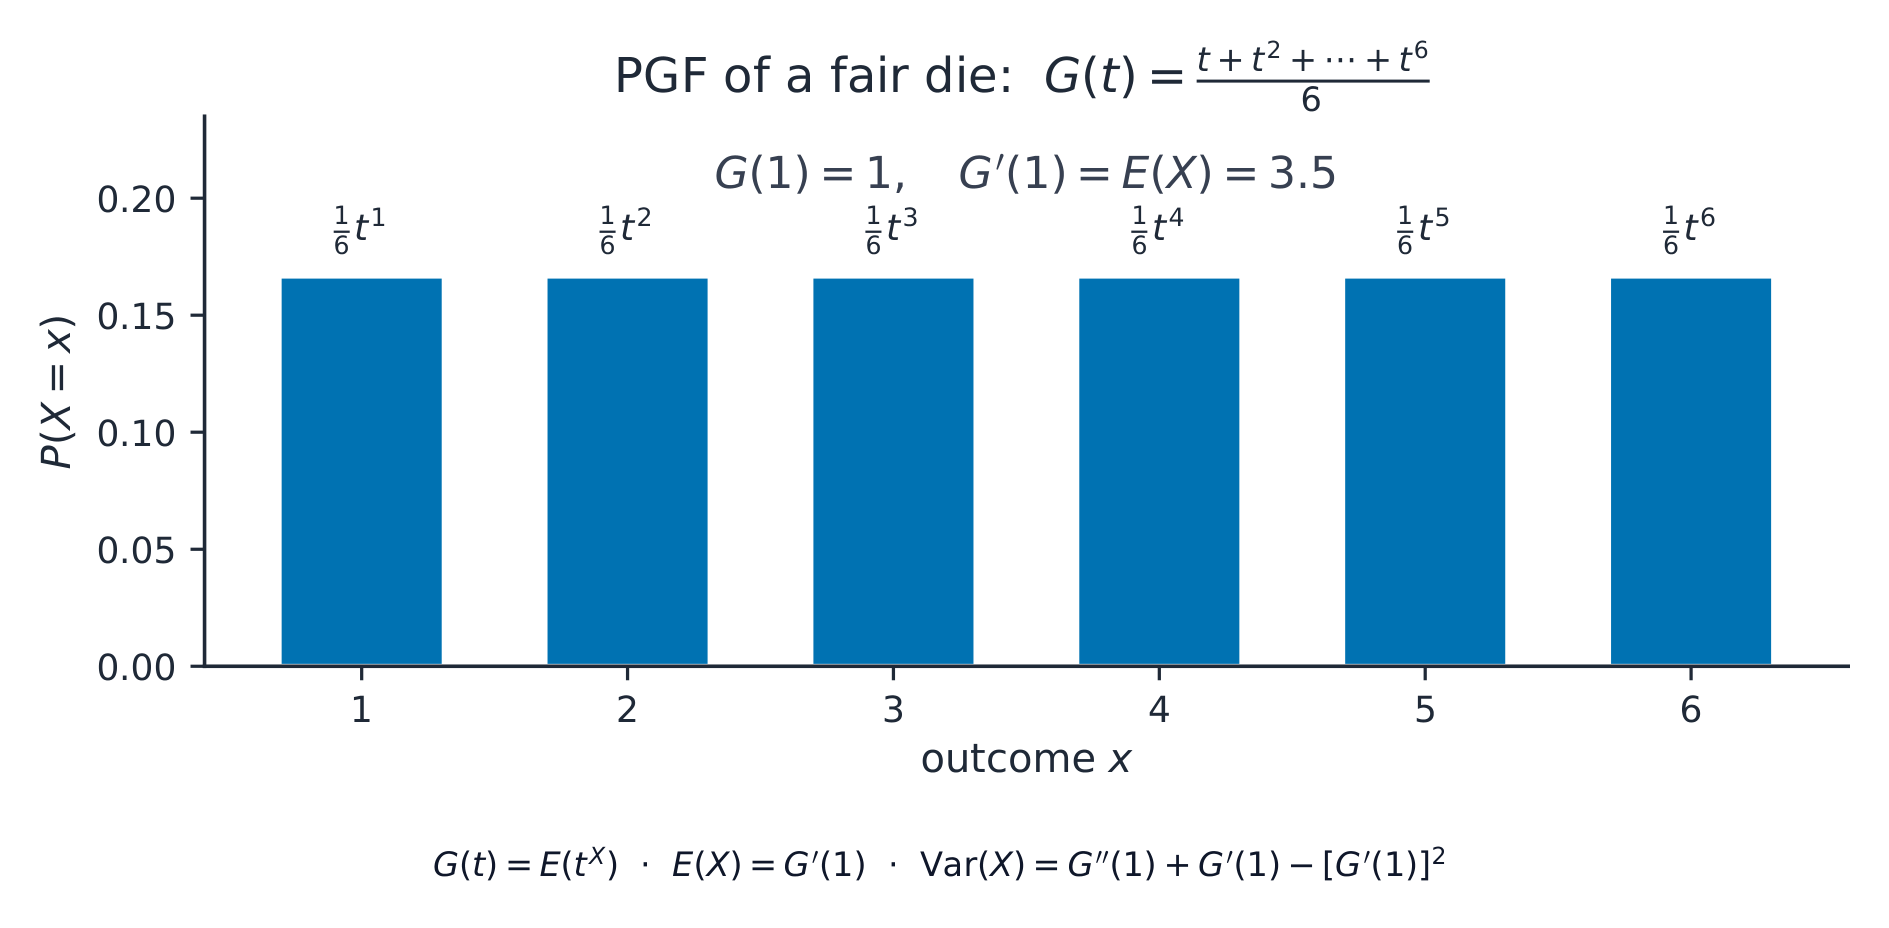
A função geradora de probabilidade 概率母函数 de uma variável discreta $X$ é
$$G(t) = E(t^X) = \sum_x P(X = x)\,t^x.$$
Ela compacta toda a distribuição em uma única função. A média e a variância vêm de suas derivadas em $t = 1$: $E(X) = G'(1)$ e $\mathrm{Var}(X) = G''(1) + G'(1) - \big(G'(1)\big)^2$. Além disso, a FGP de uma soma de variáveis independentes é o produto de suas FGPs.
Exemplo resolvido. $X$ tem $P(X=0) = 0.5$, $P(X=1) = 0.3$, $P(X=2) = 0.2$. Encontre $E(X)$ usando a FGP.
Aqui $G(t) = 0.5 + 0.3t + 0.2t^2$, então $G'(t) = 0.3 + 0.4t$ e
$$E(X) = G'(1) = 0.3 + 0.4 = 0.7.$$
Explorar
Laboratório de função geradora de probabilidade
G(x) = p0 + p1 x + p2 x^2 + ...
Altere x e veja como uma PGF armazena probabilidades em potências de x.
4.5
Dicas de prova
- Para uma variável aleatória contínua, a pdf integra-se a $1$ sobre seu intervalo, e $E(X) = \int x f(x)\,dx$.
- Use a distribuição $t$ quando a amostra é pequena e a variância populacional é desconhecida; declare os graus de liberdade.
- Para um teste qui-quadrado, compute $\sum (O-E)^2/E$, compare com o valor crítico nos graus de liberdade corretos, e combine classes com $E < 5$.
- Declare $H_0$ e $H_1$ e dê a conclusão no contexto para todo teste.
Aulas interativas sobre este tópico
Passe por ele passo a passo, com exercícios de verificação instantânea.