Aqui está uma tarefa: criar um sistema para gerenciar todo o estoque de uma loja — todos os produtos, todas as vendas, todas as entregas, todos os relatórios. Como um único problema gigante, ele é grande demais para…
English narration · English + 中文 subtitles burned in · Narração em inglês · Legendas em inglês + 中文 gravadas
Need for and benefits of using abstraction Describe the purpose of abstraction Produce an abstract model of a system by only including essential details
Describe and use decomposition
Break down problems into sub-problems leading to the concept of a program module (procedure / function)
Português
Os candidatos devem ser capazes de:
Notas e orientações
Demonstre compreensão de abstração
Necessidade e benefícios do uso de abstração Descreva o propósito de abstração Produza um modelo abstrato de um sistema incluíndo apenas detalhes essenciais
Descreva e utilize decomposição
Dividir problemas em sub-problemas levando ao conceito de módulo de programa (procedimento / função)
Source: Cambridge International syllabus · Fonte: Programa Cambridge International
English
Computational thinking 计算思维 is the set of mental tools for analysing a problem and designing a solution a computer can run. Two key ones are abstraction and decomposition.
Abstraction
Abstraction 抽象 means keeping the essential features of a problem and ignoring the irrelevant detail, giving a simpler model.
Examples:
a train-network map keeps the stations and lines but drops the geography.
a class in object-oriented programming keeps only the attributes and methods the system needs.
a function hides a piece of work behind a name.
A full model of any real problem would be too big to reason about, so abstraction is essential.
The examiner asks for the purpose of abstraction and for its benefits. Purpose: to produce a simpler model of a problem that contains only the details needed to solve it. Benefits: the problem is easier to understand and to program; the program is smaller and faster to write and test; the same model can be reused for similar problems. When you are asked to produce an abstract model of a system, list only the data and actions the task needs. For a school timetable that means the classes, rooms, teachers and periods; it does not mean the colour of the rooms or the age of the teachers.
Decomposition
Decomposition 分解 means breaking a large problem into smaller sub-problems, each easier to solve and tackled one at a time.
find the main parts of the task.
break each into smaller sub-tasks.
continue until each is small enough to design directly.
solve the small tasks and combine them.
For stock control: "manage stock" → "record sales", "record deliveries", "produce reports" → ("record sales") "look up product", "decrease stock count", "save the transaction". Decomposition makes big problems manageable, lets a team divide the work, and gives modular code — each module becomes a procedure 过程 or function.
"Explain why decomposition is used" is a three-mark question with a fixed shape. Give three separate benefits: each sub-problem 子问题 is small enough to design, code and test on its own; different programmers can work on different modules 模块 at the same time; a module that already exists (or a library routine) can be reused, and a fault is easier to find because it lies inside one module. A structure chart (topic 12) is the diagram of a decomposition: the program at the top, its modules beneath, and the data passed between them.
Português
Computational thinking 计算思维 é o conjunto de ferramentas mentais para analisar um problema e projetar uma solução que um computador possa executar. Duas principais são abstração e decomposição.
Pensamento computacional divide um grande problema em partes menores e mais fáceis — como resolver um quebra-cabeça
Abstração
Abstraction 抽象 significa manter as características essenciais de um problema e ignorar detalhes irrelevantes, fornecendo um modelo mais simples.
Exemplos:
um mapa de rede de trens mantém as estações e linhas, mas ignora a geografia.
uma class em programação orientada a objetos mantém apenas os atributos e métodos que o sistema precisa.
uma function oculta uma parte do trabalho atrás de um nome.
Um modelo completo de qualquer problema real seria muito grande para raciocinar, então a abstração é essencial.
O avaliador pede o objetivo da abstração e seus benefícios. Objetivo: produzir um modelo mais simples de um problema que contenha apenas os detalhes necessários para resolvê-lo. Benefícios: o problema fica mais fácil de entender e programar; o programa é menor e mais rápido de escrever e testar; o mesmo modelo pode ser reutilizado para problemas semelhantes. Quando solicitado a produzir um modelo abstrato de um sistema, liste apenas os dados e ações que a tarefa exige. Para uma grade escolar, isso significa as aulas, salas, professores e períodos; não significa a cor das salas ou a idade dos professores.
A abstração mantém o essencial (estações e linhas) e descarta detalhes irrelevantes (a geografia)
Decomposição
Decomposição 分解 significa dividir um grande problema em subproblemas menores, cada um mais fácil de resolver e tratado individualmente.
encontre as partes principais da tarefa.
divida cada uma em subtarefas menores.
continue até que cada uma seja pequena o suficiente para ser projetada diretamente.
resolva as tarefas pequenas e combine-as.
Para controle de estoque: "gerenciar estoque" → "registrar vendas", "registrar entregas", "produzir relatórios" → ("registrar vendas") "consultar produto", "diminuir contagem de estoque", "salvar a transação". A decomposição torna grandes problemas gerenciáveis, permite que uma equipe divida o trabalho e gera código modular — cada módulo se torna uma procedura 过程 ou função.
"Explique por que a decomposição é usada" é uma questão de três pontos com formato fixo. Dê três benefícios separados: cada subproblema 子问题 é pequeno o suficiente para ser projetado, codificado e testado independentemente; diferentes programadores podem trabalhar em diferentes módulos 模块 ao mesmo tempo; um módulo já existente (ou uma rotina de biblioteca) pode ser reutilizado, e um erro é mais fácil de encontrar porque está contido em um único módulo. Um diagrama estrutural (tópico 12) é o diagrama de uma decomposição: o programa no topo, seus módulos abaixo, e os dados passados entre eles.
Decompondo um programa em módulos e submódulos
Explore · Explorar
Resolver um problema à maneira computacional
Passe pelos quatro pilares na ordem em que você os usaria — decomponha o problema, identifique repetições, reduza aos essenciais, depois escreva os passos.
Show understanding that an algorithm is a solution to a problem expressed as a sequence of defined steps
Use suitable identifier names for the representation of data used by a problem and represent these using an identifier table
Write pseudocode that contains input, process and output
Write pseudocode using the three basic constructs of sequence, selection and iteration (repetition)
Document a simple algorithm using a structured English description, a flowchart or pseudocode
Write pseudocode from: • a structured English description • a flowchart
Draw a flowchart from: • a structured English description • pseudocode
Describe and use the process of stepwise refinement to express an algorithm to a level of detail from which the task may be programmed
Use logic statements to define parts of an algorithm solution
Português
Os candidatos devem ser capazes de:
Notas e orientações
Demonstre compreensão de que um algoritmo é uma solução para um problema expressa como uma sequência de passos definidos
Utilize nomes de identificador adequados para a representação de dados usados por um problema e represente-os usando uma tabela de identificadores
Escreva pseudocódigo que contenha entrada, processamento e saída
Escreva pseudocódigo usando as três construções básicas de sequência, seleção e iteração (repetição)
Documente um simples algoritmo usando uma descrição em inglês estruturado, um diagrama de fluxo ou pseudocódigo
Escreva pseudocódigo a partir de: • uma descrição em inglês estruturado • um diagrama de fluxo
Desenhe um diagrama de fluxo a partir de: • uma descrição em inglês estruturado • pseudocódigo
Descreva e utilize o processo de refinamento progressivo para expressar um algoritmo a um nível de detalhe a partir do qual a tarefa pode ser programada
Use declarações lógicas para definir partes de uma solução algorítmica
Source: Cambridge International syllabus · Fonte: Programa Cambridge International
English
Bubble sort, pass by pass
An algorithm 算法 is a solution expressed as a sequence of defined steps. Each step is unambiguous 无歧义 (one meaning), deterministic 确定性 (same input → same output), finite (the steps end), and effective (each can be done). An algorithm says what to do, independent of the programming language used to implement it.
Português
Ordenação bolha, passo a passo
Um algoritmo 算法 é uma solução expressa como uma sequência de passos definidos. Cada passo é unívoco 无歧义 (um único significado), determinístico 确定性 (mesma entrada → mesma saída), finito (os passos terminam) e efetivo (cada um pode ser executado). Um algoritmo diz o que fazer, independente da linguagem de programação usada para implementá-lo.
Explore · Explorar
Seleção: siga os ramos DO / SE NÃO
Arraste a pontuação e observe qual ramo é executado. A seleção testa cada condição por sua vez e toma a PRIMEIRA que for verdadeira — é assim que funciona O SE ... SENÃO SE ... SENÃO.
When you start an algorithm, list every piece of data in an identifier table 标识符表 — its identifier 标识符 (the variable 变量 name), data type 数据类型, and description. The exam's table has exactly these three columns:
Identifier
Data type
Description
Category
STRING
the product category
SaleDate
DATE
when the item was sold
ItemCost
REAL
cost of the item
InStock
BOOLEAN
TRUE if in stock
Sales
ARRAY[1:30] OF REAL
the last 30 daily sales totals
Use descriptive names (ItemCost, not x): an identifier starts with a letter, contains no spaces, and is written the same way every time it appears. Common types are INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE, plus arrays. The table forces you to name every piece of data before writing code, and a "complete the identifier table" question gives one mark for each correct data type or description, so write the type exactly as the pseudocode guide does.
Português
Ao iniciar um algoritmo, liste todas as peças de dados em uma tabela de identificadores 标识符表 — seu identificador 标识符 (o nome da variável 变量), tipo de dado 数据类型 e descrição. A tabela do exame tem exatamente estas três colunas:
Identificador
Tipo de dado
Descrição
Category
STRING
categoria do produto
SaleDate
DATE
quando o item foi vendido
ItemCost
REAL
custo do item
InStock
BOOLEAN
TRUE se estiver em estoque
Sales
ARRAY[1:30] OF REAL
os totais diários de vendas dos últimos 30 dias
Use nomes descritivos (ItemCost, não x): um identificador começa com uma letra, não contém espaços e é escrito da mesma forma toda vez que aparece. Tipos comuns são INTEGER, REAL, STRING, CHAR, BOOLEAN, DATE, além de arrays. A tabela força você a nomear todas as peças de dados antes de escrever o código, e uma questão "complete a tabela de identificadores" dá um ponto por cada tipo de dado ou descrição correta, então escreva o tipo exatamente como o guia de pseudocódigo faz.
Uma tabela de identificadores nomeia todas as peças de dados antes de escrever o código
Pseudocode — the three basic constructs · Pseudocódigo — as três construções básicas
English
Pseudocode 伪代码 is a structured, language-neutral way to describe algorithms.
1. Sequence
Steps run one after another (sequence 顺序):
2. Selection
A choice of which steps run, based on a condition (selection 选择):
For more options, use CASE OF ... ENDCASE.
3. Iteration
Repeating a block (iteration 迭代, a loop 循环):
A WHILE loop tests the condition before each pass (may run zero times); a REPEAT...UNTIL loop tests after each pass (always runs at least once).
Choosing the loop is itself a mark: FOR when you know how many times (a count-controlled loop 计数循环); WHILE when the loop might not run at all (a pre-condition loop 前测循环); REPEAT ... UNTIL when it must run at least once, as in validating an input (a post-condition loop 后测循环). A "describe the iteration construct" answer names the construct, says where the condition is tested, and gives the consequence (zero times or at least once).
Common operations
assignment 赋值: x ← 5 (an arrow; = is for comparison).
RAND(100) gives a real number from 0 up to (but not including) 100. INT(RAND(100)) + 1 gives an integer from 1 to 100.
Two habits earn marks on every question: declare every variable you use, with the type from your identifier table, and initialise 初始化 every counter 计数器 and total (Count ← 0, Total ← 0) before the loop that changes it.
Input → Process → Output
Every program follows this shape:
Listing the inputs and outputs first makes the algorithm cleaner.
Worked example. Write pseudocode that inputs 100 integers and outputs how many of them, and the total of those, that lie between 10 and 20 inclusive.
Identifier table: Count : INTEGER (loop counter), Value : INTEGER (the integer just input), InRange : INTEGER (how many were in range), Total : INTEGER (their sum).
If the question then asks you to "identify two constructs and state how each is used", answer in the same shape: iteration, the FOR loop, repeats the input 100 times; selection, the IF statement, adds a value only when it is in range.
Worked example. A program picks a secret integer from 1 to 100. The user guesses until they are right; after each wrong guess the program says "Too low" or "Too high", and at the end it outputs how many guesses were made.
Identifier table: Secret : INTEGER (the number to guess), Guess : INTEGER (the user's input), Tries : INTEGER (how many guesses so far).
A REPEAT ... UNTIL loop is the right choice because the user must guess at least once. The marks are for: the random number in the right range, a loop that ends on a correct guess, the counter that starts at zero and increases inside the loop, the two messages under the right conditions, and the final output.
Worked example. Output two different random integers, each between $-10$ and $10$ inclusive.
There are 21 possible values, so INT(RAND(21)) gives 0 to 20 and subtracting 10 shifts it to the range $-10$ to $10$. The second number must be generated again until it differs from the first:
Português
Pseudocódigo 伪代码 é uma maneira estruturada e independente de linguagem para descrever algoritmos.
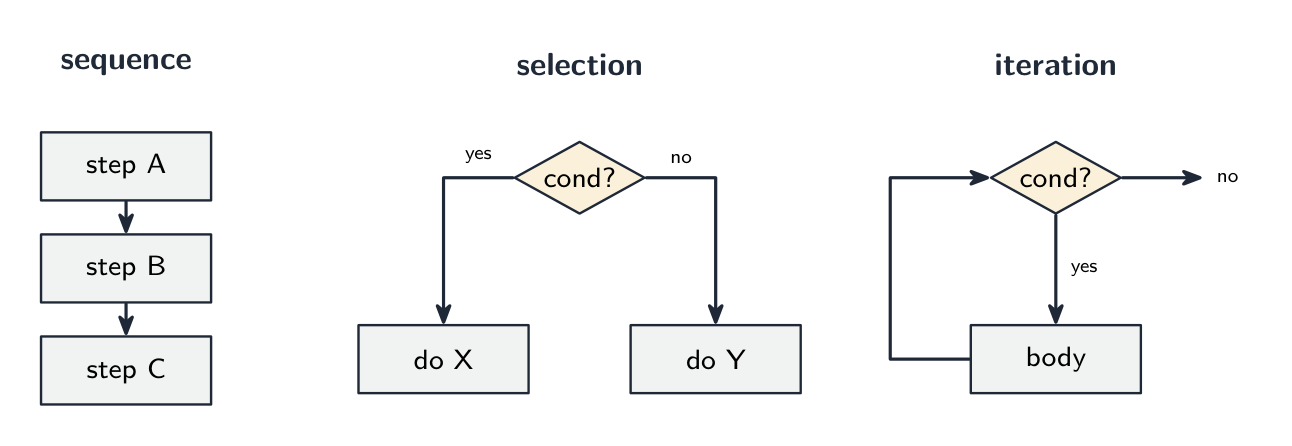
Os três blocos construtivos de qualquer algoritmo: sequência, seleção e iteração
1. Sequência
Passos são executados um após o outro (sequência 顺序):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Seleção
Uma escolha de quais passos executar, baseada em uma condição (seleção 选择):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Para mais opções, use CASE OF ... ENDCASE.
3. Iteração
Repetir um bloco (iteração 迭代, um loop 循环):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Um loop WHILE testa a condição antes de cada passagem (pode rodar zero vezes); um loop REPEAT...UNTIL testa depois de cada passagem (sempre roda pelo menos uma vez).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
Um loop WHILE testa antes do corpo rodar; um loop REPEAT ... UNTIL testa depois, então seu corpo sempre roda pelo menos uma vez
Escolher o loop vale um ponto: FOR quando você sabe quantas vezes (um loop controlado por contador 计数循环); WHILE quando o loop pode não rodar de todo (um loop pré-condição 前测循环); REPEAT ... UNTIL quando deve rodar pelo menos uma vez, como na validação de entrada (um loop pós-condição 后测循环). Uma resposta "descreva a construção de iteração" nomeia a construção, diz onde a condição é testada e dá a consequência (zero vezes ou pelo menos uma vez).
Operações comuns
atribuição 赋值: x ← 5 (uma seta; = é para comparação).
RAND(100) gera um número real de 0 até (mas não incluindo) 100. INT(RAND(100)) + 1 gera um inteiro de 1 a 100.
Dois hábitos valem pontos em todas as questões: declare toda variável que usar, com o tipo da sua tabela de identificadores, e inicialize 初始化 todo contador 计数器 e total (Count ← 0, Total ← 0) antes do loop que o altera.
Entrada → Processamento → Saída
Todo programa segue este formato:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Listar entradas e saídas primeiro deixa o algoritmo mais limpo.
Exemplo resolvido. Escreva pseudocódigo que insere 100 inteiros e outputa quantos deles, e a soma desses, estão entre 10 e 20 inclusos.
Tabela de identificadores: Count : INTEGER (contador de loop), Value : INTEGER (o inteiro inserido), InRange : INTEGER (quantos estavam no intervalo), Total : INTEGER (soma deles).
DECLARE Count, Value, InRange, Total : INTEGER
InRange ← 0
Total ← 0
FOR Count ← 1 TO 100
    INPUT Value
    IF Value >= 10 AND Value <= 20 THEN
        InRange ← InRange + 1
        Total ← Total + Value
    ENDIF
NEXT Count
OUTPUT InRange, Total
Se a questão pedir para "identificar duas construções e dizer como cada uma é usada", responda no mesmo formato: iteração, o loop FOR, repete a entrada 100 vezes; seleção, a instrução IF, adiciona um valor apenas quando está no intervalo.
Exemplo resolvido. Um programa escolhe um número secreto inteiro de 1 a 100. O usuário chuta até acertar; após cada chute errado, o programa diz "Muito baixo" ou "Muito alto", e no final ele outputa quantos palpites foram feitos.
Tabela de identificadores: Secret : INTEGER (o número a ser adivinhado), Guess : INTEGER (a entrada do usuário), Tries : INTEGER (quantos palpites até agora).
DECLARE Secret, Guess, Tries : INTEGER
Secret ← INT(RAND(100)) + 1
Tries ← 0
REPEAT
    INPUT Guess
    Tries ← Tries + 1
    IF Guess < Secret THEN
        OUTPUT "Too low"
    ELSE
        IF Guess > Secret THEN
            OUTPUT "Too high"
        ENDIF
    ENDIF
UNTIL Guess = Secret
OUTPUT "You took ", Tries, " guesses"
Um loop REPEAT ... UNTIL é a escolha certa porque o usuário deve chutar pelo menos uma vez. Os pontos são para: o número aleatório no intervalo correto, um loop que termina em um chute correto, o contador que começa em zero e aumenta dentro do loop, as duas mensagens sob as condições certas, e a saída final.
O mesmo jogo de adivinhação como flowchart: os dois losangos de decisão são as duas instruções IF, e a seta de retorno é o loop REPEAT ... UNTIL
Exemplo resolvido. Outputar dois números inteiros aleatórios diferentes, cada um entre $-10$ e $10$ inclusos.
Há 21 valores possíveis, então INT(RAND(21)) gera de 0 a 20 e subtraindo 10 desloca para o intervalo $-10$ a $10$. O segundo número deve ser gerado novamente até diferir do primeiro:
DECLARE First, Second : INTEGER
First ← INT(RAND(21)) - 10
REPEAT
    Second ← INT(RAND(21)) - 10
UNTIL Second <> First
OUTPUT First, Second
Todo programa segue o formato Entrada, Processamento, Saída
Explore · Explorar
IF … ELSE seleção
Altere o valor e observe qual ramo é executado — como um programa toma decisões.
structured English 结构化英语 — natural language with indentation and fixed keywords; good for a high-level description.
flowchart 流程图 — a diagram with standard shapes:
Shape
Meaning
Rounded rectangle
Start / Stop
Parallelogram
Input / Output
Rectangle
Process
Diamond
Decision
Arrow
Flow of control
pseudocode — the keyword notation above; closest to code.
You should be able to convert between any pair: each IF is a decision diamond, each loop is a back-arrow, and a sequence is stacked rectangles.
IF ... THEN
... ELSE ...
ENDIF
Português
O mesmo algoritmo pode ser escrito de três formas.
inglês estruturado 结构化英语 — linguagem natural com indentação e palavras-chave fixas; bom para uma descrição de alto nível.
flowchart 流程图 — um diagrama com formas padrão:
Forma
Significado
Retângulo arredondado
Início / Parada
Paralelogramo
Entrada / Saída
Retângulo
Processamento
Losango
Decisão
Seta
Fluxo de controle
pseudocódigo — a notação de palavras-chave acima; mais próximo do código.
Você deve ser capaz de converter entre qualquer par: cada IF é um losango de decisão, cada laço é uma seta de retorno, e uma sequência são retângulos empilhados.
SE ... ENTÃO
... SENÃO ...
FIM_SE
Um fluxograma para calcular a média de uma lista de números, usando as formas padrão
Stepwise refinement 逐步求精 starts with a high-level outline and expands each step until it is small enough to code. For an average of $n$ numbers:
Level 1:
Level 2:
Each refinement keeps the previous structure and adds detail.
A six-mark "apply stepwise refinement" question gives you a high-level outline and wants each step expanded into the concrete statements a programmer could code. Keep the steps in the same order, name the data each step reads or produces, and stop when every line is a single input, assignment, output, loop or condition. For example, "validate the password" becomes: input the password; check its length is at least 8; check it contains at least one digit; output "accepted" if both checks pass, otherwise output "rejected".
Português
Refinamento passo a passo 逐步求精 começa com um esboço de alto nível e expande cada etapa até que seja pequena o suficiente para ser codificada. Para uma média de $n$ números:
Nível 1:
Read in the numbers
Compute the average
Output the average
Nível 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
C refinamento mantém a estrutura anterior e adiciona detalhes.
Uma questão de seis pontos sobre "aplicar refinamento passo a passo" fornece um esboço de alto nível e pede que cada etapa seja expandida em instruções concretas que um programador poderia codificar. Mantenha as etapas na mesma ordem, nomeie os dados que cada etapa lê ou produz, e pare quando cada linha for uma única entrada, atribuição, saída, laço ou condição. Por exemplo, "validar a senha" torna-se: digite a senha; verifique se seu comprimento é pelo menos 8; verifique se contém pelo menos um dígito; saia "aceita" se ambas as verificações forem bem-sucedidas, caso contrário saia "rejeitada".
Refinamento passo a passo: expanda cada etapa de alto nível em pseudocódigo detalhado
Explore · Explorar
Refinamento passo a passo: esboço para código
Desça pelos níveis. Você começa com a tarefa inteira em uma linha e continua expandindo cada passo em partes menores — até que todos os passos sejam simples o suficiente para serem codificados diretamente.
9.2
Logic statements · Declarações lógicas
English
A logic statement 逻辑语句 is a Boolean 布尔 condition that controls branching, built from comparisons (x > 10), connectives (AND, OR, NOT) and brackets. Use it as the condition of IF, WHILE or REPEAT...UNTIL:
Precedence 优先级 (highest to lowest): NOT, then AND, then OR. Use brackets when unsure. Common mistakes:
a = 1 OR 2 is wrong — write a = 1 OR a = 2.
NOT a > 5 means NOT (a > 5), i.e. a <= 5.
NOT (A AND B) is the same as (NOT A) OR (NOT B) (De Morgan's law 德摩根定律) — handy for simplifying conditions.
Turning a sentence into a logic statement is a skill the papers test directly. "A ticket is free for anyone under 5 or over 65" becomes Age < 5 OR Age > 65. "A mark is valid if it is a whole number from 0 to 100" becomes Mark >= 0 AND Mark <= 100. "The loop stops when the file is finished or ten records have been read" becomes UNTIL EOF(File) OR Count = 10. Write each comparison in full: Age > 65 and Age < 5, never Age > 65 OR < 5.
Worked example. Write an identifier table and pseudocode to read 10 numbers and output the largest. The identifier table names each variable with its data type and purpose: Count : INTEGER (loop counter), Num : REAL (the number just read), Max : REAL (largest so far).
The design decision carrying the marks is initialising Max: it must start lower than any possible input - or, safer still, be set to the first number read. Initialise it to 0 and the algorithm wrongly returns 0 for a list of negative numbers, a bug your trace only exposes if the test data include a negative.
Português
Uma declaração lógica 逻辑语句 é uma condição Booleana 布尔 controlada por ramificações, construída a partir de comparações (x > 10), conectivos (AND, OR, NOT) e colchetes. Use-a como condição de IF, WHILE ou REPEAT...UNTIL:
WHILE attempts < 3 AND NOT loggedIn DO
    INPUT password
    IF password = correctPassword THEN
        loggedIn ← TRUE
    ELSE
        attempts ← attempts + 1
    ENDIF
ENDWHILE
Precedência 优先级 (maior para menor): NOT, depois AND, depois OR. Use colchetes quando tiver dúvidas. Erros comuns:
a = 1 OR 2 está errado — escreva a = 1 OR a = 2.
NOT a > 5 significa NOT (a > 5), ou seja, a <= 5.
NOT (A AND B) é o mesmo que (NOT A) OR (NOT B) (Lei de De Morgan 德摩根定律) — útil para simplificar condições.
Transformar uma frase em uma declaração lógica é uma habilidade testada diretamente nos exames. "Um ingresso é gratuito para qualquer pessoa com menos de 5 ou mais de 65 anos" torna-se Age < 5 OR Age > 65. "Uma nota é válida se for um número inteiro de 0 a 100" torna-se Mark >= 0 AND Mark <= 100. "O laço para quando o arquivo termina ou dez registros foram lidos" torna-se UNTIL EOF(File) OR Count = 10. Escreva cada comparação por extenso: Age > 65 e Age < 5, nunca Age > 65 OR < 5.
Precedência: NOT vincula-se a loggedIn primeiro, então AND combina os dois lados
Exemplo resolvido. Escreva uma tabela de identificadores e pseudocódigo para ler 10 números e exibir o maior. A tabela de identificadores nomeia cada variável com seu tipo de dado e propósito: Count : INTEGER (contador de laço), Num : REAL (o número acabado de ser lido), Max : REAL (maior até agora).
Max ← -999999
FOR Count ← 1 TO 10
    INPUT Num
    IF Num > Max THEN
        Max ← Num
    ENDIF
NEXT Count
OUTPUT Max
A decisão de design que carrega os pontos é inicializar Max: ela deve começar abaixo de qualquer entrada possível - ou, ainda mais seguro, ser definida como o primeiro número lido. Inicializá-la como 0 faz o algoritmo retornar incorretamente 0 para uma lista de números negativos, um bug que sua traçagem só expõe se os dados de teste incluírem um negativo.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Escolha uma e o site te seguirá — notas, provas, vídeos e prática abrirão nela.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Digite para pesquisar notas, aulas, código, vocabulário e questões de provas anteriores em todas as disciplinas.