Antes dos bancos de dados, cada programa mantinha seus próprios arquivos planos — um arquivo por programa. Imagine uma loja. O programa de vendas, o programa de faturamento e o programa de envio…
English narration · English + 中文 subtitles burned in · Narração em inglês · Legendas em inglês + 中文 gravadas
8.1
File-based storage and its limits · Armazenamento baseado em arquivos e seus limites
Syllabus · Programa
English
Candidates should be able to:
Notes and guidance
Show understanding of the limitations of using a file-based approach for the storage and retrieval of data
Describe the features of a relational database that address the limitations of a file-based approach
Show understanding of and use the terminology associated with a relational database model
Utilize um diagrama entidade-relacionamento (E-R) para documentar um projeto de base de dados
Demonstre compreensão do processo de normalização
Primeira Forma Normal (1NF), Segunda Forma Normal (2NF) e Terceira Forma Normal (3NF)
Explique porque um conjunto dado de tabelas de base de dados está ou não em 3NF
Produza um projeto de base de dados normalizado para uma descrição de uma base de dados, um conjunto dado de dados ou um conjunto dado de tabelas
Source: Cambridge International syllabus · Fonte: Programa Cambridge International
English
Before databases, programs stored data in flat files 平面文件 — usually one file per program. This is fine for small data but breaks down at scale.
Limitations
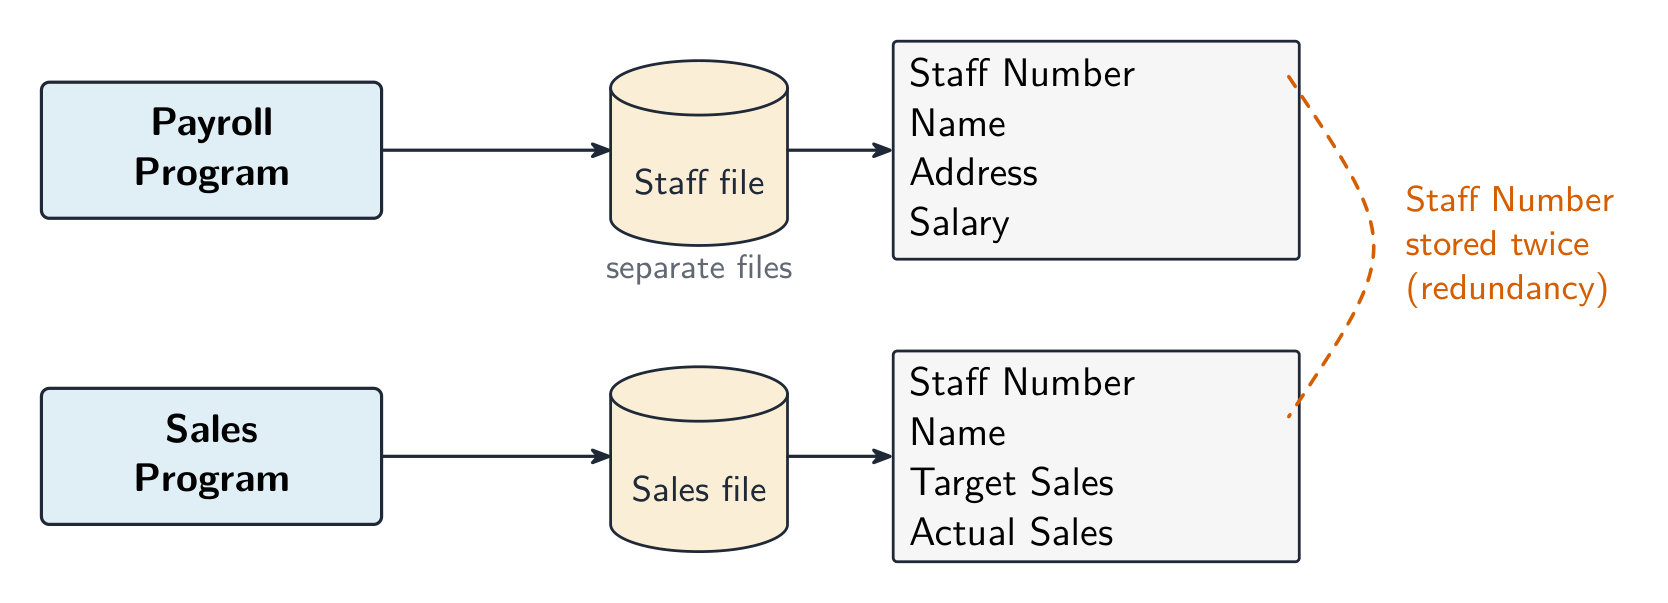
data redundancy 数据冗余 — the same data (a customer's address) is held in several files, one per program, so storage is wasted and every copy must be updated.
data inconsistency 数据不一致 — when one copy is updated and another is not, the files disagree and nobody knows which is right.
data dependence — each program is written for the exact layout of its files; change a field's length or add a field and every program that reads the file must be rewritten.
no shared access — a file is locked while one program uses it, so users cannot work on the data at the same time.
weak integrity 完整性 — no central rules stop an invalid value or a link to a customer who does not exist; weak security — access is per file, not per field; and queries across files need a new program each time.
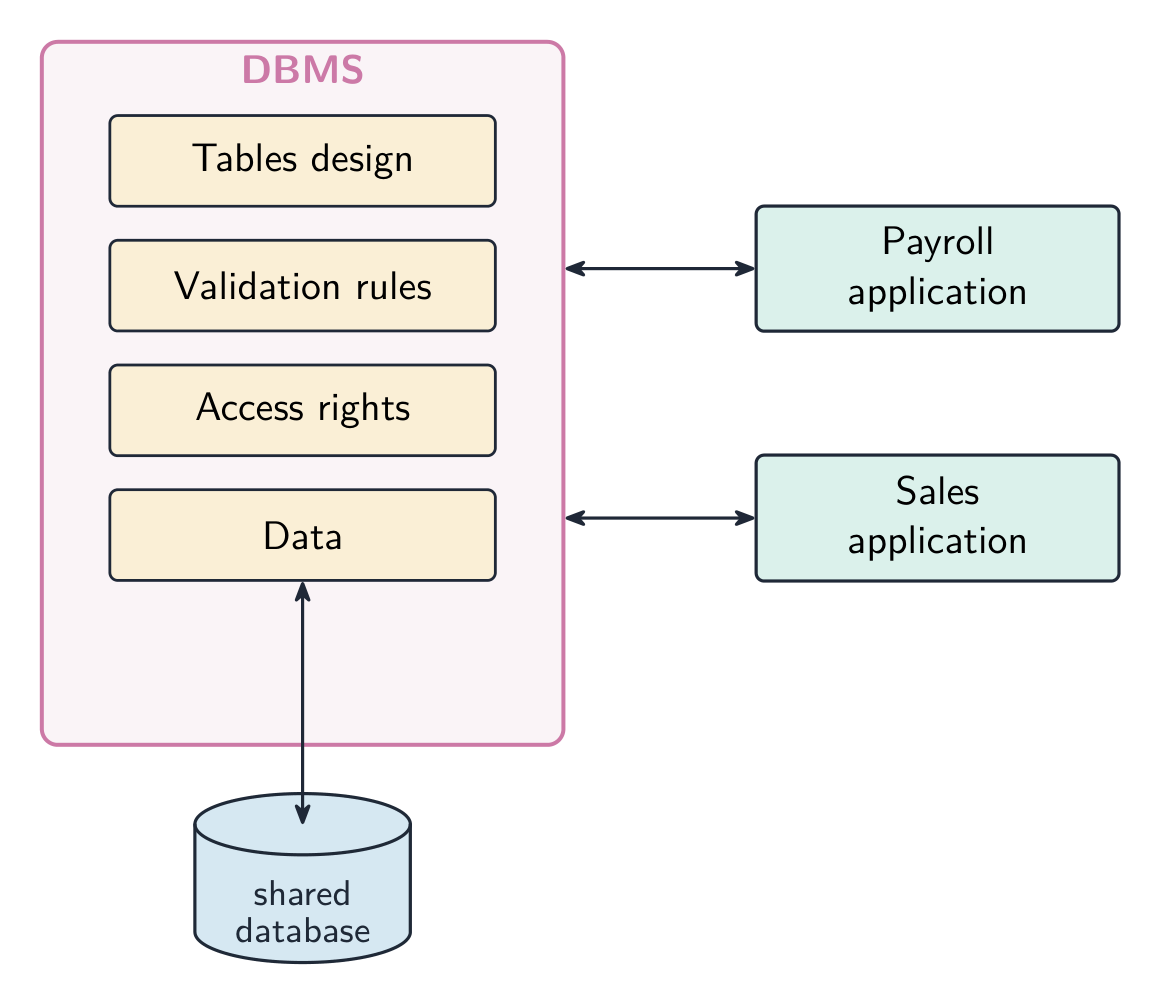
A relational database 关系数据库 fixes these by storing data in tables managed by one piece of software (the DBMS) that all programs use.
Why a relational database is better — the three-mark answer. Each item of data is stored once, in one table, and tables are linked by keys, so there is no redundancy and no inconsistency; the data is independent of the programs, which ask the DBMS for what they need and are unaffected when the structure changes; and the DBMS enforces integrity rules, controls access per user and per field, allows many users at once, and answers any query without a new program being written.
Worked example. A repair shop stores its customers, devices and repair jobs using a file-based approach, one file per program. Give three problems this causes, and describe how a relational database would remove them.
The customer's name and phone number are stored in the repairs file and the invoices file (redundancy); when a customer changes number, one file is updated and the other is not (inconsistency); and when the shop wants a new report — repairs per technician — a new program has to be written to read the files (no ad-hoc queries). In a relational database the customer is stored once in a CUSTOMER table and referred to by CustomerID from the REPAIR table, so a change is made once and is seen everywhere; the report is a single SQL query.
Português
Antes dos bancos de dados, os programas armazenavam dados em arquivos planos 平面文件 — geralmente um arquivo por programa. Isso é fine para pequenos dados, mas falha em escala.
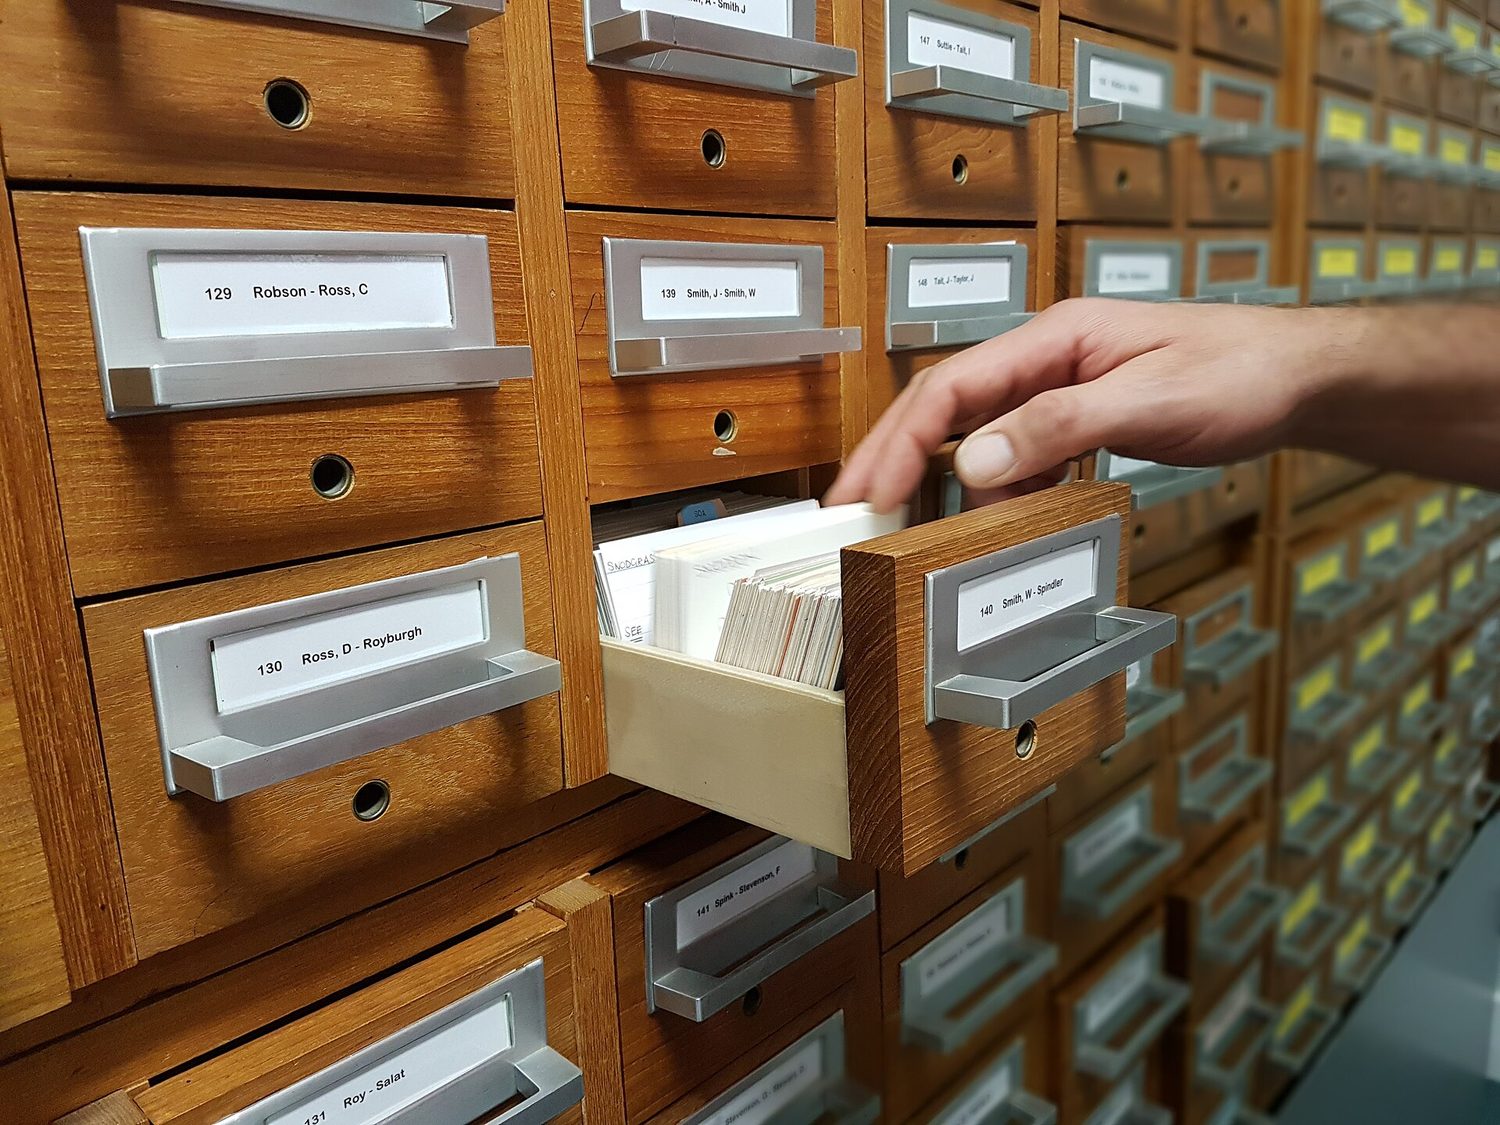
O armazenamento baseado em arquivos mantém dados em arquivos separados, como papéis em um arquivo — difícil de pesquisar e fácil de duplicar
Limitações
redundância de dados 数据冗余 — os mesmos dados (o endereço de um cliente) estão em vários arquivos, um por programa, desperdiçando armazenamento e exigindo atualização de todas as cópias.
inconsistência de dados 数据不一致 — quando uma cópia é atualizada e outra não, os arquivos divergem e ninguém sabe qual está correta.
dependência de dados — cada programa é escrito para o layout exato de seus arquivos; alterar o comprimento de um campo ou adicionar um campo exige reescrever todo programa que lê o arquivo.
sem acesso compartilhado — um arquivo é bloqueado enquanto um programa o usa, impedindo que usuários trabalhem nos dados simultaneamente.
integridade fraca 完整性 — nenhuma regra central impede valores inválidos ou links para clientes inexistentes; segurança fraca — o acesso é por arquivo, não por campo; e consultas entre arquivos exigem um novo programa cada vez.
A abordagem baseada em arquivos: cada programa mantém seus próprios arquivos
Um banco de dados relacional 关系数据库 corrige isso armazenando dados em tabelas gerenciadas por um único software (DBMS) que todos os programas usam.
A abordagem de banco de dados: um DBMS serve a todos os programas
Por que um banco de dados relacional é melhor — a resposta de três pontos. Cada item de dado é armazenado uma única vez, em uma tabela, e as tabelas são ligadas por chaves, não havendo redundância nem inconsistência; os dados são independentes dos programas, que solicitam ao SGBD o que precisam e permanecem inalterados quando a estrutura muda; e o SGBD aplica regras de integridade, controla o acesso por usuário e por campo, permite múltiplos usuários simultaneamente e executa qualquer consulta sem a necessidade de escrever um novo programa.
Exemplo resolvido. Uma oficina armazena seus clientes, dispositivos e serviços de reparo usando uma abordagem baseada em arquivos, com um arquivo por programa. Cite três problemas isso causa e descreva como um banco de dados relacional os eliminaria.
O nome e o número de telefone do cliente estão armazenados no arquivo de reparos e também no arquivo de faturas (redundância); quando um cliente muda de número, um arquivo é atualizado e o outro não (inconsistência); e quando a loja quer um novo relatório — reparos por técnico — um novo programa precisa ser escrito para ler os arquivos (sem consultas ad hoc). Em um banco de dados relacional, o cliente é armazenado uma única vez em uma tabela CUSTOMER e referenciado pelo CustomerID na tabela REPAIR, então a alteração é feita uma única vez e vista em todos os lugares; o relatório é uma única consulta SQL.
Relational model — terms · Modelo relacional — termos
English
table 表 (relation) — a grid of rows and columns; one table per type of entity 实体 (e.g. CUSTOMER).
record 记录 (row, also called a tuple 元组) — one row; one instance of the entity.
field 字段 (column, also called an attribute 属性) — one column; one piece of information about each record.
primary key 主键 — a field (or fields) that uniquely identifies each record; never null or duplicated.
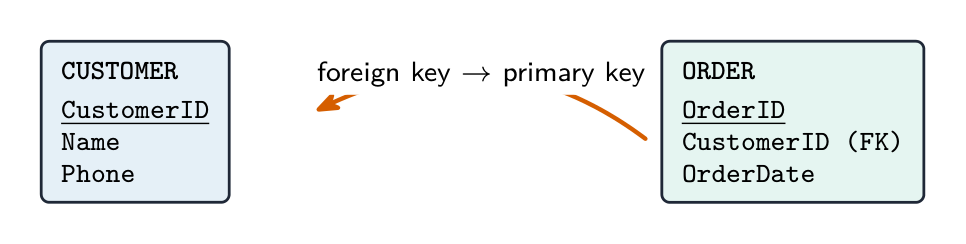
foreign key 外键 — a field whose value matches the primary key of another table, linking the two.
composite key 复合键 — a primary key made of two or more fields together.
candidate key 候选键 — any field(s) that could be the primary key.
secondary key 次键 — a non-primary field that is indexed for fast searching.
indexing 索引 — building an index on a field so look-ups and joins run faster.
referential integrity 参照完整性 — every foreign-key value must match an existing primary key (no orphan records).
A table is written in shorthand with the primary key underlined and foreign keys noted:
Worked example. State what is meant by entity, primary key and referential integrity in a relational database, and complete the term ↔ description table for tuple and attribute.
An entity is something about which data is stored — a person, object or event — which becomes one table. A primary key is the attribute (or combination of attributes) that uniquely identifies each record in a table. Referential integrity means that every foreign-key value must match the value of a primary key in the table it refers to, so a record cannot refer to one that does not exist. A tuple is one row of a table (one record); an attribute is one column (one field). Learn the pairs: table/relation, record/tuple, field/attribute.
Português
tabela 表 (relação) — uma grade de linhas e colunas; uma tabela por tipo de entidade 实体 (ex: CUSTOMER).
registro 记录 (linha, também chamado de tupla 元组) — uma linha; uma instância da entidade.
campo 字段 (coluna, também chamado de atributo 属性) — uma coluna; uma informação sobre cada registro.
chave primária 主键 — um campo (ou campos) que identifica unicamente cada registro; nunca nulo ou duplicado.
chave estrangeira 外键 — um campo cujo valor corresponde à chave primária de outra tabela, ligando as duas.
chave composta 复合键 — uma chave primária formada por dois ou mais campos juntos.
chave candidata 候选键 — qualquer campo(s) que poderia ser a chave primária.
chave secundária 次键 — um campo não primário que é indexado para busca rápida.
indexação 索引 — criar um índice em um campo para que buscas e junções sejam mais rápidas.
integridade referencial 参照完整性 — todo valor de chave estrangeira deve corresponder a uma chave primária existente (nenhum registro órfão).
Uma tabela é escrita em notação resumida com a chave primária sublinhada e chaves estrangeiras anotadas:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Uma chave estrangeira liga duas tabelas: ORDER.CustomerID corresponde à chave primária CUSTOMER.CustomerID
Exemplo resolvido. Explique o significado de entidade, chave primária e integridade referencial em um banco de dados relacional, e complete a tabela de termo ↔ descrição para tupla e atributo.
Uma entidade é algo sobre o qual dados são armazenados — uma pessoa, objeto ou evento — que se torna uma tabela. Uma chave primária é o atributo (ou combinação de atributos) que identifica unicamente cada registro em uma tabela. Integridade referencial significa que todo valor de chave estrangeira deve corresponder ao valor de uma chave primária na tabela a que se refere, para que um registro não possa apontar para um que não existe. Uma tupla é uma linha de uma tabela (um registro); um atributo é uma coluna (um campo). Aprenda os pares: tabela/relação, registro/tupla, campo/atributo.
Explore · Explorar
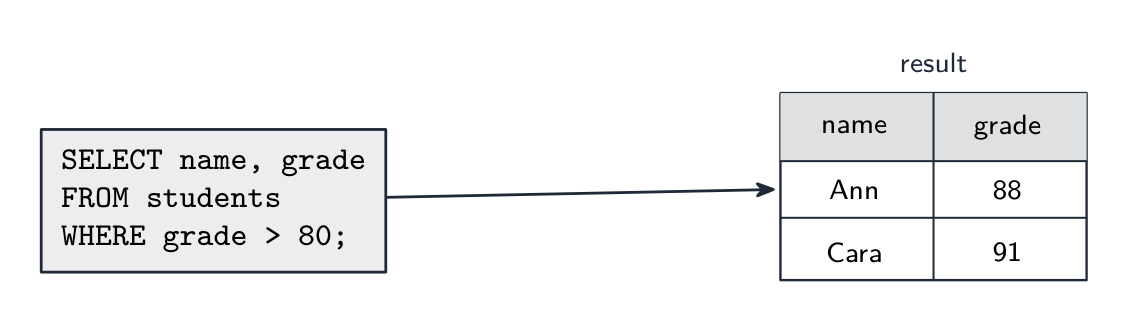
Leia uma tabela relacional com SELECT
Uma tabela relacional é apenas linhas (registros) e colunas (campos). WHERE mantém as linhas que correspondem a uma condição; SELECT então mantém apenas as colunas que você pediu.
Entity-relationship (E-R) diagrams · Diagramas de entidade-relacionamento (E-R)
English
An entity-relationship diagram 实体关系图 shows the structure: each entity is a rectangle, each relationship a line, with the cardinality 基数 marked at each end:
one-to-one (1:1).
one-to-many 一对多 (1:M) — each Customer has many Orders; each Order has one Customer.
many-to-many (M:N) — Students take many Courses, and Courses have many Students.
A many-to-many relationship cannot be stored directly. Break it into two one-to-many relationships through a link table 连接表 holding the two foreign keys:
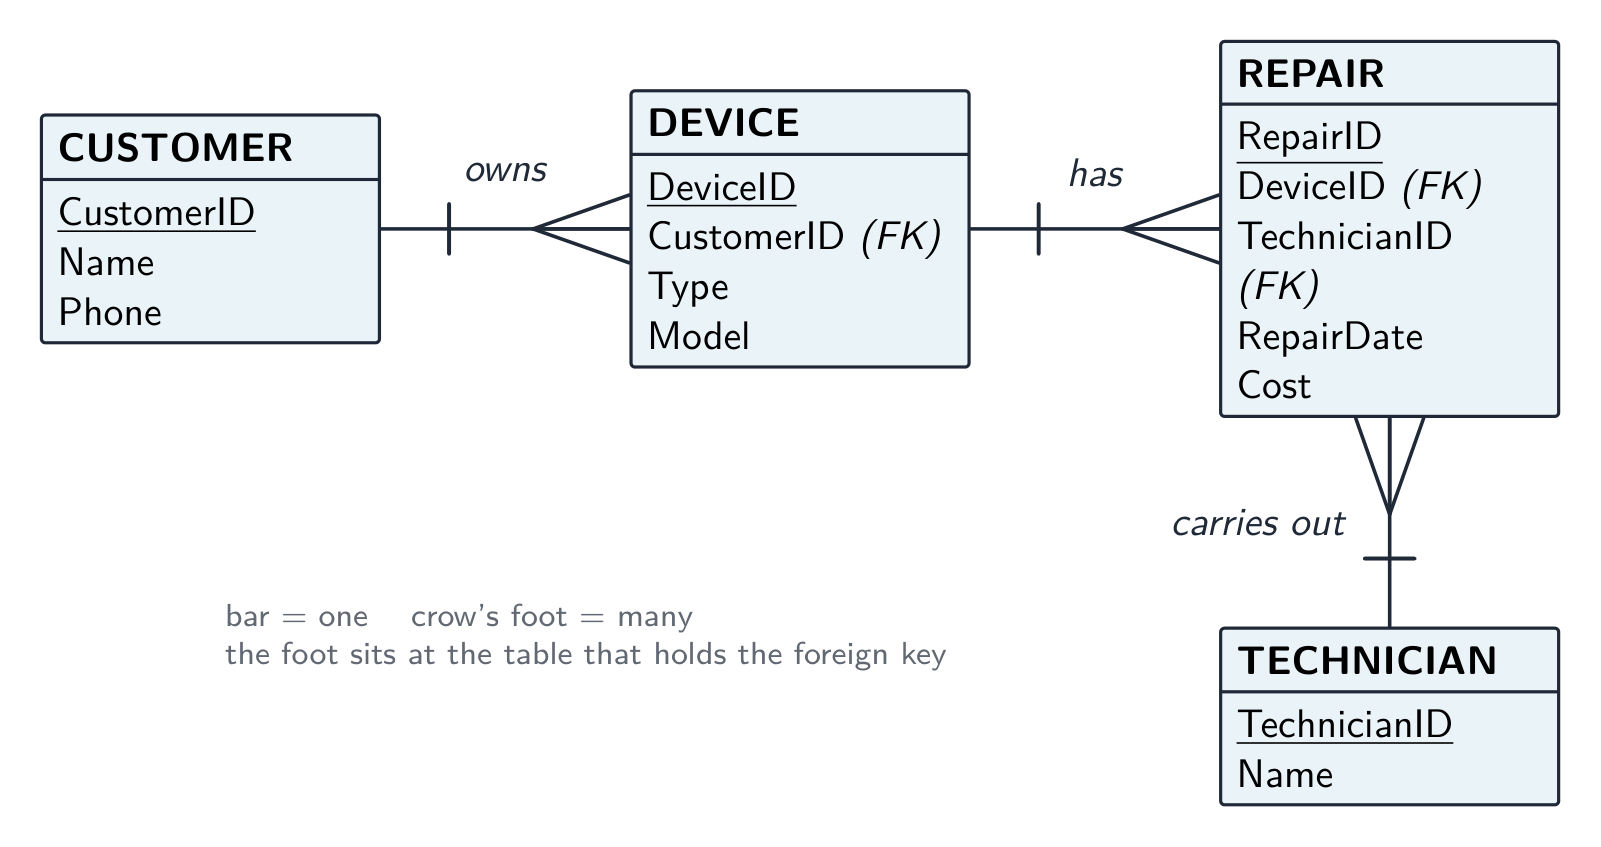
Drawing the E-R diagram for a given set of tables. Each table becomes an entity. A relationship exists wherever one table holds a foreign key to another; it runs from the table holding the foreign key (the many end) to the table whose primary key it is (the one end). A table with two foreign keys and no other identity is usually a link table resolving a many-to-many relationship. Label each line with the relationship type.
Worked example. A repair shop has the tables CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) and REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identify the relationships and their types.
DEVICE holds CustomerID, so CUSTOMER–DEVICE is one-to-many (one customer, many devices). REPAIR holds DeviceID, so DEVICE–REPAIR is one-to-many; it also holds TechnicianID, so TECHNICIAN–REPAIR is one-to-many. There is no direct CUSTOMER–REPAIR line: the link runs through DEVICE. Three lines, three crow's feet, all at the REPAIR or DEVICE ends.
Português
Um diagrama de entidade-relacionamento 实体关系图 mostra a estrutura: cada entidade é um retângulo, cada relacionamento é uma linha, com a cardinalidade 基数 marcada em cada extremidade:
um-para-um (1:1).
um-para-muitos 一对多 (1:M) — cada Cliente tem muitos Pedidos; cada Pedido tem um Cliente.
muitos-para-muitos (M:N) — Estudantes frequentam muitos Cursos, e Cursos têm muitos Estudantes.
Um diagrama E-R: uma classe tem muitos estudantesSímbolos de pé-de-galinha para a cardinalidade de um relacionamento
Um relacionamento muitos-para-muitos não pode ser armazenado diretamente. Divida-o em dois relacionamentos um-para-muitos através de uma tabela de ligação 连接表 contendo as duas chaves estrangeiras:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Uma tabela de ligação resolve um relacionamento muitos-para-muitos em dois relacionamentos um-para-muitos
Desenhando o diagrama E-R para um conjunto dado de tabelas. Cada tabela torna-se uma entidade. Um relacionamento existe sempre que uma tabela contenha uma chave estrangeira para outra; ele vai da tabela que contém a chave estrangeira (a extremidade muitos) para a tabela cuja chave primária ela é (a extremidade um). Uma tabela com duas chaves estrangeiras e nenhuma outra identidade geralmente é uma tabela de ligação resolvendo um relacionamento muitos-para-muitos. Roteie cada linha com o tipo de relacionamento.
Desenhando o diagrama a partir das tabelas: toda chave estrangeira é um relacionamento um-para-muitos, com o "muitos" na tabela que a contém
Exemplo resolvido. Uma oficina possui as tabelas CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) e REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifique os relacionamentos e seus tipos.
DEVICE contém CustomerID, então CUSTOMER–DEVICE é um-para-muitos (um cliente, muitos dispositivos). REPAIR contém DeviceID, então DEVICE–REPAIR é um-para-muitos; também contém TechnicianID, então TECHNICIAN–REPAIR é um-para-muitos. Não há linha direta CUSTOMER–REPAIR: o link passa por DEVICE. Três linhas, três pés-de-galinha, todos nas extremidades REPAIR ou DEVICE.
Normalisation 规范化 organises tables to cut redundancy and inconsistency, going through normal forms 范式 in order.
First normal form (1NF) — every field holds a single (atomic 原子) value, with no repeating groups, and a primary key.
Second normal form (2NF) — in 1NF, and every non-key field depends on the whole primary key (only matters for a composite key).
Third normal form (3NF) — in 2NF, and every non-key field depends only on the primary key, not on another non-key field (no transitive dependency 传递依赖).
A 3NF design stores each fact once, so insert/update/delete anomalies disappear. The trade-off is more tables and more joins. Aim for 3NF.
To produce a 3NF design: find the entities and their attributes; choose a primary key for each; split repeating/non-atomic fields (1NF); split fields depending on part of a composite key (2NF); split fields depending transitively on the key (3NF); add foreign keys for the relationships.
Worked example. The table ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) has the composite primary key (OrderID, ProductID). Normalise it to 3NF. Test each non-key field against the key. Quantity depends on bothOrderID and ProductID, which is fine. But CustomerID depends on OrderID alone - only part of the composite key. That is a partial dependency, so the table is not in 2NF. Split it into ORDER_LINE(OrderID, ProductID, Quantity) and ORDER(OrderID, CustomerID, CustomerName). Now test 3NF: in that new ORDER table, CustomerName depends on CustomerID, which is not the key - a transitive dependency. Split again: ORDER(OrderID, CustomerID) and CUSTOMER(CustomerID, CustomerName). Name the dependency that breaks each form (partial breaks 2NF, transitive breaks 3NF); "it has repeated data" describes the symptom and earns nothing.
The three questions to ask of any table.Is every cell a single value, with no repeating group? If not, it is not in 1NF. If the key is composite, does every non-key field depend on the whole key? If some field depends on part of it, there is a partial dependency 部分依赖 and the table is not in 2NF. Does every non-key field depend on the key alone? If a field depends on another non-key field, there is a transitive dependency and the table is not in 3NF. An "explain why the table is not in 3NF" answer names the dependency and the fields involved.
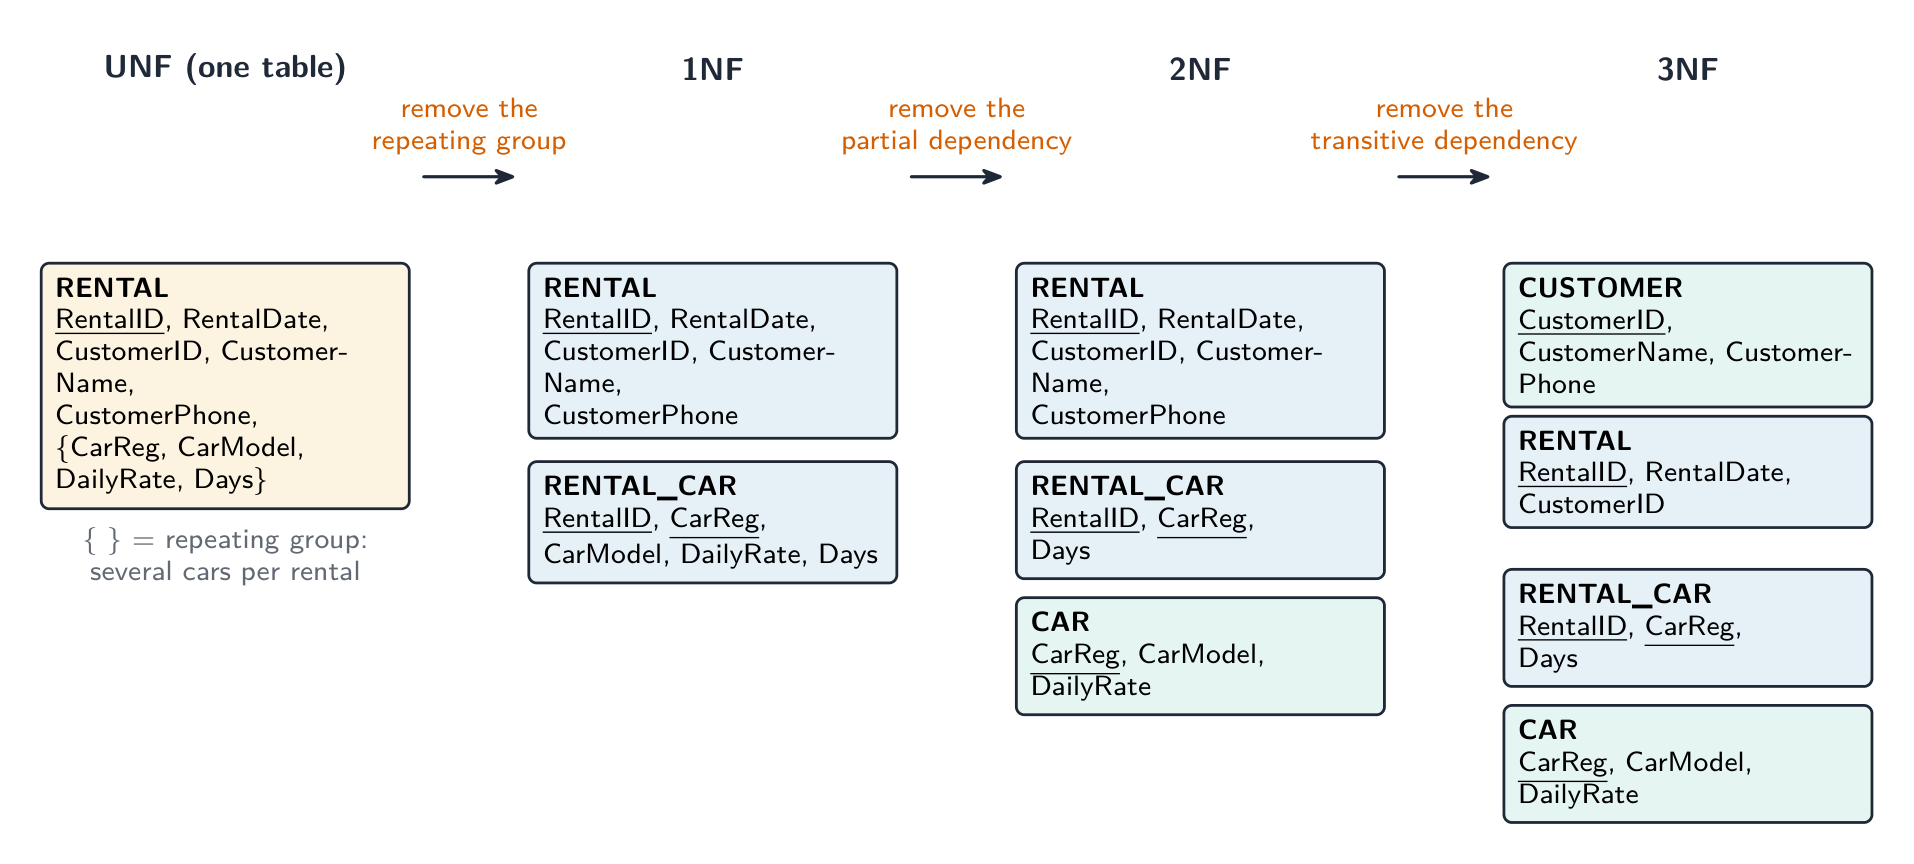
Worked example. A car-rental shop records each rental as RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), where one rental can include several cars. Explain why the table is not normalised and produce a 3NF design.
Not in 1NF: the car fields CarReg, CarModel, DailyRate, Days form a repeating group — one rental has several cars. Move them to RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) with the composite key (RentalID, CarReg). Not in 2NF: in RENTAL_CAR, CarModel and DailyRate depend on CarReg alone — a partial dependency. Move them to CAR(CarReg, CarModel, DailyRate), leaving RENTAL_CAR(RentalID, CarReg, Days). Not in 3NF: in RENTAL, CustomerName and CustomerPhone depend on CustomerID, a non-key field — a transitive dependency. Move them to CUSTOMER(CustomerID, CustomerName, CustomerPhone), leaving RENTAL(RentalID, RentalDate, CustomerID). The 3NF design is four tables — CUSTOMER, RENTAL, RENTAL_CAR, CAR — with CustomerID, RentalID and CarReg as foreign keys; underline every primary key.
Português
Normalização 规范化 organiza tabelas para reduzir redundância e inconsistência, passando pelas formas normais 范式 em ordem.
Primeira forma normal (1NF) — cada campo contém um único valor (atômico 原子), sem grupos repetidos, e possui uma chave primária.
Segunda forma normal (2NF) — em 1NF, e cada campo não-chave depende da totalidade da chave primária (importa apenas para uma chave composta).
Terceira forma normal (3NF) — em 2NF, e cada campo não-chave depende apenas da chave primária, não de outro campo não-chave (não há dependência transitiva 传递依赖).
Um design 3NF armazena cada fato uma única vez, assim anomalias de inserção/atualização/exclusão desaparecem. A contrapartida é mais tabelas e mais junções. Almeje 3NF.
Para produzir um design 3NF: encontre as entidades e seus atributos; escolha uma chave primária para cada; divida campos repetidos/não-atômicos (1NF); divida campos que dependem de parte de uma chave composta (2NF); divida campos que dependem transitivamente da chave (3NF); adicione chaves estrangeiras para os relacionamentos.
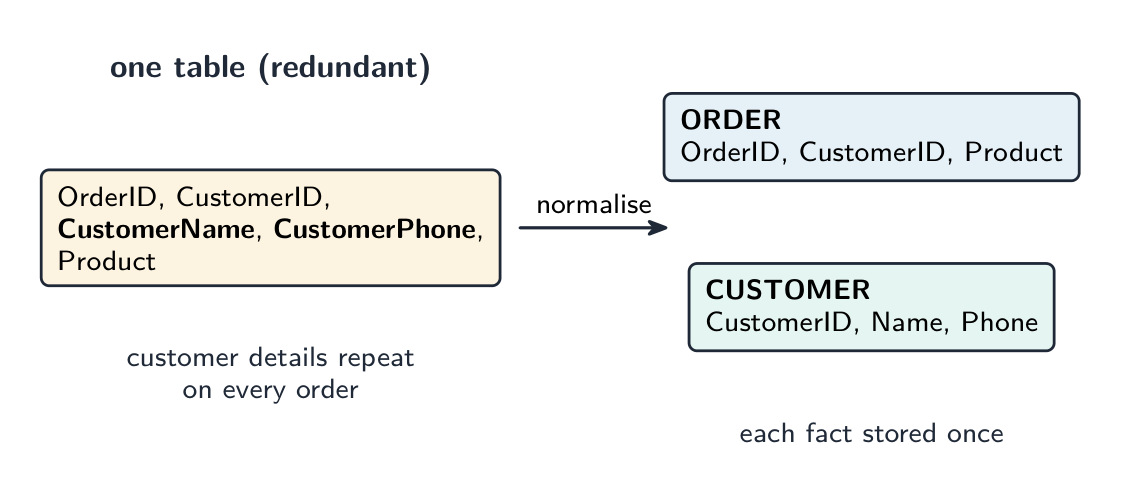
A normalização remove a redundância dividindo dados repetidos em sua própria tabela
Exemplo resolvido. A tabela ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) tem a chave primária composta (OrderID, ProductID). Normalize-a para 3NF. Teste cada campo não-chave contra a chave. Quantity depende de ambosOrderID e ProductID, o que está correto. Mas CustomerID depende de OrderID sozinho - apenas parte da chave composta. Isso é uma dependência parcial, então a tabela não está em 2NF. Divida-a em ORDER_LINE(OrderID, ProductID, Quantity) e ORDER(OrderID, CustomerID, CustomerName). Agora teste 3NF: naquela nova tabela ORDER, CustomerName depende de CustomerID, que não é a chave - uma dependência transitiva. Divida novamente: ORDER(OrderID, CustomerID) e CUSTOMER(CustomerID, CustomerName). Nomeie a dependência que viola cada forma (parcial viola 2NF, transitiva viola 3NF); "ela tem dados repetidos" descreve o sintoma e não ganha pontos.
As três perguntas para fazer a qualquer tabela.Cada célula tem um único valor, sem grupo repetido? Se não, não está em 1NF. Se a chave for composta, todo campo não-chave depende da chave inteira? Se algum campo depender de parte dela, há uma dependência parcial 部分依赖 e a tabela não está em 2NF. Todo campo não-chave depende apenas da chave? Se um campo depender de outro campo não-chave, há uma dependência transitiva e a tabela não está em 3NF. Uma resposta "explique por que a tabela não está em 3NF" nomeia a dependência e os campos envolvidos.
1NF remove o grupo repetido, 2NF a dependência parcial, 3NF a dependência transitiva
Exemplo resolvido. Uma loja de aluguel de carros registra cada aluguel como RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), onde um aluguel pode incluir vários carros. Explique por que a tabela não está normalizada e produza um design 3NF.
Não em 1NF: os campos de carro CarReg, CarModel, DailyRate, Days formam um grupo repetido — um aluguel tem vários carros. Mova-os para RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) com a chave composta (RentalID, CarReg). Não em 2NF: em RENTAL_CAR, CarModel e DailyRate dependem de CarReg sozinho — uma dependência parcial. Mova-os para CAR(CarReg, CarModel, DailyRate), deixando RENTAL_CAR(RentalID, CarReg, Days). Não em 3NF: em RENTAL, CustomerName e CustomerPhone dependem de CustomerID, um campo não-chave — uma dependência transitiva. Mova-os para CUSTOMER(CustomerID, CustomerName, CustomerPhone), deixando RENTAL(RentalID, RentalDate, CustomerID). O design 3NF é quatro tabelas — CUSTOMER, RENTAL, RENTAL_CAR, CAR — com CustomerID, RentalID e CarReg como chaves estrangeiras; sublinhe todas as chaves primárias.
Database Management System (DBMS) · Sistema de Gerenciamento de Banco de Dados (DBMS)
Syllabus · Programa
English
Candidates should be able to:
Notes and guidance
Show understanding of the features provided by a Database Management System (DBMS) that address the issues of a file based approach
Including: • data management, including maintaining a data dictionary • data modelling • logical schema • data integrity • data security, including backup procedures and the use of access rights to individuals / groups of users
Show understanding of how software tools found within a DBMS are used in practice
Including the use and purpose of: • developer interface • query processor
Português
Os candidatos devem ser capazes de:
Notas e orientações
Demonstre compreensão das funcionalidades fornecidas por um Sistema de Gestão de Bases de Dados (DBMS) que abordam as questões de uma abordagem baseada em ficheiros
Incluindo: • gestão de dados, incluindo manutenção de um dicionário de dados • modelação de dados • esquema lógico • integridade de dados • segurança de dados, incluindo procedimentos de cópia de segurança e uso de direitos de acesso para indivíduos/grupos de utilizadores
Demonstre compreensão de como ferramentas de software encontradas num DBMS são utilizadas na prática
Incluindo o uso e propósito de: • interface de desenvolvedor • processador de consultas
Source: Cambridge International syllabus · Fonte: Programa Cambridge International
English
A DBMS 数据库管理系统 manages the database centrally. Features that fix the file-based limits:
data dictionary 数据字典 — a description of every table, field, type and key; programs query it instead of hard-coding the structure.
redundancy/consistency control — each fact stored once.
concurrent access 并发访问 control — locks and transactions let many users work at once.
backup 备份 and recovery; security and per-user permissions.
integrity rules — keys, unique and range constraints, enforced centrally.
transactions 事务 — a group of operations that all succeed or all fail.
views 视图 — virtual tables that show each user "their" slice of the data.
data management 数据管理 and data modelling 数据建模 — control how data is stored and define its structure as a logical schema 逻辑模式 (the logical design, independent of physical storage).
data integrity 数据完整性 and data security 数据安全 — enforce correctness and control access centrally.
a query processor 查询处理器 runs queries; a developer interface 开发者接口 gives tools and APIs for building applications.
Its tools include a data-dictionary editor, a query builder, a forms builder, a report generator, user management, and an SQL editor.
What the data dictionary holds (a "give three items" question): the names of the tables; the names of the fields in each table; each field's data type and length; the primary and foreign keys and the relationships between tables; validation rules; indexes; and who may access each table. It is metadata — data about the data — and the DBMS uses it to check every query and every change.
How the DBMS keeps the data secure (a "describe two methods" question): authentication 身份验证 — a username and password, or a biometric, before any access; access rights — each user or group is allowed to read, write or delete only certain tables or fields, often through a view; encryption of the stored data and of data sent to it, so a copied file is unreadable; backups taken regularly, so the data can be restored after loss; and a transaction log that records who changed what.
The two software tools. The developer interface is what a programmer uses to build the database and the applications on it: create tables and set keys and validation, write queries and SQL, and design forms and reports, without knowing how the data is physically stored. The query processor takes a query (SQL from a program, or a query built in the interface), checks it against the data dictionary, works out the most efficient way to run it, retrieves the data and returns the results.
Logical schema. The DBMS keeps the logical design (which tables and fields exist and how they relate) separate from the physical storage (files, indexes, disk blocks). Programs work with the logical schema, so the physical storage can be reorganised without changing a single program — this is the data independence the file-based approach lacked.
Português
Um SGBD 数据库管理系统 gerencia o banco de dados centralmente. Funcionalidades que corrigem os limites baseados em arquivos:
dicionário de dados 数据字典 — uma descrição de cada tabela, campo, tipo e chave; programas consultam-no em vez de codificar a estrutura fixamente.
controle de redundância/consistência — cada fato armazenado uma única vez.
controle de acesso concorrente 并发访问 — bloqueios e transações permitem que muitos usuários trabalhem simultaneamente.
backup 备份 e recuperação; segurança e permissões por usuário.
regras de integridade — chaves, restrições de unicidade e intervalo, aplicadas centralmente.
transactions 事务 — um grupo de operações em que todas têm sucesso ou todas falham.
views 视图 — tabelas virtuais que mostram a cada usuário "sua" fatia dos dados.
data management 数据管理 e data modelling 数据建模 — controlam como os dados são armazenados e definem sua estrutura como um logical schema 逻辑模式 (o projeto lógico, independente do armazenamento físico).
data integrity 数据完整性 e data security 数据安全 — impõem correção e controlam o acesso centralmente.
um query processor 查询处理器 executa consultas; uma developer interface 开发者接口 fornece ferramentas e APIs para construir aplicativos.
Suas ferramentas incluem um editor de dicionário de dados, um construtor de consultas, um construtor de formulários, um gerador de relatórios, gerenciamento de usuários e um editor SQL.
O que o dicionário de dados armazena (uma questão "listar três itens"): os nomes das tabelas; os nomes dos campos em cada tabela; o tipo de dado e o comprimento de cada campo; as chaves primárias e estrangeiras e os relacionamentos entre tabelas; regras de validação; índices; e quem pode acessar cada tabela. É metadado — dados sobre os dados — e o DBMS o usa para verificar cada consulta e cada alteração.
Como o DBMS mantém os dados seguros (uma questão "descrever dois métodos"): authentication 身份验证 — um nome de usuário e senha, ou biométrico, antes de qualquer acesso; access rights — cada usuário ou grupo tem permissão para ler, escrever ou excluir apenas certas tabelas ou campos, muitas vezes através de uma view; encryption dos dados armazenados e dos dados enviados a eles, para que um arquivo copiado seja ilegível; backups feitos regularmente, para que os dados possam ser restaurados após perda; e um log de transações que registra quem alterou o quê.
As duas ferramentas de software. A developer interface é o que um programador usa para construir o banco de dados e os aplicativos sobre ele: criar tabelas e definir chaves e validações, escrever consultas e SQL, e projetar formulários e relatórios, sem saber como os dados são armazenados fisicamente. O query processor recebe uma consulta (SQL de um programa ou uma consulta construída na interface), verifica-a contra o dicionário de dados, determina a maneira mais eficiente de executá-la, recupera os dados e retorna os resultados.
Logical schema. O DBMS mantém o projeto lógico (quais tabelas e campos existem e como se relacionam) separado do physical storage (arquivos, índices, blocos de disco). Os programas trabalham com o schema lógico, para que o armazenamento físico possa ser reorganizado sem alterar um único programa — esta é a independência de dados que a abordagem baseada em arquivos não possuía.
O armazenamento físico que o schema lógico esconde: pratos girantes e cabeça de leitura/escrita de um disco rígido
Explore · Explorar
Laboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
Explore · Explorar
Laboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
Show understanding that the DBMS carries out all creation/modification of the database structure using its Data Definition Language (DDL)
Show understanding that the DBMS carries out all queries and maintenance of data using its DML
Show understanding that the industry standard for both DDL and DML is Structured Query Language (SQL)
Understand a given SQL statement
Understand given SQL (DDL) statements and be able to write simple SQL (DDL) statements using a sub-set of statements
Create a database (CREATE DATABASE) Create a table definition (CREATE TABLE), including the creation of attributes with appropriate data types: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME change a table definition (ALTER TABLE) add a primary key to a table (PRIMARY KEY (field)) add a foreign key to a table (FOREIGN KEY (field) REFERENCES Table (Field))
Write an SQL script to query or modify data (DML) which are stored in (at most two) database tables
Queries including SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG
Data maintenance including INSERT INTO, DELETE FROM, UPDATE
Português
Os candidatos devem ser capazes de:
Notas e orientações
Demonstre compreensão de que o DBMS realiza toda a criação/modificação da estrutura da base de dados utilizando sua Linguagem de Definição de Dados (DDL)
Demonstre compreensão de que o DBMS realiza todas as consultas e manutenção de dados utilizando seu DML
Demonstre compreensão de que o padrão da indústria para ambos DDL e DML é a Structured Query Language (SQL)
Compreenda uma declaração SQL dada
Compreenda declarações SQL dadas (DDL) e seja capaz de escrever simples declarações SQL (DDL) usando um subconjunto de declarações
Criar uma base de dados (CREATE DATABASE) Criar uma definição de tabela (CREATE TABLE), incluindo a criação de atributos com tipos de dados adequados: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Alterar uma definição de tabela (ALTER TABLE) Adicionar uma chave primária a uma tabela (PRIMARY KEY (field)) Adicionar uma chave estrangeira a uma tabela (FOREIGN KEY (field) REFERENCES Table (Field))
Escreva um script SQL para consultar ou modificar dados (DML) armazenados em (no máximo duas) tabelas de base de dados
Consultas incluindo SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG
Manutenção de dados incluindo INSERT INTO, DELETE FROM, UPDATE
Source: Cambridge International syllabus · Fonte: Programa Cambridge International
English
SQL 结构化查询语言 (Structured Query Language) has two halves:
Data Definition Language 数据定义语言 (DDL) — creates or changes the structure (tables, keys, constraints).
Data Manipulation Language 数据操纵语言 (DML) — works with the data (insert, update, delete, query 查询).
DDL basics
Add a foreign key:
Modify and drop:
Common types: INTEGER, REAL, VARCHAR(n), CHAR(n) (also CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
DML basics
Query with SELECT:
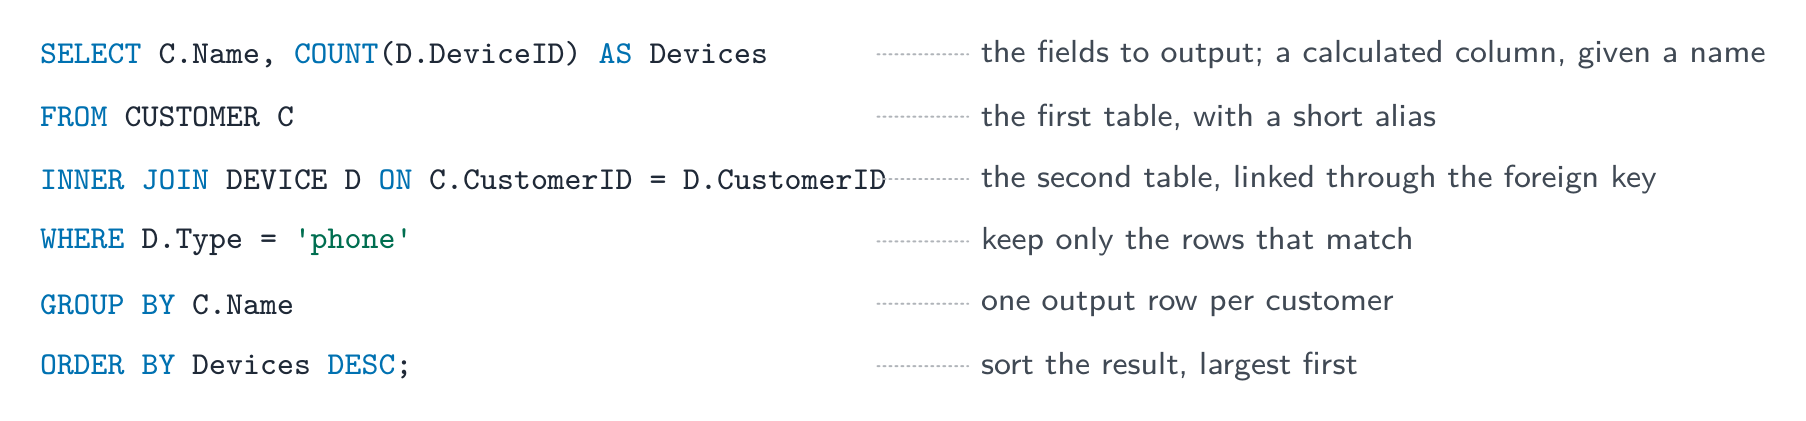
SELECT lists fields, FROM names the table, WHERE filters rows, ORDER BY sorts.
A join 连接 combines two tables using a foreign-key relationship:
Aggregate functions 聚合函数 (COUNT, SUM, AVG, MIN, MAX) are often used with GROUP BY:
Insert, update, delete:
Always put a WHERE clause on UPDATE and DELETE, or the change hits every row.
Tips for exam SQL
use the exact table and field names from the question.
quote strings with single quotes ('Smith'); don't quote numbers.
comparisons: =, <, >, <=, >=, <>.
LIKE 'A%' matches anything starting with A (% = any string, _ = one character); IN (1,2,3); BETWEEN 10 AND 20.
combine conditions with AND / OR / NOT, and end each statement with a semicolon.
The DDL pattern the exam wants. Every CREATE TABLE names each field with its type, marks the primary key, and declares each foreign key with the table it references; a composite key is declared on its own line:
Worked example. Using CUSTOMER(CustomerID, Name, Phone) and DEVICE(DeviceID, CustomerID, Type, Model), write SQL scripts to: (a) list the name and phone number of every customer who owns a device of type 'tablet', in alphabetical order of name; (b) count the devices of each type; (c) record that customer 17 now has the phone number '0771 234 5678'; (d) add a new device, ID 305, a 'laptop' of model 'X1' belonging to customer 17.
(a)
(b)
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Marks are given per clause — the fields, the tables, the join condition, the WHERE, the ORDER BY — so a script with one wrong clause still scores the rest. Write Table.Field whenever two tables are involved.
Worked example. Explain what this script does: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
It outputs each technician's name with the total cost of the repairs that technician has carried out, one row per technician: the two tables are joined on TechnicianID, the rows are grouped by name, and the costs in each group are added. When asked what a script does, describe the result, not the syntax.
Português
SQL 结构化查询语言 (Structured Query Language) possui duas partes:
DDL constrói a estrutura do banco de dados; DML trabalha com os dados
Data Definition Language 数据定义语言 (DDL) — cria ou altera a estrutura (tabelas, chaves, restrições).
Data Manipulation Language 数据操纵语言 (DML) — trabalha com os dados (inserir, atualizar, excluir, query 查询).
Noções básicas de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Uma consulta SELECT retorna apenas as linhas que correspondem à sua condição
SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT lista campos, FROM nomeia a tabela, WHERE filtra linhas, ORDER BY ordena.
Um join 连接 combina duas tabelas usando um relacionamento de chave estrangeira:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
As partes de uma consulta, na ordem em que devem ser escritas
Funções agregadas 聚合函数 (COUNT, SUM, AVG, MIN, MAX) são frequentemente usadas com GROUP BY:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
Inserir, atualizar, excluir:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Sempre coloque uma cláusula WHERE em UPDATE e DELETE, ou a alteração atingirá todas as linhas.
Dicas para SQL de exame
use exatamente os nomes de tabela e campo da questão.
cite strings com aspas simples ('Smith'); não cite números.
comparações: =, <, >, <=, >=, <>.
LIKE 'A%' corresponde a tudo que começa com A (% = qualquer string, _ = um caractere); IN (1,2,3); BETWEEN 10 AND 20.
combine condições com AND / OR / NOT, e termine cada statement com ponto e vírgula.
O padrão DDL que o exame quer. Cada CREATE TABLE nomeia cada campo com seu tipo, marca a chave primária e declara cada chave estrangeira com a tabela que ela referencia; uma chave composta é declarada em sua própria linha:
Exemplo resolvido. Usando CUSTOMER(CustomerID, Name, Phone) e DEVICE(DeviceID, CustomerID, Type, Model), escreva scripts SQL para: (a) listar o nome e o número de telefone de todo cliente que possui um dispositivo do tipo 'tablet', em ordem alfabética de nome; (b) contar os dispositivos de cada tipo; (c) registrar que o cliente 17 agora tem o número de telefone '0771 234 5678'; (d) adicionar um novo dispositivo, ID 305, um 'laptop' do modelo 'X1' pertencente ao cliente 17.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Pontuação é dada por cláusula — os campos, as tabelas, a condição de join, o WHERE, o ORDER BY — então um script com uma cláusula errada ainda pontua o resto. Escreva Table.Field sempre que duas tabelas estiverem envolvidas.
Exemplo resolvido. Explique o que este script faz: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
Um join combina linhas onde a chave estrangeira é igual à chave primária — aqui Orders.CustomerID = Customer.CustomerID — e une cada par correspondente em uma linha mais larga.
Explore · Explorar
SELECT … WHERE
Passe por uma consulta: WHERE mantém as linhas que correspondem, então SELECT escolhe as colunas que você pediu.
Define the terms exactly: entity, attribute, primary key, foreign key, and the relationship types (1:1, 1:many, many:many).
Give a reason at each normal form: 1NF (no repeating groups), 2NF (no partial dependency), 3NF (no non-key dependency) — and name the fields involved.
Explain what a DBMS provides (data independence, security, integrity, concurrent access, a data dictionary, a developer interface, a query processor).
Distinguish DDL (define the structure) from DML (query and change the data), and write SQL clause by clause: SELECT, FROM, INNER JOIN … ON, WHERE, GROUP BY, ORDER BY.
To draw an E-R diagram from tables, find each foreign key first: every foreign key is one one-to-many relationship, with the "many" at the table that holds it.
Common mistakes
Drawing a many-to-many relationship directly. It must be split into two one-to-many relationships through a link table holding both foreign keys.
Explaining "not in 3NF" by "the data is repeated". Name the dependency (partial or transitive) and the fields involved.
Double quotes round strings in SQL, or quotes round numbers. Strings take 'single quotes'; numbers take none.
Leaving out the ON condition after INNER JOIN. Without it the two tables are not linked.
Putting an ordinary field next to COUNT or SUM in a SELECT without a GROUP BY.
UPDATE or DELETE without a WHERE. It changes or removes every row in the table.
Português
Defina os termos exatamente: entity, attribute, primary key, foreign key, e os tipos de relacionamento (1:1, 1:muitos, muitos:muitos).
Dê uma razão em cada forma normal: 1NF (sem grupos repetidos), 2NF (sem dependência parcial), 3NF (sem dependência não-chave) — e nomeie os campos envolvidos.
Explique o que um DBMS fornece (independência de dados, segurança, integridade, acesso simultâneo, um dicionário de dados, uma interface de desenvolvedor, um processador de consultas).
Distinga DDL (definir a estrutura) de DML (consultar e alterar os dados), e escreva cláusulas SQL uma por uma: SELECT, FROM, INNER JOIN … ON, WHERE, GROUP BY, ORDER BY.
Para desenhar um diagrama E-R a partir de tabelas, encontre primeiro cada chave estrangeira: toda chave estrangeira representa um relacionamento de um-para-muitos, com o "muitos" na tabela que a contém.
Erros comuns
Desenhar um relacionamento de muitos-para-muitos diretamente. Ele deve ser dividido em dois relacionamentos de um-para-muitos através de uma tabela de ligação contendo ambas as chaves estrangeiras.
Explicando "não em 3NF" como "os dados estão repetidos". Nomeie a dependência (parcial ou transitiva) e os campos envolvidos.
Aspas duplas em torno de strings no SQL, ou aspas em torno de números. Strings levam 'single quotes'; números não levam nada.
Deixar de fora a condição ON depois de INNER JOIN. Sem ela, as duas tabelas não estão ligadas.
Colocar um campo comum ao lado de COUNT ou SUM em um SELECT sem um GROUP BY.
UPDATE ou DELETE sem um WHERE. Ela altera ou remove todas as linhas da tabela.
Interactive lessons on this topic · Aulas interativas sobre este tópico
Work through it step by step, with instant-check exercises. · Passe por ele passo a passo, com exercícios de verificação instantânea.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Escolha uma e o site te seguirá — notas, provas, vídeos e prática abrirão nela.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Digite para pesquisar notas, aulas, código, vocabulário e questões de provas anteriores em todas as disciplinas.