| Os candidatos devem ser capazes de: | Notas e orientações |
|---|---|
| Demonstrar compreensão das magnitudes binárias e da diferença entre prefixos binários e prefixos decimais | Compreender a diferença entre e usar: • kibi e kilo • mebi e mega • gibi e giga • tebi e tera |
| Demonstrar compreensão de diferentes sistemas numéricos | Usar as bases numéricas binário, decimal e hexadecimal e a representação Decimal Codificado por BCD (BCD), complemento de um e complemento de dois para números binários |
| Converter um valor inteiro de uma base numérica/representação para outra | |
| Realizar adição e subtração binária | Usando inteiros binários positivos e negativos |
| Demonstrar compreensão de como pode ocorrer o transbordamento | |
| Descrever aplicações práticas onde são usados Decimal Codificado por BCD (BCD) e Hexadecimal | |
| Demonstrar compreensão e ser capaz de representar dados de caracteres na sua forma binária interna, dependendo do conjunto de caracteres usado | Os alunos devem estar familiarizados com ASCII (American Standard Code for Information Interchange), ASCII estendido e Unicode. Não se espera que memorizem códigos de caracteres específicos |
Dicas
A-Level Computer Science (9618) é duas metades que parecem matérias diferentes. A metade de teoria vai desde representação de informação e comunicação através de hardware, processadores, software de sistema, segurança, bancos de dados e ética. A metade prática é algoritmos, estruturas de dados, programação e desenvolvimento de software, e o A2 adiciona recursão e programação orientada a objetos.
Os papers de teoria são marcados muito mais literalmente do que os estudantes esperam. Há um vocabulário correto — nomes de registradores, modos de endereçamento, formas normais, a diferença exata entre validação e verificação — e uma paráfrase geralmente pontua nada. Aprenda as definições na redação do syllabus.
Os papers de programação recompensam escrever código à mão até que compile na sua cabeça.
-
1
Representação de informações
Assistir aula1.1
Sistemas numéricos

Programa
Fonte: Programa Cambridge International
Contagem em binário: 0 a 15 Os três sistemas numéricos 数制 que deve dominar:
- decimal 十进制 (base 10) — usa dígitos 0–9. Os lugares valoriais são potências de dez.
- binário 二进制 (base 2) — usa 0 e 1. Os lugares valoriais são potências de dois. Cada byte 字节 tem 8 bits 位.
- hexadecimal 十六进制 (base 16) — usa 0–9 seguidos de A–F para 10–15. Cada dígito hexadecimal representa exatamente 4 bits.
Um abaco representa números por lugar valorial — a mesma ideia subjacente ao decimal, binário e hexadecimal Conversões
Decimal → binário: continue a dividir por 2 e registe os restos, lendo de baixo para cima. Ou subtraia o maior lugar valorial 位值 (potência de 2) que couber.
Exemplo: $558_{10}$: $558 = 512 + 32 + 8 + 4 + 2 = 2^{9} + 2^{5} + 2^{3} + 2^{2} + 2^{1}$. Em 12 bits:
0010 0010 1110.Binário → hexadecimal: agrupe os bits em nibbles 半字节 (4 bits) da direita para a esquerda e converta cada um.
0010 0010 1110→2 2 E→22E.Hexadecimal → binário: substitua cada dígito hexadecimal por seu padrão de 4 bits. Hexadecimal → decimal: multiplique cada dígito por seu valor posicional.
22E$= 2 \times 256 + 2 \times 16 + 14 = 558$.Exemplo resolvido. Converta o decimal 200 para binário de 8 bits, depois para hexadecimal.
$200 = 128 + 64 + 8$, então o binário é
11001000. Em nibbles,11001000$= 12$ e $8$, ou seja, $\text{C}$ e $8$, então o hexadecimal éC8.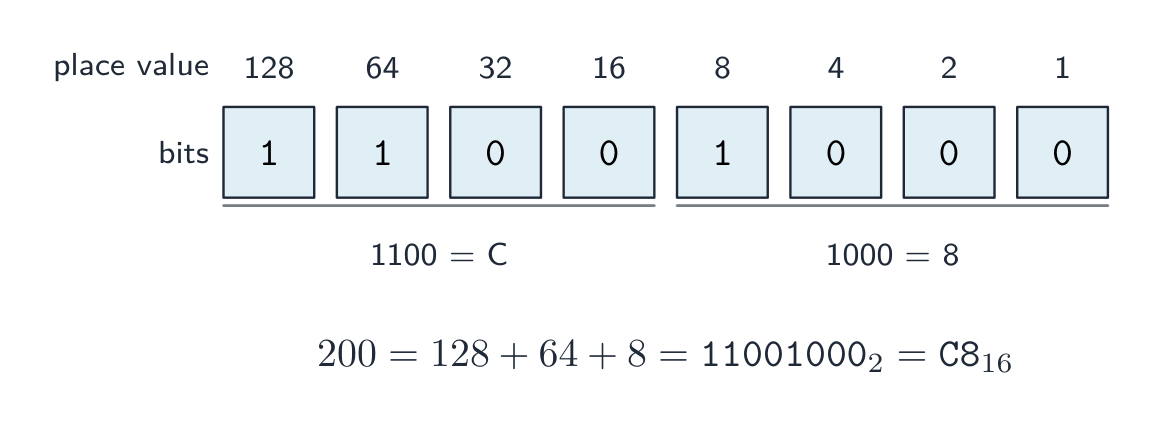
Ler 200 pelos seus lugares valoriais, depois agrupar os bits em meios bytes para obter hex C8 Quantos bits?
As questões de exame fixam a largura do registrador 寄存器宽度 (8, 12 ou 16 bits). Preencha com zeros à esquerda até essa largura: $558$ em 12 bits é
0010 0010 1110, nunca10 0010 1110.Para encontrar o número mínimo de bits necessários para armazenar um valor, pergunte quais lugares valoriais precisa:
- um inteiro sem sinal de $0$ a $2^{n} - 1$ precisa de $n$ bits: $200$ precisa de 8 bits (o topo é $255$), $1000$ precisa de 10 bits (o topo é $1023$), $16$ precisa de 5 bits (4 bits param em $15$).
- um inteiro com sinal em complemento para dois de $-2^{n-1}$ a $2^{n-1} - 1$ precisa de $n$ bits: $-200$ precisa de 9 bits, pois 8 bits param em $-128$.
- um dígito hexadecimal precisa de 4 bits, um dígito BCD precisa de 4 bits, e um carácter ASCII precisa de 7 bits (8 para ASCII expandido).
Prefijos binários vs decimais
Dois famílias de prefijos parecem semelhantes mas diferem — decimal (potências de 10) e binário (potências de 2):
Decimal (SI) Binário (memória) quilo $= 10^{3}$ kibi (Ki) $= 2^{10} = 1024$ mega $= 10^{6}$ mebi (Mi) $= 2^{20}$ giga $= 10^{9}$ gibi (Gi) $= 2^{30}$ tera $= 10^{12}$ tebi (Ti) $= 2^{40}$ Assim, um tebibyte (TiB) é ligeiramente maior que um terabyte (TB). Um disco "1 TB" armazena $10^{12}$ bytes, mas um sistema operacional que relata em TiB mostra um número menor.
ExplorarBinário, decimal e hexadecimal
Digite um número e veja-o em binário, decimal e hexadecimal ao mesmo tempo — e como os valores posicionais se somam.
Vocabulário TreinarInglês Chinês Pinyin number system/ˈnʌmbə ˈsɪstəm/ 数制 shù zhì binary/ˈbaɪnəri/ 二进制 èr jìn zhì denary/ˈdiːnəri/ 十进制 shí jìn zhì place value/pleɪs ˈvæljuː/ 位值 wèi zhí byte/baɪt/ 字节 zì jié bit/bɪt/ 位 wèi hexadecimal/ˌheksəˈdesɪml/ 十六进制 shí liù jìn zhì nibble/ˈnɪbl/ 半字节 bàn zì jié register width/ˈredʒɪstə wɪtθ/ 寄存器宽度 jì cún qì kuān dù 1.1
Aritmética binária
Adição binária
Adicione coluna por coluna da direita, carregando como na decimal:
Bit A Bit B Carry in Sum bit Carry out 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 1 0 0 1 1 1 1 1 1 Overflow 溢出 ocorre quando o resultado precisa de mais bits do que o register 寄存器 pode armazenar — o carry-out da coluna mais à esquerda é o bit de overflow.
Exemplo resolvido. Some os inteiros sem sinal de 8 bits $10110101$ e $01101100$, e comente sobre o resultado.
$10110101 + 01101100 = 1\,00100001$. A resposta precisa de 9 bits, então não cabe em um registro de 8 bits: ocorreu overflow. Uma resposta completa nomeia o erro e diz por quê, usando a largura de palavra dada pela questão: "Overflow: o resultado verdadeiro ($289$) é maior que o maior valor que um registro de 8 bits pode armazenar ($255$), então o carry out do bit mais significativo é perdido e o resultado armazenado ($00100001 = 33$) está errado."
Subtração binária
O método usual é a adição de two's complement 补码: para fazer $A - B$, forme o two's complement de $B$ (inverte todos os bits e soma 1), depois some, e descarte qualquer carry-out final.
Para subtrair $00011110$ de $01100100$ (sem sinal 8 bits):
- two's complement de $00011110$: inverta → $11100001$, some 1 → $11100010$.
- some com $01100100$: resultado $1\,01000110$ (9 bits) — descarte o 1 inicial → $01000110 = 70_{10}$. Verifique: $100 - 30 = 70$. ✓
Inteiros sinalizados em two's complement
Em um número two's complement de $n$ bits:
- o most significant bit 最高有效位 (MSB) é o sign bit 符号位: 0 = positivo, 1 = negativo.
- para ler um número negativo: inverta todos os bits, some 1, depois negue.
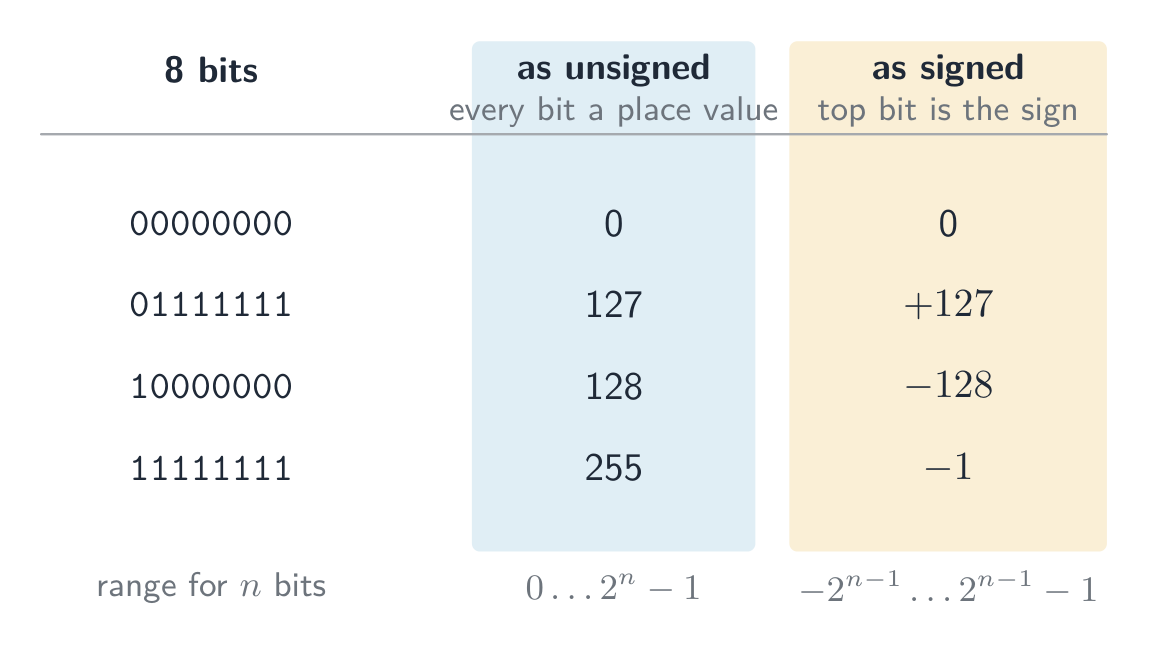
Então $11100010$ é negativo; inverta → $00011101$, some 1 → $00011110 = 30$, logo é $-30$. Este é um signed integer 有符号整数 (ao contrário de um sem sinal 无 signed one). O intervalo para $n$ bits é $-2^{n-1}$ a $+2^{n-1} - 1$; para 8 bits, $-128$ ($10000000$) a $+127$ ($01111111$).
Os mesmos bits significam números diferentes dependendo da leitura acordada. Como inteiro sem sinal, cada bit é um valor posicional, então 8 bits variam de $0$ a $255$; como inteiro sinalizado two's complement, o bit superior é o sinal, então os mesmos 8 bits variam de $-128$ a $+127$. O padrão $11111111$ é $255$ lido de uma forma e $-1$ lido da outra — nada nos próprios bits diz qual é.
O mesmo byte lido como unsigned e signed: apenas a interpretação acordada os distingue
 Two's complement de 8 bits: o sign bit divide o intervalo em negativo ($-128$ a $-1$) e positivo ($0$ a $127$)
Exemplo resolvido. Qual o valor decimal representado pelo número two's complement de 8 bits $10110100$?
O MSB é 1, então é negativo. Inverta → $01001011$, adicione 1 → $01001100 = 76$, então o valor é $-76$. Verifique com valores posicionais: $-128 + 32 + 16 + 4 = -76$.
Exemplo resolvido. Escreva $-108$ como um inteiro two's complement de 12 bits.
Comece com $+108$ em 12 bits: $108 = 64 + 32 + 8 + 4$, então
0000 0110 1100. Inverta todos os bits:1111 1001 0011. Some 1:1111 1001 0100. Verifique com valores posicionais, onde o bit superior vale $-2^{11} = -2048$: $-2048 + 1024 + 512 + 256 + 128 + 16 + 4 = -108$. ✓Para 12 bits, o intervalo é $-2048$ (
1000 0000 0000) a $+2047$ (0111 1111 1111). Questões que pedem os menores e maiores valores querem esses dois padrões, então aprenda a regra: o número mais negativo é um 1 seguido de zeros; o mais positivo é um 0 seguido de uns.Um arithmetic shift 算术移位 move todos os bits para a esquerda ou direita, mas mantém o sinal: um shift right em um lugar divide o valor ao meio e copia o sign bit no espaço vazio à esquerda, então um número negativo permanece negativo (
1111 1001 0100deslocado right três lugares é1111 1111 0010, que é $-14$: $-108 / 8 = -13.5$, e um shift right arredonda para baixo). Um shift left dobra o valor. Shifts pertencem ao conjunto de instruções assembly no tópico 4, mas esta pergunta é feita com o trabalho numérico aqui.Overflow em aritmética sinalizada ocorre quando o resultado verdadeiro cai fora deste intervalo — identificado quando o sign bit inverte incorretamente (dois positivos dando negativo, ou dois negativos dando positivo).
One's complement
Antes do two's complement, um esquema antigo chamado one's complement 反码 representava um número negativo simplesmente invertendo todos os bits do positivo — não há etapa de "somar 1".
- $+30 = 00011110$, então em one's complement $-30 = 11100001$ (apenas o inverso).
- Desvantagem: possui dois zeros — $00000000$ ($+0$) e $11111111$ ($-0$) — o que desperdiça um padrão de bits e torna a aritmática complicada.
Two's complement (inverta e some 1) elimina o zero negativo: ele tem um único zero e permite que adição e subtração usem o mesmo circuito. É por isso que computadores modernos armazenam inteiros sinalizados em two's complement, não em one's complement.
ExplorarBinário & inteiros sinalizados
byte = Σ valores de posição
Veja como um padrão de 8 bits mapeia para um número (e como transbordaria além de 255).
ExplorarBits sinalizados em complemento de dois
O bit mais à esquerda carrega um valor de posição negativo. Alterne qualquer bit — ou clique em Negate (inverta todos os bits, depois adicione 1) — e veja o valor sinalizado mudar.
Vocabulário TreinarInglês Chinês Pinyin register/ˈredʒɪstə/ 寄存器 jì cún qì unsigned/ʌnˈsaɪnd/ 无符号 wú fú hào overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū most significant bit/məʊst sɪɡˈnɪfɪkənt bɪt/ 最高有效位 zuì gāo yǒu xiào wèi two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ signed integer/saɪnd ˈɪntɪdʒə/ 有符号整数 yǒu fú hào zhěng shù sign bit/saɪn bɪt/ 符号位 fú hào wèi arithmetic shift/ˌærɪθˈmetɪk ʃɪft/ 算术移位 suàn shù yí wèi one's complement/wʌnz ˈkɒmplɪmənt/ 反码 fǎn mǎ 1.1
Decimal Coded Binary (BCD)
Em BCD 二进码十进数, cada dígito decimal é escrito como seu próprio padrão de 4 bits. O número $93$ é
1001 0011em BCD — não binário 93 ($01011101$). Cada nibble usa apenas 0–9; padrões $1010$–$1111$ são inválidos.Leitura BCD:
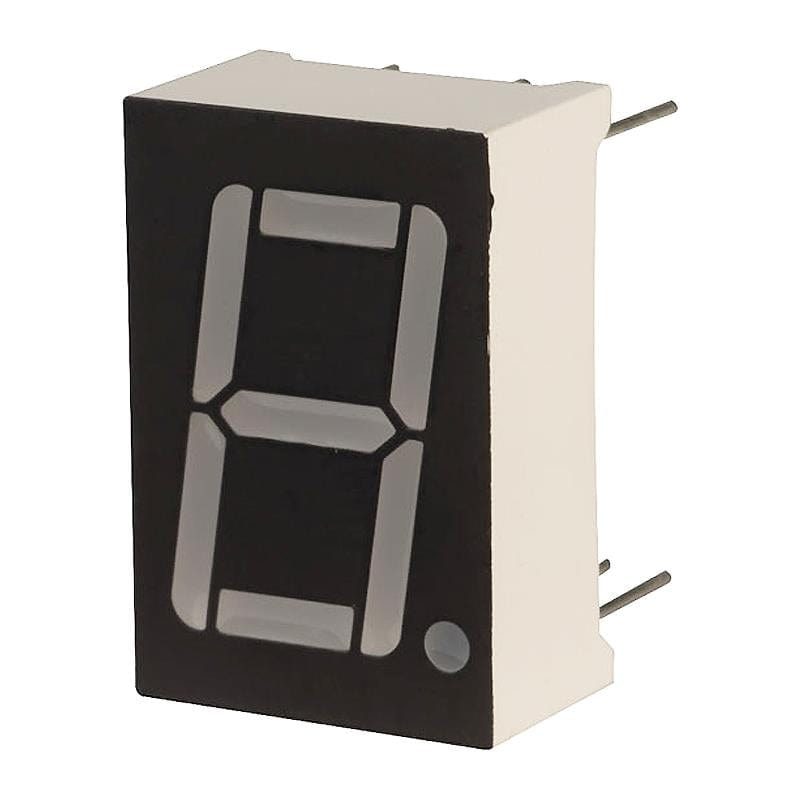
0010 0111 0101→ 2, 7, 5 → 275.Uso: calculadoras, relógios digitais e dispositivos que exibem dígitos decimais — cada dígito aciona um 7-segment display 七段显示器. O código de moeda frequentemente usa BCD para evitar erros de arredondamento ao converter frações como 0.1 em binário.
Uma resposta "justify" deve ligar o uso a uma propriedade do BCD: cada dígito decimal tem seus próprios 4 bits, então um dígito pode ser enviado diretamente para seu display, ou somado dígito por dígito, sem conversão do número todo; e uma fração decimal como $0.10$ é armazenada exatamente, algo que uma fração binária não consegue fazer.
Um display de sete segmentos mostra um dígito decimal, frequentemente acionado por BCD Vocabulário TreinarInglês Chinês Pinyin BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù 7-segment display/ˈsevən ˈseɡmənt dɪˈspleɪ/ 七段显示器 qī duàn xiǎn shì qì 1.1
Hexadecimal — usos práticos

Hex é uma forma compacta de escrever binário (1 dígito hex = 4 bits):
Um byte são dois nibbles; cada nibble é um dígito hex - memory addresses 内存地址 em programação de baixo nível —
0x7FFE. - colour values em HTML/CSS —
#FF8800. - MAC addresses —
AC:DE:48:00:11:22.
Hex não altera os dados armazenados — apenas facilita o binário para humanos.
Vocabulário TreinarInglês Chinês Pinyin memory address/ˈmeməri əˈdres/ 内存地址 nèi cún dì zhǐ 1.1
Códigos de caracteres

Computadores armazenam texto como números; cada caractere tem um code point 码点 numérico definido por um character set 字符集.
ASCII
- ASCII usa 7 bits — 128 code points. Letras latinas básicas, dígitos, pontuação e códigos de controle.
- Extended ASCII usa 8 bits — 256 code points; os primeiros 128 correspondem ao ASCII, os últimos 128 variam por região.
Cada caractere é armazenado como um número — alguns code points ASCII em decimal e binário Unicode
- Unicode é um conjunto universal de caracteres cobrindo quase todos os scripts, além de símbolos e emojis.
- encodings 编码 comuns: UTF-8 (1–4 bytes, compatível com ASCII), UTF-16 (2 ou 4 bytes), UTF-32 (fixo 4 bytes).
Por que Unicode supera ASCII
- representa muitos mais caracteres (todos os scripts, emojis); ASCII cobre apenas inglês básico.
- arquivos são portáteis sem confusão de páginas de código, e permitem texto multilíngue em um único documento.
- trade-off: arquivos Unicode costumam ser maiores para texto apenas em inglês.
Quando uma questão pede diferenças, dê-as em pares com números: ASCII usa 7 bits (ASCII estendido 8), logo 128 (256) caracteres; Unicode usa até 32 bits (UTF-8 usa 1 a 4 bytes), logo mais de um milhão de code points. ASCII cobre apenas inglês básico; Unicode cobre todos os scripts, e seus primeiros 128 code points são os do ASCII. Em UTF-8, uma letra inglesa ainda ocupa 1 byte, então um nome de arquivo de 40 letras em inglês tem 40 bytes tanto no ASCII quanto no UTF-8, enquanto um caractere chinês ocupa 3 bytes.
ExplorarUm caractere é armazenado como um número
Cada caractere tem um código numérico — 'A' é 65. Inverta os bits para ver esse código em binário e hexadecimal, exatamente como o computador o armazena.
Vocabulário TreinarInglês Chinês Pinyin code point/kəʊd pɔɪnt/ 码点 mǎ diǎn character set/ˈkærɪktə set/ 字符集 zì fú jí encoding/enˈkəʊdɪŋ/ 编码 biān mǎ 1.2
Imagens bitmap
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de como os dados de uma imagem bitmap são codificados Usar e compreender os termos: pixel, cabeçalho do arquivo, resolução da imagem, resolução da tela, profundidade de cor / profundidade de bits Realizar cálculos para estimar o tamanho do arquivo para uma imagem bitmap Demonstrar compreensão dos efeitos de alterar elementos de uma imagem bitmap na qualidade da imagem e no tamanho do arquivo Usar os termos: resolução da imagem, profundidade de cor / profundidade de bits Demonstrar compreensão de como os dados de um gráfico vetorial são codificados Usar os termos: objeto de desenho, propriedade, lista de desenho Justificar o uso de uma imagem bitmap ou um gráfico vetorial para uma tarefa dada Demonstrar compreensão de como o som é representado e codificado Usar os termos: amostragem, taxa de amostragem, resolução de amostragem, dados analógicos e dados digitais Demonstrar compreensão do impacto de alterar a taxa de amostragem e a resolução Incluindo o impacto no tamanho do arquivo e na precisão Fonte: Programa Cambridge International
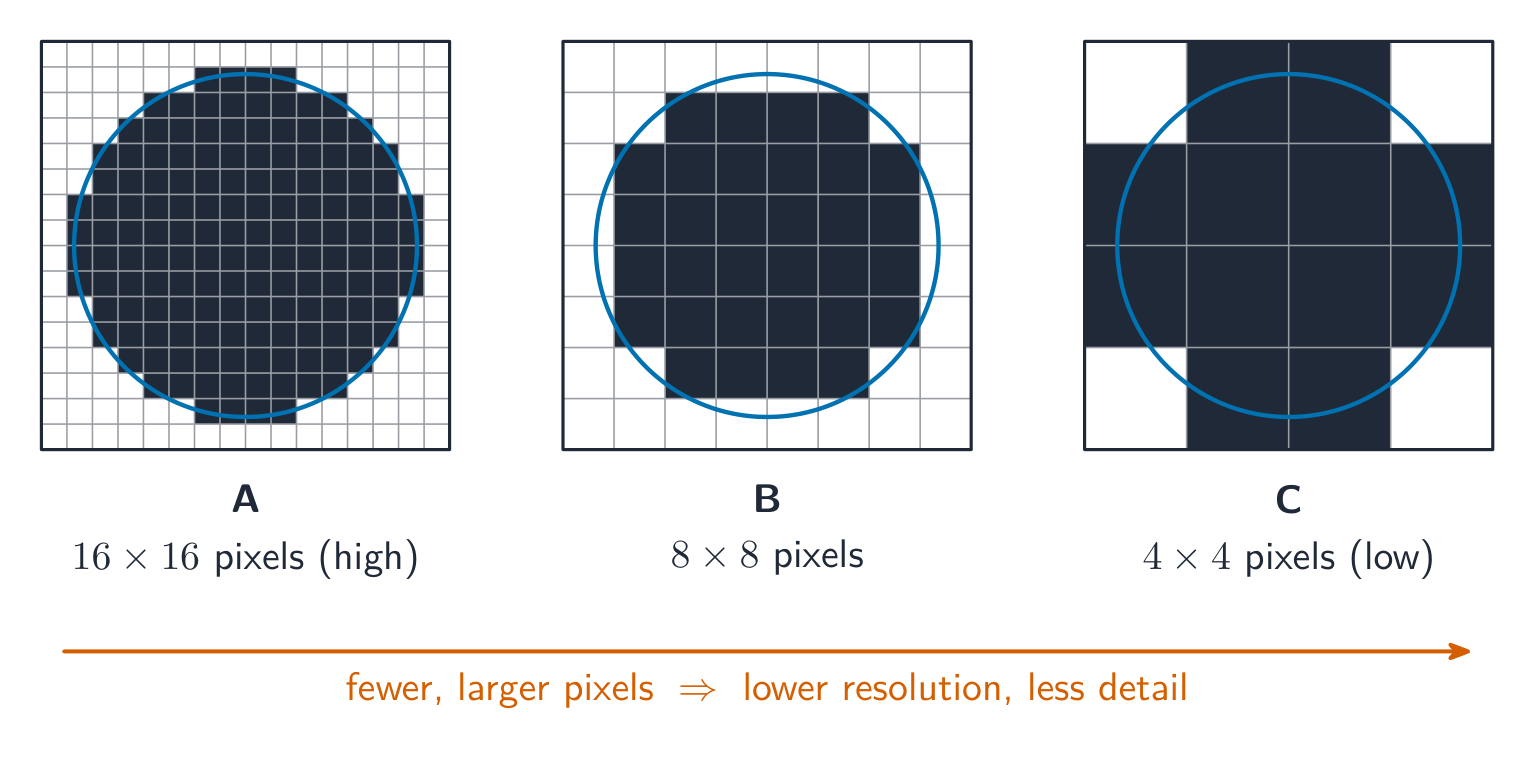
Uma imagem bitmap 位图 (também chamada de bitmapped image) armazena a cor de cada pixel 像素 em uma grade. No início do arquivo, um file header 文件头 registra os metadados da imagem — sua largura, altura e profundidade de cor — para que o software saiba como ler os dados de pixel que seguem.
- image resolution 图像 resolução: o tamanho próprio do bitmap, largura × altura em pixels (ex. 1920 × 1080).
- screen resolution 屏幕分辨率: a largura × altura que o display pode mostrar. Se a resolução de uma imagem for maior que a tela, ela é escalonada para caber; uma imagem de baixa resolução fica pixelizada quando esticada em uma tela de alta resolução.
- profundidade de cor profundidade de cor (profundidade de bits profundidade de bits): bits por pixel. 1 bit → preto e branco; 8 bits → 256 cores; 24 bits → 16.7 milhão ("cor verdadeira").
A mesma imagem armazenada em três resoluções, de alta (A) a baixa (C): menos pixels maiores significam menos detalhes Tamanho do arquivo
$$\text{size in bits} = \text{width} \times \text{height} \times \text{bit depth}.$$Divida por 8 para bytes, por 1024 para KiB, etc. Exemplo: uma imagem $3000 \times 2000$ a 24 bpp é $3000 \times 2000 \times 24 = 1.44 \times 10^{8}$ bits $\approx 17.2\ \text{MiB}$.
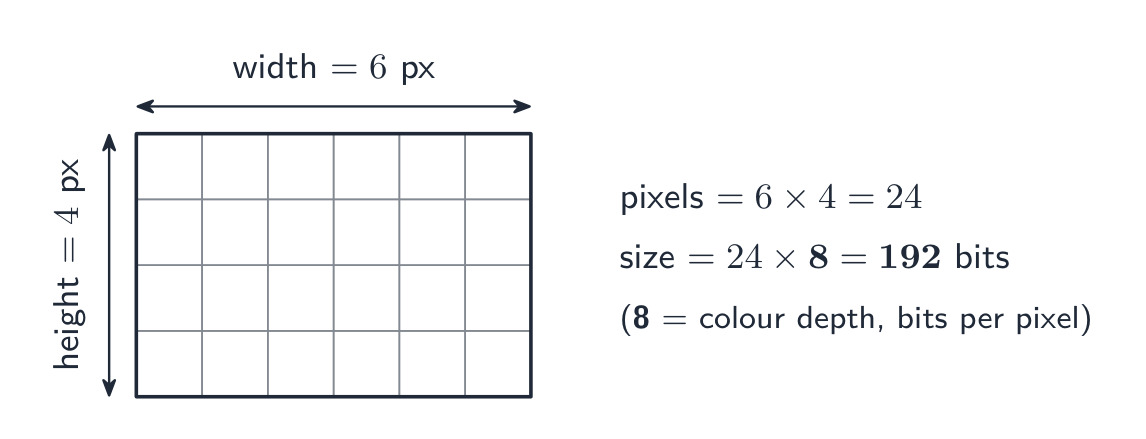
A mesma fórmula em números pequenos: conte os pixels, depois multiplique pela profundidade de cor Informe as unidades que usou. O gabarito aceita $1\ \text{MB} = 10^{6}$ bytes (prefixo SI) ou $1\ \text{MiB} = 1024 \times 1024$ bytes (prefixo binário), desde que seu cálculo mostre qual; a mesma imagem é $18.0\ \text{MB}$ ou $17.2\ \text{MiB}$. Adicione o tamanho do cabeçalho do arquivo se a questão o fornecer.
Um vídeo é uma sequência de imagens bitmap, cada uma sendo um quadro 帧. Antes da compressão, seu tamanho é o tamanho de um quadro $\times$ a taxa de quadros 帧率 (quadros por segundo) $\times$ a duração em segundos: 30 quadros por segundo de $1920 \times 1080$ pixels a 24 bits são $30 \times 1920 \times 1080 \times 24 \approx 1.5 \times 10^{9}$ bits, aproximadamente $187\ \text{MB}$, para cada segundo. É por isso que vídeos sempre são comprimidos.
Alterando configurações
- resolução mais baixa → arquivo menor, menos detalhes (aparece pixelizado quando ampliado).
- profundidade de cor mais baixa → arquivo menor, mas tons suaves mostram faixas.
- maior de qualquer um → arquivo maior, melhor qualidade.
Vocabulário TreinarInglês Chinês Pinyin bitmap/ˈbɪtmæp/ 位图 wèi tú pixel/ˈpɪksl/ 像素 xiàng sù file header/faɪl ˈhedə/ 文件头 wén jiàn tóu colour depth/ˈkʌlə depθ/ 颜色深度 yán sè shēn dù image resolution/ˈɪmɪdʒ ˌrezəˈluːʃn/ 图像分辨率 tú xiàng fēn biàn lǜ screen resolution/skriːn ˌrezəˈluːʃn/ 屏幕分辨率 píng mù fēn biàn lǜ bit depth/bɪt depθ/ 位深度 wèi shēn dù frame/freɪm/ 帧 zhēn 1.2
Gráficos vetoriais
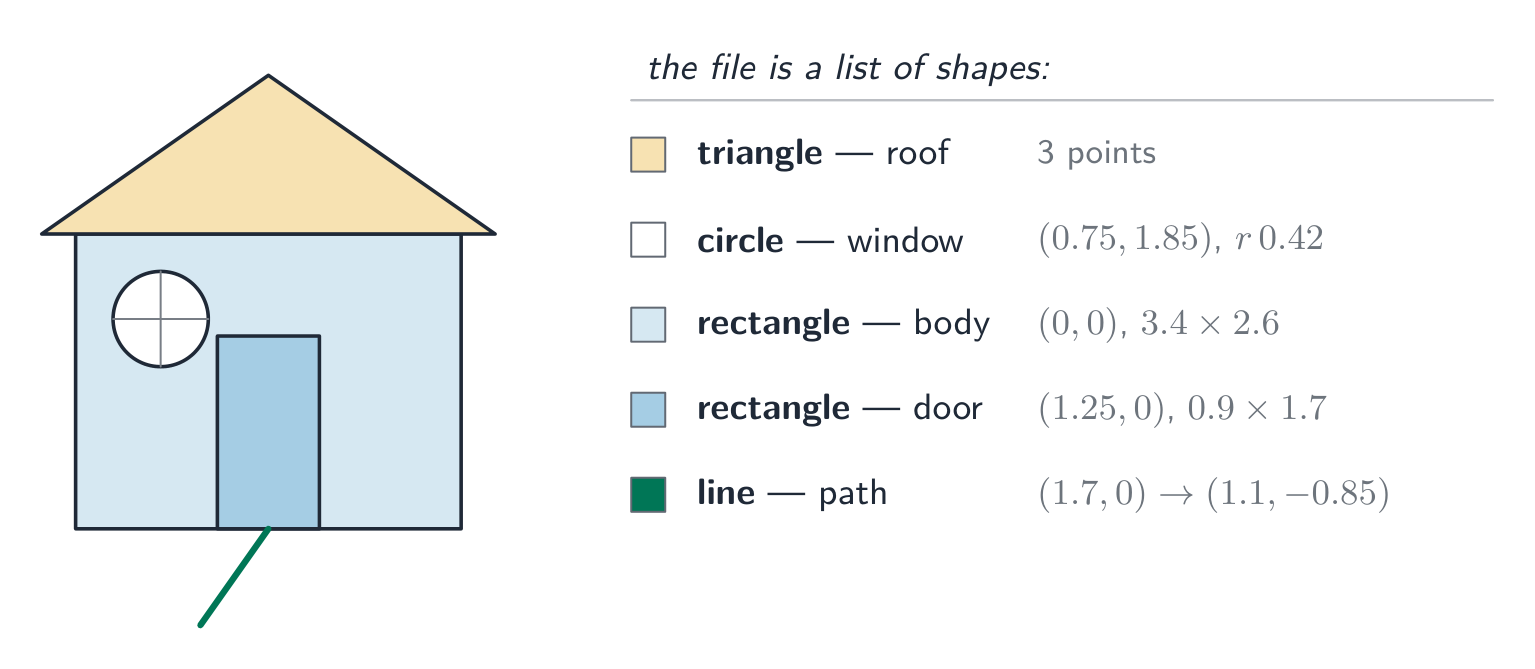
Um gráfico vetorial 矢量图形 armazena as instruções para desenhar a imagem como uma lista de desenho 绘图列表 — uma lista ordenada de objetos de desenho 绘图对象 (primitivas geométricas 图元: linhas, curvas, polígonos, círculos). Cada objeto de desenho possui propriedades 属性 como cor, preenchimento, largura da linha e posição (coordenadas). Para exibi-lo, o programa renderiza 渲染 a lista de desenhos na resolução necessária.
Uma imagem vetorial é construída a partir de formas geométricas rotuladas, cada uma com atributos Bitmap vs Vetor
Tarefa Melhor escolha Por quê Fotografia Bitmap Detalhes complexos ao nível do pixel não podem ser descritos como formas. Logotipo, ícone, sinal Vetor Bordas nítidas; escala para qualquer tamanho sem desfoque. Desenho técnico Vetor Geometria precisa e escalabilidade. Pintura, textura Bitmap Detalhe tonal suave por área. Vantagem vetorial: ele escala sem perder qualidade — um logotipo vetorial permanece nítido em qualquer tamanho, enquanto um bitmap fica desfocado quando ampliado. Desvantagem vetorial: não pode descrever detalhes arbitrários de pixels (fotografias).
Uma resposta "justificativa" vincula a escolha à tarefa. "O logotipo deve aparecer num cartão de visita e num outdoor, então deve ser um gráfico vetorial: é armazenado como objetos de desenho e é renderizado nitidamente em qualquer tamanho, enquanto um bitmap mostraria seus pixels quando ampliado." Para uma fotografia, o argumento funciona ao contrário: não há formas para descrever, então a cor de cada pixel deve ser armazenada.

Ampliado, os pixels de um bitmap tornam-se irregulares; um vetorial permanece suave em qualquer tamanho ExplorarLaboratório de conceitos de computação
Classifique exemplos concretos pelo conceito de computação que eles demonstram.
Vocabulário TreinarInglês Chinês Pinyin vector graphic/ˈvektə ˈɡræfɪk/ 矢量图形 shǐ liàng tú xíng drawing list/ˈdrɔːɪŋ lɪst/ 绘图列表 huì tú liè biǎo drawing objects/ˈdrɔːɪŋ ˈɒbdʒekts/ 绘图对象 huì tú duì xiàng primitive/ˈprɪmɪtɪv/ 图元 tú yuán properties/ˈprɒpətiz/ 属性 shǔ xìng render/ˈrendə/ 渲染 xuàn rǎn analogue data/ˈænəlɒɡ ˈdeɪtə/ 模拟数据 mó nǐ shù jù digital data/ˈdɪdʒɪtl ˈdeɪtə/ 数字数据 shù zì shù jù 1.2
Som
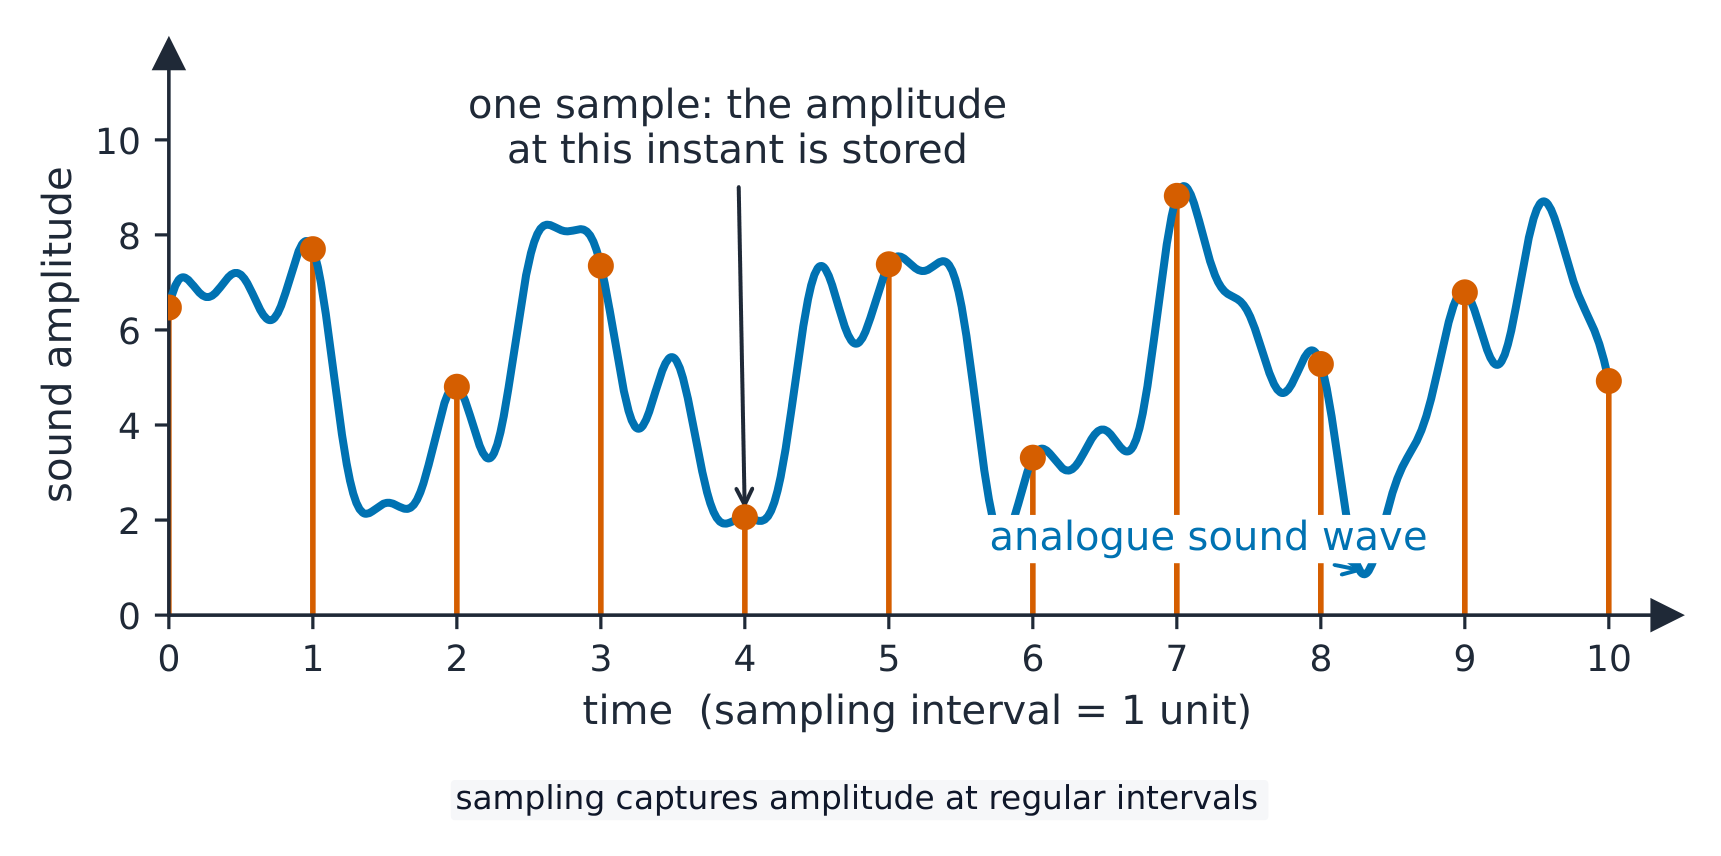
Uma onda contínua de dados analógicos 模拟数据 (o som) é convertida em dados digitais 数字数据 por amostragem 采样:
- taxa de amostragem 采样率 — amostras por segundo (Hz). Qualidade CD é $44.1\ \text{kHz}$.
- resolução de amostragem 采样分辨率 (profundidade de bits) — bits por amostra de amplitude 振幅. Qualidade CD é 16 bits.
Amostragem de uma onda sonora: sua amplitude é lida em cada intervalo de tempo Tamanho do arquivo
$$\text{size in bits} = \text{sampling rate} \times \text{resolution} \times \text{duration} \times \text{channels}.$$Um clipe estéreo CD de 10 segundos: $44100 \times 16 \times 10 \times 2 = 14\,112\,000$ bits $\approx 1.68\ \text{MiB}$.
Alterando configurações
- taxa de amostragem mais alta → capta agudos mais altos, arquivo maior.
- resolução de amostragem mais alta → passos de amplitude mais finos, menos ruído de quantização 量化, arquivo maior.
- menor de qualquer um → arquivo menor, perda clara de qualidade.
(A taxa de amostragem deve ser pelo menos duas vezes a frequência mais alta que você deseja manter.)

Taxa de amostragem é amostras por segundo; a regra de Nyquist é por que deve ser pelo menos duas vezes a frequência mais alta mantida ExplorarAmostragem de som
y = a sin(bt + c)
A amostragem mede uma onda sonora em intervalos regulares — quanto maior a taxa, mais fielmente ela é copiada.
Vocabulário TreinarInglês Chinês Pinyin digit/ˈdɪdʒɪt/ 数位 shù wèi sampling/ˈsæmplɪŋ/ 采样 cǎi yàng sampling rate/ˈsæmplɪŋ reɪt/ 采样率 cǎi yàng lǜ sampling resolution/ˈsæmplɪŋ ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ amplitude/ˈæmplɪtjuːd/ 振幅 zhèn fú sample resolution/ˈsæmpl ˌrezəˈluːʃn/ 采样分辨率 cǎi yàng fēn biàn lǜ quantisation/ˌkwɒntaɪˈzeɪʃn/ 量化 liàng huà bandwidth/ˈbændwɪdθ/ 带宽 dài kuān lossless/ˈlɒsləs/ 无损 wú sǔn lossy/ˈlɒsi/ 有损 yǒu sǔn run-length encoding/rʌn leŋθ enˈkəʊdɪŋ/ 行程编码 xíng chéng biān mǎ dictionary methods/ˈdɪkʃənəri ˈmeθədz/ 字典编码 zì diǎn biān mǎ 1.3
Compressão
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da necessidade e exemplos de uso de compactação Demonstrar compreensão de compactação com perda e sem perda e justificar o uso de um método numa situação dada Demonstrar compreensão de como um arquivo de texto, imagem bitmap, gráfico vetorial e arquivo de som podem ser compactados Incluindo o uso de codificação run-length (RLE) Fonte: Programa Cambridge International
Compressão 压缩 reduz o tamanho do arquivo, economizando armazenamento e largura de banda 带宽 de transmissão. Dois tipos:
- sem perdas 无损 — os dados originais são recuperados exatamente (texto, programas, ZIP/PNG).
- com perdas 有损 — alguns detalhes são descartados para arquivos muito menores (JPEG, MP3, vídeo).
Quando usar qual
- sem perdas para documentos, código-fonte, imagens médicas — qualquer coisa que precise de dados exatos.
- com perdas para streaming de mídia. Streaming de vídeo em tempo real usa compressão com perdas porque deve enviar grandes quantidades de dados em tempo real sobre largura de banda limitada; sem perdas não reduziria o suficiente. Vídeo HD bruto é gigabytes por minuto, então sem compressão a imagem ficaria travando constantemente.
Uma resposta "justificativa" nomeia o método, depois a razão baseada na situação: "Sem perdas, porque a planilha deve ser restaurada exatamente; um único valor alterado tornaria as contas erradas." Ou: "Com perdas, porque as fotografias são visualizadas numa tela de celular onde os detalhes perdidos não são visíveis, e os arquivos menores sobem mais rápido e usam menos armazenamento."
Métodos sem perdas
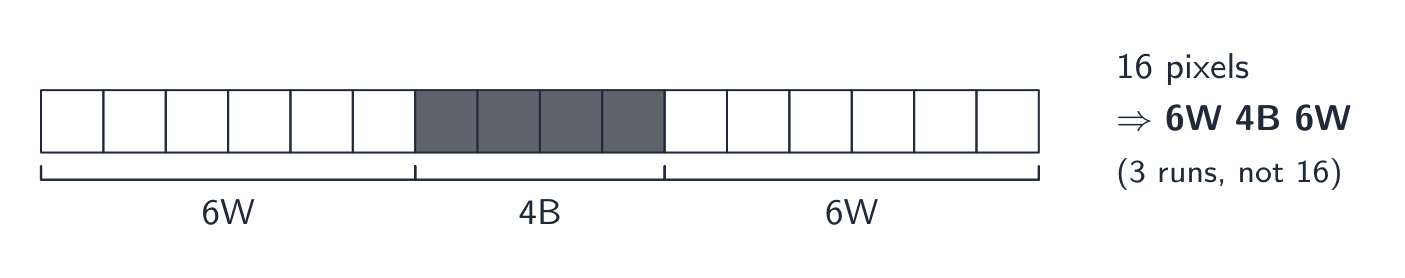
- codificação por comprimento de corrida 行程编码 (RLE): armazene "os próximos $n$ valores são $x$" em vez de repetir $x$. Ótimo para áreas planas; inútil para dados ruidosos.
- métodos de dicionário 字典编码 (ZIP, PNG): substitui sequências de bytes repetidas por uma referência curta. Bom para texto e código.
- codificação Huffman 霍夫曼编码: dá códigos curtos para símbolos comuns e longos para raros, aproximando o comprimento médio do código da entropia 熵 dos dados.
Como cada tipo de arquivo é comprimido:
- arquivo de texto: métodos de dicionário e codificação Huffman transformam palavras repetidas e caracteres comuns em códigos curtos. Texto deve permanecer sem perdas, pois um caractere alterado muda o significado.
- imagem bitmap: RLE para corridas de pixels idênticos (ícones, diagramas, digitalizações preto-e-branco); JPEG com perdas para fotografias, ou profundidade/resolução de cor mais baixa.
- gráfico vetorial: a lista de desenho já é pequena; remova objetos de desenho desnecessários, armazene coordenadas com menos casas decimais, ou aplique um método sem perdas como ZIP ao arquivo.
- arquivo de som: MP3 ou AAC com perdas remove o que o ouvido não consegue ouvir; taxa ou resolução de amostragem mais baixa também é com perdas; formatos sem perdas mantêm cada amostra e reduzem o arquivo muito menos.
Codificação por comprimento de corrida em uma única fileira: 16 pixels tornam-se 3 corridas 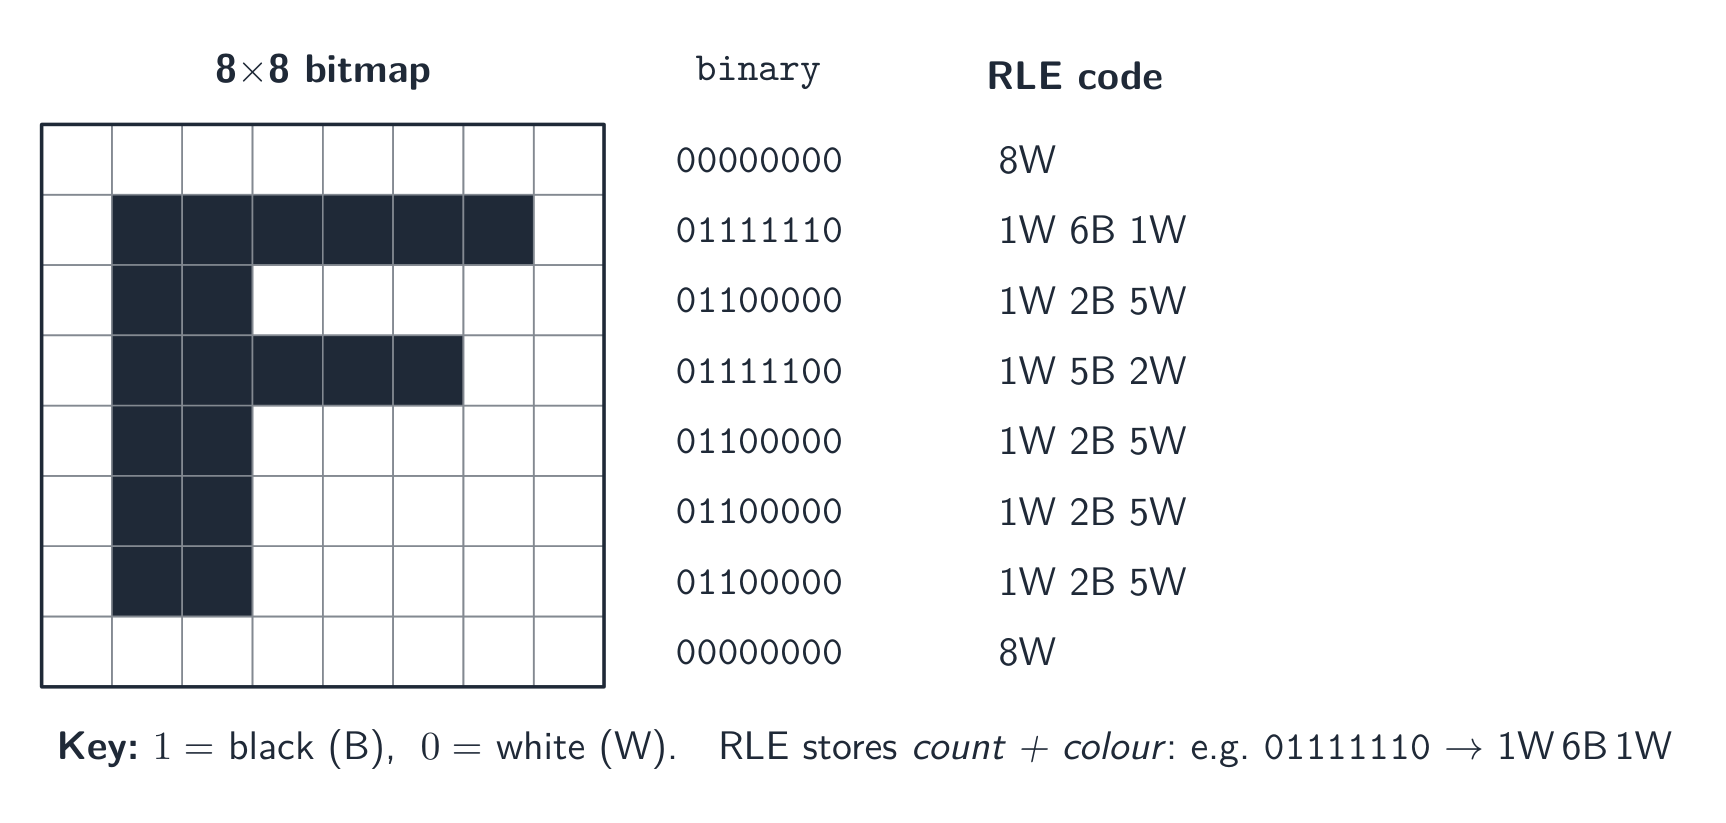
Codificação por comprimento de corrida da letra F em uma grade preto-e-branco $8\times8$ 
Codificação de dicionário: cada sequência repetida é armazenada uma vez, e cada ocorrência torna-se um índice curto 
Codificação Huffman: o símbolo mais comum recebe o código mais curto, então BANANA precisa de 10 bits em vez de 12 Métodos com perdas
- imagens (JPEG): descarta detalhes finos e diferenças de cor que o olho mal percebe.
- som (MP3, AAC): descarta agudos que ouvimos menos bem, e sons quietos escondidos por sons mais altos.
- vídeo combina compressão espacial 空间 (dentro de cada quadro, como JPEG) com compressão temporal 时间 (a maioria dos quadros armazena apenas as diferenças em relação ao quadro anterior).

Métodos de compressão: sem perdas versus com perdas, com exemplos comuns ExplorarCodificação por comprimento de corrida
Veja uma sequência de símbolos repetidos sendo comprimida em uma contagem — compressão sem perda simples.
Vocabulário TreinarInglês Chinês Pinyin compression/kəmˈpreʃn/ 压缩 yā suō frame rate/freɪm reɪt/ 帧率 zhēn lǜ Huffman coding/ˈhʌfmən ˈkəʊdɪŋ/ 霍夫曼编码 huò fū màn biān mǎ entropy/ˈentrəpi/ 熵 shāng spatial/ˈspeɪʃl/ 空间 kōng jiān temporal/ˈtempərəl/ 时间 shí jiān 1.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição bit um único dígito binário, 0 ou 1 byte um grupo de 8 bits prefixo binário um multiplicador que é uma potência de 2 (kibi = 1024) em vez de uma potência de 10 (kilo = 1000) complemento de dois uma maneira de representar inteiros sinalizados em que o bit mais significativo tem valor posicional negativo estouro o resultado de um cálculo é grande demais para ser representado no número de bits disponíveis Decimal Codificado Binariamente cada dígito decimal é armazenado como seu próprio padrão binário de 4 bits conjunto de caracteres o conjunto de caracteres que um computador pode representar, cada um com seu próprio código binário pixel o menor elemento de uma imagem bitmap, armazenando um valor de cor resolução de imagem o número de pixels em uma imagem, dado como largura por altura resolução de tela o número de pixels que um display pode mostrar, dado como largura por altura profundidade de cor o número de bits usados para armazenar a cor de um pixel taxa de amostragem o número de amostras do som tiradas por segundo resolução de amostragem o número de bits usados para armazenar a amplitude de uma amostra compressão sem perdas compressão da qual os dados originais podem ser recuperados exatamente compressão com perdas compressão que remove permanentemente alguns dados, de modo que os originais não podem ser recuperados codificação por comprimento de corrida substituir uma corrida de valores repetidos por um valor e uma contagem 1.3
Dicas de prova
- Mostre cálculos para conversões de base: decimal → binário por posições, binário → hexadecimal em nibbles (grupos de 4 bits).
- Para complemento de dois o MSB é negativo; para inverter, inverte e soma 1; atenção para transbordamento quando o bit de sinal muda incorretamente.
- Distinga bitmap (pixels; tamanho do arquivo $=$ largura $\times$ altura $\times$ profundidade de cor) de vetor (comandos de desenho; escala sem perdas).
- O tamanho do arquivo de som depende de taxa de amostragem $\times$ profundidade de bits $\times$ tempo — mais de cada um significa melhor qualidade, mas um arquivo maior.
- Compare compressão sem perdas vs. com perdas e dê um uso para cada uma.
Erros comuns
- Explicar um overflow com "a resposta foi maior que 255" ou "ele tem 9 bits". Indique o tamanho de palavra dado na questão, depois diga que o resultado não pode ser representado nele.
- Criar um número negativo definindo o bit superior como 1 e deixando o resto (sinal e magnitude). Complemento a dois significa inverter todos os bits do valor positivo, depois adicionar 1.
- Esquecer de preencher com zeros à esquerda um número convertido para a largura do registro solicitada pela questão.
- Misturar bits e bytes em um cálculo de tamanho de arquivo. Trabalhe em bits, divida por 8 apenas uma vez, e especifique se usou 1000 ou 1024.
- Responder "descreva" em linguagem cotidiana ("a imagem fica pior"). Use os termos da ementa: menos cores, banding, menor resolução de imagem, pixels maiores.
-
2
Comunicação
Assistir aula2.1
Redes: propósito e benefícios
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da finalidade e benefícios dos dispositivos de rede Demonstrar compreensão das características de uma LAN (rede local) e uma WAN (rede de longa distância) Explicar os modelos client-server e peer-to-peer de computadores em rede Papéis dos diferentes computadores dentro dos modelos de rede e sub-rede. Benefícios e desvantagens de cada modelo. Justificar o uso de um modelo para uma situação dada Demonstrar compreensão de thin-client e thick-client e as diferenças entre eles Demonstrar compreensão das topologias bus, estrela, mesh e híbridas Compreender como os pacotes são transmitidos entre dois hosts para uma topologia dada. Justificar o uso de uma topologia para uma situação dada Demonstrar compreensão de computação em nuvem Incluindo o uso de nuvens públicas e privadas. Benefícios e desvantagens da computação em nuvem Demonstrar compreensão das diferenças e implicações do uso de redes sem fio e com fios Descrever as características de cabos de cobre, cabos de fibra óptica, ondas de rádio (incluindo WiFi), micro-ondas, satélites Descrever o hardware utilizado para suportar uma LAN Incluindo switch, servidor, Placa de Interface de Rede (NIC), Placa de Interface de Rede Sem Fio (WNIC), Pontos de Acesso Sem Fio (WAP), cabos, bridge, repetidor Descrever o papel e a função de um router em uma rede Demonstrar compreensão de Ethernet e como colisões são detectadas e evitadas Incluindo Carrier Sense Multiple Access/Collision Detection (CSMA/CD) Demonstrar compreensão de bit streaming Métodos de bit streaming, ou seja, tempo real e sob demanda. Importância das taxas de bits na velocidade da banda larga no bit streaming Demonstrar compreensão das diferenças entre a World Wide Web (WWW) e a internet Descrever o hardware utilizado para suportar a internet Incluindo modems, PSTN (Rede Telefônica Comutada Pública), linhas dedicadas, rede de telefonia celular Explicar o uso de endereços IP na transmissão de dados pela internet Incluindo: • formato de um endereço IP incluindo IPv4 e IPv6 • uso de subnetting em uma rede • como um endereço IP é associado a um dispositivo em uma rede • diferença entre um endereço IP público e um endereço IP privado e as implicações para a segurança • diferença entre um endereço IP estático e um endereço IP dinâmico Explicar como um Uniform Resource Locator (URL) é usado para localizar um recurso na World Wide Web (WWW) e o papel do Domain Name Service (DNS) Fonte: Programa Cambridge International
Uma rede 网络 é um conjunto de dispositivos computacionais conectados para que possam se comunicar e compartilhar recursos. Benefícios:
- compartilhamento de recursos (impressoras, servidores de arquivos, internet) — mais barato do que equipar cada computador.
- compartilhamento de dados — muitos usuários acessam os mesmos arquivos.
- gerenciamento centralizado — instalar software, gerenciar usuários e fazer backup uma única vez no servidor.
- comunicação — e-mail, chamadas de vídeo, mensagens.
- acesso remoto — trabalhar de qualquer lugar.
ExplorarLaboratório de roteamento de rede
Siga os dados de um dispositivo através do hardware de rede e protocolos.
2.1
LAN vs WAN
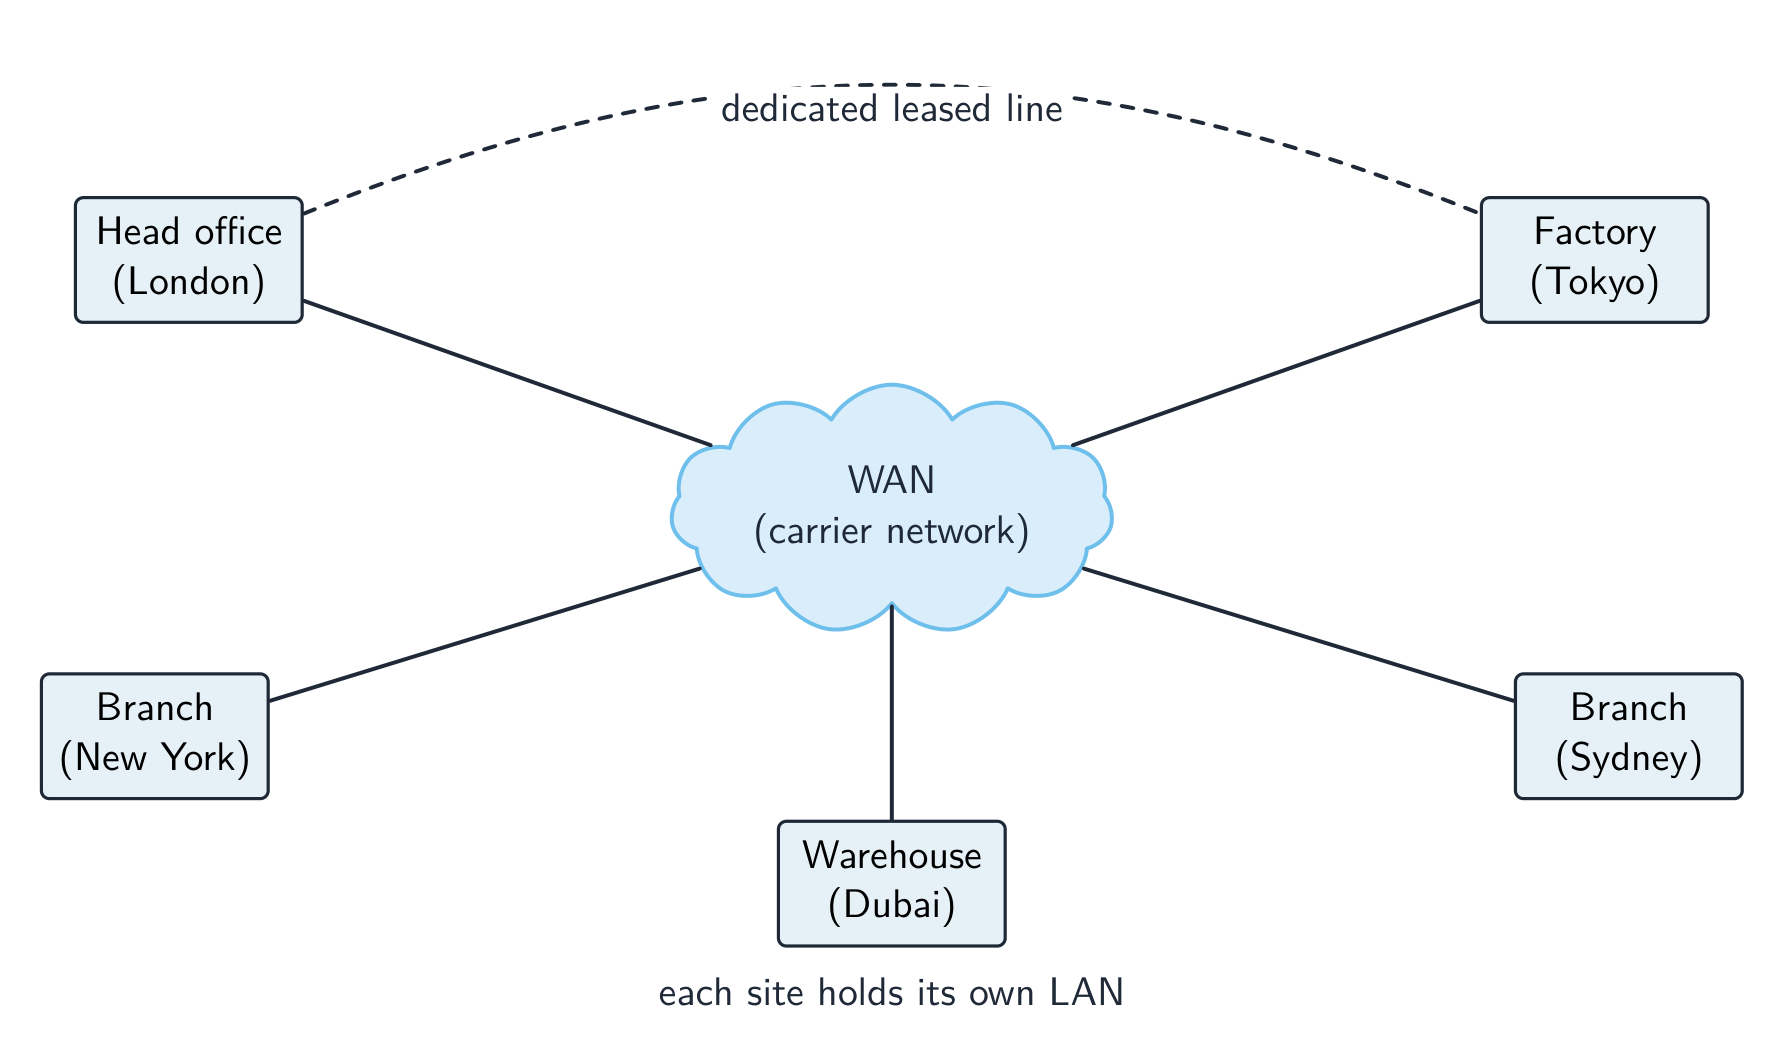
Uma rede de área local 局域网 (LAN) cobre uma área pequena — uma casa, escritório ou escola, geralmente pertencente à organização, com altas taxas de transferência de dados e baixa latência 延迟.
Uma rede de área ampla 广域网 (WAN) cobre uma grande área — uma cidade, país ou o mundo (a internet é a maior WAN). Usa infraestrutura de empresas de telecomunicações — frequentemente a Public Switched Telephone Network 公共交换电话网 (PSTN), linhas alugadas ou fibra óptica — com taxas de transferência de dados menores e latência mais alta. Uma WAN conecta várias LANs entre si.
Para "dê duas características de uma LAN": ela cobre uma área geográfica pequena (um único local ou prédio); o hardware é propriedade da organização, não alugado de uma empresa de telecom; ela se conecta através de seus próprios switches, cabos e pontos de acesso. Para "duas maneiras pelas quais uma WAN é diferente": ela cobre uma grande área geográfica; usa infraestrutura de terceiros (alugada ou pública); as taxas de transferência de dados são menores e a latência maior; geralmente conecta várias LANs. Uma escola em um único local é uma LAN; uma empresa com escritórios em duas cidades precisa de uma WAN, com uma linha alugada ou a internet entre os locais. Justifique a escolha com base na área coberta e de quem são os enlaces.
Uma rede de área ampla conecta muitos sistemas por uma grande área Vocabulário TreinarInglês Chinês Pinyin network/ˈnetwɜːk/ 网络 wǎng luò Public Switched Telephone Network/ˈpʌblɪk swɪtʃt ˈtelɪfəʊn ˈnetwɜːk/ 公共交换电话网 gōng gòng jiāo huàn diàn huà wǎng 2.1
Cliente-servidor e par-a-par

Cliente-servidor
- máquinas poderosas atuam como servidores 服务器, fornecendo serviços (arquivos, páginas web, e-mail).
- outras máquinas são clientes 客户端 que solicitam serviços.
- Centralizado e fácil de gerenciar, mas o servidor é um ponto único de falha, a menos que haja backup.
Em uma rede cliente-servidor, clientes solicitam serviços de um servidor central Par-a-par (P2P)
- todas as máquinas são pares iguais; cada uma pode ser tanto cliente quanto servidor (peer-to-peer 对等网络).
- os recursos estão distribuídos entre os pares — sem servidor central. Robusta contra uma falha, mas mais difícil de manter segura e consistente.
Escolhendo um modelo. Cliente-servidor adequa-se a uma escola ou empresa: os arquivos são armazenados e feitos backup centralmente, um usuário faz login com uma única conta de qualquer máquina, software e segurança são gerenciados uma única vez, e o servidor pode ser uma máquina poderosa. As desvantagens são o custo do servidor e de um técnico, e que o servidor é um ponto único de falha. Par-a-par adequa-se a poucos amigos compartilhando arquivos ou a um jogo: nenhum servidor para comprar, fácil de configurar, e cada usuário mantém controle de sua própria máquina. As desvantagens que o esquema lista: os arquivos estão espalhados por muitas máquinas, então são difíceis de fazer backup e um arquivo está indisponível quando a máquina do seu proprietário está desligada; cada máquina deve ser protegida separadamente; e um par que serve aos outros diminui a velocidade. Um jogo online jogado através de um navegador web com outros usuários é o modelo cliente-servidor: o navegador é o cliente, e o jogo e seu mundo virtual compartilhado rodam no servidor da empresa, que mantém a visão de cada jogador consistente.
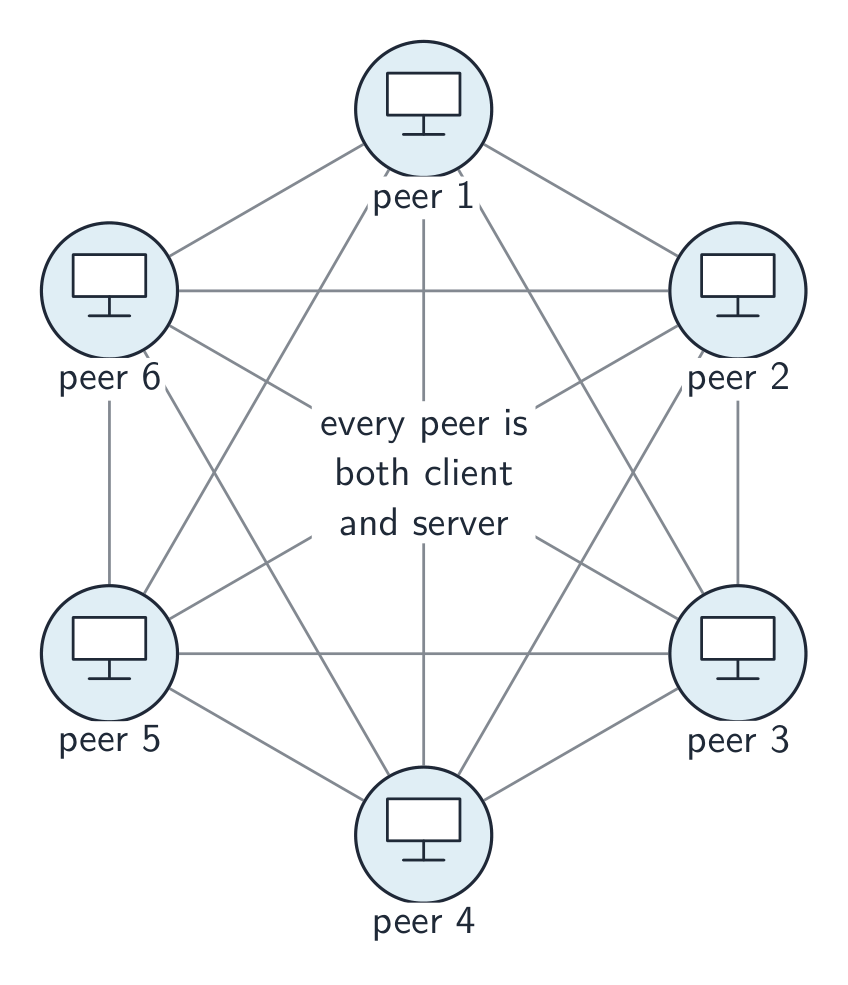
Em uma rede par-a-par, cada nó é tanto cliente quanto servidor Vocabulário TreinarInglês Chinês Pinyin server/ˈsɜːvə/ 服务器 fú wù qì client/ˈklaɪənt/ 客户端 kè hù duān peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò bus/bʌs/ 总线 zǒng xiàn bandwidth/ˈbændwɪdθ/ 带宽 dài kuān 2.1
Clientes finos e pesados
Um cliente fino 瘦 cliente faz pouco processamento local e depende de um servidor poderoso (terminais web, áreas de trabalho remotas). Um cliente pesado 胖 cliente possui forte processamento local e armazenamento e roda aplicativos completos sozinho (um PC desktop normal).
Recurso Cliente fino Cliente pesado Processamento local mínimo substancial Armazenamento local mínimo substancial Dependência da rede alta menor Carga no servidor alta menor Os papéis: em um modelo de cliente fino, o servidor faz o processamento e armazena os dados, e o cliente apenas envia entrada e mostra a saída. Um terminal barato é suficiente, e tudo é feito backup e atualizado no servidor, mas nada funciona se a rede ou o servidor falhar. Em um modelo de cliente pesado, o cliente roda o software e armazena arquivos sozinho, então pode funcionar sem conexão de rede e sobrecarrega menos o servidor, às custas de clientes mais poderosos (e caros) que devem ser atualizados e protegidos individualmente. Uma sala de informática escolar pode usar clientes finos (baratos, gerenciados centralmente); um editor de vídeo precisa de um cliente pesado.
2.1
Topologias de rede
A topologia 拓扑 é como os nós e enlaces estão organizados.
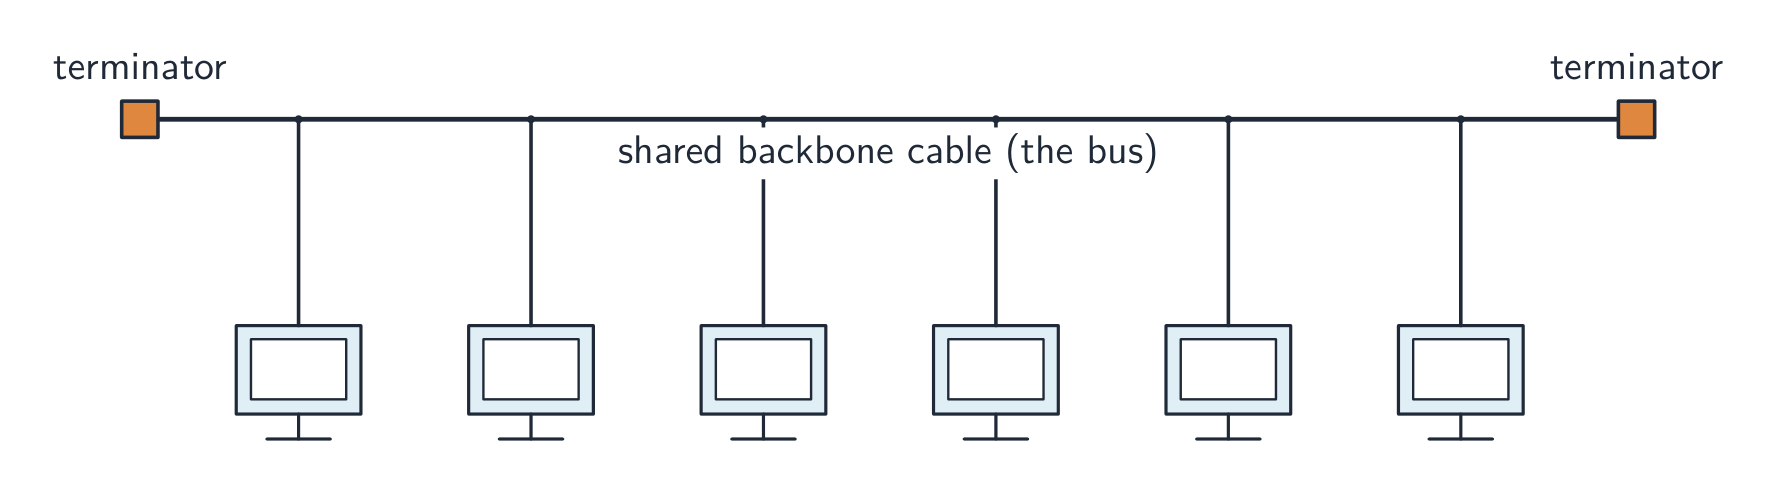
- total 总线 — todos os dispositivos em um único cabo compartilhado. Barata; toda a LAN falha se a total falhar; o desempenho cai conforme mais dispositivos compartilham a largura de banda 带宽.
- estrela 星形 — cada dispositivo se conecta a um switch central. A falha de um dispositivo não afeta os outros; a falha do switch derruba todos. Mais comum hoje.
- malha 网状 — cada dispositivo se conecta diretamente aos outros, com vários caminhos. Muito tolerante a falhas 容错 (o tráfego é redirecionado), mas exige muito cabo.
- híbrida — uma mistura (uma estrela em cada escritório, enlaces em malha entre escritórios).
Topologia total: todos os dispositivos compartilham um cabo com um terminador em cada extremidade 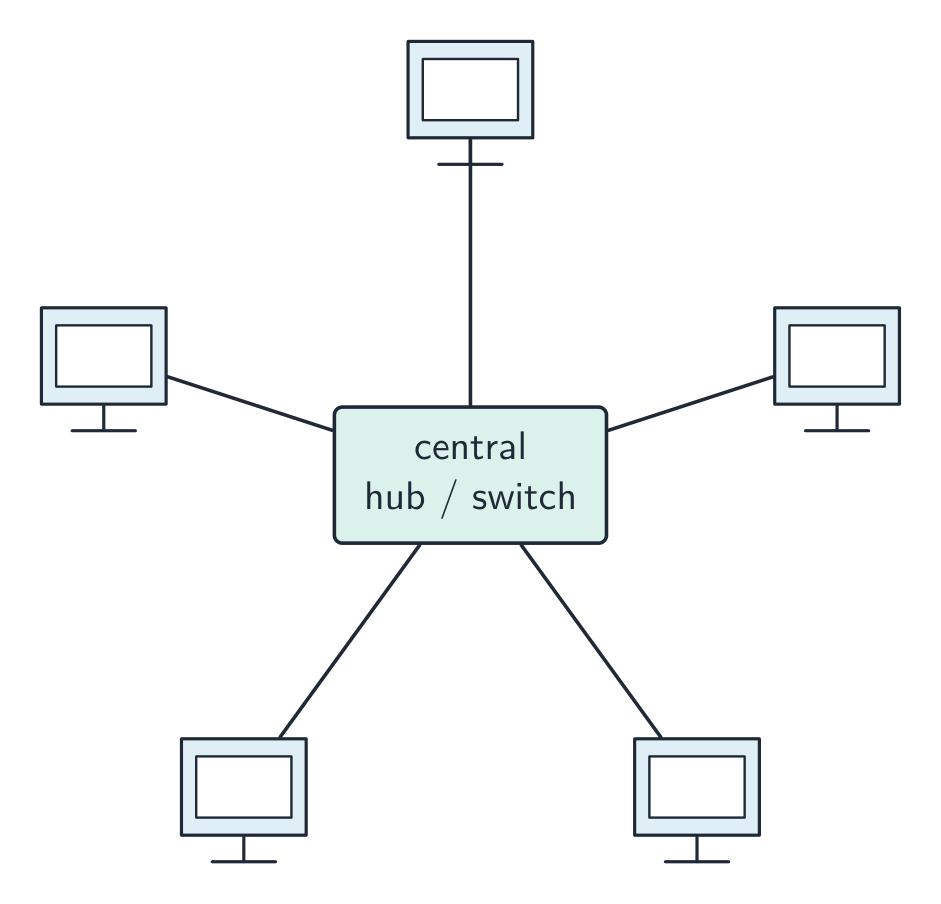
Topologia estrela: cada dispositivo se conecta a um hub ou switch central 
Topologia malha: cada dispositivo se conecta diretamente aos outros 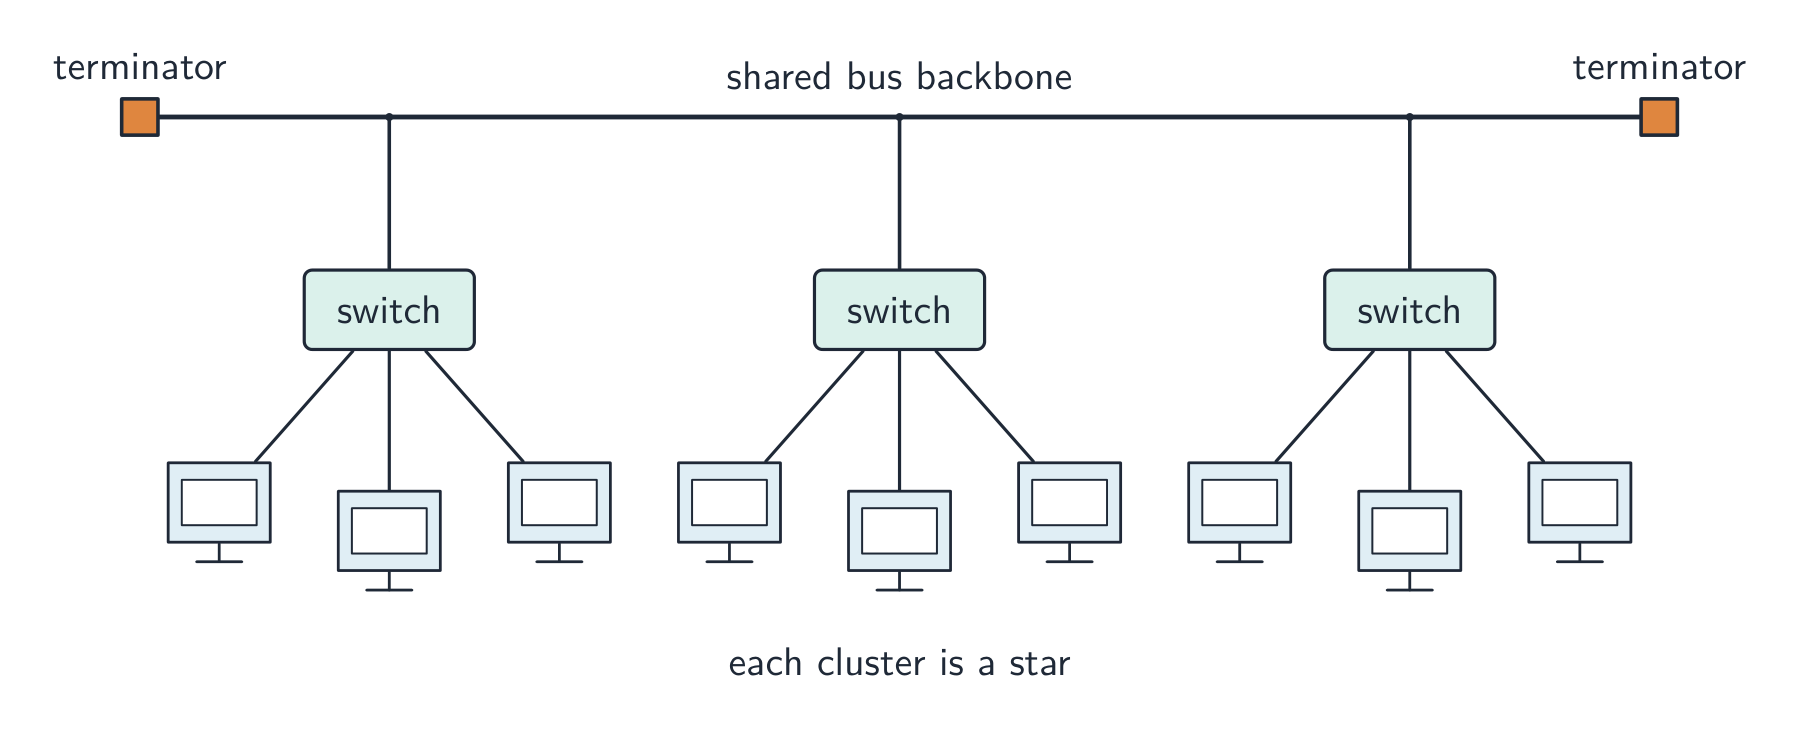
Topologia híbrida: aglomerados de estrelas unidos por uma total central Como os pacotes viajam em cada topologia
Total: o dispositivo remetente coloca o pacote no cabo compartilhado; todos os dispositivos o veem, e apenas aquele cujo endereço corresponde o aceita. Apenas um dispositivo pode transmitir por vez, então colisões ocorrem (CSMA/CD, abaixo). Estrela: o remetente passa o pacote para o switch central, que lê o endereço de destino e o encaminha apenas pelo cabo até esse dispositivo; dois outros dispositivos podem conversar ao mesmo tempo. Malha: o pacote é passado de nó a nó ao longo de um dos vários rotas possíveis até chegar ao destino; se um enlace falhar, outra rota é usada.
Para justificar uma topologia: uma estrela para uma sala de aula ou escritório (um cabo falhado afeta apenas um dispositivo; um dispositivo é fácil de adicionar; com um switch não há colisões); uma malha onde a confiabilidade importa mais (um hospital, o backbone da internet); uma total apenas onde o custo importa e poucos dispositivos a compartilham. "Desenhe a topologia estrela" significa: o switch no meio, uma linha do switch para cada computador, e o servidor (e o roteador, se houver) em suas próprias linhas para o switch.
ExplorarCompare as topologias de rede
Explore as quatro topologias. Cada uma troca custo, velocidade e resistência a falhas — observe o que interrompe toda a rede em cada uma.
Vocabulário TreinarInglês Chinês Pinyin topology/təˈpɒlədʒi/ 拓扑 tuò pū star/stɑː/ 星形 xīng xíng mesh/meʃ/ 网状 wǎng zhuàng fault-tolerant/fɒlt ˈtɒlərənt/ 容错 róng cuò 2.1
Computação em nuvem
Computação em nuvem 云计算 entrega serviços de computação (servidores, armazenamento, software) através da internet, hospedados por uma terceira parte. Benefícios: escalabilidade 可扩展性 (pague pelo que precisar), menor custo, acesso de qualquer lugar e data centers confiáveis e redundantes. Desvantagens: requer internet, seus dados são mantidos por uma terceira parte e possível bloqueio de fornecedor.
Para a definição de uma marca: computação em nuvem é serviços de computação sob demanda (armazenamento, processamento, software) fornecidos através da internet por uma terceira parte. Uma nuvem pública 公有云 é propriedade de um provedor e compartilhada por muitos clientes pela internet; uma nuvem privada 私有云 é dedicada a uma única organização, em seu próprio hardware ou hospedada exclusivamente para ela. Benefícios que o esquema aceita: os arquivos são acessíveis de qualquer dispositivo com conexão à internet; o armazenamento escala para cima e para baixo conforme necessário; o provedor cuida do hardware, backups e atualizações de segurança; não há servidor local para comprar ou manter. Desvantagens: sem acesso sem conexão à internet; os dados estão no hardware de uma terceira parte, então segurança e privacidade dependem do provedor; custo de assinatura recorrente; o provedor pode falhar ou ser atacado; arquivos grandes podem demorar para transferir. Uma resposta "por que a empresa usa uma nuvem pública" diz que eles não precisam de seu próprio hardware, pagam apenas pelo que usam, e seus usuários podem acessá-lo de qualquer lugar.
2.1
Com fio vs sem fio
- com fio (Ethernet 以太网 sobre par trançado 双绞线 ou fibra óptica 光纤): maior velocidade, menor latência, menos erros, mais seguro.
- sem fio (Wi-Fi, Bluetooth, celular): sem cabos, dispositivos podem se mover, mas mais lento, propenso a interferência e escuta clandestina.
Para a mesma geração, o com fio vence em velocidade e confiabilidade; o sem fio vence em conveniência.
Meios de transmissão
Meio Características cabo de cobre (par trançado, coaxial) barato e fácil de instalar; transmite um sinal elétrico; afetado por interferência eletromagnética; o sinal enfraquece com a distância, exigindo repetidores; largura de banda inferior à da fibra óptica cabo de fibra óptica pulsos de luz em núcleo de vidro; largura de banda muito alta; longas distâncias sem repetidores; imune a interferências; difícil de interceptar, sendo seguro; caro e requer instalação especializada ondas de rádio (incluindo WiFi) sem cabos, permitindo que dispositivos se movam; alcance de dezenas de metros, enfraquecido por paredes; frequência compartilhada, causando interferência e velocidade reduzida; pode ser interceptado, exigindo criptografia micro-ondas ondas de rádio de alta frequência para enlaces ponto a ponto; requer linha de visão; afetadas pela chuva e edifícios; alta largura de banda satélites alcançam áreas remotas e todo o globo; alto atraso (latência), pois o sinal viaja até a órbita e volta; afetados pelo tempo; caros O exame pede a comparação em ambas as direções. O cabeado supera o sem fio em velocidade, confiabilidade (sem interferência), segurança (um cabo precisa ser fisicamente acessado) e consistência; o sem fio supera o cabeado em mobilidade, custo de instalação e adição de dispositivos sem fiação. Permitir ambos permite que alunos se movam com laptops e telefones enquanto os desktops fixos mantêm a conexão mais rápida e segura, e um dispositivo sem porta de rede ainda pode se conectar. Satélite em vez de cobre alcança lugares onde nenhum cabo chega, mas com mais atraso, interferência climática e maior custo.
Vocabulário TreinarInglês Chinês Pinyin ethernet/ˈiːθənet/ 以太网 yǐ tài wǎng twisted-pair/ˈtwɪstɪd peə/ 双绞线 shuāng jiǎo xiàn fibre-optic/ˈfaɪbə ˈɒptɪk/ 光纤 guāng xiān 2.1
Hardware LAN

- placa de interface de rede 网络接口卡 (NIC) — permite que um dispositivo envie e receba dados na rede; possui um endereço MAC único MAC地址 (um endereço de hardware de 48 bits). Um dispositivo sem fio usa uma placa de interface de rede sem fio 无线网络接口卡 (WNIC).
- interruptor 交换机 — encaminha apenas quadros Ethernet para a porta correspondente ao endereço MAC de destino.
- hub 集线器 — dispositivo mais simples que copia o tráfego para todas as portas (hoje obsoleto).
- ponto de acesso sem fio 无线接入点 (WAP) — permite que clientes sem fio se conectem a uma LAN cabeada.
- fiação — par trançado para curtas distâncias; fibra óptica para distâncias maiores e velocidades mais altas.
- servidor — computador que fornece um serviço aos outros dispositivos: arquivos, impressão, páginas web, armazenamento de e-mail.
- bridge 网桥 — une dois segmentos LAN em uma única rede, passando o tráfego entre eles.
- repeater 中继器 — recebe um sinal enfraquecido e o retransmite em força total, estendendo o alcance do cabo.
As funções de uma WNIC, para uma questão de quatro marcas descreva: converte os dados em sinais de rádio e vice-versa; transporta o endereço MAC único do dispositivo; conecta o dispositivo a um ponto de acesso sem fio e segue o protocolo sem fio (qual canal e frequência usar); e decodifica os sinais entrantes para o dispositivo. Dois dispositivos que podem conectar fisicamente trinta computadores com NICs: um switch ou um hub.
Um switch de rede: o cabo de cada dispositivo é conectado a uma de suas portas 
Um plugue RJ-45 em um cabo Ethernet par trançado 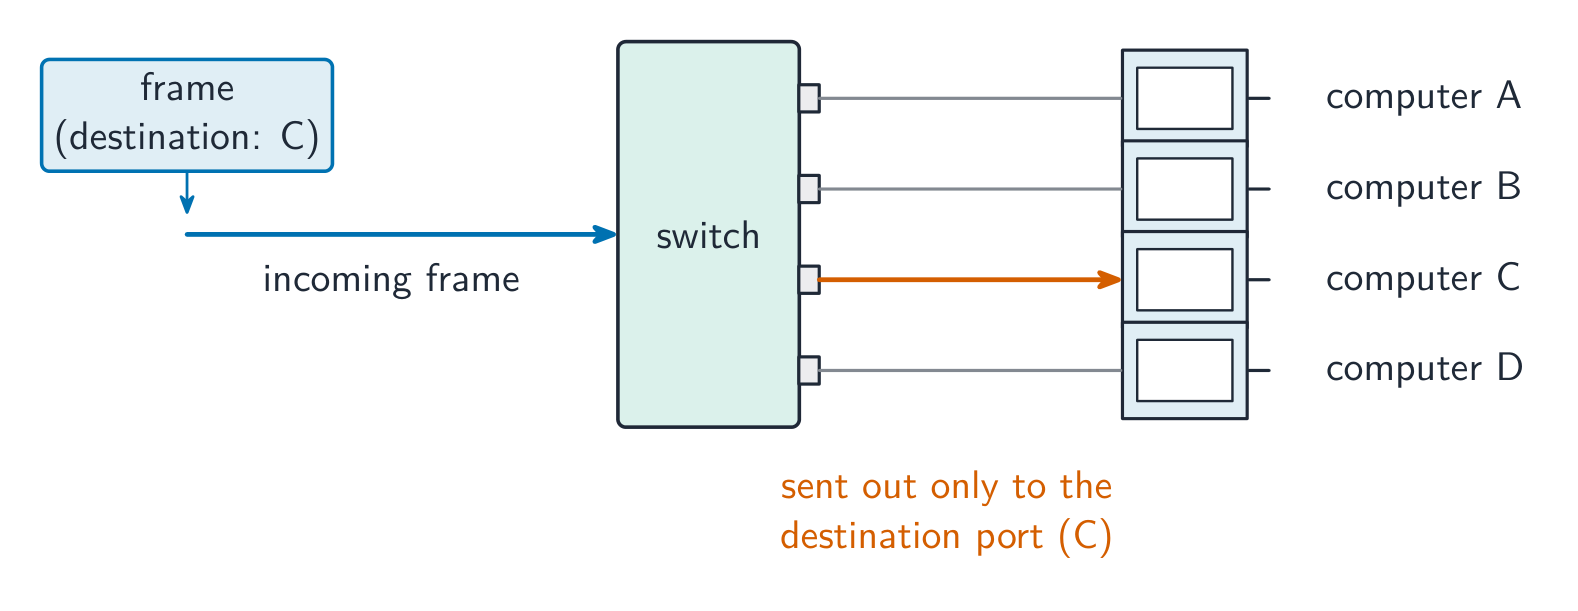
Um switch envia cada quadro apenas para a porta de seu destino Vocabulário TreinarInglês Chinês Pinyin switch/swɪtʃ/ 交换机 jiāo huàn jī hub/hʌb/ 集线器 jí xiàn qì packet/ˈpækɪt/ 数据包 shù jù bāo repeater/rɪˈpiːtə/ 中继器 zhōng jì qì network interface card/ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 网络接口卡 wǎng luò jiē kǒu kǎ MAC address/mæk əˈdres/ MAC地址 MAC dì zhǐ wireless network interface card/ˈwaɪələs ˈnetwɜːk ˈɪntəfeɪs kɑːd/ 无线网络接口卡 wú xiàn wǎng luò jiē kǒu kǎ wireless access point/ˈwaɪələs ˈækses pɔɪnt/ 无线接入点 wú xiàn jiē rù diǎn bridge/brɪdʒ/ 网桥 wǎng qiáo 2.1
Routers
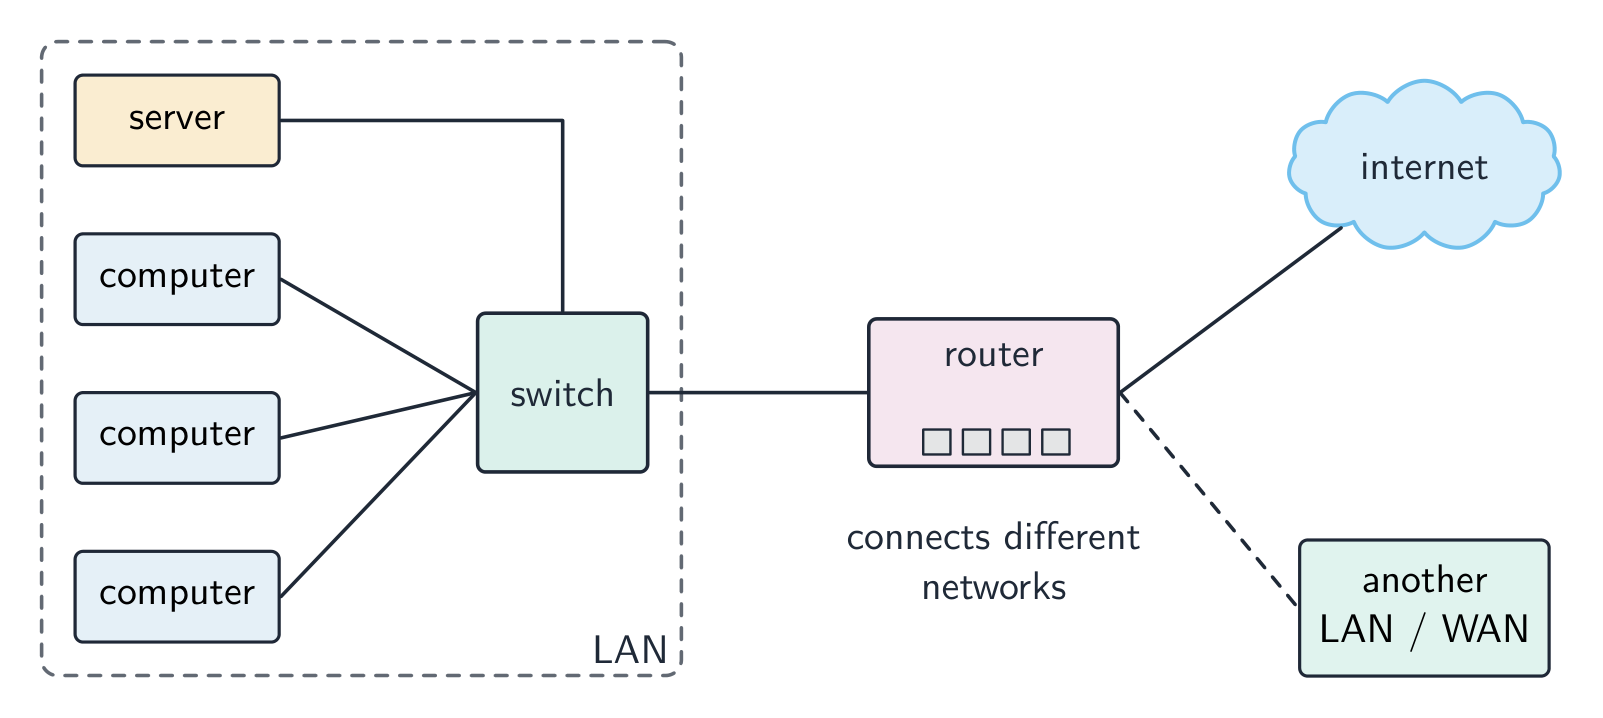
Um router 路由器 conecta redes diferentes e encaminha dados entre elas — geralmente na fronteira de uma LAN e da internet. Ele faz:
- encaminhamento — lê o endereço IP de destino IP地址 de cada pacote 数据包 e o envia pela porta correta, usando uma tabela de roteamento 路由表.
- tradução de endereços de rede 网络地址转换 (NAT) — permite que muitos endereços privados de LAN compartilhem um único IP público.
- DHCP 动态主机配置协议 — atribui endereços IP privados a dispositivos LAN.
- firewall 防火墙 — bloqueia tráfego indesejado entrante.
Na comutação de pacotes 分组交换, uma mensagem é dividida em pacotes enviados independentemente. Cada router lê o endereço IP de destino de um pacote, consulta o próximo salto em sua tabela de roteamento e o encaminha, então os pacotes de uma mesma mensagem podem tomar rotas diferentes e são reagrupados na ordem correta no destino. Um router recebe pacotes, os encaminha entre redes e distribui endereços IP; ele não descobre o IP associado a uma URL (isso é feito pelo DNS) e não armazena páginas web. Um router doméstico também contém o modem e o ponto de acesso sem fio, então um único aparelho conecta a LAN à internet.
Um router conecta uma LAN à internet ou a outra rede Vocabulário TreinarInglês Chinês Pinyin router/ˈruːtə/ 路由器 lù yóu qì cloud computing/klaʊd kəmˈpjuːtɪŋ/ 云计算 yún jì suàn scalability/ˌskeɪləˈbɪlɪti/ 可扩展性 kě kuò zhǎn xìng public cloud/ˈpʌblɪk klaʊd/ 公有云 gōng yǒu yún private cloud/ˈpraɪvət klaʊd/ 私有云 sī yǒu yún DHCP/ˌdiː eɪtʃ siː ˈpiː/ 动态主机配置协议 dòng tài zhǔ jī pèi zhì xié yì firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn 2.1
Ethernet e CSMA/CD

Ethernet é o padrão (protocolo) para LANs cabeadas: dispositivos são unidos por cabo par trançado ou fibra, os dados são enviados em quadros que contêm endereços MAC de origem e destino, e um meio compartilhado usa CSMA/CD para lidar com colisões. Em meios compartilhados, uma colisão 冲突 pode ocorrer quando dois dispositivos transmitem simultaneamente. O protocolo é CSMA/CD 载波侦听多路访问/冲突检测 (Carrier Sense Multiple Access with Collision Detection):
- detecção de portadora — escutar antes de enviar; esperar se o cabo estiver ocupado.
- acesso múltiplo — muitos dispositivos compartilham o meio.
- detecção de colisão — continuar escutando enquanto envia; um choque é uma colisão.
- em caso de colisão, ambos param, enviam um sinal de "jam" breve, depois esperam um tempo de backoff aleatório antes de tentar novamente.
As três tarefas, nas palavras do esquema: o dispositivo escuta (detecta a portadora) antes de transmitir; verifica continuamente por colisões durante a transmissão; em caso de colisão, para, envia um sinal jam, espera um tempo aleatório e retransmite.
A Ethernet comutada moderna usa enlaces ponto a ponto full-duplex 全双工, portanto colisões já não ocorrem.
O processo CSMA/CD para lidar com colisões em meios compartilhados Vocabulário TreinarInglês Chinês Pinyin collision/kəˈlɪʒn/ 冲突 chōng tū CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè full-duplex/fʊl ˈdjuːpleks/ 全双工 quán shuāng gōng 2.1
Bit streaming

Bit streaming 流式传输 envia multimídia como um fluxo contínuo que o receptor reproduz à medida que chega, em vez de baixar o arquivo inteiro primeiro.
- em tempo real (ao vivo): capturado e transmitido conforme acontece (esporte ao vivo, videochamadas). Não é possível rebobinar; baixa latência é vital.
- sob demanda: pré-gravado em um servidor (YouTube, Netflix). É possível pausar e rebobinar; o servidor pode bufferizar 缓冲 adiante.
O streaming em tempo real funciona como um curto pipeline:
- capturar e amostrar a fonte (câmera ou microfone).
- codificar, usando compressão 压缩 para reduzir os dados.
- enviar pela rede em pacotes.
- o receptor bufferiza um pouco, depois reproduz ao vivo — descartando qualquer pacote que chegue atrasado, pois um stream ao vivo não pode esperar por ele.
Compressão com perda 有损 compression é usada aqui: imagens em movimento ocultam pequenas perdas, e o stream deve ser pequeno o suficiente para caber na largura de banda.
Por que um vídeo é comprimido antes do streaming em tempo real: o stream sem compressão precisaria de mais largura de banda do que a conexão oferece, fazendo com que os frames chegassem atrasados e a reprodução travasse. A compressão reduz o número de bits, mantendo a taxa de bits 比特率 abaixo da velocidade da banda larga, o atraso pequeno e menos armazenamento e custo em ambas as extremidades. A taxa de bits deve ser menor que a velocidade da conexão: uma taxa mais alta dá melhor qualidade, mas exige conexão mais rápida; se os dados chegarem mais devagar do que são reproduzidos, o buffer esvazia e o vídeo congela. O streaming sob demanda pode bufferizar mais do arquivo adiante, lidando bem com conexões lentas; o streaming em tempo real não consegue.
Dados fluem do servidor para um buffer antes do player de mídia ler Vocabulário TreinarInglês Chinês Pinyin bit streaming/bɪt ˈstriːmɪŋ/ 流式传输 liú shì chuán shū buffer/ˈbʌfə/ 缓冲 huǎn chōng compression/kəmˈpreʃn/ 压缩 yā suō lossy/ˈlɒsi/ 有损 yǒu sǔn bit rate/bɪt reɪt/ 比特率 bǐ tè lǜ 2.1
A internet e a World Wide Web

A internet 互联网 é uma rede de redes global usando um conjunto comum de protocolos 协议 (TCP/IP). A World Wide Web 万维网 (WWW) é um serviço que roda sobre ela: documentos hiperlinkados identificados por URLs, visualizados em navegadores via HTTP/HTTPS. E-mail e transferência de arquivos são outros serviços da internet que não fazem parte da WWW.
Webmail usa ambos: a WWW, porque a caixa de entrada é uma página web acessada por uma URL em um navegador via HTTP; e a internet, porque o próprio e-mail viaja pela rede de redes (e-mail é um serviço separado da internet em relação à web).
A Web é um serviço rodando sobre a Internet Hardware que suporta a internet
- modem 调制解调器 — converte o sinal digital do computador em sinal analógico para uma linha telefônica, e vice-versa na outra extremidade (modulação e demodulação).
- PSTN — a rede telefônica pública de centrais e linhas; uma conexão dial-up ou DSL transporta dados da internet por ela.
- linha dedicada 专线 — uma linha alugada entre uma organização e seu ISP: sempre ativa, com largura de banda fixa que não é compartilhada, sendo mais rápida e confiável, mas cara.
- rede de celular 蜂窝网络 — o telefone envia dados por rádio para a torre celular mais próxima (estação base); as torres estão ligadas à rede da operadora, que roteia os dados para a internet; à medida que o telefone se move, ocorre handover de uma célula para a próxima.

Três formas de acessar a internet: modem e PSTN, linha dedicada e rede de celulares Vocabulário TreinarInglês Chinês Pinyin internet/ˈɪntənet/ 互联网 hù lián wǎng local area network/ˈləʊkl ˈeərɪə ˈnetwɜːk/ 局域网 jú yù wǎng latency/ˈleɪtənsi/ 延迟 yán chí wide area network/waɪd ˈeərɪə ˈnetwɜːk/ 广域网 guǎng yù wǎng protocol/ˈprəʊtəkɒl/ 协议 xié yì IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo network address translation/ˈnetwɜːk əˈdres trænˈsleɪʃn/ 网络地址转换 wǎng luò dì zhǐ zhuǎn huàn modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì World Wide Web/wɜːld waɪd web/ 万维网 wàn wéi wǎng dedicated line/ˈdedɪkeɪtɪd laɪn/ 专线 zhuān xiàn 2.1
Endereços IP
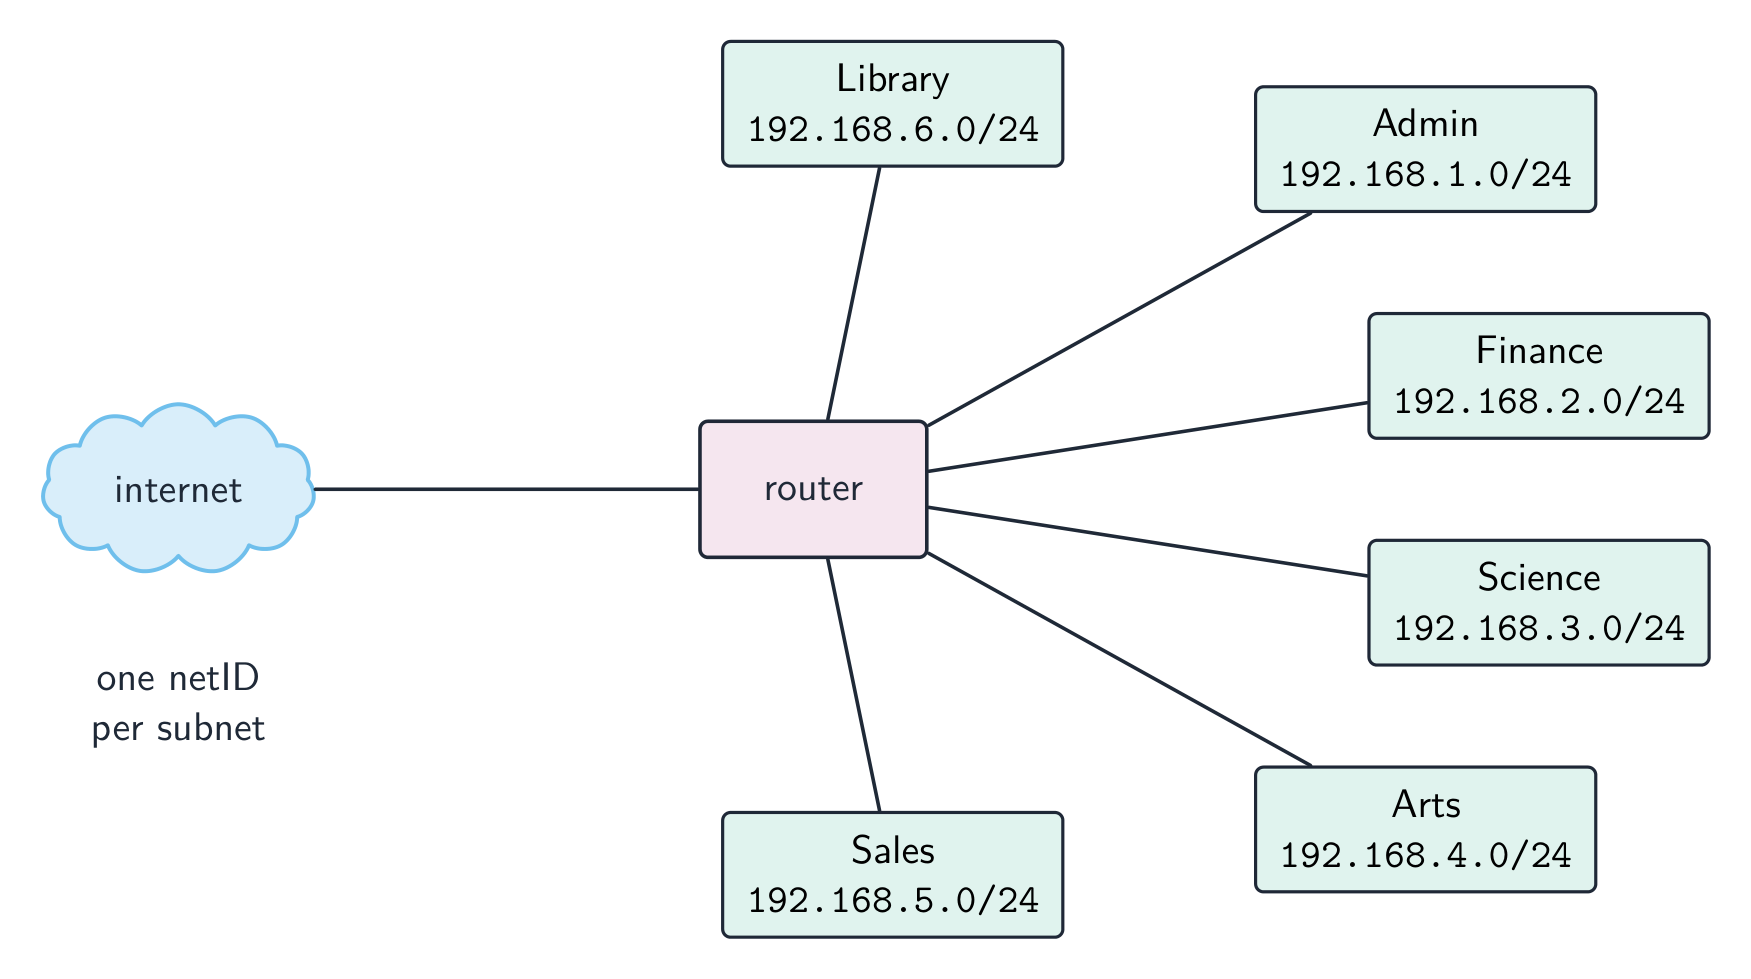
Um endereço IP identifica unicamente um dispositivo.
- IPv4 — 32 bits, quatro números decimais de 0 a 255 (
192.168.1.10); cerca de $4.3 \times 10^{9}$ endereços (agora esgotados). - IPv6 — 128 bits, oito grupos de quatro dígitos hexadecimais; cerca de $3.4 \times 10^{38}$ endereços.
O IPv4 é escrito como quatro grupos de números decimais separados por pontos; cada grupo é um número de 8 bits, variando de 0 a 255. O IPv6 é escrito como oito grupos de quatro dígitos hexadecimais separados por dois-pontos,
2001:0db8:0000:0000:0000:ff00:0042:8329, e uma sequência de grupos nulos pode ser abreviada para::. Portanto,192.168.3.2não é IPv6: tem quatro grupos, não oito, separados por pontos em vez de dois-pontos, e seus grupos são decimais, não hexadecimais.256.0.0.Anão é um endereço válido de nenhum dos tipos: um grupo IPv4 não pode exceder 255 nem conter letras, e o IPv6 precisaria de dois-pontos e oito grupos.Sub-redes
Uma rede pode ser dividida em sub-redes 子网. O endereço IP divide-se em uma parte de rede e uma parte de host, definidas por uma máscara de sub-rede 子网掩码 (ex.
255.255.255.0= os primeiros 24 bits são da rede). A subdivisão melhora a gestão, reduz o tráfego de broadcast e aumenta a segurança.As duas partes de um endereço numa sub-rede: o ID de rede (os primeiros bits, os mesmos para todos os dispositivos naquela sub-rede, dados pelos uns na máscara) e o ID de host (os bits restantes, únicos para cada dispositivo). Benefícios da subdivisão, para "descrever dois benefícios": menos tráfego em cada parte, pois as transmissões permanecem dentro da sua sub-rede; melhor segurança, porque o tráfego de um departamento é mantido fora dos outros; gestão mais fácil e diagnóstico de falhas; uso mais eficiente dos endereços. Dois dispositivos com a máscara
255.255.255.0estão em sub-redes diferentes quando seus três primeiros grupos diferem.Dividir uma rede em sub-redes, um ID de rede por departamento Endereços públicos vs privados
- endereços privados são usados dentro de uma LAN e não são roteáveis na internet (ex.
192.168.0.0/16). - um endereço IP público é globalmente único e roteável, atribuído por um ISP 互联网服务提供商.
Dispositivos atrás do NAT com endereços privados não são diretamente acessíveis pela internet, oferecendo alguma proteção.
As descrições que as tabelas pedem: um endereço público é visível na internet e único nela, alocado pelo ISP; um endereço privado é visível apenas dentro da LAN, é reutilizado por muitas LANs e precisa de NAT para alcançar a internet. Um endereço estático nunca muda (definido manualmente ou reservado, como um servidor precisa); um endereço dinâmico é alocado pelo DHCP toda vez que o dispositivo se conecta e pode mudar.
Estático vs dinâmico
- um endereço IP estático é fixo; usado para servidores que devem ser encontrados em um endereço conhecido.
- um endereço IP dinâmico é atribuído pelo DHCP e pode mudar; mais fácil para dispositivos clientes e usa eficientemente um pool de endereços limitado.
Exemplo resolvido. Um host tem endereço IP
192.168.10.130com máscara de sub-rede255.255.255.192. Em qual rede ele está, e192.168.10.200está na mesma? O último octeto da máscara,192, é11000000em binário, então os primeiros 26 bits são a parte da rede e os últimos 6 bits endereçam o host. Isso faz com que as sub-redes avançam em blocos de $256 - 192 = 64$:.0,.64,.128,.192. O endereço130cai no bloco que começa em.128, então o host está na rede192.168.10.128/26, cujos hosts utilizáveis vão de.129a.190(.191é o endereço de broadcast).200cai no bloco seguinte (.192), então está em uma sub-rede diferente e o tráfego entre os dois deve passar por um roteador. Obtenha o tamanho do bloco primeiro a partir da máscara ($256$ menos o octeto da máscara) — adivinhar pelos três primeiros octetos é o que causa erros nestes exercícios.Vocabulário TreinarInglês Chinês Pinyin ISP/ˌaɪ es ˈpiː/ 互联网服务提供商 hù lián wǎng fú wù tí gōng shāng cell phone network/sel fəʊn ˈnetwɜːk/ 蜂窝网络 fēng wō wǎng luò subnets/ˈsʌbnets/ 子网 zi wǎng subnet mask/ˈsʌbnet mæsk/ 子网掩码 zi wǎng yǎn mǎ 2.1
URL e DNS
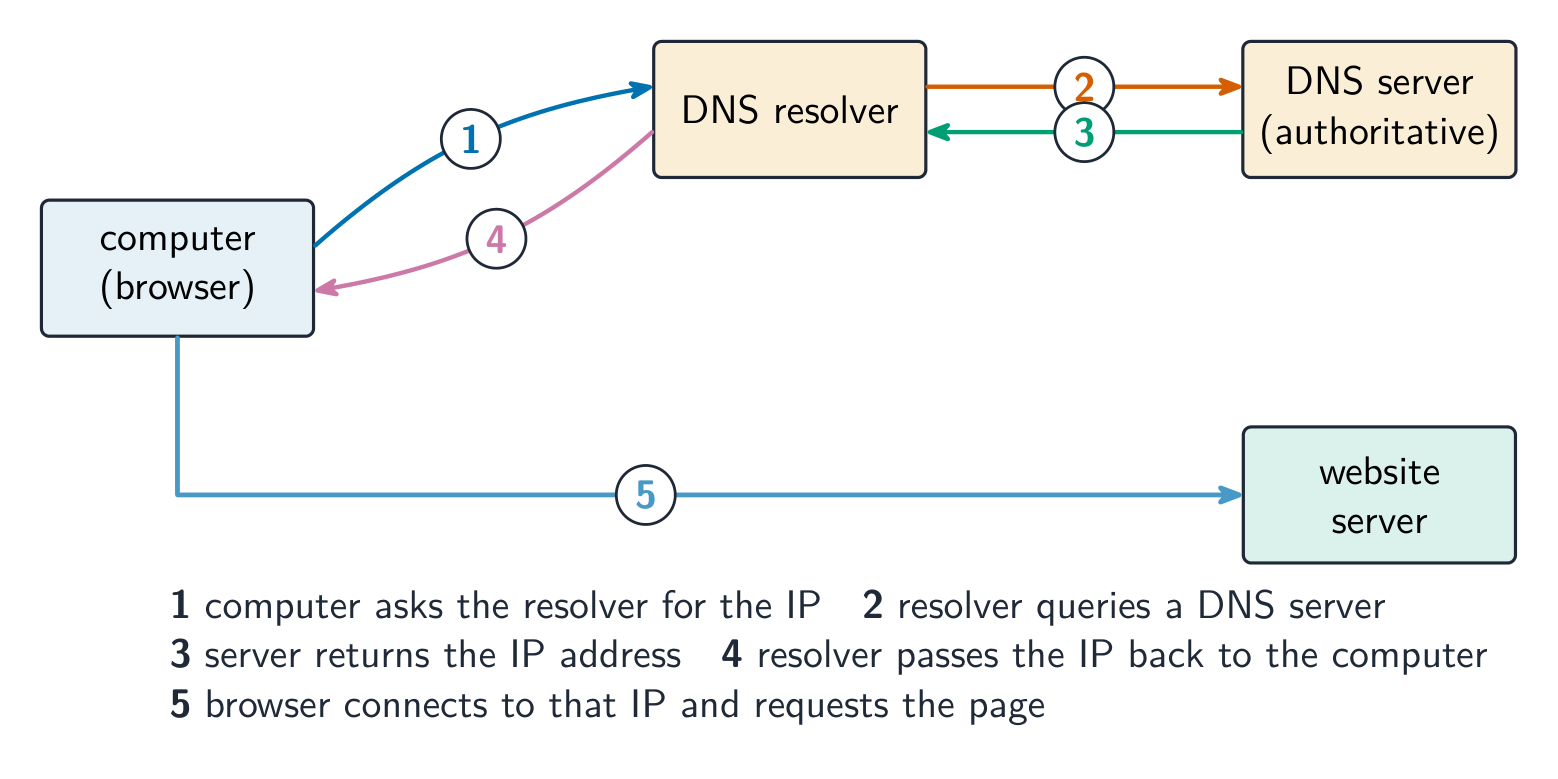
Uma URL 统一资源定位符 (Uniform Resource Locator) localiza um recurso na WWW:
https://www.example.com/about/contact.html protocol domain name path- protocolo:
http,https, etc. - nome de domínio 域名: um endereço de servidor legível.
- caminho: o recurso naquele servidor.
O Sistema de Nomes de Domínio 域名系统 (DNS, também chamado de Serviço de Nomes de Domínio) é um conjunto distribuído de servidores que converte nomes de domínio em endereços IP. Quando você digita uma URL, o navegador pede ao resolveror DNS o IP, que consulta servidores DNS (raiz → nível superior → autoritativo) até encontrá-lo; o navegador então se conecta a esse IP e solicita o caminho. O DNS poupa os humanos de memorizar endereços IP e permite que um site mude de servidor sem mudar seu nome.
Para "explique como o navegador usa a URL": o navegador divide a URL em protocolo, nome de domínio e caminho; envia o nome de domínio a um servidor DNS, que retorna o endereço IP correspondente (um cache no computador ou no ISP pode responder primeiro); abre uma conexão com esse endereço IP usando o protocolo (HTTPS na porta 443); envia uma solicitação para o caminho; e o servidor web retorna a página, que o navegador renderiza. Se a consulta DNS falhar, o navegador relata que o servidor não pôde ser encontrado.
*Como o DNS encontra o IP de um site antes que o navegador se conecteExplorarComo o DNS localiza um site
Passo a passo de uma consulta DNS. A rede roteia por IP, não por nome — então, antes de qualquer coisa carregar, o DNS deve converter o nome de domínio em um endereço IP.
Vocabulário TreinarInglês Chinês Pinyin URL/ˌjuː ɑː ˈel/ 统一资源定位符 tǒng yī zī yuán dìng wèi fú domain name/dəˈmeɪn neɪm/ 域名 yù míng Domain Name System/dəˈmeɪn neɪm ˈsɪstəm/ 域名系统 yù míng xì tǒng 2.1
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
Termo Definição LAN uma rede cobrindo uma pequena área geográfica, geralmente um local, cujo hardware é propriedade da organização WAN uma rede cobrindo uma grande área geográfica, conectando LANs através de enlaces de terceiros (alugados ou públicos) cliente-servidor um modelo em que computadores clientes solicitam serviços de um servidor central mais poderoso que os fornece par-a-par um modelo em que cada computador é igual e pode atuar tanto como cliente quanto como servidor, sem servidor central " thin client " thick client topologia mesh uma topologia em que cada dispositivo está conectado diretamente a muitos outros, proporcionando mais de uma rota entre dois dispositivos computação em nuvem serviços de computação sob demanda (armazenamento, processamento, software) fornecidos pela internet por um terceiro Ethernet o protocolo padrão para LANs cabeadas, enviando dados em quadros e usando CSMA/CD em um meio compartilhado interruptor um dispositivo que encaminha cada quadro apenas para a porta do seu endereço MAC de destino, dentro de uma LAN roteador um dispositivo que conecta redes e encaminha pacotes entre elas pelo seu endereço IP de destino streaming de bits enviar um fluxo contínuo de bits para que o receptor reproduza a mídia conforme chega, sem baixar todo o arquivo primeiro internet a rede global de redes que usa os protocolos TCP/IP World Wide Web a coleção de páginas web hiperligadas, identificadas por URLs e acessadas sobre a internet através de um navegador URL o endereço que localiza um recurso na web: protocolo, nome de domínio e caminho DNS o serviço que traduz um nome de domínio no endereço IP do servidor que detém o recurso Vocabulário TreinarInglês Chinês Pinyin thick client/θɪk ˈklaɪənt/ 胖客户端 pàng kè hù duān thin client/θɪn ˈklaɪənt/ 瘦客户端 shòu kè hù duān 2.1
Dicas de prova
- Distinguir LAN vs WAN e cliente-servidor vs par-a-par por quem armazena e controla os recursos.
- Correspondar cada topologia (barra, estrela, malha) a suas vantagens e desvantagens (custo, confiabilidade, colisões).
- Conhecer a função de cada dispositivo: um interruptor direciona dentro de uma LAN pelo endereço MAC, um roteador roteia entre redes pelo IP.
- Explicar streaming de bits e por que o buffer é necessário (os dados chegam a uma taxa diferente da reprodução).
- Distinguir IPv4 vs IPv6 e endereços públicos vs privados; DNS transforma uma URL em um endereço IP.
Erros comuns
- Dizer que um switch funciona por endereço IP. Um switch encaminha por endereço MAC dentro da LAN; o roteador encaminha por endereço IP entre redes.
- Tratar a internet e a World Wide Web como a mesma coisa. A web é um serviço que roda sobre a internet; email e transferência de arquivos são outros.
- Dar "mais rápido" como a única comparação entre cabeadas e sem fio. Diga mais rápido e mais confiável e mais seguro, e dê o lado sem fio (mobilidade, sem fiação) quando a pergunta pedir uma comparação.
- Escrever que um roteador encontra o endereço IP para uma URL. O DNS faz isso; o roteador encaminha pacotes para ele.
- Descrever o IPv6 com pontos e grupos decimais. Oito grupos de quatro dígitos hexadecimais, separados por dois-pontos.
- Desenhar uma topologia estrela como um anel ou corrente. Cada dispositivo tem sua própria linha para o switch no meio.
-
3
Hardware
Assistir aula3.1
Computadores e seus componentes
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da necessidade de entrada, saída, memória primária e armazenamento secundário (incluindo removível) Demonstrar compreensão de sistemas embutidos Incluindo: benefícios e desvantagens dos sistemas embutidos Descrever as principais operações de dispositivos de hardware Incluindo: Impressora a laser, impressora 3D, microfone, alto-falantes, disco rígido magnético, memória de estado sólido (flash), leitor/gravador de disco óptico, tela sensível ao toque, óculos de realidade virtual Demonstrar compreensão do uso de buffers Explicar as diferenças entre Memória de Acesso Aleatório (RAM) e Memória Somente Leitura (ROM) Incluindo seu uso em uma variedade de dispositivos e sistemas Explicar as diferenças entre Memória RAM Estática (SRAM) e Memória RAM Dinâmica (DRAM) Incluindo o uso de SRAM e DRAM em uma variedade de dispositivos e sistemas e os motivos para usar um em vez do outro dependendo do dispositivo e de seu uso Explicar a diferença entre ROM Programmável (PROM), ROM Programmável Apagável (EPROM) e ROM Programmável Apagavel Electricamente (EEPROM) Demonstrar compreensão de sistemas de monitoramento e controle Incluindo: • diferença entre monitoramento e controle • uso de sensores (incluindo temperatura, pressão, infravermelho, som) e atuadores • importância do feedback Fonte: Programa Cambridge International
Um computador de uso geral tem quatro blocos construtivos:
- dispositivos de entrada 输入设备 — inserem dados (teclado, mouse, microfone, scanner, sensores).
- dispositivos de saída 输出设备 — apresentam resultados (monitor, alto-falantes, impressora, atuadores).
- memória principal 主存储器 — memória rápida que o processador 处理器 (CPU) acessa diretamente (RAM e ROM). Mantém o programa em execução e seus dados.
- armazenamento secundário 辅助存储器 — mais lento, maior, mantém programas e dados quando não estão em uso (disco rígido, SSD, disco óptico, pen drive).
O programa exige saber por que cada um é necessário. Dispositivos de entrada são necessários porque o computador só pode trabalhar com dados e instruções que foram inseridos. Dispositivos de saída são necessários para apresentar os resultados em uma forma utilizável pelas pessoas. A memória principal é necessária porque o processador só pode executar instruções e usar dados que estão armazenados na memória que ele pode endereçar diretamente, e deve acessá-los rapidamente. O armazenamento secundário é necessário porque a memória principal é volátil e pequena: programas e dados devem sobreviver à desligamento da energia, em um armazenamento maior e mais barato, e o armazenamento removível permite mover dados entre computadores ou mantê-los como backup.
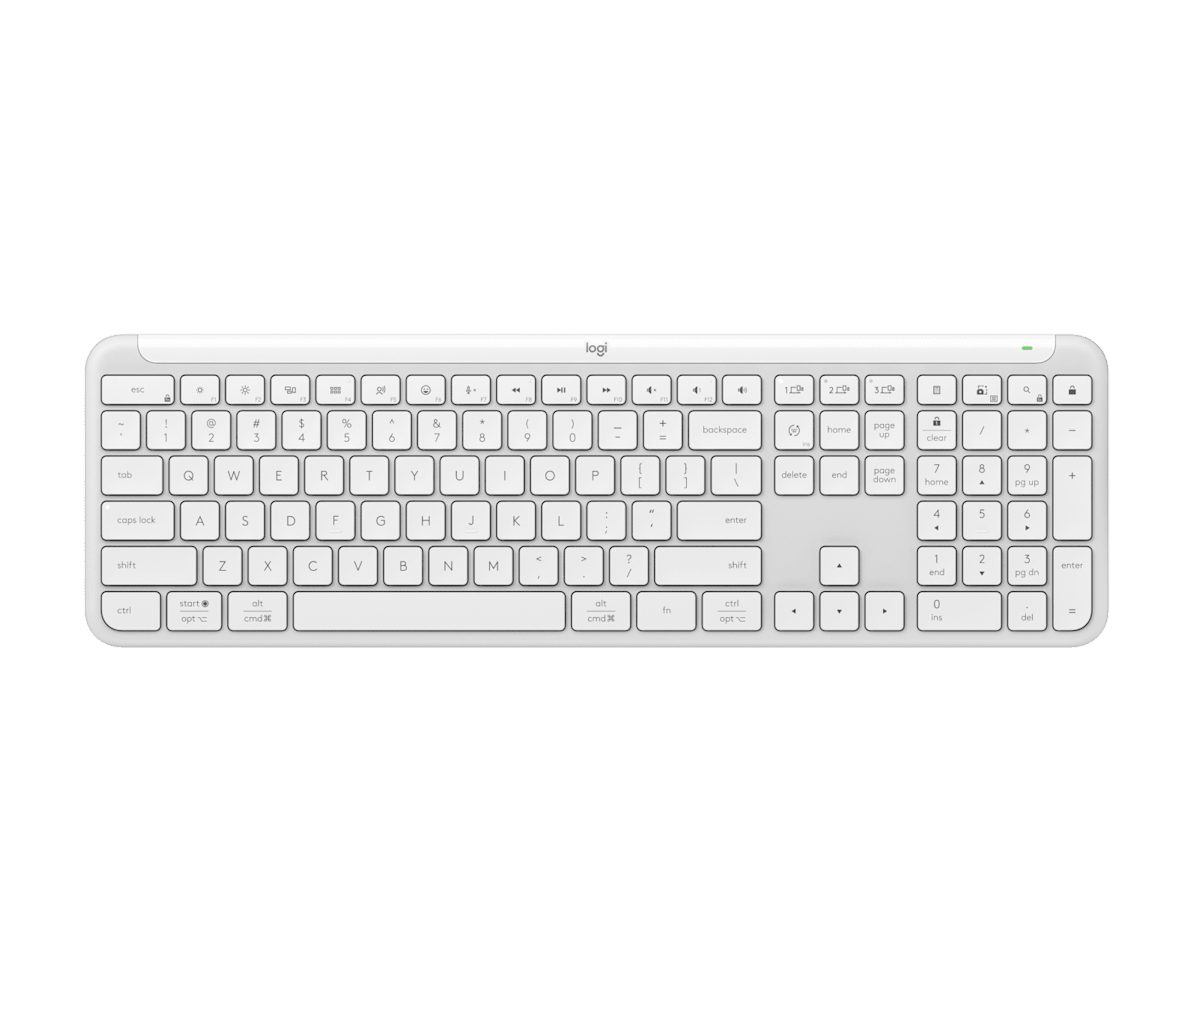
Um teclado: um dispositivo de entrada comum para digitar texto e comandos 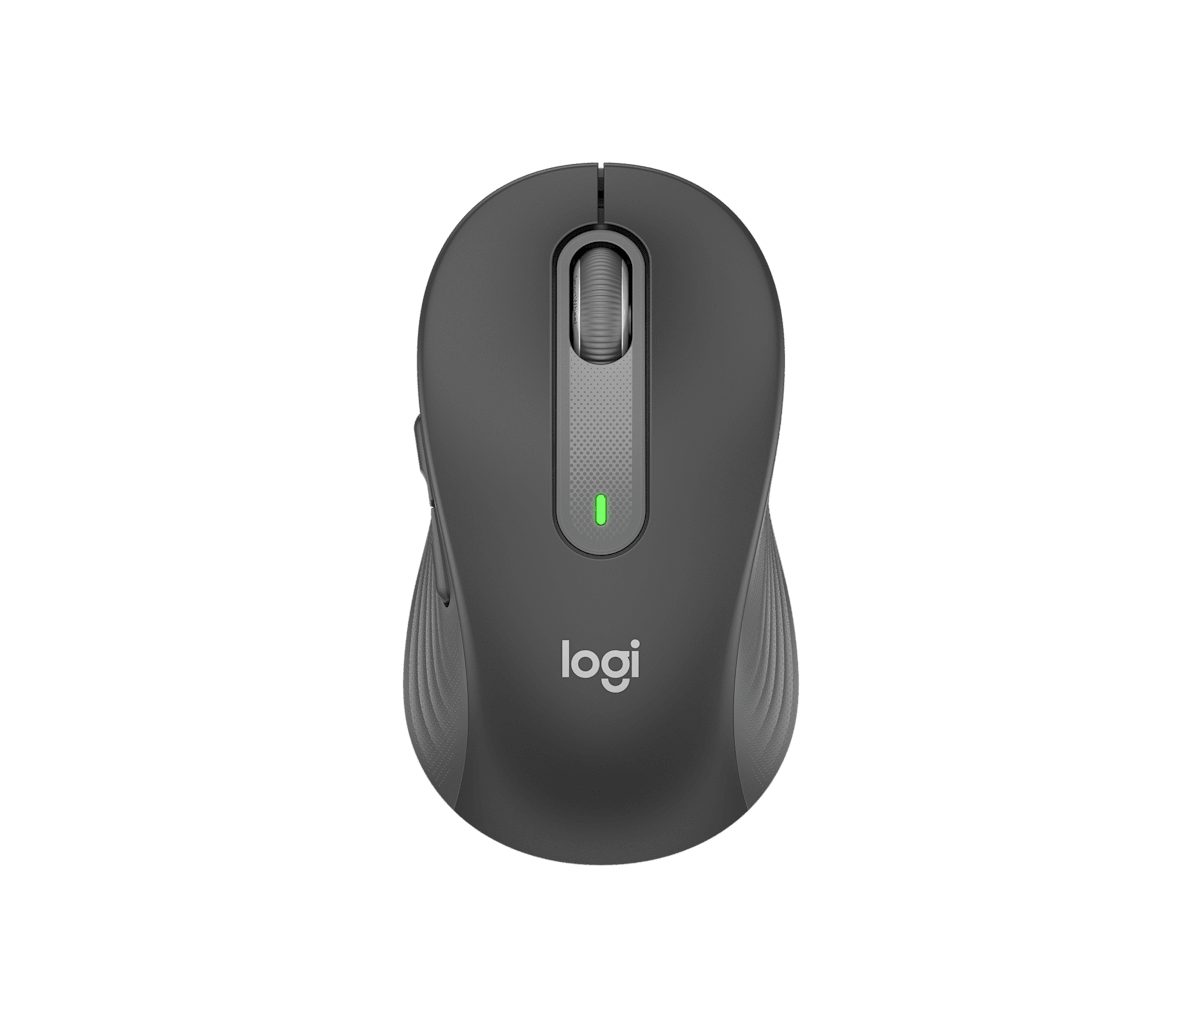
Um mouse: um dispositivo de ponteiro de entrada 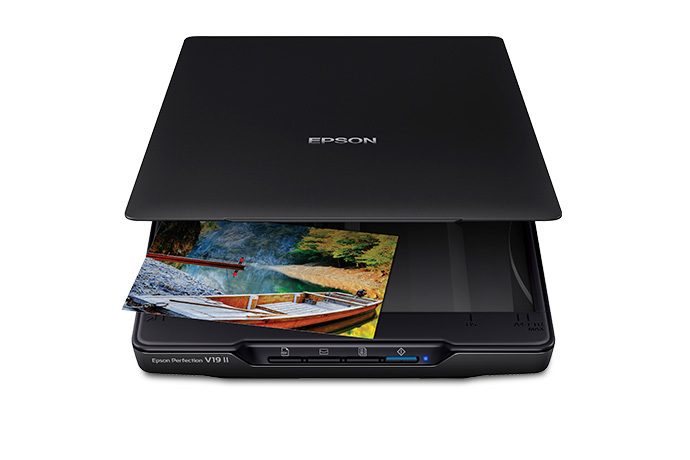
Um scanner de leito plano: um dispositivo de entrada que transforma uma página de papel em uma imagem digital 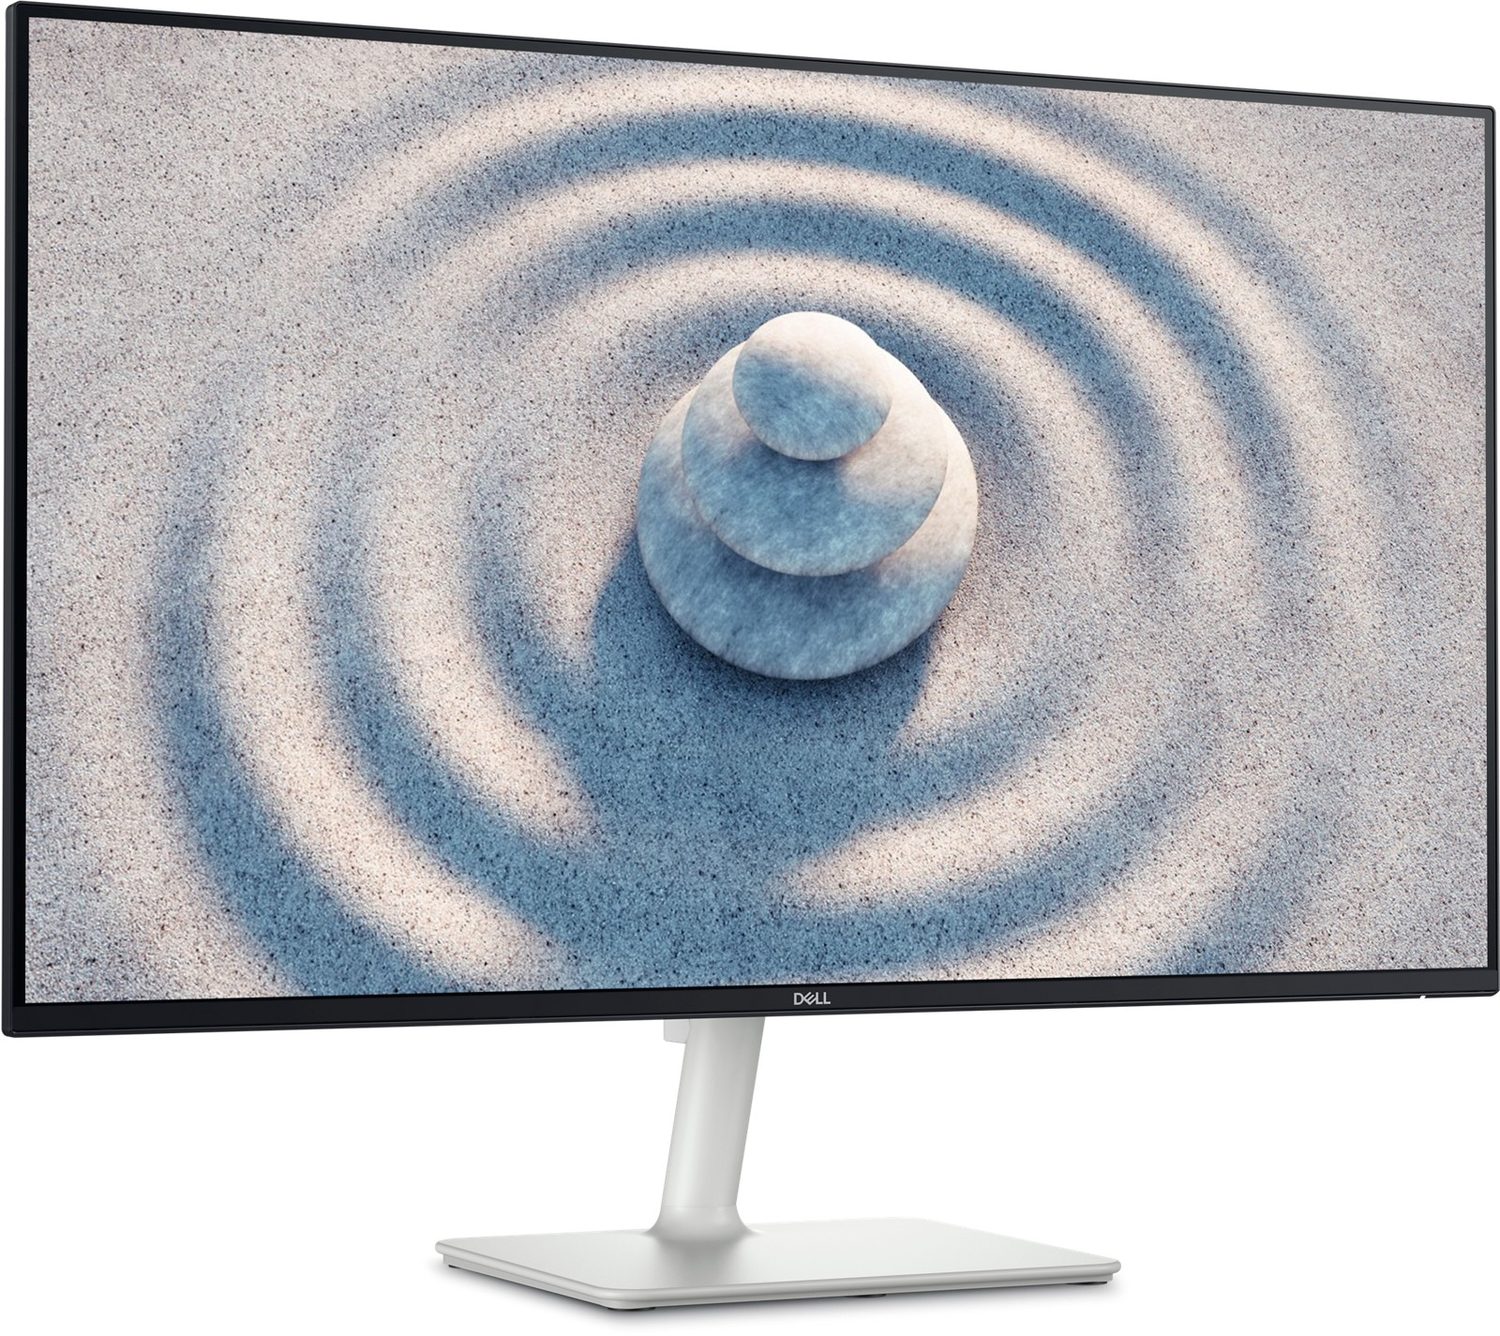
Um monitor: um dispositivo de saída comum que exibe a imagem do ecrã ExplorarToque nos blocos de um sistema de computador
Explore os quatro blocos mais a CPU. Os dados fluem entrada → processamento → saída, enquanto a memória primária segura o programa em execução e o armazenamento secundário o mantém para depois.
ExplorarLaboratório de roteamento de rede
Siga os dados de um dispositivo através do hardware de rede e protocolos.
3.1
Sistemas embarcados
Um sistema embarcado 嵌入式系统 é um computador construído dentro de outro dispositivo para realizar uma tarefa fixa (máquina de lavar, micro-ondas, unidade de motor do carro, termostato).
- vantagens: optimizado para uma única tarefa, por isso é pequeno, consome pouca energia e é barato de fabricar em grande escala; fiável, porque executa um programa fixo com poucas oportunidades de erro; inicia rapidamente e não requer configuração pelo utilizador; fácil de usar através de uma interface simples.
- desvantagens: limitado à sua única tarefa, por isso não pode ser atualizado para fazer mais coisas; difícil de atualizar (o seu firmware 固件 pode precisar de ferramentas especiais ou não pode ser alterado); difícil de diagnosticar e, geralmente, todo o dispositivo deve ser substituído quando falha; se estiver ligado a uma rede, pode ser uma fraqueza de segurança, porque o seu software raramente é corrigido.
Uma questão "descreva as desvantagens" pretende que cada desvantagem seja apresentada como um ponto completo: qual é a limitação e o que significa para o utilizador, por exemplo "o firmware não pode ser atualizado, por isso um defeito de segurança descoberto mais tarde não pode ser corrigido".
Vocabulário TreinarInglês Chinês Pinyin firmware/ˈfɜːmweə/ 固件 gù jiàn 3.1
Dispositivos de hardware principais
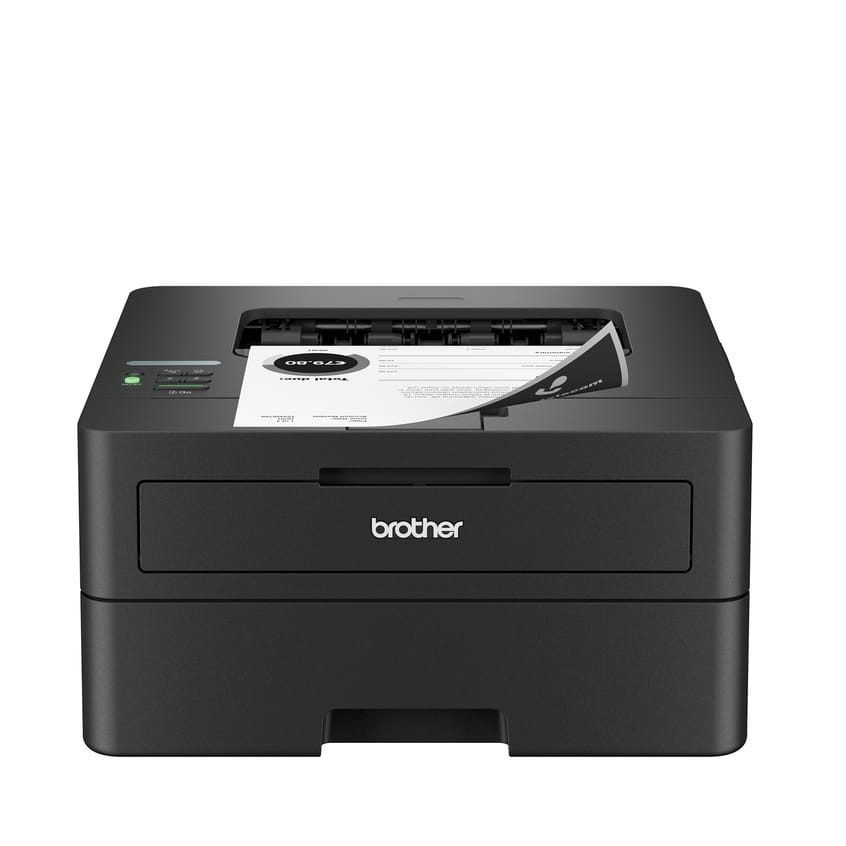
Impressora a laser
Uma impressora a laser 激光打印机 digitaliza a imagem da página num tambor fotosensível carregado. O toner 墨粉 adere às áreas carregadas, transfere-se para o papel e é fundido por um fixador. Rápida, nítida, alta capacidade.
Uma impressora a laser: impressão rápida e nítida utilizando um tambor carregado e toner Como funciona, nos passos listados no guia de correção:
- Os dados da página são enviados para o buffer da impressora.
- O tambor recebe uma carga eletrostática uniforme.
- Um laser, refletido por um espelho rotativo, digitaliza a imagem da página no tambor, removendo a carga onde atinge, de modo que a carga restante no tambor corresponde à imagem.
- O toner, um pó carregado, é atraído apenas para as partes carregadas do tambor.
- O papel recebe a carga oposta e rola contra o tambor, transferindo o toner para ele.
- O fixador 定影器, um par de rolos aquecidos, funde o toner no papel. O tambor é então descarregado e limpo para a próxima página.
Impressora 3D
Uma impressora 3D 3D打印机 constrói um objeto camada por camada: FDM derrete filamento plástico através de uma bocal; estereolitografia cura resina líquida com um laser UV. Usada para protótipos e peças médicas personalizadas.

Uma impressora 3D FDM constrói um objeto camada por camada fundindo filamento plástico Como funciona:
- Um modelo do objeto é desenhado em software CAD (ou escaneado).
- Software de fatiamento divide o modelo em camadas horizontais finas e produz as instruções para cada uma.
- A impressora constrói o objeto camada a camada: uma impressora FDM derrete filamento plástico 塑料丝 e deposita-o através de um bocal móvel; uma impressora de resina cura resina líquida com um laser ou luz UV; uma impressora de pó funde pó com um laser.
- Cada camada une-se à camada inferior, e a plataforma (ou bocal) move-se na espessura de uma camada.
- Quando a última camada está pronta, qualquer material de suporte é removido. As utilizações incluem protótipos, peças médicas personalizadas como próteses, e peças sobressalentes impressas sob demanda.
Microfone e altifalantes
Um microfone 麦克风 converte som num sinal elétrico (um diafragma vibra, alterando a carga do capacitor 电容器 ou a posição da bobina); o sinal é digitalizado por um conversor analógico-digital 模数转换器 (ADC). Um altifalante faz o inverso — um sinal variável aciona uma bobina num campo magnético, movendo um cone para produzir som.
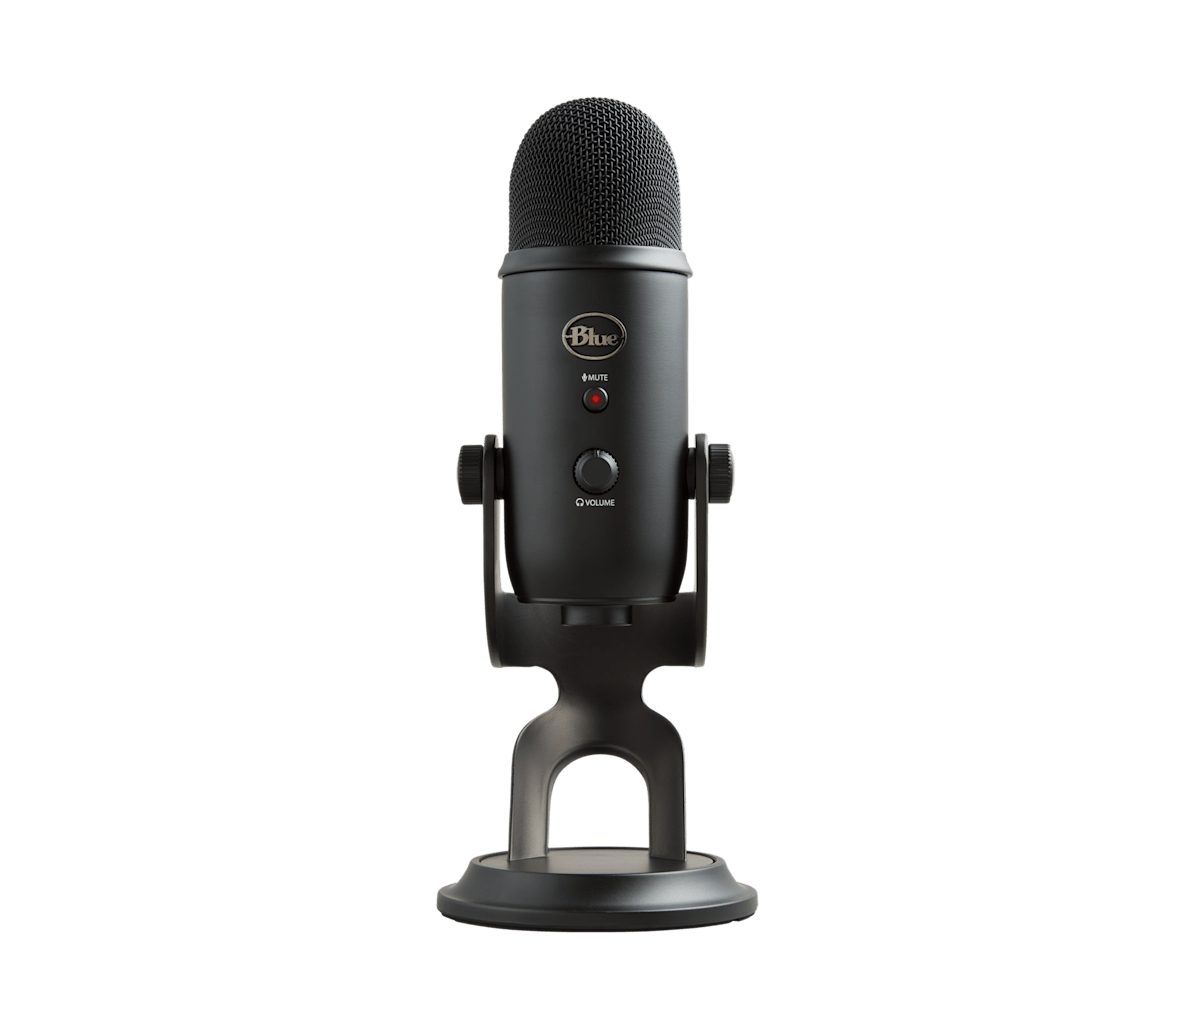
Um microfone converte som num sinal elétrico 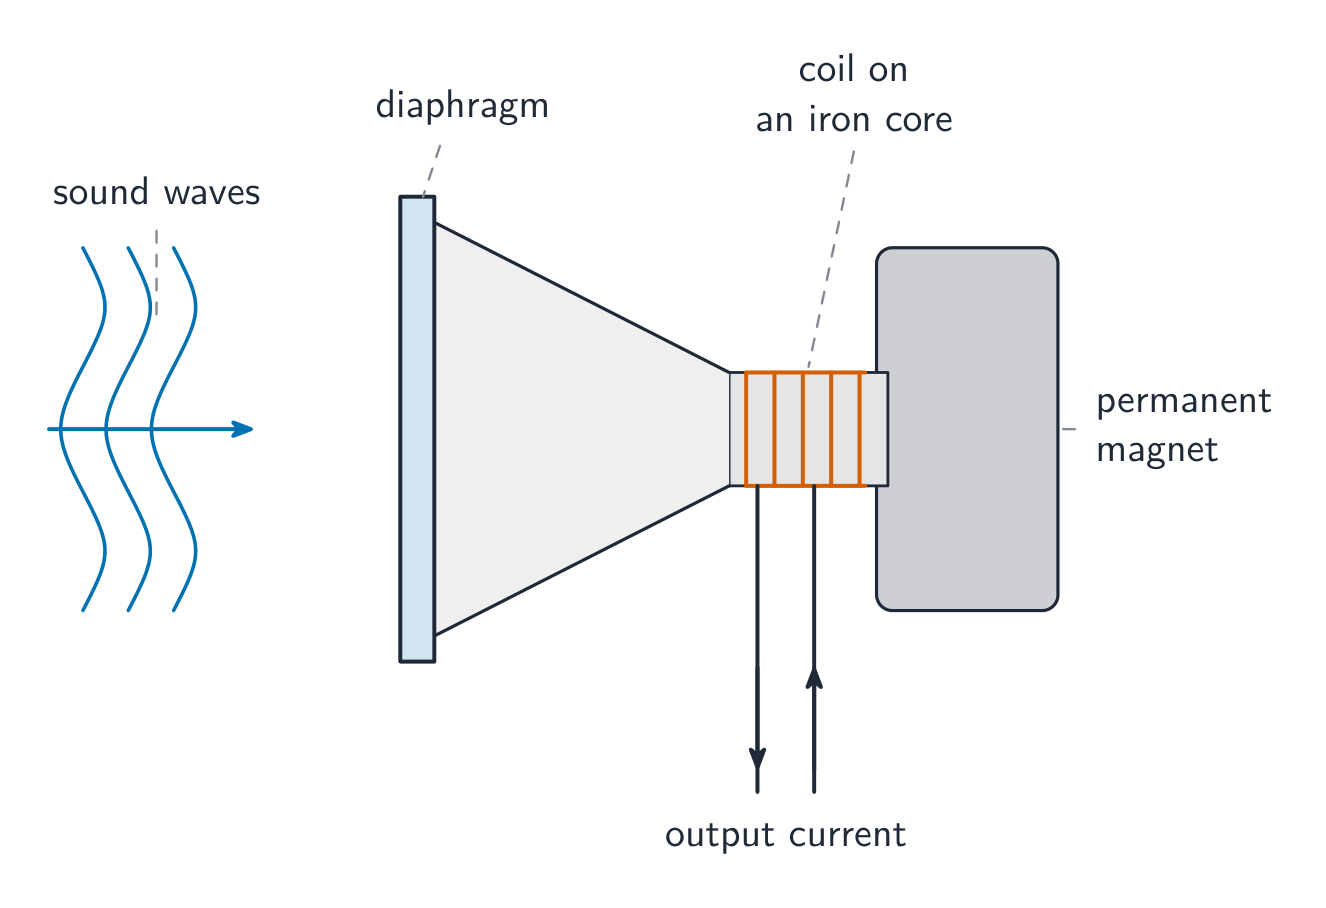
Dentro de um microfone: o som vibra o diafragma e a bobina para produzir uma corrente 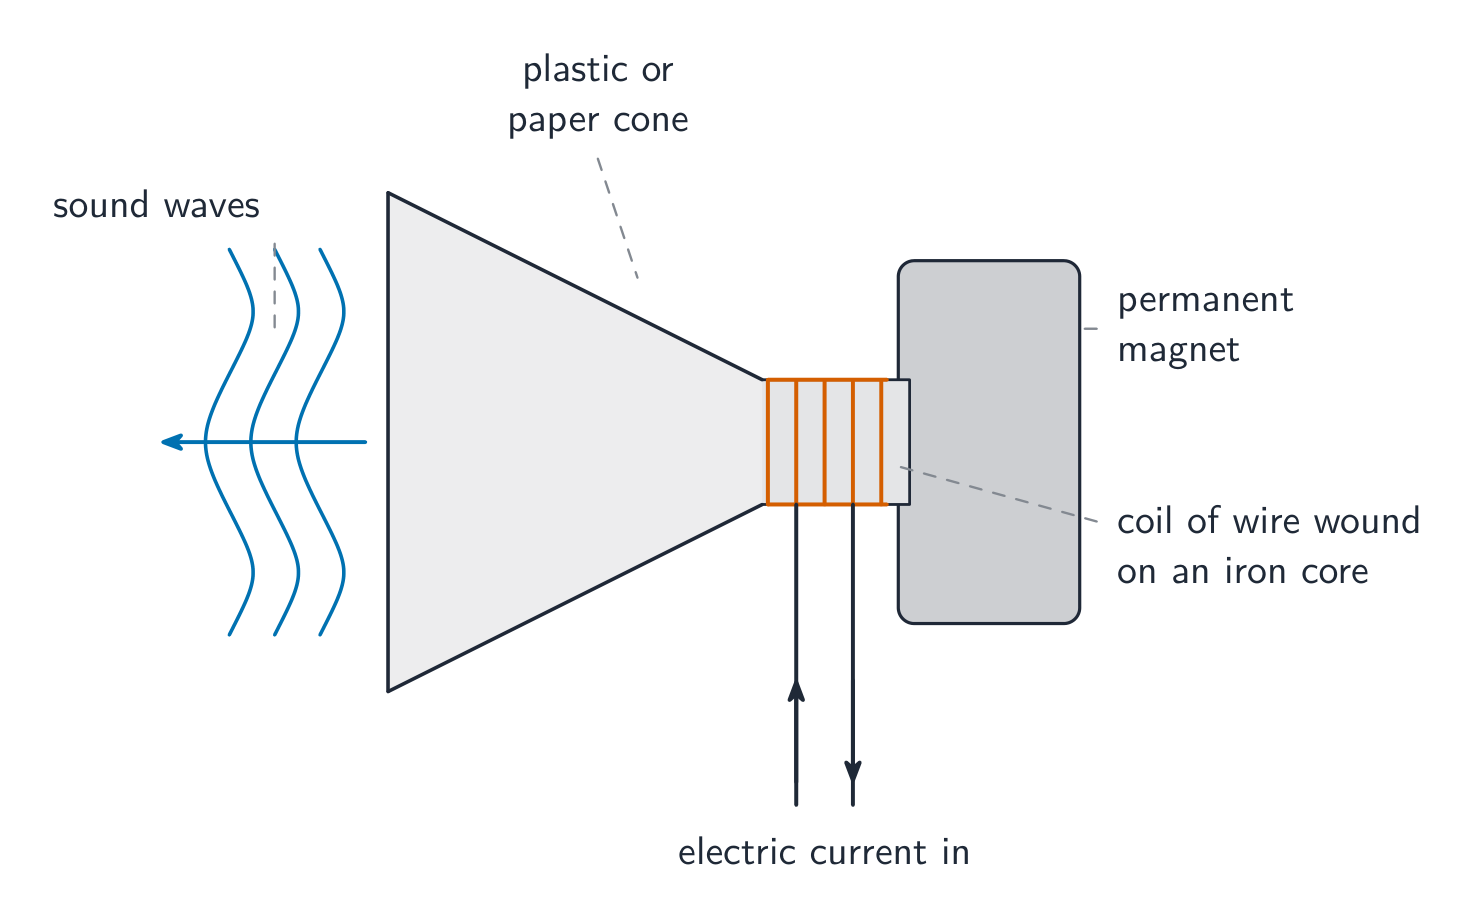
No interior de um alto-falante: uma corrente variável na bobina move o cone para produzir som Como funciona um microfone: ondas sonoras fazem um diafragma 膜片 vibrar; num microfone dinâmico, uma bobina ligada ao diafragma move-se num campo magnético, induzindo uma corrente variável nele, e num microfone condensador o diafragma é uma placa de um capacitor cuja capacitância muda conforme se move; o sinal analógico variável é depois amostrado por um ADC e armazenado como dados digitais. Um altifalante percorre a cadeia ao contrário: um conversor digital-analógico 数模转换器 (DAC) produz uma corrente variável, a corrente na bobina cria um campo magnético variável que empurra contra o íman permanente, a bobina e o cone movem-se para dentro e para fora, e o movimento do cone gera ondas de pressão no ar.
Disco rígido magnético (HDD)
Um disco rígido 硬盘 armazena dados em pratos girantes revestidos com material magnético. Cada prato tem trilhas 磁道 divididas em setores 扇区. Uma cabeça de leitura/escrita 读写头 flutua logo acima e magnetiza pequenas regiões (escrita) ou as deteta (leitura). Barato por gigabyte, mas mais lento que SSDs e possui peças móveis.
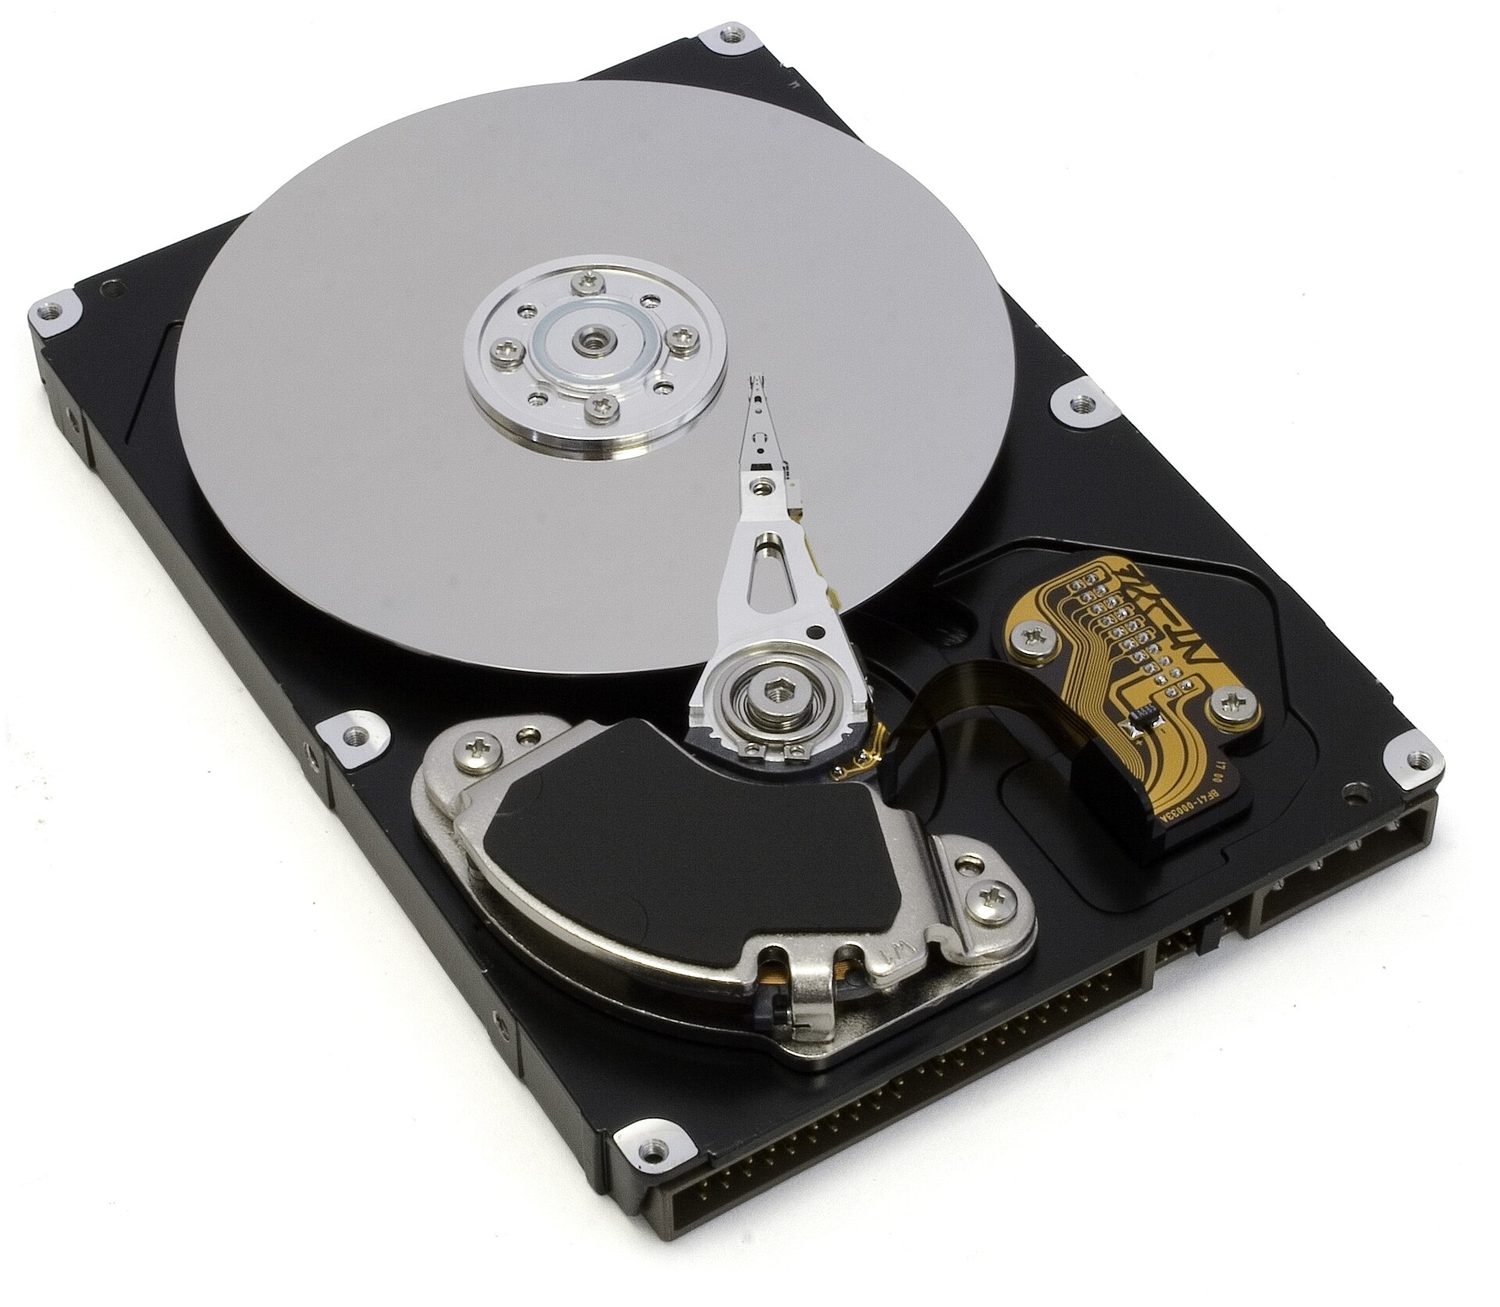
Um disco rígido aberto: o braço atuador transporta a cabeça de leitura/escrita sobre um prato 
Trilhas e setores num prato de disco rígido Como funciona: os pratos giram a alta velocidade (milhares de rotações por minuto); cada superfície é dividida em trilhas concêntricas e cada trilha em setores; cabeças de leitura/escrita em braços atuadores 磁头臂 movem-se pelos pratos até à trilha correta; para escrever, a cabeça magnetiza uma pequena região com uma das duas polaridades, representando 0 ou 1; para ler, detecta a polaridade à medida que a região passa por baixo dela. Os atrasos, esperando o braço alcançar a trilha e o setor girar, são por isso que um disco rígido é mais lento que um SSD.
Memória de estado sólido (flash)
Uma unidade de estado sólido 固态硬盘 armazena dados como carga em transistores 晶体管, sem peças móveis. Acesso aleatório mais rápido que HDDs, mais resistente, menor consumo de energia, mas mais caro por gigabyte; cada célula desgasta após muitas escritas.

No interior de um SSD: os dados são armazenados em chips de memória flash, sem peças móveis (compare com o disco rígido acima) Como funciona: cada célula é um transistor de porta flutuante 浮栅晶体管; uma carga aprisionada na porta flutuante representa um bit e permanece lá quando a alimentação é desligada; um chip controlador mapeia cada endereço para uma célula e distribui as escritas pelas células, porque uma célula suporta apenas um número limitado de escritas.
Disco rígido magnético Unidade de estado sólido Peças móveis pratos e cabeças nenhum Velocidade mais lento: atrasos de busca e rotação acesso aleatório muito mais rápido Custo por gigabyte menor maior Robustez danificado por golpes; ruidoso; mais energia resistente a choques; silencioso; menos energia Vida útil muitas reescritas; desgaste mecânico ciclos de escrita limitados por célula Uma questão "por que um servidor usa discos rígidos em vez de SSDs" pretende a coluna da esquerda: mais barato por gigabyte para capacidades muito grandes, longa vida sob reescrita constante e recuperação de dados mais fácil.
Disco ótico
Um laser deteta reflexões de pequenas crateras num disco ótico 光盘 (CD, DVD, Blu-ray). A unidade é uma leitora/gravadora de discos óticos: a gravação utiliza um laser mais forte para alterar a refletividade da superfície.
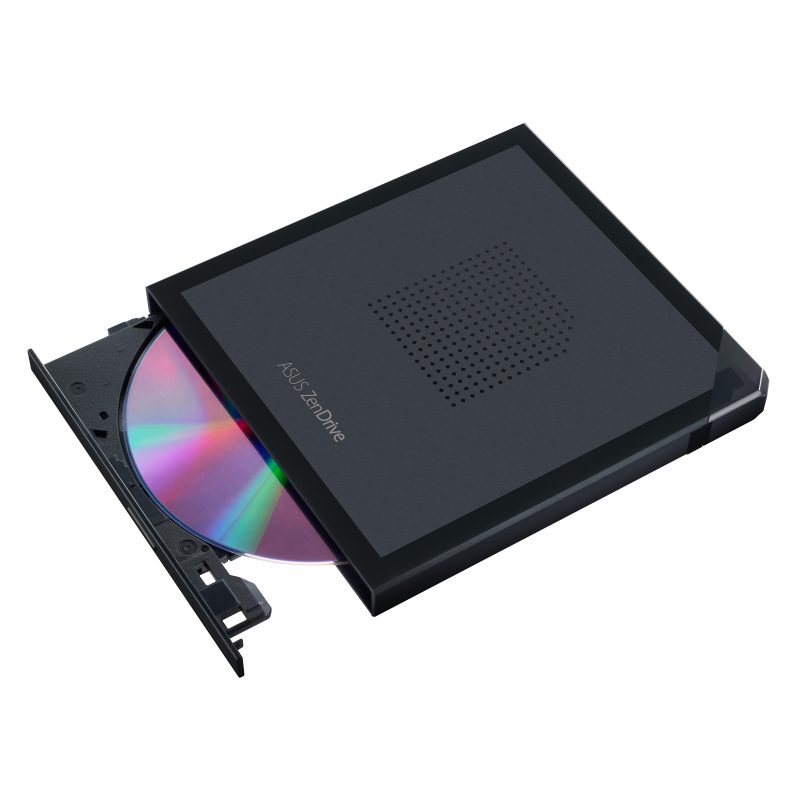
Uma unidade de disco ótico: um laser lê pequenas crateras num disco CD, DVD ou Blu-ray Como funciona: o disco transporta uma longa trilha espiral de crateras 凹坑 e terras planas 平台 (as áreas planas entre elas); o disco gira e um laser é focado na trilha; a luz refletida de uma terra plana difere da luz refletida na borda de uma cratera, e um sensor de luz lê cada mudança como um 1 e nenhuma mudança como um 0. A gravação utiliza um laser mais forte para alterar a refletividade de uma camada de corante ou liga. Um Blu-ray utiliza um laser azul com comprimento de onda mais curto, por isso suas crateras são menores e mais próximas, o que explica por que armazena mais dados que um DVD.
Ecrã tátil
Um ecrã tátil 触摸屏 deteta contacto. Resistivo 电阻式: duas camadas condutoras pressionadas juntas; funciona com tudo mas é menos preciso. Capacitivo 电容式: um dedo perturba um campo de carga; preciso, multi-toque, usado em telemóveis.
Um ecrã tátil deteta onde um dedo toca o vidro Como funciona: um ecrã resistivo tem duas camadas condutoras finas separadas por espaçadores; premir empurra a camada superior contra a inferior, fechando um circuito nesse ponto, e o controlador lê a tensão para encontrar as coordenadas. Um ecrã capacitivo tem uma camada de vidro revestida com um condutor transparente que retém uma carga; um dedo ao tocá-la desvia uma pequena corrente, a corrente é medida em cada canto, e o controlador calcula a posição do toque a partir das diferenças. Ecrãs capacitivos respondem a toques leves e a vários dedos ao mesmo tempo, mas não a um dedo enluvarado ou a uma caneta estilete comum.
Óculos de realidade virtual
Um headset de realidade virtual 虚拟现实 (VR) tem dois ecrãs pequenos (um para cada olho) e sensores de movimento (acelerómetro 加速度计, giroscópio 陀螺仪) que registam o movimento da cabeça para que a cena mude à medida que você olha à volta.

Óculos de realidade virtual: duas pequenas telas e sensores de movimento rastreiam a cabeça Como funciona: cada olho vê sua própria tela através de uma lente, e as duas imagens diferem ligeiramente, então o cérebro percebe profundidade; sensores (acelerômetro, giroscópio, às vezes câmeras) informam onde a cabeça está e para qual direção ela aponta; o computador re-renderiza a cena a partir daquele ponto de vista várias vezes por segundo, assim girar a cabeça gira a visão; fones de ouvido fornecem som que corresponde à direção. Usados para jogos, treinamento como simuladores de voo ou cirurgia, e para visualizar projetos antes de serem construídos.
Vocabulário TreinarInglês Chinês Pinyin input devices/ˈɪnpʊt dɪˈvaɪsɪz/ 输入设备 shū rù shè bèi microphone/ˈmaɪkrəfəʊn/ 麦克风 mài kè fēng optical disc/ˈɒptɪkl dɪsk/ 光盘 guāng pán volatile/ˈvɒlətaɪl/ 易失性 yì shī xìng embedded system/emˈbedɪd ˈsɪstəm/ 嵌入式系统 qiàn rù shì xì tǒng laser printer/ˈleɪzə ˈprɪntə/ 激光打印机 jī guāng dǎ yìn jī drum/drʌm/ 感光鼓 gǎn guāng gǔ toner/ˈtəʊnə/ 墨粉 mò fěn fuser/ˈfjuːsə/ 定影器 dìng yǐng qì 3D printer/ˌθriː ˈdiː ˈprɪntə/ 3D打印机 3D dǎ yìn jī filament/ˈfɪləmənt/ 塑料丝 sù liào sī diaphragm/ˈdaɪəfræm/ 膜片 mó piàn capacitor/kəˈpæsɪtə/ 电容器 diàn róng qì analogue-to-digital converter/ˈænəlɒɡ tə ˈdɪdʒɪtl kənˈvɜːtə/ 模数转换器 mó shù zhuǎn huàn qì digital-to-analogue converter/ˈdɪdʒɪtl tʊ ˈænəlɒɡ kənˈvɜːtə/ 数模转换器 shù mó zhuǎn huàn qì tracks/træks/ 磁道 cí dào sectors/ˈsektəz/ 扇区 shàn qū read/write head/riːd raɪt hed/ 读写头 dú xiě tóu actuator arms/ˈæktʃuːeɪtə ɑːmz/ 磁头臂 cí tóu bì solid-state drive/ˈsɒlɪd steɪt draɪv/ 固态硬盘 gù tài yìng pán transistors/trænˈzɪstəz/ 晶体管 jīng tǐ guǎn floating-gate transistor/ˈfləʊtɪŋ ɡeɪt trænˈzɪstə/ 浮栅晶体管 fú zhà jīng tǐ guǎn pits/pɪts/ 凹坑 āo kēng lands/lændz/ 平台 píng tái touchscreen/ˈtʌtʃskriːn/ 触摸屏 chù mō píng resistive/rɪˈzɪstɪv/ 电阻式 diàn zǔ shì capacitive/kəˈpæsɪtɪv/ 电容式 diàn róng shì virtual reality/ˈvɜːtʃuːəl rɪˈælɪti/ 虚拟现实 xū nǐ xiàn shí accelerometer/əkˌseləˈrɒmɪtə/ 加速度计 jiā sù dù jì gyroscope/ˈdʒaɪrəskəʊp/ 陀螺仪 tuó luó yí interrupt/ˈɪntərʌpt/ 中断 zhōng duàn non-volatile/nɒn ˈvɒlətaɪl/ 非易失性 fēi yì shī xìng 3.1
Buffers
Um buffer 缓冲 é memória que armazena dados temporariamente enquanto se movem entre dispositivos de velocidades diferentes. Exemplo: a CPU escreve um documento no buffer da impressora rapidamente, depois fica livre para fazer outro trabalho enquanto a impressora imprime do buffer em seu próprio ritmo. Buffers impedem que o dispositivo rápido aguarde o lento (também usado em streaming, teclado e acesso ao disco).
"Explique por que uma impressora 3D precisa de um buffer": o computador envia os dados de impressão muito mais rápido do que a impressora pode construir as camadas, então os dados são mantidos no buffer até que a impressora esteja pronta para recebê-los, e o processador é liberado para fazer outros trabalhos. Quando o buffer fica baixo, a impressora envia uma interrupção 中断 para pedir mais dados (tópico 4). Um fluxo de vídeo funciona da mesma forma: o buffer enche adiantado em relação à reprodução, para que uma pequena queda na velocidade da rede não pare a imagem.
Vocabulário TreinarInglês Chinês Pinyin buffer/ˈbʌfə/ 缓冲 huǎn chōng 3.1
RAM e ROM
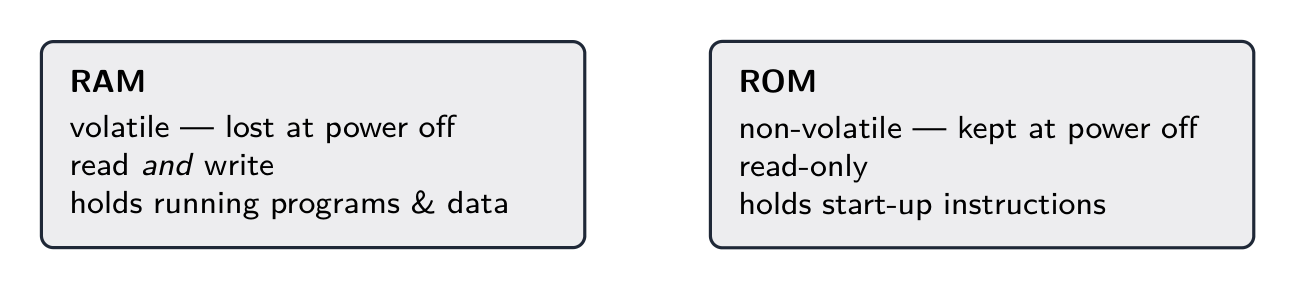
- RAM 随机存取存储器 (Random Access Memory) — volátil 易失性 (perde dados sem energia). Armazena o SO, programas em execução e seus dados; lida e escrita constantemente.
- ROM 只读存储器 (Read-Only Memory) — não volátil 非易失性 (mantém dados sem energia). Geralmente gravada apenas uma vez; armazena firmware necessário na inicialização (o BIOS / boot loader).
RAM é volátil e leitura/escrita; ROM é não volátil e apenas leitura A ROM inicia o sistema; a RAM então armazena o trabalho ativo.
RAM ROM Volátil? sim: conteúdo perdido quando desliga não: conteúdo mantido sem energia Leitura/escrita? lida e escrita constantemente apenas leitura no uso normal Armazena o sistema operacional, programas em execução e seus dados o firmware e programa de inicialização que ligam o computador Tamanho grande, e geralmente pode ser aumentado pequeno e fixo Uso típico memória principal de um computador ou celular código de inicialização de um PC; o programa inteiro de um sistema embarcado como uma máquina de lavar Mais RAM permite que um computador mantenha mais programas e dados ao mesmo tempo, trocando menos entre memória e disco e funcionando mais rápido; essa é a resposta para "explique por que o computador com mais RAM tem melhor desempenho".
Um módulo de RAM (DIMM) se conecta à placa-mãe como a memória principal rápida do computador A mesma divisão de memória importa em um dispositivo vestível: seu programa fixo deve permanecer disponível após desligar, enquanto suas leituras vivas mudam durante o uso.
Monitor de frequência cardíaca de pulso ExplorarLaboratório de Dispositivos e Armazenamento
Classifique exemplos de computação pelo que eles fazem em um sistema.
Vocabulário TreinarInglês Chinês Pinyin RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì ROM/rɒm/ 只读存储器 zhī dú cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì hard disk/hɑːd dɪsk/ 硬盘 yìng pán 3.1
SRAM vs DRAM
- SRAM 静态RAM (Static RAM) armazena cada bit em um flip-flop 触发器 de vários transistores. Rápido, mas caro e pouco denso. Usado para cache 高速缓存 da CPU.
- DRAM 动态RAM (Dynamic RAM) armazena cada bit como carga em um capacitor minúsculo. Mais barato e denso, mas mais lento, e deve ser refreshed 刷新 (reescrito) milhares de vezes por segundo. Usado para memória principal.
Use SRAM para memória pequena e rápida (cache); DRAM para memória principal grande.
SRAM DRAM Cada bit armazenado em um flip-flop de vários transistores um capacitor e um transistor Precisa de refresh? não sim, milhares de vezes por segundo Velocidade mais rápida mais lenta Densidade e custo menos bits por chip, mais caro mais bits por chip, mais barato Energia usa menos energia em repouso usa mais, devido ao refresh Usado para cache do processador memória principal, incluindo em sistemas embarcados "Explique por que o sistema embarcado usa DRAM": ele precisa de uma grande quantidade de memória a baixo custo em espaço reduzido, e seu requisito de velocidade é modesto, então o DRAM mais barato e denso é a escolha certa; a SRAM é mantida para o cache pequeno onde a velocidade importa mais.
Vocabulário TreinarInglês Chinês Pinyin SRAM/ˈesræm/ 静态 jìng tài DRAM/ˈdiːræm/ 动态 dòng tài flip-flop/flɪp flɒp/ 触发器 chù fā qì cache/kæʃ/ 高速缓存 gāo sù huǎn cún refreshed/rɪˈfreʃt/ 刷新 shuā xīn 3.1
PROM, EPROM e EEPROM
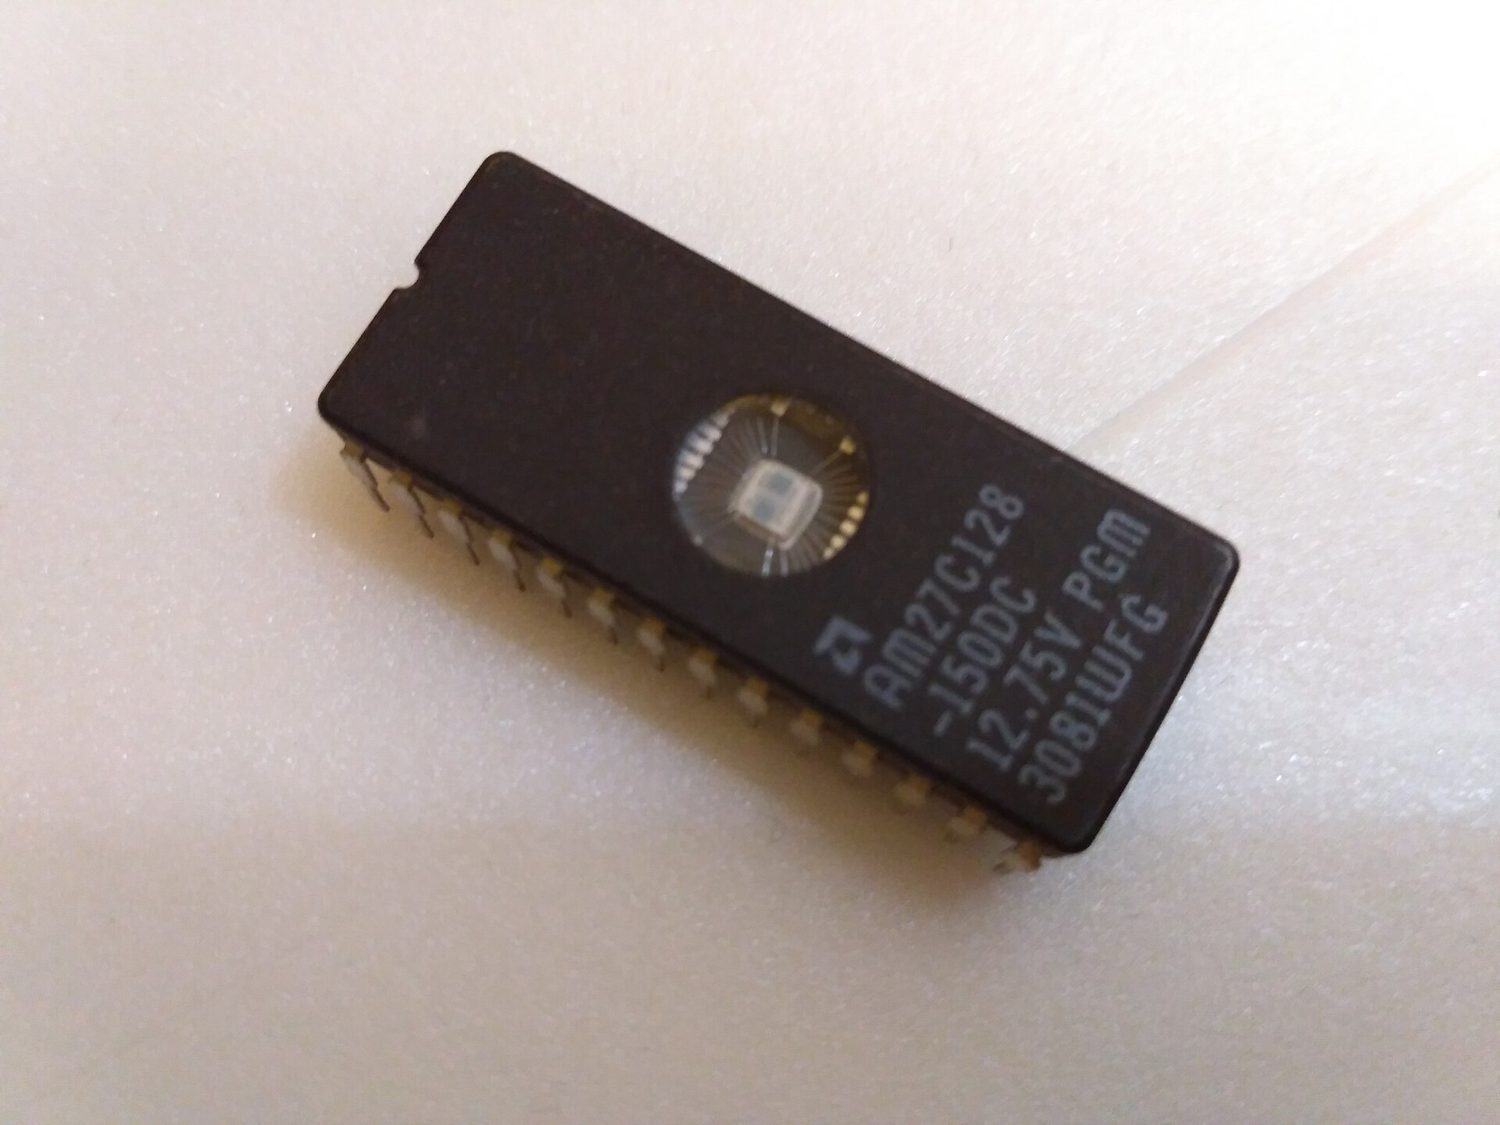
Variações de ROM que você pode programar após a fabricação:
- PROM (Programmable ROM) — escrito uma única vez (fusíveis queimados por um programador); não pode ser alterado.
- EPROM (Erasable Programmable ROM) — apagado por luz UV forte através de uma janela, depois reescrito (todo o chip de uma vez).
- EEPROM (Electrically Erasable Programmable ROM) — apagado e reescrito eletricamente, byte por byte, no circuito. A memória Flash é um derivado otimizado para apagar blocos.
Um chip EPROM com janela para apagamento ultravioleta PROM EPROM EEPROM Escrito uma vez, pelo usuário com um programador muitas vezes muitas vezes Apagado por não pode ser apagado luz ultravioleta através de uma janela de quartzo um sinal elétrico Apaga nada todo o chip de uma vez um byte ou bloco por vez Deve ser removido do circuito para reprogramar? não aplicável sim não "Dê duas diferenças entre EPROM e EEPROM" pede duas linhas desta tabela, declaradas para ambos os tipos.
3.1
Sistemas de monitoramento e controle
Ambos leem sensores; a diferença é o que fazem a seguir.
- monitoramento 监控 — coleta e relata dados, mas não toma ação (uma estação meteorológica registrando leituras).
- sistema de controle 控制系统 — usa dados dos sensores para decidir e agir através de atuadores, geralmente em um loop de feedback (um termostato ligando/desligando uma caldeira).
A resposta de três pontos "descreva as diferenças": um sistema de monitoramento apenas mede, registra ou exibe as leituras, e no máximo levanta um alerta; um sistema de controle compara cada leitura com um valor predefinido 预设值 e, se estiver fora da faixa, envia sinais para atuadores que alteram o processo físico; a mudança é então medida novamente, então um sistema de controle contém feedback e um sistema de monitoramento não. Se um dado sistema é um ou outro é decidido por esse teste: um sistema de ponte que mede a altura de um veículo e acende um sinal de aviso é monitoramento, porque nada que ele faz altera o veículo; um sistema que abaixa uma barreira é controle.
Exemplo resolvido. Descreva como um sistema automático abre uma porta quando uma pessoa está dentro de 2 metros e a fecha quando ninguém está presente.
Um sensor infravermelho ou ultrassônico mede a distância até qualquer objeto à frente da porta; a leitura analógica é convertida em digital por um ADC e enviada ao processador; o processador compara a distância com os 2 metros predefinidos; se for menor, o processador envia um sinal para o atuador (um motor) para abrir a porta; o sensor continua medindo, e quando nenhuma leitura abaixo de 2 metros é recebida, o processador sinaliza ao motor para fechar a porta. A medição repetida após cada ação é o feedback que impede que a porta abra e feche nos momentos errados.
Monitoramento relata dados; um sistema de controle age através de um loop de feedback Sensores e atuadores
Um sensor 传感器 converte uma grandeza física em um sinal: temperatura (uma termistor 热敏电阻 ou termopar), pressão (strain gauge), infravermelho, som. Sinais analógicos precisam primeiro de um ADC. Um atuador 执行器 faz o inverso — converte um sinal em uma ação (motor, válvula, aquecedor, buzina).

Uma termistor: um sensor de temperatura cuja resistência muda com o calor 
Um pequeno motor elétrico: um atuador que converte um sinal em movimento Feedback
Em um sistema de controle, o atuador altera o ambiente, que os sensores então re-medem — um loop de feedback 反馈. Sem feedback, o sistema não pode se corrigir nem saber quando parar (um termostato sem feedback de temperatura aqueceria para sempre).
ExplorarO loop de controle de feedback
Gire ao redor do loop que um termostato ou piloto automático repete. Um sistema de controle não apenas lê o mundo — ele age, depois re-mede, corrigindo-se repetidamente.
Vocabulário TreinarInglês Chinês Pinyin sensor/ˈsensə/ 传感器 chuán gǎn qì output devices/ˈaʊtpʊt dɪˈvaɪsɪz/ 输出设备 shū chū shè bèi actuator/ˈæktʃuːeɪtə/ 执行器 zhí xíng qì primary memory/ˈpraɪməri ˈmeməri/ 主存储器 zhǔ cún chǔ qì processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì monitoring/ˈmɒnɪtərɪŋ/ 监控 jiān kòng control system/kənˈtrəʊl ˈsɪstəm/ 控制系统 kòng zhì xì tǒng feedback/ˈfiːdbæk/ 反馈 fǎn kuì preset value/ˈpriːset ˈvæljuː/ 预设值 yù shè zhí thermistor/ˈθɜːmɪstə/ 热敏电阻 rè mǐn diàn zǔ 3.2
Portas lógicas

Programa
Os candidatos devem ser capazes de: Notas e orientações Usar os seguintes símbolos de porta lógica: [NOT, AND, OR, NAND, NOR, XOR] Compreender e definir as funções de: portas NOT, AND, OR, NAND, NOR e XOR (EOR) Todas as portas exceto a NOT terão apenas duas entradas. Construir a tabela-verdade para cada uma das portas lógicas acima Construir um circuito lógico A partir de: • um enunciado de problema • uma expressão lógica • uma tabela-verdade Construir uma tabela-verdade A partir de: • um enunciado de problema • um circuito lógico • uma expressão lógica Construir uma expressão lógica A partir de: • um enunciado de problema • um circuito lógico • uma tabela-verdade Fonte: Programa Cambridge International
O meio somador: XOR + AND soma dois bits Uma porta lógica 逻辑门 é um pequeno circuito que realiza uma operação Booleana 布尔. Entradas e saídas são 0 (falso, baixo) ou 1 (verdadeiro, alto). Conheça o símbolo, função e tabela-verdade 真值表 para cada porta.
Os símbolos das seis portas lógicas NOT (inversor)
A NÃO A 0 1 1 0 AND — saída 1 apenas se todos os inputs forem 1
A B A E B 0 0 0 0 1 0 1 0 0 1 1 1 OR — saída 1 se pelo menos um input for 1
A B A OU B 0 0 0 0 1 1 1 0 1 1 1 1 NAND (NÃO E) — saída 0 apenas quando todos os inputs forem 1
A B A NÃO E B 0 0 1 0 1 1 1 0 1 1 1 0 NOR (NÃO O) — saída 1 apenas quando todos os inputs forem 0
A B A NÃO O B 0 0 1 0 1 0 1 0 0 1 1 0 XOR (OU Exclusivo, também chamado EOR) — saída 1 se os inputs forem diferentes
A B A XOR B 0 0 0 0 1 1 1 0 1 1 1 0 ExplorarPortas lógicas
Alterne as entradas e escolha uma porta. Cada porta tem sua própria regra — os blocos de construção de todo circuito digital.
Vocabulário TreinarInglês Chinês Pinyin logic gate/ˈlɒdʒɪk ɡeɪt/ 逻辑门 luó jí mén Boolean/ˈbuːlɪən/ 布尔 bù ěr truth table/truːθ ˈteɪbl/ 真值表 zhēn zhí biǎo 3.2
Circuitos lógicos
Um circuito lógico 逻辑电路 é uma rede de portas que executa uma expressão Booleana. Você deve ser capaz de transitar entre um enunciado de problema, uma expressão lógica, uma tabela-verdade e um diagrama de circuito.
A prova escreve expressões em palavras,
X = (A AND NOT B) OR (B AND C), e aceita a forma algébrica $X = A\overline{B} + BC$ onde um ponto (ou nada) é AND, um sinal de mais é OR, e uma barra é NOT. Use a que a questão utilizar.De expressão para circuito
Desenhe uma porta por operador e ligue-os. Para $X = (A \text{ AND } B) \text{ OR } (\text{NOT } C)$: uma porta NOT em $C$, uma porta AND em $A$ e $B$, depois uma porta OR nos dois resultados.
Portas conectadas para executar uma expressão Booleana De circuito para expressão
Trabalhe da esquerda para a direita a partir das entradas, rotulando a saída de cada porta, até chegar à saída final.
Exemplo resolvido. Escreva a expressão do circuito abaixo e complete sua tabela-verdade.
Rotule todas as saídas intermediárias: aqui P é A AND NOT B e Q é B AND C, então X é P OR Q Rotule as saídas das portas: $P = A \text{ AND NOT } B$, $Q = B \text{ AND } C$, então $X = P \text{ OR } Q = (A \text{ AND NOT } B) \text{ OR } (B \text{ AND } C)$. Em seguida, adicione uma coluna para cada saída intermediária na tabela-verdade, para que cada linha possa ser verificada porta por porta:
A B C NOT B P Q X 0 0 0 1 0 0 0 0 0 1 1 0 0 0 0 1 0 0 0 0 0 0 1 1 0 0 1 1 1 0 0 1 1 0 1 1 0 1 1 1 0 1 1 1 0 0 0 0 0 1 1 1 0 0 1 1 Desenhar um circuito a partir de uma expressão é o mesmo caminho ao contrário: comece pelos parênteses mais internos, desenhe uma porta por operador, desenhe uma porta NOT no fio de qualquer entrada que apareça com NOT, mantenha as entradas à esquerda e a única saída à direita, e rotule a saída com sua letra. Cada linha deve terminar em uma entrada de porta ou na saída; uma linha que não vai a lugar nenhum perde a pontuação.
De circuito para tabela-verdade
Para $n$ entradas, há $2^{n}$ linhas. Liste todas as combinações de entradas; para cada uma, calcule as portas internas e depois a saída.
De tabela-verdade para expressão (soma de produtos)
Para cada linha que tem saída 1, escreva um AND das entradas (com NOT em qualquer entrada que seja 0 naquela linha); OR essas expressões juntas. Exemplo: uma tabela que é 1 apenas nas linhas $(A=0,B=1)$ e $(A=1,B=0)$ resulta em $\overline{A}B + A\overline{B}$, que é $A \text{ XOR } B$.
De um enunciado de problema
Transforme o inglês em uma expressão Booleana primeiro: "A and B" → A AND B; "A or B or both" → A OR B; "exactly one of A and B" → A XOR B; "neither A nor B" → A NOR B; "not both" → A NAND B.
Exemplo resolvido. O alarme de uma máquina $X$ soa quando a barreira está aberta ($A=1$) e o motor está em funcionamento ($B=1$) ou a temperatura está alta ($C=1$). Escreva a expressão Booleana e indique as linhas onde $X=1$. Transforme o inglês em lógica uma cláusula por vez: "either B or C" é $B + C$, e "A e that" é $X = A\cdot(B + C)$. Para as linhas, $X=1$ precisa de $A=1$ e pelo menos um de $B$, $C$ igual a 1 — então $(A,B,C) = (1,0,1)$, $(1,1,0)$ e $(1,1,1)$, três linhas de oito. Note que $A=0$ nunca pode acionar o alarme, independentemente do que $B$ e $C$ façam. Parentetize o OR antes de fazer o AND dele: $X = A\cdot B + C$ é um circuito totalmente diferente, um que acionaria o alarme em temperatura alta mesmo com a barreira fechada.
ExplorarSomador parcial
Conecte XOR e AND aos mesmos dois inputs: XOR gera o bit de soma, AND gera o carry. Clique em A e B.
ExplorarCircuitos lógicos
portas combinam para formar circuitos
Cada porta tem uma regra fixa; conectá-las constrói todos os circuitos — comece com uma porta.
Vocabulário TreinarInglês Chinês Pinyin logic circuit/ˈlɒdʒɪk ˈsɜːkɪt/ 逻辑电路 luó jí diàn lù 3.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição sistema embarcado um sistema computacional com uma função dedicada integrada a um dispositivo maior buffer uma área de memória que armazena temporariamente dados enquanto são transferidos entre dispositivos que operam em velocidades diferentes RAM memória volátil que pode ser lida e escrita, mantendo os programas e dados em uso ROM memória não volátil cujos conteúdos não podem ser alterados no uso normal, contendo as instruções de inicialização SRAM RAM estática que armazena cada bit em um flip-flop e não precisa de refresh DRAM RAM dinâmica que armazena cada bit como uma carga em um capacitor e deve ser atualizada continuamente sistema de monitoramento um sistema que usa sensores para medir e relatar sobre um processo físico sem alterá-lo sistema de controle um sistema que usa leituras de sensores para decidir e executar ações, através de atuadores, que alteram um processo físico sensor um dispositivo que mede uma grandeza física e a converte em um sinal para o computador atuador um dispositivo que converte um sinal do computador em uma ação física feedback a saída de um sistema de controle sendo medida e retroalimentada como entrada para que o sistema possa se corrigir porta lógica um circuito eletrônico que realiza uma operação Booleana sobre uma ou mais entradas binárias para gerar uma saída binária tabela-verdade uma tabela que lista todas as combinações de entradas de um circuito lógico com a saída correspondente para cada uma 3.2
Dicas de prova
- Diferencie RAM (volátil, leitura/escrita) de ROM (não volátil, mantém o bootstrap); SRAM (cache, mais rápida) de DRAM (memória principal, precisa de refresh).
- Para um circuito lógico, construa a expressão Booleana porta por porta, depois uma tabela-verdade cobrindo todas as combinações de entradas.
- Aprenda o símbolo, a expressão e a tabela-verdade de cada porta (AND, OR, NOT, NAND, NOR, XOR).
- Explique um buffer (um armazenamento temporário que liga duas velocidades diferentes) e o papel de uma interrupção.
Erros comuns
- Nomear o dispositivo em vez de descrever sua operação. "Ele usa um laser" não dá pontos; os passos (carregar o tambor, o laser remove a carga, o toner é atraído, transferido, fundido) ganham os pontos.
- Dizer que um sistema de monitoramento "controla" algo. Se nada altera o processo físico, é monitoramento; adicione o atuador e o feedback e vira controle.
- Escrever que a RAM "armazena arquivos permanentemente" ou que a ROM "armazena os dados do usuário". A RAM é memória de trabalho volátil; a ROM contém as instruções fixas de inicialização.
- Uma tabela-verdade com menos de $2^{n}$ linhas, ou linhas em ordem aleatória. Conte em binário de 000 a 111 para não perder nenhuma combinação.
- Desenhar duas linhas saindo de uma única saída de uma porta por segurança, ou deixar um fio que termina em lugar nenhum. Desenhe exatamente as conexões que a expressão requer.
-
4
Fundamentos do Processador
Assistir aula4.1
Arquitetura Von Neumann
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão do modelo básico Von Neumann para um sistema computacional e do conceito de programa armazenado Demonstrar compreensão do propósito e papel dos registros, incluindo a diferença entre registros de uso geral e registros de uso especial Registros de uso especial incluem: • Contador de Programa (PC) • Registrador de Dados de Memória (MDR) • Registrador de Endereço de Memória (MAR) • O Acumulador (ACC) • Registrador Indexado (IX) • Registrador de Instrução Atual (CIR) • Registrador de Status Demonstrar compreensão do propósito e papéis da Unidade Aritmética e Lógica (ALU), Unidade de Controle (CU) e relógio do sistema, Armazenamento de Acesso Imediato (IAS) Demonstrar compreensão de como os dados são transferidos entre vários componentes do sistema computacional usando o ** barramento de endereços**, barramento de dados e barramento de controle Demonstrar compreensão de como fatores contribuem para o desempenho do sistema computacional Incluindo: • tipo de processador e número de cores • a largura do barramento • velocidade do clock • memória cache Compreender como diferentes portas fornecem conexão para dispositivos periféricos Incluindo conexão para: • Universal Serial Bus (USB) • High Definition Multimedia Interface (HDMI) • Video Graphics Array (VGA) Descrever as etapas do ciclo Fetch-Execute (F-E) Descrever e usar notação de 'register transfer' para descrever o ciclo F-E Demonstrar compreensão do propósito de interrupções Incluindo: • possíveis causas de interrupções • aplicações de interrupções • uso de uma Rotina de Serviço de Interrupção (ISR) • quando as interrupções são detectadas durante o ciclo fetch-execute • como as interrupções são tratadas Fonte: Programa Cambridge International
O ciclo fetch-decode-execute A Arquitetura Von Neumann 冯·诺依曼体系结构 fundamenta quase todos os computadores de propósito geral:
- uma única memória — a Immediate Access Store 立即存取存储器 (IAS) — armazena tanto instruções do programa quanto dados (o conceito de stored program 存储程序).
- um processador 处理器 (CPU) busca instruções da memória e as executa uma de cada vez.
- as instruções rodam em ordem a menos que uma branch altere o fluxo.
A ideia de stored-program é o que torna um computador flexível: mude o programa e você muda o que ele faz, sem reconfigurar cabos.
ExplorarToque nas partes de um computador Von Neumann
Explore cada bloco. A CPU (unidade de controle, ALU, registradores) fala com uma única memória principal pelos barramentos — e esse único espaço de memória compartilhado para instruções E dados é a ideia de Von Neumann.
Vocabulário TreinarInglês Chinês Pinyin Immediate Access Store/ɪˈmiːdɪət ˈækses stɔː/ 立即存取存储器 lì jí cún qǔ cún chǔ qì stored program/stɔːd ˈprəʊɡræm/ 存储程序 cún chǔ chéng xù processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì arithmetic and logic unit/ˌærɪθˈmetɪk ənd ˈlɒdʒɪk ˈjuːnɪt/ 算术逻辑单元 suàn shù luó jí dān yuán RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì 4.1
Principais partes da CPU

Todas essas partes estão dentro de um único chip pequeno. O diagrama mais adiante nesta seção mostra como elas se conectam; a foto abaixo mostra o real.
Uma CPU moderna: todo o processador é um único chip pequeno (aqui visto de baixo, mostrando os contatos) 
O soquete correspondente de CPU na placa-mãe: os contatos do chip pressionam sobre esses pinos Unidade Aritmética Lógica (ALU)
A ALU 算术逻辑单元 realiza operações aritméticas (soma, subtração, ...) e lógicas (AND, OR, comparações). Ela pega operandos dos registros 寄存器 e coloca resultados de volta em um registro.
Unidade de Controle (CU)
A unidade de controle 控制单元 decodifica cada instrução e envia os sinais de controle para executá-la — abrindo caminhos de dados, dizendo à ALU o que fazer e controlando leituras e gravações na memória.
Relógio do sistema
O relógio envia uma corrente constante de pulsos que mantêm a CPU sincronizada. Cada instrução leva um número fixo de ciclos, e a clock speed 时钟频率 (ex. 3.8 GHz) é um fator no desempenho.
"Explique como a CU e o relógio do sistema trabalham juntos": o relógio emite pulsos em uma frequência fixa; a unidade de controle usa cada pulso para avançar o ciclo fetch-execute em um passo, enviando seus sinais de controle sincronizados com os pulsos, assim toda parte do processador muda de estado junto. Um clock mais rápido significa mais passos por segundo, até o ponto em que os circuitos não conseguem se estabilizar entre os pulsos.
Registros
Registros são armazenamentos pequenos e muito rápidos dentro da CPU. Os registros de propósito especial 专用寄存器 têm cada um uma tarefa fixa no ciclo:
- Program Counter 程序计数器 (PC) — o endereço da próxima instrução.
- Memory Address Register 内存地址寄存器 (MAR) — o endereço sendo lido ou escrito.
- Registro de Dados de Memória 内存数据寄存器 (MDR) — os dados que vão ou vêm da memória.
- Current Instruction Register 当前指令寄存器 (CIR) — a instrução sendo decodificada.
- Accumulator 累加器 (ACC) — o valor sobre o qual a ALU está trabalhando.
- Status Register 状态寄存器 — armazena flags 标志 (carry, zero, negativo, overflow) usados por branches. Cada flag é um bit, definido ou limpo pela ALU após uma operação: a flag zero após uma comparação que correspondeu, a flag carry quando uma soma transbordou o registro, a flag negativa quando um resultado é negativo. Um jump condicional lê as flags para decidir se deve pular, e uma flag overflow pode disparar uma interrupção.
- Index Register 变址寄存器 — um offset adicionado a um endereço em endereçamento indexado; incrementá-lo percorre um array um elemento por vez.
A questão "complete a tabela descrevendo o papel de cada registro" quer uma frase precisa por registro nestes termos: o PC armazena o endereço da próxima instrução a ser buscada; o MAR armazena o endereço do local sendo lido ou escrito; o MDR armazena os dados ou instrução acabados de serem lidos desse local, ou prestes a serem gravados; o CIR armazena a instrução atualmente sendo decodificada e executada; o ACC armazena o resultado da última operação aritmética ou lógica.
Os registros de propósito geral 通用寄存器 são usados pelo programador para valores temporários durante um cálculo. Movimentos de dados entre registros e memória são escritos em notação de register transfer 寄存器传送 — ex.
MAR ← [PC]("copie o conteúdo do PC para o MAR").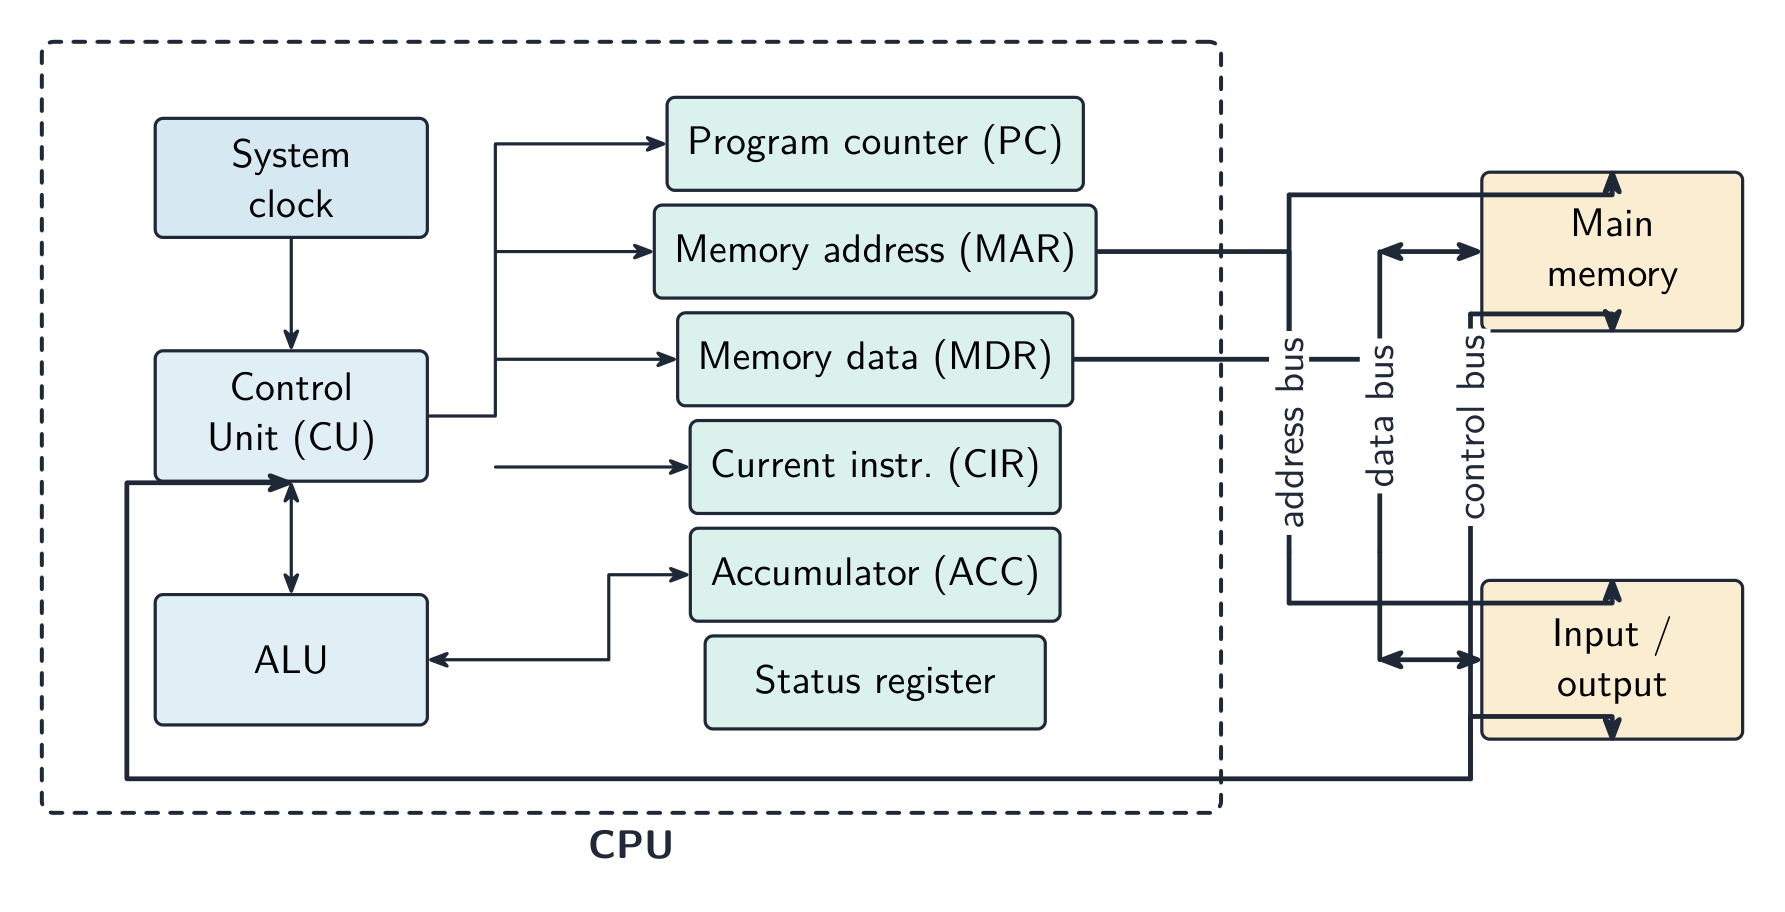
A CPU Von Neumann: registros, unidade de controle e ALU ligados por buses Vocabulário TreinarInglês Chinês Pinyin Von Neumann architecture/vɒn ˈnɔɪmən ˈɑːkɪtektʃə/ 冯·诺依曼体系结构 féng · nuò yī màn tǐ xì jié gòu ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán register/ˈredʒɪstə/ 寄存器 jì cún qì control unit/kənˈtrəʊl ˈjuːnɪt/ 控制单元 kòng zhì dān yuán clock speed/klɒk spiːd/ 时钟频率 shí zhōng pín lǜ Program Counter/ˈprəʊɡræm ˈkaʊntə/ 程序计数器 chéng xù jì shù qì Memory Address Register/ˈmeməri əˈdres ˈredʒɪstə/ 内存地址寄存器 nèi cún dì zhǐ jì cún qì Memory Data Register/ˈmeməri ˈdeɪtə ˈredʒɪstə/ 内存数据寄存器 nèi cún shù jù jì cún qì Current Instruction Register/ˈkʌrənt ɪnˈstrʌkʃn ˈredʒɪstə/ 当前指令寄存器 dāng qián zhǐ lìng jì cún qì accumulator/əˈkjuːmjʊleɪtə/ 累加器 lěi jiā qì Status Register/ˈsteɪtəs ˈredʒɪstə/ 状态寄存器 zhuàng tài jì cún qì flags/flæɡz/ 标志 biāo zhì Index Register/ˈɪndeks ˈredʒɪstə/ 变址寄存器 biàn zhǐ jì cún qì indexed addressing/ˈɪndekst əˈdresɪŋ/ 变址寻址 biàn zhǐ xún zhǐ general-purpose registers/ˈdʒenərəl ˈpɜːpəs ˈredʒɪstəz/ 通用寄存器 tōng yòng jì cún qì register transfer/ˈredʒɪstə ˈtrænsfɜː/ 寄存器传送 jì cún qì chuán sòng buses/ˈbʌsɪz/ 总线 zǒng xiàn 4.1
Barramentos

Três buses internos 总线 (conjuntos de fios paralelos) conectam as partes:
- address bus 地址总线 — transporta o endereço de memória. Unidirecional (CPU → memória).
- data bus 数据总线 — transporta os dados. Bidirecional.
- control bus 控制总线 — transporta sinais de controle (leitura, gravação, interrupção). Bidirecional.
Um barramento de endereços de $n$ bits pode acessar $2^{n}$ locais de memória. A largura do barramento de dados determina quantos bits são transferidos por acesso (frequentemente o tamanho da palavra).
Os três barramentos do sistema conectando a CPU, a memória e a entrada/saída 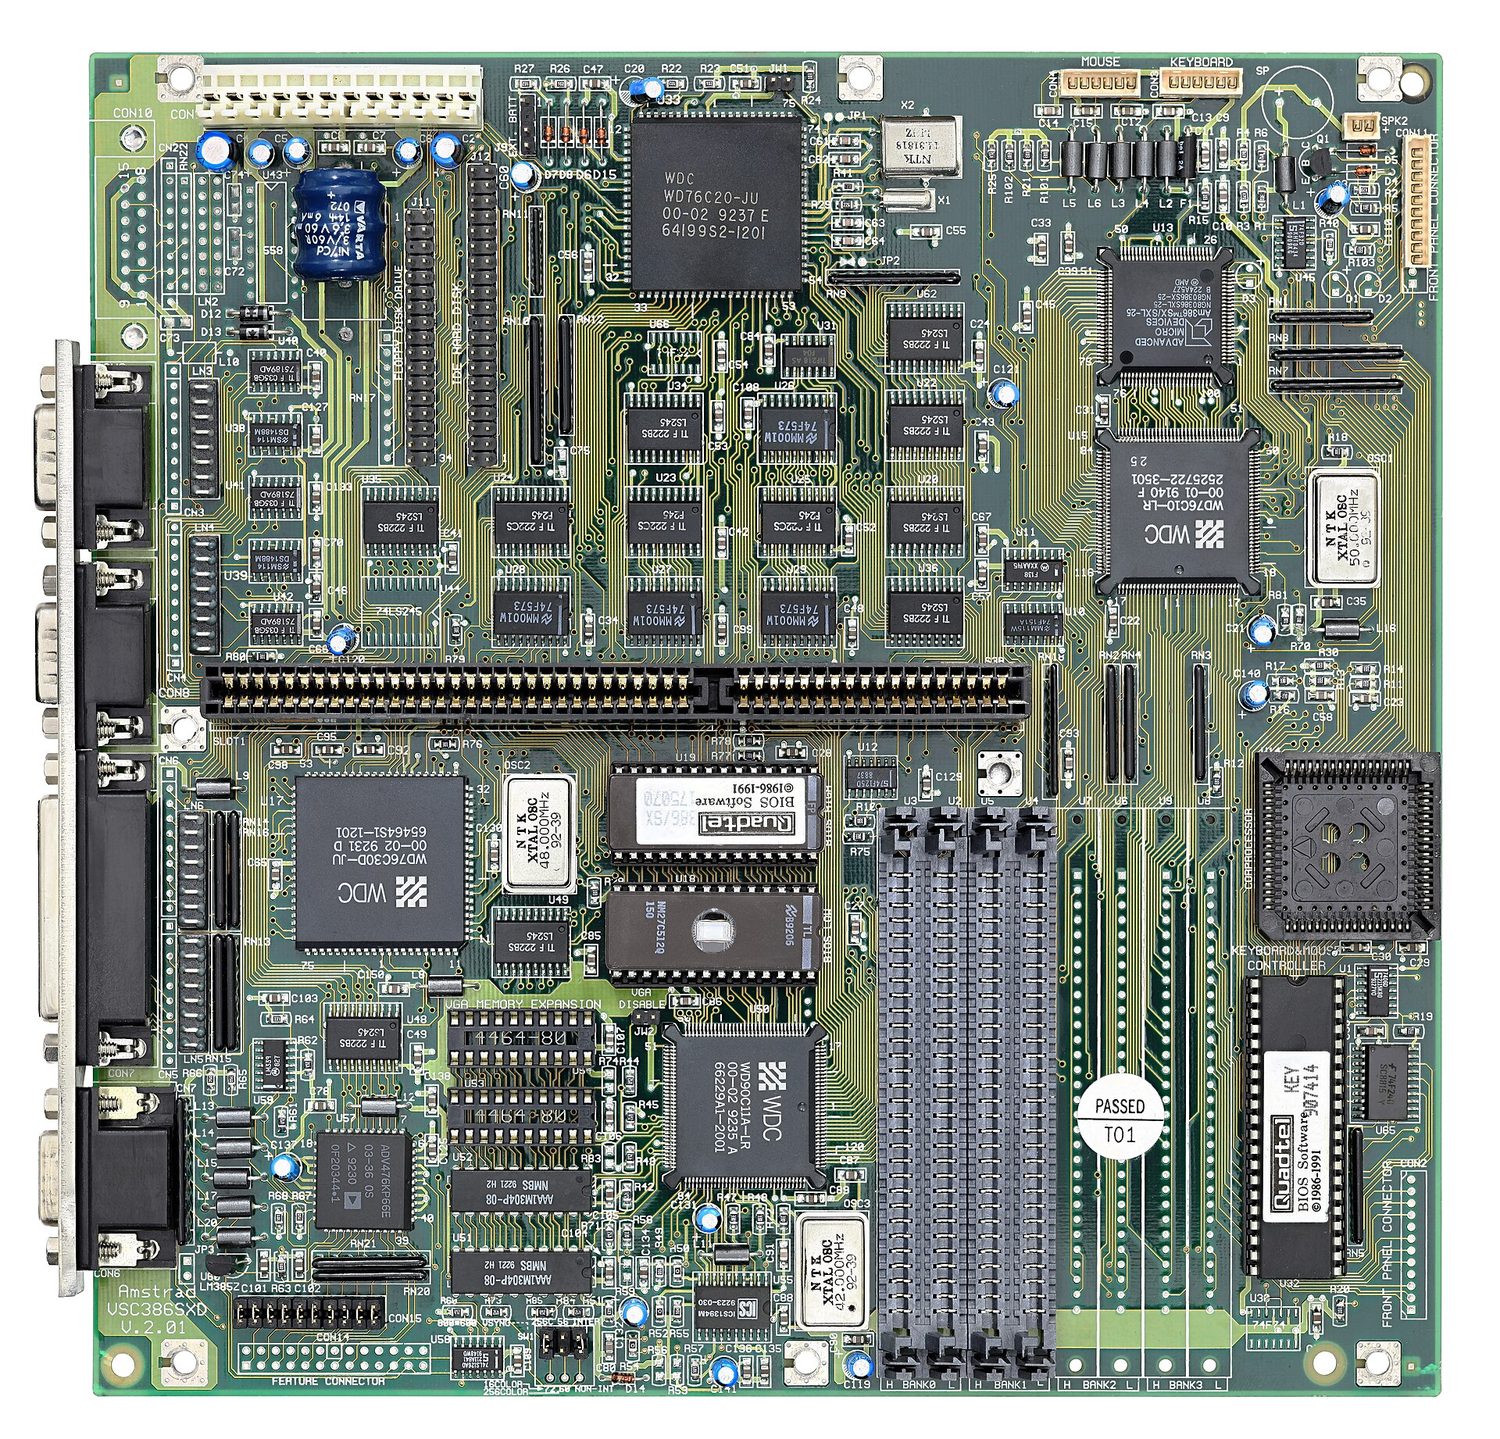
Uma placa-mãe: a CPU, a memória e a E/S estão todas em um único conjunto de barramentos — as trilhas impressas que correm entre elas Vocabulário TreinarInglês Chinês Pinyin control bus/kənˈtrəʊl bʌs/ 控制总线 kòng zhì zǒng xiàn address bus/əˈdres bʌs/ 地址总线 dì zhǐ zǒng xiàn data bus/ˈdeɪtə bʌs/ 数据总线 shù jù zǒng xiàn 4.1
O que afeta o desempenho
- clock speed — mais ciclos por segundo.
- number of cores 核心 — uma CPU multi-core executa vários threads simultaneamente.
- word size 字长 — uma CPU de 64 bits processa blocos de 64 bits por ciclo e pode acessar muito mais memória do que uma de 32 bits.
- amount of RAM 随机存取存储器 — mais RAM armazena mais do conjunto ativo; pouca RAM força o SO a fazer pagememória 页 para o disco.
- cache memory 高速缓存 size — mais cache reduz o tempo médio de acesso à memória.
- secondary storage 辅助存储器 type — um SSD carrega programas muito mais rápido que um HDD.
- bus width and speed — barramentos mais largos/rapidos movem dados mais rapidamente.
Combine as especificações com a carga de trabalho: uma quad-core supera uma dual-core em trabalhos paralelos, mas maior velocidade por core vence em trabalho single-threaded.
Cada fator é uma resposta de duas marcas com uma razão associada:
- More cores: cada core pode buscar e executar sua própria instrução ao mesmo tempo, então vários programas, ou os threads de um programa, executam em paralelo. Mas um programa deve ser escrito para usar mais de um core, então duplicar os cores não duplica a velocidade.
- Higher clock speed: mais ciclos de busca-execução por segundo, então mais instruções por segundo; o limite é o calor gerado.
- Wider bus: um barramento de dados mais largo move mais bits em cada transferência, então menos transferências são necessárias para os mesmos dados; um barramento de endereços mais largo pode acessar mais locais de memória.
- Cache memory: uma memória pequena e rápida dentro ou ao lado do processador que mantém as instruções e os dados usados mais recentemente ou com mais frequência. Lê-los do cache é muito mais rápido que da RAM, então o processador passa menos tempo esperando.
"Explique por que o novo computador tem melhor desempenho" responde-se comparando as duas especificações linha por linha: maior clock speed executa mais instruções por segundo, mais cores executam mais tarefas ao mesmo tempo, mais cache significa menos acessos lentos à RAM, e mais RAM significa menos transferências para o disco.
Vocabulário TreinarInglês Chinês Pinyin word size/wɜːd saɪz/ 字长 zì cháng number of cores/ˈnʌmbə ɒv kɔːz/ 核心 hé xīn cores/kɔːz/ 核心 hé xīn amount of RAM/əˈmaʊnt ɒv ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì page/peɪdʒ/ 页 yè cache memory/kæʃ ˈmeməri/ 高速缓存 gāo sù huǎn cún cache/kæʃ/ 高速缓存 gāo sù huǎn cún secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 4.1
Portas
Uma port 端口 é um conector físico para conectar um peripheral 外围设备:
- USB (Universal Serial Bus) — uso geral (teclados, drives, telefones).
- HDMI (High Definition Multimedia Interface) — vídeo digital e áudio para uma tela.
- VGA (Video Graphics Array) — saída de vídeo analógica antiga para um monitor.
- Ethernet (RJ-45) — LAN cablada. Jacks de áudio — fones de ouvido/microfone.
Portas diferentes usam sinais diferentes, então um cabo HDMI não se encaixa em uma porta USB. O USB-C é incomum por transportar vídeo, dados e energia.
"Explique como o computador se conecta ao monitor através do HDMI": a porta HDMI envia o vídeo e o áudio como um único sinal digital por um único cabo, então nenhuma conversão para analógico é necessária e a imagem não é degradada; o cabo suporta resoluções de alta definição e a própria porta do monitor decodifica o sinal. Um dispositivo USB é plug-and-play: quando conectado, o computador o detecta, identifica-o, carrega ou instala o driver necessário, e pode fornecer energia, tudo sem reinicialização.
Vocabulário TreinarInglês Chinês Pinyin port/pɔːt/ 端口 duān kǒu peripheral/pəˈrɪfərəl/ 外围设备 wài wéi shè bèi 4.1
Ciclo Fetch-Execute

A CPU repete o fetch-execute cycle 取指-执行周期, uma execução por instrução de máquina.
Fetch
- o endereço do PC é copiado para o MAR.
- o PC é incrementado para apontar para a próxima instrução.
- um sinal de read vai pelo barramento de controle.
- a memória coloca a instrução no barramento de dados.
- ela é copiada para o MDR, depois para o CIR.
O exame pede esses passos em register transfer notation 寄存器传送记法, onde
[X]significa o conteúdo do registro X e[[MAR]]significa o conteúdo do local de memória cujo endereço está no MAR:MAR ← [PC] the address of the next instruction goes to the MAR PC ← [PC] + 1 the PC now points to the following instruction MDR ← [[MAR]] the instruction at that address is read into the MDR CIR ← [MDR] the instruction is copied into the CIR for decodingA ordem importa: o PC é incrementado imediatamente após seu endereço ser copiado, para que um jump executado posteriormente ainda possa sobrescrevê-lo. Durante a execução, a mesma notação descreve cada instrução; para
LDD 200, por exemplo,MAR ← 200,MDR ← [[MAR]],ACC ← [MDR].
*As transferências de registro em uma busca: PC → MAR → memory → MDR → CIR, com o PC incrementadoDecode
A CU decodifica a instrução no CIR — qual operação e quais operandos ou endereços.
Execute
A CU a executa: aritmética/lógica vai para a ALU (resultado para o ACC); load/store move dados entre memória e um registro; um branch altera o PC. Então o ciclo se repete.
 *O ciclo fetch-execute, com verificação de interrupções a cada vezExplorar
O ciclo fetch-execute
Toque ao redor do loop que a CPU repete bilhões de vezes por segundo. Observe como o fetch usa os registradores PC/MAR/MDR/CIR, depois decode e execute agem sobre o que foi buscado.
ExplorarO ciclo busca-executa
Passe por como a CPU executa uma instrução — busque da memória, decodifique, então execute, repetidamente.
Vocabulário TreinarInglês Chinês Pinyin fetch-execute cycle/fetʃ ˈeksɪkjuːt ˈsaɪkl/ 取指-执行周期 qǔ zhǐ - zhí xíng zhōu qī special purpose registers/ˈspeʃl ˈpɜːpəs ˈredʒɪstəz/ 专用寄存器 zhuān yòng jì cún qì register transfer notation/ˈredʒɪstə ˈtrænsfɜː nəʊˈteɪʃn/ 寄存器传送记法 jì cún qì chuán sòng jì fǎ 4.1
Interrupts
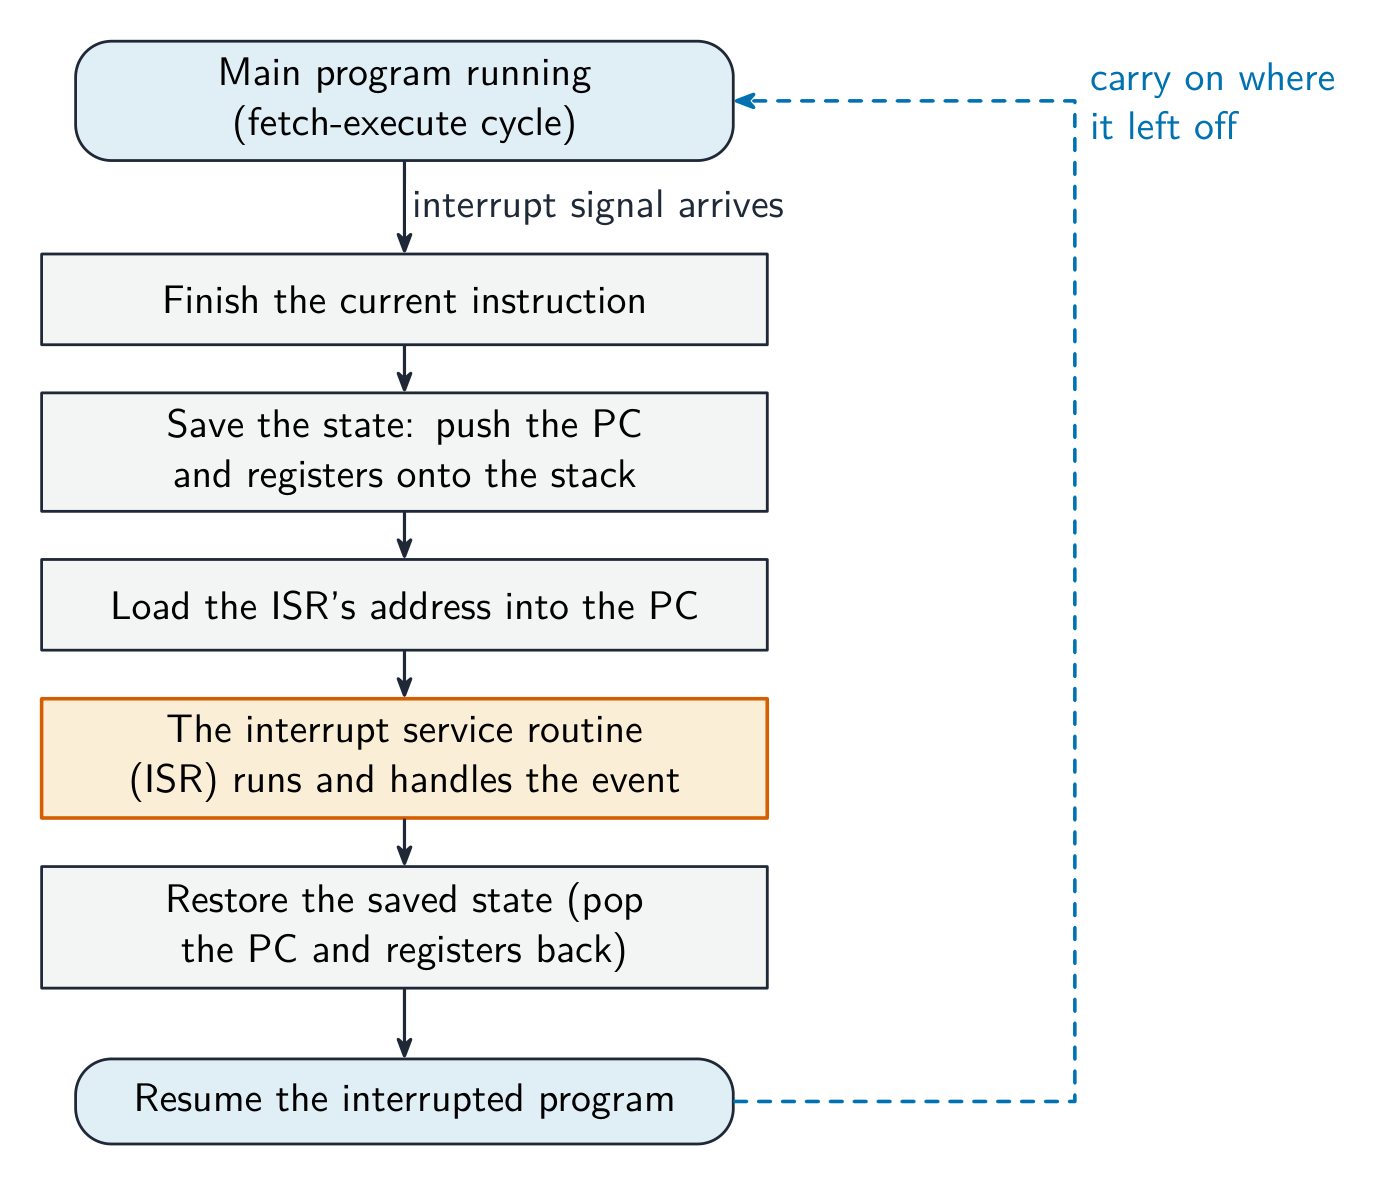
Um interrupt 中断 é um sinal que pauses o ciclo normal para que a CPU possa lidar com um evento urgente (uma tecla pressionada, um pacote chegando, uma falha de hardware, divisão por zero, o timer do SO).
Lidando com um:
- termine a instrução atual.
- save the state (PC e registros).
- carregue o endereço da interrupt service routine 中断服务程序 (ISR) no PC e execute-a.
- a ISR lida com o evento.
- restore o estado salvo e continue.
Interrupts permitem que o sistema responda prontamente sem a CPU verificar constantemente dispositivos, e são como o SO faz multitarefa.
"Explique como uma interrupção de um dispositivo de entrada é detectada e manuseada no ciclo F-E" é uma resposta de quatro marcas com estes pontos: o dispositivo envia um sinal de interrupção que define a flag de interrupção no interrupt register 中断寄存器; o processador verifica esse registro no end of every fetch-execute cycle, após a execução da instrução atual terminar; se uma flag estiver definida e a interrupção tiver prioridade maior que a tarefa atual, o conteúdo do PC e dos outros registros é salvo no pilha 栈; o endereço da rotina de serviço de interrupção é carregado no PC e a rotina é executada; quando termina, os valores salvos são restaurados do stack e o programa interrompido continua de onde parou.
Causas dignas de menção: uma interrupção de hardware de um dispositivo (uma tecla pressionada, um buffer de impressora vazio, um pacote de rede chegando), uma interrupção de software de uma falha (divisão por zero, uma instrução ilegal, overflow aritmético), uma interrupção de timer do sistema operacional marcando o fim de uma fatia de tempo, e um aviso de falha de energia.
*Como uma interrupção se encaixa no ciclo fetch-executeVocabulário TreinarInglês Chinês Pinyin interrupt/ˈɪntərʌpt/ 中断 zhōng duàn interrupt service routine/ˈɪntərʌpt ˈsɜːvɪs ruːˈtiːn/ 中断服务程序 zhōng duàn fú wù chéng xù interrupt register/ˈɪntərʌpt ˈredʒɪstə/ 中断寄存器 zhōng duàn jì cún qì stack/stæk/ 栈 zhàn 4.2
Assembly language and machine code

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da relação entre linguagem assembly e código máquina Descrever as diferentes etapas do processo de ensamblagem para um ensamblador de duas passagens Aplicar o processo de ensamblador de duas passagens a um programa simples dado em linguagem assembly Rastrear um programa simples dado em linguagem assembly Demonstrar compreensão de que um conjunto de instruções são agrupadas Incluindo os seguintes grupos: • Movimentação de dados • Entrada e saída de dados • Operações aritméticas • Instruções incondicionais e condicionais • Instruções de comparação Demonstrar compreensão e ser capaz de usar diferentes modos de endereçamento Incluindo imediato, direto, indireto, indexado, relativo Fonte: Programa Cambridge International
A CPU realmente executa machine code 机器码 — padrões de bits, específicos para uma arquitetura. Assembly language 汇编语言 é uma forma legível, com uma instrução por instrução de máquina, escrita usando mnemonics 助记符 como
LDD,ADD,JMP. Um assembler 汇编器 traduz para machine code.
*Um assembler transforma mnemonics em padrões de bits de machine codeTwo-pass assembler
Um assembler de duas passadas lê a fonte duas vezes:
- pass 1 constrói uma symbol table 符号表: sempre que um label 标签 (como
LOOP:) aparece, registre seu endereço; nenhum código ainda. - pass 2 gera código: traduza cada instrução, e quando uma se refere a um label (como
JMP LOOP), procure seu endereço na symbol table.
Duas passadas lidam com forward references 前向引用 (um jump para um label definido depois).
Worked example. Aplique o processo de duas passadas a este programa, cuja primeira instrução está no endereço 100.
        LDD  COUNT
LOOP:   DEC  ACC
        CMP  #0
        JPN  LOOP
        END
COUNT:  5
Pass 1 lê cada linha, conta o endereço que ocupará e registra todos os labels na symbol table:
LOOP= 101 (a linhaDEC) eCOUNT= 105 (a linha de dados). Nenhum código é produzido. Pass 2 lê o programa novamente e traduz cada linha em machine code, substituindo cada mnemonic por seu opcode 操作码 e cada endereço simbólico pelo número da symbol table:LDD COUNTtorna-se o opcode paraLDDcom operand 操作数 105, eJPN LOOPtorna-se o opcode paraJPNcom operand 101. O jump back paraLOOPpoderia ter sido resolvido em uma passada, mas um jump forward para um label ainda não visto não poderia, que é por que o assembler faz duas.Example instruction set
Cambridge usa um pequeno conjunto genérico, impresso na tabela de referência do exame, com um registro de propósito geral, o acumulador (ACC), e um registro índice (IX). Um operand escrito
#né um número decimal,Bnum binário e&num hexadecimal;<address>é um número de localização ou um label.Grupo Instrução O que faz Movimento de dados LDM #ncarrega o número n no ACC (imediato) LDD <address>carrega o conteúdo do endereço no ACC (direto) LDI <address>o endereço contém outro endereço; carrega o conteúdo deste último no ACC (indireto) LDX <address>adicione IX ao endereço e carregue o conteúdo do resultado em ACC (indexado) LDR #ncarregue o número n em IX MOV <register>copie ACC para o registro nomeado (IX) STO <address>armazene o conteúdo de ACC no endereço Entrada e saída INleia uma tecla pressionada e coloque seu código ASCII em ACC OUTexiba o caractere cujo código ASCII está em ACC Aritmética ADD <address>/ADD #nadicione o conteúdo do endereço, ou o número, a ACC SUB <address>/SUB #nsubtraia de ACC INC <register>/DEC <register>adicione 1 ou subtraia 1 de ACC ou IX Comparação CMP <address>/CMP #ncompare ACC com o conteúdo do endereço, ou com n, e defina a flag CMI <address>compare ACC com o conteúdo do endereço retido no endereço (indireto) Salto JMP <address>salte para o endereço incondicionalmente JPE <address>/JPN <address>salte se a última comparação foi igual / não igual Manipulação de bits AND,OR,XORcom#n,Bn,&nou<address>operação bit a bit em ACC LSL #n/LSR #ndesloque ACC logicamente n posições para a esquerda ou direita ENDtermine o programa A questão "as instruções da linguagem assembly são agrupadas" pede os nomes dos grupos e uma instrução de cada: movimento de dados, entrada e saída, aritmética, saltos incondicionais e condicionais, comparação e manipulação de bits.
ExplorarComo funciona um ensamblificador de duas passadas
Passe passo a passo. O ensamblificador lê seu código duas vezes: a passada 1 apenas encontra onde cada label está, para que a passada 2 possa preencher os endereços — é assim que um jump para uma label definida depois ainda funciona.
Vocabulário TreinarInglês Chinês Pinyin operand/ˈɒpərænd/ 操作数 cāo zuò shù assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ mnemonics/nɪˈmɒnɪks/ 助记符 zhù jì fú assembler/əˈsemblə/ 汇编器 huì biān qì symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo label/ˈleɪbl/ 标签 biāo qiān forward references/ˈfɔːwəd ˈrefrənsɪz/ 前向引用 qián xiàng yǐn yòng opcode/ˈɒpkəʊd/ 操作码 cāo zuò mǎ 4.2
Modos de endereçamento
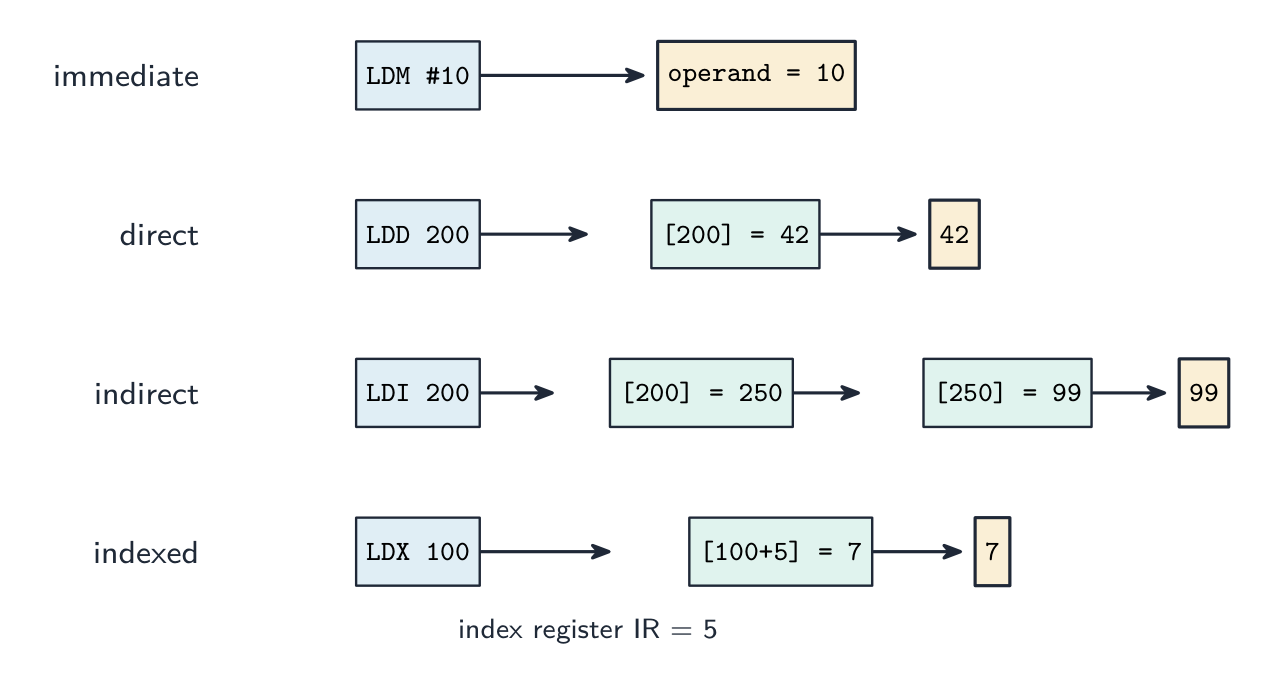
O modo de endereçamento 寻址方式 (the modes of addressing) diz como a CPU encontra o operando:
- endereçamento imediato 立即寻址 — o operando é o valor na instrução.
LDM #10carrega 10. - endereçamento direto 直接寻址 — a instrução contém um endereço; o operando é o valor lá.
LDD 200. - endereçamento indireto 间接寻址 — a instrução contém um endereço que contém outro endereço, que é o dado.
LDI 200. - endereçamento indexado 变址寻址 — endereço efetivo é
address + index register; usado para arrays.LDX 100com IR = 5 lê endereço 105.
(Endereçamento relativo 相对寻址 dá o endereço como um offset do PC — usado para saltos.)
Como cada modo de endereçamento alcança seu operando — imediato, direto, indireto e indexado Exemplo resolvido. Memória contém: local
200=250, local250=99, local105=7. O registro índice contém5. O que está no acumulador após cada um deLDM #200,LDD 200,LDI 200eLDX 100? Siga até onde cada modo precisa olhar.LDM #200é imediato - o operando é o número escrito na instrução, então o acumulador contém 200.LDD 200é direto - vá ao local 200 e pegue o que está lá: 250.LDI 200é indireto - local 200 contém 250, que é outro endereço, então vá para local 250: 99.LDX 100é indexado - some o registro índice ao endereço, $100 + 5 = 105$, e leia local 105: 7. Conte as etapas para mantê-los distintos: imediato 0, direto 1, indireto 2, indexado 1 (uma vez que o índice foi adicionado).Vocabulário TreinarInglês Chinês Pinyin addressing mode/əˈdresɪŋ məʊd/ 寻址方式 xún zhǐ fāng shì immediate addressing/ɪˈmiːdɪət əˈdresɪŋ/ 立即寻址 lì jí xún zhǐ direct addressing/daɪˈrekt əˈdresɪŋ/ 直接寻址 zhí jiē xún zhǐ indirect addressing/ɪndaɪˈrekt əˈdresɪŋ/ 间接寻址 jiàn jiē xún zhǐ relative addressing/ˈrelətɪv əˈdresɪŋ/ 相对寻址 xiāng duì xún zhǐ logical shift/ˈlɒdʒɪkl ʃɪft/ 逻辑移位 luó jí yí wèi cyclic shift/ˈsaɪklɪk ʃɪft/ 循环移位 xún huán yí wèi 4.2
Rastreamento de um programa assembly
Para rastrear ele: faça uma tabela com colunas para PC, ACC, registro índice, cada variável e quaisquer flags. Passe pelas instruções, atualizando a tabela após cada uma; siga os ramos quando mudarem o PC; pare em
END. Um padrão comum é um loop sobre um array usando endereçamento indexado.Exemplo resolvido. Rastreie este programa. Endereço 200 contém 5 e endereço 201 contém 0.
100   LDD  200
101   CMP  #0
102   JPE  108
103   OUT
104   DEC  ACC
105   STO  200
106   LDD  201
107   JMP  100
108   END
Escreva uma linha para cada instrução executada, preenchendo apenas as colunas que mudam:
Instrução ACC 200 201 Saída início 5 0 LDD 2005 CMP #0JPE 108não taken OUTcaractere com código 5 DEC ACC4 STO 2004 LDD 2010 JMP 100LDD 2004 e assim por diante, até
LDD 200carregar 0, a comparação definir a flag igual,JPE 108ser taken e o programa terminar. Três coisas que o examinador verifica: umCMPnão muda nenhum registro, apenas uma flag; um salto não taken ainda conta como executado; eOUTsai um caractere, então vai na coluna de saída, não na coluna ACC. "Diga o efeito de mudarLDD 10paraLDM #10": o ACC conteria o número 10 em vez do conteúdo do endereço 10.4.3
Deslocamentos binários

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão e realizar deslocamentos binários Lógico, aritmético e cíclico Deslocamento para a esquerda, deslocamento para a direita Demonstrar compreensão de como a manipulação de bits pode ser usada para monitorar/controlar um dispositivo Realizar operações de manipulação de bits Testar e definir um bit (usando máscara de bits) Etiqueta de Instrução | Opcode | Operando Explicação AND #n / Bn / &n Operação AND bitwise do conteúdo do ACC com o operando AND Operação AND bitwise do conteúdo do ACC com o conteúdo de XOR #n / Bn / &n Operação XOR bitwise do conteúdo do ACC com o operando XOR Operação XOR bitwise do conteúdo do ACC com o conteúdo de OR #n / Bn / &n Operação OR bitwise do conteúdo do ACC com o operando OR Operação OR bitwise do conteúdo do ACC com o conteúdo de LSL #n Bits no ACC são deslocados logicamente n posições para a esquerda. Zeros são introduzidos na extremidade direita LSR #n Bits no ACC são deslocados logicamente n posições para a direita. Zeros são introduzidos na extremidade esquerda Rótulo de uma instrução Fornece um endereço simbólico Todas as questões assumirão que há apenas um registrador de uso geral disponível (Acumulador) ACC denota Acumulador IX denota Registrador Indexado pode ser um endereço absoluto ou simbólico # denota um número decimal, ex. #123 B denota um número binário, ex. B01001010 & denota um número hexadecimal, ex. &4A Fonte: Programa Cambridge International
Um deslocamento lógico 逻辑移位 move todos os bits para a esquerda ou direita por algumas posições, preenchendo novas posições com 0.
- deslocamento à esquerda por 1 (
LSL #1) — bits movem-se para a esquerda, um 0 entra pela direita; para um número sem sinal isso é × 2. - deslocamento à direita por 1 (
LSR #1) — bits movem-se para a direita, um 0 entra pela esquerda; para um número sem sinal isso é integer ÷ 2.
Deslocar por $n$ posições multiplica ou divide por $2^{n}$. Exemplo:
00001011(11)LSL #1→00010110(22).Bits deslocados fora da extremidade são perdidos, então a multiplicação só está correta enquanto eles eram zeros.
LSL #2no inteiro two's complement11001010dá00101000: os dois 1s que caíram da esquerda foram embora, o bit de sinal mudou, e o resultado já não é mais quatro vezes o original.Um deslocamento aritmético à direita mantém o bit de sinal para que um número negativo com sinal continue negativo. Um deslocamento cíclico 循环移位 (rotate) devolve o bit que cai numa extremidade de volta na outra, então nenhum bit é perdido.
"Mostre o resultado de um deslocamento aritmético à direita de 3 posições em
10011110": copie o bit de sinal em cada lugar vazio,11110011. O mesmo deslocamento em01011100dá00001011. Um deslocamento cíclico à esquerda de 1 em10000110dá00001101: o 1 inicial reaparece à direita.Deslocamento lógico à esquerda ($\times 2$), lógico à direita ($\div 2$) e aritmético à direita (mantém o bit de sinal) A diferença entre os dois deslocamentos à direita é um único bit. Pegue
11110000, que é 240 lido como sem sinal e $-16$ lido como com sinal.LSR #1traz um 0 e dá01111000$= 120$, que é a metade correta de 240.ASR #1copia o bit de sinal e dá11111000$= -8$, que é a metade correta de $-16$. Nenhum está errado — cada um reduz pelo metade sob uma leitura.
Deslocamento lógico e aritmético à direita no mesmo byte: apenas o bit que entra pela esquerda difere Manipulação de bits para monitoramento/controle
Dispositivos embutidos muitas vezes usam um bit 位 de um registro por sinal (ex. bit $n$ = LED $n$). Usando uma máscara 掩码 — máscara de bits — você pode:
- definir bit $n$:
R = R ORuma máscara com bit $n$ definido. - limpar bit $n$:
R = R ANDuma máscara com bit $n$ limpo e o resto definido. - alternar bit $n$:
R = R XORuma máscara com bit $n$ definido. - testar bit $n$:
R ANDa máscara, depois verifique se o resultado é diferente de zero.
Defina um bit com OR, limpe-o com AND, alterne-o com XOR — cada um usando uma máscara Manipulação de bits é rápida, usa pouca memória e permite que um byte contenha até 8 estados liga/desliga.
No conjunto de instruções do exame estes são
AND,OReXORcom uma máscara escrita como operando decimal, binário ou hexadecimal. Com o ACC contendo10101100:Instrução Máscara Resultado em ACC Efeito AND B000011110000111100001100mantém apenas os quatro bits inferiores (limpa os outros) OR #10000000110101101define o bit menos significativo, deixando o resto inalterado XOR &FF1111111101010011inverte todos os bits AND B00001000entãoCMP #00000100000001000testa bit 3: a comparação não é igual, então o bit 3 estava definido LSL #210110000desloca à esquerda duas posições, perdendo os dois bits superiores LSR #300010101desloca à direita três posições, zeros entrando pela esquerda "Escreva a instrução que define o bit menos significativo em 1 e deixa os outros inalterados":
OR #1, ouOR B00000001. Para limpar um bit useANDcom uma máscara que tenha um 0 nesse lugar e 1s nos outros; para testar um bit,ANDcom uma máscara que tenha um 1 apenas nesse lugar, depois compare o resultado com zero. Em um dispositivo de monitoramento, um bit de um registro por sensor permite que um únicoANDverifique se um sensor específico está ligado, e umORativa o bit de controle de um atuador sem perturbar os outros.ExplorarDesloque e mascare os bits de um byte
Escolha um operador e veja cada bit resultante. Um deslocamento à esquerda (<<) moves every bit up one place (×2); a right shift (>>) move-os para baixo (÷2); AND com uma máscara limpa os bits que você não quer.
Vocabulário TreinarInglês Chinês Pinyin bit/bɪt/ 位 wèi mask/mæsk/ 掩码 yǎn mǎ 4.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição conceito de programa armazenado as instruções do programa e os dados estão ambos armazenados na memória principal, e as instruções são buscadas e executadas uma de cada vez registro um local de armazenamento pequeno e muito rápido dentro do processador com um propósito específico Contador de Programa o registro que contém o endereço da próxima instrução a ser buscada Registro de Endereço de Memória o registro que contém o endereço do local de memória sendo lido ou gravado Registro de Dados de Memória o registro que contém o dado ou instrução acabou de ser lido de, ou prestes a ser gravado em, memória Registro de Instrução Atual o registro que contém a instrução atualmente sendo decodificada e executada Acumulador o registro de uso geral que contém o resultado da última operação aritmética ou lógica memória cache memória pequena e rápida próxima ao processador que contém instruções e dados frequentemente usados interrupção um sinal de um dispositivo ou programa que faz o processador pausar a tarefa atual e executar uma rotina de serviço de interrupção linguagem assembly uma linguagem de baixo nível em que cada instrução mnemônica corresponde a uma instrução de código de máquina endereçamento imediato o operando é o valor escrito na instrução endereçamento direto o operando é o conteúdo do endereço escrito na instrução endereçamento indireto o endereço na instrução contém o endereço do operando endereçamento indexado o endereço do operando é o endereço na instrução mais o conteúdo do registro índice endereçamento relativo o endereço do operando é dado como um offset em relação ao endereço da instrução atual deslocamento lógico cada bit se move para o número de posições especificado e zeros preenchem os lugares vazios 4.3
Dicas de prova
- Aprenda o ciclo busca-execução em termos de transferência entre registros (PC, MAR, MDR, CIR, ACC) e o que incrementa o PC.
- Nomeie a função de cada registro; o ** barramento de endereços é unidirecional**, o barramento de dados é bidirecional.
- Diferencie os modos de endereçamento (imediato, direto, indireto, indexado) — uma questão frequente.
- Explique como a velocidade do clock, número de núcleos, tamanho do cache e comprimento da palavra afetam o desempenho.
- Para um deslocamento binário, declare se é lógico ou aritmético; um deslocamento à esquerda multiplica por 2, um deslocamento à direita divide por 2.
Erros comuns
- Dizer que o PC armazena a instrução atual, ou que o MDR armazena um endereço. O PC armazena o endereço da próxima instrução; o MDR armazena dados ou uma instrução, nunca um endereço.
- Deixar fora o incremento do PC da busca, ou colocá-lo após a execução. Ele ocorre assim que o endereço é copiado para o MAR.
- Ler
LDD 10como "carregar 10".LDD 10carrega o conteúdo do endereço 10;LDM #10carrega o número 10. - Colocar um valor na coluna ACC para
CMPouOUT. Uma comparação define apenas uma flag; uma saída vai para a coluna de saída. - Dizer que uma interrupção é tratada "imediatamente". O processador termina a instrução atual e verifica interrupções no final do ciclo.
- Usar um deslocamento lógico à direita em um número negativo em complemento de dois. Apenas um deslocamento aritmético mantém o bit de sinal.
-
5
Software de Sistema
Assistir aula5.1
Sistemas Operacionais

Programa
Os candidatos devem ser capazes de: Notas e orientações Explicar por que um sistema computacional requer um Sistema Operacional (SO) Explique as principais tarefas de gestão realizadas pelo Sistema Operacional Incluindo gestão de memória, gestão de ficheiros, gestão de segurança, gestão de hardware (entrada/saída/periféricos), gestão de processos Demonstre compreensão da necessidade de software de utilidade típico fornecido com um Sistema Operacional Incluindo formatador de disco, verificador de vírus, software de desfragmentação, análise de conteúdos de disco / software de reparação de disco, compressão de ficheiros, software de cópia de segurança Demonstre compreensão de bibliotecas de programas Incluindo: • o software em desenvolvimento é frequentemente construído utilizando código existente de bibliotecas de programas • os benefícios para o desenvolvedor do software construído utilizando ficheiros de biblioteca, incluindo ficheiros Dynamic Link Library (DLL) Fonte: Programa Cambridge International
Por que um computador precisa de um SO
Hardware sozinho pode apenas buscar e executar instruções — não sabe nada sobre arquivos, programas, redes ou usuários. O sistema operacional 操作系统 (OS) é a camada de software que:
- gerencia o hardware (processador 处理器, memória, E/S, armazenamento) para os programas em execução.
- fornece serviços (sistema de arquivos, rede, contas de usuário) através de uma interface clara, para que programas não precisem falar diretamente com o hardware.
- fornece uma interface para o usuário (linha de comando, GUI, toque).
- permite que vários programas compartilhem o hardware com segurança — cada um obtém tempo justo de CPU e é mantido fora da memória dos outros.
Sem um SO, cada programa precisaria de seus próprios drivers, e apenas um programa poderia rodar com segurança por vez.
"Descreva o propósito de um SO — lista de cinco pontos." O OS (1) fornece uma interface entre o usuário e o hardware; (2) oculta a complexidade do hardware do usuário e dos programas de aplicação; (3) gerencia os recursos de hardware — tempo de processador, memória, armazenamento e dispositivos de entrada/saída — e os compartilha entre programas; (4) carrega software de aplicação na memória e o executa, dando a todo programa a mesma plataforma para rodar; (5) permite que vários programas rodam ao mesmo tempo (multitarefa 多任务处理) enquanto os mantém, bem como os dados dos usuários, seguros. Dê cinco pontos diferentes; "ele roda o computador" ou "ele gerencia recursos" isoladamente não vale nada.
Um sistema operacional desktop gerencia a tela, arquivos e programas para o usuário 
Um telefone precisa de um tão quanto: este é um sistema operacional mobile, Android Tarefas principais de gerenciamento
O programa de estudos nomeia cinco. Cada ponto abaixo é uma coisa que o SO realmente faz, o que uma questão "descreva" quer.
- gestão de memória 内存管理 — aloca memória para cada programa quando ele é carregado, mantém a memória de cada programa separada (proteção de memória 内存保护) para que um não sobrescreva outro, libera a memória quando um programa termina, e troca páginas entre RAM 随机存取存储器 e armazenamento secundário 辅助存储器 (o disco) (memória virtual 虚拟内存 / paginação 分页) para que mais programas possam estar abertos do que a memória física permite.
- gestão de processos 进程管理 — um programa em execução é um processo 进程. O SO cria e encerra processos, decide qual processo obterá a CPU a seguir (escalonamento 调度) e por quanto tempo (uma fatia de tempo 时间片), alterna entre eles, resolve conflitos quando dois querem o mesmo recurso, e pode matar um que parar de responder.
- gestão de hardware (entrada/saída e periféricos) — conversa com cada dispositivo através de seu driver de dispositivo 设备驱动, enfileira e bufferiza dados indo para dispositivos lentos como uma impressora, responde a interrupções 中断 de dispositivos, e compartilha um dispositivo entre vários programas.
- gestão de arquivos — cria, nomeia, copia, move e exclui arquivos e pastas, mantém a estrutura de diretório 目录 e um registro de onde cada arquivo está armazenado no disco, aloca espaço de disco para arquivos, e impõe direitos de acesso 访问权限 (leitura / gravação / execução) para cada usuário.
- gestão de segurança — contas de usuário e senhas (autenticação 身份验证), direitos de acesso, criptografia de dados armazenados, firewall, atualizações de segurança automáticas, e um log de quem fez o quê.
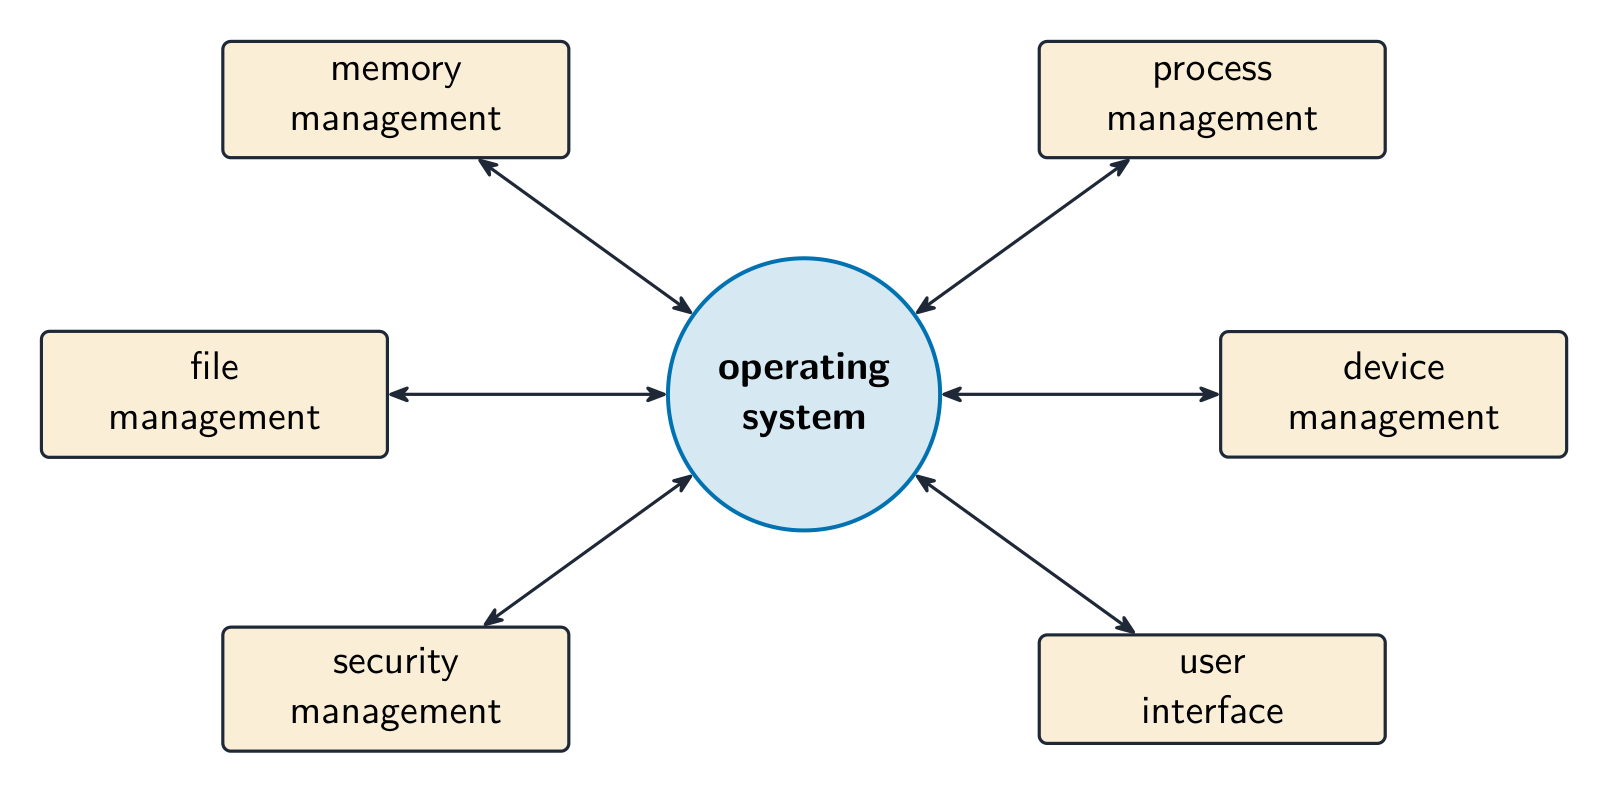
As principais tarefas que o sistema operacional gerencia 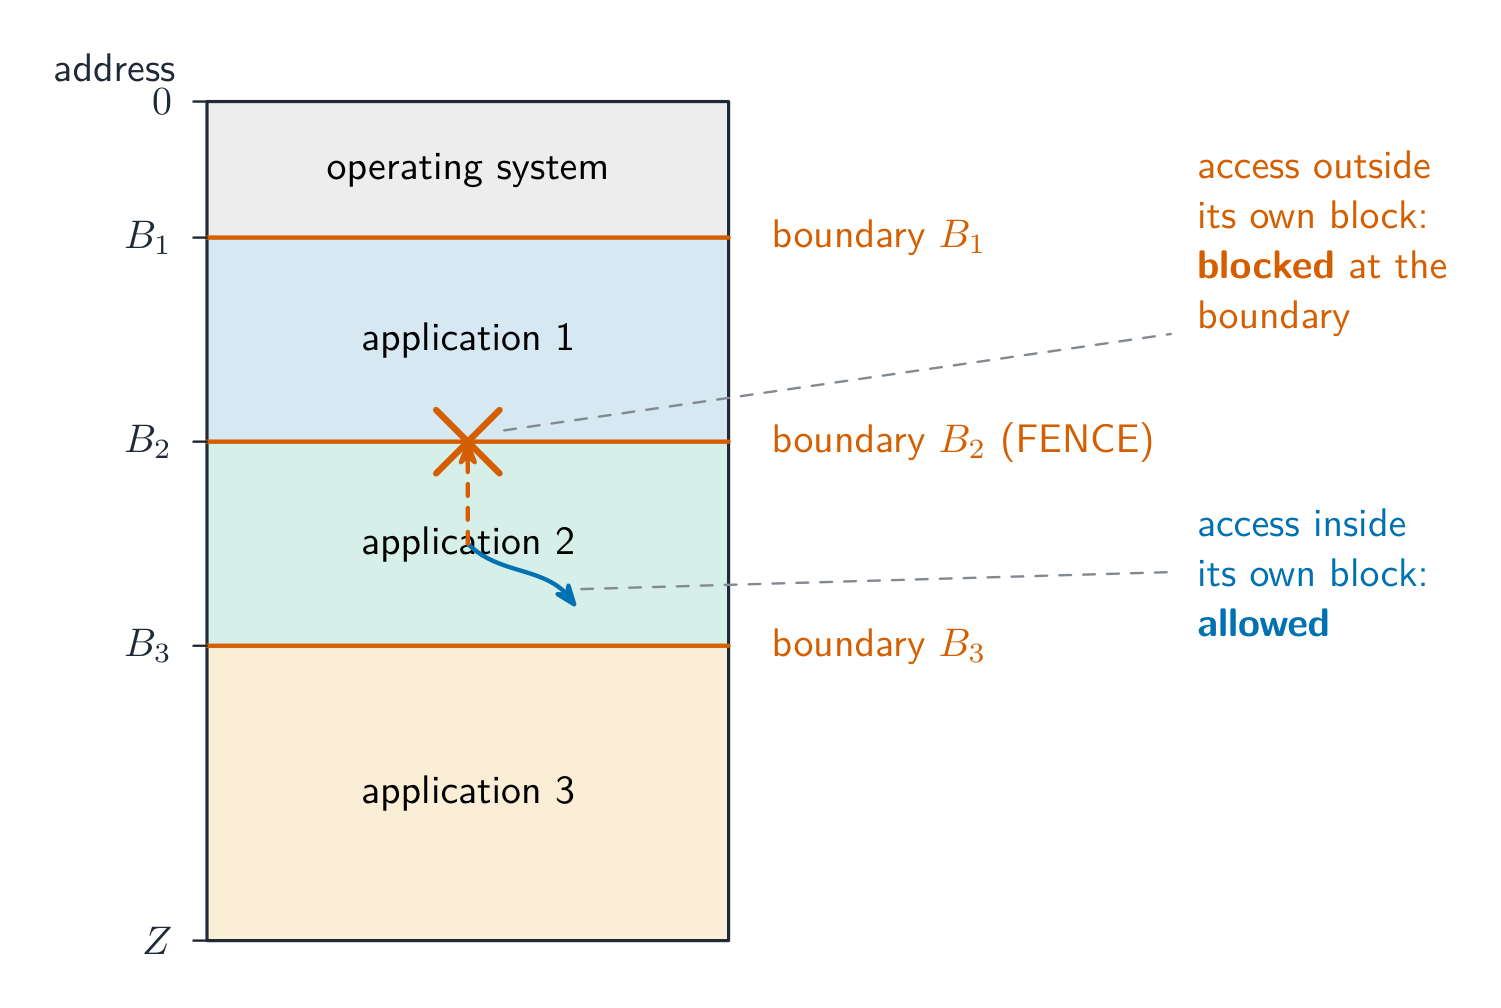
A proteção de memória mantém cada aplicativo em seu próprio bloco de memória Como a gestão de memória e de processos suporta multitarefa (um favorito de quatro pontos). A gestão de memória carrega vários programas na memória ao mesmo tempo, cada um em sua própria área protegida, e acompanha quais endereços pertencem a quais; a gestão de processos compartilha o processador entre eles — cada processo roda por uma fatia de tempo, o SO salva seu estado e alterna para o próximo, e a alternância é tão rápida que todos os programas parecem rodar juntos. Interrupções permitem que o SO retome o processador de um processo sempre que um dispositivo precisar de atenção.
Interrupções. Uma interrupção de hardware 硬件中断 vem de um dispositivo: uma tecla pressionada, um clique do mouse, uma impressora sem papel, um disco terminando uma transferência, uma falha de energia. Uma interrupção de software 软件中断 vem de um programa: divisão por zero, uma instrução inválida, uma tentativa de usar memória que não pertence, ou uma solicitação de serviço do SO. O manipulador de interrupções 中断处理程序 do SO salva o estado do processo em execução, lida com a interrupção e depois restaura o processo (o tópico 4 cobre o detalhe busca–execução).
Software utilitário
Programas utilitários 实用程序 são software de sistema que mantêm, reparam ou otimizam o computador em vez de fazer a tarefa do usuário; o examinador aceita "realiza uma tarefa específica de manutenção que melhora o desempenho ou a segurança". A maioria dos SOs embute estes:

Programas utilitários: antivírus, backup, compressão e desfragmentação - formatador de disco — prepara um disco novo (ou apaga um antigo) para uso: configura seu sistema de arquivos e partições, apagando quaisquer dados existentes.
- verificador de vírus (antivírus 杀毒软件) — varre arquivos e memória, compara código contra um banco de dados de assinaturas 签名 de vírus conhecidos e vigia comportamentos suspeitos, então isola ou exclui o que encontrar; roda em um cronograma e em cada download, e precisa ser atualizado conforme novos vírus aparecem.
- software de desfragmentação (desfragmentador de disco 碎片整理) — um disco rígido armazena um arquivo em quaisquer blocos livres que encontre, então após muitas salvamentos e exclusões um arquivo fica espalhado (fragmentado 碎片化) pelos pratos e a cabeça de leitura/escrita deve pular entre as peças. O desfragmentador move as peças de cada arquivo lado a lado e junta o espaço livre em uma única região, para que arquivos carreguem mais rápido e novos arquivos não fiquem fragmentados. Não necessário em um SSD, que não tem cabeça móvel.
- análise de conteúdo do disco / software de reparo de disco — mostra o que está usando o espaço do disco (arquivos grandes, duplicados ou temporários) para que possam ser removidos; encontra e repara setores defeituosos, clusters perdidos e erros de sistema de arquivos.
- compressão de arquivos (compressão 压缩) — encolhe arquivos para que ocupem menos armazenamento e transfiram mais rápido; arquivagem agrupa muitos arquivos em um.
- software de backup (backup 备份) — copia arquivos para outro meio (disco externo, rede, nuvem) em um cronograma para que os dados possam ser restaurados após perda, corrupção ou ataque de ransomware; uma cópia completa é seguida por backups incrementais 增量备份 de apenas o que mudou.
- um firewall 防火墙 (filtra tráfego de rede por regras) e ferramentas de criptografia, para segurança; um monitor do sistema e atualizações automáticas.
Embutir estes com o SO economiza ao usuário a instalação de cada um.
Qual utilitário faz o quê. Desempenho: desfragmentação (acesso a arquivos mais rápido), reparo de disco (um disco com erros é lento ou falha), análise de conteúdo do disco (espaço livre ao excluir lixo), compressão (mais cabe no disco). Segurança: verificador de vírus, firewall, criptografia e backup (a única recuperação de ransomware). Uma questão "trace uma linha" associa cada utilitário a exatamente um propósito — aprenda os pares acima e use os nomes do programa de estudos.
Exemplo resolvido. Explique como a desfragmentação pode melhorar o desempenho de um computador (3 pontos).
Com o tempo um arquivo é armazenado em blocos espalhados pelo disco rígido, então lê-lo precisa de muitos movimentos da cabeça de leitura/escrita. O desfragmentador rearranja os blocos para que cada arquivo seja armazenado contigüemente e o espaço livre esteja junto. Arquivos são então lidos com menos movimentos de cabeça, então carregam mais rápido, e novos arquivos podem ser escritos em um espaço contínuo.
ExplorarOnde o sistema operacional se situa
Toque em cada camada. O SO é a camada do meio — ele fica entre seus aplicativos e o hardware, compartilhando a máquina seguramente para que programas nunca toquem o hardware diretamente.
Vocabulário TreinarInglês Chinês Pinyin operating system/ˈɒpəreɪtɪŋ ˈsɪstəm/ 操作系统 cāo zuò xì tǒng processor/ˈprəʊsesə/ 处理器 chǔ lǐ qì multitasking/ˈmʌltitæskɪŋ/ 多任务处理 duō rèn wù chǔ lǐ memory management/ˈmeməri ˈmænɪdʒmənt/ 内存管理 nèi cún guǎn lǐ memory protection/ˈmeməri prəˈtekʃn/ 内存保护 nèi cún bǎo hù RAM/ræm/ 随机存取存储器 suí jī cún qǔ cún chǔ qì secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì virtual memory/ˈvɜːtʃuːəl ˈmeməri/ 虚拟内存 xū nǐ nèi cún paging/ˈpeɪdʒɪŋ/ 分页 fēn yè process management/ˈprəʊses ˈmænɪdʒmənt/ 进程管理 jìn chéng guǎn lǐ process/ˈprəʊses/ 进程 jìn chéng scheduling/ˈʃedjuːlɪŋ/ 调度 diào dù time slice/taɪm slaɪs/ 时间片 shí jiān piàn device driver/dɪˈvaɪs ˈdraɪvə/ 设备驱动 shè bèi qū dòng interrupts/ˈɪntərʌpts/ 中断 zhōng duàn directory/daɪˈrektəri/ 目录 mù lù access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng hardware interrupt/ˈhɑːdweə ˈɪntərʌpt/ 硬件中断 yìng jiàn zhōng duàn software interrupt/ˈsɒftweə ˈɪntərʌpt/ 软件中断 ruǎn jiàn zhōng duàn interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù utility program/juːˈtɪlɪti ˈprəʊɡræm/ 实用程序 shí yòng chéng xù antivirus/ˌæntɪˈvaɪrəs/ 杀毒软件 shā dú ruǎn jiàn backup/ˈbækʌp/ 备份 bèi fèn compression/kəmˈpreʃn/ 压缩 yā suō disk defragmenter/dɪsk ˌdiːˈfræɡmentə/ 碎片整理 suì piàn zhěng lǐ signatures/ˈsɪɡnɪtʃəz/ 签名 qiān míng fragmented/fræɡˈmentɪd/ 碎片化 suì piàn huà incremental backups/ˌɪŋkrɪˈmentl ˈbækʌps/ 增量备份 zēng liàng bèi fèn program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng static library/ˈstætɪk ˈlaɪbrəri/ 静态库 jìng tài kù executable/ɪɡˈzekjʊtəbl/ 可执行文件 kě zhí xíng wén jiàn dynamic library/daɪˈnæmɪk ˈlaɪbrəri/ 动态库 dòng tài kù translator/trænˈsleɪtə/ 翻译器 fān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ 5.1
Bibliotecas de Programas

Uma biblioteca de programas 程序库 é código pré-escrito (subrotinas 子程序, classes, módulos) que programas reutilizam em vez de escrevê-lo eles mesmos — ex.: uma biblioteca matemática, uma biblioteca de rede, uma biblioteca de gráficos.
Um novo programa reutilizando rotinas prontas de bibliotecas Benefícios: economiza tempo (código pronto), confiável (bem testado, amplamente utilizado) e padronizado (comportamento consistente).
A lista de benefícios para o examinador, do ponto de vista do desenvolvedor. As rotinas da biblioteca 库例程 já estão escritas e testadas, portanto o desenvolvimento é mais rápido e barato; são confiáveis e, por serem usadas por muitos programas, largely error-free; o desenvolvedor não precisa de especialização naquela área (gráficos, compressão, criptografia, busca de caminho); o programa é mais fácil de manter porque o código comum fica em um único lugar; e toda uma equipe pode usar as mesmas rotinas, garantindo resultados consistentes. Desvantagens: uma rotina pode não fazer exatamente o que você precisa e você não pode alterá-la; seu programa depende da biblioteca estar disponível, correta e segura — um bug ou uma falha de segurança na biblioteca é um bug no seu programa; e você precisa aprender como chamá-la.
- uma biblioteca estática 静态库 é copiada para o executável no tempo de compilação (funciona isoladamente, mas maior e precisa ser recompilada para atualização).
- uma biblioteca dinâmica 动态库 (DLL, Biblioteca de Ligação Dinâmica;
.so) é carregada em tempo de execução (executáveis menores, compartilhada por muitos programas, atualizada uma vez para todos).
Estática: a biblioteca é copiada para o executável. Dinâmica: um arquivo de biblioteca compartilhada é carregado no tempo de execução Arquivos de Dynamic Link Library (DLL). Uma DLL é uma biblioteca que é carregada na memória apenas quando um programa a chama, no tempo de execução, e permanece como um arquivo separado em vez de ser copiada para o executável. Benefícios: o executável é menor; vários programas em execução compartilham uma cópia da DLL na memória; uma DLL pode ser atualizada (correção de bug, novo dispositivo) sem recompilar os programas que a utilizam; e a memória é usada apenas enquanto a rotina estiver necessária. Desvantagens: o programa não funcionará se a DLL estiver ausente, movida ou for a versão errada; uma DLL atualizada pode quebrar um programa que dependia do comportamento antigo; e uma DLL falsa colocada no seu lugar roda com os direitos do programa.
Exemplo resolvido. Uma equipe escreve o software para um robô de restaurante e usa uma biblioteca de programas que inclui uma rotina para encontrar o caminho mais curto entre mesas. Explique dois benefícios e uma desvantagem para a equipe.
Benefícios: a rotina já está escrita e testada, então a equipe economiza tempo e pode confiar no resultado; a equipe não precisa entender algoritmos de busca de caminho e pode gastar o tempo nas funcionalidades próprias do robô. Desvantagem: a rotina pode não lidar exatamente com as necessidades do restaurante (mover cadeiras, corredores de sentido único) e a equipe não pode alterá-la, então podem ter que contornar suas limitações.
ExplorarLaboratório de conceitos de computação
Classifique exemplos concretos pelo conceito de computação que eles demonstram.
5.2
Tradutores de linguagem

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão da necessidade de: • software ensamblador para a tradução de um programa em linguagem assemble • um compilador para a tradução de um programa em linguagem de alto nível • um intérprete para a tradução e execução de um programa em linguagem de alto nível Explique os benefícios e desvantagens do uso de um compilador ou intérprete e justifique o uso de cada um Demonstre consciência de que programas em linguagem de alto nível podem ser parcialmente compilados e parcialmente interpretados, como Java (modo console) Descreva características encontradas num Ambiente de Desenvolvimento Integrado (IDE) típico Incluindo: • para codificação, incluindo prompts sensíveis ao contexto • para deteção inicial de erros, incluindo verificações de sintaxe dinâmicas • para apresentação, incluindo formatação automática, expansão e contração de blocos de código • para depuração, incluindo passo a passo, pontos de interrupção, i.e., variáveis, expressões, janela de relatório Fonte: Programa Cambridge International
Você escreve código-fonte; o computador executa código de máquina 机器码. Um tradutor 翻译器 converte entre eles.
Montador
Um montador 汇编器 traduz linguagem de montagem 汇编语言 em código de máquina: cada instrução mnemônica (
LDD,ADD,JMP) torna-se exatamente uma instrução de código de máquina, e endereços simbólicos e rótulos são substituídos por endereços reais. É necessário porque o processador executa apenas código de máquina, e a linguagem de montagem é usada onde o programador precisa de controle direto do hardware (sistemas embarcados, drivers de dispositivos).Compilador
Um compilador 编译器 traduz um programa de alto nível em código de máquina uma vez, antes de ser executado.
- ele relata todos os erros no tempo de compilação; uma vez limpo, produz um executável 可执行文件 independente que roda sem o compilador instalado e pode ser executado muitas vezes.
- geralmente mais rápido no tempo de execução (nenhuma tradução durante a execução), mas atrelado a uma CPU/SO — recompilar para cada plataforma.
A descrição de duas marcas: um compilador traduz o programa inteiro de alto nível em código de máquina (código objeto 目标代码) antes de ser executado, produz um arquivo executável e relata todos os erros de sintaxe juntos como uma lista no final da tradução. Ele não executa o programa.
Interpretador
Um interpretador 解释器 traduz e executa um programa de alto nível linha por linha, não produzindo nenhum executável.
- ele relata um erro quando chega nessa linha, depois para; você pode corrigi-lo e continuar — bom para desenvolvimento.
- o interpretador deve estar instalado para executar o programa; geralmente mais lento (cada execução re-traduz), mas fácil de portar entre plataformas.
A descrição de duas marcas: um interpretador traduz uma declaração do programa de alto nível por vez e a executa imediatamente antes de passar para a próxima; nenhum arquivo executável é produzido; ele para no primeiro erro encontrado e o relata. Tanto o código-fonte quanto o interpretador devem estar presentes sempre que o programa for executado.
Um compilador traduz uma vez em um programa independente; um interpretador traduz linha por linha, em cada execução Escolhendo entre eles
Use um compilador quando: Use um interpretador quando: velocidade no tempo de execução importa você quer ciclos rápidos de edição–execução distribuir para usuários sem ferramentas de desenvolvimento escrever scripts multiplataforma o programa roda muitas vezes o programa é pequeno ou rodado uma única vez ensinar iniciantes Benefícios e desvantagens, conforme a lista do gabarito.
compilador interpretador velocidade de execução rápida — já é código de máquina lenta — traduzida em cada execução o que o usuário precisa apenas o executável; sem tradutor, e o código-fonte permanece privado o código-fonte e o interpretador encontrar erros todos os erros listados de uma vez, após a tradução do programa inteiro cada erro relatado na linha onde ocorre, à medida que você desenvolve alterar o código recompilar o programa inteiro após cada alteração editar e executar novamente imediatamente portabilidade código de máquina roda em apenas uma plataforma; recompilar para cada a mesma fonte roda em qualquer lugar que exista um interpretador Exemplo resolvido. Um desenvolvedor usa um interpretador enquanto escreve um programa e um compilador quando termina. Explique como cada um é usado (4 marcas).
Durante o desenvolvimento, o interpretador executa o programa parcialmente escrito imediatamente, sem esperar por uma tradução completa; ao encontrar um erro, ele relata a linha, então o desenvolvedor corrige e executa novamente imediatamente — um ciclo rápido de edição–execução que facilita o debugging. Quando o programa está terminado, o compilador traduz todo o programa em um executável que roda mais rápido, não precisa de tradutor no computador do usuário e não revela o código-fonte, podendo ser vendido ao público.
Híbrido: Java
Java é compilado em bytecode 字节码 (uma forma intermediária independente de plataforma), que uma máquina virtual 虚拟机 (a JVM) então interpreta — ou usa compilação just-in-time 即时编译 para transformar partes quentes em código nativo. Assim, erros são capturados cedo, o bytecode roda em qualquer lugar com uma JVM (
A frase do syllabus é "parcialmente compilado e parcialmente interpretado": a etapa do compilador captura erros de sintaxe e produz bytecode compacto e portátil 可移植的; a etapa de interpretação permite que esse único arquivo de bytecode seja executado em qualquer máquina que tenha uma máquina virtual, ao custo de alguma velocidade. Java em modo console (um programa de texto executado pela linha de comando) é o exemplo do syllabus.

Java compila para bytecode portátil que qualquer JVM executa — escreva uma vez, execute em qualquer lugar Exemplo resolvido. O código-fonte Java é compilado em bytecode, que uma JVM então interpreta. Por que usar ambos, em vez de compilar diretamente para código de máquina? Um compilador produz código de máquina para um processador e sistema operacional, então um programa compilado em uma máquina não funcionará em outra. O compilador do Java, em vez disso, visa uma máquina virtual, então o bytecode que ele produz é idêntico em todos os lugares; cada plataforma então fornece sua própria JVM para interpretar esse bytecode em suas próprias instruções nativas. Um único arquivo compilado, portanto, funciona em qualquer lugar onde exista uma JVM - "escreva uma vez, execute em qualquer lugar". O preço é a velocidade: interpretar bytecode é mais lento do que executar código nativo, razão pela qual uma JVM real também usa compilação JIT para transformar bytecode frequentemente executado em código nativo enquanto o programa roda. Nomeie ambos os lados - os pontos são pela portabilidade comprada ao custo da velocidade.
ExplorarO caminho do compilador: código-fonte para programa em execução
Passe por como um compilador funciona — traduzindo todo o programa uma vez, antes de executar. Contraste com um interpretador, que traduz e executa uma linha de cada vez.
Vocabulário TreinarInglês Chinês Pinyin compiler/kəmˈpaɪlə/ 编译器 biān yì qì object code/ˈɒbdʒekt kəʊd/ 目标代码 mù biāo dài mǎ interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì portable/ˈpɔːtəbl/ 可移植的 kě yí zhí de 5.2
Ambiente de Desenvolvimento Integrado (IDE)

Um ambiente de desenvolvimento integrado 集成开发环境 (IDE) reúne as ferramentas para escrever, testar e depurar código em um único aplicativo:
Um IDE agrupa o editor, um botão Executar e um depurador O syllabus agrupa as funcionalidades em quatro tipos. Aprenda qual funcionalidade pertence a qual, porque as perguntas pedem para classificá-las e descrever uma de cada grupo.
- Para codificação: prompts sensíveis ao contexto 上下文相关提示 — conforme você digita, o IDE exibe os identificadores, palavras-chave ou parâmetros que se encaixam naquele ponto do código; auto-complete 自动补letina completa o nome para você; indentação automática e correspondência de colchetes mantêm o layout correto enquanto você digita.
- Para detecção inicial de erros: verificações de sintaxe dinâmicas 动态语法检查 — o editor verifica a sintaxe enquanto você digita e sublinha ou destaca um erro imediatamente, antes que o programa seja traduzido; após a tradução, mensagens de erro com números de linha.
- Para apresentação: prettyprint 代码美化 — palavras-chave, identificadores, strings e comentários mostrados em cores ou fontes diferentes (destaque de sintaxe 语法高亮) com indentação consistente, para que a estrutura seja visível à primeira vista; expandir e recolher blocos de código — ocultar o corpo de um loop, um IF ou uma subrotina para ver o contorno.
- Para depuração: breakpoints 断点 — o programa pausa ao atingir uma linha marcada; single stepping 单步执行 — a partir da pausa, execute uma linha por vez; uma janela que mostra os valores atuais de variáveis e expressões à medida que mudam; e uma report window 报告窗口 que lista erros, avisos e saída.
Outras funcionalidades: integração com tradutor (compilar ou executar com um atalho, erros mostrados em linha), um debugger 调试器 que aciona as funcionalidades de depuração acima, integração com version control 版本 controle (git), gerenciamento de projetos, sistema de ajuda, ferramentas de refactoring 重构 (renomeação segura) e integração com unit test 单元测试.

As funcionalidades da IDE apresentam os nomes do syllabus, nos locais onde você os veria na tela Uma IDE acelera o desenvolvimento ao colocar escrever → executar → depurar → corrigir atrás de uma única interface. IDEs comuns: Visual Studio, PyCharm, Eclipse, VS Code.

Um debugger: defina um breakpoint, execute, então pause para inspecionar variáveis e faça single stepping pelo código Exemplo resolvido. Uma função
Calculate()retorna um valor inesperado quando o programa é executado. Descreva como as funcionalidades de depuração de uma IDE típica ajudam a encontrar a causa (4 pontos).Defina um breakpoint na primeira linha de
Calculate(), para que o programa pause lá em vez de continuar executando. Em seguida, faça single-step pela função uma linha por vez. Após cada passo, leia os valores das variáveis e de qualquer expressão que você tenha pedido à IDE para watch, e compare-os com os valores esperados; a primeira linha após a qual um valor está errado é onde está o erro lógico. A report window mostra qualquer mensagem de erro de tempo de execução e a saída produzida até então.Exemplo resolvido. Coloque cada funcionalidade no seu grupo do syllabus: prettyprint, context-sensitive prompt, dynamic syntax check, breakpoint, expand/collapse code blocks, report window.
Coding: context-sensitive prompt. Detecção inicial de erros: dynamic syntax check. Apresentação: prettyprint, expand/collapse code blocks. Depuração: breakpoint, report window.
Vocabulário TreinarInglês Chinês Pinyin debugger/ˈdiːbʌɡə/ 调试器 tiáo shì qì context-sensitive prompts/ˈkɒntekst ˈsensɪtɪv prɒmpts/ 上下文相关提示 shàng xià wén xiāng guān tí shì auto-complete/ˈɔːtəʊ kəmˈpliːt/ 自动补全 zì dòng bǔ quán dynamic syntax checks/daɪˈnæmɪk ˈsɪntæks tʃeks/ 动态语法检查 dòng tài yǔ fǎ jiǎn chá prettyprint/ˈpretɪprɪnt/ 代码美化 dài mǎ měi huà syntax highlighting/ˈsɪntæks ˈhaɪlaɪtɪŋ/ 语法高亮 yǔ fǎ gāo liàng breakpoints/ˈbreɪkpɔɪnts/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng report window/rɪˈpɔːt ˈwɪndəʊ/ 报告窗口 bào gào chuāng kǒu version control/ˈvɜːʃn kənˈtrəʊl/ 版本控制 bǎn běn kòng zhì refactoring/rɪˈfæktərɪŋ/ 重构 chóng gòu unit test/ˈjuːnɪt test/ 单元测试 dān yuán cè shì 5.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição sistema operacional software que gerencia o hardware e recursos do computador e fornece uma interface entre o usuário, os programas de aplicativo e o hardware software utilitário software de sistema que executa uma tarefa específica para manter, otimizar ou proteger o computador, como um verificador de vírus ou desfragmentador biblioteca de programas conjunto de rotinas pré-escritas e testadas (subrotinas, classes, módulos) que um programa pode usar em vez de escrever as próprias Dynamic Link Library (DLL) uma biblioteca de programas cujas rotinas são carregadas na memória apenas quando o programa as chama, em tempo de execução, e são compartilhadas entre programas assembler tradutor que converte um programa de linguagem de montagem em código de máquina, uma instrução por instrução compiler tradutor que converte todo um programa de linguagem de alto nível em código de máquina antes de ser executado, produzindo um arquivo executável interpreter tradutor que traduz e executa um programa de linguagem de alto nível uma declaração por vez integrated development environment aplicativo único que fornece as ferramentas para escrever, traduzir, executar e depurar um programa context-sensitive prompt pop-up que sugere identificadores, palavras-chave ou parâmetros que se encaixam no ponto atual do código dynamic syntax check verifica a sintaxe do código à medida que é digitado e sinaliza um erro antes que o programa seja traduzido prettyprint exibe o código com palavras-chave, identificadores e comentários em cores ou fontes diferentes e com indentação consistente breakpoint linha marcada na qual o programa em execução pausa para que as variáveis possam ser inspecionadas single stepping executa um programa pausado uma declaração por vez sob o controle do programador Vocabulário TreinarInglês Chinês Pinyin assembler/əˈsemblə/ 汇编器 huì biān qì assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán integrated development environment/ˈɪntɪɡreɪtɪd dɪˈveləpmənt enˈvaɪrənmənt/ 集成开发环境 jí chéng kāi fā huán jìng 5.2
Dicas de prova
- Liste as tarefas do SO pelos seus nomes do syllabus (gestão de memória, processo, hardware, arquivos e segurança) e diga o que cada uma faz — "gerencia recursos" sozinho é muito vago.
- Comparar compiler vs interpreter vs assembler: o que cada um traduz, quando o traduz e como os erros são relatados.
- Explique o que uma IDE oferece usando os grupos do syllabus: coding, detecção inicial de erros, apresentação, depuração.
- Uma resposta de "benefício para o desenvolvedor" nomeia a economia do desenvolvedor: tempo, custo, competência, confiabilidade ou manutenção. Um "drawback" nomeia uma dependência: disponibilidade, versão, adequação, segurança.
- Para "descrever a operação de" um tradutor, dê três coisas: o que é traduzido (programa inteiro ou uma declaração), quando (antes de executar ou enquanto executa) e como os erros são relatados (todos de uma vez ou no primeiro erro).
Erros comuns
- Escrever "o OS controla o computador" ou "gerencia recursos" sem exemplo de tarefa. Cada ponto é uma tarefa nomeada com o que ela faz.
- Dizer que um interpreter "compila linha por linha". Um interpreter traduz e executa cada declaração; ele nunca produz um executável.
- Dizer que um compiler executa o programa. Ele apenas traduz; o executável roda depois, sem o compiler.
- Colocar uma DLL "dentro" do executável. Isso é uma biblioteca estática; uma DLL permanece um arquivo separado carregado em tempo de execução.
- Dizer que a desfragmentação "exclui" ou "comprime" arquivos, ou que é necessária em SSDs. Ela apenas move blocos para que cada arquivo seja armazenado contiguamente.
- Classificar prettyprint ou contrair blocos sob "depuração". Eles são funcionalidades de apresentação; depuração refere-se a breakpoints, single stepping, watching variables e report window.
-
6
Segurança, privacidade e integridade dos dados
Assistir aula6.1
Segurança, privacidade e integridade — três ideias diferentes
Programa
Os candidatos devem ser capazes de: Notas e orientações Explique a diferença entre os termos segurança, privacidade e integridade dos dados Demonstre apreciação pela necessidade tanto da segurança dos dados quanto da segurança do sistema informático Descreva medidas de segurança projetadas para proteger sistemas informáticos, desde PCs autónomos até redes de computadores Incluindo contas de utilizador, palavras-passe, técnicas de autenticação como assinaturas digitais e biometria, firewall, software antivírus, anti-spyware, criptografia Demonstre compreensão das ameaças à segurança computacional e dos dados impostas por redes e internet Incluindo malware (vírus, spyware), hackers, phishing, pharming Descreva métodos que podem ser utilizados para restringir os riscos impostos por ameaças Descreva métodos de segurança projetados para proteger a integridade dos dados Incluindo criptografia, direitos de acesso Fonte: Programa Cambridge International
Parecem semelhantes, mas significam coisas diferentes:
- security 安全 — proteger dados contra acesso, alteração ou destruição unauthorised 未授权.
- privacy 隐私 — o direito de um indivíduo de controlar quem vê seus dados pessoais, com consentimento e propósito claro.
- integrity 完整性 — os dados serem precisos e completos — não corrompidos ou alterados acidentalmente.
Um arquivo pode ser seguro (apenas as pessoas certas podem abri-lo) mas carecer de integridade (um erro de digitação o corrompeu); ou preciso, mas não privado (qualquer pessoa pode lê-lo). As três são necessárias.
Diferenças que o scheme quer, uma frase cada: security é manter os dados seguros contra perda e acesso não autorizado; privacy é manter os dados confidenciais, para que apenas aqueles com permissão possam vê-los; integrity é os dados estarem corretos, consistentes e completos. Então "a diferença entre security e privacy": security trata de proteger os dados contra acesso, alteração ou perda por pessoas que não devem; privacy trata do direito do indivíduo de decidir quem pode ver seus dados pessoais. "A diferença entre security e integrity": security protege os dados contra acesso não autorizado; integrity trata dos dados estarem precisos e atualizados, o que validação e verificação protegem.
ExplorarLaboratório de risco e responsabilidade
Classifique exemplos pela regra, risco ou proteção envolvidos.
Vocabulário TreinarInglês Chinês Pinyin security/sɪˈkjʊərɪti/ 安全 ān quán privacy/ˈprɪvəsi/ 隐私 yǐn sī integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng unauthorised/ʌnˈɔːθəraɪzd/ 未授权 wèi shòu quán 6.1
Por que a segurança importa
Duas coisas a proteger: os próprios dados (mantê-los confidenciais, intactos e disponíveis) e o sistema de computador (um sistema comprometido pode atacar outros, roubar credenciais ou ser mantido refém).
"Por que a escola precisa manter ambos seguros?" Dados: são pessoais e confidenciais, portanto não devem ser lidos, alterados ou excluídos por uma pessoa não autorizada, e sua perda pararia o funcionamento da escola. Sistema: um invasor que acessa o sistema de computador pode instalar malware, usá-lo para atacar outros sistemas, danificar hardware ou software, ou bloqueá-lo com ransomware; um sistema seguro é a primeira linha de defesa para os dados nele contidos.
6.1
Ameaças de redes e internet

Ameaças se dividem em três grupos.
Um atacante man-in-the-middle senta-se entre as duas partes - Malware 恶意软件 (malicious software) — programas nocivos:
- virus 病毒 — código autocolante que se anexa a outros programas e se espalha quando eles são executados.
- worm 蠕虫 — código autocolante que se espalha por redes 网络 sem ação do usuário.
- Trojan horse 木马 — parece útil, mas esconde código malicioso.
- spyware 间谍软件 — coleta secretamente informações (digitações, senhas).
- ransomware 勒索软件 — criptografa seus arquivos e exige pagamento.
- adware 广告软件 — impõe anúncios indesejados.
2. Enganando pessoas (ataques sociais):
- phishing 网络钓鱼 — e-mails/sites falsos que enganam usuários para darem credenciais.
- pharming 域名欺骗 redireciona um usuário para um site falso mesmo quando digitam o endereço correto.
- social engineering 社会工程 — enganar pessoas para revelarem informações.
Descrições do scheme para as quatro ameaças nomeadas: um virus é software malicioso que se replica (autocopia), anexa-se a outros arquivos e apaga ou corrompe dados; spyware é software malicioso que grava as teclas pressionadas e ações do usuário e as envia a terceiros, para obter senhas e dados pessoais; um e-mail de phishing finge vir de uma organização legítima e contém um link para um site falso onde o usuário é solicitado a fornecer detalhes pessoais ou bancários; pharming é código malicioso instalado no computador do usuário ou em um servidor web que redireciona o usuário para um site falso mesmo que tenham digitado o endereço correto. Semelhanças entre spyware e um vírus: ambos são malware, ambos são instalados sem conhecimento do usuário, ambos podem enviar dados a terceiros ou danificar o sistema; a diferença é que um vírus se replica enquanto spyware registra e transmite informações. Phishing e pharming levam o usuário a um site falso que coleta seus dados; phishing precisa que o usuário clique em um link em um e-mail, pharming funciona através de código no computador ou no servidor DNS e não precisa de e-mail.
3. Ataques à rede:
- hacking 黑客入侵 por hackers 黑客 — acesso não autorizado, muitas vezes via senhas fracas ou falhas de software.
- denial of service 拒绝服务 (DoS/DDoS) — inunda um servidor para que usuários reais não consigam acessá-lo.
- eavesdropping 窃听 — captura de dados em trânsito (risco em Wi-Fi aberto).
- man-in-the-middle 中间人攻击 — um atacante relaya secretamente ou altera mensagens entre duas partes.
Exemplo resolvido. Identifique e descreva duas ameaças aos dados em uma rede escolar, e forneça um método de prevenção diferente para cada uma.
Ameaça 1, malware: um vírus copiado para um computador a partir de um anexo de e-mail ou download se replica e corrompe ou exclui arquivos; prevenção: software antivírus que escaneia arquivos e é mantido atualizado. Ameaça 2, hacking: uma pessoa não autorizada ganha acesso à rede, por exemplo adivinhando uma senha fraca, e lê ou altera os dados; prevenção: um firewall que bloqueia conexões não autorizadas, ou senhas fortes com autenticação de dois fatores. Um terceiro par, phishing: um e-mail leva o usuário a um site falso que coleta seu login; prevenção: treinar usuários para verificar o remetente e a URL, e filtrar e-mails. A medida deve corresponder à ameaça: criptografia não impede um vírus, e software antivírus não impede phishing.
Malware por comportamento: propagação autônoma (vírus, worm) versus oculto/disfarçado (Trojan, spyware, ransomware, adware) Vocabulário TreinarInglês Chinês Pinyin malware/ˈmælweə/ 恶意软件 è yì ruǎn jiàn ransomware/ˈrænsəmweə/ 勒索软件 lè suǒ ruǎn jiàn networks/ˈnetwɜːks/ 网络 wǎng luò man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī virus/ˈvaɪrəs/ 病毒 bìng dú worm/wɜːm/ 蠕虫 rú chóng Trojan horse/ˈtrəʊdʒn hɔːs/ 木马 mù mǎ spyware/ˈspaɪweə/ 间谍软件 jiàn dié ruǎn jiàn adware/ˈædweə/ 广告软件 guǎng gào ruǎn jiàn phishing/ˈfɪʃɪŋ/ 网络钓鱼 wǎng luò diào yú pharming/ˈfɑːmɪŋ/ 域名欺骗 yù míng qī piàn social engineering/ˈsəʊʃl ˌendʒɪˈnɪərɪŋ/ 社会工程 shè huì gōng chéng hacking/ˈhækɪŋ/ 黑客入侵 hēi kè rù qīn hackers/ˈhækəz/ 黑客 hēi kè denial of service/dɪˈnaɪəl ɒv ˈsɜːvɪs/ 拒绝服务 jù jué fú wù eavesdropping/ˈiːvzdrɒpɪŋ/ 窃听 qiè tīng 6.1
Medidas de segurança

Medidas protegem tanto a segurança dos dados (contra perda, roubo ou corrupção) quanto a segurança do sistema computacional (seu hardware, software e rede).
PC standalone
- uma senha forte; antivírus mantido atualizado; atualizações de software rápidas; backup 备份 em mídia separada; criptografia 加密 de disco completo; tela bloqueada.
PC em rede
Tudo acima, mais um firewall 防火墙, permissões por usuário (direitos de admin apenas para admins), gestão centralizada de contas de usuário 用户账户, e logs de auditoria 审计日志 (quem fez login, o que tocou).
Como as medidas funcionam, na formulação que o programa avalia:
- firewall: examina toda transmissão de entrada e saída e a compara com critérios definidos (lista branca ou lista negra de endereços, portas e protocolos); bloqueia qualquer uma que não atenda aos critérios; pode impedir acesso a certos sites e alertar sobre tentativas de acesso não autorizado.
- criptografia: os dados são embaralhados (codificados) com uma chave em texto cifrado, para que uma cópia interceptada não possa ser compreendida sem a chave; o receptor usa uma chave para descriptografá-la. Protege dados em trânsito e em armazenamento, mas não impede que os dados sejam interceptados ou excluídos.
- senhas e contas de usuário: apenas um usuário que conhece a senha pode fazer login; uma senha forte (longa, caracteres mistos, alterada regularmente) não pode ser adivinhada; contas travam após falhas repetidas; cada conta possui seus próprios direitos de acesso.
- software antivírus e anti-spyware: escaneia arquivos e programas contra um banco de dados de assinaturas conhecidas de malware, verifica comportamentos, isola ou exclui o que encontrar, e deve ser atualizado para reconhecer novos malwares.
- direitos de acesso: cada usuário (ou grupo) recebe permissões para cada arquivo ou tabela, como leitura exclusiva ou leitura e escrita, para que um usuário não veja ou altere dados que não são seus; um banco de dados também pode apresentar a cada usuário uma view contendo apenas os campos necessários.
- biometria: o dispositivo captura uma imagem do rosto, impressão digital ou íris, converte em dados digitais, compara com os dados armazenados daquele usuário e permite acesso apenas em caso de correspondência; não pode ser esquecido, emprestado ou adivinhado como uma senha.
- backups: uma cópia dos dados em mídia separada, mantida fora do local, para que dados perdidos ou corrompidos possam ser restaurados.
Para restringir os riscos de malware, em três pontos: instalar software anti-malware e mantê-lo atualizado; usar um firewall; não abrir anexos ou baixar arquivos de fontes desconhecidas; manter o sistema operacional e aplicativos corrigidos; e treinar usuários.
Um firewall fica entre o computador do usuário e a internet Através da internet
- VPN 虚拟专用网 — criptografa tráfego entre o usuário e o gateway corporativo.
- HTTPS / TLS — criptografa tráfego web.
- assinaturas digitais 数字签名 — provam quem enviou uma mensagem e que ela não foi alterada em trânsito.
- detecção de intrusão — monitora tráfego por padrões de ataque conhecidos.
Como uma assinatura digital autentica um documento (cinco pontos): o remetente passa a mensagem por uma função hash para produzir um resumo; o remetente criptografa o resumo com sua chave privada, e esse resumo criptografado é a assinatura digital; a mensagem e a assinatura são enviadas juntas; o receptor descriptografa a assinatura com a chave pública do remetente para recuperar o resumo; o receptor faz hash da mensagem recebida e compara os dois resumos; se coincidirem, a mensagem veio do remetente (apenas eles detêm a chave privada) e não foi alterada na transmissão. Uma assinatura prova quem enviou a mensagem e que está intacta; não esconde o conteúdo, que é o que a criptografia da mensagem serve para fazer.
Uma assinatura digital: um hash da mensagem, criptografado com a chave privada do remetente, verificado pelo receptor contra um hash fresco Vocabulário TreinarInglês Chinês Pinyin firewall/ˈfaɪəwɔːl/ 防火墙 fáng huǒ qiáng two-factor authentication/tuː ˈfæktə ɔːˌθentɪˈkeɪʃn/ 双因素认证 shuāng yīn sù rèn zhèng authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng backup/ˈbækʌp/ 备份 bèi fèn user accounts/ˈjuːzə əˈkaʊnts/ 用户账户 yòng hù zhàng hù audit logs/ˈɔːdɪt lɒɡz/ 审计日志 shěn jì rì zhì ciphertext/ˈsaɪfətekst/ 密文 mì wén access rights/ˈækses raɪts/ 访问权限 fǎng wèn quán xiàn VPN/ˌviː piː ˈen/ 虚拟专用网 xū nǐ zhuān yòng wǎng digital signatures/ˈdɪdʒɪtl ˈsɪɡnɪtʃəz/ 数字签名 shù zì qiān míng private key/ˈpraɪvət kiː/ 私钥 sī yào public key/ˈpʌblɪk kiː/ 公钥 gōng yào authorisation/ˌɔːθəraɪˈzeɪʃn/ 授权 shòu quán least-privilege/liːst ˈprɪvɪlɪdʒ/ 最小权限 zuì xiǎo quán xiàn plaintext/ˈpleɪntekst/ 明文 míng wén Symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì access control/ˈækses kənˈtrəʊl/ 访问控制 fǎng wèn kòng zhì 6.1
Correspondendo medidas a ameaças
- interceptação em trânsito → criptografar os dados (HTTPS, VPN). Texto cifrado interceptado é inútil sem a chave.
- acesso não autorizado → forte autenticação 身份验证 (senhas longas; autenticação de dois fatores 双因素认证 com código de telefone ou chave); autorização 授权 de usuário; bloqueio após falhas de login.
- malware → software antivírus e anti-spyware 反间谍软件 com escaneamento em tempo real; correções; evitar downloads não confiáveis.
- phishing → treinamento de usuários; filtragem de e-mails; verificar a URL antes de inserir credenciais.
- ameaças internas → princípio de menor privilégio 最小权限 (dar a cada usuário apenas o necessário); auditoria.
- DDoS → limitação de taxa e filtragem de tráfego.
Para dados confidenciais cruzando a internet, o método do programa é criptografia: os dados são codificados com uma chave em texto cifrado, para que uma pessoa não autorizada que os intercepte não possa lê-los, e apenas o destinatário pretendido, que tem a chave, possa decodirá-los. Para um arquivo de programa enviado por e-mail para teste, a mesma resposta se aplica (criptografar o arquivo, ou enviá-lo por conexão criptografada), junto com uma senha no próprio arquivo.
Vocabulário TreinarInglês Chinês Pinyin anti-spyware/ˈænti ˈspaɪweə/ 反间谍软件 fǎn jiàn dié ruǎn jiàn biometrics/ˌbaɪəʊˈmetrɪks/ 生物识别 shēng wù shí bié 6.1
Protegendo os próprios dados
- criptografia — transformar texto claro 明文 em texto cifrado 密文 com uma chave. Criptografia simétrica 对称加密 (AES) usa uma chave compartilhada; criptografia assimétrica 非对称加密 (RSA) usa uma chave pública 公钥 e uma chave privada 私钥. Protege dados em repouso e em trânsito.
- controle de acesso 访问控制 — permissões de arquivo (leitura/escrita/execução) e direitos de acesso 访问权限, implementados pelo SO.
- autenticação — técnicas de autenticação verificam o usuário: algo que você sabe (senha), tem (token, telefone), ou é (biometria 生物识别 — impressão digital, rosto, íris); mais forte combinado.
- backups — manter cópias (algumas fora do local) para que perda ou corrupção seja recuperável.
- segurança física — salas de servidores trancadas, cadeados de cabos.
Direitos de acesso em um banco de dados, descritos para três pontos: cada usuário recebe uma conta com nome de usuário e senha; o administrador do banco de dados atribui a cada conta permissões para cada tabela, como leitura exclusiva, leitura e escrita, ou sem acesso; usuários veem apenas tabelas e campos aos quais têm permissão, então um cliente não pode abrir a tabela de funcionários e um funcionário pode ler mas não alterar preços. O DBMS impõe isso com seus direitos de acesso e com visualizações, e pode criptografar os dados armazenados também.
Simétrica usa uma chave compartilhada; assimétrica usa uma chave pública para criptografar e uma privada para descriptografar 
Um token de segurança mostra um código mutável para autenticação de dois fatores ('algo que você tem') 
Um leitor de impressões digitais verifica 'algo que você é' — uma característica da pessoa, não uma senha ExplorarCripte com um cifrador César
Mude o deslocamento — essa é a chave. Cada letra desliza esse número de lugares no alfabeto para formar o texto cifrado, e a mesma chave o desliva de volta. Essa chave compartilhada é criptografia simétrica em miniatura.
Vocabulário TreinarInglês Chinês Pinyin encryption/enˈkrɪpʃn/ 加密 jiā mì 6.2
Integridade dos dados
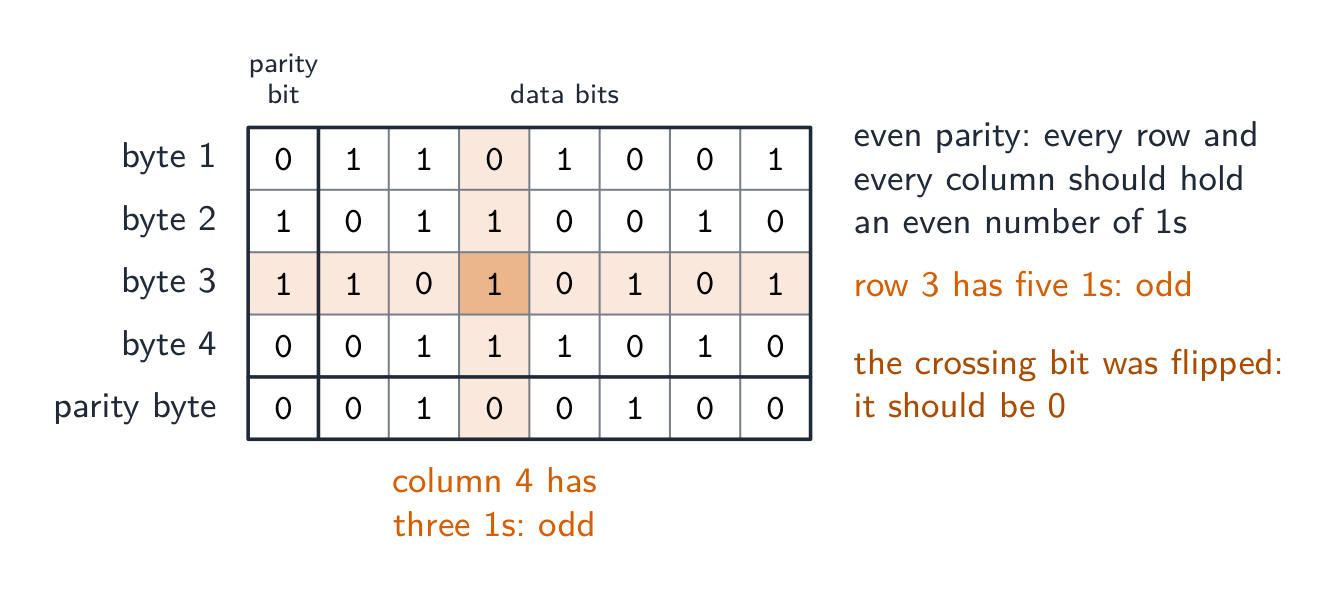
Programa
Os candidatos devem ser capazes de: Notas e orientações Descreva como a validação de dados e a verificação de dados ajudam a proteger a integridade dos dados Descreva e utilize métodos de validação de dados Incluindo verificação de intervalo, verificação de formato, verificação de comprimento, verificação de presença, verificação de existência, verificação de limite, dígito verificador Descreva e utilize métodos de verificação de dados durante a introdução e transferência de dados Durante a introdução de dados incluindo verificação visual, entrada dupla Durante a transferência de dados incluindo verificação de paridade (byte e bloco), soma de verificação Fonte: Programa Cambridge International
Dados têm integridade quando são precisos e completos. Duas técnicas: validação de dados (pegar dados ruins antes de armazenar) e verificação de dados (confirmar que os dados foram inseridos ou transferidos corretamente).
Validação — os dados fazem sentido?
Validação 验证 verifica dados contra regras sensatas, automaticamente:
- range check — dentro de limites (um mês é 1–12).
- limit check — do lado correto de um limite único (ex.: idade ≥ 18).
- existence check — o item referenciado existe (ex.: um código de produto está na tabela).
- length check — número correto de caracteres.
- type / character check — tipo certo de dado (um campo de telefone permite apenas dígitos).
- format check — corresponde a um padrão (um e-mail deve conter
@). - presence check — campos obrigatórios não estão vazios.
- check digit 校验位 — um dígito extra calculado a partir dos outros (ISBN, números de cartão) que detecta erros de transcrição.
Exemplo resolvido. Em um esquema simples de dígito de controle, o dígito de controle é o resto quando a soma dos dígitos é dividida por $10$, anexado ao número. O número $4162$ tem soma de dígitos $13$, então é armazenado como $41623$. Um usuário digita $14623$: os dois primeiros dígitos são trocados, mas a soma ainda é $13$, então o dígito de controle ainda corresponde e o erro não é capturado. Um usuário que digita $41523$ é capturado, porque $4 + 1 + 5 + 2 = 12$ dá dígito de controle $2$. Um esquema que captura dígitos trocados pondera cada posição diferentemente, como faz o ISBN-13 (pesos $1, 3, 1, 3, \ldots$, então o dígito que torna o total um múltiplo de $10$). Um dígito de controle é validação: testa o número contra uma regra no momento em que é inserido.
- verificação por consulta e verificação de consistência (ex.: data de entrega ≥ data do pedido).
A validação captura dados com formatação incorreta, mas não dados que estão corretamente formatados, porém factualmente errados ("Bob" para "Bib").
Exemplo resolvido. Identifique qual verificação de validação cada trecho de pseudocódigo realiza.
Pseudocódigo Verificação IF x < 0 OR x > 10 THEN OUTPUT "Invalid"verificação de intervalo: o valor deve estar entre dois limites IF x = "" THEN OUTPUT "Invalid"verificação de presença: o campo não pode estar vazio IF NOT(x = "Red" OR x = "Yellow" OR x = "Blue") THEN OUTPUT "Invalid"verificação por consulta (existência): o valor deve pertencer a uma lista IF LENGTH(x) <> 6 THEN OUTPUT "Invalid"verificação de comprimento: número correto de caracteres IF MID(x, 1, 1) < "A" OR MID(x, 1, 1) > "Z" THEN OUTPUT "Invalid"verificação de formato: um caractere específico deve ser uma letra Para validar um número de placa de carro que deve ter uma letra, três dígitos e duas letras: uma verificação de formato testa cada posição contra seu padrão, e uma verificação de comprimento confirma seis caracteres. Para validar uma data de nascimento: uma verificação de formato (
DD/MM/YYYY), uma verificação de intervalo (o mês é de $1$ a $12$, o ano não está no futuro) e uma verificação de presença (não está em branco). Uma nota entre $0$ e o máximo do teste precisa de verificação de tipo (inteiro) e verificação de intervalo, com o limite superior lido no próprio registro do teste: é assim que a validação protege a integridade, recusando dados que não poderiam estar corretos.Verificação — os dados foram inseridos ou transferidos corretamente?
Verificação 核对 verifica se os dados não foram alterados ao serem movidos de um lugar para outro.
Durante a entrada: dupla entrada (digite duas vezes e compare, como para uma nova senha) ou verificação visual.
Nas palavras do esquema, entrada dupla é inserir os dados duas vezes, pela mesma pessoa ou por duas pessoas, e fazer o computador comparar as duas versões e relatar qualquer diferença; uma verificação visual é a pessoa comparar o que está na tela com o documento original e corrigir qualquer diferença antes de salvar. Ambos protegem a integridade garantindo que os dados armazenados correspondam à fonte. Mesmo após validação e verificação, os dados ainda podem estar errados: podem parecer sensatos e corresponder à fonte, mas a própria fonte estava errada, ou o usuário digitou um valor diferente, mas válido, daquele pretendido.
Durante a transferência (bits podem inverter):
- verificação de paridade 奇偶校验 — um bit extra faz com que o número de 1s seja par (paridade par) ou ímpar. O receptor reconta. Detecta erros de único bit.
- soma de verificação 校验和 — o remetente envia um valor resumido dos dados; o receptor o recalcula e compara.
- verificação de redundância cíclica 循环冗余校验 (CRC) — uma soma de verificação mais forte usando divisão polinomial, detectando muitos tipos de erro adicionais.
Uma verificação de bloco de paridade 奇偶块校验 vai além e localiza o erro. Organize os bytes em uma grade: atribua um bit de paridade de linha a cada byte, depois calcule um byte de paridade extra cujos bits sejam a paridade de coluna dos bytes acima. Um único bit invertido agora falha em uma linha e uma coluna — sua interseção aponta exatamente qual bit mudou, podendo até ser corrigido.
Exemplo resolvido. Quatro bytes são enviados com paridade par, seguidos por um byte de paridade. Encontre o bit que foi corrompido.
Uma verificação de bloco de paridade: a linha que falha e a coluna que falham cruzam no bit invertido Conte os 1s em cada linha e em cada coluna. Cada linha e coluna deve ter um número par; o byte 3 tem cinco e a coluna 4 tem três. O bit onde essa linha e essa coluna se cruzam é aquele que mudou, portanto é redefinido de 1 para 0. Uma verificação de paridade sozinha detecta um erro em um byte, mas não pode dizer qual bit; dois erros no mesmo byte se cancelam e passam despercebidos. Uma soma de verificação, explicada para três marks: o remetente passa o bloco de dados por um algoritmo que produz um valor de soma de verificação; os dados e a soma de verificação são enviados juntos; o receptor executa o mesmo algoritmo nos dados recebidos; se as duas somas de verificação coincidirem, os dados são aceitos, e se não, são rejeitados e reenviados.
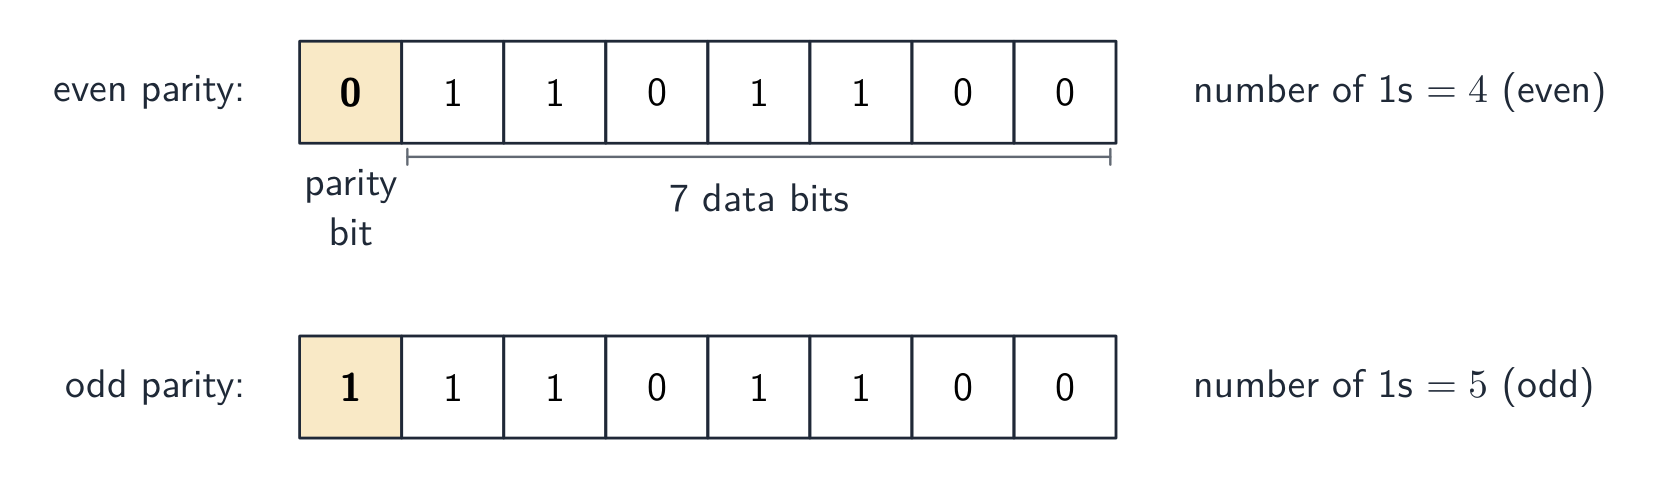
O bit de paridade é definido para tornar o número de 1s par ou ímpar 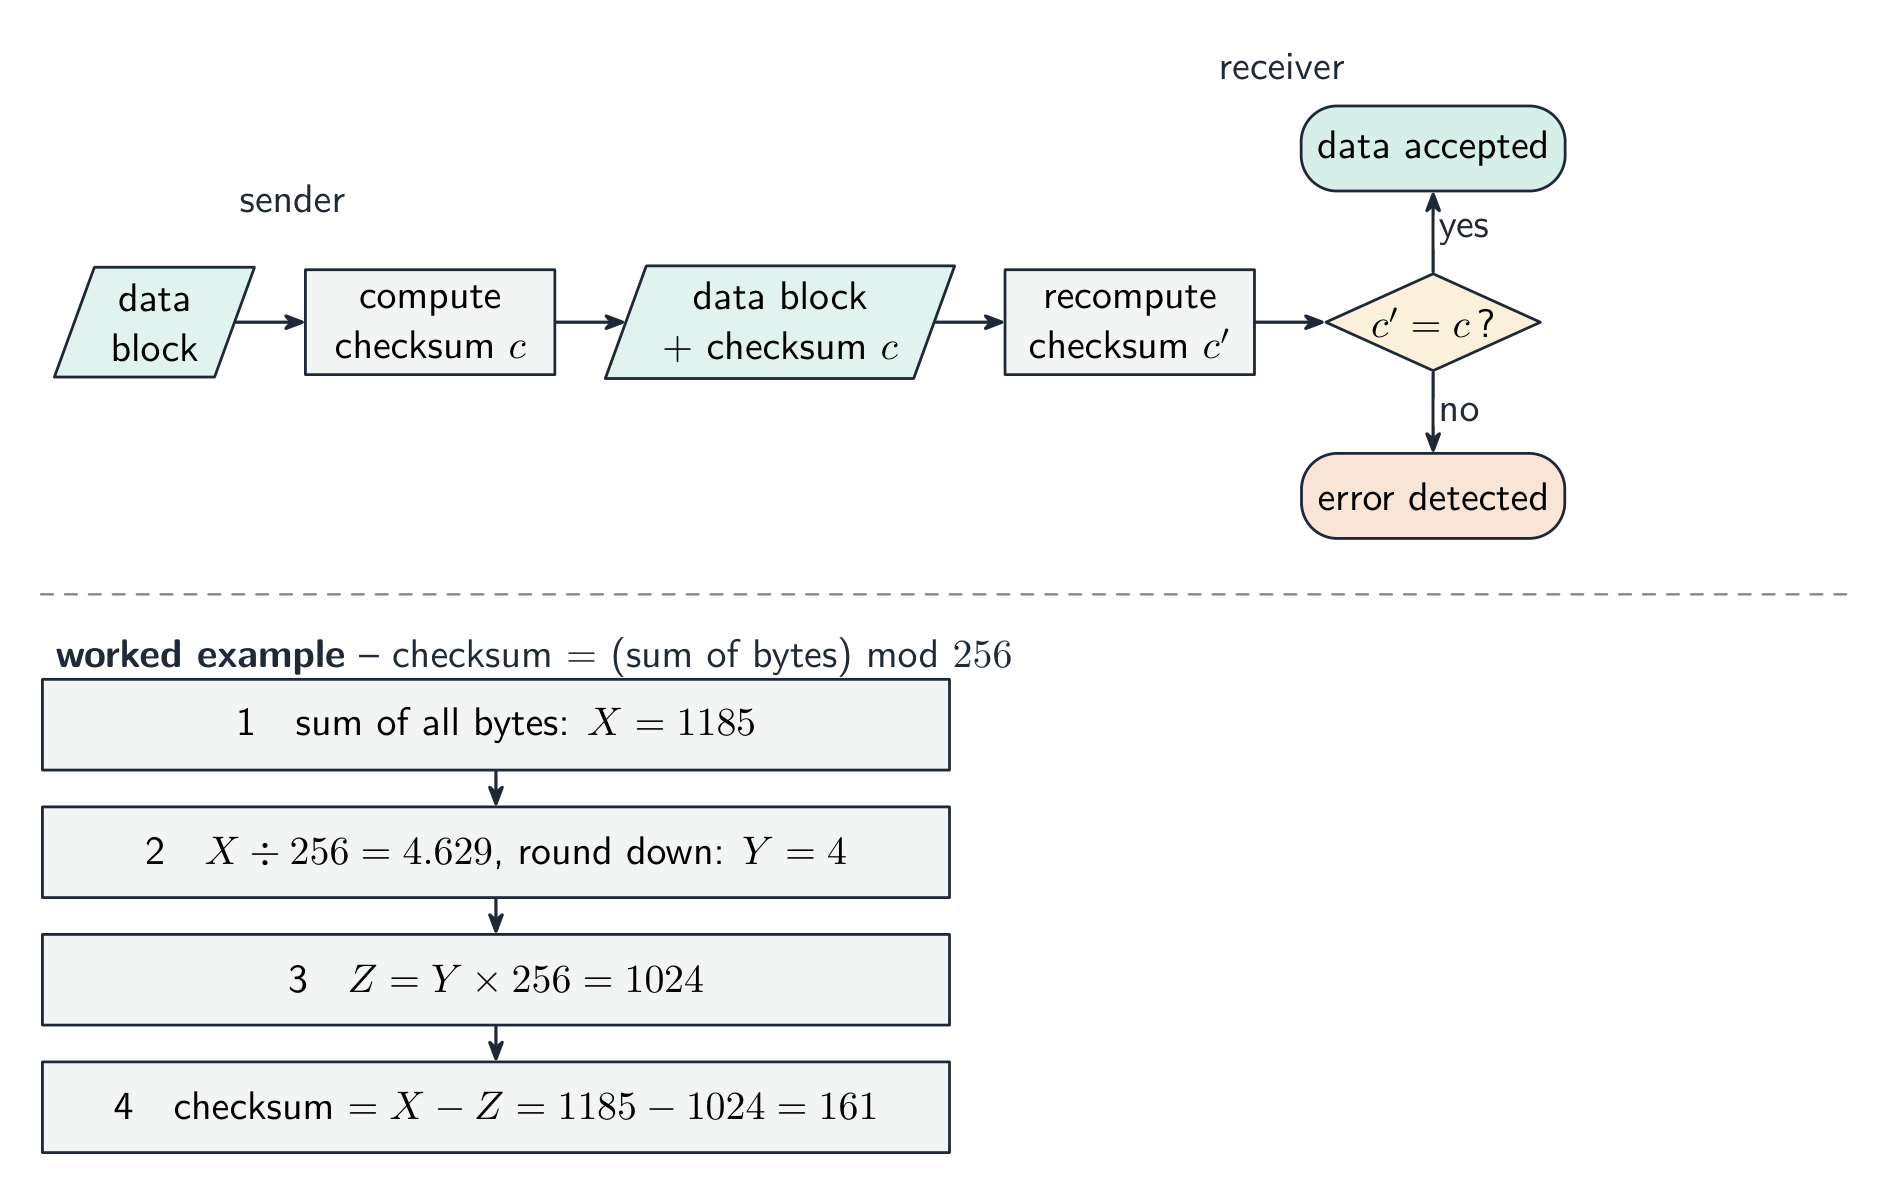
Calculando uma soma de verificação para um bloco de dados A verificação só prova que o que chegou corresponde ao que foi enviado — não que os dados estejam corretos, nem contra manipulação deliberada. A validação pergunta "isso faz sentido?"; a verificação pergunta "isso foi copiado corretamente?" — use ambas.
As perguntas da tabela classificam os métodos pelo momento de uso: durante a entrada de dados, entrada dupla e verificação visual; durante a transferência de dados, verificação de paridade (byte ou bloco) e soma de verificação. Transferir arquivos de vídeo de uma câmera para um servidor usa uma soma de verificação: a câmera a calcula, o servidor a recalcula, uma discrepância significa retransmissão.
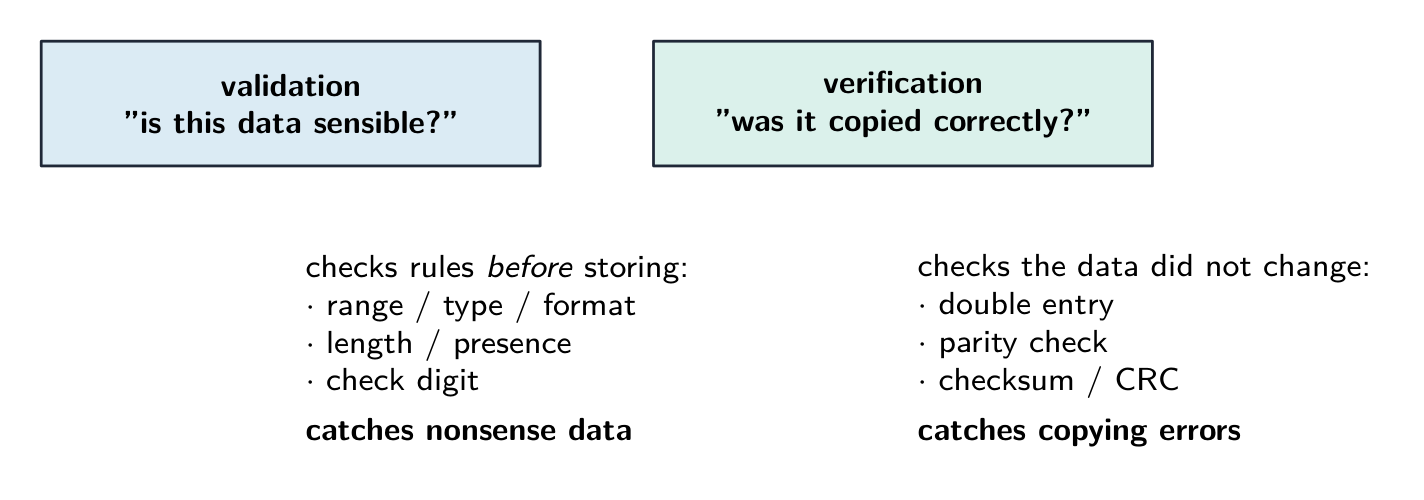
A validação verifica se os dados fazem sentido; a verificação verifica se foram copiados sem alterações Exemplo resolvido. Um usuário digita sua data de nascimento como
31/02/2009, e digita seu endereço de e-mail duas vezes. Qual verificação captura qual erro, e qual é a diferença? A validação pergunta "esse dado é sensato?" - o computador o testa contra uma regra, e uma verificação de formato ou intervalo rejeita31/02/2009porque fevereiro nunca tem 31 dias. A verificação pergunta "esse dado foi inserido corretamente?" - digitar o e-mail duas vezes é entrada dupla, e comparar as duas cópias captura um erro de digitação. O limite é o que torna esta uma questão favorita: a validação nunca pode dizer que os dados estão corretos, apenas que são possíveis -01/02/2009passa todas as regras de validação mesmo que o usuário tenha nascido realmente em outro dia. Diga o que cada verificação pode e não pode capturar.ExplorarLaboratório de conceitos de computação
Classifique exemplos concretos pelo conceito de computação que eles demonstram.
Vocabulário TreinarInglês Chinês Pinyin validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng verification/ˌverɪfɪˈkeɪʃn/ 核对 hé duì check digit/tʃek ˈdɪdʒɪt/ 校验位 jiào yàn wèi parity check/ˈpærɪti tʃek/ 奇偶校验 jī ǒu jiào yàn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé cyclic redundancy check/ˈsaɪklɪk rɪˈdʌndənsi tʃek/ 循环冗余校验 xún huán rǒng yú jiào yàn parity block check/ˈpærɪti blɒk tʃek/ 奇偶块校验 jī ǒu kuài jiào yàn 6.2
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
Termo Definição segurança de dados manter os dados seguros contra perda e acesso, alteração ou exclusão não autorizados privacidade de dados manter os dados confidenciais, de modo que sejam vistos apenas por quem tem direito a vê-los integridade de dados os dados estarem precisos, consistentes e completos malware software malicioso instalado sem o conhecimento do usuário para danificar um sistema ou roubar dados vírus malware que se replica, se anexa a outros arquivos e corrompe ou exclui dados spyware malware que registra as teclas pressionadas ou ações do usuário e as envia a terceiros phishing um e-mail fingindo ser de uma organização legítima que leva o usuário a um site falso para coletar dados pessoais pharming código malicioso que redireciona o usuário a um site falso mesmo quando o endereço correto é inserido firewall hardware ou software que examina todo o tráfego entrando ou saindo de um sistema contra critérios definidos e bloqueia o que não os atender criptografia embaralhar dados com uma chave em texto cifrado, de modo que não possa ser compreendido sem a chave para descriptografá-lo assinatura digital um hash de uma mensagem criptografado com a chave privada do remetente, usado para provar quem o enviou e que não foi alterado validação de dados verificação automática de que os dados inseridos são razoáveis e seguem regras definidas verificação de dados verificação de que os dados foram inseridos ou transferidos corretamente, comparando-os com a fonte ou com um valor recalculado dígito verificador dígito extra calculado a partir dos outros dígitos de um número e anexado a ele, de modo que um erro no número possa ser detectado verificação de paridade bit extra adicionado a um byte para que o número de 1s seja par (ou ímpar), o qual o receptor reconta soma de verificação valor calculado a partir de um bloco de dados por um algoritmo e enviado com ele, recalculado pelo receptor e comparado 6.2
Dicas de prova
- Mantenha as três ideias separadas: segurança (manter os dados seguros), privacidade (quem pode vê-los), integridade (mantê-los corretos).
- Combine cada ameaça (malware, hacking, phishing, interceptação) com uma medida (firewall, criptografia, autenticação, direitos de acesso).
- A criptografia protege confidencialidade, não integridade — use uma soma de verificação, paridade ou dígito verificador para integridade.
- Distinga um vírus, worm e Cavalo de Troia e como cada um se espalha.
Erros comuns
- Dar a mesma medida para duas ameaças, ou uma medida que não se adequa à ameaça. Cada ameaça na tabela precisa de uma prevenção diferente que realmente a impeça.
- Nomear uma medida sem explicar como ela funciona. "Firewall" pontua quando seguido por "compara o tráfego com critérios definidos e bloqueia o que falha".
- Chamar validação de uma verificação de que os dados estão corretos. A validação verifica se os dados são razoáveis; a verificação verifica se correspondem à fonte. Nenhuma delas prova que são verdadeiros.
- Dizer que uma assinatura digital criptografa a mensagem. Ela criptografa um hash da mensagem com a chave privada; o receptor a descriptografa com a chave pública e compara os hashes.
- Descrever um dígito verificador como verificação, ou uma verificação de paridade como validação. O dígito verificador é uma regra de validação na entrada; paridade e somas de verificação verificam uma transferência.
- Escrever que um vírus "envia dados para terceiros" e spyware "replica". O que replica é o vírus; o que grava é o spyware.
-
7
Ética e Propriedade
Assistir aula7.1
Ética para profissionais de computação
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão da necessidade e propósito da ética como profissional de computação Compreenda a importância de se associar a um corpo ético profissional incluindo BCS (British Computer Society), IEEE (Institute of Electrical and Electronic Engineers) Demonstre compreensão da necessidade de agir eticamente e do impacto de agir ética ou eticamente para uma situação dada Demonstre compreensão da necessidade de legislação sobre direitos autorais Demonstre compreensão dos diferentes tipos de licenciamento de software e justifique o uso de uma licença para uma situação dada Licenças devem incluir Free Software Foundation, Open Source Initiative, shareware e software comercial Demonstre compreensão de Inteligência Artificial (AI) Compreenda o impacto da IA incluindo questões sociais, económicas e ambientais Compreenda as aplicações da IA Fonte: Programa Cambridge International
Um profissional de TI é alguém cujo trabalho — software, sistemas, redes, dados — afeta outras pessoas. Como o trabalho é técnico, outros muitas vezes não conseguem julgar se foi bem ou honestamente feito. Portanto, a profissão segue ética compartilhada 伦理 (princípios para boa conduta).
Por que a ética importa
- confiança — usuários e empregadores confiam nos profissionais para atuarem em seu interesse. Sem essa confiança, o software perde credibilidade.
- impacto — software opera dispositivos médicos, bancos, veículos. Trabalho descuidado ou desonesto pode prejudicar pessoas.
Organizações profissionais (BCS, ACM, IEEE) publicam códigos de ética para membros.
CCTV levanta preocupações de privacidade — um dos problemas éticos que um profissional de TI deve ponderar 
Lixo eletrônico (e-waste) é um custo ambiental crescente da computação 
O desenvolvimento de software afeta o bem-estar público de várias maneiras Princípios típicos
- interesse público em primeiro lugar — proteger a segurança e o bem-estar daqueles afetados.
- honestidade e competência — ser honesto sobre suas habilidades; não reclamar expertise que não possui.
- confidencialidade 保密性 — proteger informações privadas de clientes e empregadores.
- evitar conflitos de interesses 利益冲突 — não aceitar trabalho onde seu interesse conflita com o do cliente.
- manter suas habilidades atualizadas; respeitar propriedade intelectual 知识产权 e privacidade 隐私; tratar colegas com justiça.
Entrando em uma organização profissional
O programa cita duas: a BCS (British Computer Society) e a IEEE (Institute of Electrical and Electronics Engineers). Ambas publicam um código de conduta 行为准则 que os membros concordam em seguir. Os benefícios de entrar, nas palavras do programa: um conjunto de diretrizes éticas para seguir, para que as decisões não fiquem à critério pessoal; treinamento, conferências e publicações que mantêm o membro atualizado; aconselhamento e suporte, incluindo ajuda jurídica, quando um problema surge; e status profissional reconhecido, para que empregadores e clientes confiem no trabalho do membro. As consequências de não entrar: sem orientação para decisões éticas, o programador pode agir de forma antiética sem perceber; menos credibilidade com empregadores e clientes, tornando mais difícil ganhar trabalhos; sem apoio em disputas; e ficar desatualizado com desenvolvimentos e leis. O propósito de um código de conduta (duas marcas): criar um ambiente de trabalho seguro, respeitoso e profissional, e garantir que cada funcionário entenda o que é esperado e as consequências de suas ações.
Exemplo resolvido. Explique por que um programador precisa agir eticamente com colegas e com o público.
Colegas: tratá-los com justiça e sem discriminação; respeitar seu trabalho, ideias e informações confidenciais; ser honesto sobre erros e dar crédito onde for devido; apoiar seu desenvolvimento em vez de sabotá-lo. O público: proteger seus dados pessoais e privacidade; produzir software seguro, confiável e devidamente testado, pois falhas podem causar danos; ser honesto sobre o que o software pode fazer; assumir apenas trabalho dentro de sua competência; obedecer à lei e considerar os efeitos mais amplos na sociedade e no meio ambiente. Cada lado ganha pontos por uma razão e sua consequência, não apenas pela palavra "justiça".
Agir eticamente vs antieticamente
Agir eticamente protege usuários, fortalece a reputação, reduz riscos jurídicos e constrói confiança. Agir antieticamente (pular testes, esconder bugs, usar dados indevidamente) pode prejudicar usuários reais, levar a demissão ou ação judicial, danificar a reputação e erodir a confiança na tecnologia em geral.
Quando você enfrenta uma decisão limítrofe: identifique cujos interesses estão envolvidos, verifique o código de ética e a lei, avalie as consequências, pergunte a um sênior de confiança e escolha a opção que proteja os usuários acima da conveniência de curto prazo.
Exemplo resolvido. A nova ferramenta de contratação de IA da sua equipe classifica currículos dez vezes mais rápido, mas você nota que rejeita mais candidatos mais velhos. Lançá-la agrada ao seu gerente, mas trata um grupo injustamente. A escolha ética é segurá-la até que o viés seja corrigido — o interesse público e a equidade vêm antes da conveniência de curto prazo.
A ética também se aplica aos usuários. Um estudante que conecta um computador pessoal à rede da escola deve respeitar a privacidade e os dados de outras pessoas, não usar redes sociais de forma inadequada ou bullizar outros, não baixar ou compartilhar material protegido por direitos autorais, não introduzir malware ou tentar acessar sistemas aos quais não tem permissão, e usar a rede para o fim para o qual foi fornecida. Uma resposta de "dê três considerações éticas" lista três dessas.
ExplorarLaboratório de risco e responsabilidade
Classifique exemplos pela regra, risco ou proteção envolvidos.
7.1
Direitos Autorais

Direito autoral 版权 é o direito legal do criador de uma obra original de controlar como ela é copiada, distribuída, modificada e executada. Aplica-se automaticamente (sem registro) a código-fonte, software, documentos, imagens, áudio e vídeo.
Sem direito autoral, qualquer um poderia copiar software livremente, o desenvolvedor não seria pago e o plágio seria legal. Com direito autoral, desenvolvedores podem lucrar com seu trabalho (incentivando mais software), usuários sabem quem o criou, e a reutilização ocorre nos termos do desenvolvedor através de licenças. O direito autoral dura muito tempo (geralmente 70 anos após a morte do criador). Ideias gerais e algoritmos não são cobertos por direito autoral, mas podem ser cobertos por uma patente 专利.
Por que um programador deveria registrar o copyright de um programa, nas palavras do programa: ser identificado como proprietário e autor (reconhecimento formal de propriedade); para que haja consequências legais se alguém copiar ou roubá-lo; para restringir competidores de vender o mesmo trabalho; e para poder ganhar dinheiro licenciando-o. O direito autoral aplica-se ao programa conforme escrito; um programa diferente que faz o mesmo trabalho não o infringe.
Direito autoral é automático e de longa duração; uma patente deve ser solicitada e dura cerca de 20 anos ExplorarLaboratório de risco e responsabilidade
Classifique exemplos pela regra, risco ou proteção envolvidos.
Vocabulário TreinarInglês Chinês Pinyin copyright/ˈkɒpɪraɪt/ 版权 bǎn quán patent/ˈpeɪtənt/ 专利 zhuān lì software licence/ˈsɒftweə ˈlaɪsəns/ 软件许可证 ruǎn jiàn xǔ kě zhèng 7.1
Licenças de Software
Uma licença de software 软件许可证 é um contrato que concede permissão para usar software nos termos do proprietário; escolher e aplicar uma é chamado de licenciamento de software.
Comercial (proprietary)
- software comercial é vendido: você compra uma licença; o software é usado apenas dentro de seus termos.
- o código-fonte não é fornecido (um produto proprietary 专有); você não pode modificá-lo ou redistribuí-lo.
- exemplos: Microsoft Office, Adobe Photoshop, a maioria dos jogos.
Usado quando o desenvolvedor quer receita por usuário e manter controle do código.
Open-source
- o código-fonte é público; usuários podem ler, modificar e redistribuí-lo (open-source 开源).
- licenças permissivas (MIT, BSD) permitem quase qualquer uso; licenças copyleft 著佐权 (GPL) exigem que versões modificadas sejam lançadas sob a mesma licença ("share-alike").
- a Free Software Foundation (FSF) e a Open Source Initiative (OSI) promovem e aprovam licenças open-source.
O programa cita ambos, e eles são marcados como respostas distintas. Software Livre (termo da FSF) significa livre como em liberdade, não preço: o usuário pode executar o programa para qualquer finalidade, estudar e alterá-lo (portanto o código-fonte deve estar disponível), redistribuir cópias e distribuir versões modificadas; uma taxa ainda pode ser cobrada por uma cópia. Open Source (definição da OSI) exige que o código-fonte esteja disponível, que o programa possa ser modificado e redistribuído, e que a licença não discrimine qualquer pessoa ou campo de uso. "Identifique dois tipos de licença que permitam que outras pessoas editem e redistribuam o programa" é respondido com estes dois.
- exemplos: Linux, Python, Apache.
Usado quando o desenvolvedor quer que o software seja amplamente usado e melhorado pela comunidade.
Freeware e shareware
- freeware 免费软件 — gratuito, sem código-fonte, pode ser redistribuído mas não modificado (Acrobat Reader, WhatsApp).
- shareware 共享软件 — gratuito por um período de teste, depois você paga para continuar usando; sem código-fonte.
As descrições do programa: shareware é distribuído gratuitamente para teste (tempo limitado ou recursos limitados) e o usuário paga para continuar usando a versão completa; software comercial é vendido por uma taxa, o código-fonte não é fornecido, a licença protege a propriedade intelectual do desenvolvedor, e a taxa geralmente compra suporte e atualizações. Benefícios do shareware para o programador: usuários podem testar o programa antes de comprar, então são mais propensos a comprar; espalha-se amplamente com quase nenhum custo de publicidade; e aqueles que o mantêm pagam. Benefícios de uma licença comercial: o desenvolvedor ganha uma taxa por cada cópia; o código e seus direitos permanecem protegidos; e a renda financia suporte, atualizações e desenvolvimento adicional.
Tipo Custo Código-Fonte Redistribuir Modificar Comercial Pago Não Não Não Código aberto Gratuito Sim Sim Frequentemente, com condições Freeware Gratuito Não Sim Não Shareware Teste grátis, depois pago Não Às vezes Não Escolher uma licença baseado no objetivo do desenvolvedor Para justificar uma escolha de licença, conecte-a ao objetivo do desenvolvedor (receita, alcance, comunidade), às necessidades do usuário (custo, personalização) e ao caso de uso.
Exemplo resolvido. Um programador escreveu um jogo para vender ao público. Identifique a licença mais adequada e justifique-a.
Uma licença comercial: o jogo é vendido por uma taxa, então o programador ganha dinheiro de cada cópia; o código-fonte não é liberado, então ninguém pode copiar o jogo ou alterá-lo e vendê-lo como próprio; a licença protege a propriedade intelectual; e compradores recebem atualizações e suporte. Open source não se encaixaria, porque o código-fonte estaria disponível, então o jogo poderia ser copiado, alterado e redistribuído sem pagamento.
Exemplo resolvido. Um programa ajuda os consumidores lendo rótulos de produtos em voz alta. Explique por que uma licença de código aberto pode não ser adequada.
O código-fonte estaria acessível, portanto poderia ser alterado; uma versão alterada poderia exibir informações incorretas sobre o produto, fazendo com que os compradores comprem o item errado; e o programador perderia controle sobre a qualidade e segurança do que é distribuído sob o nome do programa. No sentido oposto, programas são lançados como código aberto para que outros desenvolvedores possam melhorá-los e estendê-los, para que sejam adotados amplamente sem custo, e para que usuários possam adaptá-los às suas próprias necessidades.
Vocabulário TreinarInglês Chinês Pinyin proprietary/prəˈpraɪətəri/ 专有 zhuān yǒu open-source/ˈəʊpən sɔːs/ 开源 kāi yuán copyleft/ˈkɒpɪleft/ 著佐权 zhù zuǒ quán freeware/ˈfriːweə/ 免费软件 miǎn fèi ruǎn jiàn shareware/ˈʃeəweə/ 共享软件 gòng xiǎng ruǎn jiàn artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí 7.1
Inteligência Artificial (AI)

Inteligência artificial 人工智能 constrói sistemas que realizam tarefas antes consideradas que exigiam inteligência humana — reconhecimento de fala e imagens, tradução, jogos, direção.
A maioria da IA moderna usa aprendizado de máquina 机器学习 — algoritmos que melhoram em uma tarefa aprendendo padrões em grandes quantidades de dados, em vez de serem programados passo a passo. Deep learning 深度学习, usando redes neurais 神经网络 com muitas camadas, é a abordagem líder hoje.
Exemplos cotidianos
Tarefas de IA dividem-se em dois tipos — compreender entrada, e produzir saída ou decisões.
Compreender entrada:
- reconhecimento de fala 语音识别 — palavras faladas para texto (assistentes de voz).
- reconhecimento de imagem 图像识别 — encontrar objetos, rostos ou texto em imagens.
Produzindo saída ou decisões:
- tradução automática 机器翻译 — tradução automática entre idiomas.
- sistemas de recomendação 推荐系统 — sugerir produtos, vídeos ou música.
- veículos autônomos 自动驾驶汽车 e robôs.
Um cenário comum de prova: um programa lê um rótulo com uma câmera, traduz e o lê em voz alta — usando reconhecimento óptico de caracteres 光学字符识别 para encontrar as palavras, tradução automática para convertê-las e síntese de voz 文本转语音 para o áudio.
Cenário comum: OCR → tradução automática → síntese de voz lê um rótulo estrangeiro em voz alta Uma resposta de quatro pontos "explique como a IA é usada" segue o pipeline passo a passo: reconhecimento de imagem (OCR) analisa os pixels da fotografia para localizar os caracteres; os padrões de pixels são convertidos em caracteres e palavras individuais; a tradução automática converte as palavras no idioma do usuário; e a síntese de voz produz a saída falada. Cada etapa vale um ponto.
Benefícios
- acessibilidade — IA de fala/imagens ajuda usuários com deficiências; tradução ajuda falantes não nativos.
- produtividade — automatizar tarefas repetitivas libera pessoas para trabalho criativo.
- suporte à decisão — IA identifica padrões em grandes conjuntos de dados (diagnóstico médico, detecção de fraudes).
- sempre disponível e personalizada para cada usuário.
Impactos: sociais, econômicos, ambientais
O programa de estudos pede o impacto da IA sob três tópicos, e uma questão nomeia um deles. Dê o impacto e sua consequência.
- Social: benefícios — um programa de leitura de rótulos ajuda pessoas com deficiência visual, pessoas que não conseguem ler o idioma e pessoas com dificuldades de leitura; reconhecimento facial em aeroportos acelera verificações de identidade e pode impedir a entrada de pessoas procuradas. Danos — o reconhecimento facial pode identificar erroneamente pessoas e rastrear todos sem consentimento, perdendo a privacidade; alunos que usam IA para fazer lições de casa podem não desenvolver raciocínio e habilidades de resolução de problemas, podem depender dela em vez de aprender e podem perder a colaboração e a comunicação face a face que o trabalho conjunto proporciona.
- Econômico: um módulo de diagnóstico de falhas de IA em uma oficina de reparo diagnostica falhas mais rápido e com mais precisão, então mais veículos são reparados por dia e os custos caem; mas menos mecânicos qualificados podem ser necessários, então empregos são perdidos, e o módulo deve ser comprado e mantido. De forma geral, a IA aumenta a produtividade e cria novos empregos em alguns campos enquanto remove empregos rotineiros em outros.
- Ambiental: treinar e executar modelos grandes consome muita eletricidade e água para resfriamento em data centers, e o hardware se torna lixo eletrônico; por outro lado, a IA é usada para reduzir o consumo de energia em edifícios, otimizar o transporte e monitorar o meio ambiente.
- Ética (a pergunta da sala de aula): uma IA que corrige trabalhos ou vigia alunos deve ser justa com cada aluno, não pode vazar seus dados, deve ser explicável quando toma uma decisão sobre eles e não deve substituir o julgamento de um professor onde isso importa.
Preocupações
- viés 偏见 — padrões injustos nos dados de treinamento tornam-se decisões injustas de IA (contratação, empréstimos).
- substituição de empregos — a IA pode substituir alguns papéis.
- privacidade — o treinamento frequentemente usa grandes quantidades de dados pessoais.
- transparência — modelos grandes são "caixas pretas", difíceis de explicar.
- responsabilidade — quando a IA está errada, quem é responsável: desenvolvedor, usuário ou operador?
- mau uso — deepfakes, desinformação, vigilância.

Como o viés entra na IA: dados tendenciosos → modelo tendencioso → decisões injustas Profissionais devem entender os limites da IA que constroem, informar os usuários e reduzir danos.
ExplorarLaboratório de conceitos de computação
Classifique exemplos concretos pelo conceito de computação que eles demonstram.
Vocabulário TreinarInglês Chinês Pinyin ethics/ˈeθɪks/ 伦理 lún lǐ privacy/ˈprɪvəsi/ 隐私 yǐn sī confidentiality/ˌkɒnfɪˌdenʃiˈæləti/ 保密性 bǎo mì xìng conflicts of interest/ˈkɒnflɪkts ɒv ˈɪntrest/ 利益冲突 lì yì chōng tū intellectual property/ˌɪntəˈlektʃuːəl ˈprɒpəti/ 知识产权 zhī shí chǎn quán code of conduct/kəʊd ɒv ˈkɒndʌkt/ 行为准则 xíng wéi zhǔn zé bias/ˈbaɪəs/ 偏见 piān jiàn Deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì recommendation systems/ˌrekəmenˈdeɪʃn ˈsɪstəmz/ 推荐系统 tuī jiàn xì tǒng autonomous vehicles/ɔːˈtɒnəməs ˈvɪəklz/ 自动驾驶汽车 zì dòng jià shǐ qì chē optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 7.1
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
Termo Definição ética os princípios morais que regem como uma pessoa se comporta, em uma profissão os padrões estabelecidos em seu código de conduta código de conduta as regras que uma organização ou corpo profissional estabelece para como seus membros devem se comportar direitos autorais o direito legal do criador de uma obra original de controlar como ela é copiada, distribuída e modificada licença de software o acordo legal que especifica como um software pode ser usado, copiado e distribuído software comercial software vendido por taxa, sem código-fonte, sob uma licença que protege a propriedade intelectual do desenvolvedor software livre (FSF) software cujos usuários são livres de executá-lo, estudar, alterar e redistribuí-lo, portanto seu código-fonte está disponível código aberto (OSI) software cujo código-fonte está disponível e que pode ser modificado e redistribuído sob sua licença shareware software distribuído gratuitamente para período de teste ou com recursos limitados, após o qual o usuário paga para continuar freeware software que é gratuito para uso e cópia, mas cujo código-fonte não é liberado e não pode ser modificado inteligência artificial sistemas de computador que realizam tarefas que normalmente exigem inteligência humana, como reconhecimento de imagens e fala aprendizado de máquina uma forma de IA em que um sistema melhora em uma tarefa aprendendo padrões em dados em vez de programação explícita 7.1
Dicas de prova
- Responda questões de ética contra um código de conduta profissional (interesse público, competência, honestidade), não opinião pessoal.
- Distinga direitos autorais (protege a expressão) de uma patente (protege uma invenção).
- Compare licenças de software: proprietárias, open-source, freeware, shareware e FOSS.
Erros comuns
- Dar uma opinião pessoal ("é errado") em vez de uma razão com consequência ("software defeituoso pode prejudicar usuários, então deve ser testado").
- Tratar software livre e freeware como a mesma coisa. Software livre trata-se da liberdade de estudar e alterar o código; freeware é meramente gratuito.
- Dizer que código aberto significa gratuito. Significa que o código-fonte está disponível e pode ser modificado e redistribuído; uma taxa ainda pode ser cobrada.
- Escrever que direitos autorais devem ser registrados. Eles se aplicam automaticamente à obra conforme escrita.
- Nomear um impacto sem sua consequência. "Perda de empregos" pontua quando é vinculado ao motivo: a IA faz o diagnóstico, então menos mecânicos são necessários.
- Descrever o que é IA em vez de como é usada. Os pontos são para as etapas: reconhecer, converter, traduzir, falar.
-
8
Bancos de Dados
Assistir aula8.1
Armazenamento baseado em arquivos e seus limites
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão das limitações do uso de uma abordagem baseada em ficheiros para o armazenamento e recuperação de dados Descreva as características de uma base de dados relacional que abordam as limitações de uma abordagem baseada em ficheiros Demonstre compreensão e utilize a terminologia associada a um modelo de base de dados relacional Incluindo entidade, tabela, registo, campo, tupla, atributo, chave primária, chave candidata, chave secundária, chave estrangeira, relação (um-para-muitos, um-para-um, muitos-para-muitos), integridade referencial, indexação Utilize um diagrama entidade-relacionamento (E-R) para documentar um projeto de base de dados Demonstre compreensão do processo de normalização Primeira Forma Normal (1NF), Segunda Forma Normal (2NF) e Terceira Forma Normal (3NF) Explique porque um conjunto dado de tabelas de base de dados está ou não em 3NF Produza um projeto de base de dados normalizado para uma descrição de uma base de dados, um conjunto dado de dados ou um conjunto dado de tabelas Fonte: Programa Cambridge International
Antes dos bancos de dados, os programas armazenavam dados em arquivos planos 平面文件 — geralmente um arquivo por programa. Isso é fine para pequenos dados, mas falha em escala.
O armazenamento baseado em arquivos mantém dados em arquivos separados, como papéis em um arquivo — difícil de pesquisar e fácil de duplicar Limitações
- redundância de dados 数据冗余 — os mesmos dados (o endereço de um cliente) estão em vários arquivos, um por programa, desperdiçando armazenamento e exigindo atualização de todas as cópias.
- inconsistência de dados 数据不一致 — quando uma cópia é atualizada e outra não, os arquivos divergem e ninguém sabe qual está correta.
- dependência de dados — cada programa é escrito para o layout exato de seus arquivos; alterar o comprimento de um campo ou adicionar um campo exige reescrever todo programa que lê o arquivo.
- sem acesso compartilhado — um arquivo é bloqueado enquanto um programa o usa, impedindo que usuários trabalhem nos dados simultaneamente.
- integridade fraca 完整性 — nenhuma regra central impede valores inválidos ou links para clientes inexistentes; segurança fraca — o acesso é por arquivo, não por campo; e consultas entre arquivos exigem um novo programa cada vez.

A abordagem baseada em arquivos: cada programa mantém seus próprios arquivos Um banco de dados relacional 关系数据库 corrige isso armazenando dados em tabelas gerenciadas por um único software (DBMS) que todos os programas usam.
A abordagem de banco de dados: um DBMS serve a todos os programas Por que um banco de dados relacional é melhor — a resposta de três pontos. Cada item de dado é armazenado uma única vez, em uma tabela, e as tabelas são ligadas por chaves, não havendo redundância nem inconsistência; os dados são independentes dos programas, que solicitam ao SGBD o que precisam e permanecem inalterados quando a estrutura muda; e o SGBD aplica regras de integridade, controla o acesso por usuário e por campo, permite múltiplos usuários simultaneamente e executa qualquer consulta sem a necessidade de escrever um novo programa.
Exemplo resolvido. Uma oficina armazena seus clientes, dispositivos e serviços de reparo usando uma abordagem baseada em arquivos, com um arquivo por programa. Cite três problemas isso causa e descreva como um banco de dados relacional os eliminaria.
O nome e o número de telefone do cliente estão armazenados no arquivo de reparos e também no arquivo de faturas (redundância); quando um cliente muda de número, um arquivo é atualizado e o outro não (inconsistência); e quando a loja quer um novo relatório — reparos por técnico — um novo programa precisa ser escrito para ler os arquivos (sem consultas ad hoc). Em um banco de dados relacional, o cliente é armazenado uma única vez em uma tabela CUSTOMER e referenciado pelo CustomerID na tabela REPAIR, então a alteração é feita uma única vez e vista em todos os lugares; o relatório é uma única consulta SQL.
Vocabulário TreinarInglês Chinês Pinyin DBMS/ˌdiː biː em ˈes/ 数据库管理系统 shù jù kù guǎn lǐ xì tǒng 8.1
Modelo relacional — termos
- tabela 表 (relação) — uma grade de linhas e colunas; uma tabela por tipo de entidade 实体 (ex:
CUSTOMER). - registro 记录 (linha, também chamado de tupla 元组) — uma linha; uma instância da entidade.
- campo 字段 (coluna, também chamado de atributo 属性) — uma coluna; uma informação sobre cada registro.
- chave primária 主键 — um campo (ou campos) que identifica unicamente cada registro; nunca nulo ou duplicado.
- chave estrangeira 外键 — um campo cujo valor corresponde à chave primária de outra tabela, ligando as duas.
- chave composta 复合键 — uma chave primária formada por dois ou mais campos juntos.
- chave candidata 候选键 — qualquer campo(s) que poderia ser a chave primária.
- chave secundária 次键 — um campo não primário que é indexado para busca rápida.
- indexação 索引 — criar um índice em um campo para que buscas e junções sejam mais rápidas.
- integridade referencial 参照完整性 — todo valor de chave estrangeira deve corresponder a uma chave primária existente (nenhum registro órfão).
Uma tabela é escrita em notação resumida com a chave primária sublinhada e chaves estrangeiras anotadas:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Uma chave estrangeira liga duas tabelas: ORDER.CustomerID corresponde à chave primária CUSTOMER.CustomerID Exemplo resolvido. Explique o significado de entidade, chave primária e integridade referencial em um banco de dados relacional, e complete a tabela de termo ↔ descrição para tupla e atributo.
Uma entidade é algo sobre o qual dados são armazenados — uma pessoa, objeto ou evento — que se torna uma tabela. Uma chave primária é o atributo (ou combinação de atributos) que identifica unicamente cada registro em uma tabela. Integridade referencial significa que todo valor de chave estrangeira deve corresponder ao valor de uma chave primária na tabela a que se refere, para que um registro não possa apontar para um que não existe. Uma tupla é uma linha de uma tabela (um registro); um atributo é uma coluna (um campo). Aprenda os pares: tabela/relação, registro/tupla, campo/atributo.
ExplorarLeia uma tabela relacional com SELECT
Uma tabela relacional é apenas linhas (registros) e colunas (campos). WHERE mantém as linhas que correspondem a uma condição; SELECT então mantém apenas as colunas que você pediu.
Vocabulário TreinarInglês Chinês Pinyin table/ˈteɪbl/ 表 biǎo 8.1
Diagramas de entidade-relacionamento (E-R)

Um diagrama de entidade-relacionamento 实体关系图 mostra a estrutura: cada entidade é um retângulo, cada relacionamento é uma linha, com a cardinalidade 基数 marcada em cada extremidade:
- um-para-um (1:1).
- um-para-muitos 一对多 (1:M) — cada Cliente tem muitos Pedidos; cada Pedido tem um Cliente.
- muitos-para-muitos (M:N) — Estudantes frequentam muitos Cursos, e Cursos têm muitos Estudantes.
Um diagrama E-R: uma classe tem muitos estudantes 
Símbolos de pé-de-galinha para a cardinalidade de um relacionamento Um relacionamento muitos-para-muitos não pode ser armazenado diretamente. Divida-o em dois relacionamentos um-para-muitos através de uma tabela de ligação 连接表 contendo as duas chaves estrangeiras:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Uma tabela de ligação resolve um relacionamento muitos-para-muitos em dois relacionamentos um-para-muitos Desenhando o diagrama E-R para um conjunto dado de tabelas. Cada tabela torna-se uma entidade. Um relacionamento existe sempre que uma tabela contenha uma chave estrangeira para outra; ele vai da tabela que contém a chave estrangeira (a extremidade muitos) para a tabela cuja chave primária ela é (a extremidade um). Uma tabela com duas chaves estrangeiras e nenhuma outra identidade geralmente é uma tabela de ligação resolvendo um relacionamento muitos-para-muitos. Roteie cada linha com o tipo de relacionamento.
Desenhando o diagrama a partir das tabelas: toda chave estrangeira é um relacionamento um-para-muitos, com o "muitos" na tabela que a contém Exemplo resolvido. Uma oficina possui as tabelas
CUSTOMER(CustomerID, Name, Phone),DEVICE(DeviceID, CustomerID, Type, Model),TECHNICIAN(TechnicianID, Name)eREPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifique os relacionamentos e seus tipos.DEVICEcontémCustomerID, então CUSTOMER–DEVICE é um-para-muitos (um cliente, muitos dispositivos).REPAIRcontémDeviceID, então DEVICE–REPAIR é um-para-muitos; também contémTechnicianID, então TECHNICIAN–REPAIR é um-para-muitos. Não há linha direta CUSTOMER–REPAIR: o link passa por DEVICE. Três linhas, três pés-de-galinha, todos nas extremidades REPAIR ou DEVICE.Vocabulário TreinarInglês Chinês Pinyin cardinality/ˌkɑːdɪˈnælɪti/ 基数 jī shù one-to-many/wʌn tə ˈmeni/ 一对多 yī duì duō link table/lɪŋk ˈteɪbl/ 连接表 lián jiē biǎo 8.1
Normalização

Normalização 规范化 organiza tabelas para reduzir redundância e inconsistência, passando pelas formas normais 范式 em ordem.
- Primeira forma normal (1NF) — cada campo contém um único valor (atômico 原子), sem grupos repetidos, e possui uma chave primária.
- Segunda forma normal (2NF) — em 1NF, e cada campo não-chave depende da totalidade da chave primária (importa apenas para uma chave composta).
- Terceira forma normal (3NF) — em 2NF, e cada campo não-chave depende apenas da chave primária, não de outro campo não-chave (não há dependência transitiva 传递依赖).
Um design 3NF armazena cada fato uma única vez, assim anomalias de inserção/atualização/exclusão desaparecem. A contrapartida é mais tabelas e mais junções. Almeje 3NF.
Para produzir um design 3NF: encontre as entidades e seus atributos; escolha uma chave primária para cada; divida campos repetidos/não-atômicos (1NF); divida campos que dependem de parte de uma chave composta (2NF); divida campos que dependem transitivamente da chave (3NF); adicione chaves estrangeiras para os relacionamentos.
A normalização remove a redundância dividindo dados repetidos em sua própria tabela Exemplo resolvido. A tabela
ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity)tem a chave primária composta(OrderID, ProductID). Normalize-a para 3NF. Teste cada campo não-chave contra a chave.Quantitydepende de ambosOrderIDeProductID, o que está correto. MasCustomerIDdepende deOrderIDsozinho - apenas parte da chave composta. Isso é uma dependência parcial, então a tabela não está em 2NF. Divida-a emORDER_LINE(OrderID, ProductID, Quantity)eORDER(OrderID, CustomerID, CustomerName). Agora teste 3NF: naquela nova tabelaORDER,CustomerNamedepende deCustomerID, que não é a chave - uma dependência transitiva. Divida novamente:ORDER(OrderID, CustomerID)eCUSTOMER(CustomerID, CustomerName). Nomeie a dependência que viola cada forma (parcial viola 2NF, transitiva viola 3NF); "ela tem dados repetidos" descreve o sintoma e não ganha pontos.As três perguntas para fazer a qualquer tabela. Cada célula tem um único valor, sem grupo repetido? Se não, não está em 1NF. Se a chave for composta, todo campo não-chave depende da chave inteira? Se algum campo depender de parte dela, há uma dependência parcial 部分依赖 e a tabela não está em 2NF. Todo campo não-chave depende apenas da chave? Se um campo depender de outro campo não-chave, há uma dependência transitiva e a tabela não está em 3NF. Uma resposta "explique por que a tabela não está em 3NF" nomeia a dependência e os campos envolvidos.
1NF remove o grupo repetido, 2NF a dependência parcial, 3NF a dependência transitiva Exemplo resolvido. Uma loja de aluguel de carros registra cada aluguel como
RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), onde um aluguel pode incluir vários carros. Explique por que a tabela não está normalizada e produza um design 3NF.Não em 1NF: os campos de carro
CarReg, CarModel, DailyRate, Daysformam um grupo repetido — um aluguel tem vários carros. Mova-os paraRENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days)com a chave composta(RentalID, CarReg). Não em 2NF: emRENTAL_CAR,CarModeleDailyRatedependem deCarRegsozinho — uma dependência parcial. Mova-os paraCAR(CarReg, CarModel, DailyRate), deixandoRENTAL_CAR(RentalID, CarReg, Days). Não em 3NF: emRENTAL,CustomerNameeCustomerPhonedependem deCustomerID, um campo não-chave — uma dependência transitiva. Mova-os paraCUSTOMER(CustomerID, CustomerName, CustomerPhone), deixandoRENTAL(RentalID, RentalDate, CustomerID). O design 3NF é quatro tabelas —CUSTOMER,RENTAL,RENTAL_CAR,CAR— comCustomerID,RentalIDeCarRegcomo chaves estrangeiras; sublinhe todas as chaves primárias.Vocabulário TreinarInglês Chinês Pinyin normalisation/ˌnɔːməlaɪˈzeɪʃn/ 规范化 guī fàn huà normal forms/ˈnɔːml fɔːmz/ 范式 fàn shì atomic/əˈtɒmɪk/ 原子 yuán zi transitive dependency/ˈtrænsɪtɪv dɪˈpendənsi/ 传递依赖 chuán dì yī lài partial dependency/ˈpɑːʃl dɪˈpendənsi/ 部分依赖 bù fèn yī lài 8.2
Sistema de Gerenciamento de Banco de Dados (DBMS)

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão das funcionalidades fornecidas por um Sistema de Gestão de Bases de Dados (DBMS) que abordam as questões de uma abordagem baseada em ficheiros Incluindo: • gestão de dados, incluindo manutenção de um dicionário de dados • modelação de dados • esquema lógico • integridade de dados • segurança de dados, incluindo procedimentos de cópia de segurança e uso de direitos de acesso para indivíduos/grupos de utilizadores Demonstre compreensão de como ferramentas de software encontradas num DBMS são utilizadas na prática Incluindo o uso e propósito de: • interface de desenvolvedor • processador de consultas Fonte: Programa Cambridge International
Um SGBD 数据库管理系统 gerencia o banco de dados centralmente. Funcionalidades que corrigem os limites baseados em arquivos:
- dicionário de dados 数据字典 — uma descrição de cada tabela, campo, tipo e chave; programas consultam-no em vez de codificar a estrutura fixamente.
- controle de redundância/consistência — cada fato armazenado uma única vez.
- controle de acesso concorrente 并发访问 — bloqueios e transações permitem que muitos usuários trabalhem simultaneamente.
- backup 备份 e recuperação; segurança e permissões por usuário.
- regras de integridade — chaves, restrições de unicidade e intervalo, aplicadas centralmente.
- transactions 事务 — um grupo de operações em que todas têm sucesso ou todas falham.
- visualizações 视图 — tabelas virtuais que mostram a cada usuário "sua" fatia dos dados.
- data management 数据管理 e data modelling 数据建模 — controlam como os dados são armazenados e definem sua estrutura como um logical schema 逻辑模式 (o projeto lógico, independente do armazenamento físico).
- data integrity 数据完整性 e data security 数据安全 — impõem correção e controlam o acesso centralmente.
- um query processor 查询处理器 executa consultas; uma developer interface 开发者接口 fornece ferramentas e APIs para construir aplicativos.
Suas ferramentas incluem um editor de dicionário de dados, um construtor de consultas, um construtor de formulários, um gerador de relatórios, gerenciamento de usuários e um editor SQL.
O que o dicionário de dados armazena (uma questão "listar três itens"): os nomes das tabelas; os nomes dos campos em cada tabela; o tipo de dado e o comprimento de cada campo; as chaves primárias e estrangeiras e os relacionamentos entre tabelas; regras de validação; índices; e quem pode acessar cada tabela. É metadado — dados sobre os dados — e o DBMS o usa para verificar cada consulta e cada alteração.
Como o DBMS mantém os dados seguros (uma questão "descrever dois métodos"): authentication 身份验证 — um nome de usuário e senha, ou biométrico, antes de qualquer acesso; access rights — cada usuário ou grupo tem permissão para ler, escrever ou excluir apenas certas tabelas ou campos, muitas vezes através de uma view; encryption dos dados armazenados e dos dados enviados a eles, para que um arquivo copiado seja ilegível; backups feitos regularmente, para que os dados possam ser restaurados após perda; e um log de transações que registra quem alterou o quê.
As duas ferramentas de software. A developer interface é o que um programador usa para construir o banco de dados e os aplicativos sobre ele: criar tabelas e definir chaves e validações, escrever consultas e SQL, e projetar formulários e relatórios, sem saber como os dados são armazenados fisicamente. O query processor recebe uma consulta (SQL de um programa ou uma consulta construída na interface), verifica-a contra o dicionário de dados, determina a maneira mais eficiente de executá-la, recupera os dados e retorna os resultados.
Logical schema. O DBMS mantém o projeto lógico (quais tabelas e campos existem e como se relacionam) separado do physical storage (arquivos, índices, blocos de disco). Os programas trabalham com o schema lógico, para que o armazenamento físico possa ser reorganizado sem alterar um único programa — esta é a independência de dados que a abordagem baseada em arquivos não possuía.
O armazenamento físico que o schema lógico esconde: pratos girantes e cabeça de leitura/escrita de um disco rígido ExplorarLaboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
ExplorarLaboratório de serviço de banco de dados
Assista como um DBMS transforma uma consulta em acesso seguro e compartilhado aos dados.
Vocabulário TreinarInglês Chinês Pinyin integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ 关系数据库 guān xì shù jù kù transactions/trænˈsækʃnz/ 事务 shì wù backup/ˈbækʌp/ 备份 bèi fèn views/vjuːz/ 视图 shì tú data management/ˈdeɪtə ˈmænɪdʒmənt/ 数据管理 shù jù guǎn lǐ data modelling/ˈdeɪtə ˈmɒdəlɪŋ/ 数据建模 shù jù jiàn mó logical schema/ˈlɒdʒɪkl ˈskiːmə/ 逻辑模式 luó jí mó shì data integrity/ˈdeɪtə ɪnˈteɡrɪti/ 数据完整性 shù jù wán zhěng xìng data security/ˈdeɪtə sɪˈkjʊərɪti/ 数据安全 shù jù ān quán query processor/ˈkwɪərɪ ˈprəʊsesə/ 查询处理器 chá xún chǔ lǐ qì developer interface/dɪˈveləpə ˈɪntəfeɪs/ 开发者接口 kāi fā zhě jiē kǒu authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng 8.3
DDL e DML
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão de que o DBMS realiza toda a criação/modificação da estrutura da base de dados utilizando sua Linguagem de Definição de Dados (DDL) Demonstre compreensão de que o DBMS realiza todas as consultas e manutenção de dados utilizando seu DML Demonstre compreensão de que o padrão da indústria para ambos DDL e DML é a Structured Query Language (SQL) Compreenda uma declaração SQL dada Compreenda declarações SQL dadas (DDL) e seja capaz de escrever simples declarações SQL (DDL) usando um subconjunto de declarações Criar uma base de dados (CREATE DATABASE) Criar uma definição de tabela (CREATE TABLE), incluindo a criação de atributos com tipos de dados adequados: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Alterar uma definição de tabela (ALTER TABLE) Adicionar uma chave primária a uma tabela (PRIMARY KEY (field)) Adicionar uma chave estrangeira a uma tabela (FOREIGN KEY (field) REFERENCES Table (Field)) Escreva um script SQL para consultar ou modificar dados (DML) armazenados em (no máximo duas) tabelas de base de dados Consultas incluindo SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG Manutenção de dados incluindo INSERT INTO, DELETE FROM, UPDATE Fonte: Programa Cambridge International
SQL 结构化查询语言 (Structured Query Language) possui duas partes:
DDL constrói a estrutura do banco de dados; DML trabalha com os dados - Data Definition Language 数据定义语言 (DDL) — cria ou altera a estrutura (tabelas, chaves, restrições).
- Data Manipulation Language 数据操纵语言 (DML) — trabalha com os dados (inserir, atualizar, excluir, query 查询).
Noções básicas de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Adicionar uma chave estrangeira:
CREATE TABLE ORDER (
  OrderID INTEGER PRIMARY KEY,
  CustomerID INTEGER,
  OrderDate DATE,
  FOREIGN KEY (CustomerID) REFERENCES CUSTOMER(CustomerID)
);
Modificar e excluir:
ALTER TABLE CUSTOMER ADD Email VARCHAR(100);
DROP TABLE CUSTOMER;
Tipos comuns:
INTEGER,REAL,VARCHAR(n),CHAR(n)(tambémCHARACTER(n)),DATE,TIME,BOOLEAN,DECIMAL(p, s).Noções básicas de DML
Consulta com
SELECT:
Uma consulta SELECT retorna apenas as linhas que correspondem à sua condição SELECT Name, Phone FROM CUSTOMER WHERE City = 'London' ORDER BY Name ASC;SELECTlista campos,FROMnomeia a tabela,WHEREfiltra linhas,ORDER BYordena.Um join 连接 combina duas tabelas usando um relacionamento de chave estrangeira:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
As partes de uma consulta, na ordem em que devem ser escritas Funções agregadas 聚合函数 (
COUNT,SUM,AVG,MIN,MAX) são frequentemente usadas comGROUP BY:SELECT CustomerID, COUNT(*) AS NumOrders FROM ORDER GROUP BY CustomerID;Inserir, atualizar, excluir:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Sempre coloque uma cláusula
WHEREemUPDATEeDELETE, ou a alteração atingirá todas as linhas.Dicas para SQL de exame
- use exatamente os nomes de tabela e campo da questão.
- cite strings com aspas simples (
'Smith'); não cite números. - comparações:
=,<,>,<=,>=,<>. LIKE 'A%'corresponde a tudo que começa com A (%= qualquer string,_= um caractere);IN (1,2,3);BETWEEN 10 AND 20.- combine condições com
AND/OR/NOT, e termine cada statement com ponto e vírgula.
O padrão DDL que o exame quer. Cada
CREATE TABLEnomeia cada campo com seu tipo, marca a chave primária e declara cada chave estrangeira com a tabela que ela referencia; uma chave composta é declarada em sua própria linha:CREATE TABLE RENTAL_CAR ( RentalID INTEGER, CarReg VARCHAR(8), Days INTEGER, PRIMARY KEY (RentalID, CarReg), FOREIGN KEY (RentalID) REFERENCES RENTAL(RentalID), FOREIGN KEY (CarReg) REFERENCES CAR(CarReg) );Exemplo resolvido. Usando
CUSTOMER(CustomerID, Name, Phone)eDEVICE(DeviceID, CustomerID, Type, Model), escreva scripts SQL para: (a) listar o nome e o número de telefone de todo cliente que possui um dispositivo do tipo'tablet', em ordem alfabética de nome; (b) contar os dispositivos de cada tipo; (c) registrar que o cliente 17 agora tem o número de telefone'0771 234 5678'; (d) adicionar um novo dispositivo, ID 305, um'laptop'do modelo'X1'pertencente ao cliente 17.(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c)
UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;(d)INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');Pontuação é dada por cláusula — os campos, as tabelas, a condição de join, o
WHERE, oORDER BY— então um script com uma cláusula errada ainda pontua o resto. EscrevaTable.Fieldsempre que duas tabelas estiverem envolvidas.Exemplo resolvido. Explique o que este script faz:
SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;Ele输出每个技术人员姓名及其执行的维修总成本,每行一个技术人员:两个表通过TechnicianID连接,行按姓名分组,每组中的成本相加。当被问及脚本做什么时,描述结果,而不是语法。
ExplorarUnir duas tabelas com INNER JOIN
Um join combina linhas onde a chave estrangeira é igual à chave primária — aqui Orders.CustomerID = Customer.CustomerID — e une cada par correspondente em uma linha mais larga.
ExplorarSELECT … WHERE
Passe por uma consulta: WHERE mantém as linhas que correspondem, então SELECT escolhe as colunas que você pediu.
Vocabulário TreinarInglês Chinês Pinyin flat files/flæt faɪlz/ 平面文件 píng miàn wén jiàn data redundancy/ˈdeɪtə rɪˈdʌndənsi/ 数据冗余 shù jù rǒng yú data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ 数据不一致 shù jù bù yī zhì field/fiːld/ 字段 zì duàn query/ˈkwɪərɪ/ 查询 chá xún SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán primary key/ˈpraɪməri kiː/ 主键 zhǔ jiàn foreign key/ˈfɒrən kiː/ 外键 wài jiàn join/dʒɔɪn/ 连接 lián jiē Data Definition Language/ˈdeɪtə ˌdefɪˈnɪʃn ˈlæŋɡwɪdʒ/ 数据定义语言 shù jù dìng yì yǔ yán Data Manipulation Language/ˈdeɪtə məˌnɪpjʊˈleɪʃn ˈlæŋɡwɪdʒ/ 数据操纵语言 shù jù cāo zòng yǔ yán aggregate functions/ˈæɡrɪɡeɪt ˈfʌŋkʃnz/ 聚合函数 jù hé hán shù 8.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição entity algo sobre o qual dados são armazenados — uma pessoa, objeto ou evento — que se torna uma tabela em um banco de dados relacional attribute um item de dado sobre uma entidade (uma coluna da tabela) tuple uma linha de uma tabela: uma instância da entidade primary key um atributo, ou combinação de atributos, que identifica unicamente cada registro em uma tabela foreign key um atributo em uma tabela cujo valor corresponde a uma chave primária em outra tabela, usado para ligar as duas candidate key qualquer atributo (ou combinação) que poderia ser escolhido como chave primária secondary key um atributo não-primário que é indexado para que a tabela possa ser pesquisada ou ordenada rapidamente nele composite key uma chave primária feita de dois ou mais atributos juntos referential integrity todo valor de chave estrangeira deve corresponder a um valor de chave primária existente na tabela a que se refere first normal form uma tabela em que todo atributo é atômico, não há grupos repetidos e existe uma chave primária second normal form em 1NF, e todo atributo não-chave depende de toda a chave primária (nenhuma dependência parcial) third normal form em 2NF, e nenhum atributo não-chave depende de outro atributo não-chave (nenhuma dependência transitiva) data dictionary os metadados que um DBMS mantém sobre a estrutura do banco de dados: tabelas, campos, tipos, chaves, relacionamentos, validação DDL / DML a linguagem usada para definir ou alterar a estrutura de um banco de dados / a linguagem usada para consultar e manter os dados nele Vocabulário TreinarInglês Chinês Pinyin entity/ˈentɪti/ 实体 shí tǐ record/ˈrekɔːd/ 记录 jì lù tuple/ˈtuːpl/ 元组 yuán zǔ attribute/ˈætrɪbjuːt/ 属性 shǔ xìng composite key/ˈkɒmpəzɪt kiː/ 复合键 fù hé jiàn candidate key/ˈkændɪdeɪt kiː/ 候选键 hòu xuǎn jiàn secondary key/ˈsekəndəri kiː/ 次键 cì jiàn indexing/ˈɪndeksɪŋ/ 索引 suǒ yǐn referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ 参照完整性 cān zhào wán zhěng xìng entity-relationship diagram/ˈentɪti rɪˈleɪʃənʃɪp ˈdaɪəɡræm/ 实体关系图 shí tǐ guān xì tú data dictionary/ˈdeɪtə ˈdɪkʃənəri/ 数据字典 shù jù zì diǎn concurrent access/kənˈkʌrənt ˈækses/ 并发访问 bìng fā fǎng wèn 8.3
Dicas de prova
- Defina os termos exatamente: entity, attribute, primary key, foreign key, e os tipos de relacionamento (1:1, 1:muitos, muitos:muitos).
- Dê uma razão em cada forma normal: 1NF (sem grupos repetidos), 2NF (sem dependência parcial), 3NF (sem dependência não-chave) — e nomeie os campos envolvidos.
- Explique o que um DBMS fornece (independência de dados, segurança, integridade, acesso simultâneo, um dicionário de dados, uma interface de desenvolvedor, um processador de consultas).
- Distinga DDL (definir a estrutura) de DML (consultar e alterar os dados), e escreva cláusulas SQL uma por uma:
SELECT,FROM,INNER JOIN … ON,WHERE,GROUP BY,ORDER BY. - Para desenhar um diagrama E-R a partir de tabelas, encontre primeiro cada chave estrangeira: toda chave estrangeira representa um relacionamento de um-para-muitos, com o "muitos" na tabela que a contém.
Erros comuns
- Desenhar um relacionamento de muitos-para-muitos diretamente. Ele deve ser dividido em dois relacionamentos de um-para-muitos através de uma tabela de ligação contendo ambas as chaves estrangeiras.
- Explicando "não em 3NF" como "os dados estão repetidos". Nomeie a dependência (parcial ou transitiva) e os campos envolvidos.
- Aspas duplas em torno de strings no SQL, ou aspas em torno de números. Strings levam
'single quotes'; números não levam nada. - Deixar de fora a condição
ONdepois deINNER JOIN. Sem ela, as duas tabelas não estão ligadas. - Colocar um campo comum ao lado de
COUNTouSUMem umSELECTsem umGROUP BY. UPDATEouDELETEsem umWHERE. Ela altera ou remove todas as linhas da tabela.
-
9
Projeto de Algoritmos e Resolução de Problemas
Assistir aula9.1
Pensamento computacional

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão de abstração Necessidade e benefícios do uso de abstração Descreva o propósito de abstração Produza um modelo abstrato de um sistema incluíndo apenas detalhes essenciais Descreva e utilize decomposição Dividir problemas em sub-problemas levando ao conceito de módulo de programa (procedimento / função) Fonte: Programa Cambridge International
Pensamento computacional 计算思维 é o conjunto de ferramentas mentais para analisar um problema e projetar uma solução que um computador possa executar. Duas principais são abstração e decomposição.
Pensamento computacional divide um grande problema em partes menores e mais fáceis — como resolver um quebra-cabeça Abstração
Abstraction 抽象 significa manter as características essenciais de um problema e ignorar detalhes irrelevantes, fornecendo um modelo mais simples.
Exemplos:
- um mapa de rede de trens mantém as estações e linhas, mas ignora a geografia.
- uma class em programação orientada a objetos mantém apenas os atributos e métodos que o sistema precisa.
- uma função oculta uma parte do trabalho atrás de um nome.
Um modelo completo de qualquer problema real seria muito grande para raciocinar, então a abstração é essencial.
O avaliador pede o objetivo da abstração e seus benefícios. Objetivo: produzir um modelo mais simples de um problema que contenha apenas os detalhes necessários para resolvê-lo. Benefícios: o problema fica mais fácil de entender e programar; o programa é menor e mais rápido de escrever e testar; o mesmo modelo pode ser reutilizado para problemas semelhantes. Quando solicitado a produzir um modelo abstrato de um sistema, liste apenas os dados e ações que a tarefa exige. Para uma grade escolar, isso significa as aulas, salas, professores e períodos; não significa a cor das salas ou a idade dos professores.
A abstração mantém o essencial (estações e linhas) e descarta detalhes irrelevantes (a geografia) Decomposição
Decomposição 分解 significa dividir um grande problema em subproblemas menores, cada um mais fácil de resolver e tratado individualmente.
- encontre as partes principais da tarefa.
- divida cada uma em subtarefas menores.
- continue até que cada uma seja pequena o suficiente para ser projetada diretamente.
- resolva as tarefas pequenas e combine-as.
Para controle de estoque: "gerenciar estoque" → "registrar vendas", "registrar entregas", "produzir relatórios" → ("registrar vendas") "consultar produto", "diminuir contagem de estoque", "salvar a transação". A decomposição torna grandes problemas gerenciáveis, permite que uma equipe divida o trabalho e gera código modular — cada módulo se torna uma procedura 过程 ou função.
"Explique por que a decomposição é usada" é uma questão de três pontos com formato fixo. Dê três benefícios separados: cada subproblema 子问题 é pequeno o suficiente para ser projetado, codificado e testado independentemente; diferentes programadores podem trabalhar em diferentes módulos 模块 ao mesmo tempo; um módulo já existente (ou uma rotina de biblioteca) pode ser reutilizado, e um erro é mais fácil de encontrar porque está contido em um único módulo. Um diagrama estrutural (tópico 12) é o diagrama de uma decomposição: o programa no topo, seus módulos abaixo, e os dados passados entre eles.
Decompondo um programa em módulos e submódulos ExplorarResolver um problema à maneira computacional
Passe pelos quatro pilares na ordem em que você os usaria — decomponha o problema, identifique repetições, reduza aos essenciais, depois escreva os passos.
Vocabulário TreinarInglês Chinês Pinyin computational thinking/ˌkɒmpjuːˈteɪʃənl ˈθɪŋkɪŋ/ 计算思维 jì suàn sī wéi abstraction/əbˈstrækʃn/ 抽象 chōu xiàng decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě sub-problem/sʌb ˈprɒbləm/ 子问题 zi wèn tí procedure/prəˈsiːdʒə/ 过程 guò chéng modules/ˈmɒdjuːlz/ 模块 mó kuài algorithm/ˈælɡərɪθəm/ 算法 suàn fǎ sequence/ˈsiːkwəns/ 顺序 shùn xù unambiguous/ʌnæmˈbɪɡjuːəs/ 无歧义 wú qí yì deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng 9.2
Algoritmos
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstre compreensão de que um algoritmo é uma solução para um problema expressa como uma sequência de passos definidos Utilize nomes de identificador adequados para a representação de dados usados por um problema e represente-os usando uma tabela de identificadores Escreva pseudocódigo que contenha entrada, processamento e saída Escreva pseudocódigo usando as três construções básicas de sequência, seleção e iteração (repetição) Documente um simples algoritmo usando uma descrição em inglês estruturado, um diagrama de fluxo ou pseudocódigo Escreva pseudocódigo a partir de: • uma descrição em inglês estruturado • um diagrama de fluxo Desenhe um diagrama de fluxo a partir de: • uma descrição em inglês estruturado • pseudocódigo Descreva e utilize o processo de refinamento progressivo para expressar um algoritmo a um nível de detalhe a partir do qual a tarefa pode ser programada Use declarações lógicas para definir partes de uma solução algorítmica Fonte: Programa Cambridge International
Ordenação bolha, passo a passo Um algoritmo 算法 é uma solução expressa como uma sequência de passos definidos. Cada passo é unívoco 无歧义 (um único significado), determinístico 确定性 (mesma entrada → mesma saída), finito (os passos terminam) e efetivo (cada um pode ser executado). Um algoritmo diz o que fazer, independente da linguagem de programação usada para implementá-lo.
ExplorarSeleção: siga os ramos DO / SE NÃO
Arraste a pontuação e observe qual ramo é executado. A seleção testa cada condição por sua vez e toma a PRIMEIRA que for verdadeira — é assim que funciona O SE ... SENÃO SE ... SENÃO.
9.2
Tabela de identificadores

Ao iniciar um algoritmo, liste todas as peças de dados em uma tabela de identificadores 标识符表 — seu identificador 标识符 (o nome da variável 变量), tipo de dado 数据类型 e descrição. A tabela do exame tem exatamente estas três colunas:
Identificador Tipo de dado Descrição CategorySTRINGcategoria do produto SaleDateDATEquando o item foi vendido ItemCostREALcusto do item InStockBOOLEANTRUEse estiver em estoqueSalesARRAY[1:30] OF REALos totais diários de vendas dos últimos 30 dias Use nomes descritivos (
ItemCost, nãox): um identificador começa com uma letra, não contém espaços e é escrito da mesma forma toda vez que aparece. Tipos comuns sãoINTEGER,REAL,STRING,CHAR,BOOLEAN,DATE, além de arrays. A tabela força você a nomear todas as peças de dados antes de escrever o código, e uma questão "complete a tabela de identificadores" dá um ponto por cada tipo de dado ou descrição correta, então escreva o tipo exatamente como o guia de pseudocódigo faz.Uma tabela de identificadores nomeia todas as peças de dados antes de escrever o código Vocabulário TreinarInglês Chinês Pinyin identifier table/aɪˈdentɪfaɪə ˈteɪbl/ 标识符表 biāo shí fú biǎo identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú 9.2
Pseudocódigo — as três construções básicas

Pseudocódigo 伪代码 é uma maneira estruturada e independente de linguagem para descrever algoritmos.
Os três blocos construtivos de qualquer algoritmo: sequência, seleção e iteração 1. Sequência
Passos são executados um após o outro (sequência 顺序):
INPUT Name
INPUT Age
OUTPUT "Hello", Name
2. Seleção
Uma escolha de quais passos executar, baseada em uma condição (seleção 选择):
IF Age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Para mais opções, use
CASE OF ... ENDCASE.3. Iteração
Repetir um bloco (iteração 迭代, um laço 循环):
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Um loop WHILE testa a condição antes de cada passagem (pode rodar zero vezes); um loop REPEAT...UNTIL testa depois de cada passagem (sempre roda pelo menos uma vez).
WHILE Total < 100 DO
    INPUT Value
    Total ← Total + Value
ENDWHILE

REPEAT
    INPUT Mark
UNTIL Mark >= 0 AND Mark <= 100
Um loop WHILE testa antes do corpo rodar; um loop REPEAT ... UNTIL testa depois, então seu corpo sempre roda pelo menos uma vez Escolher o loop vale um ponto:
FORquando você sabe quantas vezes (um loop controlado por contador 计数循环);WHILEquando o loop pode não rodar de todo (um loop pré-condição 前测循环);REPEAT ... UNTILquando deve rodar pelo menos uma vez, como na validação de entrada (um loop pós-condição 后测循环). Uma resposta "descreva a construção de iteração" nomeia a construção, diz onde a condição é testada e dá a consequência (zero vezes ou pelo menos uma vez).Operações comuns
- atribuição 赋值:
x ← 5(uma seta;=é para comparação). - entrada/saída:
INPUT variable,OUTPUT expression. - comparações
=,<>,<,>,<=,>=; lógicaAND,OR,NOT. - aritmética
+ - * /, maisDIV(divisão inteira) eMOD(resto). - strings:
LENGTH,LEFT,RIGHT,MID, e¶ concatenação 拼接 (juntar).
O pseudocódigo que o exame espera
Toda resposta de pseudocódigo é avaliada contra o guia de pseudocódigo publicado pela Cambridge. Escreva estas formas exatamente:
Construção Pseudocódigo Variável DECLARE Total : INTEGERArray DECLARE Marks : ARRAY[1:30] OF REALConstante CONSTANT MaxTries = 3Atribuição Total ← Total + ValueEntrada / Saída INPUT NameOUTPUT "Hello ", NameSeleção CASE OF Choice1 : OUTPUT "Add"OTHERWISE OUTPUT "Error"ENDCASELoop FOR FOR i ← 1 TO 10 STEP 2...NEXT iLoop WHILE WHILE Total < 100 DO...ENDWHILELoop REPEAT REPEAT...UNTIL Mark >= 0Aritmética inteira 17 DIV 5 = 317 MOD 5 = 2Strings LENGTH(S),LEFT(S, 3),RIGHT(S, 2)MID(S, 2, 4),UCASE(S),LCASE(S)Conversões INT(3.7) = 3,NUM_TO_STR(12)STR_TO_NUM("4.5"),ASC('A') = 65,CHR(66) = 'B'Aleatório RAND(100)INT(RAND(100)) + 1RAND(100)gera um número real de 0 até (mas não incluindo) 100.INT(RAND(100)) + 1gera um inteiro de 1 a 100.Dois hábitos valem pontos em todas as questões: declare toda variável que usar, com o tipo da sua tabela de identificadores, e inicialize 初始化 todo contador 计数器 e total (
Count ← 0,Total ← 0) antes do loop que o altera.Entrada → Processamento → Saída
Todo programa segue este formato:
INPUT Length
INPUT Width
Area ← Length * Width
OUTPUT "Area = ", Area
Listar entradas e saídas primeiro deixa o algoritmo mais limpo.
Exemplo resolvido. Escreva pseudocódigo que insere 100 inteiros e outputa quantos deles, e a soma desses, estão entre 10 e 20 inclusos.
Tabela de identificadores:
Count : INTEGER(contador de loop),Value : INTEGER(o inteiro inserido),InRange : INTEGER(quantos estavam no intervalo),Total : INTEGER(soma deles).DECLARE Count, Value, InRange, Total : INTEGER InRange ← 0 Total ← 0 FOR Count ← 1 TO 100 INPUT Value IF Value >= 10 AND Value <= 20 THEN InRange ← InRange + 1 Total ← Total + Value ENDIF NEXT Count OUTPUT InRange, TotalSe a questão pedir para "identificar duas construções e dizer como cada uma é usada", responda no mesmo formato: iteração, o loop
FOR, repete a entrada 100 vezes; seleção, a instruçãoIF, adiciona um valor apenas quando está no intervalo.Exemplo resolvido. Um programa escolhe um número secreto inteiro de 1 a 100. O usuário chuta até acertar; após cada chute errado, o programa diz "Muito baixo" ou "Muito alto", e no final ele outputa quantos palpites foram feitos.
Tabela de identificadores:
Secret : INTEGER(o número a ser adivinhado),Guess : INTEGER(a entrada do usuário),Tries : INTEGER(quantos palpites até agora).DECLARE Secret, Guess, Tries : INTEGER Secret ← INT(RAND(100)) + 1 Tries ← 0 REPEAT INPUT Guess Tries ← Tries + 1 IF Guess < Secret THEN OUTPUT "Too low" ELSE IF Guess > Secret THEN OUTPUT "Too high" ENDIF ENDIF UNTIL Guess = Secret OUTPUT "You took ", Tries, " guesses"Um loop
REPEAT ... UNTILé a escolha certa porque o usuário deve chutar pelo menos uma vez. Os pontos são para: o número aleatório no intervalo correto, um loop que termina em um chute correto, o contador que começa em zero e aumenta dentro do loop, as duas mensagens sob as condições certas, e a saída final.
O mesmo jogo de adivinhação como flowchart: os dois losangos de decisão são as duas instruções IF, e a seta de retorno é o loop REPEAT ... UNTIL Exemplo resolvido. Outputar dois números inteiros aleatórios diferentes, cada um entre $-10$ e $10$ inclusos.
Há 21 valores possíveis, então
INT(RAND(21))gera de 0 a 20 e subtraindo 10 desloca para o intervalo $-10$ a $10$. O segundo número deve ser gerado novamente até diferir do primeiro:DECLARE First, Second : INTEGER First ← INT(RAND(21)) - 10 REPEAT Second ← INT(RAND(21)) - 10 UNTIL Second <> First OUTPUT First, Second
Todo programa segue o formato Entrada, Processamento, Saída ExplorarIF … ELSE seleção
Altere o valor e observe qual ramo é executado — como um programa toma decisões.
Vocabulário TreinarInglês Chinês Pinyin variable/ˈveərɪəbl/ 变量 biàn liàng data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ loop/luːp/ 循环 xún huán count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán assignment/əˈsaɪnmənt/ 赋值 fù zhí concatenation/kənˌkætəˈneɪʃn/ 拼接 pīn jiē initialise/ɪˈnɪʃəlaɪz/ 初始化 chū shǐ huà counter/ˈkaʊntə/ 计数器 jì shù qì structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ stepwise refinement/ˈstepwaɪz rɪˈfaɪnmənt/ 逐步求精 zhú bù qiú jīng logic statement/ˈlɒdʒɪk ˈsteɪtmənt/ 逻辑语句 luó jí yǔ jù precedence/ˈpresɪdəns/ 优先级 yōu xiān jí De Morgan's law/də ˈmɔːɡənz lɔː/ 德摩根定律 dé mó gēn dìng lǜ 9.2
Três notações

O mesmo algoritmo pode ser escrito de três formas.
- inglês estruturado 结构化英语 — linguagem natural com indentação e palavras-chave fixas; bom para uma descrição de alto nível.
- flowchart 流程图 — um diagrama com formas padrão:
Forma Significado Retângulo arredondado Início / Parada Paralelogramo Entrada / Saída Retângulo Processamento Losango Decisão Seta Fluxo de controle - pseudocódigo — a notação de palavras-chave acima; mais próximo do código.
Você deve ser capaz de converter entre qualquer par: cada
IFé um losango de decisão, cada laço é uma seta de retorno, e uma sequência são retângulos empilhados.SE ... ENTÃO ... SENÃO ... FIM_SE
Um fluxograma para calcular a média de uma lista de números, usando as formas padrão Vocabulário TreinarInglês Chinês Pinyin flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú selection/sɪˈlekʃn/ 选择 xuǎn zé iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài 9.2
Refinamento passo a passo

Refinamento passo a passo 逐步求精 começa com um esboço de alto nível e expande cada etapa até que seja pequena o suficiente para ser codificada. Para uma média de $n$ números:
Nível 1:
Read in the numbers
Compute the average
Output the average
Nível 2:
INPUT n
total ← 0
FOR i ← 1 TO n
    INPUT value
    total ← total + value
NEXT i
average ← total / n
OUTPUT average
C refinamento mantém a estrutura anterior e adiciona detalhes.
Uma questão de seis pontos sobre "aplicar refinamento passo a passo" fornece um esboço de alto nível e pede que cada etapa seja expandida em instruções concretas que um programador poderia codificar. Mantenha as etapas na mesma ordem, nomeie os dados que cada etapa lê ou produz, e pare quando cada linha for uma única entrada, atribuição, saída, laço ou condição. Por exemplo, "validar a senha" torna-se: digite a senha; verifique se seu comprimento é pelo menos 8; verifique se contém pelo menos um dígito; saia "aceita" se ambas as verificações forem bem-sucedidas, caso contrário saia "rejeitada".
Refinamento passo a passo: expanda cada etapa de alto nível em pseudocódigo detalhado ExplorarRefinamento passo a passo: esboço para código
Desça pelos níveis. Você começa com a tarefa inteira em uma linha e continua expandindo cada passo em partes menores — até que todos os passos sejam simples o suficiente para serem codificados diretamente.
9.2
Declarações lógicas
Uma declaração lógica 逻辑语句 é uma condição Booleana 布尔 controlada por ramificações, construída a partir de comparações (
x > 10), conectivos (AND,OR,NOT) e colchetes. Use-a como condição deIF,WHILEouREPEAT...UNTIL:WHILE attempts < 3 AND NOT loggedIn DO INPUT password IF password = correctPassword THEN loggedIn ← TRUE ELSE attempts ← attempts + 1 ENDIF ENDWHILEPrecedência 优先级 (maior para menor):
NOT, depoisAND, depoisOR. Use colchetes quando tiver dúvidas. Erros comuns:a = 1 OR 2está errado — escrevaa = 1 OR a = 2.NOT a > 5significaNOT (a > 5), ou seja,a <= 5.NOT (A AND B)é o mesmo que(NOT A) OR (NOT B)(Lei de De Morgan 德摩根定律) — útil para simplificar condições.
Transformar uma frase em uma declaração lógica é uma habilidade testada diretamente nos exames. "Um ingresso é gratuito para qualquer pessoa com menos de 5 ou mais de 65 anos" torna-se
Age < 5 OR Age > 65. "Uma nota é válida se for um número inteiro de 0 a 100" torna-seMark >= 0 AND Mark <= 100. "O laço para quando o arquivo termina ou dez registros foram lidos" torna-seUNTIL EOF(File) OR Count = 10. Escreva cada comparação por extenso:Age > 65eAge < 5, nuncaAge > 65 OR < 5.Precedência: NOT vincula-se a loggedIn primeiro, então AND combina os dois lados Exemplo resolvido. Escreva uma tabela de identificadores e pseudocódigo para ler 10 números e exibir o maior. A tabela de identificadores nomeia cada variável com seu tipo de dado e propósito:
Count : INTEGER(contador de laço),Num : REAL(o número acabado de ser lido),Max : REAL(maior até agora).Max ← -999999 FOR Count ← 1 TO 10 INPUT Num IF Num > Max THEN Max ← Num ENDIF NEXT Count OUTPUT MaxA decisão de design que carrega os pontos é inicializar
Max: ela deve começar abaixo de qualquer entrada possível - ou, ainda mais seguro, ser definida como o primeiro número lido. Inicializá-la como0faz o algoritmo retornar incorretamente 0 para uma lista de números negativos, um bug que sua traçagem só expõe se os dados de teste incluírem um negativo.Vocabulário TreinarInglês Chinês Pinyin Boolean/ˈbuːlɪən/ 布尔 bù ěr 9.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição abstração manter os detalhes essenciais de um problema e omitir os detalhes que não são necessários decomposição dividir um problema em subproblemas menores, cada um dos quais pode ser resolvido separadamente algoritmo uma solução para um problema expressa como uma sequência de passos definidos tabela de identificadores uma tabela listando cada identificador usado em um algoritmo com seu tipo de dado e uma descrição de seu propósito pseudocódigo uma forma estruturada e independente de linguagem de escrever os passos de um algoritmo fluxograma um diagrama que mostra os passos e decisões de um algoritmo usando símbolos padrão unidos por setas sequência instruções executadas uma após a outra na ordem escrita seleção escolher quais instruções executar de acordo com uma condição iteração repetir um grupo de instruções enquanto, ou até, uma condição ser satisfeita refinamento passo a passo dividir cada etapa de um esboço em etapas menores, repetidamente, até que cada etapa possa ser codificada diretamente declaração lógica uma condição construída a partir de comparações e dos operadores AND, OR e NOT que avalia como VERDADEIRO ou FALSO 9.2
Dicas de prova
- Defina um algoritmo como uma sequência inequívoca, finita e determinística de passos, independente da linguagem.
- Use as três construções corretamente — sequência, seleção, iteração — e mantenha uma tabela de identificadores com tipos de dados.
- Divida um problema por decomposição e abstração, depois refinamento passo a passo.
- Escreva pseudocódigo que realmente funcionaria: declare variáveis e siga o estilo de pseudocódigo do exame.
Erros comuns
- Usar
=para atribuir um valor. Atribuição é←;=é uma comparação. - Esquecer
ENDIF,ENDWHILE,ENDCASEouNEXT. Toda construção fecha, e a palavra de fechamento é onde o ponto da construção é verificado. - Não inicializar um total ou contador antes do laço, de modo que o algoritmo soma a um valor que nunca existiu.
- Usar um laço
FORquando o número de repetições é desconhecido. Ler até um valor sentinela ou um palpite correto precisa deWHILEouREPEAT ... UNTIL. - Escrever
Age > 65 OR < 5. Cada lado deOReANDdeve ser uma comparação completa. - Responder "explique por que a decomposição é usada" com um benefício escrito de três maneiras. Três pontos precisam de três benefícios diferentes.
-
10
Tipos e Estruturas de Dados
Assistir aula10.1
Escolhendo tipos de dados
Programa
Os candidatos devem ser capazes de: Notas e orientações Selecionar e usar tipos de dados adequados para uma solução de problema incluindo inteiro, real, char, string, Booleano, data (pseudocódigo usará os seguintes tipos de dados: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) Demonstrar compreensão do propósito de uma estrutura de registro para armazenar um conjunto de dados de diferentes tipos de dados sob um único identificador Escrever pseudocódigo para definir uma estrutura de registro Escrever pseudocódigo para ler dados de uma estrutura de registro e salvar dados em uma estrutura de registro Fonte: Programa Cambridge International
Toda variável precisa de um tipo de dado 数据类型 — o tipo de valor que ela armazena e as operações permitidas:
INTEGER— um número inteiro (42,-7). Para contagens, índices, IDs.REAL— um número com parte fracionária (3.14). Para dinheiro, medições.STRING— caracteres entre aspas ("Hello"). Para texto.CHAR— um único caractere ('A').BOOLEAN—TRUEouFALSE. Para flags.DATE— uma data do calendário.
Escolha o tipo preciso menor que se encaixe:
INTEGERpara contagens inteiras,BOOLEANpara flags (não as strings"yes"/"no").As tabelas "dê o tipo de dado apropriado" são decididas por como o valor é usado: a média das notas de uma turma é
REAL(tem parte fracionária); um endereço de e-mail éSTRING; o número de alunos éINTEGER; se um aluno pagou éBOOLEAN; uma data de nascimento éDATE; um índice de array é sempreINTEGER; uma letra de nota única éCHAR; um número de telefone é umSTRING, porque começa com0e nunca é usado em aritmética. UmBOOLEANé usado para uma flag com apenas dois estados: se uma busca encontrou seu alvo, se um membro pagou, se um assento está reservado. Para a tabela de identificadores, o nome da variável também deve ser significativo:NumberOfPeople, nãon.10.1
Registros

Um registro 记录 (uma estrutura de registro 记录结构) armazena vários campos de tipos diferentes sob um único nome — útil quando vários valores descrevem uma coisa.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Isso define o tipo
TStockItem; declare variáveis dele:DECLARE Item1 : TStockItem DECLARE Items : ARRAY[1:100] OF TStockItemUse notação de ponto para acessar cada campo 字段:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Use um registro quando valores sempre pertencerem juntos (um cliente, um item de estoque); use variáveis separadas para valores não relacionados.
Exemplo resolvido. Um clube armazena, para cada aluno, um ID de aluno (uma string), um nome, uma data de nascimento e até três números de clube (inteiros). Escreva pseudocódigo para declarar o tipo de registro, um array para armazenar $3000$ alunos, e uma instrução que armazena um nome no primeiro elemento.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Os pontos:
TYPEcom o identificador eENDTYPE; cada campo declarado com um tipo adequado; o array declarado com seus limites eOF Student; o campo acessado com o índice e um ponto. Uma questão "affe o erro na declaração do registro" geralmente aponta para umENDTYPEfaltante, um campo sem tipo, ou um campo declarado como umSTRINGque deve conter aritmética. Duas convenções pontuam por si só: um elemento não utilizado é marcado com um valor que não pode ser dados reais (uma string vazia,-1, um ID de0), e é boa prática usar o mesmo marcador em todos os lugares para que todo módulo possa reconhecer um slot não utilizado; um campo de clube não utilizado é0. Os benefícios de um array de registros, para "affe três benefícios": todos os dados de uma entidade são mantidos sob um único identificador; os campos podem ter diferentes tipos de dados; um array substitui vários arrays paralelos que precisariam ser mantidos em sincronia; o conjunto inteiro pode ser processado por um único laço ou passado como um único parâmetro; e adicionar um campo altera apenas a definição do tipo. Para um único cliente, a estrutura adequada é um registro (campos de diferentes tipos sob um nome); para todos os clientes, é um array de registros.Um registro armazena vários campos de tipos diferentes sob um único nome ExplorarUm registro agrupa campos sob um único nome
Um registro agrupa campos relacionados juntos. Cada campo é um rótulo nomeado que você acessa com notação de ponto — Item1.Categoria — não por índice numérico.
Vocabulário TreinarInglês Chinês Pinyin record/ˈrekɔːd/ 记录 jì lù record structure/ˈrekɔːd ˈstrʌktʃə/ 记录结构 jì lù jié gòu field/fiːld/ 字段 zì duàn 10.2
Matrizes

Programa
Os candidatos devem ser capazes de: Notas e orientações Usar os termos técnicos associados a arrays Incluindo índice, limite superior e limite inferior Selecionar uma estrutura de dados adequada (array 1D ou array 2D) para usar em uma tarefa dada Escrever pseudocódigo para arrays 1D e 2D Escrever pseudocódigo para processar dados de array Ordenar usando uma ordenação bubble Pesquisar usando uma busca linear Fonte: Programa Cambridge International
Um array 数组 é uma coleção ordenada de itens do mesmo tipo, sob um único nome, acessado por um índice 索引.
- elemento 元素 — um item no array.
- limites 边界 — os índices válidos mais baixos e mais altos.
- dimensão 维度 — 1-D (uma lista), 2-D (uma tabela), etc.
- limite inferior 下界 e limite superior 上界 — o primeiro e o último índice válido; o número de elementos é limite superior menos limite inferior mais um, e para um array 2-D o produto das duas contagens.
Então em
ThisArray[n] ← 42o array tem uma dimensão, o índice é a variáveln(umINTEGER), e o elemento nesse índice recebe42. Antes que um array possa ser declarado, você precisa de seu tipo de dado bem como seus limites. Para declarar $120$ valores que podem incluir um ponto decimal:DECLARE Data : ARRAY[1:120] OF REAL; uma tabela de strings de $150$ linhas, duas colunas:DECLARE Data : ARRAY[1:150, 1:2] OF STRING, que tem $300$ elementos. Os benefícios de um array sobre variáveis separadas, para uma explicação de dois pontos: um identificador em vez de trinta; os elementos podem ser processados por um loop com o índice como contador; o tamanho é fácil de alterar; e todo o conjunto pode ser passado para um módulo como um único parâmetro. Um array também pode substituir uma cadeia de declarações de seleção:DaysInMonth[Month]procura a resposta diretamente em vez de doze cláusulasIF, o que é mais curto, mais rápido de escrever e mais fácil de manter.Arrays 1-D
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Processar cada elemento com um laço
FOR:FOR i ← 1 TO 5 OUTPUT Names[i] NEXT iUm array 1-D (uma lista) com índices e limites Arrays 2-D (array 2D)
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
O primeiro índice representa a linha, o segundo a coluna. Use laços aninhados para visitar cada célula. Use 1-D para uma sequência única, 2-D para duas dimensões naturais (uma grade, linhas × colunas).

Um array 2-D (uma tabela) com índices de linha e coluna Operações comuns
Uma busca linear 线性查找 verifica cada elemento até encontrá-lo:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Para encontrar uma soma, contagem, máximo ou mínimo, defina uma variável acumuladora e percorra:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Uma ordenação por bolha 冒泡排序 coloca um array em ordem: percorre-o comparando cada par adjacente e trocando qualquer um fora de ordem; repita as passagens até que uma passagem não realize nenhuma troca.
A Prova 2 pede esses algoritmos tanto em pseudocódigo quanto em passos em palavras, e às vezes em sua forma "eficiente":
- Maior valor: defina
Largestpara o primeiro elemento; para cada elemento restante, se for maior queLargest, armazene-o emLargest; após o laço, imprimaLargest. Para a posição do maior, mantenha uma segunda variável que armazene o índice sempre queLargestmudar. - Busca linear retornando uma posição: defina
FoundAt ← -1antes do laço (um valor que nunca será um índice válido, indicando "não encontrado"); percorra o array; quando o elemento corresponder, armazene o índice e saia do laço; após o laço testeFoundAt. - Contar ou imprimir os elementos não em branco: compare cada elemento com o marcador de elemento vazio (
""ou-1) e conte ou imprima apenas aqueles que diferirem. - Remover um item: encontre seu índice por busca linear; mova todos os elementos subsequentes uma posição para a frente, fechando o espaço; marque o último elemento como vazio (ou diminua a contagem).
- Inserir em um array ordenado: encontre o primeiro índice cujo elemento seja maior; mova esse elemento e todos os seguintes uma posição para trás; armazene o novo valor no espaço vazio.
- Ordenação por bolha eficiente: uma bandeira
Swappedpara que as passagens parem assim que uma não realizar troca, e um limite superior que diminui em uma unidade a cada passagem porque o maior valor já atingiu o final.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Os pontos são pelo laço externo que se repete até não haver trocas, pela bandeira definida dentro do
IF, pela troca de três linhas com uma variável temporária e pelo limite decrescente. Uma ordenação em "passos" (refinamento passo a passo) é: repetir até ordenar; em cada passagem, comparar pares adjacentes; trocar um par fora de ordem; após cada passagem, o maior valor não ordenado fica no final. Dois arrays 1-D de registros ou de dados paralelos são processados com um laço e um índice; um array 2-D precisa de um laço aninhado, o externo sobre linhas e o interno sobre colunas, e uma busca em uma linha fixa o índice da linha e percorre a coluna.
Uma passagem de ordenação por bolha: pares adjacentes são comparados e trocados, fazendo o maior valor subir ao final ExplorarUma matriz 2-D
Escolha uma linha e uma coluna para ler um elemento — como uma grade de dados é armazenada e indexada.
Vocabulário TreinarInglês Chinês Pinyin index/ˈɪndeks/ 索引 suǒ yǐn array/əˈreɪ/ 数组 shù zǔ element/ˈelɪmənt/ 元素 yuán sù bounds/baʊndz/ 边界 biān jiè bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù file/faɪl/ 文件 wén jiàn secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ 辅助存储器 fǔ zhù cún chǔ qì 10.3
Arquivos
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão do motivo pelo qual arquivos são necessários Escrever pseudocódigo para manipular arquivos de texto que consistem em uma ou mais linhas Fonte: Programa Cambridge International
Um arquivo 文件 é dados armazenados em armazenamento secundário 辅助存储器, mantidos entre execuções de programa. Variáveis na RAM desaparecem quando o programa termina, então para salvar dados permanentemente (pontuações altas, registros, configurações) o programa escreve em um arquivo. Arquivos também permitem que programas compartilhem dados e reiniciem a partir de um estado salvo.
Variáveis na RAM desaparecem quando o programa termina; um arquivo em disco persiste entre execuções Um arquivo de texto 文本文件 contém uma ou mais linhas de caracteres legíveis; programas leem e escrevem arquivos de texto linha por linha. Abra um arquivo antes de usá-lo e arquivo depois:
OPENFILE "data.txt" FOR READ // or FOR WRITE, FOR APPEND WHILE NOT EOF("data.txt") DO READFILE "data.txt", LineString OUTPUT LineString ENDWHILE CLOSEFILE "data.txt"EOFtesta o fim de arquivo 文件结束 antes de ler. Para escrever:OPENFILE "log.txt" FOR WRITE FOR i ← 1 TO 100 WRITEFILE "log.txt", "Event " & i NEXT i CLOSEFILE "log.txt"Sempre arquivo todos os arquivos — caso contrário, as escritas em buffer podem ser perdidas e outros programas podem ficar bloqueados.
Por que arquivos (dois pontos): os dados são mantidos após o término do programa, tornando-os disponíveis na próxima execução; podem ser compartilhados com outros programas; e podem conter mais dados do que cabem na memória. A característica de um arquivo de texto que permite ao programa processá-lo é ser uma sequência de linhas, lidas uma após outra do início. Os três modos:
READpara ler do início;WRITEpara criar um novo arquivo, o que exclui qualquer conteúdo existente, logo não pode ser usado para adicionar a um arquivo;APPENDpara adicionar linhas no final de um arquivo existente. TesteEOFantes de cada leitura, e abra o arquivo apenas uma vez, mesmo quando vários módulos o utilizarem.Exemplo resolvido. Escreva pseudocódigo para um procedimento
LastLines(FileName : STRING)que imprime as últimas três linhas de um arquivo de texto, na ordem.PROCEDURE LastLines(BYVAL FileName : STRING) DECLARE LineX, LineY, LineZ : STRING LineX ← "" LineY ← "" LineZ ← "" OPENFILE FileName FOR READ WHILE NOT EOF(FileName) DO LineX ← LineY LineY ← LineZ READFILE FileName, LineZ ENDWHILE CLOSEFILE FileName OUTPUT LineX OUTPUT LineY OUTPUT LineZ ENDPROCEDURECada nova linha empurra as três anteriores, então quando o arquivo termina as três variáveis contêm suas últimas três linhas; um arquivo com menos linhas imprime cadeias vazias. Para imprimir as cinco primeiras linhas, conte as linhas lidas e pare o laço em cinco ou em
EOF, o que vier primeiro; um arquivo vazio é detectado porEOFserTRUEimediatamente após a abertura.Campos em uma linha. Um arquivo de texto contém strings, então um registro é escrito como uma linha cujos campos estão ligados por um caractere separador 分隔符, e cada número ou Booleano é convertido com
NUM_TO_STR(e lido novamente comSTR_TO_NUM, ou comparando com"TRUE"). Escolha um separador que nunca apareça nos dados: vírgula ou|para nomes e números, nunca um espaço quando um nome pode conter um. Se um campo puder conter qualquer caractere, o separador pode ser confundido com os dados; a solução é colocar cada campo em sua própria linha, ou escrever o comprimento do campo antes dele. Um item por linha é simples de ler novamente, mas usa mais linhas e torna o registro menos visível como uma unidade. Ler um arquivo cujas linhas estão em uma ordem conhecida (ascendente por ID) permite que a busca pare assim que um ID maior for lido, em vez de ler até o final. Um arquivo de salvamento criado a cada vez que o jogo é salvo precisa de um nome de arquivo significativo, por exemplo, o nome do jogador e a data e hora, para que qualquer salvamento anterior possa ser restaurado.
Uma linha de um arquivo de texto é um registro: campos ligados por um separador, convertidos para seus tipos ao serem lidos novamente ExplorarGerenciamento de arquivo: abrir → usar → fechar
Passe pelo ciclo de vida que todo arquivo segue. As duas partes fáceis de esquecer são testar EOF ao ler em um laço e sempre fechar no final.
10.4
Tipos de Dados Abstratos (ADTs)

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de que um ADT é uma coleção de dados e um conjunto de operações sobre esses dados Demonstrar compreensão de que uma pilha, fila e lista ligada são exemplos de ADTs Descrever as características principais de uma pilha, fila e lista ligada e justificar seu uso para uma situação dada Usar uma pilha, fila e lista ligada para armazenar dados Os candidatos não serão exigidos a escrever pseudocódigo para essas estruturas, mas devem ser capazes de adicionar, editar e excluir dados dessas estruturas Descrever como uma fila, pilha e lista ligada podem ser implementadas usando arrays Fonte: Programa Cambridge International
Lista ligada: inserção através da reconfiguração de ponteiros Pilha vs fila: LIFO e FIFO Um Tipo de Dado Abstrato 抽象数据类型 (ADT) é uma coleção de dados mais operações sobre eles, definido pelo o que faz, não como é armazenado. O usuário interage apenas pelas operações; a implementação é oculta, permitindo alterações sem afetar o código que usa o ADT. Conheça três: pilha, fila, lista ligada.
A definição de um ponto: um ADT é uma coleção de dados junto com um conjunto de operações sobre esses dados. Uma pilha, uma fila, uma lista ligada, uma árvore binária e um array são todos ADTs. Para justificar uma escolha: uma fila quando os itens devem ser tratados na ordem de chegada (trabalhos de impressão, pressionamentos de tecla, clientes em uma loja), pois é primeira a entrar, primeira a sair; uma pilha quando o item mais recente deve ser tratado primeiro (desfazer, navegar pelas páginas web, inverter uma ordem, endereços de retorno de chamadas aninhadas), pois é última a entrar, primeira a sair; uma lista ligada quando os itens são inseridos e removidos frequentemente no meio de uma sequência ordenada, pois apenas ponteiros mudam e nada precisa ser transferido. Para comparar uma pilha e uma fila: ambas são estruturas lineares de itens com uma ordem, ambas são implementadas com um array e ponteiros, e ambas precisam verificar se estão cheias antes de adicionar e se estão vazias antes de remover; uma pilha tem um ponteiro e adiciona/remove na mesma extremidade, uma fila tem dois ponteiros e adiciona em uma extremidade e remove na outra.
Pilha
Uma pilha 栈 opera em ordem LIFO 后进先出 (Last In, First Out). Operações: empurrão 入栈 (adicionar no topo), pop 出栈 (remover do topo), peek (verificar o topo) e testes de vazio/cheio. Usos: histórico de desfazer, endereços de retorno de chamada de função, análise de expressões, retrocesso.
Push e pop alteram o ponteiro top; o ponteiro base permanece parado Exemplo resolvido. Uma pilha de caracteres contém, de baixo para cima,
'P','N','Z','X','Y','W', com o ponteiro de topo da pilha em'W'(localização de memória 202 de 200–207). As operaçõesPOP,POP,PUSH 'A',PUSH 'B',POPsão realizadas. O que está na pilha e onde o ponteiro aponta?Os dois pops removem
'W'então'Y'; os pushes adicionam'A'então'B'em seus lugares; o último pop remove'B'. A pilha agora contém'P','N','Z','X','A'e o ponteiro está em'A', localização 203. O valor que esteve na pilha por mais tempo é o item inferior,'P'; no máximo cinco pops adicionais são possíveis antes que a pilha esteja vazia, e um pop em uma pilha vazia é um erro, razão pela qualPop()testa se está vazio primeiro. Uma funçãoPush()que retornaTRUEcom sucesso testa primeiro se o ponteiro está no topo do array (cheio) e retornaFALSEse for esse o caso. Os elementos do array não precisam ser inicializados antes do uso, porque o ponteiro sozinho diz quais elementos estão em uso.
Uma pilha de livros é uma pilha que você pode ver. Você só pode adicionar ou retirar um livro do topo, então o último que você colocou é o primeiro que você retira — isso é exatamente LIFO Fila
Uma fila 队列 funciona em ordem FIFO 先进先出 (First In, First Out). Operações: enqueue 入队 (adicionar na traseira), dequeue 出队 (remover da frente) e testes para vazio/cheio. Usos: spooling de impressão, agendamento, busca em largura, buffering.
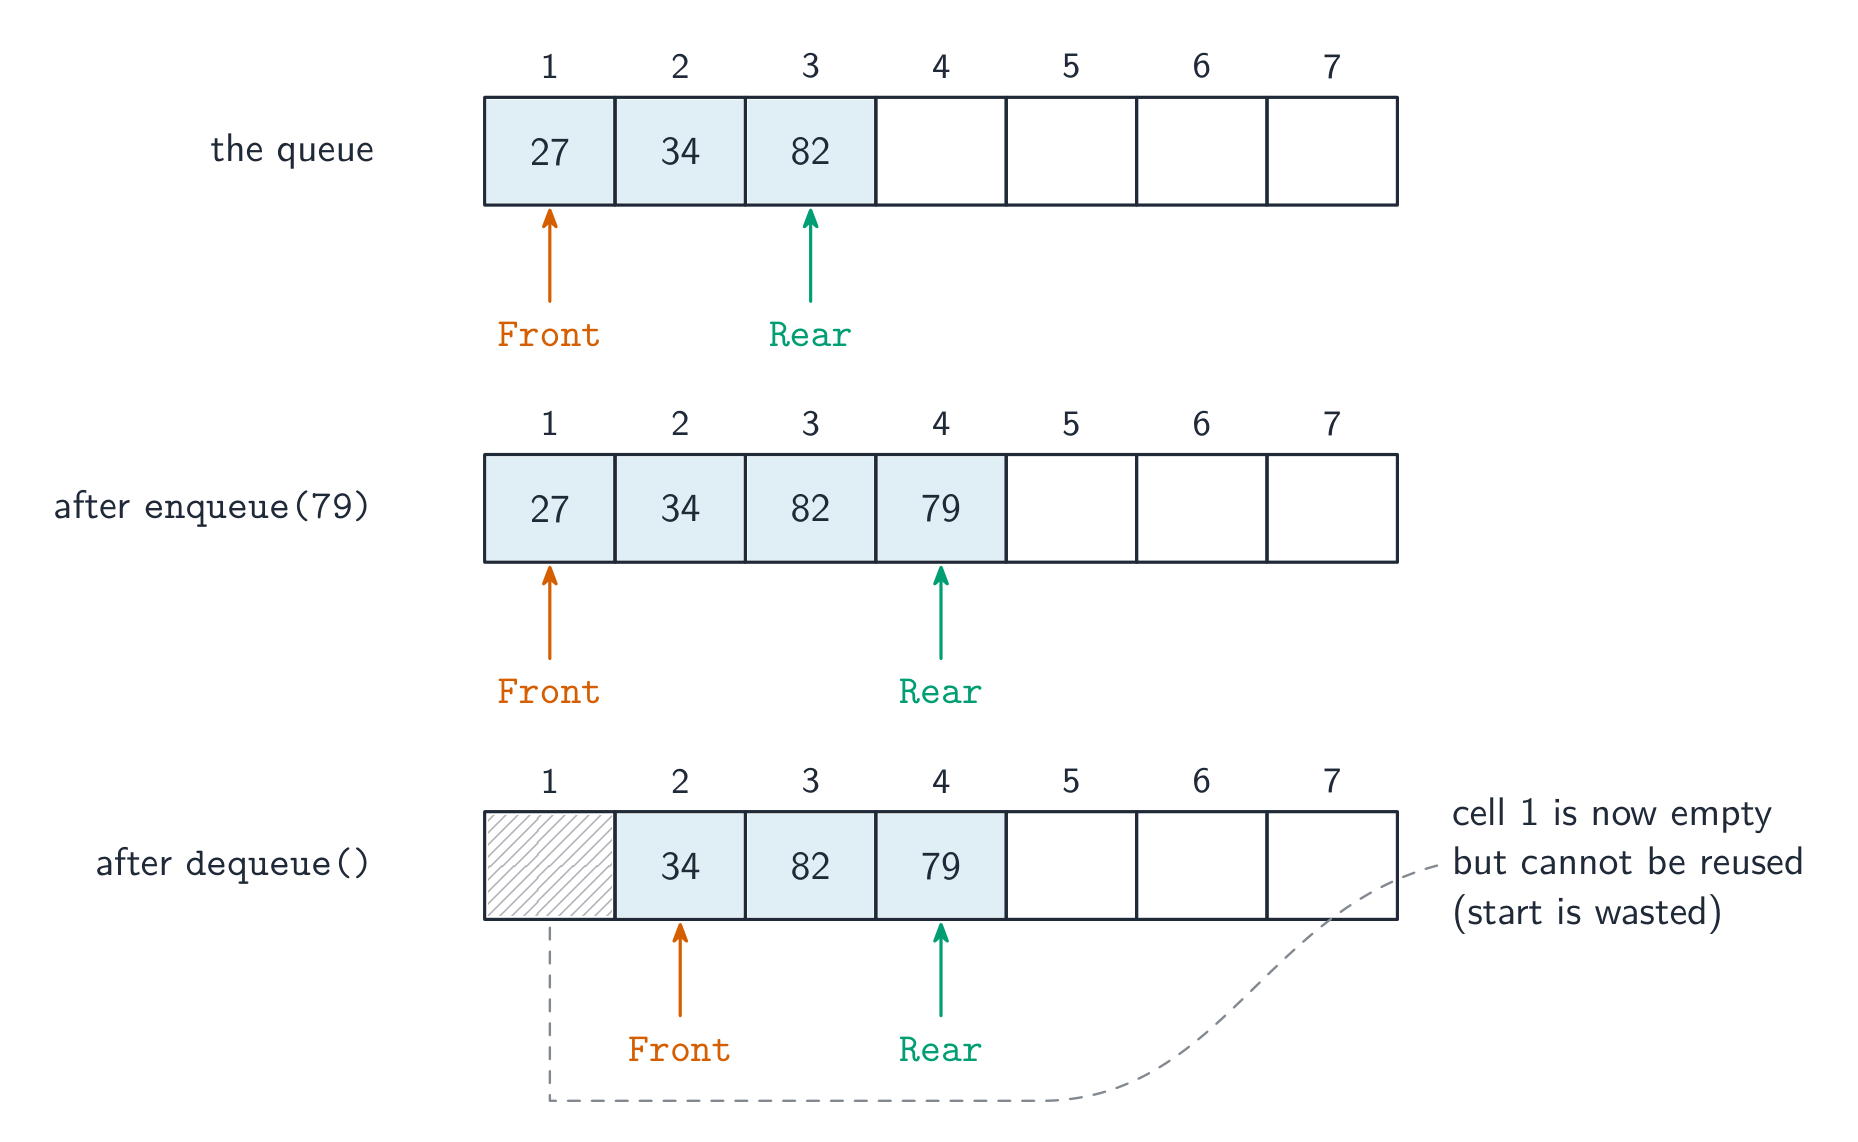
Enqueue adiciona na traseira; dequeue remove da frente Para descrever a adição de um item: verifique se a fila não está cheia; armazene o item na posição indicada pelo ponteiro final da fila; incremente o ponteiro final (e a contagem). Para descrever a remoção: verifique se a fila não está vazia; leia o item no ponteiro frontal; incremente o ponteiro frontal (e decremente a contagem). Enuncie a convenção que você usa: se o ponteiro final marca o próximo espaço livre, ponteiros frontais e finais iguais significam que a fila está vazia; se marca o último item, ponteiros iguais significam um item. Em uma fila linear, o ponteiro frontal só se move para frente, então células atrás dele são desperdiçadas; é isso que a fila circular abaixo corrige. As duas características de uma fila a enunciar: os itens são adicionados na traseira e removidos da frente, então o primeiro item adicionado é o primeiro removido.
Uma fila de pessoas é uma fila que você pode ver. Você entra na traseira e é atendido pela frente, então quem esperou mais tempo é atendido primeiro — isso é exatamente FIFO Lista encadeada
Uma lista encadeada 链表 armazena dados como uma sequência de nós 节点. Cada nó contém um valor e um ponteiro 指针 para o próximo nó; um ponteiro de início marca o começo, e o ponteiro do último nó é um sentinela (por exemplo,
NULL). Operações: inserir, excluir, pesquisar e percorrer 遍历 (visitar cada nó em ordem). Sua vantagem sobre um array é a inserção/exclusão barata (basta ajustar os ponteiros); sua desvantagem é o acesso aleatório lento (você deve seguir os ponteiros desde o início).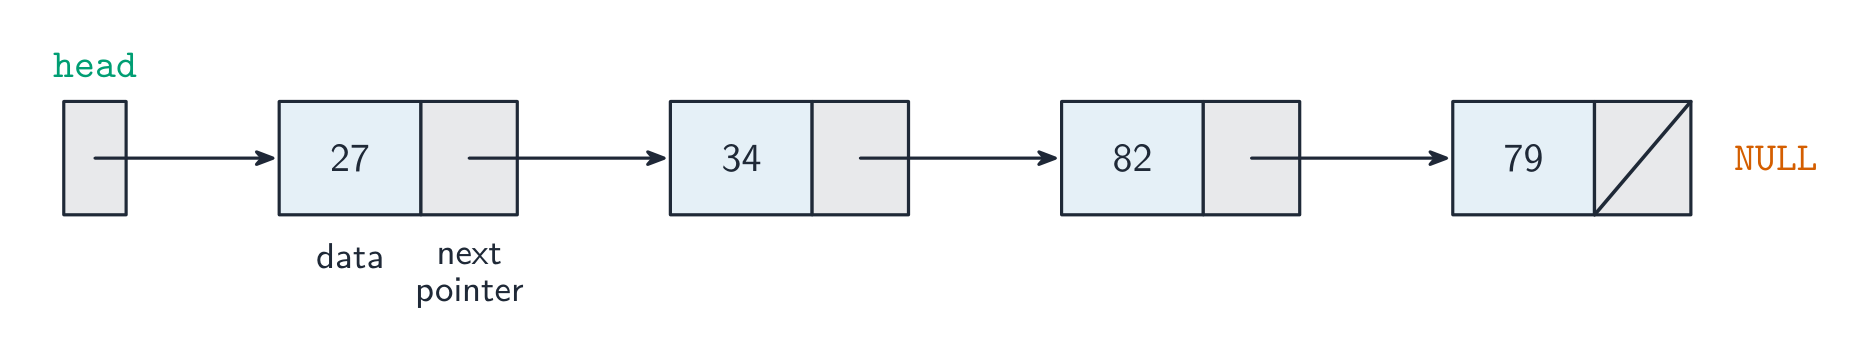
Uma lista encadeada: cada nó aponta para o próximo Adicionar um nó em ordem (quatro pontos): percorra a lista a partir do início, seguindo os ponteiros, até encontrar o nó antes da posição desejada (o último nó cujo valor seja menor); pegue um nó livre e armazene o novo valor nele; defina o ponteiro do novo nó para o endereço para o qual o nó anterior apontava; defina o ponteiro do nó anterior para o novo nó. Se o novo valor pertencer ao início, o ponteiro de início é alterado em vez disso. Excluir um nó: encontre o nó antes dele e defina o ponteiro desse nó para o endereço para o qual o nó excluído apontava, contornando-o na lista; o nó liberado retorna à lista de nós livres. Comparado com um array 1D, a inserção ou exclusão em uma lista encadeada não requer deslocamento dos outros itens, e a lista pode crescer até que a memória acabe; o custo é o ponteiro extra armazenado com cada item, e alcançar o item $n$ significa seguir $n$ ponteiros, já que não há índice direto.
ExplorarUma lista encadeada: nós unidos por ponteiros
Cada nó armazena um valor e um ponteiro para o próximo nó. Inserir ou deletar apenas religa ponteiros — nenhum item se move, diferentemente de uma matriz.
ExplorarPilhas e filas
Empurrar e retirar. Uma pilha (stack) é último a entrar, primeiro a sair; uma fila (queue) é primeiro a entrar, primeiro a sair — dois TADs principais.
Vocabulário TreinarInglês Chinês Pinyin stack/stæk/ 栈 zhàn dimension/daɪˈmenʃn/ 维度 wéi dù push/pʊʃ/ 入栈 rù zhàn separator/ˈsepəreɪtə/ 分隔符 fēn gé fú linked list/lɪŋkt lɪst/ 链表 liàn biǎo queue/kjuː/ 队列 duì liè LIFO/ˈlaɪfəʊ/ 后进先出 hòu jìn xiān chū FIFO/ˈfaɪfəʊ/ 先进先出 xiān jìn xiān chū pop/pɒp/ 出栈 chū zhàn enqueue/enˈkjuː/ 入队 rù duì dequeue/diːˈkjuː/ 出队 chū duì 10.4
Implementando ADTs usando arrays

Pilha usando um array
Mantenha os itens em
Stack[1:MaxSize]com um inteiroTop(0 quando vazio).Push(x): seTop = MaxSizea pilha estiver cheia (transbordamento 溢出); caso contrário,Top ← Top + 1;Stack[Top] ← x.Pop(): seTop = 0a pilha estiver vazia (underflow 下溢); caso contrário, retorneStack[Top]eTop ← Top - 1.
Fila usando um array circular
Uma fila simples permite que
FronteRearavancem até o final, desperdiçando o início. A correção é um array circular 循环数组 — quando um ponteiro atingeMaxSize, ele volta para 1:Enqueue(x): verificar se está cheio; caso contrário,Rear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): verificar se está vazio; caso contrário, retorneQueue[Front]eFront ← (Front MOD MaxSize) + 1.
Rastreie uma contagem separada para distinguir vazio de cheio.
O algoritmo para o ponteiro de fim, em palavras: se a contagem for igual ao tamanho, informe que a fila está cheia e pare; caso contrário, adicione um ao ponteiro de fim; se agora ele ultrapassar o último índice, defina-o como o primeiro índice; armazene o item lá e adicione um à contagem. As declarações que uma resposta de "descreva a declaração e inicialização" de cinco pontos lista: o array com seu tamanho e tipo de elemento; um ponteiro de frente e um ponteiro de fim, ambos inicializados para o primeiro índice (ou a frente para o primeiro índice e o fim para o próximo espaço livre); e uma contagem de itens, inicializada para $0$.
Por exemplo, com
MaxSize = 6: seRear = 5, então(5 MOD 6) + 1 = 6, portanto o próximo item vai na célula 6; seRear = 6, então(6 MOD 6) + 1 = 1, portanto o ponteiro volta para a célula 1.Uma fila circular devolve os ponteiros ao início do array Lista encadeada usando um array
Use um array de registros, cada um com um índice
Next:TYPE TNode DECLARE Value : INTEGER DECLARE Next : INTEGER // index of the next node, or -1 for end ENDTYPE DECLARE Nodes : ARRAY[1:MaxSize] OF TNode DECLARE Head : INTEGER // index of first node, -1 if empty DECLARE FreeListHead : INTEGER // first available free nodeUma lista de nós livres 空闲列表 encadeia as posições não utilizadas, assim como a lista de dados encadeia as utilizadas. Para inserir: pegue uma posição de
FreeListHead, defina o valor do novo nó eNext, e atualize oNextdo nó anterior (ouHead). Para excluir: desvincule o nó e devolva sua posição à lista de nós livres. Isso dá a flexibilidade de uma estrutura encadeada com a alocação estática de um array.
Uma lista encadeada armazenada em um array: um array de dados e um array de ponteiros Exemplo resolvido. Uma lista encadeada é mantida em um array
Datae um arrayPointer, comStartapontando para o índice 1. A lista é 1 → 3 → 4 (o índice 1 contémD40, o índice 3 contémD32, o índice 4 contémD11, cujo ponteiro é $\emptyset$); a lista de nós livres começa no índice 2 e continua 2 → 5. InsiraD6entreD32eD11.Pegue o primeiro nó livre, índice 2, e defina
FreeStartpara seu ponteiro, 5; armazeneD6emData[2]; definaPointer[2]para o valorPointer[3]mantido, que é 4; definaPointer[3]para 2. A lista lê 1 → 3 → 2 → 4 e a lista de nós livres é 5 → $\emptyset$. A resposta para "como a lista encadeada pode ser implementada" são exatamente estas partes: um array (ou array de registros) para os dados, um array paralelo para os ponteiros contendo índices, um ponteiro de início, um ponteiro de lista de nós livres e um valor nulo como $-1$ para o fim.Exemplo resolvido. Uma fila circular é mantida em um array de tamanho 5 (índices 0 a 4) com
Front = 3,Rear = 3e um item armazenado. Dois itens são adicionados, depois dois são removidos. Onde estão os ponteiros e por que usar uma fila circular? Cada movimento usa(pointer + 1) MOD size, então os ponteiros voltam. Adicionando duas vezes moveRear: $3 \rightarrow 4$, depois $4 \rightarrow 0$ (porque $(4+1) \bmod 5 = 0$), entãoRear = 0e três itens são armazenados. Removendo duas vezes moveFrontda mesma maneira: $3 \rightarrow 4$, depois $4 \rightarrow 0$, deixandoFront = 0e um item. O retorno é o ponto principal: em uma fila de array linear, os ponteiros avançam até o final e o espaço liberado no início é desperdiçado mesmo quando a fila está vazia. Lembre-se de que uma fila remove na Frente e adiciona na Traseira - uma pilha usa um ponteiro para ambos.ExplorarImplementando ADTs com matrizes
FIFO
Uma fila é primeira-a-entrar-primeiro-a-sair — enfileirar na parte traseira, desenfileirar pela frente.
Vocabulário TreinarInglês Chinês Pinyin pointer/ˈpɔɪntə/ 指针 zhǐ zhēn node/nəʊd/ 节点 jié diǎn traverse/trəˈvɜːs/ 遍历 biàn lì free list/friː lɪst/ 空闲列表 kòng xián liè biǎo overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū underflow/ˌʌndəˈfləʊ/ 下溢 xià yì circular array/ˈsɜːkjʊlə əˈreɪ/ 循环数组 xún huán shù zǔ 10.4
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
Termo Definição record uma estrutura de dados que mantém um conjunto de itens de dados (campos) de diferentes tipos de dados sob um único identificador array uma estrutura de dados que mantém um número fixo de elementos do mesmo tipo de dados sob um único identificador, cada um acessado por um índice index o número que identifica um elemento de um array upper bound, lower bound o maior e o menor índice válido de um array text file um arquivo que armazena dados como linhas de caracteres, que um programa lê e escreve uma linha de cada vez abstract data type uma coleção de dados junto com um conjunto de operações sobre esses dados pilha uma lista na qual os itens são adicionados e removidos da mesma extremidade, o topo, então o último item adicionado é o primeiro removido (LIFO) fila uma lista na qual os itens são adicionados na traseira e removidos da frente, então o primeiro item adicionado é o primeiro removido (FIFO) linked list uma lista na qual cada nó contém um item de dados e um ponteiro para o próximo nó, com um ponteiro de início para o primeiro nó pointer uma variável que contém o endereço (ou índice) de um nó ou de uma posição em uma estrutura busca linear verificar cada elemento sequencialmente a partir do primeiro até que o alvo seja encontrado ou o fim seja atingido bubble sort passadas repetidas pelo array comparando pares adjacentes e trocando aqueles fora de ordem, até que uma passada não faça trocas Vocabulário TreinarInglês Chinês Pinyin data type/ˈdeɪtə taɪp/ 数据类型 shù jù lèi xíng lower bound/ˈləʊə baʊnd/ 下界 xià jiè upper bound/ˈʌpə baʊnd/ 上界 shàng jiè linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo text file/tekst faɪl/ 文本文件 wén běn wén jiàn end of file/end ɒv faɪl/ 文件结束 wén jiàn jié shù Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ 抽象数据类型 chōu xiàng shù jù lèi xíng 10.4
Dicas de prova
- Escolha a estrutura de dados certa e justifique-a (um record para campos mistos, um array 2-D para uma grade).
- Saiba como implementar uma pilha, fila e lista encadeada com um array e ponteiros (topo; frente/traseira; next).
- Distinga um ADT (seu comportamento) de sua implementação (array mais ponteiros).
Erros comuns
- Uma declaração de registro sem
ENDTYPE, ou campos sem tipos. Cada campo é uma linhaDECLAREcom um tipo. - Ler além do fim de um arquivo, ou escrever com
WRITEquando o arquivo deve manter seu conteúdo. TesteEOFantes de cada leitura; useAPPENDpara adicionar. - Escrever um número em um arquivo de texto sem convertê-lo. Um arquivo mantém strings:
NUM_TO_STRpara fora,STR_TO_NUMde volta. - Esquecer as verificações.
Pushe enqueue testam se está cheio primeiro;Pope dequeue testam se está vazio primeiro, e a resposta diz isso. - Perder o resto da lista ao inserir um nó. Defina o ponteiro do novo nó para o nó next antigo antes de alterar o ponteiro do nó anterior.
- Uma busca linear que nunca diz "não encontrado". Inicialize a posição em $-1$ e teste-a após o loop.
-
11
Programação
Assistir aula11.1
Fundamentos de programação

Programa
Os candidatos devem ser capazes de: Notas e orientações Implementar e escrever pseudocódigo a partir de um projeto dado apresentado como um fluxograma de programa ou inglês estruturado Escrever instruções de pseudocódigo para: • a declaração e inicialização de constantes • a declaração de variáveis • a atribuição de valores a variáveis • expressões envolvendo qualquer um dos operadores aritméticos ou lógicos entrada do teclado e saída no console Usar funções embutidas e rotinas de biblioteca Quaisquer funções não fornecidas no guia de pseudocódigo serão fornecidas Funções de manipulação de string sempre serão fornecidas Fonte: Programa Cambridge International
Programação transforma um projeto em instruções escritas como código 
Um programador escreve o código e o testa conforme avança Do projeto ao código
Você deve ser capaz de transformar um projeto — um fluxograma 流程图 (program flowchart) ou inglês estruturado 结构化英语 — em pseudocódigo 伪代码, e depois em uma linguagem real:
- encontre as variáveis 变量 e seus tipos de dados 数据类型.
- transforme caixas de entrada/saída em
INPUT/OUTPUT. - transforme losangos de decisão em
IF...ELSE...ENDIF(ouCASE). - transforme setas de loop em
WHILE,REPEAT...UNTILouFOR. - transforme caixas de processo em atribuições ou cálculos.
- verifique traçando uma pequena entrada.
Cada símbolo de fluxograma torna-se uma palavra-chave de pseudocódigo Constantes e variáveis
Uma constante 常量 armazena um valor que nunca muda; uma variável armazena um que pode mudar. Declare-os com um tipo:
O valor de uma variável pode mudar; uma constante permanece fixa CONSTANT Pi = 3.14159 DECLARE Radius : REAL DECLARE Area : REAL Radius ← 5 Area ← Pi * Radius * RadiusUse constantes para valores fixos que se repetem (
Pi,MaxScore); elas tornam o código mais claro e fácil de alterar em um único local.Na prova, uma constante é a resposta para "identificar uma maneira mais apropriada de representar" um valor fixo, como uma taxa de imposto ou uma pontuação máxima, que aparece em vários lugares no pseudocódigo. Os benefícios listados pelo critério: o valor é definido uma vez e não pode ser alterado acidentalmente pelo programa; uma alteração é feita em um único local e alcança cada instrução que o utiliza; o identificador dá ao valor um significado (
MaxScoreem vez de100), tornando o código mais fácil de ler e verificar; e há menos risco de erro de digitação em um valor longo como3.14159. Uma questão "diga um valor que poderia ser substituído por uma constante" quer o literal do pseudocódigo (0.2,40), não um novo nome.Toda variável é declarada uma vez, com um identificador 标识符 (seu nome) e um tipo de dados, antes de ser usada. Os seis tipos no guia de pseudocódigo 9618:
Tipo Armazena Escrito no código como Uso típico INTEGERnúmeros inteiros 42,-3um contador, um índice de array, um contador de loop REALnúmeros com parte fracionária 3.75um preço, uma média CHARum único caractere 'A'(aspas simples)uma letra de nota, uma tecla de menu STRINGuma sequência de caracteres "Hello"(aspas duplas)um nome, um CEP BOOLEANTRUEouFALSETRUEuma flag como FoundDATEuma data calendar 12/05/2026uma data de nascimento Uma questão "dê o tipo de dados apropriado" é respondida a partir de como a variável é usada no pseudocódigo: um valor com ponto decimal é
REAL; algo definido comoTRUEouFALSEéBOOLEAN; um valor entre aspas simples éCHAR; um valor usado como índice de array, ou comDIVeMOD, éINTEGER. Escreva o tipo em maiúsculas, grafado como o guia o faz.Exemplo resolvido. Diga o tipo de dados apropriado para cada variável.
Found ← FALSE Initial ← 'K' Price ← 12.99 Count ← Count + 1 Name ← "Li Wei"FoundéBOOLEAN(ele contémFALSE);InitialéCHAR(um caractere entre aspas simples);PriceéREAL(um valor decimal);CountéINTEGER(um contador que aumenta em um);NameéSTRING(texto entre aspas duplas).Atribuição e expressões
Use
←para atribuição 赋值:Total ← Total + 1 Average ← Sum / CountExpressões usam operadores 运算符:
- aritméticos
+ - * /, maisDIV(divisão inteira) eMOD(resto):7 DIV 2 = 3;7 MOD 2 = 1. - comparações
=,<>,<,>,<=,>=. - lógicos
AND,OR,NOT.
Precedência 优先级 (maior para menor):
NOT→* / DIV MOD→+ -→ comparações →AND→OR. Use parênteses quando tiver dúvida.Entrada e saída
OUTPUT "Enter your name:"
INPUT Name
OUTPUT "Hello, ", Name
Funções embutidas e rotinas de biblioteca
Muitas tarefas têm rotinas de biblioteca 库例程 prontas, então você não precisa escrevê-las. A folha inserir 附页 da Prova 2 lista aquelas que você pode usar, com seus nomes exatos, parâmetros e tipos de retorno; qualquer outra função que uma questão precise é dada na própria questão. Os nomes abaixo são os da insert.
VALeSTRsão nomes IGCSE e aparecem em nenhum documento 9618, então não valem nada.UCASEeLCASEsão um caso diferente: eles são 9618, definidos no Guia de Pseudocódigo, mas recebem um únicoCHAR, e a insert não os lista de todo — para uma string inteira na Prova 2, a rotina éTO_UPPER.Uma biblioteca de programas 程序库 contém rotinas que já foram escritas, compiladas e testadas; um programa as chama em vez de escrever as próprias. Os benefícios que o critério aceita, para uma questão "diga três benefícios": as rotinas estão já testadas, portanto são menos propensas a conter erros; economizam tempo de desenvolvimento; podem fazer coisas que o programador não conseguiria escrever (estatística complexa, gráficos); são escritas por especialistas e reutilizadas em muitos programas; e uma rotina com interface fixa pode ser chamada de qualquer lugar no programa.
Rotina Retorna Exemplo LENGTH(s)o número de caracteres em sLENGTH("Hello") = 5LEFT(s, n)/RIGHT(s, n)os primeiros / últimos ncaracteresRIGHT("Hello", 2) = "lo"MID(s, start, n)ncaracteres a partir da posiçãostart(as posições contam a partir de 1)MID("Hello", 2, 3) = "ell"TO_UPPER(s)/TO_LOWER(s)sem maiúsculas / em minúsculasTO_UPPER("ab1") = "AB1"NUM_TO_STR(x)/STR_TO_NUM(s)um número como string / uma string como número STR_TO_NUM("3.5") = 3.5IS_NUM(s)TRUEsesfor um número válidoIS_NUM("12a") = FALSEASC(c)/CHR(n)o código do caractere de c/ o caractere com códigonASC('A') = 65,CHR(66) = 'B'INT(x)a parte de número inteiro de xINT(7.9) = 7RAND(n)um número real aleatório de 0 até, mas sem incluir, nINT(RAND(6)) + 1é um lançamento de dadoDAY(d),MONTH(d),YEAR(d)as partes de um ⟨ DATE⟩YEAR(TODAY())DAYINDEX(d),SETDATE(d, m, y),TODAY()o dia da semana (1 = Domingo); uma data construída a partir de três inteiros; a data de hoje EOF(f)TRUEquando o arquivofnão tem mais linhas para lerWHILE NOT EOF("data.txt")Strings são unidas com
&(concatenação 连接):"A" & "BC"é"ABC". Use os nomes exatos da inserção, com os parâmetros em sua ordem.Datas e números aleatórios aparecem como declarações de uma linha.
SETDATE(17, 11, 2007)cria 17 de novembro de 2007;12 - MONTH(MyDOB)é o número de meses do mês de nascimento até o fim do ano;IF DAYINDEX(MyDOB) = 5 THENtesta por uma quinta-feira, porque domingo é o dia 1.RAND(n)retorna um número real de0até, mas sem incluir,n, então um inteiro aleatório deLowaHighinclusive éINT(RAND(High - Low + 1)) + Low:INT(RAND(21)) - 10dá um valor de-10a10.
As rotinas comuns de strings atuando em s = "COMPUTER"(posições 1–8)Exemplo resolvido. Avalie cada expressão, dado
Word ← "Program",Code ← 'Q'eN ← 7.Expressão Valor Por quê LENGTH(Word)7sete caracteres MID(Word, 4, 2)"gr"dois caracteres, começando na posição 4 LEFT(Word, 3) & "!""Pro!"unido com &TO_UPPER(RIGHT(Word, 2))"AM"a função interna executa primeiro ASC(Code) - ASC('A')16'Q'é 81 e'A'é 65N DIV 2 + N MOD 243 + 1NUM_TO_STR(N) & "th""7th"o número torna-se uma string primeiro INT(N / 2)33.5cortado para sua parte inteiraTrabalhe de dentro para fora, e mantenha as aspas:
"7"é uma string e7é um número.Exemplo resolvido. Cada declaração pode conter um erro em seu uso de uma função ou operador. Descreva o erro, ou escreva SEM ERRO. (Assuma que todas as variáveis têm o tipo correto.)
Declaração Erro Result ← 2 & 4&une strings;2e4são inteiros, então+é necessárioSubString ← MID("pseudocode", 4, 1)SEM ERRO: um caractere da posição 4, "u"IF x = 3 OR 4 THENORprecisa de um Boolean de cada lado:IF x = 3 OR x = 4 THENResult ← Status AND INT(x / 2)ANDprecisa de dois Booleans;INT(x / 2)é um inteiroMessage ← "Done" + LENGTH(MyString)+não pode somar uma string a um inteiro:"Done" & NUM_TO_STR(LENGTH(MyString))Todo operador funciona em tipos específicos:
&em strings,+ - * / DIV MODem números,AND OR NOTem Booleans, e= <>em dois valores do mesmo tipo. Uma tabela "avalie cada expressão, ou escreva ERROR" é marcada da mesma forma:LENGTH(42)e"A" + 1são ERROR, porque o tipo não corresponde à função ou ao operador.Exemplo resolvido. Com
Points ← 100,Active ← TRUEeExempt ← FALSE, avalie cada expressão.Expressão Valor Por quê (Points > 99) OR ActiveTRUEambos os lados são verdadeiros; um bastaria (Points MOD 2 = 0) OR ExemptTRUE100 MOD 2é0(Points <= 75) AND (Active OR Exempt)FALSEo primeiro lado é falso, e ANDprecisa de ambos(Active OR NOT Active) AND NOT ExemptTRUEActive OR NOT Activeé sempre verdadeiroA última expressão simplifica:
X OR NOT XéTRUEindependente deX, então toda a expressão é apenasNOT Exempt. Avalie os parênteses primeiro, depoisNOT, depoisAND, depoisOR.ExplorarUma variável é uma caixa rotulada
Cada atribuição armazena um valor em uma caixa nomeada; reatribuir o mesmo nome sobrescreve-o. Passe pelo programa e observe cada caixa assumindo seu valor atual.
Vocabulário TreinarInglês Chinês Pinyin flowchart/ˈfləʊtʃɑːt/ 流程图 liú chéng tú structured English/ˈstrʌktʃəd ˈɪŋɡlɪʃ/ 结构化英语 jié gòu huà yīng yǔ pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ variables/ˈveərɪəblz/ 变量 biàn liàng data types/ˈdeɪtə taɪps/ 数据类型 shù jù lèi xíng assignment/əˈsaɪnmənt/ 赋值 fù zhí constant/ˈkɒnstənt/ 常量 cháng liàng identifier/aɪˈdentɪfaɪə/ 标识符 biāo shí fú array/əˈreɪ/ 数组 shù zǔ operators/ˈɒpəreɪtəz/ 运算符 yùn suàn fú precedence/ˈpresɪdəns/ 优先级 yōu xiān jí function/ˈfʌŋkʃn/ 函数 hán shù library routines/ˈlaɪbrəri ruːˈtiːnz/ 库例程 kù lì chéng insert/ˈɪnsɜːt/ 附页 fù yè parameters/pəˈræmɪtəz/ 参数 cān shù program library/ˈprəʊɡræm ˈlaɪbrəri/ 程序库 chéng xù kù concatenation/kənˌkætəˈneɪʃn/ 连接 lián jiē selection/sɪˈlekʃn/ 选择 xuǎn zé nested/ˈnestɪd/ 嵌套 qiàn tào logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo iteration/ˌɪtəˈreɪʃn/ 迭代 dié dài count-controlled loop/kaʊnt kənˈtrəʊld luːp/ 计数循环 jì shù xún huán pre-condition loop/priː kənˈdɪʃn luːp/ 前测循环 qián cè xún huán post-condition loop/pəʊst kənˈdɪʃn luːp/ 后测循环 hòu cè xún huán dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng 11.2
Seleção
Programa
Os candidatos devem ser capazes de: Notas e orientações Usar pseudocódigo para escrever: • uma instrução 'IF' incluindo a cláusula 'ELSE' e IFs aninhados • uma estrutura 'CASE' • um laço 'controlado por contador': • um laço 'pós-condição' • um laço 'pré-condição' Justificar por que uma estrutura de laço pode ser mais adequada para resolver um problema do que as outras Fonte: Programa Cambridge International
Seleção 选择 escolhe quais etapas executam.
IF age >= 18 THEN
    OUTPUT "Adult"
ELSE
    OUTPUT "Minor"
ENDIF
Um IF...ELSE testa a condição uma vez, então executa exatamente um ramo Para mais de dois casos, você pode usar um aninhado 嵌套 IF, mas aninhamentos profundos são difíceis de ler — um
CASEé mais limpo ao testar um valor contra várias opções:CASE OF Grade "A": OUTPUT "Excellent" "B": OUTPUT "Good" OTHERWISE: OUTPUT "Try again" ENDCASECambridge
CASEpermite valores únicos, listas de valores (1, 2, 3:) e intervalos (1 TO 5:).Um IF aninhado é um IF dentro de uma ramificação de outro IF. Cada
IFprecisa do seu próprioENDIF, e o examinador verifica se cada construção está fechada:IF Mark >= 50 THEN IF Mark >= 80 THEN OUTPUT "Distinction" ELSE OUTPUT "Pass" ENDIF ELSE OUTPUT "Fail" ENDIFLimites são onde se perdem marcas. "Uma nota de 50 ou mais passa" é
Mark >= 50, nãoMark > 50; a últimaCASEramificação, para "qualquer outra coisa", é escrita comoOTHERWISE, não uma condição como> 200. Uma comparação errada aqui é um erro lógico 逻辑错误: o programa executa, mas produz a saída incorreta para algumas entradas — e uma tabela de traço com um valor limite como50é como você o encontra.
Uma sentença CASE executa a ramificação que corresponde ao valor Exemplo resolvido. Reescreva isto com a mesma funcionalidade, sem usar uma estrutura CASE.
CASE OF MySwitch
    1: ThisChar ← 'a'
    2: ThisChar ← 'y'
    3: ThisChar ← '7'
    OTHERWISE: ThisChar ← '*'
ENDCASE
Cada valor torna-se uma ramificação de uma cadeia de IFs, e
OTHERWISEtorna-se o últimoELSE:IF MySwitch = 1 THEN ThisChar ← 'a' ELSE IF MySwitch = 2 THEN ThisChar ← 'y' ELSE IF MySwitch = 3 THEN ThisChar ← '7' ELSE ThisChar ← '*' ENDIF ENDIF ENDIFDuas cláusulas que atribuem o mesmo valor são fundidas em uma única cláusula com uma lista de valores:
1, 2: ThisChar ← 'a'. As guardas são testadas na ordem: com intervalos como1 TO 50:seguidos por40 TO 60:, um valor de45toma a primeira ramificação que corresponde, então uma atribuição em uma ramificação posterior pode nunca ser executada — e quando as ramificações anteriores já cobrem todos os valores possíveis, a ramificaçãoOTHERWISEtambém nunca é alcançada.No sentido oposto, IFs aninhados que testam vários booleans são mais claros como uma condição por resultado:
IF A AND B AND C THEN CALL Sub1(), depoisIF A AND B AND NOT C THEN CALL Sub2(), e assim por diante. Unir testes comANDeORremove o aninhamento, eIF A THENé aceito no lugar deIF A = TRUE THEN.ExplorarSeleção (SE / SENÃO)
Altere a entrada e veja qual ramo é executado — a essência da seleção.
11.2
Iteração

Iteração 迭代 repete um bloco. Três laços diferem na quantidade de vezes que o corpo é executado.
Loop controlado por contagem (FOR)
Um laço controlado por contagem 计数循环 — use-o quando souber quantas vezes deve repetir:
FOR i ← 1 TO 10
    OUTPUT i
NEXT i
Um
STEPpode alterar a contagem (ex.FOR i ← 10 TO 1 STEP -1). Ideal para um número fixo de repetições ou processar cada elemento de uma matriz 数组.Laço de pré-condição (WHILE)
Um laço de pré-condição 前测循环 testa a condição antes de cada passagem, podendo executar zero vezes:
WHILE total < 100 DO
    INPUT n
    total ← total + n
ENDWHILE
Laço de pós-condição (REPEAT...UNTIL)
Um laço de pós-condição 后测循环 testa a condição depois de cada passagem, executando sempre pelo menos uma vez:
REPEAT
    INPUT password
UNTIL password = correctPassword
Escolher o laço correto
Os três laços diferem em onde a condição é testada — antes do corpo (WHILE), depois dele (REPEAT) ou um número fixo de vezes (FOR) - contagem conhecida de antemão → FOR.
- pode precisar de zero passagens → WHILE.
- pelo menos uma passagem obrigatória → REPEAT...UNTIL.
Justifique sua escolha pela contagem ser conhecida e se o corpo deve executar pelo menos uma vez. Uma questão típica apresenta um cenário ("pedir senha até estar correta, mas sempre pedir pelo menos uma vez") e pergunta qual laço se adapta.
As duas marcas são para o nome do laço e a razão, nas palavras do gabarito: controlado por contagem, porque o número de iterações é conhecido antes do início; pós-condição, porque o corpo deve ser executado pelo menos uma vez; pré-condição, porque o laço pode não precisar executar. Um laço sobre os quatro elementos de uma matriz escrito como um
WHILEcom um contador é "não o mais adequado": a contagem, quatro, é conhecida, então um laçoFORse encaixa.Exemplo resolvido. Qual laço se adapta a cada tarefa? (a) imprimir a tabela de multiplicar por 12; (b) continuar lendo números até o usuário inserir 0; (c) pedir uma senha até estar correta. Escolha perguntando quantas vezes o corpo executa e quando o teste ocorre. (a) A contagem é conhecida adiante (12), use um laço FOR. (b) A contagem é desconhecida, e a própria primeira entrada pode já ser 0 — o teste deve vir antes do corpo: um laço WHILE, que executa zero ou mais vezes. (c) A contagem é desconhecida, mas você deve sempre pedir pelo menos uma vez antes de haver algo para testar — o teste vem depois do corpo: um REPEAT...UNTIL, que executa uma ou mais vezes. A pergunta decisiva é se o corpo deve executar pelo menos uma vez: WHILE pode executar zero vezes, REPEAT sempre executa uma vez.
Execução manual com tabela de traço
Uma tabela de traço 跟踪表 registra o valor de cada variável enquanto você faz execução manual 手工跟踪 (percorre à mão) um algoritmo. É como testar um laço no papel, e uma questão de seis marcas na maioria dos Paper 2s.
DECLARE Count, Total : INTEGER
Count ← 1
Total ← 0
WHILE Total < 10
    Total ← Total + Count * 2
    Count ← Count + 1
ENDWHILE
OUTPUT Count, Total
Count Total Total < 10 OUTPUT 1 0 VERDADEIRO 2 2 VERDADEIRO 3 6 VERDADEIRO 4 12 FALSO 4, 12 Regras que ganham marcas: uma coluna por variável, na ordem dada pela questão; escreva um valor apenas quando ele muda; inicie uma nova linha sempre que o laço repetir; avalie a condição com os valores atuais, e pare no momento em que for
FALSE; coloque a saída em sua própria coluna, exatamente como apareceria. Rastreie o algoritmo conforme escrito, não aquele que você acha que foi pretendido — se nunca parar, diga isso.Exemplo resolvido. Quais construções cada linha usa — seleção, iteração ou chamada de subrotina?
Pseudocódigo Seleção Iteração Subrotina IF Ready = TRUE THEN CALL Start()FIM_SE |
FOR I ← 1 TO 20 ... NEXT I| | yes | | |WHILE NOT IsFull() ... ENDWHILE| | yes | yes | |CASE OF Key ... OTHERWISE ... ENDCASE| yes | | |IFeCASEsão seleção;FOR,WHILEeREPEATsão iteração; um nome seguido por parênteses —Start(),IsFull()— é uma chamada a um procedimento ou função, onde quer que apareça, inclusive dentro de uma condição.ExplorarRastreie um laço, passagem por passagem
Uma tabela de rastro registra cada variável após cada passagem do laço. Observe o contador i subir enquanto o total acumulado se constrói — exatamente o que uma questão de rastro de exame pede para preencher.
ExplorarRastreando um loop
Passe passo a passo pelo loop e observe as variáveis mudarem a cada iteração — exatamente o que uma tabela de traçado registra.
11.3
Procedimentos e funções

Programa
Os candidatos devem ser capazes de: Notas e orientações Definir e usar uma procedura Explicar onde na construção de um algoritmo seria apropriado usar uma procedura Usar parâmetros Uma procedura pode ter nenhum, um ou mais parâmetros Um parâmetro pode ser passado por referência ou por valor Definir e usar uma função Explicar onde na construção de um algoritmo é apropriado usar uma função Uma função é usada em uma expressão, ex.: o valor retornado substitui a chamada Usar a terminologia associada a proceduras e funções incluindo cabeçalho da procedura/função, interface da procedure/função, parâmetro, argumento, valor retornado Escrever pseudocódigo eficiente Fonte: Programa Cambridge International
Programação estruturada 结构化编程 constrói um programa a partir de pequenas subrotinas 子程序 nomeadas, cada uma com uma única função.
Procedimento
Um procedimento 过程 é um bloco nomeado que realiza uma ação; pode receber parâmetros 参数 mas não retorna um valor.
PROCEDURE Greet(name : STRING)
    OUTPUT "Hello, ", name
ENDPROCEDURE

CALL Greet("Ada")
Função
Uma função 函数 é semelhante a um procedimento, mas retorna um valor que se torna parte de uma expressão.
FUNCTION Square(x : INTEGER) RETURNS INTEGER
    RETURN x * x
ENDFUNCTION

result ← Square(5) + 1     // result = 26
Use um procedimento quando a subrotina realizar uma ação; use uma função quando calcular um valor para quem a chama.
O programa de estudos pede onde na construção de um algoritmo cada um é apropriado. Um procedimento é apropriado onde o mesmo grupo de passos é necessário em vários pontos (validar uma entrada, imprimir um menu, trocar dois valores): os passos são escritos uma vez e
CALLchamados por nome. Uma função é apropriada onde um único valor deve ser calculado e depois usado em uma expressão — um total, um resultado deTRUE/FALSE, o maior de dois números — porque o valor retornado 返回值 substitui a chamada:IF IsValid(Code) THEN.Um procedimento realiza uma ação e não retorna nada; uma função retorna um valor que você usa em uma expressão Parâmetros
Um parâmetro é uma variável que uma subrotina declara para receber entrada; os valores que o chamador fornece são argumentos 实参. Duas formas de passá-los:
- pass by value 传值 — a rotina recebe uma cópia; alterações internas não afetam o chamador. Use para entradas que ela apenas lê.
- pass by reference 传引用 — a rotina recebe uma referência à variável do chamador; alterações afetam o chamador. Use quando deve atualizar um parâmetro.
Pass by value copia o valor para uma nova caixa; pass by reference permite que a rotina altere a variável do chamador PROCEDURE Swap(BYREF a : INTEGER, BYREF b : INTEGER) DECLARE temp : INTEGER temp ← a a ← b b ← temp ENDPROCEDUREO pseudocódigo Cambridge escreve o modo no cabeçalho,
BYVALouBYREF, antes de cada parâmetro. Se nenhum for escrito, assume-seBYVAL, então uma rotina que deve alterar a variável do chamador —Swap, ou um procedimento que atualiza um total acumulado — precisa deBYREFem seu cabeçalho.Exemplo resolvido. O que é impresso?
PROCEDURE Adjust(BYREF X : INTEGER, BYVAL Y : INTEGER) X ← X + Y Y ← Y * 2 ENDPROCEDURE A ← 5 B ← 3 CALL Adjust(A, B) OUTPUT A, BXé uma referência aA, entãoAtorna-se8.Yé uma cópia deB, então dobrarYdeixaBem3. A saída é8, 3. Se o cabeçalho tivesse ditoBYVAL X,Aainda seria5.Variáveis locais vs globais
Uma variável local 局部变量 é declarada dentro de uma subrotina e existe apenas enquanto esta roda. Uma variável global 全局变量 é declarada fora e é visível em toda parte. Prefira locais e parâmetros — uso intenso de globais torna o código difícil de seguir e testar. (A região onde um nome é visível é seu escopo 作用域.)
A diferença de uma linha: uma variável global pode ser acessada de qualquer lugar no programa, uma variável local apenas dentro da subrotina que a declara. Benefícios das variáveis locais aceitos pelo gabarito: o mesmo identificador pode ser usado em outra subrotina sem colisão; o valor não pode ser alterado acidentalmente por outras partes do programa; a memória é liberada quando a subrotina termina; e a subrotina é autônoma, podendo ser testada isoladamente e reutilizada em outro programa.
Uma variável local é criada cada vez que a subrotina é chamada e destruída ao retornar, não podendo carregar um valor de uma chamada para a próxima. Um procedimento que constrói uma string ao longo de chamadas repetidas, portanto, precisa que essa string seja global (ou passada
BYREF). SeMyStringfor mudado de global para local declarado dentro deMyOutput(), toda chamada começa com um novoMyStringvazio, o texto adicionado pelas chamadas anteriores é perdido, e o procedimento "não funciona como esperado".
Uma variável local é uma nova caixa vazia em cada chamada; apenas uma variável global (ou um parâmetro BYREF) mantém um valor entre chamadas 
Uma variável global é visível em toda parte; uma variável local existe apenas dentro de sua própria procedimento Quando usar uma subrotina
Use uma subrotina quando:
- a mesma lógica aparece em mais de um lugar — escreva-a uma vez, chame-a várias vezes.
- um bloco tem um propósito nomeado claro — o nome documenta o que ele faz.
- o programa é complexo — divida-o em partes (decomposição 分解).
- você quer testar um trecho isoladamente.
Não as faça tão pequenas que o custo da chamada seja maior que o trabalho interno.
Terminologia
- definição — o bloco
PROCEDURE ... ENDPROCEDURE(ou função). - chamada — onde é invocada. argumento — um valor passado. parâmetro — a variável que o recebe.
- valor de retorno — o que uma função devolve.
- cabeçalho do procedimento/função — a primeira linha dando o nome e os parâmetros (
PROCEDURE Name(params)ouFUNCTION Name(params) RETURNS type). - interface/cabecalho do procedimento/função / assinatura 签名 — nome + parâmetros + tipo de retorno: o que um chamador precisa saber para usá-la.
Exemplo resolvido. Descreva cada termo usado no cabeçalho
FUNCTION Pass2(Count : INTEGER) RETURNS BOOLEAN.Termo Significado FUNCTIONuma subrotina que retorna um valor Pass2o identificador usado para chamá-la Counto parâmetro: o identificador que recebe o argumento passado INTEGERo tipo de dados do parâmetro RETURNS BOOLEANo tipo de dados do valor que a função retorna Os dois identificadores em
PROCEDURE MyProc(Count : INTEGER, Message : STRING)são parâmetros: eles recebem os valores passados quando o procedimento é chamado, e são usados dentro dele como variáveis locais.Para converter um procedimento em uma função: mude
PROCEDUREparaFUNCTIONe adicioneRETURNS <type>; substitua oOUTPUT(ou oBYREFparâmetro que carregava o resultado para fora) por uma instruçãoRETURN; e mude todas as chamadas para que o valor retornado seja usado,Result ← Unpack(Text)em vez deCALL Unpack(Text, Result). Para uma questão "escreva o cabeçalho", escreva a linha inteira:FUNCTION Calculate(Expression : STRING) RETURNS INTEGER. Um parâmetro de array é passado por referência, então um procedimento que escreve em um array altera o array do chamador.Quando um programa ganha um novo módulo, a interface é o que é acordado primeiro: o nome, os parâmetros (quantos, em que ordem, de que tipo) e o tipo de retorno, além de quaisquer dados globais que o módulo lê ou escreve. Um módulo que envia um lembrete antes de uma data limite precisa do registro (ou seu índice) como parâmetro e não retorna nada, então é um procedimento; o programa principal o chama uma vez por registro.
Escrevendo um módulo para Paper 2
Metade do Paper 2 é "escrever pseudocódigo para o módulo X". O esquema atribui uma marca por recurso, então um módulo incompleto ainda pontua por cada parte correta. As partes que o examinador procura:
Cada parte de uma resposta de módulo carrega sua própria marca, então escreva todas elas mesmo quando uma estiver incerta - O cabeçalho, conforme descrito na questão:
PROCEDURE Name(Param : TYPE)ouFUNCTION Name(Param : TYPE) RETURNS TYPE, comBYREFonde a rotina deve alterar o argumento. - Declarações locais:
DECLAREcada variável local com seu tipo, e inicie contadores e totais (Count ← 0). - O loop que visita todos os elementos:
FOR Index ← 1 TO 50para um array cujo tamanho é dado;WHILE NOT EOF(...)para um arquivo. - A condição, com a comparação e o limite corretos, no item certo:
IF Score[Index] > Limit THEN. - A atualização dentro do ramo: a contagem aumentada, o valor armazenado, ou a mensagem exibida.
- O fim:
RETURNuma vez, após o loop, em uma função;ENDFUNCTIONouENDPROCEDURE; e todoIF,FOReWHILEfechado.
Exemplo resolvido. Um array global
Score : ARRAY[1:50] OF INTEGERcontém notas de teste. Escreva uma funçãoCountAbove(Limit : INTEGER)que retorne quantas notas são maiores queLimit.FUNCTION CountAbove(BYVAL Limit : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 50 IF Score[Index] > Limit THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count ENDFUNCTIONMarcas: o cabeçalho com seu parâmetro e
RETURNS INTEGER;Countdeclarado e definido como0; um loop sobre todos os 50 elementos; a comparação> Limit(não>=); a contagem atualizada dentro daIF;RETURN Countapós o loop. O programa principal usa o valor de retorno em uma expressão ou saída:OUTPUT "Above 70: ", CountAbove(70).Exemplo resolvido. Escreva uma função
IsValid(Code : STRING)que retorneTRUEquandoCodefor duas letras maiúsculas seguidas de quatro dígitos — o formato 格式AB1234— eFALSEcaso contrário.FUNCTION IsValid(BYVAL Code : STRING) RETURNS BOOLEAN DECLARE Index : INTEGER DECLARE Ch : STRING IF LENGTH(Code) <> 6 THEN RETURN FALSE ENDIF FOR Index ← 1 TO 6 Ch ← MID(Code, Index, 1) IF Index <= 2 THEN IF Ch < "A" OR Ch > "Z" THEN RETURN FALSE ENDIF ELSE IF Ch < "0" OR Ch > "9" THEN RETURN FALSE ENDIF ENDIF NEXT Index RETURN TRUE ENDFUNCTIONA verificação de comprimento vem primeiro, então
MIDnunca é solicitado para uma posição que não existe. Validação 验证 assim retorna umBOOLEANpara que o chamador possa escreverIF IsValid(Entry) THEN ... ELSE OUTPUT "Invalid code" ENDIF: uma mensagem ao usuário é exibida pelo chamador, não pela função — uma função calcula, um procedimento age.Exemplo resolvido. Escreva uma função
IsPalindrome(Word : STRING)que retorneTRUEquandoWordfor lido de trás para frente da mesma forma, como"RACECAR".Compare os caracteres das duas extremidades, movendo-se para dentro: a posição
Indexé pareada com a posiçãoLen - Index + 1, e apenas a primeira metade precisa ser testada.
Um teste de palíndromo pareia a posição icom a posiçãoLen - i + 1e para no meioFUNCTION IsPalindrome(BYVAL Word : STRING) RETURNS BOOLEAN DECLARE Len, Index : INTEGER Len ← LENGTH(Word) FOR Index ← 1 TO Len DIV 2 IF MID(Word, Index, 1) <> MID(Word, Len - Index + 1, 1) THEN RETURN FALSE ENDIF NEXT Index RETURN TRUE ENDFUNCTIONAs mesmas três ferramentas — um
FORsobre as posições,MID(s, i, 1)para ler um caractere, e¶ construir uma nova string — respondem à maioria dos módulos de strings no Paper 2: contar quantas vezes um caractere ocorre (IF MID(s, i, 1) = Ch THEN Count ← Count + 1), substituir todas as instâncias de um caractere (adicionar ouNewCharou o caractere original aNewStringem cada posição), esconder tudo exceto os últimos quatro dígitos de um número de cartão (adicionar'*'para cada posição atéLen - 4), ou escrever seu próprioMID()unindo os caracteres deStartaStart + Length - 1. PedirMIDpara uma posição após o final da string é um erro de tempo de execução, então verifiqueLENGTHprimeiro.Arquivos. Os valores nas variáveis desaparecem quando o programa termina, então um módulo que deve manter dados para a próxima execução os grava em um arquivo:
OPENFILE "scores.txt" FOR WRITE, umWRITEFILE "scores.txt", NUM_TO_STR(Score[Index])por linha dentro do loop, eCLOSEFILE "scores.txt"uma vez, após o loop; ler novamente usaFOR READ,READFILEeWHILE NOT EOF("scores.txt"). O Tópico 10 tem a seção completa de arquivos; aqui as marcas são para abrir no modo correto, a leitura ou escrita dentro do loop, e fechar uma vez depois dele.ExplorarA pilha de chamadas: empilha na chamada, desempilha no retorno
Chamar uma subrotina empilha um novo quadro no topo; retornar o desempilha e devolve um valor ao chamador. A chamada que está executando é sempre o quadro no topo.
Vocabulário TreinarInglês Chinês Pinyin procedure/prəˈsiːdʒə/ 过程 guò chéng structured programming/ˈstrʌktʃəd ˈprəʊɡræmɪŋ/ 结构化编程 jié gòu huà biān chéng subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù return value/rɪˈtɜːn ˈvæljuː/ 返回值 fǎn huí zhí arguments/ˈɑːɡjuːmənts/ 实参 shí cān pass by value/pæs baɪ ˈvæljuː/ 传值 chuán zhí pass by reference/pæs baɪ ˈrefrəns/ 传引用 chuán yǐn yòng global variable/ˈɡləʊbl ˈveərɪəbl/ 全局变量 quán jú biàn liàng local variable/ˈləʊkl ˈveərɪəbl/ 局部变量 jú bù biàn liàng scope/skəʊp/ 作用域 zuò yòng yù decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě signature/ˈsɪɡnɪtʃə/ 签名 qiān míng format/ˈfɔːmæt/ 格式 gé shì Validation/ˌvælɪˈdeɪʃn/ 验证 yàn zhèng run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù 11.3
Escrevendo pseudocódigo eficiente

Três recursos que tornam o pseudocódigo mais fácil de entender — a resposta para uma questão "aponte três recursos" — são identificadores significativos (
Total, nãot), indentação das instruções dentro de cada construção, e comentários (// ...) que explicam o propósito; palavras-chave em maiúsculas, uma instrução por linha e linhas em branco entre seções também são aceitas. Pseudocódigo eficiente vai mais longe:- mova invariantes para fora dos loops — se um valor (um invariante 不变量) não muda com o contador do loop, calcule-o uma vez antes do loop.
- saia de um loop cedo quando a resposta for encontrada (pare uma busca linear 线性查找 assim que o alvo aparecer).
- evite trabalho redundante — armazene um resultado e reutilize-o em vez de recalcular.
- escolha a estrutura de dados certa — um array supera muitas variáveis separadas quando os itens pertencem juntos.
- substitua IFs aninhadas profundas por CASE ao testar um valor contra muitos.
- comente a intenção, não a mecânica (
// validate the postcode, não// loop 6 times). - use nomes significativos (
numberOfPupils, nãon) e inicialize variáveis antes do uso.
Mova trabalho imutável para fora do loop para que ele rode uma vez Vocabulário TreinarInglês Chinês Pinyin invariant/ɪnˈveərɪənt/ 不变量 bù biàn liàng linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù 11.3
Testando e erros
Três tipos de erro, cada um encontrado de uma maneira diferente:
Erro O que é Exemplo Encontrado por erro de sintaxe 语法错误 uma instrução que viola as regras da linguagem um ENDIFfaltante;OUTPT "Hi"o tradutor, antes do programa rodar erro de tempo de execução 运行时错误 o programa roda, mas uma instrução não pode ser executada divisão por zero; um índice de array de 0 ou 51; uma função chamada com um parâmetro inválido; um loop que nunca termina, fazendo o programa "congelar" durante a execução: o programa para ou trava erro lógico o programa roda até o fim, mas a saída está errada >em vez de>=; um total nunca definido como0testando com uma tabela de traço e dados de teste escolhidos Um IDE 集成开发环境 ajuda a encontrar os últimos dois: um ponto de interrupção 断point para o programa em uma linha escolhida; execução passo a passo 单步执行 então roda uma instrução por vez; e a janela de relatório (ou monitor) mostra o valor de cada variável naquele momento, para que a linha onde um valor fica errado seja vista diretamente. Métodos de teste e dados de teste estão no tópico 12.
Vocabulário TreinarInglês Chinês Pinyin IDE/ˌaɪ diː ˈiː/ 集成开发环境 jí chéng kāi fā huán jìng breakpoint/ˈbreɪkpɔɪnt/ 断点 duàn diǎn single stepping/ˈsɪŋɡl ˈstepɪŋ/ 单步执行 dān bù zhí xíng 11.3
Definições aceitas pelo examinador
Uma questão de definição é marcada contra texto fixo. Aprenda estes exatamente.
Termo Definição procedure uma subrotina que executa uma tarefa (uma sequência de passos) e não retorna um valor; é chamada com CALLfunção uma subrotina que retorna um único valor ao ponto onde foi chamada, para que possa ser usada em uma expressão parameter o identificador em um cabeçalho de subrotina que recebe um valor ou uma referência quando a subrotina é chamada argument o valor (ou variável) fornecido na chamada, correspondido a um parâmetro passing by value uma cópia do valor do argumento é dada à subrotina, então mudanças internas não afetam a variável original passing by reference o endereço da variável é dado à subrotina, então mudanças internas alteram a variável original header a primeira linha de uma definição de subrotina: seu nome, seus parâmetros e, para uma função, seu tipo de retorno interface o que um programa chamador precisa saber para usar uma subrotina: seu nome, seus parâmetros (número, ordem, tipo) e seu tipo de retorno retorno o valor que uma função devolve à expressão que a chamou variável local declarada dentro de uma subrotina; existe apenas enquanto a subrotina é executada e pode ser usada apenas dentro dela variável global declarada fora de todas as subrotinas; pode ser usada em qualquer lugar do programa laço controlado por contagem repete um número fixo de vezes, controlado por um contador ( FOR ... NEXT)laço pré-condição testa sua condição antes de cada iteração, então o corpo pode nunca executar ( WHILE ... ENDWHILE)laço pós-condição testa sua condição após cada iteração, então o corpo executa pelo menos uma vez ( REPEAT ... UNTIL)constante um valor nomeado que não pode mudar enquanto o programa é executado subrotina um bloco de código autocontido que realiza uma tarefa e é chamado por nome: um procedimento ou uma função rotina de biblioteca uma subrotina que já foi escrita e testada, e está disponível para ser chamada de um programa 11.3
Dicas de prova
- Diferencie um procedimento (sem valor de retorno) de uma função (devolve um valor); entenda passagem por valor vs. por referência.
- Escolha o laço certo: controlado por contagem (FOR) quando o número de repetições é conhecido, controlado por condição (WHILE/REPEAT) caso contrário.
- Diferencie variáveis locais vs. globais e escopo; prefira variáveis locais em módulos reutilizáveis.
- Use os nomes exatos das rotinas e ordem dos parâmetros do material didático.
VALeSTRsão nomes IGCSE e não pontuam;UCASEeLCASEsão rotinas reais 9618 do Guia de Pseudocódigo, mas atuam sobre um caractere, então na Prova 2, toda uma string exigeTO_UPPERouTO_LOWER. - Em uma resposta "escreva pseudocódigo", o cabeçalho, as declarações, o laço, a condição, a atualização e o
RETURNvalem cada um uma marca: escreva todas as seis partes, mesmo se uma for incerta.
Erros comuns
- Chamar uma função sem usar o que ela devolve. Atribua o resultado, ou use-o na expressão ou saída:
Sorted ← BubbleSort(MyArray, 7). - Passar um tamanho um:
6para um array de sete elementos, ou o último índice onde o tamanho era desejado. Decida se o parâmetro é um tamanho ou um índice, e verifique se o último elemento é visitado. - Fechar um arquivo dentro do laço que o lê. Abra uma vez, feche uma vez, depois do laço.
- Usar a entrada como um nome de arquivo diretamente. Adicione a extensão dada na questão:
FileName ← Choice & ".txt". - Deixar construtos abertos. Todo
IFprecisa de seuENDIF, todoFORseuNEXT, todoWHILEseuENDWHILE, e toda função seuRETURN; o esquema tem um ponto para isso. - Limites errados:
>para "pelo menos" (que é>=), ou umFORque começa em0para um array declarado[1:50]. - Um contador ou total que nunca é definido como
0antes do laço. - Em uma tabela de traçado, reescrever toda variável em cada linha, ou alterar um valor antes da declaração que o altera ter sido executada.
- Metade de uma condição:
IF x = 3 OR 4— cada lado deOReANDdeve ser uma comparação completa. E+não junta strings;&faz isso. - Declarar como local um valor que deve sobreviver entre chamadas. Um total acumulado ou uma string construída ao longo de várias chamadas é global ou
BYREF.
-
12
Desenvolvimento de Software
Assistir aula12.1
Ciclo de vida do desenvolvimento de programas
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão do propósito de um ciclo de desenvolvimento Demonstrar compreensão da necessidade de diferentes ciclos de desenvolvimento dependendo do programa sendo desenvolvido Incluindo: waterfall, iterativo, desenvolvimento rápido de aplicação (RAD) Descrever os princípios, benefícios e desvantagens de cada tipo de ciclo de vida Demonstrar compreensão das etapas de análise, projeto, codificação, testes e manutenção nenhuma ciclo de desenvolvimento de programas Fonte: Programa Cambridge International
Um ciclo de vida de desenvolvimento 开发生命周期 é o conjunto de etapas desde a ideia até o software finalizado e mantido. Ele serve para planejar, gerenciar e controlar um projeto — construir o produto certo, no prazo, com boa qualidade.
O software é construído por equipes que seguem um ciclo de vida de desenvolvimento para manter a coordenação 
Um fluxograma planeja a lógica de um programa durante a etapa de projeto do ciclo Por que um ciclo de vida é necessário
A lista do avaliador para "o propósito de um ciclo de vida de desenvolvimento": ele divide um grande projeto em etapas que podem ser planejadas e gerenciadas; garante que os requisitos sejam encontrados e concordados antes de iniciar o projeto e a codificação; inclui testes e documentação em vez de deixá-los para o final; permite que a equipe acompanhe o progresso contra marcos e gerencie riscos; e oferece ao cliente pontos definidos para revisar o trabalho. Sem um, uma equipe codifica primeiro e descobre tarde demais que construiu a coisa errada.
Por que existem diferentes tipos
Nenhum único ciclo de vida se adapta a todo projeto, então existem vários ciclos de vida de desenvolvimento. A escolha depende do tamanho e complexidade, quão claros os requisitos 需求 são no início, quanto de mudança é esperado, o nível de risco, a equipe e o prazo.
Modelos comuns
- Cascata 瀑布模型 — uma sequência linear (Análise → Projeto → Codificação → Teste → Manutenção), cada etapa concluída antes da próxima. Claro e bem documentado; bom para requisitos estáveis, mas mau para lidar com mudanças no meio do projeto, e o cliente vê nada funcionando até o final.
- Modelo iterativo 迭代模型 — passadas repetidas, cada uma produzindo uma versão parcial que é revisada e refinada. Captura problemas mais cedo; bom quando requisitos são descobertos ao longo do tempo, mas mais difícil de estimar.
- Desenvolvimento Rápido de Aplicativos 快速应用开发 (RAD) — uso intenso de um protótipo 原型 e feedback do usuário. Entrega muito rápida da primeira versão; bom para requisitos mutáveis, mas depende da disponibilidade do usuário e se adequa a sistemas menores.
- Agile 敏捷 — iterações curtas ("sprints"), colaboração e testes constantes. Flexível e adaptativo, mas precisa de um cliente comprometido e uma equipe qualificada.
O modelo em cascata: cada etapa é concluída antes da próxima começar 
O modelo iterativo: passadas repetidas refinam o programa 
Desenvolvimento rápido de aplicativos: equipes trabalham em partes em paralelo Princípios, benefícios e desvantagens — conforme listado no esquema de correção.
Modelo Princípio Benefícios Desvantagens cascata as etapas correm em uma ordem fixa, cada uma concluída e aprovada antes da próxima começar; voltar significa reiniciar a sequência simples de gerenciar; cada etapa é totalmente documentada; requisitos são fixados cedo, então custos e datas podem ser estimados inflexível depois que uma etapa é concluída; nenhum software funcionando até tarde; um erro na análise é caro de corrigir depois; o cliente não pode ver o progresso iterativo uma versão pequena e funcional é construída primeiro, depois repetidamente melhorada através de versões further até estar completo software funcionando cedo e frequentemente; problemas encontrados em versões iniciais; o feedback do usuário molda cada versão; requisitos podem mudar difícil estimar o tempo e custo totais; testes repetidos exigem esforço; precisa que o cliente esteja disponível; pode desviar se versões não forem planejadas RAD protótipos de partes do sistema são construídos rapidamente e refinados com o usuário até serem aceitos, muitas vezes em paralelo por várias equipes entrega muito rápida da primeira versão; o usuário está envolvido durante todo o processo, então o produto atende às necessidades dele; mudanças são fáceis de absorver precisa de desenvolvedores qualificados e usuários comprometidos; documentação é fraca; menos adequado para sistemas grandes ou críticos para segurança Exemplo resolvido. Uma empresa deve ser a primeira a lançar um site para um novo console de jogos, e o design mudará à medida que os recursos do console forem anunciados. Nomeie o ciclo de vida mais adequado e justifique.
RAD. Um protótipo do site pode ser construído e mostrado aos usuários em poucos dias, e refinado à medida que os requisitos mudam; o site é pequeno o suficiente para uma abordagem guiada por protótipos, e a velocidade de entrega é o requisito principal. Cascata fixaria os requisitos antes de qualquer página ser construída e entregaria nada até o final.
As etapas padrão
Cada etapa tem um propósito, uma saída e atividades típicas — uma pergunta "descreva a etapa ..." quer duas ou três dessas.
- análise — descobrir o que o programa deve fazer. Atividades: entrevistas, questionários e observação do sistema atual; um estudo de viabilidade; acordar a especificação de requisitos, contra a qual cada etapa posterior será verificada.
- projeto — decidir como ele fará. Saídas: o diagrama de estrutura (módulos e parâmetros), fluxogramas ou pseudocódigo para cada módulo, tabelas de identificadores e estruturas de dados, layouts de tela e arquivo, e o plano de teste escrito agora, a partir da especificação, antes de qualquer código existir.
- codificação (implementação 实现) — escrever o programa em uma linguagem de alto nível, módulo por módulo, seguindo o projeto; cada módulo é testado à medida que é escrito.
- teste — executar o programa contra o plano de teste (dados normais, anormais, extremos e de fronteira) e corrigir os erros encontrados; testes de integração, alfa, beta e aceitação seguem.
- manutenção 维护 — após o lançamento, corrigir falhas, adaptar o programa a novos hardware, software ou leis, e melhorá-lo (veja abaixo).
Exemplo resolvido. Complete o diagrama de cascata Análise → ? → ? → ? → Manutenção e descreva o que acontece na etapa de projeto.
As etapas faltantes são Projeto, Codificação, Teste. Na etapa de projeto, os requisitos são transformados em um plano para o programa: o problema é decomposto em módulos (um diagrama de estrutura), o algoritmo para cada módulo é escrito como pseudocódigo ou fluxograma, as estruturas de dados e identificadores são escolhidos, as telas e arquivos são dispostos, e o plano de teste é escrito a partir da especificação.
ExplorarO ciclo de vida do desenvolvimento de software
Passe pelas etapas que todo projeto passa. Obter os requisitos corretos na análise é o mais importante — um erro capturado nos testes é muito mais caro de corrigir do que um capturado cedo.
ExplorarLaboratório de processo de software
Classifique exemplos de desenvolvimento pela etapa ou ferramenta a que pertencem.
Vocabulário TreinarInglês Chinês Pinyin development life cycle/dɪˈveləpmənt laɪf ˈsaɪkl/ 开发生命周期 kāi fā shēng mìng zhōu qī requirements/rɪˈkwaɪəmənts/ 需求 xū qiú waterfall/ˈwɔːtəfɔːl/ 瀑布模型 pù bù mó xíng iterative model/ˈɪtərətɪv ˈmɒdl/ 迭代模型 dié dài mó xíng Rapid Application Development/ˈræpɪd ˌæplɪˈkeɪʃn dɪˈveləpmənt/ 快速应用开发 kuài sù yìng yòng kāi fā prototype/ˈprəʊtəʊtaɪp/ 原型 yuán xíng Agile/ˈædʒaɪl/ 敏捷 mǐn jié 12.2
Ferramentas de projeto de programas
Programa
Os candidatos devem ser capazes de: Notas e orientações Usar um gráfico de estrutura para decompor um problema em subtarefas e expressar os parâmetros passados entre os vários módulos/proceduras/funções que fazem parte do projeto do algoritmo Descrever o propósito de um gráfico de estrutura Construir um gráfico de estrutura para um problema dado Derivar pseudocódigo equivalente a partir de um gráfico de estrutura Demonstrar compreensão do propósito de diagramas de transição de estado para documentar um algoritmo Fonte: Programa Cambridge International
Diagrama de estrutura
Um diagrama de estrutura 结构图 mostra a decomposição hierárquica 分解 de um programa em módulos (subrotinas 子程序) e os parâmetros 参数 passados entre eles. Cada módulo é um retângulo; linhas ligam o chamador (acima) ao chamado (abaixo); pequenas setas mostram dados indo para baixo e resultados voltando para cima. O projeto pode então ser convertido em pseudocódigo 伪代码 equivalente.
                CalculatePay
            /        |         \
       GetEmployee  CalculateBonus  CalculateTax
       Returns:     Takes: sales    Takes: gross
       employeeID   Returns: bonus  Returns: tax
É uma ferramenta de etapa de projeto, e você pode ler as assinaturas dos procedimentos nele.
Um diagrama de estrutura: módulos com os parâmetros passados entre eles Os símbolos que o avaliador pede. Uma caixa é um módulo; uma linha liga um chamador (acima) aos módulos que ele chama (abaixo), lida da esquerda para a direita na ordem em que são chamados. Uma pequena seta com um círculo aberto na cauda é um par de dados — um parâmetro passado para baixo dentro de um módulo ou um valor retornado para cima; uma seta com um círculo preenchido é um par de controlo, uma flag (geralmente BOOLEAN) que informa ao chamador o que aconteceu. Um losango numa ramificação significa seleção: apenas um dos módulos abaixo dele é chamado, dependendo de uma condição. Uma seta curva varrendo sobre as ligações significa iteração: os módulos sob ela são chamados repetidamente num ciclo.
Os símbolos do diagrama de estrutura: pares de dados e de controlo, um losango de seleção e uma seta de iteração Exemplo resolvido. Quatro módulos são definidos como
PROCEDURE Main(),PROCEDURE ReadData(BYREF Count : INTEGER),FUNCTION IsValid(Value : INTEGER) RETURNS BOOLEANePROCEDURE Report(Total : INTEGER, Count : INTEGER). Main chama ReadData, depois chama IsValid uma vez para cada valor lido, depois chama Report. Descreva o diagrama de estrutura.Main no topo; ReadData, IsValid e Report numa fila abaixo dele, da esquerda para a direita na ordem de chamada. Na ligação ReadData, um par de dados ascendente
Count(um parâmetro BYREF retorna). Na ligação IsValid, um par de dados descendenteValuee um par de controlo ascendente (o resultado BOOLEAN), com uma seta de iteração curva sobre essa ligação porque é chamada para cada valor. Na ligação Report, dois pares de dados descendentes,TotaleCount. Lendo no outro sentido, uma função é qualquer módulo que retorna um valor — seu cabeçalho precisa deRETURNSe do tipo retornado.Diagrama de transição de estado
Um diagrama de transição de estado 状态转换图 mostra os estados 状态 que um sistema pode estar e os eventos que o movem entre eles — bom para máquinas de venda automática, semáforos, interfaces de usuário. Diagramas de transição de estado são usados para documentar o comportamento de um algoritmo ou sistema. Cada estado é um círculo; cada transição é uma seta rotulada com o evento.
   coin inserted               item selected
[Idle] --------------→ [Awaiting selection] ----------→ [Dispensing]
Torna fácil identificar transições ausentes ("e se uma segunda moeda for inserida enquanto aguarda seleção?").
Um diagrama de transição de estado para uma fechadura de porta com código 259 Ler e desenhar um. Cada transição é rotulada entrada | saída (ou condição | ação): o que aconteceu, depois o que o sistema faz ao mudar de estado. Uma questão dá uma tabela de estado atual, entrada, saída, próximo estado e pede o diagrama, ou o inverso — cada linha da tabela corresponde exatamente a uma seta. Verifique se cada estado tem uma seta saindo dele para cada entrada que possa ocorrer, incluindo aquelas que deixam o estado inalterado (uma seta que volta para o mesmo estado).
Exemplo resolvido. Um controlador de bomba tem estados bomba desligada e bomba ligada. Em bomba desligada, a entrada nível baixo detectado produz a saída ativar bomba e move para bomba ligada; em bomba ligada, nível normal detectado produz desativar bomba e move para bomba desligada. Qualquer outra entrada deixa o estado inalterado. Desenhe a tabela.
Estado atual Entrada Saída Próximo estado bomba desligada nível baixo detectado ativar bomba bomba ligada bomba desligada nível normal detectado — bomba desligada bomba ligada nível normal detectado desativar bomba bomba desligada bomba ligada nível baixo detectado — bomba ligada As duas linhas "sem alteração" tornam-se setas de loop no diagrama; omiti-las resulta na perda de pontos por incompletude.
ExplorarLaboratório de processo de software
Classifique exemplos de desenvolvimento pela etapa ou ferramenta a que pertencem.
Vocabulário TreinarInglês Chinês Pinyin structure chart/ˈstrʌktʃə tʃɑːt/ 结构图 jié gòu tú parameters/pəˈræmɪtəz/ 参数 cān shù pseudocode/ˈsuːdəʊkəʊd/ 伪代码 wěi dài mǎ test plan/test plæn/ 测试计划 cè shì jì huà implementation/ˌɪmplɪmənˈteɪʃn/ 实现 shí xiàn boundary data/ˈbaʊndəri ˈdeɪtə/ 边界数据 biān jiè shù jù acceptance testing/əkˈseptəns ˈtestɪŋ/ 验收测试 yàn shōu cè shì hierarchical decomposition/haɪəˈrɑːkɪkl ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě decomposition/ˌdiːkɒmpəˈzɪʃn/ 分解 fēn jiě subroutines/ˈsʌbruːtiːnz/ 子程序 zi chéng xù state-transition diagram/steɪt trænˈsɪʃn ˈdaɪəɡræm/ 状态转换图 zhuàng tài zhuǎn huàn tú states/steɪts/ 状态 zhuàng tài syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù run-time error/rʌn taɪm ˈerə/ 运行时错误 yùn xíng shí cuò wù logic error/ˈlɒdʒɪk ˈerə/ 逻辑错误 luó jí cuò wù dry run/draɪ rʌn/ 手工跟踪 shǒu gōng gēn zōng trace table/treɪs ˈteɪbl/ 跟踪表 gēn zōng biǎo 12.3
Erros
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de maneiras de expor e evitar falhas em programas Localizar e identificar os diferentes tipos de erros • erros de sintaxe • erros de lógica • erros de execução Corrigir erros identificados Demonstrar compreensão dos métodos de teste disponíveis e selecionar dados adequados para um método dado Incluindo execução seca, walkthrough, caixa branca, caixa preta, integração, alpha, beta, aceitação, stub Demonstrar compreensão da necessidade de uma estratégia de teste e plano de teste e seus prováveis conteúdos Escolher dados de teste adequados para um plano de teste Incluindo normal, anormal e extremo/borda Demonstrar compreensão da necessidade de manutenção contínua de um sistema e das diferenças entre cada tipo de manutenção Incluindo perceptiva, adaptativa, corretiva Analisar um programa existente e fazer alterações para melhorar a funcionalidade Fonte: Programa Cambridge International
- erro de sintaxe 语法错误 — viola a gramática da linguagem (colchete faltando, palavra-chave grafada incorretamente). Capturado durante a tradução; o programa não executará até ser corrigido.
- erro de tempo de execução 运行时错误 — ocorre enquanto executa (divisão por zero, arquivo não encontrado, índice de array fora do intervalo). O programa falha ou levanta uma exceção; corrige adicionando verificações.
- erro lógico 逻辑错误 — o programa executa mas produz resultados errados (usar
+para-, um erro de limite de ciclo, condições em ordem incorreta). O mais difícil de encontrar; o único sinal é a saída errada, então use testes cuidadosos e rastreamento.
Quando cada erro aparece: sintaxe na tradução, tempo de execução durante a execução, lógico no output Expor e evitar falhas. Falhas são expostas por testes contra um plano de testes, por uma execução seca ou tabela de rastreamento, por uma revisão com colegas, e pelo depurador da IDE (pontos de interrupção, passo a passo, observação de variáveis). São evitadas projetando antes de codificar (diagrama de estrutura, pseudocódigo), por código modular com identificadores e comentários significativos, por validação de toda entrada, por lidar com exceções em vez de deixar um erro de tempo de execução travar o programa, e pelas verificações de sintaxe dinâmica da IDE enquanto se digita.
Exemplo resolvido. Identifique o tipo de erro em cada caso e como ele se manifesta. (a)
Result <- STR_TO_NUM(x) / STR_TO_NUM(y)é executado comy = "0". (b) A mesma linha é executada comx = "12a". (c) Um ciclo escrito comoFOR i <- 1 TO 9processa um array de dez elementos. (d)OUTPUT "Total: " Totalestá faltando uma vírgula.(a) Erro de tempo de execução — divisão por zero; o programa falha quando esta linha é executada com esses dados. (b) Erro de tempo de execução — a string não pode ser convertida em número. (c) Erro lógico — o programa executa mas o décimo elemento nunca é processado, então o output está errado. (d) Erro de sintaxe — a instrução viola as regras da linguagem e é relatada pelo tradutor antes do programa rodar.
Exemplo resolvido. Corrija os erros neste pseudocódigo, que deve output a média de dez notas.
Total <- 0
FOR i <- 1 TO 10
    INPUT Mark
    Total <- Total + Mark
NEXT i
Average <- Total / 9
OUTPUT "Average" Average
A divisão deve ser por 10, não 9 (erro lógico); a linha de output precisa de uma vírgula ou de um
&entre a string e o valor (erro de sintaxe); eAveragenunca foi declarado como REAL (erro de sintaxe ou tempo de execução, dependendo da linguagem). Diga qual linha e qual é a linha corrigida:Average <- Total / 10.12.3
Métodos de teste
- execução seca 手工跟踪 — rastreie o código no papel, anotando o valor de cada variável numa tabela.
- revisão 走查 — uma revisão em equipe do código.
- teste branco 白盒测试 — projetado a partir da estrutura interna do código, cobrindo cada instrução, ramificação e ciclo.
- teste preto 黑盒测试 — projetado apenas a partir da especificação: forneça entradas, verifique saídas.
- teste de integração 集成测试 — combine módulos e teste as interfaces entre eles.
- teste alfa α测试 — pelos desenvolvedores/interno antes do lançamento; teste beta β测试 — por um grupo limitado de usuários reais em seu próprio ambiente.
- teste de aceitação 验收测试 — pelo cliente, para decidir se o produto serve ao propósito.
- stub 桩 — um espaço reservado para um módulo que ainda não existe, para que a estrutura possa ser testada de cima para baixo.
Teste preto testa a especificação; teste branco testa os caminhos do código Qual método, quando. Um execução seca e uma revisão não precisam de computador — a execução seca é você, rastreando o algoritmo com uma tabela de rastreamento 跟踪表; a revisão é uma reunião em que o autor explica o código linha por linha e colegas buscam falhas, então também espalha conhecimento do código pela equipe e o verifica contra o projeto. Testes brancos são escritos por quem pode ver o código e visam exercitar cada caminho; testes pretos são escritos a partir da especificação e verificam apenas entradas contra saídas esperadas, então um usuário ou tester separado pode fazê-los. Teste de integração segue teste de módulo: módulos que passam sozinhos ainda podem falhar quando os dados passados entre eles têm tipo errado ou estão na ordem errada. Teste alfa é interno; teste beta entrega uma candidata a versão a uma amostra de usuários reais, que reportam falhas de uso real; teste de aceitação é o cliente verificando o produto final contra os requisitos antes de pagá-lo. Um stub permite que o teste de cima para baixo comece antes que todos os módulos existam.
Um stub substitui um módulo que ainda não foi escrito, para que os módulos acima possam ser testados agora Exemplo resolvido. Após o programa passar nos testes internos, foi entregue a um grupo de usuários para testar antes do lançamento. Nome este tipo de teste e diga o que acontece a seguir.
Teste beta — usuários reais em seu próprio ambiente, reportando falhas que os desenvolvedores não encontraram. As falhas são corrigidas, depois o cliente realiza teste de aceitação contra os requisitos e o programa é lançado; falhas encontradas em uso real são então tratadas por manutenção corretiva.
Exemplo resolvido. Cite três benefícios de testar um programa por revisão.
Erros são encontrados por pessoas que não escreveram o código e, portanto, o leem sem pressupostos; a lógica é verificada contra o projeto e a especificação, não apenas contra dados de teste; várias pessoas aprendem como o código funciona, o que ajuda na manutenção futura; e nenhum dado de teste ou computador funcional é necessário, então pode ser feito cedo.
Vocabulário TreinarInglês Chinês Pinyin stub/stʌb/ 桩 zhuāng corrective maintenance/kəˈrektɪv ˈmeɪntənəns/ 纠正性维护 jiū zhèng xìng wéi hù test strategy/test ˈstrætədʒi/ 测试策略 cè shì cè lüè normal data/ˈnɔːml ˈdeɪtə/ 正常数据 zhèng cháng shù jù abnormal data/əbˈnɔːml ˈdeɪtə/ 异常数据 yì cháng shù jù extreme data/ekˈstriːm ˈdeɪtə/ 极端数据 jí duān shù jù perfective maintenance/pəˈfektɪv ˈmeɪntənəns/ 完善性维护 wán shàn xìng wéi hù adaptive maintenance/əˈdæptɪv ˈmeɪntənəns/ 适应性维护 shì yìng xìng wéi hù 12.3
Estratégia e plano de teste
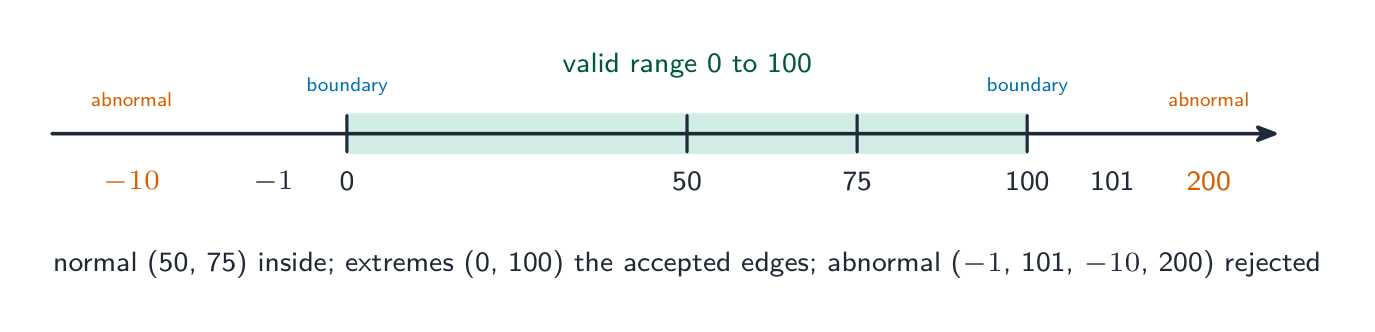
Uma estratégia de teste 测试策略 é a abordagem de alto nível — quais tipos de teste, quem os faz, quando, e os critérios para prosseguir. Um plano de teste 测试计划 é a lista detalhada de testes — cada um com dados de entrada, saída esperada, e uma coluna para a saída real.
O que cada um contém. Uma estratégia de teste estabelece quais métodos de teste serão usados em qual etapa (teste de módulo pelo programador, depois integração, alpha, beta, aceitação), quem é responsável por cada um, quais dados de teste são necessários e os critérios para passar à próxima etapa. Um plano de teste lista os testes individuais: para cada um, o módulo ou recurso em teste, os dados de entrada, a razão pela escolha dos dados (normal, anormal, extremo, limite), o resultado esperado, um espaço para o resultado real e o que fazer se diferirem. O plano é escrito na etapa de projeto, com base nas especificações, para testar o que o programa deveria fazer em vez do que ele acidentalmente faz.
Escolhendo dados de teste
Para cada campo ou condição, inclua três tipos:
- dados normais 正常数据 — valores típicos dentro da faixa válida (para notas 0–100:
50,75). - dados anormais 异常数据 — valores que deveriam ser rejeitados (
-10,200,"abc"). - dados extremos 极端数据 — os maiores e menores valores ainda aceitos (
0e100). - dados de fronteira 边界数据 — valores nas bordas, onde erros off-by-one se escondem (cada extremo aceito e o valor rejeitado logo fora dele:
0/-1,100/101).
Dados de teste para um campo 0–100: normal no interior, extremos nas fronteiras, anormal fora Exemplo resolvido. Um campo aceita uma nota de exame de 0 a 100. Forneça dados de teste de cada tipo com seu resultado esperado. Normal:
50- aceito, um valor típico dentro do intervalo. Anormal:-10,200,"abc"- todos rejeitados, estando fora do intervalo ou do tipo de dados errado. Extremo:0e100- os maiores e menores valores que ainda são aceitos. Fronteira: os pares que cruzam cada borda --1rejeitado junto com0aceito, e100aceito junto com101rejeitado. Cada valor deve carregar seu resultado esperado, ou o plano de teste não prova nada. Extremo e fronteira são o par mais frequentemente confundido: um valor extremo fica dentro e é aceito, enquanto um teste de fronteira é sempre um par de cada lado da borda - que é exatamente onde os erros off-by-one se escondem.Exemplo resolvido. Um componente passa se seu peso, medido até o gram mais próximo, estiver dentro de 3 g do alvo de 50 g, ou seja, de 47 g a 53 g inclusive. Elabore as linhas do plano de teste para a verificação.
Dados de teste Tipo Razão Resultado esperado 50 normal um valor típico bem dentro da faixa aceito 47, 53 extremo (fronteira) os menores e maiores valores que ainda devem ser aceitos aceito 46, 54 fronteira os valores logo fora da faixa, onde um erro off-by-one os aceitaria rejeitado 20, 90 anormal valores muito fora da faixa rejeitado "abc", −5 anormal tipo errado, peso negativo rejeitado Cada linha deve dizer por que o valor foi escolhido e o que deveria acontecer; uma lista nua de números não ganha pontos.
12.3
Manutenção
A maior parte do custo de vida de um programa está na manutenção. Três tipos:
Três tipos de manutenção: perfectiva, adaptativa e corretiva - manutenção perfectiva 完善性维护 — melhorar desempenho ou recursos mesmo funcionando (uma consulta mais rápida, uma nova opção).
- manutenção adaptativa 适应性维护 — mantê-lo funcionando em um ambiente em mudança (um novo SO, uma nova API, uma mudança legal).
- manutenção corretiva 纠正性维护 — corrigir bugs encontrados em uso.
Um programa pode precisar dos três durante sua vida.
Por que cada um é necessário — as razões listadas no gabarito. Corretiva: um defeito é reportado por um usuário após o lançamento, ou uma saída incorreta é notada em circunstâncias específicas que os testes não cobriram. Adaptativa: o sistema operacional, hardware ou navegador é atualizado; uma lei ou regra corporativa muda (taxas de imposto, requisitos de proteção de dados); o programa precisa funcionar com um novo sistema externo ou formato de arquivo. Perfectiva: usuários pedem recursos extras ou uma interface melhor; o programa é feito mais rápido ou usa menos memória; o código é limpo para facilitar mudanças futuras.
Exemplo resolvido. (a) Um programa lançado exibe um valor errado sob certas circunstâncias. (b) O hardware que executa um programa é substituído. (c) Clientes pedem que o programa de fidelidade de uma cafetería envie uma mensagem no aniversário do cliente. Nomeie o tipo de manutenção em cada caso.
(a) Corretiva — um defeito no programa entregue está sendo corrigido. (b) Adaptativa — o programa é alterado para rodar em seu novo ambiente. (c) Perfectiva — um recurso é adicionado a um programa que já funciona.
Vocabulário TreinarInglês Chinês Pinyin maintenance/ˈmeɪntənəns/ 维护 wéi hù 12.3
Alterando um programa existente
Quando solicitado a adicionar um recurso ou corrigir um bug:
- leia o código existente até entender o algoritmo e o fluxo de dados.
- encontre onde a alteração vai — qual subrotina, quais linhas.
- faça a alteração o menor possível — não reescreva código funcional.
- atualize partes relacionadas — todo chamador de uma lista de parâmetros alterada, toda rotina usando uma estrutura de dados alterada.
- teste o novo comportamento e o antigo (regression testing 回归测试 — verifique se não quebrou nada).
- documente a alteração.
Comentários claros, nomes significativos, subrotinas decompostas e um diagrama estrutural tornam um programa muito mais fácil de alterar — é por isso que as ferramentas de projeto importam mesmo após o primeiro lançamento.
Analisando um programa que você não escreveu. Comece pela tabela de identificadores e pelos cabeçalhos dos módulos: eles dizem o que cada módulo recebe e retorna antes de ler uma linha de seu corpo. Depois, faça o rastro do algoritmo com uma tabela de traçado para uma pequena entrada, anotando de onde vem cada valor de saída. Somente então decida onde a melhoria vai — geralmente um novo módulo chamado pelo existente, para perturbar o mínimo possível o código funcional — e escreva a pseudocódigo para a alteração e os dados de teste que a comprovam.
Vocabulário TreinarInglês Chinês Pinyin regression testing/rɪˈɡreʃn ˈtestɪŋ/ 回归测试 huí guī cè shì 12.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição ciclo de vida de desenvolvimento a sequência de etapas, da análise à manutenção, seguidas para produzir e suportar um programa modelo cascata um ciclo de vida em que as etapas são executadas em ordem fixa, cada uma concluída antes de começar a próxima modelo iterativo um ciclo de vida em que uma versão funcional é produzida e depois refinada repetidamente até ficar completa desenvolvimento rápido de aplicações um ciclo de vida que constrói protótipos rapidamente, refinando-os com feedback do usuário até serem aceitos diagrama estrutural um diagrama que mostra como um programa é decomposto em módulos, a ordem em que são chamados e os parâmetros passados entre eles diagrama de transição de estado um diagrama que mostra os estados em que um sistema pode estar e as entradas que causam sua movimentação entre eles erro de sintaxe um erro na forma como uma instrução é escrita, violando as regras da linguagem e impedindo a tradução erro lógico um erro no algoritmo, fazendo o programa rodar mas produzir resultado incorreto erro de tempo de execução um erro que ocorre enquanto o programa está rodando, como divisão por zero, e o interrompe simulação trabalhando através do algoritmo manualmente, registrando os valores das variáveis em uma tabela de rastreamento walkthrough uma revisão em que o autor passa pelo código com colegas que buscam erros stub um módulo placeholder com cabeçalho correto que retorna um valor fixo, usado para que os módulos que o chamem possam ser testados plano de teste uma lista dos testes a serem realizados, cada um com seus dados de teste, a razão para os dados e o resultado esperado dados de fronteira valores em cada borda da faixa válida, tanto o último valor aceito quanto o primeiro valor rejeitado manutenção corretiva / adaptativa / perfectiva corrigir falhas encontradas em uso / alterar o programa para se adequar a um ambiente mudado / melhorar um programa que já funciona Vocabulário TreinarInglês Chinês Pinyin walkthrough/ˈwɔːkθruː/ 走查 zǒu chá white-box testing/waɪt bɒks ˈtestɪŋ/ 白盒测试 bái hé cè shì black-box testing/blæk bɒks ˈtestɪŋ/ 黑盒测试 hēi hé cè shì integration testing/ˌɪntɪˈɡreɪʃn ˈtestɪŋ/ 集成测试 jí chéng cè shì alpha testing/ˈælfə ˈtestɪŋ/ α测试 α cè shì beta testing/ˈbiːtə ˈtestɪŋ/ β测试 β cè shì 12.3
Dicas de prova
- Compare modelos de desenvolvimento (cascata, iterativo, RAD) por princípio, benefício, desvantagem, e saiba as cinco etapas do ciclo de vida de desenvolvimento de programas e o que cada uma produz.
- Diferencie erros de sintaxe, lógica e tempo de execução pelo momento em que aparecem: na tradução, na saída, durante a execução.
- Escolha dados de teste de todos os tipos — normal, anormal, extremo e fronteira — e dê a cada valor sua razão e resultado esperado.
- Diferencie os tipos de manutenção (corretiva, adaptativa, perfectiva) pelo motivo da alteração.
- Em um diagrama estrutural, nomeie todos os símbolos: caixa, linha de chamada, acoplamento de dados, acoplamento de controle, diamante de seleção, seta de iteração. Ao ler cabeçalhos de módulo em um diagrama, lembre-se que uma função tem
RETURNS.
Erros comuns
- Descrever uma etapa do ciclo de vida apenas pelo seu nome ("na etapa de projeto o programa é projetado"). Diga o que é produzido: diagrama estrutural, pseudocódigo, plano de teste.
- Chamar uma saída errada de "erro de tempo de execução". Se o programa roda até o final, é um erro lógico.
- Dar dados de fronteira apenas como os extremos. A questão pede os valores em ambos os lados da borda.
- Tratar testes alpha e beta como iguais. Alpha é interno pelos desenvolvedores; beta é por usuários reais externos.
- Confundir manutenção adaptativa e perfectiva. Adaptativa responde a uma mudança fora do programa; perfectiva melhora um programa que ninguém precisava alterar.
- Desenhar um diagrama estrutural com os módulos em qualquer ordem. Eles são lidos da esquerda para a direita na ordem em que são chamados, e cada parâmetro precisa de sua seta.
-
13
Representação de Dados
Assistir aula13.1
Tipos de dados definidos pelo usuário

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão do porquê tipos definidos pelo usuário são necessários Definir e usar tipos não compostos Incluindo enumerado, ponteiro Definir e usar tipos de dados compostos Incluindo conjunto, registro e classe/objeto Escolher e projetar um tipo de dado definido pelo usuário adequado para um problema dado Fonte: Programa Cambridge International
Os tipos embutidos (
INTEGER,REAL,STRING,CHAR,BOOLEAN) cobrem os casos mais simples. Para problemas mais complexos, você pode definir tipos de dados definidos pelo usuário 用户定义类型, tornando o código mais claro e o compilador mais rigoroso.Por que são necessários
Um tipo embutido
STRINGpermite armazenar nonsense em um campo que deveria conter um de poucos valores legais; um tipo definido pelo usuário pode restringi-lo. Entidades reais geralmente são uma coleção de valores de diferentes tipos. EDECLARE Taxi : Vehicleé mais claro (autodocumentável) do queDECLARE Taxi : STRING."Descreva o propósito de um tipo de dado definido pelo usuário" (duas marks). Um tipo de dado definido pelo programador, construído a partir de tipos existentes (inatos), para que dados específicos do problema possam ser representados quando nenhum tipo inato se encaixa. Ambas as metades pontuam: definido pelo programador e baseado em tipos existentes. O examinador também aceita "para tornar o programa mais legível e manutenível" como ponto de apoio, nunca isoladamente.
"Explique o que se entende por tipos de dados não-compostos e compostos" (quatro marks). Um tipo não-composto é definido sem referência a outro tipo: ele armazena um único valor, por exemplo um inteiro, um real ou um valor enumerado. Um tipo composto é uma coleção de outros tipos (que podem ser compostos por sua vez): ele armazena vários valores sob um único identificador, por exemplo um registro, um conjunto, um array ou uma classe. Dê um exemplo com cada definição; o exame pede apenas um.
Tipos não-compostos
Tipo enumerado
Um tipo enumerado 枚举类型 tem valores que são uma lista fixa de constantes nomeadas:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Os nomes são valores do novo tipo (armazenados internamente como inteiros pequenos); você não pode atribuir nada fora da lista. Usos: dias da semana, cores, códigos de status.
"Afirme o que se entende por um tipo de dado enumerado." Um tipo definido pelo usuário não-composto definido listando todos os seus valores possíveis (em ordem). Como os valores são ordenados, eles podem ser comparados e percorridos: com
TYPE Month = (January, February, ..., December), o testeIF ThisMonth > Juneé legal, e os valores são armazenados internamente como inteiros. A pseudocódigo tem três partes e o exame marca cada uma: a palavra-chaveTYPE, o identificador com=, e a lista entre colchetes separada por vírgulas.Exemplo resolvido. Escreva pseudocódigo para definir um tipo enumerado para os dias em que uma escola está aberta (segunda a sexta-feira) e declare uma variável desse tipo definida como quarta-feira.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Uma variável de um tipo enumerado não pode receber um valor fora da lista, que é exatamente o ponto:
Today ← Saturdayé um erro de tempo de compilação, enquanto umSTRINGteria aceito"Saturdy".Um tipo enumerado é uma lista fixa de valores nomeados Tipo ponteiro
Um ponteiro 指针 armazena o endereço de memória de outra variável (ou
NULLpara "sem alvo"). Ponteiros constroem estruturas dinâmicas (listas encadeadas, árvores) e passam referências sem copiar.TYPE PNode = ^TNode // pointer to a TNode DECLARE p : PNode p ← NEW TNode p^.Value ← 42 // dereference to reach the fieldsPara desreferenciar 解引用 (
p^) significa alcançar a variável a qual aponta."Afirme o que se entende por um tipo de dado ponteiro." Um tipo não-composto cujo valor é o endereço de memória de (uma referência a) uma variável de um tipo dado. A pseudocódigo declara o tipo com um acento circunflexo antes do tipo ao qual aponta, e o exame pede exatamente essa linha:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Ponteiros são o que uma lista encadeada dinâmica linked list ou uma árvore binária (Tópico 19) é construída: cada nó contém um ponteiro para o próximo. Duas marks são frequentemente perdidas aqui: escrever o tipo de ponteiro como se ele contivesse o valor em si, e esquecer o acento circunflexo ao ler através do ponteiro.

Um ponteiro armazena um endereço; p^o desrefencia para acessar os campos do nóTipos compostos
Um tipo composto 复合类型 (um dos tipos de dados compostos) agrupa vários valores sob um único nome.
Um conjunto é uma coleção não ordenada de valores únicos 
Um registro agrupa campos de tipos diferentes sob um único nome - registro 记录 (Tópico 10) — campos de tipos diferentes em um bloco
TYPE ... ENDTYPE. - conjunto 集合 — uma coleção não ordenada de valores únicos, com operações add, remove, teste de pertencimento, união, interseção:
DECLARE Available : SET OF Colour Available ← {Red, Blue} IF Green IN Available THEN ... ENDIF- classe 类 / objeto 对象 — o tipo composto OOP, combinando campos de dados (atributos 属性) com operações sobre eles (métodos 方法). Um objeto é uma instância de uma classe:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Escolhendo um tipo
Use enumerado para um valor de uma lista fixa, ponteiro para indireção, registro para um grupo de campos, conjunto para uma coleção única não ordenada, e classe quando precisar de estado e comportamento juntos.
"Descreva o tipo de dado definido pelo usuário conjunto" (três marks). Um tipo composto que armazena uma coleção de valores do mesmo tipo, em nenhuma ordem específica e sem duplicatas; valores podem ser adicionados e removidos, e um valor pode ser testado quanto ao pertencimento. Declare o tipo com
SET OF, depois defina uma constante de conjunto com seus valores entre colchetes:TYPE EvenNumbers = SET OF INTEGER DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers TYPE SymbolSet = SET OF CHAR DEFINE Operators ('+', '-', '*', '/') : SymbolSet"Descreva o tipo de dado definido pelo usuário registro" (três marks). Um tipo composto composto por um número fixo de campos (itens), cada um com seu próprio identificador e seu próprio tipo, referenciado sob um único identificador; os campos são acessados com notação de ponto.
Exemplo resolvido. Escreva pseudocódigo para declarar um tipo de registro
ClubMemberpara o primeiro nome, último nome, código de membro (um inteiro), data de entrada e se as taxas foram pagas de um membro de clube; depois declare uma variável e defina dois de seus campos.TYPE ClubMember DECLARE FirstName : STRING DECLARE LastName : STRING DECLARE Code : INTEGER DECLARE DateJoined : DATE DECLARE FeesPaid : BOOLEAN ENDTYPE DECLARE NewMember : ClubMember NewMember.LastName ← "Chen" NewMember.FeesPaid ← TRUECampo precisa de sua própria linha
DECLAREcom um tipo apropriado, o bloco termina comENDTYPE, e um campo 字段 é alcançado comovariable.field. Pedido para escolher um tipo para cada campo, corresponda-o aos dados: um código que é sempre comparado é umSTRINGse puder conter letras, umINTEGERse aritmética ou ordenação for necessária; um sim/não éBOOLEAN; uma data éDATE. Um campo que pode assumir um de alguns valores nomeados (espécie de animal de estimação, cor) é aquele para fazer um tipo enumerado.
Um array de registros: cada elemento é um registro inteiro, um índice escolhe o elemento, e um ponto escolhe o campo Registros em arrays e arquivos. Uma tabela de muitos membros é
DECLARE Members : ARRAY[1:100] OF ClubMember; entãoMembers[3].LastNameé um campo de um elemento, e um loop sobre o índice processa todo o registro. Um registro também é a unidade natural escrita e lida de um arquivo (abaixo), um registro porPUTRECORDouWRITEFILE.Exemplo resolvido. Um tipo composto
Petarmazena o nome de cada pet (string), espécie (um de dog, cat, rabbit ou hamster) e peso em quilogramas (real). Defina os tipos e declare uma variável.TYPE Species = (Dog, Cat, Rabbit, Hamster) TYPE Pet DECLARE Name : STRING DECLARE Kind : Species DECLARE Weight : REAL ENDTYPE DECLARE MyPet : Pet MyPet.Kind ← RabbitO tipo enumerado é definido primeiro, porque o registro o usa: ordem importa na pseudocódigo assim como em um compilador.
Classes na pseudocódigo. Uma classe é o tipo composto que também carrega comportamento. O exame pede a declaração com seus atributos marcados
PRIVATE, um construtor 构造函数 nomeadoNEWque os define, ePUBLICmétodos para obter ou alterar eles:CLASS Appointment PRIVATE PatientName : STRING PRIVATE Treatment : STRING PRIVATE Medication : STRING PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING) PatientName ← Name Treatment ← Treat Medication ← Med ENDPROCEDURE PUBLIC FUNCTION GetTreatment() RETURNS STRING RETURN Treatment ENDFUNCTION ENDCLASS DECLARE Visit : Appointment Visit ← NEW Appointment("A. Chen", "filling", "none") OUTPUT Visit.GetTreatment()Atributos são privados para que só possam ser alterados através de métodos (encapsulamento, Tópico 20); o construtor é um procedimento chamado
NEWcom um parâmetro por atributo; um getter é uma função que retorna o atributo. Cada um desses é uma marca separada.ExplorarLaboratório de conceito de programação
Conecte exemplos à ideia de programação que eles mostram.
Vocabulário TreinarInglês Chinês Pinyin user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ 用户定义类型 yòng hù dìng yì lèi xíng field/fiːld/ 字段 zì duàn record/ˈrekɔːd/ 记录 jì lù set/set/ 集合 jí hé class/klæs/ 类 lèi composite type/ˈkɒmpəzɪt taɪp/ 复合类型 fù hé lèi xíng enumerated type/ɪˈnjuːməreɪtɪd taɪp/ 枚举类型 méi jǔ lèi xíng pointer/ˈpɔɪntə/ 指针 zhǐ zhēn linked list/lɪŋkt lɪst/ 链表 liàn biǎo dereference/ˌdiːˈrefrəns/ 解引用 jiě yǐn yòng object/ˈɒbdʒekt/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ 文件组织 wén jiàn zǔ zhī 13.2
Organização e acesso a arquivos
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão dos métodos de organização de arquivos e selecionar um método adequado de organização e acesso a arquivos para um problema dado Incluindo serial, sequencial (usando um campo chave), aleatório (usando uma chave de registro) Demonstrar compreensão dos métodos de acesso a arquivos Incluindo acesso sequencial para arquivos seriais e sequenciais. Acesso direto para arquivos sequenciais e aleatórios Demonstrar compreensão de algoritmos de hash Descrever e usar diferentes algoritmos de hash para ler e escrever dados em um arquivo aleatório/sequencial Fonte: Programa Cambridge International
Organização de arquivo 文件组织 é como os dados estão dispostos; acesso a arquivo é como o programa alcança um registro.
- arquivo serial 串行文件 — registros na ordem adicionada, sem ordenação. Acesso é sequencial apenas; anexar é rápido; buscar é lento. Usado para logs e rastreamentos de auditoria.
- arquivo sequencial 顺序文件 — registros ordenados por uma chave. Buscar é mais rápido (você pode parar cedo ou fazer busca binária); inserir é lento (registros devem ser movidos). Usado para arquivos mestres atualizados em lote.
- arquivo aleatório 随机文件 (arquivo de acesso direto) — registros em posições calculadas a partir da chave (muitas vezes por um hash). Acesso direto por chave é muito rápido; ler em ordem de chave é mais difícil. Usado para grandes tabelas de consulta e contas de clientes.
Arquivo serial: registros são mantidos na ordem em que foram adicionados 
Arquivo sequencial: registros são ordenados por um campo de chave 
Arquivo aleatório: registros ficam em posições calculadas a partir da chave Os dois métodos de acesso são acesso sequencial 顺序存取 (ler do início ao fim) e acesso direto 直接存取 (pular diretamente para uma posição conhecida). Corresponda a estrutura à operação dominante: consultas de chave única favorecem aleatório; relatórios em ordem favorecem sequencial.
Descrevendo cada organização (a formulação que pontua). Serial: registros são armazenados um após o outro na ordem em que foram adicionados, sem ordenação por chave. Sequencial: registros são armazenados em ordem de um campo de chave (ordenados). Aleatório: cada registro é armazenado em um endereço calculado a partir de sua chave por um algoritmo de hashing, então os registros não estão em nenhuma ordem. Comparando serial e sequencial: ambos armazenam registros um após o outro e ambos são lidos sequencialmente, mas um arquivo sequencial está ordenado por chave, então uma busca pode parar assim que uma chave maior que a alvo é lida, e um novo registro deve ser inserido em sua posição correta (geralmente reescrevendo o arquivo), enquanto um arquivo serial é simplesmente anexado.

Os dois métodos de acesso como procedimentos: acesso direto calcula onde olhar; acesso sequencial olha tudo em sequência Descrevendo cada método de acesso. Acesso sequencial: inicia no início do ficheiro e lê os registos um após o outro (na ordem em que estão armazenados) até encontrar o registo pretendido ou atingir o fim do ficheiro. Aplicado a um ficheiro serial, isto significa ler todos os registos até à correspondência, e ler todo o ficheiro para estabelecer que um registo está ausente; aplicado a um ficheiro sequencial, a pesquisa pode parar cedo, assim que uma chave maior que a alvo é lida. Acesso direto: o endereço do registo é calculado a partir da sua chave (por um algoritmo de hash, ou a partir de um índice), e o programa vai diretamente para aquela posição sem ler os registos anteriores; este é o método de acesso para ficheiros aleatórios, e para um registo referenciado por um endereço único num disco.
Escolha. Um ficheiro mestre de folha de pagamento ou faturação de serviços públicos processado em lote, registos um após o outro, adequa-se a um ficheiro sequencial; um registo de transações na ordem em que ocorreram adequa-se a um ficheiro serial; um ficheiro de stock ou clientes onde registos individuais são consultados e atualizados por chave durante a execução do programa adequa-se a um ficheiro aleatório com acesso direto.
Gestão de ficheiros em pseudocódigo. O exame espera as instruções padrão, e o Paper 3 define algoritmos que os utilizam:
Tarefa Instruções abrir um arquivo de texto OPENFILE "Scores.txt" FOR READ(ouFOR WRITE, que cria ou sobrescreve, ouFOR APPEND)ler ou escrever uma linha READFILE "Scores.txt", LineeWRITEFILE "Scores.txt", Linetestar o final WHILE NOT EOF("Scores.txt")fechar CLOSEFILE "Scores.txt"abrir um ficheiro aleatório OPENFILE "Stock.dat" FOR RANDOMmover para uma posição de registo SEEK "Stock.dat", Addressler ou escrever um registo completo GETRECORD "Stock.dat", ItemePUTRECORD "Stock.dat", ItemExemplo resolvido. Um ficheiro aleatório
Stock.datcontém registos do tipoStockItem, armazenados no endereço dado porItemID MOD 100. Escreva pseudocódigo que armazene um novo item no seu endereço hashed se essa posição estiver vazia, reportando a posição se já estiver em uso.DECLARE Item, Existing : StockItem DECLARE Address : INTEGER INPUT Item.ItemID, Item.Description, Item.Quantity Address ← Item.ItemID MOD 100 OPENFILE "Stock.dat" FOR RANDOM SEEK "Stock.dat", Address GETRECORD "Stock.dat", Existing IF Existing.ItemID = 0 THEN // 0 marks an empty position ENDIF SEEK "Stock.dat", Address PUTRECORD "Stock.dat", Item OUTPUT "Stored at ", Address ELSE OUTPUT "Position ", Address, " is in use" ENDIF CLOSEFILE "Stock.dat"Dois detalhes que o gabarito verifica:
SEEKantes de cadaGETRECORDouPUTRECORD(a leitura move a posição, logo busque novamente antes de escrever), e o ficheiro abertoFOR RANDOMe fechado no final. Para copiar cada registo de um ficheiro aleatório para outro, faça um loop sobre os endereços comSEEK,GETRECORDde um ficheiro ePUTRECORDpara o outro, saltando posições vazias.ExplorarRota de acesso a arquivo
Siga um arquivo do armazenamento ao programa e de volta com segurança.
Vocabulário TreinarInglês Chinês Pinyin serial file/ˈsɪərɪəl faɪl/ 串行文件 chuàn xíng wén jiàn sequential file/siːˈkwenʃl faɪl/ 顺序文件 shùn xù wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn direct access/daɪˈrekt ˈækses/ 直接存取 zhí jiē cún qǔ hash function/hæʃ ˈfʌŋkʃn/ 散列函数 sàn liè hán shù sequential access/siːˈkwenʃl ˈækses/ 顺序存取 shùn xù cún qǔ deterministic/dɪˌtɜːmɪˈnɪstɪk/ 确定性 què dìng xìng collision/kəˈlɪʒn/ 冲突 chōng tū 13.2
Hashing

Uma função de hash 散列函数 (um algoritmo de hashing) toma a chave de um registo e produz um endereço onde o registo é armazenado. Uma boa é rápida, determinística 确定性, e espalha as chaves uniformemente.
Algoritmos comuns de hashing para $N$ slots: hash módulo
address ← key MOD N; folding (dividir a chave, somar as partes, MOD N); um hash de string (somar os códigos dos caracteres, MOD N).Uma colisão 冲突 é quando duas chaves hash para o mesmo endereço. Três formas de resolvê-la:
Estratégia Como funciona Compromisso linear probing 线性探测 usar o próximo slot livre (envolvendo-se) simples, mas as chaves agrupam-se chaining 链接法 cada slot aponta para uma lista ligada 链表 de registos sem agrupamento, mas usa mais memória rehashing aplicar uma segunda função hash espalha as chaves, mas requer mais trabalho Resolução de uma colisão de hash: linear probing usa o próximo slot livre; chaining mantém uma lista ligada por slot Para pesquisar: hash a chave, leia esse slot; se as chaves corresponderem você terminou, senão siga a estratégia de resolução até uma correspondência ou um slot vazio. Para inserir: hash a chave, escreva nesse slot ou no próximo livre. Mantenha o load factor 装填因子 (registos ÷ slots) abaixo de cerca de 70% para buscas quase-O(1).
"""Explique o que se entende por um algoritmo de hash no contexto de acesso a ficheiros""" (três marcas). Um cálculo (função) realizado no campo de chave de um registo que produz um valor, que é usado como o endereço (localização) em que o registo é armazenado no ficheiro e do qual é recuperado. O mesmo cálculo na mesma chave sempre dá o mesmo endereço, pelo que o registo pode ser encontrado novamente sem pesquisa.
"""Desenhe dois métodos para superar uma colisão.""" (1) Linear probing (open addressing): armazene o registo na próxima posição livre após o endereço calculado, voltando ao início se necessário; para recuperar, comece no endereço hashed e leia para frente até a chave corresponder. (2) Uma área de overflow 溢出区 ou chaining: armazene o registo em colisão numa área de overflow separada (ou numa lista ligada anexada ao endereço), que é pesquisada sequencialmente após o endereço principal falhar em corresponder. Qualquer um pontua; descreva tanto a recuperação quanto o armazenamento.
Exemplo resolvido. Um ficheiro aleatório tem 11 posições de registo, numeradas de 0 a 10, e o algoritmo de hash é
Address ← Key MOD 11. Registos com chaves 1250, 1381, 1452, 1613 e 1470 são armazenados nessa ordem, usando linear probing. Mostre onde cada registo vai, e descreva como a chave 1470 é recuperada.$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, uma colisão com 1250, logo 1613 ocupa a próxima posição livre, 8; $1470 \bmod 11 = 7$ novamente, e as posições 7 e 8 estão cheias, logo 1470 vai para 9. Para recuperar 1470: calcule $7$, leia a posição 7 (chave 1250, sem correspondência), leia 8 (1613, não), leia 9 (1470, encontrada). Se uma posição vazia for atingida antes de uma correspondência, o registo não está no ficheiro. Colisões são o preço de um ficheiro pequeno: um bom algoritmo de hash espalha as chaves uniformemente, e o ficheiro é mantido bem abaixo do cheio para que as sondagens permaneçam curtas.
ExplorarUma tabela hash
Observe cada chave ser hasheada para um balde. Um bom hash espalha as chaves para que as buscas permaneçam rápidas.
Vocabulário TreinarInglês Chinês Pinyin linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ 线性探测 xiàn xìng tàn cè chaining/ˈtʃeɪnɪŋ/ 链接法 liàn jiē fǎ load factor/ləʊd ˈfæktə/ 装填因子 zhuāng tián yīn zi overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ 溢出区 yì chū qū overflow/ˌəʊvəˈfləʊ/ 溢出 yì chū 13.3
Números de ponto flutuante

Programa
Os candidatos devem ser capazes de: Notas e orientações Descrever o formato de números reais de ponto flutuante binário Usar a forma de complemento de dois. Compreender os efeitos da alteração da alocação de bits para a mantissa e o exponente em uma representação de ponto flutuante Converter números reais de ponto flutuante binário para decimal e vice-versa Normalizar números de ponto flutuante Compreender as razões para a normalização Demonstrar compreensão das consequências de uma representação binária ser apenas uma aproximação do número real que ela representa (em certos casos) Compreender como underflow e overflow podem ocorrer Demonstrar compreensão de que representações binárias podem gerar erros de arredondamento Fonte: Programa Cambridge International
Para armazenar números reais de tamanhos muito diferentes, computadores usam um formato ponto flutuante 浮点 — uma forma binária de notação científica, com dois campos:
- uma mantissa 尾数 — os dígitos significativos.
- um exponente 指数 — a potência de 2 para multiplicar.
Ambos são armazenados como inteiros em complemento de dois 补码. O valor é
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$Leia a mantissa como uma fração binária — o primeiro bit após o ponto vale $1/2$, o seguinte $1/4$, depois $1/8$, e assim por diante. Assim,
0.1010000é $1/2 + 1/8 = 0.625$; com exponente00000010(= 2) o valor é $0.625 \times 2^{2} = 2.5$.Os valores posicionais de uma mantissa de 8 bits e um exponente de 8 bits Conversão
- binário → decimal: leia a mantissa (use regras de complemento de dois se negativo) como uma fração, leia o exponente como um inteiro com sinal, então multiplique a mantissa por $2^{\text{exponent}}$.
- decimal → binário: escreva o número como uma fração binária × uma potência de 2, depois armazene a mantissa e o exponente nos formatos combinados.
Exemplo resolvido. Um número tem mantissa
10110000e exponente00000011. Encontre o seu valor decimal.O exponente
00000011é $+3$. A mantissa começa com um 1, logo é negativa. Lida como1.0110000em complemento de dois, o bit de sinal vale $-1$ e os bits de fração somam $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, logo a mantissa é $-1 + 0.375 = -0.625$. Então$$\text{number} = -0.625 \times 2^{3} = -5.0.$$Exemplo resolvido. Armazene $+2.5$ neste formato.
Em binário $2.5 = 10.1$. Escrito como uma fração normalizada, $2.5 = 0.101 \times 2^{2}$. Logo a mantissa é
01010000(bit de sinal 0, depois.101) e o exponente é00000010($= 2$).O formato do exame: complemento de dois, uma mantissa e um exponente
A prova estabelece um formato como 10 bits para a mantissa e 6 bits para o expoente, ambos em complemento para dois. O ponto binário da mantissa fica após seu primeiro bit (de sinal), então uma mantissa positiva é
0.xxxxxxxxxe uma negativa1.xxxxxxxxx; o expoente é um inteiro assinado comum. Toda conversão usa os mesmos três movimentos: leia a mantissa como uma fração (regras de complemento para dois se começar com 1), leia o expoente como um inteiro, multiplique por $2^{\text{exponent}}$.Exemplo resolvido (binário para decimal). Mantissa
0101100000, exponente000011.Mantissa: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exponente: $000011_2 = 3$. Valor: $0.6875 \times 2^{3} = 5.5$.
Exemplo resolvido (mantissa negativa). Mantissa
1011000000, exponente000010.A mantissa começa com 1, então ela é negativa. Seu valor é $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; expoente $= 2$; valor $-0.625 \times 4 = -2.5$. (Alternativamente, tome o complemento para dois da mantissa,
0101000000$= 0.625$, e anexe o sinal de menos.) Um expoente negativo como111110$= -2$ divide em vez de multiplicar: uma mantissa de $0.5$ com esse expoente é $0.5 \times 2^{-2} = 0.125$.Exemplo resolvido (decimal para binário). Armazene $+6.5$ e $-6.5$ no formato de 10 bits e 6 bits, normalizado.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, logo a mantissa é
0110100000e o exponente000011. Para $-6.5$, tome o complemento de dois da mantissa:1001100000(verifique: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, e $-0.8125 \times 8 = -6.5$), exponente000011inalterado. O sinal nunca vai para o exponente; um número negativo tem uma mantissa negativa.Normalização
Um número está normalizado 规格化 quando o primeiro bit significativo está imediatamente após o ponto binário (sem zeros à esquerda desperdiçados). Isto maximiza a precisão, porque cada bit da mantissa carrega informação. Para normalizar, desloque a mantissa para a esquerda e diminua o exponente (ou desloque para a direita e aumente-o) até o primeiro bit significativo estar no lugar; o valor permanece inalterado. Para mantissas negativas (complemento de dois), o bit de sinal (1) é seguido imediatamente por um 0.
Reconhecimento e produção de forma normalizada. Uma mantissa positiva normalizada começa
01; uma negativa começa10. Assim,0011000000não está normalizada (desloque para a esquerda um lugar e subtraia um do exponente:0110000000, exponente um menor) e1100000000também não está (desloque para a esquerda até o padrão ser10...). Cada deslocação para a esquerda da mantissa deve ser acompanhada por subtrair um do exponente, senão o valor muda."""Explique por que números são armazenados em forma normalizada""" (duas marcas). (1) Dá a máxima precisão (precisão) para o número de bits disponíveis, porque nenhum bit é desperdiçado em zeros à esquerda (ou uns à esquerda para um número negativo); (2) cada número tem então uma representação única, permitindo comparar números; e (3) faz o melhor uso do intervalo disponível. Quaisquer dois destes pontuam.

Normalização: desloque a mantissa para a esquerda para remover zeros à esquerda, diminuindo o exponente na mesma quantidade Aproximação e erros de arredondamento
Muitos reais decimais não podem ser armazenados exatamente em binário — ex: $0.1_{10}$ é a fração binária repetitiva $0.000110011\ldots_{2}$, que deve ser truncada. Consequências:
- erros de arredondamento 舍入误差 acumulam-se ao longo de muitas operações (
0.1 + 0.2não é exatamente0.3). - comparações falham — nunca teste um real para igualdade. Teste se a diferença é menor que uma tolerância pequena,
IF Difference < 0.000001, onde a diferença é tomada da forma correta ou através de uma função módulo que a questão definiria.ABSnão está no inserto 9618 nem no Guia de Pseudocódigo, portanto não assuma isso: o guia diz que qualquer função que a questão precise será fornecida. - subtrair dois valores quase iguais perde precisão.
- transbordamento 溢出 (um resultado muito grande para a faixa do expoente) e subdesbordamento 下溢 (um resultado muito pequeno, arredondando para zero) ocorrem quando o expoente esgota sua faixa.
Para necessidades exatas (moeda), use ponto fixo 定点 ou BCD 二进码十进数 em vez de ponto flutuante.
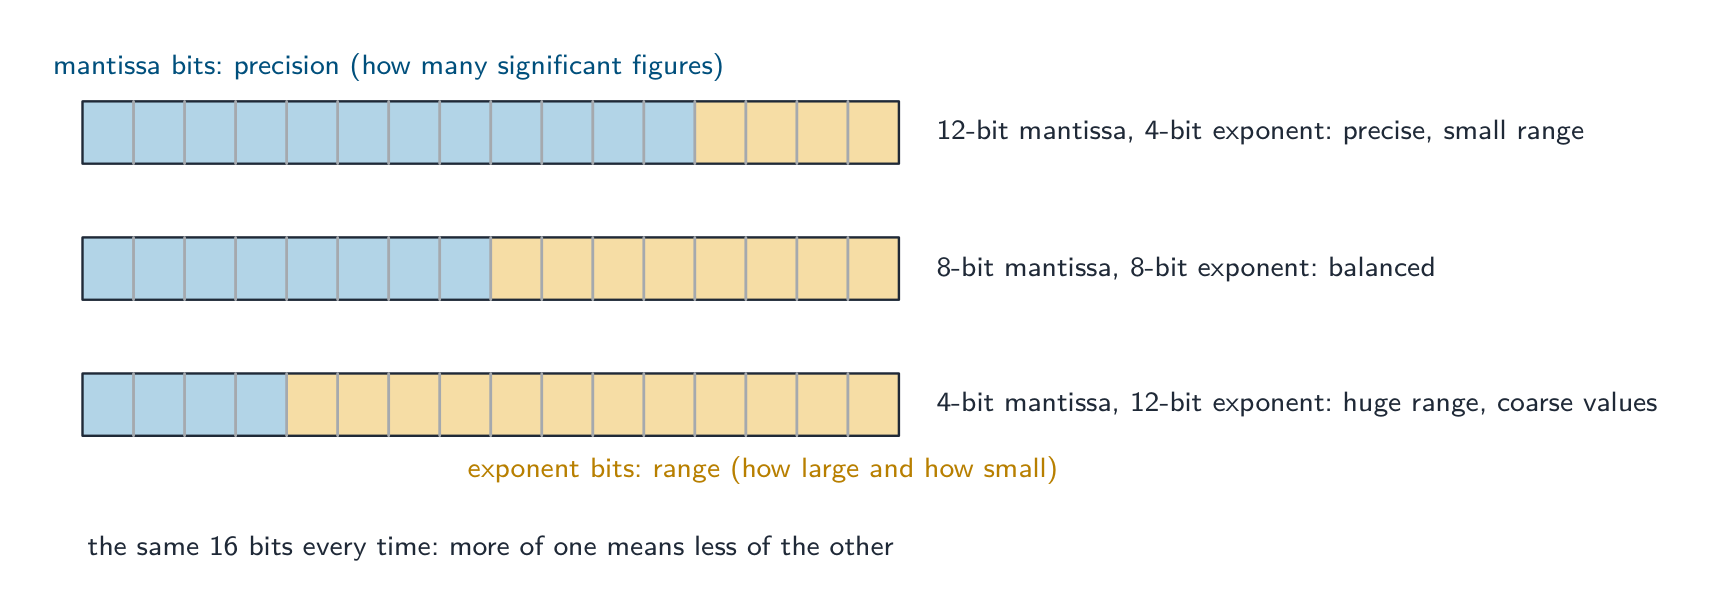
O mesmo total de bits compartilhado de duas formas: bits de mantissa compram precisão, bits de expoente compram faixa, e um só pode crescer à custa do outro "Descreva o efeito de alterar a alocação de bits" (três marcas). Com um número fixo total de bits, aumentar a mantissa e reduzir o expoente dá maior precisão 精度 (mais algarismos significativos, menores erros de arredondamento) mas uma faixa menor 范围 (as maiores e menores magnitudes que podem ser armazenadas diminuem); aumentar o expoente faz o oposto: uma faixa maior às custas da precisão. Nomeie ambos os efeitos e ambas as direções.
Maior e menor. No formato de 10 bits de mantissa e 6 bits de expoente, o maior número positivo tem mantissa
0111111111($= 1 - 2^{-9}$) e expoente011111($= 31$): cerca de $2^{31}$. O menor número normalizado positivo tem mantissa0100000000($= 0.5$) e expoente100000($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. O número mais negativo tem mantissa1000000000($= -1$) e expoente $31$: $-2^{31}$."Explique o que significa transbordamento e subdesbordamento." Transbordamento ocorre quando o resultado de um cálculo é maior que o maior número que pode ser representado, então o expoente precisaria de mais bits do que possui; subdesbordamento ocorre quando um resultado é menor que o menor (não-zero) número que pode ser representado, muito próximo de zero para o expoente expressar, então é armazenado como zero. Ambos vêm da faixa do expoente, não da mantissa.
Por que uma representação binária é apenas uma aproximação. Uma fração binária só pode representar somas de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ exatamente; um valor como $0.1$ ou $\tfrac{1}{3}$ tem uma expansão binária infinita, e a mantissa tem um número fixo de bits, então o valor armazenado é o mais próximo que se encaixa. A diferença é um erro de arredondamento; é pequeno para um número mas acumula-se em cálculos repetidos (adicionar $0.1$ dez vezes pode não dar exatamente $1$), por isso números reais nunca devem ser testados para igualdade exata.
ExplorarConstruir um número de ponto flutuante
Inverter os bits da mantissa e do expoente para formar um valor e verificar se está normalizado.
ExplorarNormalizando um número de ponto flutuante
Passos da normalização. Deslocar a mantissa para remover zeros à esquerda desperdiçados — e ajustar o expoente correspondentemente — mantém o valor inalterado, mas utiliza cada bit para precisão.
Vocabulário TreinarInglês Chinês Pinyin floating-point/ˈfləʊtɪŋ pɔɪnt/ 浮点 fú diǎn mantissa/mænˈtɪsə/ 尾数 wěi shù exponent/ekˈspəʊnənt/ 指数 zhǐ shù two's complement/tuːz ˈkɒmplɪmənt/ 补码 bǔ mǎ normalised/ˈnɔːməlaɪzd/ 规格化 guī gé huà rounding errors/ˈraʊndɪŋ ˈerəz/ 舍入误差 shě rù wù chā underflow/ˌʌndəˈfləʊ/ 下溢 xià yì fixed-point/fɪkst pɔɪnt/ 定点 dìng diǎn BCD/ˌbiː siː ˈdiː/ 二进码十进数 èr jìn mǎ shí jìn shù precision/prɪˈsɪʒn/ 精度 jīng dù range/reɪndʒ/ 范围 fàn wéi 13.3
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição tipo de dados definido pelo usuário um tipo de dados definido pelo programador, baseado em tipos existentes, para representar dados específicos do problema tipo não-composto um tipo definido sem referência a outro tipo; ele armazena um único valor (inteiro, real, enumerado, ponteiro) tipo composto um tipo feito de outros tipos; ele armazena vários valores sob um único identificador (registro, conjunto, array, classe) tipo enumerado um tipo não-composto definido listando todos os seus valores possíveis, em ordem tipo ponteiro um tipo não-composto cujo valor é o endereço de memória de uma variável de um tipo dado conjunto um tipo composto contendo uma coleção de valores de um tipo, sem ordem e sem duplicatas registro um tipo composto com um número fixo de campos, cada um com seu próprio identificador e tipo, acessado por notação de ponto classe um tipo composto combinando atributos (dados) com métodos (procedimentos e funções) que atuam sobre eles; um objeto é uma instância de uma classe arquivo serial registros armazenados um após o outro na ordem em que foram adicionados arquivo sequencial registros armazenados um após o outro em ordem de um campo chave arquivo aleatório registros armazenados em endereços calculados a partir de suas chaves por um algoritmo de hash acesso sequencial ler os registros sucessivamente do início do arquivo até encontrar o desejado acesso direto calcular o endereço de um registro a partir de sua chave e ir diretamente para aquela posição algoritmo de hash um cálculo na chave de um registro que dá o endereço em que o registro é armazenado e encontrado colisão duas chaves diferentes produzindo o mesmo endereço mantissa a parte de um número de ponto flutuante que contém seus bits significativos, como uma fração em complemento de dois expoente o inteiro em complemento de dois que dá a potência de dois pela qual a mantissa é multiplicada normalizado um número de ponto flutuante cuja mantissa começa com 01 (positivo) ou 10 (negativo), assim nenhum bit é desperdiçado com zeros ou uns iniciais transbordamento um resultado muito grande para ser representado nos bits disponíveis subdesbordamento um resultado não-zero muito pequeno para ser representado, então é armazenado como zero erro de arredondamento a diferença entre um número real e o valor mais próximo que a representação binária pode manter 13.3
Dicas de prova
- Declarações de pseudocódigo são marcadas linha por linha:
TYPE ... = (...)para enumerado,TYPE ... = ^...para ponteiro,TYPE ... = SET OF ...entãoDEFINE ... (...) : ...para um conjunto,TYPE ... DECLARE ... ENDTYPEpara um registro,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpara uma classe. - Associe o tipo aos dados: valores fixos nomeados, enumerado; um grupo de campos diferentes, registro; uma coleção de valores únicos, conjunto; dados mais comportamento, classe; um endereço, ponteiro.
- Organização de arquivos é como os registros são armazenados; acesso a arquivos é como eles são encontrados. Seriais e sequenciais são lidos sequencialmente; arquivos aleatórios usam acesso direto via hash da chave. Busca sequencial de um arquivo sequencial pode parar cedo; de um arquivo serial não pode.
- Pseudocódigo de arquivo aleatório:
OPENFILE ... FOR RANDOM,SEEKantes de cadaGETRECORDouPUTRECORD,CLOSEFILEno final. Diga como uma colisão é resolvida ao descrever o hashing. - Ponto flutuante: mantissa como fração em complemento de dois (ponto após o bit de sinal), expoente como inteiro, multiplique por $2^{\text{exponent}}$; desloque para a esquerda e subtraia um do expoente para normalizar; a mantissa compra precisão, o expoente compra faixa.
- As três respostas "explique" padrão: por que normalizar (precisão, forma única, faixa), o efeito de realocar bits (precisão contra faixa) e por que $0.1$ não pode ser armazenado exatamente (uma fração binária infinita em uma mantissa finita).
Erros comuns
- Escrever
DECLAREem vez deTYPEpara um novo tipo, ou omitirENDTYPE; declarar um conjunto semSET OF, ou um tipo enumerado com aspas em torno de seus valores. - Colocar o sinal de um número de ponto flutuante no expoente; o sinal é o primeiro bit da mantissa.
- Ler uma mantissa negativa como se fosse sinal e magnitude; é complemento de dois, então
1011000000é $-0.625$, não $-0.375$. - Deslocar a mantissa para normalizar sem alterar o expoente, ou alterá-lo da forma errada (deslocar para a esquerda, expoente para baixo).
- Descrever um arquivo aleatório como "em ordem aleatória"; os registros estão em endereços computados a partir de suas chaves.
- Dizer que acesso sequencial lê "todo o arquivo" para um arquivo sequencial; ele para quando uma chave maior é encontrada.
- Explicar hashing sem dizer para que o valor calculado é usado (o endereço para armazenar e recuperar o registro), ou sem uma maneira de lidar com colisões.
- Definir transbordamento como "muitos dígitos" em vez de um resultado além do maior valor representável, ou culpar a mantissa por isso.
- registro 记录 (Tópico 10) — campos de tipos diferentes em um bloco
-
14
Tecnologias de Comunicação e Internet
Assistir aula14.1
Por que protocolos são necessários
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da importância de um protocolo para a comunicação entre computadores Demonstrar compreensão de como a implementação de um protocolo pode ser vista como uma pilha, onde cada camada possui sua própria funcionalidade Demonstrar compreensão do conjunto de protocolos TCP/IP Quatro camadas (Aplicação, Transporte, Internet, Enlace). Propósito e função de cada camada. Aplicação quando uma mensagem é enviada de um host para outro na internet Demonstrar compreensão de protocolos (HTTP, FTP, POP3, IMAP, SMTP, BitTorrent) e seus propósitos O protocolo BitTorrent fornece compartilhamento de arquivos ponto a ponto Fonte: Programa Cambridge International
Um protocolo 协议 é um conjunto de regras para como dispositivos comunicam. Ambas as extremidades devem seguir as mesmas regras, ou os sinais de um lado são meaningless para o outro. Protocolos definem o formato dos dados (onde endereços e payload estão), a ordem das mensagens (quem fala primeiro, quandoyar ack), o significado de cada mensagem, o tempo (timeouts, retransmissões) e o que fazer em caso de erro. Sem um protocolo acordado, a comunicação falha — como duas pessoas falando idiomas diferentes sem tradutor.
"Explique por que protocolos são essenciais para comunicação entre computadores" (três marcas). (1) Um protocolo é um conjunto de regras acordado tanto pelo remetente quanto pelo receptor; (2) sem ele os dois computadores interpretariam os dados de forma diferente (formato, ordem, significado de cada parte), então a mensagem não poderia ser compreendida; (3) permite que computadores de tipos e fabricantes diferentes se comuniquem, porque todos implementam o mesmo padrão. Mencione o que as regras cobrem: o formato dos dados, a ordem das mensagens, detecção e recuperação de erros, e velocidade ou tempo.
Um protocolo são as regras compartilhadas: formato, ordem, tempo e erros Vocabulário TreinarInglês Chinês Pinyin protocol/ˈprəʊtəkɒl/ 协议 xié yì 14.1
Protocolos em camadas
Redes são complexas, então são divididas em camadas 层, cada uma com um trabalho focado, conversando apenas com a camada acima e abaixo. Benefícios: modularidade 模块化 (substituir uma camada — digamos Ethernet com Wi-Fi — sem tocar nas outras), padronização (vendedores interoperam) e abstração 抽象 (você ignora detalhes tratados em outro lugar). A internet usa o conjunto de protocolos TCP/IP 协议栈 (4 camadas).
14.1
Conjunto de protocolos TCP/IP

Camada Propósito Exemplos Aplicação o que o programa do usuário faz HTTP, FTP, SMTP, IMAP Transporte entrega fim-a-fim entre processos TCP, UDP Internet roteamento de pacotes entre redes IP Enlace envio de bits sobre o meio físico Ethernet, Wi-Fi As quatro camadas do conjunto de protocolos TCP/IP A finalidade de cada camada, conforme as palavras do gabarito. Camada de aplicação: fornece os protocolos que as aplicações de usuário usam (HTTP para a web, SMTP para e-mail) e a interface entre a aplicação e a rede; ela produz os dados a serem enviados e os passa à camada de transporte. Camada de transporte: estabelece a conexão de ponta a ponta, divide os dados em pacotes (segmentos) e adiciona números de porta e números de sequência; na recepção, ela reconstitui os pacotes na ordem correta e solicita aqueles que faltam (TCP), ou envia sem essas garantias (UDP). Camada de Internet: adiciona os endereços IP de origem e destino para formar pacotes IP (datagramas) e os roteia através das redes via roteadores; ela não garante a entrega. Camada de enlace: adiciona os endereços MAC e bits de verificação de erro para formar uma quadro e transmite os bits sobre a rede local física (Ethernet ou Wi-Fi) através da placa de interface de rede. "Completar a pilha" significa estas quatro, nesta ordem, de cima para baixo: Aplicação, Transporte, Internet, Enlace.

Encapsulamento: cada camada adiciona seu próprio cabeçalho 首部 ao que recebe da camada acima, de modo que os bits no cabo carregam quatro conjuntos de informações; o receptor os remove uma camada de cada vez "Descreva como o conjunto TCP/IP é aplicado quando uma mensagem é enviada de um host para outro" (cinco pontos). No remetente, a mensagem passa para baixo pela pilha: (1) a camada de aplicação produz os dados usando um protocolo como HTTP ou SMTP; (2) a camada de transporte divide-a em pacotes e adiciona um cabeçalho com os números de porta e um número de sequência; (3) a camada de internet adiciona um cabeçalho com os endereços IP de origem e destino e escolhe a rota; (4) a camada de enlace adiciona os endereços MAC do próximo dispositivo e envia o quadro sobre o enlace físico. Roteadores ao longo do caminho leem o cabeçalho da camada de internet e encaminham cada pacote. No receptor, o quadro passa para cima pela pilha: cada camada remove e age sobre seu próprio cabeçalho, a camada de transporte reconstitui os pacotes na ordem dos números de sequência e pede aqueles que faltam, e a camada de aplicação apresenta a mensagem. O mesmo protocolo em cada camada em ambas as extremidades é o que faz a troca funcionar.
Camada de aplicação
A camada de aplicação 应用层 fornece serviços aos programas do usuário e define os protocolos que eles falam (HTTP para web, SMTP para e-mail). É aqui que um programador mais frequentemente trabalha.
Camada de transporte
A camada de transporte 传输层 entrega dados de ponta a ponta entre processos, identificados por números de porta 端口号. Dois protocolos:
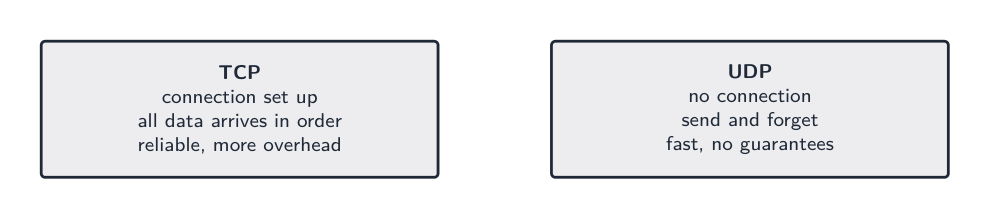
TCP conecta e entrega em ordem; UDP envia e esquece - TCP 传输控制协议 — orientado a conexão 面向连接: estabelece uma conexão, garante que todos os dados cheguem em ordem, retransmite pacotes 数据包 perdidos, controla o fluxo. Confiável, mas com sobrecarga. Usado por HTTP, HTTPS, SMTP, FTP.
- UDP 用户数据报协议 — sem conexão 无连接: envia e esquece, sem confirmações ou ordenação. Baixa sobrecarga, sem garantias. Usado para streaming, DNS e jogos, onde velocidade supera confiabilidade.
Camada de Internet
A camada de internet 网络层 transporta pacotes entre hosts usando IP. Cada pacote tem um endereço IP IP地址 de origem e destino, e roteadores 路由器 o encaminham adiante. Ela não garante a entrega — isso é trabalho do TCP.
Um roteador doméstico faz esse trabalho para sua casa: ele lê o endereço de destino de cada pacote e o envia em direção à internet, e de volta para o dispositivo correto.
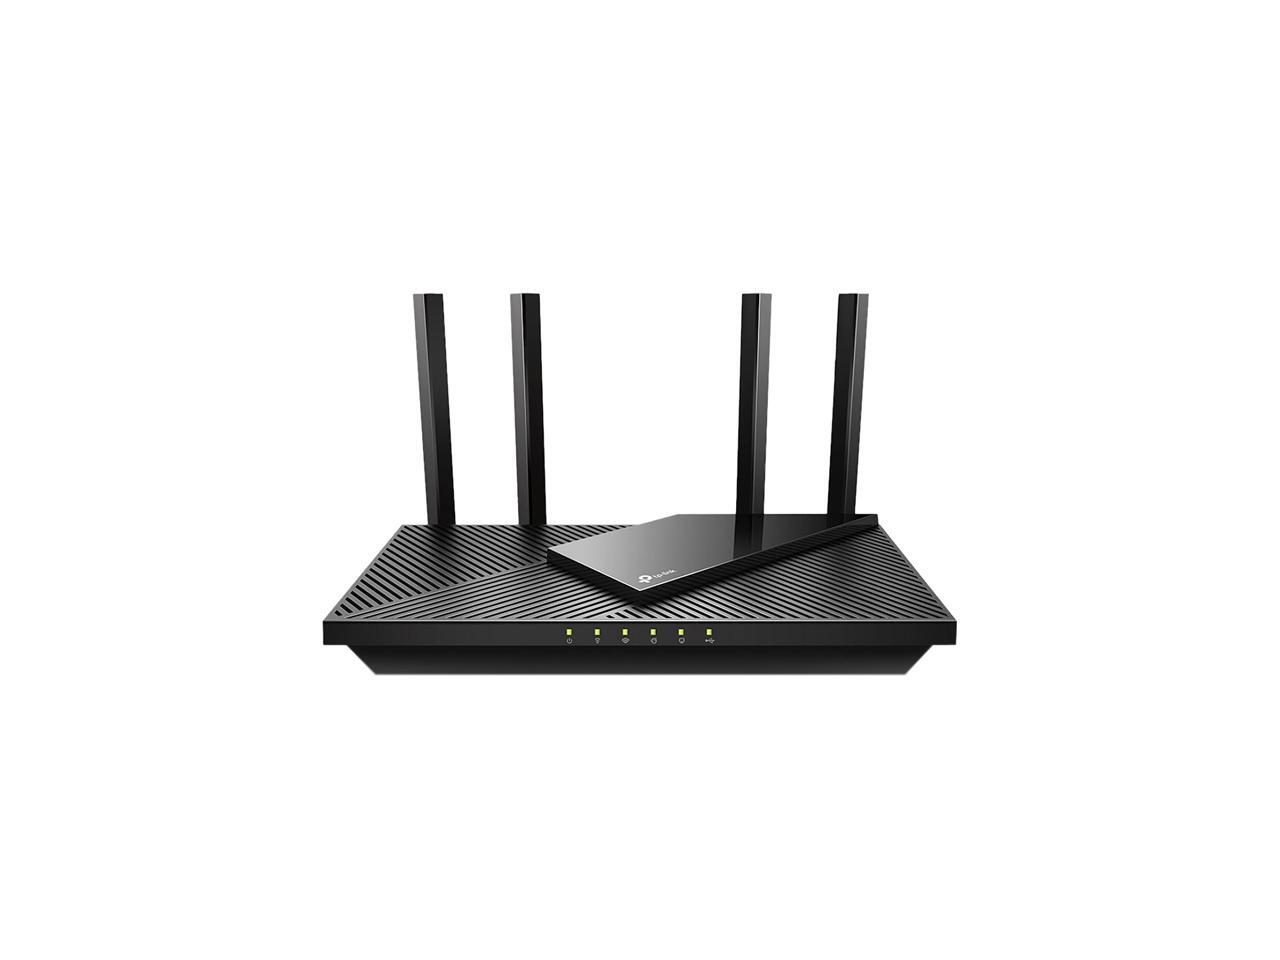
Um roteador Wi-Fi doméstico: ele encaminha pacotes entre seus dispositivos e a internet Antes que o roteador alcance a internet mais ampla, um modem 调制解调器 conecta a casa ao provedor de internet através do cabo ou linha telefônica do provedor. Suas luzes indicam que o enlace está ativo e online.
Um modem de cabo conecta uma rede doméstica ao provedor de internet Camada de enlace
A camada de enlace 链路层 envia bits sobre um único enlace físico (Ethernet, Wi-Fi). Ela adiciona um cabeçalho de quadro com endereços MAC MAC地址 e gerencia o acesso ao meio (ex.: CSMA/CD 载波侦听多路访问/冲突检测 na Ethernet).
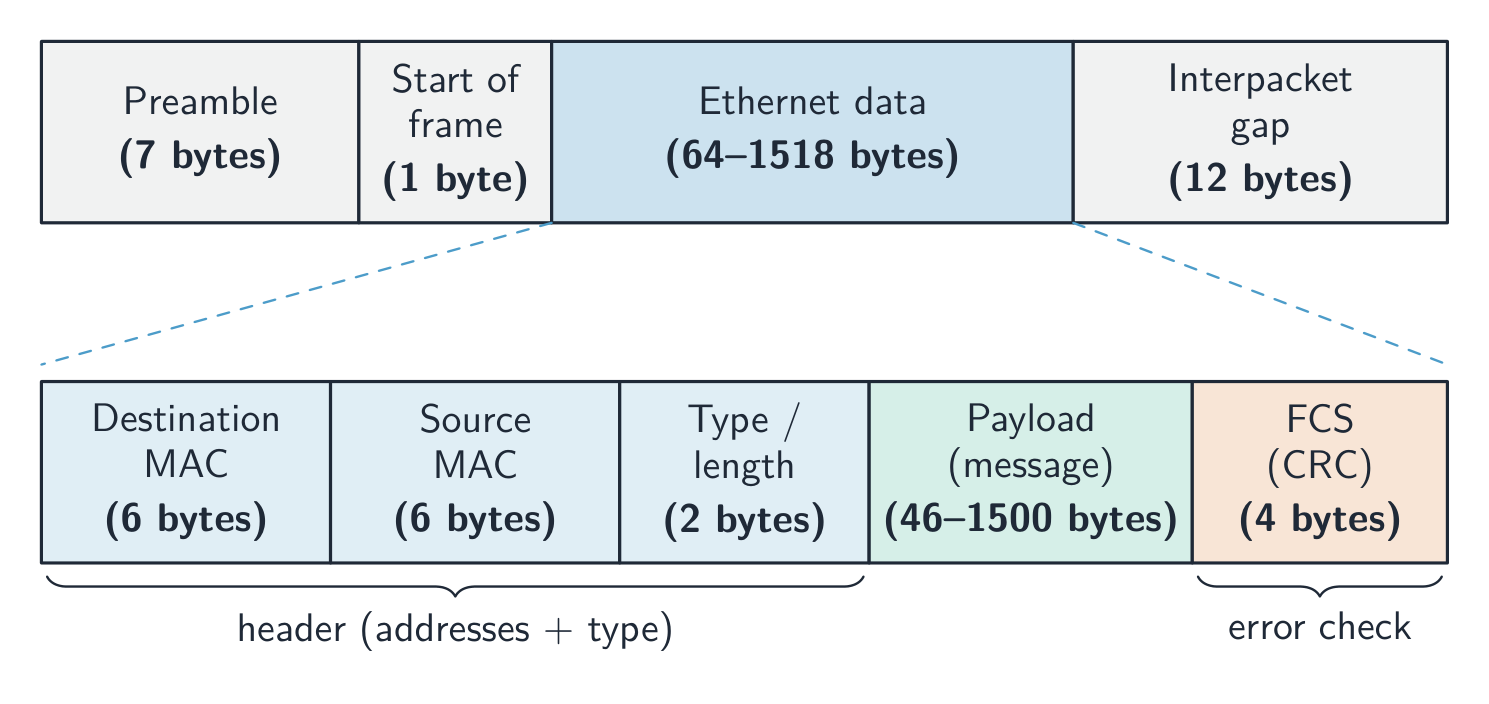
As partes de um quadro Ethernet típico Em uma rede local com fio, um interruptor 交换机 conecta muitos dispositivos. Cada dispositivo se conecta a uma porta com um cabo Ethernet (plugue RJ45), e o switch usa os endereços MAC em cada quadro para enviá-lo apenas à porta correta.
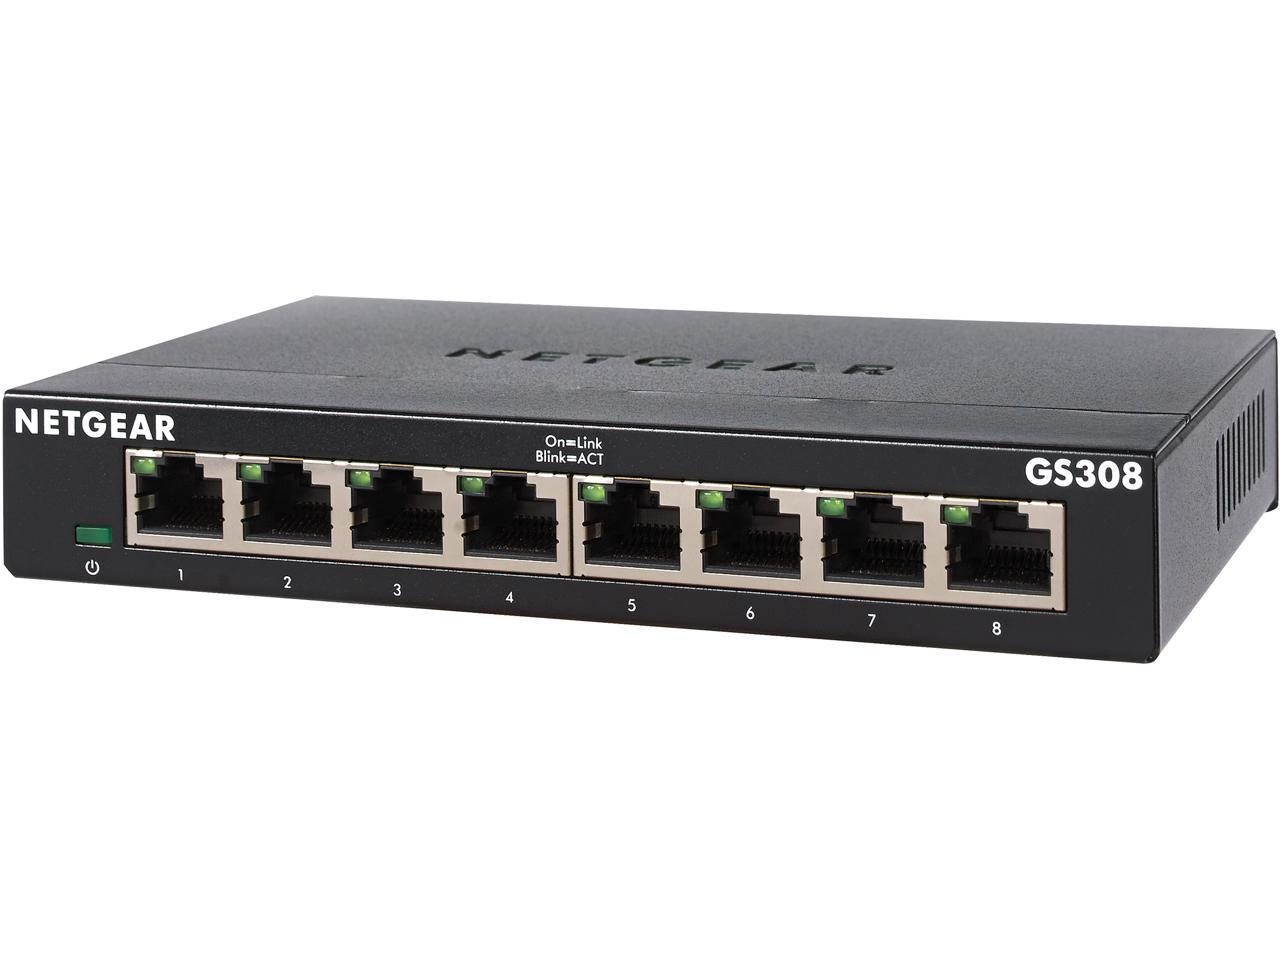
Um switch de rede conecta muitos dispositivos com fio em uma rede local O enlace físico pode ser um fio de cobre, um sinal de rádio (Wi-Fi) ou um cabo de fibra óptica 光纤. Em um cabo de fibra óptica, os bits viajam como flashes de luz através de finas fibras de vidro, o que é rápido e transporta dados por longas distâncias.
Um cabo de fibra óptica: os dados viajam como luz através de finas fibras de vidro Um enlace de rádio pode alcançar muito mais longe. Uma antena parabólica 卫星天线 envia e recebe sinais de rádio para e de um satélite, transportando dados para lugares que enlaces com fio não conseguem alcançar facilmente.
Uma antena parabólica envia e recebe dados por rádio em longa distância ExplorarToque nas quatro camadas do modelo TCP/IP
Explore cada camada. Os dados viajam PARA BAIXO pela pilha ao serem enviados (cada camada adiciona seu cabeçalho) e voltam PARA CIMA ao serem recebidos — e qualquer camada pode ser substituída sem afetar as demais.
Vocabulário TreinarInglês Chinês Pinyin layers/ˈleɪəz/ 层 céng modularity/ˌmɒdjʊˈlærɪti/ 模块化 mó kuài huà abstraction/əbˈstrækʃn/ 抽象 chōu xiàng protocol suite/ˈprəʊtəkɒl swiːt/ 协议栈 xié yì zhàn application layer/ˌæplɪˈkeɪʃn ˈleɪə/ 应用层 yìng yòng céng transport layer/ˈtrænspɔːt ˈleɪə/ 传输层 chuán shū céng port numbers/pɔːt ˈnʌmbəz/ 端口号 duān kǒu hào TCP/ˌtiː siː ˈpiː/ 传输控制协议 chuán shū kòng zhì xié yì connection-oriented/kəˈnekʃn ˈɔːrɪəntɪd/ 面向连接 miàn xiàng lián jiē packets/ˈpækɪts/ 数据包 shù jù bāo UDP/ˌjuː diː ˈpiː/ 用户数据报协议 yòng hù shù jù bào xié yì connectionless/kəˈnekʃənləs/ 无连接 wú lián jiē internet layer/ˈɪntənet ˈleɪə/ 网络层 wǎng luò céng routers/ˈruːtəz/ 路由器 lù yóu qì modem/ˈməʊdem/ 调制解调器 tiáo zhì jiě tiáo qì link layer/lɪŋk ˈleɪə/ 链路层 liàn lù céng CSMA/CD/ˌsiː es em ˈeɪ ˌsiː ˈdiː/ 载波侦听多路访问/冲突检测 zài bō zhēn tīng duō lù fǎng wèn / chōng tū jiǎn cè switch/swɪtʃ/ 交换机 jiāo huàn jī fibre-optic cable/ˈfaɪbə ˈɒptɪk ˈkeɪbl/ 光纤 guāng xiān satellite dish/ˈsætəlaɪt dɪʃ/ 卫星天线 wèi xīng tiān xiàn 14.1
Protocolos comuns da camada de aplicação
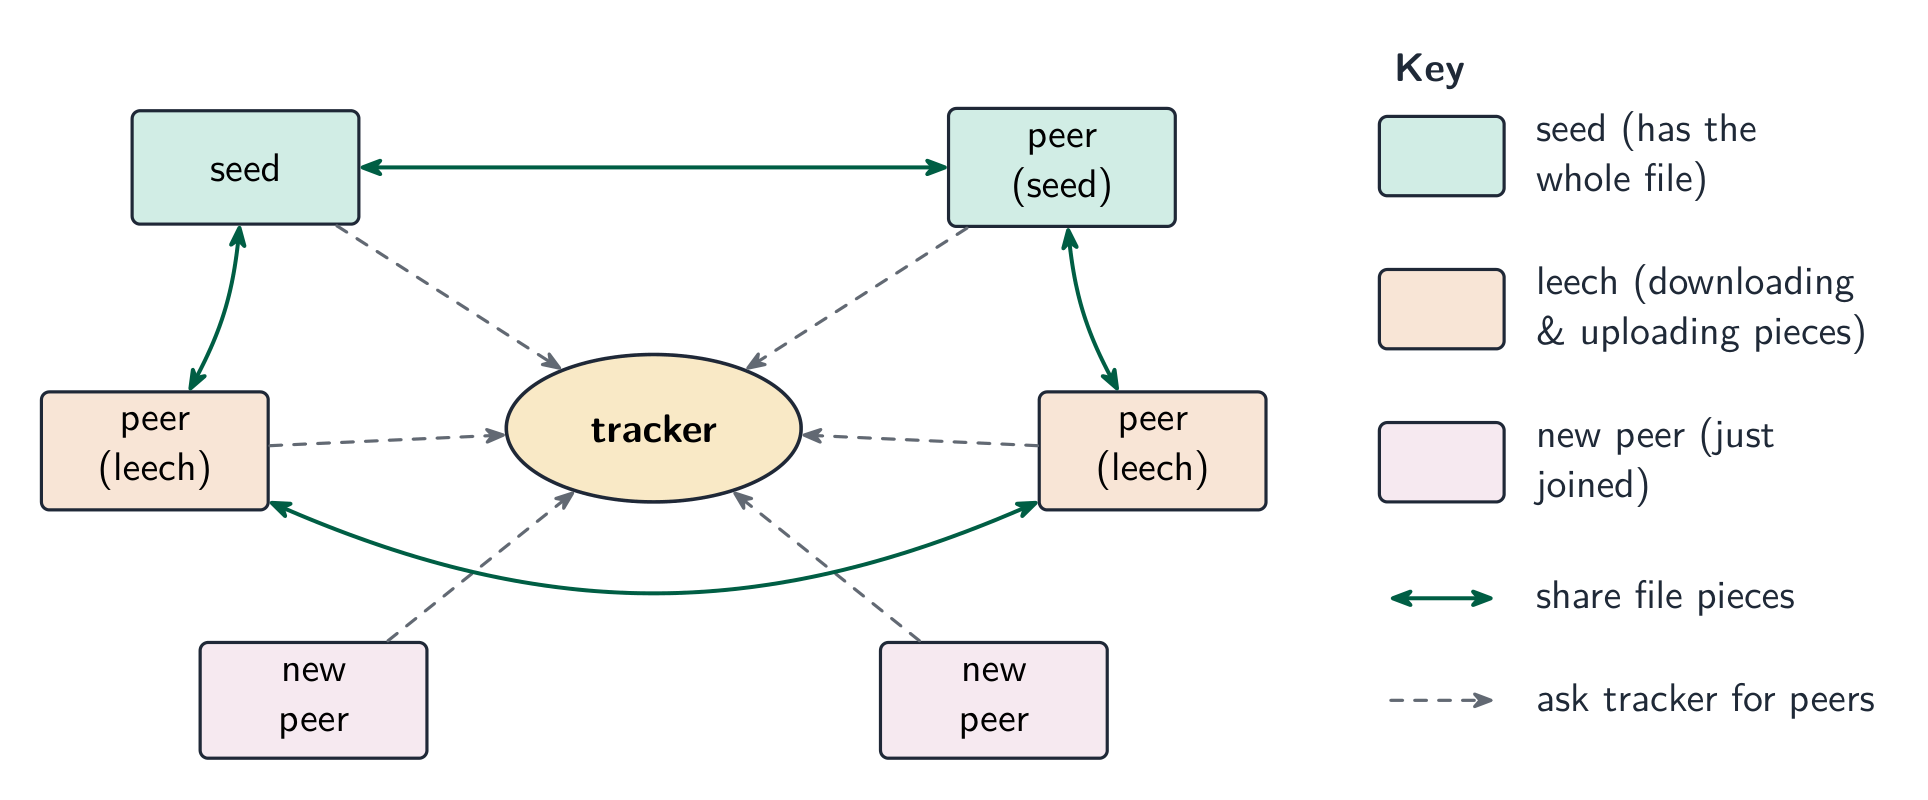
- HTTP 超文本传输协议 — navegadores buscam páginas da web em servidores (sobre TCP, porta 80). HTTPS é HTTP sobre TLS — criptografado, porta 443.
- FTP 文件传输协议 — transferir arquivos entre cliente e servidor.
- SMTP 简单邮件传输协议 — enviar e-mail entre cliente e servidor, e entre servidores. A recepção usa POP3 ou IMAP.
- POP3 — baixa e-mail e geralmente o exclui do servidor. IMAP — deixa o e-mail no servidor e sincroniza entre dispositivos, de modo que a mesma caixa de entrada aparece em todos os lugares.
- BitTorrent — um protocolo peer-to-peer 对等网络; um arquivo é dividido em pedaços baixados de muitos pares em paralelo, de modo que nenhum servidor único carrega toda a carga.
BitTorrent: um rastreador ajuda pares a se encontrarem, então eles compartilham pedaços de arquivo diretamente A finalidade de cada protocolo, nas palavras que pontuam.
Protocolo Finalidade (affe este) HTTP transfere páginas da web (hipertexto) entre um servidor web e um navegador; HTTPS é a versão criptografada FTP transfere arquivos entre um cliente e um servidor (upload para e download de um servidor de arquivos) SMTP envia e-mail de um cliente para um servidor de mail, e entre servidores de mail (um protocolo "push") POP3 baixa e-mail do servidor para o cliente, geralmente excluindo-o do servidor, de modo que é lido em um único dispositivo IMAP permite que o cliente leia e gerencie e-mails que permanecem no servidor, de modo que a mesma caixa de correio é vista em todos os dispositivos BitTorrent compartilha arquivos peer-to-peer: pedaços de um arquivo são baixados de e enviados para muitos outros usuários simultaneamente Perguntado pelos dois protocolos de e-mail, dê SMTP para envio e POP3 ou IMAP para recebimento; perguntado para descrever IMAP, diga que as mensagens permanecem no servidor e são sincronizadas entre dispositivos, que é a diferença do POP3.
"Descreva como os arquivos são compartilhados usando o protocolo BitTorrent" (quatro pontos). (1) O arquivo é dividido em pedaços (tipicamente 256 KB cada), e um pequeno arquivo torrent descreve-os (seus hashes) e nomeia um rastreador 追踪器. (2) Um par que deseja o arquivo entra em contato com o rastreador, que mantém uma lista dos pares na bandejagem 群 que compartilham aquele arquivo no momento. (3) O par baixa pedaços diferentes de muitos pares ao mesmo tempo, e assim que possui um pedaço, ele o envia para outros; um par com o arquivo inteiro é uma semente 种子, um que ainda baixa é uma lesma. (4) Quando todos os pedaços estão presentes, eles são reconstituídos e verificados contra os hashes. "Explique o que significa compartilhamento de arquivos peer-to-peer": não há servidor central segurando o arquivo; cada computador é tanto um cliente quanto um servidor, baixando de e enviando para os outros, de modo que a carga e a largura de banda são distribuídas entre a bandejagem e quanto mais pares houver, mais rápido fica.
ExplorarLaboratório de roteamento de rede
Siga os dados de um dispositivo através do hardware de rede e protocolos.
Vocabulário TreinarInglês Chinês Pinyin HTTP/ˌeɪtʃ tiː tiː ˈpiː/ 超文本传输协议 chāo wén běn chuán shū xié yì FTP/ˌef tiː ˈpiː/ 文件传输协议 wén jiàn chuán shū xié yì SMTP/ˌes em tiː ˈpiː/ 简单邮件传输协议 jiǎn dān yóu jiàn chuán shū xié yì peer-to-peer/pɪə tə pɪə/ 对等网络 duì děng wǎng luò tracker/ˈtrækə/ 追踪器 zhuī zōng qì swarm/swɔːm/ 群 qún seed/siːd/ 种子 zhǒng zi 14.2
Comutação de circuitos vs comutação de pacotes

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão da comutação por circuito Benefícios, desvantagens e onde é aplicável Demonstrar compreensão da comutação por pacote Benefícios, desvantagens e onde é aplicável. Demonstrar compreensão da função de um roteador na comutação por pacote. Explicar como a comutação por pacote é usada para passar mensagens através de uma rede, incluindo a internet Fonte: Programa Cambridge International
Comutação de circuitos
Um caminho dedicado é estabelecido entre as duas extremidades antes que qualquer dado seja enviado (comutação de circuitos 电路交换), reservado para toda a conversa, depois liberado. Ele oferece largura de banda reservada 带宽 e entrega em ordem, mas é ineficiente durante silêncios e lento para estabelecer. Exemplo clássico: a rede telefônica tradicional.
Comutação de circuitos: um caminho dedicado é reservado de ponta a ponta "Descreva a comutação de circuitos como um método de transmissão de dados" (três pontos). (1) Um caminho dedicado (circuito) é estabelecido entre o remetente e o receptor antes de qualquer dado ser enviado; (2) a mensagem inteira é enviada ao longo desse caminho, em ordem, como um fluxo contínuo; (3) o circuito é reservado pela duração da comunicação e liberado depois.
Vantagens e desvantagens. Vantagens: toda a largura de banda do circuito está disponível e garantida; os dados chegam em ordem, sem reensamblagem e sem atraso uma vez que o circuito esteja pronto; a rota não muda, então o tempo é previsível (bom para voz e vídeo em tempo real). Desvantagens: tempo é gasto configurando o circuito antes de qualquer coisa ser enviada; o circuito é reservado mesmo enquanto nenhum dado flui, assim a largura de banda é desperdiçada e outros usuários não podem compartilhá-la; ambas as extremidades devem estar livres ao mesmo tempo; uma falha em qualquer ponto da rota interrompe toda a chamada, e não há rota alternativa automática. Onde é apropriado: uma chamada telefônica ou um link de vídeo ao vivo, onde um fluxo constante e ininterrupto importa mais do que a eficiência.
Comutação por pacotes
Os dados são divididos em pacotes, cada um enviado independentemente (comutação por pacotes 分组交换). Cada pacote carrega o endereço de destino; os roteadores tomam decisões por pacote, então os pacotes podem seguir rotas diferentes e chegar fora de ordem, e o destino os reensambla. É eficiente (um enlace é multiplexado 多路复用 através de muitas conversas), robusto (redireciona ao redor de uma falha), mas tem latência variável 延迟 e possível perda (TCP trata a confiabilidade). Usado pela internet.
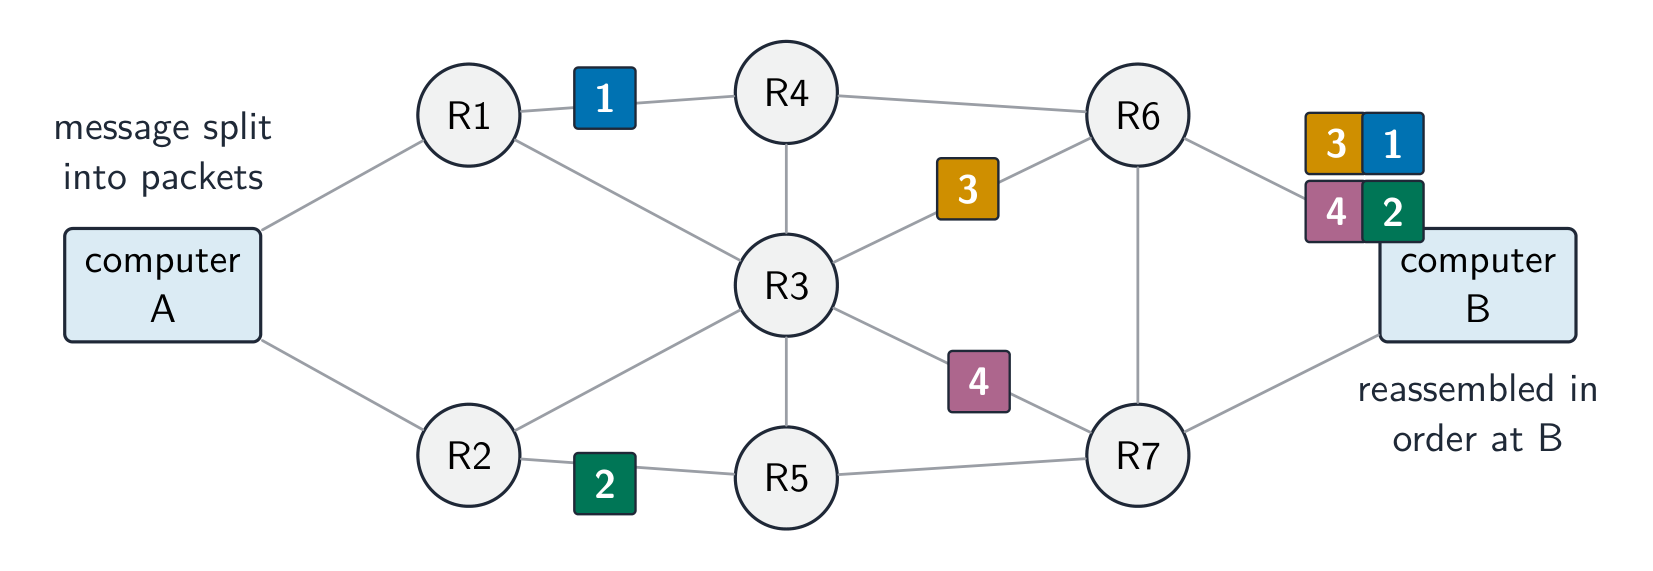
Comutação por pacotes: pacotes viajam independentemente e podem seguir rotas diferentes 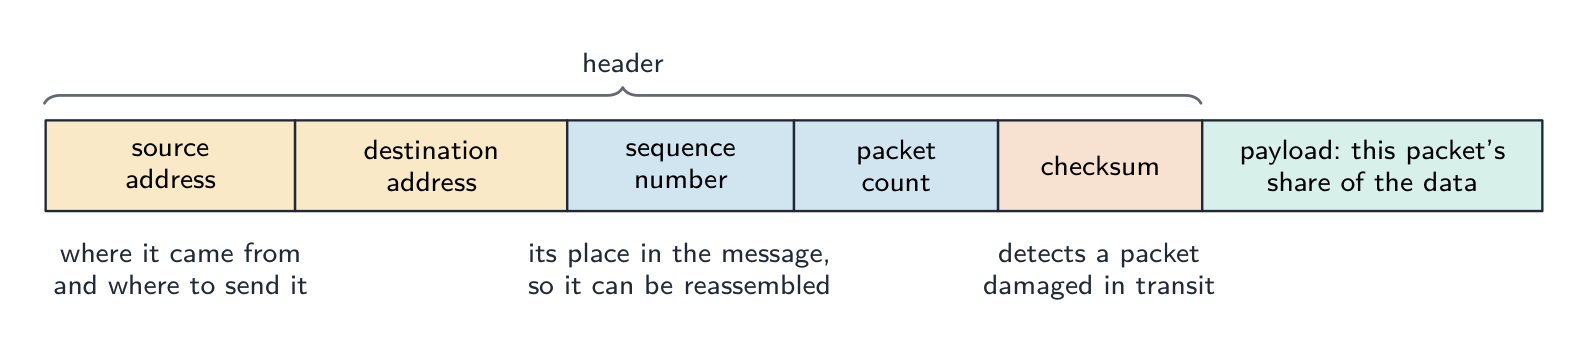
O que permite que um pacote viaje sozinho: os endereços dizem para onde, o número de sequência diz qual parte da mensagem é, e a soma de verificação mostra se chegou intacto "Descreva como a comutação por pacotes é usada para transmitir mensagens através de uma rede (quatro pontos).** (1) A mensagem é dividida em pacotes de tamanho máximo fixo; (2) cada pacote recebe um cabeçalho contendo os endereços de origem e destino, um número de sequência 序号 e uma verificação de erro; (3) cada pacote é enviado independentemente e pode seguir uma rota diferente, escolhida pelos roteadores encontrados; (4) no destino, os pacotes são reensamblos em ordem usando os números de sequência, e qualquer pacote faltante é solicitado novamente. Se a questão excluir verificação e reenvio, omita a última cláusula.
"Descreva a função de um roteador na comutação por pacotes (três pontos).** Um roteador recebe um pacote, lê o endereço IP de destino em seu cabeçalho, e consulta sua tabela de roteamento 路由表 para decidir o próximo salto melhor em direção àquele destino, levando em consideração o tráfego (congestão) e enlaces falhos; ele então encaminha o pacote para aquele enlace. Pacotes da mesma mensagem podem sair por rotas diferentes; o roteador mantém pacotes em uma fila quando um enlace está ocupado.
"Descreva duas maneiras pelas quais a comutação por pacotes garante que a mensagem completa seja recebida. (1) Cada pacote carrega um número de sequência, então o receptor pode colocar os pacotes em ordem e pode perceber que um está faltando, e (2) o receptor envia uma confirmação 确认 para pacotes que chegam; um pacote não confirmado dentro de um limite de tempo é retransmitido pelo remetente. Uma soma de verificação 校验和 em cada pacote permite ao receptor detectar um pacote corrompido e descartá-lo, o que aciona o reenvio.
Vantagens e desvantagens. Vantagens: nenhum circuito para configurar; os enlaces da rede são compartilhados por muitas mensagens, então a largura de banda é usada eficientemente; pacotes podem ser redirecionados ao redor de um enlace falho ou congestionado, então a transmissão é robusta; um pacote perdido ou danificado significa reenviar apenas aquele pacote, não a mensagem inteira. Desvantagens: pacotes podem chegar fora de ordem e precisar ser reensamblos, e alguns podem ser perdidos ou atrasados; os cabeçalhos adicionam sobrecarga; o atraso variável torna-o menos adequado para voz e vídeo em tempo real sem medidas extras; uma rede muito carregada descarta pacotes. Onde é apropriado: e-mail, páginas web, downloads de arquivos e qualquer tráfego "intermitente", e a internet em geral.
Aspecto Comutação de circuitos Comutação de pacotes Caminho dedicado, reservado compartilhado, por-pacote Tempo de configuração lento nenhum Uso de largura de banda ineficiente eficiente Ordem em ordem pode estar fora de ordem Robustez uma falha corta o circuito redirecionamento ao redor de falhas Adequado fluxos de taxa constante (voz) fluxos intermitentes (web, e-mail) Redes modernas usam comutação por pacotes por causa de sua eficiência e resiliência.
Quatro diferenças, enunciadas como pares. (1) A comutação de circuitos estabelece um caminho dedicado antes de enviar; a comutação por pacotes envia sem configurar um caminho. (2) Na comutação de circuitos, a mensagem inteira segue uma rota; na comutação por pacotes, os pacotes podem seguir rotas diferentes. (3) A comutação de circuitos entrega os dados em ordem sem reensamblagem; a comutação por pacotes precisa de números de sequência para reensamblos. (4) A comutação de circuitos reserva a largura de banda para uma conversa mesmo quando ociosa; a comutação por pacotes compartilha os enlaces entre muitas mensagens. (Também aceitável: um enlace falho quebra um circuito, mas pacotes são redirecionados; comutação de circuitos é adequada para fluxos em tempo real, comutação por pacotes é adequada para dados intermitentes.) Escreva cada diferença como ambas as metades; apenas um lado não rende pontos.
Descrevendo a comutação por pacotes em poucas frases
Uma boa resposta de prova: "A mensagem é quebrada em pequenos pacotes. Cada pacote carrega os endereços de destino e origem e um número de sequência. Cada pacote viaja pela rede independentemente, com roteadores escolhendo o próximo salto por pacote. Pacotes podem seguir caminhos diferentes e chegar fora de ordem. O destino usa os números de sequência para reensamblos a mensagem, e pacotes faltantes podem ser solicitados novamente."
Exemplo resolvido. Uma chamada telefônica e um download de arquivo grande compartilham uma rede. Qual método de comutação se adapta a cada um, e por quê? Uma chamada telefônica precisa de um fluxo constante com baixo atraso, e sofreria muito se peças chegassem tarde ou fora de ordem - então comutação de circuitos se adapta a ela: um caminho dedicado é configurado para toda a chamada e sua capacidade é reservada durante todo o período. Um download de arquivo não se importa com timing ou ordem de chegada, porque o receptor o reensambla, e se beneficia de usar qualquer capacidade que esteja disponível - então comutação por pacotes se adapta a ele: o arquivo é dividido em pacotes que viajam independentemente, cada um carregando endereços de origem e destino e um número de sequência, com roteadores escolhendo um próximo salto por pacote. Nomeie a propriedade do tráfego que decide isso: capacidade reservada e baixo atraso para a chamada, eficiência e resiliência para o download.
ExplorarA jornada de um pacote pela internet
Passo a passo do chaveamento por pacotes. A mensagem é dividida, cada pacote encontra seu próprio caminho, e o destino os recoloca — é por isso que a internet é tão eficiente e difícil de quebrar.
Vocabulário TreinarInglês Chinês Pinyin circuit switching/ˈsɜːkɪt ˈswɪtʃɪŋ/ 电路交换 diàn lù jiāo huàn reserved bandwidth/rɪˈzɜːvd ˈbændwɪdθ/ 带宽 dài kuān packet switching/ˈpækɪt ˈswɪtʃɪŋ/ 分组交换 fēn zǔ jiāo huàn multiplexed/ˌmʌltɪˈplekst/ 多路复用 duō lù fù yòng variable latency/ˈveərɪəbl ˈleɪtənsi/ 延迟 yán chí sequence number/ˈsiːkwəns ˈnʌmbə/ 序号 xù hào routing table/ˈraʊtɪŋ ˈteɪbl/ 路由表 lù yóu biǎo acknowledgement/əkˈnɒlɪdʒmənt/ 确认 què rèn checksum/ˈtʃeksəm/ 校验和 jiào yàn hé IP address/ˌaɪ ˈpiː əˈdres/ IP地址 IP dì zhǐ MAC addresses/mæk əˈdresɪz/ MAC地址 MAC dì zhǐ bandwidth/ˈbændwɪdθ/ 带宽 dài kuān latency/ˈleɪtənsi/ 延迟 yán chí header/ˈhedə/ 首部 shǒu bù 14.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição protocolo um conjunto de regras governando como os dados são transmitidos, acordado por remetente e destinatário para que ambos interpretem da mesma forma pilha de protocolos as camadas de protocolos, cada uma com sua própria função, que juntas realizam a comunicação; cada camada comunica-se apenas com as camadas acima e abaixo camada de aplicação fornece os protocolos usados por aplicativos para trocar dados (HTTP, SMTP, FTP, IMAP, POP3) camada de transporte estabelece comunicação de ponta a ponta, divide dados em pacotes com porta e números de sequência, reensambla-os e solicita faltantes (TCP), ou envia sem garantias (UDP) camada de internet adiciona endereços IP para formar pacotes e roteá-los entre redes via roteadores camada de enlace adiciona endereços MAC para formar quadros e transmite os bits sobre a rede local física roteador um dispositivo que lê o endereço de destino de um pacote e o encaminha pela melhor rota disponível em direção ao destino comutação de circuitos um caminho de comunicação dedicado é estabelecido entre as duas extremidades antes que os dados sejam enviados e mantido para toda a transmissão comutação por pacotes a mensagem é dividida em pacotes, cada um com um cabeçalho, enviado independentemente por possivelmente rotas diferentes e reensamblos no destino pacote uma unidade de dados carregando um cabeçalho (endereços, número de sequência, verificação de erro) e uma carga útil peer-to-peer compartilhamento de arquivos sem servidor central, cada computador atuando como cliente e servidor 14.2
Dicas de prova
- Por que protocolos: regras compartilhadas, mesma interpretação, qualquer marca de computador. Por que camadas: cada camada tem um trabalho e pode ser alterada independentemente.
- As quatro camadas em ordem, de cima para baixo: Aplicação, Transporte, Internet, Enlace. Dê o trabalho de cada camada em uma frase, e a resposta "mensagem de host para host" como um caminhada pela pilha e volta.
- Propósitos dos protocolos são frases curtas: HTTP páginas web, FTP arquivos, SMTP envio de e-mail, POP3 download de e-mail, IMAP e-mail mantido no servidor, BitTorrent partes peer-to-peer de uma enxame.
- Comutação de circuitos: caminho dedicado primeiro, mensagem inteira, mantida durante todo o período. Comutação por pacotes: dividido, cabeçalho com endereços e número de sequência, rotas independentes, reensambla. Vantagens e desvantagens vêm em pares de opostos.
- Um roteador lê o endereço de destino, consulta sua tabela de roteamento, encaminha pela melhor rota; é a pergunta de comutação por pacotes que a prova faz mais frequentemente.
- "Onde é apropriado": comutação de circuitos para uma ligação ou chamada de vídeo ao vivo; comutação por pacotes para e-mail, web e downloads.
Erros comuns
- Definir um protocolo como "uma linguagem" ou "software"; é um conjunto de regras.
- Colocar as camadas na ordem errada, ou dar as sete camadas OSI em vez das quatro do TCP/IP.
- Descrever a camada de transporte como "roteamento" ou a camada de internet como "dividir em pacotes"; portas e divisão são transporte, endereços IP e roteamento são internet.
- Confundir POP3 com IMAP, ou dizer que SMTP recebe e-mail.
- Descrever comutação por pacotes sem o cabeçalho (endereços e número de sequência) ou sem reensamblagem.
- Dizer que um roteador "envia o pacote para todos"; ele escolhe um único próximo salto de sua tabela de roteamento.
- Dar uma vantagem da comutação por pacotes como desvantagem da comutação de circuitos sem enunciar o lado da comutação de circuitos; cada diferença precisa de ambas as metades.
- Reivindicar que a comutação por pacotes garante entrega por si só; os números de sequência e confirmações da camada de transporte fazem isso.
-
15
Hardware e Máquinas Virtuais
Assistir aula15.1
Processadores RISC vs CISC
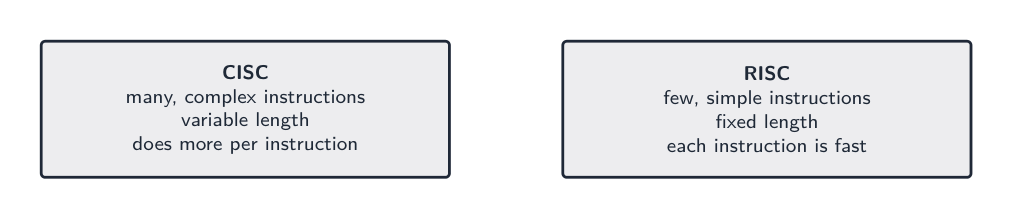
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de processadores Reduced Instruction Set Computers (RISC) e Complex Instruction Set Computers (CISC) Diferenças entre RISC e CISC. Compreender o manuseio de interrupções em processadores CISC e RISC Demonstrar compreensão da importância/usos do pipelining e registradores em processadores RISC Demonstrar compreensão das quatro arquiteturas de computador básicas SISD, SIMD, MISD, MIMD Demonstrar compreensão das características de computadores massivamente paralelos Demonstrar compreensão do conceito de máquina virtual Dar exemplos do papel das máquinas virtuais. Compreender os benefícios e limitações das máquinas virtuais Fonte: Programa Cambridge International
Dois estilos de design de CPU. A CPU em si se conecta à placa-mãe 主板, a placa principal que liga o processador, a memória e todas as outras partes do computador juntos.
CISC tem muitas instruções complexas; RISC tem poucas simples 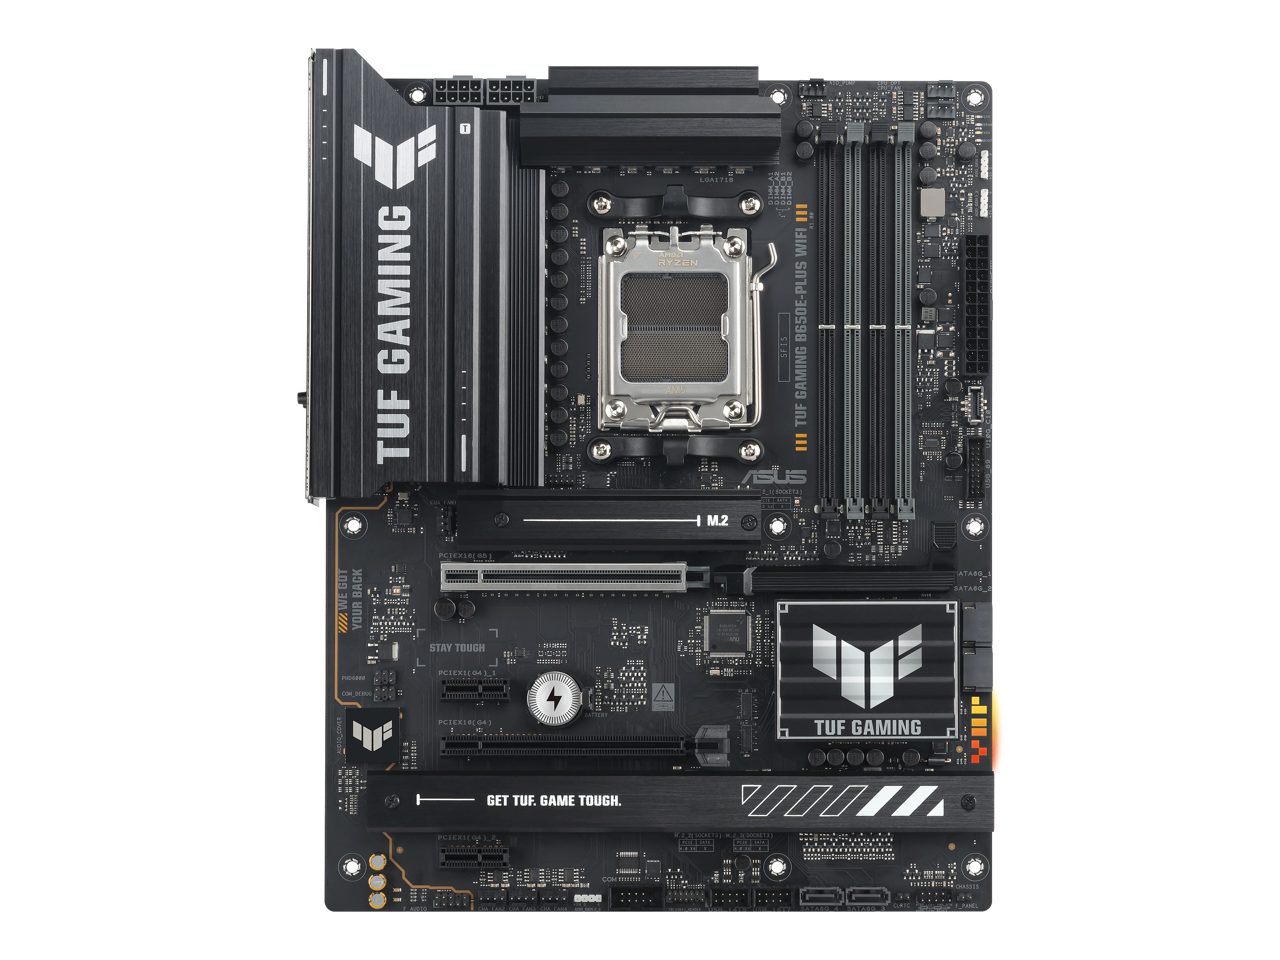
Uma placa-mãe conecta a CPU, a memória e outras partes entre si CISC
Um CISC 复杂指令集 (Computers de Conjunto de Instruções Complexas) possui muitas, frequentemente complexas instruções (uma pode realizar vários acessos à memória e operações), de comprimento variável, tornando a decodificação intricada. Ele faz mais por instrução no hardware. Exemplos: Intel x86.
RISC
Um RISC 精简指令集 (Computers de Conjunto de Instruções Reduzidas) possui um pequeno conjunto de instruções simples, cada uma realizando uma operação básica, todas de comprimento fixo (rápidas para decodificar). Apenas load e store tocam na memória; tudo o resto é de register 寄存器 a register. Os programas são maiores, mas cada instrução é rápida e previsível, o que se adequa ao pipeline. Exemplos: ARM, RISC-V.
Característica CISC RISC Conjunto de instruções muitos poucos Comprimento da instrução variável fixo Acesso à memória muitas instruções apenas load/store Amigável para pipeline mais difícil naturalmente Ciclos por instrução varia geralmente 1 O compromisso é fazer mais por instrução (CISC) vs. fazer cada instrução mais rápido e de forma mais previsível (RISC). Chips modernos da Intel traduzem instruções CISC em micro-ops mais simples semelhantes a RISC internamente.
"Identifique quatro características de um processador RISC." Quaisquer quatro de: um pequeno conjunto de instruções simples; instruções de comprimento fixo (uma palavra); a maioria das instruções conclui em um ciclo de relógio; muitos registradores de uso geral; apenas instruções load e store acessam a memória (toda aritmética é de registrador a registrador); controle hard-wired (sem microcódigo); projetado para pipeline; o compiler faz mais do trabalho, então os programas contêm mais instruções e exigem mais memória. "Identifique quatro características de um processador CISC." Quaisquer quatro de: um grande conjunto de instruções, muitas delas complexas (uma instrução pode realizar várias operações); instruções de comprimento variável; instruções que levam vários ciclos de relógio; menos registradores; instruções que podem acessar a memória diretamente; controle microprogramado; menos adequado para pipeline; programas mais curtos, permitindo um compiler mais simples e menos memória. "Descreva o que significa RISC e CISC" (dois pontos cada): nomeie a abreviação e dê a ideia definidora (poucas instruções simples monociclo; muitas instruções complexas multiciclo).
Gerenciamento de interrupções nos dois designs. Em um processador CISC, a instrução atual, por mais complexa que seja, é concluída antes que a interrupção seja atendida; o processador então salva o conteúdo de seus registradores (incluindo o ponteiro de programa) na pilha, salta para a rotina de serviço de interrupção e restaura os registradores depois. Em um processador RISC com um pipeline, várias instruções estão a meio caminho no momento em que a interrupção 中断 chega, então o processador deve ou deixar que toda instrução no pipeline termine, ou descartar (flush) as instruções parcialmente executadas e reiniciá-las após a interrupção; de qualquer forma, o pipeline é esvaziado, os registradores são salvos e a rotina de serviço roda. A formulação do exame: "o pipeline torna o gerenciamento de interrupções mais complexo, porque o conteúdo do pipeline deve ser tratado antes que a interrupção possa ser atendida".
Vocabulário TreinarInglês Chinês Pinyin motherboard/ˈmʌðəbɔːd/ 主板 zhǔ bǎn CISC/sɪsk/ 复杂指令集 fù zá zhǐ lìng jí RISC/rɪsk/ 精简指令集 jīng jiǎn zhǐ lìng jí register/ˈredʒɪstə/ 寄存器 jì cún qì interrupt/ˈɪntərʌpt/ 中断 zhōng duàn 15.1
Pipeline

Um pipeline 流水线 processa instruções em estágios sobrepostos, como uma linha de montagem: Fetch → Decode → Execute (na ALU 算术逻辑单元) → Memory access → Write back. Cada estágio trabalha em uma instrução diferente ao mesmo tempo, então assim que o pipeline está cheio, uma instrução é concluída por ciclo. As instruções RISC de comprimento fixo e simples fazem com que cada estágio leve o mesmo tempo. Um pipeline pode travar em uma hazard 冒险 — uma hazard de dados (uma instrução precisa de um resultado ainda não pronto) ou uma hazard de controle (uma branch torna o próximo endereço desconhecido).
O pipeline sobrepõe os estágios de seis instruções, de modo que uma termina a cada ciclo Chips RISC mantêm dados em muitos registradores porque a memória é lenta e os registradores são rápidos; o compiler aloca valores aos registradores de forma inteligente.
"Descreva o uso do pipeline em processadores RISC" (três pontos). (1) O ciclo fetch-execute é dividido em estágios (fetch, decode, execute, memory access, write back); (2) várias instruções estão no pipeline ao mesmo tempo, cada uma em um estágio diferente, de modo que enquanto uma está sendo executada, a próxima está sendo decodificada e a seguinte está sendo buscada; (3) uma nova instrução é iniciada, e uma concluída, em todo ciclo de relógio uma vez que o pipeline está cheio, o que aumenta a throughput 吞吐量 (o número de instruções concluídas por segundo), embora cada instrução ainda leve o mesmo tempo isoladamente. Instruções RISC monociclo de comprimento fixo são o que tornam os estágios iguais e o pipeline possível.
Exemplo resolvido. Um processador usa cinco estágios de pipeline (IF, ID, OF, EX, WB). Quatro instruções entram no pipeline uma após a outra. Em qual ciclo a última instrução conclui, e quantos ciclos levariam as quatro sem pipeline?
A instrução 1 ocupa IF no ciclo 1, ID em 2, OF em 3, EX em 4 e WB em 5; a instrução 2 começa um ciclo depois e termina no ciclo 6; a instrução 3 no ciclo 7; a instrução 4 no ciclo 8. Em geral, $n$ instruções através de $k$ etapas levam $n + k - 1$ ciclos, aqui $4 + 5 - 1 = 8$. Sem pipeline, cada instrução leva todos os cinco ciclos antes que a próxima comece: $4 \times 5 = 20$ ciclos. A tabela da prova é preenchida escrevendo as etapas de cada instrução diagonalmente, uma coluna à direita da instrução anterior.
Um processador que opera nesta velocidade gera muito calor, então um heat-sink 散热器 e um ventilador ficam acima dele. As aletas metálicas espalham o calor e o ventilador o afasta, mantendo a CPU suficientemente fria para funcionar.

Um heat-sink e ventilador de CPU transportam o calor para longe do processador ExplorarComo o pipeline enche
Passo a passo pelos ciclos de relógio. Uma vez que o pipeline está cheio, uma nova instrução termina a cada ciclo — mesmo que cada uma ainda leve várias etapas — porque as etapas de instruções diferentes se sobrepõem.
Vocabulário TreinarInglês Chinês Pinyin pipeline/ˈpaɪplaɪn/ 流水线 liú shuǐ xiàn ALU/ˌeɪ el ˈjuː/ 算术逻辑单元 suàn shù luó jí dān yuán hazard/ˈhæzəd/ 冒险 mào xiǎn throughput/ˈθruːpʊt/ 吞吐量 tūn tǔ liàng heat-sink/hiːt sɪŋk/ 散热器 sàn rè qì Flynn's taxonomy/flɪnz tækˈsɒnəmi/ 弗林分类 fú lín fēn lèi 15.1
Taxonomia de Flynn

Taxonomia de Flynn 弗林分类 classifica computadores pelo número de fluxos de instrução e dados:
- SISD — uma instrução, um fluxo de dados (um único núcleo tradicional).
- SIMD 单指令多数据 — uma instrução atua em muitos itens de dados ao mesmo tempo (GPUs, extensões vetoriais de CPU). Ótimo para imagens, vídeo, matrizes científicas.
- MISD — várias operações nos mesmos dados; raro, principalmente teórico.
- MIMD 多指令多数据 — muitos processadores executam instruções diferentes em dados diferentes (CPUs multi-core, clusters). O mais geral.
Descrever as quatro arquiteturas (dois pontos cada). SISD: um processador único executa uma instrução de cada vez em um item de dados; sem paralelismo, a máquina tradicional von Neumann. SIMD: uma instrução é aplicada simultaneamente a muitos itens de dados, por muitos elementos de processagem atuando em sincronia; usado para processamento de matrizes e gráficos. MISD: vários processadores aplicam instruções diferentes aos mesmos dados; raramente usado, por exemplo um sistema tolerante a falhas onde vários processadores verificam um único fluxo. MIMD: muitos processadores, cada um executando suas próprias instruções em seus próprios dados, independentemente; o computador multi-core e o cluster.
SIMD: muitos processadores executam a mesma instrução em dados diferentes Uma placa de vídeo 显卡 (com sua GPU) é um exemplo real de hardware SIMD: ela tem milhares de núcleos pequenos que executam a mesma instrução em muitos pixels ou números ao mesmo tempo, é por isso que GPUs são tão rápidas para imagens, vídeo e aprendizado de máquina.

Uma placa de vídeo: sua GPU executa a mesma instrução em muitos itens de dados ao mesmo tempo (SIMD) 
MIMD: cada processador executa suas próprias instruções em seus próprios dados Vocabulário TreinarInglês Chinês Pinyin SIMD/ˈsɪmdiː/ 单指令多数据 dān zhǐ lìng duō shù jù MIMD/ˈmɪmdiː/ 多指令多数据 duō zhǐ lìng duō shù jù graphics card/ˈɡræfɪks kɑːd/ 显卡 xiǎn kǎ massively parallel/ˈmæsɪvli ˈpærəlel/ 大规模并行 dà guī mó bìng xíng distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ 分布式内存 fēn bù shì nèi cún 15.1
Computadores massivamente paralelos

Um sistema massivamente paralelo 大规模并行 usa milhares de processadores em uma rede rápida, cada um com sua própria memória (memória distribuída 分布式内存), trocando dados por mensagens. É MIMD, exige software especialmente escrito (MPI, CUDA) e se adequa a simulação climática, treinamento de machine learning 机器学习 em larga escala e astrofísica. Os maiores supercomputers 超级计算机 são massivamente paralelos.
"Esboce as características de computadores massivamente paralelos" (três pontos). Um número muito grande de processadores (milhares), cada um com sua própria memória, conectados por uma rede (uma interconexão de alta velocidade ou barramento) para que possam passar mensagens uns aos outros; eles trabalham simultaneamente em partes do mesmo problema, de modo que o problema deve ser escrito como um programa que pode ser dividido em partes que executam em paralelo e combinam seus resultados. É um arrangement MIMD.
Os processadores vivem em racks de server 服务器 altos, muitas vezes enchendo uma sala inteira (um data centre 数据中心), cabeados juntos para trabalharem em um grande problema ao mesmo tempo.
Fileiras de servidores em um data center, como aqueles usados para computação massivamente paralela Vocabulário TreinarInglês Chinês Pinyin machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí supercomputers/ˌsuːpəkəmˈpjuːtəz/ 超级计算机 chāo jí jì suàn jī server/ˈsɜːvə/ 服务器 fú wù qì data centre/ˈdeɪtə ˈsentə/ 数据中心 shù jù zhōng xīn virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ 虚拟机 xū nǐ jī 15.1
Máquinas virtuais
Uma máquina virtual 虚拟机 (VM) é uma emulação por software de um computador inteiro — o software interno vê uma CPU, memória e discos que parecem reais, mas são gerenciados por software host.
- uma VM de sistema executa um OS completo. Um hypervisor 虚拟机监控器 cria e gerencia VMs, cada uma inicializando seu próprio OS convidado. Usos: executar diferentes SOs em uma máquina; consolidação de servidores; sandboxing 沙箱 (software arriscado roda isolado); snapshots.
- uma VM de processo (linguagem) executa um programa em bytecode 字节码 portátil — a JVM (Java), a CLR (.NET), CPython. Benefícios: portabilidade ("escreva uma vez, execute em qualquer lugar"), verificações de segurança em tempo de execução e just-in-time compilation 即时编译 para velocidade quase nativa. O custo é uma camada extra e precisar ter a VM instalada.
Um computador real, vários aparentes: o sistema operacional host e o hipervisor compartilham o hardware, e cada sistema operacional convidado roda como se tivesse sua própria máquina "Descreva o que se entende por máquina virtual" (duas marcas). Uma emulação (implementação) de software de um sistema computacional que roda em um computador host e se comporta, para os programas rodando dentro dele, como um computador físico separado com seu próprio processador, memória e armazenamento. O sistema operacional host 宿主操作系统 roda no hardware real, gerencia os recursos reais e (através do hipervisor) cria e controla as máquinas virtuais; cada sistema operacional convidado 客户操作系统 roda dentro de uma máquina virtual, gerencia os aplicativos nele, e não tem consciência de que seu hardware é virtual.
Benefícios (dê dois). Vários sistemas operacionais diferentes podem rodar em uma mesma máquina ao mesmo tempo; software pode ser testado em muitos sistemas sem comprar o hardware; um novo sistema computacional pode ser emulado e testado antes de ser construído; cada VM está isolada, então uma falha ou malware em uma não afeta a host ou as outras; VMs podem ser copiadas, movidas e fazer backup como arquivos, e um servidor pode ser compartilhado entre muitos usuários, reduzindo o custo de hardware. Limitações (dê duas). Uma VM roda mais devagar que o hardware real porque cada instrução passa pela camada de emulação; consome a memória e potência de processamento da host, então a host deve ser poderosa; alguns recursos ou dispositivos de hardware não são emulados exatamente, então o software testado pode se comportar diferente na máquina real; licenças são necessárias para cada OS convidado, e configurar o sistema exige experiência.
ExplorarLaboratório de conceitos de computação
Classifique exemplos concretos pelo conceito de computação que eles demonstram.
Vocabulário TreinarInglês Chinês Pinyin hypervisor/ˌhaɪpəˈvaɪzə/ 虚拟机监控器 xū nǐ jī jiān kòng qì sandboxing/ˈsændbɒksɪŋ/ 沙箱 shā xiāng bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ 即时编译 jí shí biān yì host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ 宿主操作系统 sù zhǔ cāo zuò xì tǒng guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ 客户操作系统 kè hù cāo zuò xì tǒng Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ 布尔代数 bù ěr dài shù 15.2
Álgebra booleana
Programa
Os candidatos devem ser capazes de: Notas e orientações Produzir tabelas-verdade para circuitos lógicos incluindo meio somadores e somadores completos Pode incluir portas lógicas com mais de duas entradas Demonstrar compreensão de um flip-flop (SR, JK) Desenhar um circuito lógico e derivar uma tabela-verdade para um flip-flop. Compreender o papel dos flip-flops como elementos de armazenamento de dados Demonstrar compreensão da álgebra booleana Compreender as leis de De Morgan. Realizar álgebra booleana usando as leis de De Morgan. Simplificar um circuito/expressão lógica usando álgebra booleana Demonstrar compreensão de mapas de Karnaugh (K-map) Compreender os benefícios do uso de mapas de Karnaugh. Resolver problemas lógicos usando mapas de Karnaugh Fonte: Programa Cambridge International
O meio somador: XOR + AND soma dois bits Álgebra booleana 布尔代数 simplifica expressões booleanas 布尔表达式, que também podem ser descritas por tabelas-verdade 真值表. Símbolos:
+para OR,·para AND (muitas vezes omitido), barra superior para NOT.As leis principais incluem comutativa, associativa e distributiva (como na álgebra comum), além de:
- identidade $A + 0 = A$, $A \cdot 1 = A$; nula $A + 1 = 1$, $A \cdot 0 = 0$.
- idempotente $A + A = A$; inversa $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- Leis de De Morgan 德摩根定律: $(A + B)' = A' \cdot B'$; $(A \cdot B)' = A' + B'$ — negue todo o termo, troque AND/OR, negue cada operando.
- absorção 吸收律: $A + AB = A$.
A simplificação reduz o número de termos, então o circuito lógico resultante tem menos portas. Exemplo: $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
As leis com seus nomes (cite o nome em cada passo quando for pedido "mostre todo o desenvolvimento").
Lei Forma OR Forma AND identidade $A + 0 = A$ $A \cdot 1 = A$ nula (anulação) $A + 1 = 1$ $A \cdot 0 = 0$ idempotente $A + A = A$ $A \cdot A = A$ complemento (inversa) $A + \overline{A} = 1$ $A \cdot \overline{A} = 0$ comutativa $A + B = B + A$ $A \cdot B = B \cdot A$ associativa $A + (B + C) = (A + B) + C$ $A(BC) = (AB)C$ distributiva $A + BC = (A + B)(A + C)$ $A(B + C) = AB + AC$ absorção $A + AB = A$ $A(A + B) = A$ De Morgan $\overline{A + B} = \overline{A} \cdot \overline{B}$ $\overline{A \cdot B} = \overline{A} + \overline{B}$ dupla negação $\overline{\overline{A}} = A$ Exemplo resolvido. Simplifique $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, mostrando todo o desenvolvimento.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan na barra externa) $= A \cdot B + A + B$ (dupla negação) $= A + B$ (absorção, $A + AB = A$, aplicado com $A + B$ absorvendo $AB$).
Exemplo resolvido. Simplifique $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (De Morgan) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (distributiva) $= \overline{A}\,\overline{B} + 0$ (idempotente, complemento) $= \overline{A}\,\overline{B}$.
Exemplo resolvido. Simplifique $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributiva) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complemento, identidade) $= \overline{B}(\overline{A} + AC)$ (distributiva) $= \overline{B}(\overline{A} + C)$, usando $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Aplicar De Morgan a um termo de três entradas funciona da mesma forma: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Soma-de-produtos a partir de tabela-verdade. Pegue todas as linhas cuja saída seja 1, escreva o AND de suas entradas (uma variável com barra onde for 0) e OR os termos: uma linha com $A = 1, B = 0, C = 1$ resulta em $A\,\overline{B}\,C$. Esta é a forma soma-de-produtos 积之和 que o exame pede, e é o ponto de partida tanto para simplificação algébrica quanto para mapa de Karnaugh.
ExplorarÁlgebra booleana
A·B, A+B, Ā …
A álgebra booleana são apenas essas portas escritas como expressões — compare as tabelas-verdade.
ExplorarTabelas-verdade booleanas
Escolha um operador e as entradas para construir sua tabela-verdade — a álgebra por trás dos circuitos lógicos.
Vocabulário TreinarInglês Chinês Pinyin Boolean/ˈbuːlɪən/ 布尔 bù ěr truth tables/truːθ ˈteɪblz/ 真值表 zhēn zhí biǎo De Morgan's laws/də ˈmɔːɡənz lɔːz/ 德摩根定律 dé mó gēn dìng lǜ absorption/əbˈsɔːpʃn/ 吸收律 xī shōu lǜ sum-of-products/sʌm ɒv ˈprɒdʌkts/ 积之和 jī zhī hé Karnaugh map/ˈkɑːnɔː mæp/ 卡诺图 kǎ nuò tú half adder/hɑːf ˈædə/ 半加器 bàn jiā qì 15.2
Mapas de Karnaugh
Um mapa Karnaugh 卡诺图 (K-map) simplifica uma expressão Booleana agrupando 1s adjacentes de uma tabela verdade. Colunas e linhas usam ordem Gray code 格雷码 (
00,01,11,10) para que células adjacentes diferem em uma variável.Coloque um 1 em cada célula onde a saída é 1. Encontre grupos retangulares de 1s cujos lados sejam potências de 2 (1, 2, 4, 8), voltando nas bordas se isso criar um grupo maior. Quanto maior o grupo, mais simples o termo: um grupo de 2 elimina uma variável, um grupo de 4 elimina duas, e assim por diante — variáveis que mudam dentro do grupo desaparecem. Some os termos dos grupos para a expressão simplificada. Cubra todos os 1s usando o menor número possível de grupos, mas os maiores possíveis.
Exemplo resolvido. Um mapa Karnaugh para $A$ e $B$ tem 1s nas células $\overline{A}B$ e $AB$. Simplifique. Os dois 1s são adjacentes - eles compartilham a coluna $B=1$ - então agrupe-os como um retângulo de 2. Dentro desse grupo $B$ permanece 1 durante todo o tempo enquanto $A$ muda de 0 para 1, e qualquer variável que mude dentro de um grupo desaparece. Então o grupo deixa apenas $X = B$. Compare isso com a soma de produtos lida diretamente da tabela, $\overline{A}B + AB$: o mesmo circuito, duas portas a menos. Duas regras fazem a maior parte do trabalho - faça cada grupo o maior possível (um grupo de 2 elimina uma variável, 4 elimina duas, 8 elimina três), e lembre-se de que o mapa volta em suas bordas, então as colunas mais à esquerda e mais à direita são adjacentes. Esse retorno é o agrupamento que a maioria dos candidatos perde.
Loops de 1, 2, 4 ou 8 uns; o termo para um loop mantém apenas as variáveis que não mudam dentro dele. As bordas se conectam, então um loop pode envolver-se, e os quatro cantos contam como adjacentes Construindo e lendo um mapa K. Rótule as colunas $AB$ e as linhas $C$ (ou $CD$) em ordem Gray-code
00 01 11 10, para que células vizinhas diferem em apenas uma variável. Coloque um 1 em cada célula cujo mintermo aparece na expressão (ou cuja linha da tabela verdade produz 1). Então desenhe os menores, maiores laços que cobrem todos os 1s: cada laço deve ser um retângulo de $1, 2, 4$ ou $8$ células, losos podem se sobrepor, podem voltar através das bordas esquerda-direita e topo-fundo, e os quatro cantos juntos formam um laço. Para cada laço, escreva as variáveis que são constantes dentro dele (barreadas se 0), e some os termos do laço: essa é a soma-de-produtos ótima. Por que usar um? Ele fornece a expressão mais simples sem álgebra, em poucos passos, com menos chance de erro, e o mesmo mapa serve para três ou quatro variáveis.Exemplo resolvido. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
No mapa de três variáveis, os 1s preenchem as colunas 00, 01 e 10 em ambas as linhas. O laço de quatro sobre as colunas 00 e 01 tem $A = 0$ em toda parte e $B$, $C$ variando: termo $\overline{A}$. O laço de quatro sobre as colunas 00 e 10 (envolvendo) tem $B = 0$ em toda parte: termo $\overline{B}$. Então $Z = \overline{A} + \overline{B}$, o que a álgebra booleana confirma: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Dois laços de dois também seriam corretos, mas não ótimos; um laço é tão grande quanto os 1s permitem.
Exemplo resolvido (quatro variáveis). Um mapa tem 1s apenas nos seus quatro cantos: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ e $A\,\overline{B}\,C\,\overline{D}$. Como as linhas superior e inferior são adjacentes e assim são as colunas externas, os cantos formam um único laço de quatro; $B = 0$ e $D = 0$ em todos eles enquanto $A$ e $C$ variam, então $Z = \overline{B}\,\overline{D}$.
Vocabulário TreinarInglês Chinês Pinyin Gray code/ɡreɪ kəʊd/ 格雷码 gé léi mǎ 15.2
Somador meio e somador completo

Um somador meio 半加器 soma dois bits únicos $A$ e $B$, dando uma soma $S$ e um carry 进位 $C$:
A B S C 0 0 0 0 0 1 1 0 1 0 1 0 1 1 0 1 Então $S = A \text{ XOR } B$ e $C = A \text{ AND } B$. Ele ignora qualquer carry-in — daí "meio".
Um somador meio, como um bloco e como um circuito de uma porta XOR e uma porta AND Um somador completo 全加器 soma três bits ($A$, $B$, carry-in), dando uma soma e um carry-out: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Pode ser construído de dois somadores meios mais uma porta OR. Encadear somadores completos (cada carry-out alimentando o next carry-in) faz um somador multi-bit "ripple-carry".
Um somador completo é construído de dois somadores meios e uma porta OR Tabela-verdade do somador completo. Com entradas $A$, $B$ e o carry-in $C_{\text{in}}$: a soma $S$ é 1 quando um número ímpar de entradas é 1, e o carry-out é 1 quando dois ou mais entradas são 1.
$A$ $B$ $C_{\text{in}}$ $S$ $C_{\text{out}}$ 0 0 0 0 0 0 0 1 1 0 0 1 0 1 0 0 1 1 0 1 1 0 0 1 0 1 0 1 0 1 1 1 0 0 1 1 1 1 1 1 As questões de circuito que o exame propõe. Dado um circuito de uma porta XOR e uma porta AND compartilhando duas entradas, ou dois somadores meios e uma porta OR, "complete a tabela-verdade (mostre seu desenvolvimento)" significa adicionar uma coluna para cada saída de porta intermediária e preencher as linhas em ordem; "affe o nome do circuito" é somador meio ou somador completo; "affe o propósito de cada saída" é a soma dos bits e o carry para a próxima coluna. Soma-de-produtos para o somador meio: $S = \overline{A}B + A\overline{B}$, $C = AB$. Uma cadeia de somadores completos, cada um passando seu carry-out para o next carry-in, soma dois números multi-bit.
ExplorarAs portas dentro de um somador
O bit de soma de um half-adder é uma porta XOR e seu carry é uma porta AND — alterne A e B e veja a linha da tabela-verdade acender.
Vocabulário TreinarInglês Chinês Pinyin carry/ˈkæri/ 进位 jìn wèi full adder/fʊl ˈædə/ 全加器 quán jiā qì 15.2
Flip-flops
Um flip-flop 触发器 é um circuito bistável 双稳态 — dois estados estáveis (0 e 1) — que lembra seu estado. Armazena um bit e é o elemento básico de registradores e SRAM.
Flip-flop SR
Um flip-flop SR SR触发器 tem entradas S (set) e R (reset) e saídas Q e $\overline{Q}$.
S=1,R=0define Q para 1;S=0,R=1o reseta para 0;S=0,R=0mantém;S=1,R=1é inválido. Construído de duas portas NOR acopladas cruzadamente.O flip-flop SR: duas portas NOR alimentando uma à outra. Com ambas as entradas 0, as saídas mantêm o que eram, que é a memória; S define Q para 1, R o reseta, e S = R = 1 não é permitido "Desenhe um circuito lógico para um flip-flop SR e rotule as entradas." Dois portas NOR (ou duas portas NAND), a saída de cada uma conectada de volta a uma entrada da outra; a entrada livre de uma porta é S, da outra R; as saídas são $Q$ e $\overline{Q}$. O feedback é o que vale pontos: sem ele não há memória. "Explique o propósito de um flip-flop." Armazenar um bit de dados; é o elemento básico de memória do qual registros e RAM estática são construídos, e mantém seu valor até ser intencionalmente alterado. A entrada inválida $S = R = 1$ faz com que ambas as saídas fiquem 0, de modo que $\overline{Q}$ já não seja o complemento de $Q$, e o estado após ambas as entradas retornarem a 0 é imprevisível, que é a fraqueza do flip-flop SR.
Flip-flop JK
Um flip-flop JK JK触发器 melhora isso ao usar a entrada anteriormente inválida
1,1como toggle 翻转 (a saída inverte). Isso o torna ideal para construir contadores 计数器 (uma cadeia de flip-flops com toggle). Geralmente é com clock — as entradas atuam apenas na borda do clock, mantendo os flip-flops sincronizados.
Um flip-flop JK: seu símbolo e uma construção a partir de portas NAND Flip-flops são os blocos construtivos de registros (n bits = n flip-flops), contadores e células de SRAM 静态RAM.
Tabela-verdade do flip-flop JK. A entrada clock 时钟 decide quando as entradas J e K são lidas, de modo que a saída muda apenas em um pulso de clock: com $J = K = 0$ a saída é mantida; $J = 1, K = 0$ define $Q$ para 1; $J = 0, K = 1$ zera para 0; $J = K = 1$ inverte (Q torna-se $\overline{Q}$). A última linha é exatamente a entrada proibida do flip-flop SR transformada em útil, pelo qual o JK é preferido: toda combinação de entradas é válida, e a operação com clock o torna o bloco construtivo de contadores e registros de deslocamento.
Vocabulário TreinarInglês Chinês Pinyin flip-flop/flɪp flɒp/ 触发器 chù fā qì bistable/baɪˈsteɪbl/ 双稳态 shuāng wěn tài toggle/ˈtɒɡl/ 翻转 fān zhuǎn counters/ˈkaʊntəz/ 计数器 jì shù qì SRAM/ˈesræm/ 静态RAM jìng tài RAM clock/klɒk/ 时钟 shí zhōng SR flip-flop/ˌes ˈɑː flɪp flɒp/ SR触发器 SR chù fā qì JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ JK触发器 JK chù fā qì 15.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição RISC um processador com um pequeno conjunto de instruções simples, de comprimento fixo, executadas na maioria em um ciclo de clock, usando muitos registros e pipeline CISC um processador com um grande conjunto de instruções complexas, de comprimento variável, muitas levando vários ciclos de clock e acessando memória diretamente pipeline dividir o ciclo de busca-execução em estágios para que várias instruções sejam processadas simultaneamente, cada uma em um estágio diferente SISD / SIMD / MISD / MIMD uma instrução em um item de dados; uma instrução em muitos itens de dados; muitas instruções em um item de dados; muitas instruções em muitos itens de dados computador massivamente paralelo milhares de processadores, cada um com sua própria memória, conectados por uma rede e trabalhando simultaneamente em um único problema máquina virtual uma emulação de software de um sistema de computador rodando em um computador host e comportando-se como um computador físico separado hipervisor o software que cria máquinas virtuais e compartilha o hardware do host entre elas tabela-verdade uma tabela listando todas as combinações de entradas de um circuito lógico com a(s) saída(s) resultante(s) soma-de-produtos uma expressão booleana escrita como a OR de termos AND, um termo para cada combinação de entrada que resulta em 1 mapa de Karnaugh uma grade das saídas da tabela-verdade, organizadas em ordem de Gray, em que laços de 1s adjacentes fornecem a expressão simplificada somador parcial um circuito que soma dois bits, produzindo uma soma e um acarretar somador completo um circuito que soma dois bits e um acarretar de entrada, produzindo uma soma e um acarretar de saída flip-flop um circuito bistável que armazena um bit, mantendo sua saída até que suas entradas a alterem 15.2
Dicas de prova
- RISC e CISC são respondidos como listas de características: simples, fixo, um ciclo, muitos registros, carga/armazenamento, pipeline contra complexo, variável, multi-ciclo, menos registros, acesso direto à memória, microcódigo. Quatro de cada.
- Pipeline: estágios, várias instruções ao mesmo tempo, uma concluída por ciclo, maior taxa de transferência; $n + k - 1$ ciclos para $n$ instruções através de $k$ estágios; interrupções devem esvaziar o pipeline.
- As quatro categorias de Flynn são "quantas correntes de instrução" por "quantas correntes de dados"; diga o que roda no quê. Massivamente paralelo: muitos processadores, memória própria, rede, mesmo problema.
- Máquina virtual: emulação de um computador em um host; SO host no hardware, hipervisor compartilhando-o, SO convidado dentro. Dois benefícios e duas limitações, cada um uma frase completa.
- Álgebra booleana: nomeie cada lei conforme a usa; De Morgan troca o operador e nega cada termo; verifique com uma tabela-verdade se tiver dúvidas.
- Mapa-K: ordem de Gray, maiores laços de 1/2/4/8, envolvimento permitido, um termo por laço com as variáveis inalteradas. Diga o porquê: expressão mais simples sem álgebra.
- Somador parcial dá soma e acarretar; somador completo também leva acarretar de entrada; flip-flop SR tem duas portas NOR/NAND cruzadas e armazena um bit; JK com entrada 1,1 inverte.
Erros comuns
- Inverter as listas de características RISC e CISC, ou oferecer "mais rápido" como característica; dê as características de projeto, não um veredito.
- Descrever pipeline como "executar instruções em paralelo em vários núcleos"; são estágios de um processador sobrepostos.
- Confundir SIMD (uma instrução, muitos dados) com MIMD (muitos de ambos), ou descrever MISD como o caso comum.
- Definir máquina virtual como "uma cópia de um computador" sem a palavra emulação ou o host e o convidado.
- Aplicar De Morgan apenas a parte de uma expressão sob uma barra longa, ou remover a barra sem trocar AND por OR.
- Fazer um laço de um grupo de três, ou um grupo não retangular, em um mapa-K; ordenar as colunas 00, 01, 10, 11 em vez de código Gray.
- Escrever o acarretar de um somador parcial como XOR e a soma como AND.
- Desenhar um flip-flop SR como duas portas sem feedback, ou omitir o estado inválido de sua tabela-verdade.
-
16
Software de Sistema
Assistir aula16.1
Como um SO maximiza o uso de recursos

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de como um SO pode maximizar o uso de recursos Descrever as maneiras pelas quais a interface do usuário esconde a complexidade do hardware do usuário Demonstrar compreensão do gerenciamento de processos O conceito de multitarefa e de um processo. Os estados do processo: executando, pronto e bloqueado. A necessidade de agendamento e a função e benefícios de diferentes rotinas de agendamento (incluindo round robin, shortest job first, first come first served, shortest remaining time). Como o kernel do SO atua como manipulador de interrupções e como o manuseio de interrupções é usado para gerenciar o agendamento de baixo nível Demonstrar compreensão de memória virtual, segmentação e paginação para gerenciamento de memória Os conceitos de paginação, memória virtual e segmentação. A diferença entre paginação e segmentação. Como as páginas podem ser substituídas. Como o thrashing de disco pode ocorrer Fonte: Programa Cambridge International
Um computador possui muitos recursos (tempo de CPU, memória, disco, E/S) e muitos programas competindo por eles. O SO os compartilha de forma justa e eficiente para que cada um seja bem utilizado e o sistema permaneça responsivo:
*O SO compartilha a CPU, memória, disco e E/S entre programas- multi-tarefa 多任务 — alternar rapidamente a CPU entre processos para que pareçam executar simultaneamente.
- gerenciamento de memória — atribuir a cada processo a memória necessária; usar paging 分页 no disco quando a RAM acabar.
- spooling 假脱机 e buffering — filas de trabalhos de impressão no disco para que a CPU nunca espere pela impressora.
- cache — manter dados de disco recentemente usados em cache 高速缓存 / RAM.
 *O processador é um recurso chave que o SO compartilha entre tarefas concorrentes
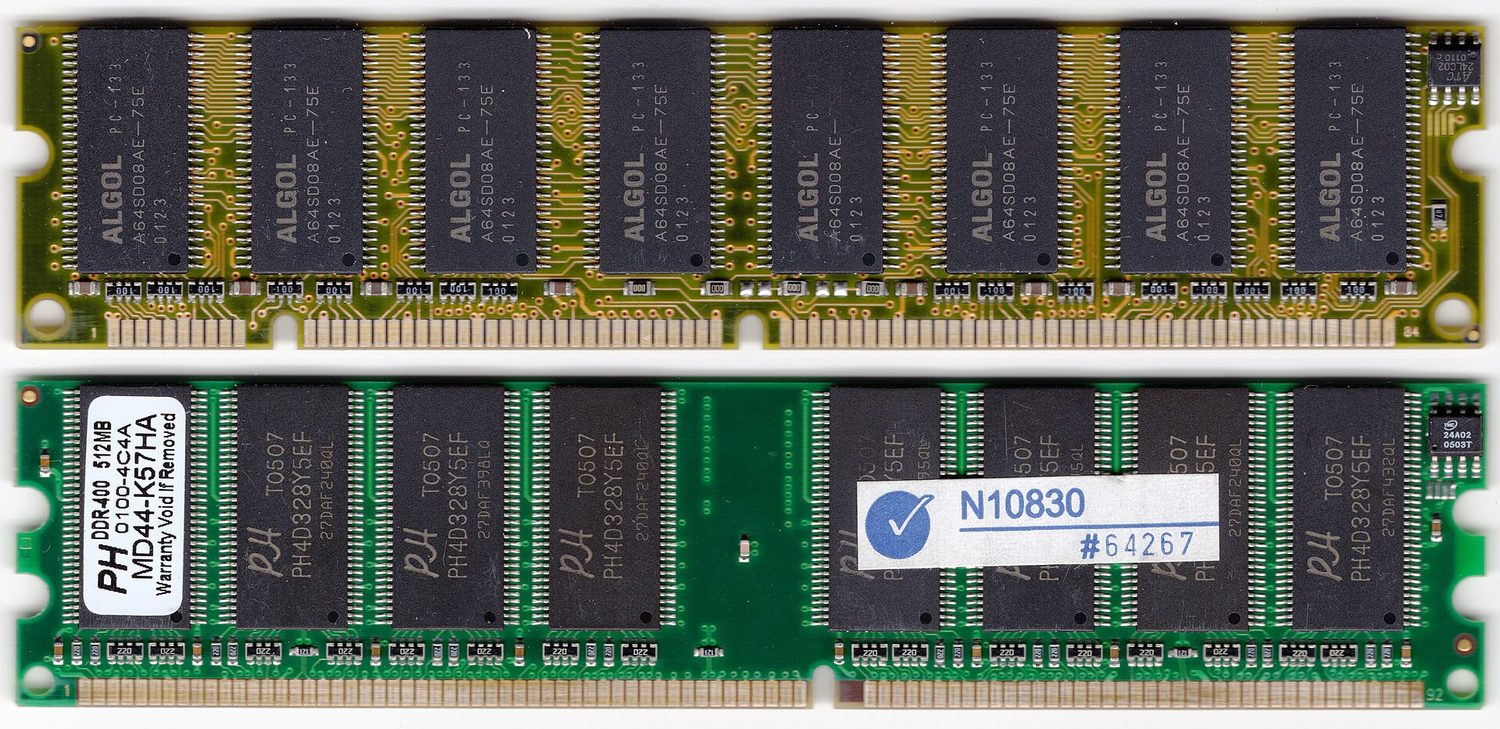 *O SO também gerencia a memória (RAM), decidindo o que manter nela e o que paging para o discoVocabulário Treinar
Inglês Chinês Pinyin multi-tasking/ˈmʌlti ˈtæskɪŋ/ 多任务 duō rèn wù paging/ˈpeɪdʒɪŋ/ 分页 fēn yè spooling/ˈspuːlɪŋ/ 假脱机 jiǎ tuō jī cache/kæʃ/ 高速缓存 gāo sù huǎn cún 16.1
Interface do usuário
A interface do usuário esconde o hardware atrás de abstrações amigáveis: o usuário vê janelas, menus e pastas, não endereços ou setores. Um clique em um ícone faz o SO encontrar o programa no disco, alocar memória, carregá-lo e iniciá-lo. Uma CLI (linha de comando) é poderosa e scriptável para especialistas; uma GUI (gráfica) é mais fácil de aprender. A maioria dos sistemas oferece ambas.
"Descreva duas formas pelas quais as complexidades do hardware são ocultadas do usuário." (1) O usuário trabalha com arquivos e pastas por nome, e o SO os traduz em faixas, setores e blocos do disco; (2) o usuário executa um programa com um clique ou comando, e o SO o carrega, aloca memória e o escala sem que o usuário saiba qualquer endereço; (3) drivers de dispositivo permitem que o usuário imprima ou salve sem saber como a impressora ou disco é controlada; (4) uma interface gráfica substitui comandos de nível de máquina por ícones, janelas e menus. O benefício para um estudante, com exemplo: o SO torna o hardware utilizável sem conhecimento técnico, por exemplo salvando um documento em um pendrive arrastando seu ícone.
"Mostre como um SO maximiza o uso de recursos." Ele escala o processador para que este nunca fique ocioso enquanto um processo está pronto; gerencia a memória, alocando-a para processos, recuperando-a e estendendo-a com memória virtual; gerencia entrada e saída, usando buffers e spooling para que dispositivos rápidos e lentos sobreponham seus trabalhos; e gerencia armazenamento, mantendo controle do espaço livre e arquivos. Cada ponto cita um recurso e o que o SO faz com ele.
16.1
Gerenciamento de processos
Um processo 进程 é um programa em execução — seu código, estado atual, memória e arquivos abertos.
Escalonamento
O escaloner 调度器 escolhe qual processo pronto executa a seguir e por quanto tempo:
- round robin 轮转 — cada processo recebe um time slice 时间片 fixo, depois vai para o final da fila.
- primeiro a chegar, primeiro a servir; menor trabalho primeiro; menor tempo restante (execute o trabalho com menos trabalho restante); prioridade; filas de feedback multinível.
O compromisso é responsividade vs taxa de transferência vs justiça.
"Descreva o que se entende por multi-tarefa e como ela beneficia o gerenciamento de processos." Vários processos são mantidos na memória ao mesmo tempo e o processador alterna entre eles tão rapidamente que parecem executar simultaneamente, cada um recebendo uma parcela de tempo do processador por vez. O benefício: o processador nunca fica ocioso enquanto um processo espera por entrada ou saída, então taxa de transferência é maior e o usuário pode trabalhar em vários programas ao mesmo tempo. "Explique a necessidade de escalonamento." Existem mais processos do que processadores, então uma decisão deve ser tomada sobre qual processo executa a seguir e por quanto tempo; o escalonamento garante que todo processo faça progresso, que o processador esteja plenamente utilizado, que tempos de resposta sejam aceitáveis e que prioridades possam ser respeitadas.
*O mesmo trabalho em uma ordem diferente: menor trabalho primeiro coloca as tarefas curtas para fora, de modo que a maioria espera menos, com o risco de uma tarefa longa esperar eternamenteAs rotinas de escalonamento, tal como o exame deseja que sejam descritas.
Rotina Função Benefício Desvantagem primeiro a chegar, primeiro a ser atendido (FCFS) os processos são executados na ordem em que chegam à fila de prontos, cada um até sua conclusão simples; todos os processos são atendidos por vez, nenhum é excluído um processo longo atrasa todos os curtos atrás dele; resposta pobre menor tempo de execução primeiro (SJF) o processo pronto com menor tempo estimado de execução roda próximo, até sua conclusão minimiza o tempo médio de espera; muitos trabalhos curtos terminam rapidamente tempos de execução devem ser conhecidos antecipadamente; um trabalho longo pode nunca rodar (exclusão) menor tempo restante (SRT) versão preemptiva 抢占式 do SJF: se um novo processo chega com menos tempo restante que o atual, ele assume o controle processos curtos são atendidos ainda mais rápido; bom throughput mais trocas de contexto; um processo longo pode ser interrompido repetidamente e excluir-se round robin (RR) cada processo pronto recebe uma fatia de tempo fixa time slice por vez; quando expira, o processo vai para o final da fila justo; todos respondem dentro de um tempo limitado, bom para uso interativo sobrecarga de troca de contexto; uma fatia muito curta desperdiça tempo, uma longa atrasa outros prioridade o processo pronto com maior prioridade roda primeiro trabalho importante ou crítico no tempo é feito primeiro processos de baixa prioridade podem excluir-se a menos que as prioridades envelham Exemplo resolvido. Três processos chegam juntos com tempos de CPU de 8, 4 e 2 ms. Compare o tempo médio de espera sob FCFS (na ordem de chegada A, B, C) e shortest job first.
FCFS: A espera 0, B espera 8, C espera 12; média $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF executa C, B, A: C espera 0, B espera 2, A espera 6; média $2.7\ \text{ms}$. O trabalho total é o mesmo, 14 ms de ambos os lados; a ordem decide quem espera. Round robin com fatia de 2 ms daria a A, B e C uma vez cada nos primeiros 6 ms, então C termina em 6 ms, B em 12 ms e A em 14 ms: o mais responsivo, não o mais rápido em média.
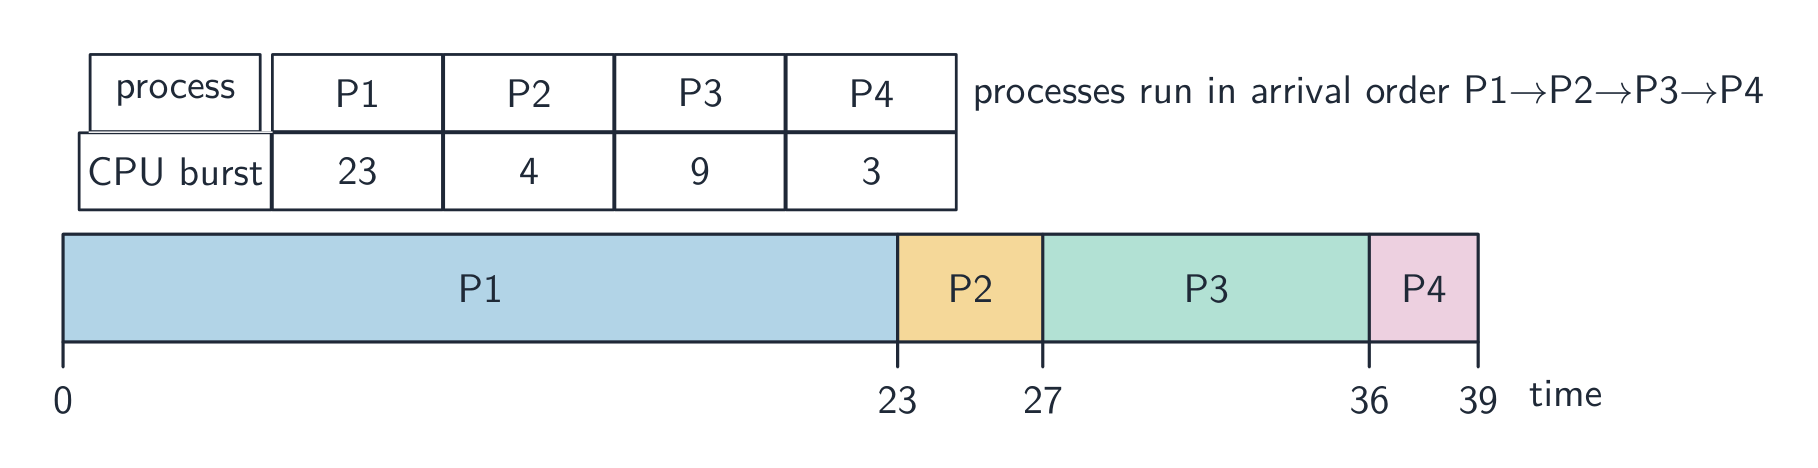
Agendamento primeiro a chegar, primeiro a ser atendido de quatro processos 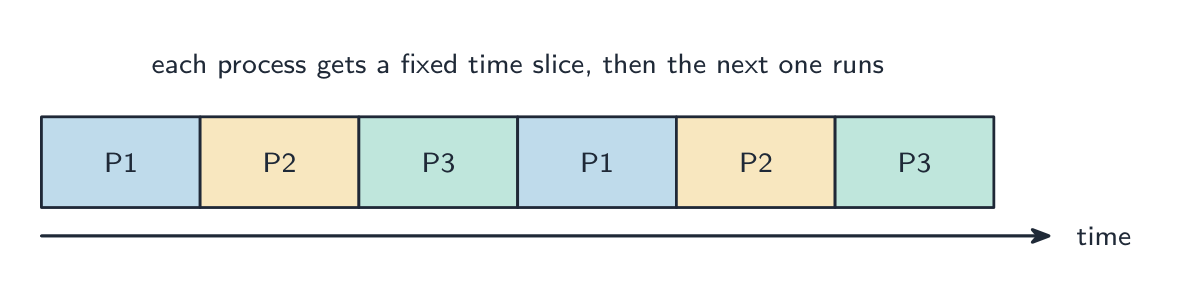
Round-robin: cada processo recebe uma fatia de tempo fixa por vez, depois o próximo roda (diferente de primeiro a chegar, primeiro a ser atendido) Estados do processo
Um processo é novo, pronto (aguardando a CPU), executando, bloqueado 阻塞 (aguardando E/S ou uma trava), ou terminado. Quando sua fatia de tempo termina, ele vai de executando → pronto; quando solicita E/S, vai de executando → bloqueado; quando a E/S termina, vai de bloqueado → pronto.
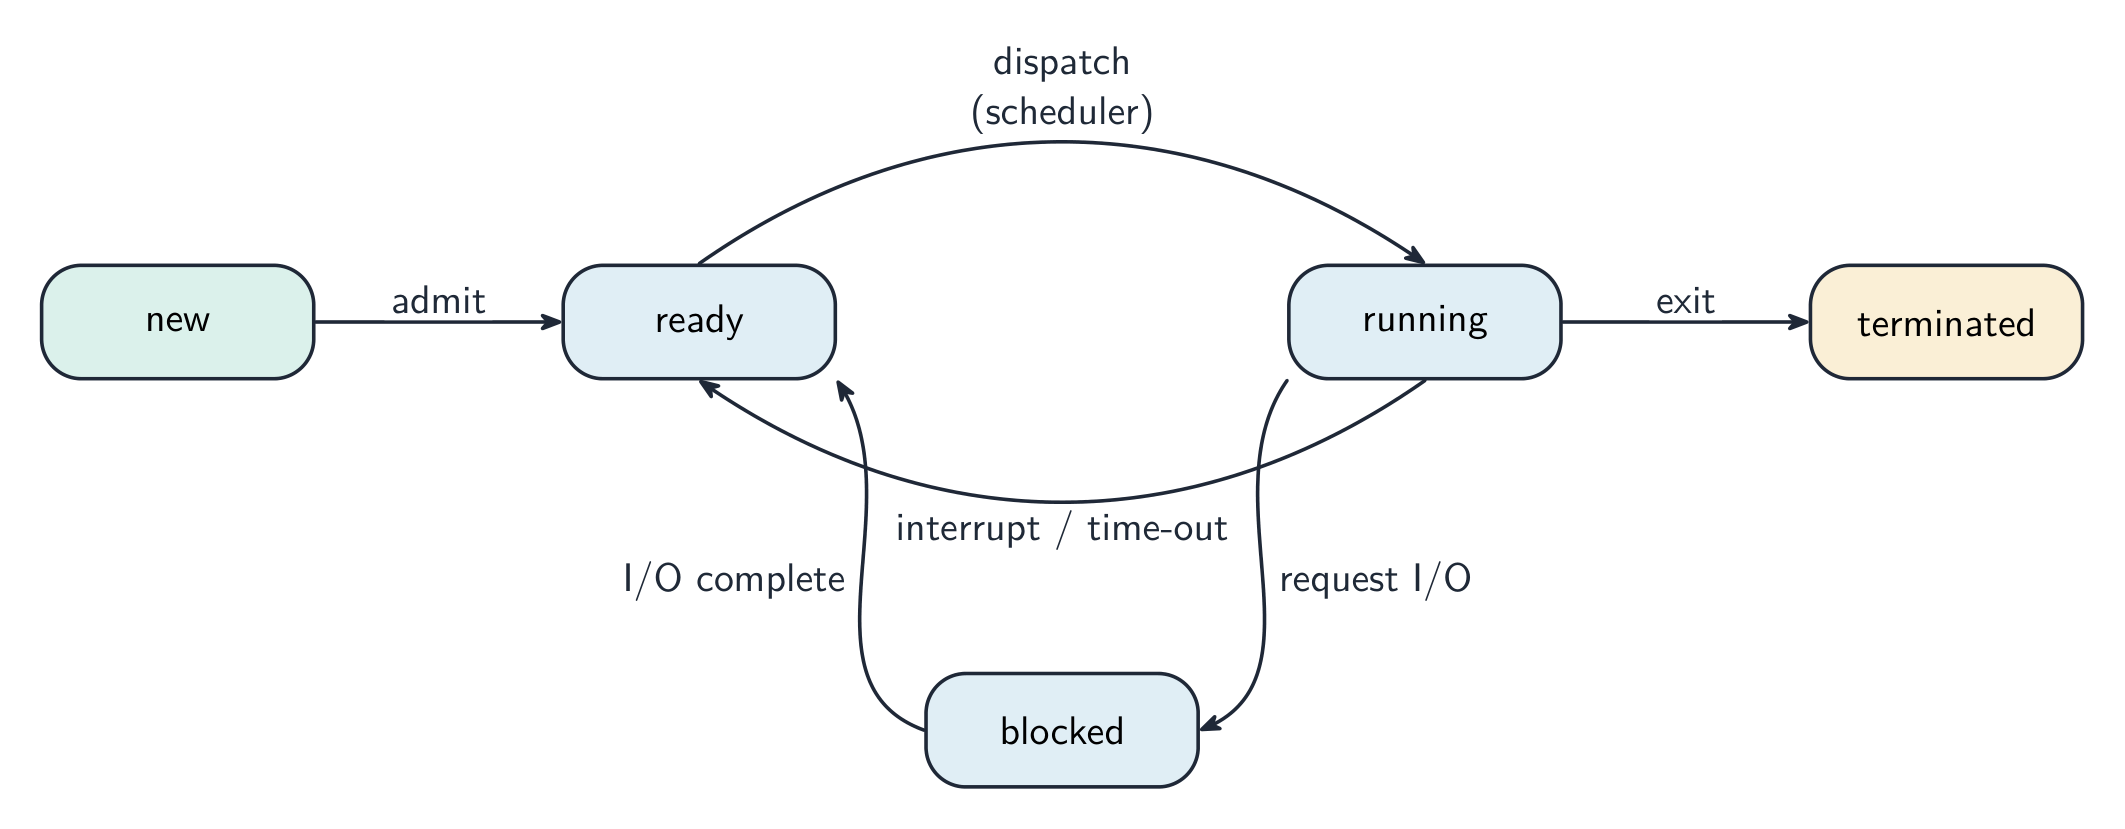
Um processo se move entre os estados novo, pronto, executando, bloqueado e terminado Os três estados e por que um processo se move. Executando: o processo tem o processador. Pronto: poderia rodar mas está esperando pelo processador. Bloqueado: não pode rodar até que algo aconteça. Razões para cada transição, das quais o exame pede uma de cada vez: executando para pronto quando seu fatia de tempo acaba, ou quando um processo de maior prioridade fica pronto e o preempte (um interrupt); executando para bloqueado quando solicita entrada ou saída ou espera por um recurso ou outro processo; bloqueado para pronto quando a E/S pela qual esperava completa (sinalizada por um interrupt); pronto para executando quando o escalona dor o despacha. Um processo bloqueado nunca pode ir diretamente para executando: deve tornar-se pronto primeiro.
Bloco de controle de processo e troca de contexto
Para cada processo, o SO mantém um bloco de controle de processo 进程控制块 (PCB) — o contador de programa salvo, registradores, estado e informações de memória.
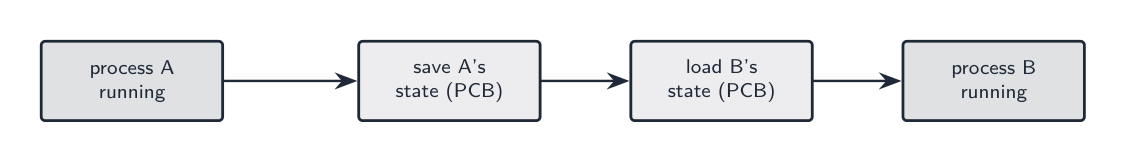
Uma troca de contexto salva o estado de um processo e carrega o de outro - uma troca de contexto 上下文切换 suspende um processo e inicia outro: salva o estado em um PCB e o restaura de outro. Esse pequeno custo é pago em toda troca.
- o kernel 内核 (núcleo do SO) atua como manipulador de interrupções 中断处理程序. Quando um dispositivo ou o temporizador gera uma interrupção, tratamento de interrupções 中断处理 salva o processo em execução e executa a rotina certa — isso é o que impulsiona o escalonamento de baixo nível.
"Descreva como o kernel age como manipulador de interrupções" (duas marcas). Quando uma interrupção é levantada, o kernel salva o estado do processo em execução (seus registradores e contador de programa, em seu bloco de controle de processo), identifica a origem e a prioridade da interrupção, executa a rotina de serviço de interrupção apropriada e, em seguida, restaura o processo interrompido (ou um de maior prioridade) para que a execução continue. É assim que o temporizador encerra uma fatia de tempo e como uma operação de E/S concluída desbloqueia um processo.
Comunicação entre processos
Processos são isolados, então o SO fornece comunicação entre processos 进程间通信: tubulações 管道 (a saída de um programa alimenta a entrada de outro), memória compartilhada 共享内存 (uma região que vários processos podem usar) e passagem de mensagens.
ExplorarA vida de um processo
Observe o ciclo pelo qual um processo passa. Ele só executa quando o escalonador o seleciona; necessitar de E/S o envia para bloqueado, e terminar seu slice de tempo o devolve à fila de prontos — rodando e rodando até que termine.
Vocabulário TreinarInglês Chinês Pinyin process/ˈprəʊses/ 进程 jìn chéng scheduler/ˈʃedjʊlə/ 调度器 diào dù qì round robin/raʊnd ˈrɒbɪn/ 轮转 lún zhuàn time slice/taɪm slaɪs/ 时间片 shí jiān piàn pre-emptive/priː ˈemptɪv/ 抢占式 qiǎng zhàn shì context switch/ˈkɒntekst swɪtʃ/ 上下文切换 shàng xià wén qiè huàn kernel/ˈkɜːnl/ 内核 nèi hé interrupt handler/ˈɪntərʌpt ˈhændlə/ 中断处理程序 zhōng duàn chǔ lǐ chéng xù interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ 中断处理 zhōng duàn chǔ lǐ inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ 进程间通信 jìn chéng jiān tōng xìn pipes/paɪps/ 管道 guǎn dào shared memory/ʃeəd ˈmeməri/ 共享内存 gòng xiǎng nèi cún virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ 虚拟地址空间 xū nǐ dì zhǐ kōng jiān pages/ˈpeɪdʒɪz/ 页 yè frames/freɪmz/ 页框 yè kuāng page fault/peɪdʒ fɒlt/ 缺页 quē yè swap file/swɒp faɪl/ 交换文件 jiāo huàn wén jiàn 16.1
Memória virtual, segmentação em páginas, segmentação
Cada processo recebe seu próprio espaço de endereços virtuais 虚拟地址空间 — uma faixa limpa e contígua de endereços que o SO mapeia para memória física. Isso dá a cada processo um espaço simples, protege processos uns dos outros e permite que a memória total exceda a RAM física.
Na segmentação em páginas, o espaço virtual é dividido em páginas 页 de tamanho fixo e a memória física em quadros 页框 do mesmo tamanho. Uma tabela de páginas mapeia cada página para um quadro. Se uma página acessada não estiver na RAM — uma falta de página 缺页 — o SO a lê do arquivo de swap 交换文件 para um quadro, expulsando outra página se a RAM estiver cheia. Falhas frequentes causam thrashing 抖动 (thrashing de disco), onde o SO passa a maior parte do tempo trocando páginas em vez de fazer trabalho útil.
A segmentação em páginas mapeia cada página de memória lógica para um quadro de memória física Na segmentação 分段, a memória é dividida em segmentos lógicos de tamanho variável (código, pilha, heap), cada um com suas próprias permissões. Muitos sistemas usam segmentação em páginas dentro de segmentos.
A segmentação mapeia segmentos de tamanho variável usando uma tabela de mapas de segmento "Explique o que significa memória virtual" (três marcas).** Armazenamento secundário (disco) é usado para estender a RAM*, de modo que a memória disponível pareça maior que a memória física; o espaço de endereços de um processo é dividido em páginas, e apenas as páginas atualmente necessárias são mantidas na RAM enquanto o resto aguarda no disco; páginas são trocadas entre RAM e disco conforme necessário, e o SO traduz cada endereço virtual em um físico. Por que um SO precisa dela: os programas em execução podem precisar de mais memória do que a RAM instalada; permite que mais (ou maiores) programas rodam ao mesmo tempo; um programa pode ser maior que a memória física; a memória é usada eficientemente porque apenas as partes ativas dos programas ocupam a RAM.
Segmentação em páginas contra segmentação: a diferença que o exame quer. Segmentação em páginas divide a memória em blocos de tamanho fixo (páginas e quadros) escolhidos pelo hardware, sem considerar a estrutura do programa, e o mapeamento é invisível ao programador; segmentação divide um programa em unidades lógicas de tamanho variável (um procedimento, uma matriz, a pilha) cujos tamanhos e limites seguem o programa, de modo que um segmento pode ser protegido ou compartilhado como unidade. "Descreva o processo de segmentação": o programa é dividido em segmentos de diferentes tamanhos, cada um receiving a número de segmento; uma tabela de segmentos registra onde cada segmento começa na memória e quanto tempo ele tem; um endereço lógico é um número de segmento mais um offset, e o SO adiciona o offset ao endereço base do segmento para encontrar a localização física.
"Explique o que significa thrashing de disco" e quando ocorre.** Thrashing de disco** 磁盘抖动 é o estado em que páginas são trocadas para dentro e para fora da RAM tão frequentemente que o processador passa mais tempo movendo páginas do que executando instruções, e o sistema desacelera quase a um ponto morto. Ocorre quando a RAM é muito pequena para as páginas que os processos em execução precisam (seus conjuntos de trabalho): uma página acabada de sair é necessária novamente quase imediatamente, então é buscada de volta, o que empurra outra página que logo será necessária, e assim por diante. Muitos processos ou um programa que acessa a memória imprevisivelmente o provocam; mais RAM ou menos processos o curam.
ExplorarO que acontece em um page fault
Passo a passo de um page fault. Quando o programa acessa uma página que não está na RAM, o SO busca silenciosamente do disco e atualiza a tabela de páginas — para que o programa veja mais memória do que fisicamente existe.
Vocabulário TreinarInglês Chinês Pinyin thrashing/ˈθræʃɪŋ/ 抖动 dǒu dòng segmentation/ˌseɡmənˈteɪʃn/ 分段 fēn duàn disk thrashing/dɪsk ˈθræʃɪŋ/ 磁盘抖动 cí pán dǒu dòng interpreter/ɪnˈtɜːprɪtə/ 解释器 jiě shì qì compiler/kəmˈpaɪlə/ 编译器 biān yì qì machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ lexical analysis/ˈleksɪkl əˈnæləsɪs/ 词法分析 cí fǎ fēn xī 16.2
Como um interpretador executa um programa
Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de como um interpretador pode executar programas sem produzir uma versão traduzida Demonstrar compreensão das várias etapas no compilador de um programa Incluindo análise léxica, análise sintática, geração de código e otimização Demonstrar compreensão de como a gramática de uma linguagem pode ser expressa usando diagramas de sintaxe ou notação Backus-Naur Form (BNF) Demonstrar compreensão de como a Notação Polonesa Reversa (RPN) pode ser usada para realizar a avaliação de expressões Fonte: Programa Cambridge International
Um interpretador 解释器 traduz e executa o código-fonte ao mesmo tempo. Para cada instrução, ele lê a linha, faz análise léxica e sintática, verifica tipos, então executa a ação e avança. Erros são reportados imediatamente e geralmente para; nenhuma versão executável é produzida. A tradução é refeita a cada execução (mais lento), mas oferece feedback rápido de desenvolvimento e é portátil.
"Explique como um interpretador executa um programa sem produzir uma versão traduzida" (três marcas).** O interpretador pega uma instrução (linha) de cada vez, traduz (analisa) e executa imediatamente, antes de passar para a próxima; nenhuma versão traduzida do programa inteiro é criada ou armazenada, então cada instrução é traduzida todas as vezes que é executada, incluindo cada passagem por um loop; se uma instrução contém um erro, a execução para ali e o erro é reportado. Isso é o que torna um interpretador bom para desenvolver e testar (erros são encontrados à medida que são alcançados, e uma mudança pode ser testada imediatamente) mas mais lento para executar programas terminados.
16.2
Etapas de compilação
Um compilador 编译器 transforma o código-fonte em código máquina 机器码 em fases:
- análise léxica 词法分析 — o lexer agrupa caracteres em tokens 词法单元 (palavras-chave, identificadores, operadores, literais), descartando espaços em branco e comentários.
- análise sintática (parsing) 语法分析 — verifica se os tokens se encaixam na gramática e constrói uma árvore de sintaxe abstrata 抽象语法树. Um colchete faltante causa um erro de sintaxe 语法错误.
- análise semântica 语义分析 — verifica se o programa faz sentido (variáveis declaradas, tipos correspondentes).
- geração de código 代码生成 — percorre a árvore e emite código-alvo, escolhe registradores e layouts.
- otimização de código — remova trabalho redundante, combine constantes, reordene para o pipeline.
The output is an executable.
As fases da compilação, do código-fonte a um executável otimizado O propósito de cada etapa, nas palavras que pontuam. Análise léxica: remove espaços em branco e comentários; converte os caracteres do código-fonte em tokens (palavras-chave, identificadores, operadores, constantes), verificando se cada um é válido na linguagem; insere identificadores na tabela de símbolos 符号表. Análise sintática: verifica se a sequência de tokens obedece à gramática (regras de sintaxe) da linguagem; constrói uma árvore de análise (árvore de sintaxe abstrata); reporta erros de sintaxe; verificação de tipos e verificação de declarações de variáveis às vezes são contadas aqui como análise semântica. Geração de código: converte a árvore verificada em código objeto ou código de máquina (possivelmente via código intermediário), alocando memória e registradores. Otimização: faz o código rodar mais rápido ou usar menos memória, removendo instruções redundantes, combinando ou simplificando cálculos e reorganizando loops, sem alterar o que o programa faz. A questão de correspondência associa cada etapa a uma dessas descrições.
ExplorarAs fases da compilação
Passo a passo do que um compilador faz com seu código-fonte. Cada fase entrega sua saída para a próxima — caracteres tornam-se tokens, tokens tornam-se uma árvore, a árvore torna-se código máquina otimizado.
Vocabulário TreinarInglês Chinês Pinyin tokens/ˈtəʊkənz/ 词法单元 cí fǎ dān yuán syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ 语法分析 yǔ fǎ fēn xī abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ 抽象语法树 chōu xiàng yǔ fǎ shù syntax error/ˈsɪntæks ˈerə/ 语法错误 yǔ fǎ cuò wù semantic analysis/səˈmæntɪk əˈnæləsɪs/ 语义分析 yǔ yì fēn xī code generation/kəʊd ˌdʒenəˈreɪʃn/ 代码生成 dài mǎ shēng chéng code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ 代码优化 dài mǎ yōu huà symbol table/ˈsɪmbl ˈteɪbl/ 符号表 fú hào biǎo grammar/ˈɡræmə/ 文法 wén fǎ 16.2
Grammar: BNF and syntax diagrams
Uma gramática diz quais sequências de tokens são programas válidos.
Backus-Naur Form 巴科斯-诺尔范式 (BNF) is textual. A production rule 产生式 has the form:
<symbol> ::= alternative1 | alternative2 | ...Cada alternativa é uma sequência de símbolos terminais (texto literal) e símbolos não terminais (outros nomes de regras):
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
A terceira regra recursiva expressa "uma letra seguida por qualquer número de letras ou dígitos". Uma instrução
IF:<if-statement> ::= IF <condition> THEN <statement> ENDIF | IF <condition> THEN <statement> ELSE <statement> ENDIFUm diagrama de sintaxe 语法图 (diagrama de ferrovia) mostra a mesma coisa graficamente: caixas para não-terminais, caixas arredondadas para terminais, setas para caminhos válidos, loops para repetição. As duas notações são equivalentes. O analisador sintático usa a gramática para decidir se um programa é válido.
A syntax (railroad) diagram for an assignment statement 
Um diagrama sintático e uma regra BNF dizem a mesma coisa: uma escolha torna-se alternativas separadas por barras, e um loop torna-se uma regra que se refere a si mesma Lendo os diagramas do exame. Cada diagrama define um não-terminal; siga as setas da entrada até a saída, e todo caminho que você puder traçar é uma string válida. Uma escolha de caixas lado a lado é um conjunto de alternativas; um laço de volta significa "repita quantas vezes quiser"; uma caixa para outro não-terminal significa "insira qualquer coisa que a regra permita". "Explique por que a string é inválida" quer a regra que ela viola, em palavras:
9Ké inválido como variável porque o primeiro caractere deve ser uma letra, não um dígito;JJ90é um código de acesso inválido se a regra permitir apenas uma letra antes dos dígitos, ou seJnão estiver no conjunto de letras listadas. Sempre verifique a string contra o conjunto de caracteres que o diagrama realmente permite, não contra o que uma linguagem real aceitaria.Escrevendo BNF a partir de um diagrama. Cada diagrama torna-se uma regra
<name> ::= ...; as alternativas são separadas por|; uma sequência é escrita um símbolo após o outro; e a repetição é escrita com recursão, porque o BNF não tem símbolo de loop: "uma ou mais letras" é<word> ::= <letter> | <letter><word>, e "zero ou mais dígitos após uma letra" é<variable> ::= <letter> | <letter><digits>com<digits> ::= <digit> | <digit><digits>.Exemplo resolvido. Complete o BNF para uma matrícula de veículo que deve começar com duas letras (de
A B C) seguidas por um, dois ou três dígitos (de0 1 2).<letter> ::= A | B | C <digit> ::= 0 | 1 | 2 <digits> ::= <digit> | <digit><digit> | <digit><digit><digit> <registration> ::= <letter><letter><digits>AB12é válido;A12não é (apenas uma letra);AB1234não é (quatro dígitos);AD1não é (Dnão é uma letra listada). Pedem para adicionar uma restrição como "o terceiro caractere também pode ser um símbolo", adicione a alternativa extra à regra para essa posição apenas e defina<symbol>com sua própria regra.Exemplo resolvido. Escreva BNF para uma expressão que seja uma variável, seguida por um operador, seguida por outra variável ou um número, onde uma variável é uma única letra minúscula de
a b ce um operador é+ou-.<variable> ::= a | b | c <operator> ::= + | - <number> ::= <digit> | <digit><number> <expression> ::= <variable><operator><variable> | <variable><operator><number>A regra recursiva
<number>permite qualquer número de dígitos; as duas alternativas de<expression>cobrem ambos os casos nomeados na definição. Mantenha todos os não-terminais entre colchetes angulares e todos os terminais sem eles.Vocabulário TreinarInglês Chinês Pinyin Backus-Naur Form/ˈbækəs nɔː fɔːm/ 巴科斯-诺尔范式 bā kē sī - nuò ěr fàn shì production rule/prəˈdʌkʃn ruːl/ 产生式 chǎn shēng shì terminal/ˈtɜːmɪnl/ 终结符 zhōng jié fú non-terminal/nɒn ˈtɜːmɪnl/ 非终结符 fēi zhōng jié fú syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ 语法图 yǔ fǎ tú 16.2
Reverse Polish Notation (RPN)
Na notação infixa 中缀, o operador fica entre seus operandos (
3 + 4 * 2), necessitando de parênteses e regras de precedência. Na Notação Polonesa Reversa 逆波兰表示法 (RPN, pós-fixa 后缀), o operador segue seus operandos (3 4 2 * +), não necessitando de parênteses.Converting infix to RPN
Use uma pilha 栈 de operadores. Varre da esquerda para a direita: output de um operando; para um operador, primeiro pop quaisquer operadores empilhados de precedência 优先级 maior ou igual ao output, depois push-o; push
(; em)pop para output até o(correspondente. No final, pop todos os operadores. Exemplo:(3 + 4) * 2→3 4 + 2 *.Evaluating RPN
Use uma pilha de operandos. Varra da esquerda para a direita: empurre cada operando; ao encontrar um operador, pop os dois superiores, aplique-o e empurre o resultado. Avaliando
3 4 2 * +:Token Stack 33 43, 4 23, 4, 2 *3, 8 +11 Resultado: 11. RPN não precisa de parênteses na avaliação e se adapta a uma máquina de pilha — que é como a JVM e muitos interpretadores de bytecode funcionam.
"Explique por que a RPN é usada para avaliar expressões" (duas marcas). Na RPN, os operadores aparecem na ordem em que são aplicados, então uma expressão pode ser avaliada em uma única passagem da esquerda para a direita com sem parênteses e sem regras de precedência; portanto, é mais simples e rápida para o compilador ou interpretador processar. "Identifique, com razões, uma estrutura de dados adequada": uma pilha, porque a avaliação precisa dos operandos empurrados mais recentemente primeiro (último a entrar, primeiro a sair): cada operando é empurrado, e cada operador pop dos dois superiores, aplica-se a si mesmo e push do resultado. Mostre o conteúdo da pilha após cada token quando solicitado.
Convertendo infix para RPN à mão. (1) Complete a expressão com parênteses usando as regras de precedência; (2) mova cada operador para logo após o parêntese fechado de seu próprio par; (3) remova os parênteses. Então $(a - b) * (a + c) / 7$ torna-se $((a - b) * (a + c)) / 7$, então
a b - a c + * 7 /. Note que*e/são aplicados da esquerda para a direita, então a divisão é o último operador, não a multiplicação. Mais conversões: $((7 + 3) - (2 * 8)) / 6$ é7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$ é7 2 - 8 + 9 5 - /; $a * b + b - d + 15$ éa b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$ é2 6 - 13 7 + * 5 /.Convertendo RPN de volta para infix. Trabalhe através da RPN com uma pilha de expressões: push de cada operando; para cada operador pop de dois, escreva-os de cada lado dele entre parênteses e push do resultado. Então
a b / 4 * a b + -é $((a / b) * 4) - (a + b)$;5 2 + 9 3 - / 3 *é $((5 + 2) / (9 - 3)) * 3$;b a c - + d b + * c /é $((b + (a - c)) * (d + b)) / c$;a b - c + c a - * d /é $(((a - b) + c) * (c - a)) / d$. Mantenha os parênteses: descartá-los pode mudar o significado.Worked example. Avaliar
a b - c d + * e /when $a = 17$, $b = 5$, $c = 7$, $d = 3$ e $e = 10$, showing the stack.token action stack (top on the right) apush 17 17 bpush 5 17, 5 -pop 5 and 17, push $17 - 5$ 12 cpush 7 12, 7 dpush 3 12, 7, 3 +pop 3 and 7, push $7 + 3$ 12, 10 *pop 10 and 12, push $12 \times 10$ 120 epush 10 120, 10 /pop 10 e 120, push $120 / 10$ 12 Resultado 12. A ordem dos pops importa para
-e/: o valor popped segundo é o operando esquerdo, entãoa b -é $a - b$, não $b - a$. Mais dois, da mesma forma:d a b + * c a - /com $a = 6, b = 12, c = 15, d = 5$ dá $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$;c a - b d + * b c + /com $a = 4, b = 12, c = 24, d = 6$ dá $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.Exemplo resolvido. Converta $(A + B) \times (C - D)$ para RPN, depois avalie $(3 + 4) \times (5 - 2)$. Varra da esquerda para a direita usando uma pilha 栈 de operadores. Push
(; outputA; push+; outputB; em)pop de volta até o(correspondente, dandoA B +até agora. Push×, e o segundo parêntese comporta-se da mesma maneira, dandoC D -. No final pop o×. Resultado:A B + C D - ×. Para avaliar os números, use uma pilha de operandos: push 3, push 4;+pop de ambos e push 7; push 5, push 2;-pop de ambos e push 3;×pop 7 e 3 e push 21. Duas coisas tornam isso confiável: os operandos mantêm sua ordem original através da conversão (apenas os operadores se movem) e cada operador atua nos dois valores imediatamente abaixo dele na pilha.ExplorarPrecedência de operadores — o que a RPN elimina
Na matemática infixa comum, × e ÷ têm precedência maior que + e −, então você deve aplicar as regras na ordem certa. A Notação Polonesa Reversa escreve os operandos primeiro (3 4 2 × + 1 −), fixando a ordem para que nenhuma regra de precedência seja necessária.
Vocabulário TreinarInglês Chinês Pinyin infix/ˈɪnfɪks/ 中缀 zhōng zhuì Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ 逆波兰表示法 nì bō lán biǎo shì fǎ postfix/ˈpəʊstfɪks/ 后缀 hòu zhuì stack/stæk/ 栈 zhàn precedence/ˈpresɪdəns/ 优先级 yōu xiān jí bytecode/ˈbaɪtkəʊd/ 字节码 zì jié mǎ 16.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição multi-tarefa vários processos mantidos na memória ao mesmo tempo, com o processador alternando entre eles para que pareçam estar sendo executados simultaneamente processo um programa que foi carregado na memória e está sendo executado (ou está pronto para ser) executando / pronto / bloqueado possui o processador / aguardando o processador / não pode continuar até que um evento, como a conclusão de E/S, ocorra escalonamento decidir qual processo pronto receberá o processador em seguida e por quanto tempo escalonamento preemptivo o processo em execução pode ser interrompido e movido para pronto para que outro processo seja executado memória virtual usar armazenamento secundário para estender a RAM, mantendo apenas as páginas necessárias atualmente na memória física paginação dividir a memória e os programas em páginas de tamanho fixo que são movidas entre o disco e a RAM conforme necessário segmentação dividir um programa em segmentos lógicos de tamanho variável, cada um mapeado para a memória por uma tabela de segmentos thrashing de disco páginas sendo trocadas entre RAM e disco tão frequentemente que pouco processamento útil é realizado interpretador traduz e executa um programa uma instrução por vez, sem produzir uma versão traduzida compilador traduz todo um programa de alto nível para código de máquina (objeto) antes de ser executado análise lexical converte o código-fonte em tokens, removendo espaços em branco e comentários, e constrói a tabela de símbolos análise sintática verifica se os tokens obedecem à gramática da linguagem e constrói uma árvore de análise Forma de Backus–Naur uma notação para a gramática de uma linguagem: regras da forma <name> ::= alternativesconstruídas a partir de terminais e não-terminaisNotação Polonesa Reversa uma maneira de escrever expressões em que cada operador vem depois dos seus operandos, permitindo avaliação com uma pilha e sem parênteses 16.2
Dicas de prova
- As questões do SO são avaliadas em mecanismos nomeados: escalonamento, gerenciamento de memória, buffering e spooling de E/S, gerenciamento de arquivos; quanto à interface, nomes de arquivo em vez de endereços, cliques em vez de comandos, drivers, GUI.
- Estados do processo com suas transições e o motivo de cada uma; rotinas de escalonamento como função mais benefício mais desvantagem; o kernel salva o estado, identifica a interrupção, atende-a, restaura.
- Memória virtual: disco estende RAM, páginas trocadas, tradução de endereço; paging é tamanho fixo e invisível, segmentação é tamanho variável e lógico; thrashing (thrashing) é troca de páginas em vez de trabalho útil.
- Interpretador: uma instrução por vez, traduzida depois executada, nada armazenado. Estágios do compilador: tokens e tabela de símbolos, gramática e árvore de análise, código, otimização.
- BNF: uma regra por diagrama,
|para escolha, recursão para repetição, terminais nus e não-terminais entre colchetes angulares. Diga qual regra uma string viola. - RPN: operadores após os operandos, avalie com uma pilha, mostre cada passo; converta adicionando parênteses completos; ao converter de volta, mantenha os parênteses.
Erros comuns
- Descrever multitarefa como "executar vários programas ao mesmo tempo" sem dizer que o processador alterna entre eles.
- Enviar um processo bloqueado diretamente para executing, ou dar "time slice ended" como razão para executing ir para blocked.
- Confundir shortest job first (não preempitivo) com shortest remaining time (preempitivo), ou round robin com prioridade.
- Definir memória virtual como "usar o disco rígido como RAM" sem mencionar que as páginas são trocadas.
- Dizer que um interpretador "converte o programa para código de máquina e então o executa"; isso é um compilador.
- Colocar verificação de sintaxe na análise léxica, ou otimização antes da geração de código na questão de correspondência.
- Escrever repetição BNF como
<letter>*ou com reticências; use recursão. Deixar colchetes angulares fora dos não-terminais. - Revertendo os operandos de
-ou/ao avaliar RPN, ou escrevendo a RPN de $a * b + c$ comoa b c + *.
Vocabulário TreinarInglês Chinês Pinyin blocked/blɒkt/ 阻塞 zǔ sè process control block/ˈprəʊses kənˈtrəʊl blɒk/ 进程控制块 jìn chéng kòng zhì kuài -
17
Segurança
Assistir aula17.1
Como funciona a criptografia

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de como a criptografia funciona Incluindo o uso de chave pública, chave privada, texto claro, texto cifrado, criptografia, criptografia de chave simétrica e criptografia de chave assimétrica. Como as chaves podem ser usadas para enviar uma mensagem privada do público para um indivíduo/organização. Como as chaves podem ser usadas para enviar uma mensagem verificada ao público. Como os dados são criptografados e descriptografados, usando criptografia simétrica e assimétrica. Propósito, benefícios e desvantagens da criptografia quântica Demonstrar conhecimento sobre Secure Socket Layer (SSL) / Transport Layer Security (TLS) Propósito de SSL/TLS. Uso de SSL/TLS em comunicação cliente-servidor. Situações onde o uso de SSL/TLS seria apropriado Demonstrar compreensão de certificação digital Como um certificado digital é adquirido. Como um certificado digital é usado para produzir assinaturas digitais Fonte: Programa Cambridge International
Criptografia 加密 transforma plaintext 明文 (texto claro) legível em ciphertext 密文 (texto cifrado) ilegível usando uma operação matemática que depende de uma chave 密钥. Apenas alguém com a chave certa pode reverter — decryption 解密 — para recuperar o plaintext. Um atacante que intercepta o ciphertext sem a chave vê apenas dados sem sentido, pois tentar todas as chaves possíveis levaria muito tempo. Uma abordagem mais recente, quantum cryptography 量子密码学, usa física quântica para compartilhar uma chave de forma a revelar qualquer espião.
A máquina Enigma criptografava mensagens na Segunda Guerra Mundial — um dispositivo de cifra mecânico inicial 
Criptografia embaralha plaintext com uma chave; decifragem inverte isso Criptografia simétrica
Criptografia simétrica 对称加密 (criptografia de chave simétrica) usa a mesma key 密钥 tanto para criptografia quanto para decifragem, portanto remetente e destinatário devem ambos possuir a chave secreta. É rápida e boa para dados em massa (disco inteiro, fluxo de vídeo). Seu problema é chave distribution 密钥分发: como você compartilha a chave com segurança inicialmente? A criptografia assimétrica resolve isso.
"Descreva o que se entende por criptografia de chave simétrica" (duas marcas). A mesma chave é usada para criptografar o plaintext e para decifrar o ciphertext, portanto a chave deve ser compartilhada entre remetente e destinatário e mantida secreta para todos os outros. Duas desvantagens. A chave precisa ser trocada antes que a mensagem possa ser enviada, e se for interceptada no trânsito o interceptador pode ler todas as mensagens; uma chave separada é necessária para todo par de correspondentes; e não fornece prova de quem enviou a mensagem, porque ambas as extremidades detêm a mesma chave. "Dê duas razões para usar criptografia de chave": para que os dados fiquem ilegíveis por quem quer que os intercepte (confidencialidade); para que o destinatário tenha certeza de que os dados vieram do remetente declarado e não foram alterados (autenticidade e integridade 完整性). Os dois métodos são criptografia de chave simétrica e assimétrica.
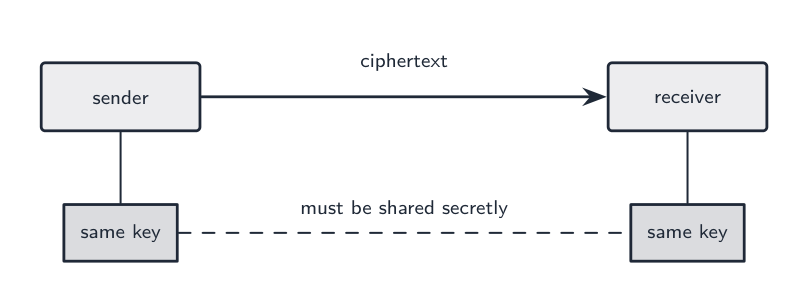
Criptografia simétrica usa a mesma chave secreta em ambas as extremidades Criptografia assimétrica (chave pública)
Criptografia assimétrica 非对称加密 (criptografia de chave assimétrica) dá a cada usuário um par de chaves relacionadas: uma public key 公钥 que publica, e uma private key 私钥 que mantém secreta. Dados criptografados com a chave pública podem ser decifrados apenas com a chave privada correspondente, e vice-versa.

Cada usuário tem uma chave pública para compartilhar e uma chave privada para manter secreta Para enviar uma mensagem secreta para Alice: obtenha sua chave pública publicada, criptografe com ela e envie. Apenas Alice — detendo a chave privada correspondente — pode decifrar. Nenhuma troca prévia de chave é necessária. O trade-off é que é muito mais lento que a simétrica, portanto não é usado para grandes volumes de dados.
"Afirme o que se entende por uma chave privada." Uma chave conhecida apenas pelo seu proprietário (nunca transmitida), usada para decifrar dados que foram criptografados com a chave pública correspondente, e para criar assinaturas digitais. "Descreva o processo de criptografia assimétrica" (quatro marcas): (1) o receptor gera um par de chaves, uma chave pública e uma chave privada, matematicamente relacionadas; (2) a public key 公钥 é disponibilizada a qualquer um que queira enviar a ele; (3) o remetente criptografa o plaintext com a public key 公钥 do receptor; (4) o ciphertext só pode ser decifrado com a private key 私钥 do receptor, que nunca sai do receptor, portanto ninguém que intercepte a mensagem pode lê-la.
Exemplo resolvido. Fred quer enviar um documento confidencial a Sheila. Explique como a criptografia assimétrica é usada.
Sheila tem um par de chaves; ela envia a Fred sua chave pública (ou ele a obtém de seu certificado). Fred criptografa o documento com a public key 公钥 de Sheila e envia o ciphertext. Apenas a private key 私钥 de Sheila pode decifrá-lo, e apenas Sheila a detém, portanto ninguém mais, incluindo Fred uma vez criptografado, pode ler o documento. As chaves são usadas no sentido do destinatário: sua chave pública para travar, sua chave privada para destravar. Uma organização que detém um par de chaves "para receber transmissões seguras" faz exatamente isso: publica a chave pública, mantém a chave privada e decifra o que chegar.
Duas diferenças entre criptografia simétrica e assimétrica. Simétrica usa uma chave para ambas as direções; assimétrica usa duas chaves relacionadas, uma para criptografar e outra para decifrar. Em criptografia simétrica a chave deve ser mantida secreta por ambas as partes e trocada com segurança; em criptografia assimétrica a chave pública pode ser publicada e apenas a chave privada é secreta. Criptografia simétrica é muito mais rápida e adequada para grandes quantidades de dados; assimétrica é mais lenta, portanto é usada para chaves e assinaturas em vez de dados em massa.
Uma chave privada deve permanecer secreta, portanto às vezes é mantida em um pequeno hardware security key 硬件安全密钥. Você o conecta ou toca nele para provar quem você é, e a chave secreta nunca sai do dispositivo.
 *Uma chave de segurança de hardware armazena uma chave secreta para provar quem você é
Abordagem híbrida (usada por quase todos os sistemas reais)
Use criptografia assimétrica para trocar uma session key 会话密钥 fresca, depois use essa chave simétrica para os dados:
- o cliente cria uma session key aleatória.
- ele criptografa a session key com a public key do servidor.
- o servidor decifra com sua private key.
- ambas as extremidades agora compartilham a session key e usam criptografia simétrica rápida para o resto.
É assim que funcionam HTTPS e SSH.
A versão do exame do problema de troca de chaves. "Uma chave simétrica será trocada antes que a mensagem seja enviada. Explique como a chave pode ser trocada com segurança." O remetente criptografa a chave simétrica com a public key 公钥 do destinatário e a envia; o destinatário a decifra com sua private key 私钥; ambos agora detêm a chave simétrica, que nunca foi exposta no trânsito, e a usam para as mensagens. A criptografia assimétrica resolve o problema de distribuição; a criptografia simétrica então faz o trabalho rápido.
 *A abordagem híbrida: criptografia assimétrica compartilha uma session key uma vez, depois criptografia simétrica rápida protege os dados
Hashing (relacionado, não criptografia)
Uma função cryptographic hash 密码散列 pega qualquer entrada e produz um digest 摘要 de tamanho fixo tal que a mesma entrada sempre produz o mesmo digest, é inviável encontrar duas entradas com o mesmo digest, e uma pequena mudança na entrada muda completamente o digest. Hashing é one-way — você não pode recuperar a entrada. É usado para armazenamento de verificações de senha, verificações de integrity 完整性 e assinaturas digitais.
 *Um cryptographic hash produz um digest fixo; uma pequena mudança na entrada o muda completamente, e não pode ser revertido
Criptografia quântica
Criptografia quântica usa a física da luz para distribuir chaves: os bits de uma chave são enviados como fótons cujos estados quânticos codificam os valores. "Descreva seu propósito": transmitir uma chave de criptografia com segurança, de modo que qualquer tentativa de interceptação possa ser detectada, pois medir um fóton altera seu estado; um espião (窃听者) portanto deixa rastros, e a chave corrompida é descartada e uma nova é enviada. Benefícios: a interceptação é sempre detectável; a chave não pode ser copiada sem ser alterada; é segura contra avanços futuros no poder de computação (uma chave matemática pode eventualmente ser quebrada, uma quântica não pode ser lida sem perturbá-la). Desvantagens: requer equipamentos especializados e caros; funciona apenas sobre distâncias limitadas em fibra ótica dedicada (ou linha de visão), não através da internet existente; distribui apenas a chave, então a criptografia comum ainda protege a mensagem; e é uma tecnologia nova com poucos fornecedores e pouca experiência.
ExplorarHashing e o efeito avalanche
Um hash é unidirecional: fácil de calcular, praticamente impossível de reverter. Uma pequena mudança na entrada inverte uma parte grande e imprevisível da saída — o efeito avalanche que torna hashes bons para senhas.
ExplorarA cifra de César
Desloque cada letra para criptografar a mensagem. Uma cifra simples mostra a ideia de uma chave — e por que uma chave pequena é fácil de quebrar.
Vocabulário TreinarInglês Chinês Pinyin encryption/enˈkrɪpʃn/ 加密 jiā mì plaintext/ˈpleɪntekst/ 明文 míng wén ciphertext/ˈsaɪfətekst/ 密文 mì wén decryption/dɪˈkrɪpʃn/ 解密 jiě mì quantum cryptography/ˈkwɒntəm krɪpˈtɒɡrəfi/ 量子密码学 liàng zǐ mì mǎ xué eavesdropper/ˈiːvzdrɒpə/ 窃听者 qiè tīng zhě symmetric encryption/sɪˈmetrɪk enˈkrɪpʃn/ 对称加密 duì chèn jiā mì key distribution/kiː ˌdɪstrɪˈbjuːʃn/ 密钥分发 mì yào fēn fā asymmetric encryption/ˌeɪsɪˈmetrɪk enˈkrɪpʃn/ 非对称加密 fēi duì chèn jiā mì integrity/ɪnˈteɡrɪti/ 完整性 wán zhěng xìng public key/ˈpʌblɪk kiː/ 公钥 gōng yào private key/ˈpraɪvət kiː/ 私钥 sī yào hardware security key/ˈhɑːdweə sɪˈkjʊərɪti kiː/ 硬件安全密钥 yìng jiàn ān quán mì yào session key/ˈseʃn kiː/ 会话密钥 huì huà mì yào cryptographic hash/ˌkrɪptəˈɡræfɪk hæʃ/ 密码散列 mì mǎ sàn liè digest/ˈdaɪdʒest/ 摘要 zhāi yào 17.1
SSL / TLS
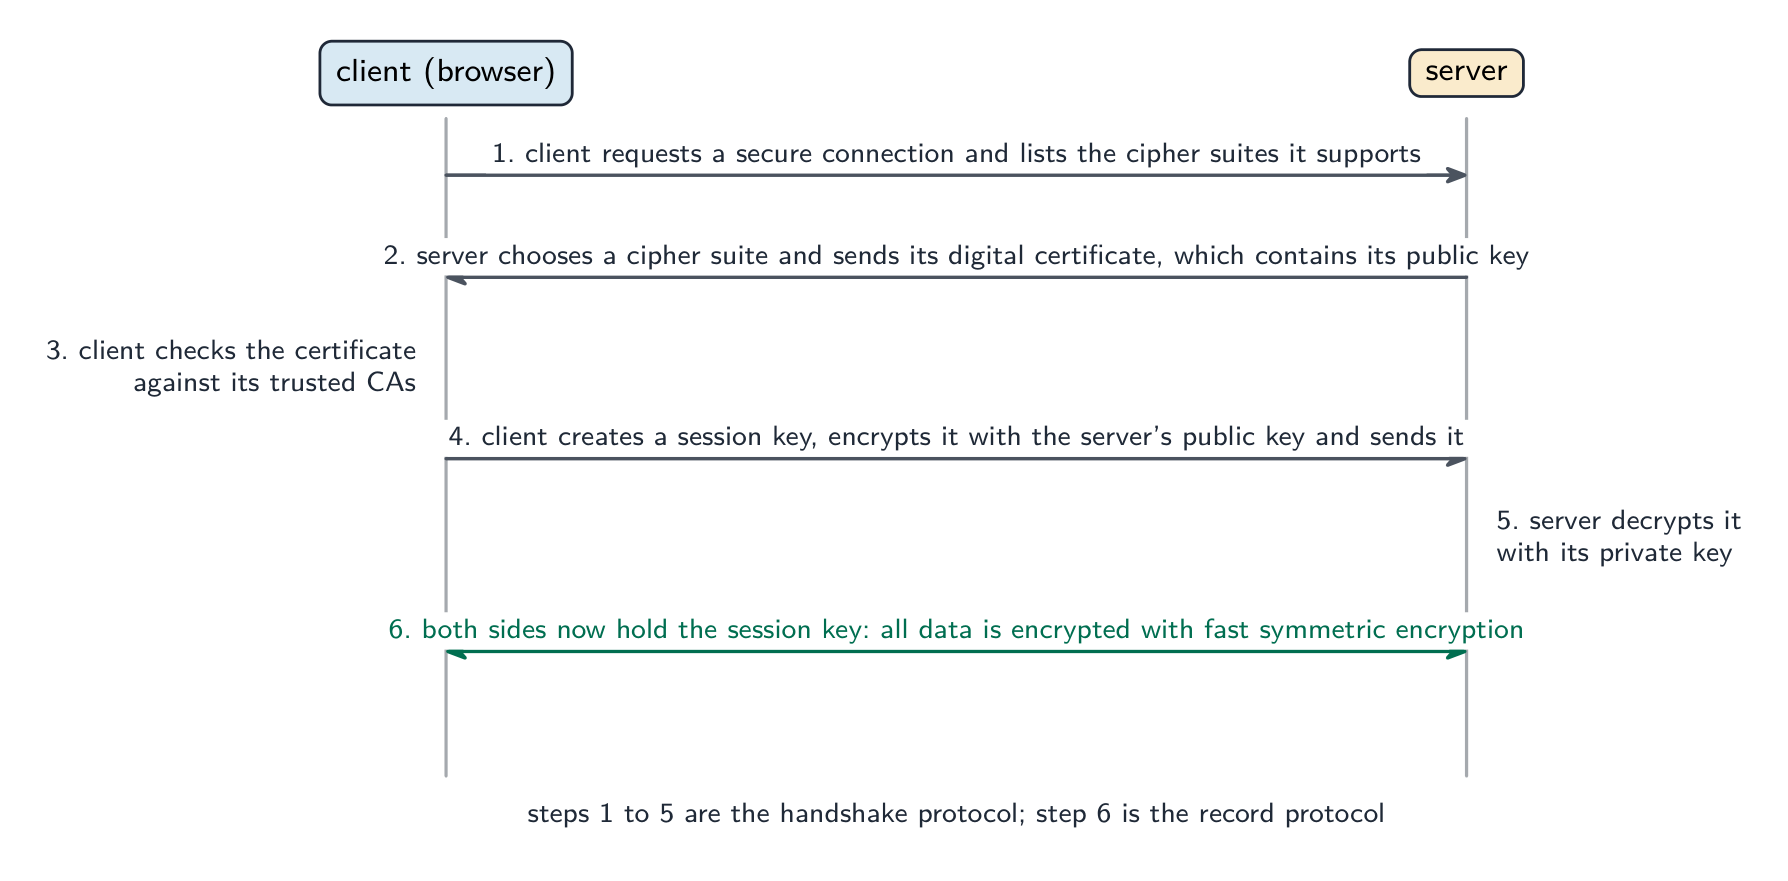
TLS Segurança na Camada de Transporte (Transport Layer Security, o sucessor do Secure Socket Layer, SSL) é um protocolo que fornece criptografia e autenticação para dados transmitidos por uma rede. Ele criptografa os dados em trânsito, autentica o servidor com um certificado e fornece integridade (detecção de adulteração).
Esboço de um handshake TLS:
- o cliente se conecta e propõe opções de cifra.
- o servidor escolhe uma e envia seu certificado digital (com sua chave pública) — emitir e validar esses certificados é certificação digital.
- o cliente verifica o certificado.
- as duas extremidades trocam uma chave de sessão fresca usando criptografia assimétrica.
- todo o tráfego subsequente usa criptografia simétrica rápida com a chave de sessão.
O resultado é um túnel criptografado, autenticado e verificado quanto à integridade para protocolos de nível superior (HTTP, SMTP). É adequado sempre que informações sensíveis são enviadas: navegação web HTTPS, banco online e pagamentos, e-mail seguro e VPNs.
"Descreva o propósito do SSL/TLS" e "cite duas funções." O propósito é fornecer comunicação segura entre um cliente e um servidor através de uma rede. Suas funções: ele criptografa os dados enviados, para que não possam ser lidos se interceptados; autentica (认证) o servidor (e opcionalmente o cliente) por meio de um certificado digital, para que o cliente saiba que está conversando com o site genuíno; e verifica a integridade dos dados, para que alterações durante o trânsito sejam detectadas. Dois exemplos onde é apropriado: banco online e compras online (pagamentos com cartão); também logins, e-mail privado, transferência de arquivos, VoIP e mensagens instantâneas: qualquer transação em que dados privados cruzem a internet.
Os dois protocolos que compõem o TLS. O protocolo de handshake (握手) configura a sessão: concorda nos algoritmos de criptografia (suite de cifras), autentica o servidor com seu certificado e troca a chave de sessão. O protocolo de record então transporta os dados: criptografa cada mensagem com a chave de sessão, adiciona uma verificação de integridade e a passa para a camada de transporte.
Como uma sessão segura começa: o certificado prova quem é o servidor, a chave pública do servidor protege a chave de sessão em trânsito, e a chave de sessão protege tudo depois disso "Explique como o SSL/TLS é usado quando a comunicação cliente-servidor é iniciada" (seis marcas). (1) O cliente (navegador) envia uma solicitação ao servidor por uma conexão segura, dizendo quais métodos de criptografia suporta. (2) O servidor devolve seu certificado digital, que contém sua chave pública. (3) O cliente verifica se o certificado é válido (emitido por uma Autoridade Certificadora confiável, não expirado, para o domínio correto). (4) O cliente gera uma chave de sessão, criptografa-a com a chave pública do servidor e a envia. (5) O servidor descriptografa a chave de sessão com sua chave privada. (6) Ambos os lados agora possuem a chave de sessão e todos os dados subsequentes são enviados usando criptografia simétrica com ela. Dê os passos nesta ordem; as marcas são para o certificado, a chave pública, a chave de sessão e a mudança para criptografia simétrica.
ExplorarO handshake TLS
Passe por cima do que acontece antes que um cadeado apareça. A criptografia de chave pública lenta é usada apenas para combinar uma chave compartilhada; a página real viaja sob criptografia simétrica rápida.
Vocabulário TreinarInglês Chinês Pinyin TLS/ˌtiː el ˈes/ 传输层安全 chuán shū céng ān quán authentication/ɔːˌθentɪˈkeɪʃn/ 身份验证 shēn fèn yàn zhèng authenticates/ɔːˈθentɪkeɪts/ 认证 rèn zhèng handshake/ˈhændʃeɪk/ 握手 wò shǒu 17.1
Certificados digitais
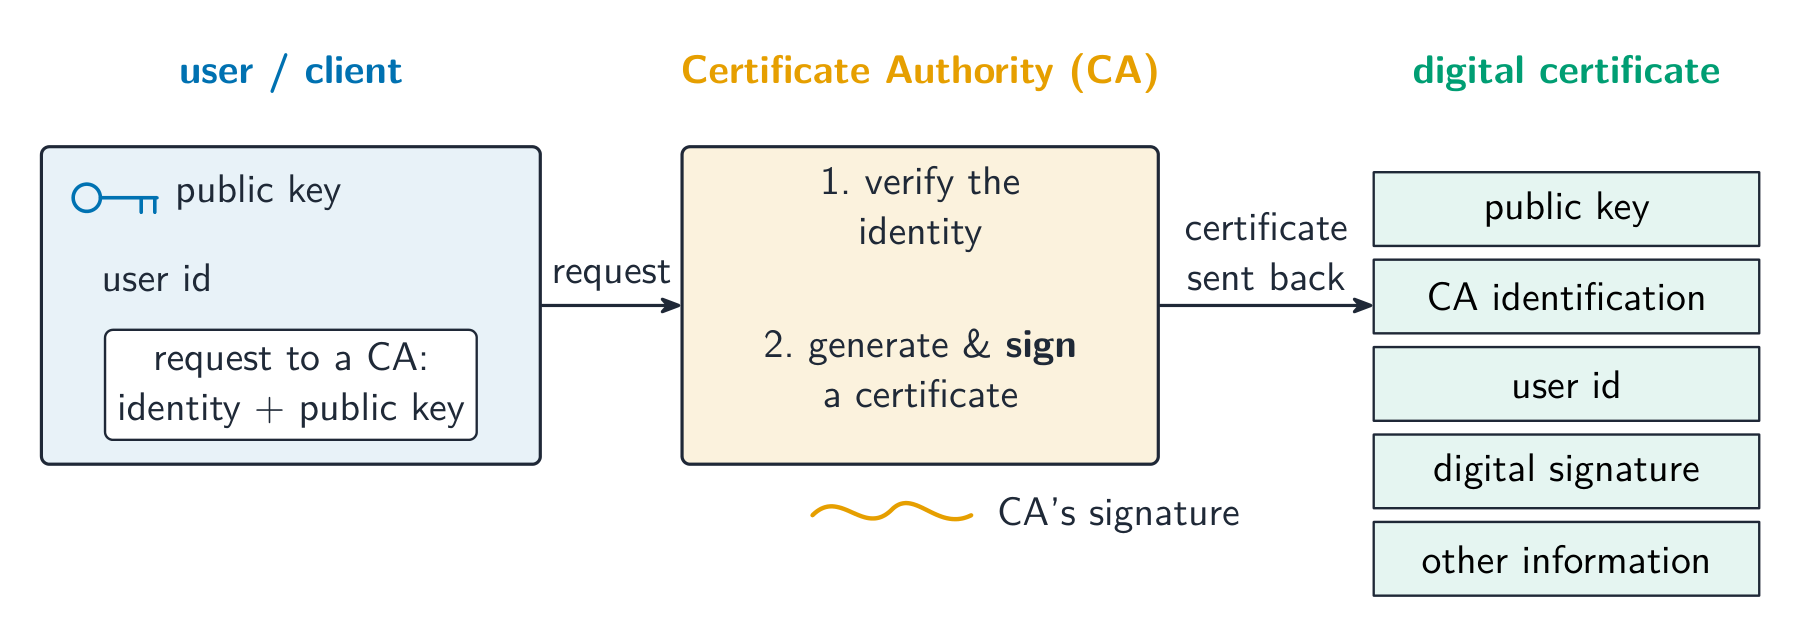
Um certificado digital (数字证书) vincula uma identidade (um domínio, uma organização) a uma chave pública, e é assinado por uma Autoridade Certificadora (CA) confiável (证书颁发机构). Contém o sujeito (quem ele identifica), a chave pública do sujeito, o emissor (a CA), um período de validade e a assinatura da CA sobre tudo isso.
Uma Autoridade Certificadora emite um certificado digital vinculando uma identidade a uma chave pública Para verificar um, o cliente (que possui uma lista de CAs raiz confiáveis):
- verifica as datas de expiração.
- verifica se o nome do sujeito corresponde à URL.
- verifica se é assinado por uma CA confiável, usando a chave pública da CA para verificar a assinatura.
- segue a cadeia de certificados até uma raiz confiável.
Se algo falhar, o navegador mostra o aviso "Sua conexão não é privada". Quando verifica limpidamente, o cliente sabe que a identidade foi verificada por uma CA confiável, que a chave pública realmente pertence àquela identidade e que o certificado está atual.
"Descreva o que significa um certificado digital" (duas marcas). Um documento eletrônico, emitido por uma Autoridade Certificadora, que verifica a identidade de seu proprietário (uma pessoa, organização ou site) e contém a chave pública do proprietário. Itens encontrados em um: o número de série; o nome do proprietário (sujeito) e, para um site, seu domínio; a chave pública do proprietário; o nome da CA emissora; o período de validade (datas); o algoritmo de assinatura usado; e a assinatura digital da CA de todo o certificado.
"Explique como uma organização adquire um certificado digital" (quatro marcas). (1) A organização gera seu próprio par de chaves, uma chave pública e uma chave privada. (2) Ela envia uma solicitação contendo sua chave pública e seus detalhes de identidade a uma Autoridade Certificadora. (3) A CA verifica a identidade (confirma que o solicitante realmente é a organização ou possui o domínio). (4) A CA cria o certificado contendo a chave pública e a identidade, assina-o com sua própria chave privada e o devolve. (5) A organização instala o certificado em seu servidor para que possa ser enviado aos clientes. A chave privada nunca sai da organização.
"Explique por que um certificado digital é necessário para validar uma assinatura digital." Para verificar uma assinatura, o receptor precisa da chave pública do remetente e precisa ter certeza de que a chave realmente pertence ao remetente declarado; o certificado fornece a chave pública junto com a identidade, e como o certificado é assinado por uma CA confiável, o receptor pode confiar nesse vínculo. Sem isso, um impostor poderia publicar uma chave pública em nome de alguém e assinar mensagens em seu nome. O mesmo raciocínio responde "o que deve ser incluído com um programa baixado da internet para provar que é genuíno": uma assinatura digital, verificada contra o certificado do publicador.
Vocabulário TreinarInglês Chinês Pinyin digital certificate/ˈdɪdʒɪtl səˈtɪfɪkət/ 数字证书 shù zì zhèng shū Certificate Authority/səˈtɪfɪkət əˈθɒrɪti/ 证书颁发机构 zhèng shū bān fā jī gòu man-in-the-middle/mæn ɪnðə ˈmɪdl/ 中间人攻击 zhōng jiān rén gōng jī 17.1
Assinaturas digitais
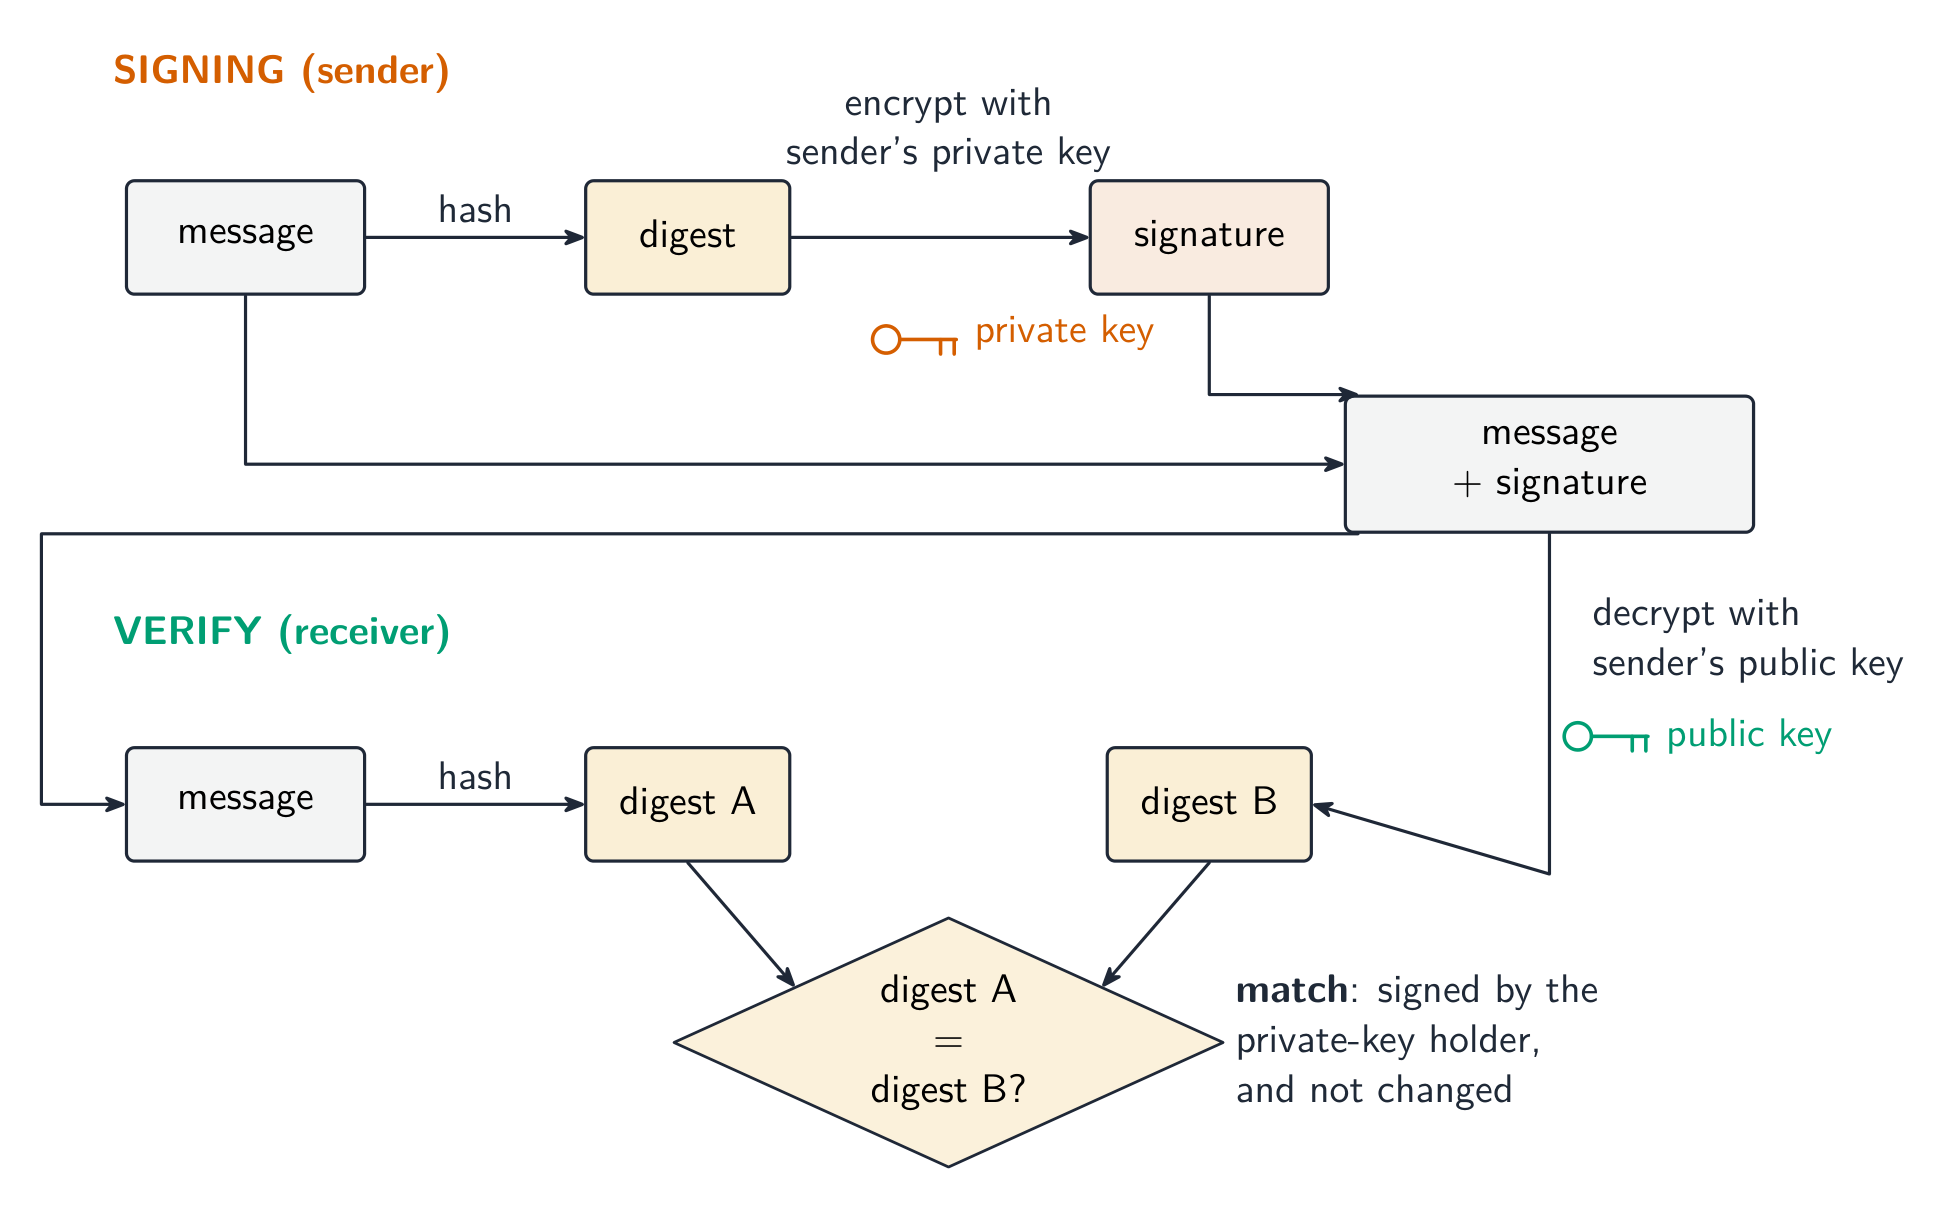
Uma assinatura digital (数字签名) prova quem assinou uma mensagem e que ela não foi alterada. Para assinar:
- calcular um hash criptográfico da mensagem.
- criptografar o hash com a chave privada do remetente — essa é a assinatura.
- enviar a mensagem e a assinatura.
Para verificar: calcular o hash da mensagem recebida; descriptografar a assinatura com a chave pública do remetente para obter o hash do remetente; comparar. Se coincidirem, a mensagem foi assinada pelo titular da chave privada (autenticação 身份验证) e não foi alterada (integridade). Uma assinatura não oculta a mensagem — para confidencialidade além disso, criptografar e assinar.
*Assinar calcula o hash da mensagem e criptografa o resumo com a chave privada; o receptor verifica com a chave pública"Explique o papel de um certificado digital na criação de uma assinatura digital" (três marcas). O certificado do remetente foi emitido por uma CA e contém a chave pública do remetente junto com a identidade do remetente; o remetente produz a assinatura hashando a mensagem e criptografando o hash com sua chave privada, o parceiro da chave no certificado; o receptor usa a chave pública do certificado para descriptografar o hash e, porque o certificado vincula essa chave ao remetente, a assinatura prova quem assinou.
"Explique como uma assinatura digital é usada para verificar uma mensagem" (quatro marcas). (1) O receptor descriptografa a assinatura com a chave pública do remetente (retirada do certificado do remetente), o que resulta no hash que o remetente calculou. (2) O receptor calcula o hash da mensagem recebida com o mesmo algoritmo de hash. (3) Os dois hashes são comparados. (4) Se eles coincidirem, a mensagem veio do titular da chave privada (autêntica) e não foi alterada desde que foi assinada (integridade); se diferirem, a mensagem é rejeitada. Um banqueiro recebendo dados confidenciais com uma assinatura faz exatamente isso antes de confiá-los; os próprios dados podem ser separadamente criptografados com a chave pública do banqueiro para confidencialidade.
Juntando tudo
Uma solicitação segura a
https://www.bank.com: o servidor envia seu certificado; o cliente o verifica contra CAs confiáveis; o cliente usa a chave pública do servidor para trocar uma chave de sessão; então os dados fluem criptografados com essa chave. A criptografia impede espiões, o certificado prova a identidade do servidor e as verificações de integridade impedem um atacante intermediário (中间人攻击) alterando os dados.Exemplo resolvido. Alice envia a Bob um contrato. Ela quer que Bob tenha certeza de que veio dela e não foi alterado, e ela quer que ninguém mais possa lê-lo. Quais chaves ela usa e em qual direção? São dois trabalhos diferentes que exigem dois pares de chaves diferentes. Para a assinatura (autenticação e integridade): Alice cria o hash do contrato e criptografa esse hash com sua própria chave privada; Bob descriptografa com a chave pública de Alice e compara contra seu próprio hash da mensagem. Apenas Alice detém sua chave privada, então apenas ela poderia ter produzido isso. Para confidencialidade: Alice criptografa o contrato em si com a chave pública de Bob, para que apenas a chave privada de Bob possa abri-la. Uma regra mantém os quatro claros: você assina com sua própria chave privada e criptografa com a chave pública do destinatário. Uma assinatura por si só não esconde a mensagem.
Vocabulário TreinarInglês Chinês Pinyin digital signature/ˈdɪdʒɪtl ˈsɪɡnɪtʃə/ 数字签名 shù zì qiān míng 17.1
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição criptografia converter texto simples em texto cifrado usando um algoritmo e uma chave para que não possa ser compreendido se interceptado texto simples / texto cifrado os dados legíveis originais / a forma criptografada e ilegível deles criptografia de chave simétrica a mesma chave secreta é usada para criptografar e descriptografar, portanto deve ser compartilhada com segurança por ambas as partes criptografia de chave assimétrica um par de chaves relacionadas é usado: a chave pública criptografa e apenas a chave privada correspondente descriptografa chave pública uma chave disponibilizada a qualquer pessoa, usada para criptografar mensagens para seu proprietário e verificar as assinaturas do proprietário chave privada uma chave conhecida apenas por seu proprietário, usada para descriptografar mensagens criptografadas com a chave pública e assinar SSL/TLS protocolos que fornecem comunicação segura (criptografada, autenticada, verificada quanto à integridade) entre um cliente e um servidor certificado digital um documento eletrônico emitido por uma Autoridade Certificadora que verifica a identidade do proprietário e contém sua chave pública assinatura digital um hash de uma mensagem criptografado com a chave privada do remetente, provando quem o enviou e que ele não foi alterado Autoridade Certificadora uma organização confiável que verifica identidades e emite e assina certificados digitais criptografia quântica o uso de estados quânticos de fótons para distribuir chaves de modo que qualquer interceptação seja detectada 17.1
Dicas de prova
- Simétrica: uma única chave secreta compartilhada, rápida, troca de chaves é a fraqueza. Assimétrica: chave pública para criptografar, chave privada para descriptografar, lenta, sem problema de troca. Duas diferenças, duas desvantagens, duas razões: o exame pede esses pontos em pares.
- Confidencialidade usa as chaves do receptor (pública para travar, privada para destravar); uma assinatura usa as chaves do remetente (privada para assinar, pública para verificar). Diga sempre a quem pertence cada chave.
- A inicialização do TLS tem seis etapas: solicitação, certificado com chave pública, verificação, chave de sessão criptografada com a chave pública, descriptografada com a chave privada, criptografia simétrica a partir daí.
- Um certificado é identidade mais chave pública, assinado por uma CA; aquisição é par de chaves, solicitação, verificação, assinatura, instalação. É necessário para validar uma assinatura porque prova a quem pertence a chave pública.
- Uma assinatura é um hash criptografado com a chave privada; verificação é descriptografar, recalcular o hash, comparar. Integridade e autenticidade são as duas coisas que ela prova.
- Criptografia quântica distribui chaves e detecta espionagem; seus limites são custo, distância e novidade.
Erros comuns
- Dizer que uma mensagem está criptografada com a chave pública do remetente; a chave pública do receptor criptografa, a chave privada do receptor descriptografa.
- Descrever uma assinatura como "criptografando a mensagem com a chave privada" em vez de criptografar seu hash.
- Afirmar que um certificado contém a chave privada; ele contém a chave pública e a identidade, assinado pela CA.
- Listar "o servidor envia sua chave privada" no handshake do TLS; apenas a chave pública viaja, dentro do certificado.
- Dar "SSL/TLS torna a conexão mais rápida" como uma função; suas funções são criptografia, autenticação e integridade.
- Confundir hash com criptografia: um hash não pode ser revertido e não possui chave; criptografia é reversível com a chave.
- Responder "por que um certificado é necessário para uma assinatura" com "para criptografá-lo"; é necessário para confiar na chave pública.
-
18
Inteligência Artificial (IA)
Assistir aula18.1
O que é IA

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de como grafos podem ser usados para auxiliar a Inteligência Artificial (IA) Propósito e estrutura de um grafo. Usar o algoritmo A* e o algoritmo de Dijkstra para realizar buscas em um grafo. Os candidatos não serão exigidos a escrever algoritmos para configurar, acessar ou realizar buscas em grafos Demonstrar compreensão de como as redes neurais artificiais ajudaram no aprendizado de máquina Demonstrar compreensão de Deep Learning, Machine Learning e Reinforcement Learning e as razões para usar esses métodos. Compreender categorias de machine learning, incluindo aprendizado supervisionado, aprendizado não supervisionado Demonstrar compreensão de propagação reversa de erros e métodos de regressão no machine learning Fonte: Programa Cambridge International
Inteligência artificial 人工智能 (AI) constrói sistemas que realizam tarefas normalmente necessárias inteligência humana — reconhecer fala e imagens, traduzir, jogar jogos, dirigir, gerar texto. A maioria das IAs modernas usa aprendizado de máquina 机器学习 — algoritmos que aprendem padrões nos dados em vez de serem programados passo a passo. Dentro dele, aprendizado profundo 深度学习, usando redes neurais 神经网络 com muitas camadas, tem sido dominante desde a década de 2010.
Um robô humanoide 人形机器人 coloca muitas dessas habilidades em um único corpo: usa IA para ver rostos, entender fala e mover seu rosto e braços de forma realista.
Um robô humanoide usa IA para ver, ouvir e responder como uma pessoa 
Aprendizado profundo é parte do aprendizado de máquina, que é parte da IA ExplorarLaboratório de tipos de aprendizado de IA
Classifique exemplos de IA pelo tipo de aprendizado ou preocupação envolvida.
Vocabulário TreinarInglês Chinês Pinyin humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ 人形机器人 rén xíng jī qì rén 18.1
Grafos na IA
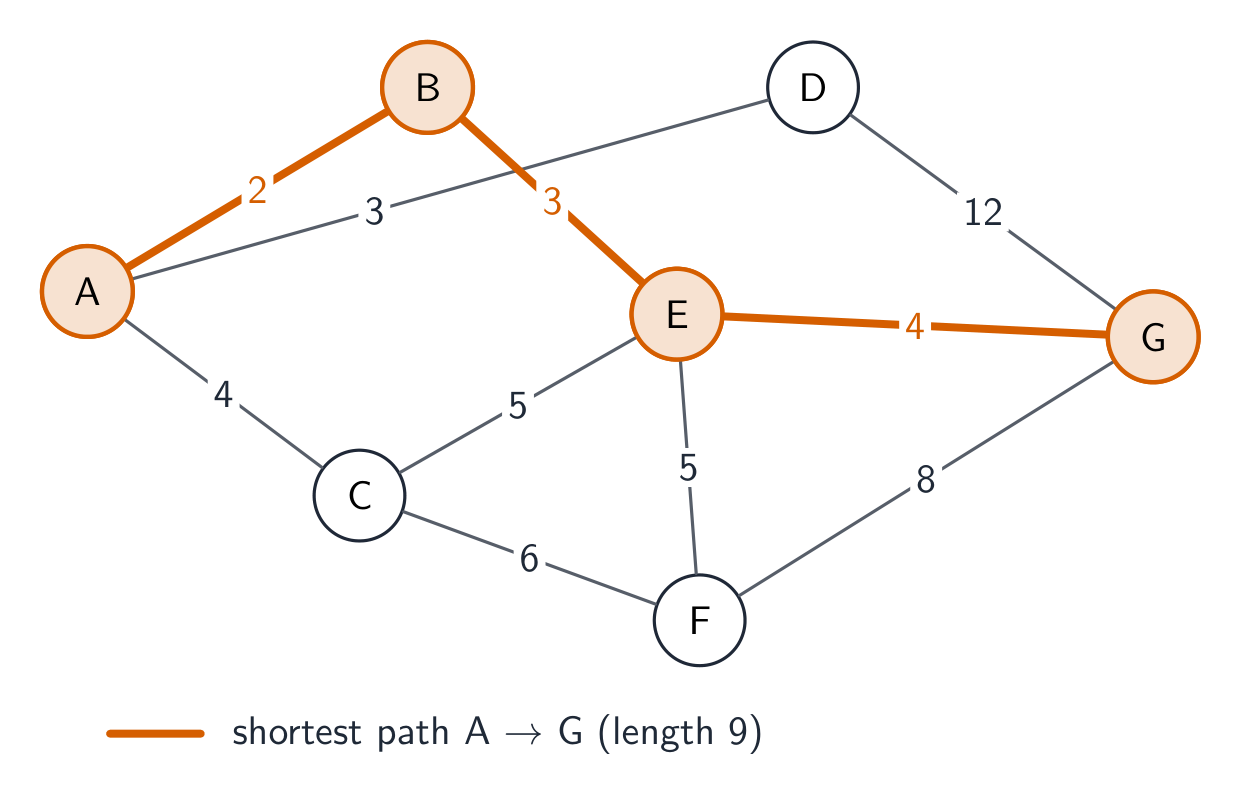
Muitos problemas de IA residem em um grafo 图 — nós 节点 (estados, lugares) unidos por arestas 边 (movimentos, relações).
- busca de caminho: estradas formam um grafo; a rota mais curta é uma busca em grafo (algoritmo de Dijkstra, algoritmo A*).
- jogos: cada posição do tabuleiro é um nó, cada movimento uma aresta; minimax 极小化极大 com poda alfa-beta busca a árvore de jogo.
- busca no espaço de estados: um problema de planejamento é mover entre estados aplicando operadores para atingir um objetivo.
- representação de conhecimento: uma rede semântica 语义网络 tem conceitos como nós e relações como arestas ("cachorro É-UM animal"); um grafo de conhecimento 知识图谱 armazena fatos sobre o mundo para motores de busca e assistentes.
Problemas de IA frequentemente residem em grafos; aqui o caminho mais curto está destacado Ferramentas padrão para navegar em grafos incluem busca em largura 广度优先搜索 e busca em profundidade 深度优先搜索.
"Descreva o propósito e a estrutura de um grafo em um sistema de IA. Propósito: representar um problema como um conjunto de estados (ou lugares) e os possíveis movimentos entre eles, para que um algoritmo possa buscá-lo por uma solução, como a rota mais curta ou mais barata, ou o melhor próximo movimento. Estrutura: um conjunto de nós (vértices), cada um representando um estado, localização ou item, unidos por arestas representando as conexões entre eles; cada aresta pode carregar um peso (um custo, distância ou tempo), e as arestas podem ser dirigidas (ida única) ou não dirigidas. "Explique o uso de grafos para auxiliar a IA:" o grafo é o modelo no qual os algoritmos de busca da IA operam: A* e o algoritmo de Dijkstra encontram caminhos ótimos através dele (navegação, roteamento), posições de jogos formam uma árvore buscada pelo melhor movimento, e conhecimento armazenado como grafo permite que um sistema raciocine sobre como os fatos estão relacionados.
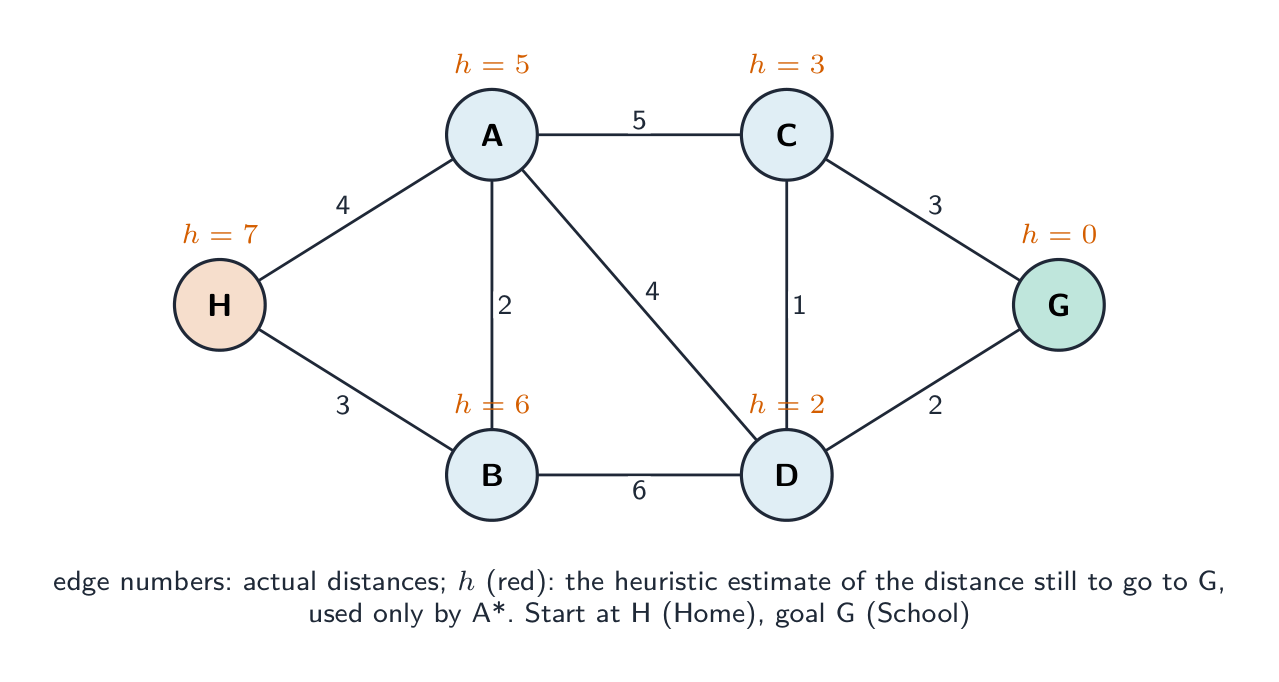 O grafo usado abaixo: os números das arestas são distâncias reais; os números vermelhos são a estimativa de heurística 启发式 de cada nó de quão longe o objetivo ainda está, o que apenas o A usa*
Algoritmo de Dijkstra. Ele encontra a menor distância do início até cada nó. Mantenha uma tabela da melhor distância encontrada até agora para cada nó (início 0, todos os outros infinito). Repita: pegue o nó não visitado com a menor distância, marque-o como visitado e, para cada vizinho, verifique se ir por este nó oferece uma distância menor; se sim, atualize-a e registre de onde veio. Pare quando todos os nós forem visitados (ou o alvo for atingido).
Exemplo resolvido. Encontre as menores distâncias de H até todos os outros nós no grafo acima.
etapa visitar H A B C D G início 0 ∞ ∞ ∞ ∞ ∞ 1 H (0) 0 4 (H) 3 (H) ∞ ∞ ∞ 2 B (3) 0 4 (H) 3 ∞ 9 (B) ∞ 3 A (4) 0 4 3 9 (A) 8 (A) ∞ 4 D (8) 0 4 3 9 (A) 8 10 (D) 5 C (9) 0 4 3 9 8 10 (D) 6 G (10) Menores distâncias: A 4, B 3, D 8, C 9, G 10, e o caminho para G é H–A–D–G (leia as etiquetas "veio de" de trás para frente). Na etapa 3, A oferece a D uma distância de $4 + 4 = 8$, melhor que as 9 encontradas através de B, então D é atualizada; na etapa 5, C poderia chegar a G em $9 + 3 = 12$, pior que 10, então nada muda. Mostrar essas comparações é o "trabalho" que a questão pede.
O algoritmo A*. Dijkstra explora em todas as direções. A* adiciona uma heurística $h$, uma estimativa da distância restante, e sempre expande o nó com a menor $f = g + h$, onde $g$ é a distância percorrida até agora. Com uma heurística sensata (nunca superestimando), ele encontra o mesmo caminho mais curto enquanto examina muito menos nós, que é por que satnavs e jogos o usam. O exame fornece $h$ para cada nó e uma tabela para preencher.
Exemplo resolvido. Encontre um caminho de H para G com A*, mostrando o trabalho.
nó expandido $g$ até agora $h$ $f = g + h$ vizinhos adicionados (nó: $g$, $h$, $f$) H 0 7 7 A: 4, 5, 9; B: 3, 6, 9 B (empate com A; qualquer um) 3 6 9 D via B: 9, 2, 11 A 4 5 9 C: 9, 3, 12; D via A: 8, 2, 10 (melhor que 11, mantenha) D 8 2 10 G: 10, 0, 10; C via D: 9 (sem melhoria) G 10 0 10 objetivo alcançado Caminho H–A–D–G, comprimento 10, o mesmo que Dijkstra, mas C nunca foi expandido. Cada vez que um nó é alcançado por uma segunda rota, mantenha a menor $g$; a busca termina quando o objetivo é o nó com a menor $f$. Declare os valores $g$, $h$ e $f$ em todas as linhas: essas são as notas.
Vocabulário TreinarInglês Chinês Pinyin graph/ɡræf/ 图 tú nodes/nəʊdz/ 节点 jié diǎn edges/ˈedʒɪz/ 边 biān minimax/ˈmɪnɪmæks/ 极小化极大 jí xiǎo huà jí dà semantic network/səˈmæntɪk ˈnetwɜːk/ 语义网络 yǔ yì wǎng luò knowledge graph/ˈnɒlɪdʒ ɡræf/ 知识图谱 zhī shí tú pǔ breadth-first search/bredθ fɜːst sɜːtʃ/ 广度优先搜索 guǎng dù yōu xiān sōu suǒ depth-first search/depθ fɜːst sɜːtʃ/ 深度优先搜索 shēn dù yōu xiān sōu suǒ weight/weɪt/ 权重 quán zhòng heuristic/hjuːˈrɪstɪk/ 启发式 qǐ fā shì labels/ˈleɪblz/ 标签 biāo qiān 18.1
Redes neurais artificiais (ANNs)
Uma ANN é inspirada pelos neurônios do cérebro. Um neurônio artificial 人工神经元:
- recebe vários valores de entrada, multiplica cada um por um peso 权重, e soma-os com um termo de bias 偏置项.
- aplica uma função de ativação 激活函数 (uma função não linear como ReLU) à soma.
- sai o resultado, que alimenta neurônios mais adiante.
Um único neurônio: cada entrada vezes seu peso, somado com um viés, seguido por uma função de ativação Neurônios estão organizados em camadas: uma camada de entrada, uma ou mais camadas ocultas 隐藏层 (onde padrões internos úteis são aprendidos), e uma camada de saída. Com muitas camadas ocultas, trata-se de uma rede neural profunda 深度神经网络, e o treinamento dela é aprendizado profundo.
Uma rede neural com uma camada de entrada, duas camadas ocultas e uma camada de saída ANNs permitem que modelos aprendam padrões complexos diretamente de dados brutos (pixels, áudio, texto) sem recursos projetados manualmente — impulsionando avanços em reconhecimento de imagens 图像识别, reconhecimento de fala 语音识别, tradução automática 机器翻译 e jogos. Funcionam bem com grandes quantidades de dados, entrada ruidosa ou muito complexa, e padrões difíceis de capturar com regras explícitas.
"Explique o que se entende por rede neural artificial." Um modelo da rede de neurônios do cérebro, composto por camadas de nós conectados: uma camada de entrada, uma ou mais camadas ocultas e uma camada de saída. Cada conexão tem um peso; cada nó soma suas entradas ponderadas e passa o resultado através de uma função de ativação para a próxima camada. "Explique como ANNs possibilitam o aprendizado de máquina" (três pontos): a rede é treinada em muitos exemplos; para cada exemplo, a saída é comparada com o resultado esperado e o erro é usado para ajustar os pesos (propagação reversa) de modo que o erro diminua; após enough exemplos, os pesos codificam os padrões nos dados, e a rede pode então classificar ou prever para novos dados que nunca viu. "Informe o motivo para múltiplas camadas ocultas": cada camada adicional combina os recursos encontrados pela camada anterior em recursos mais complexos e abstratos, permitindo que a rede aprenda relações mais complexas (bordas, depois formas, depois objetos); isso é o que torna uma rede profunda.
ExplorarToque nas partes de uma rede neural
Explore as camadas. Os dados fluem da esquerda para a direita: a camada de entrada pega os recursos, as camadas ocultas aprendem padrões e a camada de saída dá a resposta — com cada conexão carregando um peso que o treinamento ajusta.
Vocabulário TreinarInglês Chinês Pinyin artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ 人工神经元 rén gōng shén jīng yuán bias term/ˈbaɪəs tɜːm/ 偏置项 piān zhì xiàng activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ 激活函数 jī huó hán shù hidden layers/ˈhɪdn ˈleɪəz/ 隐藏层 yǐn cáng céng deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ 深度神经网络 shēn dù shén jīng wǎng luò image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ 图像识别 tú xiàng shí bié speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ 语音识别 yǔ yīn shí bié machine translation/məˈʃiːn trænˈsleɪʃn/ 机器翻译 jī qì fān yì 18.1
Aprendizado de máquina, aprendizado profundo, aprendizado por reforço
Aprendizado de máquina
O termo guarda-chuva — qualquer algoritmo que aprende a partir de dados. Três paradigmas:
- aprendizado supervisionado 监督学习 — os dados têm rótulos 标签 (imagens marcadas "gato"/"cachorro"); o algoritmo aprende entrada → rótulo. Usado para classificação 分类 (uma categoria) e regressão.
- aprendizado não supervisionado 无监督学习 — sem rótulos; o algoritmo encontra estrutura, ex.: um agrupamento 聚类 de clientes semelhantes.
- aprendizado por reforço (abaixo).
Use ML quando regras explícitas seriam impraticáveis (filtros de spam, recomendações, detecção de fraudes).
Os mesmos dados vistos de duas formas: com rótulos, a tarefa é aprender o que separa as classes; sem rótulos, a tarefa é descobrir que existem grupos "Descreva o aprendizado supervisionado e não supervisionado" (palavras marcadas). Aprendizado supervisionado: o algoritmo é treinado com dados de treinamento rotulados 训练数据, cada exemplo pareado com a saída correta (alvo); ele aprende a relação entre entradas e saídas e usa isso para classificar ou prever novas entradas; as respostas são conhecidas durante o treinamento, então o erro pode ser medido. Aprendizado não supervisionado: os dados estão sem rótulos, sem respostas corretas fornecidas; o algoritmo busca padrões, estrutura ou agrupamentos nos dados por si só (agrupar itens similares, encontrar associações); a saída é um conjunto de categorias ou relações que não foram definidas antecipadamente. Como diferem: dados rotulados contra não rotulados; saídas conhecidas contra estrutura descoberta; supervised é usado para prever (classificação, regressão), unsupervised para explorar (agrupamento, detecção de anomalias). Ambos são categorias de machine learning; o terceiro é reinforcement learning.

Aprendizado supervisionado: um modelo é treinado com dados rotulados, depois reconhece novos dados Aprendizado profundo
Um subconjunto de ML usando redes neurais profundas. Camadas inferiores aprendem padrões simples (bordas, fonemas), camadas superiores combinam-nos em conceitos abstratos. Precisa de muitos dados e muita computação (GPUs); para pequenos conjuntos de dados, métodos de ML mais simples frequentemente funcionam melhor.
"Explique o que se entende por aprendizado profundo" (três pontos). Machine learning que usa redes neurais artificiais com muitas camadas ocultas (redes profundas); a rede é treinada em quantidades muito grandes de dados, e cada camada extrai características da saída da camada abaixo, de modo que a rede aprende as características necessárias por si só, em vez de serem especificadas pelo programador. Motivos para usá-lo: pode resolver problemas muito complexos para regras escritas à mão ou modelos rasos (reconhecer rostos, entender fala, traduzir texto); melhora conforme há mais dados disponíveis; elimina a necessidade de engenharia de recursos humana; e pode lidar com dados não estruturados como imagens, som e texto. Como é feito mais eficaz: mais (e melhor rotulados) dados de treinamento; mais camadas ou nós, dentro dos limites de overfitting; mais poder de processamento (GPUs) e tempo de treinamento; ajuste da taxa de aprendizagem e outros parâmetros. Exemplos: reconhecimento de fala em assistentes de voz, reconhecimento de imagens em exames médicos e carros autônomos, tradução automática, sistemas de recomendação.
Aprendizado por reforço
Em aprendizado por reforço 强化学习, um agente 智能体 age em um ambiente; cada ação muda o estado e retorna uma recompensa 奖励. O agente aprende uma política 策略 (uma estratégia) que maximiza a recompensa total ao longo do tempo, por tentativa e erro sem rótulos prévios. Usado para problemas de decisão sequencial — jogos, controle robótico, direção autônoma.
"Explique o que se entende por aprendizado por reforço" (três pontos). Um agente aprende interagindo com seu ambiente: ele toma uma ação, o ambiente muda para um novo estado e retorna uma recompensa (ou penalidade), e o agente ajusta seu comportamento para maximizar a recompensa total ao longo do tempo. Não há dados rotulados: o agente aprende por tentativa e erro, descobrindo quais ações são boas pelas recompensas coletadas, e gradualmente forma uma política que diz o que fazer em cada estado. Usado onde a resposta certa não é conhecida antecipadamente, mas o resultado de uma ação pode ser pontuado: jogos (xadrez, Go), controle robótico, sinalização de trânsito, alocação de recursos. Um computador jogando um jogo de tabuleiro contra um usuário aprende dessa forma, ou busca na árvore de jogos com minimax para escolher o movimento cujo pior resultado seja o melhor.
Aprendizado por reforço: o agente age, o ambiente retorna um novo estado e uma recompensa, e o agente aprende com isso Um carro autônomo 自动驾驶汽车 é um exemplo real. Sensores Lidar 激光雷达 e câmeras (a unidade giratória no teto) constroem uma imagem viva da estrada, e uma política aprendida decide como virar, acelerar e frear com segurança.

Um carro autônomo usa câmeras e sensores Lidar para ver a estrada ao seu redor 
Braços robóticos industriais em uma linha de produção: aprendizado por reforço pode ensinar um robô a controlar seus movimentos Vocabulário TreinarInglês Chinês Pinyin artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ 人工智能 rén gōng zhì néng machine learning/məˈʃiːn ˈlɜːnɪŋ/ 机器学习 jī qì xué xí reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ 强化学习 qiáng huà xué xí supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ 监督学习 jiān dū xué xí classification/ˌklæsɪfɪˈkeɪʃn/ 分类 fēn lèi self-driving car/self ˈdraɪvɪŋ kɑː/ 自动驾驶汽车 zì dòng jià shǐ qì chē agent/ˈeɪdʒənt/ 智能体 zhì néng tǐ reward/rɪˈwɔːd/ 奖励 jiǎng lì policy/ˈpɒlɪsi/ 策略 cè lüè lidar/ˈlaɪdɑː/ 激光雷达 jī guāng léi dá 18.1
Treinando uma ANN: backpropagation
O treinamento ajusta os pesos para que as saídas correspondam aos alvos. O método padrão é backpropagation 反向传播 (propagação reversa de erros) com descida de gradiente 梯度下降. Para cada exemplo de treinamento:
- passagem direta — alimente a entrada até a saída.
- calcule o erro com uma função de perda 损失函数 (um número único sobre o quão errada é a saída).
- passagem reversa — propague o erro para trás, encontrando o gradiente de cada peso (quanto contribuiu para o erro) usando a regra da cadeia.
- atualize os pesos com um pequeno passo (definido pela taxa de aprendizagem 学习率) que reduza o erro.
Repita sobre muitos exemplos e muitas passagens (épocas 训练轮次) até que o erro deixe de diminuir. O nome "back" vem do passo 3: o erro flui da saída de volta em direção à entrada, assim o gradiente de cada peso é encontrado em uma varredura. Após o treinamento, uma nova entrada precisa apenas de uma passagem direta para obter uma previsão.
"Descreva o método de propagação reversa de erros" (quatro pontos). (1) Uma entrada é enviada para frente através da rede e sua saída é comparada com a saída esperada (alvo); (2) a diferença é o erro; (3) o erro é passado para trás através da rede, camada por camada da saída para a entrada, e a parte do erro atribuída a cada peso é calculada; (4) os pesos são ajustados em proporção à sua contribuição, na direção que reduz o erro; (5) o processo é repetido com muitos exemplos até que o erro seja tão pequeno quanto necessário. O ponto do método é que uma rede com camadas ocultas não tem maneira direta de saber qual peso interno causou um erro de saída; a propagação reversa atribui a culpa.
O treinamento ajusta os pesos para alcançar o erro mínimo Vocabulário TreinarInglês Chinês Pinyin backpropagation/ˌbækprəpəˈɡeɪʃn/ 反向传播 fǎn xiàng chuán bō gradient descent/ˈɡreɪdɪənt dɪˈsent/ 梯度下降 tī dù xià jiàng loss function/lɒs ˈfʌŋkʃn/ 损失函数 sǔn shī hán shù epochs/ˈiːpɒks/ 训练轮次 xùn liàn lún cì 18.1
Regressão

Alguns tasks preveem um número (preço de uma casa, temperatura de amanhã) — regressão 回归, ao contrário de classificação (uma categoria).
Regressão linear 线性 regression ajusta uma linha reta (ou hiperplano):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$Escolha os coeficientes para minimizar a soma dos erros quadrados em relação aos dados de treinamento. Use-o quando a relação parecer aproximadamente linear e você quiser um modelo interpretável. Para dados curvos, use métodos de regressão polinomial, árvore de decisão ou rede neural — mesma ideia: defina um modelo, defina uma função de perda e ajuste os parâmetros para minimizá-la. Regressão e classificação são ambas supervisionadas; a escolha depende se a resposta é um número ou uma categoria.
"Descreva métodos de regressão em aprendizado de máquina" (duas marcas). Métodos estatísticos que encontram a relação entre variáveis de entrada e uma saída contínua, ajustando uma função (uma linha ou curva) aos dados de treinamento com o menor erro total; a função ajustada é então usada para prever a saída para novos inputs. A regressão linear ajusta uma linha reta; outros métodos ajustam curvas. A regressão prediz um valor (um preço, uma temperatura, um tempo); a classificação prediz uma categoria, que é a distinção que o exame pede.
A regressão linear ajusta a linha que torna o erro quadrado total (os espaços tracejados) o menor possível ExplorarAjustando uma linha de regressão
Arraste os controles. A regressão linear desenha a linha reta que minimiza as distâncias quadráticas aos pontos de dados — então ela prediz um número para qualquer nova entrada.
Vocabulário TreinarInglês Chinês Pinyin regression/rɪˈɡreʃn/ 回归 huí guī unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ 无监督学习 wú jiān dū xué xí cluster/ˈklʌstə/ 聚类 jù lèi training data/ˈtreɪnɪŋ ˈdeɪtə/ 训练数据 xùn liàn shù jù learning rate/ˈlɜːnɪŋ reɪt/ 学习率 xué xí lǜ linear regression/ˈlɪnɪə rɪˈɡreʃn/ 线性回归 xiàn xìng huí guī optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ 光学字符识别 guāng xué zì fú shí bié text-to-speech/tekst tə spiːtʃ/ 文本转语音 wén běn zhuǎn yǔ yīn 18.1
Como a IA é usada em um cenário real
Muitos cenários de exames usam o mesmo padrão — um modelo de deep learning treinado em dados rotulados, muitas vezes vários combinados em um pipeline:
- identificação de clientes em uma loja automatizada: o sistema é treinado com imagens de rostos rotuladas; uma câmera captura um rosto; o reconhecimento de imagem extrai uma representação; ela é comparada com clientes registrados; a correspondência mais próxima identifica a pessoa.
- leitura de texto em imagens: o reconhecimento de imagem encontra regiões de texto; reconhecimento óptico de caracteres 光学字符识别 extrai os caracteres; tradução por máquina os converte; texto-para-fala 文本转语音 os lê em voz alta.
- detecção de itens no caixa: IA de detecção de objetos, treinada em imagens de produtos rotuladas, vê quais itens entram na cesta e cobra a conta.
No momento em que um usuário interage com o sistema, o modelo é rápido — ele faz apenas inferência de passagem direta; a inteligência está nos padrões aprendidos durante o treinamento.
Respostas modelo para as perguntas de cenário. Uma câmera de estacionamento lê números de placa: a câmera captura uma imagem; uma IA treinada em muitos imagens rotuladas de placas localiza a placa na imagem; reconhecimento de caracteres (um classificador de deep learning, novamente treinado em caracteres rotulados) converte a placa em texto; o texto é armazenado com a hora e comparado quando o carro sai. Um sistema de CCTV detecta e rastreia uma pessoa: software de reconhecimento de imagem treinado em imagens rotuladas de pessoas identifica uma pessoa em cada quadro; o sistema compara quadros sucessivos para seguir seu movimento; movimento incomum pode acionar um alerta. Fala convertida em comandos: reconhecimento de fala treinado em muitas vozes gravadas converte o som em texto; o sistema compara o texto com um conjunto de comandos conhecidos; melhora à medida que é corrigido. Uma câmera que foca em rostos: um modelo de detecção de rosto treinado em rostos rotulados encontra a região do rosto, e a lente é ajustada para trazer essa região para foco. Login de reconhecimento facial de um banco: o app captura o rosto, uma rede profunda extrai seus recursos, e eles são comparados com os recursos armazenados daquele cliente. Em todos os casos, o padrão é: treinado em exemplos rotulados, extrai recursos, corresponde ou classifica nova entrada.
Exemplo resolvido. Para cada tarefa, diga se precisa de regressão ou classificação, e como seria a camada de saída de uma ANN: (a) prever a temperatura de amanhã; (b) decidir se um e-mail é spam. Pergunte qual tipo de coisa está sendo previsto. (a) Uma temperatura é um número em uma escala contínua, então isso é regressão, e a camada de saída é um único neurônio segurando esse valor. (b) Spam ou não-spam é uma categoria, então isso é classificação, e a saída dá uma probabilidade por classe. Ambas são aprendizagem supervisionada: cada uma precisa de exemplos rotulados para treinar, e o treinamento ajusta os pesos por propagação reversa para reduzir o erro. A pergunta decisiva é simplesmente número-ou-categoria - não quão difícil a tarefa parece.
Vocabulário TreinarInglês Chinês Pinyin deep learning/diːp ˈlɜːnɪŋ/ 深度学习 shēn dù xué xí neural networks/ˈnjuːrəl ˈnetwɜːks/ 神经网络 shén jīng wǎng luò 18.1
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição grafo (em IA) um conjunto de nós representando estados ou locais, ligados por arestas representando conexões, frequentemente ponderadas, que um algoritmo de busca pode explorar Algoritmo de Dijkstra encontra a menor distância de um nó inicial para todos os outros nós visitando sempre o nó não visitado com a menor distância até agora Algoritmo A* uma busca de caminho mais curto que expande o nó com a menor soma da distância até agora mais uma estimativa heurística da distância ao objetivo rede neural artificial um modelo dos neurônios do cérebro: camadas de nós ligados por conexões ponderadas, treinadas ajustando os pesos aprendizado de máquina algoritmos que aprendem com dados e melhoram com a experiência em vez de seguir regras fixas aprendizado supervisionado aprendizado a partir de dados de treinamento rotulados nos quais a saída correta para cada entrada é conhecida aprendizado não supervisionado aprendizado a partir de dados sem rótulos encontrando padrões, agrupamentos ou estrutura neles aprendizado por reforço um agente aprende por tentativa e erro, escolhendo ações em um ambiente para maximizar as recompensas que recebe deep learning aprendizado de máquina usando redes neurais com muitas camadas ocultas, treinadas em grandes quantidades de dados, cada camada extraindo recursos da camada abaixo propagação reversa de erros comparar a saída da rede com o alvo, passar o erro de volta através das camadas e ajustar cada peso para reduzi-lo regressão ajustar uma função aos dados de treinamento para prever um valor de saída contínuo a partir de entradas 18.1
Dicas de prova
- Respostas de grafos nomeiam nós, arestas e pesos, e o que representam; depois o algoritmo. Dijkstra: tabela de distâncias, visite o menor, atualize vizinhos. A*: $g$, $h$ e $f = g + h$ em cada linha, expanda o menor $f$.
- Respostas de ANN nomeiam as camadas, as conexões ponderadas e o treinamento; deep learning adiciona muitas camadas ocultas, grandes quantidades de dados e extração automática de recursos, com uma razão e um exemplo.
- As três categorias em uma linha cada: dados rotulados e saídas conhecidas; dados sem rótulos e estrutura descoberta; agente, ambiente, ações e recompensas.
- Propagação reversa: compare com o alvo, erro para trás através das camadas, ajuste os pesos para reduzi-lo, repita. Regressão prediz um valor; classificação prediz uma categoria.
- Perguntas de cenário querem o pipeline: treinado em exemplos rotulados, extrai recursos, reconhece ou classifica nova entrada; nomeie o tipo de IA (reconhecimento de imagem, reconhecimento de fala, deep learning).
Erros comuns
- Descrever um grafo como "um gráfico"; em IA são nós e arestas.
- Executar Dijkstra escolhendo o vizinho mais próximo do nó atual em vez da menor distância geral não visitada; ou esquecer de atualizar um nó quando uma rota mais curta aparece.
- Adicionar $h$ em $g$ para o próximo passo em A*; $g$ é apenas a distância real, $h$ é recomputado a partir da tabela.
- Dizer que deep learning é "aprender muito"; são as muitas camadas ocultas.
- Confundir aprendizado não supervisionado com aprendizado por reforço; o primeiro encontra estrutura em dados, o segundo aprende com recompensas.
- Descrever propagação reversa sem a comparação com a saída esperada ou sem dizer que os pesos são ajustados.
- Chamar uma previsão de preço de "classificação"; um valor contínuo é regressão.
-
19
Pensamento computacional e resolução de problemas
Assistir aula19.1
Algoritmos de busca

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão dos métodos de busca linear e busca binária Escrever um algoritmo para implementar uma busca linear. Escrever um algoritmo para implementar uma busca binária. As condições necessárias para o uso de uma busca binária. Como o desempenho de uma busca binária varia conforme o número de itens de dados Demonstrar compreensão dos métodos de inserção sort e bubble sort Escrever um algoritmo para implementar um insertion sort. Escrever um algoritmo para implementar um bubble sort. O desempenho de uma rotina de ordenação pode depender da ordem inicial dos dados e do número de itens de dados Demonstrar compreensão e uso de Tipos de Dados Abstratos (ADT) Escrever algoritmos para encontrar um item em cada um dos seguintes: linked list, binary tree. Escrever algoritmos para inserir um item em cada um dos seguintes: pilha, fila, linked list, binary tree. Escrever algoritmos para excluir um item de cada um dos seguintes: pilha, fila, linked list. Demonstrar compreensão de que um grafo é um exemplo de ADT. Descrever as características principais de um grafo e justificar seu uso para uma situação dada. Os candidatos não serão exigidos a escrever código para uma estrutura de grafo Demonstrar como é possível implementar ADTs a partir de outro ADT Descrever os seguintes ADTs e demonstrar como podem ser implementados a partir de tipos embutidos adequados ou outros ADTs: pilha, fila, linked list, dictionary, binary tree Demonstrar compreensão de que diferentes algoritmos que realizam a mesma tarefa podem ser comparados usando critérios (por exemplo, tempo necessário para completar a tarefa e memória usada) Incluindo o uso da notação Big O para especificar complexidade de tempo e espaço Fonte: Programa Cambridge International
Big O: como os algoritmos escalam Insertion sort: deslize cada cartão para o lugar Ordenação bolha, passo a passo Busca binária: divida pela metade e conquiste Uma busca encontra um valor-alvo em uma coleção (geralmente uma array 数组) e retorna sua posição, ou "não encontrado".
Buscar em uma lista ordenada, como um livro telefônico, é muito mais rápido do que verificar cada entrada uma por uma Busca linear
Uma busca linear 线性查找 percorre do início ao fim, comparando cada elemento com o alvo:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Nenhuma preparação é necessária, então funciona em qualquer lista. Pior caso O($n$) (alvo no final ou ausente); melhor caso 1 comparação. Use-a em dados não ordenados ou listas pequenas. (O retorno
-1é um valor sentinela — uma posição impossível que significa "não encontrado"; quem chama testaIF result = -1.)A versão do exame. O Paper 3 pede para completar uma busca linear escrita com uma flag e um loop
WHILE, e o Paper 4 pede para escrever uma função que retorne o índice ou uma contagem. Ambos parecem assim:FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER DECLARE Index, Count : INTEGER Count ← 0 FOR Index ← 1 TO 100 IF Data[Index] = Target THEN Count ← Count + 1 ENDIF NEXT Index RETURN Count // how many times Target occurs; 0 means not found ENDFUNCTIONPara parar na primeira correspondência, use um loop
WHILE Index <= 100 AND NOT Foundque defineFound ← TRUEe lembra o índice. As marcas são pelo loop sobre todo elemento, a comparação e o que é retornado quando o valor está ausente.
A busca linear verifica cada letra por ordem — 23 comparações para encontrar W Busca binária
Uma busca binária 二分查找 precisa dos dados ordenados. Olhe para o elemento do meio; se for o alvo, pronto; se o alvo for menor, busque na metade esquerda, senão na direita — dividindo o intervalo pela metade cada vez:
low ← 1
high ← n
WHILE low <= high DO
    mid ← (low + high) DIV 2
    IF A[mid] = target THEN
        RETURN mid
    ENDIF
    IF A[mid] < target THEN
        low ← mid + 1
    ELSE
        high ← mid - 1
    ENDIF
ENDWHILE
RETURN -1
Pior caso O($\log_{2} n$) — para um milhão de itens, cerca de 20 comparações. Muito mais rápida que a busca linear em arrays grandes ordenados, mas você deve ordenar primeiro (um custo único O($n \log n$)), vale a pena se buscar muitas vezes.
"Enuncie a condição necessária para uma busca binária." Os dados devem estar em ordem (ordenados, ascendentes ou descendentes, na chave sendo buscada). "Descreva como realizar uma busca binária" (três marcas): (1) encontre o item meio da lista (ou do intervalo atual) e compare-o com o alvo; (2) se corresponder, a busca termina; se o alvo for menor, repita na metade inferior, se maior, na metade superior; (3) continue dividindo pela metade o intervalo até que o item seja encontrado ou o intervalo esteja vazio, o que significa que não está presente.
A versão do exame, com os limites e uma flag, é a que você deve reproduzir quando solicitado a completar o algoritmo:
DECLARE Lower, Upper, Mid : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    Mid ← (Lower + Upper) DIV 2
    IF Names[Mid] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[Mid] < Target THEN
            Lower ← Mid + 1
        ELSE
            Upper ← Mid - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT Mid
ELSE
    OUTPUT "Not found"
ENDIF
"Explique como o desempenho varia com o número de itens." Cada comparação reduz à metade o número de itens restantes, então o número máximo de comparações é aproximadamente $\log_{2} n$: dobrar o tamanho da lista adiciona apenas uma comparação a mais. Isso é O($\log n$). "Compare busca linear e busca binária": uma busca linear precisa de até $n$ comparações (O($n$)) e, em média, metade disso, mas funciona em dados não ordenados; uma busca binária precisa no máximo de $\log_{2} n$ (O($\log n$)) e é muito mais rápida para listas grandes, mas os dados devem estar previamente ordenados e deve permitir acesso direto ao item do meio (um array, não uma lista ligada). Para $1000$ itens: $1000$ contra $10$ comparações.
A busca binária reduz o intervalo pela metade a cada etapa (baixo / meio / alto) — apenas 3 comparações para encontrar W  *Um catálogo de cartões: registros ordenados são o que tornam a busca binária possível — reduza pela metade, olhe, reduza novamenteExplorar
Busca linear vs busca binária
Procure por um valor. A busca binária reduz a lista pela metade a cada etapa (apenas em dados ordenados); a busca linear verifica um por um.
Vocabulário TreinarInglês Chinês Pinyin binary search/ˈbaɪnəri sɜːtʃ/ 二分查找 èr fēn chá zhǎo array/əˈreɪ/ 数组 shù zǔ linear search/ˈlɪnɪə sɜːtʃ/ 线性查找 xiàn xìng chá zhǎo 19.1
Algoritmos de ordenação
Bubble sort (Ordenação por bolha)
Um bubble sort 冒泡排序 percorre repetidamente o array, trocando pares adjacentes que estão fora de ordem, assim o maior "bolha" vai para o final a cada passada:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Melhor caso O($n$) (já ordenado, com saída antecipada); médio/pior caso O($n^{2}$). Simples, mas lento para grandes $n$.
Insertion sort (Ordenação por inserção)
Um insertion sort 插入排序 constrói um prefixo ordenado da esquerda, inserindo cada novo elemento em seu lugar desviando os maiores para a direita:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Melhor caso O($n$) (já ordenado); pior caso O($n^{2}$). Bom para arrays pequenos ou quase ordenados. Ordena in place 原地 e é estável 稳定 (mantém a ordem dos elementos iguais).
Rastreamento de uma ordenação
Uma tarefa comum é mostrar o array após cada passagem externa. Para
[D, T, H, R]com insertion sort: passada 1 (chave T) sem mudança; passada 2 (chave H) →[D, H, T, R]; passada 3 (chave R) →[D, H, R, T].Escrever uma ordenação do zero. "Escreva pseudocódigo para ordenar
DataArray[1:1000]em ordem crescente" é respondido por um bubble sort completo com flag de saída antecipada, ou um insertion sort, declarado e recuado; ambos obtêm nota máxima se funcionarem para toda entrada:DECLARE Pass, Index, Temp : INTEGER DECLARE Swapped : BOOLEAN Pass ← 1 REPEAT Swapped ← FALSE FOR Index ← 1 TO 1000 - Pass IF DataArray[Index] > DataArray[Index + 1] THEN Temp ← DataArray[Index] DataArray[Index] ← DataArray[Index + 1] DataArray[Index + 1] ← Temp Swapped ← TRUE ENDIF NEXT Index Pass ← Pass + 1 UNTIL Swapped = FALSE OR Pass = 1000Para ordem decrescente, altere
>para<; para ordenar registros ou um array 2D por um campo, compare esse campo mas troque o registro inteiro (ou todas as colunas). Se perguntado a escrever um insertion sort "que realize a mesma tarefa" que um dado bubble sort, mantenha o mesmo nome de array e direção e reproduza o insertion sort acima invertendo a comparação se a ordem for decrescente."Descreva duas maneiras pelas quais o desempenho de uma ordenação é afetado pelos dados" (duas marcas). (1) O número de itens: uma ordenação $O(n^{2})$ leva quatro vezes mais tempo para o dobro de itens. (2) O quão perto os dados já estão de estar em ordem: um bubble sort com flag, ou um insertion sort, termina em uma única passada sobre dados já ordenados ($O(n)$) e realiza o máximo de trabalho em dados em ordem inversa; o número de trocas depende de quantos pares estão fora de ordem. (Também aceito: o intervalo ou número de valores duplicados, e se os itens são registros grandes que são caros de mover.) Bubble sort e insertion sort são ambos O($n^{2}$) nos casos pior e médio e O($n$) no melhor caso; quicksort e merge sort são O($n \log n$), que é por que são usados para grandes volumes de dados.
Um insertion sort de [D, T, H, R], deslocando cada chave para seu lugar, passo a passoExplorarAssista uma ordenação rodar
Passe passo a passo por uma ordenação e observe as barras se acomodarem na ordem — como um algoritmo de ordenação funciona iteração por iteração.
Vocabulário TreinarInglês Chinês Pinyin insertion sort/ɪnˈsɜːʃn sɔːt/ 插入排序 chā rù pái xù bubble sort/ˈbʌbl sɔːt/ 冒泡排序 mào pào pái xù in place/ɪn pleɪs/ 原地 yuán dì stable/ˈsteɪbl/ 稳定 wěn dìng 19.1
ADTs em algoritmos
Os Abstract Data Types (ADTs) do Tema 10 aparecem dentro de muitos algoritmos: uma pilha 栈 impulsiona a travessia em profundidade e o desfazer; uma fila 队列 impulsiona a travessia em largura e a ordem de impressão; uma linked list 链表 permite que os dados cresçam e encolham.
ADTs podem ser construídos a partir de outros ADTs, não apenas de arrays: uma queue a partir de duas stacks; uma stack a partir de uma linked list (push = prepend um nó cabeça nó 节点); uma queue a partir de uma linked list com ponteiros de cabeça e cauda pointers 指针; uma binary tree 二叉树 a partir de nós com dois ponteiros de filho; um dictionary 字典 armazena pares chave→valor (muitas vezes em uma hash table). Camadas dessa forma separam responsabilidades — o algoritmo que usa o ADT não precisa saber como ele é construído.
Os ADTs que o exame pede para você descrever e implementar
Stack (último a entrar, primeiro a sair): os itens são adicionados (empilhados) e removidos (desempilhados) na mesma extremidade, o topo; um ponteiro
TopOfStackguarda o índice do item no topo. Implementado com um array e aquele único ponteiro: push verifica se a stack não está cheia, incrementa o ponteiro e armazena o item; pop verifica se não está vazia, retorna o item no topo e decrementa o ponteiro.FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN IF TopOfStack = 9 THEN // full (array 0 to 9) RETURN FALSE ENDIF TopOfStack ← TopOfStack + 1 StackData[TopOfStack] ← Item RETURN TRUE ENDFUNCTION FUNCTION Pop() RETURNS INTEGER IF TopOfStack = -1 THEN // empty RETURN -1 ENDIF TopOfStack ← TopOfStack - 1 RETURN StackData[TopOfStack + 1] ENDFUNCTIONQueue (primeiro a entrar, primeiro a sair): os itens entram na parte traseira (enfilam) e saem pela frente (desfilam); dois ponteiros e uma contagem. Em uma queue linear, o ponteiro da frente corre pelo array até que o espaço no início seja desperdiçado; uma circular queue 循环队列 faz ambas as ponteiros voltarem com
MOD, reutilizando cada célula.
*Uma circular queue: os ponteiros traseiro e frontal avançam com MOD, reutilizando as primeiras células do array assim que seus itens saemFUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN IF Count = 6 THEN // full RETURN FALSE ENDIF Rear ← (Rear + 1) MOD 6 QueueArray[Rear] ← Item Count ← Count + 1 RETURN TRUE ENDFUNCTION FUNCTION Dequeue() RETURNS STRING IF Count = 0 THEN // empty RETURN "" ENDIF DECLARE Item : STRING Item ← QueueArray[Front] Front ← (Front + 1) MOD 6 Count ← Count - 1 RETURN Item ENDFUNCTIONLinked list: uma sequência de nodes, cada um segurando um item de dados e um pointer para o próximo node; um start pointer dá o primeiro node e um ponteiro nulo (0 ou $-1$) encerra a lista. Em uma implementação com array, dois arrays paralelos seguram os dados e os ponteiros, e células não utilizadas são encadeadas em uma free list 空闲列表 para que uma inserção saiba onde colocar o novo node.
 *Uma linked list em dois arrays: a ordem da lista está nos ponteiros, não nas posições; inserir um nome significa pegar uma célula da free list e religar dois ponteiros
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Para inserir em uma lista ordenada: pegue a primeira célula livre (
NewNode ← FreeList,FreeList ← Pointer[FreeList]), armazene o item, depois percorra a lista com um ponteiroPreviouseCurrentatéData[Current] > Itemou o fim; definaPointer[NewNode] ← CurrentePointer[Previous] ← NewNode(ouStart ← NewNodese for o primeiro). Para excluir, religue o node anterior além do excluído e devolva a célula à free list.Binary tree: um nó raiz, cada nó segurando dados, um left pointer para um subtree de valores menores e um right pointer para um subtree de valores maiores. Implementado como um array 2D (ou três arrays 1D)
Tree[Index, 0..2]para left pointer, dados, right pointer, com um root pointer e um next-free pointer.FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER // index, or -1 DECLARE Current : INTEGER Current ← Root WHILE Current <> -1 IF Tree[Current, 1] = Target THEN RETURN Current ENDIF IF Target < Tree[Current, 1] THEN Current ← Tree[Current, 0] // go left ELSE Current ← Tree[Current, 2] // go right ENDIF ENDWHILE RETURN -1 ENDFUNCTIONPara inserir: armazene o item no próximo nó livre com ambos os ponteiros $-1$; se a árvore estiver vazia, faça-a a root; caso contrário, percorra descendo da root, indo à esquerda ou à direita por comparação, até que o ponteiro que você seguiria fosse $-1$, e defina aquele ponteiro para o novo nó. Um ADT a partir de outro ADT: uma stack é uma linked list onde push e pop funcionam ambos no início; uma queue é uma linked list com um ponteiro de início e um de fim; uma queue pode ser feita a partir de duas stacks (push em uma, pop na outra, movendo tudo quando a segunda estiver vazia); os nós de uma binary tree são records ou objetos ligados por ponteiros, então é construído a partir de uma estrutura ligada de nós. Diga quais operações do novo ADT mapeiam para quais operações do antigo.
 *Uma binary tree: cada nó tem até dois nós filhos
 *Três travessias depth-first de uma binary tree: pre-order, in-order (ordem ordenada) e post-orderVocabulário Treinar
Inglês Chinês Pinyin linked list/lɪŋkt lɪst/ 链表 liàn biǎo stack/stæk/ 栈 zhàn queue/kjuː/ 队列 duì liè node/nəʊd/ 节点 jié diǎn pointers/ˈpɔɪntəz/ 指针 zhǐ zhēn binary tree/ˈbaɪnəri triː/ 二叉树 èr chā shù dictionary/ˈdɪkʃənəri/ 字典 zì diǎn circular queue/ˈsɜːkjʊlə kjuː/ 循环队列 xún huán duì liè free list/friː lɪst/ 空闲列表 kòng xián liè biǎo time complexity/taɪm kəmˈpleksɪti/ 时间复杂度 shí jiān fù zá dù Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ 大O表示法 dà O biǎo shì fǎ space complexity/speɪs kəmˈpleksɪti/ 空间复杂度 kōng jiān fù zá dù 19.1
Comparando algoritmos
Complexidade temporal
Complexidade temporal 时间复杂度 é como o tempo de execução cresce com o tamanho de entrada $n$, escrito em notação Big-O 大O表示法 (o termo dominante): O(1) constante, O($\log n$) busca binária, O($n$) busca linear, O($n \log n$) boas ordenações, O($n^{2}$) bubble/insertion sort. Uma ordem menor é melhor em escala, mesmo se outro algoritmo for mais rápido para pequenos $n$.
Para tornar isso concreto: para ordenar um milhão de itens, uma ordenação $O(n \log n)$ termina em fração de segundo, enquanto uma ordenação $O(n^{2})$ pode levar minutos.
Exemplo resolvido. Uma lista ordenada contém $1000$ itens. Quantas comparações cada busca precisa no pior caso?
Uma busca linear verifica itens um de cada vez, então pode precisar de até $1000$ comparações — isso é $O(n)$. Uma busca binária reduz a lista pela metade a cada passo, então precisa no máximo de $\lceil \log_2 1000 \rceil = 10$ comparações — isso é $O(\log n)$. Dobrar a lista para $2000$ itens adiciona apenas uma comparação à busca binária, mas até mais $1000$ à busca linear — que é por que a ordem de crescimento, não a velocidade bruta, decide o vencedor em escala.
Descrevendo uma ordem. O(1): o tempo é constante, independente do número de itens (push em uma pilha, leitura de um elemento de array). O($\log n$): o tempo cresce com o logaritmo do número de itens, então dobrar os dados adiciona apenas uma etapa extra fixa (busca binária). O($n$): o tempo cresce proporcionalmente ao número de itens (busca linear, uma passagem por uma lista). O($n \log n$): um pouco pior que linear (classificações eficientes). O($n^{2}$): o tempo cresce com o quadrado do número de itens, então dobrar os dados quadruplica o tempo (bubble sort e insertion sort). "Declare a Big O de uma busca binária de
Names[0:99]" é respondida $O(\log n)$, e "descreva seu significado" como acima; Big O mede como o tempo ou memória escala, não o tempo real.
*Como as ordens comuns de crescimento se comparam: uma ordem menor vence em escala
Como o tempo de classificação cresce com o número de elementos $n$: $O(n^2)$ classifica afastam-se de uma classificação $O(n\log n)$ Complexidade de espaço
Complexidade de espaço 空间复杂度 é a memória extra necessária. Bubble sort e insertion sort usam O(1) extra (in-place); merge sort usa O($n$); recursão usa memória de pilha proporcional à sua profundidade. Frequentemente existe um compromisso entre tempo e memória.
Outros critérios
Simplicidade (mais fácil de codificar e manter), estabilidade e adaptabilidade (mais rápido em dados quase ordenados). O algoritmo correto depende dos dados e das restrições.
ExplorarComo o tempo de execução cresce com n
Deslize n para cima e compare as curvas: O(1) e O(log n) permanecem quase planas, O(n) sobe consistentemente, O(n²) explode. É por isso que o Big-O — não um cronômetro — é como comparamos algoritmos em entradas grandes.
ExplorarCrescimento Big-O
Altere o tamanho da entrada n e compare quão rapidamente o trabalho de cada algoritmo cresce — a ideia por trás da complexidade temporal.
19.2
Recursão

Programa
Os candidatos devem ser capazes de: Notas e orientações Demonstrar compreensão de recursão Características essenciais da recursão. Como a recursão é expressa em uma linguagem de programação. Escrever e rastrear algoritmos recursivos. Quando o uso de recursão é benéfico Demonstrar conhecimento do que um compilador precisa fazer para traduzir código de programação recursivo Uso de pilhas e desenrolamento Fonte: Programa Cambridge International
Recursão: a pilha de chamadas sobe e desce Algoritmos recursivos usam recursão 递归: a rotina chama-se a si mesma com uma versão menor do mesmo problema, até que um caso base 基本情形 termine a cadeia. Tem duas partes: o caso base (pequeno o suficiente para ser resolvido diretamente — sem ele a recursão nunca para) e o caso recursivo 递归情形 (reduzir a entrada e chamar-se a si mesma).
Fatorial 阶乘:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
A recursão é natural para problemas autorreferenciais: árvores, divide-and-conquer 分治 (busca binária, merge sort) e dados aninhados. Quando não se adapta bem, um ciclo costuma ser mais limpo.
"Descreva o que significa recursão (duas marcas)." Uma função ou procedimento definido em termos de si mesmo: ela chama-se a si mesma dentro do seu próprio corpo, com uma versão menor do problema cada vez, até que um caso base seja alcançado. "Enuncie três características essenciais da recursão": (1) um caso base (condição de paragem) que retorna um valor sem uma chamada adicional; (2) um caso geral 一般情形 em que a rotina chama-se a si mesma; (3) cada chamada aproxima o problema do caso base (o parâmetro é reduzido), para que a recursão termine. Alguns esquemas adicionam: os valores são retornados conforme as chamadas desenrolam.
"Descreva quando o uso de recursão é benéfico e dê um exemplo." Quando o problema é naturalmente definido em termos de versões menores de si mesmo, de modo que a solução recursiva seja mais curta, clara e próxima da definição matemática do que um ciclo seria: um fatorial ou número de Fibonacci, uma busca binária, percorrer uma árvore binária, merge sort ou quicksort, e processar estruturas aninhadas como pastas dentro de pastas. É uma má escolha quando a profundidade é grande (a pilha pode transbordar) ou quando o mesmo sub-problema é calculado muitas vezes (Fibonacci ingênuo).
Rastreando uma chamada recursiva
Para
Factorial(4): as chamadas descem atéFactorial(1)=1, depois desenrolar multiplica de volta para cima:2*1=2,3*2=6,4*6=24. Resultado final24. Rastreie cada chamada pendente numa pilha.Exemplo resolvido. A função abaixo é dada sem explicação. Rastreie
Unknown(3, 5)e indique a sua saída e valor de retorno.FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER IF X < Y THEN OUTPUT X + Y RETURN Unknown(X + 1, Y - 1) + 1 ELSE RETURN 0 ENDIF ENDFUNCTIONChamada 1: $X = 3, Y = 5$: $3 < 5$, saída 8, chama
Unknown(4, 4). Chamada 2: $4 < 4$ é falso, retorna 0. Desenrolamento: chamada 1 retorna $0 + 1 = 1$. Saída 8, valor de retorno 1. Escreva o rastro como uma tabela com uma linha por chamada (parâmetros, condição, saída, o que retorna) e faça os retornos da chamada mais profunda para cima: este é o desenrolamento que o gabarito procura.Exemplo resolvido (Fibonacci).
Fib(n)retornanquandon < 2, caso contrárioFib(n - 1) + Fib(n - 2). EncontreFib(5).Fib(5) = Fib(4) + Fib(3);Fib(4) = Fib(3) + Fib(2);Fib(3) = Fib(2) + Fib(1);Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. AssimFib(3) = 1 + 1 = 2,Fib(4) = 2 + 1 = 3,Fib(5) = 3 + 2 = 5. O caso base é alcançado muitas vezes (Fib(2)é calculado três vezes), razão pela qual esta versão é lenta: faz 15 chamadas para $n = 5$ e dobra aproximadamente as chamadas para cada aumento em $n$.Convertendo recursão em iteração. Toda rotina recursiva pode ser reescrita com um ciclo, que usa menos memória e é mais rápida: mantenha um resultado acumulado e瞪ue do caso base para cima. Fatorial como um ciclo:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Ao ser solicitado a alterar uma ordenação por inserção recursiva ou busca em uma iterativa, substitua a auto-chamada por um ciclo sobre o índice pelo qual a recursão estava avançando, e transforme o caso base na condição de saída do ciclo.
Recursão usa a pilha de chamadas: chamadas empilham quadros para baixo até ao caso base, depois retornos desenrolam para cima Riscos
- recursão infinita se o caso base for omitido — falha com transbordamento de pilha 栈溢出.
- alto uso de memória para recursão profunda.
- lento se repetir trabalho (Fibonacci ingênuo é exponencial — use um ciclo ou memoização 记忆化).
ExplorarA recursão desenrola das folhas para cima
Passo a passo de fib(4) na ordem em que as chamadas realmente terminam: as folhas (casos base) resolvem primeiro, depois cada pai combina seus filhos. Note que fib(2) é calculado duas vezes — esse trabalho repetido é por que a recursão ingênua é lenta.
Vocabulário TreinarInglês Chinês Pinyin recursion/rɪˈkɜːʃn/ 递归 dì guī call stack/kɔːl stæk/ 调用栈 diào yòng zhàn base case/beɪs keɪs/ 基本情形 jī běn qíng xíng recursive case/rɪˈkɜːsɪv keɪs/ 递归情形 dì guī qíng xíng factorial/fækˈtɔːrɪəl/ 阶乘 jiē chéng divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ 分治 fēn zhì general case/ˈdʒenərəl keɪs/ 一般情形 yì bān qíng xíng parameters/pəˈræmɪtəz/ 参数 cān shù stack overflow/stæk ˌəʊvəˈfləʊ/ 栈溢出 zhàn yì chū memoisation/ˌmeməʊaɪˈzeɪʃn/ 记忆化 jì yì huà local variables/ˈləʊkl ˈveərɪəblz/ 局部变量 jú bù biàn liàng stack frame/stæk freɪm/ 栈帧 zhàn zhēn return address/rɪˈtɜːn əˈdres/ 返回地址 fǎn huí dì zhǐ 19.2
O que o compilador faz para código recursivo
A recursão precisa de cada chamada ter sua própria cópia dos seus parâmetros 参数 e variáveis locais 局部变量. O compilador mantém estes na pilha de chamadas 调用栈. Para cada chamada, empilha um quadro de pilha 栈帧 contendo os parâmetros, as variáveis locais e o endereço de retorno 返回地址 (onde retomar no chamador). Quando a função retorna, o valor de retorno é passado, o quadro é removido e o controle retoma no endereço de retorno.
Porque cada chamada tem seu próprio quadro, chamadas recursivas não sobrepõem as variáveis umas das outras. A pilha pode crescer muito para recursão profunda, razão pela qual recursão muito profunda pode transbordá-la. Este é o mesmo mecanismo de chamada e retorno usado para chamadas ordinárias (não recursivas) — não há um "mecanismo de recursão" especial.
"Explique por que uma pilha é adequada para implementar recursão (três marcas)." Cada chamada recursiva deve salvar seu endereço de retorno, seus parâmetros e suas variáveis locais, e as chamadas são concluídas na ordem invertida àquela em que foram feitas (a última chamada feita é a primeira a terminar), o que é exatamente o comportamento último a entrar, primeiro a sair de uma pilha: cada nova chamada empilha um quadro, e cada retorno remove o quadro mais recente, restaurando o estado do chamador e dizendo-lhe onde continuar. Este é o trabalho do compilador quando traduz código recursivo: ele gera o empilhamento de um quadro de pilha em cada chamada e a remoção em cada retorno, e os quadros são desenrolados conforme os resultados voltam.
19.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição busca linear verificando cada item sucessivamente a partir do início até que o alvo seja encontrado ou o fim seja atingido busca binária comparando repetidamente o alvo com o item central de uma lista ordenada e descartando a metade que não pode contê-lo bubble sort passando repetidamente pela lista, trocando itens adjacentes que estão na ordem errada, até que uma passagem não realize trocas insertion sort pegando cada item sucessivamente e inserindo-o no seu lugar correto entre os itens já ordenados tipo de dado abstrato uma coleção de dados e as operações que podem ser realizadas sobre eles, definidas independentemente de como são armazenadas pilha uma estrutura último-entra-primeiro-sai com push e pop no topo fila uma estrutura primeiro-entra-primeiro-sai com itens adicionados na traseira e removidos da frente lista ligada uma sequência de nós, cada um segurando dados e um ponteiro para o próximo nó, com um ponteiro inicial árvore binária nós segurando dados e ponteiros para uma subárvore esquerda de valores menores e uma subárvore direita de valores maiores notação Big O uma forma de classificar o tempo (ou memória) que um algoritmo precisa dependendo de como cresce com o tamanho da entrada recursão uma rotina que chama-se a si mesma com uma versão menor do problema até que um caso base pare as chamadas caso base a condição sob a qual uma rotina recursiva retorna sem chamar-se a si mesma desenrolamento os retornos de uma cadeia de chamadas recursivas, da chamada mais profunda de volta à primeira, conforme os quadros de pilha são removidos 19.2
Dicas de prova
- Buscas: linear não precisa de ordem e O($n$); binária precisa de um array ordenado, divide ao meio a cada passo e é O($\log n$). Saiba ambos os algoritmos de cor, incluindo os limites e a flag.
- Ordenações: bubble com flag de troca, insertion com chave que desloca itens maiores para a direita; ambos O($n^{2}$) no pior caso, O($n$) em dados ordenados. O desempenho depende do número de itens e do quão ordenados eles estão.
- Implementações de TDA são gerenciamento de ponteiros: um ponteiro superior; front, rear e count com MOD; start, ponteiros e uma lista livre; raiz com ponteiros esquerdo e direito. Sempre verifique se está cheio e vazio.
- Big O trata de escalonamento: constante, logarítmica, linear, quadrada. Diga "dobrar os dados adiciona uma comparação" para uma busca binária.
- Recursão: caso base, caso geral, progresso em direção ao caso base; benéfico quando o problema é definido em termos de si mesmo; uma pilha guarda os endereços de retorno e variáveis porque as chamadas retornam em ordem inversa. Rastreie com uma tabela e desenrole da chamada mais profunda.
Erros comuns
- Usar uma busca binária em dados não ordenados, ou em uma lista ligada; e definir
Lower ← Midem vez deMid + 1, o que loopa eternamente. - Um loop interno de bubble sort que roda até o fim do array a cada passada, ou uma troca sem variável temporária.
- Um push ou enqueue que não testa para cheio, ou um pop ou dequeue que não testa para vazio.
- Mover o ponteiro frontal da fila sem MOD em uma fila circular, ou tratar front = rear como significando sempre vazio.
- Inserir em uma lista ligada deslocando o conteúdo do array; apenas os ponteiros mudam.
- Uma função recursiva sem caso base, ou cujas chamadas recursivas não tornam o problema menor.
- Rastrear uma chamada recursiva mas esquecer adicionar o trabalho pendente no caminho de volta para cima.
- Responder "por que uma pilha" com "porque é rápida"; a razão é a ordem último-entra-primeiro-sai dos retornos.
-
20
Programação Avançada
Assistir aula20.1
Paradigmas de programação

Programa
Os candidatos devem ser capazes de: Notas e orientações Compreender o que se entende por um paradigma de programação Demonstrar compreensão das características de vários paradigmas de programação: • Baixo nível Programação de Baixo Nível: • compreensão e capacidade de escrever código de baixo nível usando vários modos de endereçamento: imediato, direto, indireto, indexado e relativo • Imperativo (Procedural) Programação Imperativa (Procedural): • conhecimento pressuposto e compreensão de Programação Estruturada (ver detalhes na seção de conteúdo AS 11.3) • compreensão e capacidade de escrever código de programação imperativa (procedural) que usa variáveis, construções, procedimentos e funções. Ver detalhes no conteúdo AS • Orientado a Objetos Programação Orientada a Objetos (POO): • compreensão da terminologia associada à POO (incluindo objetos, propriedades/atributos, métodos, classes, herança, polimorfismo, contenção (agregação), encapsulamento, getters, setters, instâncias) • compreensão de como resolver um problema projetando classes apropriadas • compreensão e capacidade de escrever código que demonstre o uso de POO • Declarativo Programação Declarativa: • compreensão e capacidade de resolver um problema escrevendo fatores e regras adequados baseados nas informações fornecidas • compreensão e capacidade de escrever código que possa satisfazer um objetivo usando fatos e regras Fonte: Programa Cambridge International
Um paradigma de programação 编程范式 é um estilo de programação — uma maneira de estruturar programas, com suas próprias ideias e recursos de linguagem. Quatro paradigmas de programação estão neste programa.
"Descreva o que significa uma linguagem imperativa (procedural) (duas marcas)." Uma linguagem na qual o programa é uma sequência de instruções executadas em ordem e que alteram o estado do programa; o programador diz como a tarefa é feita, usando procedimentos, sequência, seleção e iteração. "Descreva o que significa uma linguagem declarativa": o programa declara fatos e regras (o que é conhecido e o que se quer) e o motor de inferência da linguagem descobre como encontrar a resposta; o programador não dá a sequência de passos.
Identifique o paradigma a partir de um exemplo de código (uma questão típica do Paper 3):
LDD 200,ADD #5,STO 201são de baixo nível (mnemônicos, registradores, endereços de memória);FOR Count ← 1 TO 10 … NEXT Countcom procedimentos e atribuições é imperativo;CLASS Dog … PRIVATE Name : STRING … PUBLIC PROCEDURE NEW(…)é orientado a objetos;type(lion, wild).edangerous(X) IF type(X, wild)são declarativos (lógica). Na questão de correspondência: baixo nível combina com "mnemônicos que correspondem diretamente às instruções da máquina", imperativo com "uma sequência de instruções que alteram o estado", OOP com "objetos que combinam atributos e métodos" e declarativo com "fatos e regras, sem ordem de execução dada".Quatro paradigmas: baixo nível, imperativo, orientado a objetos e declarativo Programação de baixo nível
Programação próxima ao hardware em código de máquina 机器码 ou linguagem de montagem 汇编语言, onde cada instrução mapeia para o que a CPU executa. Fornece acesso direto a registradores 寄存器和 endereços de memória 内存地址, usando diferentes modos de endereçamento 寻址方式 (imediato, direto, indireto, indexado e relativo). É muito rápido e compacto, mas específico da arquitetura, tedioso e difícil de manter. Esta é a programação de baixo nível 低级, usada para drivers de dispositivos, firmware e bootloaders.
Os cinco modos de endereçamento. A ementa pede código de baixo nível que use cada modo de endereçamento (o conjunto de instruções está no Topic 4). O operando de uma instrução de carga pode ser lido de cinco formas, e o exame fornece os conteúdos da memória e pergunta qual o acumulador contém:
O mesmo operando, 105, lido de cinco formas: como um valor, como um endereço, como o endereço de um endereço, como um endereço mais o registrador índice, e como um offset a partir da instrução atual - imediato (
LDM #105): o operando é o valor; ACC torna-se 105. - direto (
LDD 105): o operando é o endereço do valor; ACC torna-se o conteúdo de 105, aqui 27. - indireto (
LDI 105): o operando é o endereço de um endereço; ACC torna-se o conteúdo de 27, aqui 91. Usado para ponteiros e para dados cuja posição é decidida em tempo de execução. - indexado (
LDX 105): o endereço é o operando mais o registrador índice IX; com IX = 2, ACC torna-se o conteúdo de 107. Usado para percorrer uma matriz incrementando IX. - relativo (
JMR +65): o destino é um offset a partir do endereço da instrução atual, o que torna o código relocalizável.
Exemplo resolvido. Memória: 105 contém 27, 106 contém 64, 200 contém 0. Escreva código para somar os conteúdos de 105 e 106, armazenar o resultado em 200 e exibi-lo.
LDD 105(ACC = 27),ADD 106(ACC = 91),STO 200,OUT. Para dobrar o valor em 105 em vez disso:LDD 105,ADD 105,STO 105. Indique o conteúdo dos registradores após cada linha quando solicitado a rastrear.Programação imperativa (procedural)
Na programação imperativa 命令式编程, o programador escreve uma sequência de comandos que alteram o estado do programa — atribuições, condicionais, laços, chamadas de função. Variáveis 变量 mantêm o estado; as instruções o alteram; o código é organizado em procedimentos e funções (também chamado de programação estruturada). Este é o estilo dos Topics 9 e 11 (Python, C). Forte quando o algoritmo tem passos sequenciais claros.
Programação orientada a objetos (OOP)
Na programação orientada a objetos 面向对象编程, programas são construídos a partir de objetos 对象 — unidades que combinam dados (atributos 属性) e operações (métodos 方法). Objetos são instâncias 实例 de classes 类. Os quatro pilares:
- encapsulamento 封装 — os dados de um objeto estão ocultos atrás de seus métodos; o código externo usa apenas os métodos públicos, não os dados diretamente. Isso protege o objeto e permite que seu interior mude sem quebrar quem o chama. Por exemplo, um
BankAccountesconde seusbalance; você os altera apenas através dedeposit()ewithdraw(), que podem impor uma regra como "nunca descer abaixo de zero". - herança 继承 — uma subclasse 子类 especializa uma superclasse 父类, herdando seus atributos e métodos e adicionando ou sobrescrevendo 重写 eles. Modela "é-um" ("Um Gerente é um Funcionário").
- polimorfismo 多态 — objetos diferentes respondem à mesma chamada de método de forma diferente; quem chama não precisa saber o tipo exato. Todo
ShapetemArea(), e umCirclee umRectangleo implementam de suas próprias maneiras. - abstração 抽象 — mostrar uma interface simples e ocultar a implementação.
Outros termos:
- um construtor 构造函数 é um método especial executado quando um objeto é criado, para configurar seus atributos.
- getters e setters leem e gravam os atributos de um objeto (suas propriedades) através de métodos.
- agregação 聚合 e contenção 包含 constroem um objeto a partir de outros objetos (uma relação "tem-um").
OOP é usado para sistemas grandes, interfaces gráficas, simulações e jogos.
 *Polimorfismo: a mesma chamada de método executa o código próprio de cada objeto
 *Um diagrama de classe para Shape: atributos privados e métodos públicos
 *Herança: partTime e fullTime são subclases de employee
 *Encapsulamento: os dados de um objeto são privados, acessados apenas através de seus métodos públicos
OOP conforme o avaliador pontua
Definições. Classe: uma planta (projeto) que define os atributos e métodos dos objetos desse tipo. Objeto: uma instância de uma classe, criada a partir dela, com seus próprios valores para os atributos ("uma ocorrência de um objeto" é a expressão do exame para instância). Atributo (propriedade): um item de dado pertencente a uma classe. Método: um procedimento ou função pertencente a uma classe que atua sobre seus atributos. Encapsulamento: combinar atributos e métodos em uma classe e restringir o acesso externo aos dados: os atributos são privados e só podem ser lidos ou alterados através de métodos públicos. Herança: uma subclasse adquire os atributos e métodos de sua classe pai (super) e pode adicionar os seus próprios ou sobrescrevê-los. Polimorfismo: métodos com o mesmo nome que se comportam diferentemente em classes diferentes; tipicamente uma subclasse ** redefine** um método de seu pai, e a versão certa roda para cada objeto. Contenção: uma classe tem um objeto de outra classe como atributo (um carro tem um motor). "Identificar o recurso que restringe o acesso externo aos dados" é encapsulamento; "o termo para uma ocorrência de um objeto" é instância.
"Esboce a estrutura de uma classe" (três marcas): atributos (propriedades) que mantêm os dados do objeto, geralmente declarados como privados; métodos (procedimentos e funções) que atuam sobre esses atributos, geralmente públicos; e um construtor, um método que roda quando um objeto é criado para inicializar os atributos. "Dê três benefícios da OOP": o código é reutilizado através da herança; os dados são protegidos pelo encapsulamento, então só podem ser alterados pelos métodos próprios da classe; um programa grande é dividido em classes que são escritas e testadas independentemente, facilitando a manutenção e expansão; as classes modelam entidades do mundo real, tornando o design mais fácil de entender; o polimorfismo permite que a mesma chamada funcione para objetos diferentes.
A classe em pseudocódigo, conforme o Paper 3 a define:
CLASS Car
    PRIVATE Registration : STRING
    PRIVATE Year : INTEGER
    PRIVATE Mileage : INTEGER
    PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER)
        Registration ← NewReg
        Year ← NewYear
        Mileage ← 0
    ENDPROCEDURE
    PUBLIC FUNCTION GetMileage() RETURNS INTEGER
        RETURN Mileage
    ENDFUNCTION
    PUBLIC PROCEDURE AddMileage(Extra : INTEGER)
        Mileage ← Mileage + Extra
    ENDPROCEDURE
ENDCLASS
Um objeto é criado com
MyCar ← NEW Car("AB12 CDE", 2020)e usado comMyCar.AddMileage(150)eOUTPUT MyCar.GetMileage(). Uma subclasse reutiliza o construtor do pai através deSUPER:CLASS ElectricCar INHERITS Car PRIVATE BatteryCapacity : REAL PUBLIC PROCEDURE NEW(NewReg : STRING, NewYear : INTEGER, NewCapacity : REAL) SUPER.NEW(NewReg, NewYear) BatteryCapacity ← NewCapacity ENDPROCEDURE ENDCLASSA mesma classe em Python, conforme o Paper 4 espera: os atributos tornam-se privados com dois underscores, o construtor é
__init__, e uma subclasse nomeia seu pai entre parênteses e chamasuper().__init__(…):class Car: def __init__(self, reg, year): self.__registration = reg self.__year = year self.__mileage = 0 def get_mileage(self): return self.__mileage def add_mileage(self, extra): self.__mileage = self.__mileage + extra class ElectricCar(Car): def __init__(self, reg, year, capacity): super().__init__(reg, year) self.__capacity = capacity cars = [] cars.append(Car("AB12 CDE", 2020)) cars.append(ElectricCar("EV21 XYZ", 2023, 75.0)) cars[1].add_mileage(150) print(cars[1].get_mileage())Em Java, as mesmas ideias são
private/publiccampos, um construtor com o nome da classe,extendsesuper(…); em VB.NETPrivate/Public,Sub New,InheritseMyBase.New. Um método polimórfico é escrito no pai e sobrescrito no filho com o mesmo nome; uma chamada através de uma variável do tipo pai executa a versão do filho.Estruturas de dados como objetos. O Paper 4 constrói uma pilha, lista encadeada ou árvore binária a partir de uma
Nodeclasse cujos atributos são os dados e uma ou duas referências para outros nós; umaTree(ouLinkedList) classe mantém a raiz (ou início) e os métodos.
Uma árvore binária construída a partir de objetos: cada Node mantém Data além das referências Left e Right, e o Tree mantém o Root; a inserção percorre as referências CLASS Node PUBLIC Data : INTEGER PUBLIC Left : Node // NULL when there is no child PUBLIC Right : Node PUBLIC PROCEDURE NEW(NewData : INTEGER) Data ← NewData Left ← NULL Right ← NULL ENDPROCEDURE ENDCLASS CLASS Tree PRIVATE Root : Node PUBLIC PROCEDURE Insert(NewData : INTEGER) DECLARE NewNode, Current : Node DECLARE Placed : BOOLEAN NewNode ← NEW Node(NewData) IF Root = NULL THEN Root ← NewNode ELSE Current ← Root Placed ← FALSE WHILE NOT Placed IF NewData < Current.Data THEN IF Current.Left = NULL THEN Current.Left ← NewNode Placed ← TRUE ELSE Current ← Current.Left ENDIF ELSE IF Current.Right = NULL THEN Current.Right ← NewNode Placed ← TRUE ELSE Current ← Current.Right ENDIF ENDIF ENDWHILE ENDIF ENDPROCEDURE ENDCLASSUm método find percorre o mesmo caminho e retorna
TRUEquandoCurrent.Data = Target,FALSEquando atingeNULL; um método produção in-order é recursivo: output da subárvore esquerda, do nó, então da subárvore direita. Para uma lista encadeada o nó tem uma referência,Next, e a classe da lista mantémStart; para uma pilha construída a partir de uma lista, push e pop ambos funcionam emStart.Exemplo resolvido. Um jogo tem personagens. Cada um tem um nome, saúde (começando em 100) e uma posição dada por X e Y. Escreva uma classe
Charactercom um construtor e um métodoMove(DX, DY); então uma subclassWizardque adicionaMana(começando em 50) e um métodoCastSpell()que consome 10 mana e retornaTRUEse houvesse suficiente.CLASS Character PRIVATE Name : STRING PRIVATE Health : INTEGER PRIVATE X : INTEGER PRIVATE Y : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) Name ← NewName Health ← 100 X ← StartX Y ← StartY ENDPROCEDURE PUBLIC PROCEDURE Move(DX : INTEGER, DY : INTEGER) X ← X + DX Y ← Y + DY ENDPROCEDURE ENDCLASS CLASS Wizard INHERITS Character PRIVATE Mana : INTEGER PUBLIC PROCEDURE NEW(NewName : STRING, StartX : INTEGER, StartY : INTEGER) SUPER.NEW(NewName, StartX, StartY) Mana ← 50 ENDPROCEDURE PUBLIC FUNCTION CastSpell() RETURNS BOOLEAN IF Mana >= 10 THEN Mana ← Mana - 10 RETURN TRUE ELSE RETURN FALSE ENDIF ENDFUNCTION ENDCLASSAs marcas são para atributos privados, um construtor que define todos os atributos, a linha de herança, a chamada ao construtor do pai e um método que usa e altera os dados próprios do objeto. Quando a questão pede um diagrama de classe, desenhe uma caixa em três partes (nome; atributos com
-para privado; métodos com+para público) e junte uma subclasse a seu pai com uma seta apontando para o pai.Programação declarativa
Em programação declarativa 声明式编程, você diz o que calcular, não como — a execução decide os passos. Dois tipos:
- programação funcional 函数式编程 — construída a partir de funções puras 纯函数 (sem efeitos colaterais 副作用; mesma entrada sempre gera mesma saída) compostas entre si. Exemplos: Haskell, Lisp.
- programação lógica 逻辑编程 — declara fatos e regras; o motor responde a um objetivo (interrogação) por inferência. Exemplo: Prolog.
Um exemplo familiar de programação declarativa é SQL 结构化查询语言:
SELECT * FROM Customer WHERE Country = 'UK'diz o que você quer, não como percorrer os registros.Fatos, regras e objetivos são o que as provas testam no paradigma declarativo. Dados esses fatos 事实 (afirmações verdadeiras) e uma regra 规则 (uma conclusão válida quando suas condições forem válidas):
01 type(leopard, wild).
02 type(lion, wild).
03 type(tabby, domestic).
04 size(leopard, large).
05 size(lion, large).
06 size(tabby, small).
07 dangerous(X) IF type(X, wild) AND size(X, large).
"Escreva o resultado do objetivo
type(X, wild)":*X = leopard, X = lion. O motor compara o objetivo com cada fato sequencialmente; toda correspondência é uma solução, e uma letra maiúscula é uma variável preenchida pela correspondência. "Escreva um fato para mostrar que um guepardo é selvagem":type(cheetah, wild)."Explique o que a linha 07 faz": ela define uma regra com a conclusãodangerous(X), que é verdadeira para qualquerXque seja tanto selvagem quanto grande, entãodangerous(A)retornaA = leopard, A = lion. "Escreva uma regra: um recursoFpode estar disponível para um estilo de carroceriaBseFfor um recurso eBfor um estilo de carroceria eFnão estiver indisponível paraB":may_be_available(F, B) IF feature(F) AND body_style(B) AND NOT unavailable(F, B). Copie exatamente os nomes dos predicados e a ordem dos argumentos usados nos fatos da questão; um novo fato termina com ponto final, e as condições de uma regra são unidas porAND.Comparando paradigmas
Paradigma Força Linguagens típicas Baixo nível controle máximo, velocidade assembly Imperativa direta, intuitiva C, Python Orientada a objetos modular, modela entidades Java, C#, Python Funcional clara, sem efeitos colaterais Haskell, F# Lógica inferência, regras Prolog Banco de dados consultas de dados SQL Linguagens modernas frequentemente misturam paradigmas — Python suporta todos os de procedural, POO e funcional. A escolha depende do problema.
ExplorarLaboratório de conceito de programação
Conecte exemplos à ideia de programação que eles mostram.
Vocabulário TreinarInglês Chinês Pinyin programming paradigm/ˈprəʊɡræmɪŋ ˈpærədaɪm/ 编程范式 biān chéng fàn shì facts/fækts/ 事实 shì shí rule/ruːl/ 规则 guī zé low-level/ləʊ ˈlevl/ 低级 dī jí registers/ˈredʒɪstəz/ 寄存器 jì cún qì memory addresses/ˈmeməri əˈdresɪz/ 内存地址 nèi cún dì zhǐ objects/ˈɒbdʒekts/ 对象 duì xiàng attributes/ˈætrɪbjuːts/ 属性 shǔ xìng methods/ˈmeθədz/ 方法 fāng fǎ machine code/məˈʃiːn kəʊd/ 机器码 jī qì mǎ assembly language/əˈsemblɪ ˈlæŋɡwɪdʒ/ 汇编语言 huì biān yǔ yán addressing modes/əˈdresɪŋ məʊdz/ 寻址方式 xún zhǐ fāng shì classes/ˈklæsɪz/ 类 lèi encapsulation/ɪnˌkæpsjʊˈleɪʃn/ 封装 fēng zhuāng inheritance/ɪnˈherɪtəns/ 继承 jì chéng subclass/ˈsʌbklæs/ 子类 zi lèi superclass/ˈsuːpəklæs/ 父类 fù lèi overriding/ˌəʊvəˈraɪdɪŋ/ 重写 chóng xiě polymorphism/ˈpɒlɪmɔːfɪzəm/ 多态 duō tài abstraction/əbˈstrækʃn/ 抽象 chōu xiàng constructor/kənˈstrʌktə/ 构造函数 gòu zào hán shù aggregation/ˌæɡrɪˈɡeɪʃn/ 聚合 jù hé containment/kənˈteɪnmənt/ 包含 bāo hán declarative programming/dɪˈklærətɪv ˈprəʊɡræmɪŋ/ 声明式编程 shēng míng shì biān chéng functional programming/ˈfʌŋkʃənl ˈprəʊɡræmɪŋ/ 函数式编程 hán shù shì biān chéng pure functions/pjʊə ˈfʌŋkʃnz/ 纯函数 chún hán shù side effects/saɪd ɪˈfekts/ 副作用 fù zuò yòng logic programming/ˈlɒdʒɪk ˈprəʊɡræmɪŋ/ 逻辑编程 luó jí biān chéng SQL/ˌes kjuː ˈel/ 结构化查询语言 jié gòu huà chá xún yǔ yán 20.2
Processamento de arquivos
Programa
Os candidatos devem ser capazes de: Notas e orientações Escrever código para realizar operações de processamento de arquivos Abrir (no modo leitura, escrita, anexar) e fechar um arquivo Ler um registro de um arquivo e escrever um registro em um arquivo Realizar operações de processamento de arquivos em arquivos série, sequenciais, aleatórios Demonstre compreensão de uma exception e da importância do exception handling Saiba quando é apropriado usar exception handling Escreva código de programa para usar exception handling Fonte: Programa Cambridge International
Isso estende o manuseio de arquivo 文件 do Tema 10, processando arquivos seriais, sequenciais e aleatórios (acesso direto). Operações em pseudocódigo:
OPENFILE name FOR READ | WRITE | APPEND(READ abre um arquivo existente, WRITE cria/sobrescreve, APPEND adiciona ao final);READFILE name, line;WRITEFILE name, value;CLOSEFILE name; eEOF(name)que é VERDADEIRO no final.Leia um arquivo inteiro:
OPENFILE "names.txt" FOR READ
WHILE NOT EOF("names.txt") DO
    READFILE "names.txt", thisName
    OUTPUT thisName
ENDWHILE
CLOSEFILE "names.txt"
Pesquise um arquivo (pare ao encontrar):
found ← FALSE
OPENFILE "people.txt" FOR READ
WHILE NOT EOF("people.txt") AND NOT found DO
    READFILE "people.txt", line
    IF line = target THEN
        found ← TRUE
    ENDIF
ENDWHILE
CLOSEFILE "people.txt"
Atualizando um arquivo in-place
A maioria das linguagens não pode editar um arquivo de texto in-place. Em vez disso: abra o original para READ e um arquivo temporário para WRITE; para cada linha, escreva a nova versão se deve mudar, senão a original; feche ambos; depois substitua o original pelo arquivo temporário. O mesmo padrão lida com exclusão de linhas (pule-as) e inserção de linhas.
Atualizando um arquivo in-place: leia o original, escreva alterações para um arquivo temp, depois substitua o original Registros e arquivos de acesso aleatório
Modos de abertura.
READ: o arquivo deve existir e a leitura começa no início.WRITE: um arquivo novo é criado, e um arquivo existente desse nome é sobrescrito.APPEND: a escrita adiciona ao final de um arquivo existente. Todo arquivo aberto é fechado comCLOSEFILE, eEOF(name)éTRUEquando o último item foi lido.Três organizações de arquivos. Em um arquivo serial, os registros estão na ordem em que foram adicionados; em um arquivo sequencial, estão em ordem de chave; ambos são lidos do início. Um arquivo aleatório 随机文件 (arquivo de acesso direto) armazena cada registro em um endereço calculado a partir de sua chave por uma função de hashing 哈希, permitindo encontrar um registro sem ler os outros. Registros são declarados como tipo definido pelo usuário:
TYPE AccountRecord
    DECLARE AccNo : INTEGER
    DECLARE Name : STRING
    DECLARE Balance : REAL
    DECLARE Active : BOOLEAN
ENDTYPE
Encontrando um registro em um arquivo aleatório: a chave é hashada para um endereço, o ponteiro do arquivo vai diretamente até aquele slot e o registro é lido; nenhum outro registro é tocado As operações de arquivo aleatório em pseudocódigo são
OPENFILE "Acc.dat" FOR RANDOM,SEEK "Acc.dat", Address(move o ponteiro do arquivo para esse registro),GETRECORD "Acc.dat", Rec(lê o registro ali) ePUTRECORD "Acc.dat", Rec(escreve o registro ali). Encontrar um cliente por número de conta, conforme definido no Paper 3:DECLARE Rec : AccountRecord DECLARE Target, Address : INTEGER INPUT Target Address ← Target MOD 1000 // the hashing function OPENFILE "Acc.dat" FOR RANDOM SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec WHILE Rec.AccNo <> Target AND Rec.AccNo <> 0 // 0 marks an empty slot Address ← Address + 1 // a collision: try the next slot SEEK "Acc.dat", Address GETRECORD "Acc.dat", Rec ENDWHILE IF Rec.AccNo = Target THEN OUTPUT Rec.Name, Rec.Balance ELSE OUTPUT "No such account" ENDIF CLOSEFILE "Acc.dat"Para armazenar um registro, hashie sua chave,
SEEKpara o endereço ePUTRECORD, avançando sobre qualquer slot já ocupado. Marcas vão para o hash, o SEEK antes do GET ou PUT, a comparação com o alvo, o tratamento de colisão e o fechamento do arquivo.Exemplo resolvido.
ActiveFile.datcontémAccountRecordregistros. Escreva pseudocódigo que copie todos os registros cujo campoActivesejaFALSEpara o final deArchiveFile.dat.DECLARE Rec : AccountRecord OPENFILE "ActiveFile.dat" FOR READ OPENFILE "ArchiveFile.dat" FOR APPEND WHILE NOT EOF("ActiveFile.dat") READFILE "ActiveFile.dat", Rec IF Rec.Active = FALSE THEN WRITEFILE "ArchiveFile.dat", Rec ENDIF ENDWHILE CLOSEFILE "ActiveFile.dat" CLOSEFILE "ArchiveFile.dat"Arquivos de texto em Python (Paper 4):
file = open("HighScore.txt", "r"), depoisfor line in file:comline.strip()eline.split(",")para separar os campos,int(…)para converter uma pontuação, efile.close(); para escrever,open(name, "w")(ou"a"para anexar) efile.write(str(score) + "\n"). Uma tabela de maiores pontuações é lida em uma lista de registros, a nova pontuação inserida em seu lugar, e toda a lista reescrita. O examinador atribui marcas pela abertura com modo correto, um laço que lê cada linha, a conversão de texto para números e o fechamento.Armadilhas
Esquecer de fechar um arquivo (dados podem ser perdidos); abrir para WRITE quando queria APPEND (sobrescreve tudo); ler além de
EOF; caminhos fixos — um caminho como/Users/Admin/data.txtfalha em outra máquina, então use uma constante relativa comoDataFile = "./data/scores.txt".ExplorarRota de acesso a arquivo
Siga um arquivo do armazenamento ao programa e de volta com segurança.
Vocabulário TreinarInglês Chinês Pinyin file/faɪl/ 文件 wén jiàn random file/ˈrændəm faɪl/ 随机文件 suí jī wén jiàn hashing/ˈhæʃɪŋ/ 哈希 hā xī 20.2
Tratamento de exceções
Uma exceção 异常 é um erro ou condição inesperada durante a execução — divisão por zero, arquivo não encontrado, falha de rede, índice de array 数组 fora do intervalo. Tratamento de exceções 异常处理 permite que um programa detecte isso e responda graciosamente em vez de travar.
Importa porque programas reais enfrentam erros que não podem ser prevenidos antecipadamente (arquivos movidos, redes caídas, entrada inválida); sem isso, cada operação precisaria de sua própria verificação
IF; e separa o fluxo normal do tratamento de erros, mantendo o caminho principal limpo. Por exemplo, um arquivo pode ser deletado por outro usuário entre seu programa verificar que existe e realmente abri-lo — você não pode prevenir isso, apenas lidar com a falha quando ocorrer."Descreva, com um exemplo, o que significa uma exceção (duas marcas). Um evento inesperado ou erro que ocorre durante a execução de um programa (em tempo de execução) e interrompe seu fluxo normal; por exemplo, dividir por zero, abrir um arquivo que não existe, converter entrada não numérica em inteiro, índice de array fora do intervalo ou esgotar memória. "Identifique duas possíveis causas de exceções" é respondido a partir dessa lista, mais "um dispositivo ou rede não está disponível" e "tipo de dado inválido inserido".
"Enumere as razões para incluir tratamento de exceções (três marcas). Para evitar que o programa trave (termine inesperadamente); para exibir uma mensagem significativa ao usuário em vez de um erro do sistema; para permitir que o programa recupere e continue, por exemplo pedindo a entrada novamente, ou fechar arquivos com segurança antes de terminar; e porque alguns erros não podem ser previstos quando o programa é escrito. "Descreva como evitar o término do programa devido a uma exceção: coloque as instruções que poderiam levantar uma exceção dentro de um bloco TENTAR; escreva um bloco EXCEPT (catch) para essa exceção que a trate, por exemplo exibindo uma mensagem, para que a execução continue após o bloco em vez de parar. "Explique o que significa tratamento de exceções: detectar uma exceção quando ocorre e executar código (o manipulador) que a lidem para que o programa continue.
Padrão
TRY
    OPENFILE "data.txt" FOR READ
    READFILE "data.txt", line
    OUTPUT line
    CLOSEFILE "data.txt"
EXCEPT FileNotFound
    OUTPUT "Sorry, the file does not exist."
EXCEPT ReadError
    OUTPUT "Sorry, error reading the file."
ENDTRY
O bloco
TRYcontém o código que pode falhar; o primeiro blocoEXCEPTcorrespondente é executado. Linguagens reais também têm um catch-allEXCEPTe um blocoFINALLYque roda independentemente de exceção ter ocorrido — útil para limpeza (fechar arquivos).Fluxo de exceção: uma exceção salta para o EXCEPT correspondente; FINALLY sempre roda antes do programa continuar Levantando uma exceção
Uma subrotina que detecta um erro pode levantar 抛出 uma exceção para que o chamador a trate:
PROCEDURE Divide(a : INTEGER, b : INTEGER) RETURNS INTEGER
    IF b = 0 THEN
        RAISE DivideByZero
    ENDIF
    RETURN a DIV b
ENDPROCEDURE
Onde tratar exceções
Trate-as perto do erro se a resposta for simples (uma mensagem, uma retrial), ou mais acima na pilha de chamada 调用栈 se apenas o código externo souber o que fazer (um loop GUI de nível superior registra o erro e mostra um diálogo amigável). Não engula exceções silenciosamente — pelo menos registre-as, caso contrário a depuração torna-se impossível.
Exceções comuns:
FileNotFound,IOError,DivisionByZero,IndexOutOfRange,InvalidArgument,NullReference,OutOfMemory. Envolver cada operação falhante em umTRYcom manipuladoresEXCEPTadequados dá a um programa que degrada graciosamente em vez de travar.Exemplo resolvido (Paper 4). Escreva uma função que leia números inteiros, um por linha, de um arquivo cujo nome é passado como parâmetro e os retorne em uma lista. Ela não deve travar se o arquivo não existir ou uma linha não for um número inteiro.
def read_scores(filename):
    scores = []
    try:
        file = open(filename, "r")
        for line in file:
            scores.append(int(line))
        file.close()
    except FileNotFoundError:
        print("The file", filename, "does not exist")
    except ValueError:
        print("A line in the file was not a whole number")
    return scores
O bloco
trycontém o código que pode falhar (a abertura e a conversão); cadaexceptnomeia uma exceção e faz algo útil; a função ainda retorna uma lista, então o chamador continua. Em Java a mesma estrutura étry { … } catch (FileNotFoundException e) { … } catch (NumberFormatException e) { … }; em VB.NETTry … Catch ex As FileNotFoundException … End Try. Marcas: as instruções arriscadas dentro do try, os nomes corretos de exceção, uma mensagem para cada, e o programa continuando depois; um catch-allexcept:ganha a marca de crash mas não a de "exceção apropriada".Exemplo resolvido. Um arquivo de texto com membros precisa que o número de telefone de um membro seja alterado. Por que o programa não pode simplesmente sobrescrever essa linha, e qual é o padrão? As linhas de um arquivo de texto têm comprimentos diferentes, e o arquivo não possui espaços para absorver a diferença: uma substituição mais longa invadiria o próximo registro, e uma mais curta deixaria parte da linha antiga para trás. Portanto, o padrão consiste em abrir o original para LEITURA e um arquivo temporário para ESCRITA, ler cada linha sequencialmente, escrever a versão nova para a linha que muda e a linha original para todas as outras, fechar ambos e, em seguida, substituir o original pelo arquivo temporário. A mesma estrutura serve para excluir (omitar a linha) e inserir (escrever a linha extra). Observe que todas as linhas são escritas, não apenas a alterada — escrever apenas o novo registro e perder o resto do arquivo é um erro clássico.
ExplorarComo o tratamento de exceções flui
Passe passo a passo sobre o que acontece quando o código falha. A exceção salta fora do fluxo normal para um manipulador, FINALLY limpa de qualquer forma, e o programa continua em vez de travar.
Vocabulário TreinarInglês Chinês Pinyin array/əˈreɪ/ 数组 shù zǔ imperative programming/ɪmˈperətɪv ˈprəʊɡræmɪŋ/ 命令式编程 mìng lìng shì biān chéng Variables/ˈveərɪəblz/ 变量 biàn liàng object-oriented programming/ˈɒbdʒekt ˈɔːrɪəntɪd ˈprəʊɡræmɪŋ/ 面向对象编程 miàn xiàng duì xiàng biān chéng instances/ˈɪnstənsɪz/ 实例 shí lì exception/ekˈsepʃn/ 异常 yì cháng exception handling/ekˈsepʃn ˈhændlɪŋ/ 异常处理 yì cháng chǔ lǐ raise/reɪz/ 抛出 pāo chū call stack/kɔːl stæk/ 调用栈 diào yòng zhàn 20.2
Definições aceitas pelo examinador
Uma questão de definição é avaliada contra wording fixo. Aprenda estas exatamente, e dê apenas uma resposta.
Termo Definição paradigma de programação um estilo ou modo de programar, com sua própria forma de estruturar um programa linguagem imperativa o programa é uma sequência de instruções que alteram o estado do programa; o programador diz como a tarefa é realizada linguagem declarativa o programa declara fatos e regras, e o motor de inferência descobre como encontrar a resposta classe um modelo que define os atributos e métodos dos objetos desse tipo objeto (instância) uma ocorrência de uma classe, com seus próprios valores para os atributos atributo um item de dados pertencente a uma classe método um procedimento ou função pertencente a uma classe e que atua sobre seus atributos encapsulamento manter os atributos e métodos juntos em uma classe e restringir o acesso externo aos dados, de modo que sejam alterados apenas por meio de métodos públicos herança uma subclasse adquire os atributos e métodos de sua superclasse e pode adicioná-los ou sobrescrevê-los polimorfismo métodos com o mesmo nome que se comportam de maneira diferente para classes distintas construtor um método que é executado quando um objeto é criado e inicializa seus atributos contenção uma classe possui um objeto de outra classe como um de seus atributos fato uma afirmação em um programa declarativo que é verdadeira regra uma conclusão que vale quando suas condições são verdadeiras arquivo serial, sequencial, aleatório registros na ordem em que foram adicionados; registros em ordem de chave; cada registro em um endereço calculado a partir de sua chave exceção um erro ou evento inesperado durante a execução que interrompe o fluxo normal tratamento de exceções detectar uma exceção quando ela ocorre e executar código que a trata, para que o programa continue 20.2
Dicas de prova
- Paradigmas: saiba a descrição de uma linha de cada um e esteja pronto para nomear o paradigma a partir de um trecho de código; perguntas de nível baixo exigem os cinco modos de endereçamento e o que o acumulador recebe.
- Definições de POO aparecem em toda sessão: classe, objeto, atributo, método, encapsulamento, herança, polimorfismo, construtor. Escreva uma classe em pseudocódigo com atributos PRIVADOS, um CONSTRUTOR PÚBLICO e getters; uma subclasse com HERDA e SUPER.CONSTRUTOR.
- Declarativa: um objetivo com uma variável retorna todos os fatos correspondentes; uma regra é uma conclusão SE condições unidas com E; copie exatamente os nomes dos predicados da questão.
- Arquivos: os três modos e o que cada um faz com um arquivo existente; READFILE em um loop WHILE NOT EOF; arquivos aleatórios usam hash, SEEK, GETRECORD e PUTRECORD, com colisão de passo-over.
- Exceções: definição com exemplo, três razões para tratá-las, e TRY com EXCEPT nomeado que permite ao programa continuar.
Erros comuns
- Descrever um programa declarativo como "uma sequência de passos que dá a resposta"; ele declara o que é verdadeiro e o que se deseja, não como.
- Confundir um objeto com uma classe, ou uma instância com um atributo; a pergunta "uma ocorrência de um objeto" quer dizer instância.
- Declarar os atributos PÚBLICOS, ou acessá-los de fora da classe em vez de por meio de um getter, o que perde as marcas de encapsulamento.
- O construtor de uma subclasse que define diretamente os atributos do pai em vez de chamar SUPER.CONSTRUTOR.
- Explicar polimorfismo como "muitos objetos"; é o mesmo nome de método se comportando diferentemente para classes distintas.
- Abrir um arquivo FOR WRITE para adicionar um registro, o que destrói o conteúdo existente; use APPEND.
- Ler um arquivo aleatório do início; USE SEEK no endereço hash primeiro.
- Colocar o manipulador de exceções ao redor de código que não pode falhar, ou capturar tudo sem mensagem, ou descrever tratamento de exceções como "verificar a entrada com IF".
- imediato (