| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de cómo un SO puede maximizar el uso de los recursos | |
| Describir las formas en que la interfaz de usuario oculta las complejidades del hardware al usuario | |
| Demostrar comprensión de la gestión de procesos | El concepto de multitarea y un proceso Los estados del proceso: ejecución, listo y bloqueado La necesidad de planificación y la función y beneficios de diferentes rutinas de planificación (incluyendo round robin, shortest job first, first come first served, shortest remaining time) Cómo el kernel del SO actúa como manejador de interrupciones y cómo el manejo de interrupciones se utiliza para gestionar la planificación a bajo nivel |
| Demostrar comprensión de la memoria virtual, el paginación y la segmentación para la gestión de memoria | Los conceptos de paginación, memoria virtual y segmentación La diferencia entre paginación y segmentación Cómo pueden reemplazarse las páginas Cómo puede ocurrir el thrashing (agotamiento) del disco |
Software de sistema
A-Level Ciencias de la Computación · Tema 16
 14:07
Recursos, compiladores y RPN
Abre un navegador, un reproductor de música y un juego. Tienes un procesador — quizás varios núcleos — y todos parecen ejecutarse al mismo tiempo. Y juntos quieren más…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
16.1
Cómo el SO maximiza el uso de recursos

Syllabus
Fuente: Plan de estudios Cambridge International
Un ordenador dispone de muchos recursos (tiempo de CPU, memoria, disco, E/S) y varios programas compiten por ellos. El SO los comparte de forma justa y eficiente para que cada uno se utilice adecuadamente y el sistema permanezca reactivo:
- multitarea — cambiar rápidamente la CPU entre procesos para que varios parezcan ejecutarse a la vez.
- gestión de memoria — asignar a cada proceso la memoria que necesita; utilizar el paging 分页 del disco cuando se agota la RAM.
- spooling 假脱机 y buffering: las tareas de impresión se encolan en el disco para que la CPU nunca espere a la impresora.
- caching: mantener datos recientes del disco en una cache 高速缓存 / RAM.

Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| multi-tasking/ˈmʌlti ˈtæskɪŋ/ | 多任务 | duō rèn wù |
| paging/ˈpeɪdʒɪŋ/ | 分页 | fēn yè |
| spooling/ˈspuːlɪŋ/ | 假脱机 | jiǎ tuō jī |
| cache/kæʃ/ | 高速缓存 | gāo sù huǎn cún |
| process/ˈprəʊses/ | 进程 | jìn chéng |
| scheduler/ˈʃedjʊlə/ | 调度器 | diào dù qì |
16.1
La interfaz de usuario
La interfaz de usuario oculta el hardware detrás de abstracciones amigables: el usuario ve ventanas, menús y carpetas, no direcciones ni sectores. Un solo clic en un icono hace que el SO localice el programa en el disco, le asigne memoria, lo cargue y lo inicie. Una CLI (línea de comandos) es potente y scriptable para expertos; una GUI (gráfica) es más fácil de aprender. La mayoría de sistemas ofrecen ambos.
"Describa dos formas en que se ocultan al usuario las complejidades del hardware." (1) El usuario trabaja con archivos y carpetas por nombre, y el SO los traduce en pistas, sectores y bloques del disco; (2) el usuario ejecuta un programa con un clic o un comando, y el SO lo carga, le asigna memoria y lo programa sin que el usuario conozca ninguna dirección; (3) los controladores de dispositivo permiten al usuario imprimir o guardar sin saber cómo se controla la impresora o el disco; (4) una interfaz gráfica sustituye los comandos a nivel de máquina por iconos, ventanas y menús. El beneficio para un estudiante, con un ejemplo: el SO hace que el hardware sea utilizable sin conocimientos técnicos, por ejemplo, guardando un documento en una unidad USB arrastrando su icono.
"Muestre cómo un SO maximiza el uso de recursos." Programa el procesador para que nunca esté inactivo mientras haya un proceso listo; gestiona la memoria, asignándola a los procesos, recuperándola y ampliándola con memoria virtual; gestiona la entrada y salida, utilizando buffers y spooling para que dispositivos rápidos y lentos superpongan sus trabajos; y gestiona el almacenamiento, llevando un registro del espacio libre y los archivos. Cada punto nombra un recurso y lo que hace el SO con él.
16.1
Gestión de procesos
Un proceso 进程 es un programa en ejecución: su código, estado actual, memoria y archivos abiertos.
Programación
El programador 调度器 elige qué proceso listo se ejecutará a continuación y durante cuánto tiempo:
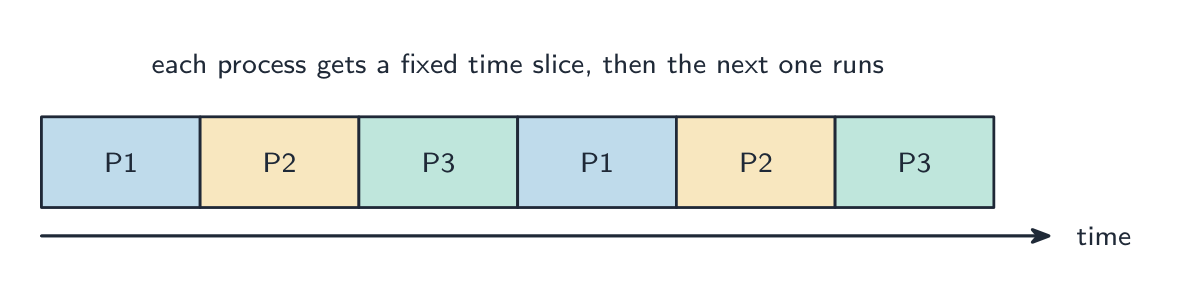
- round robin 轮转 — cada proceso recibe un time slice 时间片 fijo y luego pasa al final de la cola.
- primero en llegar, primero en ser atendido; trabajo más corto primero; tiempo restante más corto (ejecutar el trabajo con menos trabajo pendiente); prioridad; colas de retroalimentación multinivel.
El compromiso es la reactividad frente al rendimiento frente a la equidad.
"Describa lo que significa multitarea y cómo beneficia a la gestión de procesos." Varios procesos se mantienen en memoria al mismo tiempo y el procesador cambia entre ellos tan rápido que parecen ejecutarse simultáneamente, recibiendo cada uno turnos de tiempo de procesador a su vez. El beneficio: el procesador nunca queda inactivo mientras un proceso espera entrada o salida, por lo que el rendimiento es mayor y el usuario puede trabajar con varios programas a la vez. "Explique la necesidad de programar." Hay más procesos que procesadores, por lo que se debe decidir cuál proceso se ejecutará a continuación y por cuánto tiempo; la programación asegura que todos los procesos avanzen, que el procesador esté plenamente utilizado, que los tiempos de respuesta sean aceptables y que se puedan respetar las prioridades.
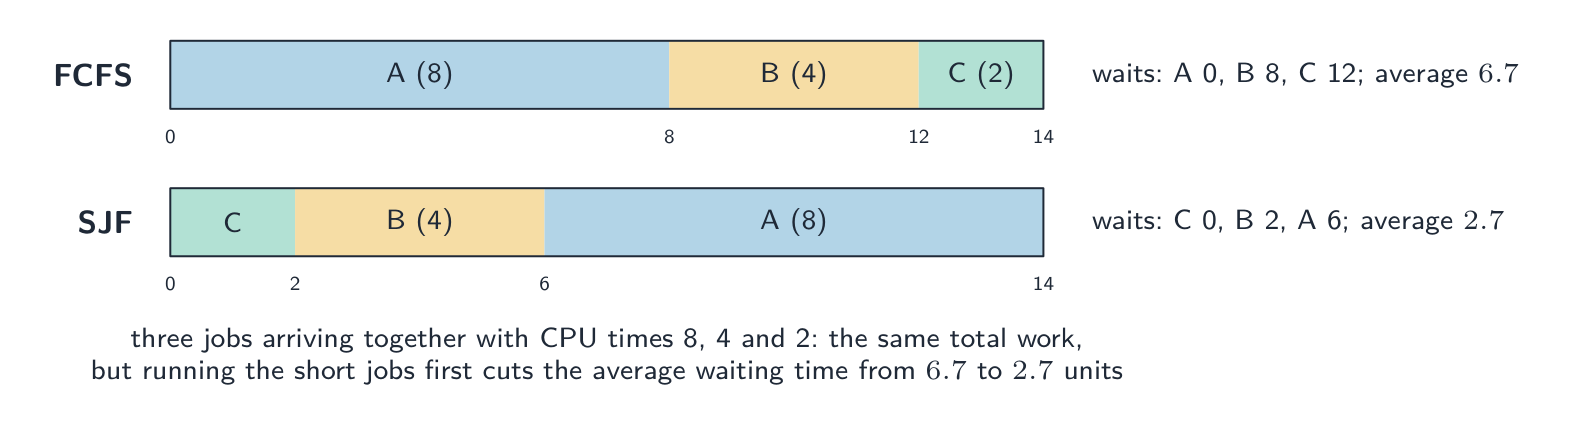
Las rutinas de programación, tal como las pide el examen.
| Rutina | Función | Beneficio | Inconveniente |
|---|---|---|---|
| primero en llegar, primero en ser atendido (FCFS) | los procesos se ejecutan en el orden en que llegan a la cola de listos, hasta completarse | simple; cada proceso se atiende a su turno, ninguno es privado de servicio | un proceso largo retrasa a todos los cortos que están detrás; mala respuesta |
| trabajo más corto primero (SJF) | el proceso listo con el tiempo de ejecución estimado más corto se ejecuta a continuación, hasta completarse | minimiza el tiempo de espera promedio; muchos trabajos cortos terminan rápidamente | los tiempos de ejecución deben conocerse de antemano; un trabajo largo podría no ejecutarse nunca (privación de servicio) |
| tiempo restante más corto (SRT) | versión preemptive 抢占式 de SJF: si llega un nuevo proceso con menos tiempo restante que el que se está ejecutando, toma el control | los procesos cortos se atienden aún más rápido; buen rendimiento | más cambios de contexto; un trabajo largo puede ser interrumpido repetidamente y sufrir privación de servicio |
| round robin (RR) | cada proceso listo recibe un time slice fijo a su vez; cuando expira, el proceso pasa al final de la cola | justo; cada proceso responde dentro de un tiempo acotado, bueno para uso interactivo | sobrecarga por cambio de contexto; un time slice muy corto desperdicia tiempo, uno largo retrasa a otros |
| prioridad | el proceso listo con mayor prioridad se ejecuta primero | el trabajo importante o crítico en el tiempo se realiza primero | los procesos de baja prioridad pueden sufrir privación de servicio a menos que las prioridades envejecan |
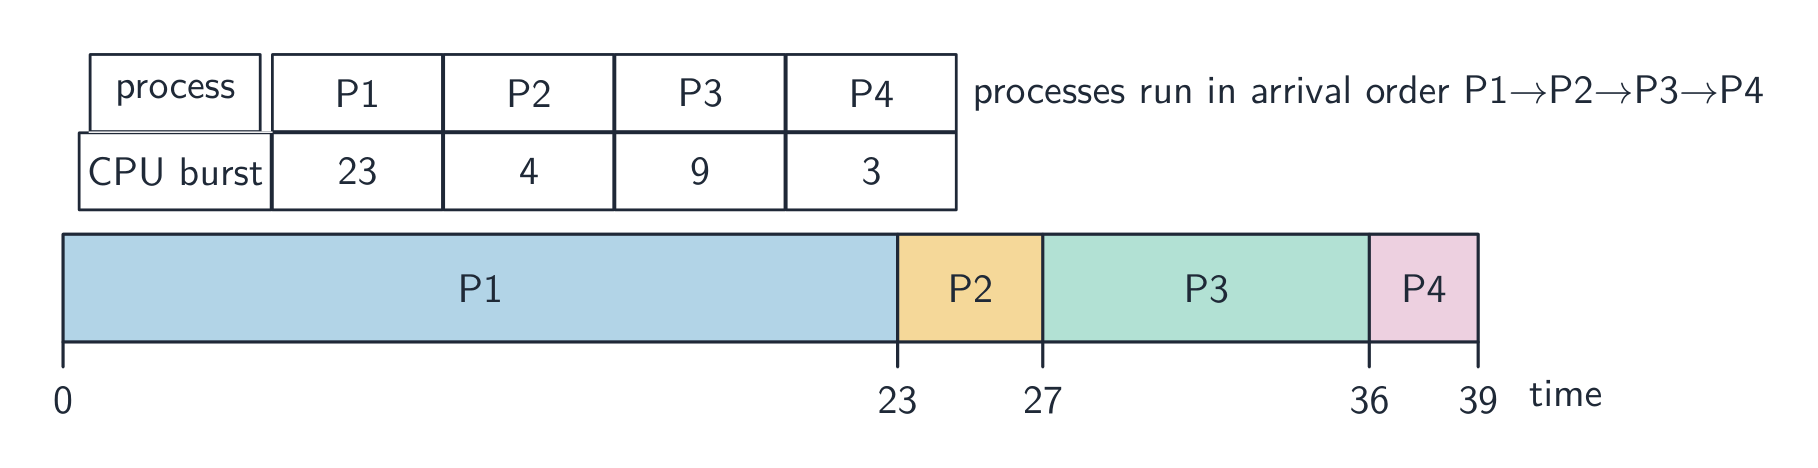
Ejemplo resuelto. Tres procesos llegan juntos con tiempos de CPU de 8, 4 y 2 ms. Compare el tiempo de espera promedio bajo FCFS (en orden de llegada A, B, C) y bajo shortest job first.
FCFS: A espera 0, B espera 8, C espera 12; promedio $(0 + 8 + 12)/3 = 6.7\ \text{ms}$. SJF ejecuta C, B, A: C espera 0, B espera 2, A espera 6; promedio $2.7\ \text{ms}$. El trabajo total es el mismo, 14 ms en ambos casos; el orden decide quién espera. Round robin con un time slice de 2 ms daría a A, B y C un turno en los primeros 6 ms, por lo que C termina en 6 ms, B en 12 ms y A en 14 ms: el más reactivo, no necesariamente el más rápido en promedio.
Estados de proceso
Un proceso es nuevo, listo (esperando la CPU), en ejecución, bloqueado 阻塞 (esperando E/S o un bloqueo) o terminado. Cuando termina su time slice pasa de executing → ready; cuando solicita E/S pasa de executing → blocked; cuando finaliza la E/S pasa de blocked → ready.
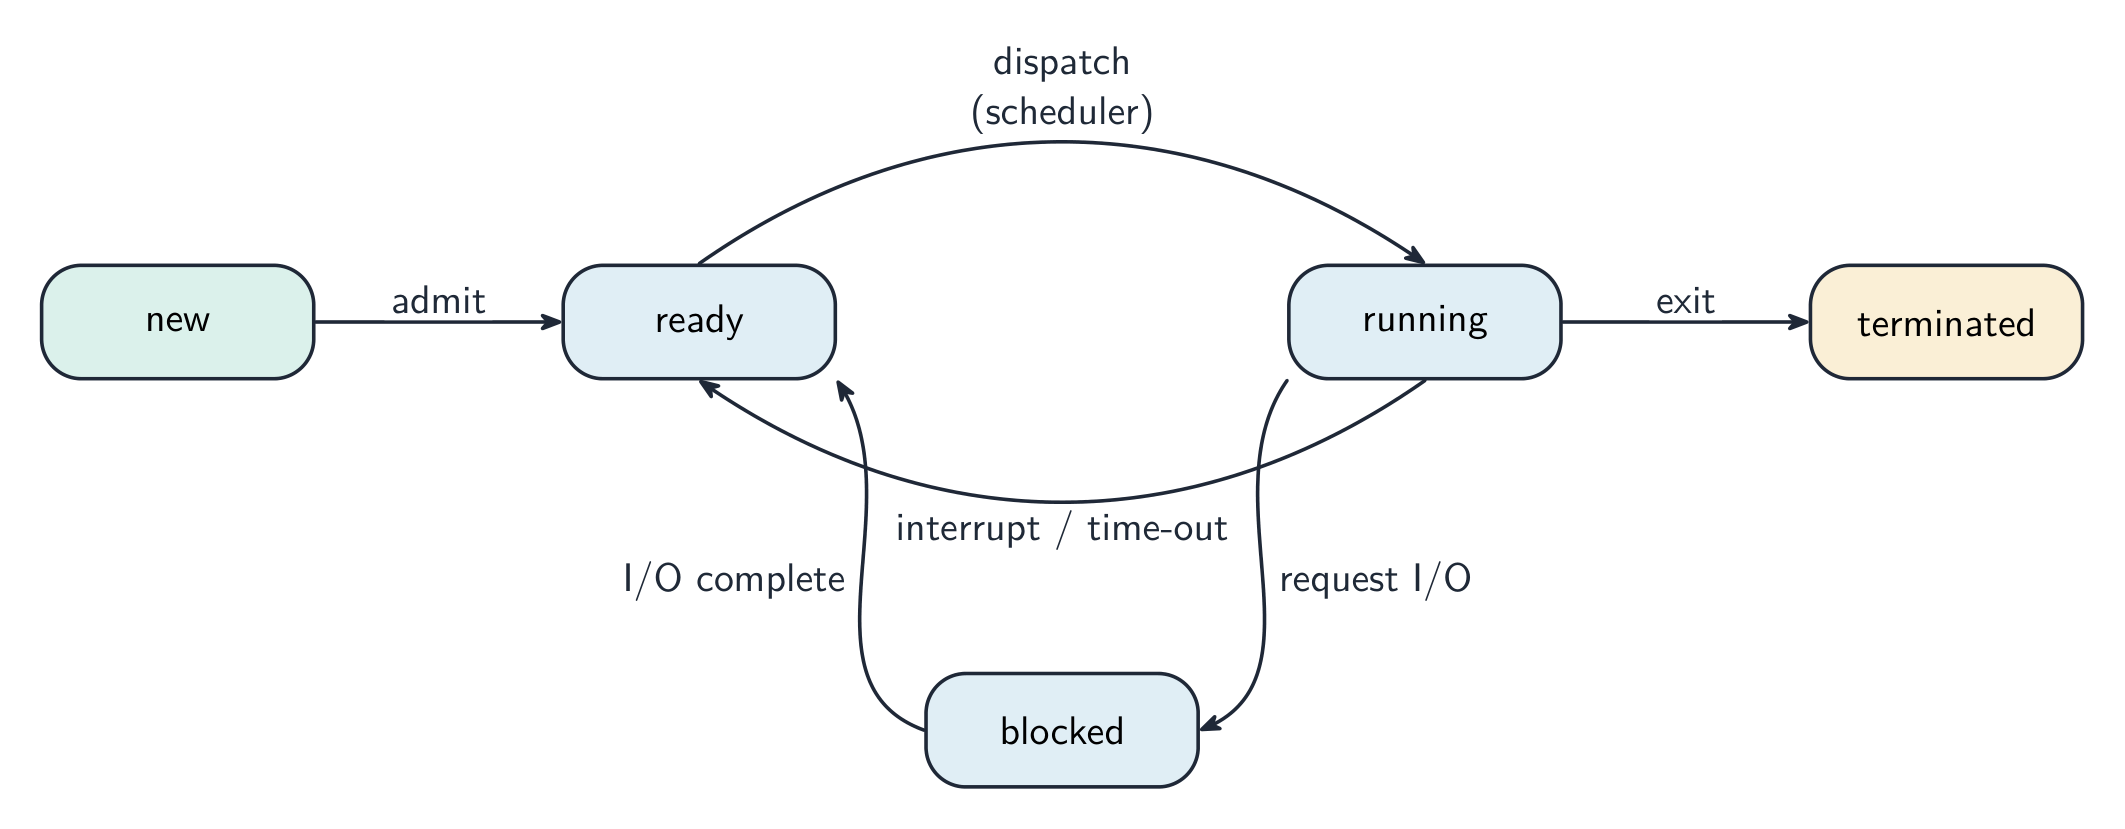
Los tres estados y las razones por las que un proceso cambia de estado. En ejecución: el proceso tiene el procesador. Listo para ejecutar: podría ejecutarse pero está esperando por el procesador. Bloqueado: no puede ejecutarse hasta que ocurra algo más. Razones para cada transición, lo cual el examen pide una a la vez: de ejecución a listo cuando termina su intervalo de tiempo, o cuando un proceso de mayor prioridad se vuelve listo y lo preempe (una interrupción); de ejecución a bloqueado cuando solicita entrada/salida o espera por un recurso u otro proceso; de bloqueado a listo cuando finaliza la E/S en la que estaba esperando (señalada por una interrupción); de listo a ejecución cuando el planificador lo despacha. Un proceso bloqueado nunca pasa directamente a ejecución: primero debe convertirse en listo.
Bloque de control de proceso y cambio de contexto
Para cada proceso, el SO mantiene un bloque de control de proceso 进程控制块 (PCB) — el contador de programa guardado, registros, estado e información de memoria.
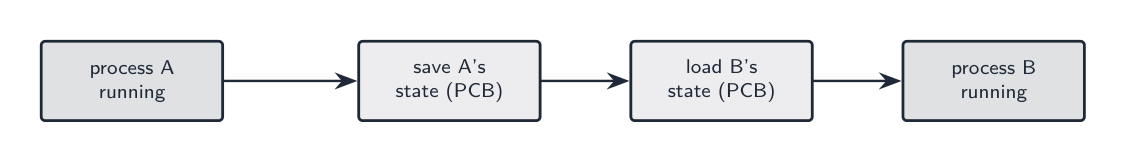
- un cambio de contexto 上下文切换 suspende un proceso e inicia otro: guarda el estado en un PCB y lo restaura desde otro. Este pequeño costo se paga en cada cambio.
- el núcleo 内核 (el núcleo del SO) actúa como manejador de interrupciones 中断处理程序. Cuando un dispositivo o el temporizador generan una interrupción, el manejo de interrupciones 中断处理 salva el proceso en ejecución y ejecuta la rutina adecuada — esto es lo que impulsa la planificación de bajo nivel.
"Describa cómo actúa el núcleo como manejador de interrupciones" (dos puntos). Cuando se genera una interrupción, el núcleo guarda el estado del proceso en ejecución (sus registros y contador de programa, en su bloque de control de proceso), identifica la fuente y la prioridad de la interrupción, ejecuta la rutina de servicio de interrupción correspondiente y luego restaura el proceso interrumpido (o uno de mayor prioridad) para que la ejecución continúe. Así es como el temporizador termina un intervalo de tiempo y cómo una operación de E/S completada desbloquea un proceso.
Comunicación entre procesos
Los procesos están aislados, por lo que el SO proporciona comunicación entre procesos 进程间通信: tuberías 管道 (la salida de un programa alimenta la entrada de otro), memoria compartida 共享内存 (una región que varios procesos pueden usar) y paso de mensajes.
Explorar
La vida de un proceso
Toca alrededor del bucle que recorre un proceso. Solo se ejecuta cuando el planificador lo selecciona; necesitar E/S lo envía a bloqueado, y terminar su tiempo de CPU lo devuelve a listo — rode y rode hasta que termine.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| round robin/raʊnd ˈrɒbɪn/ | 轮转 | lún zhuàn |
| time slice/taɪm slaɪs/ | 时间片 | shí jiān piàn |
| pre-emptive/priː ˈemptɪv/ | 抢占式 | qiǎng zhàn shì |
| blocked/blɒkt/ | 阻塞 | zǔ sè |
| process control block/ˈprəʊses kənˈtrəʊl blɒk/ | 进程控制块 | jìn chéng kòng zhì kuài |
| context switch/ˈkɒntekst swɪtʃ/ | 上下文切换 | shàng xià wén qiè huàn |
16.1
Memoria virtual, segmentación y paginación
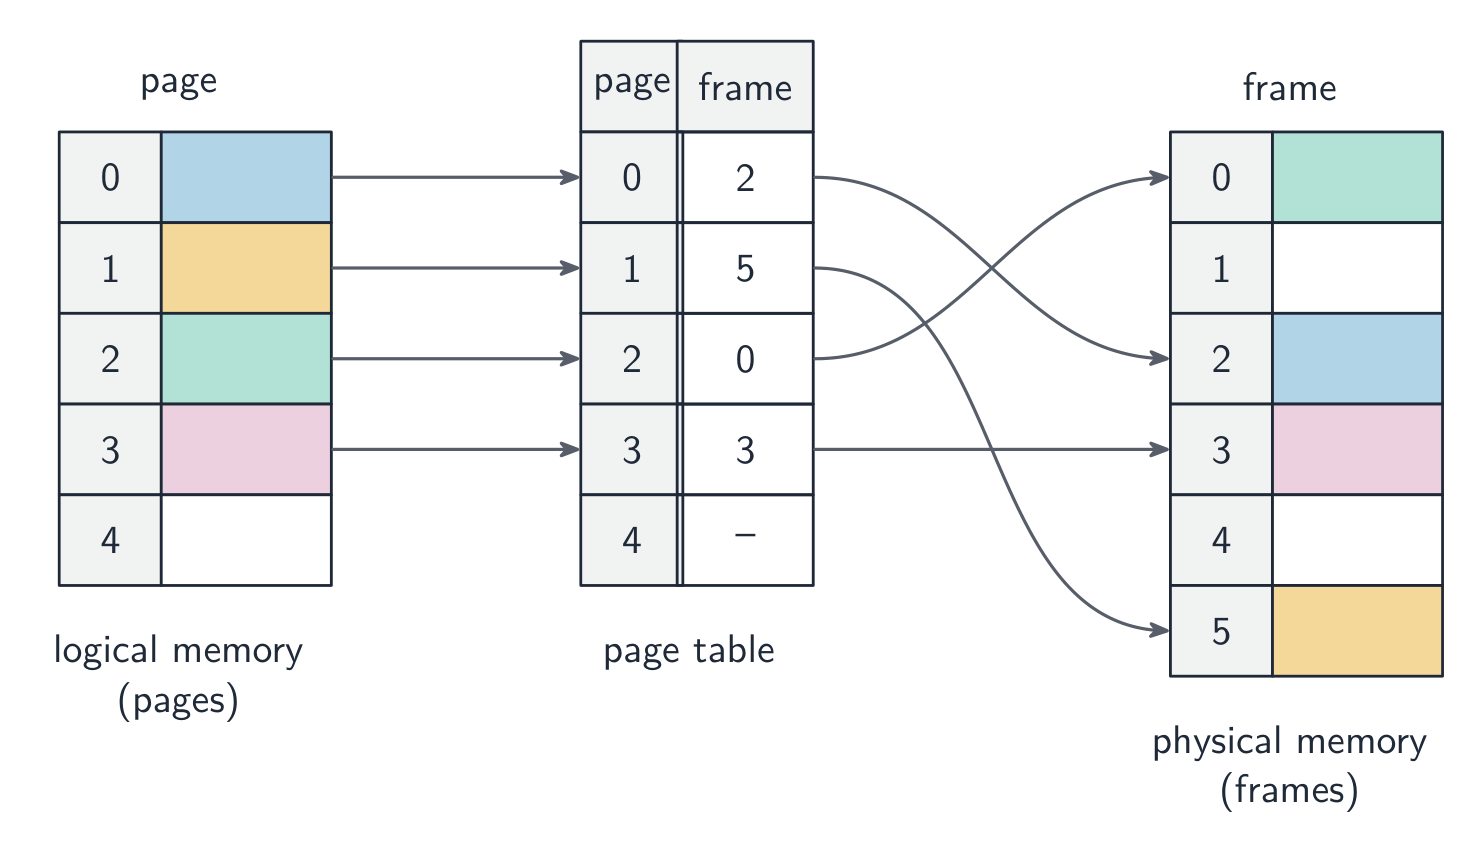
Cada proceso recibe su propio espacio de direcciones virtuales 虚拟地址 espacio — un rango limpio y contiguo de direcciones que el SO mapea a la memoria física. Esto otorga a cada proceso un espacio sencillo, protege los procesos entre sí y permite que la memoria total exceda la RAM física.
En la paginación, el espacio virtual se divide en páginas 页 de tamaño fijo y la memoria física en marcos 页框 del mismo tamaño. Una tabla de páginas mapea cada página a un marco. Si una página accedida no está en RAM —un fallo de página 缺页—, el SO la lee desde el archivo de intercambio 交换文件 hacia un marco, eliminando otra página si la RAM está llena. Los fallos frecuentes causan thrashing 抖动 (thrashing de disco), donde el SO dedica la mayor parte del tiempo a intercambiar páginas en lugar de realizar trabajo útil.
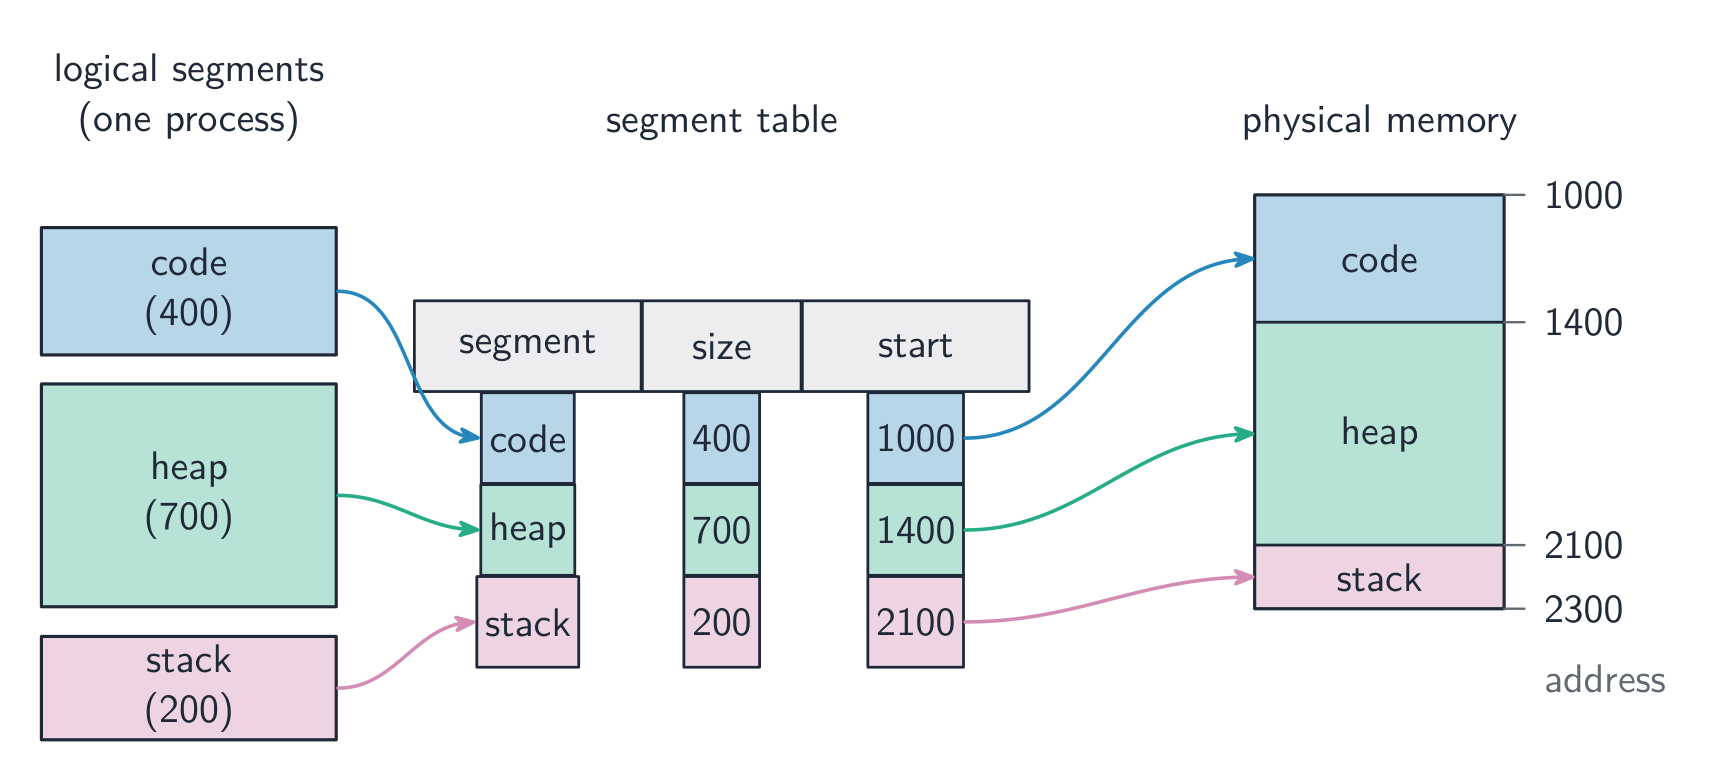
En la segmentación 分段, la memoria se divide en segmentos lógicos de tamaño variable (código, pila, heap), cada uno con sus propios permisos. Muchos sistemas utilizan paginación dentro de segmentos.
"Explique qué se entiende por memoria virtual" (tres puntos). El almacenamiento secundario (disco) se utiliza para extender la RAM, de modo que la memoria disponible parece mayor que la memoria física; el espacio de direcciones de un proceso se divide en páginas, y solo las páginas actualmente necesarias se mantienen en RAM mientras el resto esperan en disco; las páginas se intercambian entre RAM y disco según sea necesario, y el SO traduce cada dirección virtual en una física. ¿Por qué lo necesita el SO: los programas en ejecución pueden necesitar más memoria de la instalada; permite que más (o más grandes) programas se ejecuten a la vez; un programa puede ser más grande que la memoria física; la memoria se usa eficientemente porque solo las partes activas de los programas ocupan RAM.
Paginación frente a segmentación: la diferencia que busca el examen. La paginación divide la memoria en bloques de tamaño fijo (páginas y marcos) elegidos por el hardware, sin importar la estructura del programa, y el mapeo es invisible para el programador; la segmentación divide un programa en unidades lógicas de tamaño variable (un procedimiento, una matriz, la pila) cuyos tamaños y límites siguen al programa, de modo que un segmento puede protegerse o compartirse como unidad. "Describa el proceso de segmentación": el programa se divide en segmentos de diferentes tamaños, a cada uno se le asigna un número de segmento; una tabla de segmentos registra dónde comienza cada segmento en la memoria y cuánto mide; una dirección lógica es un número de segmento más un desplazamiento, y el SO suma el desplazamiento a la dirección base del segmento para encontrar la ubicación física.
"Explique qué se entiende por thrashing de disco" y cuándo ocurre. Thrashing de disco 磁盘抖动 es el estado en el que las páginas se intercambian dentro y fuera de RAM con tanta frecuencia que el procesador pasa más tiempo moviendo páginas que ejecutando instrucciones, y el sistema se ralentiza casi hasta detenerse. Ocurre cuando la RAM es demasiado pequeña para las páginas que necesitan los procesos en ejecución (sus conjuntos de trabajo): una página acabada de eliminar se vuelve a necesitar casi de inmediato, por lo que se recupera, lo que elimina otra página que pronto también será necesaria, y así sucesivamente. Demasiados procesos, o un programa que accede a la memoria de forma impredecible, lo provocan; más RAM o menos procesos lo solucionan.
Explorar
Qué ocurre en una falta de página
Recorra paso a paso una falta de página. Cuando el programa accede a una página que no está en la RAM, el SO la obtiene silenciosamente del disco y actualiza la tabla de páginas, haciendo que el programa vea más memoria de la que físicamente existe.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| thrashing/ˈθræʃɪŋ/ | 抖动 | dǒu dòng |
| segmentation/ˌseɡmənˈteɪʃn/ | 分段 | fēn duàn |
| disk thrashing/dɪsk ˈθræʃɪŋ/ | 磁盘抖动 | cí pán dǒu dòng |
| interpreter/ɪnˈtɜːprɪtə/ | 解释器 | jiě shì qì |
| compiler/kəmˈpaɪlə/ | 编译器 | biān yì qì |
| machine code/məˈʃiːn kəʊd/ | 机器码 | jī qì mǎ |
| lexical analysis/ˈleksɪkl əˈnæləsɪs/ | 词法分析 | cí fǎ fēn xī |
16.2
Cómo ejecuta un programa un intérprete
Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de cómo un intérprete puede ejecutar programas sin producir una versión traducida | |
| Demostrar comprensión de las diversas etapas en la compilación de un programa | Incluyendo el análisis léxico, análisis sintáctico, generación de código y optimización |
| Demostrar comprensión de cómo la gramática de un lenguaje puede expresarse mediante diagramas de sintaxis o notación Forma Normal de Backus-Naur (BNF) | |
| Demostrar comprensión de cómo se puede utilizar la Notación Polaca Inversa (NPI) para llevar a cabo la evaluación de expresiones |
Fuente: Plan de estudios Cambridge International
Un intérprete 解释器 traduce y ejecuta el código fuente al mismo tiempo. Para cada instrucción lee la línea, realiza análisis léxico y sintáctico, verifica tipos y luego ejecuta la acción, y continúa. Los errores se reportan inmediatamente y generalmente se detiene; no se produce un ejecutable. La traducción se rehace en cada ejecución (más lento), pero ofrece retroalimentación rápida de desarrollo y es portable.
"Explique cómo un intérprete ejecuta un programa sin producir una versión traducida" (tres puntos). El intérprete toma una instrucción (línea) a la vez, la traduce (analiza) y la ejecuta inmediatamente, antes de pasar a la siguiente; no se crea ni almacena una versión traducida de todo el programa, por lo que cada instrucción se traduce cada vez que se ejecuta, incluyendo cada paso por un bucle; si una instrucción contiene un error, la ejecución se detiene allí y se reporta el error. Esto es lo que hace que un intérprete sea bueno para el desarrollo y las pruebas (los errores se encuentran a medida que se alcanzan y un cambio puede probarse de inmediato) pero más lento para ejecutar programas terminados.
16.2
Fases de compilación
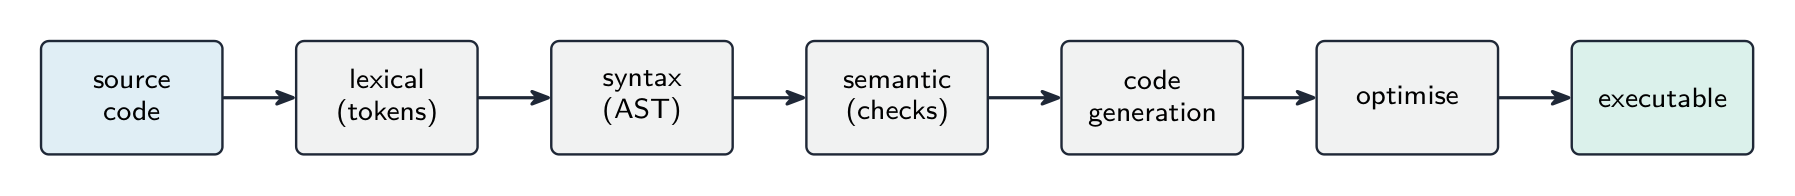
Un compilador 编译器 convierte el código fuente en código máquina 机器码 en fases:
- análisis léxico — El lexer agrupa caracteres en tokens (palabras clave, identificadores, operadores, literales), descartando espacios en blanco y comentarios.
- análisis sintáctico (parsing) — Verifica que los tokens se ajusten a la gramática y construye un árbol de sintaxis abstracta. Un paréntesis faltante genera un error de sintaxis.
- análisis semántico — Verifica que el programa tenga sentido (variables declaradas, tipos coincidentes).
- generación de código — Recorre el árbol y emite código objetivo, eligiendo registros y distribuciones.
- optimización de código — Elimina trabajo redundante, pliega constantes y reordena para la tubería.
La salida es un ejecutable.
El propósito de cada etapa, con las palabras clave. Análisis léxico: elimina espacios en blanco y comentarios; convierte los caracteres del código fuente en tokens (palabras clave, identificadores, operadores, constantes), verificando que cada uno sea válido en el lenguaje; registra los identificadores en la tabla de símbolos. Análisis sintáctico: verifica que la secuencia de tokens obedezca la gramática (reglas de sintaxis) del lenguaje; construye un árbol de análisis (árbol de sintaxis abstracta); informa errores de sintaxis; la verificación de tipos y la comprobación de declaraciones de variables a veces se cuentan aquí como análisis semántico. Generación de código: convierte el árbol validado en código objeto o código máquina (posiblemente mediante código intermedio), asignando memoria y registros. Optimización: hace que el código ejecute más rápido o utilice menos memoria, eliminando instrucciones redundantes, combinando o simplificando cálculos y reorganizando bucles, sin alterar lo que hace el programa. La pregunta de emparejamiento asocia cada etapa con una de estas descripciones.
Explorar
Las fases de la compilación
Recorra paso a paso lo que hace un compilador con su código fuente. Cada fase entrega su salida a la siguiente: los caracteres se convierten en tokens, los tokens en un árbol, y el árbol en código máquina optimizado.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| tokens/ˈtəʊkənz/ | 词法单元 | cí fǎ dān yuán |
| syntax analysis (parsing)/ˈsɪntæks əˈnæləsɪs/ | 语法分析 | yǔ fǎ fēn xī |
| abstract syntax tree/ˈæbstrækt ˈsɪntæks triː/ | 抽象语法树 | chōu xiàng yǔ fǎ shù |
| syntax error/ˈsɪntæks ˈerə/ | 语法错误 | yǔ fǎ cuò wù |
| semantic analysis/səˈmæntɪk əˈnæləsɪs/ | 语义分析 | yǔ yì fēn xī |
| code generation/kəʊd ˌdʒenəˈreɪʃn/ | 代码生成 | dài mǎ shēng chéng |
| code optimisation/kəʊd ˌɒptɪmaɪˈzeɪʃn/ | 代码优化 | dài mǎ yōu huà |
| symbol table/ˈsɪmbl ˈteɪbl/ | 符号表 | fú hào biǎo |
| grammar/ˈɡræmə/ | 文法 | wén fǎ |
16.2
Gramáticas: BNF y diagramas de sintaxis
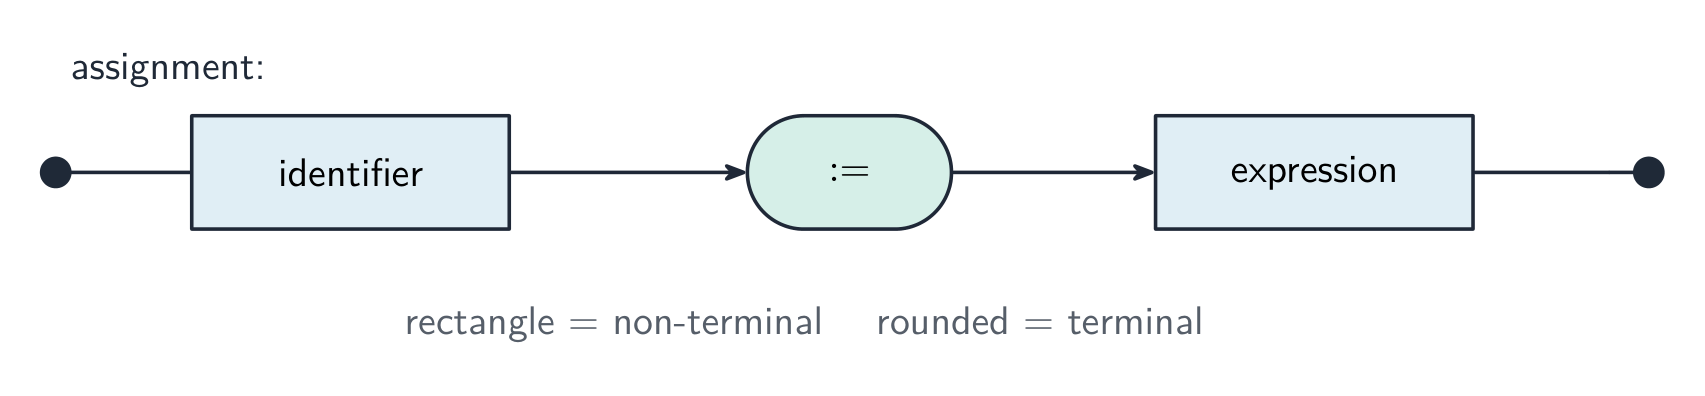
Una gramática dice qué secuencias de tokens son programas válidos.
Backus-Naur Form (BNF) es textual. Una regla de producción tiene la forma:
<symbol> ::= alternative1 | alternative2 | ...
Cada alternativa es una secuencia de símbolos terminales (texto literal) y símbolos no terminales (otros nombres de reglas):
<digit>      ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<identifier> ::= <letter> | <identifier> <letter> | <identifier> <digit>
La tercera regla recursiva expresa "una letra seguida de cualquier número de letras o dígitos". Una instrucción IF:
<if-statement> ::= IF <condition> THEN <statement> ENDIF
                 | IF <condition> THEN <statement> ELSE <statement> ENDIF
Un diagrama de sintaxis (diagrama de vías) muestra lo mismo gráficamente: cajas para no terminales, cajas redondeadas para terminales, flechas para caminos válidos, bucles para repetición. Las dos notaciones son equivalentes. El analizador usa la gramática para decidir si un programa es válido.
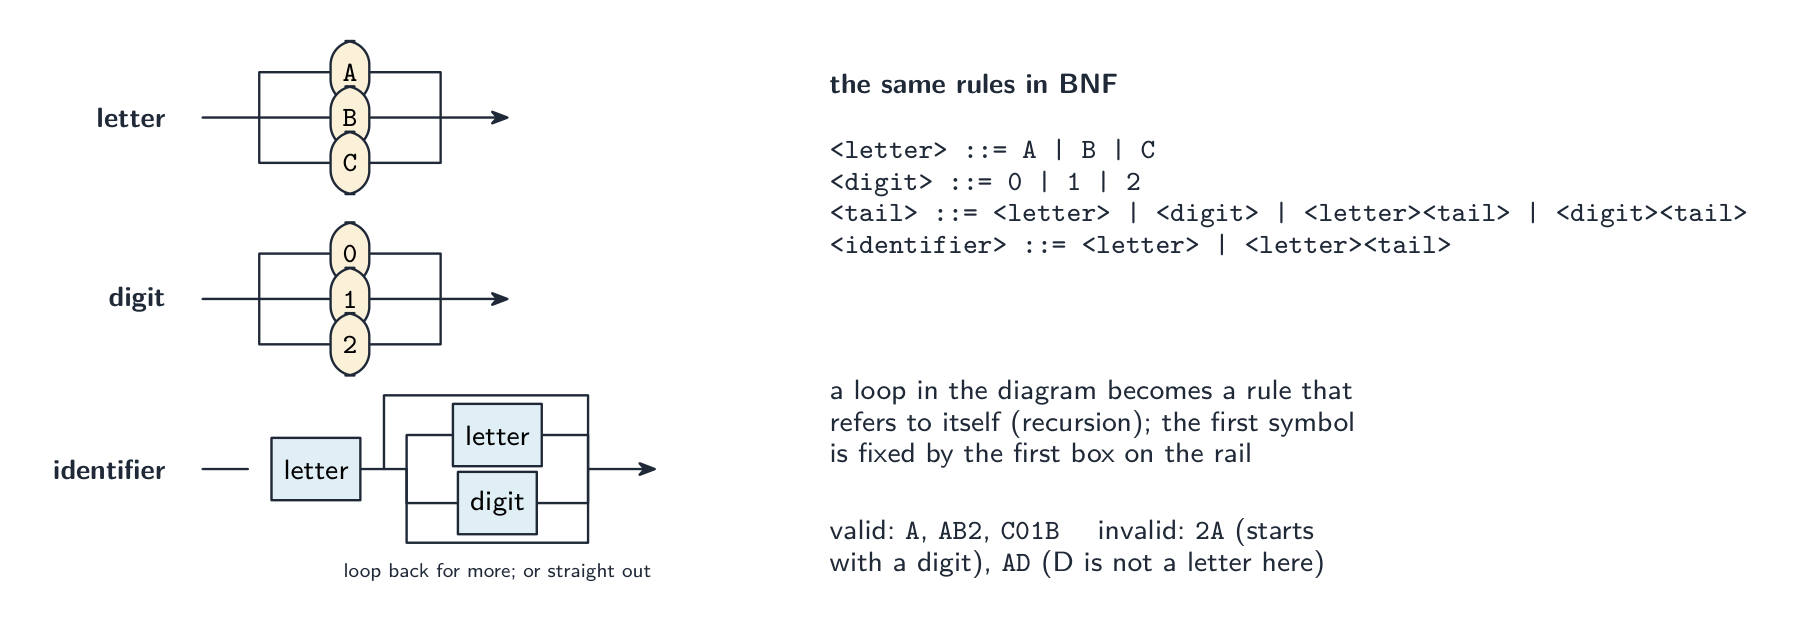
Lectura de los diagramas del examen. Cada diagrama define un no terminal; sigue las flechas desde la entrada hasta la salida, y cada camino que puedas trazar es una cadena válida. Una elección de cajas lado a lado es un conjunto de alternativas; un bucle hacia atrás significa "repetir tantas veces como quieras"; una caja para otro no terminal significa "insertar cualquier cosa que permita esa regla". "Explica por qué la cadena es inválida" pide la regla que rompe, en palabras: 9K es inválido como variable porque el primer carácter debe ser una letra, no un dígito; JJ90 es una contraseña inválida si la regla permite solo una letra antes de los dígitos, o si J no está en el conjunto de letras listadas. Siempre verifica la cadena contra el conjunto de caracteres que el diagrama realmente permite, no contra lo que aceptaría un lenguaje real.
Escritura de BNF a partir de un diagrama. Cada diagrama se convierte en una regla <name> ::= ...; las alternativas se separan por |; una secuencia se escribe un símbolo después del otro; y la repetición se escribe con recursión, porque BNF no tiene símbolo de bucle: "una o más letras" es <word> ::= <letter> | <letter><word>, y "cero o más dígitos después de una letra" es <variable> ::= <letter> | <letter><digits> con <digits> ::= <digit> | <digit><digits>.
Ejemplo resuelto. Completa el BNF para un número de matrícula de vehículo que debe comenzar con dos letras (de A B C) seguidas de uno, dos o tres dígitos (de 0 1 2).
<letter>       ::= A | B | C
<digit>        ::= 0 | 1 | 2
<digits>       ::= <digit> | <digit><digit> | <digit><digit><digit>
<registration> ::= <letter><letter><digits>
AB12 es válido; A12 no lo es (solo una letra); AB1234 no lo es (cuatro dígitos); AD1 no lo es (D no es una letra listada). Se pide añadir una restricción como "el tercer carácter también puede ser un símbolo", añade la alternativa extra a la regla de esa posición únicamente, y define <symbol> con su propia regla.
Ejemplo resuelto. Escribe BNF para una expresión que es una variable, seguida de un operador, seguido de ya sea una variable o un número, donde una variable es una sola letra minúscula de a b c y un operador es + o -.
<variable>   ::= a | b | c
<operator>   ::= + | -
<number>     ::= <digit> | <digit><number>
<expression> ::= <variable><operator><variable> | <variable><operator><number>
La regla recursiva <number> permite cualquier número de dígitos; las dos alternativas de <expression> cubren ambos casos nombrados en la definición. Mantén cada no terminal entre ángulos y cada terminal sin ellos.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| Backus-Naur Form/ˈbækəs nɔː fɔːm/ | 巴科斯-诺尔范式 | bā kē sī - nuò ěr fàn shì |
| production rule/prəˈdʌkʃn ruːl/ | 产生式 | chǎn shēng shì |
| terminal/ˈtɜːmɪnl/ | 终结符 | zhōng jié fú |
| non-terminal/nɒn ˈtɜːmɪnl/ | 非终结符 | fēi zhōng jié fú |
| syntax diagram/ˈsɪntæks ˈdaɪəɡræm/ | 语法图 | yǔ fǎ tú |
| infix/ˈɪnfɪks/ | 中缀 | zhōng zhuì |
| Reverse Polish Notation/rɪˈvɜːs ˈpəʊlɪʃ nəʊˈteɪʃn/ | 逆波兰表示法 | nì bō lán biǎo shì fǎ |
| postfix/ˈpəʊstfɪks/ | 后缀 | hòu zhuì |
| stack/stæk/ | 栈 | zhàn |
| precedence/ˈpresɪdəns/ | 优先级 | yōu xiān jí |
16.2
Notación Polaca Inversa (RPN)
En la notación infija el operador se sitúa entre sus operandos (3 + 4 * 2), requiriendo paréntesis y reglas de precedencia. En la Notación Polaca Inversa (RPN, postfija) el operador sigue a sus operandos (3 4 2 * +), no requiriendo paréntesis.
Conversión de infija a RPN
Usa una pila de operadores. Escanea de izquierda a derecha: emite un operando; para un operador, primero popa cualesquiera operadores apilados de precedencia igual o superior a la salida, luego empújalo; empuja (; sobre ) popa a la salida hasta el correspondiente (. Al final, popa todos los operadores. Ejemplo: (3 + 4) * 2 → 3 4 + 2 *.
Evaluación de RPN
Usa una pila de operandos. Escanea de izquierda a derecha: empuja cada operando; sobre un operador, popa los dos superiores, aplícalo y empuja el resultado. Evaluando 3 4 2 * +:
| Token | Pila |
|---|---|
3 |
3 |
4 |
3, 4 |
2 |
3, 4, 2 |
* |
3, 8 |
+ |
11 |
Resultado: 11. La RPN no requiere paréntesis en el momento de la evaluación y se adapta a una máquina de pila — que es como funcionan la JVM y muchos interpretadores de bytecode.
"Explique por qué se utiliza la RPN para evaluar expresiones" (dos puntos). En la RPN, los operadores aparecen en el orden en que se aplican, por lo que una expresión puede evaluarse mediante un único recorrido de izquierda a derecha sin necesidad de paréntesis ni de reglas de precedencia; por tanto, es más simple y rápida para que el compilador o el intérprete la procesen. "Identifique, con justificación, una estructura de datos adecuada": una pila, porque la evaluación necesita primero los operandos empujados más recientemente (último en entrar, primero en salir): cada operando se empuja, y cada operador extrae los dos superiores, aplica su operación y empuja el resultado. Muestre el contenido de la pila tras cada token cuando se solicite.
Conversión manual de infija a RPN. (1) Encierre completamente la expresión usando las reglas de precedencia; (2) mueva cada operador justo después del paréntesis de cierre correspondiente; (3) elimine los paréntesis. Así, $(a - b) * (a + c) / 7$ se convierte en $((a - b) * (a + c)) / 7$, y luego en a b - a c + * 7 /. Tenga en cuenta que * y / se aplican de izquierda a derecha, por lo que la división es el último operador, no la multiplicación. Más conversiones: $((7 + 3) - (2 * 8)) / 6$ es 7 3 + 2 8 * - 6 /; $(7 - 2 + 8) / (9 - 5)$ es 7 2 - 8 + 9 5 - /; $a * b + b - d + 15$ es a b * b + d - 15 +; $(2 - 6) * (13 + 7) / 5$ es 2 6 - 13 7 + * 5 /.
Conversión de RPN de vuelta a infija. Procese la RPN utilizando una pila de expresiones: empuje cada operando; para cada operador, extraiga dos elementos, escríbalos a ambos lados del mismo entre paréntesis, y empuje el resultado. Así, a b / 4 * a b + - es $((a / b) * 4) - (a + b)$; 5 2 + 9 3 - / 3 * es $((5 + 2) / (9 - 3)) * 3$; b a c - + d b + * c / es $((b + (a - c)) * (d + b)) / c$; a b - c + c a - * d / es $(((a - b) + c) * (c - a)) / d$. Mantenga los paréntesis: eliminarlos puede alterar el significado.
Ejemplo resuelto. Evalúe a b - c d + * e / sabiendo que $a = 17$, $b = 5$, $c = 7$, $d = 3$ y $e = 10$, mostrando la pila.
| token | acción | pila (arriba a la derecha) |
|---|---|---|
a |
apilar 17 | 17 |
b |
apilar 5 | 17, 5 |
- |
desapilar 5 y 17, apilar $17 - 5$ | 12 |
c |
apilar 7 | 12, 7 |
d |
apilar 3 | 12, 7, 3 |
+ |
desapilar 3 y 7, apilar $7 + 3$ | 12, 10 |
* |
desapilar 10 y 12, apilar $12 \times 10$ | 120 |
e |
apilar 10 | 120, 10 |
/ |
desapilar 10 y 120, apilar $120 / 10$ | 12 |
Resultado 12. El orden de las desapilaciones es importante para - y /: el valor desapilado segundo es el operando izquierdo, por lo que a b - es $a - b$, no $b - a$. Dos más, de la misma manera: d a b + * c a - / con $a = 6, b = 12, c = 15, d = 5$ da como resultado $5 \times (6 + 12) / (15 - 6) = 90 / 9 = 10$; c a - b d + * b c + / con $a = 4, b = 12, c = 24, d = 6$ da como resultado $(24 - 4) \times (12 + 6) / (12 + 24) = 360 / 36 = 10$.
Ejemplo resuelto. Convertir $(A + B) \times (C - D)$ a RPN, luego evaluar $(3 + 4) \times (5 - 2)$. Escanear de izquierda a derecha usando una pila de operadores. Apilar (; emitir A; apilar +; emitir B; al encontrar ), desapilar hasta el par correspondiente (, obteniendo A B + hasta ahora. Apilar ×, y el segundo corchete se comporta de la misma manera, dando como resultado C D -. Al final, desapilar el ⟨×⟩. Resultado: A B + C D - ×. Para evaluar los números, usar una pila de operandos: apilar 3, apilar 4; + desapila ambos y apila 7; apilar 5, apilar 2; - desapila ambos y apila 3; × desapila 7 y 3 y apila 21. Dos factores hacen esto confiable: los operandos mantienen su orden original durante la conversión (solo se mueven los operadores), y cada operador actúa sobre los dos valores inmediatamente inferiores en la pila.
Explorar
Precedencia de operadores — lo que elimina la RPN
En matemáticas infixas ordinarias, × y ÷ tienen mayor precedencia que + y −, por lo que se deben aplicar reglas en el orden correcto. La Notación Polaca Inversa escribe los operandos primero (3 4 2 × + 1 −), fijando el orden para que no sean necesarias reglas de precedencia.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
16.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| multitarea | varios procesos mantenidos en memoria a la vez, con el procesador alternando entre ellos para que parezcan ejecutarse simultáneamente |
| proceso | un programa que ha sido cargado en memoria y se está ejecutando (o está listo para serlo) |
| ejecutando / listo / bloqueado | tiene el procesador / esperando por el procesador / no puede continuar hasta que un evento como una E/S se complete |
| programación | decidir qué proceso listo obtendrá el procesador a continuación y durante cuánto tiempo |
| programación preemptiva | el proceso en ejecución puede ser interrumpido y movido al estado listo para que otro proceso se ejecute |
| memoria virtual | usar almacenamiento secundario para extender la RAM, manteniendo solo las páginas actualmente necesarias en memoria física |
| segmentación | dividir la memoria y los programas en páginas de tamaño fijo que se mueven entre disco y RAM según sea necesario |
| segmentación | dividir un programa en segmentos lógicos de tamaño variable, cada uno mapeado a la memoria mediante una tabla de segmentos |
| thrashing del disco | páginas siendo intercambiadas entre RAM y disco tan frecuentemente que se realiza muy poco procesamiento útil |
| intérprete | traduce y ejecuta un programa una instrucción a la vez, sin producir una versión traducida |
| compilador | traduce un programa completo de alto nivel a código máquina (objeto) antes de su ejecución |
| análisis léxico | convierte el código fuente en tokens, eliminando espacios en blanco y comentarios, y construye la tabla de símbolos |
| análisis sintáctico | verifica que los tokens obedezcan la gramática del lenguaje y construye un árbol de análisis |
| Forma Backus-Naur | una notación para la gramática de un lenguaje: reglas de la forma <name> ::= alternatives construidas desde terminales y no terminales |
| Notación Polaca Inversa | una manera de escribir expresiones con cada operador después de sus operandos, de modo que puedan evaluarse con una pila y sin paréntesis |
16.2
Consejos para el examen
- Las preguntas del SO se evalúan sobre mecanismos nombrados: programación, gestión de memoria, bufferización y spooling de E/S, gestión de archivos; para la interfaz, nombres de archivo no direcciones, clics no comandos, controladores, GUI.
- Estados del proceso con sus transiciones y la razón de cada una; rutinas de programación como función más beneficio más desventaja; el kernel guarda el estado, identifica la interrupción, la atiende, la restaura.
- Memoria virtual: el disco extiende la RAM, páginas intercambiadas, traducción de direcciones; la segmentación es de tamaño fijo e invisible, la segmentación es de tamaño variable y lógica; el thrashing es intercambiar en lugar de trabajar.
- Intérprete: una instrucción a la vez, traducido luego ejecutado, nada almacenado. Etapas del compilador: tokens y tabla de símbolos, gramática y árbol de análisis, código, optimización.
- BNF: una regla por diagrama,
|para elección, recursión para repetición, terminales desnudos y no terminales entre ángulos. Decir qué regla rompe una cadena. - RPN: operadores después de operandos, evaluar con una pila, mostrar cada paso; convertir completamente entre paréntesis; al convertir de vuelta, mantener los paréntesis.
Errores comunes
- Describir la multitarea como "ejecutar varios programas al mismo tiempo" sin mencionar que el procesador alterna entre ellos.
- Enviar un proceso bloqueado directamente al estado ejecutando, o dar "se acabó el intervalo de tiempo" como razón para pasar de ejecutando a bloqueado.
- Confundir shortest job first (no preemptivo) con shortest remaining time (preemptivo), o round robin con prioridad.
- Definir la memoria virtual como "usar el disco duro como RAM" sin mencionar que las páginas son intercambiadas.
- Decir que un intérprete "convierte el programa a código máquina y luego lo ejecuta"; eso es un compilador.
- Colocar la verificación sintáctica en el análisis léxico, o la optimización antes de la generación de código en la pregunta de emparejamiento.
- Escribir la repetición en BNF como
<letter>*o con puntos suspensivos; usar recursión. Dejar fuera los paréntesis angulares de los no terminales. - Invertir los operandos de
-o/al evaluar RPN, o escribir la RPN de $a * b + c$ comoa b c + *.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| kernel/ˈkɜːnl/ | 内核 | nèi hé |
| interrupt handler/ˈɪntərʌpt ˈhændlə/ | 中断处理程序 | zhōng duàn chǔ lǐ chéng xù |
| interrupt handling/ˈɪntərʌpt ˈhændlɪŋ/ | 中断处理 | zhōng duàn chǔ lǐ |
| inter-process communication/ˈɪntə ˈprəʊses kəˌmjuːnɪˈkeɪʃn/ | 进程间通信 | jìn chéng jiān tōng xìn |
| pipes/paɪps/ | 管道 | guǎn dào |
| shared memory/ʃeəd ˈmeməri/ | 共享内存 | gòng xiǎng nèi cún |
| virtual address space/ˈvɜːtʃuːəl əˈdres speɪs/ | 虚拟地址空间 | xū nǐ dì zhǐ kōng jiān |
| pages/ˈpeɪdʒɪz/ | 页 | yè |
| frames/freɪmz/ | 页框 | yè kuāng |
| page fault/peɪdʒ fɒlt/ | 缺页 | quē yè |
| swap file/swɒp faɪl/ | 交换文件 | jiāo huàn wén jiàn |
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.