| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de los procesadores RISC (Reduced Instruction Set Computers, Computadoras con Juego de Instrucciones Reducidas) y CISC (Complex Instruction Set Computers, Computadoras con Juego de Instrucciones Complejo) | Diferencias entre RISC y CISC. Comprensión del manejo de interrupciones en procesadores CISC y RISC. |
| Demostrar comprensión de la importancia/uso del pipelining (procesoamiento en cascada) y los registros en procesadores RISC | |
| Demostrar comprensión de las cuatro arquitecturas informáticas básicas | SISD, SIMD, MISD, MIMD |
| Demostrar comprensión de las características de las computadoras paralelas masivas | |
| Demostrar comprensión del concepto de una máquina virtual | Dar ejemplos del papel de las máquinas virtuales. Comprender las ventajas y limitaciones de las máquinas virtuales. |
Hardware y máquinas virtuales
A-Level Ciencias de la Computación · Tema 15
 15:02
RISC, pipelines y lógica
Dos diseñadores de chips enfrentan el mismo problema: hacer que los programas corran rápido. Uno dice — construye instrucciones poderosas, para que cada una haga mucho trabajo. El otro dice — mantén…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
15.1
Procesadores RISC frente a CISC
Syllabus
Fuente: Plan de estudios Cambridge International
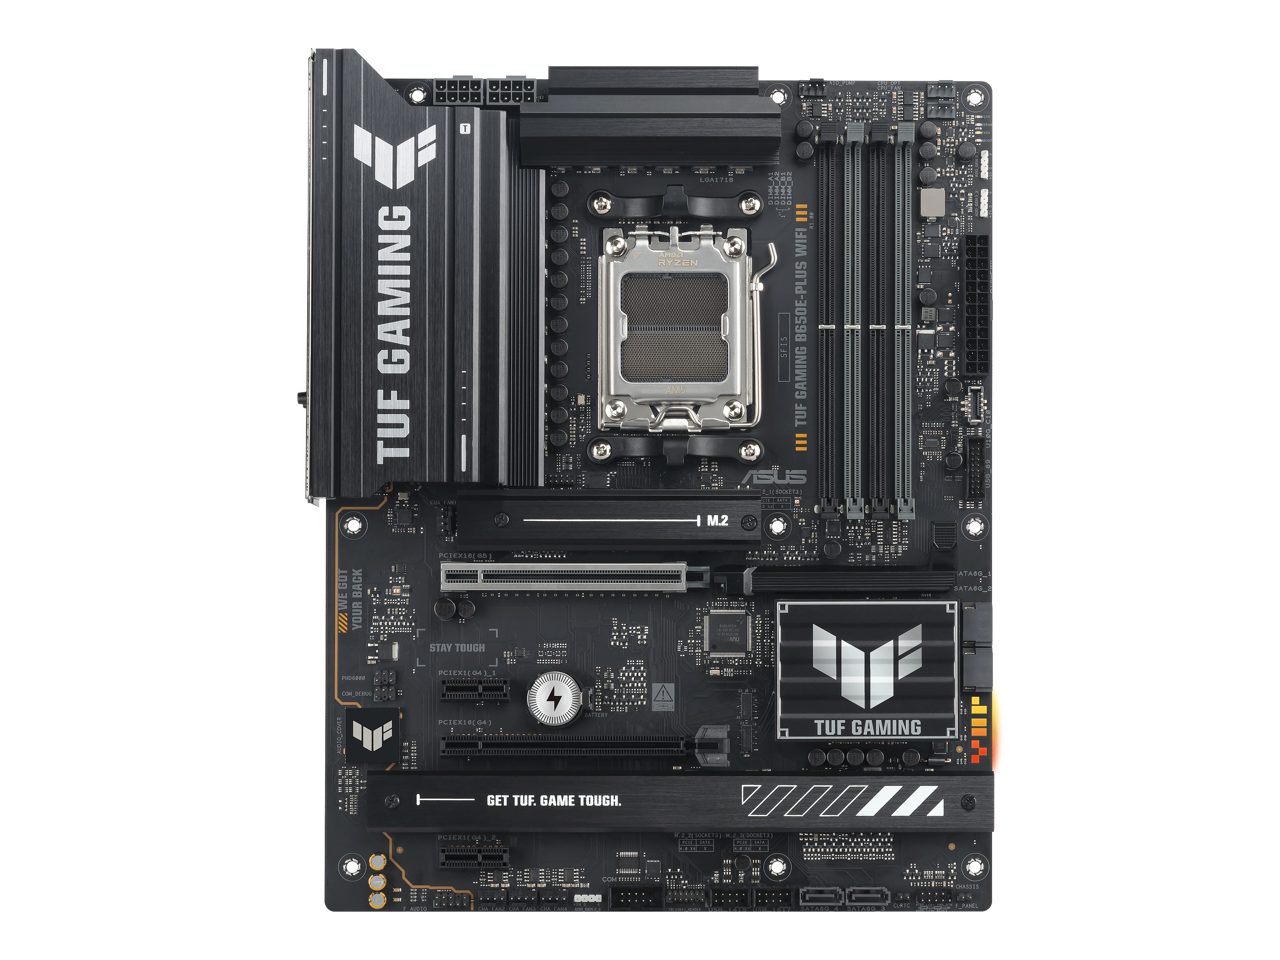
Dos estilos de diseño de CPU. La CPU se conecta directamente a la placa base 主板, la placa principal que une el procesador, la memoria y todas las demás partes del ordenador.
CISC
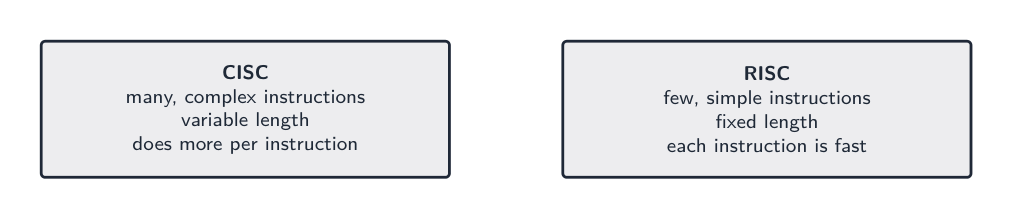
Un CISC 复杂指令集 (Computers con Conjunto de Instrucciones Complejas) dispone de muchas instrucciones, a menudo complejas (una puede realizar varios accesos a memoria y operaciones), de longitud variable, por lo que su decodificación es intrincada. Realiza más tareas por instrucción en el hardware. Ejemplos: Intel x86.
RISC
Un RISC 精简指令集 (Computers con Conjunto de Instrucciones Reducidas) cuenta con un conjunto pequeño de instrucciones simples, donde cada una realiza una única operación básica, todas de longitud fija (rápido de decodificar). Solo las instrucciones de carga y almacenamiento acceden a la memoria; todo lo demás es registro a registro 寄存器. Los programas son más largos, pero cada instrucción es rápida y predecible, lo cual favorece la canalización. Ejemplos: ARM, RISC-V.
| Característica | CISC | RISC |
|---|---|---|
| Conjunto de instrucciones | muchas | pocas |
| Longitud de instrucción | variable | fija |
| Acceso a memoria | muchas instrucciones | solo carga/almacenamiento |
| Compatible con canalización | más difícil | naturalmente |
| Ciclos por instrucción | varía | generalmente 1 |
La compensación consiste en hacer más por instrucción (CISC) frente a ejecutar cada instrucción más rápido y de forma más predecible (RISC). Los chips Intel modernos traducen las instrucciones CISC a micro-ops más simples similares a RISC internamente.
"Identifica cuatro características de un procesador RISC." Cualquier cuatro de: un conjunto pequeño de instrucciones simples; instrucciones de longitud fija (una palabra); la mayoría de las instrucciones se completan en un ciclo de reloj; muchos registros de propósito general; solo las instrucciones de carga y almacenamiento acceden a la memoria (toda la aritmética es de registro a registro); control por cableado fijo (sin microcódigo); diseñado para pipelining; el compilador hace más trabajo, por lo que los programas contienen más instrucciones y necesitan más memoria. "Identifica cuatro características de un procesador CISC." Cualquier cuatro de: un conjunto grande de instrucciones, muchas de ellas complejas (una instrucción puede hacer varias operaciones); instrucciones de longitud variable; instrucciones que toman varios ciclos de reloj; menos registros; instrucciones que pueden acceder a la memoria directamente; control microprogramado; menos adecuado para pipelining; programas más cortos, por lo que un compilador más simple y menos memoria. "Describe qué significa RISC y CISC" (dos marcas cada una): nombra la expansión y da la idea definitoria (pocas instrucciones simples de un solo ciclo; muchas instrucciones complejas de múltiples ciclos).
Manejo de interrupciones en los dos diseños. En un procesador CISC, la instrucción actual, por compleja que sea, se completa antes de que se atienda la interrupción; el procesador entonces guarda el contenido de sus registros (incluido el contador de programa) en la pila, salta a la rutina de servicio de interrupción y restaura los registros después. En un procesador RISC con una pipeline, varias instrucciones están a mitad de ejecución en el momento en que llega la interrupción, por lo que el procesador debe permitir que cada instrucción en la pipeline termine, o descartar (vaciar) las instrucciones parcialmente ejecutadas y reiniciarlas después de la interrupción; en cualquier caso, la pipeline se vacía, los registros se guardan y se ejecuta la rutina de servicio. La redacción del examen: "la pipelining hace más complejo el manejo de interrupciones, porque los contenidos de la pipeline deben gestionarse antes de que se pueda atender la interrupción".
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| motherboard/ˈmʌðəbɔːd/ | 主板 | zhǔ bǎn |
| CISC/sɪsk/ | 复杂指令集 | fù zá zhǐ lìng jí |
| RISC/rɪsk/ | 精简指令集 | jīng jiǎn zhǐ lìng jí |
| register/ˈredʒɪstə/ | 寄存器 | jì cún qì |
| interrupt/ˈɪntərʌpt/ | 中断 | zhōng duàn |
| pipeline/ˈpaɪplaɪn/ | 流水线 | liú shuǐ xiàn |
15.1
Pipelining

Una pipeline procesa instrucciones en etapas superpuestas, como una línea de ensamblaje: Búsqueda → Decodificación → Ejecución (en la ALU) → Acceso a memoria → Escritura de resultado. Cada etapa trabaja en una instrucción diferente al mismo tiempo, por lo que una vez que la pipeline está llena, una instrucción se completa por ciclo. Las instrucciones simples y de longitud fija de RISC hacen que cada etapa tome el mismo tiempo. Una pipeline puede detenerse debido a un peligro — un peligro de datos (una instrucción necesita un resultado que aún no está listo) o un peligro de control (una ramificación hace desconocida la siguiente dirección).
Los chips RISC mantienen los datos en muchos registros porque la memoria es lenta y los registros son rápidos; el compilador asigna los valores a los registros de manera inteligente.
"Describe el uso de la canalización (pipelining) en procesadores RISC" (tres puntos). (1) El ciclo fetch–execute se divide en etapas (fetch, decode, execute, memory access, write back); (2) varias instrucciones están en la canalización al mismo tiempo, cada una en una etapa diferente, por lo que mientras una se está ejecutando, la siguiente se está decodificando y la siguiente se está buscando; (3) se inicia una nueva instrucción y se completa una en cada ciclo de reloj una vez que la canalización está llena, lo que aumenta throughput 吞吐量 (el número de instrucciones completadas por segundo), aunque cada instrucción sigue tomando el mismo tiempo por sí sola. Las instrucciones RISC de longitud fija y un solo ciclo son las que hacen que las etapas sean iguales y permitan la canalización.
Ejemplo resuelto. Un procesador utiliza cinco etapas de canalización (IF, ID, OF, EX, WB). Cuatro instrucciones entran en la canalización una tras otra. En qué ciclo completa la última instrucción, y cuántos ciclos tardarían las cuatro sin canalización?
La instrucción 1 ocupa IF en el ciclo 1, ID en 2, OF en 3, EX en 4 y WB en 5; la instrucción 2 comienza un ciclo después y termina en el ciclo 6; la instrucción 3 en el ciclo 7; la instrucción 4 en el ciclo 8. En general $n$ instrucciones a través de $k$ etapas toman $n + k - 1$ ciclos, aquí $4 + 5 - 1 = 8$. Sin pipelining cada instrucción toma todos los cinco ciclos antes de que comience la siguiente: $4 \times 5 = 20$ ciclos. La tabla del examen se llena escribiendo las etapas de cada instrucción en diagonal, una columna a la derecha de la instrucción anterior.
Un procesador que funciona rápido genera mucho calor, por lo que un disipador de calor 散热器 y un ventilador están colocados encima. Las aletas metálicas dispersan el calor y el ventilador lo expulsa, manteniendo la CPU lo suficientemente fría para funcionar.

Explorar
Cómo se llena el pipeline
Pase por los ciclos de reloj. Una vez que el pipeline está lleno, una nueva instrucción termina cada ciclo —aunque cada una todavía requiere varios stages— porque los stages de diferentes instrucciones se superponen.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| ALU/ˌeɪ el ˈjuː/ | 算术逻辑单元 | suàn shù luó jí dān yuán |
| hazard/ˈhæzəd/ | 冒险 | mào xiǎn |
| throughput/ˈθruːpʊt/ | 吞吐量 | tūn tǔ liàng |
| heat-sink/hiːt sɪŋk/ | 散热器 | sàn rè qì |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | 弗林分类 | fú lín fēn lèi |
15.1
Taxonomía de Flynn

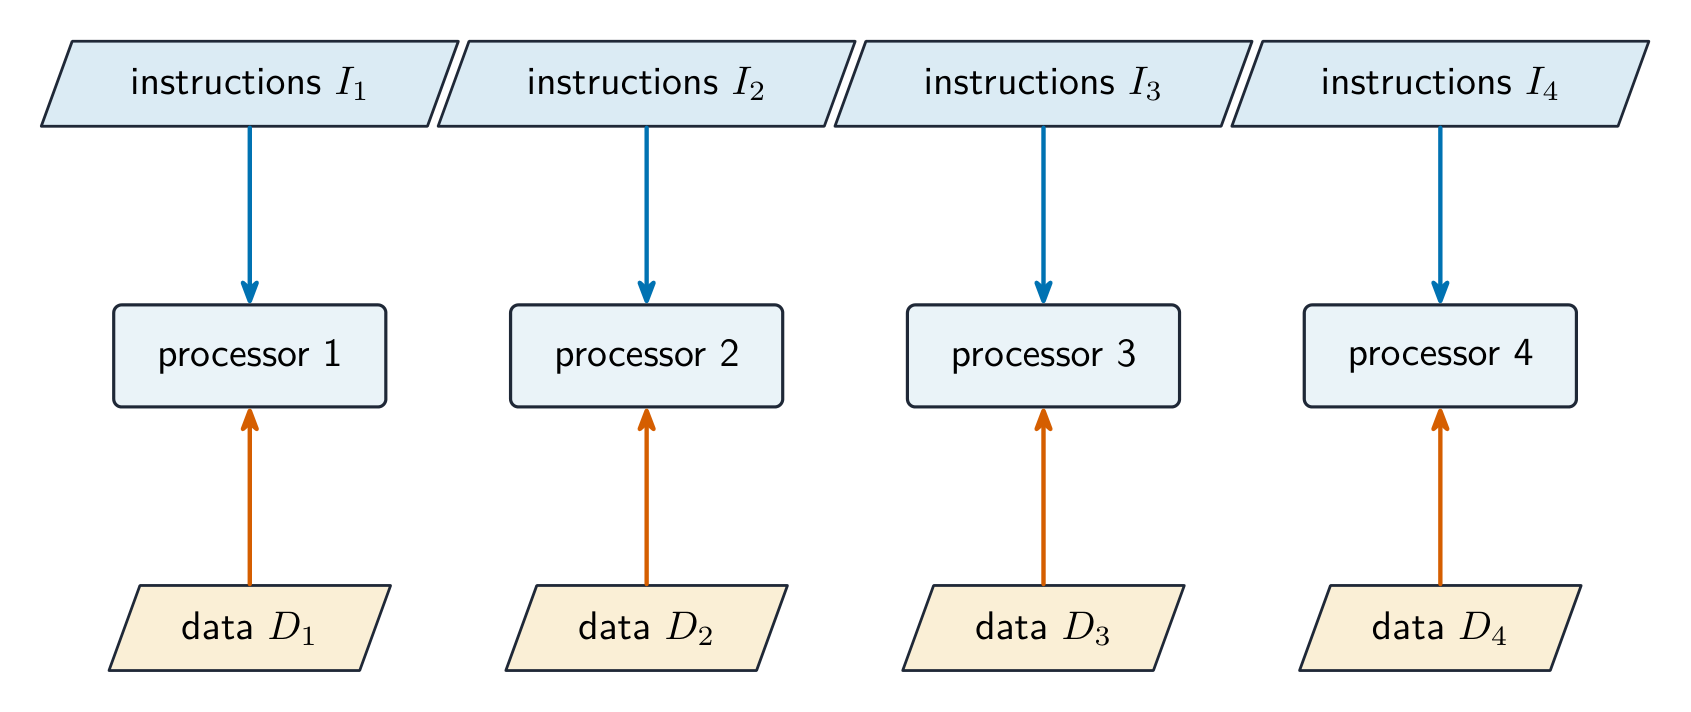
La taxonomía de Flynn 弗林分类 clasifica las computadoras según el número de flujos de instrucciones y datos:
- SISD — un flujo de instrucción, un flujo de datos (un núcleo único tradicional).
- SIMD 单指令多数据 — una instrucción opera sobre muchos elementos de datos a la vez (GPUs, extensiones vectoriales de CPU). Ideal para imágenes, video y arreglos científicos.
- MISD — varias operaciones sobre los mismos datos; raro, principalmente teórico.
- MIMD 多指令多数据 — muchos procesadores ejecutan diferentes instrucciones sobre diferentes datos (CPUs multi-núcleo, clústers). El más general.
Describiendo las cuatro arquitecturas (dos puntos cada una). SISD: un procesador único ejecuta una instrucción a la vez sobre un solo elemento de datos; no hay paralelismo, es la máquina tradicional de von Neumann. SIMD: una sola instrucción se aplica simultáneamente a muchos elementos de datos, por medio de muchos elementos de procesamiento que actúan sincronizados; se utiliza para el procesamiento de matrices y gráficos. MISD: varios procesadores aplican instrucciones diferentes al mismo dato; raramente se usa, por ejemplo en sistemas tolerantes a fallos donde varios procesadores verifican un mismo flujo de datos. MIMD: muchos procesadores, cada uno ejecutando sus propias instrucciones sobre sus propios datos, de forma independiente; es la computadora multicore y el clúster.
Una tarjeta gráfica 显卡 (con su GPU) es un ejemplo real de hardware SIMD: tiene miles de núcleos pequeños que ejecutan la misma instrucción sobre muchos píxeles o números al mismo tiempo, razón por la cual las GPUs son tan rápidas para imágenes, video y aprendizaje automático.

Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| SIMD/ˈsɪmdiː/ | 单指令多数据 | dān zhǐ lìng duō shù jù |
| MIMD/ˈmɪmdiː/ | 多指令多数据 | duō zhǐ lìng duō shù jù |
| graphics card/ˈɡræfɪks kɑːd/ | 显卡 | xiǎn kǎ |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | 大规模并行 | dà guī mó bìng xíng |
| distributed memory/ˈdɪstrɪbjuːtɪd ˈmeməri/ | 分布式内存 | fēn bù shì nèi cún |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | 超级计算机 | chāo jí jì suàn jī |
15.1
Computadoras masivamente paralelas

Un sistema masivamente paralelo 大规模并行 utiliza miles de procesadores en una red rápida, cada uno con su propia memoria (memoria distribuida 分布式内存), intercambiando datos mediante mensajes. Es MIMD, requiere software escrito especialmente (MPI, CUDA) y se adapta a simulaciones climáticas, entrenamiento de gran escala de aprendizaje automático 机器学习 y astrofísica. Los mayores supercomputadores 超级计算机 son masivamente paralelos.
"Enumere las características de las computadoras masivamente paralelas" (tres puntos). Un número muy grande de procesadores (miles), cada uno con su propia memoria, conectados por una roja (un interconector de alta velocidad o bus) para poder pasarse mensajes entre sí; trabajan simultáneamente en partes del mismo problema, por lo que este debe programarse como un programa que pueda dividirse en partes que se ejecuten en paralelo y combinen sus resultados. Es una disposición MIMD.
Los procesadores se encuentran en gabinetes altos de servidores 服务器, que a menudo llenan toda una habitación (un centro de datos 数据中心), cableados juntos para que puedan trabajar en un gran problema al mismo tiempo.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| server/ˈsɜːvə/ | 服务器 | fú wù qì |
| data centre/ˈdeɪtə ˈsentə/ | 数据中心 | shù jù zhōng xīn |
| virtual machine/ˈvɜːtʃuːəl məˈʃiːn/ | 虚拟机 | xū nǐ jī |
| hypervisor/ˌhaɪpəˈvaɪzə/ | 虚拟机监控器 | xū nǐ jī jiān kòng qì |
| sandboxing/ˈsændbɒksɪŋ/ | 沙箱 | shā xiāng |
15.1
Máquinas virtuales
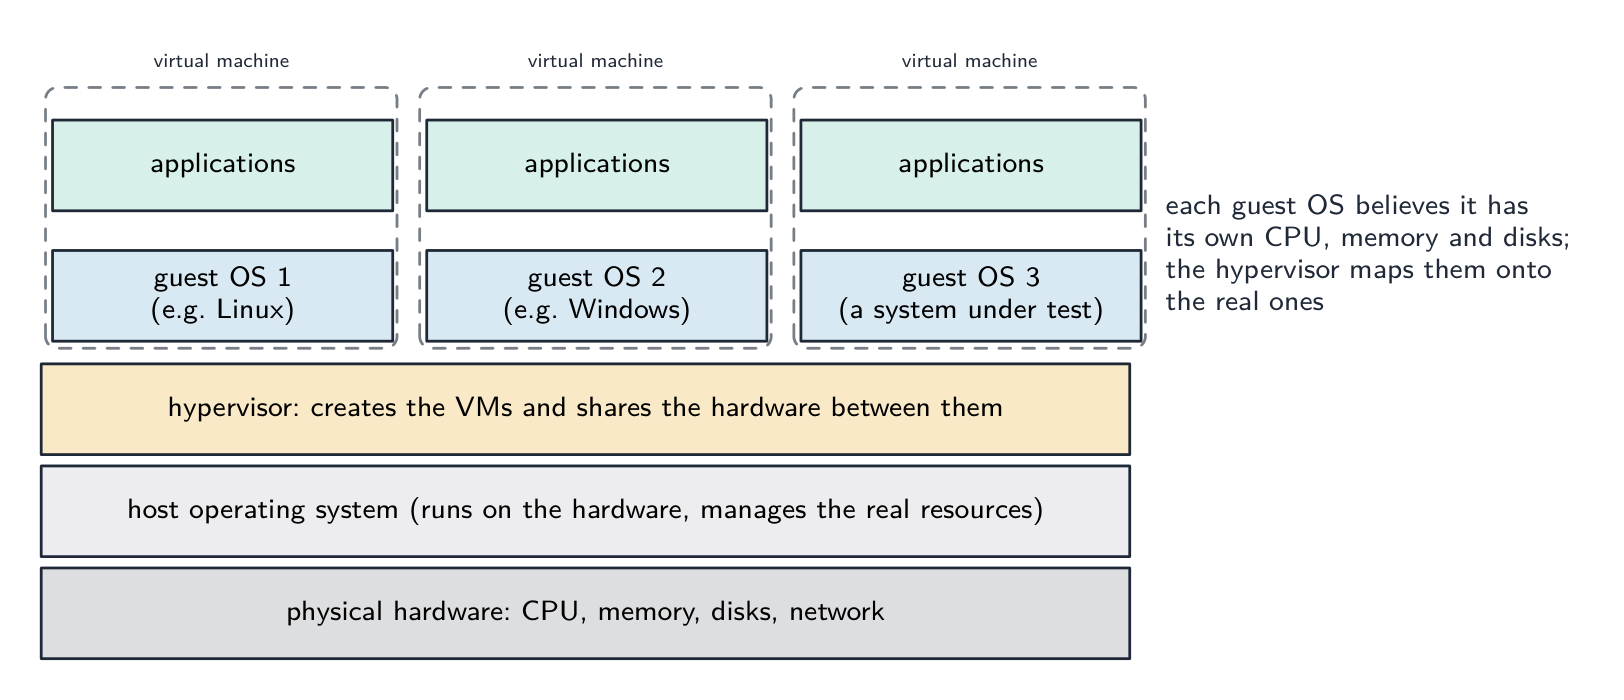
Una máquina virtual 虚拟机 es una emulación por software de una computadora completa: el software interno ve una CPU, memoria y discos que parecen reales pero que son gestionados por el software anfitrión.
- Una máquina virtual de sistema ejecuta un SO completo. Un hipervisor 虚拟机监控器 crea y gestiona máquinas virtuales, cada una iniciando su propio SO invitado. Usos: ejecutar distintos SOs en una misma máquina; consolidación de servidores; aislamiento 沙箱 (el software riesgoso se ejecuta aislado); instantáneas.
- Una máquina virtual de proceso (lenguaje) ejecuta un programa en bytecode 字节码 portable: la JVM (Java), el CLR (.NET), CPython. Beneficios: portabilidad ("escribir una vez, ejecutar en cualquier lugar"), comprobaciones de seguridad en tiempo de ejecución y compilación just-in-time 即时编译 para velocidad cercana a la nativa. El coste es una capa adicional y la necesidad de tener instalada la VM.
"Describa qué se entiende por máquina virtual" (dos puntos). Una emulación (implementación) por software de un sistema informático que se ejecuta en una computadora anfitriona y se comporta, para los programas que corren en su interior, como una computadora física separada con su propio procesador, memoria y almacenamiento. El sistema operativo anfitrión 宿主操作系统 se ejecuta sobre el hardware real, gestiona los recursos físicos y (a través del hipervisor) crea y controla las máquinas virtuales; cada sistema operativo invitado 客户操作系统 corre dentro de una máquina virtual, gestiona las aplicaciones en ella y no sabe que su hardware es virtual.
Beneficios (de dos). Pueden correr distintos sistemas operativos en una misma máquina al mismo tiempo; el software puede ser probado en múltiples sistemas sin comprar el hardware; un nuevo sistema informático puede ser emulado y probado antes de construirse; cada VM está aislada, por lo que un fallo o malware en una no afecta al anfitrión ni a las demás; las VMs pueden ser copiadas, movidas y respaldadas como archivos, y un servidor puede compartirse entre muchos usuarios, reduciendo el costo de hardware. Limitaciones (de dos). Una VM ejecuta más lentamente que el hardware real porque cada instrucción pasa por la capa de emulación; consume la memoria y potencia de procesamiento del anfitrión, por lo que este debe ser potente; algunas funciones o dispositivos de hardware no se emulan exactamente, por lo que el software probado puede comportarse de forma distinta en la máquina real; se necesitan licencias para cada SO invitado, y configurar el sistema requiere experiencia.
Explorar
Laboratorio de conceptos informáticos
Clasificar ejemplos concretos según la idea informática que demuestran.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| bytecode/ˈbaɪtkəʊd/ | 字节码 | zì jié mǎ |
| just-in-time compilation/dʒʌst ɪn taɪm ˌkɒmpɪˈleɪʃn/ | 即时编译 | jí shí biān yì |
| host operating system/həʊst ˈɒpəreɪtɪŋ ˈsɪstəm/ | 宿主操作系统 | sù zhǔ cāo zuò xì tǒng |
| guest operating system/ɡest ˈɒpəreɪtɪŋ ˈsɪstəm/ | 客户操作系统 | kè hù cāo zuò xì tǒng |
| Boolean algebra/ˈbuːlɪən ˈældʒɪbrə/ | 布尔代数 | bù ěr dài shù |
15.2
Álgebra de Boole
Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Elaborar tablas de verdad para circuitos lógicos que incluyan semisumadores y sumadores completos | Pueden incluir puertas lógicas con más de dos entradas |
| Demostrar comprensión de un flip-flop (SR, JK) | Dibujar un circuito lógico y derivar una tabla de verdad para un flip-flop. Comprender el papel de los flip-flops como elementos de almacenamiento de datos |
| Demostrar comprensión del álgebra de Boole | Comprender las leyes de De Morgan. Realizar operaciones con álgebra de Boole aplicando las leyes de De Morgan. Simplificar un circuito o expresión lógica mediante el álgebra de Boole |
| Demostrar comprensión de los mapas de Karnaugh (K-map) | Comprender los beneficios del uso de los mapas de Karnaugh. Resolver problemas lógicos utilizando mapas de Karnaugh |
Fuente: Plan de estudios Cambridge International
El álgebra de Boole 布尔代数 simplifica expresiones Booleanas 布尔, que también pueden describirse mediante tablas de verdad 真值表. Símbolos: + para OR, · para AND (a menudo omitido), una barra superior para NOT.
Las leyes clave incluyen las conmutativa, asociativa y distributiva (como en el álgebra ordinaria), además de:
- identidad $A + 0 = A$, $A \cdot 1 = A$; nulo $A + 1 = 1$, $A \cdot 0 = 0$.
- idempotente $A + A = A$; inverso $A + \overline{A} = 1$, $A \cdot \overline{A} = 0$.
- Leyes de De Morgan 德摩根定律: $(A + B)' = A' \cdot B'$; $(A \cdot B)' = A' + B'$ — negar todo, cambiar AND/OR, negar cada operandos.
- absorción 吸收律: $A + AB = A$.
La simplificación reduce el número de términos, de modo que el circuito lógico resultante tiene menos puertas lógicas. Ejemplo: $Z = AB + A\overline{B} = A(B + \overline{B}) = A$.
Las leyes con sus nombres (cite el nombre en cada paso cuando se pida "mostrar todo el procedimiento").
| Ley | Forma OR | Forma AND |
|---|---|---|
| identidad | $A + 0 = A$ | $A \cdot 1 = A$ |
| nulo (anulación) | $A + 1 = 1$ | $A \cdot 0 = 0$ |
| idempotente | $A + A = A$ | $A \cdot A = A$ |
| complemento (inverso) | $A + \overline{A} = 1$ | $A \cdot \overline{A} = 0$ |
| conmutativa | $A + B = B + A$ | $A \cdot B = B \cdot A$ |
| asociativa | $A + (B + C) = (A + B) + C$ | $A(BC) = (AB)C$ |
| distributiva | $A + BC = (A + B)(A + C)$ | $A(B + C) = AB + AC$ |
| absorción | $A + AB = A$ | $A(A + B) = A$ |
| De Morgan | $\overline{A + B} = \overline{A} \cdot \overline{B}$ | $\overline{A \cdot B} = \overline{A} + \overline{B}$ |
| doble negación | $\overline{\overline{A}} = A$ |
Ejercicio resuelto. Simplifique $X = \overline{\overline{(A \cdot B)} \cdot \overline{(A + B)}}$, mostrando todo el procedimiento.
$X = \overline{\overline{(A \cdot B)}} + \overline{\overline{(A + B)}}$ (De Morgan en la barra exterior) $= A \cdot B + A + B$ (doble negación) $= A + B$ (absorción, $A + AB = A$, aplicada con $A + B$ absorbiendo $AB$).
Ejemplo resuelto. Simplifique $(\overline{A + B}) \cdot (\overline{A} + B)$.
$= \overline{A} \cdot \overline{B} \cdot (\overline{A} + B)$ (De Morgan) $= \overline{A}\,\overline{B}\,\overline{A} + \overline{A}\,\overline{B}\,B$ (distributiva) $= \overline{A}\,\overline{B} + 0$ (idempotente, complemento) $= \overline{A}\,\overline{B}$.
Ejemplo resuelto. Simplifique $Y = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + A\,\overline{B}\,C$.
$= \overline{A}\,\overline{B}(\overline{C} + C) + A\,\overline{B}\,C$ (distributiva) $= \overline{A}\,\overline{B} + A\,\overline{B}\,C$ (complemento, identidad) $= \overline{B}(\overline{A} + AC)$ (distributiva) $= \overline{B}(\overline{A} + C)$, usando $\overline{A} + AC = (\overline{A} + A)(\overline{A} + C) = \overline{A} + C$. Aplicar De Morgan a un término de tres entradas funciona de la misma manera: $\overline{A + B + C} = \overline{A} \cdot \overline{B} \cdot \overline{C}$.
Suma de productos a partir de una tabla de verdad. Tome cada fila cuya salida sea 1, escriba el AND de sus entradas (una variable con barra donde es 0), y OR los términos: una fila con $A = 1, B = 0, C = 1$ da como resultado $A\,\overline{B}\,C$. Esta es la forma suma de productos 积之和 que pide el examen, y es el punto de partida tanto para la simplificación algebraica como para el mapa de Karnaugh.
Explorar
Álgebra de Boole
A·B, A+B, Ā …
El álgebra de Boole son simplemente estas compuertas escritas como expresiones — compara las tablas de verdad.
Explorar
Tablas de verdad booleanas
Elige un operador y las entradas para construir su tabla de verdad: el álgebra detrás de los circuitos lógicos.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| Boolean/ˈbuːlɪən/ | 布尔 | bù ěr |
| truth tables/truːθ ˈteɪblz/ | 真值表 | zhēn zhí biǎo |
| De Morgan's laws/də ˈmɔːɡənz lɔːz/ | 德摩根定律 | dé mó gēn dìng lǜ |
| absorption/əbˈsɔːpʃn/ | 吸收律 | xī shōu lǜ |
| sum-of-products/sʌm ɒv ˈprɒdʌkts/ | 积之和 | jī zhī hé |
| Karnaugh map/ˈkɑːnɔː mæp/ | 卡诺图 | kǎ nuò tú |
| Gray code/ɡreɪ kəʊd/ | 格雷码 | gé léi mǎ |
| half adder/hɑːf ˈædə/ | 半加器 | bàn jiā qì |
15.2
Mapas de Karnaugh
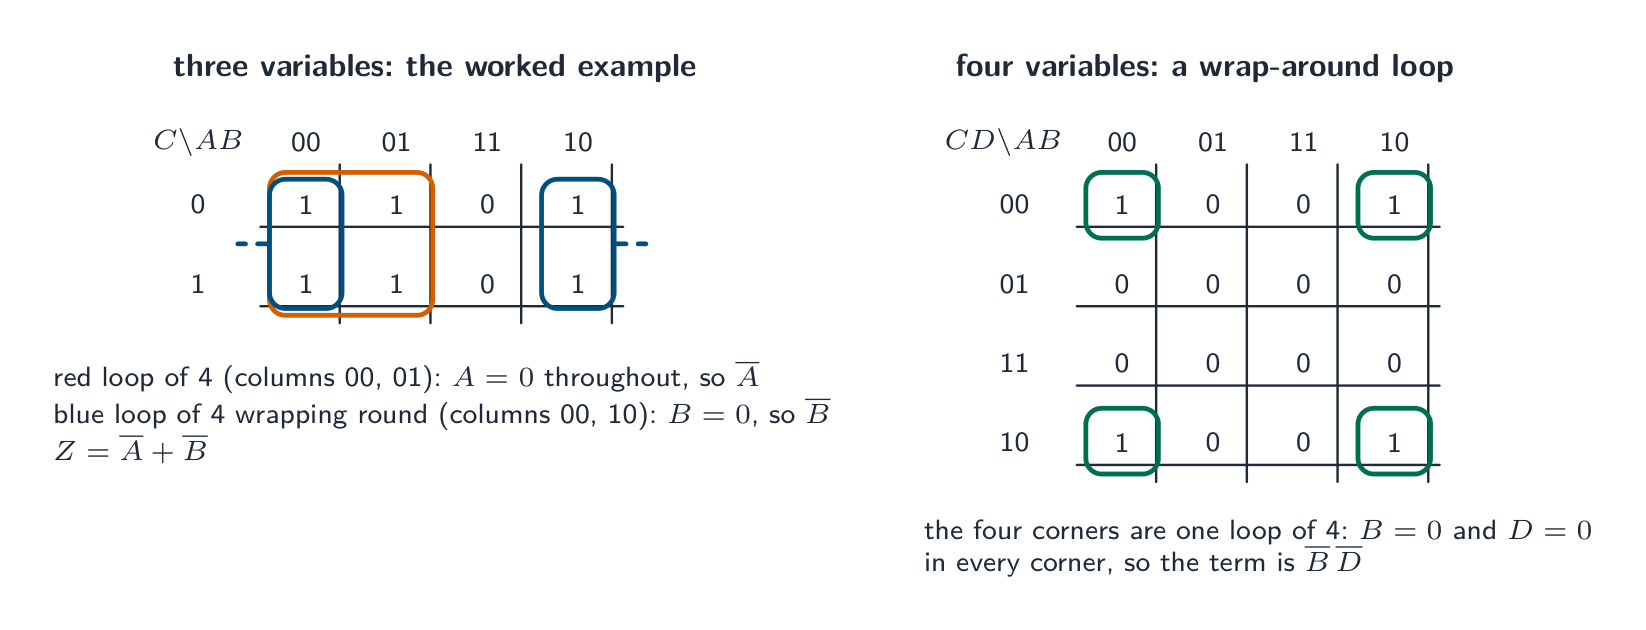
Un mapa de Karnaugh 卡诺图 (K-map) simplifica una expresión Booleana agrupando 1s adyacentes de una tabla de verdad. Las columnas y filas utilizan el orden de código Gray 格雷码 (00, 01, 11, 10) para que las celdas adyacentes difieran en una variable.
Coloca un 1 en cada celda donde la salida sea 1. Encuentra grupos rectangulares de 1s cuyos lados sean potencias de 2 (1, 2, 4, 8), envolviendo alrededor de los bordes si esto hace un grupo más grande. Cuanto mayor sea el grupo, más simple será el término: un grupo de 2 elimina una variable, un grupo de 4 elimina dos, y así sucesivamente — las variables que cambian dentro del grupo desaparecen. OR los términos del grupo juntos para la expresión simplificada. Cubre cada 1 usando tan pocos grupos grandes como sea posible.
Ejemplo resuelto. Un mapa de Karnaugh para $A$ y $B$ tiene 1s en las celdas $\overline{A}B$ y $AB$. Simplificar. Los dos 1s son adyacentes - comparten la columna $B=1$ - por lo que se agrupan como un rectángulo de 2. Dentro de ese grupo $B$ permanece 1 constantemente mientras $A$ cambia de 0 a 1, y cualquier variable que cambie dentro de un grupo desaparece. Por lo tanto, el grupo deja simplemente $X = B$. Comparar eso con la suma de productos leída directamente desde la tabla, $\overline{A}B + AB$: el mismo circuito, dos puertas menos. Dos reglas realizan la mayor parte del trabajo: hacer cada grupo lo más grande posible (un grupo de 2 elimina una variable, 4 elimina dos, 8 elimina tres), y recordar que el mapa se envuelve en sus bordes, por lo que las columnas izquierda y derecha son adyacentes. Ese envoltorio es el agrupamiento que la mayoría de los candidatos pasan por alto.
Construcción y lectura de un mapa K. Etiquete las columnas $AB$ y las filas $C$ (o $CD$) en orden de código Gray 00 01 11 10, de modo que las celdas vecinas difieran en solo una variable. Coloque un 1 en cada celda cuyo mintermo aparezca en la expresión (o cuya fila de la tabla de verdad tenga salida 1). Luego dibuje los menos, más grandes bucles posibles que cubran cada 1: cada bucle debe ser un rectángulo de $1, 2, 4$ o $8$ celdas, los bucles pueden superponerse, pueden envolverse a través de los bordes izquierdo-derecho y superior-inferior, y las cuatro esquinas juntas forman un bucle. Para cada bucle, escriba las variables que son constantes dentro de él (con barra si son 0), y OR los términos de los bucles: esa es la suma de productos óptima. ¿Por qué usar uno? Proporciona la expresión más simple sin álgebra, en pocos pasos, con menos probabilidad de error, y el mismo mapa sirve para tres o cuatro variables.
Ejemplo resuelto. $Z = \overline{A}\,\overline{B}\,\overline{C} + \overline{A}\,\overline{B}\,C + \overline{A}\,B\,\overline{C} + \overline{A}\,B\,C + A\,\overline{B}\,\overline{C} + A\,\overline{B}\,C$.
En el mapa de tres variables, los 1s llenan las columnas 00, 01 y 10 en ambas filas. El bucle de cuatro sobre las columnas 00 y 01 tiene $A = 0$ en toda su extensión y $B$, $C$ varían: término $\overline{A}$. El bucle de cuatro sobre las columnas 00 y 10 (envolviendo) tiene $B = 0$ en toda su extensión: término $\overline{B}$. Por lo tanto $Z = \overline{A} + \overline{B}$, lo cual la álgebra booleana confirma: $\overline{A}(\overline{B} + B) + \ldots = \overline{A} + \overline{B}$. Dos bucles de dos también serían correctos pero no óptimos; un bucle debe ser tan grande como lo permitan los 1s.
Ejemplo resuelto (cuatro variables). Un mapa tiene 1s únicamente en sus cuatro esquinas: $\overline{A}\,\overline{B}\,\overline{C}\,\overline{D}$, $A\,\overline{B}\,\overline{C}\,\overline{D}$, $\overline{A}\,\overline{B}\,C\,\overline{D}$ y $A\,\overline{B}\,C\,\overline{D}$. Dado que las filas superior e inferior son adyacentes y lo son también las columnas exteriores, las esquinas forman un solo bucle de cuatro; $B = 0$ y $D = 0$ están presentes en todos ellos mientras que $A$ y $C$ varían, por lo tanto $Z = \overline{B}\,\overline{D}$.
15.2
Sumador medio y sumador completo

Un sumador medio 半加器 suma dos bits simples $A$ y $B$, produciendo una suma $S$ y una llevada 进位 $C$:
| A | B | S | C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
Por lo tanto $S = A \text{ XOR } B$ y $C = A \text{ AND } B$. Ignora cualquier entrada de llevar —de ahí "medio".
Un sumador completo 全加器 suma tres bits ($A$, $B$, entrada de llevar), produciendo una suma y una salida de llevar: $S = A \text{ XOR } B \text{ XOR } C_{\text{in}}$. Puede construirse a partir de dos sumadores medios más una compuerta OR. Encadenar sumadores completos (donde cada salida de llevar alimenta la siguiente entrada de llevar) forma un sumador "ripple-carry" de múltiples bits.
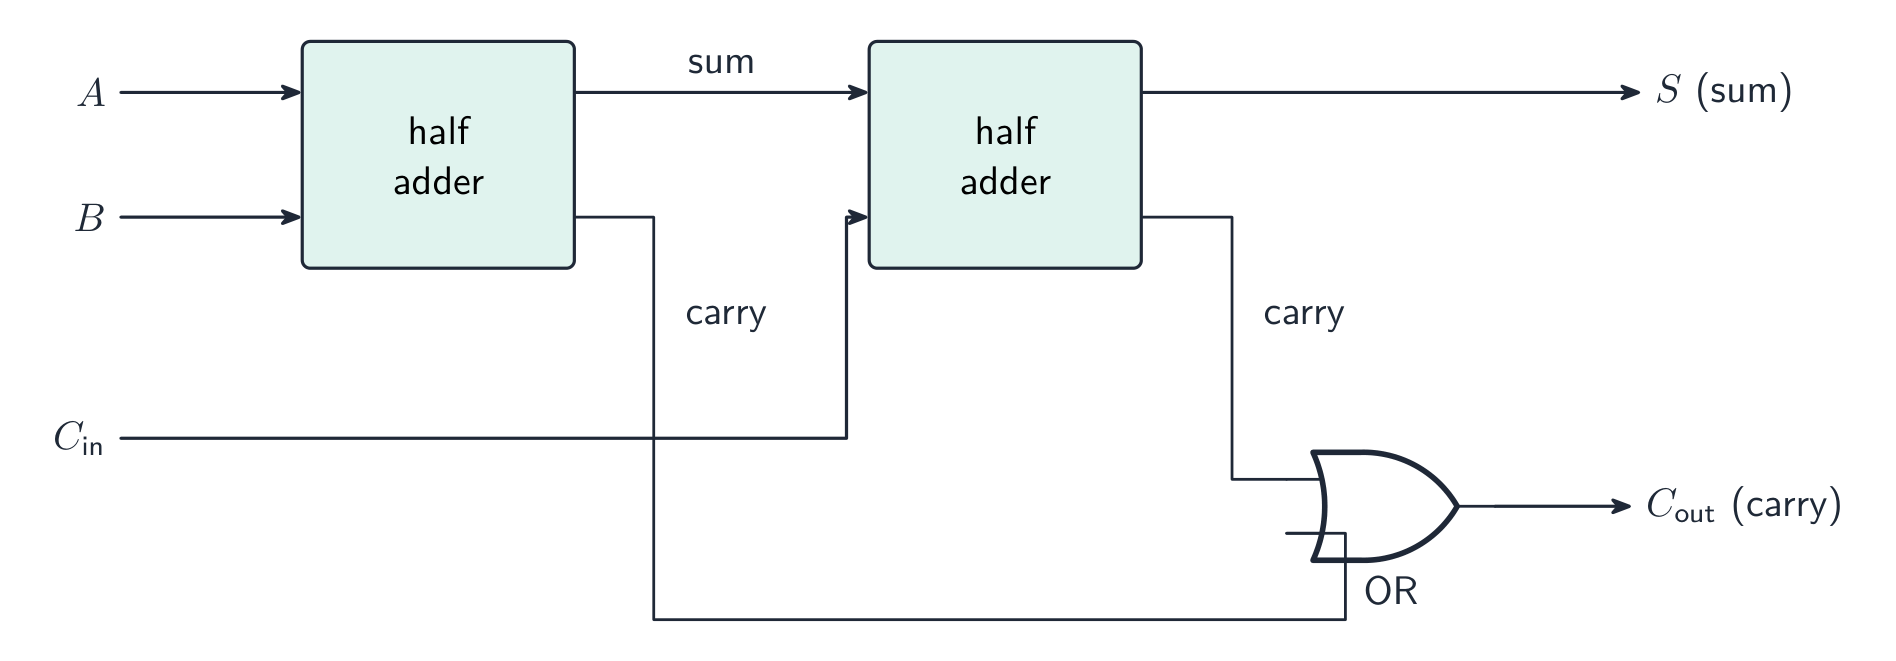
La tabla de verdad del sumador completo. Con entradas $A$, $B$ y la entrada de llevar $C_{\text{in}}$: la suma $S$ es 1 cuando un número impar de entradas es 1, y la salida de llevar es 1 cuando dos o más entradas son 1.
| $A$ | $B$ | $C_{\text{in}}$ | $S$ | $C_{\text{out}}$ |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
Las preguntas de circuitos que plantea el examen. Dado un circuito con una XOR y una AND compartiendo dos entradas, o dos sumadores medios y una OR, "completar la tabla de verdad (mostrar el procedimiento)" significa añadir una columna para cada salida intermedia de compuerta y rellenar las filas en orden; "indicar el nombre del circuito" es sumador medio o sumador completo; "indicar el propósito de cada salida" es la suma de los bits y la llevada hacia la siguiente columna. Suma de productos para el sumador medio: $S = \overline{A}B + A\overline{B}$, $C = AB$. Una cadena de sumadores completos, donde cada uno pasa su salida de llevar a la siguiente entrada de llevar, suma dos números de múltiples bits.
Explorar
Las puertas dentro de un sumador
El bit de suma de un medio sumador es una puerta XOR y su acarreo es una puerta AND; alterna A y B y observa cómo se ilumina la fila de la tabla de verdad.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| carry/ˈkæri/ | 进位 | jìn wèi |
| full adder/fʊl ˈædə/ | 全加器 | quán jiā qì |
15.2
Flip-flops
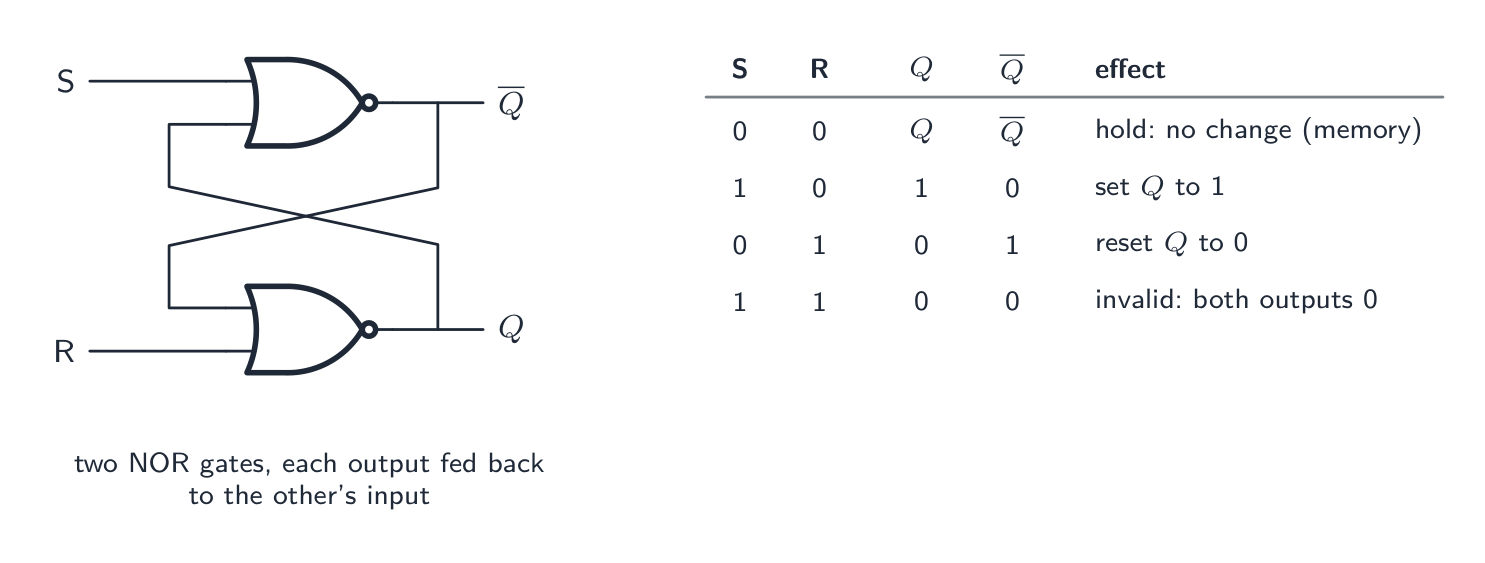
Un flip-flop 触发器 es un circuito bistable 双稳态 —dos estados estables (0 y 1)— que recuerda su estado. Almacena un bit y es el elemento básico de registros y SRAM.
Flip-flop SR
Un flip-flop SR SR触发器 tiene entradas S (set) y R (reset) y salidas Q y $\overline{Q}$. S=1,R=0 establece Q en 1; S=0,R=1 lo restablece a 0; S=0,R=0 mantiene el valor; S=1,R=1 es inválido. Construido con dos puertas NOR acopladas cruzadamente.
"Dibuje un circuito lógico para un flip-flop SR y etiquete las entradas." Dos puertas NOR (o dos puertas NAND), la salida de cada una conectada de vuelta a una entrada de la otra; la entrada libre de una puerta es S, la de la otra R; las salidas son $Q$ y $\overline{Q}$. La retroalimentación es por lo que se otorgan puntos: sin ella no hay memoria. "Indique el propósito de un flip-flop." Almacenar un bit de datos; es el elemento básico de memoria del que se construyen registros y RAM estática, y mantiene su valor hasta que se cambia deliberadamente. La entrada inválida $S = R = 1$ hace que ambas salidas sean 0, por lo que $\overline{Q}$ deja de ser el complemento de $Q$, y el estado después de que ambas entradas vuelven a 0 es impredecible, lo cual es la debilidad del flip-flop SR.
Flip-flop JK
Un flip-flop JK JK触发器 mejora al anterior utilizando la entrada anteriormente inválida 1,1 como un toggle 翻转 (la salida cambia). Esto lo hace ideal para construir contadores 计数器 (una cadena de flip-flops con toggle). Generalmente es con reloj: las entradas actúan solo en un flanco de reloj, manteniendo los flip-flops sincronizados.
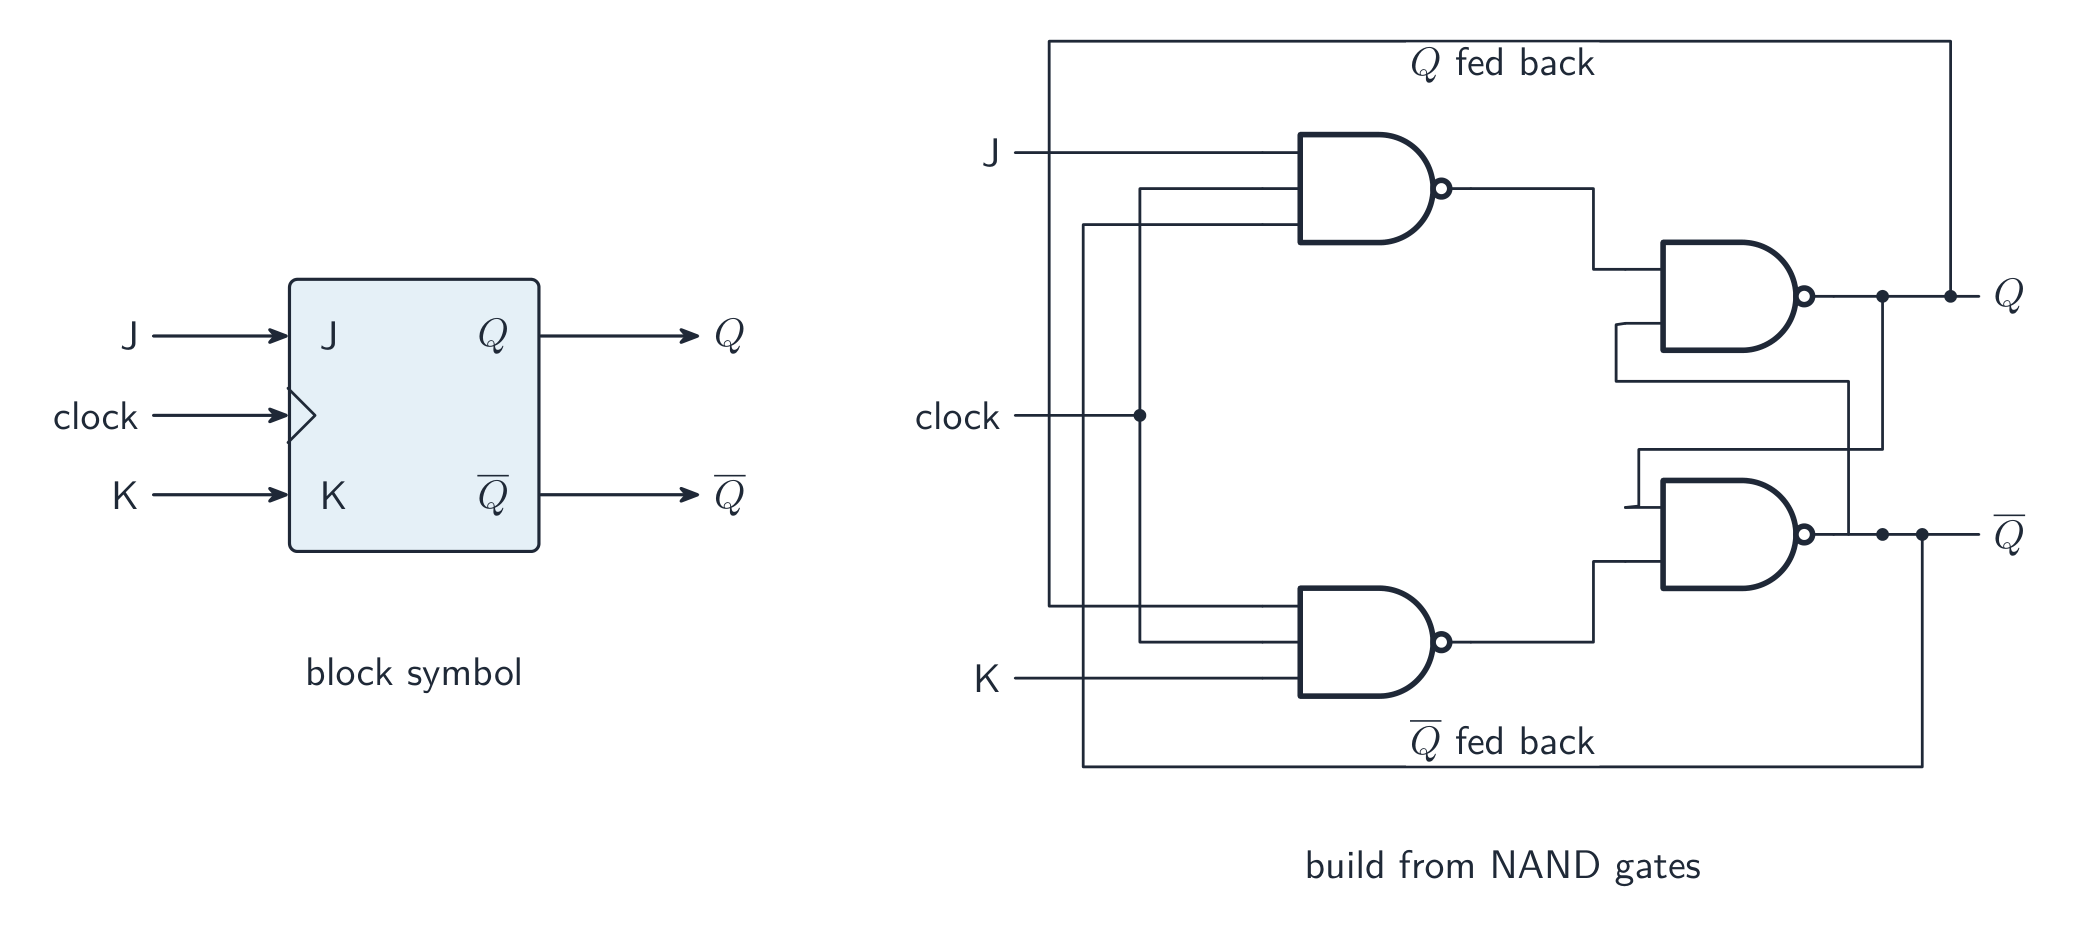
Los flip-flops son los bloques de construcción de registros (n bits = n flip-flops), contadores y celdas de SRAM 静态RAM.
Tabla de verdad del flip-flop JK. La entrada clock 时钟 decide cuándo se leen las entradas J y K, por lo que la salida cambia solo en un pulso de reloj: con $J = K = 0$ la salida se mantiene; $J = 1, K = 0$ establece $Q$ en 1; $J = 0, K = 1$ lo restablece a 0; $J = K = 1$ lo cambia (Q se convierte en $\overline{Q}$). La última fila es exactamente la entrada prohibida del flip-flop SR convertida en una útil, por eso se prefiere el JK: todas las combinaciones de entrada son válidas, y la operación con reloj lo convierte en el bloque de construcción de contadores y registros de desplazamiento.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| flip-flop/flɪp flɒp/ | 触发器 | chù fā qì |
| bistable/baɪˈsteɪbl/ | 双稳态 | shuāng wěn tài |
| toggle/ˈtɒɡl/ | 翻转 | fān zhuǎn |
| counters/ˈkaʊntəz/ | 计数器 | jì shù qì |
| SRAM/ˈesræm/ | 静态RAM | jìng tài RAM |
| clock/klɒk/ | 时钟 | shí zhōng |
| SR flip-flop/ˌes ˈɑː flɪp flɒp/ | SR触发器 | SR chù fā qì |
| JK flip-flop/ˌdʒeɪ ˈkeɪ flɪp flɒp/ | JK触发器 | JK chù fā qì |
15.2
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| RISC | un procesador con un conjunto pequeño de instrucciones simples, de longitud fija, ejecutadas mayoritariamente en un ciclo de reloj, usando muchos registros y pipelining |
| CISC | un procesador con un gran conjunto de instrucciones complejas, de longitud variable, muchas que requieren varios ciclos de reloj y acceden directamente a la memoria |
| pipelining | dividir el ciclo de búsqueda-ejecución en etapas para que varias instrucciones se procesen a la vez, cada una en una etapa diferente |
| SISD / SIMD / MISD / MIMD | una instrucción sobre un ítem de datos; una instrucción sobre muchos ítems de datos; muchas instrucciones sobre un ítem de datos; muchas instrucciones sobre muchos ítems de datos |
| computadora masivamente paralela | miles de procesadores, cada uno con su propia memoria, conectados por una red y trabajando simultáneamente en un mismo problema |
| máquina virtual | una emulación de software de un sistema informático que se ejecuta en una computadora anfitriona y se comporta como una computadora física independiente |
| hipervisor | el software que crea máquinas virtuales y comparte el hardware del anfitrión entre ellas |
| tabla de verdad | una tabla que enumera cada combinación de entradas de un circuito lógico con la(s) salida(s) resultante(s) |
| suma de productos | una expresión booleana escrita como la OR de términos AND, un término para cada combinación de entrada que da 1 |
| mapa de Karnaugh | una cuadrícula de las salidas de la tabla de verdad, organizadas en orden de código Gray, en la que bucles de 1s adyacentes dan la expresión simplificada |
| sumador medio | un circuito que suma dos bits, produciendo una suma y un acarreo |
| sumador completo | un circuito que suma dos bits y un acarreo de entrada, produciendo una suma y un acarreo de salida |
| flip-flop | un circuito bistable que almacena un bit, manteniendo su salida hasta que sus entradas lo cambian |
15.2
Consejos para el examen
- RISC y CISC se responden como listas de características: simple, fija, un ciclo, muchos registros, carga/almacenamiento, pipeline frente a complejo, variable, multi-ciclo, menos registros, acceso directo a memoria, microcódigo. Cuatro de cada una.
- Pipelining: etapas, varias instrucciones a la vez, una completada por ciclo, mayor rendimiento; $n + k - 1$ ciclos para $n$ instrucciones a través de $k$ etapas; las interrupciones deben vaciar el pipeline.
- Las cuatro categorías de Flynn son "cuántos flujos de instrucciones" por "cuántos flujos de datos"; diga qué se ejecuta en qué. Masivamente paralela: muchos procesadores, memoria propia, red, mismo problema.
- Máquina virtual: emulación de una computadora en un anfitrión; SO anfitrión en el hardware, hipervisor compartiendo, SO huésped dentro. Dos beneficios y dos limitaciones, cada uno una oración completa.
- Álgebra de Boole: nombre cada ley a medida que la use; De Morgan intercambia el operador y niega cada término; verifique con una tabla de verdad si tiene dudas.
- Mapa K: orden de código Gray, bucles más grandes de 1/2/4/8, permite envoltura, un término por bucle con las variables invariables. Indique por qué: expresión más simple sin álgebra.
- Sumador medio da suma y acarreo; sumador completo también toma acarreo de entrada; flip-flop SR son dos puertas NOR/NAND acopladas cruzadamente y almacena un bit; el input 1,1 del JK realiza toggle.
Errores comunes
- Intercambiar las listas de características de RISC y CISC, u ofrecer "más rápido" como característica; dé las características de diseño, no un juicio.
- Describir el pipelining como "ejecutar instrucciones en paralelo en varios núcleos"; son etapas de un solo procesador superpuestas.
- Confundir SIMD (una instrucción, muchos datos) con MIMD (muchos de ambos), o describir MISD como el caso común.
- Definir una máquina virtual como "una copia de una computadora" sin la palabra emulación o el anfitrión y el huésped.
- Aplicar De Morgan solo a parte de una expresión bajo una barra larga, o eliminar la barra sin intercambiar AND por OR.
- Hacer un bucle con un grupo de tres, o un grupo no rectangular, en un mapa K; ordenar las columnas 00, 01, 10, 11 en lugar de código Gray.
- Escribir el acarreo de un sumador medio como XOR y la suma como AND.
- Dibujar un flip-flop SR como dos puertas sin retroalimentación, u omitir el estado inválido de su tabla de verdad.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.