Кембридж, девятнадцатые двадцатые годы. На садовом празднике дама говорит кое-что удивительное. Она утверждает, что на вкус отличит, было ли молоко налито в чашку…
English narration · English + 中文 subtitles burned in · Английское озвучивание · Английский + китайские субтитры (встроенные)
English
This handout covers Topic 6: Probability & Statistics 概率统计 2. It adds the Poisson model, combining random variables, continuous distributions, and the ideas of estimation and testing.
Русский
Этот раздаточный материал охватывает тему 6: Вероятность и статистика 2. Он добавляет пуассоновскую модель, комбинирование случайных величин, непрерывные распределения, а также идеи оценки и проверки гипотез.
6.1
The Poisson distribution · Распределение Пуассона
Syllabus · Программа
Candidates should be able to:
Notes and examples
• use formulae to calculate probabilities for the distribution $\text{Po}(\lambda)$
• use the fact that if $X \sim \text{Po}(\lambda)$ then the mean and variance of $X$ are each equal to $\lambda$
Proofs are not required.
• understand the relevance of the Poisson distribution to the distribution of random events, and use the Poisson distribution as a model
• use the Poisson distribution as an approximation to the binomial distribution where appropriate
The conditions that $n$ is large and $p$ is small should be known; $n > 50$ and $np < 5$, approximately.
• use the normal distribution, with continuity correction, as an approximation to the Poisson distribution where appropriate.
The condition that $\lambda$ is large should be known; $\lambda > 15$, approximately.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
The Poisson distribution 泊松分布$X \sim \mathrm{Po}(\lambda)$ models the number of random events in a fixed interval, when events happen at a steady average rate $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
For a Poisson variable the mean and the variance are both equal to $\lambda$. The Poisson distribution is a good approximation 近似 to the binomial distribution when $n$ is large and $p$ is small. The normal distribution (with continuity correction) approximates the Poisson when $\lambda$ is large.
Worked example.$X \sim \mathrm{Po}(3)$. Find $P(X = 2)$.
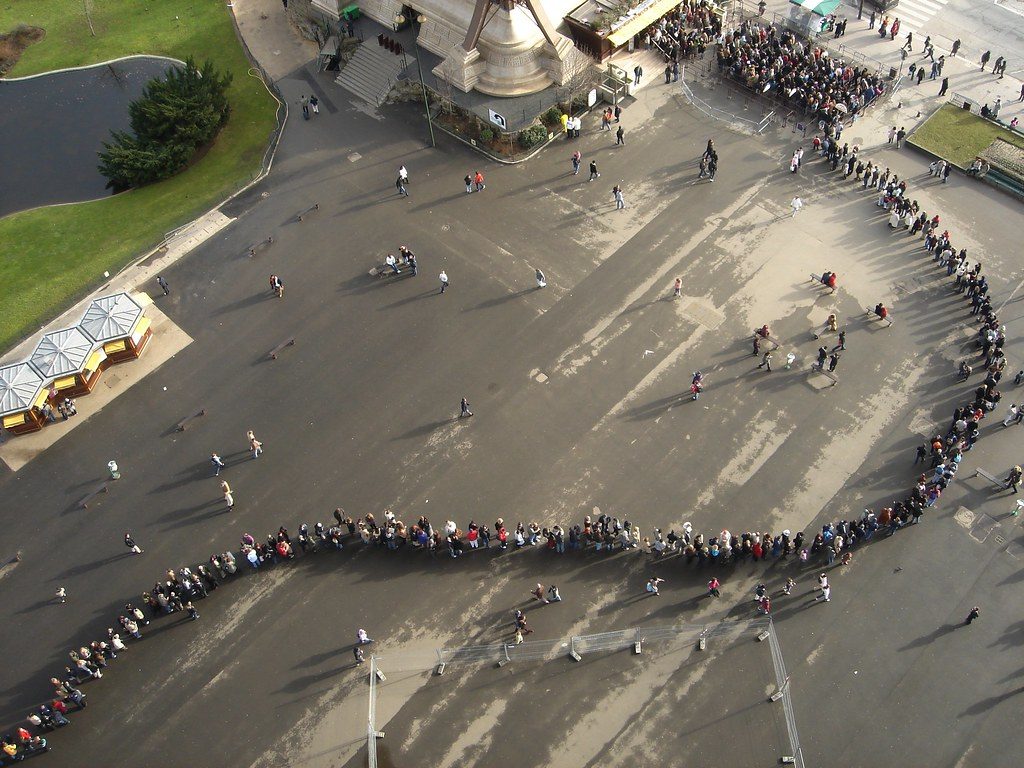
Приходящие случайно в очередь люди подчиняются распределению Пуассона.
Распределение Пуассона $X \sim \mathrm{Po}(\lambda)$ моделирует количество случайных событий за фиксированный интервал, когда события происходят со стабильной средней скоростью $\lambda$:
$$P(X = r) = e^{-\lambda}\frac{\lambda^r}{r!}.$$
Для переменной Пуассона среднее и дисперсия равны $\lambda$. Распределение Пуассона является хорошей аппроксимацией для биномиального распределения, когда $n$ велико, а $p$ мало. Нормальное распределение (с поправкой на непрерывность) аппроксимирует распределение Пуассона, когда $\lambda$ велико.
Распределение Пуассона $\mathrm{Po}(3)$: для переменной Пуассона среднее и дисперсия равны $\lambda$.
Explore · Исследовать
The Poisson distribution · Распределение Пуассона
Change the mean λ. Poisson models the number of random events in a fixed interval — rare events give a skewed shape. · Измените среднее λ. Распределение Пуассона моделирует количество случайных событий в фиксированном интервале — редкие события дают скошенную форму.
6.2
Linear combinations of random variables · Линейные комбинации случайных величин
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
• use, when solving problems, the results that – $\text{E}(aX + b) = a\text{E}(X) + b$ and $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ for independent $X$ and $Y$ – if $X$ has a normal distribution then so does $aX + b$ – if $X$ and $Y$ have independent normal distributions then $aX + bY$ has a normal distribution – if $X$ and $Y$ have independent Poisson distributions then $X + Y$ has a Poisson distribution.
Proofs of these results are not required.
Русский
Кандидаты должны уметь:
Примечания и примеры
• использовать при решении задач следующие результаты – $\text{E}(aX + b) = a\text{E}(X) + b$ и $\text{Var}(aX + b) = a^2\text{Var}(X)$ – $\text{E}(aX + bY) = a\text{E}(X) + b\text{E}(Y)$ – $\text{Var}(aX + bY) = a^2\text{Var}(X) + b^2\text{Var}(Y)$ для независимых $X$ и $Y$ – если $X$ имеет нормальное распределение, то и $aX + b$ – если $X$ и $Y$ имеют независимые нормальные распределения, то $aX + bY$ имеет нормальное распределение – если $X$ и $Y$ имеют независимые распределения Пуассона, то $X + Y$ имеет распределение Пуассона.
Доказательства этих результатов не требуются.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
When you change a variable by a linear rule, the expectation 期望 (mean) and variance 方差 follow these rules:
$$E(aX + b) = aE(X) + b, \qquad \mathrm{Var}(aX + b) = a^2\,\mathrm{Var}(X).$$
Два полезных факта: если $X$ имеет нормальное распределение, то и $aX + b$ имеет; а сумма независимых переменных Пуассона снова подчиняется распределению Пуассона.
Разобранный пример.$X$ имеет среднее $5$ и дисперсию $4$. Найдите $E(3X - 1)$ и $\mathrm{Var}(3X - 1)$.
Linear combination lab · Лабораторная работа по линейным комбинациям
E(aX + b) = aE(X) + b
Change a scaling factor and see how the expected value scales. · Измените множитель масштабирования и посмотрите, как масштабируется математическое ожидание.
Continuous random variables · Непрерывные случайные величины
Syllabus · Программа
English
Candidates should be able to:
Notes and examples
• understand the concept of a continuous random variable, and recall and use properties of a probability density function
For density functions defined over a single interval only; the domain may be infinite, e.g. $\frac{3}{x^4}$ for $x \geqslant 1$.
• use a probability density function to solve problems involving probabilities, and to calculate the mean and variance of a distribution.
Including location of the median or other percentiles of a distribution by direct consideration of an area using the density function. Explicit knowledge of the cumulative distribution function is not included.
Русский
Кандидаты должны уметь:
Примечания и примеры
• понимать концепцию непрерывной случайной величины и вспоминать и использовать свойства функции плотности вероятности
Только для функций плотности, определенных на одном интервале; область определения может быть бесконечной, напр. $\frac{3}{x^4}$ для $x \geqslant 1$.
• использовать функцию плотности вероятности для решения задач, связанных с вероятностями, а также для вычисления среднего арифметического и дисперсии распределения.
Включая определение медианы или других перцентилей распределения прямым рассмотрением площади с использованием функции плотности. Явное знание функции распределения не входит в программу.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A continuous random variable 连续型随机变量 can take any value in a range. Its probabilities come from a probability density function 概率密度函数$f(x)$, with two key properties:
A probability is the area under $f$, and the mean is found by integration:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
The cumulative distribution function 累积分布函数 is $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; the median 中位数 solves $F(m) = 0.5$, and other percentiles 百分位数 solve $F(x) = p$.
Worked example. A continuous variable has $f(x) = \tfrac12 x$ for $0 \leqslant x \leqslant 2$ (and $0$ elsewhere). Find $E(X)$.
The variance uses the same idea, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. For the same $f(x)=\tfrac12 x$ on $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, so $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Русский
Непрерывная случайная величина может принимать любое значение в диапазоне. Ее вероятности определяются функцией плотности вероятности$f(x)$, которая обладает двумя ключевыми свойствами:
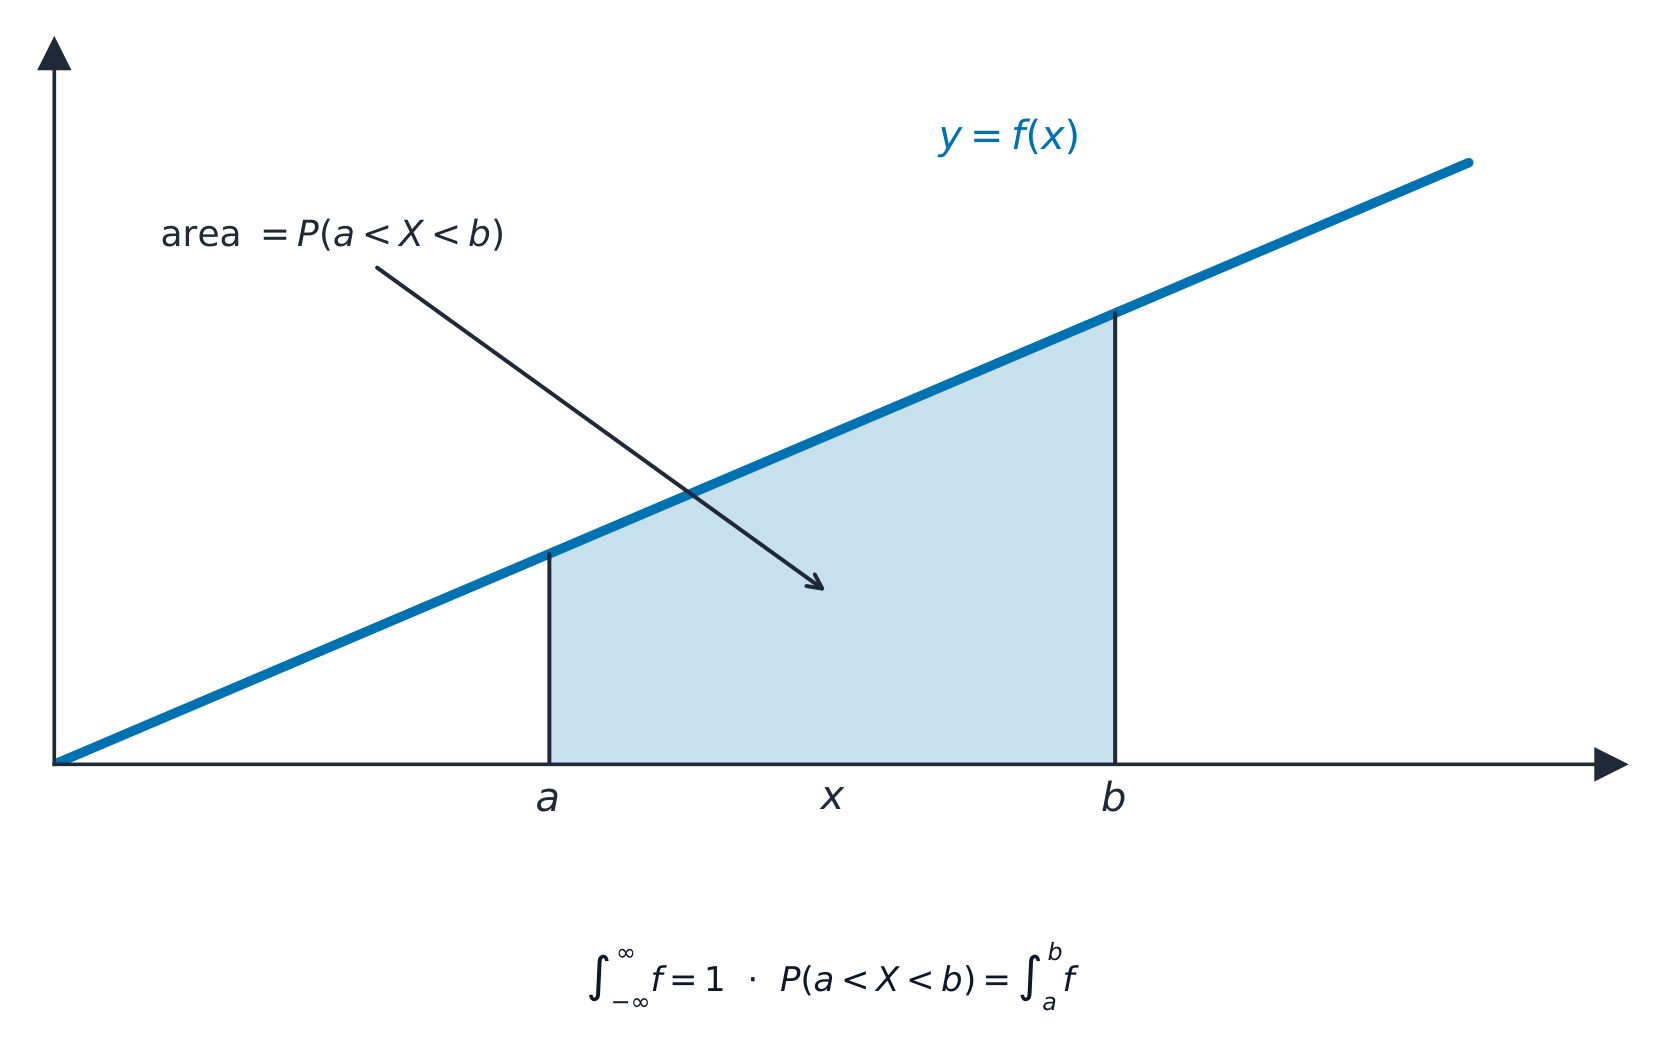
Вероятность — это площадь под $f$, а среднее находится путем интегрирования:
$$P(a < X < b) = \int_a^b f(x)\,dx, \qquad E(X) = \int_{-\infty}^{\infty} x\,f(x)\,dx.$$
Функция распределения есть $F(x) = P(X \leqslant x) = \int_{-\infty}^{x} f(t)\,dt$; медиана решает уравнение $F(m) = 0.5$, а другие процентили решают уравнение $F(x) = p$.
Для непрерывной переменной вероятность $P(a — это площадь под $f(x)$ между $a$ и $b$.
Разбор примера. Непрерывная переменная имеет $f(x) = \tfrac12 x$ для $0 \leqslant x \leqslant 2$ (и $0$ в остальных случаях). Найти $E(X)$.
Дисперсия использует ту же идею, $\mathrm{Var}(X)=\displaystyle\int_{-\infty}^{\infty}x^2 f(x)\,dx-\big(E(X)\big)^2$. Для той же $f(x)=\tfrac12 x$ на $[0,2]$: $\displaystyle\int_0^2 x^2\cdot\tfrac12 x\,dx=\left[\tfrac{x^4}{8}\right]_0^2=2$, следовательно $\mathrm{Var}(X)=2-\left(\tfrac43\right)^2=2-\tfrac{16}{9}=\tfrac{2}{9}$.
Explore · Исследовать
Area = probability · Площадь = вероятность
P(a < X < b) = ∫ f(x) dx
For a continuous variable, probability is the area under the density curve between two values. · Для непрерывной случайной величины вероятность — это площадь под кривой плотности между двумя значениями.
• understand the distinction between a sample and a population, and appreciate the necessity for randomness in choosing samples
• explain in simple terms why a given sampling method may be unsatisfactory
Including an elementary understanding of the use of random numbers in producing random samples. Knowledge of particular sampling methods, such as quota or stratified sampling, is not required.
• recognise that a sample mean can be regarded as a random variable, and use the facts that $\text{E}(\overline{X}) = \mu$ and that $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$
• use the fact that $\overline{X}$ has a normal distribution if $X$ has a normal distribution
• use the Central Limit Theorem where appropriate
Only an informal understanding of the Central Limit Theorem (CLT) is required; for large sample sizes, the distribution of a sample mean is approximately normal.
• calculate unbiased estimates of the population mean and variance from a sample, using either raw or summarised data
Only a simple understanding of the term 'unbiased' is required, e.g. that although individual estimates will vary the process gives an accurate result 'on average'.
• determine and interpret a confidence interval for a population mean in cases where the population is normally distributed with known variance or where a large sample is used
• determine, from a large sample, an approximate confidence interval for a population proportion.
Русский
Кандидаты должны уметь:
Примечания и примеры
• понимать различие между выборкой и генеральной совокупностью, а также необходимость случайности при отборе выборки
• объяснять простыми словами, почему данный метод выборки может быть неудовлетворительным
Включая элементарное понимание использования случайных чисел для получения случайных выборок. Знание конкретных методов выборки, таких как квотная или стратифицированная выборка, не требуется.
• распознавать, что среднее значение выборки можно рассматривать как случайную величину, и использовать факты, что $\text{E}(\overline{X}) = \mu$ и что $\text{Var}(\overline{X}) = \frac{\sigma^2}{n}$
• использовать тот факт, что $\overline{X}$ имеет нормальное распределение, если $X$ имеет нормальное распределение
• применять центральную предельную теорему там, где это уместно
Требуется только неформальное понимание центральной предельной теоремы (ЦПТ); для больших объемов выборки распределение среднего значения выборки приблизительно является нормальным.
• вычислять несмещенные оценки генерального среднего и дисперсии по выборке, используя либо сырые, либо сводные данные
Требуется лишь простое понимание термина «несмещенность», например, того, что хотя отдельные оценки будут варьироваться, процесс дает точный результат «в среднем».
определять и интерпретировать доверительный интервал для среднего значения генеральной совокупности в случаях, когда генеральная совокупность нормально распределена с известной дисперсией или используется большая выборка
определять по большой выборке приблизительный доверительный интервал для доли генеральной совокупности.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A sample 样本 is a small group chosen from the whole population 总体. A random sample needs randomness 随机性, so that every member has a fair chance of being chosen.
Some methods are unsatisfactory because they are biased 有偏: sampling only volunteers, or the first 20 people to arrive, over-represents certain kinds of people. A genuinely random sample uses random numbers – number every member of the population, then draw numbers (from a table or a generator) to decide who is in the sample.
The sample mean $\bar{X}$ is itself a random variable, with
By the Central Limit Theorem 中心极限定理, for a large sample $\bar{X}$ is approximately normal, whatever the shape of the population.
From a sample you can find unbiased estimates 无偏估计 of the population mean and variance. A confidence interval 置信区间 gives a range that probably contains the true mean. When the population is normal with known $\sigma$ (or the sample is large), a $95\%$ interval is
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$
You can also find a confidence interval for a population proportion 总体比例 from a large sample.
Worked example. A sample of $n = 64$ has mean $\bar{x} = 50$, from a population with $\sigma = 8$. Find a $95\%$ confidence interval for the population mean.
Статистика изучает выборку, чтобы узнать о всей генеральной совокупности.
Выборка — небольшая группа, выбранная из всей генеральной совокупности. Случайная выборка требует случайности, чтобы каждый член имел справедливый шанс быть выбранным.
Некоторые методы являются неудовлетворительными, потому что они смещены: опрос только добровольцев или первых 20 прибывших людей дает чрезмерное представительство определенных типов людей. Истинно случайная выборка использует случайные числа — пронумеруйте каждого члена совокупности, затем выберите номера (из таблицы или генератора), чтобы решить, кто попадет в выборку.
Среднее выборки $\bar{X}$ само по себе является случайной величиной, имеющей
Согласно Центральной предельной теореме, для большой выборки $\bar{X}$ приблизительно нормально распределено, независимо от формы генеральной совокупности.
Независимо от формы совокупности, среднее выборки $\bar{X}$ имеет узкое, близкое к нормальному распределение, центрированное на $\mu$.
По выборке можно найти несмещенные оценки среднего и дисперсии генеральной совокупности. Доверительный интервал дает диапазон, который, вероятно, содержит истинное среднее. Когда генеральная совокупность нормальна с известным $\sigma$ (или выборка велика), доверительный интервал $95\%$ равен
$$\bar{x} \pm 1.96\,\frac{\sigma}{\sqrt{n}}.$$
Доверительный интервал $95\%$ простирается на $1.96$ стандартных ошибок в каждую сторону от среднего выборки.
Также можно найти доверительный интервал для доли генеральной совокупности по большой выборке.
Разобранный пример. Выборка из $n = 64$ имеет среднее $\bar{x} = 50$, из совокупности с $\sigma = 8$. Найдите доверительный интервал $95\%$ для среднего генеральной совокупности.
The sampling distribution · Выборочное распределение
X̄ ~ N(μ, σ²/n)
By the Central Limit Theorem, sample means follow a normal curve — narrower for bigger samples. · Согласно Центральной предельной теореме, выборочные средние следуют нормальному закону — более узкому для больших выборок.
• understand the nature of a hypothesis test, the difference between one-tailed and two-tailed tests, and the terms null hypothesis, alternative hypothesis, significance level, rejection region (or critical region), acceptance region and test statistic
Outcomes of hypothesis tests are expected to be interpreted in terms of the contexts in which questions are set.
• formulate hypotheses and carry out a hypothesis test in the context of a single observation from a population which has a binomial or Poisson distribution, using – direct evaluation of probabilities – a normal approximation to the binomial or the Poisson distribution, where appropriate
• formulate hypotheses and carry out a hypothesis test concerning the population mean in cases where the population is normally distributed with known variance or where a large sample is used
• understand the terms Type I error and Type II error in relation to hypothesis tests
• calculate the probabilities of making Type I and Type II errors in specific situations involving tests based on a normal distribution or direct evaluation of binomial or Poisson probabilities.
Русский
Кандидаты должны уметь:
Примечания и примеры
• понимать суть статистической гипотезы, различие между однонаправленными и двухнаправленными тестами, а также термины нулевая гипотеза, альтернативная гипотеза, уровень значимости, область отклонения (или критическая область), область принятия и тестовая статистика
Ожидаются результаты статистических гипотез, которые должны интерпретироваться с учетом контекста поставленных вопросов.
• формулировать гипотезы и проводить статистическую гипотезу в контексте одиночного наблюдения из генеральной совокупности, имеющей биномиальное или распределение Пуассона, используя – прямую оценку вероятностей – нормальное приближение биномиального или распределения Пуассона, где это уместно
• формулировать гипотезы и проводить статистическую гипотезу относительно среднего значения генеральной совокупности в случаях, когда генеральная совокупность нормально распределена с известной дисперсией или используется большая выборка
• понимать термины ошибка I рода и ошибка II рода в отношении статистических гипотез
• вычислять вероятности совершения ошибок I и II рода в конкретных ситуациях, связанных с тестами, основанными на нормальном распределении или прямой оценке биномиальных или пуассоновских вероятностей.
Source: Cambridge International syllabus · Источник: Программа Cambridge International
English
A hypothesis test 假设检验 uses sample data to judge a claim. You set up two statements: the null hypothesis 原假设$H_0$ (the claim being tested, usually "no change") and the alternative hypothesis 备择假设$H_1$ (what you suspect instead). The test is one-tailed 单尾 if $H_1$ points one way (e.g. $\mu > 50$) and two-tailed 双尾 if it allows both ways ($\mu \neq 50$).
You fix a significance level 显著性水平 (often $5\%$), work out a test statistic 检验统计量 from the data, and see whether it lands in the rejection region 拒绝域 (also called the critical region); if it does you reject $H_0$, otherwise the statistic is in the acceptance region.
Two mistakes are possible: a Type I error 第一类错误 is rejecting $H_0$ when it is actually true; a Type II error 第二类错误 is accepting $H_0$ when it is actually false. You can find their probabilities from the rejection region: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ – this equals the significance level – and $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ true for a stated value$)$, computed from the binomial, Poisson, or normal distribution.
Worked example. A population is claimed to have mean $50$, with $\sigma = 8$. A sample of $n = 64$ gives $\bar{x} = 52$. Test at the $5\%$ level whether the mean has changed.
$H_0\!: \mu = 50$ and $H_1\!: \mu \neq 50$ (two-tailed). The test statistic is
The critical value at $5\%$ (two-tailed) is $1.96$. Since $2 > 1.96$, you reject $H_0$: there is evidence the mean has changed.
Worked example (a binomial test). A coin is claimed fair but suspected of landing heads too rarely: $H_0\!:p=0.5$, $H_1\!:p<0.5$. In $n=30$ tosses you see $X=9$ heads. Under $H_0$, $X\sim B(30,0.5)$, so the one-tailed tail probability is
Since $0.021<0.05$, reject $H_0$: the coin does seem biased against heads. (For large $n$ the binomial is approximated by a normal; a Poisson test works the same way for rare events. And here, if the rule is "reject when $X\leqslant 9$", then $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Русский
Проверка гипотезы использует данные выборки для оценки утверждения. Вы устанавливаете два высказывания: нулевая гипотеза$H_0$ (проверяемое утверждение, обычно «нет изменений») и альтернативная гипотеза$H_1$ (то, что вы подозреваете вместо этого). Тест является односторонним, если $H_1$ указывает в одну сторону (например, $\mu > 50$), и двусторонним, если он допускает оба направления ($\mu \neq 50$).
Вы устанавливаете уровень значимости (часто $5\%$), вычисляете тестовую статистику по данным и смотрите, попадает ли она в область отклонения (также называемую критической областью); если да, вы отвергаете $H_0$, иначе статистика находится в области принятия.
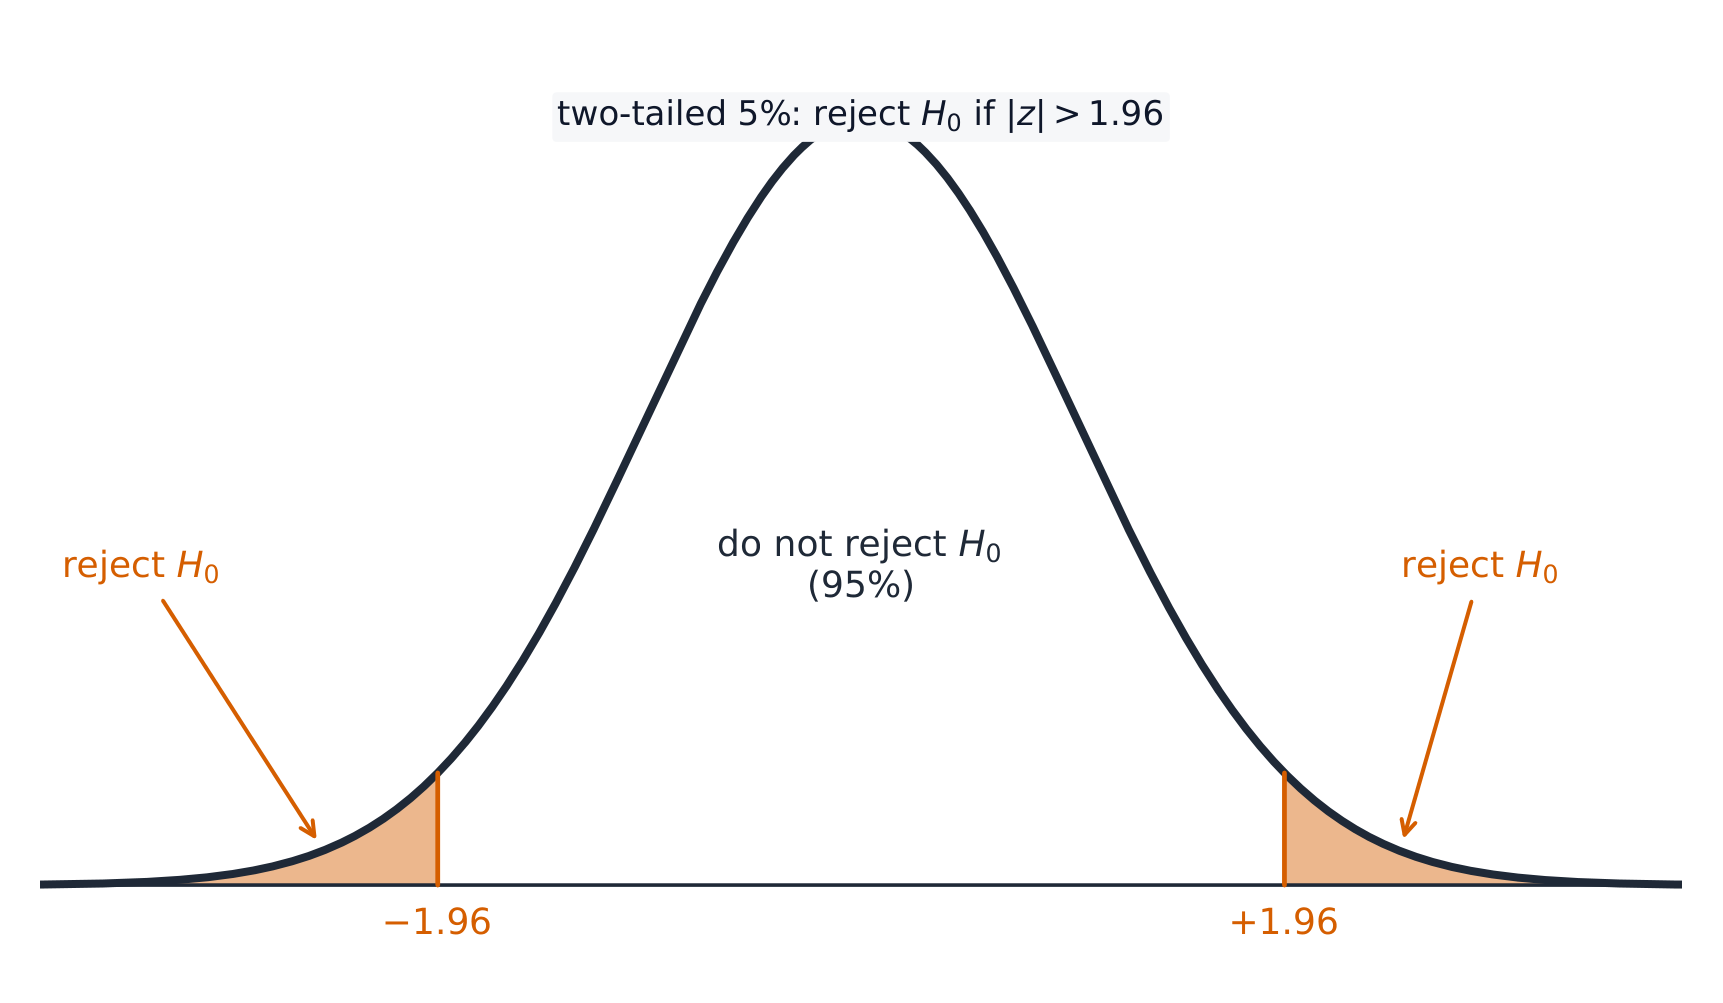
Двусторонний тест при $5\%$ отвергает $H_0$ только тогда, когда тестовая статистика попадает в закрашенный хвост за пределами $\pm1.96$.
Возможны две ошибки: Ошибка I рода — это отвержение $H_0$, когда оно на самом деле истинно; Ошибка II рода — это принятие $H_0$, когда оно на самом деле ложно. Вы можете найти их вероятности из области отклонения: $P(\text{Type I})=P(\text{statistic in the rejection region}\mid H_0)$ — это уровень значимости — и $P(\text{Type II})=P(\text{statistic in the acceptance region}\mid H_1$ для указанного значения$)$, вычисленного по биномиальному, пуассоновскому или нормальному распределению.
Разобранный пример. Утверждается, что среднее значение генеральной совокупности равно $50$, при $\sigma = 8$. Выборка объемом $n = 64$ дает результат $\bar{x} = 52$. Проведите тест на уровне $5\%$, чтобы проверить, изменилось ли среднее значение.
$H_0\!: \mu = 50$ и $H_1\!: \mu \neq 50$ (двусторонний). Тестовая статистика равна
Критическое значение при $5\%$ (двусторонний) равно $1.96$. Поскольку $2 > 1.96$, мы отвергаем $H_0$: есть доказательства того, что среднее значение изменилось.
Разобранный пример (биномиальный тест). Монета считается честной, но подозревается, что она слишком редко выпадает орлом: $H_0\!:p=0.5$, $H_1\!:p<0.5$. При $n=30$ бросках вы观察到$X=9$ орлов. При $H_0$, $X\sim B(30,0.5)$, поэтому односторонняя вероятность хвоста составляет
Поскольку $0.021<0.05$, отвергаем $H_0$: монета действительно склонна к выпадению решки. (Для больших $n$ биномиальное распределение аппроксимируется нормальным; пуассоновский тест работает так же для редких событий. И здесь, если правило гласит «отвергать, когда $X\leqslant 9$», то $P(\text{Type I})=P(X\leqslant 9\mid p=0.5)\approx0.021$.)
Explore · Исследовать
The rejection region · Критическая область
reject H₀ if z < −z* · отклонить H₀ если z < −z*
The shaded tail is the rejection region — if the test statistic lands there, reject H₀. · Заштрихованный хвост — это критическая область — если статистика критерия попадает туда, отклоните H₀.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Выберите один, и сайт будет вести вас — конспекты, работы, видео и практика откроются там.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Введите запрос для поиска заметок, уроков, кода, словаря и вопросов с реальных экзаменов по всем предметам.