| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Выбирать и использовать подходящие типы данных для решения задачи | включая integer, real, char, string, Boolean, date (псевдокод будет использовать следующие типы данных: INTEGER, REAL, CHAR, STRING, BOOLEAN, DATE, ARRAY, FILE) |
| Демонстрировать понимание назначения структуры записи для хранения набора данных разных типов под одним идентификатором | Написать псевдокод для определения структуры записи |
| Написать псевдокод для чтения данных из структуры записи и сохранения данных в структуру записи |
Типы данных и структуры данных
Информатика A-Level · Тема 10
 17:40
Типы данных и структуры
Каждое значение, которое хранит программа, требует типа данных — и выбор правильного имеет значение. Допустим, вы сохраняете, есть ли товар в наличии. Вы могли бы записать слово yes…
Английское озвучивание · Английский + китайские субтитры (встроенные)
10.1
Выбор типов данных
Программа
Источник: Программа Cambridge International
Каждая переменная требует типа данных — вида хранимого значения и разрешенных операций:
INTEGER— целое число (42,-7). Для подсчета, индексов, ID.REAL— число с дробной частью (3.14). Для денег, измерений.STRING— символы в кавычках ("Hello"). Для текста.CHAR— один символ ('A').BOOLEAN—TRUEилиFALSE. Для флагов.DATE— календарная дата.
Выбирайте наименьший точный тип, подходящий по назначению: INTEGER для целых количеств, BOOLEAN для флагов (не строки "yes"/"no").
«Укажите соответствующий тип данных» определяется способом использования значения: средний балл класса — это REAL (имеет дробную часть); адрес электронной почты — это STRING; количество студентов — это INTEGER; оплатил ли студент — это BOOLEAN; дата рождения — это DATE; индекс массива всегда — это INTEGER; одна буква оценки — это CHAR; номер телефона — это STRING, потому что он начинается с 0 и никогда не используется в арифметике. BOOLEAN используется для флага с двумя состояниями: нашел ли поиск цель, заплатил ли участник, забронировано ли место. Для таблицы идентификаторов имя переменной также должно быть осмысленным: NumberOfPeople, а не n.
10.1
Записи

Запись (структура записи) хранит несколько полей различных типов под одним именем — полезно, когда несколько значений описывают одну вещь.
TYPE TStockItem
    DECLARE ItemID : INTEGER
    DECLARE Category : STRING
    DECLARE ItemCost : REAL
    DECLARE InStock : BOOLEAN
ENDTYPE
Это определяет тип TStockItem; объявите переменные этого типа:
DECLARE Item1 : TStockItem
DECLARE Items : ARRAY[1:100] OF TStockItem
Используйте точку (dot notation) для доступа к каждому полю:
Item1.Category ← "Fruit"
OUTPUT Item1.Category, " costs ", Item1.ItemCost
Используйте структуру (record), когда значения всегда принадлежат вместе (например, клиент и товар на складе); используйте отдельные переменные для не связанных между собой значений.
Разобранный пример. Клуб хранит для каждого студента ID студента (строка), имя, дату рождения и до трёх номеров клуба (целые числа). Напишите псевдокод для объявления типа структуры, массива для хранения $3000$ студентов и оператора, который сохраняет имя в первый элемент.
TYPE Student
    DECLARE StudentID : STRING
    DECLARE Name : STRING
    DECLARE DateOfBirth : DATE
    DECLARE Club : ARRAY[1:3] OF INTEGER
ENDTYPE

DECLARE Membership : ARRAY[1:3000] OF Student
Membership[1].Name ← "Li Wei"
Оценки: TYPE с идентификатором и ENDTYPE; каждое поле объявлено с подходящим типом; массив объявлен с его границами и OF Student; доступ к полю осуществляется через индекс и точку. Задание «укажите ошибку в объявлении структуры» обычно указывает на отсутствующий ENDTYPE, поле без типа или поле, объявленное как STRING, которое должно хранить арифметические данные. Две конвенции оцениваются отдельно: неиспользуемый элемент помечается значением, которое не может быть реальными данными (пустая строка, -1, ID со значением 0), и это хорошая практика использовать один и тот же маркер везде, чтобы каждый модуль мог распознать неиспользуемый слот; неиспользуемое поле клуба — это 0. Преимущества массива структур для задания «назовите три преимущества»: все данные одной сущности хранятся под одним идентификатором; поля могут иметь разные типы данных; один массив заменяет несколько параллельных массивов, которые пришлось бы синхронизировать; весь набор можно обработать одним циклом или передать как один параметр; добавление поля изменяет только определение типа. Для одного клиента подходящей структурой является структура (поля разных типов под одним именем); для всех клиентов — массив структур.
Исследовать
Запись группирует поля под одним именем
Запись объединяет связанные поля вместе. Каждое поле — это именованная метка, к которой вы обращаетесь через точечную нотацию — Item1.Category — а не по числовому индексу.
Словарь
Тренировать
| English | Русский |
|---|---|
| array/əˈreɪ/ | Массив |
| record/ˈrekɔːd/ | запись |
| record structure/ˈrekɔːd ˈstrʌktʃə/ | Структура записи |
| field/fiːld/ | поле |
| element/ˈelɪmənt/ | Элемент |
| bounds/baʊndz/ | Границы |
10.2
Массивы

Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Использовать технические термины, связанные с массивами | Включая индекс, верхняя граница и нижняя граница |
| Выбрать подходящую структуру данных (1D или 2D массив) для конкретной задачи | |
| Написать псевдокод для одномерных 1D и двумерных 2D массивов | |
| Написать псевдокод для обработки данных массива | Сортировка с помощью пузырьковой сортировки Поиск с помощью линейного поиска |
Источник: Программа Cambridge International
Массив — это упорядоченная совокупность элементов одного типа, объединённых под одним именем, доступ к которым осуществляется через индекс.
- элемент — один элемент в массиве.
- границы — наименьший и наибольший допустимые индексы.
- размерность — 1-D (список), 2-D (таблица) и т. д.
- нижняя граница и верхняя граница — первый и последний допустимые индексы; количество элементов равно верхней границе минус нижняя граница плюс один, а для 2-мерного массива это произведение обоих счетчиков.
Таким образом, в ThisArray[n] ← 42 массив имеет одно измерение, индексом является переменная n (тип INTEGER), а элемент по этому индексу получает значение 42. Перед объявлением массива также необходимо указать его тип данных. Для объявления $120$ значений, которые могут содержать десятичную дробь: DECLARE Data : ARRAY[1:120] OF REAL; таблицы строк размером $150$ строк и два столбца: DECLARE Data : ARRAY[1:150, 1:2] OF STRING, которая содержит $300$ элементов. Преимущества массива перед отдельными переменными (объясните на два балла): вместо тридцати отдельных переменных используется один идентификатор; элементы можно обрабатывать с помощью цикла, используя индекс в качестве счетчика; размер легко изменить; весь набор можно передать модулю как единый параметр. Массив также может заменить цепочку условий: DaysInMonth[Month] напрямую находит ответ вместо двенадцати условий IF, что короче, быстрее пишется и легче поддерживать.
1-мерные массивы
DECLARE Names : ARRAY[1:5] OF STRING
Names[3] ← "Cara"
OUTPUT Names[3]
Обработайте каждый элемент с помощью цикла FOR:
FOR i ← 1 TO 5
    OUTPUT Names[i]
NEXT i
2-мерные массивы (2-мерный массив)
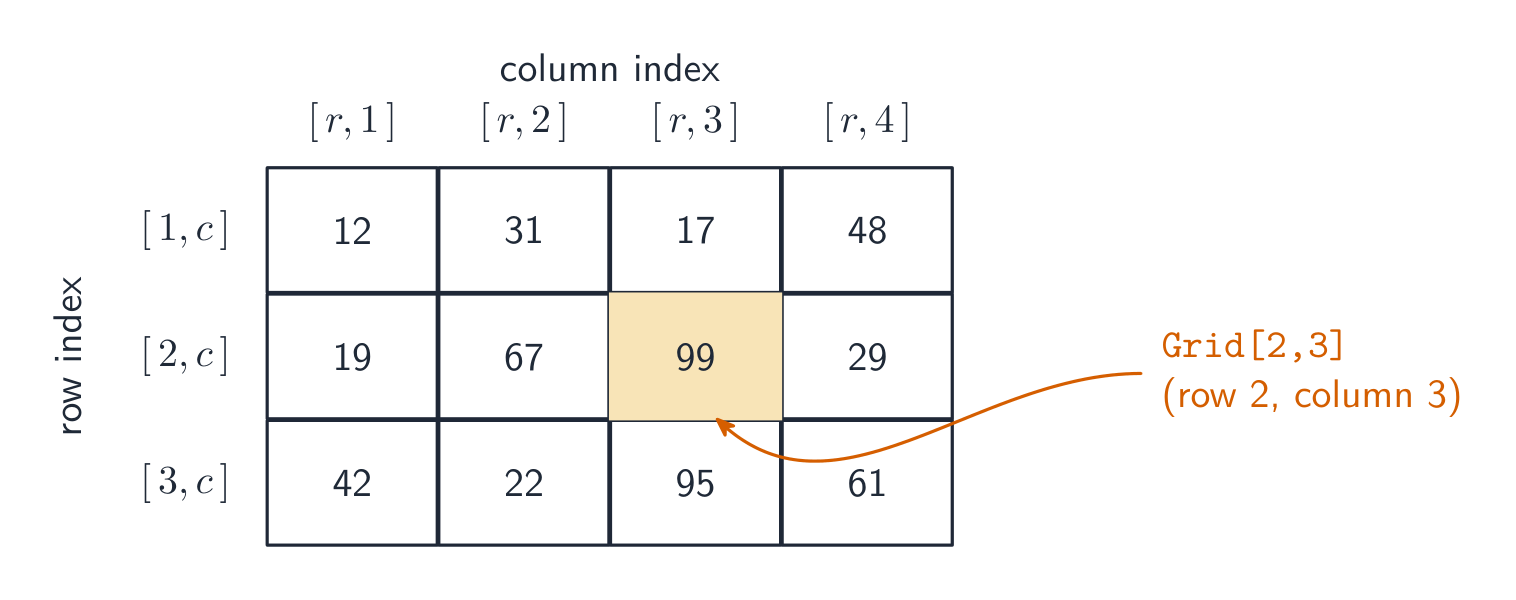
DECLARE Grid : ARRAY[1:3, 1:4] OF INTEGER
Grid[2, 3] ← 99
Первый индекс обозначает строку, второй — столбец. Используйте вложенные циклы для посещения каждой ячейки. Используйте 1-мерный массив для одной последовательности, 2-мерный массив для двух естественных измерений (сетка, строки × столбцы).
Распространенные операции
Линейный поиск проверяет каждый элемент, пока не будет найден:
FOR i ← 1 TO n
    IF A[i] = Target THEN
        OUTPUT "Found at ", i
    ENDIF
NEXT i
Для нахождения суммы, количества, максимума или минимума задайте накапливающую переменную, затем пройдите по массиву:
Max ← A[1]
FOR i ← 2 TO n
    IF A[i] > Max THEN
        Max ← A[i]
    ENDIF
NEXT i
Пузырьковая сортировка упорядочивает массив: проходите по нему, сравнивая каждую пару соседних элементов и меняя местами те, которые расположены неверно; повторяйте проходы, пока один проход не завершится без обменов.
В Билете 2 требуется описать эти алгоритмы как псевдокод и как шаги словами, а иногда и в их «оптимизированной» форме:
- Наибольшее значение: установите
Largestравным первому элементу; для каждого оставшегося элемента, если он большеLargest, сохраните его вLargest; после завершения цикла выведитеLargest. Для позиции наибольшего значения держите вторую переменную, которая хранит индекс каждый раз, когдаLargestменяется. - Линейный поиск, возвращающий позицию: установите
FoundAt ← -1перед циклом (значение, которое никогда не может быть допустимым индексом, поэтому оно означает «не найдено»); пройдите по массиву; когда элемент совпадает, сохраните индекс и выйдите из цикла; после цикла проверьтеFoundAt. - Подсчет или вывод непустых элементов: сравните каждый элемент с маркером неиспользуемого элемента (
""или-1) и считайте или выводите только те, которые отличаются. - Удаление элемента: найдите его индекс с помощью линейного поиска; сдвиньте каждый последующий элемент на одну позицию ближе к началу, чтобы закрыть пустое место; отметьте последний элемент как неиспользуемый (или уменьшите счетчик).
- Вставка в отсортированный массив: найдите первый индекс, элемент которого больше; сдвиньте этот элемент и все последующие на одну позицию ближе к концу; сохраните новое значение в образовавшуюся пустоту.
- Оптимизированная пузырьковая сортировка: флаг
Swapped, позволяющий прервать проходы, как только один проход не принесет обменов, и верхний предел, который уменьшается на единицу при каждом проходе, так как наибольшее значение уже достигло конца.
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO Limit - 1
        IF Data[Index] > Data[Index + 1] THEN
            Temp ← Data[Index]
            Data[Index] ← Data[Index + 1]
            Data[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Limit ← Limit - 1
UNTIL Swapped = FALSE
Баллы начисляются за внешний цикл, который повторяется до тех пор, пока не будут выполнены все обмены, флаг, устанавливаемый внутри IF, трехстрочный обмен с использованием временной переменной и уменьшение лимита. Сортировка «шагами» (пошаговая проработка) включает: повторять до полной сортировки; на каждом проходе сравнивать соседние пары; менять местами пару, нарушающую порядок; после каждого прохода наибольшее неотсортированное значение оказывается в конце. Два 1-мерных массива записей или параллельных данных обрабатываются одним циклом и одним индексом; для 2-мерного массива требуется вложенный цикл, внешний по строкам и внутренний по столбцам, а поиск в одной строке фиксирует индекс строки и выполняет цикл по столбцам.

Исследовать
Массив 2-D
Выберите строку и столбец для чтения одного элемента — как хранится и индексируется сетка данных.
Словарь
Тренировать
| English | Русский |
|---|---|
| index/ˈɪndeks/ | Индекс |
| bubble sort/ˈbʌbl sɔːt/ | сортировка пузырьком |
10.3
Файлы

Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Демонстрировать понимание необходимости файлов | |
| Написать псевдокод для работы с текстовыми файлами, состоящими из одной или нескольких строк |
Источник: Программа Cambridge International
Файл — это данные, хранящиеся на вторичном носителе, между запусками программы. Переменные в ОЗУ исчезают при завершении программы, поэтому для постоянного сохранения данных (рекорды, записи, настройки) программа записывает их в файл. Файлы также позволяют программам обмениваться данными и возобновлять работу из сохраненного состояния.
Текстовый файл содержит одну или несколько строк читаемых символов; программы читают и записывают текстовые файлы построчно. Откройте файл перед использованием и закройте его после:
OPENFILE "data.txt" FOR READ      // or FOR WRITE, FOR APPEND
WHILE NOT EOF("data.txt") DO
    READFILE "data.txt", LineString
    OUTPUT LineString
ENDWHILE
CLOSEFILE "data.txt"
EOF проверяет конец файла перед чтением. Для записи:
OPENFILE "log.txt" FOR WRITE
FOR i ← 1 TO 100
    WRITEFILE "log.txt", "Event " & i
NEXT i
CLOSEFILE "log.txt"
Всегда закрывайте каждый файл — иначе буферизированные записи могут быть утеряны, а другие программы могут быть заблокированы.
Зачем нужны файлы (два очка): данные сохраняются после завершения программы, поэтому они доступны при следующем запуске; их можно делиться с другими программами; они могут содержать больше данных, чем помещается в памяти. Характеристика текстового файла, позволяющая программе обрабатывать его последовательно, заключается в том, что он представляет собой последовательность строк, которые читаются одна за другой от начала. Три режима: READ для чтения с начала; WRITE для создания нового файла, который удаляет существующее содержимое, поэтому его нельзя использовать для добавления данных к файлу; APPEND для добавления строк в конец существующего файла. Проверяйте EOF перед каждым чтением и открывайте файл только один раз, даже если несколько модулей используют его.
Разобранное решение. Напишите псевдокод процедуры LastLines(FileName : STRING), которая выводит последние три строки текстового файла в правильном порядке.
PROCEDURE LastLines(BYVAL FileName : STRING)
    DECLARE LineX, LineY, LineZ : STRING
    LineX ← ""
    LineY ← ""
    LineZ ← ""
    OPENFILE FileName FOR READ
    WHILE NOT EOF(FileName) DO
        LineX ← LineY
        LineY ← LineZ
        READFILE FileName, LineZ
    ENDWHILE
    CLOSEFILE FileName
    OUTPUT LineX
    OUTPUT LineY
    OUTPUT LineZ
ENDPROCEDURE
Каждая новая строка сдвигает предыдущие три вперед, поэтому при окончании файла три переменные содержат последние три строки; если в файле меньше строк, выводятся пустые строки. Чтобы вывести первые пять строк, подсчитывайте прочитанные строки и останавливайте цикл на пяти или на EOF, в зависимости от того, что наступит раньше; пустой файл определяется тем, что EOF становится TRUE сразу после открытия.
Поля в строке. Текстовый файл хранит строки, поэтому запись записывается как одна строка, где поля соединены символом-разделителем, а каждое число или логическое значение преобразуется с помощью NUM_TO_STR (и читается обратно с помощью STR_TO_NUM или путем сравнения со "TRUE"). Выберите разделитель, который никогда не встретится в данных: запятая или | для имен и чисел, никогда не используйте пробел, если имя может его содержать. Если поле может содержать любой символ, разделитель может совпасть с данными; решение — поместить каждое поле на отдельную строку или записать длину поля перед ним. Одна запись на строку легко читается, но занимает больше строк и затрудняет восприятие записи как единого целого. Чтение файла, строки которого расположены в известном порядке (по возрастанию ID), позволяет поиску остановиться, как только будет прочитан больший ID, вместо того чтобы читать до конца. Файл сохранения, создаваемый каждый раз при сохранении игры, должен иметь осмысленное имя, например имя игрока, дату и время, чтобы любое предыдущее сохранение можно было восстановить.

Исследовать
Обработка файла: открытие → использование → закрытие
Пройдите по жизненному циклу, которому следует каждый файл. Две легко упускаемые части — это проверка EOF во время чтения в цикле и обязательное закрытие в конце.
Словарь
Тренировать
| English | Русский |
|---|---|
| file/faɪl/ | файл |
| secondary storage/ˈsekəndəri ˈstɔːrɪdʒ/ | Вторичное хранилище |
10.4
Абстрактные типы данных (АТД)

Программа
| Кандидаты должны уметь: | Примечания и рекомендации |
|---|---|
| Демонстрировать понимание того, что ADT — это совокупность данных и набор операций над этими данными | |
| Демонстрировать понимание того, что стек, очередь и связный список являются примерами ADT | Описать ключевые особенности стека, очереди и связного списка и обосновать их использование для конкретной ситуации |
| Использовать стек, очередь и связный список для хранения данных | Кандидатам не потребуется писать псевдокод для этих структур, но они должны уметь добавлять, редактировать и удалять данные из этих структур |
| Описывать, как очередь, стек и связный список могут быть реализованы с использованием массивов |
Источник: Программа Cambridge International
Абстрактный тип данных (АТД) — это набор данных плюс операции над ними, определяемый тем, что он делает, а не тем, как он хранится. Пользователь работает только через операции; реализация скрыта, поэтому ее можно изменить без изменения кода, использующего АТД. Знать три: стек, очередь, связный список.
Определение на один балл: ADT (абстрактный тип данных) — это совокупность данных вместе с набором операций над этими данными. Стек, очередь, связный список, бинарное дерево и массив являются ADT. Чтобы обосновать выбор: очередь используется, когда элементы должны обрабатываться в порядке их поступления (печатные задания, нажатия клавиш, клиенты в магазине), так как она работает по принципу «первым пришел — первым ушел»; стек используется, когда последним добавленным элементом нужно управлять первым (отмена действия, переход назад по веб-страницам, реверсирование порядка, адреса возврата для вложенных вызовов), так как он работает по принципу «последним пришел — первым ушел»; связный список используется, когда элементы часто вставляются и удаляются в середине упорядоченной последовательности, потому что изменяются только указатели, а сдвиг элементов не требуется. Чтобы сравнить стек и очередь: обе являются линейными структурами элементов с определенным порядком, обе реализуются с помощью массива и указателей, и обе требуют проверки на переполнение перед добавлением и на пустоту перед удалением; у стека один указатель, и добавление/удаление происходит с одного конца, у очереди два указателя, и добавление происходит с одного конца, а удаление — с другого.
Стек
Стек работает в порядке LIFO (Last In, First Out — последним пришел, первым ушел). Операции: push (добавить сверху), pop (удалить сверху), peek (посмотреть на верхний элемент) и проверки на пустоту/переполнение. Применение: история отмены, адреса возврата вызовов функций, разложение выражений, обратный поиск.
Разобранный пример. Стопка символов содержит снизу вверх: 'P', 'N', 'Z', 'X', 'Y', 'W', при этом указатель вершины стека находится на позиции 'W' (ячейка памяти 202 диапазона 200–207). Выполняются операции POP, POP, PUSH 'A', PUSH 'B', POP. Что находится в стеке и куда указывает указатель?
Два удаления (pop) убирают ⟨⟩ 'W', затем ⟨⟩ 'Y'; два добавления (push) добавляют ⟨⟩ 'A', затем ⟨⟩ 'B' вместо них; последнее удаление убирает ⟨⟩ 'B'. Теперь стек содержит ⟨⟩ 'P', ⟨⟩ 'N', ⟨⟩ 'Z', ⟨⟩ 'X', ⟨⟩ 'A', указатель находится на ⟨⟩ 'A', позиции ⟨⟩ 203. Значение, которое находилось в стеке дольше всего — это нижний элемент, ⟨⟩ 'P'; возможно максимум пять дополнительных удалений перед опустошением стека, а попытка удаления из пустого стека вызывает ошибку, поэтому функция Pop() сначала проверяет пустоту. Функция Push(), возвращающая ⟨⟩ TRUE при успехе, сначала проверяет, находится ли указатель на вершине массива (переполнение), и возвращает ⟨⟩ FALSE, если да. Элементы массива не требуют предварительной инициализации, так как указатель сам говорит, какие элементы используются.
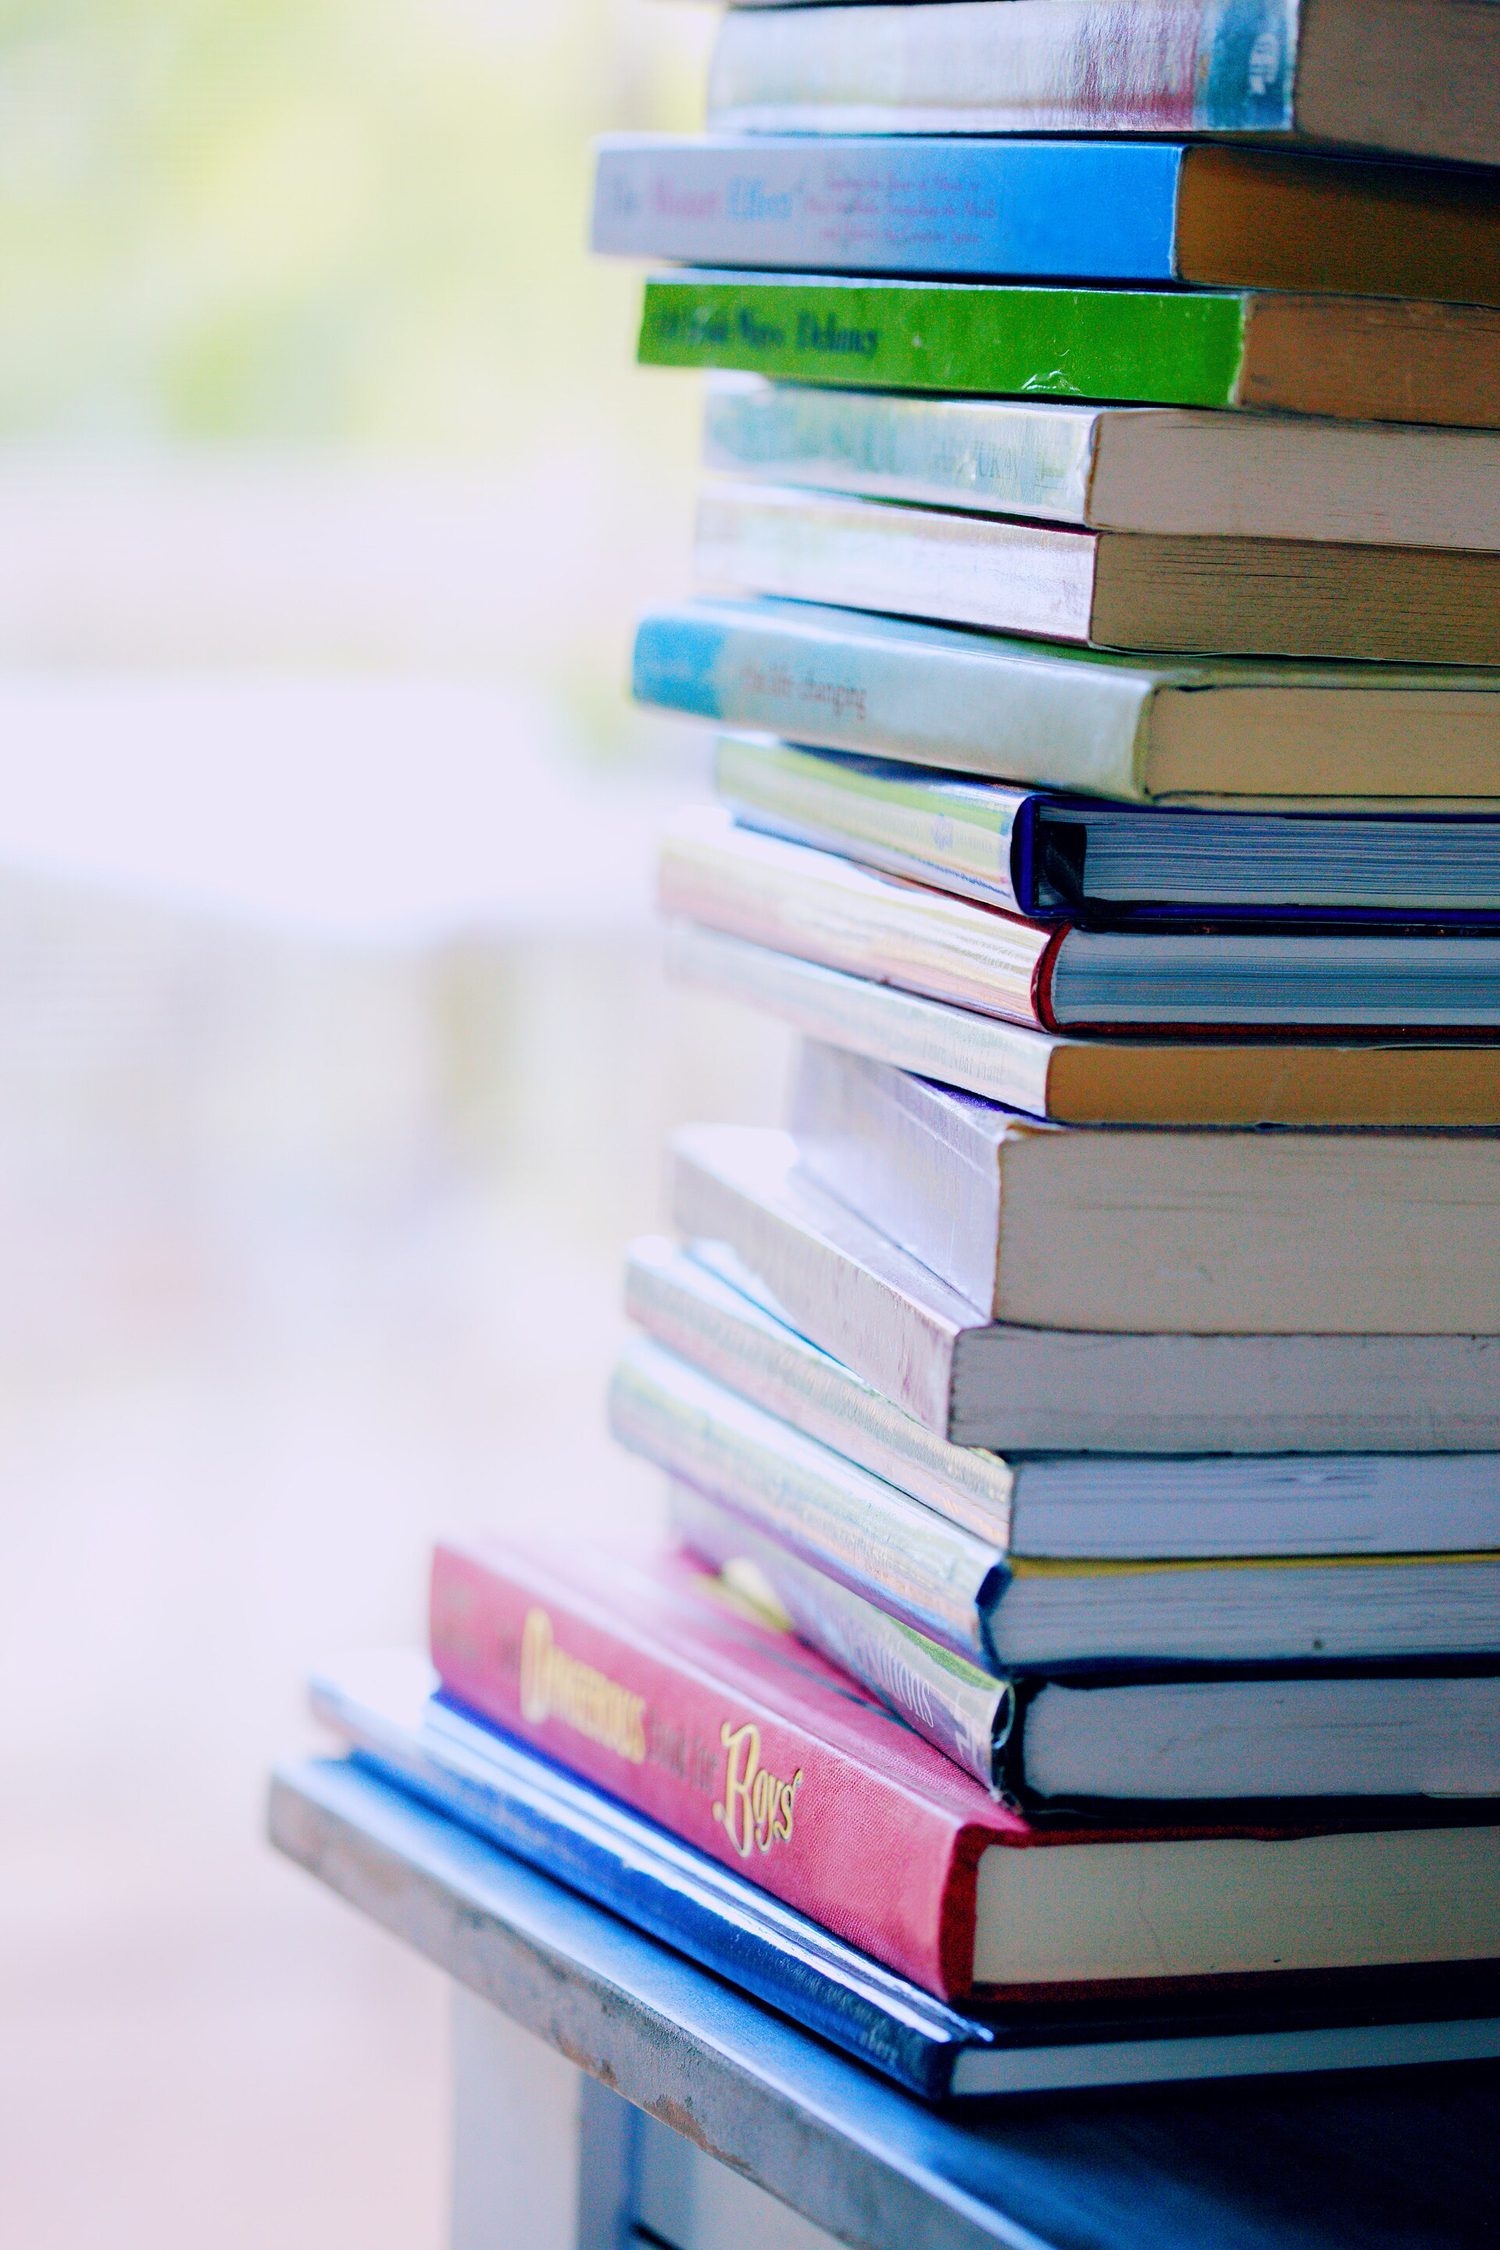 *Стопка книг — это видимый стек. Вы можете добавить или взять книгу только с верхней стороны, поэтому последняя положенная книга будет первой снятой — это в точности LIFO
Очередь
Очередь работает в порядке FIFO (First In, First Out — первым пришел, первым ушел). Операции: enqueue (добавить сзади), dequeue (удалить спереди) и проверки на пустоту/переполнение. Применение: спутинг печати, планирование, поиск в ширину, буферизация.
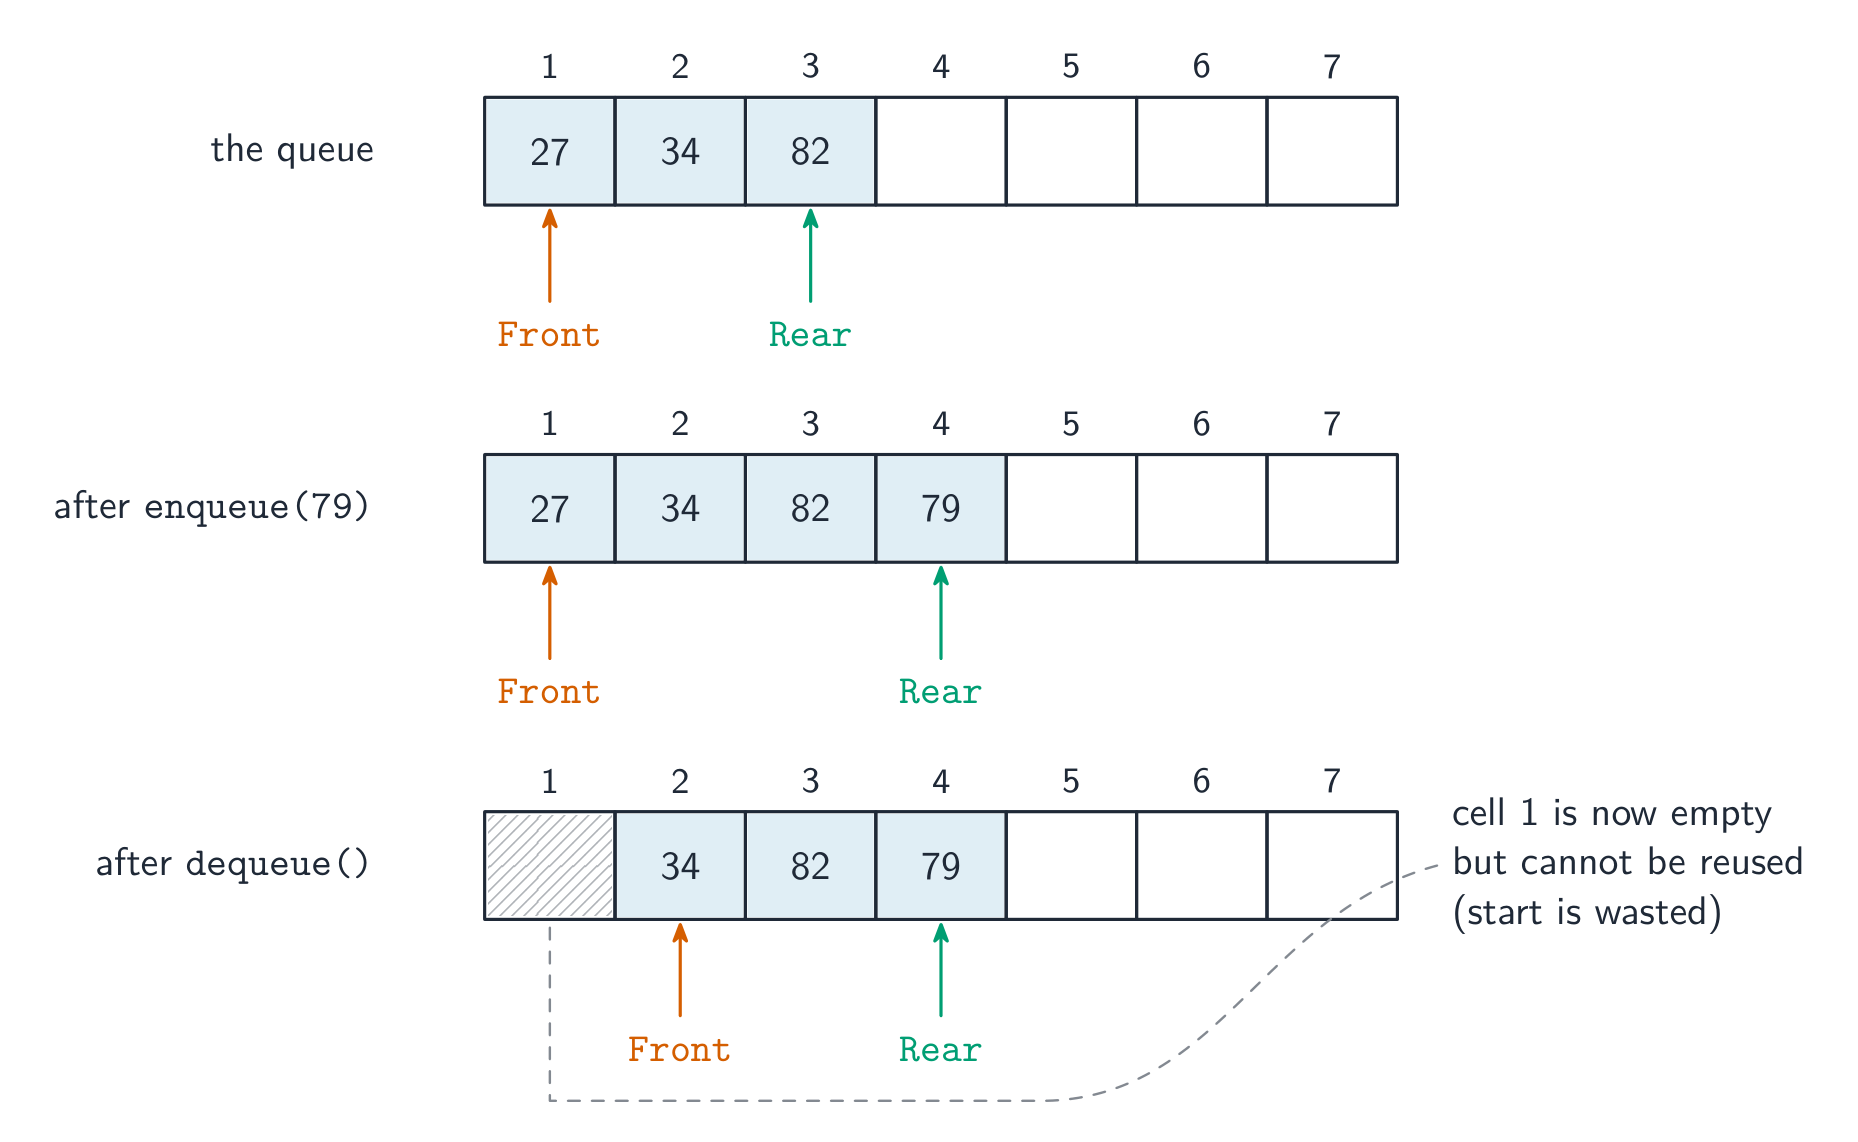 *Enqueue добавляет сзади; dequeue удаляет спереди
Чтобы описать добавление элемента: убедитесь, что очередь не переполнена; сохраните элемент по позиции, указанной указателем конца очереди; увеличьте указатель конца (и счетчик). Чтобы описать удаление: убедитесь, что очередь не пуста; прочитайте элемент по указателю начала; увеличьте указатель начала (и уменьшите счетчик). Укажите используемую конвенцию: если указатель конца обозначает следующее свободное место, равенство указателей front и end означает, что очередь пуста; если он обозначает последний элемент, равенство указателей означает наличие одного элемента. В линейной очереди указатель front может двигаться только вперед, поэтому ячейки позади него остаются неиспользованными; именно это исправляет круговая очередь ниже. Два свойства очереди, которые следует указать: элементы добавляются сзади и удаляются спереди, поэтому первый добавленный элемент является и первым удаленным.
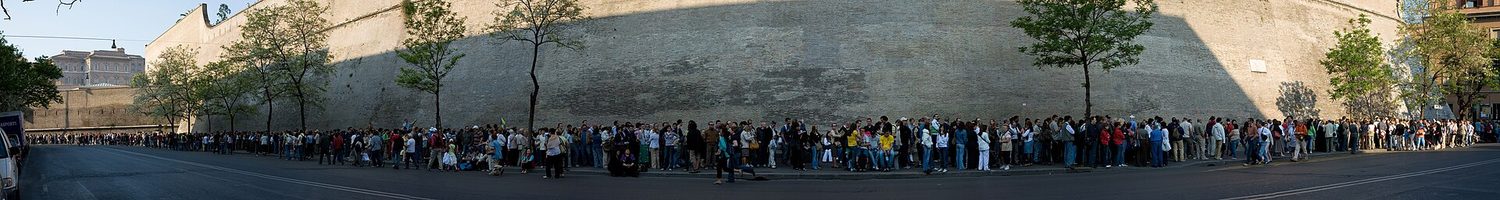 *Очередь людей — это видимая очередь. Вы становитесь в конец, а обслуживаются вы из начала, поэтому тот, кто ждал дольше всех, обслуживается первым — это в точности FIFO
Связный список
Связный список хранит данные в виде последовательности узлов. Каждый узел содержит значение и указатель на следующий узел; указатель head обозначает начало, а указатель последнего узла является сентинельным (например, NULL). Операции: вставка, удаление, поиск и обход (посещение каждого узла по порядку). Его преимущество перед массивом — дешевая вставка/удаление (достаточно изменить указатели); его недостаток — медленный произвольный доступ (необходимо следовать по указателям от head).

Добавление узла в правильном порядке (четыре балла): пройдитесь по списку от начала, следуя указателям, пока не будет найден узел перед нужной позицией (последний узел со значением меньше искомого); возьмите свободный узел и сохраните новое значение в нем; установите указатель нового узла на адрес, на который указывал предыдущий узел; установите указатель предыдущего узла на новый узел. Если новое значение должно стоять в начале, изменяется указатель начала. Удаление узла: найдите узел перед ним и установите указатель этого узла на адрес, на который указывал удаляемый узел, чтобы список обошел его; освобожденный узел возвращается в список свободных узлов. По сравнению с 1-мерным массивом, вставка или удаление в связном списке не требует перемещения остальных элементов, и список может расти до исчерпания памяти; платой за это является дополнительный указатель, хранящийся с каждым элементом, а также необходимость прохождения через $n$ элементов, следя за $n$ указателями, поскольку нет прямого доступа по индексу.
Исследовать
Связный список: узлы соединены указателями.
Каждый узел хранит значение и указатель на следующий узел. Вставка или удаление только перенаправляют указатели — элементы не сдвигаются, в отличие от массива.
Исследовать
Стеки и очереди
Push и pop. Стек — это last-in-first-out; очередь — first-in-first-out — две ключевые ADT.
Словарь
Тренировать
| English | Русский |
|---|---|
| stack/stæk/ | Стек |
| dimension/daɪˈmenʃn/ | Измерение |
| push/pʊʃ/ | поместить в стек |
| separator/ˈsepəreɪtə/ | разделитель |
| linked list/lɪŋkt lɪst/ | связный список |
| pointer/ˈpɔɪntə/ | указатель |
| queue/kjuː/ | очередь |
| LIFO/ˈlaɪfəʊ/ | LIFO (последним вошёл — первым вышел) |
| FIFO/ˈfaɪfəʊ/ | FIFO (первым вошёл — первым вышел) |
| pop/pɒp/ | извлечь из стека |
| enqueue/enˈkjuː/ | поместить в очередь |
| dequeue/diːˈkjuː/ | извлечь из очереди |
10.4
Реализация абстрактных типов данных с помощью массивов
Стек на основе массива
Хранить элементы в Stack[1:MaxSize] с целочисленным Top (0 при пустоте).
Push(x): еслиTop = MaxSizeстек переполнен (переполнение); иначеTop ← Top + 1;Stack[Top] ← x.Pop(): еслиTop = 0стек пуст (переполнение снизу); иначе вернитеStack[Top]иTop ← Top - 1.
Очередь на основе кольцевого массива
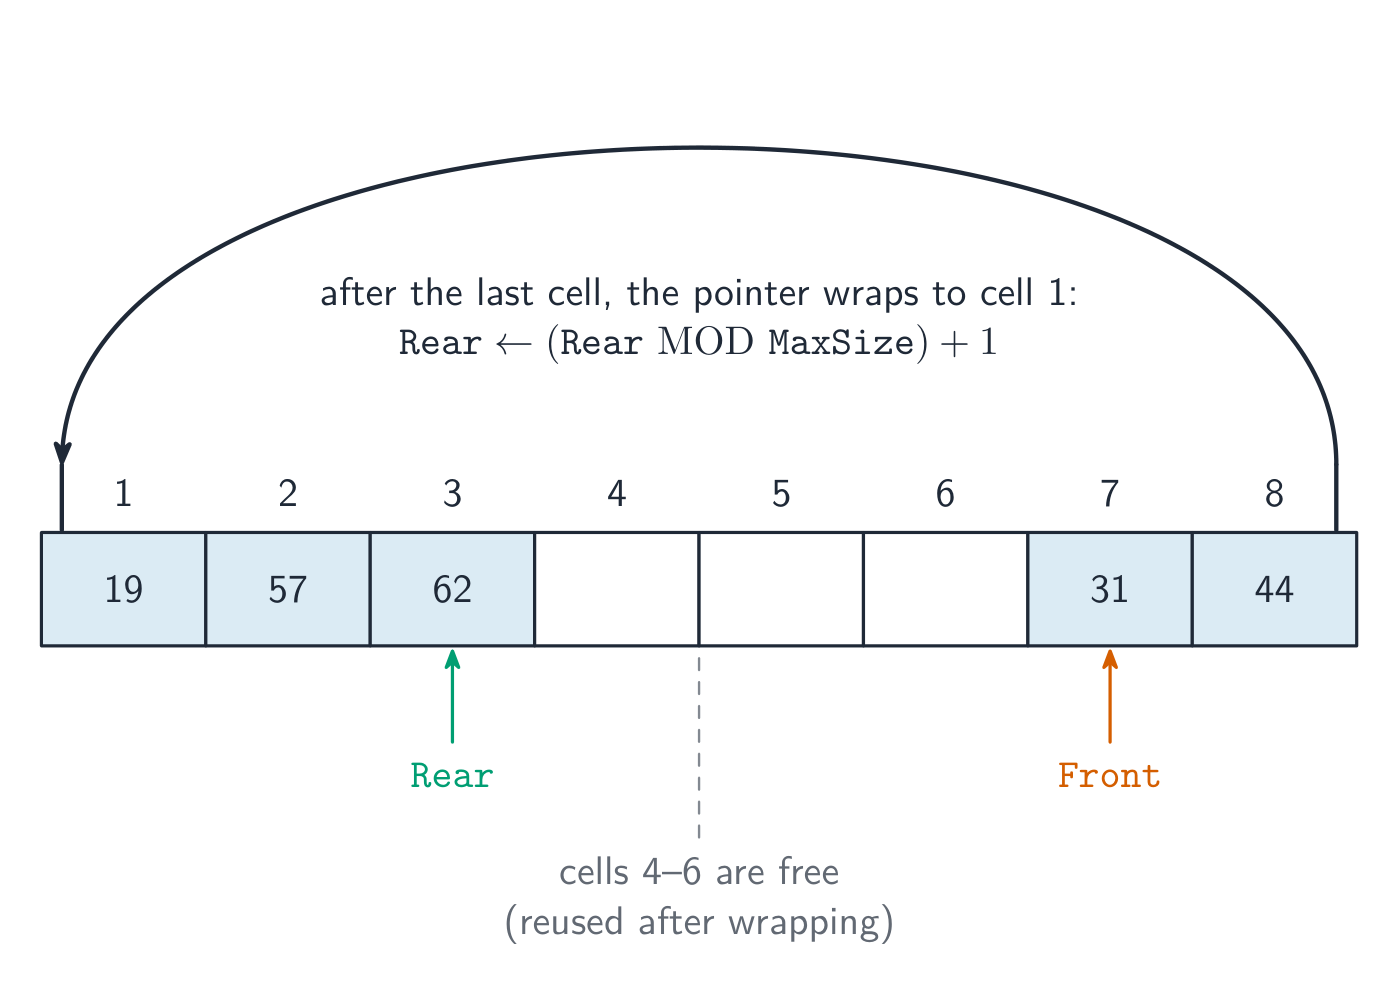
Простая очередь позволяет ⟨⟩ Front и ⟨⟩ Rear двигаться к концу, тратя начало. Исправление — циклический массив: когда указатель достигает ⟨⟩ MaxSize, он перенаправляется обратно к ⟨⟩ 1:
Enqueue(x): проверка на полноту; иначеRear ← (Rear MOD MaxSize) + 1;Queue[Rear] ← x.Dequeue(): проверка на пустоту; иначе вернитеQueue[Front]иFront ← (Front MOD MaxSize) + 1.
Отслеживайте отдельный счетчик, чтобы различать пустую и полную очереди.
Алгоритм для указателя конца словами: если счетчик равен размеру, сообщите, что очередь полна, и остановитесь; иначе увеличьте указатель конца на единицу; если он теперь вышел за пределы последнего индекса, установите его на первый индекс; сохраните элемент по этому адресу и увеличьте счетчик элементов. Декларации, которые должен перечислить ответ на «опишите декларацию и инициализацию» (5 баллов): массив с его размером и типом элемента; указатель начала и указатель конца, оба инициализированные первым индексом (или начало первым индексом, а конец — следующим свободным местом); и счетчик элементов, инициализированный $0$.
Например, при MaxSize = 6: если Rear = 5, то (5 MOD 6) + 1 = 6, поэтому следующий элемент помещается в ячейку 6; если Rear = 6, то (6 MOD 6) + 1 = 1, поэтому указатель возвращается в ячейку 1.
Связный список на основе массива
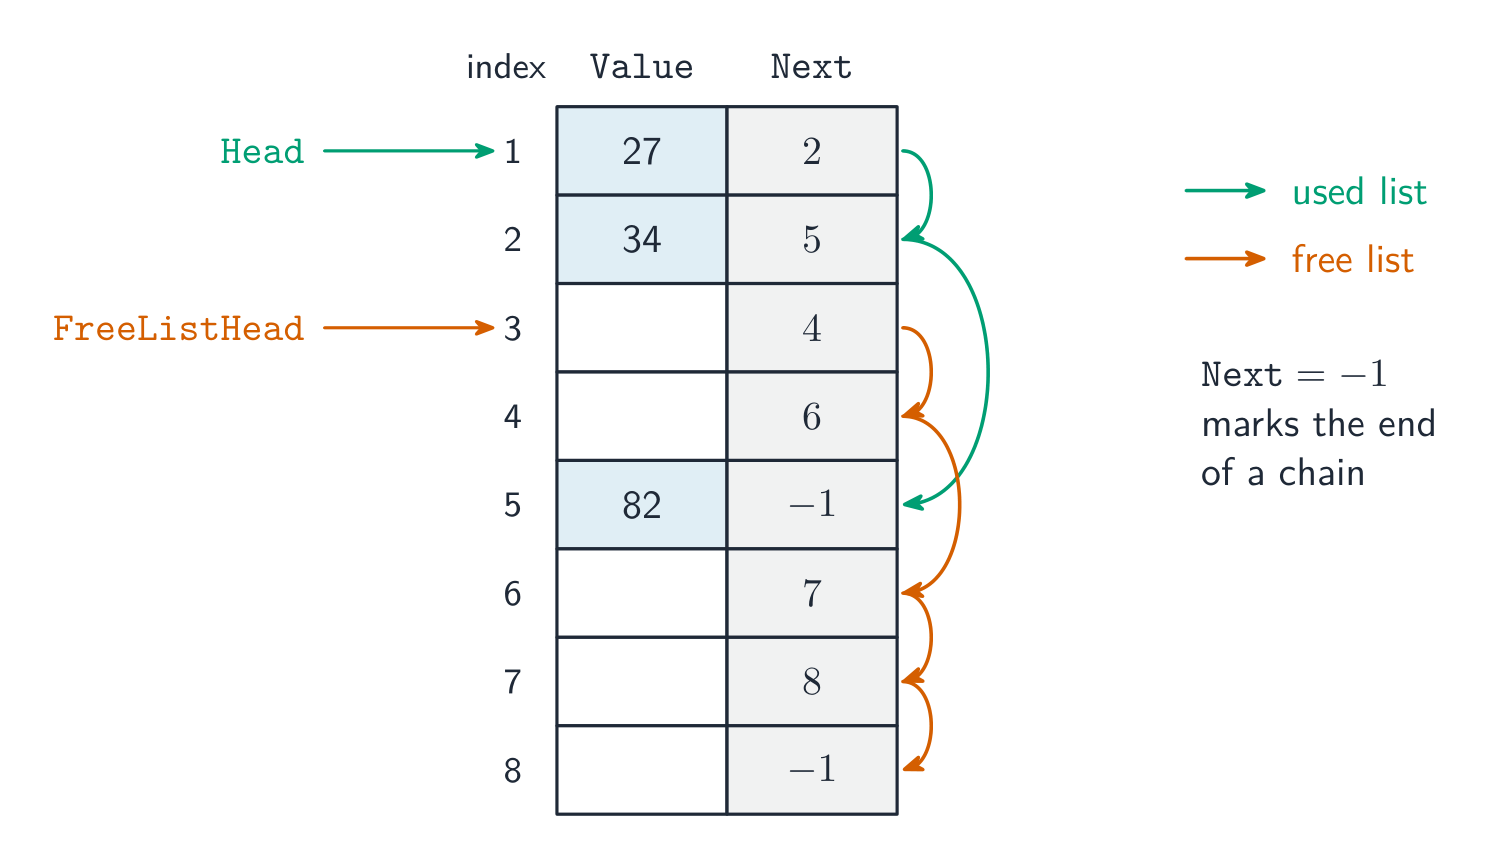
Используйте массив записей, каждая из которых имеет индекс Next:
TYPE TNode
    DECLARE Value : INTEGER
    DECLARE Next : INTEGER     // index of the next node, or -1 for end
ENDTYPE

DECLARE Nodes : ARRAY[1:MaxSize] OF TNode
DECLARE Head : INTEGER         // index of first node, -1 if empty
DECLARE FreeListHead : INTEGER // first available free node
Список свободных ячеек связывает неиспользуемые слоты так же, как список данных связывает используемые. Для вставки: возьмите слот из ⟨⟩ FreeListHead, установите значение нового узла и его указатель ⟨⟩ Next, обновите указатель предыдущего узла ⟨⟩ Next (или ⟨⟩ Head). Для удаления: разъедините узел и верните его слот в список свободных ячеек. Это дает гибкость связанного списка с статическим выделением памяти массива.
Разобранный пример. Связный список хранится в массиве данных ⟨⟩ Data и массиве указателей ⟨⟩ Pointer, где ⟨⟩ Start указывает на индекс ⟨⟩ 1. Список выглядит как ⟨⟩ 1 → ⟨⟩ 3 → ⟨⟩ 4 (индекс ⟨⟩ 1 хранит ⟨⟩ D40, индекс ⟨⟩ 3 хранит ⟨⟩ D32, индекс ⟨⟩ 4 хранит ⟨⟩ D11, чей указатель равен ⟨⟩ $\emptyset$); список свободных ячеек начинается с индекса ⟨⟩ 2 и продолжается как ⟨⟩ 2 → ⟨⟩ 5. Вставьте ⟨⟩ D6 между ⟨⟩ D32 и ⟨⟩ D11.
Возьмите первый свободный узел, индекс 2, и установите его указатель FreeStart равным значению ⟨5⟩; сохраните ⟨D6⟩ в ⟨Data[2]⟩; установите ⟨Pointer[2]⟩ равным значению ⟨Pointer[3]⟩, которое составляет ⟨4⟩; задайте ⟨Pointer[3]⟩ значение ⟨2⟩. Список выглядит так: ⟨1⟩ → ⟨3⟩ → ⟨2⟩ → ⟨4⟩, а список свободных узлов: ⟨5⟩ → ⟨$\emptyset$⟩. Ответ на вопрос «как можно реализовать связный список» состоит именно из этих частей: массив (или массив записей) для данных, параллельный массив для указателей, хранящих индексы, указатель начала, указатель списка свободных узлов и значение NULL, например, ⟨$-1$⟩, для конца.
Разобранный пример. Циклическая очередь хранится в массиве размера ⟨⟩ 5 (индексы от ⟨⟩ 0 до ⟨⟩ 4), где хранятся ⟨⟩ Front = 3, ⟨⟩ Rear = 3 и один элемент. Добавляются два элемента, затем удаляются два. Где находятся указатели и зачем вообще использовать циклическую очередь? Каждый шаг использует операцию (pointer + 1) MOD size, поэтому указатели перезагружаются. Два добавления сдвигают ⟨⟩ Rear: сначала в ⟨⟩ $3 \rightarrow 4$, затем в ⟨⟩ $4 \rightarrow 0$ (потому что ⟨⟩ $(4+1) \bmod 5 = 0$), поэтому хранится ⟨⟩ Rear = 0 и три элемента. Два удаления сдвигают ⟨⟩ Front тем же образом: сначала в ⟨⟩ $3 \rightarrow 4$, затем в ⟨⟩ $4 \rightarrow 0$, оставляя ⟨⟩ Front = 0 и один элемент. Перезагрузка — это вся суть: в очереди на линейном массиве указатели движутся к концу, а освобожденное место спереди теряется даже тогда, когда очередь пуста. Помните, что очередь удаляет с Front (передней части) и добавляет с Rear (задней части) — у стека для обоих действий используется один указатель.
Исследовать
Реализация ADT с помощью массивов.
FIFO.
Очередь работает по принципу FIFO — enqueue сзади, dequeue с фронта.
Словарь
Тренировать
| English | Русский |
|---|---|
| node/nəʊd/ | узел |
| traverse/trəˈvɜːs/ | обход |
| free list/friː lɪst/ | список свободных ячеек |
| overflow/ˌəʊvəˈfləʊ/ | переполнение |
| underflow/ˌʌndəˈfləʊ/ | переполнение снизу |
| circular array/ˈsɜːkjʊlə əˈreɪ/ | циклический массив |
10.4
Определения, принимаемые экзаменатором
Вопросы с определениями оцениваются по фиксированной формулировке. Выучите их точно.
| Термин | Определение |
|---|---|
| record (запись) | структура данных, содержащая набор элементов данных (полей) различных типов данных под одним идентификатором |
| array (массив) | структура данных, содержащая фиксированное количество элементов одного типа данных под одним идентификатором, каждый из которых доступен по индексу |
| index (индекс) | число, идентифицирующее один элемент массива |
| upper bound, lower bound (верхняя граница, нижняя граница) | наибольшее и наименьшее допустимые индексы массива |
| text file (текстовый файл) | файл, хранящий данные в виде строк символов, которые программа читает и записывает по одной строке за раз |
| abstract data type (абстрактный тип данных) | совокупность данных вместе с набором операций над этими данными |
| stack (стек) | список, в котором элементы добавляются и удаляются с одного конца, вершины, поэтому последний добавленный элемент является первым удаленным (LIFO) |
| queue (очередь) | список, в котором элементы добавляются сзади и удаляются спереди, поэтому первый добавленный элемент является первым удаленным (FIFO) |
| связный список | структура, в которой каждый узел содержит элемент данных и указатель на следующий узел, а также начальный указатель на первый узел |
| указатель | переменная, хранящая адрес (или индекс) узла или позиции в структуре |
| линейный поиск | последовательная проверка каждого элемента от первого до тех пор, пока целевой элемент не будет найден или не достигнут конец структуры |
| сортировка пузырьком | многократное прохождение по массиву с сравнением соседних пар и обменом элементов, нарушающих порядок, до момента, когда одно из прохождений не даст ни одного обмена |
Словарь
Тренировать
| English | Русский |
|---|---|
| data type/ˈdeɪtə taɪp/ | data type |
| lower bound/ˈləʊə baʊnd/ | Нижняя граница |
| upper bound/ˈʌpə baʊnd/ | Верхняя граница |
| linear search/ˈlɪnɪə sɜːtʃ/ | линейный поиск |
| text file/tekst faɪl/ | текстовый файл |
| end of file/end ɒv faɪl/ | конец файла |
| Abstract Data Type/ˈæbstrækt ˈdeɪtə taɪp/ | Абстрактный тип данных |
10.4
Советы для экзамена
- Выбрать правильную структуру данных и обосновать выбор (запись для смешанных полей, 2-мерный массив для сетки).
- Знать, как реализовать стек, очередь и связный список с использованием массива и указателей (верх; начало/конец; следующий).
- Различать абстрактный тип данных (ADT) (его поведение) и его реализацию (массив плюс указатели).
Распространенные ошибки
- Объявление записи без
ENDTYPEили полей без типов. Каждая строка поля являетсяDECLAREс указанием типа. - Чтение за пределами конца файла или запись с
WRITE, когда файл должен сохранить свое содержимое. ПроверяйтеEOFперед каждым чтением; используйтеAPPENDдля добавления. - Запись числа в текстовый файл без преобразования. Файл хранит строки:
NUM_TO_STRна вывод,STR_TO_NUMобратно. - Забывание проверок.
Pushи enqueue проверяют сначала переполнение;Popи dequeue проверяют сначала пустоту, и ответ об этом говорит. - Потеря остальной части списка при вставке узла. Установите указатель нового узла на старый следующий узел до изменения указателя предыдущего узла.
- Линейный поиск, который никогда не сообщает "не найдено". Инициализируйте позицию $-1$ и проверьте её после цикла.
Интерактивные уроки по этой теме
Пройдите его шаг за шагом с упражнениями мгновенной проверки.