RISC, CISC and pipelining · RISC, CISC e pipeline
| English | Português |
|---|---|
| CISC/sɪsk/ | CISC |
| RISC/rɪsk/ | RISC |
| pipelining/ˈpaɪplaɪnɪŋ/ | pipelining |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Taxonomia de Flynn |
| register/ˈredʒɪstə/ | registrador |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | hazard |
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | massivamente paralelo |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | supercomputadores |
The phone in your pocket does not run Intel
- For thirty years the fastest processors were the most complicated ones: add instructions, and each one does more work. Intel built an empire on it.
- Then a small British company put a deliberately simple processor in a phone. Fewer instructions, all the same length, almost none touching memory. It could not do as much per instruction, and it won anyway.
- It won because simple, uniform instructions can be overlapped, and overlapping is worth more than complexity.
- This lesson is CISC 复杂指令集 and RISC 精简指令集, pipelining 流水线, the four architectures of Flynn's taxonomy, and where a processor's heat and speed limits lead.
O telefone no seu bolso não roda Intel
- Por trinta anos, os processadores mais rápidos eram os mais complicados: adicione instruções, e cada uma faz mais trabalho. A Intel construiu um império nisso.
- Então, uma pequena empresa britânica colocou um processador deliberadamente simples em um telefone. Menos instruções, todas do mesmo comprimento, quase nenhuma tocando memória. Não podia fazer tanto por instrução, e venceu de qualquer forma.
- Venceu porque instruções simples e uniformes podem ser sobrepostas, e sobreposição vale mais que complexidade.
- Esta lição trata de CISC Complex Instruction Set Computer e RISC Reduced Instruction Set Computer, pipelining流水线 (流水線), as quatro arquiteturas da taxonomia de Flynn, e onde os limites de calor e velocidade de um processador levam.
CISC and RISC
- A CISC, Complex Instruction Set Computer, has many, often complex instructions: one may perform several memory accesses and operations. They are of variable length, so decoding is intricate. It does more per instruction, in hardware. Example: Intel x86.
- A RISC, Reduced Instruction Set Computer, has a small set of simple instructions, each doing one basic operation, all of fixed length and quick to decode. Only load and store touch memory; everything else is register 寄存器 to register. Example: ARM.
- RISC programs are longer, but each instruction is quick and predictable, which is exactly what a pipeline needs.
More per instruction, or faster and more predictable per instruction
CISC e RISC
- Uma CISC, Computador com Conjunto de Instruções Complexo, tem muitas, muitas vezes complexas instruções: uma pode realizar vários acessos à memória e operações. Elas têm comprimento variável, então a decodificação é intrincada. Faz mais por instrução, no hardware. Exemplo: Intel x86.
- Uma RISC, Computador com Conjunto de Instruções Reduzido, tem um pequeno conjunto de instruções simples, cada uma fazendo uma operação básica, todas de comprimento fixo e rápida decodificação. Apenas load e store tocam memória; tudo o resto é register 寄存器 (寄存器) a register. Exemplo: ARM.
- Programas RISC são maiores, mas cada instrução é rápida e previsível, o que é exatamente o que um pipeline precisa.
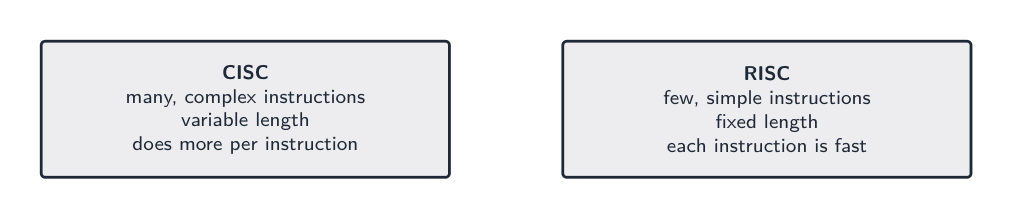
Mais por instrução, ou mais rápido e previsível por instrução
A RISC processor is characterised by: · Um processador RISC é caracterizado por:
RISC keeps instructions few, simple and fixed-length (usually 1 cycle); CISC has many complex variable-length ones. · RISC mantém instruções poucas, simples e de comprimento fixo (geralmente 1 ciclo); CISC tem muitas complexas de comprimento variável.
The differences the exam wants
| Feature | CISC | RISC |
|---|---|---|
| instruction set | many, complex | few, simple |
| instruction length | variable | fixed |
| memory access | many instructions may access memory | only load and store |
| registers | fewer | many |
| cycles per instruction | varies | usually one |
| pipelining | harder | natural |
- Modern Intel chips translate their CISC instructions into simpler RISC-like micro-operations internally, which is the clearest evidence of which design won the argument.
As diferenças que o exame quer
| Característica | CISC | RISC |
|---|---|---|
| conjunto de instruções | muitos, complexos | poucos, simples |
| comprimento da instrução | variável | fixo |
| acesso à memória | muitas instruções podem acessar memória | apenas load e store |
| registradores | fewer | many |
| ciclos por instrução | varia | geralmente um |
| pipeline | mais difícil | natural |
- Chips modernos da Intel traduzem suas instruções CISC em micro-operações RISC-like mais simples internamente, que é a evidência mais clara de qual projeto venceu a disputa.
Match each term to its description. · Combine cada termo com sua descrição.
RISC = simple + fixed-length + load/store; CISC = complex + variable-length; pipelining overlaps stages for speed. · RISC = simples + comprimento fixo + carregar/armazenar; CISC = complexo + comprimento variável; pipeline sobrepõe etapas para velocidade.
In a RISC processor, the only instructions that access memory are load and ____. · Em um processador RISC, as únicas instruções que acessam a memória são carregar e ____.
Everything else is register to register. That restriction is what makes instructions fixed-length, uniform in timing and easy to pipeline. · Tudo o resto é registro para registro. Essa restrição é o que torna as instruções de comprimento fixo, uniformes no tempo e fáceis de pipeline.
Pipelining
- A pipeline processes instructions in overlapping stages, like an assembly line: fetch, decode, execute in the ALU 算术逻辑单元, memory access, write back.
- Each stage works on a different instruction at the same time, so once the pipeline is full, one instruction completes per cycle.
- It does not make any single instruction faster. It increases throughput: more instructions finish per second.
- RISC's fixed-length, simple instructions make every stage take the same time, which is why RISC pipelines cleanly and CISC does not.
Six instructions in flight, one finishing each cycle
Pipelining
- Um pipeline processa instruções em etapas sobrepostas, como uma linha de montagem: busca, decodificação, execução na ALU 算术逻辑单元 (算术逻辑单元), acesso à memória, gravação.
- Cada estágio trabalha em uma instrução diferente ao mesmo tempo, então assim que o pipeline estiver cheio, uma instrução é concluída por ciclo.
- Não torna nenhuma única instrução mais rápida. Aumenta a taxa de transferência: mais instruções terminam por segundo.
- As instruções RISC de comprimento fixo e simples fazem com que cada etapa leve o mesmo tempo, é por isso que pipelines RISC funcionam limpa e CISC não.
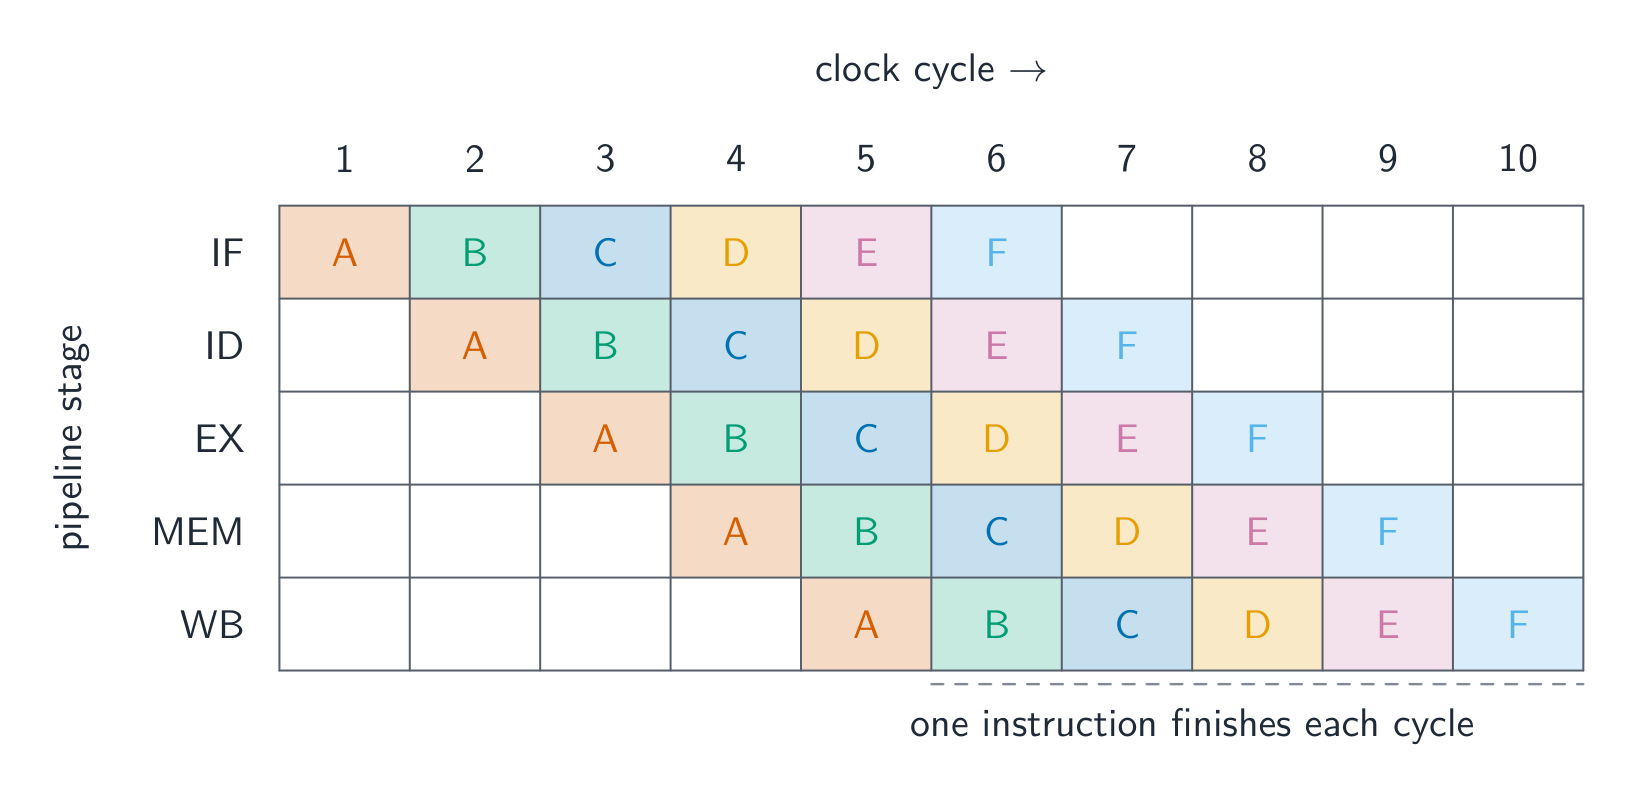
Seis instruções em voo, uma terminando a cada ciclo
How pipelining fills up · Como o pipeline enche
Step through the clock cycles. Once the pipeline is full, a new instruction finishes every cycle — even though each one still takes several stages — because the stages of different instructions overlap. · Passo a passo pelos ciclos de relógio. Uma vez que o pipeline está cheio, uma nova instrução termina a cada ciclo — mesmo que cada uma ainda leve várias etapas — porque as etapas de instruções diferentes se sobrepõem.
When a pipeline is full, it completes about: · Quando um pipeline está cheio, ele completa cerca de:
Overlapping the stages means a new instruction finishes each cycle once the pipeline is full. · Sobrepor as etapas significa que uma nova instrução termina a cada ciclo uma vez que o pipeline está cheio.
Pipelining speeds up a processor by: · Pipeline acelera um processador ao:
Stages of different instructions run at the same time. · As etapas de instruções diferentes rodam ao mesmo tempo.
Worked example: why pipelining is faster
- A five-stage pipeline runs at one cycle per stage. Explain why it is faster than executing instructions one after another.
- Without a pipeline, each instruction occupies the processor for all five stages, so one finishes every five cycles.
- With a pipeline, the fetch unit starts the next instruction while the current one is still decoding, so five instructions are in progress at once and, once it is full, one completes every cycle.
- No individual instruction is executed faster; the throughput rises about fivefold. Say that explicitly: it is the mark most often missed.
Exemplo resolvido: por que pipelining é mais rápido
- Um pipeline de cinco estágios executa a um ciclo por estágio. Explique por que é mais rápido do que executar instruções uma após a outra.
- Sem pipeline, cada instrução ocupa o processador por todos os cinco estágios, então uma termina a cada cinco ciclos.
- Com pipeline, a unidade de busca inicia a próxima instrução enquanto a atual ainda está sendo decodificada, então cinco instruções estão em andamento ao mesmo tempo e, assim que cheio, uma completa a cada ciclo.
- Nenhuma instrução individual é executada mais rápido; a taxa de transferência aumenta cerca de cinco vezes. Diga isso explicitamente: é a marca mais frequentemente perdida.
What does pipelining actually improve? · O que o pipeline realmente melhora?
Stages overlap, so five instructions are in progress at once and one completes per cycle. No individual instruction is executed any faster. · As etapas se sobrepõem, então cinco instruções estão em progresso ao mesmo tempo e uma termina por ciclo. Nenhuma instrução individual é executada mais rápido.
Hazards
- A hazard 冒险 stalls the pipeline. A data hazard occurs when an instruction needs a result the previous one has not yet produced, so it must wait.
- A control hazard occurs at a branch: until the branch is resolved, the processor does not know which instruction to fetch next.
- Both waste cycles, which is why processors predict branches and forward results between stages.
Hazards (Atrasos/Perigos)
- Um hazard 冒险 (Atraso) estanca o pipeline. Um data hazard ocorre quando uma instrução precisa de um resultado que a anterior ainda não produziu, então deve esperar.
- Um control hazard ocorre em um branch: até que o branch seja resolvido, o processador não sabe qual instrução buscar next.
- Ambos desperdiçam ciclos, é por isso que processadores preveem branches e encaminham resultados entre estágios.
A data hazard stalls the pipeline when an instruction needs a result that is not ready yet; a control hazard comes from a branch changing which instruction runs next. · Um perigo de dados estagna o pipeline quando uma instrução precisa de um resultado que ainda não está pronto; um perigo de controle vem de uma ramificação que muda qual instrução roda a seguir.
Hazards force the pipeline to stall (or flush), which is why they reduce the ideal one-per-cycle throughput. · Perigos forçam o pipeline a estagnar (ou limpar), que é por que eles reduzem a taxa ideal de uma instrução por ciclo.
Match each pipeline hazard to what causes it. · Combine cada perigo de pipeline com o que o causa.
Both stall the pipeline and waste cycles, which is why processors forward results between stages and predict branches. · Ambos estagam o pipeline e desperçam ciclos, que é por que processadores encaminham resultados entre etapas e preveem ramificações.
Flynn's taxonomy
- Flynn's taxonomy 弗林分类 sorts computers by how many instruction streams and data streams they have.
- SISD: one instruction stream, one data stream, a traditional single core.
- SIMD 单指令多数据: one instruction operates on many data items at once. This is a GPU or a CPU's vector unit, and it suits images, video and scientific arrays.
- MISD: several operations on the same data; rare and mostly theoretical. MIMD 多指令多数据: many processors run different instructions on different data, which is a multi-core CPU or a cluster, and it is the most general.
One instruction, many data items
Taxonomia de Flynn
- Flynn's taxonomy 弗林分类 (Taxonomia de Flynn) classifica computadores por quantos streams de instrução e streams de dados eles têm.
- SISD: um stream de instrução, um stream de dados, um núcleo único tradicional.
- SIMD 单指令多数据 (Uma instrução, muitos dados): uma instrução opera em muitos itens de dados ao mesmo tempo. Este é uma GPU ou a unidade vetorial de uma CPU, e se adapta a imagens, vídeo e arrays científicos.
- MISD: várias operações nos mesmos dados; raro e principalmente teórico. MIMD 多指令多数据 (Muitas instruções, muitos dados): muitos processadores executam instruções diferentes em dados diferentes, que é uma CPU multi-core ou cluster, e é o mais geral.
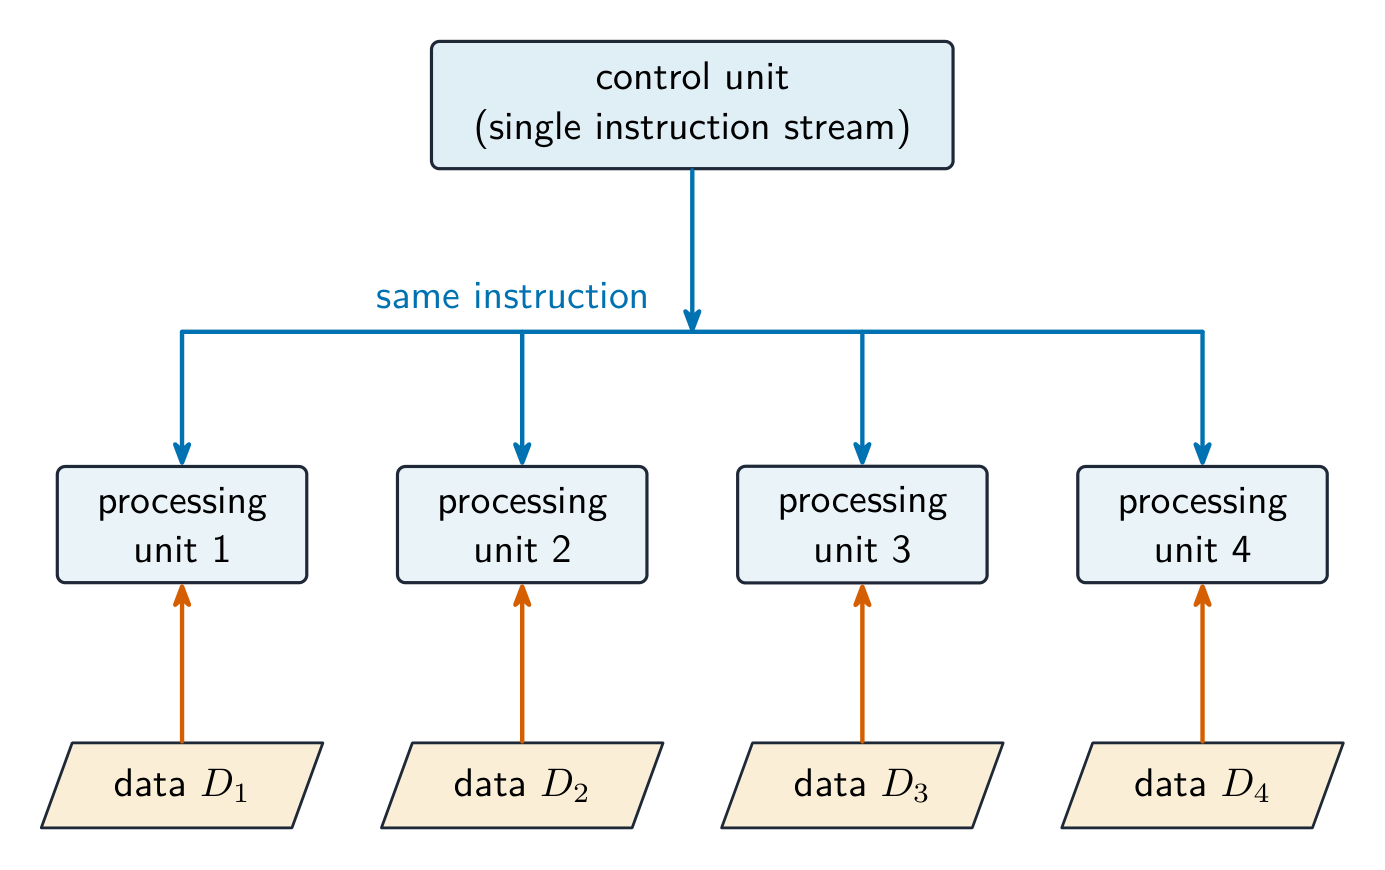
Uma instrução, muitos itens de dados
Which describe SIMD? Select all · todos that apply. · Quais descrevem SIMD? Selecione todos os que se aplicam.
Different programs on different data is MIMD, the multi-core case. SIMD is one instruction stream over many data streams. · Programas diferentes em dados diferentes é MIMD, o caso multi-core. SIMD é um fluxo de instruções sobre muitos fluxos de dados.
Massively parallel computers
- A massively parallel 大规模并行 system uses thousands of processors connected by a fast network, each with its own memory, exchanging data by messages rather than sharing memory.
- It is MIMD, and it needs specially written software, because the programmer must divide the problem and manage the communication.
- This is what the largest supercomputers 超级计算机 are: climate simulation, machine-learning training and astrophysics all run this way.
Computadores massivamente paralelos
- Um sistema massivamente parallel 大规模并行 (Massivamente Paralelo) usa milhares de processadores conectados por uma rede rápida, cada um com sua própria memória, trocando dados por mensagens em vez de compartilhar memória.
- É MIMD, e precisa de software escrito especialmente, porque o programador deve dividir o problema e gerenciar a comunicação.
- É isso que os maiores supercomputers 超级计算机 (Supercomputadores) são: simulação climática, treinamento de machine-learning e astrofísica todos rodam assim.
A massively parallel computer's processors share one block of memory. · Os processadores de um computador massivamente paralelo compartilham um único bloco de memória.
Each processor has its own memory, and they exchange data by messages over a fast network. That distributed memory is what the term means. · Cada processador tem sua própria memória, e eles trocam dados por mensagens através de uma rede rápida. É essa memória distribuída que o termo significa.
Worked example: place the machine
- A graphics card applies the same brightness adjustment to two million pixels. SIMD: one instruction, many data items, which is precisely what the GPU's thousands of small cores are built for.
- A four-core laptop runs a browser, a compiler and a music player at once. MIMD: different instructions on different data, one stream per core.
- A weather centre divides the atmosphere into a grid across ten thousand processors, each with its own memory, passing boundary values as messages. Massively parallel, which is a form of MIMD.
- Name the category, then justify with the number of instruction and data streams.
Exemplo resolvido: posicionar a máquina
- Uma placa de vídeo aplica o mesmo ajuste de brilho a dois milhões de pixels. SIMD: uma instrução, muitos itens de dados, que é exatamente para o que milhares de núcleos pequenos da GPU são construídos.
- Um laptop de quatro núcleos roda um navegador, um compilador e um player de música ao mesmo tempo. MIMD: instruções diferentes em dados diferentes, um stream por núcleo.
- Um centro meteorológico divide a atmosfera em uma grade através de dez mil processadores, cada um com sua própria memória, passando valores de fronteira como mensagens. Massivamente parallel, que é uma forma de MIMD.
- Nomeie a categoria, depois justifique com o número de streams de instrução e dados.
Marks that slip away
- Pipelining raises throughput; it does not shorten any single instruction. Say so.
- In RISC, only load and store touch memory. That one fact explains the fixed length, the many registers and the clean pipeline.
- SIMD is one instruction on many data; MIMD is many instructions on many data. Count the streams before answering.
- Massively parallel means thousands of processors with distributed memory and message passing, not just "a fast computer".
Marcas que escapam
- Pipelining eleva a taxa de transferência; não encurta nenhuma instrução individual. Diga isso.
- Em RISC, apenas load e store tocam memória. Esse único fato explica o comprimento fixo, os muitos registradores e o pipeline limpo.
- SIMD é uma instrução em muitos dados; MIMD é muitas instruções em muitos dados. Conte os streams antes de responder.
- Massivamente parallel significa milhares de processadores com memória distribuída e passagem de mensagens, não apenas "um computador rápido".
You've got it
- CISC: many complex variable-length instructions, more per instruction · RISC: few simple fixed-length instructions, load and store only, many registers, one cycle each
- a pipeline overlaps fetch, decode, execute, memory and write-back, so one instruction completes per cycle once full: higher throughput, not faster instructions; data and control hazards stall it
- Flynn: SISD, SIMD (a GPU), MISD, MIMD (multi-core)
- massively parallel: thousands of processors, distributed memory, message passing, MIMD, used by supercomputers
Entendeu?
- CISC: muitas instruções complexas de comprimento variável, mais por instrução · RISC: poucas instruções simples de comprimento fixo, apenas load e store, muitos registradores, um ciclo cada
- Um pipeline sobrepõe busca, decodificação, execução, memória e write-back, então uma instrução completa por ciclo assim que cheio: maior taxa de transferência, não instruções mais rápidas; data e control hazards estancam-no
- Flynn: SISD, SIMD (uma GPU), MISD, MIMD (multi-core)
- massivamente parallel: milhares de processadores, memória distribuída, passagem de mensagens, MIMD, usado por supercomputadores