| Kandidat harus mampu: | Catatan dan panduan |
|---|---|
| Tunjukkan pemahaman tentang metode linear search dan binary search | Tulis algoritma untuk mengimplementasikan linear search Tulis algoritma untuk mengimplementasikan binary search Kondisi yang diperlukan untuk penggunaan binary search Bagaimana kinerja binary search bervariasi sesuai dengan jumlah item data |
| Tunjukkan pemahaman tentang dan gunakan metode insertion sort dan bubble sort | Tulis algoritma untuk mengimplementasikan insertion sort Tulis algoritma untuk mengimplementasikan bubble sort Kinerja routine pengurutan mungkin bergantung pada urutan awal data dan jumlah item data |
| Tunjukkan pemahaman tentang dan gunakan Abstract Data Types (ADT) | Tulis algoritma untuk menemukan item di setiap berikut: linked list, binary tree Tulis algoritma untuk menyisipkan item ke dalam setiap berikut: stack, queue, linked list, binary tree Tulis algoritma untuk menghapus item dari setiap berikut: stack, queue, linked list Tunjukkan pemahaman bahwa graph adalah contoh dari ADT. Jelaskan fitur kunci dari graph dan justifikasi penggunaannya untuk situasi tertentu. Kandidat tidak akan diminta untuk menulis kode untuk struktur graph |
| Tunjukkan bagaimana ADTs dapat diimplementasikan dari ADT lain | Jelaskan ADTs berikut dan tunjukkan bagaimana mereka dapat diimplementasikan dari tipe bawaan atau ADTs yang sesuai: stack, queue, linked list, dictionary, binary tree |
| Tunjukkan pemahaman bahwa algoritma berbeda yang melakukan tugas yang sama dapat dibandingkan menggunakan kriteria (misalnya waktu yang dibutuhkan untuk menyelesaikan tugas dan memori yang digunakan) | Termasuk penggunaan Big O notation untuk menentukan kompleksitas waktu dan ruang |
Berpikir komputasional dan pemecahan masalah
Ilmu Komputer A-Level · Topik 19
 15:33
Pencarian & Pengurutan
Buku telepon dengan satu juta nama. Jika Anda memeriksanya satu per satu, Anda mungkin melakukan satu juta perbandingan. Namun Anda sudah tahu triknya: buka di tengah…
Narasi bahasa Inggris · Subtitle bahasa Inggris + 中文 disematkan langsung
19.1
Algoritma Pencarian
Silabus
Sumber: Silabus Cambridge International
Sebuah pencarian menemukan nilai target dalam koleksi (sering berupa array) dan mengembalikan posisinya, atau "tidak ditemukan".
Pencarian linear
Sebuah pencarian linear berjalan dari awal hingga akhir, membandingkan setiap elemen dengan target:
FOR i ← 1 TO n
    IF A[i] = target THEN
        RETURN i
    ENDIF
NEXT i
RETURN -1   // not found
Tidak perlu persiapan, sehingga bekerja pada daftar apa pun. Kasus terburuk O($n$) (target di akhir atau tidak ada); kasus terbaik 1 perbandingan. Gunakan pada data tidak diurutkan atau daftar kecil. (-1 yang dikembalikan adalah nilai penanda — posisi mustahil yang berarti "tidak ditemukan"; pemanggil menguji IF result = -1.)
Versi ujian. Kertas 3 meminta Anda melengkapi pencarian linear yang ditulis dengan penanda dan loop WHILE, dan Kertas 4 untuk menulis fungsi yang mengembalikan indeks atau jumlah. Keduanya terlihat seperti ini:
FUNCTION LinearSearch(Data : ARRAY OF INTEGER, Target : INTEGER) RETURNS INTEGER
    DECLARE Index, Count : INTEGER
    Count ← 0
    FOR Index ← 1 TO 100
        IF Data[Index] = Target THEN
            Count ← Count + 1
        ENDIF
    NEXT Index
    RETURN Count          // how many times Target occurs; 0 means not found
ENDFUNCTION
Untuk berhenti pada kecocokan pertama, gunakan loop WHILE Index <= 100 AND NOT Found yang menetapkan Found ← TRUE dan mengingat indeks. Nilai penuh diberikan untuk loop atas setiap elemen, perbandingan, dan apa yang dikembalikan ketika nilai tidak ada.

Pencarian biner
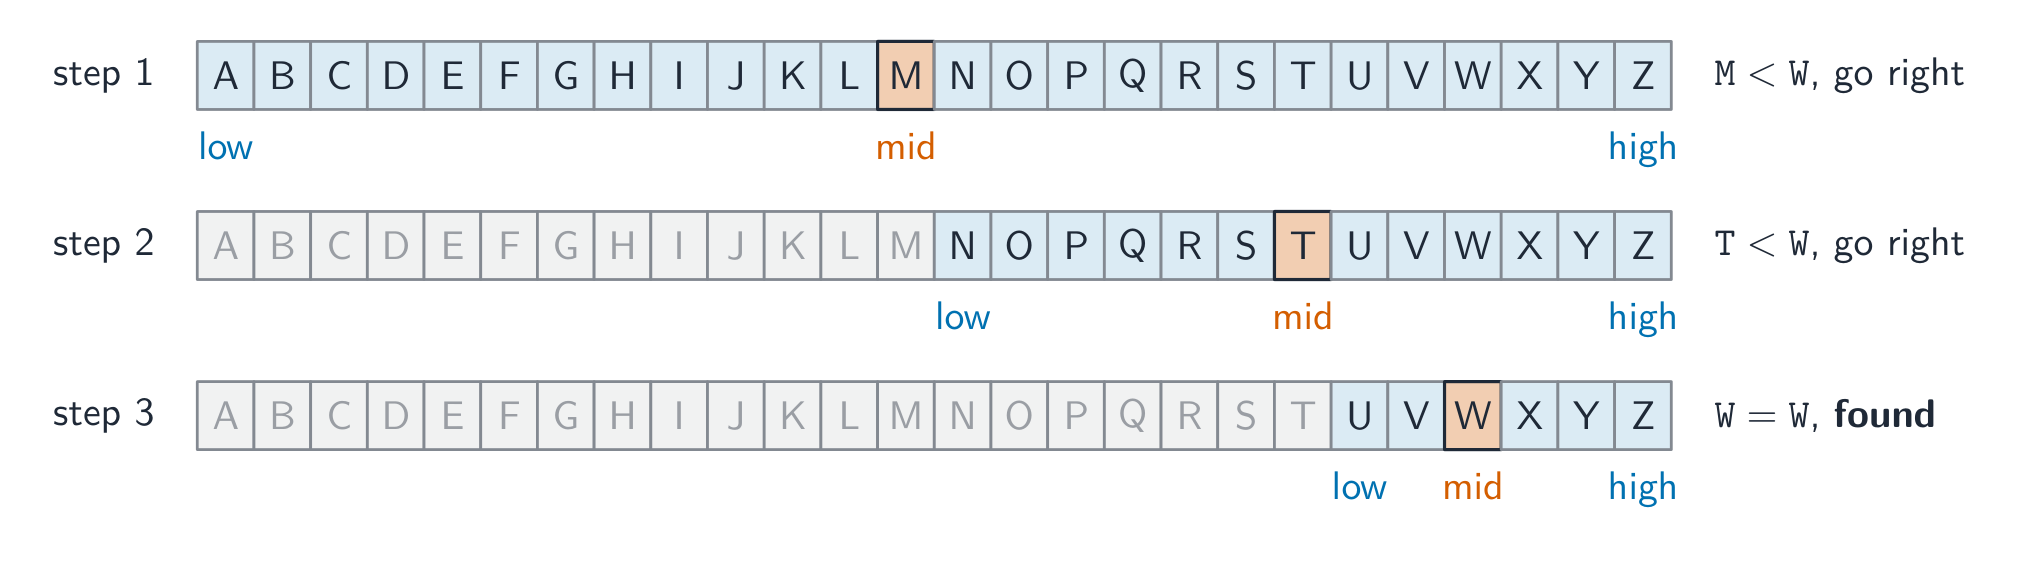
Sebuah pencarian biner membutuhkan data terurut. Lihat elemen tengah; jika itu target, selesai; jika target lebih kecil, cari setengah kiri, jika tidak setengah kanan — membagi dua rentang setiap kali:
low ← 1
high ← n
WHILE low <= high DO
    mid ← (low + high) DIV 2
    IF A[mid] = target THEN
        RETURN mid
    ENDIF
    IF A[mid] < target THEN
        low ← mid + 1
    ELSE
        high ← mid - 1
    ENDIF
ENDWHILE
RETURN -1
Kasus terburuk O($\log_{2} n$) — untuk satu juta item, sekitar 20 perbandingan. Jauh lebih cepat daripada pencarian linear pada array besar yang sudah diurutkan, tetapi Anda harus mengurutkannya terlebih dahulu (biaya O($n \log n$) sekali), sepadan jika Anda mencari berkali-kali.
"Nyatakan syarat yang diperlukan untuk pencarian biner." Data harus dalam urutan (terurut, naik atau turun, berdasarkan kunci yang dicari). "Jelaskan cara melakukan pencarian biner (tiga nilai):" (1) temukan item tengah dari daftar (atau dari rentang saat ini) dan bandingkan dengan target; (2) jika cocok, pencarian berakhir; jika target lebih kecil, ulangi pada setengah bawah, jika lebih besar, pada setengah atas; (3) terus membagi dua rentang hingga item ditemukan atau rentang kosong, yang berarti tidak ada.
Versi ujian, dengan batas dan penanda, adalah yang harus direproduksi ketika diminta melengkapi algoritma:
DECLARE Lower, Upper, Mid : INTEGER
DECLARE Found : BOOLEAN
Lower ← 0
Upper ← 99
Found ← FALSE
WHILE Lower <= Upper AND NOT Found
    Mid ← (Lower + Upper) DIV 2
    IF Names[Mid] = Target THEN
        Found ← TRUE
    ELSE
        IF Names[Mid] < Target THEN
            Lower ← Mid + 1
        ELSE
            Upper ← Mid - 1
        ENDIF
    ENDIF
ENDWHILE
IF Found THEN
    OUTPUT Mid
ELSE
    OUTPUT "Not found"
ENDIF
"Jelaskan bagaimana kinerja berubah seiring dengan bertambahnya jumlah item." Setiap perbandingan mengurangi separuh jumlah item yang tersisa, sehingga jumlah maksimum perbandingan adalah sekitar $\log_{2} n$: menggandakan ukuran daftar hanya menambahkan satu perbandingan lagi. Ini adalah O($\log n$). "Bandingkan pencarian linear dan biner": pencarian linear membutuhkan hingga $n$ perbandingan (O($n$)) dan, rata-rata, setengah dari itu, tetapi bekerja pada data tidak terurut; pencarian biner membutuhkan paling banyak $\log_{2} n$ (O($\log n$)) dan jauh lebih cepat untuk daftar besar, tetapi datanya harus terlebih dahulu terurut dan harus memungkinkan akses langsung ke item tengah (array, bukan daftar terhubung). Untuk $1000$ item: $1000$ berbanding $10$ perbandingan.
Jelajahi
Pencarian linear vs pencarian biner
Cari nilai. Pencarian biner membagi dua daftar setiap langkah (hanya pada data terurut); pencarian linear memeriksa satu per satu.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| insertion sort/ɪnˈsɜːʃn sɔːt/ | insertion sort |
| bubble sort/ˈbʌbl sɔːt/ | bubble sort |
| binary search/ˈbaɪnəri sɜːtʃ/ | pencarian biner |
| array/əˈreɪ/ | array |
| linear search/ˈlɪnɪə sɜːtʃ/ | pencarian linear |
19.1
Algoritma pengurutan

Pengurutan gelembung
Pengurutan gelembung berulang kali melintasi array, menukar pasangan tetangga yang tidak berurutan, sehingga elemen terbesar "menggelembung" ke akhir setiap lintasan:
FOR pass ← 1 TO n - 1
    swapped ← FALSE
    FOR i ← 1 TO n - pass
        IF A[i] > A[i + 1] THEN
            temp ← A[i]
            A[i] ← A[i + 1]
            A[i + 1] ← temp
            swapped ← TRUE
        ENDIF
    NEXT i
    IF swapped = FALSE THEN      // already sorted
        EXIT FOR
    ENDIF
NEXT pass
Kasus terbaik O($n$) (sudah terurut, dengan keluar dini); rata-rata/terburuk O($n^{2}$). Sederhana tetapi lambat untuk $n$ besar.
Pengurutan sisip
Pengurutan sisip membangun awalan terurut dari kiri, menyisipkan setiap elemen baru ke tempatnya dengan menggeser elemen yang lebih besar ke kanan:
FOR i ← 2 TO n
    key ← A[i]
    j ← i - 1
    WHILE j >= 1 AND A[j] > key DO
        A[j + 1] ← A[j]
        j ← j - 1
    ENDWHILE
    A[j + 1] ← key
NEXT i
Kasus terbaik O($n$) (sudah terurut); terburuk O($n^{2}$). Baik untuk array kecil atau hampir terurut. Ia mengurutkan di tempat dan stabil (menjaga urutan elemen yang sama).
Menelusuri pengurutan
Tugas umum adalah menampilkan array setelah setiap lintasan luar. Untuk [D, T, H, R] dengan pengurutan sisip: lintasan 1 (key T) tidak ada perubahan; lintasan 2 (key H) → [D, H, T, R]; lintasan 3 (key R) → [D, H, R, T].
Menulis pengurutan dari awal. "Tulis pseudocode untuk mengurutkan DataArray[1:1000] secara ascending" dijawab dengan pengurutan gelembung lengkap dengan flag keluar dini, atau pengurutan sisip, yang dideklarasikan dan diindentasi; keduanya mendapat nilai penuh jika berfungsi untuk setiap input:
DECLARE Pass, Index, Temp : INTEGER
DECLARE Swapped : BOOLEAN
Pass ← 1
REPEAT
    Swapped ← FALSE
    FOR Index ← 1 TO 1000 - Pass
        IF DataArray[Index] > DataArray[Index + 1] THEN
            Temp ← DataArray[Index]
            DataArray[Index] ← DataArray[Index + 1]
            DataArray[Index + 1] ← Temp
            Swapped ← TRUE
        ENDIF
    NEXT Index
    Pass ← Pass + 1
UNTIL Swapped = FALSE OR Pass = 1000
Untuk pengurutan descending ubah > menjadi <; untuk mengurutkan record atau array 2D berdasarkan satu field, bandingkan field tersebut tetapi tukar seluruh record (atau setiap kolom). Ditanya menulis pengurutan sisip "yang melakukan tugas yang sama" seperti pengurutan gelembung tertentu, gunakan nama array dan arah yang sama serta salin pengurutan sisip di atas dengan perbandingan dibalik jika urutannya descending.
"Jelaskan dua cara kinerja pengurutan dipengaruhi oleh data" (dua nilai). (1) Jumlah item: pengurutan $O(n^{2})$ memakan waktu empat kali lebih lama untuk dua kali lipat jumlah item. (2) Seberapa jauh data sudah terurut: bubble sort dengan flag, atau insertion sort, selesai dalam satu kali lewatan atas data yang sudah terurut ($O(n)$) dan melakukan pekerjaan paling banyak pada data berurutan terbalik; jumlah pertukaran bergantung pada berapa banyak pasangan yang tidak terurut. (Juga diterima: jangkauan atau jumlah nilai duplikat, dan apakah item adalah rekord besar yang mahal untuk dipindahkan.) Bubble sort dan insertion sort keduanya O($n^{2}$) dalam kasus terburuk dan rata-rata serta O($n$) dalam kasus terbaik; quicksort dan merge sort adalah O($n \log n$), itulah sebabnya mereka digunakan untuk data besar.
[D, T, H, R], menggeser setiap kunci ke tempatnya secara bertahap
Jelajahi
Lihat proses pengurutan berjalan
Lakukan langkah-langkah pengurutan dan saksikan bilah-bilahnya tersusun ke dalam urutan — bagaimana algoritma pengurutan bekerja langkah demi langkah.
19.1
ADT dalam algoritma
Tipe Data Abstrak (ADTs) dari Topik 10 muncul di dalam banyak algoritma: tumpukan mendorong traversal kedalaman-terdulu dan undo; antrean mendorong traversal lebar-terdulu dan urutan cetak; daftar terhubung memungkinkan data tumbuh dan menyusut.
ADT dapat dibangun dari ADT lain, bukan hanya dari array: antrean dari dua tumpukan; tumpukan dari daftar terhubung (push = tambahkan kepala simpul); antrean dari daftar terhubung dengan pointer kepala dan ekor pointer; pohon biner dari simpul dengan dua pointer anak; kamus menyimpan pasangan kunci→nilai (sering di hash table). Mengelompokkan seperti ini memisahkan tanggung jawab — algoritma yang menggunakan ADT tidak perlu tahu bagaimana itu dibangun.
ADT yang ujian meminta Anda untuk jelaskan dan implementasikan
Tumpukan (last in, first out): item ditambahkan (pushed) dan dihapus (popped) di ujung yang sama, yaitu atas; pointer TopOfStack menyimpan indeks item atas. Diimplementasikan dengan array dan satu pointer itu: push memeriksa tumpukan tidak penuh, incremented pointer dan menyimpan item; pop memeriksa tidak kosong, mengembalikan item atas dan decrement pointer.
FUNCTION Push(Item : INTEGER) RETURNS BOOLEAN
    IF TopOfStack = 9 THEN      // full (array 0 to 9)
        RETURN FALSE
    ENDIF
    TopOfStack ← TopOfStack + 1
    StackData[TopOfStack] ← Item
    RETURN TRUE
ENDFUNCTION
FUNCTION Pop() RETURNS INTEGER
    IF TopOfStack = -1 THEN      // empty
        RETURN -1
    ENDIF
    TopOfStack ← TopOfStack - 1
    RETURN StackData[TopOfStack + 1]
ENDFUNCTION
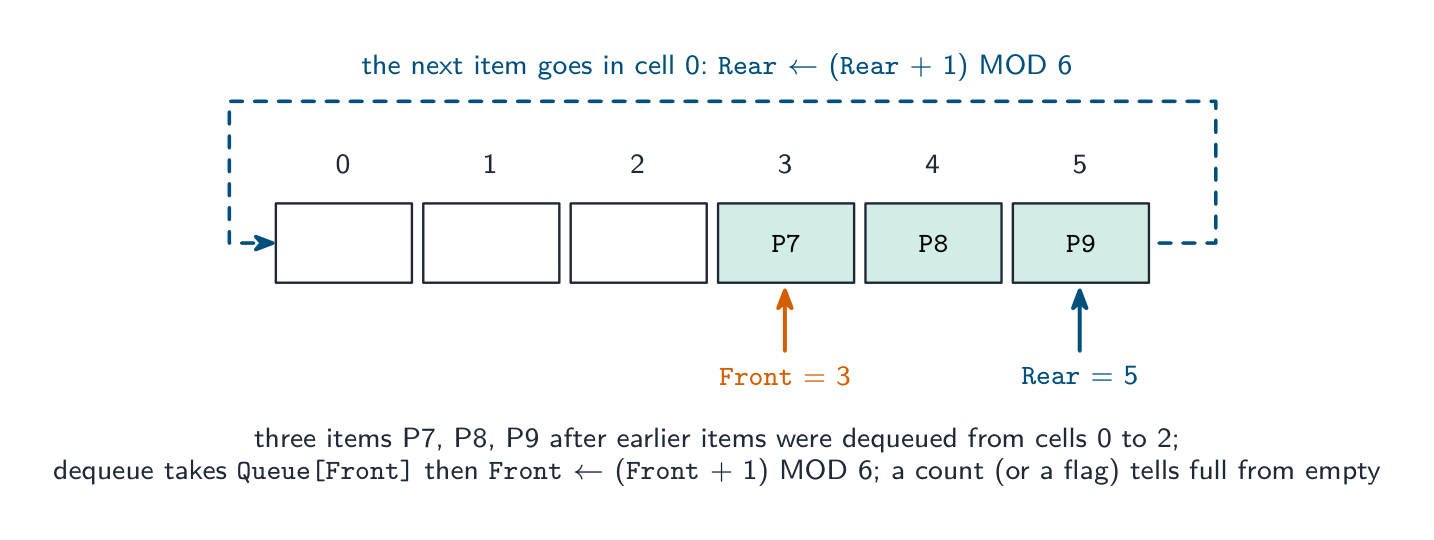
Antrean (first in, first out): item bergabung di belakang (enqueue) dan keluar dari depan (dequeue); dua pointer dan sebuah hitungan. Dalam antrean linear pointer depan merayap sepanjang array hingga ruang di awal terbuang; antrean melingkar membungkus kedua pointer dengan MOD, sehingga setiap sel digunakan kembali.
FUNCTION Enqueue(Item : STRING) RETURNS BOOLEAN
    IF Count = 6 THEN      // full
        RETURN FALSE
    ENDIF
    Rear ← (Rear + 1) MOD 6
    QueueArray[Rear] ← Item
    Count ← Count + 1
    RETURN TRUE
ENDFUNCTION
FUNCTION Dequeue() RETURNS STRING
    IF Count = 0 THEN      // empty
        RETURN ""
    ENDIF
    DECLARE Item : STRING
    Item ← QueueArray[Front]
    Front ← (Front + 1) MOD 6
    Count ← Count - 1
    RETURN Item
ENDFUNCTION
Daftar terhubung: serangkaian simpul, masing-masing memegang item data dan pointer ke simpul berikutnya; pointer mulai memberikan simpul pertama dan pointer null (0 atau $-1$) mengakhiri daftar. Dalam implementasi array dua array paralel memegang data dan pointer, dan sel yang tidak terpakai dirantai ke dalam daftar bebas sehingga insert tahu di mana menempatkan simpul baru.
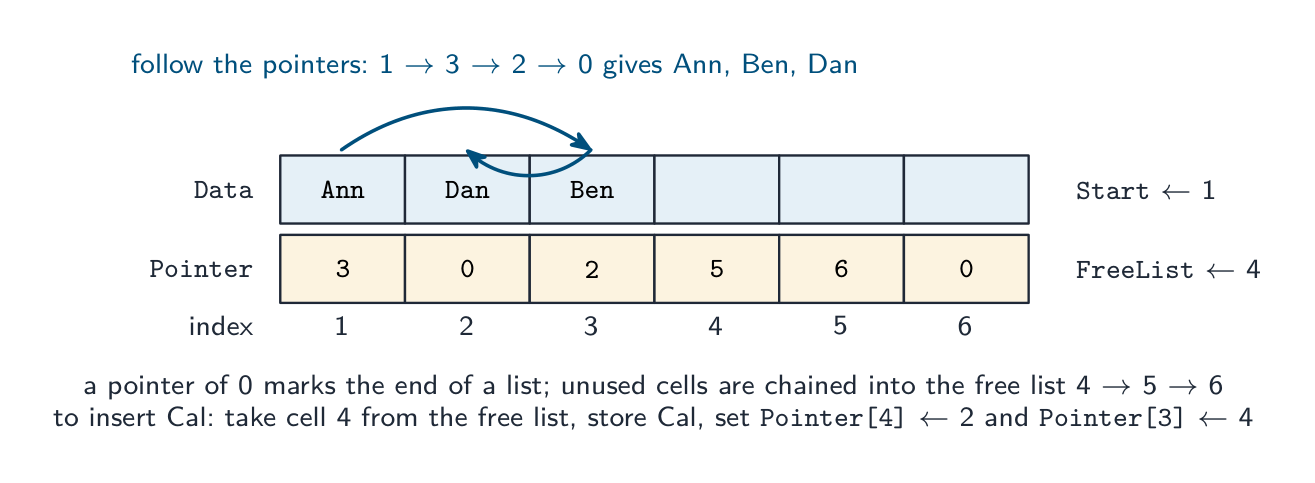
FUNCTION FindInList(Target : STRING) RETURNS INTEGER   // index, or 0 if absent
    DECLARE Current : INTEGER
    Current ← Start
    WHILE Current <> 0
        IF Data[Current] = Target THEN
            RETURN Current
        ENDIF
        Current ← Pointer[Current]
    ENDWHILE
    RETURN 0
ENDFUNCTION
Untuk menyisipkan ke dalam daftar terurut: ambil sel bebas pertama (NewNode ← FreeList, FreeList ← Pointer[FreeList]), simpan item, lalu jalan list dengan Previous dan Current pointer sampai Data[Current] > Item atau akhir; set Pointer[NewNode] ← Current dan Pointer[Previous] ← NewNode (atau Start ← NewNode jika masuk pertama). Untuk menghapus, hubungkan ulang simpul sebelumnya melewati yang dihapus dan kembalikan sel ke daftar bebas.
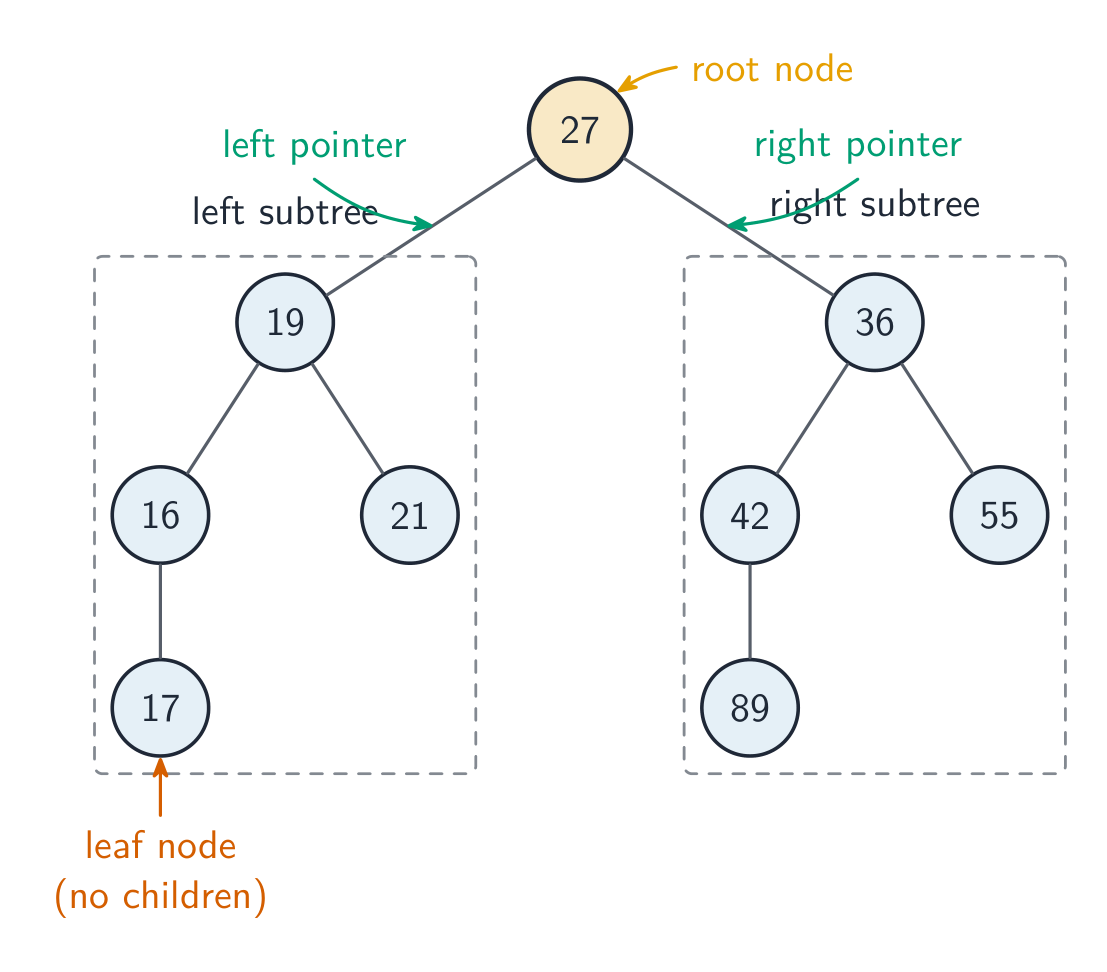
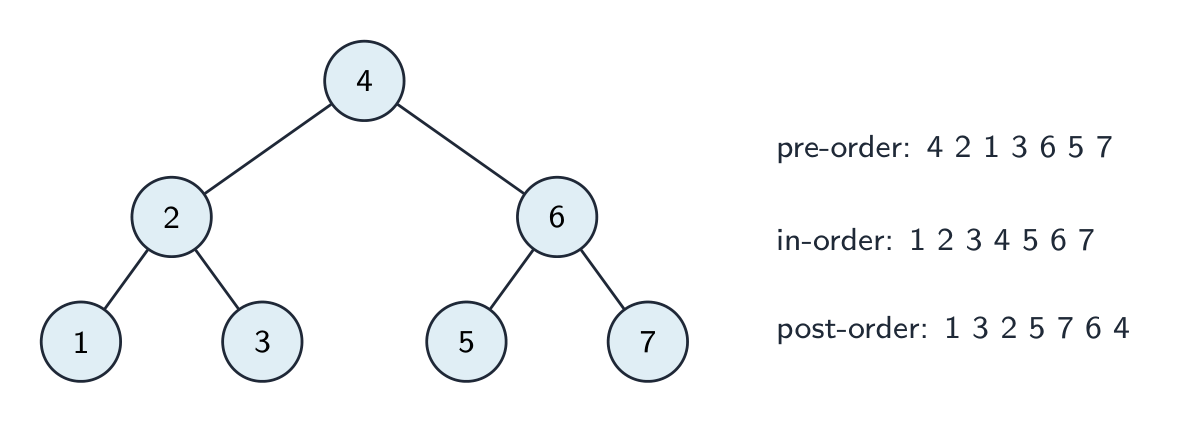
Pohon biner: simpul akar, setiap simpul memegang data, pointer kiri ke subtree nilai lebih kecil dan pointer kanan ke subtree nilai lebih besar. Diimplementasikan sebagai array 2D (atau tiga array 1D) Tree[Index, 0..2] untuk pointer kiri, data, pointer kanan, dengan pointer akar dan pointer next-free.
FUNCTION FindInTree(Target : INTEGER) RETURNS INTEGER   // index, or -1
    DECLARE Current : INTEGER
    Current ← Root
    WHILE Current <> -1
        IF Tree[Current, 1] = Target THEN
            RETURN Current
        ENDIF
        IF Target < Tree[Current, 1] THEN
            Current ← Tree[Current, 0]      // go left
        ELSE
            Current ← Tree[Current, 2]      // go right
        ENDIF
    ENDWHILE
    RETURN -1
ENDFUNCTION
Untuk menyisipkan: simpan item di simpul bebas berikutnya dengan kedua pointer $-1$; jika pohon kosong jadikan sebagai akar; sebaliknya jalan turun dari akar, pergi kiri atau kanan berdasarkan perbandingan, sampai pointer yang akan Anda ikuti adalah $-1$, dan set pointer itu ke simpul baru. ADT dari ADT lain: tumpukan adalah daftar terhubung di mana push dan pop bekerja di awal; antrean adalah daftar terhubung dengan pointer mulai dan akhir; antrean bisa dibuat dari dua tumpukan (push ke satu, pop dari yang lain, memindahkan semuanya saat yang kedua kosong); simpul pohon biner adalah record atau objek yang dihubungkan oleh pointer, jadi itu dibangun dari struktur daftar terhubung. Sebutkan operasi apa dari ADT baru memetakan ke operasi apa dari ADT lama.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| linked list/lɪŋkt lɪst/ | daftar linked |
| stack/stæk/ | tumpukan |
| queue/kjuː/ | antrean |
| node/nəʊd/ | simpul |
| binary tree/ˈbaɪnəri triː/ | pohon biner |
| dictionary/ˈdɪkʃənəri/ | kamus |
| circular queue/ˈsɜːkjʊlə kjuː/ | antrean melingkar |
| free list/friː lɪst/ | daftar bebas |
| time complexity/taɪm kəmˈpleksɪti/ | kompleksitas waktu |
| Big-O notation/bɪɡ əʊ nəʊˈteɪʃn/ | Notasi Big-O |
| space complexity/speɪs kəmˈpleksɪti/ | kompleksitas ruang |
19.1
Membandingkan algoritma

Kompleksitas waktu
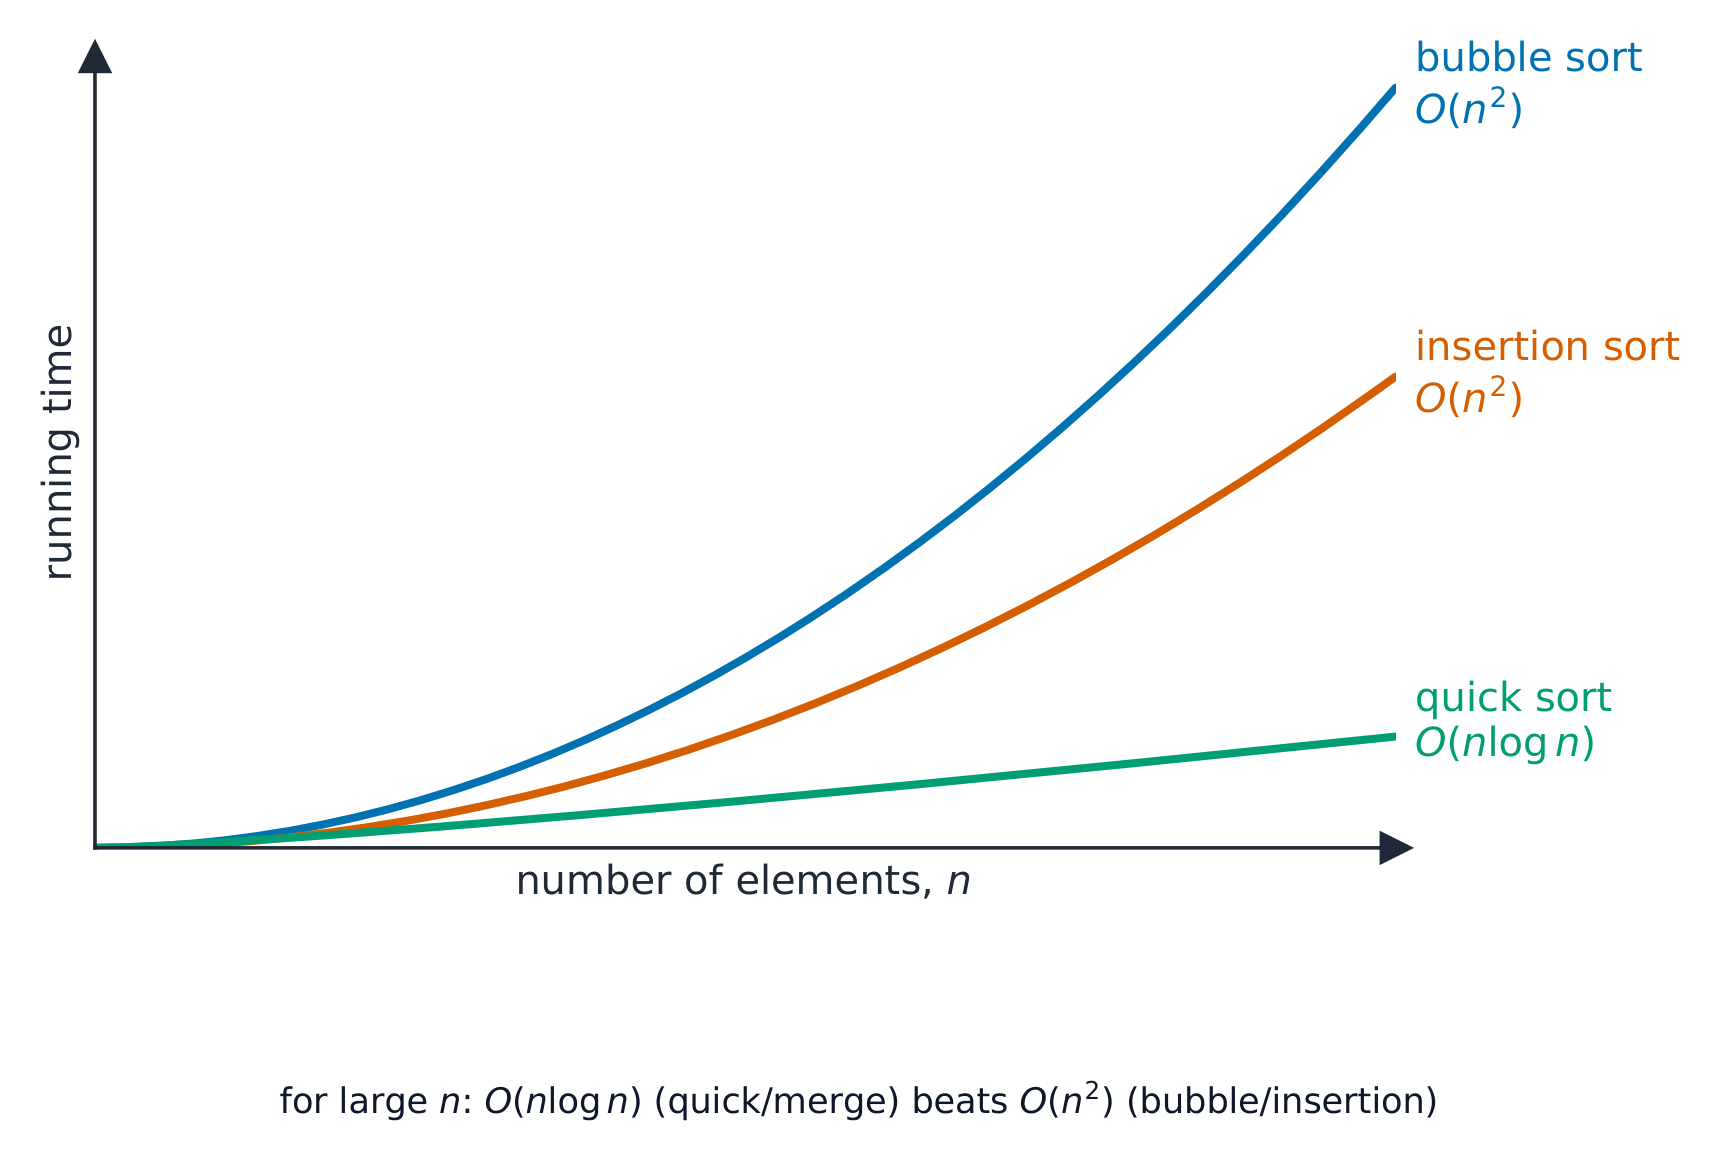
Kompleksitas waktu adalah bagaimana waktu eksekusi bertambah seiring dengan ukuran input $n$, ditulis dalam notasi Big-O (suku dominan): O(1) konstan, O($\log n$) pencarian biner, O($n$) pencarian linear, O($n \log n$) pengurutan yang baik, O($n^{2}$) bubble/insertion sort. Orde yang lebih kecil lebih unggul pada skala besar, meskipun algoritma lain mungkin lebih cepat untuk ukuran $n$ yang kecil.
Untuk membuatnya lebih nyata: untuk mengurutkan satu juta item, algoritma $O(n \log n)$ selesai dalam pecahan detik, sementara algoritma $O(n^{2})$ bisa memakan waktu beberapa menit.
Contoh terpecahkan. Daftar terurut berisi $1000$ item. Berapa banyak perbandingan yang dibutuhkan masing-masing pencarian dalam kasus terburuk?
Pencarian linear memeriksa item satu per satu, sehingga mungkin membutuhkan hingga $1000$ perbandingan — ini adalah $O(n)$. Pencarian biner membagi dua daftar setiap langkahnya, sehingga membutuhkan paling banyak $\lceil \log_2 1000 \rceil = 10$ perbandingan — ini adalah $O(\log n)$. Menggandakan daftar menjadi $2000$ item hanya menambah satu perbandingan pada pencarian biner, tetapi hingga tambahan $1000$ pada pencarian linear — inilah mengapa orde pertumbuhan, bukan kecepatan mentah, menentukan pemenang pada skala besar.
Mendeskripsikan sebuah orde. O(1): waktu bersifat konstan, tidak bergantung pada jumlah item (menambah ke tumpukan, membaca elemen array). O($\log n$): waktu bertambah sesuai dengan logaritma jumlah item, sehingga menggandakan data hanya menambahkan satu langkah tetap (pencarian biner). O($n$): waktu bertambah sebanding dengan jumlah item (pencarian linear, satu kali lintasan melalui daftar). O($n \log n$): sedikit lebih buruk dari linear (pengurutan efisien). O($n^{2}$): waktu bertambah sesuai dengan kuadrat jumlah item, sehingga menggandakan data empat kali lipatkan waktunya (bubble dan insertion sort). "Nyatakan Big O dari pencarian biner pada Names[0:99]" dijawab dengan $O(\log n)$, dan "jelaskan maknanya" seperti di atas; Big-O mengukur bagaimana waktu atau memori diskala-kan, bukan waktu aktual.
Kompleksitas ruang
Kompleksitas ruang adalah memori tambahan yang diperlukan. Bubble dan insertion sort menggunakan O(1) ekstra (in-place); merge sort menggunakan O($n$); rekursi menggunakan memori tumpukan sebanding dengan kedalamannya. Seringkali terdapat trade-off antara waktu dan memori.
Kriteria lainnya
Kesederhanaan (lebih mudah dikodekan dan dipelihara), stabilitas, dan adaptabilitas (lebih cepat pada data yang hampir terurut). Algoritma yang tepat bergantung pada data dan batasan-batasan yang ada.
Jelajahi
Bagaimana waktu eksekusi bertambah seiring n
Geser n ke atas dan bandingkan kurvanya: O(1) dan O(log n) tetap hampir datar, O(n) naik secara stabil, O(n²) meledak. Inilah mengapa Big-O — bukan stopwatch — digunakan untuk membandingkan algoritma pada input besar.
Jelajahi
Pertumbuhan Big-O
Ubah ukuran input n dan bandingkan seberapa cepat kerja setiap algoritma tumbuh — gagasan di balik kompleksitas waktu.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| in place/ɪn pleɪs/ | in place |
| stable/ˈsteɪbl/ | stabil |
19.2
Rekursi
Silabus
| Kandidat harus mampu: | Catatan dan panduan |
|---|---|
| Tunjukkan pemahaman tentang recursion | Fitur esensial dari recursion Bagaimana recursion dinyatakan dalam bahasa pemrograman Tulis dan telusuri recursive algorithms Kapan penggunaan recursion bermanfaat |
| Tunjukkan kesadaran tentang apa yang harus dilakukan compiler untuk menerjemahkan kode pemrograman recursive | Penggunaan stacks dan unwinding |
Sumber: Silabus Cambridge International
Algoritma rekursif menggunakan rekursi: routine memanggil dirinya sendiri dengan versi masalah yang lebih kecil, hingga kasus dasar mengakhiri rantai tersebut. Ini memiliki dua bagian: kasus dasar (cukup kecil untuk diselesaikan langsung — tanpa hal ini rekursi tidak akan pernah berhenti) dan kasus rekursif (mengurangi input dan memanggil dirinya sendiri).
Faktorial:
FUNCTION Factorial(n : INTEGER) RETURNS INTEGER
    IF n = 0 OR n = 1 THEN
        RETURN 1
    ELSE
        RETURN n * Factorial(n - 1)
    ENDIF
ENDFUNCTION
Rekursi alami untuk masalah yang mirip diri sendiri: pohon, bagi-dan-taklukkan (pencarian biner, merge sort), dan data bersarang. Ketika ini kurang cocok, loop biasanya lebih bersih.
"Jelaskan apa yang dimaksud dengan rekursi (dua nilai). Suatu fungsi atau prosedur yang didefinisikan berdasarkan dirinya sendiri: ia memanggil dirinya sendiri dari dalam tubuhnya sendiri, dengan versi masalah yang lebih kecil setiap kali, hingga mencapai kasus dasar. "Nyatakan tiga fitur esensial rekursi": (1) kasus dasar (kondisi berhenti) yang mengembalikan nilai tanpa pemanggilan lebih lanjut; (2) kasus umum di mana routine memanggil dirinya sendiri; (3) setiap pemanggilan membawa masalah lebih dekat ke kasus dasar (parameternya berkurang), sehingga rekursi berakhir. Beberapa skema juga menambahkan: nilai dikembalikan saat pemanggilan membuka kembali.
"Jelaskan kapan penggunaan rekursi menguntungkan, dan berikan contoh." Ketika masalah didefinisikan secara alami berdasarkan versi yang lebih kecil dari dirinya sendiri, sehingga solusi rekursif lebih pendek, lebih jelas, dan lebih dekat dengan definisi matematis daripada loop: faktorial atau bilangan Fibonacci, pencarian biner, menelusuri pohon biner, merge sort atau quicksort, dan memproses struktur bersarang seperti folder dalam folder. Ini adalah pilihan buruk ketika kedalamannya besar (tumpukan mungkin penuh) atau ketika sub-masalah yang sama dihitung berkali-kali (Fibonacci naif).
Melacak pemanggilan rekursif
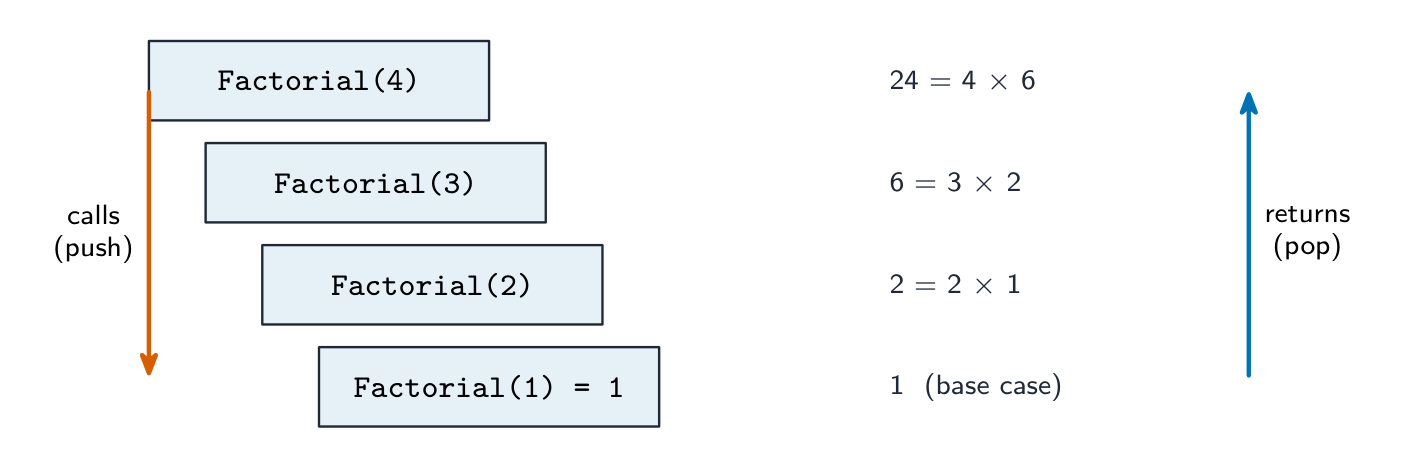
Untuk Factorial(4): pemanggilan turun hingga Factorial(1)=1, lalu pembukaan kembali mengalikan naik: 2*1=2, 3*2=6, 4*6=24. Hasil akhir 24. Lacak setiap pemanggilan yang tertunda pada tumpukan.
Contoh terpecahkan. Fungsi di bawah ini diberikan tanpa penjelasan. Lacak Unknown(3, 5) dan nyatakan output serta nilainya.
FUNCTION Unknown(BYVAL X, BYVAL Y : INTEGER) RETURNS INTEGER
    IF X < Y THEN
        OUTPUT X + Y
        RETURN Unknown(X + 1, Y - 1) + 1
    ELSE
        RETURN 0
    ENDIF
ENDFUNCTION
Pemanggilan 1: $X = 3, Y = 5$: $3 < 5$, output 8, panggil Unknown(4, 4). Pemanggilan 2: $4 < 4$ adalah false, return 0. Pembukaan kembali: pemanggilan 1 mengembalikan $0 + 1 = 1$. Output 8, nilai return 1. Tulis jejak sebagai tabel dengan baris per pemanggilan (parameter, kondisi, output, apa yang dikembalikan), dan lakukan pengembalian dari pemanggilan terdalam ke atas: itulah pembukaan kembali yang dicari kunci jawaban.
Contoh terpecahkan (Fibonacci). Fib(n) mengembalikan n jika n < 2, sebaliknya Fib(n - 1) + Fib(n - 2). Temukan Fib(5).
Fib(5) = Fib(4) + Fib(3); Fib(4) = Fib(3) + Fib(2); Fib(3) = Fib(2) + Fib(1); Fib(2) = Fib(1) + Fib(0) = 1 + 0 = 1. Jadi Fib(3) = 1 + 1 = 2, Fib(4) = 2 + 1 = 3, Fib(5) = 3 + 2 = 5. Kasus dasar dicapai banyak kali (Fib(2) dihitung tiga kali), itulah sebabnya versi ini lambat: ia membuat 15 pemanggilan untuk $n = 5$ dan kira-kira menggandakan pemanggilan untuk setiap kenaikan $n$.
Mengubah rekursi menjadi iterasi. Setiap rutin rekursif dapat ditulis ulang dengan perulangan, yang menggunakan lebih sedikit memori dan lebih cepat: simpan hasil berjalan dan lakukan perulangan dari kasus dasar ke atas. Faktorial sebagai perulangan:
FUNCTION Factorial(N : INTEGER) RETURNS INTEGER
    DECLARE Result, Count : INTEGER
    Result ← 1
    FOR Count ← 2 TO N
        Result ← Result * Count
    NEXT Count
    RETURN Result
ENDFUNCTION
Ketika diminta mengubah sorting atau pencarian insert rekursif menjadi iteratif, ganti pemanggilan diri sendiri dengan perulangan atas indeks yang dilalui oleh rekursi, dan ubah kasus dasar menjadi kondisi keluar perulangan.
Risiko
- rekursi tak hingga jika kasus dasar terlewat — menyebabkan crash dengan tumpukan meluap (stack overflow).
- penggunaan memori tinggi untuk rekursi dalam.
- lambat jika mengulang pekerjaan (Fibonacci naif bersifat eksponensial — gunakan perulangan atau memoisasi).
Jelajahi
Recursion terbuka dari daun ke atas
Langkah melalui fib(4) sesuai urutan pemanggilan selesai: daun (kasus dasar) diselesaikan dulu, lalu setiap induk menggabungkan anak-anaknya. Perhatikan bahwa fib(2) dihitung dua kali — pekerjaan berulang inilah yang membuat rekursi naif lambat.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| recursion/rɪˈkɜːʃn/ | rekursi |
| call stack/kɔːl stæk/ | call stack |
| base case/beɪs keɪs/ | kasus dasar |
| recursive case/rɪˈkɜːsɪv keɪs/ | kasus rekursif |
| factorial/fækˈtɔːrɪəl/ | faktorial |
| divide-and-conquer/dɪˈvaɪd ænd ˈkɒŋkə/ | bagi dan taklukkan |
| general case/ˈdʒenərəl keɪs/ | kasus umum |
| parameters/pəˈræmɪtəz/ | parameter |
| stack overflow/stæk ˌəʊvəˈfləʊ/ | stack overflow |
| memoisation/ˌmeməʊaɪˈzeɪʃn/ | memoization |
| local variables/ˈləʊkl ˈveərɪəblz/ | variabel lokal |
| stack frame/stæk freɪm/ | frame tumpukan pemanggilan |
| return address/rɪˈtɜːn əˈdres/ | alamat kembalinya |
19.2
Apa yang dilakukan kompiler untuk kode rekursif
Rekursi memerlukan setiap panggilan memiliki salinannya sendiri dari parameter dan variabel lokal. Kompiler menyimpannya di tumpukan panggilan. Untuk setiap panggilan, ia mendorong bingkai tumpukan yang berisi parameter, variabel lokal, dan alamat pengembalian (di mana melanjutkan pada Caller). Ketika fungsi kembali, nilai pengembalian dikembalikan, bingkai dipop, dan kendali berlanjut di alamat pengembalian.
Karena setiap panggilan memiliki bingkainya sendiri, panggilan rekursif tidak menimpa variabel satu sama lain. Tumpukan bisa tumbuh besar untuk rekursi dalam, itulah sebabnya rekursi yang sangat dalam mungkin membuatnya meluap. Ini adalah mekanisme panggil-kembali yang sama yang digunakan untuk panggilan biasa (non-rekursif) — tidak ada "mekanisme rekursi" khusus.
"Jelaskan mengapa tumpukan cocok untuk mengimplementasikan rekursi (tiga poin).** Setiap panggilan rekursif harus menyimpan alamat pengembalian, parameternya dan variabel lokalnya, dan panggilan diselesaikan dalam urutan terbalik terhadap urutan pembuatannya (panggilan terakhir dibuat adalah yang pertama selesai), yang merupakan perilaku last in, first out dari tumpukan: setiap panggilan baru mendorong bingkai, dan setiap pengembalian mempop bingkai paling baru, memulihkan状态 Caller dan memberi tahu di mana ia harus melanjutkan. Ini adalah tugas kompiler ketika menerjemahkan kode rekursif: ia menghasilkan dorongan bingkai tumpukan pada setiap panggilan dan pop pada setiap pengembalian, dan bingkai-bingkai itu dibongkar saat hasilnya kembali.
19.2
Definisi yang diterima oleh penguji
Soal definisi dinilai berdasarkan frasa tetap. Hafalkan ini persis, dan berikan hanya satu jawaban.
| Istilah | Definisi |
|---|---|
| pencarian linear | memeriksa setiap item secara berurutan dari awal hingga target ditemukan atau akhir dicapai |
| pencarian biner | berulang kali membandingkan target dengan item tengah dari daftar terurut dan membuang setengah yang tidak dapat menyimpankannya |
| sorting gelembung | berulang kali melewati daftar, menukar item bersebelahan yang berada dalam urutan salah, hingga sebuah lintasan tidak melakukan penukaran |
| sorting sisip | mengambil setiap item secara berurutan dan menyisipkannya ke tempat yang benar di antara item-item yang sudah terurut |
| tipe data abstrak | kumpulan data dan operasi yang dapat dilakukan padanya, didefinisikan secara independen dari cara penyimpanannya |
| tumpukan | struktur last-in-first-out dengan push dan pop di bagian atas |
| antrean | struktur first-in-first-out dengan item ditambahkan di belakang dan dihapus dari depan |
| daftar linked | urutan node, masing-masing memegang data dan pointer ke node berikutnya, dengan pointer awal |
| pohon biner | node masing-masing memegang data dan pointer ke subtrees kiri bernilai lebih kecil dan subtrees kanan bernilai lebih besar |
| notasi Big O | cara mengklasifikasikan waktu (atau memori) yang dibutuhkan algoritma berdasarkan bagaimana hal itu tumbuh seiring ukuran input |
| rekursi | rutin yang memanggil dirinya sendiri dengan versi masalah yang lebih kecil hingga kasus dasar menghentikan panggilan |
| kasus dasar | kondisi di mana rutin rekursif mengembalikan tanpa memanggil dirinya sendiri |
| pembongkaran | pengembalian dari rantai panggilan rekursif, dari panggilan terdalam kembali ke yang pertama, saat bingkai tumpukan dipop |
19.2
Tips ujian
- Pencarian: linear tidak perlu urutan dan O($n$); biner membutuhkan array terurut, membagi dua setiap kali dan O($\log n$). Hafalkan kedua algoritma ini, termasuk batas dan flag-nya.
- Sorting: bubble dengan flag pertukaran, insertion dengan key yang menggeser item lebih besar ke kanan; keduanya O($n^{2}$) terburuk, O($n$) pada data terurut. Kinerja bergantung pada jumlah item dan seberapa terurut mereka.
- Implementasi ADT adalah pencatatan pointer: pointer atas; front, rear dan count dengan MOD; start, pointers dan daftar bebas; root dengan pointer kiri dan kanan. Selalu periksa untuk penuh dan kosong.
- Big O tentang skala: konstan, logaritmik, linear, kuadrat. Katakan "menggandakan data menambahkan satu perbandingan" untuk pencarian biner.
- Rekursi: kasus dasar, kasus umum, kemajuan menuju kasus dasar; bermanfaat ketika masalah didefinisikan dalam istilah dirinya sendiri; tumpukan menahan alamat pengembalian dan variabel karena panggilan kembali dalam urutan terbalik. Jejak dengan tabel dan bongkar dari panggilan terdalam.
Kesalahan umum
- Menggunakan pencarian biner pada data tidak terurut, atau pada daftar linked; dan menetapkan
Lower ← Midalih-alihMid + 1, yang akan looping selamanya. - Loop dalam bubble sort yang berjalan sampai akhir array setiap kali lintasan, atau pertukaran tanpa variabel sementara.
- Push atau enqueue yang tidak menguji untuk penuh, atau pop atau dequeue yang tidak menguji untuk kosong.
- Memindahkan pointer depan antrean tanpa MOD dalam antrean melingkar, atau menganggap front = rear selalu berarti kosong.
- Menyisipkan ke dalam daftar linked dengan menggeser isi array; hanya pointer yang berubah.
- Fungsi rekursif tanpa kasus dasar, atau yang pemanggilan rekursifnya tidak membuat masalah menjadi lebih kecil.
- Melacak pemanggilan rekursif tetapi lupa menambahkan pekerjaan yang tertunda saat kembali ke atas.
- Menjawab "mengapa menggunakan tumpukan" dengan "karena cepat"; alasannya adalah urutan last-in-first-out dari pengembalian nilai.
Kosa kata
Latih
| English | Bahasa Indonesia |
|---|---|
| pointers/ˈpɔɪntəz/ | pointer |
Pelajaran interaktif untuk topik ini
Kerjakan langkah demi langkah, dengan latihan pengecekan instan.