Skip to content · ⁨Passer au contenu⁩

Acides nucléiques et synthèse des protéines

Biologie A-Level · Topic 6 · ⁨Sujet 6⁩

Train · ⁨Entrainer⁩
Video lesson for this topic · ⁨Leçon vidéo pour ce sujet⁩ Open the video page · ⁨Ouvrir la page vidéo⁩
9:37

ADN & Synthèse des protéines

À l'intérieur de presque chacune de vos cellules repose une molécule longue d'environ deux mètres, pliée si serrément que vous ne pouvez pas la voir. C'est l'ADN, et il est écrit selon un…

English narration · English + 中文 subtitles burned in · ⁨Narration en anglais · Sous-titres anglais + 中文 incrustés⁩

6.1

Nucleotides — the building blocks · ⁨Nucléotides — les briques élémentaires⁩

Syllabus · ⁨Programme⁩
English
  1. describe the structure of nucleotides, including the phosphorylated nucleotide ATP (structural formulae are not expected)
  2. state that the bases adenine and guanine are purines with a double ring structure, and that the bases cytosine, thymine and uracil are pyrimidines with a single ring structure (structural formulae for bases are not expected)
  3. describe the structure of a DNA molecule as a double helix, including: • the importance of complementary base pairing between the 5′ to 3′ strand and the 3′ to 5′ strand (antiparallel strands) • differences in hydrogen bonding between C–G and A–T base pairs • linking of nucleotides by phosphodiester bonds
  4. describe the semi-conservative replication of DNA during the S phase of the cell cycle, including: • the roles of DNA polymerase and DNA ligase (knowledge of other enzymes in DNA replication in cells and different types of DNA polymerase is not expected) • the differences between leading strand and lagging strand replication as a consequence of DNA polymerase adding nucleotides only in a 5′ to 3′ direction
  5. describe the structure of an RNA molecule, using the example of messenger RNA (mRNA)
Français
  1. décrire la structure des nucléotides, y compris le nucléotide phosphorylé ATP (les formules structurales ne sont pas attendues)
  2. indiquer que les bases adénine et guanine sont des purines ayant une structure à double anneau, et que les bases cytosine, thymine et uracile sont des pyrimidines ayant une structure à simple anneau (les formules structurales des bases ne sont pas attendues)
  3. décrire la structure d'une molécule d'ADN sous forme de double hélice, y compris : • l'importance de l'appariement complémentaire des bases entre le brin 5′ vers 3′ et le brin 3′ vers 5′ (brins antiparallèles) • différences dans la liaison hydrogène entre les appariements C–G et A–T • liaison des nucléotides par des liaisons phosphodiester
  4. décrire la réplication semi-conservative de l'ADN durant la phase S du cycle cellulaire, y compris : • les rôles de la DNA polymérase et de la DNA ligase (la connaissance d'autres enzymes intervenant dans la réplication de l'ADN dans les cellules et des différents types de DNA polymérases n'est pas attendue) • les différences entre la réplication du brin continu et du brin discontinu en conséquence de l'ajout de nucléotides par la DNA polymérase uniquement dans le sens 5′ vers 3′
  5. décrire la structure d'une molécule d'ARN, en utilisant l'exemple de l'ARN messager (ARNm)
Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English
DNA replication: unzip and copy

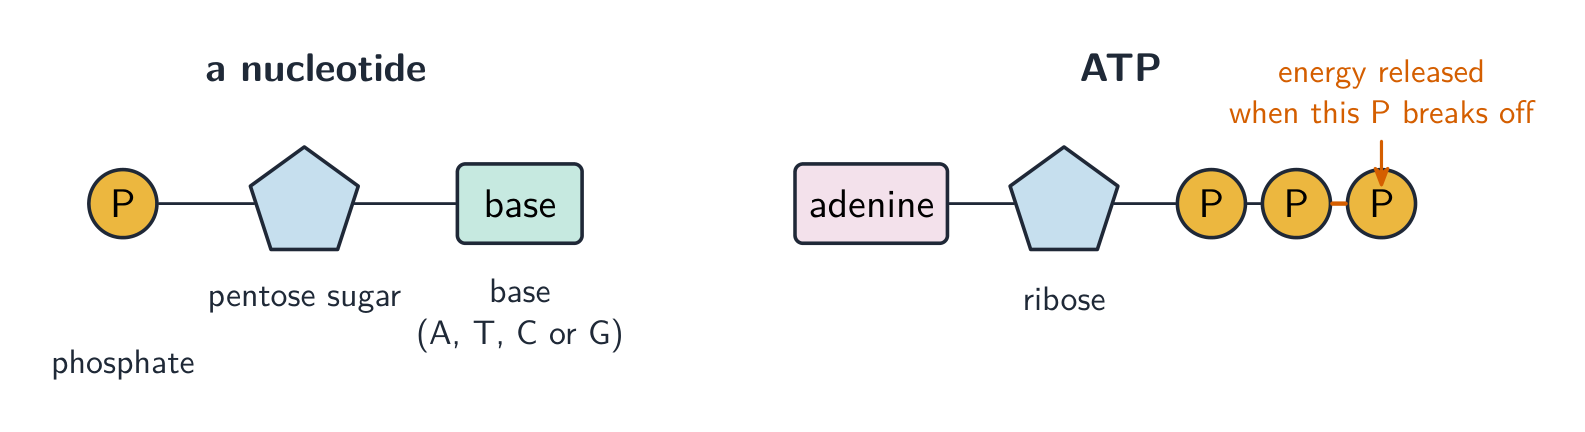
Nucleic acids 核酸 (DNA and RNA) are polymers of small units called nucleotides 核苷酸. Each nucleotide is made of three parts joined together:

  • a phosphate 磷酸 group,
  • a sugar (a 5-carbon sugar),
  • a nitrogen-containing base 碱基.

ATP is a special nucleotide. It has the base adenine 腺嘌呤, the sugar ribose 核糖, and three phosphate groups. Breaking off the last phosphate releases energy 能量 for the cell.

There are five bases, in two groups:

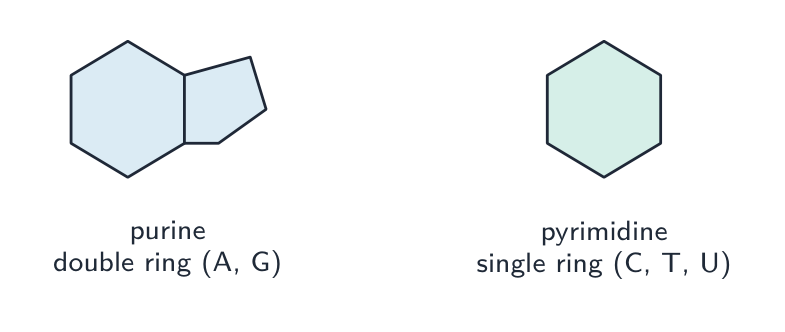
  • purines 嘌呤 have a double ring (two rings): adenine and guanine 鸟嘌呤.
  • pyrimidines 嘧啶 have a single ring (one ring): cytosine 胞嘧啶, thymine 胸腺嘧啶 and uracil 尿嘧啶.
Français
Réplication de l'ADN : déroulement et copie

Les acides nucléiques 核酸 (ADN et ARN) sont des polymères constitués de petites unités appelées nucléotides 核苷酸. Chaque nucléotide est composé de trois parties assemblées ensemble :

  • un groupe phosphate 磷酸,
  • un sucre (un sucre à 5 carbones),
  • une base 碱基 contenant de l'azote.

L'ATP est un nucléotide spécial. Il possède la base adénine 腺嘌呤, le sucre ribose 核糖, et trois groupes phosphate. Casser le dernier phosphate libère de l'énergie 能量 pour la cellule.

Un nucléotide dessiné comme un phosphate, un sucre pentose et une base joints ensemble ; à côté, l'ATP comme adénine, ribose et trois phosphates avec la dernière liaison marquée comme haute énergie
Un nucléotide est un phosphate, un sucre et une base ; l'ATP est un nucléotide avec trois phosphates
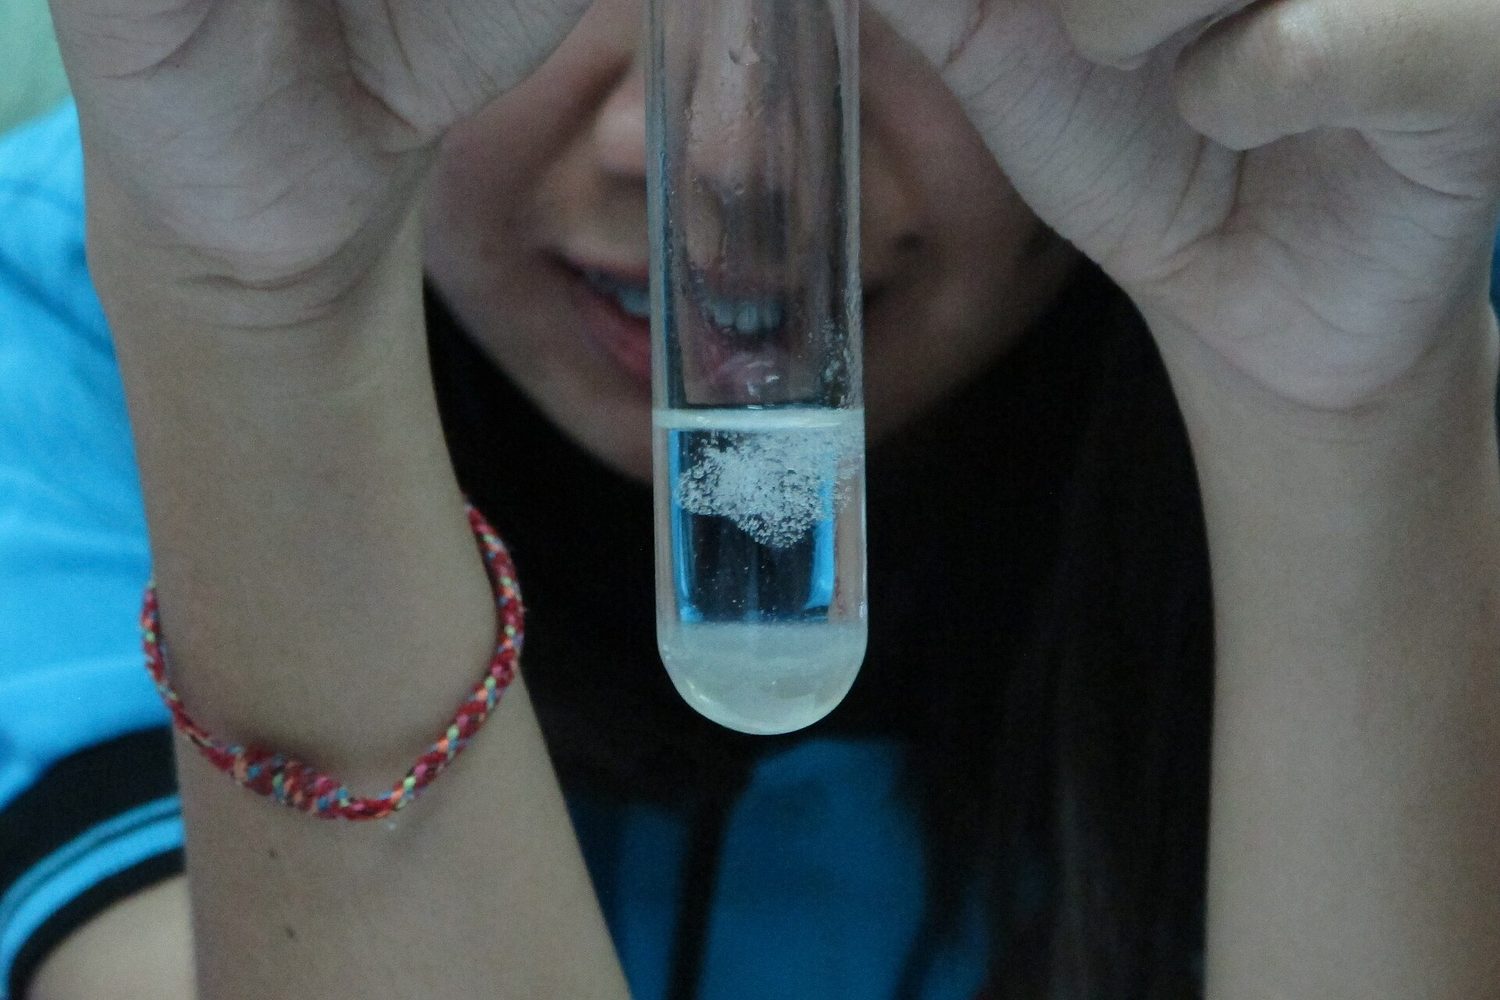
Des brins pâles et filamenteux d'ADN dans un tube
L'ADN extrait des cellules apparaît sous forme de brins pâles et filamenteux de ces polymères de nucléotides

Il existe cinq bases, regroupées en deux catégories :

  • les purines 嘌呤 ont un double anneau (deux anneaux) : adénine et guanine 鸟嘌呤.
  • les pyrimidines 嘧啶 ont un anneau unique (un anneau) : cytosine 胞嘧啶, thymine 胸腺嘧啶 et uracile 尿嘧啶.
Deux formes circulaires : une purine dessinée comme deux anneaux fusionnés, une pyrimidine dessinée comme un seul anneau
Les deux groupes diffèrent par la forme : une purine est un double anneau, une pyrimidine un anneau unique — c'est pourquoi une purine s'apparie toujours avec une pyrimidine
Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
nucleic acid/njuːˈklɪɪk ˈæsɪd/ 核酸 hé suān
nucleotide/ˈnjuːklɪɒtaɪd/ 核苷酸 hé gān suān
phosphate/ˈfɒsfeɪt/ 磷酸 lín suān
base/beɪs/ 碱基 jiǎn jī
adenine/ˈædəniːn/ 腺嘌呤 xiàn piào líng
ribose/ˈrɪbəʊs/ 核糖 hé táng
energy/ˈenədʒi/ 能量 néng liàng
purine/ˈpjʊəriːn/ 嘌呤 piào líng
guanine/ˈɡwɑːnaɪn/ 鸟嘌呤 niǎo piào líng
pyrimidine/ˈpɪrɪmɪdiːn/ 嘧啶 mì dìng
cytosine/ˈsaɪtəsaɪn/ 胞嘧啶 bāo mì dìng
thymine/ˈθaɪmaɪn/ 胸腺嘧啶 xiōng xiàn mì dìng
uracil/ˈjʊərəsɪl/ 尿嘧啶 niào mì dìng
double helix/ˈdʌbl ˈhiːlɪks/ 双螺旋 shuāng luó xuán
strand/strænd/ 链 liàn
deoxyribose/diːˈɒksɪrɪbəʊs/ 脱氧核糖 tuō yǎng hé táng
phosphodiester bond/ˈfɒsfəʊdɪstə bɒnd/ 磷酸二酯键 lín suān èr zhǐ jiàn
complementary base pairing/ˌkɒmplɪˈmentəri beɪs ˈpeərɪŋ/ 碱基互补配对 jiǎn jī hù bǔ pèi duì
hydrogen bond/ˈhaɪdrədʒn bɒnd/ 氢键 qīng jiàn
replication/ˌreplɪˈkeɪʃn/ 复制 fù zhì
semi-conservative replication/ˈsemi kənˈsɜːvətɪv ˌreplɪˈkeɪʃn/ 半保留复制 bàn bǎo liú fù zhì
6.1

The structure of DNA · ⁨Structure de l'ADN⁩

English

A DNA molecule is two strands twisted together into a double helix 双螺旋.

Each strand 链 has a backbone of alternating sugar (here the sugar is deoxyribose 脱氧核糖) and phosphate. The sugar of one nucleotide is joined to the phosphate of the next by a phosphodiester bond 磷酸二酯键.

The two strands are held together by their bases, which meet in the middle. The pairing is exact — this is complementary base pairing 碱基互补配对:

  • A always pairs with T, held by two hydrogen bonds 氢键.
  • C always pairs with G, held by three hydrogen bonds (so a C–G base pair 碱基对 is harder to separate).

The two strands run in opposite directions: one goes 5′ to 3′ while the other goes 3′ to 5′. We say they are antiparallel 反平行.

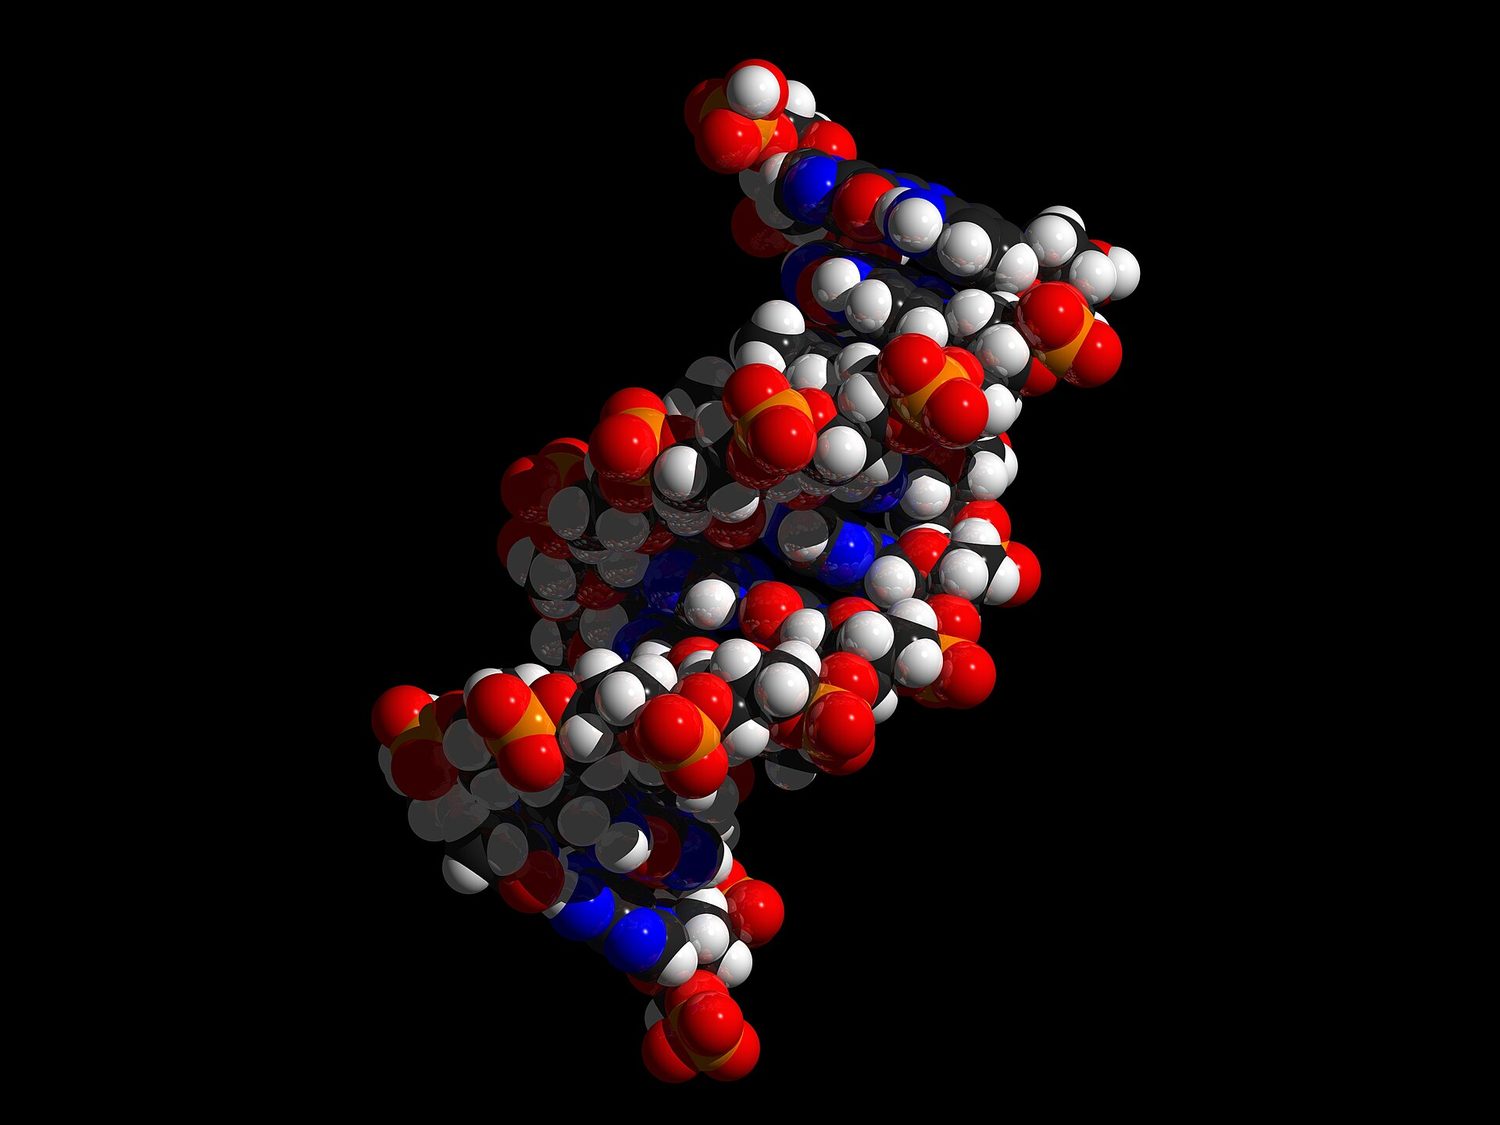
The flat ladder above is twisted into a spiral. This space-filling model, where every atom is a ball, shows the real shape of the double helix:

Français

Une molécule d'ADN est constituée de deux brins torsadés ensemble formant une double hélice 双螺旋.

Chaque brin 链 possède un squelette alternant de sucre (ici le sucre est la désoxyribose 脱氧核糖) et de phosphate. Le sucre d'un nucléotide est lié au phosphate du suivant par une liaison phosphodiester 磷酸二酯键.

Les deux brins sont maintenus ensemble par leurs bases, qui se rencontrent au centre. L'appariement est exact : c'est l'appariement complémentaire des bases 碱基互补配对 :

  • A s'apparie toujours avec T, maintenu par deux liaisons hydrogène 氢键.
  • C s'apparie toujours avec G, maintenu par trois liaisons hydrogène (ainsi une paire de bases C–G 碱基对 est plus difficile à séparer).

Les deux brins courent dans des directions opposées : l'un va de 5′ vers 3′ tandis que l'autre va de 3′ vers 5′. On dit qu'ils sont antiparallèles 反平行.

Diagramme en échelle de l'ADN : deux squelettes sucre-phosphate antiparallèles avec les paires de bases A=T liées par deux liaisons hydrogène et C=G par trois
Appariement complémentaire des bases : A s'apparie avec T (2 liaisons hydrogène), C avec G (3) ; les brins sont antiparallèles

L'échelle plate ci-dessus est tordue en spirale. Ce modèle volumétrique, où chaque atome est une boule, montre la forme réelle de l'hélice double :

Modèle volumétrique informatique d'un court fragment d'ADN sur fond noir : des centaines d'atomes colorés (rouge, orange, bleu, gris et blanc) empilés dans deux brins qui s'enroulent l'un autour de l'autre pour former une hélice double
Modèle volumétrique de l'ADN : les deux brins s'enroulent l'un autour de l'autre formant l'hélice double — l'échelle du diagramme, enroulée
Explore · ⁨Explorer⁩

Explorer l'échelle de l'ADN

Touchez chaque partie de l'hélice double — deux brins antiparallèles avec des appariements de bases complémentaires comme barreaux.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
base pair/beɪs peə/ 碱基对 jiǎn jī duì
antiparallel/ˌæntɪˈpærəlel/ 反平行 fǎn píng xíng
6.1

DNA replication · ⁨Réplication de l'ADN⁩

English

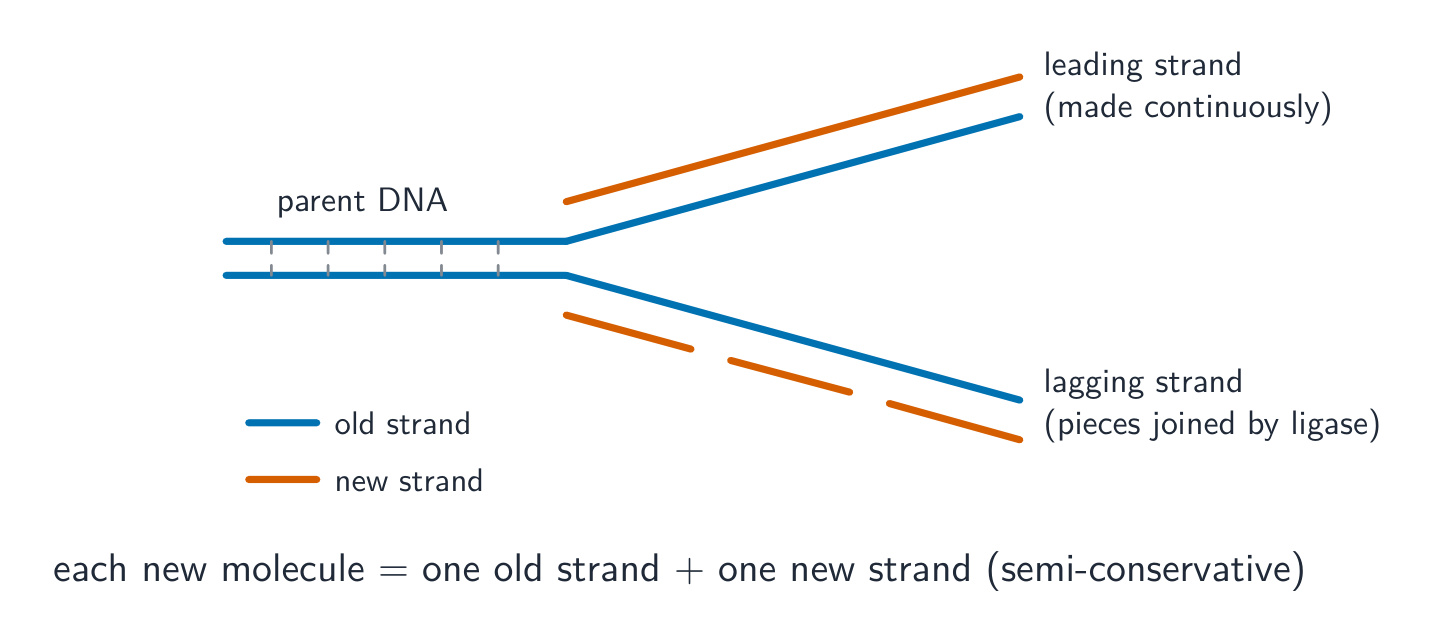
DNA replication 复制 (copying) happens during the S phase of the cell cycle. It is semi-conservative 半保留复制: each new molecule keeps one old strand and one new strand. The steps are:

  1. the double helix unwinds and the hydrogen bonds break, so the two strands separate.
  2. each old strand acts as a template. Free nucleotides pair with the exposed bases by complementary base pairing.
  3. the enzyme 酶 DNA polymerase 聚合酶 joins the new nucleotides into a strand. It can only add nucleotides in the 5′ to 3′ direction.

Because of that 5′ to 3′ rule, the two new strands are made differently:

  • the leading strand 前导链 is built continuously, following the unwinding.
  • the lagging strand 后随链 is built in short pieces, working away from the unwinding point. The enzyme DNA ligase 连接酶 then joins these pieces together.
Français

La réplication de l'ADN 复制 (copie) a lieu lors de la phase S du cycle cellulaire. Elle est semi-conservative 半保留复制 : chaque nouvelle molécule conserve un ancien brin et un nouveau brin. Les étapes sont :

  1. l'hélice double se dérouler et les liaisons hydrogène se rompent, ce qui sépare les deux brins.
  2. chaque brin ancien sert de matrice. Des nucléotides libres s'apparent aux bases exposées par appariement complémentaire des bases.
  3. l'enzyme 酶 ADN polymérase 聚合酶 lie les nouveaux nucléotides dans un brin. Elle ne peut ajouter des nucléotides que dans le sens 5′ vers 3′.

En raison de cette règle 5′ vers 3′, les deux nouveaux brins sont synthétisés différemment :

  • le brin avant 前导链 est construit de manière continue, en suivant le déroulement.
  • le brin arrière 后随链 est construit en petits morceaux, en s'éloignant du point de déroulement. L'enzyme ADN ligase 连接酶 relie ensuite ces morceaux entre eux.
Fourche de réplication : l'hélice double parente se déroule et chaque brin ancien sert de matrice à un nouveau brin — le brin avant étant construit continuellement, le brin arrière en fragments
La réplication est semi-conservative : chaque nouvelle molécule conserve un brin ancien (bleu) et un brin nouveau (orange)
Explore · ⁨Explorer⁩

Réplication semi-conservative

Étape par étape de la copie de l'ADN. L'hélice se dérouler, chaque ancien brin sert de matrice à un nouveau, et vous obtenez deux molécules identiques.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
enzyme/ˈenzaɪm/ 酶 méi
polymerase/ˌpɒlɪməˈreɪz/ 聚合酶 jù hé méi
leading strand/ˈliːdɪŋ strænd/ 前导链 qián dǎo liàn
lagging strand/ˈlæɡɪŋ strænd/ 后随链 hòu suí liàn
ligase/ˈlɪɡeɪs/ 连接酶 lián jiē méi
gene/dʒiːn/ 基因 jī yīn
6.1

RNA · ⁨ARN⁩

English

RNA is also made of nucleotides, but it is a single strand, its sugar is ribose, and it uses uracil in place of thymine. The most important type here is messenger RNA (mRNA), which carries a copy of a gene's instructions out of the nucleus to be used.

Français

L'ARN est également composé de nucléotides, mais il s'agit d'un seul brin, son sucre est le ribose, et il utilise l'uracile à la place de la thymine. Le type le plus important ici est l'ARN messager (ARNm), qui transporte une copie des instructions d'un gène hors du noyau pour être utilisée.

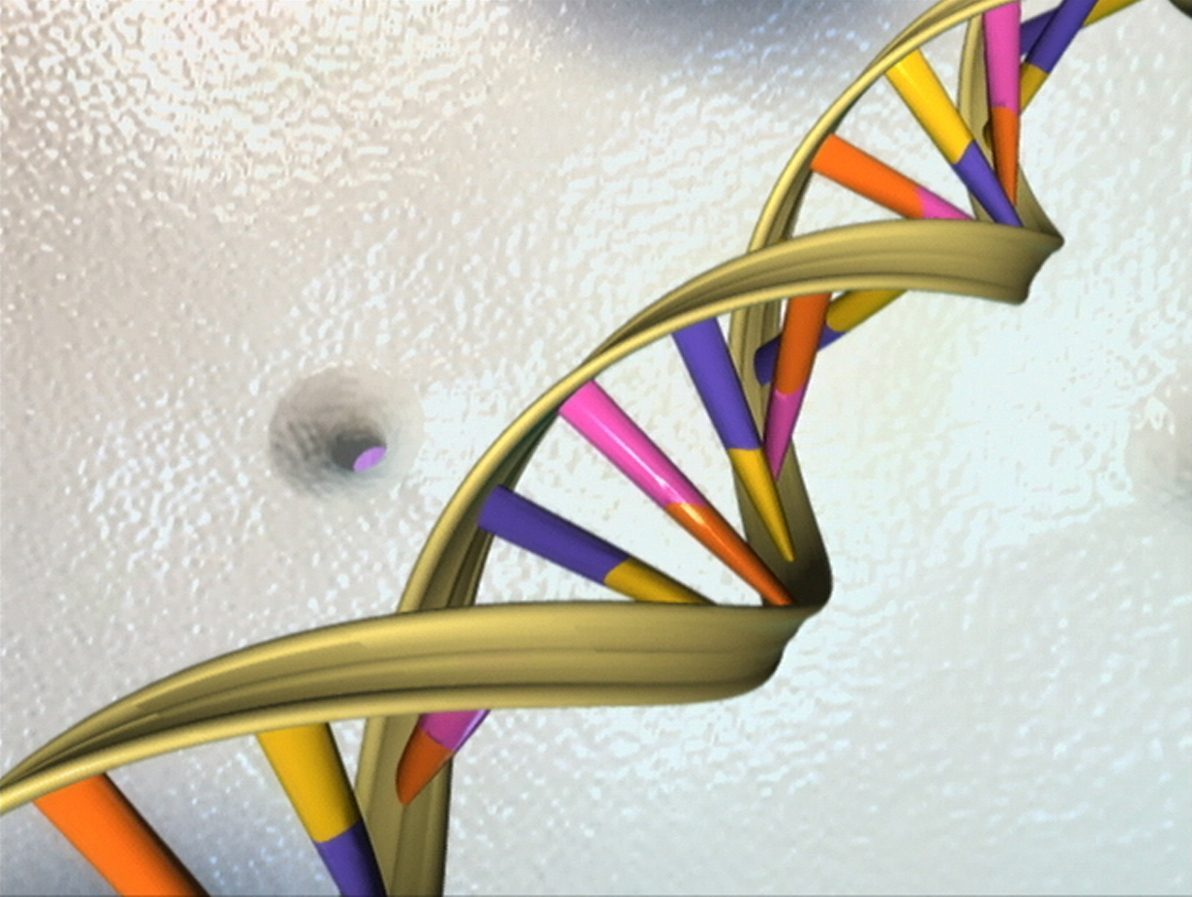
Hélice double de l'ADN : l'ARN est un acide nuclé apparenté qui transporte l'information génétique vers la synthèse des protéines
6.2

The genetic code · ⁨Le code génétique⁩

Syllabus · ⁨Programme⁩
English
  1. state that a polypeptide is coded for by a gene and that a gene is a sequence of nucleotides that forms part of a DNA molecule
  2. describe the principle of the universal genetic code in which different triplets of DNA bases either code for specific amino acids or correspond to start and stop codons
  3. describe how the information in DNA is used during transcription and translation to construct polypeptides, including the roles of: • RNA polymerase • messenger RNA (mRNA) • codons • transfer RNA (tRNA) • anticodons • ribosomes
  4. state that the strand of a DNA molecule that is used in transcription is called the transcribed or template strand and that the other strand is called the non-transcribed strand
  5. explain that, in eukaryotes, the RNA molecule formed following transcription (primary transcript) is modified by the removal of non-coding sequences (introns) and the joining together of coding sequences (exons) to form mRNA
  6. state that a gene mutation is a change in the sequence of base pairs in a DNA molecule that may result in an altered polypeptide
  7. explain that a gene mutation is a result of substitution or deletion or insertion of nucleotides in DNA and outline how each of these types of mutation may affect the polypeptide produced
Français
  1. affirmer qu'un polypeptide est codé par un gène et qu'un gène est une séquence de nucléotides faisant partie d'une molécule d'ADN
  2. décrire le principe du code génétique universel selon lequel différents triplets de bases de l'ADN codent soit pour des acides aminés spécifiques, soit correspondent à des codons de départ et d'arrêt
  3. décrire comment l'information contenue dans l'ADN est utilisée lors de la transcription et de la traduction pour construire des polypeptides, y compris les rôles de : • ARN polymérase • ARN messager (ARNm) • codons • ARN de transfert (ARNt) • anticodons • ribosomes
  4. affirmer que le brin d'une molécule d'ADN utilisé lors de la transcription est appelé brin transcrit ou brin matrice et que l'autre brin est appelé brin non transcrit
  5. expliquer que, chez les eucaryotes, la molécule d'ARN formée après la transcription (transcrit primaire) est modifiée par la suppression de séquences non codantes (introns) et la jonction de séquences codantes (exons) pour former l'ARNm
  6. affirmer qu'une mutation génique est un changement dans la séquence des paires de bases d'une molécule d'ADN qui peut entraîner un polypeptide altéré
  7. expliquer qu'une mutation génique résulte d'une substitution ou d'une deletion ou d'une insertion de nucléotides dans l'ADN et exposer comment chacun de ces types de mutations peut affecter le polypeptide produit

Source: Cambridge International syllabus · ⁨Source : Programme Cambridge International⁩

English
Protein synthesis: DNA to protein

A gene 基因 is a sequence of DNA nucleotides that codes for one polypeptide 多肽.

The code is read in triplets 三联体 — groups of three bases. Each triplet either codes for one specific amino acid 氨基酸, or acts as a start or stop signal. The code is universal: nearly all living things use the same triplets for the same amino acids.

There are 64 possible triplets but only 20 common amino acids, so most amino acids are coded by more than one triplet.

Français
Synthèse des protéines : de l'ADN à la protéine

Un gène 基因 est une séquence de nucléotides d'ADN codant pour une polypeptide 多肽.

Le code est lu par triplets 三联体 — des groupes de trois bases. Chaque triplet code soit pour un acide aminé 氨基酸 spécifique, soit sert de signal de départ ou d'arrêt. Le code est universel : la quasi-totalité des êtres vivants utilisent les mêmes triplets pour les mêmes acides aminés.

Il y a 64 triplets possibles mais seulement 20 acides aminés courants, donc la plupart des acides aminés sont codés par plus d'un triplet.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
polypeptide/ˌpɒlɪˈpeptaɪd/ 多肽 duō tài
triplet/ˈtrɪplɪt/ 三联体 sān lián tǐ
amino acid/əˈmiːnəʊ ˈæsɪd/ 氨基酸 ān jī suān
Watch lesson · ⁨Regarder la leçon⁩
6.2

Protein synthesis: transcription and translation · ⁨Synthèse des protéines : transcription et traduction⁩

English

Transcription (in the nucleus)

The DNA gene is copied into mRNA. This is transcription 转录.

  • the strand of DNA that is copied is the template strand 模板链; the partner strand is the non-transcribed strand 非转录链.
  • the enzyme RNA polymerase joins RNA nucleotides that pair with the template bases (with uracil pairing to adenine).
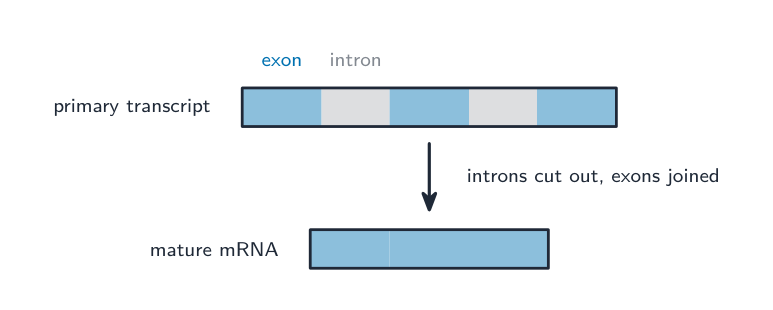
  • in eukaryotes the first RNA made (the primary transcript 初级转录本) contains coding parts called exons 外显子 and non-coding parts called introns 内含子. The introns are cut out and the exons joined together to form the finished mRNA.

Translation (at the ribosome)

The mRNA leaves the nucleus and attaches to a ribosome 核糖体. Building the polypeptide from the mRNA code is translation 翻译.

  • the mRNA is read in codons 密码子 (each codon is one triplet of mRNA bases).
  • molecules of transfer RNA (tRNA) bring amino acids to the ribosome. Each tRNA has an anticodon 反密码子 that pairs with a matching codon.
  • as the codons are read in order, the ribosome joins the amino acids with peptide bonds 肽键, building the polypeptide.

Worked example. A DNA template strand reads TAC GGA CTT. Give the mRNA codons, and say how long the polypeptide is. Transcribe by complementary base pairing, remembering that RNA uses uracil in place of thymine: TAC gives AUG, GGA gives CCU, CTT gives GAA. So the mRNA reads AUG CCU GAA. AUG is the start codon (methionine), so the polypeptide is three amino acids long - two once the start methionine is removed. Two errors cost most of the marks here: pairing A with T instead of U when writing mRNA, and transcribing the coding strand instead of the template strand. The mRNA is complementary to the template, and identical to the coding strand apart from U replacing T.

Français

Transcription (dans le noyau)

Le gène ADN est copié en ARNm. C'est la transcription 转录.

  • le brin d'ADN qui est copié est le brin matrice 模板链 ; le brin partenaire est le brin non transcrit 非转录链.
  • l'enzyme ARN polymérase joint les nucléotides d'ARN qui s'apparent aux bases de la matrice (avec l'uracile s'appariant à l'adénine).
  • chez les eucaryotes, le premier ARN produit (le transcrit primaire 初级转录本) contient des parties codantes appelées exons 外显one et des parties non codantes appelées introns 内含子. Les introns sont coupés et les exons sont joints pour former l'ARNm mature.
Un transcrit primaire avec des exons et des introns alternés ; les introns sont supprimés et les exons joints pour former un ARNm mature plus court
Épissage : les introns non codants sont coupés et les exons codants sont joints pour former l'ARNm final

Traduction (au ribosome)

L'ARNm quitte le noyau et se fixe sur un ribosome 核糖体. Construire la polypeptide à partir du code ARNm est la traduction 翻译.

  • l'ARNm est lu par codons 密码子 (chaque codon est un triplet de bases ARNm).
  • les molécules d'ARN de transfert (ARNt) apportent des acides aminés au ribosome. Chaque ARNt possède un anticodon 反密码子 qui s'apparie avec un codon correspondant.
  • alors que les codons sont lus dans l'ordre, le ribosome lie les acides aminés par des liaisons peptidiques 肽键, construisant la polypeptide.
Aperçu de la synthèse des protéines : dans le noyau, l'ADN est transcrit en ARNm, qui quitte le noyau et est traduit au niveau d'un ribosome où l'ARNt apporte les acides aminés pour construire une polypeptide
La transcription copie l'ADN en ARNm dans le noyau ; la traduction au ribosome construit la polypeptide

Exemple résolu. Un brin matrice ADN lit TAC GGA CTT. Donnez les codons ARNm et précisez la longueur de la polypeptide. Transcrivez par appariement complémentaire des bases, en vous rappelant que l'ARN utilise l'uracile à la place de la thymine : TAC donne AUG, GGA donne CCU, CTT donne GAA. Donc l'ARNm lit AUG CCU GAA. AUG est le codon de départ (méthionine), donc la polypeptide fait trois acides aminés de long - deux une fois la méthionine de départ retirée. Deux erreurs ont coûté la plupart des points ici : appairer A avec T au lieu de U lors de l'écriture de l'ARNm, et transcrire le brin codant au lieu du brin matrice. L'ARNm est complémentaire à la matrice et identique au brin codant à part U remplaçant T.

Explore · ⁨Explorer⁩

Du gène à la protéine

Étape par étape de la doctrine centrale : la matrice ADN est transcrit en ARNm par appariement de bases (A→U, T→A, G→C, C→G), puis lu en codons et traduit en chaîne d'acides aminés.

Explore · ⁨Explorer⁩

Du gène à la protéine

Parcourez comment un gène devient une protéine. La transcription copie l'ADN en ARNm ; la traduction lit l'ARNNm pour construire le polypeptide.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
codon/ˈkəʊdɒn/ 密码子 mì mǎ zi
transcription/trænˈskrɪpʃn/ 转录 zhuǎn lù
template strand/ˈtempleɪt strænd/ 模板链 mú bǎn liàn
non-transcribed strand/nɒn trænˈskraɪbd strænd/ 非转录链 fēi zhuǎn lù liàn
primary transcript/ˈpraɪməri ˈtrænskrɪpt/ 初级转录本 chū jí zhuǎn lù běn
exon/eɡˈzɒn/ 外显子 wài xiǎn zi
intron/ɪnˈtrɒn/ 内含子 nèi hán zi
ribosome/ˈriːbəʊsəʊm/ 核糖体 hé táng tǐ
translation/trænˈsleɪʃn/ 翻译 fān yì
anticodon/ˌæntɪˈkəʊdɒn/ 反密码子 fǎn mì mǎ zi
peptide bond/ˈpeptaɪd bɒnd/ 肽键 tài jiàn
6.2

Gene mutations · ⁨Mutations géniques⁩

English

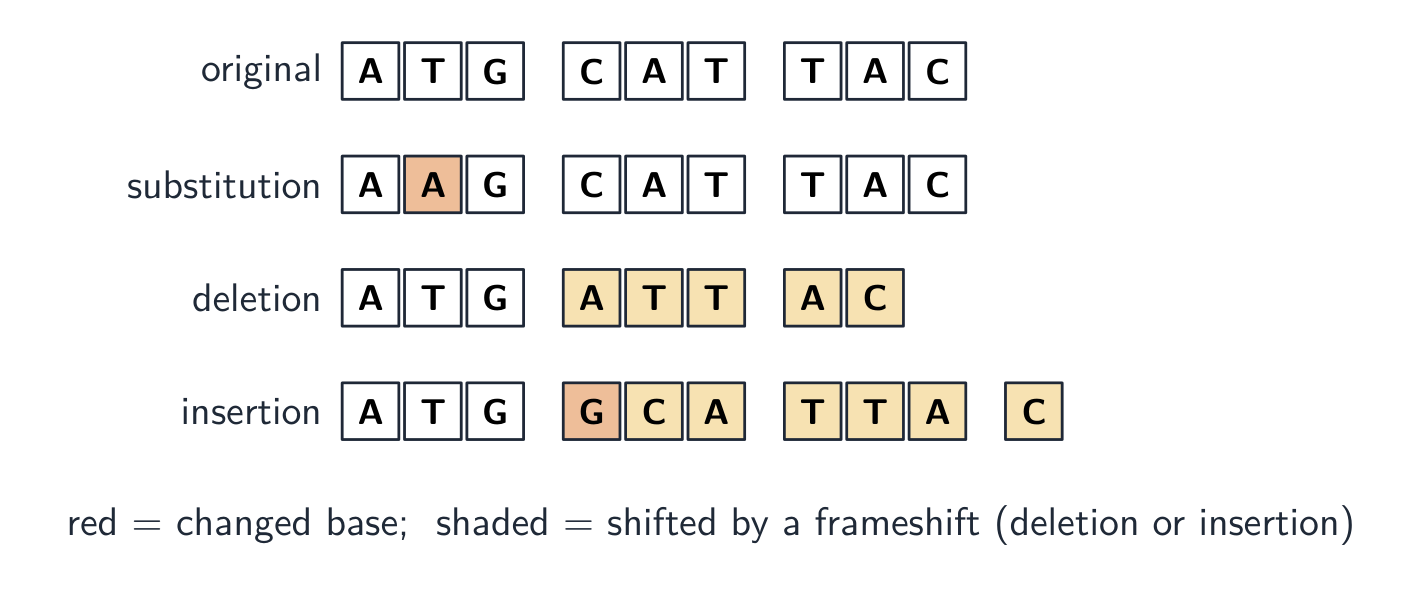
A gene mutation 突变 is a change in the base sequence of a DNA molecule. It may change the polypeptide made. There are three types:

  • substitution 替换 — one base is swapped for a different base. This changes at most one amino acid, and sometimes none (because most amino acids have more than one triplet).
  • deletion 缺失 — a base is removed.
  • insertion 插入 — an extra base is added.

A deletion or insertion shifts how every later triplet is read, so it usually changes many amino acids after that point and has a large effect on the polypeptide.

Français

Une mutation génique 突变 est un changement dans la séquence de bases d'une molécule d'ADN. Elle peut modifier la polypeptide produite. Il existe trois types :

  • substitution 替换 — une base est échangée contre une autre base différente. Cela change au maximum un acide aminé, et parfois aucun (car la plupart des acides aminés ont plus d'un triplet).
  • déletion 缺失 — une base est supprimée.
  • insertion 插入 — une base supplémentaire est ajoutée.

Une délétion ou une insertion décale la lecture de tous les triplets suivants, elle modifie donc généralement de nombreux acides aminés après ce point et a un grand effet sur la polypeptide.

Séquence de bases lue par triplets présentée quatre fois : l'original, une substitution changeant une base, une délétion et une insertion — toutes deux décalant tous les triplets suivants
Une substitution change un triplet ; une délétion ou une insertion décale tous les triplets suivants (un déplacement du cadre de lecture)
Explore · ⁨Explorer⁩

Laboratoire sur le type de mutation

Comparez la substitution, l'insertion et la délétion selon leur effet sur le code.

Vocabulary · ⁨Vocabulaire⁩ Train · ⁨Entrainer⁩
English · ⁨Anglais⁩ Chinese · ⁨Chinois⁩ Pinyin
mutation/mjuːˈteɪʃn/ 突变 tū biàn
substitution/ˌsʌbstɪˈtjuːʃn/ 替换 tì huàn
deletion/dɪˈliːʃn/ 缺失 quē shī
insertion/ɪnˈsɜːʃn/ 插入 chā rù
6.2

Exam tips · ⁨Conseils d'examen⁩

English
  • DNA is antiparallel, held by hydrogen bonds (A=T two, C≡G three); replication is semi-conservative (each product keeps one old strand).
  • State where and what: transcription (nucleus → mRNA), translation (ribosome, mRNA + tRNA → polypeptide).
  • Describe the code with all four terms: triplet, non-overlapping, degenerate, universal.
  • For a gene mutation (substitution, insertion, deletion) explain the effect on the protein — and why a substitution can be silent (degeneracy).
Français
  • L'ADN est antiparallèle, maintenu par des liaisons hydrogène (A=T deux, C≡G trois) ; la réplication est semi-conservative (chaque produit conserve un brin ancien).
  • Indiquez où et quoi : transcription (noyau → ARNm), traduction (ribosome, ARNm + ARNt → polypeptide).
  • Décrivez le code avec les quatre termes : triplet, non chevauchant, dégénéré, universel.
  • Pour une mutation génique (substitution, insertion, délétion), expliquez l'effet sur la protéine — et pourquoi une substitution peut être silencieuse (dégénérescence).

Interactive lessons on this topic · ⁨Leçons interactives sur ce sujet⁩

Work through it step by step, with instant-check exercises. · ⁨Traversez-le étape par étape, avec des exercices à vérification instantanée.⁩

Past Papers · ⁨Épreuves Passées⁩

More topics in Biologie A-Level · ⁨Plus de sujets dans Biologie A-Level⁩

Log in or create account · ⁨Se connecter ou créer un compte⁩

IGCSE, A-Level & AP