Antes de las bases de datos, cada programa mantenía sus propios archivos planos — un archivo por programa. Imagina una tienda. El programa de ventas, el programa de facturación y el programa de envío…
English narration · English + 中文 subtitles burned in · Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
8.1
File-based storage and its limits · Almacenamiento basado en archivos y sus límites
Syllabus
English
Candidates should be able to:
Notes and guidance
Show understanding of the limitations of using a file-based approach for the storage and retrieval of data
Describe the features of a relational database that address the limitations of a file-based approach
Show understanding of and use the terminology associated with a relational database model
Use an entity-relationship (E-R) diagram to document a database design
Show understanding of the normalisation process
First Normal Form (1NF), Second Normal Form (2NF) and Third Normal Form (3NF)
Explain why a given set of database tables are, or are not, in 3NF
Produce a normalised database design for a description of a database, a given set of data, or a given set of tables
Español
Los candidatos deben ser capaces de:
Notas y orientación
Demostrar comprensión de las limitaciones del uso de un enfoque basado en archivos para el almacenamiento y recuperación de datos
Describir las características de una base de datos relacional que abordan las limitaciones de un enfoque basado en archivos
Demostrar comprensión y utilizar la terminología asociada con un modelo de base de datos relacional
Incluye entidad, tabla, registro, campo, tupla, atributo, clave primaria, clave candidata, clave secundaria, clave foránea, relación (uno a muchos, uno a uno, muchos a muchos), integridad referencial, indexación
Utilizar un diagrama de entidad-relación (E-R) para documentar un diseño de base de datos
Demostrar comprensión del proceso de normalización
Primera Forma Normal (1FN), Segunda Forma Normal (2FN) y Tercera Forma Normal (3FN)
Explicar por qué un conjunto dado de tablas de base de datos está o no está en 3FN
Producir un diseño de base de datos normalizado a partir de una descripción de una base de datos, un conjunto dado de datos o un conjunto dado de tablas
Source: Cambridge International syllabus · Fuente: Plan de estudios Cambridge International
English
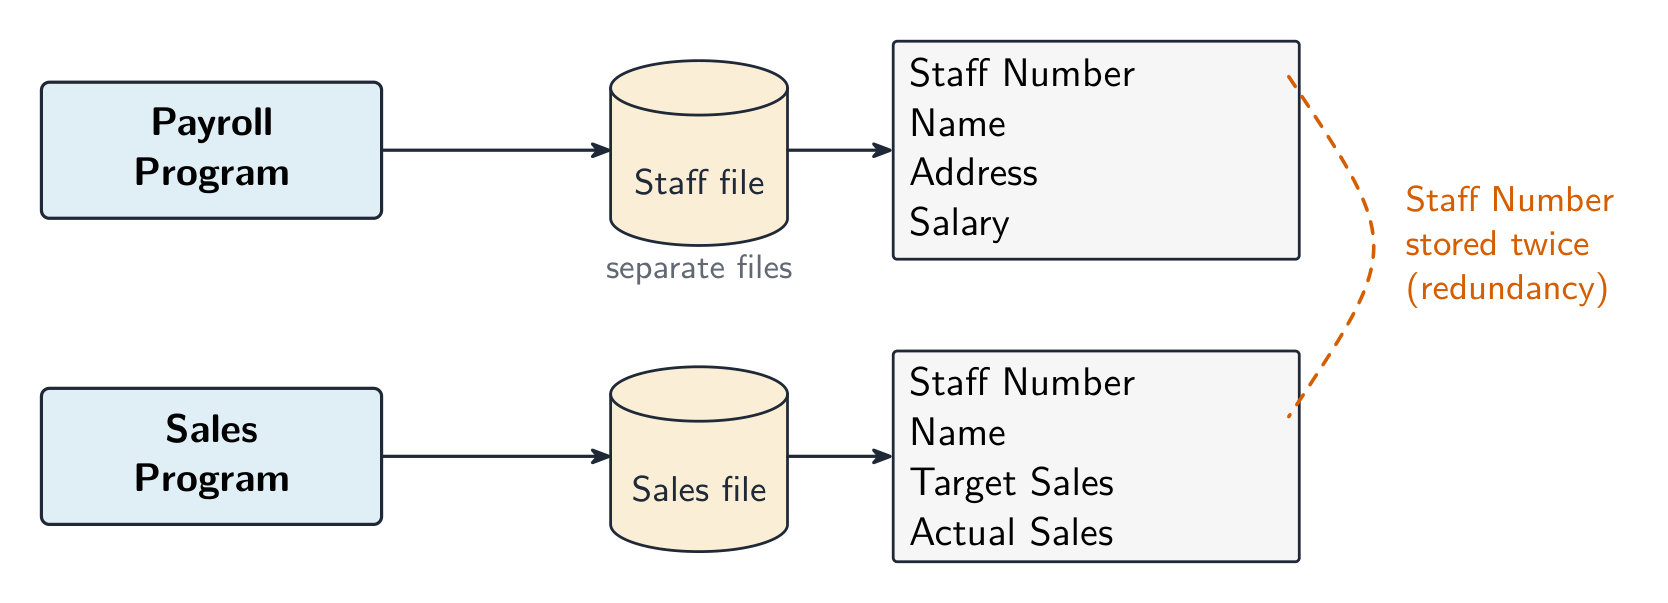
Before databases, programs stored data in flat files 平面文件 — usually one file per program. This is fine for small data but breaks down at scale.
Limitations
data redundancy 数据冗余 — the same data (a customer's address) is held in several files, one per program, so storage is wasted and every copy must be updated.
data inconsistency 数据不一致 — when one copy is updated and another is not, the files disagree and nobody knows which is right.
data dependence — each program is written for the exact layout of its files; change a field's length or add a field and every program that reads the file must be rewritten.
no shared access — a file is locked while one program uses it, so users cannot work on the data at the same time.
weak integrity 完整性 — no central rules stop an invalid value or a link to a customer who does not exist; weak security — access is per file, not per field; and queries across files need a new program each time.
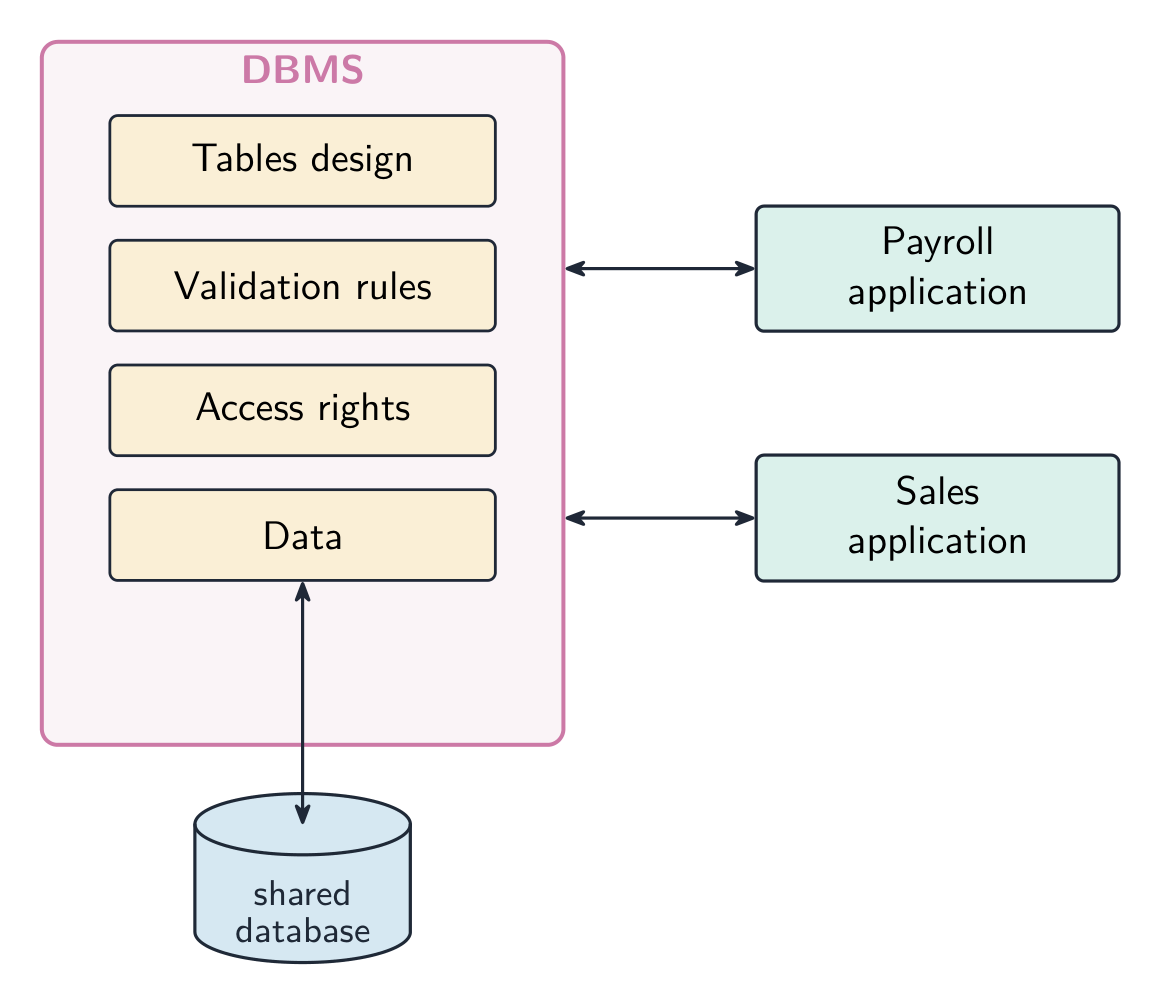
A relational database 关系数据库 fixes these by storing data in tables managed by one piece of software (the DBMS) that all programs use.
Why a relational database is better — the three-mark answer. Each item of data is stored once, in one table, and tables are linked by keys, so there is no redundancy and no inconsistency; the data is independent of the programs, which ask the DBMS for what they need and are unaffected when the structure changes; and the DBMS enforces integrity rules, controls access per user and per field, allows many users at once, and answers any query without a new program being written.
Worked example. A repair shop stores its customers, devices and repair jobs using a file-based approach, one file per program. Give three problems this causes, and describe how a relational database would remove them.
The customer's name and phone number are stored in the repairs file and the invoices file (redundancy); when a customer changes number, one file is updated and the other is not (inconsistency); and when the shop wants a new report — repairs per technician — a new program has to be written to read the files (no ad-hoc queries). In a relational database the customer is stored once in a CUSTOMER table and referred to by CustomerID from the REPAIR table, so a change is made once and is seen everywhere; the report is a single SQL query.
Español
Antes de las bases de datos, los programas almacenaban datos en archivos planos — usualmente un archivo por programa. Esto es adecuado para datos pequeños, pero falla a gran escala.
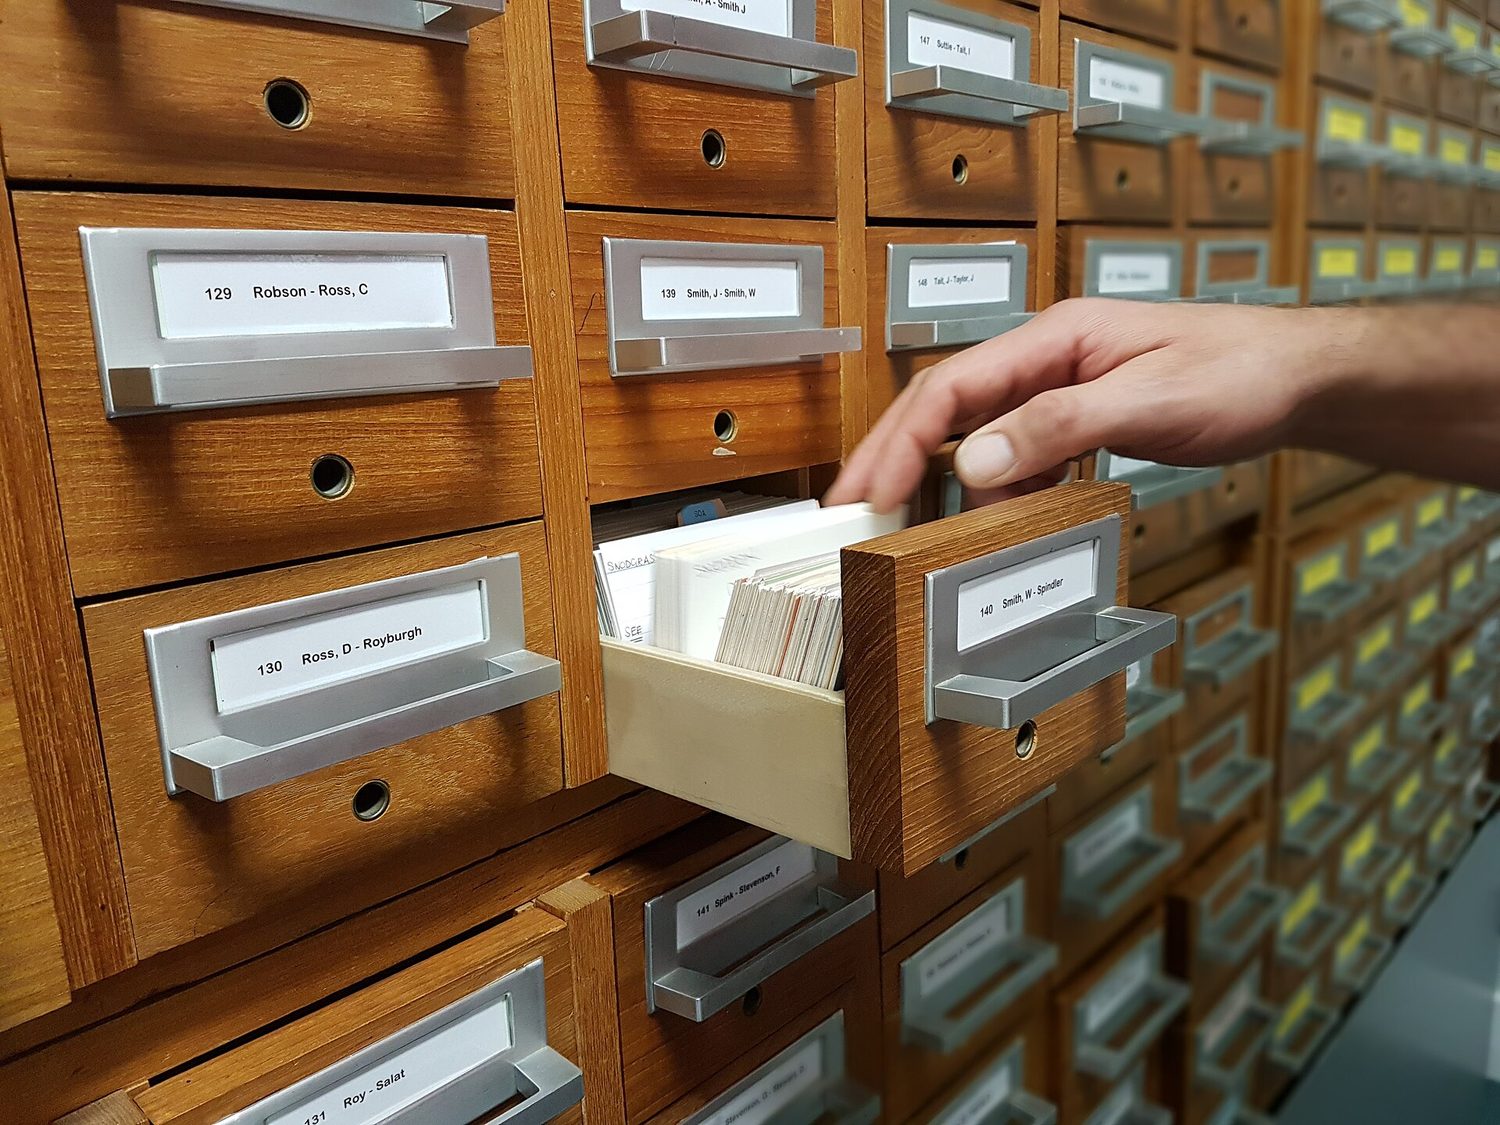
El almacenamiento basado en archivos mantiene los datos en archivos separados, como papeles en un archivador — difícil de buscar y fácil de duplicar
Limitaciones
redundancia de datos — los mismos datos (la dirección de un cliente) se mantienen en varios archivos, uno por programa; se desperdicia almacenamiento y cada copia debe actualizarse.
inconsistencia de datos — cuando una copia se actualiza y otra no, los archivos discrepan y nadie sabe cuál es la correcta.
dependencia de datos — cada programa está escrito para el layout exacto de sus archivos; si se cambia la longitud de un campo o se añade uno nuevo, todos los programas que leen el archivo deben reescribirse.
sin acceso compartido — un archivo se bloquea mientras un programa lo usa, por lo que los usuarios no pueden trabajar en los datos simultáneamente.
integridad débil — no hay reglas centrales que impidan valores inválidos o enlaces a clientes que no existen; seguridad débil — el acceso es por archivo, no por campo; y las consultas entre archivos requieren un programa nuevo cada vez.
El enfoque basado en archivos: cada programa mantiene sus propios archivos
Una base de datos relacional corrige esto almacenando datos en tablas gestionadas por un único software (el SGBD) que utilizan todos los programas.
El enfoque de base de datos: un SGBD sirve a todos los programas
Por qué una base de datos relacional es mejor — la respuesta de tres puntos. Cada elemento de dato se almacena una sola vez, en una tabla, y las tablas están vinculadas por claves, por lo que no hay redundancia ni inconsistencia; los datos son independientes de los programas, que solicitan al SGBD lo que necesitan y no se ven afectados cuando cambia la estructura; y el SGBD aplica reglas de integridad, controla el acceso por usuario y por campo, permite muchos usuarios a la vez y responde cualquier consulta sin necesidad de escribir un programa nuevo.
Ejercicio resuelto. Una tienda de reparaciones almacena sus clientes, dispositivos y trabajos de reparación usando un enfoque basado en archivos, un archivo por programa. Indique tres problemas que esto causa y describa cómo una base de datos relacional los eliminaría.
El nombre y el teléfono del cliente se almacenan en el archivo de reparaciones y en el archivo de facturas (redundancia); cuando un cliente cambia su número, se actualiza un archivo y el otro no (inconsistencia); y cuando la tienda desea un informe nuevo — reparaciones por técnico — se debe escribir un programa nuevo para leer los archivos (sin consultas ad-hoc). En una base de datos relacional, el cliente se almacena una sola vez en una tabla CUSTOMER y se hace referencia mediante CustomerID desde la tabla REPAIR, por lo que el cambio se realiza una sola vez y se ve en todas partes; el informe es una única consulta SQL.
8.1
Relational model — terms · Modelo relacional — términos
English
table 表 (relation) — a grid of rows and columns; one table per type of entity 实体 (e.g. CUSTOMER).
record 记录 (row, also called a tuple 元组) — one row; one instance of the entity.
field 字段 (column, also called an attribute 属性) — one column; one piece of information about each record.
primary key 主键 — a field (or fields) that uniquely identifies each record; never null or duplicated.
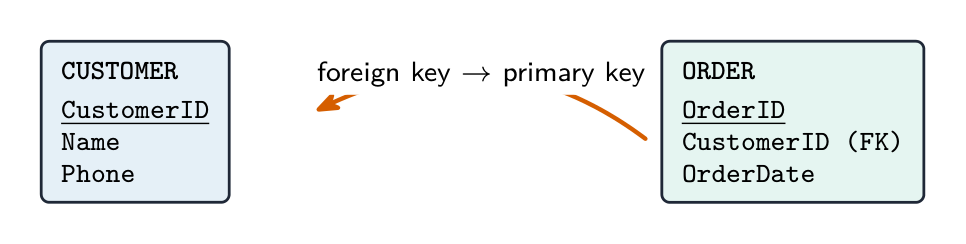
foreign key 外键 — a field whose value matches the primary key of another table, linking the two.
composite key 复合键 — a primary key made of two or more fields together.
candidate key 候选键 — any field(s) that could be the primary key.
secondary key 次键 — a non-primary field that is indexed for fast searching.
indexing 索引 — building an index on a field so look-ups and joins run faster.
referential integrity 参照完整性 — every foreign-key value must match an existing primary key (no orphan records).
A table is written in shorthand with the primary key underlined and foreign keys noted:
Worked example. State what is meant by entity, primary key and referential integrity in a relational database, and complete the term ↔ description table for tuple and attribute.
An entity is something about which data is stored — a person, object or event — which becomes one table. A primary key is the attribute (or combination of attributes) that uniquely identifies each record in a table. Referential integrity means that every foreign-key value must match the value of a primary key in the table it refers to, so a record cannot refer to one that does not exist. A tuple is one row of a table (one record); an attribute is one column (one field). Learn the pairs: table/relation, record/tuple, field/attribute.
Español
tabla — una cuadrícula de filas y columnas; una tabla por tipo de entidad (ej. CUSTOMER).
registro (fila, también llamado tupla) — una fila; una instancia de la entidad.
campo (columna, también llamado atributo) — una columna; una pieza de información sobre cada registro.
clave primaria — un campo (o campos) que identifica de forma única cada registro; nunca nulo ni duplicado.
clave foránea — un campo cuyo valor coincide con la clave primaria de otra tabla, vinculándolas.
clave compuesta — una clave primaria formada por dos o más campos juntos.
clave candidata — cualquier campo(s) que podría ser la clave primaria.
clave secundaria — un campo no primario que está indexado para búsquedas rápidas.
indexación — crear un índice en un campo para que las búsquedas y uniones sean más rápidas.
integridad referencial — cada valor de clave foránea debe coincidir con una clave primaria existente (no hay registros huérfanos).
Una tabla se escribe en abreviatura subrayando la clave primaria y señalando las claves foráneas:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is FK → CUSTOMER
Una clave foránea vincula dos tablas: ORDER.CustomerID coincide con la clave primaria CUSTOMER.CustomerID
Ejercicio resuelto. Explique qué significan entidad, clave primaria e integridad referencial en una base de datos relacional, y complete la tabla de término ↔ descripción para tupla y atributo.
Una entidad es algo sobre lo cual se almacenan datos — una persona, objeto o evento — que se convierte en una tabla. Una clave primaria es el atributo (o combinación de atributos) que identifica de forma única cada registro en una tabla. La integridad referencial significa que cada valor de clave foránea debe coincidir con el valor de una clave primaria en la tabla a la que hace referencia, por lo que un registro no puede referirse a uno que no existe. Una tupla es una fila de una tabla (un registro); un atributo es una columna (un campo). Aprenda los pares: tabla/relación, registro/tupla, campo/atributo.
Explore · Explorar
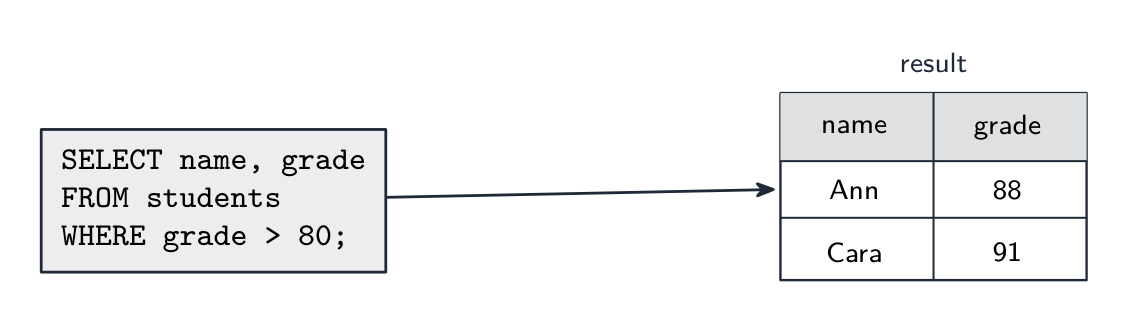
Leer una tabla relacional con SELECT
Una tabla relacional son simplemente filas (registros) y columnas (campos). WHERE mantiene las filas que coinciden con una condición; SELECT luego mantiene solo las columnas que solicitaste.
Entity-relationship (E-R) diagrams · Diagramas de entidad-relación (E-R)
English
An entity-relationship diagram 实体关系图 shows the structure: each entity is a rectangle, each relationship a line, with the cardinality 基数 marked at each end:
one-to-one (1:1).
one-to-many 一对多 (1:M) — each Customer has many Orders; each Order has one Customer.
many-to-many (M:N) — Students take many Courses, and Courses have many Students.
A many-to-many relationship cannot be stored directly. Break it into two one-to-many relationships through a link table 连接表 holding the two foreign keys:
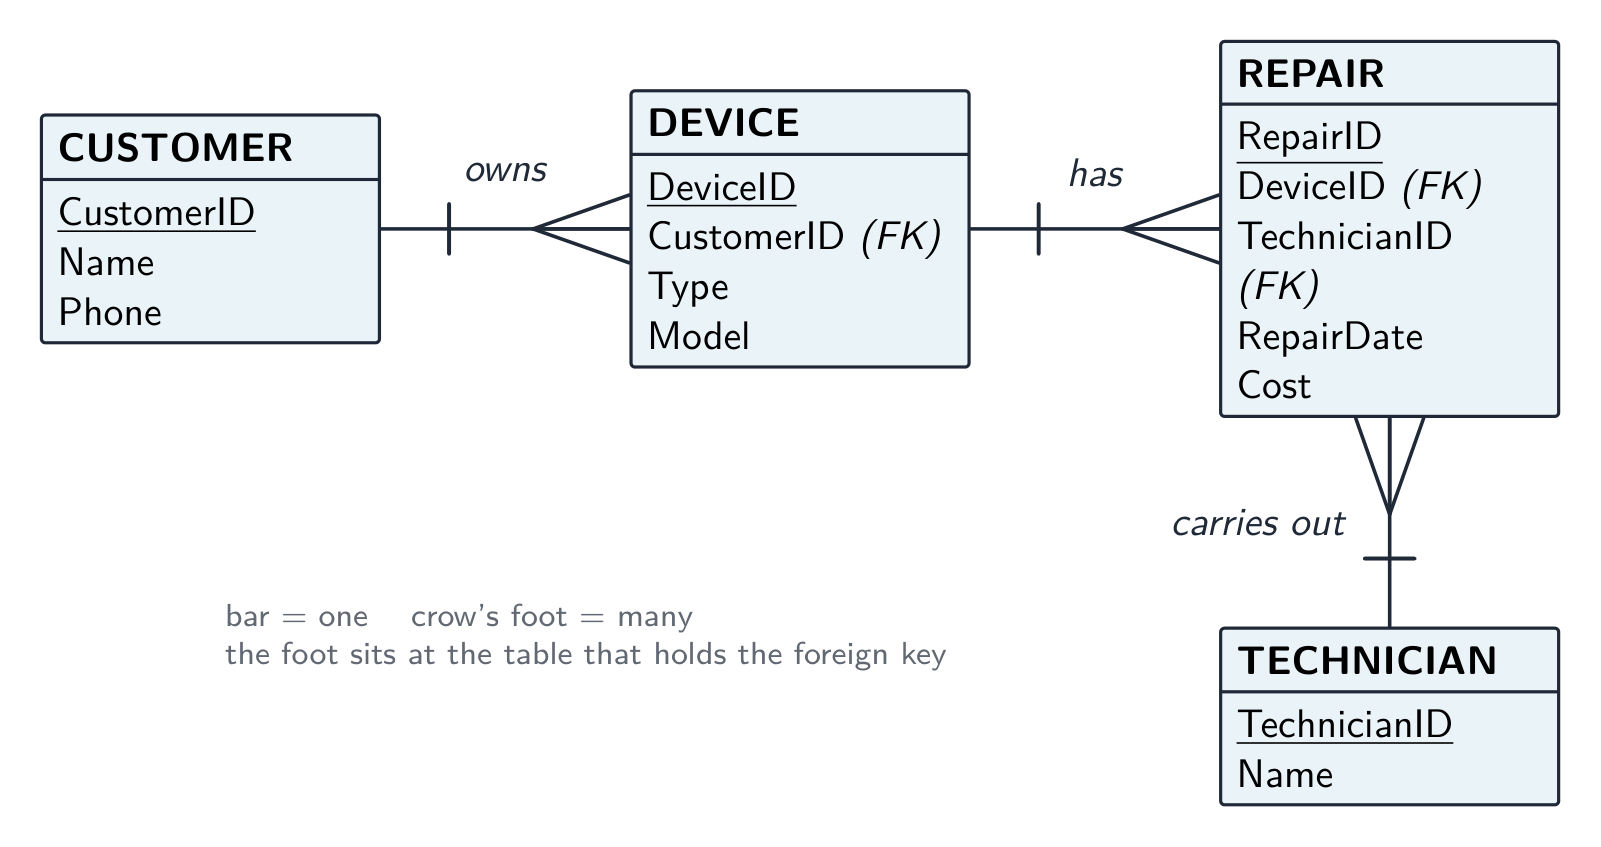
Drawing the E-R diagram for a given set of tables. Each table becomes an entity. A relationship exists wherever one table holds a foreign key to another; it runs from the table holding the foreign key (the many end) to the table whose primary key it is (the one end). A table with two foreign keys and no other identity is usually a link table resolving a many-to-many relationship. Label each line with the relationship type.
Worked example. A repair shop has the tables CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) and REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identify the relationships and their types.
DEVICE holds CustomerID, so CUSTOMER–DEVICE is one-to-many (one customer, many devices). REPAIR holds DeviceID, so DEVICE–REPAIR is one-to-many; it also holds TechnicianID, so TECHNICIAN–REPAIR is one-to-many. There is no direct CUSTOMER–REPAIR line: the link runs through DEVICE. Three lines, three crow's feet, all at the REPAIR or DEVICE ends.
Español
Un diagrama de entidad-relación muestra la estructura: cada entidad es un rectángulo, cada relación una línea, con la cardinalidad marcada en cada extremo:
uno a uno (1:1).
uno a muchos (1:M) — cada Cliente tiene muchos Pedidos; cada Pedido tiene un Cliente.
muchos a muchos (M:N) — los Estudiantes toman muchos Cursos, y los Cursos tienen muchos Estudiantes.
Un diagrama E-R: una clase tiene muchos estudiantesSímbolos de pie de gallo para la cardinalidad de una relación
Una relación de muchos a muchos no se puede almacenar directamente. Divídala en dos relaciones de uno a muchos a través de una tabla de enlace que contiene las dos claves foráneas:
ENROLMENT(StudentID, CourseID, EnrolmentDate)
Una tabla de enlace resuelve una relación de muchos a muchos en dos relaciones de uno a muchos
Dibujar el diagrama E-R para un conjunto dado de tablas. Cada tabla se convierte en una entidad. Existe una relación donde una tabla contiene una clave foránea hacia otra; esta va desde la tabla que contiene la clave foránea (el extremo muchos) hasta la tabla cuya clave primaria es (el extremo uno). Una tabla con dos claves foráneas y sin otra identidad suele ser una tabla de enlace que resuelve una relación de muchos a muchos. Etiquete cada línea con el tipo de relación.
El diagrama se dibuja a partir de las tablas: cada clave foránea representa una relación uno a muchos, con el "muchos" en la tabla que la contiene
Ejemplo resuelto. Una taller de reparaciones tiene las tablas CUSTOMER(CustomerID, Name, Phone), DEVICE(DeviceID, CustomerID, Type, Model), TECHNICIAN(TechnicianID, Name) y REPAIR(RepairID, DeviceID, TechnicianID, RepairDate, Cost). Identifique las relaciones y sus tipos.
DEVICE contiene CustomerID, por lo tanto CUSTOMER–DEVICE es uno a muchos (un cliente, muchos dispositivos). REPAIR contiene DeviceID, por lo tanto DEVICE–REPAIR es uno a muchos; también contiene TechnicianID, por lo tanto TECHNICIAN–REPAIR es uno a muchos. No hay línea directa CUSTOMER–REPAIR: el enlace pasa a través de DEVICE. Tres líneas, tres patas de gallo, todas en los extremos REPAIR o DEVICE.
Normalisation 规范化 organises tables to cut redundancy and inconsistency, going through normal forms 范式 in order.
First normal form (1NF) — every field holds a single (atomic 原子) value, with no repeating groups, and a primary key.
Second normal form (2NF) — in 1NF, and every non-key field depends on the whole primary key (only matters for a composite key).
Third normal form (3NF) — in 2NF, and every non-key field depends only on the primary key, not on another non-key field (no transitive dependency 传递依赖).
A 3NF design stores each fact once, so insert/update/delete anomalies disappear. The trade-off is more tables and more joins. Aim for 3NF.
To produce a 3NF design: find the entities and their attributes; choose a primary key for each; split repeating/non-atomic fields (1NF); split fields depending on part of a composite key (2NF); split fields depending transitively on the key (3NF); add foreign keys for the relationships.
Worked example. The table ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) has the composite primary key (OrderID, ProductID). Normalise it to 3NF. Test each non-key field against the key. Quantity depends on bothOrderID and ProductID, which is fine. But CustomerID depends on OrderID alone - only part of the composite key. That is a partial dependency, so the table is not in 2NF. Split it into ORDER_LINE(OrderID, ProductID, Quantity) and ORDER(OrderID, CustomerID, CustomerName). Now test 3NF: in that new ORDER table, CustomerName depends on CustomerID, which is not the key - a transitive dependency. Split again: ORDER(OrderID, CustomerID) and CUSTOMER(CustomerID, CustomerName). Name the dependency that breaks each form (partial breaks 2NF, transitive breaks 3NF); "it has repeated data" describes the symptom and earns nothing.
The three questions to ask of any table.Is every cell a single value, with no repeating group? If not, it is not in 1NF. If the key is composite, does every non-key field depend on the whole key? If some field depends on part of it, there is a partial dependency 部分依赖 and the table is not in 2NF. Does every non-key field depend on the key alone? If a field depends on another non-key field, there is a transitive dependency and the table is not in 3NF. An "explain why the table is not in 3NF" answer names the dependency and the fields involved.
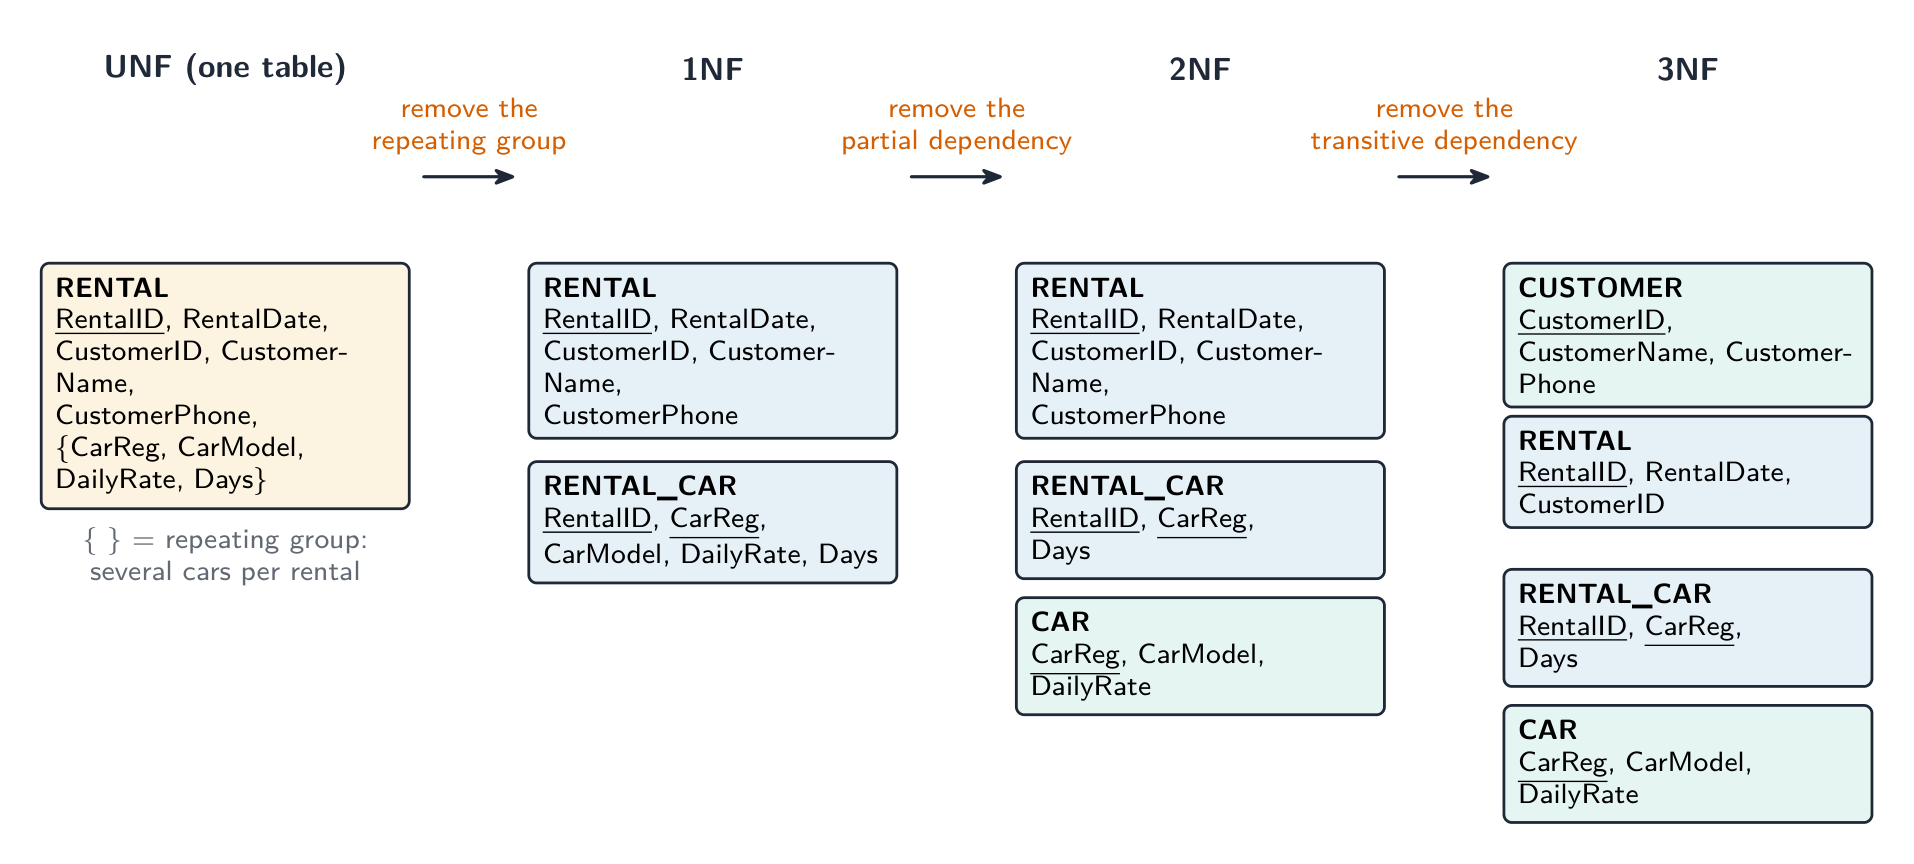
Worked example. A car-rental shop records each rental as RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), where one rental can include several cars. Explain why the table is not normalised and produce a 3NF design.
Not in 1NF: the car fields CarReg, CarModel, DailyRate, Days form a repeating group — one rental has several cars. Move them to RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) with the composite key (RentalID, CarReg). Not in 2NF: in RENTAL_CAR, CarModel and DailyRate depend on CarReg alone — a partial dependency. Move them to CAR(CarReg, CarModel, DailyRate), leaving RENTAL_CAR(RentalID, CarReg, Days). Not in 3NF: in RENTAL, CustomerName and CustomerPhone depend on CustomerID, a non-key field — a transitive dependency. Move them to CUSTOMER(CustomerID, CustomerName, CustomerPhone), leaving RENTAL(RentalID, RentalDate, CustomerID). The 3NF design is four tables — CUSTOMER, RENTAL, RENTAL_CAR, CAR — with CustomerID, RentalID and CarReg as foreign keys; underline every primary key.
Español
Normalización 规范化 organiza las tablas para reducir la redundancia e inconsistencia, pasando por formas normales 范式 en orden.
Primera forma normal (1NF) — cada campo contiene un único valor (atómico 原子), sin grupos repetidos, y con una clave primaria.
Segunda forma normal (2NF) — en 1NF, y cada campo no clave depende de la clave primaria entera (solo importa si es una clave compuesta).
Tercera forma normal (3NF) — en 2NF, y cada campo no clave depende únicamente de la clave primaria, no de otro campo no clave (sin dependencia transitiva 传递依赖).
Un diseño 3NF almacena cada dato una sola vez, por lo que desaparecen las anomalías de inserción, actualización y eliminación. La contrapartida es tener más tablas y más uniones (joins). Se debe apuntar a 3NF.
Para obtener un diseño 3NF: encuentre las entidades y sus atributos; elija una clave primaria para cada una; divida campos repetidos o no atómicos (1NF); divida campos que dependen de parte de una clave compuesta (2NF); divida campos que dependen transitivamente de la clave (3NF); añada claves foráneas para las relaciones.
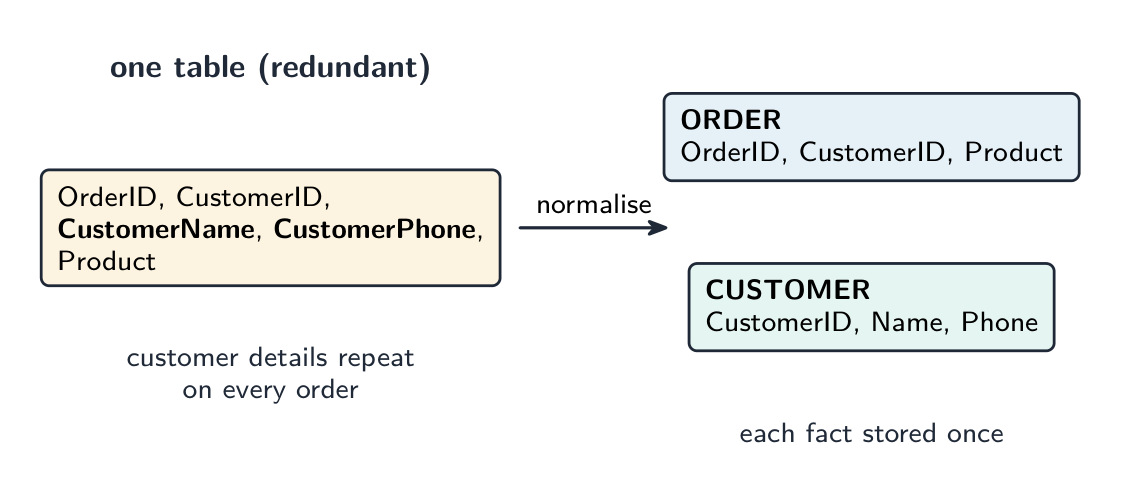
La normalización elimina la redundancia al separar los datos repetidos en su propia tabla
Ejemplo resuelto. La tabla ORDER(OrderID, CustomerID, CustomerName, ProductID, Quantity) tiene la clave primaria compuesta (OrderID, ProductID). Normalícela a 3NF. Pruebe cada campo no clave contra la clave. Quantity depende de ambosOrderID y ProductID, lo cual está bien. Pero CustomerID depende de OrderID solo - solo parte de la clave compuesta. Eso es una dependencia parcial, por lo que la tabla no está en 2NF. Divídala en ORDER_LINE(OrderID, ProductID, Quantity) y ORDER(OrderID, CustomerID, CustomerName). Ahora pruebe 3NF: en esa nueva tabla ORDER, CustomerName depende de CustomerID, que no es la clave - una dependencia transitiva. Vuelva a dividir: ORDER(OrderID, CustomerID) y CUSTOMER(CustomerID, CustomerName). Nombren la dependencia que rompe cada forma (la parcial rompe 2NF, la transitiva rompe 3NF); decir "tiene datos repetidos" describe el síntoma pero no otorga puntos.
Las tres preguntas para hacer a cualquier tabla.¿Celda contiene un único valor, sin grupo repetido? Si no, no está en 1NF. Si la clave es compuesta, ¿cada campo no clave depende de toda la clave? Si algún campo depende de parte de ella, hay una dependencia parcial 部分依赖 y la tabla no está en 2NF. ¿Cada campo no clave depende solo de la clave? Si un campo depende de otro campo no clave, hay una dependencia transitiva y la tabla no está en 3NF. Una respuesta a "explique por qué la tabla no está en 3NF" debe nombrar la dependencia y los campos implicados.
1NF elimina el grupo repetido, 2NF la dependencia parcial, 3NF la dependencia transitiva
Ejemplo resuelto. Un alquiler de coches registra cada alquiler como RENTAL(RentalID, RentalDate, CustomerID, CustomerName, CustomerPhone, CarReg, CarModel, DailyRate, Days), donde un alquiler puede incluir varios coches. Explique por qué la tabla no está normalizada y produzca un diseño 3NF.
No está en 1NF: los campos de CarReg, CarModel, DailyRate, Days forman un grupo repetitivo — una renta tiene varios coches. Moverlos a RENTAL_CAR(RentalID, CarReg, CarModel, DailyRate, Days) con la clave compuesta (RentalID, CarReg). No está en 2NF: en RENTAL_CAR, CarModel y DailyRate dependen solo de CarReg — una dependencia parcial. Moverlos a CAR(CarReg, CarModel, DailyRate), dejando RENTAL_CAR(RentalID, CarReg, Days). No está en 3NF: en RENTAL, CustomerName y CustomerPhone dependen de CustomerID, un campo no clave — una dependencia transitiva. Moverlos a CUSTOMER(CustomerID, CustomerName, CustomerPhone), dejando RENTAL(RentalID, RentalDate, CustomerID). El diseño en 3NF son cuatro tablas — CUSTOMER, RENTAL, RENTAL_CAR, CAR — con CustomerID, RentalID y CarReg como claves foráneas; subrayar todas las claves primarias.
Database Management System (DBMS) · Sistema de Gestión de Bases de Datos (DBMS)
Syllabus
English
Candidates should be able to:
Notes and guidance
Show understanding of the features provided by a Database Management System (DBMS) that address the issues of a file based approach
Including: • data management, including maintaining a data dictionary • data modelling • logical schema • data integrity • data security, including backup procedures and the use of access rights to individuals / groups of users
Show understanding of how software tools found within a DBMS are used in practice
Including the use and purpose of: • developer interface • query processor
Español
Los candidatos deben ser capaces de:
Notas y orientación
Demostrar comprensión de las características que proporciona un Sistema de Gestión de Bases de Datos (DBMS) para abordar los problemas del enfoque basado en archivos
Incluyendo: • gestión de datos, incluyendo el mantenimiento de un diccionario de datos • modelado de datos • esquema lógico • integridad de datos • seguridad de datos, incluyendo procedimientos de copia de seguridad y el uso de permisos de acceso a individuos/grupos de usuarios
Demostrar comprensión de cómo se utilizan en la práctica las herramientas de software incluidas en un DBMS
Incluyendo el uso y propósito de: • interfaz de desarrollador • procesador de consultas
Source: Cambridge International syllabus · Fuente: Plan de estudios Cambridge International
English
A DBMS 数据库管理系统 manages the database centrally. Features that fix the file-based limits:
data dictionary 数据字典 — a description of every table, field, type and key; programs query it instead of hard-coding the structure.
redundancy/consistency control — each fact stored once.
concurrent access 并发访问 control — locks and transactions let many users work at once.
backup 备份 and recovery; security and per-user permissions.
integrity rules — keys, unique and range constraints, enforced centrally.
transactions 事务 — a group of operations that all succeed or all fail.
views 视图 — virtual tables that show each user "their" slice of the data.
data management 数据管理 and data modelling 数据建模 — control how data is stored and define its structure as a logical schema 逻辑模式 (the logical design, independent of physical storage).
data integrity 数据完整性 and data security 数据安全 — enforce correctness and control access centrally.
a query processor 查询处理器 runs queries; a developer interface 开发者接口 gives tools and APIs for building applications.
Its tools include a data-dictionary editor, a query builder, a forms builder, a report generator, user management, and an SQL editor.
What the data dictionary holds (a "give three items" question): the names of the tables; the names of the fields in each table; each field's data type and length; the primary and foreign keys and the relationships between tables; validation rules; indexes; and who may access each table. It is metadata — data about the data — and the DBMS uses it to check every query and every change.
How the DBMS keeps the data secure (a "describe two methods" question): authentication 身份验证 — a username and password, or a biometric, before any access; access rights — each user or group is allowed to read, write or delete only certain tables or fields, often through a view; encryption of the stored data and of data sent to it, so a copied file is unreadable; backups taken regularly, so the data can be restored after loss; and a transaction log that records who changed what.
The two software tools. The developer interface is what a programmer uses to build the database and the applications on it: create tables and set keys and validation, write queries and SQL, and design forms and reports, without knowing how the data is physically stored. The query processor takes a query (SQL from a program, or a query built in the interface), checks it against the data dictionary, works out the most efficient way to run it, retrieves the data and returns the results.
Logical schema. The DBMS keeps the logical design (which tables and fields exist and how they relate) separate from the physical storage (files, indexes, disk blocks). Programs work with the logical schema, so the physical storage can be reorganised without changing a single program — this is the data independence the file-based approach lacked.
Español
Un DBMS 数据库管理系统 gestiona la base de datos centralmente. Funcionalidades que corrigen las limitaciones basadas en archivos:
data dictionary 数据字典 — una descripción de cada tabla, campo, tipo y clave; los programas la consultan en lugar de codificar la estructura de forma fija.
control de redundancia/consistencia — cada dato se almacena una sola vez.
control de acceso concurrente 并发访问 — los bloqueos y transacciones permiten que muchos usuarios trabajen simultáneamente.
backup 备份 y recuperación; seguridad y permisos por usuario.
reglas de integridad — claves, restricciones de unicidad y rango, aplicadas centralmente.
transacciones 事务 — un grupo de operaciones que todas tienen éxito o todas fallan.
vistas 视图 — tablas virtuales que muestran a cada usuario "su" fragmento de los datos.
gestión de datos 数据管理 y modelado de datos 数据建模 — controlan cómo se almacenan los datos y definen su estructura como un esquema lógico 逻辑模式 (el diseño lógico, independiente del almacenamiento físico).
integridad de datos 数据完整性 y seguridad de datos 数据安全 — garantizan la corrección y controlan el acceso centralmente.
un procesador de consultas 查询处理器 ejecuta consultas; una interfaz de desarrollador 开发者接口 proporciona herramientas y APIs para crear aplicaciones.
Sus herramientas incluyen un editor de diccionario de datos, un constructor de consultas, un constructor de formularios, un generador de informes, gestión de usuarios y un editor SQL.
Lo que contiene el diccionario de datos (una pregunta de "dar tres elementos"): los nombres de las tablas; los nombres de los campos en cada tabla; el tipo de dato y longitud de cada campo; las claves primarias y foráneas y las relaciones entre tablas; reglas de validación; índices; y quién puede acceder a cada tabla. Es metadatos — datos sobre los datos — y el DBMS lo usa para verificar cada consulta y cada cambio.
Cómo mantiene seguro el DBMS los datos (una pregunta de "describir dos métodos"): autenticación 身份验证 — un nombre de usuario y contraseña, o biométrica, antes de cualquier acceso; derechos de acceso — a cada usuario o grupo se le permite leer, escribir o eliminar solo ciertas tablas o campos, a menudo a través de una vista; cifrado de los datos almacenados y de los datos enviados a ellos, para que un archivo copiado sea ilegible; copias de seguridad tomadas regularmente, para restaurar los datos tras una pérdida; y un registro de transacciones que registra quién cambió qué.
Las dos herramientas de software. La interfaz de desarrollador es lo que utiliza un programador para construir la base de datos y las aplicaciones sobre ella: crear tablas y establecer claves y validaciones, escribir consultas y SQL, y diseñar formularios e informes, sin saber cómo se almacenan físicamente los datos. El procesador de consultas toma una consulta (SQL desde un programa, o una consulta construida en la interfaz), la verifica contra el diccionario de datos, determina la forma más eficiente de ejecutarla, recupera los datos y devuelve los resultados.
Esquema lógico. El DBMS mantiene el diseño lógico (qué tablas y campos existen y cómo se relacionan) separado del almacenamiento físico (archivos, índices, bloques de disco). Los programas trabajan con el esquema lógico, por lo que el almacenamiento físico puede reorganizarse sin cambiar un solo programa — esta es la independencia de datos que carecía el enfoque basado en archivos.
El almacenamiento físico que oculta el esquema lógico: platos giratorios y cabezal de lectura/escritura de un disco duro
Explore · Explorar
Laboratorio de servicio de base de datos
Observa cómo un SGBD transforma una consulta en acceso seguro a datos compartidos.
Explore · Explorar
Laboratorio de servicio de base de datos
Observa cómo un SGBD transforma una consulta en acceso seguro a datos compartidos.
Show understanding that the DBMS carries out all creation/modification of the database structure using its Data Definition Language (DDL)
Show understanding that the DBMS carries out all queries and maintenance of data using its DML
Show understanding that the industry standard for both DDL and DML is Structured Query Language (SQL)
Understand a given SQL statement
Understand given SQL (DDL) statements and be able to write simple SQL (DDL) statements using a sub-set of statements
Create a database (CREATE DATABASE) Create a table definition (CREATE TABLE), including the creation of attributes with appropriate data types: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME change a table definition (ALTER TABLE) add a primary key to a table (PRIMARY KEY (field)) add a foreign key to a table (FOREIGN KEY (field) REFERENCES Table (Field))
Write an SQL script to query or modify data (DML) which are stored in (at most two) database tables
Queries including SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG
Data maintenance including INSERT INTO, DELETE FROM, UPDATE
Español
Los candidatos deben ser capaces de:
Notas y orientación
Demostrar comprensión de que el SGDB realiza toda la creación/modificación de la estructura de la base de datos mediante su Lenguaje de Definición de Datos (DDL)
Demostrar comprensión de que el SGDB realiza todas las consultas y mantenimiento de los datos mediante su DML
Demostrar comprensión de que el estándar de la industria tanto para el DDL como para el DML es el Lenguaje de Consulta Estructurado (SQL)
Comprender una instrucción SQL dada
Comprender instrucciones SQL (DDL) dadas y ser capaces de escribir instrucciones simples SQL (DDL) utilizando un subconjunto de instrucciones
Crear una base de datos (CREATE DATABASE) Crear una definición de tabla (CREATE TABLE), incluyendo la creación de atributos con tipos de datos apropiados: • CHARACTER • VARCHAR(n) • BOOLEAN • INTEGER • REAL • DATE • TIME Cambiar una definición de tabla (ALTER TABLE) Añadir una clave primaria a una tabla (PRIMARY KEY (campo)) Añadir una clave foránea a una tabla (FOREIGN KEY (campo) REFERENCES Tabla (Campo))
Escribir un script SQL para consultar o modificar los datos (DML) almacenados en (como máximo dos) tablas de base de datos
Consultas que incluyen SELECT... FROM, WHERE, ORDER BY, GROUP BY, INNER JOIN, SUM, COUNT, AVG
Mantenimiento de datos que incluye INSERT INTO, DELETE FROM, UPDATE
Source: Cambridge International syllabus · Fuente: Plan de estudios Cambridge International
English
SQL 结构化查询语言 (Structured Query Language) has two halves:
Data Definition Language 数据定义语言 (DDL) — creates or changes the structure (tables, keys, constraints).
Data Manipulation Language 数据操纵语言 (DML) — works with the data (insert, update, delete, query 查询).
DDL basics
Add a foreign key:
Modify and drop:
Common types: INTEGER, REAL, VARCHAR(n), CHAR(n) (also CHARACTER(n)), DATE, TIME, BOOLEAN, DECIMAL(p, s).
DML basics
Query with SELECT:
SELECT lists fields, FROM names the table, WHERE filters rows, ORDER BY sorts.
A join 连接 combines two tables using a foreign-key relationship:
Aggregate functions 聚合函数 (COUNT, SUM, AVG, MIN, MAX) are often used with GROUP BY:
Insert, update, delete:
Always put a WHERE clause on UPDATE and DELETE, or the change hits every row.
Tips for exam SQL
use the exact table and field names from the question.
quote strings with single quotes ('Smith'); don't quote numbers.
comparisons: =, <, >, <=, >=, <>.
LIKE 'A%' matches anything starting with A (% = any string, _ = one character); IN (1,2,3); BETWEEN 10 AND 20.
combine conditions with AND / OR / NOT, and end each statement with a semicolon.
The DDL pattern the exam wants. Every CREATE TABLE names each field with its type, marks the primary key, and declares each foreign key with the table it references; a composite key is declared on its own line:
Worked example. Using CUSTOMER(CustomerID, Name, Phone) and DEVICE(DeviceID, CustomerID, Type, Model), write SQL scripts to: (a) list the name and phone number of every customer who owns a device of type 'tablet', in alphabetical order of name; (b) count the devices of each type; (c) record that customer 17 now has the phone number '0771 234 5678'; (d) add a new device, ID 305, a 'laptop' of model 'X1' belonging to customer 17.
(a)
(b)
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Marks are given per clause — the fields, the tables, the join condition, the WHERE, the ORDER BY — so a script with one wrong clause still scores the rest. Write Table.Field whenever two tables are involved.
Worked example. Explain what this script does: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
It outputs each technician's name with the total cost of the repairs that technician has carried out, one row per technician: the two tables are joined on TechnicianID, the rows are grouped by name, and the costs in each group are added. When asked what a script does, describe the result, not the syntax.
Español
SQL 结构化查询语言 (Structured Query Language) tiene dos mitades:
DDL construye la estructura de la base de datos; DLM trabaja con los datos
Data Definition Language 数据定义语言 (DDL) — crea o modifica la estructura (tablas, claves, restricciones).
Data Manipulation Language 数据操纵语言 (DML) — trabaja con los datos (insertar, actualizar, eliminar, consultar 查询).
Fundamentos de DDL
CREATE TABLE CUSTOMER (
  CustomerID INTEGER PRIMARY KEY,
  Name VARCHAR(50) NOT NULL,
  Phone VARCHAR(20)
);
Una consulta SELECT devuelve solo las filas que coinciden con su condición
SELECT Name, Phone
FROM CUSTOMER
WHERE City = 'London'
ORDER BY Name ASC;
SELECT lista los campos, FROM nombra la tabla, WHERE filtra las filas y ORDER BY ordena.
Un join (unión) combina dos tablas mediante una relación de clave foránea:
SELECT C.Name, O.OrderDate
FROM CUSTOMER C INNER JOIN ORDER O
  ON C.CustomerID = O.CustomerID
WHERE O.OrderDate >= '2024-01-01';
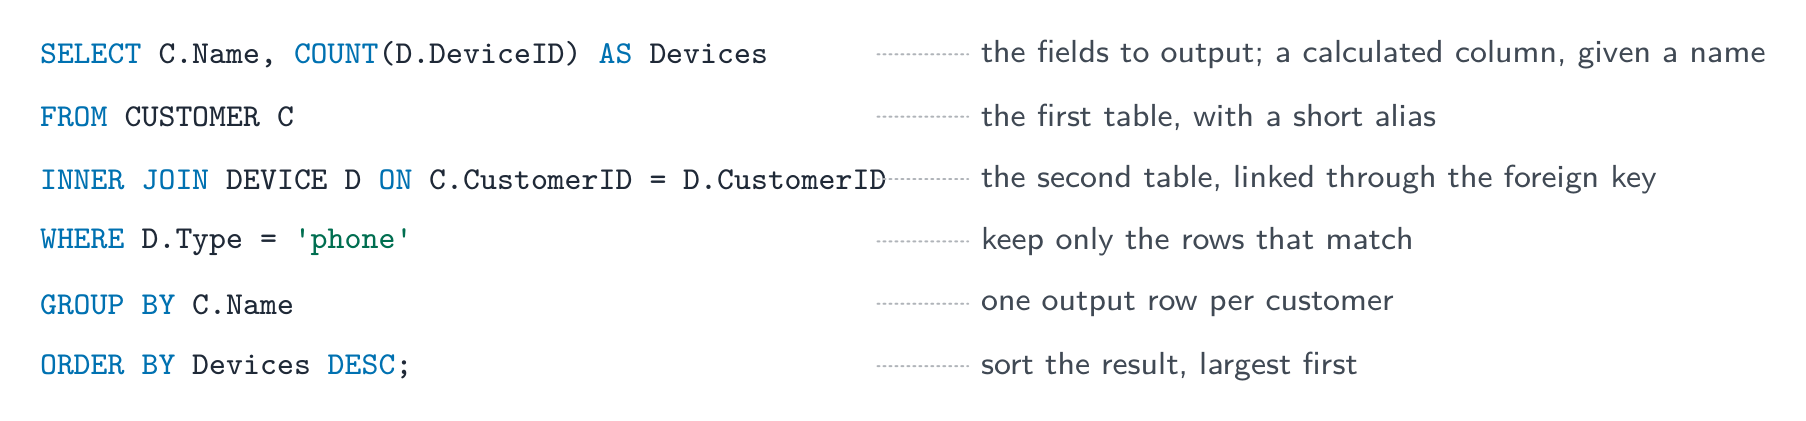
Las partes de una consulta, en el orden en que deben escribirse
Las funciones agregadas (COUNT, SUM, AVG, MIN, MAX) se utilizan a menudo con GROUP BY:
SELECT CustomerID, COUNT(*) AS NumOrders
FROM ORDER
GROUP BY CustomerID;
Insertar, actualizar, eliminar:
INSERT INTO CUSTOMER (CustomerID, Name, Phone)
VALUES (101, 'Ada Lovelace', '020-1234-5678');

UPDATE CUSTOMER SET Phone = '020-9999-0000' WHERE CustomerID = 101;

DELETE FROM CUSTOMER WHERE CustomerID = 101;
Siempre incluya una cláusula WHERE en UPDATE y DELETE; de lo contrario, el cambio afectará todas las filas.
Consejos para el examen de SQL
Use los nombres exactos de tablas y campos del enunciado.
Encierre las cadenas entre comillas simples ('Smith'); no encierre los números.
Operadores de comparación: =, <, >, <=, >=, <>.
LIKE 'A%' coincide con cualquier cadena que empiece por A (% = cualquier cadena, _ = un carácter); IN (1,2,3); BETWEEN 10 AND 20.
Combine condiciones con AND / OR / NOT y termine cada sentencia con punto y coma.
El patrón DDL que busca el examen. Cada CREATE TABLE nombra cada campo con su tipo, marca la clave primaria y declara cada clave foránea indicando la tabla referenciada; una clave compuesta se declara en su propia línea:
Ejemplo resuelto. Usando CUSTOMER(CustomerID, Name, Phone) y DEVICE(DeviceID, CustomerID, Type, Model), escriba scripts SQL para: (a) listar el nombre y número de teléfono de todos los clientes que poseen un dispositivo de tipo 'tablet', en orden alfabético por nombre; (b) contar los dispositivos de cada tipo; (c) registrar que el cliente 17 tiene ahora el número de teléfono '0771 234 5678'; (d) añadir un nuevo dispositivo, ID 305, un 'laptop' del modelo 'X1' perteneciente al cliente 17.
(a)
SELECT CUSTOMER.Name, CUSTOMER.Phone
FROM CUSTOMER INNER JOIN DEVICE
  ON CUSTOMER.CustomerID = DEVICE.CustomerID
WHERE DEVICE.Type = 'tablet'
ORDER BY CUSTOMER.Name ASC;
(b)
SELECT Type, COUNT(DeviceID) AS NumberOfDevices
FROM DEVICE
GROUP BY Type;
(c) UPDATE CUSTOMER SET Phone = '0771 234 5678' WHERE CustomerID = 17;
(d) INSERT INTO DEVICE (DeviceID, CustomerID, Type, Model) VALUES (305, 17, 'laptop', 'X1');
Se otorgan marcas por cláusula — los campos, las tablas, la condición de unión, el WHERE, el ORDER BY — por lo que un script con una sola cláusula incorrecta aún obtiene crédito en el resto. Escribe Table.Field siempre que se involucren dos tablas.
Ejemplo resuelto. Explica qué hace este script: SELECT T.Name, SUM(R.Cost) AS Total FROM TECHNICIAN T INNER JOIN REPAIR R ON T.TechnicianID = R.TechnicianID GROUP BY T.Name;
Expresa el nombre de cada técnico junto con el coste total de las reparaciones realizadas por ese técnico, una fila por técnico: las dos tablas se unen mediante TechnicianID, las filas se agrupan por nombre y los costes de cada grupo se suman. Cuando te pidan explicar qué hace un script, describe el resultado, no la sintaxis.
Explore · Explorar
Combinar dos tablas con INNER JOIN
Un join coincide filas donde la clave foránea es igual a la clave primaria — aquí Orders.CustomerID = Customer.CustomerID — y combina cada par coincidente en una sola fila más ancha.
Explore · Explorar
SELECT … WHERE
Recorre una consulta: DONDE conserva las filas que coinciden, luego SELECCIONAR selecciona las columnas solicitadas.
Definitions the examiner accepts · Definiciones aceptadas por el examinador
English
A definition question is marked against fixed wording. Learn these exactly, and give one answer only.
Term
Definition
entity
something about which data is stored — a person, object or event — which becomes a table in a relational database
attribute
one item of data about an entity (a column of the table)
tuple
one row of a table: one instance of the entity
primary key
an attribute, or combination of attributes, that uniquely identifies each record in a table
foreign key
an attribute in one table whose value matches a primary key in another table, used to link the two
candidate key
any attribute (or combination) that could be chosen as the primary key
secondary key
a non-primary attribute that is indexed so the table can be searched or sorted on it quickly
composite key
a primary key made of two or more attributes together
referential integrity
every foreign-key value must match an existing primary-key value in the table it refers to
first normal form
a table in which every attribute is atomic, there are no repeating groups, and there is a primary key
second normal form
in 1NF, and every non-key attribute depends on the whole of the primary key (no partial dependency)
third normal form
in 2NF, and no non-key attribute depends on another non-key attribute (no transitive dependency)
data dictionary
the metadata a DBMS keeps about the structure of the database: tables, fields, types, keys, relationships, validation
DDL / DML
the language used to define or change the structure of a database / the language used to query and maintain the data in it
Español
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
Término
Definición
entidad
algo sobre el cual se almacena datos — una persona, objeto o evento — que se convierte en una tabla en una base de datos relacional
atributo
un único dato sobre una entidad (una columna de la tabla)
tupla
una única fila de una tabla: una instancia de la entidad
clave primaria
un atributo, o combinación de atributos, que identifica de forma única cada registro en una tabla
clave foránea
un atributo en una tabla cuyo valor coincide con una clave primaria en otra tabla, utilizado para vincular ambas
clave candidata
cualquier atributo (o combinación) que podría elegirse como clave primaria
clave secundaria
un atributo no primario que está indexado para permitir búsquedas o clasificaciones rápidas en la tabla
clave compuesta
una clave primaria formada por dos o más atributos juntos
integridad referencial
cada valor de clave foránea debe coincidir con un valor de clave primaria existente en la tabla a la que hace referencia
primera forma normal
una tabla en la que cada atributo es atómico, no hay grupos repetidos y existe una clave primaria
segunda forma normal
en 1NF, y cada atributo no clave depende de toda la clave primaria (sin dependencias parciales)
tercera forma normal
en 2NF, y ningún atributo no clave depende de otro atributo no clave (sin dependencias transitivas)
diccionario de datos
los metadatos que un SGBD conserva sobre la estructura de la base de datos: tablas, campos, tipos, claves, relaciones, validación
DDL / DML
el lenguaje utilizado para definir o cambiar la estructura de una base de datos / el lenguaje utilizado para consultar y mantener los datos en ella
8.3
Exam tips · Consejos para el examen
English
Define the terms exactly: entity, attribute, primary key, foreign key, and the relationship types (1:1, 1:many, many:many).
Give a reason at each normal form: 1NF (no repeating groups), 2NF (no partial dependency), 3NF (no non-key dependency) — and name the fields involved.
Explain what a DBMS provides (data independence, security, integrity, concurrent access, a data dictionary, a developer interface, a query processor).
Distinguish DDL (define the structure) from DML (query and change the data), and write SQL clause by clause: SELECT, FROM, INNER JOIN … ON, WHERE, GROUP BY, ORDER BY.
To draw an E-R diagram from tables, find each foreign key first: every foreign key is one one-to-many relationship, with the "many" at the table that holds it.
Common mistakes
Drawing a many-to-many relationship directly. It must be split into two one-to-many relationships through a link table holding both foreign keys.
Explaining "not in 3NF" by "the data is repeated". Name the dependency (partial or transitive) and the fields involved.
Double quotes round strings in SQL, or quotes round numbers. Strings take 'single quotes'; numbers take none.
Leaving out the ON condition after INNER JOIN. Without it the two tables are not linked.
Putting an ordinary field next to COUNT or SUM in a SELECT without a GROUP BY.
UPDATE or DELETE without a WHERE. It changes or removes every row in the table.
Español
Define los términos exactamente: entidad, atributo, clave primaria, clave foránea, y los tipos de relación (1:1, 1:muchos, muchos:muchos).
Da una razón en cada forma normal: 1FN (sin grupos repetidos), 2FN (sin dependencia parcial), 3FN (sin dependencia no clave) — y nombra los campos implicados.
Explica qué ofrece un SGBD (independencia de datos, seguridad, integridad, acceso concurrente, un diccionario de datos, una interfaz para desarrolladores, un procesador de consultas).
Distingue DDL (define la estructura) de DML (consulta y modifica los datos), y escribe la cláusula SQL por cláusula: SELECT, FROM, INNER JOIN … ON, WHERE, GROUP BY, ORDER BY.
Para dibujar un diagrama E-R a partir de tablas, busca primero cada clave foránea: cada clave foránea representa una relación uno-a-muchos, siendo el "muchos" la tabla que la contiene.
Errores comunes
Dibujar una relación muchos-a-muchos directamente. Debe dividirse en dos relaciones uno-a-muchos a través de una tabla de enlace que contenga ambas claves foráneas.
Explicar "no está en 3FN" simplemente diciendo "los datos están repetidos". Nombra la dependencia (parcial o transitiva) y los campos implicados.
Usar comillas dobles alrededor de cadenas en SQL, o comillas alrededor de números. Las cadenas requieren 'single quotes'; los números no requieren ninguno.
Omisión de la condición ON después de INNER JOIN. Sin ella, las dos tablas no quedan vinculadas.
Colocar un campo ordinario junto a COUNT o SUM dentro de un SELECT sin especificar un GROUP BY.
UPDATE o DELETE sin incluir un WHERE. Este cambia o elimina todas las filas de la tabla.
Interactive lessons on this topic · Lecciones interactivas sobre este tema
Work through it step by step, with instant-check exercises. · Trátalo paso a paso, con ejercicios de verificación instantánea.
Pick one and the site follows you — notes, papers, videos and practice all open on it. · Selecciona uno y el sitio te sigue — notas, documentos, videos y práctica se abren en él.
Type to search notes, lessons, code, vocabulary and past-paper questions across every subject. · Escribe para buscar notas, lecciones, código, vocabulario y preguntas de exámenes anteriores en todas las materias.