| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de cómo los grafos pueden utilizarse para apoyar la Inteligencia Artificial (IA) | Propósito y estructura de un grafo. Utilizar el algoritmo A* y el algoritmo de Dijkstra para realizar búsquedas en un grafo. No se requerirá a los candidatos que escriban algoritmos para configurar, acceder o realizar búsquedas en grafos. |
| Demostrar comprensión de cómo las redes neuronales artificiales han contribuido al aprendizaje automático | |
| Demostrar comprensión del Aprendizaje Profundo, el Aprendizaje Automático y el Aprendizaje por Refuerzo, así como de las razones para utilizar estos métodos. | Comprender las categorías del aprendizaje automático, incluido el aprendizaje supervisado y el aprendizaje no supervisado. |
| Demostrar comprensión de la propagación inversa del error y los métodos de regresión en el aprendizaje automático |
Inteligencia artificial (AI)
A-Level Ciencias de la Computación · Tema 18
 13:12
Qué es la IA
Nadie nunca escribió las reglas para distinguir un gato de un perro. Ningún programador se sentó a escribir "si tiene orejas puntiagudas y bigotes". Y sin embargo tu teléfono lo hace…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
18.1
Qué es la IA

Syllabus
Fuente: Plan de estudios Cambridge International
Inteligencia artificial (IA) construye sistemas que realizan tareas que normalmente requieren inteligencia humana: reconocimiento de voz e imágenes, traducción, juego, conducción y generación de texto. La mayoría de la IA moderna utiliza aprendizaje automático — algoritmos que aprenden patrones a partir de datos en lugar de ser programados paso a paso. Dentro de este campo, el aprendizaje profundo, que utiliza redes neuronales con muchas capas, ha sido dominante desde la década de 2010.
Un robot humanoide integra muchas de estas capacidades en un solo cuerpo: utiliza la IA para ver rostros, comprender el habla y mover su rostro y brazos de una manera realista.

Explorar
Laboratorio de tipos de aprendizaje de IA
Clasificar ejemplos de IA según el tipo de aprendizaje o la preocupación involucrada.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| artificial intelligence/ˌɑːtɪˈfɪʃl ɪnˈtelɪdʒəns/ | 人工智能 | rén gōng zhì néng |
| machine learning/məˈʃiːn ˈlɜːnɪŋ/ | 机器学习 | jī qì xué xí |
| deep learning/diːp ˈlɜːnɪŋ/ | 深度学习 | shēn dù xué xí |
| neural networks/ˈnjuːrəl ˈnetwɜːks/ | 神经网络 | shén jīng wǎng luò |
| humanoid robot/ˈhjuːmənɔɪd ˈrəʊbɒt/ | 人形机器人 | rén xíng jī qì rén |
18.1
Grafos en la IA
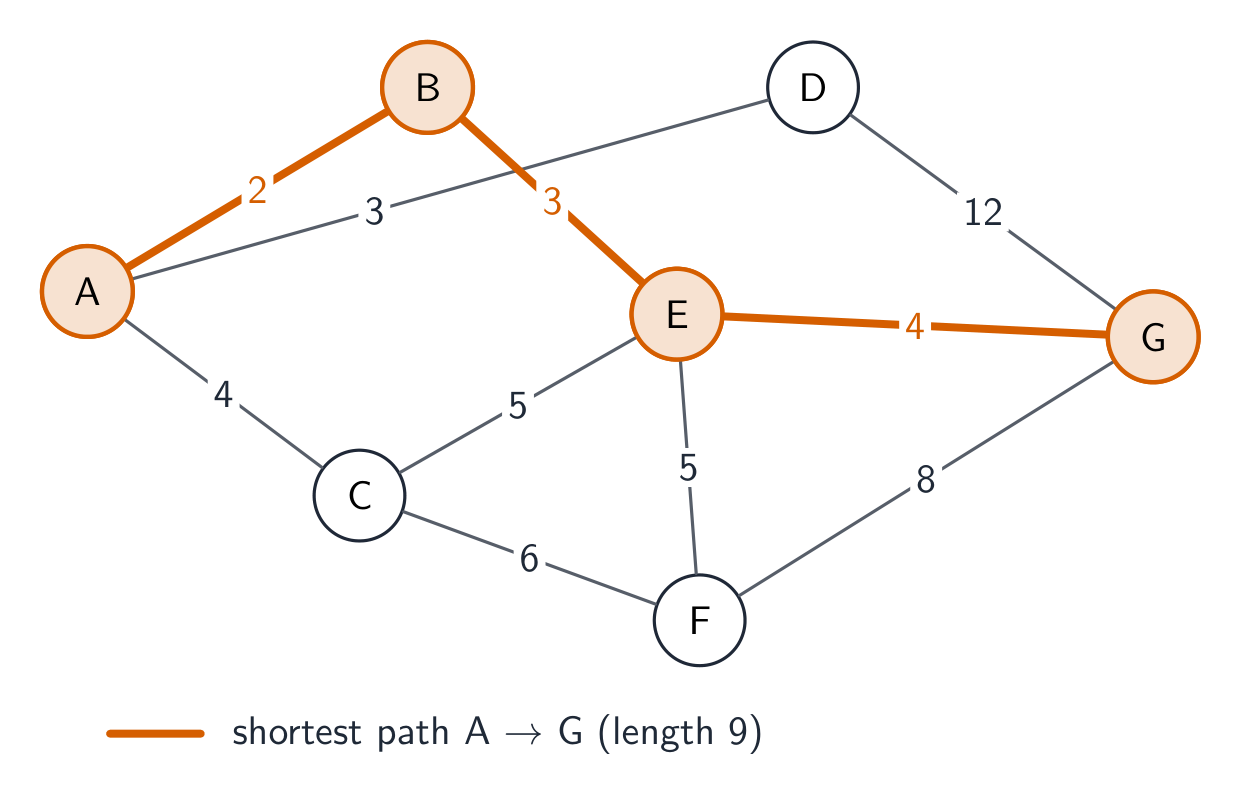
Muchos problemas de IA se sitúan sobre un grafo: nodos (estados, lugares) unidos por aristas (movimientos, relaciones).
- búsqueda de rutas: las carreteras forman un grafo; la ruta más corta es una búsqueda en grafos (algoritmo de Dijkstra, algoritmo A*).
- juego: cada posición del tablero es un nodo, cada movimiento es una arista; minimax con poda alfa-beta busca en el árbol del juego.
- búsqueda en espacio de estados: un problema de planificación implica moverse entre estados aplicando operadores para alcanzar una meta.
- representación del conocimiento: una red semántica tiene conceptos como nodos y relaciones como aristas ("perro ES-UN animal"); un grafo de conocimiento almacena hechos sobre el mundo para buscadores y asistentes.
Las herramientas estándar para navegar en grafos incluyen la búsqueda en anchura y la búsqueda en profundidad.
"Describe el propósito y la estructura de un grafo en un sistema de IA." Propósito: representar un problema como un conjunto de estados (o lugares) y los posibles movimientos entre ellos, para que un algoritmo pueda buscarlo en busca de una solución, como la ruta más corta o barata, o el mejor siguiente movimiento. Estructura: un conjunto de nodos (vértices), cada uno representando un estado, ubicación o elemento, unidos por aristas que representan las conexiones entre ellos; cada arista puede llevar un peso (un costo, distancia o tiempo), y las aristas pueden ser dirigidas (de un solo sentido) o no dirigidas. "Explica el uso de grafos para ayudar a la IA": el grafo es el modelo sobre el cual funcionan los algoritmos de búsqueda de la IA: A* y el algoritmo de Dijkstra encuentran caminos óptimos a través de él (navegación, enrutamiento), las posiciones del juego forman un árbol buscado para encontrar el mejor movimiento, y el conocimiento almacenado como un grafo permite a un sistema razonar sobre cómo se relacionan los hechos.
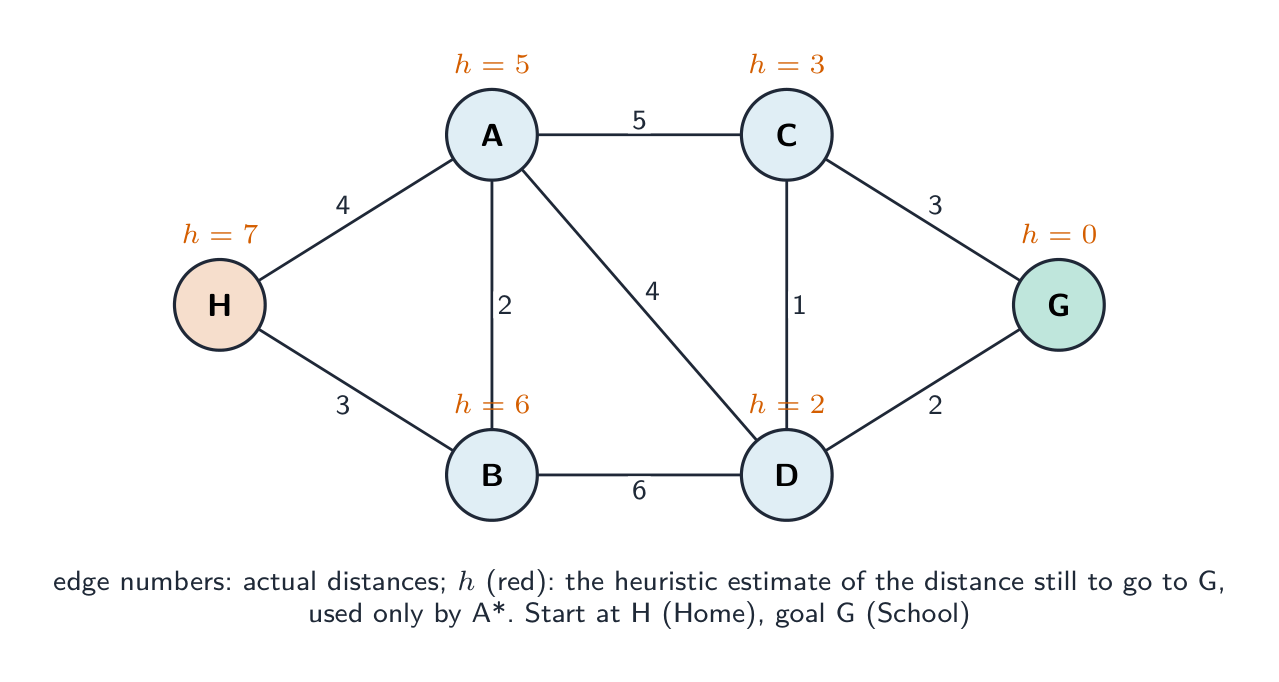
Algoritmo de Dijkstra. Encuentra la distancia más corta desde el inicio hasta cada nodo. Mantén una tabla con la mejor distancia encontrada hasta ahora a cada nodo (inicio 0, todos los demás infinito). Repite tomar el nodo no visitado con la distancia más pequeña, márcalo como visitado, y para cada vecino verifica si pasar por este nodo da una distancia más corta; si es así, actualízala y registra de dónde vino. Detente cuando todos los nodos estén visitados (o se alcance el objetivo).
Ejemplo trabajado. Encuentra las distancias más cortas desde H hasta cada otro nodo en el grafo anterior.
| paso | visitar | H | A | B | C | D | G |
|---|---|---|---|---|---|---|---|
| inicio | 0 | ∞ | ∞ | ∞ | ∞ | ∞ | |
| 1 | H (0) | 0 | 4 (H) | 3 (H) | ∞ | ∞ | ∞ |
| 2 | B (3) | 0 | 4 (H) | 3 | ∞ | 9 (B) | ∞ |
| 3 | A (4) | 0 | 4 | 3 | 9 (A) | 8 (A) | ∞ |
| 4 | D (8) | 0 | 4 | 3 | 9 (A) | 8 | 10 (D) |
| 5 | C (9) | 0 | 4 | 3 | 9 | 8 | 10 (D) |
| 6 | G (10) |
Distancias más cortas: A 4, B 3, D 8, C 9, G 10, y el camino a G es H–A–D–G (lee las etiquetas "vino de" hacia atrás). En el paso 3, A ofrece a D una distancia de $4 + 4 = 8$, mejor que el 9 encontrado a través de B, así que D se actualiza; en el paso 5, C podría llegar a G en $9 + 3 = 12$, peor que 10, así que nada cambia. Mostrar estas comparaciones es el "procedimiento" que pide la pregunta.
El algoritmo A*. Dijkstra explora en todas direcciones. A* añade una heurística $h$, una estimación de la distancia restante, y siempre expande el nodo con el menor $f = g + h$, donde $g$ es la distancia recorrida hasta ahora. Con una heurística sensata (que nunca sobreestime), encuentra la misma ruta más corta mientras mira muchos menos nodos, por eso los satnavs y los juegos lo usan. El examen da $h$ para cada nodo y una tabla para rellenar.
Ejemplo trabajado. Encuentra un camino de H a G con A*, mostrando el procedimiento.
| nodo expandido | $g$ hasta ahora | $h$ | $f = g + h$ | vecinos añadidos (nodo: $g$, $h$, $f$) |
|---|---|---|---|---|
| H | 0 | 7 | 7 | A: 4, 5, 9; B: 3, 6, 9 |
| B (empate con A; cualquiera) | 3 | 6 | 9 | D vía B: 9, 2, 11 |
| A | 4 | 5 | 9 | C: 9, 3, 12; D vía A: 8, 2, 10 (mejor que 11, mantener) |
| D | 8 | 2 | 10 | G: 10, 0, 10; C vía D: 9 (no mejor) |
| G | 10 | 0 | 10 | meta alcanzada |
Camino H–A–D–G, longitud 10, el mismo que Dijkstra, pero C nunca fue expandido. Cada vez que un nodo se alcanza por una segunda ruta, mantén el $g$ más pequeño; la búsqueda termina cuando la meta es el nodo con el $f$ más pequeño. Indica los valores de $g$, $h$ y $f$ en cada fila: esos son los puntos.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| graph/ɡræf/ | 图 | tú |
| nodes/nəʊdz/ | 节点 | jié diǎn |
| edges/ˈedʒɪz/ | 边 | biān |
| minimax/ˈmɪnɪmæks/ | 极小化极大 | jí xiǎo huà jí dà |
| semantic network/səˈmæntɪk ˈnetwɜːk/ | 语义网络 | yǔ yì wǎng luò |
| knowledge graph/ˈnɒlɪdʒ ɡræf/ | 知识图谱 | zhī shí tú pǔ |
| breadth-first search/bredθ fɜːst sɜːtʃ/ | 广度优先搜索 | guǎng dù yōu xiān sōu suǒ |
| depth-first search/depθ fɜːst sɜːtʃ/ | 深度优先搜索 | shēn dù yōu xiān sōu suǒ |
| weight/weɪt/ | 权重 | quán zhòng |
| heuristic/hjuːˈrɪstɪk/ | 启发式 | qǐ fā shì |
| labels/ˈleɪblz/ | 标签 | biāo qiān |
18.1
Redes neuronales artificiales (ANNs)
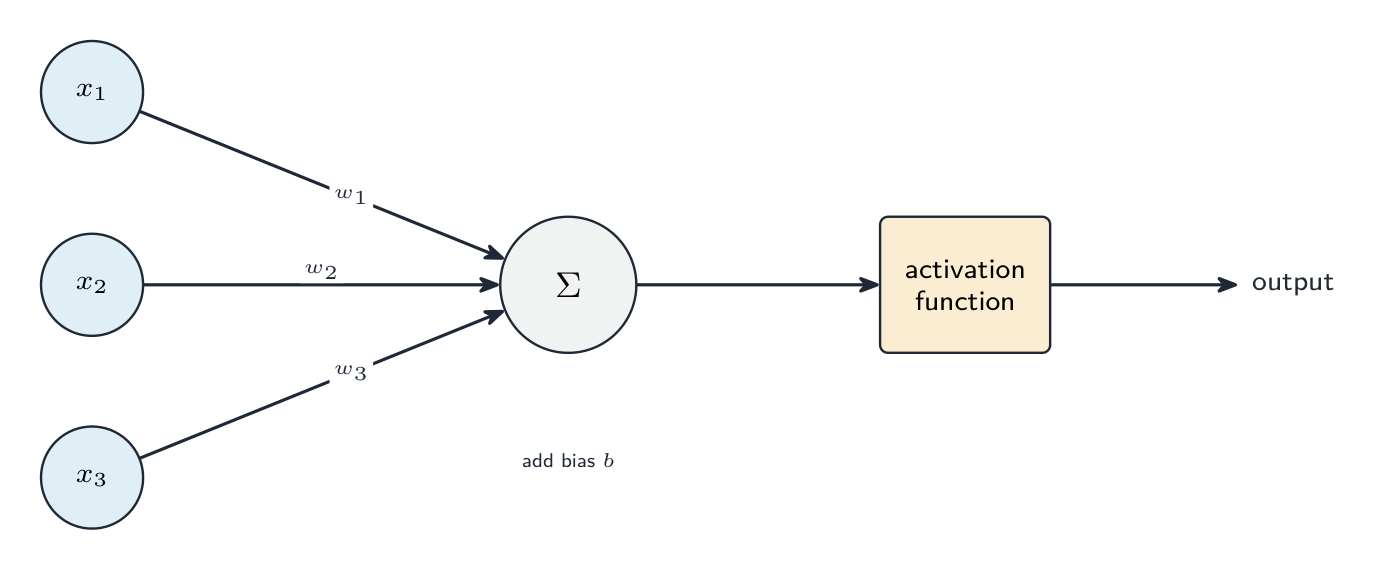
Una ANN está inspirada en las neuronas del cerebro. Un neurona artificial:
- toma varios valores de entrada, multiplica cada uno por un peso, y los suma junto con un término de sesgo.
- aplica una función de activación (una función no lineal como ReLU) a la suma.
- entrega el resultado, que alimenta a neuronas más adelante.
Las neuronas están en capas: una capa de entrada, una o más capas ocultas (donde se aprenden patrones internos útiles), y una capa de salida. Con muchas capas ocultas es una red neuronal profunda, y entrenarla es aprendizaje profundo.
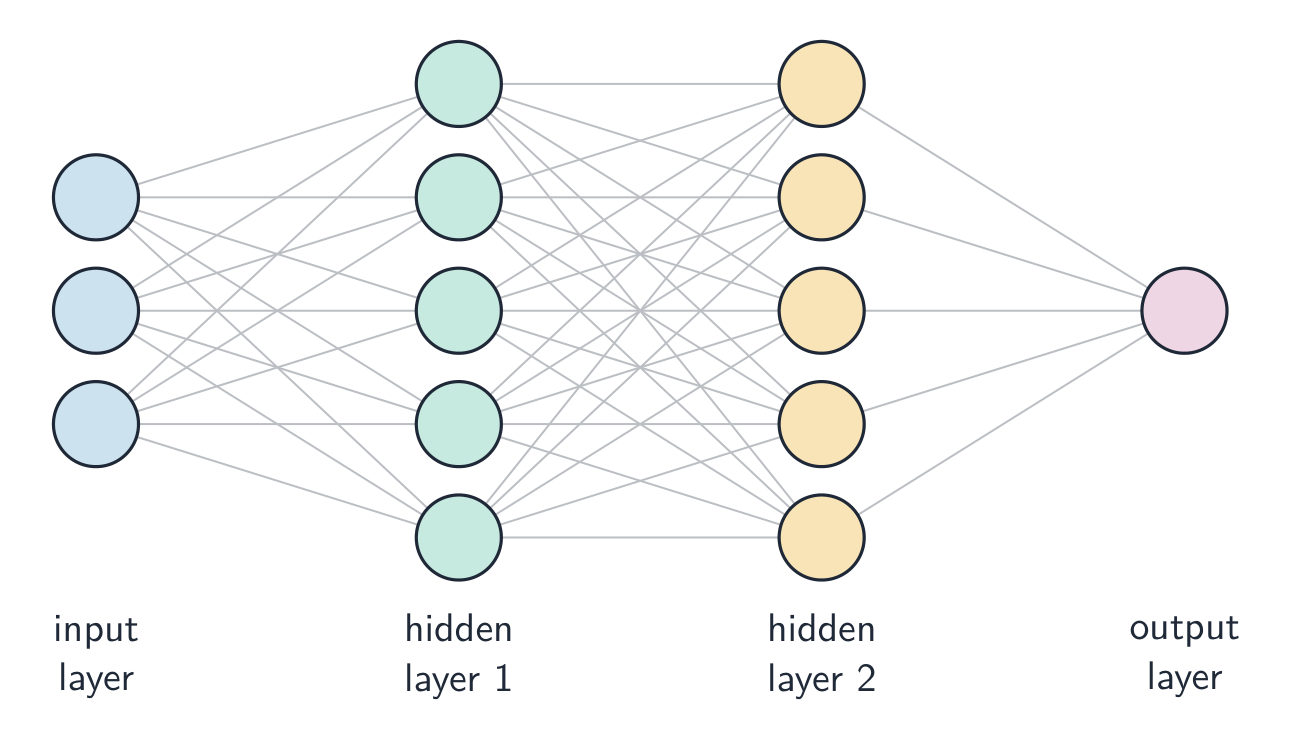
Las ANNs permiten a los modelos aprender patrones complejos directamente desde datos crudos (píxeles, audio, texto) sin características diseñadas manualmente — impulsando avances en reconocimiento de imágenes, reconocimiento de voz, traducción automática y juego. Funcionan bien con grandes cantidades de datos, entrada ruidosa o muy compleja, y patrones demasiado difíciles de capturar con reglas explícitas.
"Explica qué se entiende por una red neuronal artificial." Un modelo de la red de neuronas del cerebro, hecho de capas de nodos conectados: una capa de entrada, una o más capas ocultas y una capa de salida. Cada conexión tiene un peso; cada nodo suma sus entradas ponderadas y pasa el resultado a través de una función de activación a la siguiente capa. "Explica cómo las ANNs habilitan el aprendizaje automático" (tres puntos): la red se entrena con muchos ejemplos; para cada ejemplo la salida se compara con el resultado esperado y el error se usa para ajustar los pesos (propagación hacia atrás) para que el error disminuya; después de suficientes ejemplos los pesos codifican los patrones en los datos, y la red puede entonces clasificar o predecir para nuevos datos que nunca ha visto. "Indica la razón para múltiples capas ocultas": cada capa adicional combina las características encontradas por la capa anterior en características más complejas y más abstractas, para que la red pueda aprender relaciones más complejas (bordes, luego formas, luego objetos); eso es lo que hace que una red sea profunda.
Explorar
Toca las partes de una red neuronal
Explora las capas. Los datos fluyen de izquierda a derecha: la capa de entrada toma las características, las capas intermedias aprenden patrones y la capa de salida da la respuesta — con cada conexión que lleva un peso que el entrenamiento ajusta.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| artificial neuron/ˌɑːtɪˈfɪʃl ˈnjuːrɒn/ | 人工神经元 | rén gōng shén jīng yuán |
| bias term/ˈbaɪəs tɜːm/ | 偏置项 | piān zhì xiàng |
| activation function/ˌæktɪˈveɪʃn ˈfʌŋkʃn/ | 激活函数 | jī huó hán shù |
| hidden layers/ˈhɪdn ˈleɪəz/ | 隐藏层 | yǐn cáng céng |
| deep neural network/diːp ˈnjuːrəl ˈnetwɜːk/ | 深度神经网络 | shēn dù shén jīng wǎng luò |
| image recognition/ˈɪmɪdʒ ˌrekəɡˈnɪʃn/ | 图像识别 | tú xiàng shí bié |
| speech recognition/spiːtʃ ˌrekəɡˈnɪʃn/ | 语音识别 | yǔ yīn shí bié |
| machine translation/məˈʃiːn trænˈsleɪʃn/ | 机器翻译 | jī qì fān yì |
| reinforcement learning/ˌriːɪnˈfɔːsmənt ˈlɜːnɪŋ/ | 强化学习 | qiáng huà xué xí |
| supervised learning/ˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 监督学习 | jiān dū xué xí |
| classification/ˌklæsɪfɪˈkeɪʃn/ | 分类 | fēn lèi |
18.1
Aprendizaje automático, aprendizaje profundo, aprendizaje por refuerzo
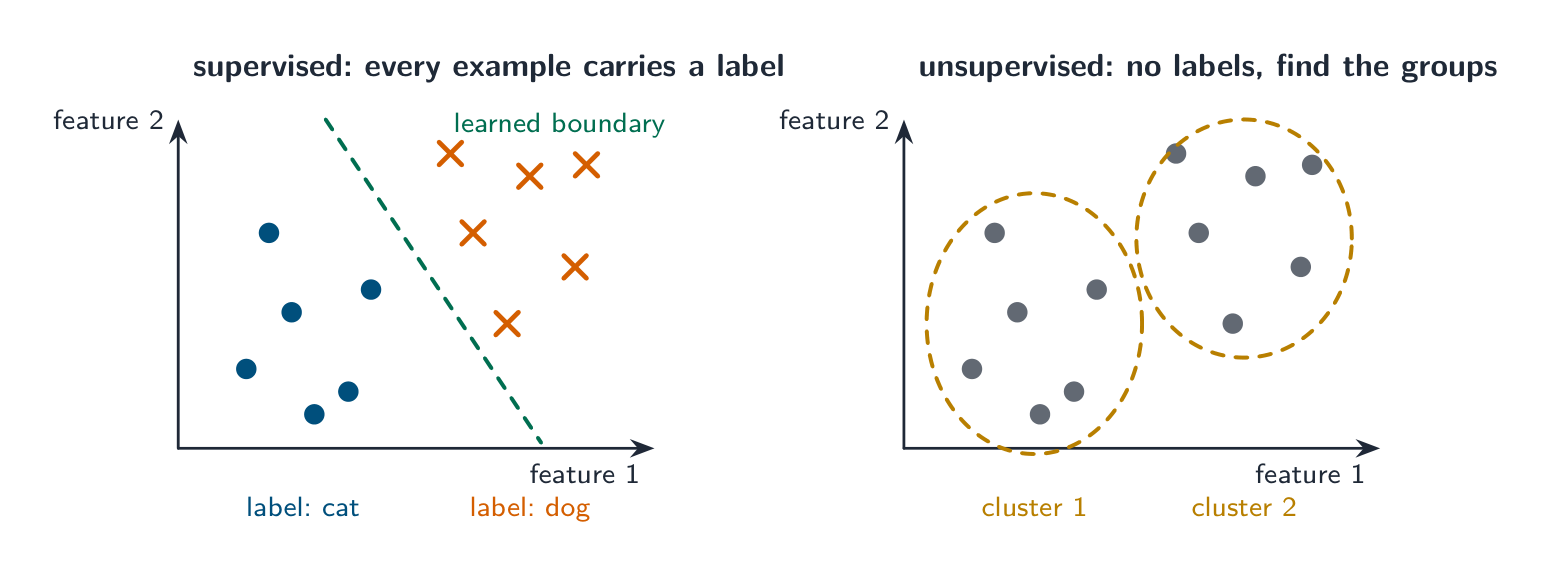
Aprendizaje automático
El término paraguas — cualquier algoritmo que aprende de datos. Tres paradigmas:
- aprendizaje supervisado — los datos tienen etiquetas (imágenes etiquetadas "gato"/"perro"); el algoritmo aprende entrada → etiqueta. Usado para clasificación (una categoría) y regresión.
- aprendizaje no supervisado — sin etiquetas; el algoritmo encuentra estructura, p. ej. un grupo de clientes similares.
- aprendizaje por refuerzo (abajo).
Usa ML cuando las reglas explícitas serían imprácticas (filtros de spam, recomendaciones, detección de fraudes).
"Describe el aprendizaje supervisado y no supervisado" (las palabras marcadas). Aprendizaje supervisado: el algoritmo se entrena con datos de entrenamiento etiquetados, cada ejemplo emparejado con la salida correcta (el objetivo); aprende la relación entre entradas y salidas y la usa para clasificar o predecir para nuevas entradas; las respuestas son conocidas durante el entrenamiento, por lo que el error se puede medir. Aprendizaje no supervisado: los datos están sin etiquetar, sin respuestas correctas dadas; el algoritmo busca patrones, estructura o agrupaciones en los datos por sí mismo (agrupar elementos similares, encontrar asociaciones); la salida es un conjunto de categorías o relaciones que no se definieron de antemano. Cómo difieren: datos etiquetados contra datos sin etiquetar; salidas conocidas contra estructura descubierta; el supervisado se usa para predecir (clasificación, regresión), el no supervisado para explorar (agrupamiento, detección de anomalías). Ambos son categorías de aprendizaje automático; el tercero es el aprendizaje por refuerzo.

Aprendizaje profundo
Un subconjunto de ML que usa redes neuronales profundas. Las capas inferiores aprenden patrones simples (bordes, fonemas), las capas superiores los combinan en conceptos abstractos. Necesita muchos datos y mucho cálculo (GPUs); para conjuntos de datos pequeños, métodos de ML más simples a menudo funcionan mejor.
"Explica qué se entiende por aprendizaje profundo" (tres puntos). Aprendizaje automático que usa redes neuronales artificiales con muchas capas ocultas (redes profundas); la red se entrena con cantidades muy grandes de datos, y cada capa extrae características de la salida de la capa inferior, para que la red aprenda las características que necesita por sí misma en lugar de tenerlas especificadas por el programador. Razones para usarlo: puede resolver problemas demasiado complejos para reglas escritas a mano o modelos poco profundos (reconocer caras, comprender el habla, traducir texto); mejora a medida que hay más datos disponibles; elimina la necesidad de ingeniería de características humana; y puede manejar datos no estructurados como imágenes, sonido y texto. Cómo se hace más efectivo: más (y mejor etiquetados) datos de entrenamiento; más capas o nodos, dentro de los límites del sobreajuste; más potencia de procesamiento (GPUs) y tiempo de entrenamiento; ajustar la tasa de aprendizaje y otros parámetros. Ejemplos: reconocimiento de voz en asistentes de voz, reconocimiento de imágenes en escaneos médicos y coches autónomos, traducción automática, sistemas de recomendación.
Aprendizaje por refuerzo
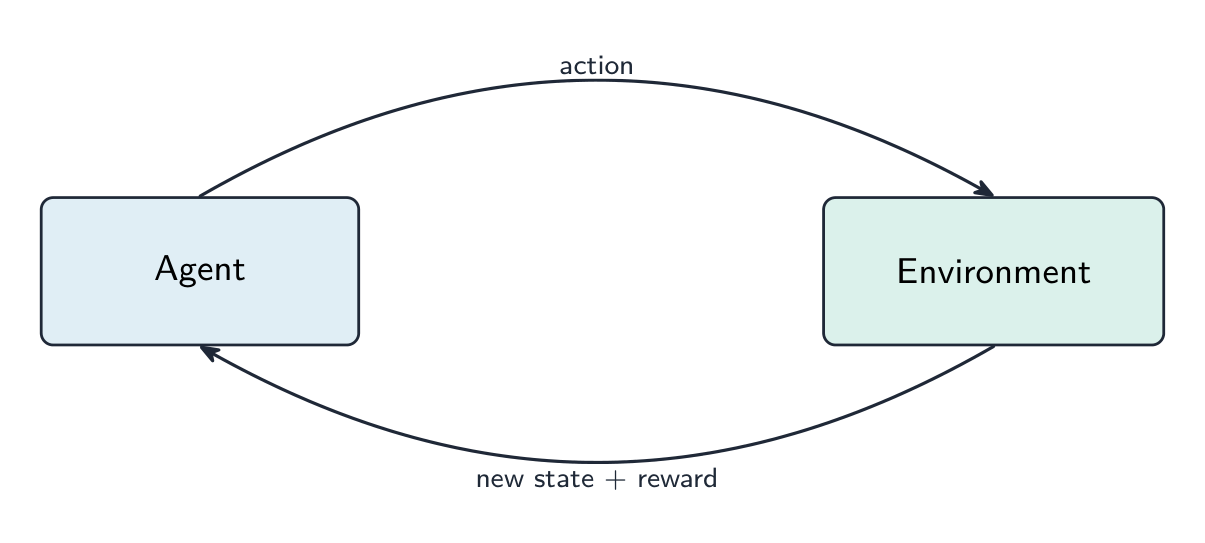
En aprendizaje por refuerzo, un agente actúa en un entorno; cada acción cambia el estado y devuelve una recompensa. El agente aprende una política (una estrategia) que maximiza la recompensa total con el tiempo, mediante ensayo y error sin etiquetas previas. Usado para problemas de decisión secuencial — juegos, control de robots, conducción autónoma.
"Explica qué se entiende por aprendizaje por refuerzo" (tres puntos). Un agente aprende interactuando con su entorno: toma una acción, el entorno se mueve a un nuevo estado y devuelve una recompensa (o penalización), y el agente ajusta su comportamiento para maximizar la recompensa total con el tiempo. No hay datos etiquetados: el agente aprende por ensayo y error, descubriendo qué acciones son buenas a partir de las recompensas que recoge, y gradualmente forma una política que dice qué hacer en cada estado. Usado donde la respuesta correcta no se conoce de antemano pero el resultado de una acción se puede puntuar: juego (ajedrez, Go), control de robots, temporización de semáforos, asignación de recursos. Una computadora jugando un juego de mesa contra un usuario aprende de esta manera, o busca el árbol del juego con minimax para elegir el movimiento cuyo peor resultado sea el mejor.
Un coche autónomo es un ejemplo real. Los sensores Lidar y de cámara (la unidad giratoria en el techo) construyen una imagen en vivo de la carretera, y una política aprendida decide cómo girar, acelerar y frenar con seguridad.


Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| self-driving car/self ˈdraɪvɪŋ kɑː/ | 自动驾驶汽车 | zì dòng jià shǐ qì chē |
| agent/ˈeɪdʒənt/ | 智能体 | zhì néng tǐ |
| reward/rɪˈwɔːd/ | 奖励 | jiǎng lì |
| policy/ˈpɒlɪsi/ | 策略 | cè lüè |
| lidar/ˈlaɪdɑː/ | 激光雷达 | jī guāng léi dá |
| backpropagation/ˌbækprəpəˈɡeɪʃn/ | 反向传播 | fǎn xiàng chuán bō |
18.1
Entrenar una ANN: propagación hacia atrás
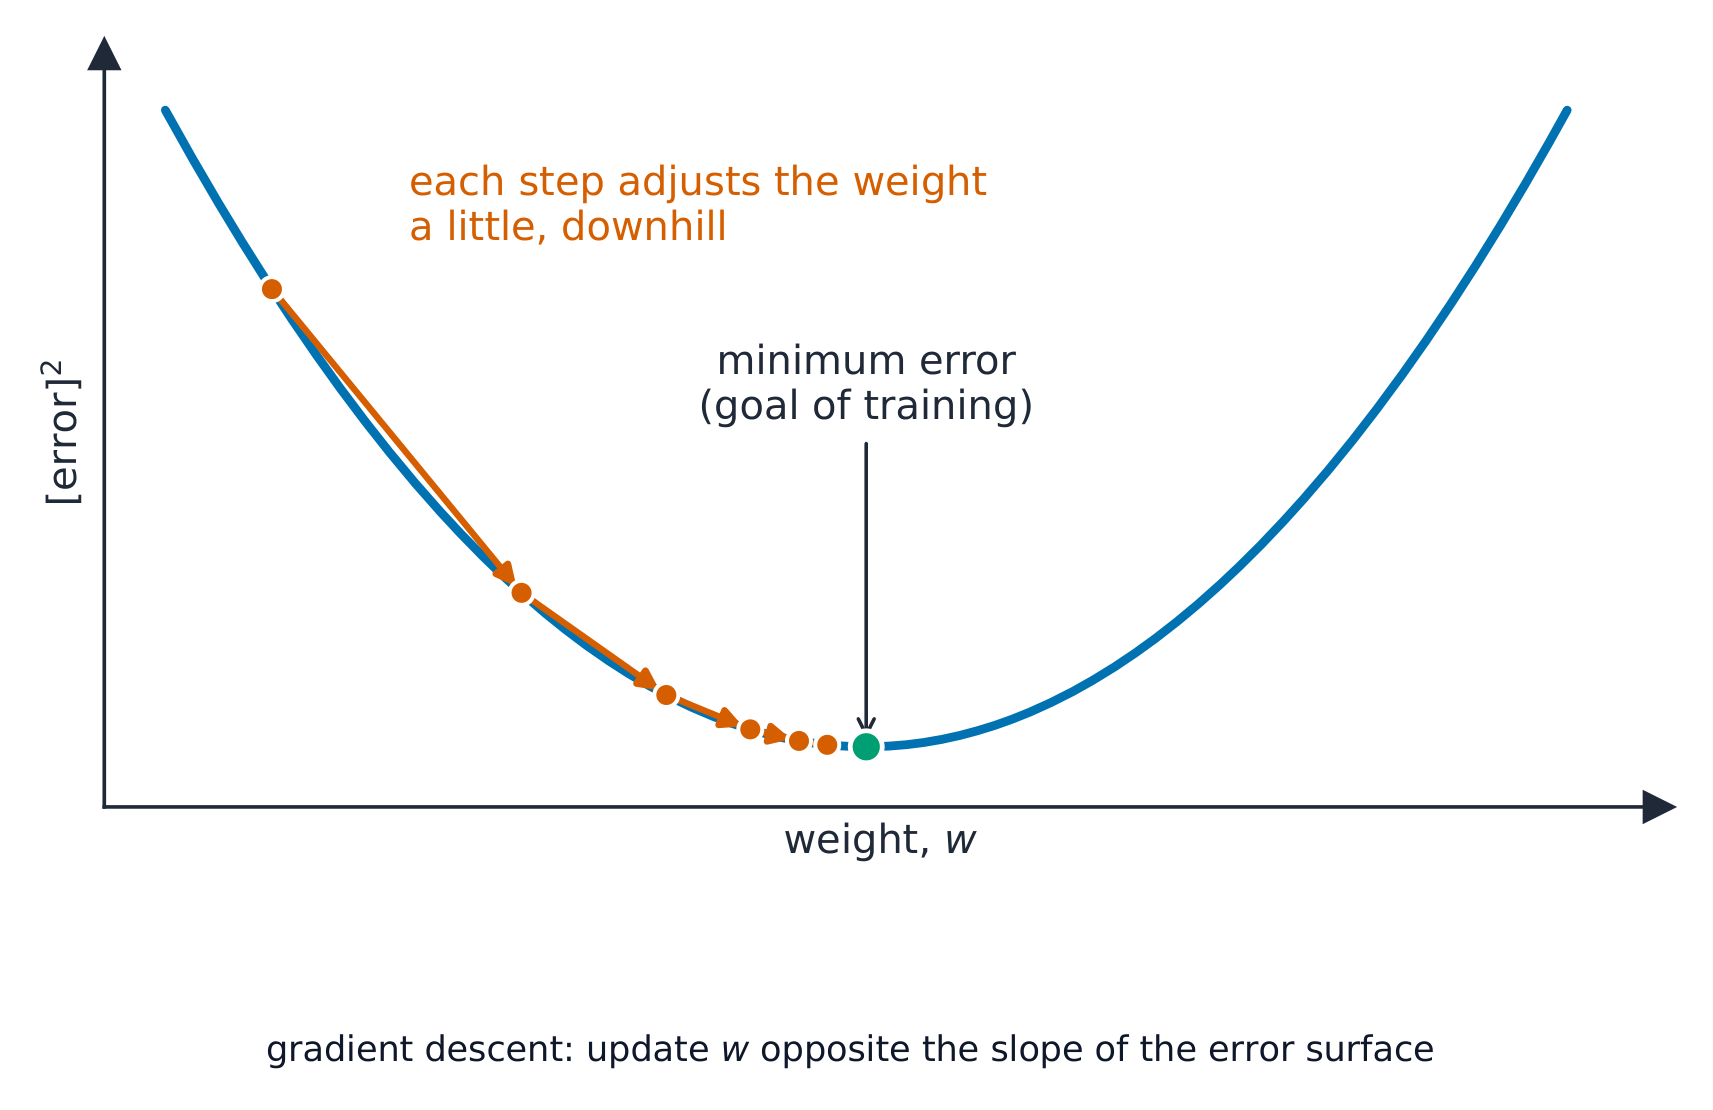
El entrenamiento ajusta los pesos para que las salidas coincidan con los objetivos. El método estándar es la propagación hacia atrás (propagación de errores) con descenso de gradiente. Para cada ejemplo de entrenamiento:
- paso hacia adelante — alimenta la entrada hasta la salida.
- calcula el error con una función de pérdida (un número único de qué tan incorrecta es la salida).
- paso hacia atrás — propaga el error hacia atrás, encontrando el gradiente de cada peso (cuánto contribuyó al error) usando la regla de la cadena.
- actualiza los pesos con un pequeño paso (determinado por la tasa de aprendizaje) que reduce el error.
Repite sobre muchos ejemplos y muchas pasadas (épocas) hasta que el error deje de disminuir. El nombre "hacia atrás" proviene del paso 3: el error fluye desde la salida hacia atrás hacia la entrada, por lo que el gradiente de cada peso se encuentra en una sola pasada. Después del entrenamiento, una nueva entrada necesita solo una pasada hacia adelante para obtener una predicción.
"Describe el método de propagación hacia atrás de errores" (cuatro puntos). (1) Se introduce una entrada hacia adelante a través de la red y su salida se compara con la salida esperada (objetivo); (2) la diferencia es el error; (3) el error se pasa hacia atrás a través de la red, capa por capa desde la salida hacia la entrada, y se calcula la participación de cada peso en el error; (4) los pesos se ajustan en proporción a su contribución, en la dirección que reduce el error; (5) el proceso se repite con muchos ejemplos hasta que el error es tan pequeño como se requiere. El punto del método es que una red con capas ocultas no tiene una forma directa de saber qué peso interno causó un error de salida; la propagación hacia atrás reparte la culpa.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| gradient descent/ˈɡreɪdɪənt dɪˈsent/ | 梯度下降 | tī dù xià jiàng |
| loss function/lɒs ˈfʌŋkʃn/ | 损失函数 | sǔn shī hán shù |
| epochs/ˈiːpɒks/ | 训练轮次 | xùn liàn lún cì |
18.1
Regresión

Algunas tareas predicen un número (precio de una casa, temperatura de mañana) — regresión, en contraste con la clasificación (una categoría).
La regresión lineal ajusta una línea recta (o hiperplano):
$$y = m_{1} x_{1} + m_{2} x_{2} + \ldots + m_{n} x_{n} + c.$$
Elige los coeficientes para minimizar la suma de errores cuadrados contra los datos de entrenamiento. Úsalo cuando la relación parece aproximadamente lineal y quieres un modelo interpretable. Para datos curvos, usa métodos de regresión polinomial, de árboles de decisión o de redes neuronales — misma idea: define un modelo, define una pérdida, y ajusta los parámetros para minimizarla. La regresión y la clasificación son ambas supervisadas; la elección depende de si la respuesta es un número o una categoría.
"Describe los métodos de regresión en el aprendizaje automático" (dos puntos). Métodos estadísticos que encuentran la relación entre variables de entrada y una salida continua, ajustando una función (una línea o curva) a los datos de entrenamiento con el error total más pequeño; la función ajustada se usa luego para predecir la salida para nuevas entradas. La regresión lineal ajusta una línea recta; otros métodos ajustan curvas. La regresión predice un valor (un precio, una temperatura, un tiempo); la clasificación predice una categoría, que es la distinción que pide el examen.
Explorar
Ajuste de una línea de regresión
Arrastra los controles. La regresión lineal traza la línea recta que hace que las distancias al cuadrado a los puntos de datos sean lo más pequeñas posible — luego predice un número para cualquier entrada nueva.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| regression/rɪˈɡreʃn/ | 回归 | huí guī |
| unsupervised learning/ʌnˈsuːpəvaɪzd ˈlɜːnɪŋ/ | 无监督学习 | wú jiān dū xué xí |
| cluster/ˈklʌstə/ | 聚类 | jù lèi |
| training data/ˈtreɪnɪŋ ˈdeɪtə/ | 训练数据 | xùn liàn shù jù |
| learning rate/ˈlɜːnɪŋ reɪt/ | 学习率 | xué xí lǜ |
| linear regression/ˈlɪnɪə rɪˈɡreʃn/ | 线性回归 | xiàn xìng huí guī |
| optical character recognition/ˈɒptɪkl ˈkærɪktə ˌrekəɡˈnɪʃn/ | 光学字符识别 | guāng xué zì fú shí bié |
| text-to-speech/tekst tə spiːtʃ/ | 文本转语音 | wén běn zhuǎn yǔ yīn |
18.1
Cómo se usa la IA en un escenario real
Muchos escenarios de examen usan el mismo patrón — un modelo de aprendizaje profundo entrenado con datos etiquetados, a menudo varios combinados en una tubería:
- identificación de clientes en una tienda automatizada: el sistema se entrena con imágenes de rostro etiquetadas; una cámara captura un rostro; el reconocimiento de imágenes extrae una representación; se compara con clientes registrados; la coincidencia más cercana identifica a la persona.
- lectura de texto de imágenes: el reconocimiento de imágenes encuentra regiones de texto; el reconocimiento óptico de caracteres extrae los caracteres; la traducción automática los convierte; la síntesis de voz los lee en voz alta.
- detección de artículos en caja registradora: IA de detección de objetos, entrenada con imágenes de productos etiquetadas, ve qué artículos van a la cesta y cobra la cuenta.
Para cuando un usuario interactúa con el sistema, el modelo es rápido — solo realiza inferencia de paso hacia adelante; la inteligencia está en los patrones aprendidos durante el entrenamiento.
Respuestas modelo para las preguntas del escenario. Una cámara de aparcamiento lee matrículas: la cámara captura una imagen; una IA entrenada con muchas imágenes etiquetadas de matracas localiza la placa en la imagen; el reconocimiento de caracteres (un clasificador de aprendizaje profundo, nuevamente entrenado con caracteres etiquetados) convierte la placa en texto; el texto se almacena con la hora y se compara cuando el coche sale. Un sistema CCTV detecta y rastrea a una persona: software de reconocimiento de imágenes entrenado con imágenes etiquetadas de personas identifica a una persona en cada fotograma; el sistema compara fotogramas sucesivos para seguir su movimiento; un movimiento inusual puede desencadenar una alerta. Discurso convertido en comandos: reconocimiento de voz entrenado con muchas voces grabadas convierte el sonido en texto; el sistema compara el texto con un conjunto de comandos conocidos; mejora a medida que se corrige. Una cámara que enfoca rostros: un modelo de detección de rostro entrenado con rostros etiquetados encuentra la región del rostro, y la lente se ajusta para poner esa región en foco. Inicio de sesión con reconocimiento facial de un banco: la app captura el rostro, una red profunda extrae sus características, y se comparan con las características almacenadas para ese cliente. En todos los casos el patrón es: entrenado con ejemplos etiquetados, extrae características, coincide o clasifica nueva entrada.
Ejemplo trabajado. Para cada tarea, di si necesita regresión o clasificación, y cómo se vería la capa de salida de una ANN: (a) predecir la temperatura de mañana; (b) decidir si un correo es spam. Pregunta qué tipo de cosa se está prediciendo. (a) Una temperatura es un número en una escala continua, así que esto es regresión, y la capa de salida es una neurona individual que sostiene ese valor. (b) Spam o no-spam es una categoría, así que esto es clasificación, y la salida da una probabilidad por clase. Ambos son aprendizaje supervisado: cada uno necesita ejemplos etiquetados para entrenar, y el entrenamiento ajusta los pesos mediante propagación hacia atrás para reducir el error. La pregunta decisiva es simplemente número-categoría - no qué difícil parezca la tarea.
18.1
Definiciones que acepta el examinador
Una pregunta de definición se califica contra un texto fijo. Aprende estas exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| grafo (en IA) | un conjunto de nodos que representan estados o lugares, unidos por aristas que representan conexiones, a menudo ponderadas, que un algoritmo de búsqueda puede explorar |
| Algoritmo de Dijkstra | encuentra la distancia más corta desde un nodo inicial hasta cada otro nodo visitando siempre el nodo no visitado con la distancia más corta hasta ahora |
| Algoritmo A* | una búsqueda de camino más corto que expande el nodo con el menor total de distancia recorrida más una estimación heurística de la distancia a la meta |
| red neuronal artificial | un modelo de las neuronas del cerebro: capas de nodos unidos por conexiones ponderadas, entrenado ajustando los pesos |
| aprendizaje automático | algoritmos que aprenden de datos y mejoran con la experiencia en lugar de seguir reglas fijas |
| aprendizaje supervisado | aprendizaje a partir de datos de entrenamiento etiquetados en los que se conoce la salida correcta para cada entrada |
| aprendizaje no supervisado | aprendizaje a partir de datos sin etiquetar encontrando patrones, agrupaciones o estructura en ellos |
| aprendizaje por refuerzo | un agente aprende por ensayo y error, eligiendo acciones en un entorno para maximizar las recompensas que recibe |
| aprendizaje profundo | aprendizaje automático que usa redes neuronales con muchas capas ocultas, entrenadas con grandes cantidades de datos, cada capa extrayendo características de la inferior |
| propagación hacia atrás de errores | comparar la salida de la red con el objetivo, pasar el error hacia atrás a través de las capas y ajustar cada peso para reducirlo |
| regresión | ajustar una función a los datos de entrenamiento para predecir un valor de salida continuo a partir de entradas |
18.1
Consejos para el examen
- Las respuestas de grafos deben nombrar nodos, aristas y pesos, y explicar qué representan; luego describir el algoritmo. Dijkstra: tabla de distancias, visitar la menor, actualizar vecinos. A*: $g$, $h$ y $f = g + h$ en cada fila, expandir la menor $f$.
- Las respuestas de ANN deben nombrar las capas, las conexiones ponderadas y el entrenamiento; el aprendizaje profundo añade muchas capas ocultas, grandes volúmenes de datos y extracción automática de características, con una razón y un ejemplo.
- Las tres categorías en una línea cada una: datos etiquetados y salidas conocidas; datos no etiquetados y estructura descubierta; agente, entorno, acciones y recompensas.
- Retropropagación: comparar con el objetivo, propagar el error hacia atrás a través de las capas, ajustar los pesos para reducirlo, repetir. La regresión predice un valor; la clasificación predice una categoría.
- Las preguntas de escenario requieren describir la tubería: entrenado con ejemplos etiquetados, extrae características, reconoce o clasifica nuevas entradas; nombrar el tipo de IA (reconocimiento de imágenes, reconocimiento de voz, aprendizaje profundo).
Errores comunes
- Describir un grafo como "un gráfico"; en IA son nodos y aristas.
- Ejecutar Dijkstra eligiendo el vecino más cercano del nodo actual en lugar de la distancia más pequeña en general que aún no ha sido visitada; u olvidar actualizar un nodo cuando aparece una ruta más corta.
- Añadir $h$ dentro de $g$ para el siguiente paso en A*; $g$ es solo la distancia real, $h$ se recalcula desde la tabla.
- Decir que el aprendizaje profundo es "aprender mucho"; se refiere a las muchas capas ocultas.
- Confundir el aprendizaje no supervisado con el aprendizaje por refuerzo; el primero encuentra estructuras en los datos, el segundo aprende de las recompensas.
- Describir la retropropagación sin mencionar la comparación con la salida esperada o sin indicar que los pesos se ajustan.
- Llamar "clasificación" a la predicción de un precio; un valor continuo es regresión.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.