Перейти к содержанию

Data Collections (Наборы данных)

AP Информатика A · Тема 4

Видеоурок по этой теме Открыть страницу видео
13:32

Data Collections (Наборы данных)

Сделайте одно фото на телефоне. Для компьютера это вовсе не картинка — это сетка чисел, по одному на каждый пиксель, около двенадцати миллионов из них. Попробуйте теперь…

Английское озвучивание · Английский + китайские субтитры (встроенные)

4.1

Этика сбора данных

Программа

Цель обучения 4.1.A: Объяснить риски для конфиденциальности при сборе и хранении персональных данных на компьютерных системах.

  • 4.1.A.1 При использовании компьютера возникает угроза конфиденциальности. При разработке новых программ разработчики должны стремиться защитить личную конфиденциальность пользователя.

Цель обучения 4.1.B: Объяснить важность оценки качества данных и потенциальных проблем при работе с набором данных.

  • 4.1.B.1 Алгоритмическая предвзятость описывает систематические и повторяющиеся ошибки в программе, которые приводят к несправедливым результатам для определенной группы пользователей.
  • 4.1.B.2 Разработчики должны знать метод сбора набора данных и потенциал предвзятости при его использовании до применения данных для извлечения новой информации или формулирования выводов.
  • 4.1.B.3 Некоторые наборы данных неполны или содержат неточные данные. Использование таких данных при разработке или эксплуатации программы может привести к неправильной или неэффективной работе программы.

Цель обучения 4.1.C: Определить подходящий набор данных для решения задачи или ответа на конкретный вопрос.

  • 4.1.C.1 Содержимое набора данных может быть связано с конкретным вопросом или темой и может не подходить для получения правильных ответов или извлечения информации по другому вопросу или теме.
Источник: Описание курса и экзамена College Board AP

Серверные стойки в дата-центре — большие объемы данных порождают этические вопросы о сборе и использовании информации
Серверные стойки в центре обработки данных — большие объемы данных вызывают этические вопросы о сборе и использовании

Программы, собирающие данные, поднимают вопросы конфиденциальности и согласия. Собирайте только необходимое, защищайте его и будьте честны в отношении его использования. Данные могут содержать предвзятость, если они не представляют всех справедливо, что приводит к несправедливым результатам — это ответственность, которая возникает при хранении информации.

4.2

Почему нам нужны структуры данных

Программа

Цель обучения 4.2.A: Представлять паттерны и алгоритмы, связанные с наборами данных, встречающимися в повседневной жизни, с помощью письменного текста или диаграмм.

  • 4.2.A.1 Набор данных — это совокупность конкретных сведений или данных.
  • 4.2.A.2 Наборы данных можно обрабатывать и анализировать для решения проблемы или ответа на вопрос. При анализе наборов данных значения внутри множества извлекаются и используются по одному, а затем обрабатываются согласно желаемому результату.
  • 4.2.A.3 Данные можно представить в виде диаграммы с использованием графика или таблицы. Эта визуализация может использоваться для планирования алгоритма, который будет применяться для обработки данных.

Источник: Описание курса и экзамена College Board AP

Шкаф для документов: структуры данных хранят множество значений под одним именем, позволяя алгоритмам обрабатывать их
Шкаф для документов: коллекции хранят множество значений под одним именем, чтобы алгоритмы могли их обрабатывать

Одна переменная хранит одно значение; реальные задачи требуют хранения множества связанных данных — списка учеников, пикселей показаний датчиков. Структура данных организовывает набор элементов, позволяя эффективно хранить, находить и обрабатывать информацию. Курс AP использует три вида: массив, ArrayList и 2D массив.

English Русский
privacy/ˈprɪvəsi/ конфиденциальности
consent/kənˈsent/ согласие
bias/ˈbaɪəs/ предвзятость
data structure/ˈdeɪtə ˈstrʌktʃə/ структура данных
array/əˈreɪ/ массив (array)
Traverse/trəˈvɜːs/ Обход
autoboxing/ˌɔːtəʊˈbɒksɪŋ/ автоупаковкой
ArrayList/əˈreɪ lɪst/ ArrayList
2D array/ˌtuː ˈdiː əˈreɪ/ 2-мерный массив
row-major order/rəʊ ˈmeɪdʒə ˈɔːdə/ порядок по строкам
4.3

Создание и чтение массива

Программа

Цель обучения 4.3.A: Разрабатывать код для представления коллекций связанных данных с использованием объектов одномерных (1D) массивов.

  • 4.3.A.1 Массив хранит несколько значений одного типа. Значения могут быть примитивными типами или ссылками на объекты.
  • 4.3.A.2 Длина массива устанавливается во время создания и не может быть изменена. Длину массива можно получить через атрибут length.
  • 4.3.A.3 Когда массив создается с ключевым словом new, все его элементы инициализируются значениями по умолчанию для типа данных элемента. Значение по умолчанию для int равно 0, для double — 0.0, для boolean — false, а для ссылочного типа — null.
  • 4.3.A.4 Для создания и инициализации массивов могут использоваться списки инициализатора.
  • 4.3.A.5 Квадратные скобки [ ] используются для доступа и изменения элемента в 1D массиве с помощью индекса.
  • 4.3.A.6 Допустимые значения индексов для массива находятся в диапазоне от 0 до длины массива минус один включительно. Использование значения индекса вне этого диапазона приведет к возникновению ошибки ArrayIndexOutOfBoundsException.

Источник: Описание курса и экзамена College Board AP

Массив — это упорядоченная коллекция значений одного типа фиксированного размера. Индексы идут от 0 до length - 1:

Одномерный массив (список) с его индексами и границами
int[] nums = new int[5];        // five zeros
int[] vals = {3, 1, 4, 1, 5};   // initialized
int first = vals[0];            // 3
int n = vals.length;            // 5 (a field, not a method)

Обращение к индексу вне диапазона 0..length-1 вызывает ошибку ArrayIndexOutOfBoundsException.

4.4

Обход каждого элемента массива

Программа

Учебная цель 4.4.A: Написать код для обхода элементов одномерного массива 1D и определения результата этих обходов.

  • 4.4.A.1 Обход массива — это использование операторов повторения для доступа ко всем элементам массива или их упорядоченной последовательности.
  • 4.4.A.2 Обход массива с использованием индексированного цикла for или цикла while требует доступа к элементам с использованием их индексов.
  • 4.4.A.3 Заголовок расширенного цикла for включает переменную, называемую переменной расширенного цикла for. Для каждой итерации расширенного цикла for переменной расширенного цикла for присваивается копия элемента без использования его индекса.
  • 4.4.A.4 Присвоение новой переменной расширенного цикла for не изменяет значение, хранящееся в массиве.
  • 4.4.A.5 Когда массив хранит ссылки на объекты, атрибуты можно изменить, вызывая методы у переменной расширенного цикла for. Это не изменяет ссылки на объекты, хранящиеся в массиве.
  • 4.4.A.6 Код, написанный с использованием расширенного цикла for для обхода элементов в массиве, может быть переписан с использованием индексированного цикла for или цикла while.

Источник: Описание курса и экзамена College Board AP

Обходите массив циклом for (дает индекс) или расширенным for / for-each циклом (дает каждое значение, только для чтения):

for (int i = 0; i < a.length; i++) { a[i] *= 2; }   // can modify
for (int v : a) { System.out.println(v); }          // read each value
4.5

Стандартные алгоритмы для массивов

Программа

Цель обучения 4.5.A: Разработать код для стандартных и оригинальных алгоритмов в конкретном контексте или спецификации, включающем массивы, и определить результат работы этих алгоритмов.

  • 4.5.A.1 Существуют стандартные алгоритмы, использующие обход массивов для:
    • определения минимального или максимального значения
    • вычисления суммы или среднего значения
    • определения наличия хотя бы одного элемента с определенным свойством
    • определения наличия свойства у всех элементов
    • подсчета количества элементов с определенным свойством
    • доступа ко всем последовательным парам элементов
    • определения наличия или отсутствия дубликатов элементов
    • перемещения или поворота элементов влево или вправо
    • реверсирования порядка элементов

Источник: Описание курса и экзамена College Board AP

Овладейте этими шаблонами: вычислить сумму или среднее, найти максимум/минимум, подсчитать элементы, удовлетворяющие условию, проверить наличие дубликата и развернуть или сдвинуть элементы. Каждый из них — это обход с накопленным результатом:

int sum = 0;
for (int v : a) sum += v;
double avg = (double) sum / a.length;
4.6

Чтение данных из текстового файла

Программа

Цель обучения 4.6.A: Разработать код для чтения данных из текстового файла.

  • 4.6.A.1 Файл — это хранилище данных, которое сохраняется после завершения работы программы. Данные в файле могут быть получены во время выполнения программы.
  • 4.6.A.2 Файл может быть подключен к программе с помощью классов File и Scanner.
  • 4.6.A.3 Файл можно открыть, создав объект File, передав имя файла в качестве аргумента конструктору.
    • File(String str) — это конструктор File, который принимает имя файла String для открытия в режиме чтения, где str — путь к файлу.
  • 4.6.A.4 При использовании класса File необходимо указать, что делать, если файл с указанным именем не может быть открыт. Один из способов — добавить throws IOException в заголовок метода, использующего файл. Если имя файла недействительно, программа завершится.
  • 4.6.A.5 Классы File и IOException являются частью пакета java.io. Для использования этих классов в программе необходимо использовать оператор import import.
  • 4.6.A.6 Следующие методы и конструкторы класса Scanner — включая их назначение и моменты применения — входят в Справочник по Java (Java Quick Reference):
    • Scanner(File f) — это конструктор Scanner, который принимает File для чтения.
    • int nextInt() возвращает следующее значение int, прочитанное из файла или источника ввода, если оно доступно. Если следующее значение int отсутствует или выходит за допустимый диапазон, возникает ошибка InputMismatchException.
    • double nextDouble() возвращает следующее значение double, прочитанное из файла или источника ввода. Если следующее значение double не существует, это приведет к исключению InputMismatchException.
    • boolean nextBoolean() возвращает следующее значение boolean, прочитанное из файла или источника ввода. Если следующее значение boolean не существует, это приведет к исключению InputMismatchException.
    • String nextLine() возвращает следующую строку текста как строковое значение String, прочитанное из файла или источника ввода; может вернуть пустую строку, если вызывается непосредственно после другого метода Scanner, который читает из файла или источника ввода.
    • String next() возвращает следующее значение String, прочитанное из файла или источника ввода.
    • Метод boolean hasNext() возвращает true, если есть следующий элемент для чтения в файле или источнике ввода; в противном случае возвращает false.
    • void close() закрывает этот сканер.
    • Исключение: Получение ввода с клавиатуры не входит в курс и экзамен AP Computer Science A.
  • 4.6.A.7 Использование nextLine и других методов Scanner совместно на одном источнике ввода иногда требует написания кода для корректной обработки различных способов этих методов работы с пробельными символами.
    • Исключение: Написание или анализ кода, использующего одновременно nextLine и другие методы Scanner на одном и том же источнике ввода, не входит в курс и экзамен AP Computer Science A.
  • 4.6.A.8 Следующий дополнительный метод класса String — включая его назначение и моменты применения — входит в Справочник по Java (Java Quick Reference):
    • String[] split(String del) возвращает массив String, где каждый элемент является подстрокой this String, которая была разделена вокруг совпадений заданного выражения del.
    • Исключение: Параметр del использует формат, называемый регулярным выражением. Написание или анализ кода, использующего любые специальные свойства регулярных выражений (например, \\*, \\.), не входит в курс и экзамен AP Computer Science A.
  • 4.6.A.9 Цикл for-each со while может использоваться для определения того, содержит ли файл еще элементы для чтения, путем использования метода hasNext в качестве условия цикла.
  • 4.6.A.10 Файл следует закрыть, когда программа перестала им пользоваться. Для закрытия файла вызывается метод close от объекта Scanner.

Источник: Описание курса и экзамена College Board AP

File и IOException находятся в java.io, поэтому программа, читающая файл, требует import java.io.*;. Открытие файла может не удалась (возможно, он не существует), и Java обязывает вас обработать это — самый простой способ добавить throws IOException в заголовок метода. Затем Scanner читает файл построчно, используя hasNext... для проверки перед чтением:

import java.io.*;
...
public static void readFile() throws IOException {
    Scanner f = new Scanner(new File("data.txt"));
    while (f.hasNextLine()) {
        String line = f.nextLine();
    }
}

Чтение токенов определенного типа с помощью nextInt(), nextDouble() или nextBoolean() вызывает исключение InputMismatchException, если следующий токен имеет неправильный тип — например, вызов nextInt(), когда следующее в файле — слово cat.

4.7

Упаковка числа в объект

Программа

Цель обучения 4.7.A: Разработать код для использования объектов Integer и Double вместо примитивных аналогов и определить результат применения этих объектов.

  • 4.7.A.1 Класс Integer и класс Double являются частью пакета java.lang. Объект Integer является неизменяемым (immutable), то есть после создания объекта Integer его атрибуты нельзя изменить. Объект Double является неизменяемым, то есть после создания объекта Double его атрибуты нельзя изменить.
  • 4.7.A.2 Аутоупаковка (Autoboxing) — это автоматическое преобразование, которое компилятор Java выполняет между примитивными типами и соответствующими им классами-обертками объектов. Это включает преобразование int в Integer и double в Double. Компилятор Java применяет аутоупаковку, когда примитивное значение:
    • передается в качестве параметра методу, ожидающему объект соответствующего оберточного класса
    • присваивается переменной соответствующего оберточного класса
  • 4.7.A.3 Автоматическое распаковывание (unboxing) — это автоматическое преобразование, которое компилятор Java выполняет из класса-обёртки в примитивный тип. Это включает преобразование Integer в int и Double в double. Компилятор Java применяет автоматическое распаковывание, когда объект класса-обёртки:
    • передается в качестве параметра методу, ожидающему значение соответствующего примитивного типа
    • присваивается переменной соответствующего примитивного типа
  • 4.7.A.4 Следующий метод класса Integer — включая его назначение и моменты применения — входит в Справочник по Java (Java Quick Reference):
    • static int parseInt(String s) возвращает аргумент типа String как значение типа int.
  • 4.7.A.5 Следующий метод класса Double — включая его назначение и моменты применения — входит в Справочник по Java (Java Quick Reference):
    • static double parseDouble(String s) возвращает аргумент типа String как строковое значение double.

Источник: Описание курса и экзамена College Board AP

ArrayList хранит объекты, а не примитивы, поэтому примитив упаковывается в объект: Integer упаковывает int, Double упаковывает double. Java делает это автоматически с помощью автоматической упаковки (из int в Integer) и автоматической распаковки (обратно), так что вы можете писать list.add(5) и int x = list.get(0).

4.8

Инструментарий ArrayList

Программа

Цель обучения 4.8.A: Разработать код для коллекций связанных объектов с использованием объектов ArrayList и определить результат вызова методов на этих объектах.

  • 4.8.A.1 Объект ArrayList изменяем по размеру и содержит ссылки на объекты.
  • 4.8.A.2 Конструктор ArrayList ArrayList() создает пустой список.
  • 4.8.A.3 Java позволяет использовать обобщенный тип ArrayList<E>, где параметр типа E указывает тип элементов. Когда ArrayList<E> указан, типы параметров-ссылок и возвращаемого типа при использовании методов ArrayList являются типом E. ArrayList<E> предпочтительнее, чем ArrayList. Например, ArrayList<String> names = new ArrayList<String>(); позволяет компилятору находить ошибки, которые в противном случае были бы обнаружены во время выполнения программы.
  • 4.8.A.4 Класс ArrayList является частью пакета java.util. Для использования этого класса в программе необходимо использовать оператор/инструкцию import.
  • 4.8.A.5 Следующие методы ArrayList — включая их назначение и моменты использования — входят в Справочник по Java:
    • int size() возвращает количество элементов в списке.
    • boolean add(E obj) добавляет obj в конец списка; возвращает true.
    • void add(int index, E obj) вставляет obj на позицию index (0 <= index <= size), сдвигая элементы на позициях index и выше вправо (добавляя 1 к их индексам) и увеличивая размер на 1.
    • E get(int index) возвращает элемент в позиции index в списке.
    • E set(int index, E obj) заменяет элемент на позиции index на obj; возвращает элемент, который ранее находился на позиции index.
    • E remove(int index) удаляет элемент из позиции index, перемещая элементы в позициях index + 1 и выше влево (уменьшая их индексы на 1) и уменьшая размер на 1; возвращает элемент, который ранее находился в позиции index.
  • 4.8.A.6 Индексы для объекта ArrayList начинаются с 0 и заканчиваются количеством элементов - 1.

Источник: Описание курса и экзамена College Board AP

*Чем на самом деле является ArrayList

ArrayList увеличивается и уменьшается по мере добавления или удаления элементов. Объявите его с типом элемента в <>:

ArrayList<String> names = new ArrayList<String>();
names.add("Amy");           // append
names.add(0, "Bob");        // insert at index
names.get(0);               // read
names.set(1, "Cara");       // replace
names.remove(0);            // delete, shifts the rest left
names.size();               // count (a method, unlike array.length)
4.9

Обход каждого элемента ArrayList

Программа

Цель обучения 4.9.A: Написать код для обхода элементов объекта ArrayList и определить результаты этих обходов.

  • 4.9.A.1 Обход объекта ArrayList — это использование циклов или рекурсивных инструкций для доступа ко всем элементам или упорядоченной последовательности элементов в объекте ArrayList.
  • 4.9.A.2 Удаление элементов во время обхода объекта ArrayList требует использования специальных техник во избежание пропуска элементов.
  • 4.9.A.3 Попытка обращения к значению индекса вне допустимого диапазона приведет к возникновению ошибки IndexOutOfBoundsException.
  • 4.9.A.4 Изменение размера объекта ArrayList во время его обхода с использованием улучшенного цикла for может привести к ошибке ConcurrentModificationException. Поэтому, используя улучшенный цикл for для обхода объекта ArrayList, не следует добавлять или удалять элементы.

Источник: Описание курса и экзамена College Board AP

Обходите с помощью цикла по индексу или цикла for-each, как и массивы (используйте size() и get(i)):

for (int i = 0; i < list.size(); i++) { ... list.get(i) ... }
for (String s : list) { ... }

Экзаменационный навык: при удалении элементов в цикле по индексу либо двигайтесь назад, либо не увеличивайте i после удаления — иначе удаление сдвигает элементы влево, и вы пропустите один. И никогда не добавляйте и не удаляйте элементы во время обхода ArrayList с помощью for-each цикла: изменение его размера во время цикла вызывает исключение ConcurrentModificationException, поэтому используйте цикл по индексу (назад, как указано выше), whenever вам нужно удалить.

4.10

Стандартные алгоритмы для ArrayList

Программа

Цель обучения 4.10.A: Разрабатывать код для стандартных и оригинальных алгоритмов для конкретного контекста или спецификации, включающих объекты ArrayList, и определять результат этих алгоритмов.

  • 4.10.A.1 Существуют стандартные алгоритмы для ArrayList, использующие обход для:
    • определения минимального или максимального значения
    • вычисления суммы или среднего значения
    • определения наличия хотя бы одного элемента с определенным свойством
    • определения наличия свойства у всех элементов
    • подсчета количества элементов с определенным свойством
    • доступа ко всем последовательным парам элементов
    • определения наличия или отсутствия дубликатов элементов
    • перемещения или поворота элементов влево или вправо
    • реверсирования порядка элементов
    • вставки элементов
    • удаления элементов
  • 4.10.A.2 Некоторые алгоритмы требуют одновременного обхода нескольких объектов String, массивов или объектов ArrayList.

Источник: Описание курса и экзамена College Board AP

Те же алгоритмы, что и для массивов — максимум/минимум, подсчет, сумма — плюс вставка и удаление, которые массивам сделать трудно. Распространенная задача — удалить все элементы, соответствующие условию, осторожно обрабатывая сдвиг индекса.

4.11

Решетки: Двумерные массивы

Программа

Цель обучения 4.11.A: Написать код, используемый для представления совокупностей связанных данных с помощью объектов двухмерных (2D) массивов.

  • 4.11.A.1 Массив 2D хранится как массив массивов. Поэтому способ создания и индексации массивов 2D подобен объектам массивов 1D. Размер массива 2D устанавливается в момент создания и не может быть изменен. Массивы 2D могут хранить либо примитивные данные, либо данные ссылок на объекты.
    • Условие исключения: Неректэнгулярные объекты массивов 2D выходят за рамки курса и экзамена AP Computer Science A.
  • 4.11.A.2 При создании двумерного массива (2D) с помощью ключевого слова new все его элементы инициализируются значениями по умолчанию для типа данных элементов. Значение по умолчанию для int равно 0, для double — 0.0, для boolean — false, а для ссылочного типа — null.
  • 4.11.A.3 Список инициализаторов, используемый для создания и инициализации двумерного массива (2D), состоит из списков инициализаторов, представляющих одномерные массивы (1D); например, int[][] arr2D = { {1, 2, 3}, {4, 5, 6} };.
  • 4.11.A.4 Квадратные скобки [row][col] используются для доступа к элементу и изменения его значения в двумерном массиве (2D). Для целей экзамена при обращении к элементу на позиции arr[first][second] первый индекс используется для строк, второй — для столбцов.
  • 4.11.A.5 Один массив, являющийся строкой массива 2D, может быть получен с использованием имени массива 2D и одного набора квадратных скобок, содержащих индекс строки.
  • 4.11.A.6 Количество строк, содержащихся в двумерном массиве (2D), можно получить через атрибут length. Допустимые значения индексов строк для массива (2D) находятся в диапазоне от 0 до одного меньше количества строк или длины массива включительно. Количество столбцов, содержащихся в двумерном массиве (2D), можно получить через атрибут length одной из строк. Допустимые значения индексов столбцов для массива (2D) находятся в диапазоне от 0 до одного меньше количества столбцов или длины любой данной строки массива включительно. Например, для двумерного массива (2D) с именем values количество строк составляет values.length, а количество столбцов — values[0].length. Использование значения индекса вне этих диапазонов приведет к возникновению ошибки (ArrayIndexOutOfBoundsException).

Источник: Описание курса и экзамена College Board AP

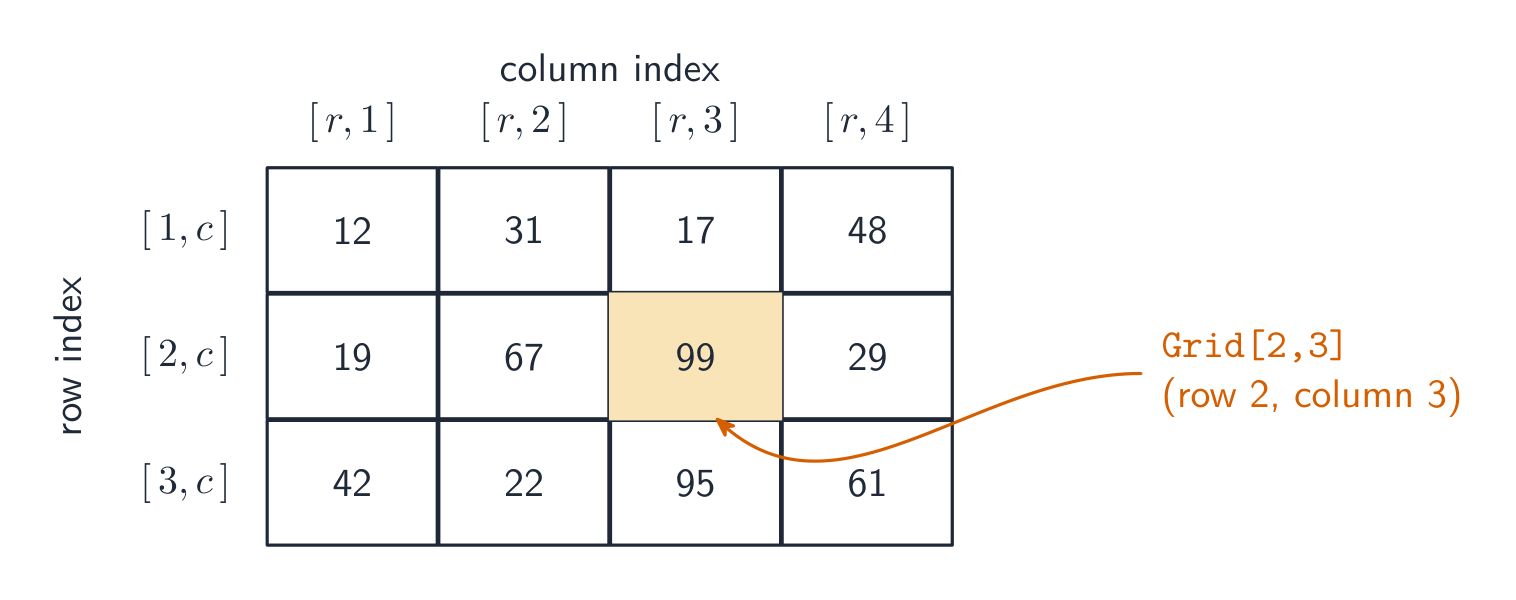
2D массив — это сетка (строки и столбцы), то есть массив из массивов:

Двумерный массив (таблица) с индексами строк и столбцов
int[][] grid = new int[3][4];   // 3 rows, 4 columns
grid[r][c] = 7;                 // row r, column c
int rows = grid.length;         // 3
int cols = grid[0].length;      // 4
Исследовать

Индексирование массива 2D по строке и столбцу

2D массив — это сетка, индексируемая [row][col]. Перемещайте индексы и следите, какую ячейку они выбирают — сначала строку, затем столбец, обе счет ведутся с 0.

4.12

Проход по решетке

Программа

Цель обучения 4.12.A: Разработать код для обхода элементов в одномерном массиве 2D и определения результата этих обходов.

  • 4.12.A.1 Вложенные операторы итерации используются для обхода и доступа ко всем или упорядоченной последовательности элементов в двумерном массиве 2D. Поскольку массивы 2D хранятся как массивы массивов, способ обхода массивов 2D с использованием циклов for и улучшенных циклов for похож на объекты массивов 1D. Вложенные операторы итерации могут быть написаны для обхода массива 2D в порядке по строкам, порядке по столбцам или уникально определенном порядке. Порядок по строкам относится к упорядочиванию элементов массива 2D, где обход происходит по каждой строке, тогда как порядок по столбцам осуществляется вниз по каждому столбцу.
  • 4.12.A.2 Внешний цикл вложенного расширенного цикла for для обхода многомерного массива размера 2D проходит по строкам. Следовательно, переменная расширенного цикла for должна иметь тип каждой строки, который представляет собой массив размера 1D. Внутренний цикл проходит по одной строке. Следовательно, переменная внутреннего расширенного цикла for должна иметь тот же тип, что и элементы, хранящиеся в массиве размера 1D. Присвоение нового значения переменной расширенного цикла for не изменяет значение, хранящееся в массиве.

Источник: Описание курса и экзамена College Board AP

Обход одномерного (2-D) массива

Посетите каждую ячейку с помощью вложенных циклов — внешний по строкам, внутренний по столбцам (порядок по строкам):

for (int r = 0; r < grid.length; r++)
    for (int c = 0; c < grid[0].length; c++)
        System.out.print(grid[r][c]);
4.13

Стандартные алгоритмы для 2-мерных массивов

Программа

Цель обучения 4.13.A: Разработать код для стандартных и оригинальных алгоритмов для конкретного контекста или спецификации,涉及ая одномерные массивы 2D, и определить результат этих алгоритмов.

  • 4.13.A.1 Существуют стандартные алгоритмы, использующие обход массивов размера 2D для:
    • определения минимального или максимального значения среди всех элементов или для выделенной строки, столбца или другого подраздела
    • вычисления суммы или среднего значения всех элементов или для выделенной строки, столбца или другого подраздела
    • определения, имеет ли хотя бы один элемент particular свойство во всем массиве 2D или для выделенной строки, столбца или другого подраздела
    • определения того, обладают ли все элементы массива размера 2D или выделенная строка, столбец или другой подраздел определённым свойством
    • подсчёта количества элементов в массиве размера 2D или в выделенной строке, столбце или другом подразделе, обладающих определённым свойством
    • доступа ко всем последовательным парам элементов
    • определения наличия или отсутствия дублирующихся элементов в массиве размера 2D или в выделенной строке, столбце или другом подразделе
    • перемещения или вращения элементов в строке влево или вправо, или в столбце вверх или вниз
    • реверсирования порядка элементов в строке или столбце

Источник: Описание курса и экзамена College Board AP

Типичные задачи решетки: сложить строку или столбец, найти максимум в решетке, подсчитать совпадающие ячейки или сложить диагональ (где r == c). Каждая из них — вложенный обход с накопленным результатом.

4.14

Поиск значения: линейный и бинарный поиск

Программа

Цель обучения 4.14.A: Разработать код, используемый для алгоритмов линейного поиска для поиска конкретной информации в коллекции, и определить результаты выполнения поиска.

  • 4.14.A.1 Алгоритмы линейного поиска — это стандартные алгоритмы, которые проверяют каждый элемент по порядку, пока не будет найдено желаемое значение или пока не будут проверены все элементы массива или списка ArrayList. Алгоритмы линейного поиска могут начинать процесс поиска с любого конца массива или списка ArrayList.
  • 4.14.A.2 При применении алгоритмов линейного поиска к двумерным массивам 2D необходимо последовательно обращаться к каждой строке и выполнять линейный поиск для каждой строки трехмерного массива 2D.

Источник: Описание курса и экзамена College Board AP

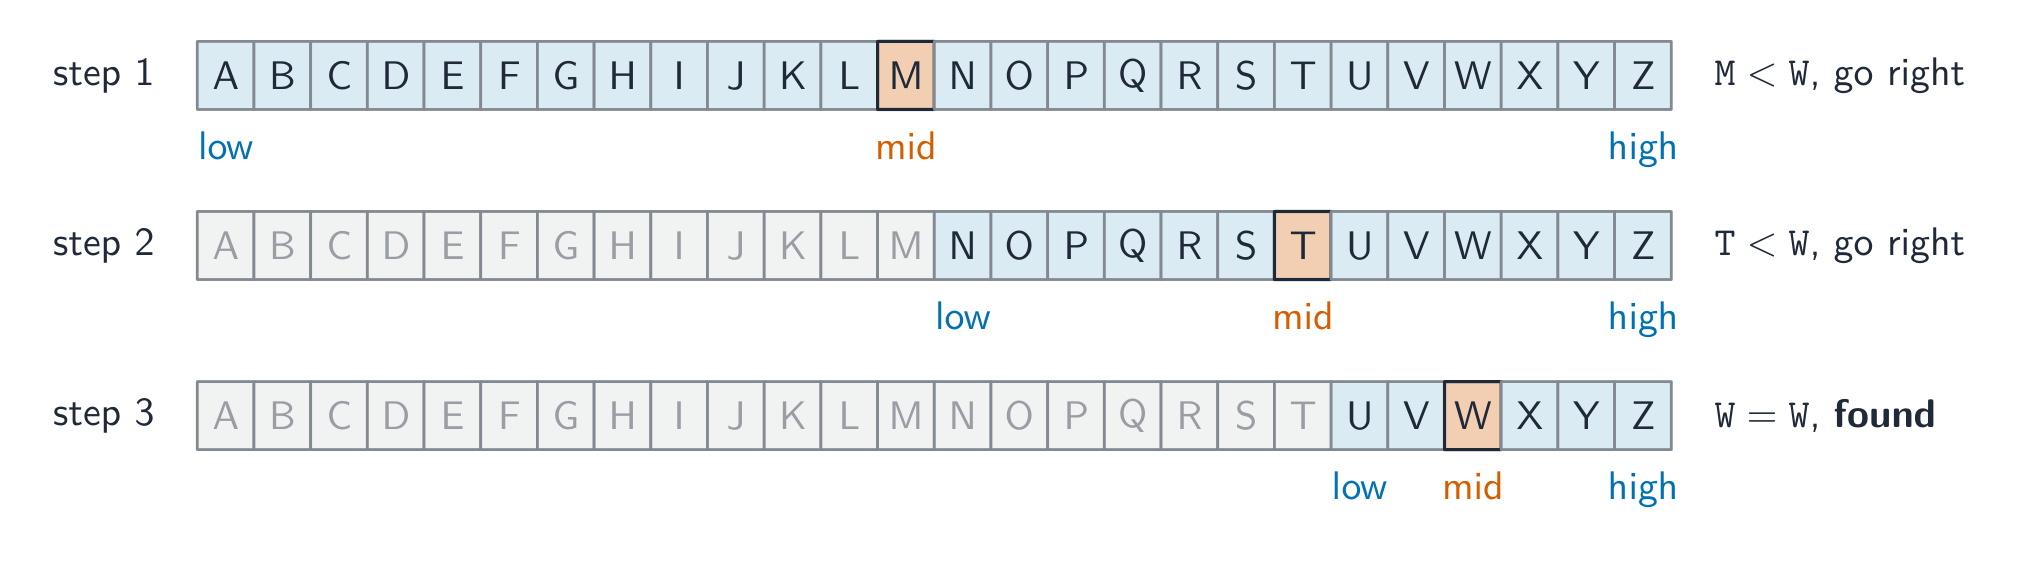
Бинарный поиск: делите пополам и побеждайте
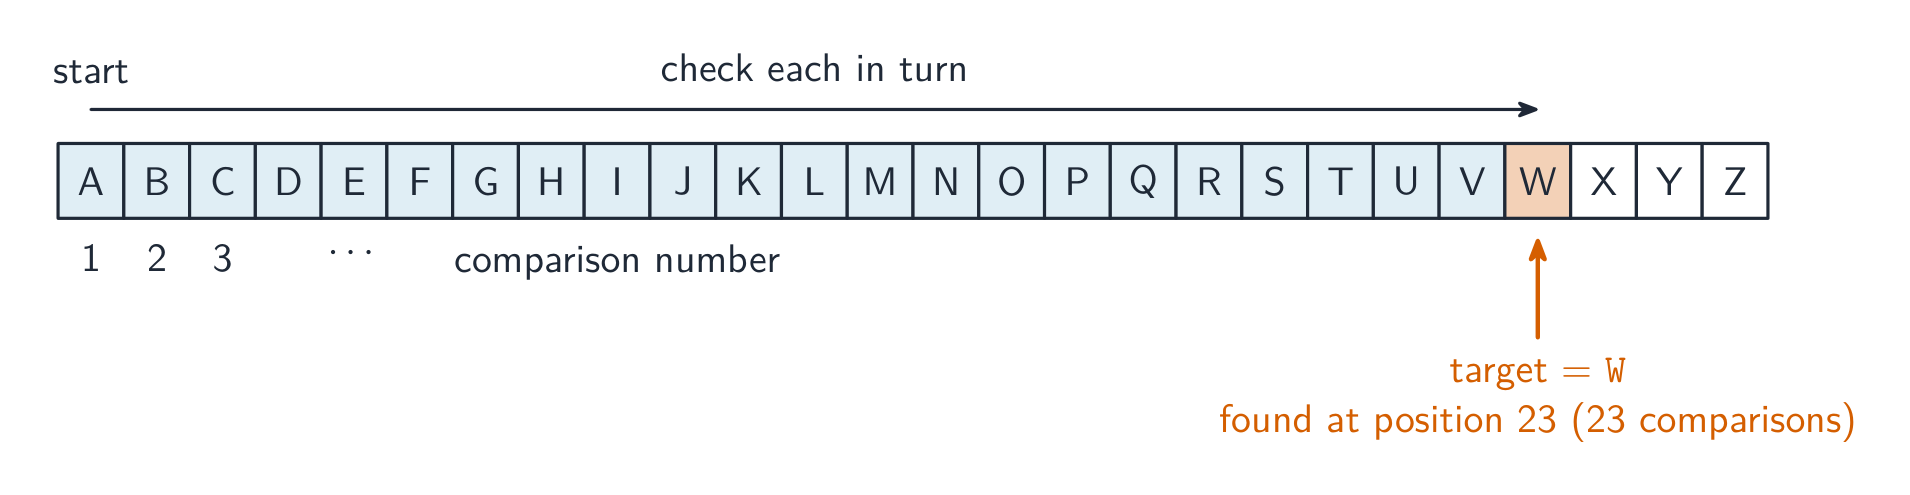
  • Линейный поиск последовательно проверяет каждый элемент — работает с любым списком, требуя до $n$ шагов.
  • Бинарный поиск работает только со отсортированным списком: проверяет середину, затем отбрасывает половину, в которой не может находиться целевой элемент, повторяя процесс. Он требует около $\log_2 n$ шагов — значительно быстрее на больших объемах данных.
Бинарный поиск уменьшает диапазон пополам на каждом шаге
Линейный поиск последовательно проверяет каждый элемент, пока не будет найден целевой
Линейный поиск последовательно проверяет каждый элемент, пока не найдет целевой
int lo = 0, hi = a.length - 1;
while (lo <= hi) {
    int mid = (lo + hi) / 2;
    if (a[mid] == target) return mid;
    else if (a[mid] < target) lo = mid + 1;
    else hi = mid - 1;
}

Навык для экзамена: бинарный поиск требует сортированных данных; нужно знать количество сравнений и как lo, hi, mid обновляются.

Разобранная задача. Поиск элемента target = 40 в отсортированном массиве {3, 9, 14, 23, 31, 42, 55} (индексы 0–6). Начало lo=0, hi=6:

  • mid = (0+6)/2 = 3, a[3]=23 < 40, значит lo = 4;
  • mid = (4+6)/2 = 5, a[5]=42 > 40, значит hi = 4;
  • mid = (4+4)/2 = 4, a[4]=31 < 40, значит lo = 5;
  • теперь условие lo (5) > hi (4) выполнено, цикл завершается – элемент 40 отсутствует.

Каждый шаг уменьшал диапазон вдвое, поэтому даже этот промах занял всего три сравнения.

Исследовать

Сравните линейный и бинарный поиск

Линейный поиск проверяет каждый элемент по очереди; бинарный поиск делит отсортированный список пополам на каждом шаге. Наблюдайте, как бинарный поиск находит цель гораздо быстрее.

English Русский
Linear search/ˈlɪnɪə sɜːtʃ/ Линейный поиск
Binary search/ˈbaɪnəri sɜːtʃ/ Бинарный поиск
Selection sort/sɪˈlekʃn sɔːt/ Сортировка выбором
4.15

Упорядочивание данных: Сортировка выбором и сортировка вставками

Программа

Цель обучения 4.15.A: Определить результат выполнения каждого шага алгоритмов сортировки для сортировки элементов коллекции.

  • 4.15.A.1 Сортировка выбором (selection sort) и сортировка вставками (insertion sort) — это итеративные алгоритмы сортировки, которые могут использоваться для сортировки элементов в массиве или списке ArrayList.
  • 4.15.A.2 Сортировка выбором многократно выбирает наименьший (или наибольший) элемент из неотсортированной части списка и меняет его местами с элементом, стоящим на правильной (и окончательной) позиции в отсортированной части списка.
  • 4.15.A.3 Сортировка вставками помещает элемент из неотсортированной части списка на его правильное (но не обязательно конечное) место в отсортированной части списка, сдвигая элементы отсортированной части, чтобы освободить место для нового элемента.

Источник: Описание курса и экзамена College Board AP

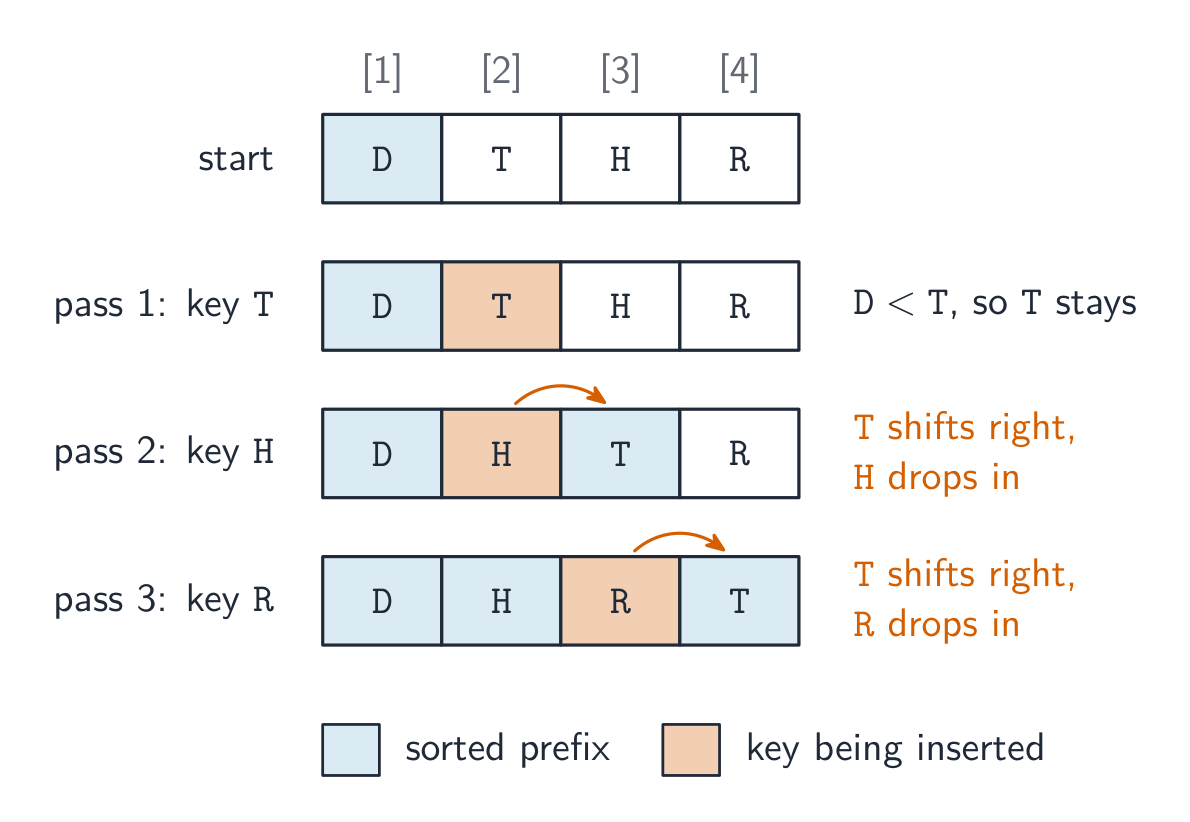
Сортировка вставками
Сортировка пузырьком, проход за проходом
  • Сортировка выбором многократно находит наименьший из оставшихся элементов и меняет его местами.
  • Сортировка вставками формирует отсортированную часть спереди, вставляя каждый новый элемент на нужное место.
Сортировка вставками: перемещение каждого ключа на нужное место шаг за шагом
Сортировка вставками, перемещая каждый ключ на свое место за один проход

Оба алгоритма просты и требуют примерно $n^2$ шагов в среднем — подходят для небольших массивов. Нужно уметь отслеживать массив после каждого прохода.

Исследовать

Наблюдайте, как алгоритм сортировки упорядочивает список

Сортировка переставляет элементы в порядке. Пройдитесь по выборочной/вставочной сортировке, чтобы увидеть, как отсортированная область растет на один элемент за раз.

English Русский
Insertion sort/ɪnˈsɜːʃn sɔːt/ Сортировка вставками
4.16

Методы, вызывающие сами себя: Рекурсия

Программа

Цель обучения 4.16.A: Определять результат вызова рекурсивных методов.

  • 4.16.A.1 Рекурсивный метод — это метод, который вызывает сам себя. Рекурсивные методы содержат как минимум одно базовое условие, останавливающее рекурсию, и как минимум один рекурсивный вызов. Рекурсия является еще одной формой повторения.
  • 4.16.A.2 Каждый рекурсивный вызов имеет свой собственный набор локальных переменных, включая параметры. Значения параметров фиксируют прогресс рекурсивного процесса, подобно тому, как значения управляющей переменной цикла фиксируют прогресс цикла.
  • 4.16.A.3 Любое рекурсивное решение может быть реализовано с помощью итеративного подхода, и наоборот.
    • Исключение: Написание рекурсивного кода не входит в курс и экзамен по информатике AP Computer Science A.

Источник: Описание курса и экзамена College Board AP

Рекурсия и стек вызовов

Рекурсия — это метод, который вызывает сам себя на меньшем объеме входных данных. Она требует базового случая, останавливающего вызовы, и рекурсивного случая, приближающего к базовому:

public static int factorial(int n) {
    if (n <= 1) return 1;          // base case
    return n * factorial(n - 1);   // recursive case
}

Без достижимого базового случая рекурсия никогда не остановится (переполнение стека).

Рекурсия и итерация взаимозаменяемы. Любое рекурсивное решение можно переписать с помощью цикла (итеративный подход), и любой цикл можно переписать с помощью рекурсии — они решают одни и те же задачи. Приведенный выше factorial эквивалентен итеративной версии:

public static int factorial(int n) {
    int result = 1;
    for (int i = 2; i <= n; i++) result *= i;   // same answer, no self-call
    return result;
}

Таким образом, выбор зависит от ясности, а не возможностей: рекурсия читается естественнее для задач со самоподобной структурой (деревья, слиянием), тогда как итерация избегает затрат памяти на хранение кадра вызова на каждом шаге. На экзамене могут попросить преобразовать одно в другое.

Исследовать

Разверните рекурсивный вызов

Рекурсивный метод вызывает сам себя на меньшем входе до достижения базового случая, затем результаты сворачиваются обратно. Пройдитесь по шагам, чтобы увидеть, как вызовы накапливаются и разворачиваются.

English Русский
Recursion/rɪˈkɜːʃn/ Рекурсия
base case/beɪs keɪs/ базовым случаем
4.17

Рекурсивный поиск и сортировка слиянием

Программа

Цель обучения 4.17.A: Определять результат выполнения рекурсивных алгоритмов, использующих строки или коллекции.

  • 4.17.A.1 Рекурсию можно использовать для обхода String объектов, массивов и ArrayList объектов.

Цель обучения 4.17.B: Определять результат каждой итерации алгоритма бинарного поиска, используемого для поиска информации в коллекции.

  • 4.17.B.1 Данные должны быть отсортированы для использования алгоритма бинарного поиска. Бинарный поиск начинается с середины отсортированного массива или ArrayList и отбрасывает половину массива или ArrayList при каждом рекурсивном вызове, пока не будет найдено нужное значение или все элементы не будут исключены.
  • 4.17.B.2 Бинарный поиск обычно эффективнее линейного поиска.
    • Исключение: Алгоритмы поиска, отличные от линейного и бинарного, не входят в курс и экзамен по информатике AP Computer Science A.
  • 4.17.B.3 Алгоритм бинарного поиска может быть написан как итеративно, так и рекурсивно.

Цель обучения 4.17.C: Определять результат каждой итерации алгоритма сортировки слиянием при использовании для сортировки коллекции.

  • 4.17.C.1 Сортировка слиянием — это рекурсивный алгоритм сортировки, который можно использовать для упорядочивания элементов в массиве или ArrayList.
    • Исключение: Алгоритмы сортировки, отличные от сортировки выбором, сортировки вставками и сортировки слиянием, не входят в курс и экзамен по информатике AP Computer Science A.
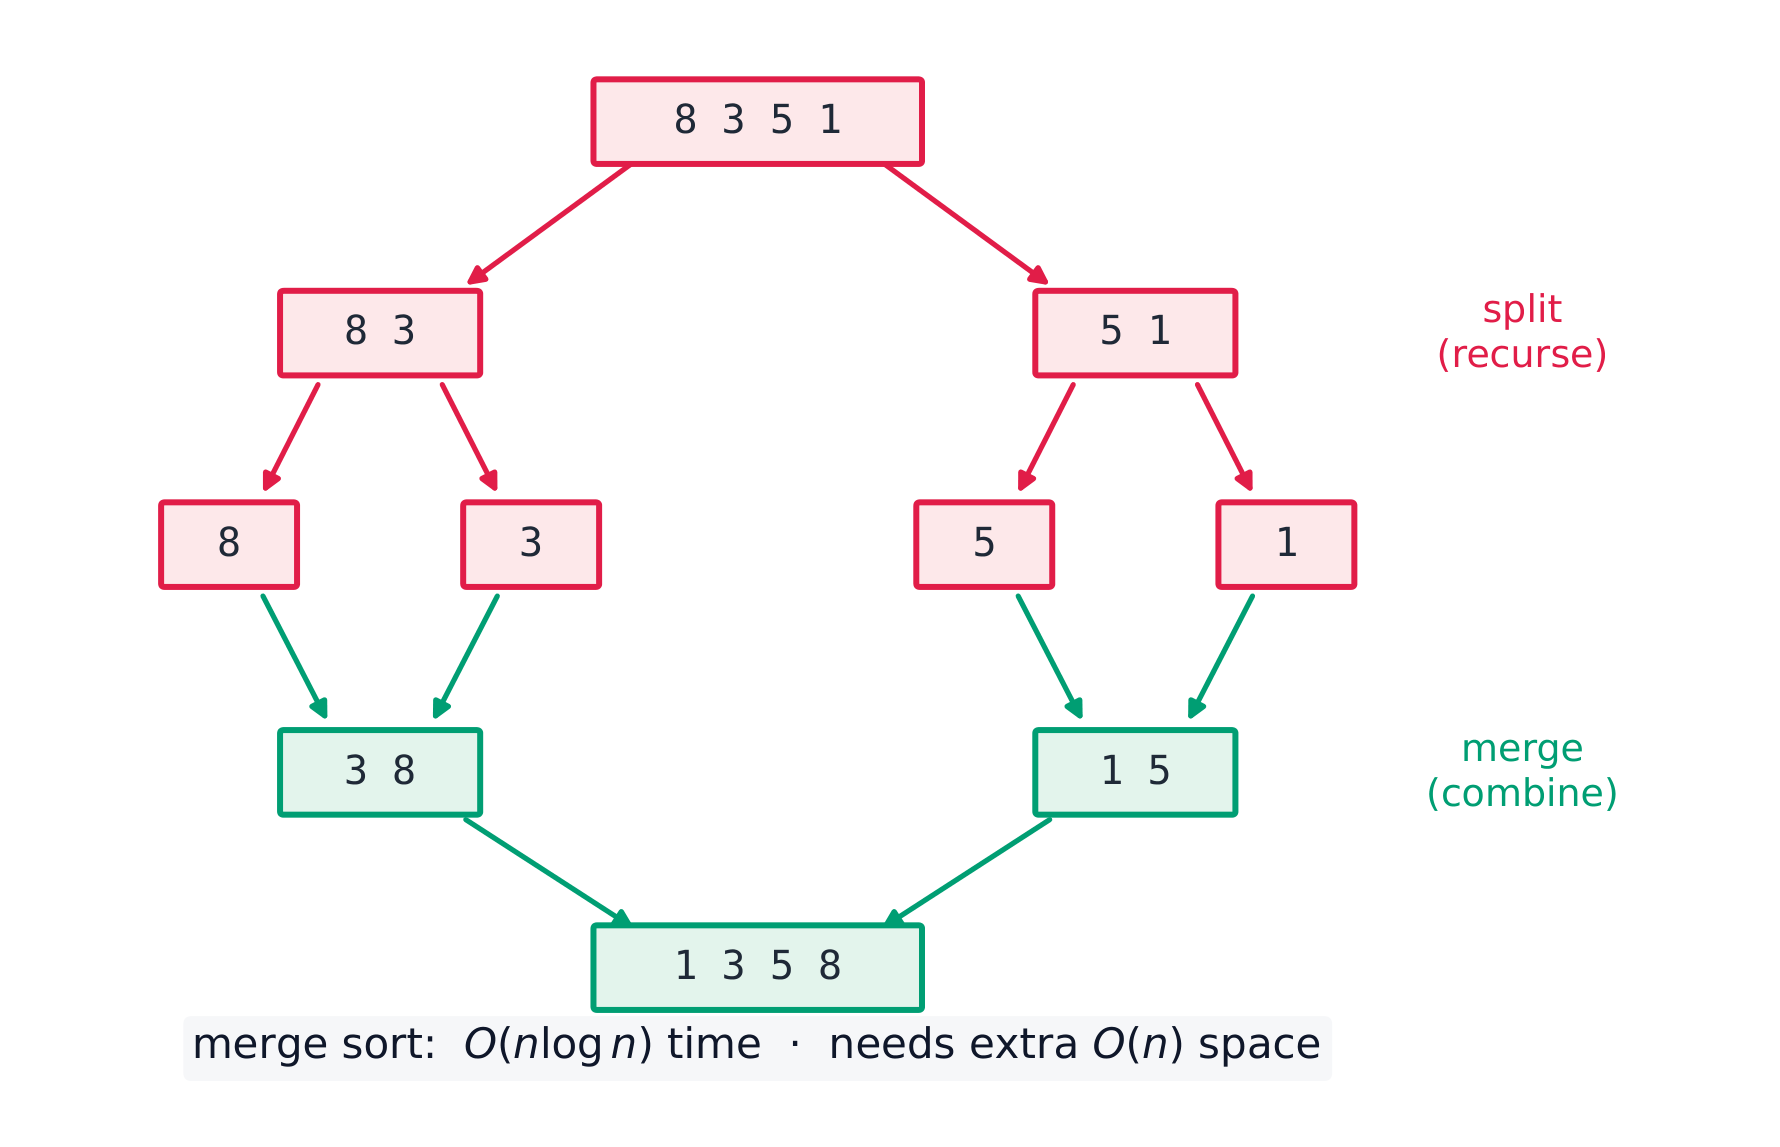
  • 4.17.C.2 Сортировка слиянием постоянно делит массив на меньшие подмассивы до тех пор, пока каждый подмассив не станет состоять из одного элемента, а затем рекурсивно объединяет отсортированные подмассивы обратно в отсортированном порядке, образуя итоговый отсортированный массив.

Источник: Описание курса и экзамена College Board AP

Сортировка слиянием: разделение, затем слияние

Рекурсия обеспечивает эффективные алгоритмы. Бинарный поиск можно написать рекурсивно (поиск в нужной половине). Сортировка слиянием делит массив пополам, рекурсивно сортирует каждую половину, а затем сливает две отсортированные половины — занимая около $n\log_2 n$ шагов, что намного быстрее, чем сортировка выбором или вставками на больших данных.

Сортировка слиянием разбивает массив до отдельных элементов, затем объединяет отсортированные половины обратно
Сортировка слиянием разбивает массив на отдельные элементы, затем сливает отсортированные половины обратно вверх

Разобранное решение. Отследите работу функции factorial(4). Каждый вызов переносится на меньший: factorial(4) = 4 * factorial(3) = 4 * 3 * factorial(2) = 4 * 3 * 2 * factorial(1). Функция factorial(1) достигает базового случая и возвращает значение 1, поэтому вызовы разворачиваются внутрь: 2 * 1 = 2, затем 3 * 2 = 6, затем 4 * 6 = 24. Запись каждого вызова над возвращаемым им значением — надежный способ отладки рекурсии.

Навык для экзамена: отслеживайте рекурсивный метод, расписывая каждый вызов и возвращаемое значение, и знайте, что эффективность сортировки слиянием ($n\log n$) превосходит $n^2$ простые сортировки.

English Русский
Merge sort/mɜːdʒ sɔːt/ Сортировка слиянием
4.17

Советы для экзамена

  • Оценивайте как преимущества, так и недостатки сбора данных — эта тема проверяется через краткое письменное обоснование, а не код.
  • Защищайте лично идентифицируемую информацию (PII) и объясняйте риски конфиденциальности и безопасности в контексте.
  • Называйте реальные ущербы: утечки данных, слежку и алгоритмический предвзятость из-за нерепрезентативных данных.
  • Соблюдайте интеллектуальную собственность и лицензирование при повторном использовании кода или данных.
  • Дайте конкретный, аргументированный ответ — расплывчатое «это может быть плохо» не принесет баллов.

Интерактивные уроки по этой теме

Пройдите его шаг за шагом с упражнениями мгновенной проверки.

Архив экзаменационных работ

Больше тем в AP Информатика A

Войти или создать аккаунт

IGCSE, A-Level & AP