Por que bancos de dados e o modelo relacional
| English | Português |
|---|---|
| table/ˈteɪbl/ | tabela |
| relational database/rɪˈleɪʃənl ˈdeɪtəbeɪs/ | banco de dados relacional |
| flat files/flæt faɪlz/ | arquivos planos |
| data redundancy/ˈdeɪtə rɪˈdʌndənsi/ | redundância de dados |
| data inconsistency/ˈdeɪtə ˌɪnkənˈsɪstənsi/ | inconsistência de dados |
| integrity/ɪnˈteɡrɪti/ | integridade |
| field/fiːld/ | campo |
| entity/ˈentɪti/ | entidade |
| record/ˈrekɔːd/ | registrar |
| tuple/ˈtuːpl/ | tupla |
| attribute/ˈætrɪbjuːt/ | atributo |
| primary key/ˈpraɪməri kiː/ | chave primária |
| composite key/ˈkɒmpəzɪt kiː/ | chave composta |
| candidate key/ˈkændɪdeɪt kiː/ | chave candidata |
| secondary key/ˈsekəndəri kiː/ | chave secundária |
| indexing/ˈɪndeksɪŋ/ | indexação |
| foreign key/ˈfɒrən kiː/ | chave estrangeira |
| referential integrity/ˌrefəˈrenʃl ɪnˈteɡrɪti/ | integridade referencial |
| one-to-many/wʌn tə ˈmeni/ | um-para-muitos |
| many-to-many/ˈmeni tə ˈmeni/ | muitos-para-muitos |
O documento que a IBM não queria publicar
- Em 1970, um pesquisador da IBM chamado Edgar Codd publicou um documento de doze páginas propondo que os dados fossem armazenados em tabelas simples, ligadas por valores partilhados, e pedidas numa linguagem que dissesse o que você queria em vez de onde estava no disco.
- A IBM já vendia uma base de dados que armazenava dados como árvores ligadas ao layout de ficheiros, assim o ignorou durante anos. Cada programa escrito contra esses ficheiros tinha de ser reescrito sempre que o layout mudava.
- Na década de 1980, todos os bancos, companhias aéreas e departamentos governamentais estavam a migrar para as tabelas do Codd. Meio século depois, ainda funcionam sobre elas.
- Esta lição trata dos problemas da abordagem baseada em ficheiros, como uma base de dados relacional 关系数据库 os resolve, e das palavras que deve usar exatamente.
A abordagem baseada em ficheiros
- Antes das bases de dados, cada programa mantinha os seus próprios ficheiros planos 平面文件: o programa de vendas tinha um ficheiro de clientes, o programa de contas tinha outro, o programa de entregas tinha um terceiro.
- Cada ficheiro tinha um layout fixo dependente do código do programa, e nada fora do programa sabia o que estava nele.
- Funciona para um único programa pequeno. Os problemas começam quando o segundo programa precisa dos mesmos dados.
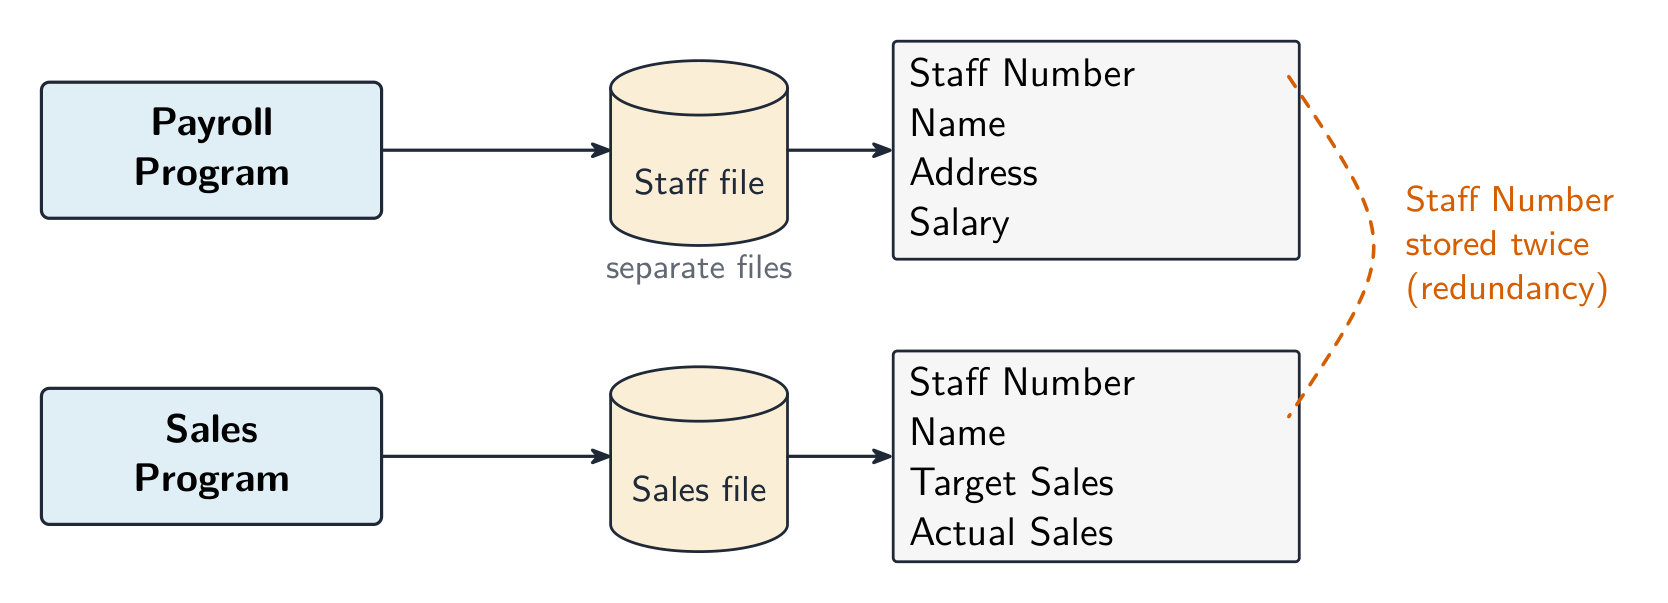
Três programas, três cópias do cliente
As limitações
- Redundância de dados 数据冗余: os mesmos dados, como um endereço de cliente, estão guardados em vários ficheiros, desperdiçando armazenamento e esforço.
- Inconsistência de dados 数据不一致: as cópias são atualizadas separadamente, assim divergem e ninguém sabe qual está correta.
- Dependência de dados: os programas estão ligados ao formato do ficheiro, assim uma mudança no layout significa reescrever todos os programas que usam o ficheiro.
- A integridade 完整性 é difícil de garantir, os dados são difíceis de partilhar com segurança, a pesquisa através de ficheiros é lenta e a segurança não pode ser definida por campo.
Armazenar o endereço de um cliente em vários arquivos separados leva a:
Os mesmos dados armazenados em muitos lugares (redundância) podem ser atualizados separadamente e se tornar inconsistentes.
Em um sistema de arquivo plano, os mesmos dados são frequentemente duplicados entre arquivos, o que pode levar a inconsistências quando apenas uma cópia é atualizada.
Essa redundância e a inconsistência resultante são o problema central que o modelo relacional resolve.
Quais são as limitações da abordagem baseada em arquivos? Selecione todas as opções aplicáveis.
Redundância, inconsistência e dependência de dados são as três limitações nomeadas. Tabelas e joins pertencem à abordagem relacional que a substitui.
Como uma base de dados relacional responde a estas limitações
- Uma base de dados relacional armazena os dados em tabelas 表 geridas por um único software, o DBMS, que todos os programas utilizam.
- Cada facto é armazenado uma única vez, eliminando a redundância e a inconsistência: um endereço é alterado num lugar e todos os programas veem a alteração.
- Os programas pedem dados ao DBMS pelo seu nome, assim o armazenamento pode mudar sem que os programas se alterem: independência de dados.
- Regras de integridade, direitos de acesso e cópias de segurança são aplicadas centralmente, e qualquer tabela pode ser pesquisada ou ligada a outra.
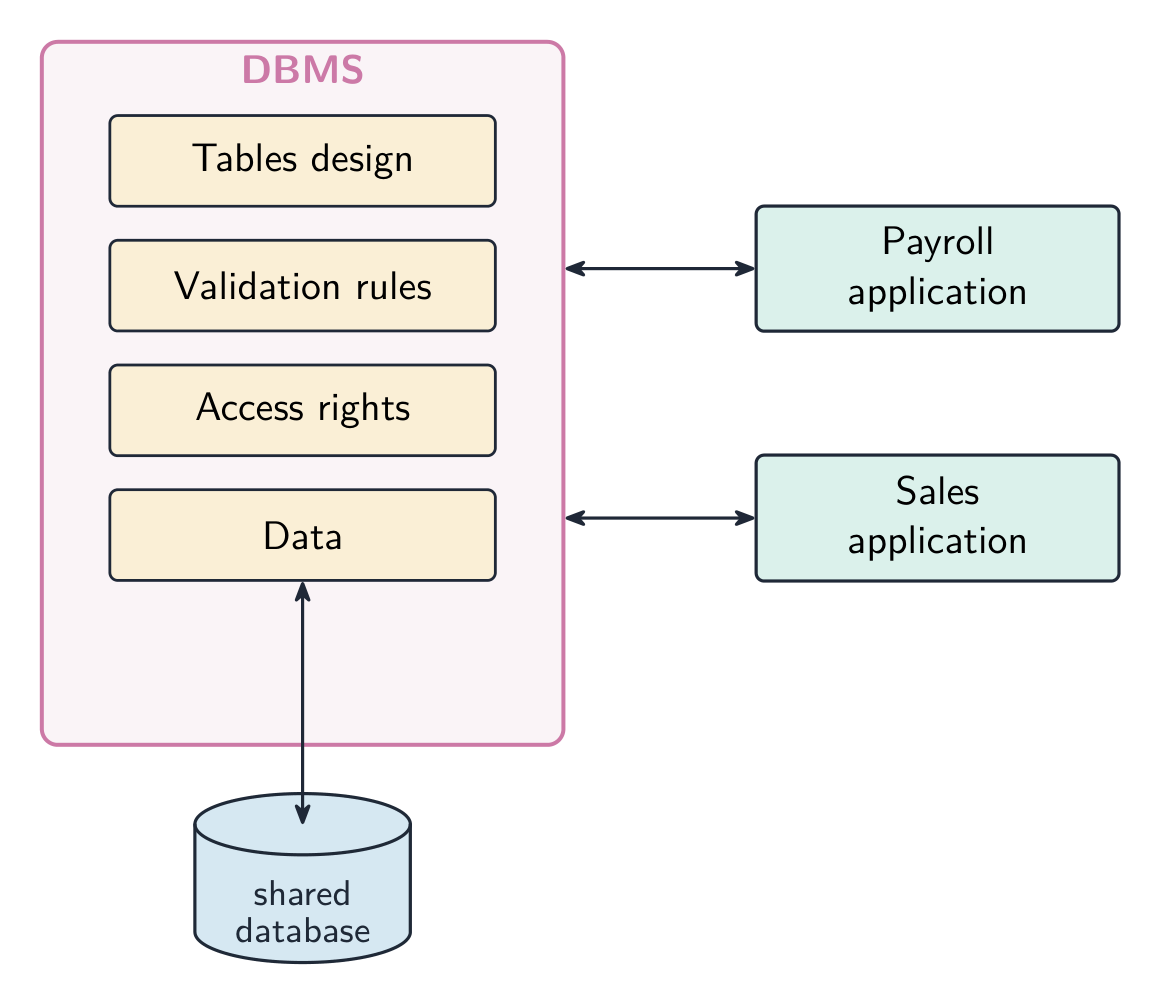
Uma única cópia dos dados, um único guardião
Como um banco de dados relacional remove a inconsistência de dados?
Uma cópia, uma atualização, sem divergência. O DBMS fornece a cada programa o mesmo valor atual.
O vocabulário: tabelas, linhas e colunas
- Uma tabela (uma relação) é uma grelha de linhas e colunas, uma tabela para cada tipo de entidade 实体, uma coisa sobre a qual os dados são armazenados:
CUSTOMER,ORDER,PRODUCT. - Um registo 记录 é uma linha, uma instância da entidade; a palavra formal é tuplo 元组.
- Um campo 字段 é uma coluna, uma informação sobre cada registo; a palavra formal é atributo 属性.
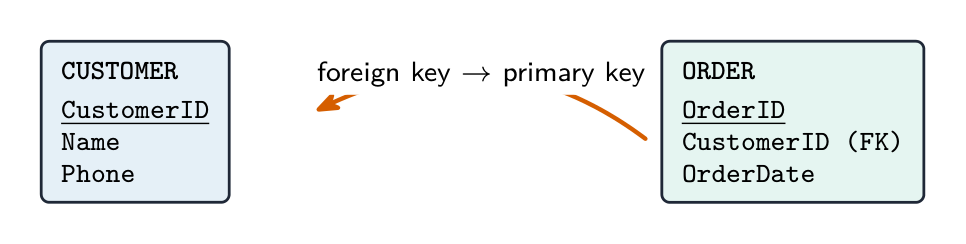
Linhas são registos, colunas são campos, e uma coluna atinge a outra tabela
Leia uma tabela relacional com SELECT
Uma tabela relacional é apenas linhas (registros) e colunas (campos). WHERE mantém as linhas que correspondem a uma condição; SELECT então mantém apenas as colunas que você pediu.
O vocabulário: chaves
- Uma chave primária 主键 é um campo, ou combinação de campos, que identifica unicamente cada registo; nunca é nula e nunca é duplicada. Uma chave composta 复合键 é uma chave primária feita de dois ou mais campos.
- Uma chave candidata 候选键 é qualquer campo ou combinação que poderia servir como chave primária. Uma chave secundária 次键 é um campo não primário que é indexado para pesquisa rápida; indexação 索引 cria um índice num campo para que as consultas e ligações sejam mais rápidas.
- Uma chave estrangeira 外键 é um campo cujo valor corresponde à chave primária de outra tabela, ligando as duas. Em resumo, a chave primária é sublinhada e a chave estrangeira assinalada:
CUSTOMER(CustomerID, Name, Phone)
ORDER(OrderID, CustomerID, OrderDate)   -- CustomerID is a foreign key → CUSTOMER
Uma chave primária:
A chave primária identifica unicamente cada linha. Uma chave estrangeira é a que linka para outra tabela.
Associe cada tipo de chave ao seu significado.
A chave primária identifica uma linha; uma chave estrangeira linka para outra tabela; composta = vários campos juntos; candidata = uma possível chave primária.
Um campo cujo valor corresponde à chave primária de outra tabela é uma chave ______.
A chave estrangeira é o que cria o relacionamento entre duas tabelas.
Exemplo resolvido: nomeie as partes de uma base de dados de biblioteca
- Uma biblioteca regista os seus livros, os seus membros e cada empréstimo. Identifique as entidades, uma chave primária para cada uma, e as chaves estrangeiras.
- Entidades:
BOOK,MEMBER,LOAN. Chaves primárias:BookID,MemberID,LoanID, cada uma escolhida porque é única para cada registo e nunca está em branco; um título ou um nome não servem, pois dois livros podempartilhar um título. LOAN(LoanID, BookID, MemberID, DateOut, DateDue):BookIDeMemberIDsão chaves estrangeiras, cada uma correspondendo à chave primária da sua própria tabela. O número de telemóvel de um membro pertence aMEMBER, não a cada empréstimo.
Em LOAN(LoanID, BookID, MemberID, DateOut), BookID e MemberID são chaves ____.
Cada uma corresponde à chave primária de outra tabela, BOOK e MEMBER, e liga o empréstimo a elas.
Relações e integridade referencial
- Uma relação liga duas entidades. Um-para-um: cada membro tem um cartão de biblioteca. Um-para-muitos 一对多: um membro tem muitos empréstimos; cada empréstimo pertence a um membro. Muitos-para-muitos 多对多: um livro tem muitos autores e um autor escreve muitos livros.
- A integridade referencial 参照完整性 significa que todo o valor de uma chave estrangeira deve corresponder a uma chave primária existente na tabela a que se refere: nenhum empréstimo para um membro que não exista, nenhum registo órfão.
- O DBMS aplica-a: recusa uma inserção com uma chave estrangeira desconhecida e recusa apagar um registo que outros registos ainda referenciam.
A integridade referencial garante que:
Evita registros órfãos — você não pode referenciar uma chave primária que não existe.
Associe cada relacionamento ao seu tipo.
Conte quantas entidades de um lado podem ser ligadas a uma do outro. Muitos-para-muitos precisa de uma tabela de ligação para armazenar.
Exemplo resolvido: o que a integridade referencial impede
- Um cliente com três pedidos pendentes é apagado da tabela
CUSTOMER. Explique como a integridade referencial se aplica. - A
CustomerIDde cada pedido é uma chave estrangeira que deve corresponder a um cliente existente. Apagar o cliente deixaria três pedidos a apontar para um registo que já não existe: registos órfãos. - O DBMS, portanto, recusa a eliminação até que os pedidos sejam apagados ou reassignados, ou, se configurado para cascata, apaga também os pedidos. De qualquer forma, nenhum pedido referencia um cliente que não esteja lá.
- Diga qual é a regra, o que a quebraria e o que o DBMS faz.
A integridade referencial permite excluir um cliente enquanto pedidos em outra tabela ainda se referem a esse cliente.
Isso criaria registros órfãos. O DBMS recusa a exclusão ou a propaga aos pedidos, mantendo toda chave estrangeira apontando para um registro existente.
Definições aceitas pelo avaliador
| Termo | Definição |
|---|---|
| entidade | uma coisa sobre a qual os dados são armazenados, representada por uma tabela |
| atributo | um item de dados sobre uma entidade, uma coluna |
| tuplo | uma linha de uma tabela, um registo |
| chave primária | um atributo ou combinação de atributos que identifica unicamente cada tuplo |
| chave candidata | um atributo ou combinação que poderia ser escolhido como chave primária |
| chave secundária | um atributo indexado usado para pesquisar a tabela rapidamente |
| chave estrangeira | um atributo numa tabela que é a chave primária de outra, formando a ligação |
| integridade referencial | todo o valor de uma chave estrangeira refere-se a uma chave primária existente |
Marcas que escapam
- Um tuplo é uma linha, um atributo é uma coluna. Invertê-los custa ambas as notas.
- "Único" sozinho não define uma chave primária; ele identifica cada registo e nunca é nulo.
- Uma chave estrangeira pode repetir: um cliente, muitos pedidos. É a chave primária que não pode.
- Uma chave secundária é para pesquisa rápida, não para identificação. Não a chame de "segunda chave primária".
Entendeu?
- a abordagem baseada em ficheiros sofre de redundância, inconsistência e dependência de dados, com fraca integridade, partilha, pesquisa e segurança
- uma base de dados relacional armazena cada fato uma única vez em tabelas gerenciadas por um único SGBD, assim os programas são independentes do armazenamento e as regras são aplicadas centralmente
- entidade → tabela · tupla → registro, linha · atributo → campo, coluna · chave primária identifica, chave estrangeira vincula, candidata poderia identificar, secundária é indexada para busca
- integridade referencial: toda chave estrangeira corresponde a uma chave primária existente, evitando registros órfãos