Skip to content · ⁨Pular para o conteúdo⁩

Ácidos nucleicos e síntese proteica

Biologia do A-Level · Topic 6 · ⁨Tópico 6⁩

Train · ⁨Treinar⁩
Video lesson for this topic · ⁨Videoaula para este tópico⁩ Open the video page · ⁨Abrir a página do vídeo⁩
9:37

DNA & Síntese Proteica

Dentro de quase cada uma das suas células há uma molécula com cerca de dois metros de comprimento, enrolada tão apertado que não dá para vê-la. É o DNA, e ele é escrito em um…

English narration · English + 中文 subtitles burned in · ⁨Narração em inglês · Legendas em inglês + 中文 gravadas⁩

6.1

Nucleotides — the building blocks · ⁨Nucleotídeos — os blocos construtivos⁩

Syllabus · ⁨Programa⁩
English
  1. describe the structure of nucleotides, including the phosphorylated nucleotide ATP (structural formulae are not expected)
  2. state that the bases adenine and guanine are purines with a double ring structure, and that the bases cytosine, thymine and uracil are pyrimidines with a single ring structure (structural formulae for bases are not expected)
  3. describe the structure of a DNA molecule as a double helix, including: • the importance of complementary base pairing between the 5′ to 3′ strand and the 3′ to 5′ strand (antiparallel strands) • differences in hydrogen bonding between C–G and A–T base pairs • linking of nucleotides by phosphodiester bonds
  4. describe the semi-conservative replication of DNA during the S phase of the cell cycle, including: • the roles of DNA polymerase and DNA ligase (knowledge of other enzymes in DNA replication in cells and different types of DNA polymerase is not expected) • the differences between leading strand and lagging strand replication as a consequence of DNA polymerase adding nucleotides only in a 5′ to 3′ direction
  5. describe the structure of an RNA molecule, using the example of messenger RNA (mRNA)
Português
  1. descreva a estrutura dos nucleotídeos, incluindo o nucleotídeo fosforilado ATP (fórmulas estruturais não são esperadas)
  2. declare que as bases adenina e guanina são purinas com estrutura de duplo anel, e que as bases citosina, timina e uracila são pirimidinas com estrutura de anel único (fórmulas estruturais para bases não são esperadas)
  3. descreva a estrutura de uma molécula de DNA como uma dupla hélice, incluindo: • a importância do emparelhamento de bases complementar entre a fita 5′ para 3′ e a fita 3′ para 5′ (fitas antiparalelas) • diferenças no emparelhamento de hidrogênio entre pares de bases C–G e A–T • ligação de nucleotídeos por ligações fosfodiéster
  4. descreva a replicação semiconservativa do DNA durante a fase S do ciclo celular, incluindo: • os papéis da DNA polimerase e DNA ligase (conhecimento de outras enzimas na replicação do DNA em células e diferentes tipos de DNA polimerase não são esperados) • as diferenças entre a replicação da fita líder e da fita rezante como consequência da adição de nucleotídeos pela DNA polimerase apenas em direção 5′ para 3′
  5. descreva a estrutura de uma molécula de RNA, usando o exemplo de ARN mensageiro (ARNm)
Source: Cambridge International syllabus · ⁨Fonte: Programa Cambridge International⁩

English
DNA replication: unzip and copy

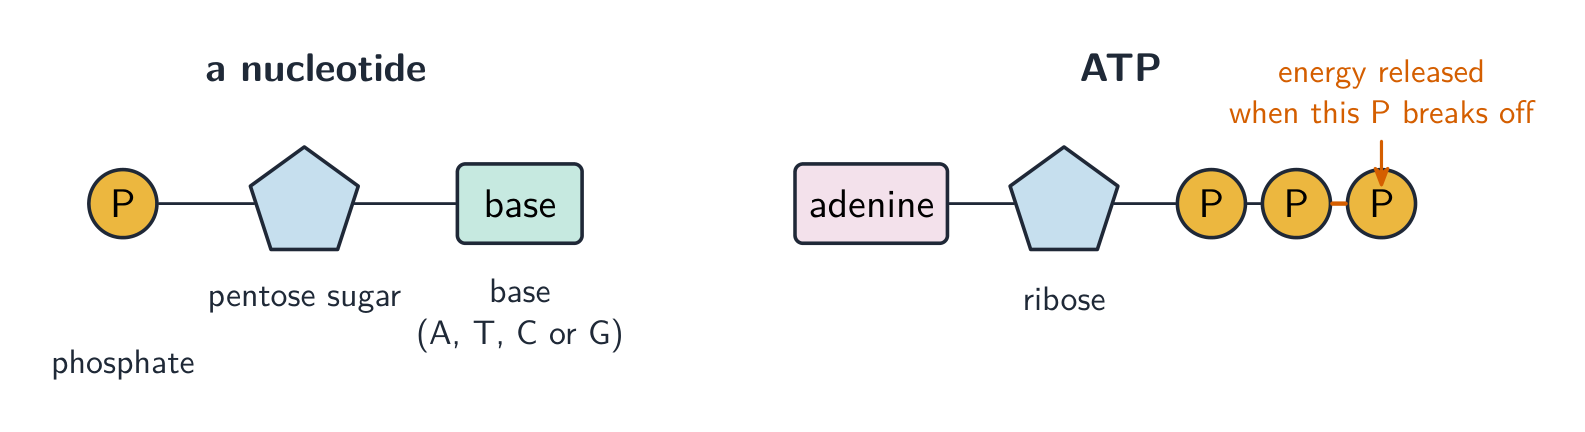
Nucleic acids 核酸 (DNA and RNA) are polymers of small units called nucleotides 核苷酸. Each nucleotide is made of three parts joined together:

  • a phosphate 磷酸 group,
  • a sugar (a 5-carbon sugar),
  • a nitrogen-containing base 碱基.

ATP is a special nucleotide. It has the base adenine 腺嘌呤, the sugar ribose 核糖, and three phosphate groups. Breaking off the last phosphate releases energy 能量 for the cell.

There are five bases, in two groups:

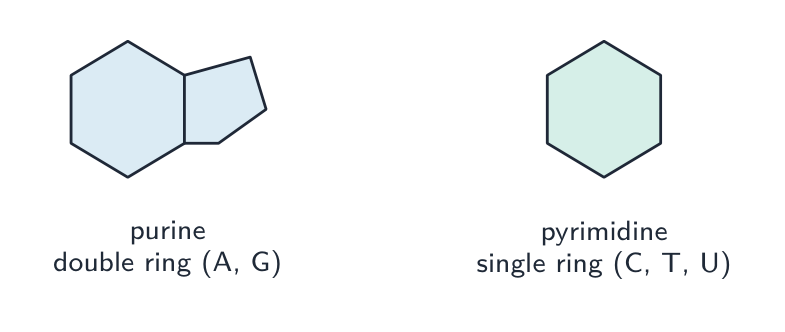
  • purines 嘌呤 have a double ring (two rings): adenine and guanine 鸟嘌呤.
  • pyrimidines 嘧啶 have a single ring (one ring): cytosine 胞嘧啶, thymine 胸腺嘧啶 and uracil 尿嘧啶.
Português
Replicação do DNA: desenrolar e copiar

Ácidos nucleicos 核酸 (DNA e RNA) são polímeros de unidades pequenas chamadas nucleotídeos 核苷酸. Cada nucleotídeo é composto por três partes unidas:

  • um grupo fosfato 磷酸,
  • um açúcar (um açúcar de 5 carbonos),
  • uma base nitrogenada 碱基.

ATP é um nucleotídeo especial. Possui a base adenina 腺嘌呤, o açúcar ribose 核糖, e três grupos fosfato. Romper o último fosfato libera energia 能量 para a célula.

Um nucleotídeo desenhado como um fosfato, um açúcar pentose e uma base unidos juntos; ao lado, ATP como adenina, ribose e três fosfatos com a última ligação marcada como de alta energia
Um nucleotídeo é um fosfato, um açúcar e uma base; ATP é um nucleotídeo com três fosfatos
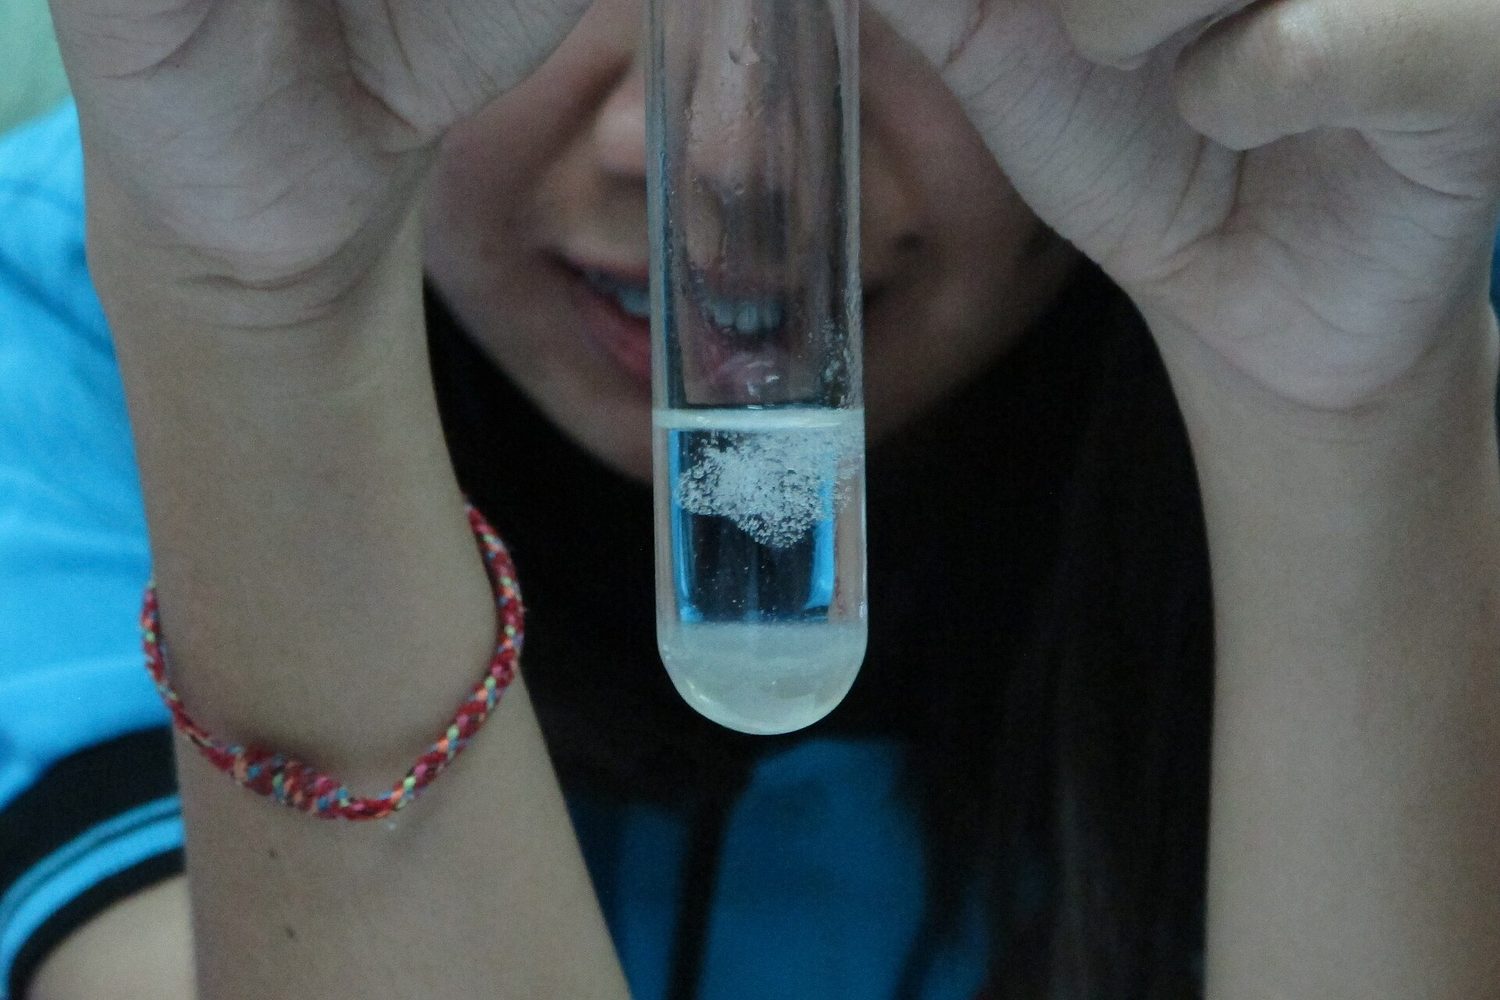
Fios pálidos e fibrosos de DNA em um tubo
DNA extraído de células aparece como fios pálidos e fibrosos desses polímeros de nucleotídeos

Existem cinco bases, em dois grupos:

  • purinas 嘌呤 têm um anel duplo (dois anéis): adenina e guanina 鸟嘌呤.
  • pirimidinas 嘧啶 têm um anel simples (um anel): citosina 胞嘧啶, timina 胸腺嘧啶 e uracila 尿嘧啶.
Duas formas de anel: uma purina desenhada como dois anéis fundidos, uma pirimidina desenhada como um anel
Os dois grupos diferem na forma: uma purina é um anel duplo, uma pirimidina é um anel simples — é por isso que uma purina sempre pareia com uma pirimidina
Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
nucleic acid/njuːˈklɪɪk ˈæsɪd/ 核酸 hé suān
nucleotide/ˈnjuːklɪɒtaɪd/ 核苷酸 hé gān suān
phosphate/ˈfɒsfeɪt/ 磷酸 lín suān
ribose/ˈrɪbəʊs/ 核糖 hé táng
energy/ˈenədʒi/ 能量 néng liàng
purine/ˈpjʊəriːn/ 嘌呤 piào líng
guanine/ˈɡwɑːnaɪn/ 鸟嘌呤 niǎo piào líng
pyrimidine/ˈpɪrɪmɪdiːn/ 嘧啶 mì dìng
cytosine/ˈsaɪtəsaɪn/ 胞嘧啶 bāo mì dìng
thymine/ˈθaɪmaɪn/ 胸腺嘧啶 xiōng xiàn mì dìng
uracil/ˈjʊərəsɪl/ 尿嘧啶 niào mì dìng
double helix/ˈdʌbl ˈhiːlɪks/ 双螺旋 shuāng luó xuán
strand/strænd/ 链 liàn
deoxyribose/diːˈɒksɪrɪbəʊs/ 脱氧核糖 tuō yǎng hé táng
phosphodiester bond/ˈfɒsfəʊdɪstə bɒnd/ 磷酸二酯键 lín suān èr zhǐ jiàn
complementary base pairing/ˌkɒmplɪˈmentəri beɪs ˈpeərɪŋ/ 碱基互补配对 jiǎn jī hù bǔ pèi duì
hydrogen bond/ˈhaɪdrədʒn bɒnd/ 氢键 qīng jiàn
replication/ˌreplɪˈkeɪʃn/ 复制 fù zhì
semi-conservative replication/ˈsemi kənˈsɜːvətɪv ˌreplɪˈkeɪʃn/ 半保留复制 bàn bǎo liú fù zhì
enzyme/ˈenzaɪm/ 酶 méi
polymerase/ˌpɒlɪməˈreɪz/ 聚合酶 jù hé méi
leading strand/ˈliːdɪŋ strænd/ 前导链 qián dǎo liàn
lagging strand/ˈlæɡɪŋ strænd/ 后随链 hòu suí liàn
6.1

The structure of DNA · ⁨A estrutura do DNA⁩

English

A DNA molecule is two strands twisted together into a double helix 双螺旋.

Each strand 链 has a backbone of alternating sugar (here the sugar is deoxyribose 脱氧核糖) and phosphate. The sugar of one nucleotide is joined to the phosphate of the next by a phosphodiester bond 磷酸二酯键.

The two strands are held together by their bases, which meet in the middle. The pairing is exact — this is complementary base pairing 碱基互补配对:

  • A always pairs with T, held by two hydrogen bonds 氢键.
  • C always pairs with G, held by three hydrogen bonds (so a C–G base pair 碱基对 is harder to separate).

The two strands run in opposite directions: one goes 5′ to 3′ while the other goes 3′ to 5′. We say they are antiparallel 反平行.

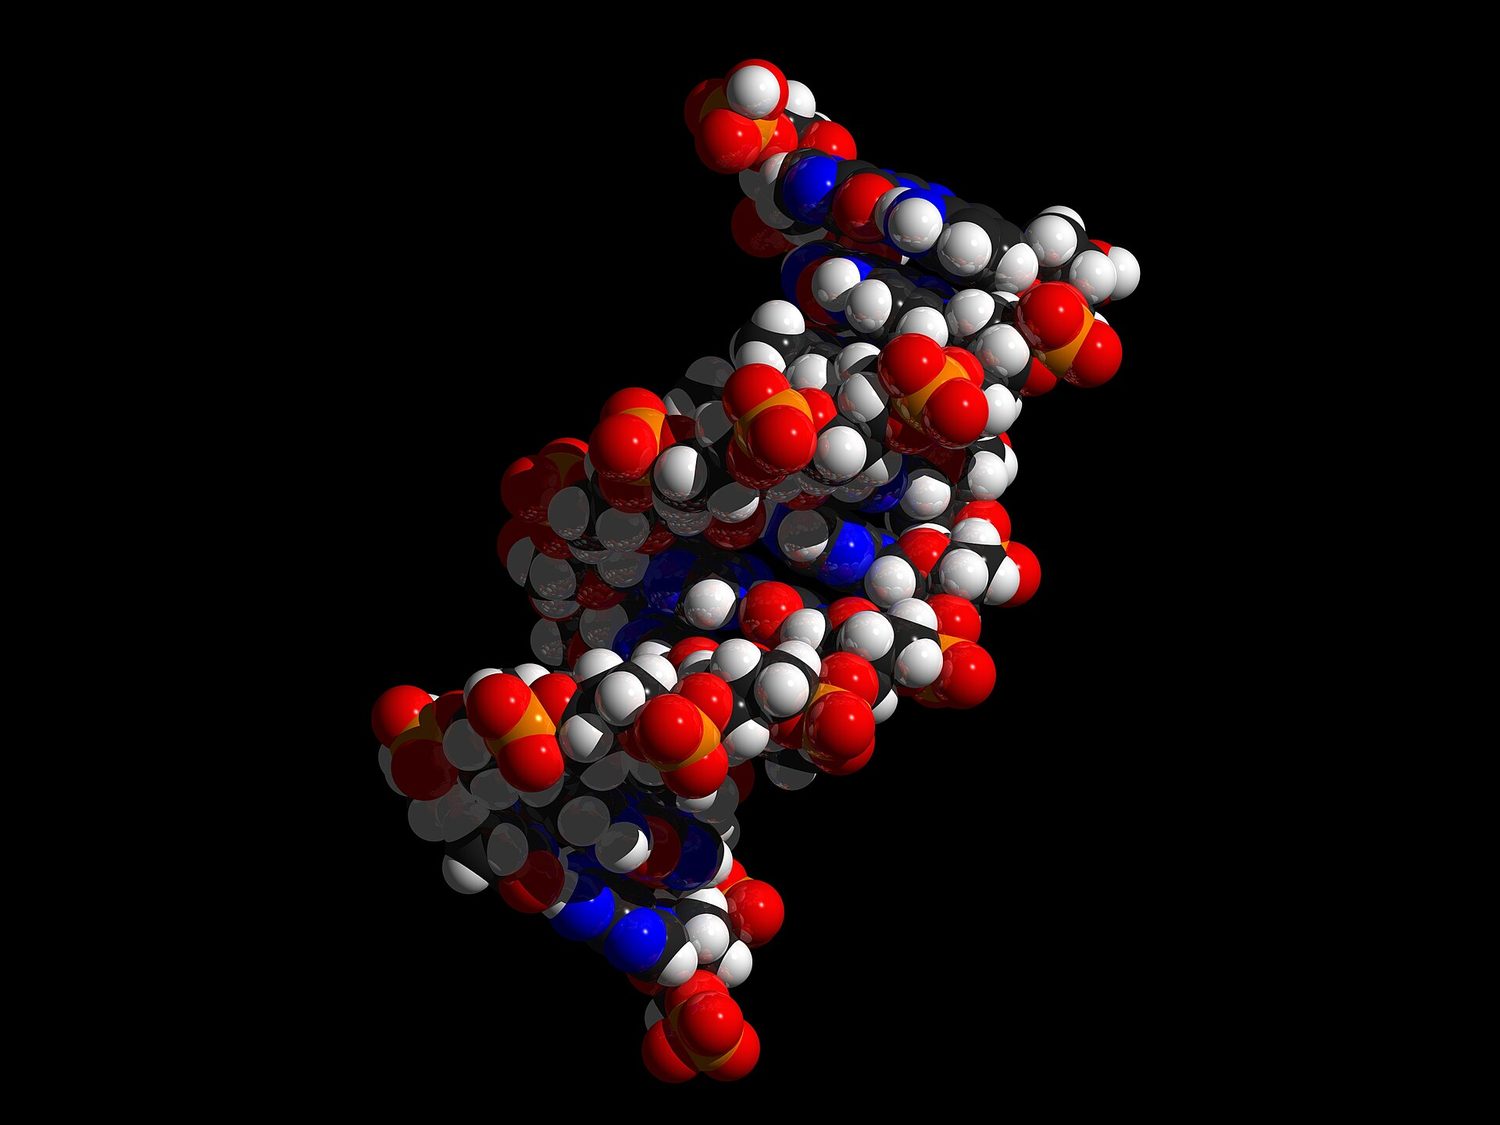
The flat ladder above is twisted into a spiral. This space-filling model, where every atom is a ball, shows the real shape of the double helix:

Português

Uma molécula de DNA é formada por duas fitas torcidas juntas em uma dupla hélice 双螺旋.

Cada fita 链 tem uma cadeia principal alternada de açúcar (neste caso, o açúcar é a desoxirribose 脱氧核糖) e fosfato. O açúcar de um nucleotídeo está ligado ao fosfato do seguinte por uma ligação fosfodiéster 磷酸二酯键.

As duas fitas são mantidas unidas pelas suas bases, que se encontram no centro. O pareamento é exato — isso é pareamento de bases complementares 碱基互补配对:

  • A sempre se pareia com T, mantido por dois ligações de hidrogênio 氢键.
  • C sempre se pareia com G, mantido por três ligações de hidrogênio (portanto, um par de bases 碱基对 C–G é mais difícil de separar).

As duas fitas percorrem em direções opostas: uma vai de 5′ para 3′ enquanto a outra vai de 3′ para 5′. Dizemos que elas são antiparalelas 反平行.

Diagrama de escada do DNA: duas cadeias principais de açúcar-fosfato antiparalelas com pares de bases A=T mantidos por duas ligações de hidrogênio e C=G por três
Pareamento de bases complementares: A pareia com T (2 ligações de hidrogênio), C com G (3); as fitas são antiparalelas

A escada plana acima é torcida em espiral. Este modelo de preenchimento espacial, onde cada átomo é uma bola, mostra a forma real do hélice dupla:

Modelo de preenchimento espacial computacional de um pequeno trecho de DNA sobre fundo preto: centenas de átomos coloridos (vermelho, laranja, azul, cinza e branco) empacotados em duas fitas que se torcem umas em torno das outras para formar uma hélice dupla em espiral
Um modelo de preenchimento espacial do DNA: as duas fitas se torcem umas em torno das outras formando a hélice dupla — a escada do diagrama, enrolada
Explore · ⁨Explorar⁩

Explore a escada de DNA

Toque em cada parte da dupla hélice — duas espinhas antiparalelas com pares de bases complementares como os degraus.

Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
base/beɪs/ 碱基 jiǎn jī
adenine/ˈædəniːn/ 腺嘌呤 xiàn piào líng
base pair/beɪs peə/ 碱基对 jiǎn jī duì
antiparallel/ˌæntɪˈpærəlel/ 反平行 fǎn píng xíng
6.1

DNA replication · ⁨Replicação do DNA⁩

English

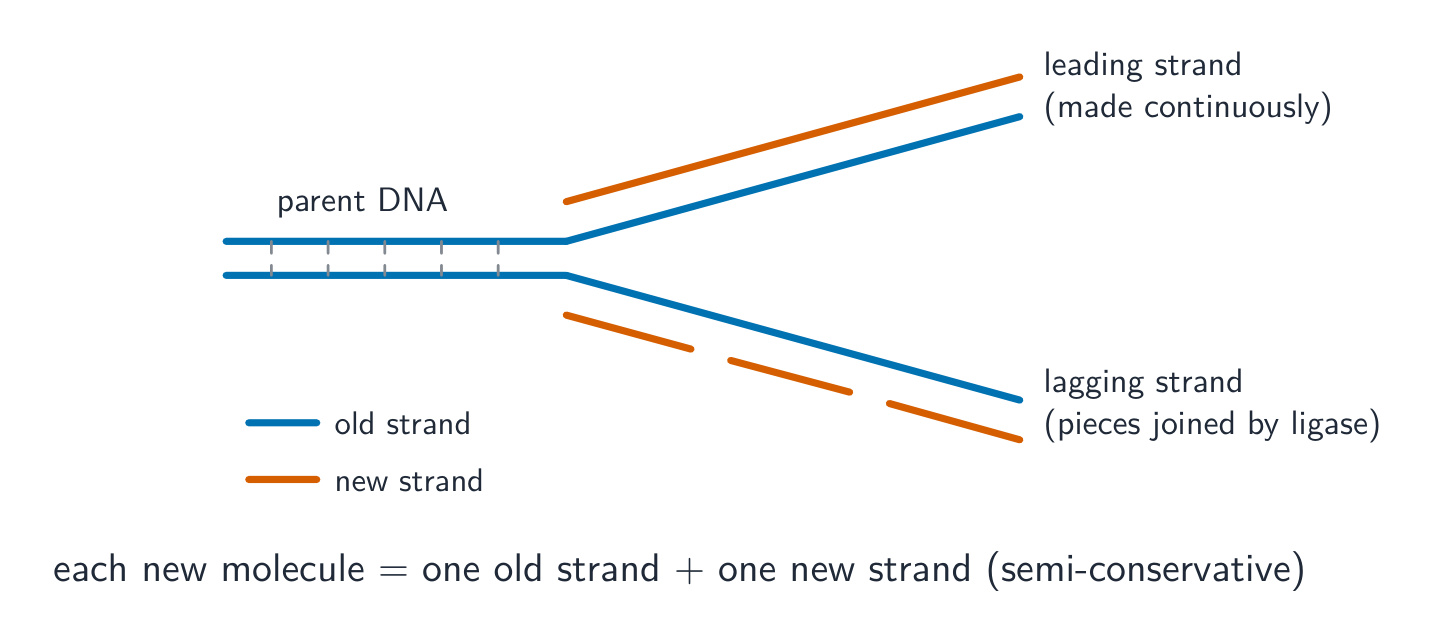
DNA replication 复制 (copying) happens during the S phase of the cell cycle. It is semi-conservative 半保留复制: each new molecule keeps one old strand and one new strand. The steps are:

  1. the double helix unwinds and the hydrogen bonds break, so the two strands separate.
  2. each old strand acts as a template. Free nucleotides pair with the exposed bases by complementary base pairing.
  3. the enzyme 酶 DNA polymerase 聚合酶 joins the new nucleotides into a strand. It can only add nucleotides in the 5′ to 3′ direction.

Because of that 5′ to 3′ rule, the two new strands are made differently:

  • the leading strand 前导链 is built continuously, following the unwinding.
  • the lagging strand 后随链 is built in short pieces, working away from the unwinding point. The enzyme DNA ligase 连接酶 then joins these pieces together.
Português

A replicação 复制 do DNA (cópia) ocorre durante a fase S do ciclo celular. É semi-conservativa 半保留复制: cada nova molécula mantém uma fita antiga e uma nova fita. Os passos são:

  1. a hélice dupla desenrola e as ligações de hidrogênio se quebram, fazendo com que as duas fitas se separam.
  2. cada fita antiga atua como molde. Nucleotídeos livres pareiam-se com as bases expostas por pareamento de bases complementares.
  3. a enzima 酶 DNA polimerase 聚合酶 une os novos nucleotídeos em uma fita. Ela só pode adicionar nucleotídeos na direção 5′ para 3′.

Devido a essa regra de 5′ para 3′, as duas novas fitas são construídas de maneira diferente:

  • a fita líder 前导链 é construída continuamente, seguindo o desenrolamento.
  • a fita atrasada 后随链 é construída em pequenos pedaços, trabalhando para longe do ponto de desenrolamento. A enzima DNA ligase 连接酶 então une esses pedaços juntos.
Vork de replicação: a hélice dupla parental desenrola e cada fita antiga molda uma nova — a fita líder feita continuamente, a fita atrasada em pedaços
A replicação é semi-conservativa: cada nova molécula mantém uma fita antiga (azul) e uma nova fita (laranja)
Explore · ⁨Explorar⁩

Replicação semiconservativa

Passe passo a passo pela cópia do DNA. A héice desenrola, cada fita antiga serve de molde para uma nova, resultando em duas moléculas idênticas.

Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
ligase/ˈlɪɡeɪs/ 连接酶 lián jiē méi
6.1

RNA

English

RNA is also made of nucleotides, but it is a single strand, its sugar is ribose, and it uses uracil in place of thymine. The most important type here is messenger RNA (mRNA), which carries a copy of a gene's instructions out of the nucleus to be used.

Português

O RNA também é feito de nucleotídeos, mas é uma fita simples, seu açúcar é a ribose, e ele usa uracila no lugar da timina. O tipo mais importante aqui é o ARN mensageiro (mRNA) 信使RNA, que transporta uma cópia das instruções de um gene fora do núcleo para ser usado.

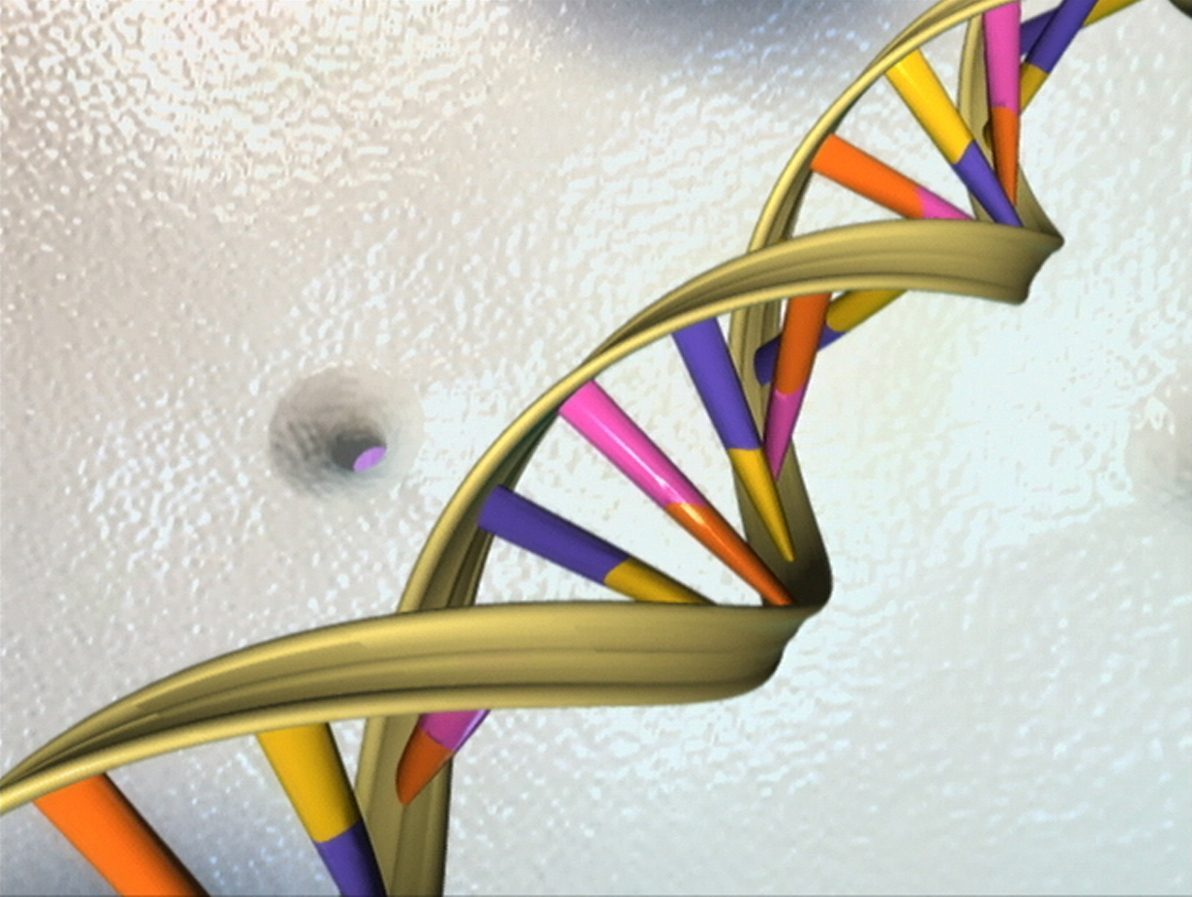
Hélice dupla de DNA: o RNA é um ácido nucleico relacionado que carrega informação genética para a síntese de proteínas
6.2

The genetic code · ⁨O código genético⁩

Syllabus · ⁨Programa⁩
English
  1. state that a polypeptide is coded for by a gene and that a gene is a sequence of nucleotides that forms part of a DNA molecule
  2. describe the principle of the universal genetic code in which different triplets of DNA bases either code for specific amino acids or correspond to start and stop codons
  3. describe how the information in DNA is used during transcription and translation to construct polypeptides, including the roles of: • RNA polymerase • messenger RNA (mRNA) • codons • transfer RNA (tRNA) • anticodons • ribosomes
  4. state that the strand of a DNA molecule that is used in transcription is called the transcribed or template strand and that the other strand is called the non-transcribed strand
  5. explain that, in eukaryotes, the RNA molecule formed following transcription (primary transcript) is modified by the removal of non-coding sequences (introns) and the joining together of coding sequences (exons) to form mRNA
  6. state that a gene mutation is a change in the sequence of base pairs in a DNA molecule that may result in an altered polypeptide
  7. explain that a gene mutation is a result of substitution or deletion or insertion of nucleotides in DNA and outline how each of these types of mutation may affect the polypeptide produced
Português
  1. afirmem que um polipeptídeo é codificado por um gene e que um gene é uma sequência de nucleotídeos que faz parte de uma molécula de DNA
  2. descrevam o princípio do código genético universal, no qual diferentes tripletes de bases do DNA codificam aminoácidos específicos ou correspondem a codons de início e parada
  3. descrevam como a informação no DNA é utilizada durante a transcrição e tradução para construir polipeptídeos, incluindo os papéis de: • ARN polimerase • ARN mensageiro (ARNm) • codons • ARN transferidor (ARNt) • anticodons • ribossomos
  4. afirmem que a fita de uma molécula de DNA que é usada na transcrição é chamada de fita transcrita ou fita molde e que a outra fita é chamada de fita não transcrita
  5. expliquem que, em eucariotos, a molécula de RNA formada após a transcrição (transcrito primário) é modificada pela remoção de sequências não codificantes (introns) e pela junção de sequências codificantes (exons) para formar ARNm
  6. afirmem que uma mutação gênica é uma mudança na sequência de pares de bases em uma molécula de DNA que pode resultar em um polipeptídeo alterado
  7. expliquem que uma mutação gênica é resultado de substituição ou deleção ou inserção de nucleotídeos no DNA e esbocem como cada um desses tipos de mutação pode afetar o polipeptídeo produzido

Source: Cambridge International syllabus · ⁨Fonte: Programa Cambridge International⁩

English
Protein synthesis: DNA to protein

A gene 基因 is a sequence of DNA nucleotides that codes for one polypeptide 多肽.

The code is read in triplets 三联体 — groups of three bases. Each triplet either codes for one specific amino acid 氨基酸, or acts as a start or stop signal. The code is universal: nearly all living things use the same triplets for the same amino acids.

There are 64 possible triplets but only 20 common amino acids, so most amino acids are coded by more than one triplet.

Português
Síntese de proteínas: DNA para proteína

Um gene 基因 é uma sequência de nucleotídeos de DNA que codifica uma polipeptídeo 多肽.

O código é lido em tripletes 三联体 — grupos de três bases. Cada tripleto ou codifica um aminoácido 氨基酸 específico, ou atua como sinal de início ou parada. O código é universal: quase todos os seres vivos usam os mesmos tripletes para os mesmos aminoácidos.

Existem 64 tripletes possíveis, mas apenas 20 aminoácidos comuns, portanto a maioria dos aminoácidos é codificada por mais de um tripleto.

Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
gene/dʒiːn/ 基因 jī yīn
polypeptide/ˌpɒlɪˈpeptaɪd/ 多肽 duō tài
triplet/ˈtrɪplɪt/ 三联体 sān lián tǐ
amino acid/əˈmiːnəʊ ˈæsɪd/ 氨基酸 ān jī suān
Watch lesson · ⁨Assistir aula⁩
6.2

Protein synthesis: transcription and translation · ⁨Síntese de proteínas: transcrição e tradução⁩

English

Transcription (in the nucleus)

The DNA gene is copied into mRNA. This is transcription 转录.

  • the strand of DNA that is copied is the template strand 模板链; the partner strand is the non-transcribed strand 非转录链.
  • the enzyme RNA polymerase joins RNA nucleotides that pair with the template bases (with uracil pairing to adenine).
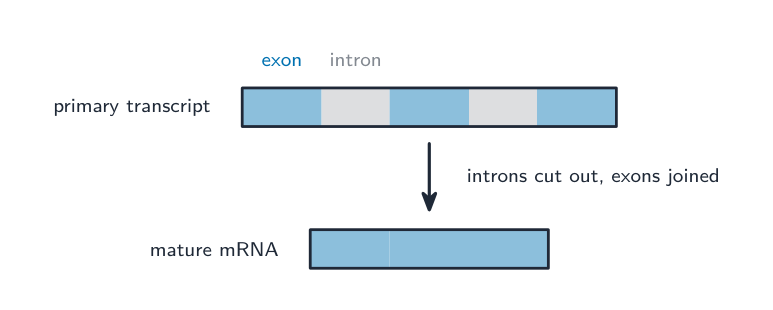
  • in eukaryotes the first RNA made (the primary transcript 初级转录本) contains coding parts called exons 外显子 and non-coding parts called introns 内含子. The introns are cut out and the exons joined together to form the finished mRNA.

Translation (at the ribosome)

The mRNA leaves the nucleus and attaches to a ribosome 核糖体. Building the polypeptide from the mRNA code is translation 翻译.

  • the mRNA is read in codons 密码子 (each codon is one triplet of mRNA bases).
  • molecules of transfer RNA (tRNA) bring amino acids to the ribosome. Each tRNA has an anticodon 反密码子 that pairs with a matching codon.
  • as the codons are read in order, the ribosome joins the amino acids with peptide bonds 肽键, building the polypeptide.

Worked example. A DNA template strand reads TAC GGA CTT. Give the mRNA codons, and say how long the polypeptide is. Transcribe by complementary base pairing, remembering that RNA uses uracil in place of thymine: TAC gives AUG, GGA gives CCU, CTT gives GAA. So the mRNA reads AUG CCU GAA. AUG is the start codon (methionine), so the polypeptide is three amino acids long - two once the start methionine is removed. Two errors cost most of the marks here: pairing A with T instead of U when writing mRNA, and transcribing the coding strand instead of the template strand. The mRNA is complementary to the template, and identical to the coding strand apart from U replacing T.

Português

Transcrição (no núcleo)

O gene de DNA é copiado em ARNm. Isso é transcrição 转录.

  • a fita de DNA que é copiada é a fita molde 模板链; a fita parceira é a fita não transcrita 非转录链.
  • a enzima ARN polimerase 聚合酶 une nucleotídeos de ARN que pareiam com as bases molde (com uracila pareando com adenina).
  • nos eucariotos, o primeiro ARN produzido (o transcrito primário 初级转录本) contém partes codificadoras chamadas éxons 外显子 e partes não codificadoras chamadas íntrons 内含子. Os íntrons são cortados e os éxons são ligados para formar o ARNm maduro.
Transcrito primário com éxons e íntrons alternados; os íntrons são removidos e os éxons ligados em um ARNm maduro mais curto
Empilhamento: os íntrons não codificadores são cortados e os éxons codificadores são ligados para fazer o ARNm final

Tradução (no ribossomo)

O ARNm sai do núcleo e se liga a um ribossomo 核糖体. Construir a polipeptídeo a partir do código do ARNm é a tradução 翻译.

  • o ARNm é lido em codons 密码子 (cada codon é um tripleto de bases de ARNm).
  • moléculas de ARN de transferência (ARNt) 转运RNA trazem aminoácidos para o ribossomo. Cada ARNt tem um anticodão 反密码子 que pareia com um codon correspondente.
  • à medida que os codons são lidos em ordem, o ribossomo une os aminoácidos com ligações peptídicas 肽键, construindo a polipeptídeo.
Visão geral da síntese de proteínas: no núcleo o DNA é transcrito em ARNm, que sai do núcleo e é traduzido em um ribossomo onde o ARNt traz aminoácidos para construir uma polipeptídeo
A transcrição copia o DNA em ARNm no núcleo; a tradução no ribossomo constrói a polipeptídeo

Exemplo resolvido. Uma fita molde de DNA lê TAC GGA CTT. Dê os códons do ARNm e diga o quanto a polipeptídeo é longa. Transcreva por pareamento de bases complementares, lembrando que o ARN usa uracila 尿嘧啶 no lugar da timina: TAC dá AUG, GGA dá CCU, CTT dá GAA. Então o ARNm lê AUG CCU GAA. AUG é o codon de início 起始密码子 (metionina), então a polipeptídeo tem três aminoácidos de comprimento - dois após a metionina de início ser removida. Dois erros custam a maior parte das notas aqui: parear A com T 胸腺嘧啶 em vez de U 尿嘧啶 ao escrever o ARNm, e transcrever a fita codificante 编码链 em vez da fita molde 模板链. O ARNm é complementar à fita molde e idêntico à fita codificante exceto pela U substituindo a T.

Explore · ⁨Explorar⁩

De gene a proteína

Passe passo a passo pela dogma central: o molde de DNA é transcrito em mRNA por pareamento de bases (A→U, T→A, G→C, C→G), depois lido em códons e traduzido em uma cadeia de aminoácidos.

Explore · ⁨Explorar⁩

De gene a proteína

Passe por como um gene se torna uma proteína. Transcrição copia o DNA em mRNA; tradução lê o mRNA para construir o polipeptídeo.

Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
codon/ˈkəʊdɒn/ 密码子 mì mǎ zi
transcription/trænˈskrɪpʃn/ 转录 zhuǎn lù
template strand/ˈtempleɪt strænd/ 模板链 mú bǎn liàn
non-transcribed strand/nɒn trænˈskraɪbd strænd/ 非转录链 fēi zhuǎn lù liàn
primary transcript/ˈpraɪməri ˈtrænskrɪpt/ 初级转录本 chū jí zhuǎn lù běn
exon/eɡˈzɒn/ 外显子 wài xiǎn zi
intron/ɪnˈtrɒn/ 内含子 nèi hán zi
ribosome/ˈriːbəʊsəʊm/ 核糖体 hé táng tǐ
translation/trænˈsleɪʃn/ 翻译 fān yì
anticodon/ˌæntɪˈkəʊdɒn/ 反密码子 fǎn mì mǎ zi
peptide bond/ˈpeptaɪd bɒnd/ 肽键 tài jiàn
6.2

Gene mutations · ⁨Mutações gênicas⁩

English

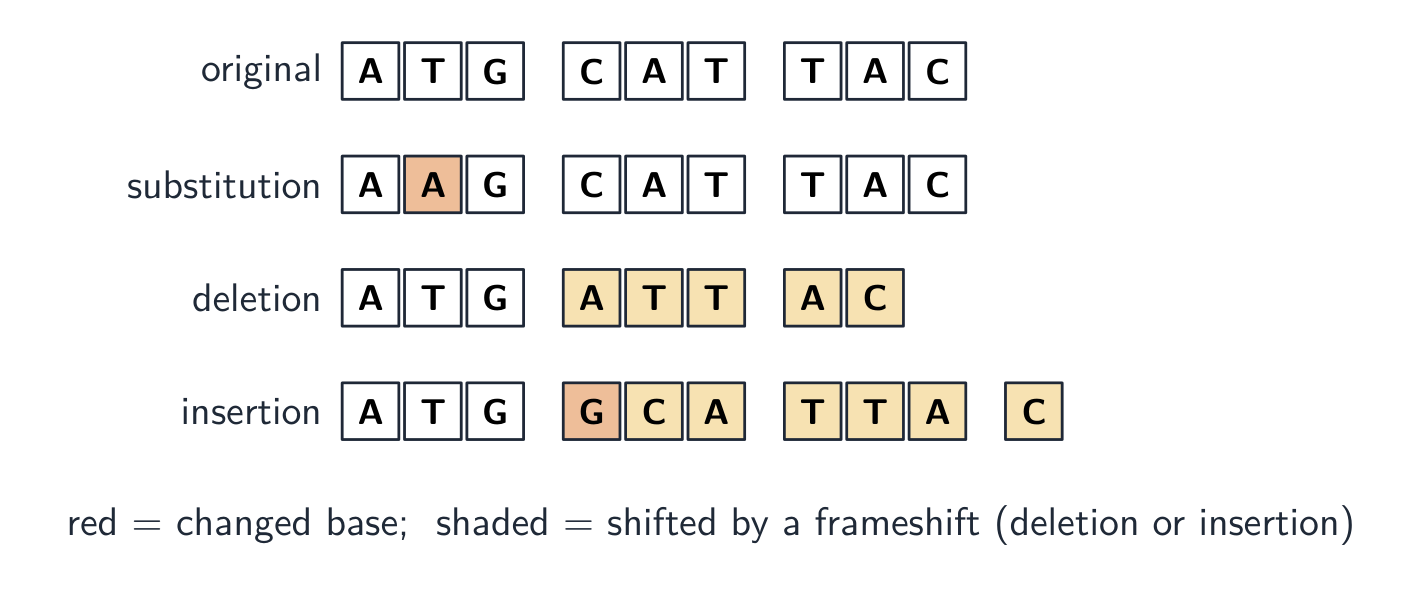
A gene mutation 突变 is a change in the base sequence of a DNA molecule. It may change the polypeptide made. There are three types:

  • substitution 替换 — one base is swapped for a different base. This changes at most one amino acid, and sometimes none (because most amino acids have more than one triplet).
  • deletion 缺失 — a base is removed.
  • insertion 插入 — an extra base is added.

A deletion or insertion shifts how every later triplet is read, so it usually changes many amino acids after that point and has a large effect on the polypeptide.

Português

Uma mutação 突变 gênica é uma mudança na sequência de bases de uma molécula de DNA. Pode alterar a polipeptídeo produzida. Existem três tipos:

  • substituição 替换 — uma base é trocada por uma base diferente. Isso altera no máximo um aminoácido, e àssemelho nenhum (porque a maioria dos aminoácidos tem mais de um tripleto).
  • deleção 缺失 — uma base é removida.
  • inserção 插入 — uma base extra é adicionada.

Uma deleção ou inserção desloca a leitura de todo tripleto posterior, então geralmente muda muitos aminoácidos após esse ponto e tem um grande efeito na polipeptídeo.

Uma sequência de bases lida em tripletes mostrada quatro vezes: a original, uma substituição mudando uma base, uma deleção e uma inserção — ambas das quais deslocam todo tripleto posterior *Uma substituição muda um tripleto; uma deleção ou inserção desloca todo tripleto posterior (um frameshift)

Explore · ⁨Explorar⁩

Laboratório de tipos de mutação

Comparar substituição, inserção e deleção usando seu efeito no código.

Vocabulary · ⁨Vocabulário⁩ Train · ⁨Treinar⁩
English · ⁨Inglês⁩ Chinese · ⁨Chinês⁩ Pinyin
mutation/mjuːˈteɪʃn/ 突变 tū biàn
substitution/ˌsʌbstɪˈtjuːʃn/ 替换 tì huàn
deletion/dɪˈliːʃn/ 缺失 quē shī
insertion/ɪnˈsɜːʃn/ 插入 chā rù
6.2

Exam tips · ⁨Dicas de prova⁩

English
  • DNA is antiparallel, held by hydrogen bonds (A=T two, C≡G three); replication is semi-conservative (each product keeps one old strand).
  • State where and what: transcription (nucleus → mRNA), translation (ribosome, mRNA + tRNA → polypeptide).
  • Describe the code with all four terms: triplet, non-overlapping, degenerate, universal.
  • For a gene mutation (substitution, insertion, deletion) explain the effect on the protein — and why a substitution can be silent (degeneracy).
Português
  • O DNA é antiparalelo, mantido por ligações de hidrogênio (A=T dois, C≡G três); a replicação é semi-conservativa (cada produto mantém uma fita antiga).
  • Declare onde e o quê: transcrição (núcleo → ARNm), tradução (ribossomo, ARNm + ARNt → polipeptídeo).
  • Descreva o código com todos os quatro termos: triplete, não sobreposto, degenerado, universal.
  • Para uma mutação gênica (substituição, inserção, deleção) explique o efeito na proteína — e por que uma substituição pode ser silenciosa (degenerescência).

Interactive lessons on this topic · ⁨Aulas interativas sobre este tópico⁩

Work through it step by step, with instant-check exercises. · ⁨Passe por ele passo a passo, com exercícios de verificação instantânea.⁩

Past Papers · ⁨Provas Anteriores⁩

More topics in Biologia do A-Level · ⁨Mais tópicos em Biologia do A-Level⁩

Log in or create account · ⁨Entrar ou criar conta⁩

IGCSE, A-Level & AP