RISC, CISC dan pipelining
| English | Bahasa Indonesia |
|---|---|
| CISC/sɪsk/ | CISC |
| RISC/rɪsk/ | RISC |
| pipelining/ˈpaɪplaɪnɪŋ/ | pipelining |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Taksonomi Flynn |
| register/ˈredʒɪstə/ | register |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | hazard |
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | paralel masif |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | superkomputer |
Ponsel di saku Anda tidak menjalankan Intel
- Selama tiga puluh tahun prosesor tercepat adalah yang paling rumit: tambahkan instruksi, dan setiap satu melakukan lebih banyak pekerjaan. Intel membangun kekaisaran atas itu.
- Kemudian sebuah perusahaan kecil dari Inggris memasukkan prosesor yang sengaja sederhana ke dalam ponsel. Lebih sedikit instruksi, semua panjangnya sama, hampir tidak ada menyentuh memori. Tidak bisa melakukan sebanyak per instruksi, namun tetap menang.
- Ia menang karena instruksi sederhana dan seragam dapat ditumpuk (overlapped), dan penumpukan bernilai lebih tinggi daripada kerumitan.
- Pelajaran ini adalah CISC dan RISC, pipelining, empat arsitektur taksonomi Flynn, dan di mana batas panas dan kecepatan prosesor mengarah.
CISC dan RISC
- Sebuah CISC, Komputer的一组指令集复杂, memiliki banyak, sering kali kompleks instruksi: satu mungkin melakukan beberapa akses memori dan operasi. Mereka memiliki panjang bervariasi, sehingga dekoding rumit. Melakukan lebih banyak per instruksi, dalam perangkat keras. Contoh: Intel x86.
- RISC, Reduced Instruction Set Computer, memiliki himpunan instruksi sederhana yang kecil, masing-masing melakukan satu operasi dasar, semuanya dengan panjang tetap dan cepat didekode. Hanya load (memuat) dan store (menyimpan) yang mengakses memori; segalanya lainnya adalah register ke register. Contoh: ARM.
- Program RISC lebih panjang, tetapi setiap instruksi cepat dan dapat diprediksi, yang merupakan persis apa yang dibutuhkan oleh sebuah pipeline.
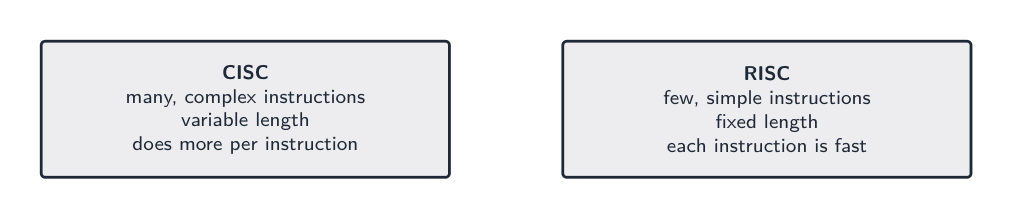
Lebih banyak per instruksi, atau lebih cepat dan lebih dapat diprediksi per instruksi
Prosesor RISC ditandai dengan:
RISC mempertahankan instruksi sedikit, sederhana, dan panjang tetap (biasanya 1 siklus); CISC memiliki banyak instruksi kompleks, panjang bervariasi.
Perbedaan yang ingin diujikan
| Fitur | CISC | RISC |
|---|---|---|
| himpunan instruksi | banyak, kompleks | sedikit, sederhana |
| panjang instruksi | variabel | tetap |
| akses memori | banyak instruksi mungkin mengakses memori | hanya load dan store |
| register | lebih sedikit | banyak |
| siklus per instruksi | bervariasi | biasanya satu |
| pipelining | lebih sulit | alami |
- Chip Intel modern menerjemahkan instruksi CISC mereka menjadi mikro-operasi RISC-like yang lebih sederhana secara internal, yang merupakan bukti paling jelas dari desain mana yang memenangkan perdebatan tersebut.
Cocokkan setiap istilah dengan deskripsinya.
RISC = sederhana + panjang tetap + muat/simpan; CISC = kompleks + panjang bervariasi; pipelining menumpangkan tahap untuk kecepatan.
Dalam prosessor RISC, instruksi yang hanya mengakses memori adalah muat dan ____.
Semua lainnya adalah register ke register. Batasan inilah yang membuat instruksi memiliki panjang tetap, seragam dalam waktu eksekusi, dan mudah dipipelining.
Pipelining
- Sebuah pipeline memproses instruksi dalam tahap-tahap yang tumpang tindih, seperti jalur perakitan: fetch (pengambilan), decode (dodekoding), eksekusi di ALU, akses memori, write back (penulisan kembali).
- Setiap tahap bekerja pada instruksi yang berbeda pada saat yang sama, jadi begitu pipeline penuh, satu instruksi selesai per siklus.
- Hal ini tidak membuat satu instruksi pun menjadi lebih cepat. Ini meningkatkan throughput: lebih banyak instruksi selesai per detik.
- Instruksi RISC dengan panjang tetap dan sederhana membuat setiap tahap memakan waktu yang sama, itulah sebabnya pipeline RISC berjalan mulus dan CISC tidak.
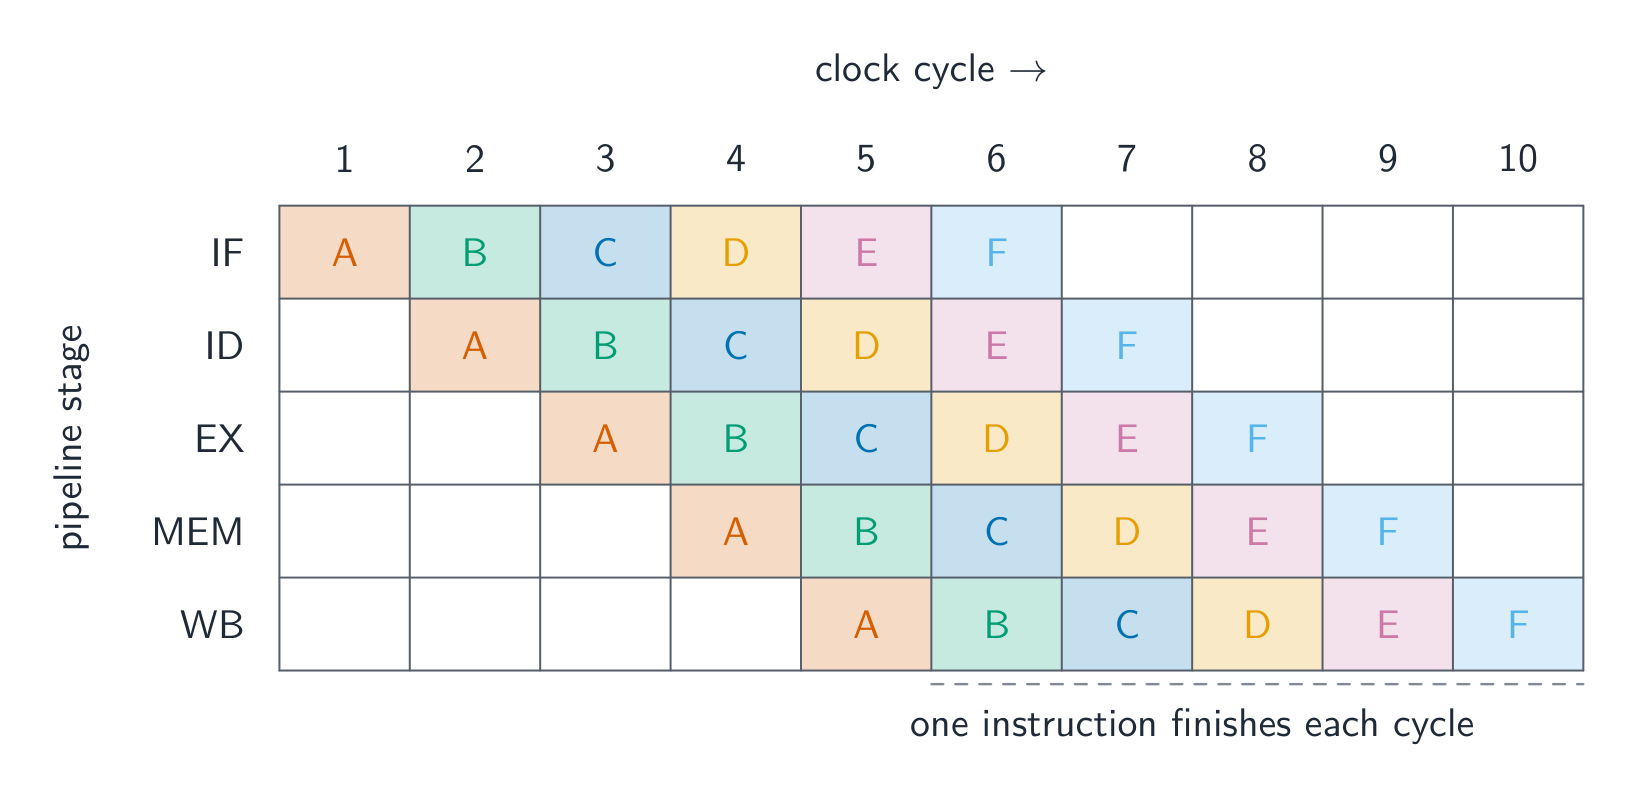
*Enam instruksi sedang diproses, satu selesai setiap siklus
Bagaimana pipelining terisi penuh
Ikuti siklus clock. Setelah pipeline penuh, instruksi baru selesai setiap siklus — meskipun masing-masing masih memerlukan beberapa tahap — karena tahap instruksi yang berbeda tumpang tindih.
Ketika pipeline penuh, ia menyelesaikan sekitar:
Tumpang tindih tahap berarti satu instruksi baru selesai setiap siklus setelah pipeline penuh.
Pipelining mempercepat prosesor dengan cara:
Tahap-tahap dari instruksi berbeda berjalan pada waktu yang sama.
Contoh terpecahkan: mengapa pipelining lebih cepat
- Sebuah pipeline lima tahap berjalan dengan satu siklus per tahap. Jelaskan mengapa hal itu lebih cepat daripada mengeksekusi instruksi satu per satu.
- Tanpa pipeline, setiap instruksi menempati prosesor untuk kelima tahap, sehingga satu selesai setiap lima siklus.
- Dengan pipeline, unit fetch mulai instruksi berikutnya sementara yang saat ini masih dalam proses dodecoding, sehingga lima instruksi sedang diproses sekaligus dan, begitu penuh, satu selesai setiap siklus.
- Tidak ada instruksi individu yang dieksekusi lebih cepat; throughput meningkat sekitar lima kali lipat. Katakan secara eksplisit: itu adalah poin nilai yang paling sering terlewatkan.
Apa yang sebenarnya ditingkatkan oleh pipelining?
Tahap-tahap saling tumpang tindih, sehingga lima instruksi sedang diproses sekaligus dan satu selesai per siklus. Tidak ada instruksi individu yang dieksekusi lebih cepat.
Hazards
- Sebuah hazard (gangguan) menghentikan pipeline. Data hazard terjadi ketika sebuah instruksi memerlukan hasil yang belum dihasilkan oleh instruksi sebelumnya, sehingga harus menunggu.
- Control hazard terjadi pada percabangan: hingga percabangan diselesaikan, prosesor tidak tahu instruksi apa yang akan diambil selanjutnya.
- Keduanya membuang siklus, itulah mengapa prosesor memprediksi percabangan dan meneruskan hasil antar tahap.
Hazard data menyebabkan pipeline terhenti ketika sebuah instruksi membutuhkan hasil yang belum siap; hazard kontrol berasal dari percabangan (branch) yang mengubah instruksi mana yang akan dijalankan berikutnya.
Hazards memaksa pipeline untuk berhenti (atau flush), itulah sebabnya mereka mengurangi throughput ideal satu per siklus.
Cocokkan setiap hazard pipeline dengan penyebabnya.
Keduanya menghentikan pipeline dan membuang siklus, itulah mengapa prosesor meneruskan hasil antar tahap dan memprediksi percabangan.
Taksonomi Flynn
- Taksonomi Flynn mengelompokkan komputer berdasarkan berapa banyak instruksi stream dan data stream yang dimilikinya.
- SISD: satu stream instruksi, satu stream data, inti tunggal tradisional.
- SIMD: satu instruksi beroperasi pada banyak item data sekaligus. Ini adalah GPU atau unit vektor CPU, dan cocok untuk gambar, video, dan array ilmiah.
- MISD: beberapa operasi pada data yang sama; jarang dan sebagian besar teoritis. MIMD: banyak prosesor menjalankan instruksi berbeda pada data berbeda, yang merupakan CPU multi-core atau klaster, dan ini yang paling umum.
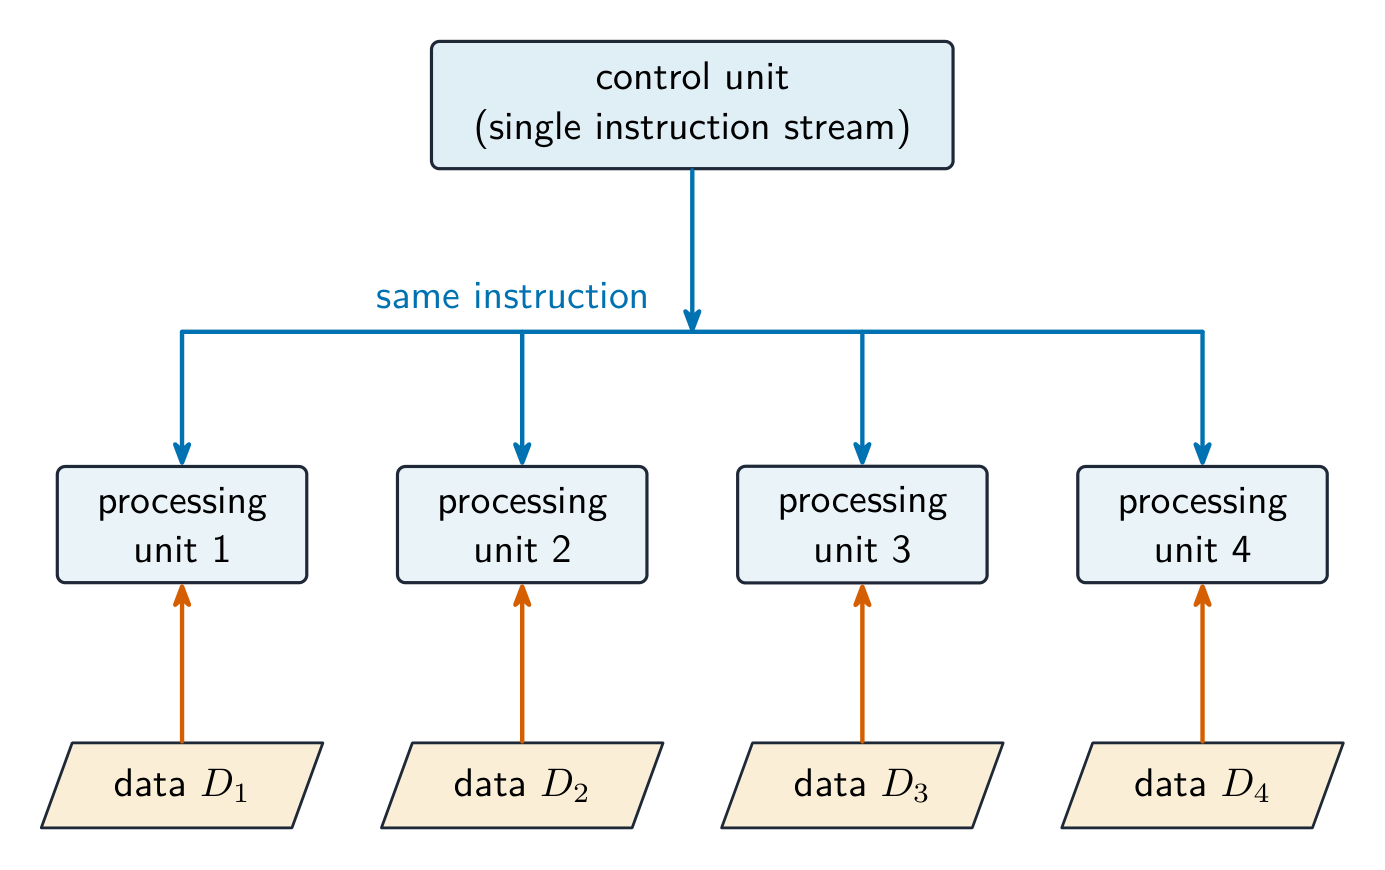
*Satu instruksi, banyak item data
Manakah yang mendeskripsikan SIMD? Pilih semua yang berlaku.
Program berbeda pada data berbeda adalah MIMD, kasus multi-core. SIMD adalah satu aliran instruksi atas banyak aliran data.
Komputer paralel masif
- Sistem paralel masif menggunakan ribuan prosesor yang terhubung melalui jaringan cepat, masing-masing dengan memori sendiri, bertukar data melalui pesan alih-alih berbagi memori.
- Ini adalah MIMD, dan membutuhkan perangkat lunak khusus, karena pemrogram harus membagi masalah dan mengelola komunikasi.
- Inilah superkomputer terbesar: simulasi iklim, pelatihan machine-learning, dan astrofisika semuanya berjalan dengan cara ini.
Prosesor komputer paralel masif berbagi satu blok memori.
Setiap prosesor memiliki memorinya sendiri, dan mereka bertukar data melalui pesan di jaringan cepat. Memori terdistribusilah yang dimaksud oleh istilah tersebut.
Contoh terpecahkan: tentukan jenis mesin
- Kartu grafis menerapkan penyesuaian kecerahan yang sama pada dua juta piksel. SIMD: satu instruksi, banyak item data, yang merupakan tujuan dari ribuan inti kecil pembangun GPU.
- Laptop empat-inte menjalankan browser, compiler, dan pemutar musik sekaligus. MIMD: instruksi berbeda pada data berbeda, satu stream per inti.
- Pusat cuaca membagi atmosfer menjadi grid di atas sepuluh ribu prosesor, masing-masing dengan memori sendiri, melewati nilai batas sebagai pesan. Paralel masif, yang merupakan bentuk MIMD.
- Sebutkan kategorinya, lalu justifikasikan dengan jumlah stream instruksi dan data.
⟦⟧ Nilai yang sering terlewat
- Pipelining meningkatkan throughput; itu tidak memperpendek satu instruksi pun. Katakan demikian.
- Dalam RISC, hanya load dan store yang menyentuh memori. Fakta tunggal ini menjelaskan panjang tetap, banyak register, dan pipeline yang bersih.
- SIMD adalah satu instruksi pada banyak data; MIMD adalah banyak instruksi pada banyak data. Hitung stream sebelum menjawab.
- Paralel masif berarti ribuan prosesor dengan memori terdistribusi dan pertukaran pesan, bukan sekadar "komputer cepat".
Anda telah memahaminya
- CISC: banyak instruksi kompleks variabel-length, lebih banyak per instruksi · RISC: sedikit instruksi sederhana fixed-length, load and store only, banyak register, satu siklus per instruksi
- pipeline tumpang tindih antara fetch, decode, execute, memory dan write-back, sehingga satu instruksi selesai per siklus setelah penuh: throughput lebih tinggi, bukan instruksi yang lebih cepat; data hazards dan control hazards menghentikannya
- Flynn: SISD, SIMD (GPU), MISD, MIMD (multi-core)
- massively parallel: ribuan prosesor, memori terdistribusi, pesan antar-prosesor, MIMD, digunakan oleh superkomputer