| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de la necesidad de los tipos definidos por el usuario | |
| Definir y utilizar tipos no compuestos | Incluyendo enumerados, punteros |
| Definir y utilizar tipos de datos compuestos | Incluyendo conjuntos, registros y clases/objetos |
| Elegir y diseñar un tipo de dato definido por el usuario adecuado para un problema dado |
Representación de datos
A-Level Ciencias de la Computación · Tema 13
 15:16
Tipos de datos definidos por el usuario
Un campo de cadena simple almacenará desorden felizmente. Pide un tipo de vehículo, y alguien escribe Bananas — el programa lo acepta sin murmurar. Pero si tú…
Narración en inglés · Subtítulos en inglés + 中文 quemados en pantalla
13.1
Tipos de datos definidos por el usuario

Syllabus
Fuente: Plan de estudios Cambridge International
Los tipos integrados (INTEGER, REAL, STRING, CHAR, BOOLEAN) cubren los casos más simples. Para problemas más complejos, puedes definir tipos definidos por el usuario 用户定义类型, lo que hace el código más claro y al compilador más estricto.
Por qué son necesarios
Un tipo integrado STRING permite almacenar sin sentido en un campo que debería contener uno de unos pocos valores legales; un tipo definido por el usuario puede restringirlo. Las entidades reales suelen ser una colección de valores de diferentes tipos. Y DECLARE Taxi : Vehicle es más claro (autodocumentado) que DECLARE Taxi : STRING.
"Describe la función de un tipo de dato definido por el usuario" (dos puntos). Un tipo de dato definido por el programador, construido a partir de tipos existentes (integrados), para que los datos específicos del problema puedan representarse cuando ningún tipo integrado se ajusta. Ambas mitades puntúan: definido por el programador y basado en tipos existentes. El examinador también acepta "para facilitar la lectura y el mantenimiento del programa" como punto de apoyo, nunca por sí solo.
"Explica qué significan los tipos de datos no compuestos y compuestos" (cuatro puntos). Un tipo no compuesto está definido sin referencia a otro tipo: almacena un único valor, por ejemplo un entero, un real o un valor enumerado. Un tipo compuesto es una colección de otros tipos (que pueden ser ellos mismos compuestos): almacena varios valores bajo un único identificador, por ejemplo un registro, un conjunto, una matriz o una clase. Da un ejemplo con cada definición; el examen pide uno.
Tipos no compuestos
Tipo enumerado
Un tipo enumerado 枚举类型 tiene valores que son una lista fija de constantes nombradas:
TYPE Vehicle = (M100, M230, T101, T102, T120, T150)
DECLARE MyTaxi : Vehicle
MyTaxi ← T102
Los nombres son valores del nuevo tipo (almacenados internamente como enteros pequeños); no se puede asignar nada fuera de la lista. Usos: días de la semana, colores, códigos de estado.
"Indica qué significa un tipo de dato enumerado." Un tipo definido por el usuario no compuesto definido listando todos sus posibles valores (en orden). Como los valores están ordenados, se pueden comparar y recorrer secuencialmente: con TYPE Month = (January, February, ..., December), la prueba IF ThisMonth > June es legal, y los valores se almacenan internamente como enteros. El pseudocódigo tiene tres partes y el examen puntúa cada una: la palabra clave TYPE, el identificador con =, y la lista entre corchetes separada por comas.
Ejemplo resuelto. Escribe pseudocódigo para definir un tipo enumerado para los días en que una escuela está abierta (lunes a viernes), y declara una variable de ese tipo establecida en miércoles.
TYPE SchoolDay = (Monday, Tuesday, Wednesday, Thursday, Friday)
DECLARE Today : SchoolDay
Today ← Wednesday
Una variable de un tipo enumerado no puede recibir un valor fuera de la lista, que es todo el punto: Today ← Saturday es un error de tiempo de compilación, mientras que un STRING habría aceptado "Saturdy".
Tipo puntero
Un puntero 指针 almacena la dirección de memoria de otra variable (o NULL para "sin destino"). Los punteros construyen estructuras dinámicas (listas enlazadas, árboles) y pasan referencias sin copiar.
TYPE PNode = ^TNode    // pointer to a TNode
DECLARE p : PNode
p ← NEW TNode
p^.Value ← 42          // dereference to reach the fields
Desreferenciar 解引用 (p^) significa acceder a la variable a la que apunta.
"Indica qué significa un tipo de dato puntero." Un tipo no compuesto cuyo valor es la dirección de memoria de (una referencia a) una variable de un tipo dado. El pseudocódigo declara el tipo con un acento circunflejo antes del tipo al que apunta, y el examen pide exactamente esa línea:
TYPE SelectParts = ^Parts        // a pointer to a value of type Parts
DECLARE Chosen : SelectParts
Chosen ← ^Keyboard               // Chosen now holds the address of Keyboard
OUTPUT Chosen^                   // dereference: the value stored at that address
Los punteros son lo que constituye una lista enlazada dinámica o un árbol binario (Tema 19): cada nodo contiene un puntero al siguiente. Se pierden comúnmente dos puntos aquí: escribir el tipo puntero como si almacenara el valor en sí, y olvidar el acento circunflejo al leer a través del puntero.

p^ lo desreferencia para acceder a los campos del nodoTipos compuestos
Un tipo compuesto 复合类型 (uno de los tipos de datos compuestos) agrupa varios valores bajo un mismo nombre.

- registro 记录 (Tema 10) — campos de diferentes tipos en un bloque
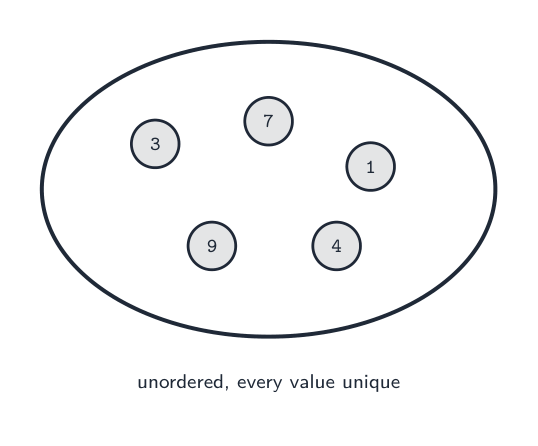
TYPE ... ENDTYPE. - conjunto 集合 — una colección desordenada de valores únicos, con operaciones añadir, eliminar, prueba de pertenencia, unión, intersección:
DECLARE Available : SET OF Colour
Available ← {Red, Blue}
IF Green IN Available THEN
    ...
ENDIF
- clase 类 / objeto 对象 — el tipo compuesto POO, combinando campos de datos (atributos 属性) con operaciones sobre ellos (métodos 方法). Un objeto es una instancia de una clase:
CLASS Taxi
    PRIVATE Capacity : INTEGER
    PUBLIC FUNCTION GetCapacity() RETURNS INTEGER
        RETURN Capacity
    ENDFUNCTION
ENDCLASS
Elegir un tipo
Usa enumerado para un valor de una lista fija, puntero para indirección, registro para un grupo de campos, conjunto para una colección única desordenada, y clase cuando necesitas estado y comportamiento juntos.
"Describe el tipo de dato definido por el usuario conjunto" (tres puntos). Un tipo compuesto que almacena una colección de valores del mismo tipo, sin un orden específico y sin duplicados; se pueden añadir y eliminar valores, y se puede probar la pertenencia de un valor. Declara el tipo con SET OF, luego define una constante de conjunto con sus valores entre corchetes:
TYPE EvenNumbers = SET OF INTEGER
DEFINE Evens (2, 4, 6, 8, 10, 12) : EvenNumbers
TYPE SymbolSet = SET OF CHAR
DEFINE Operators ('+', '-', '*', '/') : SymbolSet
"Describe el tipo de dato definido por el usuario registro" (tres puntos). Un tipo compuesto formado por un número fijo de campos (elementos), cada uno con su propio identificador y su propio tipo, referidos bajo un único identificador; los campos se acceden con notación de punto.
Ejemplo resuelto. Escribe pseudocódigo para declarar un tipo de registro ClubMember para el nombre, apellido, código de membresía (un entero), fecha de adhesión y si se han pagado las cuotas de un miembro de un club; luego declara una variable y establece dos de sus campos.
TYPE ClubMember
    DECLARE FirstName : STRING
    DECLARE LastName : STRING
    DECLARE Code : INTEGER
    DECLARE DateJoined : DATE
    DECLARE FeesPaid : BOOLEAN
ENDTYPE

DECLARE NewMember : ClubMember
NewMember.LastName ← "Chen"
NewMember.FeesPaid ← TRUE
Cada campo necesita su propia línea DECLARE con un tipo apropiado, el bloque termina con ENDTYPE, y un campo 字段 se alcanza como variable.field. Al pedir elegir un tipo para cada campo, empareja con los datos: un código que solo se compara es un STRING si puede contener letras, un INTEGER si se necesita aritmética o ordenamiento; un sí/no es BOOLEAN; una fecha es DATE. Un campo que puede tomar uno de unos pocos valores nombrados (la especie de una mascota, un color) es el que debe convertirse en un tipo enumerado.

Registros en matrices y archivos. Una tabla de muchos miembros es DECLARE Members : ARRAY[1:100] OF ClubMember; entonces Members[3].LastName es un campo de un elemento, y un bucle sobre el índice procesa cada registro. Un registro también es la unidad natural escrita y leída de un archivo (más abajo), un registro por PUTRECORD o WRITEFILE.
Ejemplo resuelto. Un tipo compuesto Pet almacena el nombre de cada mascota (cadena), la especie (uno de perro, gato, conejo o hámster) y el peso en kilogramos (real). Defina los tipos y declare una variable.
TYPE Species = (Dog, Cat, Rabbit, Hamster)
TYPE Pet
    DECLARE Name : STRING
    DECLARE Kind : Species
    DECLARE Weight : REAL
ENDTYPE
DECLARE MyPet : Pet
MyPet.Kind ← Rabbit
El tipo enumerado se define primero, porque el registro lo utiliza: el orden importa en el pseudocódigo al igual que en un compilador.
Clases en pseudocódigo. Una clase es el tipo compuesto que también transporta comportamiento. El examen pide la declaración con sus atributos marcados PRIVATE, un constructor 构造函数 llamado NEW que los establece, y PUBLIC métodos para obtenerlos o cambiarlos:
CLASS Appointment
    PRIVATE PatientName : STRING
    PRIVATE Treatment : STRING
    PRIVATE Medication : STRING
    PUBLIC PROCEDURE NEW(Name : STRING, Treat : STRING, Med : STRING)
        PatientName ← Name
        Treatment ← Treat
        Medication ← Med
    ENDPROCEDURE
    PUBLIC FUNCTION GetTreatment() RETURNS STRING
        RETURN Treatment
    ENDFUNCTION
ENDCLASS

DECLARE Visit : Appointment
Visit ← NEW Appointment("A. Chen", "filling", "none")
OUTPUT Visit.GetTreatment()
Los atributos son privados para que solo puedan cambiarse a través de métodos (encapsulamiento, Tema 20); el constructor es un procedimiento llamado NEW con un parámetro por atributo; un getter es una función que devuelve el atributo. Cada uno de estos es una calificación separada.
Explorar
Laboratorio de conceptos de programación
Conectar ejemplos con la idea de programación que muestran.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| user-defined type/ˈjuːzə dɪˈfaɪnd taɪp/ | 用户定义类型 | yòng hù dìng yì lèi xíng |
| field/fiːld/ | 字段 | zì duàn |
| record/ˈrekɔːd/ | 记录 | jì lù |
| set/set/ | 集合 | jí hé |
| class/klæs/ | 类 | lèi |
| composite type/ˈkɒmpəzɪt taɪp/ | 复合类型 | fù hé lèi xíng |
| enumerated type/ɪˈnjuːməreɪtɪd taɪp/ | 枚举类型 | méi jǔ lèi xíng |
| pointer/ˈpɔɪntə/ | 指针 | zhǐ zhēn |
| linked list/lɪŋkt lɪst/ | 链表 | liàn biǎo |
| dereference/ˌdiːˈrefrəns/ | 解引用 | jiě yǐn yòng |
| object/ˈɒbdʒekt/ | 对象 | duì xiàng |
| attributes/ˈætrɪbjuːts/ | 属性 | shǔ xìng |
| methods/ˈmeθədz/ | 方法 | fāng fǎ |
| constructor/kənˈstrʌktə/ | 构造函数 | gòu zào hán shù |
| File organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | 文件组织 | wén jiàn zǔ zhī |
13.2
Organización y acceso a archivos
Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Demostrar comprensión de los métodos de organización de archivos y seleccionar un método apropiado de organización y acceso a archivos para un problema dado | Incluyendo secuencial, lineal (usando un campo clave), aleatorio (usando una clave de registro) |
| Demostrar comprensión de los métodos de acceso a archivos | Incluye Acceso lineal para archivos secuenciales y lineales Acceso directo para archivos lineales y aleatorios |
| Demostrar comprensión de algoritmos de hash Describir y utilizar diferentes algoritmos de hash para leer datos y escribir en un archivo aleatorio/lineal |
Fuente: Plan de estudios Cambridge International
Organización de archivos 文件组织 es cómo se dispone los datos; acceso a archivos es cómo el programa accede a un registro.
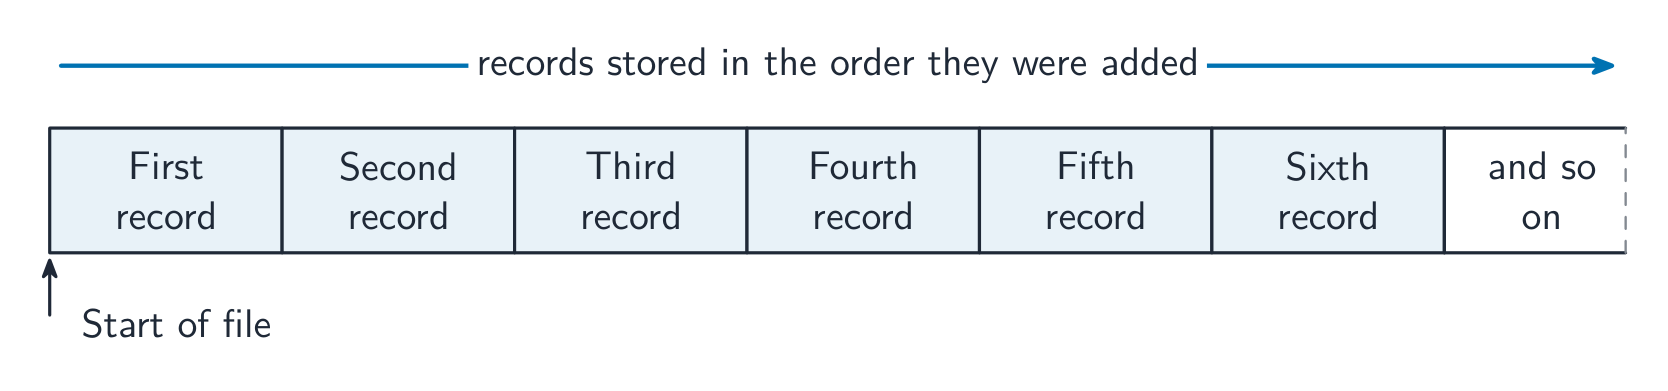
- archivo serial 串行文件 — registros en el orden de adición, sin ordenar. El acceso es solo secuencial; la anexión es rápida; la búsqueda es lenta. Usado para registros y rastros de auditoría.
- archivo secuencial 顺序文件 — registros ordenados por una clave. La búsqueda es más rápida (se puede detener antes o buscar binariamente); la inserción es lenta (los registros deben desplazarse). Usado para archivos maestros actualizados por lotes.
- archivo aleatorio 随机文件 (archivo de acceso directo) — registros en posiciones calculadas a partir de la clave (a menudo mediante un hash). El acceso directo por clave es muy rápido; leer en orden de clave es más difícil. Usado para grandes tablas de consulta y cuentas de clientes.
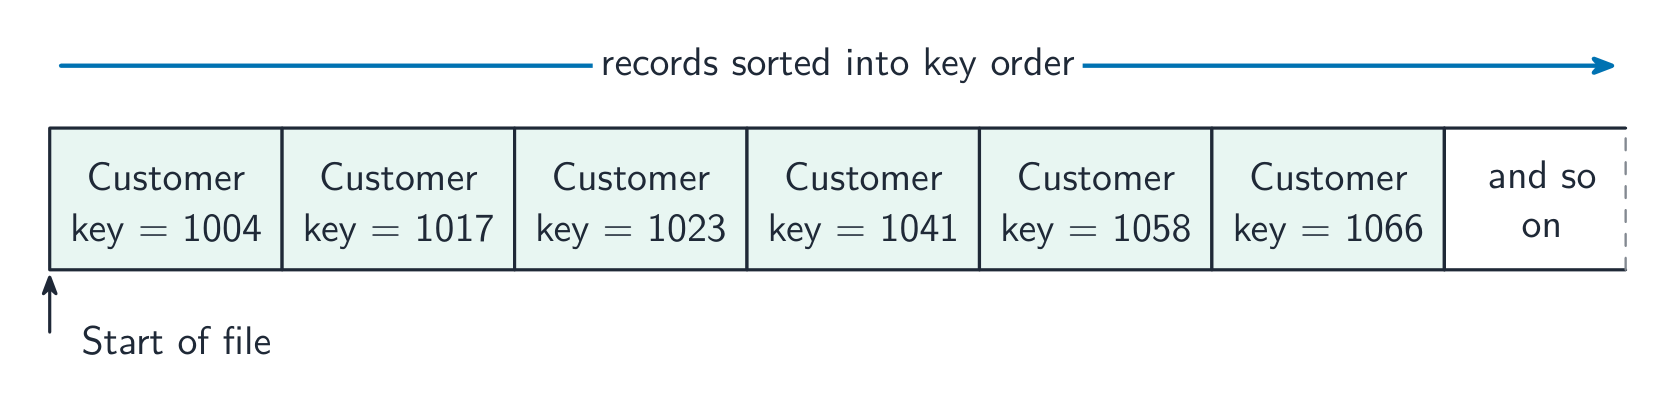

Los dos métodos de acceso son acceso secuencial 顺序存取 (leer desde el inicio hasta el final) y acceso directo 直接存取 (saltar directamente a una posición conocida). Alinee la estructura con la operación dominante: las búsquedas de una sola clave favorecen el aleatorio; los informes en orden favorecen el secuencial.
Describiendo cada organización (el redacción que obtiene puntos). Serial: los registros se almacenan uno tras otro en el orden en que fueron añadidos, sin ordenamiento por clave. Secuencial: los registros se almacenan en orden de un campo clave (ordenados). Aleatorio: cada registro se almacena en una dirección calculada a partir de su clave mediante un algoritmo de hash, por lo que los registros no están en ningún orden. Comparando serial y secuencial: ambos almacenan registros uno tras otro y ambos se leen secuencialmente, pero un archivo secuencial está ordenado por clave, por lo que una búsqueda puede detenerse tan pronto como se lee una clave mayor que la objetivo, y un nuevo registro debe insertarse en su posición correcta (generalmente reescribiendo el archivo), mientras que un archivo serial simplemente se anexiona.

Describiendo cada método de acceso. Acceso secuencial: comienza en el inicio del archivo y lee los registros uno tras otro (en el orden almacenado) hasta que se encuentra el registro requerido o se alcanza el final del archivo. Aplicado a un archivo serial esto significa leer todos los registros hasta la coincidencia, y leer todo el archivo para establecer que un registro está ausente; aplicado a un archivo secuencial la búsqueda puede detenerse antes, tan pronto como se lee una clave mayor que la objetivo. Acceso directo: la dirección del registro se calcula a partir de su clave (mediante un algoritmo de hash, o a partir de un índice), y el programa va directamente a esa posición sin leer los registros anteriores; este es el método de acceso para archivos aleatorios, y para un registro referenciado por una dirección única en un disco.
Elección. Un archivo maestro de nómina o facturación de servicios procesado por lotes, cada registro a su vez, se adapta a un archivo secuencial; un registro de transacciones en el orden en que ocurrieron se adapta a un archivo serial; un archivo de existencias o clientes donde se buscan y actualizan registros individuales por clave mientras el programa se ejecuta se adapta a un archivo aleatorio con acceso directo.
Manejo de archivos en pseudocódigo. El examen espera las sentencias estándar, y el Examen 3 establece algoritmos que las utilizan:
| Tarea | Sentencias |
|---|---|
| abrir un archivo de texto | OPENFILE "Scores.txt" FOR READ (o FOR WRITE, que crea o sobrescribe, o FOR APPEND) |
| leer o escribir una línea | READFILE "Scores.txt", Line y WRITEFILE "Scores.txt", Line |
| probar el final | WHILE NOT EOF("Scores.txt") |
| cerrar | CLOSEFILE "Scores.txt" |
| abrir un archivo aleatorio | OPENFILE "Stock.dat" FOR RANDOM |
| mover a una posición de registro | SEEK "Stock.dat", Address |
| leer o escribir un registro completo | GETRECORD "Stock.dat", Item y PUTRECORD "Stock.dat", Item |
Ejemplo resuelto. Un archivo aleatorio Stock.dat contiene registros de tipo StockItem, almacenados en la dirección dada por ItemID MOD 100. Escriba pseudocódigo que almacene un nuevo artículo en su dirección hasheada si esa posición está vacía, informando la posición si ya está en uso.
DECLARE Item, Existing : StockItem
DECLARE Address : INTEGER
INPUT Item.ItemID, Item.Description, Item.Quantity
Address ← Item.ItemID MOD 100
OPENFILE "Stock.dat" FOR RANDOM
SEEK "Stock.dat", Address
GETRECORD "Stock.dat", Existing
IF Existing.ItemID = 0 THEN
    // 0 marks an empty position
ENDIF
    SEEK "Stock.dat", Address
    PUTRECORD "Stock.dat", Item
    OUTPUT "Stored at ", Address
ELSE
    OUTPUT "Position ", Address, " is in use"
ENDIF
CLOSEFILE "Stock.dat"
Dos detalles que verifica el esquema de corrección: SEEK antes de cada GETRECORD o PUTRECORD (la lectura avanza la posición, por lo que hay que volver a buscar antes de escribir), y el archivo abierto FOR RANDOM y cerrado al final. Para copiar cada registro de un archivo aleatorio a otro, se recorre con bucle las direcciones usando SEEK, GETRECORD desde un archivo y PUTRECORD hacia el otro, omitiendo las posiciones vacías.
Explorar
Ruta de acceso al archivo
Seguir un archivo desde el almacenamiento hasta el programa y de vuelta de forma segura.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| serial file/ˈsɪərɪəl faɪl/ | 串行文件 | chuàn xíng wén jiàn |
| sequential file/siːˈkwenʃl faɪl/ | 顺序文件 | shùn xù wén jiàn |
| random file/ˈrændəm faɪl/ | 随机文件 | suí jī wén jiàn |
| direct access/daɪˈrekt ˈækses/ | 直接存取 | zhí jiē cún qǔ |
| hash function/hæʃ ˈfʌŋkʃn/ | 散列函数 | sàn liè hán shù |
| sequential access/siːˈkwenʃl ˈækses/ | 顺序存取 | shùn xù cún qǔ |
| deterministic/dɪˌtɜːmɪˈnɪstɪk/ | 确定性 | què dìng xìng |
| collision/kəˈlɪʒn/ | 冲突 | chōng tū |
| linear probing/ˈlɪnɪə ˈprəʊbɪŋ/ | 线性探测 | xiàn xìng tàn cè |
| chaining/ˈtʃeɪnɪŋ/ | 链接法 | liàn jiē fǎ |
| load factor/ləʊd ˈfæktə/ | 装填因子 | zhuāng tián yīn zi |
| overflow area/ˌəʊvəˈfləʊ ˈeərɪə/ | 溢出区 | yì chū qū |
| overflow/ˌəʊvəˈfləʊ/ | 溢出 | yì chū |
13.2
Hashing

Una función hash 散列函数 (un algoritmo de hashing) toma una clave de registro y produce una dirección donde se almacena el registro. Una buena función es rápida, determinista 确定性, y distribuye las claves de manera uniforme.
Algoritmos de hashing comunes para $N$ ranuras: hash por módulo address ← key MOD N; plegado (dividir la clave, sumar las piezas, MOD N); un hash de cadena (sumar los códigos de carácter, MOD N).
Una colisión 冲突 ocurre cuando dos claves tienen el mismo hash en la misma dirección. Tres formas de resolverla:
| Estrategia | Cómo funciona | Compromiso |
|---|---|---|
| prueba lineal 线性探测 | usar la siguiente ranura libre (envolviendo) | simple, pero las claves se agrupan |
| encadenamiento 链接法 | cada ranura apunta a una lista enlazada 链表 de registros | sin agrupación, pero usa más memoria |
| rehashing | aplicar una segunda función hash | dispersa las claves, pero requiere más trabajo |
Para buscar: hashear la clave, leer esa ranura; si las claves coinciden, has terminado, de lo contrario seguir la estrategia de resolución hasta encontrar una coincidencia o una ranura vacía. Para insertar: hashear la clave, escribir en esa ranura o en la siguiente libre. Mantener el factor de carga 装填因子 (registros ÷ ranuras) por debajo del 70% aproximadamente para búsquedas casi O(1).
"Explica qué se entiende por algoritmo de hashing en el contexto de acceso a archivos" (tres marcas). Un cálculo (función) realizado sobre el campo clave de un registro que produce un valor, que se utiliza como la dirección (ubicación) en la que se almacena el registro en el archivo y desde la cual se recupera. El mismo cálculo sobre la misma clave siempre da la misma dirección, por eso el registro se puede encontrar nuevamente sin búsqueda.
"Describe dos métodos para superar una colisión." (1) Sondeo lineal (direccionamiento abierto): almacene el registro en la siguiente posición libre después de la dirección calculada, volviendo al inicio si es necesario; para recuperar, comience en la dirección hash y lea hacia adelante hasta que la clave coincida. (2) Un área de desbordamiento o encadenamiento: almacene el registro que colisiona en un área de desbordamiento separada (o en una lista enlazada adjunta a la dirección), la cual se busca secuencialmente después de que la dirección principal no coincida. Se otorgan puntos por cualquiera de las dos respuestas; describa tanto el almacenamiento como la recuperación.
Ejemplo resuelto. Un archivo aleatorio tiene 11 posiciones de registro, numeradas del 0 al 10, y el algoritmo de hash es Address ← Key MOD 11. Los registros con claves 1250, 1381, 1452, 1613 y 1470 se almacenan en ese orden, utilizando sondeo lineal. Muestre dónde va cada registro y describa cómo se recupera la clave 1470.
$1250 \bmod 11 = 7$; $1381 \bmod 11 = 6$; $1452 \bmod 11 = 0$; $1613 \bmod 11 = 7$, una colisión con 1250, por lo que 1613 toma la siguiente posición libre, 8; $1470 \bmod 11 = 7$ nuevamente, y las posiciones 7 y 8 están llenas, por lo que 1470 va a la 9. Para recuperar 1470: calcule $7$, lea la posición 7 (clave 1250, sin coincidencia), lea la 8 (1613, sin coincidencia), lea la 9 (1470, encontrada). Si se alcanza una posición vacía antes de una coincidencia, el registro no está en el archivo. Las colisiones son el precio de un archivo pequeño: un buen algoritmo de hash distribuye las claves uniformemente, y el archivo se mantiene muy por debajo de su capacidad completa para que las sondas permanezcan cortas.
Explorar
Una tabla hash
Observa cómo cada clave se transforma mediante hash en un bucket. Un buen hash distribuye las claves para que las búsquedas sigan siendo rápidas.
13.3
Números de punto flotante

Syllabus
| Los candidatos deben ser capaces de: | Notas y orientación |
|---|---|
| Describir el formato de los números reales binarios de punto flotante | Utilizar la forma de complemento a dos. Comprender los efectos de cambiar la asignación de bits a la manta y al exponente en una representación de punto flotante. |
| Convertir números reales binarios de punto flotante a decimal y viceversa | |
| Normalizar números de punto flotante | Comprender las razones para la normalización. |
| Demostrar comprensión de las consecuencias de que una representación binaria sea solo una aproximación al número real que representa (en ciertos casos) | Comprender cómo pueden ocurrir el desbordamiento hacia abajo (underflow) y el desbordamiento hacia arriba (overflow). |
| Demostrar comprensión de que las representaciones binarias pueden dar lugar a errores de redondeo |
Fuente: Plan de estudios Cambridge International
Para almacenar números reales de tamaños muy diferentes, las computadoras utilizan un formato de punto flotante — una forma binaria de notación científica, con dos campos:
- una mantisa — los dígitos significativos.
- un exponente — la potencia de 2 por la que se multiplica.
Ambos se almacenan como enteros en complemento a dos. El valor es
$$\text{number} = \text{mantissa} \times 2^{\text{exponent}}.$$
Lee la mantisa como una fracción binaria: el primer bit después del punto vale $1/2$, el siguiente $1/4$, luego $1/8$, y así sucesivamente. Por lo tanto, 0.1010000 es $1/2 + 1/8 = 0.625$; con exponente 00000010 (= 2), el valor es $0.625 \times 2^{2} = 2.5$.
Conversión
- binario → decimal: lee la mantisa (utiliza las reglas del complemento a dos si es negativa) como una fracción, lee el exponente como un entero con signo y luego multiplica la mantisa por $2^{\text{exponent}}$.
- decimal → binario: escribe el número como una fracción binaria multiplicada por una potencia de 2 y, a continuación, almacena la mantisa y el exponente en los formatos acordados.
Ejemplo resuelto. Un número tiene una mantisa 10110000 y un exponente 00000011. Encuentra su valor decimal.
El exponente 00000011 es $+3$. La mantisa comienza con un 1, por lo que es negativa. Leída como 1.0110000 en complemento a dos, el bit de signo vale $-1$ y los bits fraccionarios suman $\tfrac{1}{4} + \tfrac{1}{8} = 0.375$, por lo que la mantisa es $-1 + 0.375 = -0.625$. Entonces
$$\text{number} = -0.625 \times 2^{3} = -5.0.$$
Ejemplo resuelto. Almacena $+2.5$ en este formato.
En binario $2.5 = 10.1$. Escrito como fracción normalizada, $2.5 = 0.101 \times 2^{2}$. Por lo tanto, la mantisa es 01010000 (bit de signo 0, seguido de .101) y el exponente es 00000010 ($= 2$).
El formato del examen: complemento a dos, una mantisa y un exponente
El examen establece un formato tal como 10 bits para la mantisa y 6 bits para el exponente, ambos en complemento a dos. El punto binario de la mantisa se sitúa después de su primer bit (signo), por lo que una mantisa positiva es 0.xxxxxxxxx y una negativa 1.xxxxxxxxx; el exponente es un entero con signo ordinario. Cada conversión utiliza los mismos tres pasos: leer la mantisa como una fracción (reglas de complemento a dos si comienza con 1), leer el exponente como un entero y multiplicar por $2^{\text{exponent}}$.
Ejercicio resuelto (binario a decimal). Mantisa 0101100000, exponente 000011.
Mantisa: $0.101100000_2 = \tfrac{1}{2} + \tfrac{1}{8} + \tfrac{1}{16} = 0.6875$. Exponente: $000011_2 = 3$. Valor: $0.6875 \times 2^{3} = 5.5$.
Ejercicio resuelto (mantisa negativa). Mantisa 1011000000, exponente 000010.
La mantisa comienza con 1, por lo que es negativa. Su valor es $-1 + 0.011000000_2 = -1 + (\tfrac{1}{4} + \tfrac{1}{8}) = -0.625$; exponente $= 2$; valor $-0.625 \times 4 = -2.5$. (Alternativamente, tome el complemento a dos de la mantisa, 0101000000 $= 0.625$, y anexe el signo menos). Un exponente negativo como 111110 $= -2$ divide en lugar de multiplicar: una mantisa de $0.5$ con ese exponente es $0.5 \times 2^{-2} = 0.125$.
Ejercicio resuelto (decimal a binario). Almacene $+6.5$ y $-6.5$ en el formato de 10 bits y 6 bits, respectivamente, normalizado.
$6.5 = 110.1_2 = 0.1101_2 \times 2^{3}$, por lo que la mantisa es 0110100000 y el exponente 000011. Para $-6.5$, tome el complemento a dos de la mantisa: 1001100000 (compruebe: $-1 + 0.0011_2 = -1 + 0.1875 = -0.8125$, y $-0.8125 \times 8 = -6.5$), exponente 000011 sin cambios. El signo nunca pasa al exponente; un número negativo tiene una mantisa negativa.
Normalización
Un número está normalizado cuando el primer bit significativo está inmediatamente después del punto binario (sin ceros iniciales desperdiciados). Esto maximiza la precisión, ya que cada bit de la mantisa transporta información. Para normalizar, desplace la mantisa a la izquierda y disminuya el exponente (o desplace a la derecha y aumentéelo) hasta que el primer bit significativo esté en su posición; el valor permanece inalterado. Para mantisas negativas (en complemento a dos), el bit de signo (1) va seguido inmediatamente de un 0.
Reconocer y producir forma normalizada. Una mantisa positiva normalizada comienza 01; una negativa comienza 10. Por lo tanto, 0011000000 no está normalizado (desplazar a la izquierda un lugar y restar uno al exponente: 0110000000, exponente uno menos) y 1100000000 tampoco lo está (desplazar a la izquierda hasta que el patrón sea 10...). Cada desplazamiento a la izquierda de la mantisa debe ir seguido de restar uno al exponente, o el valor cambiará.
"Explique por qué los números se almacenan en forma normalizada" (dos marcas). (1) Proporciona la máxima precisión (exactitud) para el número de bits disponibles, ya que no se desperdician bits en ceros iniciales (o unos iniciales para un número negativo); (2) cada número tiene así una representación única, por lo que los números pueden compararse; y (3) hace el mejor uso del rango disponible. Cualquier dos de estas respuestas son válidas.

Errores de aproximación y redondeo
Muchos reales decimales no pueden almacenarse exactamente en binario — p. ej., $0.1_{10}$ es la fracción binaria periódica $0.000110011\ldots_{2}$, que debe truncarse. Consecuencias:
- errores de redondeo 舍入误差 se acumulan tras muchas operaciones (
0.1 + 0.2no es exactamente0.3). - fallan las comparaciones — nunca compruebe si un real es igual. Compruebe que la diferencia sea menor que una tolerancia pequeña,
IF Difference < 0.000001, donde la diferencia se calcule en el orden correcto o mediante una función módulo que definiría el enunciado.ABSno figura ni en el inserto 9618 ni en la Guía de Pseudocódigo, por lo que no asuma su existencia: la guía indica que cualquier función necesaria será proporcionada. - restar dos valores casi iguales pierde precisión.
- desbordamiento 溢出 (un resultado demasiado grande para el rango del exponente) e inundación inferior 下溢 (un resultado demasiado pequeño, redondeándose a cero) ocurren cuando el exponente sale de su rango válido.
Para necesidades de exactitud (moneda), utilice punto fijo 定点 o BCD 二进码十进数 en lugar de punto flotante.
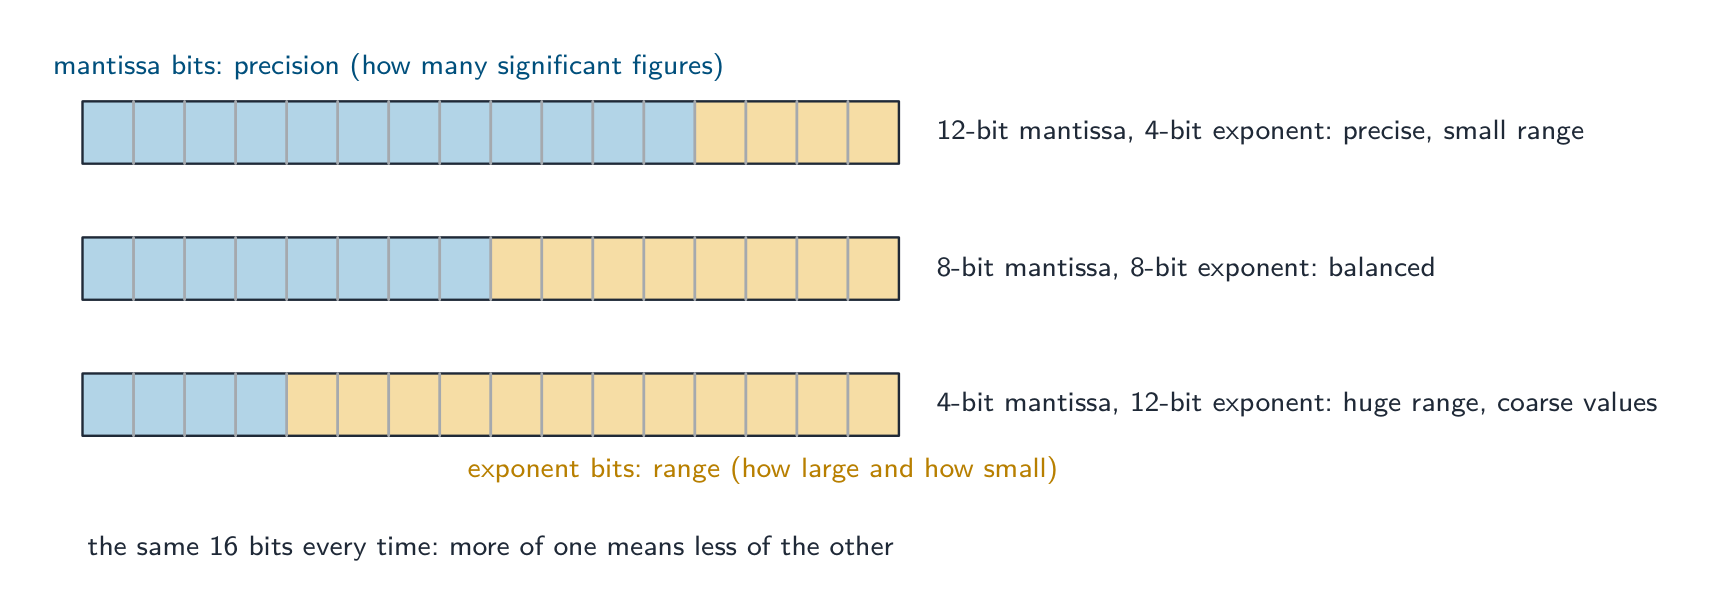
"Describa el efecto de cambiar la asignación de bits" (tres marcas). Con un número total de bits fijo, aumentar la mantisa y reducir el exponente otorga mayor precisión 精度 (más cifras significativas, menores errores de redondeo) pero un rango más pequeño 范围 (las magnitudes máxima y mínima que pueden almacenarse disminuyen); aumentar el exponente hace lo contrario: un rango mayor a costa de la precisión. Nombren ambos efectos y ambas direcciones.
Mayor y menor. En el formato de mantisa de 10 bits y exponente de 6 bits, el número positivo más grande tiene mantisa 0111111111 ($= 1 - 2^{-9}$) y exponente 011111 ($= 31$): aproximadamente $2^{31}$. El número positivo normalizado más pequeño tiene mantisa 0100000000 ($= 0.5$) y exponente 100000 ($= -32$): $0.5 \times 2^{-32} = 2^{-33}$. El número más negativo tiene mantisa 1000000000 ($= -1$) y exponente $31$: $-2^{31}$.
"Explique qué se entiende por desbordamiento e inundación inferior." El desbordamiento ocurre cuando el resultado de un cálculo es mayor que el número más grande que puede representarse, por lo que el exponente necesitaría más bits de los que tiene; la inundación inferior ocurre cuando un resultado es menor que el más pequeño (no nulo) que puede representarse, demasiado cercano a cero para que el exponente lo exprese, por lo que se almacena como cero. Ambos provienen del rango del exponente, no del de la mantisa.
Por qué una representación binaria es solo una aproximación. Una fracción binaria solo puede representar sumas de $\tfrac{1}{2}, \tfrac{1}{4}, \tfrac{1}{8}, \ldots$ con exactitud; un valor como $0.1$ o $\tfrac{1}{3}$ tiene una expansión binaria infinita, y la mantisa tiene un número fijo de bits, por lo que el valor almacenado es el más cercano que cabe. La diferencia es un error de redondeo; es pequeño para un número pero se acumula en cálculos repetidos (sumar $0.1$ diez veces puede no dar exactamente $1$), razón por la cual los reales nunca deben probarse para igualdad exacta.
Explorar
Construir un número de punto flotante
Invertir los bits de la mantisa y del exponente para obtener un valor, y verificar si está normalizado.
Explorar
Normalización de un número de punto flotante
Paso a paso por la normalización. Desplazar la mantisa para eliminar ceros iniciales innecesarios —y ajustar el exponente en consecuencia— mantiene el valor sin cambios pero utiliza cada bit para la precisión.
Vocabulario
Entrenar
| Inglés | Chino | Pinyin |
|---|---|---|
| floating-point/ˈfləʊtɪŋ pɔɪnt/ | 浮点 | fú diǎn |
| mantissa/mænˈtɪsə/ | 尾数 | wěi shù |
| exponent/ekˈspəʊnənt/ | 指数 | zhǐ shù |
| two's complement/tuːz ˈkɒmplɪmənt/ | 补码 | bǔ mǎ |
| normalised/ˈnɔːməlaɪzd/ | 规格化 | guī gé huà |
| rounding errors/ˈraʊndɪŋ ˈerəz/ | 舍入误差 | shě rù wù chā |
| underflow/ˌʌndəˈfləʊ/ | 下溢 | xià yì |
| fixed-point/fɪkst pɔɪnt/ | 定点 | dìng diǎn |
| BCD/ˌbiː siː ˈdiː/ | 二进码十进数 | èr jìn mǎ shí jìn shù |
| precision/prɪˈsɪʒn/ | 精度 | jīng dù |
| range/reɪndʒ/ | 范围 | fàn wéi |
13.3
Definiciones aceptadas por el examinador
Una pregunta de definición se califica según un texto fijo. Aprende estas definiciones exactamente, y da solo una respuesta.
| Término | Definición |
|---|---|
| tipo de dato definido por el usuario | un tipo de dato definido por el programador, basado en tipos existentes, para representar datos específicos del problema |
| tipo no compuesto | un tipo definido sin referencia a otro tipo; contiene un único valor (entero, real, enumerado, puntero) |
| tipo compuesto | un tipo formado por otros tipos; contiene varios valores bajo un mismo identificador (registro, conjunto, matriz, clase) |
| tipo enumerado | un tipo no compuesto definido listando todos sus posibles valores, en orden |
| tipo puntero | un tipo no compuesto cuyo valor es la dirección de memoria de una variable de un tipo dado |
| conjunto | un tipo compuesto que contiene una colección de valores de un solo tipo, sin orden y sin duplicados |
| registro | un tipo compuesto con un número fijo de campos, cada uno con su propio identificador y tipo, accedido mediante notación de puntos |
| clase | un tipo compuesto que combina atributos (datos) con métodos (procedimientos y funciones) que actúan sobre ellos; un objeto es una instancia de una clase |
| archivo serial | registros almacenados uno tras otro en el orden en que fueron añadidos |
| archivo secuencial | registros almacenados uno tras otro en orden de un campo clave |
| archivo aleatorio | registros almacenados en direcciones calculadas a partir de sus claves mediante un algoritmo de hash |
| acceso secuencial | leer los registros sucesivamente desde el inicio del archivo hasta encontrar el requerido |
| acceso directo | calcular la dirección de un registro a partir de su clave y acceder directamente a esa posición |
| algoritmo de hash | un cálculo realizado sobre la clave de un registro que proporciona la dirección en la que se almacena y encuentra el registro |
| colisión | dos claves diferentes que producen la misma dirección |
| mantisa | la parte de un número de punto flotante que contiene sus bits significativos, como fracción en complemento a dos |
| exponente | el entero en complemento a dos que da la potencia de dos por la cual se multiplica la mantisa |
| normalizado | un número de punto flotante cuya mantisa comienza 01 (positivo) o 10 (negativo), de modo que no se desperdician bits en ceros o unos iniciales |
| desbordamiento | un resultado demasiado grande para ser representado con el número de bits disponibles |
| inundación inferior | un resultado no nulo demasiado pequeño para ser representado, por lo que se almacena como cero |
| error de redondeo | la diferencia entre un número real y el valor más cercano que la representación binaria puede contener |
13.3
Consejos para el examen
- Las declaraciones de pseudocódigo se marcan línea por línea:
TYPE ... = (...)para enumerado,TYPE ... = ^...para puntero,TYPE ... = SET OF ...y luegoDEFINE ... (...) : ...para un conjunto,TYPE ... DECLARE ... ENDTYPEpara un registro,CLASS ... PRIVATE ... PUBLIC PROCEDURE NEW ... ENDCLASSpara una clase. - Asocia el tipo con los datos: valores fijos nominales, enumerado; un grupo de campos diferentes, registro; una colección de valores únicos, conjunto; datos más comportamiento, clase; una dirección, puntero.
- La organización de archivos es cómo se almacenan los registros; el acceso a archivos es cómo se localizan. Serial y secuencial se leen secuencialmente; los archivos aleatorios usan acceso directo mediante un hash de la clave. La búsqueda secuencial de un archivo secuencial puede detenerse anticipadamente; en un archivo serial no puede.
- Pseudocódigo de archivo aleatorio:
OPENFILE ... FOR RANDOM,SEEKantes de cadaGETRECORDoPUTRECORD,CLOSEFILEal final. Explica cómo se resuelve una colisión al describir el hashing. - Punto flotante: mantisa como fracción en complemento a dos (punto después del bit de signo), exponente como entero, multiplicar por $2^{\text{exponent}}$; desplazar a la izquierda y restar uno al exponente para normalizar; la mantisa compra precisión, el exponente compra rango.
- Las tres respuestas estándar de "explicar": por qué normalizar (precisión, forma única, rango), el efecto de reasignar bits (precisión contra rango) y por qué $0.1$ no se puede almacenar exactamente (una fracción binaria infinita en una mantisa finita).
Errores comunes
- Escribir
DECLAREen lugar deTYPEpara un nuevo tipo, u omitirENDTYPE; declarar un conjunto sinSET OF, o un tipo enumerado con comillas alrededor de sus valores. - Colocar el signo de un número de punto flotante en el exponente; el signo es el primer bit de la mantisa.
- Leer una mantisa negativa como si fuera signo-magnitud; es complemento a dos, por lo que
1011000000es $-0.625$, no $-0.375$. - Desplazar la mantisa para normalizar sin cambiar el exponente, o cambiarlo de manera incorrecta (desplazamiento a la izquierda, exponente hacia abajo).
- Describir un archivo aleatorio como "en orden aleatorio"; los registros están en direcciones calculadas a partir de sus claves.
- Decir que el acceso secuencial lee "todo el archivo" para un archivo secuencial; se detiene cuando se encuentra una clave mayor.
- Explicar el hashing sin decir para qué se usa el valor calculado (la dirección para almacenar y recuperar el registro), o sin un método para manejar colisiones.
- Definir desbordamiento como "demasiados dígitos" en lugar de un resultado más allá del valor representable más grande, o culpar a la mantisa por ello.
Lecciones interactivas sobre este tema
Trátalo paso a paso, con ejercicios de verificación instantánea.