RISC, CISC และการ ?
| English | ไทย |
|---|---|
| CISC/sɪsk/ | CISC |
| RISC/rɪsk/ | RISC |
| pipelining/ˈpaɪplaɪnɪŋ/ | การทำExpense pipeline |
| Flynn's taxonomy/flɪnz tækˈsɒnəmi/ | Classification ของ Flynn |
| register/ˈredʒɪstə/ | รีจิสเตอร์ (register) |
| ALU/ˌeɪ el ˈjuː/ | ALU |
| hazard/ˈhæzəd/ | อันตราย |
| SIMD/ˈsɪmdiː/ | SIMD |
| MIMD/ˈmɪmdiː/ | MIMD |
| massively parallel/ˈmæsɪvli ˈpærəlel/ | แบบขนานมาก |
| supercomputers/ˌsuːpəkəmˈpjuːtəz/ | ซูเปอร์คอมพิวเตอร์ |
โทรศัพท์ในกระเป๋าของคุณไม่ได้ใช้ Intel
- เป็นเวลาสามสิบปีпроцессอร์ที่เร็วที่สุดคือProcessorที่มีความซับซ้อนมากที่สุด: เพิ่มคำสั่ง และแต่ละตัวจะทำงานได้มากขึ้น Intel ก่อตั้งจักรวรรดิจากสิ่งนี้
- จากนั้นบริษัทอังกฤษขนาดเล็กได้ใส่ โปรเซสเซอร์ที่เรียบง่ายอย่างตั้งใจ (deliberately simple processor) ลงในโทรศัพท์ คำสั่งน้อยลง ความยาวเท่ากัน แทบไม่มีการเข้าถึงหน่วยความจำ มันไม่สามารถทำงานได้มากเท่าเดิมต่อคำสั่ง แต่ยังคงชนะได้ในที่สุด
- มันชนะเพราะคำสั่งที่เรียบง่ายและสม่ำเสมอสามารถถูก ซ้อนทับกัน (overlapped) และการซ้อนทับมีค่ามากกว่าความซับซ้อน
- บทเรียนนี้คือ CISC และ RISC, พิพไลนิ่ง (pipelining), สถาปัตยกรรมทั้งสี่ของฟลายน์ (Flynn's taxonomy), และสิ่งที่จำกัดด้านความร้อนและความเร็วของโปรเซสเซอร์นำไปสู่
CISC and RISC
- CISC, Computer with Complex Instruction Set, มี คำสั่งจำนวนมาก มักจะซับซ้อน: คำสั่งหนึ่งอาจทำการเข้าถึงหน่วยความจำและการดำเนินการหลายครั้ง它们的具有 ความยาวแปรผัน (variable length) ดังนั้นการถอดรหัสจึงซับซ้อน มันทำมากกว่าต่อคำสั่ง ในฮาร์ดแวร์ ตัวอย่าง: Intel x86
- RISC (Reduced Instruction Set Computer) มีชุดคำสั่งที่ เล็กและเรียบง่าย Each instruction ทำหน้าที่พื้นฐานเพียงอย่างเดียว, มีความยาว คงที่ และถอดรหัสได้รวดเร็ว มีเพียง load และ store เท่านั้นที่เข้าถึงหน่วยความจำ; ส่วนอื่นๆ เป็น register ไปยัง register ตัวอย่าง: ARM.
- โปรแกรม RISC มีขนาด ยาวกว่า แต่แต่ละคำสั่งทำงานเร็วและคาดเดาได้ ซึ่งเป็นสิ่งที่ pipeline ต้องการเป๊ะๆ
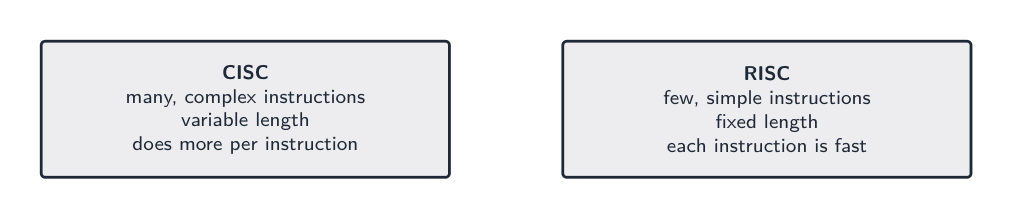
มากต่อหนึ่งคำสั่ง หรือเร็วและคาดเดาได้มากกว่าต่อหนึ่งคำสั่ง
โปรเซสเซอร์ RISC มีลักษณะเด่นคือ:
RISC รักษาคำสั่งให้มีน้อย ง่าย และความยาวคงที่ (มักจะเป็น 1 รอบ); CISC มีคำสั่งซับซ้อนหลากหลายความยาวจำนวนมาก
ความแตกต่างที่ข้อสอบต้องการ
| คุณสมบัติ | CISC | RISC |
|---|---|---|
| ชุดคำสั่ง | มาก, ซับซ้อน | น้อย, เรียบง่าย |
| ความยาวคำสั่ง | เปลี่ยนแปลงได้ | คงที่ |
| การเข้าถึงหน่วยความจำ | คำสั่งหลายตัวอาจเข้าถึงหน่วยความจำ | มีเพียง load และ store เท่านั้น |
| รีจิสเตอร์ | น้อย | มาก |
| รอบต่อนำคำสั่ง | เปลี่ยนแปลงได้ | โดยทั่วไปหนึ่งรอบ |
| การทำ Pipeline | ยาก | เป็นธรรมชาติ |
- ชิป Intel รุ่นใหม่จะแปลงคำสั่ง CISC ของตัวเองเป็น micro-operations แบบ RISC ที่ง่ายขึ้นภายใน ซึ่งเป็นการพิสูจน์ชัดเจนที่สุดว่าแบบออกแบบใดชนะการถกเถียงนี้
จับคู่แต่ละคำศัพท์กับคำอธิบาย
RISC = ง่าย + ความยาวคงที่ + โหลด/จัดเก็บ; CISC = ซับซ้อน + หลากหลายความยาว; ? ซ้อนทับขั้นตอนเพื่อเพิ่มความเร็ว
ในโปรเซสเซอร์ RISC คำสั่งที่เข้าถึงหน่วยความจำได้มีเพียงการโหลดและ ____ เท่านั้น
ส่วนที่เหลือทั้งหมดเป็นการบันทึกข้อมูลระหว่างรีจิสเตอร์กับรีจิสเตอร์ ข้อจำกัดนี้เองที่ทำให้คำสั่งมีความยาวคงที่ มีเวลาดำเนินการสม่ำเสมอ และง่ายต่อการทำพайพลายน์
การทำ Pipeline
- Pipeline ประมวลผลคำสั่งใน ขั้นตอนที่ซ้อนทับกัน เหมือนสายการผลิต: ดึงข้อมูล, ถอดรหัส, ประมวลผลใน ALU, เข้าถึงหน่วยความจำ, เขียนกลับ
- แต่ละขั้นตอนทำงานกับ คำสั่งที่แตกต่างกัน ในเวลาเดียวกัน ดังนั้นเมื่อ pipeline เต็มแล้ว จะมีคำสั่ง เสร็จสมบูรณ์หนึ่งตัวต่อหนึ่งรอบ
- มันไม่ทำให้คำสั่งใดคำสั่งหนึ่งเร็วขึ้น แต่เพิ่ม throughput: มีคำสั่งเสร็จสมบูรณ์มากขึ้นต่อวินาที
- คำcommands RISC ที่มีความยาวคงที่และเรียบง่าย ทำให้แต่ละขั้นตอนใช้เวลาเท่ากัน นี่คือเหตุผลที่ RISC ใช้ pipeline ได้สะอาดตา ในขณะที่ CISC ไม่ได้
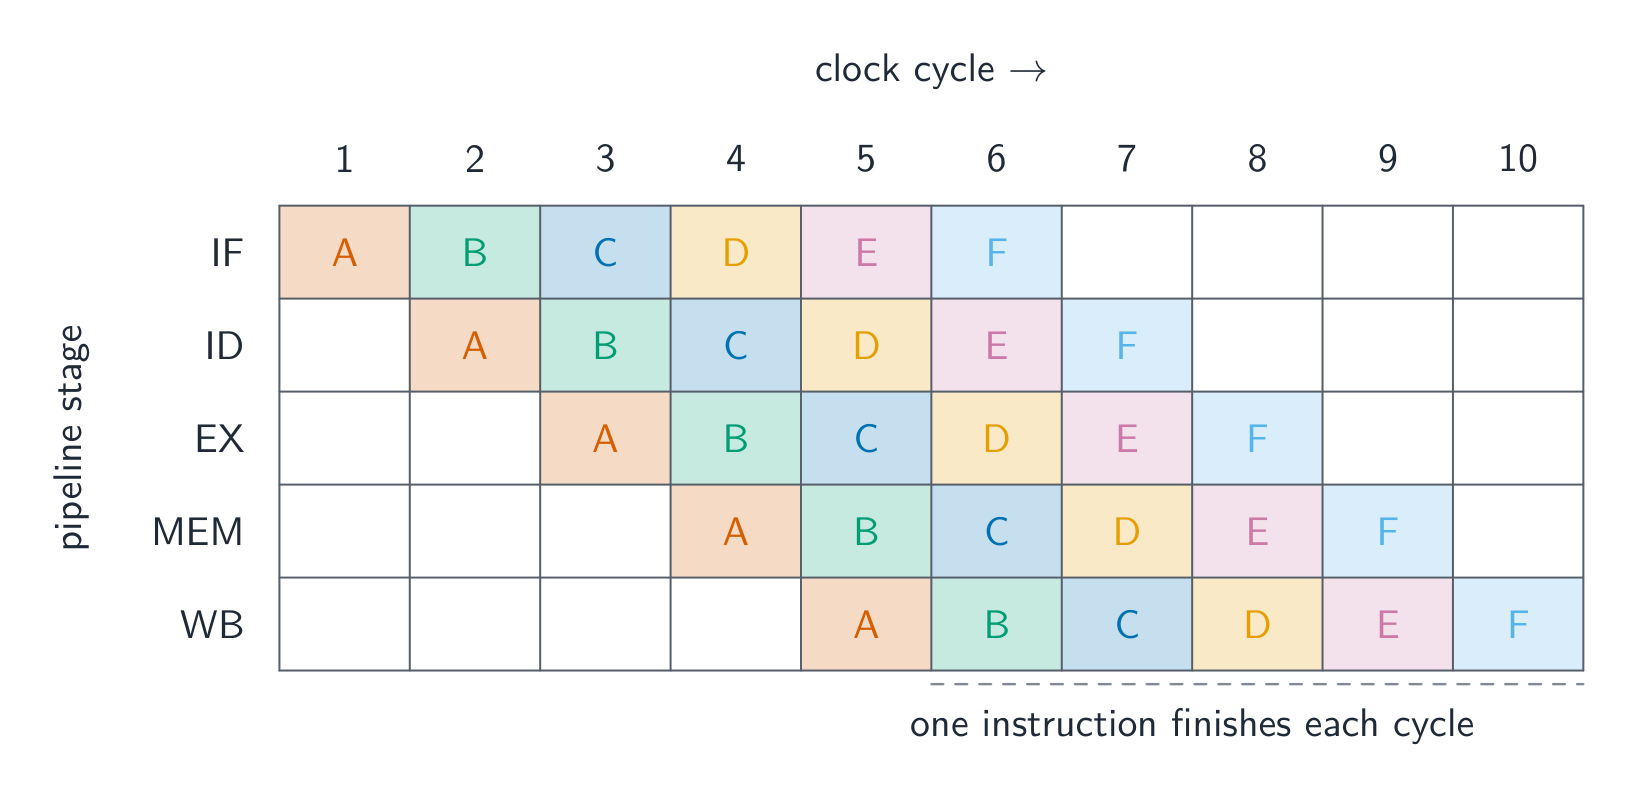
*คำสั่งหกตัวกำลังดำเนินการ, เสร็จหนึ่งตัวต่อรอบ
การ ? เติมเต็ม
ดูขั้นตอนรอบนาฬิกา: เมื่อ ? เต็มแล้ว คำสั่งใหม่จะเสร็จสิ้นทุก ๆ รอบนาฬิกา — แม้ว่าจะใช้เวลาหลายขั้นตอน — เนื่องจากขั้นตอนของคำสั่งที่ต่างกันซ้อนทับกัน
เมื่อพайพลายน์เต็มแล้ว จะสามารถดำเนินการเสร็จสิ้นได้ประมาณ:
การซ้อนทับขั้นตอนหมายถึง การที่คำสั่งใหม่จะเสร็จสิ้นทุก-cycle เมื่อพайพลายน์เต็มแล้ว
การทำพайพลายน์ช่วยเร่งความเร็วโปรเซสเซอร์โดยวิธี:
ขั้นตอนของคำสั่งที่ต่างกันทำงานพร้อมกัน
ตัวอย่างวิธีทำ: ทำไม pipeline ถึงเร็วกว่า
- Pipeline ห้าขั้น ทำงานด้วยหนึ่งรอบต่อหนึ่งขั้น อธิบายทำไมมันจึงเร็วกว่าการรันคำสั่งทีละตัวตามลำดับ
- بدون pipeline แต่ละคำสั่งจะกินทรัพยากรโปรเซสเซอร์ตลอดทั้งห้าขั้น ทำให้มีคำสั่งเสร็จหนึ่งตัวทุกห้ารอบ
- เมื่อมี pipeline หน่วยดึงข้อมูลจะเริ่มคำสั่งถัดไปในขณะที่คำสั่งปัจจุบันยังคงอยู่ในขั้นตอนถอดรหัส ทำให้มีห้าคำสั่งกำลังดำเนินการพร้อมกัน และเมื่อเต็มแล้ว จะเสร็จ ทุกๆ รอบ
- ไม่มีคำสั่งใดถูกประมวลผลเร็วขึ้น; แต่ throughput เพิ่มขึ้นประมาณห้าเท่า ต้องระบุให้ชัดเจน: นี่คือจุดที่คนส่วนใหญ่พลาดคะแนนมากที่สุด
การทำพайพลายน์ปรับปรุงสิ่งใดจริง ๆ?
ขั้นตอนซ้อนทับกัน ดังนั้นคำสั่งห้าคำสั่งจึงกำลังดำเนินการพร้อมกันและหนึ่งคำสั่งจะเสร็จสิ้นต่อรอบ ไม่มีคำสั่งใดถูก اجراเร็วขึ้นเป็นรายบุคคล
Hazards (อุปสรรค/สิ่งกีดขวาง)
- Hazard ทำให้ pipeline หยุดชะงัก Data hazard เกิดขึ้นเมื่อคำสั่งต้องการผลลัพธ์ที่คำสั่งก่อนหน้ายังไม่ได้สร้าง จึงต้องรอ
- Control hazard เกิดขึ้นที่การ branching: จนกว่าการ branching จะถูกตัดสินใจ โปรเซสเซอร์จะไม่รู้ว่าควรดึงคำสั่งถัดไปตัวไหน
- ทั้งสองอย่างนี้เสียรอบการทำงาน จึงเป็นเหตุที่โปรเซสเซอร์ใช้การทำนายการ branching และการส่งต่อผลลัพธ์ระหว่างขั้นตอน
ความขัดแย้งด้านข้อมูล (Data hazard) ทำให้พайพลายน์หยุดชะงักเมื่อคำสั่งต้องการผลลัพธ์ที่ยังไม่พร้อม; ความขัดแย้งด้านการควบคุม (Control hazard) เกิดจากการเปลี่ยนทิศทางของ Branch ที่กำหนดว่าคำสั่งถัดไปคือคำสั่งอะไร
ความขัดแย้งบังคับให้พайพลายน์หยุดชะงัก (หรือล้างข้อมูล) ซึ่งนี่คือเหตุผลที่มันลดผลผลิตในอุดมคติที่เป็นหนึ่งต่อรอบ
จับคู่ความขัดแย้งของพайพลายน์แต่ละชนิดกับสาเหตุที่เกิดขึ้น
ทั้งสองอย่างทำให้พайพลายน์หยุดชะงักและเสียรอบนาฬิกา นี่คือเหตุผลที่โปรเซสเซอร์ส่งต่อผลลัพธ์ระหว่างขั้นตอนและทำนาย Branch
Flynn's taxonomy
- Flynn's taxonomy จัดประเภทคอมพิวเตอร์โดยจำนวน instruction streams และ data streams ที่มี
- SISD: instruction stream หนึ่งตัว, data stream หนึ่งตัว, คือแกนเดียวแบบดั้งเดิม
- SIMD: คำสั่งหนึ่งตัวทำงานกับ ข้อมูลจำนวนมากพร้อมกัน นี่คือ GPU หรือหน่วยเวกเตอร์ของ CPU เหมาะสำหรับการประมวลผลภาพ วิดีโอ และ数组ทางวิทยาศาสตร์
- MISD: หลายการกระทำบนข้อมูลเดียวกัน; พบบ่อยมากและส่วนใหญ่เป็นทฤษฎี MIMD:许多 processors运行 different instructions on different data, ซึ่งเป็น multi-core CPU หรือ cluster และเป็นรูปแบบที่กว้างที่สุด
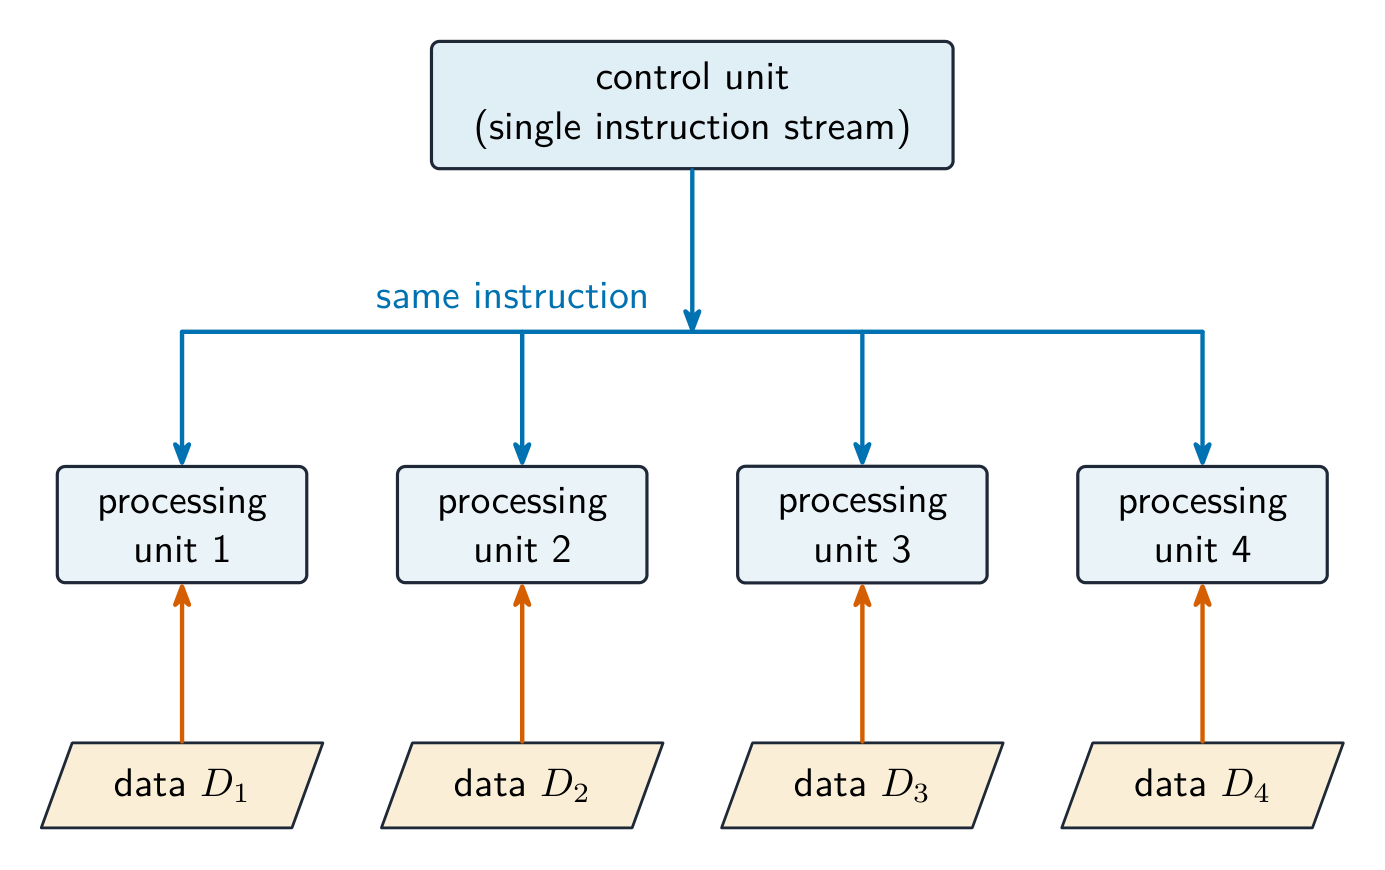
*คำสั่งหนึ่งตัว, ข้อมูลจำนวนมาก
ข้อใดอธิบาย SIMD? เลือก ทุก ข้อที่เกี่ยวข้อง
โปรแกรมที่แตกต่างกันบนข้อมูลที่ต่างกันคือ MIMD ในกรณี multi-core ส่วน SIMD คือสตรีมคำสั่งเดียวเหนือสตรีมข้อมูลหลายสตรีม
คอมพิวเตอร์แบบขนานมหาศาล
- ระบบ massively parallel ใช้ โปรเซสเซอร์นับพัน เชื่อมต่อกันด้วยเครือข่ายความเร็วสูง แต่ละตัวมี หน่วยความจำของตัวเอง ส่งข้อมูลผ่าน messages แทนการแชร์หน่วยความจำ
- มันเป็น MIMD และต้องใช้ซอฟต์แวร์ที่เขียนเฉพาะ เพราะโปรแกรมเมอร์ต้องแบ่งปัญหาและจัดการการสื่อสาร
- นี่คือสิ่งที่ supercomputers ขนาดใหญ่ที่สุดคือ: การจำลองสภาพภูมิอากาศ, การฝึก machine-learning และดาราศาสตร์ ล้วนทำงานแบบนี้
คอมพิวเตอร์แบบขนานขนาดใหญ่มีโปรเซสเซอร์แชร์หน่วยความจำ блоกเดียวกัน
โปรเซสเซอร์แต่ละตัวมีหน่วยความจำของตัวเอง และแลกเปลี่ยนข้อมูลผ่านข้อความบนเครือข่ายที่รวดเร็ว นั่นคือสิ่งที่คำว่า Distributed memory หมายถึง
ตัวอย่างวิธีทำ: กำหนดประเภทเครื่อง
- การ์ดกราฟิกปรับความสว่างให้พิกเซลสองล้านพิกเซล SIMD: คำสั่งหนึ่งตัว, ข้อมูล-many items, ซึ่งตรงกับที่ cores เล็กนับพันของ GPU ถูกสร้างขึ้นเพื่อ
- แล็ปท็อปสี่แกนรันเบราว์เซอร์, компายเลอร์ และเพลง player พร้อมกัน MIMD: คำสั่งต่างกันบนข้อมูลต่างกัน, One stream per core
- ศูนย์พยากรณ์อากาศแบ่งบรรยากาศเป็น grid บนโปรเซสเซอร์หมื่นตัว, แต่ละตัวมีหน่วยความจำของตัวเอง, ส่งค่าขอบเขตเป็น messages Massively parallel, ซึ่งเป็นรูปแบบหนึ่งของ MIMD
- ระบุชื่อหมวดหมู่ แล้วอธิบายด้วยจำนวน instruction และ data streams
คะแนนที่หลุดหายไป
- Pipeline เพิ่ม throughput; ไม่ลดความยาวของคำสั่งใดคำสั่งหนึ่ง ต้องพูดให้ชัด
- ใน RISC, มีเพียง load และ store เท่านั้นที่เข้าถึงหน่วยความจำ ข้อเท็จจริง这一个解释 fixed length, many registers และ clean pipeline
- SIMD คือ one instruction on many data; MIMD คือ many instructions on many data นับ streams ก่อนตอบคำถาม
- Massively parallel หมายถึง thousands of processors with distributed memory และ message passing, ไม่ใช่แค่ "computer ที่เร็ว"
คุณเข้าใจแล้ว
- CISC: คำสั่งซับซ้อนหลายตัว ความยาวแปรผัน, มากต่อหนึ่ง指令 · RISC: คำสั่งเรียบง่ายน้อย ความยาวคงที่, load และ store เท่านั้น, Many registers, One cycle each
- pipeline (สายการผลิตรถยนต์) ครอบคลุมขั้นตอน fetch, decode, execute, memory และ write-back ทำให้มีคำสั่งหนึ่งเสร็จสิ้นต่อ cycle เมื่อระบบเต็มประสิทธิภาพ: เพิ่ม throughput ไม่ใช่ความเร็วของคำสั่งแต่ละตัว; data hazards และ control hazards ทำให้เกิดความล่าช้า
- Flynn: SISD, SIMD (เช่น GPU), MISD, MIMD (multi-core)
- massively parallel: ใช้โปรเซสเซอร์นับพันเครื่อง, มี distributed memory, สื่อสารผ่าน message passing, ใช้ MIMD, นำโดยซูเปอร์คอมพิวเตอร์