การจัดระเบียบและการเข้าถึงไฟล์ (File organisation and access)
| English | ไทย |
|---|---|
| file organisation/faɪl ˌɔːɡənaɪˈzeɪʃn/ | การจัดระเบียบไฟล์ |
| access method/ˈækses ˈmeθəd/ | วิธีการเข้าถึง |
| serial file/ˈsɪərɪəl faɪl/ | ไฟล์อนุกรม |
| sequential file/siːˈkwenʃl faɪl/ | ไฟล์ลำดับ |
| key field/kiː fiːld/ | ฟิลด์คีย์ |
| direct access/daɪˈrekt ˈækses/ | การเข้าถึงโดยตรง |
| sequential access/siːˈkwenʃl ˈækses/ | การเข้าถึงแบบลำดับ |
| random file/ˈrændəm faɪl/ | ไฟล์สุ่ม |
ทำไมงานกลางคืนของธนาคารจึงใช้เวลาทั้งคืน
- จนถึงยุค 1980 บัญชีของธนาคารอยู่บนเทปแม่เหล็ก. เทปอ่านได้เฉพาะจากปลายหนึ่งไปยังอีกฝ่ายหนึ่ง, ดังนั้นธุรกรรมประจำวันจึงถูกจัดอันดับกลางคืนและไฟล์หลักทั้งหมดถูกอ่านตั้งแต่ต้นจนจบ, ครั้งเดียว, เพื่อนำไปใช้
- ขอยอดเงินฝากของลูกค้าคนหนึ่งตรงกลางบ่ายคำตอบคือ: จนกว่าพรุ่งนี้. การจัดระเบียบไฟล์, ไม่ใช่ความเร็วของคอมพิวเตอร์, ตัดสินว่าธนาคารจะเสนออะไรได้
- ดิสก์ทำให้การจัดระเบียบแบบใหม่เป็นไปได้: คำนวณตำแหน่งของเรคอร์ดจากคีย์ของมันและกระโดดไปที่นั่น. นั่นคือสิ่งที่ทำให้ ATM ตอบกลับได้ในหนึ่งวินาที
- บทเรียนนี้คือ การจัดระเบียบไฟล์, วิธีการเข้าถึง ทั้งสอง,以及如何เลือกจากสิ่งที่โปรแกรมส่วนใหญ่ทำ
สามการจัดระเบียบ
- ไฟล์แบบ serial เก็บเรคอร์ดตาม ลำดับที่ถูกเพิ่ม, โดยไม่มีการจัดอันดับ. การต่อท้าย (appending) รวดเร็ว;การค้นหาหมายถึงการอ่านตั้งแต่ต้น. ใช้สำหรับบันทึกและประวัติการตรวจสอบ
- ไฟล์แบบ sequential เก็บเรคอร์ด เรียงตามฟิลด์คีย์. การค้นหารวดเร็วขึ้น, เพราะคุณสามารถหยุดก่อนหรือ binary-search; การแทรกช้าลง, เพราะเรคอร์ดถัดไปต้องเลื่อน. ใช้สำหรับไฟล์หลักที่อัปเดตแบบ batch
- ไฟล์แบบ random, หรือ direct-access, ไฟล์ เก็บแต่ละเรคอร์ดที่ตำแหน่ง คำนวณจากคีย์เรคอร์ดของมัน, มักโดย hash. Lookup by key รวดเร็วมาก; อ่านตามลำดับคีย์ยาก. ใช้สำหรับตารางค้นหาขนาดใหญ่และบัญชีลูกค้า

Serial: ลำดับการมาถึง, ไม่มีอะไร więcej
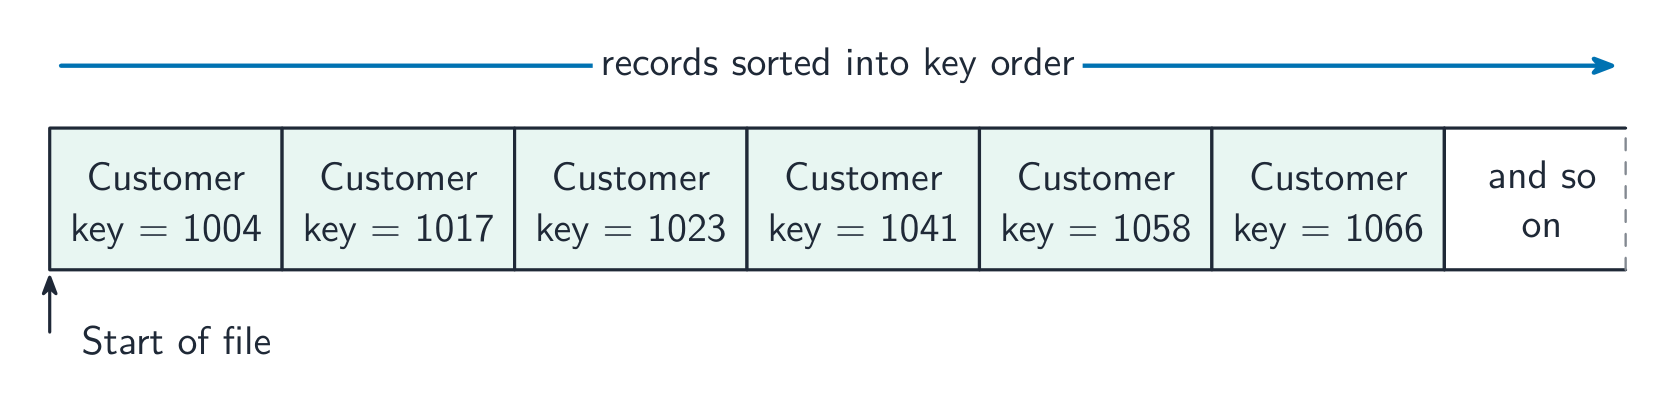
Sequential: เรคอร์ดเดียวกัน, ตามลำดับคีย์
วิธีการเข้าถึงทั้งสอง
- Sequential access อ่านข้อมูลตั้งแต่ต้นไฟล์ไปจนถึงเรคอร์ดที่ต้องการ เป็นวิธีการเข้าถึงเดียวที่ serial file รองรับ และเป็นวิธีที่ sequential file ถูกประมวลผลในรูปแบบ batch
- Direct access ข้ามไปยังตำแหน่งที่ทราบไว้โดยตรงโดยไม่ต้องอ่านสิ่งที่มาก่อนหน้า เป็นวิธีการอ่านของ random file และ sequential file ก็สามารถอ่านแบบ direct ได้เมื่อทราบตำแหน่งของ key หรือมี index
- ดังนั้นการจับคู่ตามหลักสูตรคือ: sequential access สำหรับ serial และ sequential files; direct access สำหรับ sequential และ random files

Random: key บอกให้รู้ว่าต้องมองหาที่ไหน
ช่องทางเข้าถึงไฟล์ (File access route)
ติดตามไฟล์จากหน่วยจัดเก็บเข้าสู่โปรแกรมและกลับคืนมาอย่างปลอดภัย
ไฟล์แบบอนุกรม (serial file) เก็บเรคอร์ด:
ไฟล์แบบอนุกรมเก็บเรคอร์ดตามลำดับการเข้ามา — เพิ่มข้อมูลได้เร็ว แต่ค้นหาช้า ไฟล์แบบเรียงลำดับ (sequential files) จะเรียงตามคีย์
จับคู่การจัดระเบียบไฟล์แต่ละชนิดกับวิธีการเก็บเรคอร์ด
แบบอนุกรม = ลำดับการเข้ามา; แบบเรียงลำดับ = เรียงตามคีย์; แบบสุ่ม = ตำแหน่งจากแฮช; แบบมีดัชนีและเรียงลำดับ = เรียงตามคีย์ + ดัชนี
ไฟล์แบบสุ่ม (ตรงเข้า) วางแต่ละเรคอร์ด:
คีย์ถูกแปลง (มักโดยใช้แฮช) เป็นตำแหน่ง ดังนั้นการค้นหาด้วยคีย์เดียวจึงรวดเร็วมาก
ความแตกต่างระหว่างไฟล์แบบอนุกรมกับไฟล์แบบเรียงลำดับคืออะไร?
ลำดับการเข้ามาเทียบกับเรียงตามคีย์ ความแตกต่างเพียงข้อนี้ทำให้ไฟล์แบบเรียงลำดับค้นหาได้ก่อนกำหนดแต่เพิ่มข้อมูลได้ช้า
ตัวอย่างวิธีทำ: เลือกองค์กร
- โปรแกรมบัญชีเงินเดือนอ่านเรคอร์ดพนักงานทั้งหมดเดือนละครั้ง按照 employee-number order เพื่อสร้างใบแจ้งเงินเดือน องค์กรและการเข้าถึงแบบใด และทำไม?
- Sequential organization with sequential access: ประมวลผลทุกเรคอร์ด จึงไม่มีการประหยัดจากการกระโดดไปมา และการจัดเก็บตามลำดับ key ทำให้ใบแจ้งเงินเดือนออกเรียงลำดับได้โดยไม่จำเป็นต้องขั้นตอนการจัดเรียงใหม่
- เครื่อง ATM ต้องดึงข้อมูลบัญชีหนึ่งโดยเลขที่ภายในหนึ่งวินาที Random organization with direct access: ตำแหน่งคำนวณจากเลขที่บัญชี ดังนั้นต้องการอ่านเพียงครั้งเดียวแทนการค้นหาในจำนวนล้านเรคอร์ด
- แอปเซิร์ฟเวอร์เว็บเพิ่มบรรทัดหนึ่งต่อคำขอลงใน log Serial: การ add เข้าท้ายสำคัญที่สุด และการ add เข้าท้ายเป็นสิ่งที่เร็วที่สุดสำหรับ serial file
ไฟล์แบบเรียงลำดับสามารถอ่านด้วยการเข้าถึงแบบเรียงลำดับและแบบตรงเข้าได้
การเข้าถึงแบบเรียงลำดับใช้กับไฟล์แบบอนุกรมและแบบเรียงลำดับ; การเข้าถึงแบบตรงเข้าใช้กับไฟล์แบบเรียงลำดับและแบบสุ่ม มีเพียงไฟล์แบบอนุกรมที่ถูกจำกัดไว้ที่วิธีเดียวเท่านั้น
เรียงขั้นตอนการดึงบัญชีหนึ่งจากไฟล์แบบสุ่มให้ถูกต้อง
ไม่มีการค้นหา: คีย์ถูกแปลงเป็นตำแหน่งและอ่านครั้งเดียว การตรวจสอบสุดท้ายจะจับการชนกัน (collision)
ข้อแลกเปลี่ยน, เปรียบเคียงกัน
| serial | sequential | random | |
|---|---|---|---|
| ลำดับเรคอร์ด | ตามที่เพิ่มเข้ามา | เรียงตาม key | คำนวณจาก key |
| เพิ่มเรคอร์ด | เร็ว, add เข้าท้าย | ช้า, เรคอร์ดขยับตำแหน่ง | เร็ว, หากช่องว่างมีอยู่ |
| หาเรคอร์ดหนึ่ง | ช้า, อ่านทั้งหมด | รวดเร็วกว่า, สามารถหยุดก่อนได้ | รวดเร็วที่สุด, อ่านเพียงครั้งเดียว |
| อ่านตามลำดับ key | ต้องใช้ sort | เป็นธรรมชาติ | ต้องใช้ sort |
- คำตอบที่ถูกต้องต้องอธิบายจาก dominant operation: โปรแกรมนี้ทำอะไรมากที่สุด?
การจัดระเบียบไฟล์แบบเรียงลำดับเหมาะสำหรับการประมวลผลทุกเรคอร์ดทีละตัว
การเข้าถึงแบบตรงเข้าเหมาะสำหรับการค้นหาระคอร์ดเดียว
จับคู่แต่ละสถานการณ์กับการจัดระเบียบไฟล์ที่เหมาะสม
เพิ่มข้อมูลเท่านั้น, ประมวลผลทุกอย่างตามลำดับ, หรือค้นหาเรคอร์ดเดียว: การดำเนินการหลัก决定了การจัดระเบียบ
ตัวอย่างวิธีทำ: อธิบายเหตุผลของการเปลี่ยนแปลง
- ไฟล์หนังสือของห้องสมุดเป็น serial การค้นหาชื่อเรื่องหนึ่งช้า แนะนำการเปลี่ยนแปลงและอธิบายเหตุผล
- จัดระเบียบใหม่เป็น random file โดยใช้ hashing ISBN เป็นที่อยู่这样การค้นหาคือการอ่านแบบ direct ครั้งเดียวแทนการสแกนทั้งไฟล์
- ถ้าห้องสมุดยังพิมพ์แคตตาล็อกตามชื่อเรื่องด้วย sequential organization by title จะรองรับทั้งสองอย่างได้ดีพอ: แคตตาล็อกไม่ต้องsort และการค้นหาสามารถหยุดก่อนหรือใช้ binary-search
- ชื่อ organization, ชื่อวิธีการเข้าถึง, และเชื่อมโยงทั้งสองเข้ากับ operation ที่โจทย์กล่าวถึง
เพื่อสร้างรายงานตามลำดับคีย์ การจัดระเบียบไฟล์ที่ดีที่สุดคือ:
ไฟล์แบบเรียงลำดับอยู่ในลำดับคีย์อยู่แล้ว ดังนั้นการอ่านแบบเรียงลำดับจะให้รายงานที่เรียงลำดับ
เลือกการจัดระเบียบไฟล์โดยดูที่การดำเนินการ ____ ของโปรแกรม
ทุกการจัดระเบียบมีความเร็วและความช้าต่างกัน ดังนั้นการดำเนินการที่ทำบ่อยที่สุด决定了การเลือก
Key ต้องเป็นอย่างไร และทำไม hashing ถึงล้มเหลว
- Direct access ต้องการ key และ key ต้อง unique กับเรคอร์ดหนึ่งเท่านั้น LastName ไม่ใช่ key แต่customer number คือ
- Hashing แปลง key นั้นเป็นที่อยู่เรคอร์ดด้วยการคำนวณเพียงครั้งเดียว ดังนั้นการอ่านเพียงครั้งเดียวจะเข้าถึงเรคอร์ดไม่ว่าไฟล์จะมีขนาดใหญ่แค่ไหนก็ตาม
- Two different keys สามารถ hash ไปยัง address เดียวกัน นั่นคือ collision และไม่ใช่ข้อผิดพลาดของอัลกอริทึม: มันหลีกเลี่ยงไม่ได้เมื่อจำนวน key ที่เป็นไปได้มากกว่า address
- วิธีแก้ไขที่ระบุใน mark scheme คือ overflow area หรือการเก็บ pointer ที่ address เพื่อชี้ไปยัง chain ของเรคอร์ดที่ใช้ที่เดียวกัน ดังนั้น collision จะ costing การอ่านเพิ่มอีกครั้ง ไม่ใช่การสูญเสียเรคอร์ด
- ดังนั้นการเปรียบเทียบที่จริงใจคือ: hashing ให้การเข้าถึงที่เกือบคงที่ จนกว่าไฟล์จะเต็ม และประสิทธิภาพจะลดลงเมื่อ collision สะสมขึ้น Sequential access ไม่เคยเสื่อมสภาพแต่ไม่เคยรวดเร็ว
สองเรคอร์ดแฮชไปที่ที่อยู่เดียวกัน ข้อใดถูกต้อง? เลือก ทั้งหมด ที่เกี่ยวข้อง
ไม่มีอะไรสูญหาย; การชนกันเสียค่าใช้จ่ายในการอ่านเพิ่มหนึ่งครั้ง เป็นเรื่องที่ไม่อาจหลีกเลี่ยงได้ในทางทฤษฎี เพราะมีคีย์ที่เป็นไปได้มากกว่าที่อยู่เสมอ
คะแนนที่หลุดหายไป
- Serial คือลำดับการมาถึง; sequential คือเรียงตาม key พวกเขาไม่ใช่คำ синоนิม และข้อสอบทดสอบความแตกต่างนั้นโดยเฉพาะ
- Organization คือวิธีที่เรคอร์ดถูกวาง; Access คือวิธีที่โปรแกรมเข้าถึงหนึ่ง реคอร์ด โจทย์จะระบุอย่างใดอย่างหนึ่ง
- Sequential file รองรับ both methods of access; serial file รองรับเฉพาะ sequential access เท่านั้น
- อธิบายเหตุผลจาก dominant operation ไม่ใช่จาก "มันเร็วกว่า" บอกว่าเร็วกว่าอะไร และทำไม
คุณเข้าใจแล้ว
- serial: ลำดับการเพิ่ม, add เข้าท้ายเร็ว, ค้นหาช้า, ใช้สำหรับ logs · sequential: เรียงตาม key field, เหมาะสำหรับการประมวลผลแบบ batch และการ output แบบเรียงลำดับ · random: ตำแหน่งคำนวณจาก record key, อ่านครั้งเดียวเพื่อหาเรคอร์ด
- Sequential access อ่านจากต้น; Direct access ข้ามไปยังตำแหน่ง
- Sequential access服务于 serial และ sequential files; direct access服务于 sequential และ random files
- เลือกจาก dominant operation: ประมวลผลทุกอย่าง, มองหาหนึ่ง, หรือแค่ add เข้าท้าย