Normalisation · Нормализация
Why normalise?
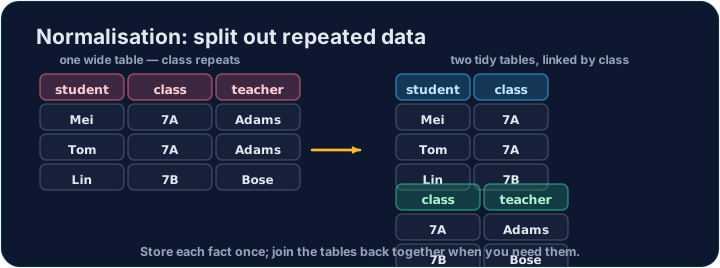
Imagine storing every club booking in one table, with the coach repeated on every row: each booking of the Chess club would carry "Mr Ng" again and again.
That repetition causes problems. If Mr Ng leaves, you must update many rows; miss one and the data becomes inconsistent. Normalisation organises tables to remove this kind of redundancy.
Зачем нормализовать?
Представьте хранение всех бронирований клуба в одной таблице, где тренер повторяется в каждой строке: каждая бронь в шахматном клубе снова и снова содержала бы «Мистер Нг».
Такая повторяемость вызывает проблемы. Если мистер Нг уйдёт, вам придётся обновить многие строки; пропустите одну, и данные станут несоответствующими. Нормализация организует таблицы для устранения такого рода избыточности.
The normal forms
You normalise in steps:
- 1NF — every cell holds a single value (no lists or repeating groups), and the table has a primary key.
- 2NF — already 1NF, and no non-key column depends on only part of a composite key.
- 3NF — already 2NF, and no non-key column depends on another non-key column (no transitive dependency).
In the one-table version, coach depends on the club, not on the booking — a transitive dependency, so it is not in 3NF.
Нормальные формы
Вы нормализуете поэтапно:
- 1NF — каждая ячейка содержит одно значение (нет списков или повторяющихся групп), и у таблицы есть первичный ключ.
- 2NF — уже 1NF, и ни один неключевой столбец не зависит только от части составного ключа.
- 3NF — уже 2NF, и ни один неключевой столбец не зависит от другого неключевого столбца (нет транзитивной зависимости).
В одно-табличной версии coach зависит от club, а не от бронирования — это транзитивная зависимость, поэтому он не находится в 3NF.
The normalised design
We split the data into two tables (the ones loaded here):
club(club_id, name, coach)— each club and its coach, stored once.booking(booking_id, student, club_id)— each booking, linked by the foreign keyclub_id.
Now a coach is stored once. A JOIN puts the information back together whenever you need it — write that join below.
Нормализованный проект
Мы разделили данные на две таблицы (те, которые загружены здесь):
club(club_id, name, coach)— каждый клуб и его тренер, хранятся один раз.booking(booking_id, student, club_id)— каждое бронирование, связанное с помощью внешнего ключаclub_id.
Теперь тренер хранится один раз. JOIN собирает информацию обратно каждый раз, когда она вам нужна — напишите этот код ниже.
Common mistakes
- Split repeating groups into their own table instead of many similar columns.
- Each table should describe one kind of thing.
Частые ошибки
- Разделите повторяющиеся группы в отдельную таблицу вместо множества похожих столбцов.
- Каждая таблица должна описывать один тип данных.
Reassemble the data: list each booking's student next to their club's coach, by joining booking to club on club_id, ordered by booking.booking_id. · Соберите данные снова: перечислите для каждой бронирования ее student рядом со coach клуба, выполняя join таблицы booking к club по club_id, отсортировано по booking.booking_id.
Click Run to see the output here. · Нажмите Запустить, чтобы увидеть результат здесь.
The split tables still answer questions together. Count how many bookings each club has: join booking to club, show club.name and COUNT(*) AS bookings, group by the club, and order by club.name. · Разделенные таблицы по-прежнему отвечают на вопросы совместно. Посчитайте, сколько бронирований имеет каждый клуб: соедините booking с club, выведите club.name и COUNT(*) AS bookings, сгруппируйте по клубу и отсортируйте по club.name.
Click Run to see the output here. · Нажмите Запустить, чтобы увидеть результат здесь.