Inference using normal and t-distributions · Inferencia usando distribuciones normal y t
| English | Español |
|---|---|
| sample/ˈsæmpl/ | muestra |
| distribution/ˌdɪstrɪˈbjuːʃn/ | distribución |
| variance/ˈveərɪəns/ | varianza |
| tail/teɪl/ | cola |
| confidence interval/ˈkɒnfɪdəns ˈɪntəvl/ | intervalo de confianza |
| degrees of freedom/dɪˈɡriːz ɒv ˈfriːdəm/ | grados de libertad |
| standard error/ˈstændəd ˈerə/ | error estándar |
| paired/peəd/ | pareados |
| pooled estimate/puːld ˈestɪmət/ | estimación combinada |
Small samples 样本, honest uncertainty
- With a huge sample you can use the normal distribution 分布. But with only, say, 8 measurements and an unknown spread, the normal is too confident.
- William Gosset, brewing at Guinness, invented the $t$-distribution to handle exactly this — small samples with unknown variance 方差.
Muestras pequeñas 样本, incertidumbre honesta
- Con una muestra enorme puedes usar la distribución normal 分布. Pero con solo, digamos, 8 mediciones y una dispersión desconocida, la normal es demasiado segura.
- William Gosset, cervecero en Guinness, inventó la distribución-$t$ para manejar exactamente esto — muestras pequeñas con varianza desconocida 方差.
When to use the t-distribution
- Use the $t$-distribution when the sample is small and the population variance is unknown (you estimate it with the sample's $s$).
- It is bell-shaped like the normal but with heavier tails 尾部 — wider, to admit the extra uncertainty.
The t-distribution is bell-shaped like the normal but with heavier tails; as the sample grows it approaches the normal.
Cuándo usar la distribución t
- Usa la distribución-$t$ cuando la muestra es pequeña y la varianza de la población es desconocida (la estimas con la $s$ de la muestra).
- Tiene forma de campana como la normal pero con colas más pesadas 尾部 — más anchas, para admitir la incertidumbre adicional.
La distribución t tiene forma de campana como la normal pero con colas más pesadas; a medida que la muestra crece, se aproxima a la normal.
Inference & the normal curve · Inferencia y la curva normal
P(Z < z)
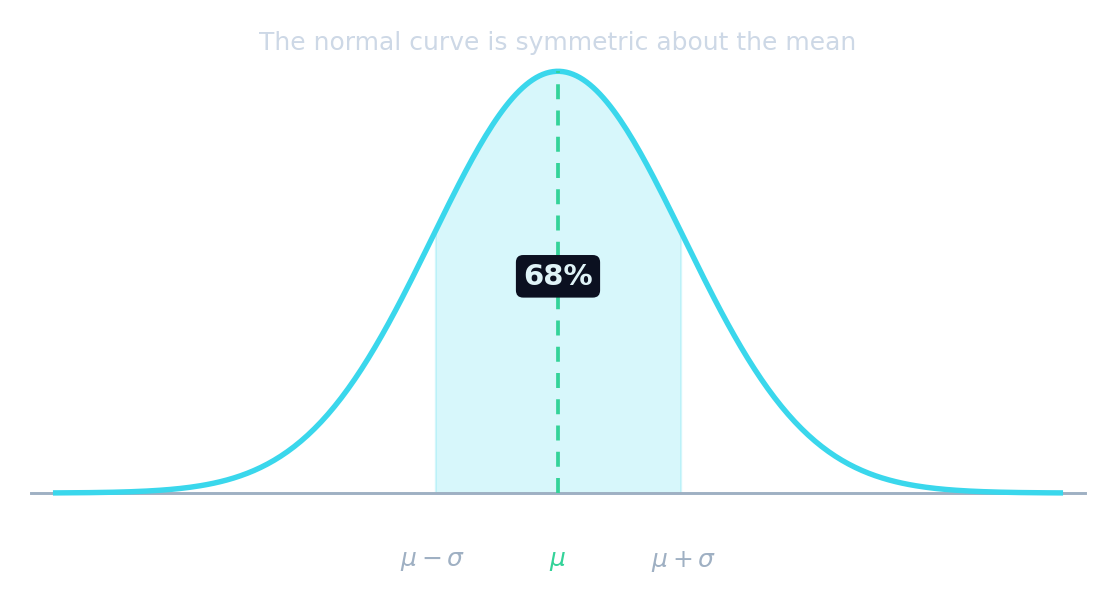
Tests and intervals read areas under the normal curve — slide z to find them. · Las pruebas e intervalos leen áreas bajo la curva normal — deslice z para encontrarlas.
You use the t-distribution (rather than the normal) when: · Usted usa la distribución t (en lugar de la normal) cuando:
Small n with unknown σ → estimate with s and use t. · n pequeño con σ desconocido → estimar con s y usar t.
The t-distribution has heavier tails than the normal distribution. · La distribución t tiene colas más pesadas que la distribución normal.
Heavier tails reflect the extra uncertainty from estimating the variance; t → normal as n grows. · Las colas más pesadas reflejan la incertidumbre adicional al estimar la varianza; t → normal a medida que n crece.
Confidence interval 置信区间 for the mean
- A confidence interval for the population mean:
- $t$ comes from the $t$-tables with $n - 1$ degrees of freedom 自由度; $\dfrac{s}{\sqrt n}$ is the standard error 标准误.
Intervalo de confianza 置信区间 para la media
- Un intervalo de confianza para la media de la población:
- $t$ proviene de las tablas $t$ con $n - 1$ grados de libertad 自由度; $\dfrac{s}{\sqrt n}$ es el error estándar 标准误.
For a single sample of size n = 10, how many degrees of freedom does the t-value use? · Para una sola muestra de tamaño n = 10, ¿cuántos grados de libertad usa el valor t?
Degrees of freedom = n − 1 = 9. · Grados de libertad = n − 1 = 9.
The quantity s/√n is called the standard ______. · La cantidad s/√n se llama error estándar ______.
The standard error of the mean is s/√n. · El error estándar de la media es s/√n.
Worked example
- A sample of $n = 10$ has $s = 4$; for 95% with 9 degrees of freedom, $t = 2.262$.
- Margin $= t\dfrac{s}{\sqrt n} = 2.262 \times \dfrac{4}{\sqrt{10}} = 2.86$ (2 dp).
The t-distribution has a lower peak and heavier tails than the normal
Ejemplo resuelto
- Una muestra de $n = 10$ tiene $s = 4$; para el 95% con 9 grados de libertad, $t = 2.262$.
- Margen $= t\dfrac{s}{\sqrt n} = 2.262 \times \dfrac{4}{\sqrt{10}} = 2.86$ (2 dp).

La distribución t tiene un pico más bajo y colas más pesadas que la normal
A sample n = 10 has s = 4. With t = 2.262, what is the margin t × s/√n? (2 dp) · Una muestra n = 10 tiene s = 4. Con t = 2.262, ¿cuál es el margen t × s/√n? (2 decimales)
2.262 × 4/√10 = 2.262 × 1.265 = 2.86.
Comparing two populations
- A 2-sample or paired 配对 $t$-test compares two populations.
- When the two are assumed to share a variance, combine them into a pooled estimate 合并估计 of $s^2$.
Degrees of freedom, not $n$. The $t$-value uses $n - 1$ degrees of freedom, not $n$. Reading the wrong row of the table is the most common error.
- For a small sample, base a hypothesis test on the $t$-distribution: a 2-sample t-test or a paired sample t-test.
Comparando dos poblaciones
- Una prueba $t$ de 2 muestras o apareada 配对 compara dos poblaciones.
- Cuando se asume que las dos comparten una varianza, combínalas en una estimación combinada 合并估计 de $s^2$.
Grados de libertad, no $n$. El valor $t$ usa $n - 1$ grados de libertad, no $n$. Leer la fila incorrecta de la tabla es el error más común.
- Para una muestra pequeña, basa una prueba de hipótesis en la distribución $t$: una prueba t de 2 muestras o una prueba t de muestras apareadas.
You've got it
- small sample + unknown variance → use the $t$-distribution ($n-1$ degrees of freedom)
- CI for the mean: $\bar{x} \pm t\dfrac{s}{\sqrt{n}}$, with standard error $\dfrac{s}{\sqrt n}$
- compare two populations with a 2-sample or paired $t$-test (pool the variance when shared)
Lo has entendido
- muestra pequeña + varianza desconocida → usa la distribución-$t$ ($n-1$ grados de libertad)
- IC para la media: $\bar{x} \pm t\dfrac{s}{\sqrt{n}}$, con error estándar $\dfrac{s}{\sqrt n}$
- compara dos poblaciones con una prueba $t$ de 2 muestras o apareada (combina la varianza cuando es compartida)